Share
Embed
Kaggleで鍛えたスキルの実務での活かし方 競技とプロダクト開発のリアル
2026/2/27に、RECRUIT TECH CONFERENCE 2026で発表した阿内・羽鳥・中間の資料になります。
Transcript
33 slides
-
Agenda 1. 自己紹介 2. トピック1「Kaggle関連実績紹介」 a. 個人の実績紹介 b. 会社の実績紹介 3.
トピック2「こぼれ話」(対談) a. コンペを始めたきっかけ b. 思い出に残るハプニングや修羅場、印象的な出来事 4. トピック3「Kaggleの学びをどう仕事に活かしているか」 a. Two-Towerモデルと近似最近傍探索による候補生成の事例 b. 設計・レビューの向上/モデル案件の正しさ・全体設計への応用 -
Agenda 1. 自己紹介 2. トピック1「Kaggle関連実績紹介」 a. 個人の実績紹介 b. 会社の実績紹介 3.
トピック2「こぼれ話」(対談) a. コンペを始めたきっかけ b. 思い出に残るハプニングや修羅場、印象的な出来事 4. トピック3「Kaggleの学びをどう仕事に活かしているか」 a. Two-Towerモデルと近似最近傍探索による候補生成の事例 b. 設計・レビューの向上/モデル案件の正しさ・全体設計への応用 -
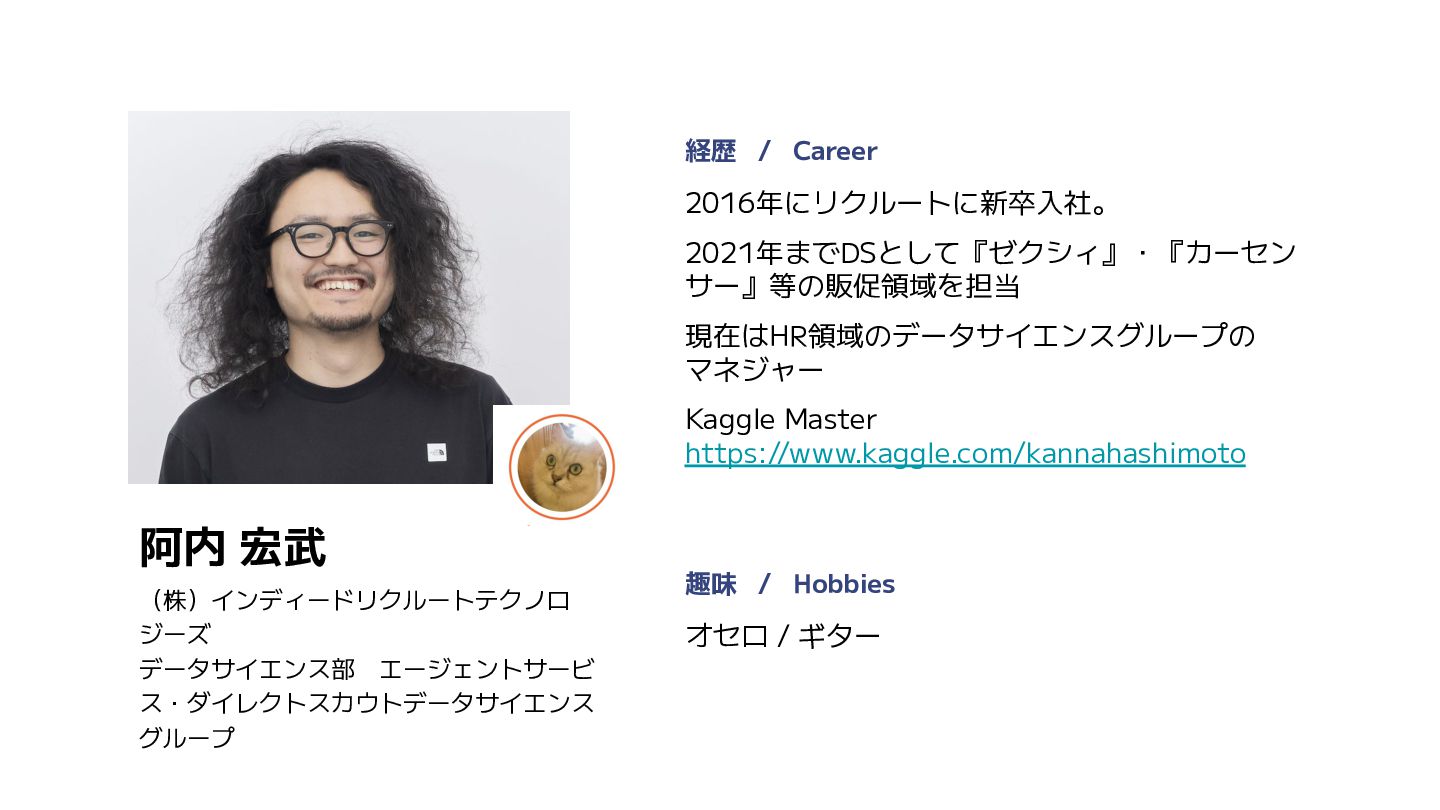
阿内 宏武 オセロ / ギター 経歴 / Career 2016年にリクルートに新卒入社。 2021年までDSとして『ゼクシィ』・『カーセン
サー』等の販促領域を担当 現在はHR領域のデータサイエンスグループの マネジャー Kaggle Master https://www.kaggle.com/kannahashimoto 趣味 / Hobbies (株)インディードリクルートテクノロ ジーズ データサイエンス部 エージェントサービ ス・ダイレクトスカウトデータサイエンス グループ -
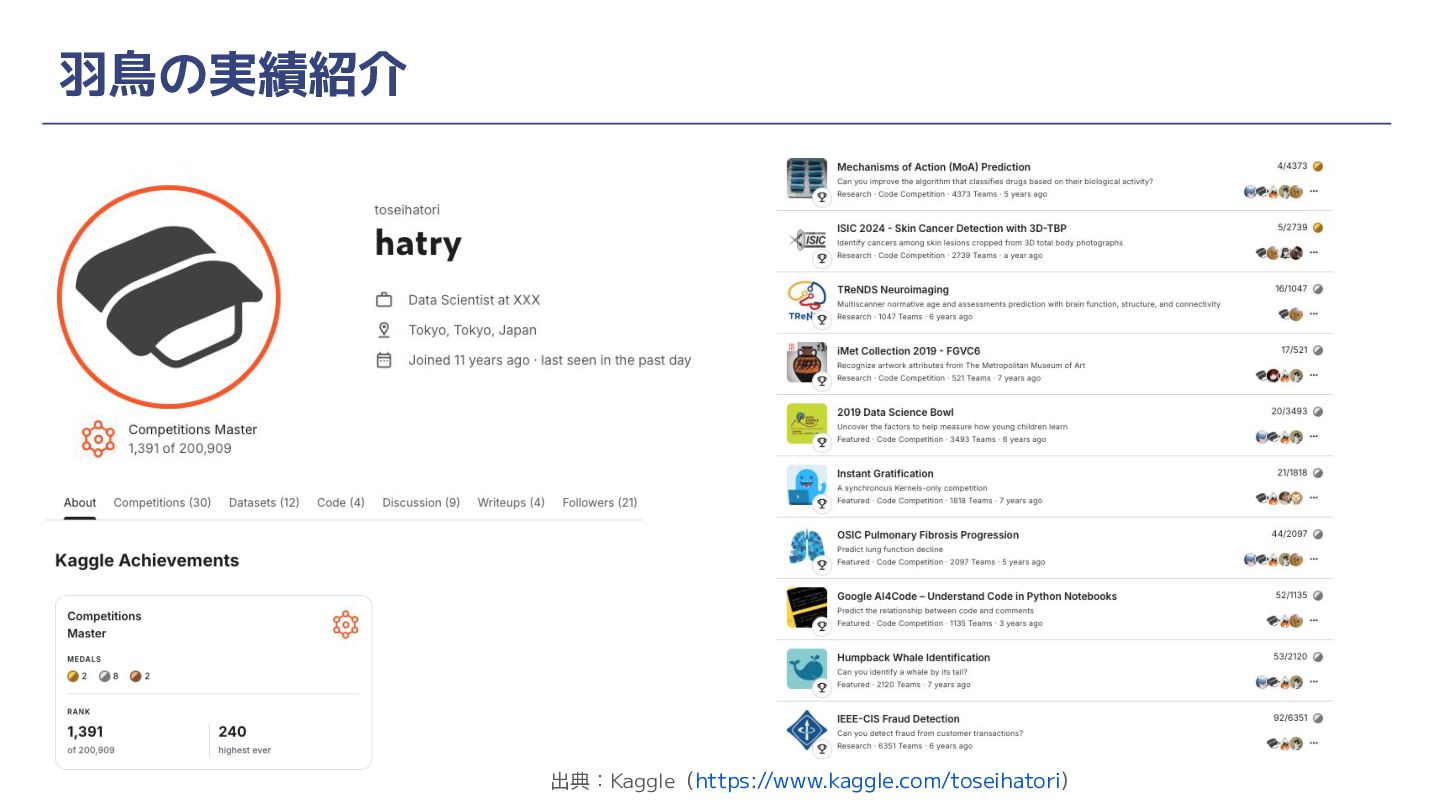
羽鳥 冬星 ストリートファイター6、Kaggle 経歴 / Career 2015年にリクルートに新卒入社。 シニアデータサイエンティスト DSとしてHR領域を中心として 複数の領域のレコメンドモデルの改善に取り組む
Kaggle Master https://www.kaggle.com/toseihatori 趣味 / Hobbies (株)リクルート プロダクト開発 データ推進室 データテクノロジーユニット アジリティテクノロジー部 アジリティアナリティクスグループ -
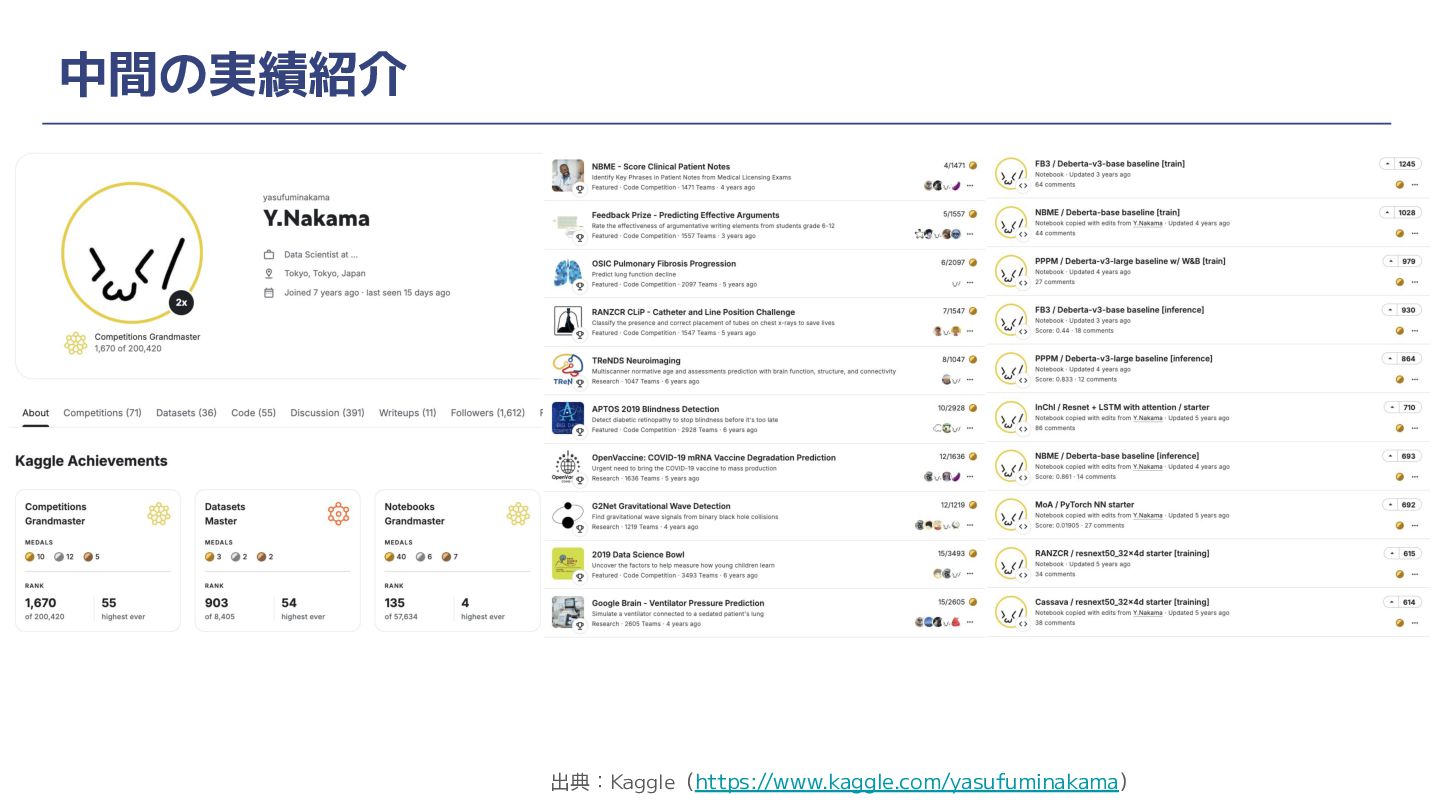
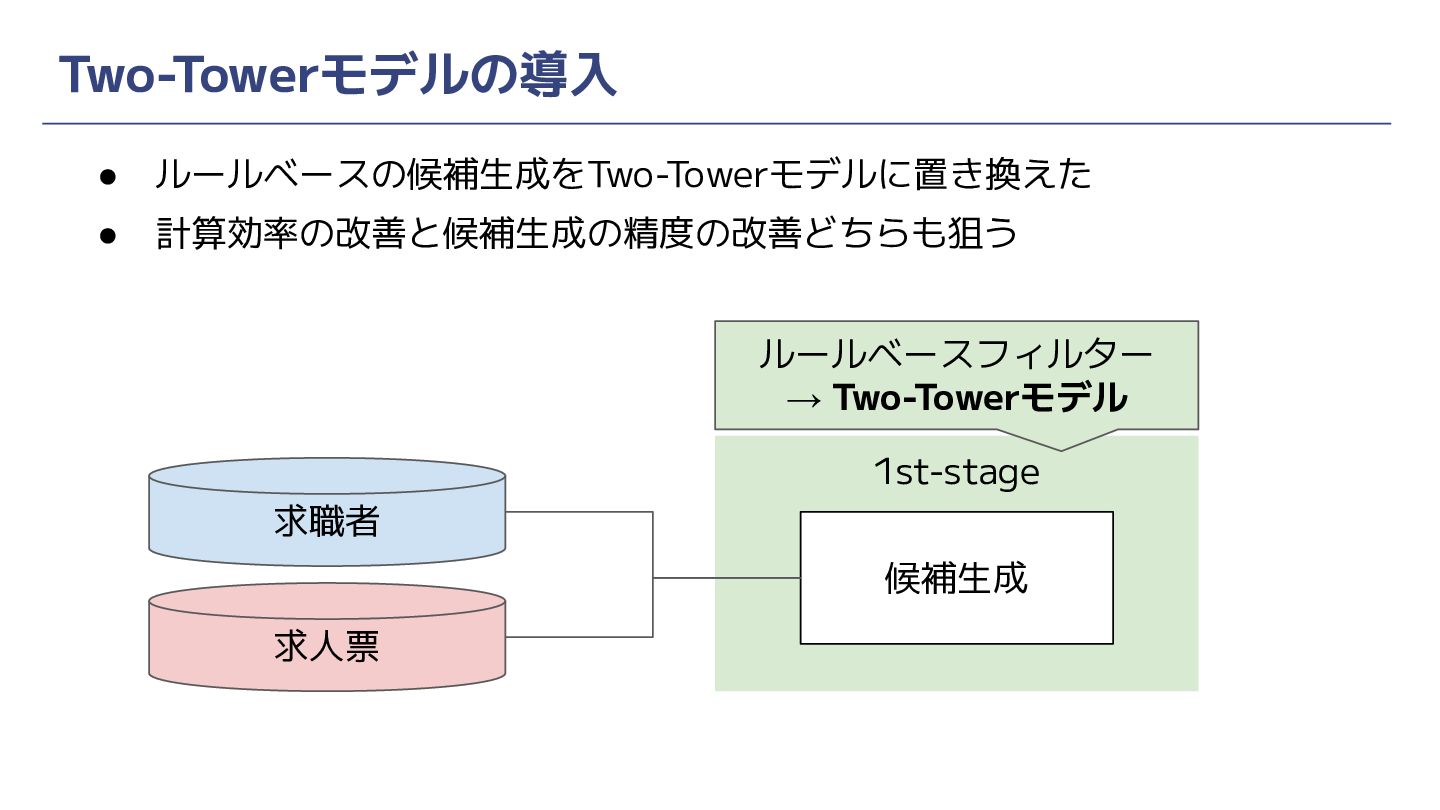
中間 康文 アニメ・漫画・ゲーム・野球・釣り 経歴 / Career 2021年にリクルートに新卒入社。 DSとして、HR領域の各プロダクトにおける レコメンドシステムの改善に取り組む。 Two-Towerモデルと近似最近傍探索による候補
生成ロジック導入の案件が、リクルートのナレッ ジ共有イベント(FORUM)に選出される。 Kaggle Grandmaster。 https://www.kaggle.com/yasufuminakama 趣味 / Hobbies (株)インディードリクルートテクノロ ジーズ データサイエンス部 オンラインプラット フォームデータサイエンスグループ -
Agenda 1. 自己紹介 2. トピック1「Kaggle関連実績紹介」 a. 個人の実績紹介 b. 会社の実績紹介 3.
トピック2「こぼれ話」(対談) a. コンペを始めたきっかけ b. 思い出に残るハプニングや修羅場、印象的な出来事 4. トピック3「Kaggleの学びをどう仕事に活かしているか」 a. Two-Towerモデルと近似最近傍探索による候補生成の事例 b. 設計・レビューの向上/モデル案件の正しさ・全体設計への応用 -
Agenda 1. 自己紹介 2. トピック1「Kaggle関連実績紹介」 a. 個人の実績紹介 b. 会社の実績紹介 3.
トピック2「こぼれ話」(対談) a. コンペを始めたきっかけ b. 思い出に残るハプニングや修羅場、印象的な出来事 4. トピック3「Kaggleの学びをどう仕事に活かしているか」 a. Two-Towerモデルと近似最近傍探索による候補生成の事例 b. 設計・レビューの向上/モデル案件の正しさ・全体設計への応用 -
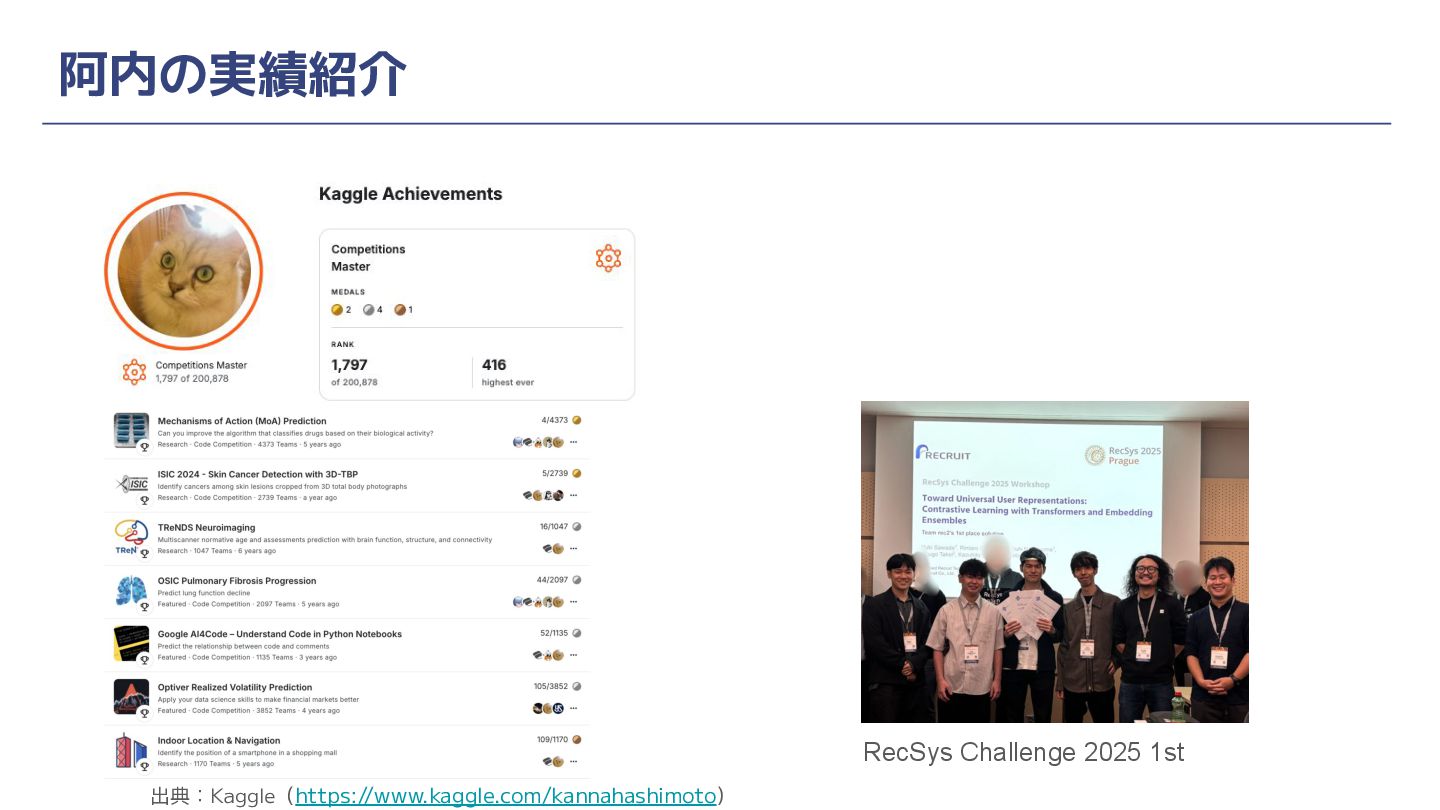
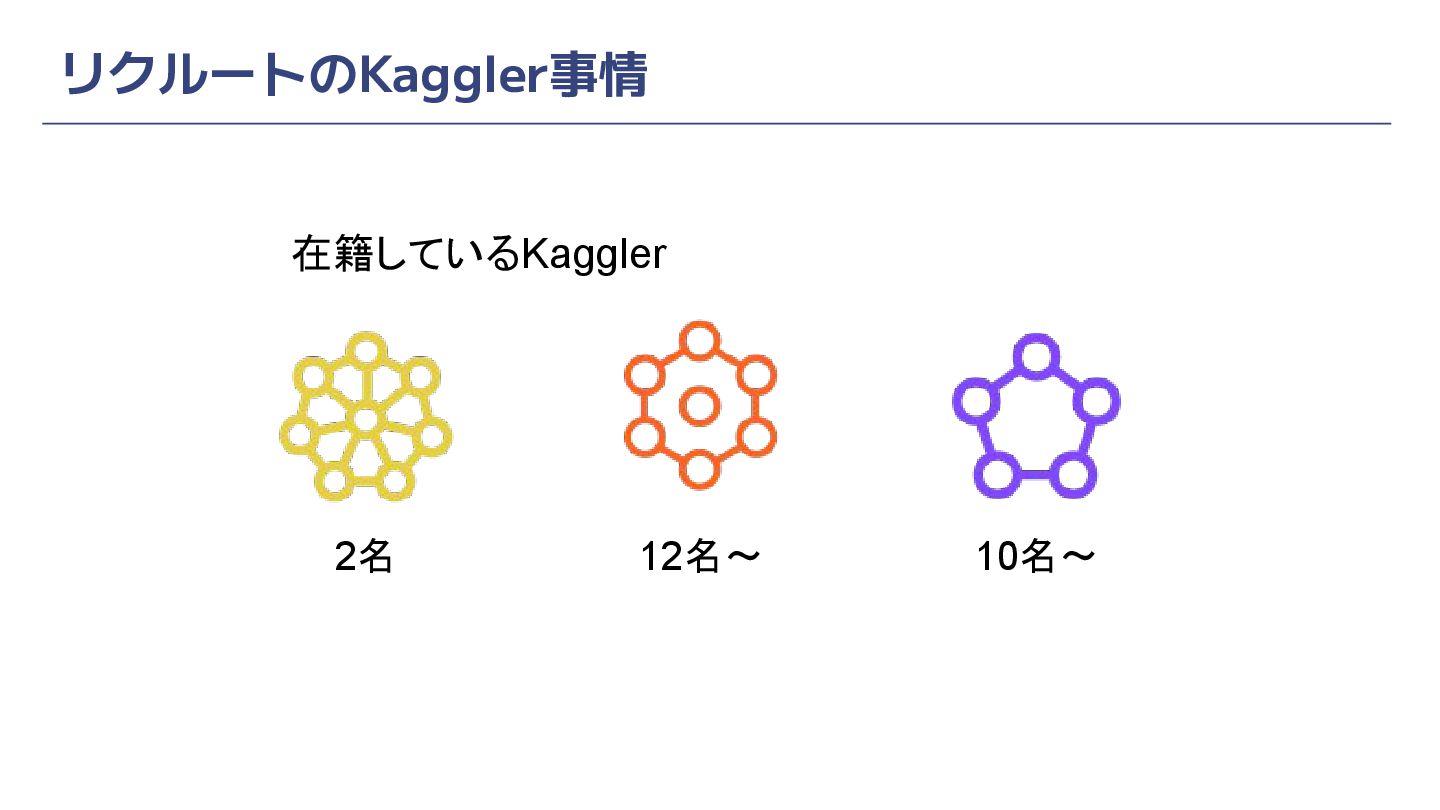
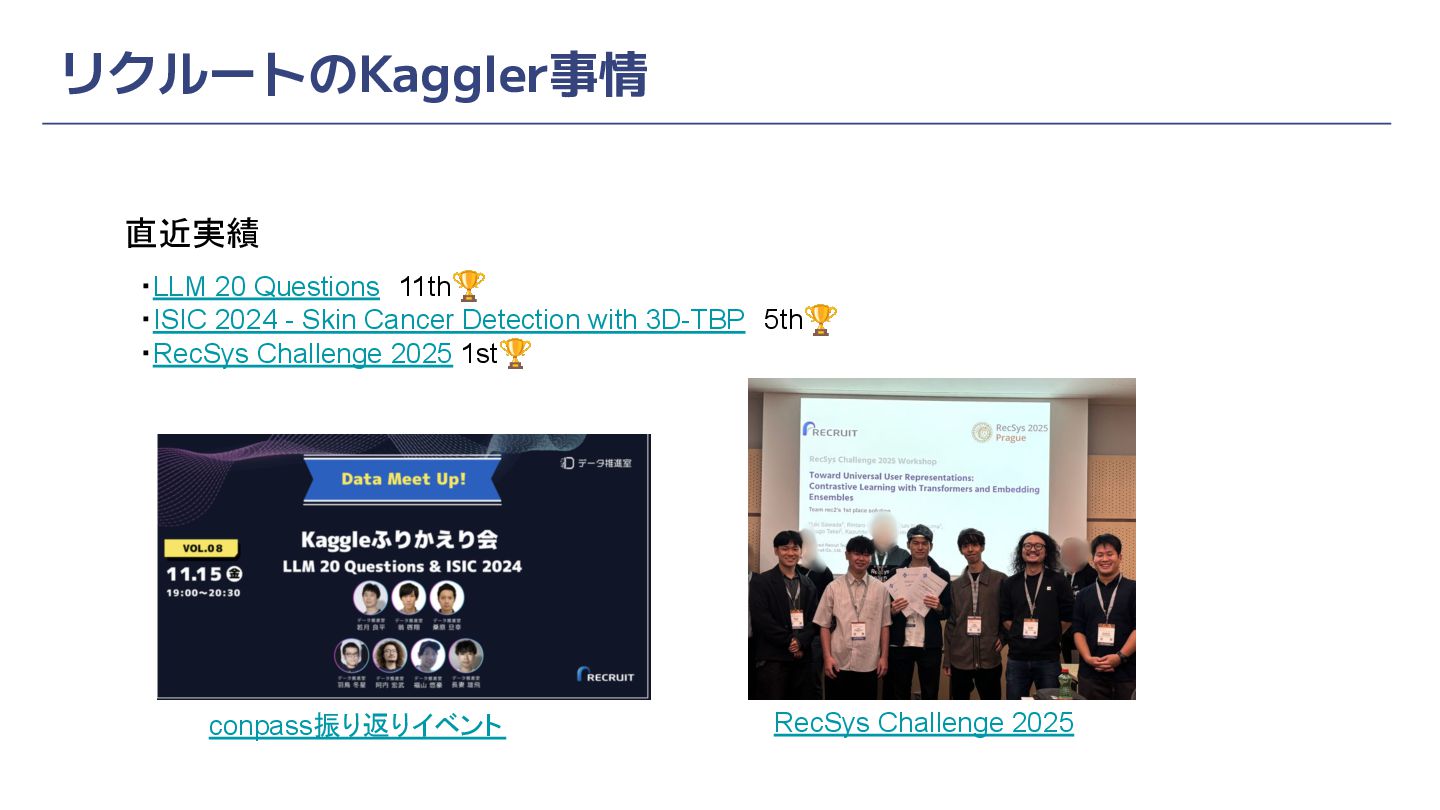
リクルートのKaggler事情 直近実績 ・LLM 20 Questions 11th🏆 ・ISIC 2024 - Skin Cancer
Detection with 3D-TBP 5th🏆 ・RecSys Challenge 2025 1st🏆 conpass振り返りイベント RecSys Challenge 2025 -
Agenda 1. 自己紹介 2. トピック1「Kaggle関連実績紹介」 a. 個人の実績紹介 b. 会社の実績紹介 3.
トピック2「こぼれ話」(対談) a. コンペを始めたきっかけ b. 思い出に残るハプニングや修羅場、印象的な出来事 4. トピック3「Kaggleの学びをどう仕事に活かしているか」 a. Two-Towerモデルと近似最近傍探索による候補生成の事例 b. 設計・レビューの向上/モデル案件の正しさ・全体設計への応用 -
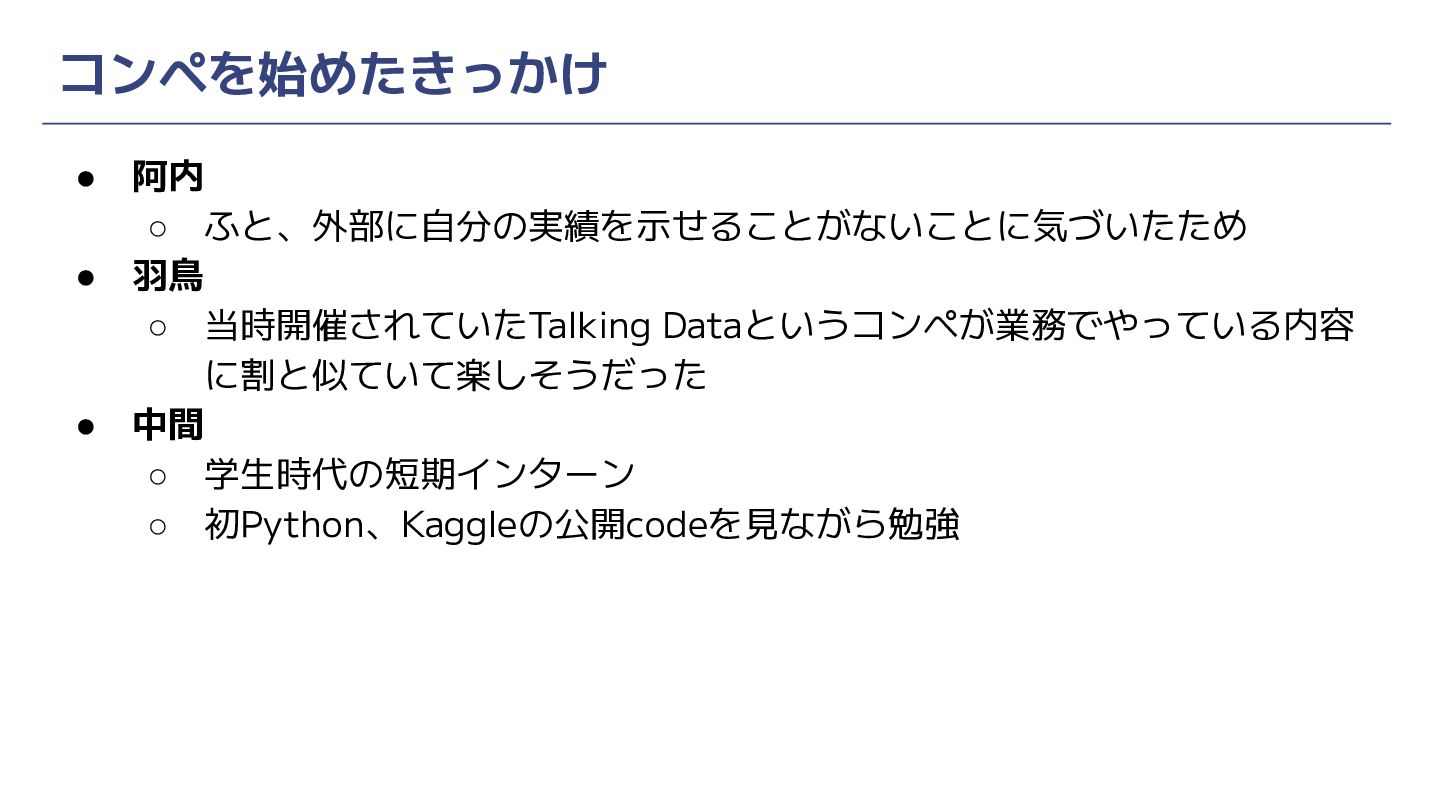
コンペを始めたきっかけ • 阿内 ◦ ふと、外部に自分の実績を示せることがないことに気づいたため • 羽鳥 ◦ 当時開催されていたTalking Dataというコンペが業務でやっている内容
に割と似ていて楽しそうだった • 中間 ◦ 学生時代の短期インターン ◦ 初Python、Kaggleの公開codeを見ながら勉強 -
Agenda 1. 自己紹介 2. トピック1「Kaggle関連実績紹介」 a. 個人の実績紹介 b. 会社の実績紹介 3.
トピック2「こぼれ話」(対談) a. コンペを始めたきっかけ b. 思い出に残るハプニングや修羅場、印象的な出来事 4. トピック3「Kaggleの学びをどう仕事に活かしているか」 a. Two-Towerモデルと近似最近傍探索による候補生成の事例 b. 設計・レビューの向上/モデル案件の正しさ・全体設計への応用 -
思い出に残るハプニングや修羅場、印象的な出来事 • 阿内 ◦ ラストsubmissionの選択を朝やろうと言っていたのにリーダーが起きな い ◦ 初参加ではしっかりPublic激強notebookを何も考えずにコピペして痛い 目に会う •
羽鳥 ◦ 朝5時まで実装 & 提出をした結果めちゃくちゃshake downしてしまった ◦ 阿内さんと同じチームで何度もコンペに出て「もうちょっとで金メダル だったのに」を100回繰り返した • 中間 ◦ 複数人チームで、各自の予測ファイルから最終予測ファイルを作るとき に、締切ギリギリまで粘ってやりがち -
Agenda 1. 自己紹介 2. トピック1「Kaggle関連実績紹介」 a. 個人の実績紹介 b. 会社の実績紹介 3.
トピック2「こぼれ話」(対談) a. コンペを始めたきっかけ b. 思い出に残るハプニングや修羅場、印象的な出来事 4. トピック3「Kaggleの学びをどう仕事に活かしているか」 a. Two-Towerモデルと近似最近傍探索による候補生成の事例 b. 設計・レビューの向上/モデル案件の正しさ・全体設計への応用 -
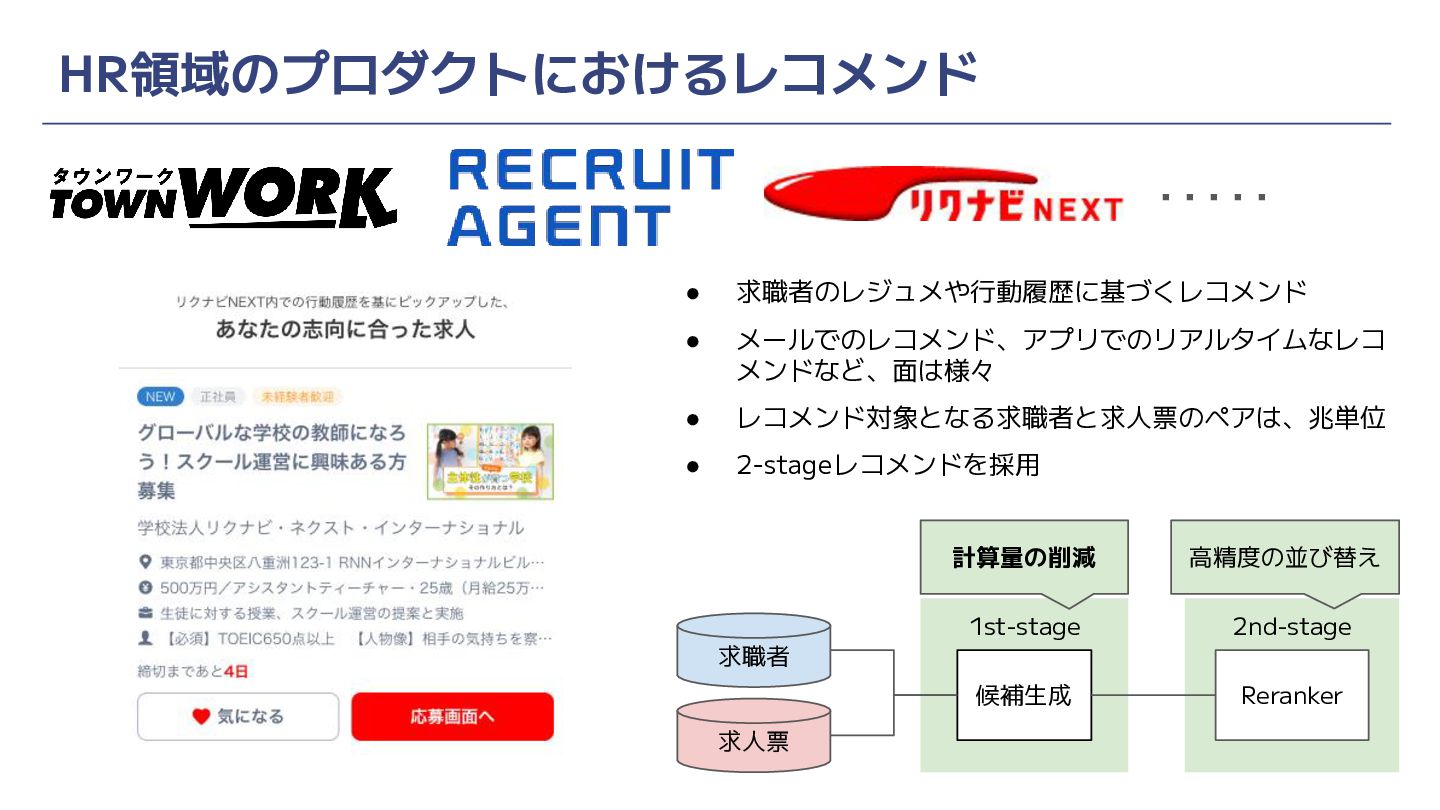
HR領域のプロダクトにおけるレコメンド • 求職者のレジュメや行動履歴に基づくレコメンド • メールでのレコメンド、アプリでのリアルタイムなレコ メンドなど、面は様々 • レコメンド対象となる求職者と求人票のペアは、兆単位 • 2-stageレコメンドを採用
2nd-stage 1st-stage Reranker 求職者 求人票 候補生成 高精度の並び替え 計算量の削減 -
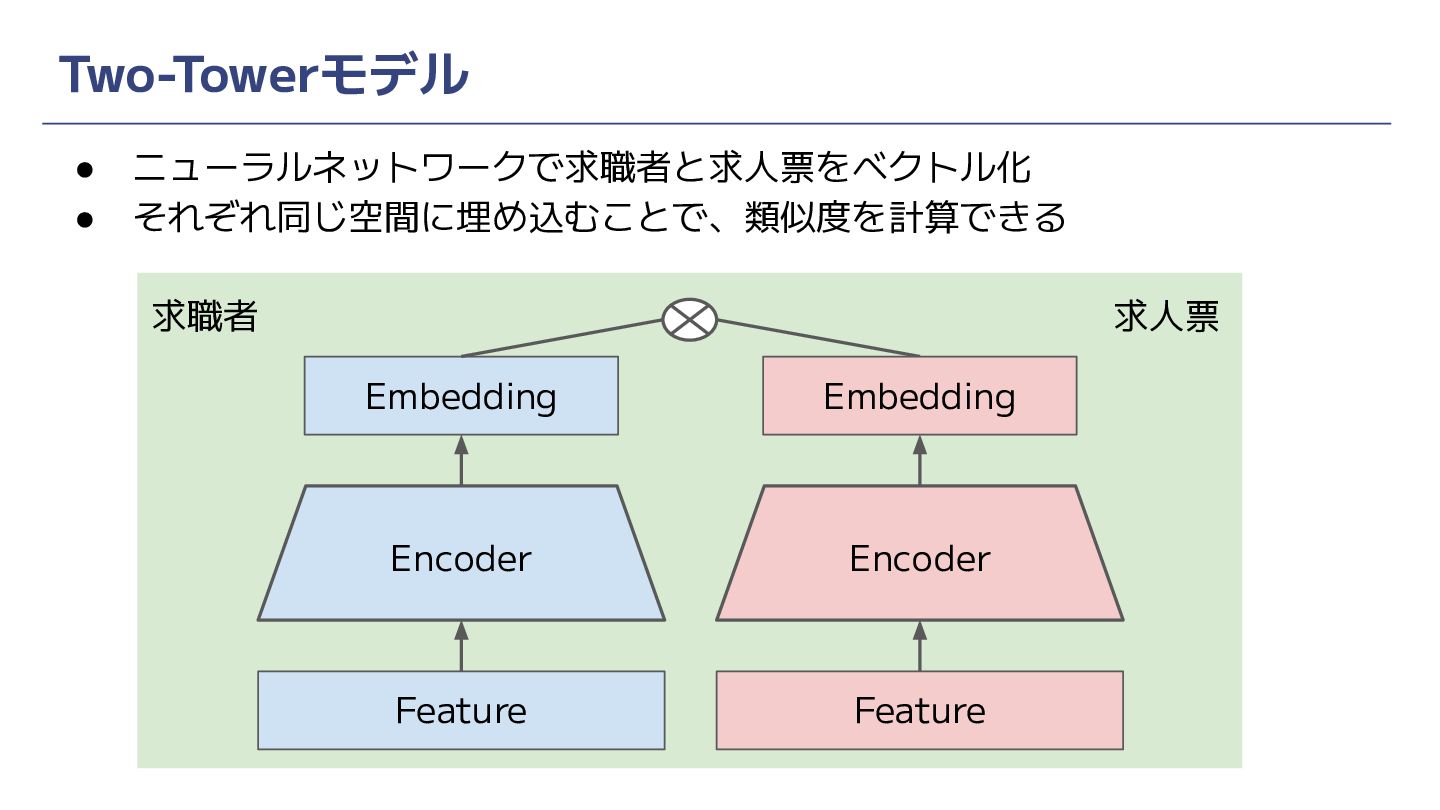
Two-Towerモデル Embedding Encoder Feature • ニューラルネットワークで求職者と求人票をベクトル化 • それぞれ同じ空間に埋め込むことで、類似度を計算できる 求職者 求人票
Embedding Encoder Feature -
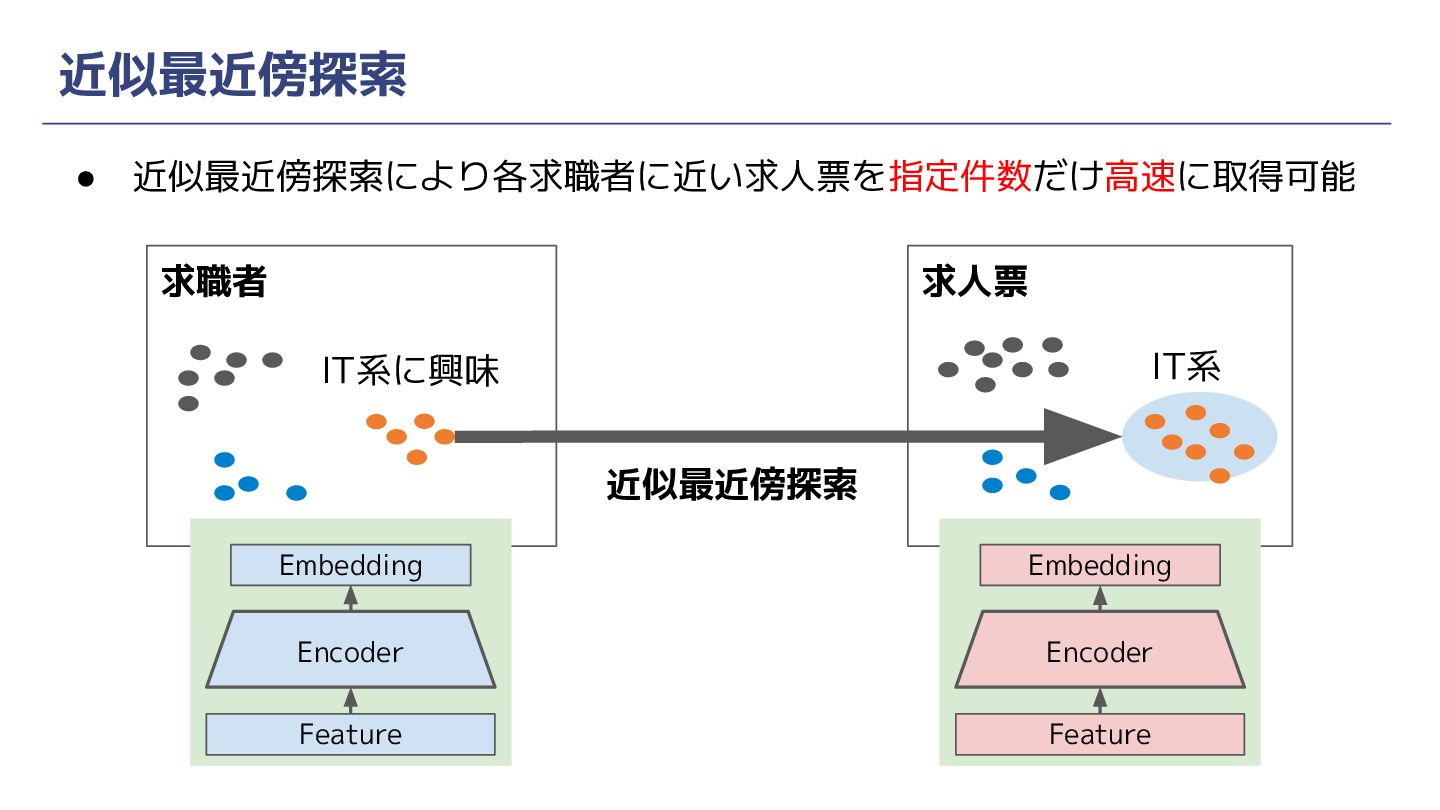
近似最近傍探索 求人票 求職者 IT系 IT系に興味 近似最近傍探索 • 近似最近傍探索により各求職者に近い求人票を指定件数だけ高速に取得可能 Encoder Feature
Embedding Embedding Encoder Feature -
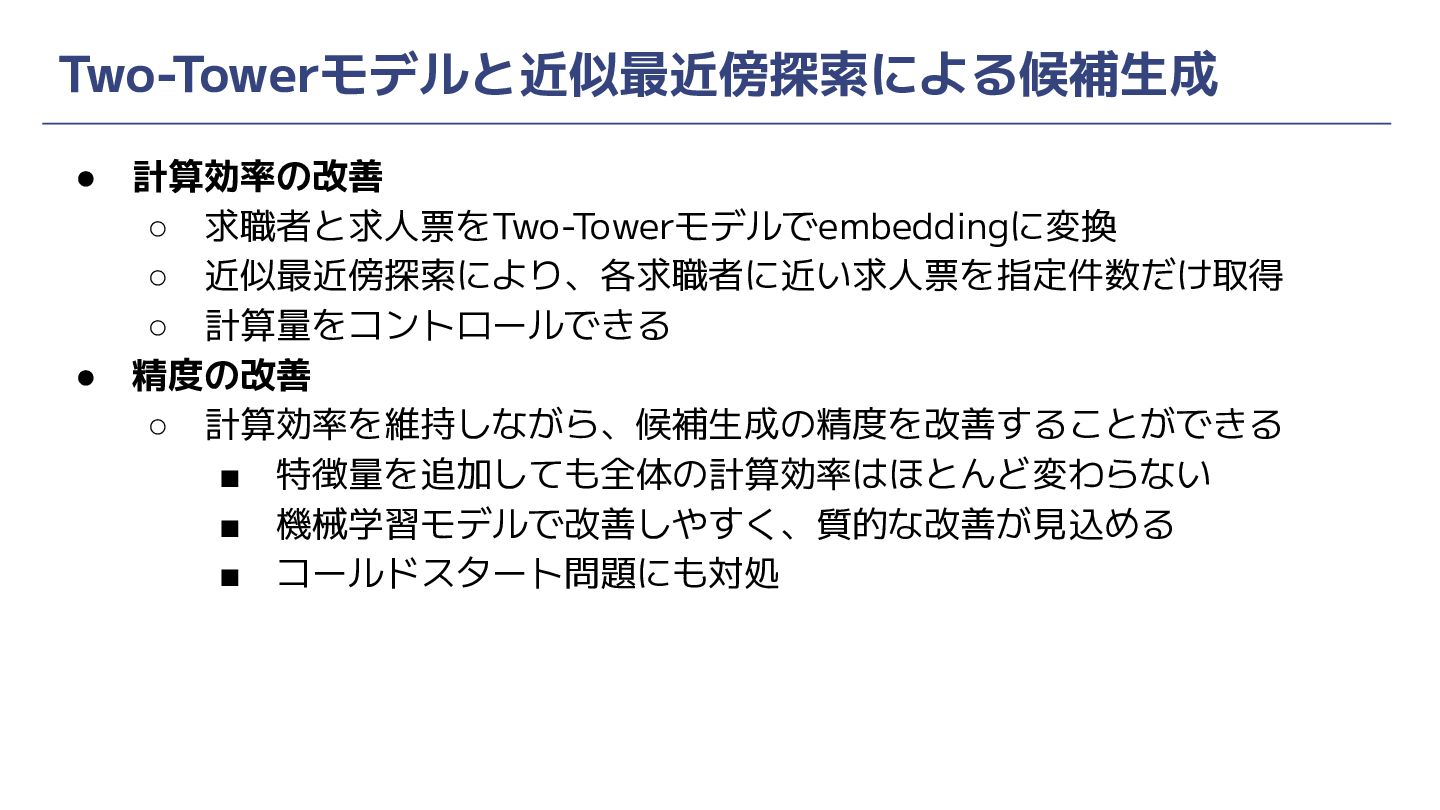
Two-Towerモデルと近似最近傍探索による候補生成 • 計算効率の改善 ◦ 求職者と求人票をTwo-Towerモデルでembeddingに変換 ◦ 近似最近傍探索により、各求職者に近い求人票を指定件数だけ取得 ◦ 計算量をコントロールできる •
精度の改善 ◦ 計算効率を維持しながら、候補生成の精度を改善することができる ▪ 特徴量を追加しても全体の計算効率はほとんど変わらない ▪ 機械学習モデルで改善しやすく、質的な改善が見込める ▪ コールドスタート問題にも対処 -
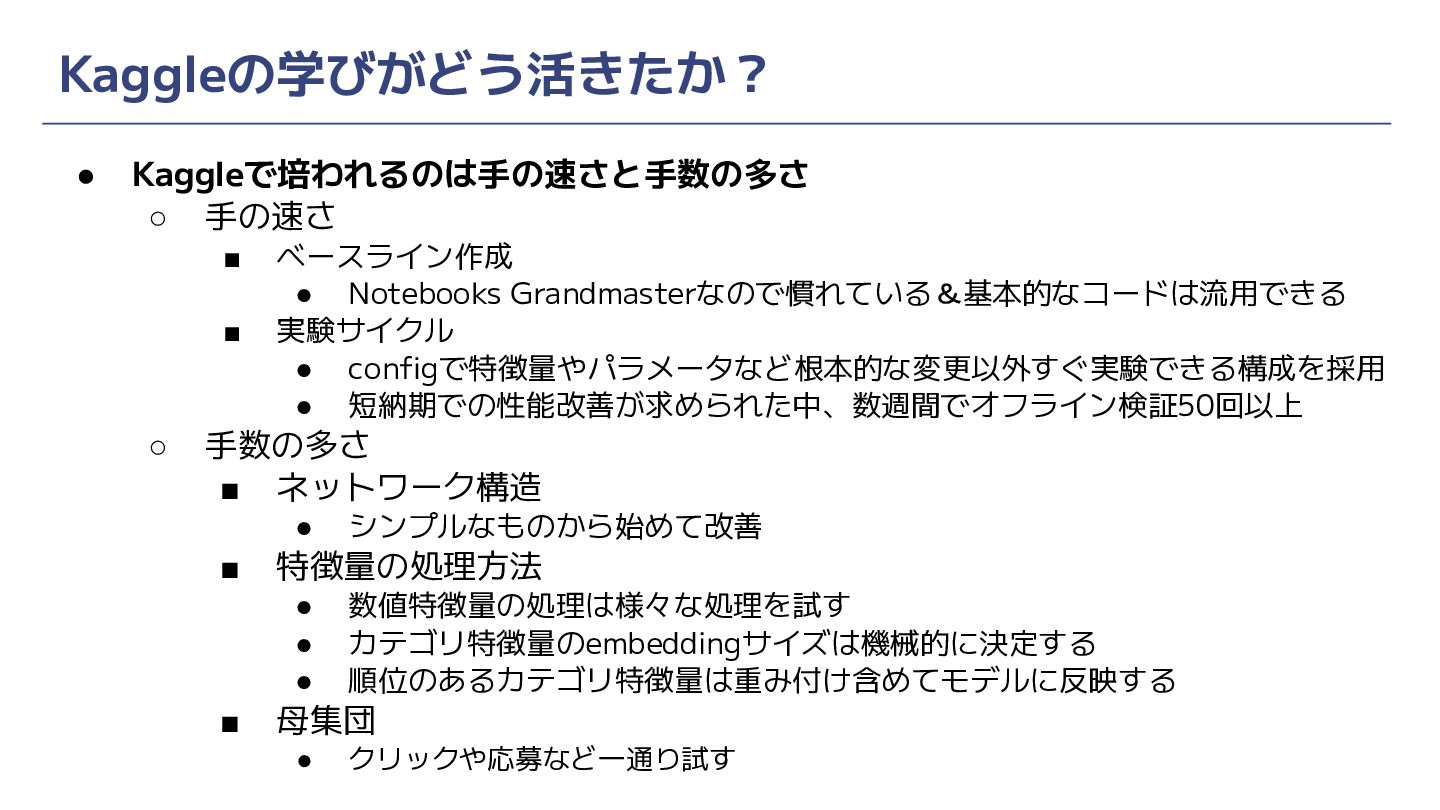
Kaggleの学びがどう活きたか? • Kaggleで培われるのは手の速さと手数の多さ ◦ 手の速さ ▪ ベースライン作成 • Notebooks Grandmasterなので慣れている&基本的なコードは流用できる
▪ 実験サイクル • configで特徴量やパラメータなど根本的な変更以外すぐ実験できる構成を採用 • 短納期での性能改善が求められた中、数週間でオフライン検証50回以上 ◦ 手数の多さ ▪ ネットワーク構造 • シンプルなものから始めて改善 ▪ 特徴量の処理方法 • 数値特徴量の処理は様々な処理を試す • カテゴリ特徴量のembeddingサイズは機械的に決定する • 順位のあるカテゴリ特徴量は重み付け含めてモデルに反映する ▪ 母集団 • クリックや応募など一通り試す -
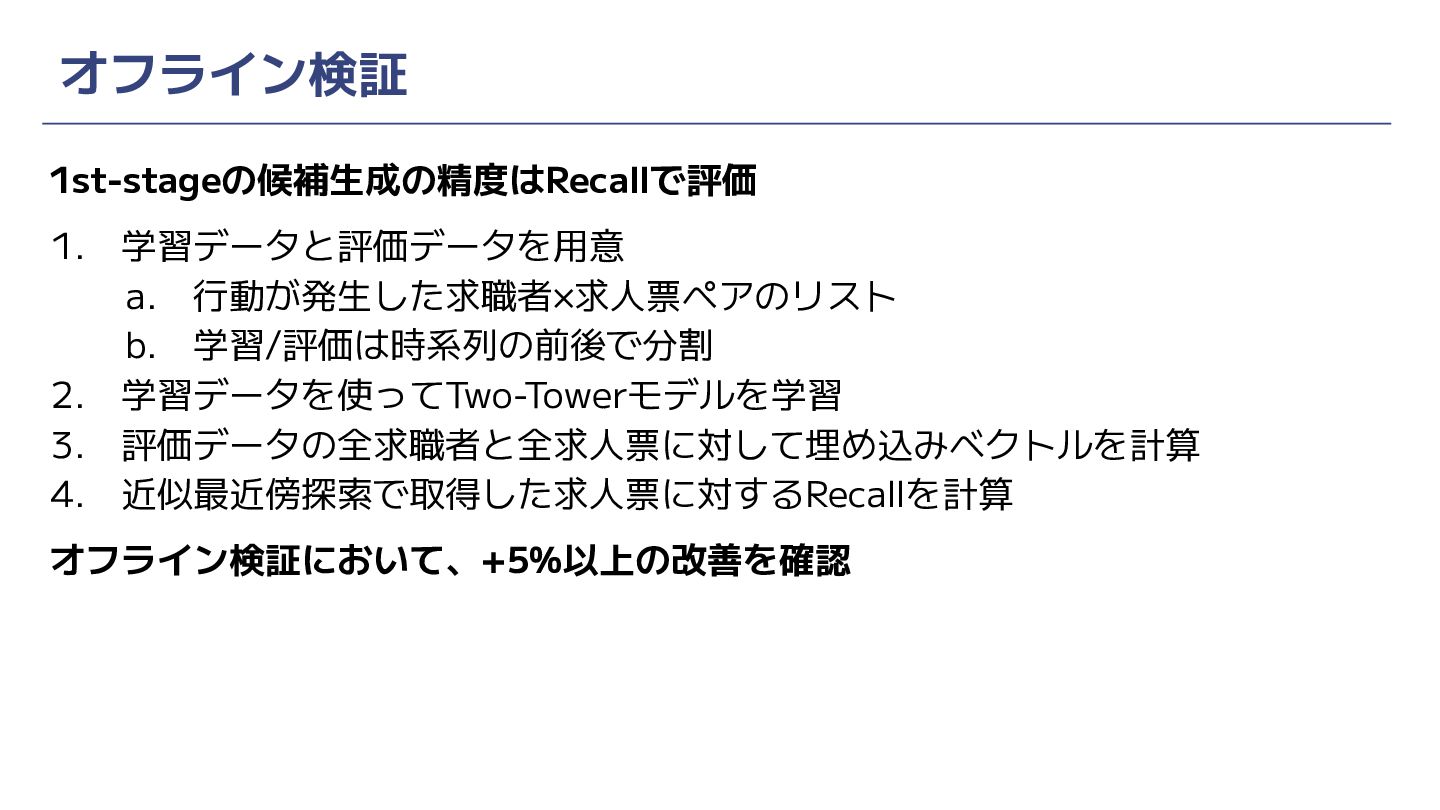
オフライン検証 1st-stageの候補生成の精度はRecallで評価 1. 学習データと評価データを用意 a. 行動が発生した求職者×求人票ペアのリスト b. 学習/評価は時系列の前後で分割 2. 学習データを使ってTwo-Towerモデルを学習
3. 評価データの全求職者と全求人票に対して埋め込みベクトルを計算 4. 近似最近傍探索で取得した求人票に対するRecallを計算 オフライン検証において、+5%以上の改善を確認 -
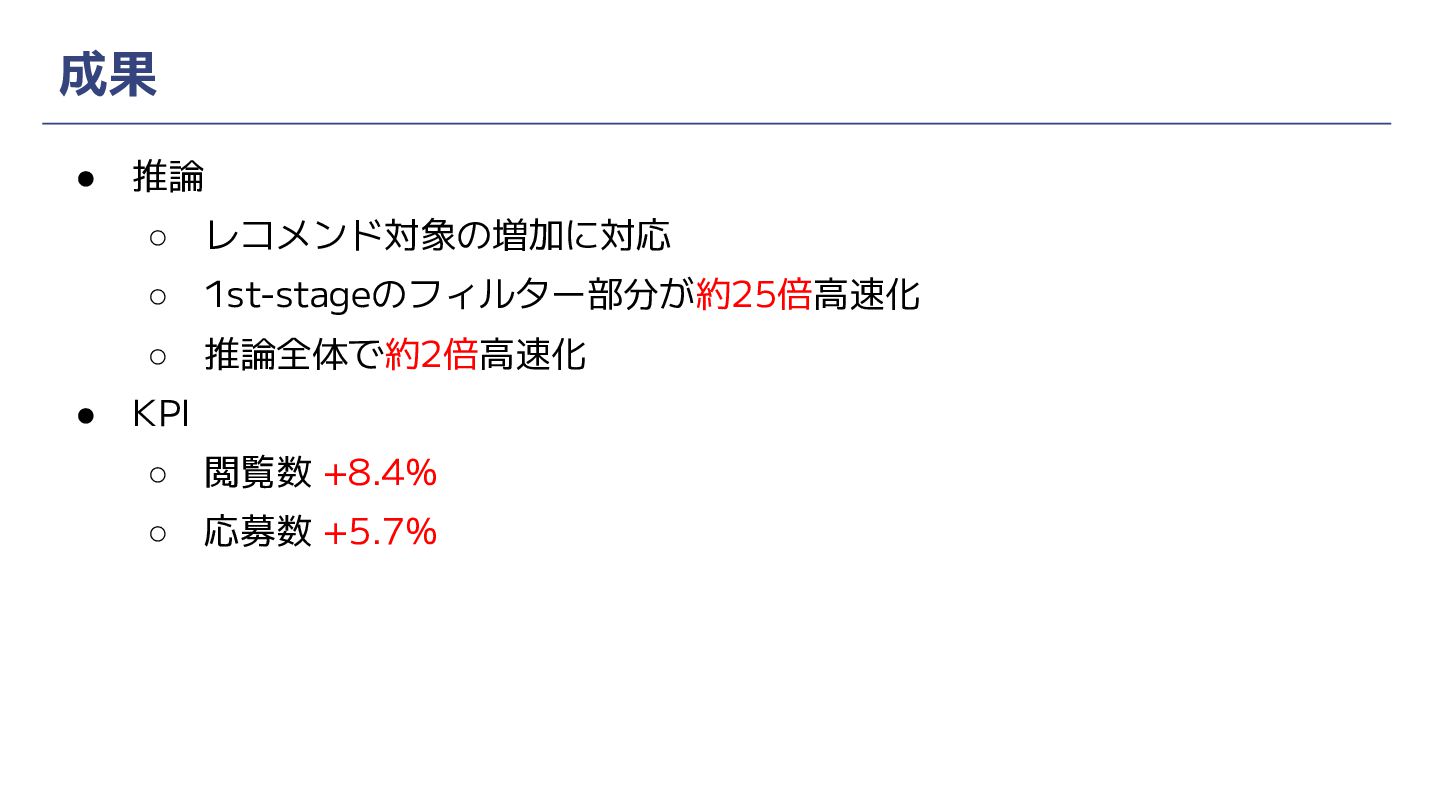
成果 • 推論 ◦ レコメンド対象の増加に対応 ◦ 1st-stageのフィルター部分が約25倍高速化 ◦ 推論全体で約2倍高速化 •
KPI ◦ 閲覧数 +8.4% ◦ 応募数 +5.7% -
Agenda 1. 自己紹介 2. トピック1「Kaggle関連実績紹介」 a. 個人の実績紹介 b. 会社の実績紹介 3.
トピック2「こぼれ話」(対談) a. コンペを始めたきっかけ b. 思い出に残るハプニングや修羅場、印象的な出来事 4. トピック3「Kaggleの学びをどう仕事に活かしているか」 a. Two-Towerモデルと近似最近傍探索による候補生成の事例 b. 設計・レビュー力の向上/モデル案件の正しさ・全体設計への応用 -
設計・レビューの向上/モデル案件の正しさ・全体設計への応用 • 阿内: ◦ Kaggleで勝敗を分けるのが、いかに正しいオフライン評価を行うか ◦ 正しいオフライン評価とは、オンライン評価と相関するような検証方法を設計&実行す ること ▪ オンライン評価
= KaggleでいうとPrivateLeaderBoardはKaggle側だけが持って いる正解データによる評価。ビジネスの現場だとA/Bテスト等で実際に得られる データで行う評価 ◦ この設計にすごく力を入れてきたので実際にもこの観点で指摘できることは多い -
設計・レビューの向上/モデル案件の正しさ・全体設計への応用 • 羽鳥 • 「これ怪しい」センサーが働く ◦ CVスコアが良すぎる → validation設計に誤りがあるかも。validationに過度にfit したハイパーパラメータチューニングがされているかも
◦ 特徴量重要度の上位に不自然なものがある → 特徴量作成時にリークしてるかも • 評価指標の妥当性判断 ◦ RMSE -> 大きい値に敏感、MAPE -> 小さい値に敏感 ▪ どちらを案件の評価基準にするべきか ▪ 例えば売上予測の案件などでは、RMSEでモデル選択をすると大手企業の予 測値が良いモデルが選ばれがちで、MAPEでモデル選択をすると小規模企業 の予測値が良いモデルが選ばれがち ▪ 案件状況・ビジネス目的に沿った評価指標を考える必要がある -
設計・レビューの向上/モデル案件の正しさ・全体設計への応用 • アンチパターンの理解 ◦ GBDT系 ▪ 学習率をチューニングパラメータにしない ▪ (初手から)欠損埋めをしない ▪
(初手から)特徴量の標準化をしない ▪ (初手から)外れ値の除去をしない ◦ validation構築・評価系 ▪ 時系列データをシャッフルしてtrain, validation分割しない ▪ holdoutをみながらチューニングしない ◦ その他 ▪ (設計上不適切な場合)IDを特徴量に含めない ▪ 本番推論時に使えない特徴量を使わない ▪ いきなり複雑なモデルから始めない -
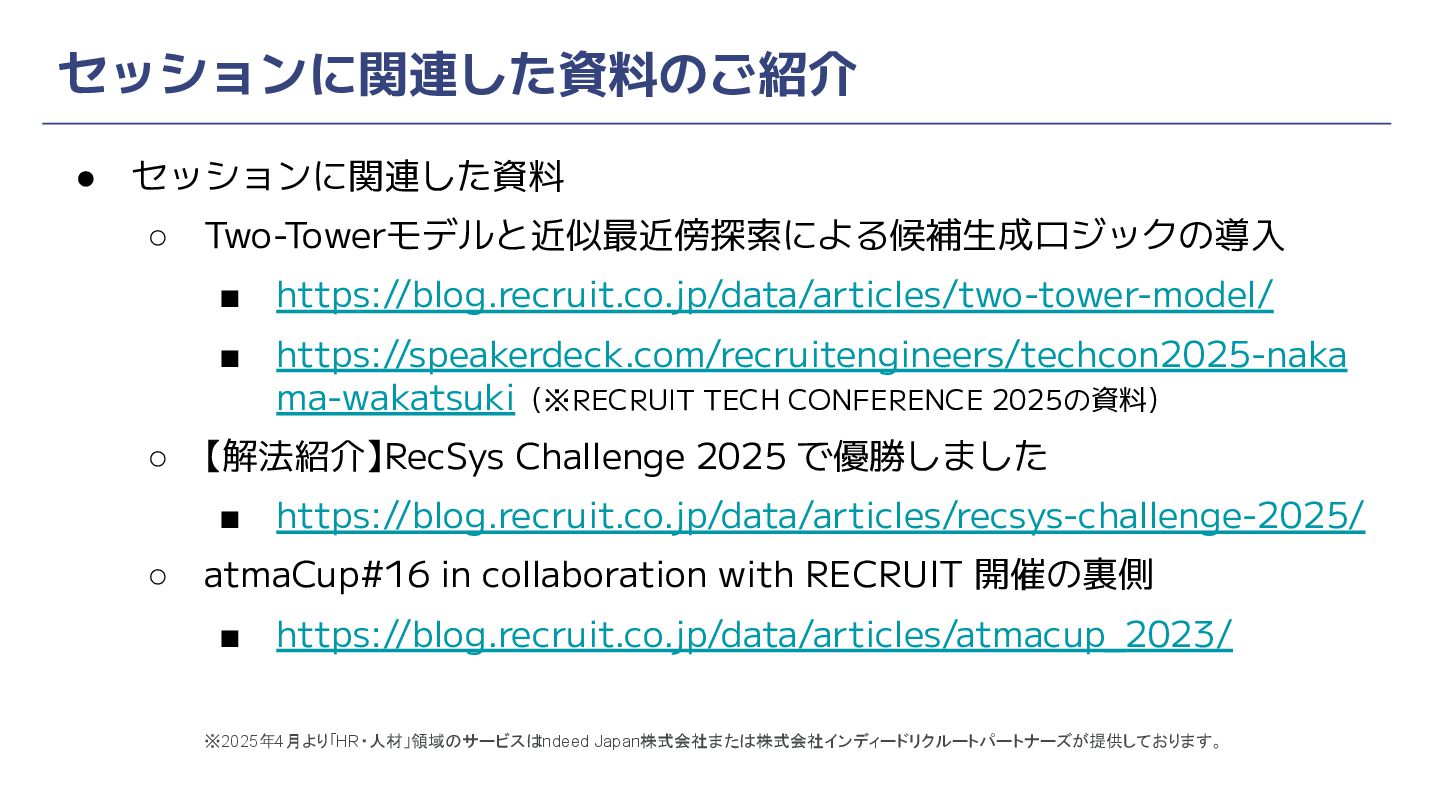
セッションに関連した資料のご紹介 • セッションに関連した資料 ◦ Two-Towerモデルと近似最近傍探索による候補生成ロジックの導入 ▪ https://blog.recruit.co.jp/data/articles/two-tower-model/ ▪ https://speakerdeck.com/recruitengineers/techcon2025-naka ma-wakatsuki(※RECRUIT
TECH CONFERENCE 2025の資料) ◦ 【解法紹介】RecSys Challenge 2025 で優勝しました ▪ https://blog.recruit.co.jp/data/articles/recsys-challenge-2025/ ◦ atmaCup#16 in collaboration with RECRUIT 開催の裏側 ▪ https://blog.recruit.co.jp/data/articles/atmacup_2023/ ※2025年4月より「HR・人材」領域のサービスは Indeed Japan株式会社または株式会社インディードリクルートパートナーズが提供しております。