Share
Embed
Transcript
15 slides
-
論文紹介 Agentic Rubrics as Contextual Verifiers for SWE Agents (ACL2026
Main, Long Paper) Mohit Raghavendra, Anisha Gunjal, Bing Liu, Yunzhong He Presenter: Ryo Fujii (Future Corporation / Tohoku University) @ 最先端NLP勉強会2026 -
概要 (どんな論文?) 3行まとめ • エージェントを支えるLLMの品質改善には「検証」が重要だが、実行を伴うSWタスクの検証は高コスト • タスク固有のRubricを動的に生成し、実行せずに候補パッチを採点する Agentic Rubrics を提案
• 推論時に複数候補から最終候補を選ぶ設定で、最良ベースラインを 3.5pp.上回るタスク成功率を達成 この論文を選んだ理由 • 自身のテーマと近い領域の研究 • Rubric, Checklistを扱う研究が最近盛んな印象があるが、その能力を「正解を定義しやすい」 SWのドメインで 検証している点が興味深い 2026/8/30, 31 最先 端N LP勉強 会2026 2 -
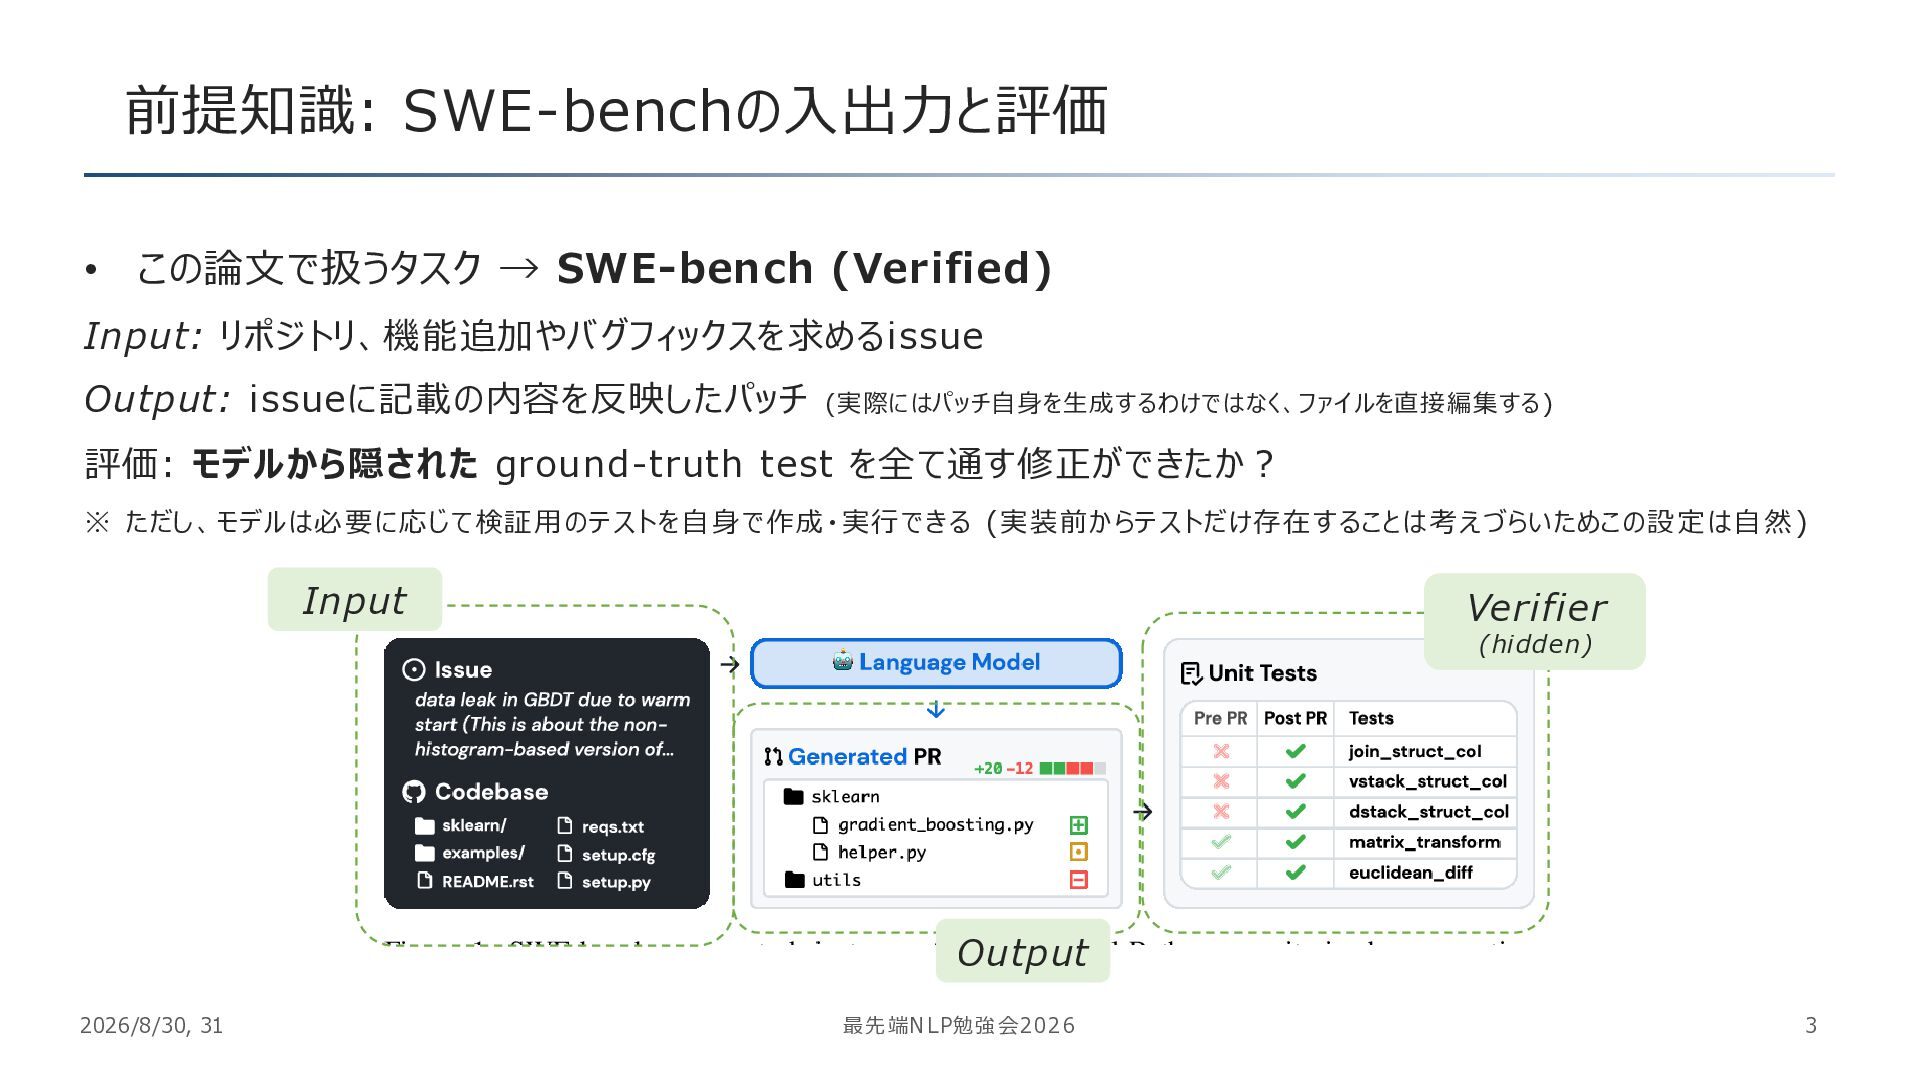
前提知識: SWE-benchの入出力と評価 • この論文で扱うタスク → SWE-bench (Verified) Input: リポジトリ、機能追加やバグフィックスを求めるissue Output:
issueに記載の内容を反映したパッチ (実際にはパッチ自身を生成するわけではなく、ファイルを直接 編集する ) 評価: モデルから隠された ground-truth test を全て通す修正ができたか? ※ た だし 、モデルは必 要 に 応 じて 検証 用 のテ ストを自 身 で作 成 ・実行 できる (実 装 前か らテ ストだ け存 在 すること は考 え づらい ためこの設 定 は自 然 ) Input Verifier (hidden) Output 2026/8/30, 31 最先 端N LP勉強 会2026 3 -
背景・課題 • SWEエージェントの性能向上には「検証」が重要 ✓ Post-training: 検証結果をverif iable rewardとして学習 ✓ Test-time
scaling:複数候補を生成し、検証結果に基づいて最良の候補を選択 • テスト実行による検証はコードにグラウンディングされるが、 環境構築が重くスケールしない • 一方で、既存の実行を伴わない方法はリポジトリコンテキスト非依存の浅いシグナルになりがち スケーラブル、かつコードにグラウンディングした 検証方法の検討が必要 2026/8/30, 31 最先 端N LP勉強 会2026 4 -
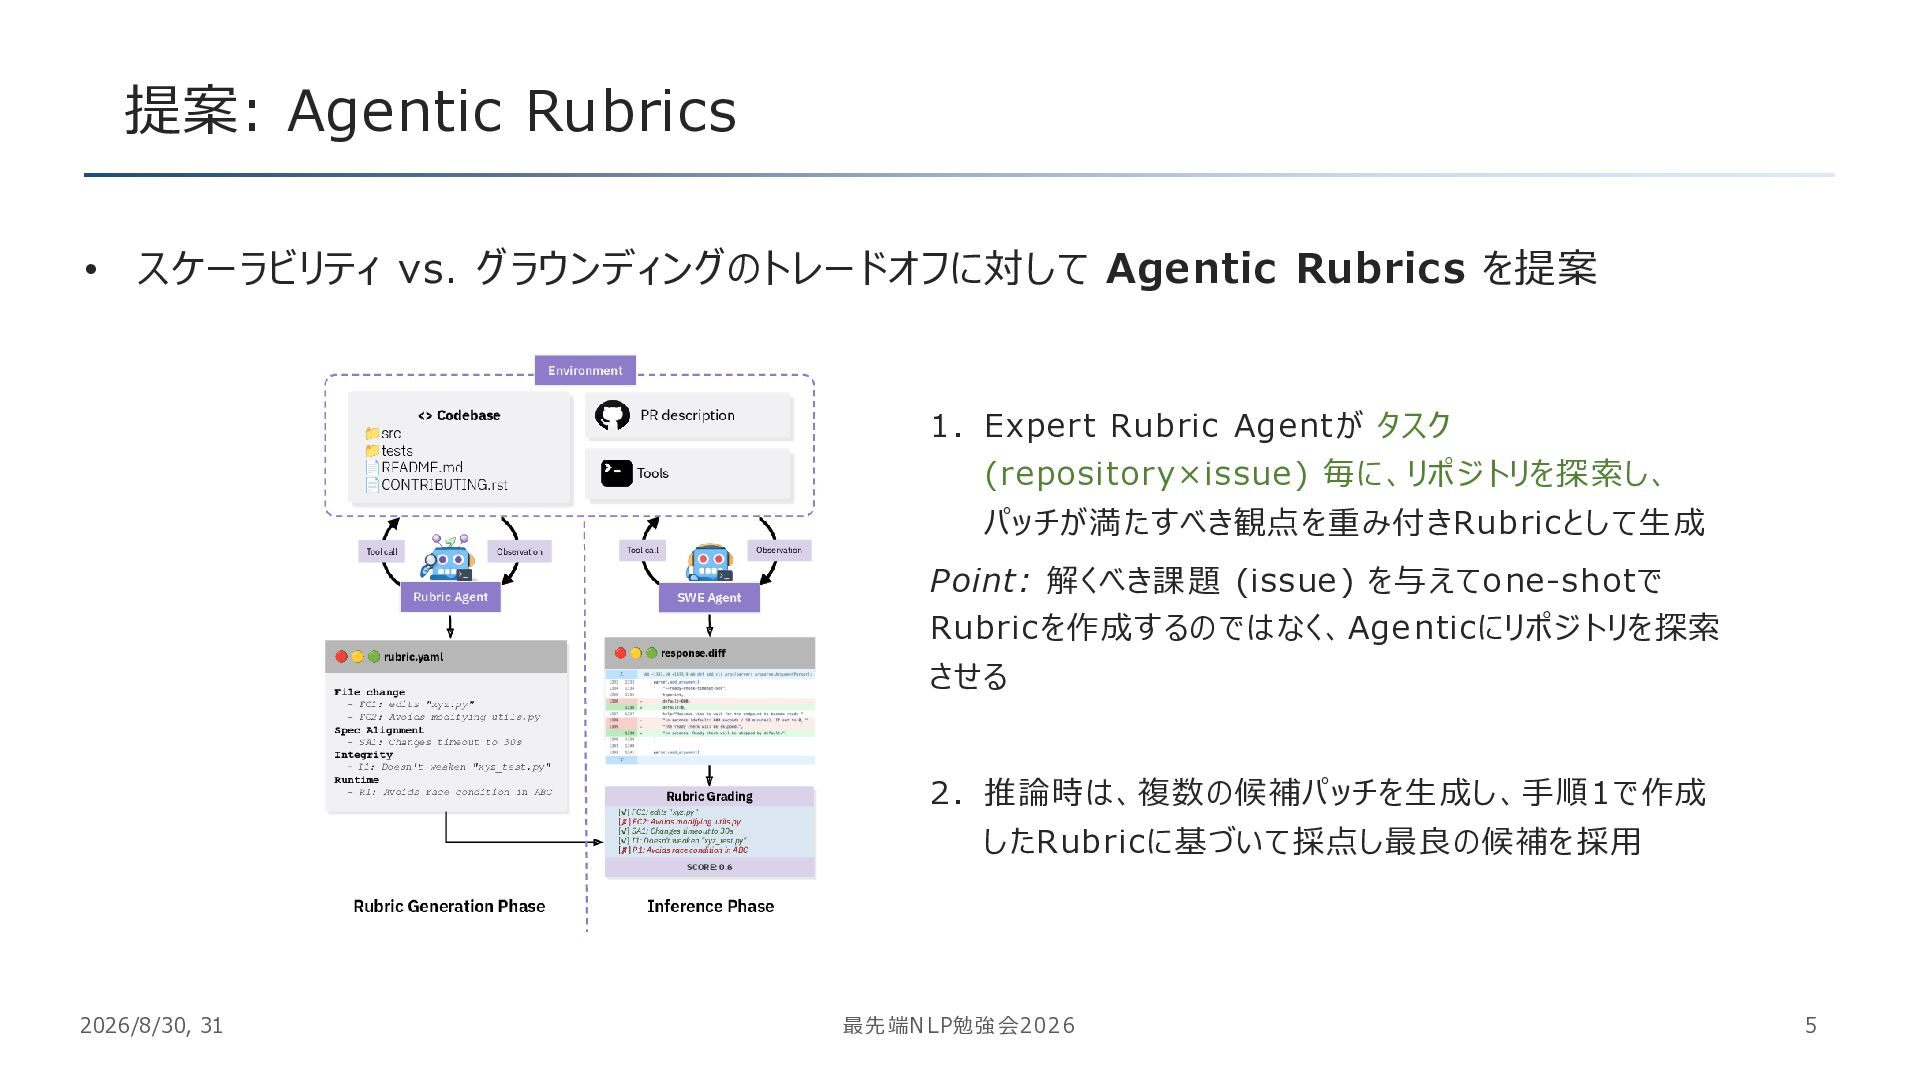
提案: Agentic Rubrics • スケーラビリティ vs. グラウンディングのトレードオフに対して Agentic Rubrics を提案
1. Expert Rubric Agent が タスク (repository×issue) 毎に、リポジトリを探索し、 パッ チが満たすべき観点を重み付きRubricとして生成 Point: 解くべき課題 (issue ) を与えてone-sh otで Rubricを作成す るのではなく、Age nticにリポジトリを 探索 させる 2. 推論時は、複数の候補パ ッチを生成し、手順1で作成 したRubricに基づいて採点し最良の候補を 採用 2026/8/30, 31 最先 端N LP勉強 会2026 5 -
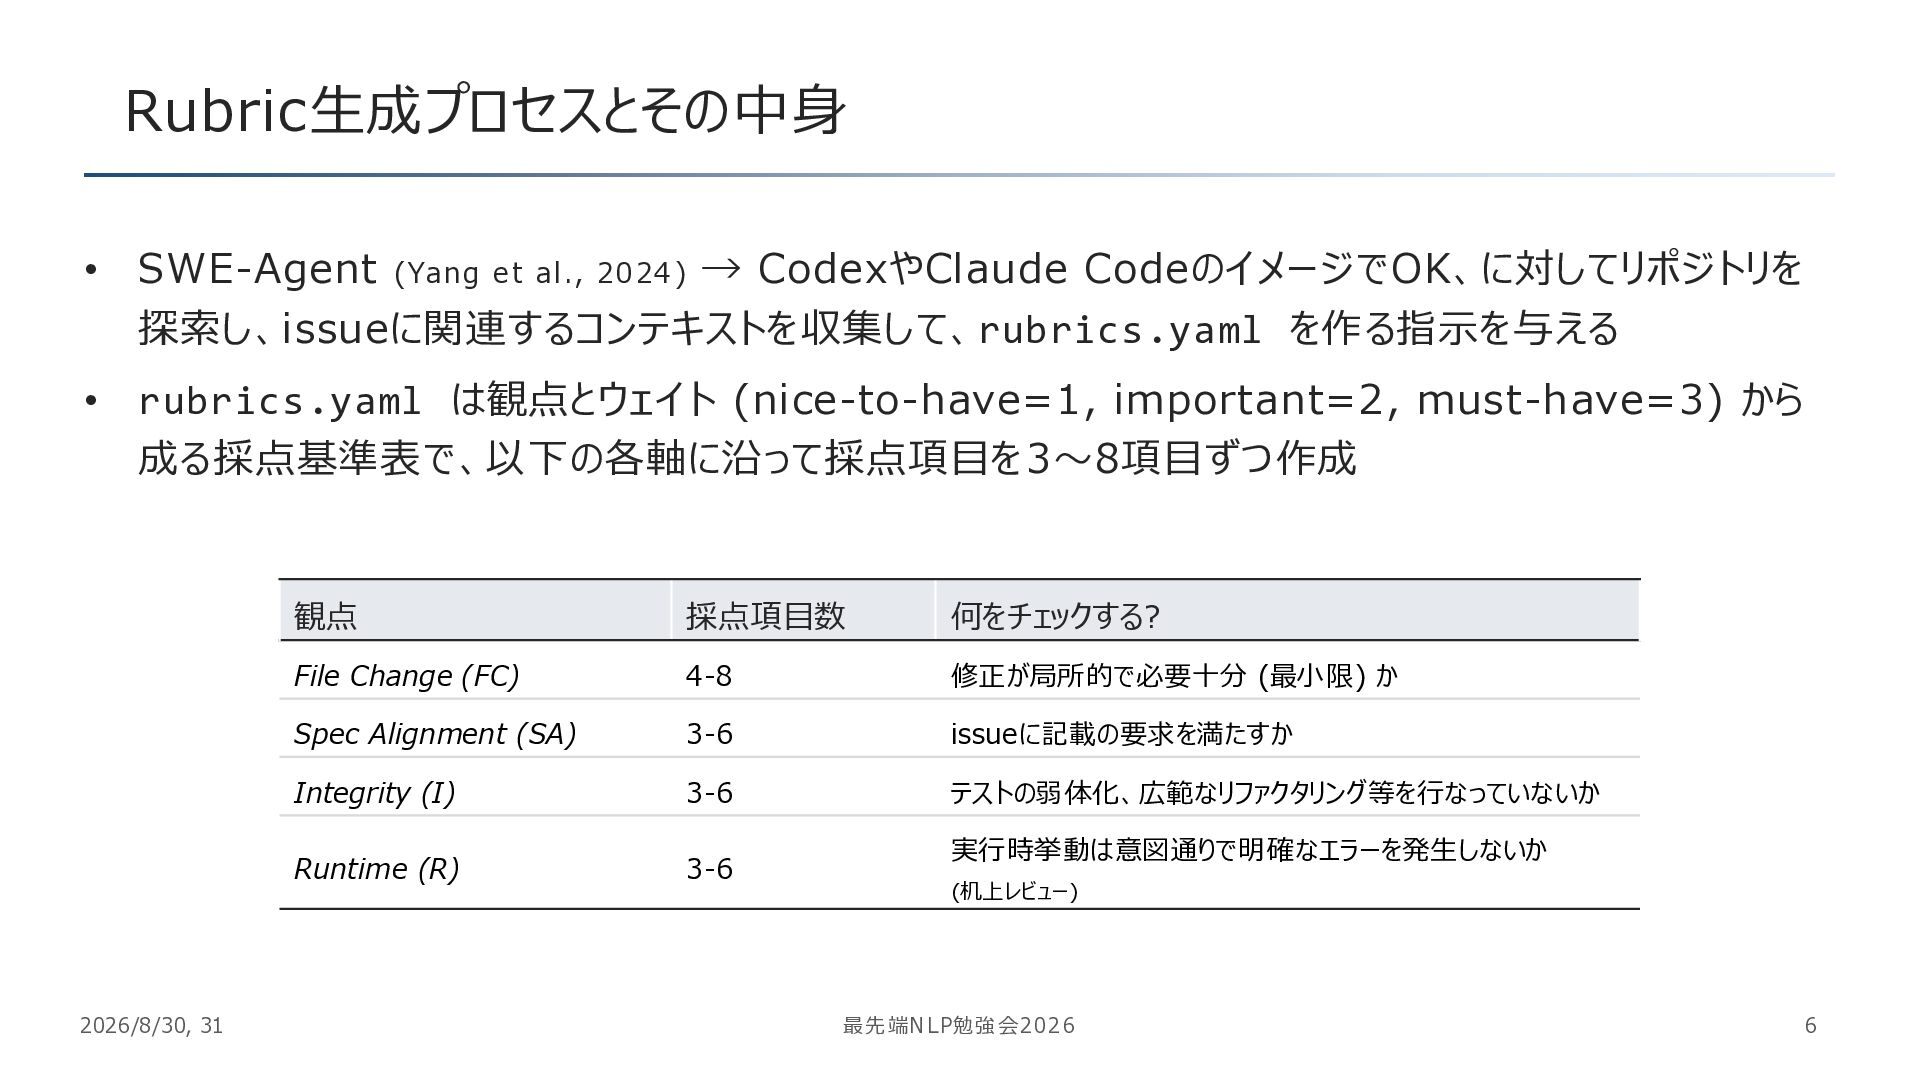
Rubric生成プロセスとその中身 • SWE-Agent (Ya ng e t al ., 20
24 ) → CodexやClaude CodeのイメージでOK、に対してリポジトリを 探索し、issueに関連するコンテキストを収集して、rubrics.yaml を作る指示を与える • rubrics.yaml は観点とウェイト (nice-to-have=1, important=2, must-have=3) から 成る採点基準表で、以下の各軸に沿って採点項目を 3〜8項目ずつ作成 2026/8/30, 31 観点 採点項目数 何をチェックする? File Change (FC) 4-8 修正が局所的で必要十分 (最小限) か Spec Alignment (SA) 3-6 issueに記載の要求を満たすか Integrity (I) 3-6 テストの弱体化、広範なリファクタリング等を行なっていないか Runtime (R) 3-6 実行時挙動は意図通りで明確なエラーを発生しないか (机上レビュー) 最先 端N LP勉強 会2026 6 -
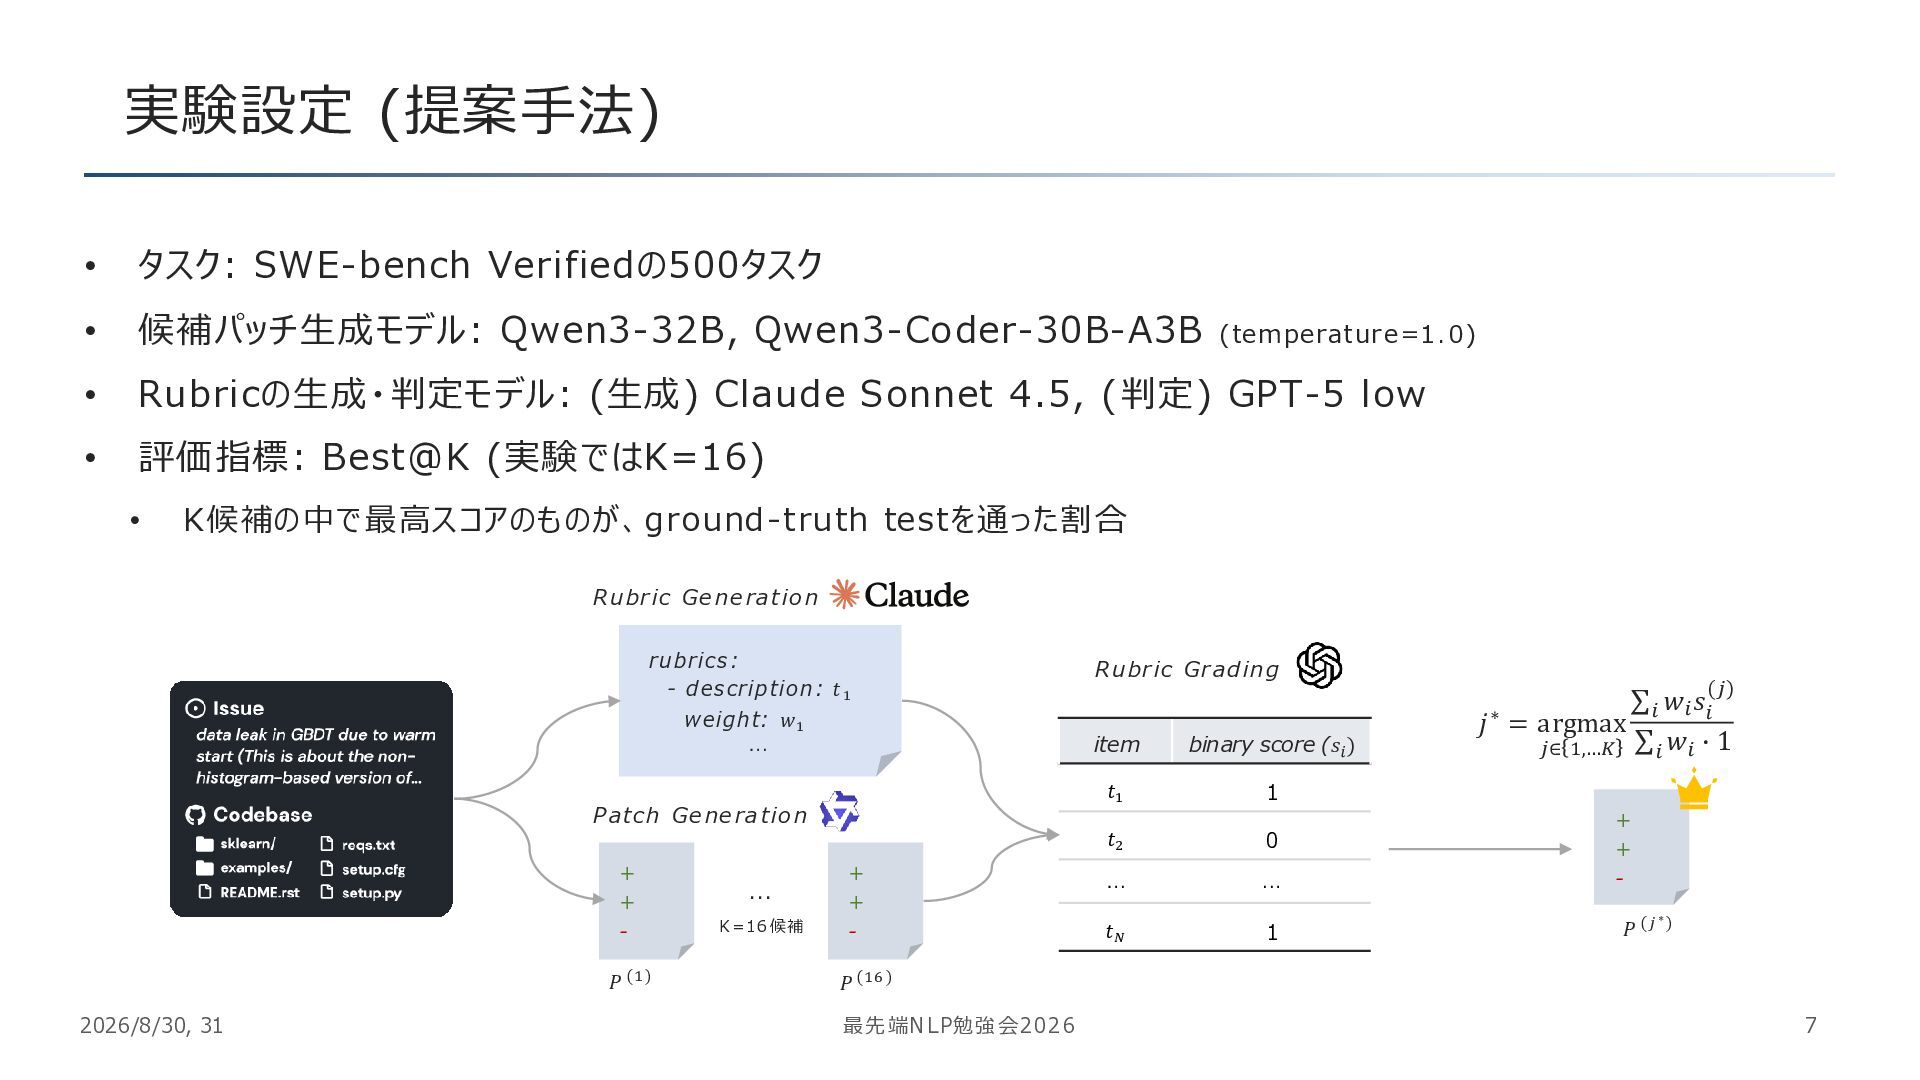
実験設定 (提案手法) • タスク: SWE-bench Verifiedの500タスク • 候補パッチ生成モデル: Qwen3-32B, Qwen3-Coder-30B-A3B
(temperatur e=1. 0) • Rubricの生成・判定モデル: (生成) Claude Sonnet 4.5, (判定) GPT-5 low • 評価指標: Best@K (実験ではK=16) • K候補の中で最高スコア のものが、ground-tru th te stを通った割合 R u br ic Ge ne ra tio n rub rics : - d es cri p ti o n: 𝑡 1 w eig ht: 𝑤 1 … - 𝑃 (1) 2026/8/30, 31 … K = 1 6 候補 (𝑗) σ𝑖 𝑤𝑖 𝑠𝑖 𝑗 ∗ = argmax 𝑗∈ 1,…𝐾 σ𝑖 𝑤𝑖 ∙ 1 item binary score (𝑠𝑖 ) 𝑡1 1 𝑡2 0 + + + + … … - - 𝑡𝑁 1 𝑃 (𝑗 ) P atch Ge ne ra tio n + + R u br ic Gr ad in g ∗ 𝑃 ( 16 ) 最先 端N LP勉強 会2026 7 -
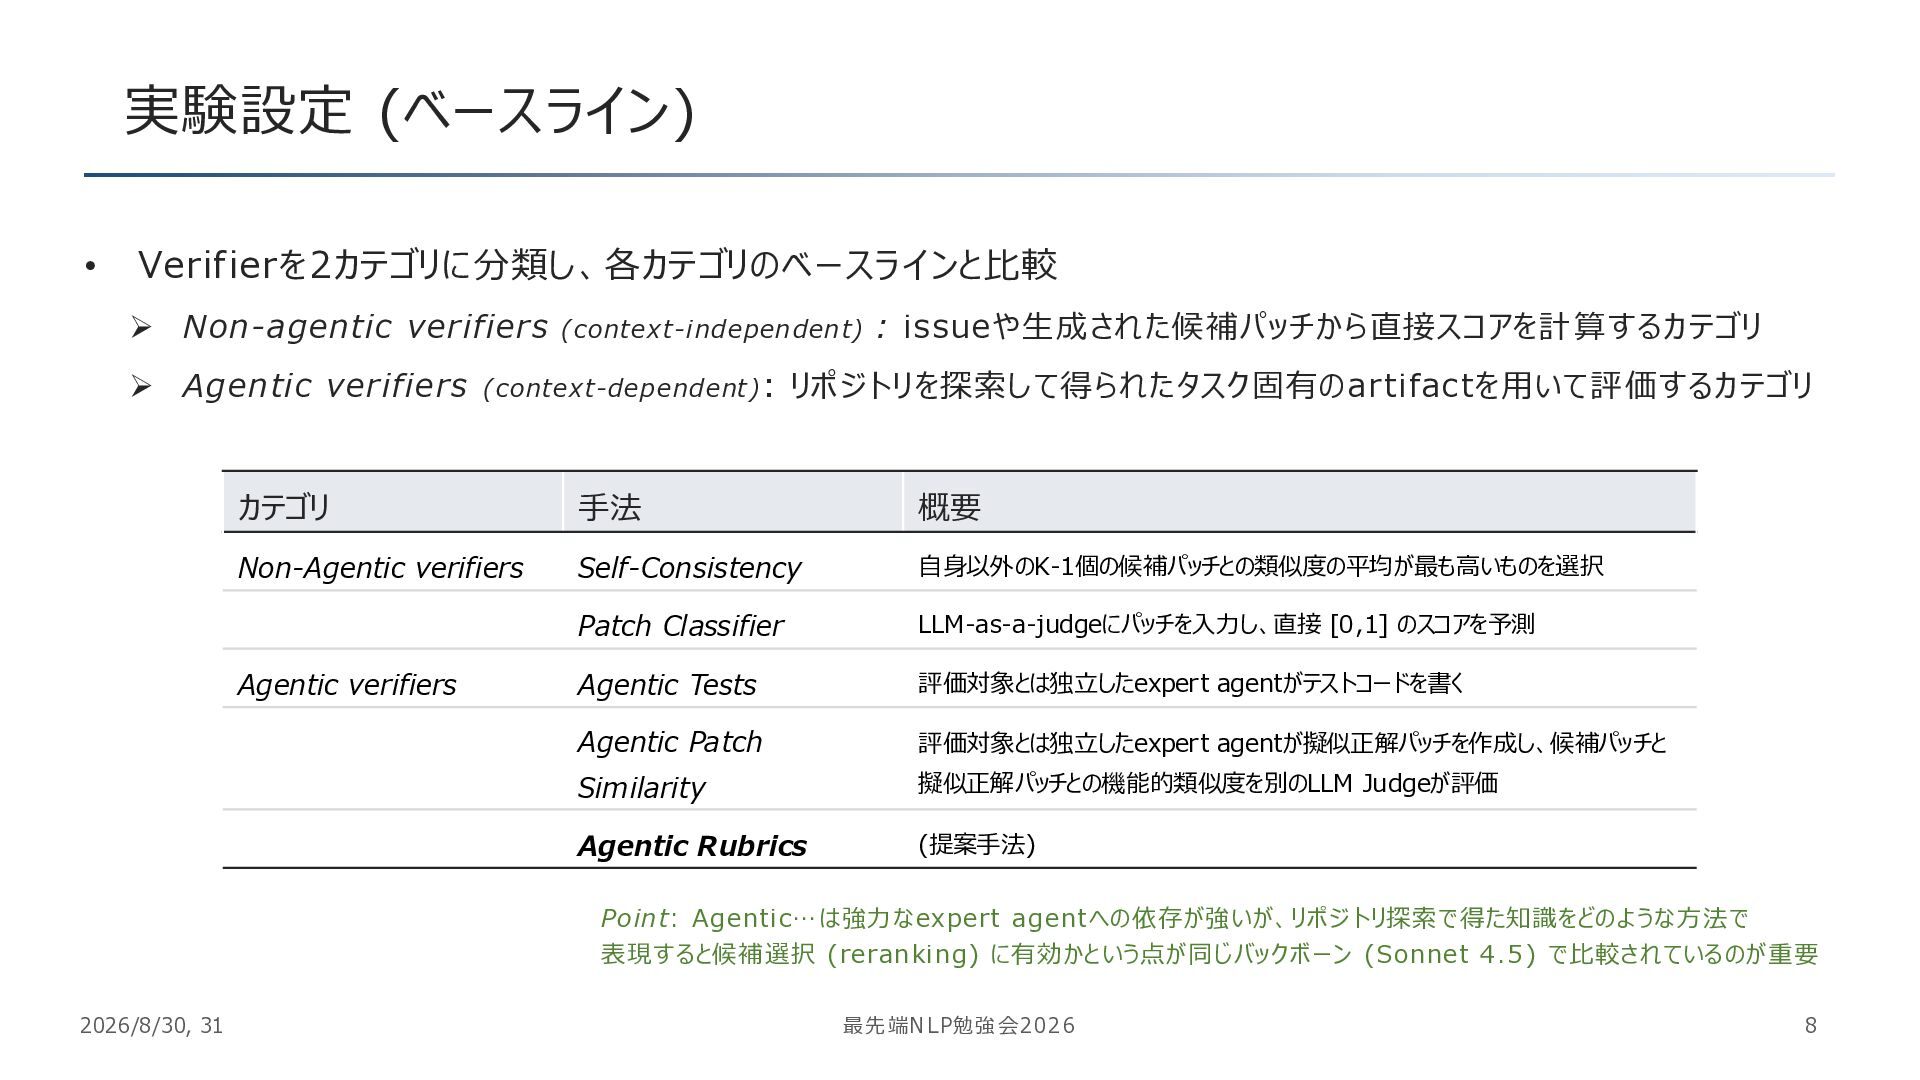
実験設定 (ベースライン) • Verif ierを2カテゴリに分類し、各カテゴリのベースラインと比較 ➢ Non-agentic verifiers (context-independent) :
issueや生成され た候補パッチから直接スコアを計算するカ テゴリ ➢ Agen ti c verifie rs (context-dependent) : リポジトリを探索して得られたタスク固有のartifactを用いて評価するカ テゴリ カテゴリ 手法 概要 Non-Agentic verifiers Self-Consistency 自身以外のK-1個の候補パッチとの類似度の平均が最も高いものを選択 Patch Classifier LLM-as-a-judgeにパッチを入力し、直接 [0,1] のスコアを予測 Agentic Tests 評価対象とは独立したexpert agentがテストコードを書く Agentic Patch 評価対象とは独立したexpert agentが擬似正解パッチを作成し、候補パッチと Similarity 擬似正解パッチとの機能的類似度を別のLLM Judgeが評価 Agentic Rubrics (提案手法) Agentic verifiers Po int: Agentic…は強力なexpert agent への依存が強いが、リポジ トリ探索で得た知識をどのような方法で 表現すると候補 選択 (reranking) に有効 かという点が同じバックボーン (Sonnet 4.5) で比較されているのが重要 2026/8/30, 31 最先 端N LP勉強 会2026 8 -
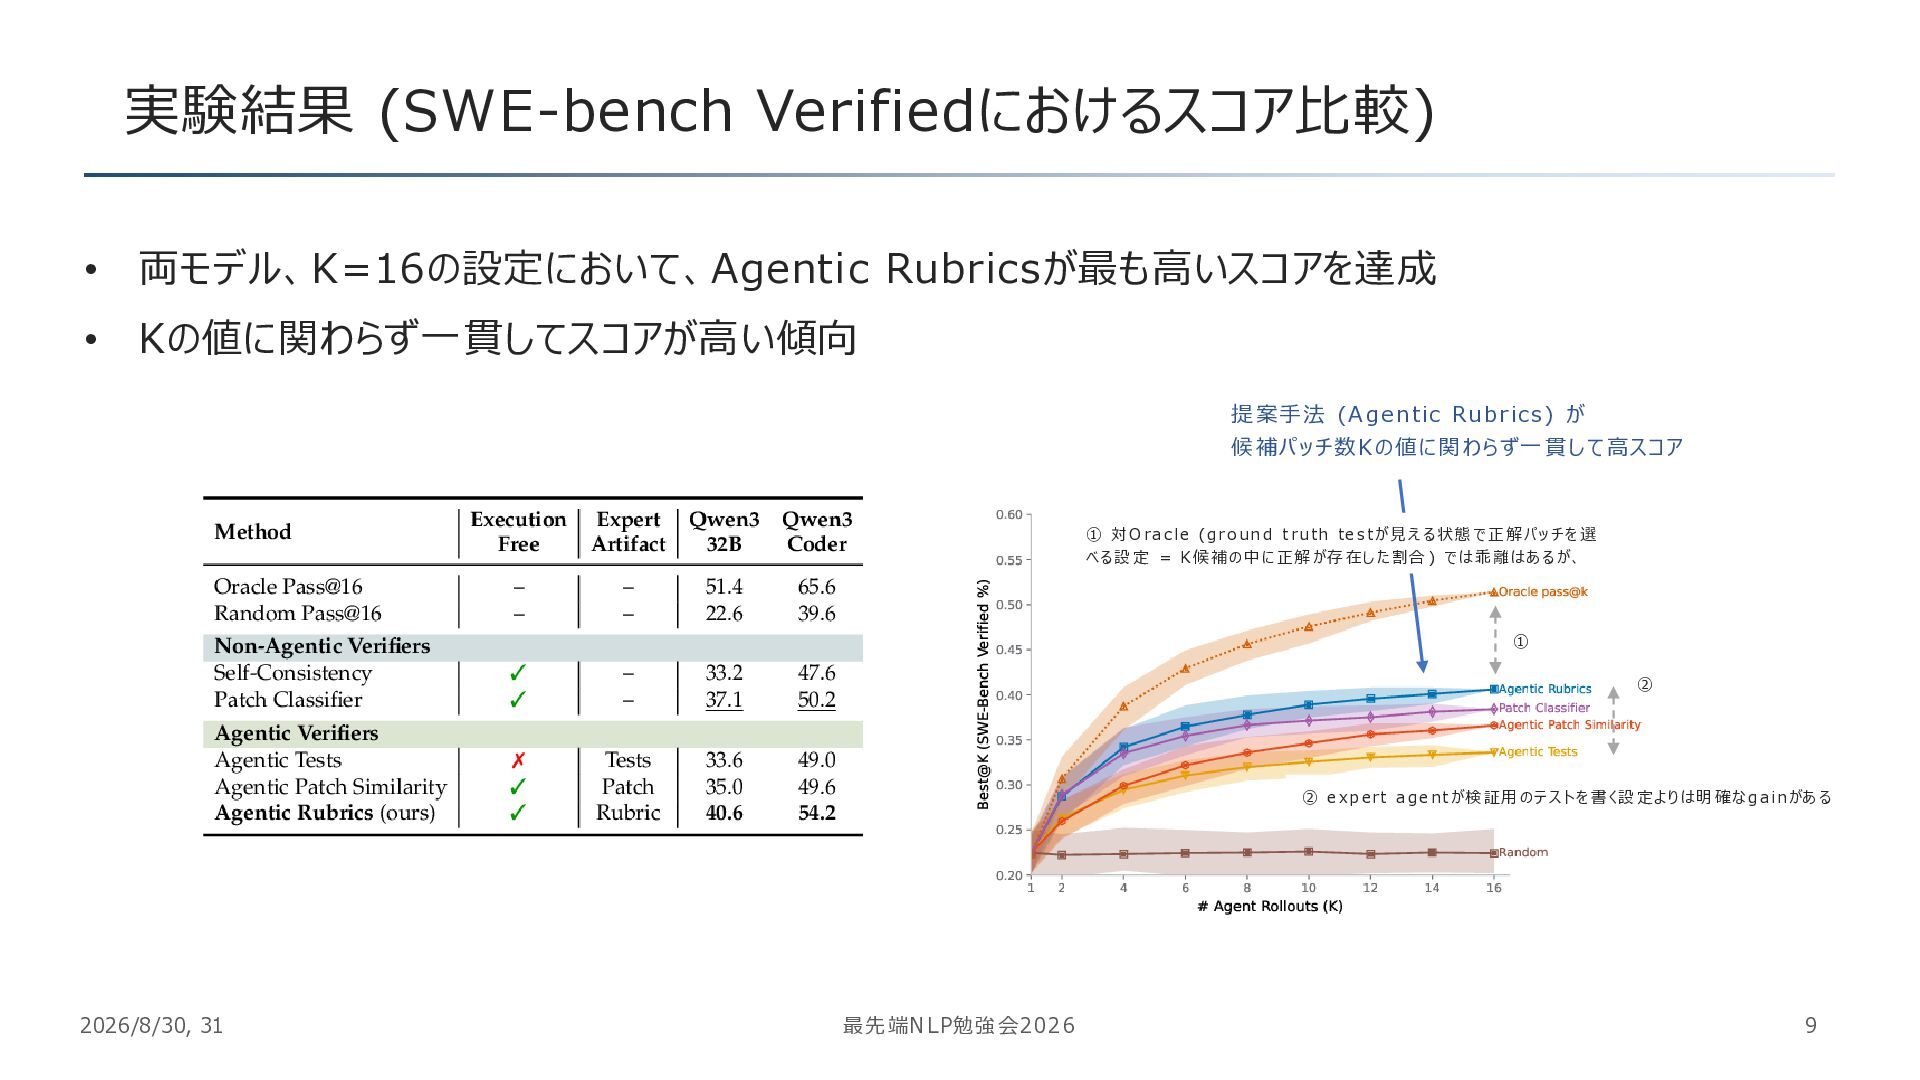
実験結果 (SWE-bench Verifiedにおけるスコア比較) • 両モデル、K=16の設定において、Agentic Rubricsが最も高いスコアを達成 • Kの値に関わらず一貫してスコアが高い傾向 提 案手
法 (A g en tic Ru b r ics) が 候 補パ ッチ数 K の 値 に関 わら ず一 貫 して 高ス コ ア ① 対 O r a c l e ( g r o u n d t r u th te s t が見 え る 状態 で正 解パ ッ チ を 選 べる 設 定 = K 候補 の中 に 正解 が存 在し た 割合 ) では 乖 離は あ る が、 ① ② ② e xp er t a g e n t が検 証用 のテ ス ト を 書 く設 定よ り は明 確な g a i n があ る 2026/8/30, 31 最先 端N LP勉強 会2026 9 -
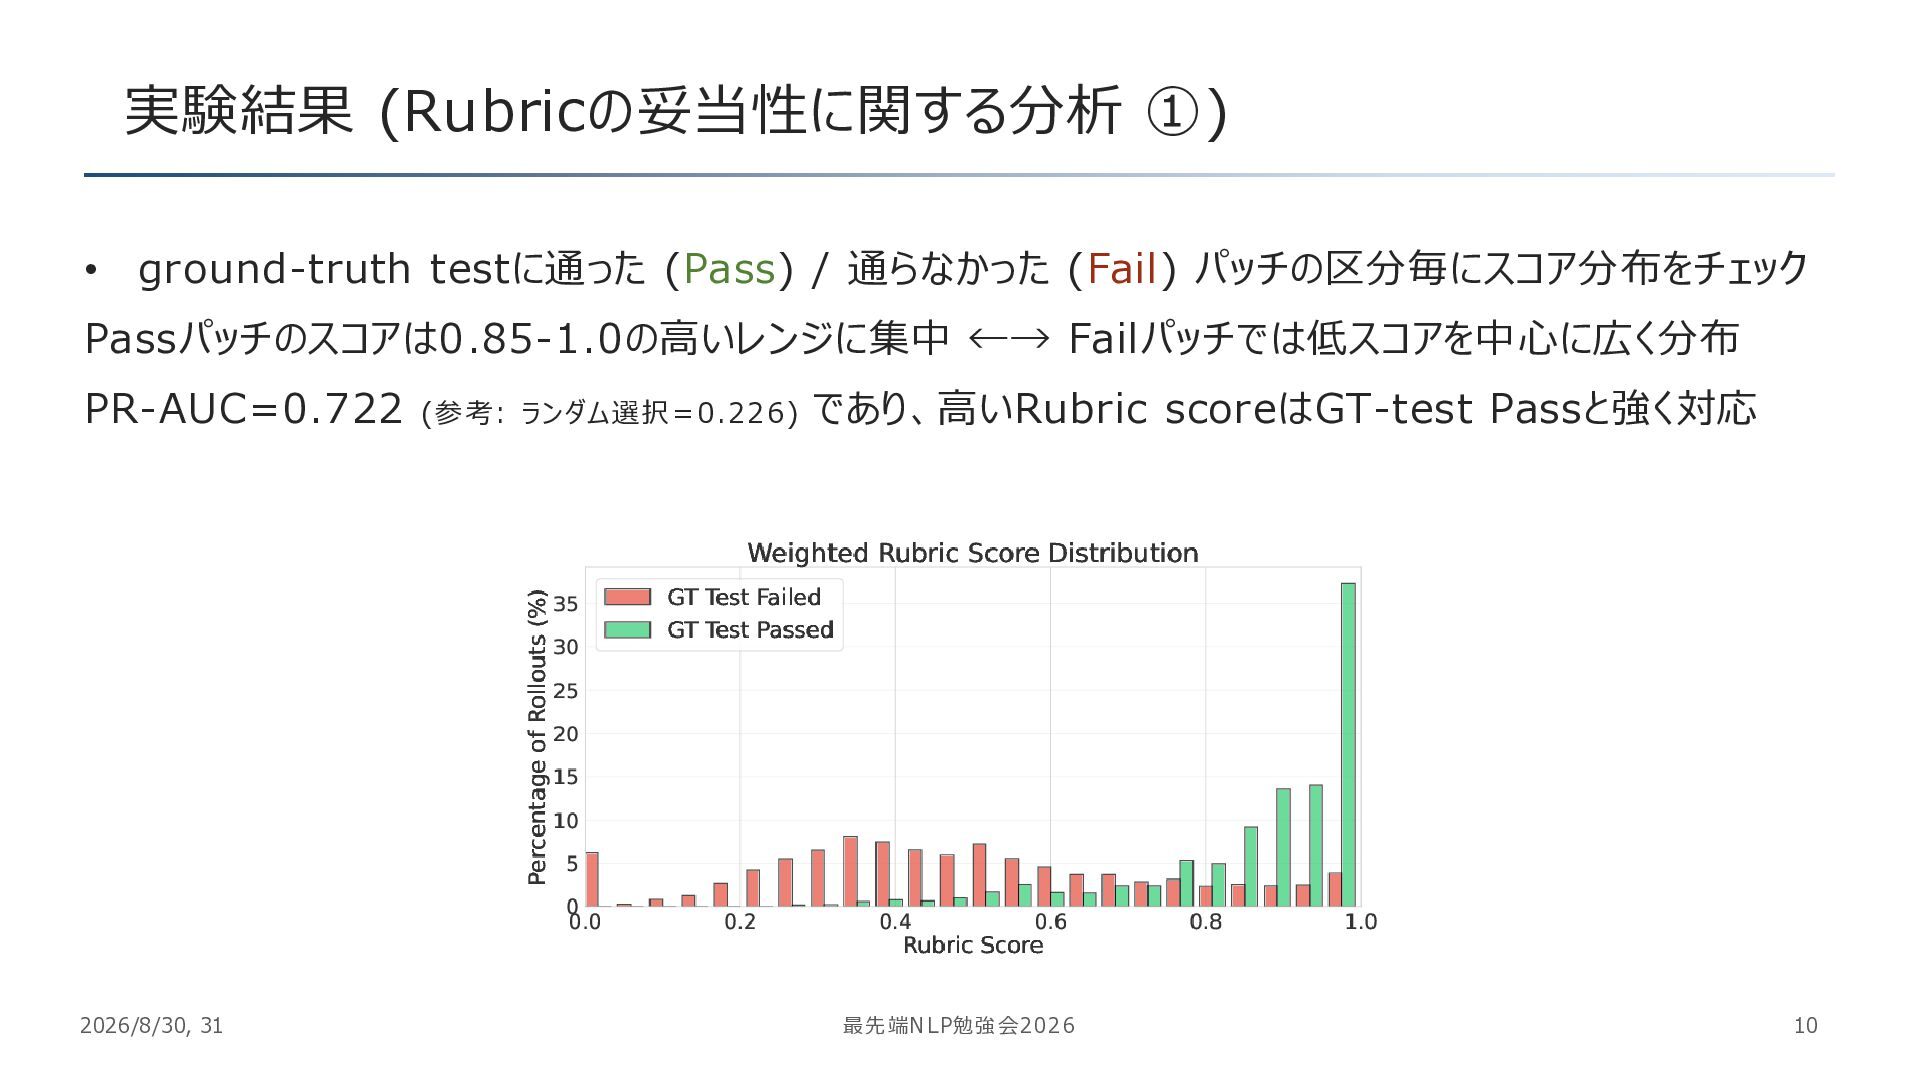
実験結果 (Rubricの妥当性に関する分析 ①) • ground-truth testに通った (Pass) / 通らなかった (Fail)
パッチの区分毎にスコア分布をチェック Passパッチのスコアは0.85-1.0の高いレンジに集中 ←→ Failパッチでは低スコアを中心に広く分布 PR-AUC=0.722 (参 考: ランダム選 択 =0 .22 6) であり、高いRubric scoreはGT-test Passと強く対応 2026/8/30, 31 最先 端N LP勉強 会2026 10 -
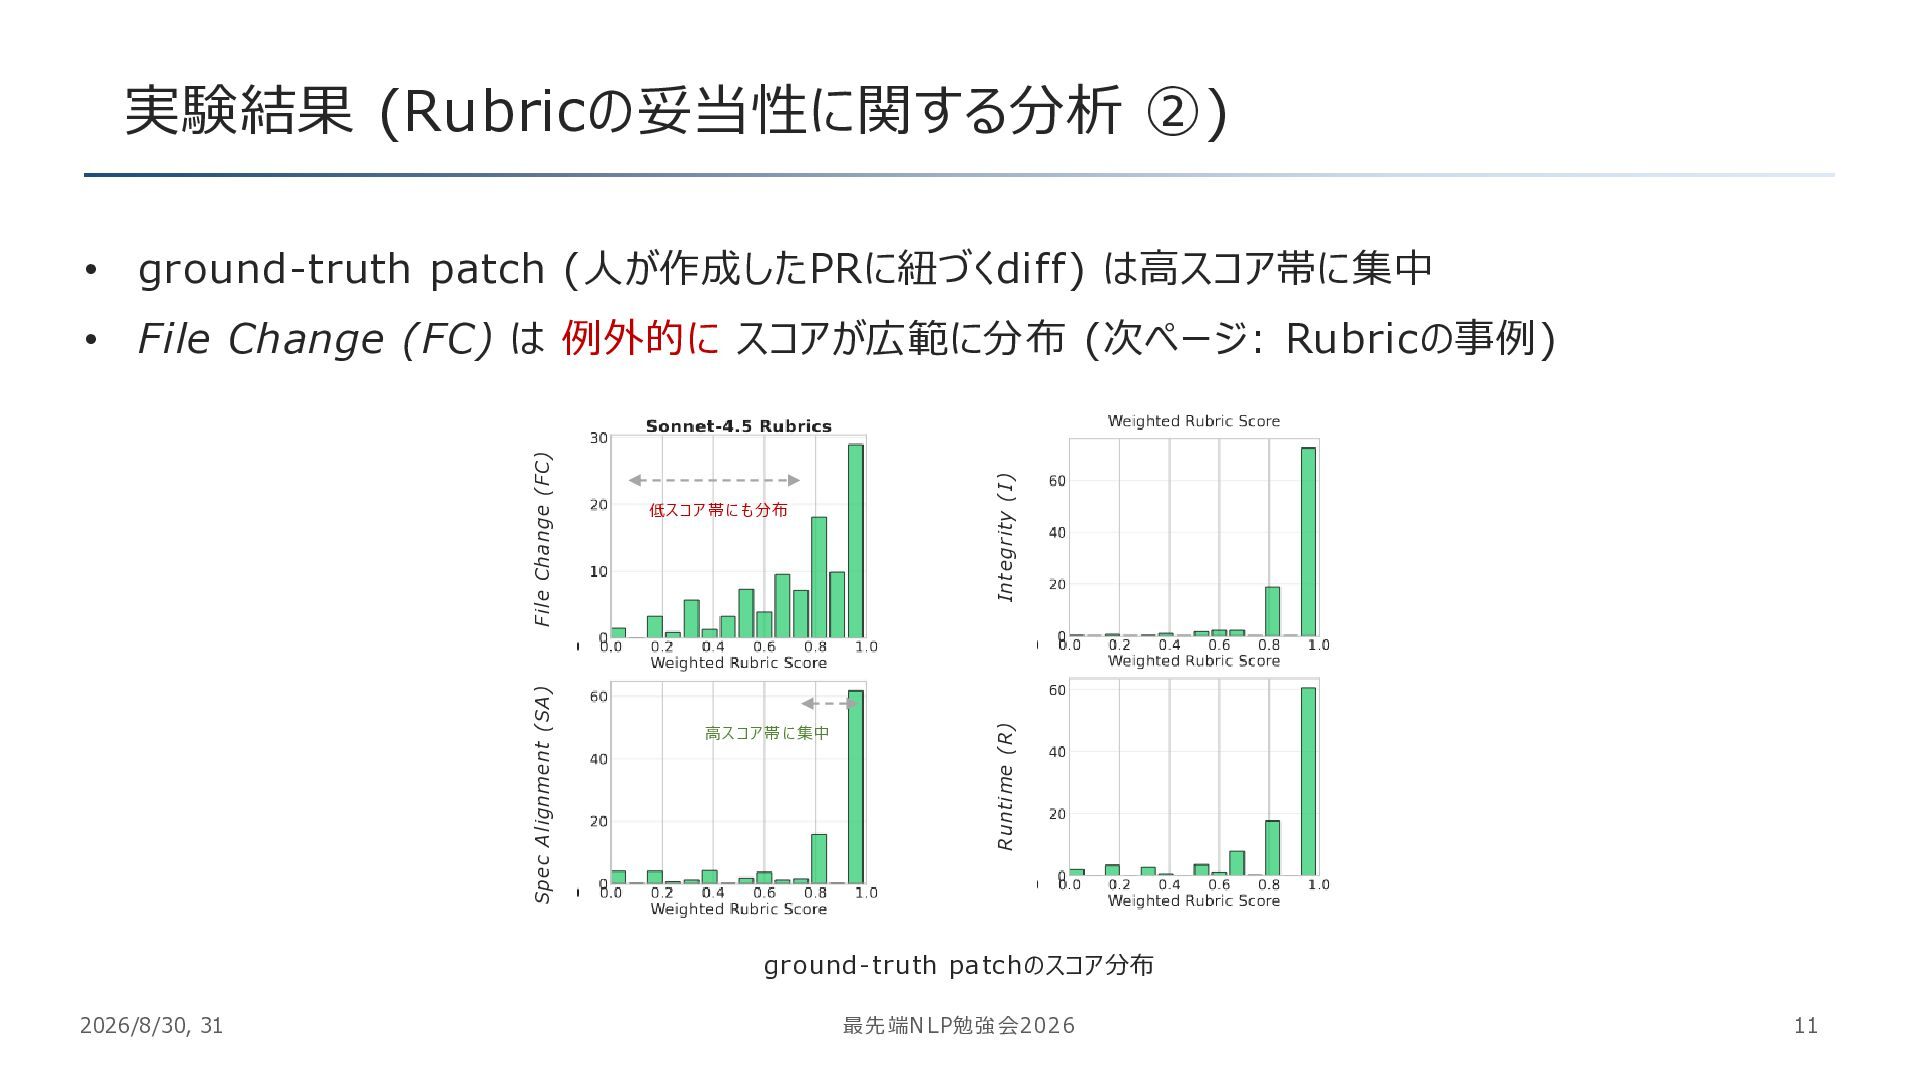
実験結果 (Rubricの妥当性に関する分析 ②) • ground-truth patch (人が作成したPRに紐づくdiff) は高スコア帯に集中 高ス コ
ア 帯 に 集中 Int egr ity (I ) 低ス コ ア 帯 に も 分布 Runti me ( R) Spe c Al ignme nt (SA) F il e Cha nge (FC ) • File Change (FC) は 例外的に スコアが広範に分布 (次ページ: Rubricの事例) gr ound-truth pa tchのスコア分布 2026/8/30, 31 最先 端N LP勉強 会2026 11 -
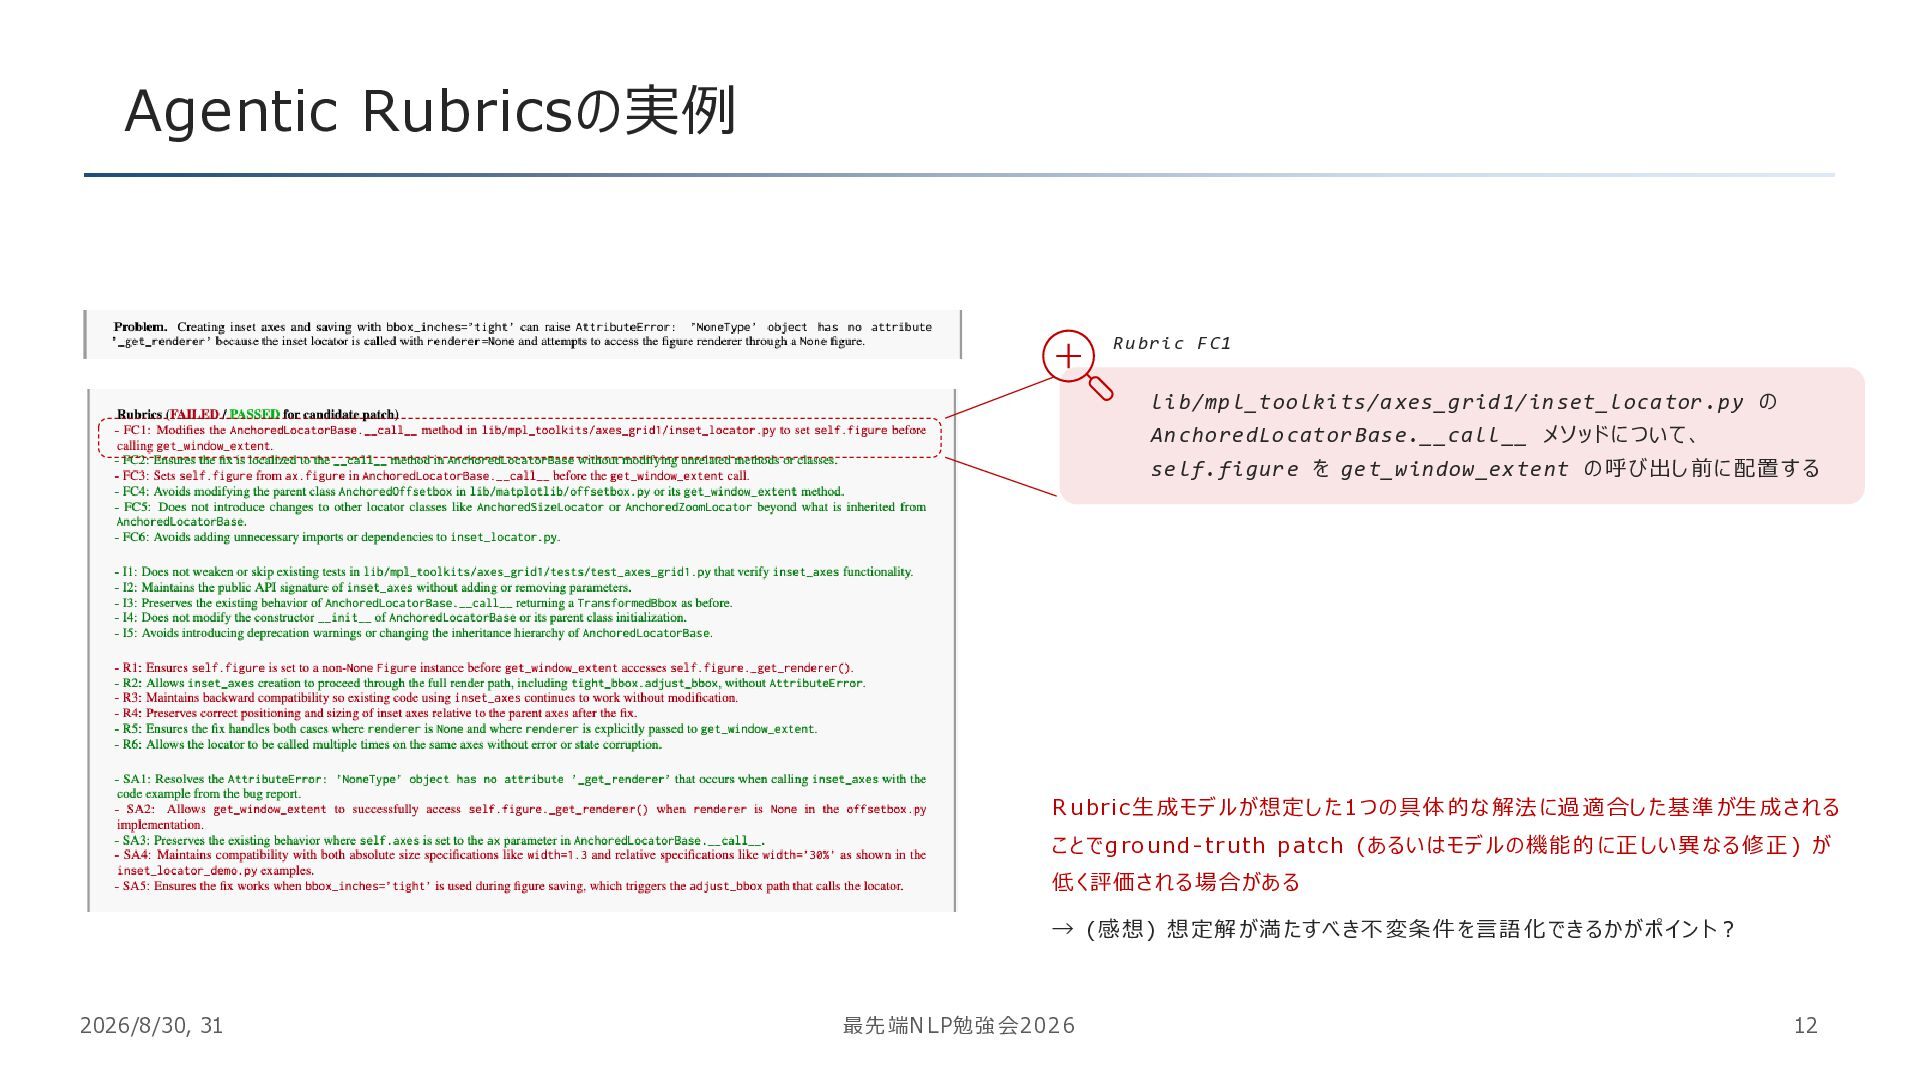
Agentic Rubricsの実例 Ru bri c F C1 li b/mp l_t
oo lki ts/a xes _g rid 1/in set _l oca tor .p y の An cho re dLo cat or Bas e._ _ca ll __ メ ソ ッドに つい て、 se lf. fi gur e を ge t_w in dow _ex te nt の 呼 び 出し 前に 配置 す る R u br ic 生 成モ デ ル が 想定 し た1 つの 具 体 的な 解法 に過 適 合し た基 準 が生 成 さ れ る こ と で g ro un d - tr u th p atch (あ る い はモ デ ル の 機能 的 に正 しい 異 なる 修 正 ) が 低 く評価 さ れ る 場 合が あ る → ( 感 想) 想 定解 が 満 たすべ き 不 変条 件 を 言語 化 でき る か が ポ イン ト? 2026/8/30, 31 最先 端N LP勉強 会2026 12 -
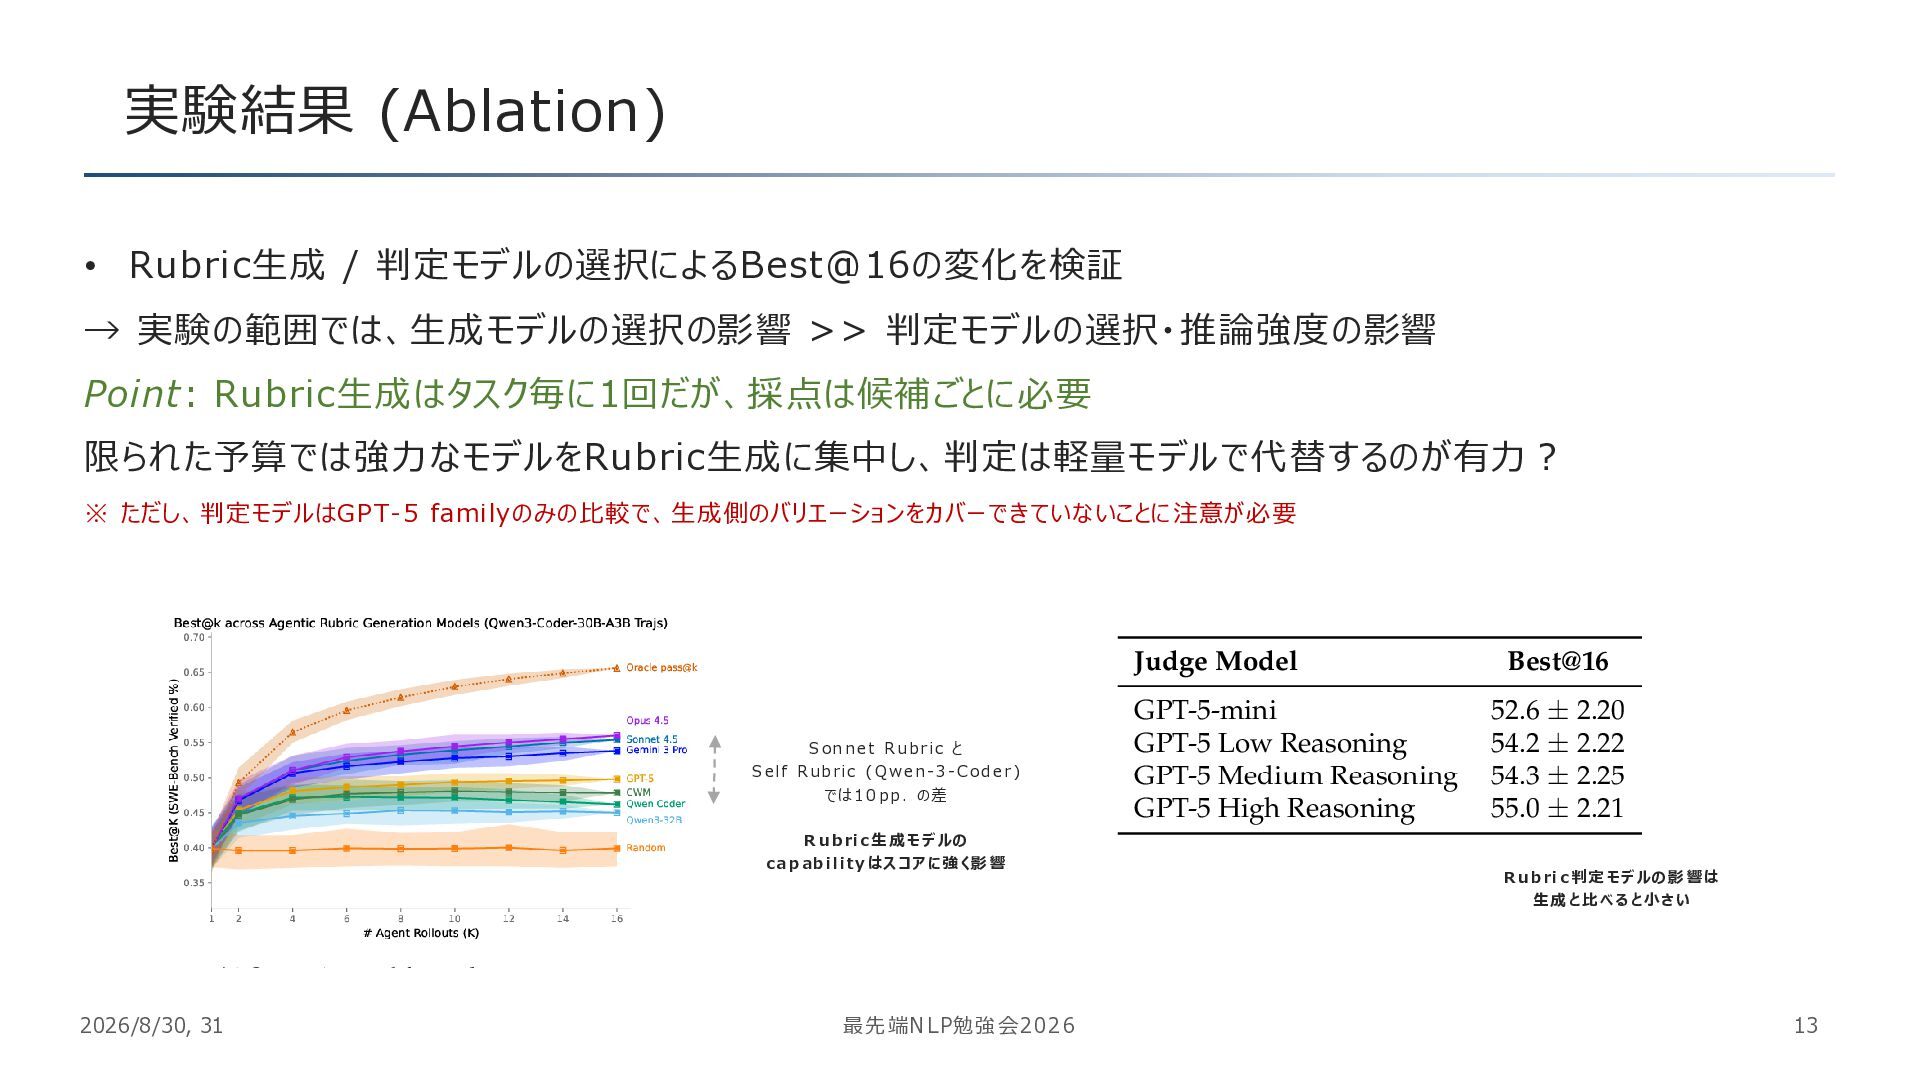
実験結果 (Ablation) • Rubric生成 / 判定モデルの選択によるBest@16の変化を検証 → 実験の範囲では、生成モデルの選択の影響 >> 判定モデルの選択・推論強度の影響
Point: Rubric生成はタスク毎に1回だが、採点は候補ごとに必要 限られた予算では強力なモデルをRubric生成に集中し、判定は軽量モデルで代替するのが有力? ※ ただし、 判定モデルはGPT-5 family のみの比較で、 生成側のバリエーションをカ バーできていないことに注意が必要 S on n e t R u b r i c と S el f R u b r i c ( Q we n - 3 - C o d e r ) では 1 0 p p . の差 R u b ri c 生成 モ デ ルの ca p ab i l it y は ス コア に強 く影 響 2026/8/30, 31 最先 端N LP勉強 会2026 R u b ri c 判定 モ デ ルの 影 響は 生成 と 比 べる と 小さ い 13 -
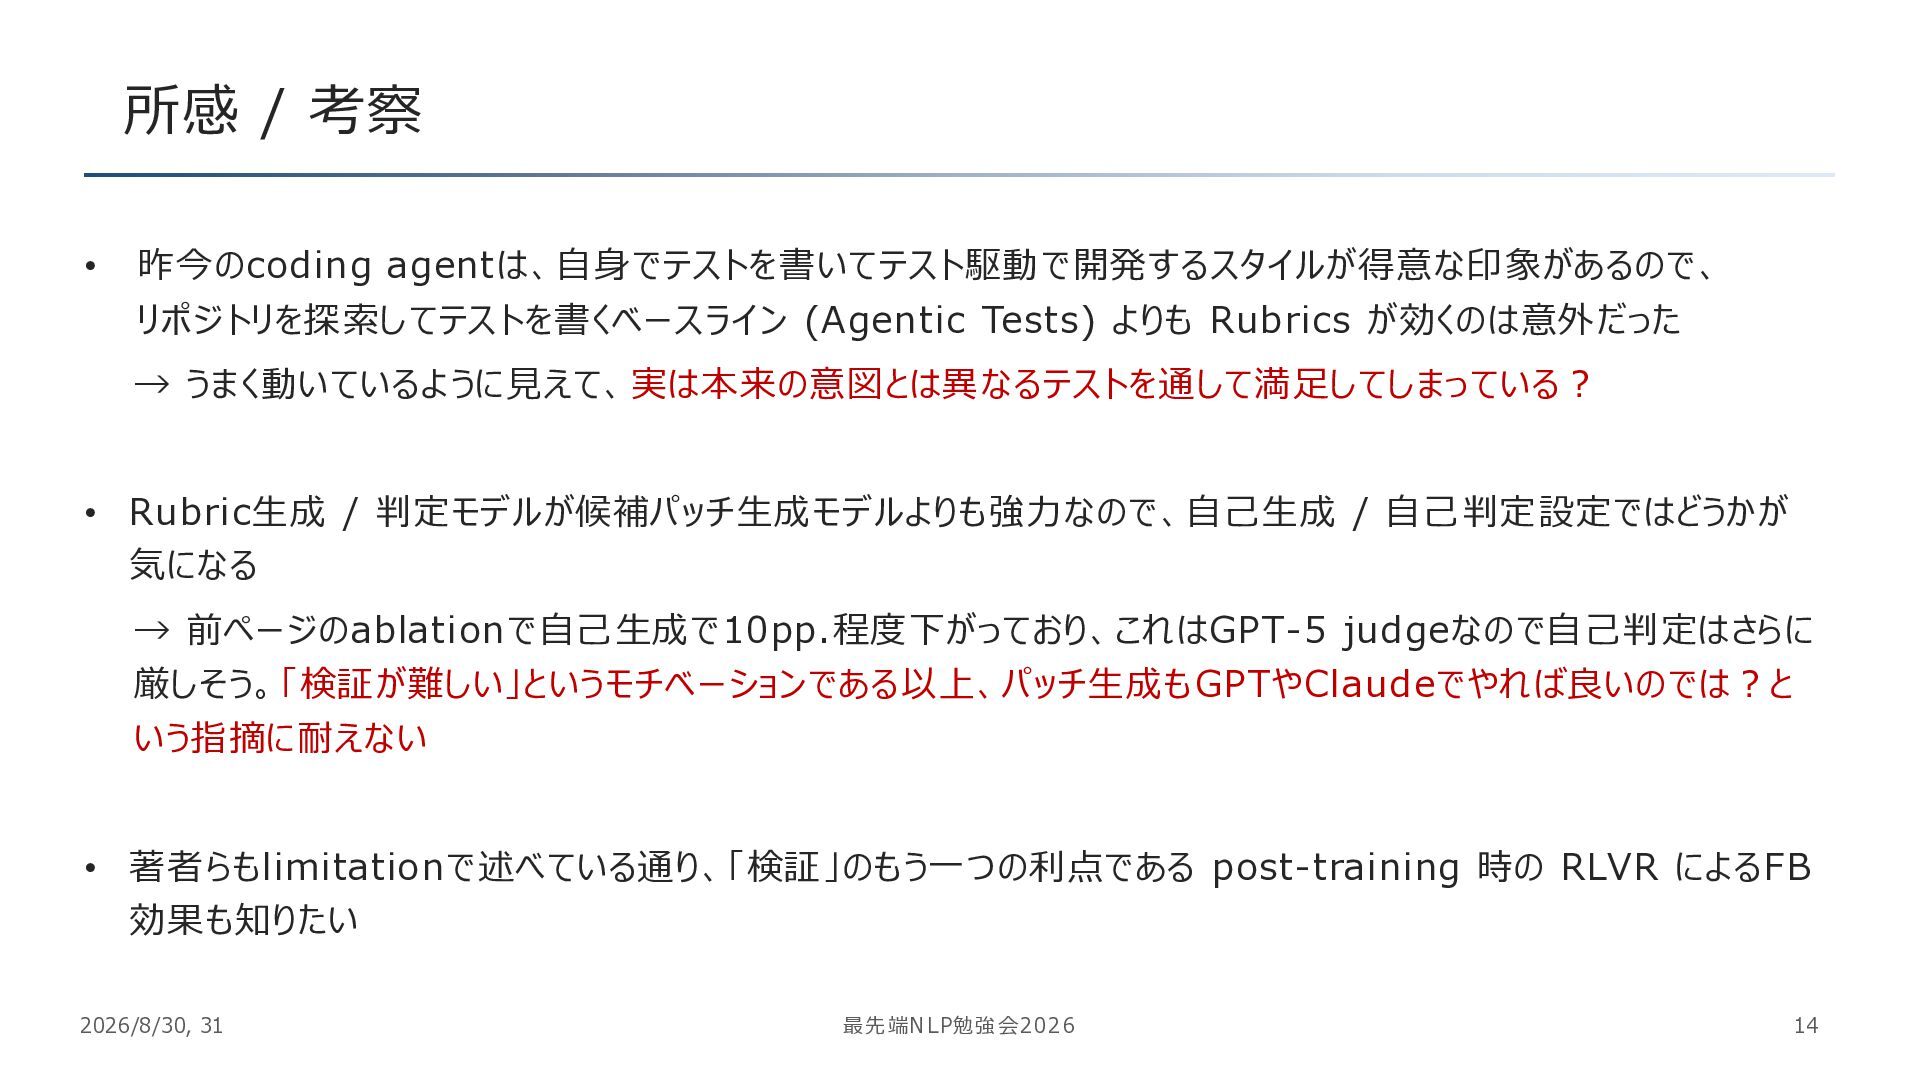
所感 / 考察 • 昨今のcoding agentは、自身でテストを書いてテスト駆動で開発するスタイルが得意な印象があるので、 リポジトリを探索してテストを書くベースライン (Agentic Tests) よりも
Rubrics が効くのは意外だった → うまく動いているように見えて、実は本来の意図とは異なるテストを通して満足してしまっている? • Rubric生成 / 判定モデルが候補パッチ生成モデルよりも強力なので、自己生成 / 自己判定設定ではどうかが 気になる → 前ページのablationで自己生成で10pp.程度下がっており、これはGPT-5 judgeなので自己判定はさらに 厳しそう。「検証が難しい」というモチベーションである以上、パッチ生成もGPTやClaudeでやれば良いのでは?と いう指摘に耐えない • 著者らもlimitationで述べている通り、「検証」のもう一つの利点である post-training 時の RLVR によるFB 効果も知りたい 2026/8/30, 31 最先 端N LP勉強 会2026 14 -
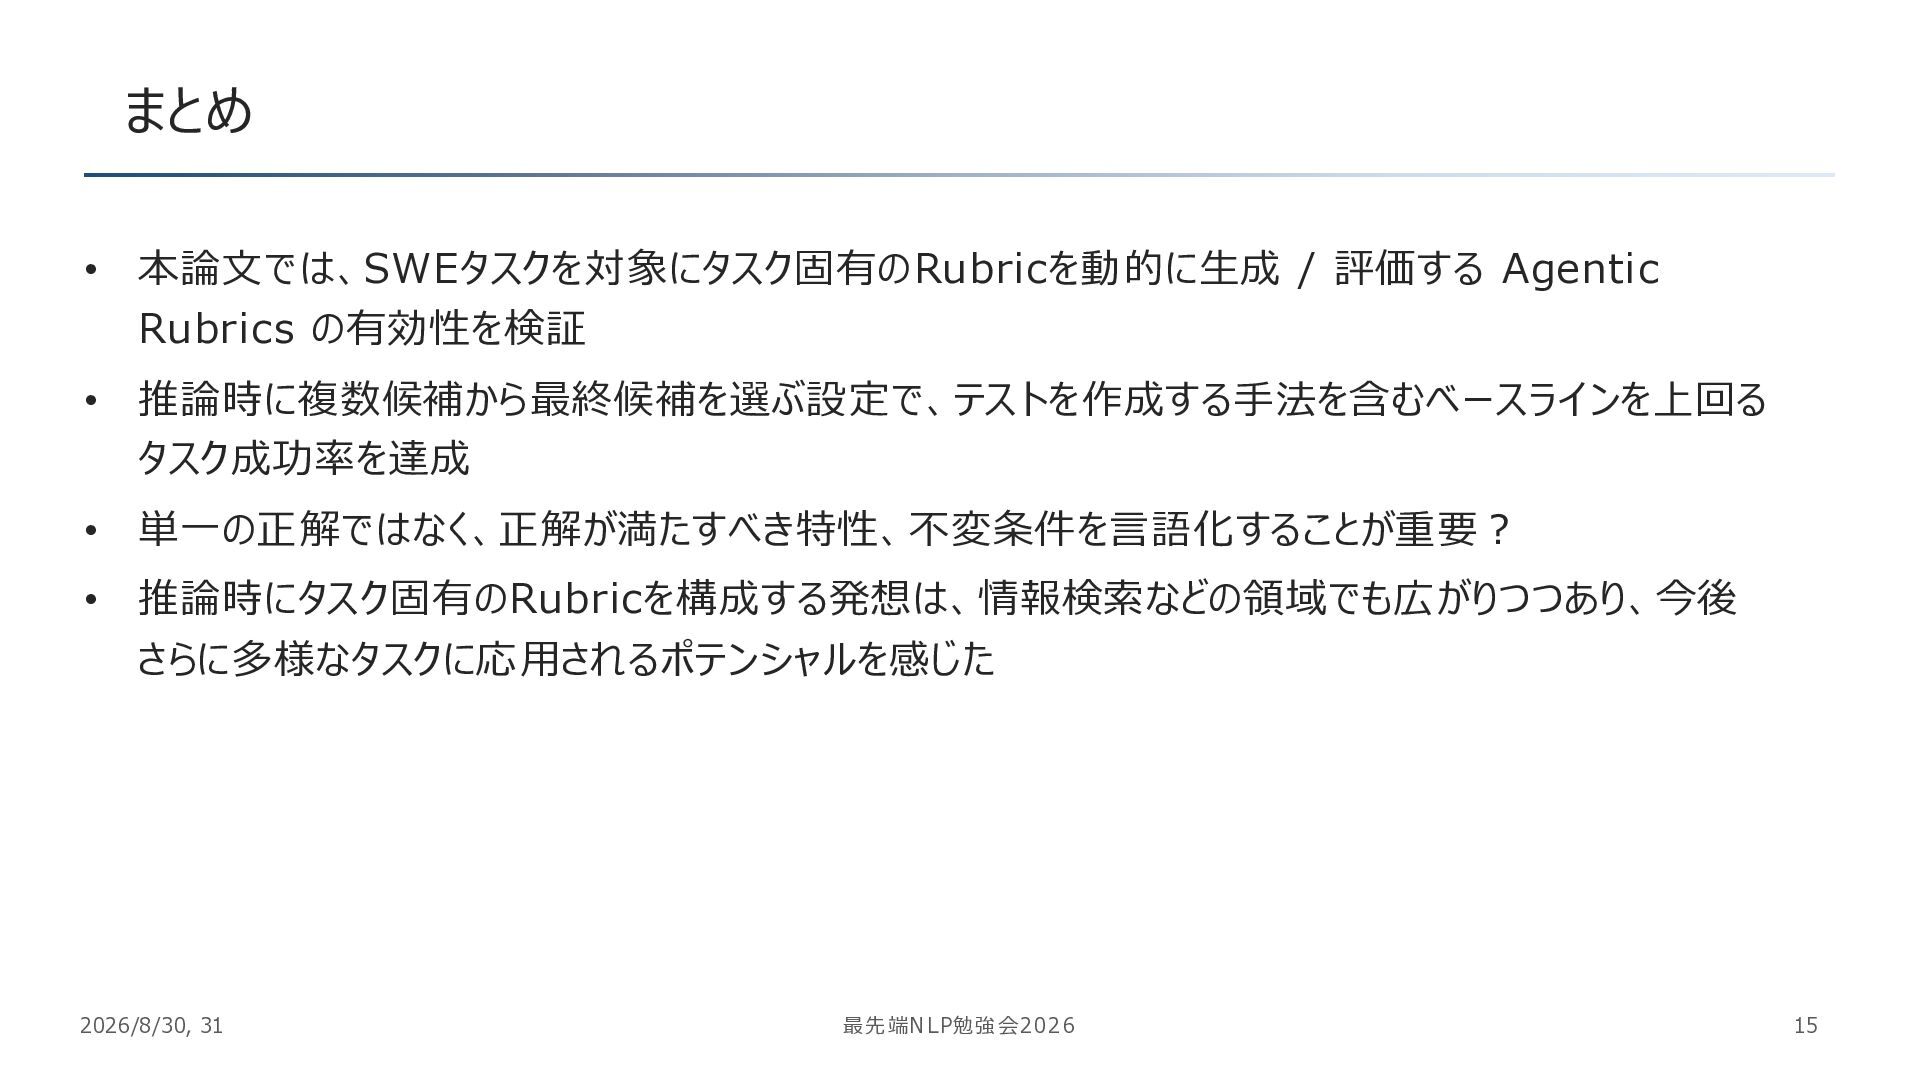
まとめ • 本論文では、SWEタスクを対象にタスク固有のRubricを動的に生成 / 評価する Agentic Rubrics の有効性を検証 • 推論時に複数候補から最終候補を選ぶ設定で、テストを作成する手法を含むベースラインを上回る
タスク成功率を達成 • 単一の正解ではなく、正解が満たすべき特性、不変条件を言語化することが重要? • 推論時にタスク固有のRubricを構成する発想は、情報検索などの領域でも広がりつつあり、今後 さらに多様なタスクに応用されるポテンシャルを感じた 2026/8/30, 31 最先 端N LP勉強 会2026 15