Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
そのAIレビュー、レビューしてますか? / Are you reviewing those A...
Search
r-kagaya
January 21, 2026
Programming
5.6k
7
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
そのAIレビュー、レビューしてますか? / Are you reviewing those AI reviews?
CodeRabbit User Group Tokyo #0 〜立ち上げキックオフ〜の登壇資料です。
https://crug.connpass.com/event/378621/
r-kagaya
January 21, 2026
More Decks by r-kagaya
See All by r-kagaya
速く作れる。その次は、速く確かめられる開発へ 〜AIネイティブ開発を支える、Shift Down〜 / Can build fast. Next, moving to development where we can verify fast.
rkaga
5
4.5k
AI活用は、個人から組織へ|マルチプレイヤーエージェントハーネス「QM」の社内活用事例 / AI use is moving from individuals to orgs
rkaga
1
190
AI Engineeringは、AIプロダクトだけのものか? 〜AIがソフトウェアを作る時代の新しい当たり前〜 / No AI in your product. AI Engineering in your development.
rkaga
5
760
エンジニアにデザインハーネスを 〜デザインプロセスを規定するためのハーネス〜 / Design harness from an engineer's perspective
rkaga
2
3.5k
「AIで開発し、AIを届ける」をEvalでつなぐ 〜AIネイティブに始めるプロダクト開発の実践〜 / Connecting "Develop with AI, deliver AI" with Eval
rkaga
4
6.3k
ハーネスエンジニアリングにどう向き合うか 〜ルールファイルを超えて開発プロセスを設計する〜 / How to approach harness engineering
rkaga
31
32k
AIエージェント、”どう作るか”で差は出るか? / AI Agents: Does the "How" Make a Difference?
rkaga
5
2.4k
Context is King? 〜Verifiability時代とコンテキスト設計 / Beyond "Context is King"
rkaga
10
4k
AIエンジニアリングのご紹介 / Introduction to AI Engineering
rkaga
7
5.2k
Other Decks in Programming
See All in Programming
iOSDC Japan 2026 - Swiftで作って学ぼう!データベース自作入門
kaseken
2
330
アクセシビリティから考える情報設計
high_g_engineer
0
390
AWS Step Functions 大規模並列の壁を越える / jaws-sonic-2026-niigata-step-functions
kasacchiful
PRO
1
520
Kiroで創り、AgentCoreで繋ぐ!AWSで実践する「AI-DLC」から「AIエージェント統合」までの最新地図
licux
4
780
Are APIs Still Relevant in the AI Era?
soyuka
0
310
【高い買い物LT会】初任給で話題の国産フィジカルAIを買った話
akagami
PRO
0
170
XP祭りでしか伝わらないフリップネタ #xpjug
murabayashi
0
150
UPDATE をやめる — EF Core でマスタをバージョン管理する
panda728
PRO
0
570
Apple Intelligence を用いた個人情報誤送信防止、及びユーザーリクエスト体験の改善について
yukiny
0
130
一人だけ、Kiroが静止する日
hideg
0
130
変化を抱擁するドキュメントの作り方 - ビジネスルール駆動開発がもたらす、コードとの新しい関係
ioki
2
220
Ghostty + Neovimで作る 透明でカッコ良い開発環境
j341nono
0
120
Featured
See All Featured
The Organizational Zoo: Understanding Human Behavior Agility Through Metaphoric Constructive Conversations (based on the works of Arthur Shelley, Ph.D)
kimpetersen
PRO
0
470
WCS-LA-2024
lcolladotor
0
830
ReactJS: Keep Simple. Everything can be a component!
pedronauck
666
130k
Tell your own story through comics
letsgokoyo
1
1.1k
Building Experiences: Design Systems, User Experience, and Full Site Editing
marktimemedia
1
610
Build The Right Thing And Hit Your Dates
maggiecrowley
39
3.5k
Building Better People: How to give real-time feedback that sticks.
wjessup
370
20k
Designing Powerful Visuals for Engaging Learning
tmiket
1
580
The Impact of AI in SEO - AI Overviews June 2024 Edition
aleyda
6
1.2k
The Curious Case for Waylosing
cassininazir
1
540
Abbi's Birthday
coloredviolet
4
10k
The World Runs on Bad Software
bkeepers
PRO
72
12k
Transcript
2026年1月21日 Asterminds株式会社 r.kagaya CodeRabbit User Group Tokyo #0 〜立ち上げキックオフ〜 そのAIレビュー、レビューしてますか?
〜AI as a Judgeから考えるAIコードレビューの育成〜
2022年に株式会社ログラスに入社 経営管理SaaSの開発、開発生産性向上に取り組んだのち、 生成AI/LLMチームを立ち上げ、新規AIプロダクトの立ち 上げに従事、その後、25年8月に独立・現職 翻訳を担当したAIエンジニアリングが オライリージャパンより出版 Asterminds(アスターマインズ)株式会社 共同創業者・CTO r.kagaya(@ry0_kaga) 自己紹介
そのAIコードレビュー、レビューしてますか?
フィードバックして、育てられていますか?
AIコードレビューは 「人間の代わりに、コードを“判断”させている」
AIコードレビューは 「人間の代わりに、コードを“判断”させている」 LLM as a Judgeの知見が使えるのでは?
LLM as a Judgeの事例・プラクティス から考えるAIコードレビューの育て方 今日の内容
CodeRabbitの機能解説は少なめです...🙇
簡単にLLM as a Judge とは
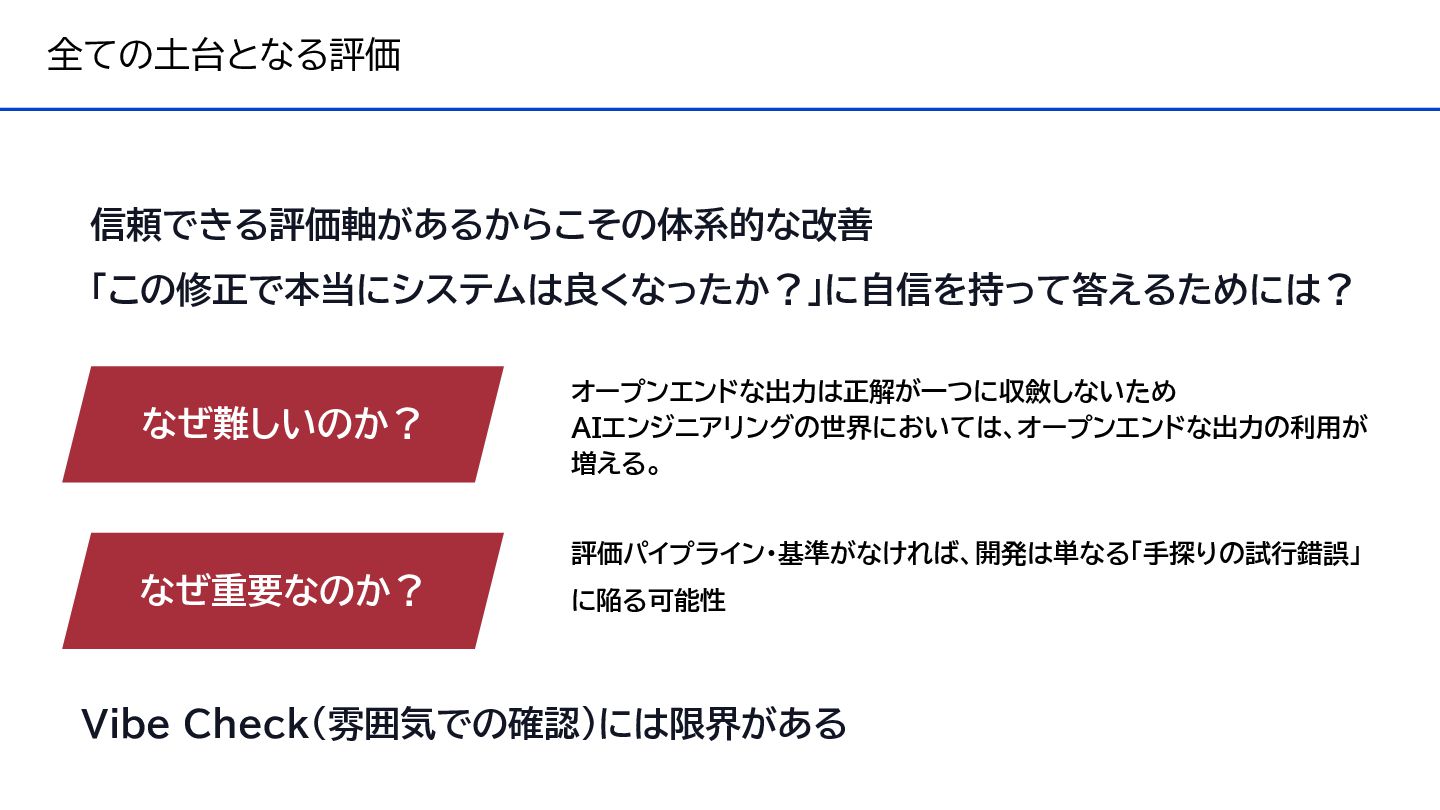
全ての土台となる評価 信頼できる評価軸があるからこその体系的な改善 「この修正で本当にシステムは良くなったか?」に自信を持って答えるためには? Vibe Check(雰囲気での確認)には限界がある なぜ難しいのか? オープンエンドな出力は正解が一つに収斂しないため AIエンジニアリングの世界においては、オープンエンドな出力の利用が 増える。 なぜ重要なのか?
評価パイプライン・基準がなければ、開発は単なる「手探りの試行錯誤」 に陥る可能性
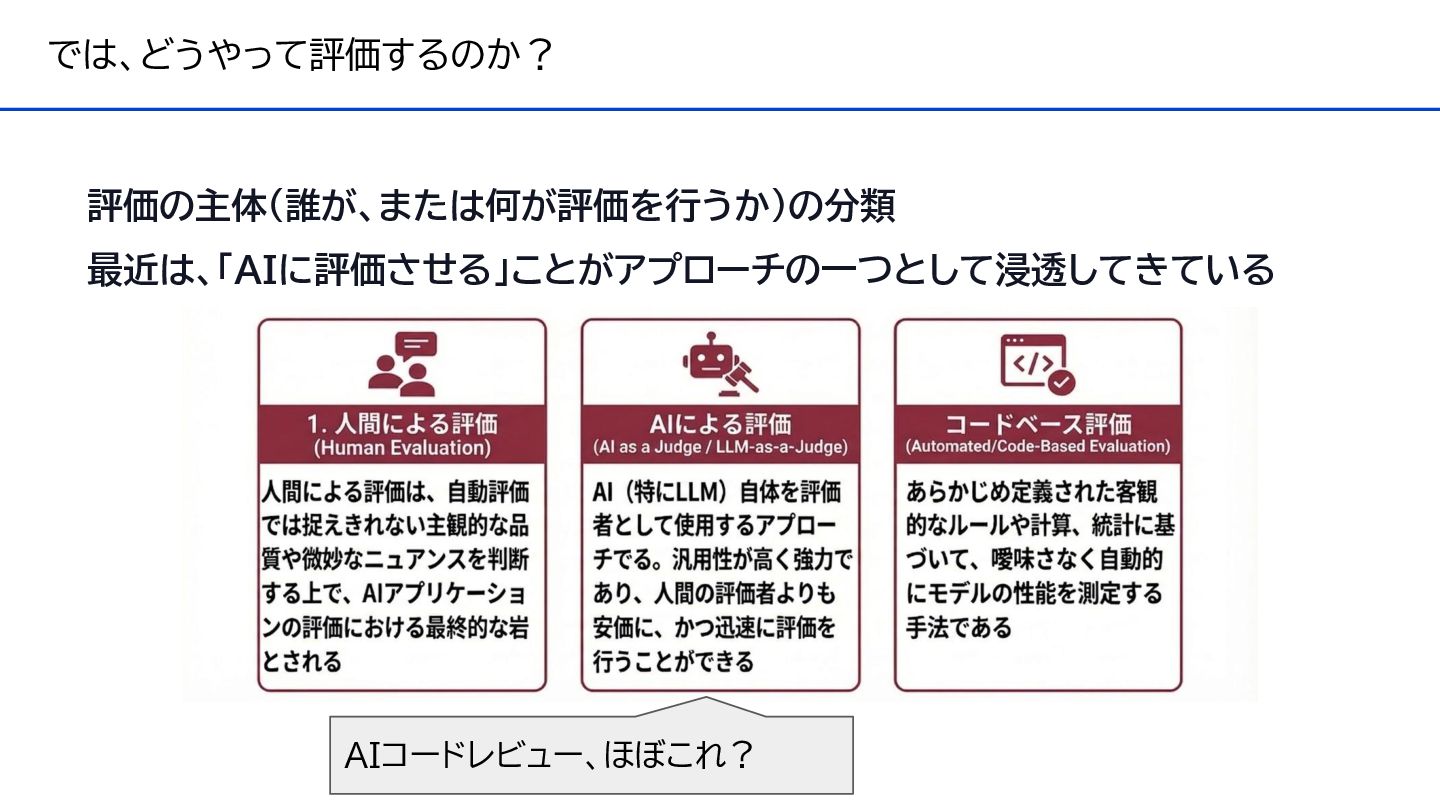
評価の主体(誰が、または何が評価を行うか)の分類 最近は、「AIに評価させる」ことがアプローチの一つとして浸透してきている では、どうやって評価するのか? AIコードレビュー、ほぼこれ?
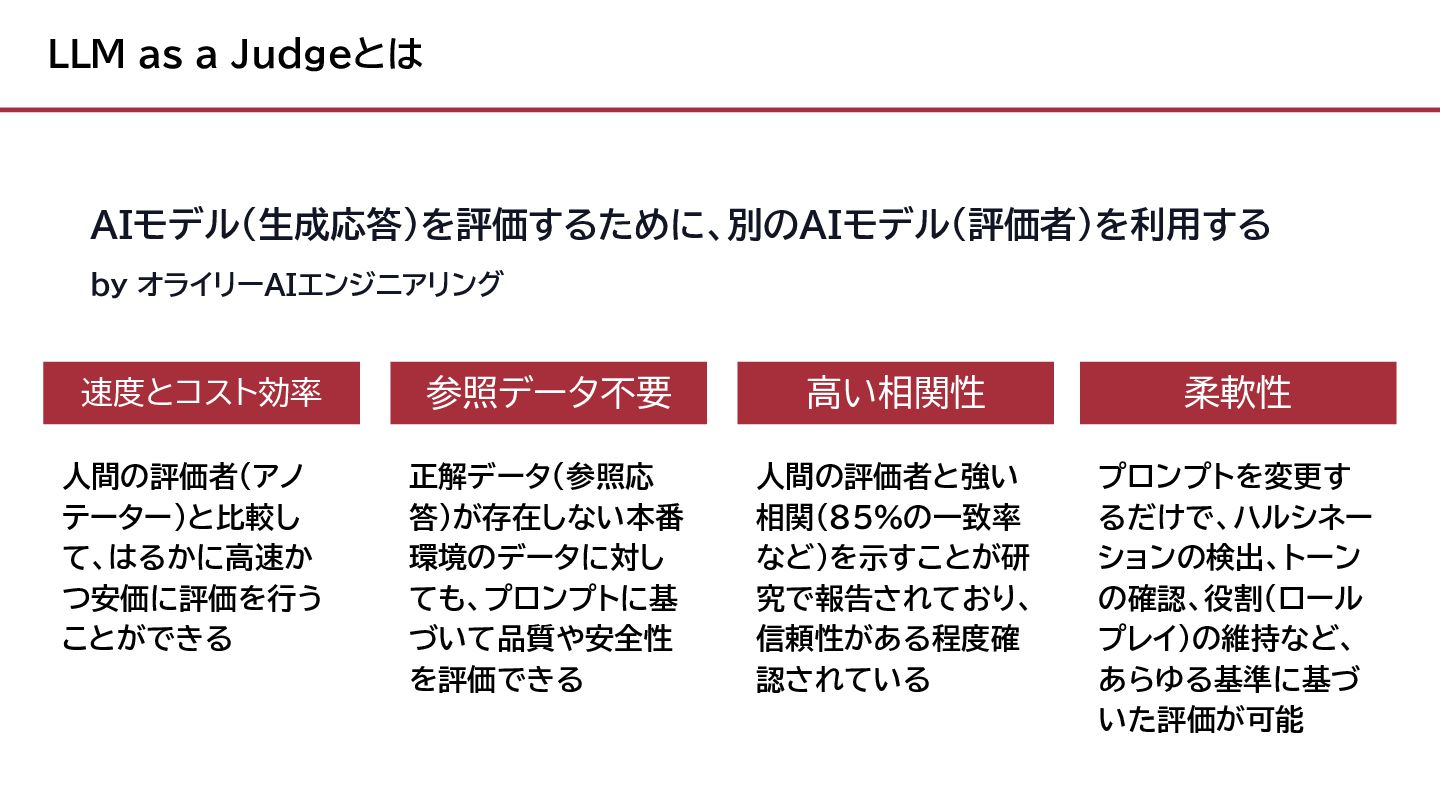
LLM as a Judgeとは AIモデル(生成応答)を評価するために、別のAIモデル(評価者)を利用する by オライリーAIエンジニアリング 速度とコスト効率 参照データ不要 高い相関性
人間の評価者(アノ テーター)と比較し て、はるかに高速か つ安価に評価を行う ことができる 正解データ(参照応 答)が存在しない本番 環境のデータに対し ても、プロンプトに基 づいて品質や安全性 を評価できる 人間の評価者と強い 相関(85%の一致率 など)を示すことが研 究で報告されており、 信頼性がある程度確 認されている 柔軟性 プロンプトを変更す るだけで、ハルシネー ションの検出、トーン の確認、役割(ロール プレイ)の維持など、 あらゆる基準に基づ いた評価が可能
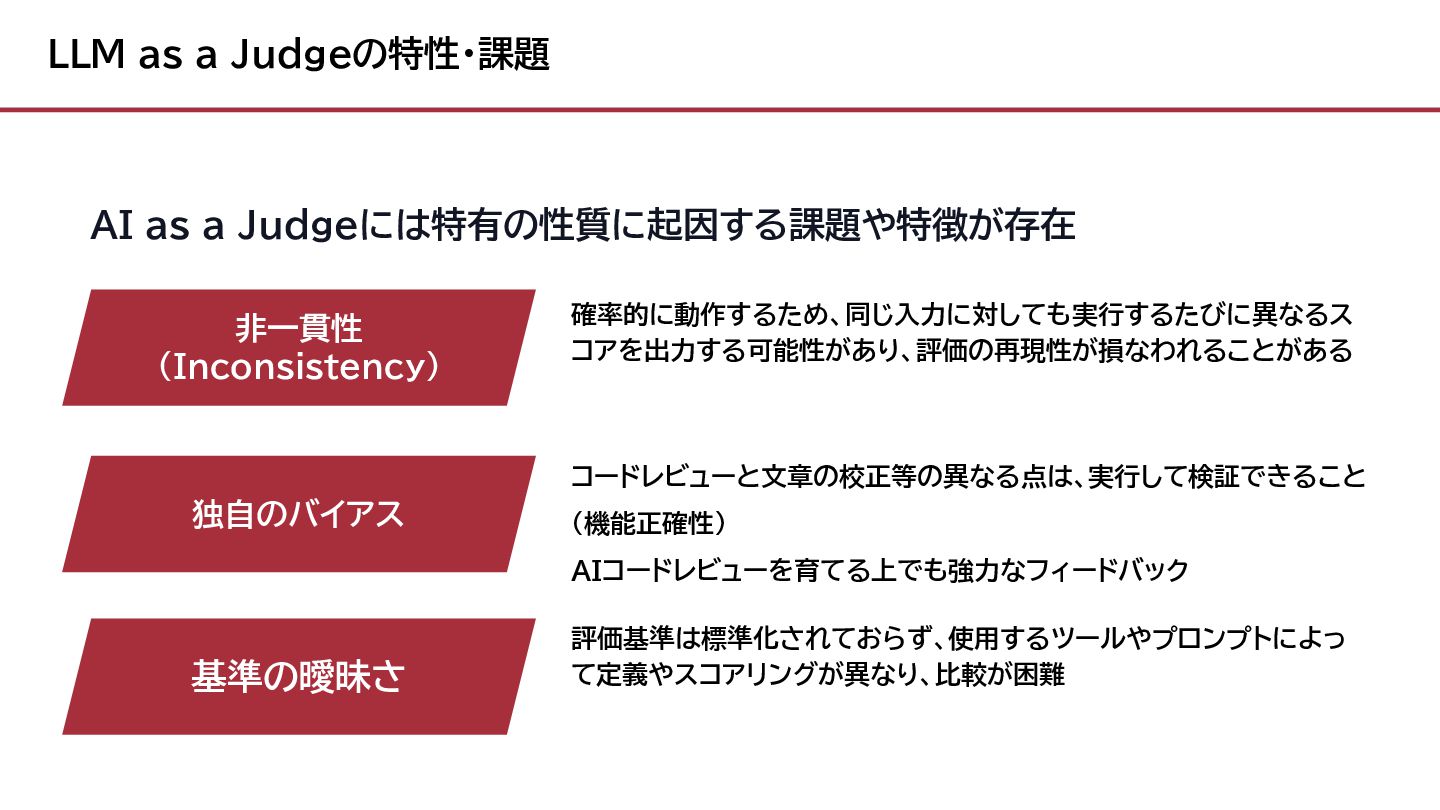
LLM as a Judgeの特性・課題 評価基準は標準化されておらず、使用するツールやプロンプトによっ て定義やスコアリングが異なり、比較が困難 非一貫性 (Inconsistency) 確率的に動作するため、同じ入力に対しても実行するたびに異なるス コアを出力する可能性があり、評価の再現性が損なわれることがある
独自のバイアス コードレビューと文章の校正等の異なる点は、実行して検証できること (機能正確性) AIコードレビューを育てる上でも強力なフィードバック 基準の曖昧さ AI as a Judgeには特有の性質に起因する課題や特徴が存在
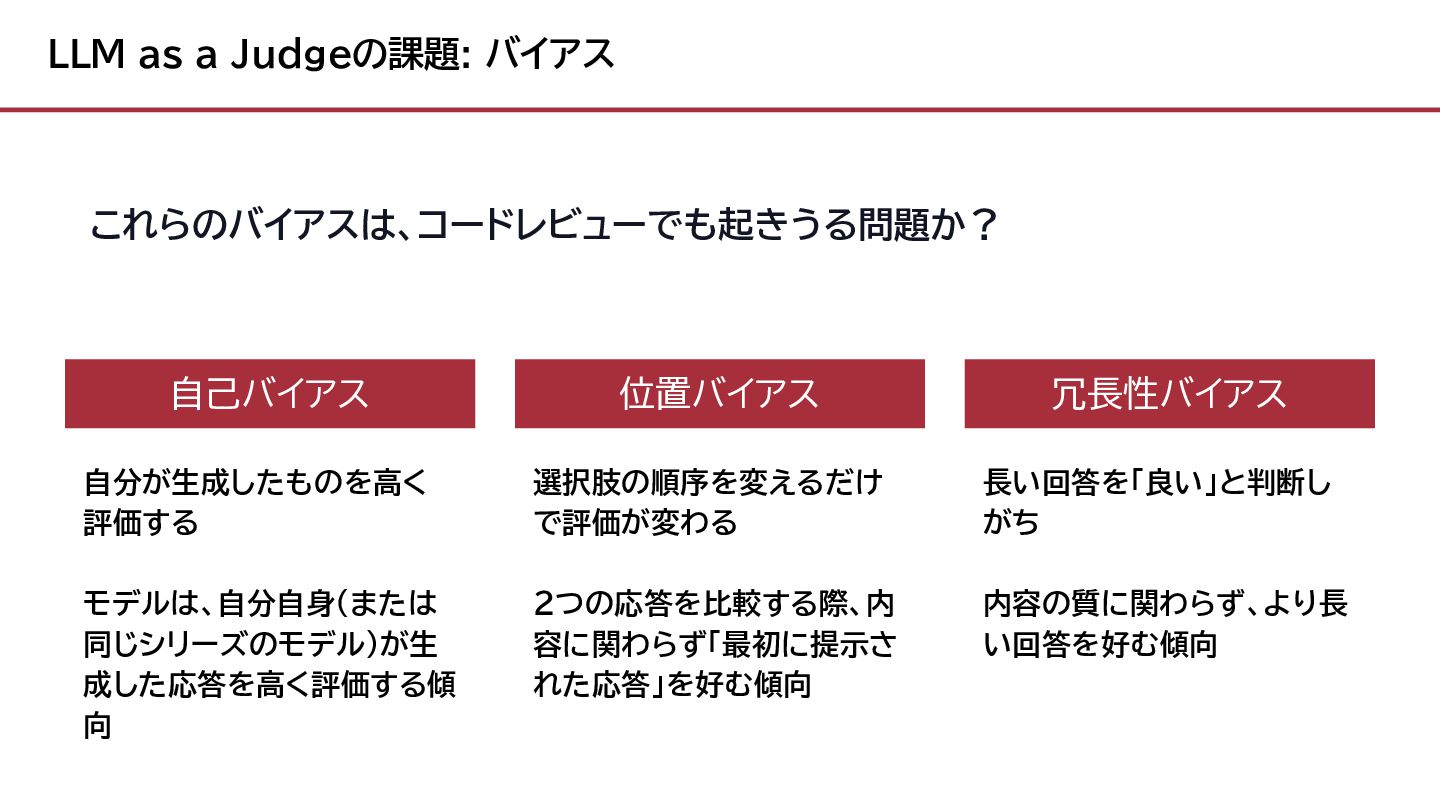
LLM as a Judgeの課題: バイアス これらのバイアスは、コードレビューでも起きうる問題か? 自己バイアス 位置バイアス 冗長性バイアス 自分が生成したものを高く
評価する モデルは、自分自身(または 同じシリーズのモデル)が生 成した応答を高く評価する傾 向 選択肢の順序を変えるだけ で評価が変わる 2つの応答を比較する際、内 容に関わらず「最初に提示さ れた応答」を好む傾向 長い回答を「良い」と判断し がち 内容の質に関わらず、より長 い回答を好む傾向
LLM as a Judgeの事例・プラクティス から考えるAIコードレビューの育て方
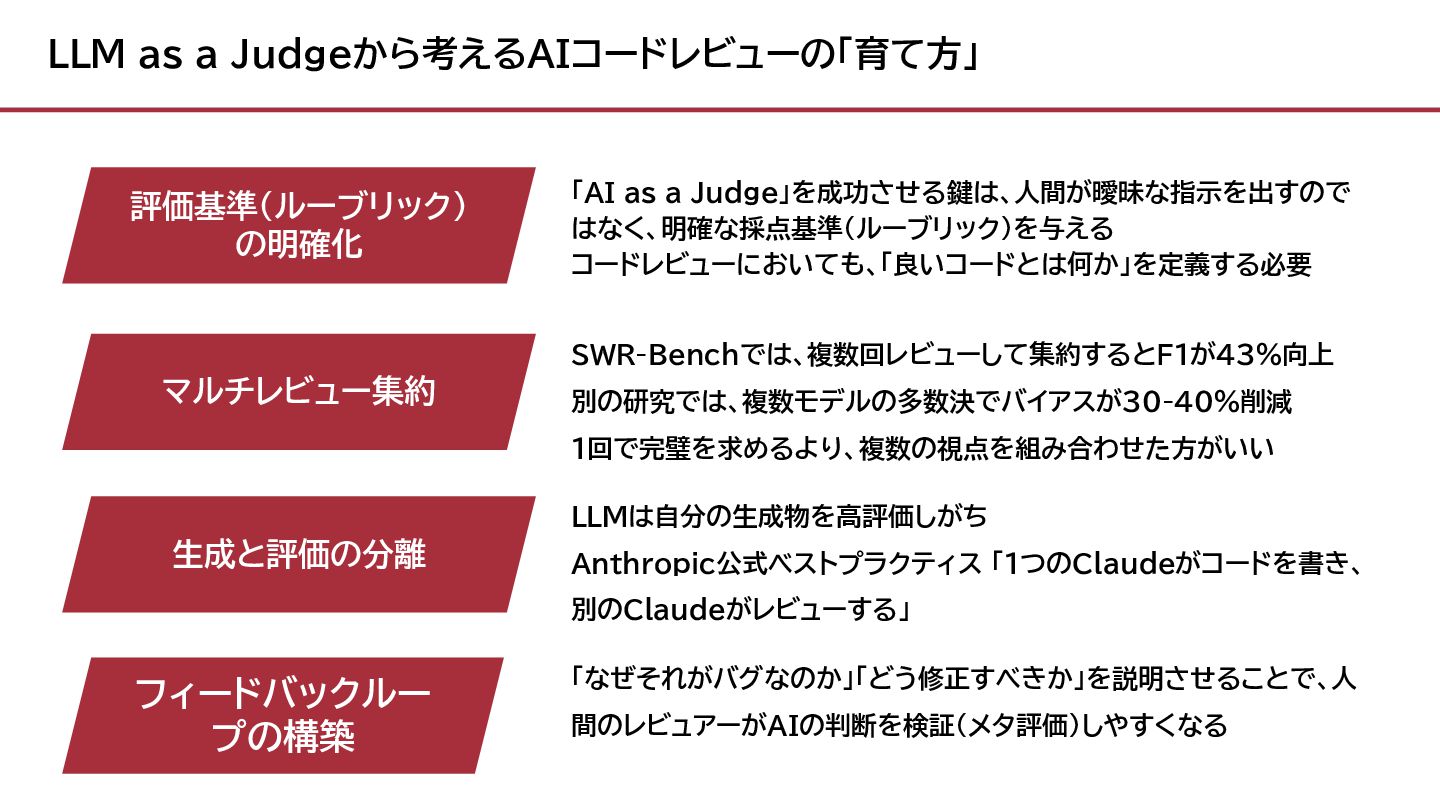
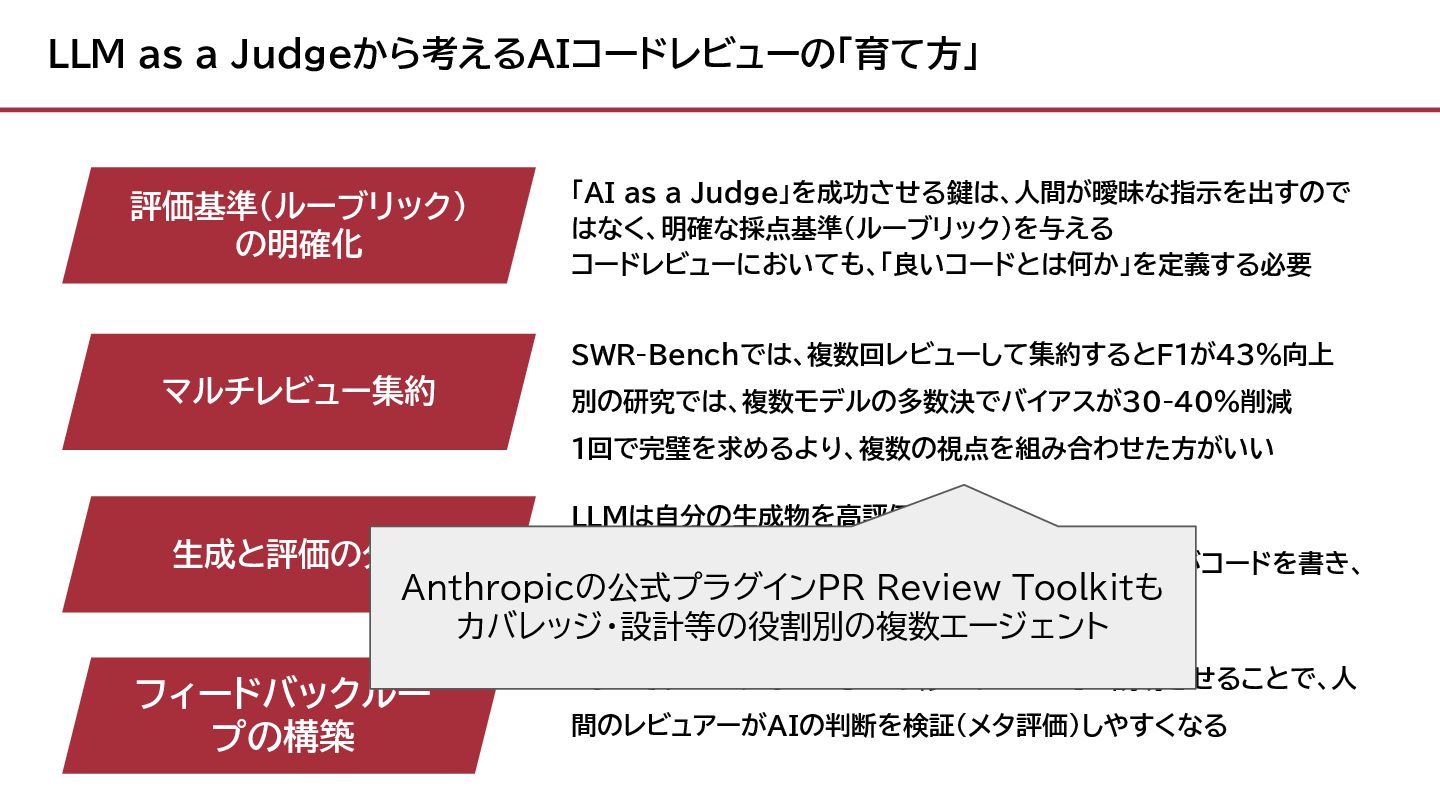
LLM as a Judgeから考えるAIコードレビューの「育て方」 LLMは自分の生成物を高評価しがち Anthropic公式ベストプラクティス 「1つのClaudeがコードを書き、 別のClaudeがレビューする」 フィードバックルー プの構築
「なぜそれがバグなのか」「どう修正すべきか」を説明させることで、人 間のレビュアーがAIの判断を検証(メタ評価)しやすくなる 評価基準(ルーブリック) の明確化 「AI as a Judge」を成功させる鍵は、人間が曖昧な指示を出すので はなく、明確な採点基準(ルーブリック)を与える コードレビューにおいても、「良いコードとは何か」を定義する必要 マルチレビュー集約 SWR-Benchでは、複数回レビューして集約するとF1が43%向上 別の研究では、複数モデルの多数決でバイアスが30-40%削減 1回で完璧を求めるより、複数の視点を組み合わせた方がいい 生成と評価の分離
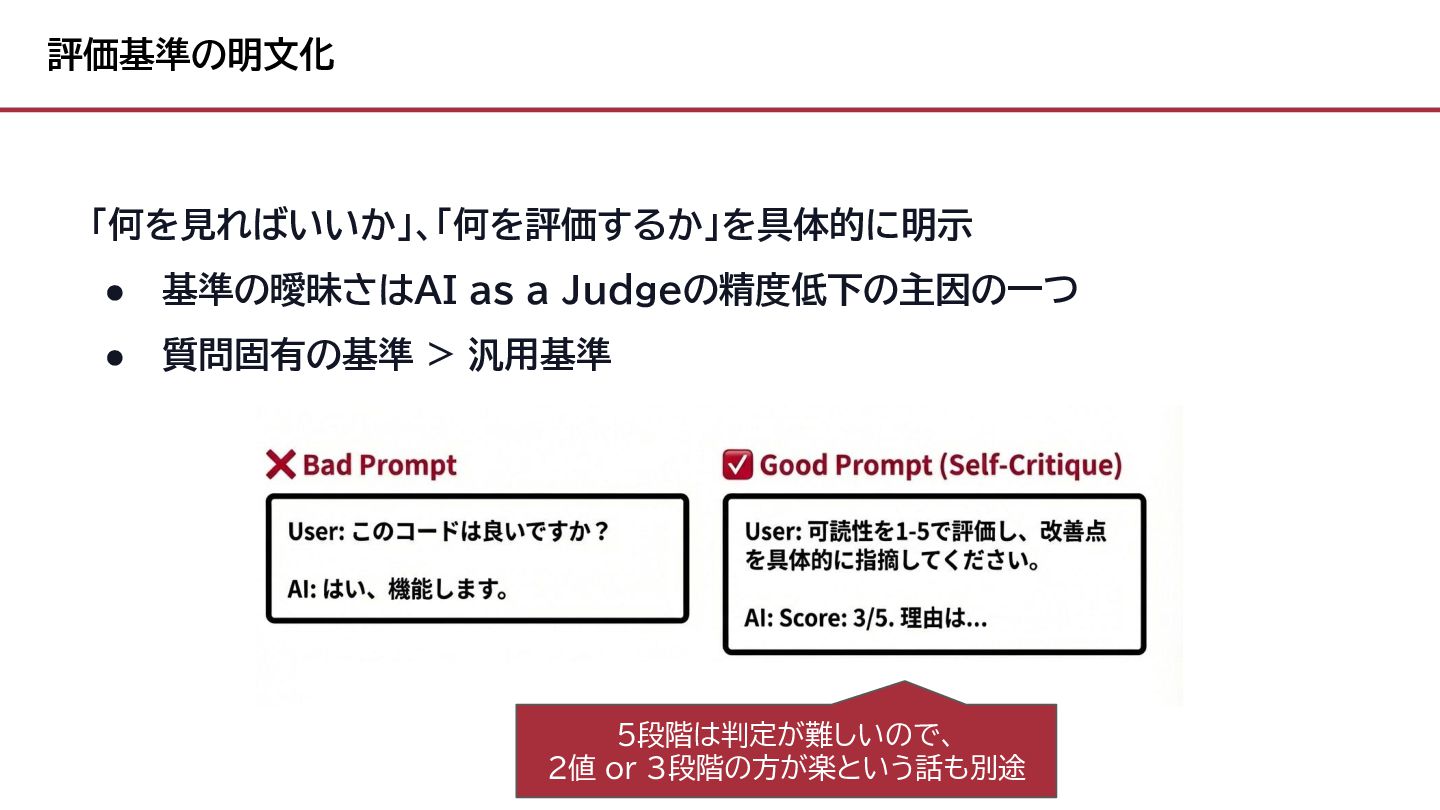
評価基準の明文化 「何を見ればいいか」、「何を評価するか」を具体的に明示 • 基準の曖昧さはAI as a Judgeの精度低下の主因の一つ • 質問固有の基準 >
汎用基準 5段階は判定が難しいので、 2値 or 3段階の方が楽という話も別途
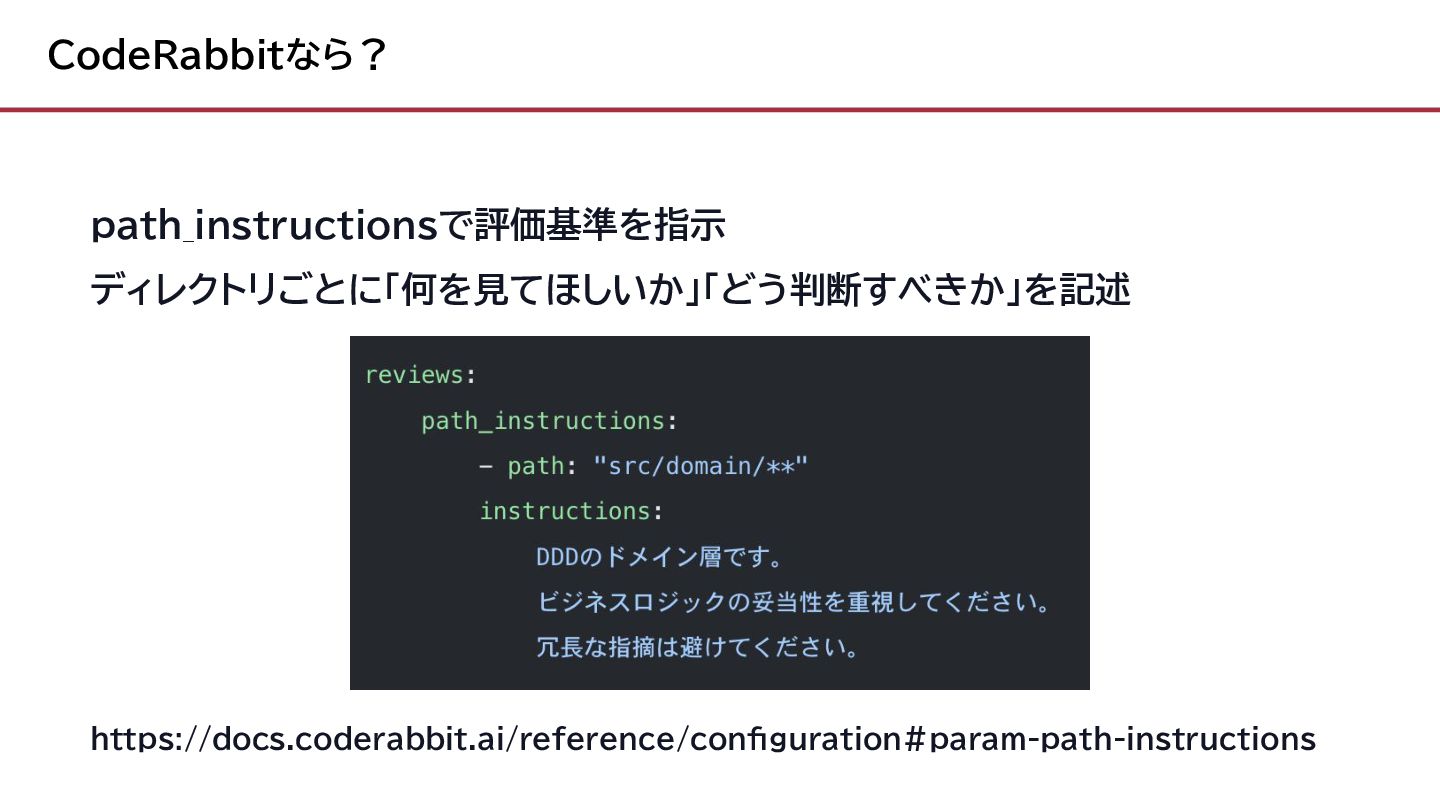
CodeRabbitなら? path_instructionsで評価基準を指示 ディレクトリごとに「何を見てほしいか」「どう判断すべきか」を記述 https://docs.coderabbit.ai/reference/configuration#param-path-instructions
LLM as a Judgeから考えるAIコードレビューの「育て方」 LLMは自分の生成物を高評価しがち Anthropic公式ベストプラクティス 「1つのClaudeがコードを書き、 別のClaudeがレビューする」 フィードバックルー プの構築
「なぜそれがバグなのか」「どう修正すべきか」を説明させることで、人 間のレビュアーがAIの判断を検証(メタ評価)しやすくなる 評価基準(ルーブリック) の明確化 「AI as a Judge」を成功させる鍵は、人間が曖昧な指示を出すので はなく、明確な採点基準(ルーブリック)を与える コードレビューにおいても、「良いコードとは何か」を定義する必要 マルチレビュー集約 SWR-Benchでは、複数回レビューして集約するとF1が43%向上 別の研究では、複数モデルの多数決でバイアスが30-40%削減 1回で完璧を求めるより、複数の視点を組み合わせた方がいい 生成と評価の分離 Anthropicの公式プラグインPR Review Toolkitも カバレッジ・設計等の役割別の複数エージェント
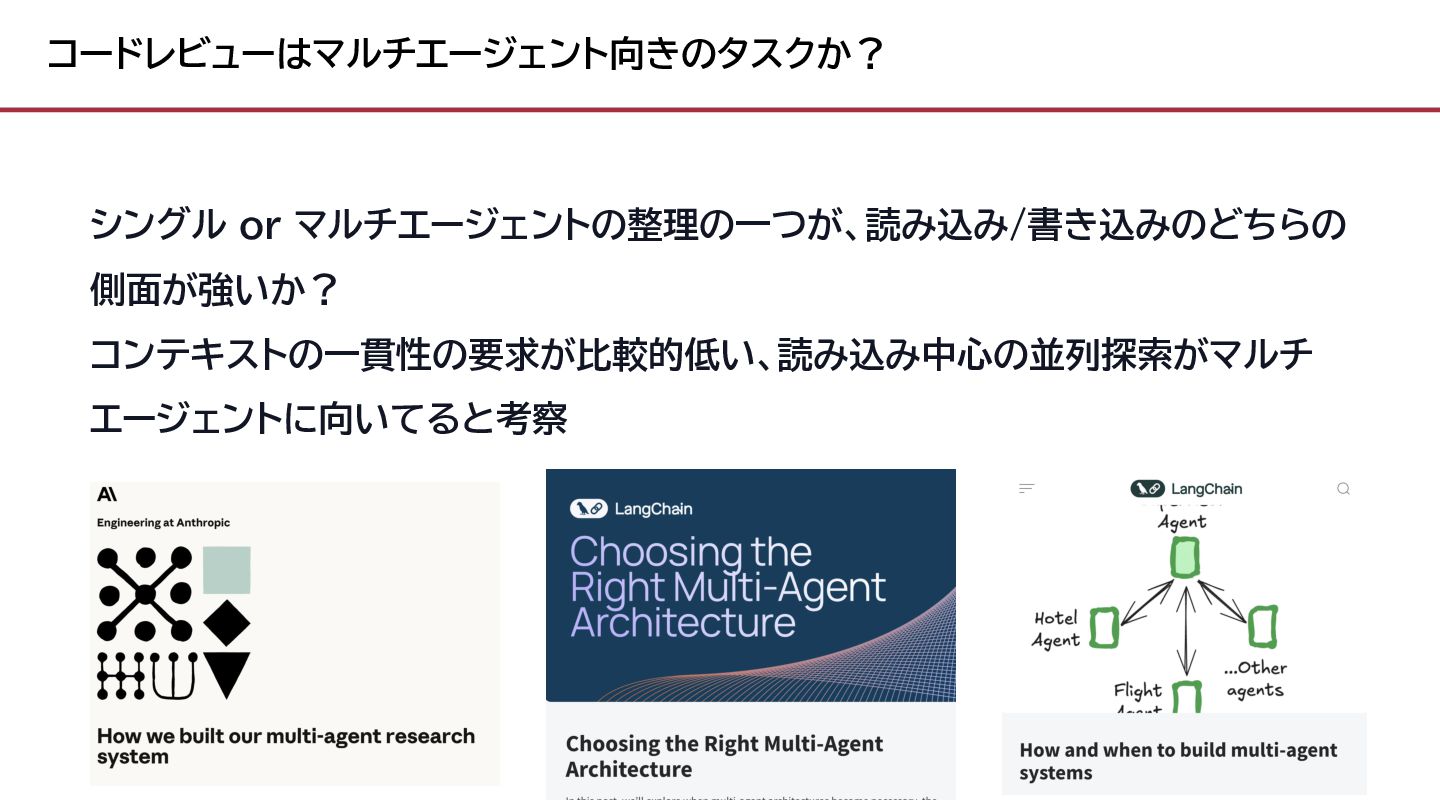
コードレビューはマルチエージェント向きのタスクか? シングル or マルチエージェントの整理の一つが、読み込み/書き込みのどちらの 側面が強いか? コンテキストの一貫性の要求が比較的低い、読み込み中心の並列探索がマルチ エージェントに向いてると考察
説明可能性:スコアだけでなく、理由を語る AIコードレビューを育てるための判断基準として理由を語らせる • 「このレビューコメントは本当に正しいですか?」と自問自答させ、間違いが あれば修正させる • レビュー結果に対して「なぜその指摘をしたのか」を振り返らせ、論理的な不 整合がないかを確認する (CodeRabbitで上手く実現する方法があれば教えて貰えたら嬉しい...!)
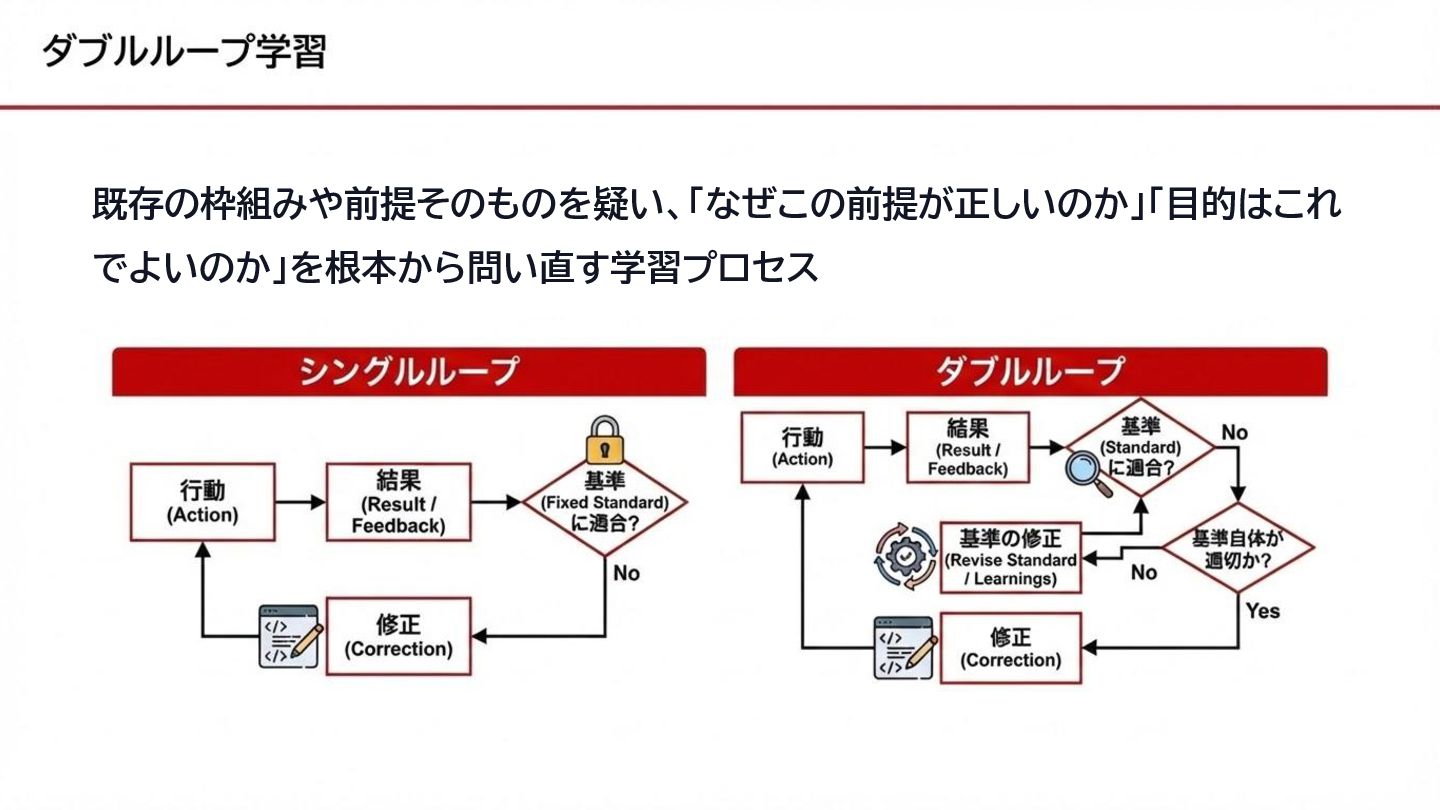
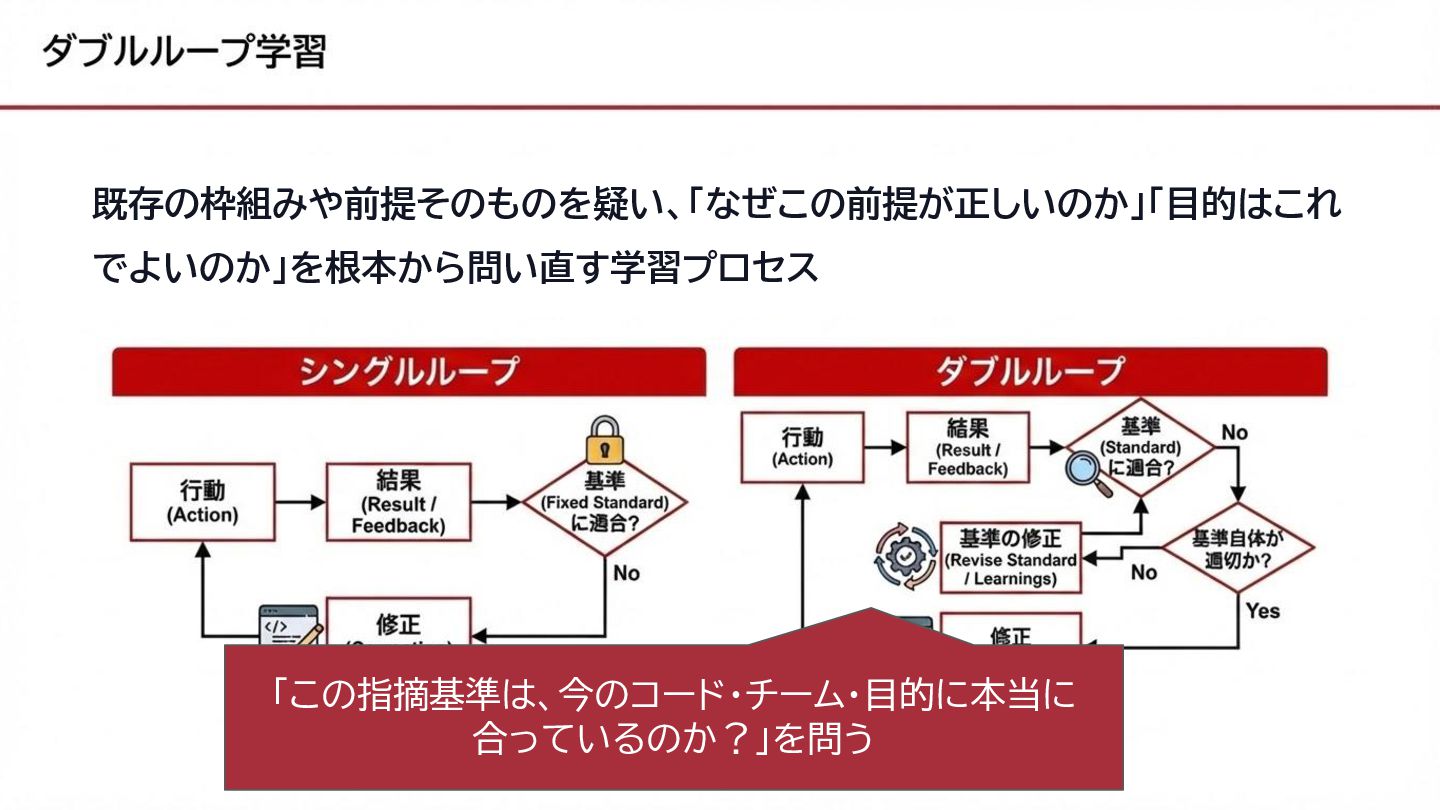
既存の枠組みや前提そのものを疑い、「なぜこの前提が正しいのか」「目的はこれ でよいのか」を根本から問い直す学習プロセス
既存の枠組みや前提そのものを疑い、「なぜこの前提が正しいのか」「目的はこれ でよいのか」を根本から問い直す学習プロセス 「この指摘基準は、今のコード・チーム・目的に本当に 合っているのか?」を問う
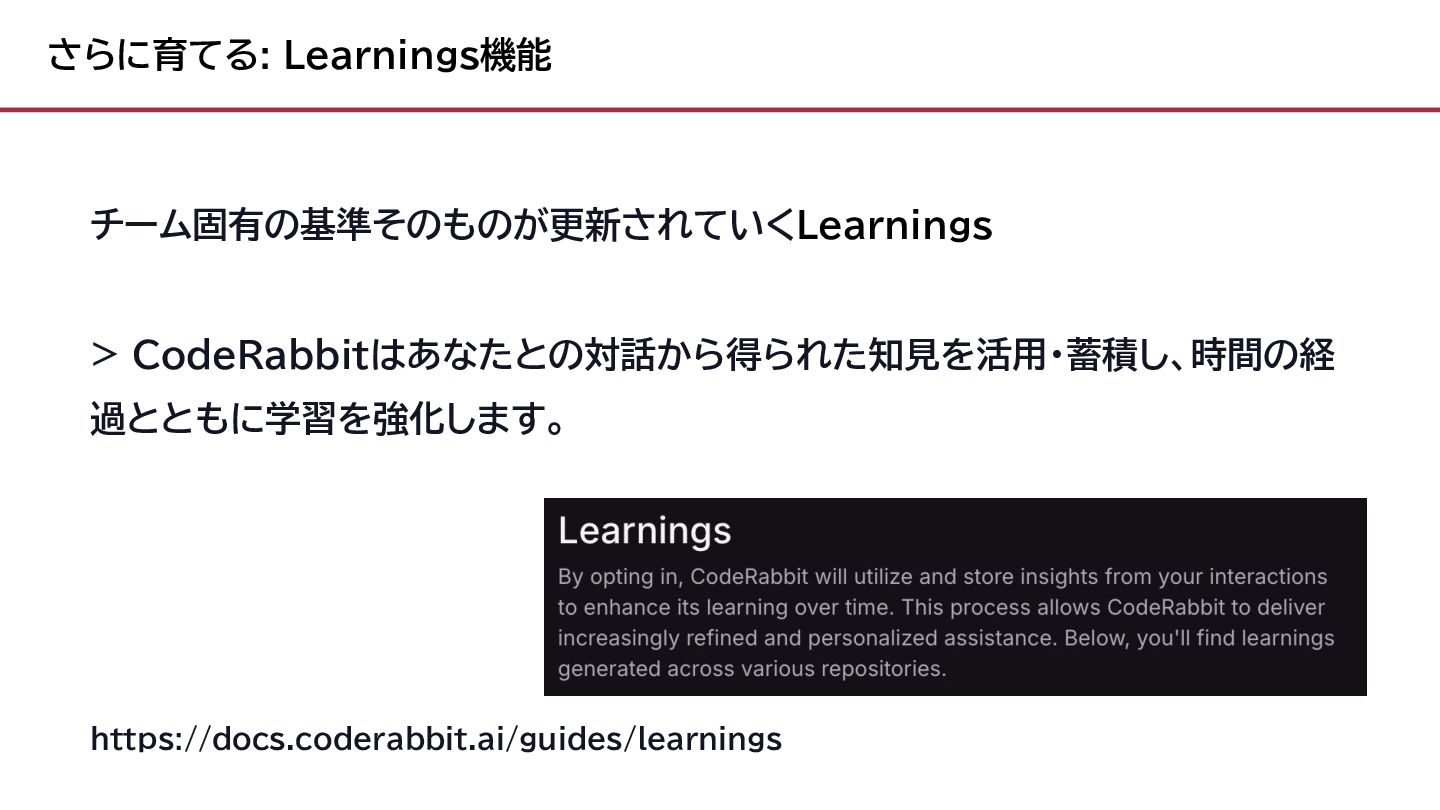
さらに育てる: Learnings機能 チーム固有の基準そのものが更新されていくLearnings > CodeRabbitはあなたとの対話から得られた知見を活用・蓄積し、時間の経 過とともに学習を強化します。 https://docs.coderabbit.ai/guides/learnings
理由を説明させたり、良い・悪いレビューを問いながら レビュー基準そのものをダブルループ学習で育てていく そのための機能もCodeRabbitにある
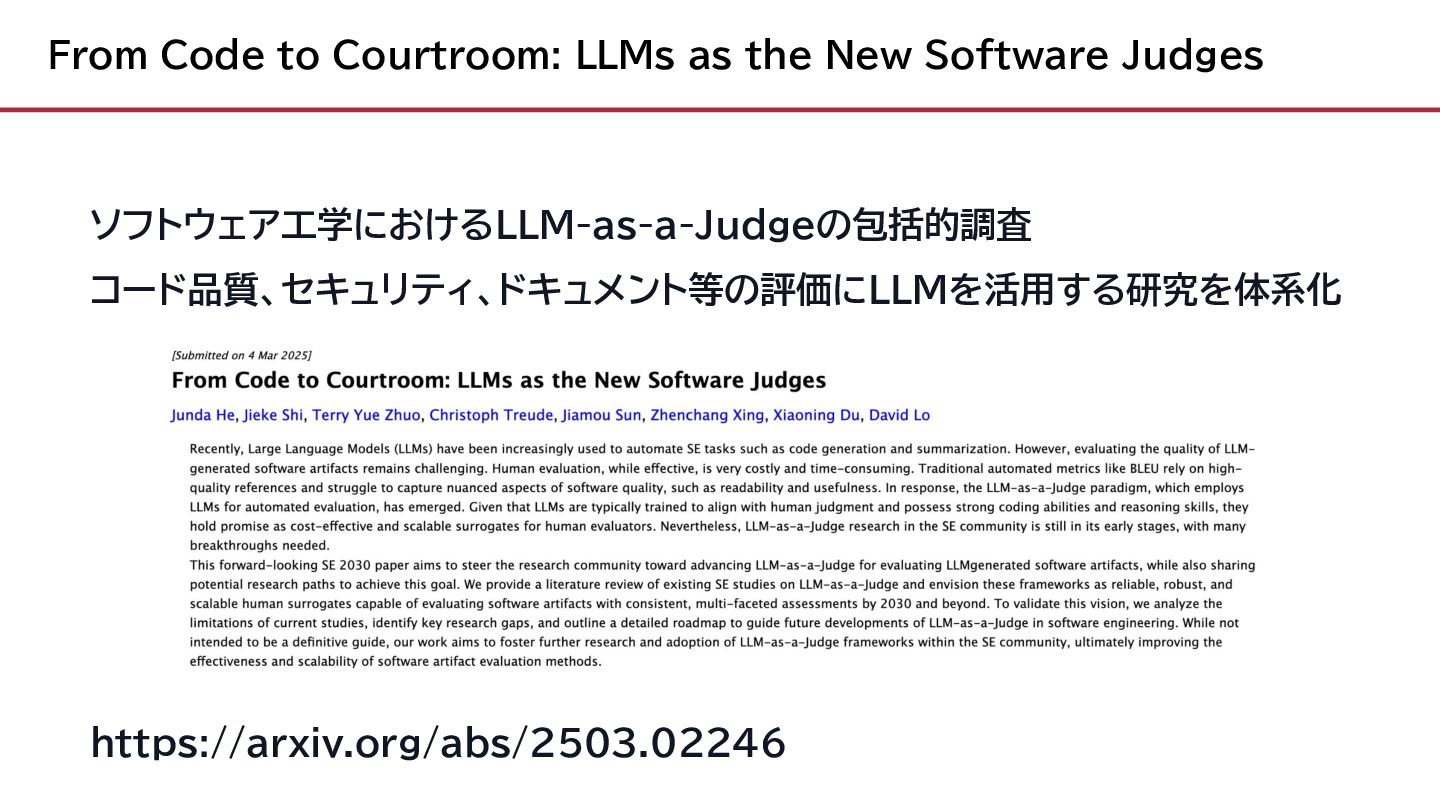
From Code to Courtroom: LLMs as the New Software Judges
ソフトウェア工学におけるLLM-as-a-Judgeの包括的調査 コード品質、セキュリティ、ドキュメント等の評価にLLMを活用する研究を体系化 https://arxiv.org/abs/2503.02246
まとめ
まとめ • AIコードレビューは評価基準とフィードバックで育てるもの • LLM as a Judgeの事例やプラクティスは、AIコードレビューのレビューや 育成を考える上で、参考になる点はある ◦
今回取り上げられなかった内容やTips、学びを得られそうな事例/研究 は沢山ある • コーディングエージェントの圧倒的な手数による可能性を感じる時代、コー ディング以外のプロセスのスクラップ&ビルドは求められる ◦ コードレビューはその代表例に感じる
そのAIコードレビュー、レビューしてますか? フィードバックして、育てられていますか?
終わり


 rkaga
 kaseken
 high_g_engineer
 kasacchiful
 licux
 soyuka
 akagami
 murabayashi
 panda728
 yukiny
 hideg
 ioki
 j341nono
 kimpetersen
 lcolladotor
 pedronauck
 letsgokoyo
 marktimemedia
 maggiecrowley
 wjessup
 tmiket
 aleyda
 cassininazir
 coloredviolet
 bkeepers