Share
Embed
ElasticStack on AWS Deep Dive
2019/02/13 Yahoo! JAPANインフラ技術カンファレンスでの、日比野の講演資料になります

Recruit Technologies
February 13, 2019
Transcript
22 slides
-
(C) Recruit Technologies Co., Ltd. All rights reserved. 自己紹介 2
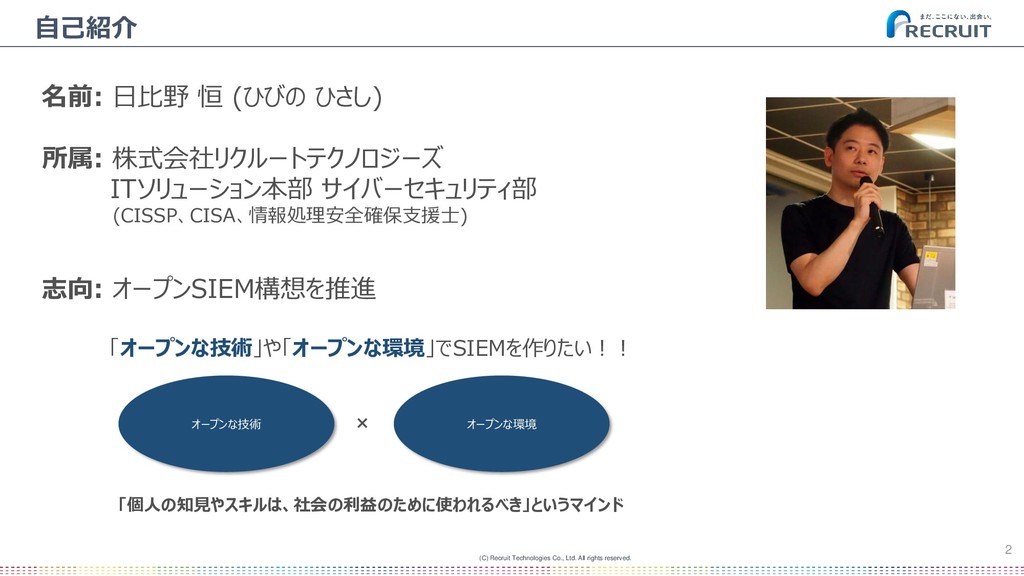
名前: 日比野 恒 (ひびの ひさし) 所属: 株式会社リクルートテクノロジーズ ITソリューション本部 サイバーセキュリティ部 (CISSP、CISA、情報処理安全確保支援士) 志向: オープンSIEM構想を推進 オープンな技術 オープンな環境 × 「オープンな技術」や「オープンな環境」でSIEMを作りたい!! 「個人の知見やスキルは、社会の利益のために使われるべき」というマインド -
(C) Recruit Technologies Co., Ltd. All rights reserved. Data Enrichment
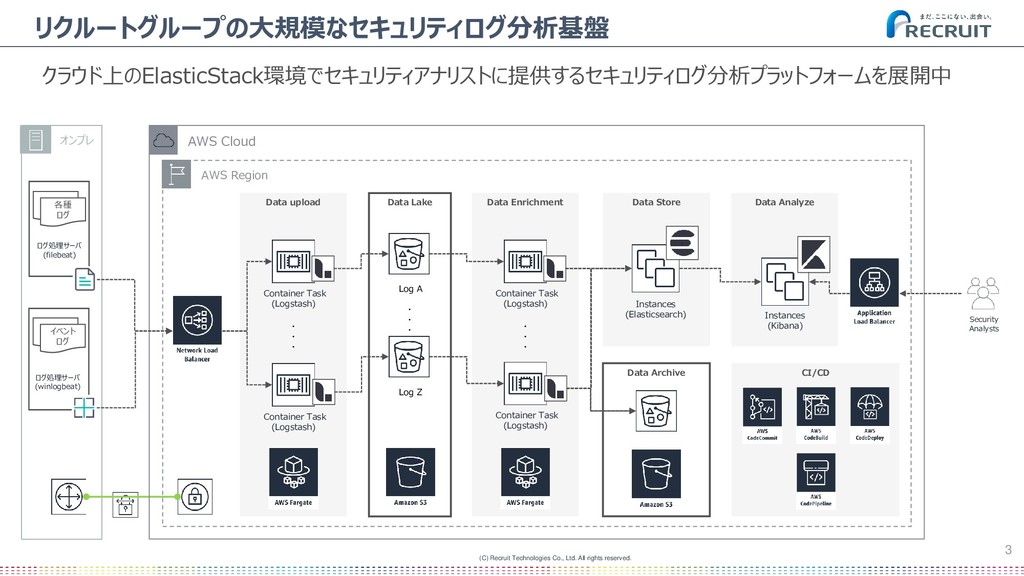
Data upload Data Store Data Analyze 3 リクルートグループの大規模なセキュリティログ分析基盤 クラウド上のElasticStack環境でセキュリティアナリストに提供するセキュリティログ分析プラットフォームを展開中 Container Task (Logstash) オンプレ ログ処理サーバ (filebeat) SFPログ 各種 ログ Security Analysts ログ処理サーバ (winlogbeat) SFPログ イベント ログ AWS Region Data Lake Log A Log Z ・ ・ ・ ・ ・ ・ Container Task (Logstash) Container Task (Logstash) ・ ・ ・ Container Task (Logstash) AWS Cloud Data Archive Instances (Elasticsearch) Instances (Kibana) CI/CD -
(C) Recruit Technologies Co., Ltd. All rights reserved. Auto Scaling
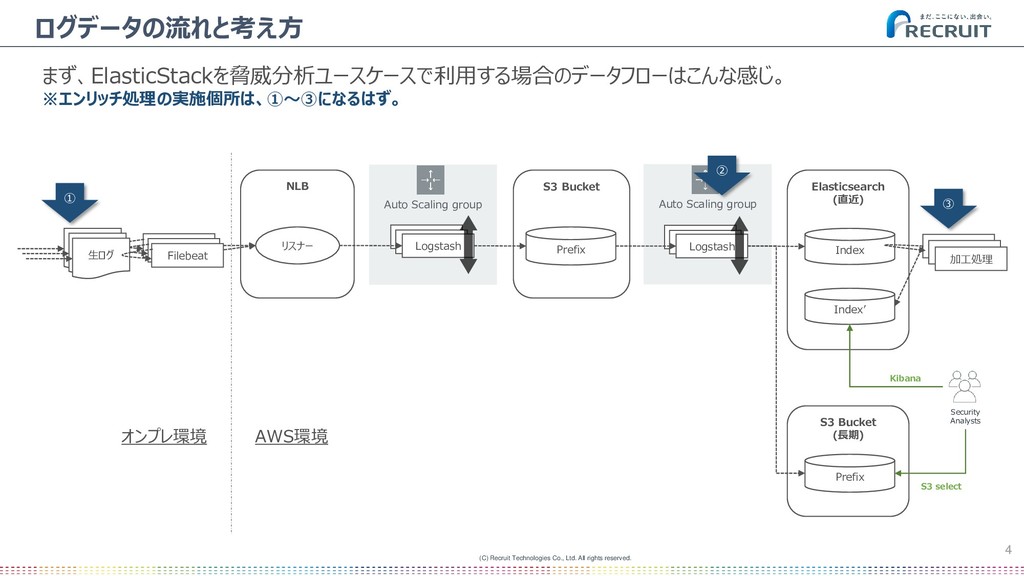
group Auto Scaling group ログデータの流れと考え方 まず、ElasticStackを脅威分析ユースケースで利用する場合のデータフローはこんな感じ。 ※エンリッチ処理の実施個所は、①~③になるはず。 生ログ NLB S3 Bucket Elasticsearch (直近) リスナー Filebeat Logstash Prefix Logstash Index オンプレ環境 AWS環境 加工処理 Index’ ③ S3 Bucket (長期) Prefix ② ① Security Analysts S3 select Kibana 4 生ログ Filebeat 加工処理 加工処理 生ログ Filebeat -
(C) Recruit Technologies Co., Ltd. All rights reserved. 5 本日、伝えたいこと
インフラコアな非機能っぽい話をElasticStack on AWSをネタに!! 大規模ゆえに運用設計で考えておくべき地味なツラミも楽しくね (*'▽’)// なんと7分でねw -
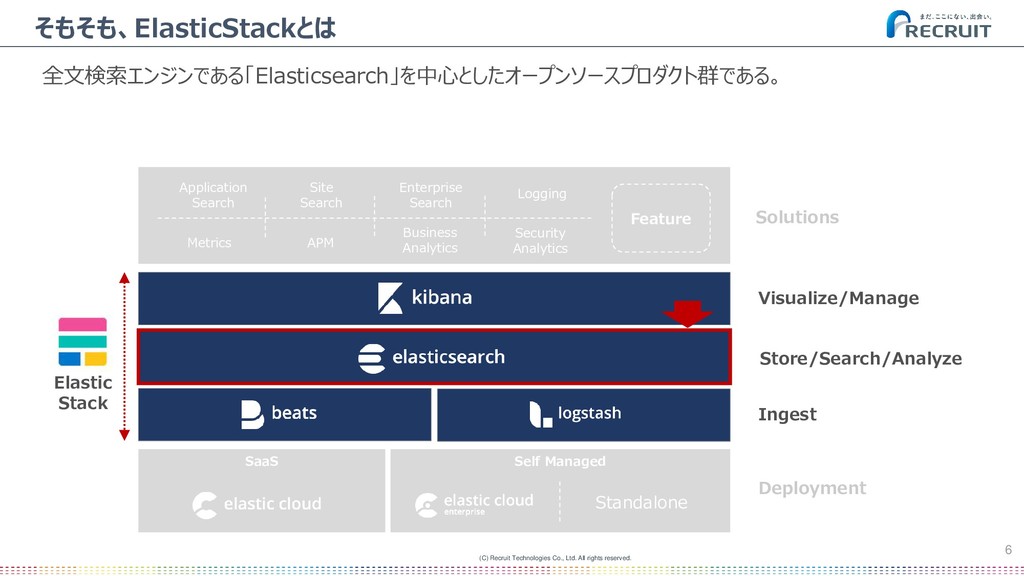
(C) Recruit Technologies Co., Ltd. All rights reserved. 6 そもそも、ElasticStackとは
全文検索エンジンである「Elasticsearch」を中心としたオープンソースプロダクト群である。 SaaS Self Managed Standalone Deployment Ingest Store/Search/Analyze Visualize/Manage Solutions Application Search Metrics Site Search APM Enterprise Search Business Analytics Logging Security Analytics Feature Elastic Stack -
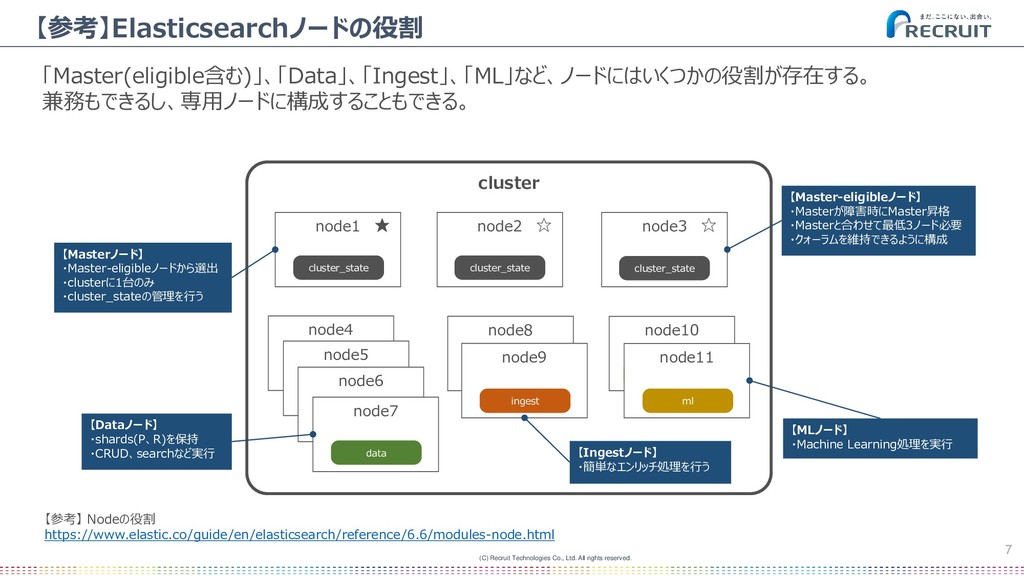
(C) Recruit Technologies Co., Ltd. All rights reserved. 7 【参考】Elasticsearchノードの役割
cluster node1 cluster_state ★ node2 cluster_state ☆ node3 cluster_state ☆ node4 data node5 data node6 data node7 data node8 ingest node9 ingest node10 ingest node11 ml 【Masterノード】 ・Master-eligibleノードから選出 ・clusterに1台のみ ・cluster_stateの管理を行う 【Master-eligibleノード】 ・Masterが障害時にMaster昇格 ・Masterと合わせて最低3ノード必要 ・クォーラムを維持できるように構成 【Dataノード】 ・shards(P、R)を保持 ・CRUD、searchなど実行 【Ingestノード】 ・簡単なエンリッチ処理を行う 【MLノード】 ・Machine Learning処理を実行 「Master(eligible含む)」、「Data」、「Ingest」、「ML」など、ノードにはいくつかの役割が存在する。 兼務もできるし、専用ノードに構成することもできる。 【参考】 Nodeの役割 https://www.elastic.co/guide/en/elasticsearch/reference/6.6/modules-node.html -
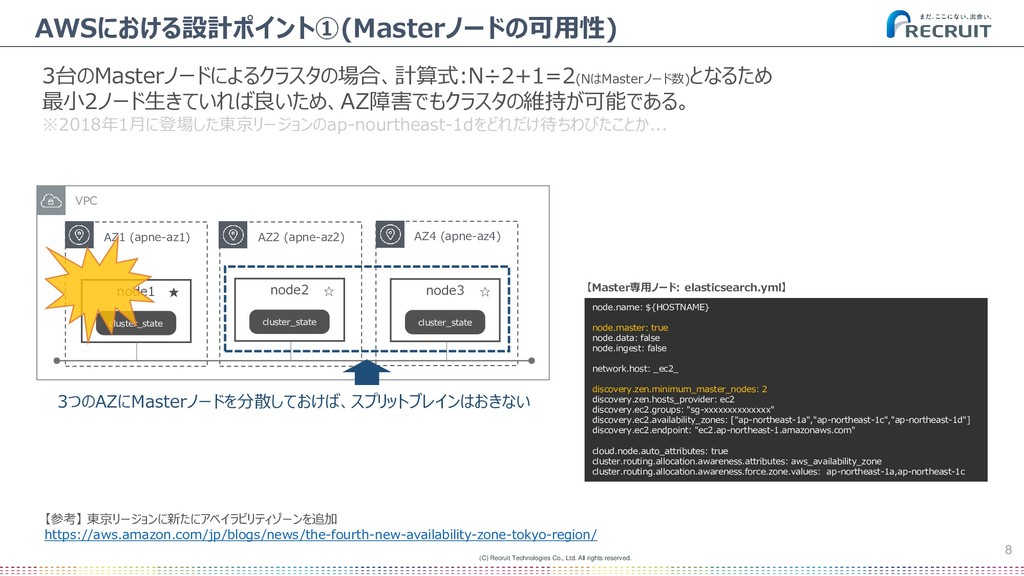
(C) Recruit Technologies Co., Ltd. All rights reserved. 8 AWSにおける設計ポイント①(Masterノードの可用性)
node1 cluster_state ★ node2 cluster_state ☆ node3 cluster_state ☆ AZ1 (apne-az1) AZ2 (apne-az2) AZ4 (apne-az4) VPC node.name: ${HOSTNAME} node.master: true node.data: false node.ingest: false network.host: _ec2_ discovery.zen.minimum_master_nodes: 2 discovery.zen.hosts_provider: ec2 discovery.ec2.groups: "sg-xxxxxxxxxxxxxx" discovery.ec2.availability_zones: ["ap-northeast-1a","ap-northeast-1c","ap-northeast-1d"] discovery.ec2.endpoint: "ec2.ap-northeast-1.amazonaws.com" cloud.node.auto_attributes: true cluster.routing.allocation.awareness.attributes: aws_availability_zone cluster.routing.allocation.awareness.force.zone.values: ap-northeast-1a,ap-northeast-1c 【Master専用ノード: elasticsearch.yml】 3つのAZにMasterノードを分散しておけば、スプリットブレインはおきない 3台のMasterノードによるクラスタの場合、計算式:N÷2+1=2(NはMasterノード数) となるため 最小2ノード生きていれば良いため、AZ障害でもクラスタの維持が可能である。 ※2018年1月に登場した東京リージョンのap-nourtheast-1dをどれだけ待ちわびたことか... 【参考】 東京リージョンに新たにアベイラビリティゾーンを追加 https://aws.amazon.com/jp/blogs/news/the-fourth-new-availability-zone-tokyo-region/ -
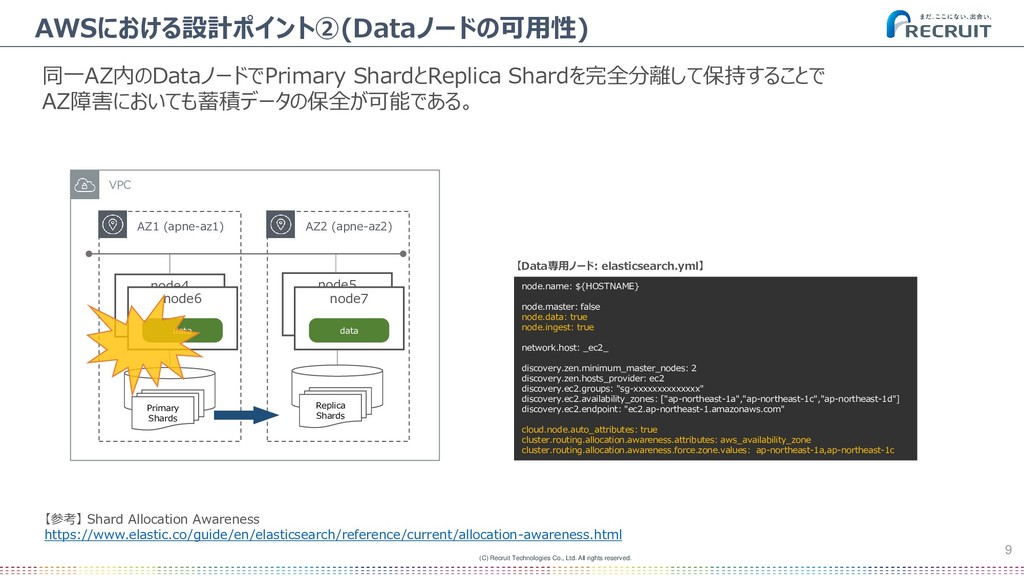
(C) Recruit Technologies Co., Ltd. All rights reserved. 9 AWSにおける設計ポイント②(Dataノードの可用性)
node4 data node5 data AZ1 (apne-az1) AZ2 (apne-az2) VPC node.name: ${HOSTNAME} node.master: false node.data: true node.ingest: true network.host: _ec2_ discovery.zen.minimum_master_nodes: 2 discovery.zen.hosts_provider: ec2 discovery.ec2.groups: "sg-xxxxxxxxxxxxxx" discovery.ec2.availability_zones: ["ap-northeast-1a","ap-northeast-1c","ap-northeast-1d"] discovery.ec2.endpoint: "ec2.ap-northeast-1.amazonaws.com" cloud.node.auto_attributes: true cluster.routing.allocation.awareness.attributes: aws_availability_zone cluster.routing.allocation.awareness.force.zone.values: ap-northeast-1a,ap-northeast-1c 【Data専用ノード: elasticsearch.yml】 Primary Shards Replica Shards node6 data node7 data 同一AZ内のDataノードでPrimary ShardとReplica Shardを完全分離して保持することで AZ障害においても蓄積データの保全が可能である。 【参考】 Shard Allocation Awareness https://www.elastic.co/guide/en/elasticsearch/reference/current/allocation-awareness.html -
(C) Recruit Technologies Co., Ltd. All rights reserved. 10 ちょっと余談で...
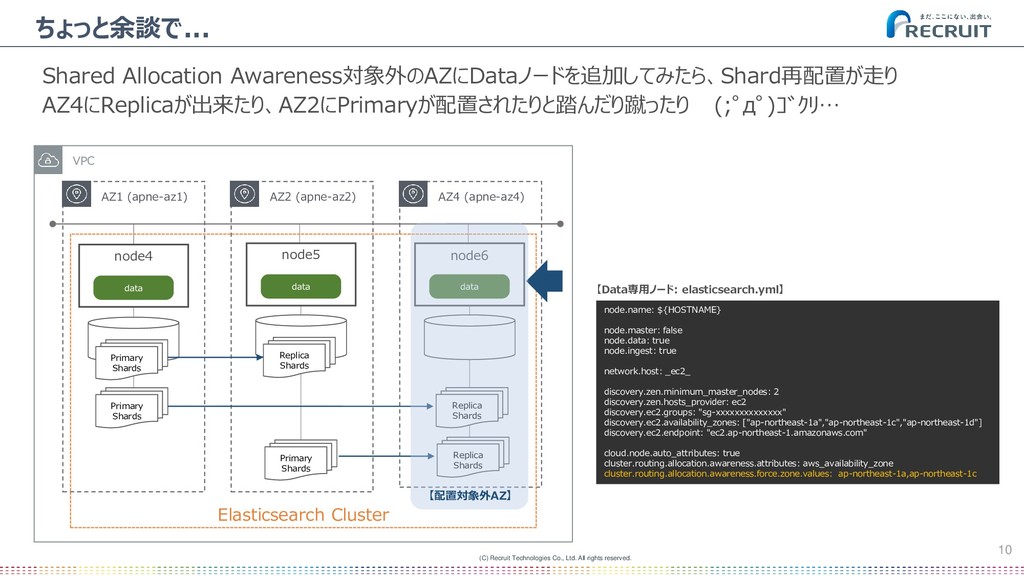
node5 data AZ1 (apne-az1) AZ2 (apne-az2) VPC Primary Shards Replica Shards Shared Allocation Awareness対象外のAZにDataノードを追加してみたら、Shard再配置が走り AZ4にReplicaが出来たり、AZ2にPrimaryが配置されたりと踏んだり蹴ったり (;゚д゚)ゴクリ… node.name: ${HOSTNAME} node.master: false node.data: true node.ingest: true network.host: _ec2_ discovery.zen.minimum_master_nodes: 2 discovery.zen.hosts_provider: ec2 discovery.ec2.groups: "sg-xxxxxxxxxxxxxx" discovery.ec2.availability_zones: ["ap-northeast-1a","ap-northeast-1c","ap-northeast-1d"] discovery.ec2.endpoint: "ec2.ap-northeast-1.amazonaws.com" cloud.node.auto_attributes: true cluster.routing.allocation.awareness.attributes: aws_availability_zone cluster.routing.allocation.awareness.force.zone.values: ap-northeast-1a,ap-northeast-1c node6 data AZ4 (apne-az4) Elasticsearch Cluster Primary Shards Replica Shards Primary Shards Replica Shards 【Data専用ノード: elasticsearch.yml】 node4 data 【配置対象外AZ】 -
(C) Recruit Technologies Co., Ltd. All rights reserved. 11 【参考】クラスタからの離脱方法
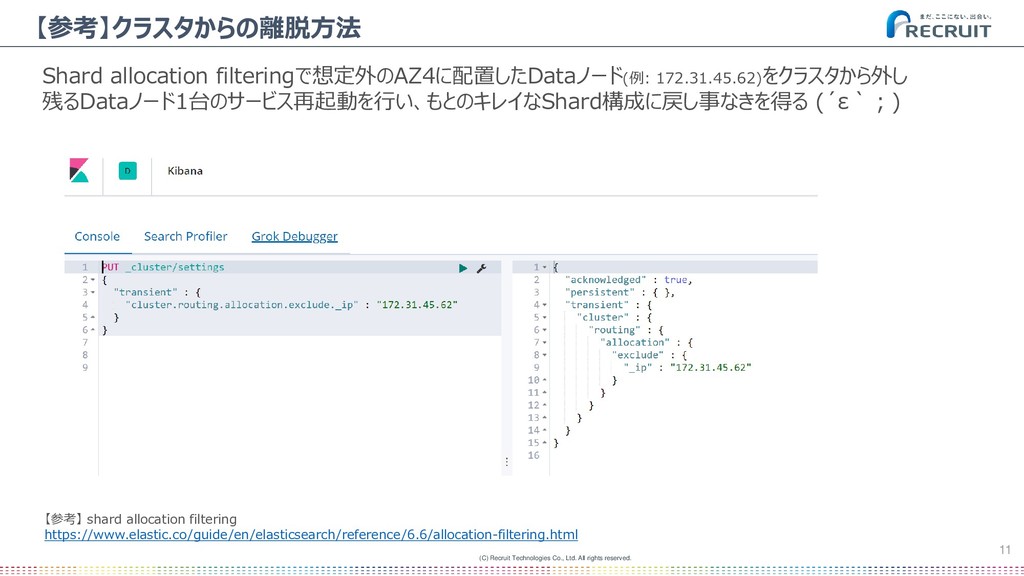
Shard allocation filteringで想定外のAZ4に配置したDataノード(例: 172.31.45.62)をクラスタから外し 残るDataノード1台のサービス再起動を行い、もとのキレイなShard構成に戻し事なきを得る (´ε`;) 【参考】 shard allocation filtering https://www.elastic.co/guide/en/elasticsearch/reference/6.6/allocation-filtering.html -
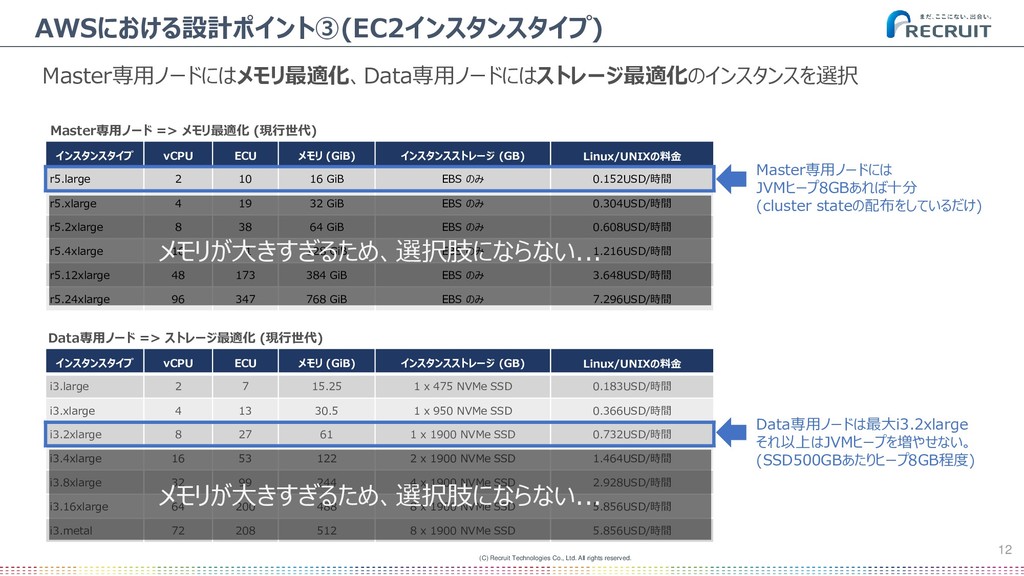
(C) Recruit Technologies Co., Ltd. All rights reserved. AWSにおける設計ポイント③(EC2インスタンスタイプ) インスタンスタイプ
vCPU ECU メモリ (GiB) インスタンスストレージ (GB) Linux/UNIXの料金 i3.large 2 7 15.25 1 x 475 NVMe SSD 0.183USD/時間 i3.xlarge 4 13 30.5 1 x 950 NVMe SSD 0.366USD/時間 i3.2xlarge 8 27 61 1 x 1900 NVMe SSD 0.732USD/時間 i3.4xlarge 16 53 122 2 x 1900 NVMe SSD 1.464USD/時間 i3.8xlarge 32 99 244 4 x 1900 NVMe SSD 2.928USD/時間 i3.16xlarge 64 200 488 8 x 1900 NVMe SSD 5.856USD/時間 i3.metal 72 208 512 8 x 1900 NVMe SSD 5.856USD/時間 Data専用ノード => ストレージ最適化 (現行世代) インスタンスタイプ vCPU ECU メモリ (GiB) インスタンスストレージ (GB) Linux/UNIXの料金 r5.large 2 10 16 GiB EBS のみ 0.152USD/時間 r5.xlarge 4 19 32 GiB EBS のみ 0.304USD/時間 r5.2xlarge 8 38 64 GiB EBS のみ 0.608USD/時間 r5.4xlarge 16 71 128 GiB EBS のみ 1.216USD/時間 r5.12xlarge 48 173 384 GiB EBS のみ 3.648USD/時間 r5.24xlarge 96 347 768 GiB EBS のみ 7.296USD/時間 Master専用ノード => メモリ最適化 (現行世代) 12 Master専用ノードには JVMヒープ8GBあれば十分 (cluster stateの配布をしているだけ) Data専用ノードは最大i3.2xlarge それ以上はJVMヒープを増やせない。 (SSD500GBあたりヒープ8GB程度) Master専用ノードにはメモリ最適化、Data専用ノードにはストレージ最適化のインスタンスを選択 メモリが大きすぎるため、選択肢にならない... メモリが大きすぎるため、選択肢にならない... -
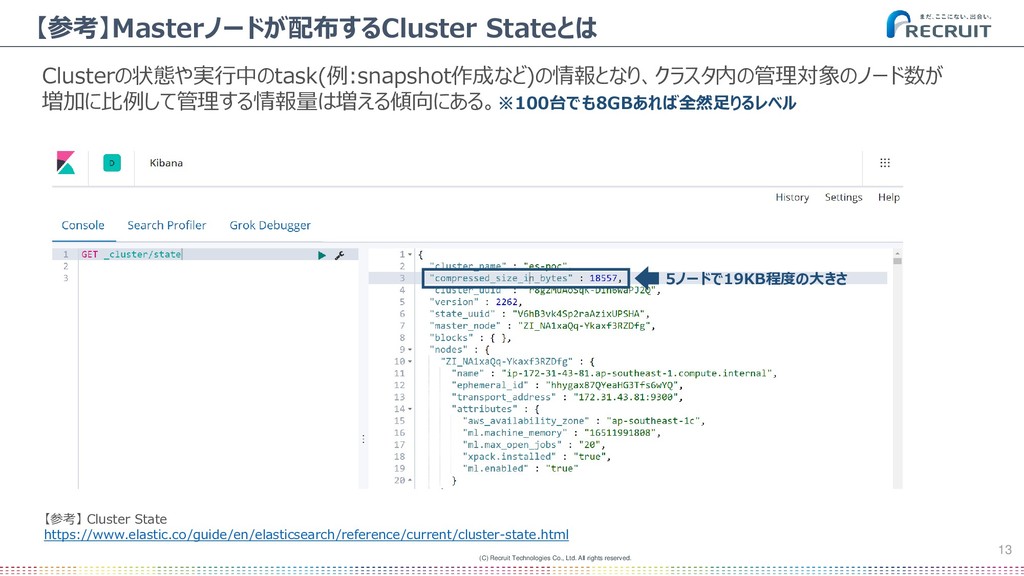
(C) Recruit Technologies Co., Ltd. All rights reserved. 13 【参考】Masterノードが配布するCluster
Stateとは Clusterの状態や実行中のtask(例:snapshot作成など)の情報となり、クラスタ内の管理対象のノード数が 増加に比例して管理する情報量は増える傾向にある。※100台でも8GBあれば全然足りるレベル 5ノードで19KB程度の大きさ 【参考】 Cluster State https://www.elastic.co/guide/en/elasticsearch/reference/current/cluster-state.html -
(C) Recruit Technologies Co., Ltd. All rights reserved. 14 AZってa、c、dって3つあるけど、az1、az2、az4というAZ
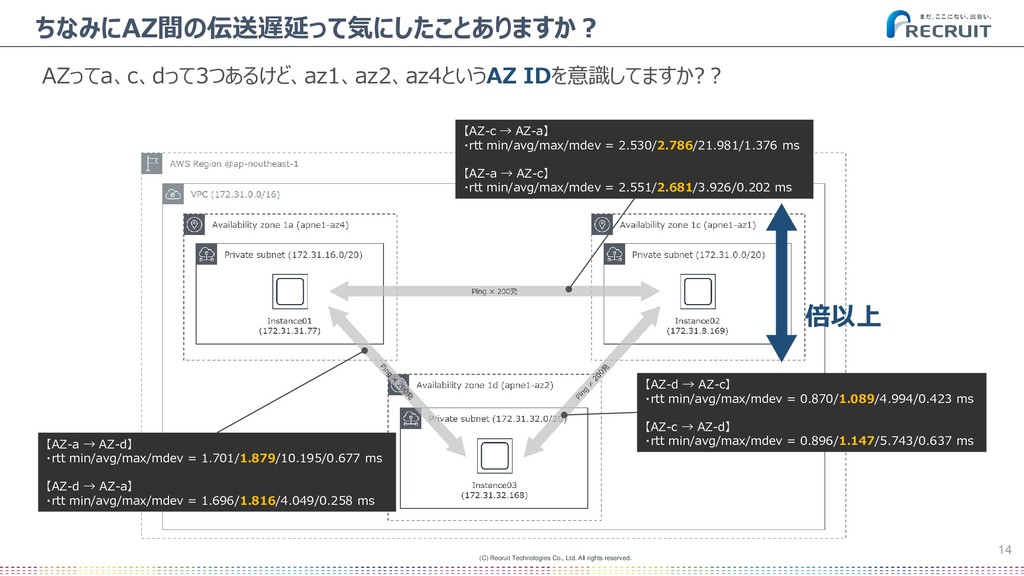
IDを意識してますか?? ちなみにAZ間の伝送遅延って気にしたことありますか? 【AZ-d → AZ-c】 ・rtt min/avg/max/mdev = 0.870/1.089/4.994/0.423 ms 【AZ-c → AZ-d】 ・rtt min/avg/max/mdev = 0.896/1.147/5.743/0.637 ms 【AZ-a → AZ-d】 ・rtt min/avg/max/mdev = 1.701/1.879/10.195/0.677 ms 【AZ-d → AZ-a】 ・rtt min/avg/max/mdev = 1.696/1.816/4.049/0.258 ms 【AZ-c → AZ-a】 ・rtt min/avg/max/mdev = 2.530/2.786/21.981/1.376 ms 【AZ-a → AZ-c】 ・rtt min/avg/max/mdev = 2.551/2.681/3.926/0.202 ms 倍以上 -
(C) Recruit Technologies Co., Ltd. All rights reserved. 15 物理的なデータセンターの位置から考えてみる
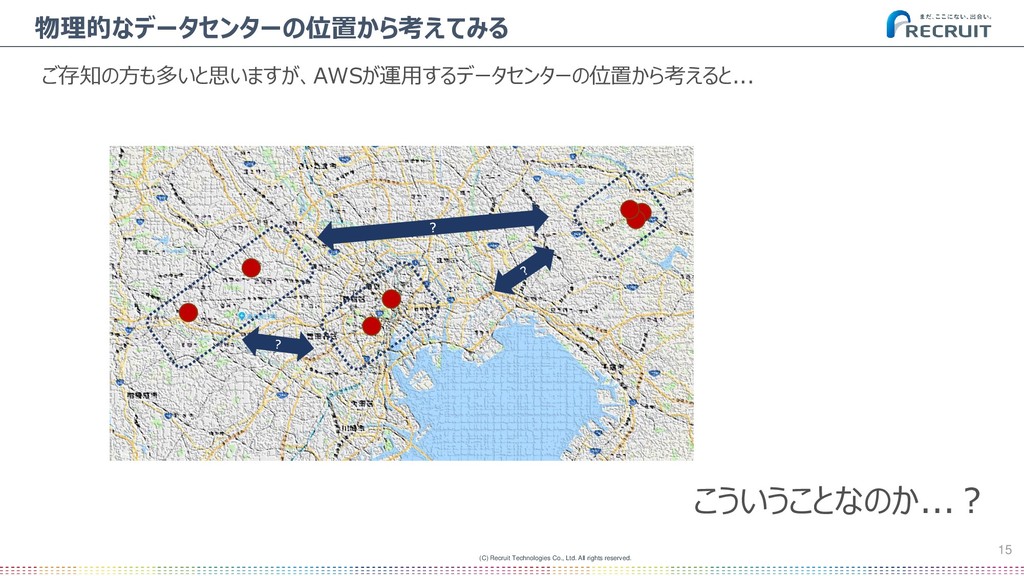
ご存知の方も多いと思いますが、AWSが運用するデータセンターの位置から考えると... こういうことなのか...? -
(C) Recruit Technologies Co., Ltd. All rights reserved. 16 ということで、「可用性・信頼性・拡張性」を考えるとこんな感じになった
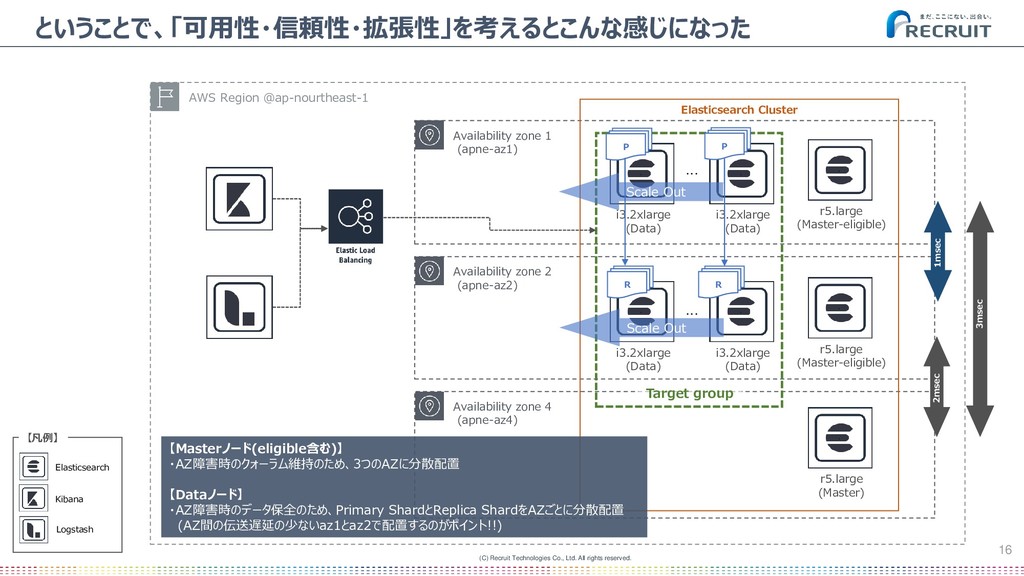
Availability zone 1 (apne-az1) AWS Region @ap-nourtheast-1 Availability zone 2 (apne-az2) Availability zone 4 (apne-az4) r5.large (Master-eligible) r5.large (Master-eligible) r5.large (Master) i3.2xlarge (Data) i3.2xlarge (Data) i3.2xlarge (Data) i3.2xlarge (Data) Elasticsearch Cluster 1msec 2msec 1msec 3msec Elasticsearch Kibana Logstash 【凡例】 Target group ・・・ ・・・ P R R P Scale Out Scale Out 【Masterノード(eligible含む)】 ・AZ障害時のクォーラム維持のため、3つのAZに分散配置 【Dataノード】 ・AZ障害時のデータ保全のため、Primary ShardとReplica ShardをAZごとに分散配置 (AZ間の伝送遅延の少ないaz1とaz2で配置するのがポイント!!) -
(C) Recruit Technologies Co., Ltd. All rights reserved. 17 運用性や運用コストも規模が大きいと気になるポイント
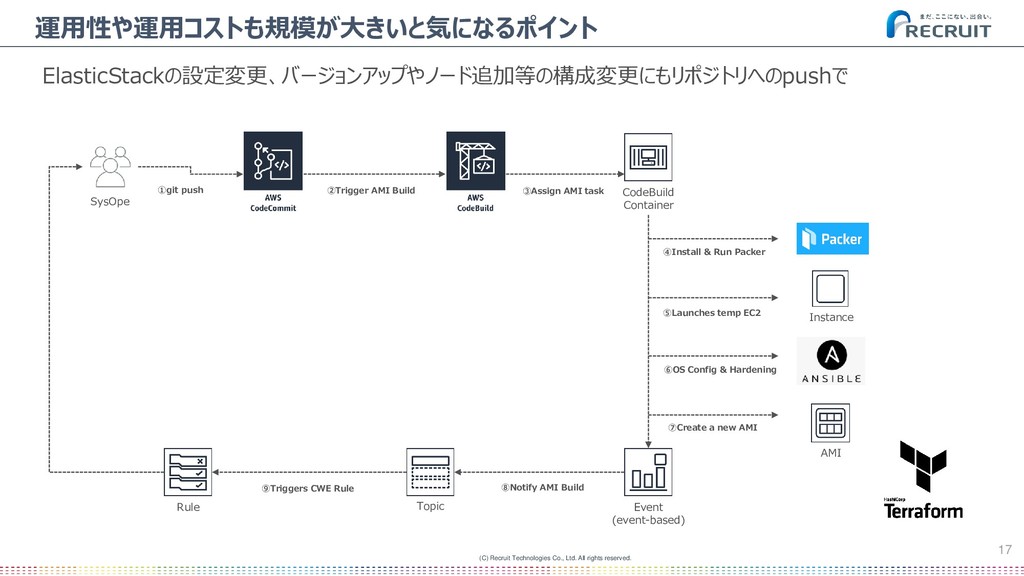
ElasticStackの設定変更、バージョンアップやノード追加等の構成変更にもリポジトリへのpushで AMI Instance Event (event-based) Rule Topic CodeBuild Container SysOpe ①git push ②Trigger AMI Build ③Assign AMI task ④Install & Run Packer ⑤Launches temp EC2 ⑥OS Config & Hardening ⑦Create a new AMI ⑧Notify AMI Build ⑨Triggers CWE Rule -
(C) Recruit Technologies Co., Ltd. All rights reserved. 18 しかし、ElasticsearchのNodeID重複問題
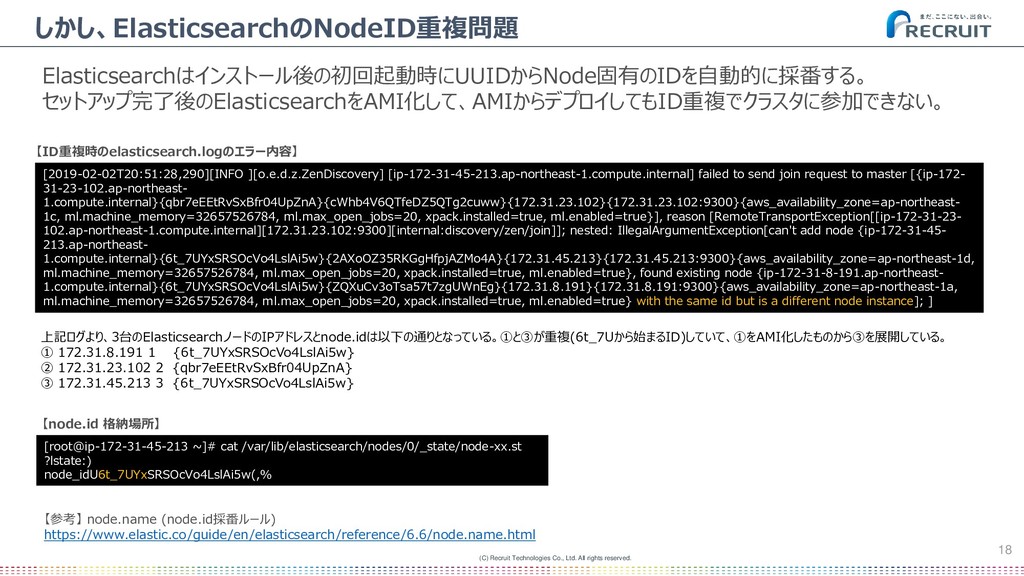
Elasticsearchはインストール後の初回起動時にUUIDからNode固有のIDを自動的に採番する。 セットアップ完了後のElasticsearchをAMI化して、AMIからデプロイしてもID重複でクラスタに参加できない。 [2019-02-02T20:51:28,290][INFO ][o.e.d.z.ZenDiscovery] [ip-172-31-45-213.ap-northeast-1.compute.internal] failed to send join request to master [{ip-172- 31-23-102.ap-northeast- 1.compute.internal}{qbr7eEEtRvSxBfr04UpZnA}{cWhb4V6QTfeDZ5QTg2cuww}{172.31.23.102}{172.31.23.102:9300}{aws_availability_zone=ap-northeast- 1c, ml.machine_memory=32657526784, ml.max_open_jobs=20, xpack.installed=true, ml.enabled=true}], reason [RemoteTransportException[[ip-172-31-23- 102.ap-northeast-1.compute.internal][172.31.23.102:9300][internal:discovery/zen/join]]; nested: IllegalArgumentException[can't add node {ip-172-31-45- 213.ap-northeast- 1.compute.internal}{6t_7UYxSRSOcVo4LslAi5w}{2AXoOZ35RKGgHfpjAZMo4A}{172.31.45.213}{172.31.45.213:9300}{aws_availability_zone=ap-northeast-1d, ml.machine_memory=32657526784, ml.max_open_jobs=20, xpack.installed=true, ml.enabled=true}, found existing node {ip-172-31-8-191.ap-northeast- 1.compute.internal}{6t_7UYxSRSOcVo4LslAi5w}{ZQXuCv3oTsa57t7zgUWnEg}{172.31.8.191}{172.31.8.191:9300}{aws_availability_zone=ap-northeast-1a, ml.machine_memory=32657526784, ml.max_open_jobs=20, xpack.installed=true, ml.enabled=true} with the same id but is a different node instance]; ] 【ID重複時のelasticsearch.logのエラー内容】 【参考】 node.name (node.id採番ルール) https://www.elastic.co/guide/en/elasticsearch/reference/6.6/node.name.html 上記ログより、3台のElasticsearchノードのIPアドレスとnode.idは以下の通りとなっている。①と③が重複(6t_7Uから始まるID)していて、①をAMI化したものから③を展開している。 ① 172.31.8.191 1 {6t_7UYxSRSOcVo4LslAi5w} ② 172.31.23.102 2 {qbr7eEEtRvSxBfr04UpZnA} ③ 172.31.45.213 3 {6t_7UYxSRSOcVo4LslAi5w} [root@ip-172-31-45-213 ~]# cat /var/lib/elasticsearch/nodes/0/_state/node-xx.st ?lstate:) node_idU6t_7UYxSRSOcVo4LslAi5w(,% 【node.id 格納場所】 -
(C) Recruit Technologies Co., Ltd. All rights reserved. 19 解決策の1つとして
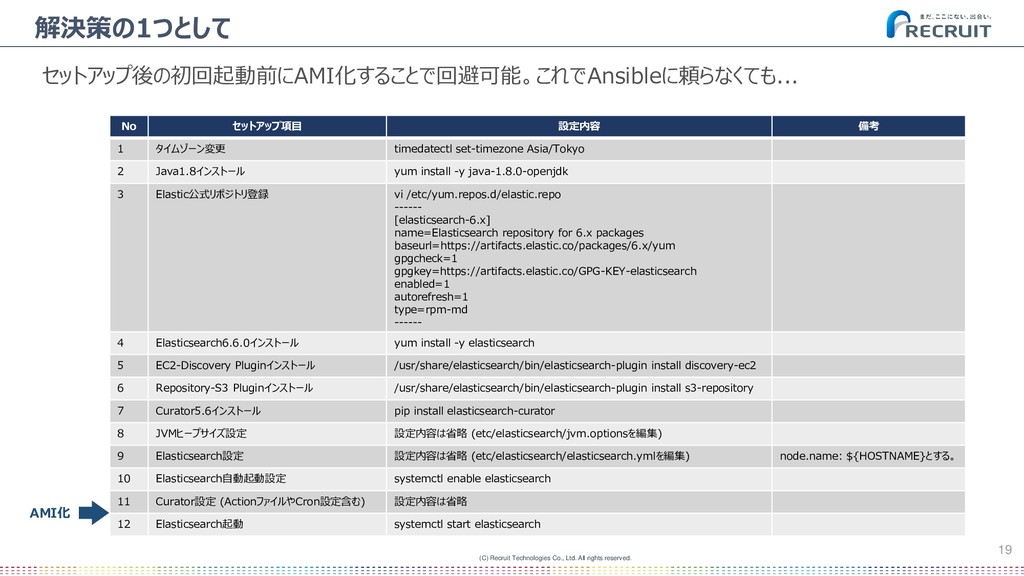
セットアップ後の初回起動前にAMI化することで回避可能。これでAnsibleに頼らなくても... No セットアップ項目 設定内容 備考 1 タイムゾーン変更 timedatectl set-timezone Asia/Tokyo 2 Java1.8インストール yum install -y java-1.8.0-openjdk 3 Elastic公式リポジトリ登録 vi /etc/yum.repos.d/elastic.repo ------ [elasticsearch-6.x] name=Elasticsearch repository for 6.x packages baseurl=https://artifacts.elastic.co/packages/6.x/yum gpgcheck=1 gpgkey=https://artifacts.elastic.co/GPG-KEY-elasticsearch enabled=1 autorefresh=1 type=rpm-md ------ 4 Elasticsearch6.6.0インストール yum install -y elasticsearch 5 EC2-Discovery Pluginインストール /usr/share/elasticsearch/bin/elasticsearch-plugin install discovery-ec2 6 Repository-S3 Pluginインストール /usr/share/elasticsearch/bin/elasticsearch-plugin install s3-repository 7 Curator5.6インストール pip install elasticsearch-curator 8 JVMヒープサイズ設定 設定内容は省略 (etc/elasticsearch/jvm.optionsを編集) 9 Elasticsearch設定 設定内容は省略 (etc/elasticsearch/elasticsearch.ymlを編集) node.name: ${HOSTNAME}とする。 10 Elasticsearch自動起動設定 systemctl enable elasticsearch 11 Curator設定 (ActionファイルやCron設定含む) 設定内容は省略 12 Elasticsearch起動 systemctl start elasticsearch AMI化 -
(C) Recruit Technologies Co., Ltd. All rights reserved. Data Node
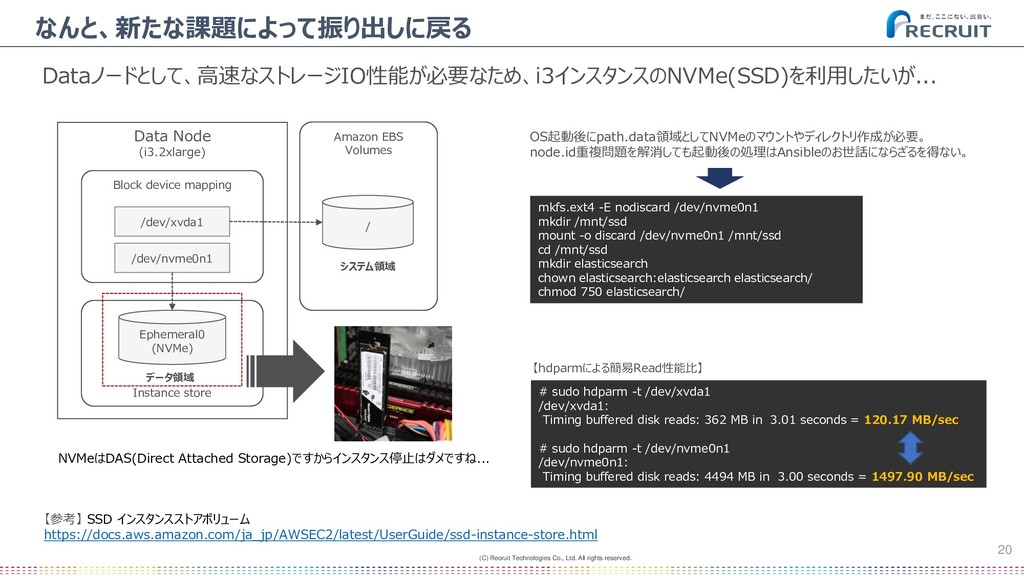
(i3.2xlarge) Instance store 20 なんと、新たな課題によって振り出しに戻る Dataノードとして、高速なストレージIO性能が必要なため、i3インスタンスのNVMe(SSD)を利用したいが... 【参考】 SSD インスタンスストアボリューム https://docs.aws.amazon.com/ja_jp/AWSEC2/latest/UserGuide/ssd-instance-store.html データ領域 NVMeはDAS(Direct Attached Storage)ですからインスタンス停止はダメですね... mkfs.ext4 -E nodiscard /dev/nvme0n1 mkdir /mnt/ssd mount -o discard /dev/nvme0n1 /mnt/ssd cd /mnt/ssd mkdir elasticsearch chown elasticsearch:elasticsearch elasticsearch/ chmod 750 elasticsearch/ OS起動後にpath.data領域としてNVMeのマウントやディレクトリ作成が必要。 node.id重複問題を解消しても起動後の処理はAnsibleのお世話にならざるを得ない。 Block device mapping Ephemeral0 (NVMe) Amazon EBS Volumes / /dev/nvme0n1 /dev/xvda1 システム領域 # sudo hdparm -t /dev/xvda1 /dev/xvda1: Timing buffered disk reads: 362 MB in 3.01 seconds = 120.17 MB/sec # sudo hdparm -t /dev/nvme0n1 /dev/nvme0n1: Timing buffered disk reads: 4494 MB in 3.00 seconds = 1497.90 MB/sec 【hdparmによる簡易Read性能比】 -
(C) Recruit Technologies Co., Ltd. All rights reserved. 21 まとめ
サービスの進化は速く、学ぶことは多いし考えることも多いけど、幅を広げることでバリエーションが増える! 要件も大事だけど、変化やエラーに強いアーキテクチャをチームで考えることはやっぱり楽しいよね!
 rtechkouhou
 carta_engineering
 fj_yoshimura_kosuke
 kintotechdev
 minorun365
 nealle
 amarelo_n24
 sergicalsix
 ota1022
 pipepasta
 inariku
 xkxaxkx
 jacobian
 inesmontani
 michielstock
 holman
 jonyablonski
 sonatard
 axbom
 rasagy
 techseoconnect
 keithpitt
 bkeepers
 madoxten