Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
SS2PLを採用しているSamehadaDBでのPhantom Read抑止ロジックの検討
Search
Ryo Kanbayashi
September 30, 2024
32
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
SS2PLを採用しているSamehadaDBでのPhantom Read抑止ロジックの検討
多分、5枚目のスライドの方法でうまくいくはず。
となったが、実装には至っていない。
Ryo Kanbayashi
September 30, 2024
More Decks by Ryo Kanbayashi
See All by Ryo Kanbayashi
誰でも情報通になれる人力情報収集プラットフォームGrapevinet
ryo_grid
0
31
私がチャレンジしたSBMデータマイニング
ryo_grid
0
14
仮想マシンを用いた分散システムの耐故障性評価環境
ryo_grid
0
15
Featured
See All Featured
SERP Conf. Vienna - Web Accessibility: Optimizing for Inclusivity and SEO
sarafernandez
2
1.6k
エンジニアに許された特別な時間の終わり
watany
109
250k
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
530
Stop Working from a Prison Cell
hatefulcrawdad
274
21k
[RailsConf 2023] Rails as a piece of cake
palkan
59
7.1k
The Impact of AI in SEO - AI Overviews June 2024 Edition
aleyda
6
1.2k
The Hidden Cost of Media on the Web [PixelPalooza 2025]
tammyeverts
2
530
How to build an LLM SEO readiness audit: a practical framework
nmsamuel
2
950
Bash Introduction
62gerente
615
220k
How STYLIGHT went responsive
nonsquared
100
6.3k
Facilitating Awesome Meetings
lara
57
7.2k
Docker and Python
trallard
47
4.2k
Transcript
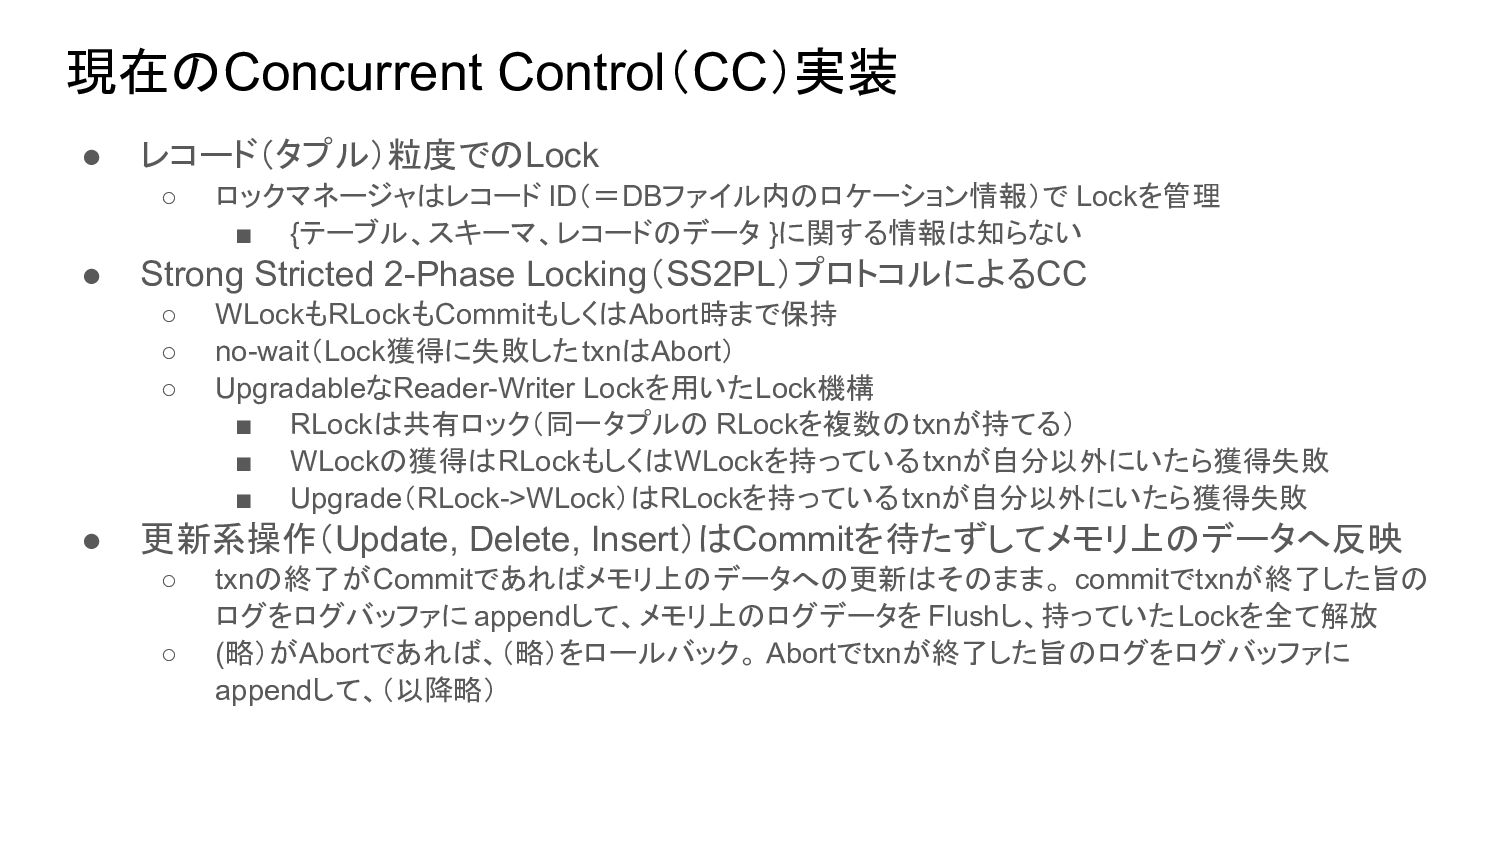
現在のConcurrent Control(CC)実装 • レコード(タプル)粒度でのLock ◦ ロックマネージャはレコード ID(=DBファイル内のロケーション情報)で Lockを管理 ▪ {テーブル、スキーマ、レコードのデータ
}に関する情報は知らない • Strong Stricted 2-Phase Locking(SS2PL)プロトコルによるCC ◦ WLockもRLockもCommitもしくはAbort時まで保持 ◦ no-wait(Lock獲得に失敗したtxnはAbort) ◦ UpgradableなReader-Writer Lockを用いたLock機構 ▪ RLockは共有ロック(同一タプルの RLockを複数のtxnが持てる) ▪ WLockの獲得はRLockもしくはWLockを持っているtxnが自分以外にいたら獲得失敗 ▪ Upgrade(RLock->WLock)はRLockを持っているtxnが自分以外にいたら獲得失敗 • 更新系操作(Update, Delete, Insert)はCommitを待たずしてメモリ上のデータへ反映 ◦ txnの終了がCommitであればメモリ上のデータへの更新はそのまま。 commitでtxnが終了した旨の ログをログバッファに appendして、メモリ上のログデータを Flushし、持っていたLockを全て解放 ◦ (略)がAbortであれば、(略)をロールバック。 Abortでtxnが終了した旨のログをログバッファに appendして、(以降略)
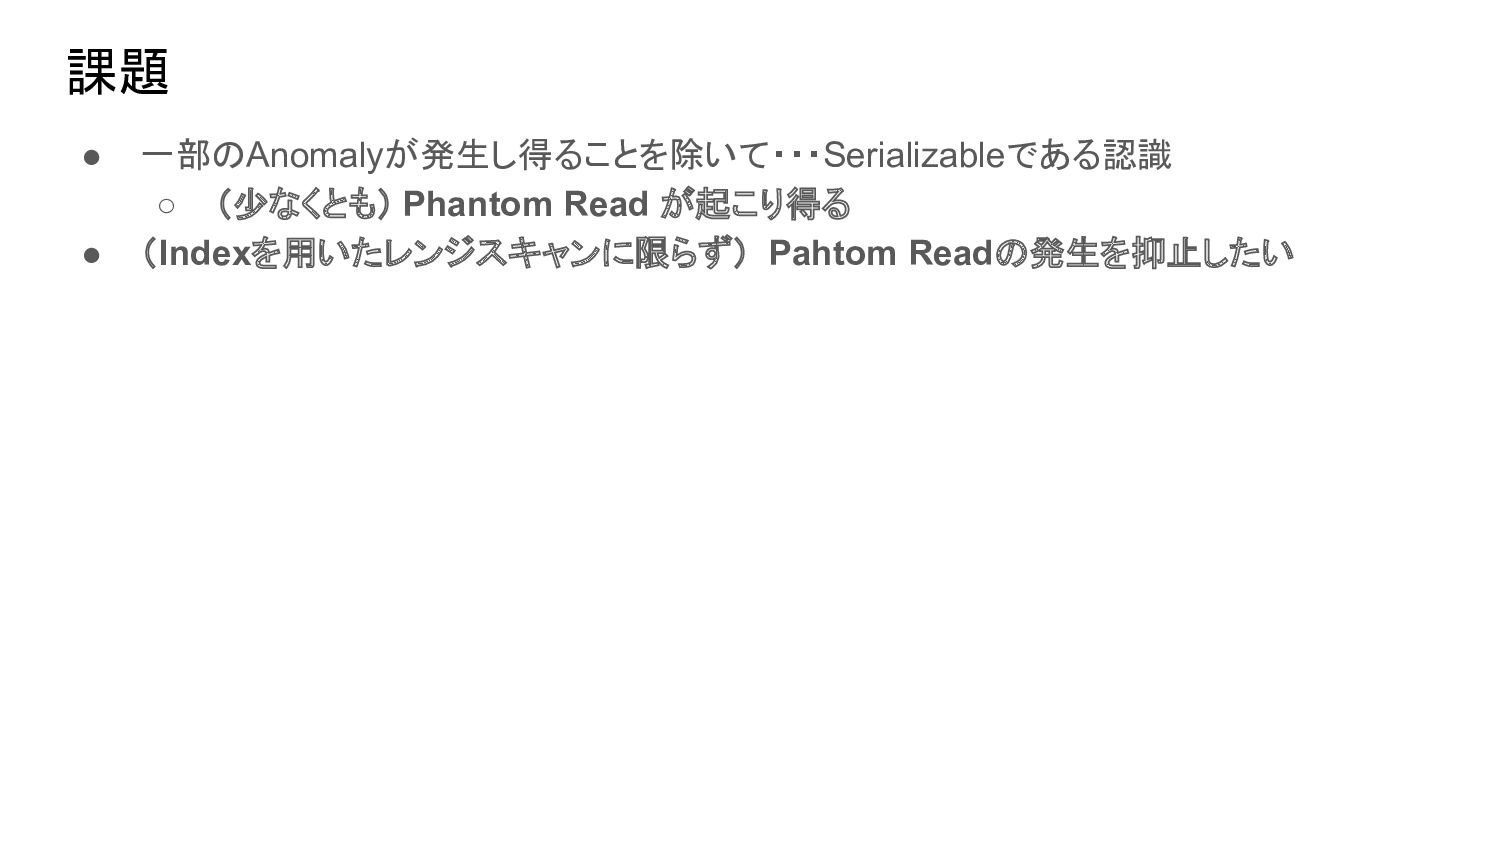
課題 • 一部のAnomalyが発生し得ることを除いて・・・Serializableである認識 ◦ (少なくとも) Phantom Read が起こり得る • (Indexを用いたレンジスキャンに限らず)
Pahtom Readの発生を抑止したい
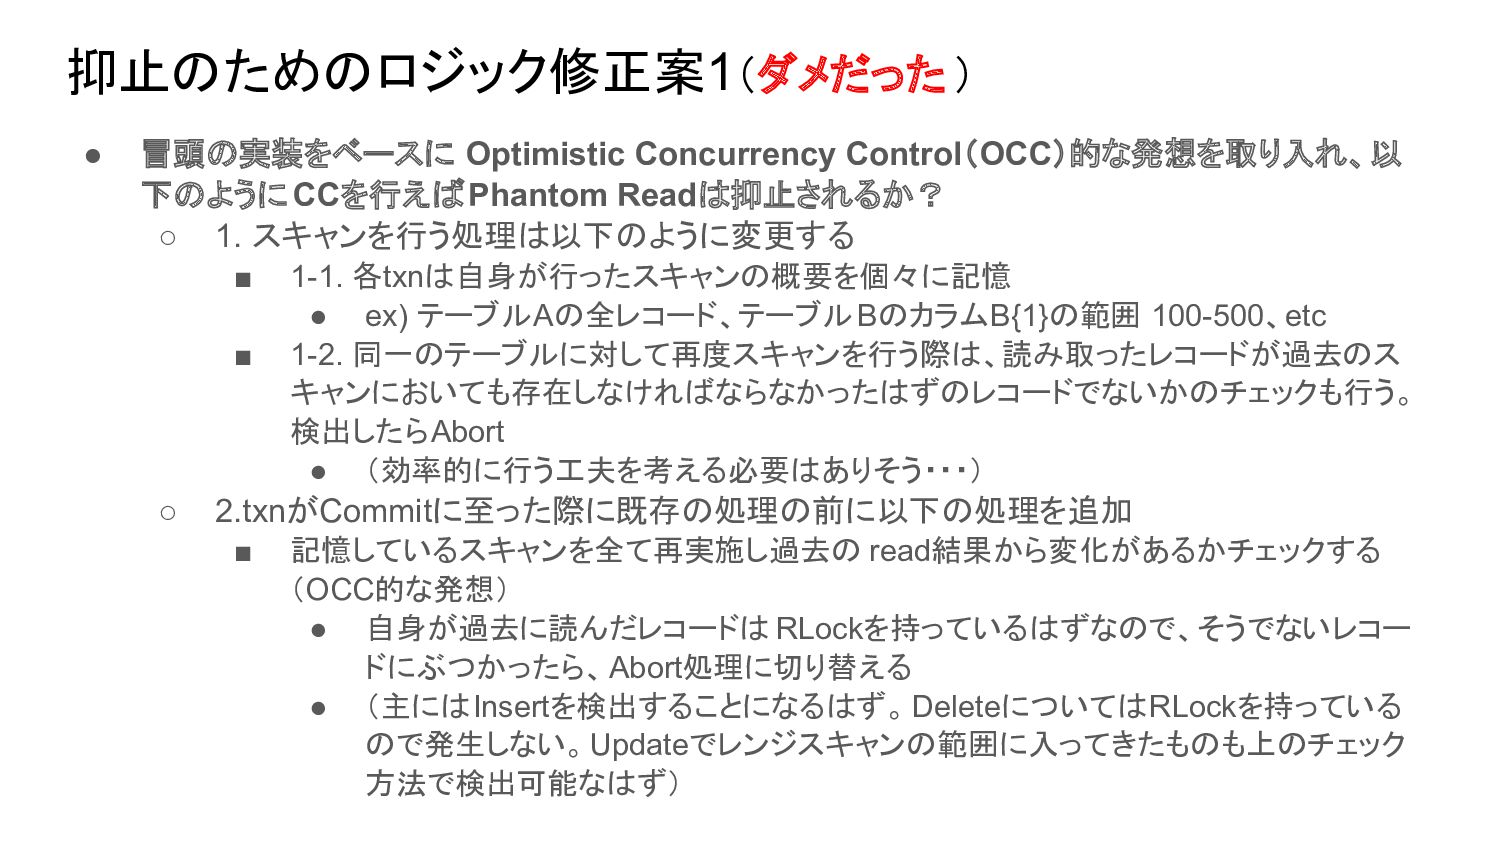
抑止のためのロジック修正案1(ダメだった ) • 冒頭の実装をベースに Optimistic Concurrency Control(OCC)的な発想を取り入れ、以 下のように CCを行えばPhantom Readは抑止されるか?
◦ 1. スキャンを行う処理は以下のように変更する ▪ 1-1. 各txnは自身が行ったスキャンの概要を個々に記憶 • ex) テーブルAの全レコード、テーブルBのカラムB{1}の範囲 100-500、etc ▪ 1-2. 同一のテーブルに対して再度スキャンを行う際は、読み取ったレコードが過去のス キャンにおいても存在しなければならなかったはずのレコードでないかのチェックも行う。 検出したらAbort • (効率的に行う工夫を考える必要はありそう・・・) ◦ 2.txnがCommitに至った際に既存の処理の前に以下の処理を追加 ▪ 記憶しているスキャンを全て再実施し過去の read結果から変化があるかチェックする (OCC的な発想) • 自身が過去に読んだレコードは RLockを持っているはずなので、そうでないレコー ドにぶつかったら、Abort処理に切り替える • (主にはInsertを検出することになるはず。 DeleteについてはRLockを持っている ので発生しない。Updateでレンジスキャンの範囲に入ってきたものも上のチェック 方法で検出可能なはず)
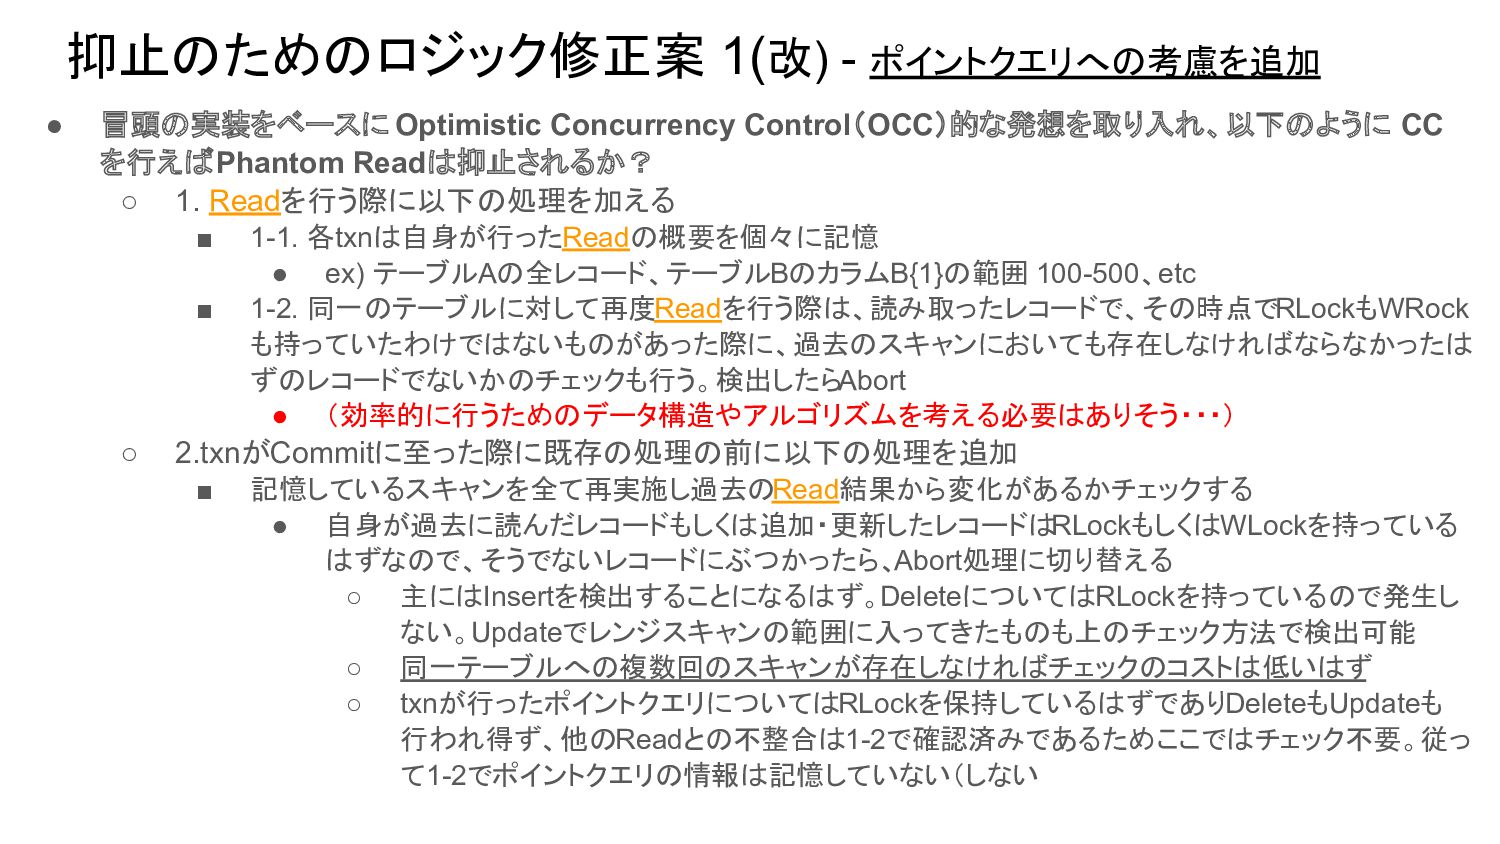
抑止のためのロジック修正案 1(改) - ポイントクエリへの考慮を追加 • 冒頭の実装をベースに Optimistic Concurrency Control(OCC)的な発想を取り入れ、以下のように CC
を行えばPhantom Readは抑止されるか? ◦ 1. Readを行う際に以下の処理を加える ▪ 1-1. 各txnは自身が行ったReadの概要を個々に記憶 • ex) テーブルAの全レコード、テーブルBのカラムB{1}の範囲 100-500、etc ▪ 1-2. 同一のテーブルに対して再度Readを行う際は、読み取ったレコードで、その時点でRLockもWRock も持っていたわけではないものがあった際に、過去のスキャンにおいても存在しなければならなかったは ずのレコードでないかのチェックも行う。検出したらAbort • (効率的に行うためのデータ構造やアルゴリズムを考える必要はありそう・・・) ◦ 2.txnがCommitに至った際に既存の処理の前に以下の処理を追加 ▪ 記憶しているスキャンを全て再実施し過去のRead結果から変化があるかチェックする • 自身が過去に読んだレコードもしくは追加・更新したレコードはRLockもしくはWLockを持っている はずなので、そうでないレコードにぶつかったら、Abort処理に切り替える ◦ 主にはInsertを検出することになるはず。DeleteについてはRLockを持っているので発生し ない。Updateでレンジスキャンの範囲に入ってきたものも上のチェック方法で検出可能 ◦ 同一テーブルへの複数回のスキャンが存在しなければチェックのコストは低いはず ◦ txnが行ったポイントクエリについてはRLockを保持しているはずでありDeleteもUpdateも 行われ得ず、他のReadとの不整合は1-2で確認済みであるためここではチェック不要。従っ て1-2でポイントクエリの情報は記憶していない(しない
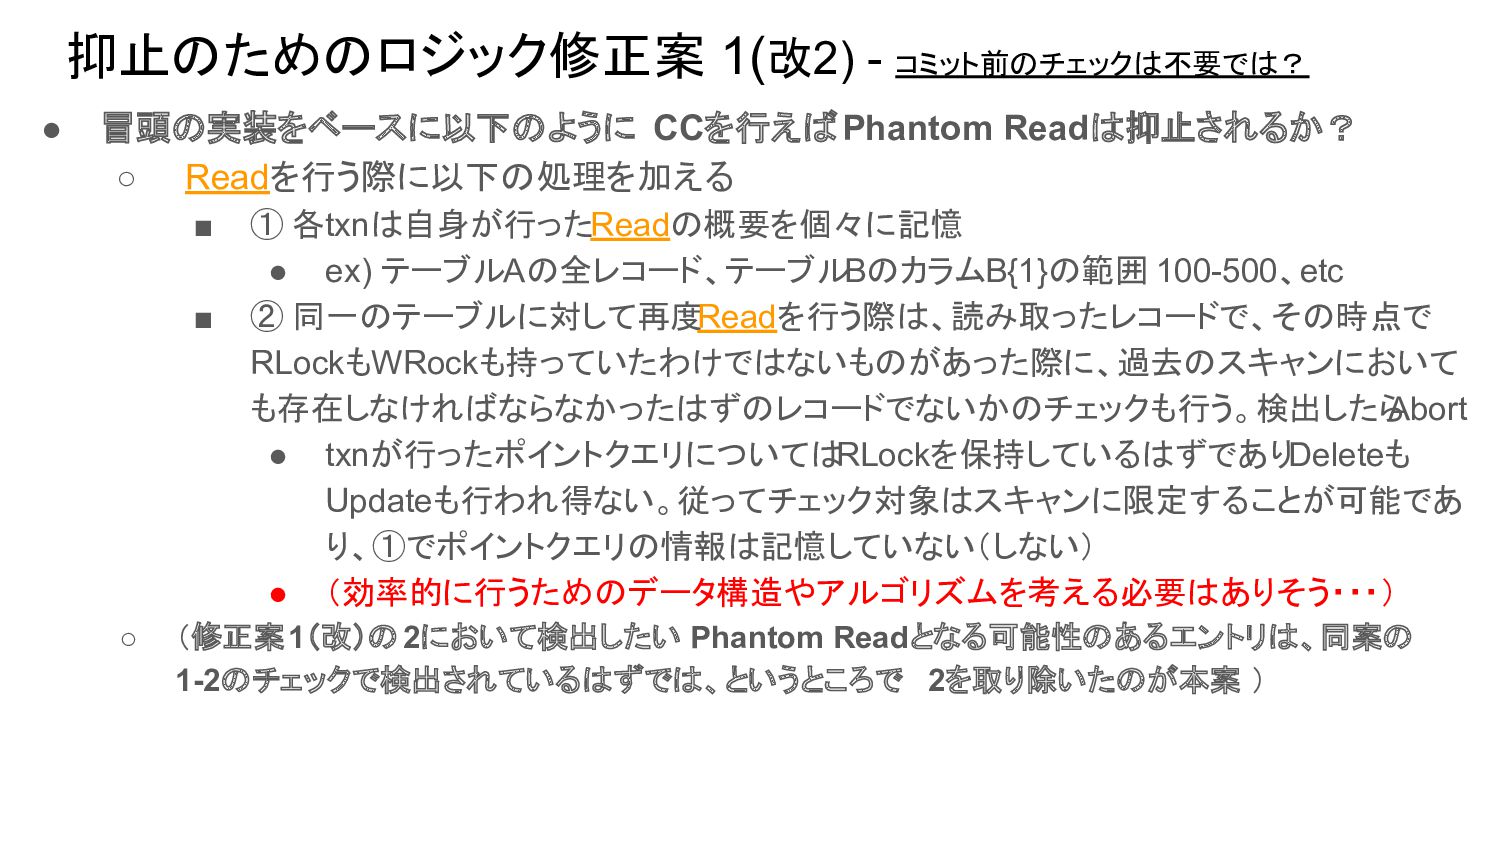
抑止のためのロジック修正案 1(改2) - コミット前のチェックは不要では? • 冒頭の実装をベースに以下のように CCを行えばPhantom Readは抑止されるか? ◦ Readを行う際に以下の処理を加える
▪ ① 各txnは自身が行ったReadの概要を個々に記憶 • ex) テーブルAの全レコード、テーブルBのカラムB{1}の範囲 100-500、etc ▪ ② 同一のテーブルに対して再度Readを行う際は、読み取ったレコードで、その時点で RLockもWRockも持っていたわけではないものがあった際に、過去のスキャンにおいて も存在しなければならなかったはずのレコードでないかのチェックも行う。検出したら Abort • txnが行ったポイントクエリについては RLockを保持しているはずでありDeleteも Updateも行われ得ない。従ってチェック対象はスキャンに限定することが可能であ り、①でポイントクエリの情報は記憶していない(しない) • (効率的に行うためのデータ構造やアルゴリズムを考える必要はありそう・・・) ◦ (修正案1(改)の2において検出したい Phantom Readとなる可能性のあるエントリは、同案の 1-2のチェックで検出されているはずでは、というところで 2を取り除いたのが本案 )
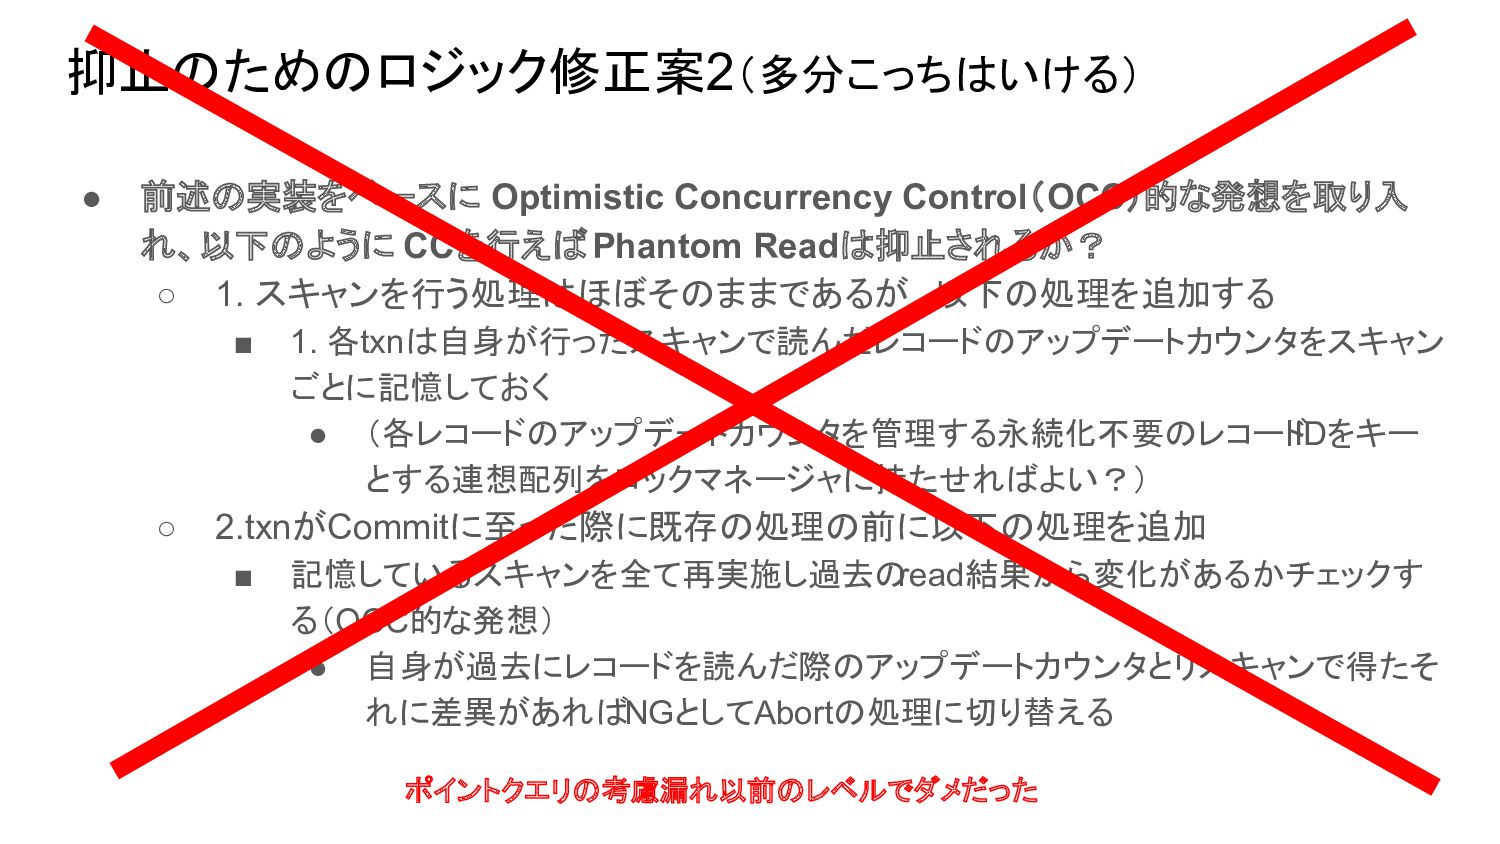
抑止のためのロジック修正案2(多分こっちはいける) • 前述の実装をベースに Optimistic Concurrency Control(OCC)的な発想を取り入 れ、以下のように CCを行えばPhantom Readは抑止されるか? ◦
1. スキャンを行う処理はほぼそのままであるが、以下の処理を追加する ▪ 1. 各txnは自身が行ったスキャンで読んだレコードのアップデートカウンタをスキャン ごとに記憶しておく • (各レコードのアップデートカウンタを管理する永続化不要のレコード IDをキー とする連想配列をロックマネージャに持たせればよい?) ◦ 2.txnがCommitに至った際に既存の処理の前に以下の処理を追加 ▪ 記憶しているスキャンを全て再実施し過去の read結果から変化があるかチェックす る(OCC的な発想) • 自身が過去にレコードを読んだ際のアップデートカウンタとリスキャンで得たそ れに差異があればNGとしてAbortの処理に切り替える ポイントクエリの考慮漏れ以前のレベルでダメだった


 ryo_grid
 sarafernandez
 watany
 jct
 hatefulcrawdad
 palkan
 aleyda
 tammyeverts
 nmsamuel
 62gerente
 nonsquared
 lara
 trallard