Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Features
Speaker Deck
PRO
Sign in
Sign up for free
Search
Search
令和のミニ四駆!? AWS DeepRacer で強化学習に入門してみた
Search
ryu-ki
May 01, 2025
440
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
令和のミニ四駆!? AWS DeepRacer で強化学習に入門してみた
ryu-ki
May 01, 2025
More Decks by ryu-ki
See All by ryu-ki
北海道の地名をAIは読めるのか
ryuki0947
1
170
AgentCore Harness × AgentCore Browser × Live View
ryuki0947
1
130
VPCとも向き合いたい2026(年度)
ryuki0947
0
340
Strands Agents × AWS DevOps Agent 〜自作エージェントに組み込んでみた〜
ryuki0947
0
93
AI-DLCを試してみて困ったことを共有したい
ryuki0947
0
510
Claude Codeに要件をヒアリングしてもらった体験がかなり良かった(2026年版)
ryuki0947
0
520
Qiita 週1投稿を1年間完走した感想
ryuki0947
0
66
AWS × LINE で始める FinOps ~Terraform を添えて~
ryuki0947
0
170
A2A のトレース事情 〜親子エージェントの動きをLangfuseで可視化してみる〜
ryuki0947
1
650
Featured
See All Featured
How STYLIGHT went responsive
nonsquared
100
6.3k
Evolution of real-time – Irina Nazarova, EuRuKo, 2024
irinanazarova
9
1.5k
Getting science done with accelerated Python computing platforms
jacobtomlinson
2
470
技術選定の審美眼(2025年版) / Understanding the Spiral of Technologies 2025 edition
twada
PRO
120
120k
Put a Button on it: Removing Barriers to Going Fast.
kastner
60
4.6k
Six Lessons from altMBA
skipperchong
29
4.5k
Art, The Web, and Tiny UX
lynnandtonic
304
22k
Designing for Performance
lara
611
70k
Imperfection Machines: The Place of Print at Facebook
scottboms
270
14k
The Pragmatic Product Professional
lauravandoore
37
7.4k
Design in an AI World
tapps
1
300
AI in Enterprises - Java and Open Source to the Rescue
ivargrimstad
0
1.5k
Transcript
令和のミニ四駆!? AWS DeepRacerで強化学習に入門してみた 2025/05/10(土) JAWS-UG 彩の国埼玉支部#1 ~AWS Summit前のウォームアップ~ 知識をアップデート!
自己紹介 ┃所属:TIS株式会社 ‐ 年次:2年目(24卒) ‐ 担当業務:社内サービス(AWS/Terraform/React) ┃大宮初上陸です! ┃好きなAWSサービス:AWS Lambda 2
井町 瑠貴 (umitsu) 昨年末からQiitaへの記事投稿を 始めました!(AWS・生成AIなど)
はじめに ┃本日お話しすること 3 AWS DeepRacerについて 強化学習の概要について
はじめに ┃本日お話しすること 4 AWS DeepRacerについて 強化学習の概要について ・サービス概要 ・使い方 ・学習結果の確認(デモ) ・基本要素
・学習の流れ(プロセス)
5 AWS DeepRacer をご存じでしょうか?
AWS DeepRacer ┃公式より引用[1] 6 強化学習を楽しく、実践的に学べる プラットフォーム あらゆるレベルレベルのデベロッパーが、クラウドベースの3Dレーシング シミュレーター、強化学習により駆動する1/18スケールの 完全自走型レーシングカーを通じて機械学習を実践的に学べます。 [1]
https://aws.amazon.com/jp/deepracer/
AWS DeepRacer ┃公式より引用[1] 7 強化学習を楽しく、実践的に学べる プラットフォーム あらゆるレベルレベルのデベロッパーが、クラウドベースの3Dレーシング シミュレーター、強化学習により駆動する1/18スケールの 完全自走型レーシングカーを通じて機械学習を実践的に学べます。 [1]
https://aws.amazon.com/jp/deepracer/ ※2025/12 で終了予定
AWS DeepRacer ┃昨年のAWS Summit Japanでは日本一決定戦も実施[2] 8 [2] https://aws.amazon.com/jp/builders-flash/202408/deepracer-jp-championship/
9 強化学習とはなんでしょうか?
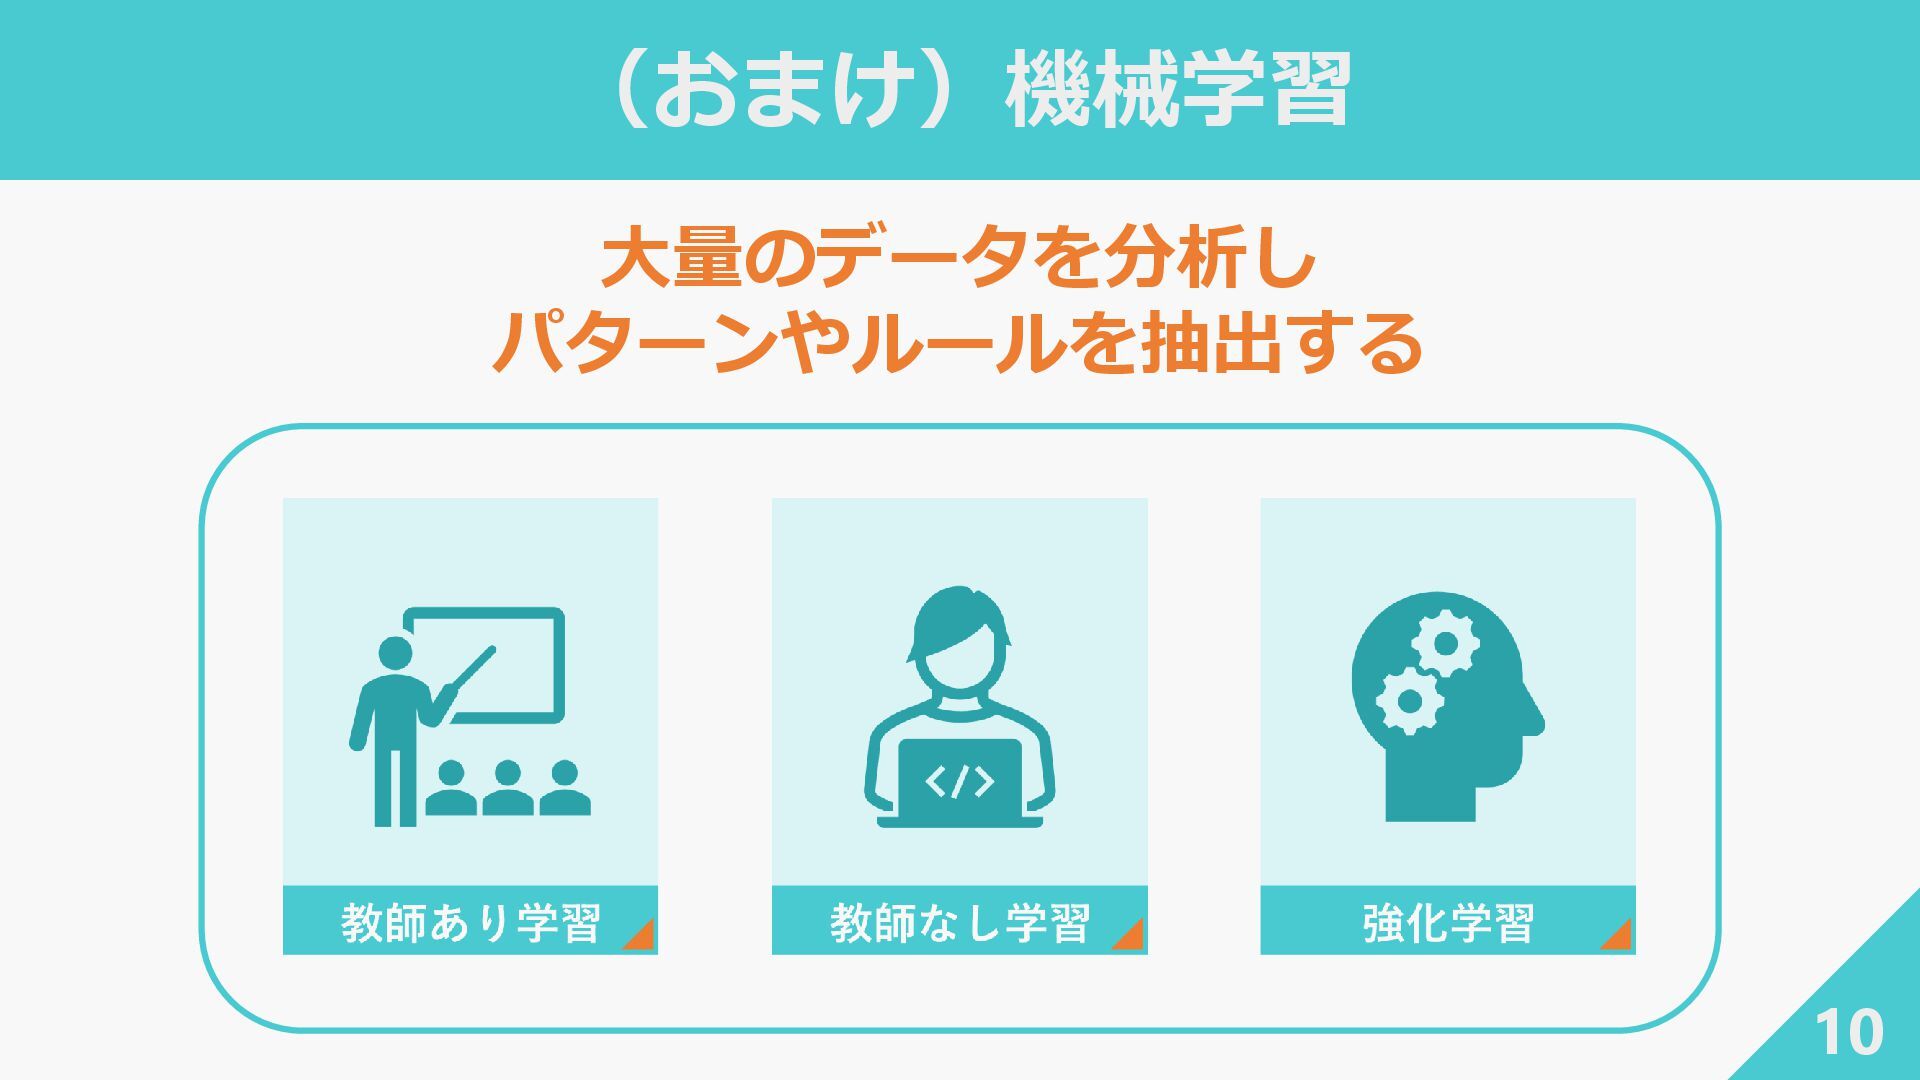
(おまけ)機械学習 10 大量のデータを分析し パターンやルールを抽出する
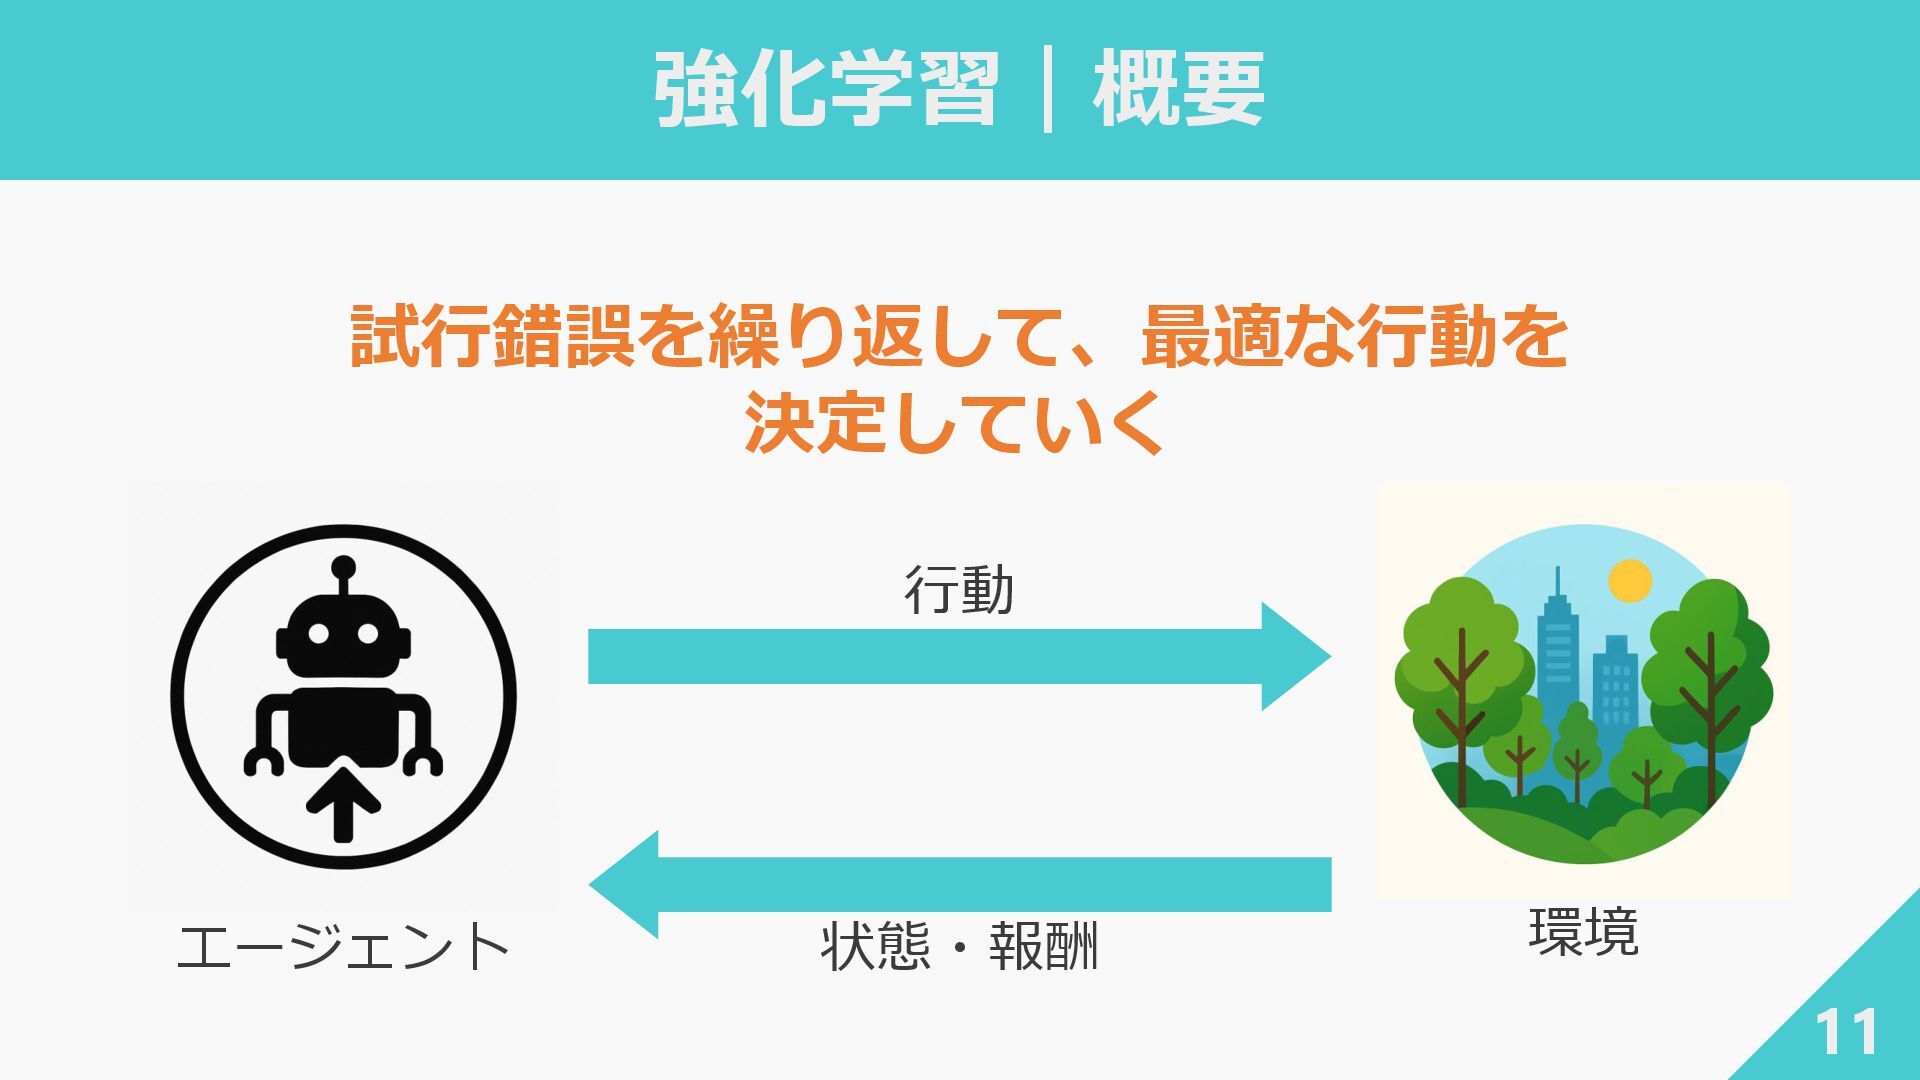
強化学習|概要 11 試行錯誤を繰り返して、最適な行動を 決定していく 行動 状態・報酬 エージェント 環境
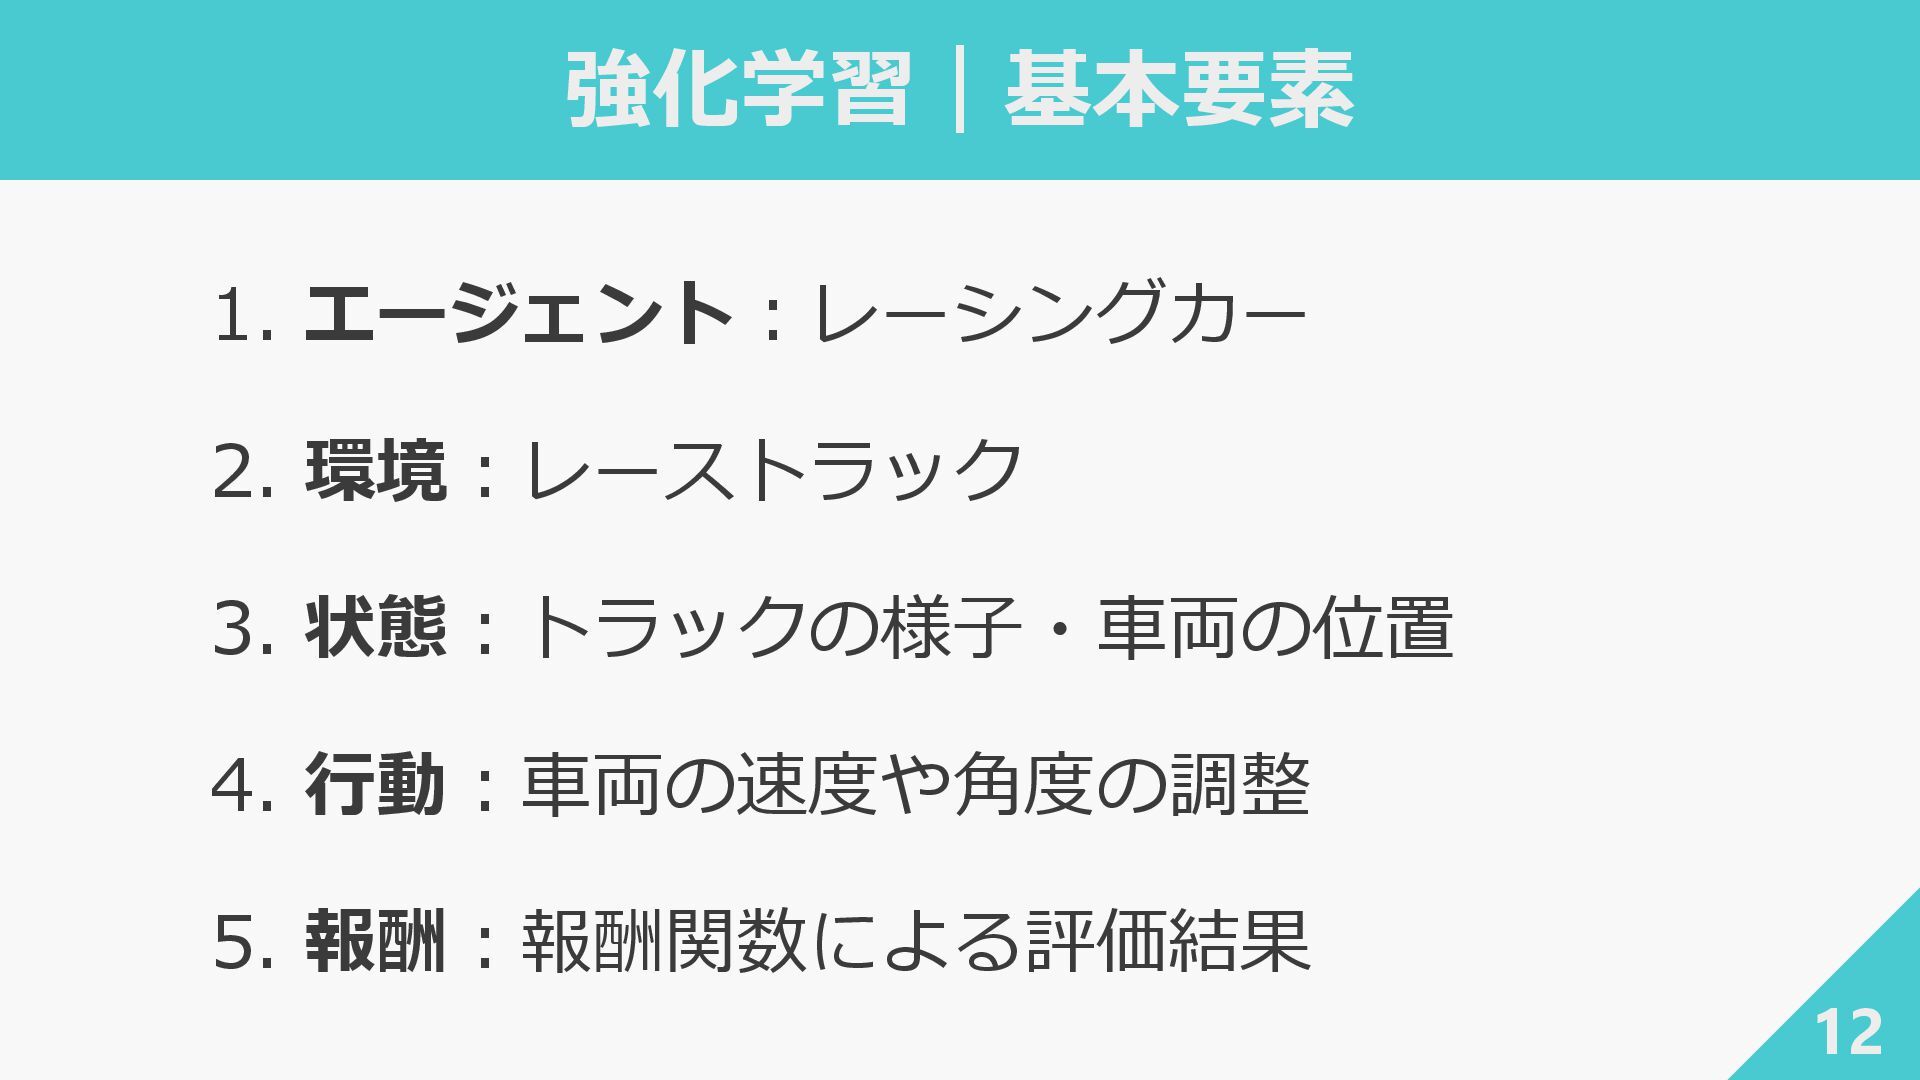
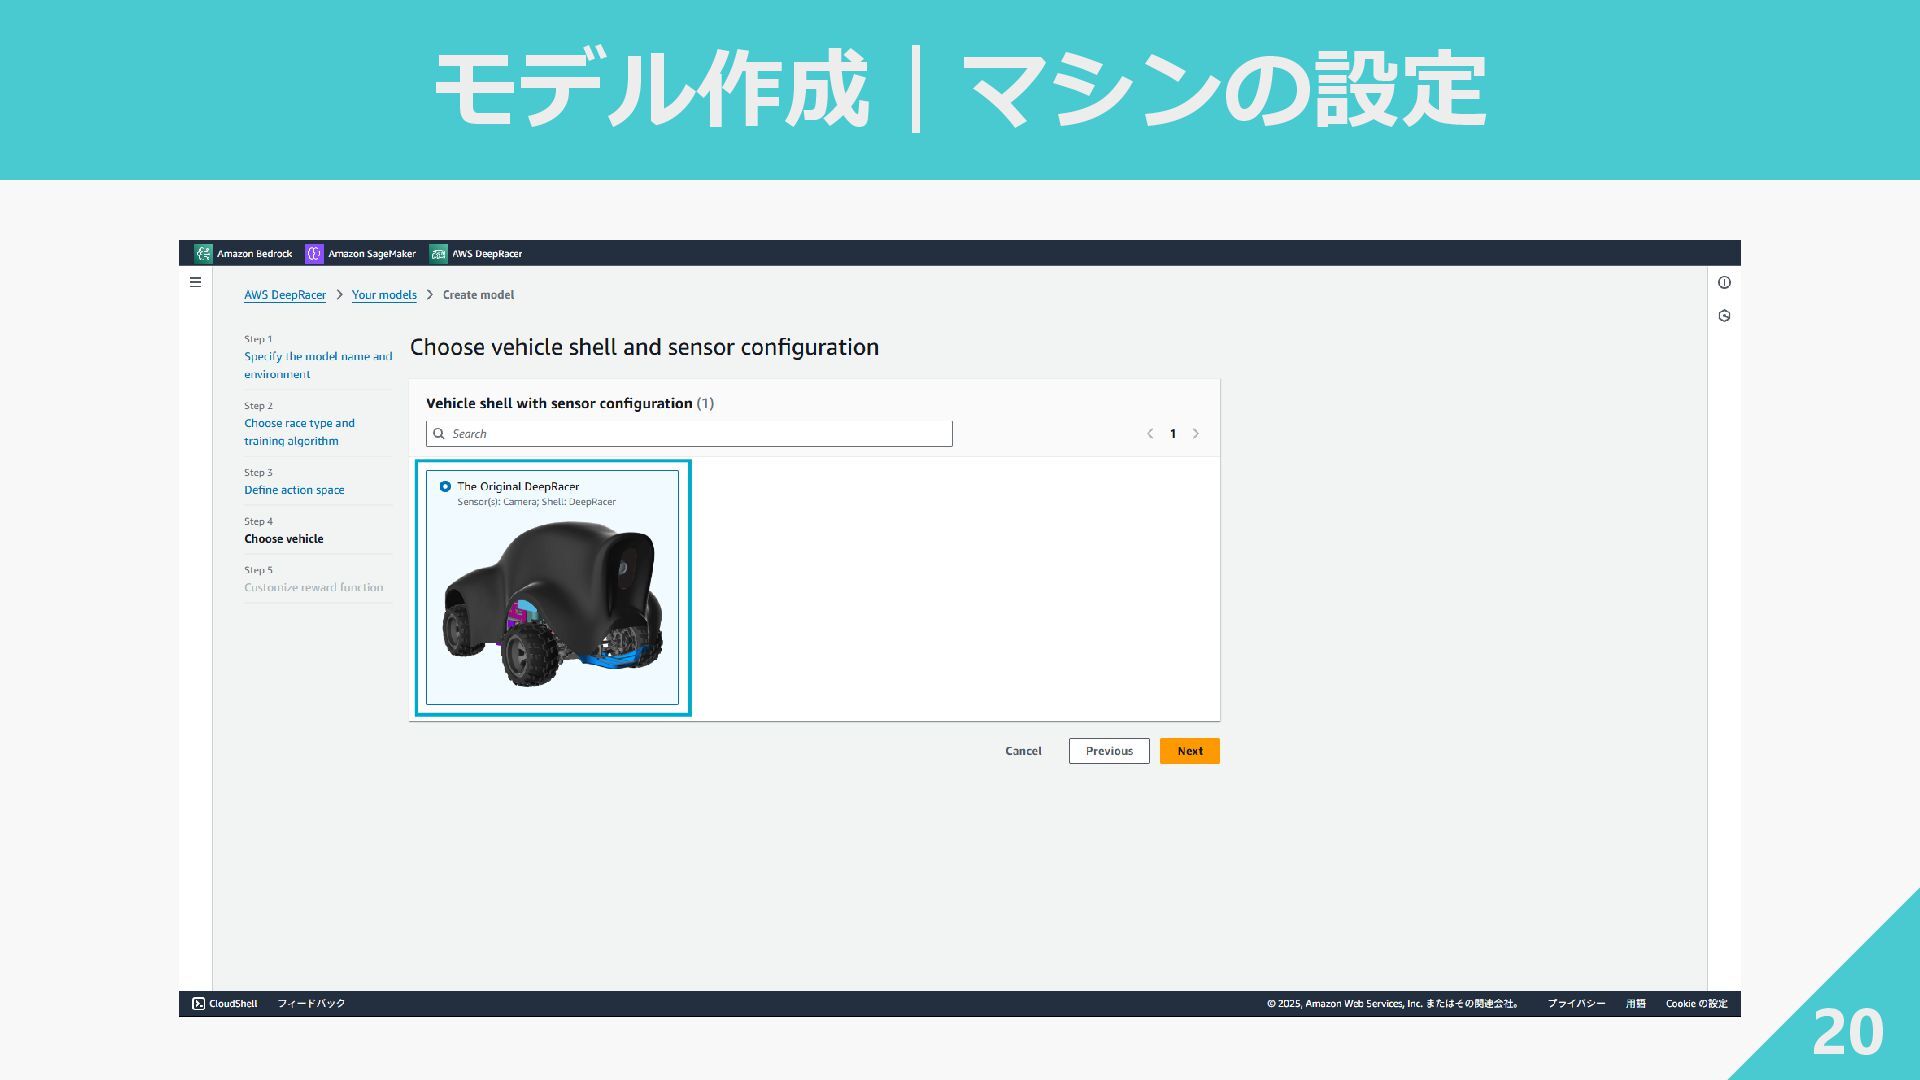
強化学習|基本要素 12 1. エージェント:レーシングカー 2. 環境:レーストラック 3. 状態:トラックの様子・車両の位置 4. 行動:車両の速度や角度の調整
5. 報酬:報酬関数による評価結果
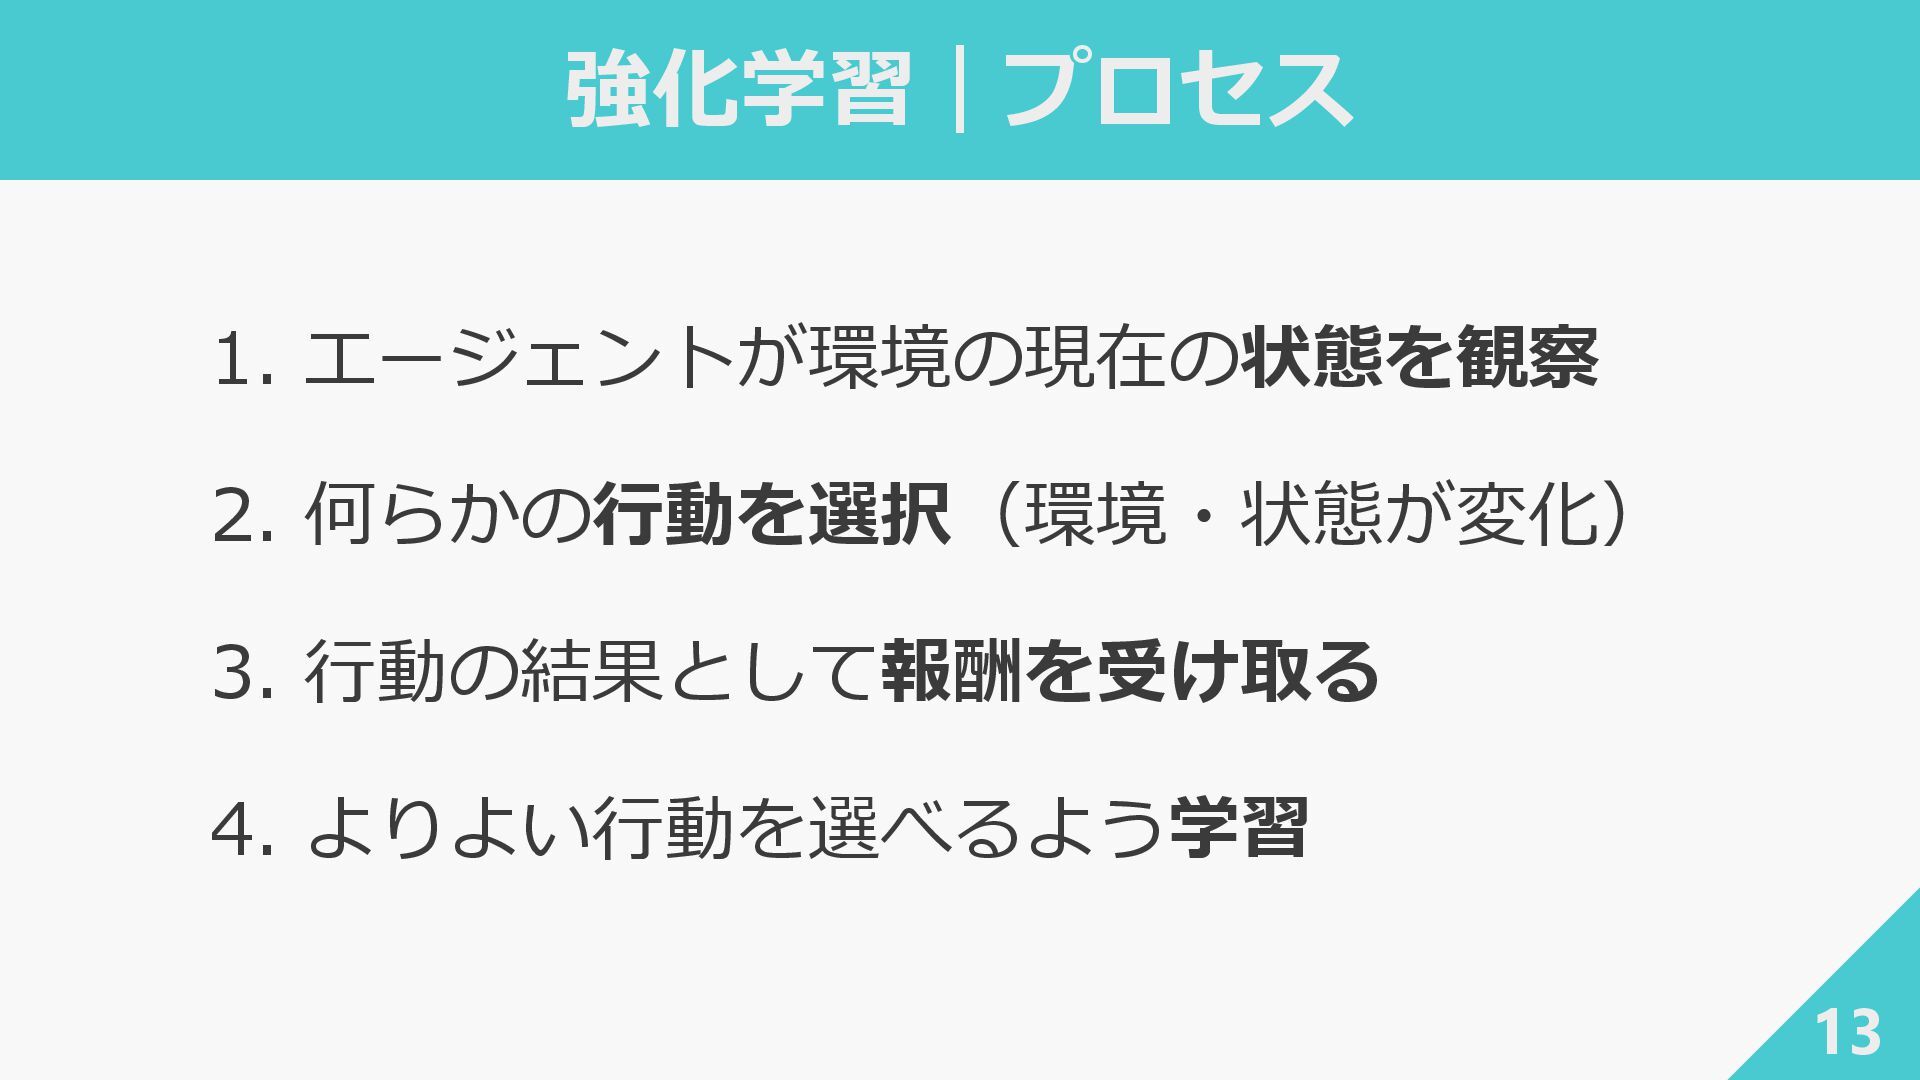
強化学習|プロセス 13 1. エージェントが環境の現在の状態を観察 2. 何らかの行動を選択(環境・状態が変化) 3. 行動の結果として報酬を受け取る 4. よりよい行動を選べるよう学習
14 実際にDeepRacerを触ってみましょう
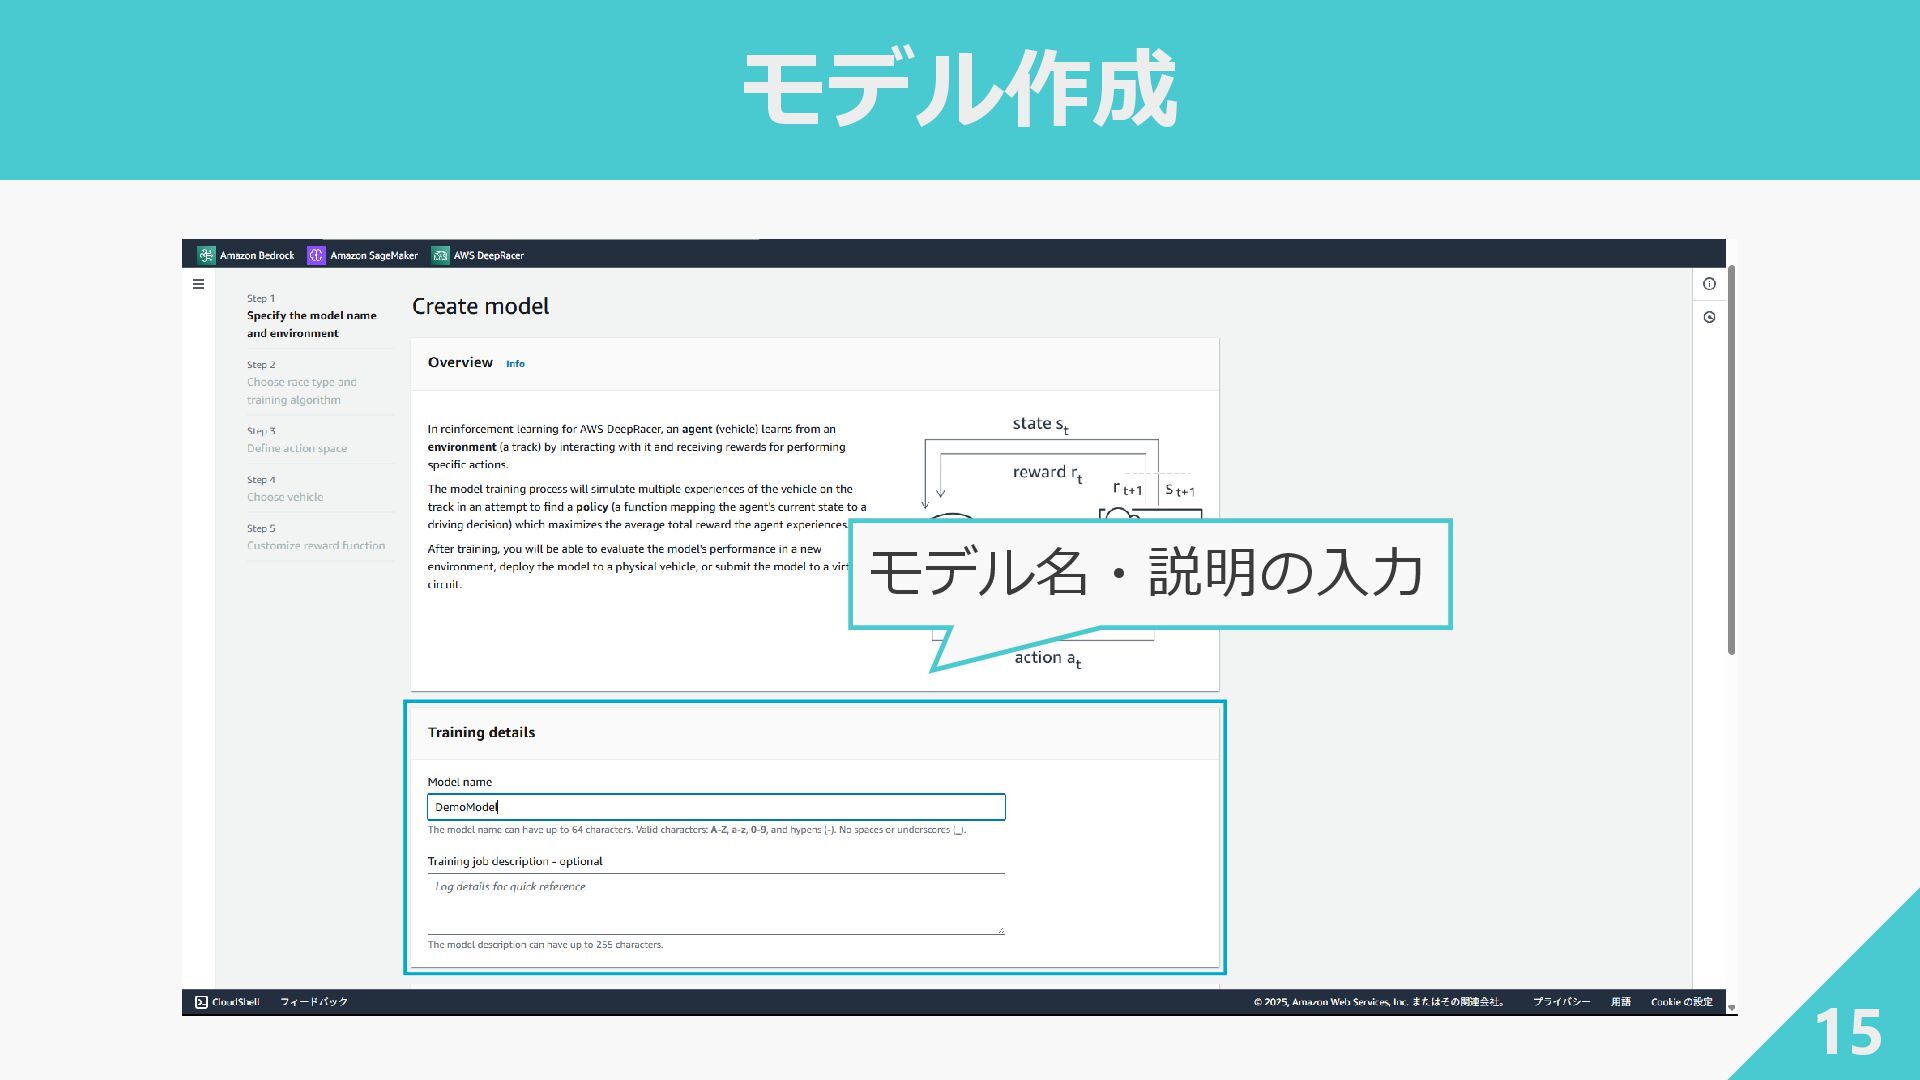
モデル作成 15 モデル名・説明の入力
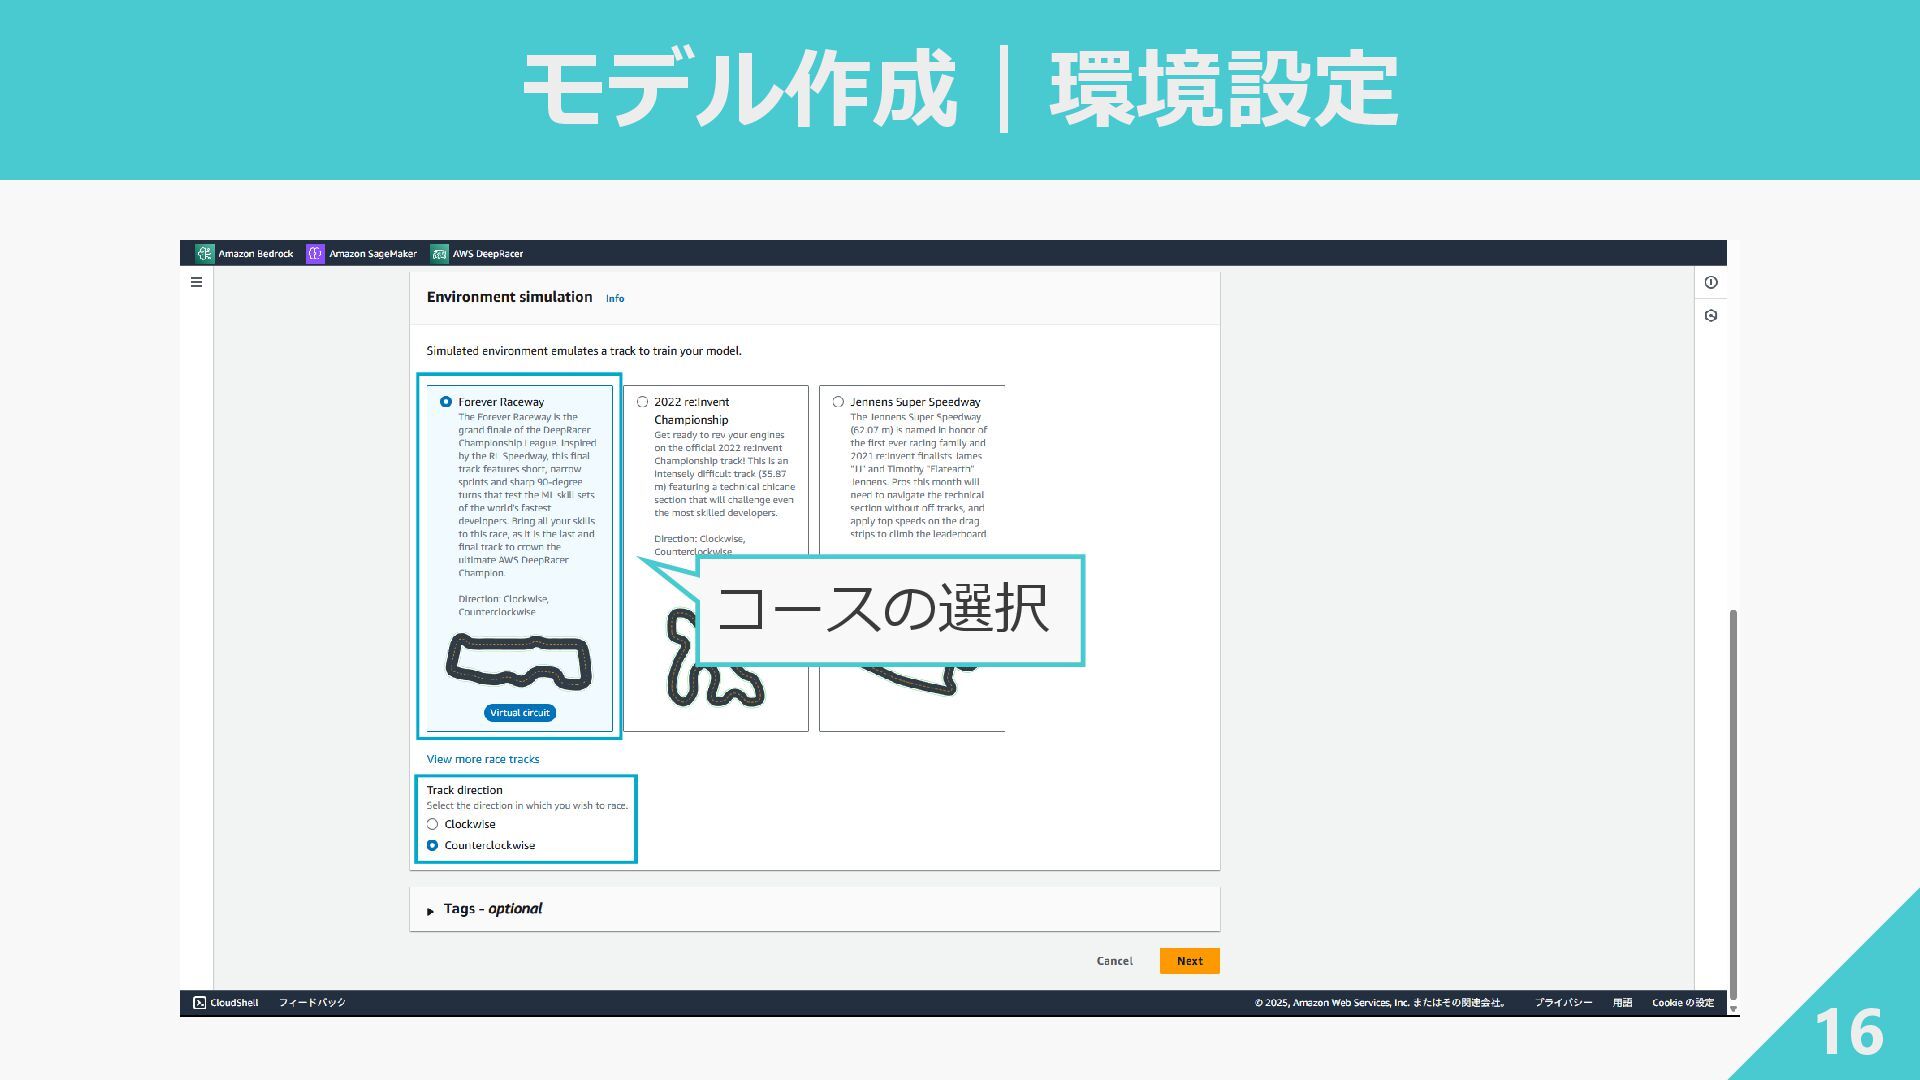
モデル作成|環境設定 16 コースの選択
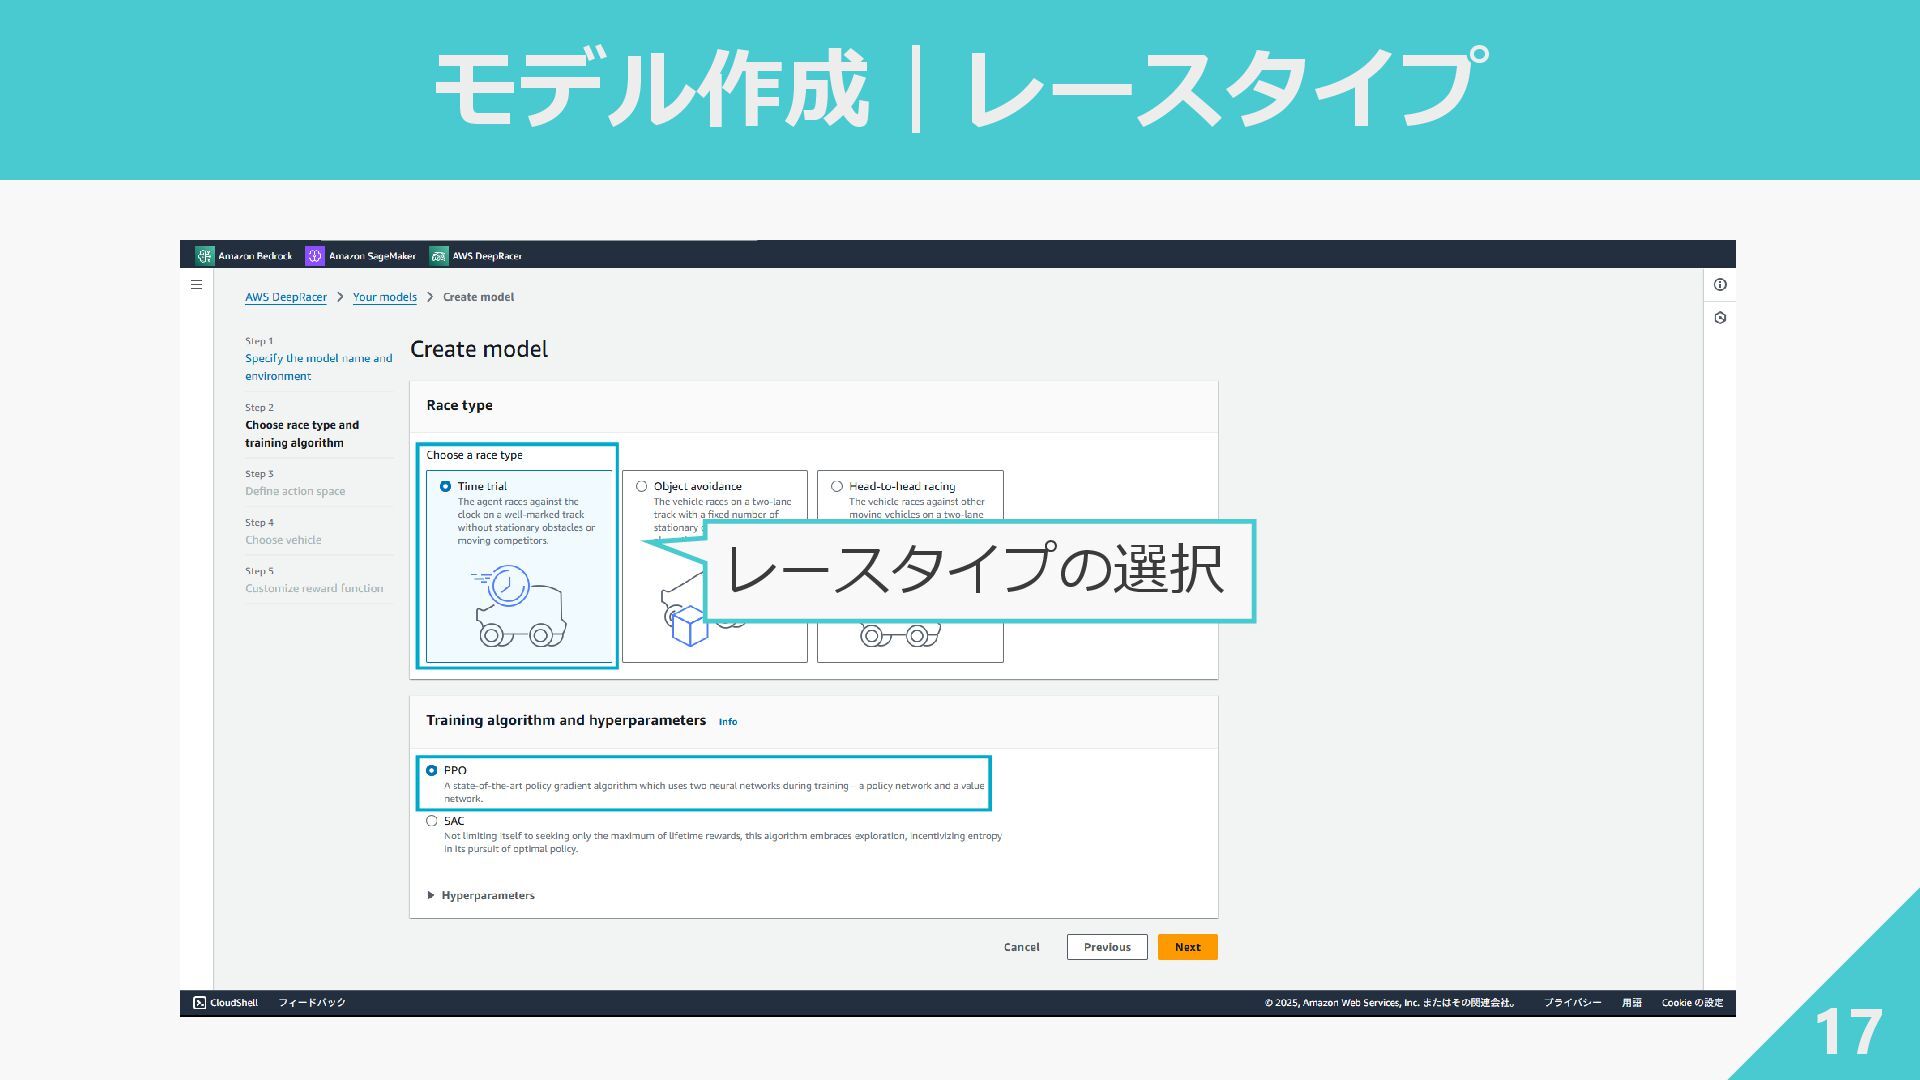
モデル作成|レースタイプ 17 レースタイプの選択
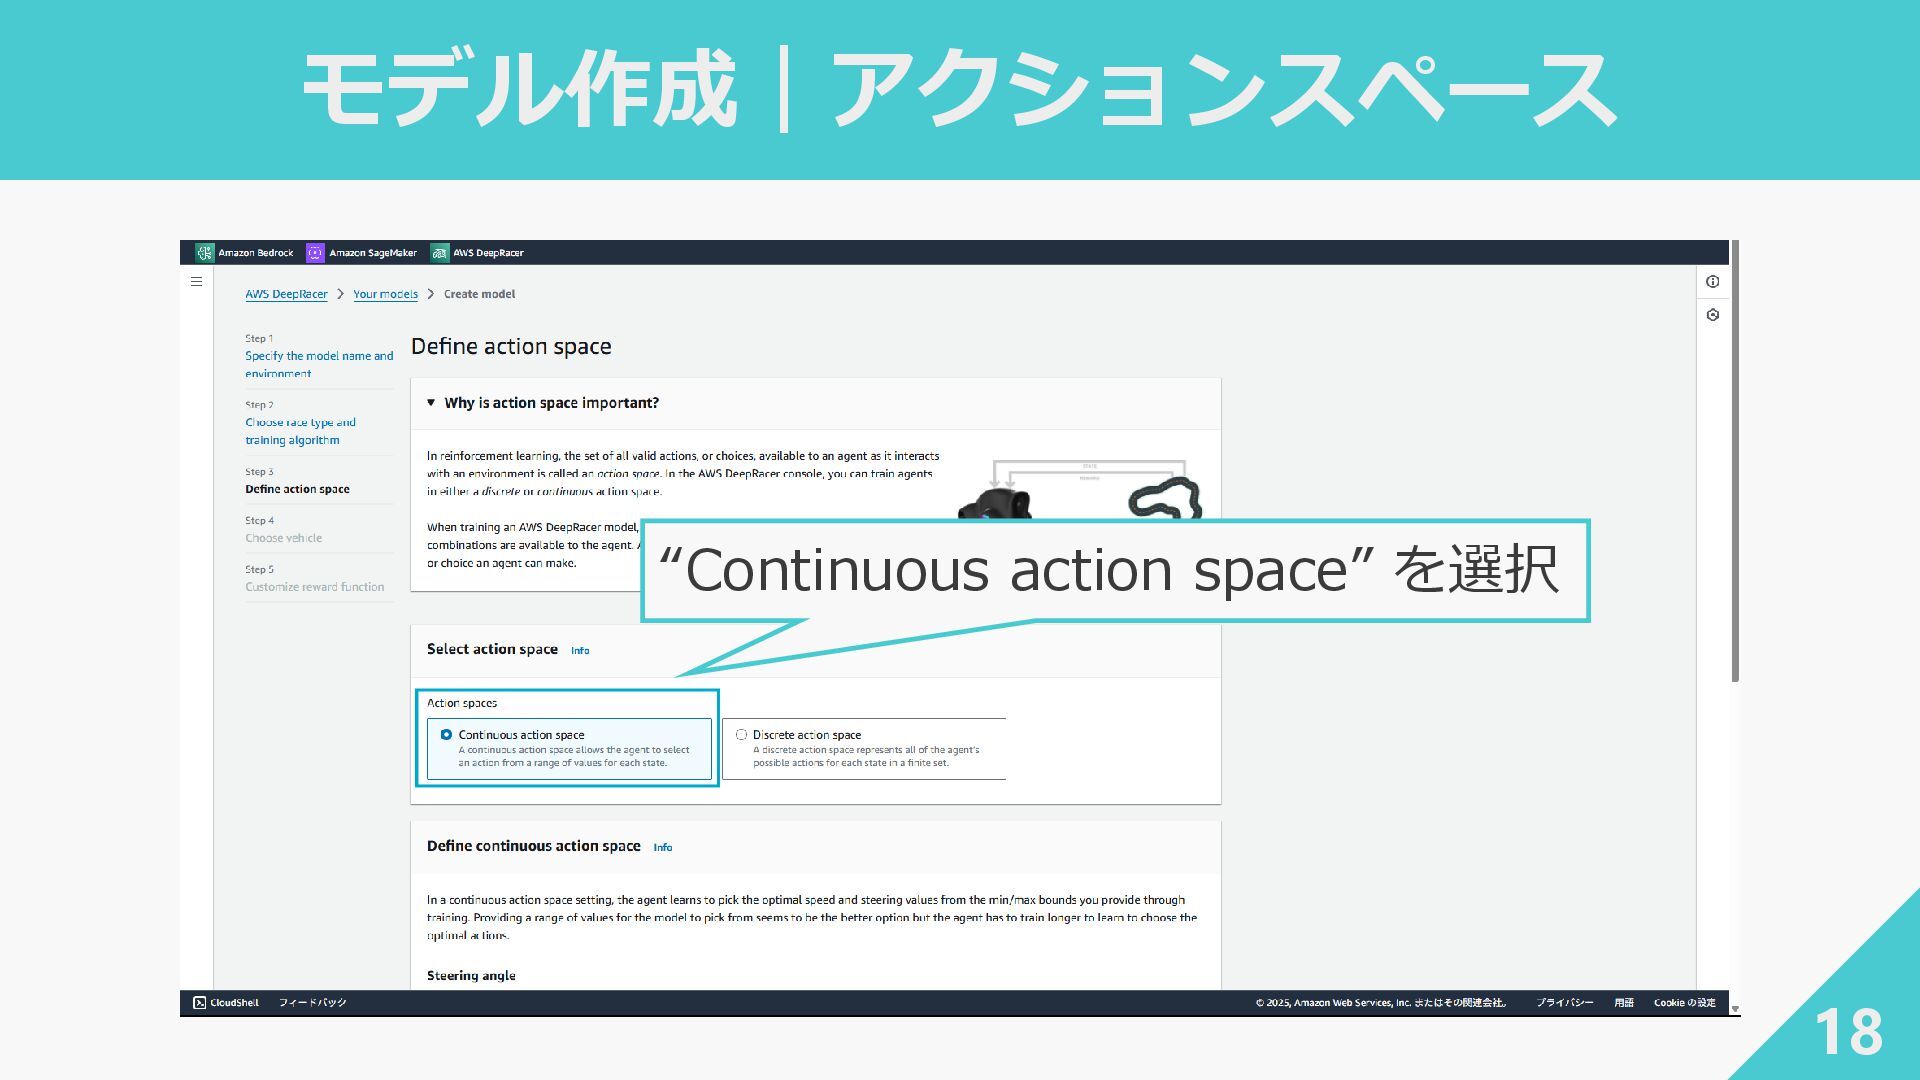
モデル作成|アクションスペース 18 “Continuous action space” を選択
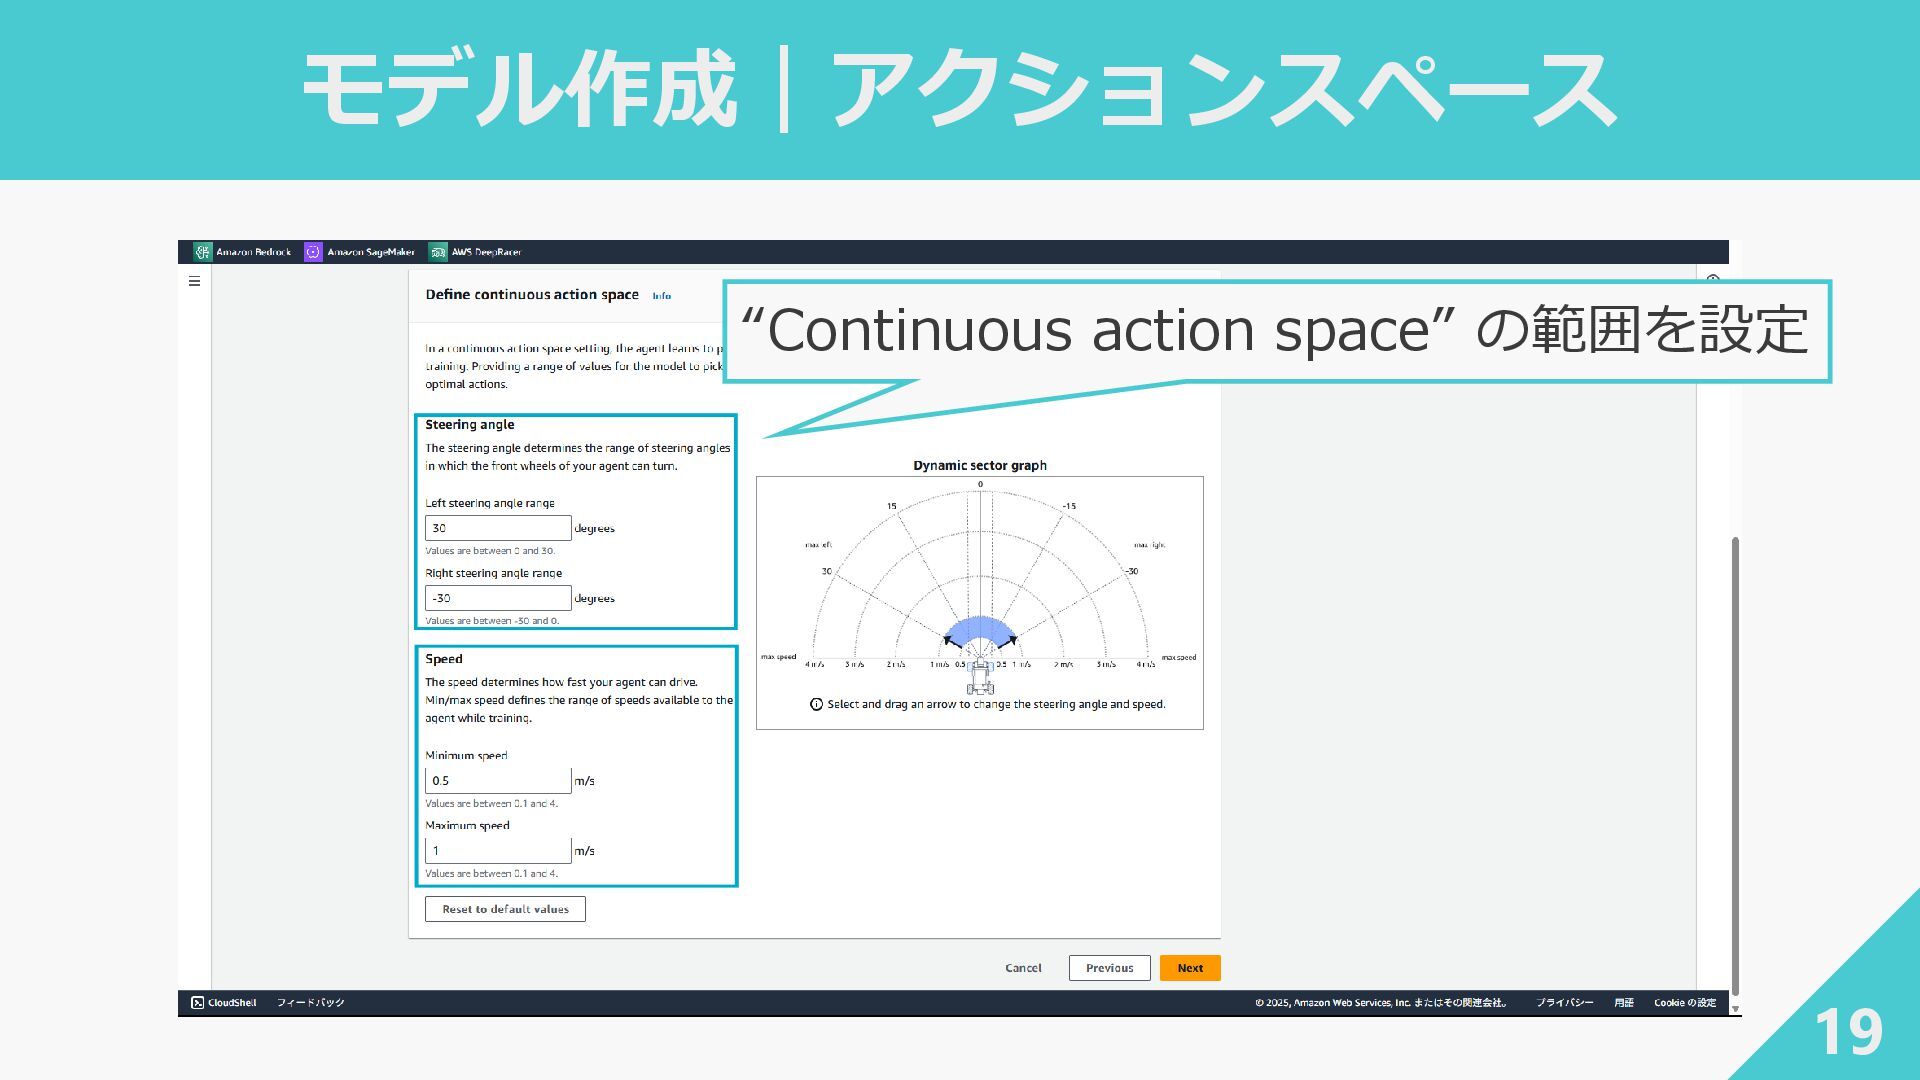
モデル作成|アクションスペース 19 “Continuous action space” の範囲を設定
モデル作成|マシンの設定 20
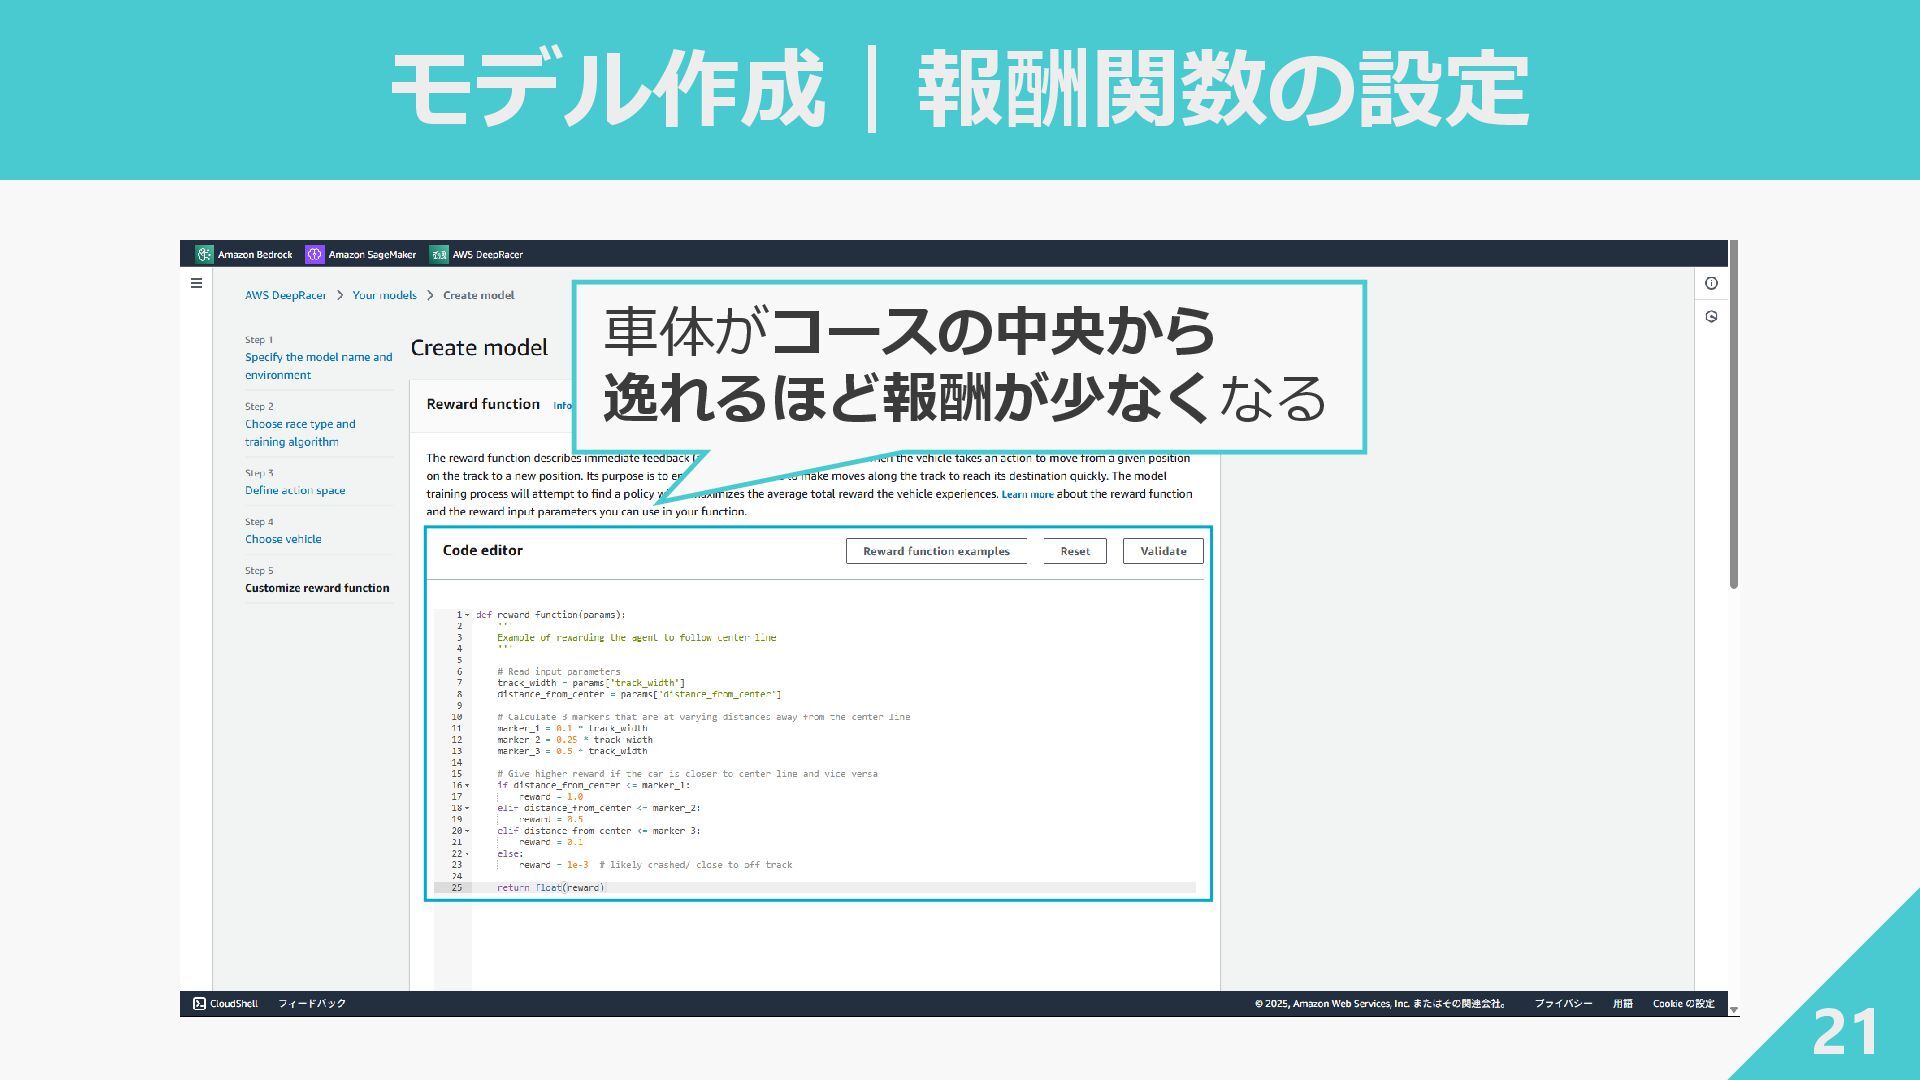
モデル作成|報酬関数の設定 21 車体がコースの中央から 逸れるほど報酬が少なくなる
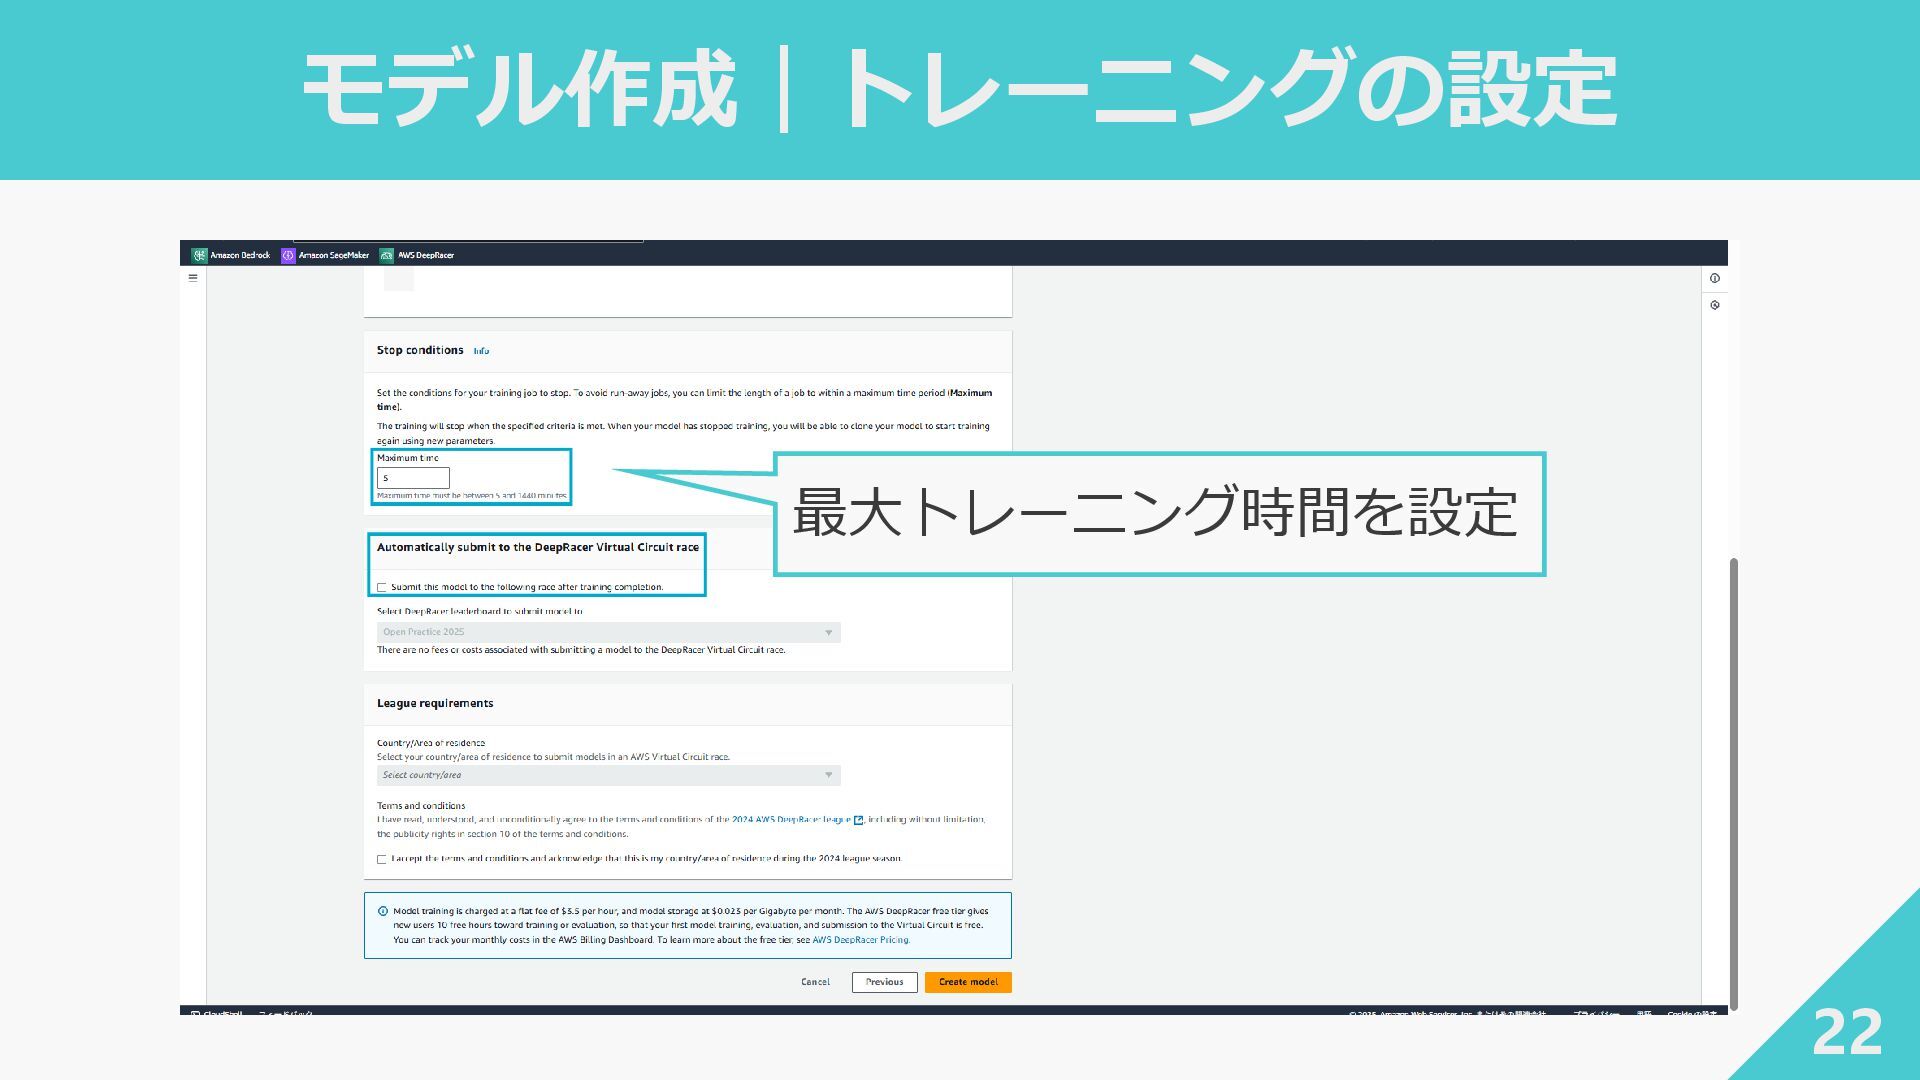
モデル作成|トレーニングの設定 22 最大トレーニング時間を設定
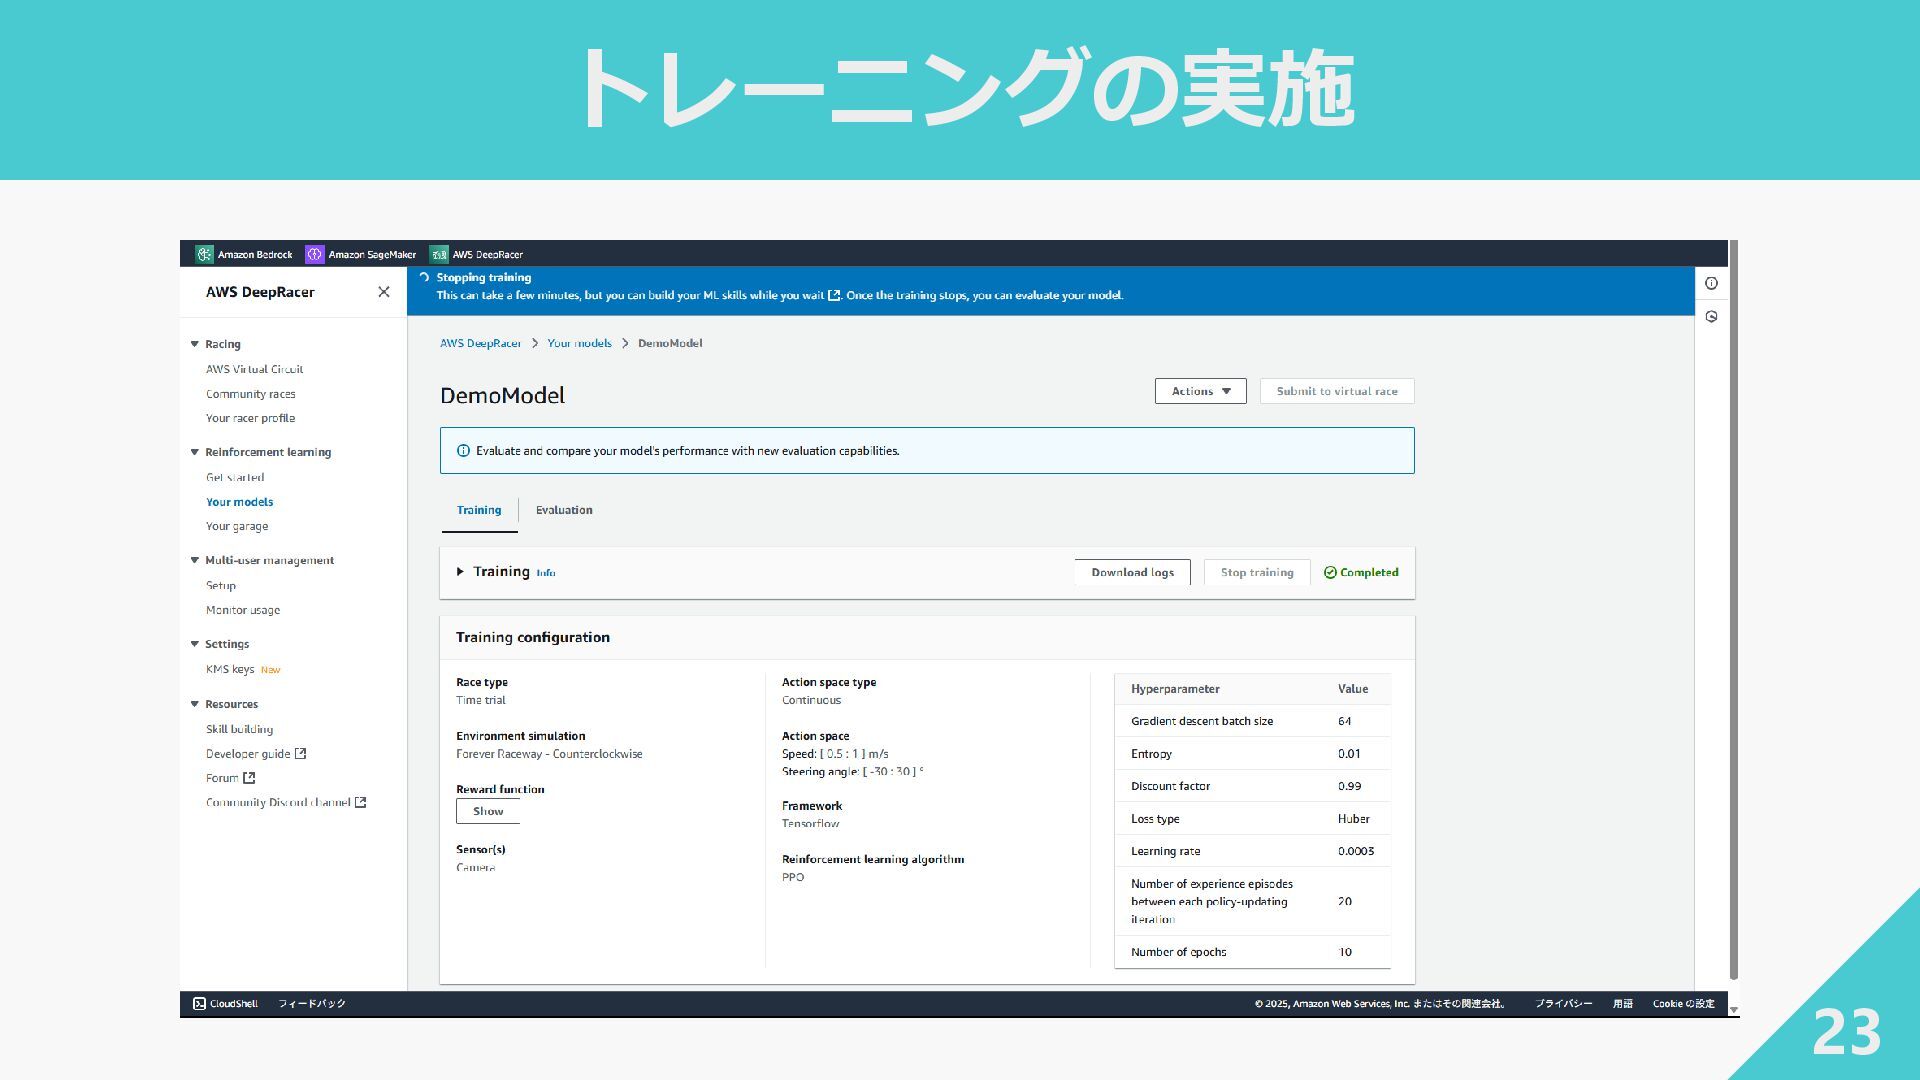
トレーニングの実施 23
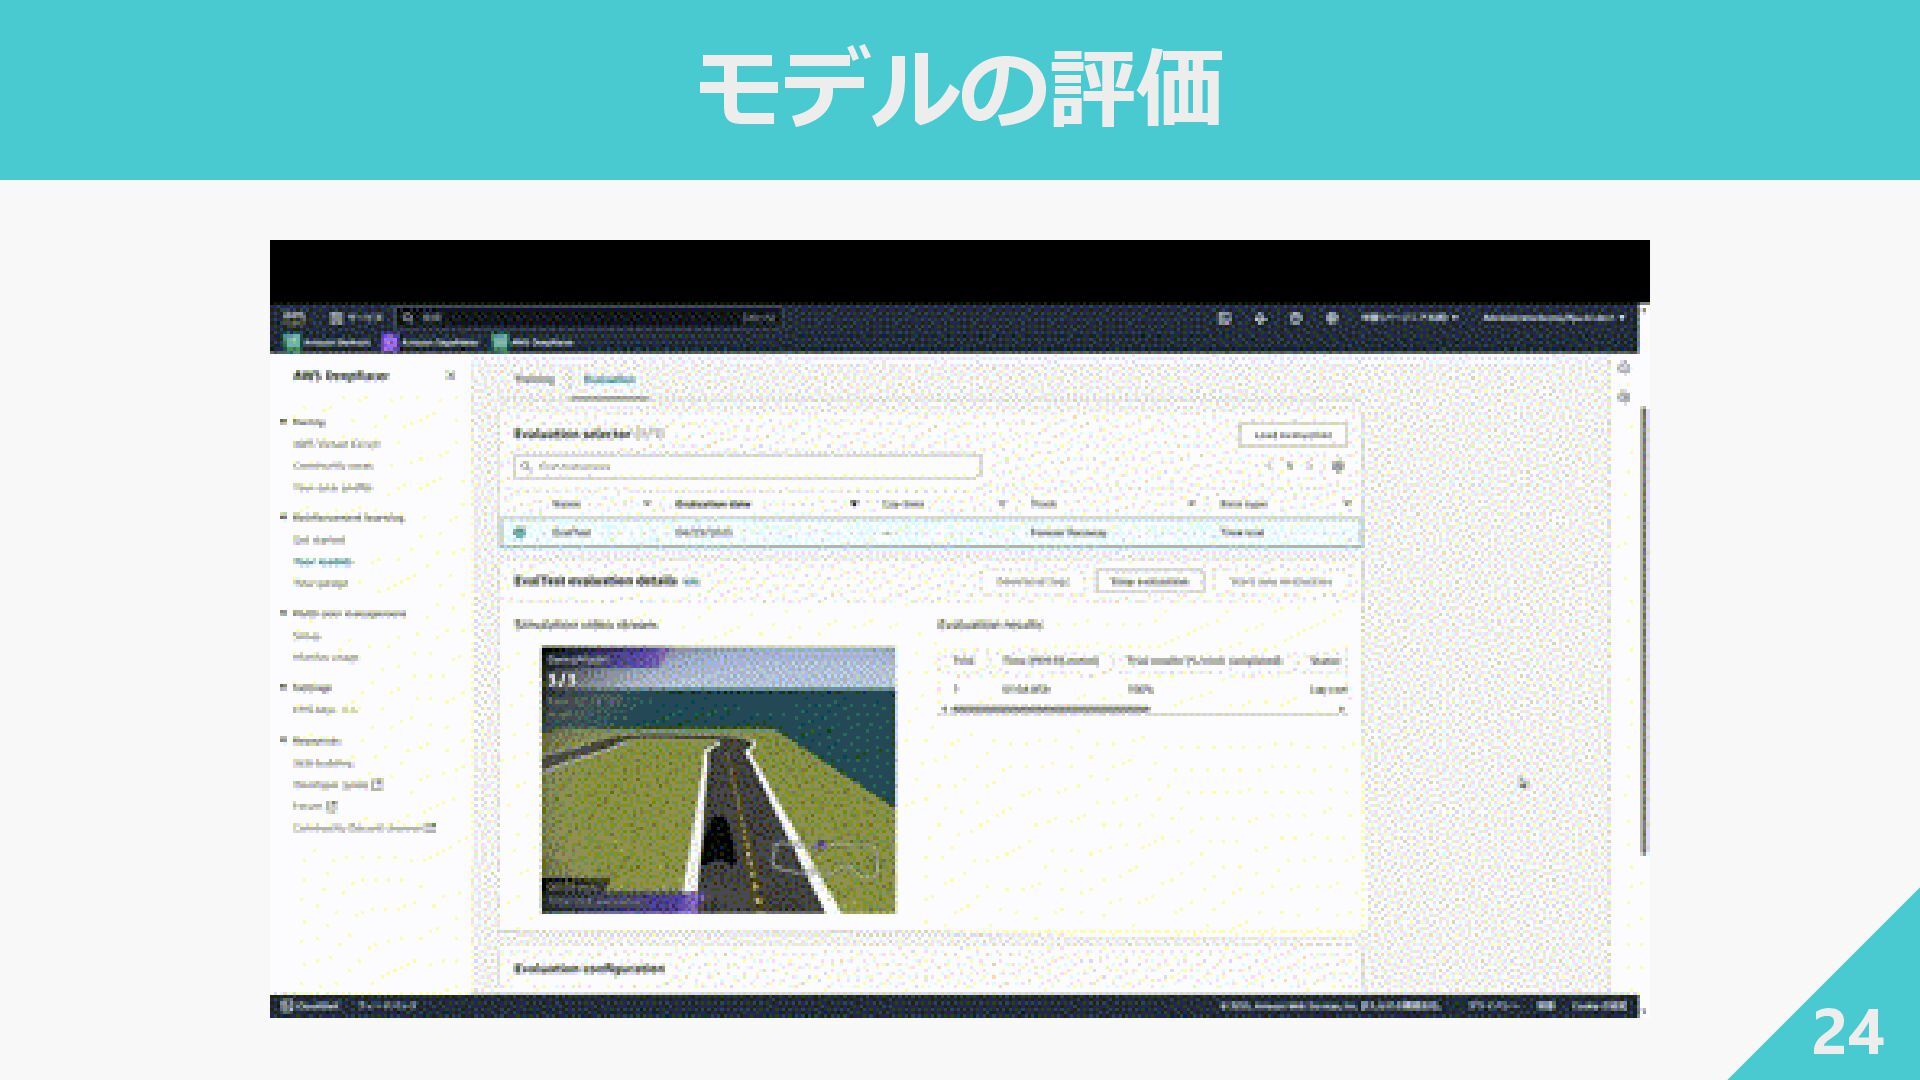
モデルの評価 24
25 報酬関数を改善してみましょう
報酬関数の改善|改善前 26 def reward_function(params): track_width = params['track_width'] distance_from_center = params['distance_from_center']
marker_1 = 0.1 * track_width marker_2 = 0.25 * track_width marker_3 = 0.5 * track_width if distance_from_center <= marker_1: reward = 1.0 elif distance_from_center <= marker_2: reward = 0.5 elif distance_from_center <= marker_3: reward = 0.1 else: reward = 1e-3 return float(reward)
報酬関数の改善|改善前 27 def reward_function(params): track_width = params['track_width'] distance_from_center = params['distance_from_center']
marker_1 = 0.1 * track_width marker_2 = 0.25 * track_width marker_3 = 0.5 * track_width if distance_from_center <= marker_1: reward = 1.0 elif distance_from_center <= marker_2: reward = 0.5 elif distance_from_center <= marker_3: reward = 0.1 else: reward = 1e-3 return float(reward) 車体がコースの中央から 逸れるほど報酬が少なくなる
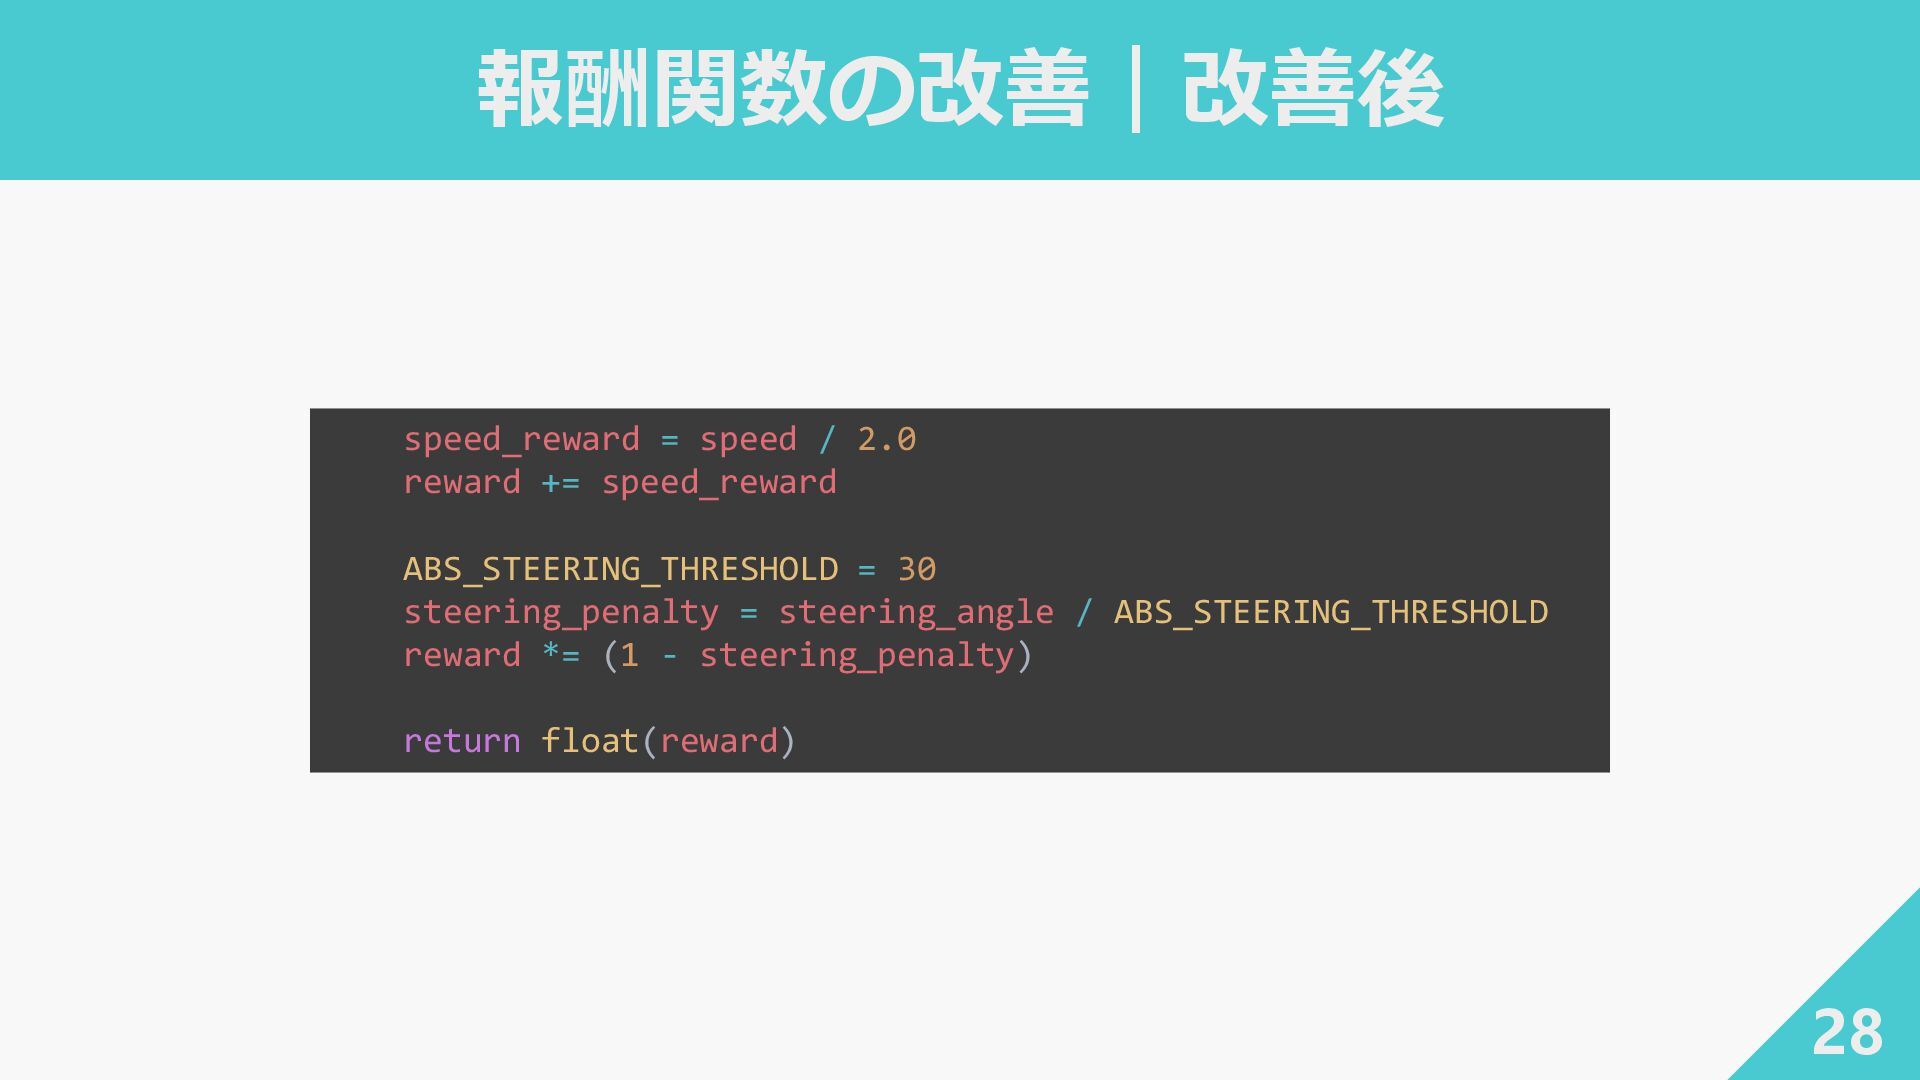
報酬関数の改善|改善後 28 speed_reward = speed / 2.0 reward += speed_reward
ABS_STEERING_THRESHOLD = 30 steering_penalty = steering_angle / ABS_STEERING_THRESHOLD reward *= (1 - steering_penalty) return float(reward)
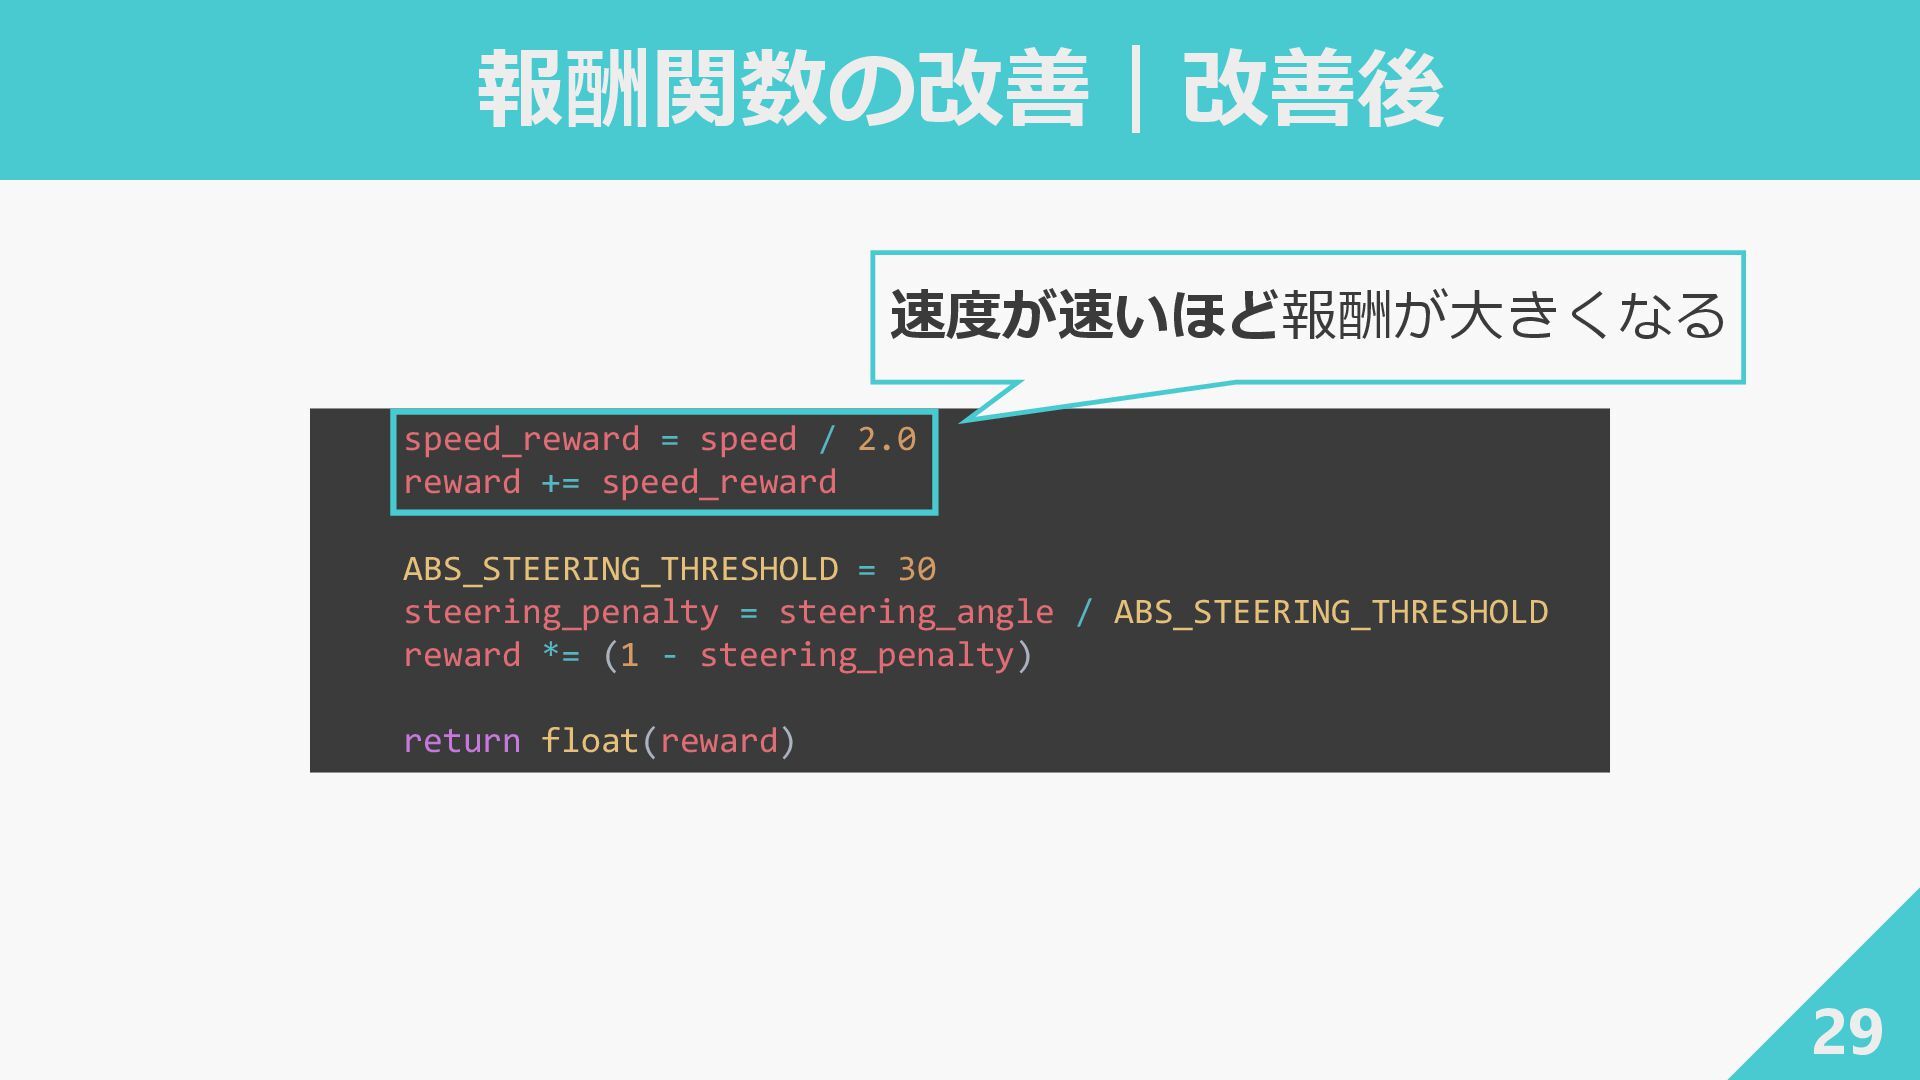
報酬関数の改善|改善後 29 speed_reward = speed / 2.0 reward += speed_reward
ABS_STEERING_THRESHOLD = 30 steering_penalty = steering_angle / ABS_STEERING_THRESHOLD reward *= (1 - steering_penalty) return float(reward) 速度が速いほど報酬が大きくなる
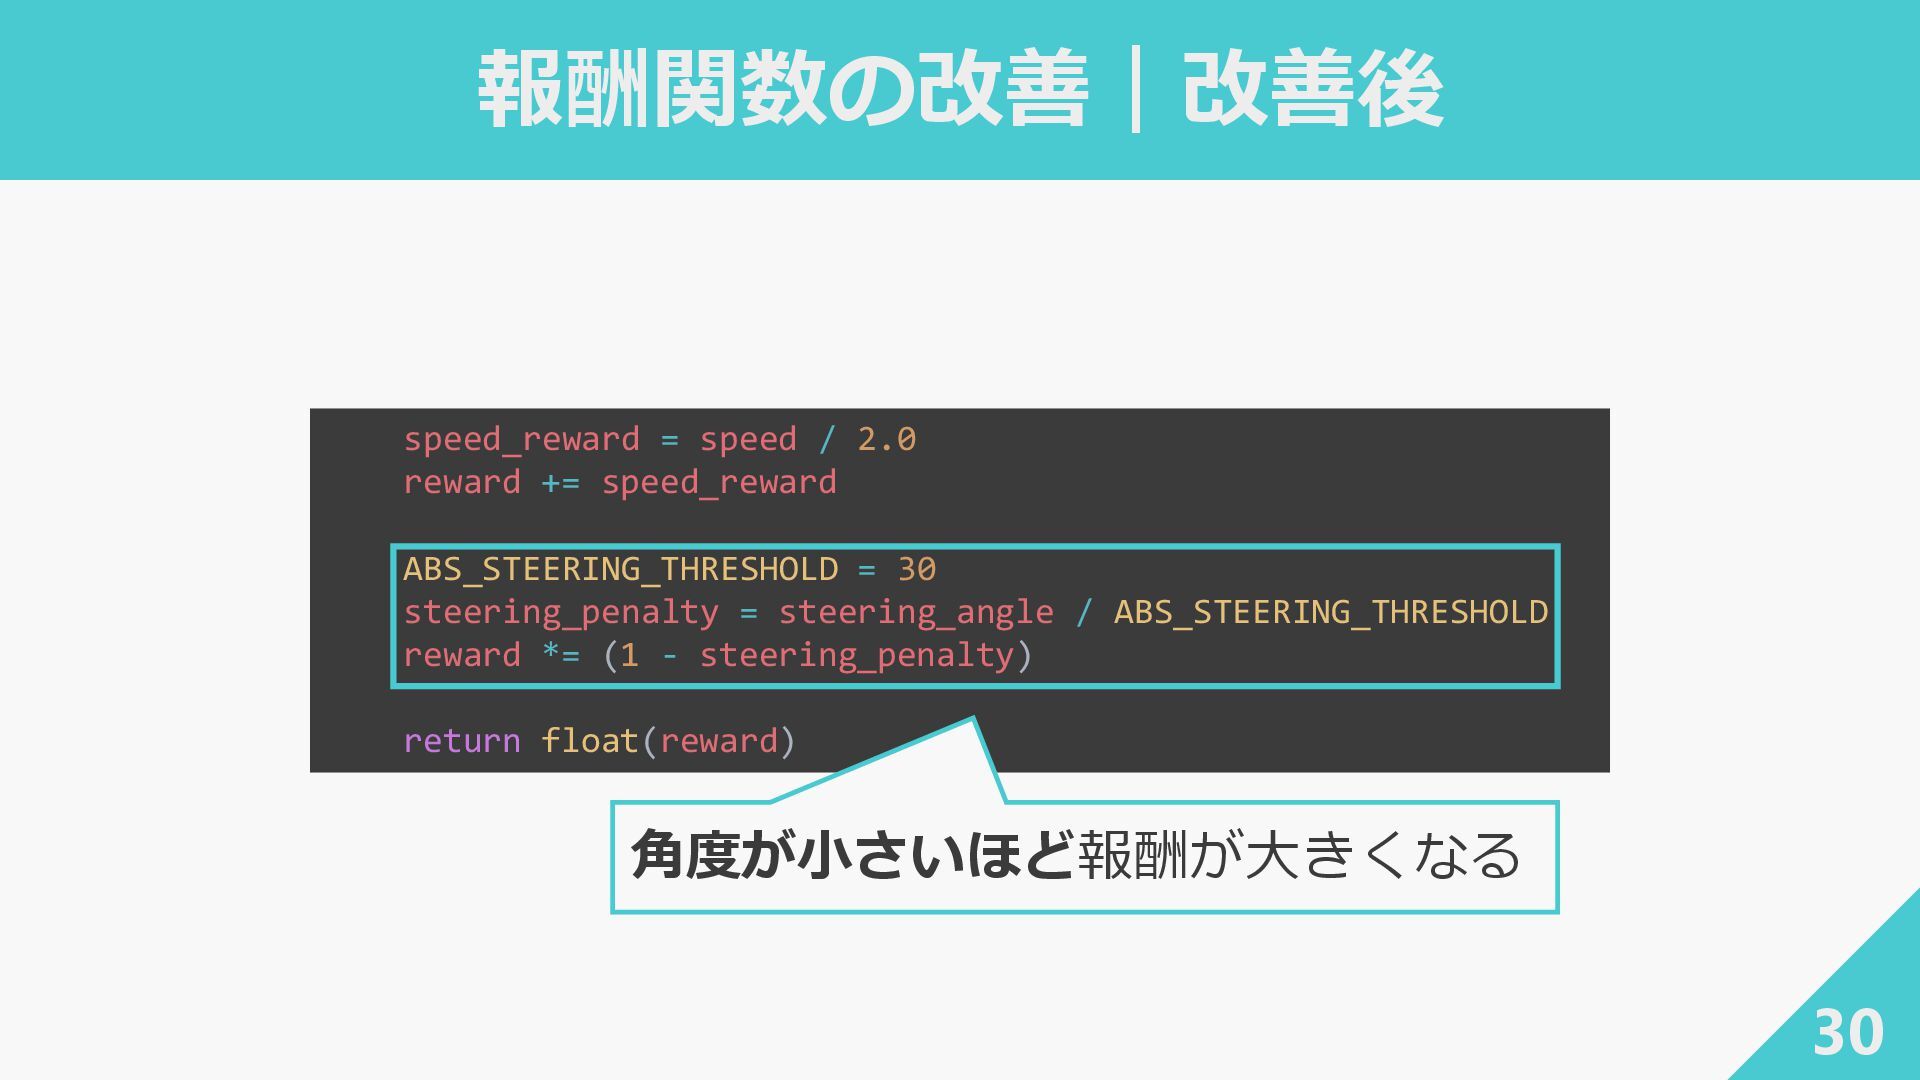
報酬関数の改善|改善後 30 speed_reward = speed / 2.0 reward += speed_reward
ABS_STEERING_THRESHOLD = 30 steering_penalty = steering_angle / ABS_STEERING_THRESHOLD reward *= (1 - steering_penalty) return float(reward) 角度が小さいほど報酬が大きくなる
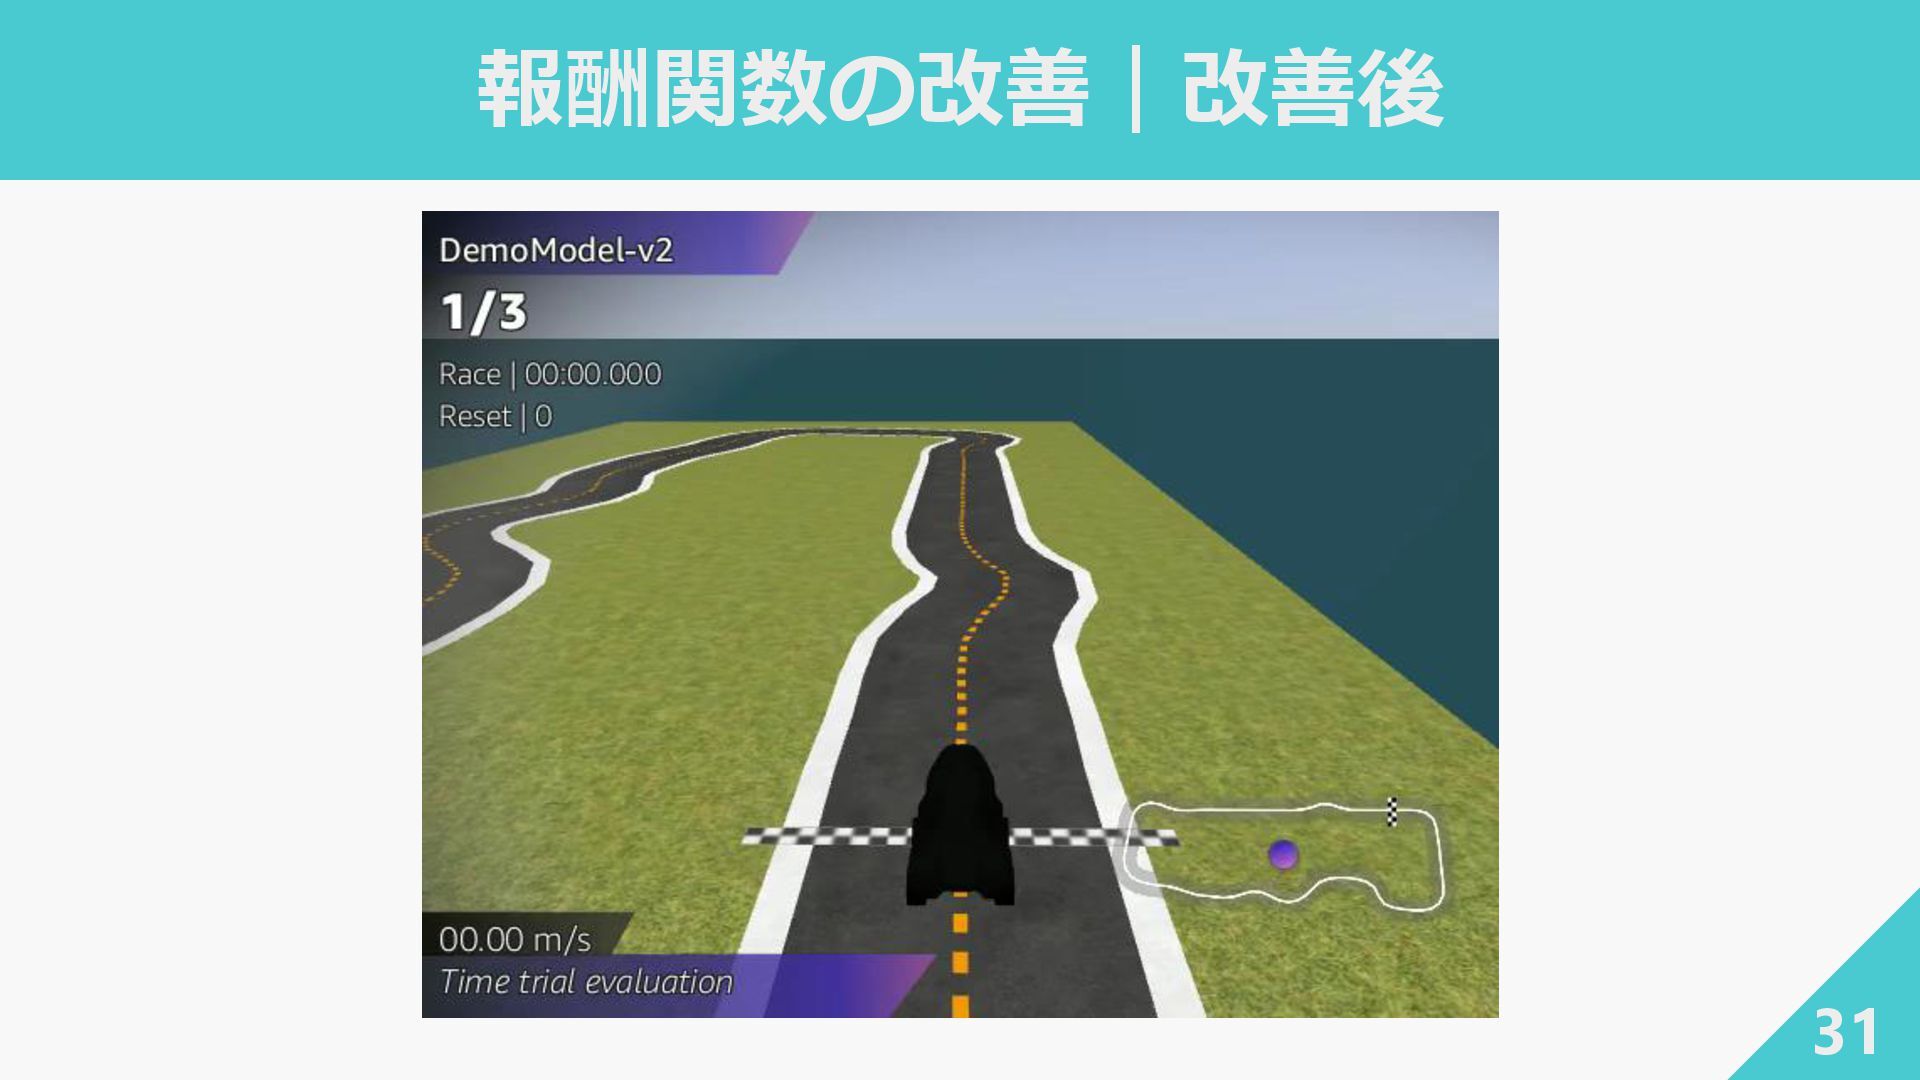
報酬関数の改善|改善後 31
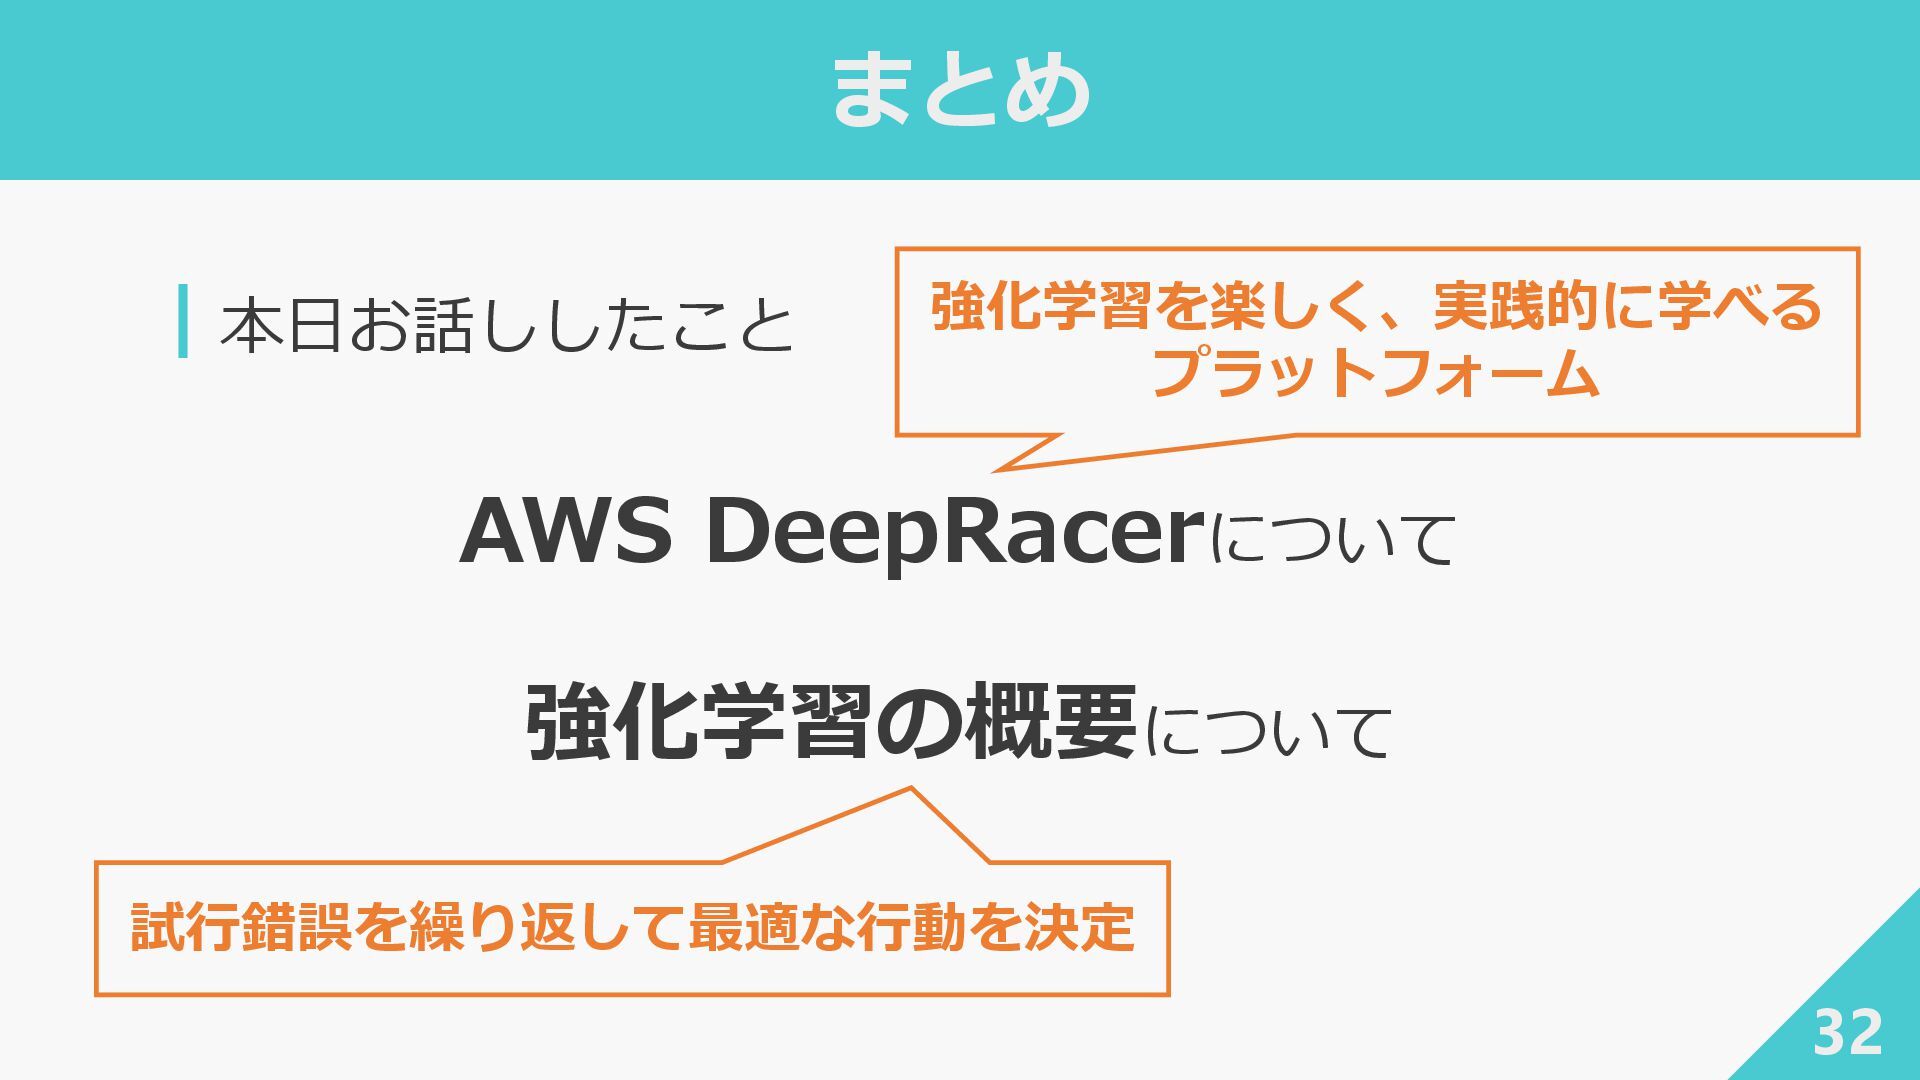
まとめ ┃本日お話ししたこと 32 AWS DeepRacerについて 強化学習の概要について 強化学習を楽しく、実践的に学べる プラットフォーム 試行錯誤を繰り返して最適な行動を決定
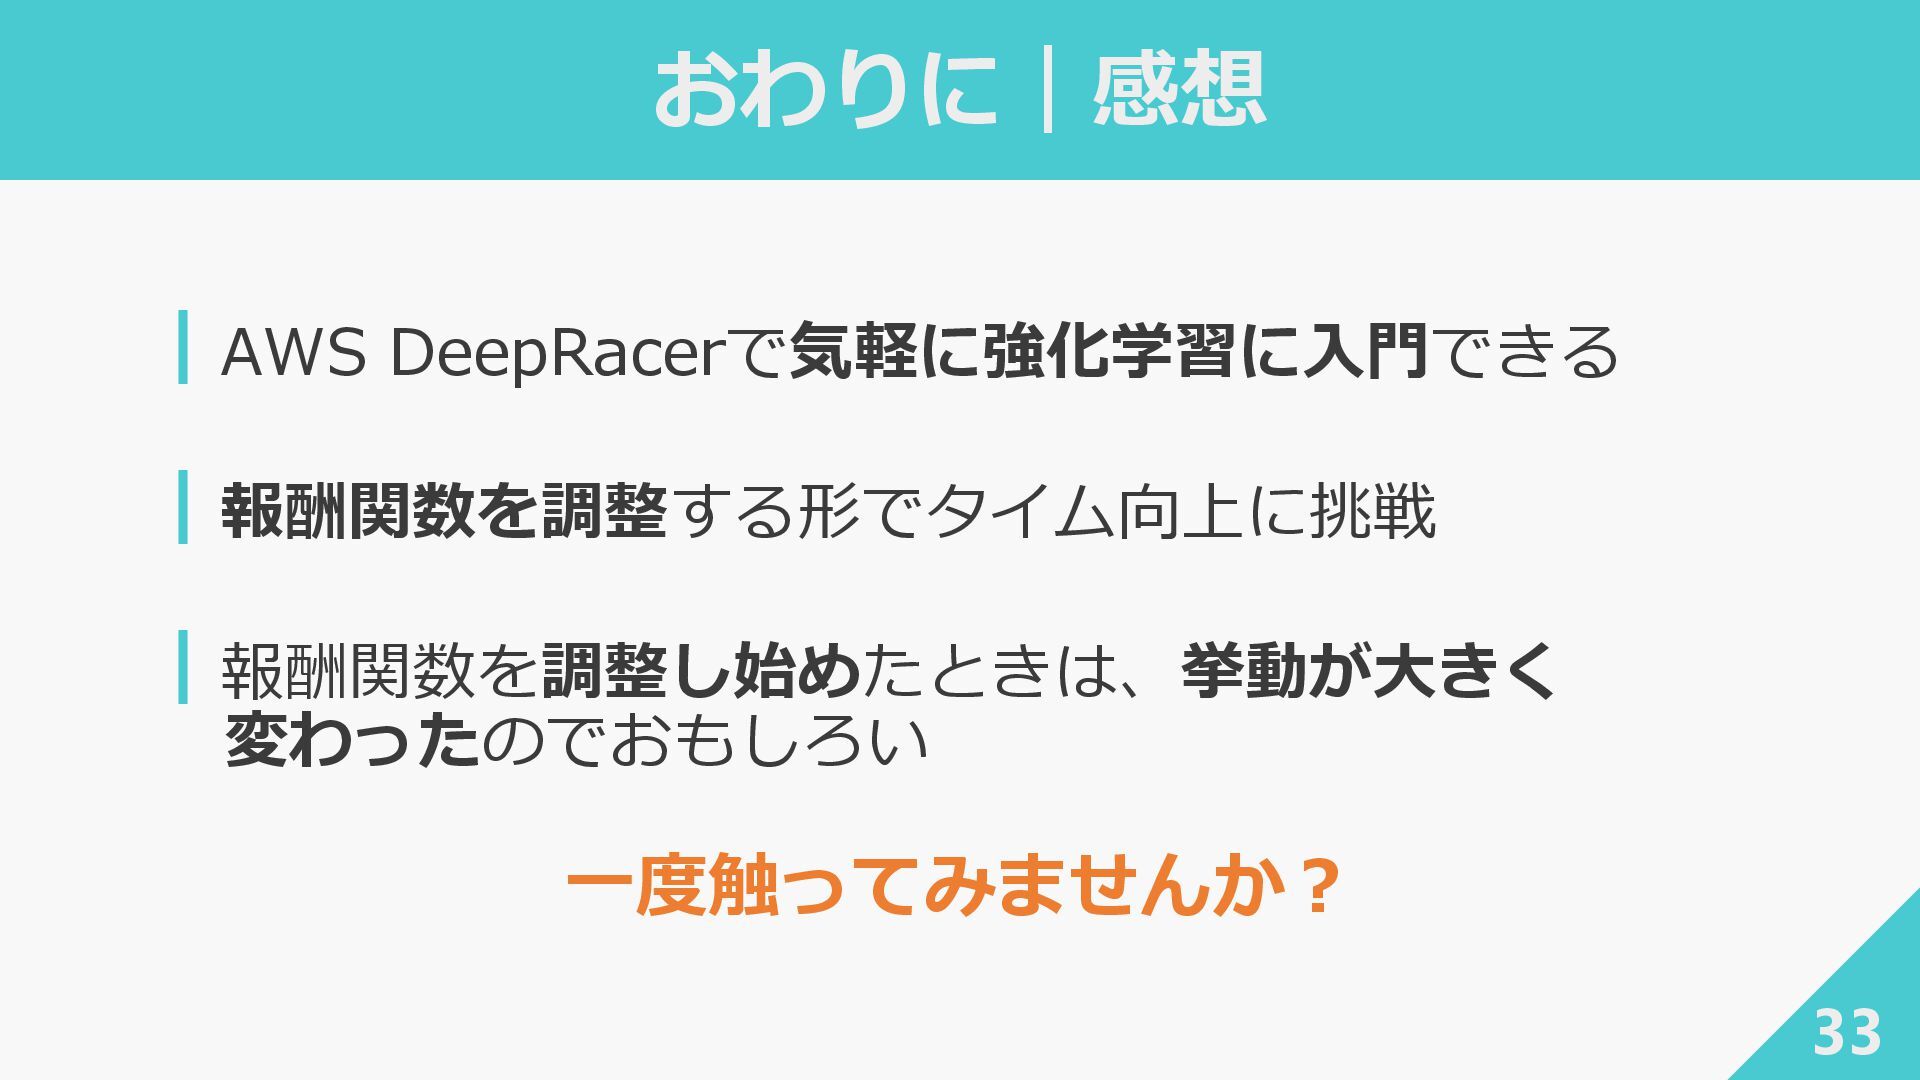
おわりに|感想 33 ┃AWS DeepRacerで気軽に強化学習に入門できる ┃報酬関数を調整する形でタイム向上に挑戦 ┃報酬関数を調整し始めたときは、挙動が大きく 変わったのでおもしろい 一度触ってみませんか?


 ryuki0947
 nonsquared
 irinanazarova
 jacobtomlinson
 twada
 kastner
 skipperchong
 lynnandtonic
 lara
 scottboms
 lauravandoore
 tapps
 ivargrimstad