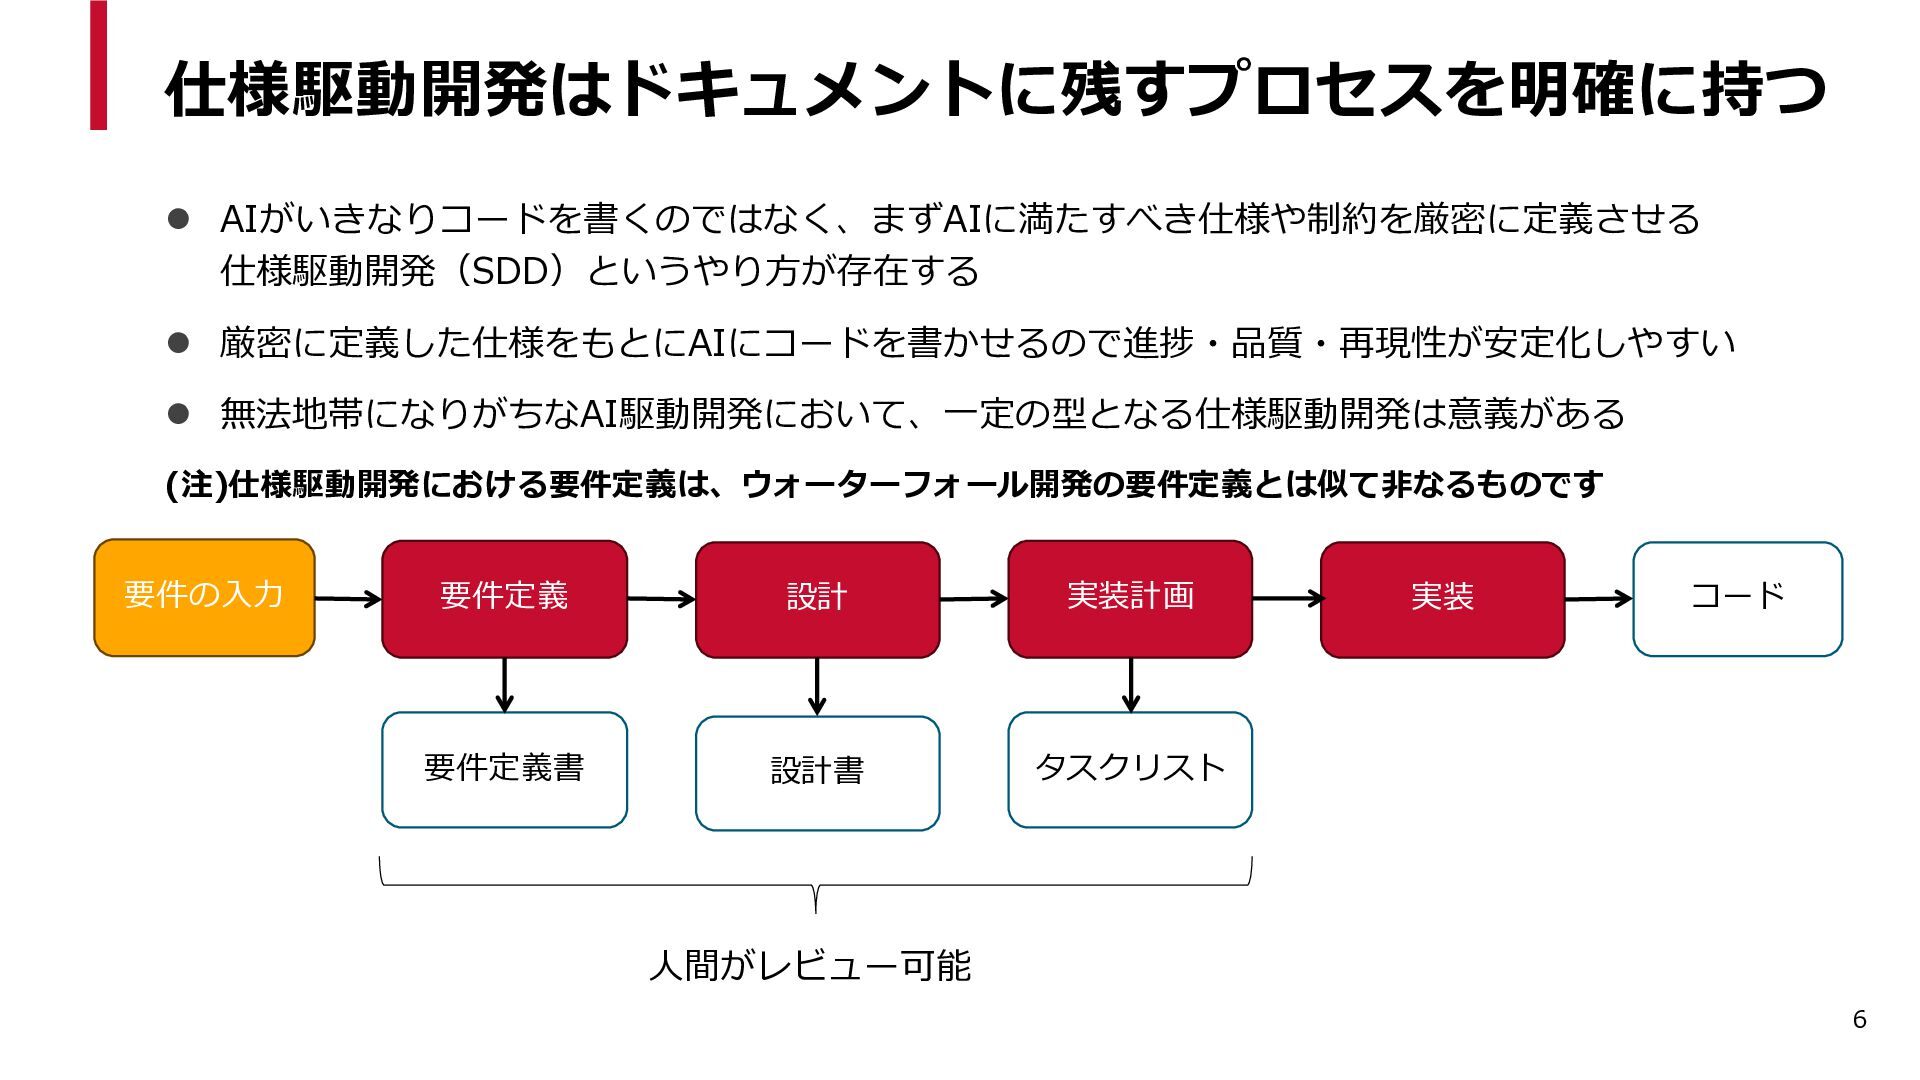
Share
Embed
Transcript
23 slides
-
Speaker Introduction 氏名:兼安 聡 所属:株式会社サーバーワークス アプリケーションサービス本部 在住:広島 担当: PM、SM、DevOps、仕様駆動開発 SNS(X):@satoshi256kbyte
• • • • • • 2026 Japan AWS Ambassadors 2024-26 Japan AWS Top Engineers 2024-26 Japan AWS All Certifications Engineers 2025-26 AWS Community Builders 認定スクラムマスター PMP 2 -
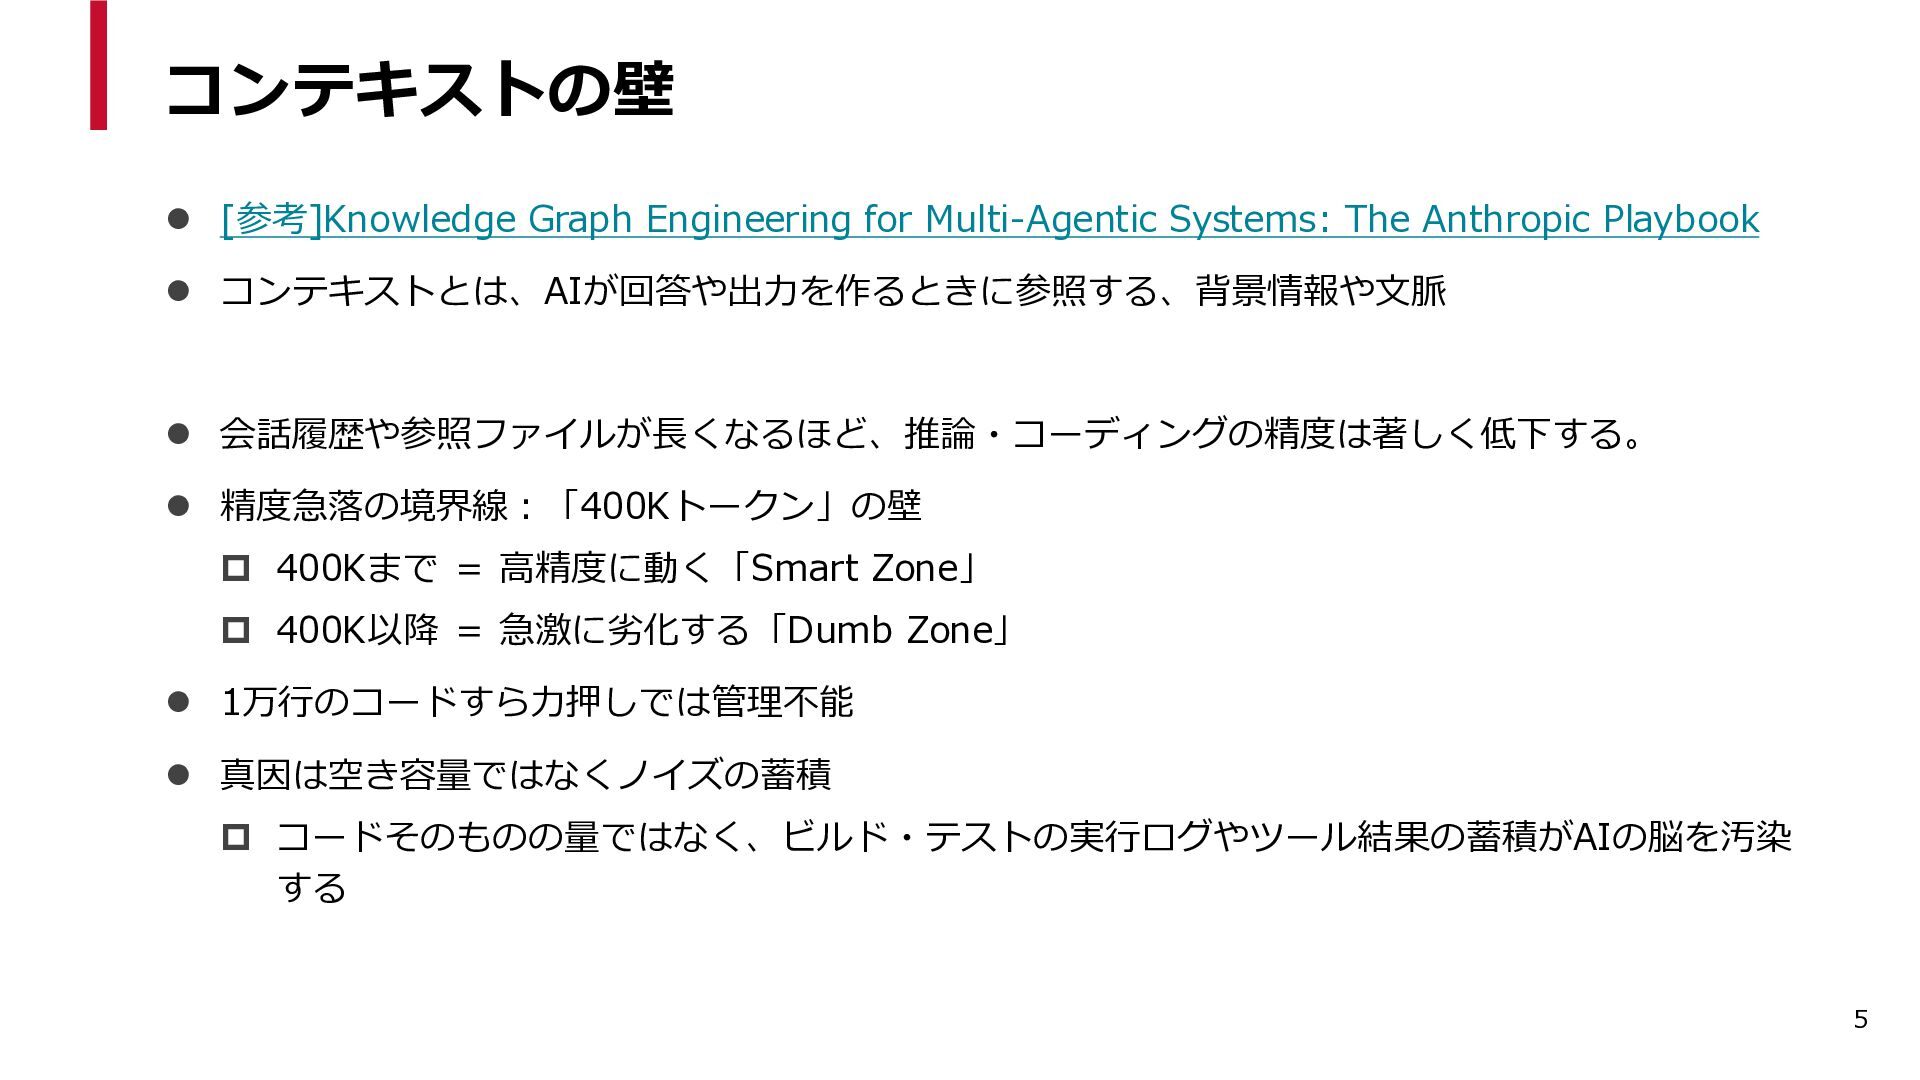
コンテキストの壁 ⚫ [参考]Knowledge Graph Engineering for Multi-Agentic Systems: The Anthropic
Playbook ⚫ コンテキストとは、AIが回答や出力を作るときに参照する、背景情報や文脈 ⚫ 会話履歴や参照ファイルが長くなるほど、推論・コーディングの精度は著しく低下する。 ⚫ 1万行のコードすら力押しでは管理不能 ⚫ 真因は空き容量ではなくノイズの蓄積 コードそのものの量ではなく、 ビルド・テストの実行ログやツール結果の蓄積がAIの脳を汚染する ⚫ 精度急落の境界線:「400Kトークン」の壁 400Kまで = 高精度に動く「Smart Zone」 400K以降 = 急激に劣化する「Dumb Zone」 5 -
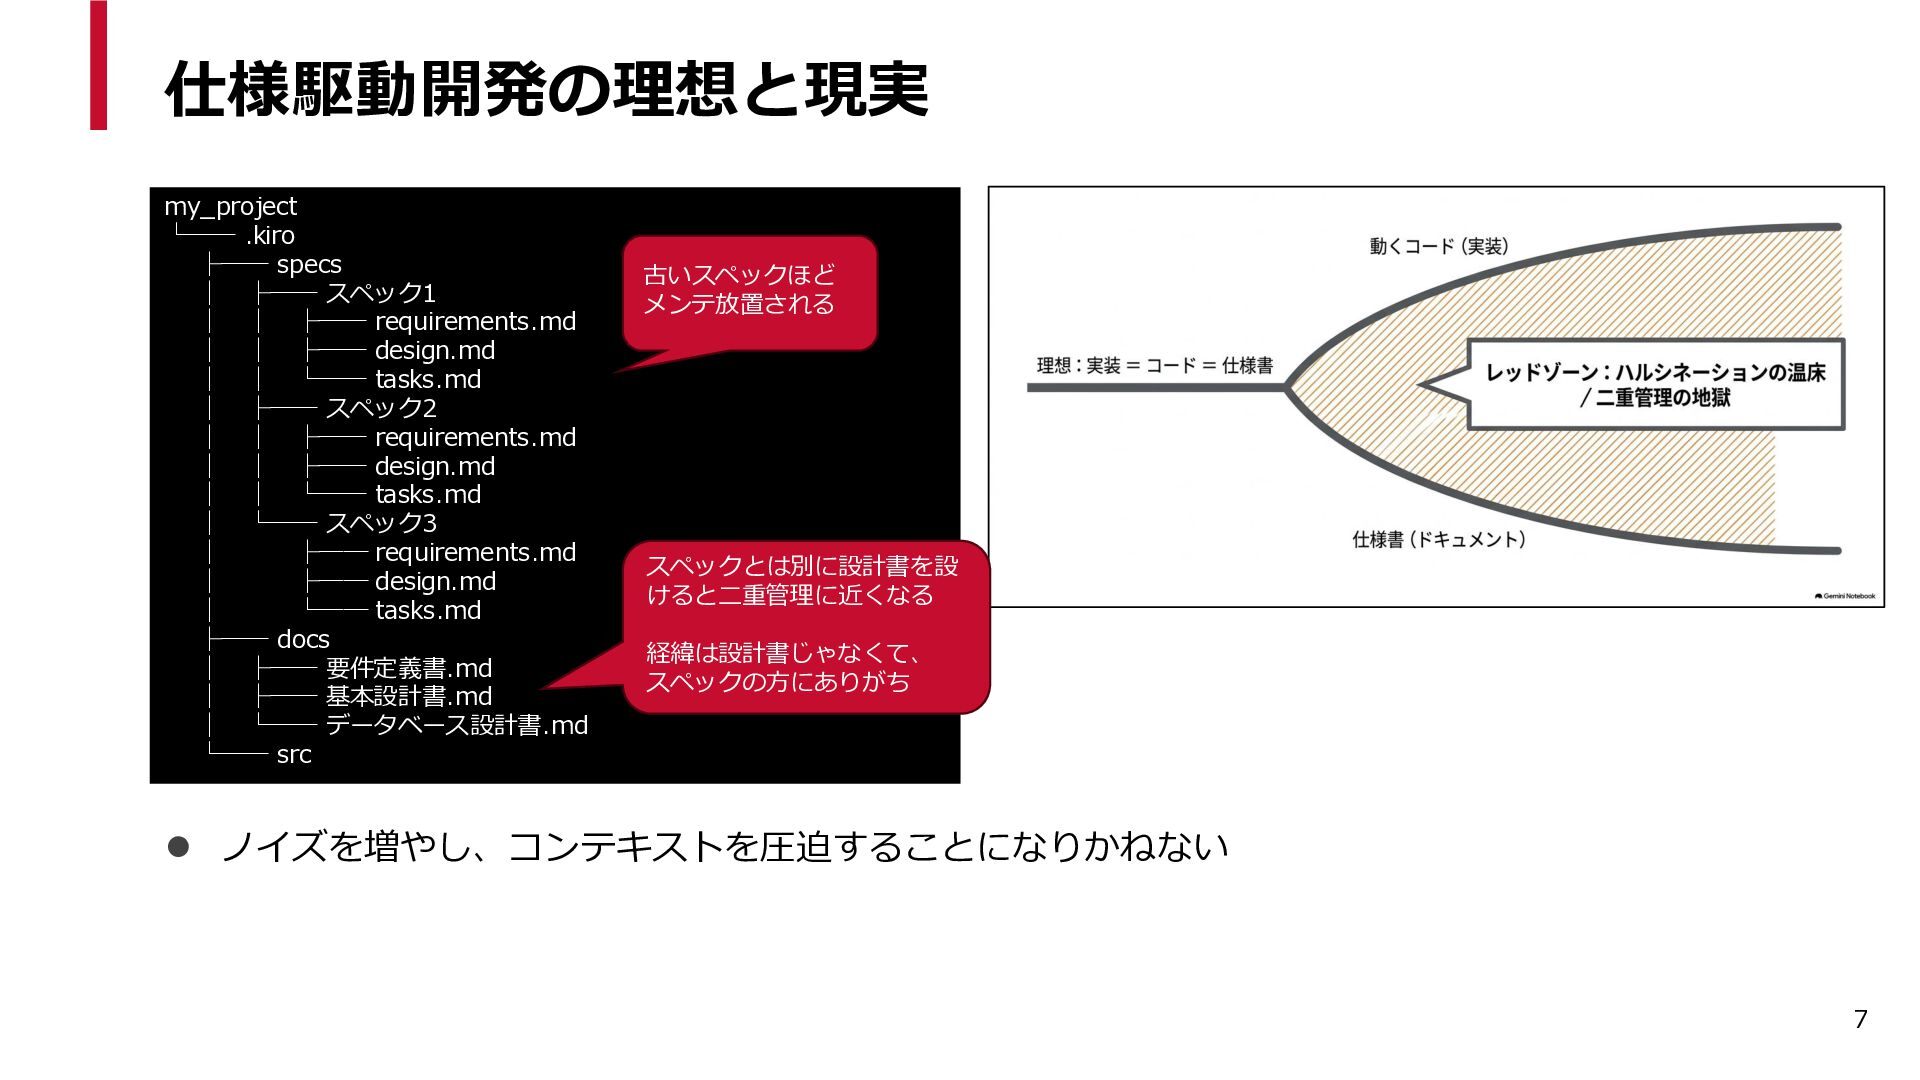
仕様駆動開発の理想と現実 my_project └── .kiro ├── specs │ ├── スペック1 │
│ ├── requirements.md │ │ ├── design.md │ │ └── tasks.md │ ├── スペック2 │ │ ├── requirements.md │ │ ├── design.md │ │ └── tasks.md │ └── スペック3 │ ├── requirements.md │ ├── design.md │ └── tasks.md ├── docs │ ├── 要件定義書.md │ ├── 基本設計書.md │ └── データベース設計書.md └── src 古いスペックほど メンテ放置される スペックとは別に設計書を設 けると二重管理に近くなる 経緯は設計書じゃなくて、 スペックの方にありがち ⚫ ノイズを増やし、コンテキストを圧迫することになりかねない 7 -
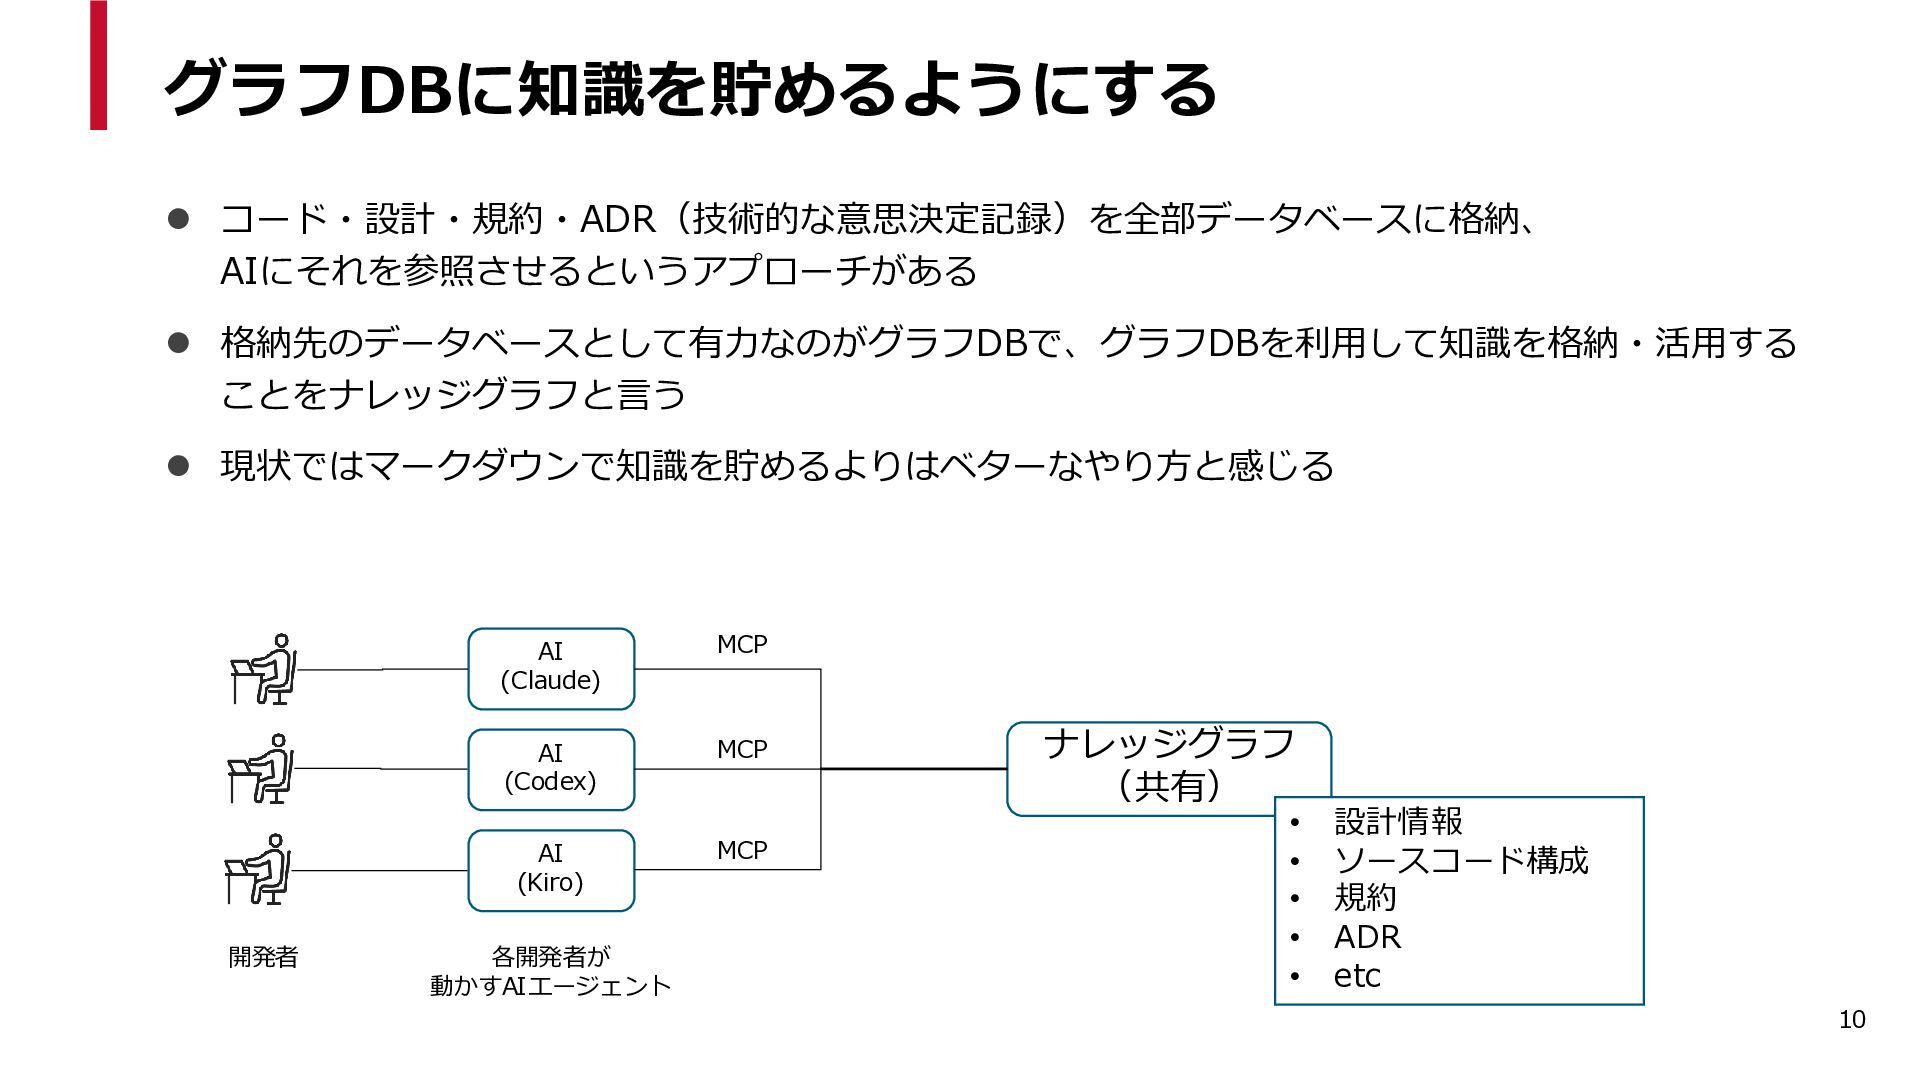
グラフDBに知識を貯めるようにする ⚫ コード・設計・規約・ADR(技術的な意思決定記録)を全部データベースに格納、 AIにそれを参照させるというアプローチがある ⚫ 格納先のデータベースとして有力なのがグラフDBで、グラフDBを利用して知識を格納・活用する ことをナレッジグラフと言う ⚫ 現状ではマークダウンで知識を貯めるよりはベターなやり方と感じる 開発者
AI (Claude) MCP AI (Codex) MCP AI (Kiro) MCP 各開発者が 動かすAIエージェント ナレッジグラフ (共有) • • • • • 設計情報 ソースコード構成 規約 ADR etc 10 -
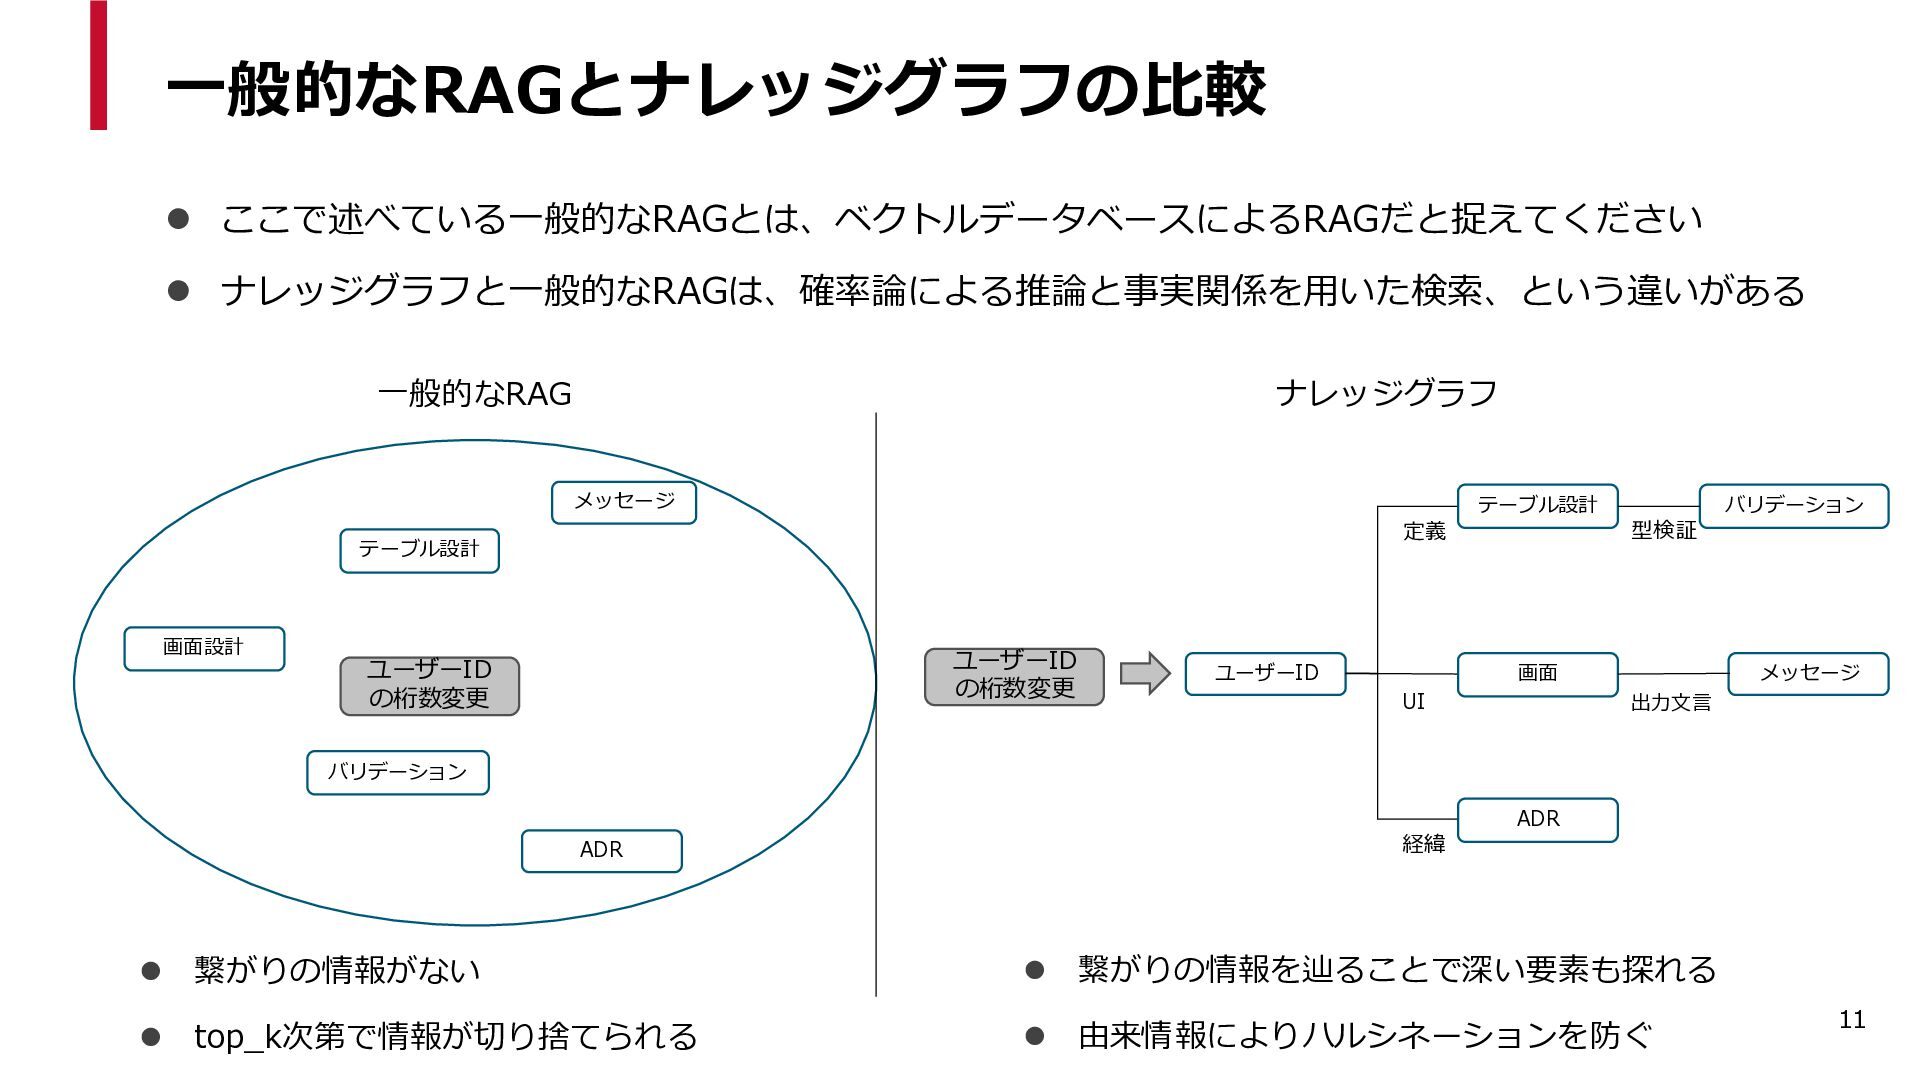
一般的なRAGとナレッジグラフの比較 ⚫ ここで述べている一般的なRAGとは、ベクトルデータベースによるRAGだと捉えてください ⚫ 一般的なRAGとナレッジグラフとの違いは、確率論による推論と事実関係を用いた検索 一般的なRAG top_k=3の場合 ナレッジグラフ テーブル設計 ③テーブル設計
②画面設計 ⑤メッセージ (切り捨て) ユーザーID の桁数変更 ユーザーID の桁数変更 ユーザーID バリデーション 型検証 定義 メッセージ 画面 UI 出力文言 ①バリデーション ADR ④ADR (切り捨て) 経緯 ⚫ 距離で探す ⚫ 繋がりで探す ⚫ top_k次第で情報が切り捨てられる ⚫ 由来情報によりハルシネーションを防ぐ 11 -
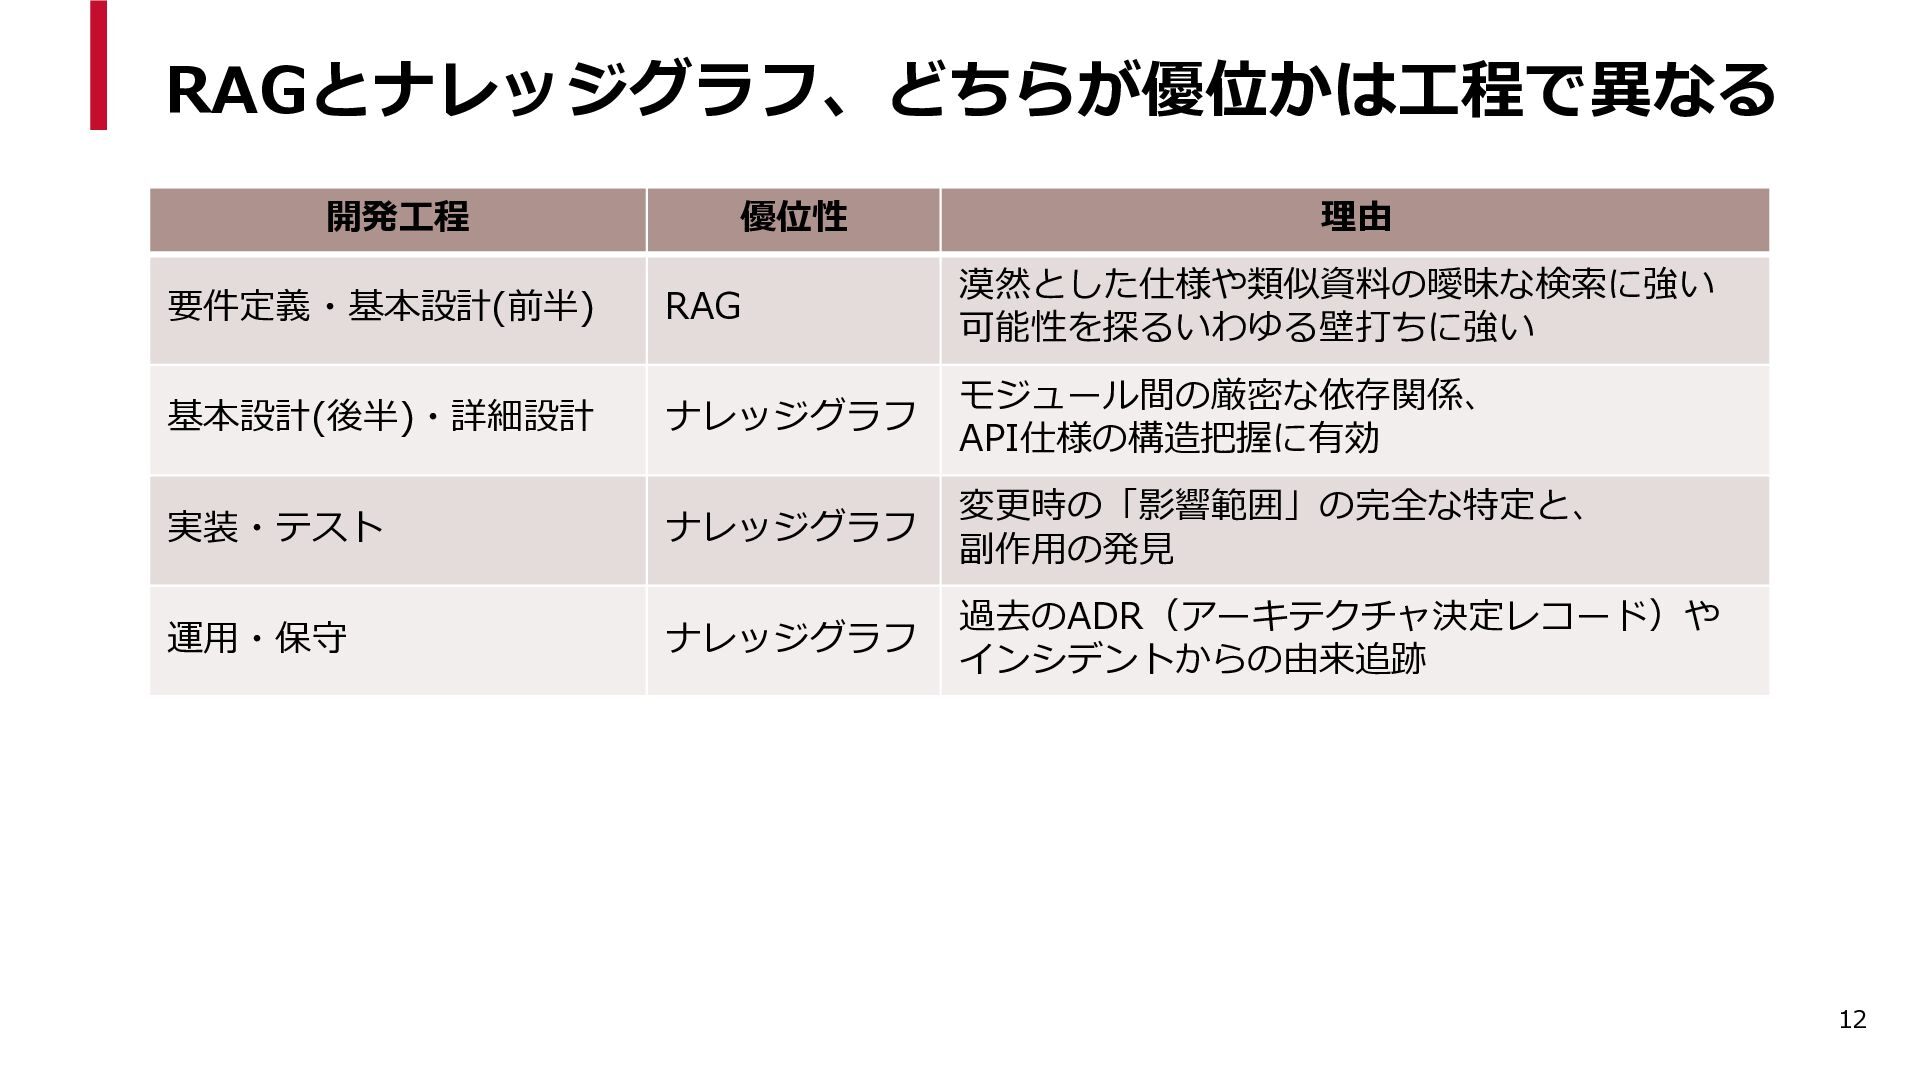
RAGとナレッジグラフ、どちらが優位かは工程で異なる 開発工程 優位性 理由 要件定義・基本設計(前半) RAG 漠然とした仕様や類似資料の曖昧な検索に強い 可能性を探るいわゆる壁打ちに強い 基本設計(後半)・詳細設計 ナレッジグラフ
モジュール間の厳密な依存関係、 API仕様の構造把握に有効 実装・テスト ナレッジグラフ 変更時の「影響範囲」の完全な特定と、 副作用の発見 運用・保守 ナレッジグラフ 過去のADR(アーキテクチャ決定レコード)や インシデントからの由来追跡 12 -
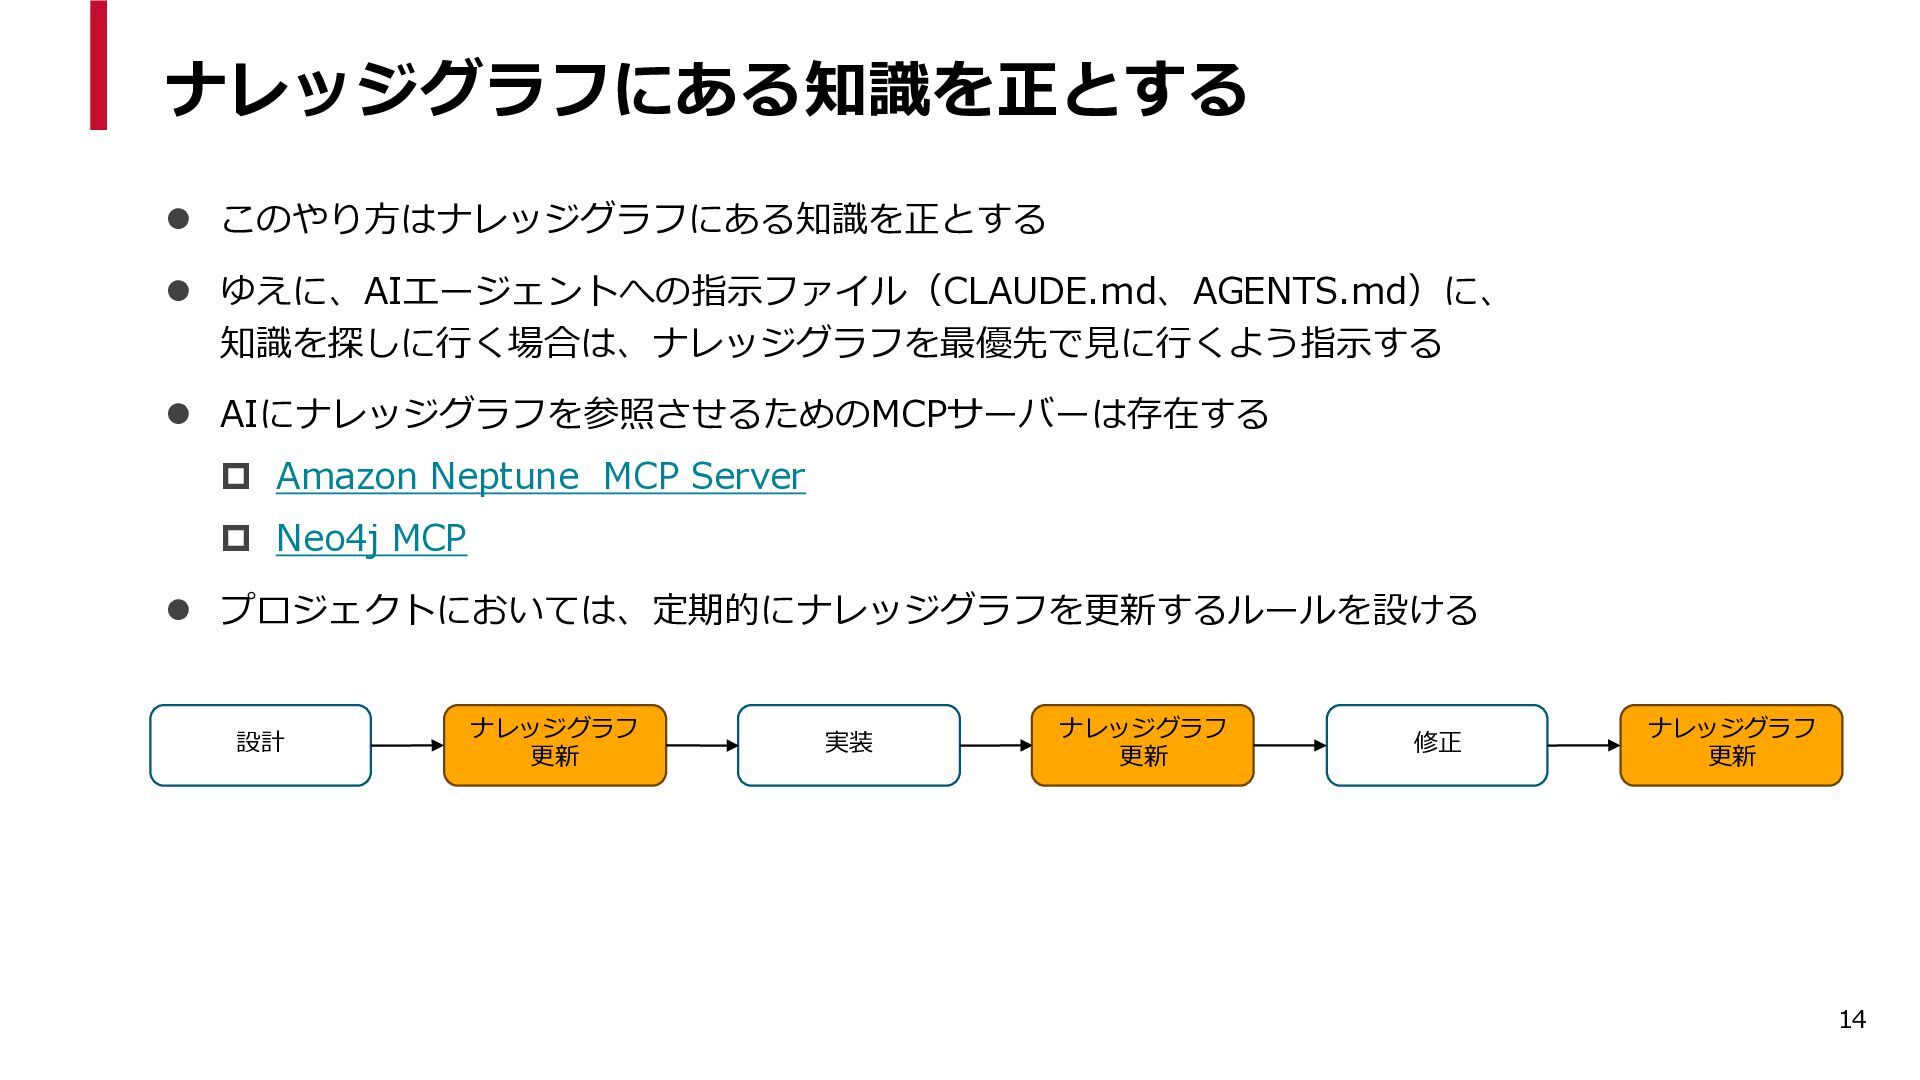
ナレッジグラフにある知識を正とする ⚫ このやり方はナレッジグラフにある知識を正とする ⚫ ゆえに、AIエージェントへの指示ファイル(CLAUDE.md、AGENTS.md)に、 知識を探しに行く場合は、ナレッジグラフを最優先で見に行くよう指示する ⚫ AIにナレッジグラフを参照させるためのMCPサーバーは存在する Amazon
Neptune MCP Server Neo4j MCP ⚫ プロジェクトにおいては、定期的にナレッジグラフを更新するルールを設ける 設計 ナレッジグラフ 更新 実装 ナレッジグラフ 更新 修正 ナレッジグラフ 更新 14 -
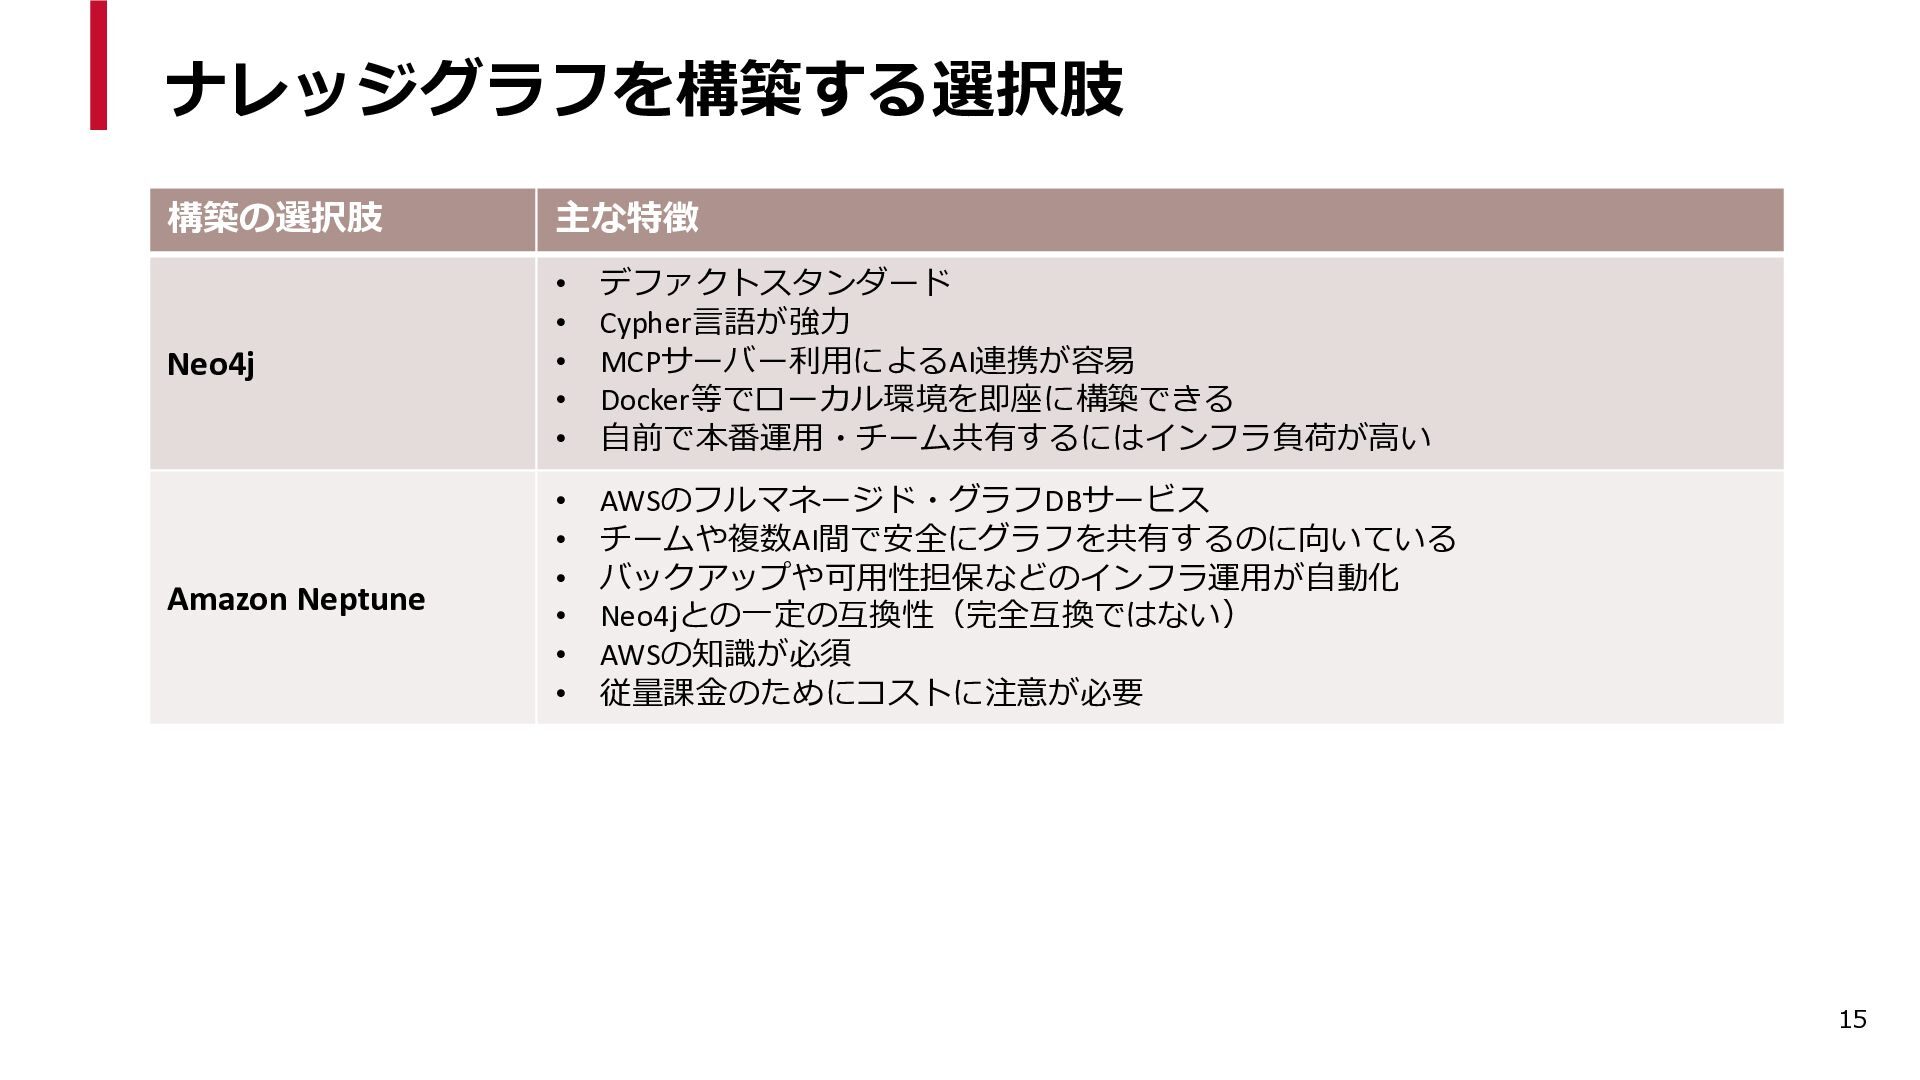
ナレッジグラフを構築する選択肢 構築の選択肢 主な特徴 Neo4j • • • • • デファクトスタンダード
Cypher言語が強力 MCPサーバー利用によるAI連携が容易 Docker等でローカル環境を即座に構築できる 自前で本番運用・チーム共有するにはインフラ負荷が高い Amazon Neptune • • • • • • AWSのフルマネージド・グラフDBサービス チームや複数AI間で安全にグラフを共有するのに向いている バックアップや可用性担保などのインフラ運用が自動化 Neo4jとの一定の互換性(完全互換ではない) AWSの知識が必須 従量課金のためにコストに注意が必要 15 -
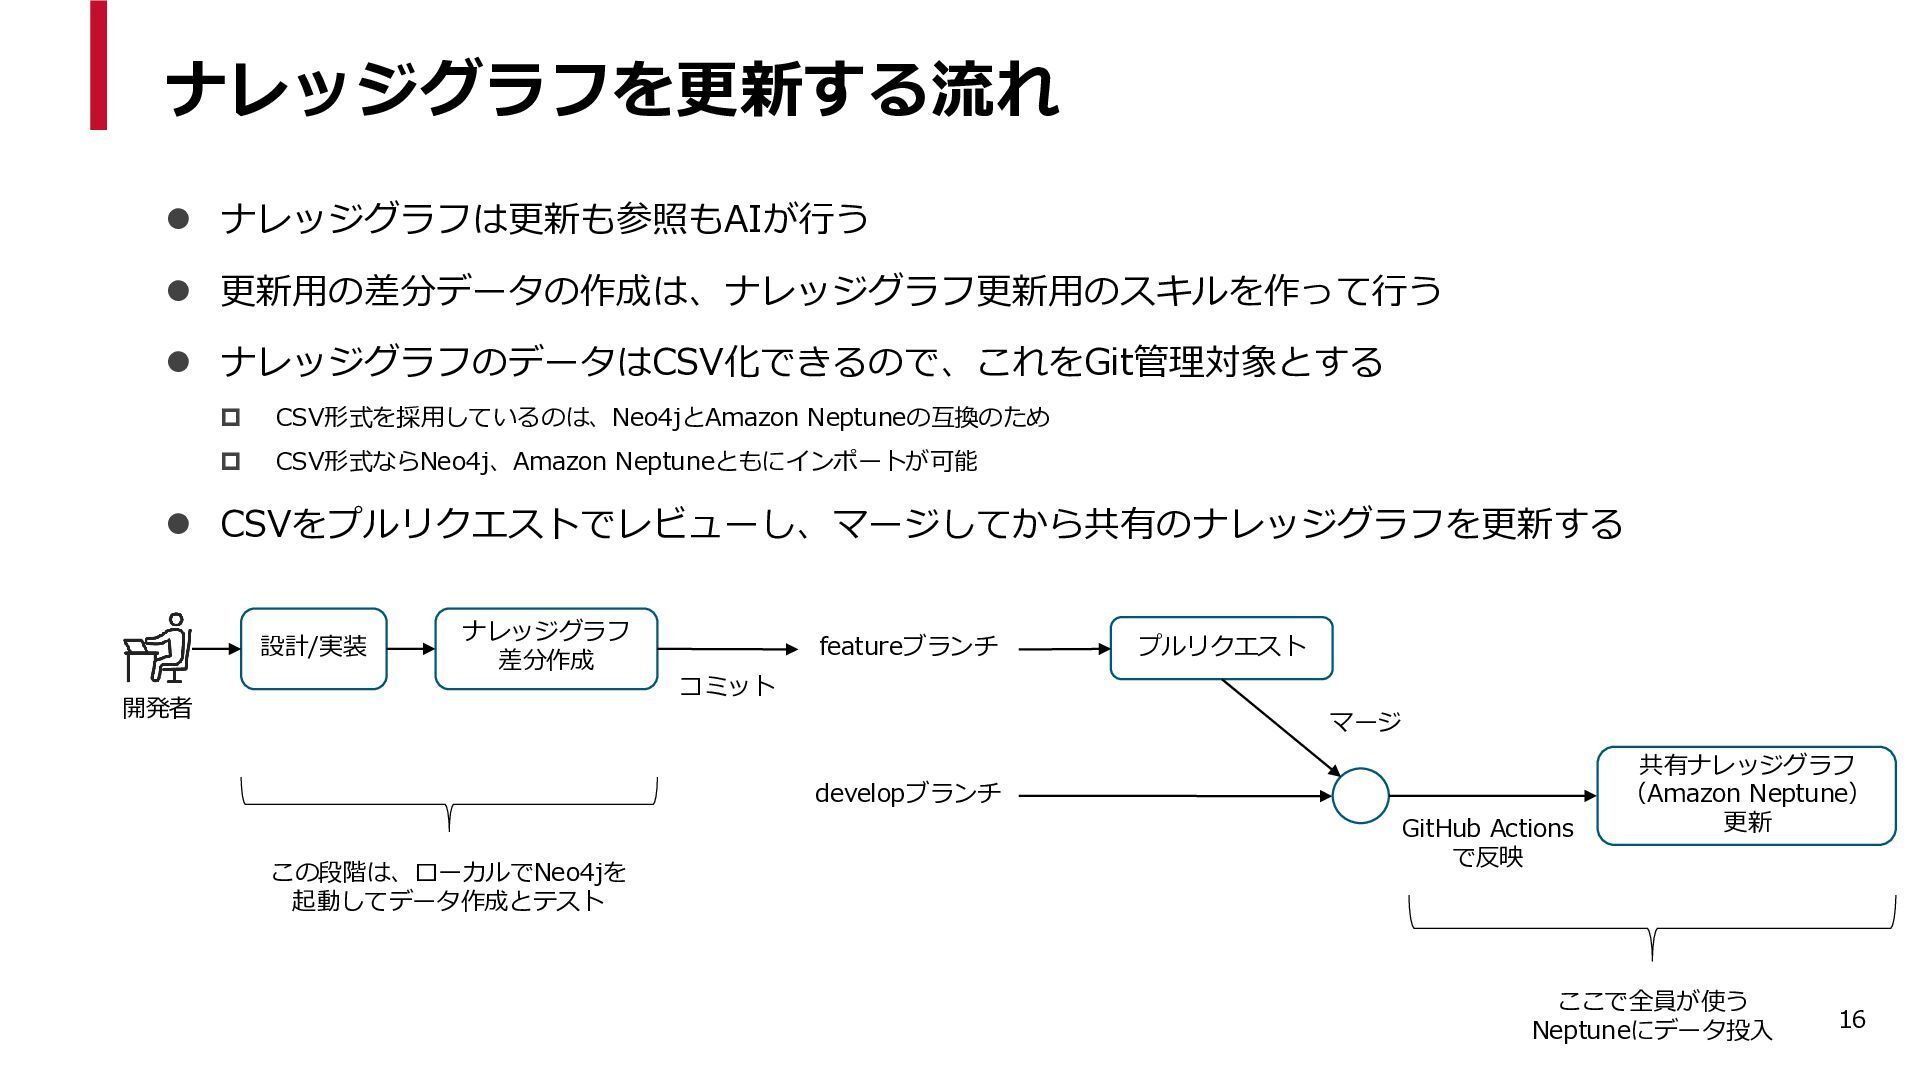
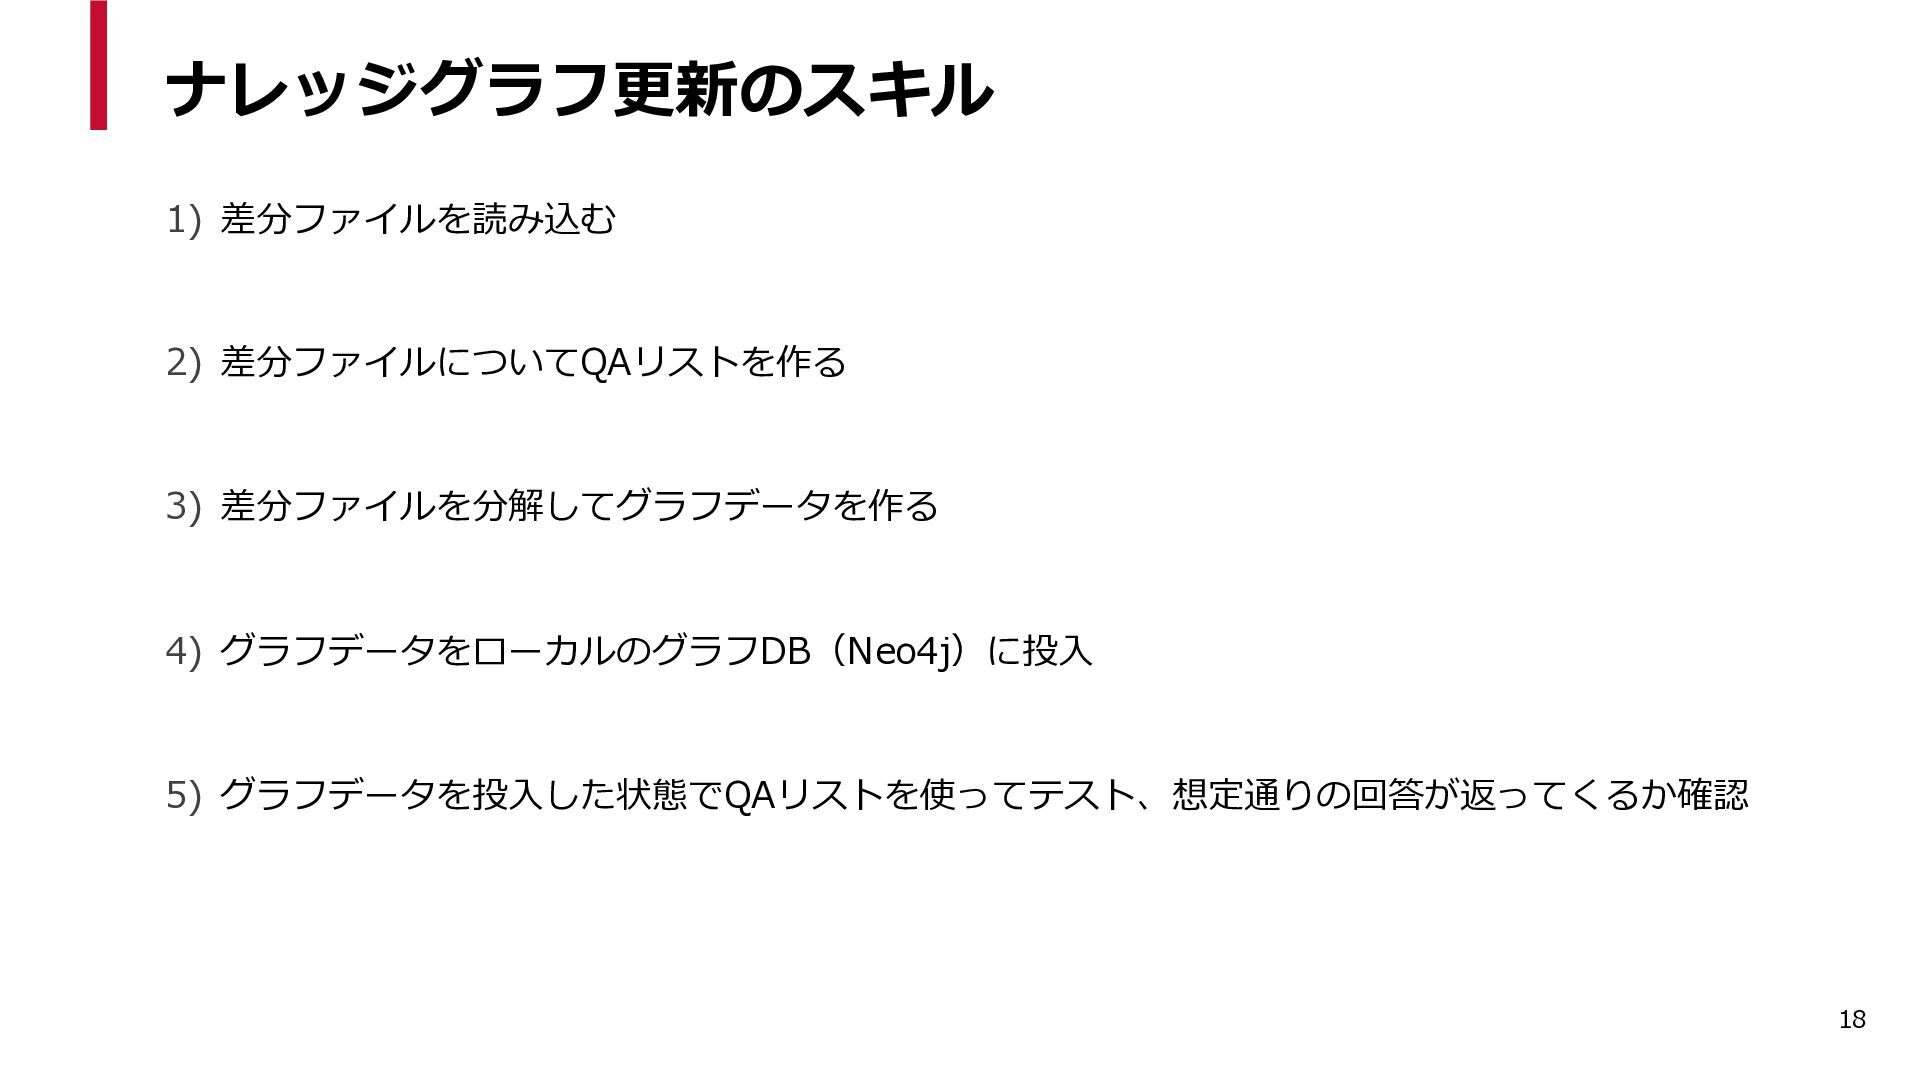
ナレッジグラフを更新する流れ ⚫ ナレッジグラフは更新も参照もAIが行う ⚫ 更新用の差分データの作成は、ナレッジグラフ更新用にClaude Codeのスキルを作って行う ⚫ ナレッジグラフのデータはCSV化できるので、これをGit管理対象とする CSV形式を採用しているのは、Neo4jとAmazon
Neptuneの互換のため CSV形式ならNeo4j、Amazon Neptuneともにインポートが可能 ⚫ CSVをプルリクエストでレビューし、マージしてから共有のナレッジグラフを更新する 設計/実装 ナレッジグラフ 差分作成 開発者 featureブランチ プルリクエスト コミット マージ developブランチ この段階は、ローカルでNeo4jを 起動してデータ作成とテスト GitHub Actions で反映 共有ナレッジグラフ (Amazon Neptune) 更新 ここで全員が使う Neptuneにデータ投入 16 -
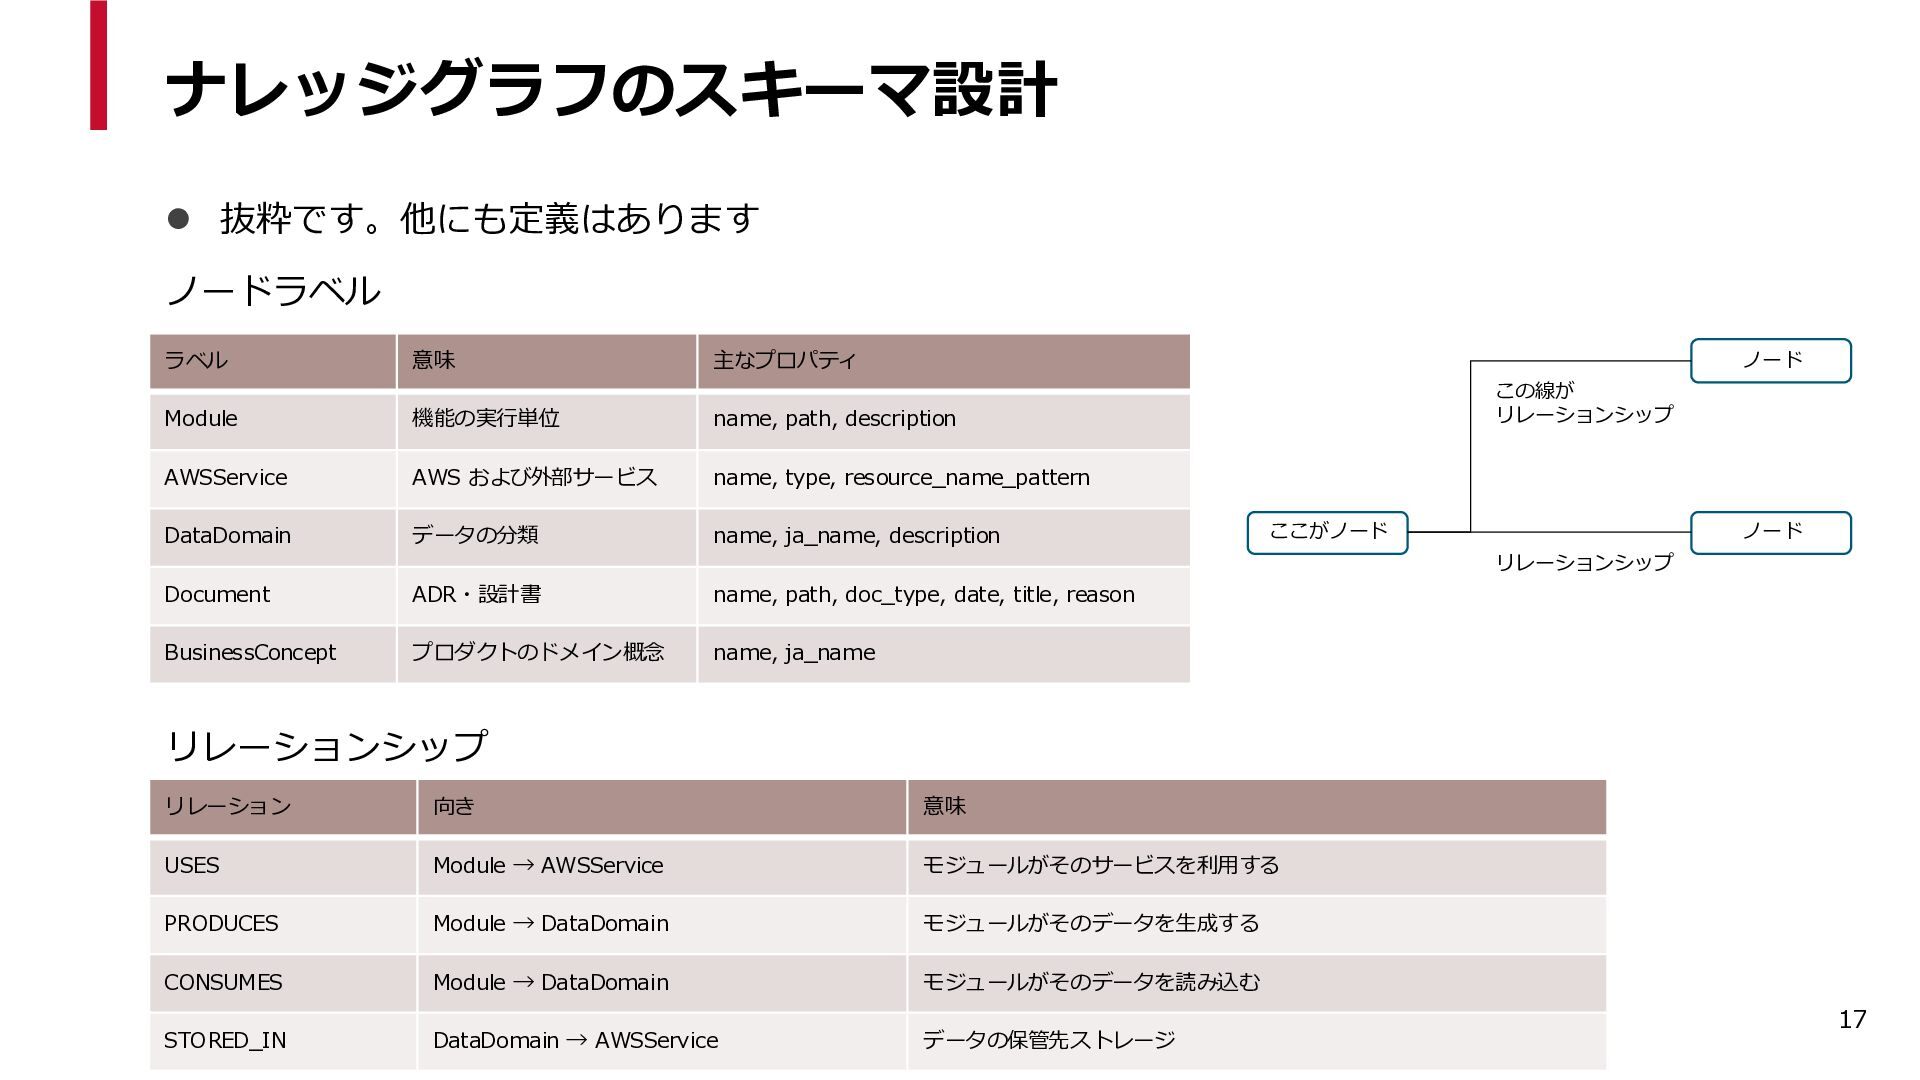
ナレッジグラフのスキーマ設計 ⚫ 抜粋です。他にも定義はあります ノードラベル ラベル 意味 主なプロパティ ノード Module 機能の実行単位
name, path, description AWSService AWS および外部サービス name, type, resource_name_pattern DataDomain データの分類 name, ja_name, description この線が リレーションシップ (またはエッジ) ここがノード ノード リレーションシップ Document ADR・設計書 name, path, doc_type, date, title, reason BusinessConcept プロダクトのドメイン概念 name, ja_name リレーションシップ(またはエッジとも言う) リレーション 向き 意味 USES Module → AWSService モジュールがそのサービスを利用する PRODUCES Module → DataDomain モジュールがそのデータを生成する CONSUMES Module → DataDomain モジュールがそのデータを読み込む STORED_IN DataDomain → AWSService データの保管先ストレージ 17 -
ナレッジグラフ更新のスキル 1) 差分ファイルを読み込む 2) 差分ファイルについてQAリストを作る 3) 差分ファイルを分解してグラフデータを作る 4) グラフデータをローカルのグラフDB(Neo4j)に投入 5)
グラフデータを投入した状態でQAリストを使ってテスト、想定通りの回答が返ってくるか確認 18 -
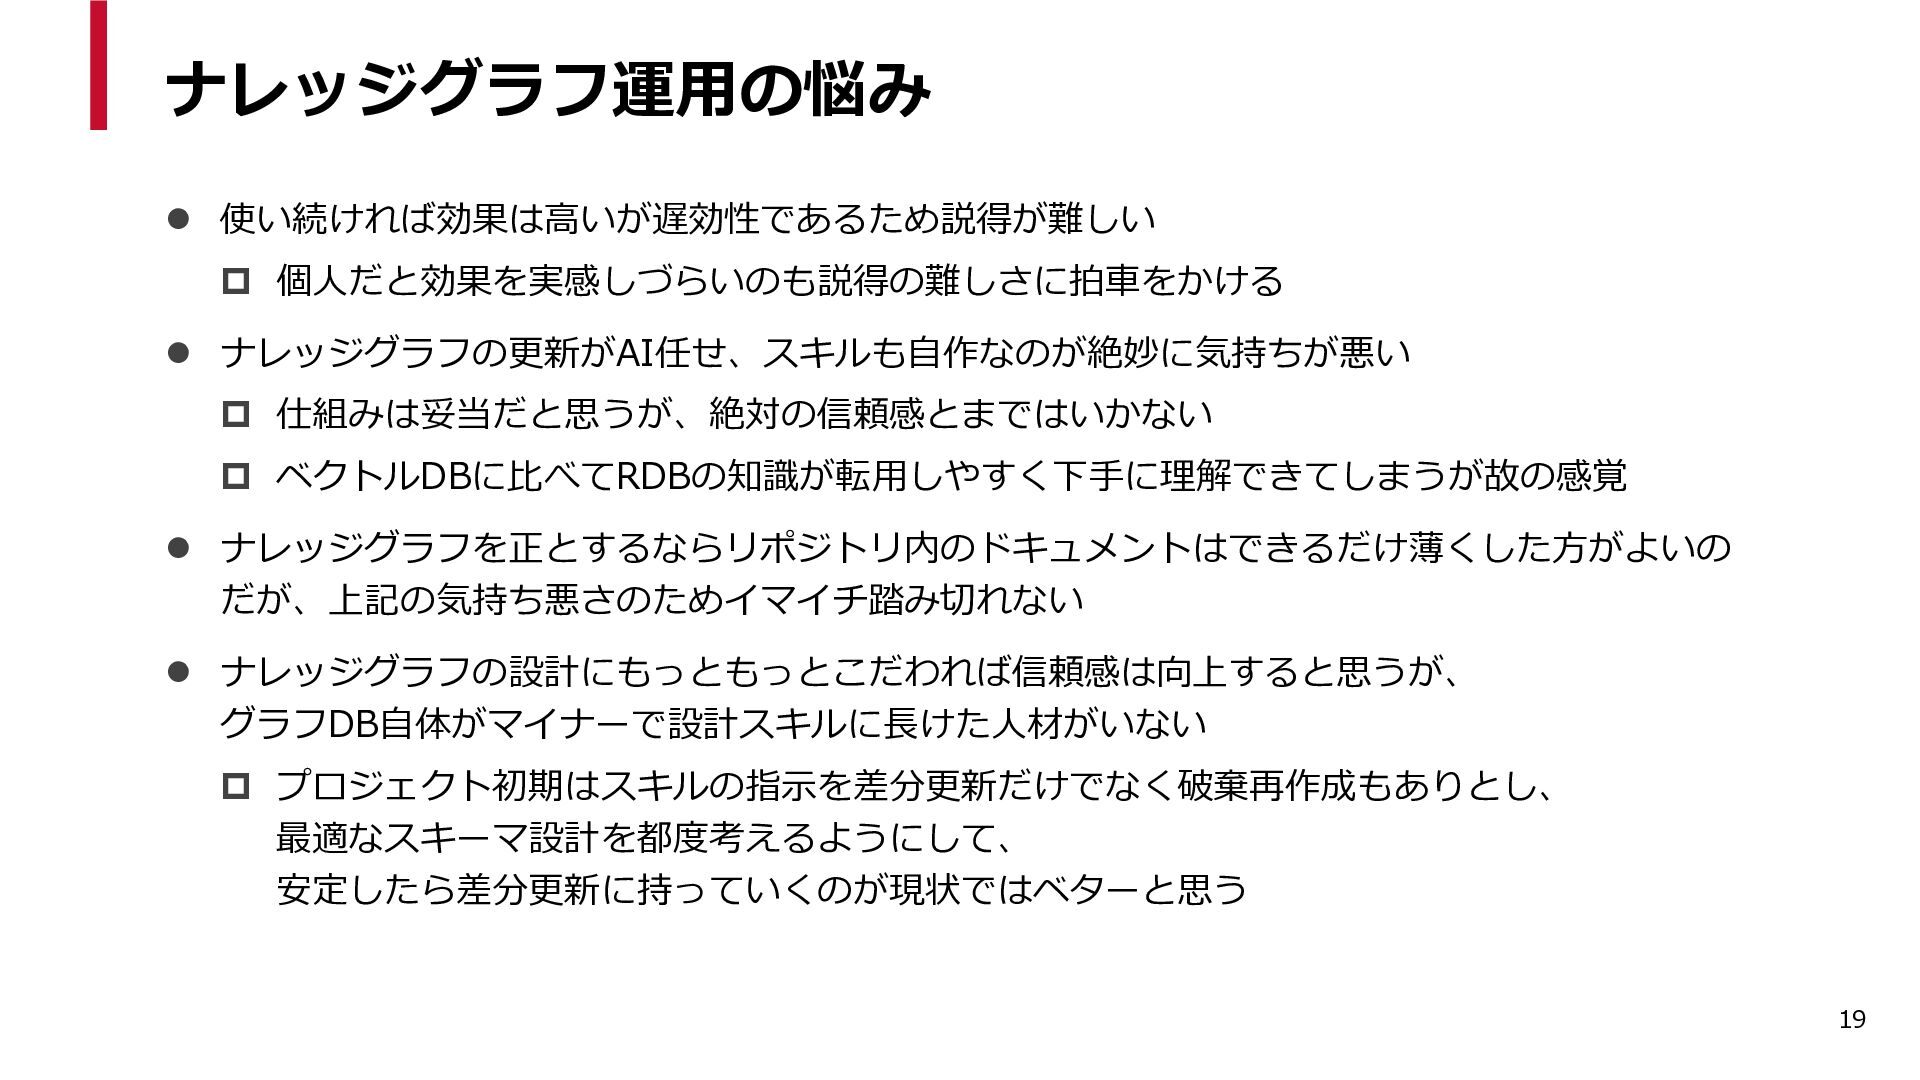
ナレッジグラフ運用の悩み ⚫ 使い続ければ効果は高いが遅効性であるため説得が難しい 個人だと効果を実感しづらいのも説得の難しさに拍車をかける ⚫ ナレッジグラフの更新がAI任せ、スキルも自作なのが絶妙に気持ちが悪い 仕組みは妥当だと思うが、絶対の信頼感とまではいかない
ベクトルDBに比べてRDBの知識が転用しやすく下手に理解できてしまうが故の感覚 ⚫ ナレッジグラフを正とするならリポジトリ内のドキュメントはできるだけ薄くした方がよいの だが、上記の気持ち悪さのためイマイチ踏み切れない ⚫ ナレッジグラフの設計にもっともっとこだわれば信頼感は向上すると思うが、 グラフDB自体がマイナーで設計スキルに長けた人材がいない プロジェクト初期はスキルの指示を差分更新だけでなく破棄再作成もありとし、 最適なスキーマ設計を都度考えるようにして、 安定したら差分更新に持っていくのが現状ではベターと思う 19 -
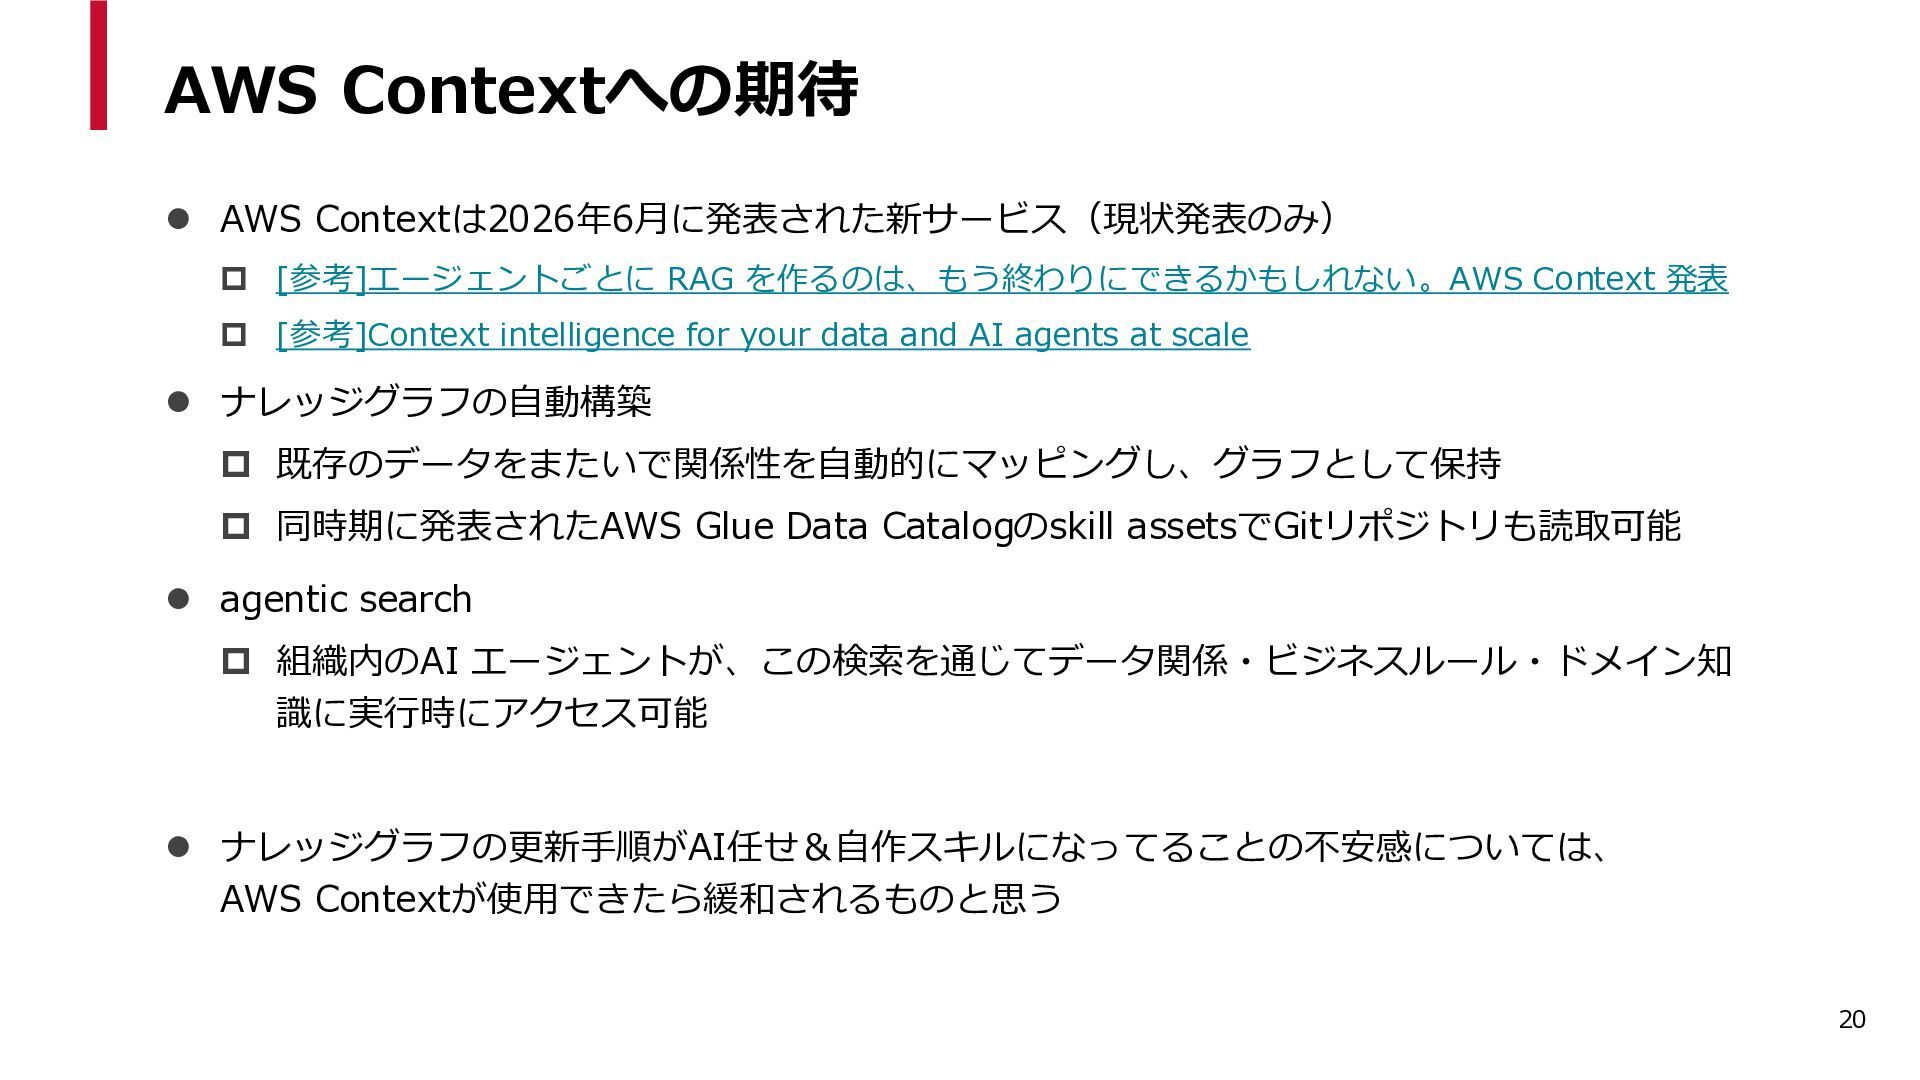
AWS Contextへの期待 ⚫ AWS Contextは2026年6月に発表された新サービス(現状発表のみ) [参考]エージェントごとに RAG を作るのは、もう終わりにできるかもしれない。AWS Context
発表 [参考]Context intelligence for your data and AI agents at scale ⚫ ナレッジグラフの自動構築 既存のデータをまたいで関係性を自動的にマッピングし、グラフとして保持 同時期に発表されたAWS Glue Data Catalogのskill assetsでGitリポジトリも読取可能 ⚫ agentic search 組織内のAI エージェントが、この検索を通じてデータ関係・ビジネスルール・ドメイン知 識に実行時にアクセス可能 ⚫ ナレッジグラフの更新手順がAI任せ&自作スキルになってることの不安感については、 AWS Contextが使用できたら緩和されるものと思う 20 -
まとめ ⚫ 参照ファイルが多くなるほど、推論・コーディングの精度は低下する ⚫ 真因は空き容量ではなくノイズの蓄積 ⚫ AIが効率的に知識を検索しやすい仕組みとしてナレッジグラフは有効 ⚫ ナレッジグラフと一般的なRAGとは活躍する場面が異なる ⚫
ナレッジグラフはまだ絶対の信頼感までは感じていないが、注目に値する技術 ⚫ AWS Contextに期待 22