Upgrade to Pro — share decks privately, control downloads, hide ads and more …

【データ横丁主催】AI Agentがコンテキストを使って仕事をした後、何が残るのか― 組織の経...

Sponsored · SiteGround - Reliable hosting with speed, security, and support you can count on. →
Avatar for KoheiOgawa KoheiOgawa
September 29, 2026

【データ横丁主催】AI Agentがコンテキストを使って仕事をした後、何が残るのか― 組織の経験を次の判断に引き継ぐ「Agent Memory」

【データの世界観チャンネル#1】AIエージェント時代のエンタープライズ基盤
<全3回>第1回テーマは「コンテキストとエージェントの記憶 ーAIが組織で働くための設計」
https://datayokocho.connpass.com/event/404893/

Avatar for KoheiOgawa

KoheiOgawa

September 29, 2026

More Decks by KoheiOgawa

Other Decks in Technology

Transcript

  1. 仕事の終わり データの世界観チャンネル #1 AIエージェント時代のエンタープライズ基盤 log 第1回 コンテキストとエージェントの記憶 ーAIが組織で動くための設計 AI Agentが

    コンテキストを使って 仕事をした後、 何が残るのか mail 次の判断へ ticket tool result 組織の経験を次の判断に引き継ぐ「Agent Memory」 登壇者 ⼩川 航平 ⽇本オラクル株式会社 Principal Enterprise AI GTM Architect EnterpriseZine連載「AIエージェントのための記憶と境界の設計論」著者 01 データの世界観チャンネル #1(2026-09-29, オンライン) chat
  2. ⾃⼰紹介 Data for AI, AI for Data, AIを社会実装する仕事 ⼩川 航平

    Kohei Ogawa Principal Enterprise AI GTM Architect aiX, ACE, Cloud Business Unit X @shisyu_gaku フォロー&DM Welcomeです︕ 02 本⼈の過去登壇資料(Developers Summit 2026・2026年6⽉の⾃⼰紹介) BOOKS 共著 SERIES 連載中 EnterpriseZine ⼩川航平の「AIエージェントのための 記憶と境界の設計論」 今⽇の話は、この連載の第1〜4回がベースです
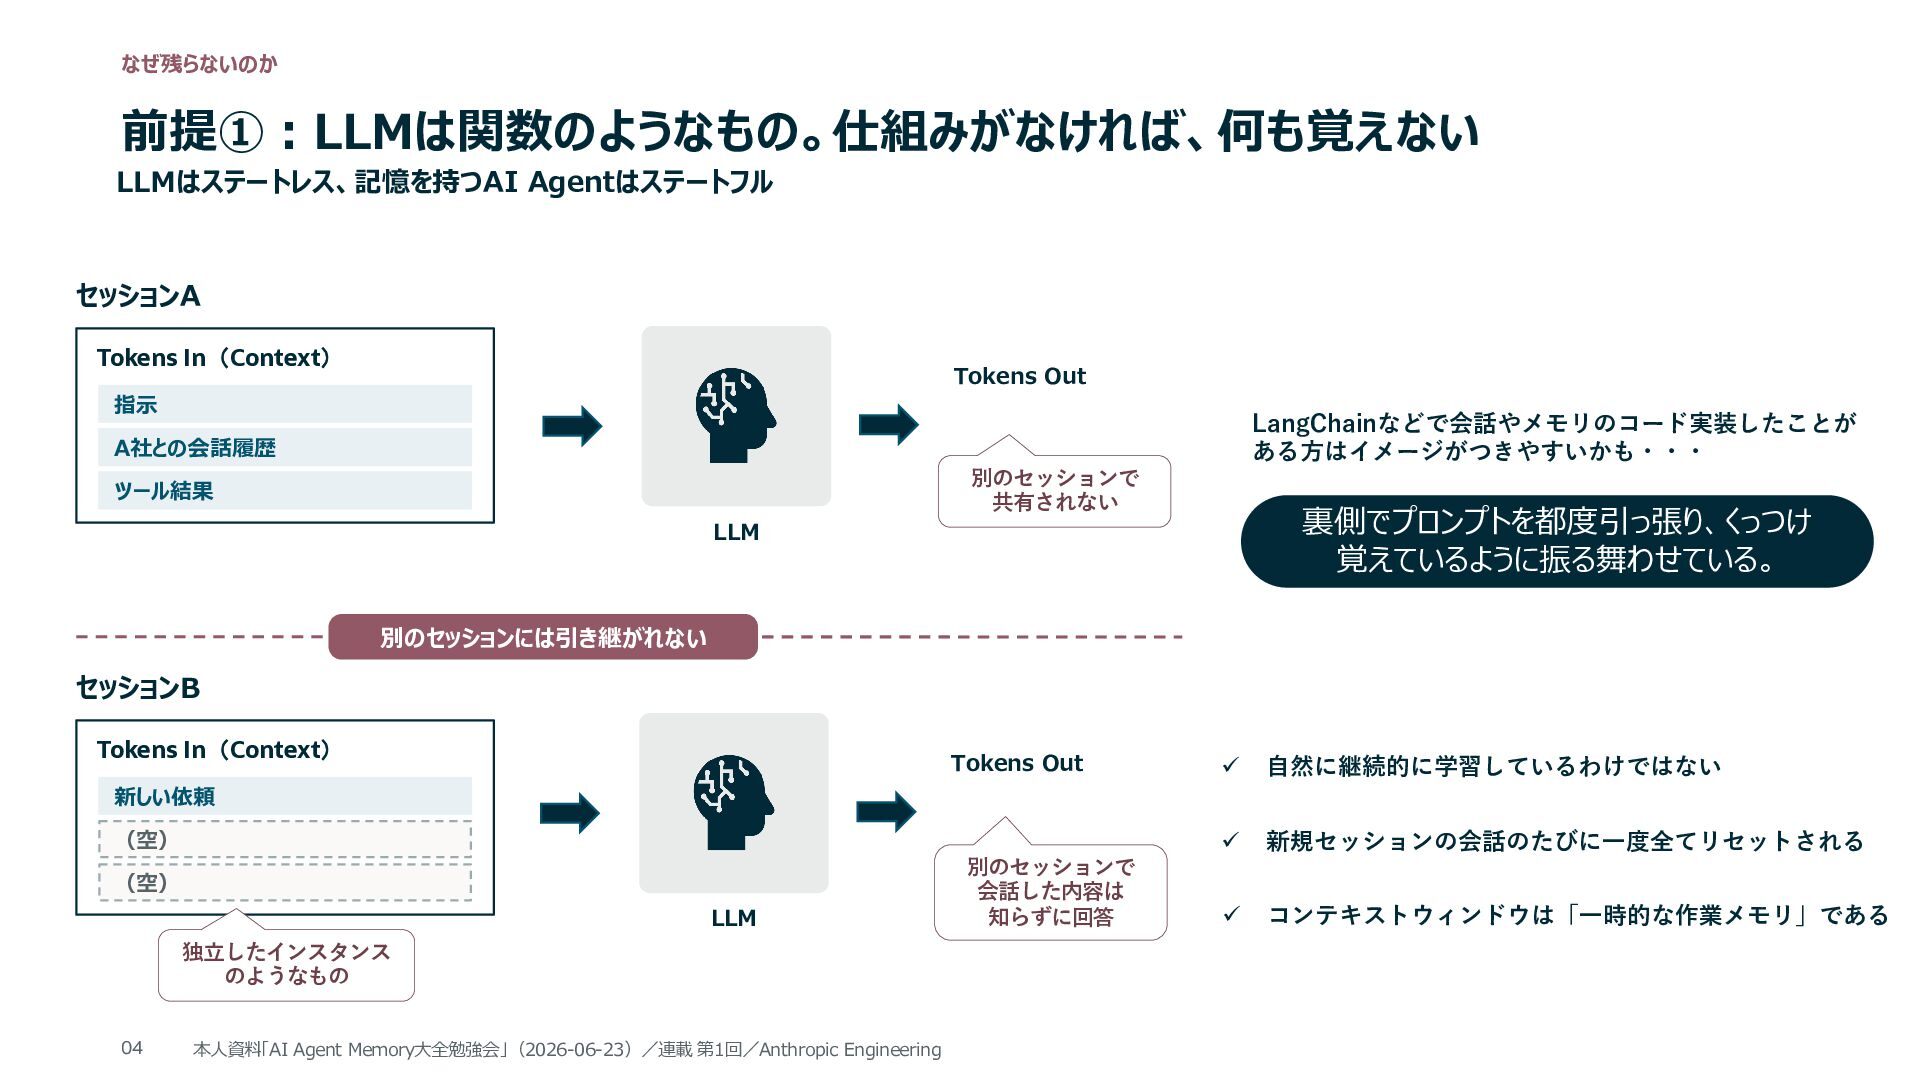
  3. なぜ残らないのか 前提①︓LLMは関数のようなもの。仕組みがなければ、何も覚えない LLMはステートレス、記憶を持つAI Agentはステートフル セッションA Tokens In(Context) Tokens Out 指⽰

    LangChainなどで会話やメモリのコード実装したことが ある⽅はイメージがつきやすいかも・・・ A社との会話履歴 別のセッションで 共有されない ツール結果 裏側でプロンプトを都度引っ張り、くっつけ 覚えているように振る舞わせている。 LLM 別のセッションには引き継がれない セッションB Tokens In(Context) Tokens Out ü ⾃然に継続的に学習しているわけではない ü 新規セッションの会話のたびに⼀度全てリセットされる ü コンテキストウィンドウは「⼀時的な作業メモリ」である 新しい依頼 (空) (空) LLM 独⽴したインスタンス のようなもの 04 本⼈資料「AI Agent Memory⼤全勉強会」(2026-06-23)/連載 第1回/Anthropic Engineering 別のセッションで 会話した内容は 知らずに回答
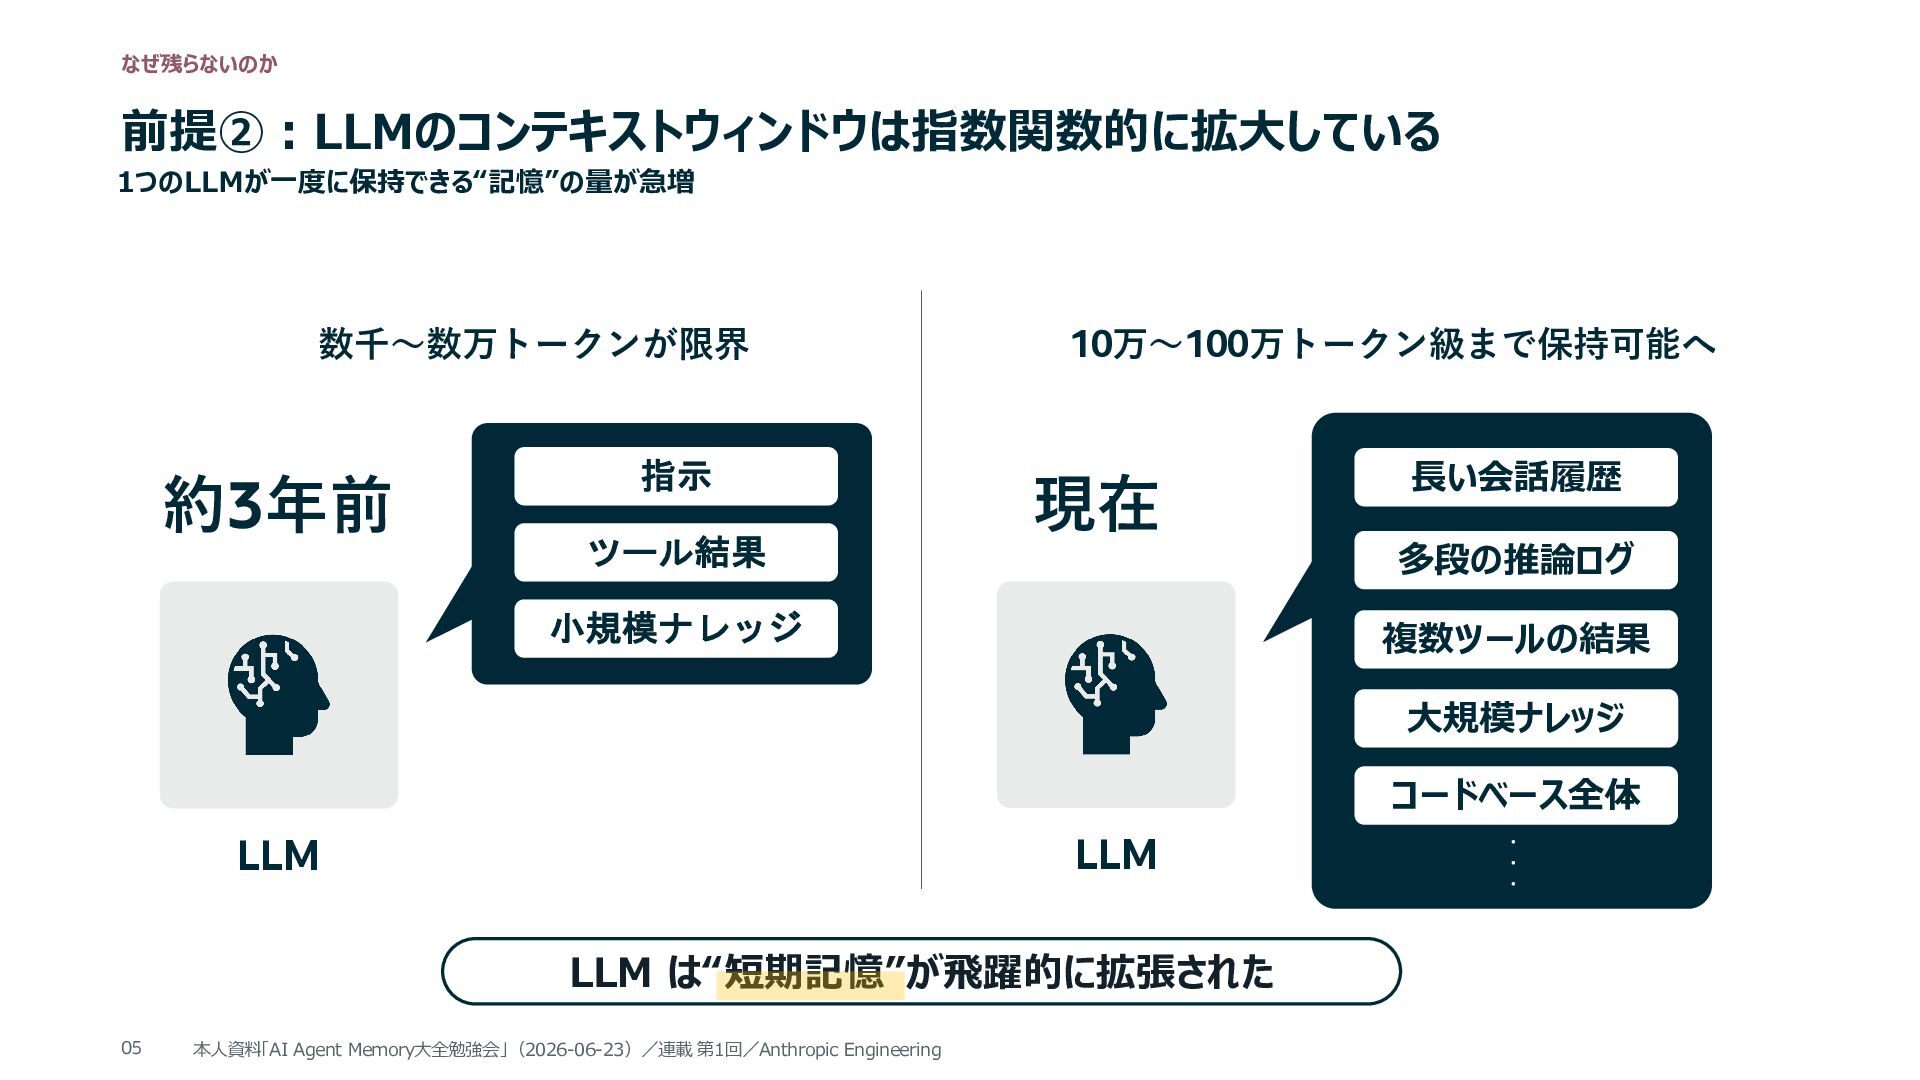
  4. なぜ残らないのか 前提②︓LLMのコンテキストウィンドウは指数関数的に拡⼤している 1つのLLMが⼀度に保持できる“記憶”の量が急増 数千〜数万トークンが限界 約3年前 指示 ツール結果 10万〜100万トークン級まで保持可能へ 現在 小規模ナレッジ

    ⻑い会話履歴 多段の推論ログ 複数ツールの結果 ⼤規模ナレッジ コードベース全体 LLM は“短期記憶”が⾶躍的に拡張された 05 本⼈資料「AI Agent Memory⼤全勉強会」(2026-06-23)/連載 第1回/Anthropic Engineering ・・・ LLM LLM
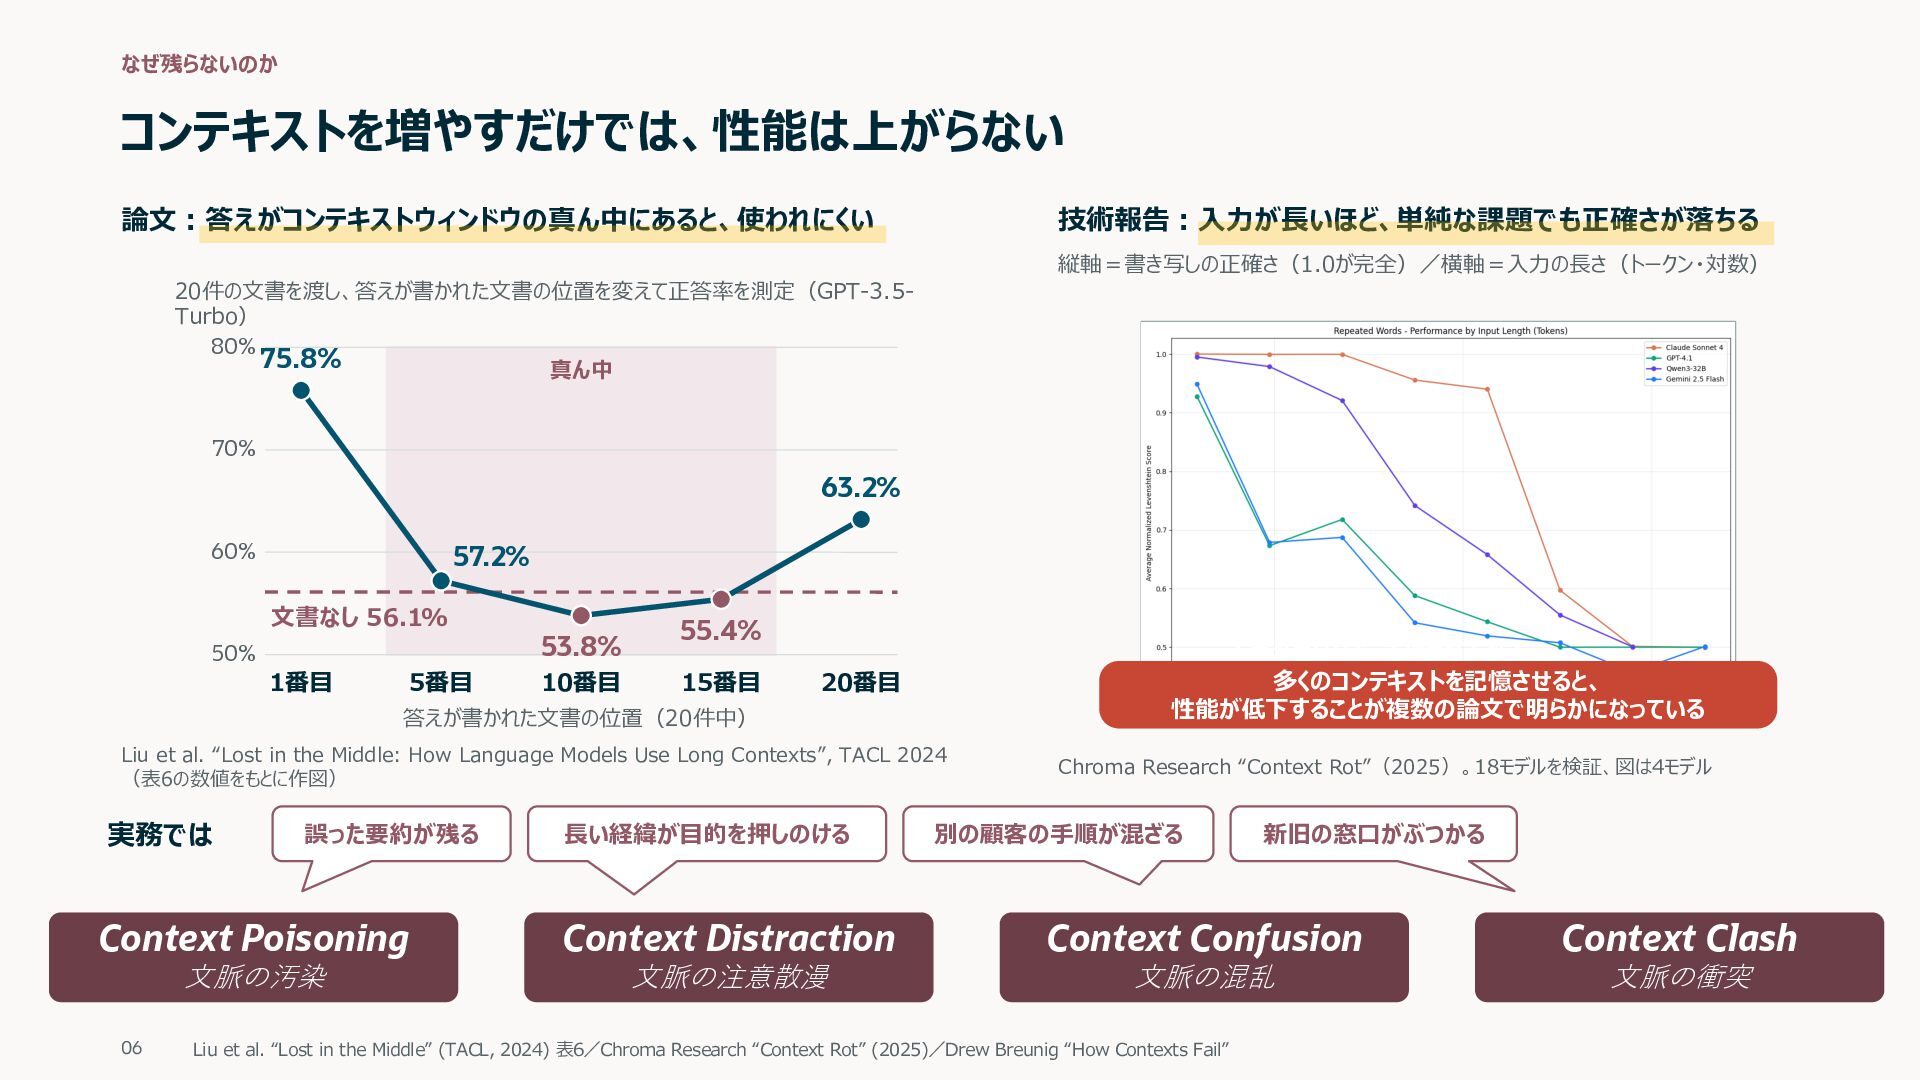
  5. なぜ残らないのか コンテキストを増やすだけでは、性能は上がらない 論⽂︓答えがコンテキストウィンドウの真ん中にあると、使われにくい 技術報告︓⼊⼒が⻑いほど、単純な課題でも正確さが落ちる 縦軸=書き写しの正確さ(1.0が完全)/横軸=⼊⼒の⻑さ(トークン・対数) 20件の⽂書を渡し、答えが書かれた⽂書の位置を変えて正答率を測定(GPT-3.5Turbo) 80% 75.8% 真ん中 70%

    63.2% 60% 57.2% ⽂書なし 56.1% 50% 1番⽬ 5番⽬ 53.8% 10番⽬ 55.4% 15番⽬ ⼊⼒が⻑いほど、正確さが下がる 多くのコンテキストを記憶させると、 性能が低下することが複数の論⽂で明らかになっている 20番⽬ 答えが書かれた⽂書の位置(20件中) Liu et al. “Lost in the Middle: How Language Models Use Long Contexts”, TACL 2024 (表6の数値をもとに作図) 実務では 誤った要約が残る ⻑い経緯が⽬的を押しのける Chroma Research “Context Rot”(2025)。18モデルを検証、図は4モデル 別の顧客の⼿順が混ざる 新旧の窓⼝がぶつかる Context Poisoning Context Distraction Context Confusion Context Clash ⽂脈の汚染 ⽂脈の注意散漫 ⽂脈の混乱 ⽂脈の衝突 06 Liu et al. “Lost in the Middle” (TACL, 2024) 表6/Chroma Research “Context Rot” (2025)/Drew Breunig “How Contexts Fail”
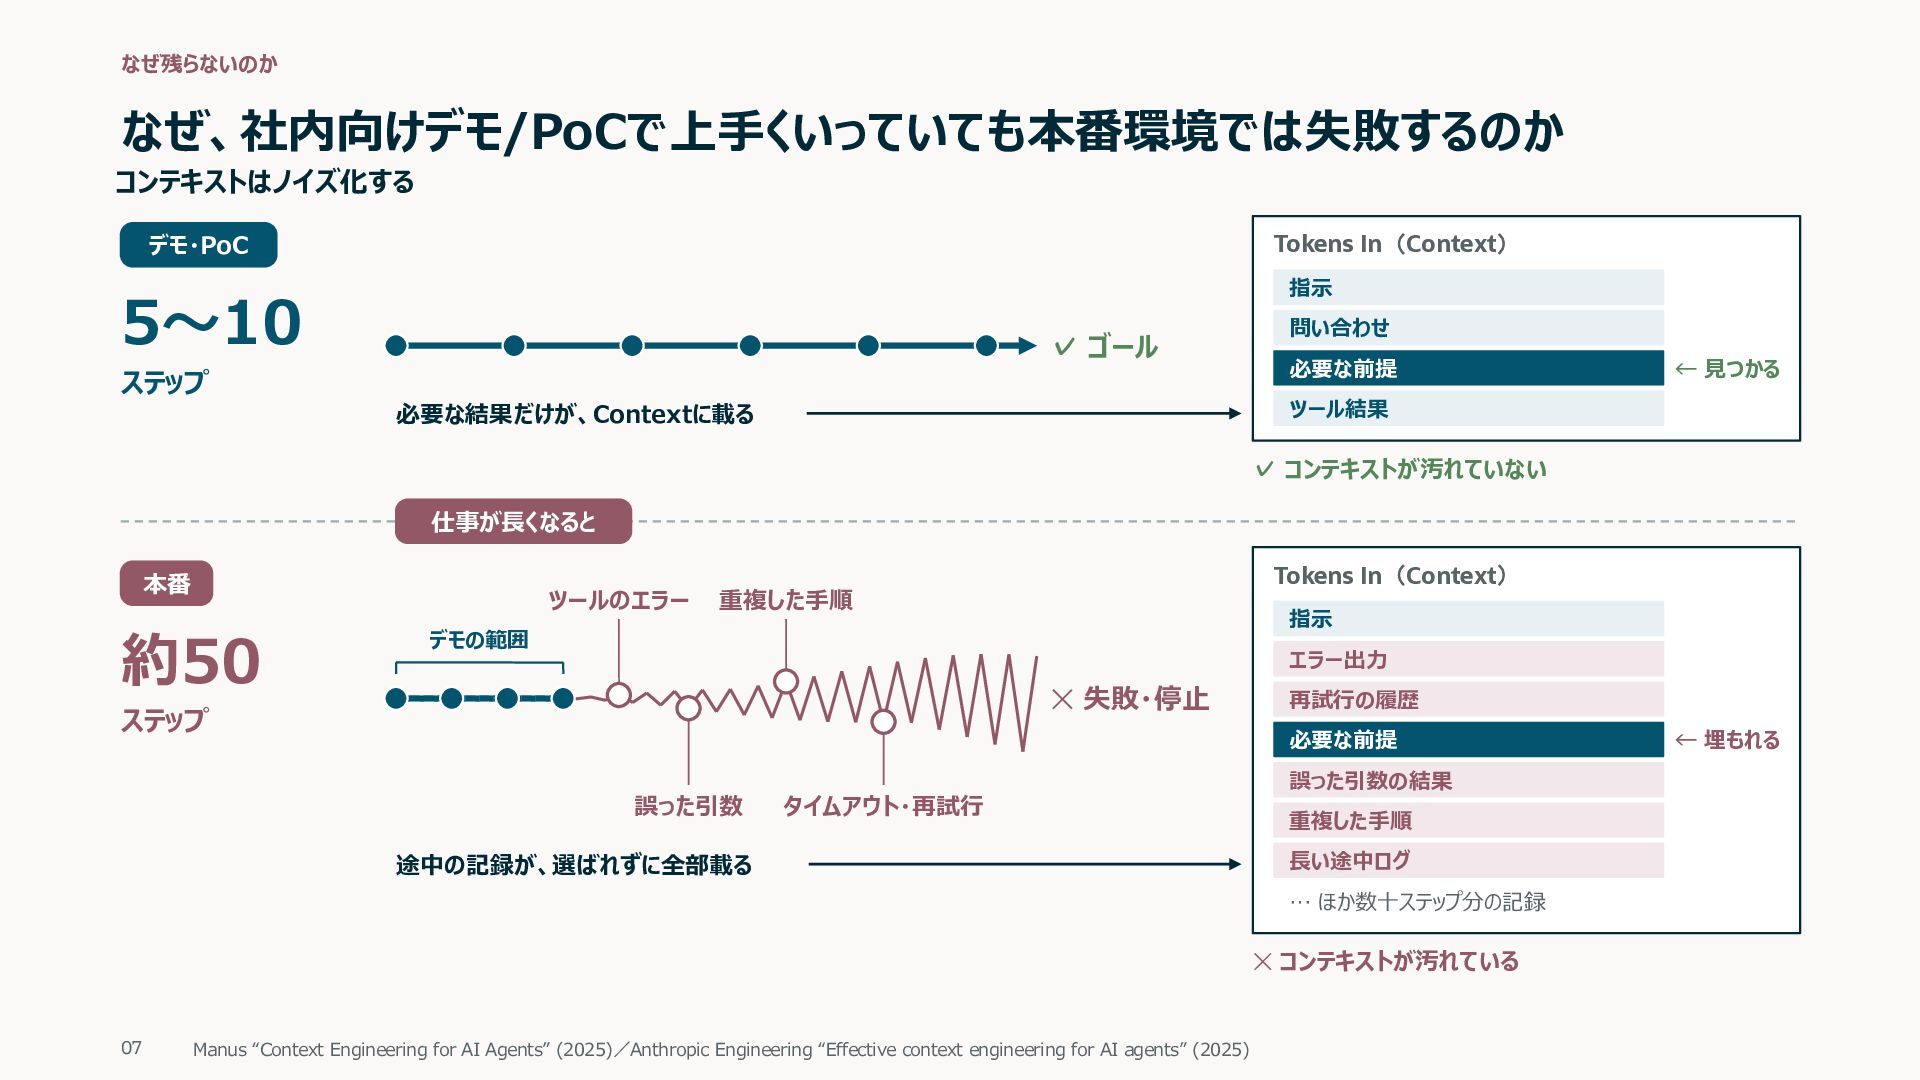
  6. なぜ残らないのか なぜ、社内向けデモ/PoCで上⼿くいっていても本番環境では失敗するのか コンテキストはノイズ化する Tokens In(Context) デモ・PoC 指⽰ 5〜10 ステップ ✓

    ゴール 問い合わせ 必要な前提 ← ⾒つかる ツール結果 必要な結果だけが、Contextに載る ✓ コンテキストが汚れていない 仕事が⻑くなると 本番 ツールのエラー 約50 Tokens In(Context) 重複した⼿順 指⽰ デモの範囲 エラー出⼒ ✕ 失敗・停⽌ ステップ 再試⾏の履歴 必要な前提 誤った引数 タイムアウト・再試⾏ 途中の記録が、選ばれずに全部載る 誤った引数の結果 重複した⼿順 ⻑い途中ログ … ほか数⼗ステップ分の記録 ✕ コンテキストが汚れている 07 Manus “Context Engineering for AI Agents” (2025)/Anthropic Engineering “Effective context engineering for AI agents” (2025) ← 埋もれる
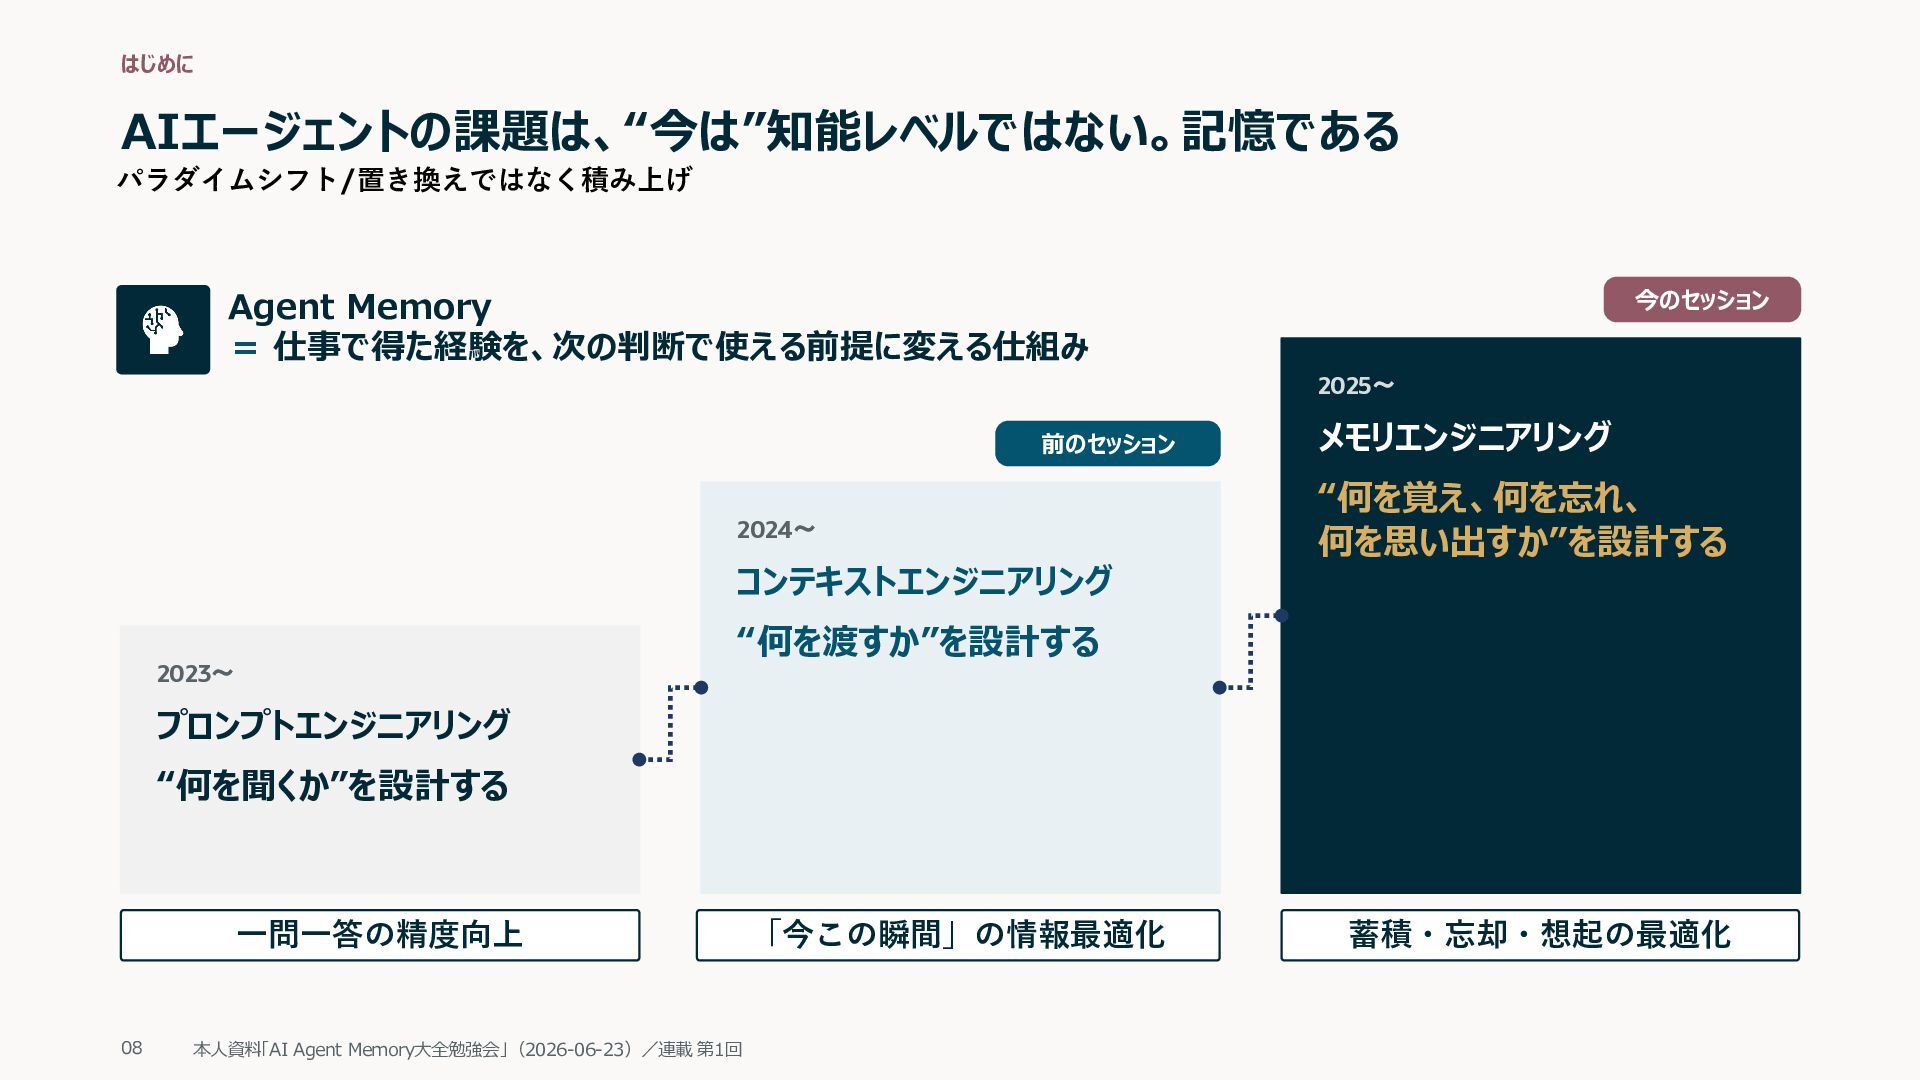
  7. はじめに AIエージェントの課題は、“今は”知能レベルではない。記憶である パラダイムシフト/置き換えではなく積み上げ Agent Memory = 仕事で得た経験を、次の判断で使える前提に変える仕組み 今のセッション 2025〜 前のセッション

    2024〜 コンテキストエンジニアリング メモリエンジニアリング “何を覚え、何を忘れ、 何を思い出すか”を設計する “何を渡すか”を設計する 2023〜 プロンプトエンジニアリング “何を聞くか”を設計する ⼀問⼀答の精度向上 08 本⼈資料「AI Agent Memory⼤全勉強会」(2026-06-23)/連載 第1回 「今この瞬間」の情報最適化 蓄積・忘却・想起の最適化
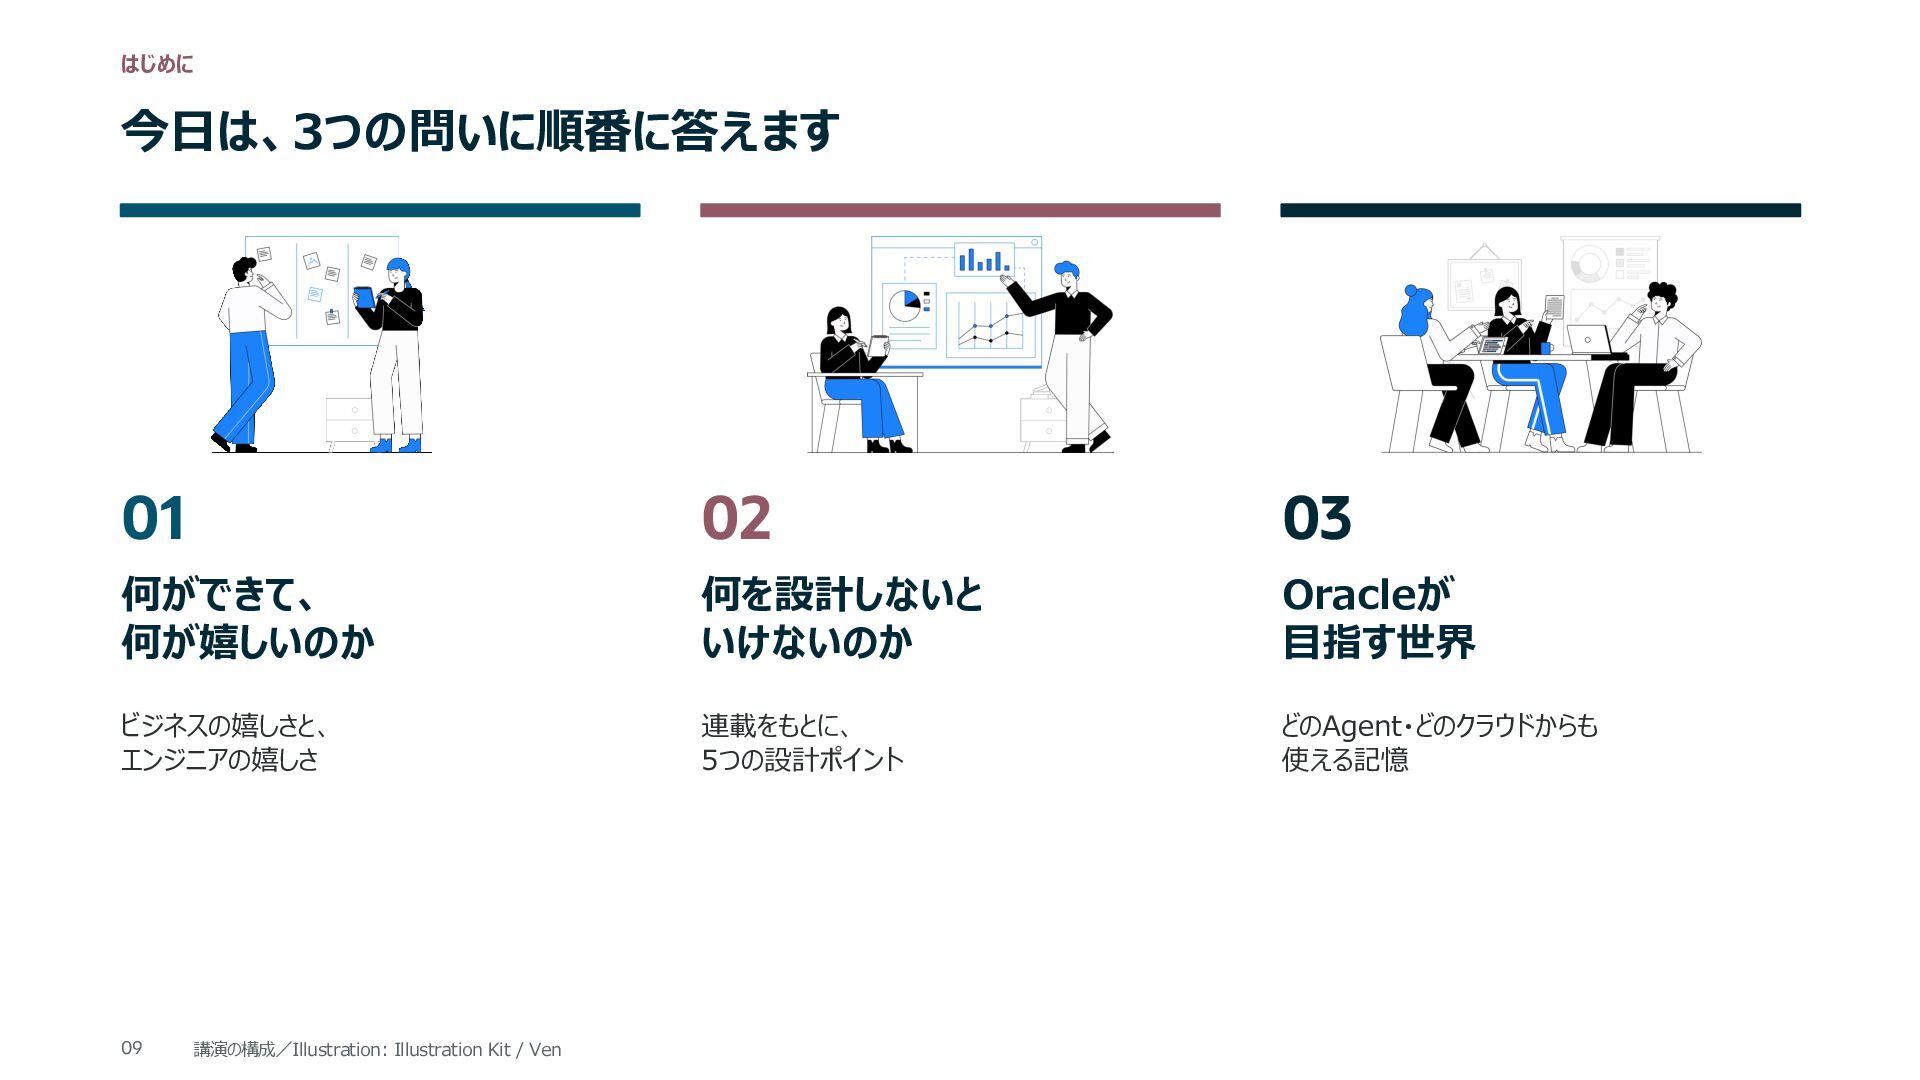
  8. はじめに 今⽇は、3つの問いに順番に答えます 01 02 03 何ができて、 何が嬉しいのか 何を設計しないと いけないのか Oracleが

    ⽬指す世界 ビジネスの嬉しさと、 エンジニアの嬉しさ 連載をもとに、 5つの設計ポイント どのAgent・どのクラウドからも 使える記憶 09 講演の構成/Illustration: Illustration Kit / Ven
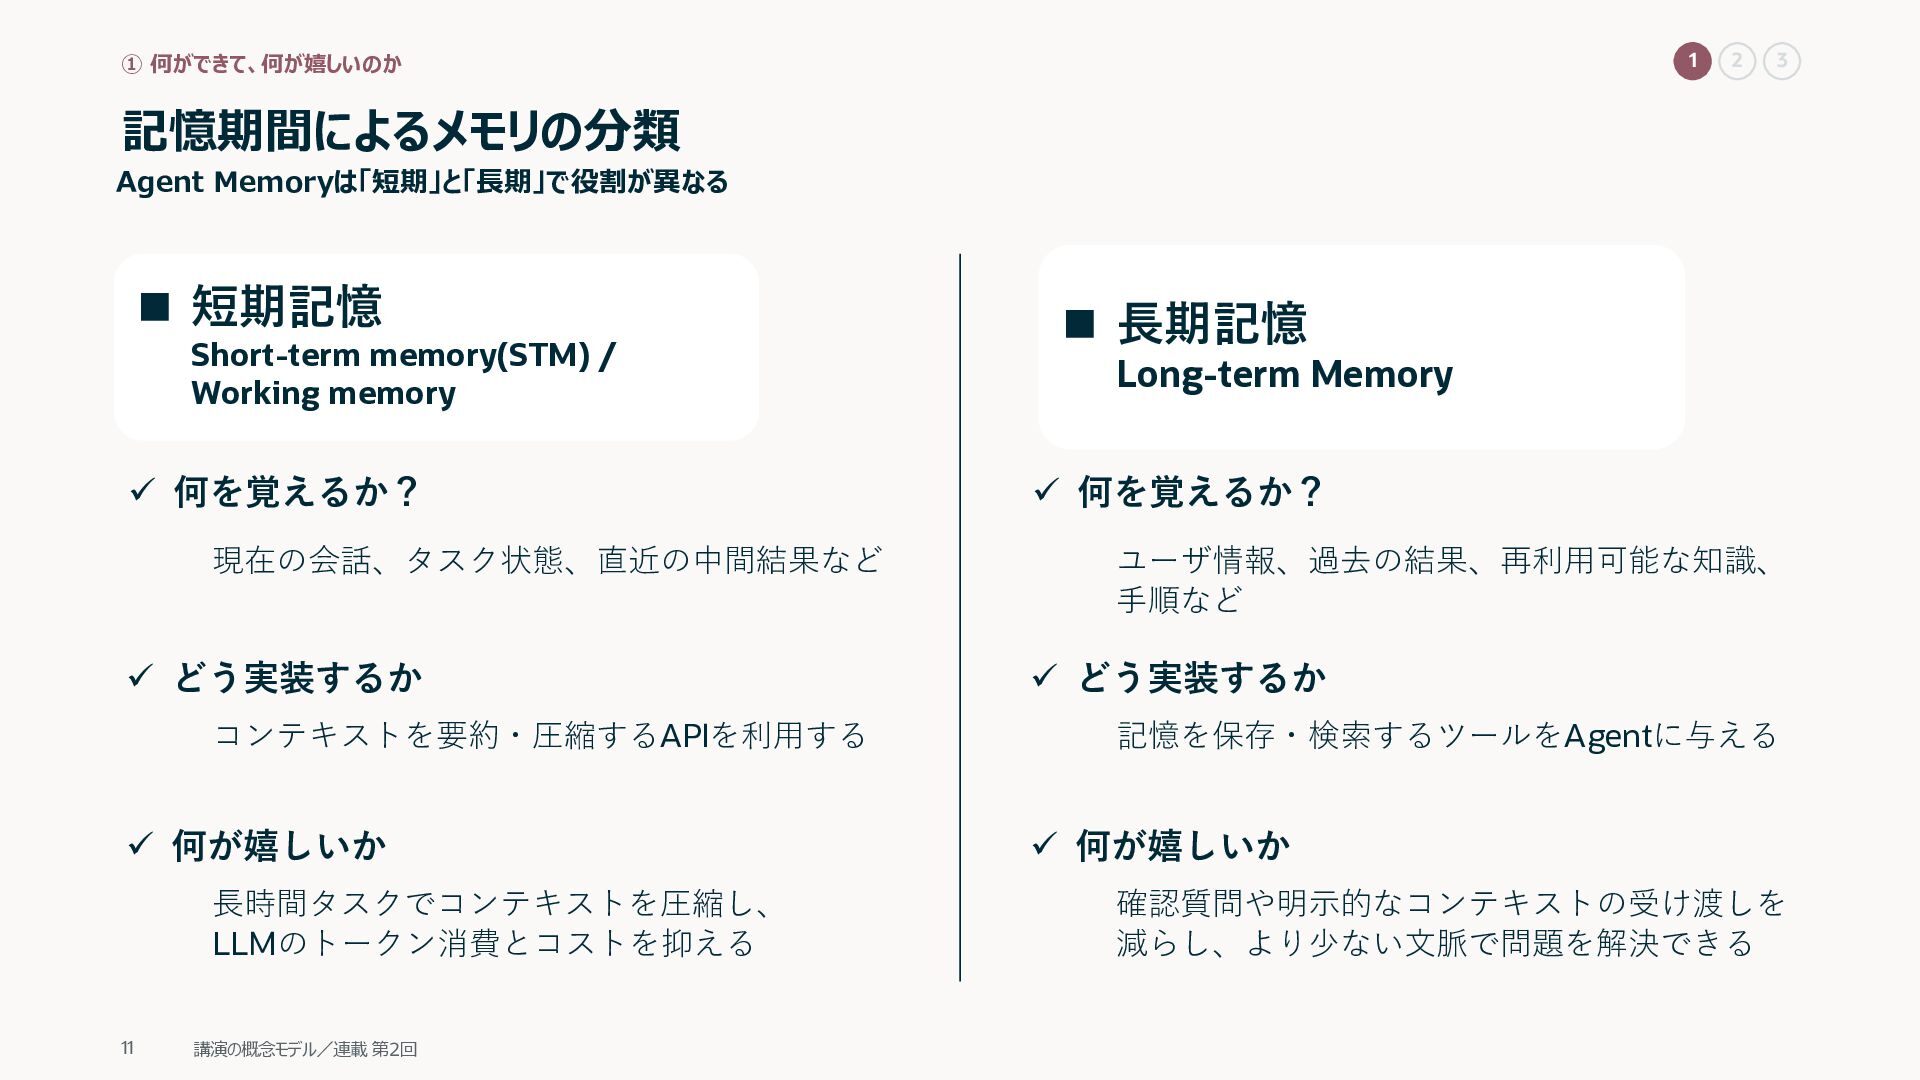
  9. 1 ① 何ができて、何が嬉しいのか 2 3 記憶期間によるメモリの分類 Agent Memoryは「短期」と「⻑期」で役割が異なる n 短期記憶

    Short-term memory(STM) / Working memory ü 何を覚えるか? 現在の会話、タスク状態、直近の中間結果など ü どう実装するか コンテキストを要約・圧縮するAPIを利⽤する ü 何が嬉しいか ⻑時間タスクでコンテキストを圧縮し、 LLMのトークン消費とコストを抑える 11 講演の概念モデル/連載 第2回 n ⻑期記憶 Long-term Memory ü 何を覚えるか? ユーザ情報、過去の結果、再利⽤可能な知識、 ⼿順など ü どう実装するか 記憶を保存・検索するツールをAgentに与える ü 何が嬉しいか 確認質問や明⽰的なコンテキストの受け渡しを 減らし、より少ない⽂脈で問題を解決できる
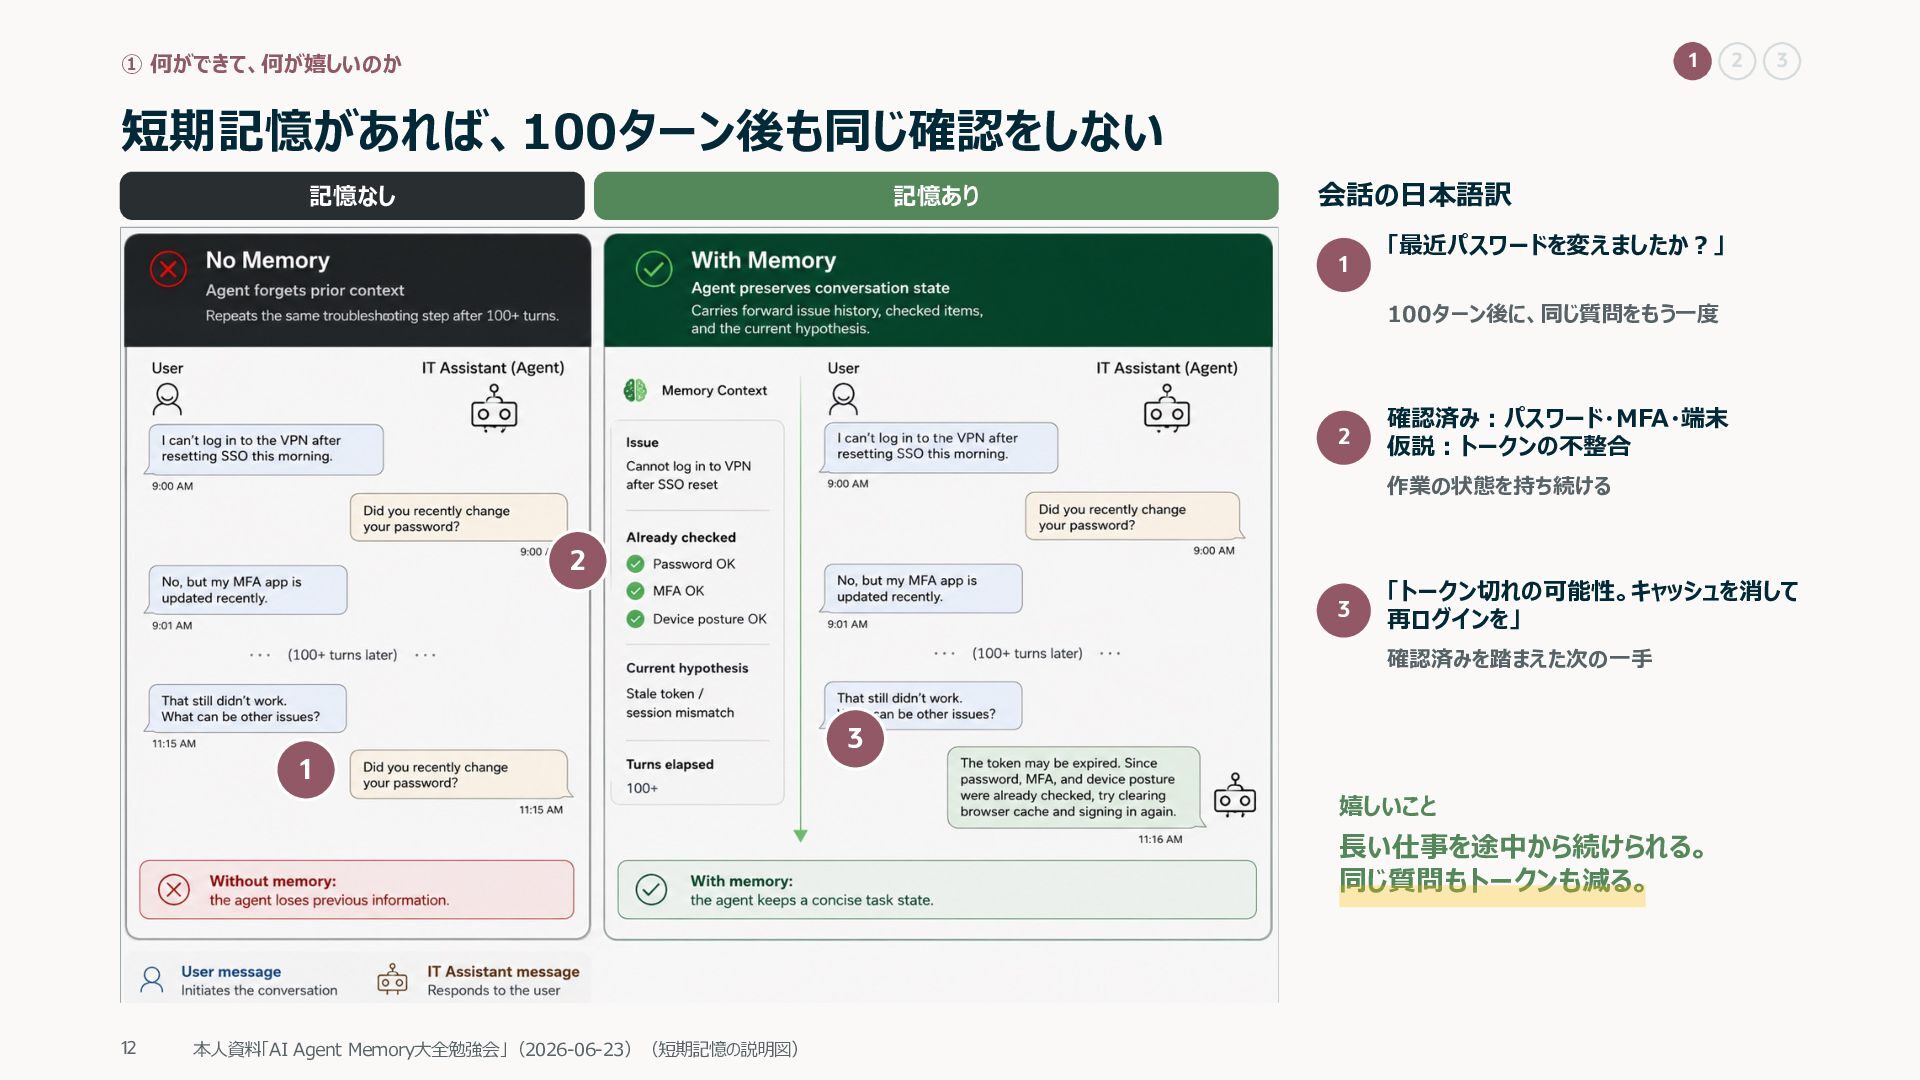
  10. 1 ① 何ができて、何が嬉しいのか 2 3 短期記憶があれば、100ターン後も同じ確認をしない 記憶なし 記憶あり 会話の⽇本語訳 1

    「最近パスワードを変えましたか︖」 100ターン後に、同じ質問をもう⼀度 2 確認済み︓パスワード・MFA・端末 仮説︓トークンの不整合 作業の状態を持ち続ける 2 3 「トークン切れの可能性。キャッシュを消して 再ログインを」 確認済みを踏まえた次の⼀⼿ 1 3 嬉しいこと ⻑い仕事を途中から続けられる。 同じ質問もトークンも減る。 12 本⼈資料「AI Agent Memory⼤全勉強会」(2026-06-23)(短期記憶の説明図)
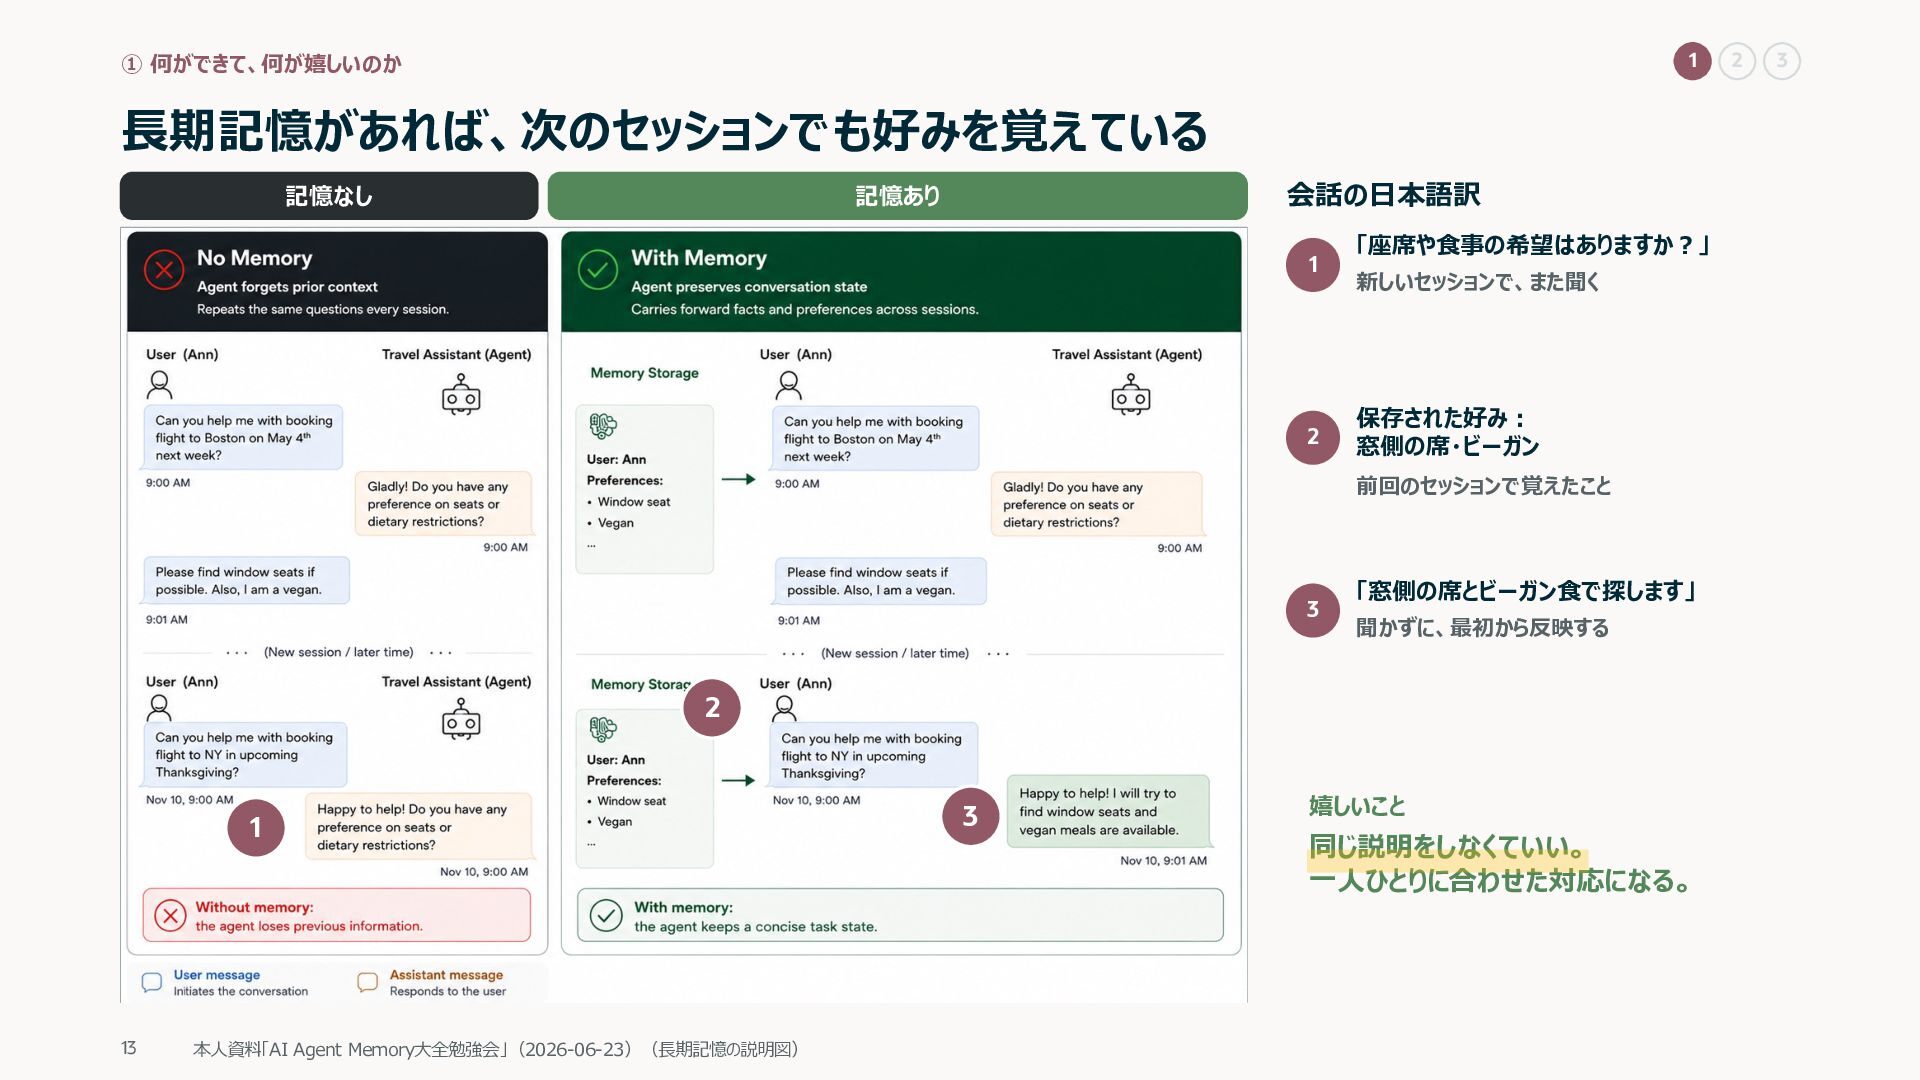
  11. 1 ① 何ができて、何が嬉しいのか ⻑期記憶があれば、次のセッションでも好みを覚えている 記憶なし 会話の⽇本語訳 記憶あり 1 2 「座席や⾷事の希望はありますか︖」

    新しいセッションで、また聞く 保存された好み︓ 窓側の席・ビーガン 前回のセッションで覚えたこと 3 「窓側の席とビーガン⾷で探します」 聞かずに、最初から反映する 2 1 13 本⼈資料「AI Agent Memory⼤全勉強会」(2026-06-23)(⻑期記憶の説明図) 3 嬉しいこと 同じ説明をしなくていい。 ⼀⼈ひとりに合わせた対応になる。 2 3
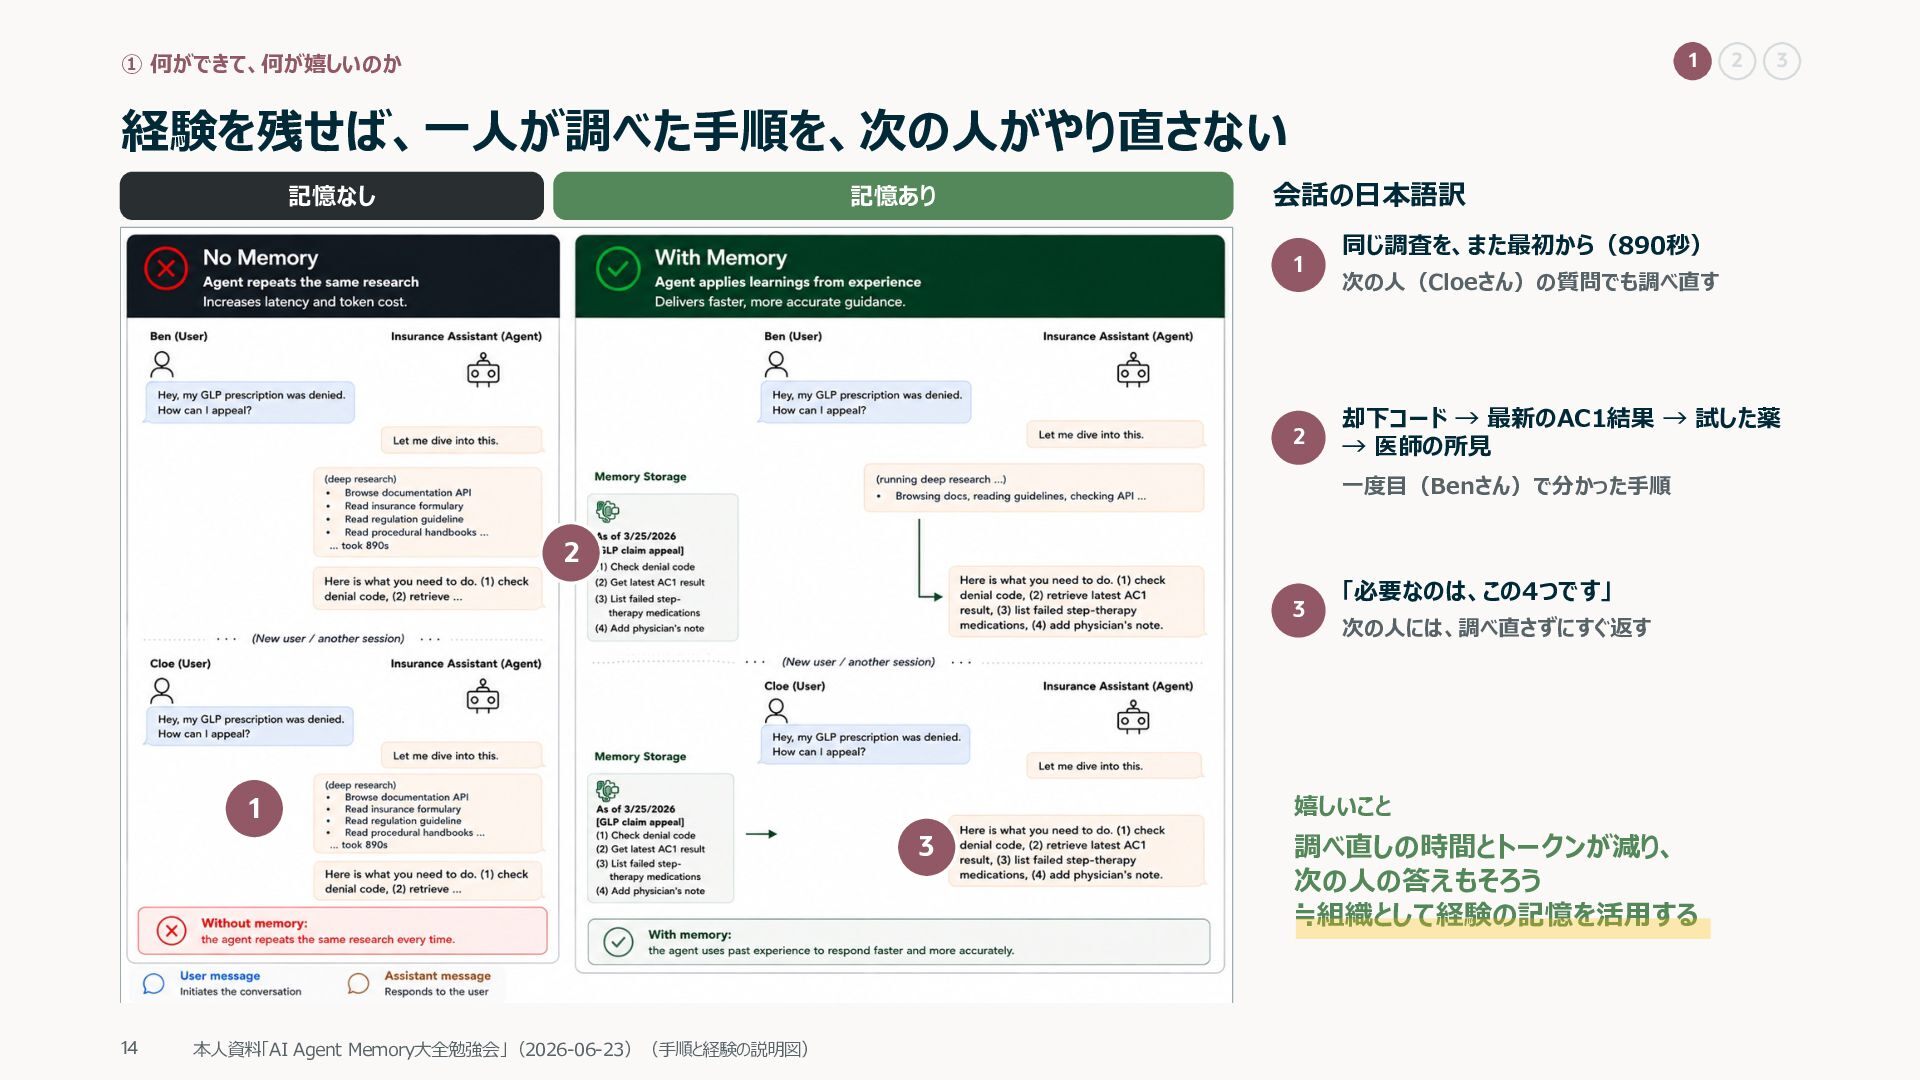
  12. 1 ① 何ができて、何が嬉しいのか 2 3 経験を残せば、⼀⼈が調べた⼿順を、次の⼈がやり直さない 記憶なし 記憶あり 会話の⽇本語訳 1

    2 同じ調査を、また最初から(890秒) 次の⼈(Cloeさん)の質問でも調べ直す 却下コード → 最新のAC1結果 → 試した薬 → 医師の所⾒ ⼀度⽬(Benさん)で分かった⼿順 2 3 1 本⼈資料「AI Agent Memory⼤全勉強会」(2026-06-23)(⼿順と経験の説明図) 次の⼈には、調べ直さずにすぐ返す 嬉しいこと 3 14 「必要なのは、この4つです」 調べ直しの時間とトークンが減り、 次の⼈の答えもそろう ≒組織として経験の記憶を活⽤する
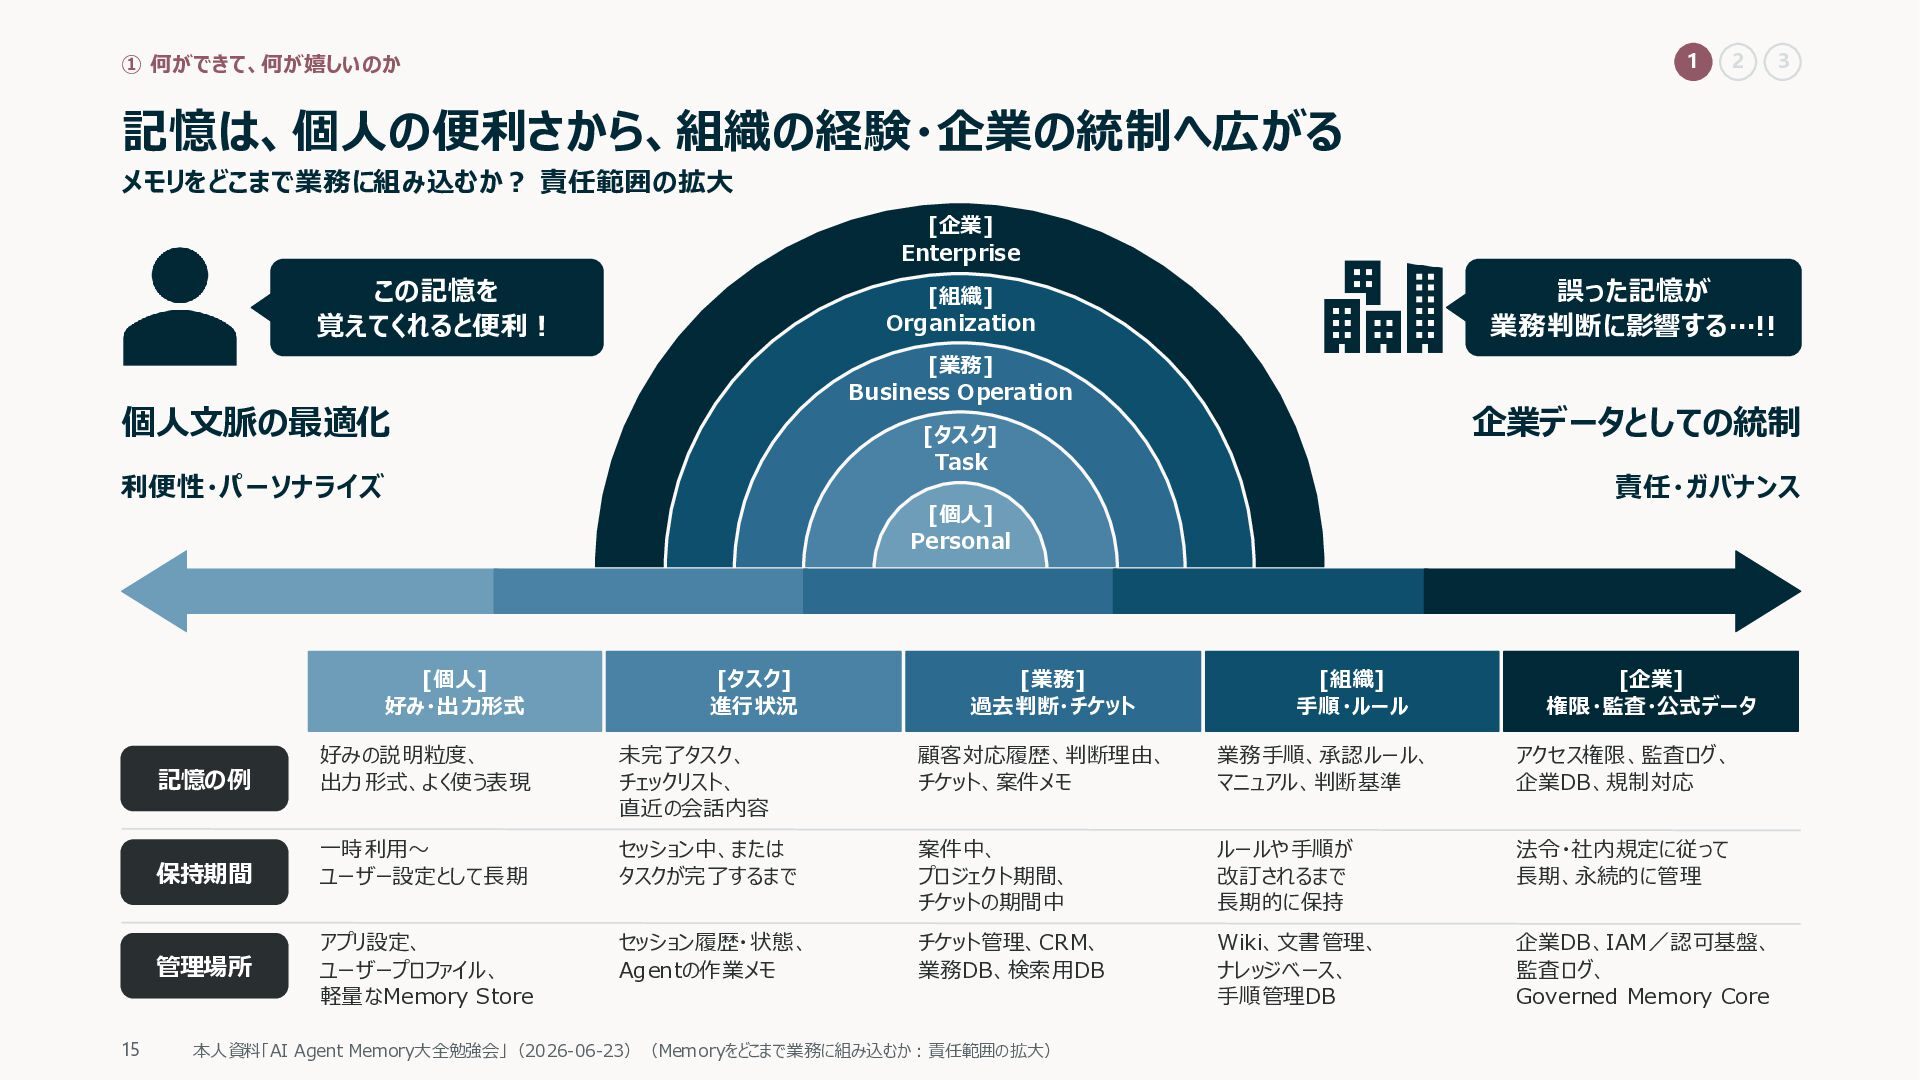
  13. 1 ① 何ができて、何が嬉しいのか 2 3 記憶は、個⼈の便利さから、組織の経験・企業の統制へ広がる メモリをどこまで業務に組み込むか︖ 責任範囲の拡⼤ [企業] Enterprise

    この記憶を 覚えてくれると便利︕ [業務] Business Operation 個⼈⽂脈の最適化 企業データとしての統制 [タスク] Task 利便性・パーソナライズ 責任・ガバナンス [個⼈] Personal [個⼈] 好み・出⼒形式 [タスク] 進⾏状況 [業務] 過去判断・チケット [組織] ⼿順・ルール [企業] 権限・監査・公式データ 記憶の例 好みの説明粒度、 出⼒形式、よく使う表現 未完了タスク、 チェックリスト、 直近の会話内容 顧客対応履歴、判断理由、 チケット、案件メモ 業務⼿順、承認ルール、 マニュアル、判断基準 アクセス権限、監査ログ、 企業DB、規制対応 保持期間 ⼀時利⽤〜 ユーザー設定として⻑期 セッション中、または タスクが完了するまで 案件中、 プロジェクト期間、 チケットの期間中 ルールや⼿順が 改訂されるまで ⻑期的に保持 法令・社内規定に従って ⻑期、永続的に管理 アプリ設定、 ユーザープロファイル、 軽量なMemory Store セッション履歴・状態、 Agentの作業メモ チケット管理、CRM、 業務DB、検索⽤DB Wiki、⽂書管理、 ナレッジベース、 ⼿順管理DB 企業DB、IAM/認可基盤、 監査ログ、 Governed Memory Core 管理場所 15 誤った記憶が 業務判断に影響する…!! [組織] Organization 本⼈資料「AI Agent Memory⼤全勉強会」(2026-06-23)(Memoryをどこまで業務に組み込むか︓責任範囲の拡⼤)
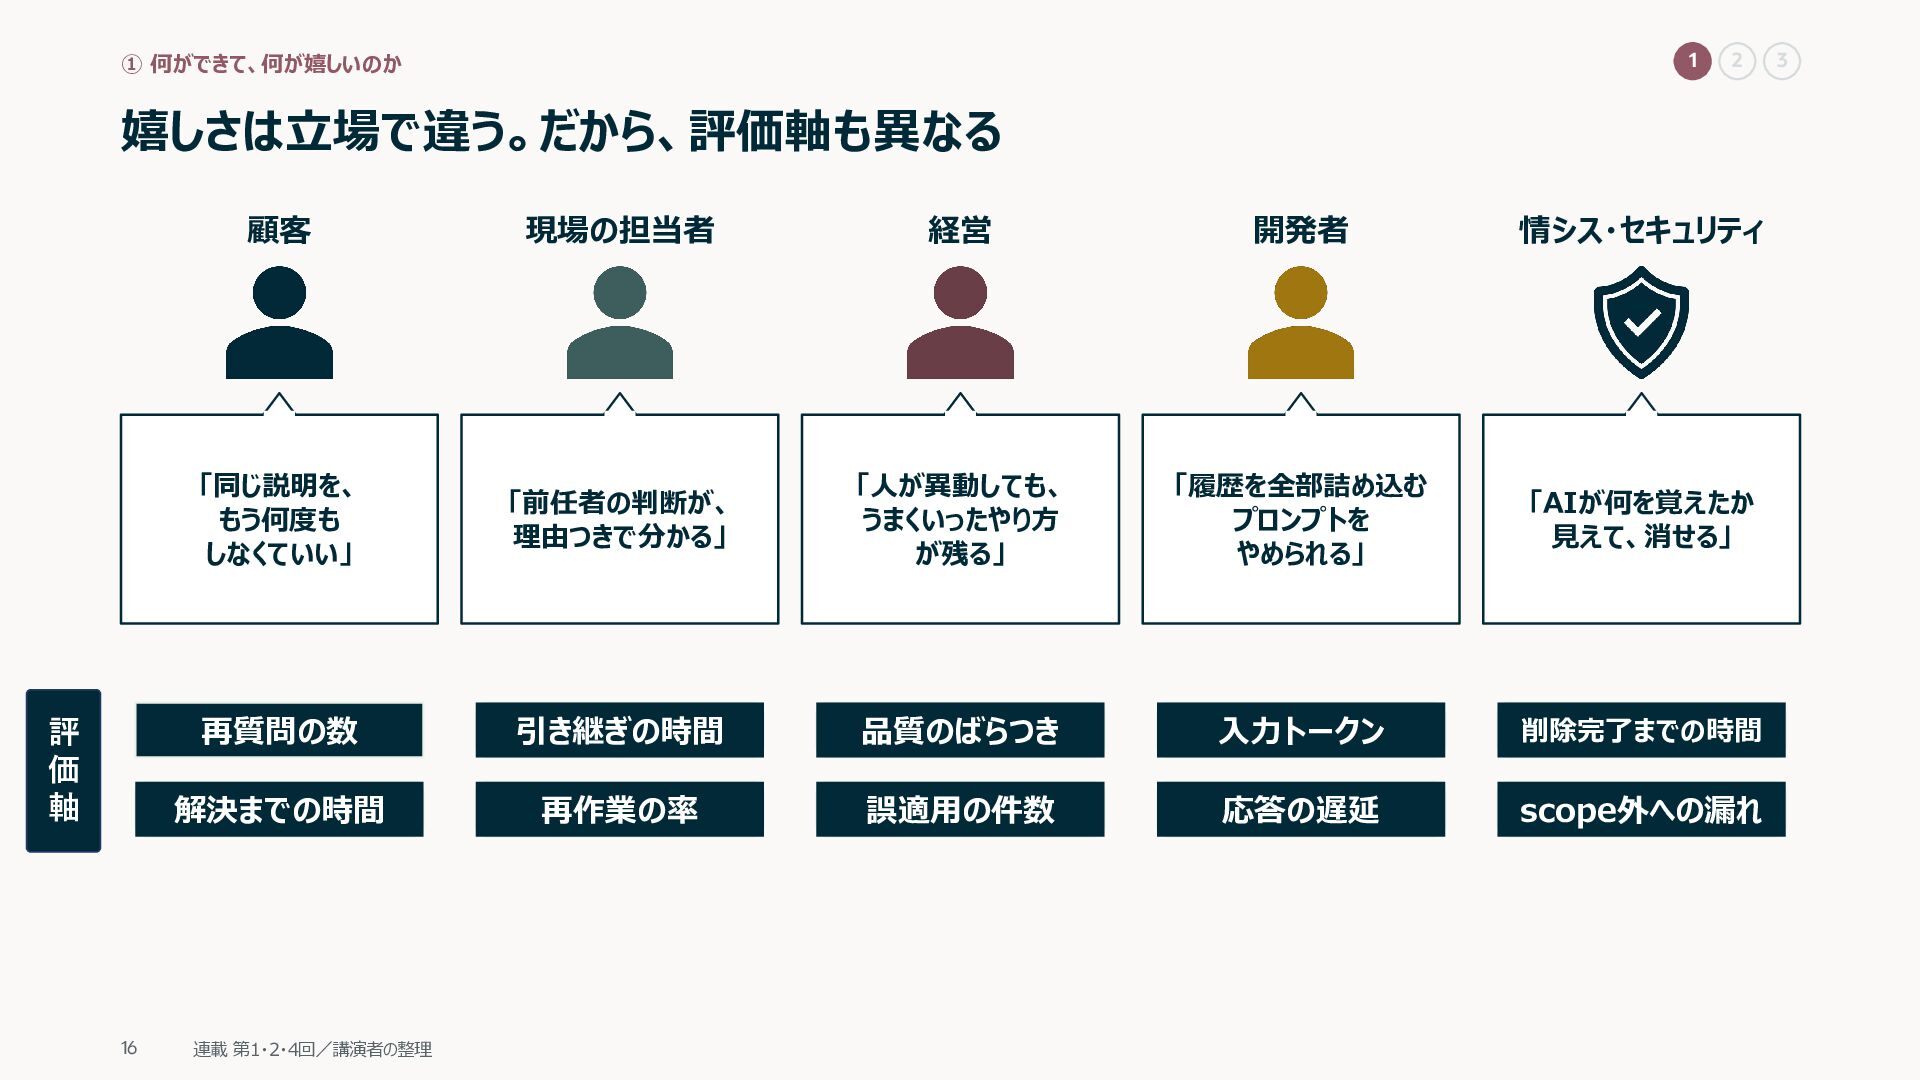
  14. 1 ① 何ができて、何が嬉しいのか 2 嬉しさは⽴場で違う。だから、評価軸も異なる 評 価 軸 16 顧客

    現場の担当者 経営 開発者 情シス・セキュリティ 「同じ説明を、 もう何度も しなくていい」 「前任者の判断が、 理由つきで分かる」 「⼈が異動しても、 うまくいったやり⽅ が残る」 「履歴を全部詰め込む プロンプトを やめられる」 「AIが何を覚えたか ⾒えて、消せる」 再質問の数 引き継ぎの時間 品質のばらつき ⼊⼒トークン 削除完了までの時間 解決までの時間 再作業の率 誤適⽤の件数 応答の遅延 scope外への漏れ 連載 第1・2・4回/講演者の整理 3
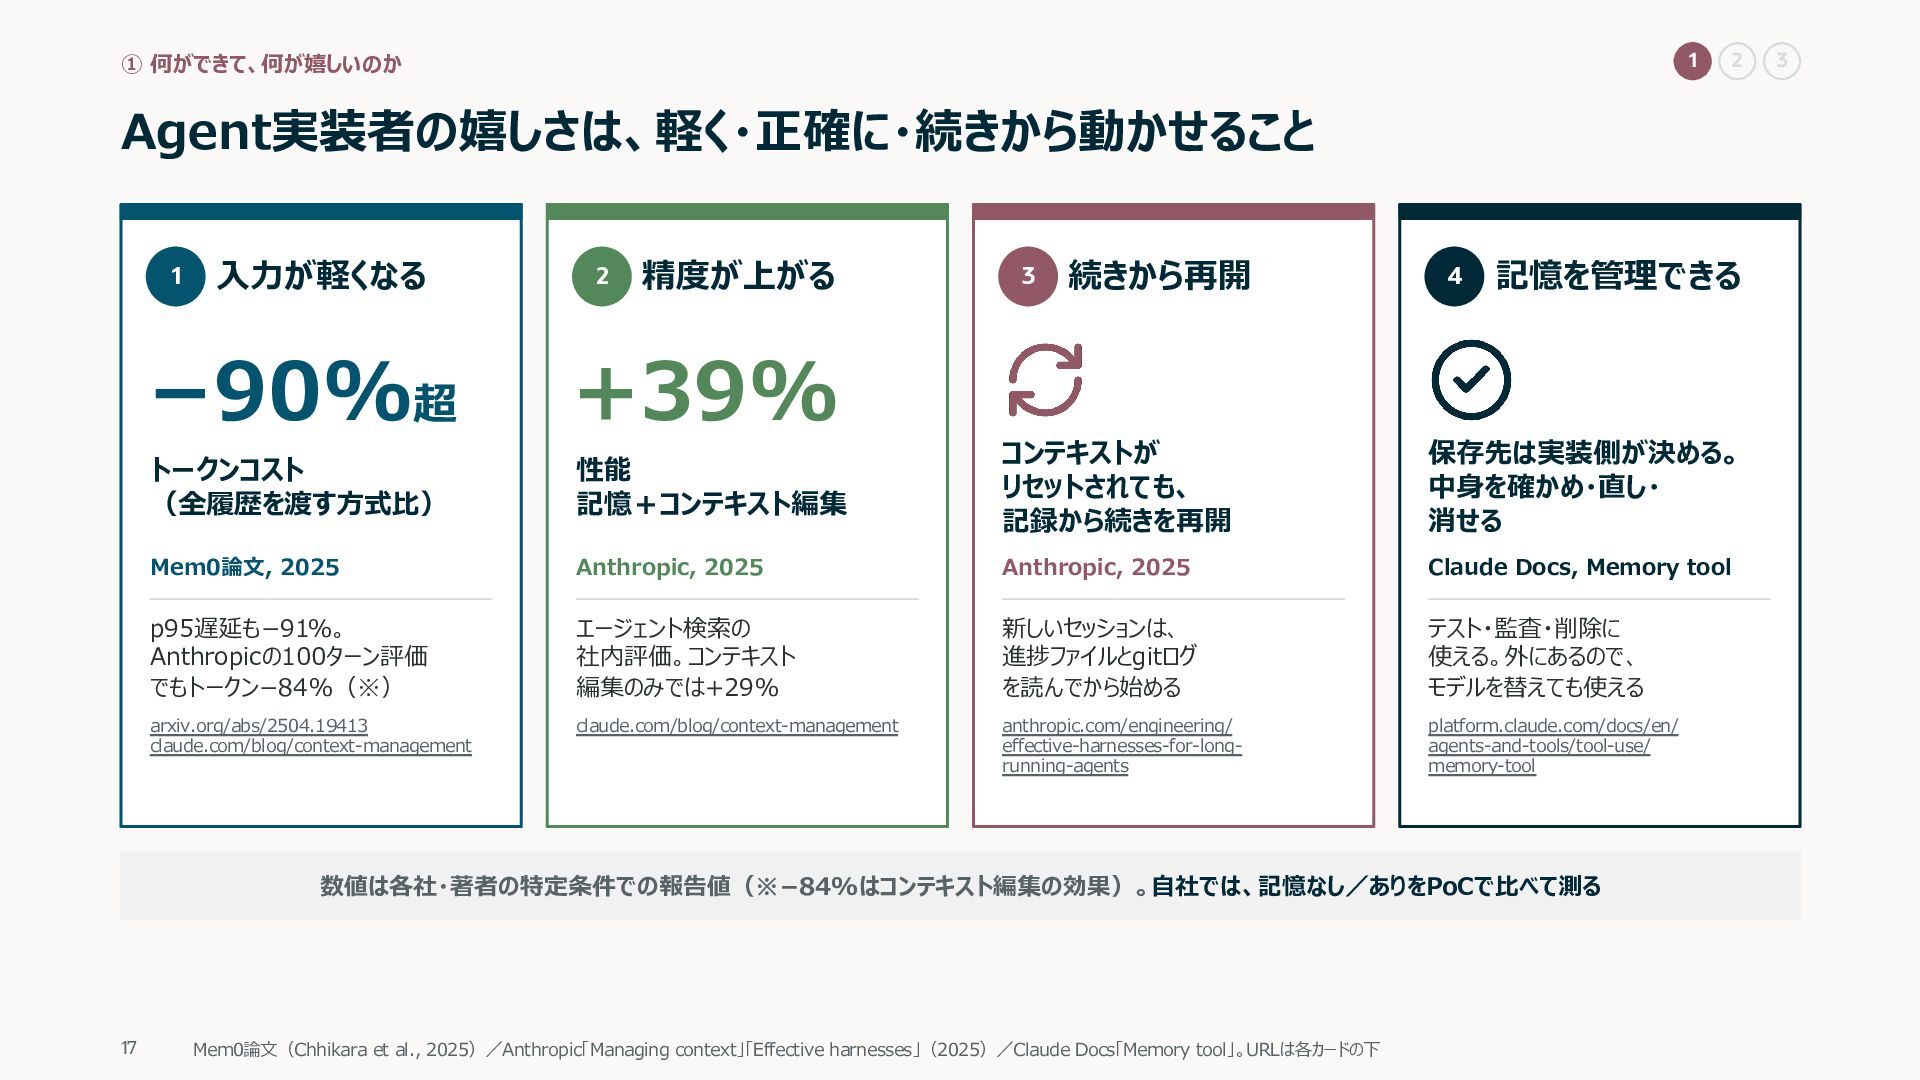
  15. 1 ① 何ができて、何が嬉しいのか 2 Agent実装者の嬉しさは、軽く・正確に・続きから動かせること 1 ⼊⼒が軽くなる 2 精度が上がる 3

    続きから再開 4 記憶を管理できる ­90%超 +39% トークンコスト (全履歴を渡す⽅式⽐) 性能 記憶+コンテキスト編集 コンテキストが リセットされても、 記録から続きを再開 保存先は実装側が決める。 中⾝を確かめ・直し・ 消せる Mem0論⽂, 2025 Anthropic, 2025 Anthropic, 2025 Claude Docs, Memory tool p95遅延も­91%。 Anthropicの100ターン評価 でもトークン­84%(※) エージェント検索の 社内評価。コンテキスト 編集のみでは+29% 新しいセッションは、 進捗ファイルとgitログ を読んでから始める テスト・監査・削除に 使える。外にあるので、 モデルを替えても使える arxiv.org/abs/2504.19413 claude.com/blog/context-management claude.com/blog/context-management anthropic.com/engineering/ effective-harnesses-for-longrunning-agents platform.claude.com/docs/en/ agents-and-tools/tool-use/ memory-tool 数値は各社・著者の特定条件での報告値(※­84%はコンテキスト編集の効果)。⾃社では、記憶なし/ありをPoCで⽐べて測る 17 Mem0論⽂(Chhikara et al., 2025)/Anthropic「Managing context」「Effective harnesses」(2025)/Claude Docs「Memory tool」。URLは各カードの下 3
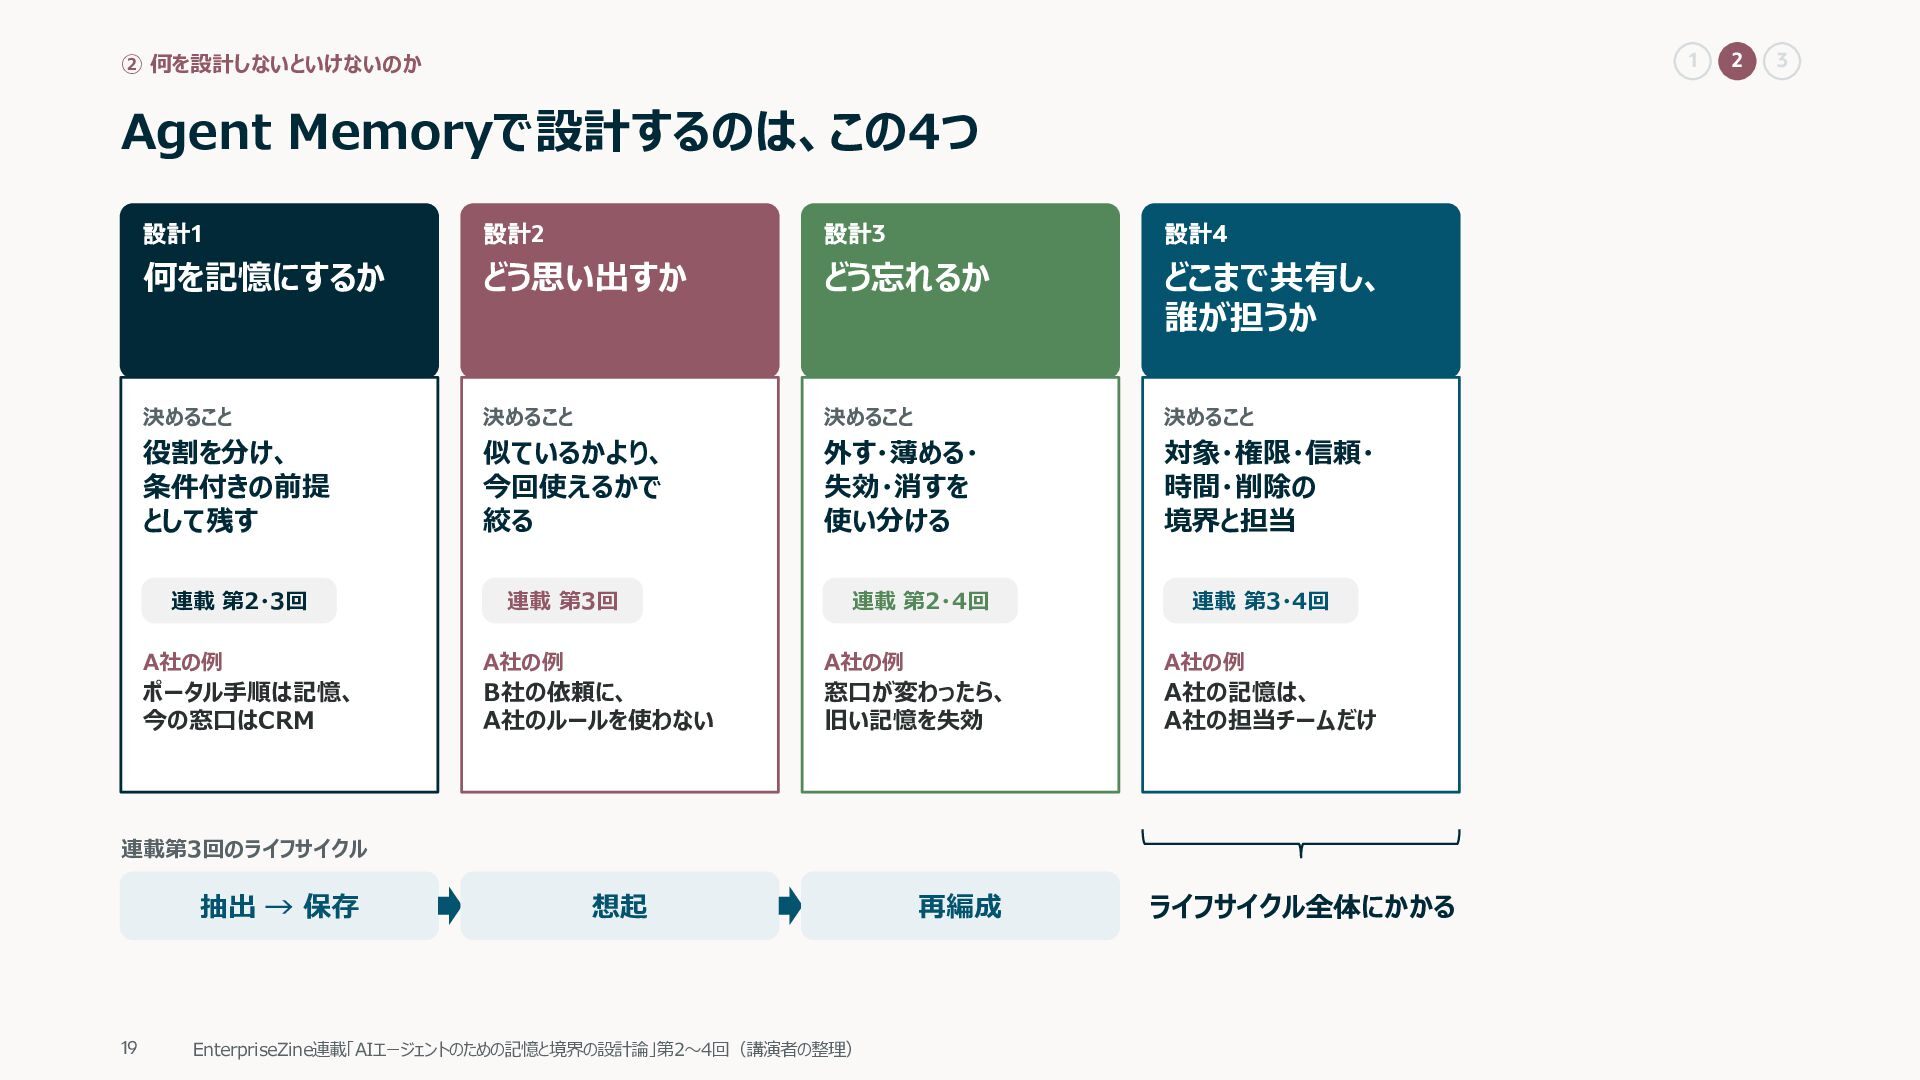
  16. 1 ② 何を設計しないといけないのか Agent Memoryで設計するのは、この4つ 設計1 設計2 設計3 設計4 何を記憶にするか

    どう思い出すか どう忘れるか どこまで共有し、 誰が担うか 決めること 決めること 決めること 決めること 役割を分け、 条件付きの前提 として残す 似ているかより、 今回使えるかで 絞る 外す・薄める・ 失効・消すを 使い分ける 対象・権限・信頼・ 時間・削除の 境界と担当 連載 第2・3回 連載 第3回 連載 第2・4回 連載 第3・4回 A社の例 A社の例 A社の例 A社の例 ポータル⼿順は記憶、 今の窓⼝はCRM B社の依頼に、 A社のルールを使わない 窓⼝が変わったら、 旧い記憶を失効 A社の記憶は、 A社の担当チームだけ 連載第3回のライフサイクル 抽出 → 保存 19 想起 EnterpriseZine連載「AIエージェントのための記憶と境界の設計論」第2〜4回(講演者の整理) 再編成 ライフサイクル全体にかかる 2 3
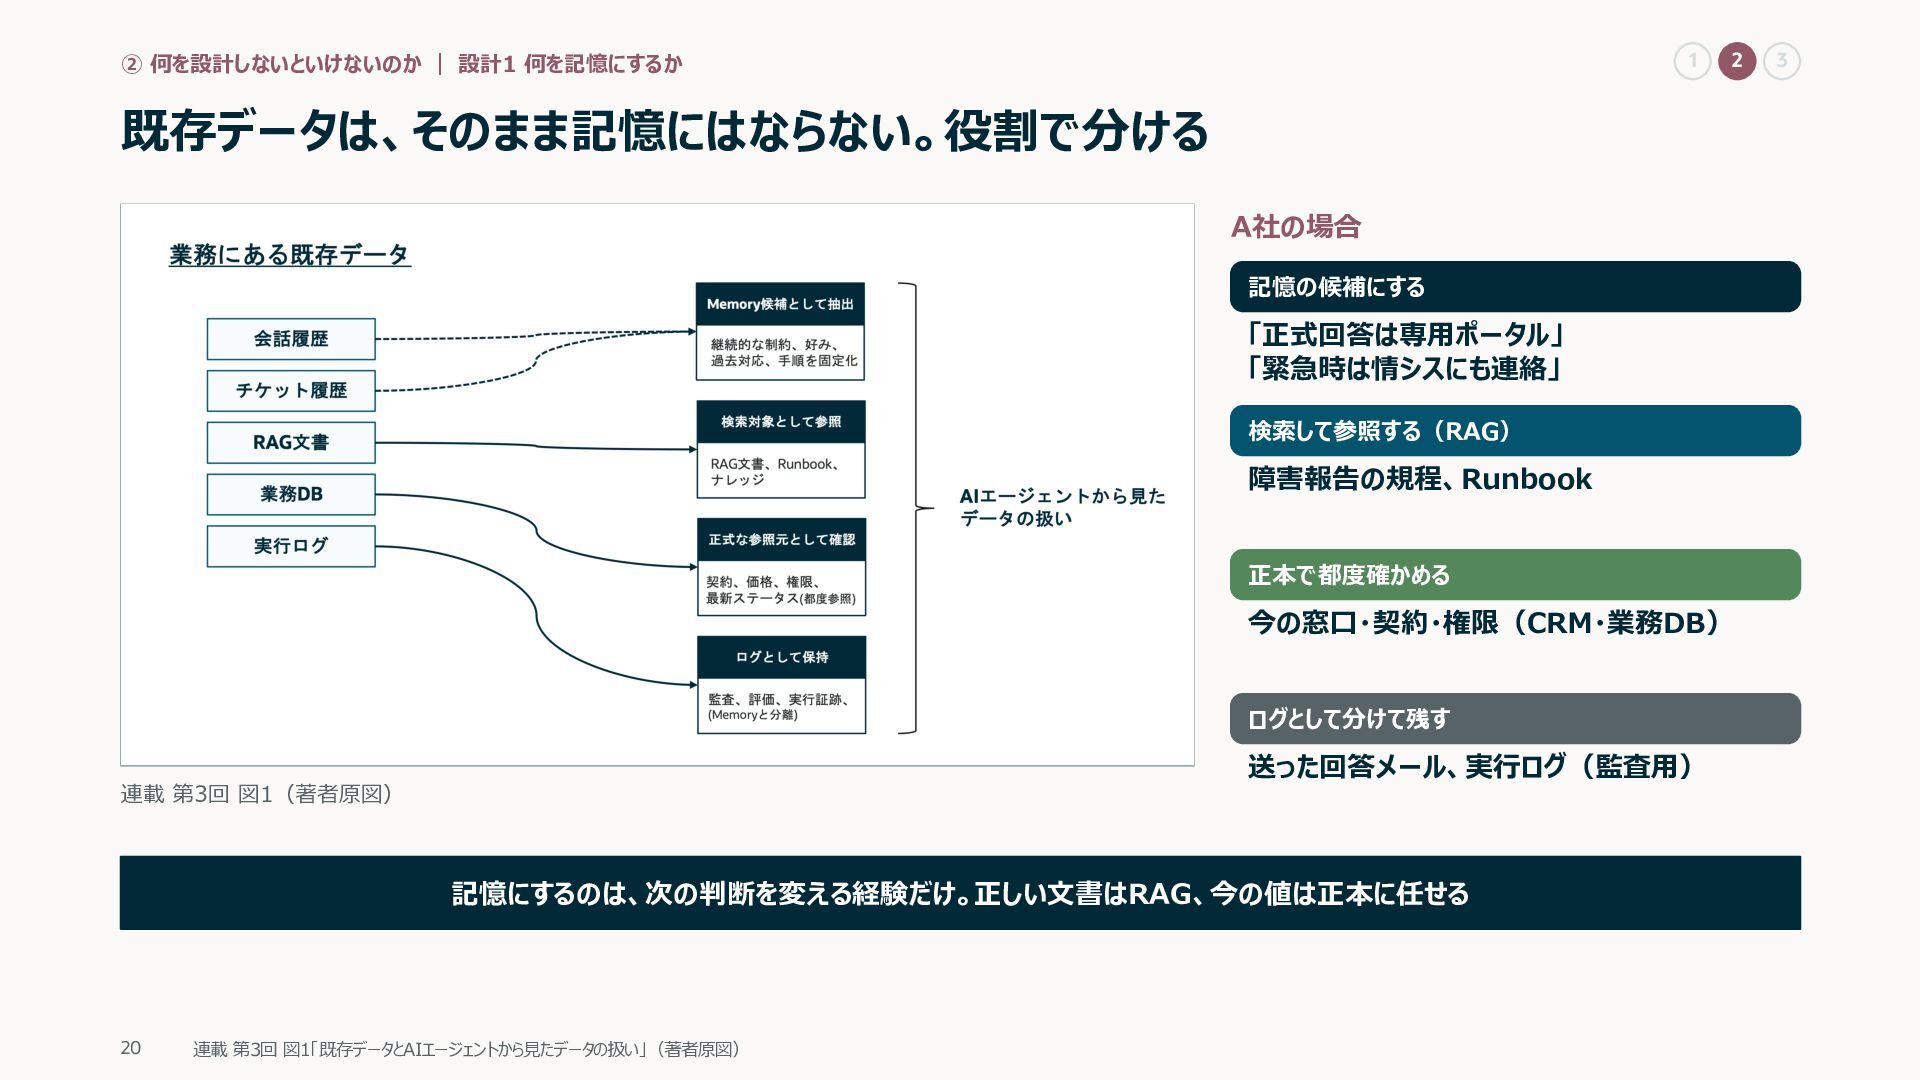
  17. 1 ② 何を設計しないといけないのか | 設計1 何を記憶にするか 2 既存データは、そのまま記憶にはならない。役割で分ける A社の場合 記憶の候補にする

    「正式回答は専⽤ポータル」 「緊急時は情シスにも連絡」 検索して参照する(RAG) 障害報告の規程、Runbook 正本で都度確かめる 今の窓⼝・契約・権限(CRM・業務DB) ログとして分けて残す 送った回答メール、実⾏ログ(監査⽤) 連載 第3回 図1(著者原図) 記憶にするのは、次の判断を変える経験だけ。正しい⽂書はRAG、今の値は正本に任せる 20 連載 第3回 図1「既存データとAIエージェントから⾒たデータの扱い」(著者原図) 3
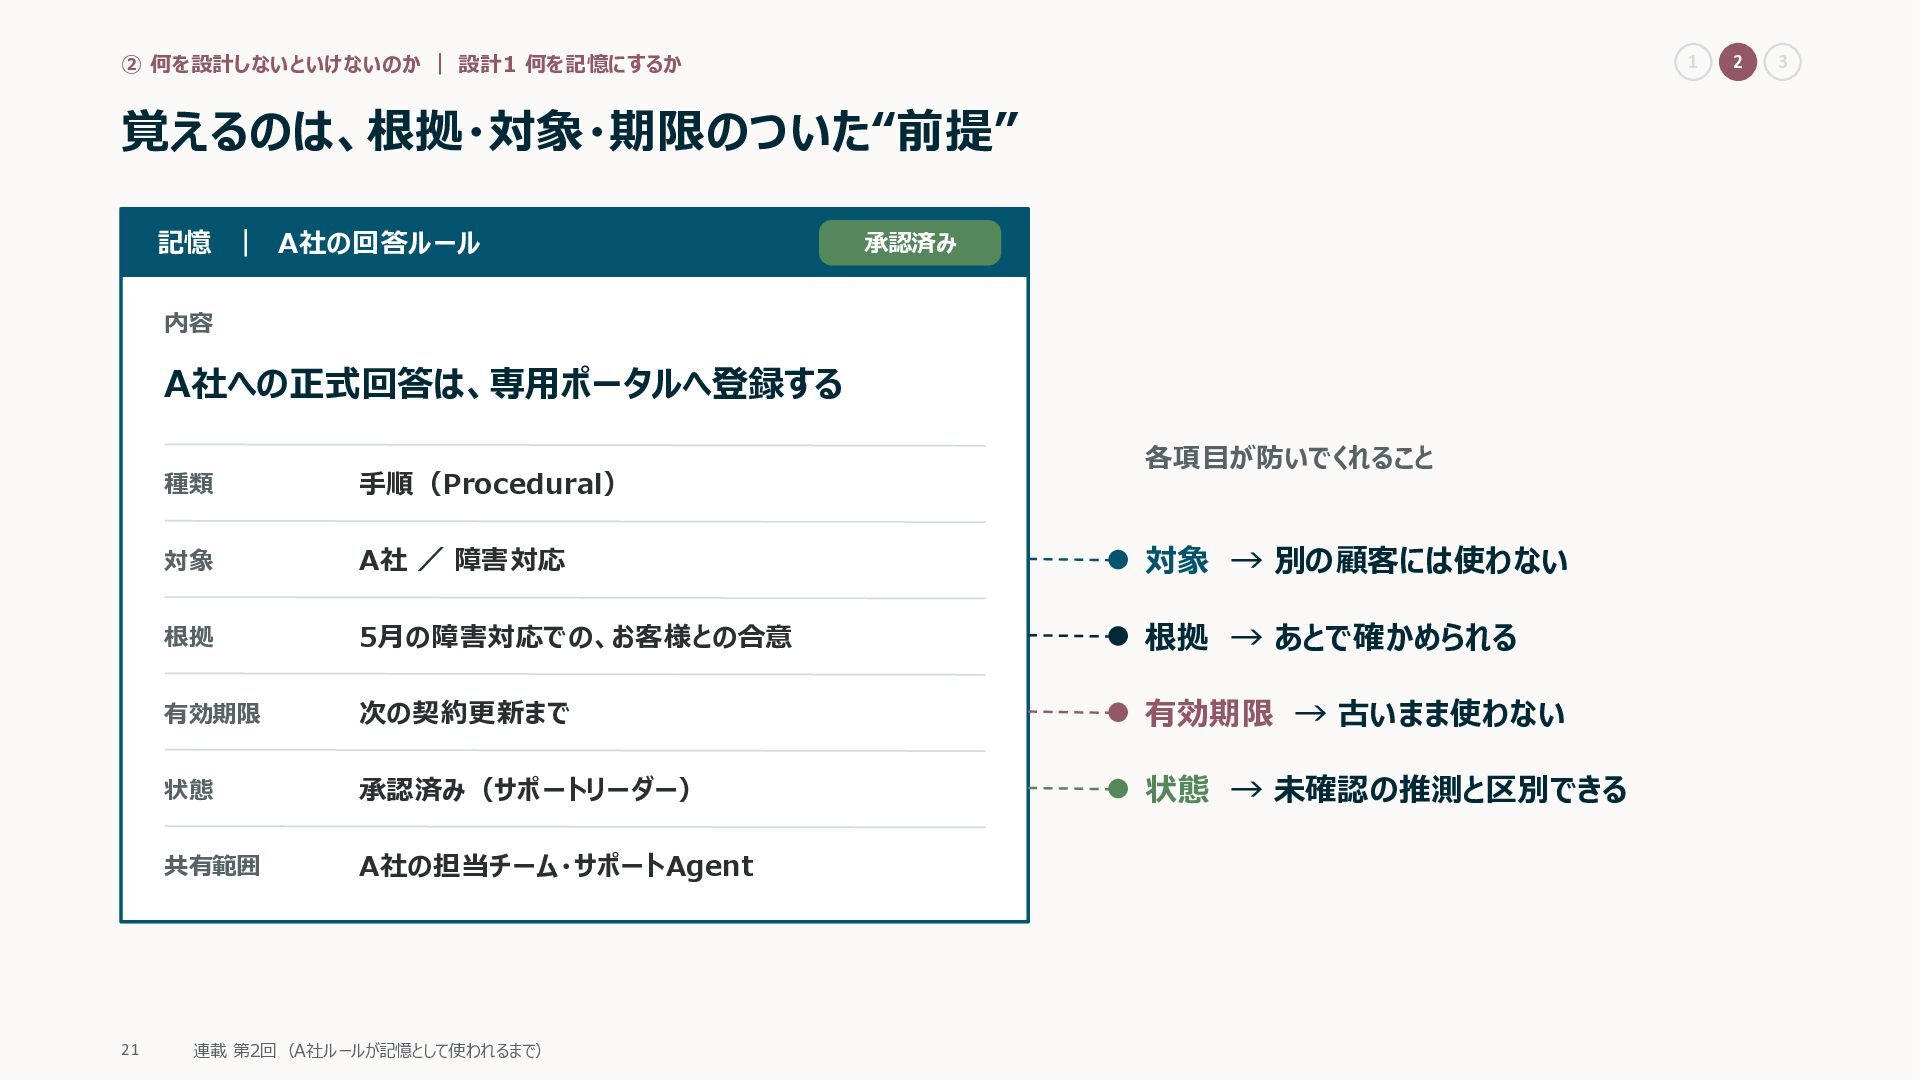
  18. 1 ② 何を設計しないといけないのか | 設計1 何を記憶にするか 覚えるのは、根拠・対象・期限のついた“前提” 記憶 | A社の回答ルール

    承認済み 内容 A社への正式回答は、専⽤ポータルへ登録する 21 各項⽬が防いでくれること 種類 ⼿順(Procedural) 対象 A社 / 障害対応 対象 → 別の顧客には使わない 根拠 5⽉の障害対応での、お客様との合意 根拠 → あとで確かめられる 有効期限 次の契約更新まで 有効期限 → 古いまま使わない 状態 承認済み(サポートリーダー) 状態 → 未確認の推測と区別できる 共有範囲 A社の担当チーム・サポートAgent 連載 第2回(A社ルールが記憶として使われるまで) 2 3
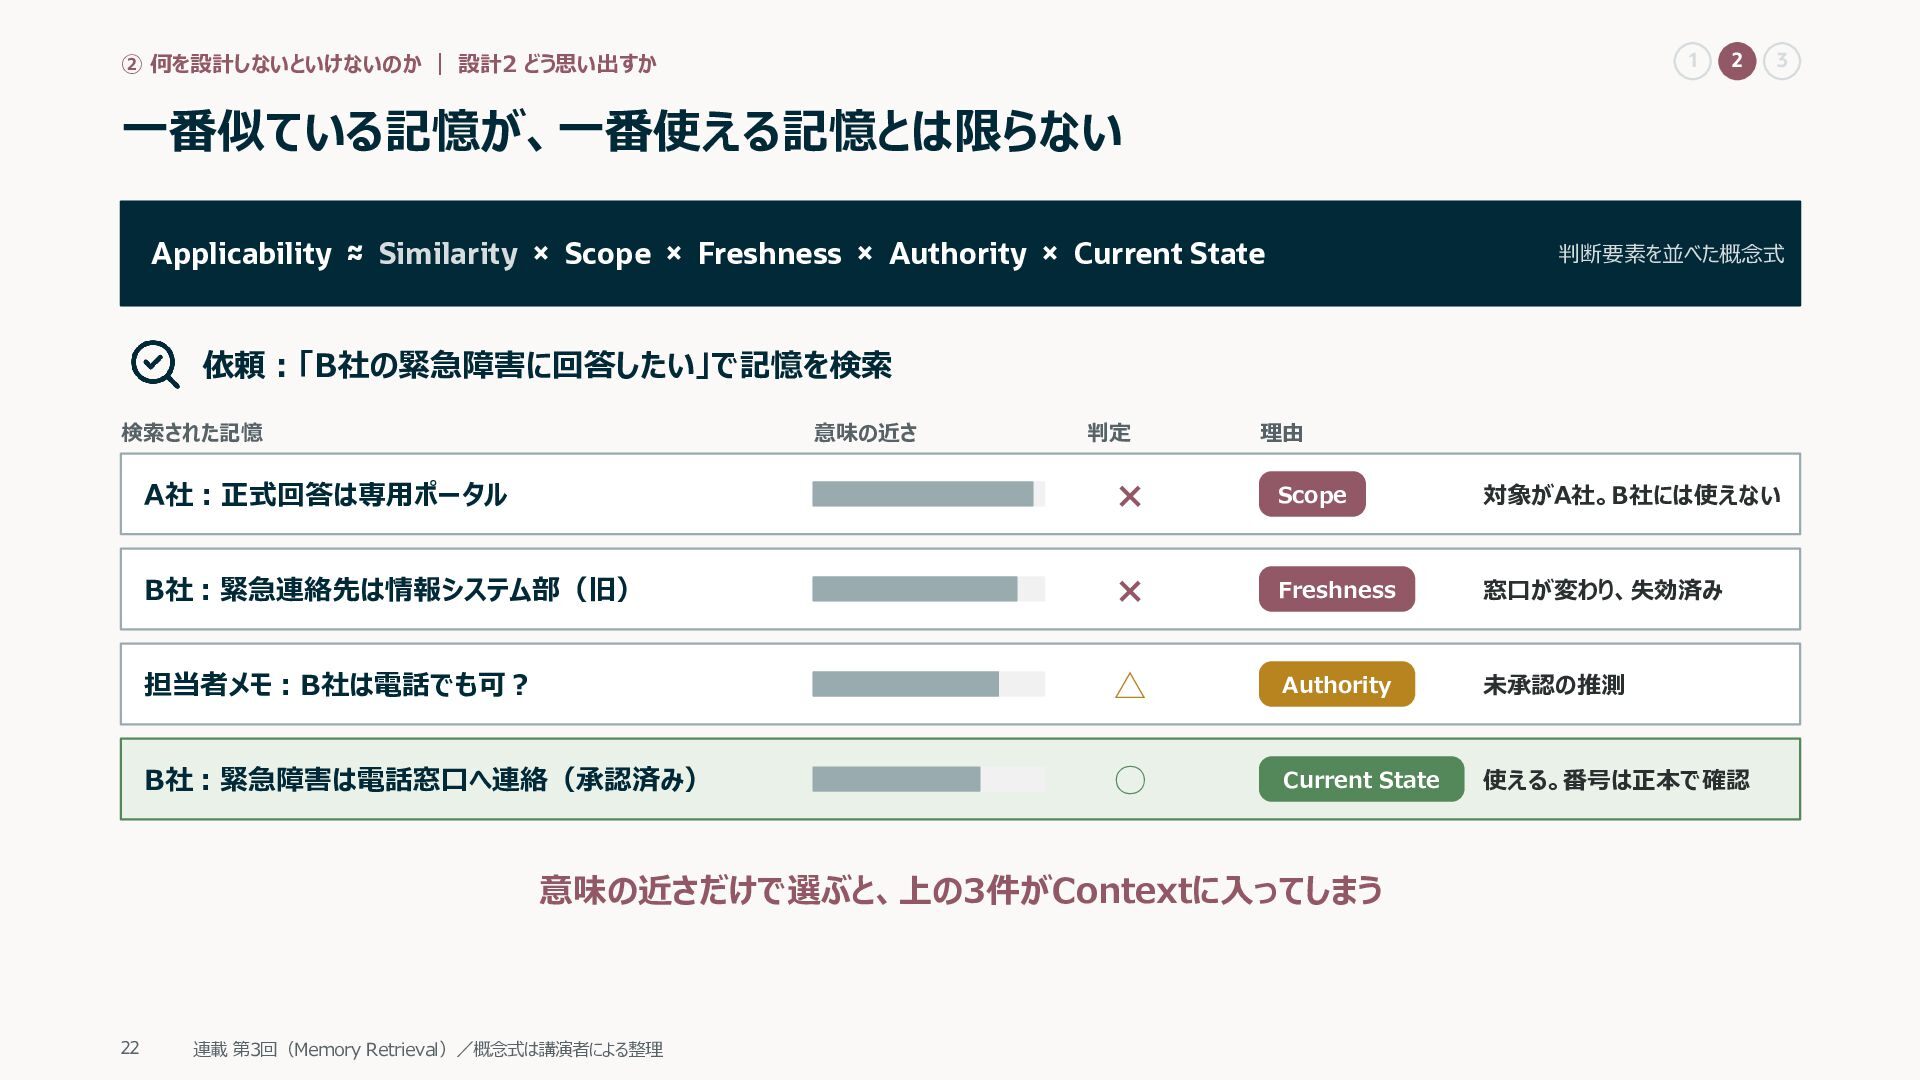
  19. 1 ② 何を設計しないといけないのか | 設計2 どう思い出すか 2 3 ⼀番似ている記憶が、⼀番使える記憶とは限らない Applicability

    ≈ Similarity × Scope × Freshness × Authority × Current State 判断要素を並べた概念式 依頼︓「B社の緊急障害に回答したい」で記憶を検索 検索された記憶 意味の近さ 判定 理由 A社︓正式回答は専⽤ポータル × Scope 対象がA社。B社には使えない B社︓緊急連絡先は情報システム部(旧) × Freshness 窓⼝が変わり、失効済み 担当者メモ︓B社は電話でも可︖ △ Authority 未承認の推測 B社︓緊急障害は電話窓⼝へ連絡(承認済み) ◦ Current State 使える。番号は正本で確認 意味の近さだけで選ぶと、上の3件がContextに⼊ってしまう 22 連載 第3回(Memory Retrieval)/概念式は講演者による整理
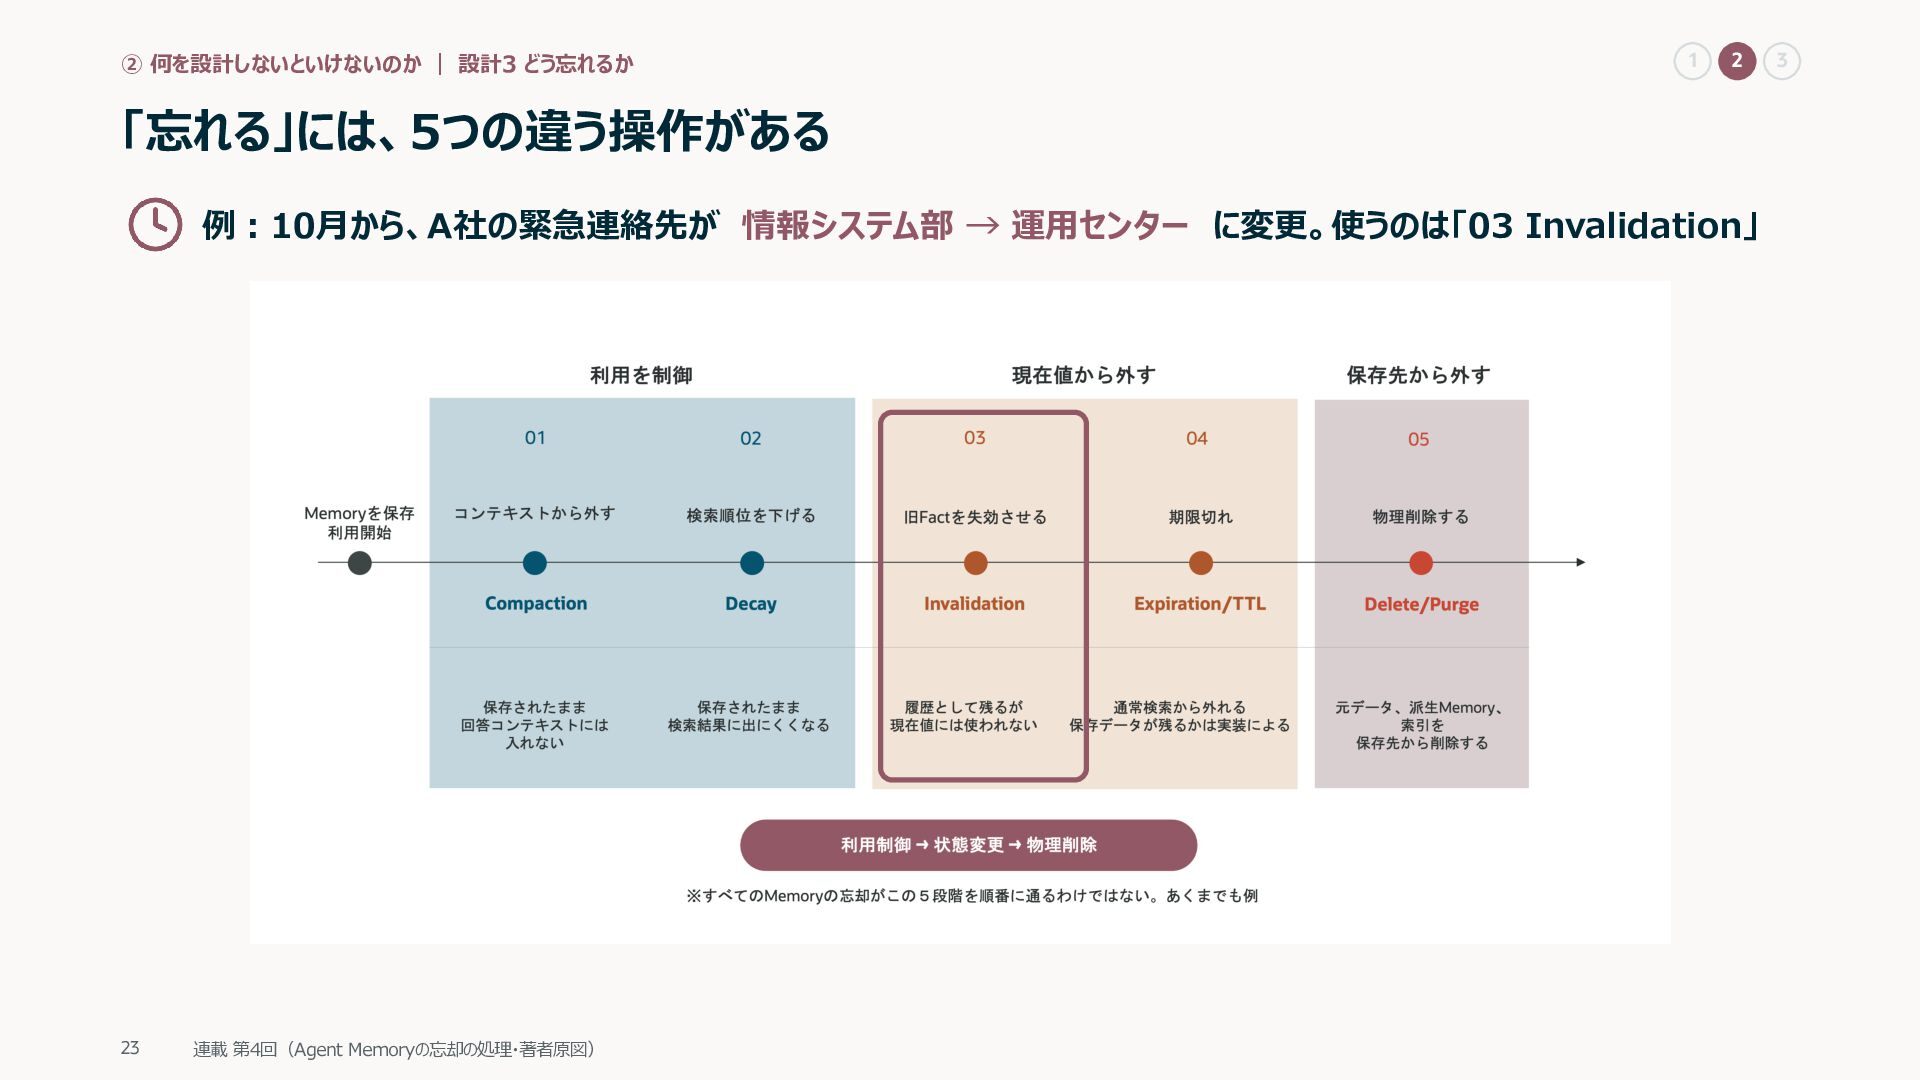
  20. ② 何を設計しないといけないのか | 設計3 どう忘れるか 1 2 「忘れる」には、5つの違う操作がある 例︓10⽉から、A社の緊急連絡先が 情報システム部

    → 運⽤センター に変更。使うのは「03 Invalidation」 23 連載 第4回(Agent Memoryの忘却の処理・著者原図) 3
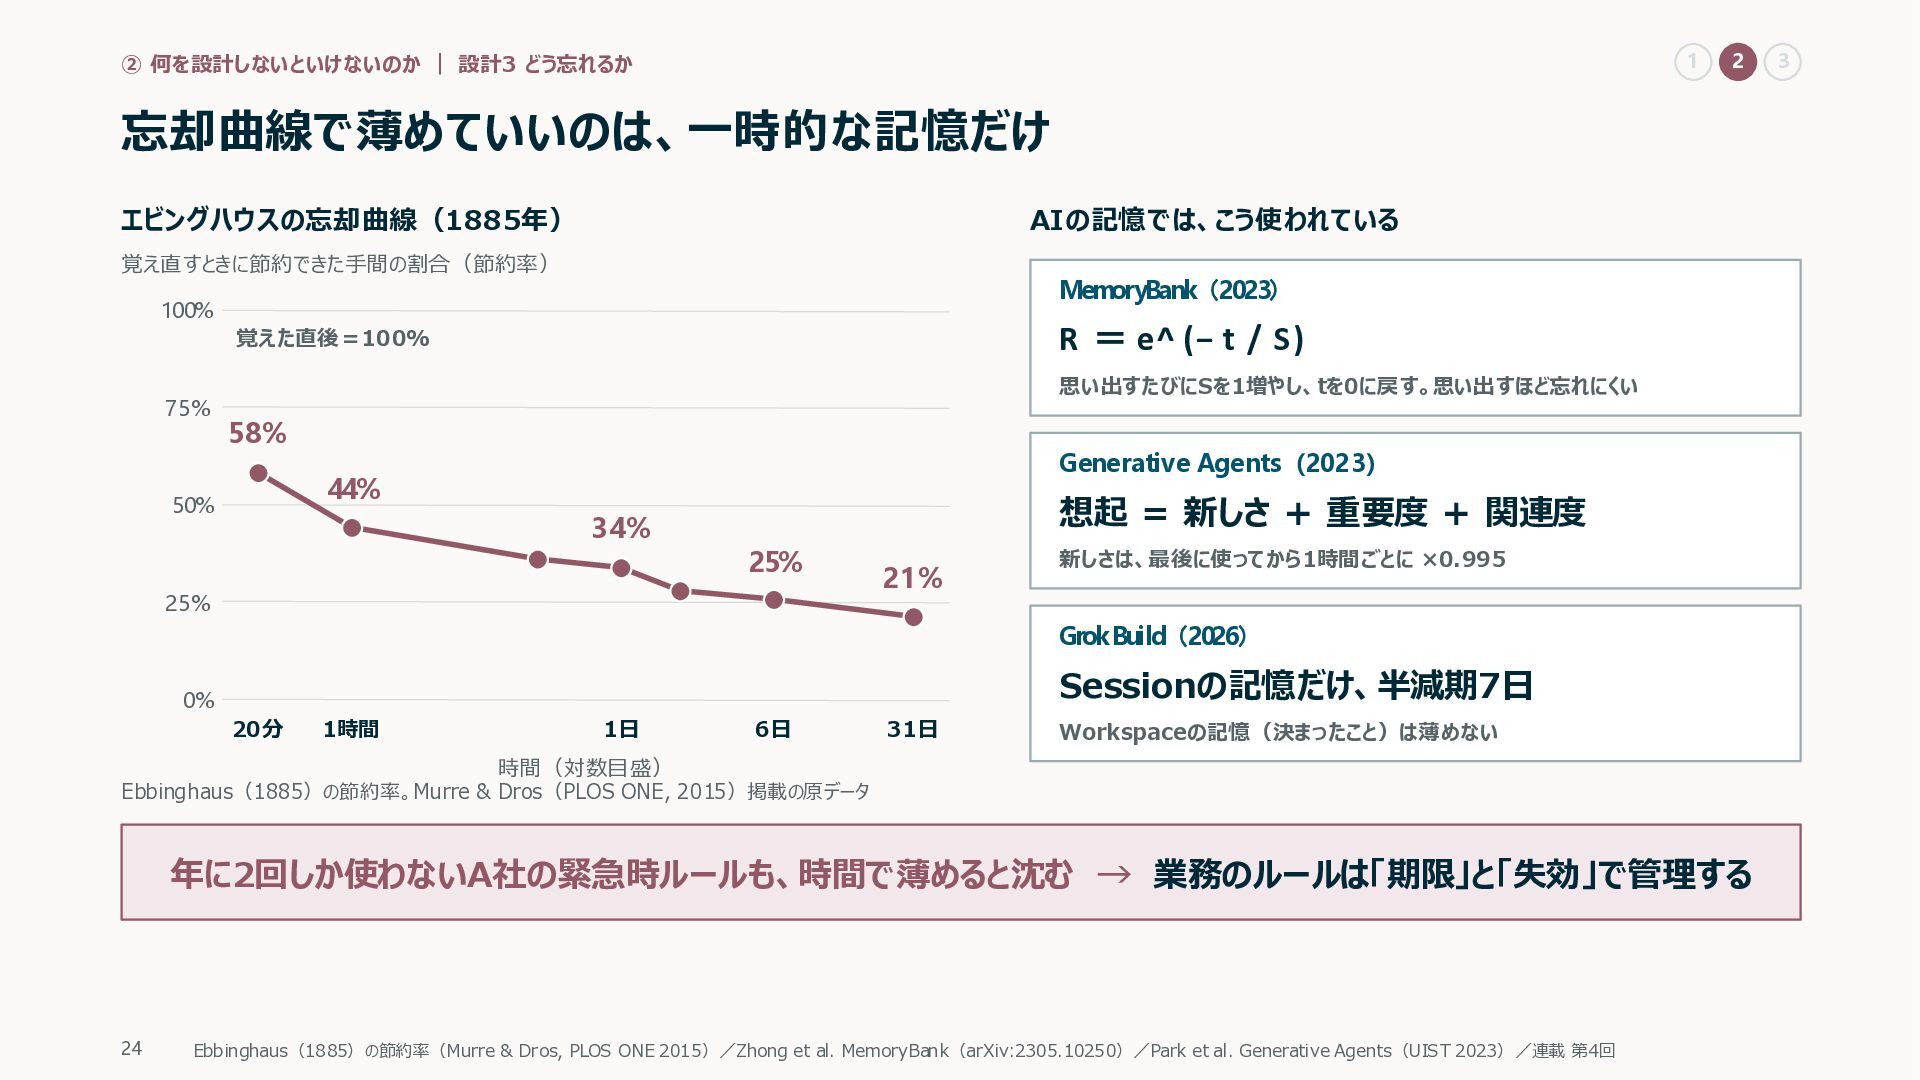
  21. 1 ② 何を設計しないといけないのか | 設計3 どう忘れるか 2 忘却曲線で薄めていいのは、⼀時的な記憶だけ エビングハウスの忘却曲線(1885年) AIの記憶では、こう使われている

    覚え直すときに節約できた⼿間の割合(節約率) MemoryBank(2023) 100% R = e^(−t / S) 覚えた直後=100% 75% 思い出すたびにSを1増やし、tを0に戻す。思い出すほど忘れにくい 58% Generative Agents(2023) 44% 50% 34% 想起 = 新しさ + 重要度 + 関連度 25% 25% 21% 新しさは、最後に使ってから1時間ごとに ×0.995 Grok Build(2026) Sessionの記憶だけ、半減期7⽇ 0% 20分 1時間 1⽇ 6⽇ 31⽇ Workspaceの記憶(決まったこと)は薄めない 時間(対数⽬盛) Ebbinghaus(1885)の節約率。Murre & Dros(PLOS ONE, 2015)掲載の原データ 年に2回しか使わないA社の緊急時ルールも、時間で薄めると沈む → 業務のルールは「期限」と「失効」で管理する 24 Ebbinghaus(1885)の節約率(Murre & Dros, PLOS ONE 2015)/Zhong et al. MemoryBank(arXiv:2305.10250)/Park et al. Generative Agents(UIST 2023)/連載 第4回 3
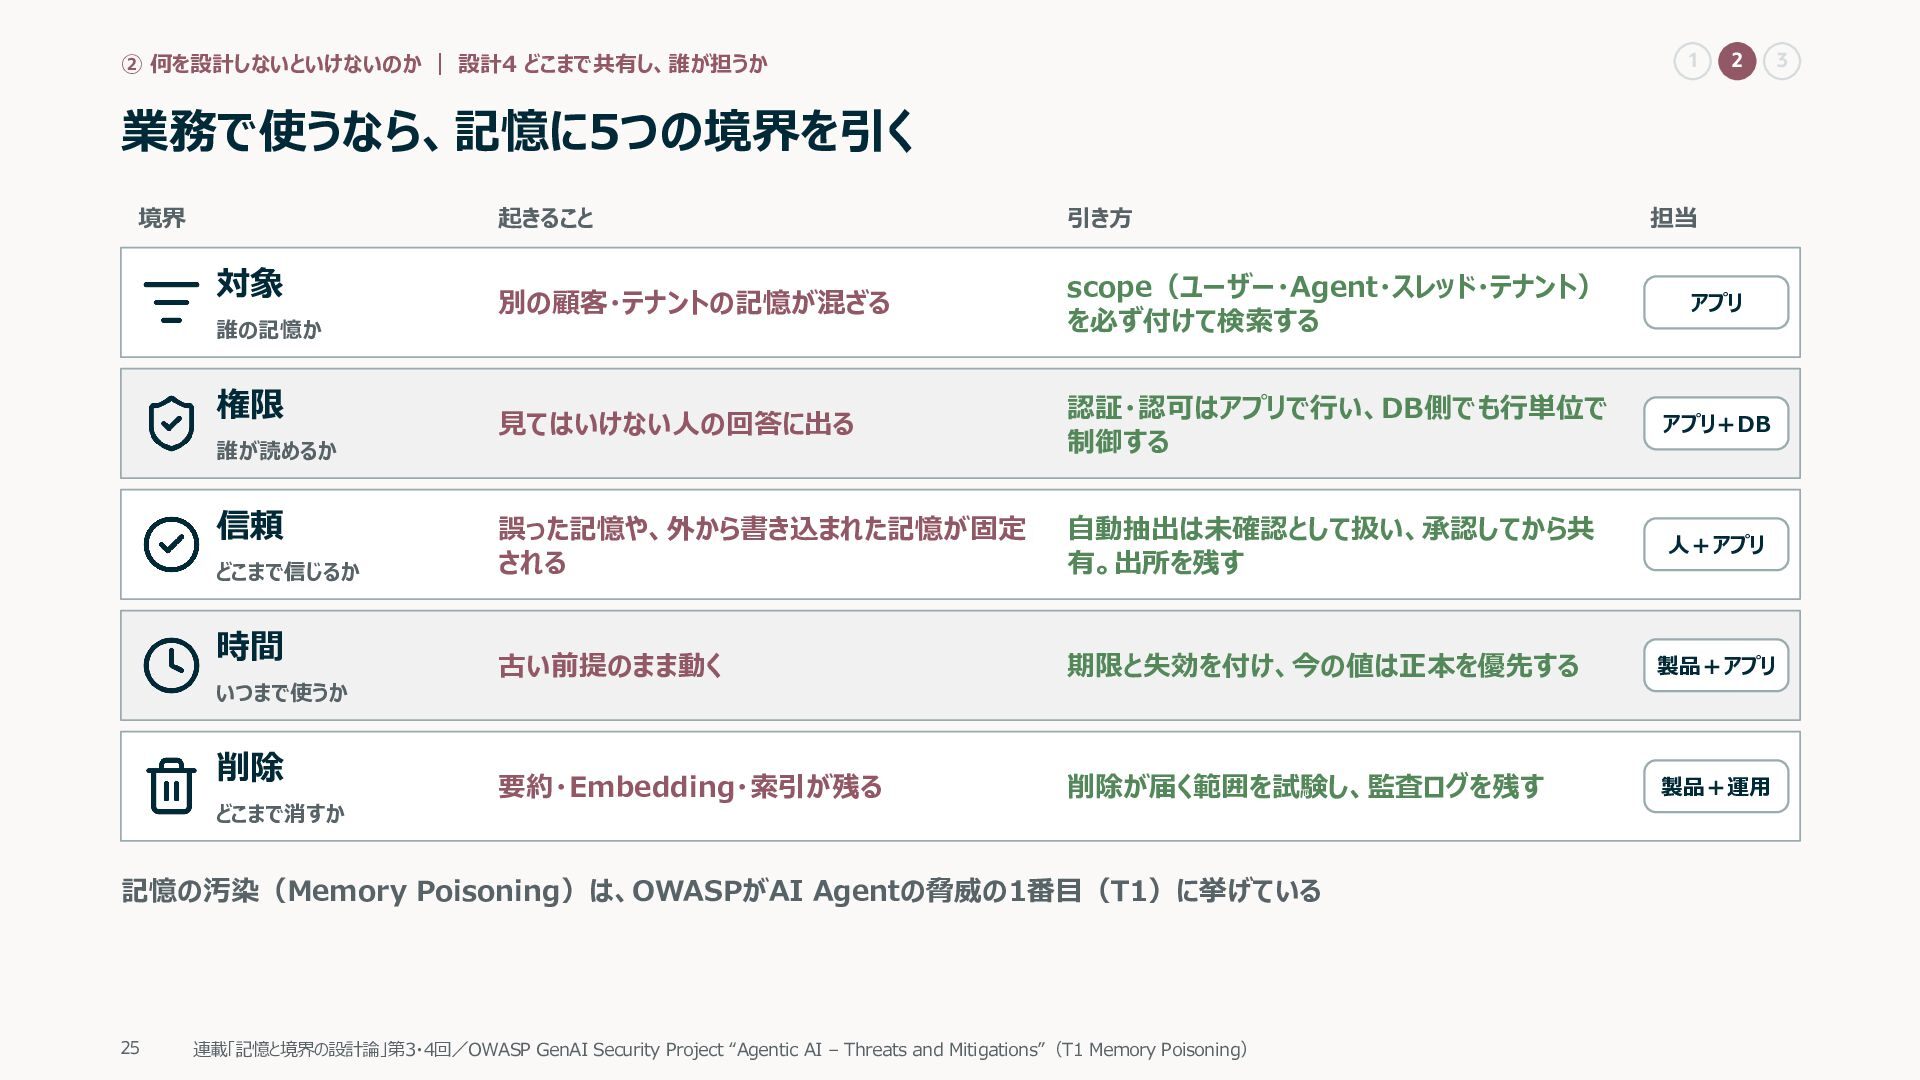
  22. 1 ② 何を設計しないといけないのか | 設計4 どこまで共有し、誰が担うか 2 業務で使うなら、記憶に5つの境界を引く 境界 対象

    誰の記憶か 権限 誰が読めるか 信頼 どこまで信じるか 時間 いつまで使うか 削除 どこまで消すか 起きること 引き⽅ 別の顧客・テナントの記憶が混ざる scope(ユーザー・Agent・スレッド・テナント) を必ず付けて検索する アプリ ⾒てはいけない⼈の回答に出る 認証・認可はアプリで⾏い、DB側でも⾏単位で 制御する アプリ+DB 誤った記憶や、外から書き込まれた記憶が固定 される ⾃動抽出は未確認として扱い、承認してから共 有。出所を残す ⼈+アプリ 古い前提のまま動く 期限と失効を付け、今の値は正本を優先する 製品+アプリ 要約・Embedding・索引が残る 削除が届く範囲を試験し、監査ログを残す 製品+運⽤ 記憶の汚染(Memory Poisoning)は、OWASPがAI Agentの脅威の1番⽬(T1)に挙げている 25 連載「記憶と境界の設計論」第3・4回/OWASP GenAI Security Project “Agentic AI – Threats and Mitigations”(T1 Memory Poisoning) 担当 3
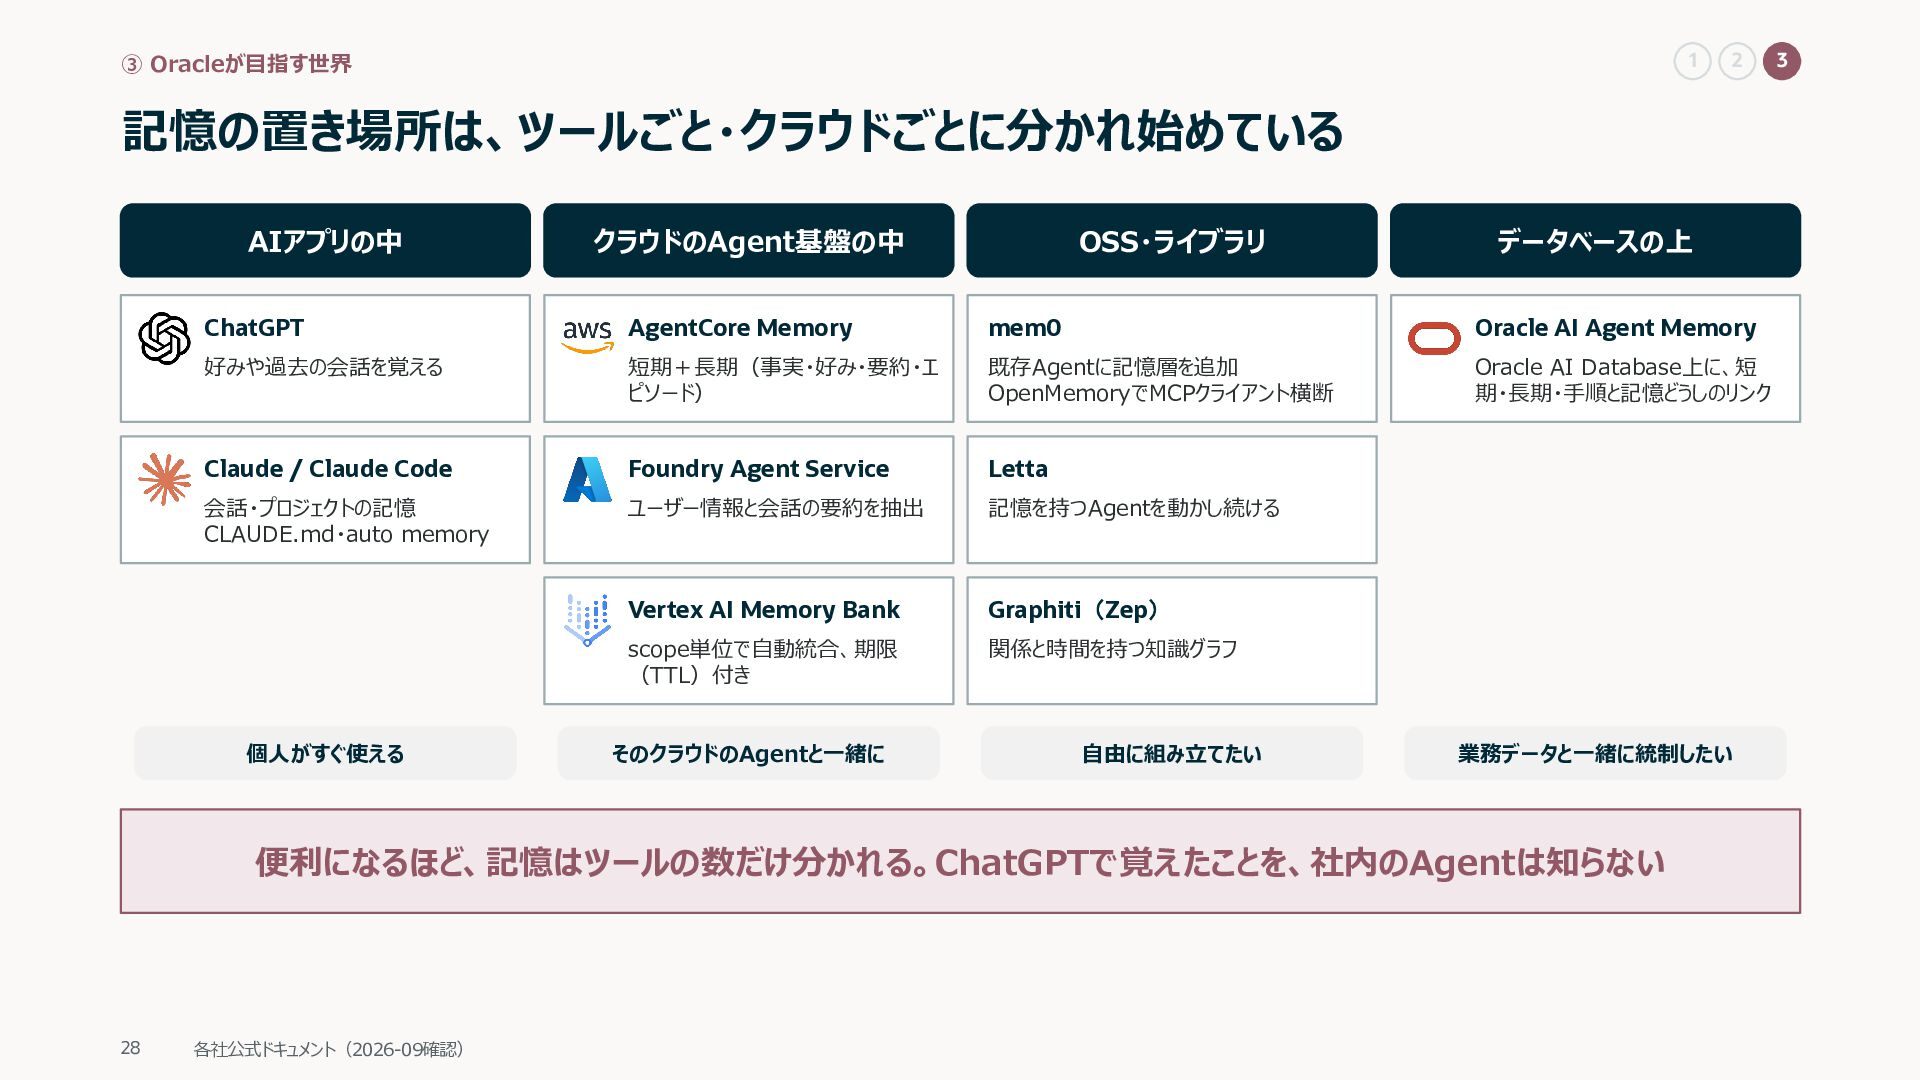
  23. 1 ③ Oracleが⽬指す世界 2 記憶の置き場所は、ツールごと・クラウドごとに分かれ始めている AIアプリの中 クラウドのAgent基盤の中 OSS・ライブラリ データベースの上 ChatGPT

    AgentCore Memory mem0 Oracle AI Agent Memory 好みや過去の会話を覚える 短期+⻑期(事実・好み・要約・エ ピソード) 既存Agentに記憶層を追加 OpenMemoryでMCPクライアント横断 Oracle AI Database上に、短 期・⻑期・⼿順と記憶どうしのリンク Claude / Claude Code Foundry Agent Service Letta 会話・プロジェクトの記憶 CLAUDE.md・auto memory ユーザー情報と会話の要約を抽出 記憶を持つAgentを動かし続ける Vertex AI Memory Bank Graphiti(Zep) scope単位で⾃動統合、期限 (TTL)付き 関係と時間を持つ知識グラフ 個⼈がすぐ使える そのクラウドのAgentと⼀緒に ⾃由に組み⽴てたい 業務データと⼀緒に統制したい 便利になるほど、記憶はツールの数だけ分かれる。ChatGPTで覚えたことを、社内のAgentは知らない 28 各社公式ドキュメント(2026-09確認) 3
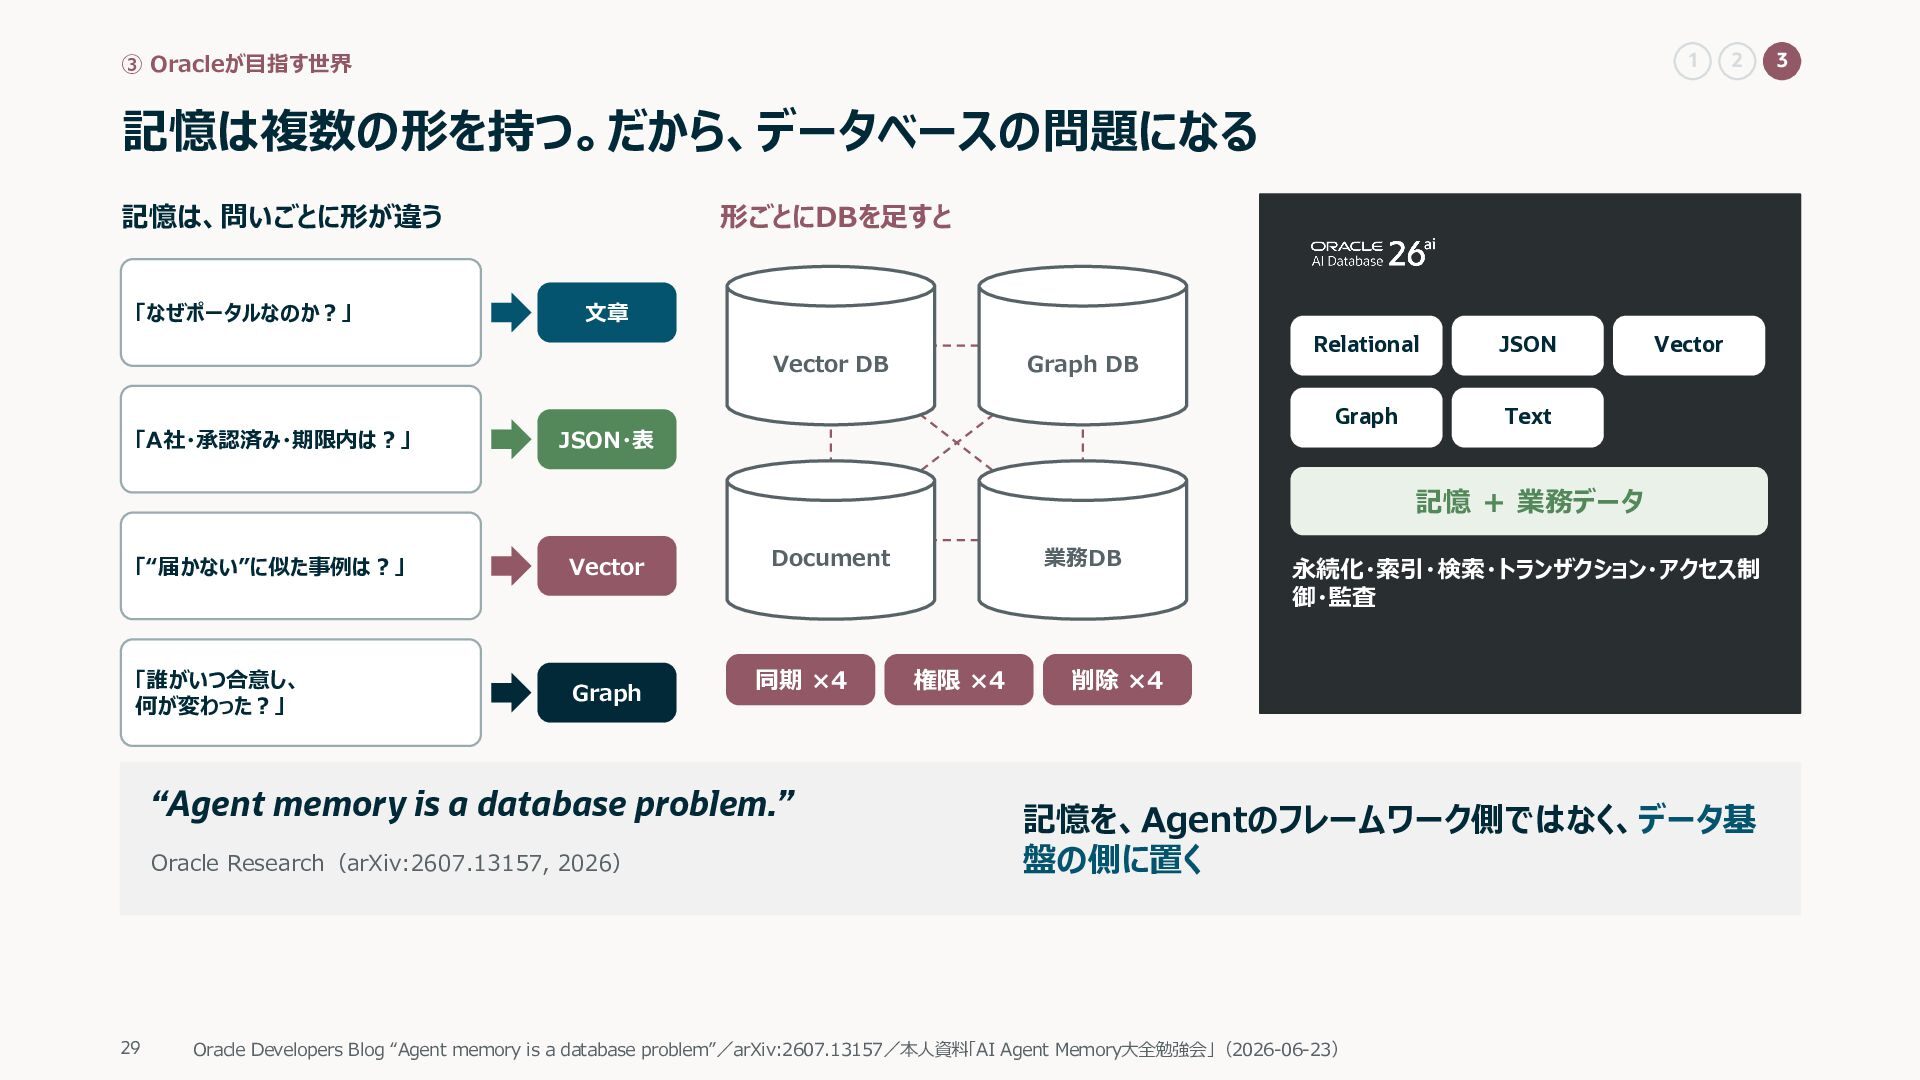
  24. 1 ③ Oracleが⽬指す世界 2 記憶は複数の形を持つ。だから、データベースの問題になる 記憶は、問いごとに形が違う 「なぜポータルなのか︖」 形ごとにDBを⾜すと ⽂章 Vector

    DB 「A社・承認済み・期限内は︖」 Graph DB JSON・表 Relational JSON Graph Text Vector 記憶 + 業務データ 「“届かない”に似た事例は︖」 Vector 「誰がいつ合意し、 何が変わった︖」 Graph Document 同期 ×4 “Agent memory is a database problem.” Oracle Research(arXiv:2607.13157, 2026) 29 業務DB 権限 ×4 永続化・索引・検索・トランザクション・アクセス制 御・監査 削除 ×4 記憶を、Agentのフレームワーク側ではなく、データ基 盤の側に置く Oracle Developers Blog “Agent memory is a database problem”/arXiv:2607.13157/本⼈資料「AI Agent Memory⼤全勉強会」(2026-06-23) 3
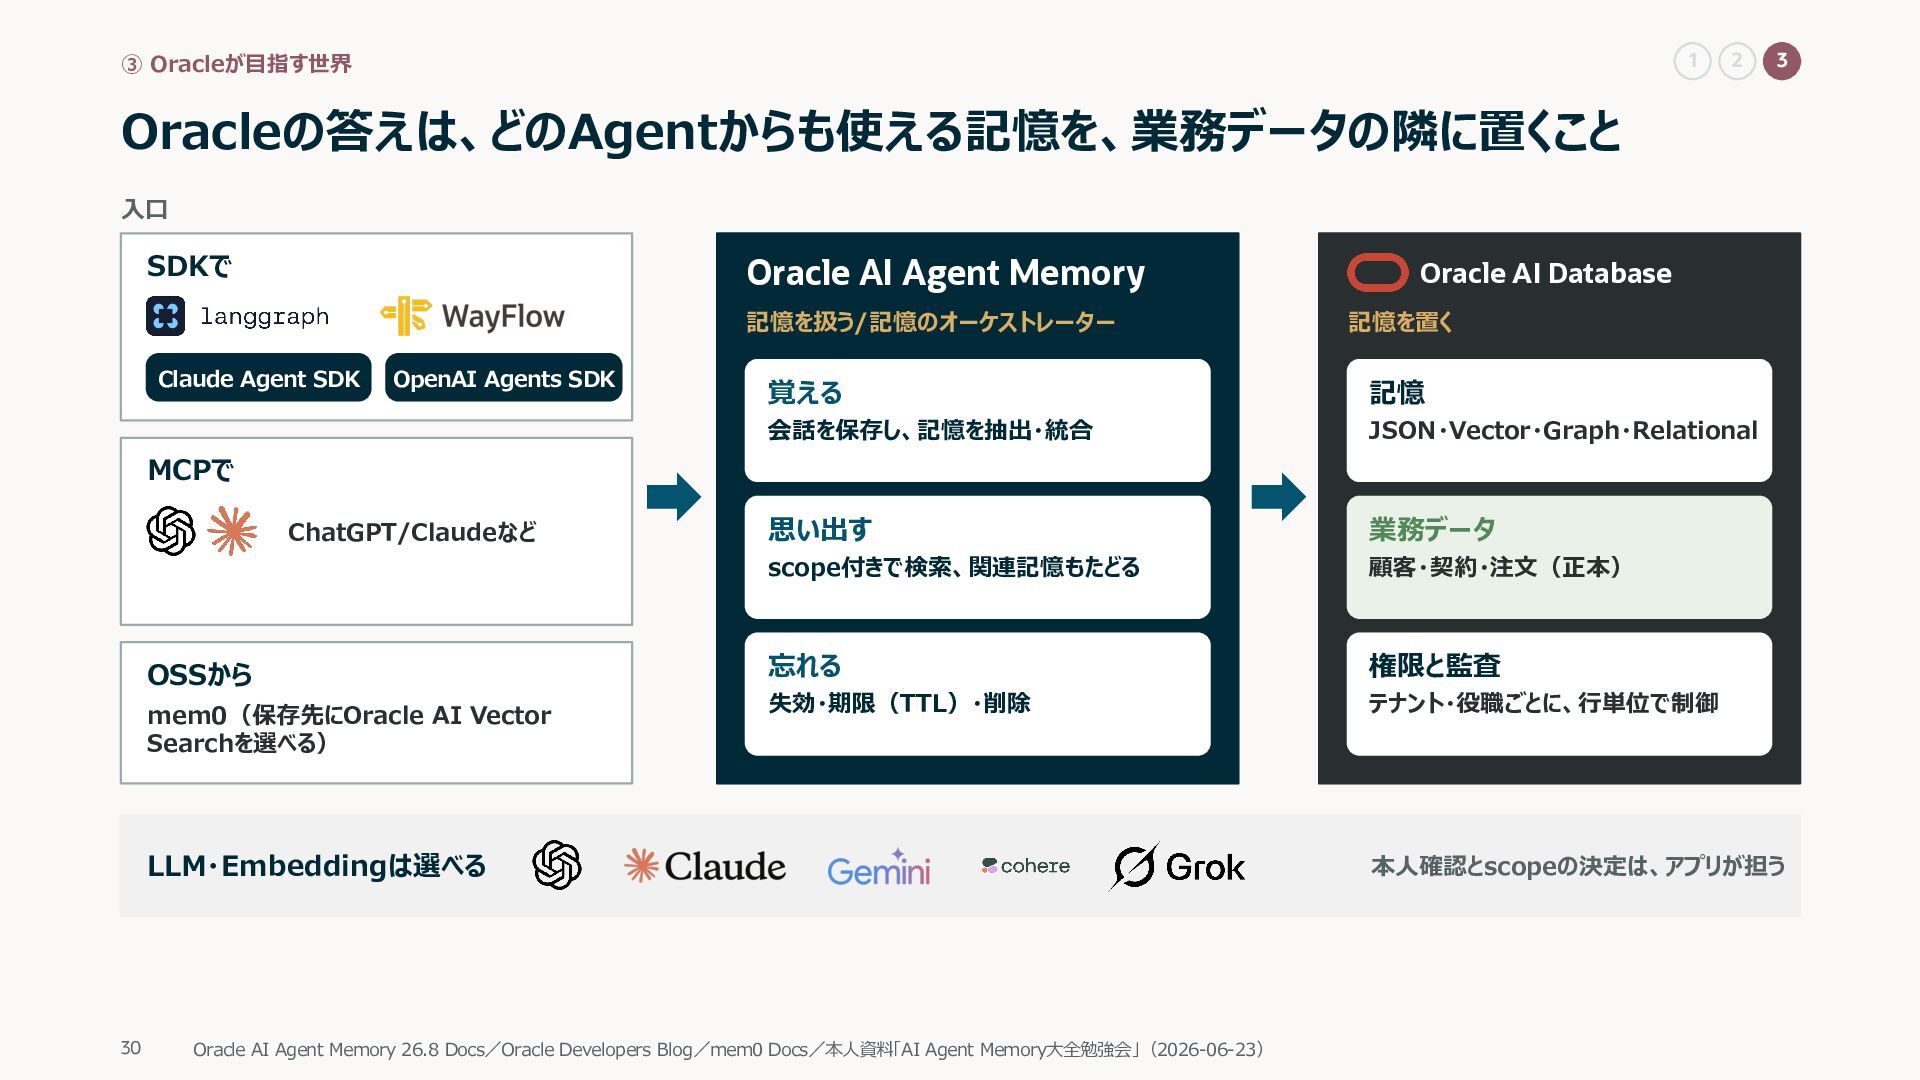
  25. 1 ③ Oracleが⽬指す世界 2 3 Oracleの答えは、どのAgentからも使える記憶を、業務データの隣に置くこと ⼊⼝ SDKで Oracle AI

    Agent Memory 記憶を扱う/記憶のオーケストレーター Claude Agent SDK OpenAI Agents SDK Oracle AI Database 記憶を置く 覚える 記憶 会話を保存し、記憶を抽出・統合 JSON・Vector・Graph・Relational 思い出す 業務データ scope付きで検索、関連記憶もたどる 顧客・契約・注⽂(正本) 忘れる 権限と監査 失効・期限(TTL)・削除 テナント・役職ごとに、⾏単位で制御 MCPで ChatGPT/Claudeなど OSSから mem0(保存先にOracle AI Vector Searchを選べる) LLM・Embeddingは選べる 30 Oracle AI Agent Memory 26.8 Docs/Oracle Developers Blog/mem0 Docs/本⼈資料「AI Agent Memory⼤全勉強会」(2026-06-23) 本⼈確認とscopeの決定は、アプリが担う
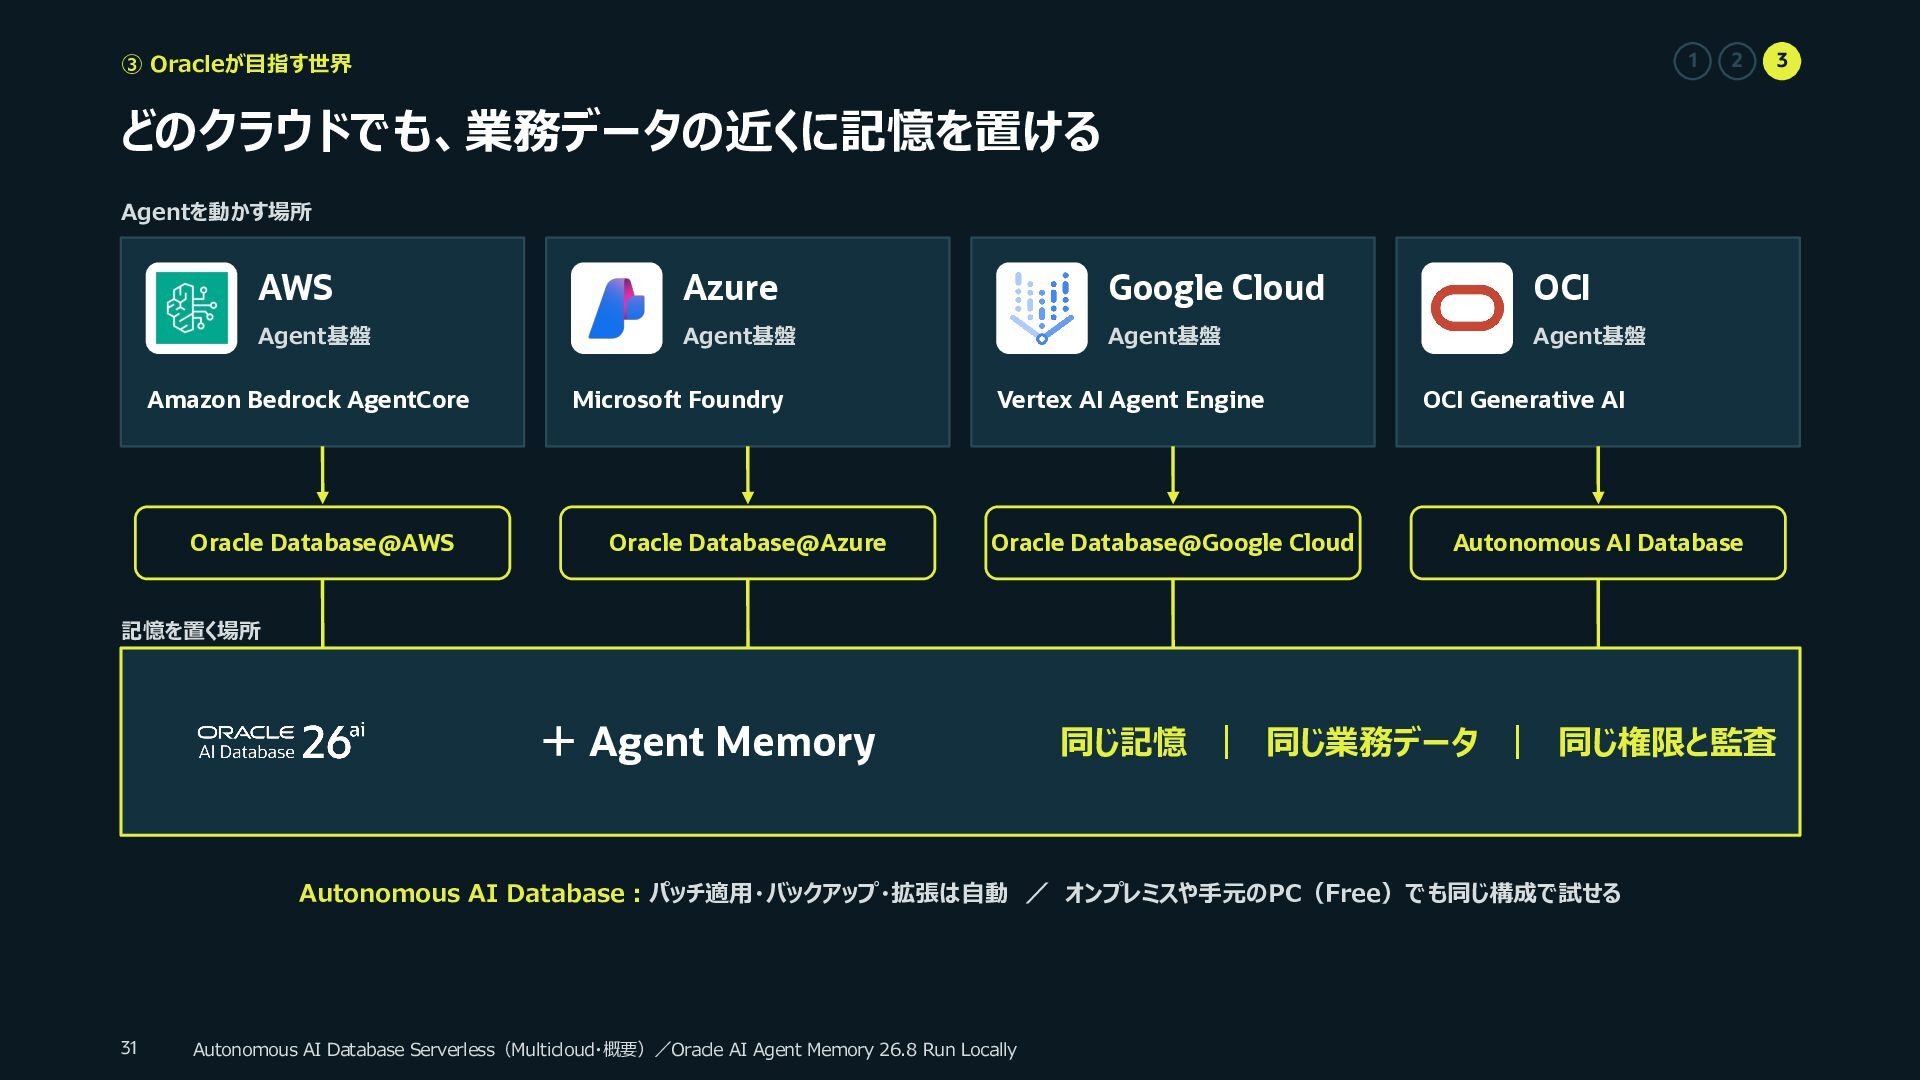
  26. 1 ③ Oracleが⽬指す世界 2 3 どのクラウドでも、業務データの近くに記憶を置ける Agentを動かす場所 AWS Azure Google

    Cloud OCI Agent基盤 Agent基盤 Agent基盤 Agent基盤 Amazon Bedrock AgentCore Oracle Database@AWS Microsoft Foundry Oracle Database@Azure Vertex AI Agent Engine Oracle Database@Google Cloud OCI Generative AI Autonomous AI Database 記憶を置く場所 + Agent Memory 同じ記憶 | 同じ業務データ | 同じ権限と監査 Autonomous AI Database︓パッチ適⽤・バックアップ・拡張は⾃動 / オンプレミスや⼿元のPC(Free)でも同じ構成で試せる 31 Autonomous AI Database Serverless(Multicloud・概要)/Oracle AI Agent Memory 26.8 Run Locally
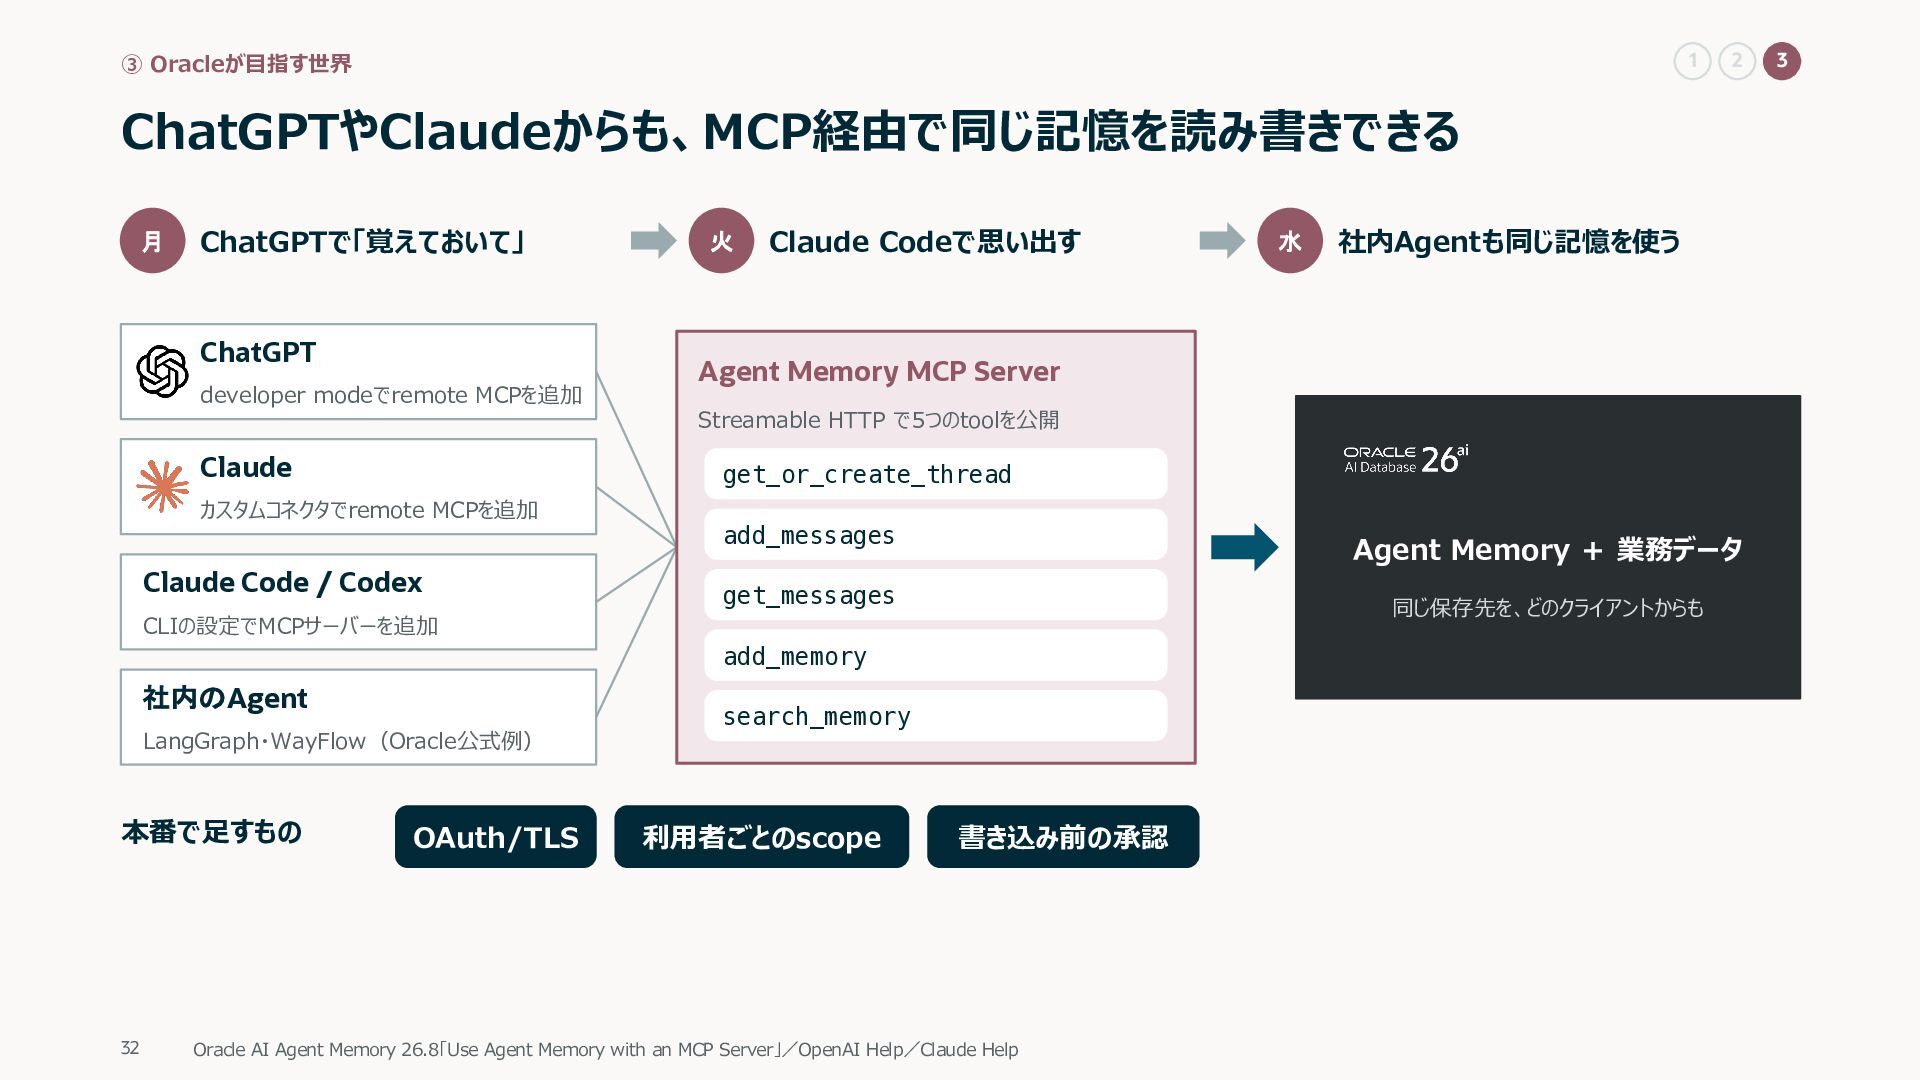
  27. 1 ③ Oracleが⽬指す世界 2 ChatGPTやClaudeからも、MCP経由で同じ記憶を読み書きできる 月 ChatGPTで「覚えておいて」 ChatGPT developer modeでremote

    MCPを追加 Claude 火 Claude Codeで思い出す Claude Code / Codex Agent Memory MCP Server Streamable HTTP で5つのtoolを公開 add_messages Agent Memory + 業務データ get_messages 同じ保存先を、どのクライアントからも CLIの設定でMCPサーバーを追加 add_memory 社内のAgent LangGraph・WayFlow(Oracle公式例) 32 社内Agentも同じ記憶を使う get_or_create_thread カスタムコネクタでremote MCPを追加 本番で⾜すもの 水 OAuth/TLS search_memory 利⽤者ごとのscope 書き込み前の承認 Oracle AI Agent Memory 26.8「Use Agent Memory with an MCP Server」/OpenAI Help/Claude Help 3
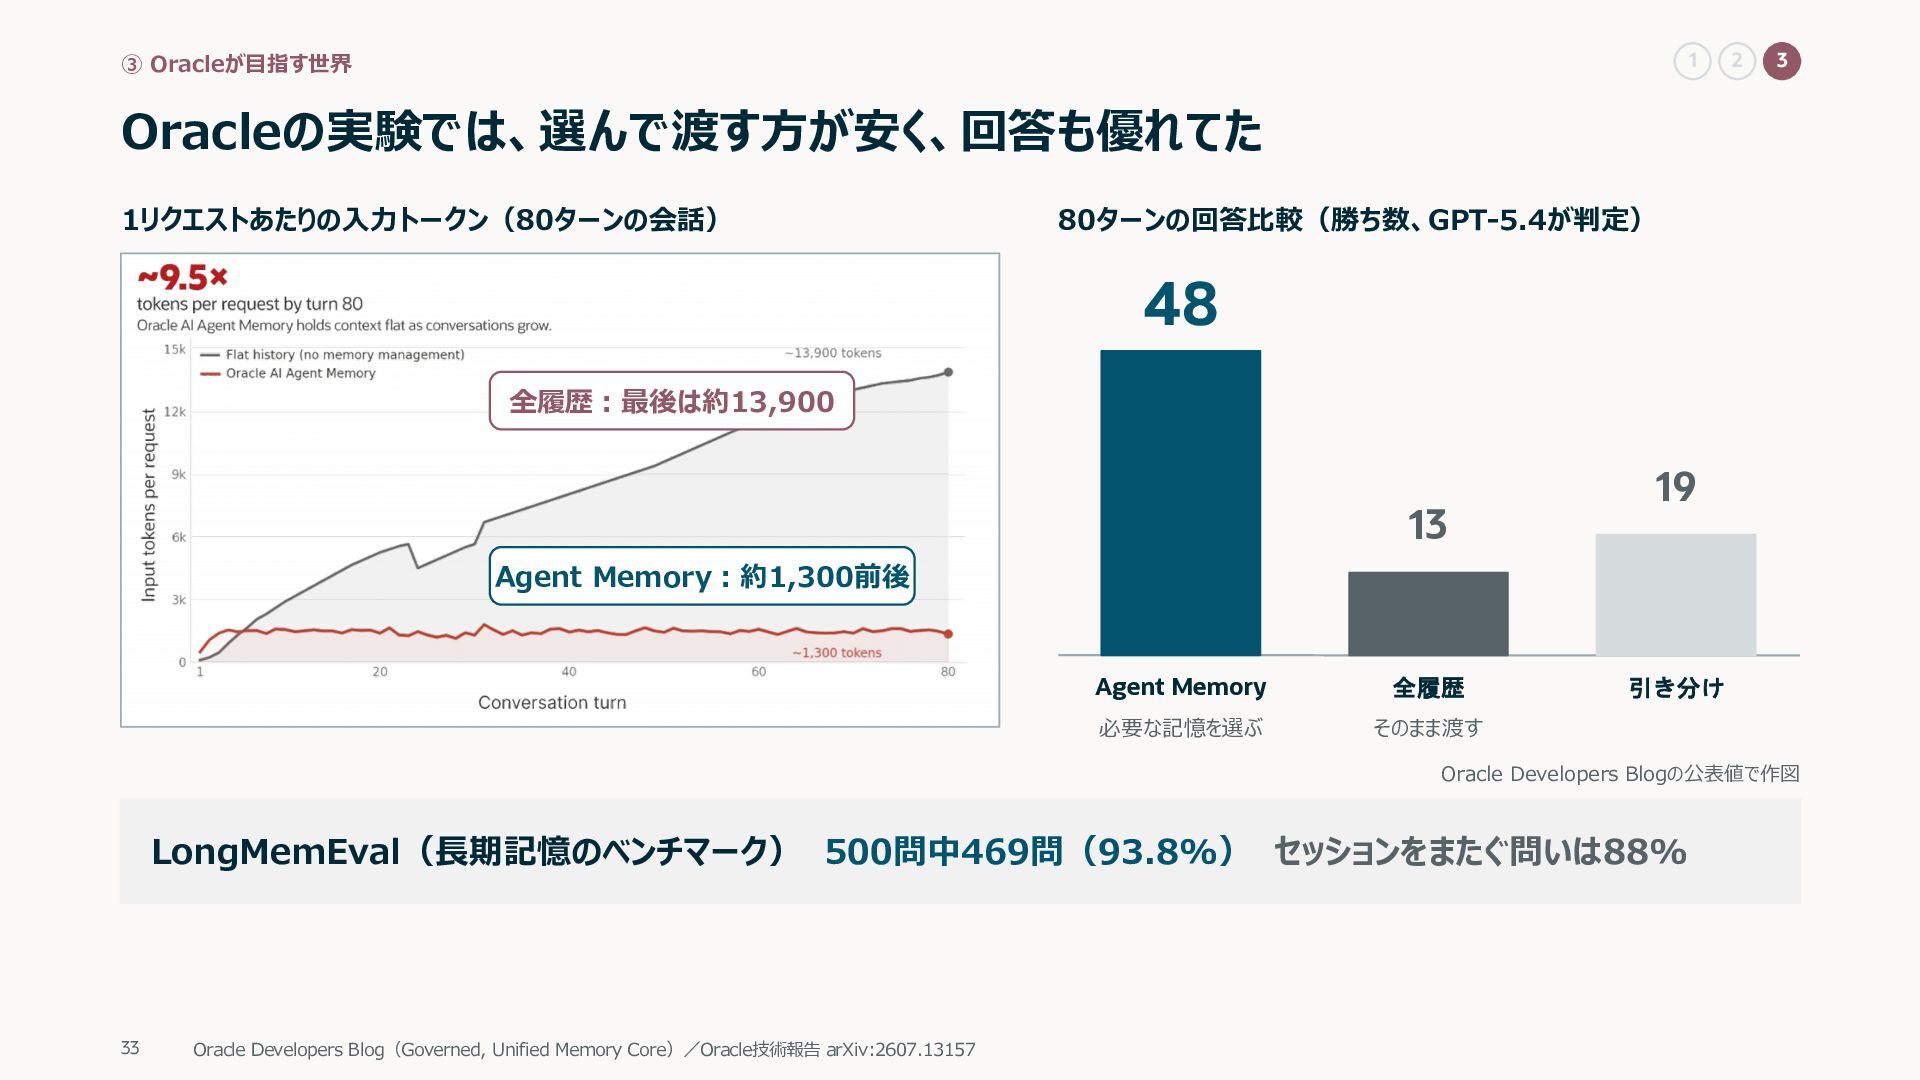
  28. 1 ③ Oracleが⽬指す世界 2 3 Oracleの実験では、選んで渡す⽅が安く、回答も優れてた 1リクエストあたりの⼊⼒トークン(80ターンの会話) 80ターンの回答⽐較(勝ち数、GPT-5.4が判定) 48 全履歴︓最後は約13,900

    13 19 Agent Memory︓約1,300前後 Agent Memory 全履歴 必要な記憶を選ぶ そのまま渡す 引き分け Oracle Developers Blogの公表値で作図 LongMemEval(⻑期記憶のベンチマーク) 500問中469問(93.8%) セッションをまたぐ問いは88% 33 Oracle Developers Blog(Governed, Unified Memory Core)/Oracle技術報告 arXiv:2607.13157
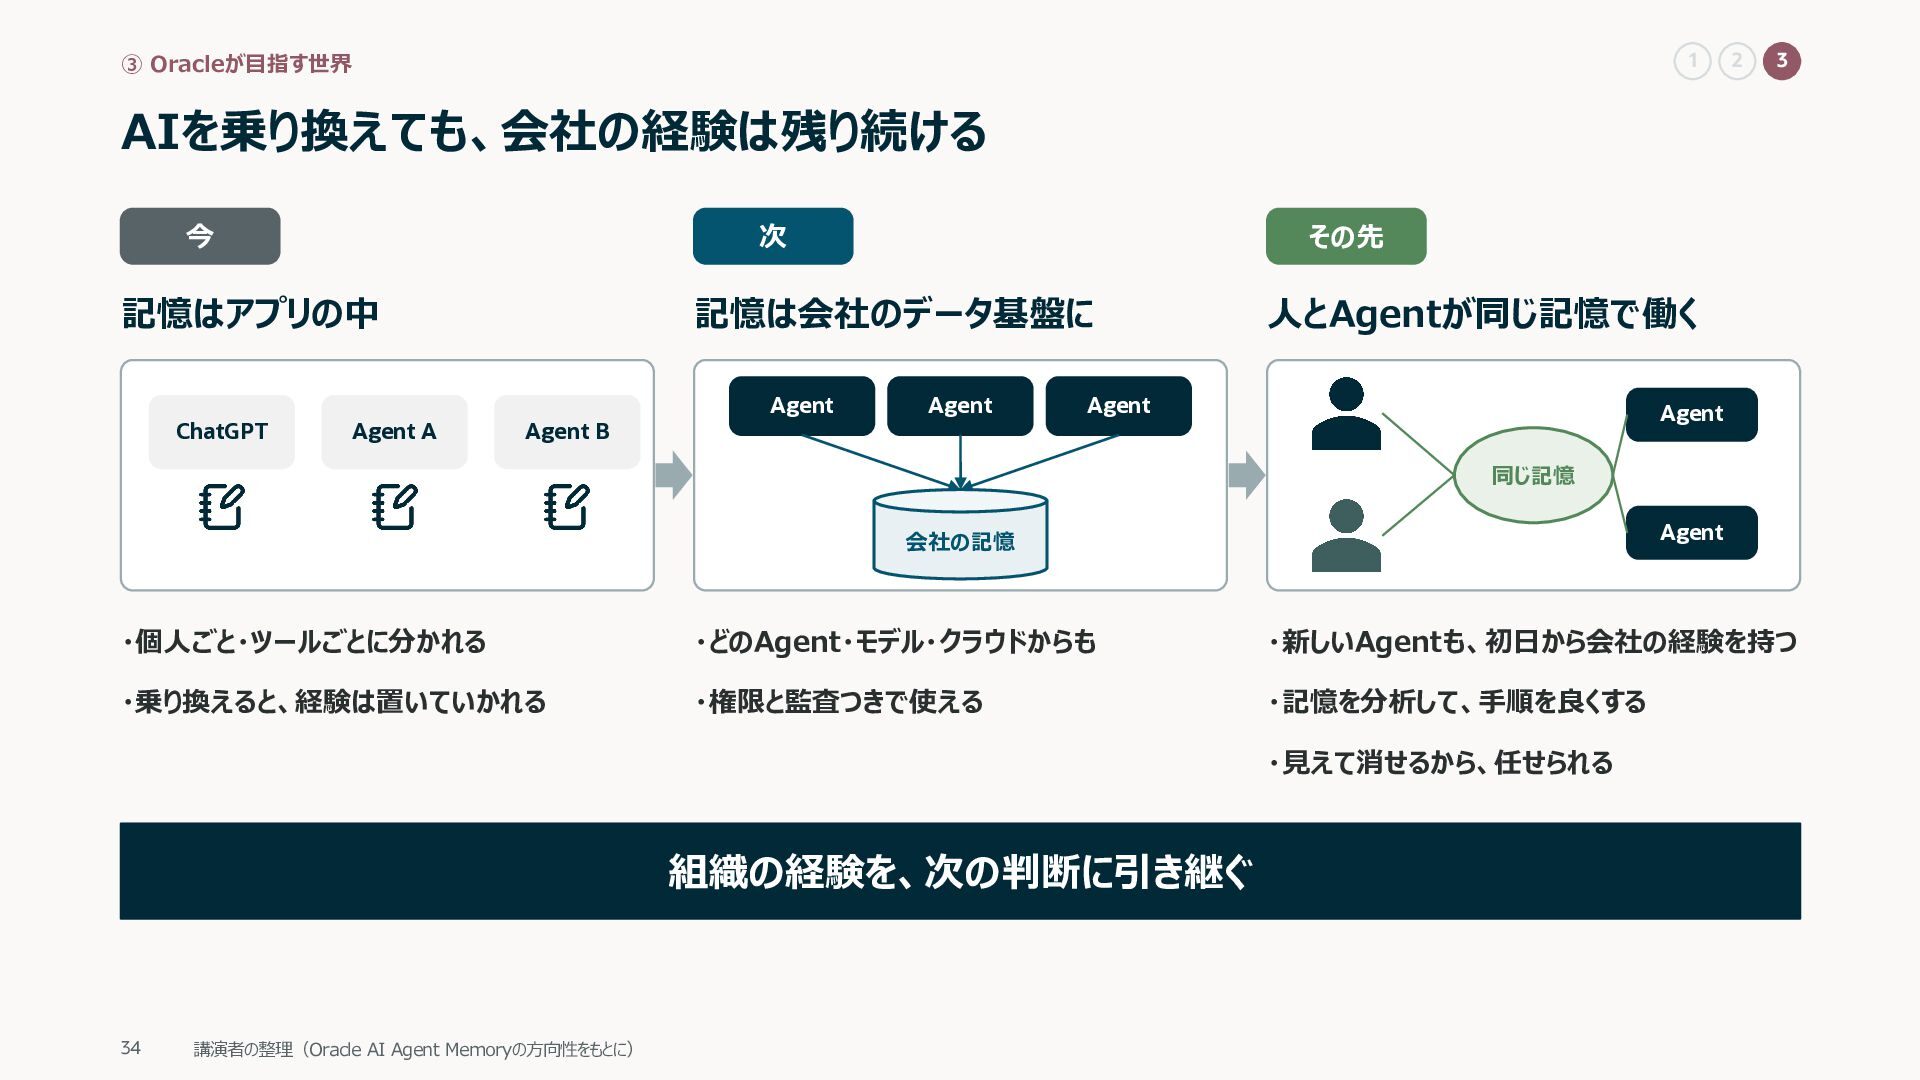
  29. 1 ③ Oracleが⽬指す世界 2 3 AIを乗り換えても、会社の経験は残り続ける 今 次 記憶はアプリの中 ChatGPT

    Agent A その先 記憶は会社のデータ基盤に Agent B Agent Agent ⼈とAgentが同じ記憶で働く Agent Agent 同じ記憶 Agent 会社の記憶 ・個⼈ごと・ツールごとに分かれる ・どのAgent・モデル・クラウドからも ・新しいAgentも、初⽇から会社の経験を持つ ・乗り換えると、経験は置いていかれる ・権限と監査つきで使える ・記憶を分析して、⼿順を良くする ・⾒えて消せるから、任せられる 組織の経験を、次の判断に引き継ぐ 34 講演者の整理(Oracle AI Agent Memoryの⽅向性をもとに)