Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
全社共通データ基盤をつくる。ソニーのDatabricks活用とデータガバナンス設計の裏側
Search
ソニー株式会社
September 29, 2026
Technology
100
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
全社共通データ基盤をつくる。ソニーのDatabricks活用とデータガバナンス設計の裏側
ソニー株式会社
September 29, 2026
More Decks by ソニー株式会社
See All by ソニー株式会社
Sony-DroidKaigi2026
sony
1
1.1k
Flutterをカメラで動かしたかった話
sony
1
230
Sony_KMP_Journey_KotlinConf2026
sony
3
300
ソニーのスマホ通信制御エンジニアから東大博士へ~東大で 5G/6G研究に挑んだ 3年間~
sony
1
370
ソニー Creators' Cloudチームのハッカソン ~生成AIで加速するイノベーション~
sony
1
240
Connpass-Xperia_Camera_App_by_HCD.pdf
sony
2
830
GitHub を組織的に使いこなすために ソニーが実践した全社展開のプラクティス
sony
28
20k
マイクロリブート ~ACEマインドセットで実現するアジャイル~
sony
2
910
ソニーの遊びのUXデザイン_アクセスコントローラー
sony
1
220
Other Decks in Technology
See All in Technology
猫でもわかるKiro Web
kentapapa
1
120
Harness Engineering on Rails
joelq
0
630
AIエージェント時代のPlatform as a Product —— テックリードがPdMとして回す発見・導入・計測 / Platform as a Product in the AI Agent Era
toshi0607
1
350
GitHub Agentic Workflows を触ってみる
htkym
2
740
作って終わりじゃないサーバーレス 〜9年運用する大規模EC物流API基盤の設計・運用のリアル〜
zozotech
PRO
0
550
3人で1000GPU超を統合運用する?マルチクラウド&オンプレを跨ぐ、構築と運用のリアル!
kazukun0716
2
500
AIエージェントの一手は 誰も見ていない - Falco拡張OSS「Prempti」とeBPFで サーバーレス実行基盤を二層防御する
keitah
1
600
Apache Iceberg が拓く AI 時代のオープンレイクハウス
tomtanaka
0
110
音声コミュニティを守るAI監視基盤_ 90%以上の入力削減を支えたServerless設計と運用判断
shuheioka123
0
110
Oracle Base Database Service 技術詳細
oracle4engineer
PRO
16
120k
Datadog で始める トークンセーフティなAI 導⼊と定着
vkbaba
1
110
AgentCore Runtime上にAgentic Coding基盤を構築・展開する際の設計ポイントと限界点 / Design considerations and limitations when building an agentic coding platform on AgentCore Runtime
har1101
7
780
Featured
See All Featured
Unsuck your backbone
ammeep
672
58k
The Pragmatic Product Professional
lauravandoore
37
7.5k
Practical Orchestrator
shlominoach
192
12k
Game over? The fight for quality and originality in the time of robots
wayneb77
1
290
Agile Leadership in an Agile Organization
kimpetersen
PRO
0
250
How to build an LLM SEO readiness audit: a practical framework
nmsamuel
2
920
StorybookのUI Testing Handbookを読んだ
zakiyama
31
6.9k
Exploring the relationship between traditional SERPs and Gen AI search
raygrieselhuber
PRO
3
4.3k
Building Adaptive Systems
keathley
44
3.2k
Navigating Weather and Climate Data
rabernat
0
540
The AI Revolution Will Not Be Monopolized: How open-source beats economies of scale, even for LLMs
inesmontani
PRO
3
3.7k
The Limits of Empathy - UXLibs8
cassininazir
1
690
Transcript
全社共通データ基盤をつくる ソニーのDatabricks活用とデータガバナンス設計の裏側 ソニー株式会社 技術センター 設計DX部門 AI & Cloud Center of
Excellence
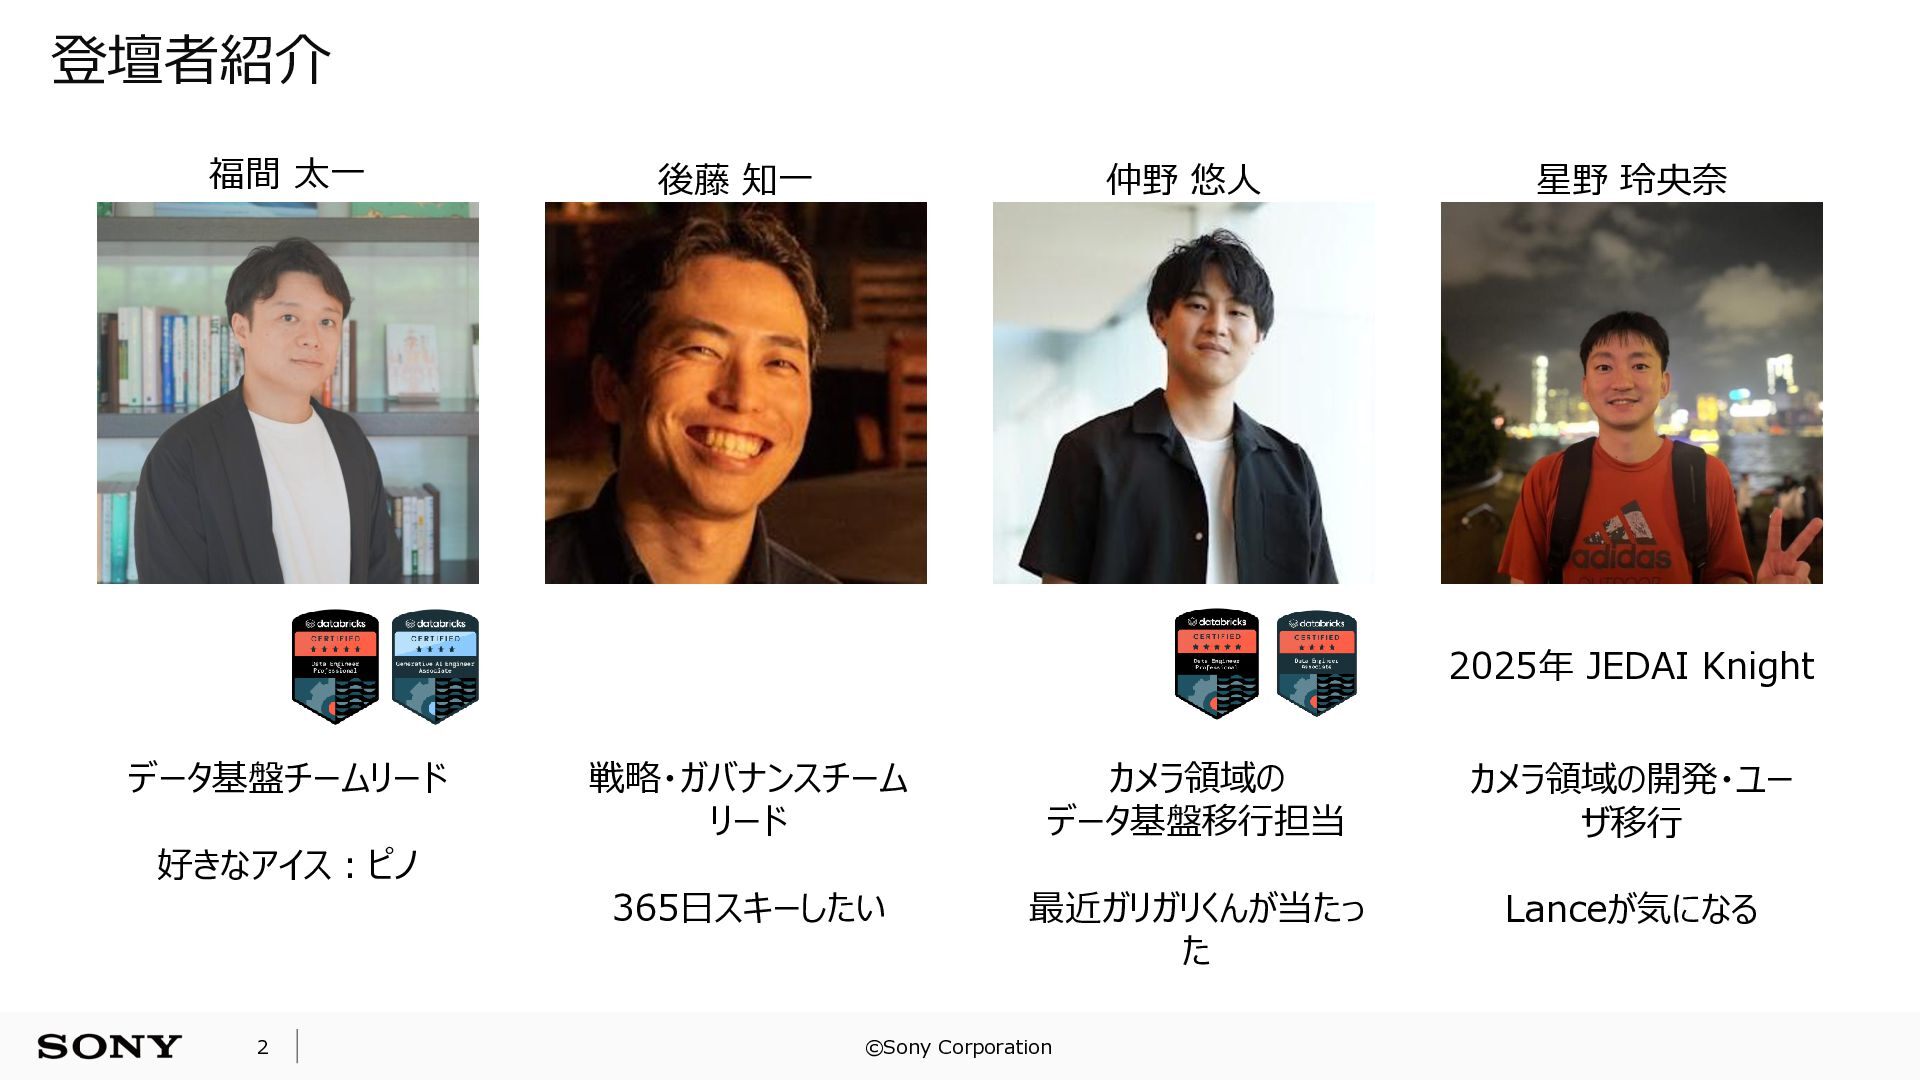
登壇者紹介 福間 太一 後藤 知一 仲野 悠人 星野 玲央奈 2025年
JEDAI Knight データ基盤チームリード 戦略・ガバナンスチーム リード カメラ領域の データ基盤移行担当 カメラ領域の開発・ユー ザ移行 365日スキーしたい 最近ガリガリくんが当たっ た Lanceが気になる 好きなアイス:ピノ 2 ©Sony Corporation
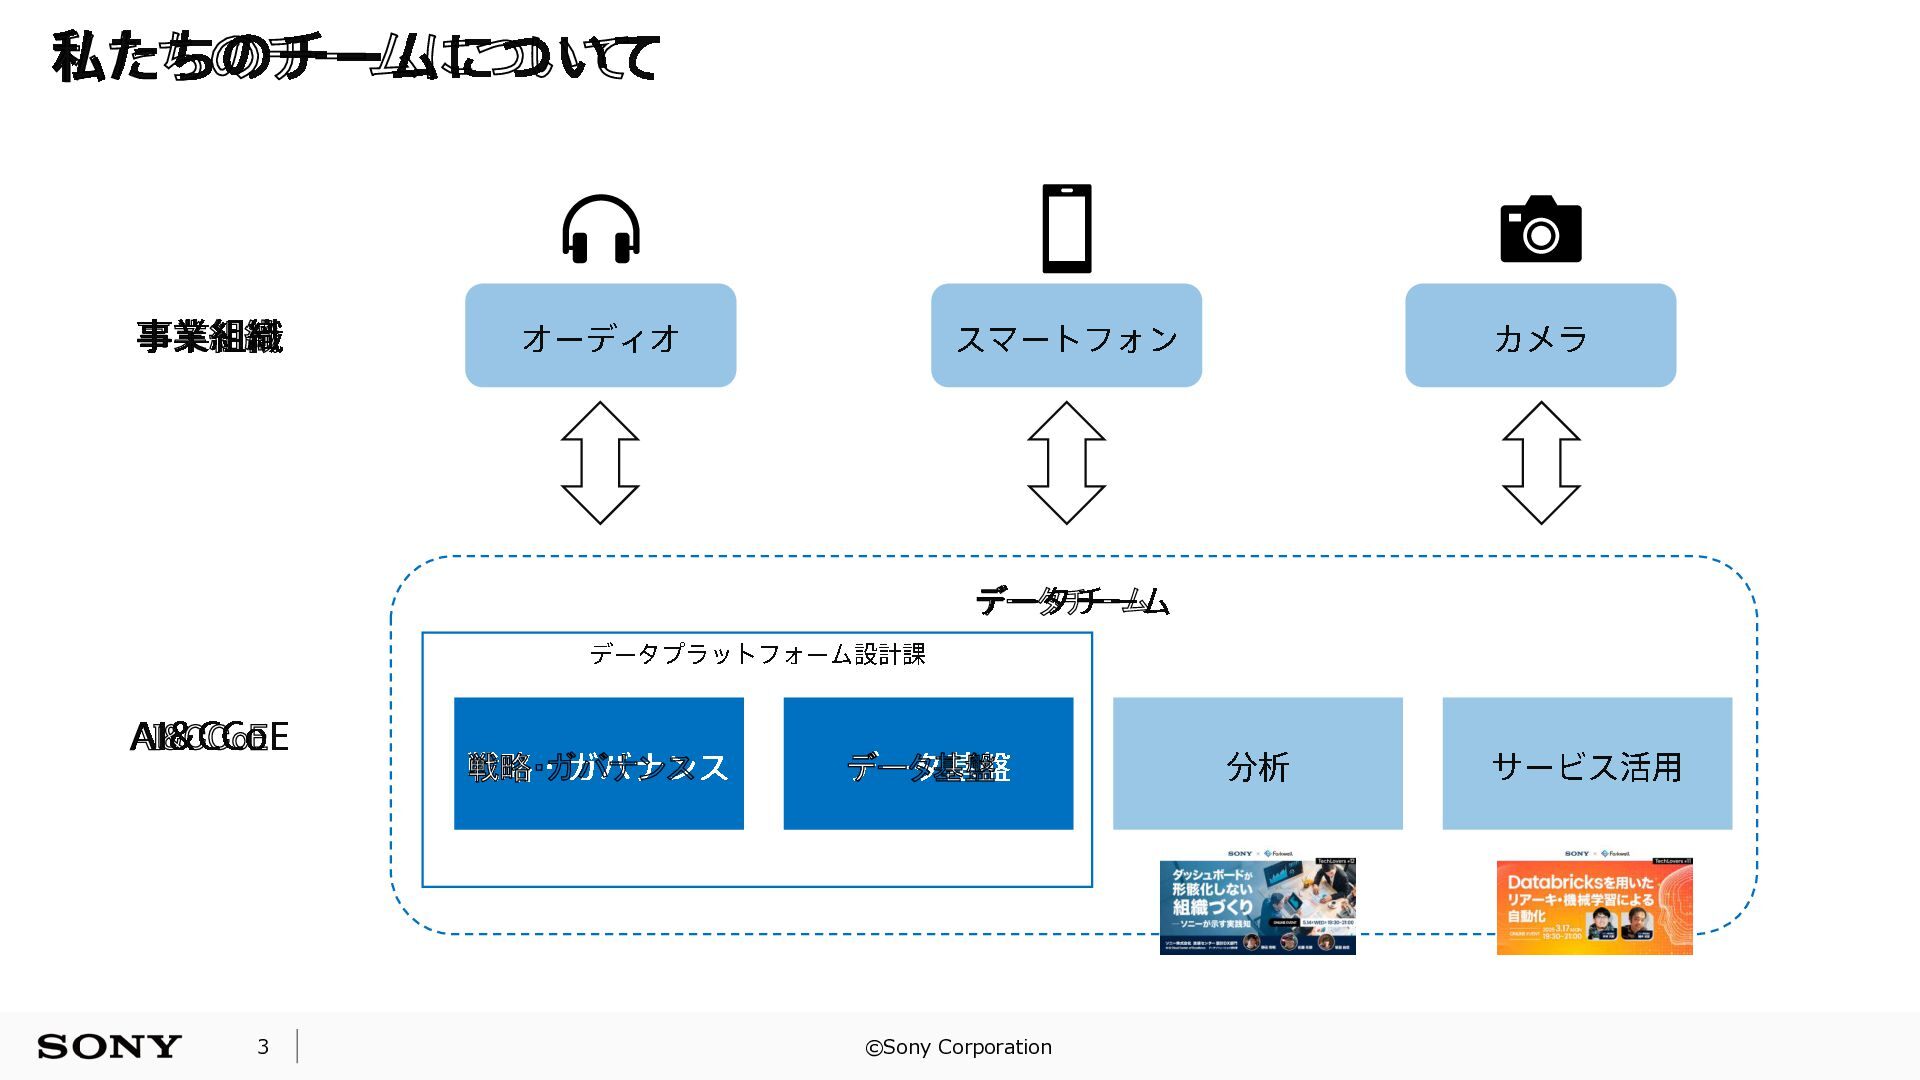
私たちのチームについて 事業組織 オーディオ スマートフォン カメラ データチーム データプラットフォーム設計課 AI&CCoE 3 戦略・ガバナンス
データ基盤 ©Sony Corporation 分析 サービス活用
Agenda 1 ソニーについて 2 データ基盤の技術選定とアーキテクチャ 3 データガバナンス 4 カメラ領域におけるデータ基盤移行・活用 4
©Sony Corporation
Agenda 1 ソニーについて 2 データ基盤の技術選定とアーキテクチャ 3 データガバナンス 4 カメラ領域におけるデータ基盤移行・活用 5
©Sony Corporation
None
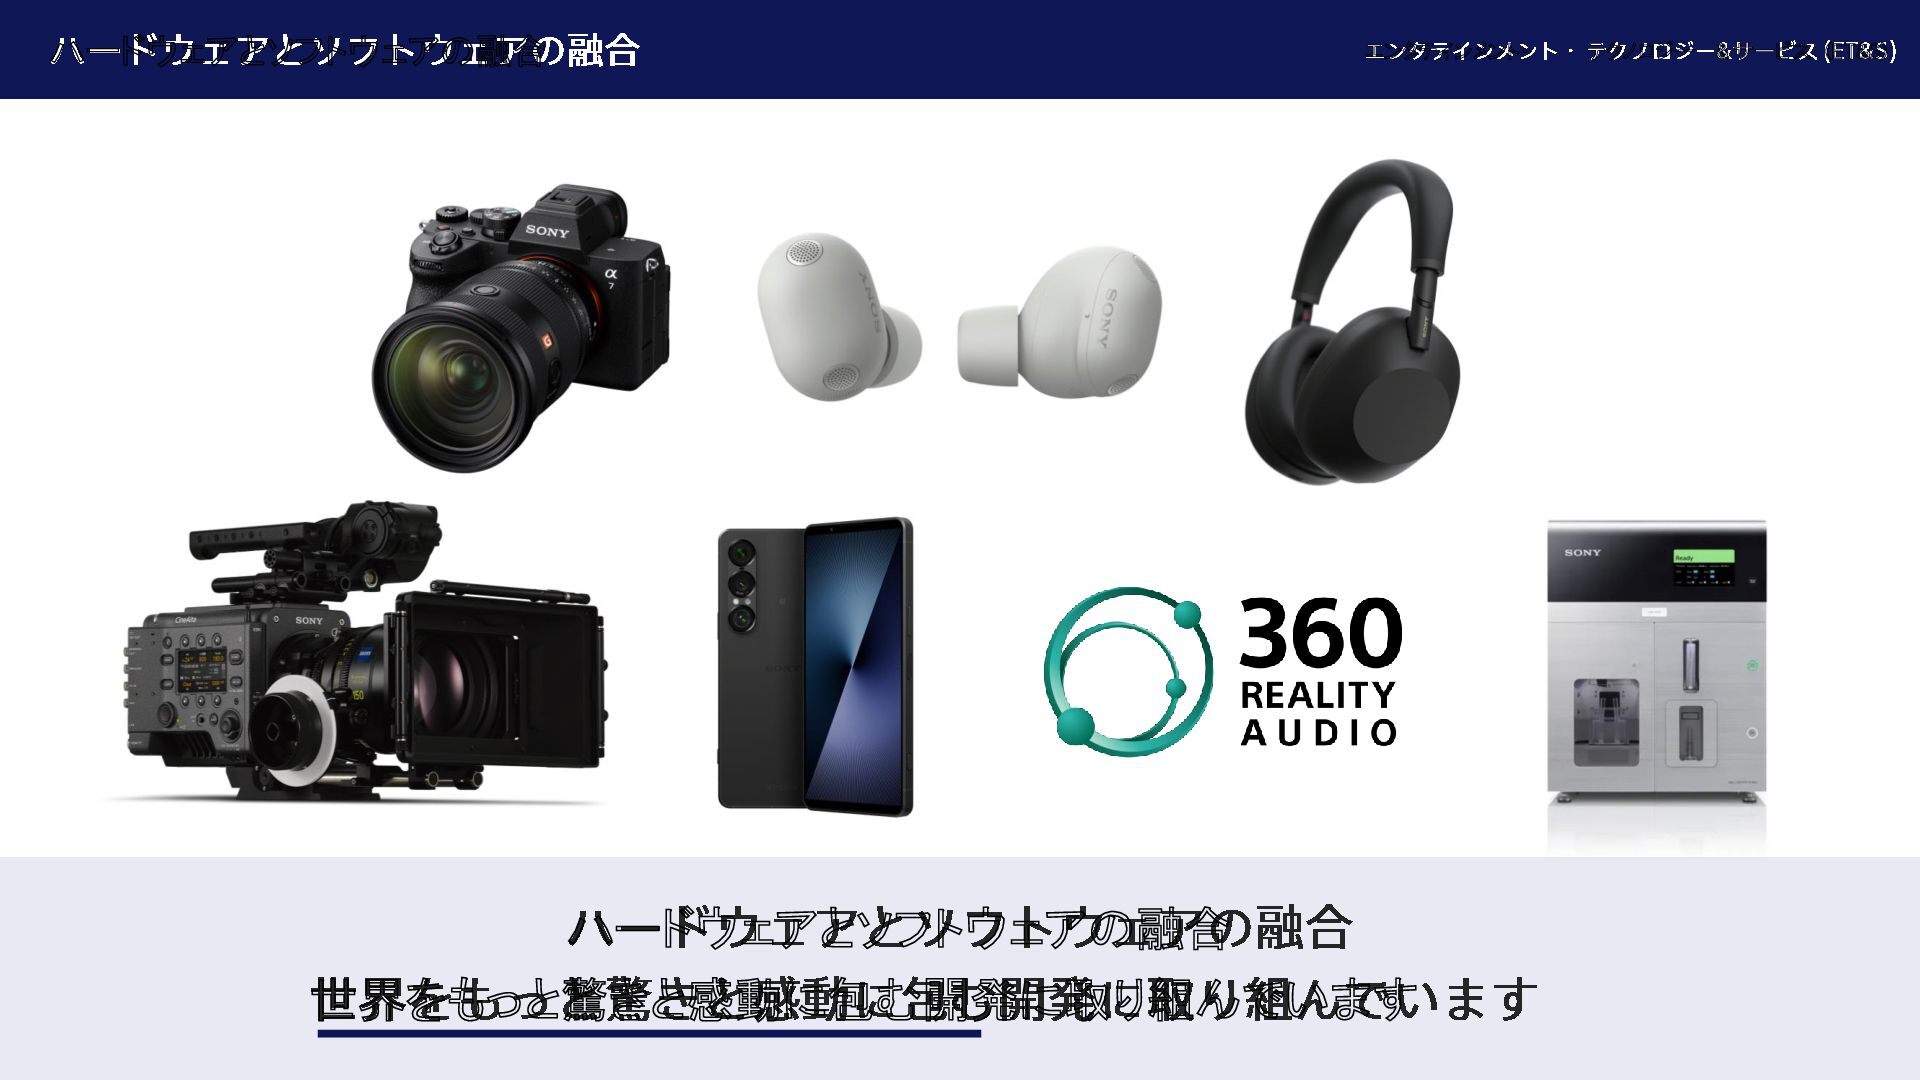
ハードウェアとソフトウェアの融合 エンタテインメント・ テクノロジー&サービス (ET&S) ハードウェアとソフトウェアの融合 世界をもっと驚きと感動に包む開発に取り組んでいます
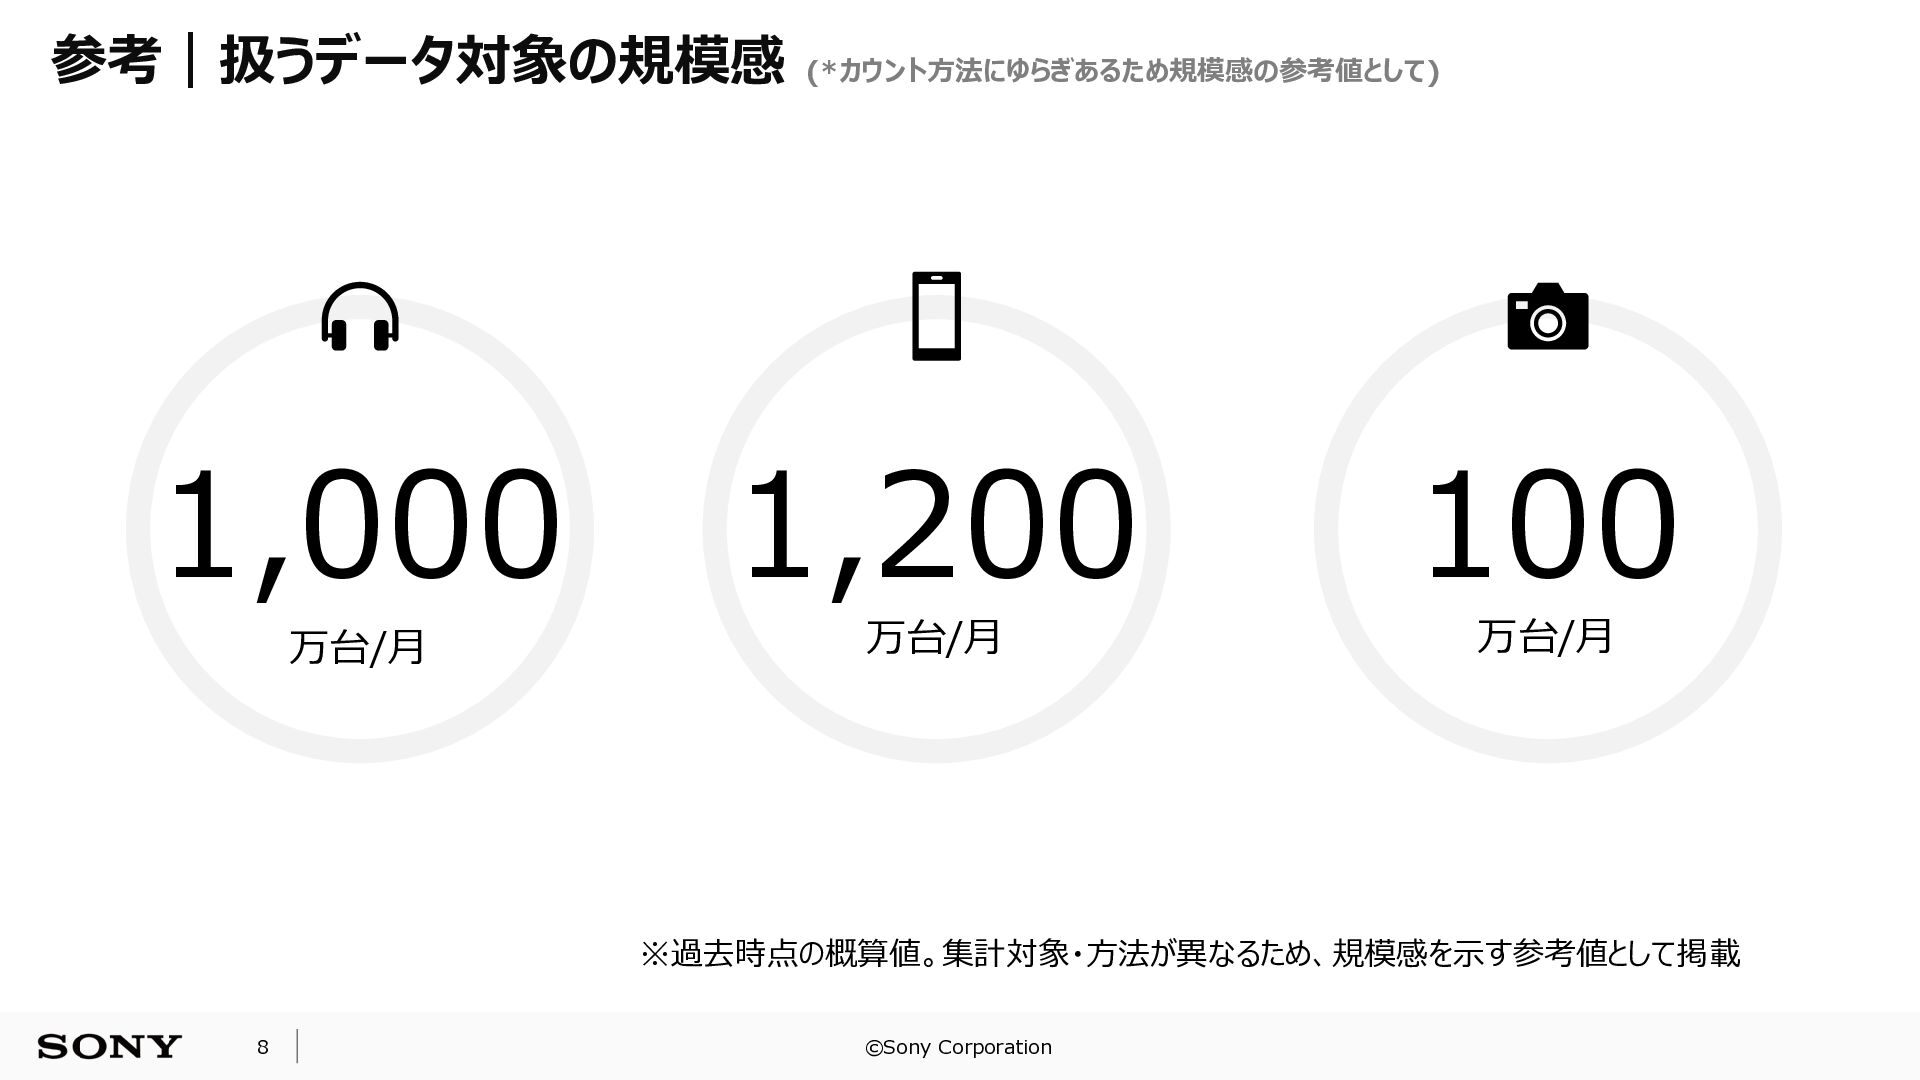
参考|扱うデータ対象の規模感 (*カウント方法にゆらぎあるため規模感の参考値として) 1,000 1,200 100 万台/月 万台/月 万台/月 ※過去時点の概算値。集計対象・方法が異なるため、規模感を示す参考値として掲載 8
©Sony Corporation
Agenda 1 ソニーについて 2 データ基盤の技術選定とアーキテクチャ 3 データガバナンス 4 カメラ領域におけるデータ基盤移行・活用 9
©Sony Corporation
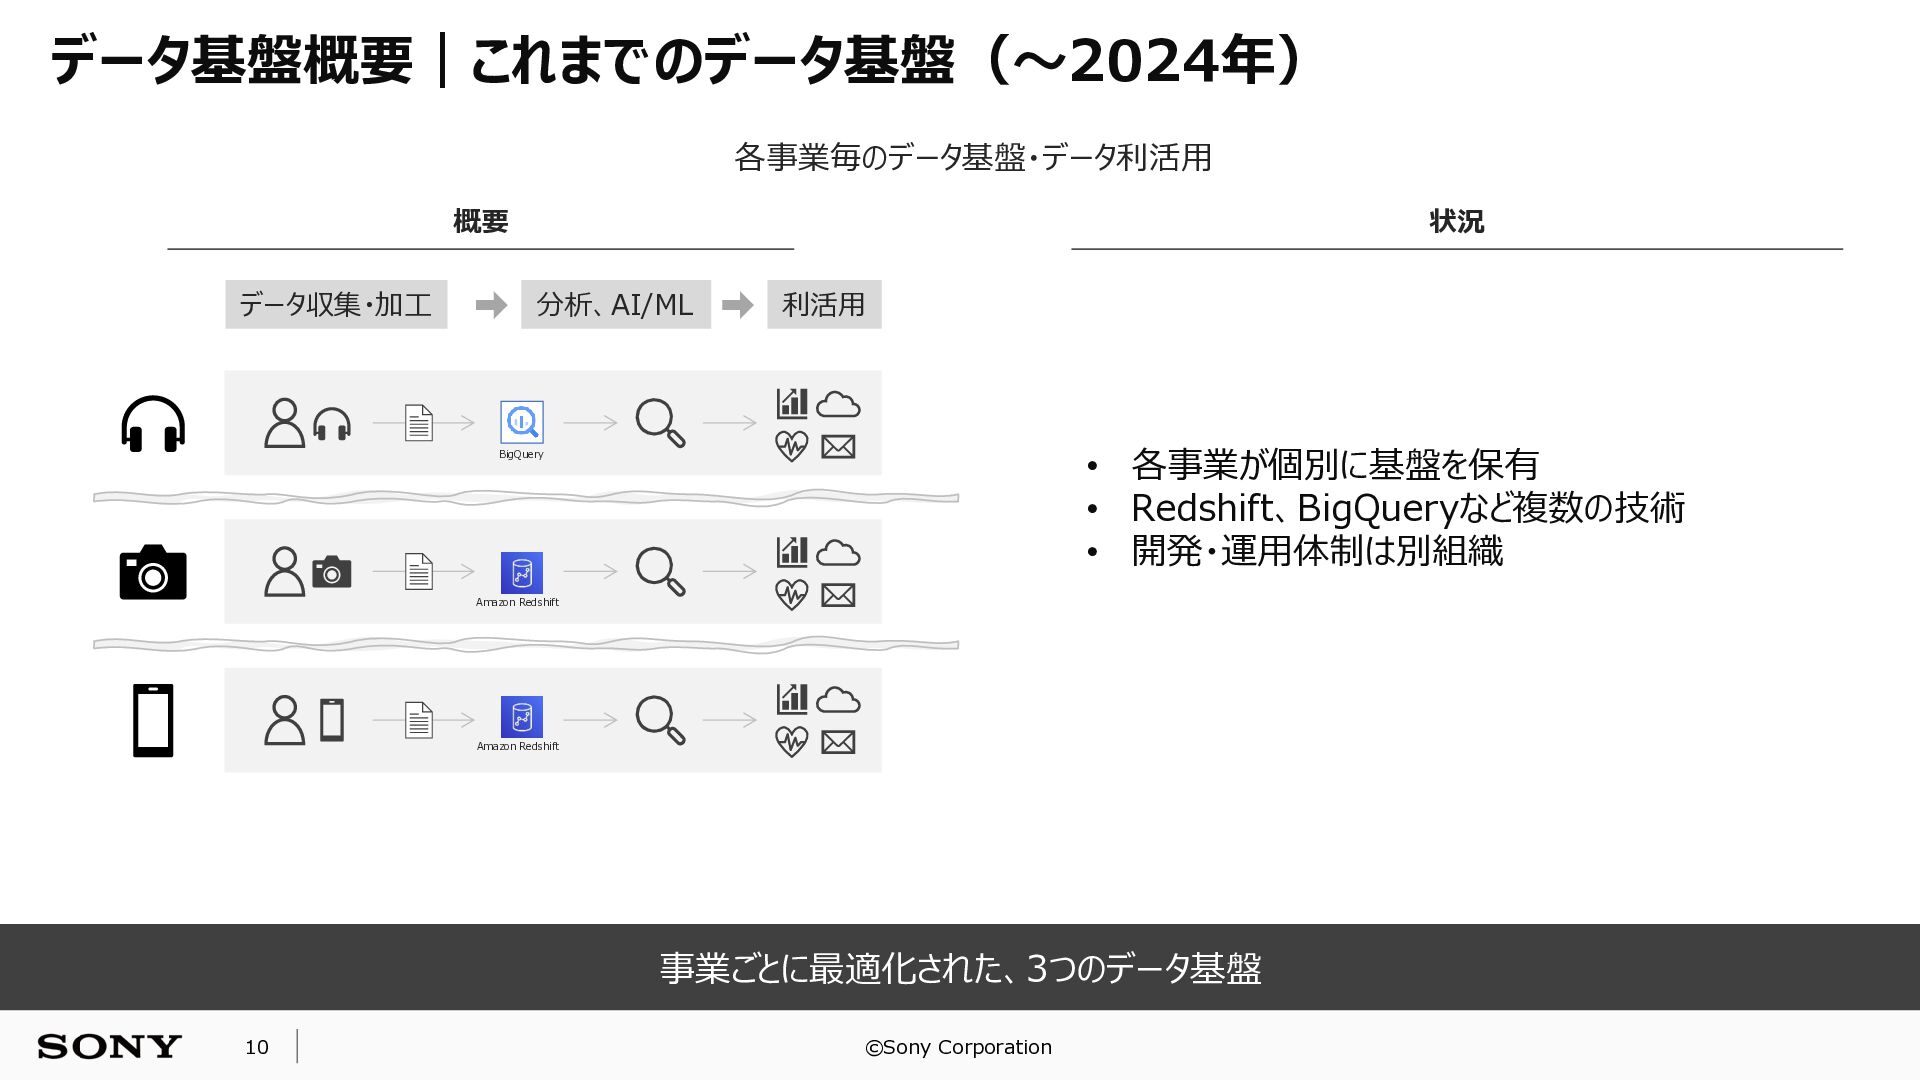
データ基盤概要|これまでのデータ基盤(〜2024年) 各事業毎のデータ基盤・データ利活用 状況 概要 データ収集・加工 分析、AI/ML 利活用 • 各事業が個別に基盤を保有 •
Redshift、BigQueryなど複数の技術 • 開発・運用体制は別組織 BigQuery Amazon Redshift Amazon Redshift 事業ごとに最適化された、3つのデータ基盤 10 ©Sony Corporation
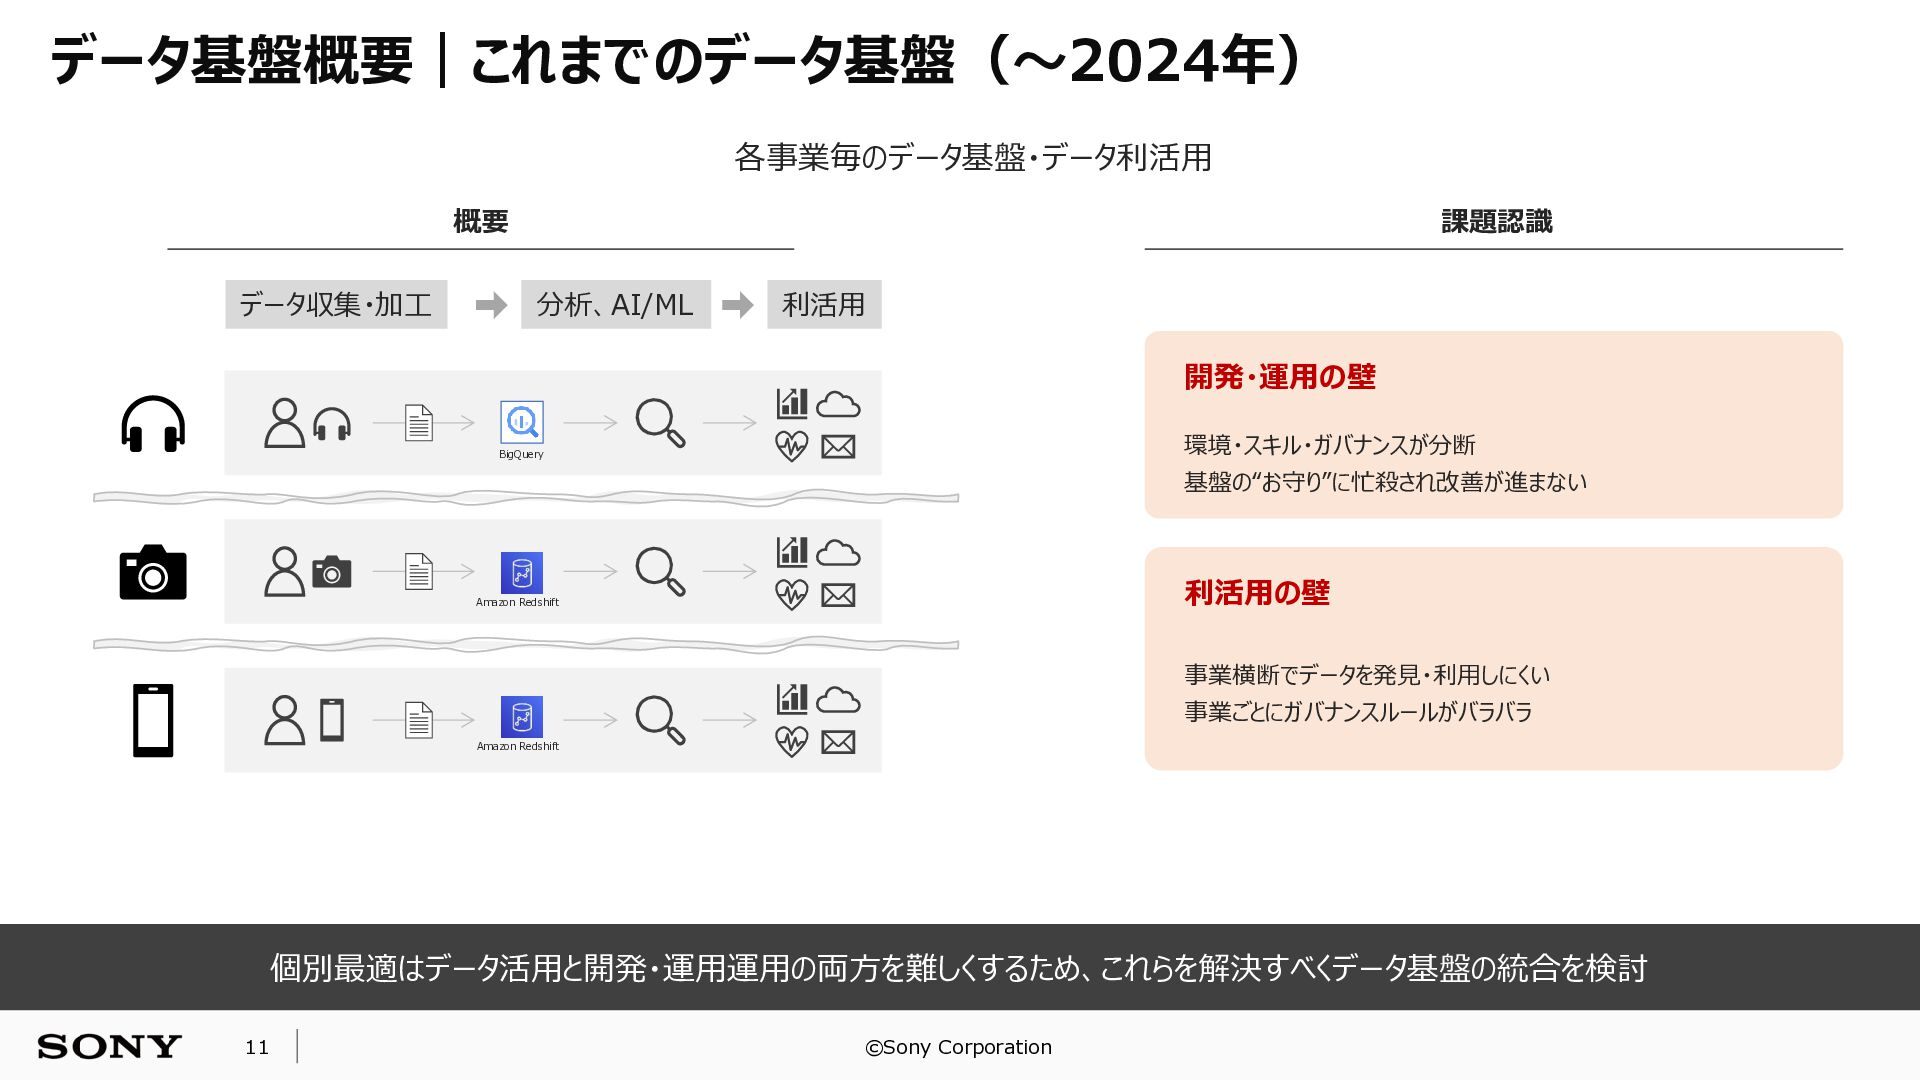
データ基盤概要|これまでのデータ基盤(〜2024年) 各事業毎のデータ基盤・データ利活用 課題認識 概要 データ収集・加工 分析、AI/ML 利活用 開発・運用の壁 環境・スキル・ガバナンスが分断 BigQuery
基盤の“お守り”に忙殺され改善が進まない 利活用の壁 Amazon Redshift 事業横断でデータを発見・利用しにくい 事業ごとにガバナンスルールがバラバラ Amazon Redshift 個別最適はデータ活用と開発・運用運用の両方を難しくするため、これらを解決すべくデータ基盤の統合を検討 11 ©Sony Corporation
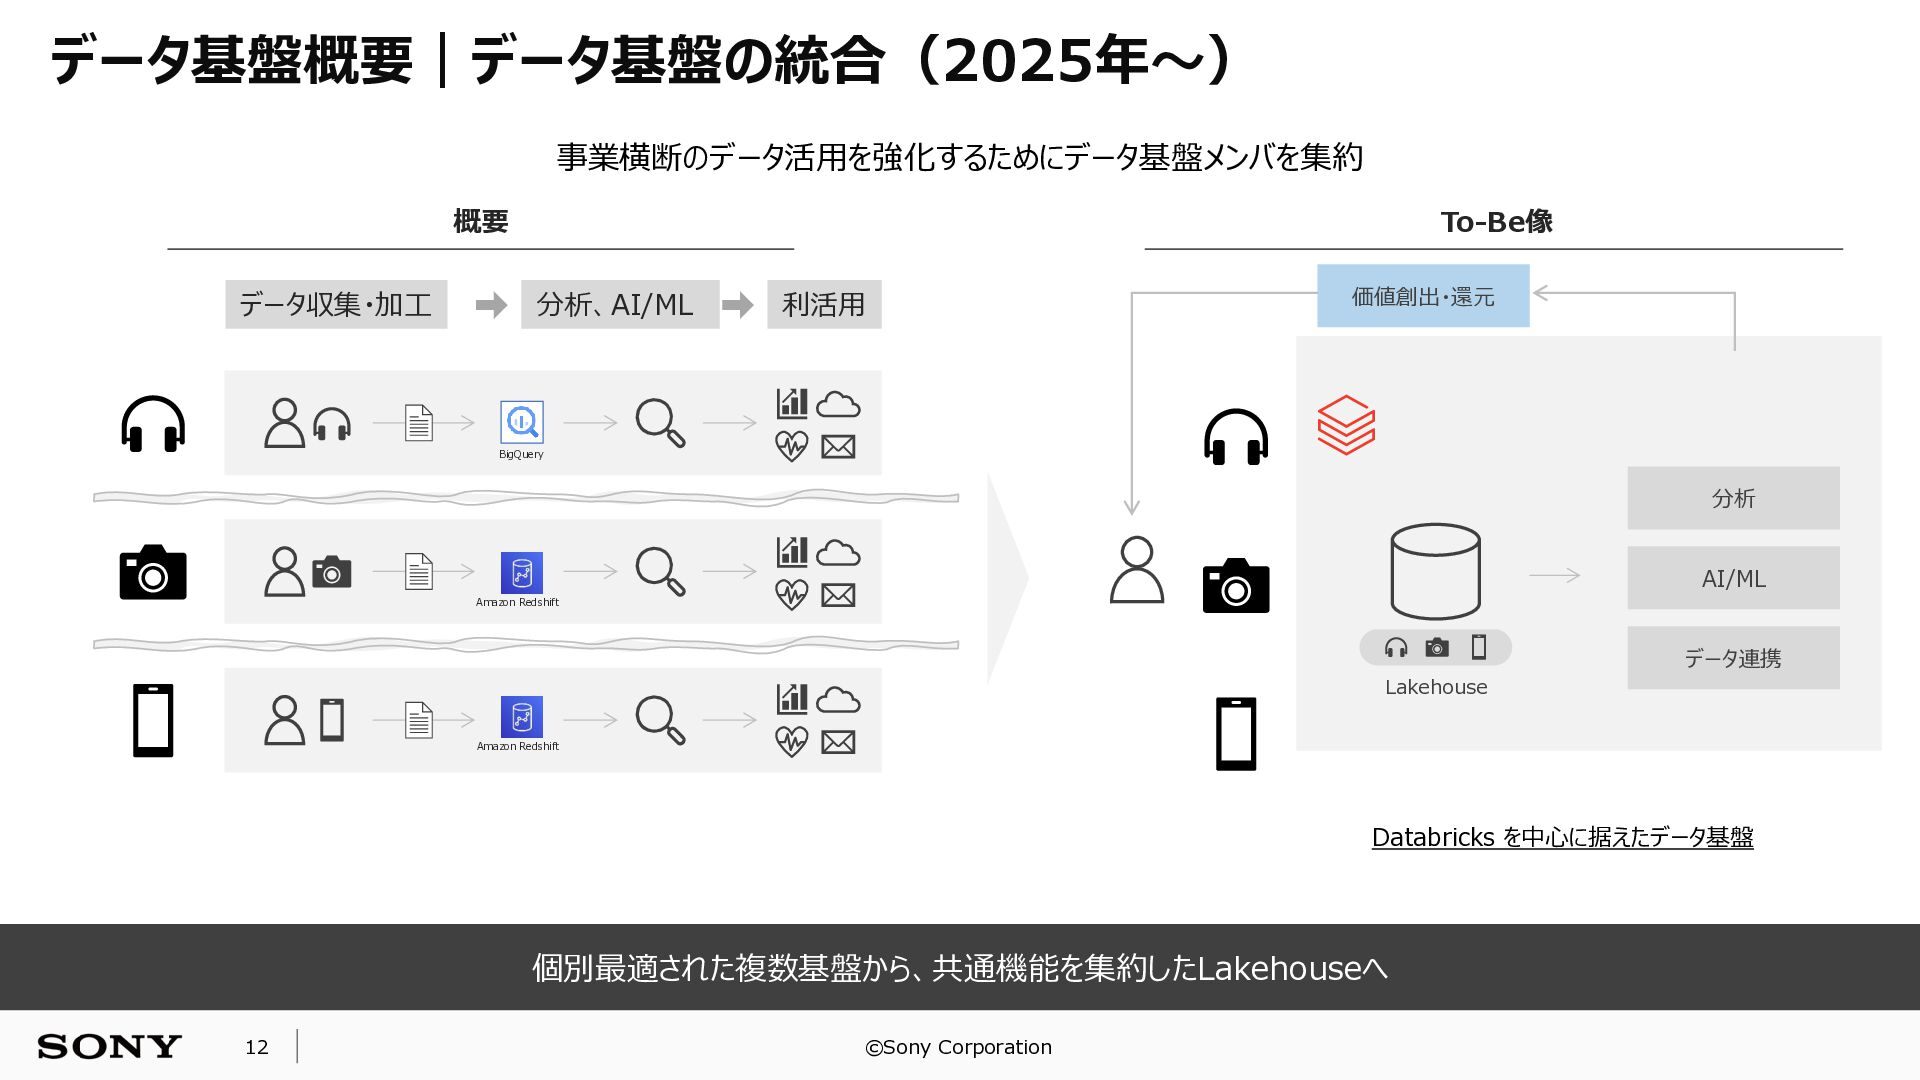
データ基盤概要|データ基盤の統合(2025年〜) 事業横断のデータ活用を強化するためにデータ基盤メンバを集約 To-Be像 概要 データ収集・加工 分析、AI/ML 利活用 価値創出・還元 BigQuery 分析
AI/ML Amazon Redshift データ連携 Lakehouse Amazon Redshift Databricks を中心に据えたデータ基盤 個別最適された複数基盤から、共通機能を集約したLakehouseへ 12 ©Sony Corporation
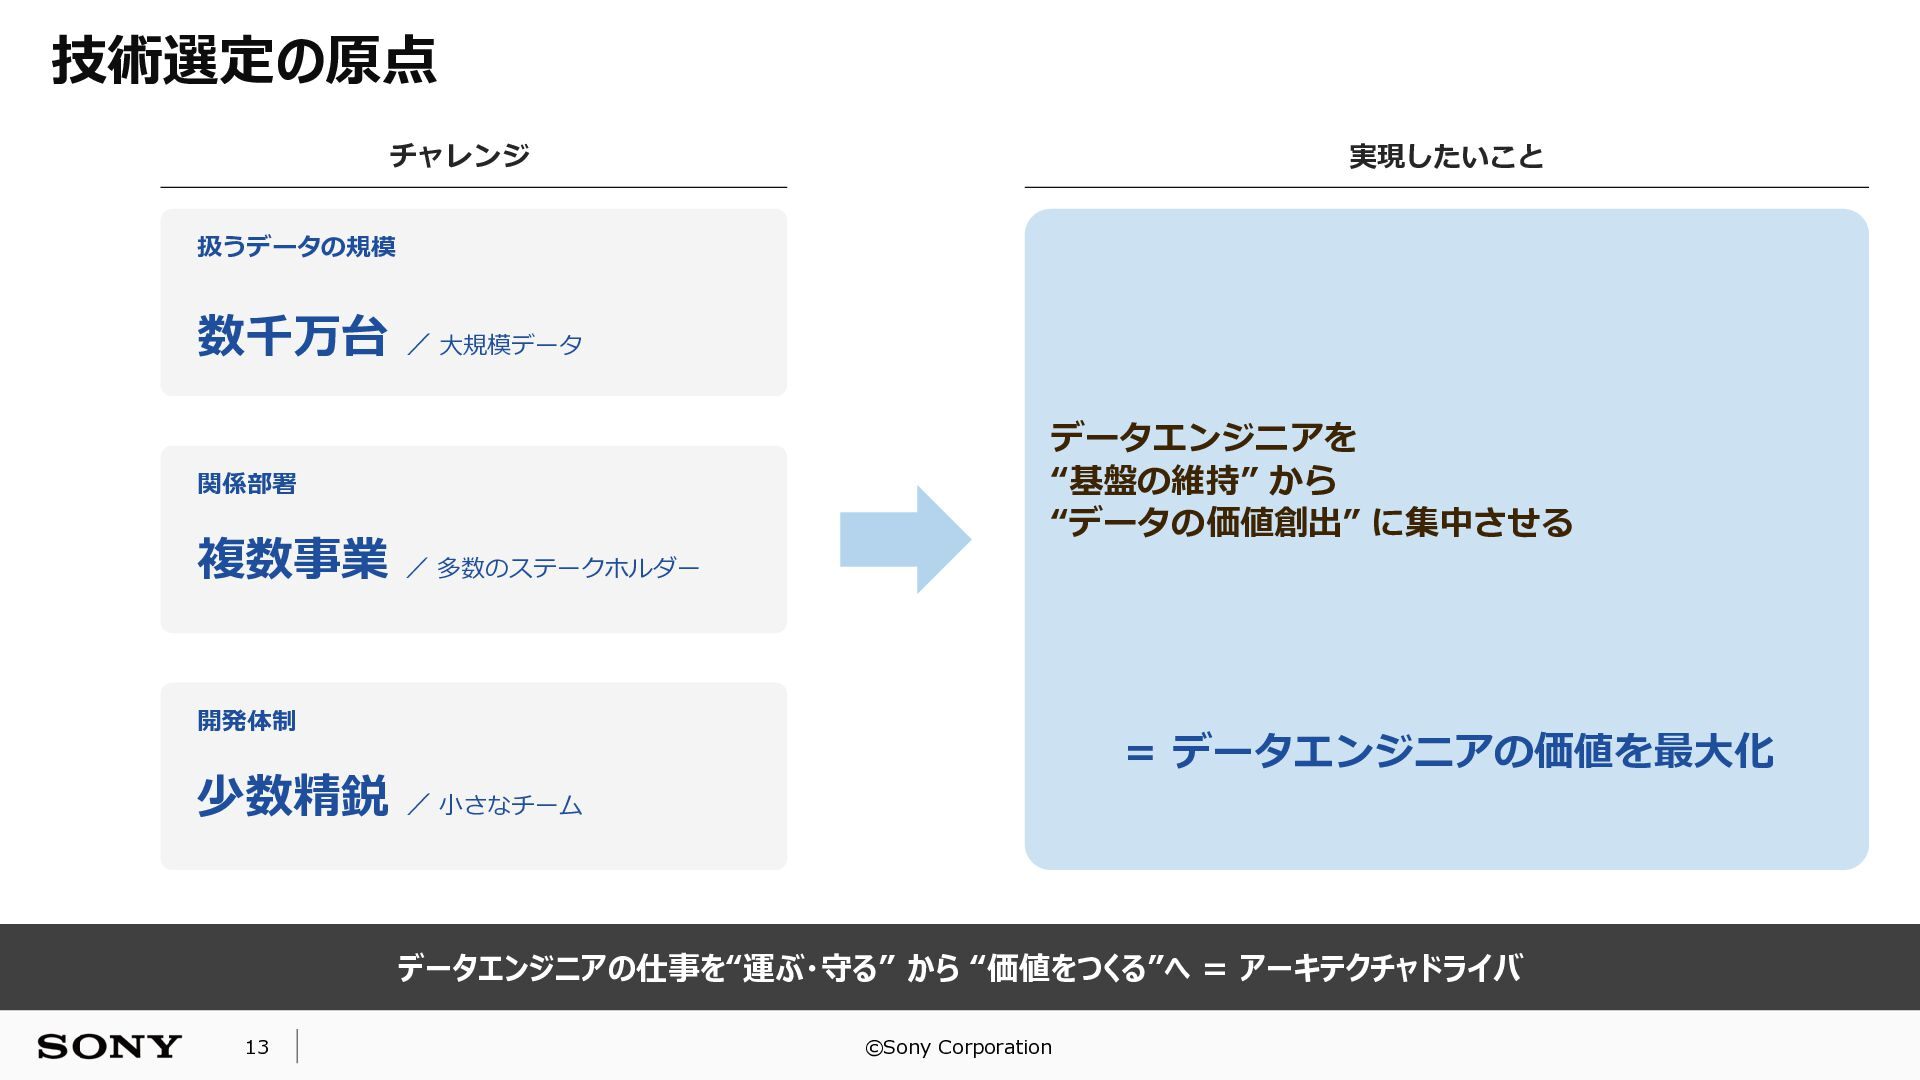
技術選定の原点 チャレンジ 実現したいこと 扱うデータの規模 数千万台 / 大規模データ 関係部署 複数事業 /
多数のステークホルダー データエンジニアを “基盤の維持” から “データの価値創出” に集中させる 開発体制 = データエンジニアの価値を最大化 少数精鋭 / 小さなチーム データエンジニアの仕事を“運ぶ・守る” から “価値をつくる”へ = アーキテクチャドライバ 13 ©Sony Corporation
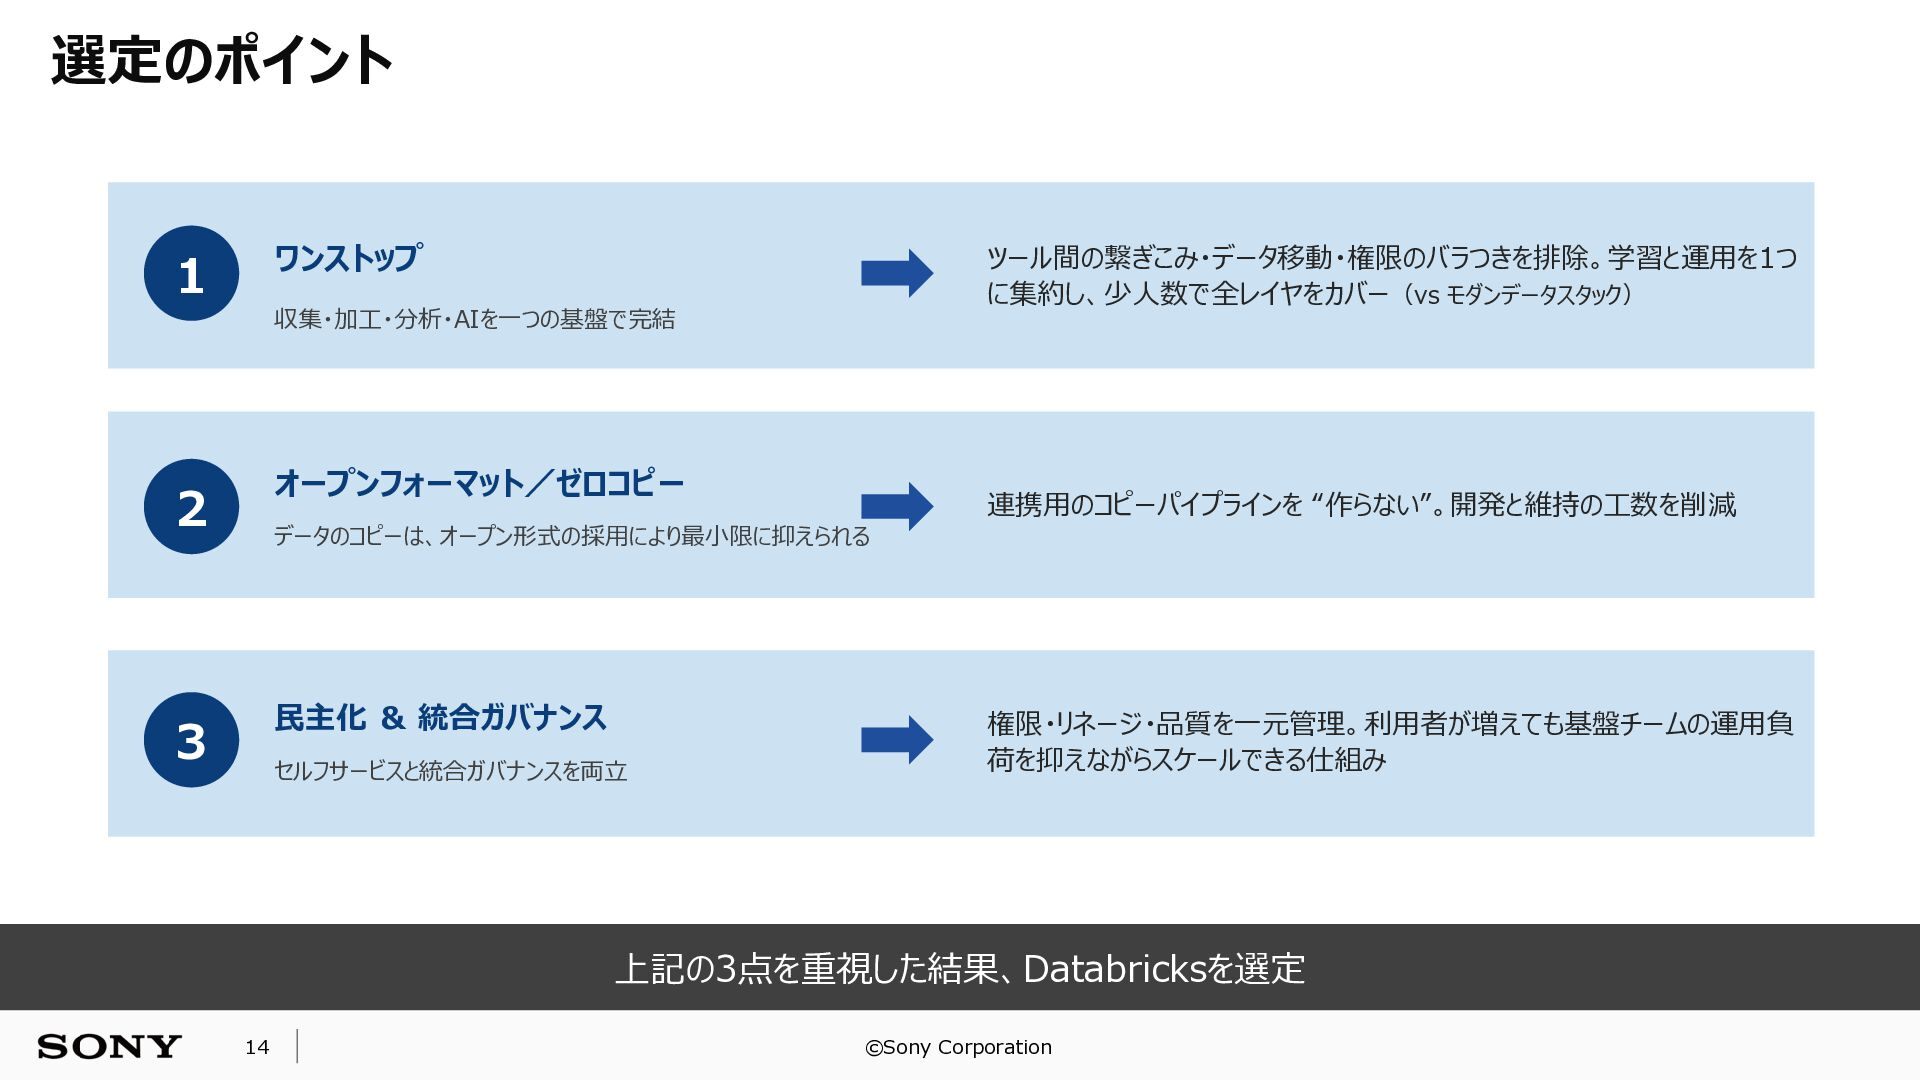
選定のポイント ワンストップ 1 ツール間の繋ぎこみ・データ移動・権限のバラつきを排除。学習と運用を1つ に集約し、少人数で全レイヤをカバー(vs モダンデータスタック) 収集・加工・分析・AIを一つの基盤で完結 2 オープンフォーマット/ゼロコピー 3
民主化 & 統合ガバナンス 連携用のコピーパイプラインを “作らない”。開発と維持の工数を削減 データのコピーは、オープン形式の採用により最小限に抑えられる セルフサービスと統合ガバナンスを両立 権限・リネージ・品質を一元管理。利用者が増えても基盤チームの運用負 荷を抑えながらスケールできる仕組み 上記の3点を重視した結果、Databricksを選定 14 ©Sony Corporation
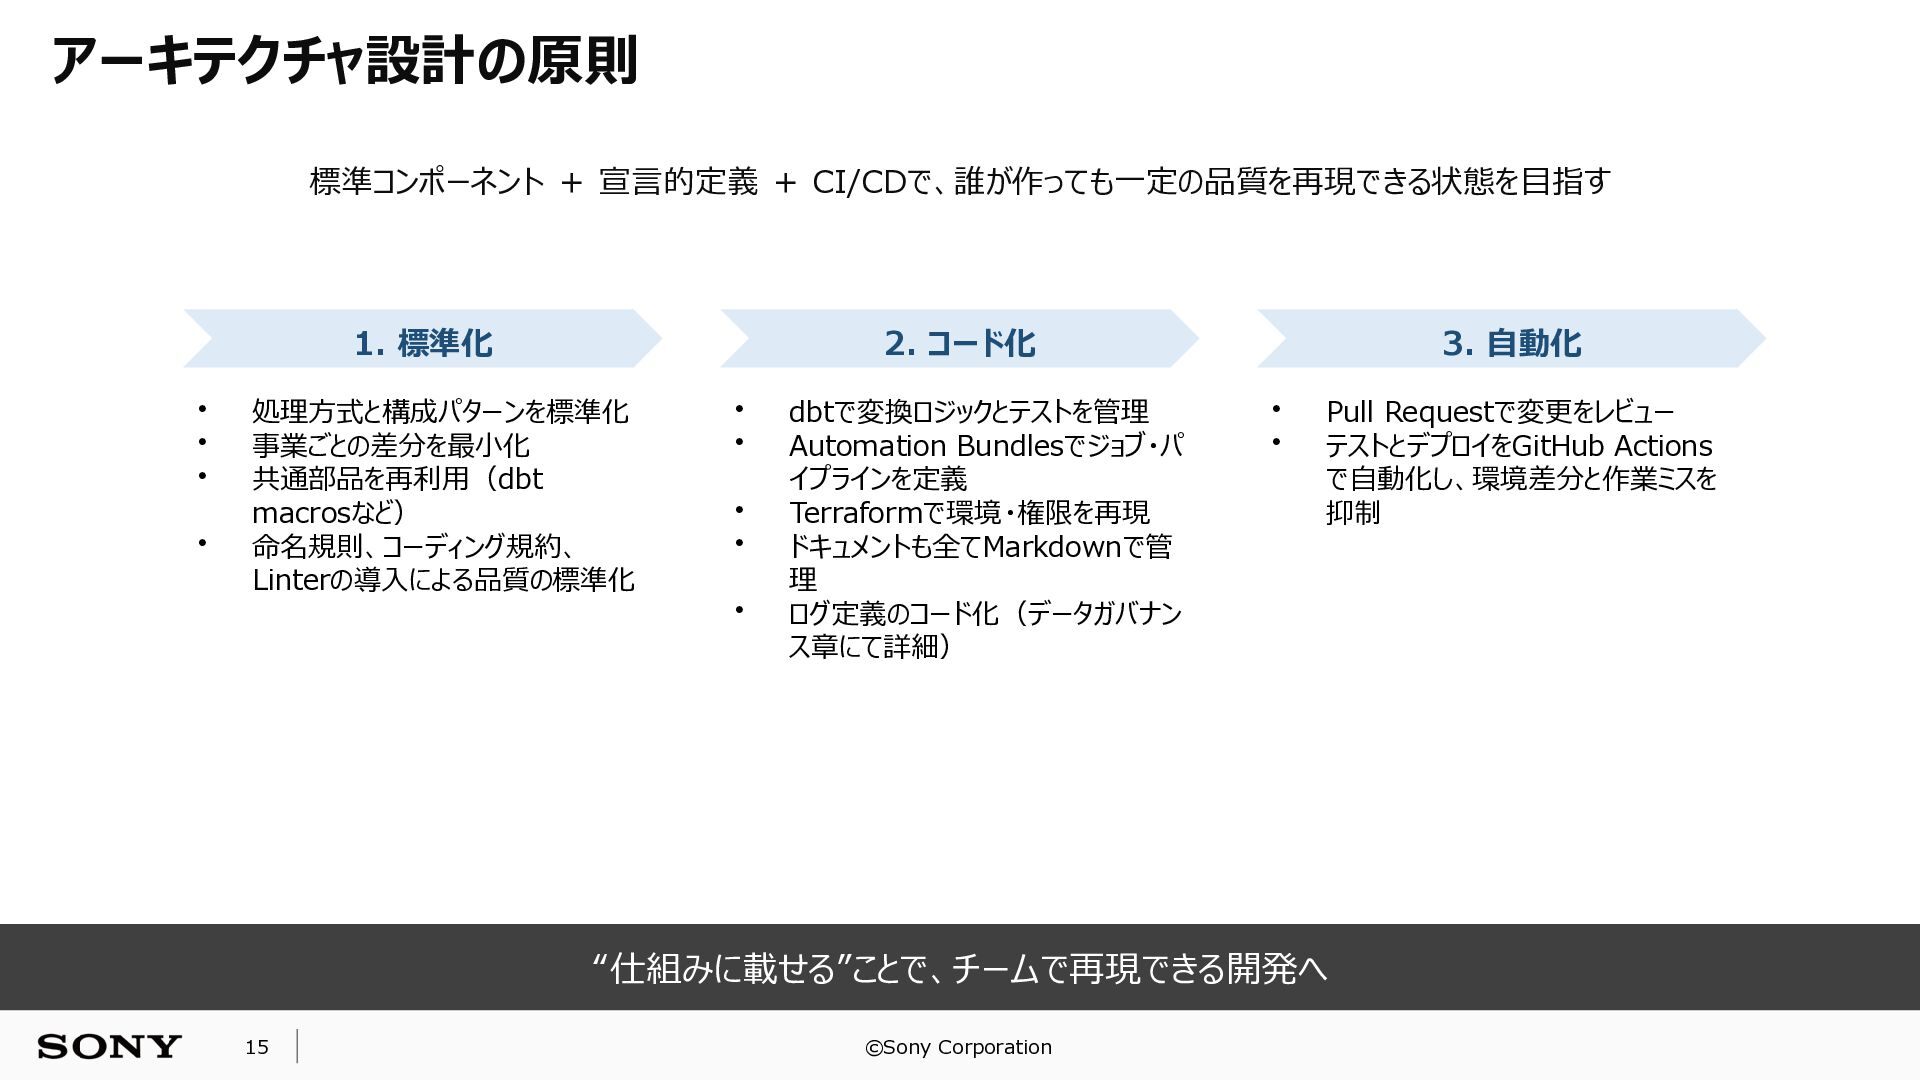
アーキテクチャ設計の原則 標準コンポーネント + 宣言的定義 + CI/CDで、誰が作っても一定の品質を再現できる状態を目指す 1. 標準化 • •
• • 2. コード化 処理方式と構成パターンを標準化 事業ごとの差分を最小化 共通部品を再利用(dbt macrosなど) 命名規則、コーディング規約、 Linterの導入による品質の標準化 • • • • • dbtで変換ロジックとテストを管理 Automation Bundlesでジョブ・パ イプラインを定義 Terraformで環境・権限を再現 ドキュメントも全てMarkdownで管 理 ログ定義のコード化(データガバナン ス章にて詳細) 3. 自動化 • • Pull Requestで変更をレビュー テストとデプロイをGitHub Actions で自動化し、環境差分と作業ミスを 抑制 “仕組みに載せる”ことで、チームで再現できる開発へ 15 ©Sony Corporation
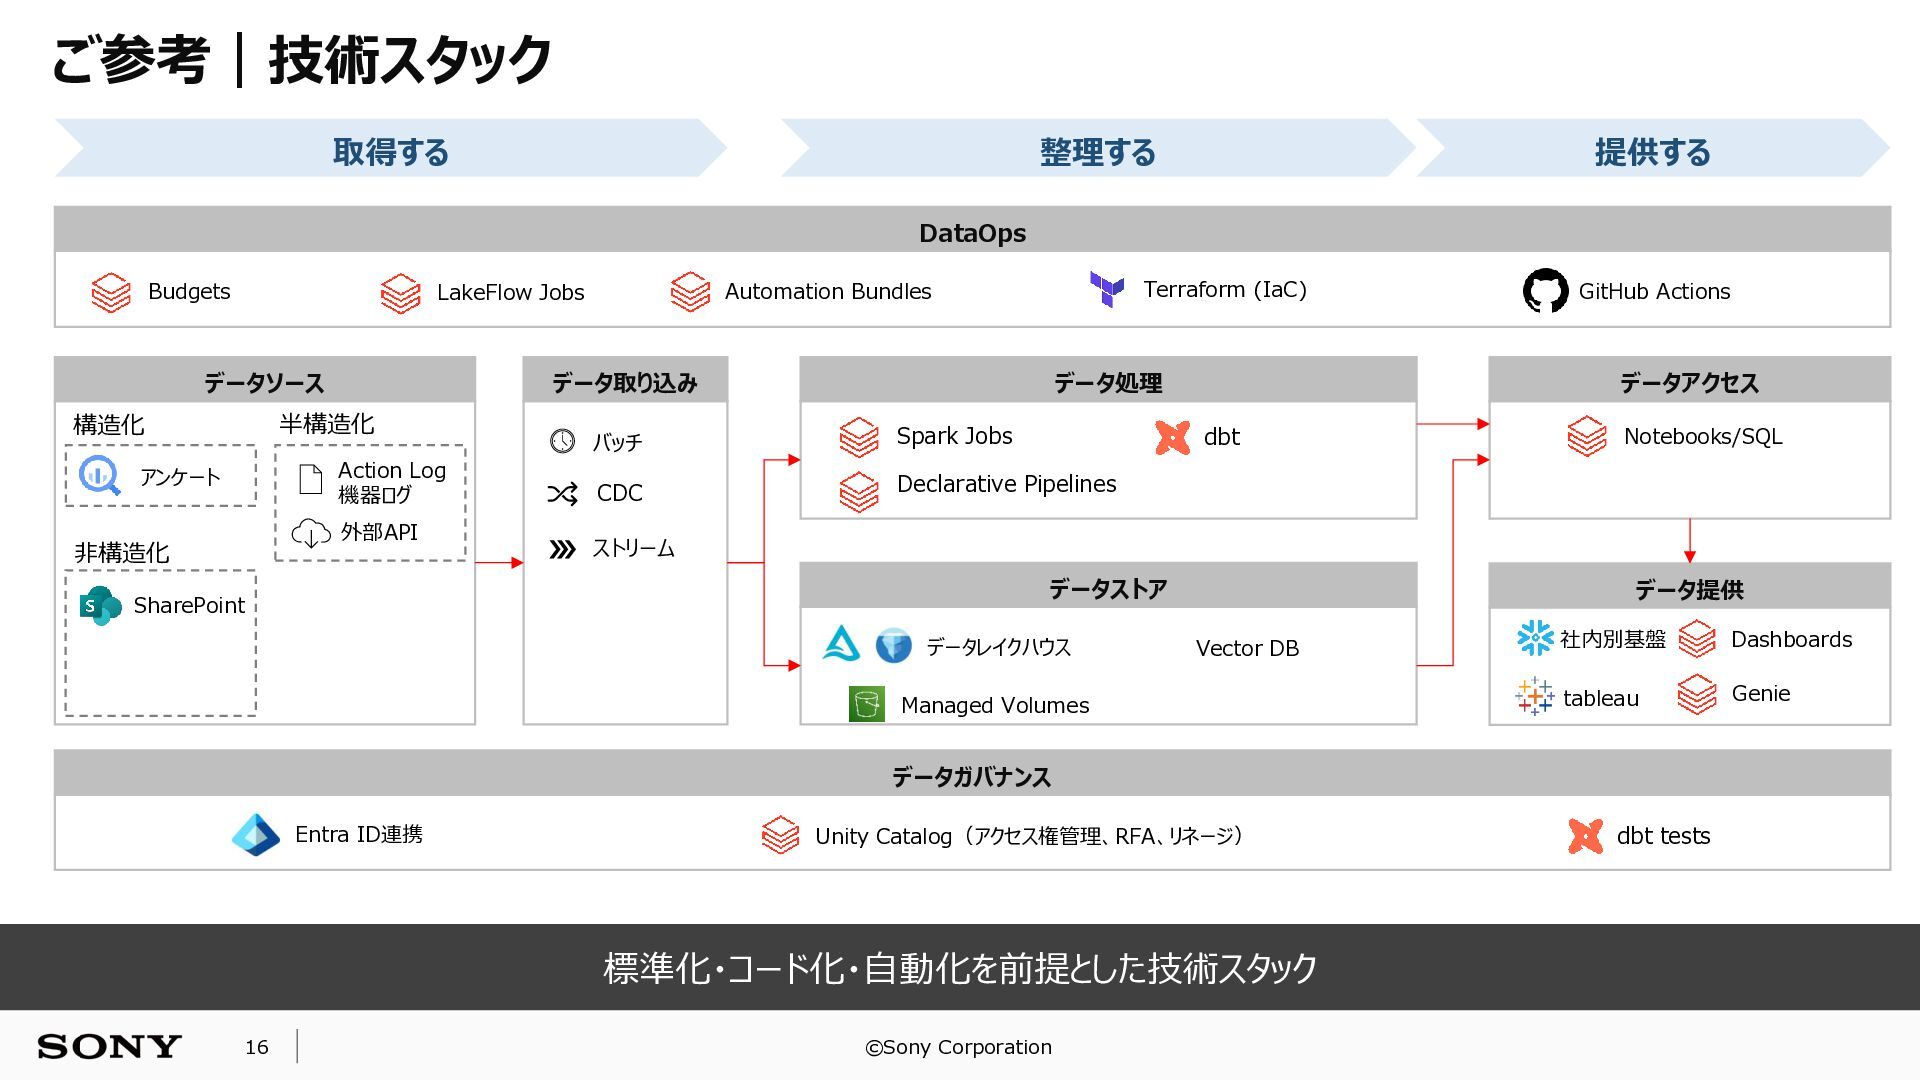
ご参考|技術スタック 取得する 整理する 提供する DataOps Budgets データソース データ取り込み 半構造化 構造化
Action Log 機器ログ アンケート 外部API 非構造化 Terraform (IaC) Automation Bundles LakeFlow Jobs データ処理 バッチ Spark Jobs CDC Declarative Pipelines データアクセス dbt Notebooks/SQL ストリーム データストア SharePoint GitHub Actions データレイクハウス データ提供 Vector DB Managed Volumes 社内別基盤 Dashboards tableau Genie データガバナンス Entra ID連携 Unity Catalog(アクセス権管理、RFA、リネージ) 標準化・コード化・自動化を前提とした技術スタック 16 ©Sony Corporation dbt tests
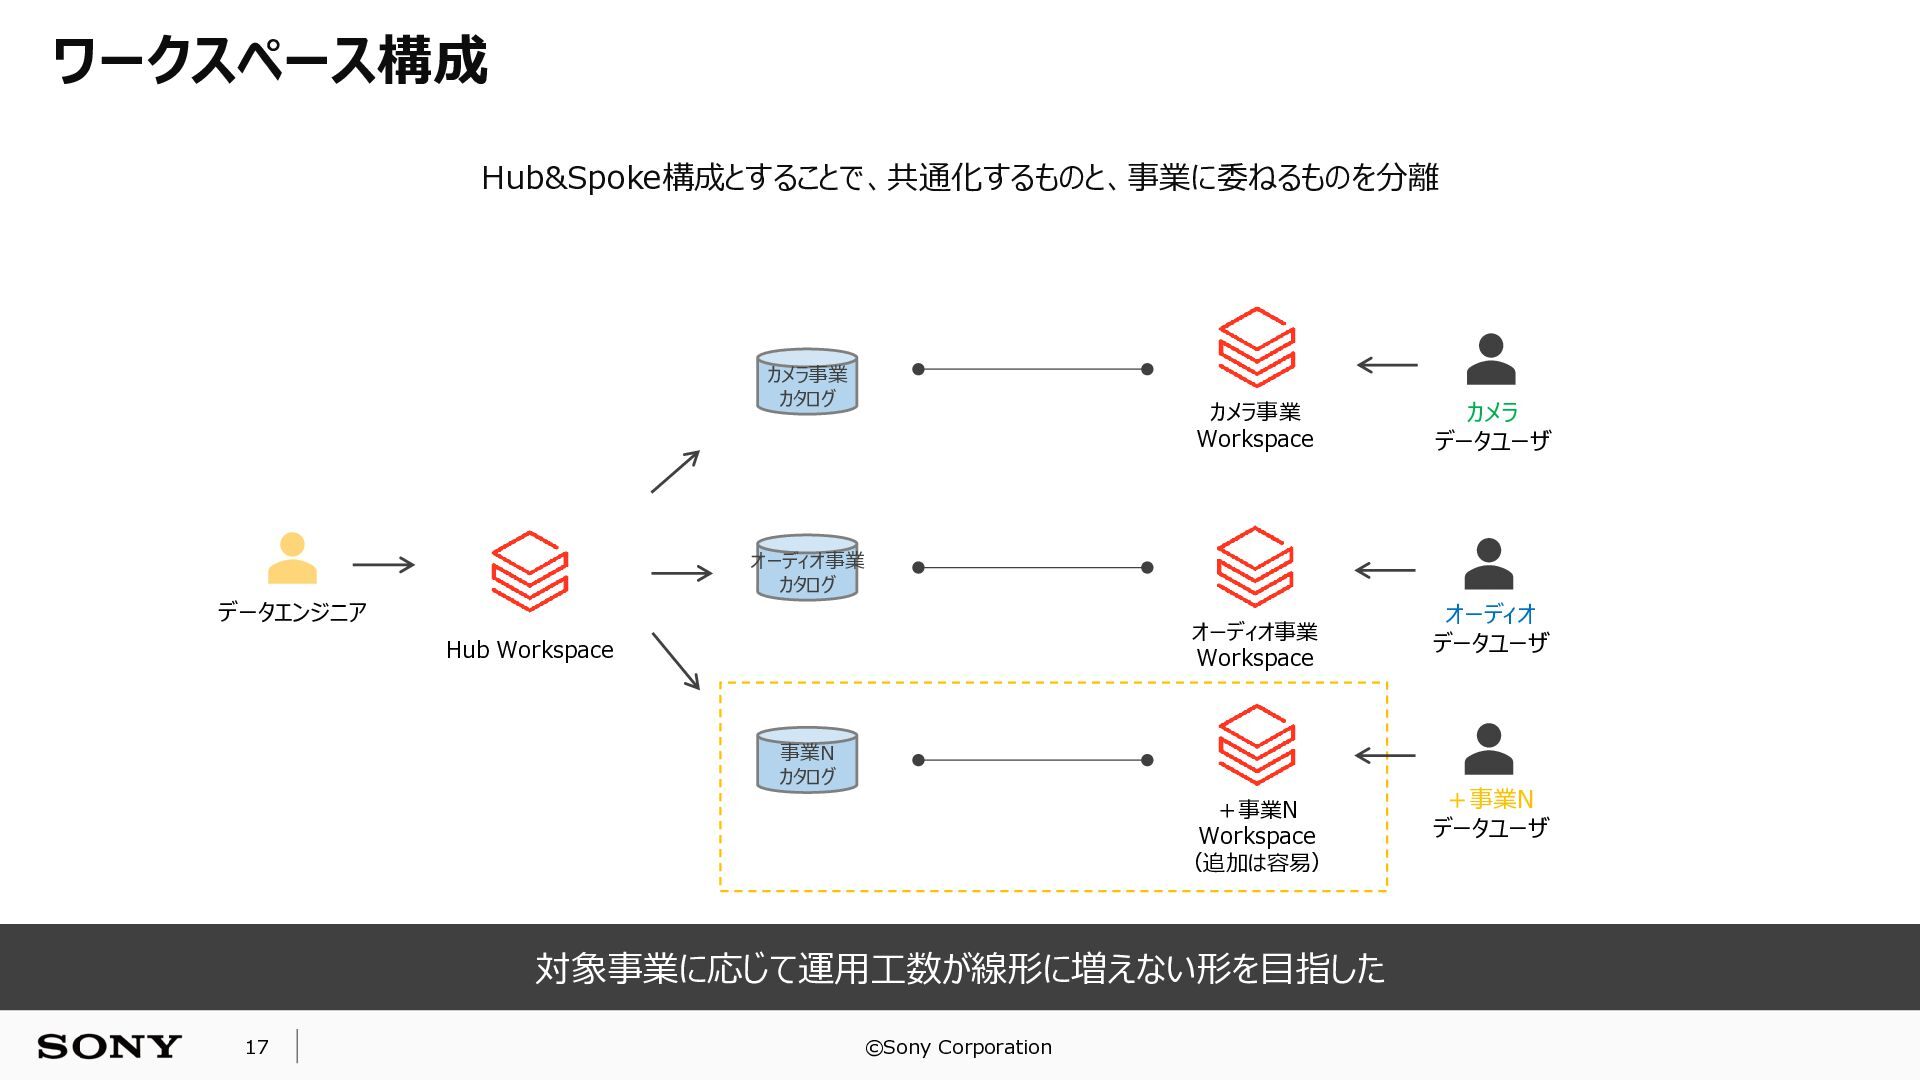
ワークスペース構成 Hub&Spoke構成とすることで、共通化するものと、事業に委ねるものを分離 カメラ事業 カタログ カメラ事業 Workspace カメラ データユーザ オーディオ事業 カタログ
データエンジニア オーディオ事業 Workspace Hub Workspace 事業N カタログ +事業N Workspace (追加は容易) 対象事業に応じて運用工数が線形に増えない形を目指した 17 ©Sony Corporation オーディオ データユーザ +事業N データユーザ
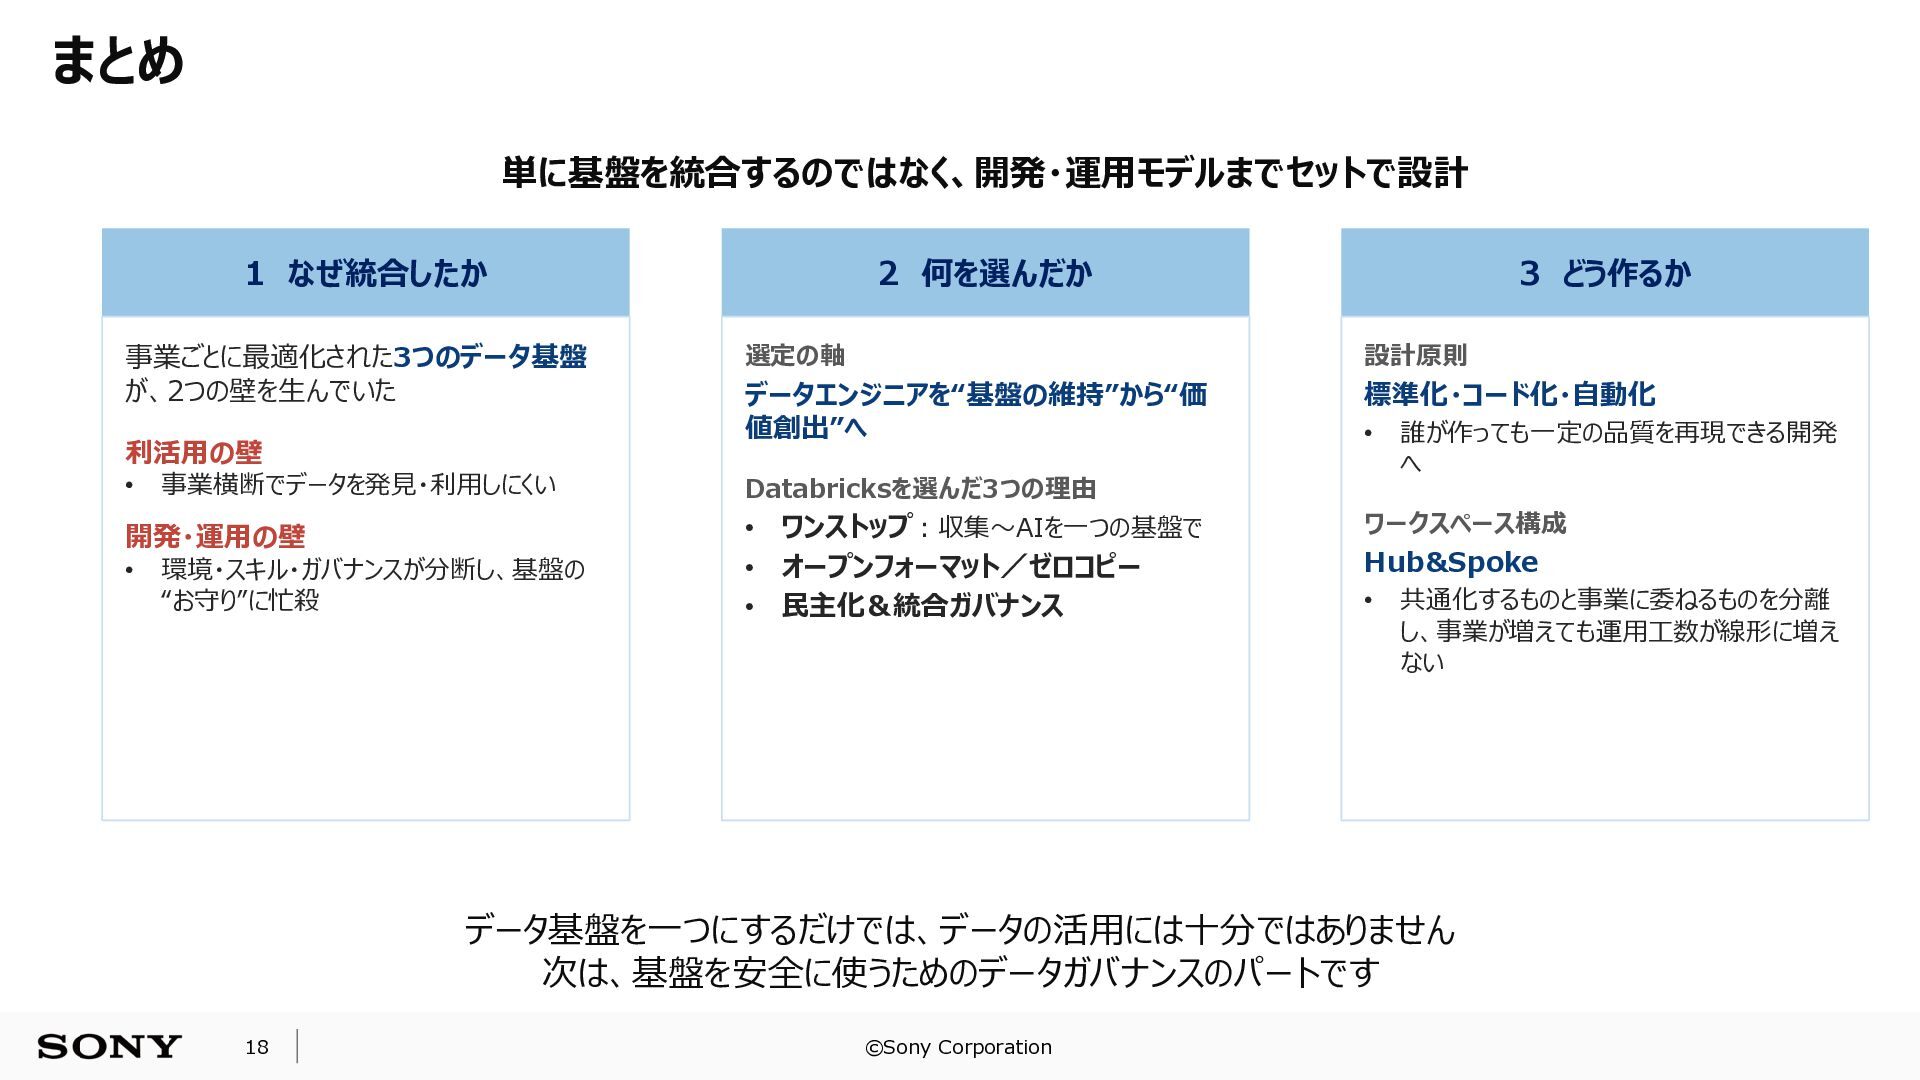
まとめ 単に基盤を統合するのではなく、開発・運用モデルまでセットで設計 1 なぜ統合したか 事業ごとに最適化された3つのデータ基盤 が、2つの壁を生んでいた 利活用の壁 • 事業横断でデータを発見・利用しにくい 開発・運用の壁
• 環境・スキル・ガバナンスが分断し、基盤の “お守り”に忙殺 2 何を選んだか 3 どう作るか 選定の軸 設計原則 データエンジニアを“基盤の維持”から“価 値創出”へ 標準化・コード化・自動化 • Databricksを選んだ3つの理由 • ワンストップ:収集〜AIを一つの基盤で • オープンフォーマット/ゼロコピー • 民主化&統合ガバナンス 誰が作っても一定の品質を再現できる開発 へ ワークスペース構成 Hub&Spoke • 共通化するものと事業に委ねるものを分離 し、事業が増えても運用工数が線形に増え ない データ基盤を一つにするだけでは、データの活用には十分ではありません 次は、基盤を安全に使うためのデータガバナンスのパートです 18 ©Sony Corporation
Agenda 1 ソニーについて 2 データ基盤の技術選定とアーキテクチャ 3 データガバナンス 4 カメラ領域におけるデータ基盤移行・活用 19
©Sony Corporation
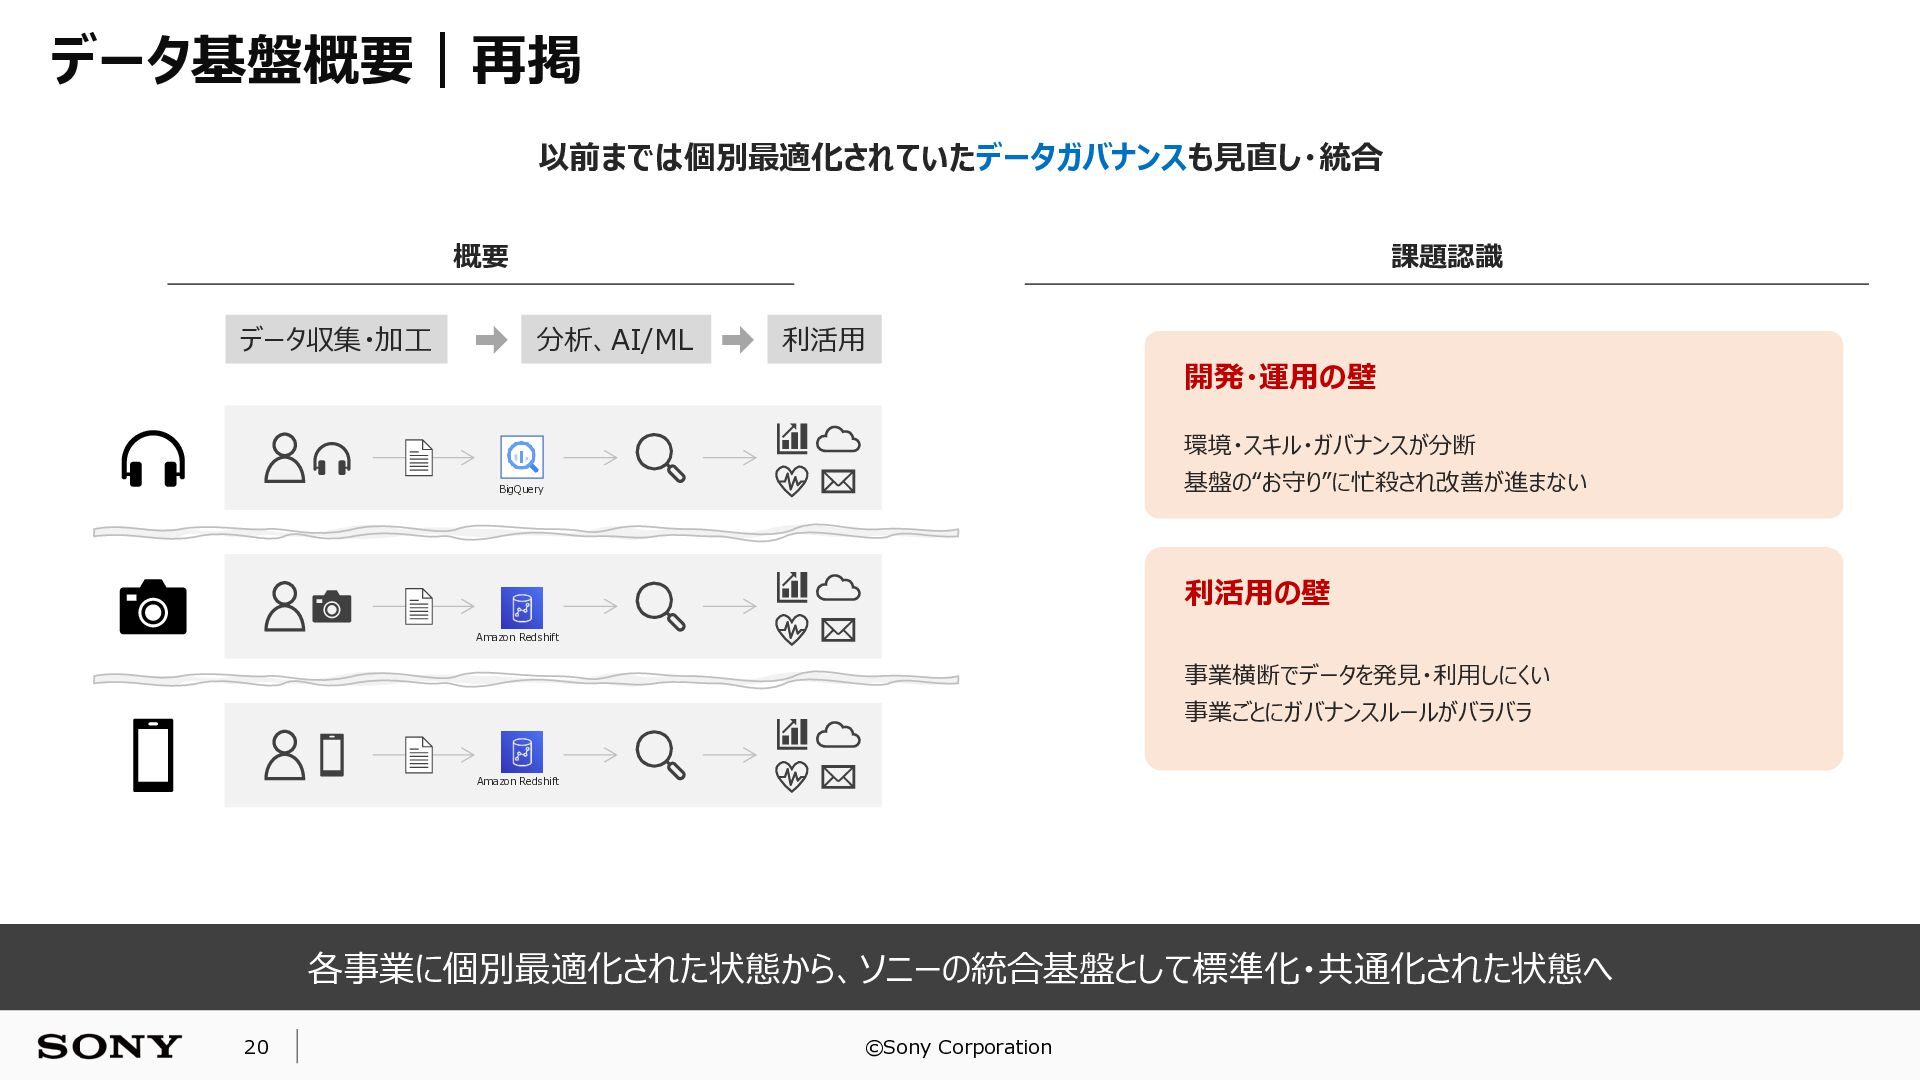
データ基盤概要|再掲 以前までは個別最適化されていたデータガバナンスも見直し・統合 課題認識 概要 データ収集・加工 分析、AI/ML 利活用 開発・運用の壁 環境・スキル・ガバナンスが分断 基盤の“お守り”に忙殺され改善が進まない
BigQuery 利活用の壁 Amazon Redshift 事業横断でデータを発見・利用しにくい 事業ごとにガバナンスルールがバラバラ Amazon Redshift 各事業に個別最適化された状態から、ソニーの統合基盤として標準化・共通化された状態へ 20 ©Sony Corporation
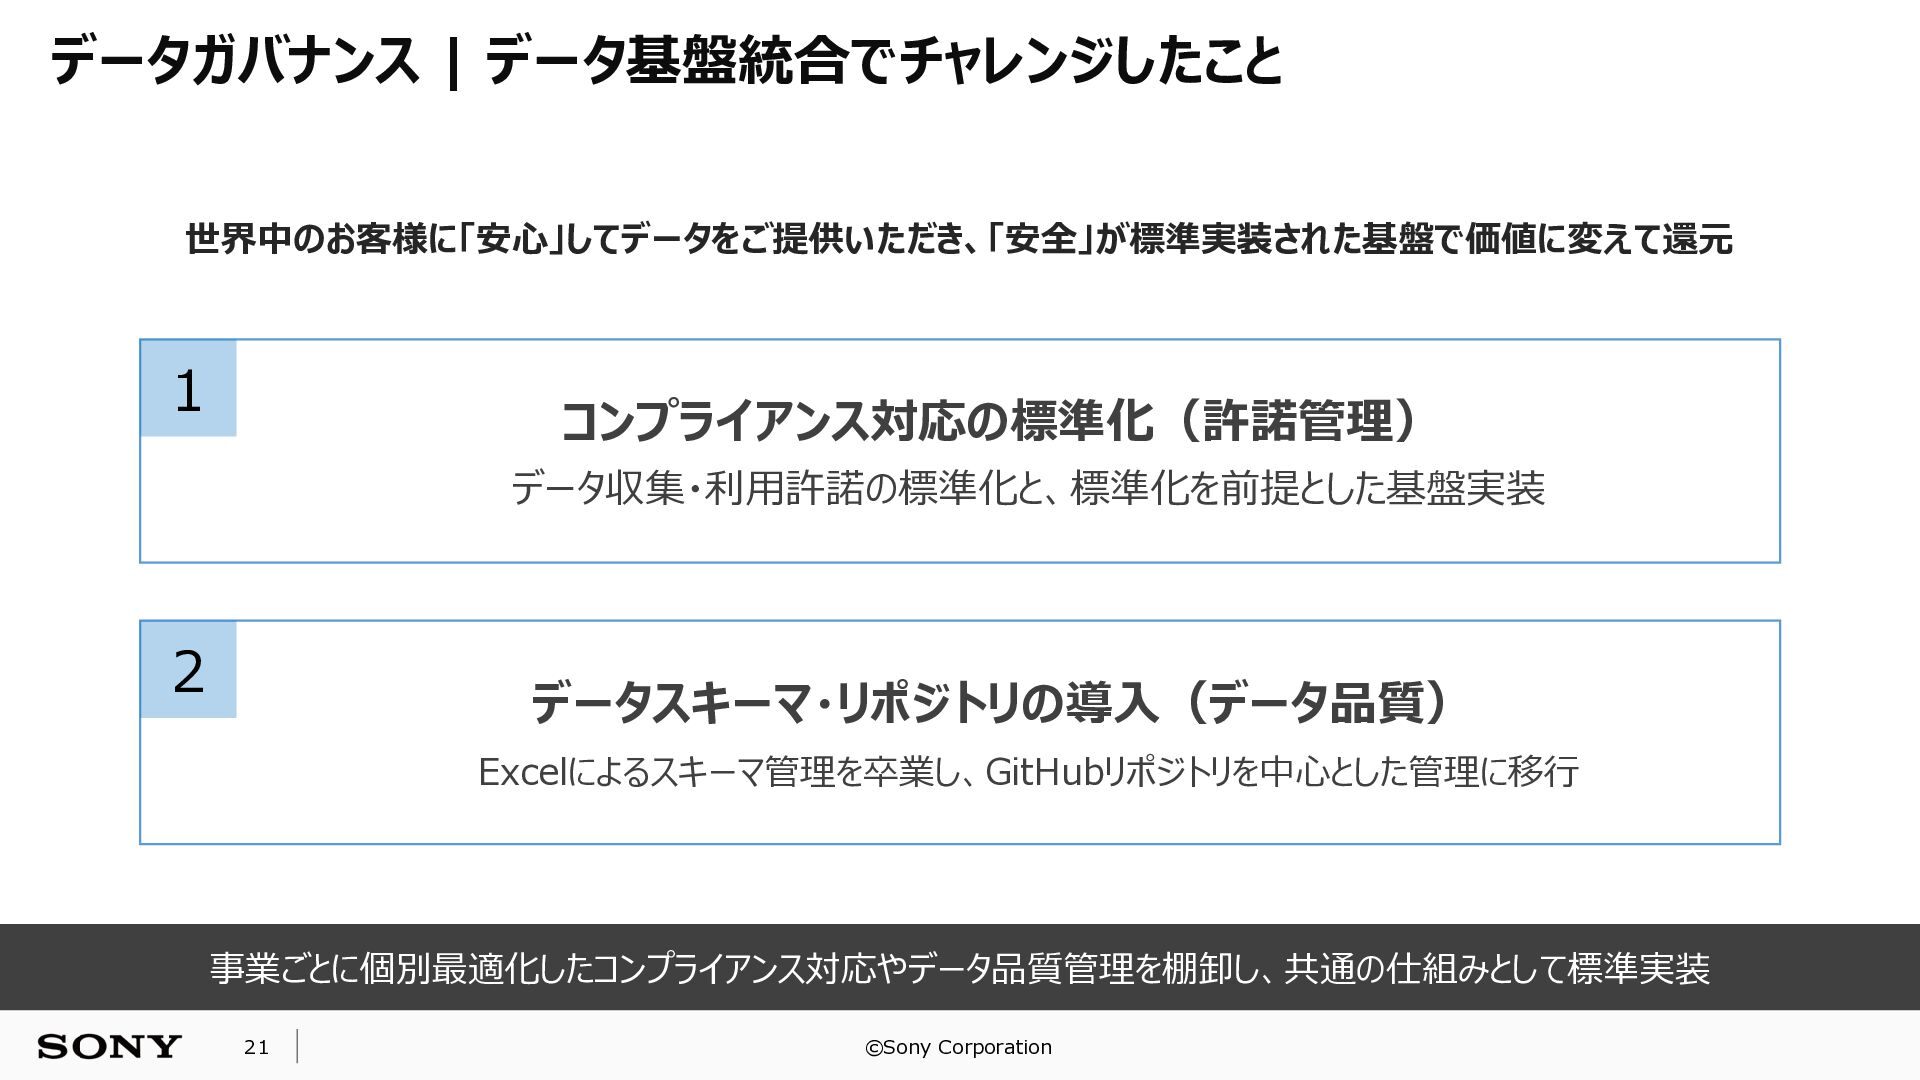
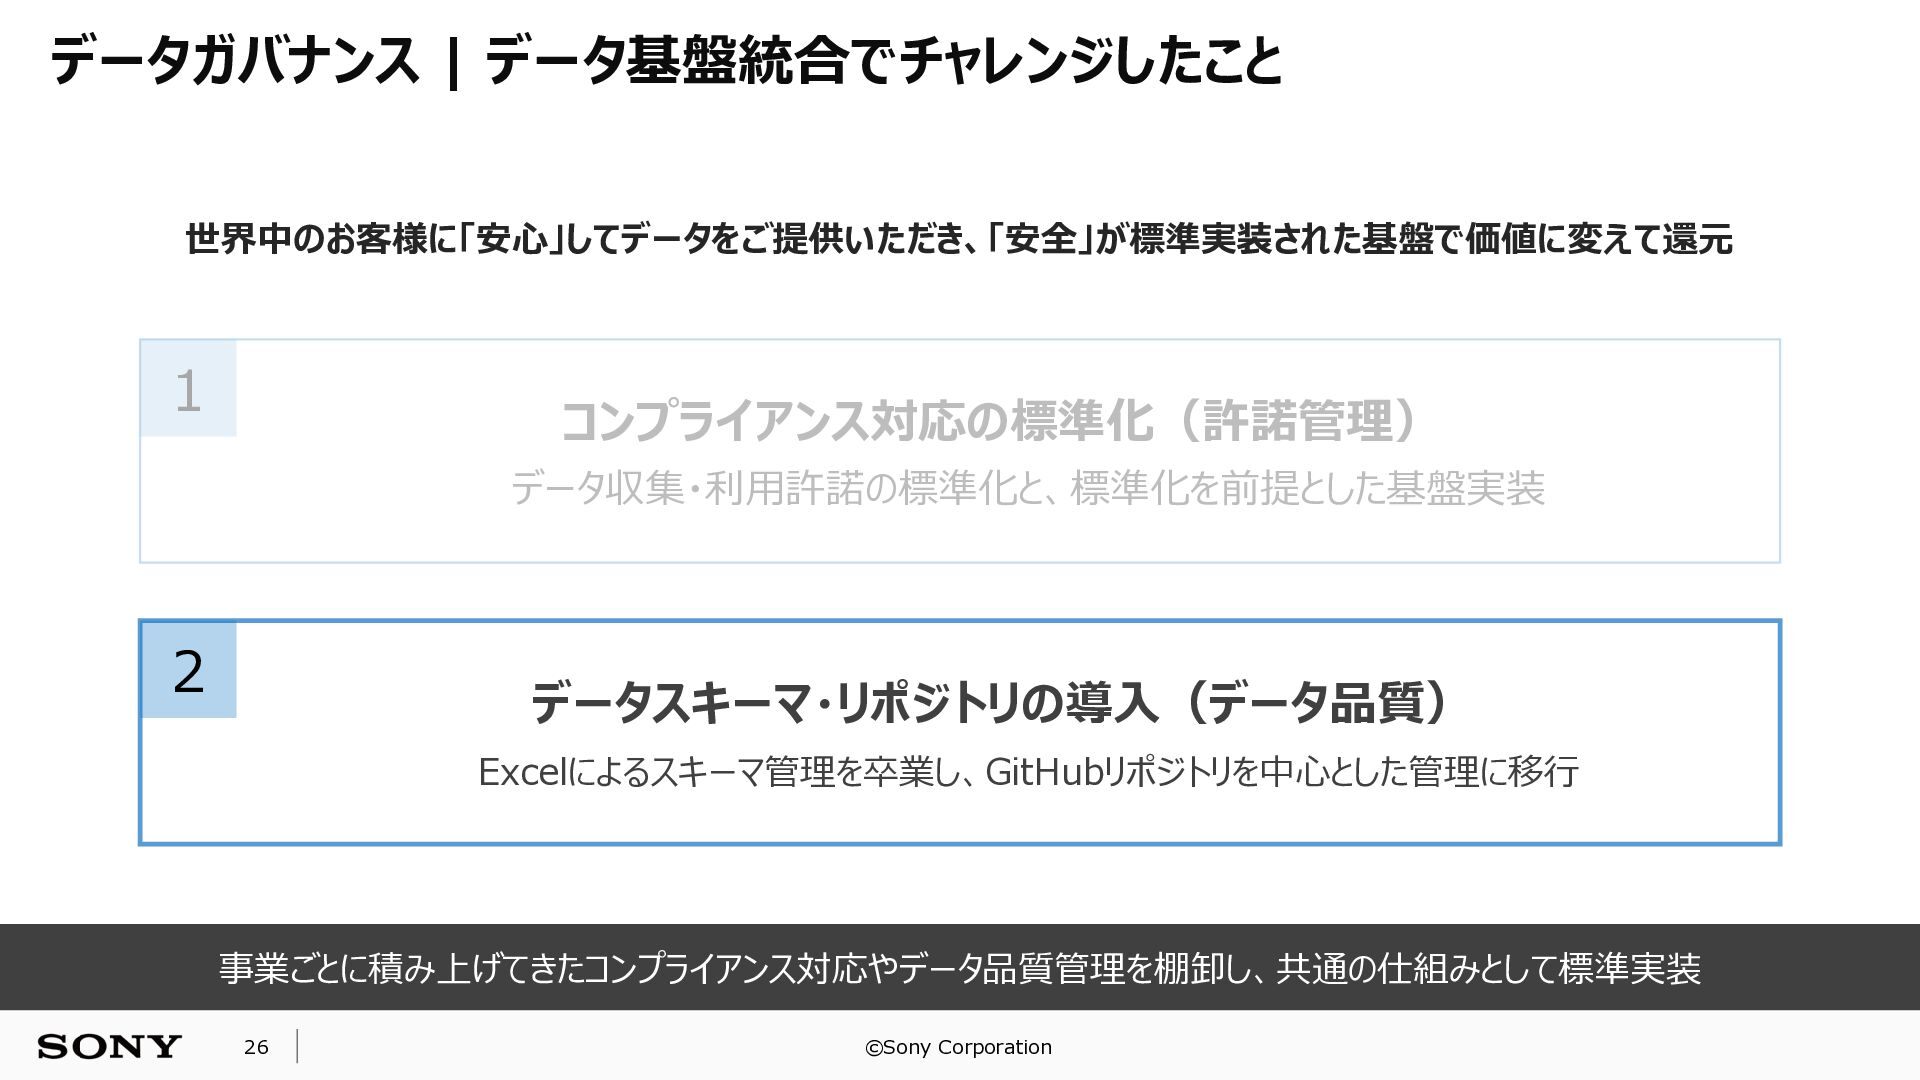
データガバナンス | データ基盤統合でチャレンジしたこと 世界中のお客様に「安心」してデータをご提供いただき、「安全」が標準実装された基盤で価値に変えて還元 1 コンプライアンス対応の標準化(許諾管理) データ収集・利用許諾の標準化と、標準化を前提とした基盤実装 2 データスキーマ・リポジトリの導入(データ品質) Excelによるスキーマ管理を卒業し、GitHubリポジトリを中心とした管理に移行
事業ごとに個別最適化したコンプライアンス対応やデータ品質管理を棚卸し、共通の仕組みとして標準実装 21 ©Sony Corporation
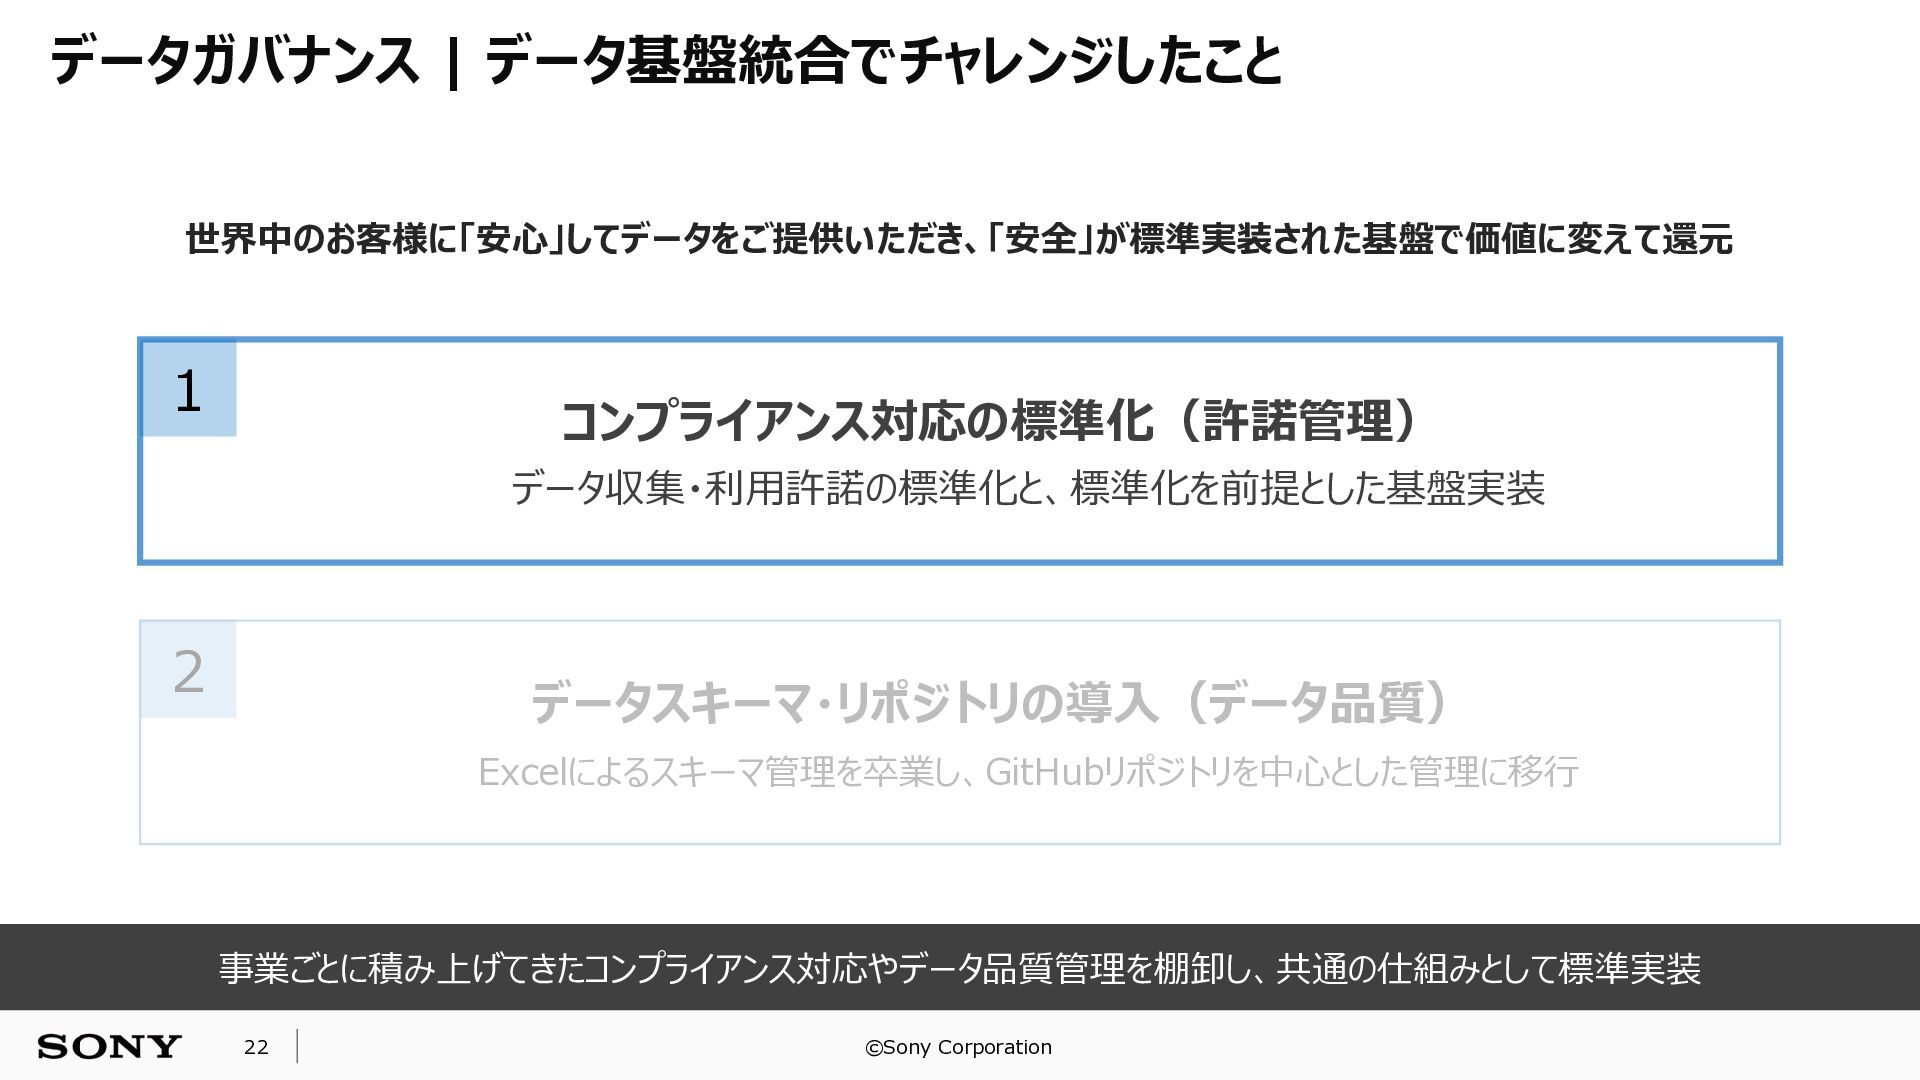
データガバナンス | データ基盤統合でチャレンジしたこと 世界中のお客様に「安心」してデータをご提供いただき、「安全」が標準実装された基盤で価値に変えて還元 1 コンプライアンス対応の標準化(許諾管理) データ収集・利用許諾の標準化と、標準化を前提とした基盤実装 2 データスキーマ・リポジトリの導入(データ品質) Excelによるスキーマ管理を卒業し、GitHubリポジトリを中心とした管理に移行
事業ごとに積み上げてきたコンプライアンス対応やデータ品質管理を棚卸し、共通の仕組みとして標準実装 22 ©Sony Corporation
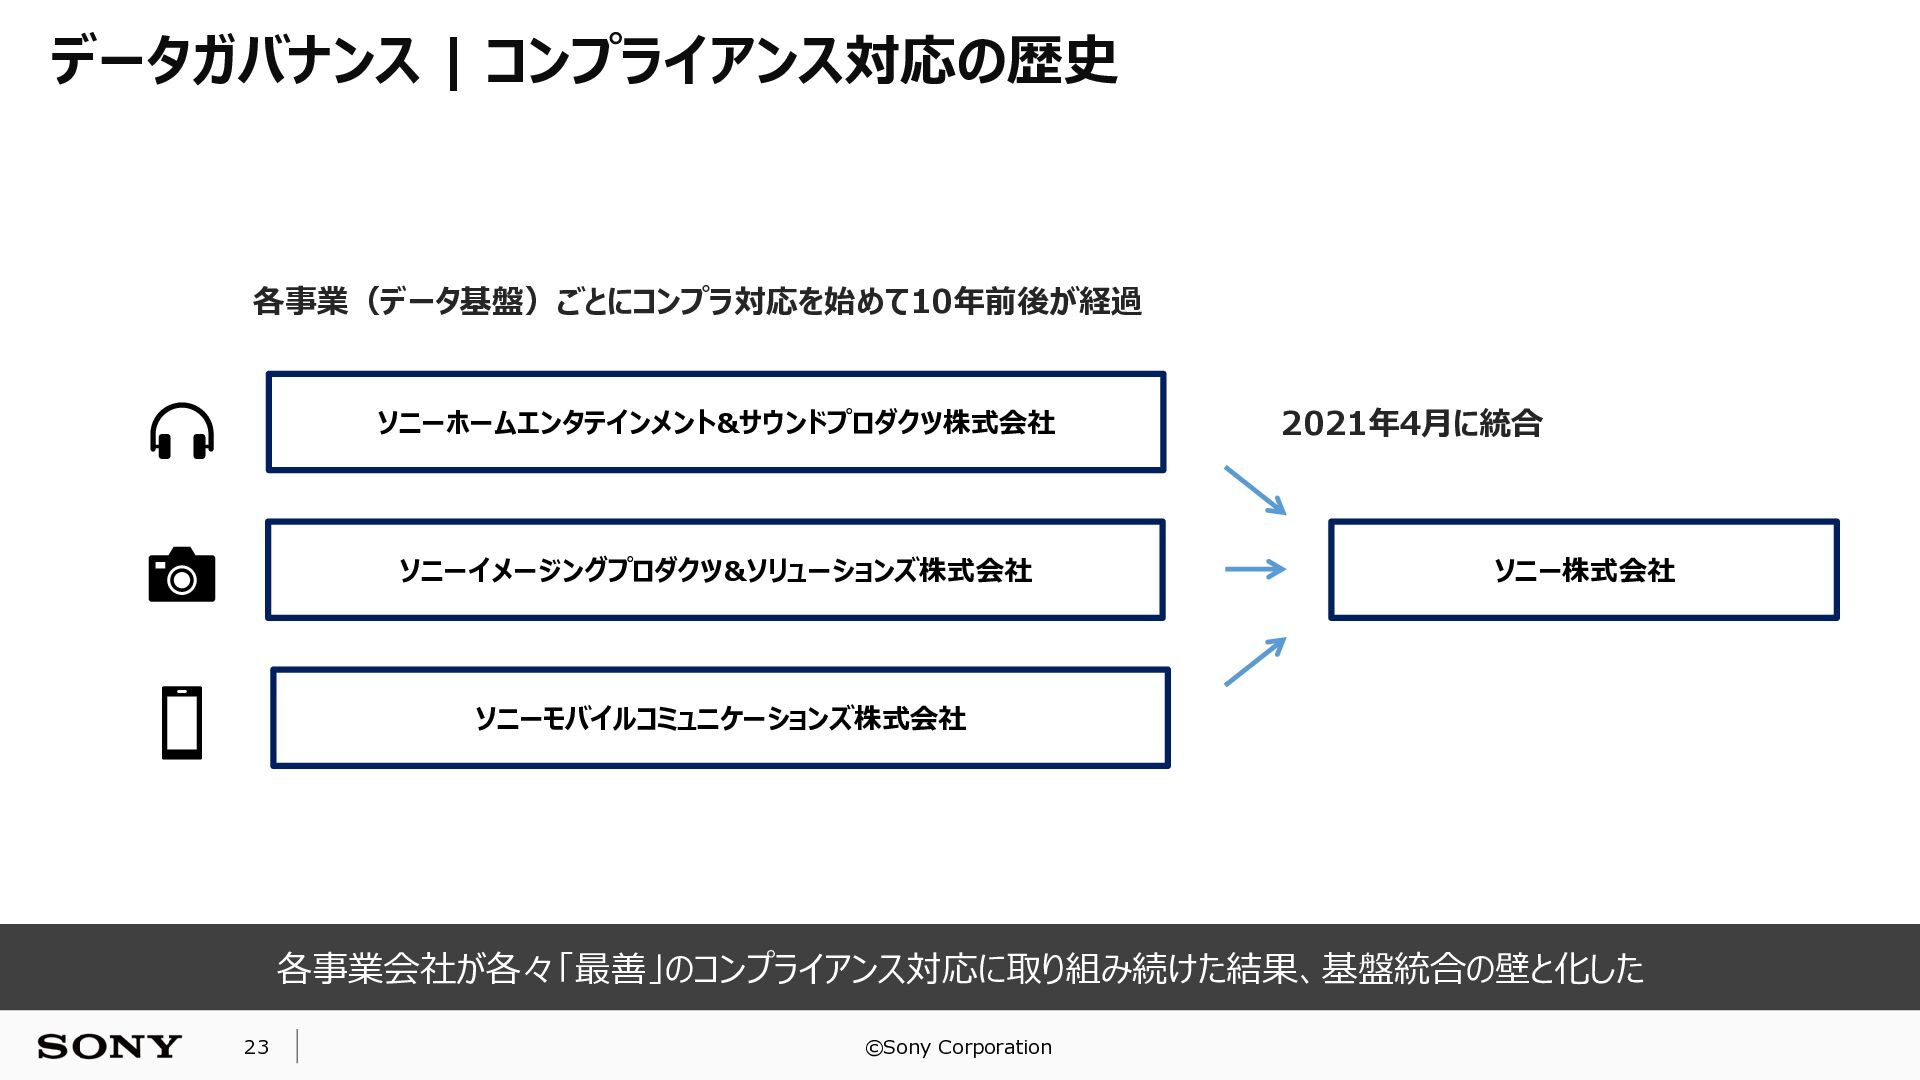
データガバナンス | コンプライアンス対応の歴史 各事業(データ基盤)ごとにコンプラ対応を始めて10年前後が経過 ソニーホームエンタテインメント&サウンドプロダクツ株式会社 ソニーイメージングプロダクツ&ソリューションズ株式会社 2021年4月に統合 ソニー株式会社 ソニーモバイルコミュニケーションズ株式会社 各事業会社が各々「最善」のコンプライアンス対応に取り組み続けた結果、基盤統合の壁と化した
23 ©Sony Corporation
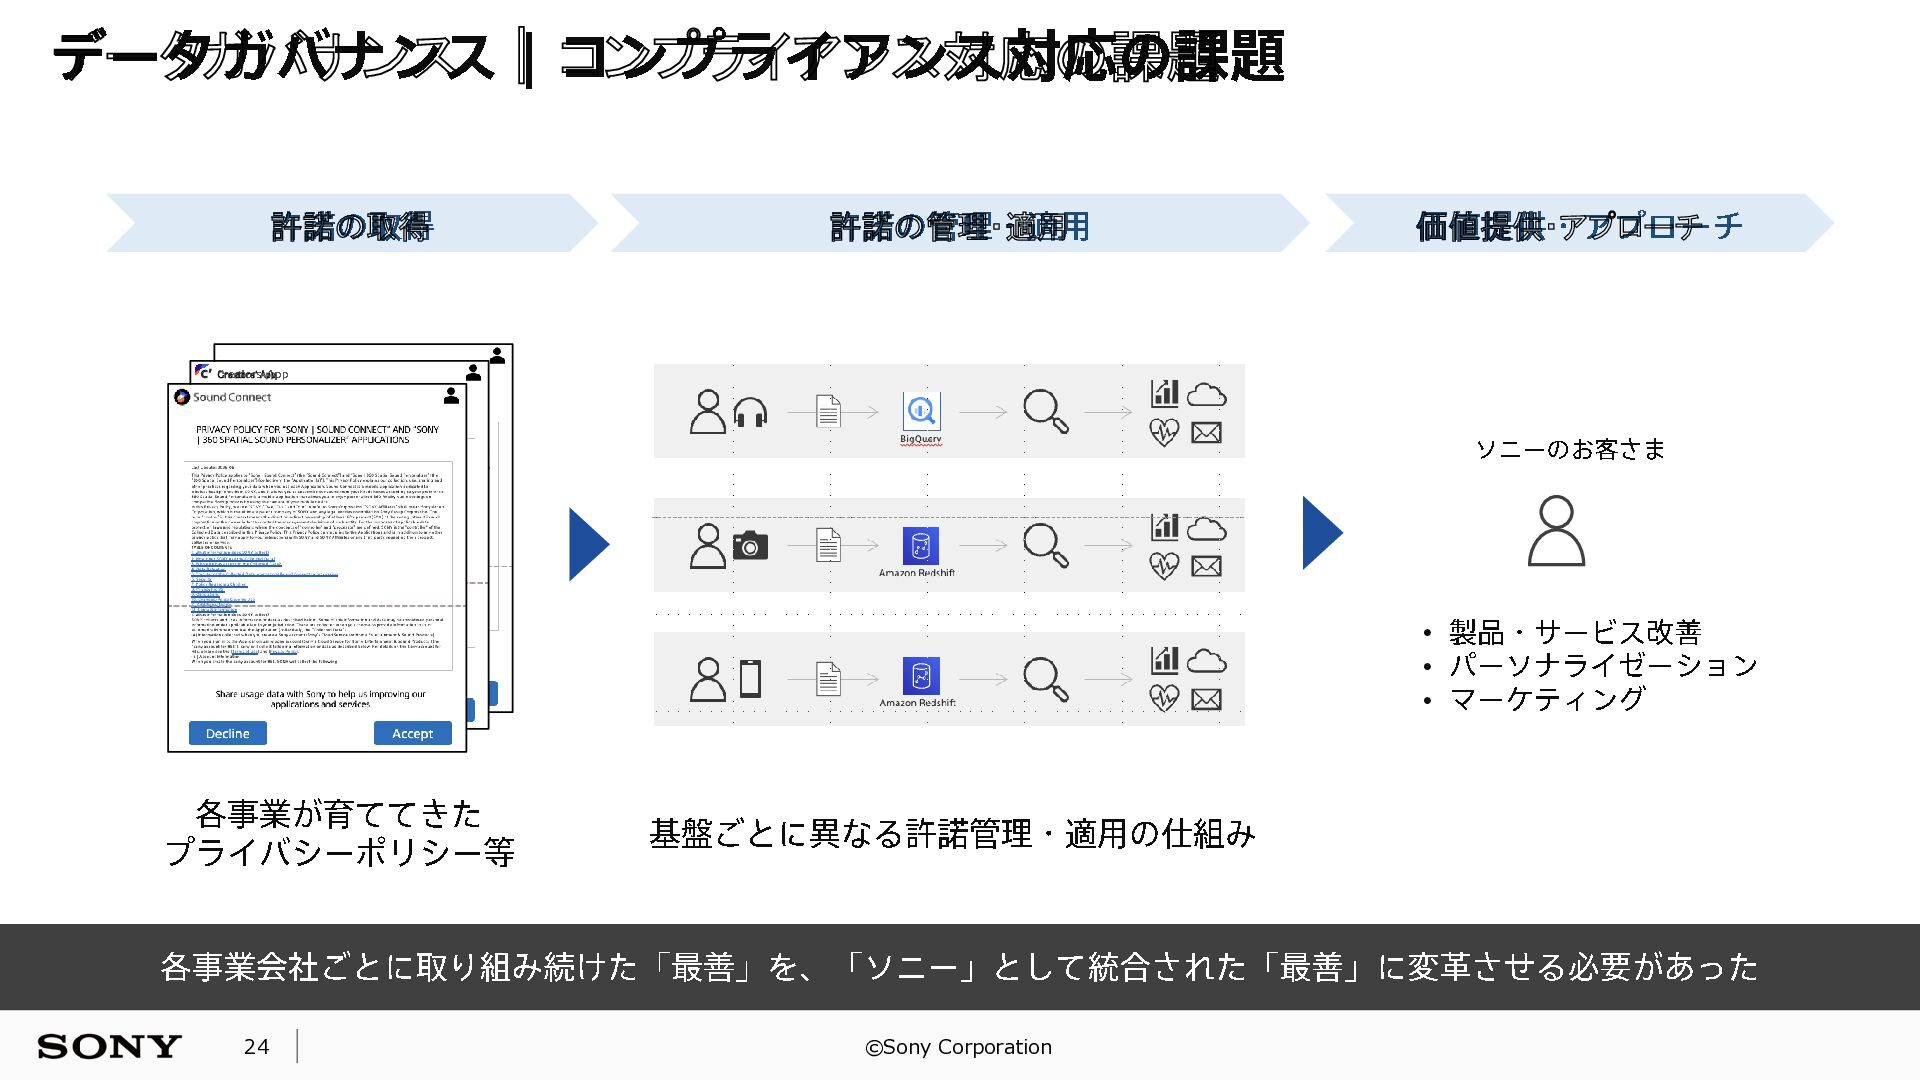
データガバナンス | コンプライアンス対応の課題 許諾の取得 許諾の管理・適用 価値提供・アプローチ Creators' App ソニーのお客さま •
製品・サービス改善 • パーソナライゼーション • マーケティング 各事業が育ててきた プライバシーポリシー等 基盤ごとに異なる許諾管理・適用の仕組み 各事業会社ごとに取り組み続けた「最善」を、「ソニー」として統合された「最善」に変革させる必要があった 24 ©Sony Corporation
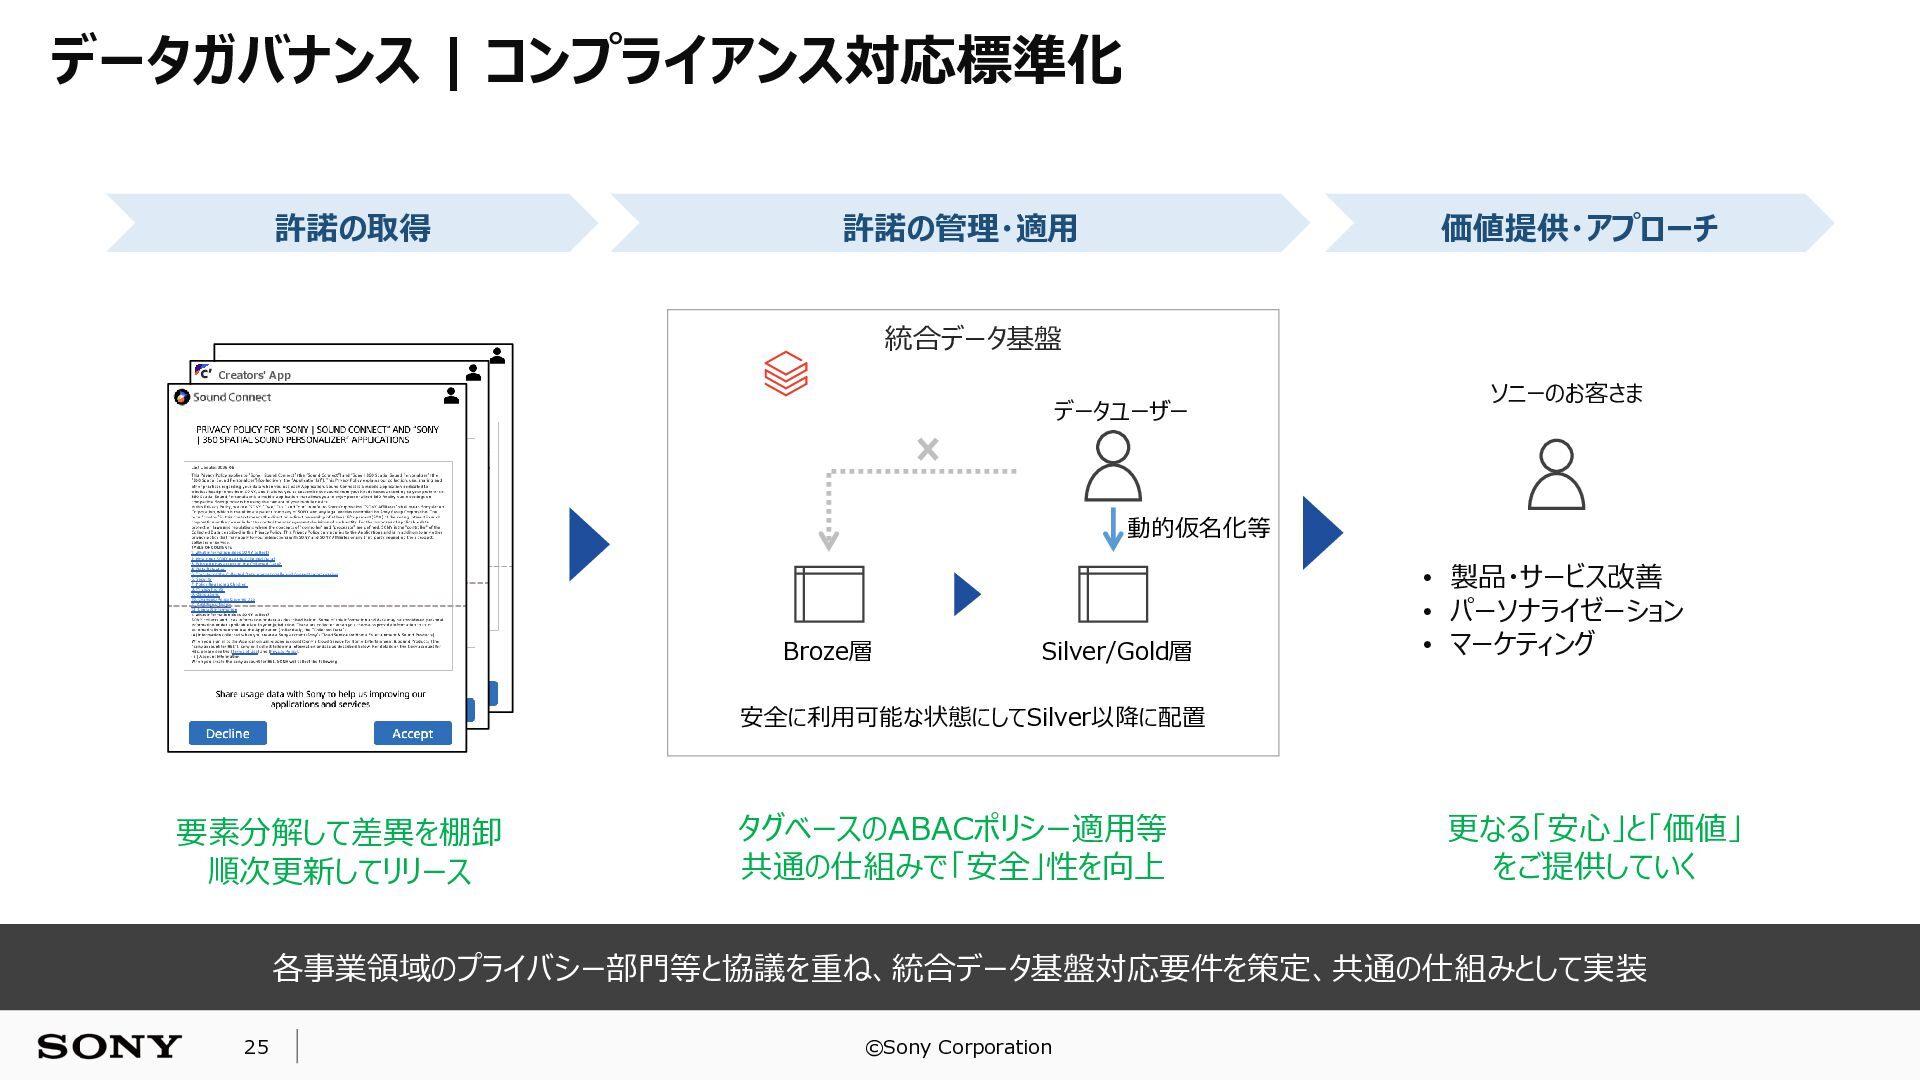
データガバナンス | コンプライアンス対応標準化 許諾の取得 許諾の管理・適用 価値提供・アプローチ 統合データ基盤 Creators' App データユーザー
ソニーのお客さま 動的仮名化等 Broze層 Silver/Gold層 • 製品・サービス改善 • パーソナライゼーション • マーケティング 安全に利用可能な状態にしてSilver以降に配置 要素分解して差異を棚卸 順次更新してリリース タグベースのABACポリシー適用等 共通の仕組みで「安全」性を向上 更なる「安心」と「価値」 をご提供していく 各事業領域のプライバシー部門等と協議を重ね、統合データ基盤対応要件を策定、共通の仕組みとして実装 25 ©Sony Corporation
データガバナンス | データ基盤統合でチャレンジしたこと 世界中のお客様に「安心」してデータをご提供いただき、「安全」が標準実装された基盤で価値に変えて還元 1 コンプライアンス対応の標準化(許諾管理) データ収集・利用許諾の標準化と、標準化を前提とした基盤実装 2 データスキーマ・リポジトリの導入(データ品質) Excelによるスキーマ管理を卒業し、GitHubリポジトリを中心とした管理に移行
事業ごとに積み上げてきたコンプライアンス対応やデータ品質管理を棚卸し、共通の仕組みとして標準実装 26 ©Sony Corporation
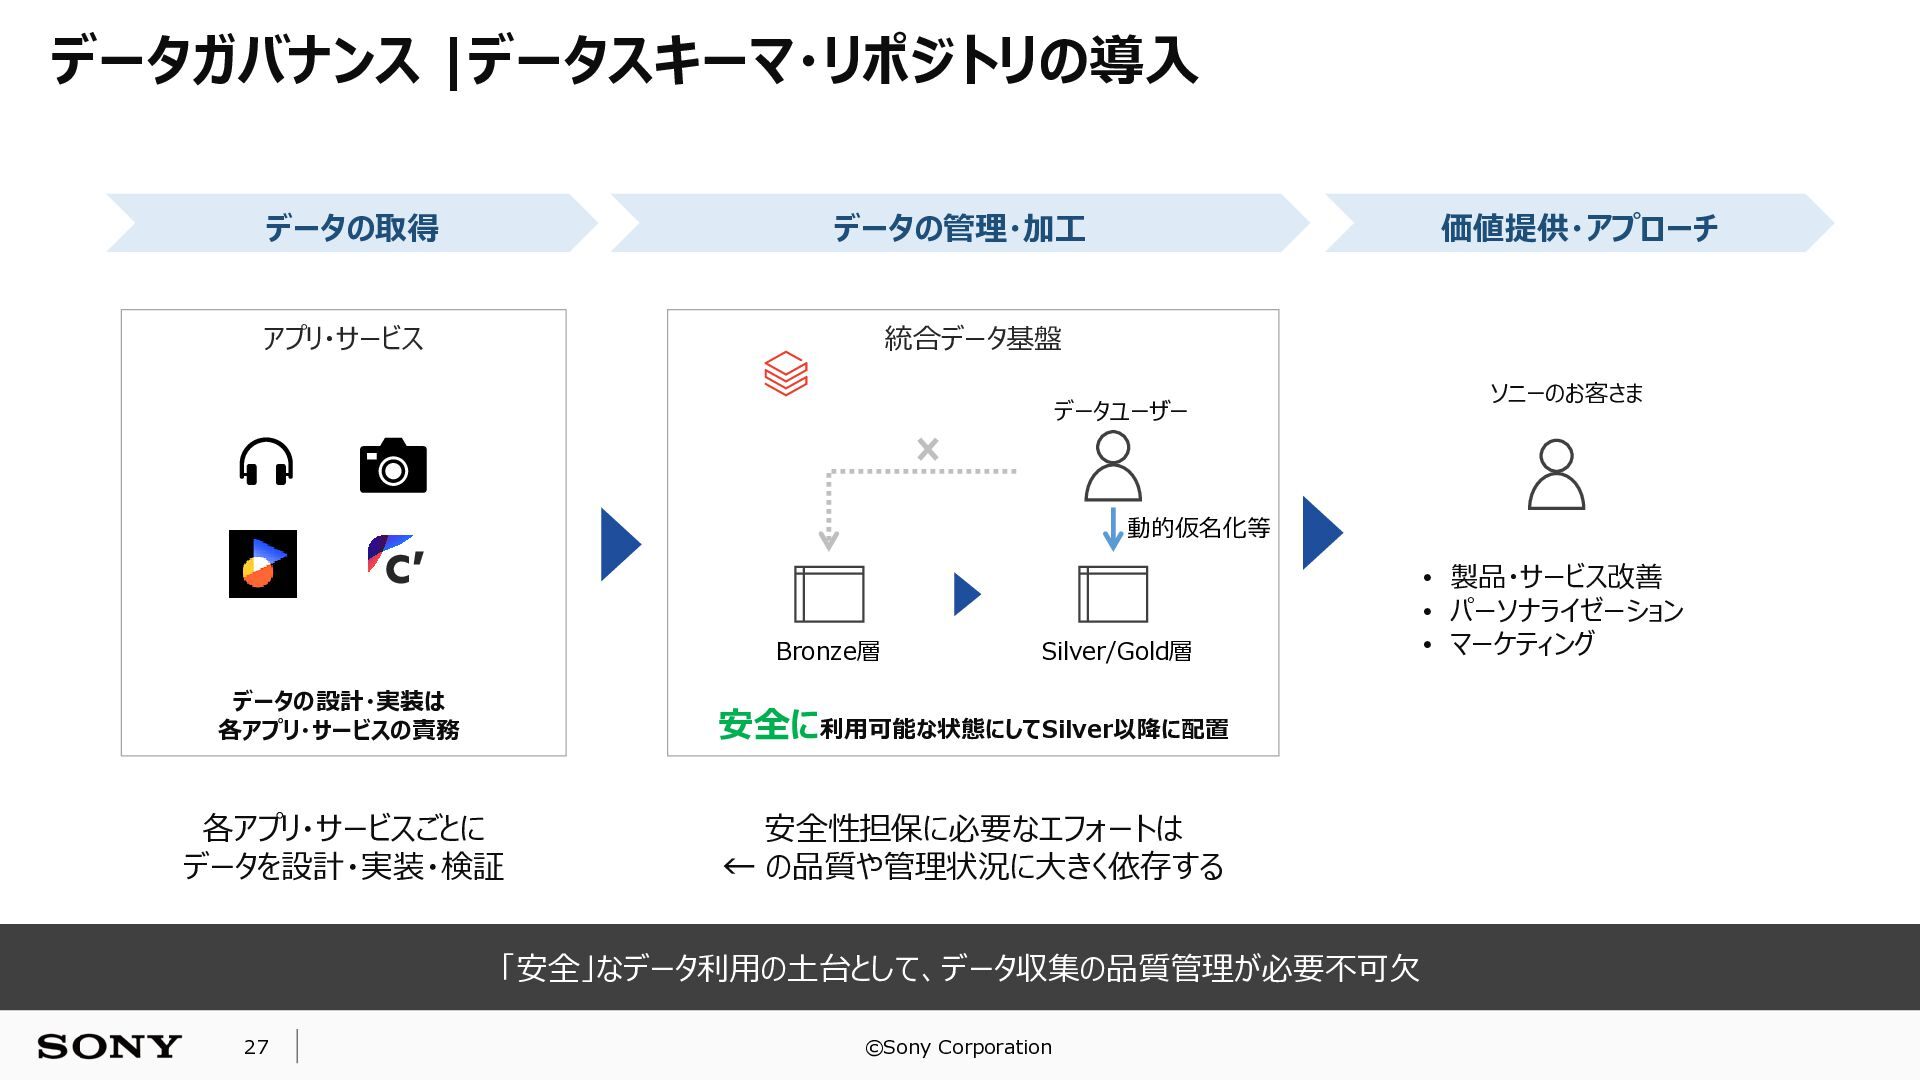
データガバナンス |データスキーマ・リポジトリの導入 データの取得 データの管理・加工 アプリ・サービス 統合データ基盤 価値提供・アプローチ データユーザー ソニーのお客さま 動的仮名化等
Bronze層 Silver/Gold層 データの設計・実装は 各アプリ・サービスの責務 安全に利用可能な状態にしてSilver以降に配置 各アプリ・サービスごとに データを設計・実装・検証 安全性担保に必要なエフォートは ← の品質や管理状況に大きく依存する 「安全」なデータ利用の土台として、データ収集の品質管理が必要不可欠 27 ©Sony Corporation • 製品・サービス改善 • パーソナライゼーション • マーケティング
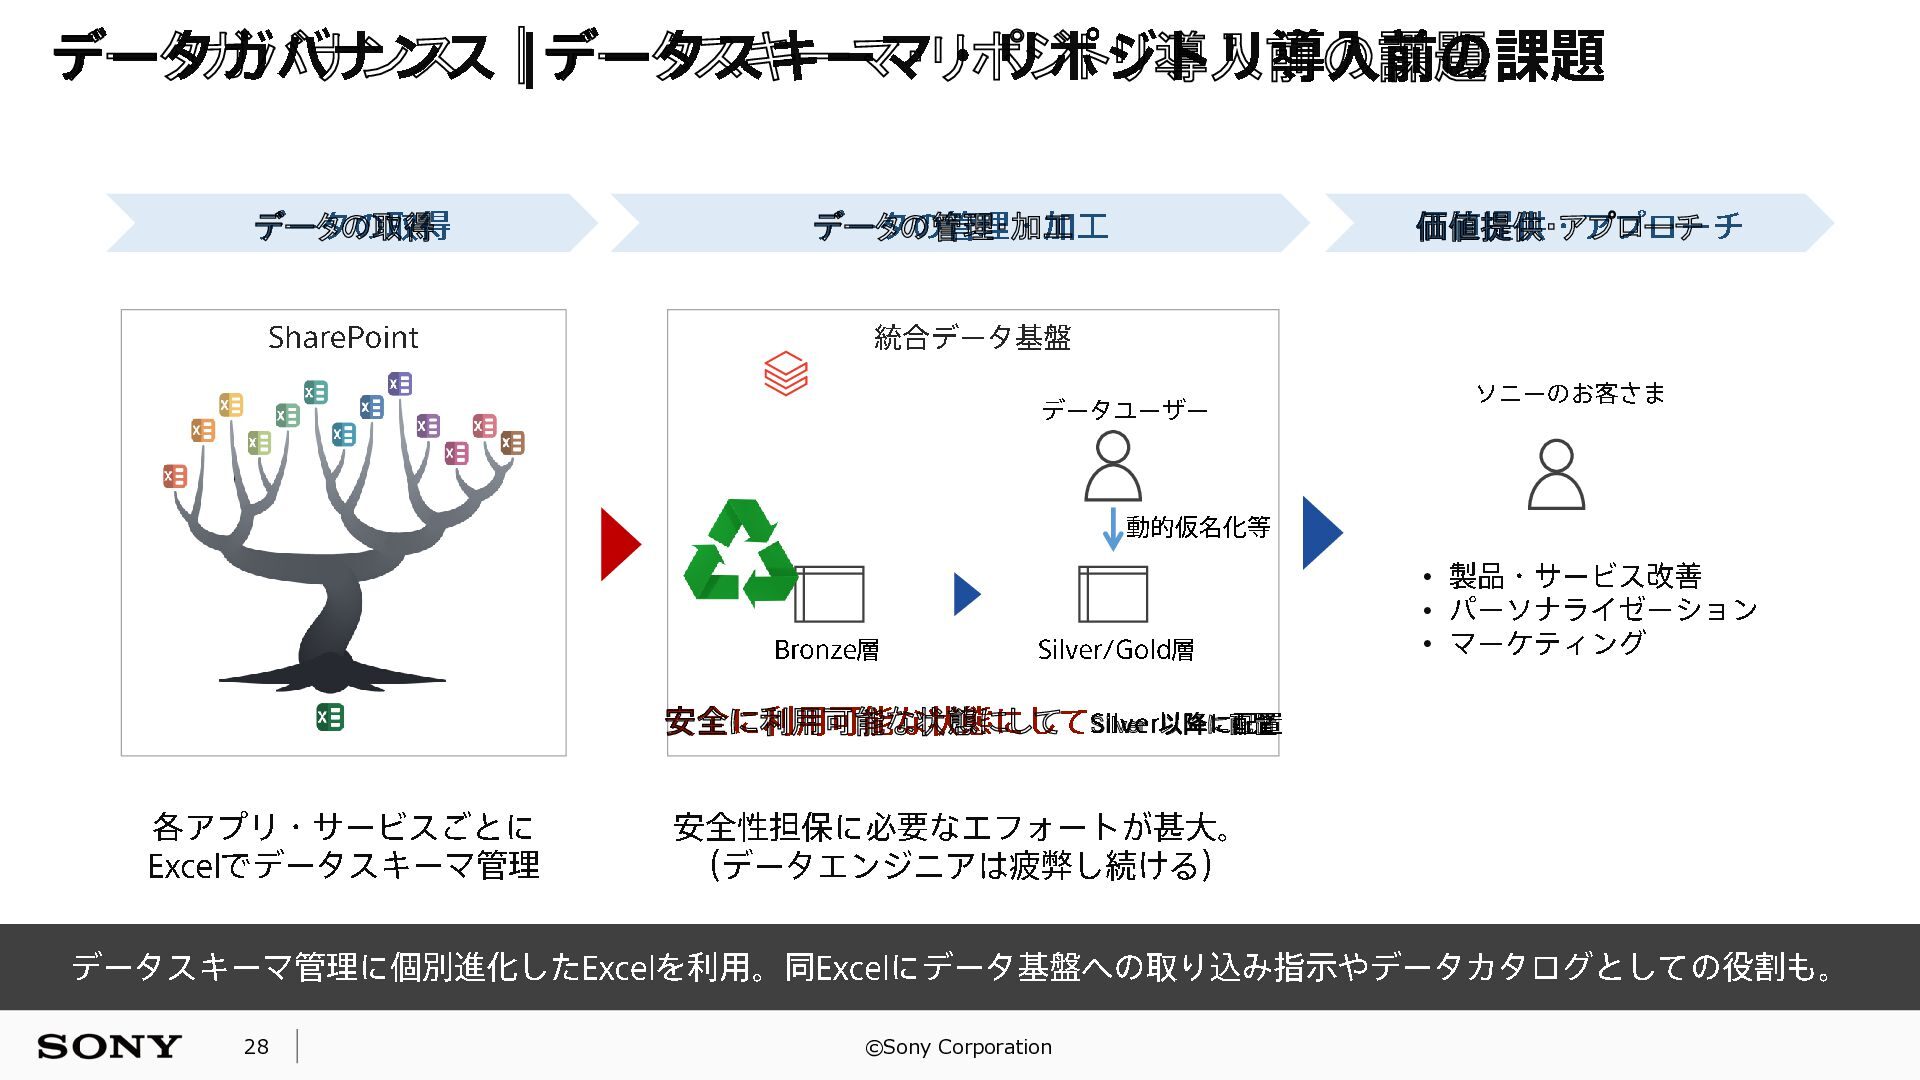
データガバナンス |データスキーマ・リポジトリ導入前の課題 データの取得 データの管理・加工 SharePoint 統合データ基盤 価値提供・アプローチ データユーザー ソニーのお客さま 動的仮名化等
Bronze層 Silver/Gold層 • 製品・サービス改善 • パーソナライゼーション • マーケティング 安全に利用可能な状態にしてSilver以降に配置 各アプリ・サービスごとに Excelでデータスキーマ管理 安全性担保に必要なエフォートが甚大。 (データエンジニアは疲弊し続ける) データスキーマ管理に個別進化したExcelを利用。同Excelにデータ基盤への取り込み指示やデータカタログとしての役割も。 28 ©Sony Corporation
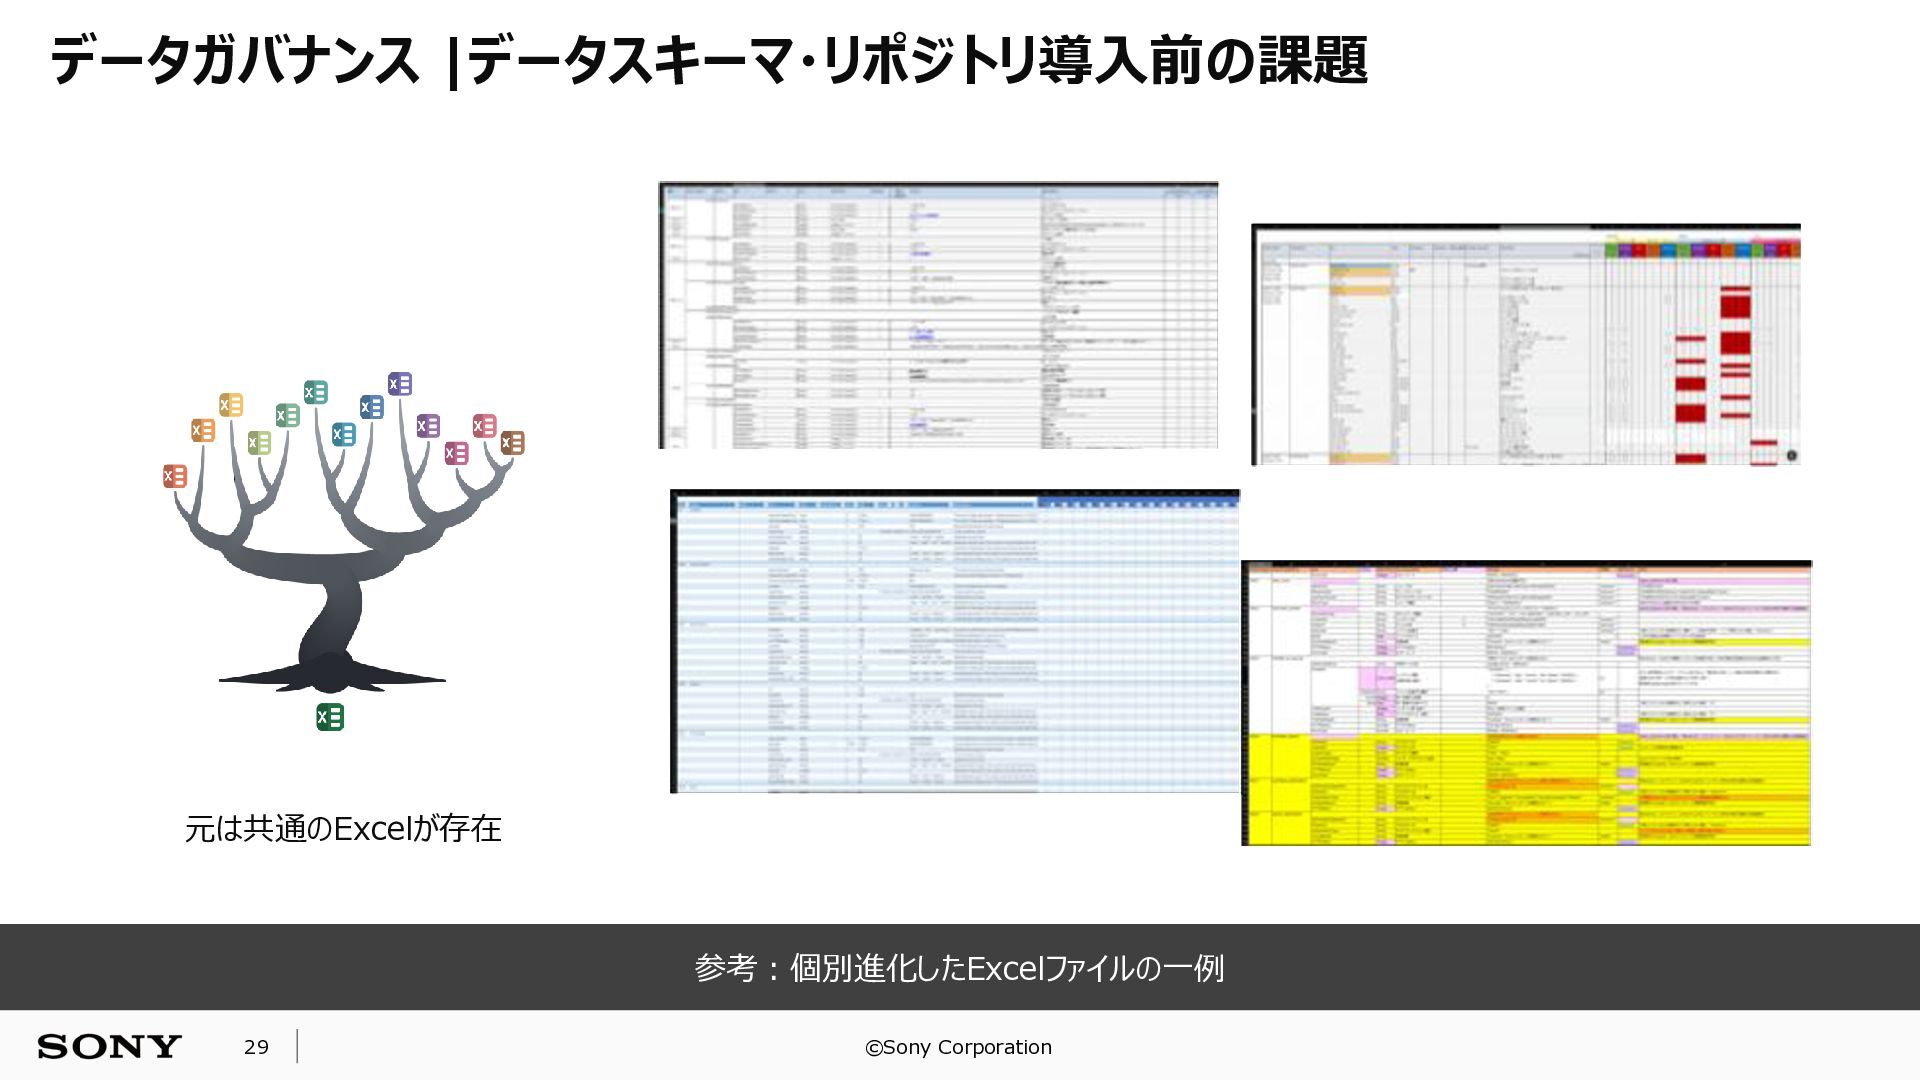
データガバナンス |データスキーマ・リポジトリ導入前の課題 元は共通のExcelが存在 参考:個別進化したExcelファイルの一例 29 ©Sony Corporation
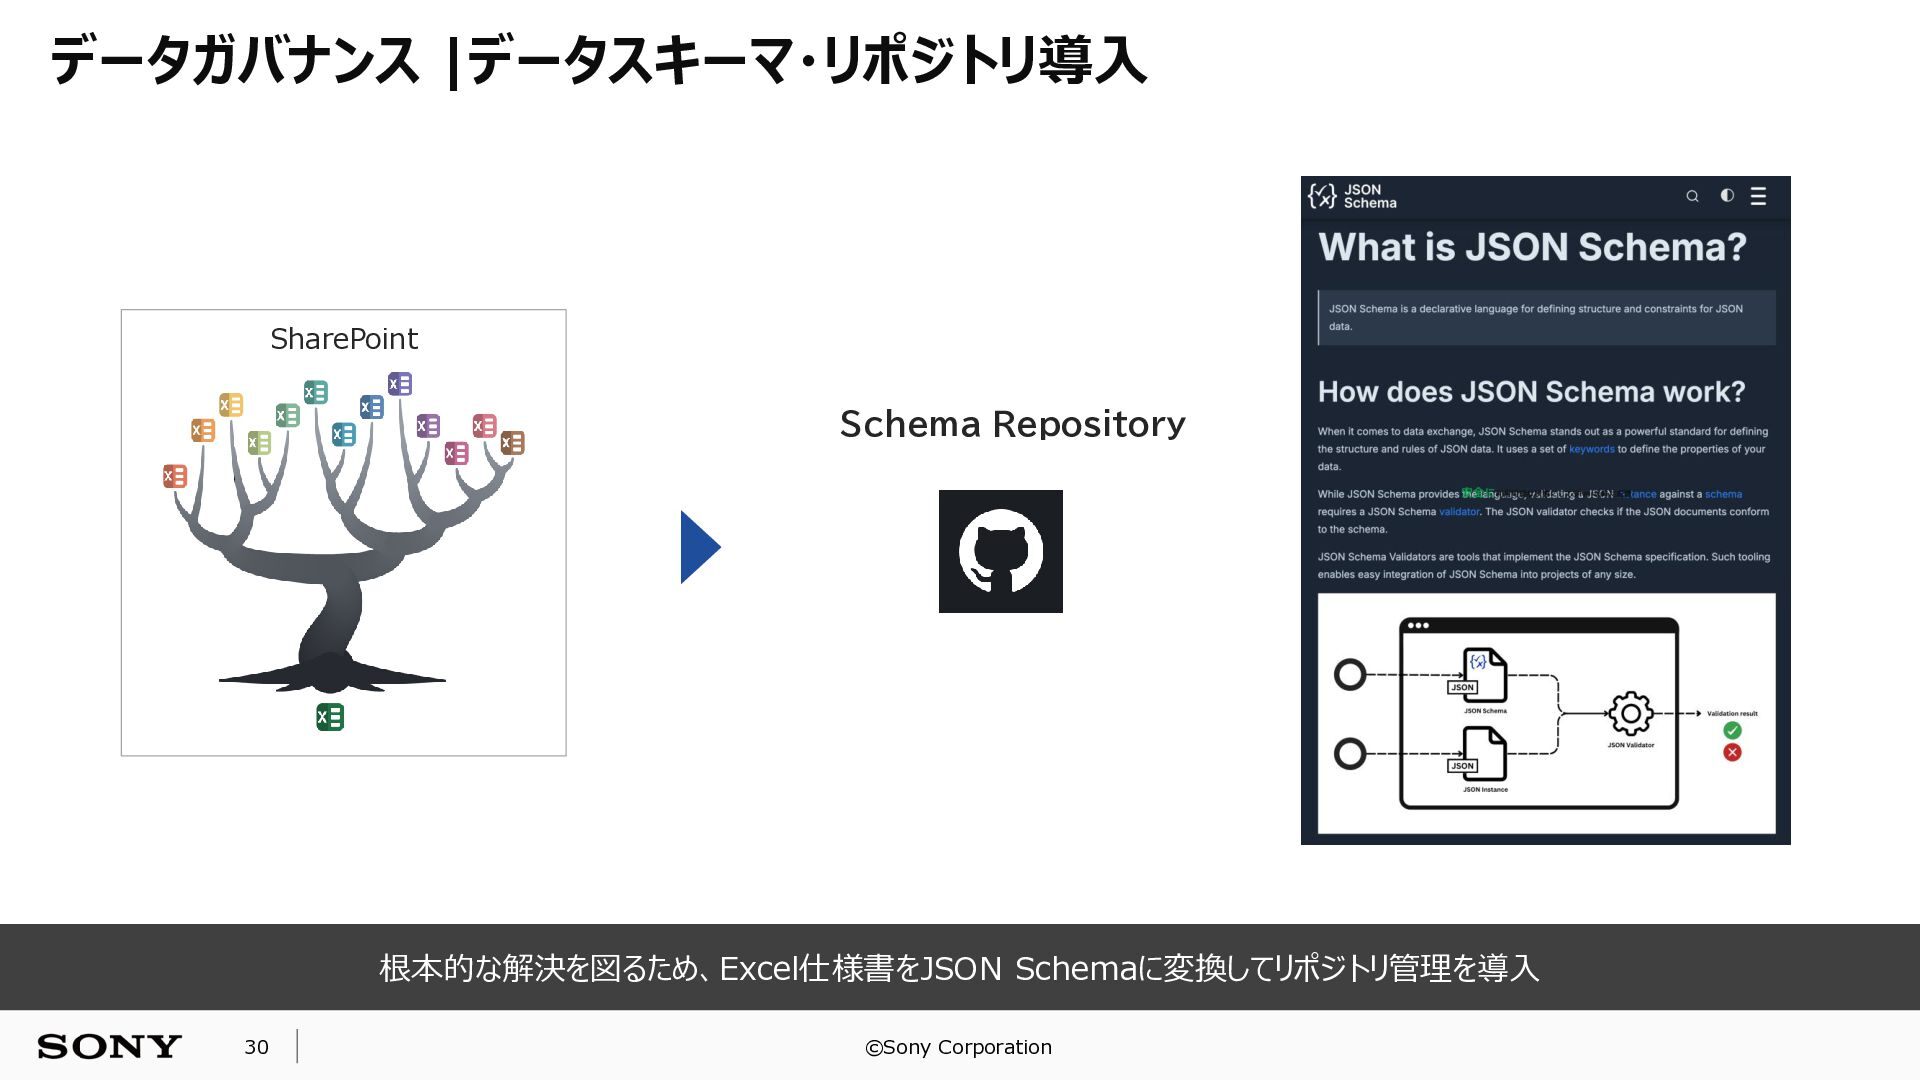
データガバナンス |データスキーマ・リポジトリ導入 SharePoint Schema Repository 根本的な解決を図るため、Excel仕様書をJSON Schemaに変換してリポジトリ管理を導入 30 ©Sony Corporation
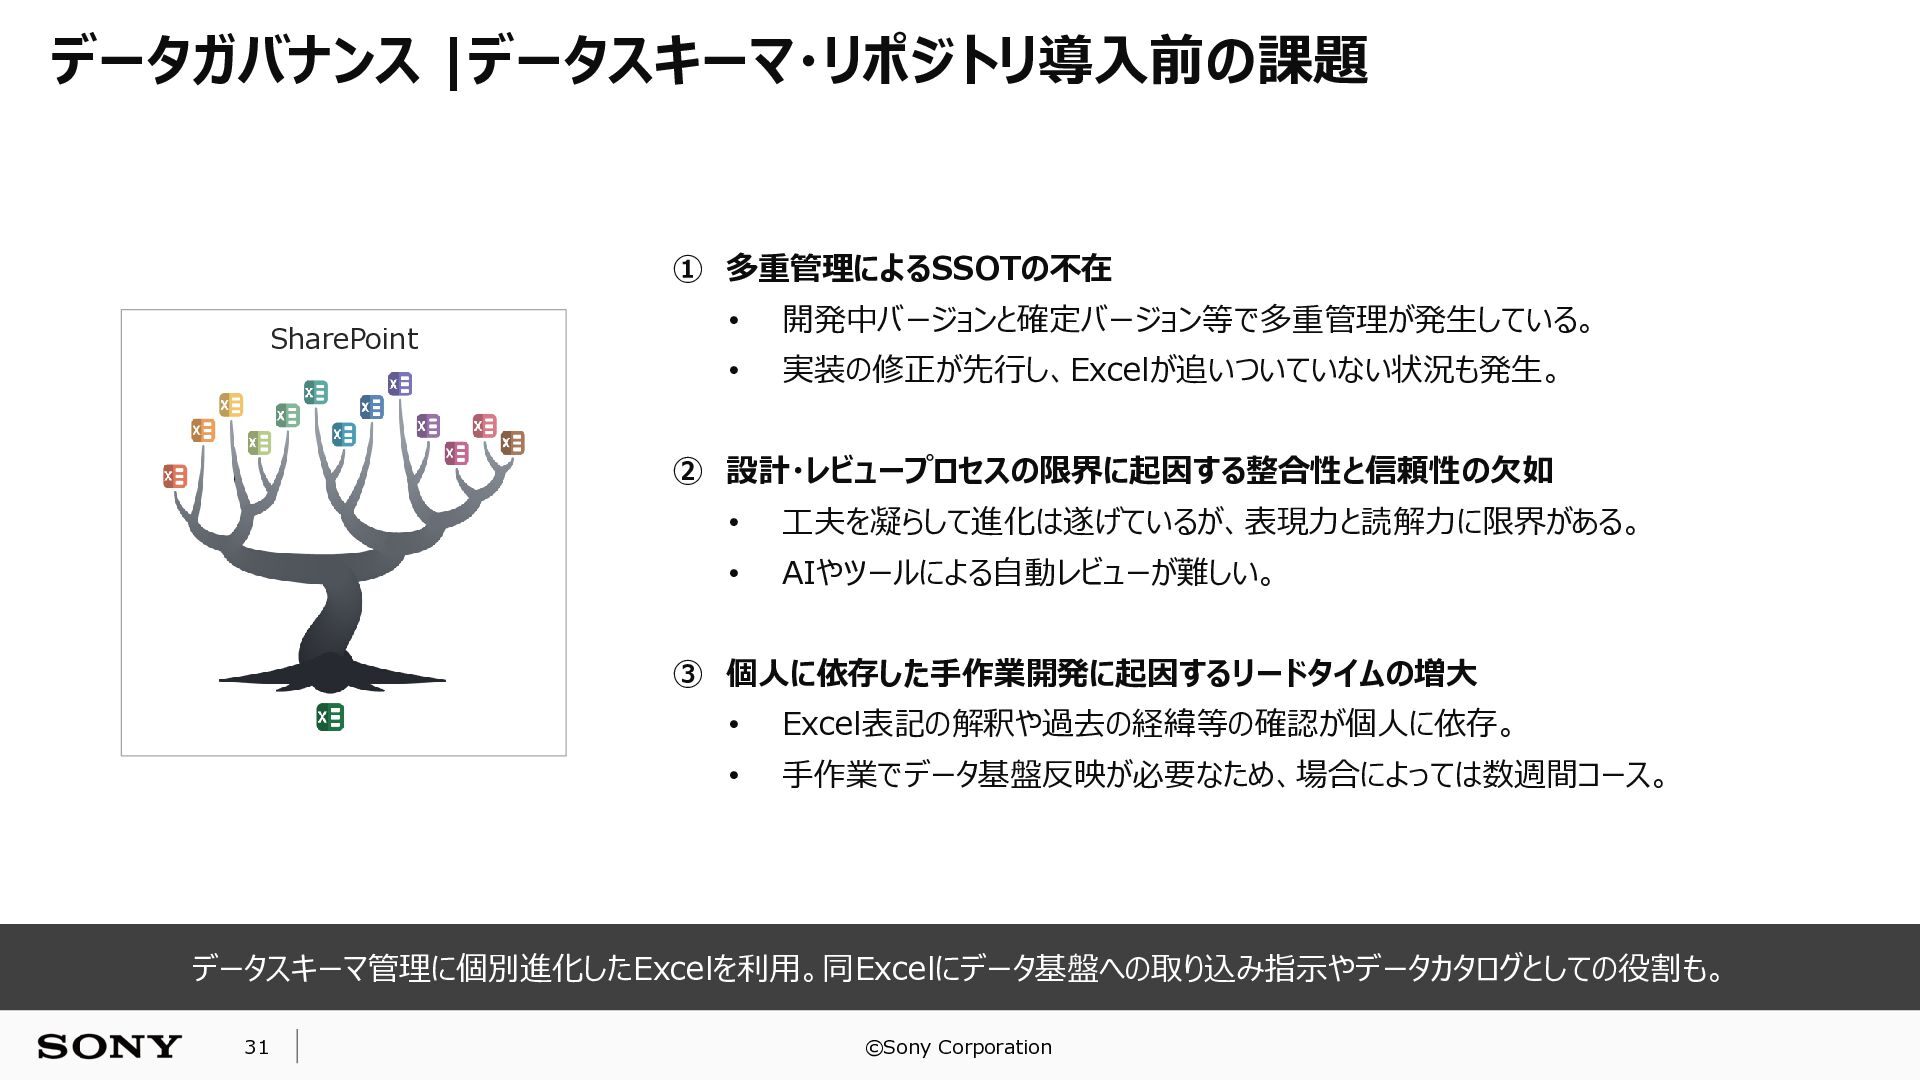
データガバナンス |データスキーマ・リポジトリ導入前の課題 ① 多重管理によるSSOTの不在 SharePoint • 開発中バージョンと確定バージョン等で多重管理が発生している。 • 実装の修正が先行し、Excelが追いついていない状況も発生。 ②
設計・レビュープロセスの限界に起因する整合性と信頼性の欠如 • 工夫を凝らして進化は遂げているが、表現力と読解力に限界がある。 • AIやツールによる自動レビューが難しい。 ③ 個人に依存した手作業開発に起因するリードタイムの増大 • Excel表記の解釈や過去の経緯等の確認が個人に依存。 • 手作業でデータ基盤反映が必要なため、場合によっては数週間コース。 データスキーマ管理に個別進化したExcelを利用。同Excelにデータ基盤への取り込み指示やデータカタログとしての役割も。 31 ©Sony Corporation
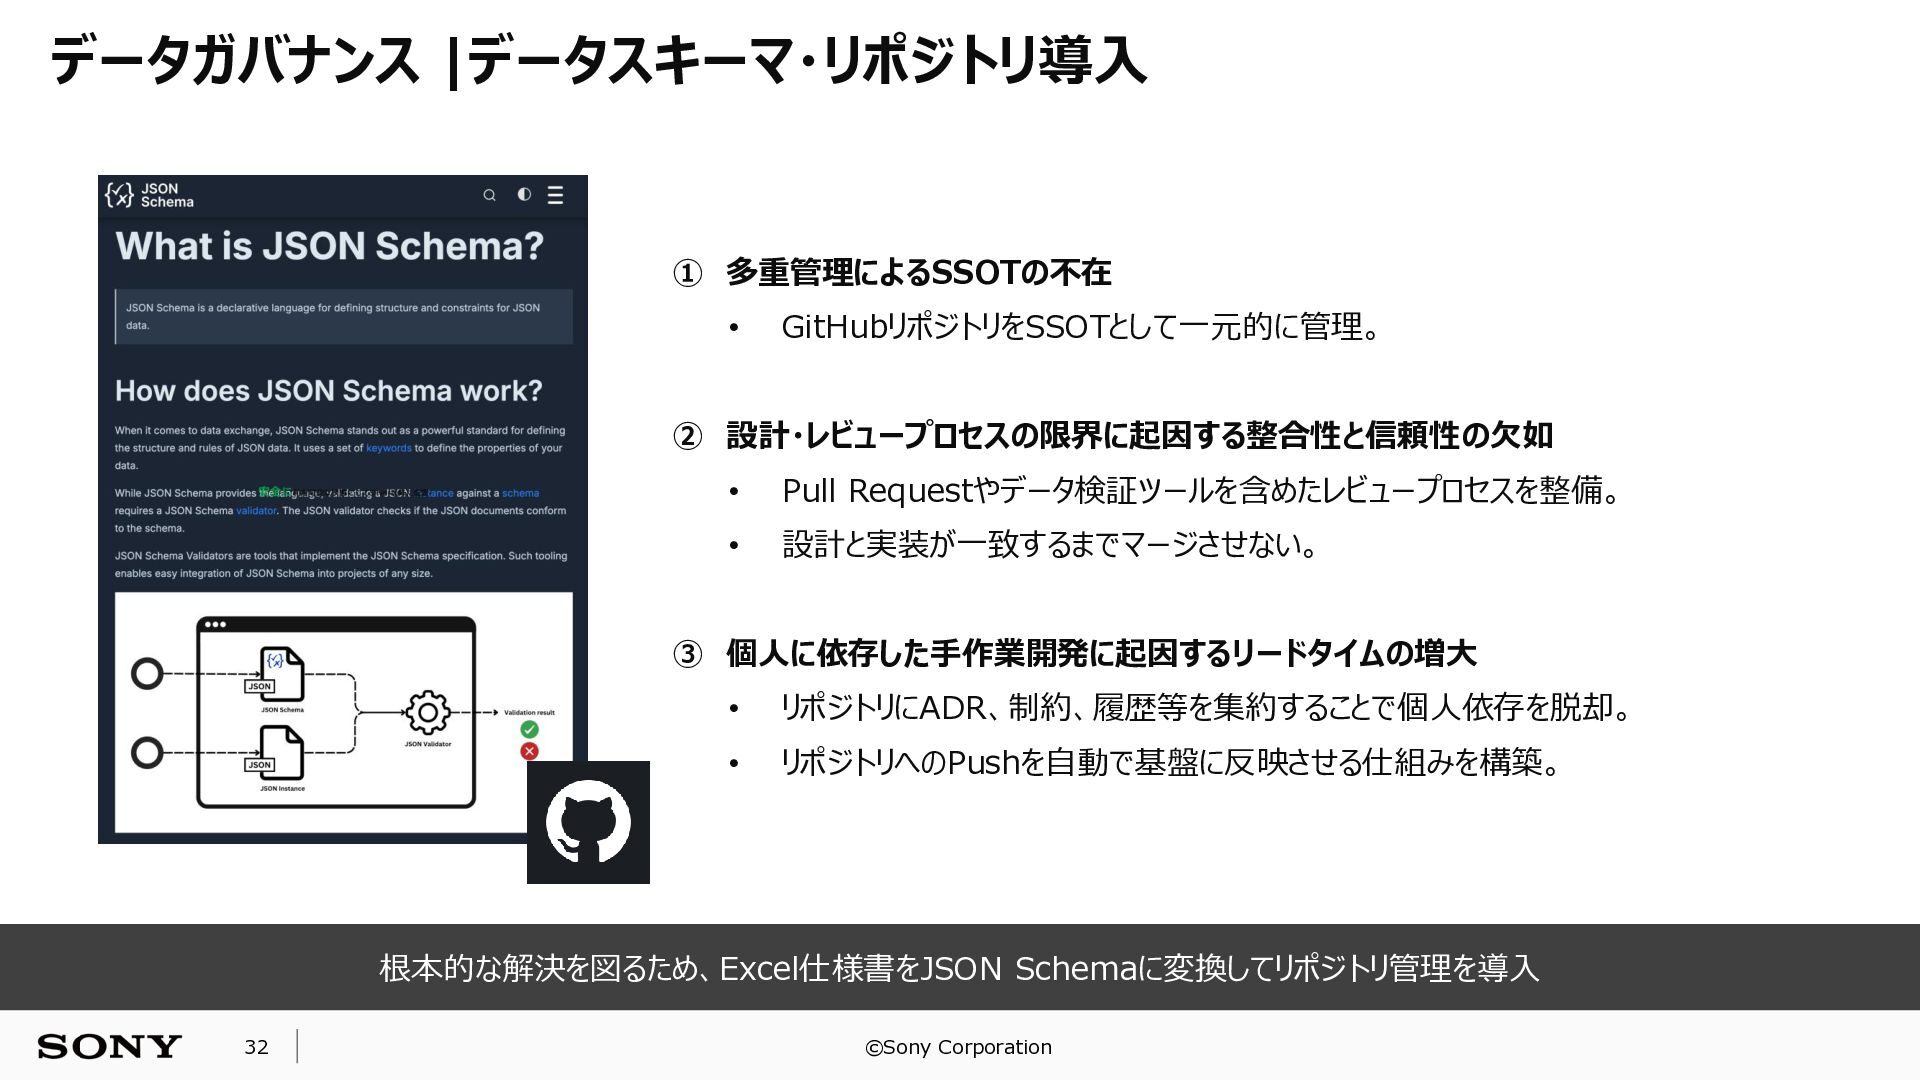
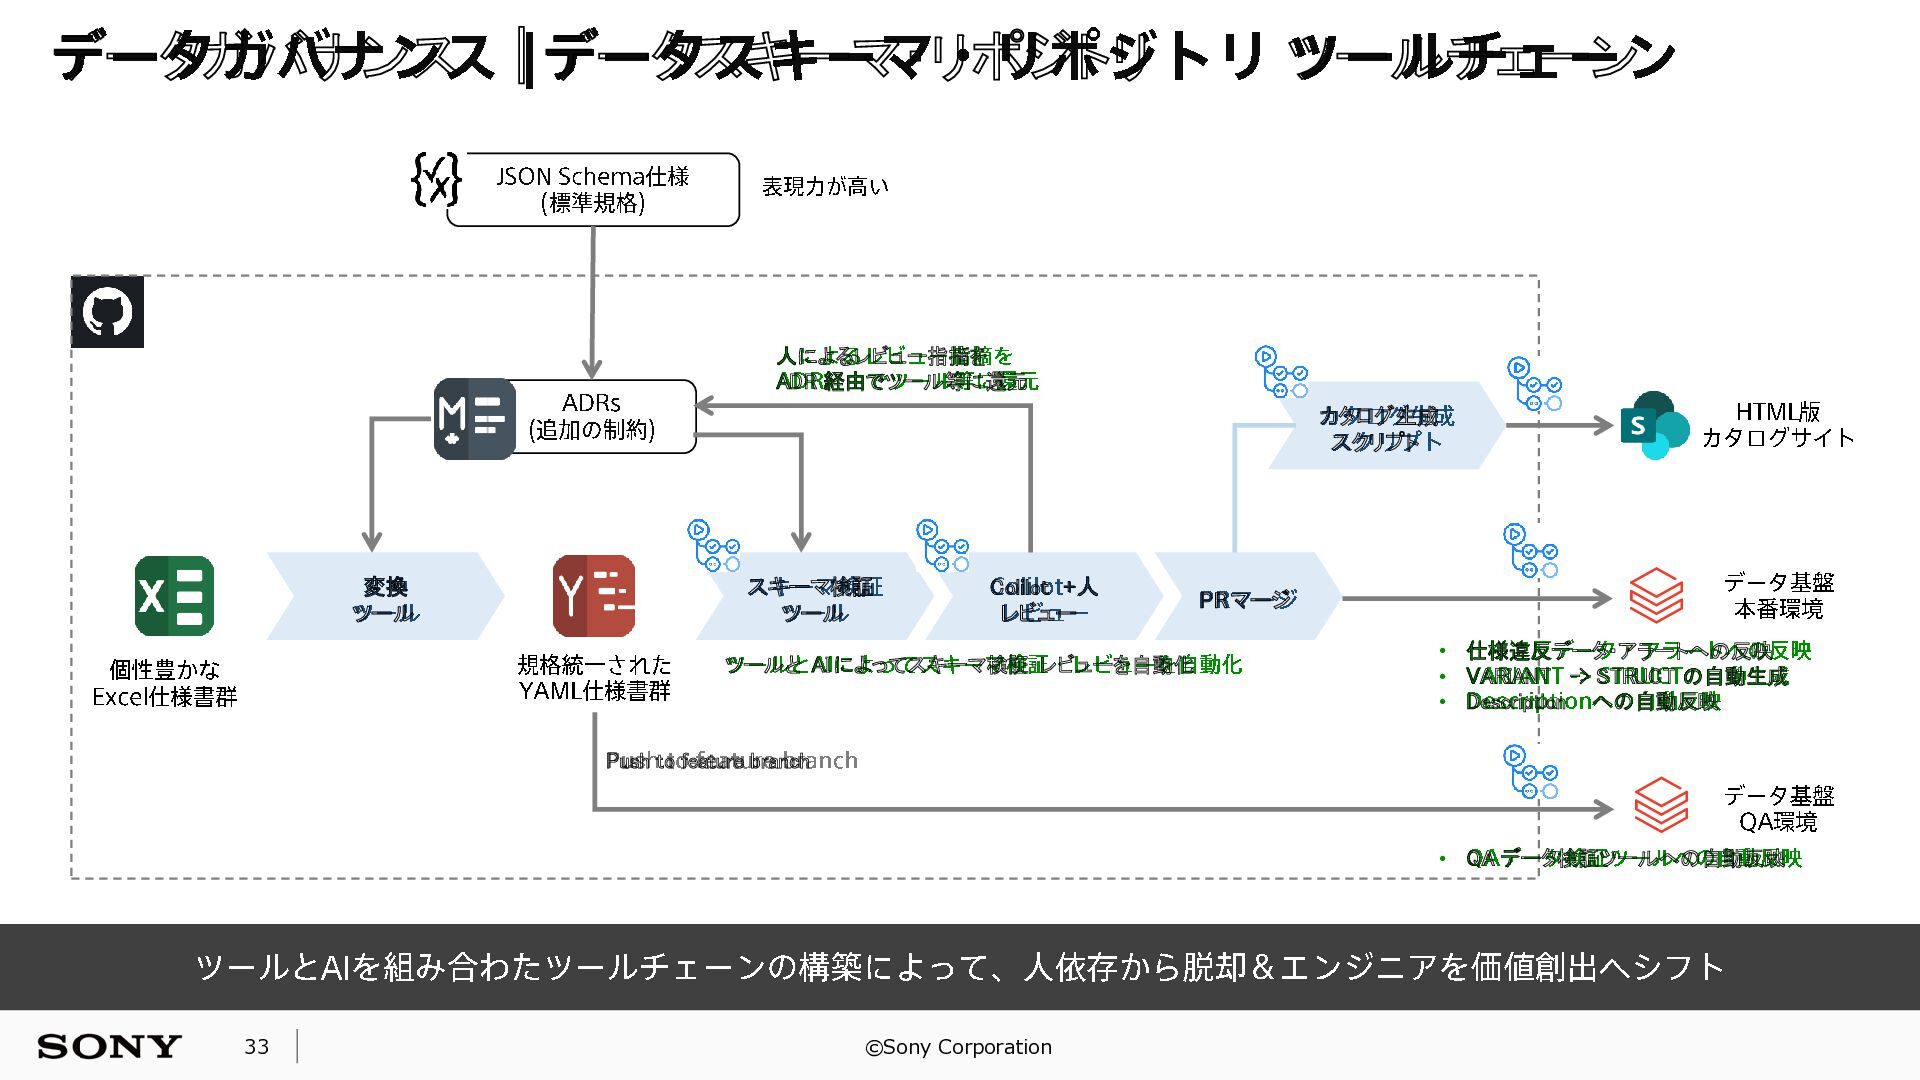
データガバナンス |データスキーマ・リポジトリ導入 ① 多重管理によるSSOTの不在 • GitHubリポジトリをSSOTとして一元的に管理。 ② 設計・レビュープロセスの限界に起因する整合性と信頼性の欠如 • Pull
Requestやデータ検証ツールを含めたレビュープロセスを整備。 • 設計と実装が一致するまでマージさせない。 ③ 個人に依存した手作業開発に起因するリードタイムの増大 • リポジトリにADR、制約、履歴等を集約することで個人依存を脱却。 • リポジトリへのPushを自動で基盤に反映させる仕組みを構築。 根本的な解決を図るため、Excel仕様書をJSON Schemaに変換してリポジトリ管理を導入 32 ©Sony Corporation
データガバナンス |データスキーマ・リポジトリ ツールチェーン JSON Schema仕様 (標準規格) ADRs (追加の制約) 変換 ツール
人によるレビュー指摘を ADR経由でツール等に還元 カタログ生成 スクリプト スキーマ検証 ツール 規格統一された YAML仕様書群 個性豊かな Excel仕様書群 表現力が高い Colilot+人 レビュー ツールとAIによってスキーマ検証・レビューを自動化 HTML版 カタログサイト データ基盤 本番環境 PRマージ • 仕様違反データ・アラートへの反映 • VARIANT -> STRUCTの自動生成 • Descriptionへの自動反映 Push to feature branch データ基盤 QA環境 • QAデータ検証ツールへの自動反映 ツールとAIを組み合わたツールチェーンの構築によって、人依存から脱却&エンジニアを価値創出へシフト 33 ©Sony Corporation
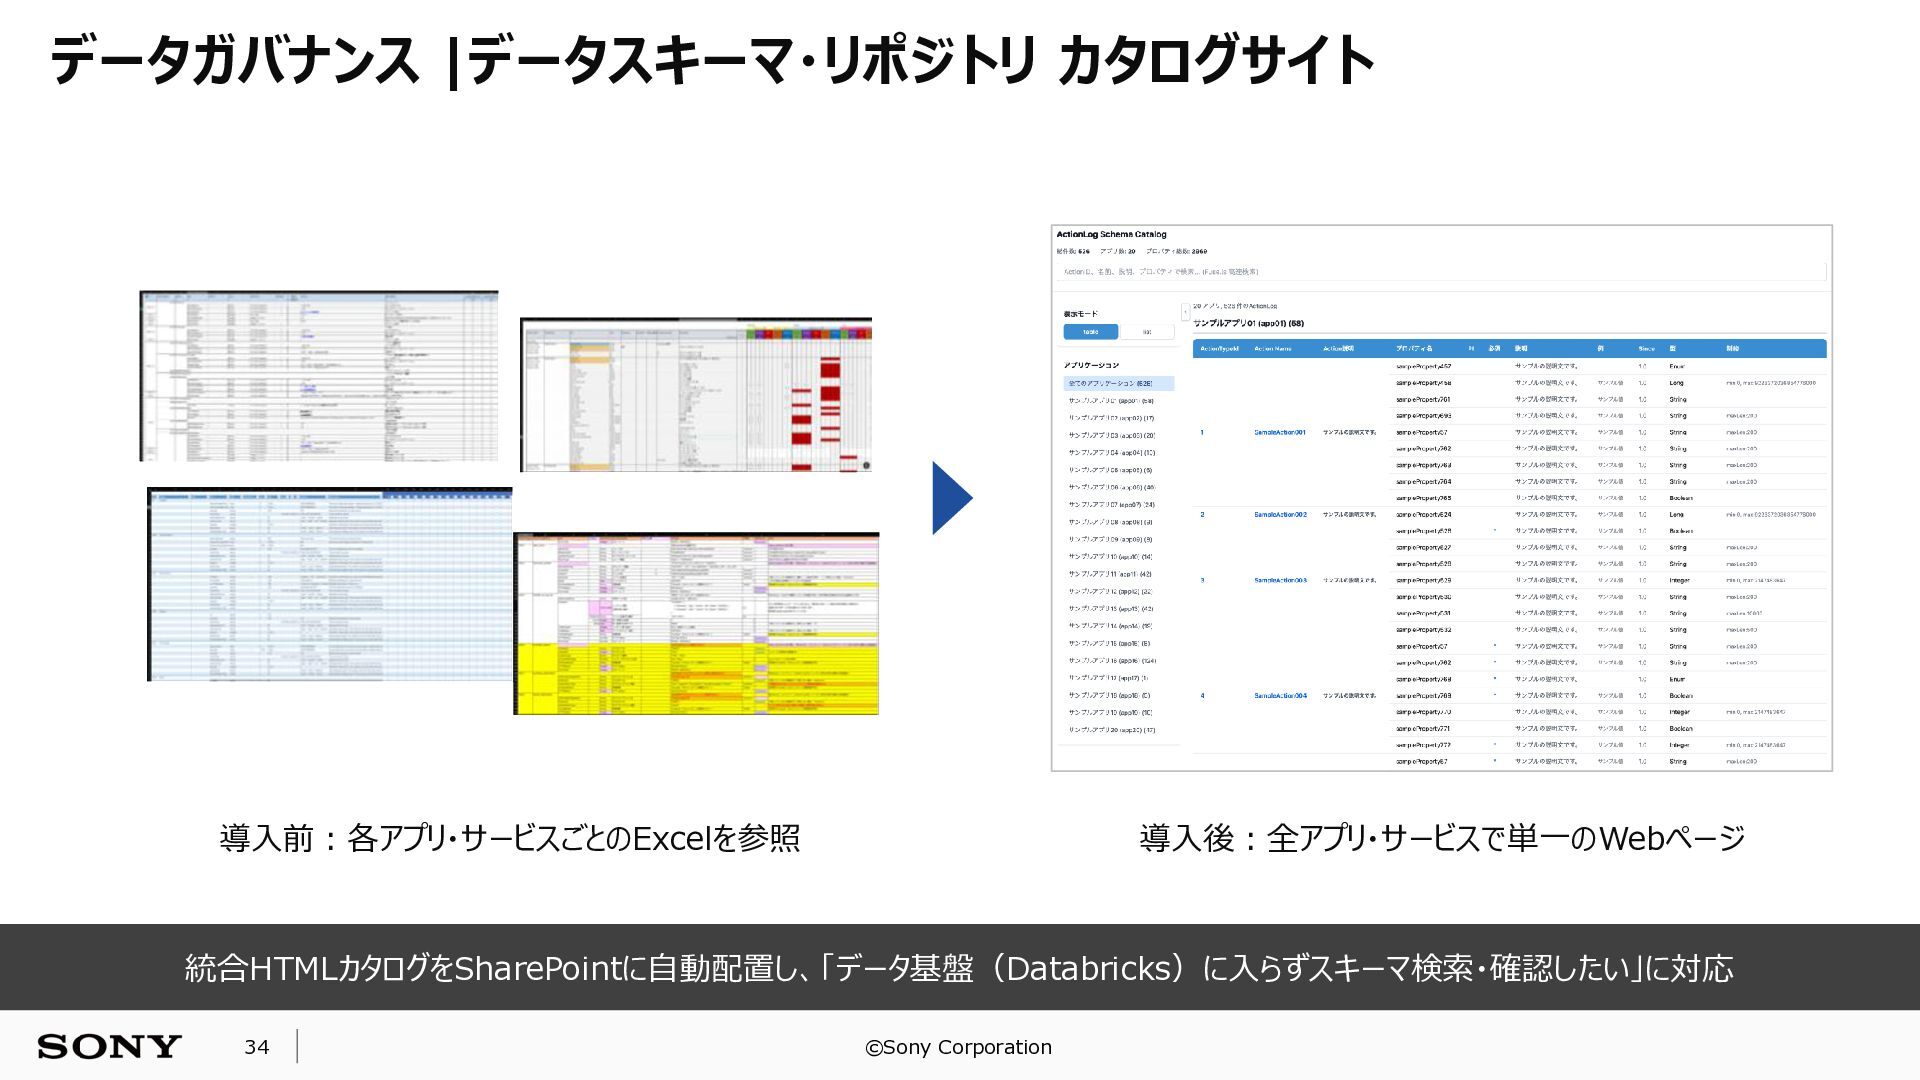
データガバナンス |データスキーマ・リポジトリ カタログサイト 導入前:各アプリ・サービスごとのExcelを参照 導入後:全アプリ・サービスで単一のWebページ 統合HTMLカタログをSharePointに自動配置し、「データ基盤(Databricks)に入らずスキーマ検索・確認したい」に対応 34 ©Sony Corporation
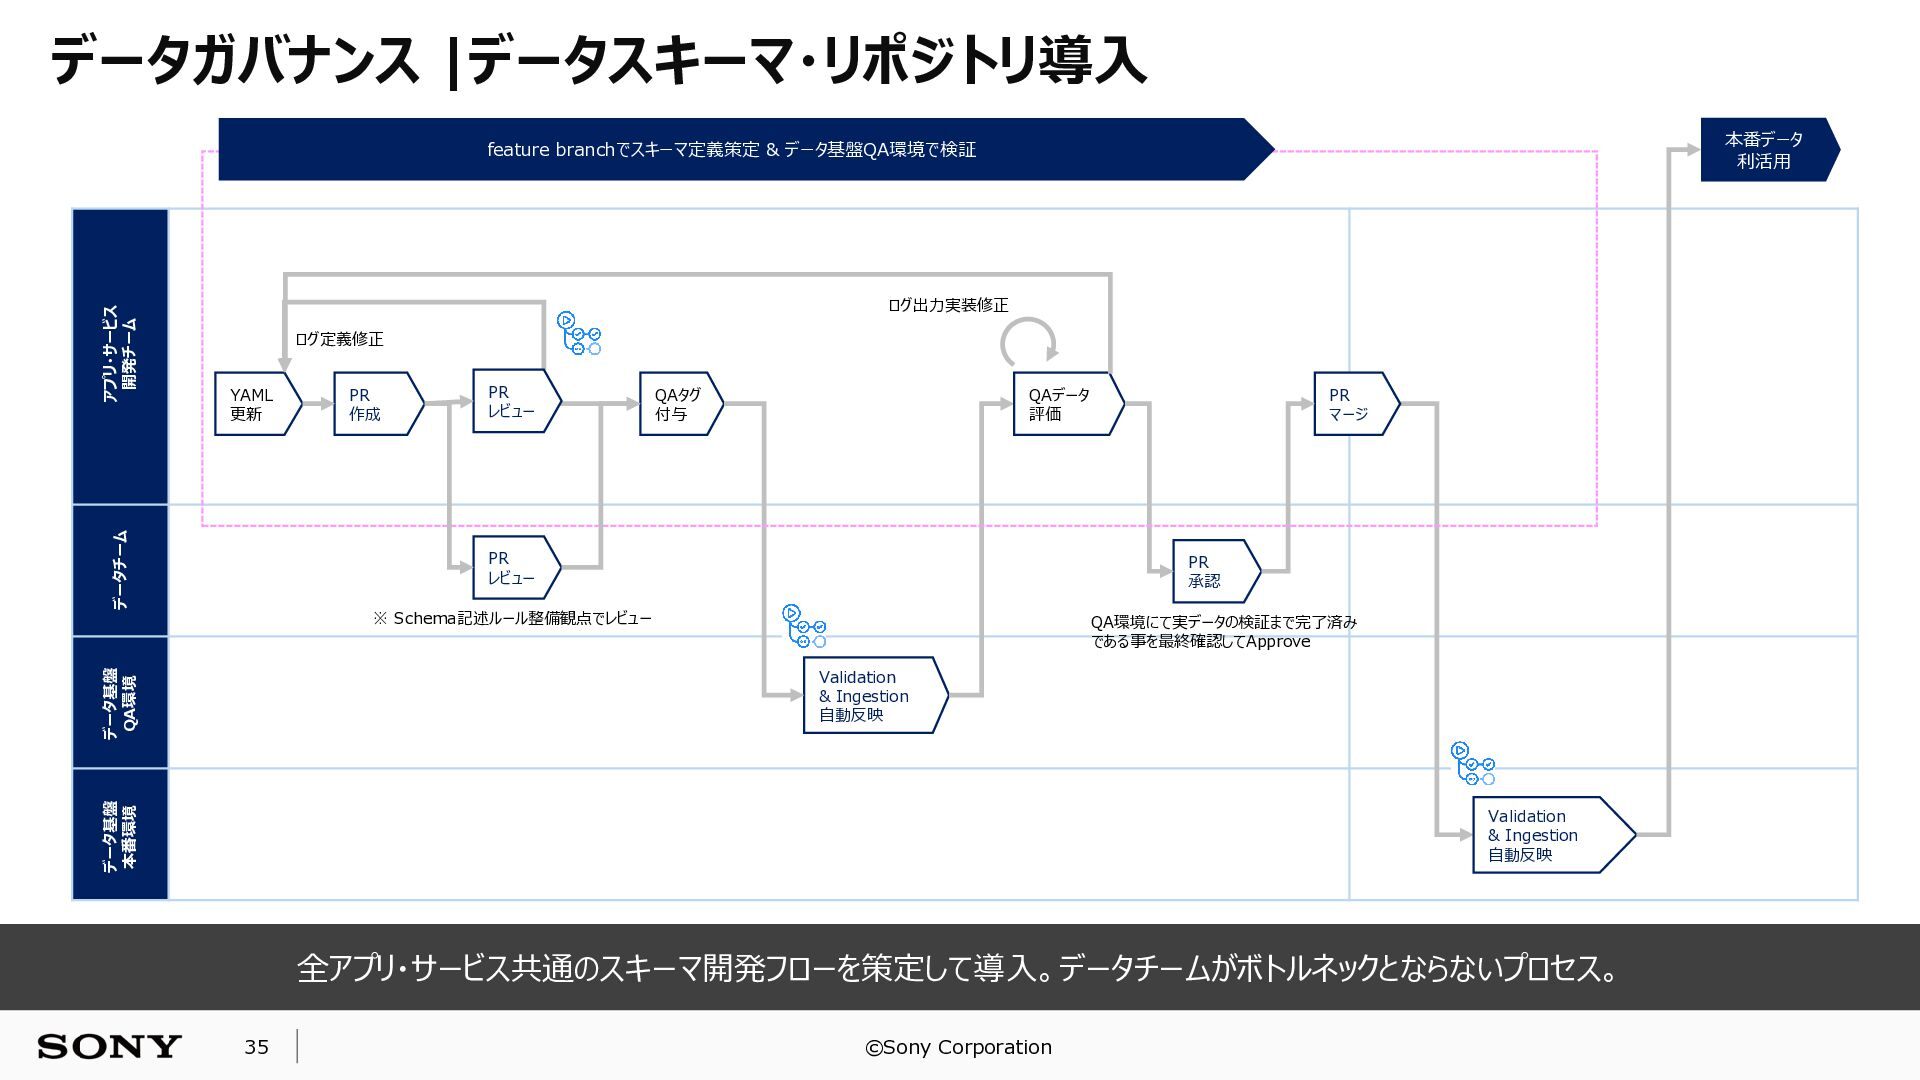
データガバナンス |データスキーマ・リポジトリ導入 本番データ 利活用 ログ出力実装修正 ログ定義修正 YAML 更新 データチーム アプリ・サービス
開発チーム feature branchでスキーマ定義策定 & データ基盤QA環境で検証 PR 作成 PR レビュー QAタグ 付与 QAデータ 評価 PR レビュー PR マージ PR 承認 ※ Schema記述ルール整備観点でレビュー QA環境にて実データの検証まで完了済み である事を最終確認してApprove データ基盤 本番環境 データ基盤 QA環境 Validation & Ingestion 自動反映 Validation & Ingestion 自動反映 全アプリ・サービス共通のスキーマ開発フローを策定して導入。データチームがボトルネックとならないプロセス。 35 ©Sony Corporation
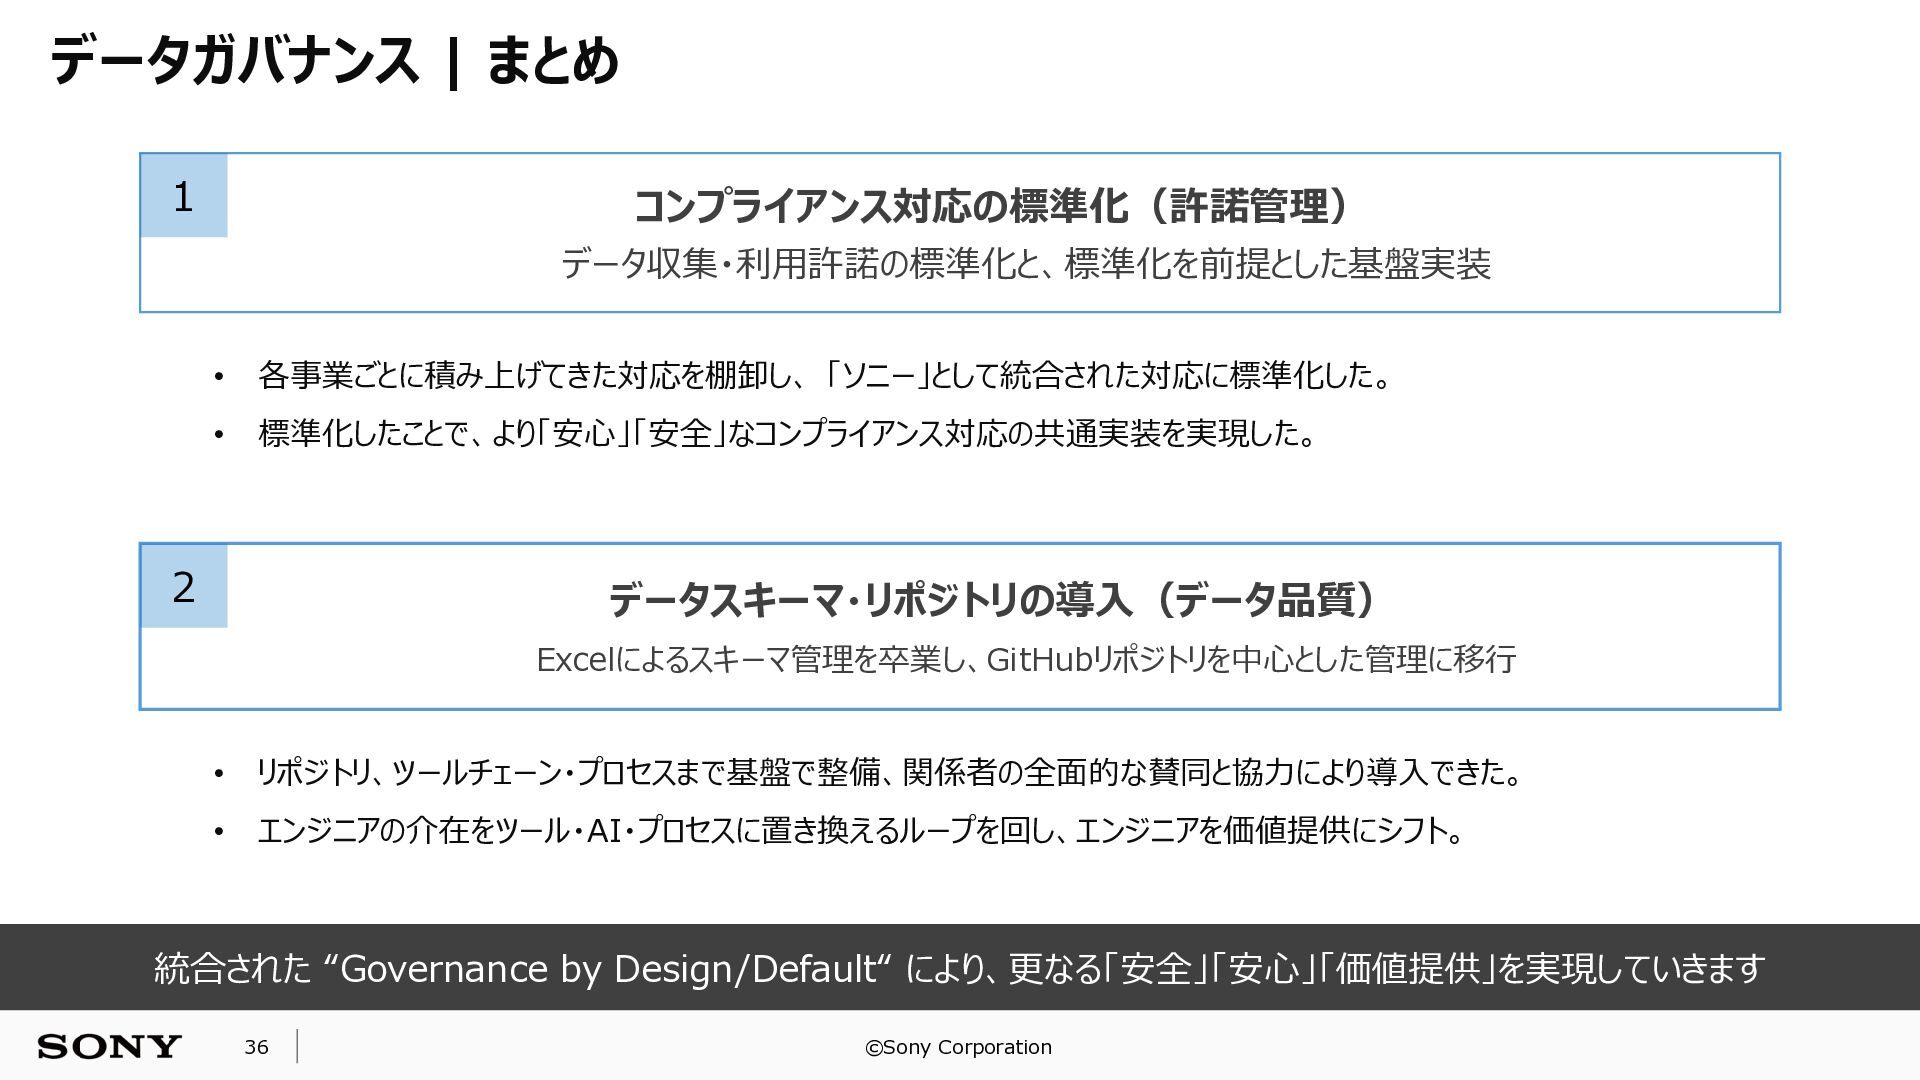
データガバナンス | まとめ 1 コンプライアンス対応の標準化(許諾管理) データ収集・利用許諾の標準化と、標準化を前提とした基盤実装 • 各事業ごとに積み上げてきた対応を棚卸し、 「ソニー」として統合された対応に標準化した。 •
標準化したことで、より「安心」「安全」なコンプライアンス対応の共通実装を実現した。 2 データスキーマ・リポジトリの導入(データ品質) Excelによるスキーマ管理を卒業し、GitHubリポジトリを中心とした管理に移行 • リポジトリ、ツールチェーン・プロセスまで基盤で整備、関係者の全面的な賛同と協力により導入できた。 • エンジニアの介在をツール・AI・プロセスに置き換えるループを回し、エンジニアを価値提供にシフト。 統合された “Governance by Design/Default“ により、更なる「安全」「安心」「価値提供」を実現していきます 36 ©Sony Corporation
Agenda 1 ソニーについて 2 データ基盤の技術選定とアーキテクチャ 3 データガバナンス 4 カメラ領域におけるデータ基盤移行・活用 37
©Sony Corporation
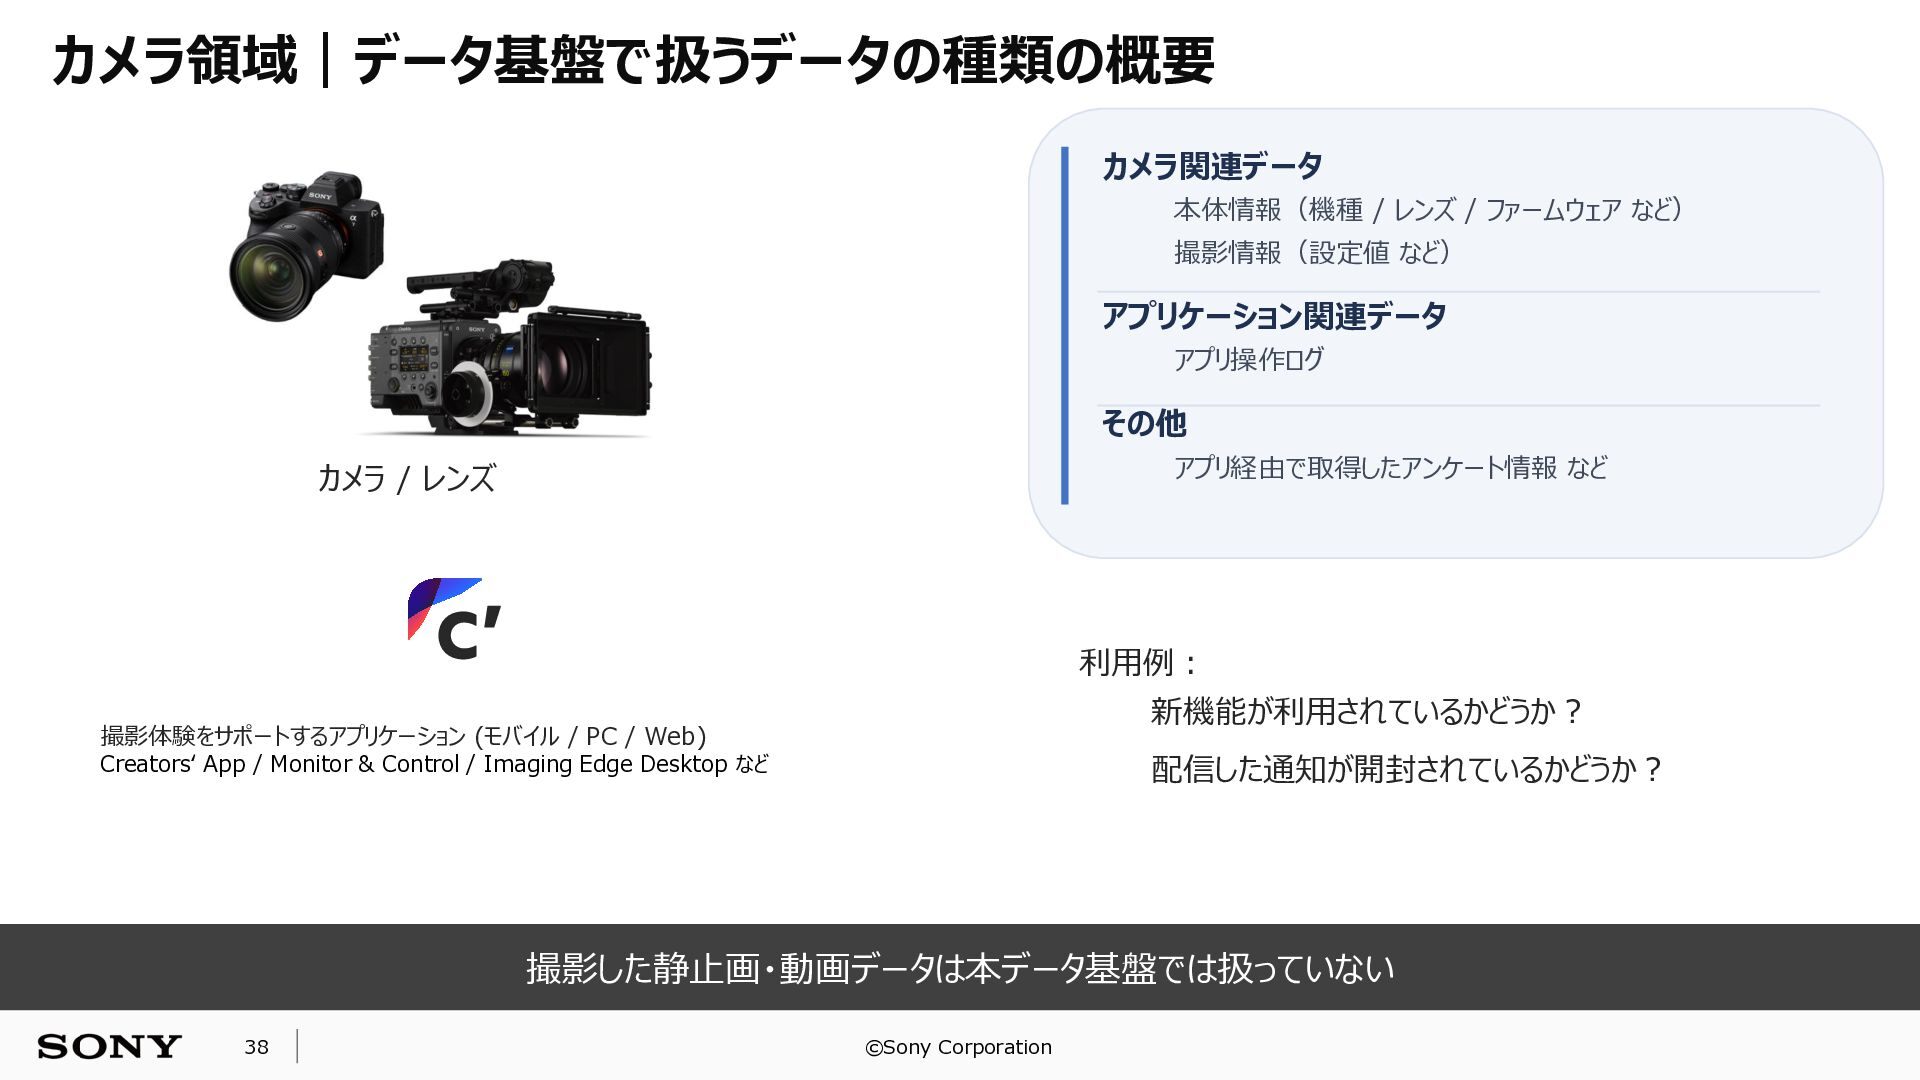
カメラ領域|データ基盤で扱うデータの種類の概要 カメラ関連データ 本体情報(機種 / レンズ / ファームウェア など) 撮影情報(設定値 など)
アプリケーション関連データ アプリ操作ログ その他 アプリ経由で取得したアンケート情報 など カメラ / レンズ 利用例: 新機能が利用されているかどうか? 撮影体験をサポートするアプリケーション (モバイル / PC / Web) 配信した通知が開封されているかどうか? Creators‘ App / Monitor & Control / Imaging Edge Desktop など 撮影した静止画・動画データは本データ基盤では扱っていない 38 ©Sony Corporation
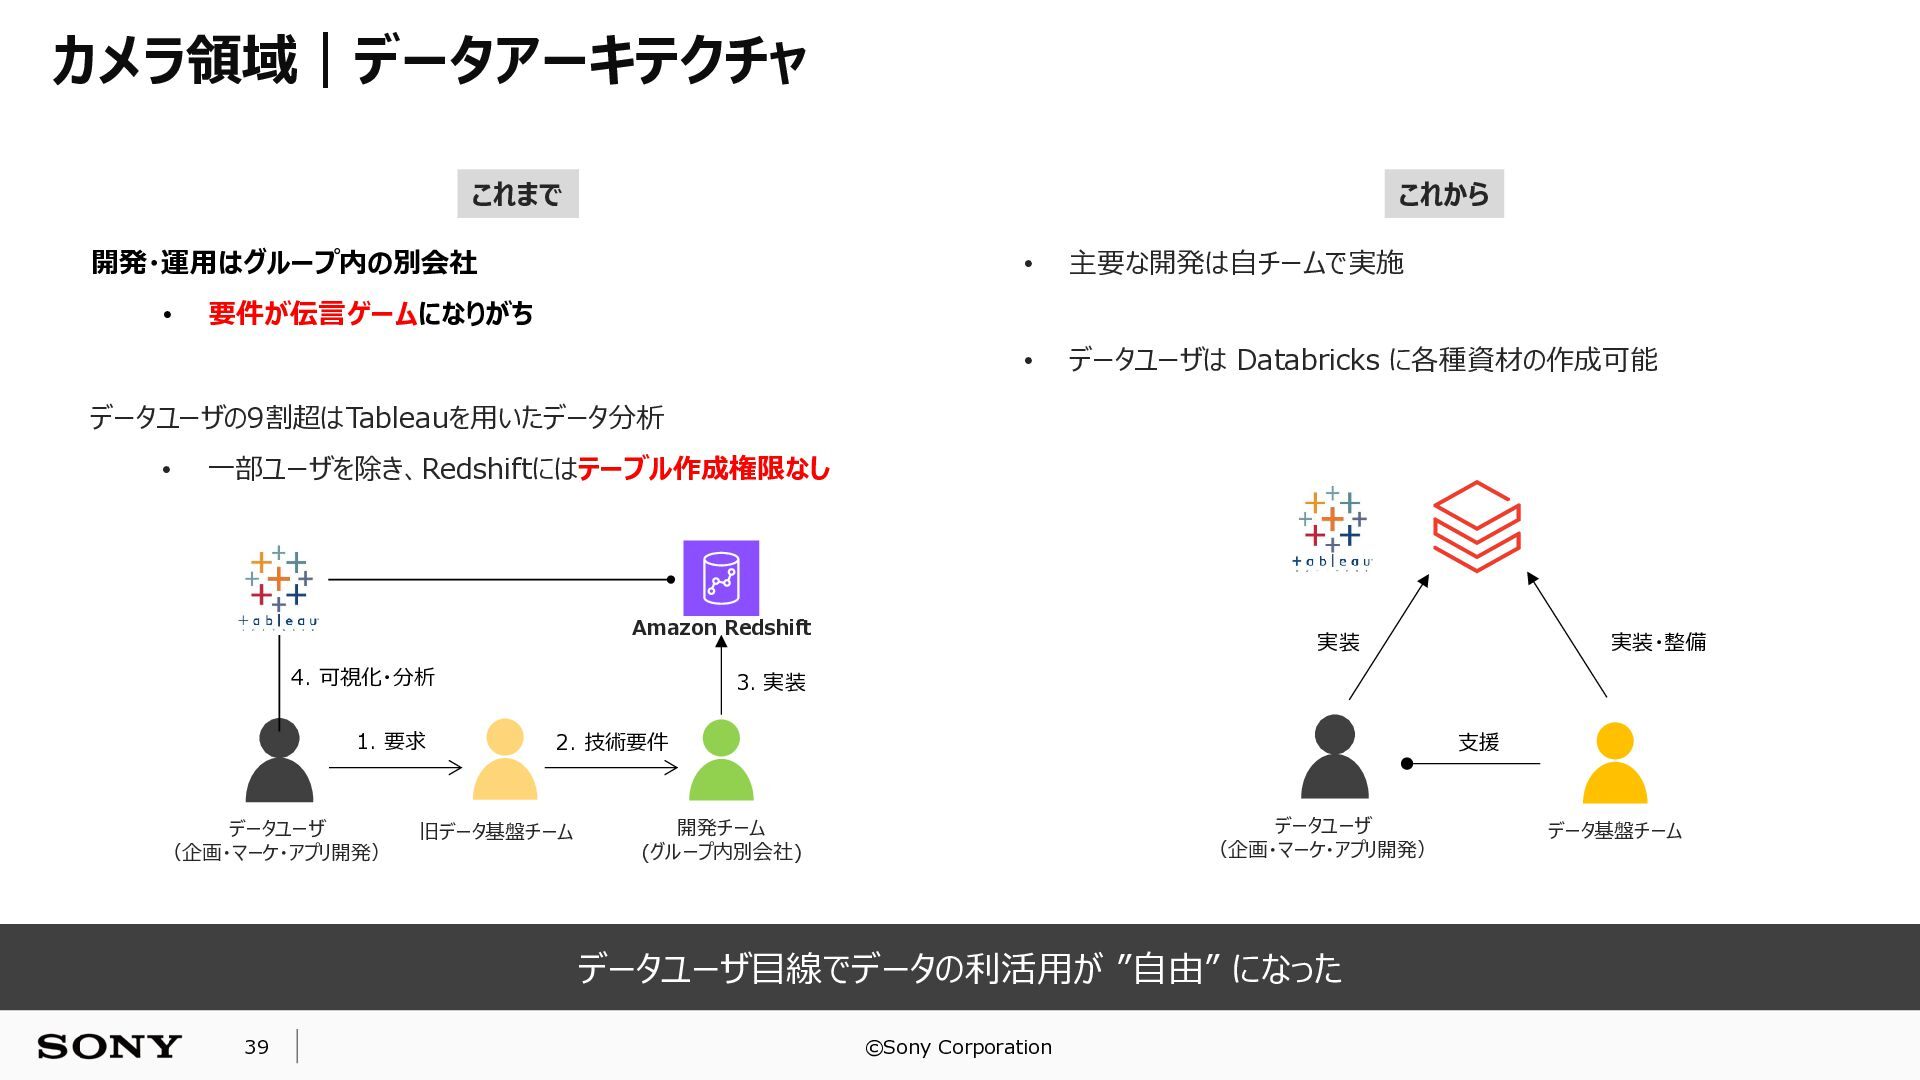
カメラ領域|データアーキテクチャ これまで これから 開発・運用はグループ内の別会社 • • 主要な開発は自チームで実施 • データユーザは Databricks
に各種資材の作成可能 要件が伝言ゲームになりがち データユーザの9割超はTableauを用いたデータ分析 • 一部ユーザを除き、Redshiftにはテーブル作成権限なし Amazon Redshift 4. 可視化・分析 1. 要求 データユーザ (企画・マーケ・アプリ開発) 実装 3. 実装 2. 技術要件 旧データ基盤チーム 支援 データユーザ (企画・マーケ・アプリ開発) 開発チーム (グループ内別会社) データユーザ目線でデータの利活用が ”自由” になった 39 実装・整備 ©Sony Corporation データ基盤チーム
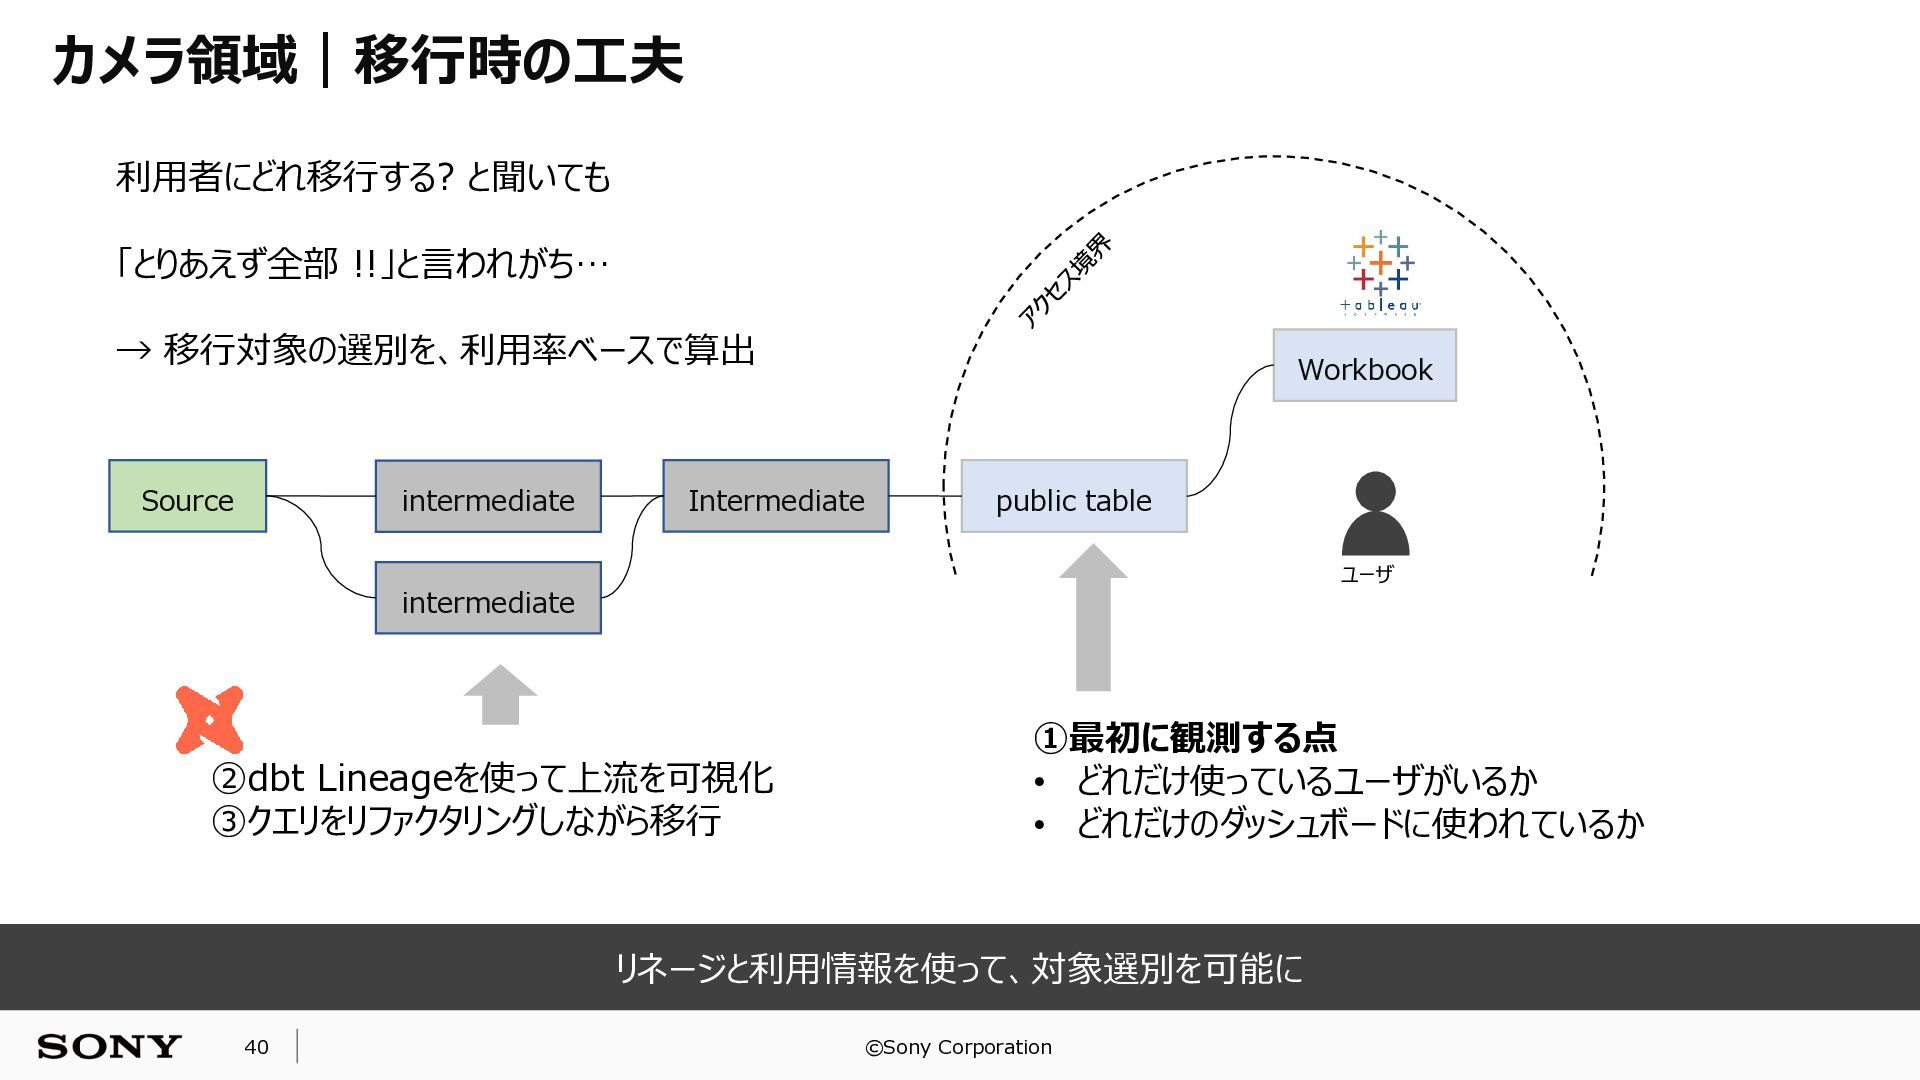
カメラ領域|移行時の工夫 利用者にどれ移行する? と聞いても 「とりあえず全部 !!」と言われがち… → 移行対象の選別を、利用率ベースで算出 Source intermediate Workbook
Intermediate public table ユーザ intermediate ②dbt Lineageを使って上流を可視化 ③クエリをリファクタリングしながら移行 ①最初に観測する点 • どれだけ使っているユーザがいるか • どれだけのダッシュボードに使われているか リネージと利用情報を使って、対象選別を可能に 40 ©Sony Corporation
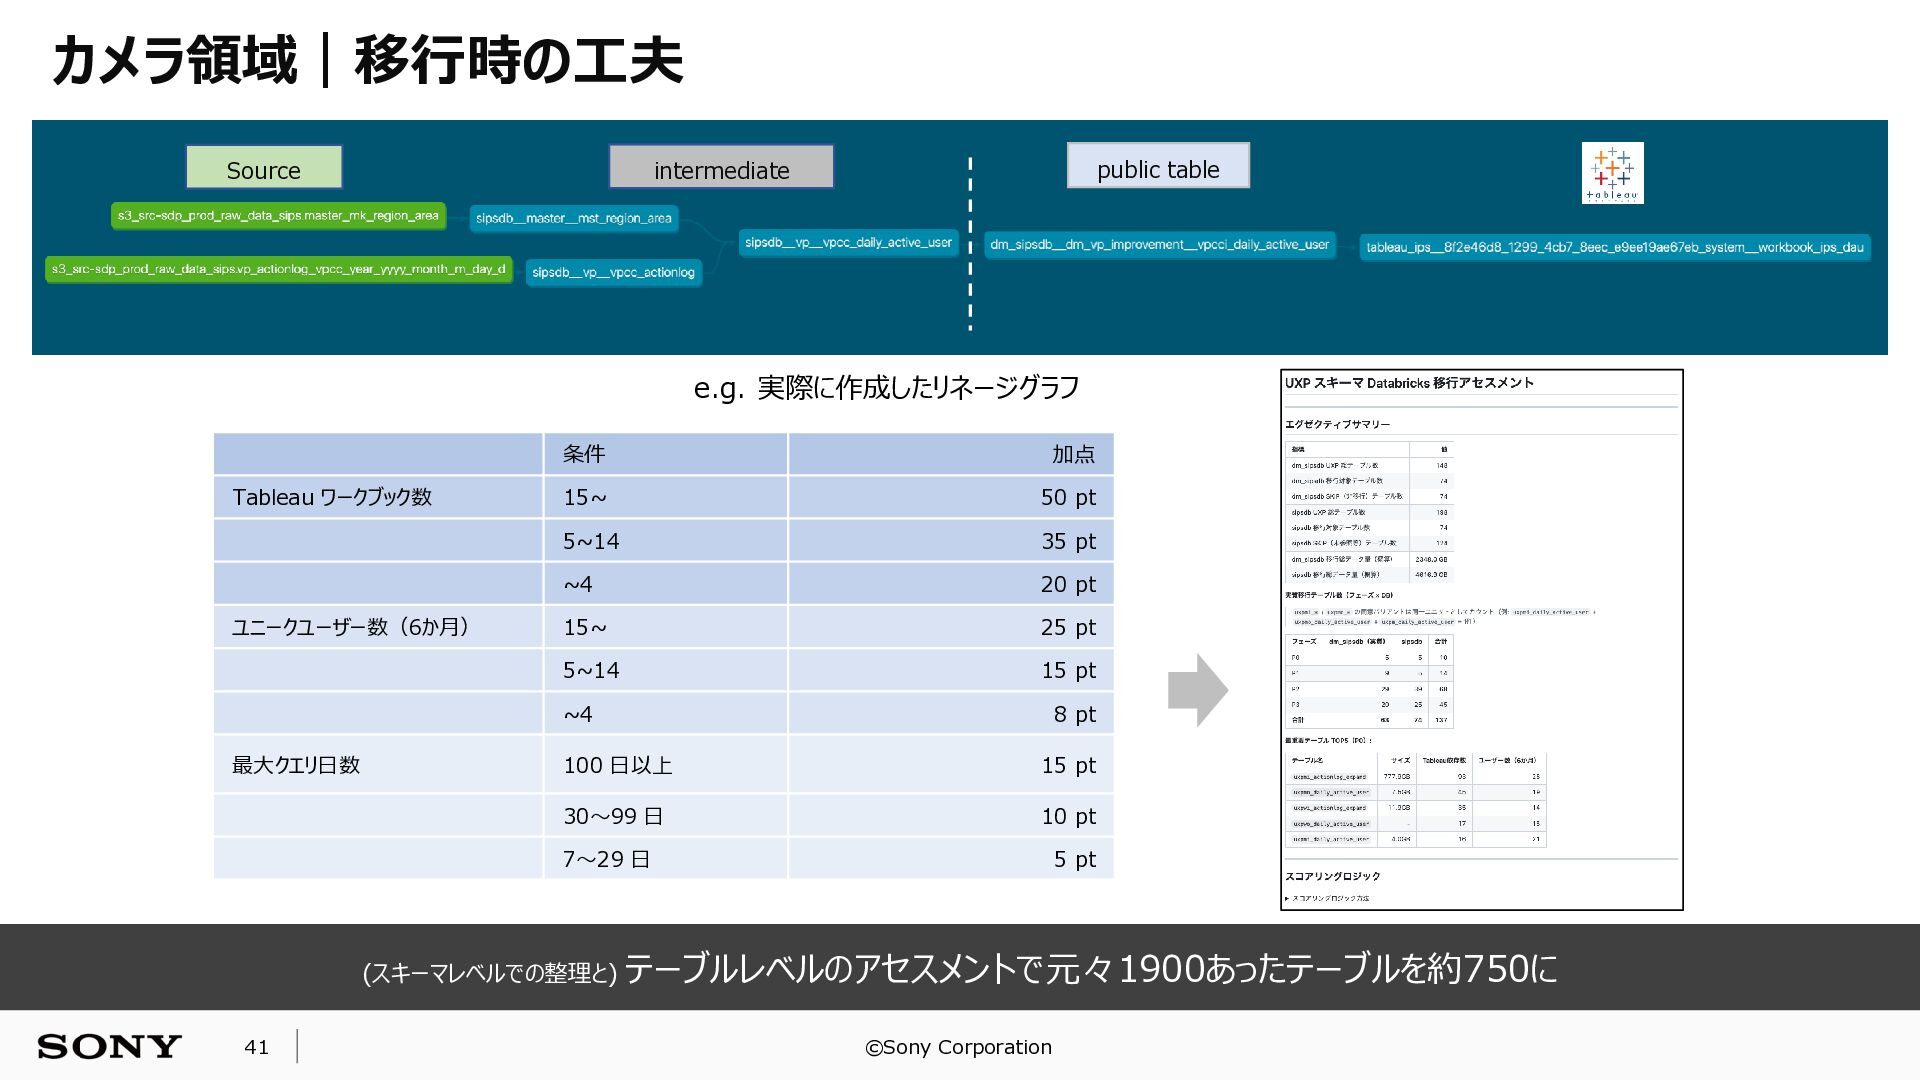
カメラ領域|移行時の工夫 public table intermediate Source e.g. 実際に作成したリネージグラフ Tableau ワークブック数 ユニークユーザー数(6か月)
最大クエリ日数 条件 加点 15~ 50 pt 5~14 35 pt ~4 20 pt 15~ 25 pt 5~14 15 pt ~4 8 pt 100 日以上 15 pt 30〜99 日 10 pt 7〜29 日 5 pt (スキーマレベルでの整理と) テーブルレベルのアセスメントで元々1900あったテーブルを約750に e.g. 移行の指針となるアセスメント 41 ©Sony Corporation
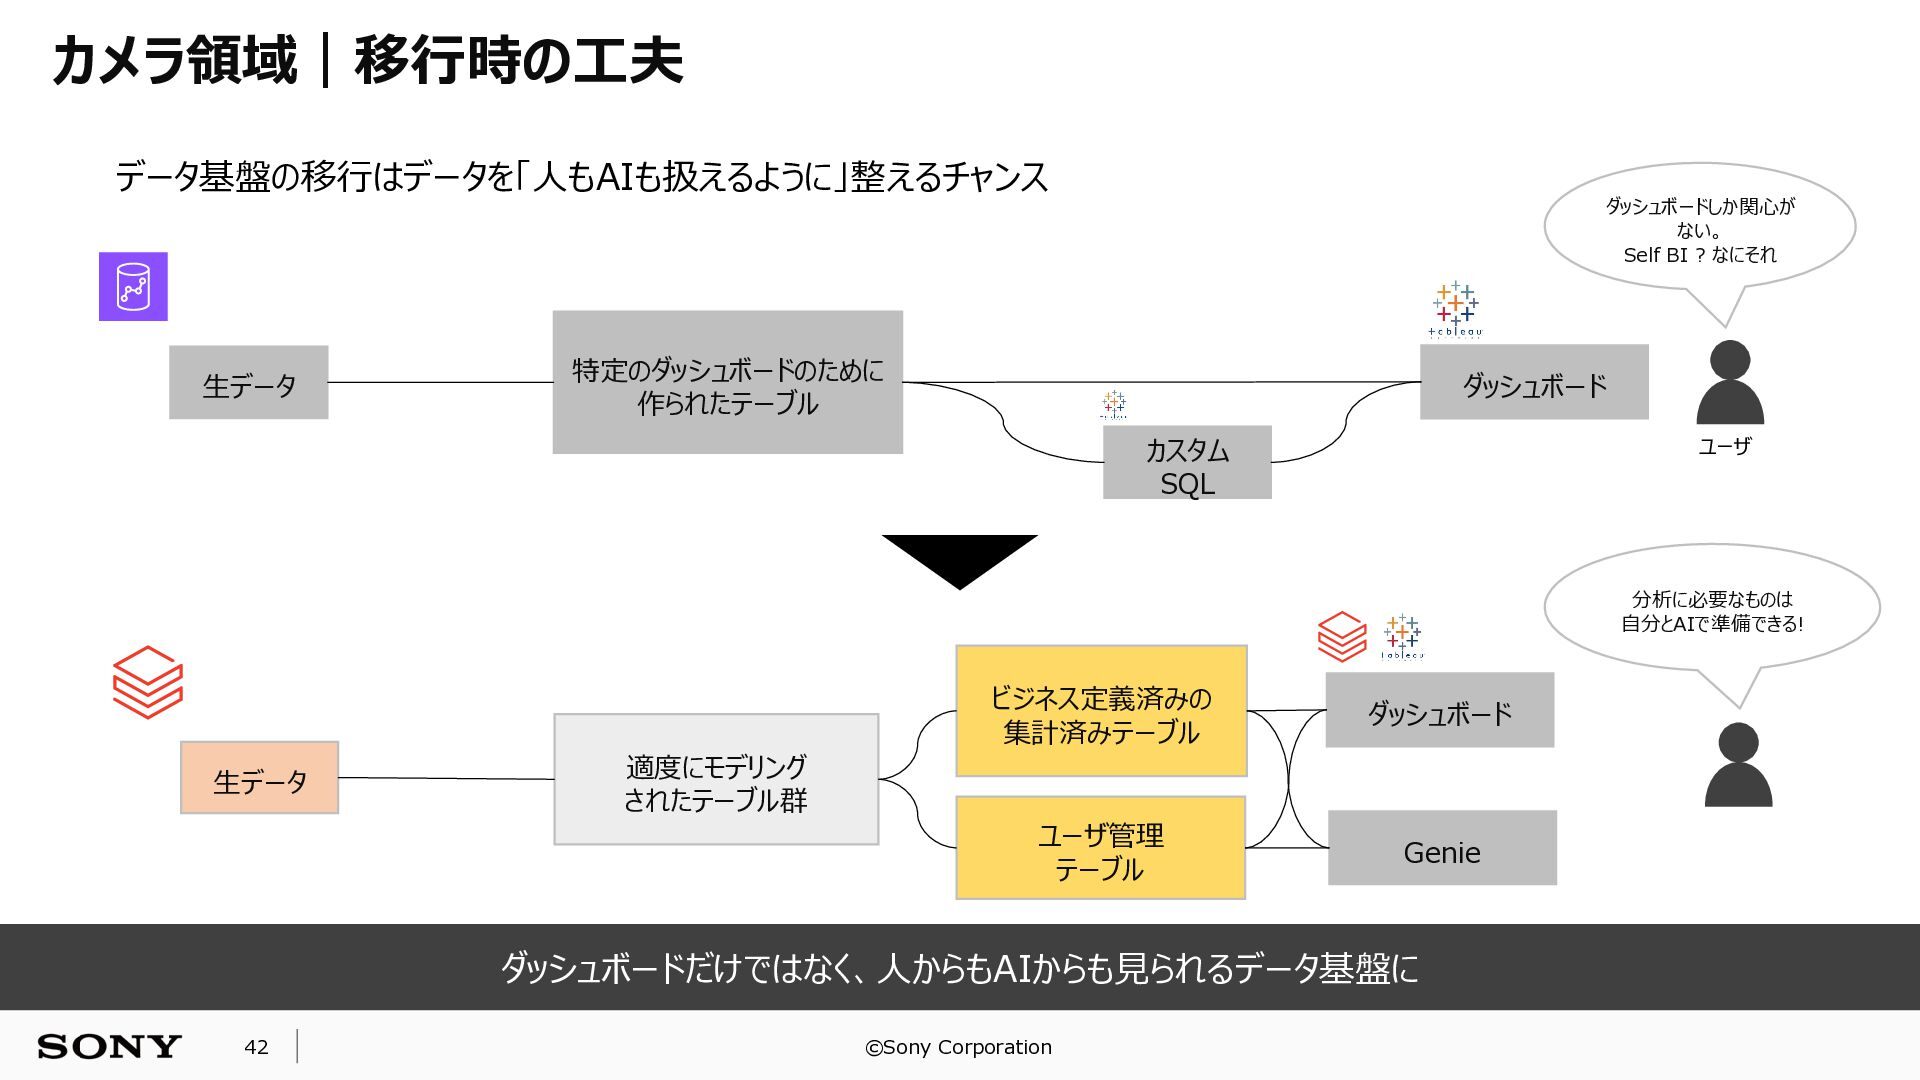
カメラ領域|移行時の工夫 データ基盤の移行はデータを「人もAIも扱えるように」整えるチャンス 生データ ダッシュボードしか関心が ない。 Self BI ? なにそれ 特定のダッシュボードのために
作られたテーブル ダッシュボード カスタム SQL ユーザ 分析に必要なものは 自分とAIで準備できる! 生データ ビジネス定義済みの 集計済みテーブル ダッシュボード ユーザ管理 テーブル Genie 適度にモデリング されたテーブル群 ダッシュボードだけではなく、人からもAIからも見られるデータ基盤に 42 ©Sony Corporation
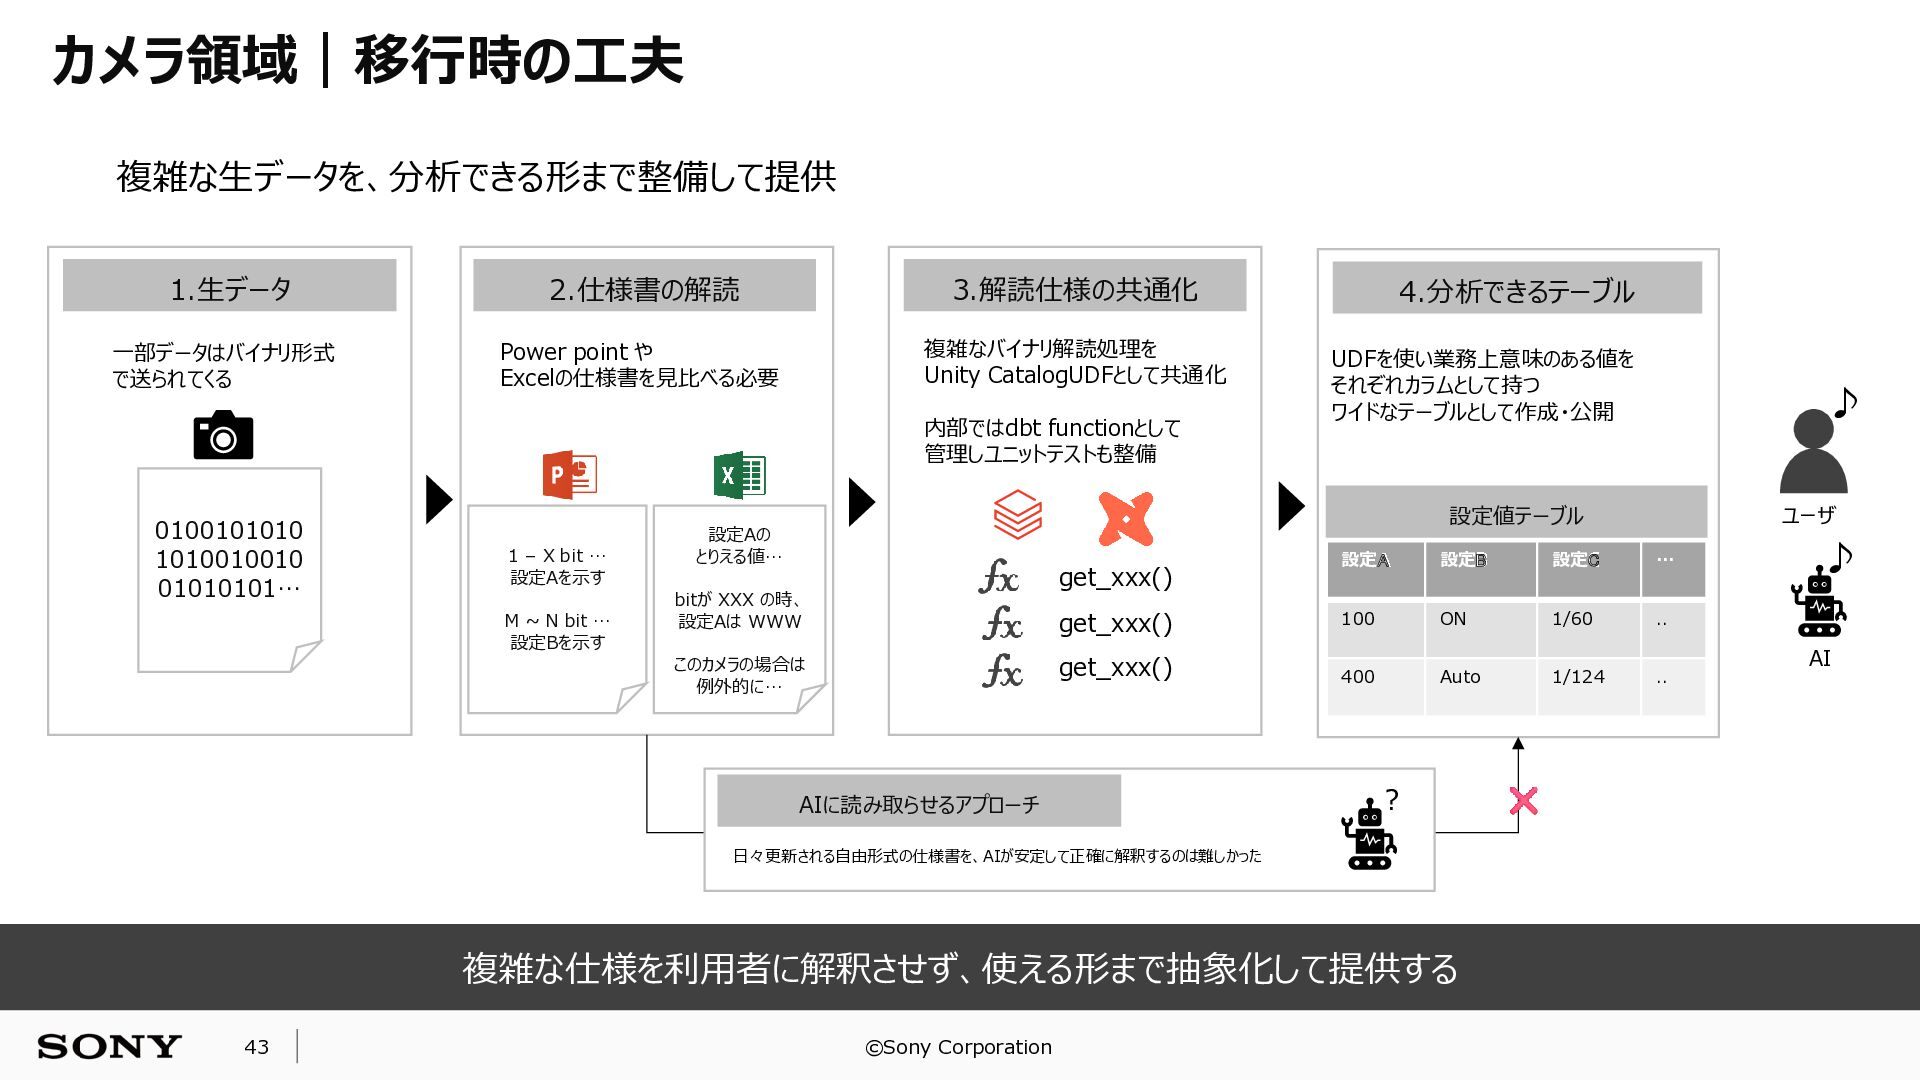
カメラ領域|移行時の工夫 複雑な生データを、分析できる形まで整備して提供 1.生データ 2.仕様書の解読 3.解読仕様の共通化 一部データはバイナリ形式 で送られてくる Power point や
Excelの仕様書を見比べる必要 複雑なバイナリ解読処理を Unity CatalogUDFとして共通化 内部ではdbt functionとして 管理しユニットテストも整備 0100101010 1010010010 01010101… 1 – X bit … 設定Aを示す M ~ N bit … 設定Bを示す 4.分析できるテーブル UDFを使い業務上意味のある値を それぞれカラムとして持つ ワイドなテーブルとして作成・公開 ユーザ 設定値テーブル 設定Aの とりえる値… 設定A 設定B 設定C … get_xxx() 100 ON 1/60 .. get_xxx() 400 Auto 1/124 .. get_xxx() bitが XXX の時、 設定Aは WWW このカメラの場合は 例外的に… AIに読み取らせるアプローチ ? 日々更新される自由形式の仕様書を、AIが安定して正確に解釈するのは難しかった 複雑な仕様を利用者に解釈させず、使える形まで抽象化して提供する 43 ♪ ©Sony Corporation ♪ AI
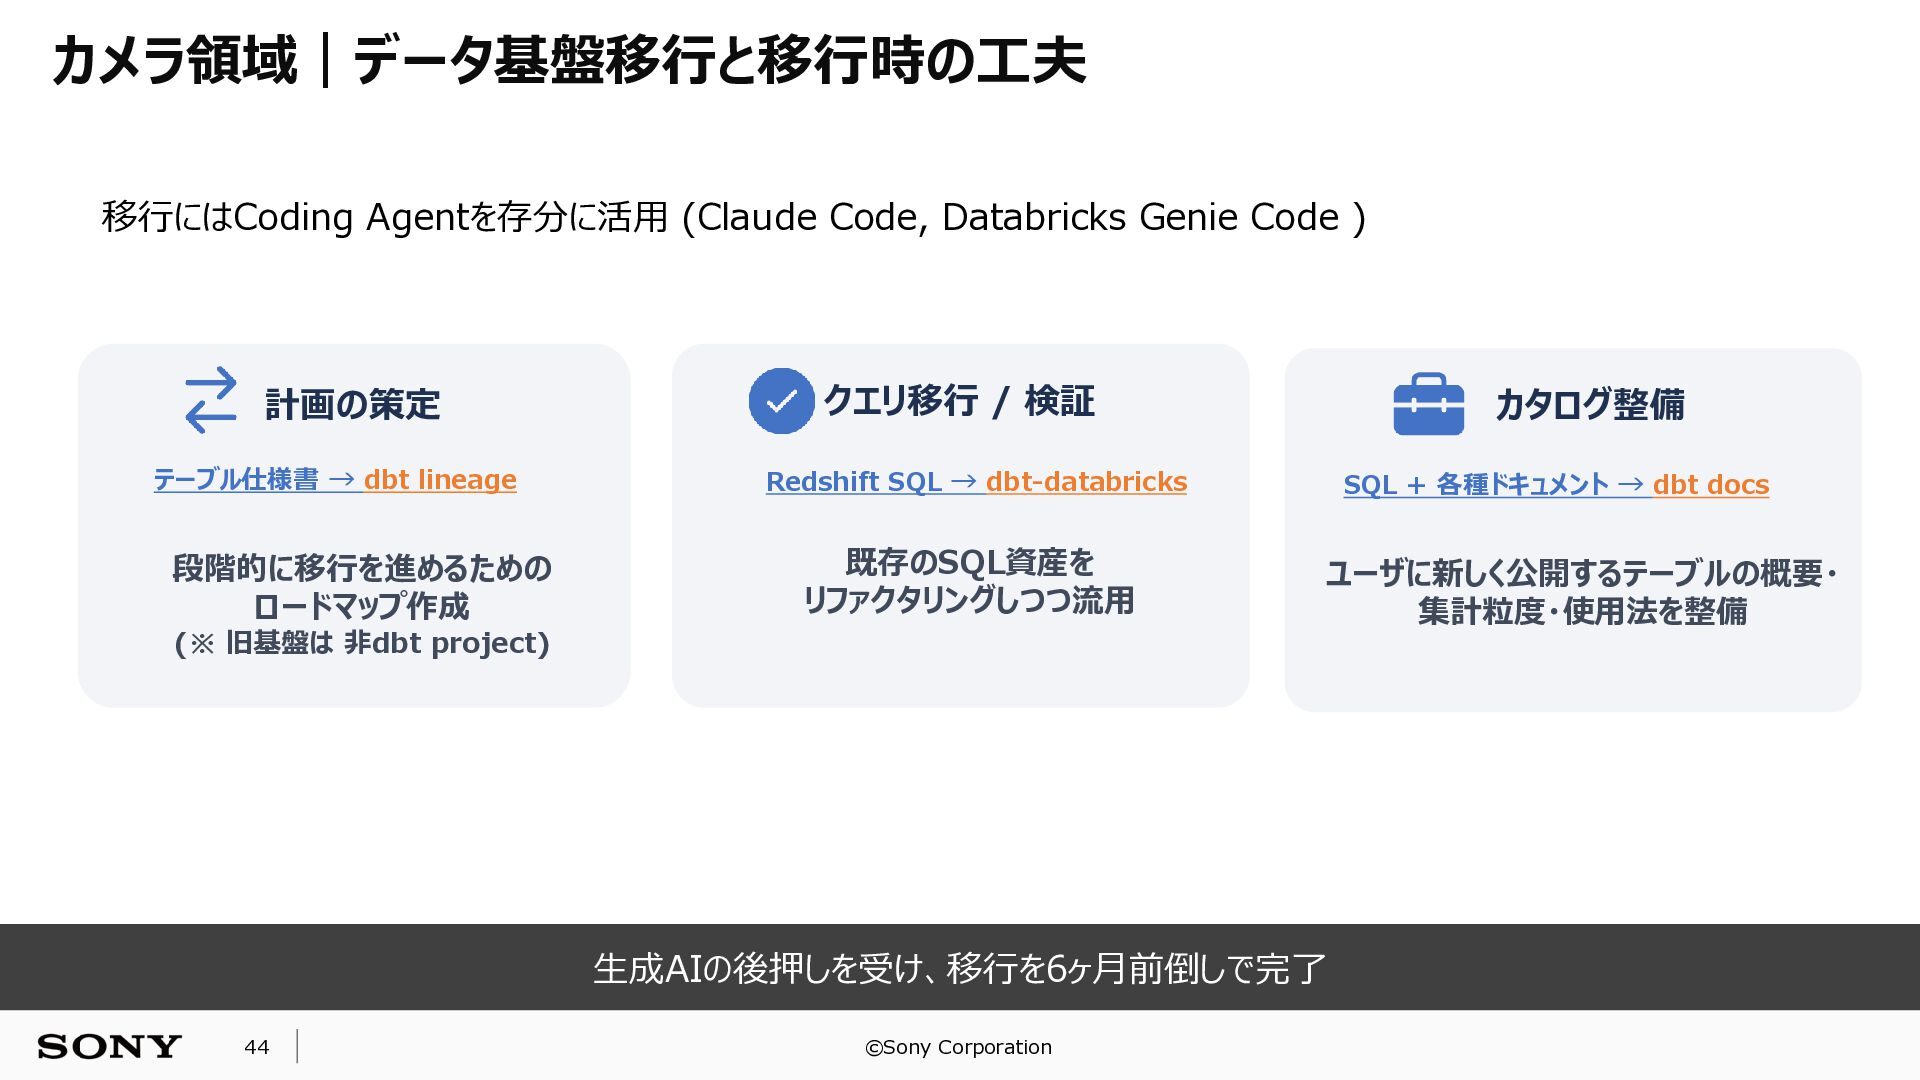
カメラ領域|データ基盤移行と移行時の工夫 移行にはCoding Agentを存分に活用 (Claude Code, Databricks Genie Code ) 計画の策定
クエリ移行 / 検証 テーブル仕様書 → dbt lineage Redshift SQL → dbt-databricks 段階的に移行を進めるための ロードマップ作成 既存のSQL資産を リファクタリングしつつ流用 (※ 旧基盤は 非dbt project) カタログ整備 SQL + 各種ドキュメント → dbt docs ユーザに新しく公開するテーブルの概要・ 集計粒度・使用法を整備 生成AIの後押しを受け、移行を6ヶ月前倒しで完了 44 ©Sony Corporation
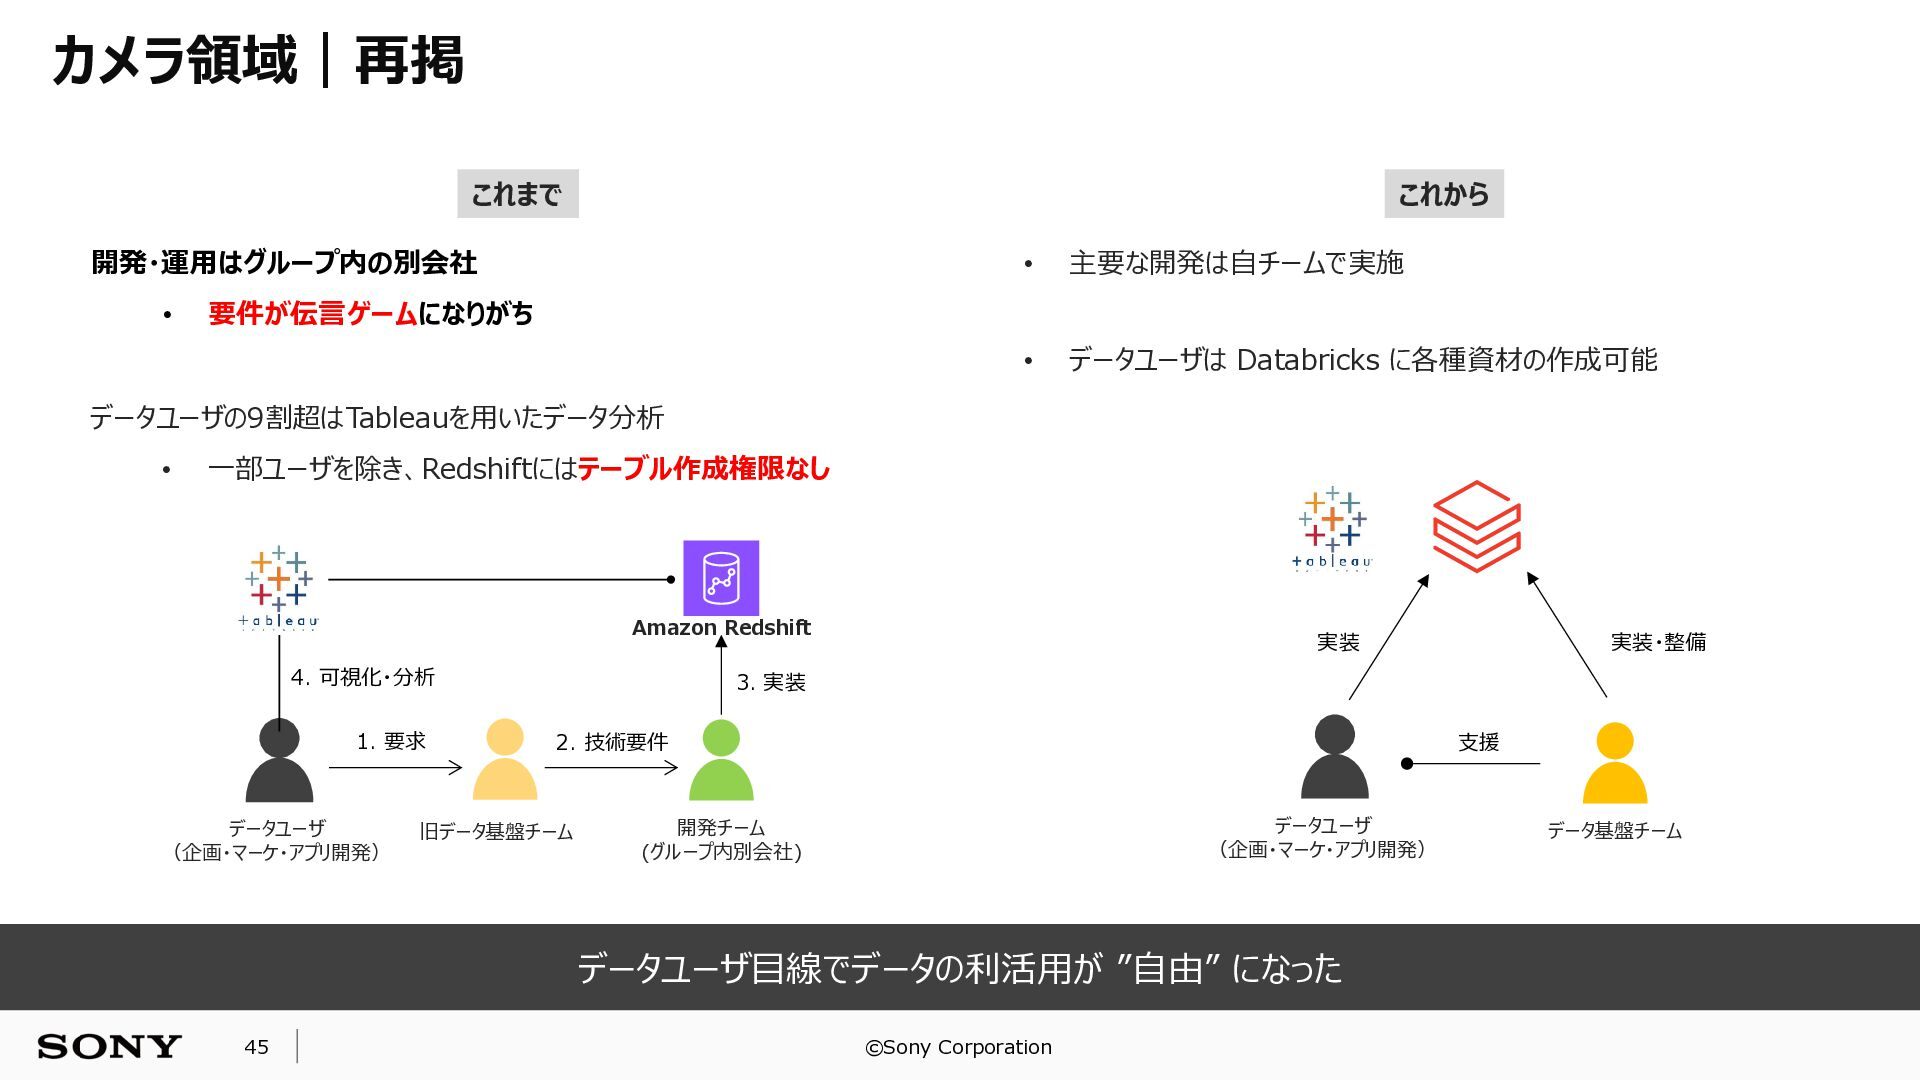
カメラ領域|再掲 これまで これから 開発・運用はグループ内の別会社 • • 主要な開発は自チームで実施 • データユーザは Databricks
に各種資材の作成可能 要件が伝言ゲームになりがち データユーザの9割超はTableauを用いたデータ分析 • 一部ユーザを除き、Redshiftにはテーブル作成権限なし Amazon Redshift 4. 可視化・分析 1. 要求 データユーザ (企画・マーケ・アプリ開発) 実装 3. 実装 2. 技術要件 旧データ基盤チーム 支援 データユーザ (企画・マーケ・アプリ開発) 開発チーム (グループ内別会社) データユーザ目線でデータの利活用が ”自由” になった 45 実装・整備 ©Sony Corporation データ基盤チーム
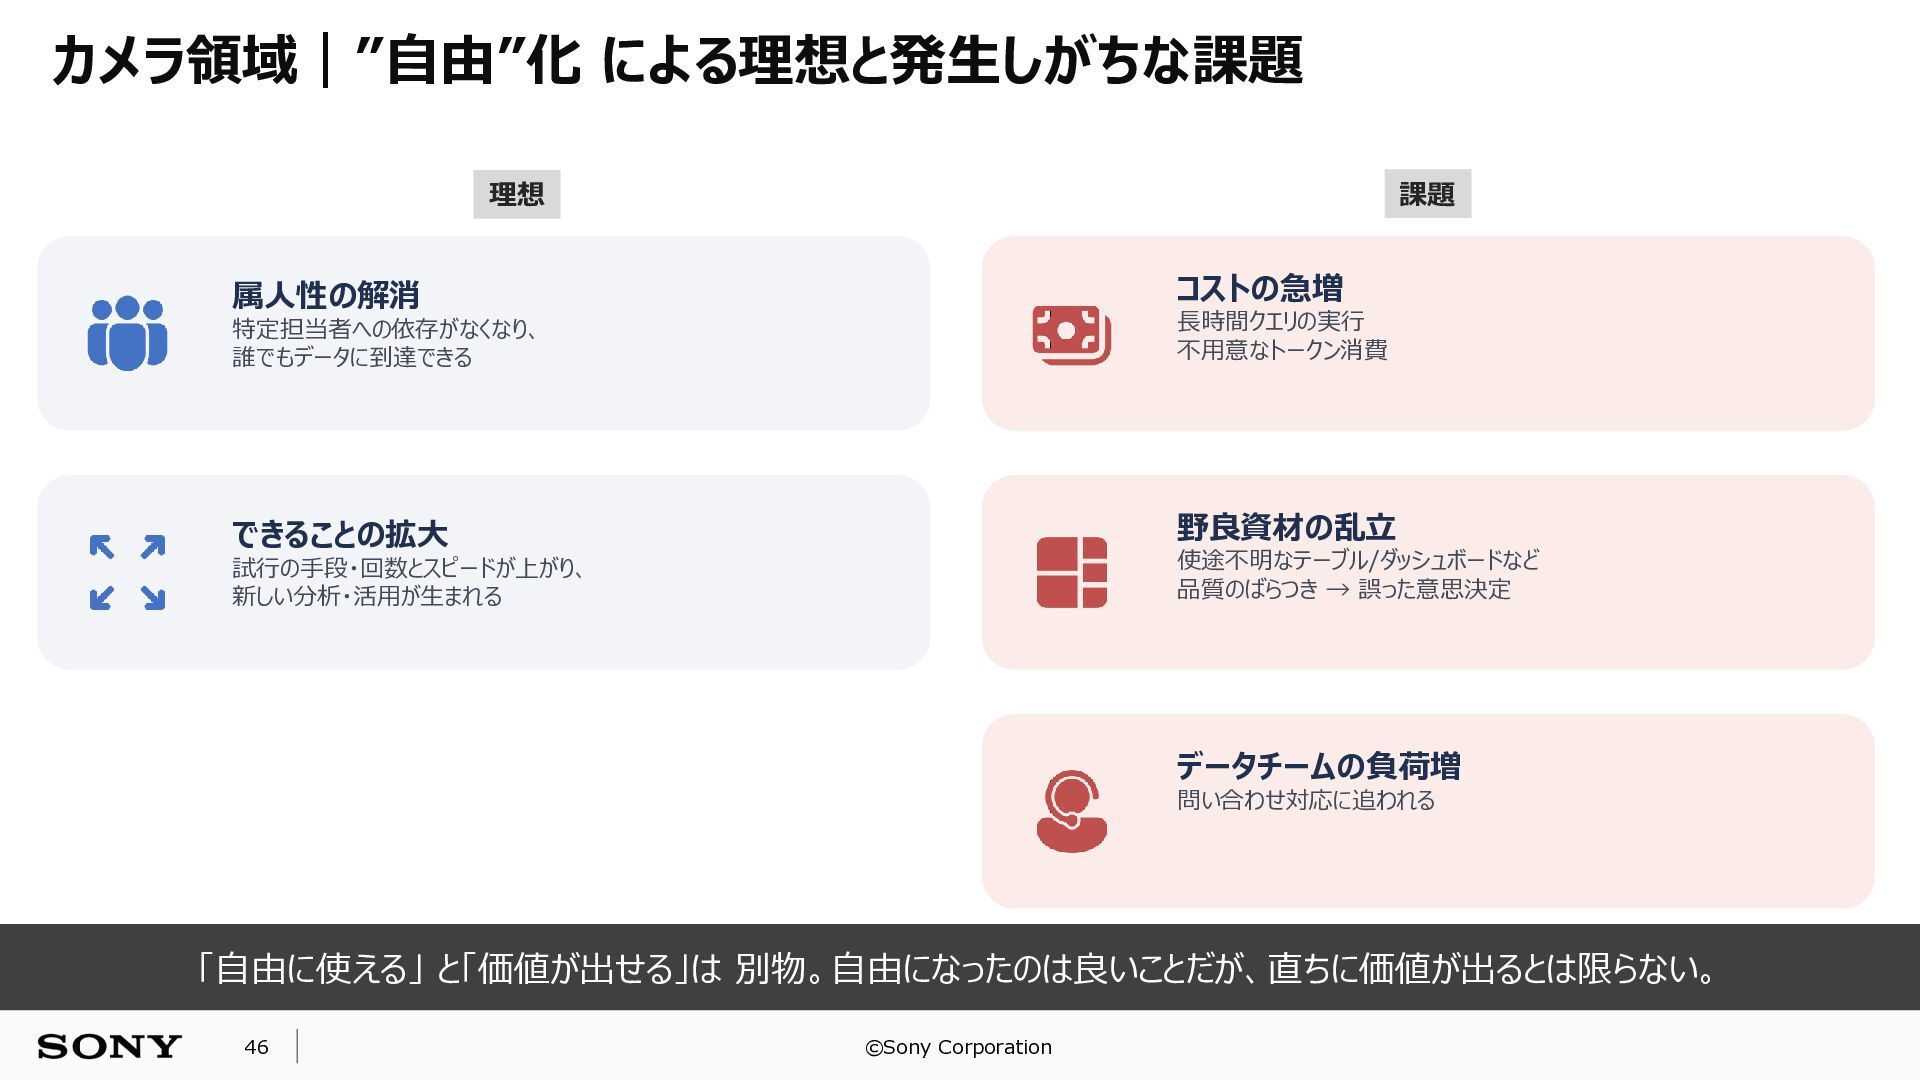
カメラ領域|”自由”化 による理想と発生しがちな課題 課題 理想 コストの急増 属人性の解消 特定担当者への依存がなくなり、 誰でもデータに到達できる 長時間クエリの実行 不用意なトークン消費
できることの拡大 野良資材の乱立 使途不明なテーブル/ダッシュボードなど 品質のばらつき → 誤った意思決定 試行の手段・回数とスピードが上がり、 新しい分析・活用が生まれる データチームの負荷増 問い合わせ対応に追われる 「自由に使える」 と「価値が出せる」は 別物。自由になったのは良いことだが、直ちに価値が出るとは限らない。 46 ©Sony Corporation
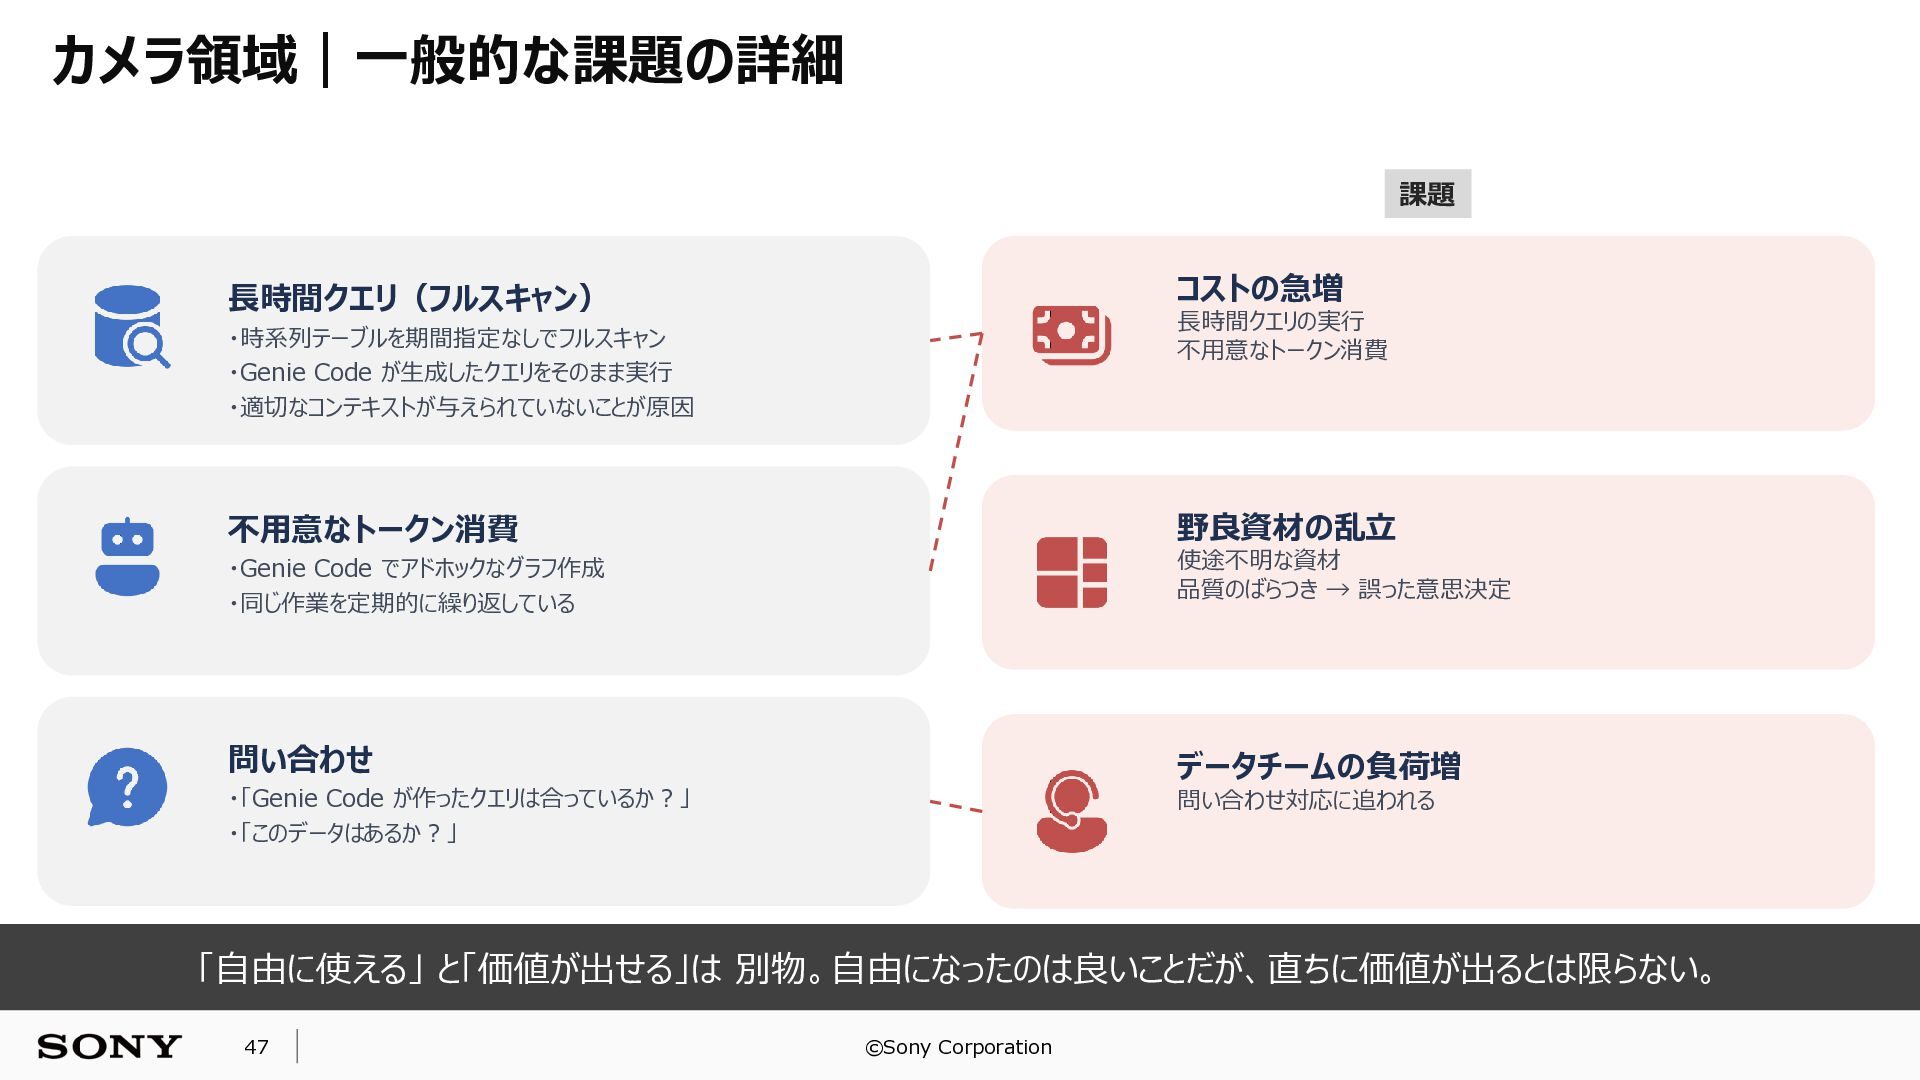
カメラ領域|一般的な課題の詳細 課題 コストの急増 長時間クエリ(フルスキャン) 長時間クエリの実行 不用意なトークン消費 ・時系列テーブルを期間指定なしでフルスキャン ・Genie Code が生成したクエリをそのまま実行
・適切なコンテキストが与えられていないことが原因 野良資材の乱立 不用意なトークン消費 ・Genie Code でアドホックなグラフ作成 ・同じ作業を定期的に繰り返している 使途不明な資材 品質のばらつき → 誤った意思決定 問い合わせ データチームの負荷増 ・「Genie Code が作ったクエリは合っているか?」 ・「このデータはあるか?」 問い合わせ対応に追われる 「自由に使える」 と「価値が出せる」は 別物。自由になったのは良いことだが、直ちに価値が出るとは限らない。 47 ©Sony Corporation
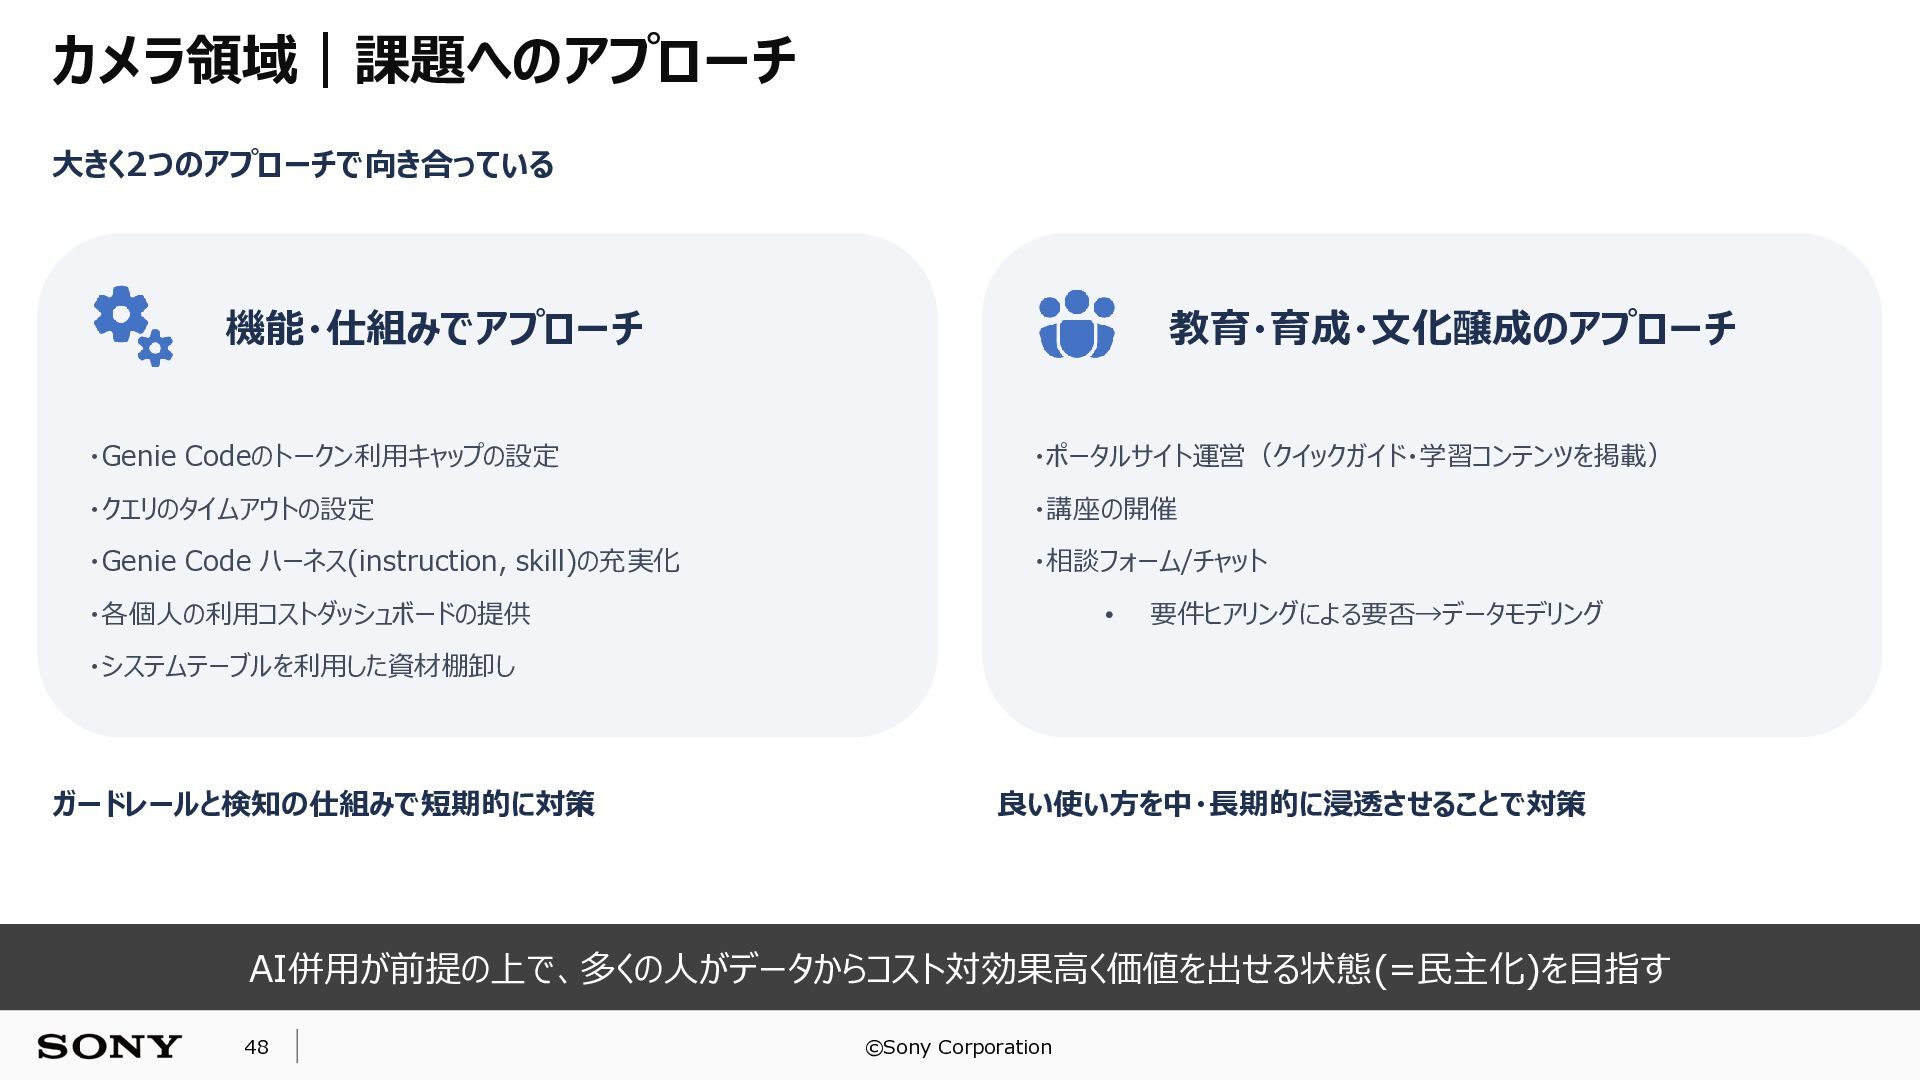
カメラ領域|課題へのアプローチ 大きく2つのアプローチで向き合っている 機能・仕組みでアプローチ 教育・育成・文化醸成のアプローチ ・Genie Codeのトークン利用キャップの設定 ・ポータルサイト運営(クイックガイド・学習コンテンツを掲載) ・クエリのタイムアウトの設定 ・講座の開催 ・Genie
Code ハーネス(instruction, skill)の充実化 ・相談フォーム/チャット ・各個人の利用コストダッシュボードの提供 • 要件ヒアリングによる要否→データモデリング ・システムテーブルを利用した資材棚卸し ガードレールと検知の仕組みで短期的に対策 良い使い方を中・長期的に浸透させることで対策 AI併用が前提の上で、多くの人がデータからコスト対効果高く価値を出せる状態(=民主化)を目指す 48 ©Sony Corporation
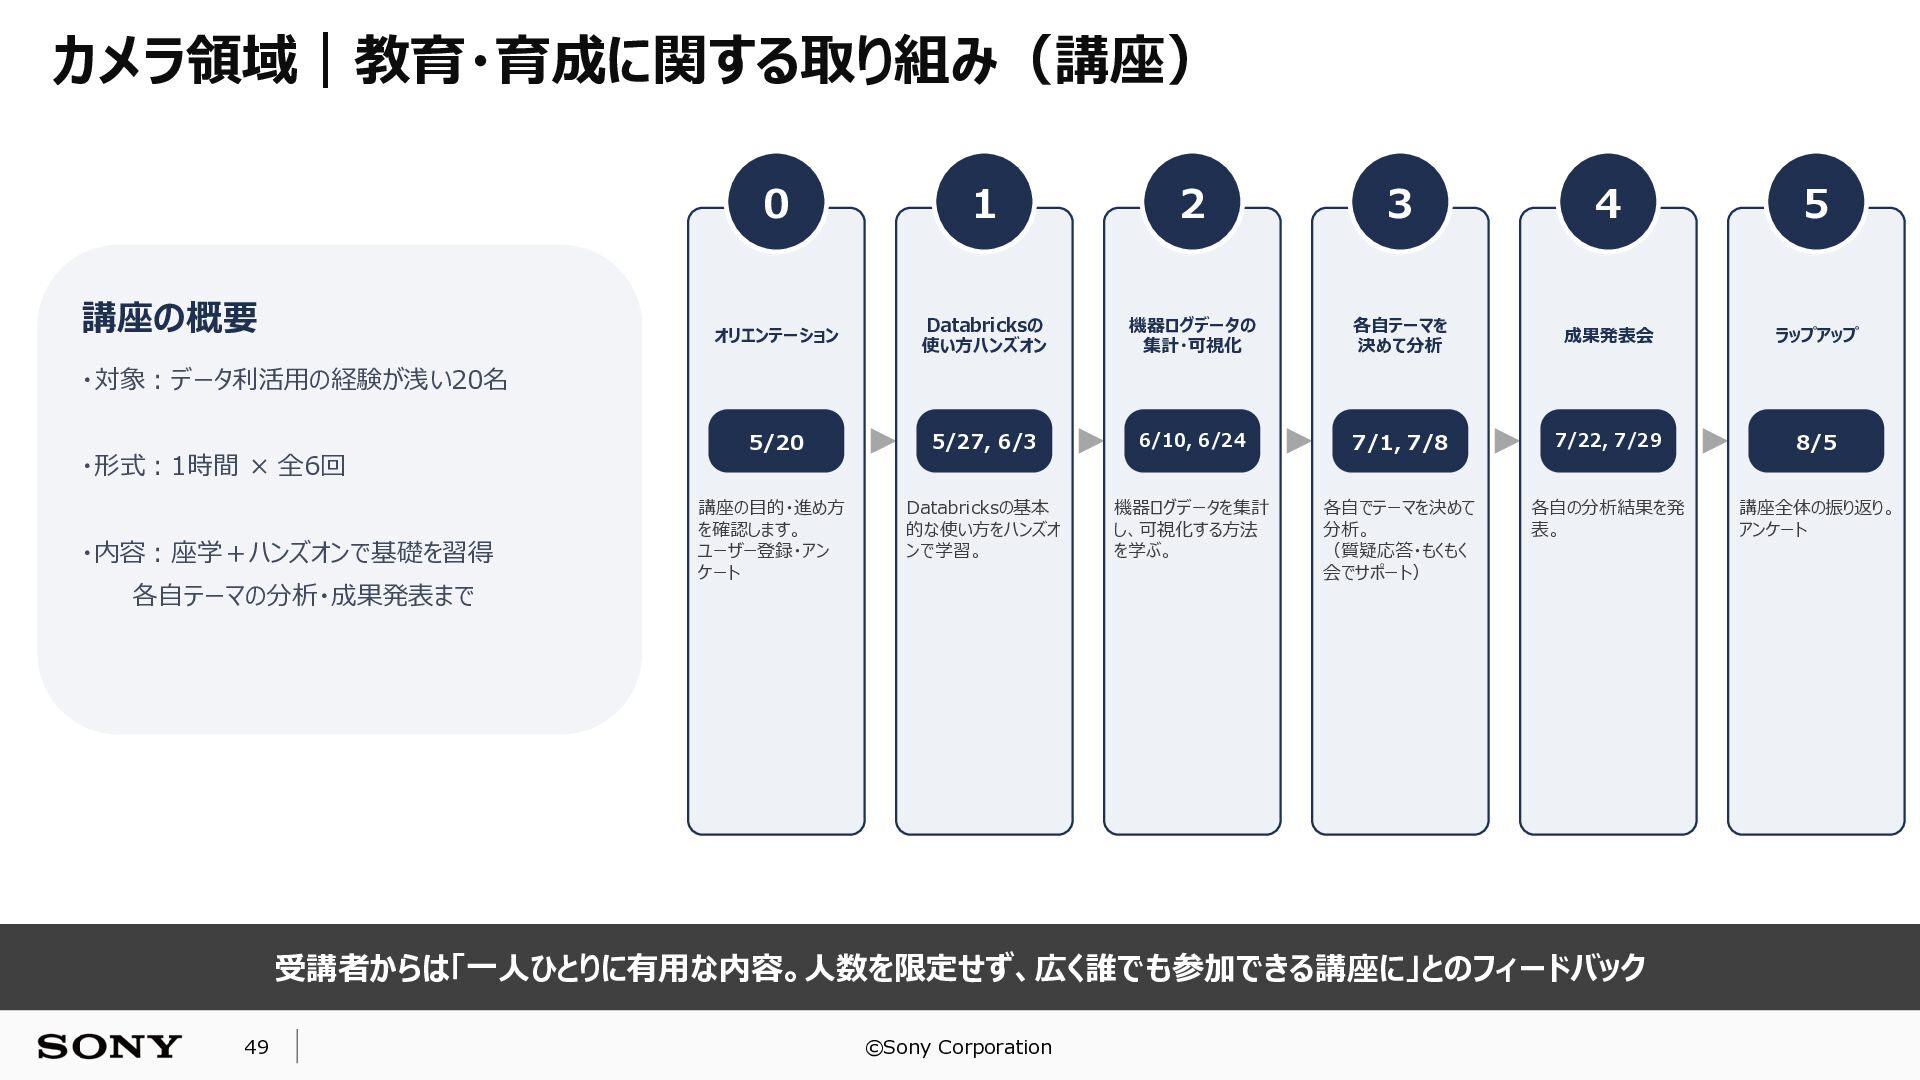
カメラ領域|教育・育成に関する取り組み(講座) 講座の概要 0 1 2 3 4 5 オリエンテーション Databricksの
使い方ハンズオン 機器ログデータの 集計・可視化 各自テーマを 決めて分析 成果発表会 ラップアップ 5/20 5/27, 6/3 6/10, 6/24 7/1, 7/8 7/22, 7/29 8/5 講座の目的・進め方 を確認します。 ユーザー登録・アン ケート Databricksの基本 的な使い方をハンズオ ンで学習。 機器ログデータを集計 し、可視化する方法 を学ぶ。 各自でテーマを決めて 分析。 (質疑応答・もくもく 会でサポート) 各自の分析結果を発 表。 講座全体の振り返り。 アンケート ・対象:データ利活用の経験が浅い20名 ・形式:1時間 × 全6回 ・内容:座学+ハンズオンで基礎を習得 各自テーマの分析・成果発表まで 受講者からは「一人ひとりに有用な内容。人数を限定せず、広く誰でも参加できる講座に」とのフィードバック 49 ©Sony Corporation
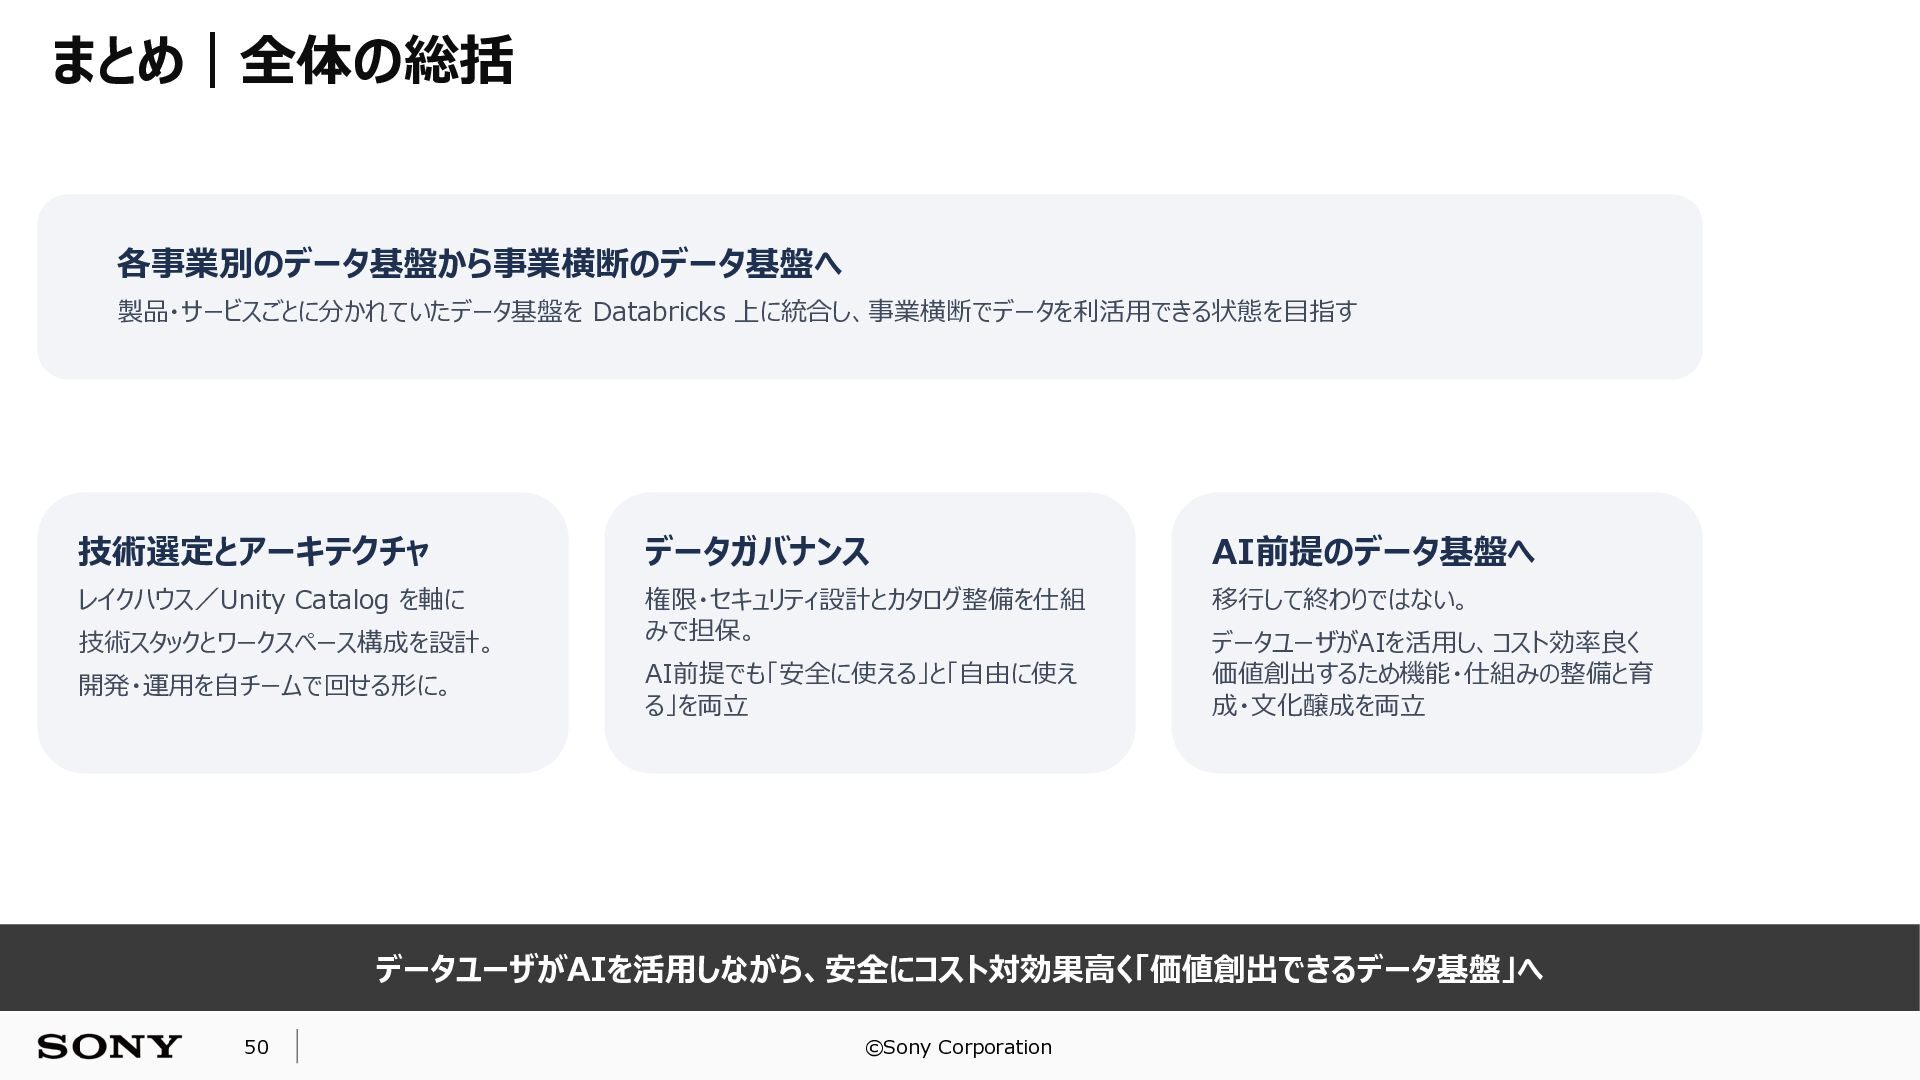
まとめ|全体の総括 各事業別のデータ基盤から事業横断のデータ基盤へ 製品・サービスごとに分かれていたデータ基盤を Databricks 上に統合し、事業横断でデータを利活用できる状態を目指す 技術選定とアーキテクチャ データガバナンス AI前提のデータ基盤へ レイクハウス/Unity Catalog
を軸に 権限・セキュリティ設計とカタログ整備を仕組 みで担保。 移行して終わりではない。 技術スタックとワークスペース構成を設計。 開発・運用を自チームで回せる形に。 AI前提でも「安全に使える」と「自由に使え る」を両立 データユーザがAIを活用し、コスト効率良く 価値創出するため機能・仕組みの整備と育 成・文化醸成を両立 データユーザがAIを活用しながら、安全にコスト対効果高く「価値創出できるデータ基盤」へ 50 ©Sony Corporation
SONYはソニーグループ株式会社の登録商標または商標です。 各ソニー製品の商品名・サービス名はソニーグループ株式会社またはグループ各社の登録商標または商標です。その他の製品および会社名は、各社の商号、登録商標または商標です。


 sony
 kentapapa
 joelq
 toshi0607
 htkym
 zozotech
 kazukun0716
 keitah
 tomtanaka
 shuheioka123
 oracle4engineer
 vkbaba
 har1101
 ammeep
 lauravandoore
 shlominoach
 wayneb77
 kimpetersen
 nmsamuel
 zakiyama
 raygrieselhuber
 keathley
 rabernat
 inesmontani
 cassininazir