Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
大規模のユーザー行動データの高速分析に特化した 分散OLAPデータベース「mila」
Search
Sota Sato
March 03, 2026
Technology
92
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
大規模のユーザー行動データの高速分析に特化した 分散OLAPデータベース「mila」
DEIM2026 発表のスライドです
https://pub.confit.atlas.jp/ja/event/deim2026
Sota Sato
March 03, 2026
Other Decks in Technology
See All in Technology
実践! SRE × AI - ABEMA における AIOps -
tetsuya28
8
3.1k
ソフトウェア ファクトリー - 再現性のあるソフトウェアの工場づくり / Software factory
iktakahiro
6
5.1k
Rust で関数型ドメインモデリング
takonda
0
170
フィンテック養成勉強会#68
finengine
0
150
脆弱性診断って、何をしているの? 〜弱点を見つけて、会社の改善につなげるまで〜
keeg
0
930
パスキーの自動テストはどこまでいけるのか
teamlab
PRO
0
280
Conditional PED-ANOVA: Hyperparameter Importance in Hierarchical & Dynamic Search Spaces
pfn
PRO
0
140
トークン化預金DCJPYの取り組みと活用ユースケース
finengine
0
160
JAWSUG TOHOKU 青森支部 「LoGoチャット」のAWS移行で 乗り越えたこと
taketakekaho
0
340
Active Record Connection Adaptersにおける長年の課題に再び取り組む
yahonda
0
200
AI駆動で「他アプリの音を加工できる」アプリを作った
satomasahiro2005
0
170
How to Design Configuration for Rails Applications
willnet
1
830
Featured
See All Featured
Discover your Explorer Soul
emna__ayadi
2
1.3k
Into the Great Unknown - MozCon
thekraken
41
2.8k
Build your cross-platform service in a week with App Engine
jlugia
234
19k
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
2
2k
Embracing the Ebb and Flow
colly
88
5.2k
30 Presentation Tips
portentint
PRO
1
430
The Invisible Side of Design
smashingmag
301
52k
The B2B funnel & how to create a winning content strategy
katarinadahlin
PRO
1
570
CoffeeScript is Beautiful & I Never Want to Write Plain JavaScript Again
sstephenson
162
16k
A Soul's Torment
seathinner
8
3.8k
Gemini Prompt Engineering: Practical Techniques for Tangible AI Outcomes
mfonobong
2
590
The AI Search Optimization Roadmap by Aleyda Solis
aleyda
2
6.3k
Transcript
| © PLAID Inc. | © PLAID Inc. 1 佐藤 創太 ⼤規模のユーザー⾏動データの⾼速分析に特化した
分散OLAPデータベース「mila」
| © PLAID, Inc. ⽬次 2 2 • 「mila」の概要と開発の背景 • 汎⽤DWH(BigQuery)
で⽣じたオーバーヘッド • ユーザー⾏動分析におけるクエリの最適化 • ベンチマークでの他DBとの⽐較 • まとめと今後の展望
| © PLAID Inc. | © PLAID Inc. 「mila」概要と開発の背景 3
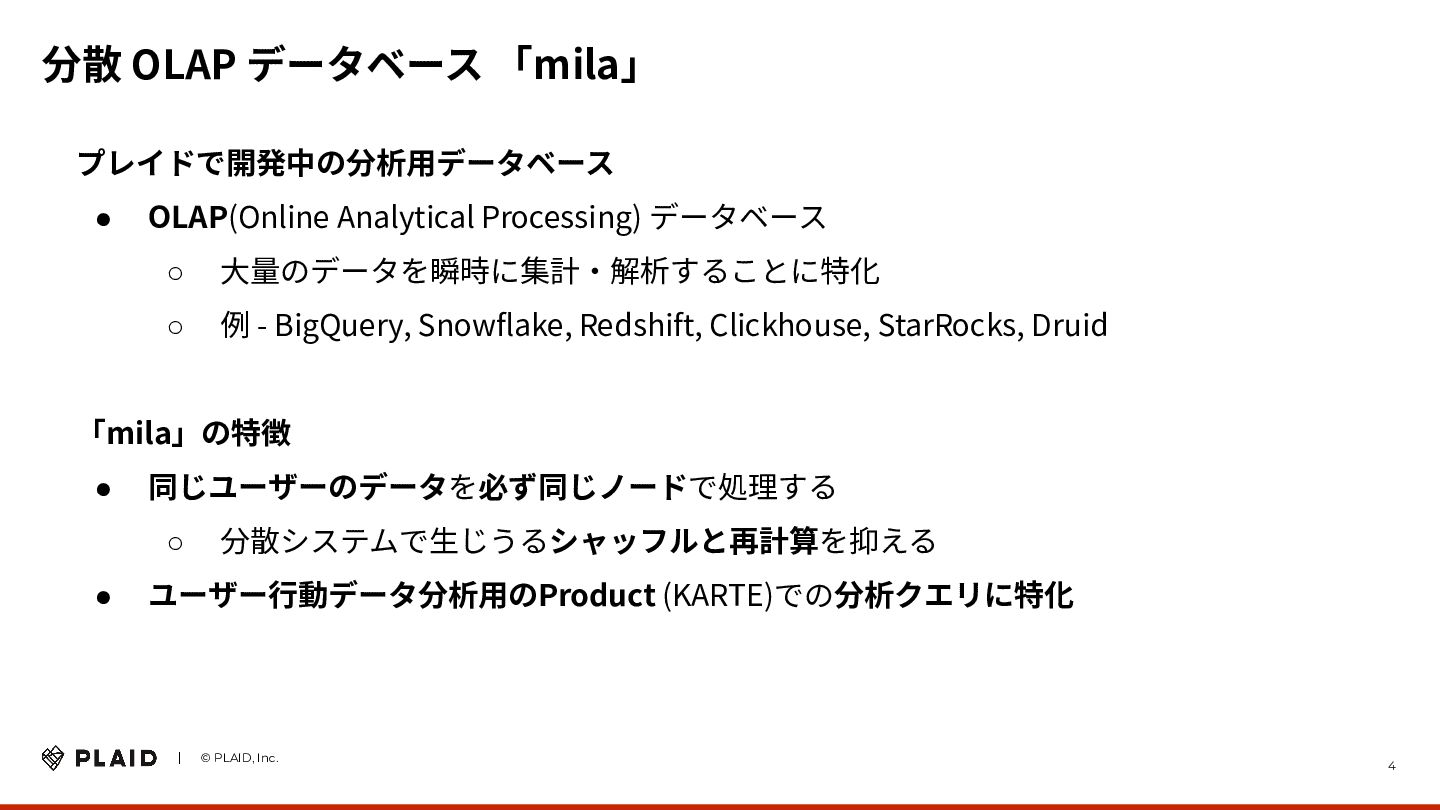
| © PLAID, Inc. 分散 OLAP データベース 「mila」 4 4 プレイドで開発中の分析⽤データベース
• OLAP(Online Analytical Processing) データベース ◦ ⼤量のデータを瞬時に集計‧解析することに特化 ◦ 例 - BigQuery, Snowflake, Redshift, Clickhouse, StarRocks, Druid 「mila」の特徴 • 同じユーザーのデータを必ず同じノードで処理する ◦ 分散システムで⽣じうるシャッフルと再計算を抑える • ユーザー⾏動データ分析⽤のProduct (KARTE)での分析クエリに特化
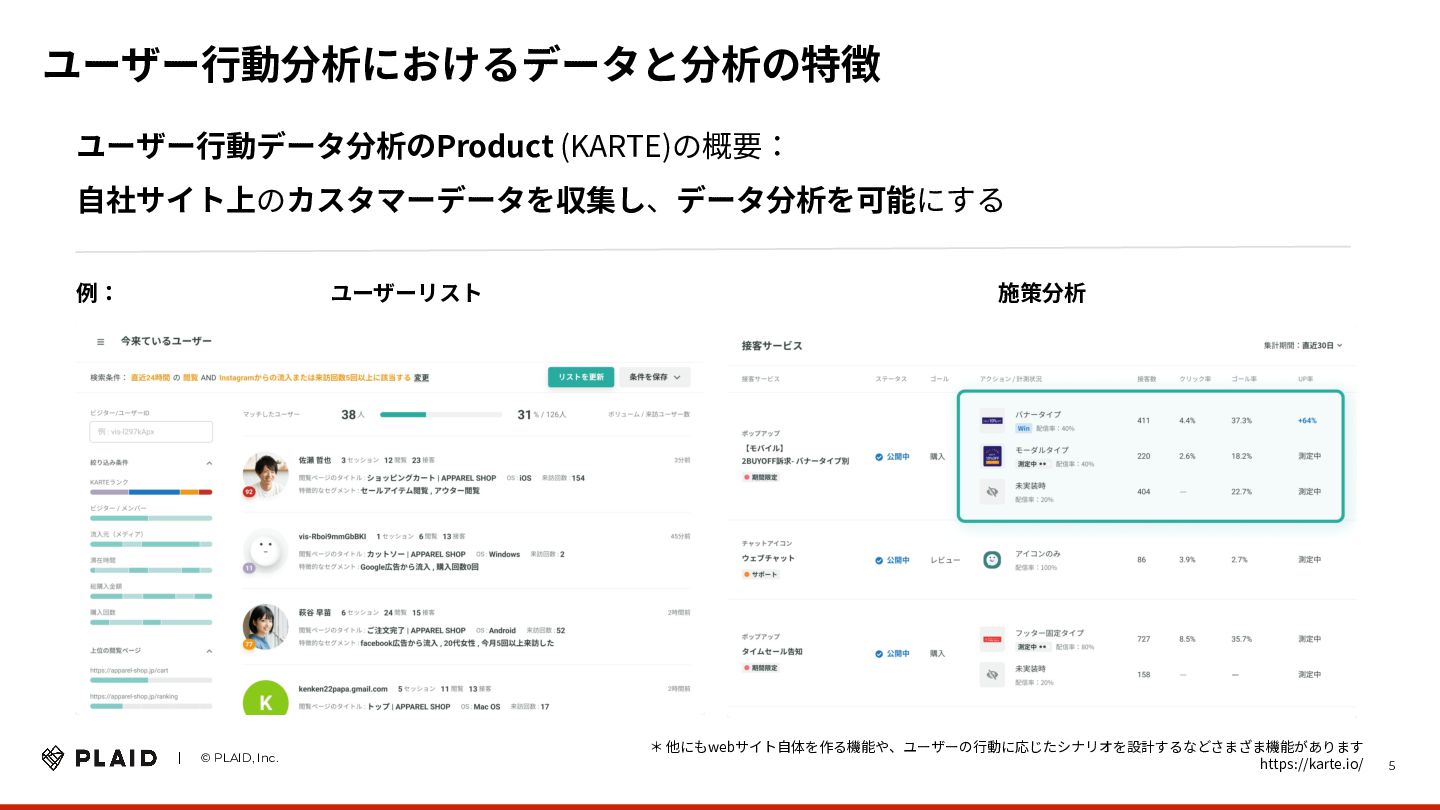
| © PLAID, Inc. ユーザー⾏動分析におけるデータと分析の特徴 5 5 ユーザー⾏動データ分析のProduct (KARTE)の概要: ⾃社サイト上のカスタマーデータを収集し、データ分析を可能にする ユーザーリスト
施策分析 * 他にもwebサイト⾃体を作る機能や、ユーザーの⾏動に応じたシナリオを設計するなどさまざま機能があります https://karte.io/ 例:
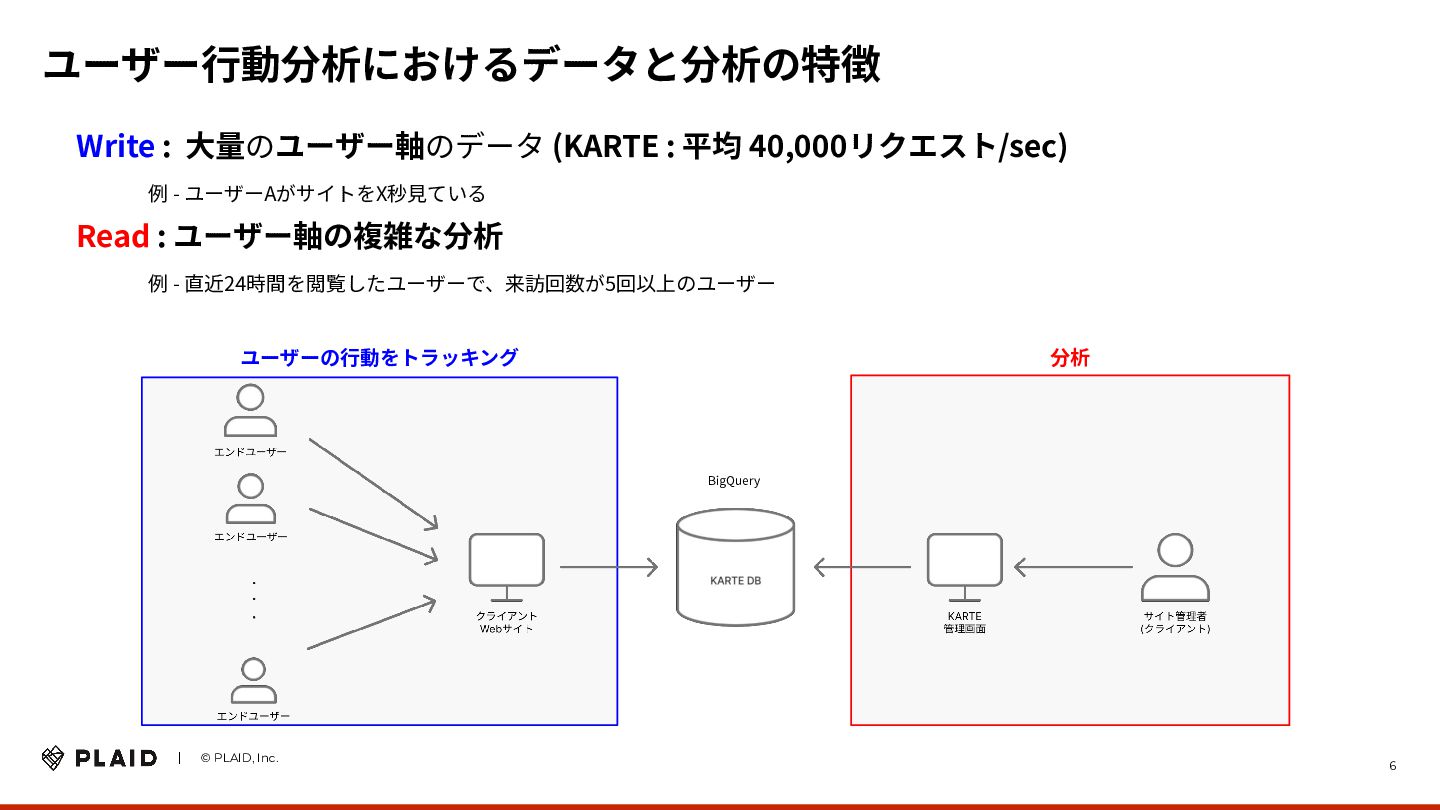
| © PLAID, Inc. ユーザー⾏動分析におけるデータと分析の特徴 6 6 Write : ⼤量のユーザー軸のデータ (KARTE
: 平均 40,000リクエスト/sec) 例 - ユーザーAがサイトをX秒⾒ている Read : ユーザー軸の複雑な分析 例 - 直近24時間を閲覧したユーザーで、来訪回数が5回以上のユーザー ユーザーの⾏動をトラッキング 分析 BigQuery
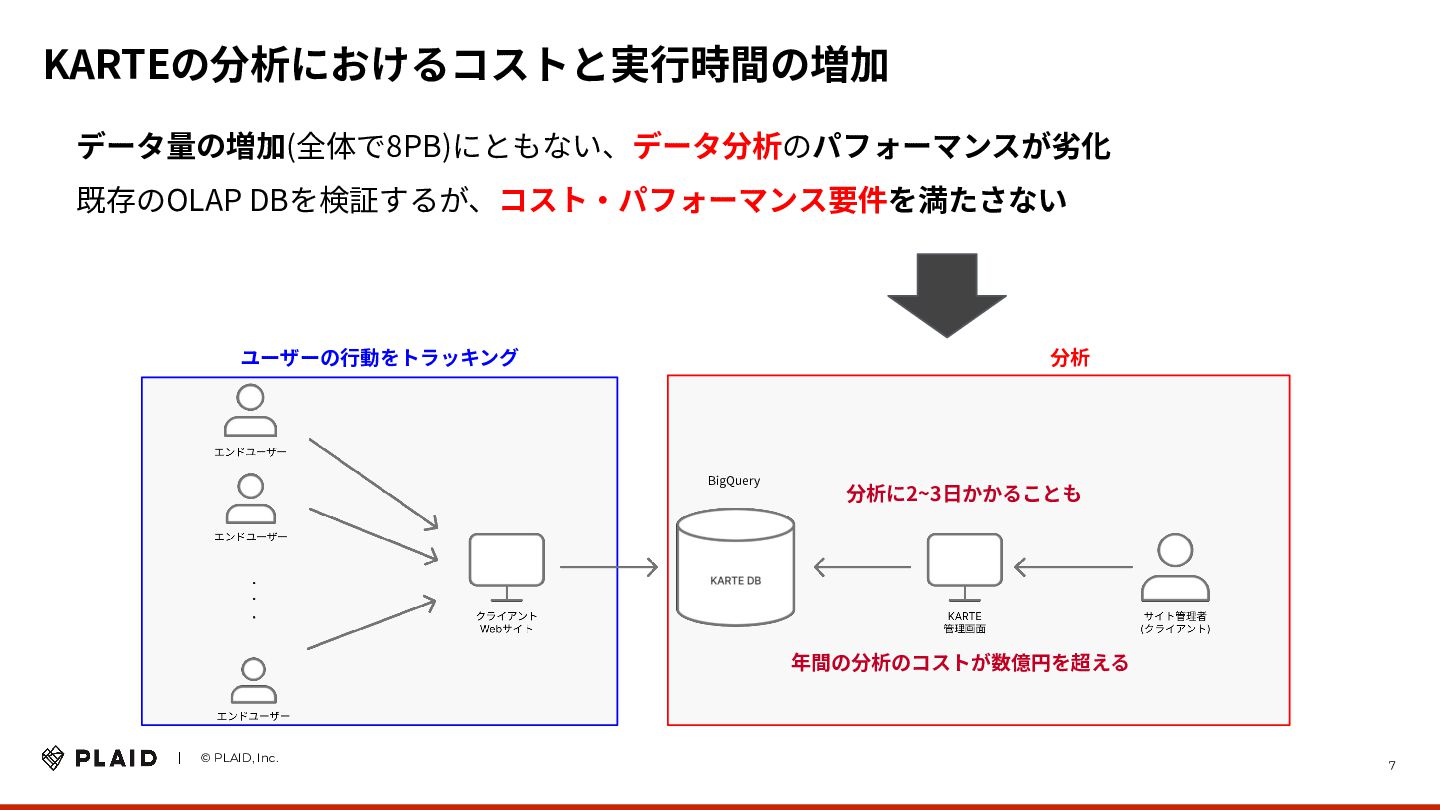
| © PLAID, Inc. KARTEの分析におけるコストと実⾏時間の増加 7 7 データ量の増加(全体で8PB)にともない、データ分析のパフォーマンスが劣化 既存のOLAP DBを検証するが、コスト‧パフォーマンス要件を満たさない ユーザーの⾏動をトラッキング
分析 BigQuery 分析に2~3⽇かかることも 年間の分析のコストが数億円を超える
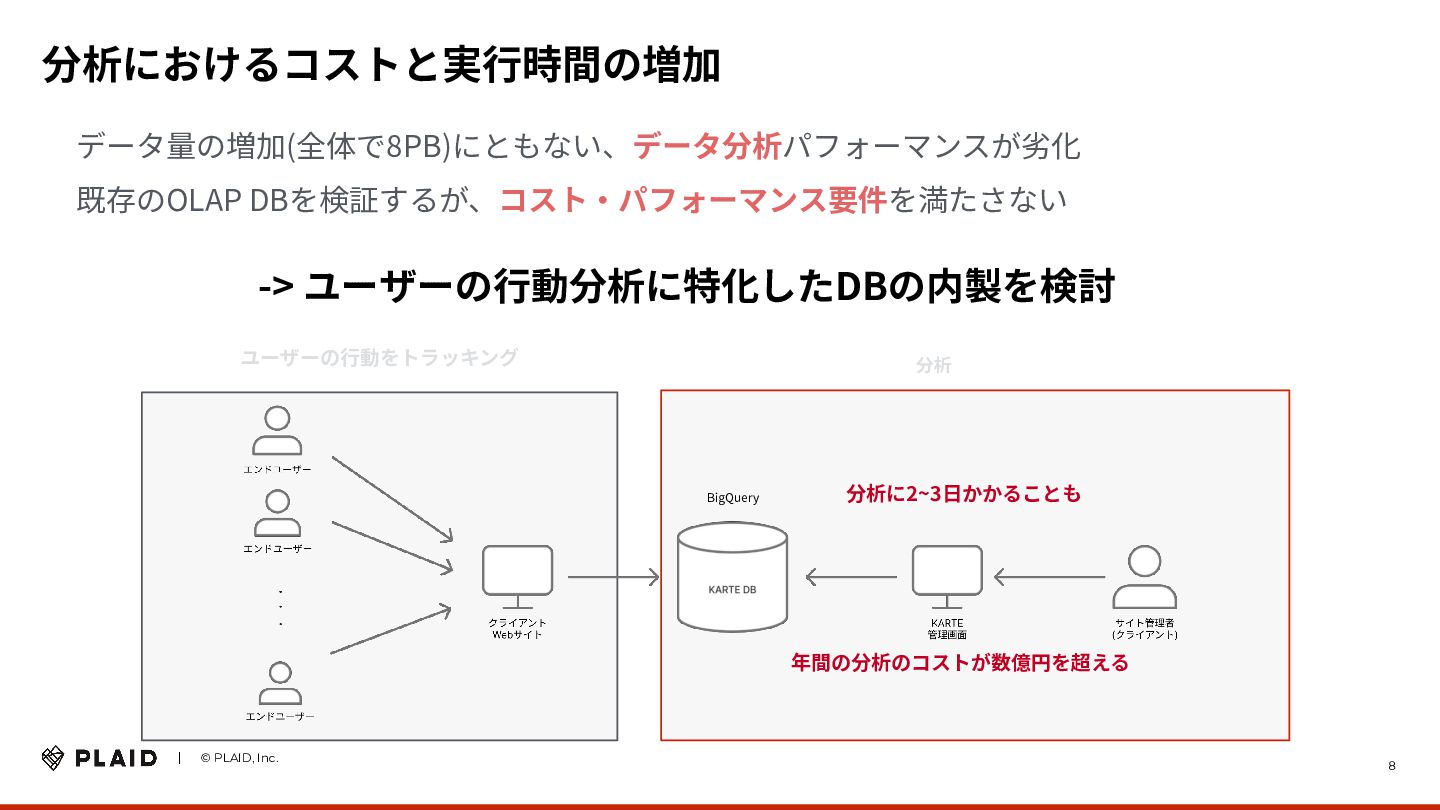
| © PLAID, Inc. 分析におけるコストと実⾏時間の増加 8 8 データ量の増加(全体で8PB)にともない、データ分析パフォーマンスが劣化 既存のOLAP DBを検証するが、コスト‧パフォーマンス要件を満たさない 分析
-> ユーザーの⾏動分析に特化したDBの内製を検討 BigQuery ユーザーの⾏動をトラッキング 分析に2~3⽇かかることも 年間の分析のコストが数億円を超える
| © PLAID Inc. | © PLAID Inc. 汎用DWH BigQuery) で生じたオーバーヘッド 9
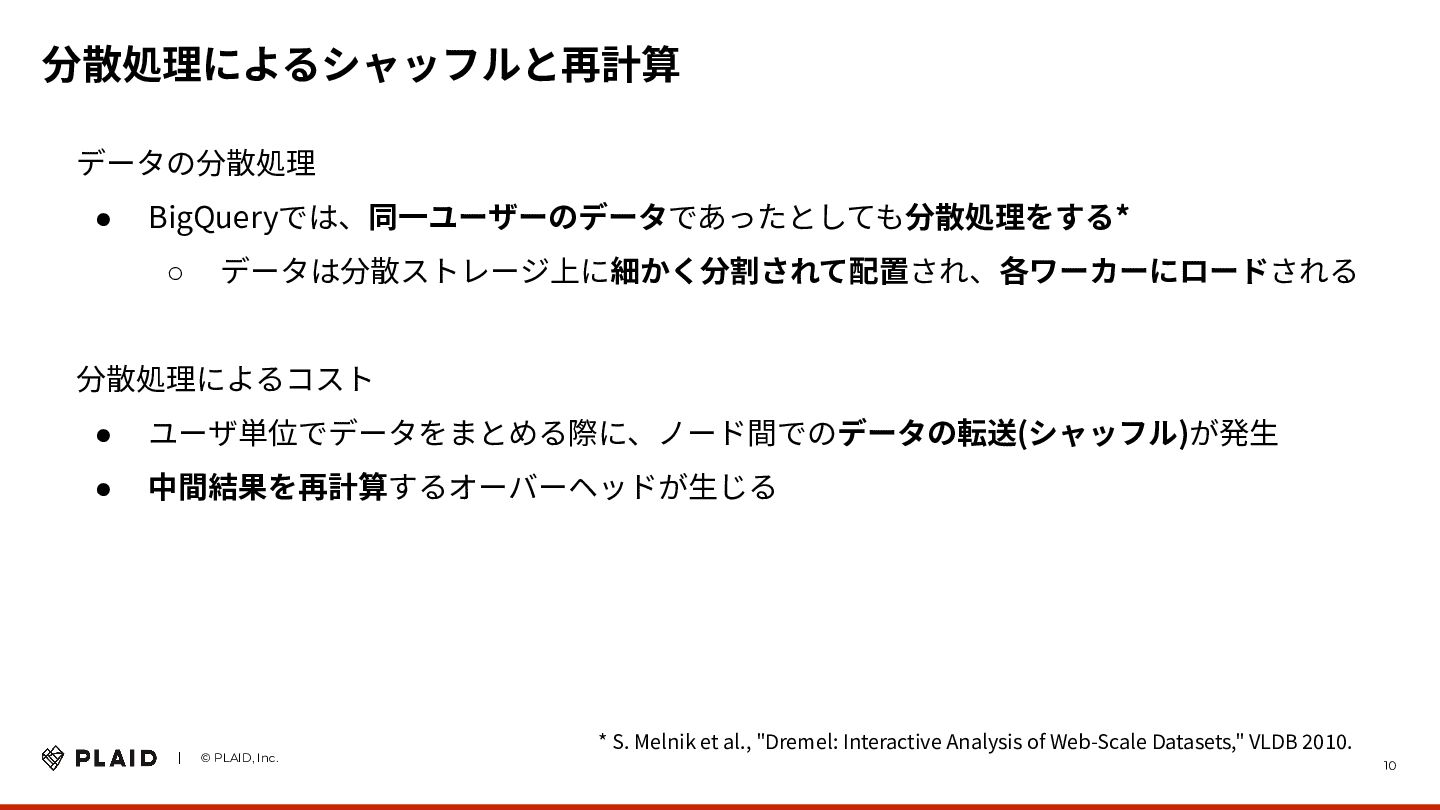
| © PLAID, Inc. データの分散処理 • BigQueryでは、同⼀ユーザーのデータであったとしても分散処理をする* ◦ データは分散ストレージ上に細かく分割されて配置され、各ワーカーにロードされる 分散処理によるコスト •
ユーザ単位でデータをまとめる際に、ノード間でのデータの転送(シャッフル)が発⽣ • 中間結果を再計算するオーバーヘッドが⽣じる 分散処理によるシャッフルと再計算 10 10 * S. Melnik et al., "Dremel: Interactive Analysis of Web-Scale Datasets," VLDB 2010.
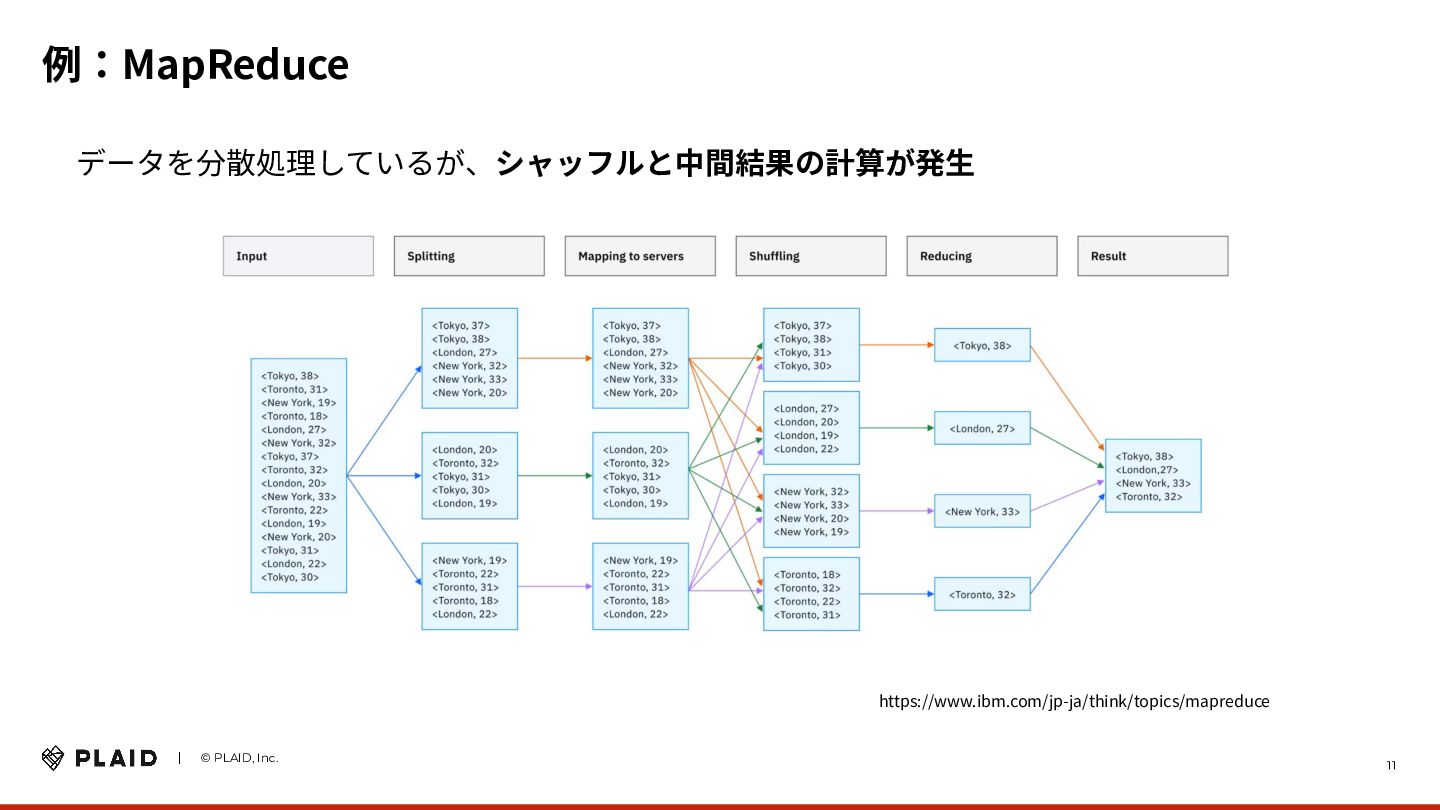
| © PLAID, Inc. 例:MapReduce 11 11 https://www.ibm.com/jp-ja/think/topics/mapreduce データを分散処理しているが、シャッフルと中間結果の計算が発⽣
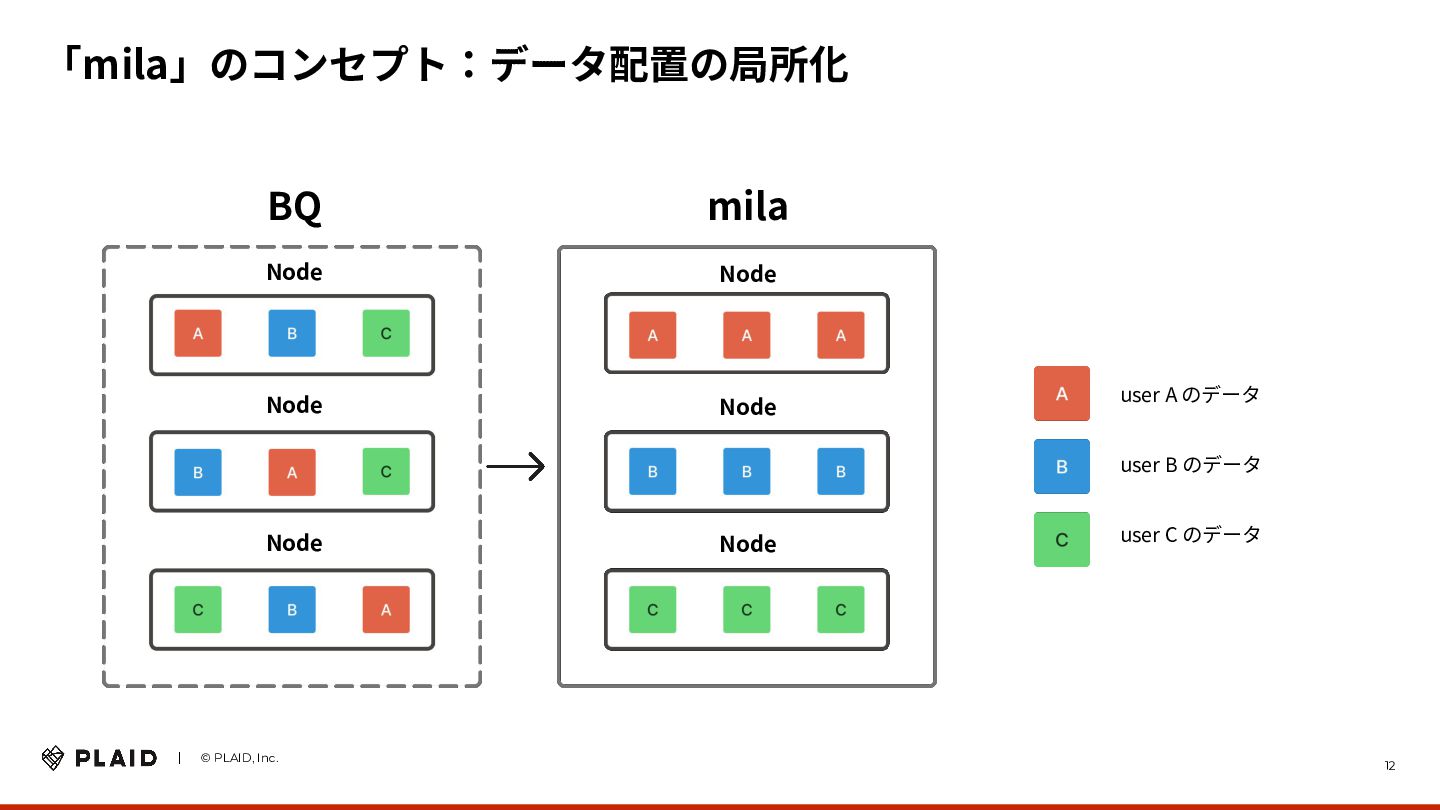
| © PLAID, Inc. 「mila」のコンセプト:データ配置の局所化 12 12 Node Node Node Node
Node Node mila BQ user A のデータ user B のデータ user C のデータ
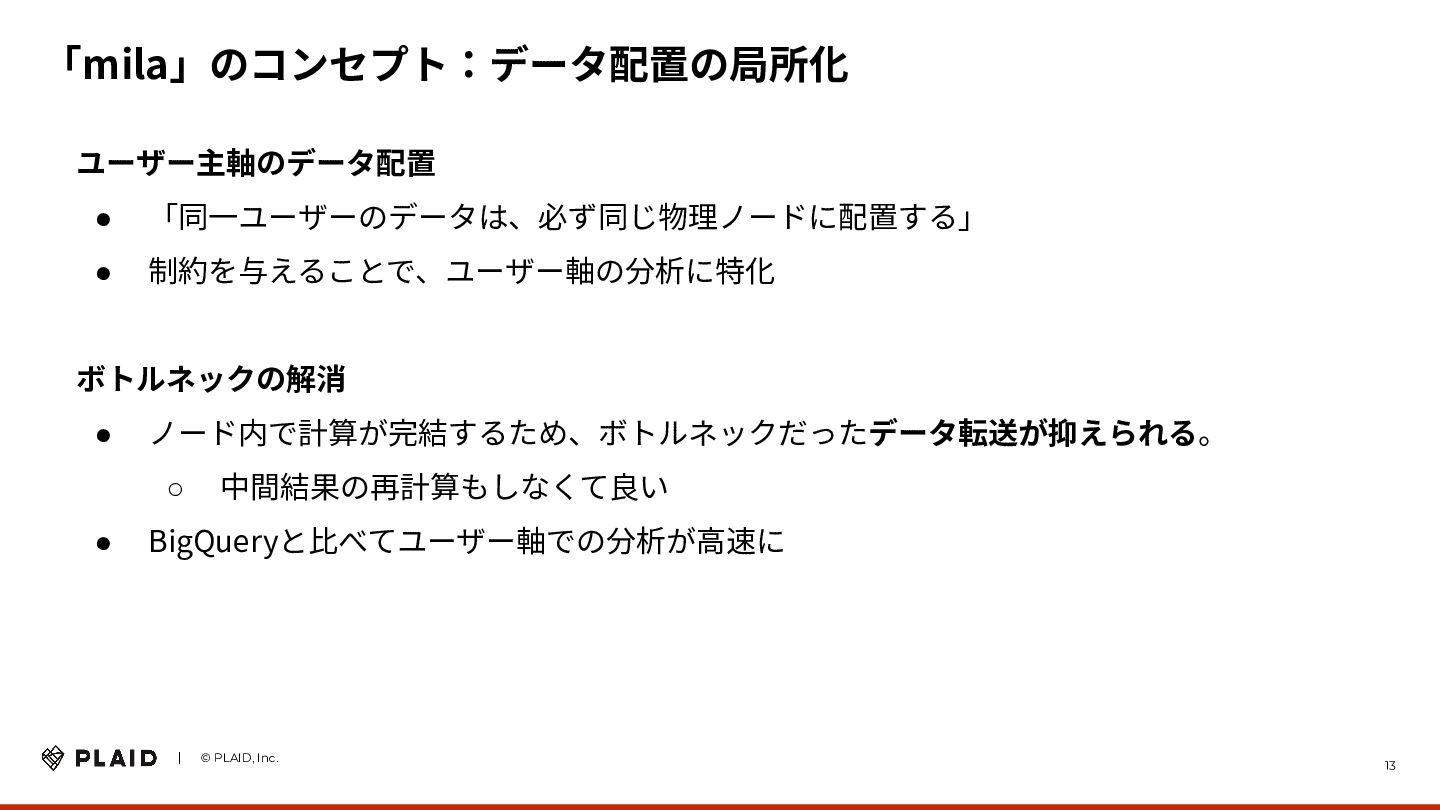
| © PLAID, Inc. 「mila」のコンセプト:データ配置の局所化 13 13 ユーザー主軸のデータ配置 • 「同⼀ユーザーのデータは、必ず同じ物理ノードに配置する」 •
制約を与えることで、ユーザー軸の分析に特化 ボトルネックの解消 • ノード内で計算が完結するため、ボトルネックだったデータ転送が抑えられる。 ◦ 中間結果の再計算もしなくて良い • BigQueryと⽐べてユーザー軸での分析が⾼速に
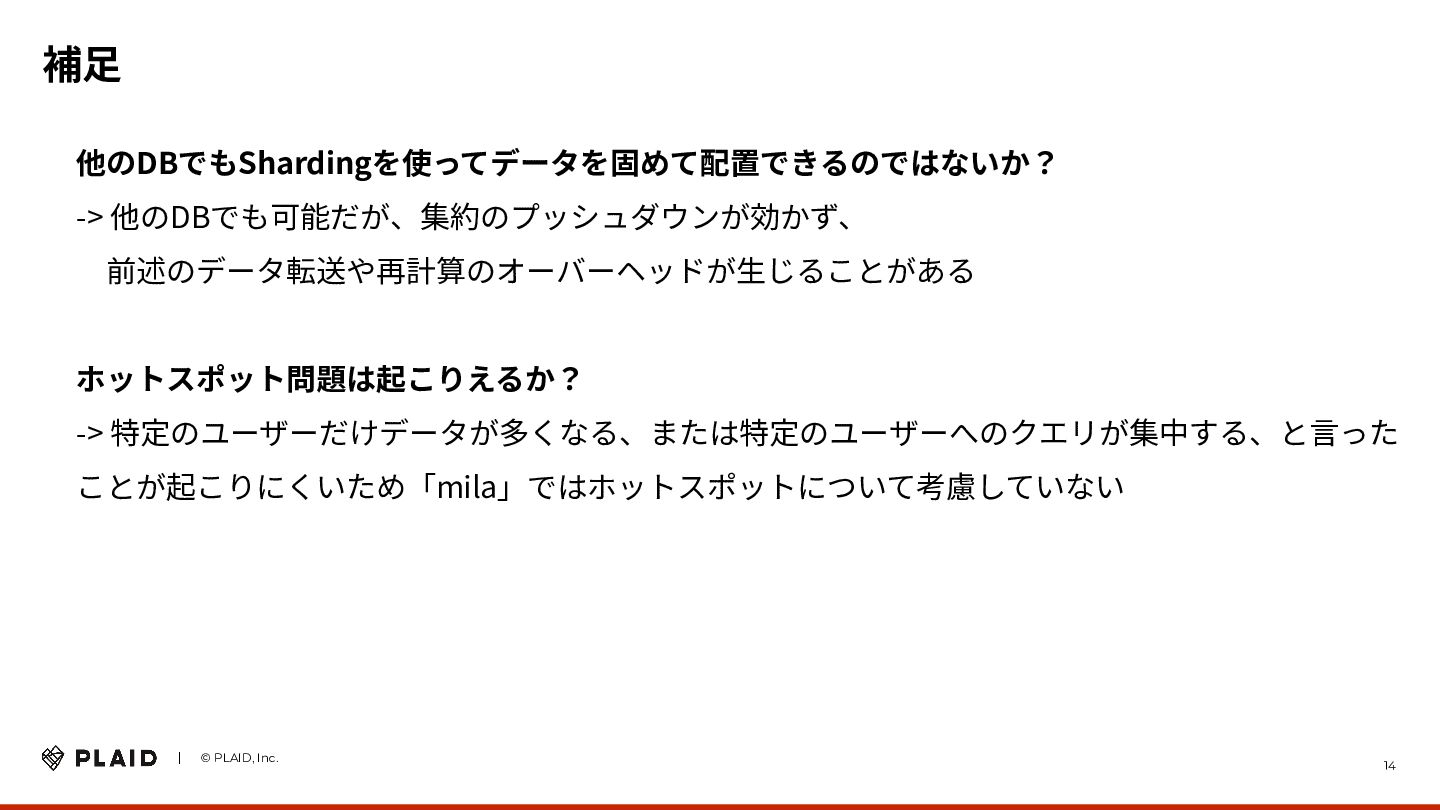
| © PLAID, Inc. 補⾜ 14 14 他のDBでもShardingを使ってデータを固めて配置できるのではないか? -> 他のDBでも可能だが、集約のプッシュダウンが効かず、 前述のデータ転送や再計算のオーバーヘッドが⽣じることがある
ホットスポット問題は起こりえるか? -> 特定のユーザーだけデータが多くなる、または特定のユーザーへのクエリが集中する、と⾔った ことが起こりにくいため「mila」ではホットスポットについて考慮していない
| © PLAID Inc. | © PLAID Inc. ユーザー行動分析における クエリの最適化 15
| © PLAID, Inc. • FUNNEL関数 • COUNT(Distinct) • Window関数 •
etc 対象のクエリ 16 16
| © PLAID, Inc. • FUNNEL関数 <- 今回お話しするクエリ • COUNT(Distinct) <-
今回お話しするクエリ • Window関数 • etc 対象のクエリ 17 17
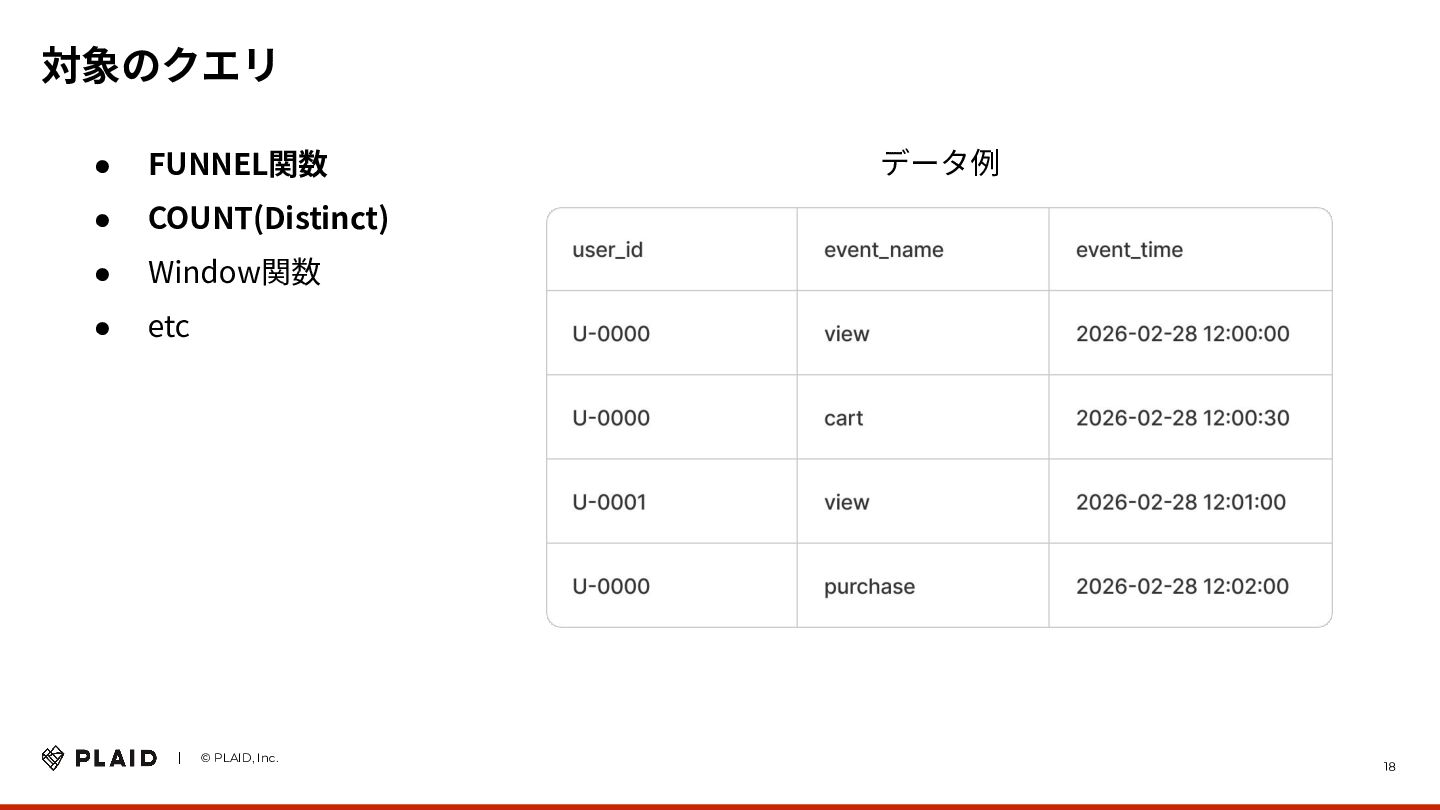
| © PLAID, Inc. • FUNNEL関数 • COUNT(Distinct) • Window関数 •
etc 対象のクエリ 18 18 データ例
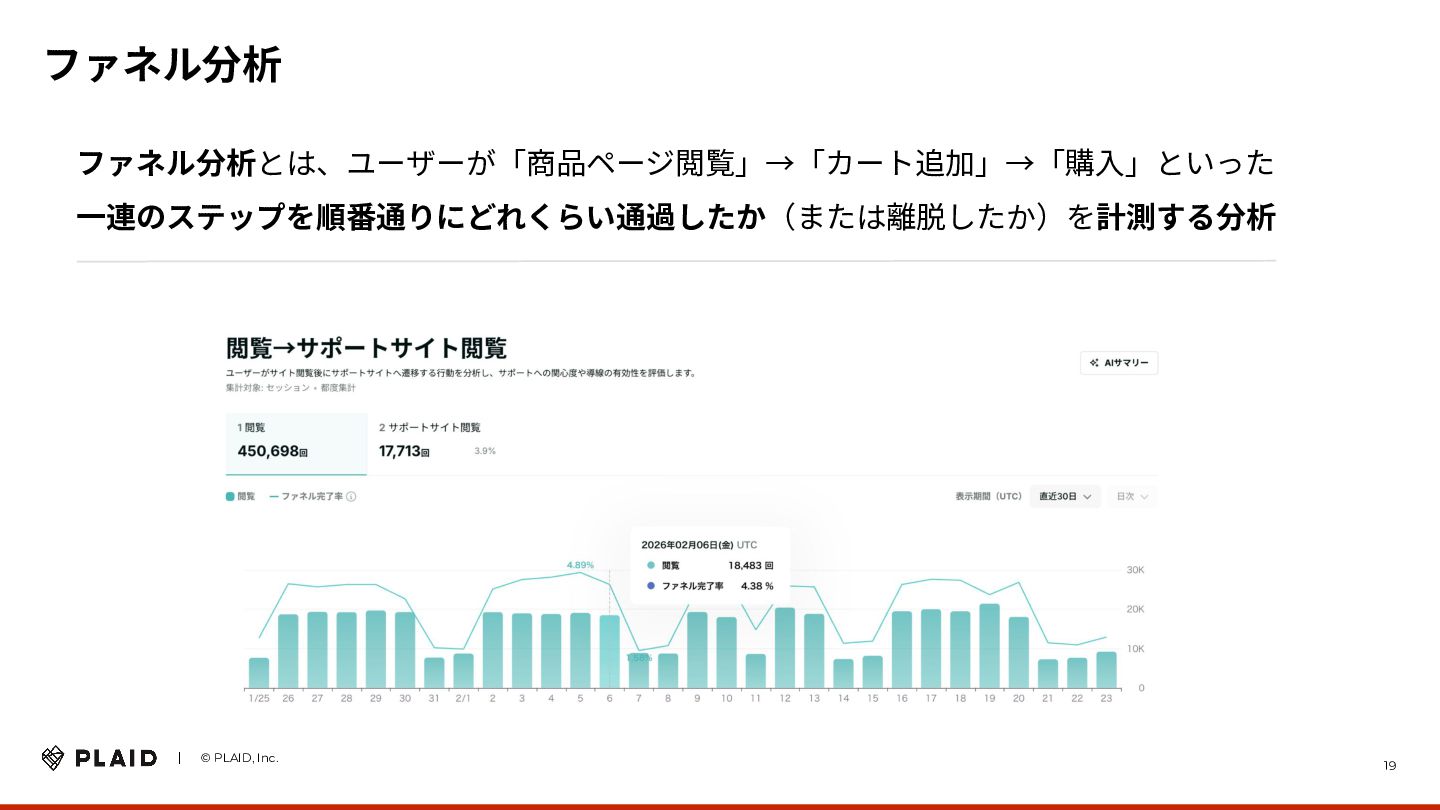
| © PLAID, Inc. ファネル分析とは、ユーザーが「商品ページ閲覧」→「カート追加」→「購⼊」といった ⼀連のステップを順番通りにどれくらい通過したか(または離脱したか)を計測する分析 ファネル分析 19 19
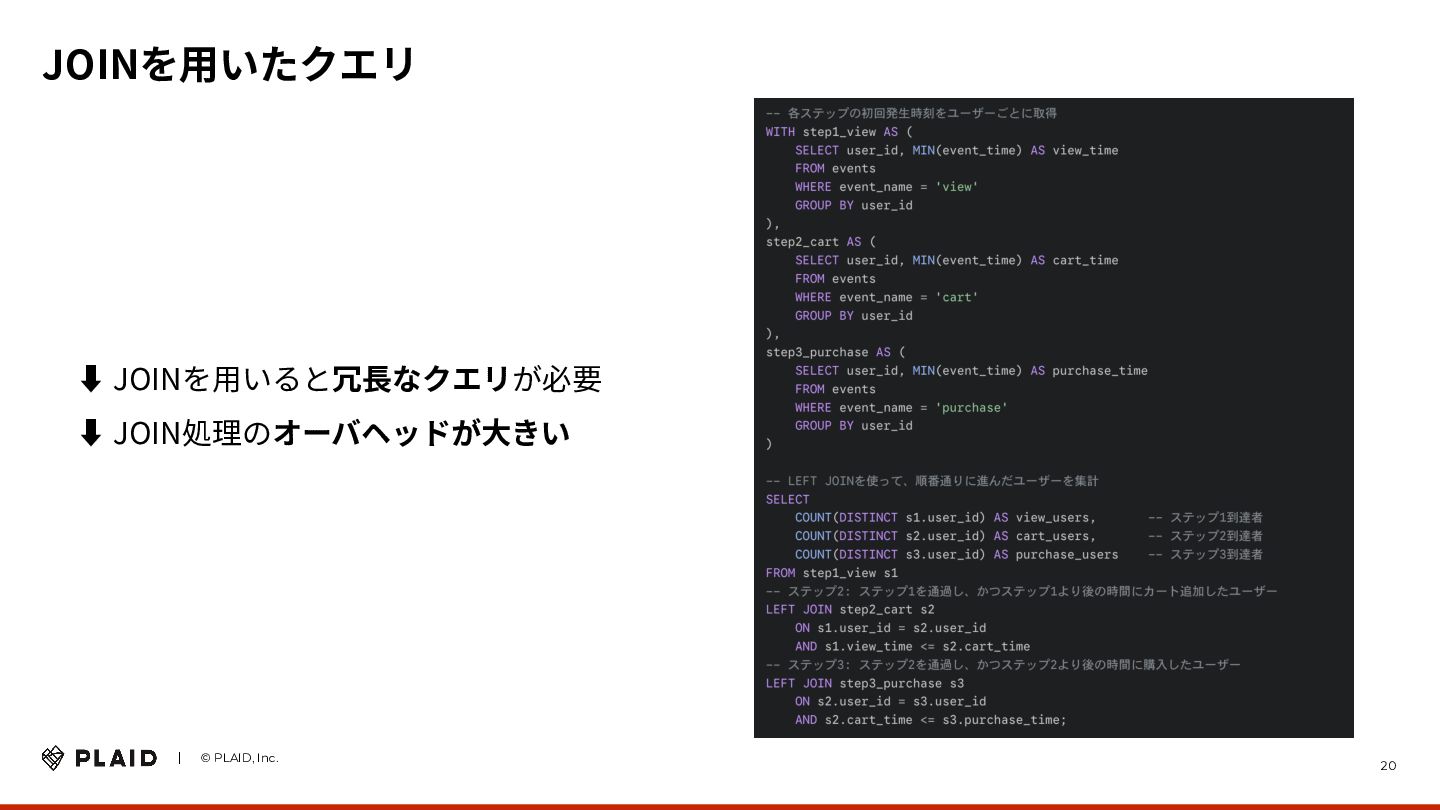
| © PLAID, Inc. ⬇ JOINを⽤いると冗⻑なクエリが必要 ⬇ JOIN処理のオーバヘッドが⼤きい JOINを⽤いたクエリ 20 20
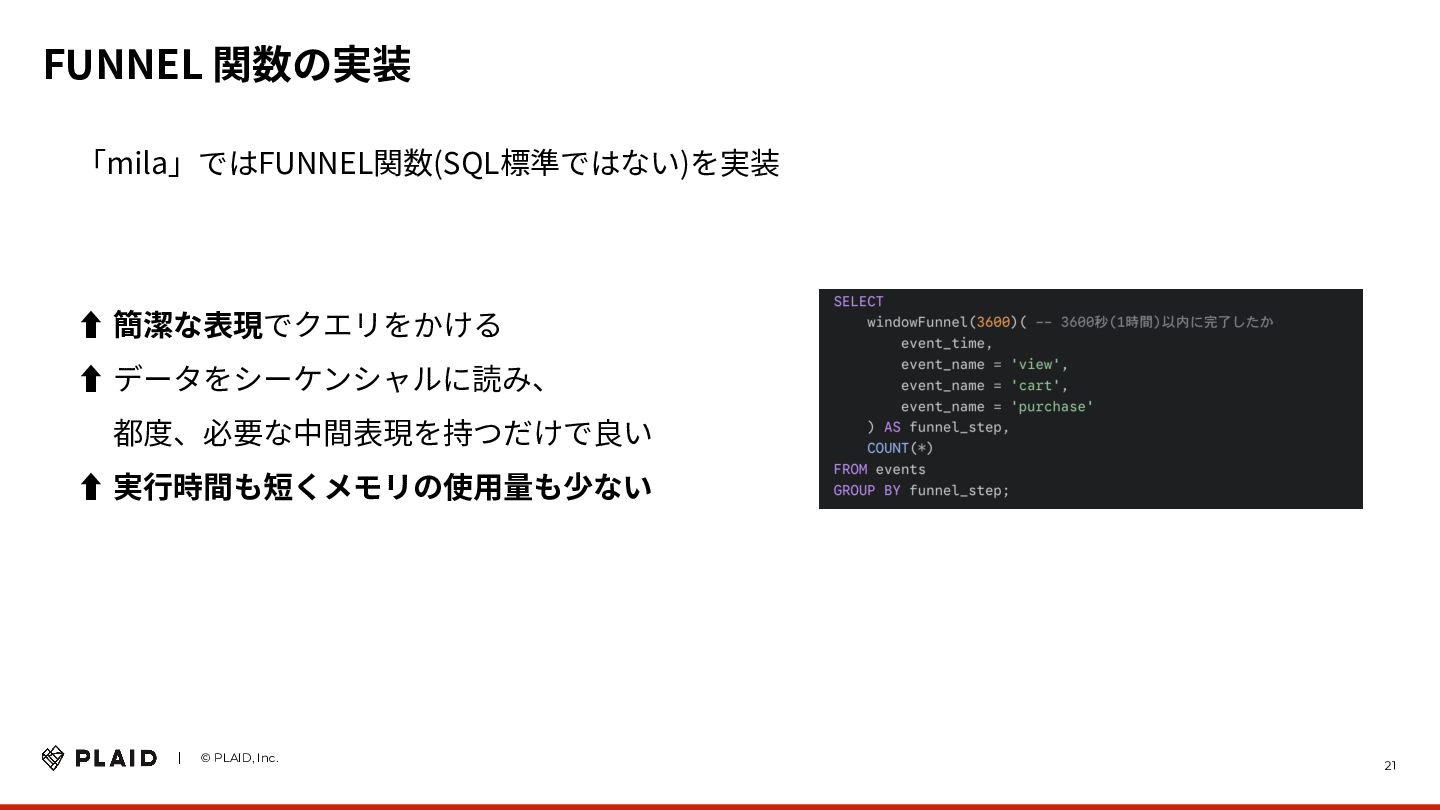
| © PLAID, Inc. 「mila」ではFUNNEL関数(SQL標準ではない)を実装 ⬆ 簡潔な表現でクエリをかける ⬆ データをシーケンシャルに読み、 都度、必要な中間表現を持つだけで良い ⬆
実⾏時間も短くメモリの使⽤量も少ない FUNNEL 関数の実装 21 21
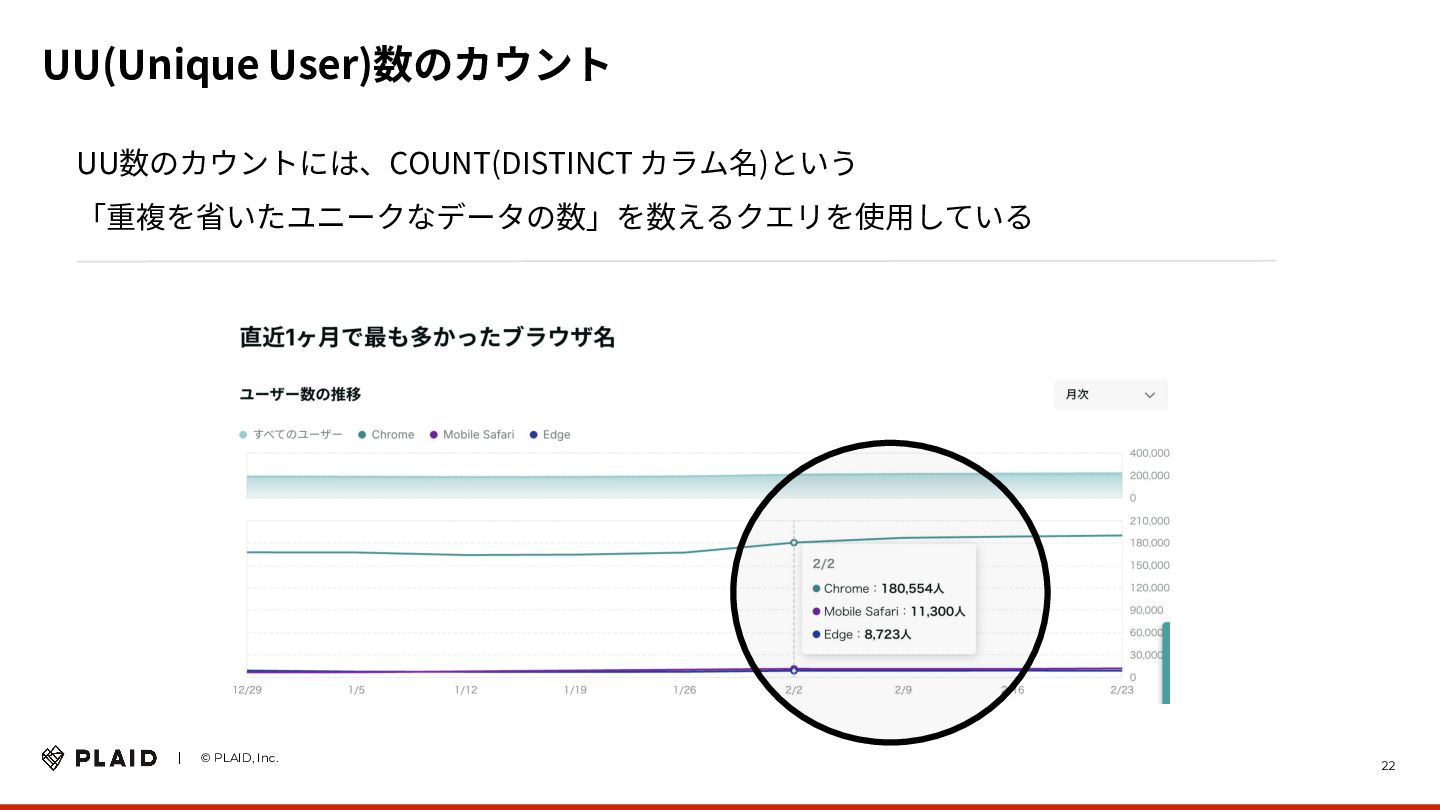
| © PLAID, Inc. UU数のカウントには、COUNT(DISTINCT カラム名)という 「重複を省いたユニークなデータの数」を数えるクエリを使⽤している UU(Unique User)数のカウント 22 22
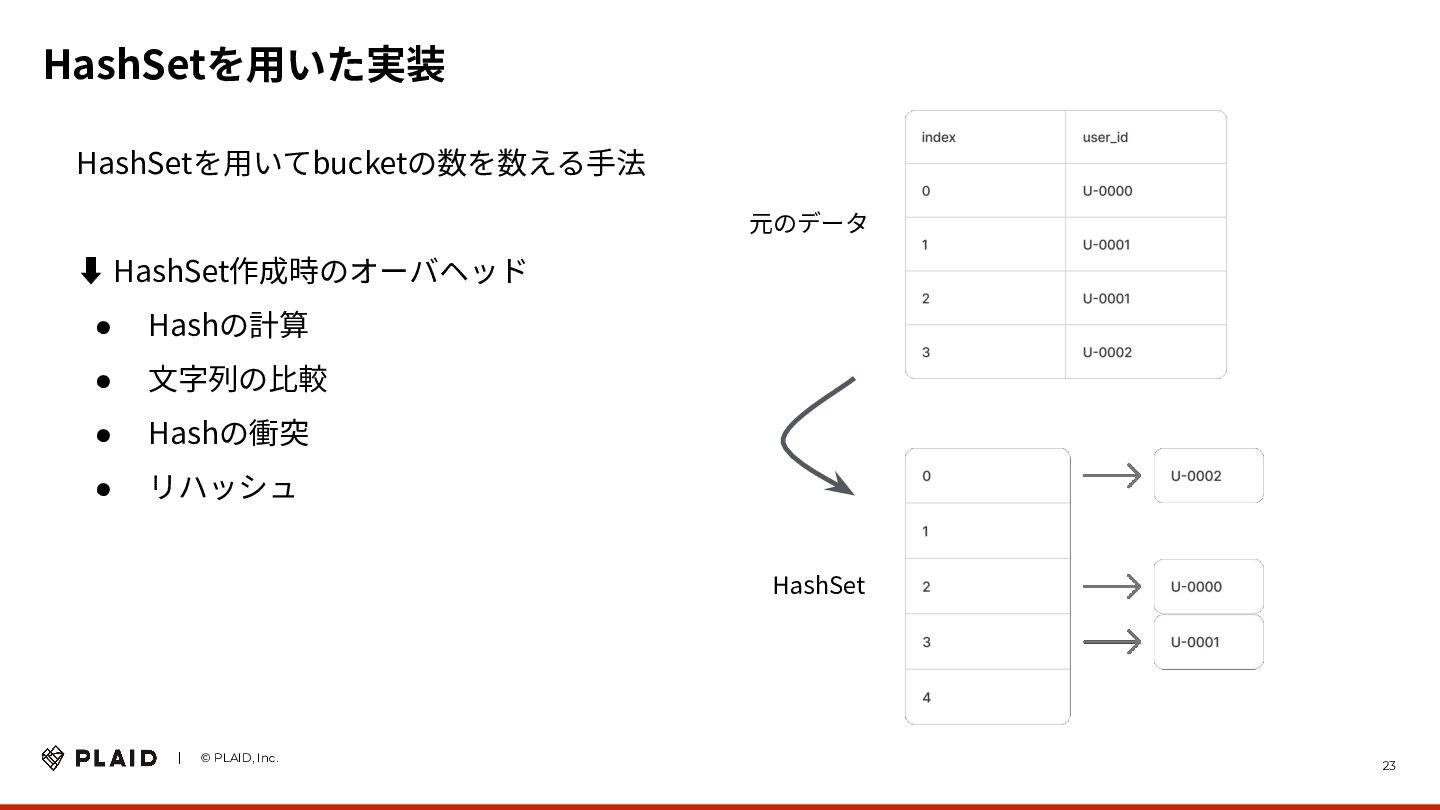
| © PLAID, Inc. HashSetを⽤いてbucketの数を数える⼿法 ⬇ HashSet作成時のオーバヘッド • Hashの計算 • ⽂字列の⽐較
• Hashの衝突 • リハッシュ HashSetを⽤いた実装 23 23 元のデータ HashSet
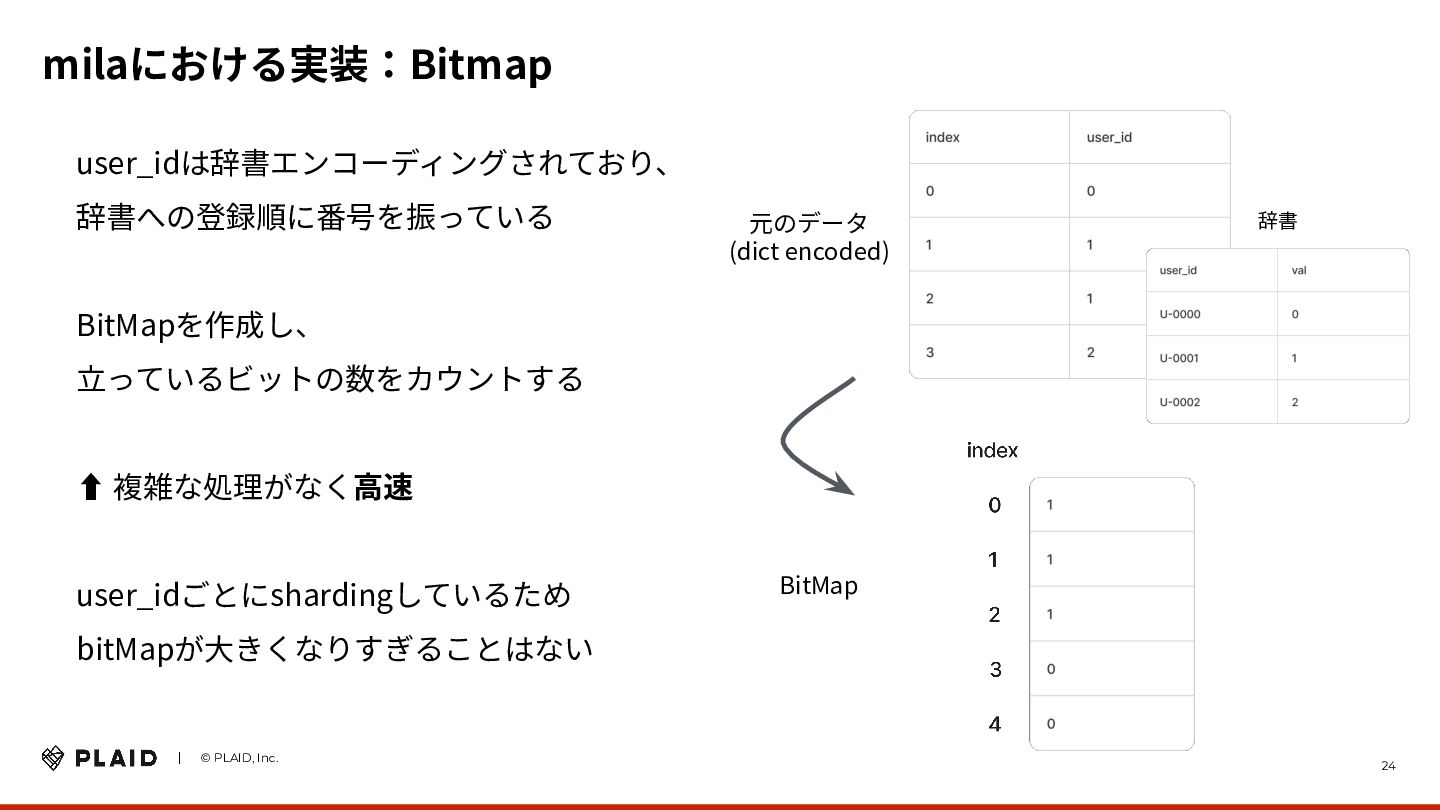
| © PLAID, Inc. user_idは辞書エンコーディングされており、 辞書への登録順に番号を振っている BitMapを作成し、 ⽴っているビットの数をカウントする ⬆ 複雑な処理がなく⾼速 user_idごとにshardingしているため
bitMapが⼤きくなりすぎることはない milaにおける実装:Bitmap 24 24 辞書 元のデータ (dict encoded) BitMap
| © PLAID Inc. | © PLAID Inc. ベンチマークでの他 DBとの比較 25
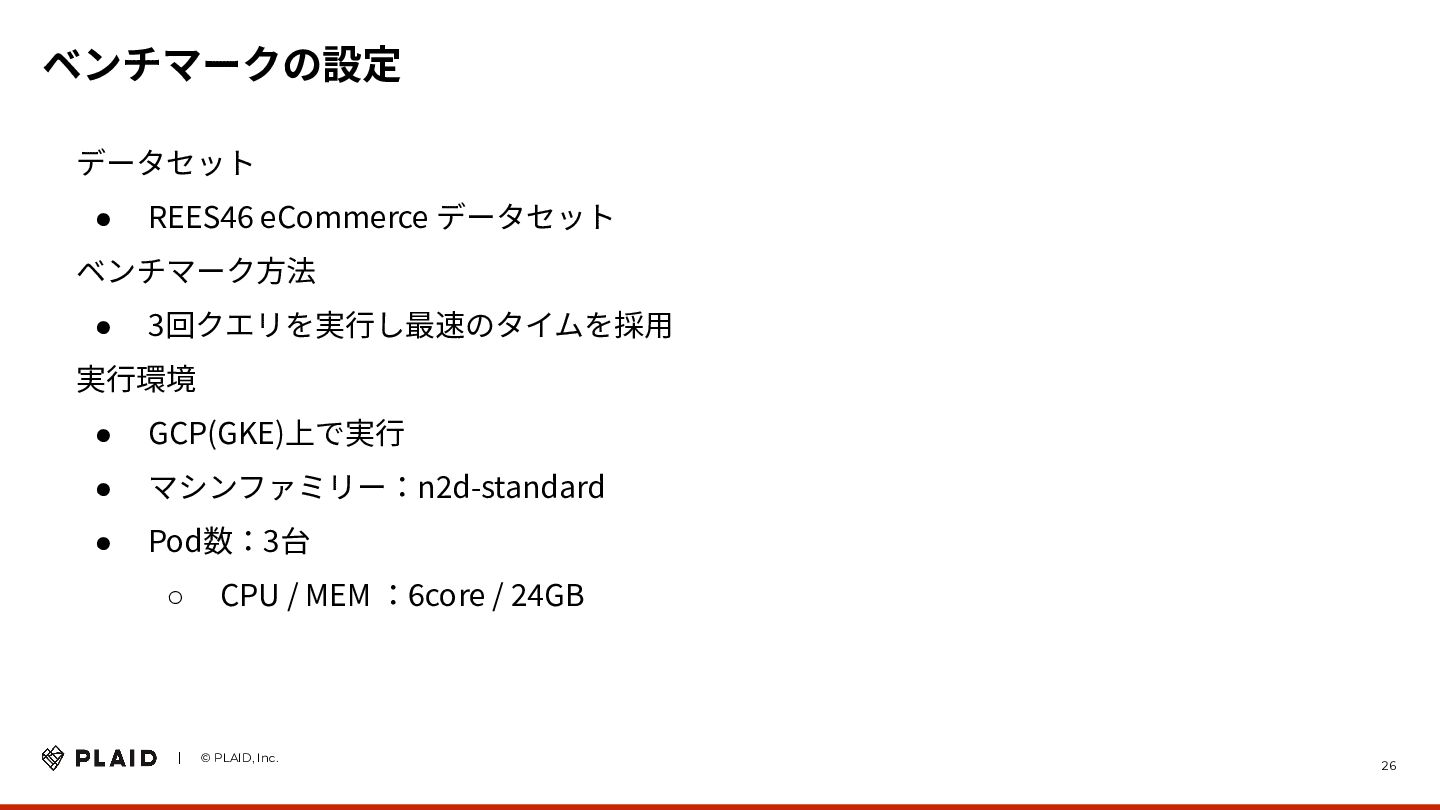
| © PLAID, Inc. データセット • REES46 eCommerce データセット ベンチマーク⽅法 •
3回クエリを実⾏し最速のタイムを採⽤ 実⾏環境 • GCP(GKE)上で実⾏ • マシンファミリー:n2d-standard • Pod数:3台 ◦ CPU / MEM :6core / 24GB ベンチマークの設定 26 26
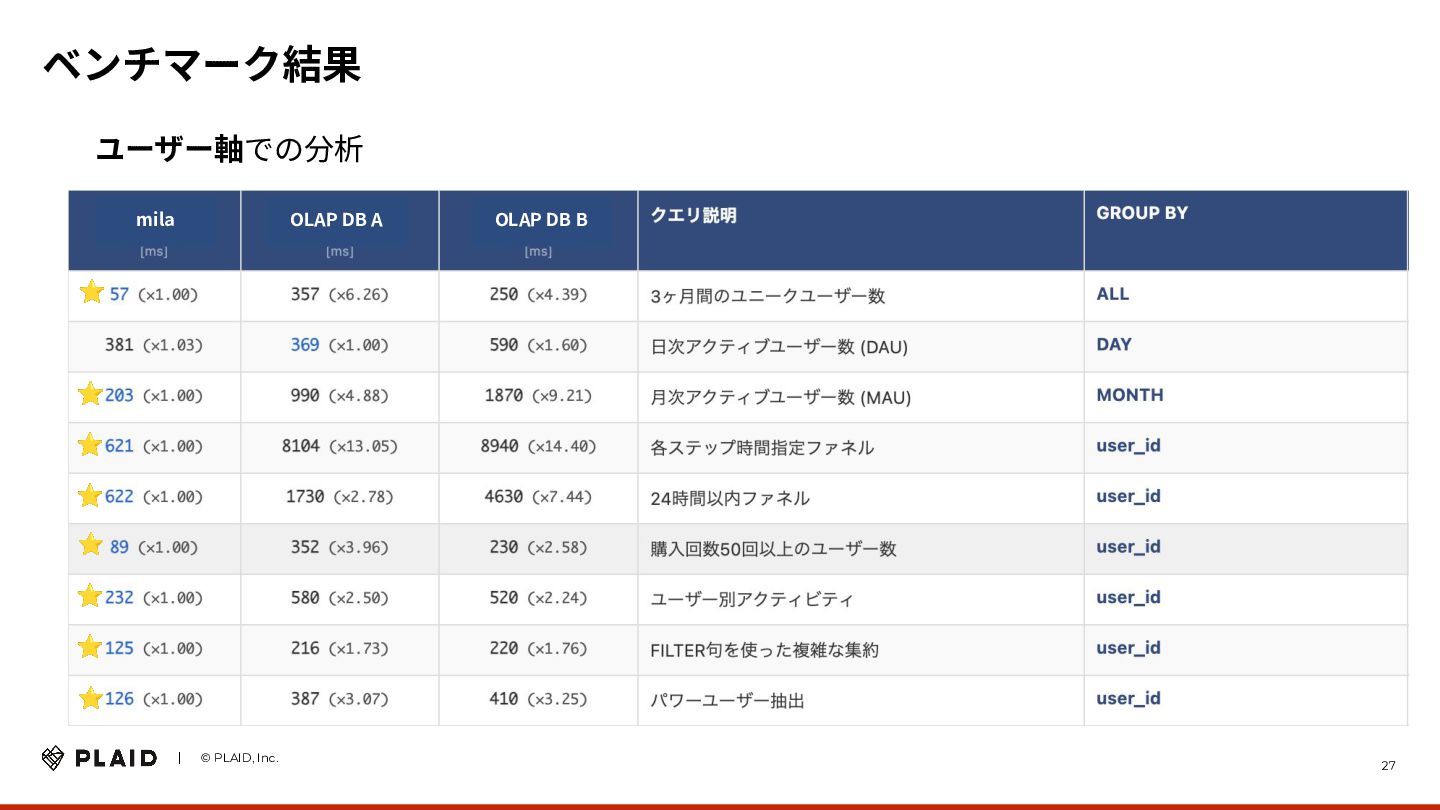
| © PLAID, Inc. ユーザー軸での分析 ベンチマーク結果 27 27 OLAP DB A
mila OLAP DB B ⭐ ⭐ ⭐ ⭐ ⭐ ⭐ ⭐ ⭐
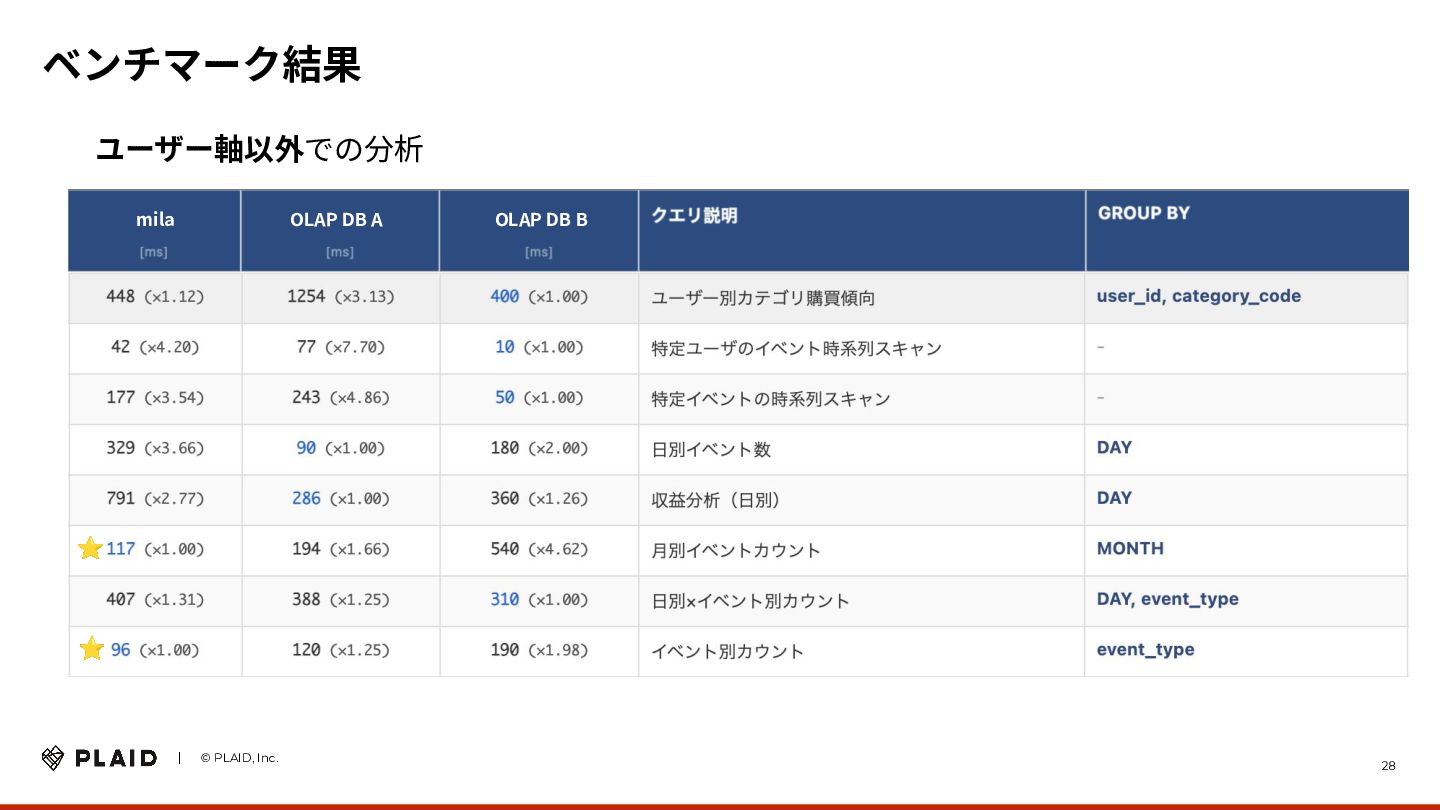
| © PLAID, Inc. ユーザー軸以外での分析 ベンチマーク結果 28 28 OLAP DB A
mila OLAP DB B ⭐ ⭐
| © PLAID Inc. | © PLAID Inc. まとめと今後の展望 29
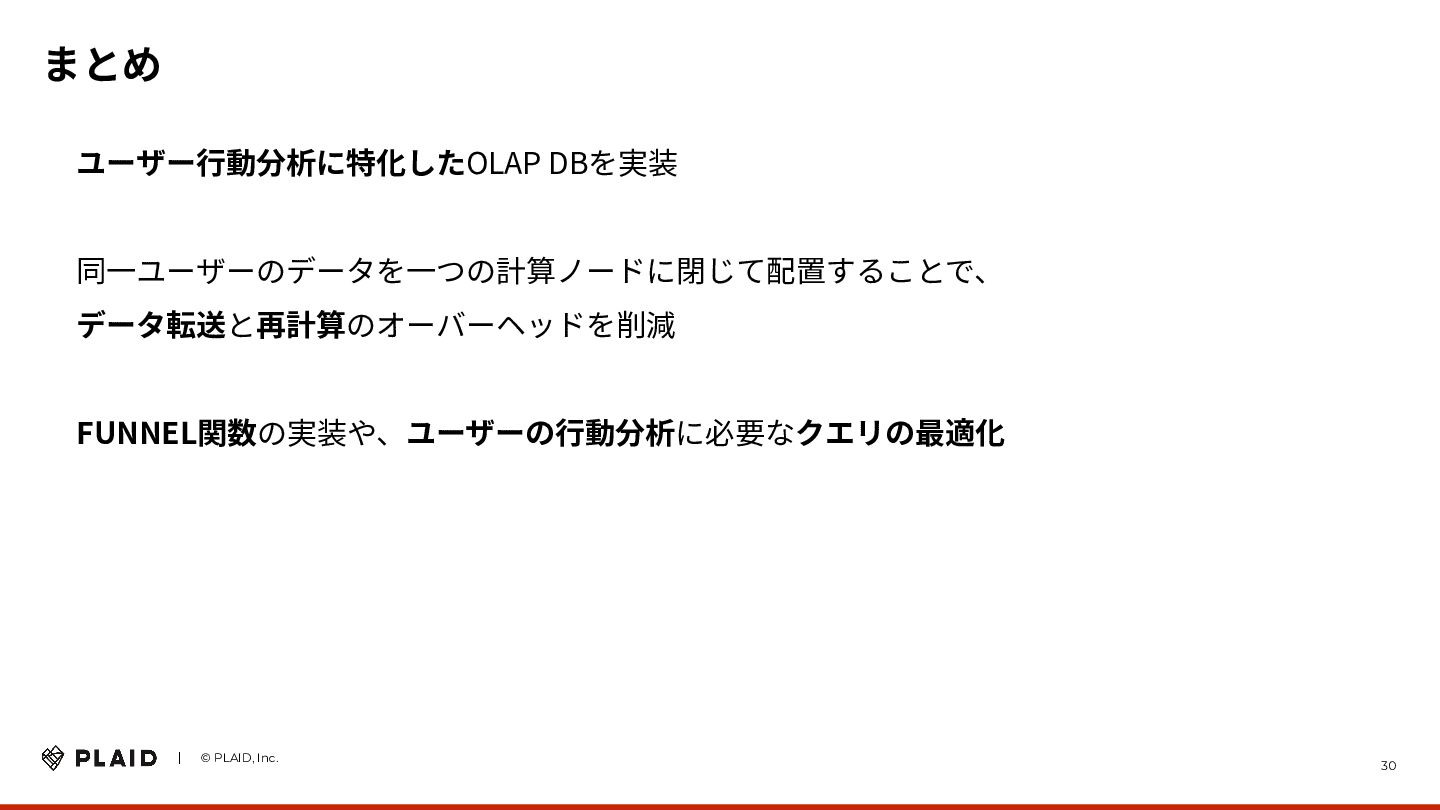
| © PLAID, Inc. ユーザー⾏動分析に特化したOLAP DBを実装 同⼀ユーザーのデータを⼀つの計算ノードに閉じて配置することで、 データ転送と再計算のオーバーヘッドを削減 FUNNEL関数の実装や、ユーザーの⾏動分析に必要なクエリの最適化 まとめ 30
30
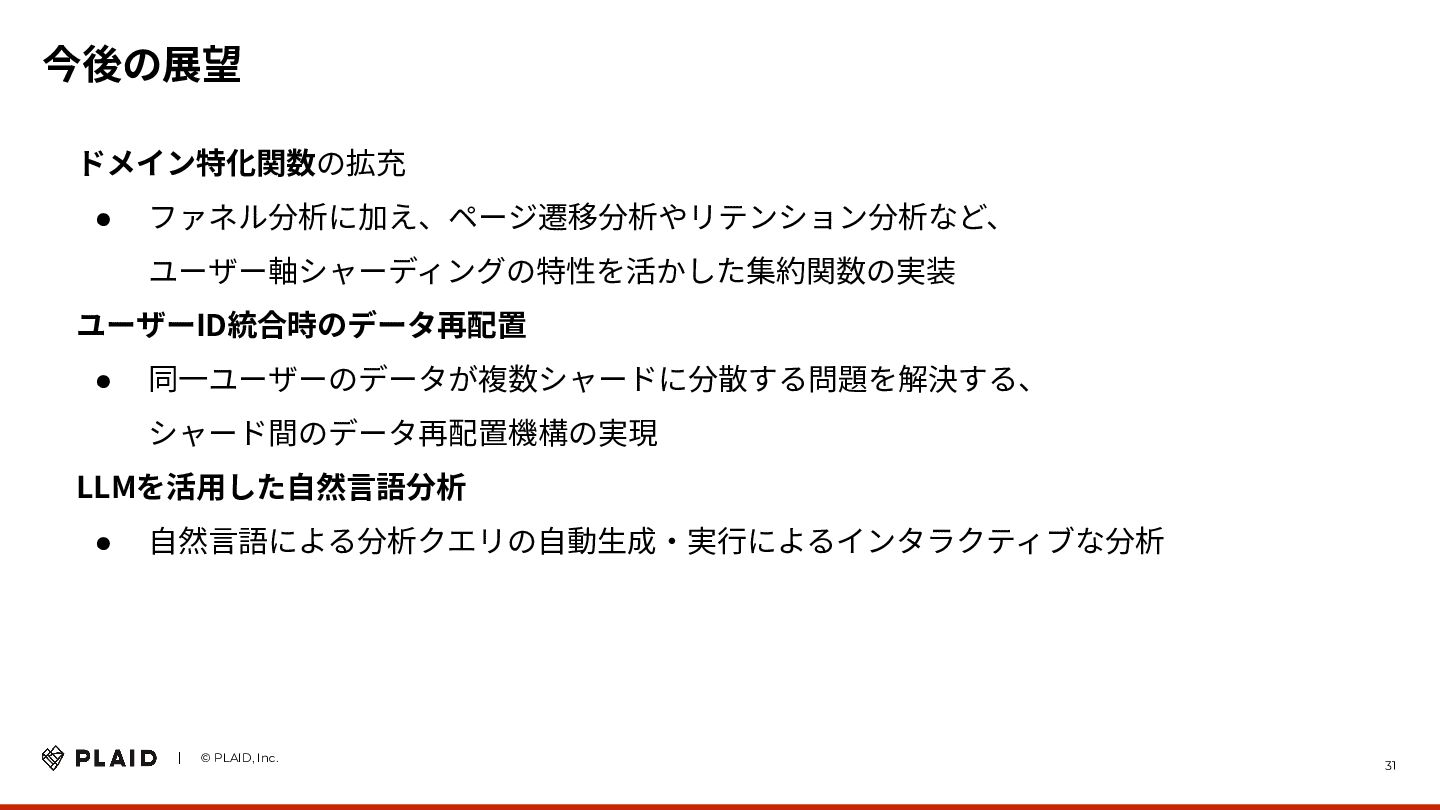
| © PLAID, Inc. ドメイン特化関数の拡充 • ファネル分析に加え、ページ遷移分析やリテンション分析など、 ユーザー軸シャーディングの特性を活かした集約関数の実装 ユーザーID統合時のデータ再配置 • 同⼀ユーザーのデータが複数シャードに分散する問題を解決する、
シャード間のデータ再配置機構の実現 LLMを活⽤した⾃然⾔語分析 • ⾃然⾔語による分析クエリの⾃動⽣成‧実⾏によるインタラクティブな分析 今後の展望 31 31
| © PLAID Inc. 32 👉 https://recruit.plaid.co.jp/ We Are Hiring !


 tetsuya28
 iktakahiro
 takonda
 finengine
 keeg
 teamlab
 pfn
 taketakekaho
 yahonda
 satomasahiro2005
 willnet
 emna__ayadi
 thekraken
 jlugia
 joshbly
 colly
 portentint
 smashingmag
 katarinadahlin
 sstephenson
 seathinner
 mfonobong
 aleyda