Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
LLM Content Moderationを支える評価・改善ループの実践
Search
suikabar
October 21, 2026
Technology
480
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
LLM Content Moderationを支える評価・改善ループの実践
suikabar
October 21, 2026
Transcript
29 slides
LLM Content Moderationを支える 評価・改善ループの実践 2026/10/22 生成AI会 Vol.3 Mizuho Yanagi (@suikabar_umai)
1
自己紹介 栁 泉穂(やなぎ みずほ) 株式会社タイミー データサイエンティスト • 2022年 ブレインパッド新卒入社 →
2025年 タイミー • Trust & Safety領域のDS TeamのLeadを担当 • 最近の趣味:ボルダリング 🧗 2
3
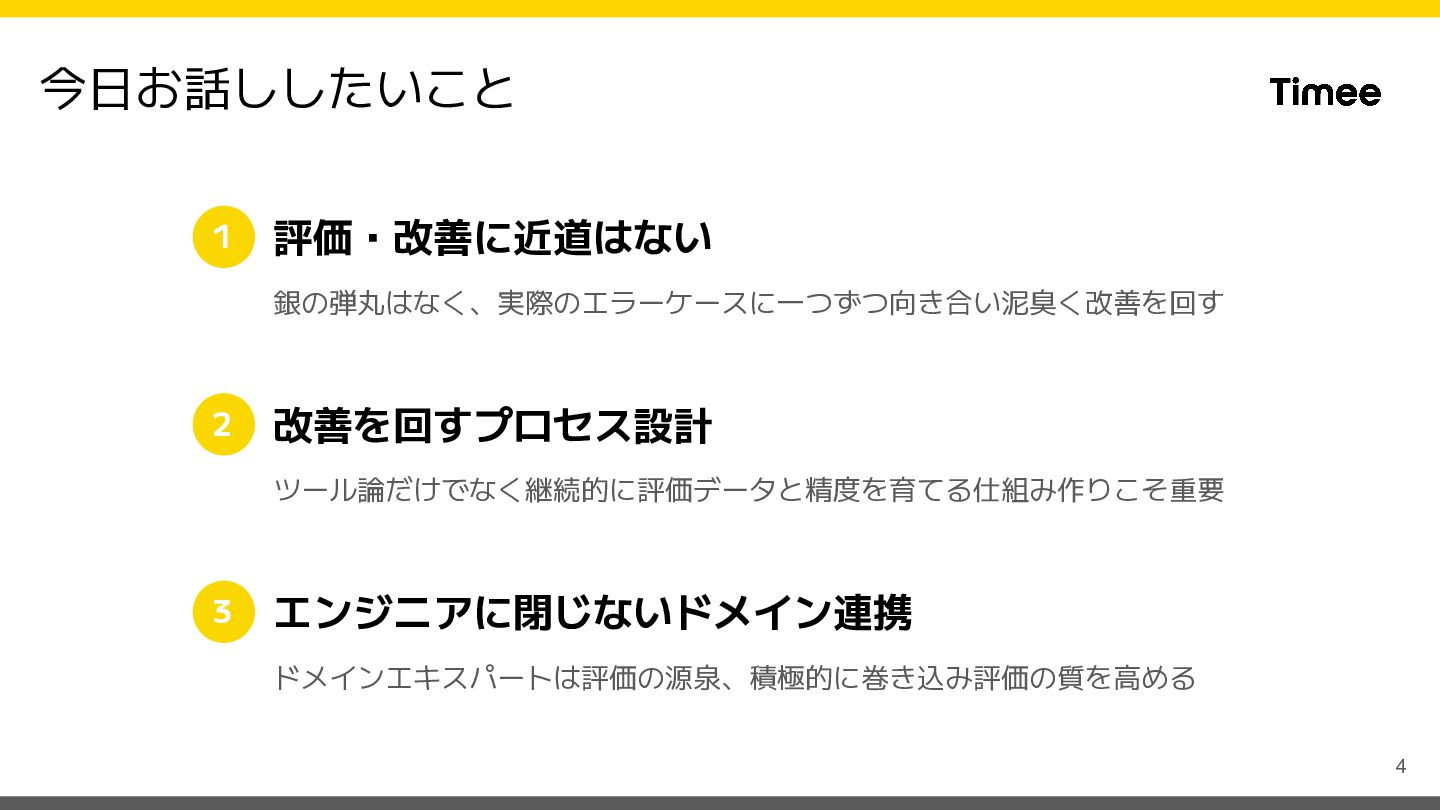
今日お話ししたいこと 1 評価・改善に近道はない 銀の弾丸はなく、実際のエラーケースに一つずつ向き合い泥臭く改善を回す 2 改善を回すプロセス設計 ツール論だけでなく継続的に評価データと精度を育てる仕組み作りこそ重要 3 エンジニアに閉じないドメイン連携 ドメインエキスパートは評価の源泉、積極的に巻き込み評価の質を高める
4
Content Moderationの取り組み
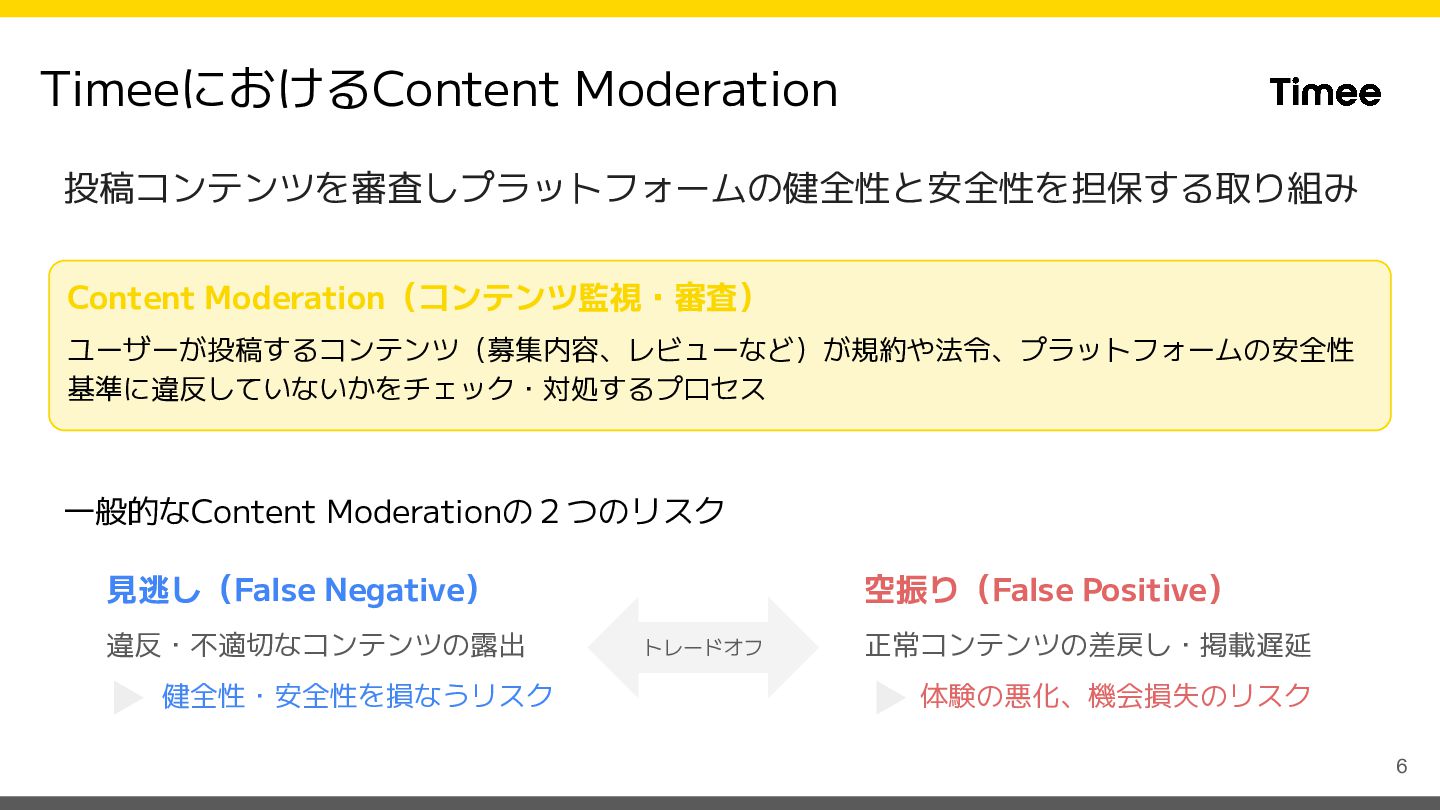
TimeeにおけるContent Moderation 投稿コンテンツを審査しプラットフォームの健全性と安全性を担保する取り組み Content Moderation(コンテンツ監視・審査) ユーザーが投稿するコンテンツ(募集内容、レビューなど)が規約や法令、プラットフォームの安全性 基準に違反していないかをチェック・対処するプロセス 一般的なContent Moderationの2つのリスク 見逃し(False
Negative) 違反・不適切なコンテンツの露出 健全性・安全性を損なうリスク 空振り(False Positive) トレードオフ 正常コンテンツの差戻し・掲載遅延 体験の悪化、機会損失のリスク 6
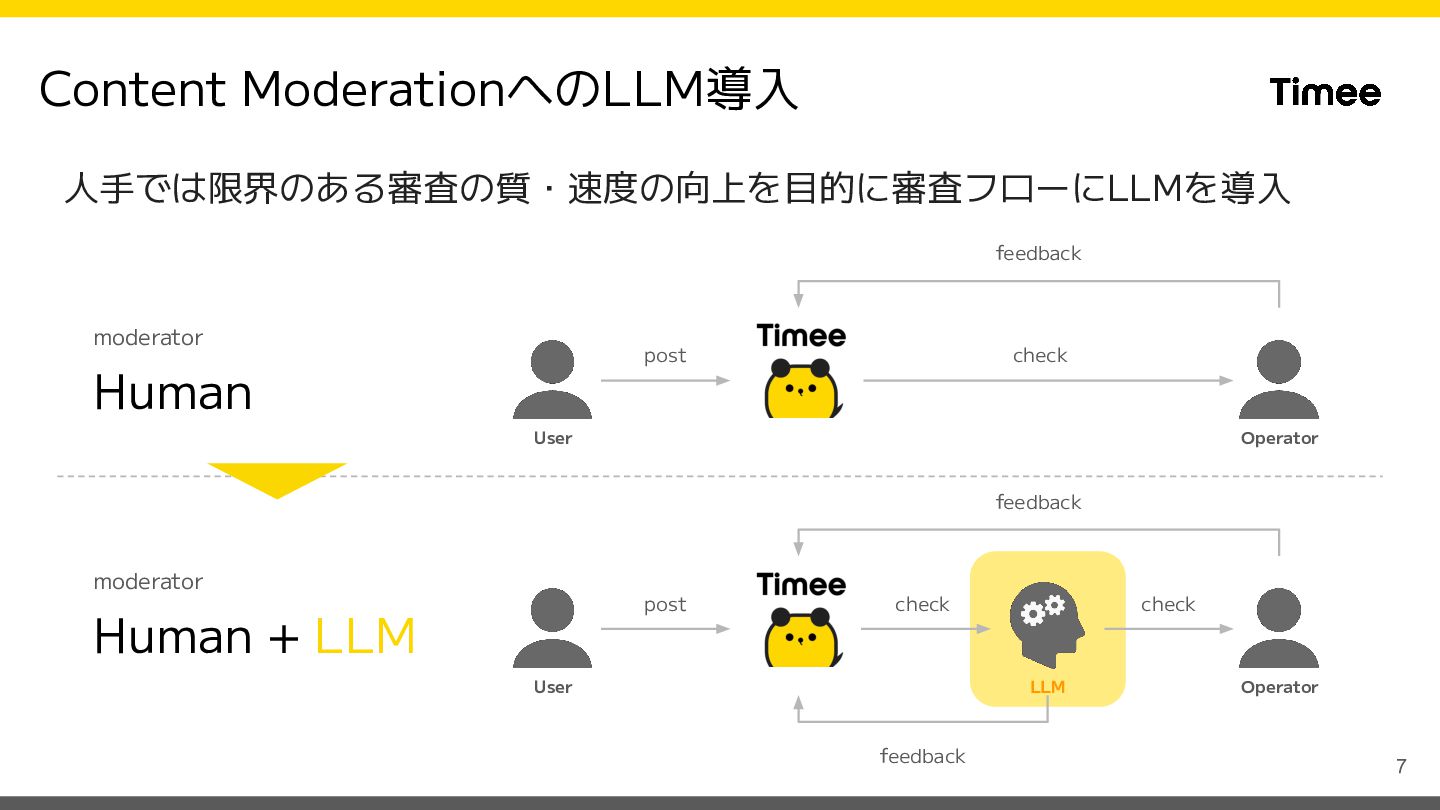
Content ModerationへのLLM導入 人手では限界のある審査の質・速度の向上を目的に審査フローにLLMを導入 feedback moderator post check Human User Operator
feedback moderator post Human + LLM check User check LLM feedback Operator 7
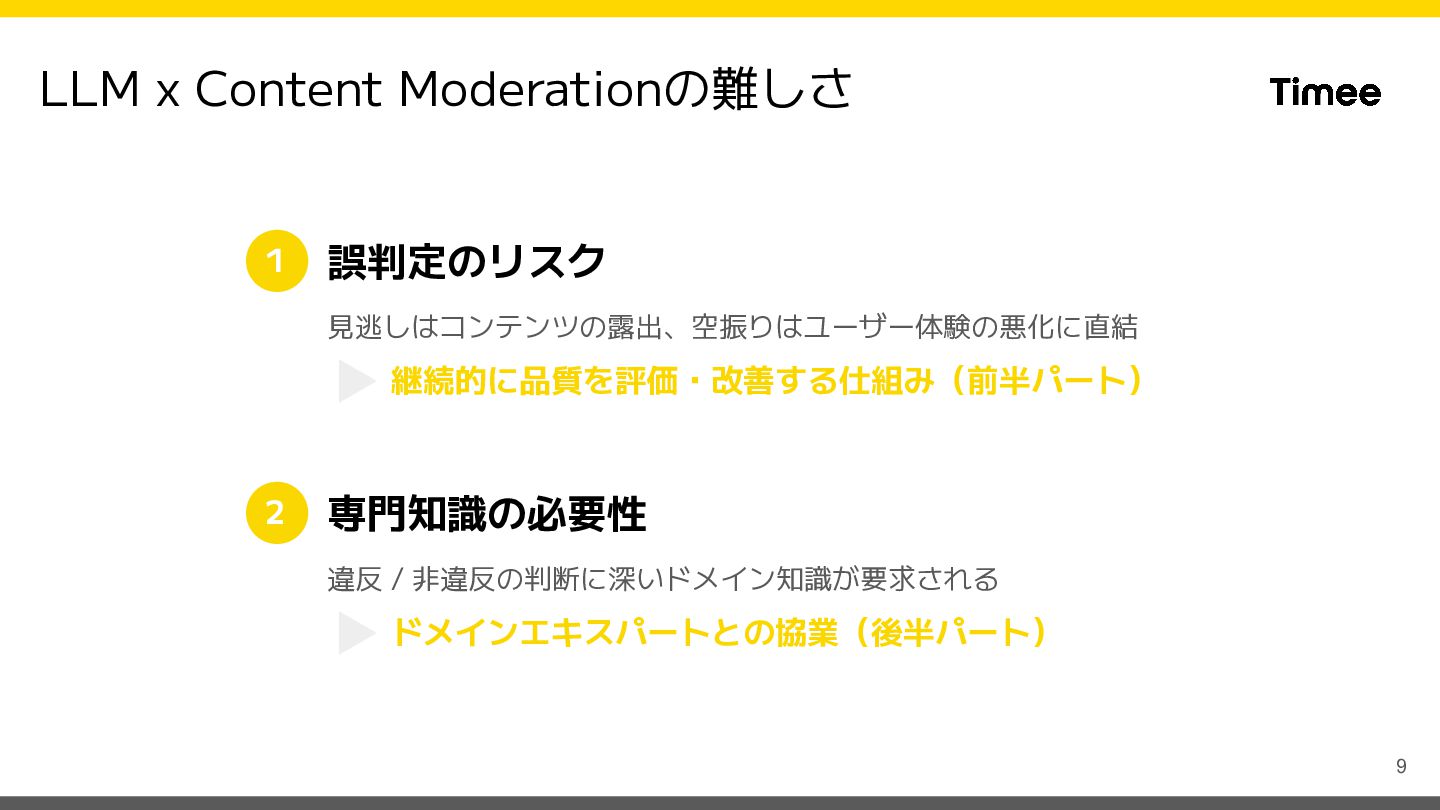
LLM x Content Moderationの難しさ 1 誤判定のリスク 見逃しはコンテンツの露出、空振りはユーザー体験の悪化に直結 2 専門知識の必要性 違反
/ 非違反の判断に深いドメイン知識が要求される 8
LLM x Content Moderationの難しさ 1 誤判定のリスク 見逃しはコンテンツの露出、空振りはユーザー体験の悪化に直結 継続的に品質を評価・改善する仕組み(前半パート) 2 専門知識の必要性
違反 / 非違反の判断に深いドメイン知識が要求される ドメインエキスパートとの協業(後半パート) 9
1 評価駆動 ゴールデンデータを中心とした改善ループ 10
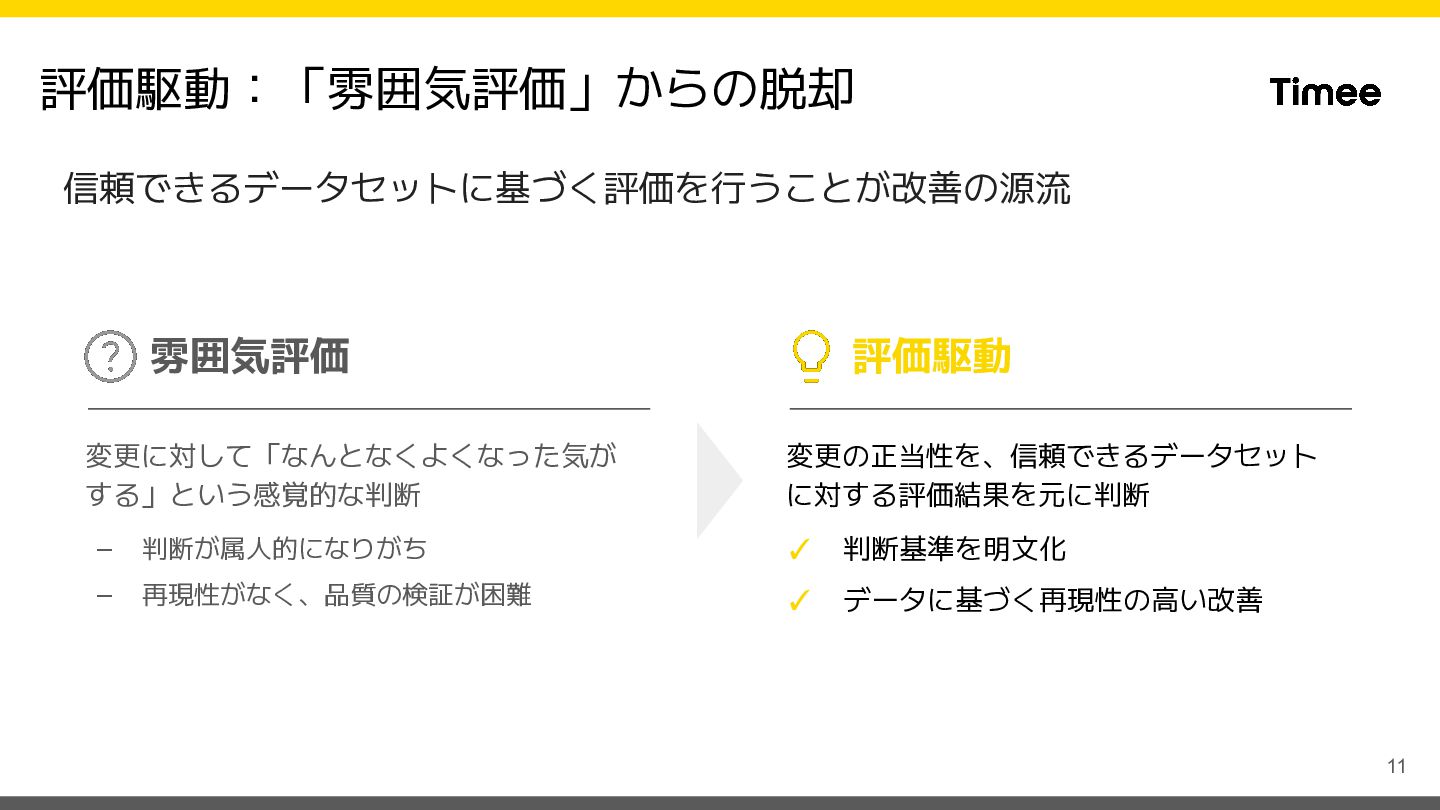
評価駆動:「雰囲気評価」からの脱却 信頼できるデータセットに基づく評価を行うことが改善の源流 雰囲気評価 評価駆動 変更に対して「なんとなくよくなった気が する」という感覚的な判断 変更の正当性を、信頼できるデータセット に対する評価結果を元に判断 − 判断が属人的になりがち
✓ 判断基準を明文化 − 再現性がなく、品質の検証が困難 ✓ データに基づく再現性の高い改善 11
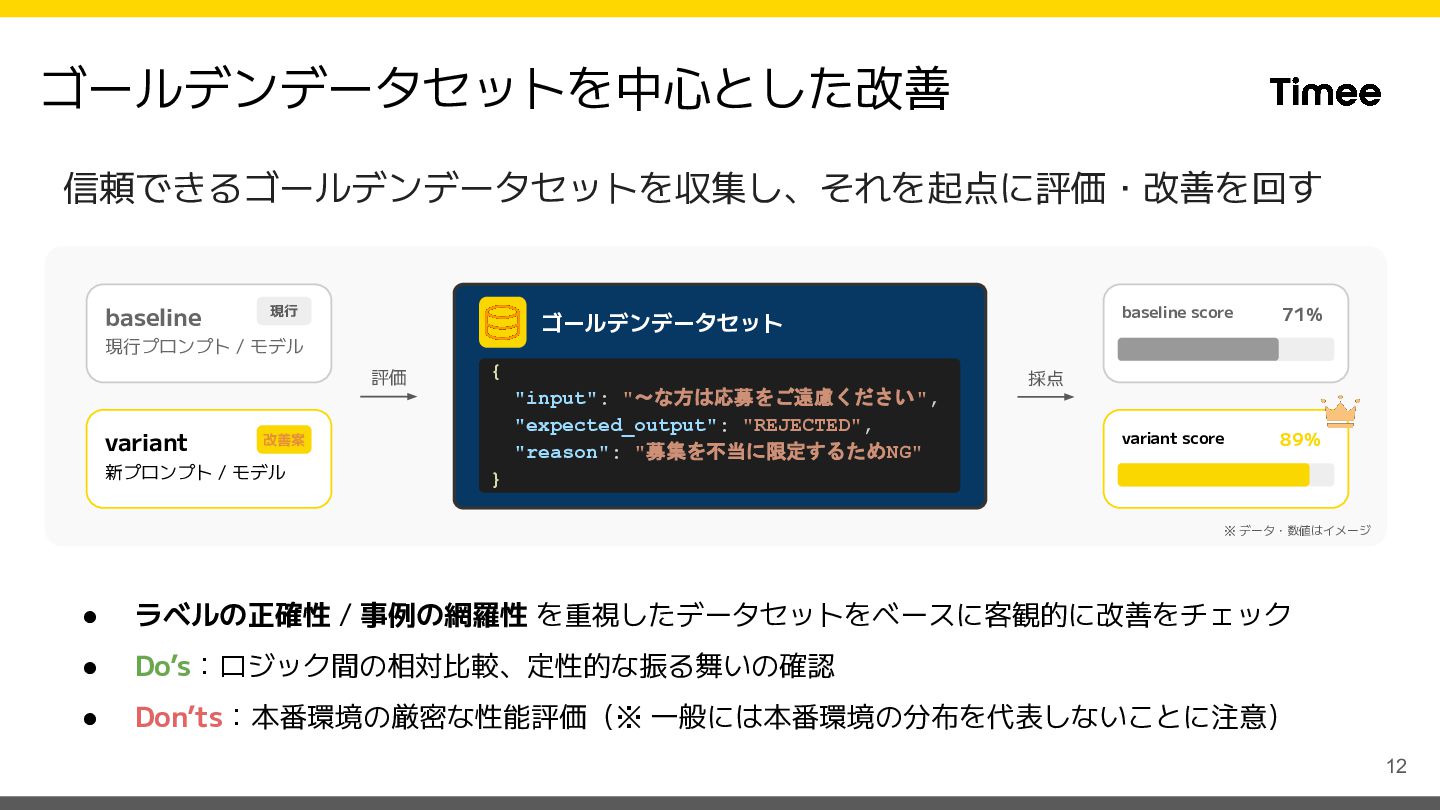
ゴールデンデータセットを中心とした改善 信頼できるゴールデンデータセットを収集し、それを起点に評価・改善を回す baseline 現行 ゴールデンデータセット baseline score 71% variant score
89% 現行プロンプト / モデル 評価 variant { 改善案 新プロンプト / モデル 採点 "input": "〜な方は応募をご遠慮ください", "expected_output": "REJECTED", "reason": "募集を不当に限定するためNG" } ※ データ・数値はイメージ • ラベルの正確性 / 事例の網羅性 を重視したデータセットをベースに客観的に改善をチェック • Do’s:ロジック間の相対比較、定性的な振る舞いの確認 • Don’ts:本番環境の厳密な性能評価(※ 一般には本番環境の分布を代表しないことに注意) 12
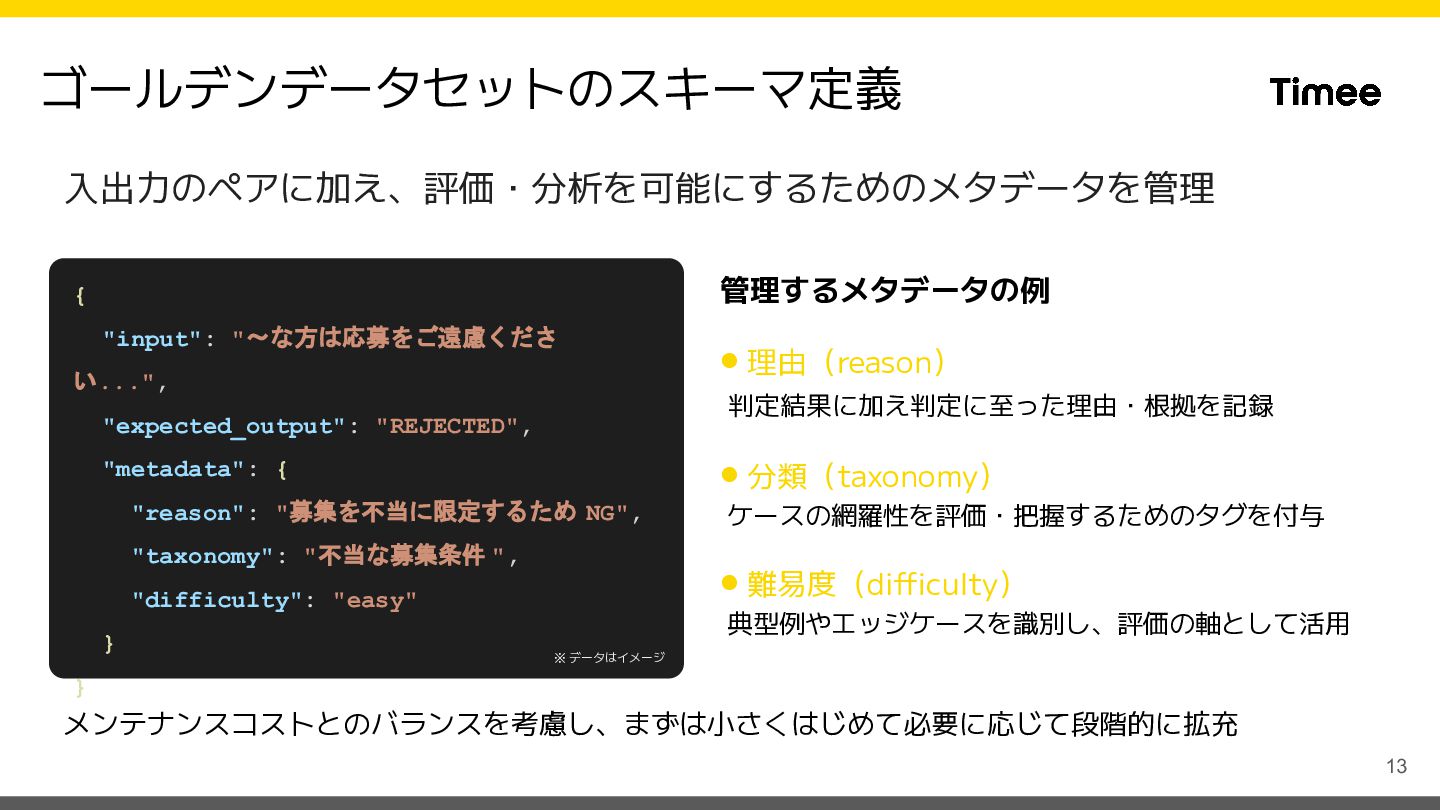
ゴールデンデータセットのスキーマ定義 入出力のペアに加え、評価・分析を可能にするためのメタデータを管理 管理するメタデータの例 { "input": "〜な方は応募をご遠慮くださ い...", ⚫ 理由(reason) 判定結果に加え判定に至った理由・根拠を記録
"expected_output": "REJECTED", ⚫ 分類(taxonomy) "metadata": { "reason": "募集を不当に限定するため NG", ケースの網羅性を評価・把握するためのタグを付与 "taxonomy": "不当な募集条件 ", ⚫ 難易度(difficulty) "difficulty": "easy" } 典型例やエッジケースを識別し、評価の軸として活用 ※ データはイメージ } メンテナンスコストとのバランスを考慮し、まずは小さくはじめて必要に応じて段階的に拡充 13
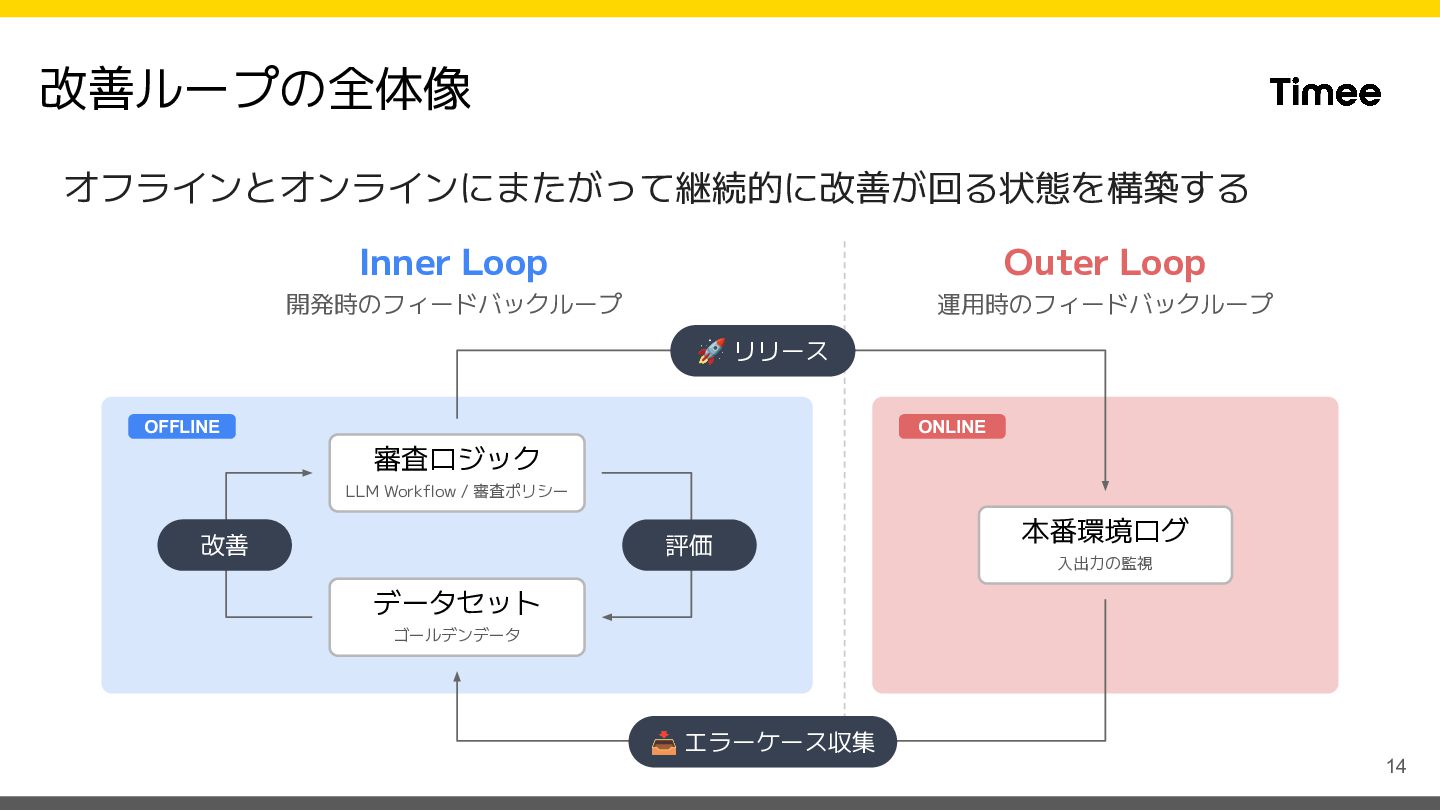
改善ループの全体像 オフラインとオンラインにまたがって継続的に改善が回る状態を構築する Inner Loop Outer Loop 開発時のフィードバックループ 運用時のフィードバックループ 🚀 リリース
ONLINE OFFLINE 審査ロジック LLM Workflow / 審査ポリシー 改善 評価 本番環境ログ 入出力の監視 データセット ゴールデンデータ 📥 エラーケース収集 14
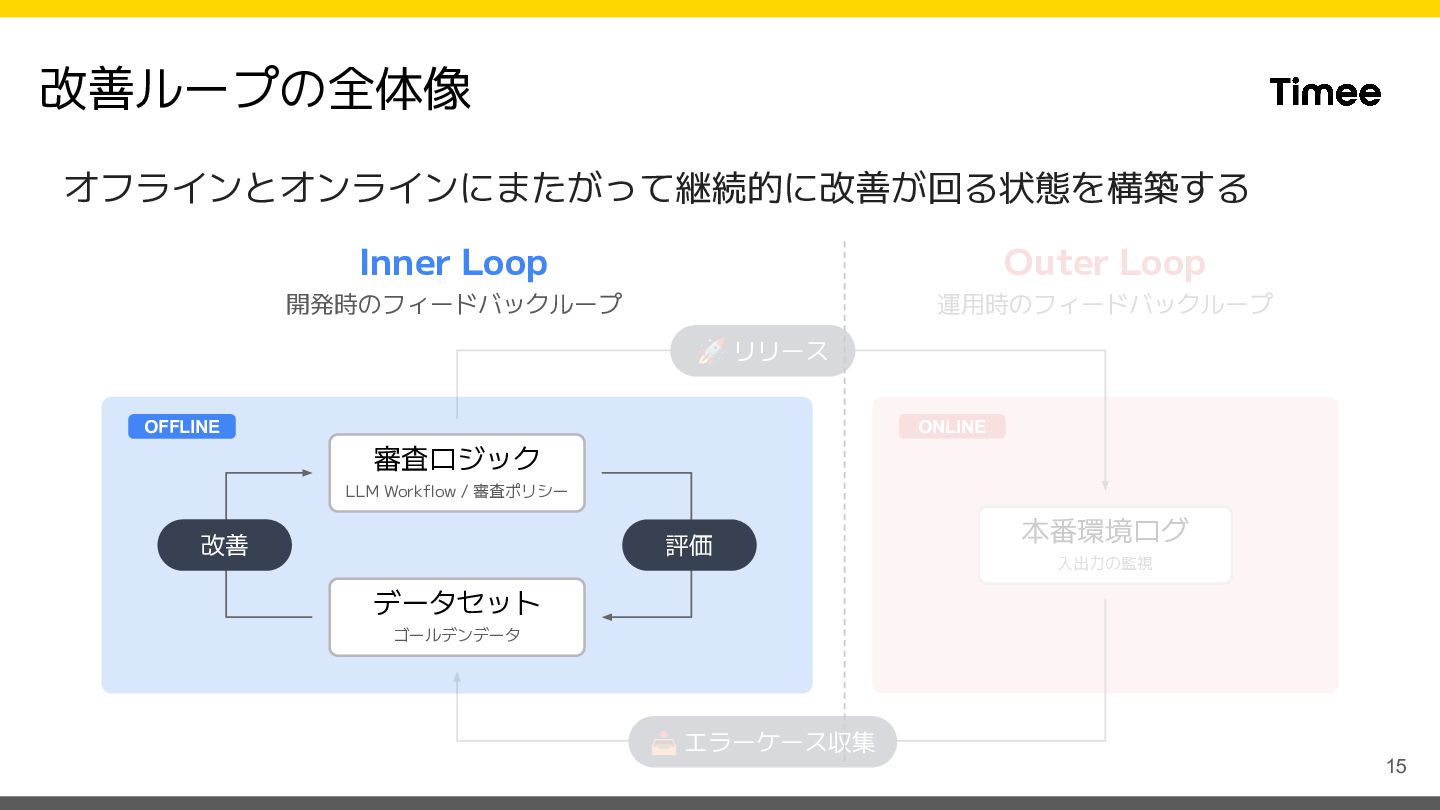
改善ループの全体像 オフラインとオンラインにまたがって継続的に改善が回る状態を構築する Inner Loop Outer Loop 開発時のフィードバックループ 運用時のフィードバックループ 🚀 リリース
ONLINE OFFLINE 審査ロジック LLM Workflow / 審査ポリシー 改善 評価 本番環境ログ 入出力の監視 データセット ゴールデンデータ 📥 エラーケース収集 15
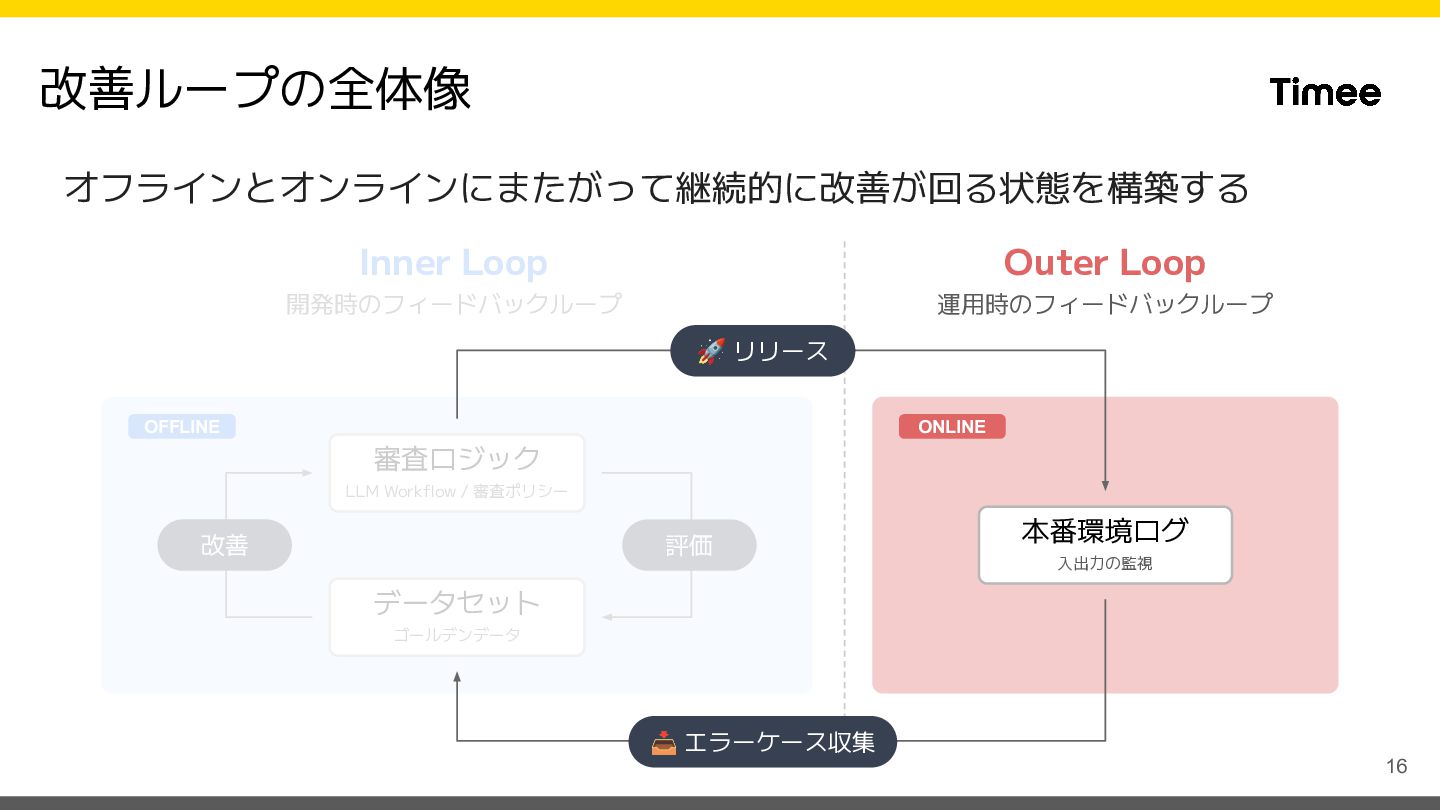
改善ループの全体像 オフラインとオンラインにまたがって継続的に改善が回る状態を構築する Inner Loop Outer Loop 開発時のフィードバックループ 運用時のフィードバックループ 🚀 リリース
ONLINE OFFLINE 審査ロジック LLM Workflow / 審査ポリシー 改善 評価 本番環境ログ 入出力の監視 データセット ゴールデンデータ 📥 エラーケース収集 16
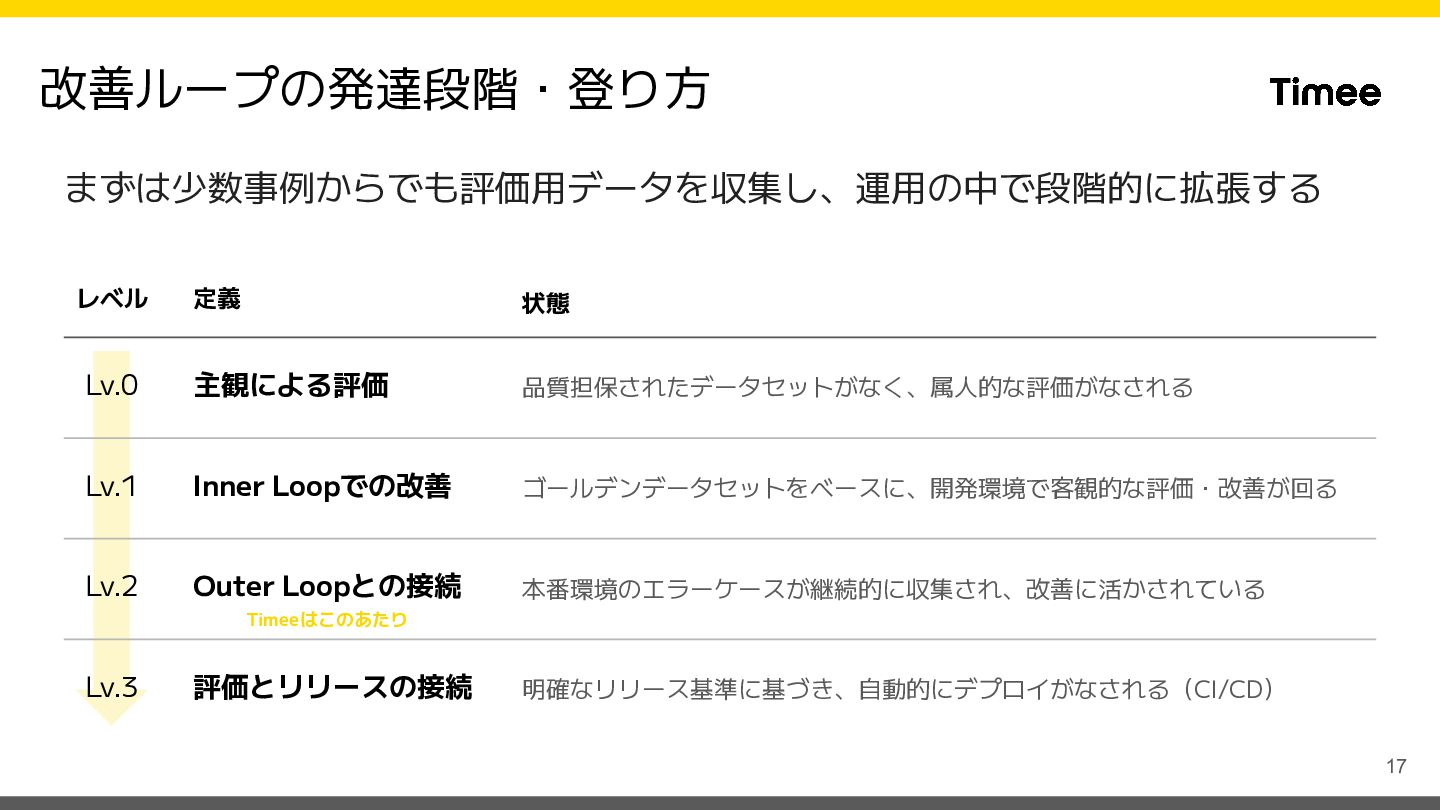
改善ループの発達段階・登り方 まずは少数事例からでも評価用データを収集し、運用の中で段階的に拡張する レベル 定義 状態 Lv.0 主観による評価 品質担保されたデータセットがなく、属人的な評価がなされる Lv.1 Inner
Loopでの改善 ゴールデンデータセットをベースに、開発環境で客観的な評価・改善が回る Lv.2 Outer Loopとの接続 本番環境のエラーケースが継続的に収集され、改善に活かされている Timeeはこのあたり Lv.3 評価とリリースの接続 明確なリリース基準に基づき、自動的にデプロイがなされる(CI/CD) 17
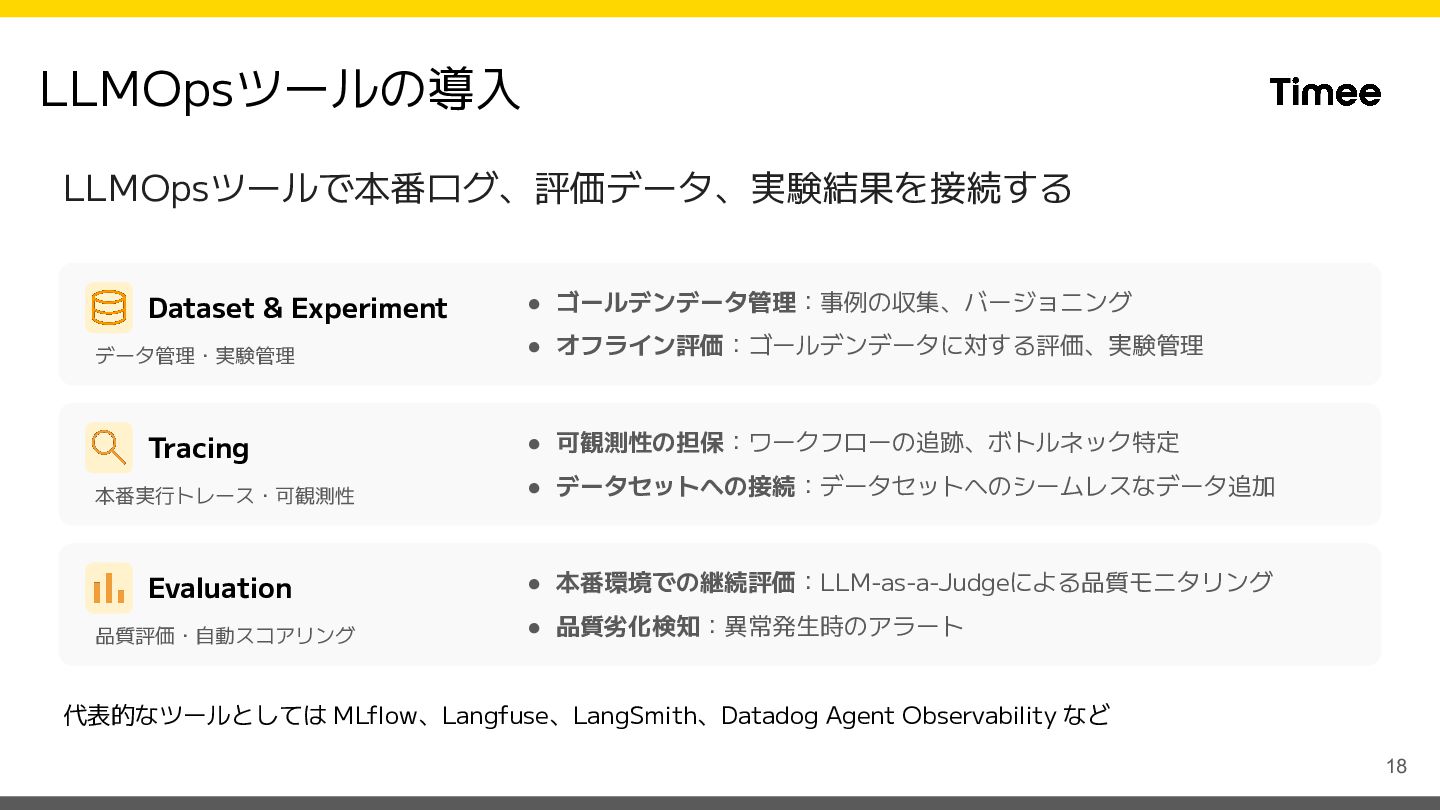
LLMOpsツールの導入 LLMOpsツールで本番ログ、評価データ、実験結果を接続する Dataset & Experiment • ゴールデンデータ管理:事例の収集、バージョニング データ管理・実験管理 • オフライン評価:ゴールデンデータに対する評価、実験管理
Tracing • 可観測性の担保:ワークフローの追跡、ボトルネック特定 本番実行トレース・可観測性 • データセットへの接続:データセットへのシームレスなデータ追加 Evaluation • 本番環境での継続評価:LLM-as-a-Judgeによる品質モニタリング 品質評価・自動スコアリング • 品質劣化検知:異常発生時のアラート 代表的なツールとしては MLflow、Langfuse、LangSmith、Datadog Agent Observability など 18
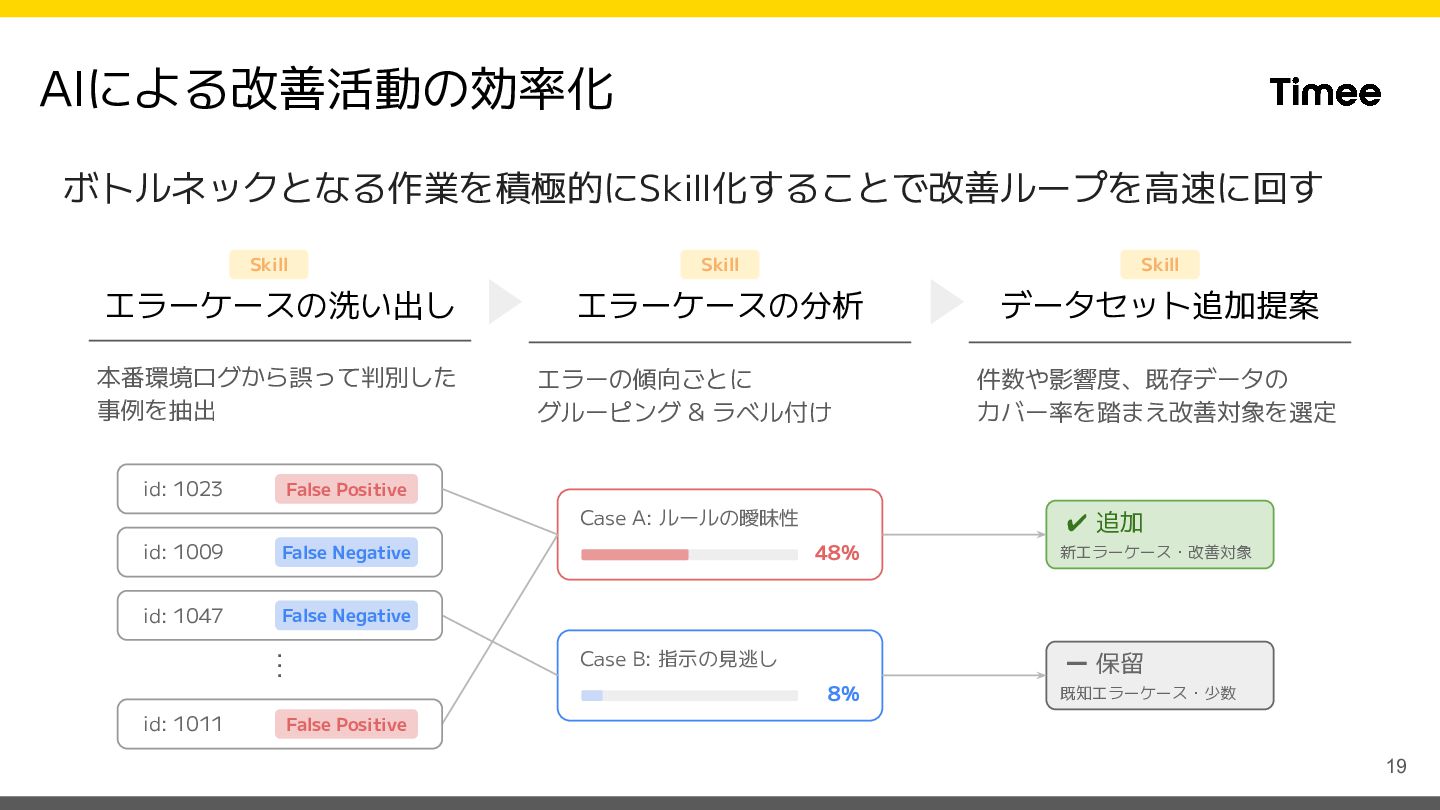
AIによる改善活動の効率化 ボトルネックとなる作業を積極的にSkill化することで改善ループを高速に回す Skill Skill Skill エラーケースの洗い出し エラーケースの分析 データセット追加提案 本番環境ログから誤って判別した 事例を抽出
id: 1023 エラーの傾向ごとに グルーピング & ラベル付け False Positive Case A: ルールの曖昧性 id: 1009 False Negative id: 1047 False Negative ✔ 追加 48% ・・・ Case B: 指示の見逃し 新エラーケース・改善対象 ー 保留 8% id: 1011 件数や影響度、既存データの カバー率を踏まえ改善対象を選定 既知エラーケース・少数 False Positive 19
2 ドメインエキスパートとの協業 改善ループに専門知をどう組み込むか 20
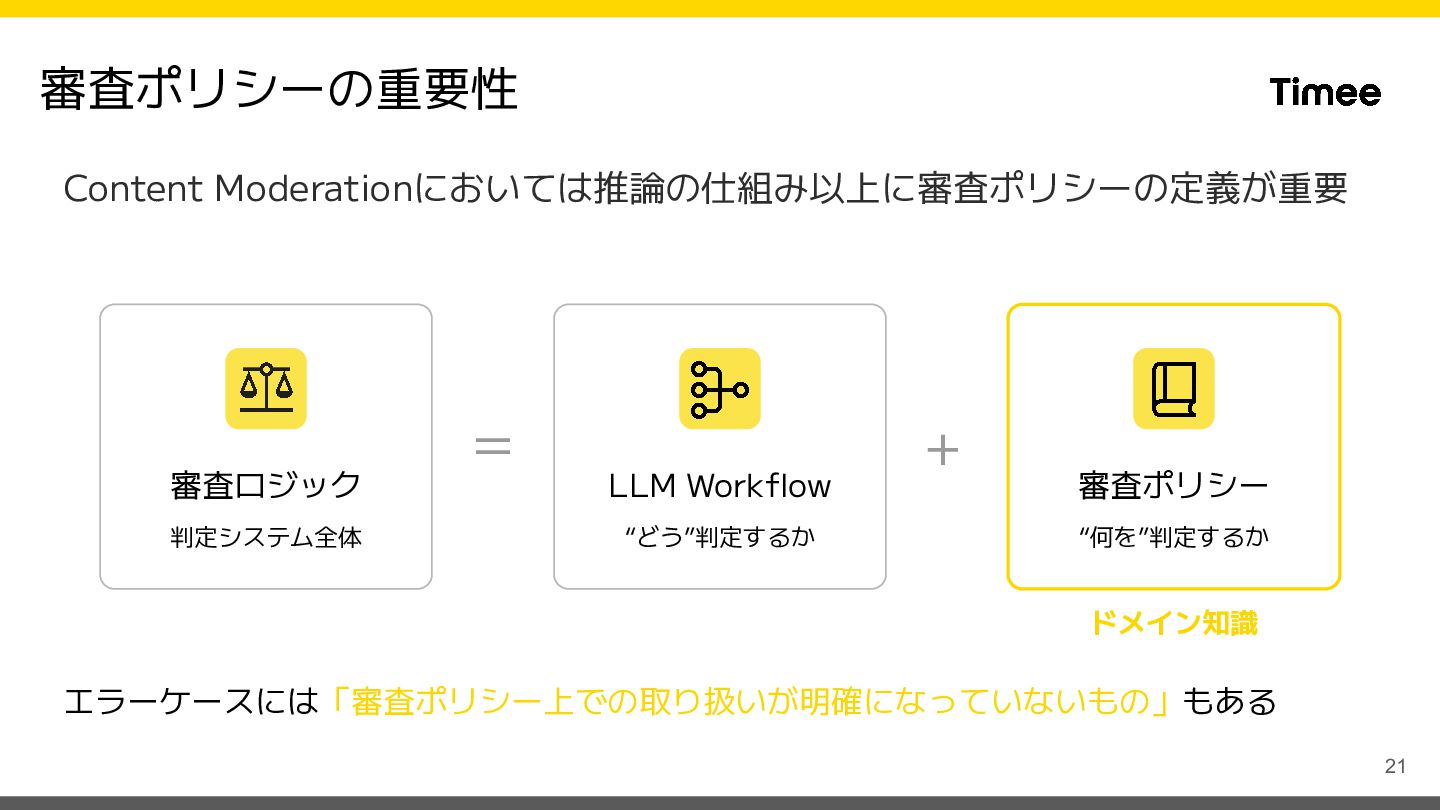
審査ポリシーの重要性 Content Moderationにおいては推論の仕組み以上に審査ポリシーの定義が重要 審査ロジック 判定システム全体 = LLM Workflow “どう”判定するか +
審査ポリシー “何を”判定するか ドメイン知識 エラーケースには「審査ポリシー上での取り扱いが明確になっていないもの」もある 21
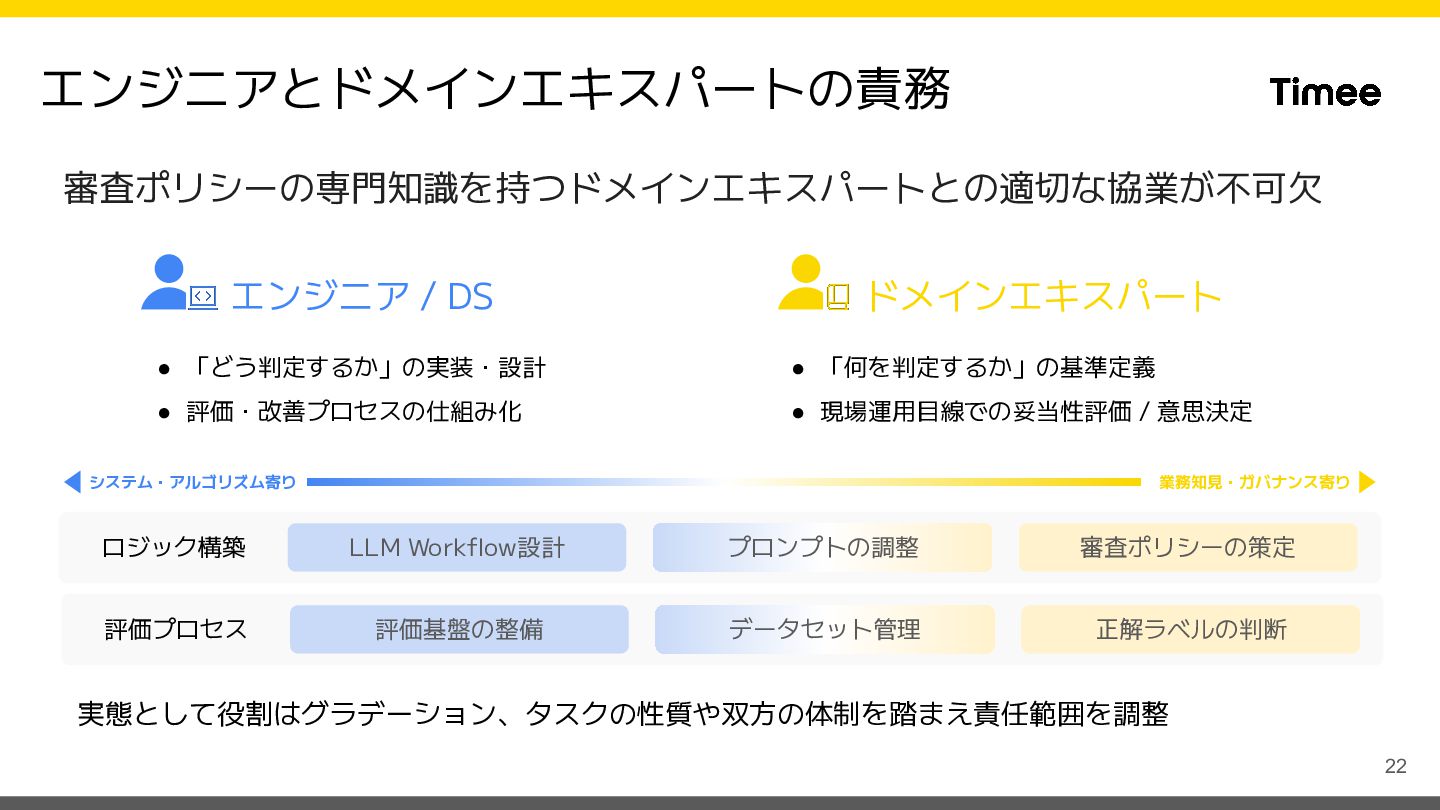
エンジニアとドメインエキスパートの責務 審査ポリシーの専門知識を持つドメインエキスパートとの適切な協業が不可欠 エンジニア / DS ドメインエキスパート • 「どう判定するか」の実装・設計 • 「何を判定するか」の基準定義
• 評価・改善プロセスの仕組み化 • 現場運用目線での妥当性評価 / 意思決定 システム・アルゴリズム寄り 業務知見・ガバナンス寄り ロジック構築 LLM Workflow設計 プロンプトの調整 審査ポリシーの策定 評価プロセス 評価基盤の整備 データセット管理 正解ラベルの判断 実態として役割はグラデーション、タスクの性質や双方の体制を踏まえ責任範囲を調整 22
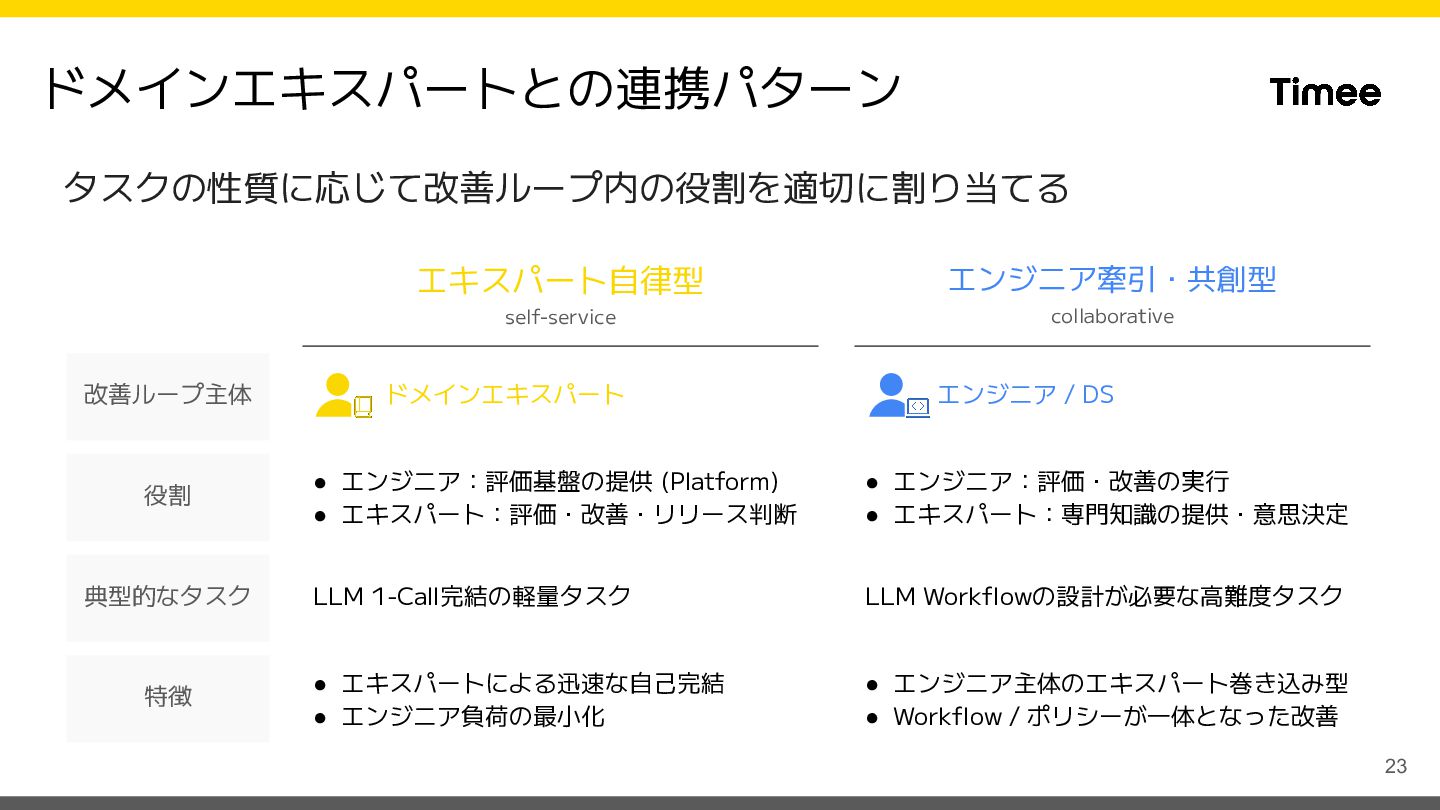
ドメインエキスパートとの連携パターン タスクの性質に応じて改善ループ内の役割を適切に割り当てる 改善ループ主体 役割 典型的なタスク 特徴 エキスパート自律型 エンジニア牽引・共創型 self-service collaborative
ドメインエキスパート エンジニア / DS • エンジニア:評価基盤の提供 (Platform) • エキスパート:評価・改善・リリース判断 • エンジニア:評価・改善の実行 • エキスパート:専門知識の提供・意思決定 LLM 1-Call完結の軽量タスク LLM Workflowの設計が必要な高難度タスク • エキスパートによる迅速な自己完結 • エンジニア負荷の最小化 • エンジニア主体のエキスパート巻き込み型 • Workflow / ポリシーが一体となった改善 23
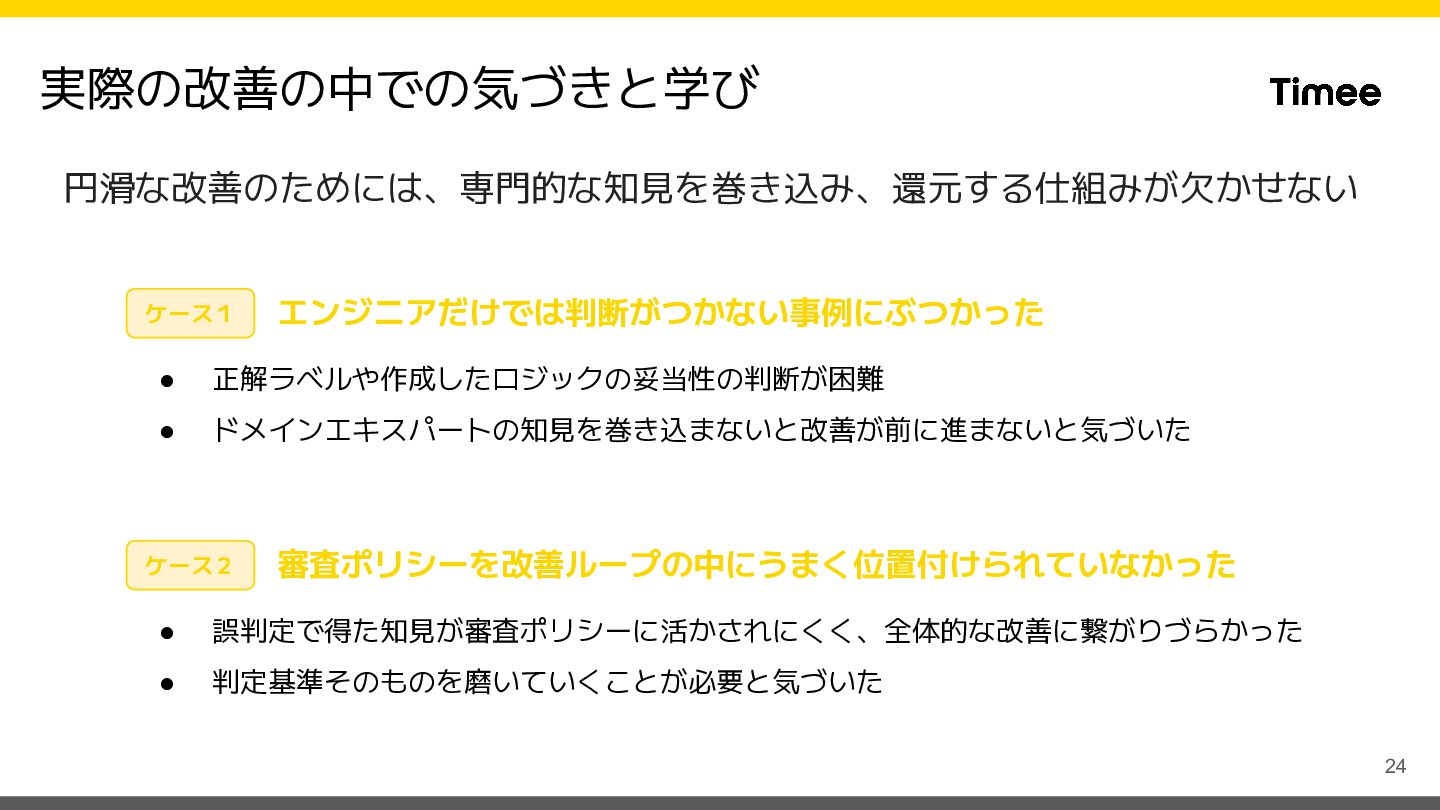
実際の改善の中での気づきと学び 円滑な改善のためには、専門的な知見を巻き込み、還元する仕組みが欠かせない ケース1 エンジニアだけでは判断がつかない事例にぶつかった • 正解ラベルや作成したロジックの妥当性の判断が困難 • ドメインエキスパートの知見を巻き込まないと改善が前に進まないと気づいた ケース2 審査ポリシーを改善ループの中にうまく位置付けられていなかった
• 誤判定で得た知見が審査ポリシーに活かされにくく、全体的な改善に繋がりづらかった • 判定基準そのものを磨いていくことが必要と気づいた 24
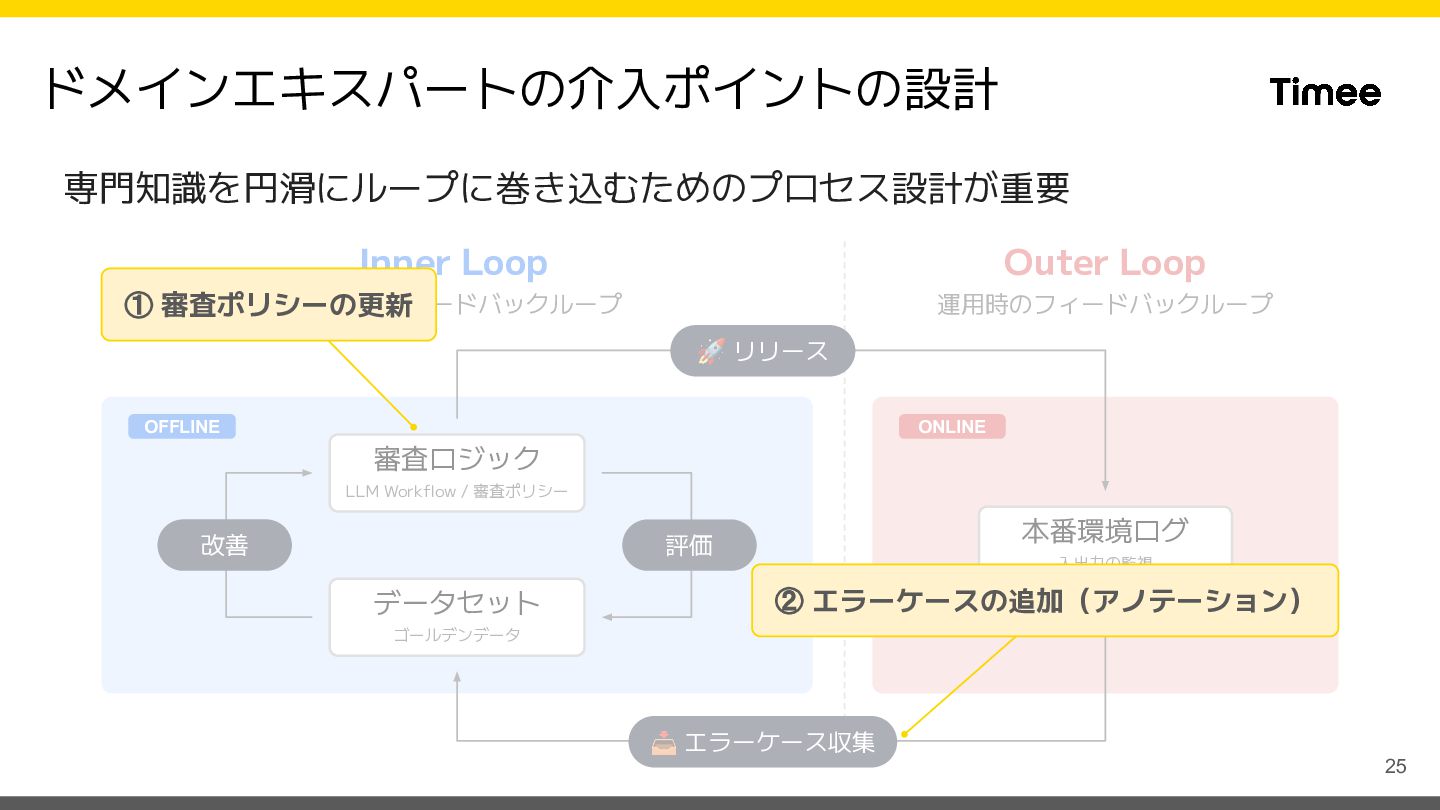
ドメインエキスパートの介入ポイントの設計 専門知識を円滑にループに巻き込むためのプロセス設計が重要 Inner Loop Outer Loop 開発時のフィードバックループ ① 審査ポリシーの更新 運用時のフィードバックループ
🚀 リリース ONLINE OFFLINE 審査ロジック LLM Workflow / 審査ポリシー 改善 本番環境ログ 評価 データセット 入出力の監視 ② エラーケースの追加(アノテーション) ゴールデンデータ 📥 エラーケース収集 25
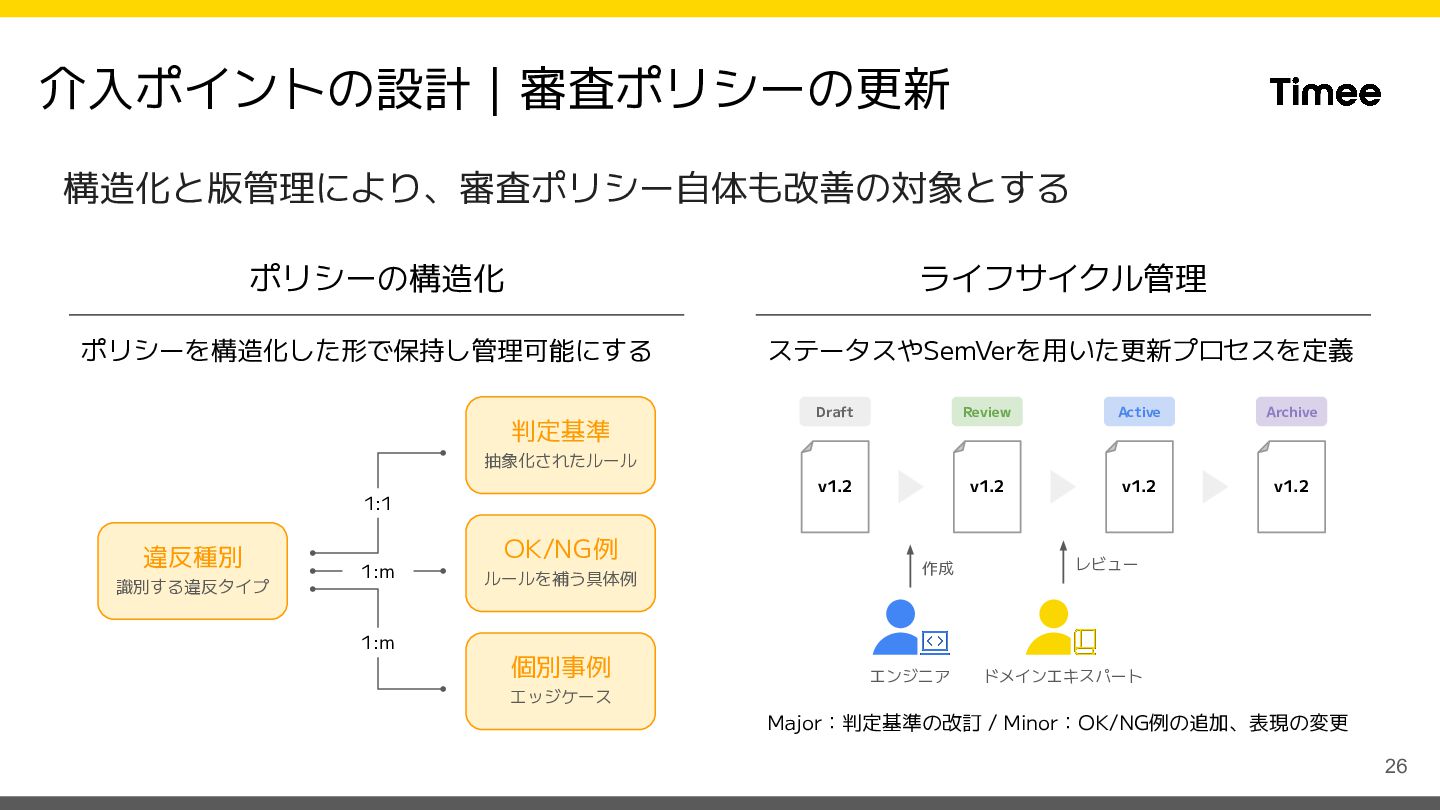
介入ポイントの設計|審査ポリシーの更新 構造化と版管理により、審査ポリシー自体も改善の対象とする ポリシーの構造化 ライフサイクル管理 ポリシーを構造化した形で保持し管理可能にする ステータスやSemVerを用いた更新プロセスを定義 判定基準 Draft Review Active
Archive v1.2 v1.2 v1.2 v1.2 抽象化されたルール 1:1 違反種別 識別する違反タイプ OK/NG例 1:m ルールを補う具体例 作成 レビュー エンジニア ドメインエキスパート 1:m 個別事例 エッジケース Major:判定基準の改訂 / Minor:OK/NG例の追加、表現の変更 26
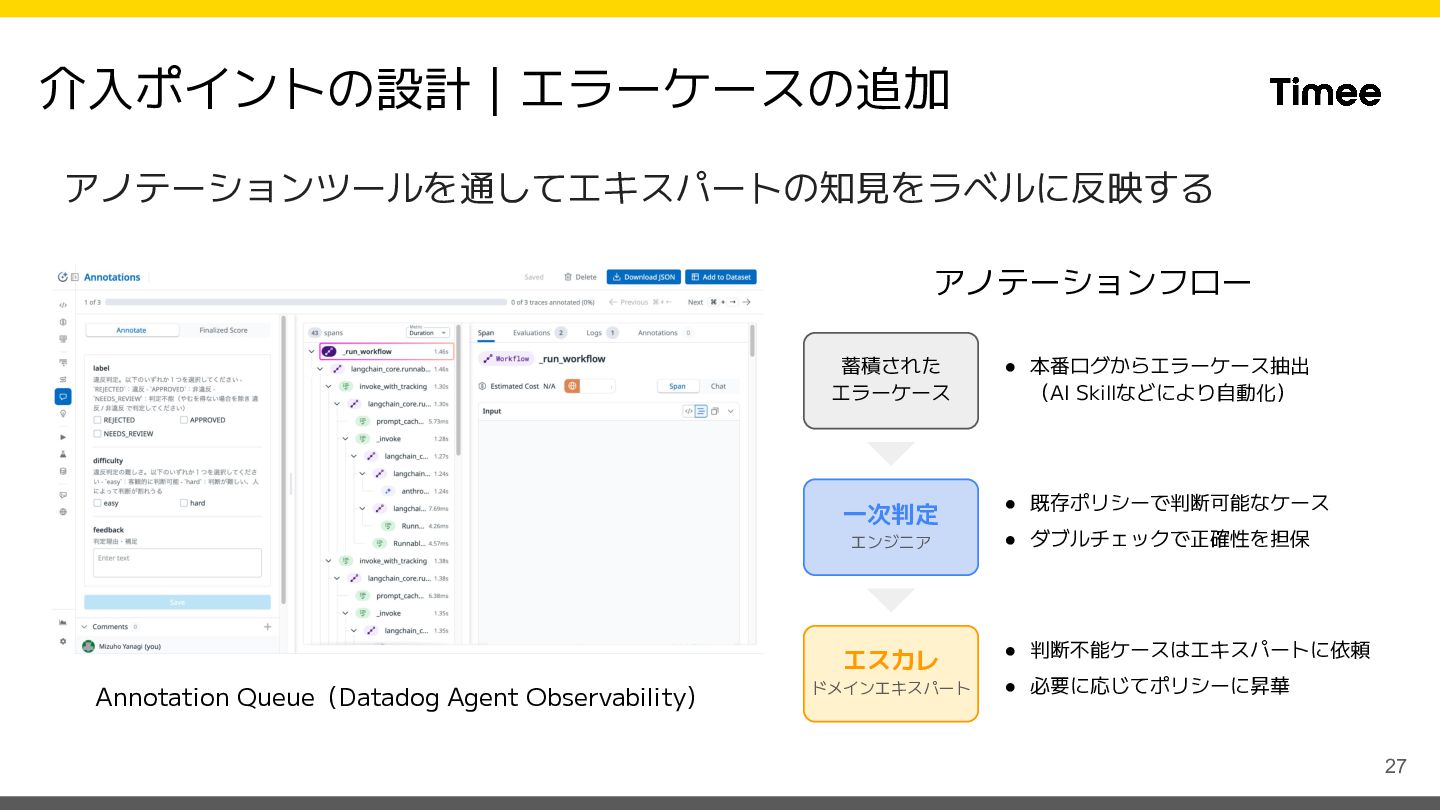
介入ポイントの設計|エラーケースの追加 アノテーションツールを通してエキスパートの知見をラベルに反映する アノテーションフロー 蓄積された エラーケース • 本番ログからエラーケース抽出 (AI Skillなどにより自動化) 一次判定
• 既存ポリシーで判断可能なケース エンジニア エスカレ Annotation Queue(Datadog Agent Observability) ドメインエキスパート • ダブルチェックで正確性を担保 • 判断不能ケースはエキスパートに依頼 • 必要に応じてポリシーに昇華 27
まとめ
円滑なプロセスを設計し、愚直に改善を回す 1 信頼できるゴールデンデータを用意し客観的に評価できる土台を作る 2 開発と本番をつなぎゴールデンデータを育てながら段階的に改善する 3 エンジニアと専門家が協業するための効果的なプロセスを設計する 29
More Decks by suikabar
See All by suikabar
LLMによるContent Moderationの本番運用の裏側と品質担保への挑戦
suikabar
3
1.1k
Other Decks in Technology
See All in Technology
顧客合意を取りながら進めるAWSコスト削減の実践
optim
0
170
セキュリティ専任チームなしで攻撃を先回りするSREが実践したSIEM on Amazon OpenSearch Service
cscengineer
PRO
1
850
プロダクションコードにおける encoding/json から encoding/json/v2 へのスムーズな移行
sansantech
PRO
1
400
農夫は秘伝のタレを知らない - NOBODY KNOWS THE HIDDEN SOURCE - Kaggriculture 3rd Place Solution
masspeaks
0
230
開発者とAIで共に歩み育てていく OSS開発 ~創造しながら育てていく~ / 20261105 Masaki Okuda
shift_evolve
PRO
1
110
SREのためのFinOps入門
muziyoshiz
3
1.5k
内製アプリとClaudeスキルのセキュリティチェック、 Backlogの課題で回しています。
ayaka_egaaa
0
180
Ebitengine製iOSアプリ公開ボタンを押す会
eiei114
0
120
Kiro IDE 入門 (画面の各部から、頼み方、任せ方、戻し方まで) | 目指せ Kiro マスター 02
inariku
PRO
4
220
AIが会計業務の伴走者に。 マネーフォワード クラウド会計MCPサーバーで実現するAI前提の新しい業務プロセス
nobitabashi
0
110
20261113_JAWS_Osaka
takuyay0ne
0
240
サボる子はいねぇがー!AgentCoreハーネスの脆弱性に学ぶ、エージェントの入力バリデーション
iwamot
PRO
5
330
Featured
See All Featured
Tell your own story through comics
letsgokoyo
1
1.1k
From π to Pie charts
rasagy
1
440
Skip the Path - Find Your Career Trail
mkilby
1
290
Winning Ecommerce Organic Search in an AI Era - #searchnstuff2025
aleyda
2
2.2k
Unlocking the hidden potential of vector embeddings in international SEO
frankvandijk
0
1k
The AI Search Optimization Roadmap by Aleyda Solis
aleyda
2
6.4k
Design and Strategy: How to Deal with People Who Don’t "Get" Design
morganepeng
133
20k
How GitHub (no longer) Works
holman
316
150k
How Software Deployment tools have changed in the past 20 years
geshan
3
35k
HDC tutorial
michielstock
2
1k
How to Grow Your eCommerce with AI & Automation
katarinadahlin
PRO
2
350
Context Engineering - Making Every Token Count
addyosmani
9
1.3k


 suikabar
 optim
 cscengineer
 sansantech
 masspeaks
 shift_evolve
 muziyoshiz
 ayaka_egaaa
 eiei114
 inariku
 nobitabashi
 takuyay0ne
 iwamot
 letsgokoyo
 rasagy
 mkilby
 aleyda
 frankvandijk
 morganepeng
 holman
 geshan
 michielstock
 katarinadahlin
 addyosmani