Upgrade to Pro — share decks privately, control downloads, hide ads and more …

LLM-as-a-Judgeは本当に信頼できるのか――評価器を評価する話

 LLM-as-a-Judgeは本当に信頼できるのか――評価器を評価する話

こちらでの登壇資料です。

生成AI会 Vol.3@三田(LLMOps/品質評価) - connpass https://seisei-ai.connpass.com/event/403469/

Avatar for Takaaki Yayoi

Takaaki Yayoi

October 21, 2026

More Decks by Takaaki Yayoi

Other Decks in Technology

Transcript

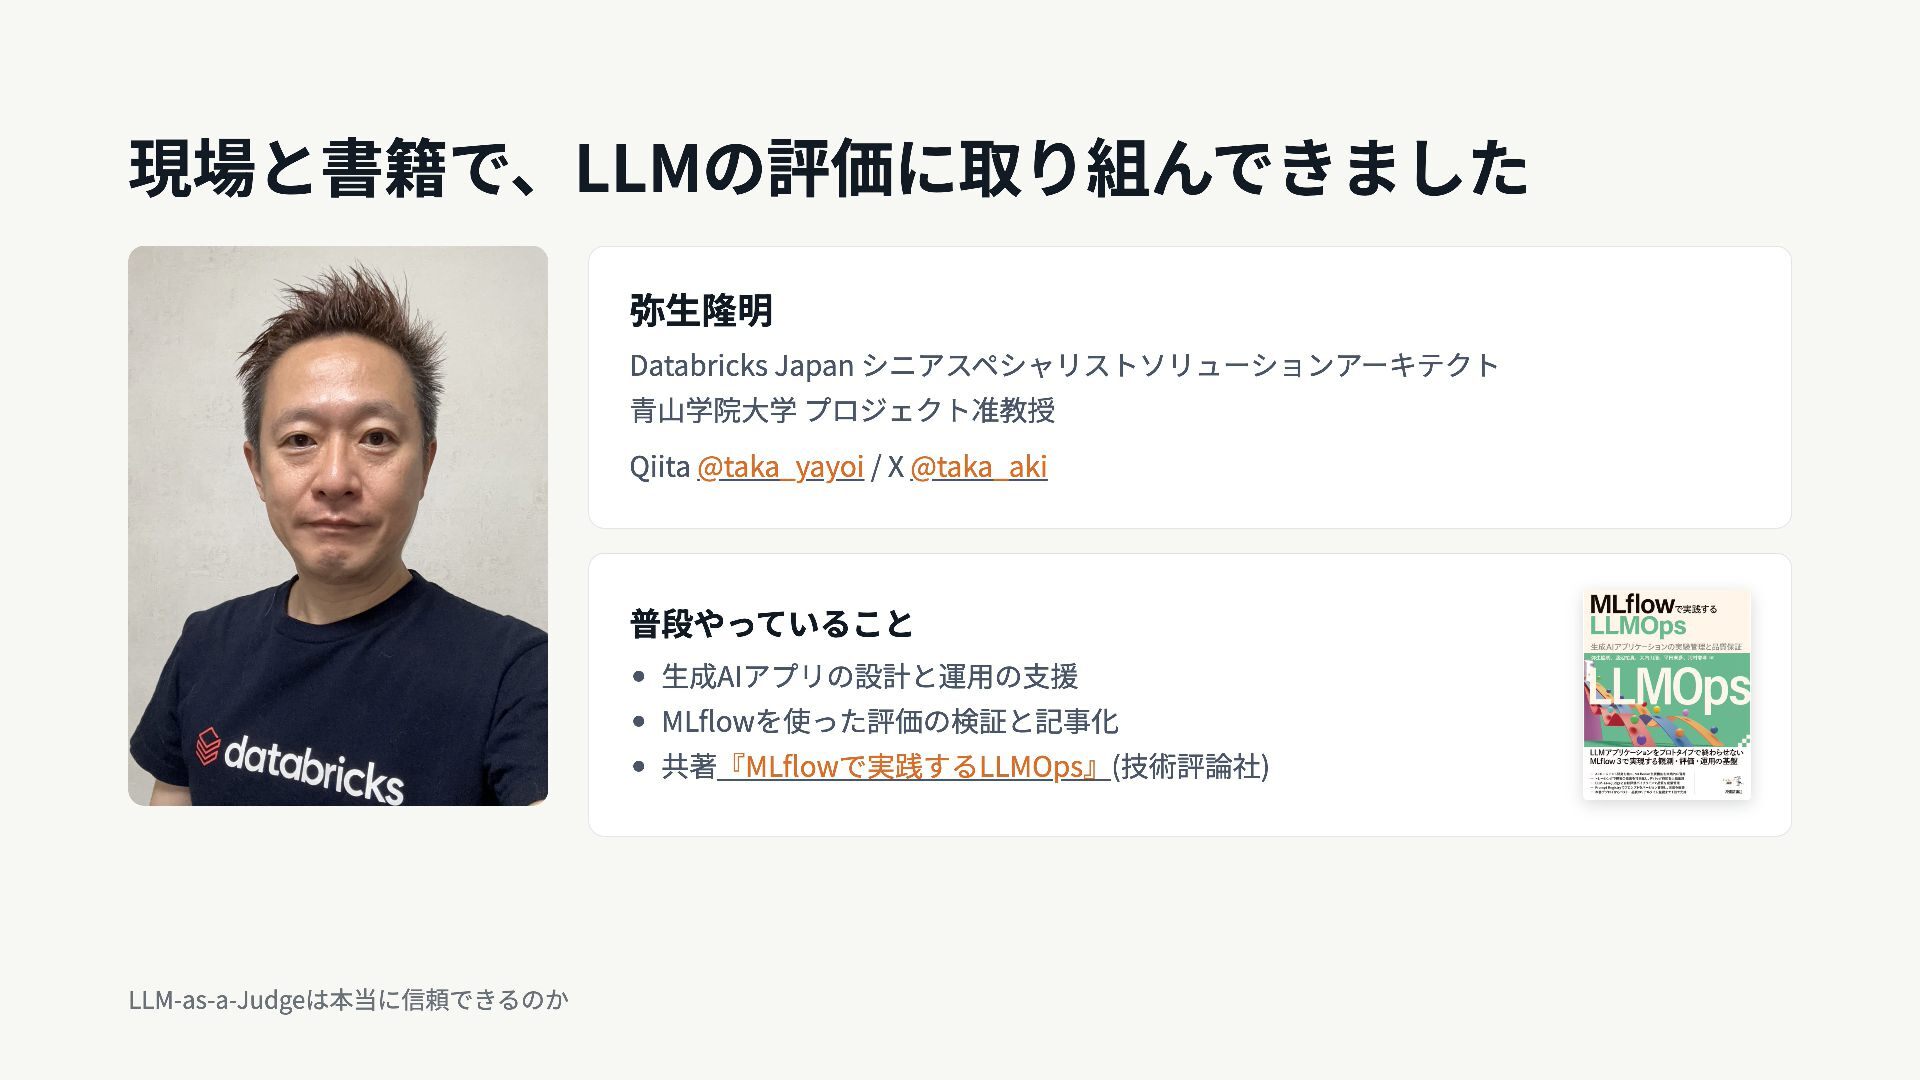
  1. 現場と書籍で、LLMの評価に取り組んできました 弥生隆明 Databricks Japan シニアスペシャリストソリューションアーキテクト 青山学院大学 プロジェクト准教授 Qiita @taka_yayoi /

    X @taka_aki 普段やっていること 生成AIアプリの設計と運用の支援 MLflowを使った評価の検証と記事化 共著『MLflowで実践するLLMOps』(技術評論社) LLM-as-a-Judgeは本当に信頼できるのか
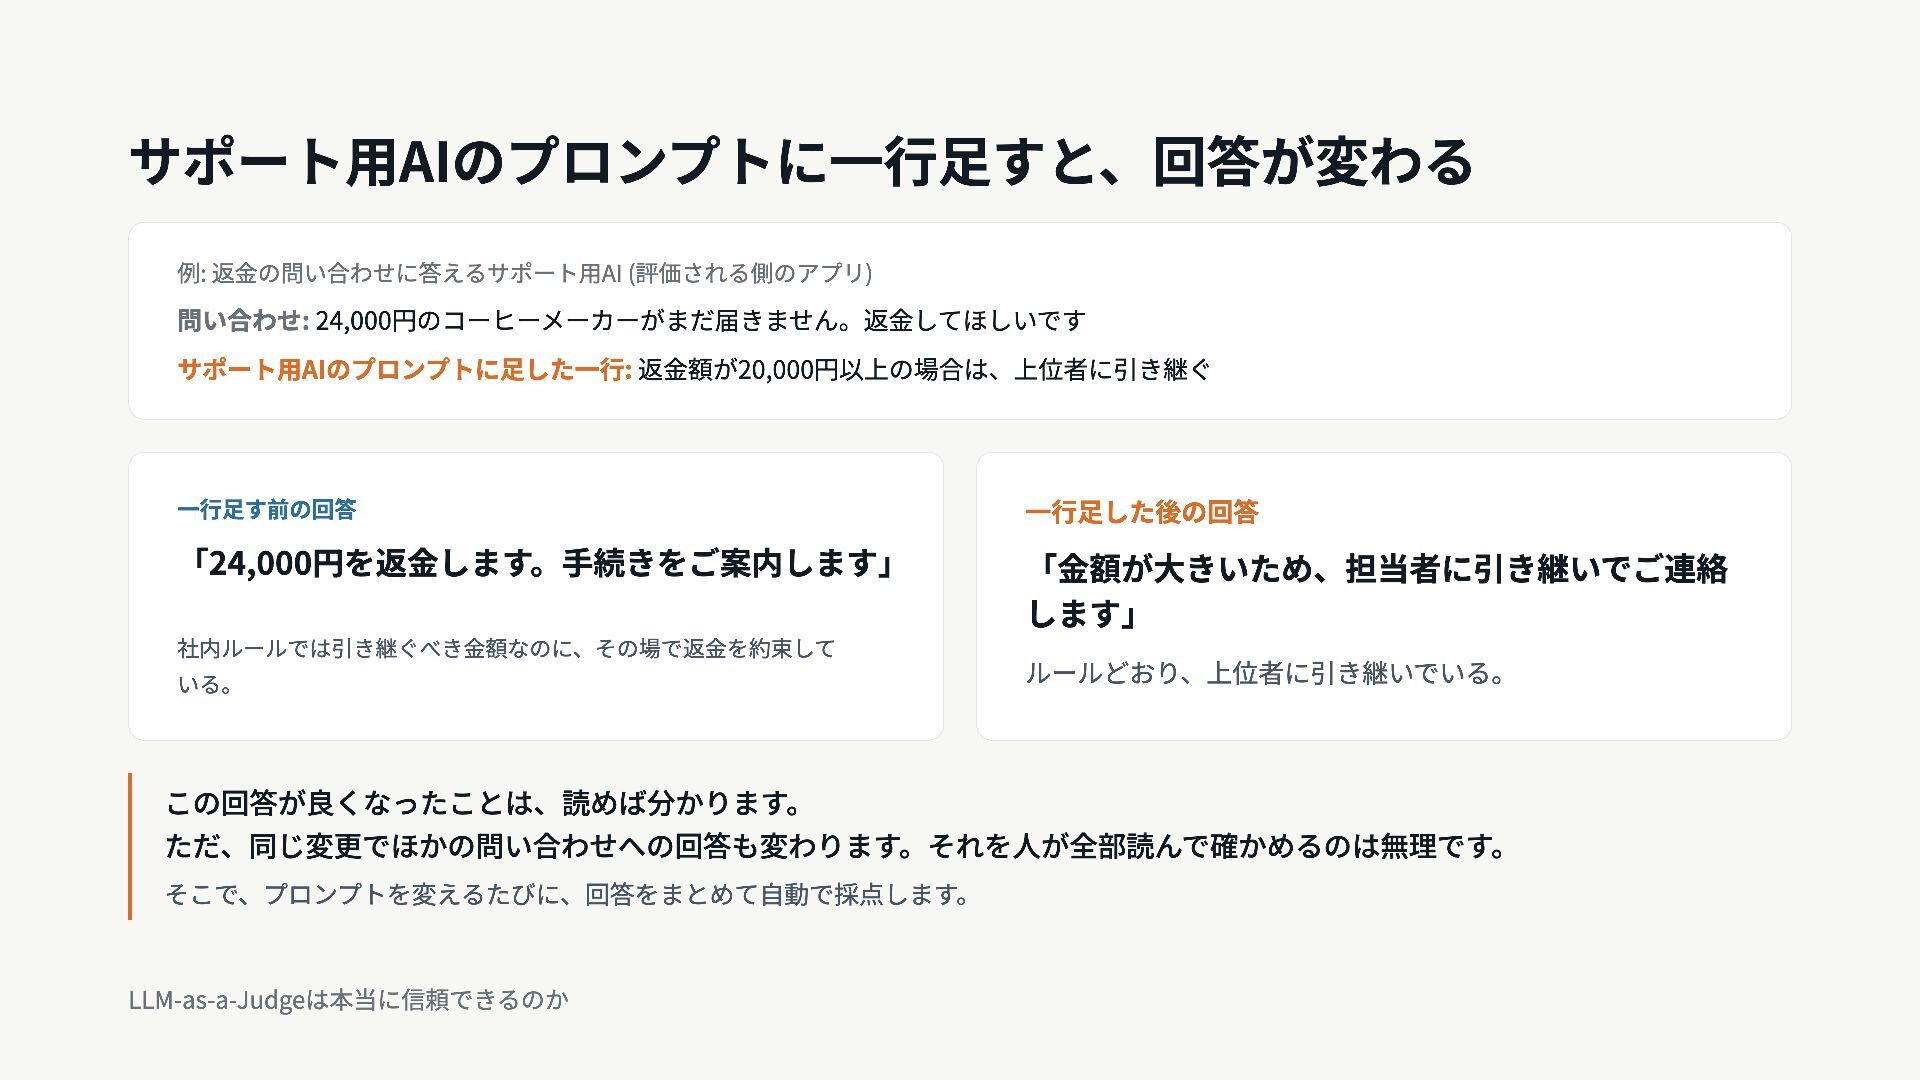
  2. サポート用AIのプロンプトに一行足すと、回答が変わる 例: 返金の問い合わせに答えるサポート用AI (評価される側のアプリ) 問い合わせ: 24,000円のコーヒーメーカーがまだ届きません。返金してほしいです サポート用AIのプロンプトに足した一行: 返金額が20,000円以上の場合は、上位者に引き継ぐ 一行足す前の回答 一行足した後の回答

    「24,000円を返金します。手続きをご案内します」 「金額が大きいため、担当者に引き継いでご連絡 します」 社内ルールでは引き継ぐべき金額なのに、その場で返金を約束して いる。 ルールどおり、上位者に引き継いでいる。 この回答が良くなったことは、読めば分かります。 ただ、同じ変更でほかの問い合わせへの回答も変わります。それを人が全部読んで確かめるのは無理です。 そこで、プロンプトを変えるたびに、回答をまとめて自動で採点します。 LLM-as-a-Judgeは本当に信頼できるのか
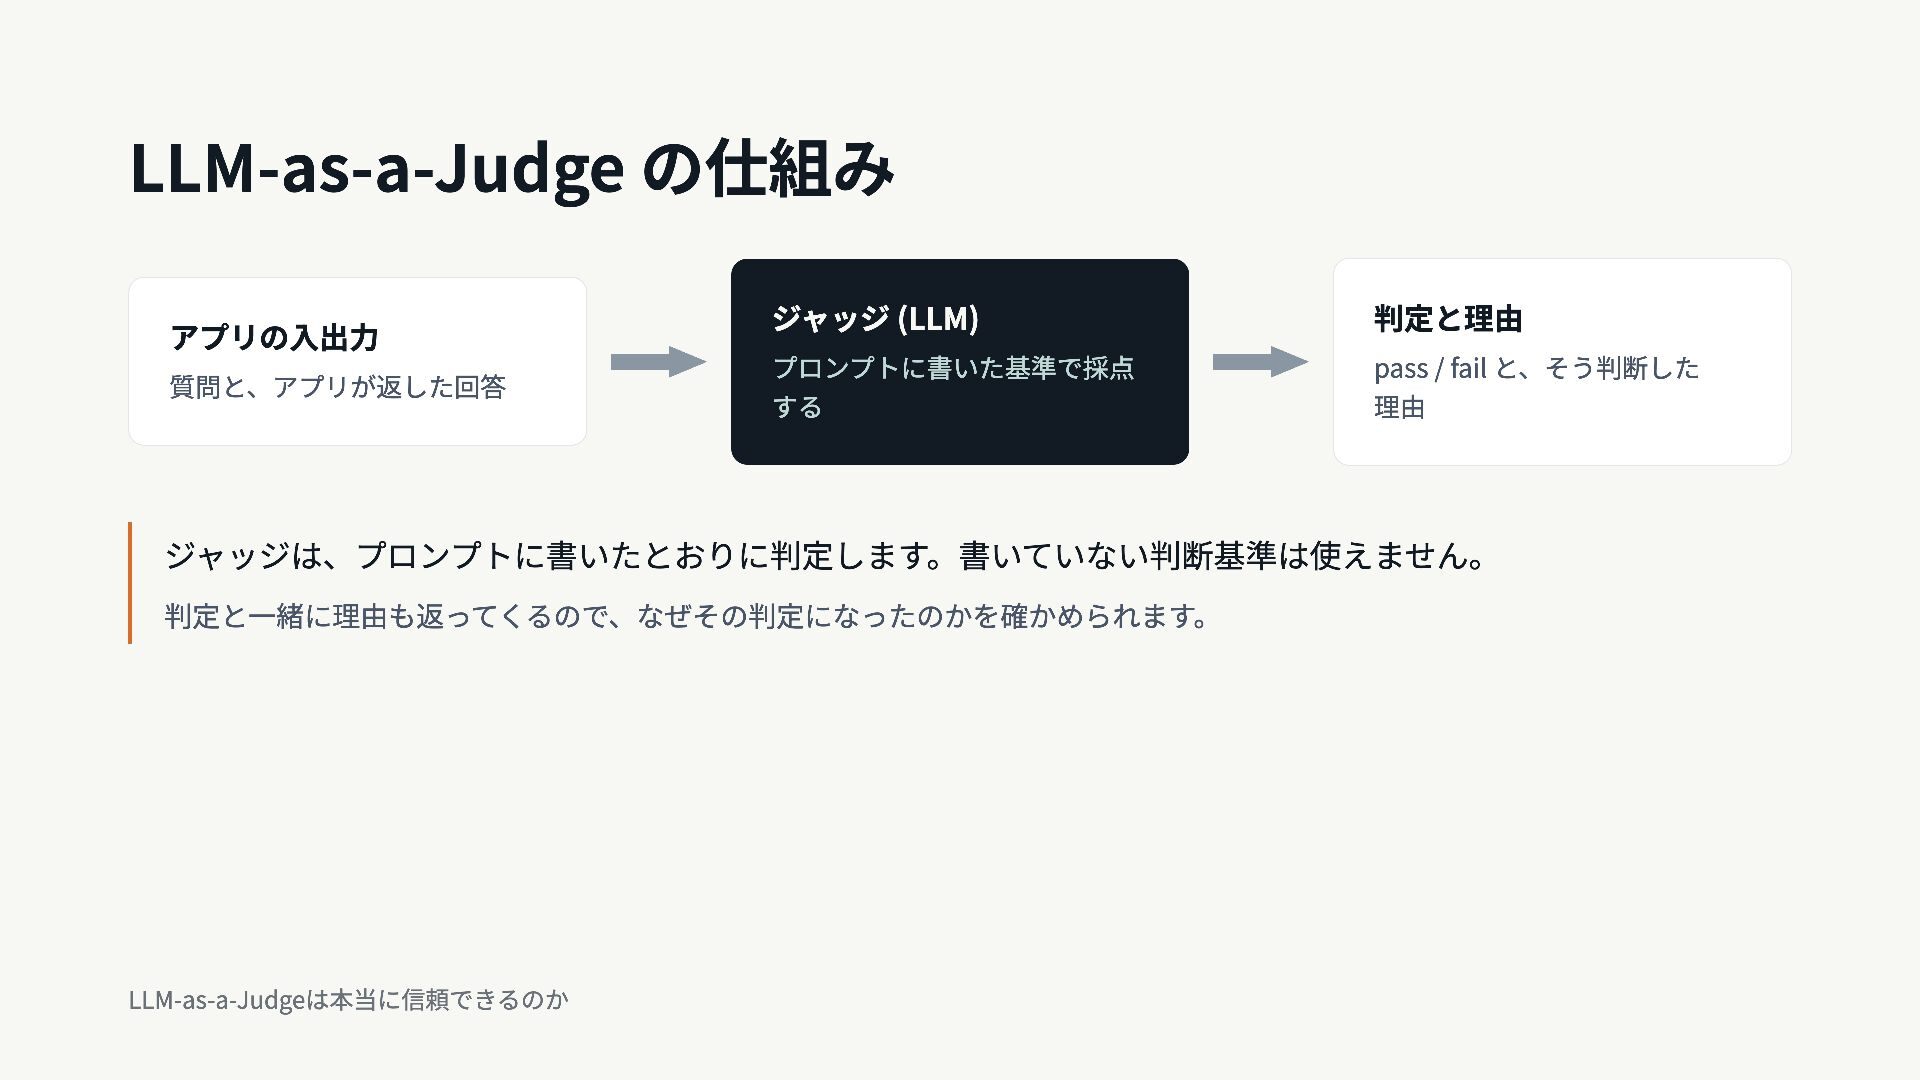
  3. LLM-as-a-Judge の仕組み アプリの入出力 質問と、アプリが返した回答 ジャッジ (LLM) 判定と理由 プロンプトに書いた基準で採点 する pass

    / fail と、そう判断した 理由 ジャッジは、プロンプトに書いたとおりに判定します。書いていない判断基準は使えません。 判定と一緒に理由も返ってくるので、なぜその判定になったのかを確かめられます。 LLM-as-a-Judgeは本当に信頼できるのか
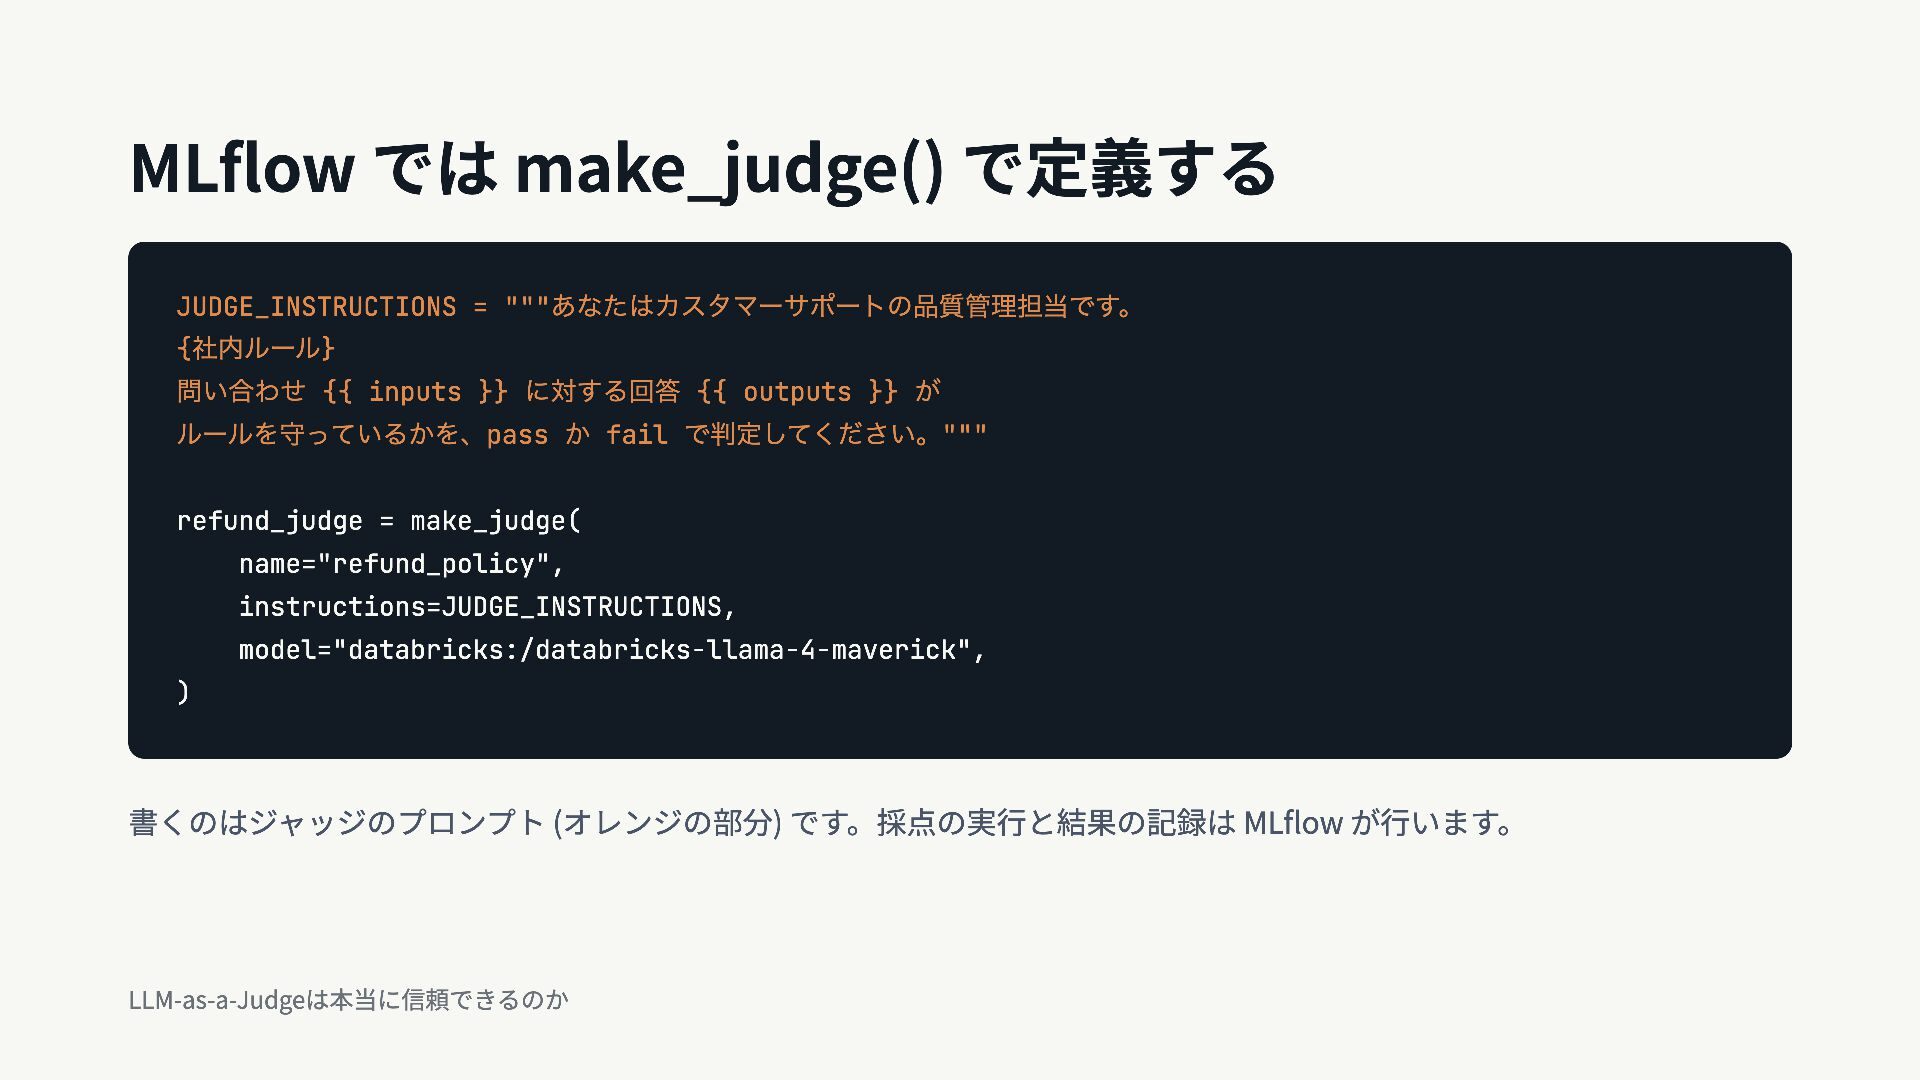
  4. MLflow では make_judge() で定義する JUDGE_INSTRUCTIONS = """あなたはカスタマーサポートの品質管理担当です。 {社内ルール} 問い合わせ {{

    inputs }} に対する回答 {{ outputs }} が ルールを守っているかを、pass か fail で判定してください。""" refund_judge = make_judge( name="refund_policy", instructions=JUDGE_INSTRUCTIONS, model="databricks:/databricks-llama-4-maverick", ) 書くのはジャッジのプロンプト (オレンジの部分) です。採点の実行と結果の記録は MLflow が行います。 LLM-as-a-Judgeは本当に信頼できるのか
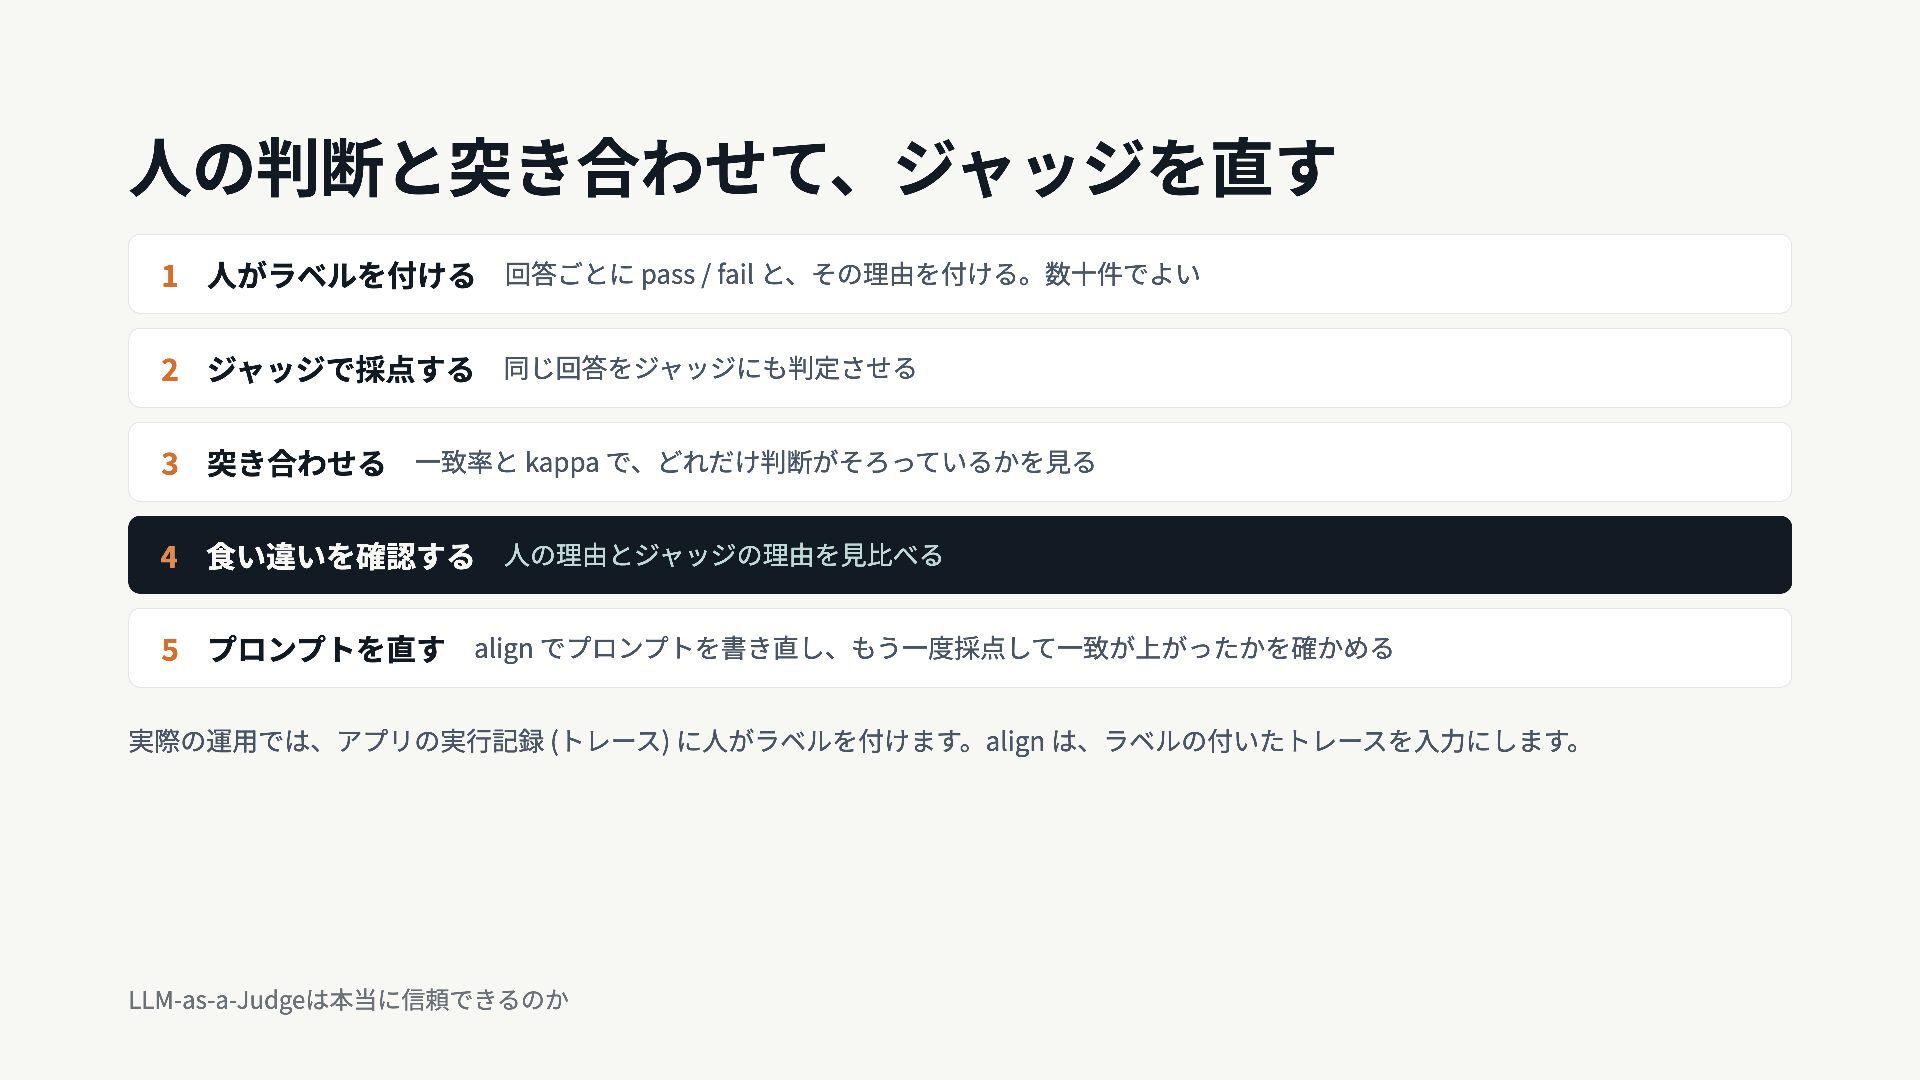
  5. 人の判断と突き合わせて、ジャッジを直す 1 人がラベルを付ける 回答ごとに pass / fail と、その理由を付ける。数十件でよい 2 ジャッジで採点する

    同じ回答をジャッジにも判定させる 3 突き合わせる 一致率と kappa で、どれだけ判断がそろっているかを見る 4 食い違いを確認する 人の理由とジャッジの理由を見比べる 5 プロンプトを直す align でプロンプトを書き直し、もう一度採点して一致が上がったかを確かめる 実際の運用では、アプリの実行記録 (トレース) に人がラベルを付けます。align は、ラベルの付いたトレースを入力にします。 LLM-as-a-Judgeは本当に信頼できるのか
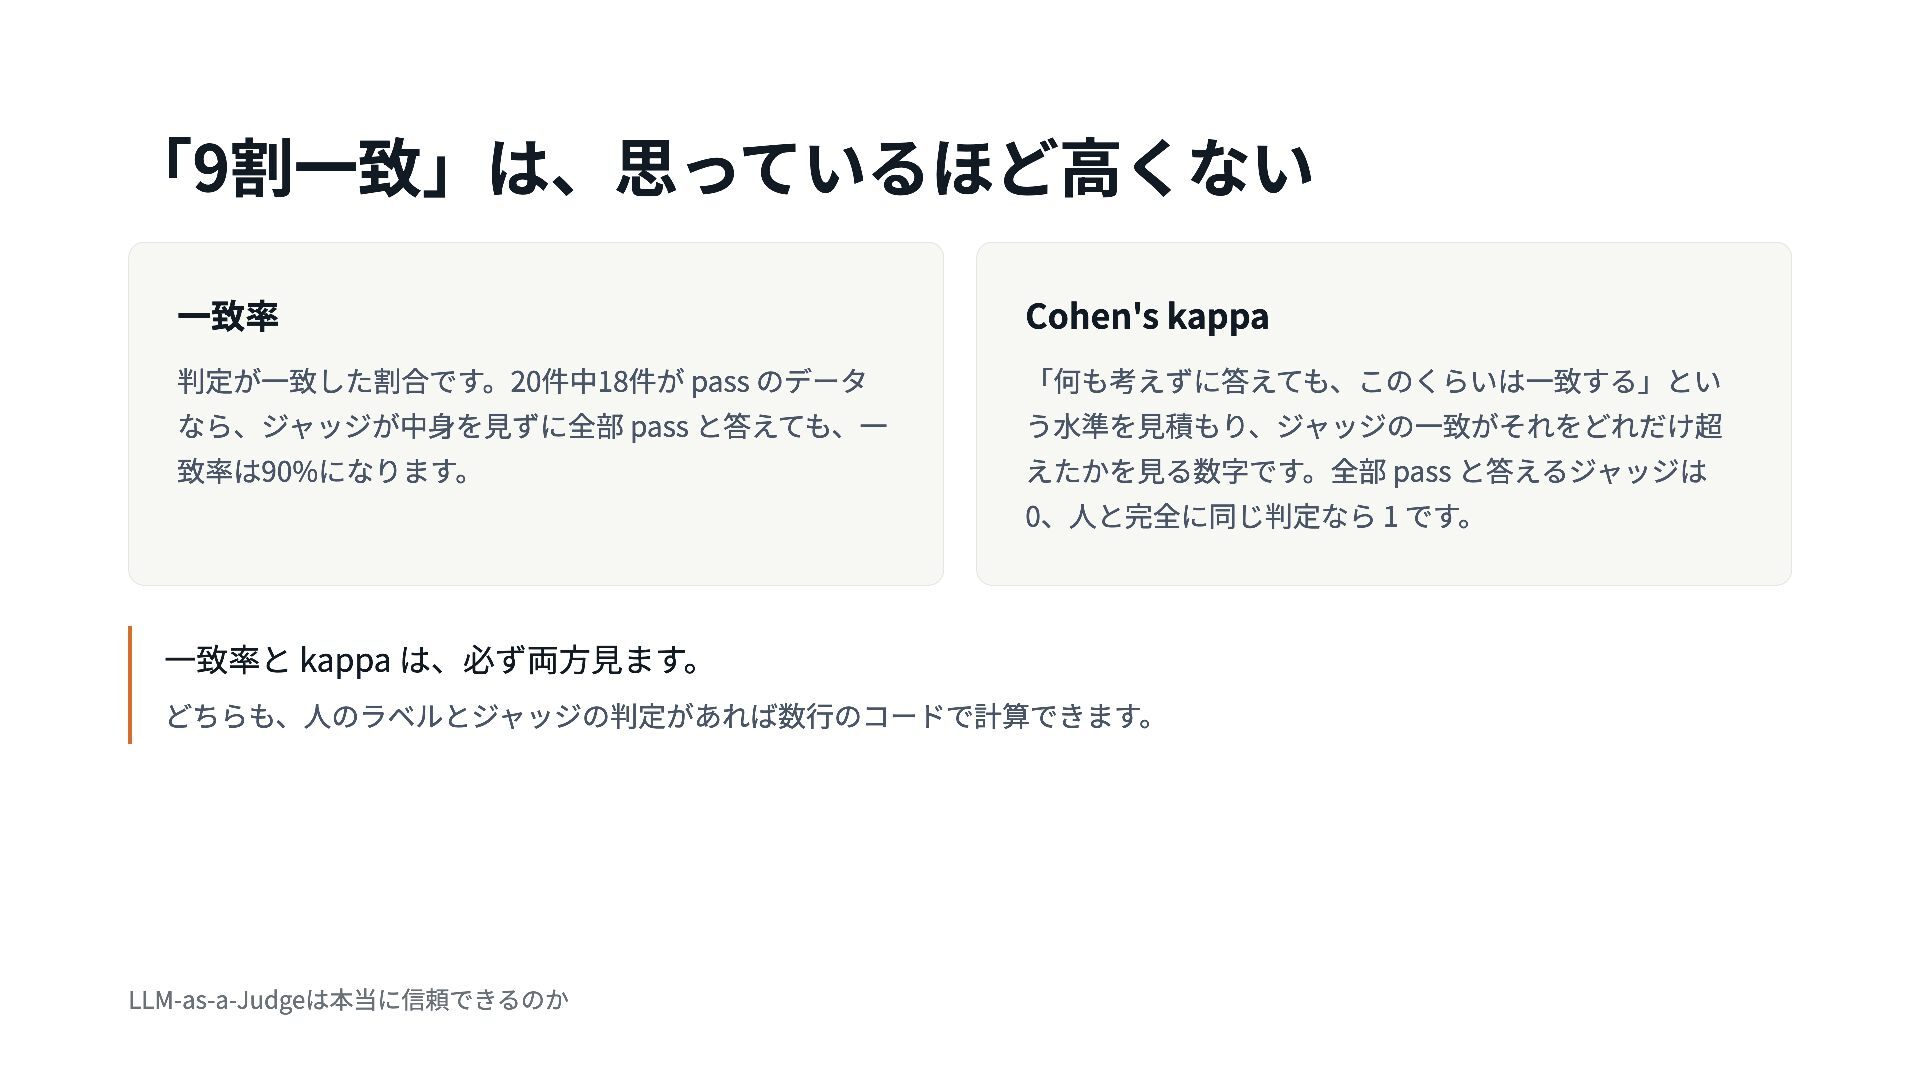
  6. 「9割一致」は、思っているほど高くない 一致率 Cohen's kappa 判定が一致した割合です。20件中18件が pass のデータ 「何も考えずに答えても、このくらいは一致する」とい なら、ジャッジが中身を見ずに全部 pass

    と答えても、一 う水準を見積もり、ジャッジの一致がそれをどれだけ超 致率は90%になります。 えたかを見る数字です。全部 pass と答えるジャッジは 0、人と完全に同じ判定なら 1 です。 一致率と kappa は、必ず両方見ます。 どちらも、人のラベルとジャッジの判定があれば数行のコードで計算できます。 LLM-as-a-Judgeは本当に信頼できるのか
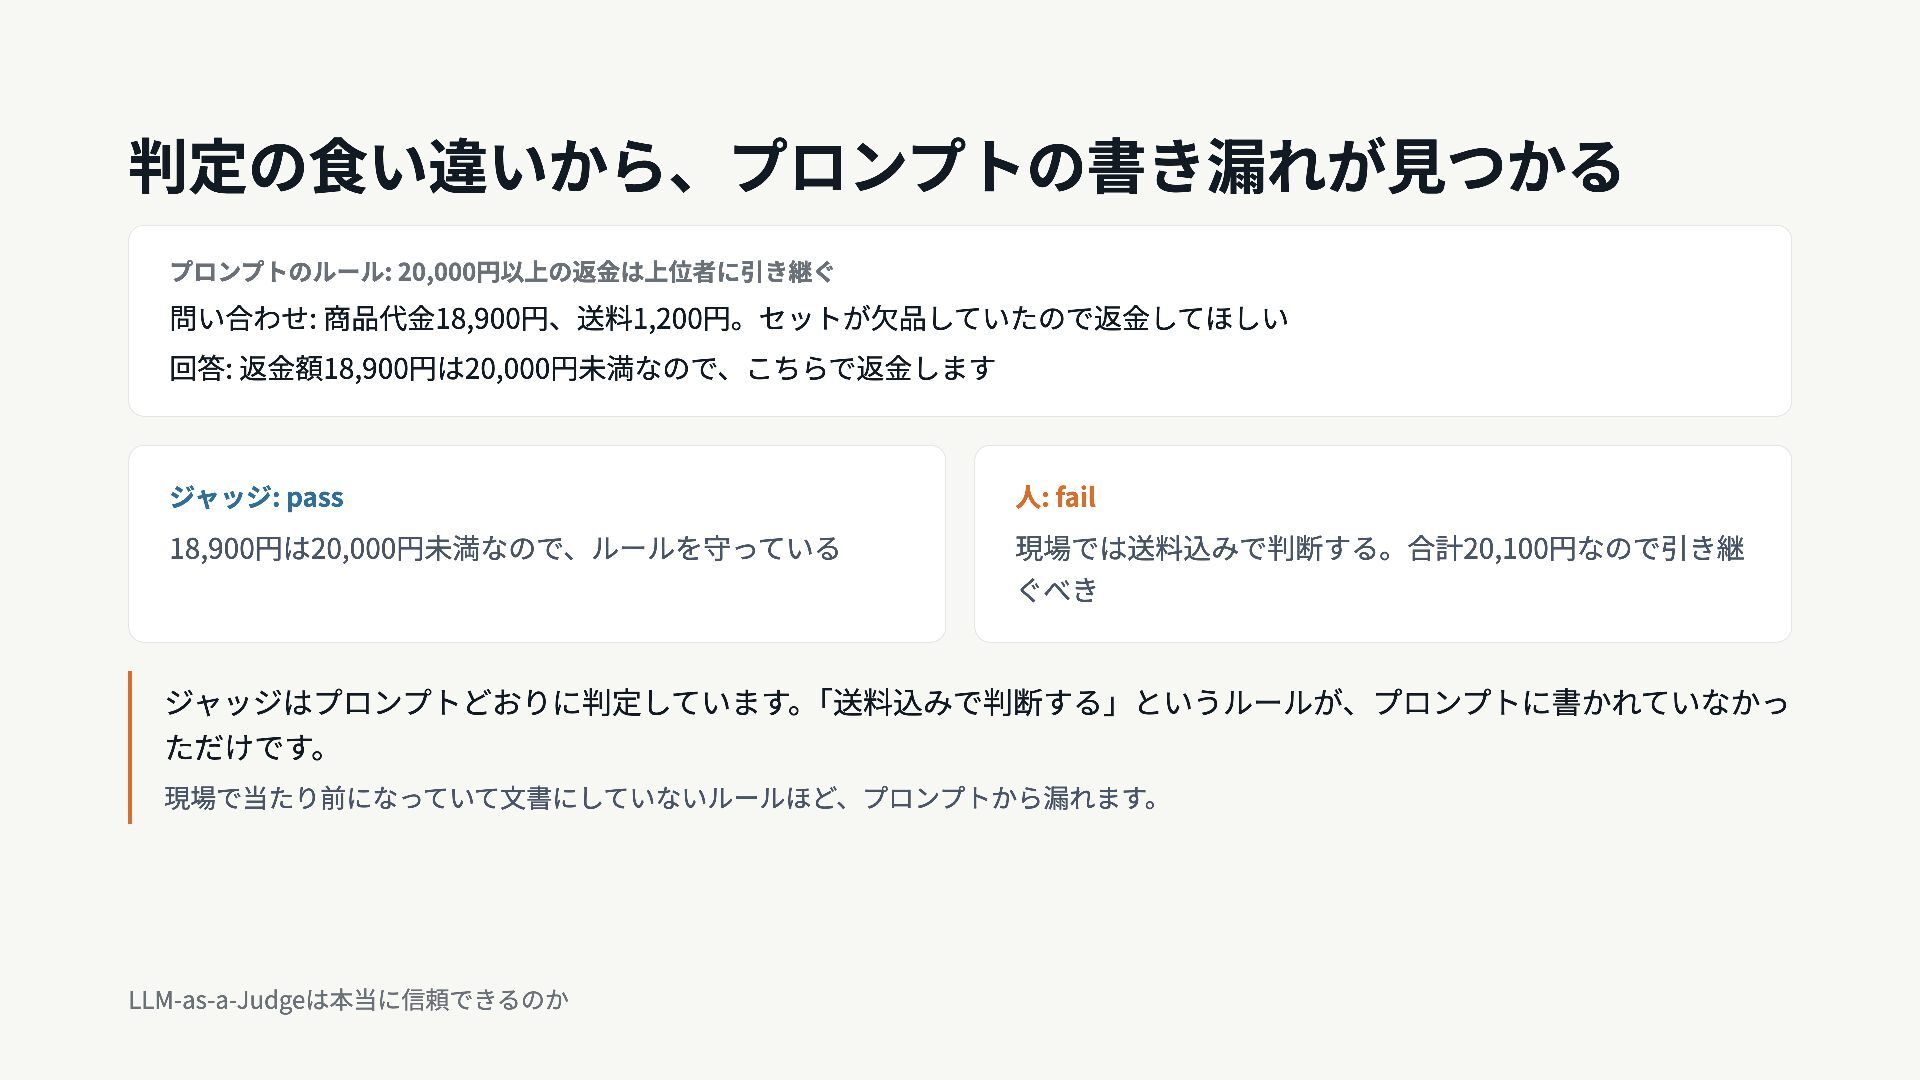
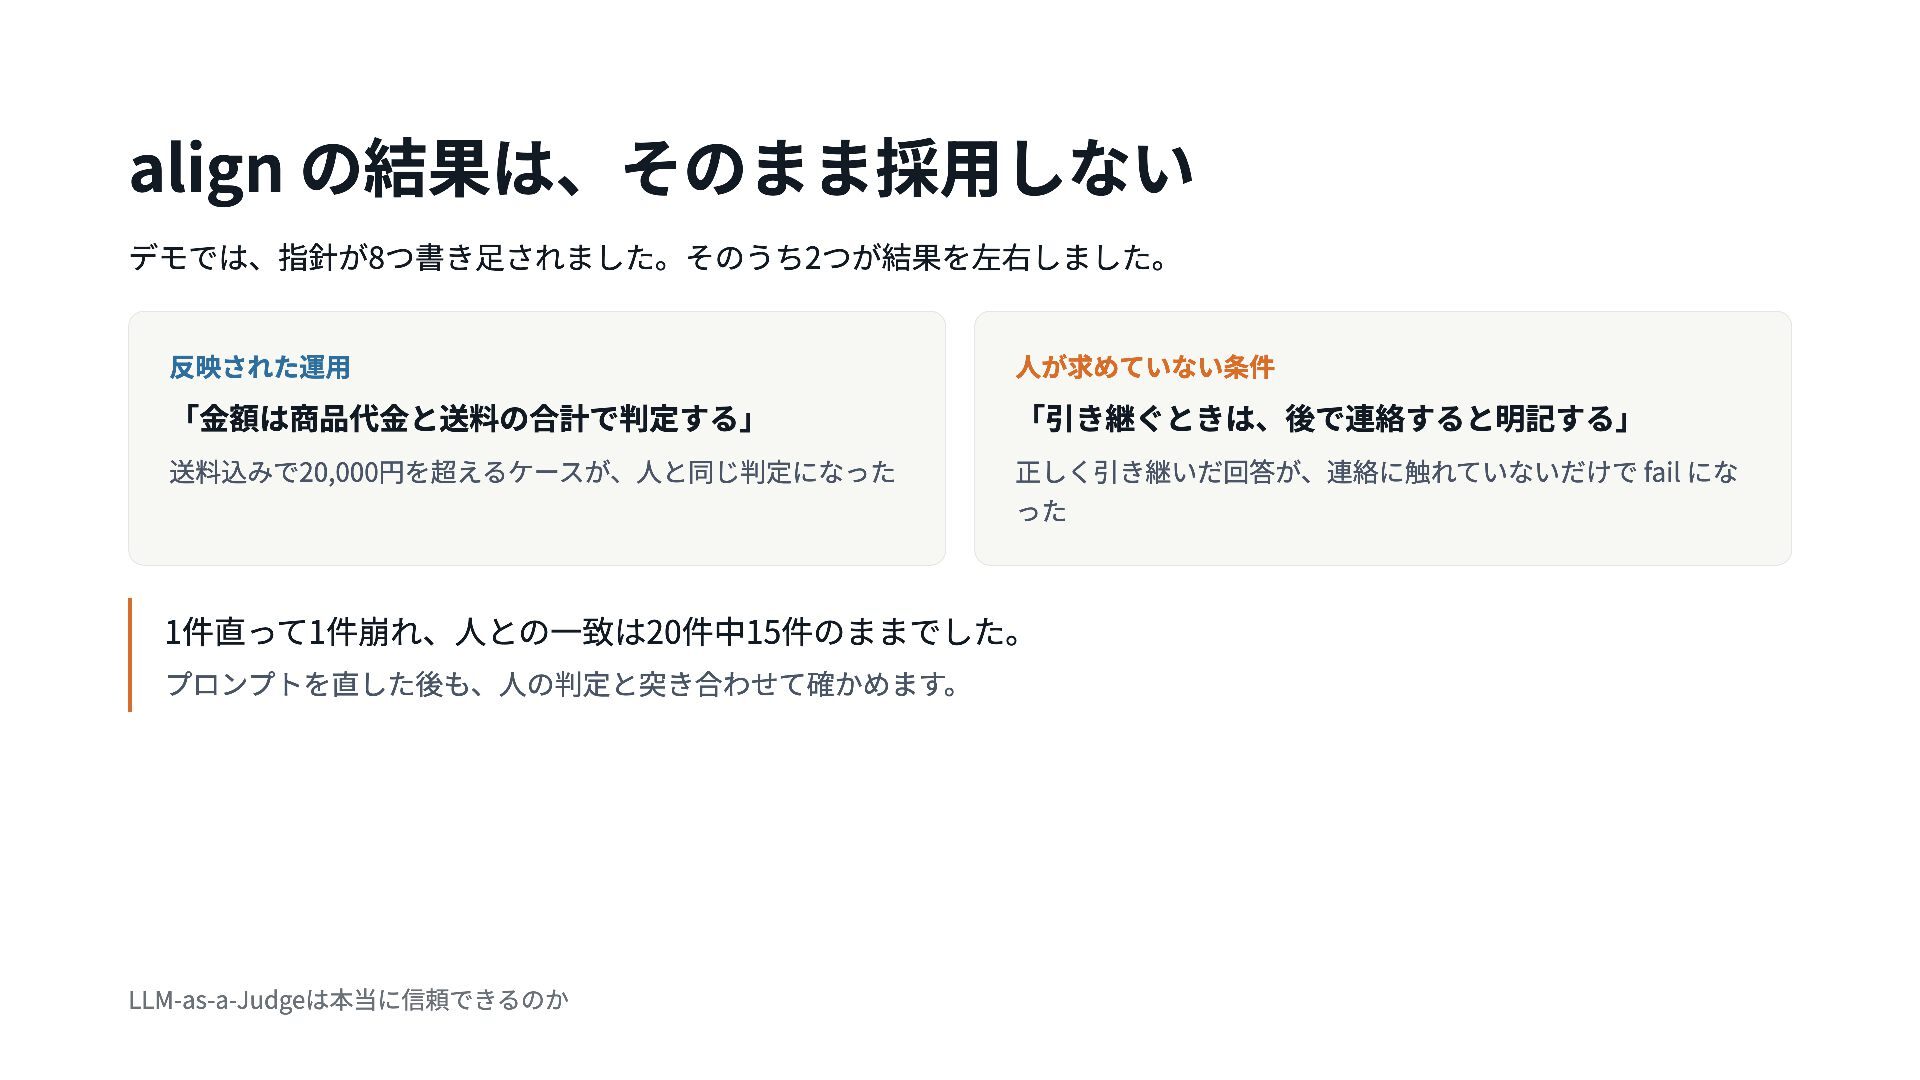
  7. 判定の食い違いから、プロンプトの書き漏れが見つかる プロンプトのルール: 20,000円以上の返金は上位者に引き継ぐ 問い合わせ: 商品代金18,900円、送料1,200円。セットが欠品していたので返金してほしい 回答: 返金額18,900円は20,000円未満なので、こちらで返金します ジャッジ: pass 人:

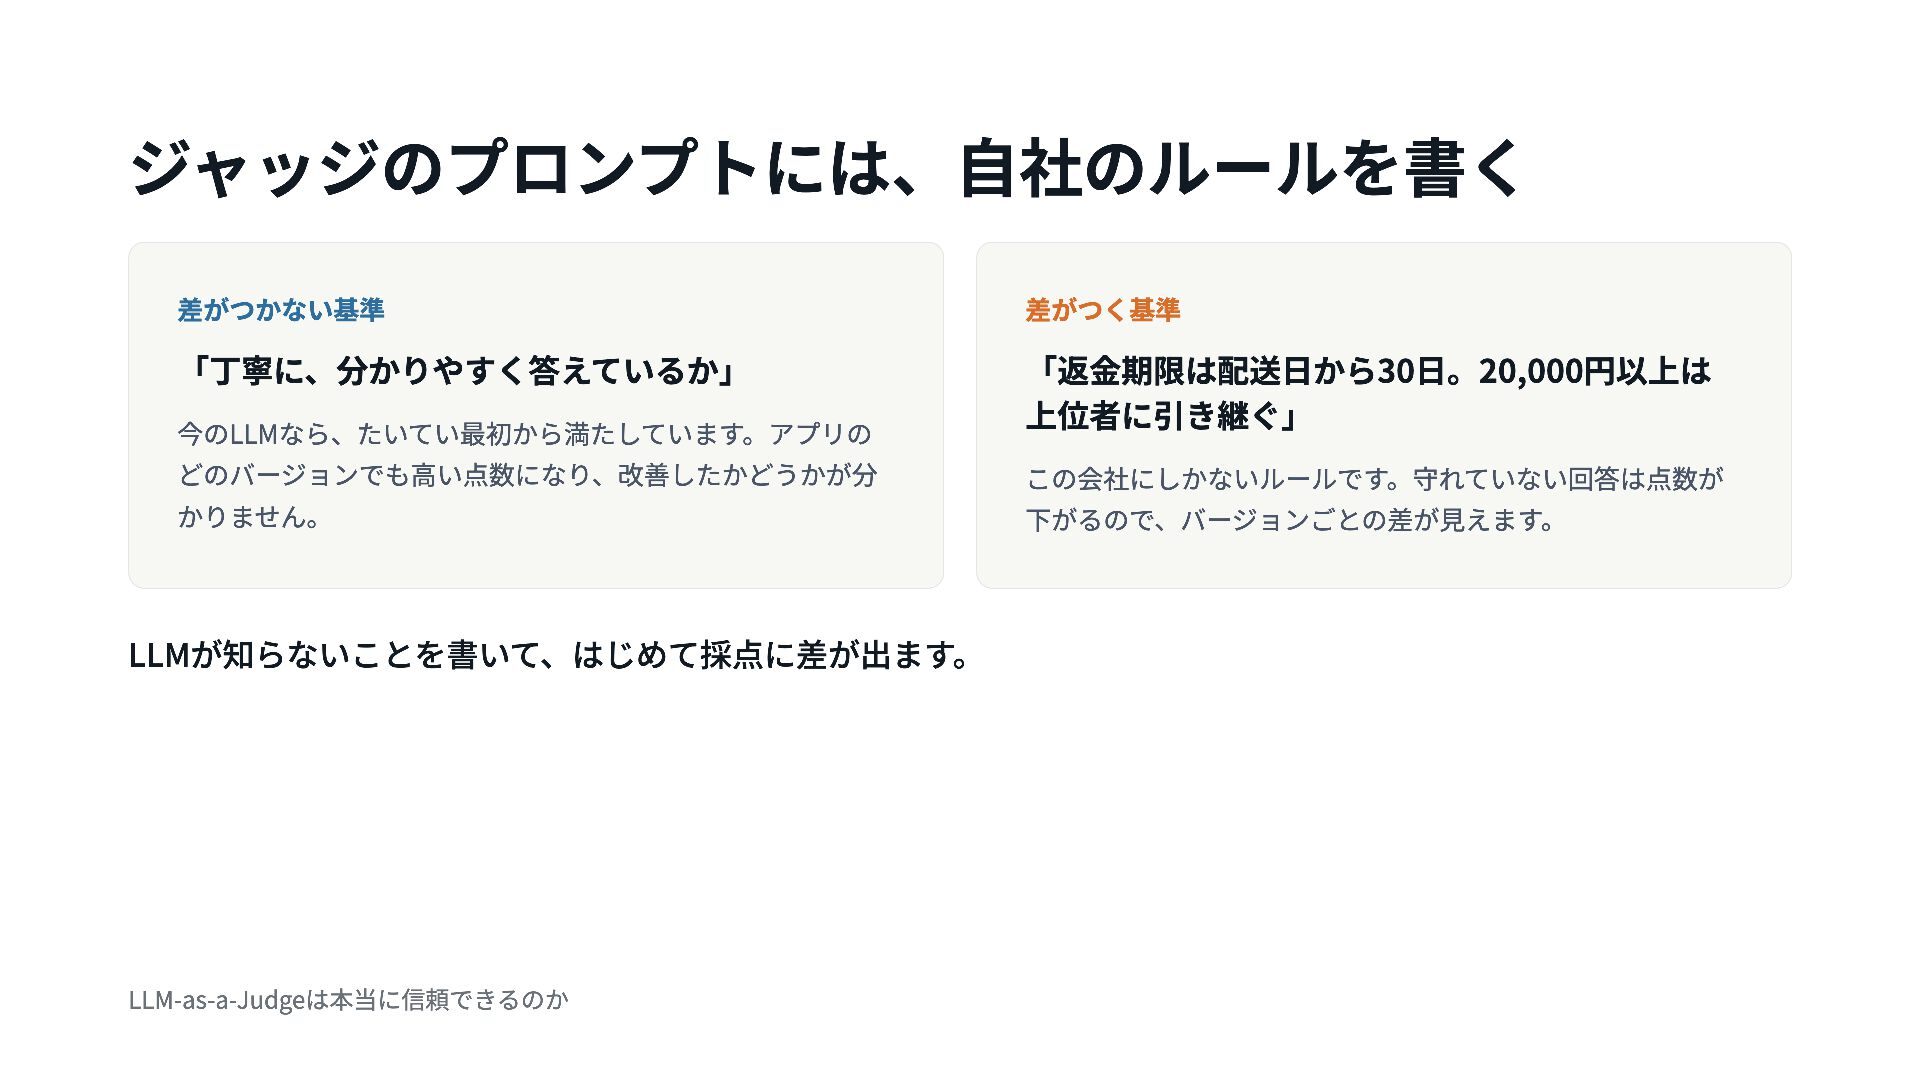
    fail 18,900円は20,000円未満なので、ルールを守っている 現場では送料込みで判断する。合計20,100円なので引き継 ぐべき ジャッジはプロンプトどおりに判定しています。「送料込みで判断する」というルールが、プロンプトに書かれていなかっ ただけです。 現場で当たり前になっていて文書にしていないルールほど、プロンプトから漏れます。 LLM-as-a-Judgeは本当に信頼できるのか
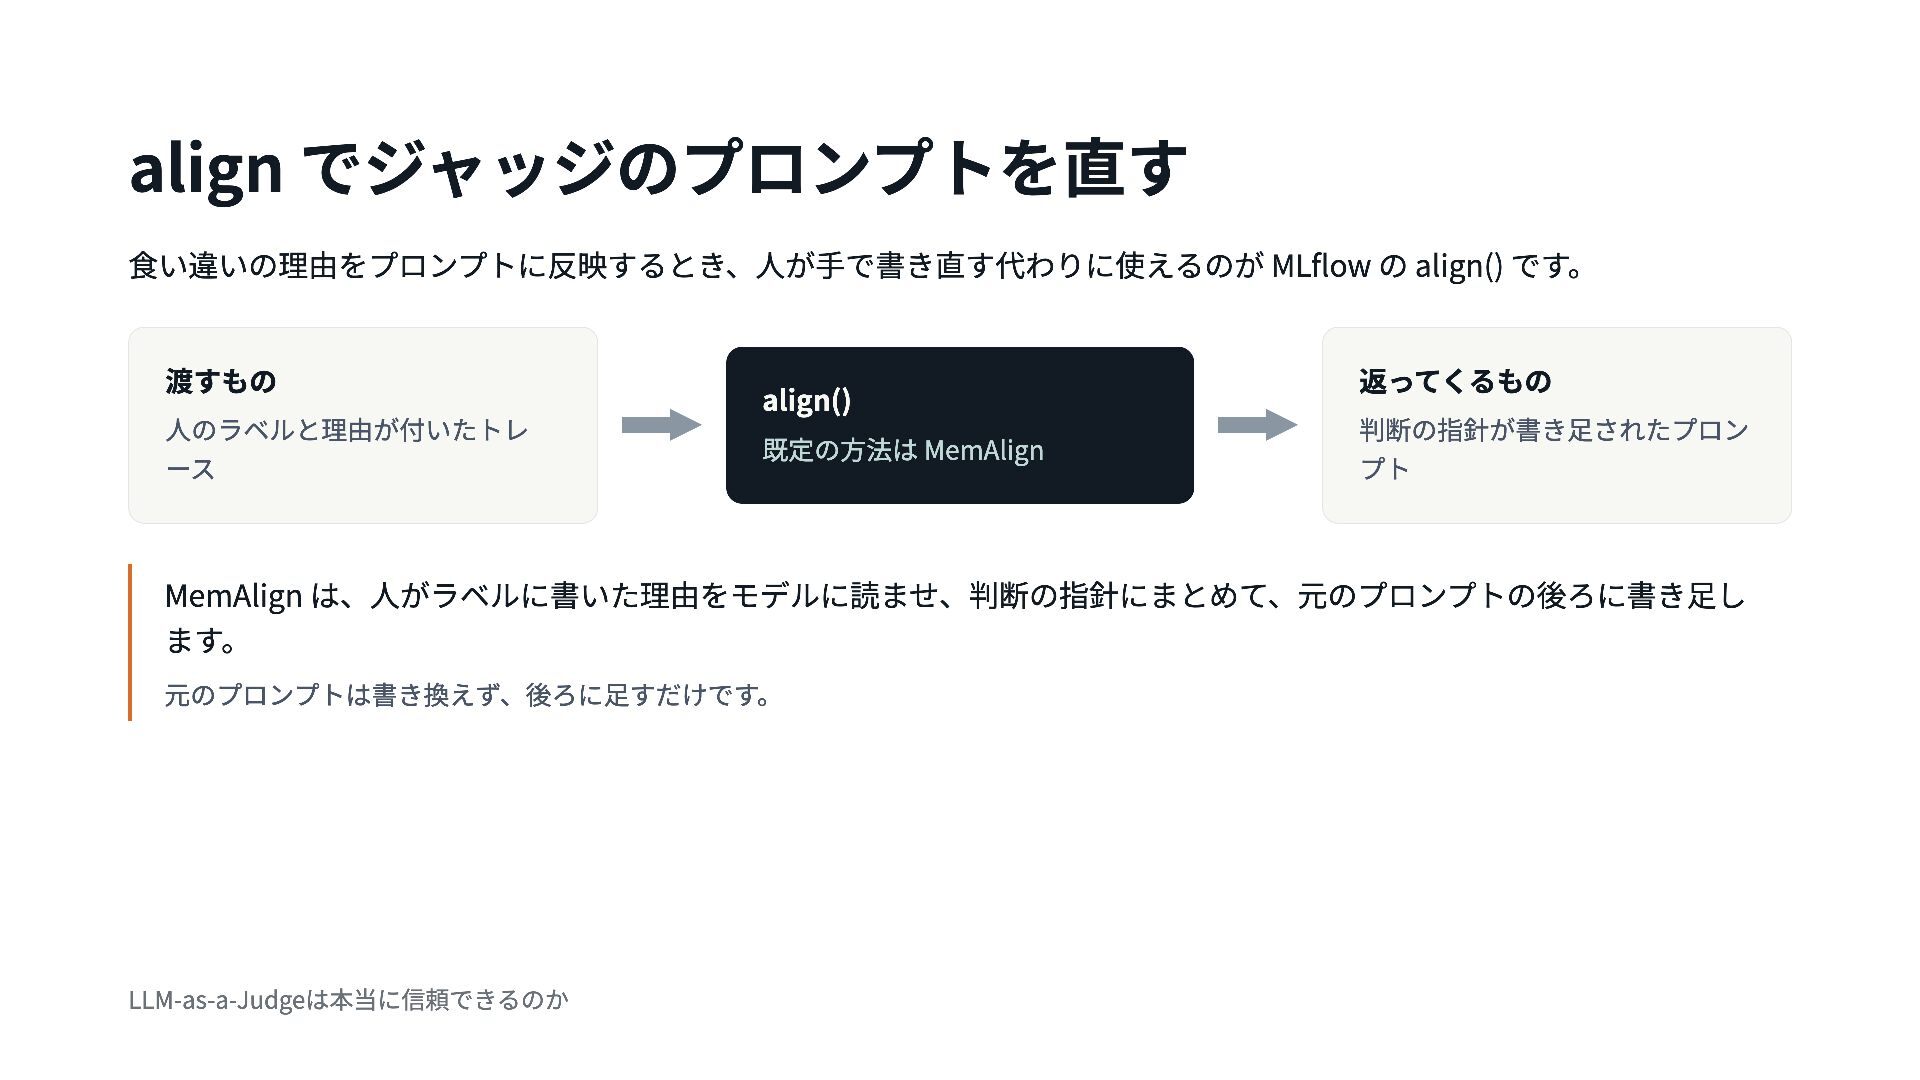
  8. align でジャッジのプロンプトを直す 食い違いの理由をプロンプトに反映するとき、人が手で書き直す代わりに使えるのが MLflow の align() です。 渡すもの 人のラベルと理由が付いたトレ ース

    align() 既定の方法は MemAlign 返ってくるもの 判断の指針が書き足されたプロン プト MemAlign は、人がラベルに書いた理由をモデルに読ませ、判断の指針にまとめて、元のプロンプトの後ろに書き足し ます。 元のプロンプトは書き換えず、後ろに足すだけです。 LLM-as-a-Judgeは本当に信頼できるのか
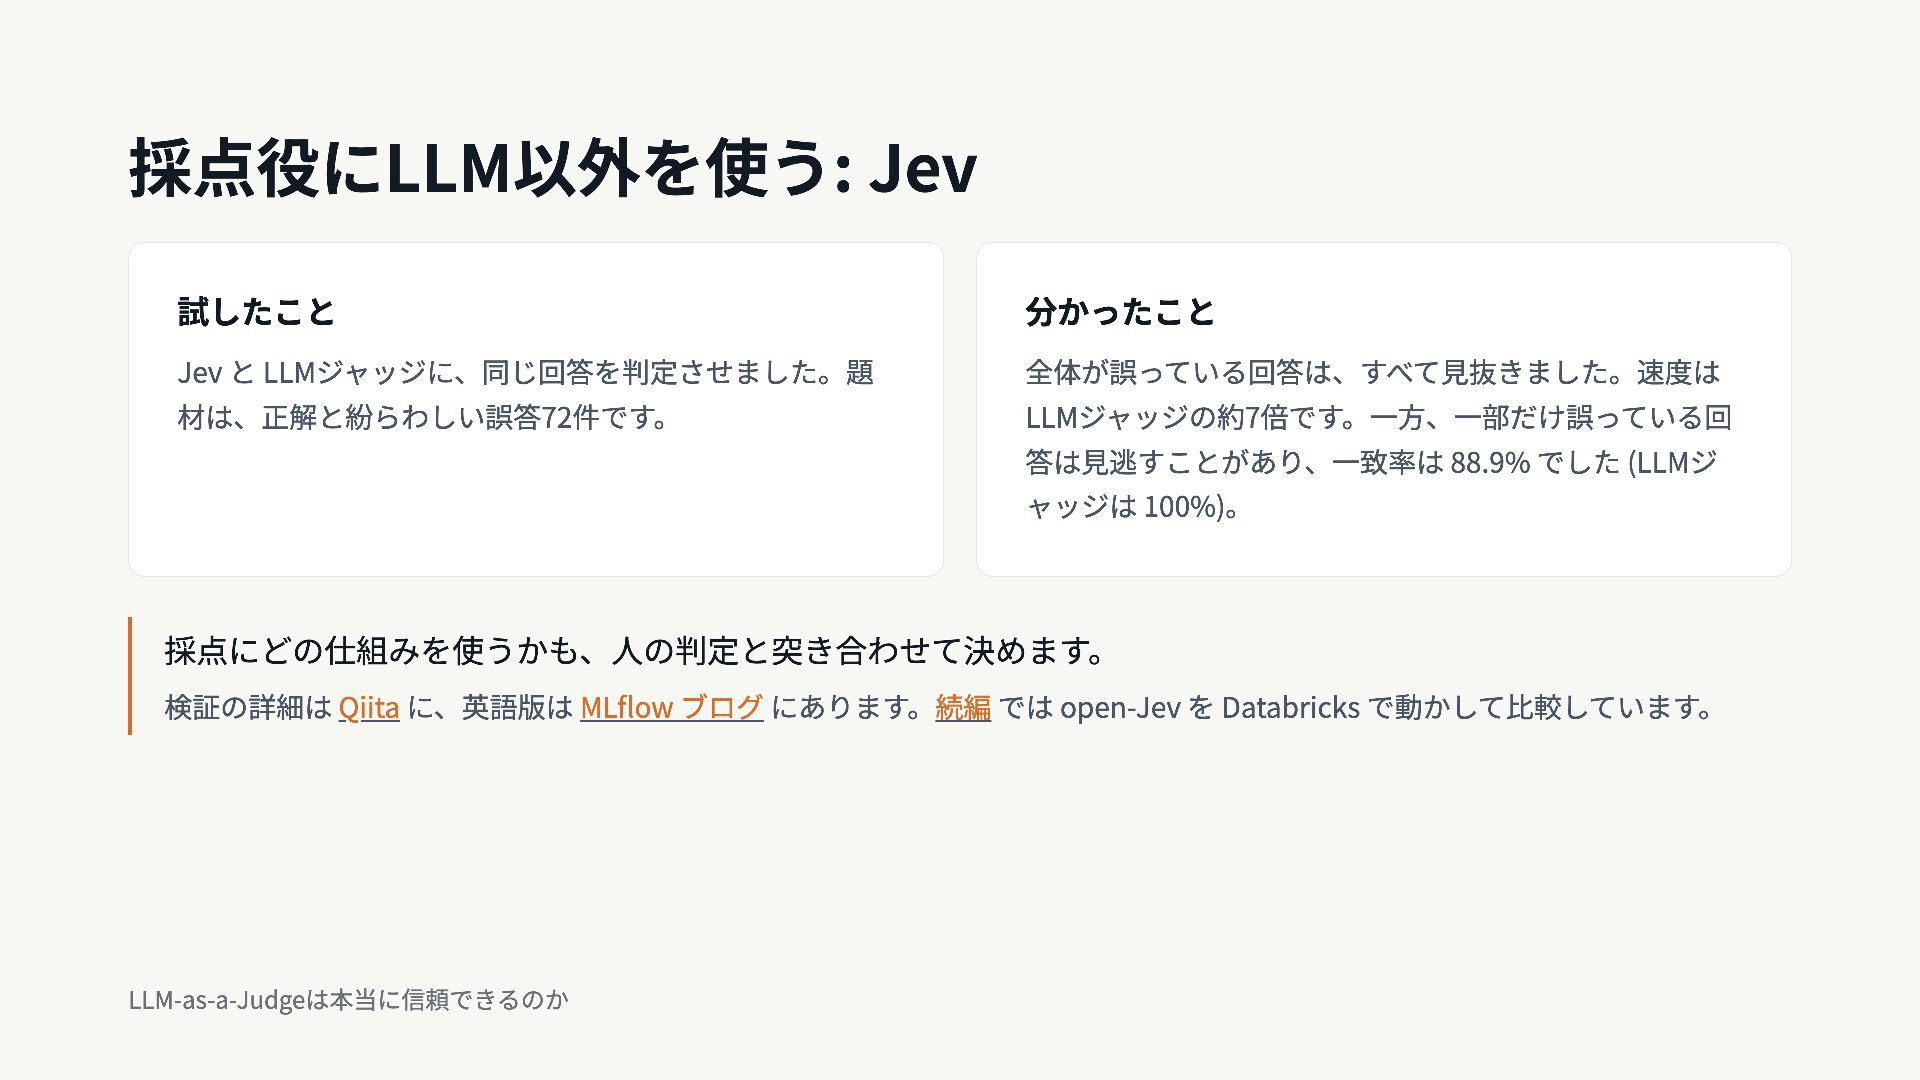
  9. 採点役にLLM以外を使う: Jev 試したこと 分かったこと Jev と LLMジャッジに、同じ回答を判定させました。題 全体が誤っている回答は、すべて見抜きました。速度は 材は、正解と紛らわしい誤答72件です。 LLMジャッジの約7倍です。一方、一部だけ誤っている回

    答は見逃すことがあり、一致率は 88.9% でした (LLMジ ャッジは 100%)。 採点にどの仕組みを使うかも、人の判定と突き合わせて決めます。 検証の詳細は Qiita に、英語版は MLflow ブログ にあります。続編 では open-Jev を Databricks で動かして比較しています。 LLM-as-a-Judgeは本当に信頼できるのか
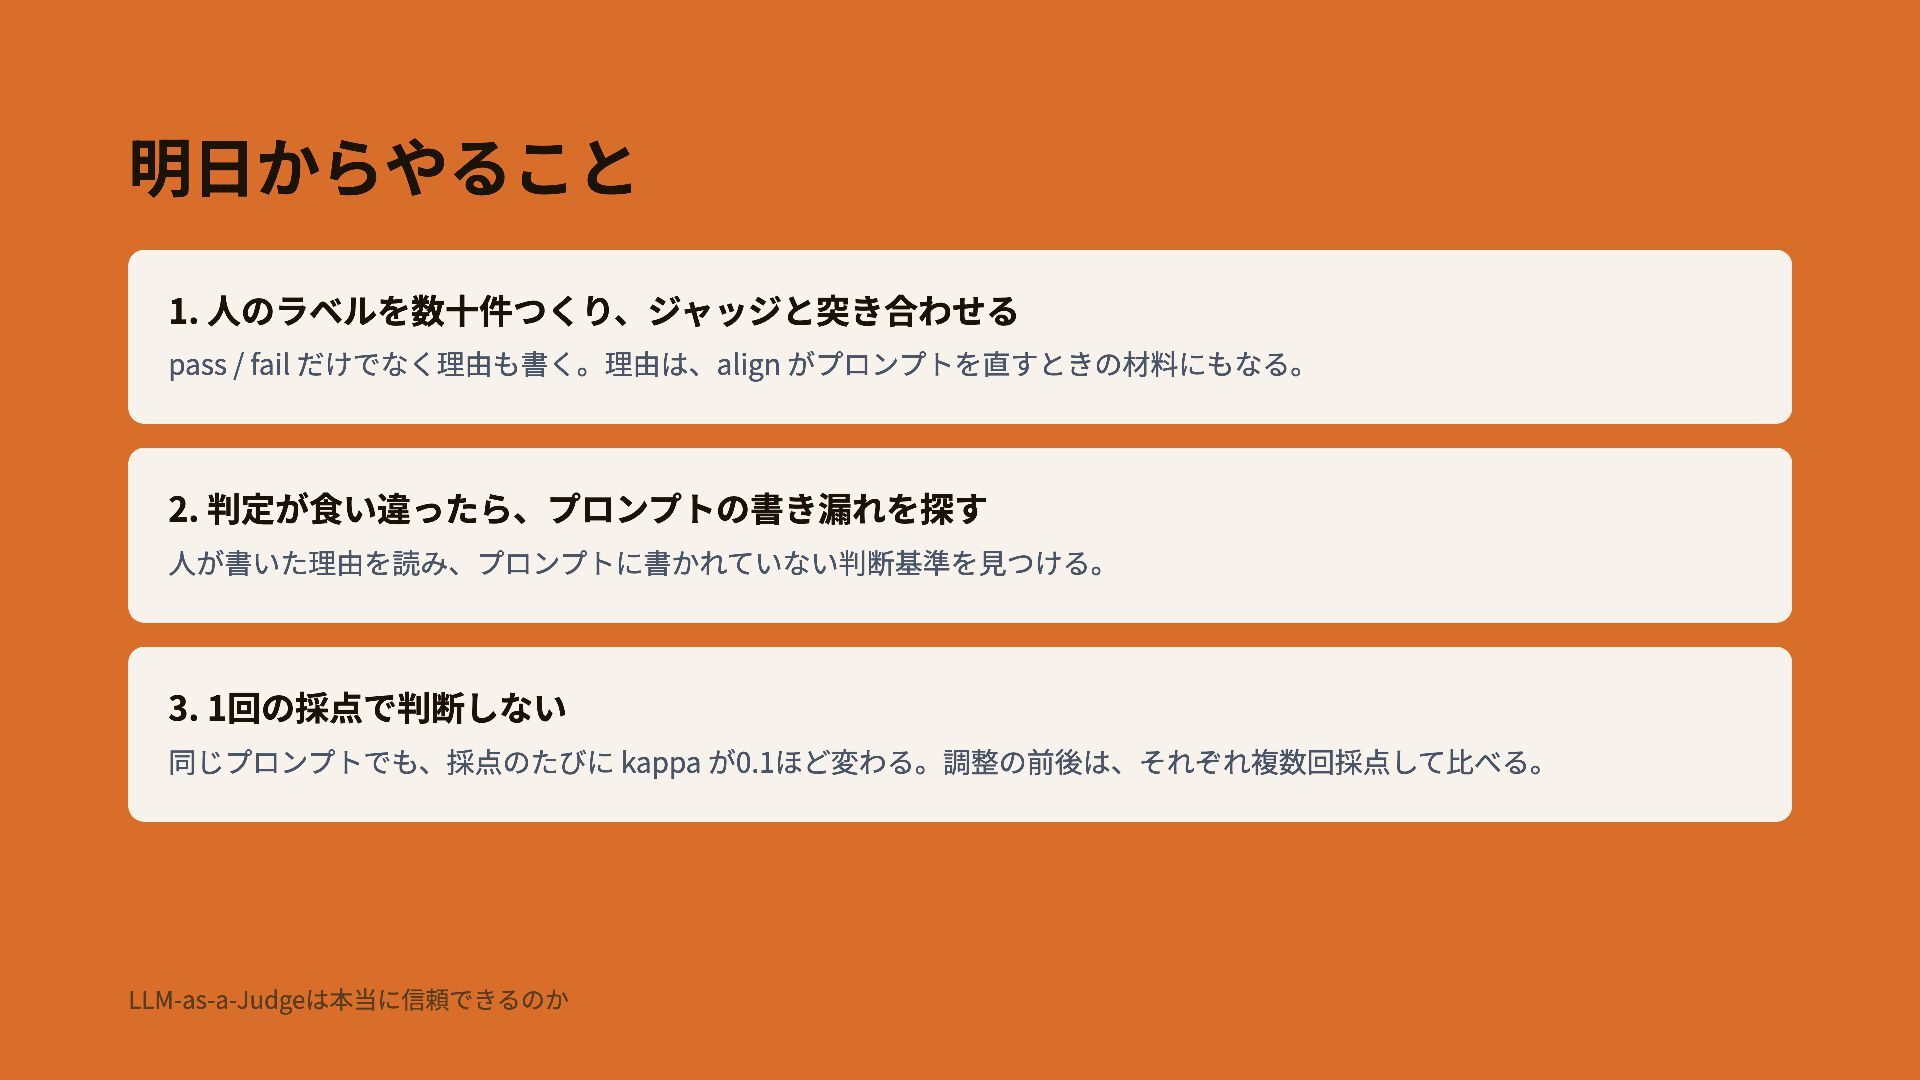
  10. 明日からやること 1. 人のラベルを数十件つくり、ジャッジと突き合わせる pass / fail だけでなく理由も書く。理由は、align がプロンプトを直すときの材料にもなる。 2. 判定が食い違ったら、プロンプトの書き漏れを探す

    人が書いた理由を読み、プロンプトに書かれていない判断基準を見つける。 3. 1回の採点で判断しない 同じプロンプトでも、採点のたびに kappa が0.1ほど変わる。調整の前後は、それぞれ複数回採点して比べる。 LLM-as-a-Judgeは本当に信頼できるのか
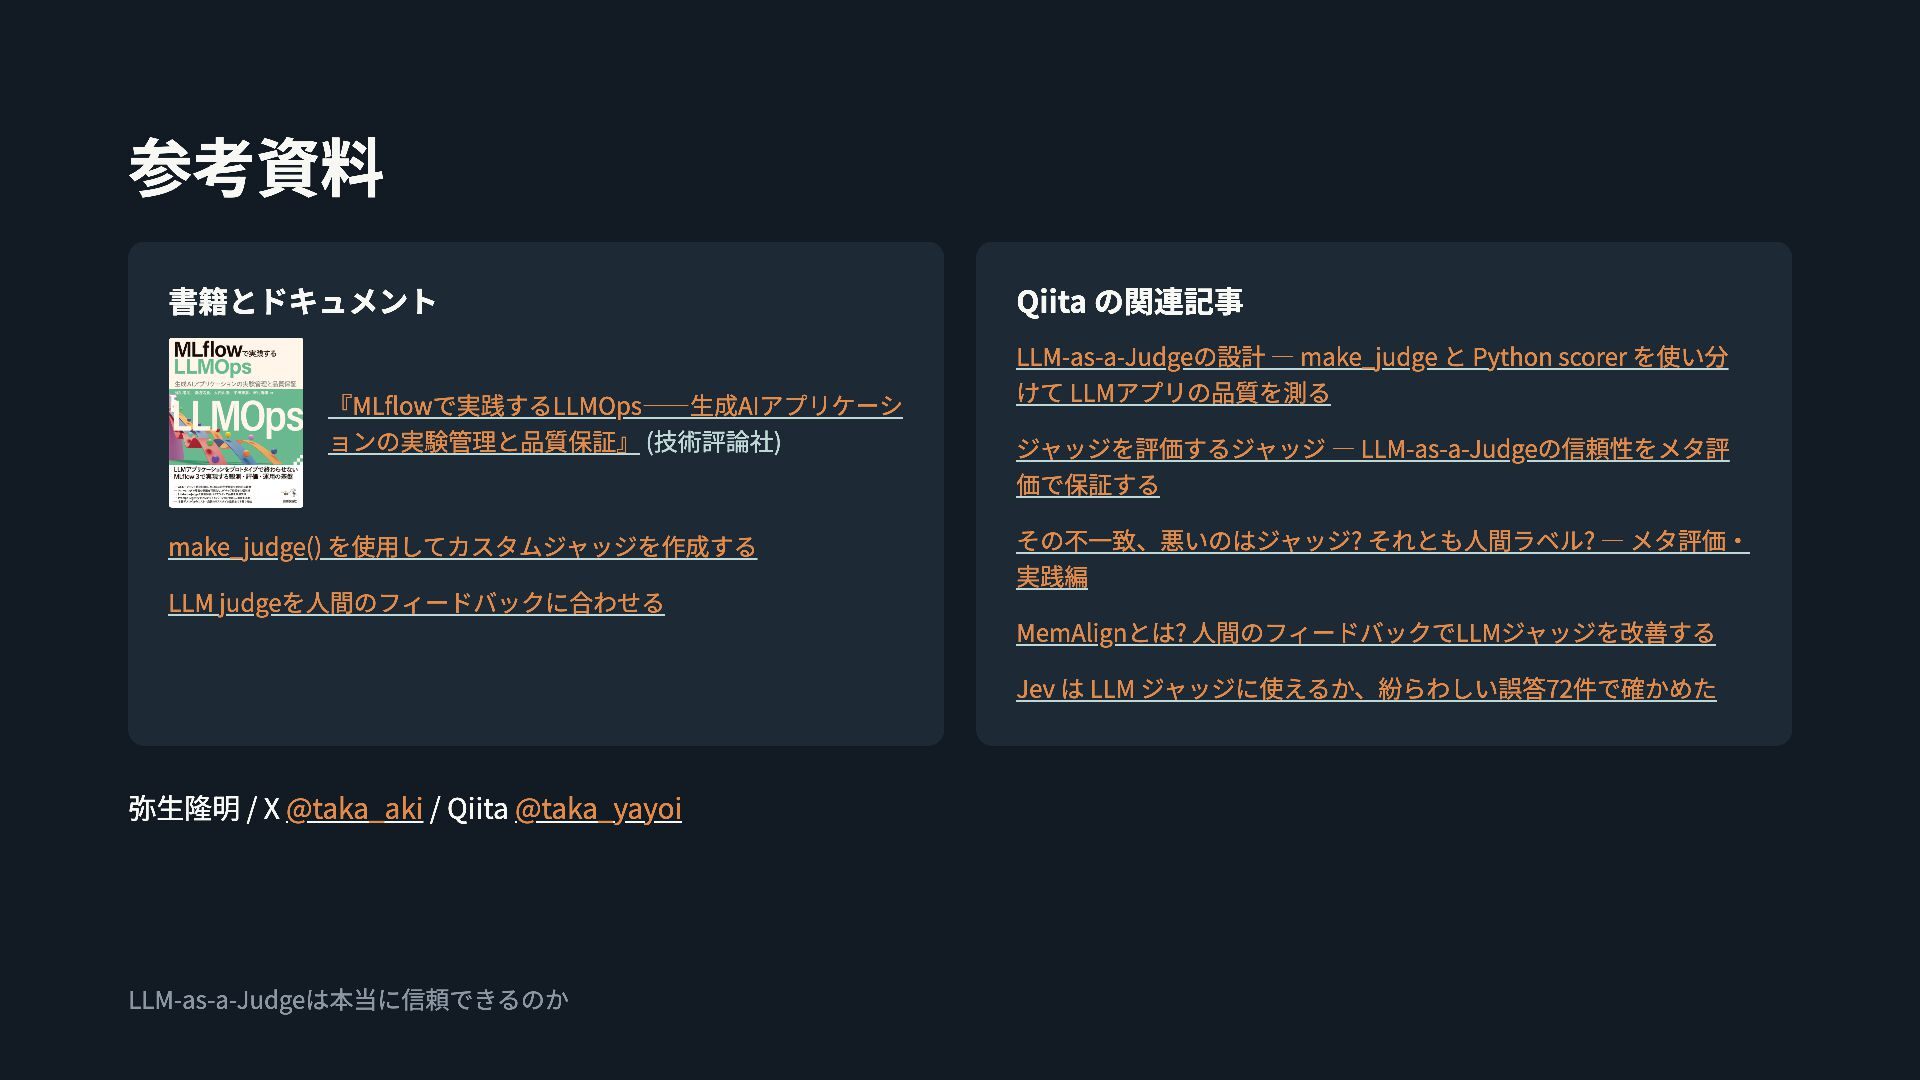
  11. 参考資料 書籍とドキュメント 『MLflowで実践するLLMOps――生成AIアプリケーシ ョンの実験管理と品質保証』 (技術評論社) make_judge() を使用してカスタムジャッジを作成する Qiita の関連記事 LLM-as-a-Judgeの設計

    ― make_judge と Python scorer を使い分 けて LLMアプリの品質を測る ジャッジを評価するジャッジ ― LLM-as-a-Judgeの信頼性をメタ評 価で保証する その不一致、悪いのはジャッジ? それとも人間ラベル? ― メタ評価・ 実践編 LLM judgeを人間のフィードバックに合わせる MemAlignとは? 人間のフィードバックでLLMジャッジを改善する Jev は LLM ジャッジに使えるか、紛らわしい誤答72件で確かめた 弥生隆明 / X @taka_aki / Qiita @taka_yayoi LLM-as-a-Judgeは本当に信頼できるのか