Upgrade to Pro — share decks privately, control downloads, hide ads and more …

20250326_生成AIによる_レビュー承認システムの実現.pdf

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →

 20250326_生成AIによる_レビュー承認システムの実現.pdf

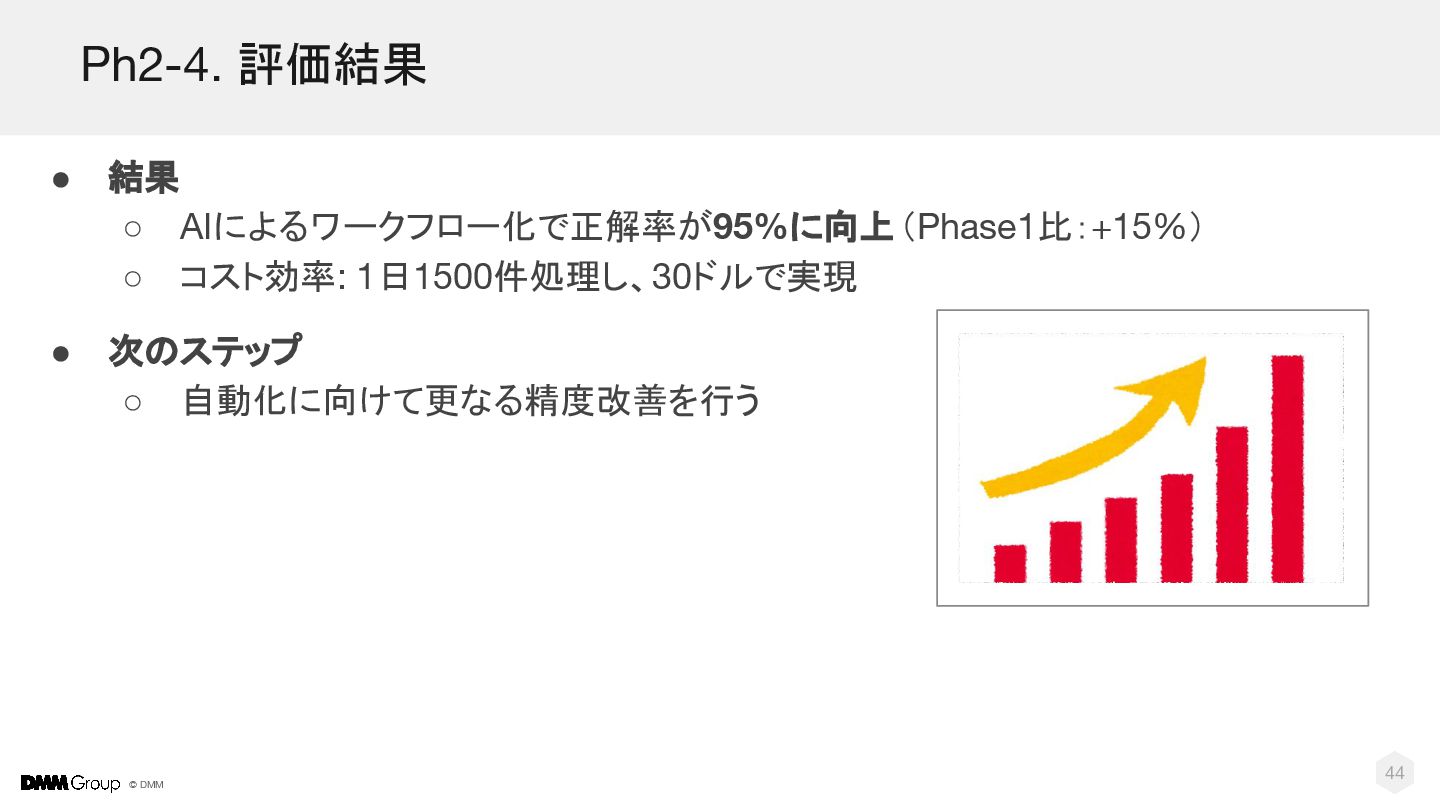
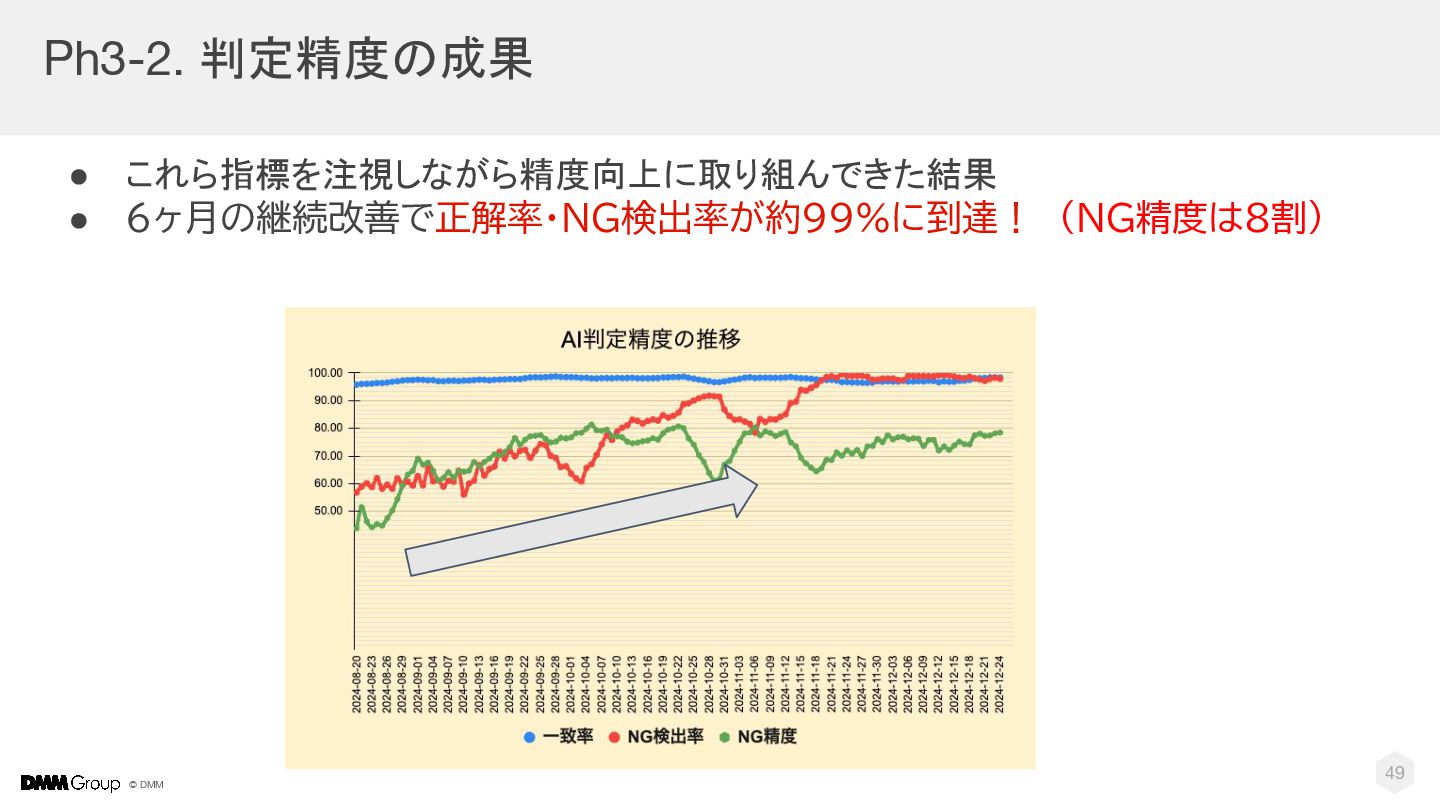
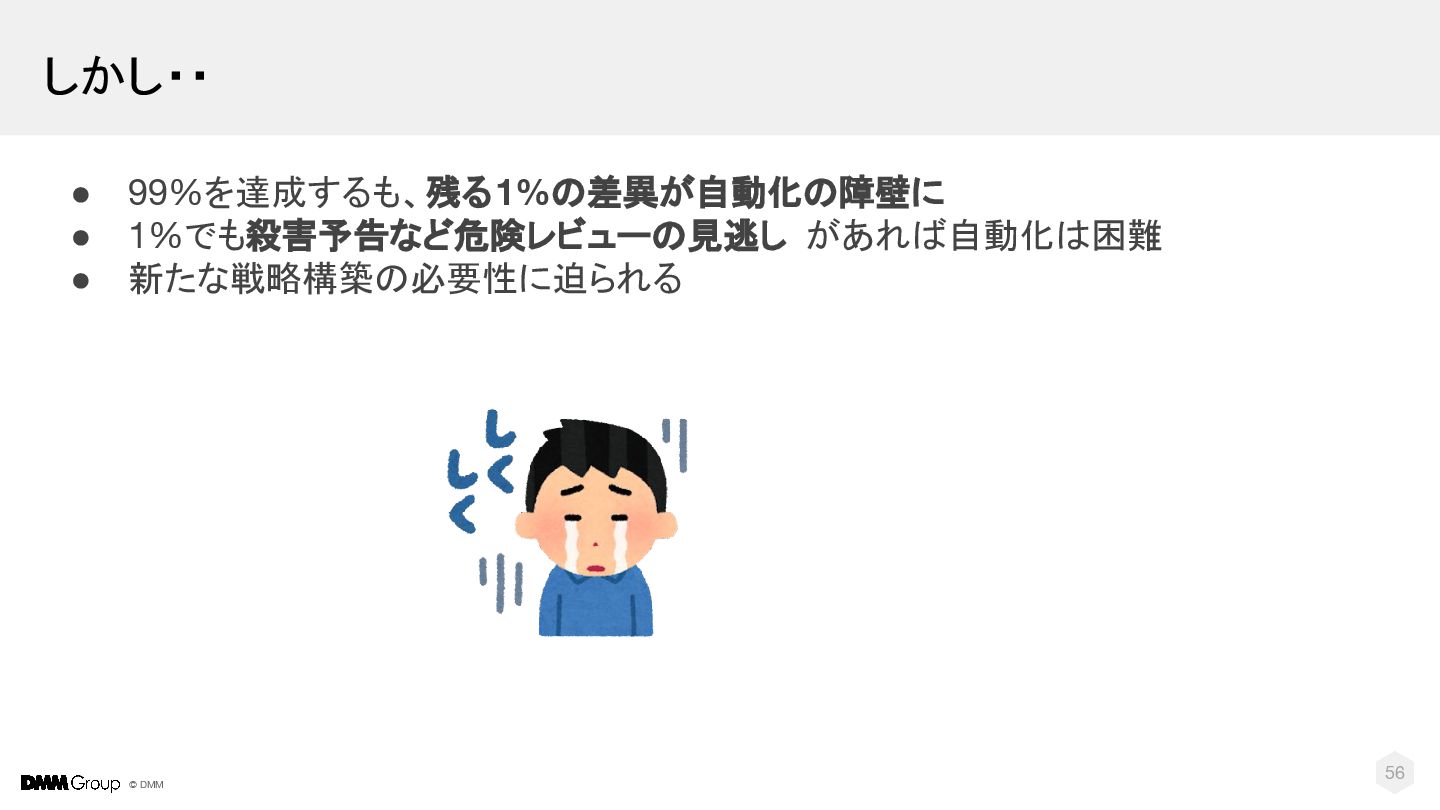
DMMの4000万人規模プラットフォームで実現した、画期的なレビュー承認自動化プロジェクトについてご紹介します。 従来、生成AIを業務の重要な判断に使用することは稀でしたが、私たちは生成AIの精度を高め、人との判断一致率99%を達成しました。 そしてこの高精度な結果を基に承認を自動化し、運用開始後わずか2週間で、投稿レビューの60%をAIが承認するまでに至りました。 また、従来1週間程度かかっていた承認作業もAIにより10分以内に完了し、サービスの大幅な向上に貢献しています。 本セッションでは、技術的課題の解決策から今後の展望まで、革新的な取り組みの全容を解説します。

matsui-dmm

March 18, 2025

Transcript
89 slides
  1. © DMM Agenda • 1章. はじめに • 2章. 商品レビューシステムの概要と課題 •

    3章. 生成AIの活用 • 4章. 自動化までの取り組み • 5章. 自動化の実績 • 6章. 今後とまとめ 2
  2. © DMM 6 松井 高宏(まつい たかひろ) • 所属: PF第1開発部 •

    業務: レビュープロダクト BEエンジニア • 役職: チームリーダー SNS • 登壇者:@matsui_tk • DMM Tech:@DMMcom_tech 自己紹介
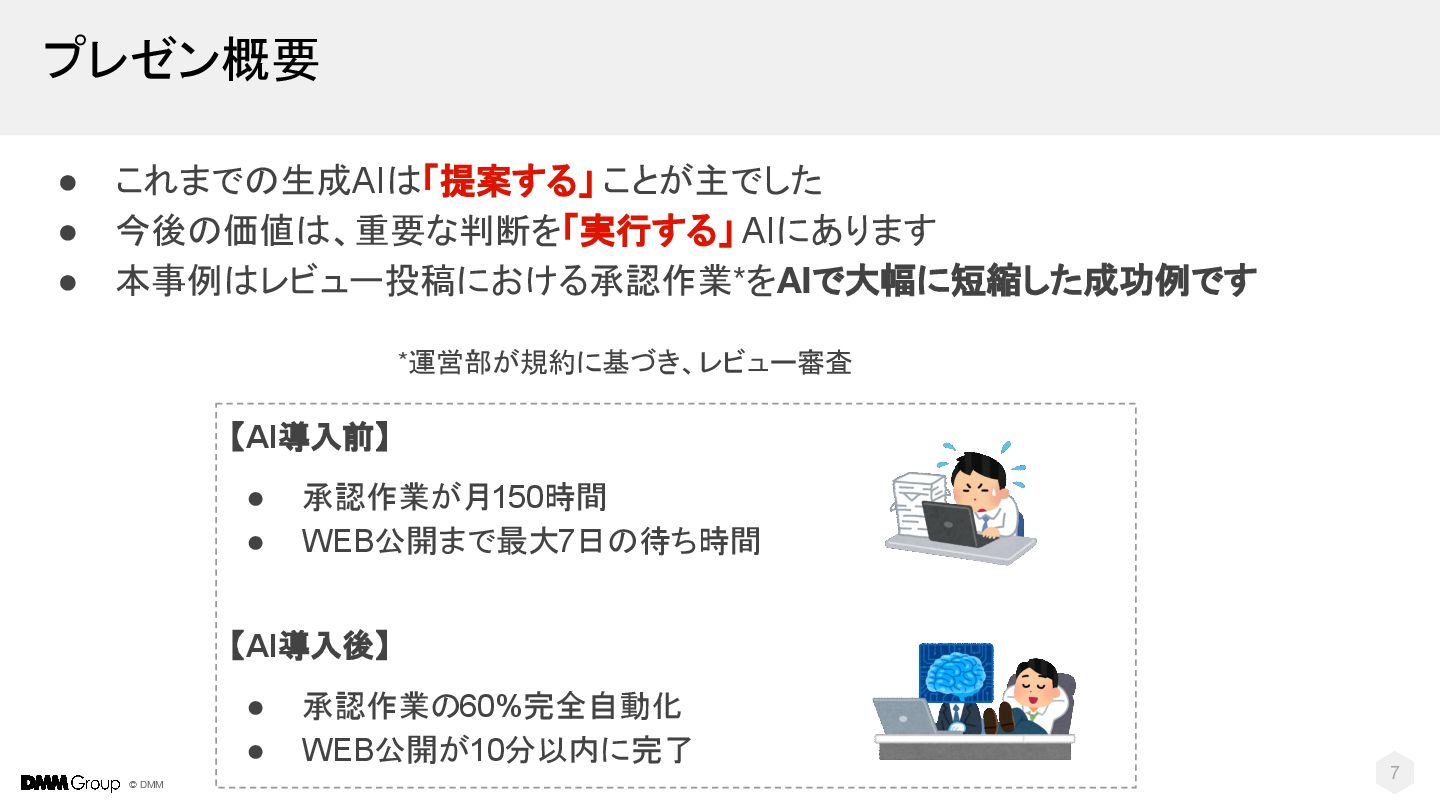
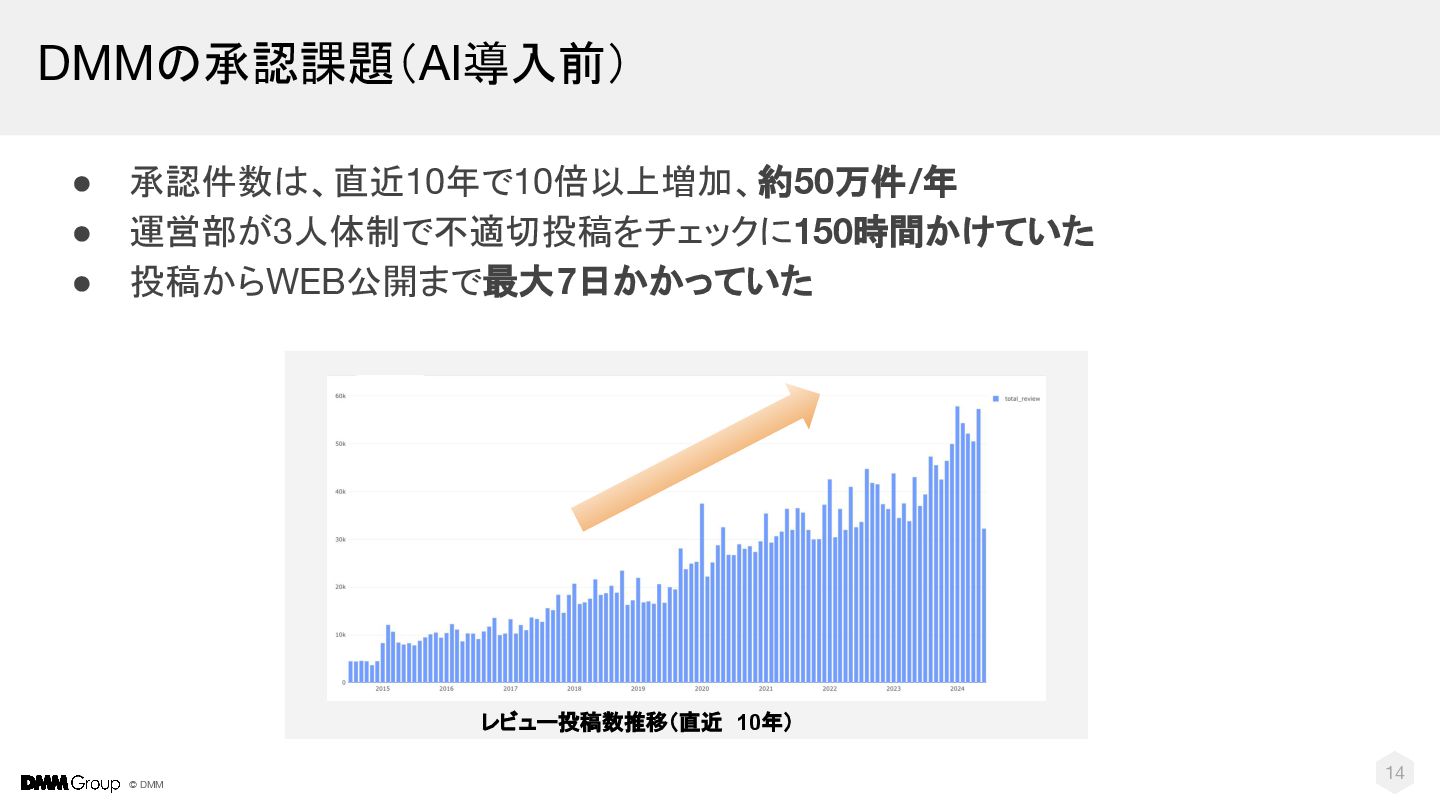
  3. © DMM プレゼン概要 • これまでの生成AIは「提案する」 ことが主でした • 今後の価値は、重要な判断を「実行する」 AIにあります •

    本事例はレビュー投稿における承認作業*をAIで大幅に短縮した成功例です 7 【AI導入前】 • 承認作業が月150時間 • WEB公開まで最大7日の待ち時間 【AI導入後】 • 承認作業の60%完全自動化 • WEB公開が10分以内に完了 *運営部が規約に基づき、レビュー審査
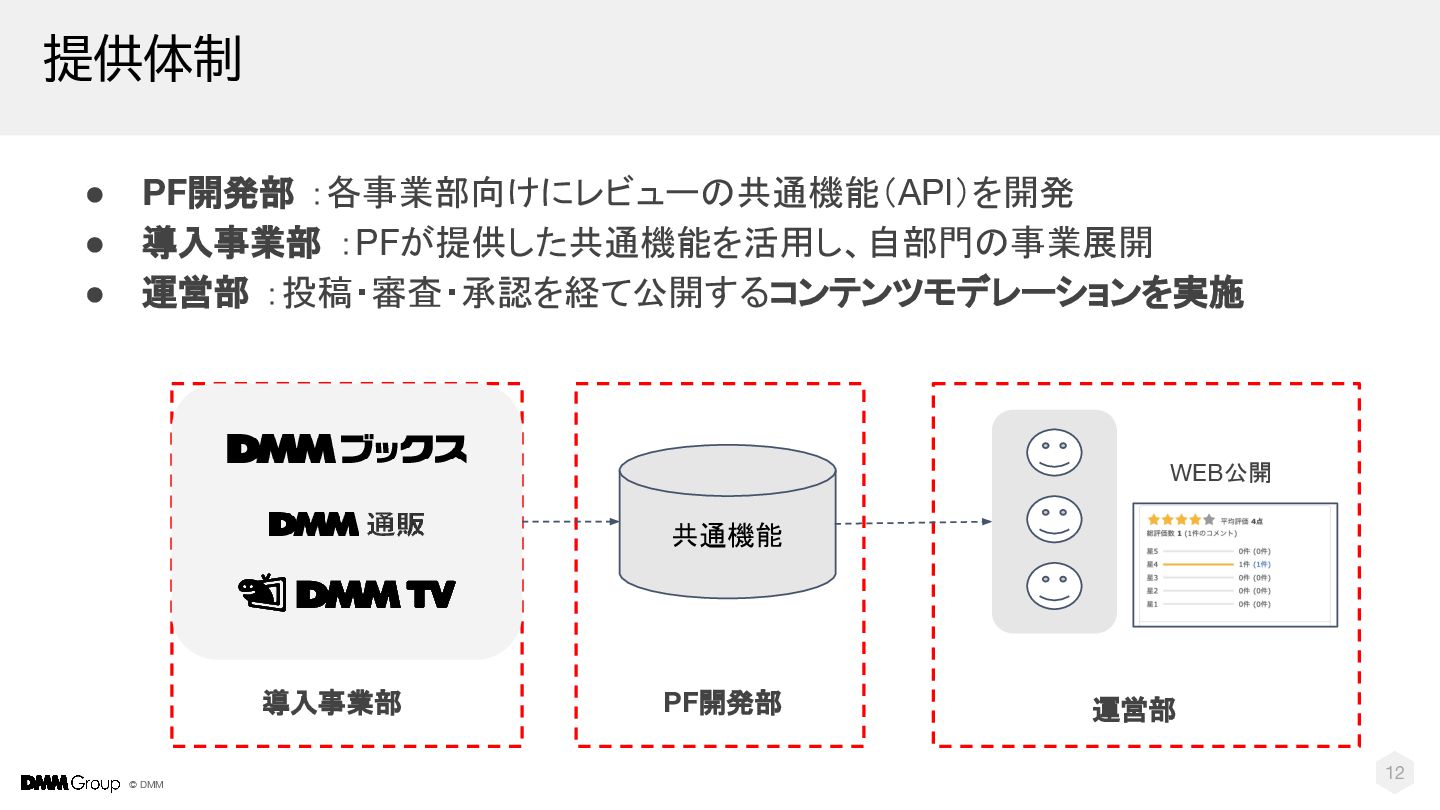
  4. © DMM 提供体制 • PF開発部 :各事業部向けにレビューの共通機能(API)を開発 • 導入事業部 :PFが提供した共通機能を活用し、自部門の事業展開 •

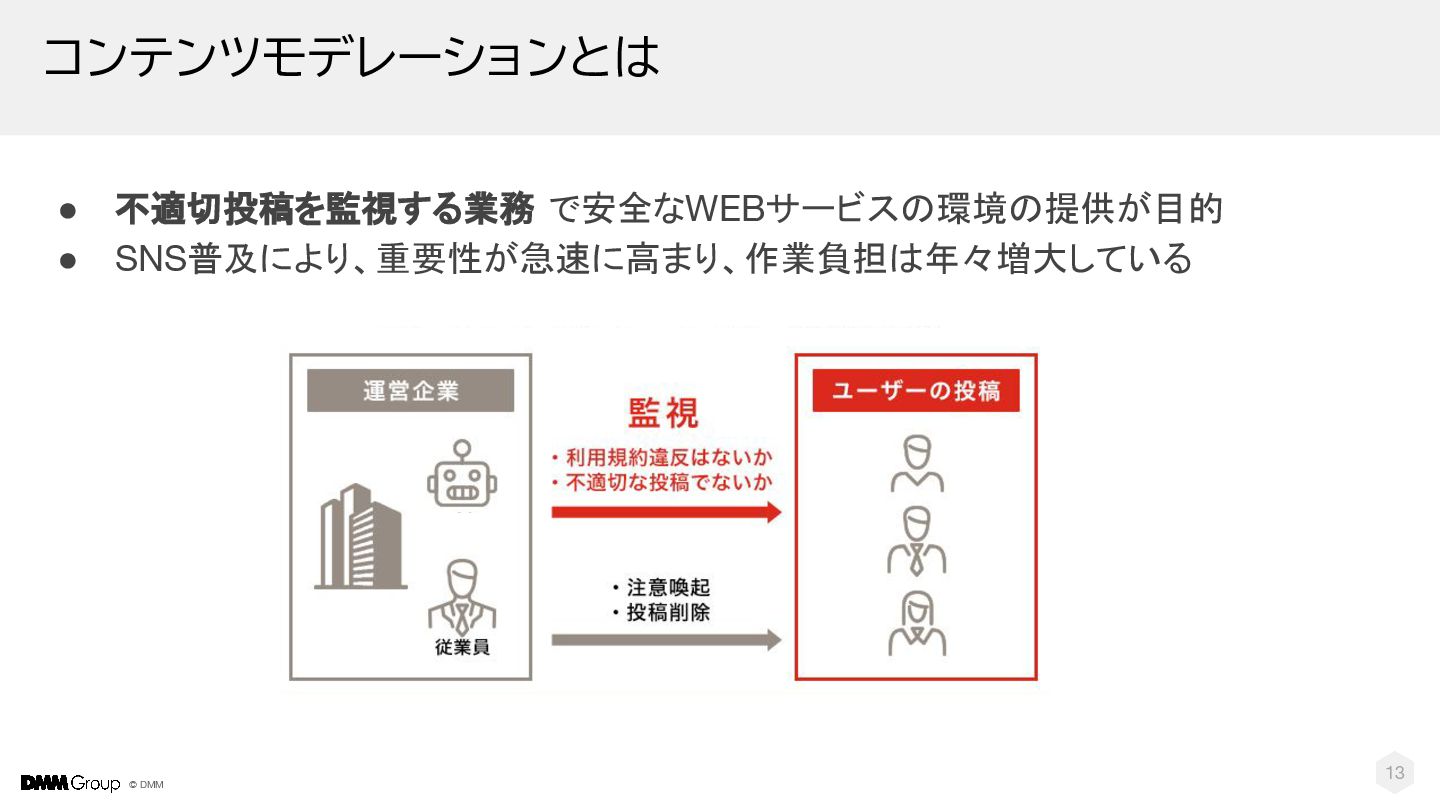
    運営部 :投稿・審査・承認を経て公開するコンテンツモデレーションを実施 共通機能 PF開発部 導入事業部 運営部 12 WEB公開
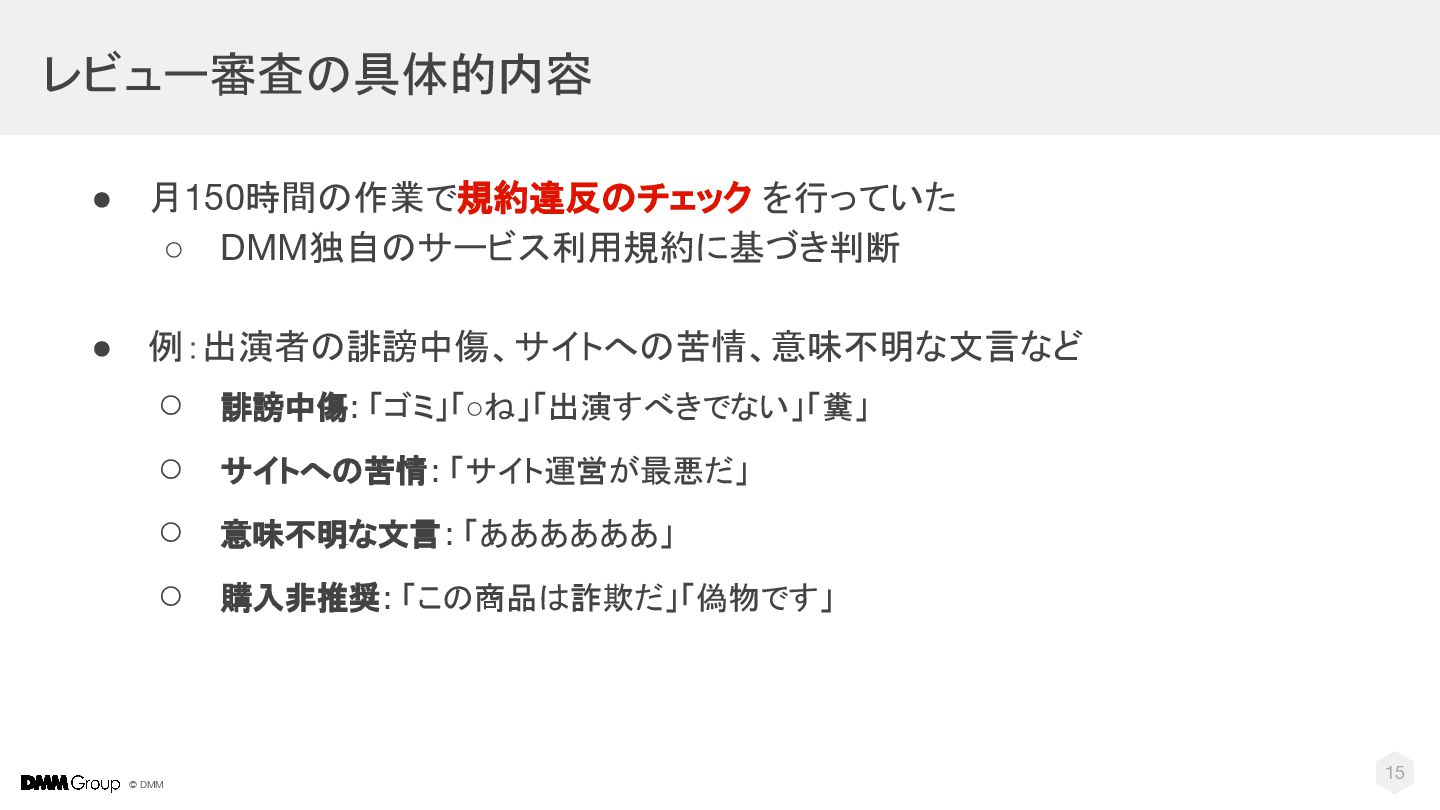
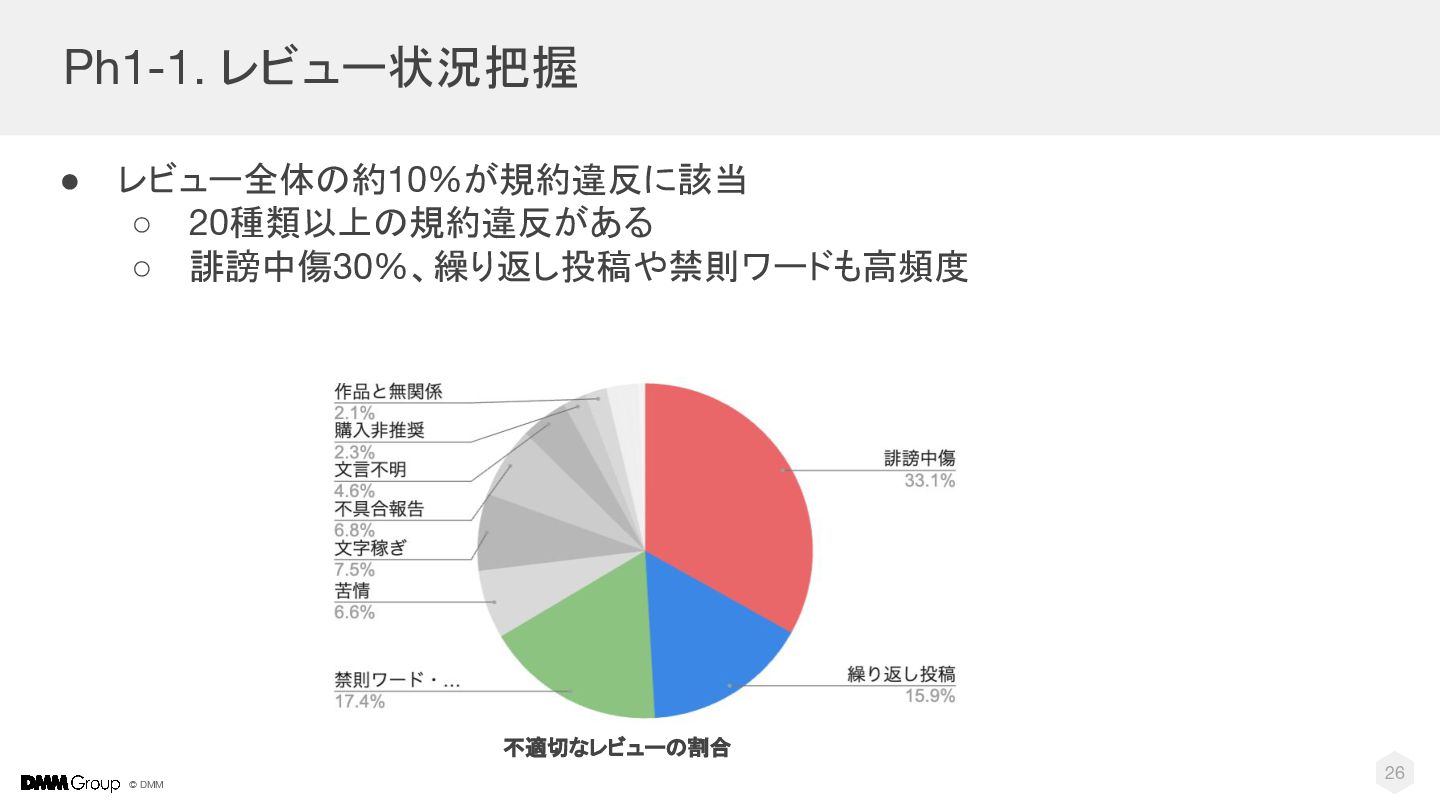
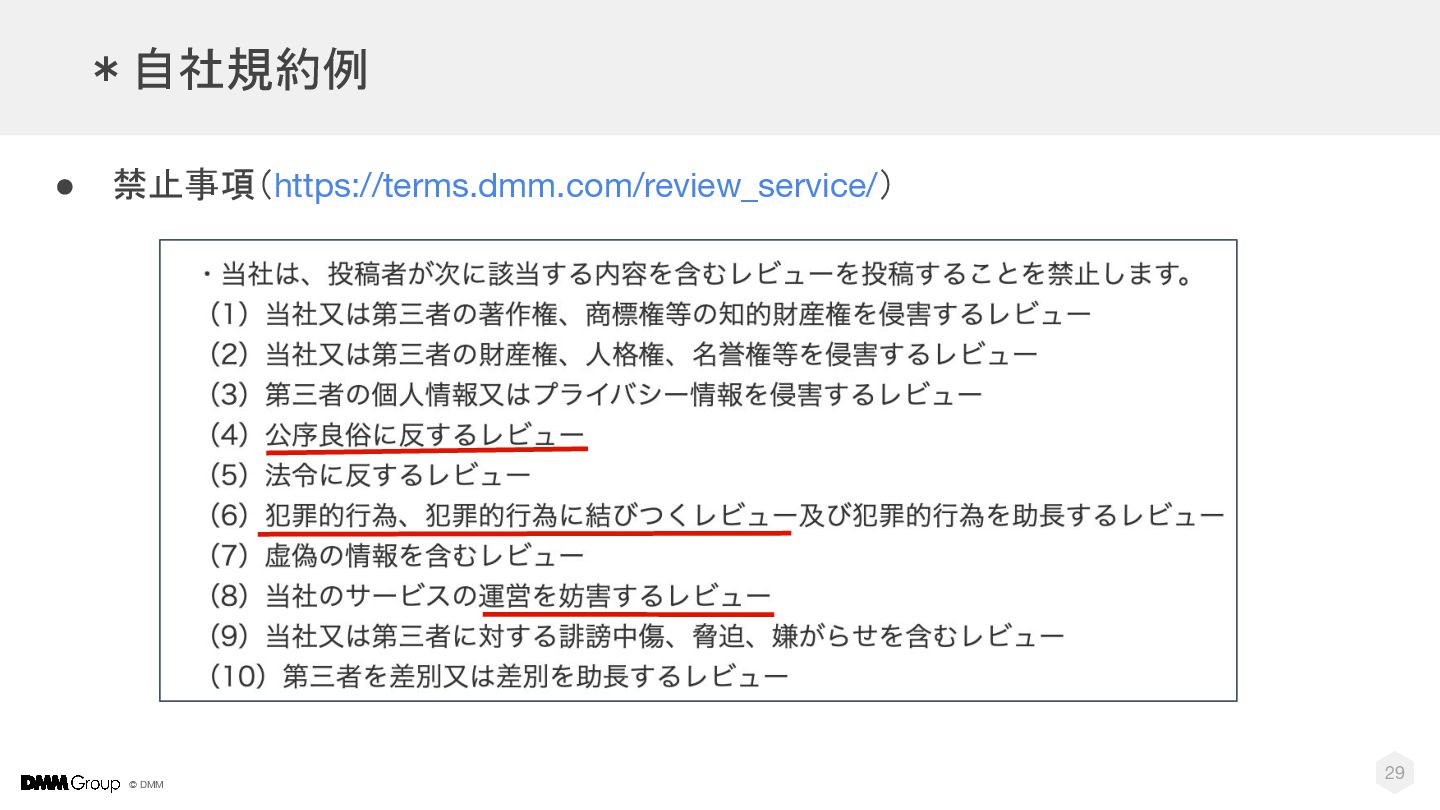
  5. © DMM 15 • 月150時間の作業で規約違反のチェック を行っていた ◦ DMM独自のサービス利用規約に基づき判断 • 例:出演者の誹謗中傷、サイトへの苦情、意味不明な文言など

    ◦ 誹謗中傷: 「ゴミ」「◦ね」「出演すべきでない」「糞」 ◦ サイトへの苦情: 「サイト運営が最悪だ」 ◦ 意味不明な文言: 「ああああああ」 ◦ 購入非推奨: 「この商品は詐欺だ」「偽物です」 レビュー審査の具体的内容
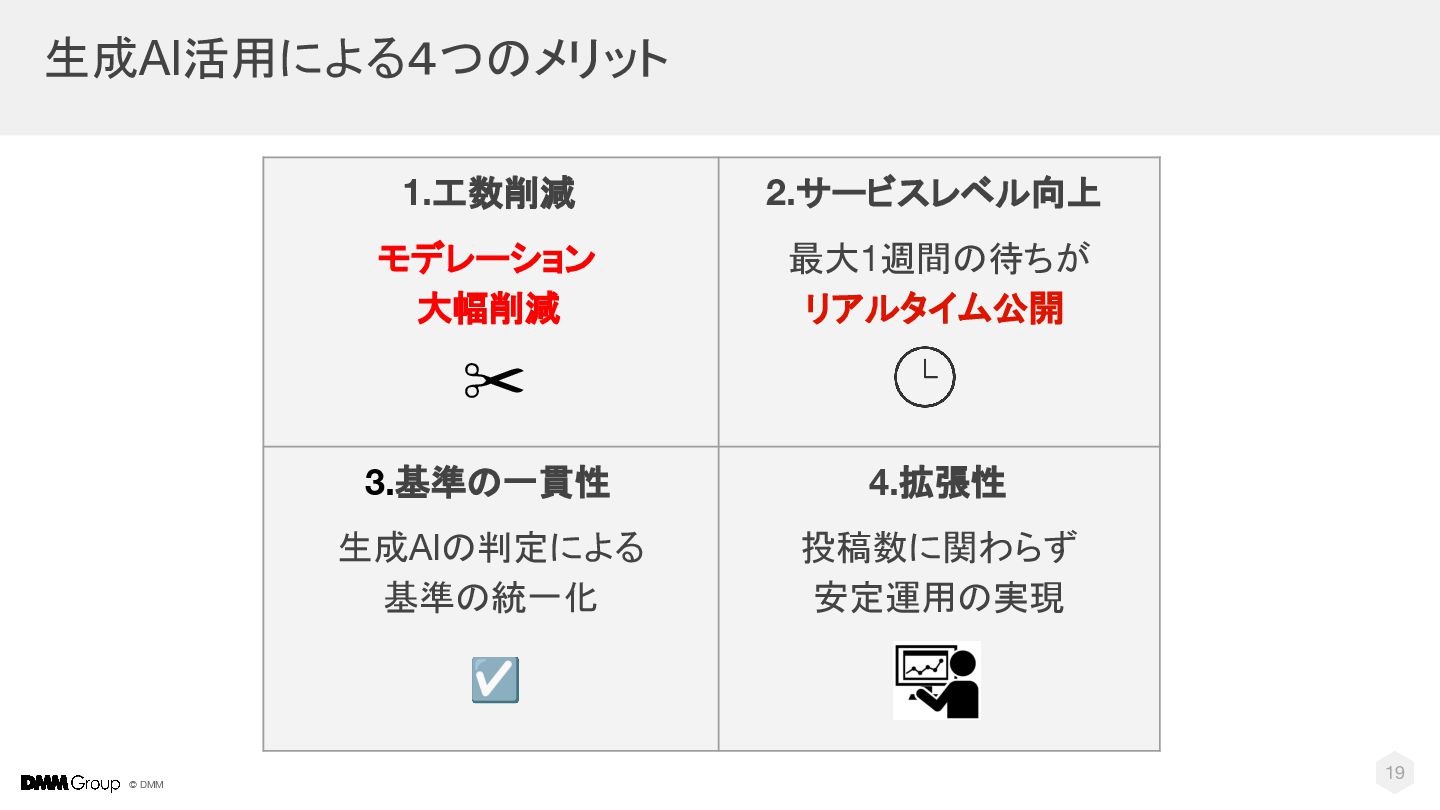
  6. © DMM 生成AI活用による4つのメリット 19 1.工数削減 モデレーション 大幅削減 2.サービスレベル向上 最大1週間の待ちが リアルタイム公開

    3.基準の一貫性 生成AIの判定による 基準の統一化 4.拡張性 投稿数に関わらず 安定運用の実現 ✂ ☑
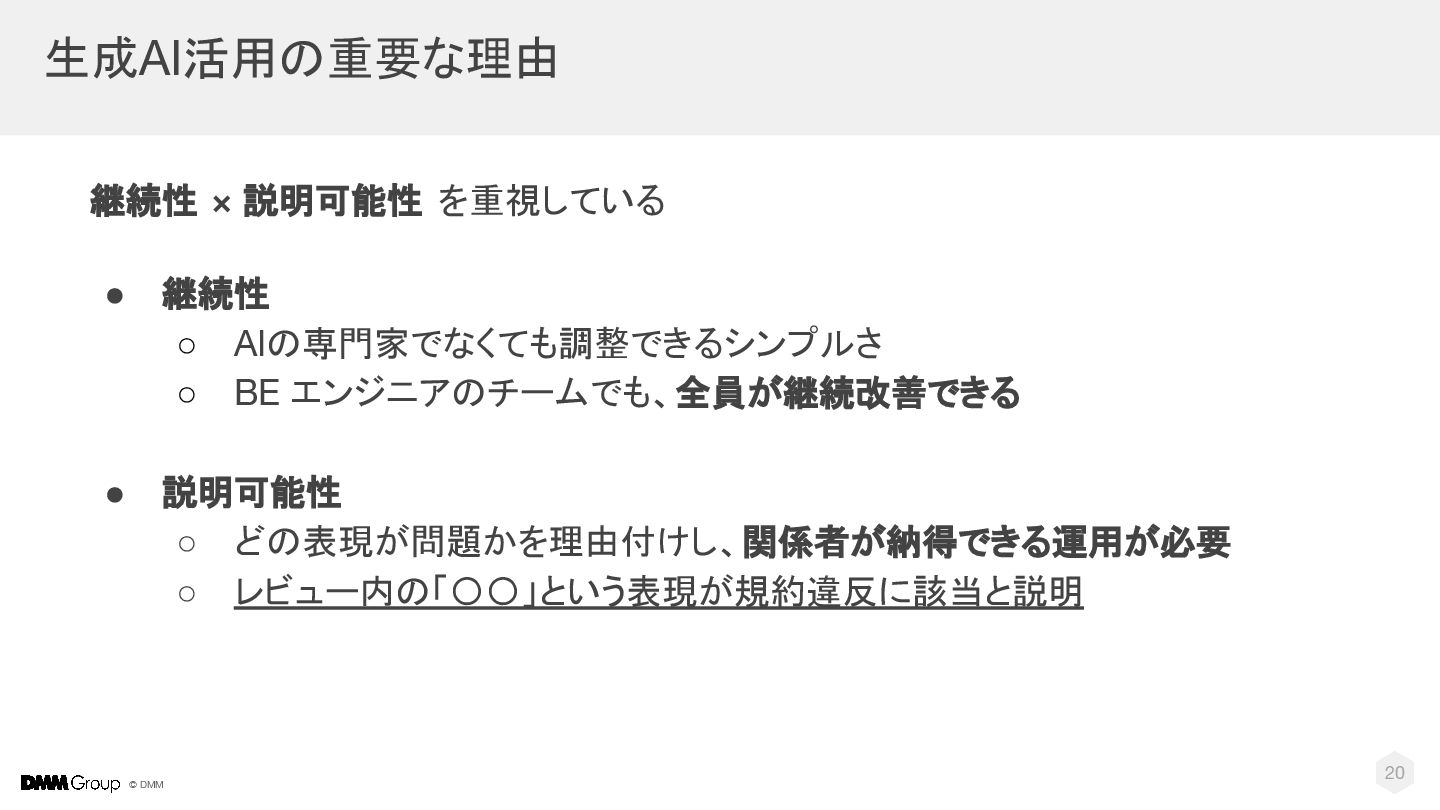
  7. © DMM 生成AI活用の重要な理由 20 継続性 × 説明可能性 を重視している • 継続性

    ◦ AIの専門家でなくても調整できるシンプルさ ◦ BE エンジニアのチームでも、全員が継続改善できる • 説明可能性 ◦ どの表現が問題かを理由付けし、関係者が納得できる運用が必要 ◦ レビュー内の「〇〇」という表現が規約違反に該当と説明
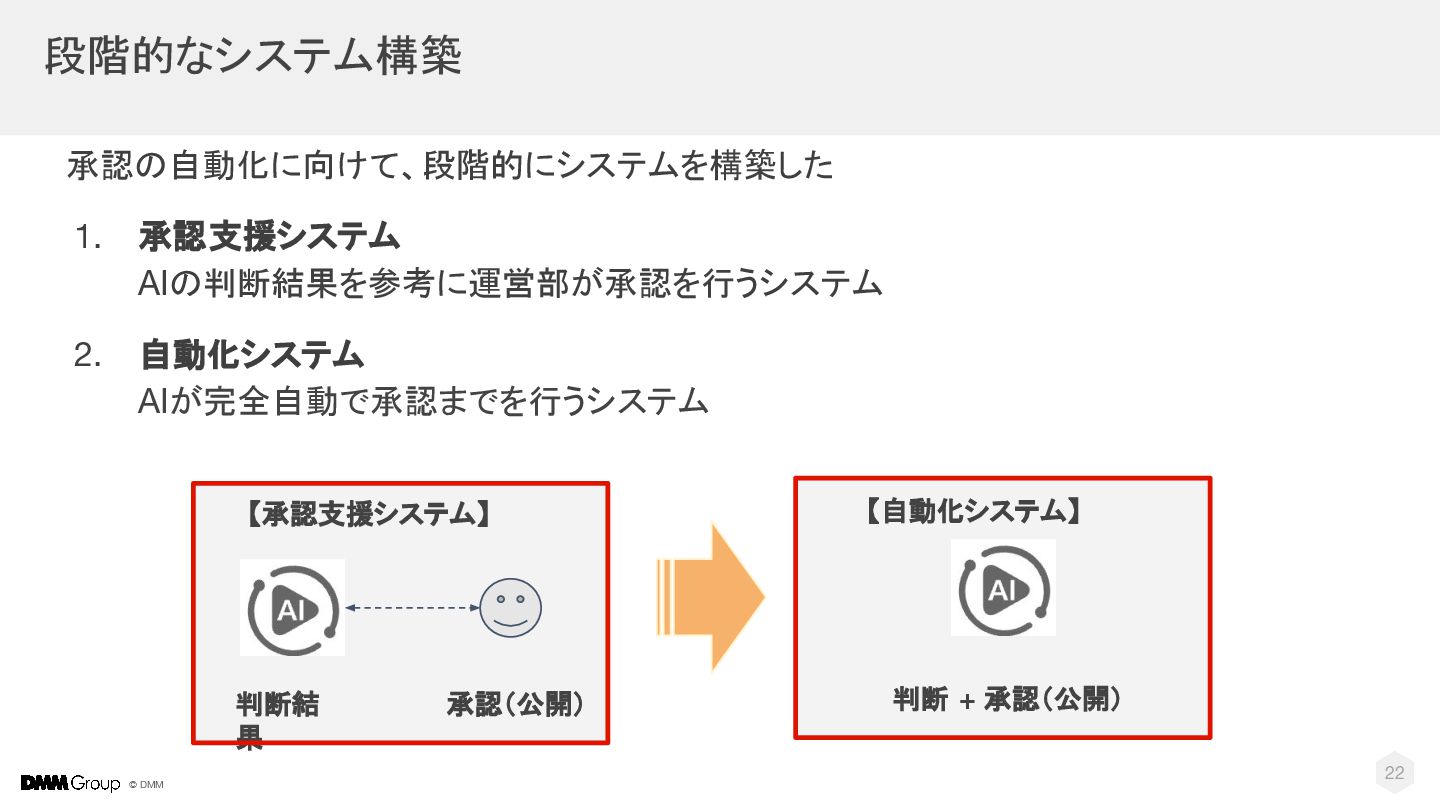
  8. © DMM 段階的なシステム構築 22 承認の自動化に向けて、段階的にシステムを構築した 1. 承認支援システム AIの判断結果を参考に運営部が承認を行うシステム 2. 自動化システム

    AIが完全自動で承認までを行うシステム 承認(公開) 判断 + 承認(公開) 判断結 果 【承認支援システム】 【自動化システム】
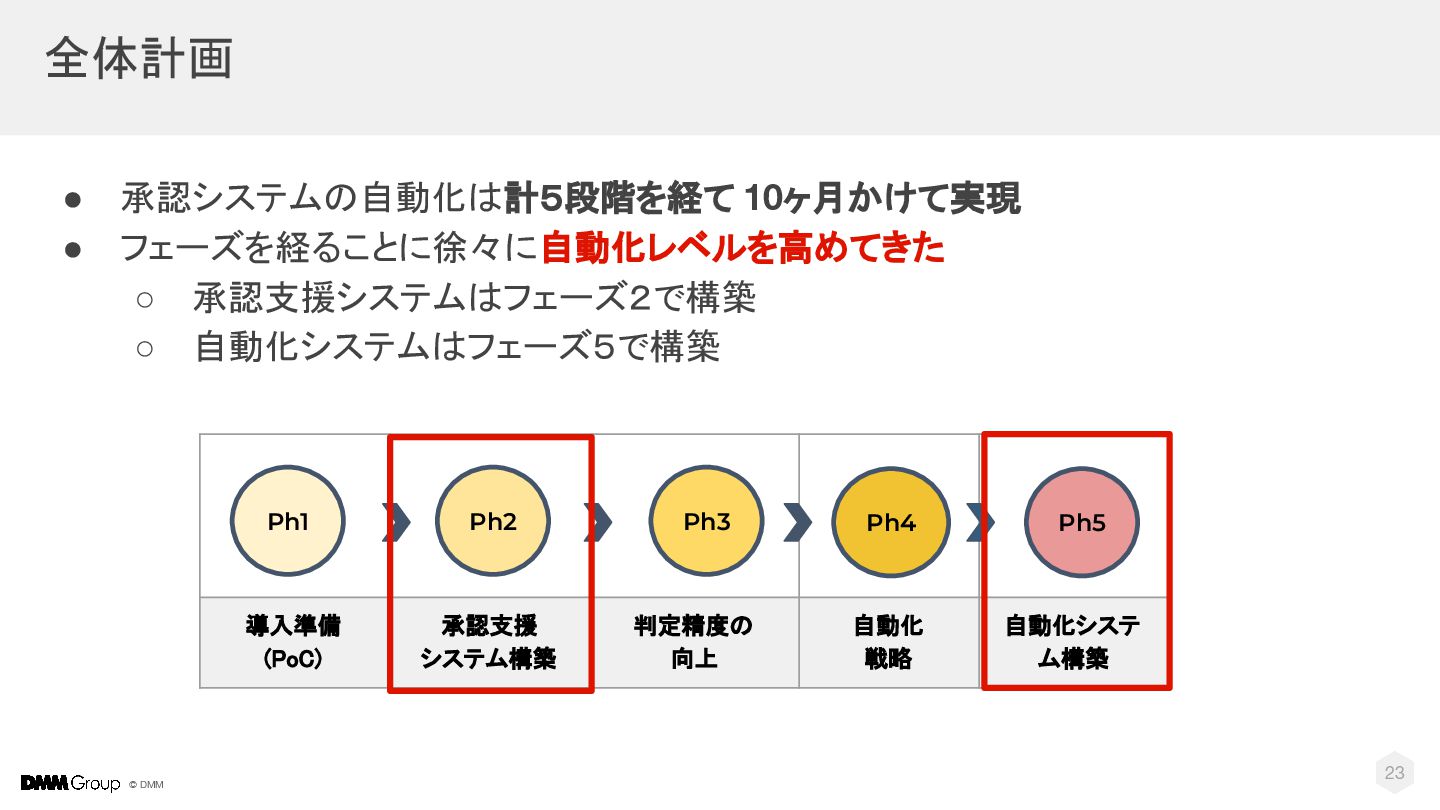
  9. © DMM 導入準備
 (PoC) 承認支援
 システム構築 判定精度の 
 向上 自動化


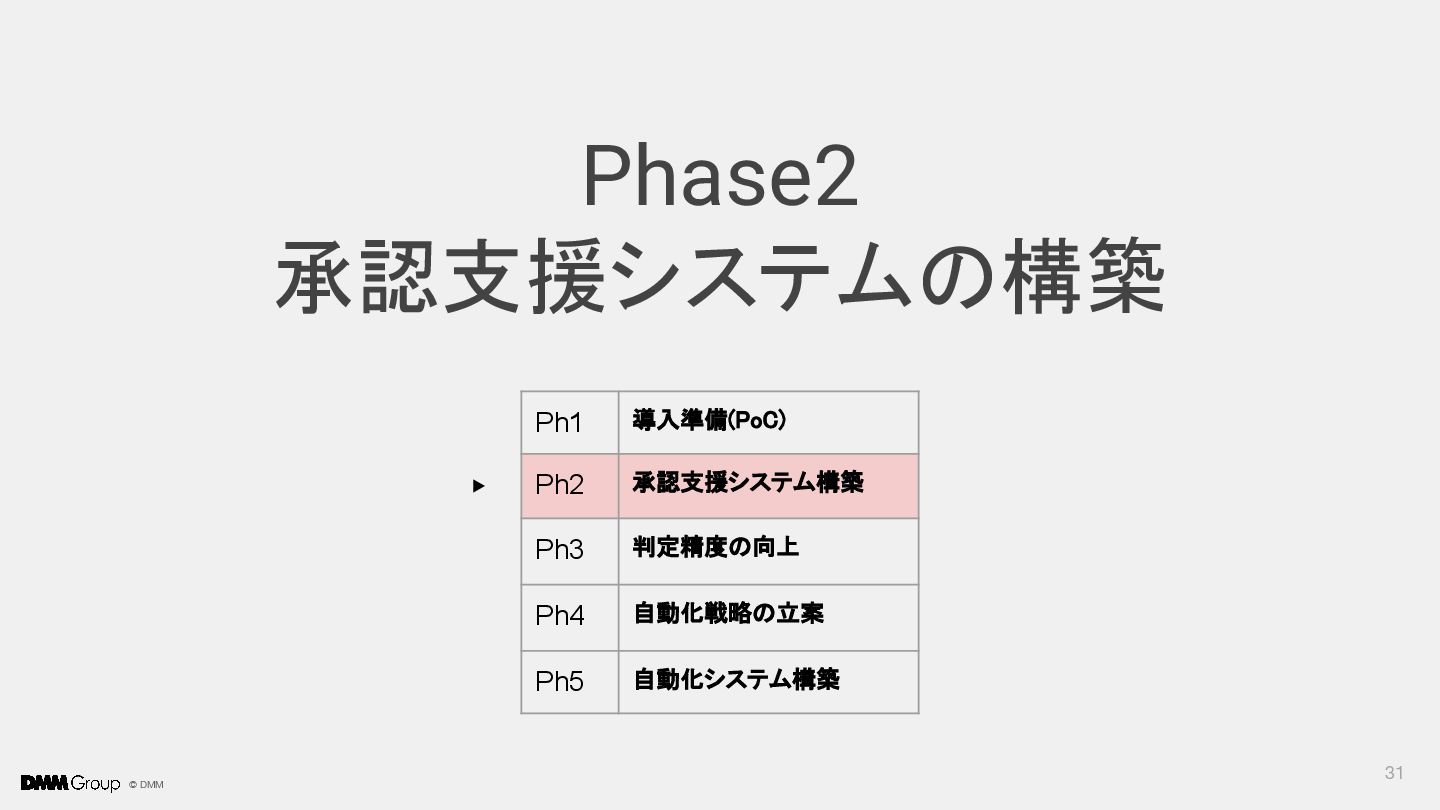
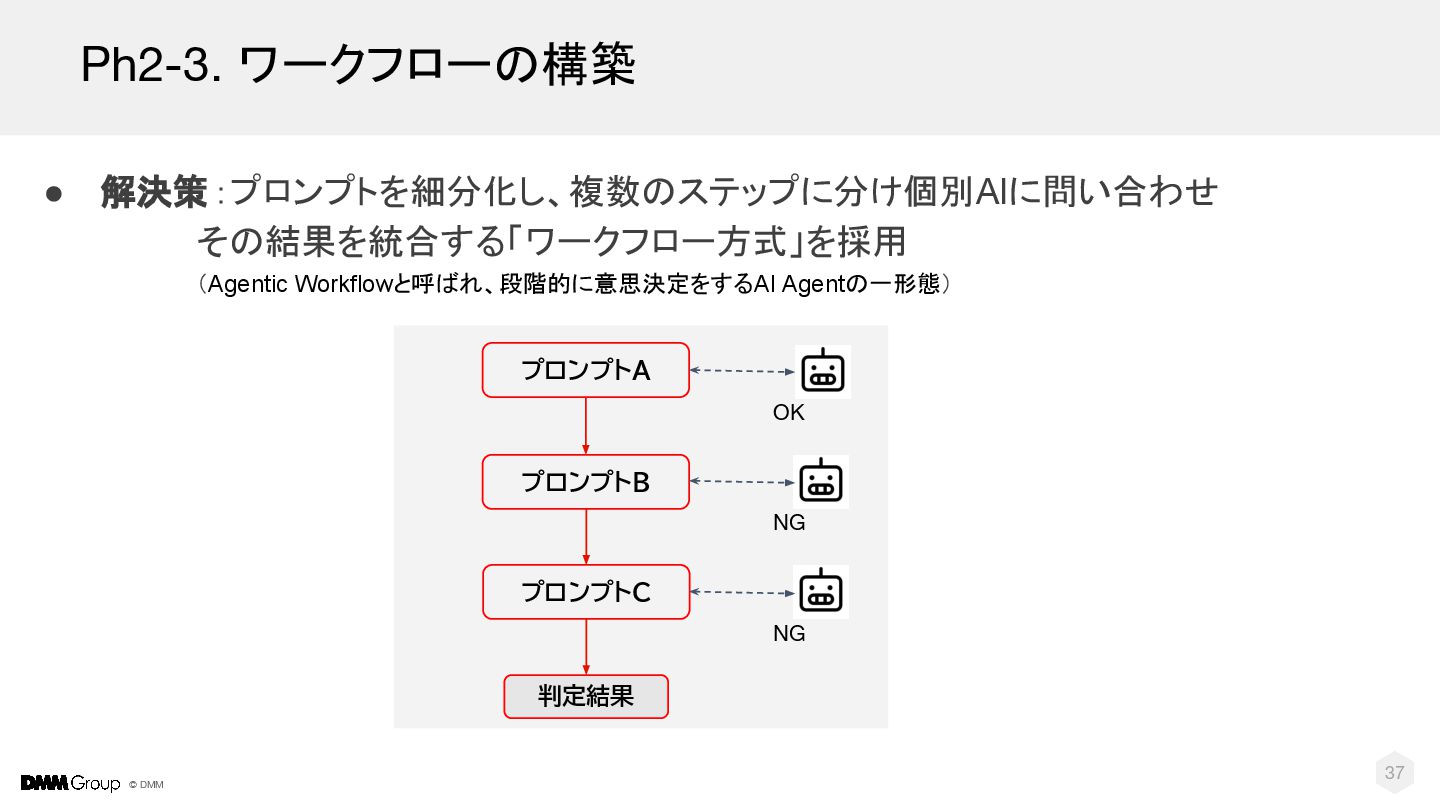
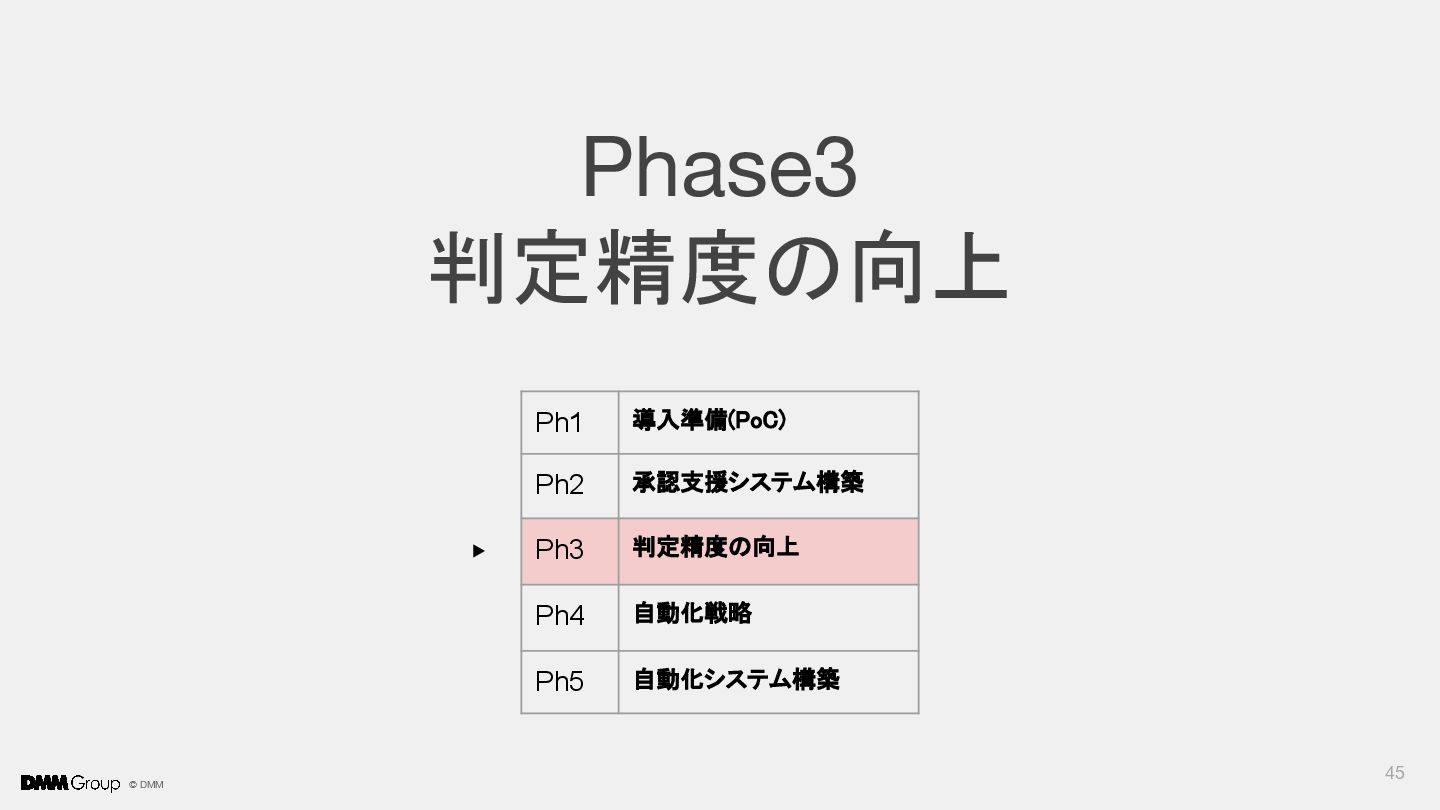
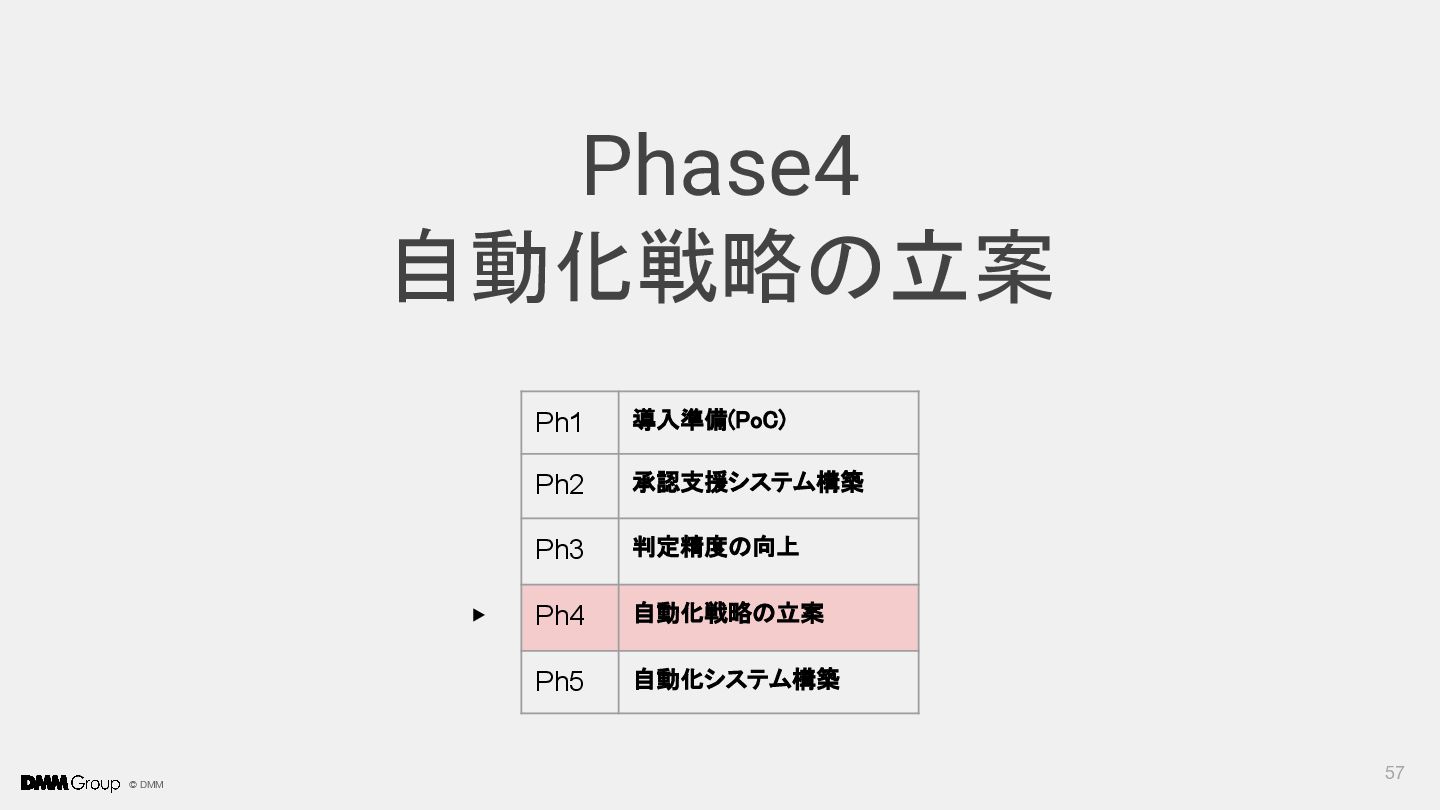
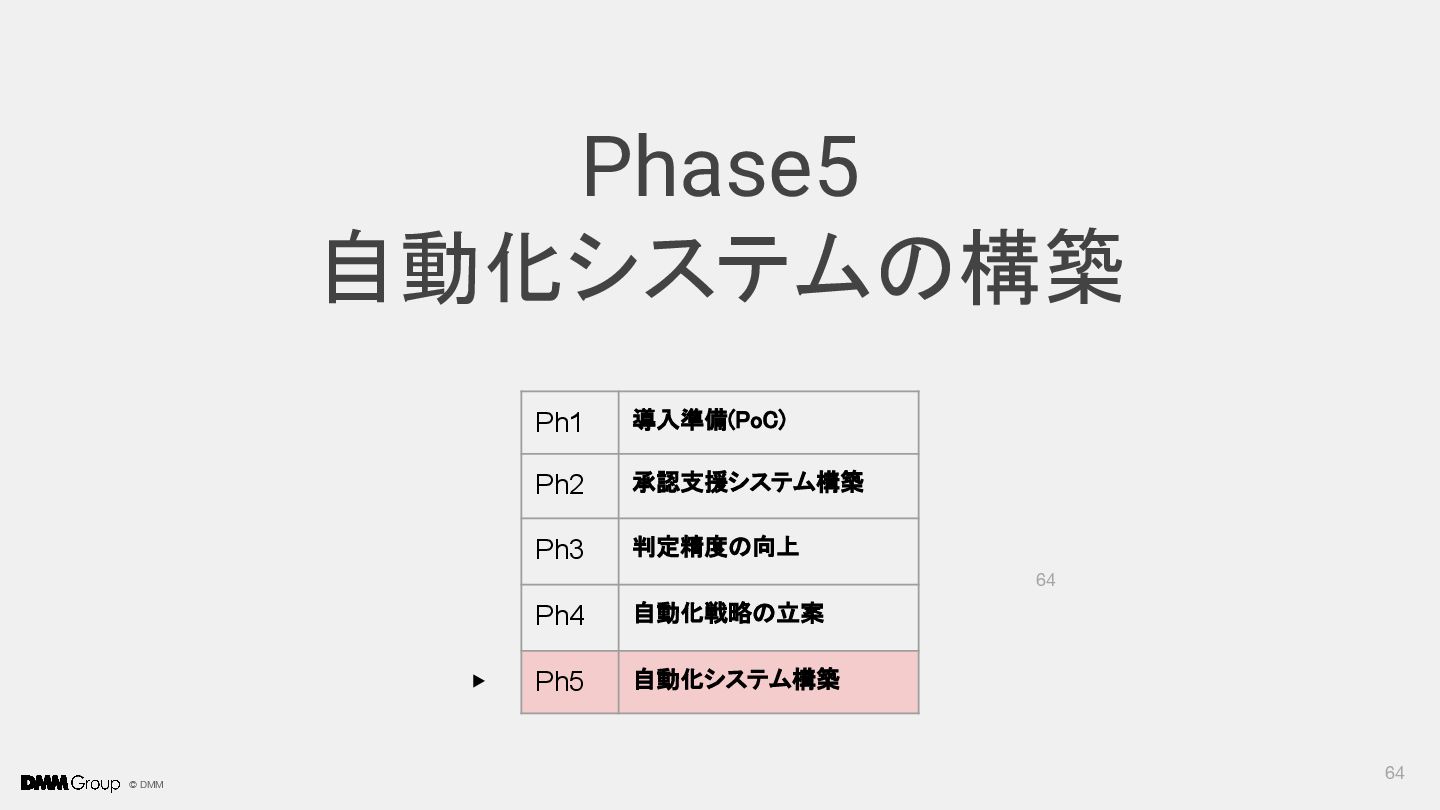
    戦略 自動化システ ム構築 全体計画 23 • 承認システムの自動化は計5段階を経て 10ヶ月かけて実現 • フェーズを経ることに徐々に自動化レベルを高めてきた ◦ 承認支援システムはフェーズ2で構築 ◦ 自動化システムはフェーズ5で構築 Ph1 Ph2 Ph3 Ph4 Ph5
  10. © DMM Ph1. 導入準備(PoC) • 生成AIの可能性を検証する • 2024年4月〜5月(2か月) 25 各Part

    • Ph1-1. レビュー状況の把握 • Ph1-2. モデル評価 • Ph1-3. 結論と方向性
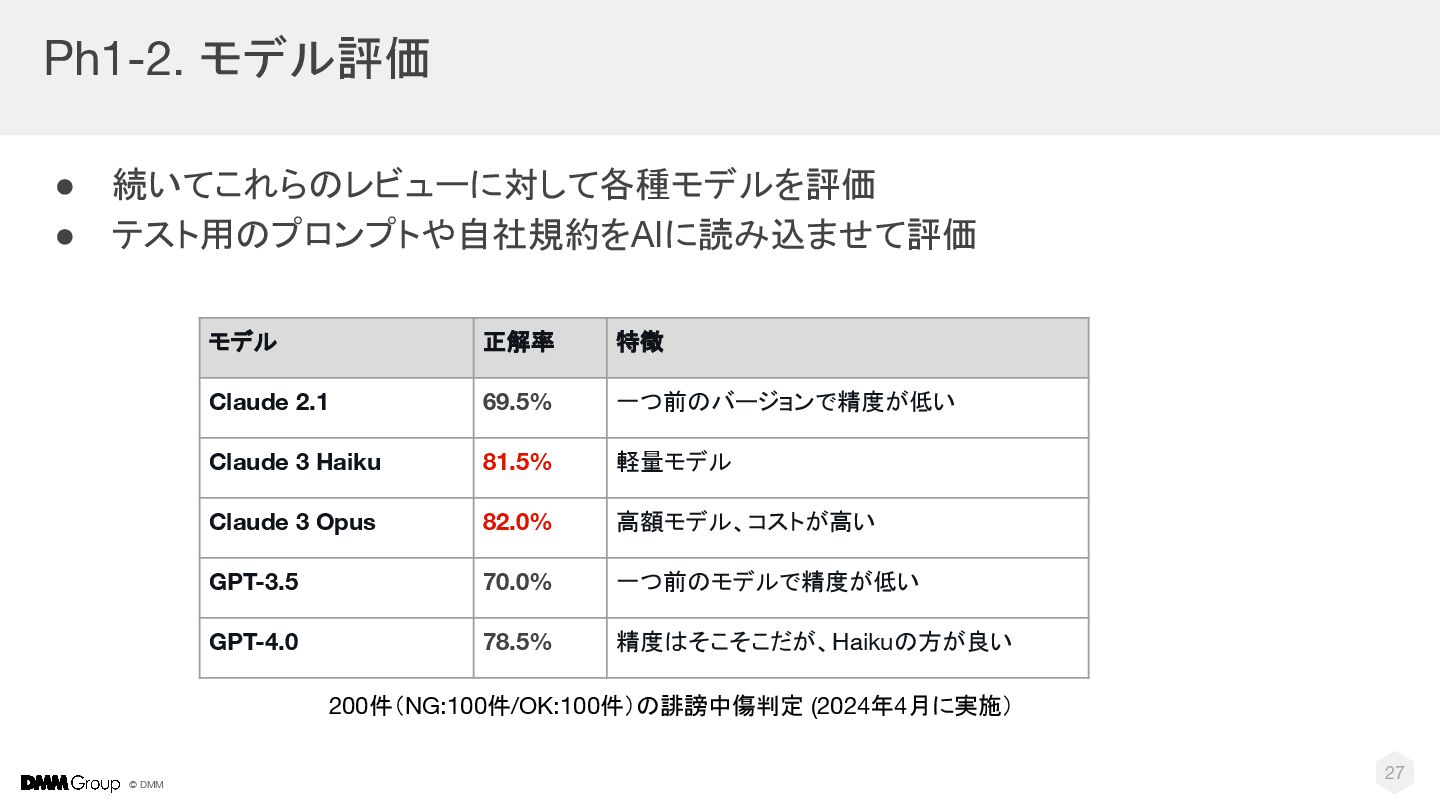
  11. © DMM Ph1-2. モデル評価 27 • 続いてこれらのレビューに対して各種モデルを評価 • テスト用のプロンプトや自社規約をAIに読み込ませて評価 モデル

    正解率 特徴 Claude 2.1 69.5% 一つ前のバージョンで精度が低い Claude 3 Haiku 81.5% 軽量モデル Claude 3 Opus 82.0% 高額モデル、コストが高い GPT-3.5 70.0% 一つ前のモデルで精度が低い GPT-4.0 78.5% 精度はそこそこだが、Haikuの方が良い 200件(NG:100件/OK:100件)の誹謗中傷判定 (2024年4月に実施)
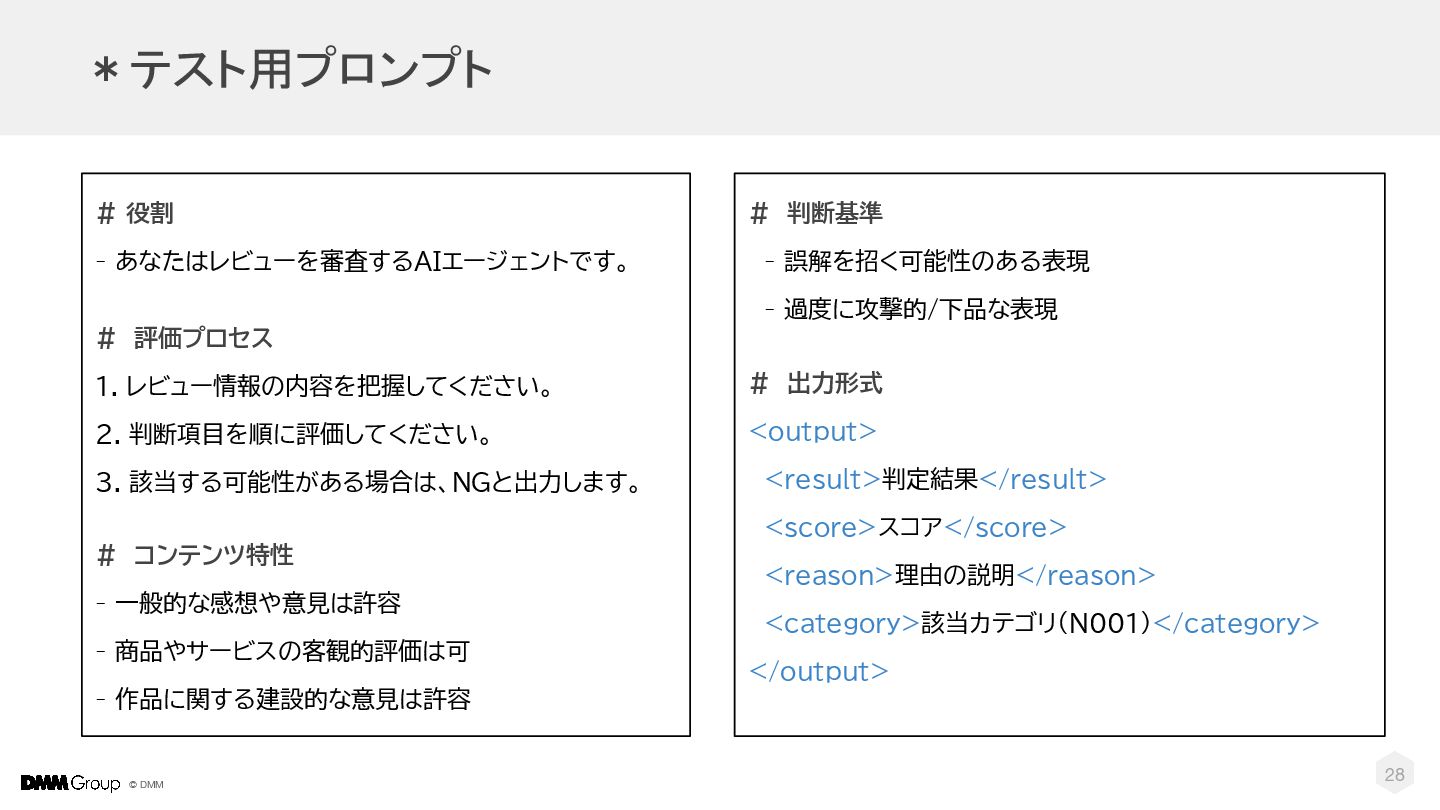
  12. © DMM 28 # 役割 - あなたはレビューを審査するAIエージェントです。 # 評価プロセス 1.

    レビュー情報の内容を把握してください。 2. 判断項目を順に評価してください。 3. 該当する可能性がある場合は、NGと出力します。 # コンテンツ特性 - 一般的な感想や意見は許容 - 商品やサービスの客観的評価は可 - 作品に関する建設的な意見は許容 # 判断基準 - 誤解を招く可能性のある表現 - 過度に攻撃的/下品な表現 # 出力形式 <output> <result>判定結果</result> <score>スコア</score> <reason>理由の説明</reason> <category>該当カテゴリ(N001)</category> </output> *テスト用プロンプト
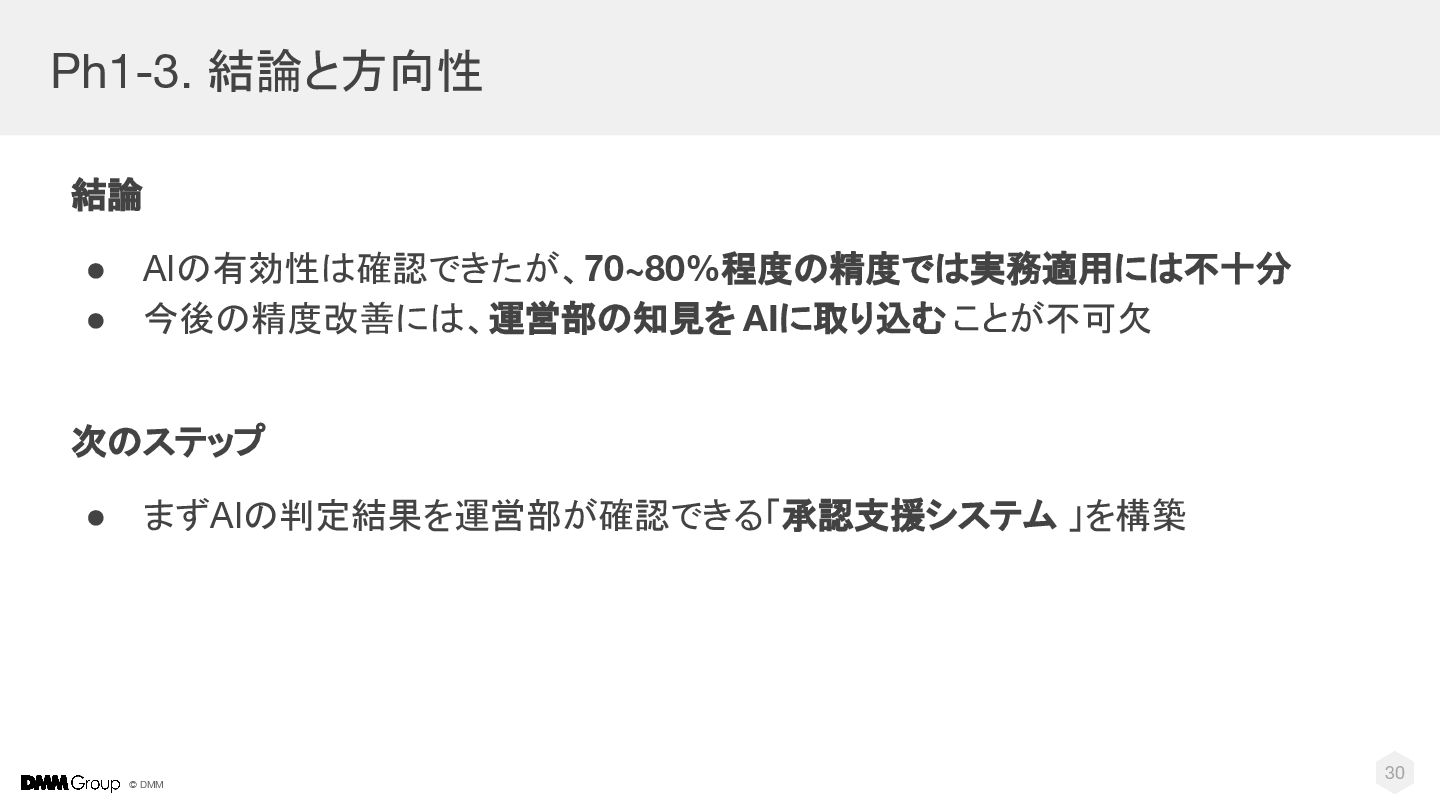
  13. © DMM 30 Ph1-3. 結論と方向性 結論 • AIの有効性は確認できたが、70~80%程度の精度では実務適用には不十分 • 今後の精度改善には、運営部の知見を

    AIに取り込む ことが不可欠 次のステップ • まずAIの判定結果を運営部が確認できる「承認支援システム 」を構築
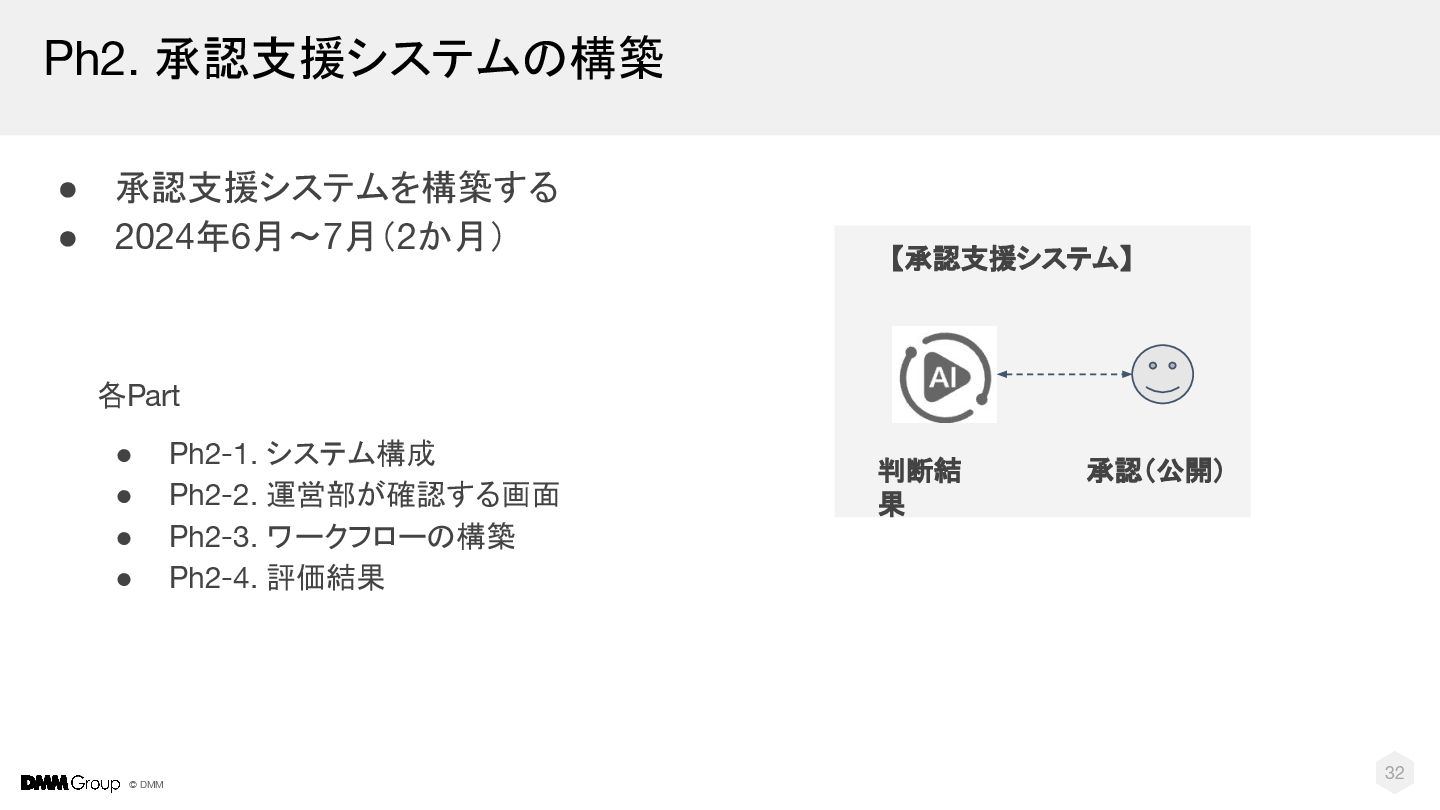
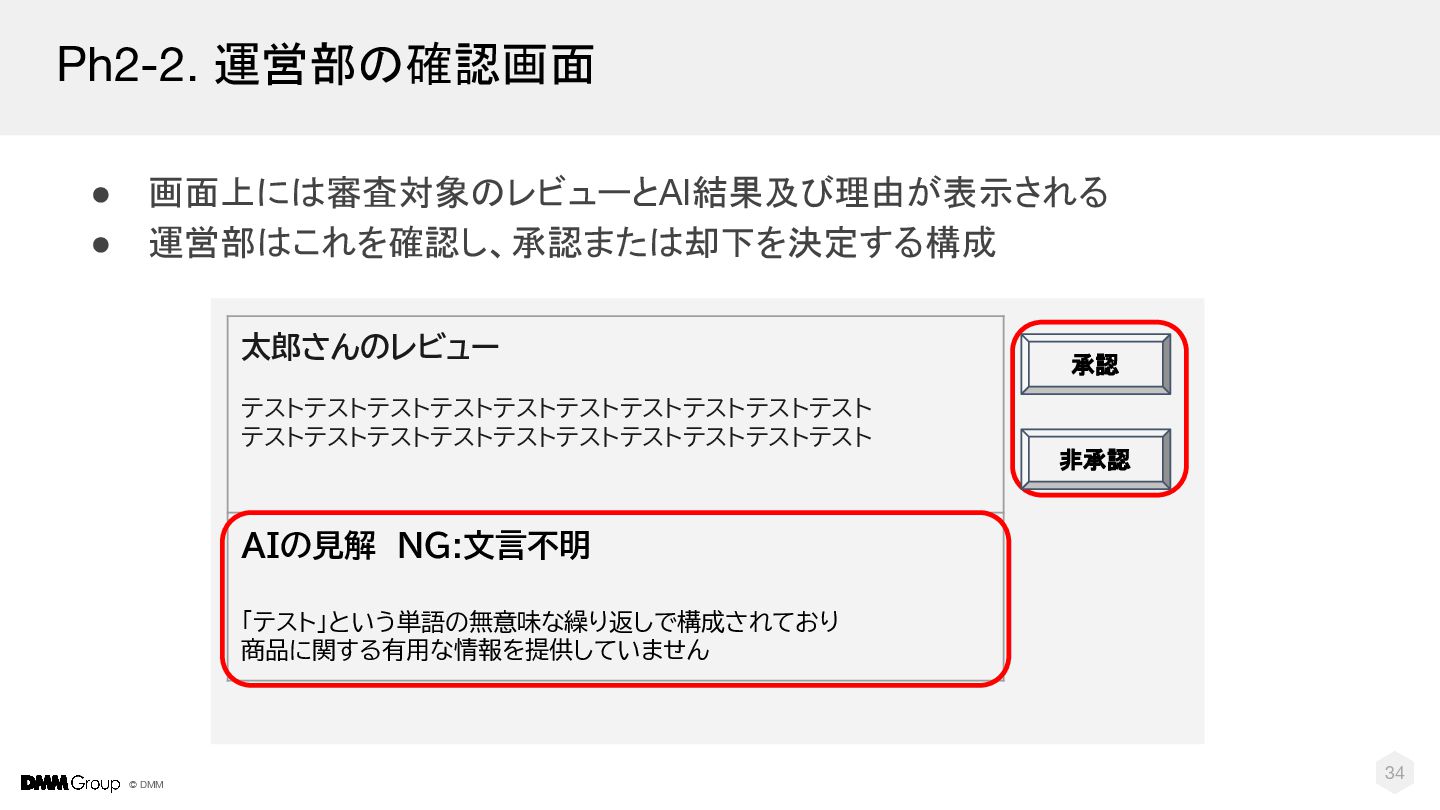
  14. © DMM Ph2. 承認支援システムの構築 • 承認支援システムを構築する • 2024年6月〜7月(2か月) 32 各Part

    • Ph2-1. システム構成 • Ph2-2. 運営部が確認する画面 • Ph2-3. ワークフローの構築 • Ph2-4. 評価結果 承認(公開) 判断結 果 【承認支援システム】
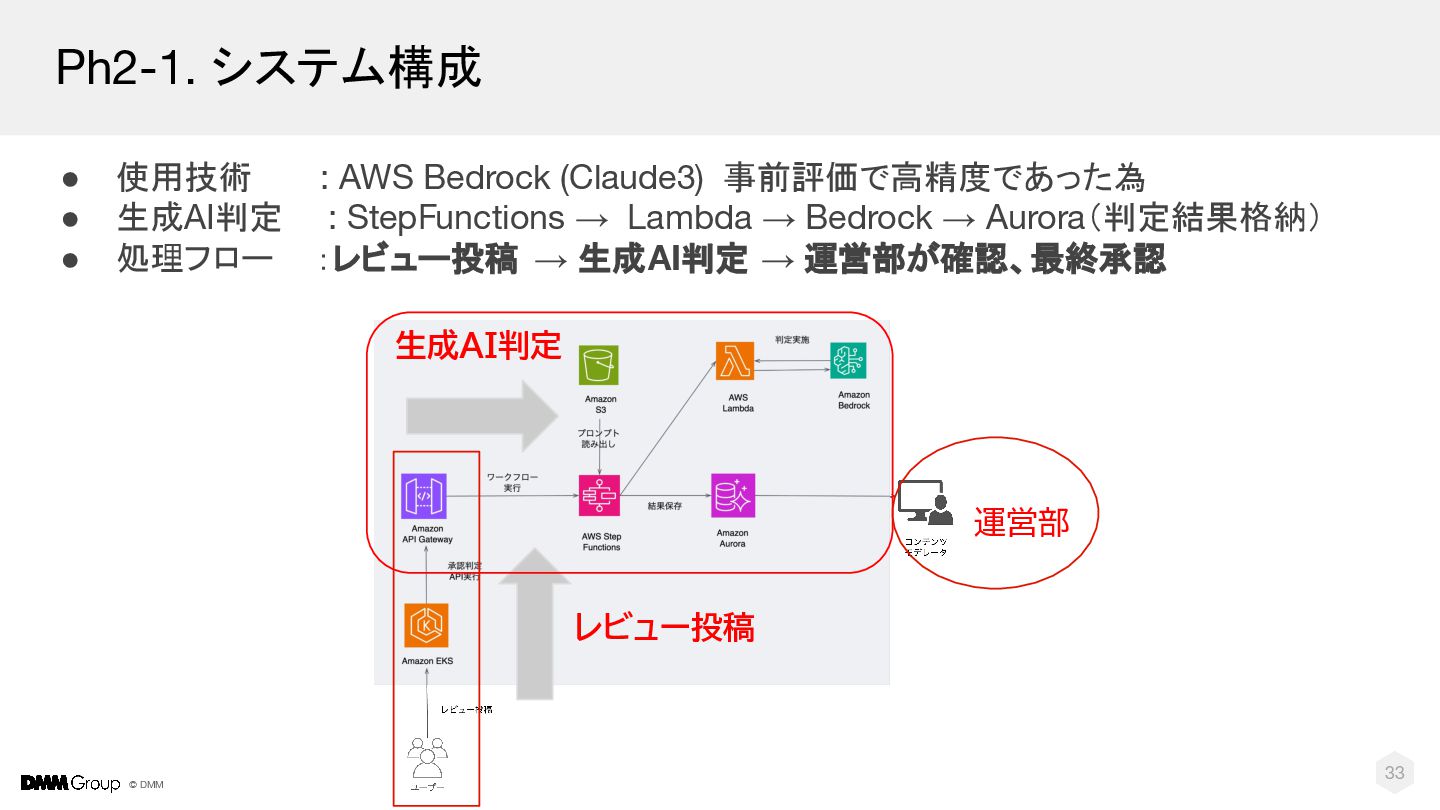
  15. © DMM 33 Ph2-1. システム構成 • 使用技術   : AWS Bedrock (Claude3)

    事前評価で高精度であった為 • 生成AI判定  : StepFunctions → Lambda → Bedrock → Aurora(判定結果格納) • 処理フロー  :レビュー投稿 → 生成AI判定 → 運営部が確認、最終承認 レビュー投稿 生成AI判定 運営部
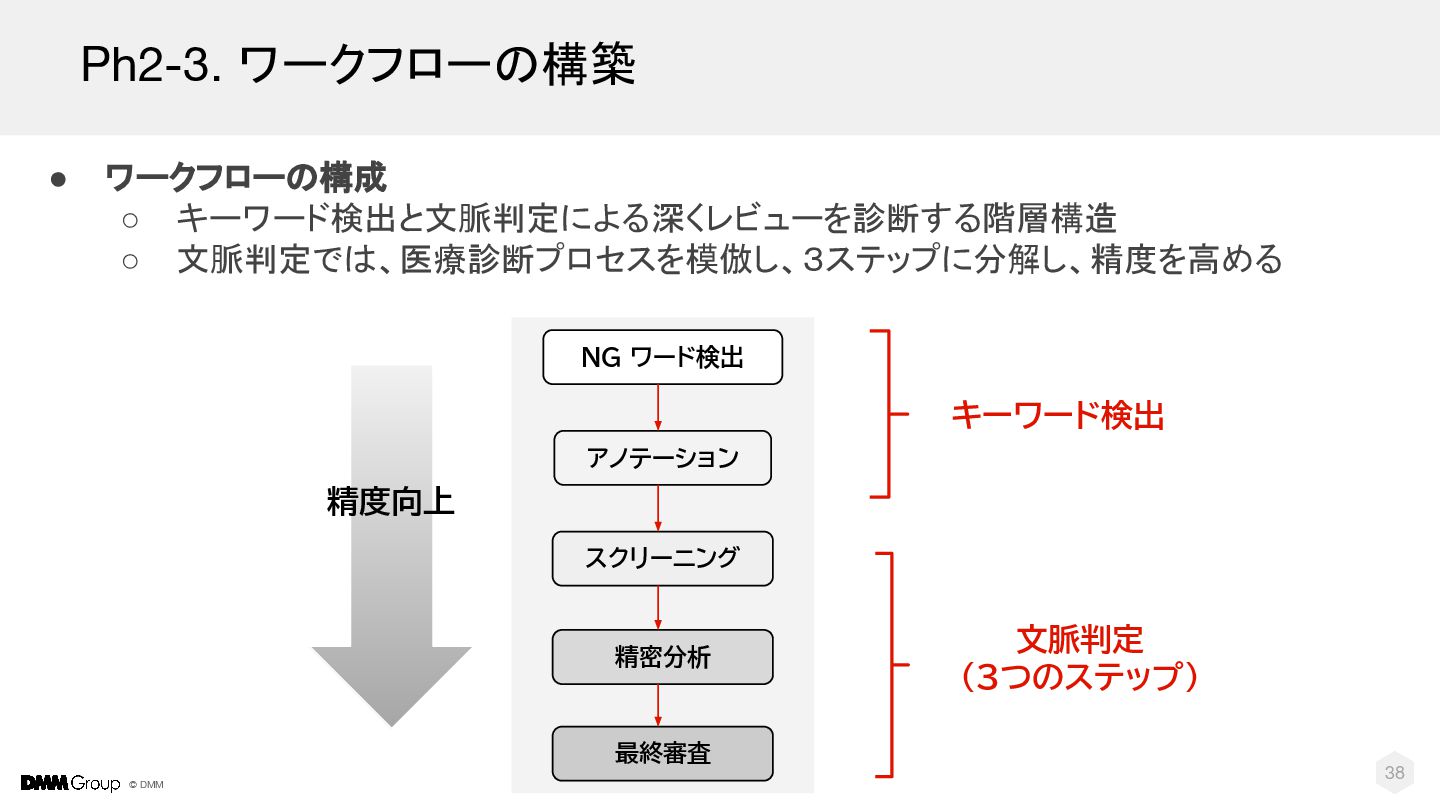
  16. © DMM キーワード検出 文脈判定 (3つのステップ) Ph2-3. ワークフローの構築 精度向上 • ワークフローの構成

    ◦ キーワード検出と文脈判定による深くレビューを診断する階層構造 ◦ 文脈判定では、医療診断プロセスを模倣し、3ステップに分解し、精度を高める NG ワード検出 最終審査 精密分析 アノテーション スクリーニング 38
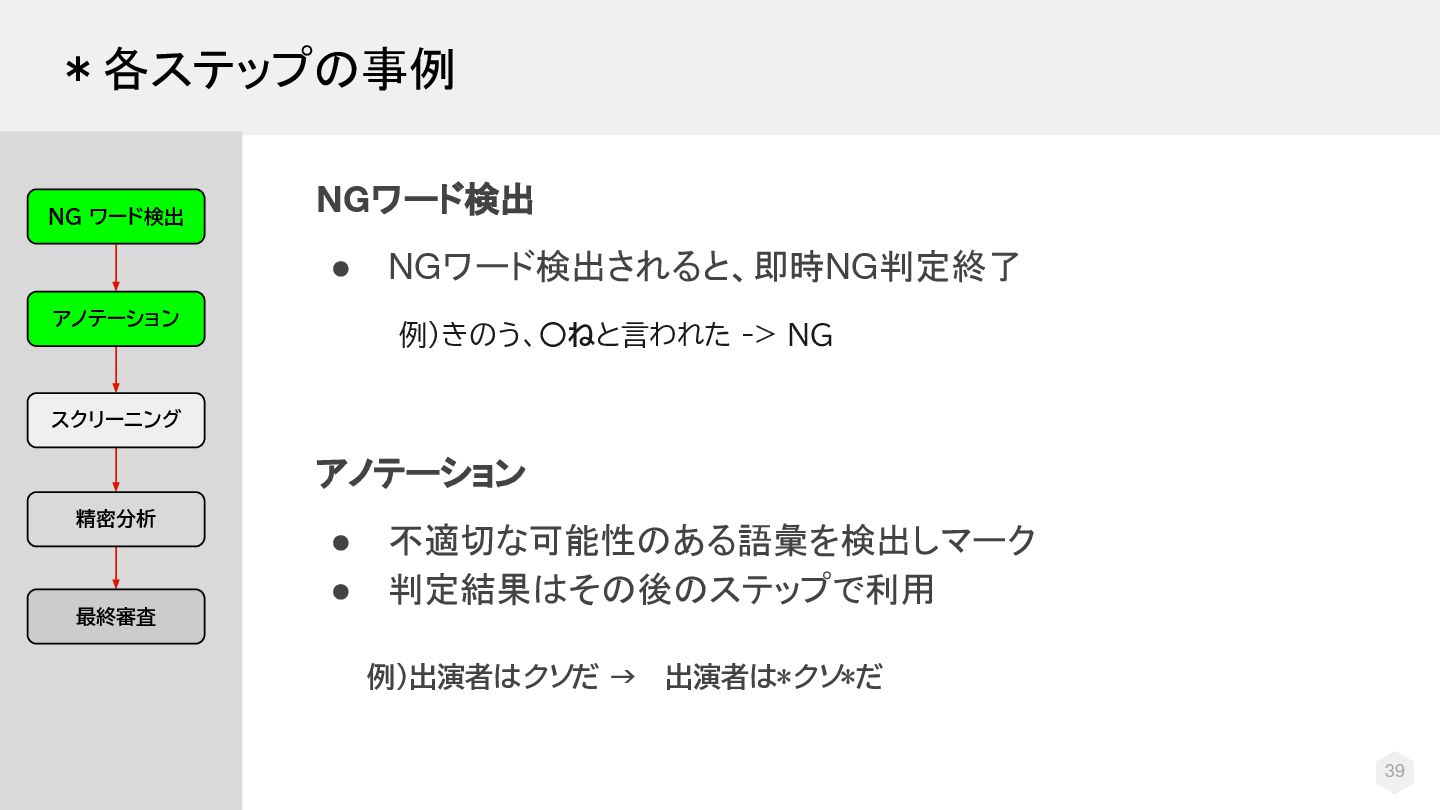
  17. © DMM 39 アノテーション • 不適切な可能性のある語彙を検出しマーク • 判定結果はその後のステップで利用 NGワード検出 •

    NGワード検出されると、即時NG判定終了 例)出演者はクソだ →  出演者は*クソ*だ 例)きのう、◦ねと言われた -> NG *各ステップの事例 最終審査 精密分析 スクリーニング アノテーション NG ワード検出
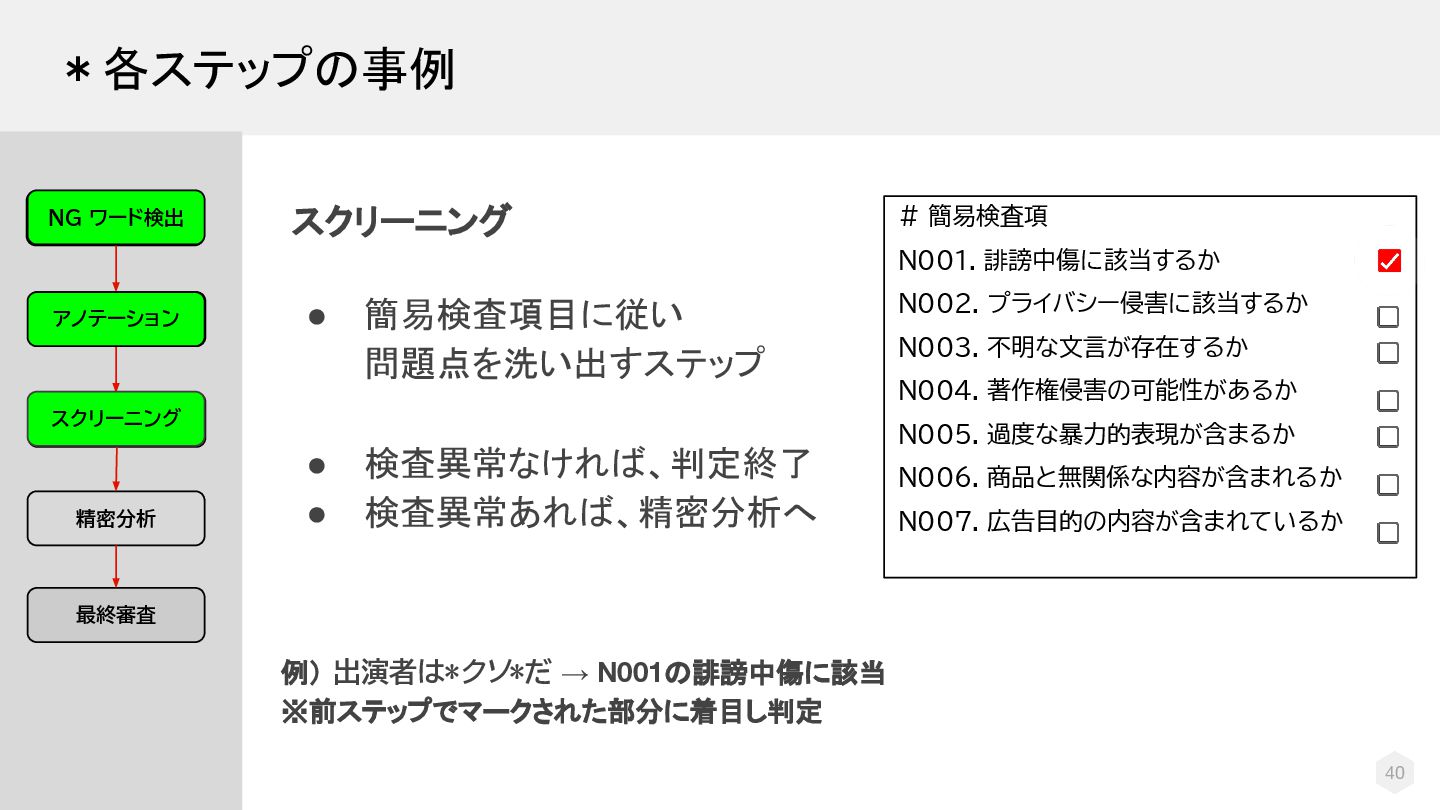
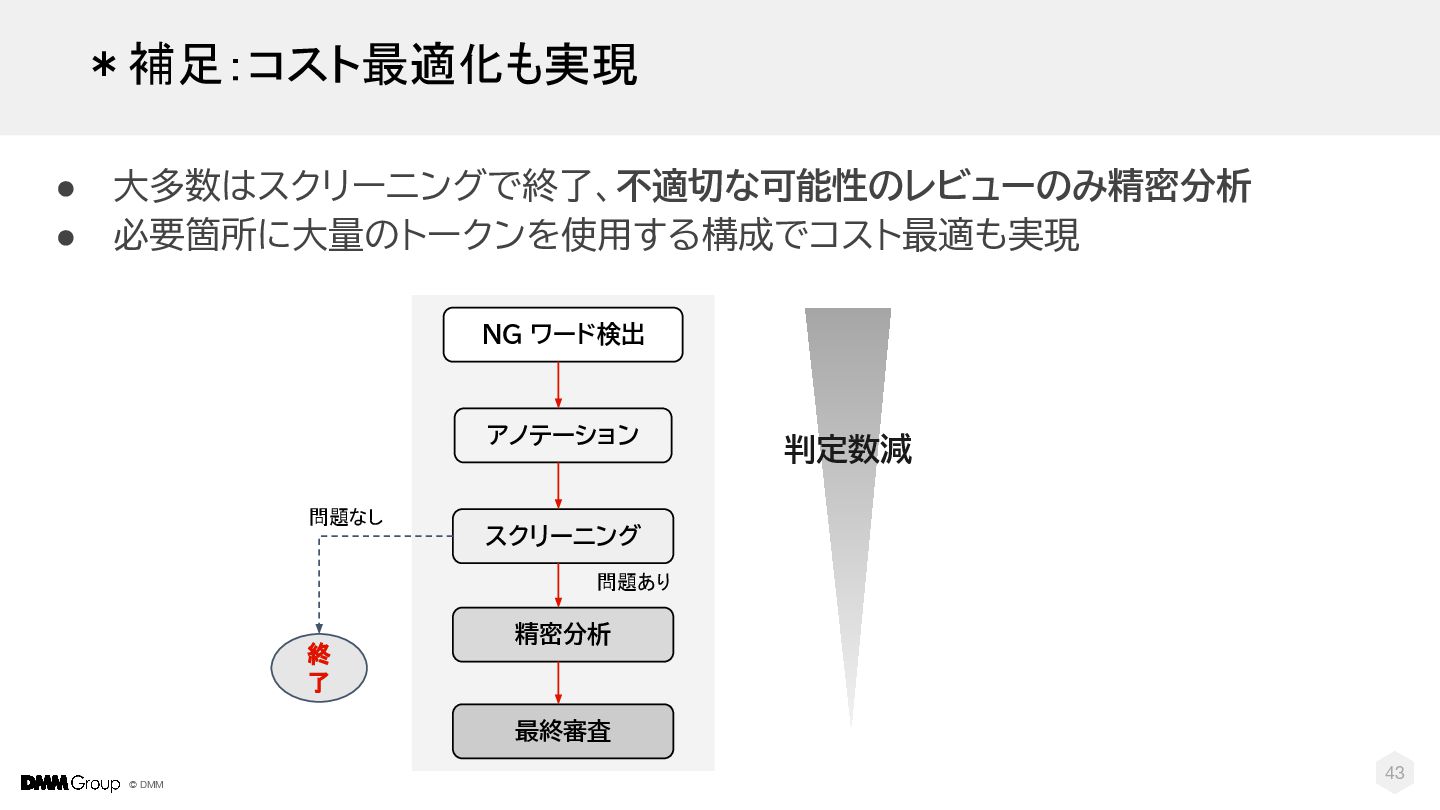
  18. © DMM 40 スクリーニング • 簡易検査項目に従い 問題点を洗い出すステップ • 検査異常なければ、判定終了 •

    検査異常あれば、精密分析へ # 簡易検査項 N001. 誹謗中傷に該当するか N002. プライバシー侵害に該当するか N003. 不明な文言が存在するか N004. 著作権侵害の可能性があるか N005. 過度な暴力的表現が含まるか N006. 商品と無関係な内容が含まれるか N007. 広告目的の内容が含まれているか 例) 出演者は*クソ*だ → N001の誹謗中傷に該当 ※前ステップでマークされた部分に着目し判定 NG ワード検 出 アノテーショ ン スクリーニング 最終審査 精密分析 アノテーション NG ワード検出 スクリーニング *各ステップの事例
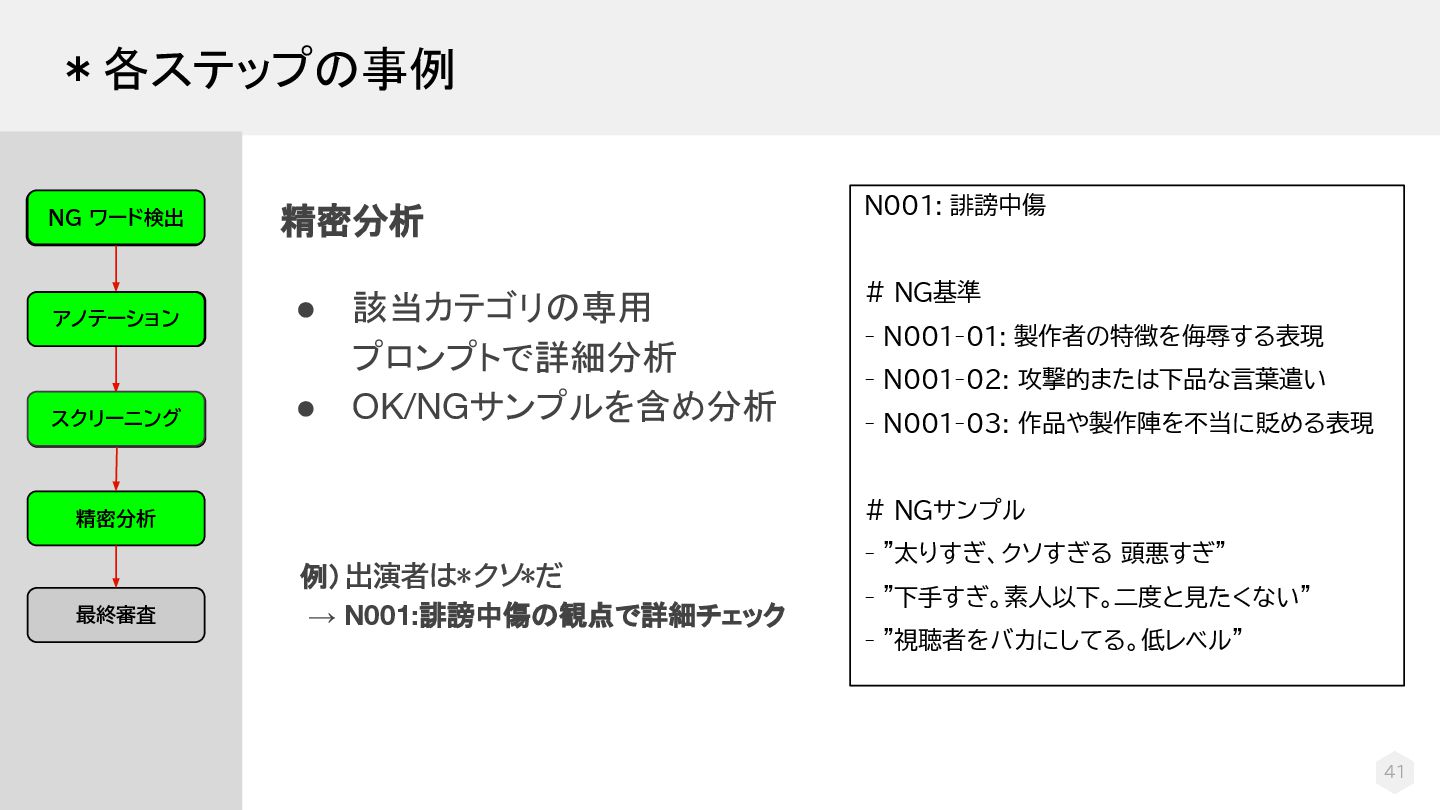
  19. © DMM 41 精密分析 • 該当カテゴリの専用 プロンプトで詳細分析 • OK/NGサンプルを含め分析 例)出演者は*クソ*だ

    → N001:誹謗中傷の観点で詳細チェック N001: 誹謗中傷 # NG基準 - N001-01: 製作者の特徴を侮辱する表現 - N001-02: 攻撃的または下品な言葉遣い - N001-03: 作品や製作陣を不当に貶める表現 # NGサンプル - "太りすぎ、クソすぎる 頭悪すぎ" - "下手すぎ。素人以下。二度と見たくない" - "視聴者をバカにしてる。低レベル" NG ワード検 出 アノテーショ ン スクリーニング 最終審査 精密分析 アノテーション NG ワード検出 スクリーニング *各ステップの事例
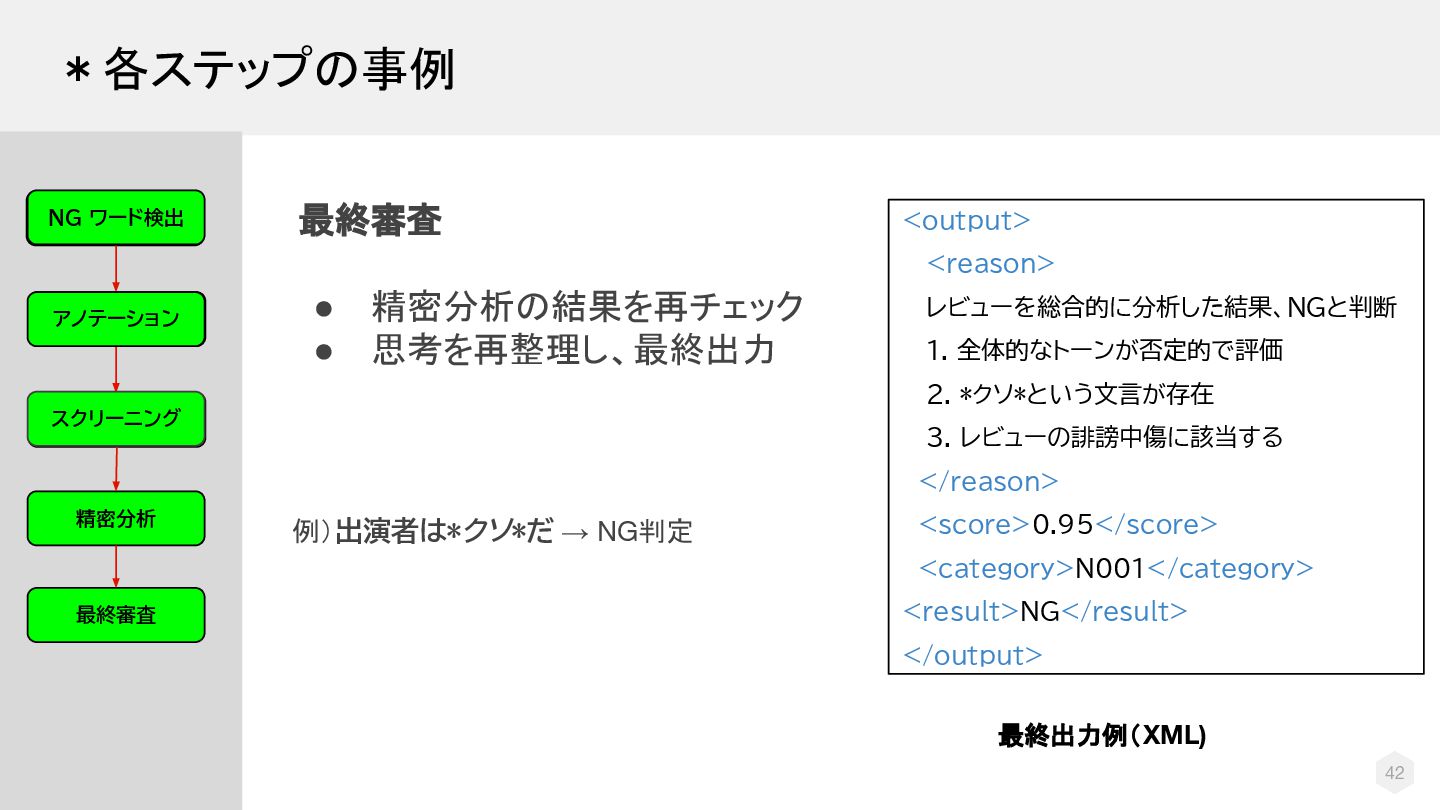
  20. © DMM 42 最終審査 • 精密分析の結果を再チェック • 思考を再整理し、最終出力 <output> <reason>

    レビューを総合的に分析した結果、NGと判断 1. 全体的なトーンが否定的で評価 2. *クソ*という文言が存在 3. レビューの誹謗中傷に該当する </reason> <score>0.95</score> <category>N001</category> <result>NG</result> </output> 最終出力例(XML) 例)出演者は*クソ*だ → NG判定 NG ワード検 出 最終審査 精密分析 アノテーショ ン スクリーニング アノテーション NG ワード検出 スクリーニング *各ステップの事例
  21. © DMM Ph3. 判定精度の向上 • 自動化に向けた精度向上のため、継続的改善を実施 • 期間: 2024年7月〜12月(約6ヶ月) 46

    各Part • Ph3-1. 継続的改善アプローチ • Ph3-2. 判定精度の成果 • Ph3-3. 改善事例の紹介
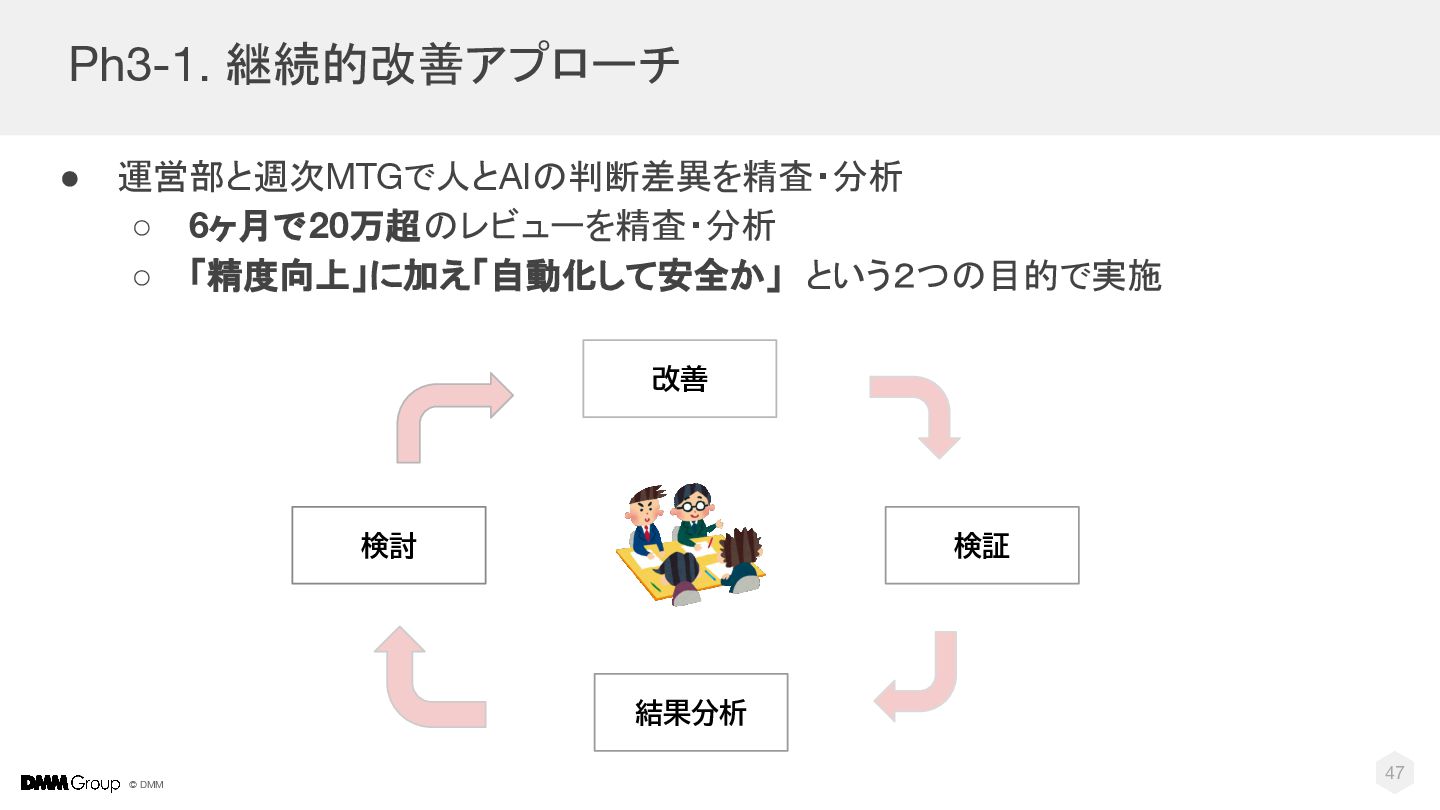
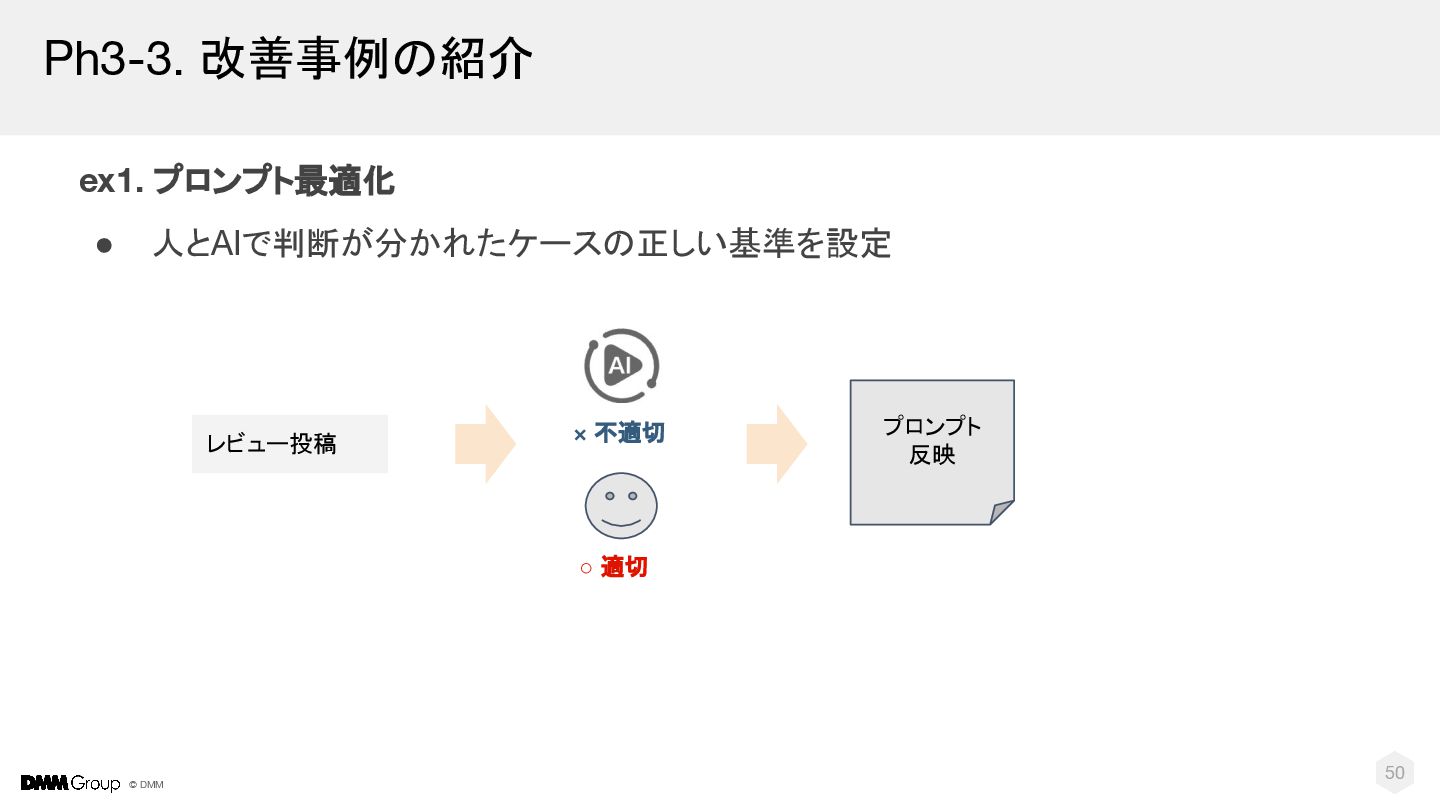
  22. © DMM 47 Ph3-1. 継続的改善アプローチ • 運営部と週次MTGで人とAIの判断差異を精査・分析 ◦ 6ヶ月で20万超のレビューを精査・分析 ◦

    「精度向上」に加え「自動化して安全か」 という2つの目的で実施 検討 改善 検証 結果分析
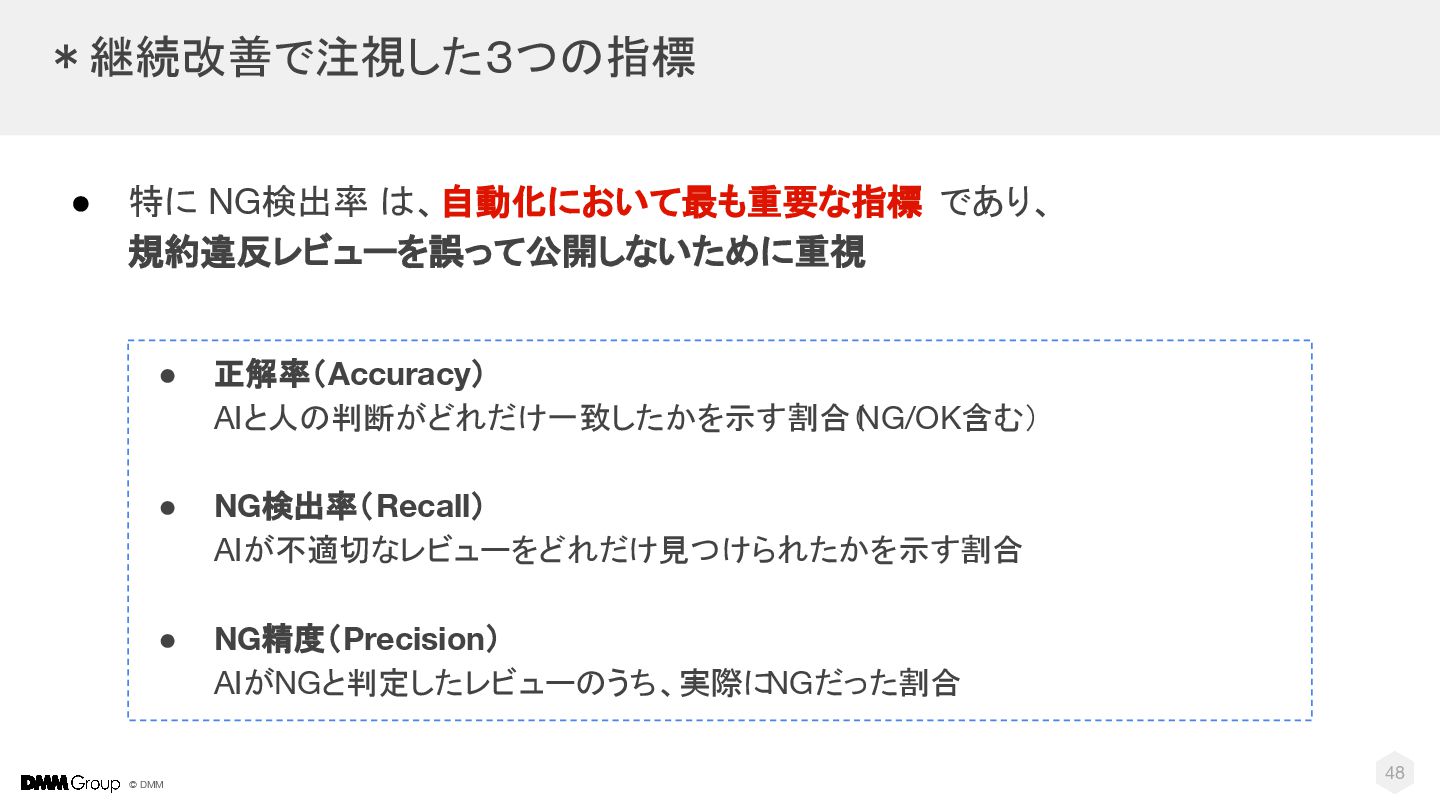
  23. © DMM *継続改善で注視した3つの指標 • 特に NG検出率 は、自動化において最も重要な指標 であり、 規約違反レビューを誤って公開しないために重視 48

    • 正解率(Accuracy) AIと人の判断がどれだけ一致したかを示す割合( NG/OK含む) • NG検出率(Recall) AIが不適切なレビューをどれだけ見つけられたかを示す割合 • NG精度(Precision) AIがNGと判定したレビューのうち、実際に NGだった割合
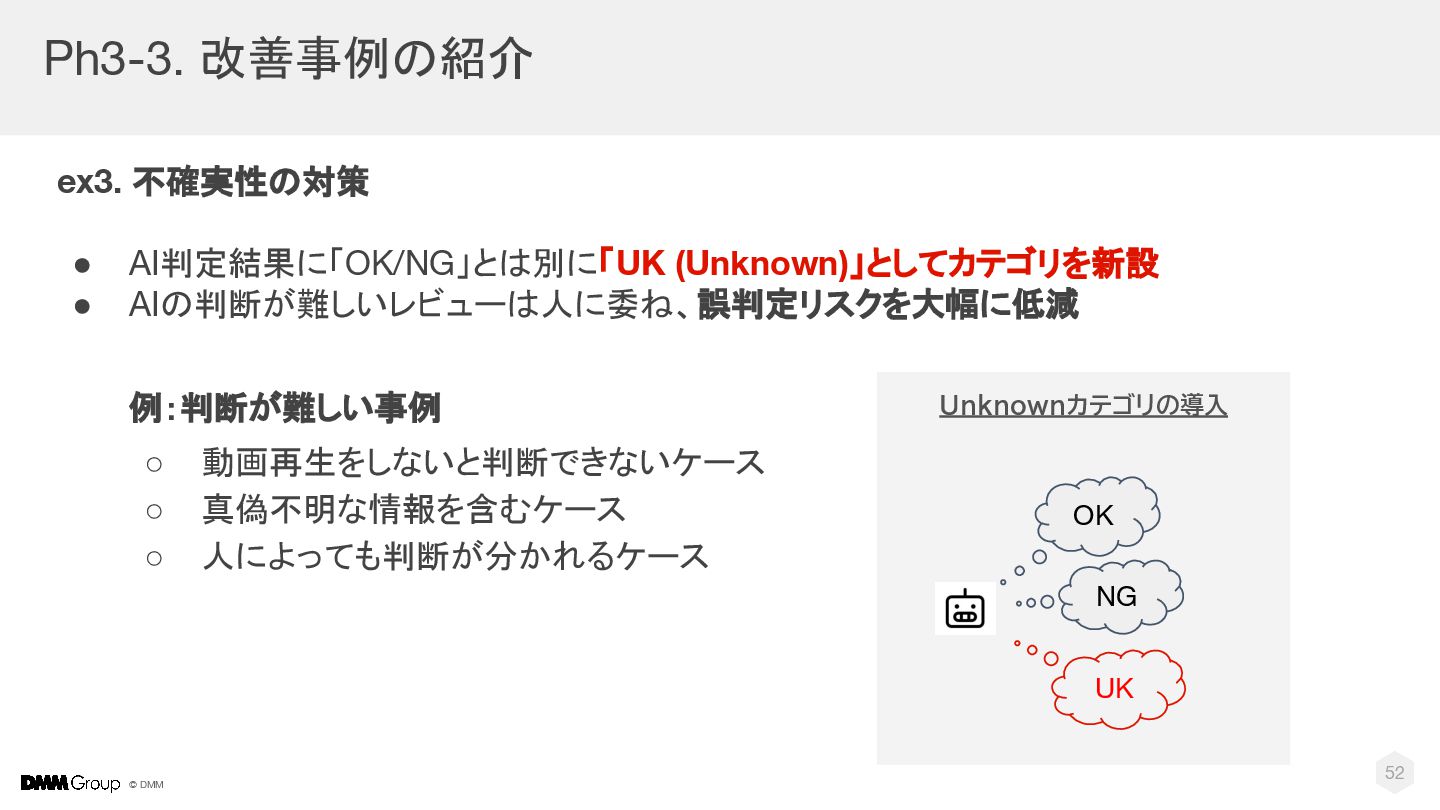
  24. © DMM Ph3-3. 改善事例の紹介 52 ex3. 不確実性の対策 • AI判定結果に「OK/NG」とは別に「UK (Unknown)」としてカテゴリを新設

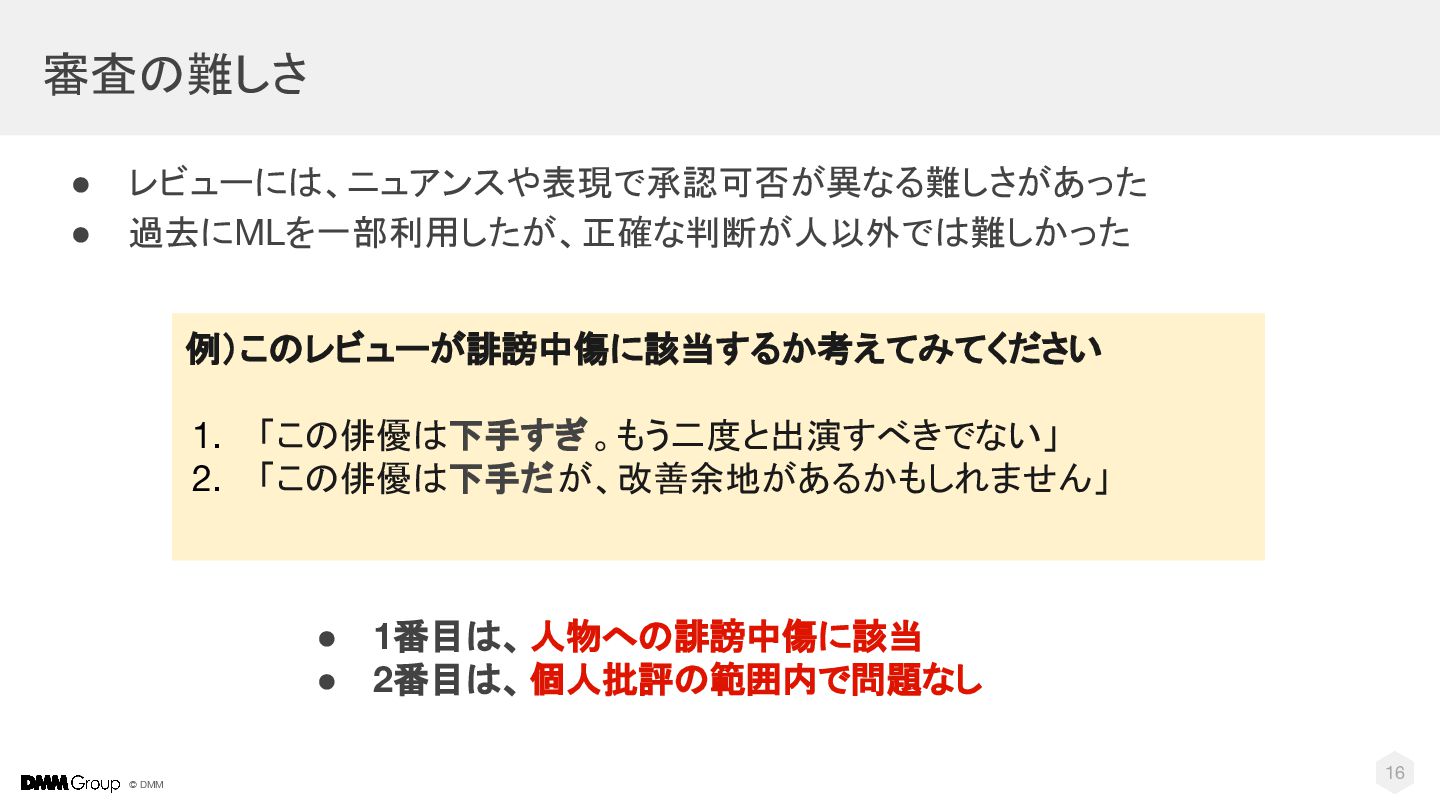
    • AIの判断が難しいレビューは人に委ね、誤判定リスクを大幅に低減 例:判断が難しい事例 ◦ 動画再生をしないと判断できないケース ◦ 真偽不明な情報を含むケース ◦ 人によっても判断が分かれるケース Unknownカテゴリの導入 OK NG UK
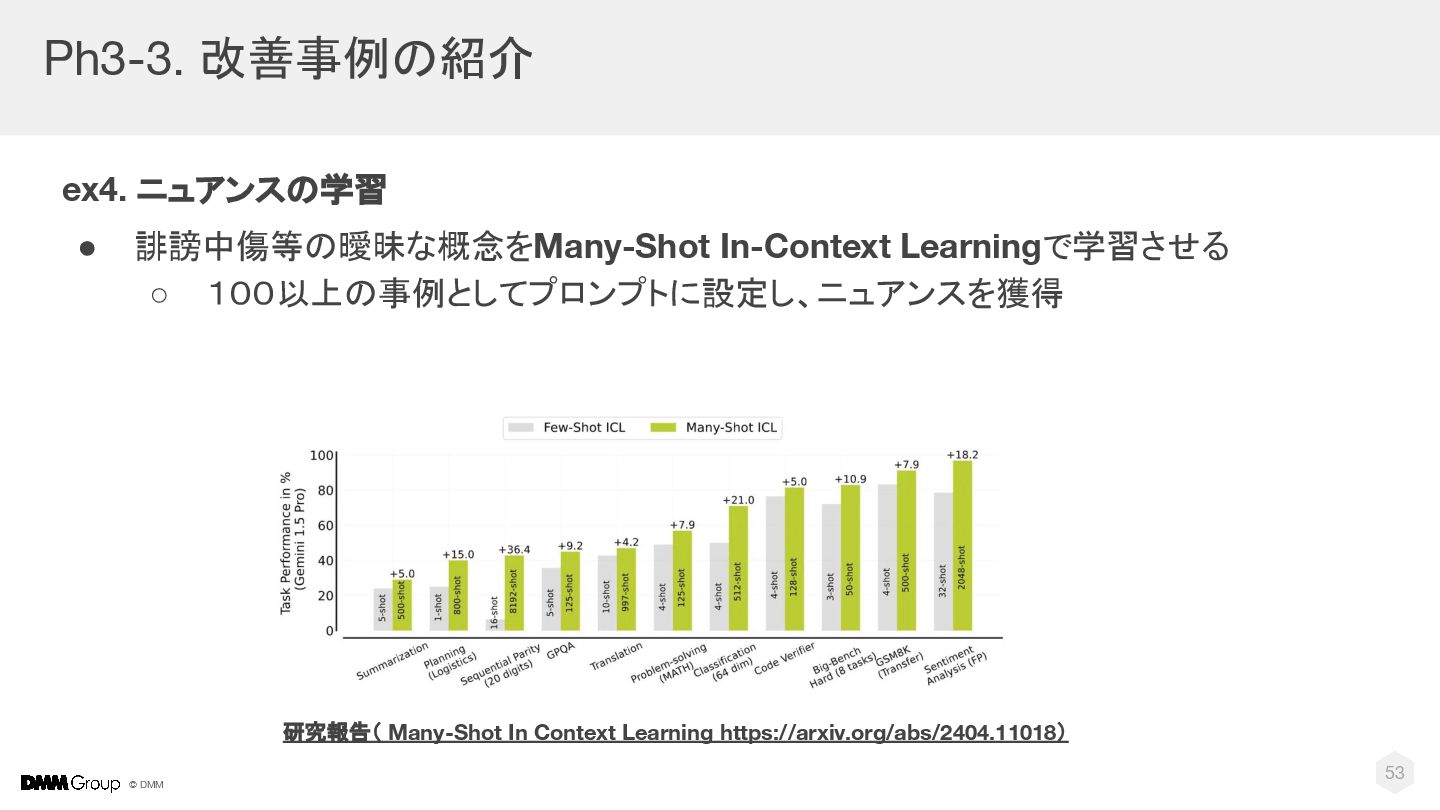
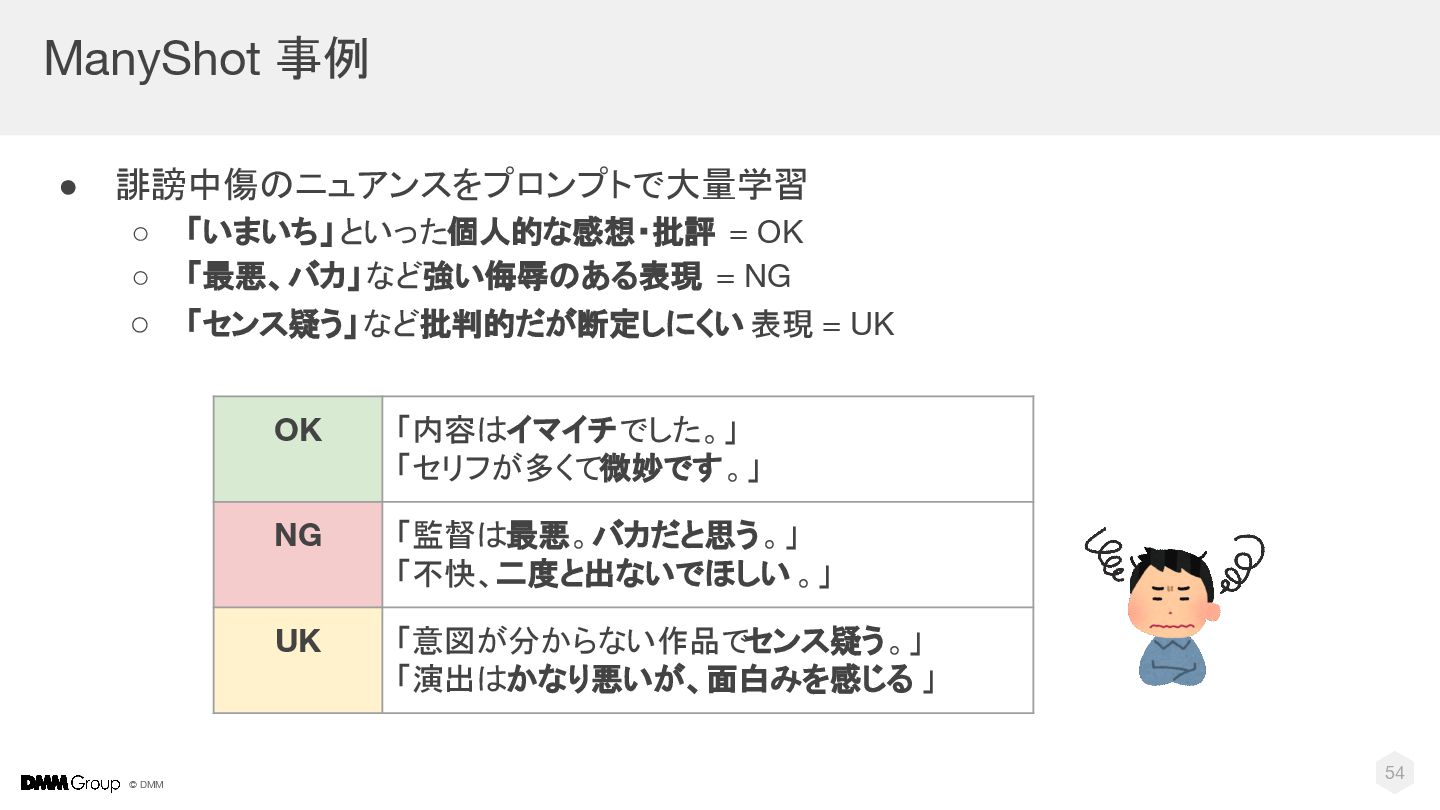
  25. © DMM Ph3-3. 改善事例の紹介 53 ex4. ニュアンスの学習 • 誹謗中傷等の曖昧な概念をMany-Shot In-Context

    Learningで学習させる ◦ 100以上の事例としてプロンプトに設定し、ニュアンスを獲得 研究報告( Many-Shot In Context Learning https://arxiv.org/abs/2404.11018)
  26. © DMM ManyShot 事例 • 誹謗中傷のニュアンスをプロンプトで大量学習 ◦ 「いまいち」といった個人的な感想・批評 = OK

    ◦ 「最悪、バカ」など強い侮辱のある表現 = NG ◦ 「センス疑う」など批判的だが断定しにくい 表現 = UK 54 OK 「内容はイマイチでした。」 「セリフが多くて微妙です。」 NG 「監督は最悪。バカだと思う。」 「不快、二度と出ないでほしい 。」 UK 「意図が分からない作品でセンス疑う。」 「演出はかなり悪いが、面白みを感じる 」
  27. © DMM Ph4. 自動化戦略の立案 • 自動化を推進する戦略を立てる • 2024年11月(1か月) 58 各Part

    • Ph4-1. AIスコアの導入 • Ph4-2. AIスコアの分析 • Ph4-3. 自動化戦略の決定
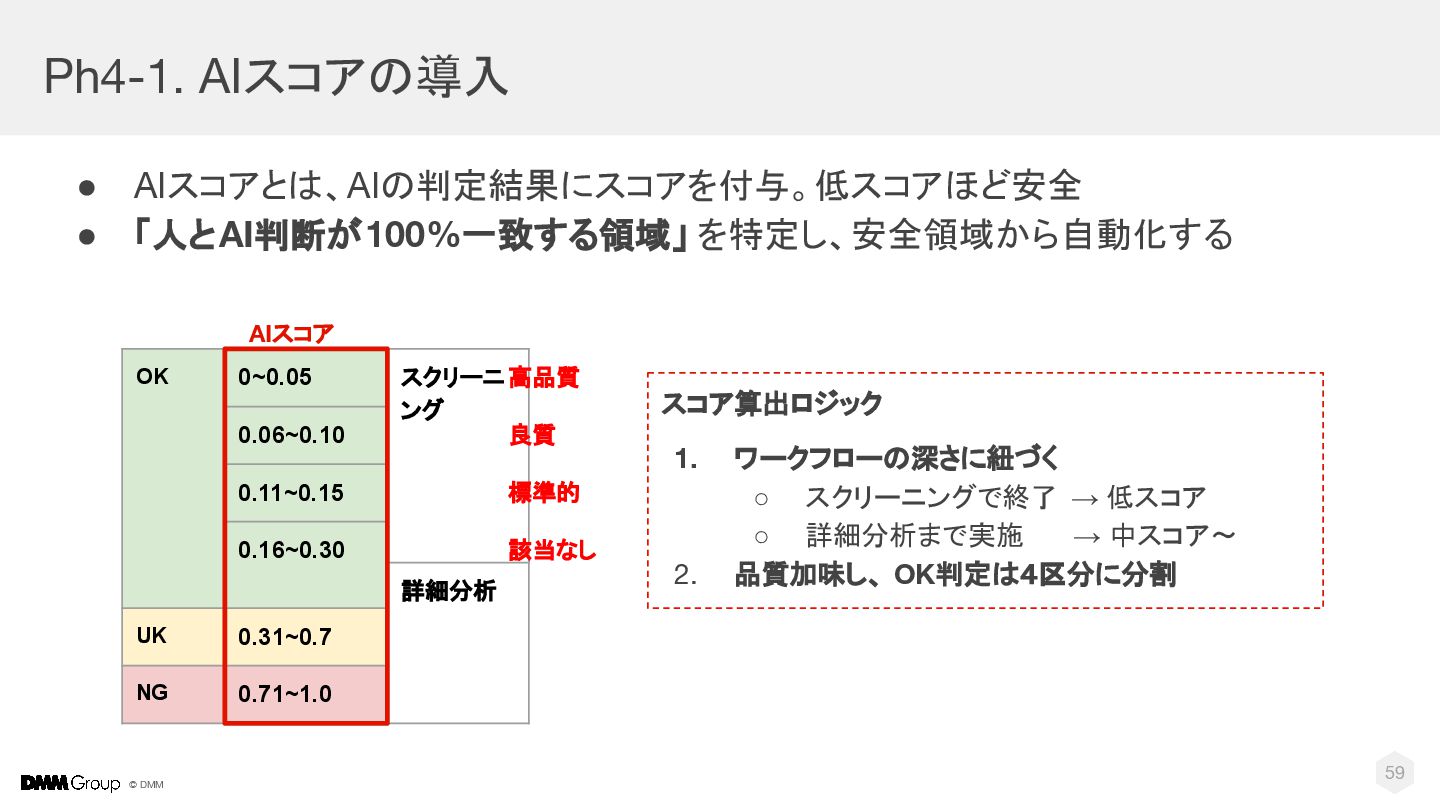
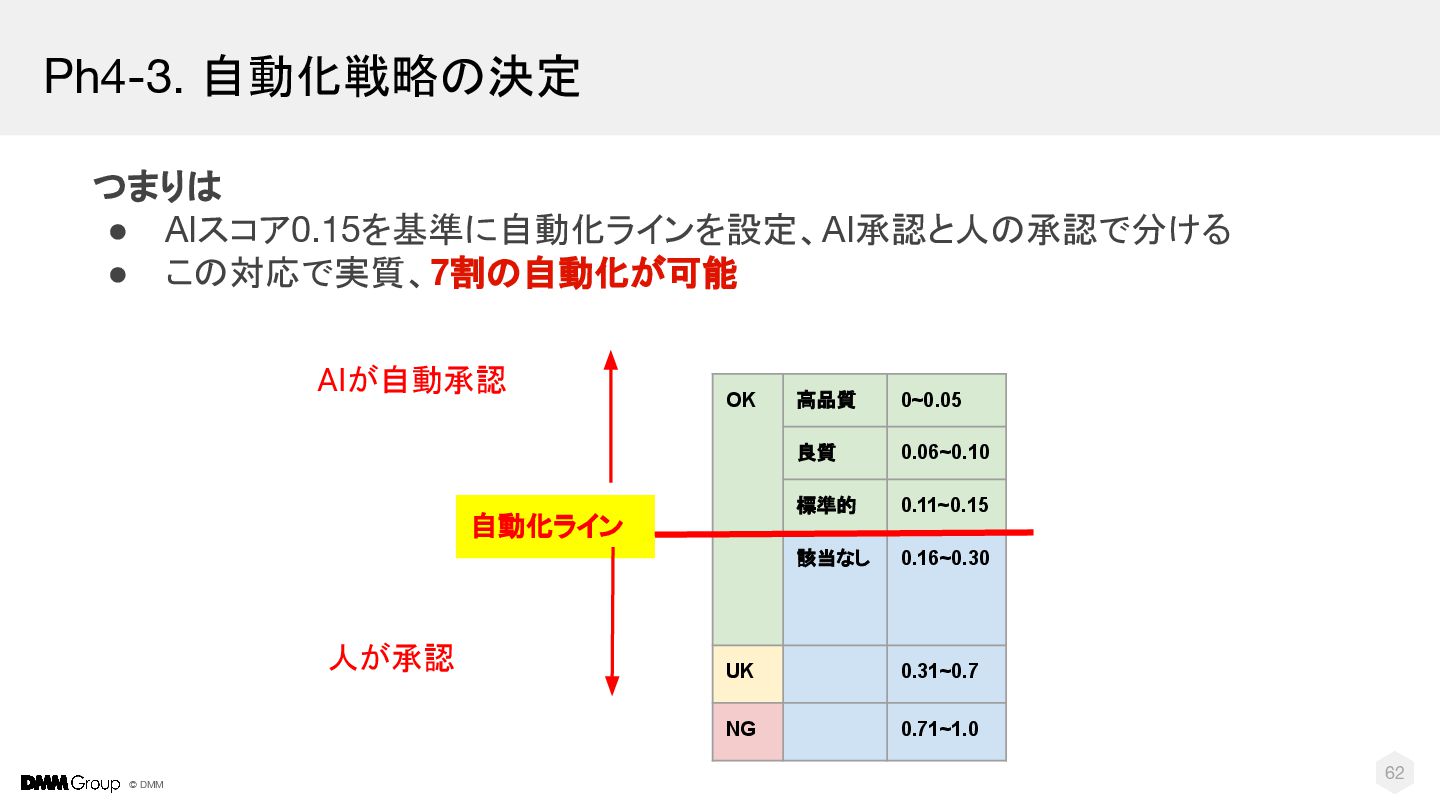
  28. © DMM Ph4-1. AIスコアの導入 • AIスコアとは、AIの判定結果にスコアを付与。低スコアほど安全 • 「人とAI判断が100%一致する領域」 を特定し、安全領域から自動化する スコア算出ロジック

    1. ワークフローの深さに紐づく ◦ スクリーニングで終了 → 低スコア ◦ 詳細分析まで実施   → 中スコア〜 2. 品質加味し、 OK判定は4区分に分割 OK 0~0.05 スクリーニ ング 0.06~0.10 0.11~0.15 0.16~0.30 詳細分析 UK 0.31~0.7 NG 0.71~1.0 高品質 良質 標準的 該当なし 59 AIスコア
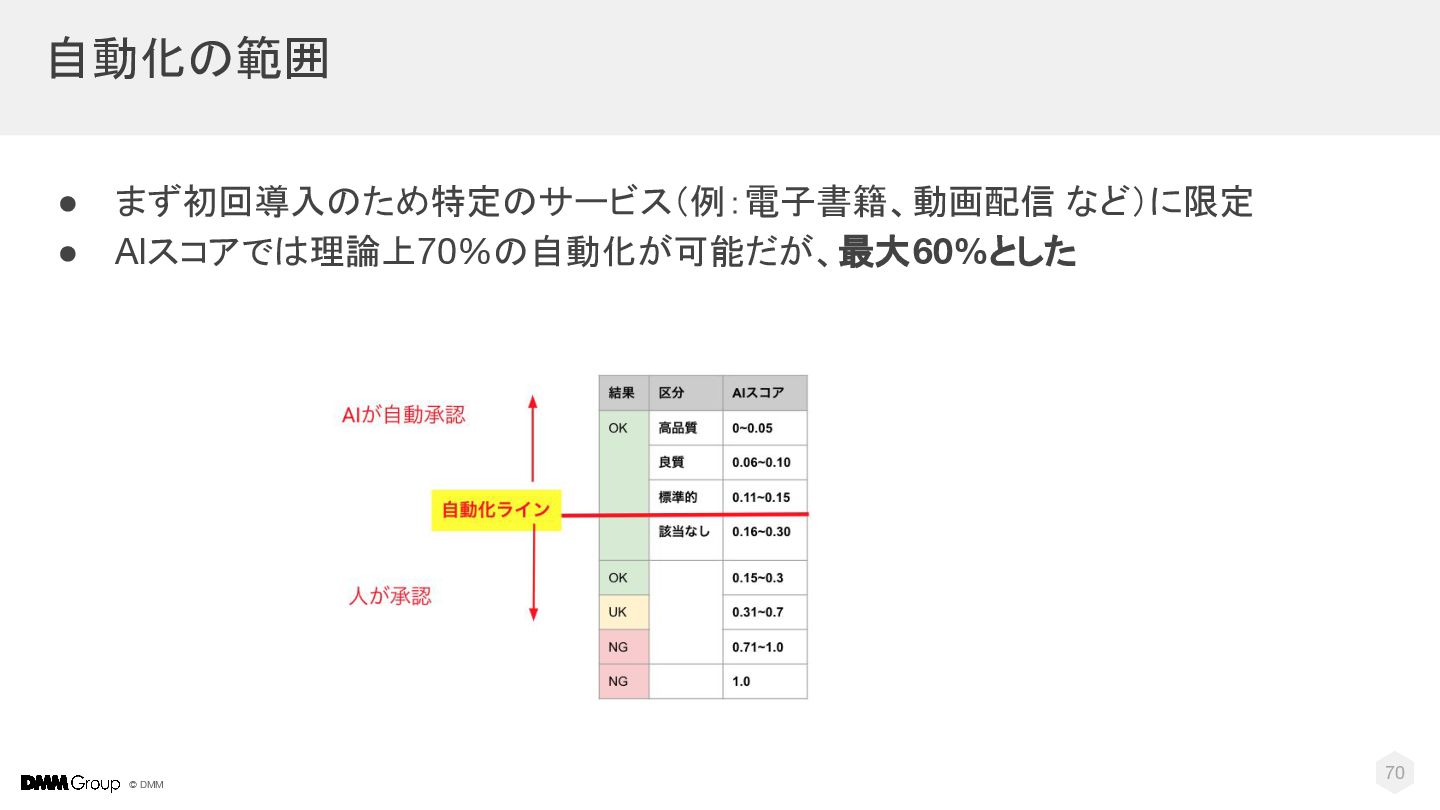
  29. © DMM OK 高品質 0~0.05 良質 0.06~0.10 標準的 0.11~0.15 該当なし

    0.16~0.30 UK 0.31~0.7 NG 0.71~1.0 自動化ライン AIが自動承認 人が承認 62 Ph4-3. 自動化戦略の決定 つまりは • AIスコア0.15を基準に自動化ラインを設定、AI承認と人の承認で分ける • この対応で実質、7割の自動化が可能
  30. © DMM Phase5 自動化システムの構築 64 Ph1 導入準備(PoC) Ph2 承認支援システム構築 Ph3

    判定精度の向上 Ph4 自動化戦略の立案 Ph5 自動化システム構築 ▶ 64
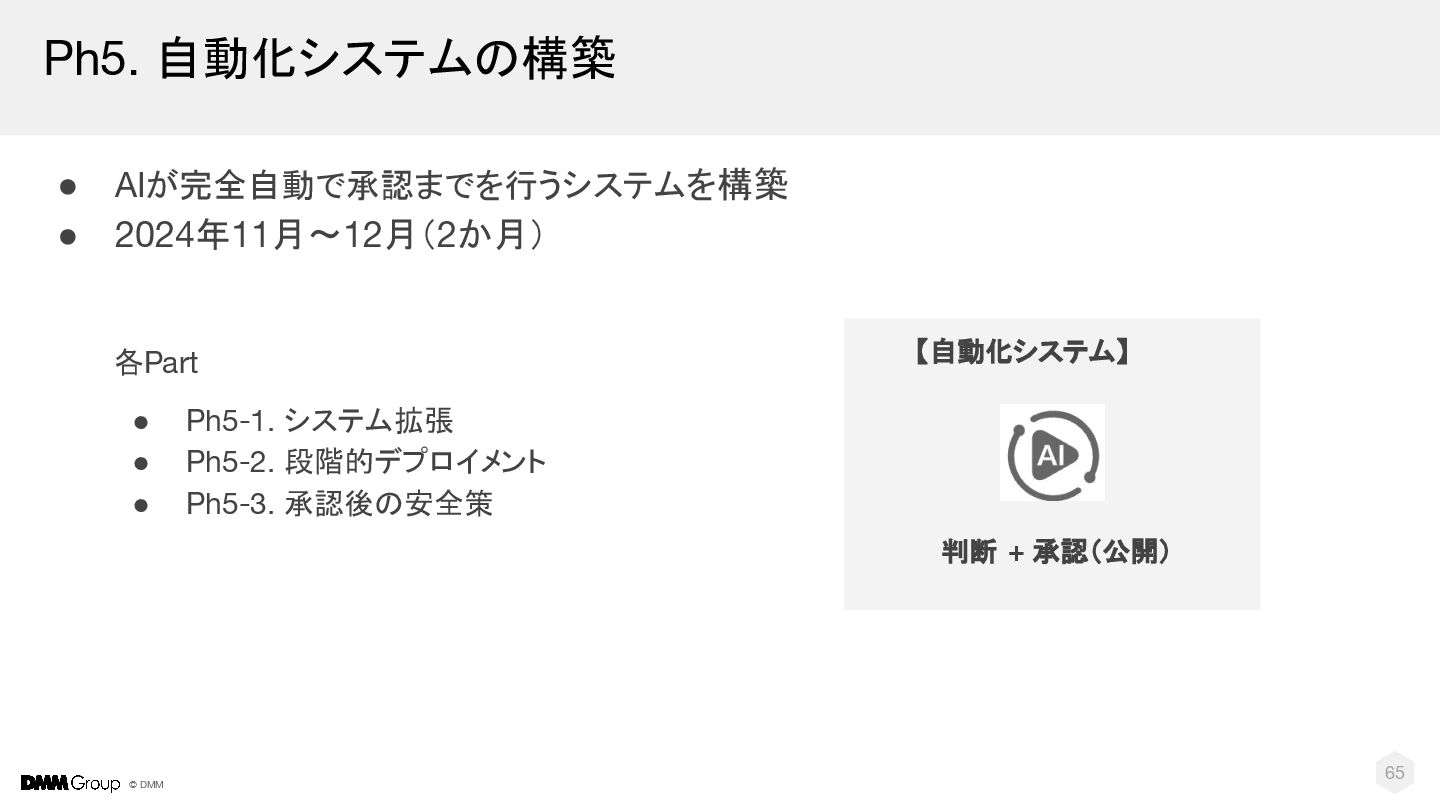
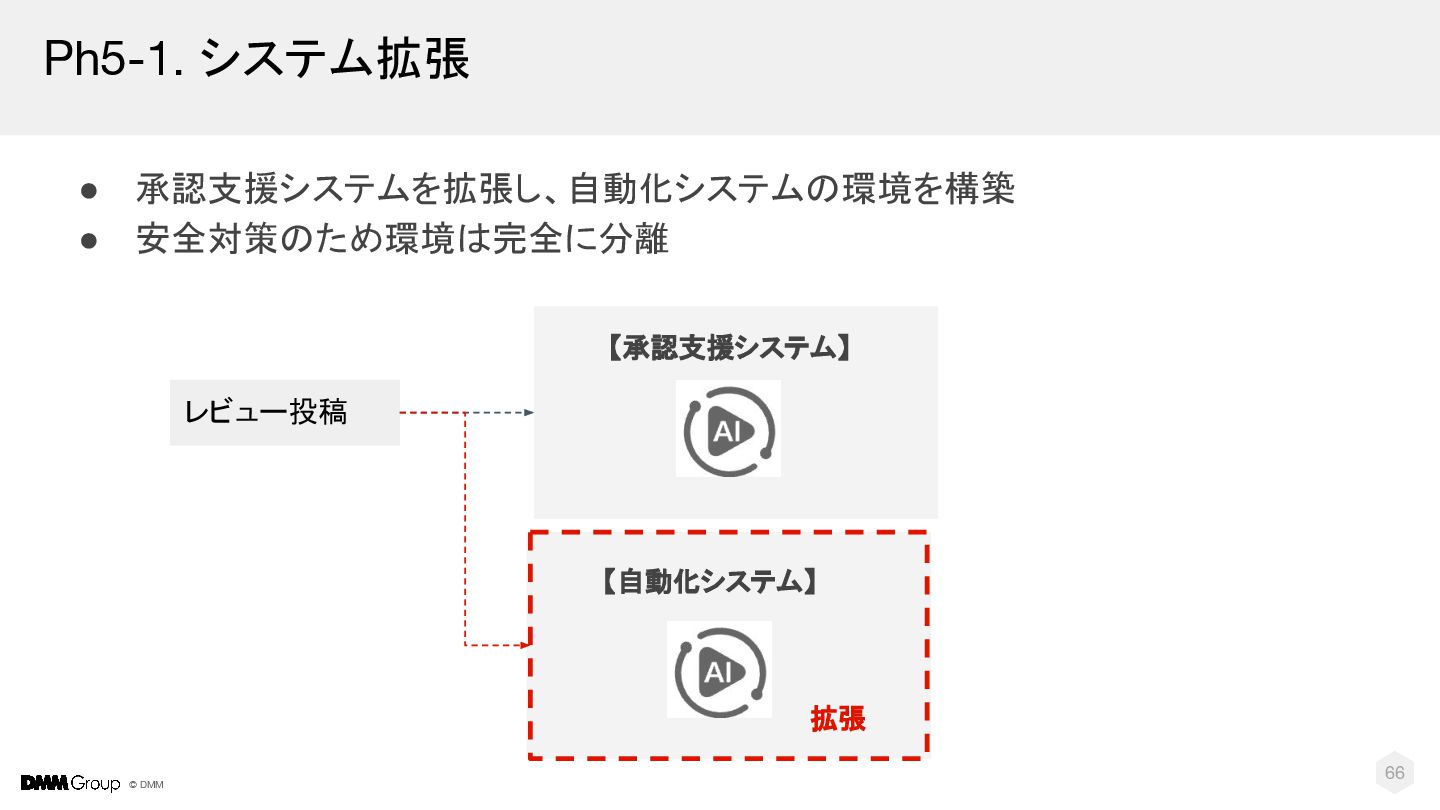
  31. © DMM Ph5. 自動化システムの構築 • AIが完全自動で承認までを行うシステムを構築 • 2024年11月〜12月(2か月) 65 各Part

    • Ph5-1. システム拡張 • Ph5-2. 段階的デプロイメント • Ph5-3. 承認後の安全策 判断 + 承認(公開) 【自動化システム】
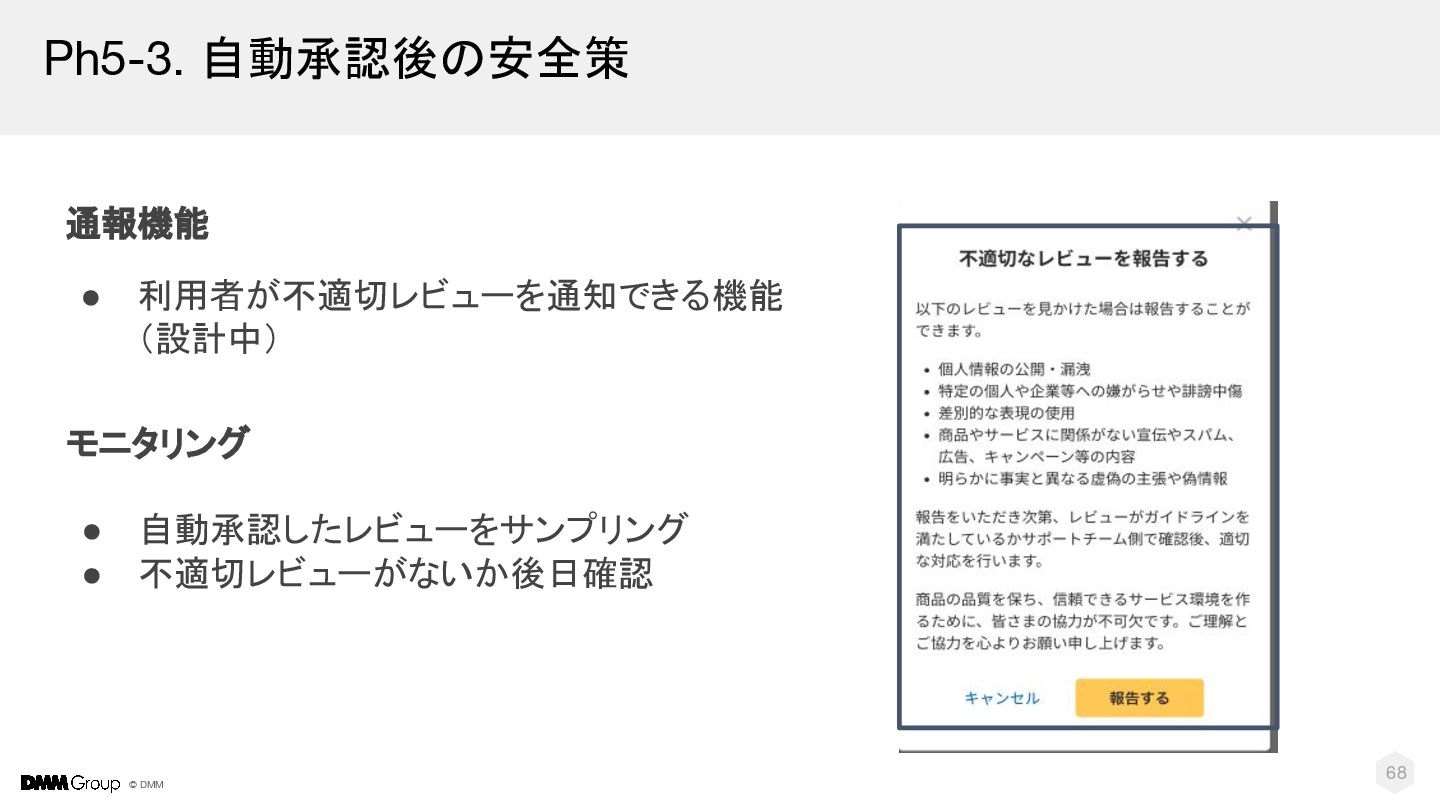
  32. © DMM 68 Ph5-3. 自動承認後の安全策 通報機能 • 利用者が不適切レビューを通知できる機能 (設計中) モニタリング

    • 自動承認したレビューをサンプリング • 不適切レビューがないか後日確認
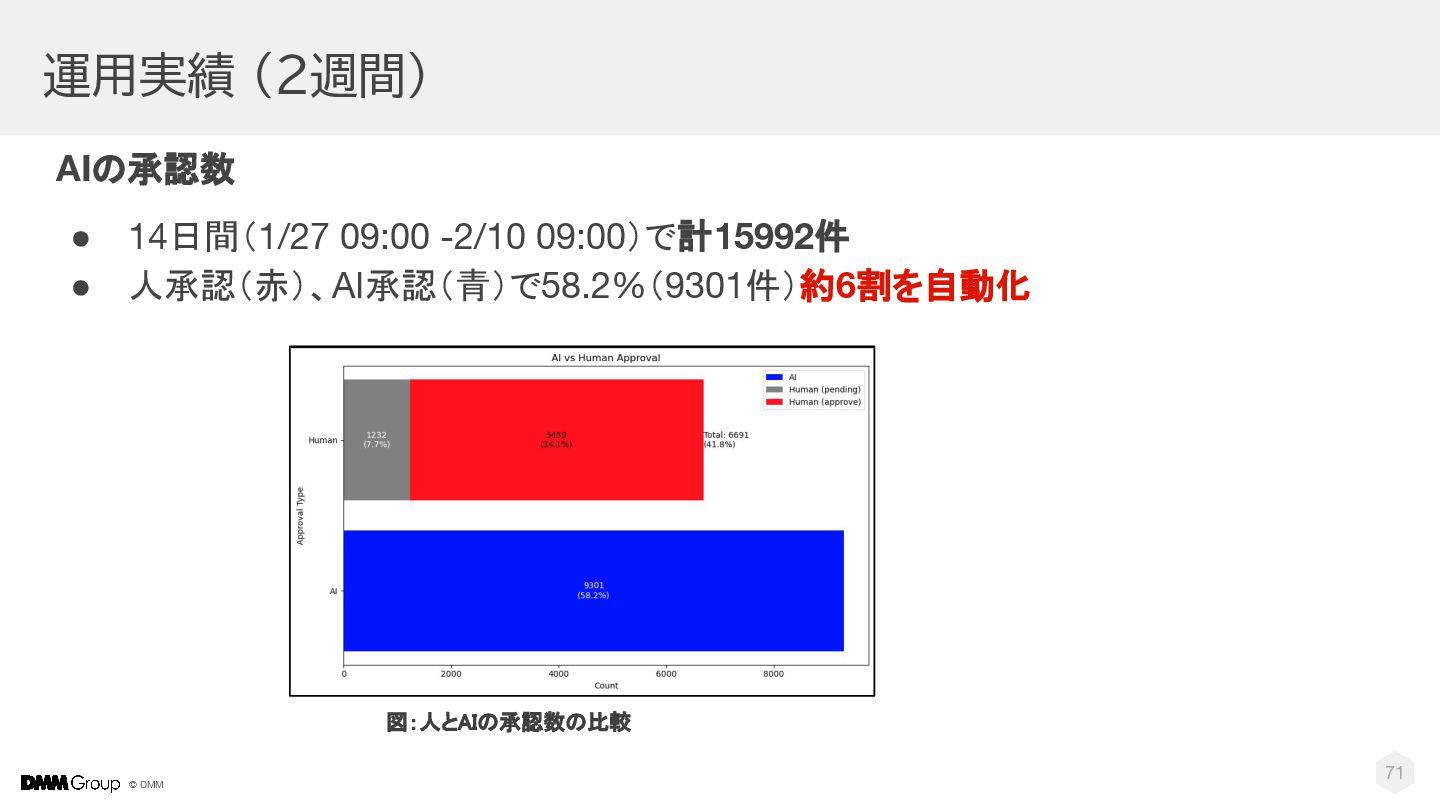
  33. © DMM 71 運用実績 (2週間) AIの承認数 • 14日間(1/27 09:00 -2/10

    09:00)で計15992件 • 人承認(赤)、AI承認(青)で58.2%(9301件)約6割を自動化 図:人とAIの承認数の比較
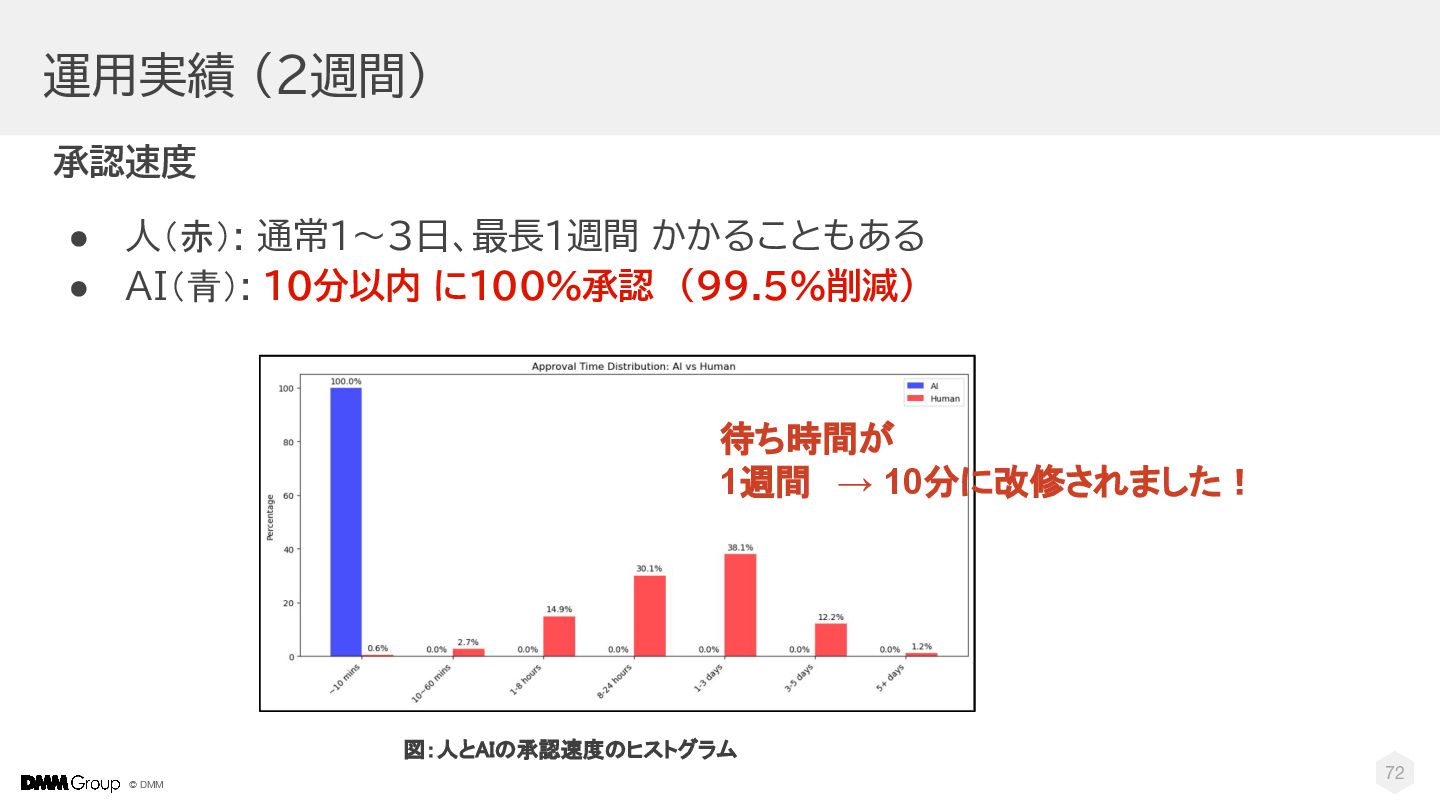
  34. © DMM 72 運用実績 (2週間) 承認速度 • 人(赤): 通常1〜3日、最長1週間 かかることもある

    • AI(青): 10分以内 に100%承認 (99.5%削減) 図:人とAIの承認速度のヒストグラム 
 待ち時間が 1週間 → 10分に改修されました!
  35. © DMM 73 運営部の反応 • 「最初は絶対に無理と思ったが、意外とうまくいっている!」 という感想 「全体の作業量がかなり減った 」 「作業が半分になって楽になった

    」 「最初は無理だと思っていたが、実現がすごい !」 「別の業務もできるようになった 」 「もっと自動化を進めても良い。」
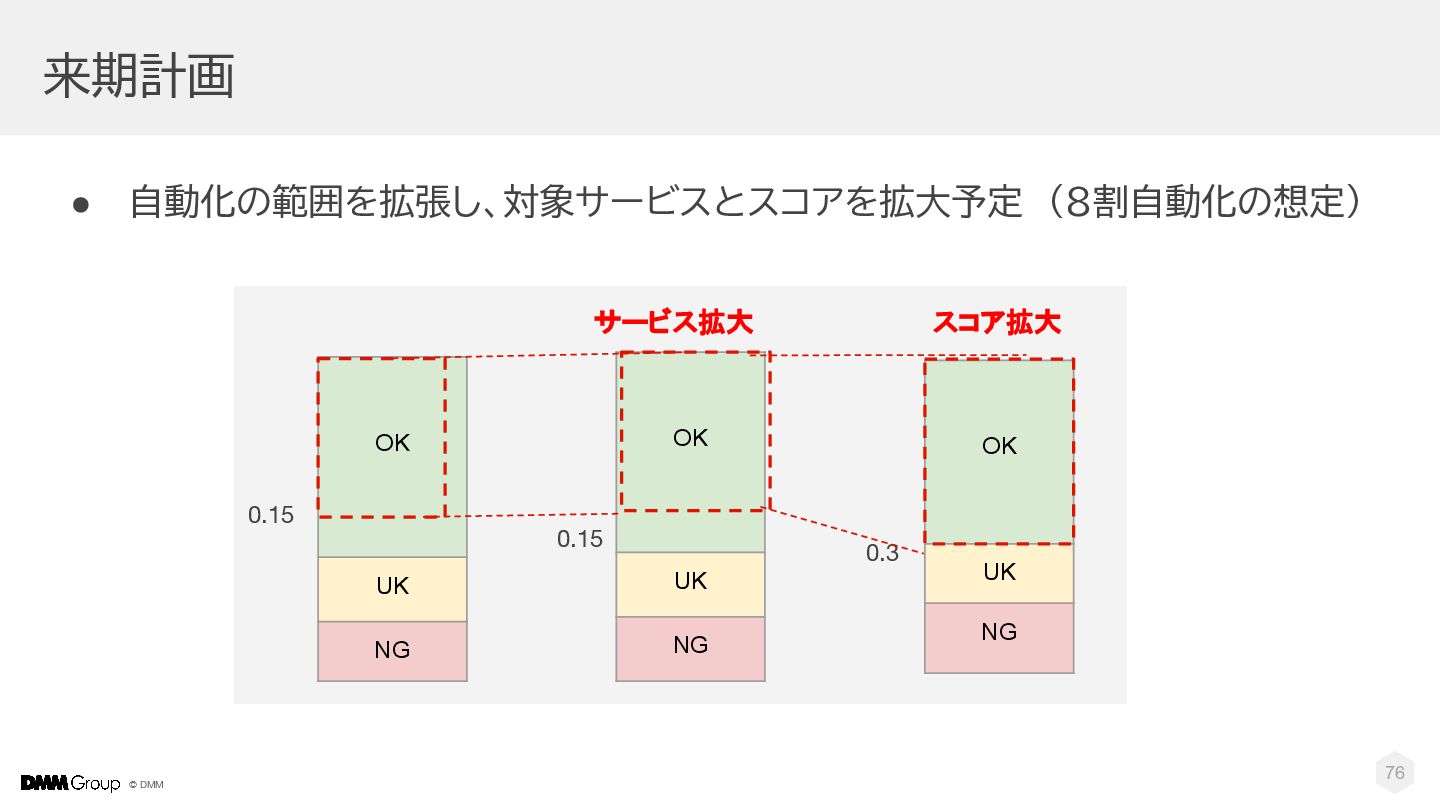
  36. © DMM OK UK NG OK UK NG 76 来期計画

    • 自動化の範囲を拡張し、対象サービスとスコアを拡大予定 (8割自動化の想定) OK UK NG 0.15 0.3 スコア拡大 サービス拡大 0.15
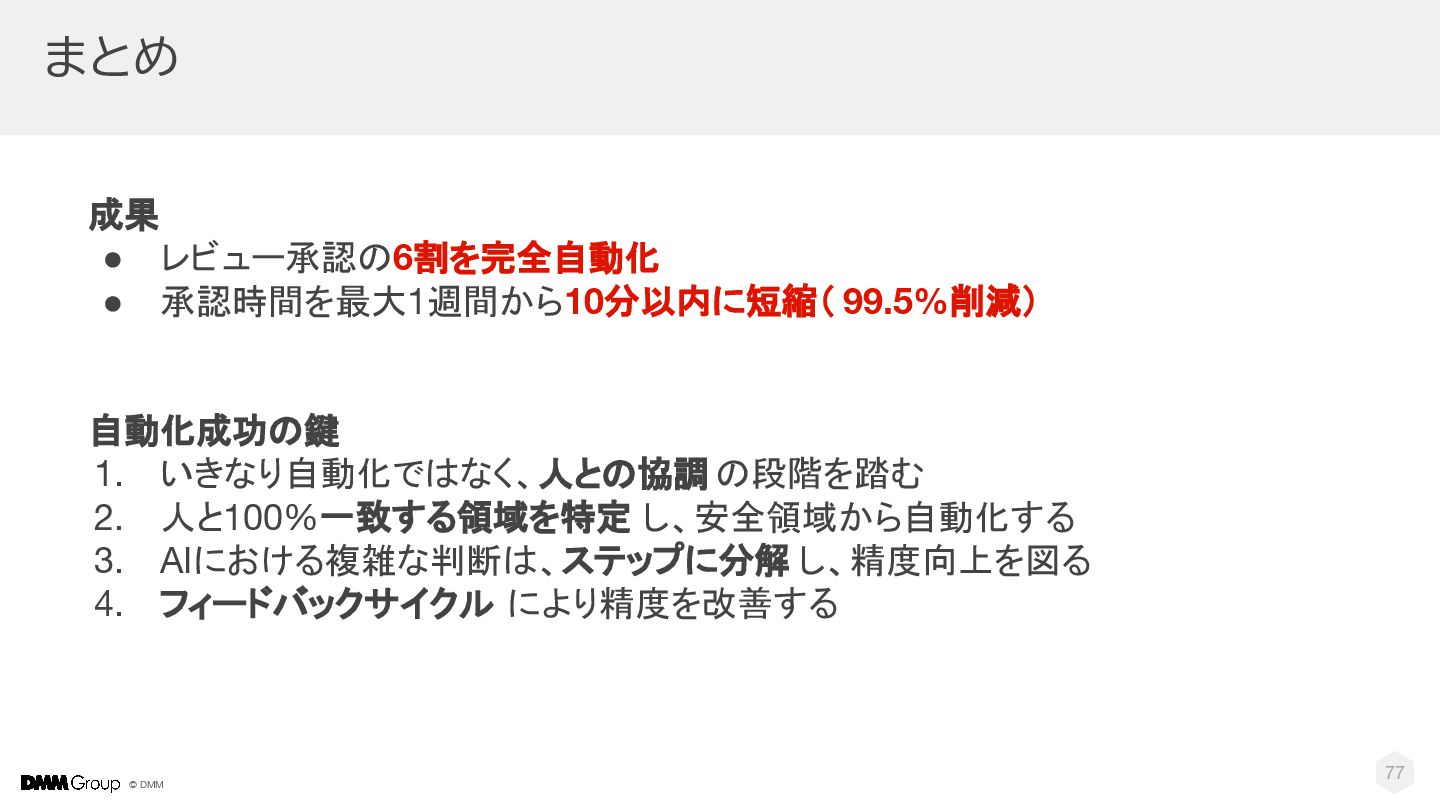
  37. © DMM 成果 • レビュー承認の6割を完全自動化 • 承認時間を最大1週間から10分以内に短縮( 99.5%削減) 自動化成功の鍵 1.

    いきなり自動化ではなく、人との協調 の段階を踏む 2. 人と100%一致する領域を特定 し、安全領域から自動化する 3. AIにおける複雑な判断は、ステップに分解 し、精度向上を図る 4. フィードバックサイクル により精度を改善する まとめ 77
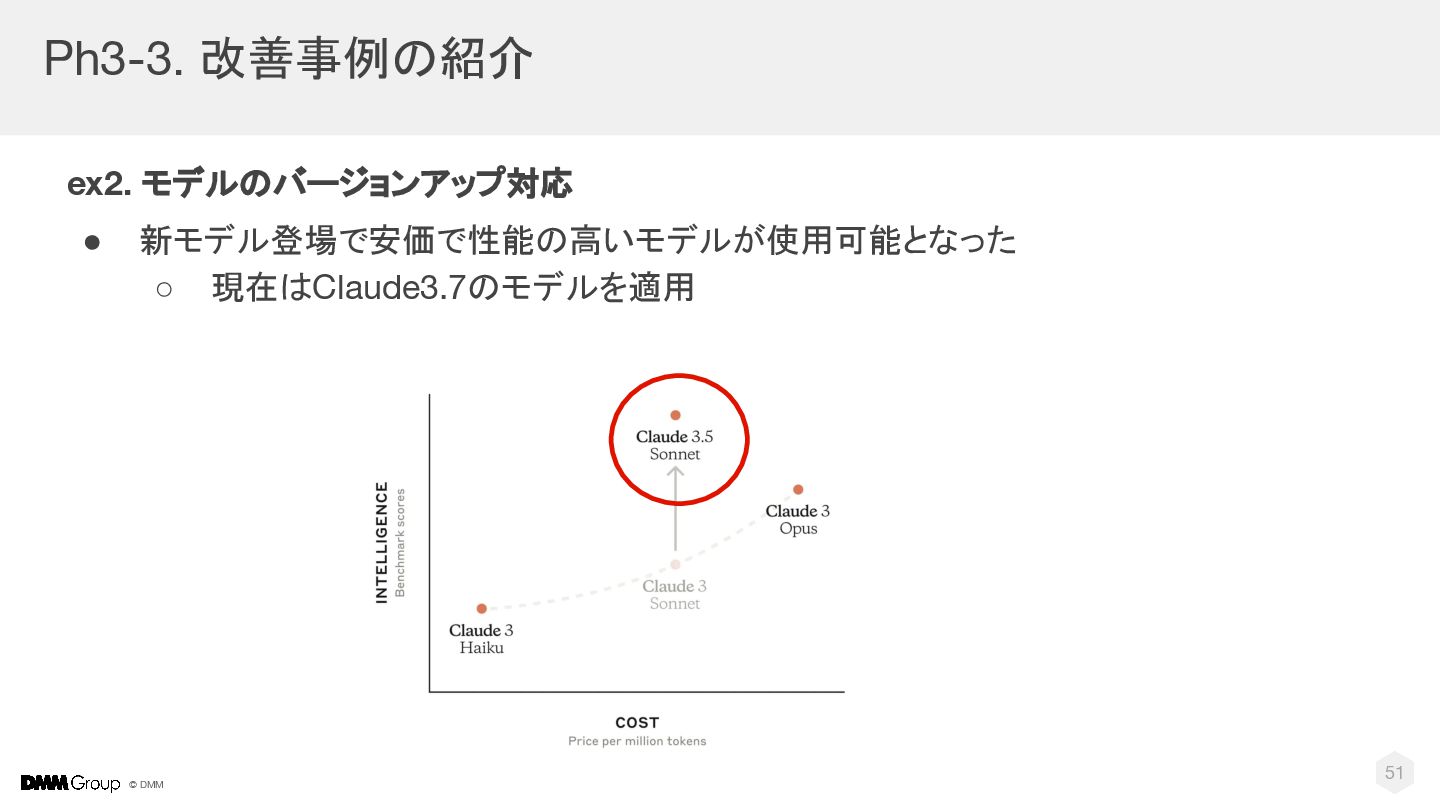
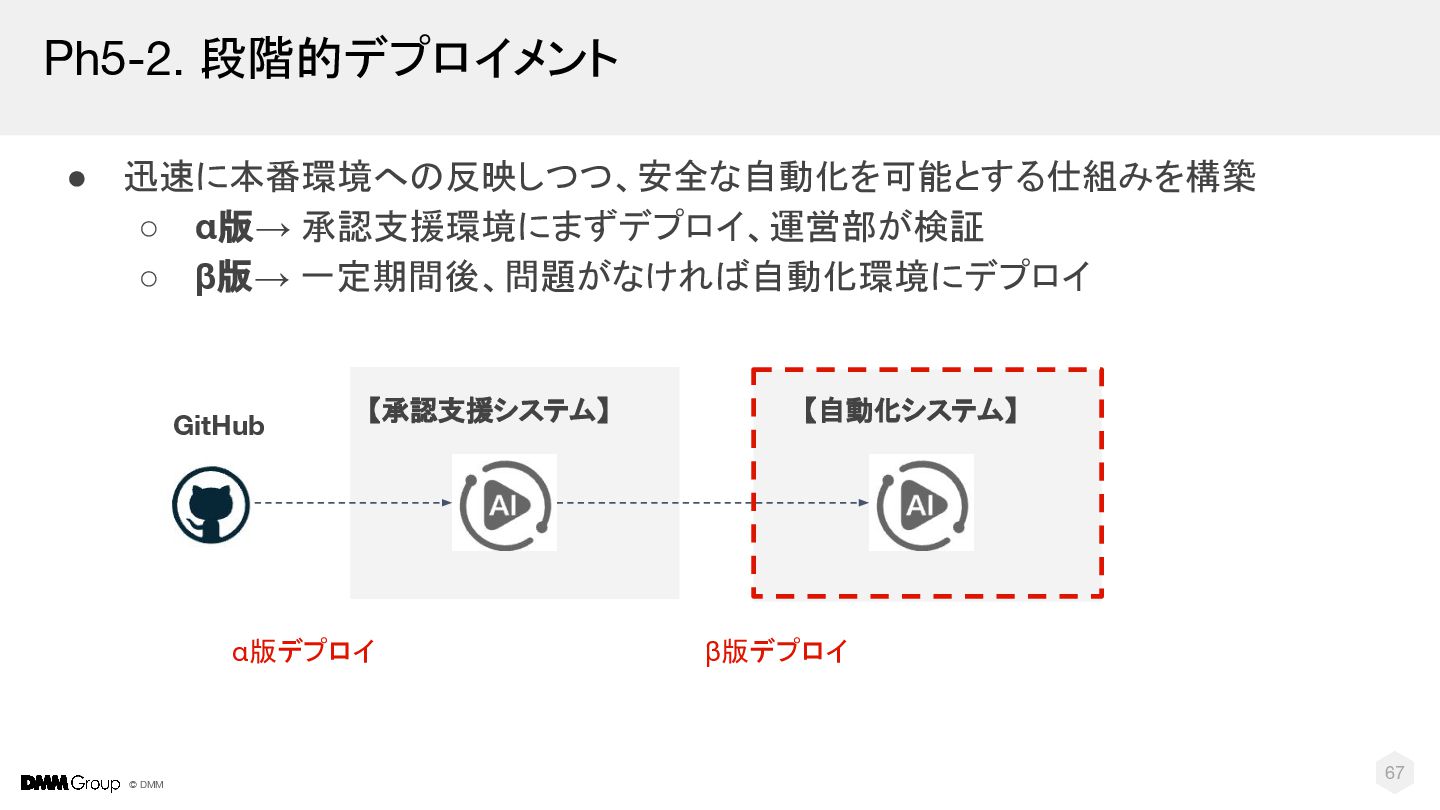
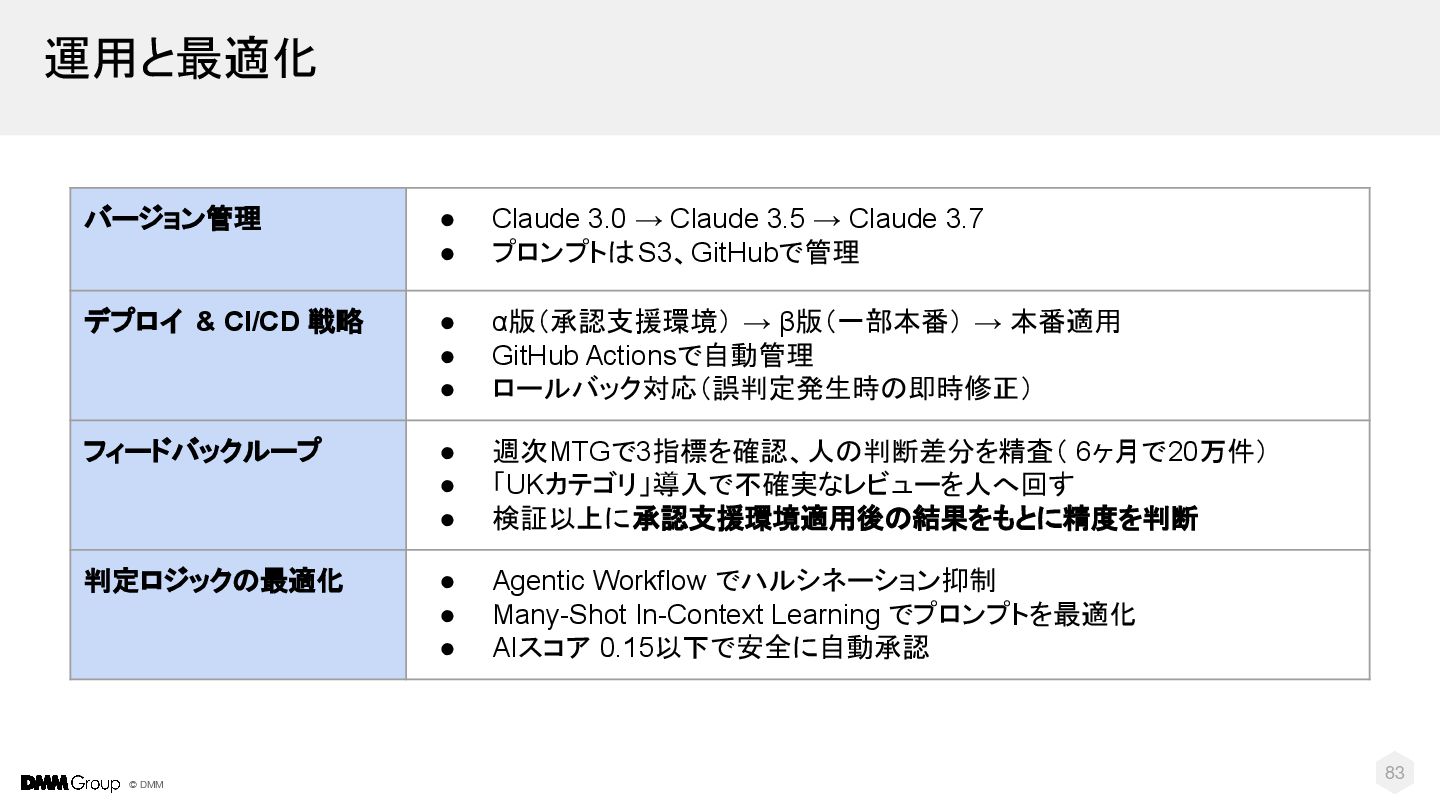
  38. © DMM 運用と最適化 83 バージョン管理 • Claude 3.0 → Claude

    3.5 → Claude 3.7 • プロンプトはS3、GitHubで管理 デプロイ & CI/CD 戦略 • α版(承認支援環境) → β版(一部本番) → 本番適用 • GitHub Actionsで自動管理 • ロールバック対応(誤判定発生時の即時修正) フィードバックループ • 週次MTGで3指標を確認、人の判断差分を精査( 6ヶ月で20万件) • 「UKカテゴリ」導入で不確実なレビューを人へ回す • 検証以上に承認支援環境適用後の結果をもとに精度を判断 判定ロジックの最適化 • Agentic Workflow でハルシネーション抑制 • Many-Shot In-Context Learning でプロンプトを最適化 • AIスコア 0.15以下で安全に自動承認
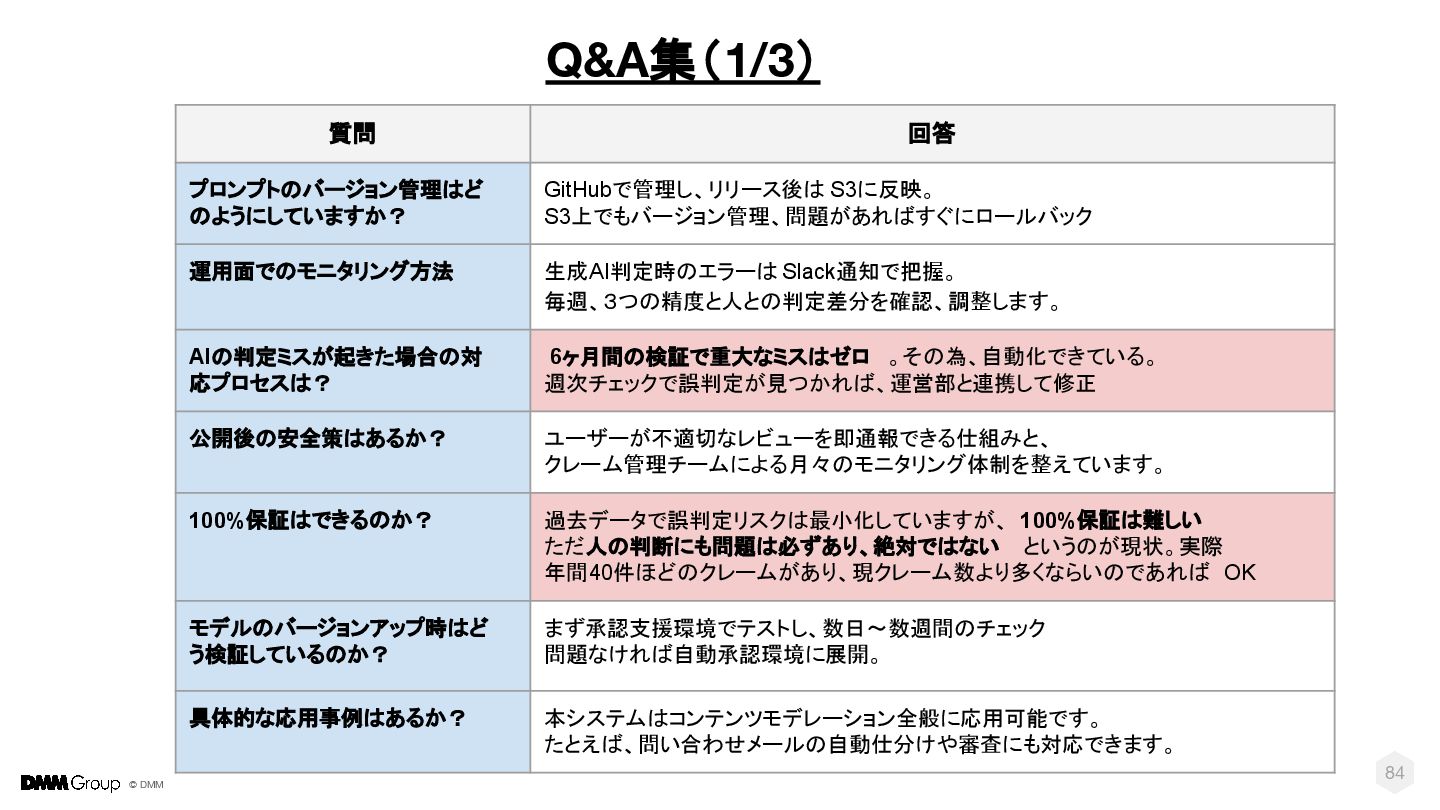
  39. © DMM Q&A集(1/3) 質問 回答 プロンプトのバージョン管理はど のようにしていますか? GitHubで管理し、リリース後は S3に反映。 S3上でもバージョン管理、問題があればすぐにロールバック

    運用面でのモニタリング方法 生成AI判定時のエラーは Slack通知で把握。 毎週、3つの精度と人との判定差分を確認、調整します。 AIの判定ミスが起きた場合の対 応プロセスは? 6ヶ月間の検証で重大なミスはゼロ 。その為、自動化できている。 週次チェックで誤判定が見つかれば、運営部と連携して修正 公開後の安全策はあるか? ユーザーが不適切なレビューを即通報できる仕組みと、 クレーム管理チームによる月々のモニタリング体制を整えています。 100%保証はできるのか? 過去データで誤判定リスクは最小化していますが、 100%保証は難しい ただ人の判断にも問題は必ずあり、絶対ではない というのが現状。実際 年間40件ほどのクレームがあり、現クレーム数より多くならいのであれば OK モデルのバージョンアップ時はど う検証しているのか? まず承認支援環境でテストし、数日~数週間のチェック 問題なければ自動承認環境に展開。 具体的な応用事例はあるか? 本システムはコンテンツモデレーション全般に応用可能です。 たとえば、問い合わせメールの自動仕分けや審査にも対応できます。 84
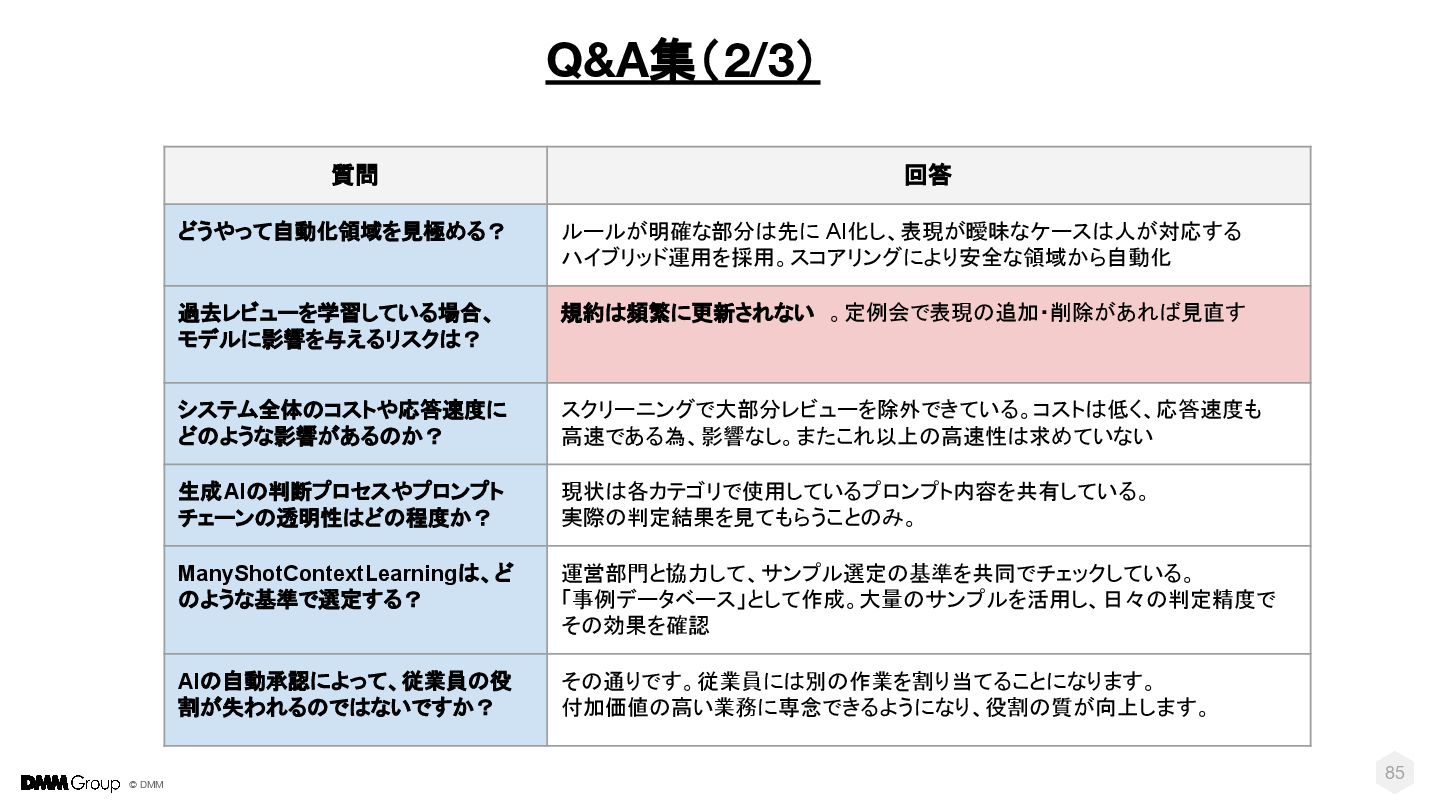
  40. © DMM 質問 回答 どうやって自動化領域を見極める? ルールが明確な部分は先に AI化し、表現が曖昧なケースは人が対応する ハイブリッド運用を採用。スコアリングにより安全な領域から自動化 過去レビューを学習している場合、 モデルに影響を与えるリスクは?

    規約は頻繁に更新されない 。定例会で表現の追加・削除があれば見直す システム全体のコストや応答速度に どのような影響があるのか? スクリーニングで大部分レビューを除外できている。コストは低く、応答速度も 高速である為、影響なし。またこれ以上の高速性は求めていない 生成AIの判断プロセスやプロンプト チェーンの透明性はどの程度か? 現状は各カテゴリで使用しているプロンプト内容を共有している。 実際の判定結果を見てもらうことのみ。 ManyShotContextLearningは、ど のような基準で選定する? 運営部門と協力して、サンプル選定の基準を共同でチェックしている。 「事例データベース」として作成。大量のサンプルを活用し、日々の判定精度で その効果を確認 AIの自動承認によって、従業員の役 割が失われるのではないですか? その通りです。従業員には別の作業を割り当てることになります。 付加価値の高い業務に専念できるようになり、役割の質が向上します。 85 Q&A集(2/3)
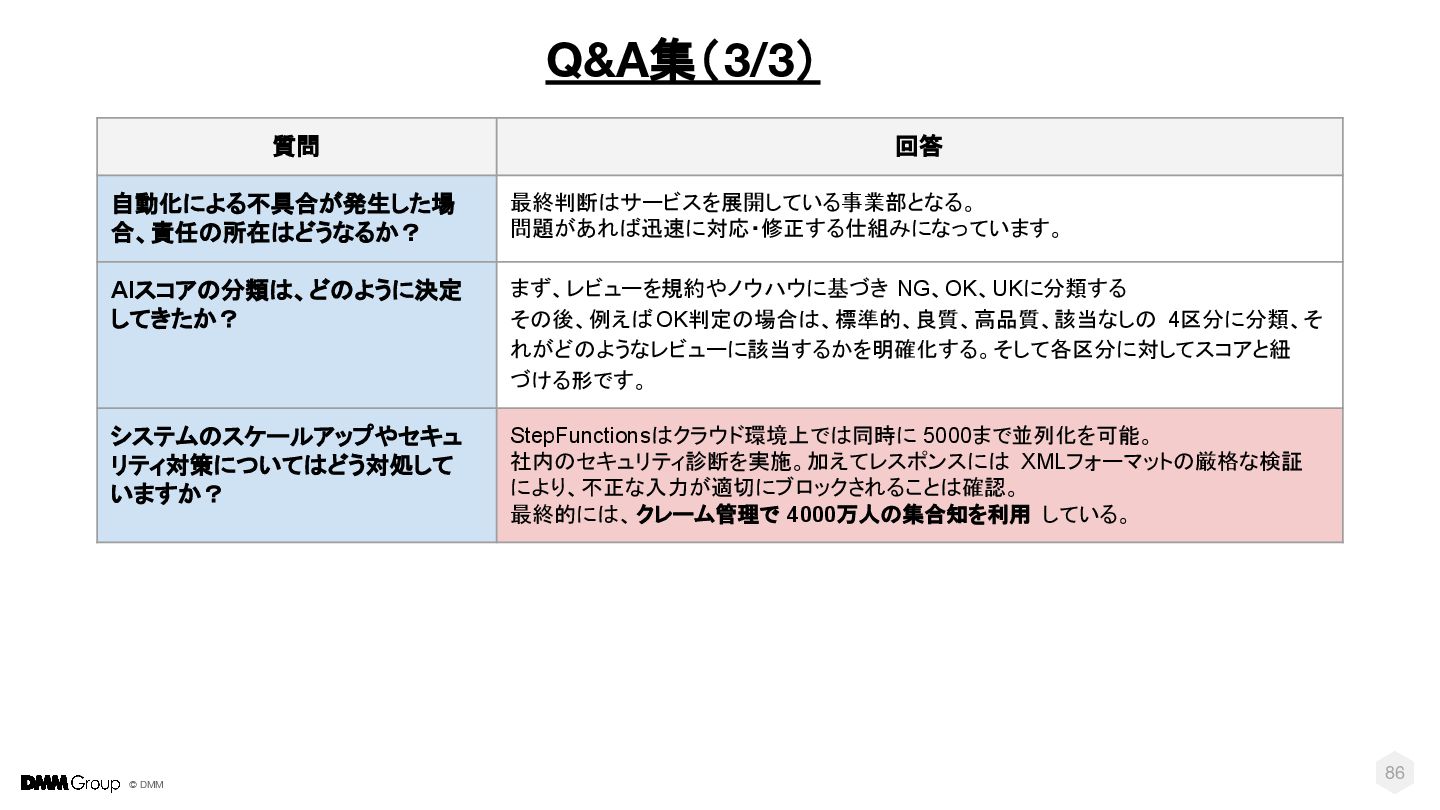
  41. © DMM 質問 回答 自動化による不具合が発生した場 合、責任の所在はどうなるか? 最終判断はサービスを展開している事業部となる。 問題があれば迅速に対応・修正する仕組みになっています。 AIスコアの分類は、どのように決定 してきたか?

    まず、レビューを規約やノウハウに基づき NG、OK、UKに分類する その後、例えばOK判定の場合は、標準的、良質、高品質、該当なしの 4区分に分類、そ れがどのようなレビューに該当するかを明確化する。そして各区分に対してスコアと紐 づける形です。 システムのスケールアップやセキュ リティ対策についてはどう対処して いますか? StepFunctionsはクラウド環境上では同時に 5000まで並列化を可能。 社内のセキュリティ診断を実施。加えてレスポンスには XMLフォーマットの厳格な検証 により、不正な入力が適切にブロックされることは確認。 最終的には、クレーム管理で 4000万人の集合知を利用 している。 86 Q&A集(3/3)
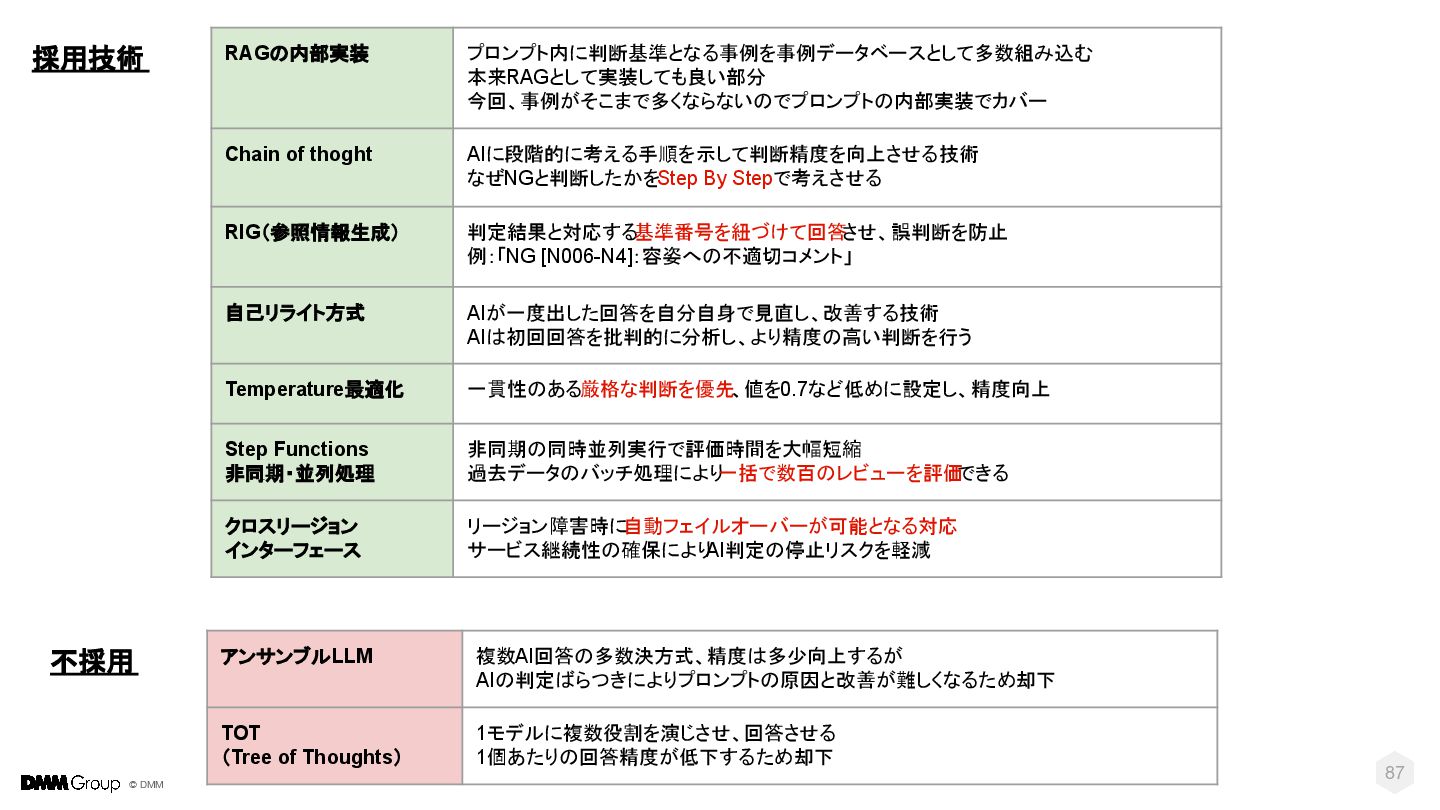
  42. © DMM 87 RAGの内部実装 プロンプト内に判断基準となる事例を事例データベースとして多数組み込む 本来RAGとして実装しても良い部分 今回、事例がそこまで多くならないのでプロンプトの内部実装でカバー Chain of thoght

    AIに段階的に考える手順を示して判断精度を向上させる技術 なぜNGと判断したかをStep By Stepで考えさせる RIG(参照情報生成) 判定結果と対応する 基準番号を紐づけて回答 させ、誤判断を防止 例:「NG [N006-N4]:容姿への不適切コメント」 自己リライト方式 AIが一度出した回答を自分自身で見直し、改善する技術 AIは初回回答を批判的に分析し、より精度の高い判断を行う Temperature最適化 一貫性のある厳格な判断を優先、値を0.7など低めに設定し、精度向上 Step Functions 非同期・並列処理 非同期の同時並列実行で評価時間を大幅短縮 過去データのバッチ処理により 一括で数百のレビューを評価 できる クロスリージョン インターフェース リージョン障害時に自動フェイルオーバーが可能となる対応 サービス継続性の確保により AI判定の停止リスクを軽減 採用技術 アンサンブルLLM 複数AI回答の多数決方式、精度は多少向上するが AIの判定ばらつきによりプロンプトの原因と改善が難しくなるため却下 TOT (Tree of Thoughts) 1モデルに複数役割を演じさせ、回答させる 1個あたりの回答精度が低下するため却下 不採用

More Decks by matsui-dmm

Other Decks in Programming