Share
Embed
DeNA, MoT AI勉強会発表資料「顔認識と最近のArcFaceまわりと」 / Face Recognition & ArcFace papers
DeNA, Mobility TechnologiesのAI勉強会で発表した資料です
・顔認識分野周りってどんな感じなの
・特に、最近のArcFaceまわりの手法どうなってきてるの
紹介論文:
AdaptiveFace (CVPR’19)
AdaCos (CVPR’19)
(MV-ArcFace (AAAI’20))
CurricularFace (CVPR’20)
GroupFace (CVPR’20)
Sub-center ArcFace (ECCV’20)
MagFace (CVPR’21)
ElasticFace (CVPRW’22)
AdaFace (CVPR’22)

Takumi Karasawa
May 13, 2022
Transcript
50 slides
-
2 自分の整理のための資料感が若干ありますが、 n 顔認識分野周りってどんな感じなの n 特に、最近のArcFaceまわりの手法どうなってきてるの あたりが伝えられればと思います はじめに 唐澤(からさわ) n
DeNA19新卒 → MoT n DRIVE CHART4年目 n 外カメチーム 兼 顔認証チーム n テニスを週1, 2とかでしてます -
一般的に以下2つのタスクのこと Face Recognition: n Face Identification (1:N) 顔画像からどの人物かを識別 n Face
Verification (1:1) 顔画像から同一人物かどうかを判定 学習観点では (現状、)手法的な差は特にないイメージ 顔認識(Face Recognition, FR) Face Recognition の状況設定の違い(SphereFace*より引⽤) *Sphereface: Deep hypersphere embedding for face recognition. [W. Liu+, CVPRʼ20] open/closed-set: 学習時に存在しないクラスが推論時に存在する/しない状況設定 -
n 使用する顔ランドマーク:両目、鼻、口の両端(5点) n ランドマーク検出:MTCNN*1が使用される慣習アリ n →最近のデータセットではRetinaFace*2が使用され始めてる n 変換:5点ランドマークで相似変換して特定座標へ n 平行移動、回転、スケール。最低ペア数3
n 変換後サイズ: (w, h) = (112, 112), (120, 120)とかが多い n CosFaceくらいまでは(w, h) = (96, 112) 顔認識の一般的前処理 *1 Joint Face Detection and Alignment using Multi-task Cascaded Convolutional Networks [K. Zhang+, arXiv’16] *2 RetinaFace: Single-stage Dense Face Localisation in the Wild [J. Deng+, CVPR‘20] CosFace 112 112 最近の主流 5点ランドマーク *データセットは基本的に何らかの処理済みで配布されていることが多い -
*初期のDeep FR手法であるFacebookのDeepFace, GoogleのFaceNetらは privateな大規模データセットで学習が行われていた n CASIA-WebFace (2014) Deep FRの学習データとして使える最初のpublicなデータセットとして広く用いられた n
MS-Celeb-1M(-V*) (2016) 近年の学習データとしては主流な印象のデータセット データ数が多いがノイズも有り、半自動でクリーニングされたMS-Celeb-1M-V2, MS-Celeb-1M-V3が学習に用いられることが多い ▪ ちなみに、MS-Celeb-1M-V2はArcFace(CVPR’19)論文内で提案 n VGGFace2 (2018) pose, age, illuminationなどの観点で多様性があるように構築されたデータセット ▪ MS-Celeb-1M(クラス数多めだが各クラスの画像数少なめ)で学習したあと、 各クラスに多様性の有るVGGFace2でfine-tuningするのが良いことを示した 顔認識データセット:学習用 *いずれにせよ顔認識のpublic datasetは今はアクセスできないとか⾊々あるのがツラミ… -
「大規模」「特定の目的(pose, age)」「動画中からの」などデータ収集の観点はいくつか。 n LFW(2007):最もポピュラー/古いデータセット。Yahoo Newsから顔検出で収集。 n MegaFace(2016):大規模。学習データ含む。 n CFP-FP(2016):正面と横顔(FP: Frontal-to-Profile)
n CALFW(2017):年齢による変化(CA: Cross-Age) n CPLFW(2018):ポーズによる変化(CP:Cross-Pose) n IJB-A/B/C (2015/2017/2018): ▪ identification/verification両方可能な難しめのbenchmark ▪ 手動で収集しているため顔認識と顔検出両方の評価が可能 顔認識データセット:評価用 -
「大規模」「特定の目的(pose, age)」「動画中からの」などデータ収集の観点はいくつか。 n LFW(2007):最もポピュラー/古いデータセット。Yahoo Newsから顔検出で収集。 n MegaFace(2016):大規模。学習データ含む。 n CFP-FP(2016):正面と横顔(FP: Frontal-to-Profile)
n CALFW(2017):年齢による変化(CA: Cross-Age) n CPLFW(2018):ポーズによる変化(CP:Cross-Pose) n IJB-A/B/C (2015/2017/2018): 顔認識データセット:評価用 CFP-FP(論⽂より引⽤) LFW(論⽂より引⽤) CALFW (論⽂より引⽤) CPLFW (論⽂より引⽤) IJB-A IJB-B IJB-C (IJB-C論⽂より引⽤) -
「大規模」「特定の目的(pose, age)」「動画中からの」などデータ収集の観点はいくつか。 n LFW(2007):最もポピュラー/古いデータセット。Yahoo Newsから顔検出で収集。 n MegaFace(2016):大規模。学習データ含む。 n CFP-FP(2016):正面と横顔(FP: Frontal-to-Profile)
n CALFW(2017):年齢による変化(CA: Cross-Age) n CPLFW(2018):ポーズによる変化(CP:Cross-Pose) n IJB-A/B/C (2015/2017/2018): 顔認識データセット:評価用 LFW, CFP-FP, CALFW, CPLFWとかはほぼサチり MagFace (CVPRʼ20)でも"easy benchmarks"との記載 IJB-B, IJB-Cは"difficult benchmarks"という位置づけ -
顔認識手法のざっくりとした流れ *Deep Face Recognition: A Survey [M. Wang+, 2018] 2020年8月にv9へ更新されている
顔認識サーベイ論⽂*より引⽤ サーベイ論⽂の図をそのまま拝借 ArcFace Euclidean distanceベース Facebook Google DeepIDシリーズ Triplet Loss Center Loss Contrastive Loss -
ざっくりいうと、 「GTへの予測にmarginペナルティを付与したうえで、クラス分類の枠組みで学習することで 距離学習を実現する手法」 → marginぶん他クラスに差をつけた上で正解する必要があるイメージ n ちなみにmarginベースの手法における「距離の近さ」は、cosine similarity ▪ 距離的な意味合いであれば
(1 – cos) n SphereFace・CosFace・ArcFaceの違いは、marginペナルティの付与の仕方 ▪ あとは特徴をnormalizeするか、とか細かいところ ArcFace を代表とするmarginベースの距離学習⼿法 -
15 一般的に用いられる、 n 前処理後の画像サイズ: (112, 112) n 顔特徴の次元数:512 としたとき ArcFace
モデル構造 112 4 3 N-dim(512/1280/..) (バックボーン依存) 112 4 Feature Extractor Pre-processed Image Feature Map N-dim GAP BN Dropout FC BN 512 Neck Face Feature FlattenならN-dim*16 N-class (FC) ArcFace Head 512 ⁄ 𝑥! 𝑥! 顔特徴抽出 このneckを挟むのがわりと⼀般的 (慣習的に⽤いられてるだけ感はある︖) この段階で4x4 CNN ⼿法のメイン部分 -
16 ArcFace Head(手法のメイン部分) 512 Face Feature 512 N-class FC Weight
x N-class Cosine Similarity W 𝑐𝑜𝑠𝜃!! 𝑐𝑜𝑠(𝜃!! +𝑚) Scale & SoftMax prob GT ⁄ 𝑊 " 𝑊 " normalizeされているので この内積計算はfeatureと 各重みのcosine similarityを 計算してることと同じ 正解ラベルの類似度だけ marginペナルティを加えてあげる (ハイパラ1) logitsの値が⼩さすぎるので scale(ハイパラ2) Cross-entropy loss 𝑦! FC層のバイアスはなし(𝑏 = 0) →学習によって、 実質各クラスの代表ベクトル 予測が完全にfeatureと重みの⾓度だけで表現される 重みもnormalize -
Loss Function 通常のsoftmax loss n normalize & b=0 → cosine
n scale n pos/negを分離して記述 marginを付与 SphereFace, CosFace, ArcFaceのmarginの与え⽅の違い を含めた⼀般式 𝑚# : SphereFace, 𝑚$ : ArcFace, 𝑚% : CosFace 𝜃軸でのクラス境界⾯におけるmarginの違い(ArcFace*より引⽤) *ArcFace: Additive angular margin loss for deep face recognition. [J. Deng+, CVPRʼ19] ArcFace loss -
19 以下の論文を紹介: n AdaptiveFace (CVPR’19) n AdaCos (CVPR’19) n (MV-ArcFace
(AAAI’20)) n CurricularFace (CVPR’20) n GroupFace (CVPR’20) n Sub-center ArcFace (ECCV’20) n MagFace (CVPR’21) n ElasticFace (CVPRW’22) n AdaFace (CVPR’22) 紹介論文 年代参考︓ n SphereFace (CVPRʼ17) n CosFace (CVPRʼ18) n ArcFace (CVPRʼ19) -
20 以下の論文を紹介: n AdaptiveFace (CVPR’19) n AdaCos (CVPR’19) n (MV-ArcFace
(AAAI’20)) n CurricularFace (CVPR’20) n GroupFace (CVPR’20) n Sub-center ArcFace (ECCV’20) n MagFace (CVPR’21) n ElasticFace (CVPRW’22) n AdaFace (CVPR’22) 紹介論文 hard mining scaleパラメータ marginパラメータ noisy samples curriculum learning hard mining negative cosine hard mining negative cosine marginパラメータ fc weight marginパラメータ feature norm image quality architecture <超ざっくりタグ> ↑どこに変更加えてるか観点 marginパラメータ feature norm image quality -
21 【モチベーション】ArcFaceなどのmarginベースの手法は、全クラスに統一的なmarginが 使用されているが、データセットはアンバランスでクラスごとのサンプル数が異なるため、 クラスごとにmarginが設定されるべき 【提案】3つのコンポーネントで構成される AdaptiveFace 1. Adaptive Margin Softmax
(AdaM Softmax) loss: クラスごとに適応的にmarginを調整する損失関数を提案(メイン) AdaptiveFace (CVPR’19) また、学習に用いるクラスとサンプルを選定し、効率的な学習を実現 2. Hard Prototype Mining (HPM) 各クラスの重み(prototype)の類似度でANN(angle nearest neighbor) グラフを 使って最近傍kクラスを選択して学習 3. Adaptive Data Sampling (ADS) 各サンプルにサンプリング確率をアサインし、正解不正解によってサンプリング確率を 更新してhardサンプルを学習しやすくする hard mining marginパラメータ -
22 AdaM Softmax Loss marginがクラスごとかつlearnable CosFace AdaM Softmax λが⼤きいほど、全体としてmarginが⼤きくなる (ので、ハイパラ⾃体が減るということではない)
marginが⼩さくなっていくことを防ぐ項 各クラスのサンプル数とmarginの関係︓ サンプル数が⼩さいほどmarginは⼤きくなっている λとmarginの分布の違い ↕ 形は同じ -
24 【モチベーション】 ArcFaceなどのmarginベースの手法は強力だが、ハイパラチューニングが重要となっていて 最終的な性能に大きな影響を与える 【貢献と提案】 n margin, scaleパラメータが持つ影響について調査: (≒marginもscaleも小さくても大きくてもダメですよね、という話) →margin,
scaleともに同じ役割を持つと考えられるため、scaleのみに着目 n 自動でscaleパラメータをチューニングする AdaCos を提案 ▪ fixバージョンと dynamicバージョンの2通り。 ▪ 収束性の向上と高精度化 AdaCos (CVPR’19) scaleパラメータ -
内田さんQiitaの説明例がわかりやすいのでそのまま拝借 logitsが大きいほどmax関数の近似となる →ArcFaceは、logitsがcosine値で小さい値となってしまうため scalingが必要、という話 AdaCosは、このscaleハイパラがGTを強める/弱める役割として marginと同じ役割だという主張 →結論:scaleを自動チューニングすれば良い (参考)scaleハイパラの影響について 内⽥さんのQiita https://qiita.com/yu4u/items/078054dfb5592cbb80cc
softmaxの温度パラメータを含めた説明は元リンクをご参照ください 𝑠 = 1 x=[1.0,0.8,0.6,0.4,0.2] をs倍してからsoftmaxしたときの値の違い 𝑠 = 2 𝑠 = 5 𝑠 = 10 Cosine Similarity 𝑐𝑜𝑠(𝜃!! +𝑚) Scale & SoftMax prob 先程の説明の⼀部 -
26 Adaptive scale parameter GTじゃない全てのクラスのlogitsの合計 学習中の θ の変化。 (⾚)︓GTじゃないクラスに対しての平均 Classification
probability Grad が最⼤となるときが最も効率的、という考えのもと 最適なscaleは以下のようになる︓ ( ) Fixed AdaCos 「学習中、GTじゃないクラスへのθは𝜋/2に張り付く」 ことを考慮し以下のscale定数を提案 Dynamic AdaCos 各iterationで𝐵! を更新し、動的に適切なscaleを計算 n 初期値はFixed AdaCosの値を使⽤ -
27 Adaptive scale parameter Fixed AdaCos 「学習中、GTじゃないクラスへのθは𝜋/2に張り付く」 ことを考慮し以下のscale定数を提案 Dynamic AdaCos
各iterationで𝐵! を更新し、動的に適切なscaleを計算 n 初期値はFixed AdaCosの値を使⽤ ↑ ざっくりとらえると、 クラス数に応じてscaleを変えなきゃね、というもの。 ただ、クラス数が3001か30001かでscaleは3しか変わらない • C-1=30000: 𝑠& =14.579 • C-1=3000: 𝑠& =11.323 動的にしても10~14程度 -
28 【モチベーション】 ArcFaceなどのmarginベースの手法に対して、近年hardサンプルmining手法が良い結果を 残しているが、サンプルの重要性を十分に活用できておらず、また学習初期でhardサンプル miningするのは収束性の問題がある 【提案】Adaptive Curriculum Learning Loss (CurricularFace)
n 単に誤予測サンプルを区別するのでなくhardさに基づいた重み付け n curriculum leaningの基本的な考え方「学習前半はeasyサンプル、後半はhardサンプル を重視」をlossに取り入れ *MV-Arc-Softmax (AAAI’20)との対比が強めなのでそちらも含めて紹介 CurricularFace (CVPR’20) curriculum learning hard mining negative cosine -
29 MV-ArcFace (AAAI’20) positive cosine similarity (ArcFaceなら cos(𝜃'! + 𝑚))
MV-Arc-Softmax positive cosine similarityより類似度が⾼いnegative sampleを強調 tは⼿動調整のハイパラ。(対象サンプルに対して重みは⼀律) tのチューニングが重要で、ちょっと⼤きかったりすると(𝑡 > 1.4とかすると)収束が難しくなるとされている。 marginベース lossの⼀般化 negative cosine similarity (ArcFaceなら𝑐𝑜𝑠𝜃" ) ArcFaceなどのmarginベース⼿法は、GTに対するmarginのみ考慮し、GTではないクラスを 活⽤できていないとし、negative cosine similarityを活⽤してhardサンプルをmining -
30 CurricularFace loss パラメータtの推定と更新(with EMA) 経験的にpositive cosine similarityの平均が学習段階の indicatorとして良さげだったとのことで採⽤ n
𝑡( = 0, 𝛼 = 0.99 (左)𝜃" とnegative similarityにかかる係数の⼤きさの関係性 (右)𝜃" とnegative similarity全体の⼤きさの関係性 CurricularFace Loss n サンプルごとのhardさを活⽤するため、𝑡だけでなく 𝑐𝑜𝑠𝜃に基づいて重み付け n 𝑡は⾃動的に推定 ここの区別はMV-Arcと同じ ⼿動調整の必要なし -
31 【モチベーション】 loss functionの改善は進んでいるが、ネットワーク構造がface recognitionタスクの特有さ を考慮できていない “grouping” が、大規模なクラス数を扱い、推論時にunknownなターゲットを含む face recognitionタスクに対して効果的な考え方
【提案】 face recognitionに特化した、group-awareな特徴を活用するモデル構造 GroupFace n このとき、groupに関するlabelは必要とせず、 self-supervisedな形で学習 GroupFace (CVPR’20) architecture -
32 GroupFace Instance-based representation = 従来のスキームで得られるfeature 同様のFCでgroup representation⽤のfeatureをK個抽出 Group Decision
Network (GDN): instance-based representationからGroup probabilityを予測 Softに適⽤するならweighted sum Hardに適⽤するならargmax ⾃動で⽣成されるラベル (𝜆 = 0.1) -
35 【モチベーション】 ArcFaceらの手法は、学習データのラベルノイズの影響を受けやすく、データセットを きれいにする人手の作業を必要としてしまっており、ロバスト性に欠ける 【提案】 クラス内の制約を緩和し、ノイズへのロバスト性を向上させる Sub-center ArcFace を提案 n
クラスごとに、1個ではなく、K個のsub-center(重み)を用意してあげて学習 Sub-center ArcFace (ECCV’20) noisy samples fc weight -
36 Sub-center ArcFace Head Face Feature 512 N-class FC Weight
≒ each user feature → kセット⽤意 * Cosine Similarity W 正解ラベルの類似度だけ ペナルティを加えてあげる (angular margin penalty) 𝑐𝑜𝑠𝜃!! 𝑐𝑜𝑠(𝜃!! +𝑚) ⁄ 𝑊 " 𝑊 " W W 512 k k N-class Max pooling … 重みをk倍確保して、通常のforwardのあとにmax poolingするだけ(実装的にも簡単) ここからは同じ -
37 学習後、non-dominantな重みはドロップ (→noisyなラベルを排除してcleanならラベルで学習、とかも) 学習後の特徴分布 →ArcFace 半⼿動でクリーニングされたデータセットMS1M-V3を使⽤し、 noisyラベルを切り分けてサンプルとsubcenter間のangleの分布を可視化 Dominantサンプルと 最近傍sub-center間 Non-dominantサンプルと
最近傍sub-center間 non-dominantな重みdrop後 Dominant center Non-dominant centers subcenterが多いと 空っぽのsubclassも -
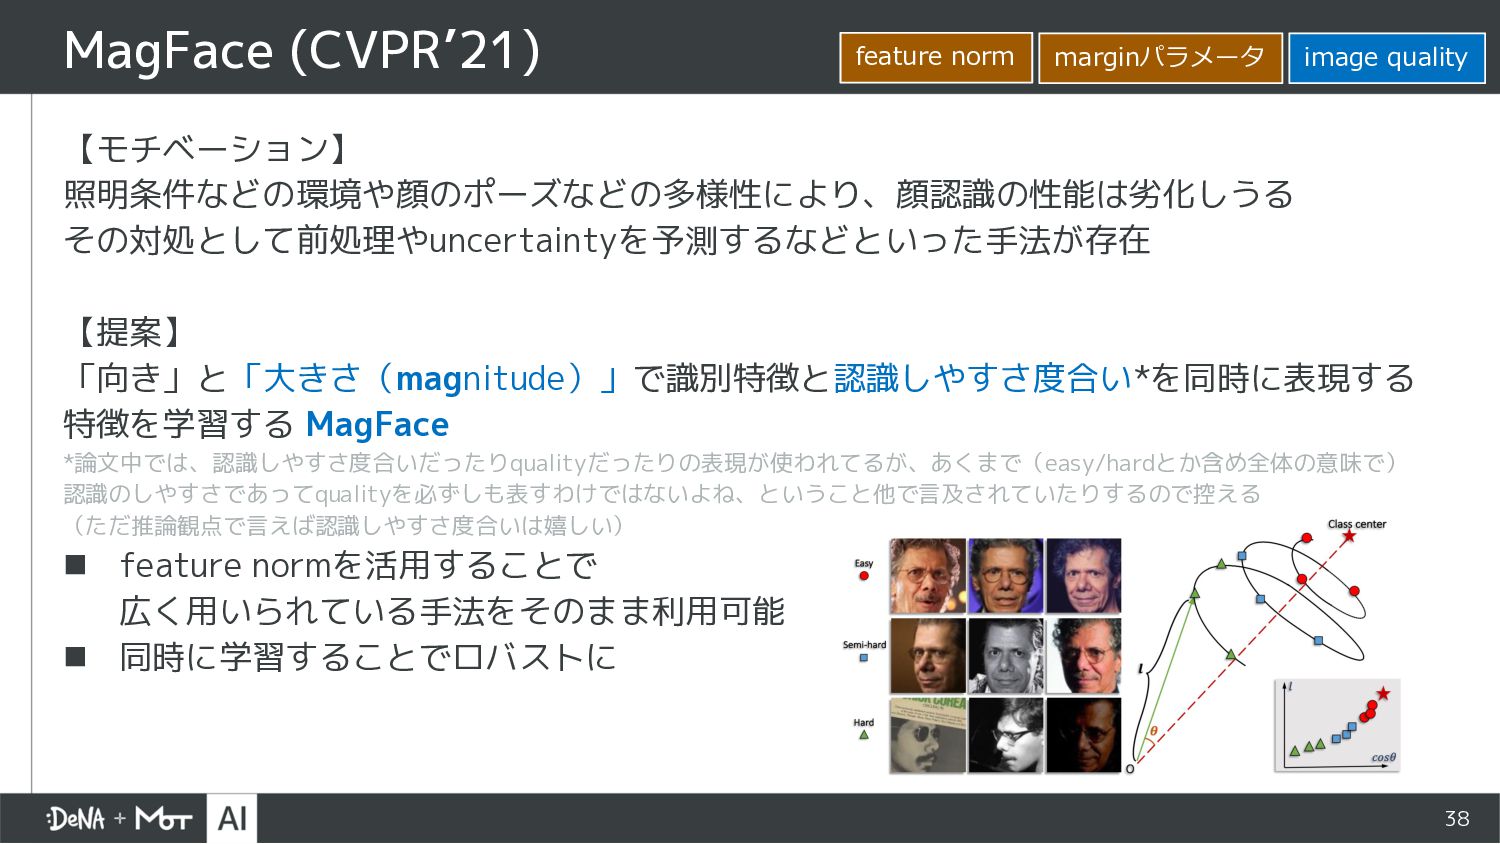
38 【モチベーション】 照明条件などの環境や顔のポーズなどの多様性により、顔認識の性能は劣化しうる その対処として前処理やuncertaintyを予測するなどといった手法が存在 【提案】 「向き」と「大きさ(magnitude)」で識別特徴と認識しやすさ度合い*を同時に表現する 特徴を学習する MagFace *論文中では、認識しやすさ度合いだったりqualityだったりの表現が使われてるが、あくまで(easy/hardとか含め全体の意味で) 認識のしやすさであってqualityを必ずしも表すわけではないよね、ということ他で言及されていたりするので控える
(ただ推論観点で言えば認識しやすさ度合いは嬉しい) n feature normを活用することで 広く用いられている手法をそのまま利用可能 n 同時に学習することでロバストに MagFace (CVPR’21) marginパラメータ feature norm image quality -
39 MagFace magnitudeが⼩さくなりさえすればよくなる (marginが⼩さくなっていく)ことを防ぐ正則化項 減少関数。magnitude⼤きいほど損失が⼩さく magnitudeにより定まるmargin (magnitude-aware margin) 増加関数。magnitude⼤きいほどmargin⼤きく magnitude-awareなmarginのため
feature space のイメージはこうなる (ArcFaceはmagnitudeの制限は特になし) marginを⼤きくしても損失が下がっていける(=認識しやすい) → magnitudeが⼤きくなっていく このバランスが取れた最適なmagnitudeが存在する条件 MagFace Loss: feature norm (magnitude) が⼤きいほど認識しやすい、を表すように学習 論⽂中/実装で使⽤されていた、(左)margin (右)正則化項 *lower/upper外も描画してしまってますmm λはある程度⼤きい必要あり -
40 magnitudeと画像の例 MagFace 実装は簡単だがハイパラの量がすごい… n scale (𝑠) n lower margin
(𝑙@ ) n upper margin (𝑢@ ) n lower magnitude (𝑙A ) n upper magnitude (𝑢A ) n lambda (𝜆B ) *(𝑙# , 𝑢# , 𝑙$ , 𝑢$ ) = (0.45, 0.8, 10, 110) fine-tuningする場合、学習後に抽出したmagnitudeの範囲が [𝑙) , 𝑢) ]に収まるように設定すると良いとのこと →実際にmagnitudeと認識しやすさは相関しているように感じたが、 学習データに存在しないパターンの悪い画像には使えなさげだった(中間くらいのmagnitudeが出⼒されてしまってた) -
41 【モチベーション】 ArcFaceなどのmarginベースの手法が統一的なmarginで学習するのは、 データセットの多様性(クラスごとに多様性異なったり、データ全体が画質悪かったり)に 対して制約が強い 【提案】 ランダムに取得されたmarginを使用することによって制約を緩和した ElasticFace を提案 n
+α:ランダムに取得されたmarginを、各iterationにてcosθが小さいサンプルほど 大きいmarginを割り当てるようにソート(ElasticFace+) ElasticFace (CVPRW’22) marginパラメータ -
42 ElasticFace loss ElasticFaceをArcFaceに適⽤した場合(ElasticFace-Arc) ElasticFaceをCosFaceに適⽤した場合(ElasticFace-Cos) 𝐸(𝑚, 𝜎): 平均m、標準偏差σのガウス分布のランダム値 σはこれくらいの値︓ n
ElasticFace-Arc: (m, σ) = (0.5, 0.05) n ElasticFace-Cos: (m, σ) = (0.35, 0.05) -
43 【モチベーション】 hardサンプル(mis-classifiedサンプル)をマイニングする手法があるが、 サンプルのimportanceは難易度とimage quality両方に基づくべき。 qualityが低すぎる場合、情報が欠損し識別不可能な画像となりうる。 【貢献・提案】 1. feature normは画像の質を表現しているという知見の獲得
2. feature normを活用した、image quality-awareな学習手法 AdaFaceの提案 ▪ loss functionについても勾配観点で見直し AdaFace (CVPR’22) marginパラメータ feature norm image quality -
marginベースで学習されたfeature normと、 image quality*1には相関*2が見られることを確認 *1: image qualityは、リファレンス画像不要なIQA手法、BRISQUEにより計算された値 *2:学習データMS1MV2からランダムにサンプルされた1534画像に対して0.5235 また、 n
この傾向は学習初期からで使いやすい n GTへの予測probabilityとは独立(≒easy/hardとは独立) feature normとimage quality Image Quality Indicator (with EMA, 𝛼 = 0.99): 相関が有ることに関する保証、裏付け理論的な話はなさそう 最終epochにおけるimage quality(BRISQUE)と、 (左)feature norm(右)GTへのprobabilityの関係性 ↑扱いやすさのため-1から1でクリッピング ガウス分布だと1sigma 68%ほどなので調整するため ℎ = 0.33 を⼊れてる -
45 marginの形と勾配 marginの影響を受けない部分 marginの影響を受ける部分 → Gradient Scaling Term (GST) とする
ArcFace形はdifficultyにより勾配がスケール かつ、決定境界でピークとなる形でhardサンプルをうまく強調できていない ArcFaceのmarginを負にした場合 -
46 AdaFace Loss ここはbackpropしない MagFaceとはbackpropされるかが⼤きく異なる あくまでfeature normはindicator quality-awareかつhardさに応じたmargin形式を提案 (negative angular
margin with shift) AdaFace Loss 全体図 image quality indicator n high norm: 境界から遠いほど⼤きい勾配スケール n low norm: 境界に近いほど⼤きい勾配スケール low normは境界から離れているサンプルを強調しない -
47 SphereFace Sphereface: Deep hypersphere embedding for face recognition. W.
Liu, et. al., CVPR2017 CosFace CosFace: Large margin cosine loss for deep face recognition. H. Wang et. al., CVPR2018 ArcFace ArcFace: Additive angular margin loss for deep face recognition. J. Deng, et. al., CVPR2019 AdaptiveFace AdaptiveFace: Adaptive margin and sampling for face recognition. H. Liu, et. al., CVPR2019 AdaCos AdaCos: Adaptively scaling cosine logits for effectively learning deep face representations. X. Zhang, et. al., CVPR2019 CurricularFace CurricularFace: Adaptive Curriculum Learning Loss for Deep Face Recognition. Y. Huang, et. al., CVPR2020 Reference 1 -
48 GroupFace GroupFace: Learning Latent Groups and Constructing Group-Based Representations
for Face Recognition. Y. Kim, et. al., CVPR2020 MV-Arc-Softmax Mis-Classified Vector Guided Softmax Loss for Face Recognition. X. Wang, et. al., AAAI2020 Sub-center ArcFace Sub-center arcface: Boosting face recognition by large-scale noisy web faces. D. Jiankang, et al., ECCV2020 MagFace MagFace: A Universal Representation for Face Recognition and Quality Assessment. Q. Meng, et. al., CVPR2021 ElasticFace ElasticFace: Elastic Margin Loss for Deep Face Recognition. F. Boutros, et. al., CVPRW2022 AdaFace AdaFace: Quality Adaptive Margin for Face Recognition. M. Kim, et. al., CVPR2022 Reference 2 -
49 LFW Labeled faces in the wild: A database for
studying face recognition in unconstrained environments. G. B. Huang, et. al., Technical Report2007 YTF Face recognition in unconstrained videos with matched background similarity. L. Wolf , et. al., CVPR2011 CASIA WebFace Learning face representation from scratch. D. Yi , et. al., arXiv2014 VGGFace Deep face recognition. O.M. Parkhi, et. al., BMVC2015 VGGFace2 Vggface2: A dataset for recognising faces across pose and age. Q. Cao, et. al., FG2018 CFP-FP Frontal to profile face verification in the wild. S. Sengupta , et. al., WACV2016 MS-Celeb-1M Ms-celeb-1m: A dataset and benchmark for large-scale face recognition. Y. Guo , et. al., ECCV2016 Reference 3 (dataset papers) -
50 MegaFace The megaface benchmark: 1 million faces for recognition
at scale. I. Kemelmacher-Shlizerman , et. al., CVPR2016 AgeDB-30 Agedb: The first manually collected in-the-wild age database. S.Moschoglou , et. al., CVPRW2017 CALFW Cross-age lfw: A database for studying cross-age face recognition in unconstrained environments. T. Zheng , et. al., arXiv2017 CPLFW Cross-pose lfw: A database for studying cross-pose face recognition in unconstrained environments. T. Zheng , et. al., Technical Report2018 IJB-A Pushing the Frontiers of Unconstrained Face Detection and Recognition: IARPA Janus Benchmark A. B. F. Klare, et. al., CVPR2015 IJB-B Iarpa janus benchmark-b face dataset. C. Whitelam, et. al., CVPRW2017 IJB-C Iarpa janus benchmark–c: Face dataset and protocol. B. Maze , et. al., ICV2018 Reference 4 (dataset papers)
 takarasawa_
 mikimhk
 ayatokanada
 kanojikajino
 hirachan
 institutdelelevage
 s_mizuki_nlp
 pomcho555
 beale
 aleyda
 raygrieselhuber
 ks91
 addyosmani
 chriscoyier
 apolaine
 jcasabona
 tamaranovitovic
 akademiya2063
 stephaniewalter