Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ゼロから作るアンサンブル学習(第1回)
Search
tatamiya
March 28, 2019
Technology
200
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ゼロから作るアンサンブル学習(第1回)
tatamiya
March 28, 2019
More Decks by tatamiya
See All by tatamiya
生成AIと進める探索的データ分析(2026.10.03 第122回Tokyo.R勉強会)
tatamiya
2
1.5k
サイコロで理解する統計的仮説検定の考え方
tatamiya
5
3.5k
状態空間時系列モデルで見た R と Python の比較 〜 KFAS と statsmodels 〜
tatamiya
1
2k
第1回沖本計量時系列分析輪読
tatamiya
1
760
ゼロから作るアンサンブル学習 第2回資料
tatamiya
0
380
20190409_FasterPythonMeetUp_TAMIYA
tatamiya
0
310
Other Decks in Technology
See All in Technology
SharedWorkerを使ったキャッシュでネイティブアプリに負けないユーザー体験を目指す
kakehashi
PRO
1
110
How to Design Configuration for Rails Applications
willnet
1
860
夫婦で子育てするための育児標準化
codmoninc
PRO
0
480
CTO Night|NotionのAIエージェントとFDE
kzkhykw1991
0
260
DGX Spark でどこまでハッキングができるのか?
kash1064
3
1.4k
Temporal 最高!でも改めて「日付」について調べたら人類の負債すぎる件
riyaamemiya
0
210
Conditional PED-ANOVA: Hyperparameter Importance in Hierarchical & Dynamic Search Spaces
pfn
PRO
0
140
DBについての基礎説明(MySQL編) - コロプラ 2026年度 新卒研修
colopl
0
140
OptunaHub: ブラックボックス最適化のためのプラットフォーム
pfn
PRO
0
150
M5Stackで作る BLEマウス GPSログの世界
tomokusaba
PRO
0
450
AI コーディングと人間の認知スループット / CTO Night & Day 2026 Morning Session / AI Coding and Human Cognitive Throughput
prog893
5
1.3k
V8のArray.prototype.flatを最大約20倍速くするまでと、巨大OSSへの大規模コミットの道のり
riyaamemiya
0
310
Featured
See All Featured
Test your architecture with Archunit
thirion
2
2.4k
Navigating Weather and Climate Data
rabernat
0
560
Designing for Performance
lara
612
70k
Joys of Absence: A Defence of Solitary Play
codingconduct
1
550
Efficient Content Optimization with Google Search Console & Apps Script
katarinadahlin
PRO
1
930
Ethics towards AI in product and experience design
skipperchong
2
440
Templates, Plugins, & Blocks: Oh My! Creating the theme that thinks of everything
marktimemedia
31
2.9k
The Director’s Chair: Orchestrating AI for Truly Effective Learning
tmiket
1
330
Raft: Consensus for Rubyists
vanstee
142
7.8k
Refactoring Trust on Your Teams (GOTO; Chicago 2020)
rmw
35
3.9k
The AI Search Optimization Roadmap by Aleyda Solis
aleyda
2
6.3k
Chrome DevTools: State of the Union 2024 - Debugging React & Beyond
addyosmani
10
1.4k
Transcript
ゼロから作るアンサンブル学習 ~OSSに学ぶ機械学習の実装~ 第1回 決定⽊・ランダムフォレストの理解と実装 たみや@tatatatatamiya
このセミナーについて u ⽬的 u アルゴリズムの理解 u OSSから良い実装を学ぶ u スケジュール u
第1回(3/28 本⽇) : 決定⽊・ランダムフォレストの理解と実装 u 第2回(4⽉下旬) : scikit-learnの読解 u 第3回(5⽉下旬) : 勾配ブースティング〜XGBoost, LightGBM
アルゴリズムの概要 - 決定⽊ - ランダムフォレスト
決定⽊
決定⽊とは︖ プロフィール 年齢 33歳 ⾝⻑ 168cm 体重 65kg 収⼊ 700万円
!? ⾝⻑ > 170cm? 体重 > 70kg? 体重 > 100kg? 年齢 >30? 収⼊ >1000万円? No No Yes Yes No Yes No Yes No Yes モ テ ⾮ モ テ モ テ ⾮ モ テ モ テ ⾮ モ テ 閾値を設けてYes/Noで振り分けていく モテる︖モテない︖ 課題 - どの特徴量で切る︖ - 閾値はいくつにする︖
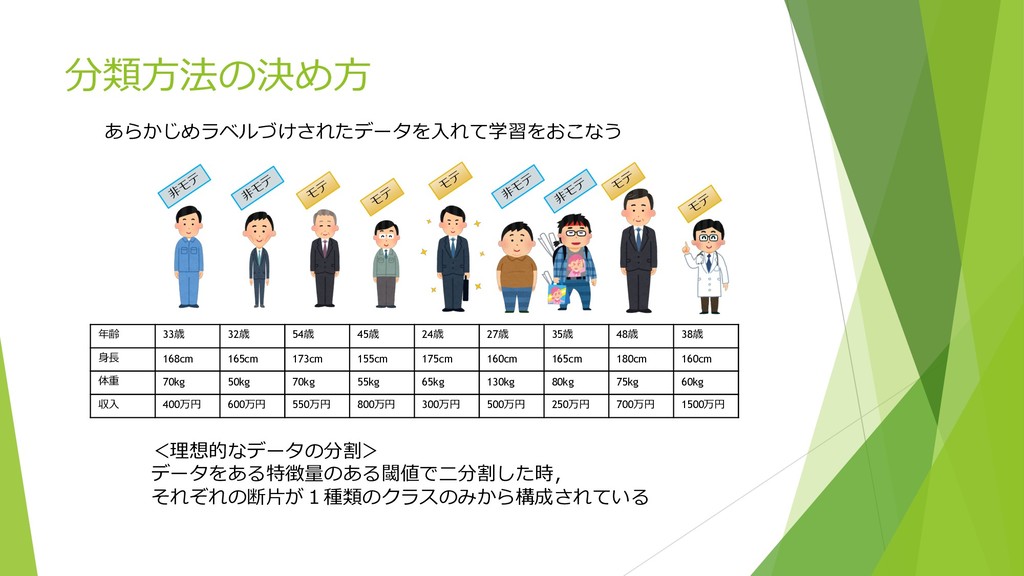
分類⽅法の決め⽅ 年齢 33歳 32歳 54歳 45歳 24歳 27歳 35歳 48歳
38歳 ⾝⻑ 168cm 165cm 173cm 155cm 175cm 160cm 165cm 180cm 160cm 体重 70kg 50kg 70kg 55kg 65kg 130kg 80kg 75kg 60kg 収⼊ 400万円 600万円 550万円 800万円 300万円 500万円 250万円 700万円 1500万円 モ テ モ テ モ テ ⾮ モ テ ⾮ モ テ モ テ モ テ ⾮ モ テ ⾮ モ テ <理想的なデータの分割> データをある特徴量のある閾値で⼆分割した時, それぞれの断⽚が1種類のクラスのみから構成されている あらかじめラベルづけされたデータを⼊れて学習をおこなう
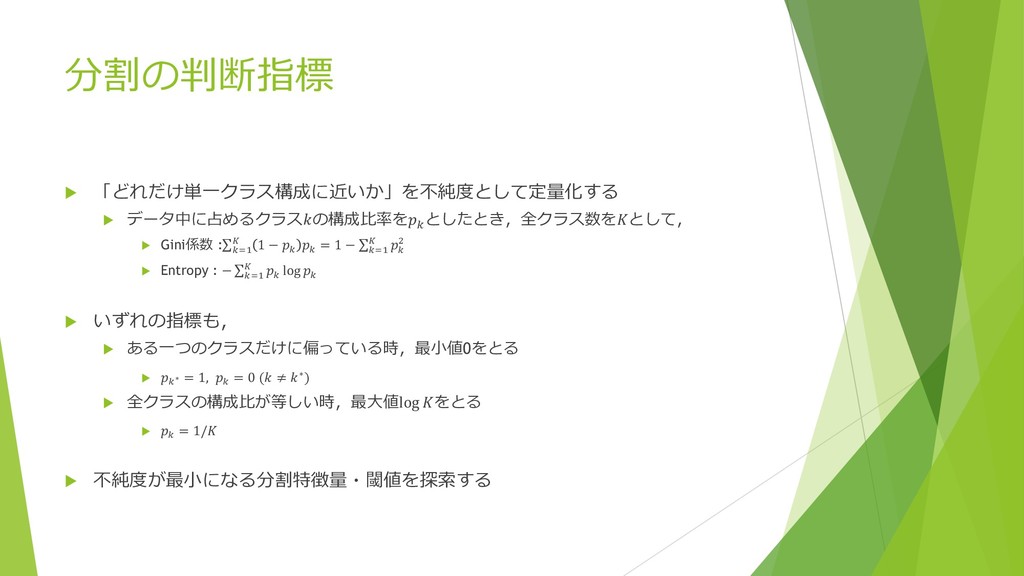
分割の判断指標 u 「どれだけ単⼀クラス構成に近いか」を不純度として定量化する u データ中に占めるクラスの構成⽐率を# としたとき,全クラス数をとして, u Gini係数 :∑#&' (
1 − # # = 1 − ∑#&' ( # , u Entropy : − ∑#&' ( # log # u いずれの指標も, u ある⼀つのクラスだけに偏っている時,最⼩値0をとる u #∗ = 1, # = 0 ( ≠ ∗) u 全クラスの構成⽐が等しい時,最⼤値log をとる u # = 1/ u 不純度が最⼩になる分割特徴量・閾値を探索する
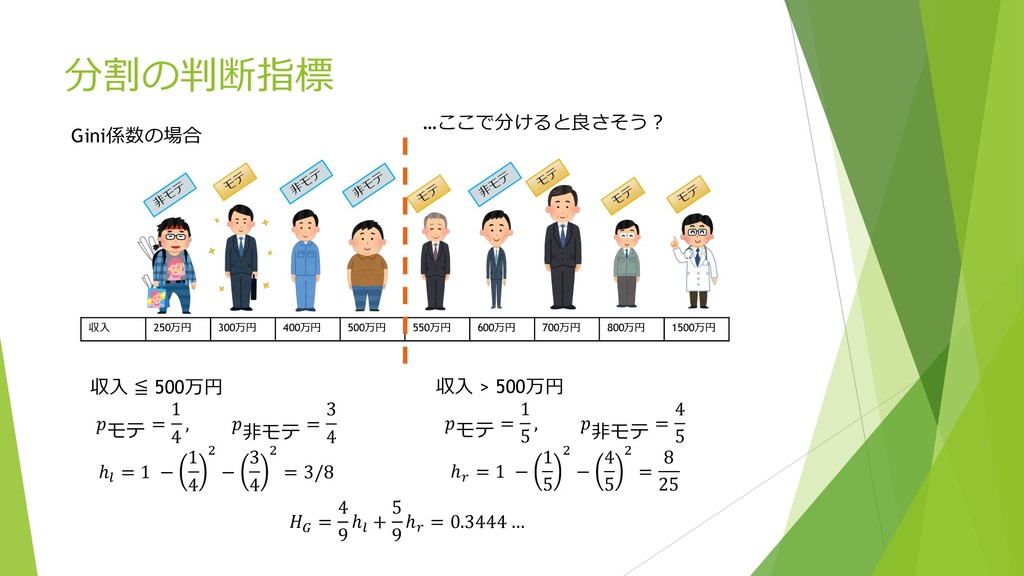
分割の判断指標 モ テ モ テ モ テ ⾮ モ テ
⾮ モ テ モ テ モ テ ⾮ モ テ ⾮ モ テ 収⼊ 250万円 300万円 400万円 500万円 550万円 600万円 700万円 800万円 1500万円 収⼊ ≦ 500万円 モテ = 1 4 , ⾮モテ = 3 4 ℎ; = 1 − 1 4 , − 3 4 , = 3/8 収⼊ > 500万円 モテ = 1 5 , ⾮モテ = 4 5 ℎ> = 1 − 1 5 , − 4 5 , = 8 25 A = 4 9 ℎ; + 5 9 ℎ> = 0.3444 … Gini係数の場合 …ここで分けると良さそう︖
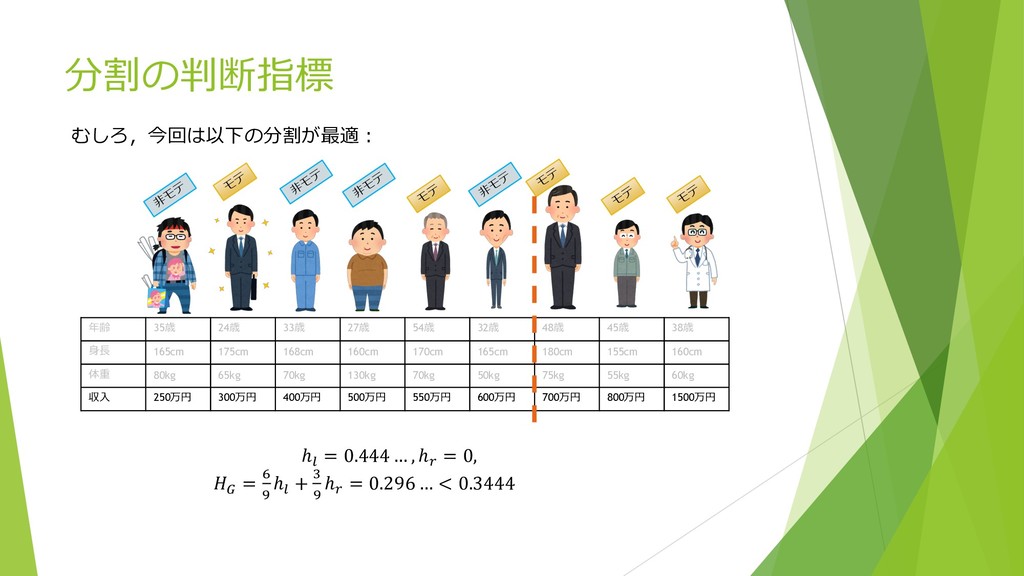
分割の判断指標 モ テ モ テ モ テ ⾮ モ テ
⾮ モ テ モ テ モ テ ⾮ モ テ ⾮ モ テ 年齢 35歳 24歳 33歳 27歳 54歳 32歳 48歳 45歳 38歳 ⾝⻑ 165cm 175cm 168cm 160cm 170cm 165cm 180cm 155cm 160cm 体重 80kg 65kg 70kg 130kg 70kg 50kg 75kg 55kg 60kg 収⼊ 250万円 300万円 400万円 500万円 550万円 600万円 700万円 800万円 1500万円 ℎ; = 0.444 … , ℎ> = 0, A = F G ℎ; + H G ℎ> = 0.296 … < 0.3444 むしろ,今回は以下の分割が最適︓
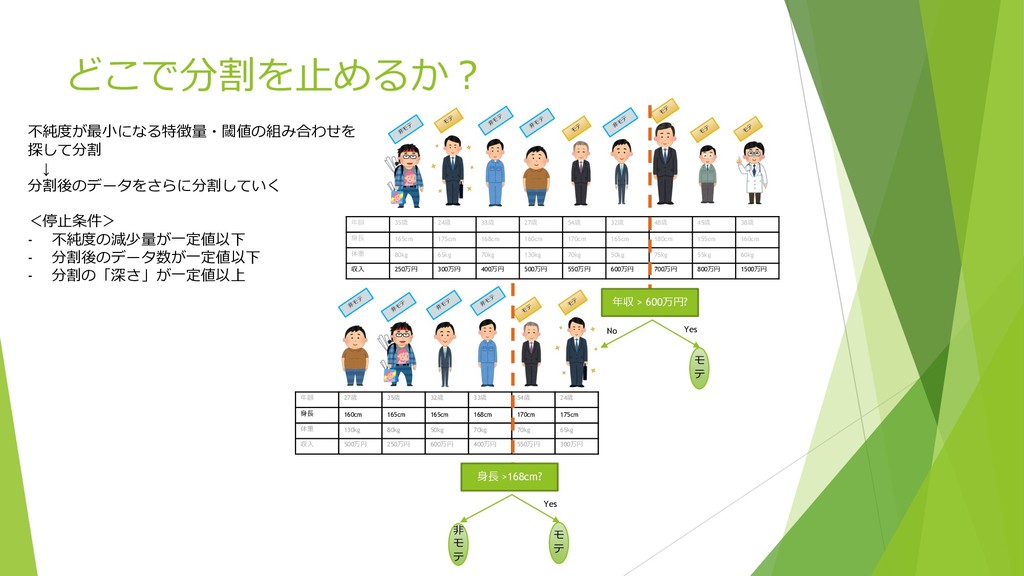
どこで分割を⽌めるか︖ モ テ モ テ モ テ ⾮ モ テ
⾮ モ テ モ テ モ テ ⾮ モ テ ⾮ モ テ 年齢 35歳 24歳 33歳 27歳 54歳 32歳 48歳 45歳 38歳 ⾝⻑ 165cm 175cm 168cm 160cm 170cm 165cm 180cm 155cm 160cm 体重 80kg 65kg 70kg 130kg 70kg 50kg 75kg 55kg 60kg 収⼊ 250万円 300万円 400万円 500万円 550万円 600万円 700万円 800万円 1500万円 年収 > 600万円? No Yes モ テ 年齢 27歳 35歳 32歳 33歳 54歳 24歳 ⾝⻑ 160cm 165cm 165cm 168cm 170cm 175cm 体重 130kg 80kg 50kg 70kg 70kg 65kg 収⼊ 500万円 250万円 600万円 400万円 550万円 300万円 ⾮ モ テ モ テ モ テ ⾮ モ テ ⾮ モ テ ⾮ モ テ ⾝⻑ >168cm? Yes モ テ ⾮ モ テ 不純度が最⼩になる特徴量・閾値の組み合わせを 探して分割 ↓ 分割後のデータをさらに分割していく <停⽌条件> - 不純度の減少量が⼀定値以下 - 分割後のデータ数が⼀定値以下 - 分割の「深さ」が⼀定値以上
ランダムフォレスト
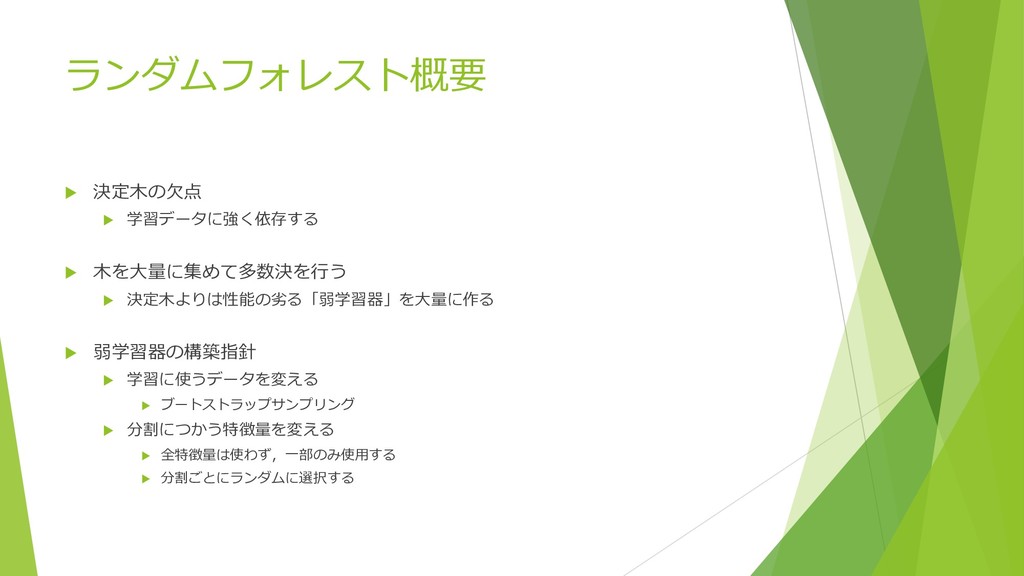
ランダムフォレスト概要 u 決定⽊の⽋点 u 学習データに強く依存する u ⽊を⼤量に集めて多数決を⾏う u 決定⽊よりは性能の劣る「弱学習器」を⼤量に作る u
弱学習器の構築指針 u 学習に使うデータを変える u ブートストラップサンプリング u 分割につかう特徴量を変える u 全特徴量は使わず,⼀部のみ使⽤する u 分割ごとにランダムに選択する
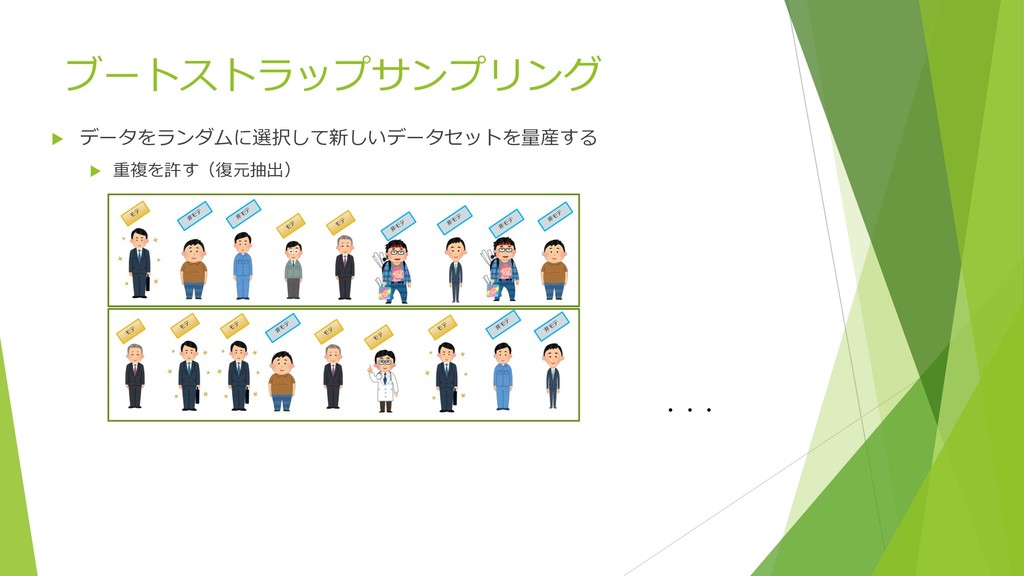
ブートストラップサンプリング u データをランダムに選択して新しいデータセットを量産する u 重複を許す(復元抽出) モ テ ⾮ モ テ
⾮ モ テ モ テ モ テ ⾮ モ テ ⾮ モ テ ⾮ モ テ ⾮ モ テ モ テ モ テ モ テ ⾮ モ テ モ テ モ テ モ テ ⾮ モ テ ⾮ モ テ ・・・
特徴量のランダム選択 u 分割の際に,⼀部のランダムに選んだ特徴量のみを⾒る モ テ ⾮ モ テ ⾮ モ
テ モ テ モ テ ⾮ モ テ ⾮ モ テ ⾮ モ テ ⾮ モ テ 年齢 24歳 27歳 33歳 45歳 54歳 35歳 32歳 35歳 27歳 ⾝⻑ 175cm 160cm 168cm 155cm 170cm 165cm 165cm 165cm 160cm 体重 65kg 130kg 70kg 55kg 70kg 80kg 50kg 80kg 130kg 収⼊ 300万円 500万円 400万円 800万円 550万円 250万円 600万円 250万円 500万円


 tatamiya
 kakehashi
 willnet
 codmoninc
 kzkhykw1991
 kash1064
 riyaamemiya
 pfn
 colopl
 tomokusaba
 prog893
 thirion
 rabernat
 lara
 codingconduct
 katarinadahlin
 skipperchong
 marktimemedia
 tmiket
 vanstee
 rmw
 aleyda
 addyosmani