Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Blackholeにおけるパフォーマンスエンジニアリングの実践

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →
Avatar for Tenstorrent Japan Tenstorrent Japan
October 20, 2026
89

 Blackholeにおけるパフォーマンスエンジニアリングの実践

Tenstorrent TechTalk #10, Session2

Avatar for Tenstorrent Japan

Tenstorrent Japan

October 20, 2026

Transcript

  1. 自己紹介 吉藤 尚生 YOSHIFUJI Naoki (@LWisteria) • テンストレントジャパン Field Application

    Engineer (2026-) • フィックスターズ リードエンジニア・ディレクター (2013-2025) ◦ LLM事業推進室 室長 (2023-2024) ◦ パフォーマンスエンジニアリング・ラボ ラボ長 (2025) (Online avatar) [主な業績] • 『実践的パフォーマンスエンジニアリングによるAI高速化』筆頭編 著者 • LLM/AIの事業立ち上げ・展開 • HWの特性を活かしたSW開発・高速化の支援 • HPC・LLM・計算土木力学分野にて論文投稿・学会発表 2
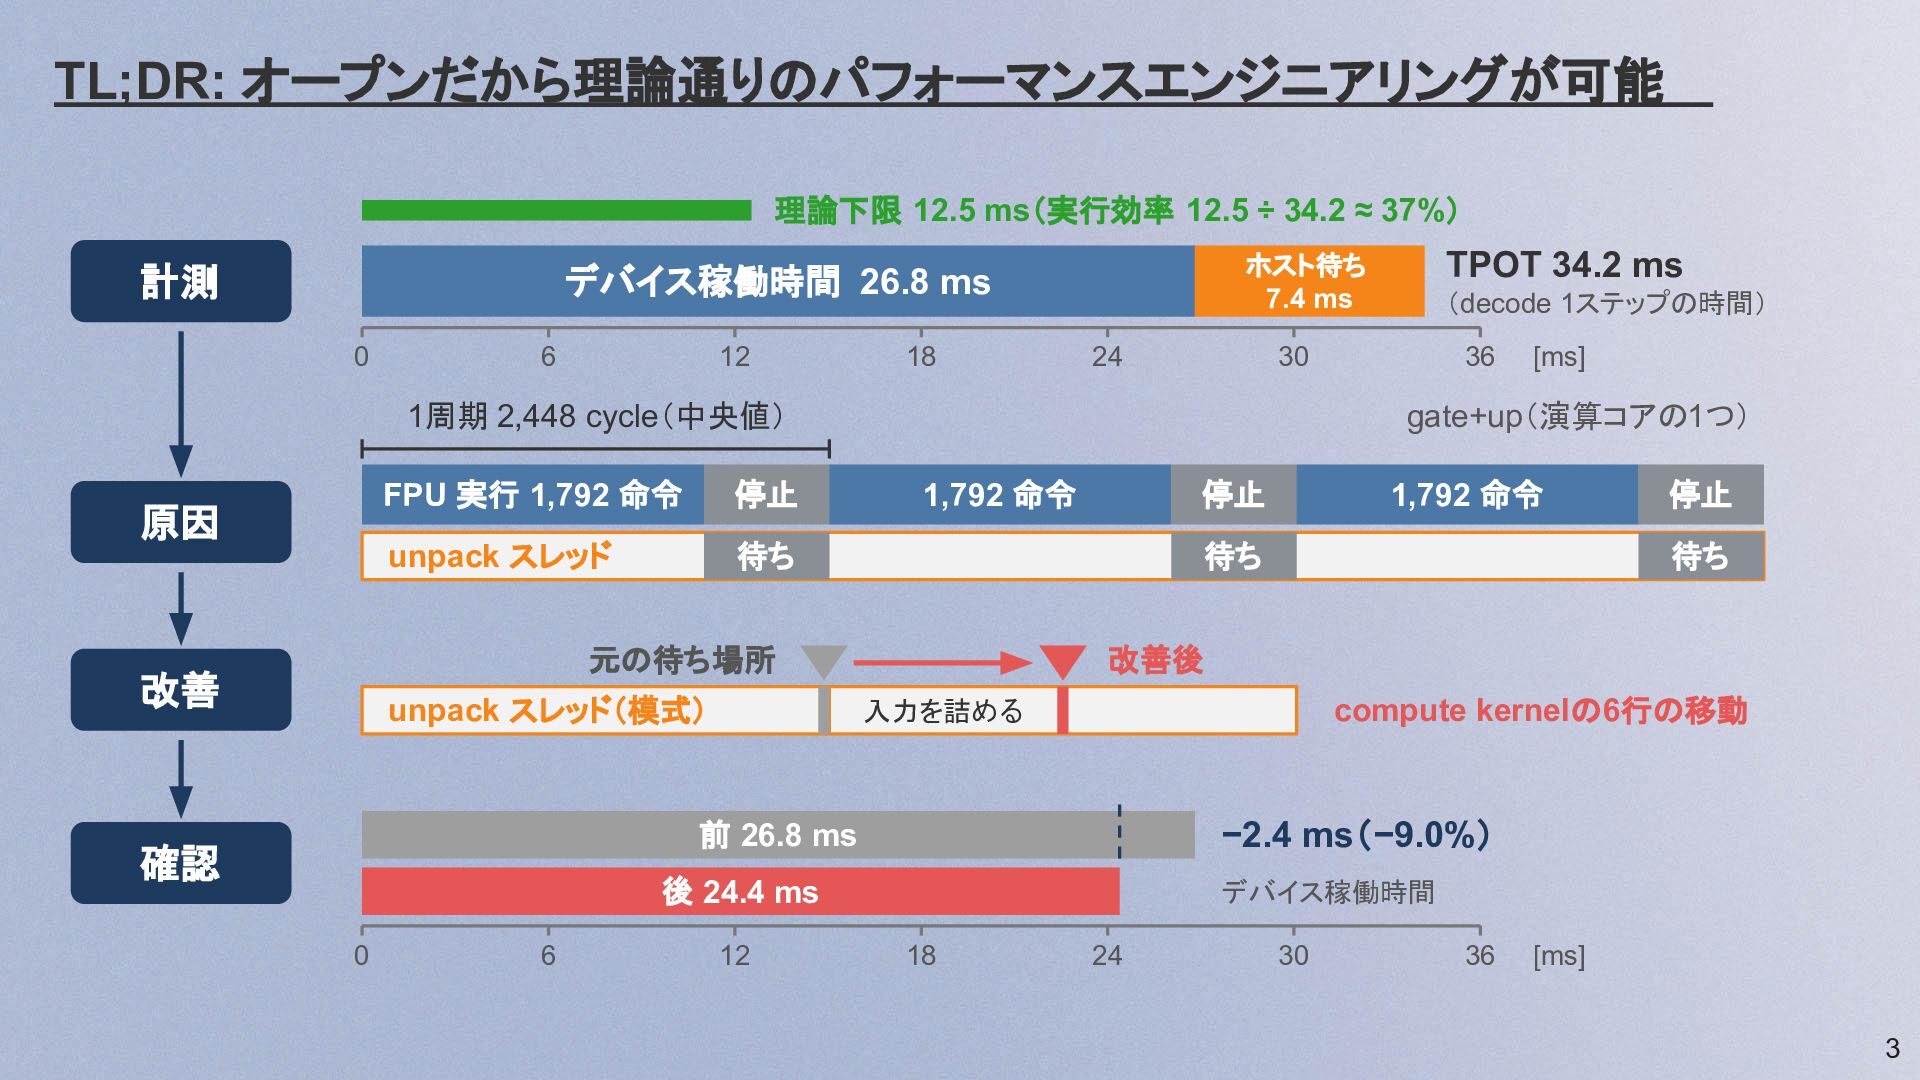
  2. TL;DR: オープンだから理論通りのパフォーマンスエンジニアリングが可能 理論下限 12.5 ms(実行効率 12.5 ÷ 34.2 ≈ 37%)

    計測 ホスト待ち 7.4 ms デバイス稼働時間 26.8 ms 0 6 12 18 24 原因 停止 unpack スレッド 待ち unpack スレッド(模式) 1,792 命令 停止 6 1,792 命令 待ち 入力を詰める 12 停止 改善後 compute kernelの6行の移動 −2.4 ms(−9.0%) 後 24.4 ms 0 [ms] 待ち 前 26.8 ms 確認 36 gate+up(演算コアの1つ) 元の待ち場所 改善 (decode 1ステップの時間) 30 1周期 2,448 cycle(中央値) FPU 実行 1,792 命令 TPOT 34.2 ms デバイス稼働時間 18 24 30 36 [ms] 3
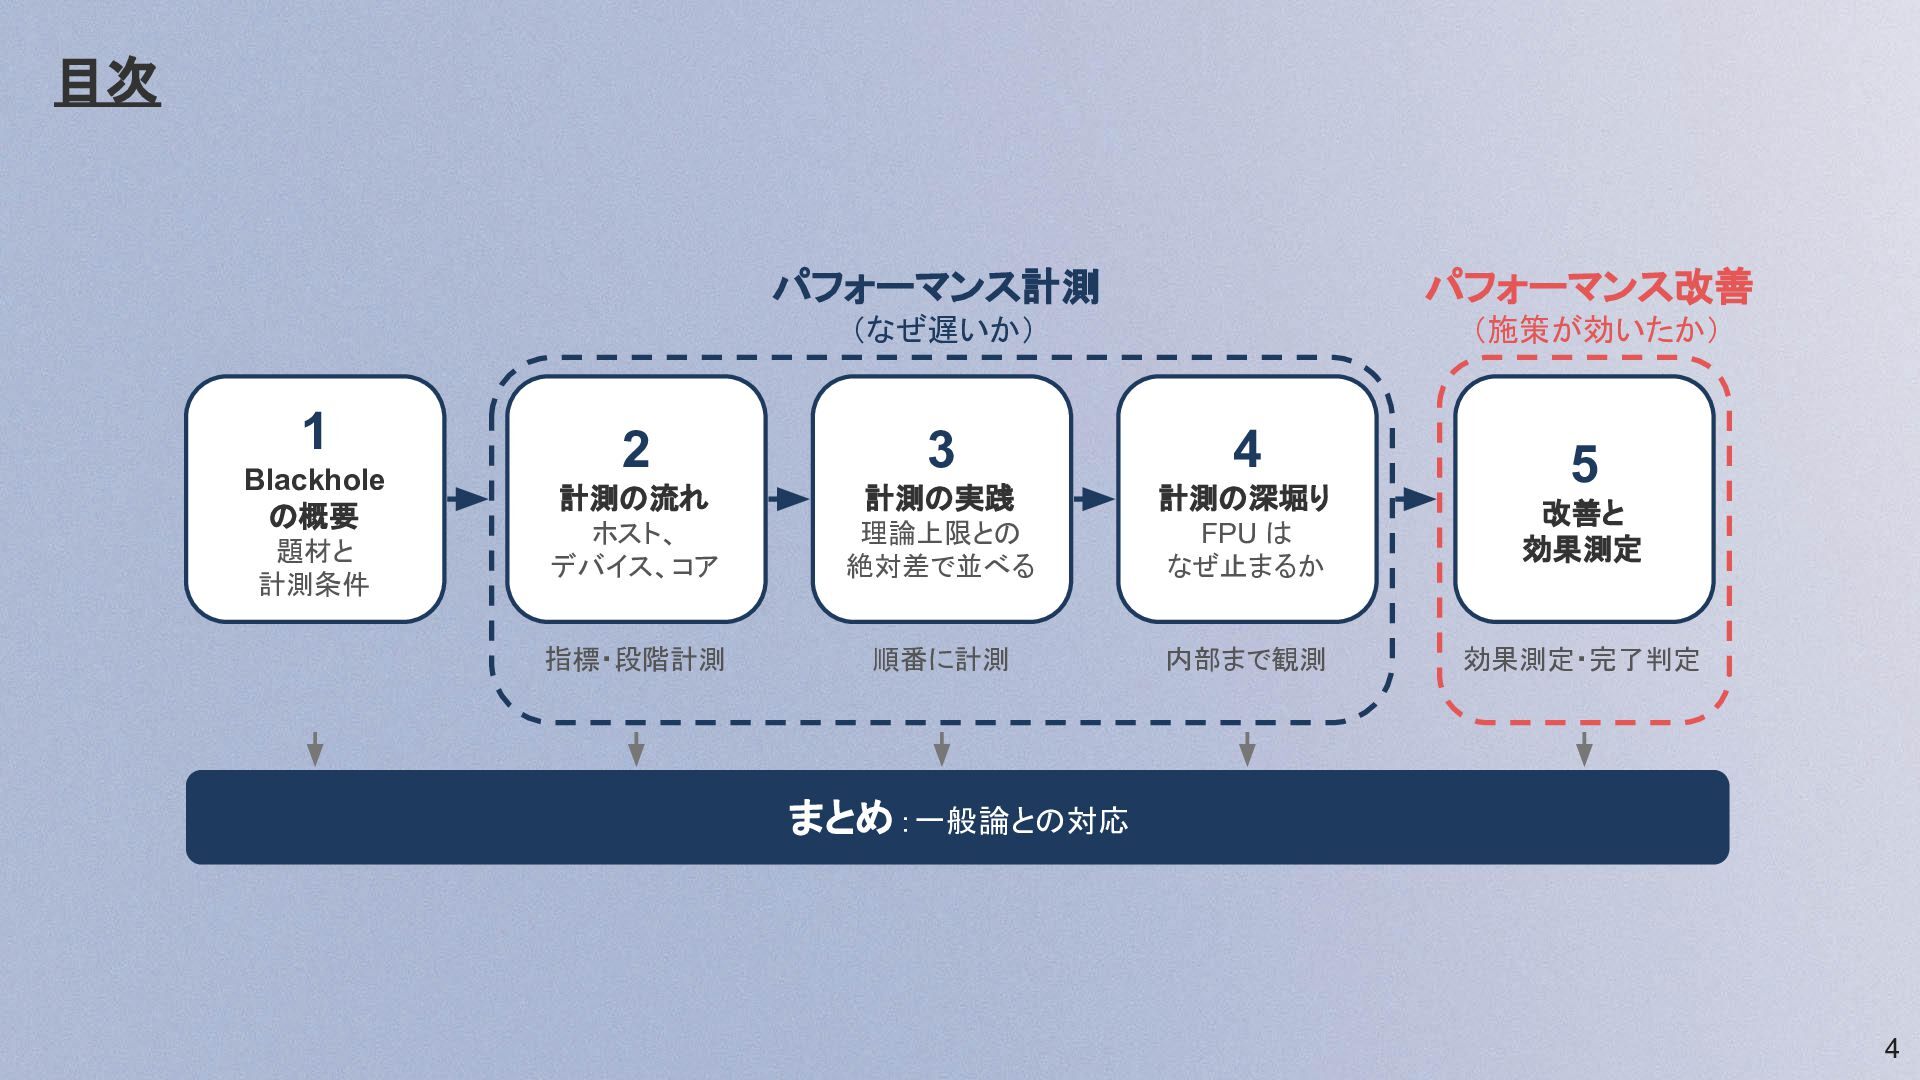
  3. 目次 1 Blackhole の概要 題材と 計測条件 パフォーマンス計測 パフォーマンス改善 (なぜ遅いか) (施策が効いたか)

    2 3 4 計測の流れ 計測の実践 計測の深堀り ホスト、 デバイス、コア 理論上限との 絶対差で並べる FPU は なぜ止まるか 指標・段階計測 順番に計測 内部まで観測 5 改善と 効果測定 効果測定・完了判定 まとめ :一般論との対応 4
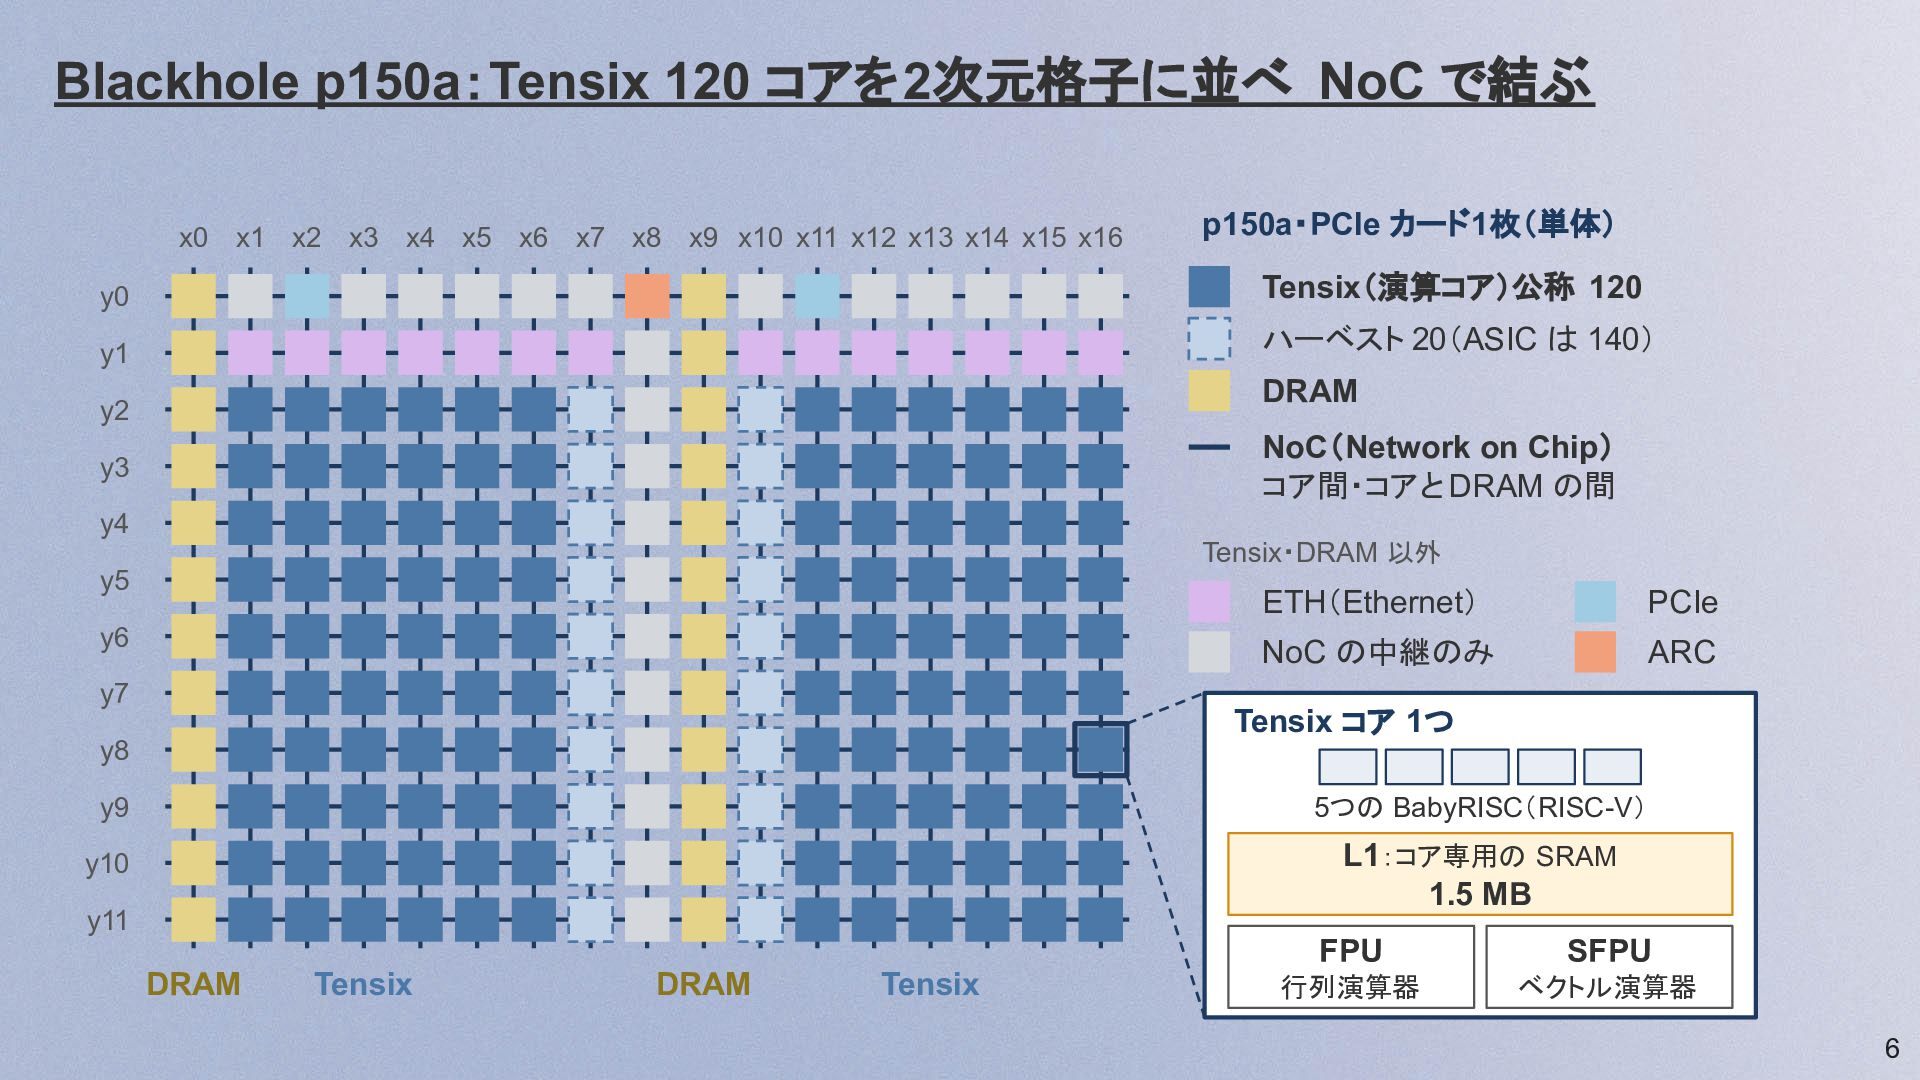
  4. Blackhole p150a:Tensix 120 コアを2次元格子に並べ NoC で結ぶ x0 x1 x2 x3

    x4 x5 x6 x7 x8 x9 x10 x11 x12 x13 x14 x15 x16 p150a・PCIe カード1枚(単体) y0 Tensix(演算コア)公称 120 y1 ハーベスト 20(ASIC は 140) DRAM y2 NoC(Network on Chip) コア間・コアと DRAM の間 y3 y4 Tensix・DRAM 以外 y5 y6 y7 ETH(Ethernet) PCIe NoC の中継のみ ARC Tensix コア 1つ y8 y9 5つの BabyRISC(RISC-V) y10 L1:コア専用の SRAM 1.5 MB y11 DRAM Tensix DRAM Tensix FPU SFPU 行列演算器 ベクトル演算器 6
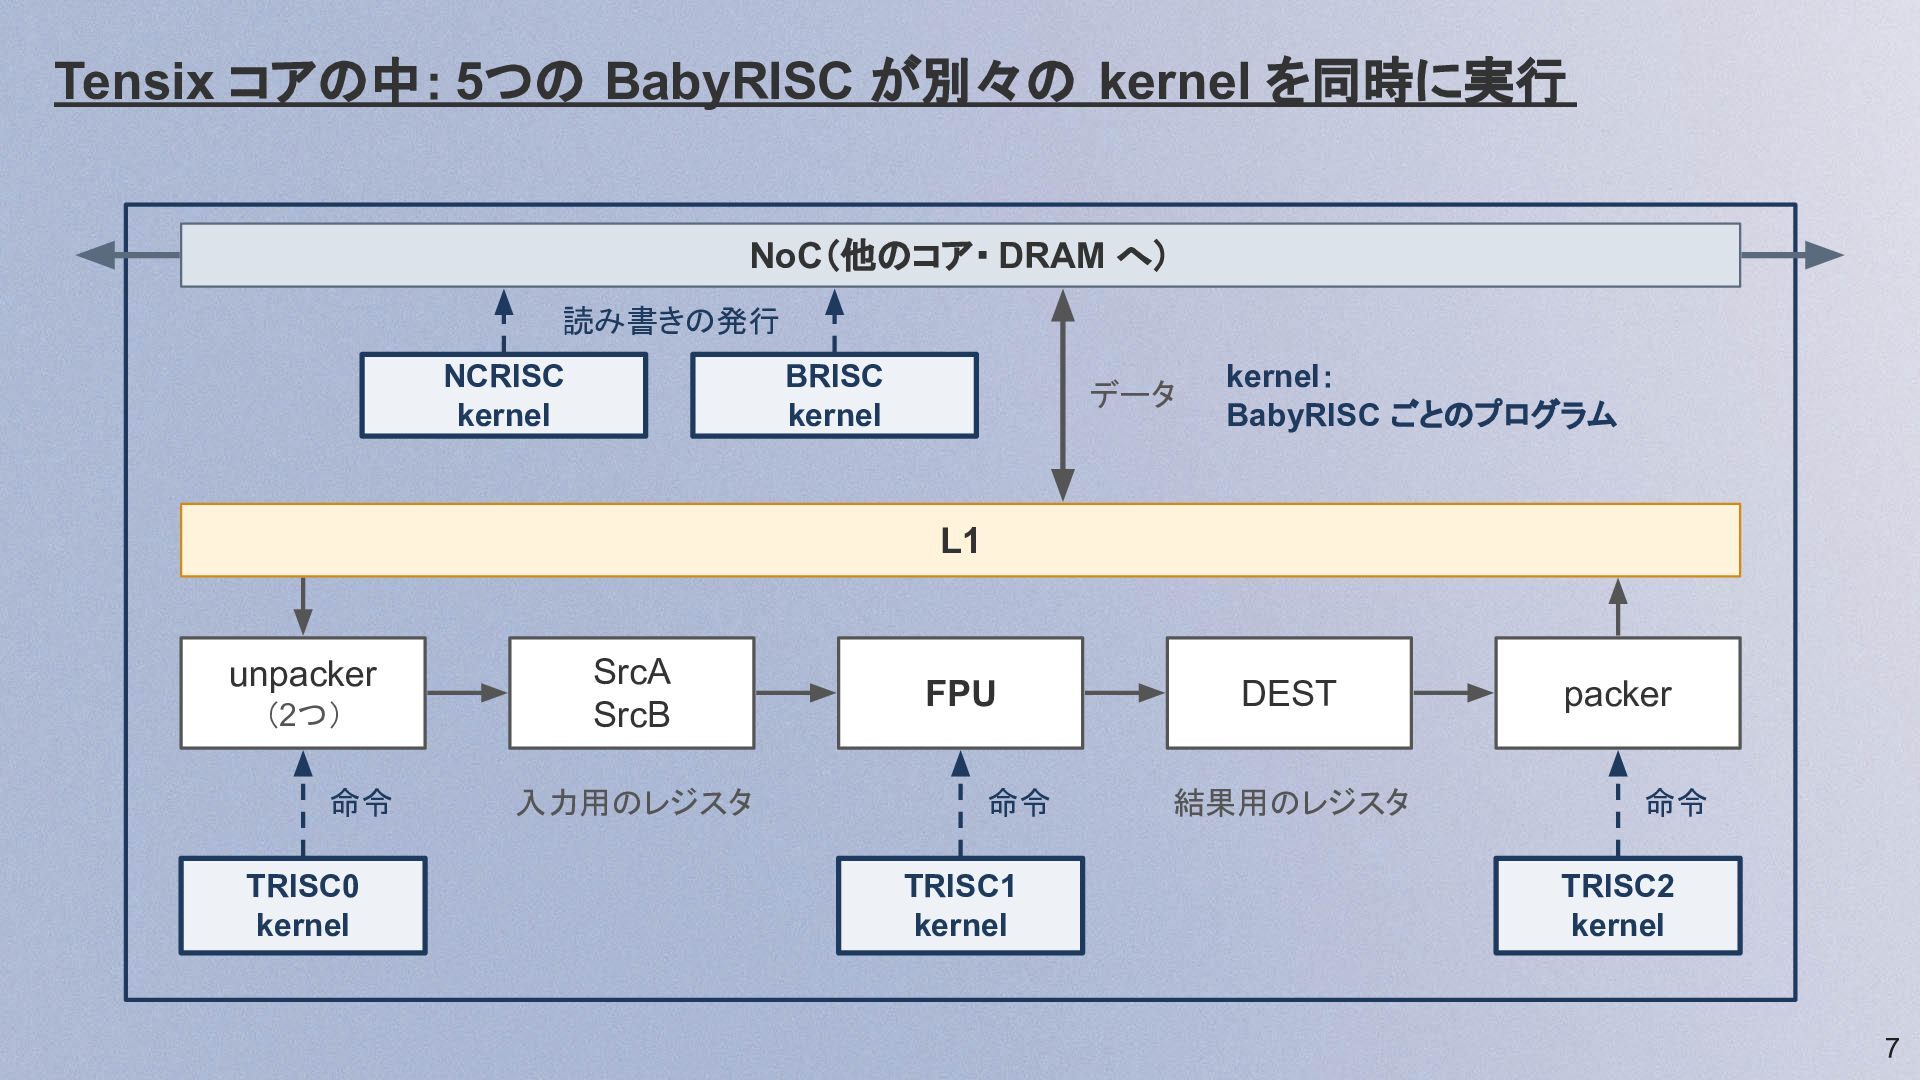
  5. Tensix コアの中: 5つの BabyRISC が別々の kernel を同時に実行 NoC(他のコア・ DRAM へ)

    読み書きの発行 NCRISC kernel BRISC kernel データ kernel: BabyRISC ごとのプログラム L1 unpacker (2つ) 命令 TRISC0 kernel SrcA SrcB 入力用のレジスタ FPU 命令 TRISC1 kernel DEST 結果用のレジスタ packer 命令 TRISC2 kernel 7
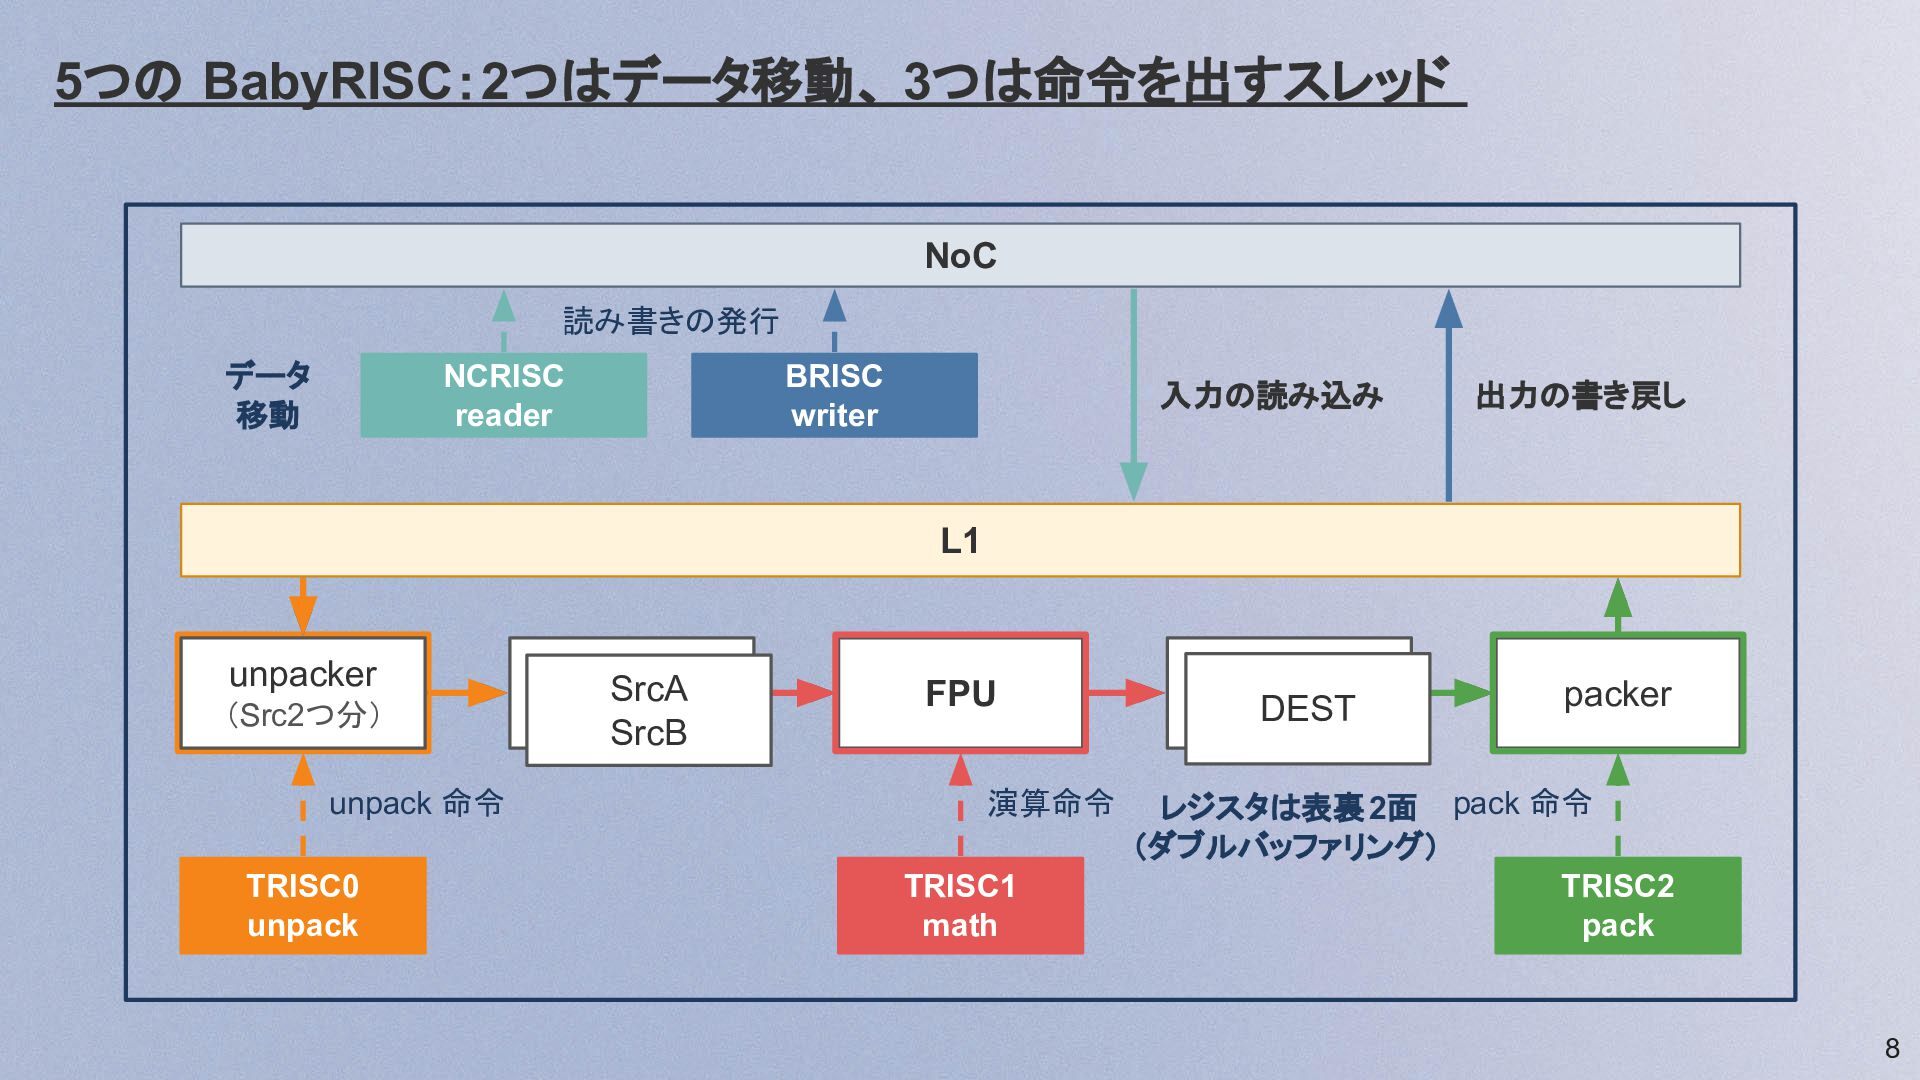
  6. 5つの BabyRISC:2つはデータ移動、 3つは命令を出すスレッド NoC 読み書きの発行 データ 移動 NCRISC reader BRISC

    writer 入力の読み込み 出力の書き戻し L1 unpacker (Src2つ分) unpack 命令 TRISC0 unpack SrcA SrcA SrcB SrcB FPU 演算命令 TRISC1 math DEST DEST packer レジスタは表裏 2面 pack 命令 (ダブルバッファリング) TRISC2 pack 8
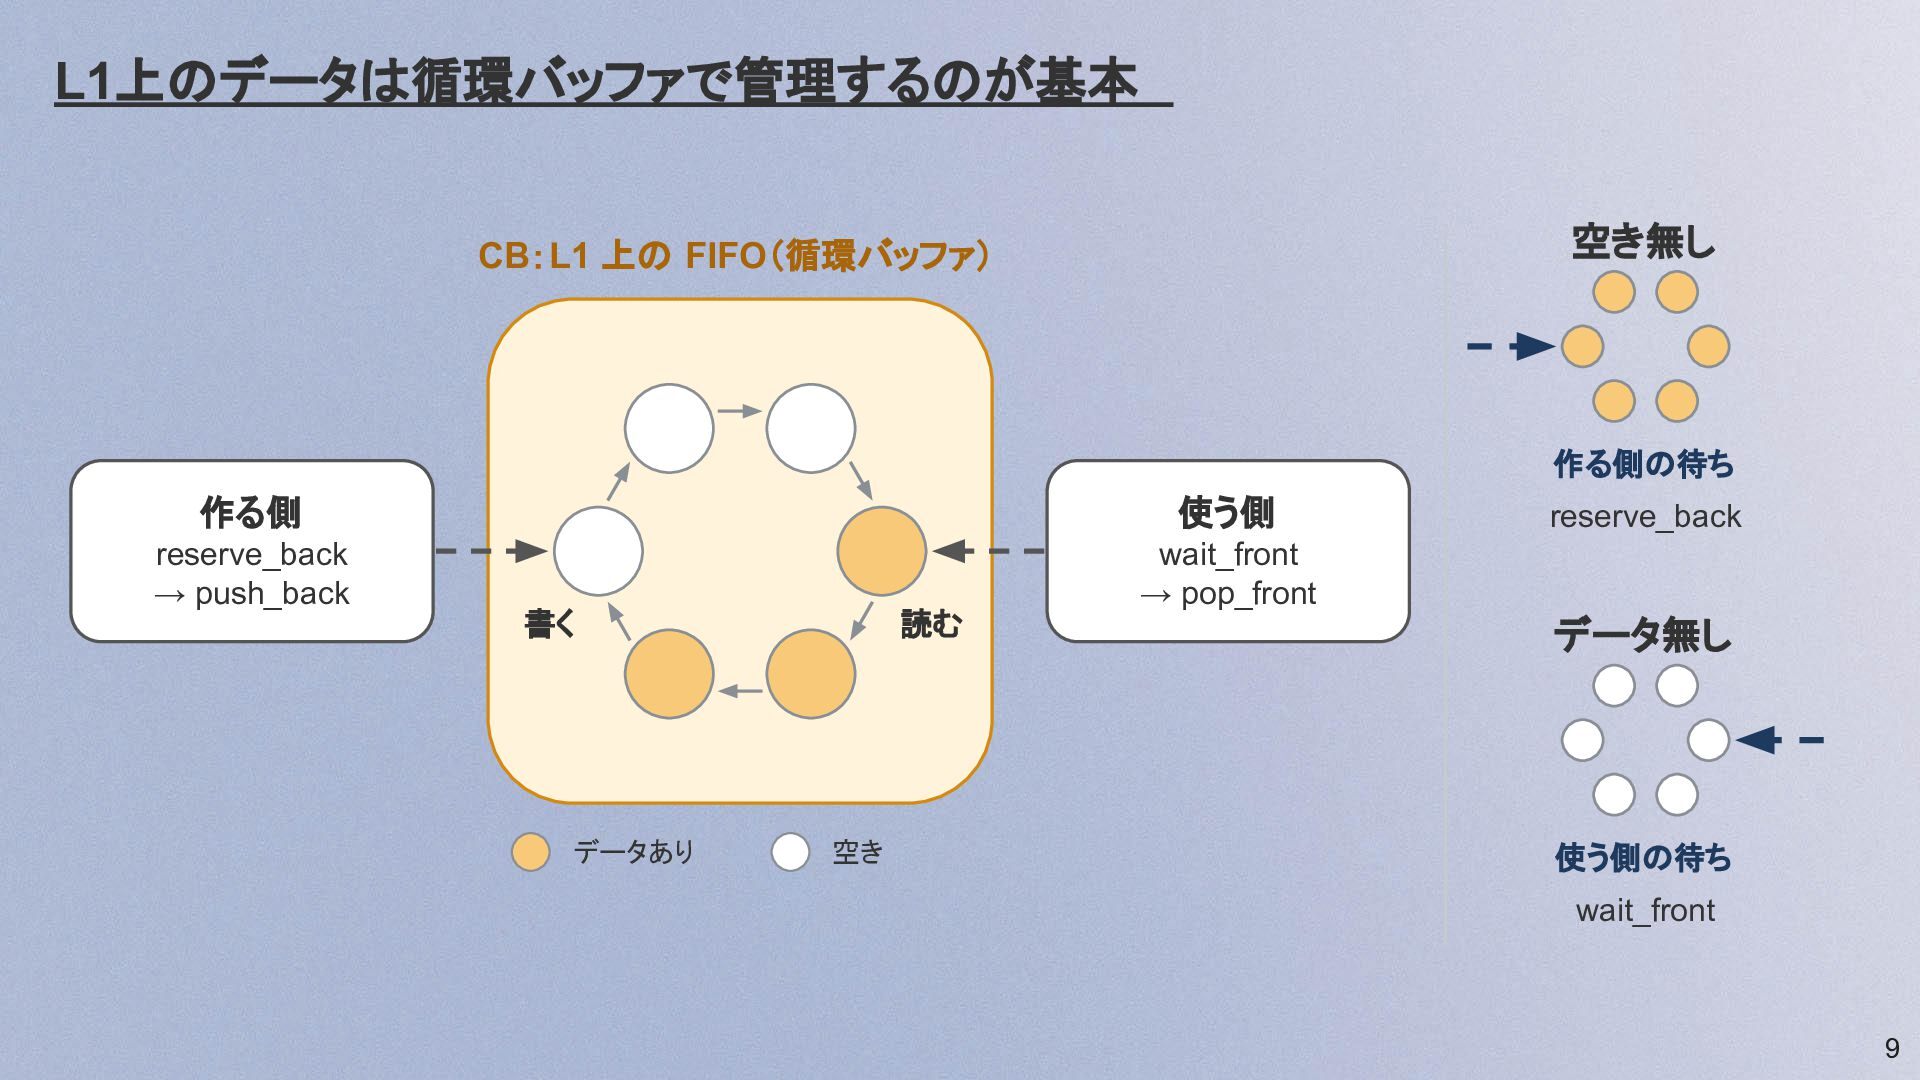
  7. L1上のデータは循環バッファで管理するのが基本 空き無し CB:L1 上の FIFO(循環バッファ) 作る側の待ち 作る側 使う側 reserve_back →

    push_back wait_front → pop_front 書く データあり 読む 空き reserve_back データ無し 使う側の待ち wait_front 9
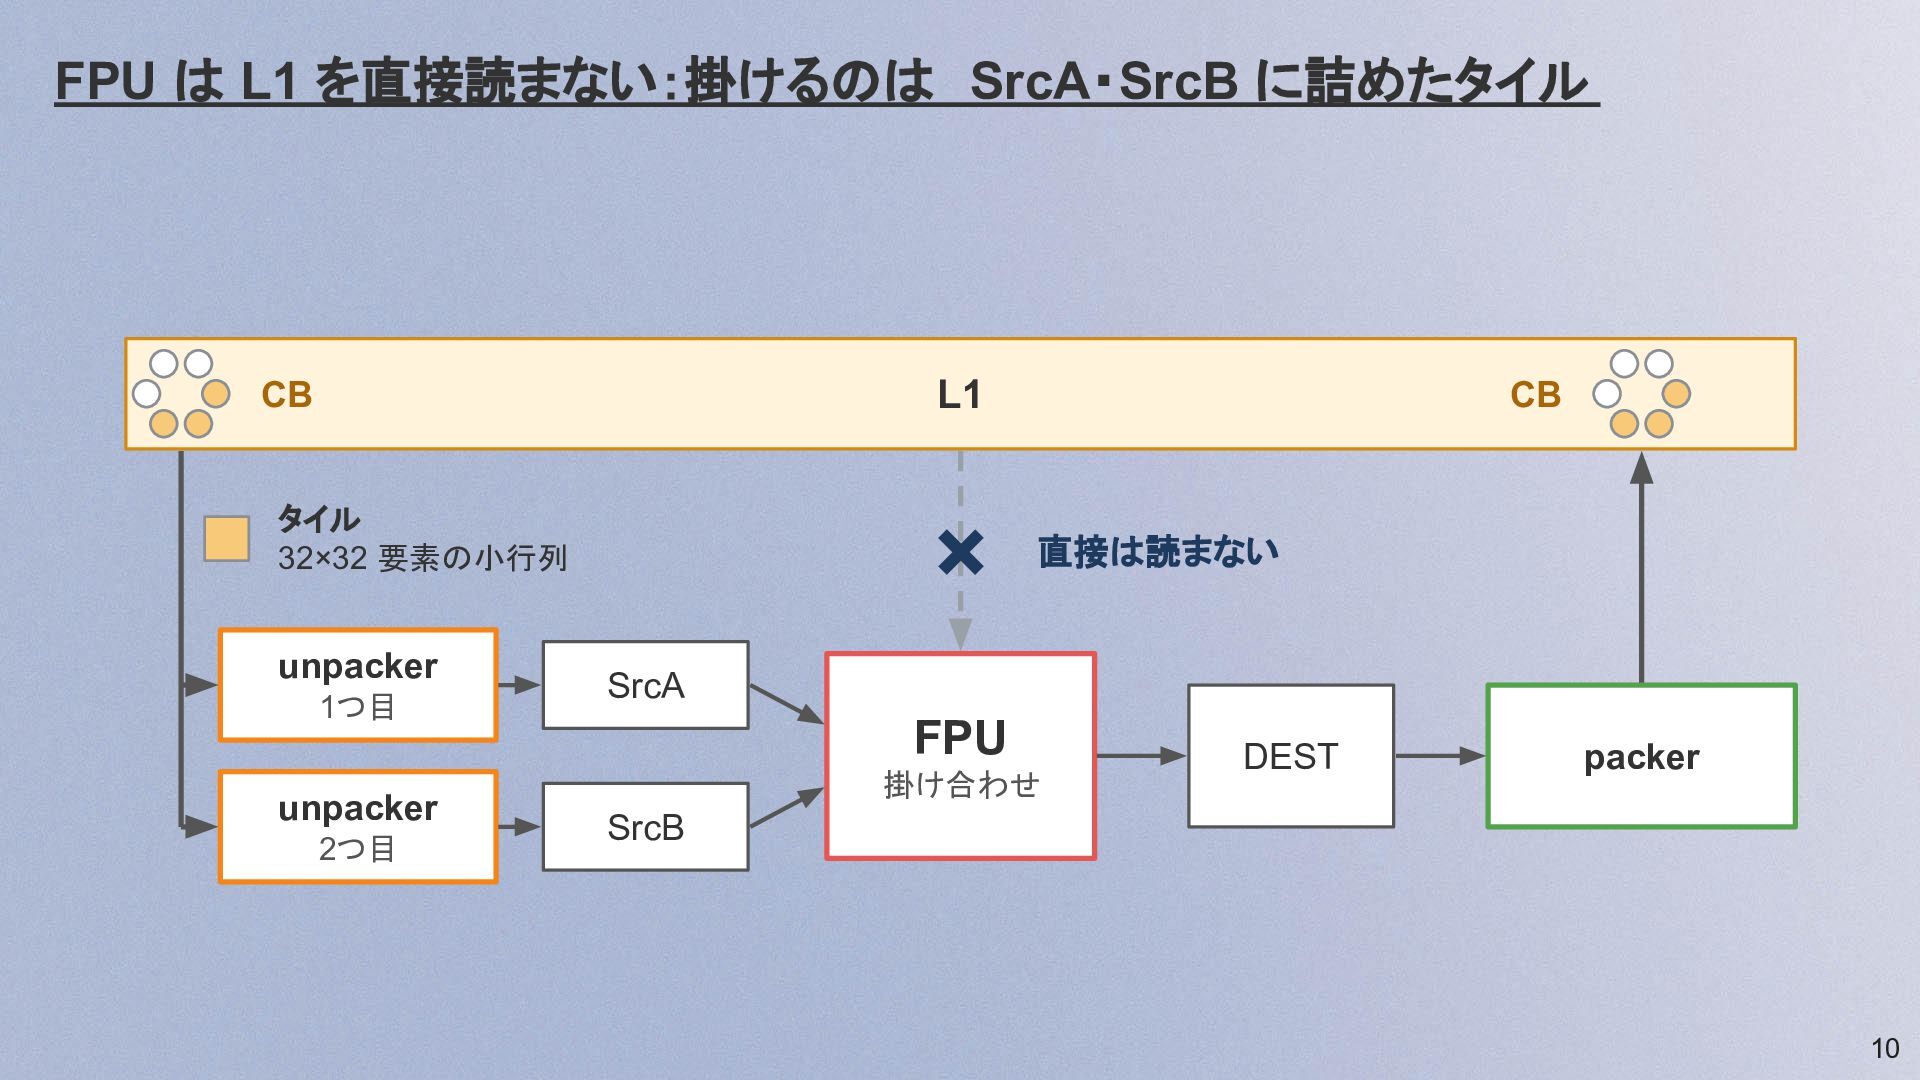
  8. FPU は L1 を直接読まない:掛けるのは SrcA・SrcB に詰めたタイル CB L1 タイル 32×32

    要素の小行列 × unpacker 1つ目 unpacker 2つ目 CB 直接は読まない SrcA FPU 掛け合わせ DEST packer SrcB 10
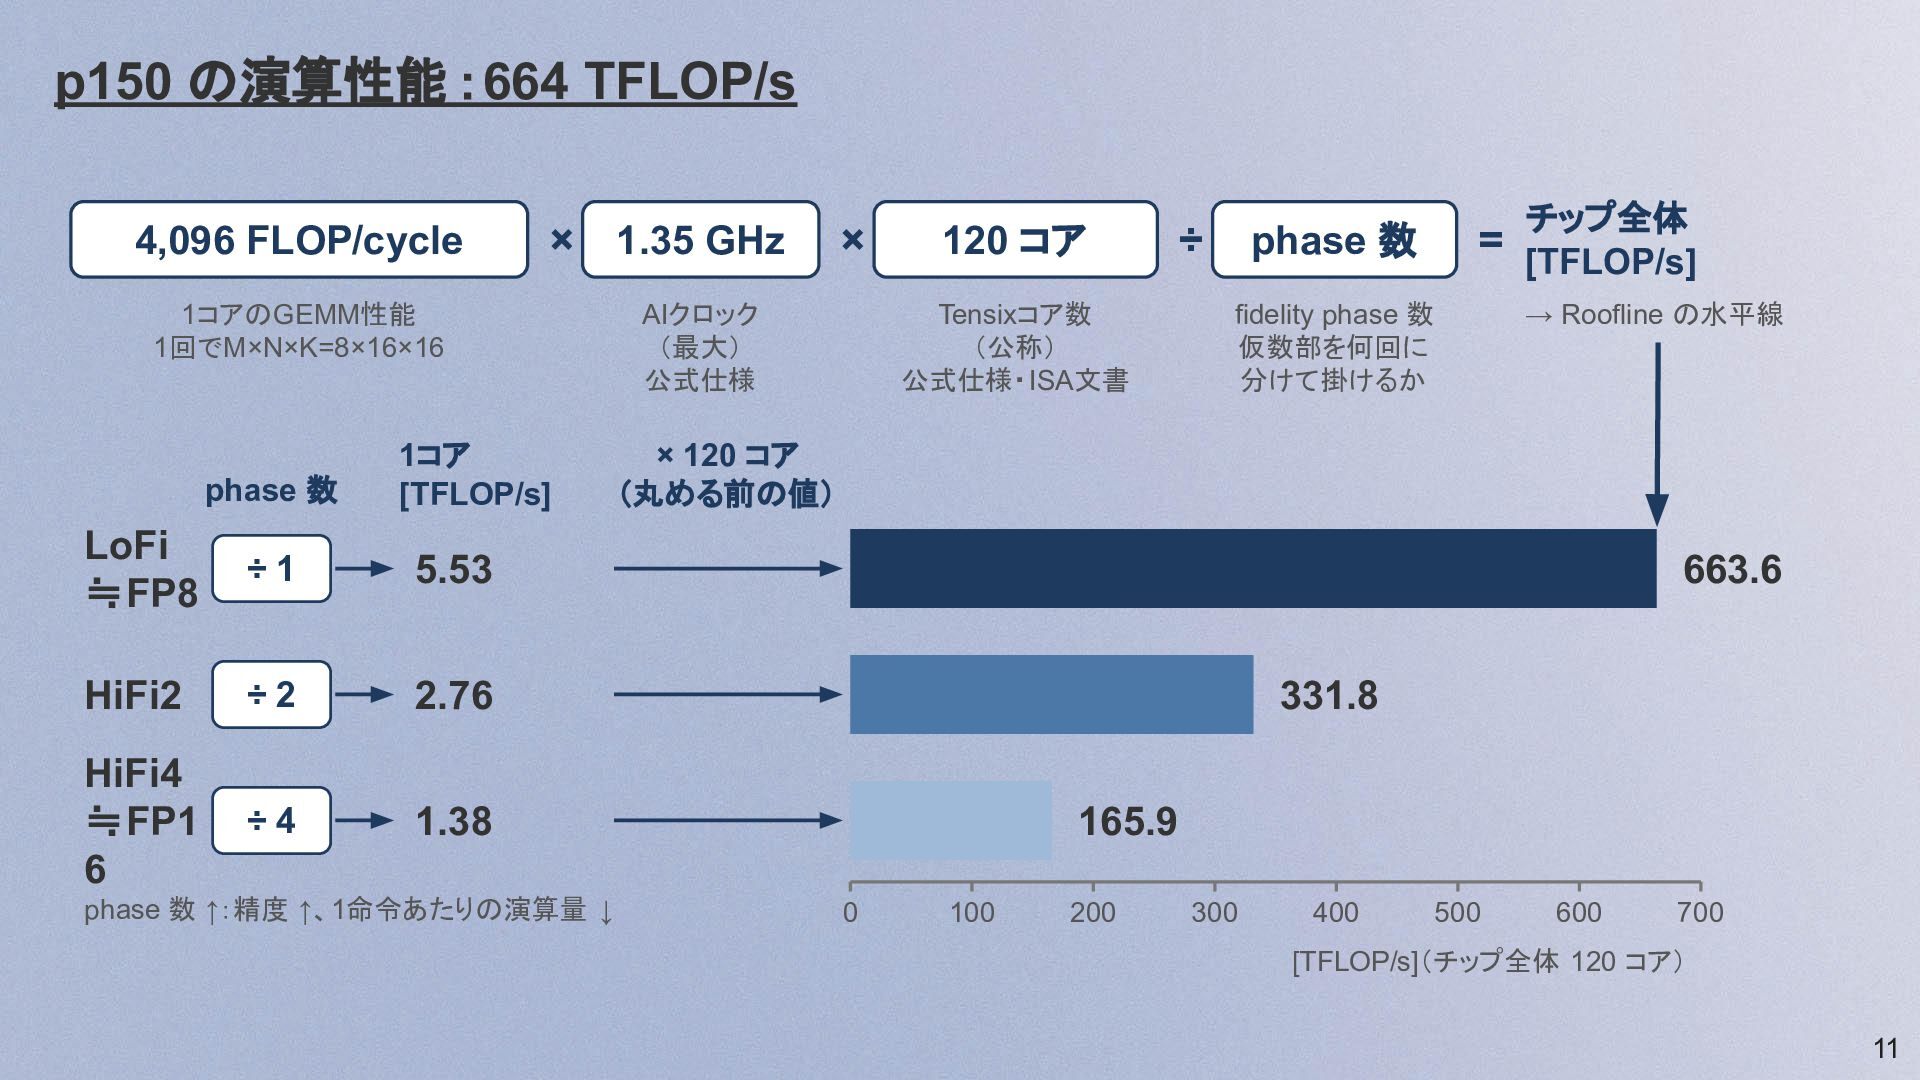
  9. p150 の演算性能 :664 TFLOP/s 4,096 FLOP/cycle × 1.35 GHz 1コアのGEMM性能

    1回でM×N×K=8×16×16 phase 数 1コア [TFLOP/s] LoFi ≒FP8 ÷1 5.53 HiFi2 ÷2 2.76 HiFi4 ≒FP1 6 ÷4 1.38 phase 数 ↑:精度 ↑、1命令あたりの演算量 ↓ × AIクロック (最大) 公式仕様 120 コア Tensixコア数 (公称) 公式仕様・ISA文書 phase 数 ÷ チップ全体 = [TFLOP/s] fidelity phase 数 仮数部を何回に 分けて掛けるか → Roofline の水平線 × 120 コア (丸める前の値) 663.6 331.8 165.9 0 100 200 300 400 500 600 700 [TFLOP/s](チップ全体 120 コア) 11
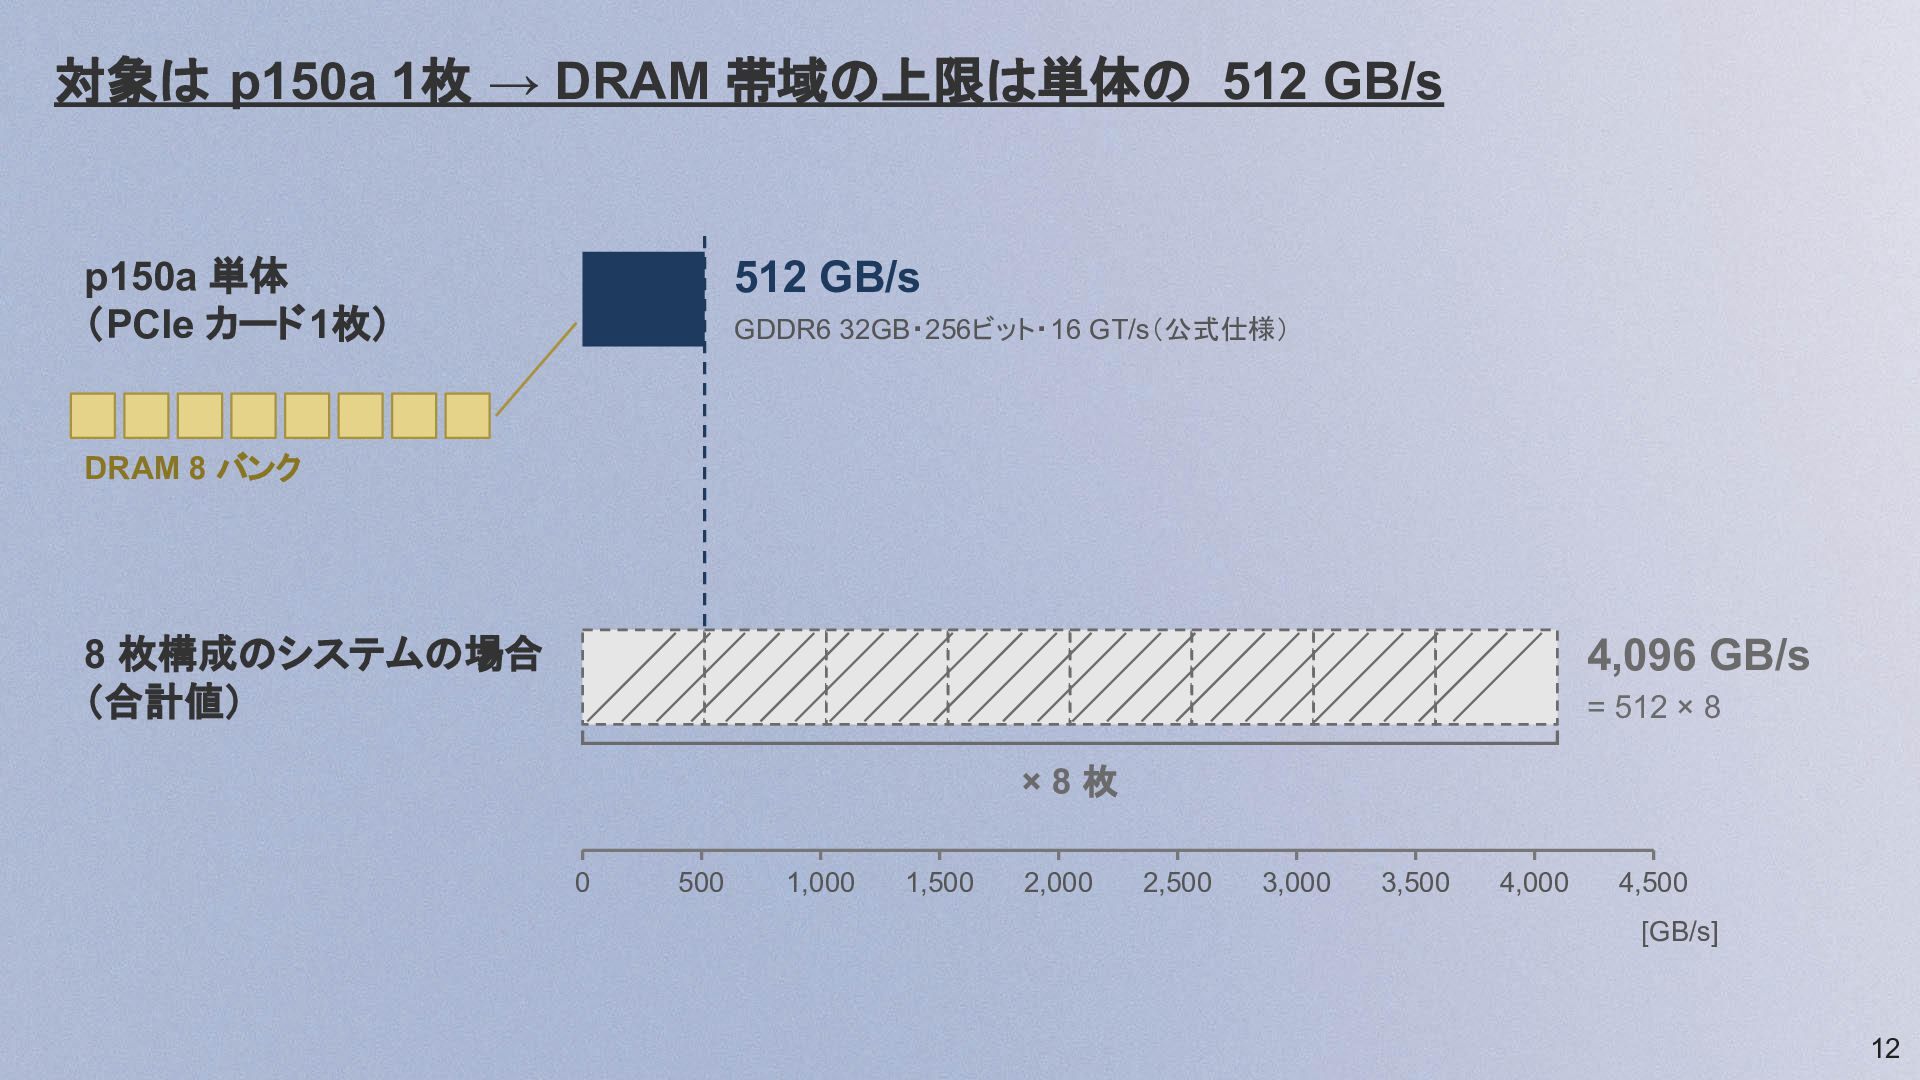
  10. 対象は p150a 1枚 → DRAM 帯域の上限は単体の 512 GB/s p150a 単体

    (PCIe カード1枚) 512 GB/s GDDR6 32GB・256ビット・16 GT/s(公式仕様) DRAM 8 バンク 8 枚構成のシステムの場合 (合計値) 4,096 GB/s = 512 × 8 ×8枚 0 500 1,000 1,500 2,000 2,500 3,000 3,500 4,000 4,500 [GB/s] 12
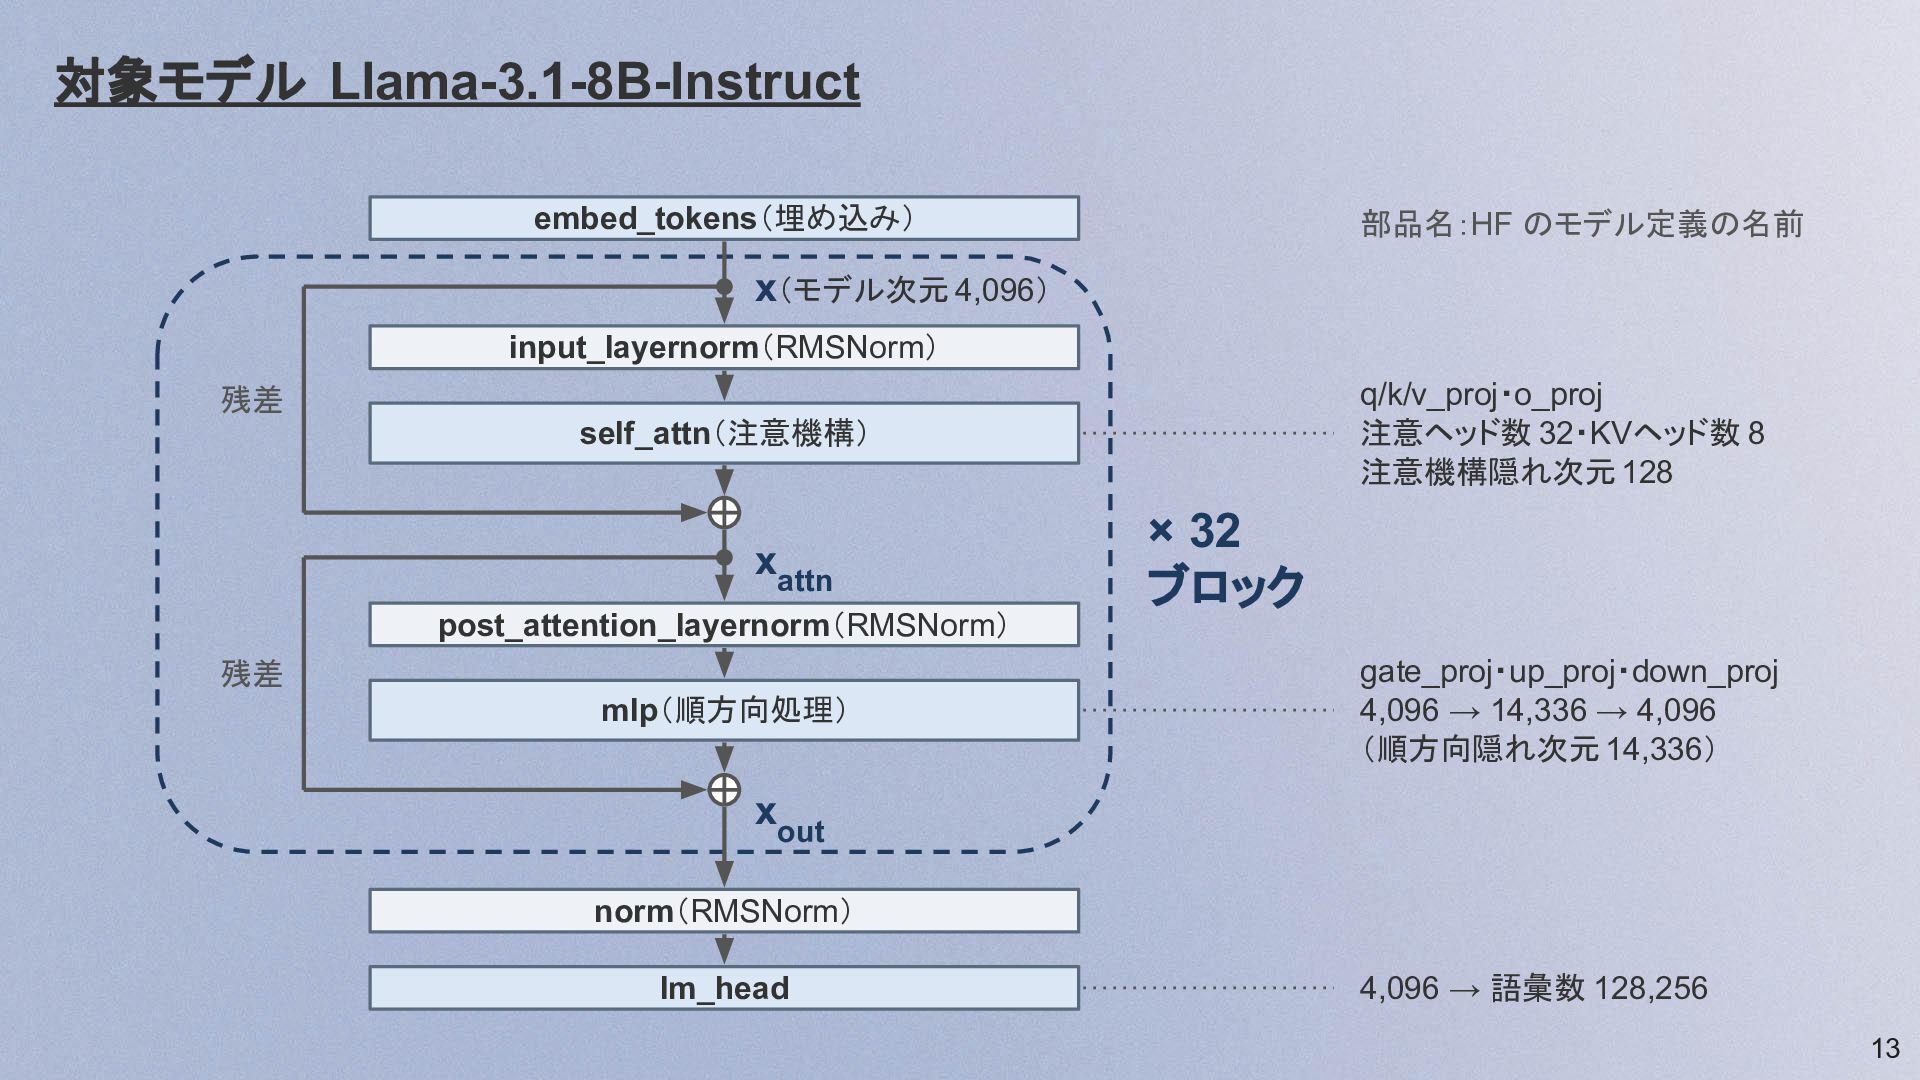
  11. 対象モデル Llama-3.1-8B-Instruct embed_tokens(埋め込み) 部品名:HF のモデル定義の名前 x(モデル次元 4,096) input_layernorm(RMSNorm) q/k/v_proj・o_proj 注意ヘッド数

    32・KVヘッド数 8 注意機構隠れ次元 128 残差 self_attn(注意機構) xattn × 32 ブロック post_attention_layernorm(RMSNorm) 残差 mlp(順方向処理) gate_proj・up_proj・down_proj 4,096 → 14,336 → 4,096 (順方向隠れ次元 14,336) xout norm(RMSNorm) lm_head 4,096 → 語彙数 128,256 13
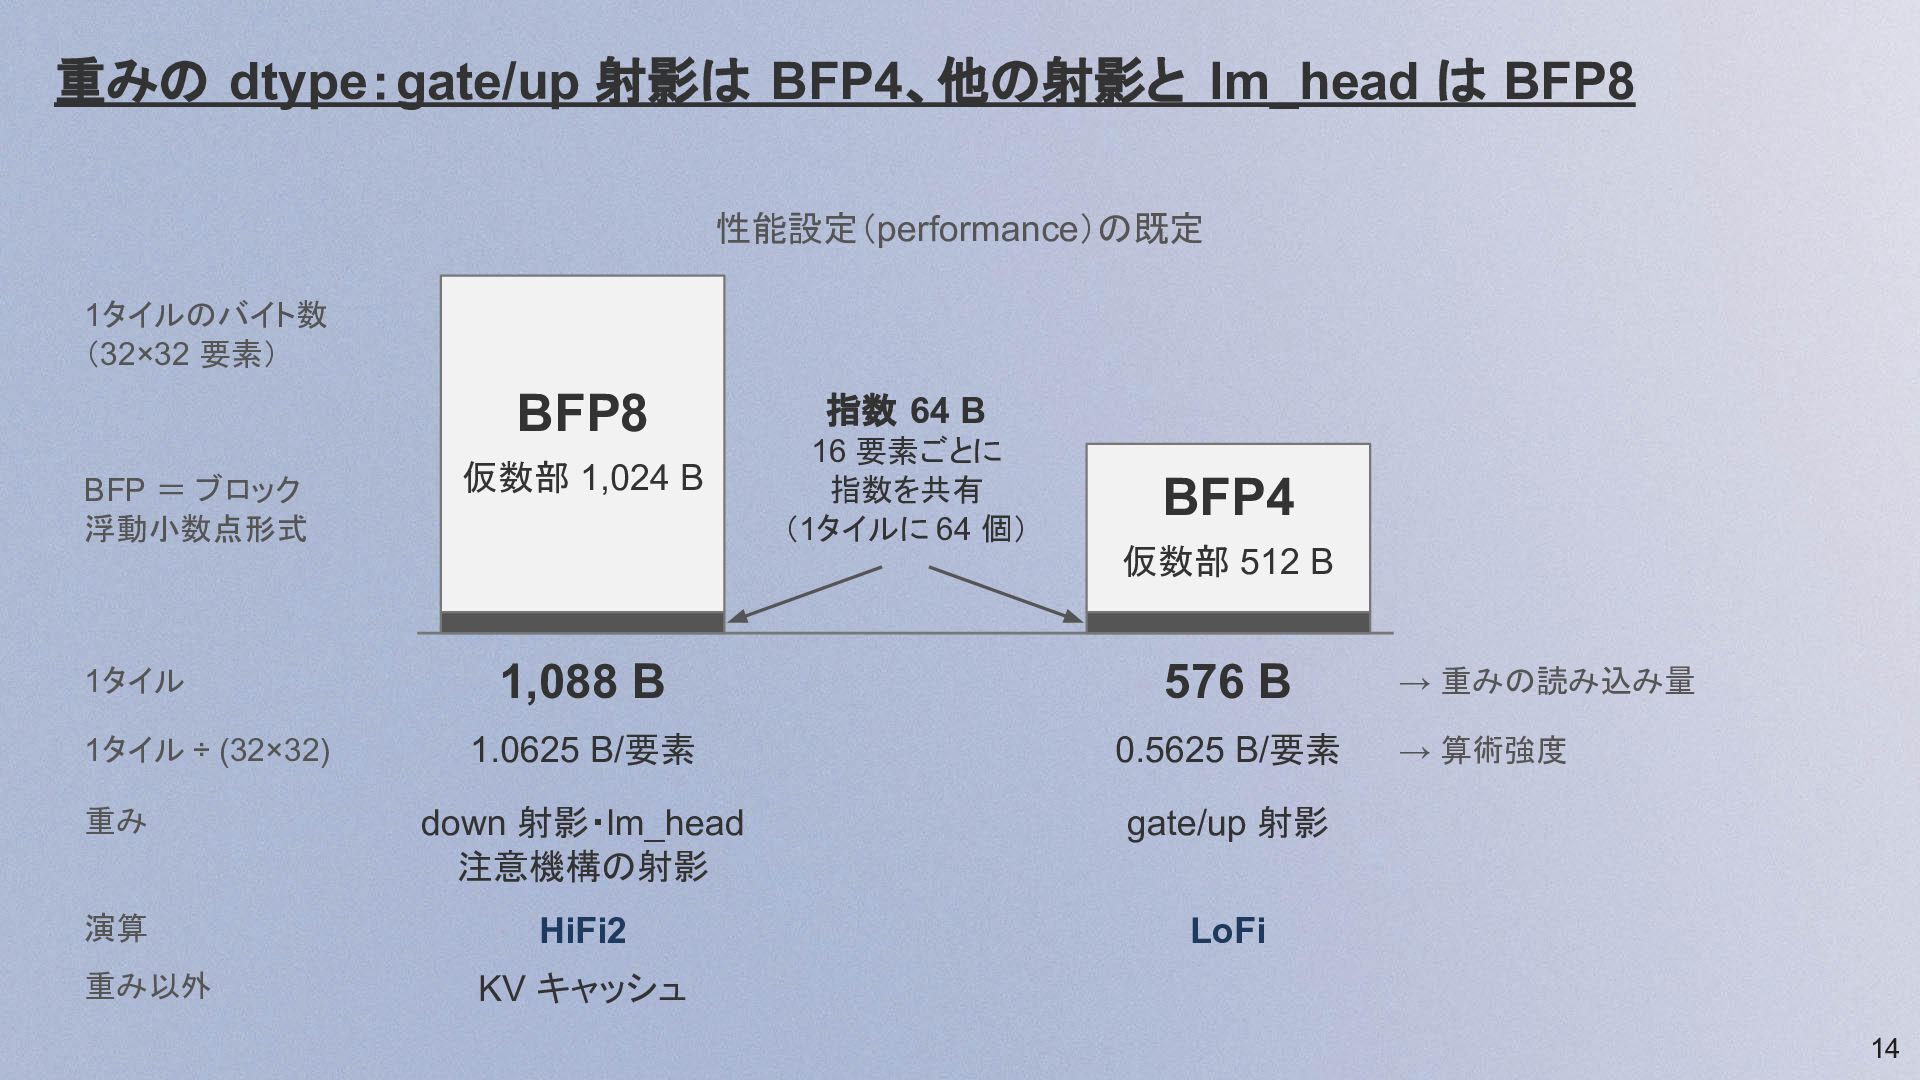
  12. 重みの dtype:gate/up 射影は BFP4、他の射影と lm_head は BFP8 性能設定(performance)の既定 1タイルのバイト数 (32×32

    要素) BFP8 BFP = ブロック 浮動小数点形式 仮数部 1,024 B 指数 64 B 16 要素ごとに 指数を共有 (1タイルに 64 個) BFP4 仮数部 512 B 1,088 B 576 B 1.0625 B/要素 0.5625 B/要素 重み down 射影・lm_head 注意機構の射影 gate/up 射影 演算 HiFi2 LoFi 1タイル 1タイル ÷ (32×32) 重み以外 → 重みの読み込み量 → 算術強度 KV キャッシュ 14
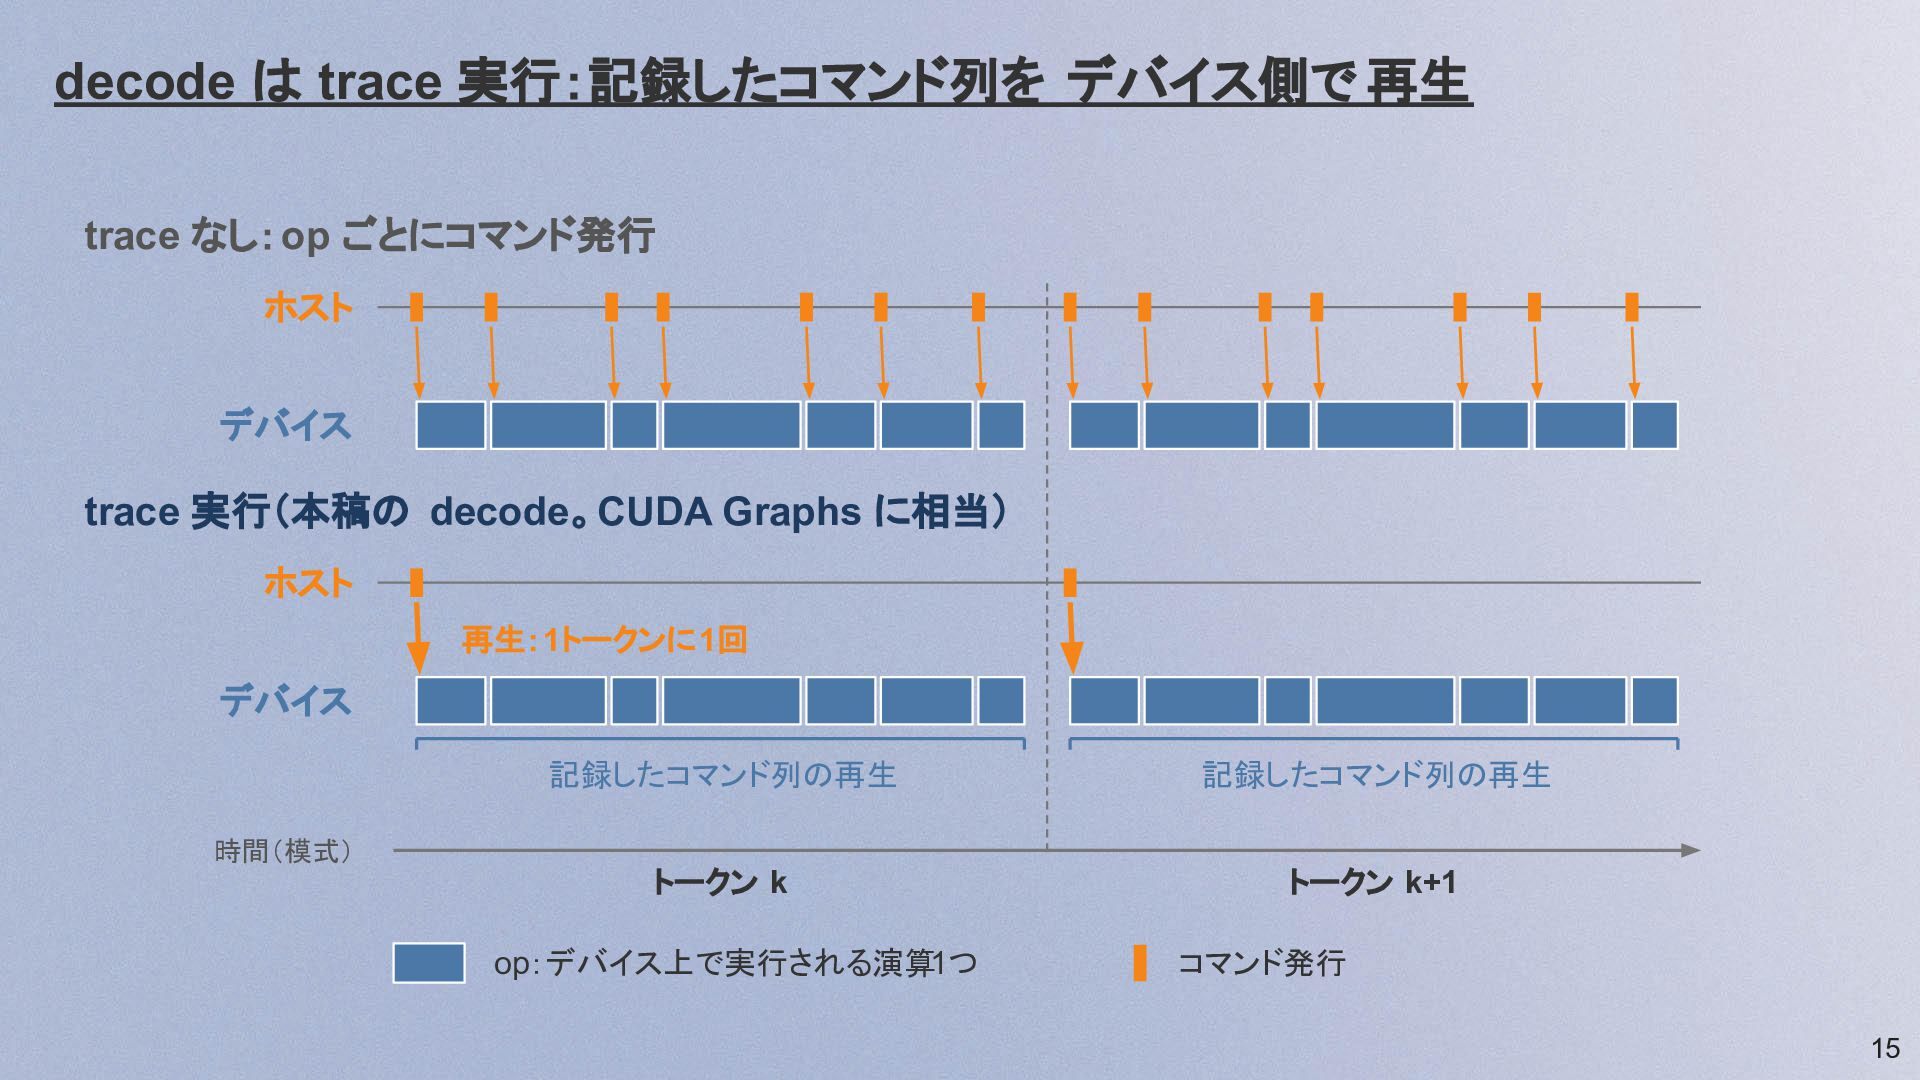
  13. decode は trace 実行:記録したコマンド列を デバイス側で 再生 trace なし:op ごとにコマンド発行 ホスト

    デバイス trace 実行(本稿の decode。CUDA Graphs に相当) ホスト 再生:1トークンに1回 デバイス 記録したコマンド列の再生 記録したコマンド列の再生 トークン k トークン k+1 時間(模式) op:デバイス上で実行される演算1つ コマンド発行 15
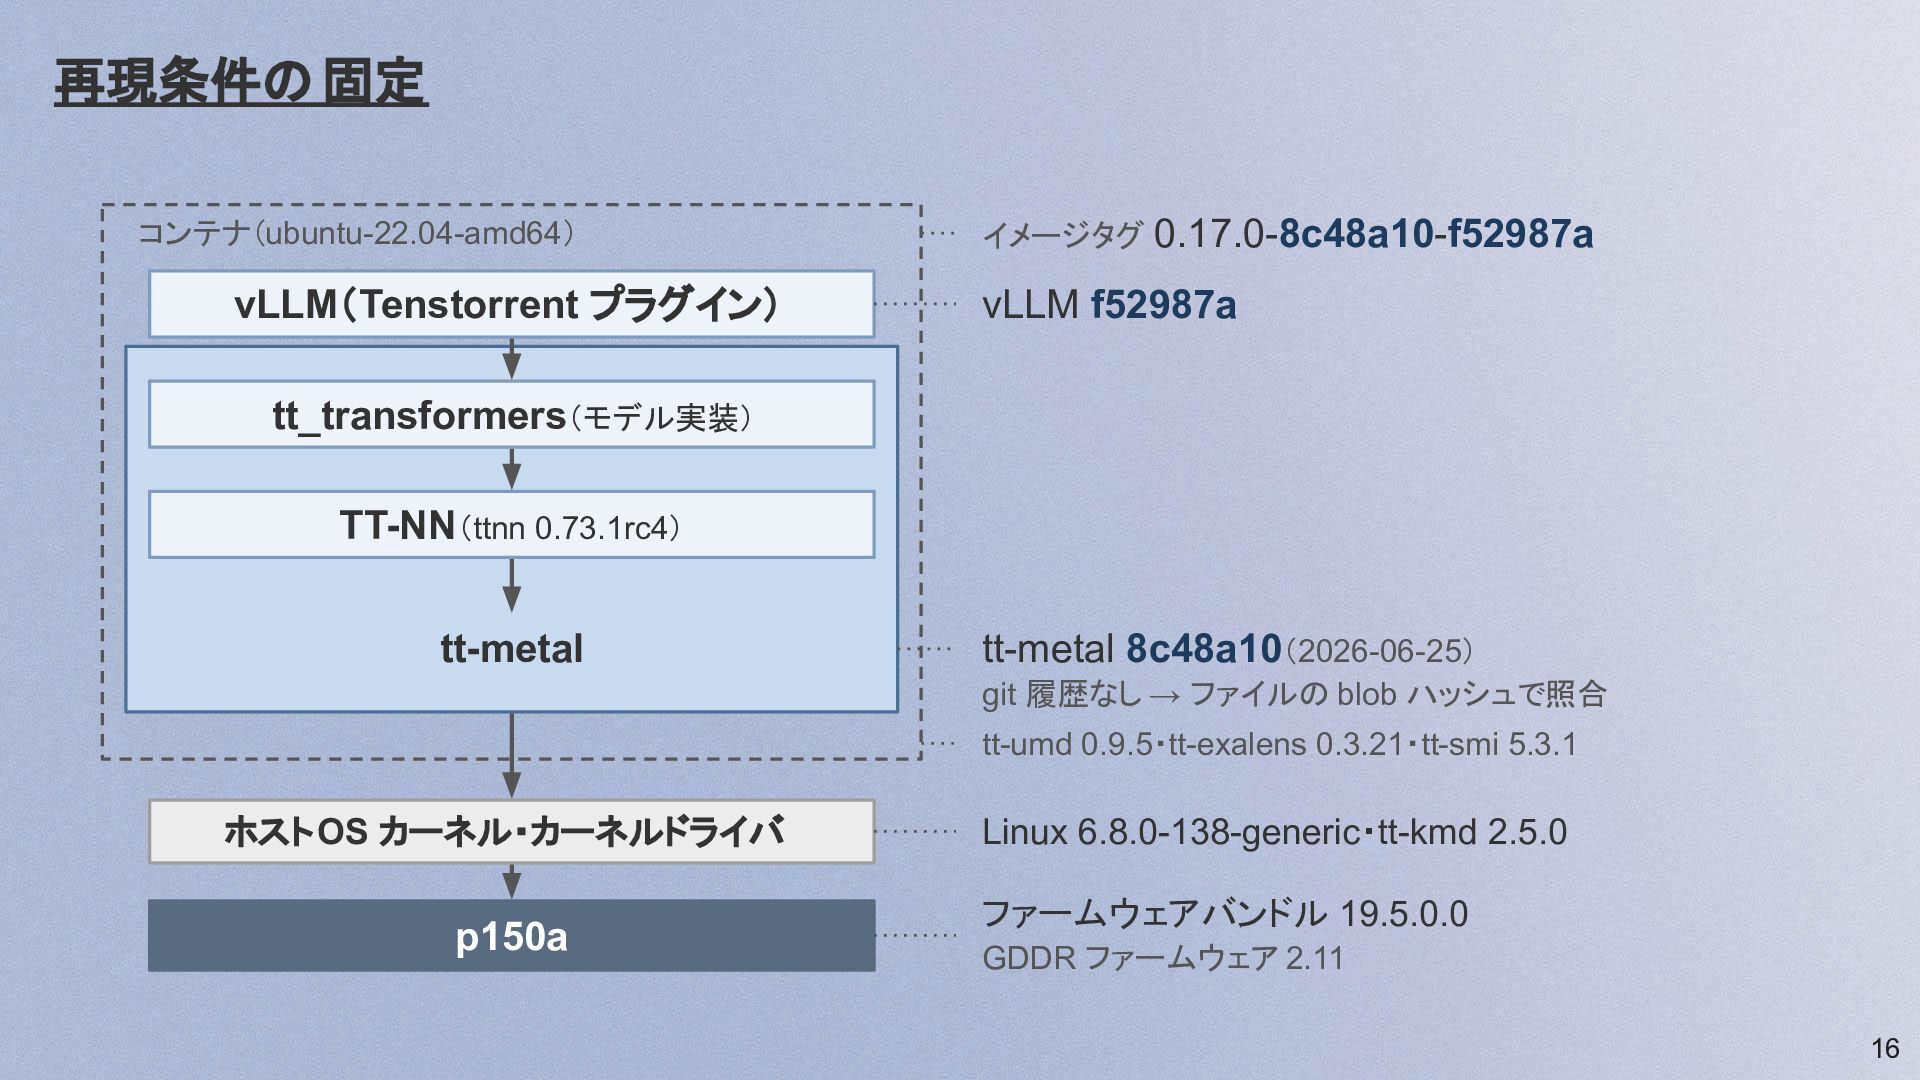
  14. 再現条件の 固定 コンテナ(ubuntu-22.04-amd64) vLLM(Tenstorrent プラグイン) イメージタグ 0.17.0-8c48a10-f52987a vLLM f52987a tt_transformers(モデル実装)

    TT-NN(ttnn 0.73.1rc4) tt-metal tt-metal 8c48a10(2026-06-25) git 履歴なし → ファイルの blob ハッシュで照合 tt-umd 0.9.5・tt-exalens 0.3.21・tt-smi 5.3.1 ホストOS カーネル・カーネルドライバ p150a Linux 6.8.0-138-generic・tt-kmd 2.5.0 ファームウェアバンドル 19.5.0.0 GDDR ファームウェア 2.11 16
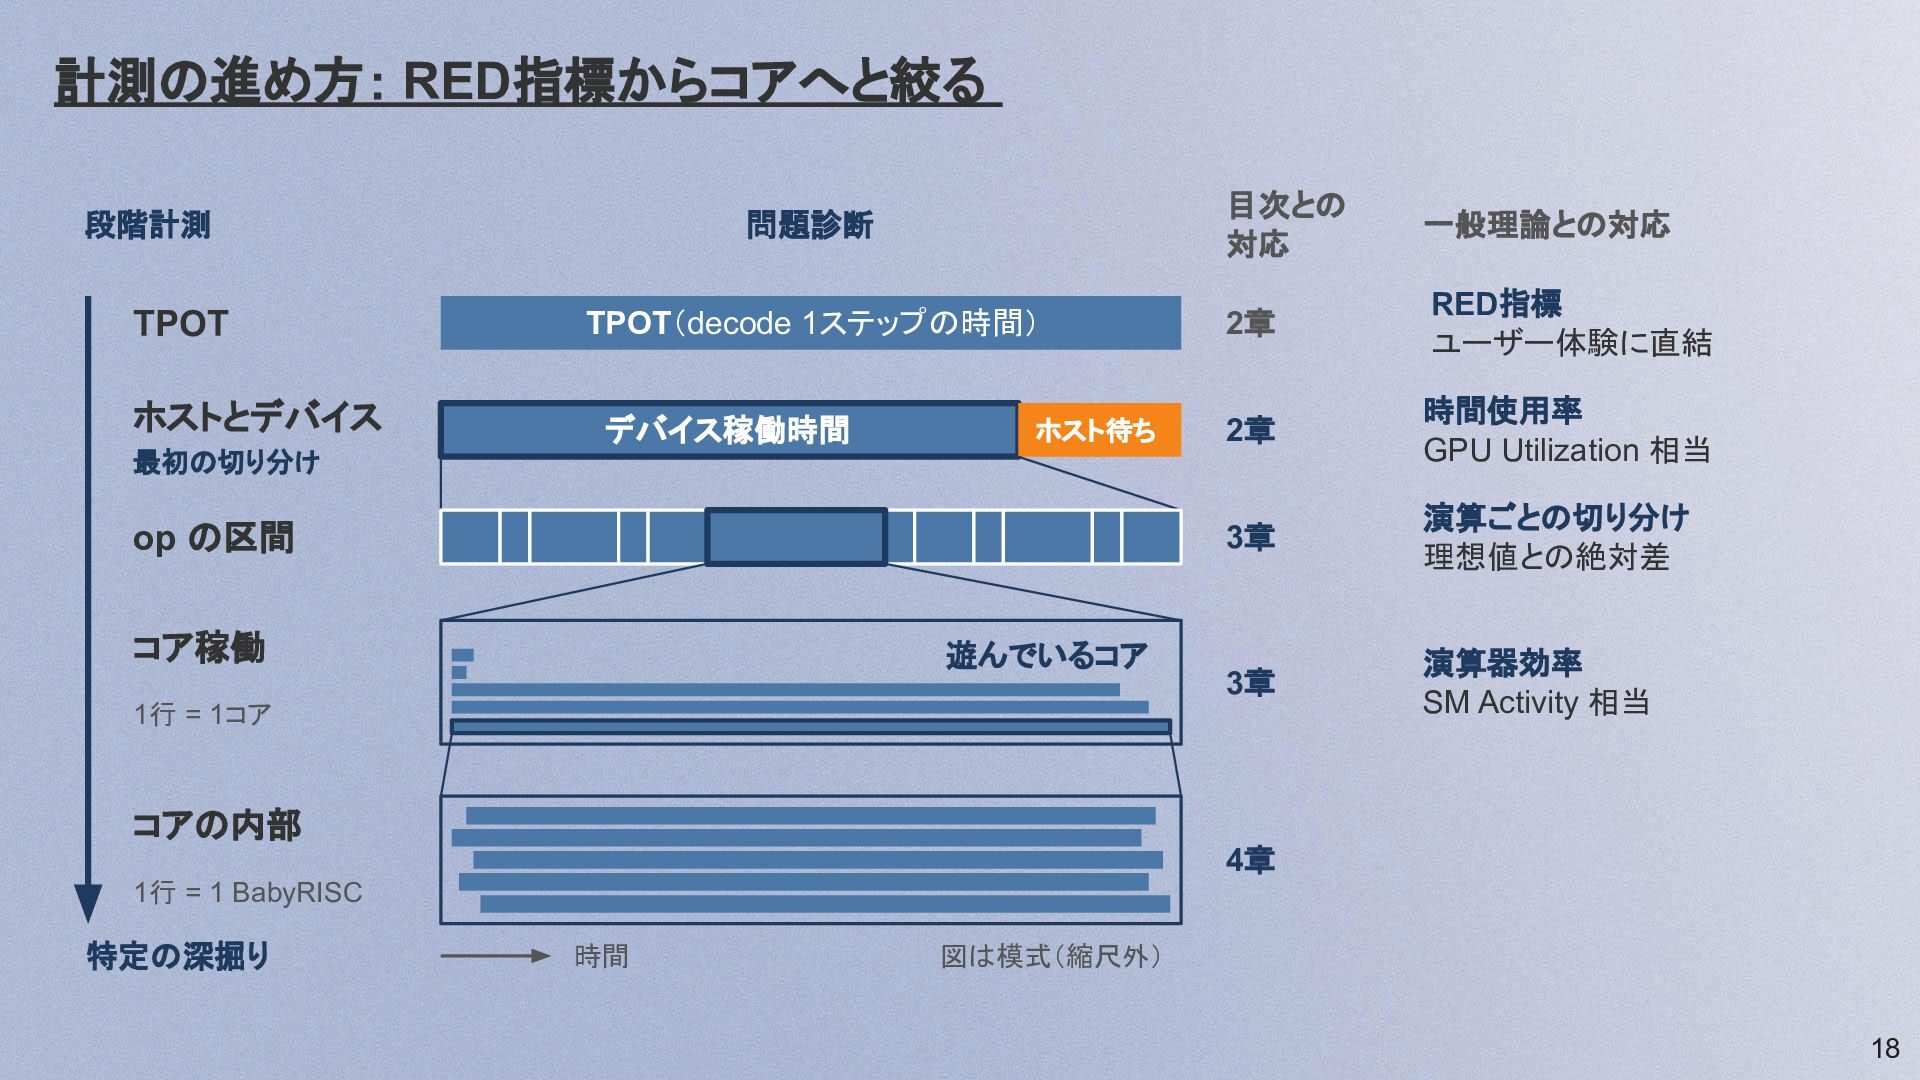
  15. 計測の進め方: RED指標からコアへと絞る 段階計測 問題診断 目次との 対応 一般理論との対応 TPOT TPOT(decode 1ステップの時間)

    2章 RED指標 ユーザー体験に直結 ホストとデバイス デバイス稼働時間 2章 時間使用率 GPU Utilization 相当 3章 演算ごとの切り分け 理想値との絶対差 3章 演算器効率 SM Activity 相当 ホスト待ち 最初の切り分け op の区間 コア稼働 遊んでいるコア 1行 = 1コア コアの内部 4章 1行 = 1 BabyRISC 特定の深掘り 時間 図は模式(縮尺外) 18
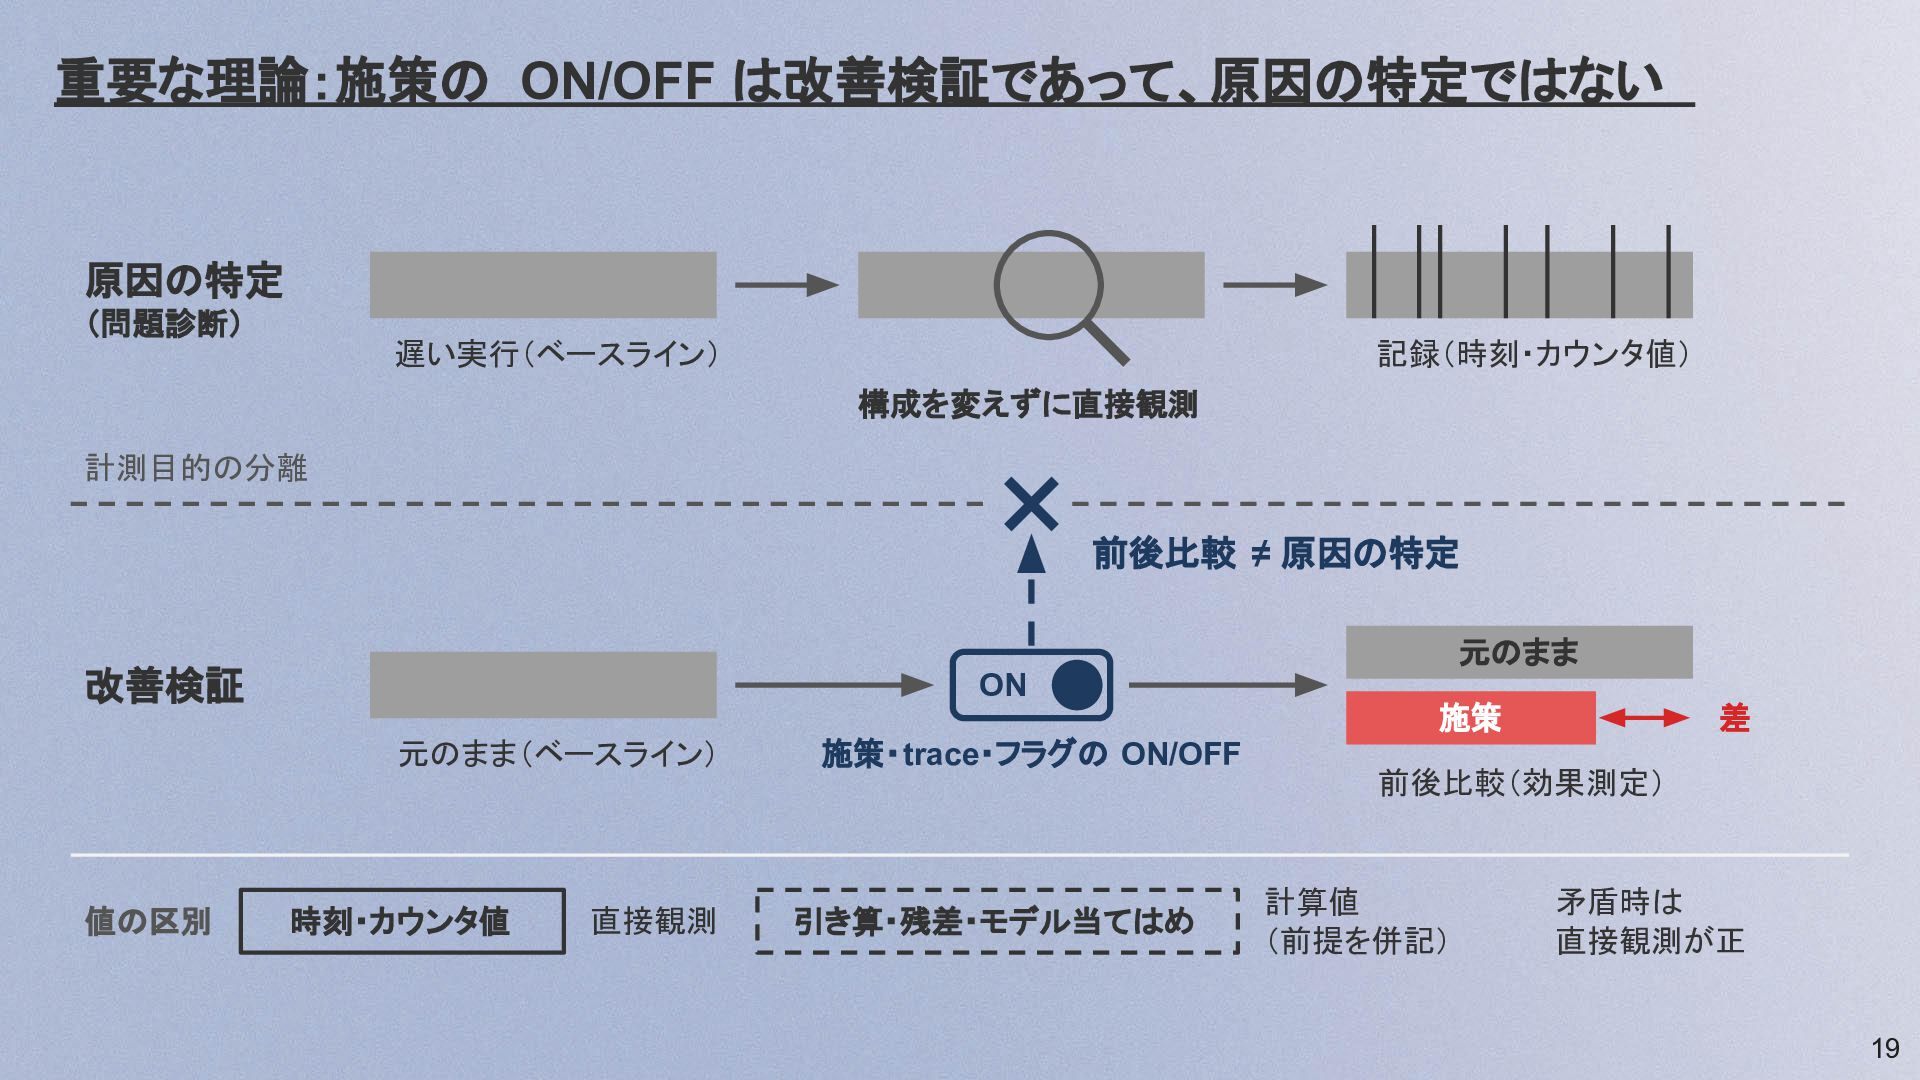
  16. 重要な理論:施策の ON/OFF は改善検証であって、原因の特定ではない 原因の特定 (問題診断) 遅い実行(ベースライン) 記録(時刻・カウンタ値) 構成を変えずに直接観測 計測目的の分離 前後比較

    ≠ 原因の特定 元のまま 改善検証 ON 元のまま(ベースライン) 値の区別 時刻・カウンタ値 直接観測 施策・trace・フラグの ON/OFF 引き算・残差・モデル当てはめ 施策 差 前後比較(効果測定) 計算値 (前提を併記) 矛盾時は 直接観測が正 19
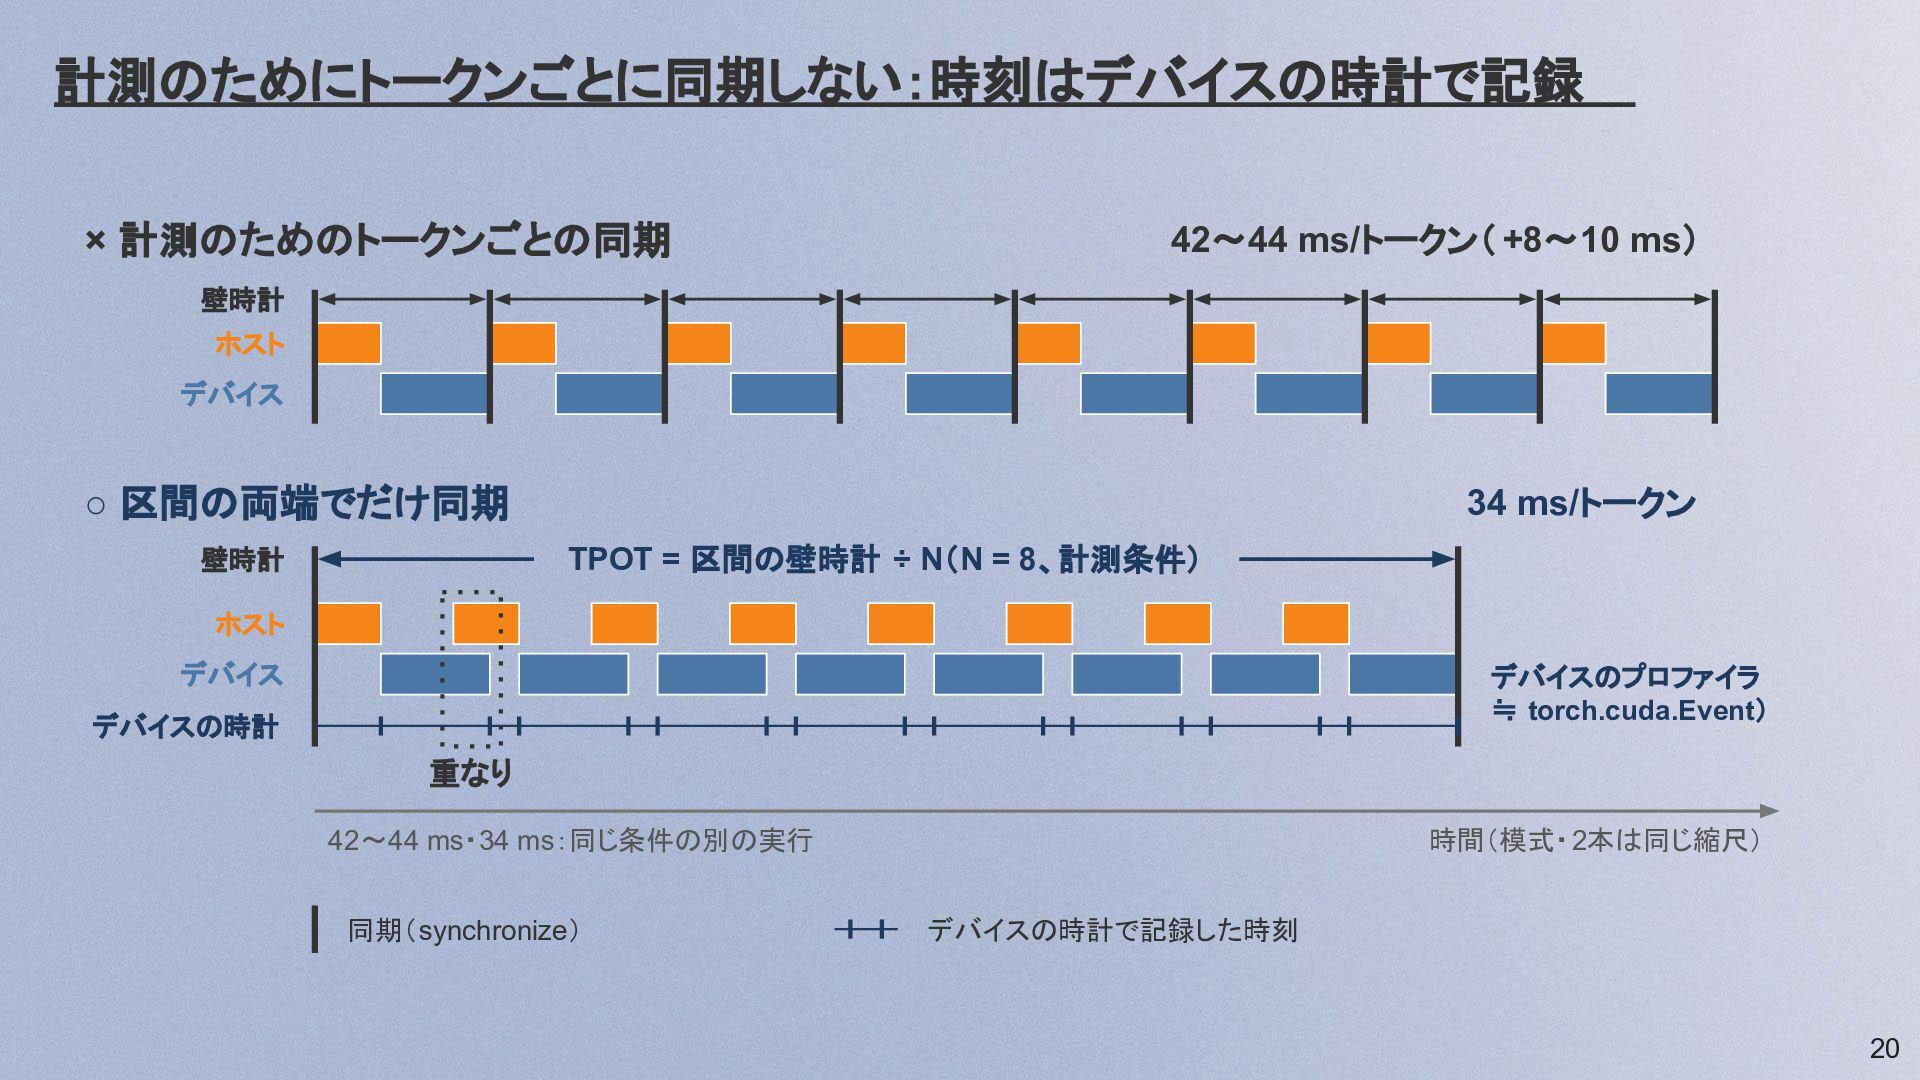
  17. 計測のためにトークンごとに同期しない:時刻はデバイスの時計で記録 × 計測のためのトークンごとの同期 42〜44 ms/トークン( +8〜10 ms) 壁時計 ホスト デバイス

    ◦ 区間の両端でだけ同期 34 ms/トークン TPOT = 区間の壁時計 ÷ N(N = 8、計測条件) 壁時計 ホスト デバイス デバイスのプロファイラ ≒ torch.cuda.Event) デバイスの時計 重なり 時間(模式・2本は同じ縮尺) 42〜44 ms・34 ms:同じ条件の別の実行 同期(synchronize) デバイスの時計で記録した時刻 20
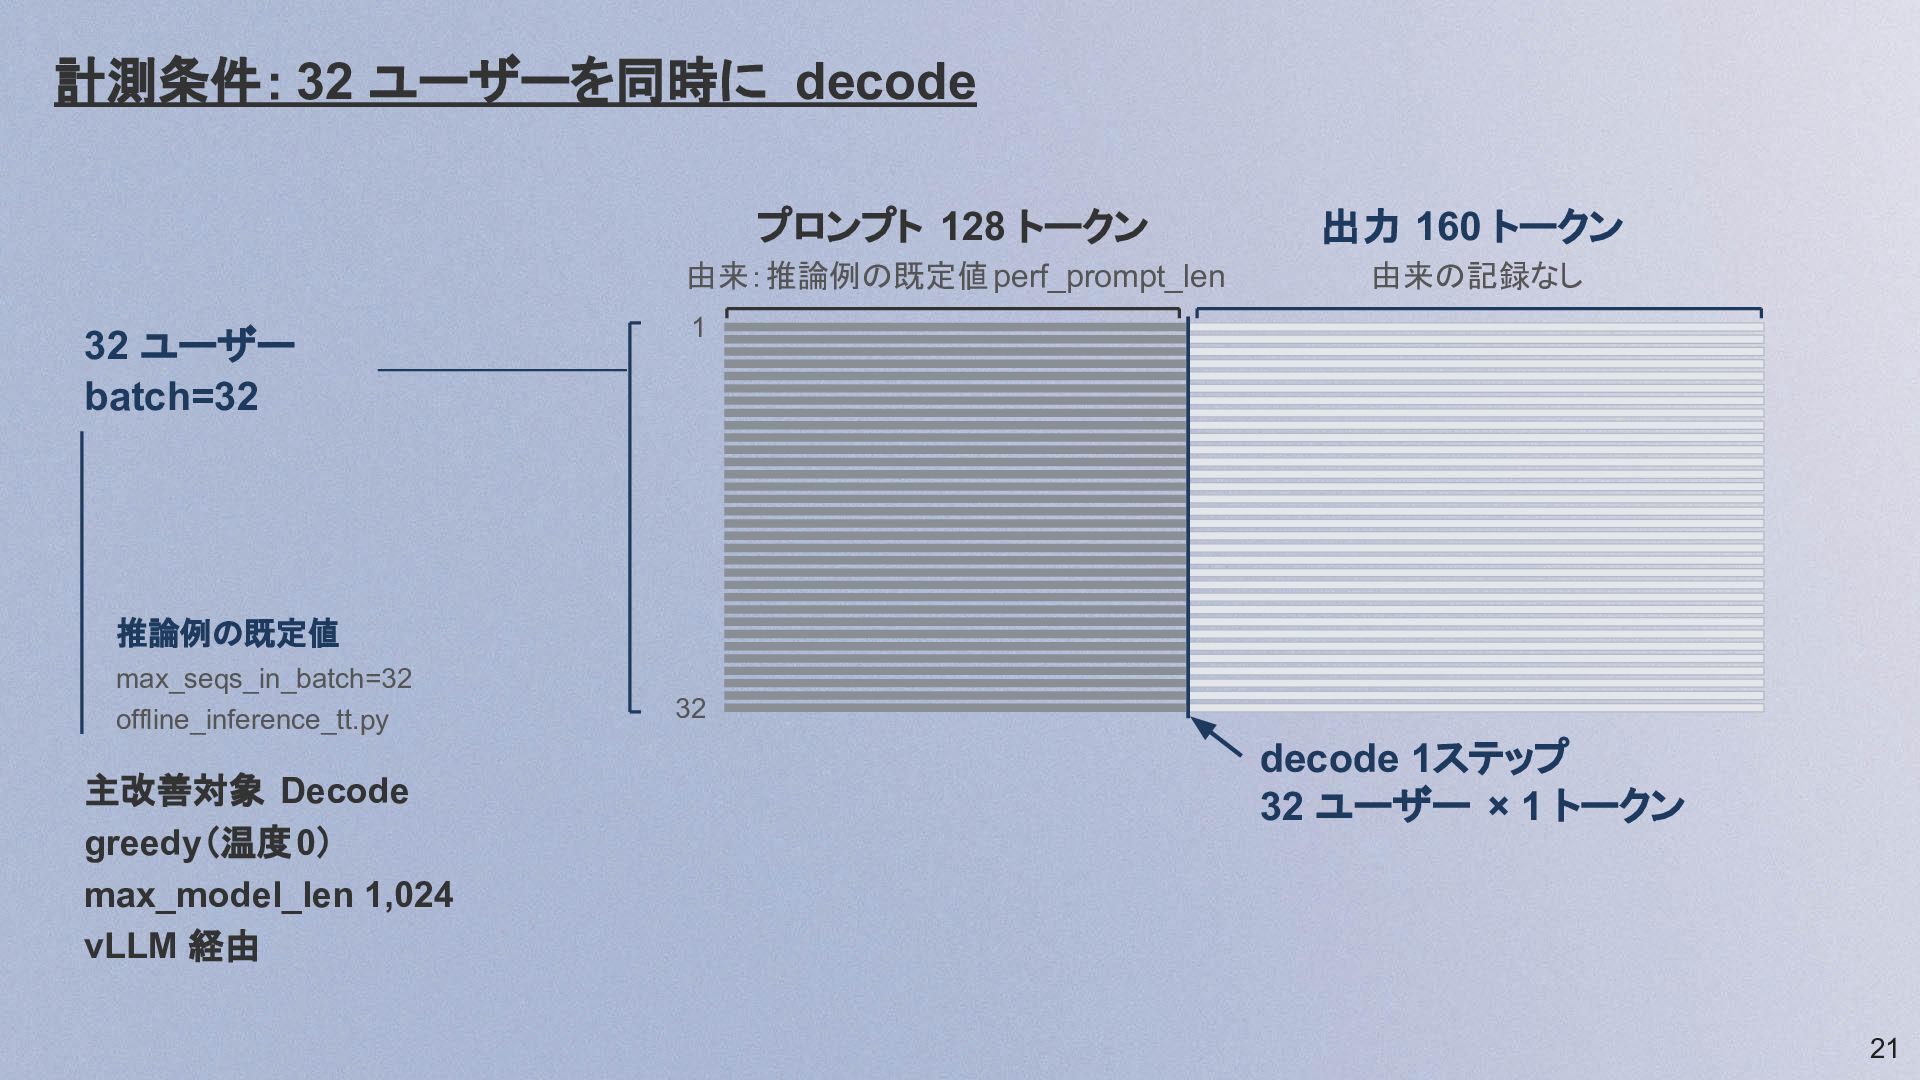
  18. 計測条件: 32 ユーザーを同時に decode 32 ユーザー batch=32 プロンプト 128 トークン

    出力 160 トークン 由来:推論例の既定値 perf_prompt_len 由来の記録なし 1 推論例の既定値 max_seqs_in_batch=32 offline_inference_tt.py 主改善対象 Decode greedy(温度0) max_model_len 1,024 vLLM 経由 32 decode 1ステップ 32 ユーザー × 1 トークン 21
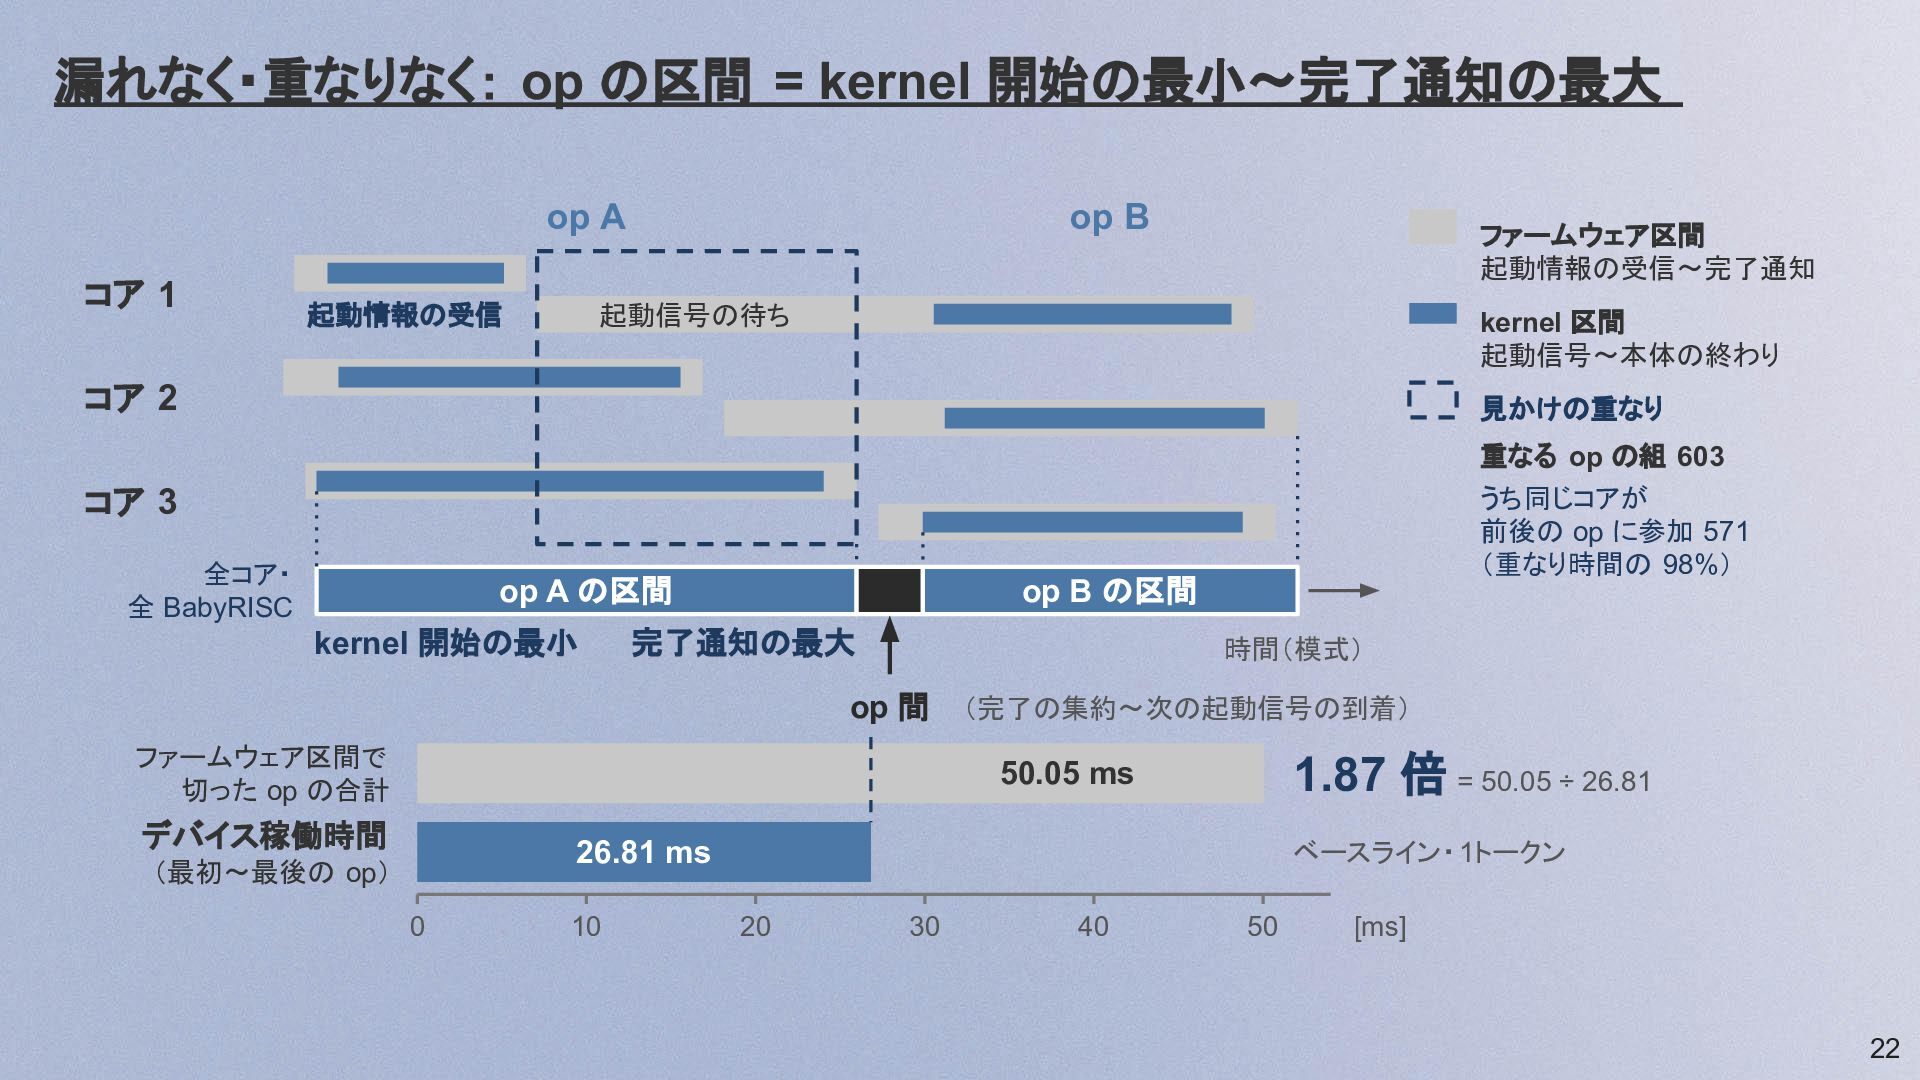
  19. 漏れなく・重なりなく: op の区間 = kernel 開始の最小〜完了通知の最大 op A コア 1

    起動情報の受信 op B ファームウェア区間 起動情報の受信〜完了通知 起動信号の待ち kernel 区間 起動信号〜本体の終わり コア 2 見かけの重なり 重なる op の組 603 コア 3 全コア・ 全 BabyRISC op A の区間 kernel 開始の最小 うち同じコアが 前後の op に参加 571 (重なり時間の 98%) op B の区間 完了通知の最大 時間(模式) op 間 ファームウェア区間で 切った op の合計 (完了の集約〜次の起動信号の到着) 1.87 倍 = 50.05 ÷ 26.81 50.05 ms デバイス稼働時間 ベースライン・ 1トークン 26.81 ms (最初〜最後の op) 0 10 20 30 40 50 [ms] 22
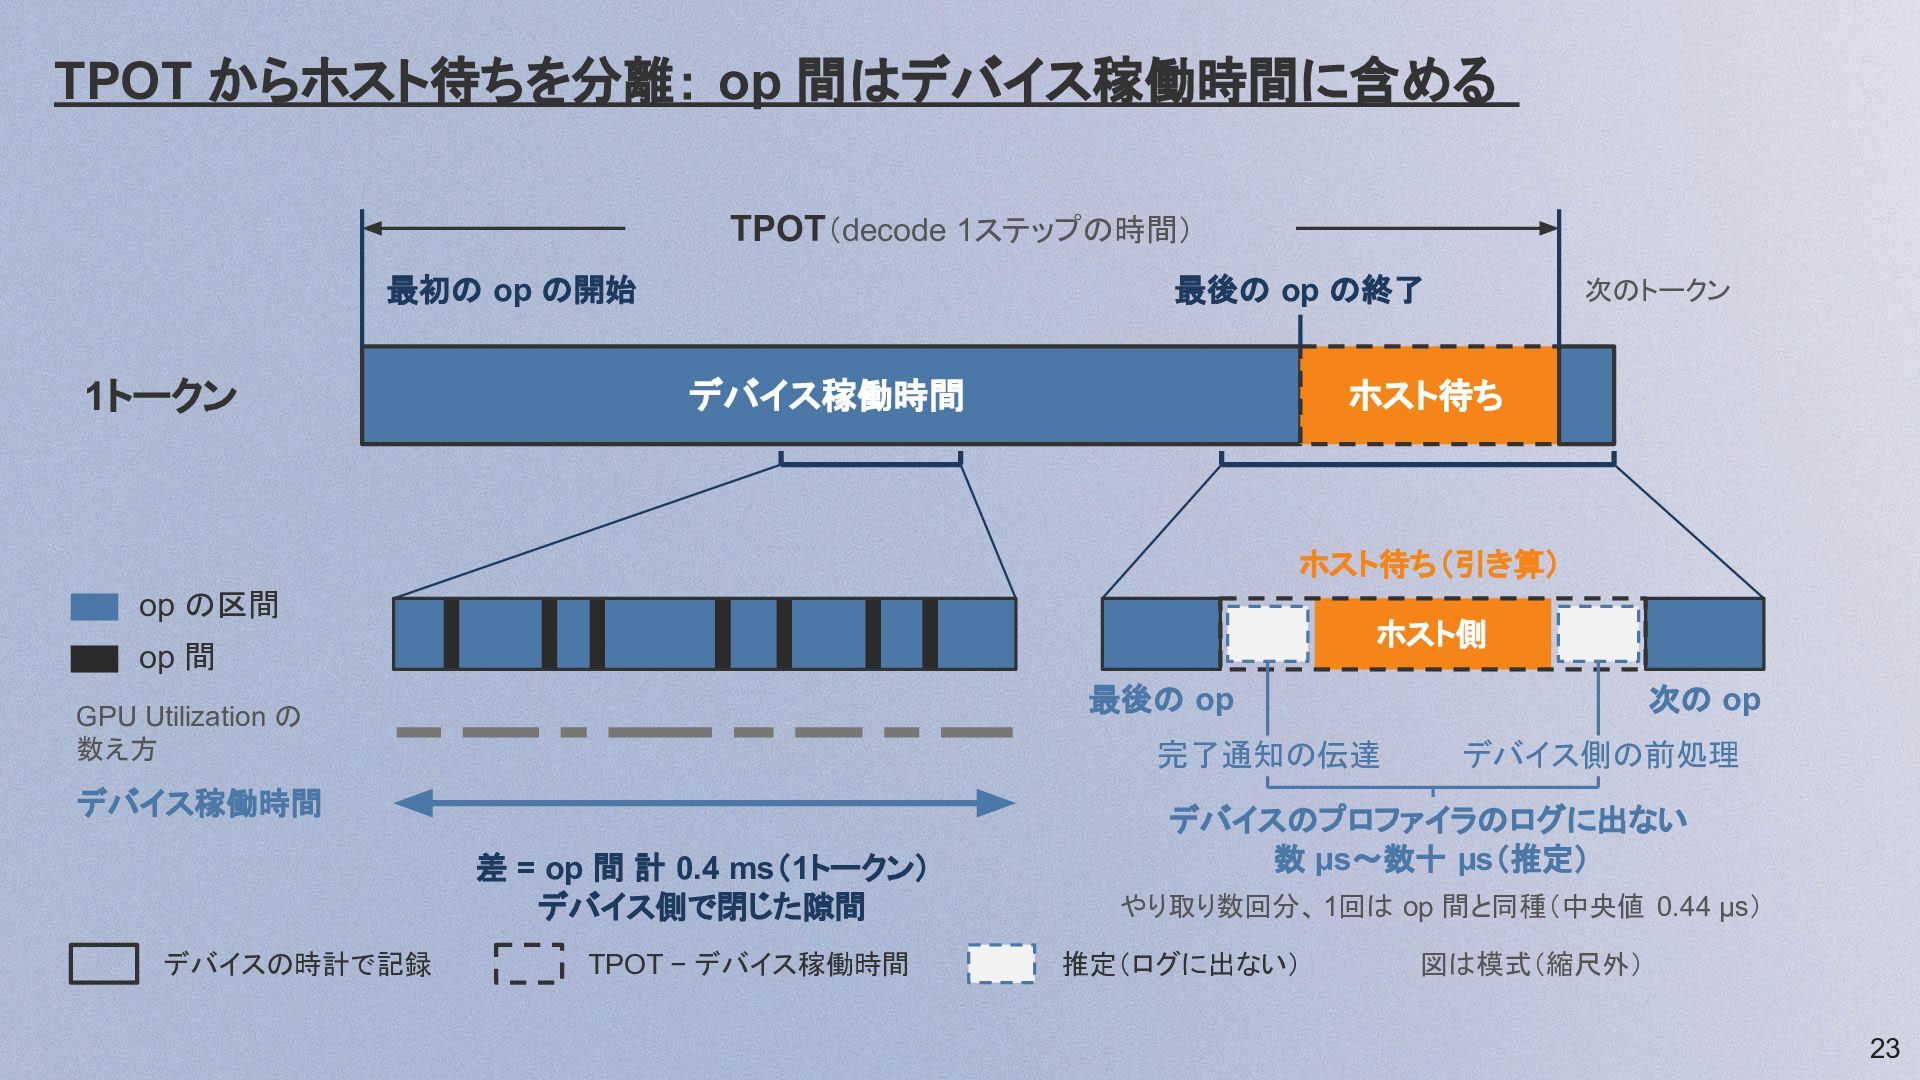
  20. TPOT からホスト待ちを分離: op 間はデバイス稼働時間に含める TPOT(decode 1ステップの時間) 最初の op の開始 1トークン

    最後の op の終了 デバイス稼働時間 次のトークン ホスト待ち ホスト待ち(引き算) op の区間 ホスト側 op 間 最後の op GPU Utilization の 数え方 完了通知の伝達 デバイス稼働時間 差 = op 間 計 0.4 ms(1トークン) デバイス側で閉じた隙間 デバイスの時計で記録 TPOT − デバイス稼働時間 次の op デバイス側の前処理 デバイスのプロファイラのログに出ない 数 µs〜数十 µs(推定) やり取り数回分、 1回は op 間と同種(中央値 0.44 µs) 推定(ログに出ない) 図は模式(縮尺外) 23
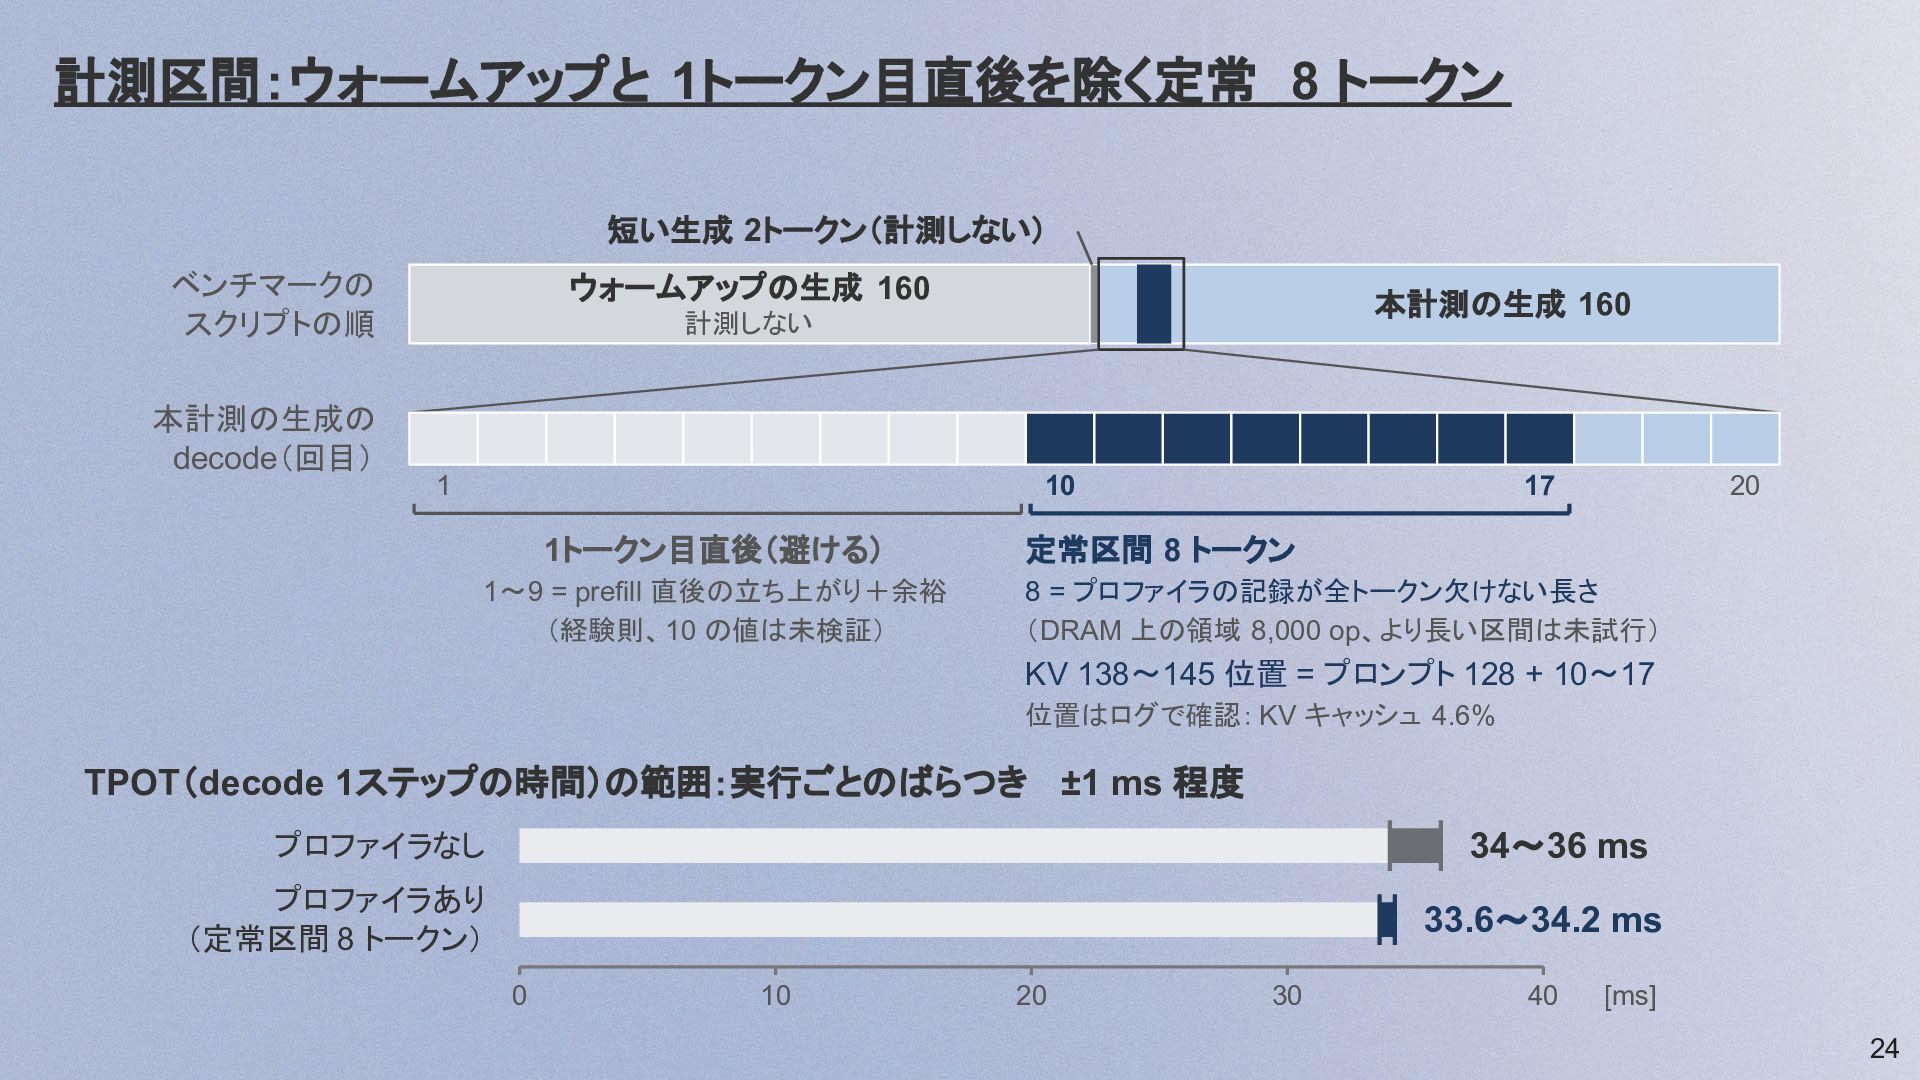
  21. 計測区間:ウォームアップと 1トークン目直後を除く定常 8 トークン 短い生成 2トークン(計測しない) ベンチマークの スクリプトの順 本計測の生成の decode(回目)

    ウォームアップの生成 160 本計測の生成 160 計測しない 1 10 1トークン目直後(避ける) 1〜9 = prefill 直後の立ち上がり+余裕 (経験則、10 の値は未検証) 17 20 定常区間 8 トークン 8 = プロファイラの記録が全トークン欠けない長さ (DRAM 上の領域 8,000 op、より長い区間は未試行) KV 138〜145 位置 = プロンプト 128 + 10〜17 位置はログで確認: KV キャッシュ 4.6% TPOT(decode 1ステップの時間)の範囲:実行ごとのばらつき ±1 ms 程度 プロファイラなし 34〜36 ms プロファイラあり (定常区間 8 トークン) 33.6〜34.2 ms 0 10 20 30 40 [ms] 24
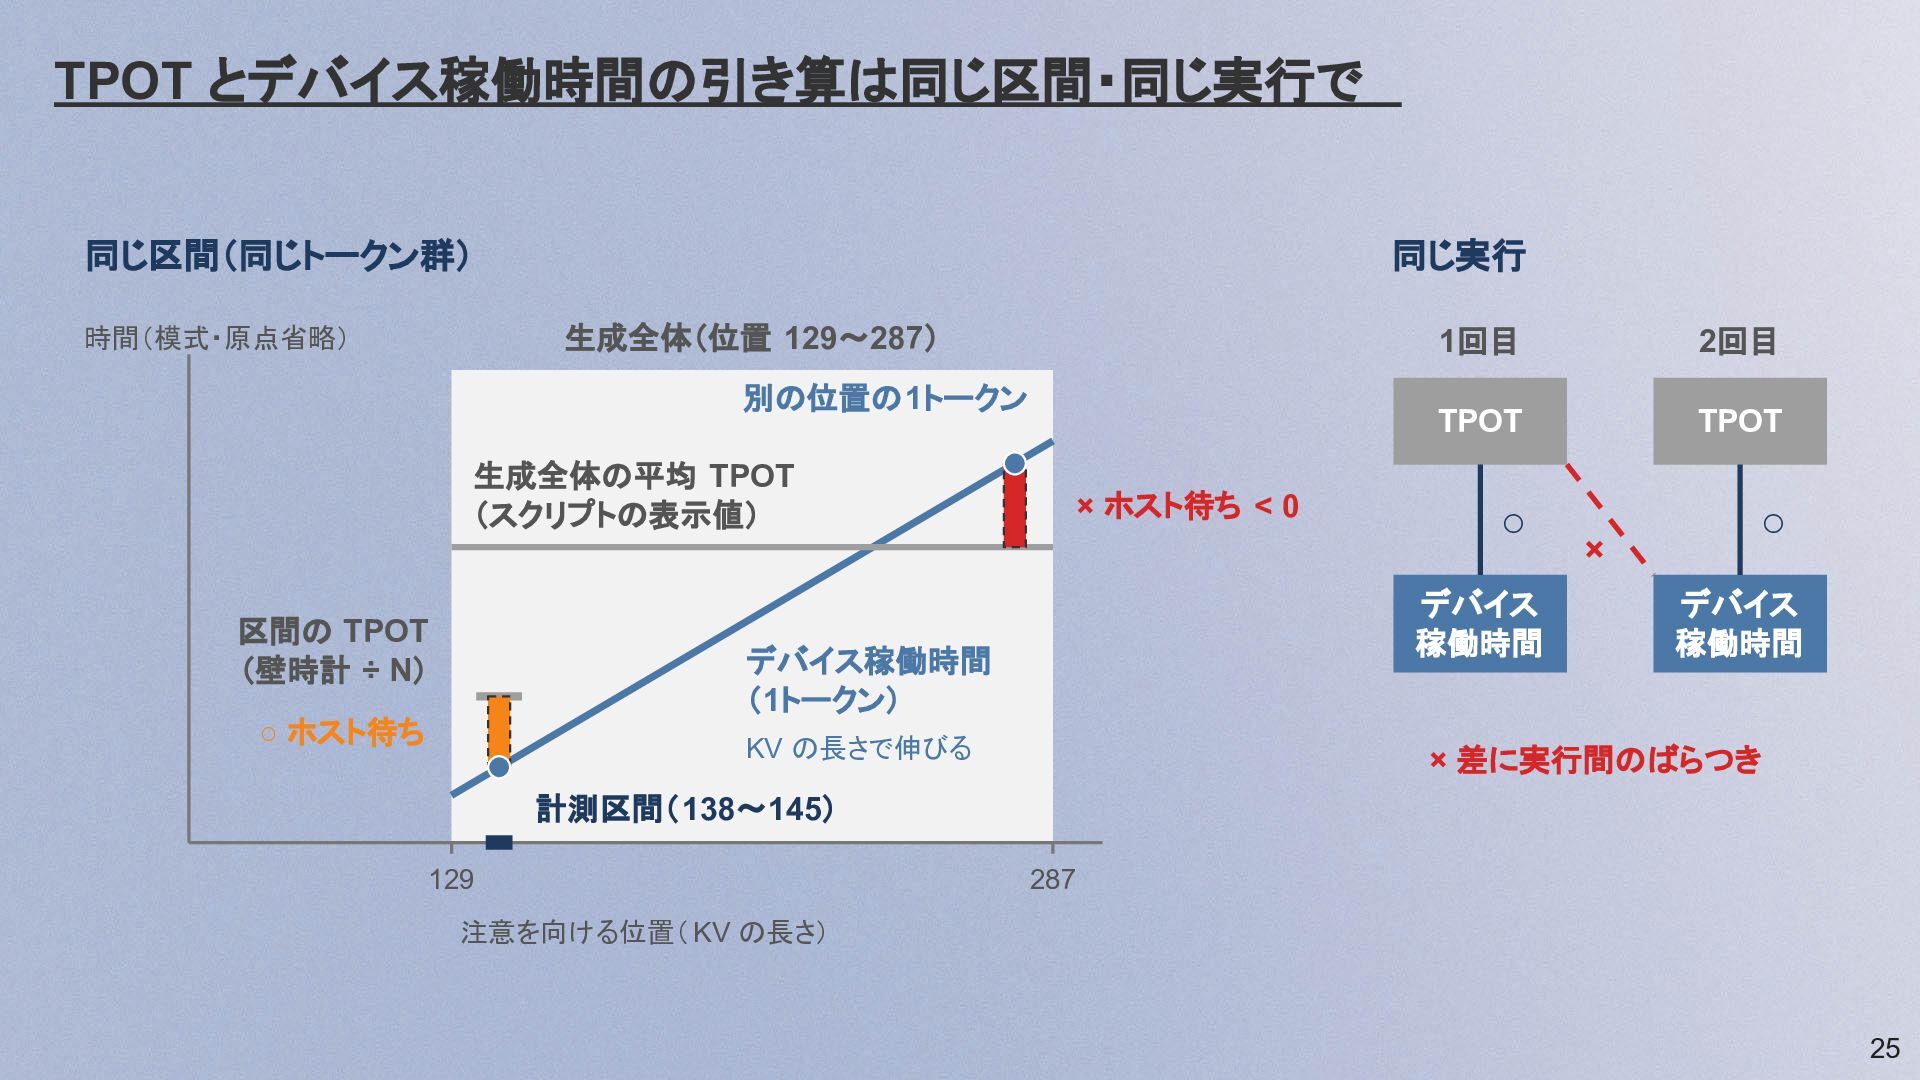
  22. TPOT とデバイス稼働時間の引き算は同じ区間・同じ実行で 同じ区間(同じトークン群) 同じ実行 生成全体(位置 129〜287) 時間(模式・原点省略) 別の位置の1トークン 生成全体の平均 TPOT

    (スクリプトの表示値) 区間の TPOT (壁時計 ÷ N) × ホスト待ち < 0 2回目 TPOT TPOT ◦ ◦ デバイス 稼働時間 デバイス稼働時間 (1トークン) ◦ ホスト待ち 1回目 KV の長さで伸びる × デバイス 稼働時間 × 差に実行間のばらつき 計測区間(138〜145) 129 287 注意を向ける位置( KV の長さ) 25
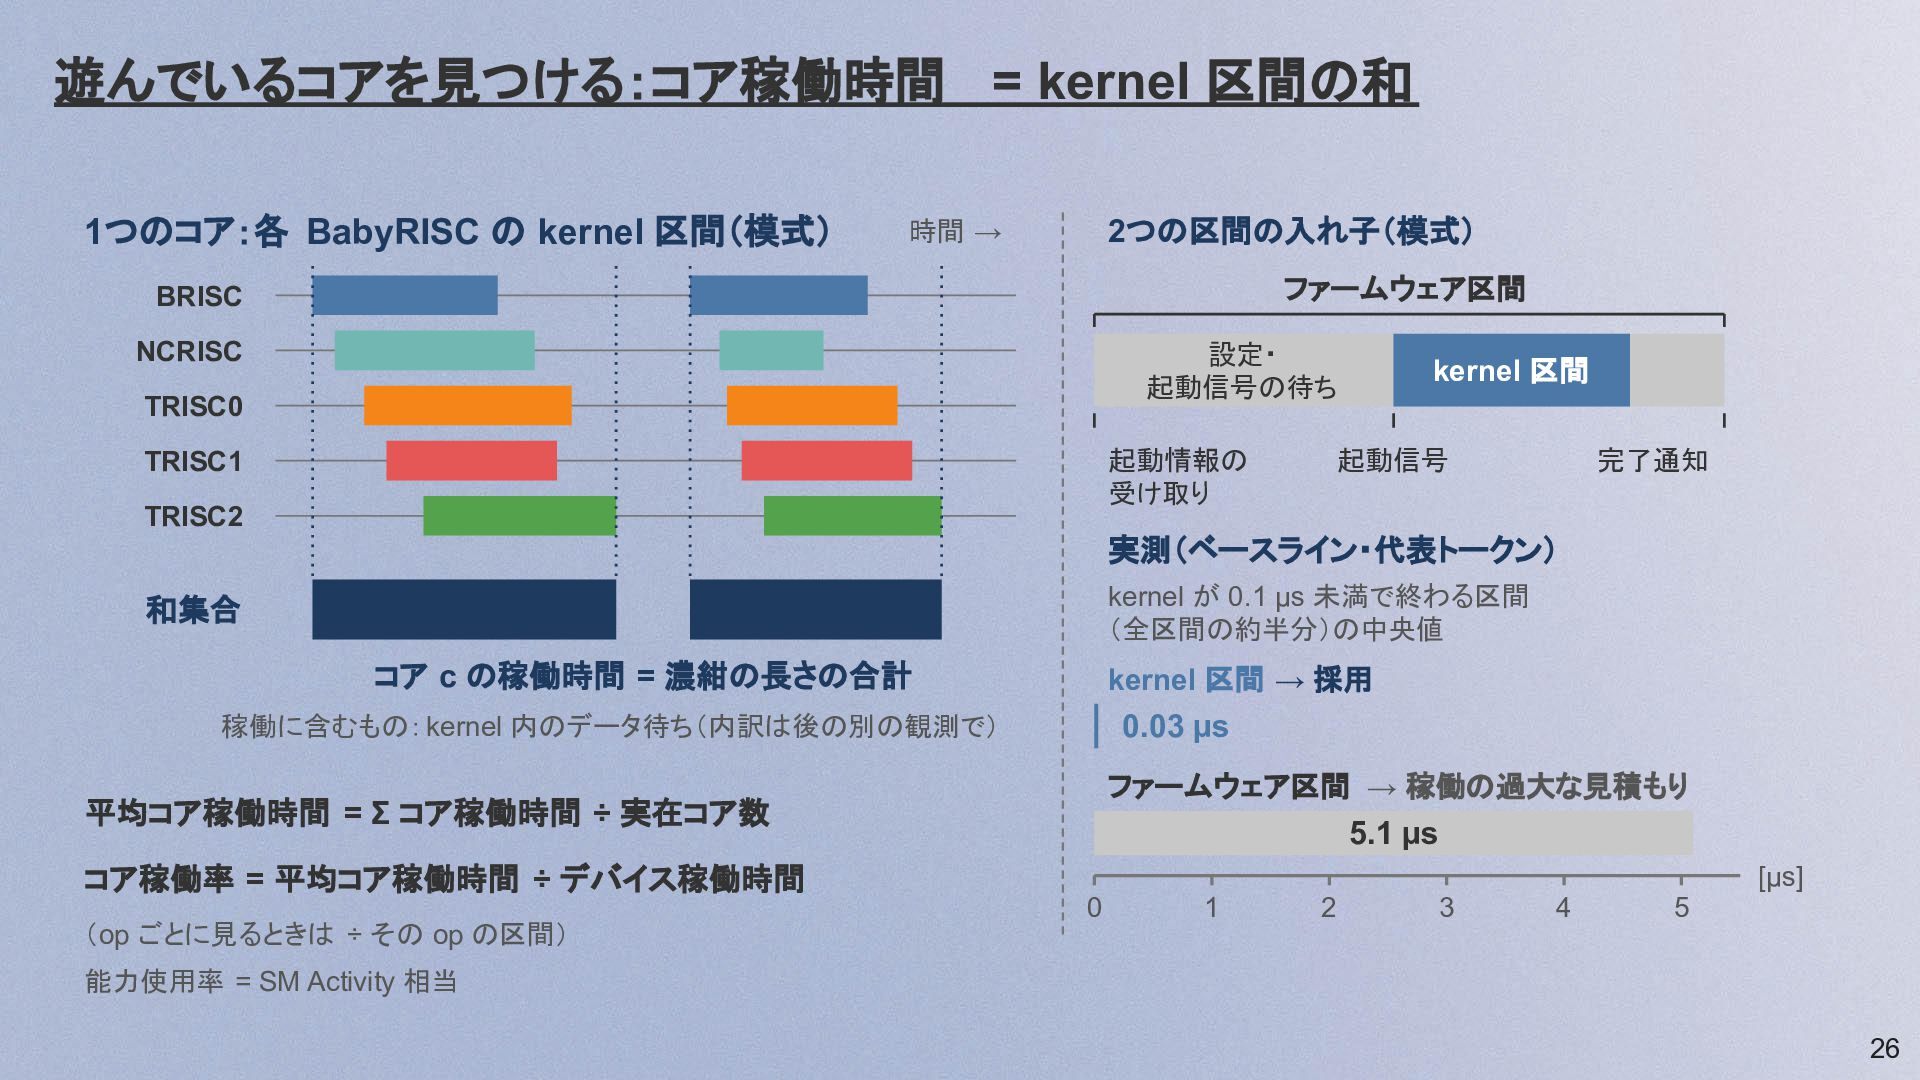
  23. 遊んでいるコアを見つける:コア稼働時間 = kernel 区間の和 1つのコア:各 BabyRISC の kernel 区間(模式) 時間

    → 2つの区間の入れ子(模式) ファームウェア区間 BRISC 設定・ 起動信号の待ち NCRISC TRISC0 起動情報の 受け取り TRISC1 TRISC2 kernel 区間 起動信号 完了通知 実測(ベースライン・代表トークン) kernel が 0.1 µs 未満で終わる区間 (全区間の約半分)の中央値 和集合 コア c の稼働時間 = 濃紺の長さの合計 kernel 区間 → 採用 稼働に含むもの: kernel 内のデータ待ち(内訳は後の別の観測で) 0.03 µs ファームウェア区間 → 稼働の過大な見積もり 平均コア稼働時間 = Σ コア稼働時間 ÷ 実在コア数 5.1 µs コア稼働率 = 平均コア稼働時間 ÷ デバイス稼働時間 (op ごとに見るときは ÷ その op の区間) [µs] 0 1 2 3 4 5 能力使用率 = SM Activity 相当 26
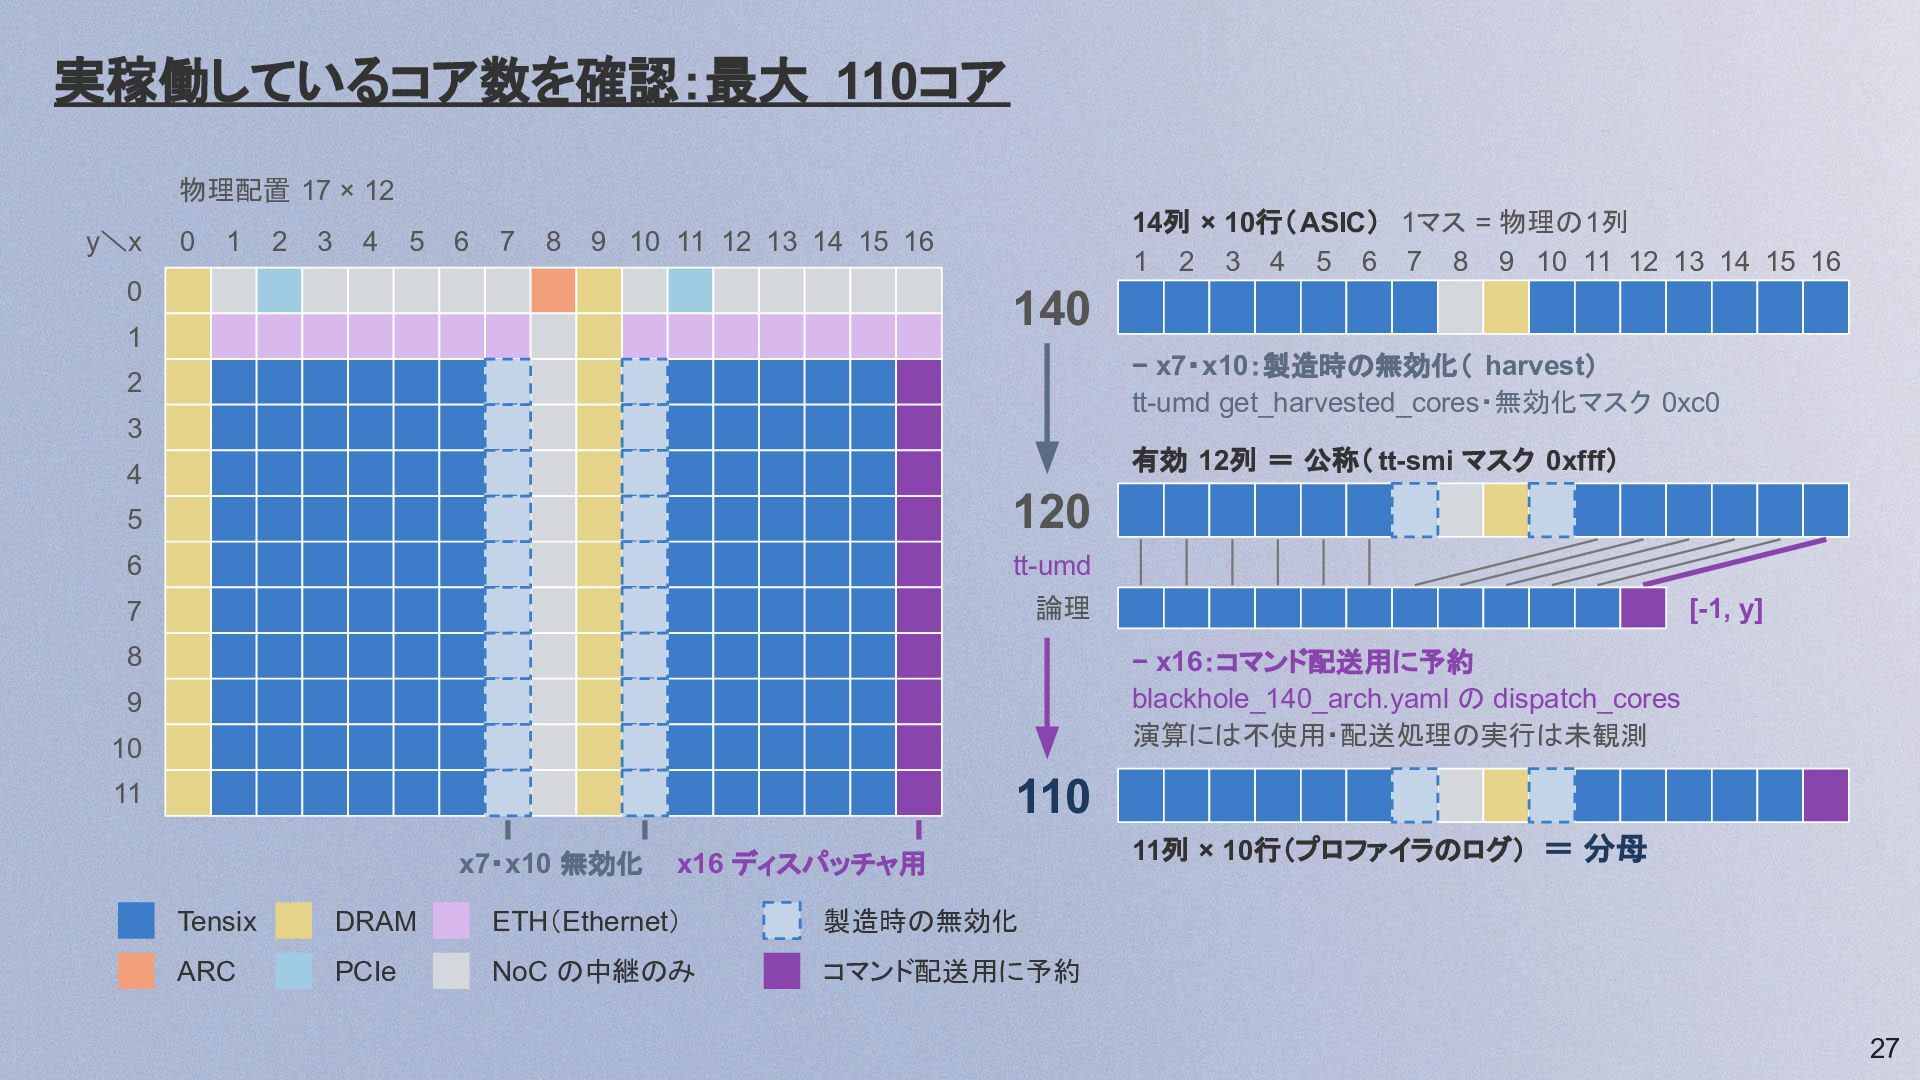
  24. 実稼働しているコア数を確認:最大 110コア 物理配置 17 × 12 y\x 0 1 2

    3 4 5 6 7 8 14列 × 10行(ASIC) 1マス = 物理の1列 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 9 10 11 12 13 14 15 16 0 140 1 − x7・x10:製造時の無効化( harvest) tt-umd get_harvested_cores・無効化マスク 0xc0 2 3 有効 12列 = 公称( tt-smi マスク 0xfff) 4 5 120 6 tt-umd 7 論理 8 [-1, y] − x16:コマンド配送用に予約 blackhole_140_arch.yaml の dispatch_cores 演算には不使用・配送処理の実行は未観測 9 10 110 11 x7・x10 無効化 x16 ディスパッチャ用 Tensix DRAM ETH(Ethernet) 製造時の無効化 ARC PCIe NoC の中継のみ コマンド配送用に予約 11列 × 10行(プロファイラのログ) = 分母 27
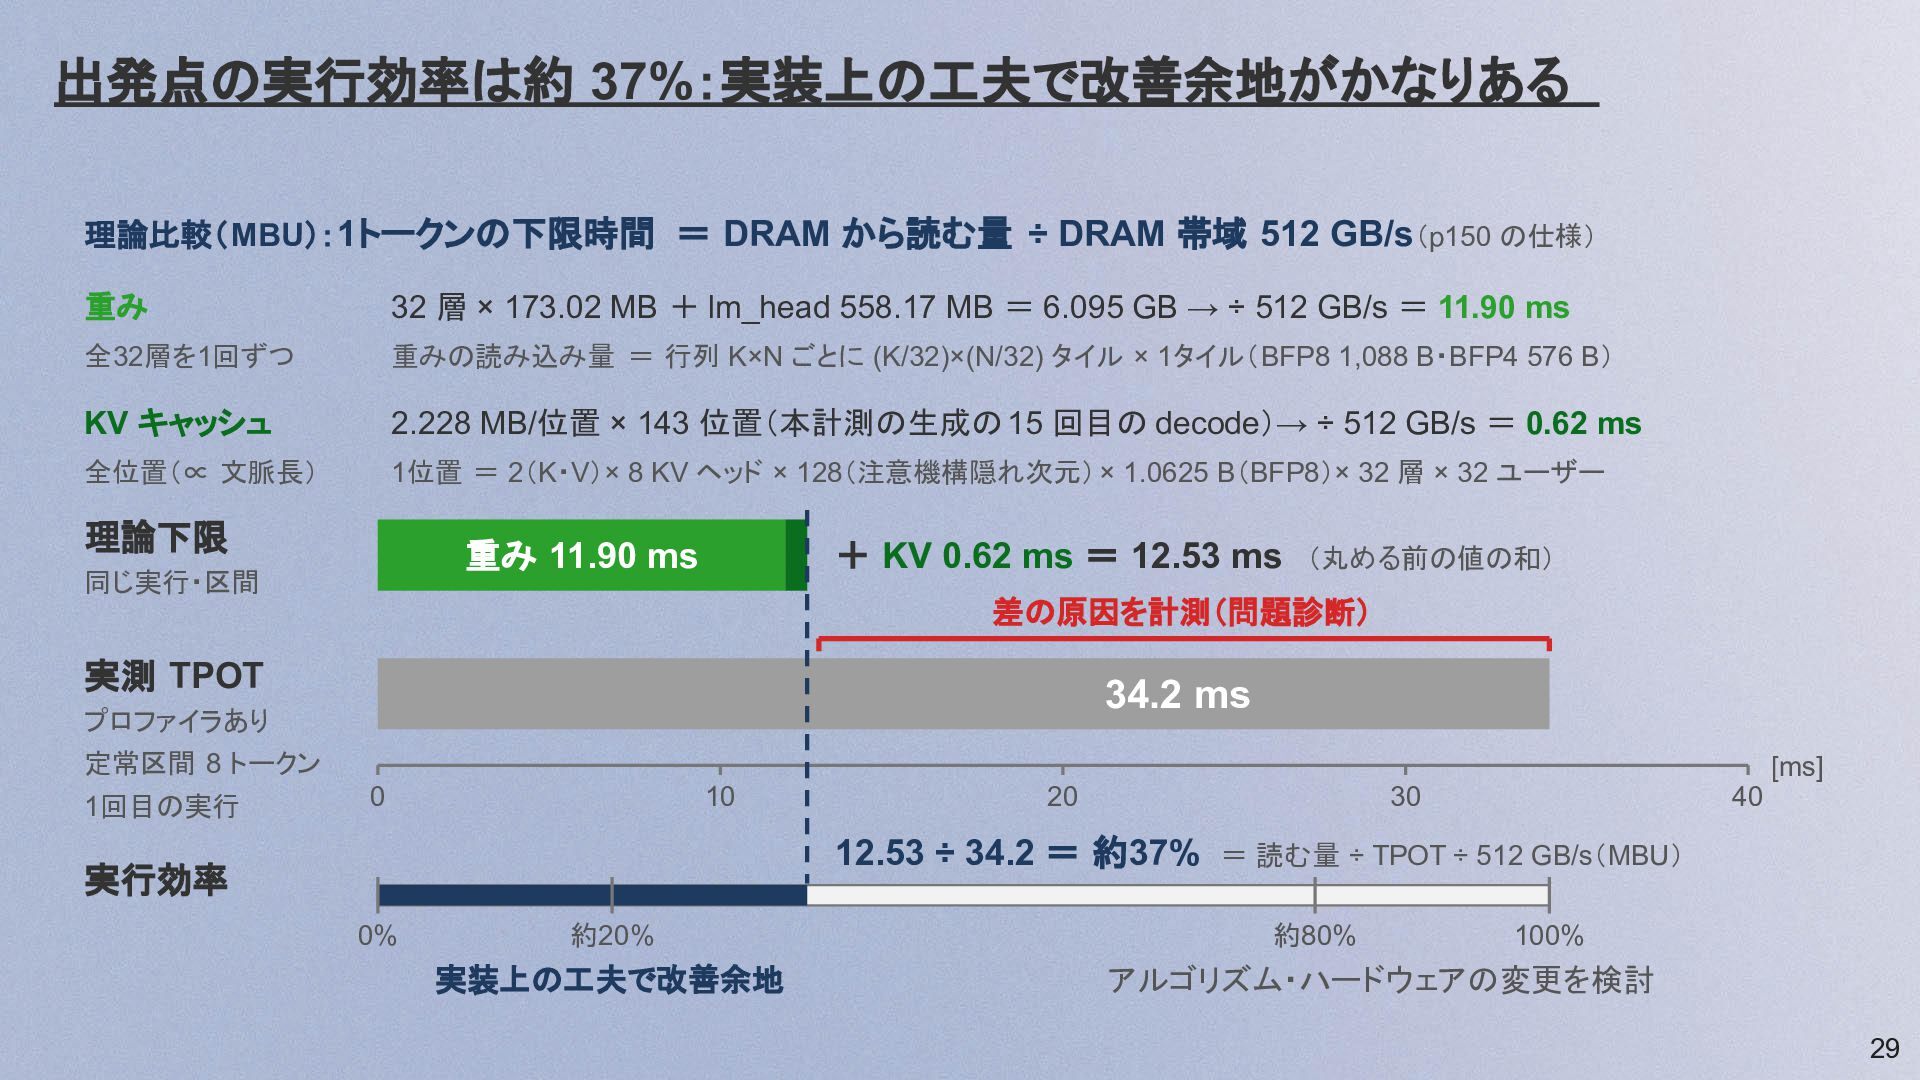
  25. 出発点の実行効率は約 37%:実装上の工夫で改善余地がかなりある 理論比較(MBU): 1トークンの下限時間 = DRAM から読む量 ÷ DRAM 帯域

    512 GB/s(p150 の仕様) 重み 32 層 × 173.02 MB + lm_head 558.17 MB = 6.095 GB → ÷ 512 GB/s = 11.90 ms 全32層を1回ずつ 重みの読み込み量 = 行列 K×N ごとに (K/32)×(N/32) タイル × 1タイル(BFP8 1,088 B・BFP4 576 B) KV キャッシュ 2.228 MB/位置 × 143 位置(本計測の生成の 15 回目の decode)→ ÷ 512 GB/s = 0.62 ms 全位置(∝ 文脈長) 1位置 = 2(K・V)× 8 KV ヘッド × 128(注意機構隠れ次元) × 1.0625 B(BFP8)× 32 層 × 32 ユーザー 理論下限 重み 11.90 ms 同じ実行・区間 + KV 0.62 ms = 12.53 ms (丸める前の値の和) 差の原因を計測(問題診断) 実測 TPOT 34.2 ms プロファイラあり 定常区間 8 トークン 1回目の実行 [ms] 0 10 20 30 40 12.53 ÷ 34.2 = 約37% = 読む量 ÷ TPOT ÷ 512 GB/s(MBU) 実行効率 0% 約20% 実装上の工夫で改善余地 約80% 100% アルゴリズム・ハードウェアの変更を検討 29
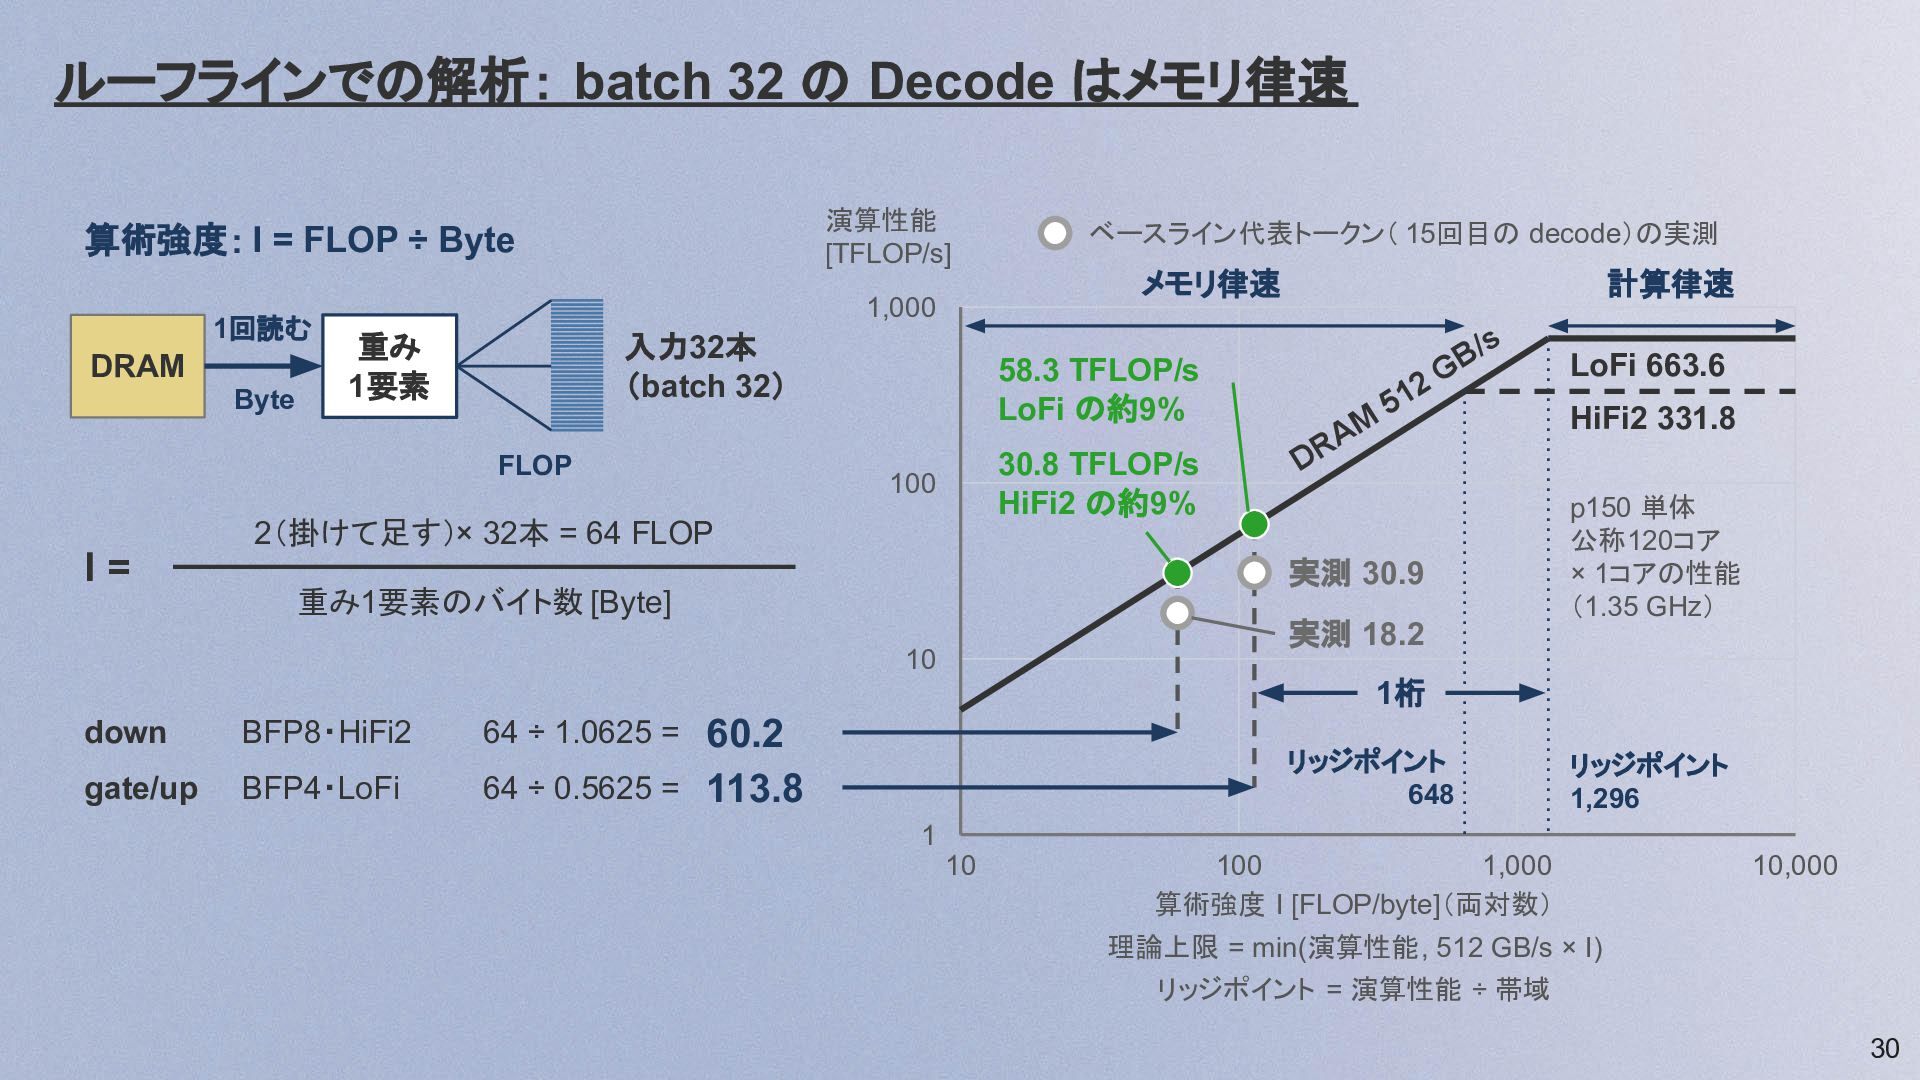
  26. ルーフラインでの解析: batch 32 の Decode はメモリ律速 演算性能 [TFLOP/s] 算術強度: I

    = FLOP ÷ Byte 1回読む DRAM Byte 1,000 入力32本 (batch 32) 重み 1要素 FLOP メモリ律速 計算律速 /s B 2G 58.3 TFLOP/s LoFi の約9% 30.8 TFLOP/s HiFi2 の約9% 100 2(掛けて足す)× 32本 = 64 FLOP I= ベースライン代表トークン( 15回目の decode)の実測 M RA 51 実測 18.2 10 HiFi2 331.8 D 実測 30.9 重み1要素のバイト数 [Byte] LoFi 663.6 p150 単体 公称120コア × 1コアの性能 (1.35 GHz) 1桁 down BFP8・HiFi2 gate/up BFP4・LoFi 60.2 64 ÷ 0.5625 = 113.8 64 ÷ 1.0625 = リッジポイント 648 リッジポイント 1,296 1 10 100 1,000 算術強度 I [FLOP/byte](両対数) 10,000 理論上限 = min(演算性能, 512 GB/s × I) リッジポイント = 演算性能 ÷ 帯域 30
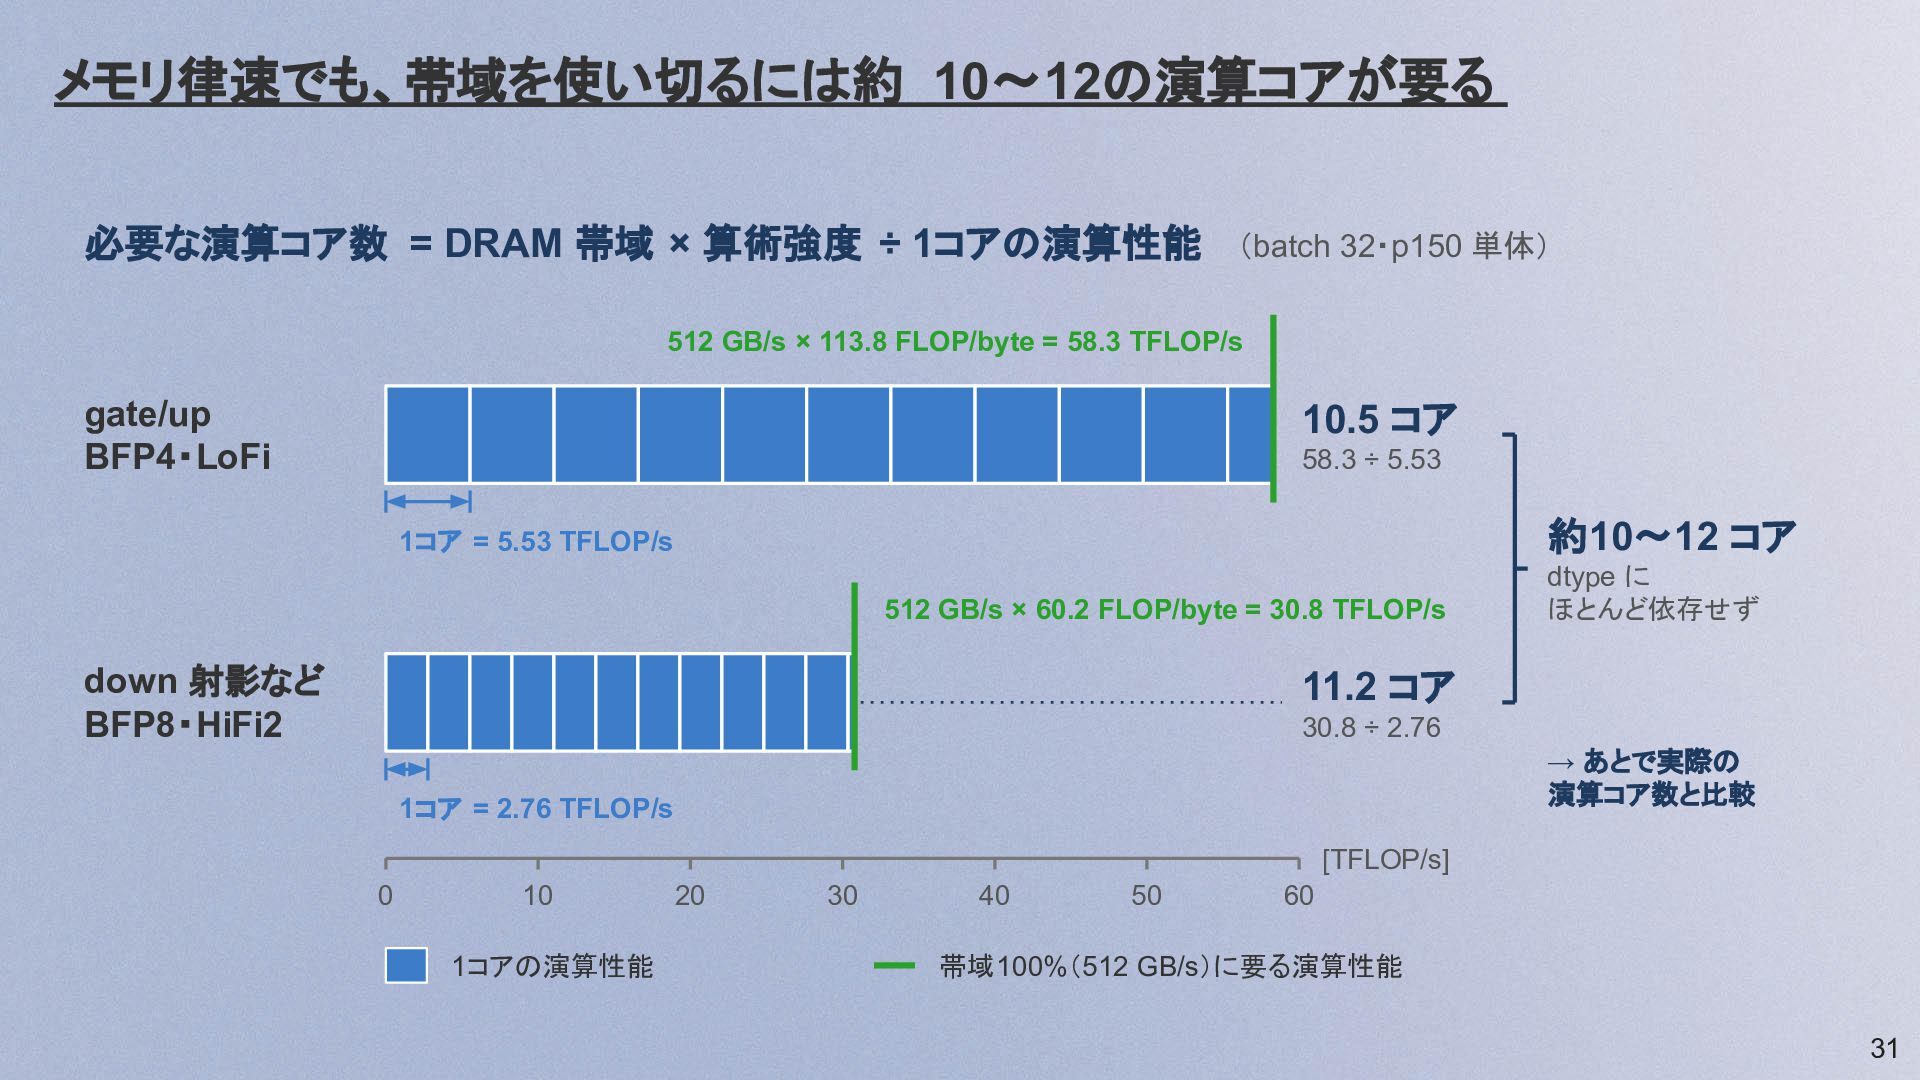
  27. メモリ律速でも、帯域を使い切るには約 10〜12の演算コアが要る 必要な演算コア数 = DRAM 帯域 × 算術強度 ÷ 1コアの演算性能

    (batch 32・p150 単体) 512 GB/s × 113.8 FLOP/byte = 58.3 TFLOP/s 10.5 コア gate/up BFP4・LoFi 58.3 ÷ 5.53 約10〜12 コア 1コア = 5.53 TFLOP/s 512 GB/s × 60.2 FLOP/byte = 30.8 TFLOP/s down 射影など BFP8・HiFi2 dtype に ほとんど依存せず 11.2 コア 30.8 ÷ 2.76 → あとで実際の 演算コア数と比較 1コア = 2.76 TFLOP/s [TFLOP/s] 0 10 1コアの演算性能 20 30 40 50 60 帯域100%(512 GB/s)に要る演算性能 31
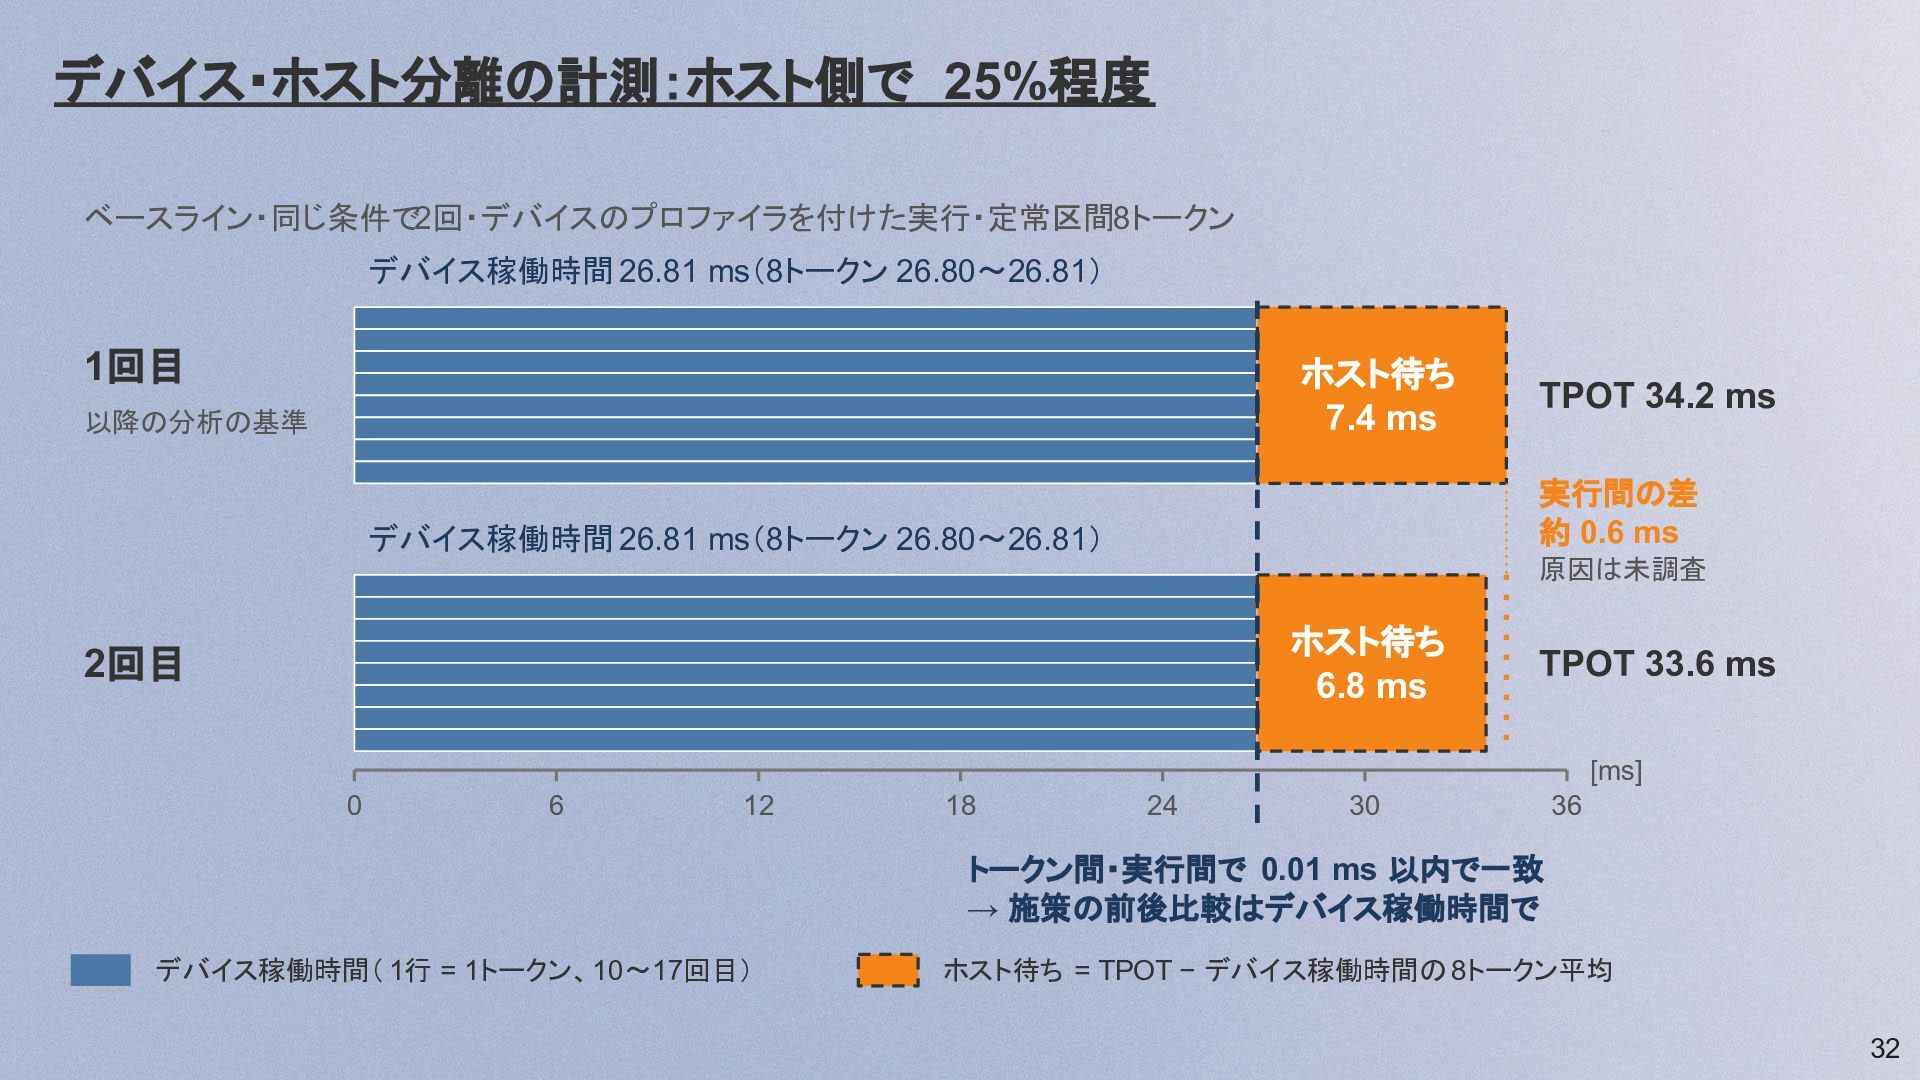
  28. デバイス・ホスト分離の計測:ホスト側で 25%程度 ベースライン・同じ条件で2回・デバイスのプロファイラを付けた実行・定常区間8トークン デバイス稼働時間 26.81 ms(8トークン 26.80〜26.81) 1回目 ホスト待ち 7.4

    ms 以降の分析の基準 TPOT 34.2 ms 実行間の差 約 0.6 ms デバイス稼働時間 26.81 ms(8トークン 26.80〜26.81) 原因は未調査 ホスト待ち 6.8 ms 2回目 TPOT 33.6 ms [ms] 0 6 12 18 24 30 36 トークン間・実行間で 0.01 ms 以内で一致 → 施策の前後比較はデバイス稼働時間で デバイス稼働時間( 1行 = 1トークン、10〜17回目) ホスト待ち = TPOT − デバイス稼働時間の 8トークン平均 32
  29. ホスト側で目立つのはトークン選択:デバイス上の選択は既定で無効 ベースライン・毎トークンの模式図 計時:ホストの時計(vLLM の execute_model 内のタイマー) トークン選択( greedy なので argmax)

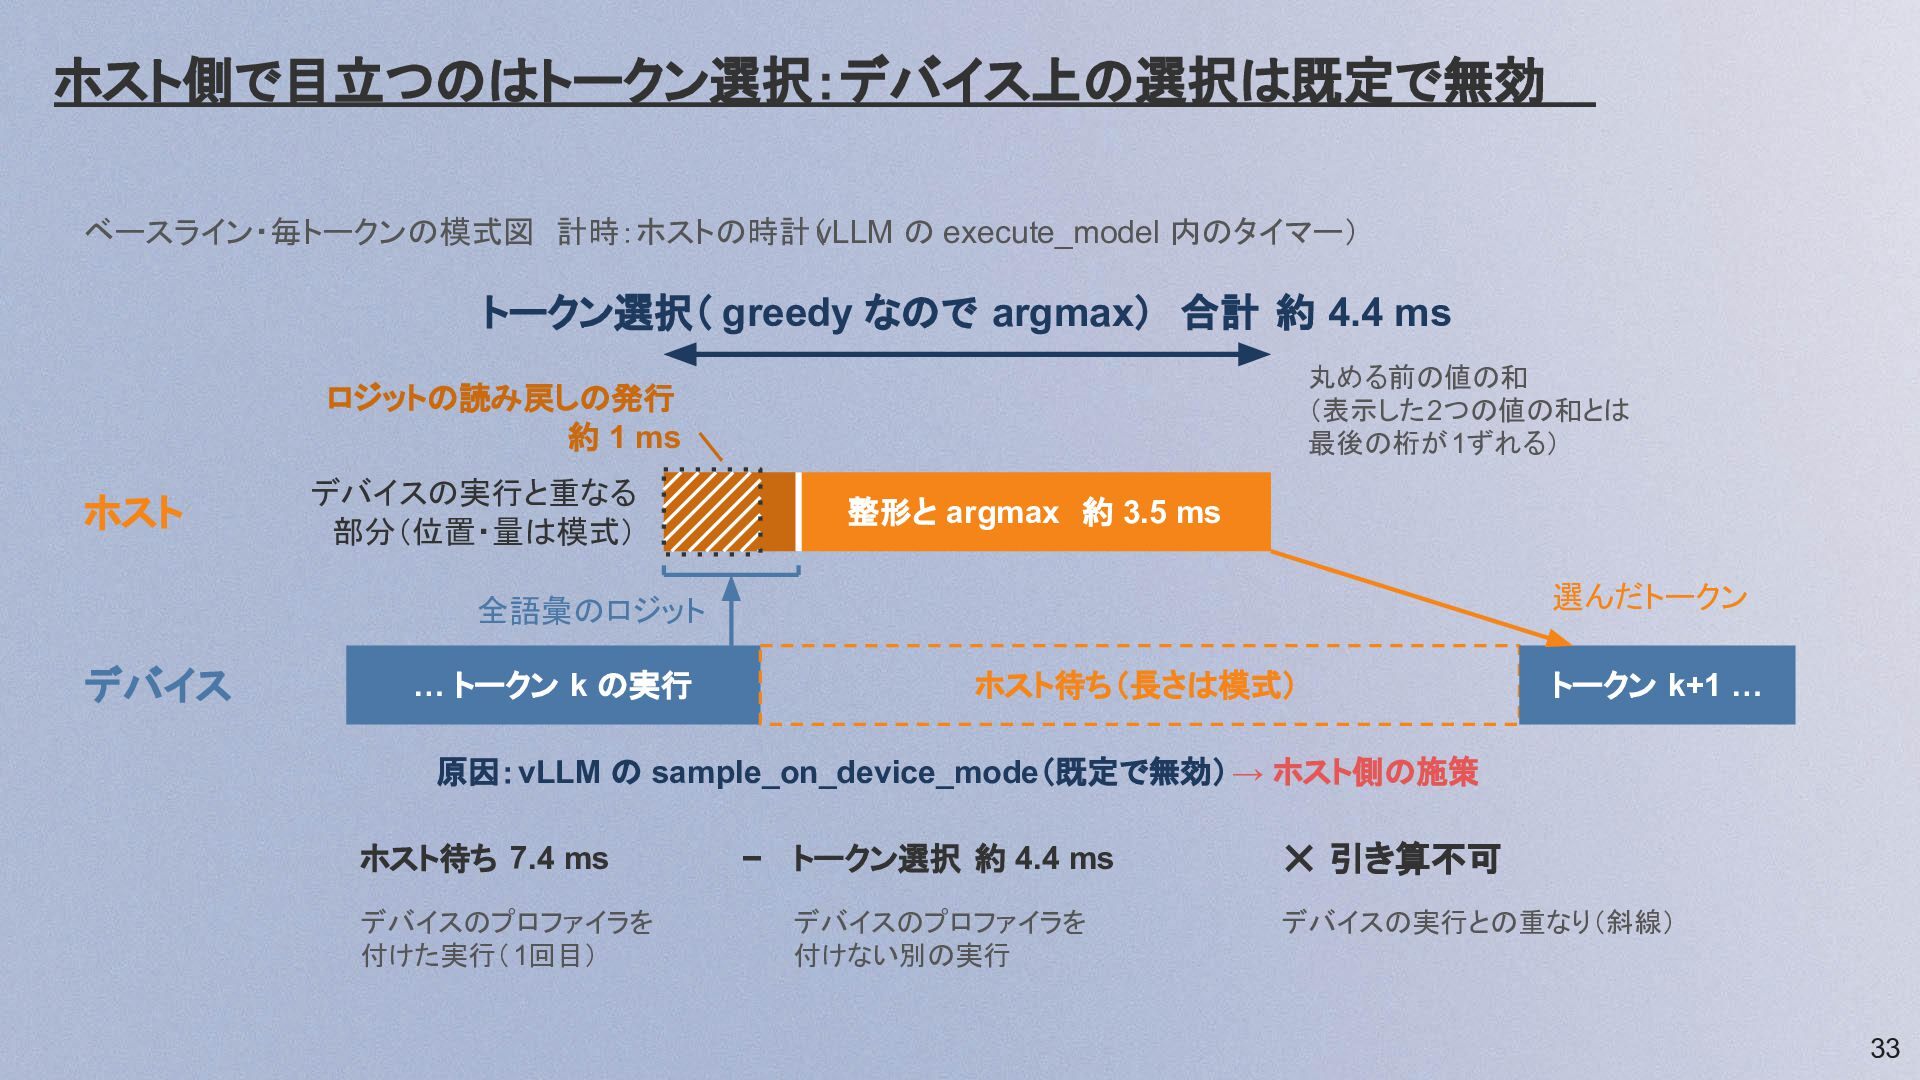
    合計 約 4.4 ms 丸める前の値の和 (表示した2つの値の和とは 最後の桁が1ずれる) ロジットの読み戻しの発行 約 1 ms ホスト デバイスの実行と重なる 部分(位置・量は模式) 整形と argmax 約 3.5 ms 選んだトークン 全語彙のロジット デバイス … トークン k の実行 ホスト待ち(長さは模式) トークン k+1 … 原因:vLLM の sample_on_device_mode(既定で無効) → ホスト側の施策 ホスト待ち 7.4 ms デバイスのプロファイラを 付けた実行(1回目) − トークン選択 約 4.4 ms デバイスのプロファイラを 付けない別の実行 ✕ 引き算不可 デバイスの実行との重なり(斜線) 33
  30. コア稼働率 32%:平均でデバイス稼働時間の約 7割は kernel 実行なし ベースライン・代表トークン( 15回目の decode)・ログに現れる 110 コアすべてで

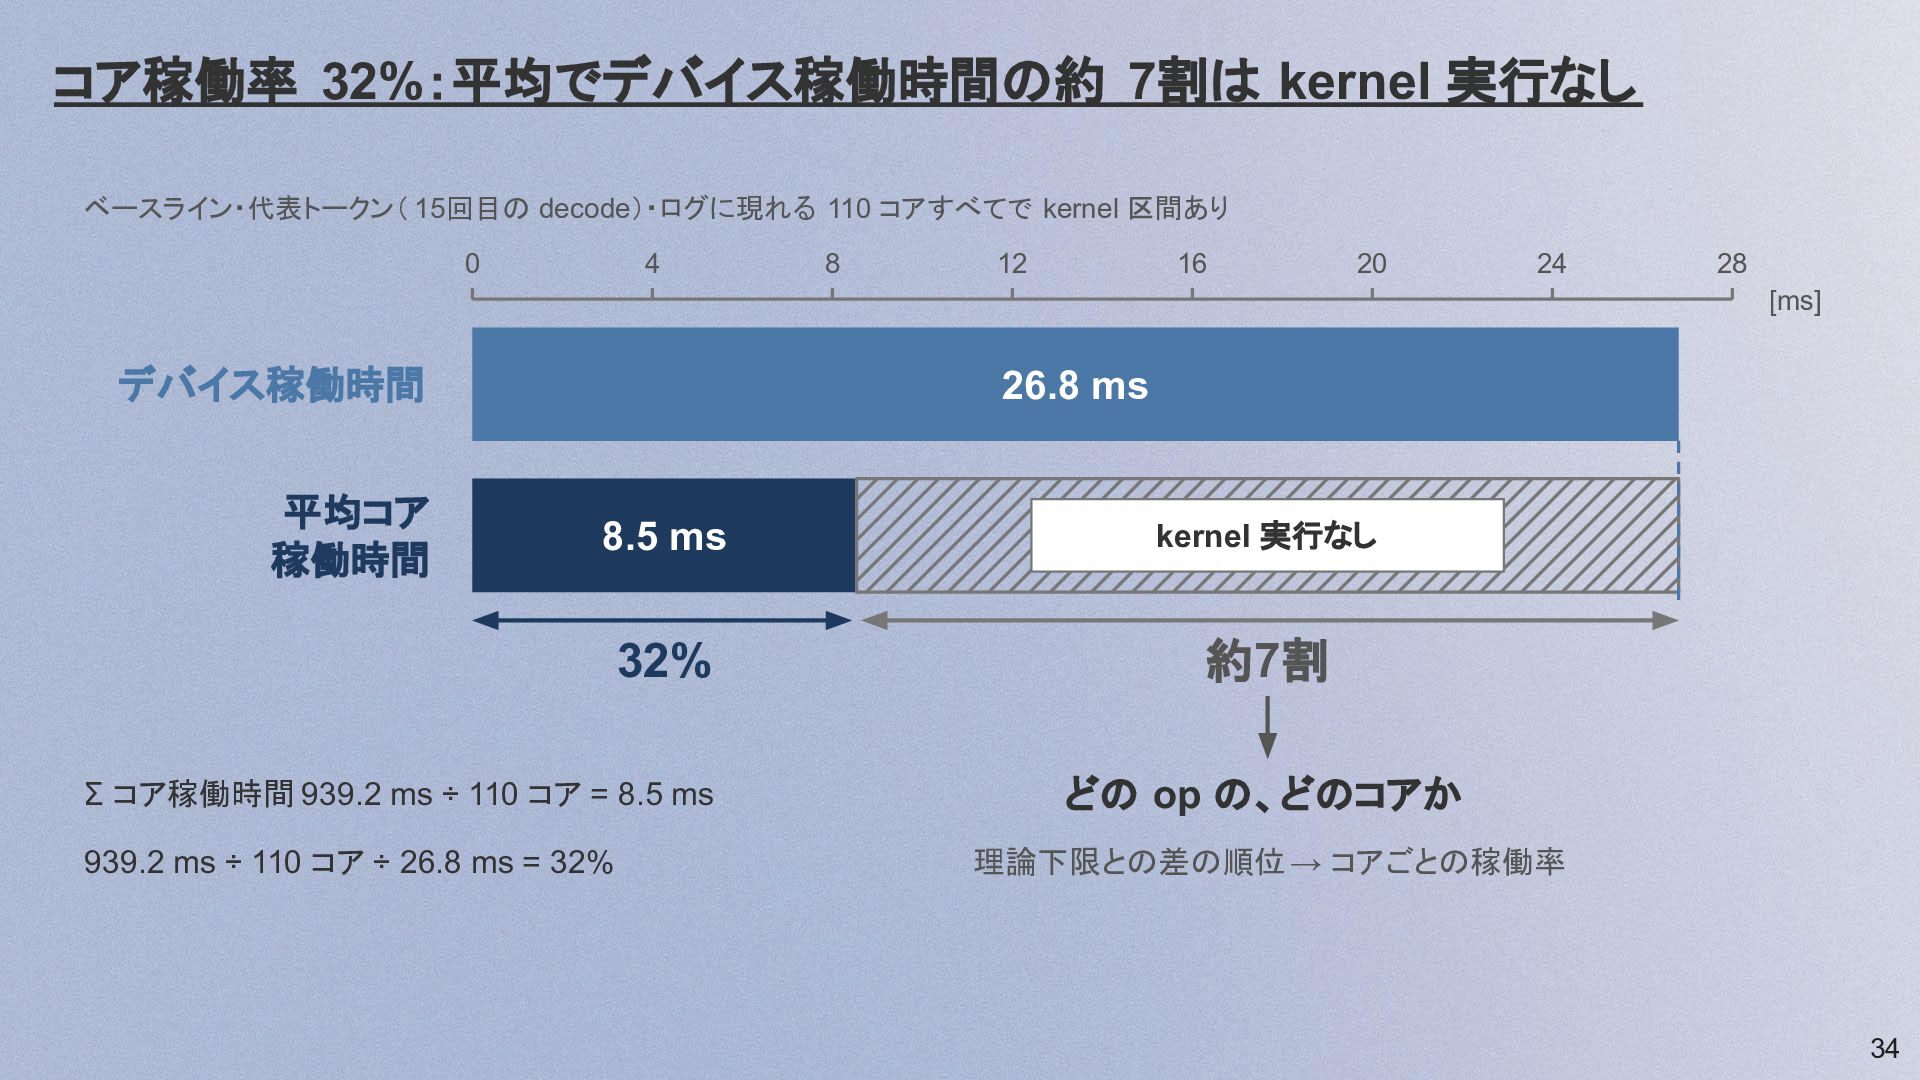
    kernel 区間あり 0 4 8 12 16 20 24 28 [ms] デバイス稼働時間 平均コア 稼働時間 26.8 ms 8.5 ms kernel 実行なし 32% 約7割 Σ コア稼働時間 939.2 ms ÷ 110 コア = 8.5 ms 939.2 ms ÷ 110 コア ÷ 26.8 ms = 32% どの op の、どのコアか 理論下限との差の順位 → コアごとの稼働率 34
  31. op分解:gate+upが最も重い ベースライン・代表トークン( 15回目の decode) = 重み K(縦)× N(横)・同じ縮尺 op(HF の名前が主)

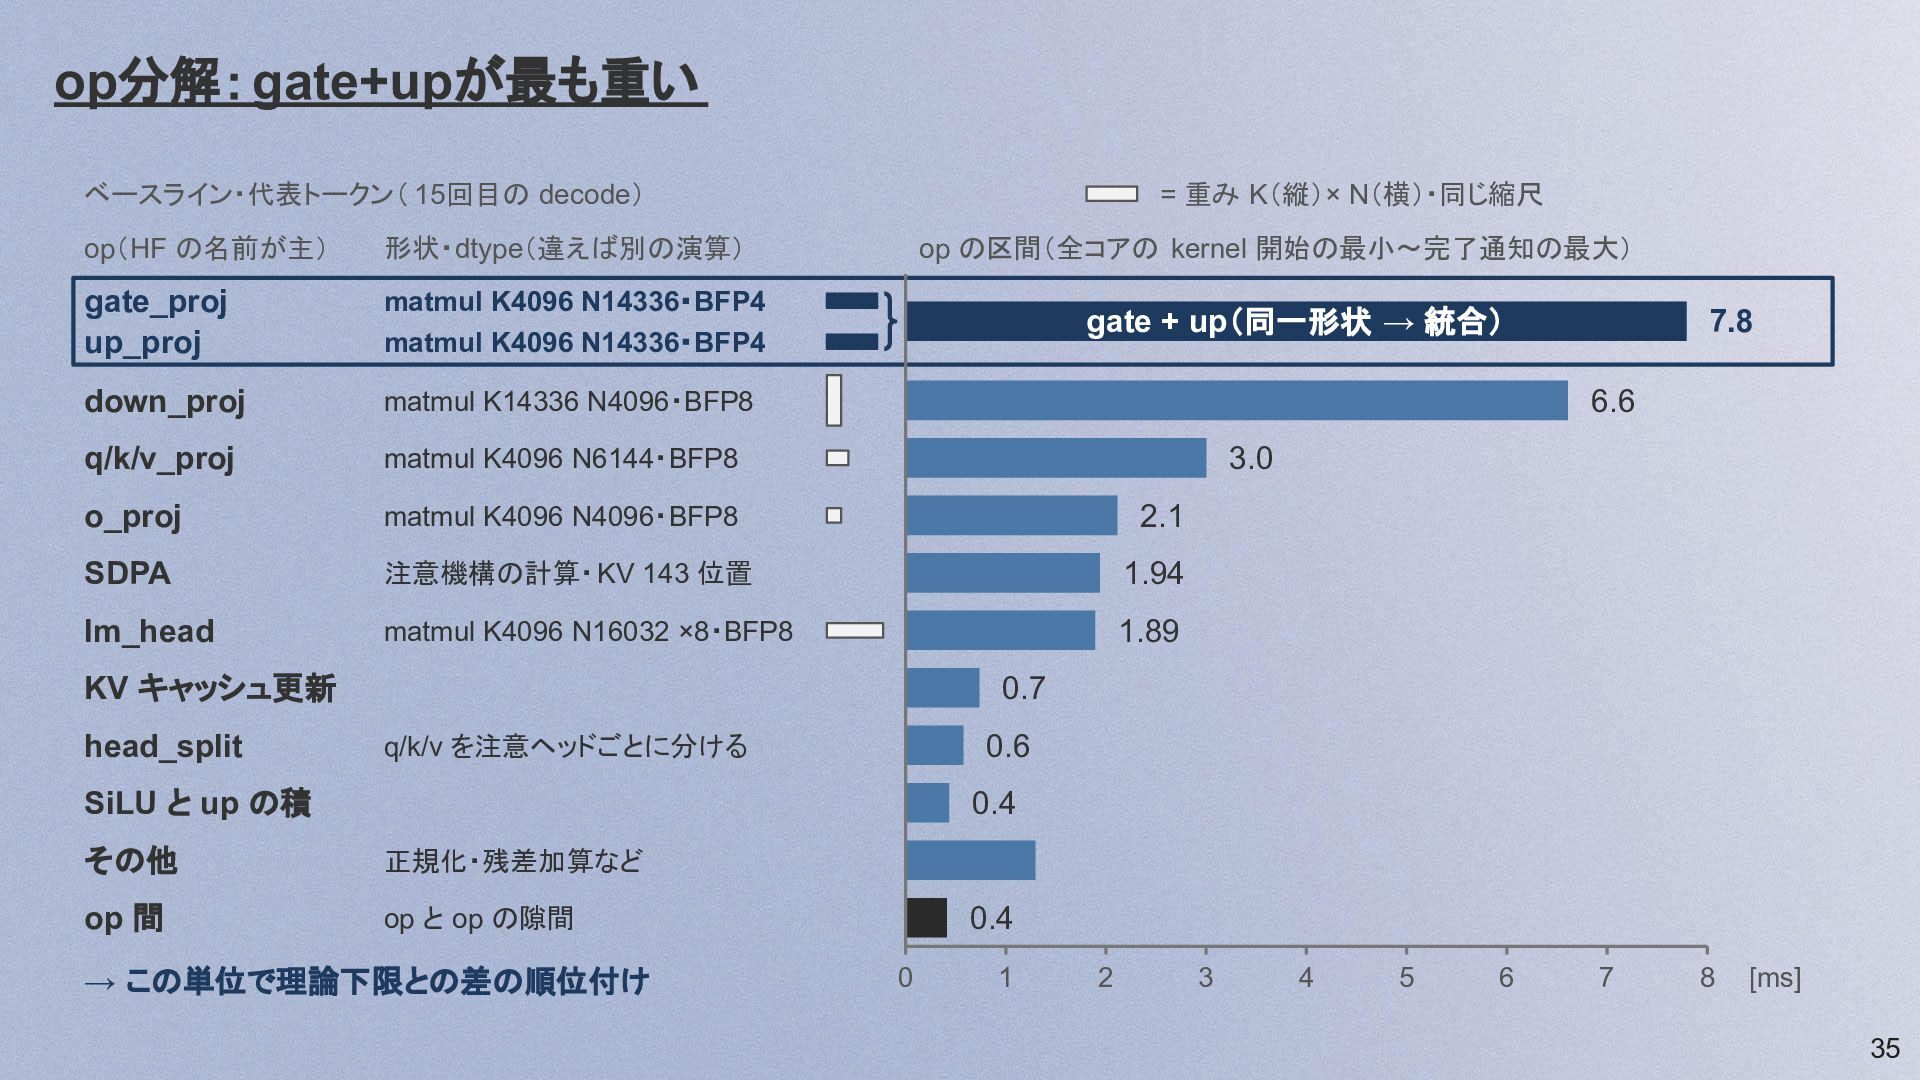
    形状・dtype(違えば別の演算) op の区間(全コアの kernel 開始の最小〜完了通知の最大) gate_proj up_proj matmul K4096 N14336・BFP4 matmul K4096 N14336・BFP4 gate + up(同一形状 → 統合) down_proj matmul K14336 N4096・BFP8 q/k/v_proj matmul K4096 N6144・BFP8 o_proj matmul K4096 N4096・BFP8 2.1 SDPA 注意機構の計算・ KV 143 位置 1.94 lm_head matmul K4096 N16032 ×8・BFP8 1.89 6.6 3.0 KV キャッシュ更新 head_split 7.8 0.7 q/k/v を注意ヘッドごとに分ける 0.6 SiLU と up の積 0.4 その他 正規化・残差加算など op 間 op と op の隙間 → この単位で理論下限との差の順位付け 0.4 0 1 2 3 4 5 6 7 8 [ms] 35
  32. op分解の検算: Σ op の区間 + Σ op 間 = デバイス稼働時間、重なり

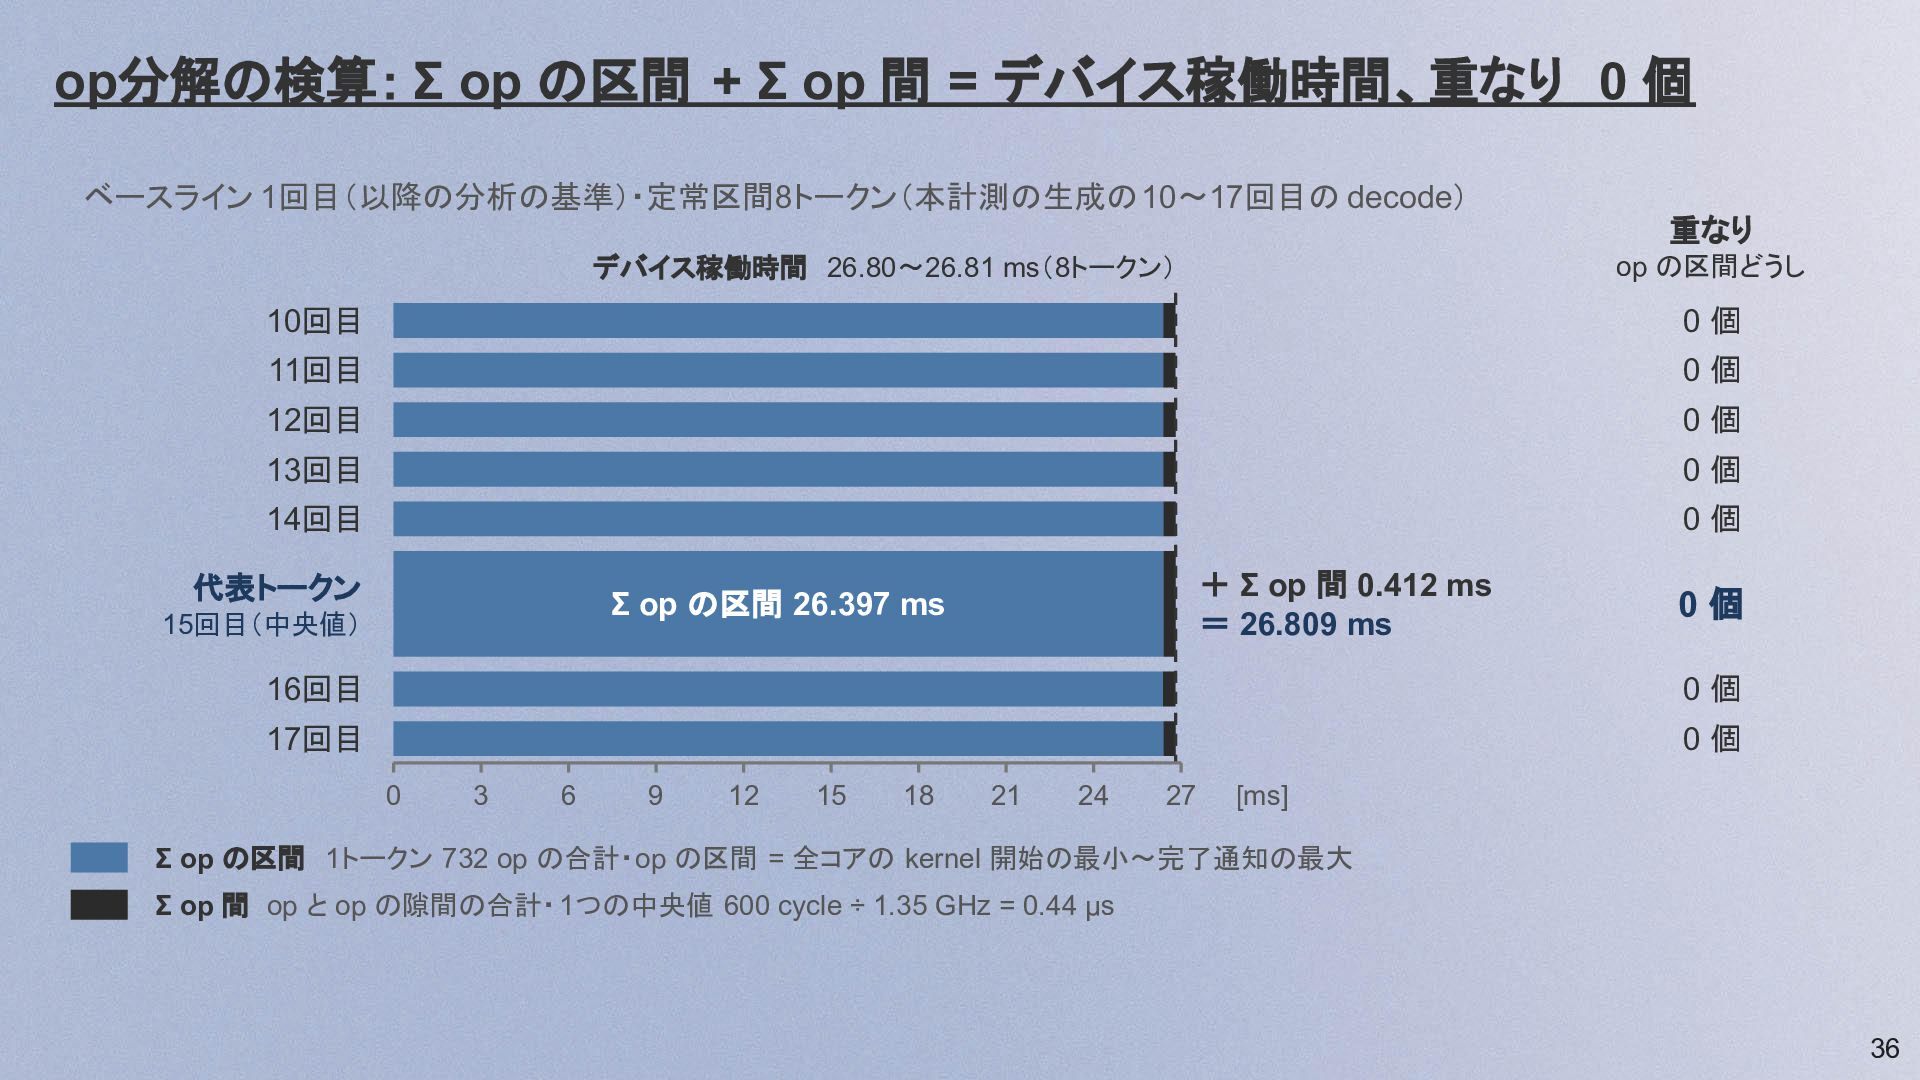
    0 個 ベースライン 1回目(以降の分析の基準)・定常区間 8トークン(本計測の生成の 10〜17回目の decode) 重なり op の区間どうし デバイス稼働時間 26.80〜26.81 ms(8トークン) 10回目 0個 11回目 0個 12回目 0個 13回目 0個 14回目 0個 代表トークン + Σ op 間 0.412 ms = 26.809 ms Σ op の区間 26.397 ms 15回目(中央値) 0個 16回目 0個 17回目 0個 0 3 6 9 12 15 18 21 24 27 [ms] Σ op の区間 1トークン 732 op の合計・op の区間 = 全コアの kernel 開始の最小〜完了通知の最大 Σ op 間 op と op の隙間の合計・ 1つの中央値 600 cycle ÷ 1.35 GHz = 0.44 µs 36
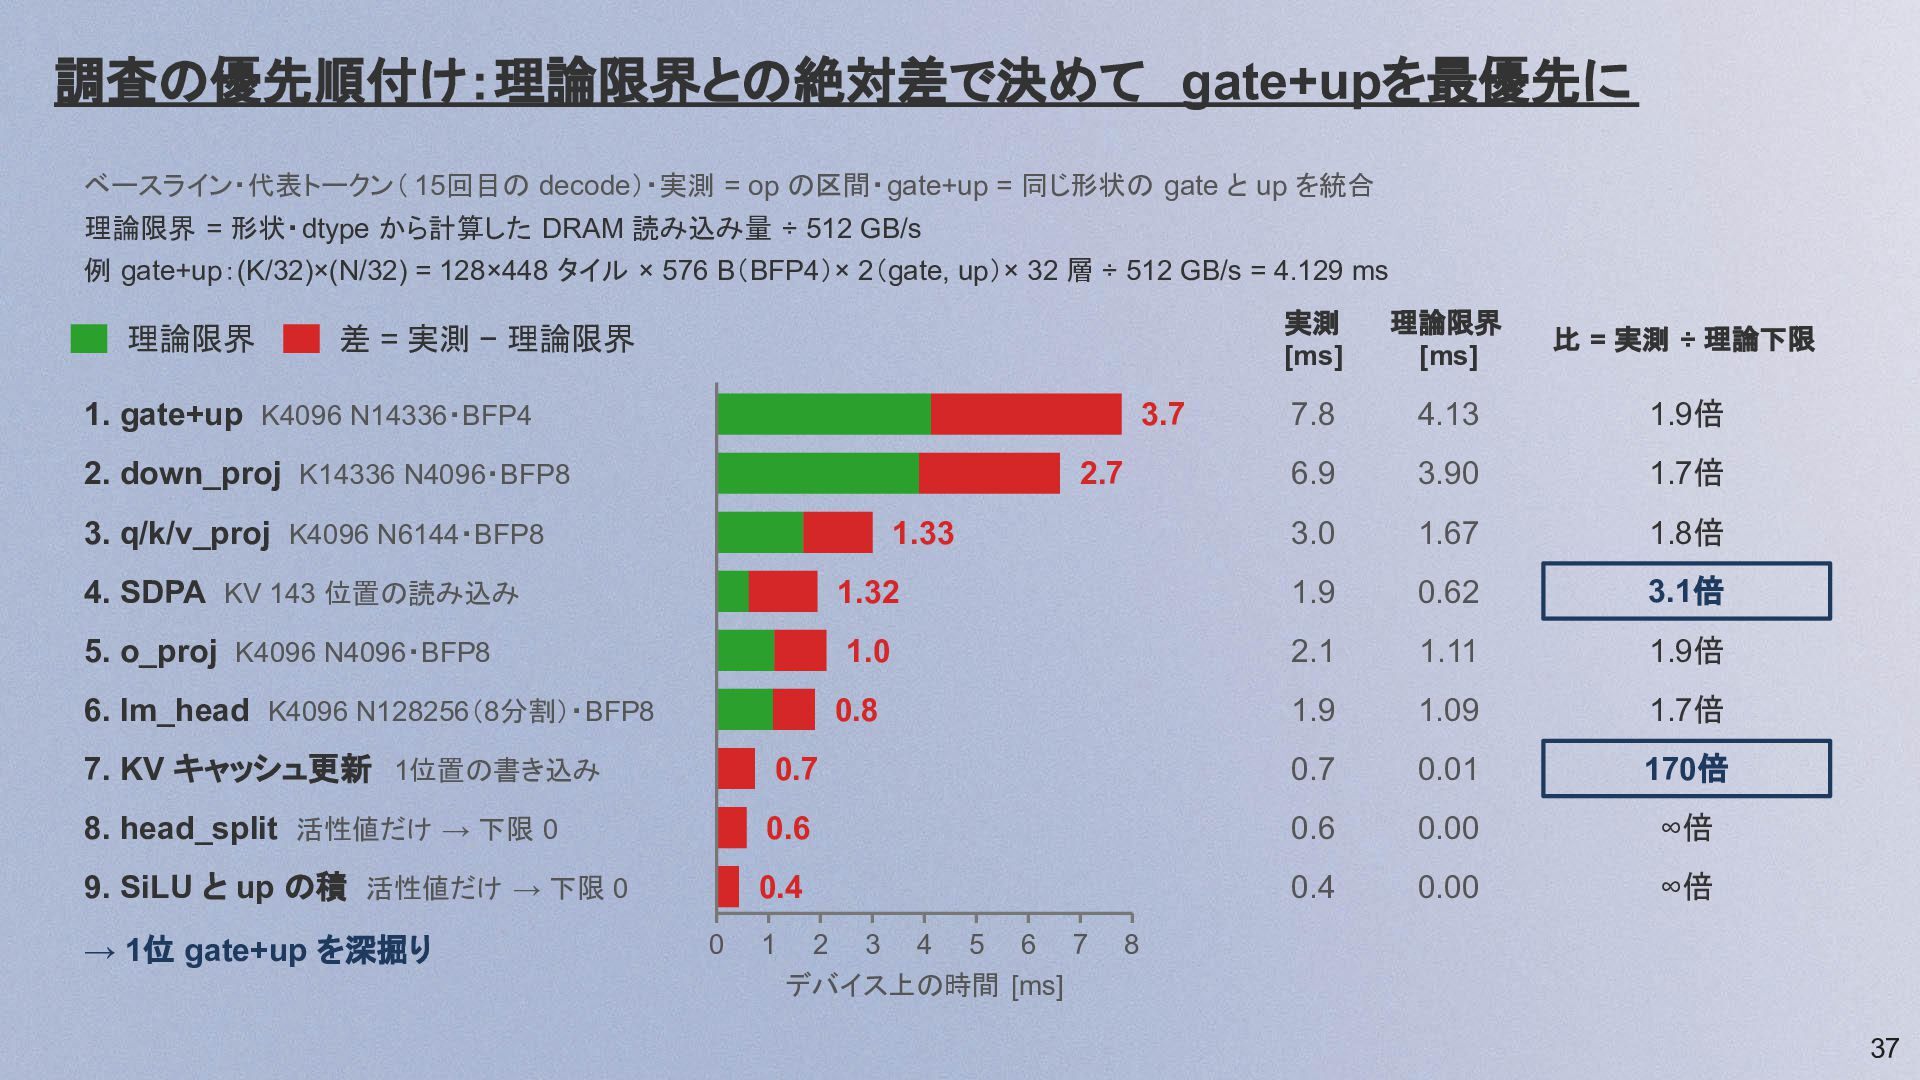
  33. 調査の優先順付け:理論限界との絶対差で決めて gate+upを最優先に ベースライン・代表トークン( 15回目の decode)・実測 = op の区間・gate+up = 同じ形状の

    gate と up を統合 理論限界 = 形状・dtype から計算した DRAM 読み込み量 ÷ 512 GB/s 例 gate+up:(K/32)×(N/32) = 128×448 タイル × 576 B(BFP4)× 2(gate, up)× 32 層 ÷ 512 GB/s = 4.129 ms 理論限界 差 = 実測 − 理論限界 1. gate+up K4096 N14336・BFP4 3.7 2. down_proj K14336 N4096・BFP8 2.7 3. q/k/v_proj K4096 N6144・BFP8 1.33 実測 [ms] 理論限界 [ms] 比 = 実測 ÷ 理論下限 7.8 4.13 1.9倍 6.9 3.90 1.7倍 3.0 1.67 1.8倍 4. SDPA KV 143 位置の読み込み 1.32 1.9 0.62 3.1倍 5. o_proj K4096 N4096・BFP8 1.0 2.1 1.11 1.9倍 6. lm_head K4096 N128256(8分割)・BFP8 0.8 1.9 1.09 1.7倍 7. KV キャッシュ更新 1位置の書き込み 0.7 0.7 0.01 170倍 8. head_split 活性値だけ → 下限 0 0.6 0.6 0.00 ∞倍 9. SiLU と up の積 活性値だけ → 下限 0 0.4 0.4 0.00 ∞倍 → 1位 gate+up を深掘り 0 1 2 3 4 5 6 7 デバイス上の時間 [ms] 8 37
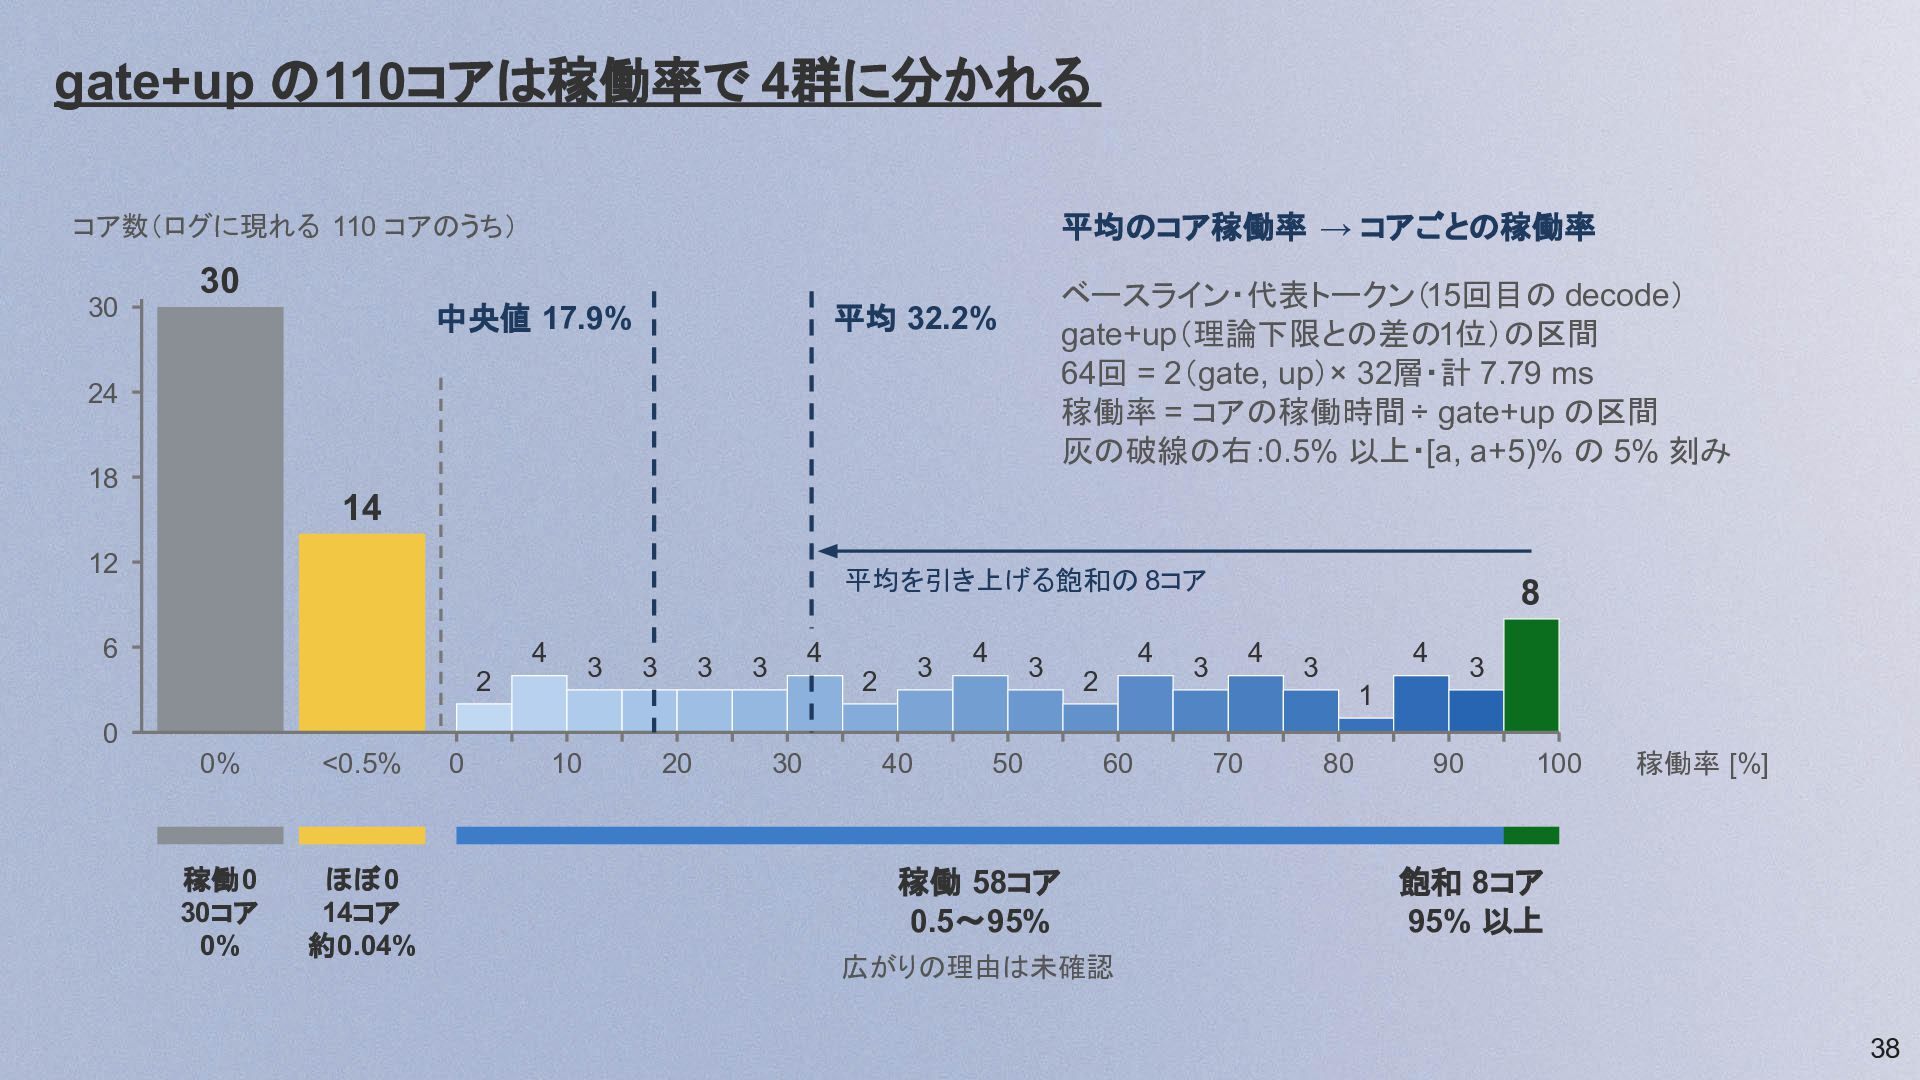
  34. gate+up の110コアは稼働率で 4群に分かれる 平均のコア稼働率 → コアごとの稼働率 コア数(ログに現れる 110 コアのうち) 30

    30 中央値 17.9% ベースライン・代表トークン(15回目の decode) gate+up(理論下限との差の1位)の区間 64回 = 2(gate, up)× 32層・計 7.79 ms 稼働率 = コアの稼働時間 ÷ gate+up の区間 灰の破線の右:0.5% 以上・[a, a+5)% の 5% 刻み 平均 32.2% 24 18 14 12 平均を引き上げる飽和の 8コア 6 4 3 2 3 3 4 3 3 2 4 3 4 2 8 4 3 4 3 3 1 0 0% <0.5% 稼働0 30コア 0% ほぼ0 14コア 約0.04% 0 10 20 30 40 50 60 稼働 58コア 0.5〜95% 70 80 90 100 稼働率 [%] 飽和 8コア 95% 以上 広がりの理由は未確認 38
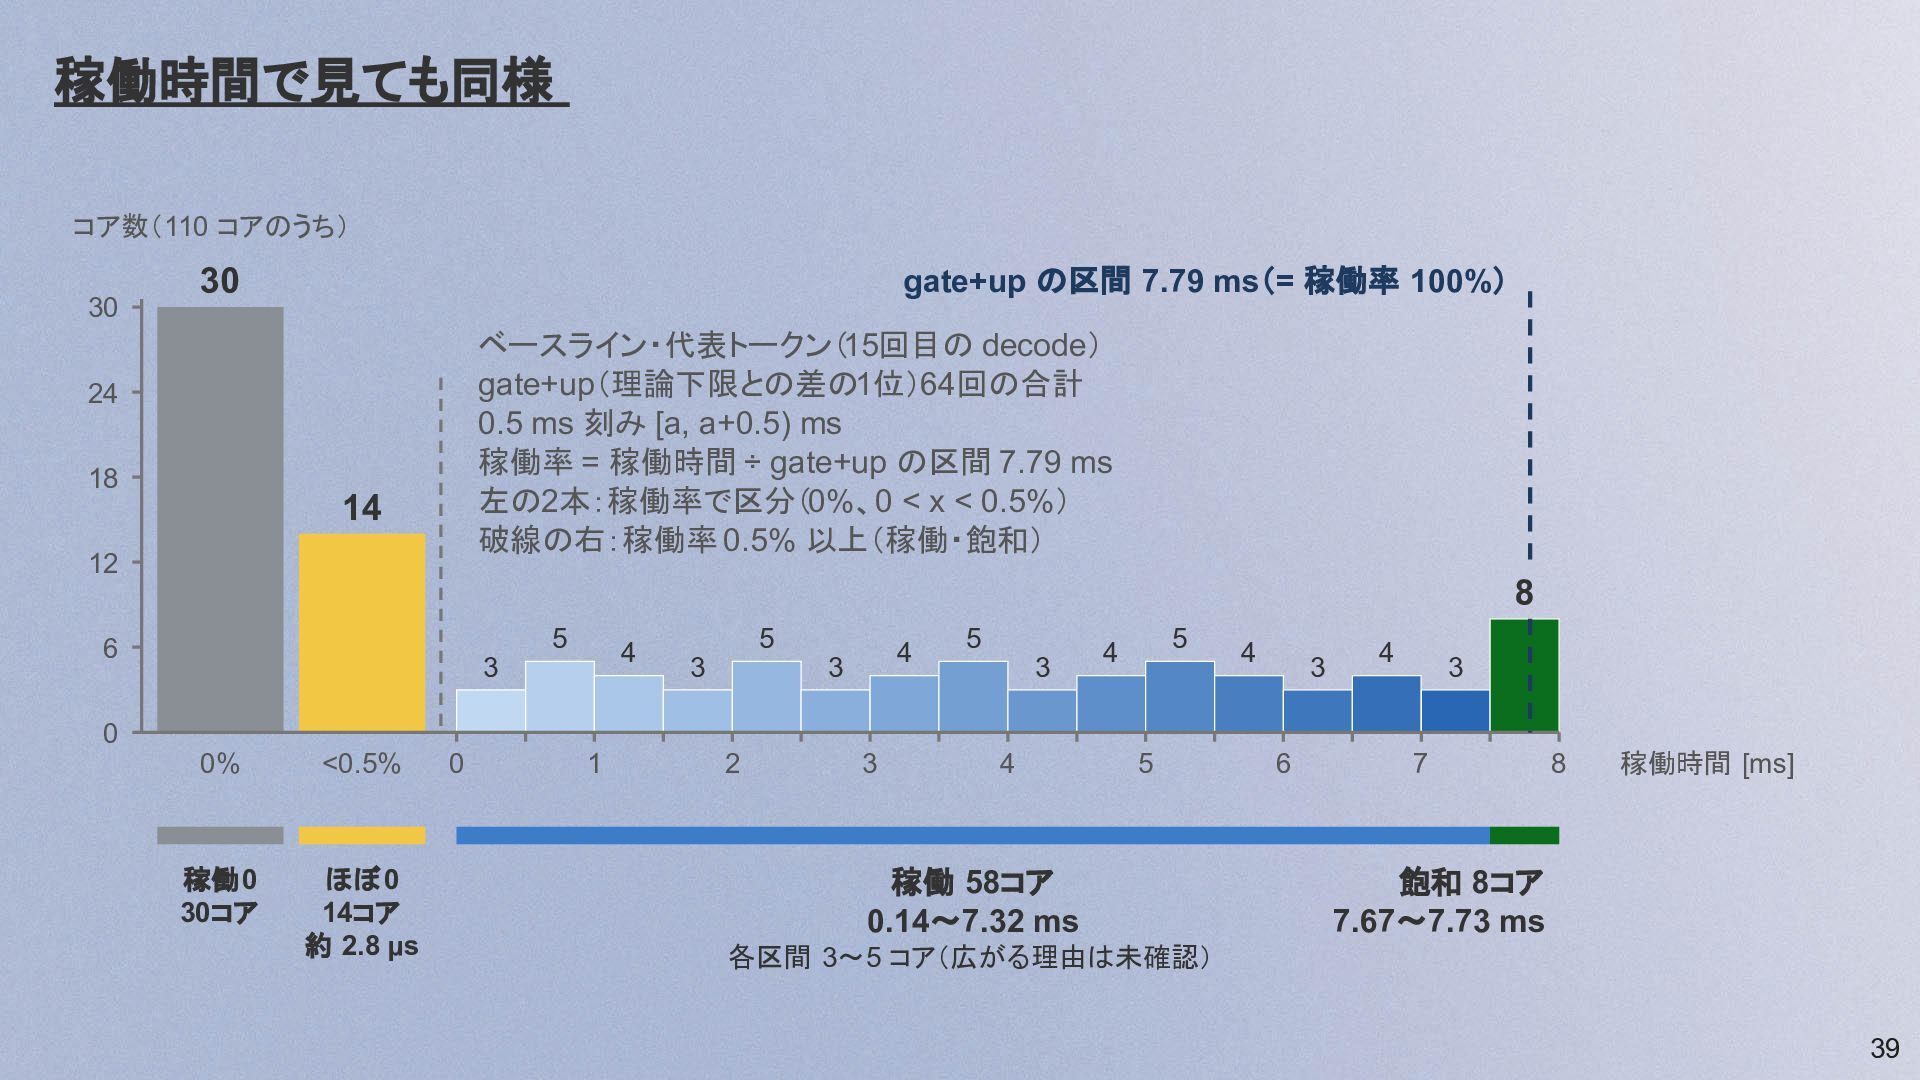
  35. 稼働時間で見ても同様 コア数(110 コアのうち) 30 gate+up の区間 7.79 ms(= 稼働率 100%)

    30 ベースライン・代表トークン(15回目の decode) gate+up(理論下限との差の1位)64回の合計 0.5 ms 刻み [a, a+0.5) ms 稼働率 = 稼働時間 ÷ gate+up の区間 7.79 ms 左の2本:稼働率で区分(0%、0 < x < 0.5%) 破線の右:稼働率 0.5% 以上(稼働・飽和) 24 18 14 12 8 5 6 4 3 5 3 4 3 5 3 5 4 4 3 4 3 0 0% <0.5% 稼働0 30コア ほぼ0 14コア 約 2.8 µs 0 1 2 3 4 5 稼働 58コア 0.14〜7.32 ms 6 7 8 稼働時間 [ms] 飽和 8コア 7.67〜7.73 ms 各区間 3〜5 コア(広がる理由は未確認) 39
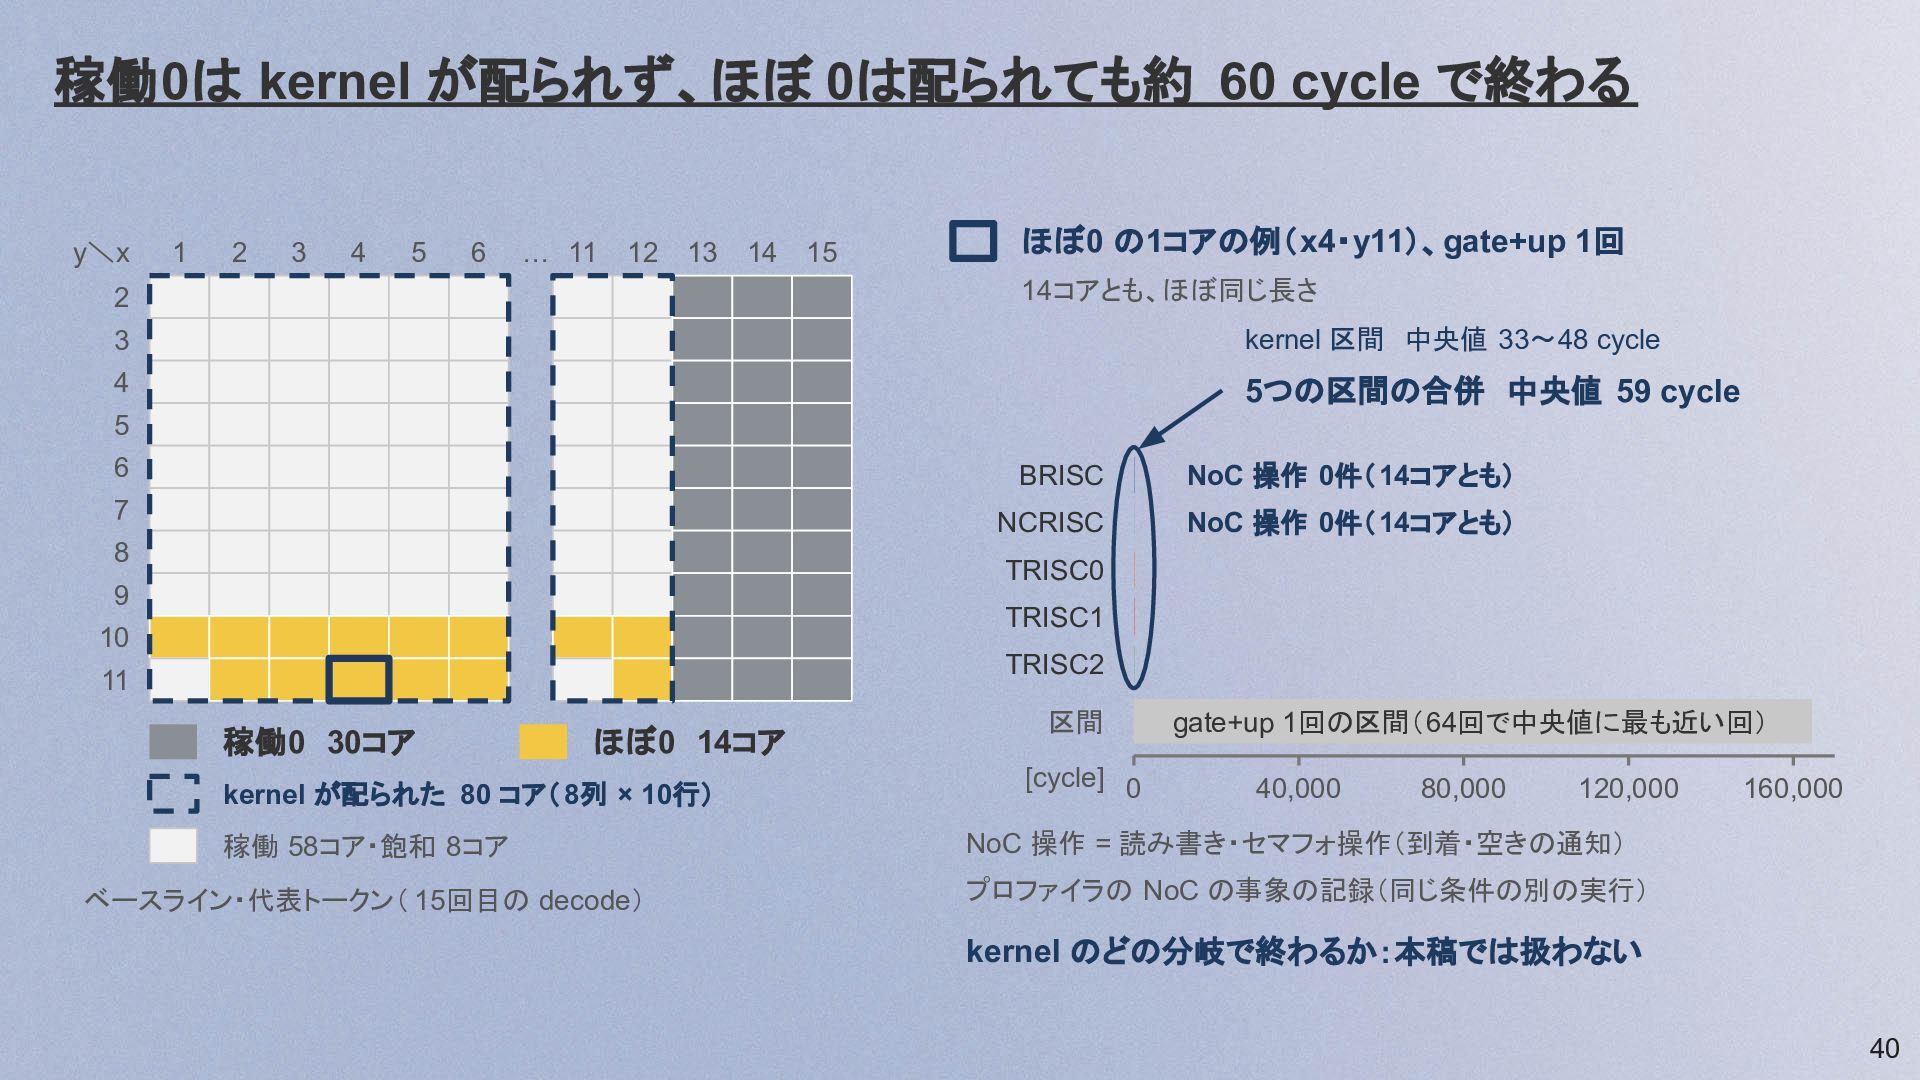
  36. 稼働0は kernel が配られず、ほぼ 0は配られても約 60 cycle で終わる y\x 1 2

    3 4 5 6 … 11 12 13 14 15 ほぼ0 の1コアの例(x4・y11)、gate+up 1回 14コアとも、ほぼ同じ長さ 2 3 kernel 区間 中央値 33〜48 cycle 4 5つの区間の合併 中央値 59 cycle 5 6 BRISC NoC 操作 0件(14コアとも) 7 NCRISC NoC 操作 0件(14コアとも) 8 TRISC0 9 TRISC1 10 TRISC2 11 稼働0 30コア ほぼ0 14コア kernel が配られた 80 コア( 8列 × 10行) 区間 [cycle] 0 gate+up 1回の区間(64回で中央値に最も近い回) 40,000 80,000 120,000 稼働 58コア・飽和 8コア NoC 操作 = 読み書き・セマフォ操作(到着・空きの通知) ベースライン・代表トークン( 15回目の decode) プロファイラの NoC の事象の記録(同じ条件の別の実行) 160,000 kernel のどの分岐で終わるか:本稿では扱わない 40
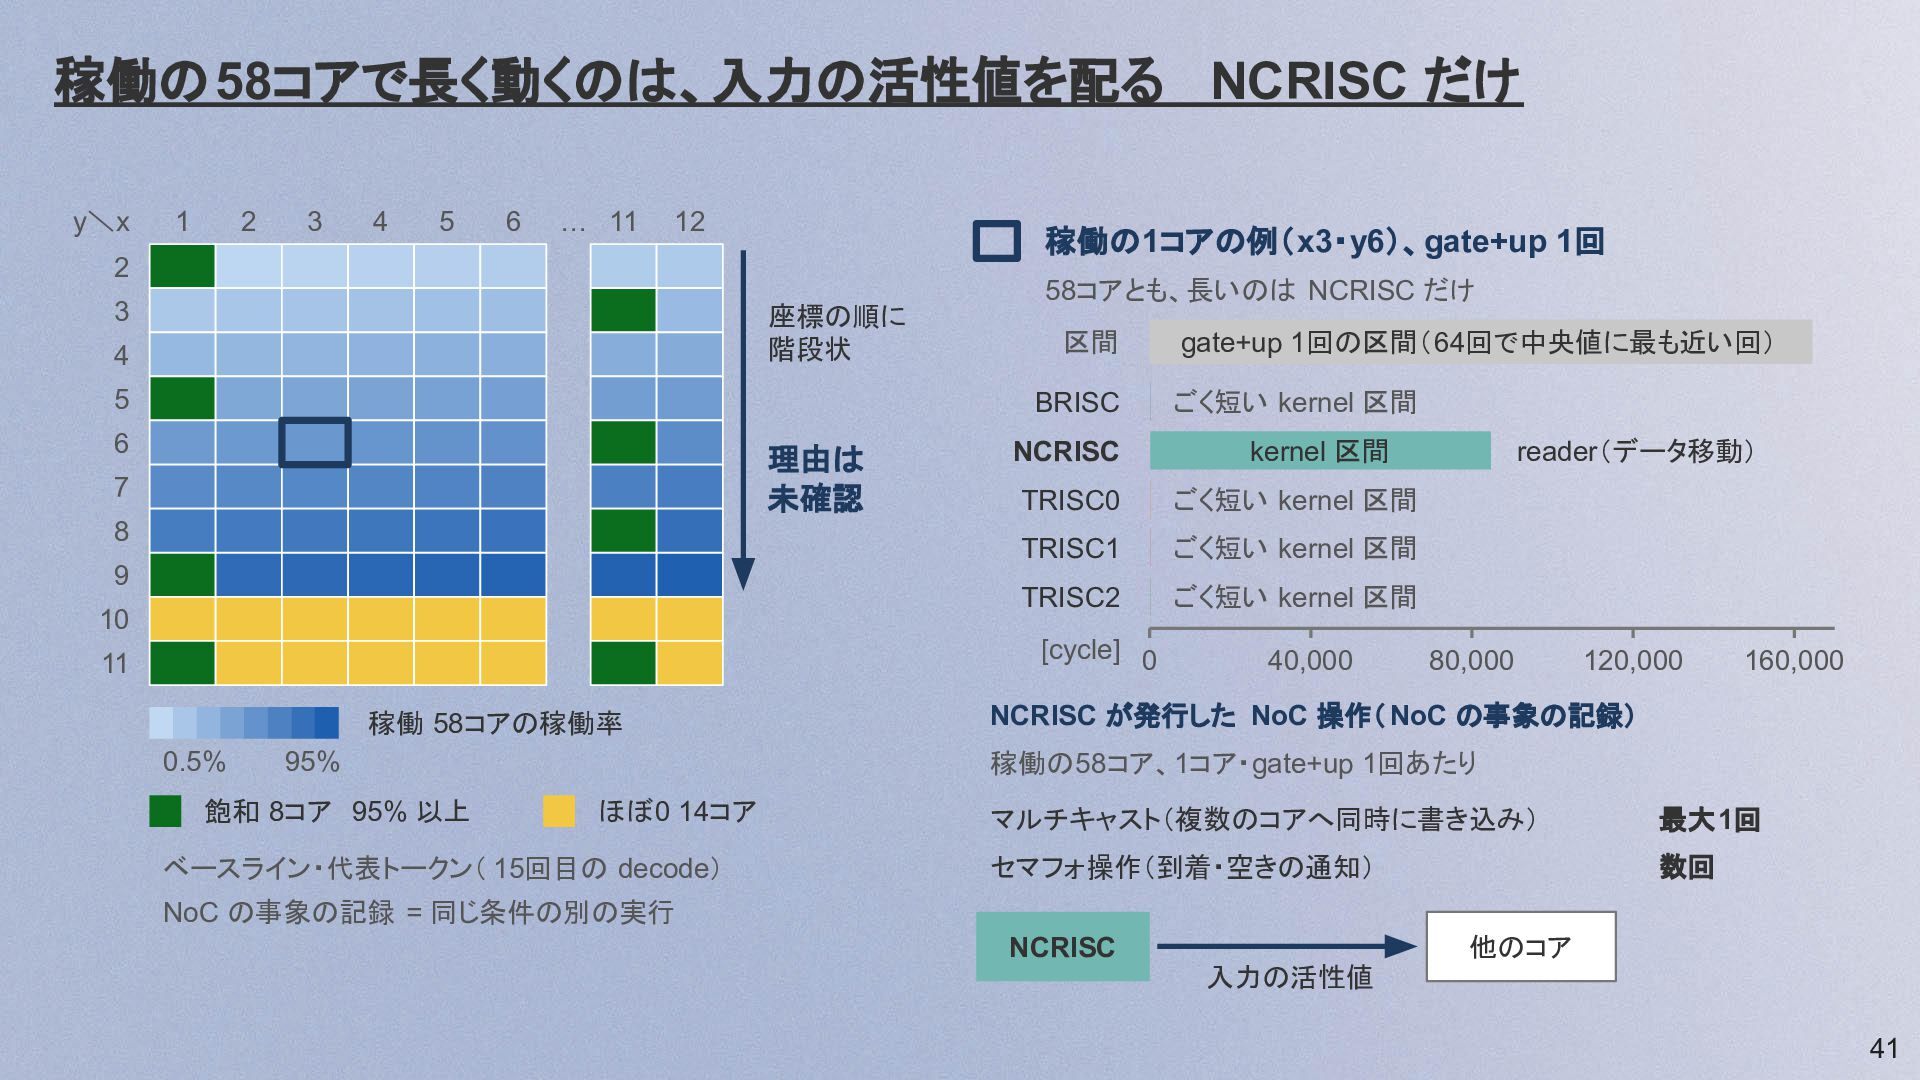
  37. 稼働の58コアで長く動くのは、入力の活性値を配る NCRISC だけ y\x 1 2 3 4 5 6

    … 11 12 稼働の1コアの例(x3・y6)、gate+up 1回 2 3 座標の順に 階段状 4 5 58コアとも、長いのは NCRISC だけ 区間 BRISC 6 理由は 未確認 7 8 9 10 NCRISC 稼働 58コアの稼働率 0.5% kernel 区間 ごく短い kernel 区間 TRISC1 ごく短い kernel 区間 TRISC2 ごく短い kernel 区間 40,000 reader(データ移動) 80,000 120,000 160,000 NCRISC が発行した NoC 操作( NoC の事象の記録) 稼働の58コア、1コア・gate+up 1回あたり 95% 飽和 8コア 95% 以上 ごく短い kernel 区間 TRISC0 [cycle] 0 11 gate+up 1回の区間(64回で中央値に最も近い回) ほぼ0 14コア ベースライン・代表トークン( 15回目の decode) マルチキャスト(複数のコアへ同時に書き込み) 最大1回 セマフォ操作(到着・空きの通知) 数回 NoC の事象の記録 = 同じ条件の別の実行 NCRISC 他のコア 入力の活性値 41
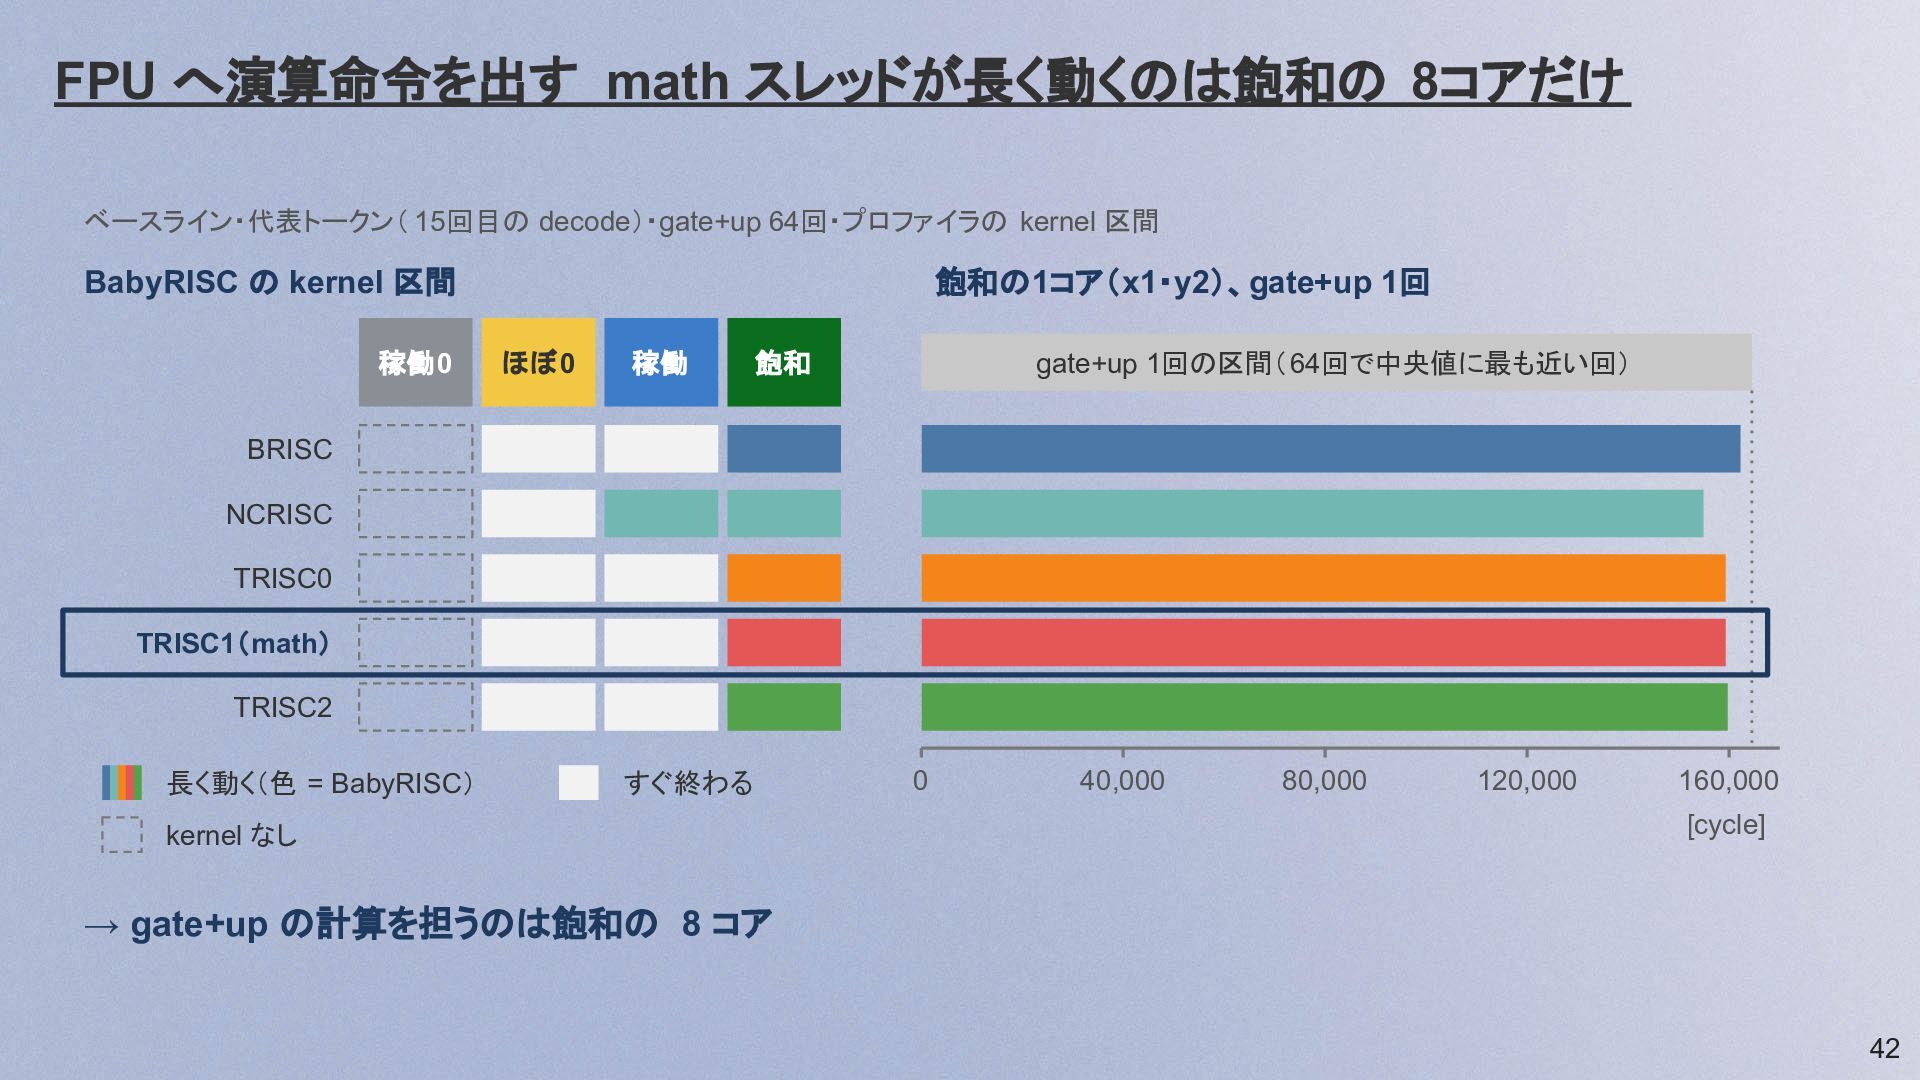
  38. FPU へ演算命令を出す math スレッドが長く動くのは飽和の 8コアだけ ベースライン・代表トークン( 15回目の decode)・gate+up 64回・プロファイラの kernel

    区間 BabyRISC の kernel 区間 稼働0 飽和の1コア(x1・y2)、gate+up 1回 ほぼ0 稼働 飽和 gate+up 1回の区間(64回で中央値に最も近い回) BRISC NCRISC TRISC0 TRISC1(math) TRISC2 長く動く(色 = BabyRISC) すぐ終わる kernel なし 0 40,000 80,000 120,000 160,000 [cycle] → gate+up の計算を担うのは飽和の 8 コア 42
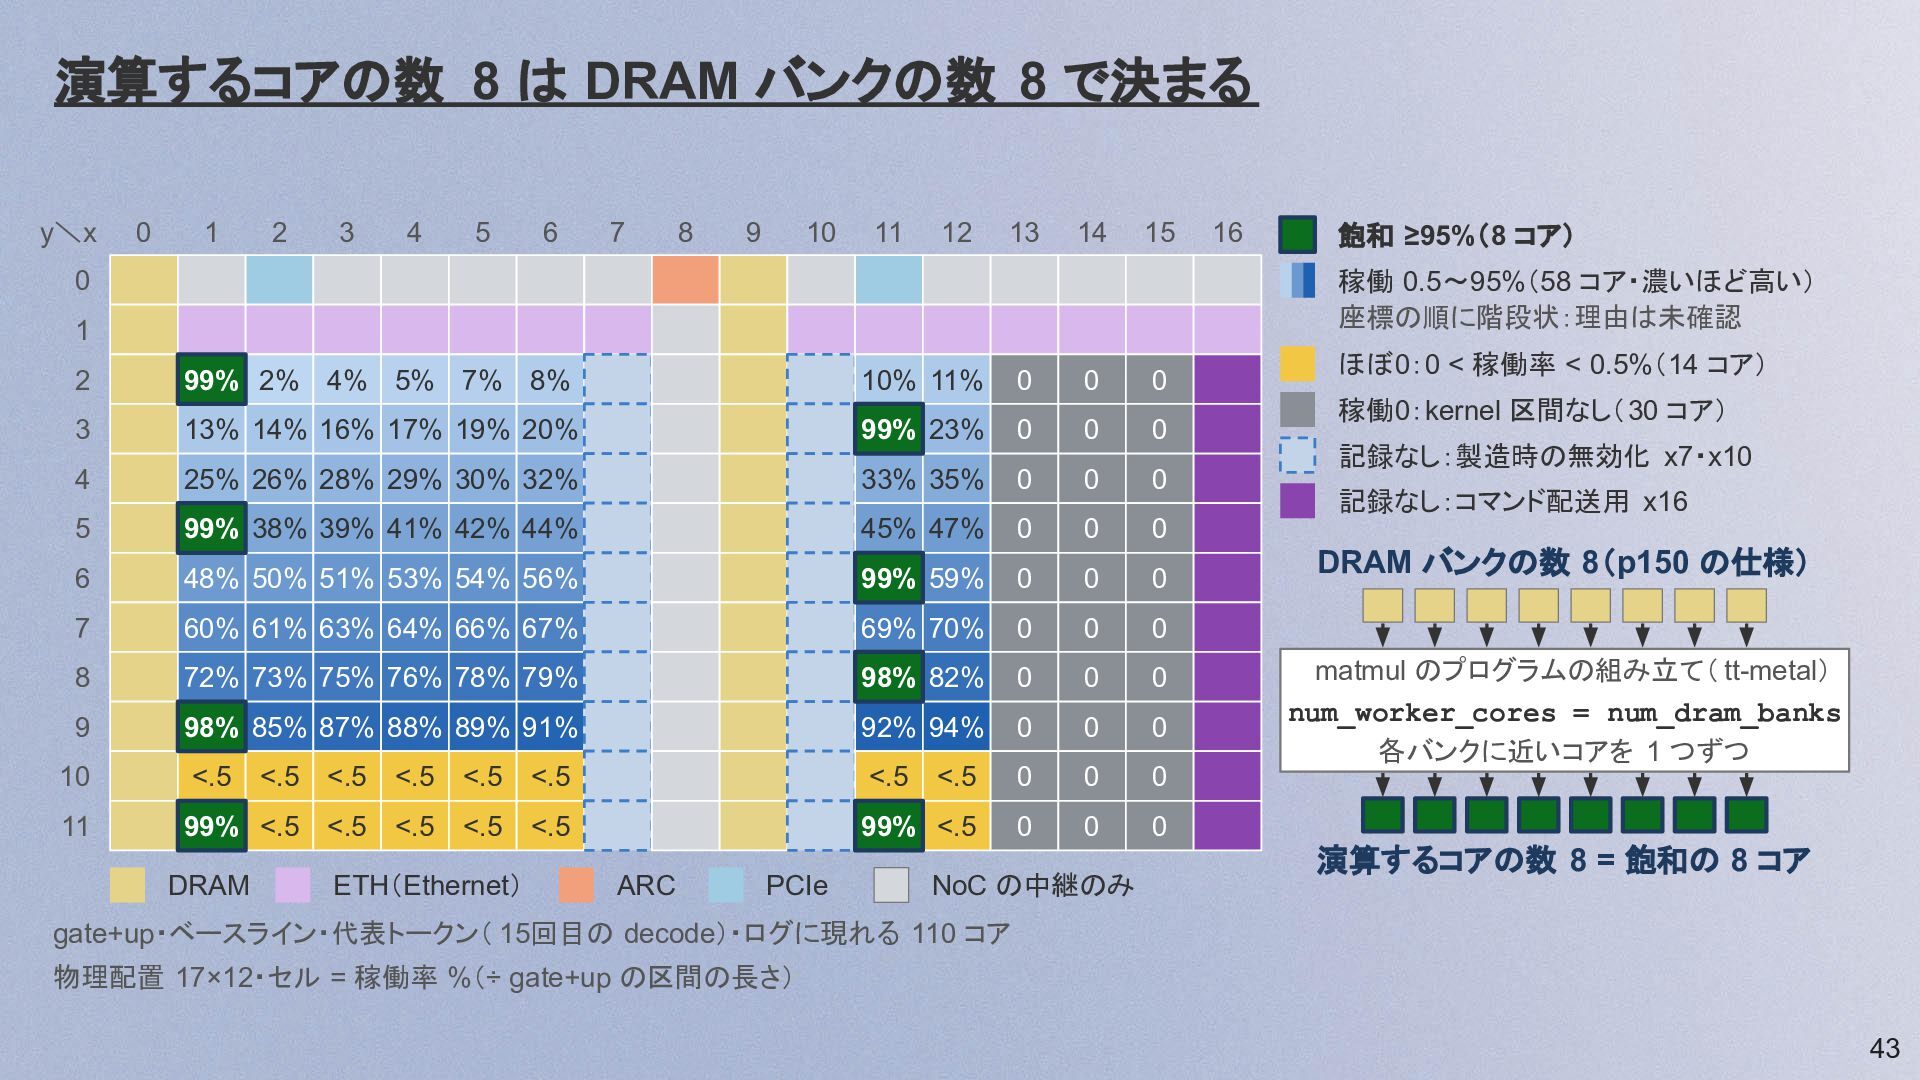
  39. 演算するコアの数 8 は DRAM バンクの数 8 で決まる y\x 0 1

    2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 飽和 ≥95%(8 コア) 稼働 0.5〜95%(58 コア・濃いほど高い) 座標の順に階段状:理由は未確認 0 1 2 99% 2% 4% 5% 7% 8% 10% 11% 0 0 0 3 13% 14% 16% 17% 19% 20% 99% 23% 0 0 0 4 25% 26% 28% 29% 30% 32% 33% 35% 0 0 0 5 99% 38% 39% 41% 42% 44% 45% 47% 0 0 0 6 48% 50% 51% 53% 54% 56% 99% 59% 0 0 0 7 60% 61% 63% 64% 66% 67% 69% 70% 0 0 0 8 72% 73% 75% 76% 78% 79% 98% 82% 0 0 0 9 98% 85% 87% 88% 89% 91% 92% 94% 0 0 0 10 <.5 <.5 <.5 <.5 <.5 <.5 <.5 <.5 0 0 0 11 99% <.5 <.5 <.5 <.5 <.5 99% <.5 0 0 0 DRAM ETH(Ethernet) ARC PCIe NoC の中継のみ ほぼ0:0 < 稼働率 < 0.5%(14 コア) 稼働0:kernel 区間なし(30 コア) 記録なし:製造時の無効化 x7・x10 記録なし:コマンド配送用 x16 DRAM バンクの数 8(p150 の仕様) matmul のプログラムの組み立て( tt-metal) num_worker_cores = num_dram_banks 各バンクに近いコアを 1 つずつ 演算するコアの数 8 = 飽和の 8 コア gate+up・ベースライン・代表トークン( 15回目の decode)・ログに現れる 110 コア 物理配置 17×12・セル = 稼働率 %(÷ gate+up の区間の長さ) 43
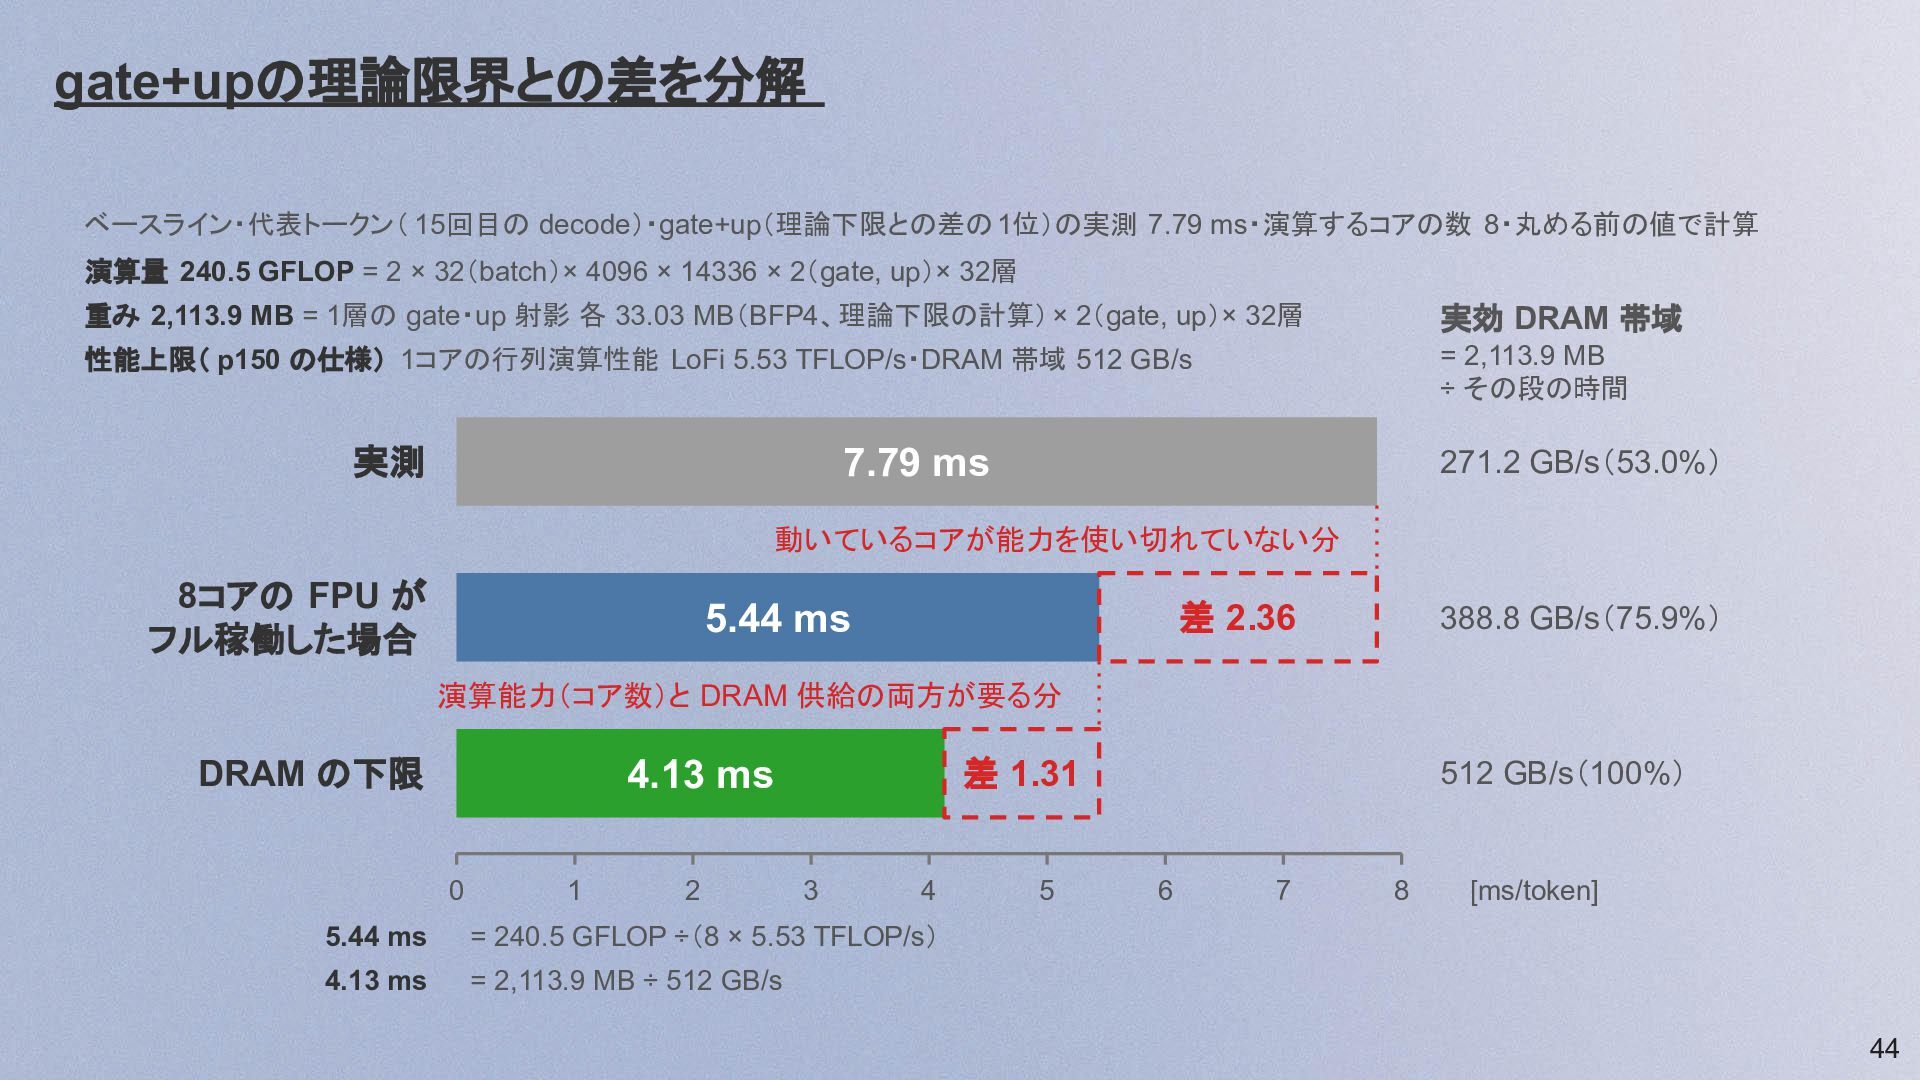
  40. gate+upの理論限界との差を分解 ベースライン・代表トークン( 15回目の decode)・gate+up(理論下限との差の 1位)の実測 7.79 ms・演算するコアの数 8・丸める前の値で計算 演算量 240.5

    GFLOP = 2 × 32(batch)× 4096 × 14336 × 2(gate, up)× 32層 重み 2,113.9 MB = 1層の gate・up 射影 各 33.03 MB(BFP4、理論下限の計算) × 2(gate, up)× 32層 実効 DRAM 帯域 性能上限( p150 の仕様) 1コアの行列演算性能 LoFi 5.53 TFLOP/s・DRAM 帯域 512 GB/s = 2,113.9 MB ÷ その段の時間 実測 7.79 ms 271.2 GB/s(53.0%) 動いているコアが能力を使い切れていない分 8コアの FPU が フル稼働した場合 差 2.36 5.44 ms 388.8 GB/s(75.9%) 演算能力(コア数)と DRAM 供給の両方が要る分 DRAM の下限 差 1.31 4.13 ms 0 1 2 3 4 5.44 ms = 240.5 GFLOP ÷(8 × 5.53 TFLOP/s) 4.13 ms = 2,113.9 MB ÷ 512 GB/s 5 512 GB/s(100%) 6 7 8 [ms/token] 44
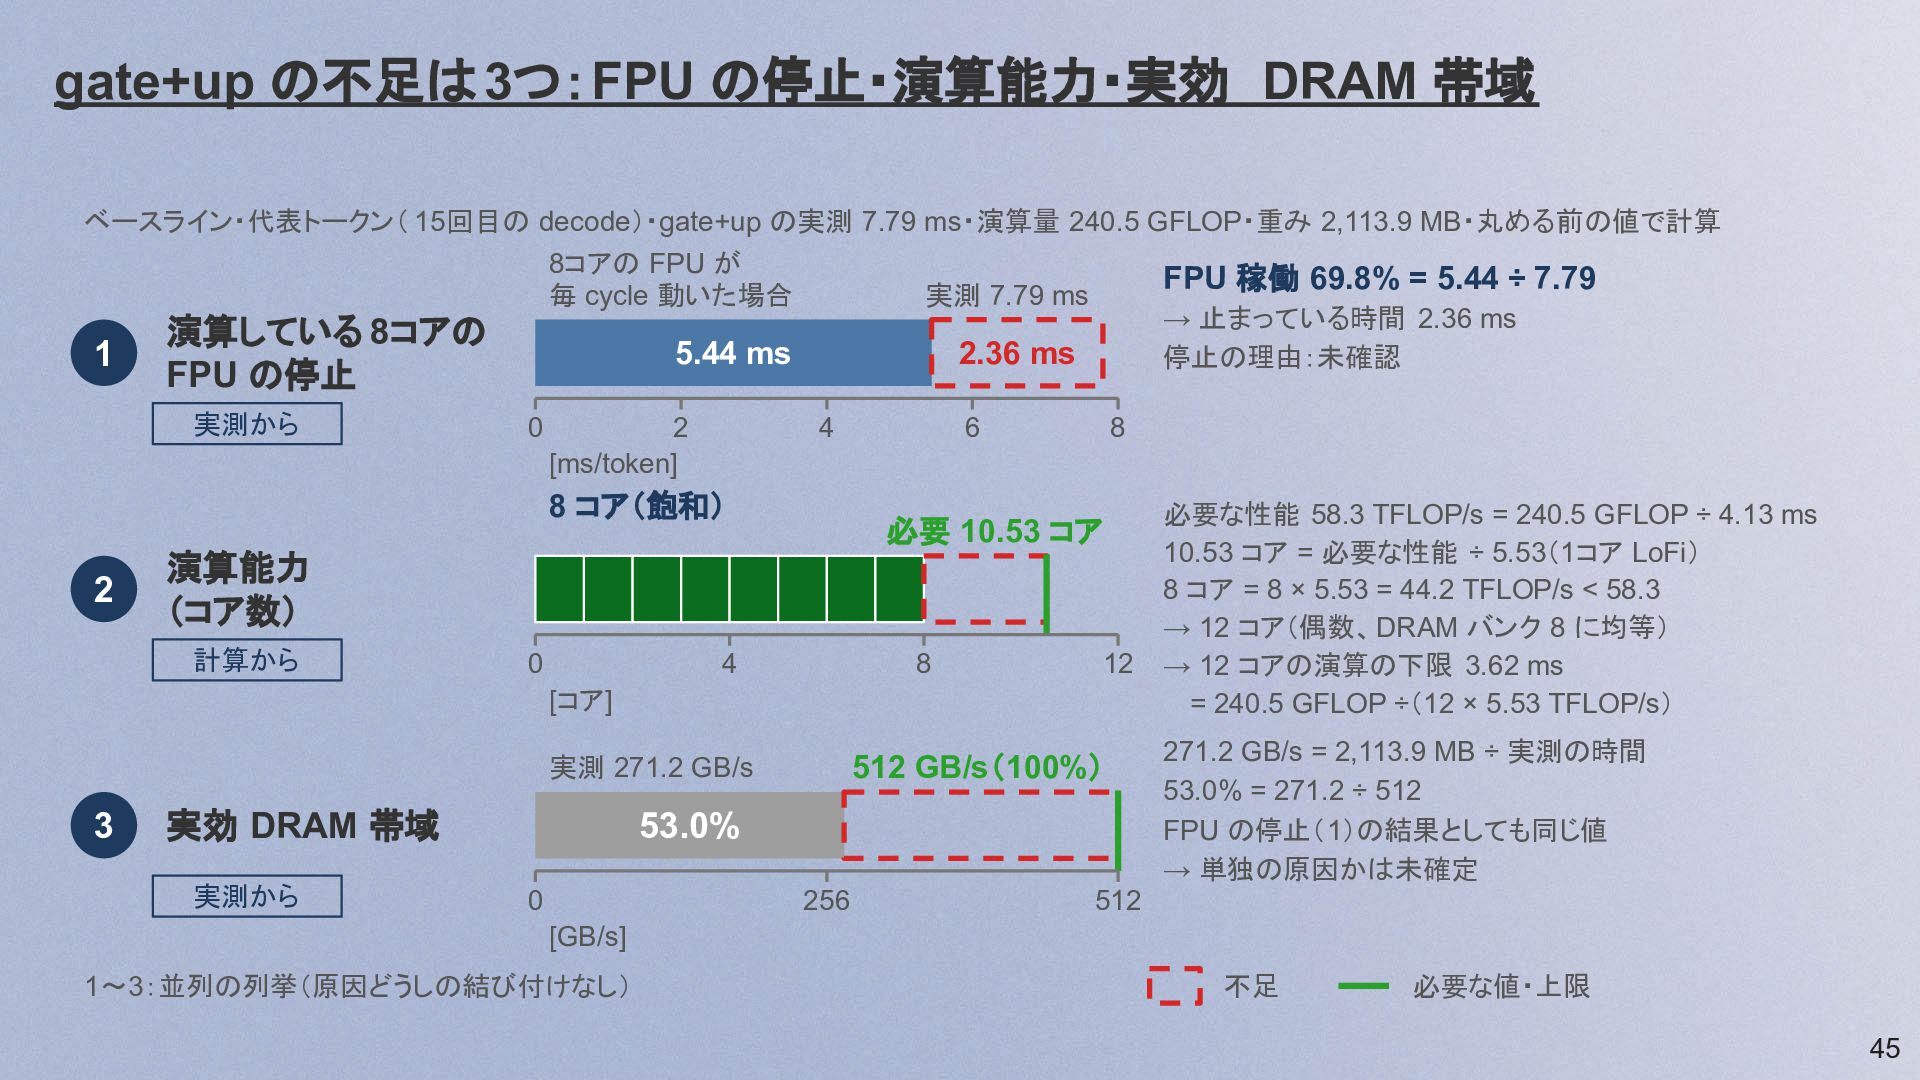
  41. gate+up の不足は 3つ:FPU の停止・演算能力・実効 DRAM 帯域 ベースライン・代表トークン( 15回目の decode)・gate+up の実測

    7.79 ms・演算量 240.5 GFLOP・重み 2,113.9 MB・丸める前の値で計算 1 8コアの FPU が 毎 cycle 動いた場合 実測 7.79 ms 5.44 ms 2.36 ms 演算している 8コアの FPU の停止 実測から 0 2 [ms/token] 4 8 コア(飽和) 2 FPU 稼働 69.8% = 5.44 ÷ 7.79 → 止まっている時間 2.36 ms 停止の理由:未確認 6 8 必要 10.53 コア 演算能力 (コア数) 計算から 0 4 8 12 [コア] 実測 271.2 GB/s 3 実効 DRAM 帯域 実測から 512 GB/s(100%) 53.0% 0 256 必要な性能 58.3 TFLOP/s = 240.5 GFLOP ÷ 4.13 ms 10.53 コア = 必要な性能 ÷ 5.53(1コア LoFi) 8 コア = 8 × 5.53 = 44.2 TFLOP/s < 58.3 → 12 コア(偶数、DRAM バンク 8 に均等) → 12 コアの演算の下限 3.62 ms = 240.5 GFLOP ÷(12 × 5.53 TFLOP/s) 271.2 GB/s = 2,113.9 MB ÷ 実測の時間 53.0% = 271.2 ÷ 512 FPU の停止(1)の結果としても同じ値 → 単独の原因かは未確定 512 [GB/s] 1〜3:並列の列挙(原因どうしの結び付けなし) 不足 必要な値・上限 45
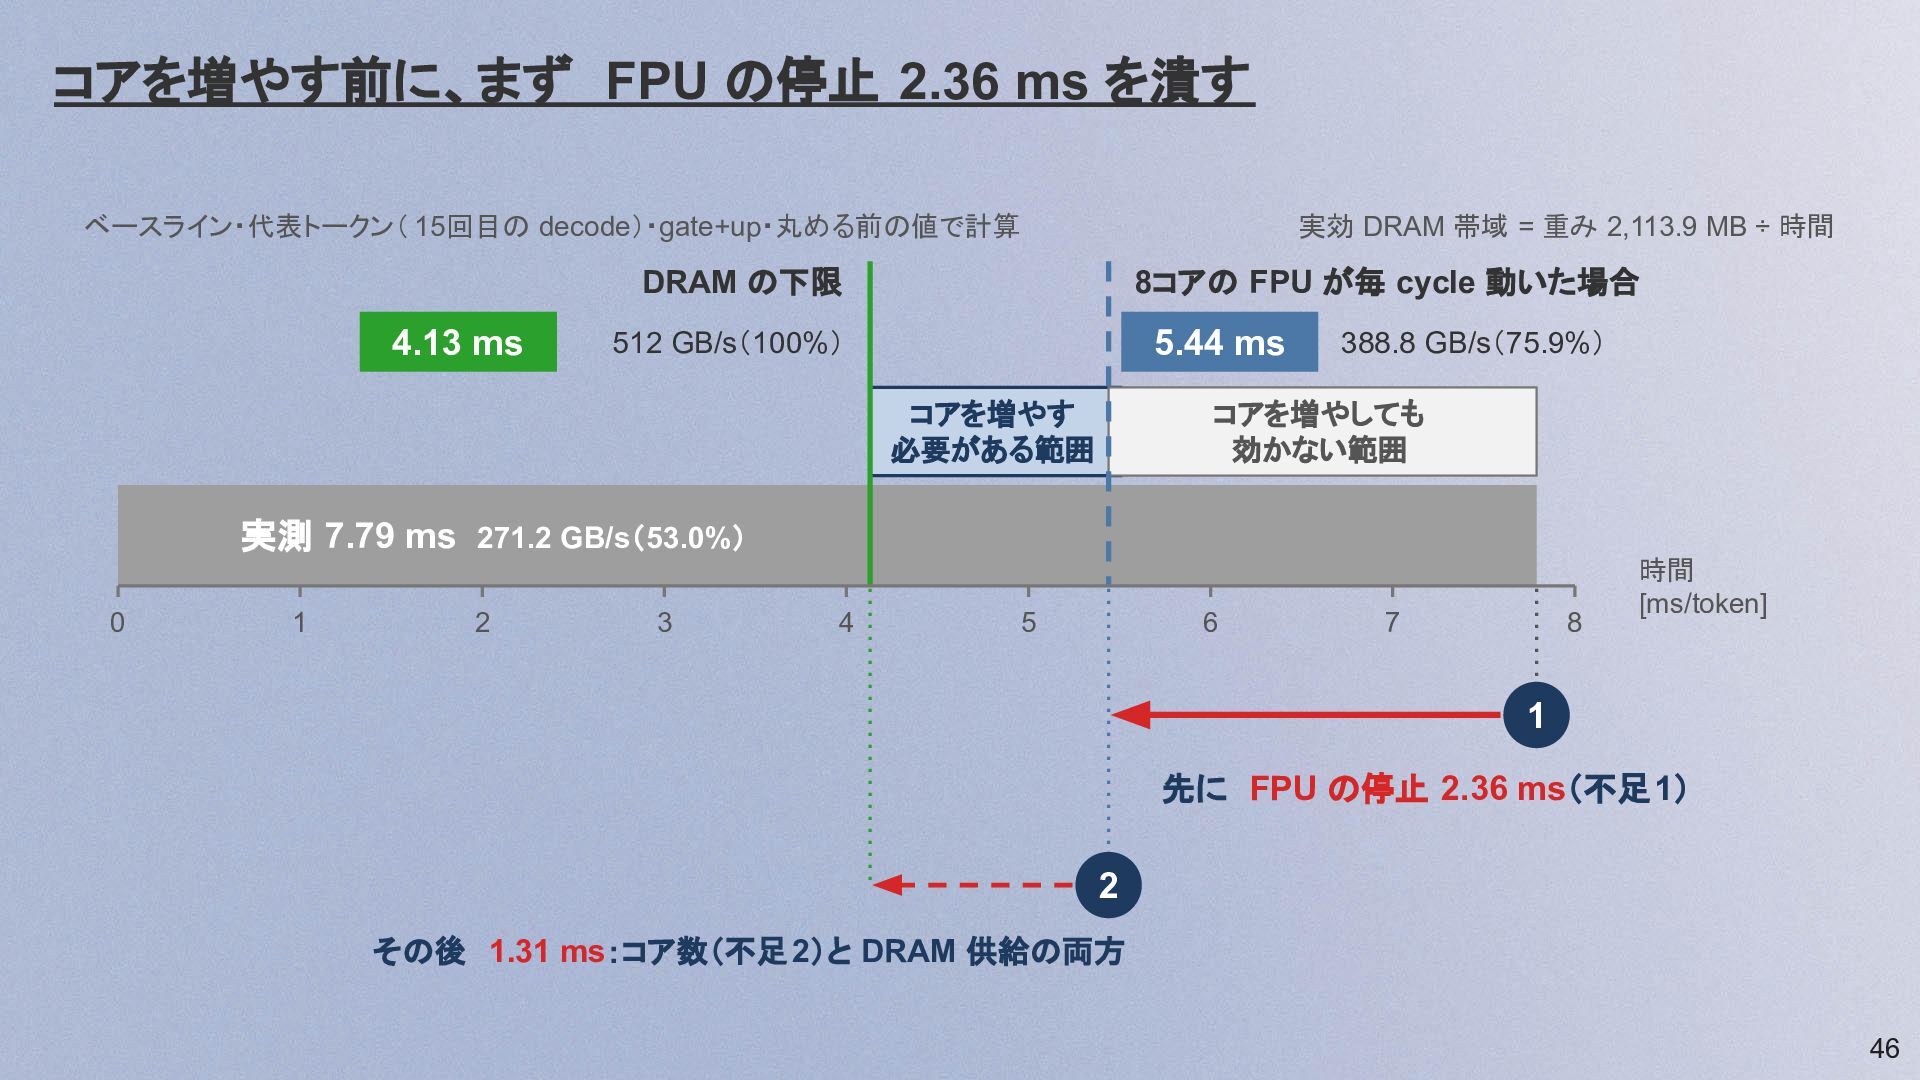
  42. コアを増やす前に、まず FPU の停止 2.36 ms を潰す ベースライン・代表トークン( 15回目の decode)・gate+up・丸める前の値で計算 実効

    DRAM 帯域 = 重み 2,113.9 MB ÷ 時間 DRAM の下限 4.13 ms 8コアの FPU が毎 cycle 動いた場合 5.44 ms 512 GB/s(100%) コアを増やす 必要がある範囲 388.8 GB/s(75.9%) コアを増やしても 効かない範囲 実測 7.79 ms 271.2 GB/s(53.0%) 0 1 2 3 4 5 6 7 8 時間 [ms/token] 1 先に FPU の停止 2.36 ms(不足1) 2 その後 1.31 ms:コア数(不足 2)と DRAM 供給の両方 46
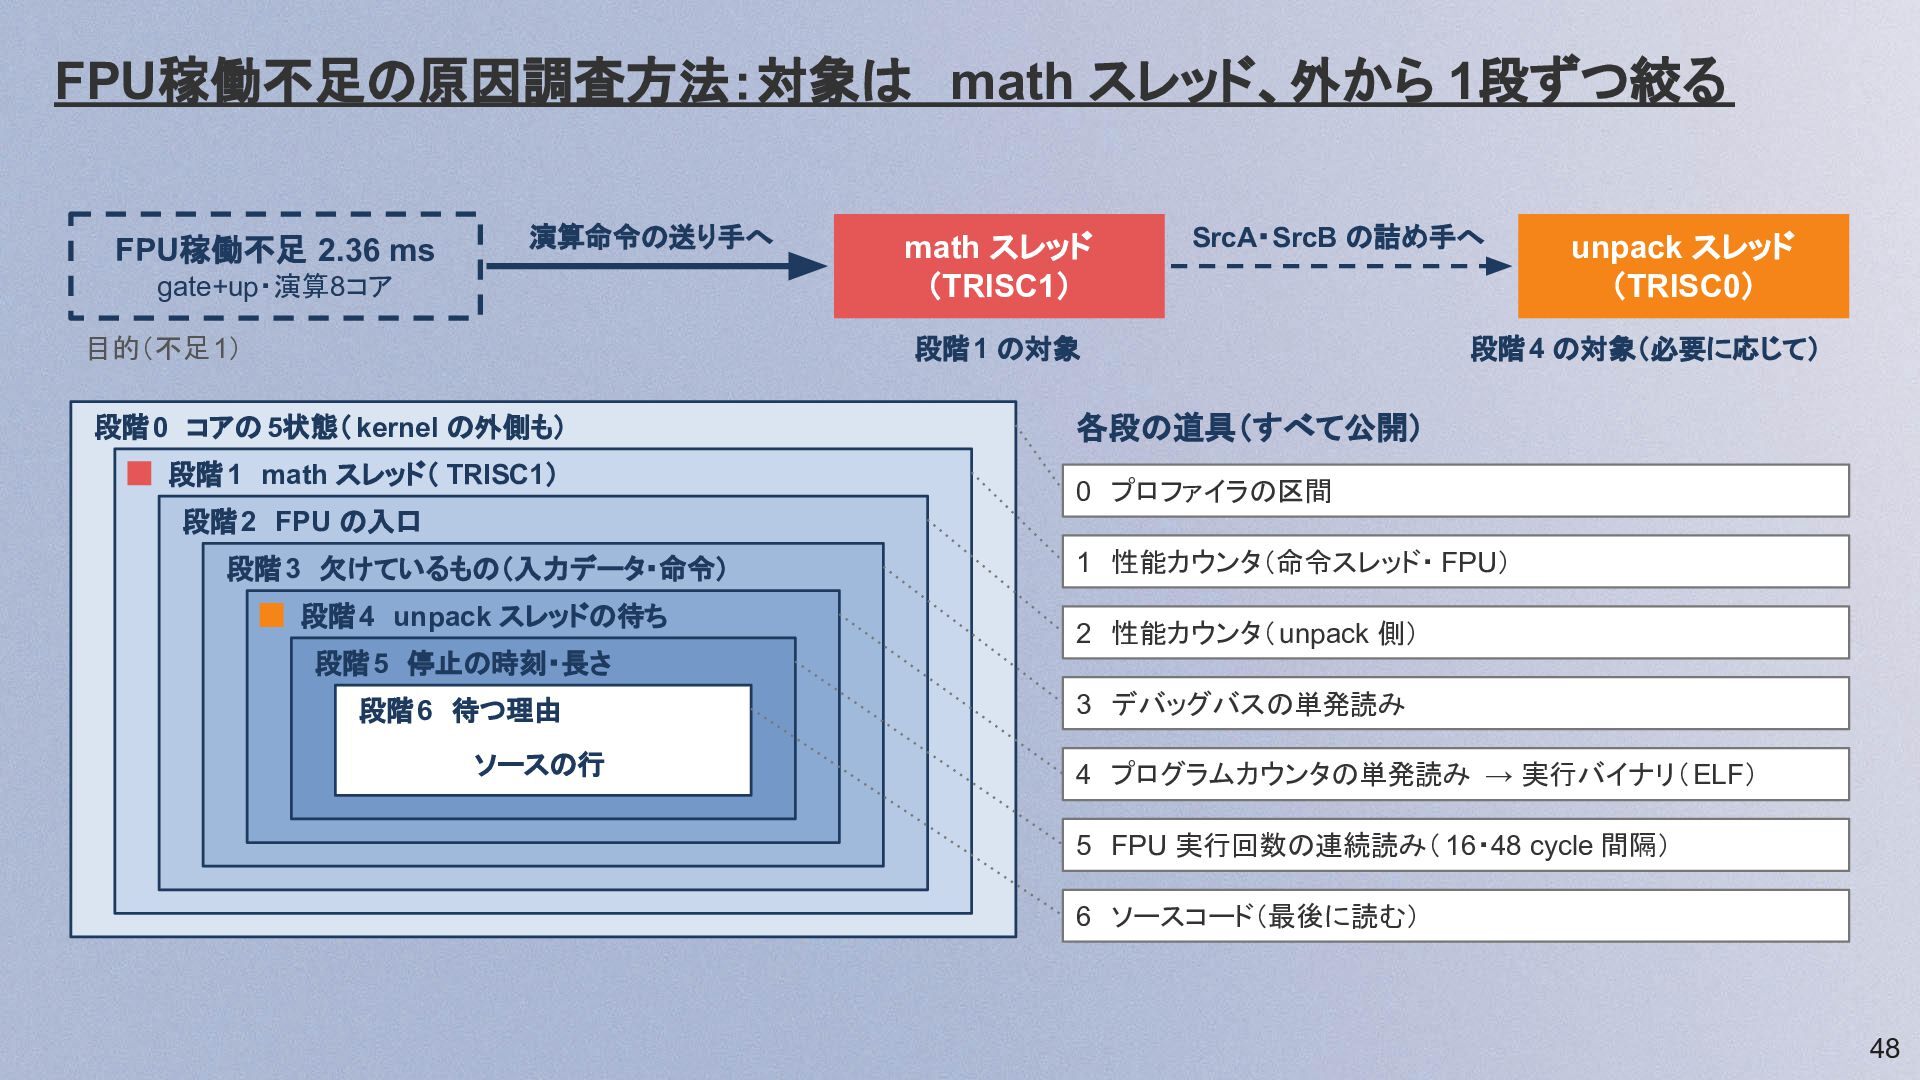
  43. FPU稼働不足の原因調査方法:対象は math スレッド、外から 1段ずつ絞る FPU稼働不足 2.36 ms 演算命令の送り手へ gate+up・演算8コア 目的(不足1)

    math スレッド (TRISC1) SrcA・SrcB の詰め手へ 段階1 の対象 段階0 コアの 5状態( kernel の外側も) 段階1 math スレッド( TRISC1) unpack スレッド (TRISC0) 段階4 の対象(必要に応じて) 各段の道具(すべて公開) 0 プロファイラの区間 段階2 FPU の入口 段階3 欠けているもの(入力データ・命令) 段階4 unpack スレッドの待ち 1 性能カウンタ(命令スレッド・ FPU) 2 性能カウンタ( unpack 側) 段階5 停止の時刻・長さ 段階6 待つ理由 ソースの行 3 デバッグバスの単発読み 4 プログラムカウンタの単発読み → 実行バイナリ( ELF) 5 FPU 実行回数の連続読み( 16・48 cycle 間隔) 6 ソースコード(最後に読む) 48
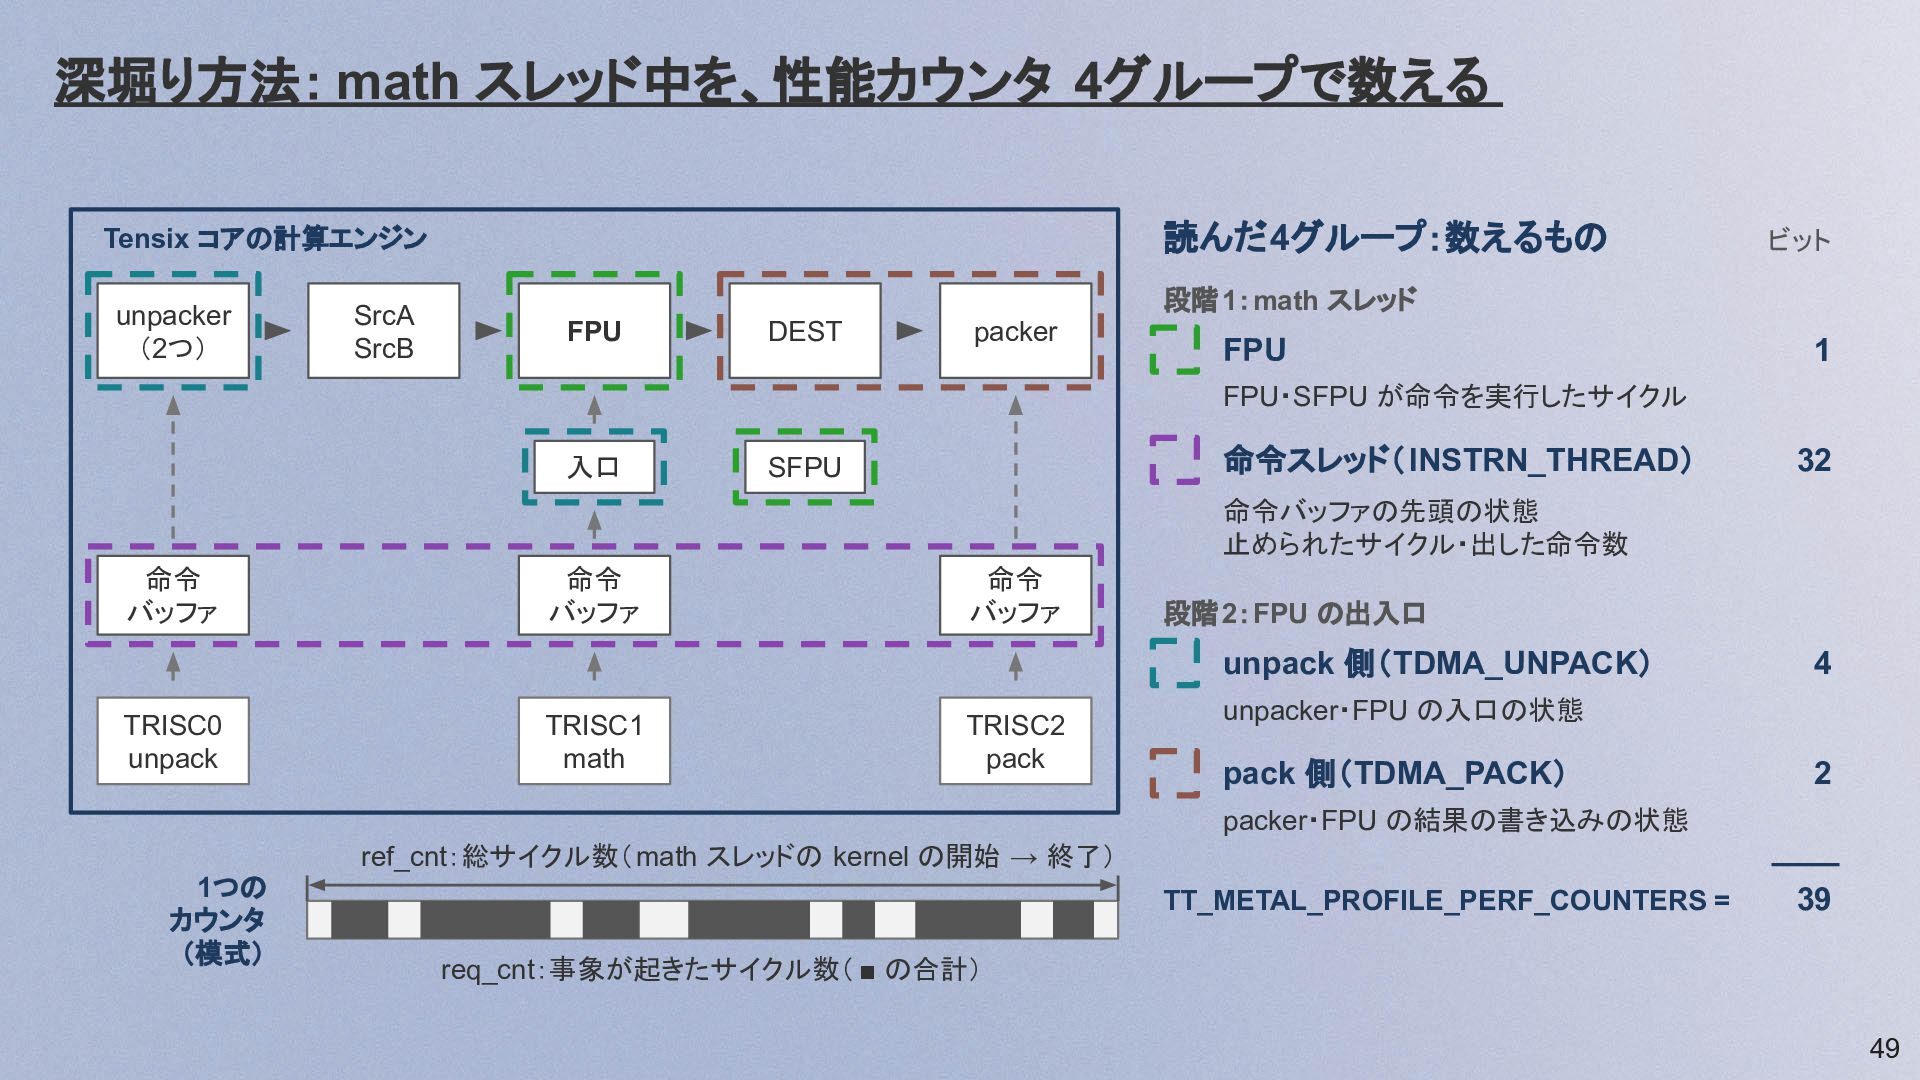
  44. 深堀り方法: math スレッド中を、性能カウンタ 4グループで数える 読んだ4グループ:数えるもの Tensix コアの計算エンジン unpacker (2つ) SrcA

    SrcB ビット 段階1:math スレッド FPU DEST packer FPU 1 FPU・SFPU が命令を実行したサイクル 入口 命令スレッド( INSTRN_THREAD) SFPU 32 命令バッファの先頭の状態 止められたサイクル・出した命令数 命令 バッファ 命令 バッファ 命令 バッファ 段階2:FPU の出入口 unpack 側(TDMA_UNPACK) TRISC0 unpack TRISC1 math TRISC2 pack 4 unpacker・FPU の入口の状態 pack 側(TDMA_PACK) 2 packer・FPU の結果の書き込みの状態 ref_cnt:総サイクル数( math スレッドの kernel の開始 → 終了) 1つの カウンタ (模式) TT_METAL_PROFILE_PERF_COUNTERS = 39 req_cnt:事象が起きたサイクル数( ▪ の合計) 49
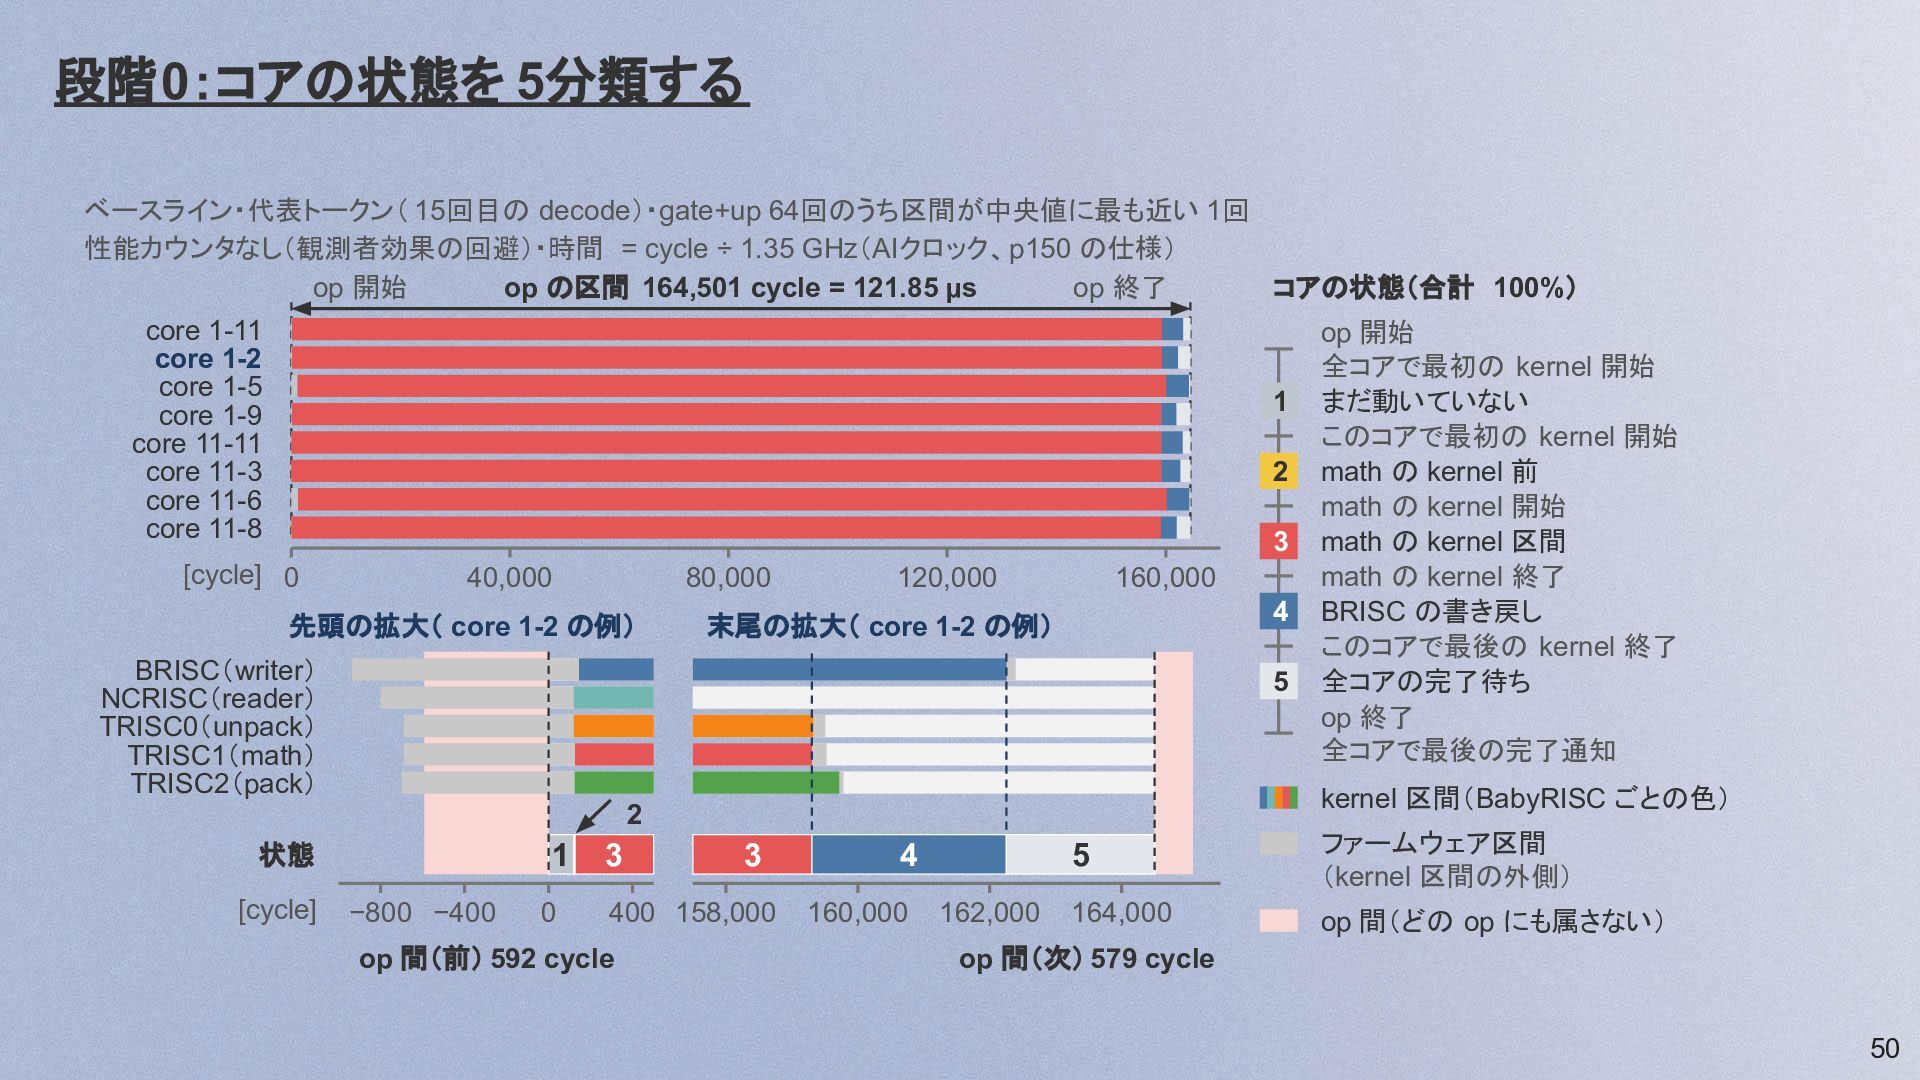
  45. 段階0:コアの状態を 5分類する ベースライン・代表トークン( 15回目の decode)・gate+up 64回のうち区間が中央値に最も近い 1回 性能カウンタなし(観測者効果の回避)・時間 = cycle

    ÷ 1.35 GHz(AIクロック、p150 の仕様) op 開始 op の区間 164,501 cycle = 121.85 µs op 終了 コアの状態(合計 100%) core 1-11 core 1-2 core 1-5 core 1-9 core 11-11 core 11-3 core 11-6 core 11-8 1 2 3 [cycle] 0 40,000 80,000 先頭の拡大( core 1-2 の例) 120,000 160,000 4 末尾の拡大( core 1-2 の例) BRISC(writer) NCRISC(reader) TRISC0(unpack) TRISC1(math) TRISC2(pack) 5 kernel 区間(BabyRISC ごとの色) 2 状態 [cycle] −800 −400 1 3 3 4 0 400 158,000 160,000 op 間(前) 592 cycle op 開始 全コアで最初の kernel 開始 まだ動いていない このコアで最初の kernel 開始 math の kernel 前 math の kernel 開始 math の kernel 区間 math の kernel 終了 BRISC の書き戻し このコアで最後の kernel 終了 全コアの完了待ち op 終了 全コアで最後の完了通知 162,000 5 ファームウェア区間 (kernel 区間の外側) 164,000 op 間(どの op にも属さない) op 間(次) 579 cycle 50
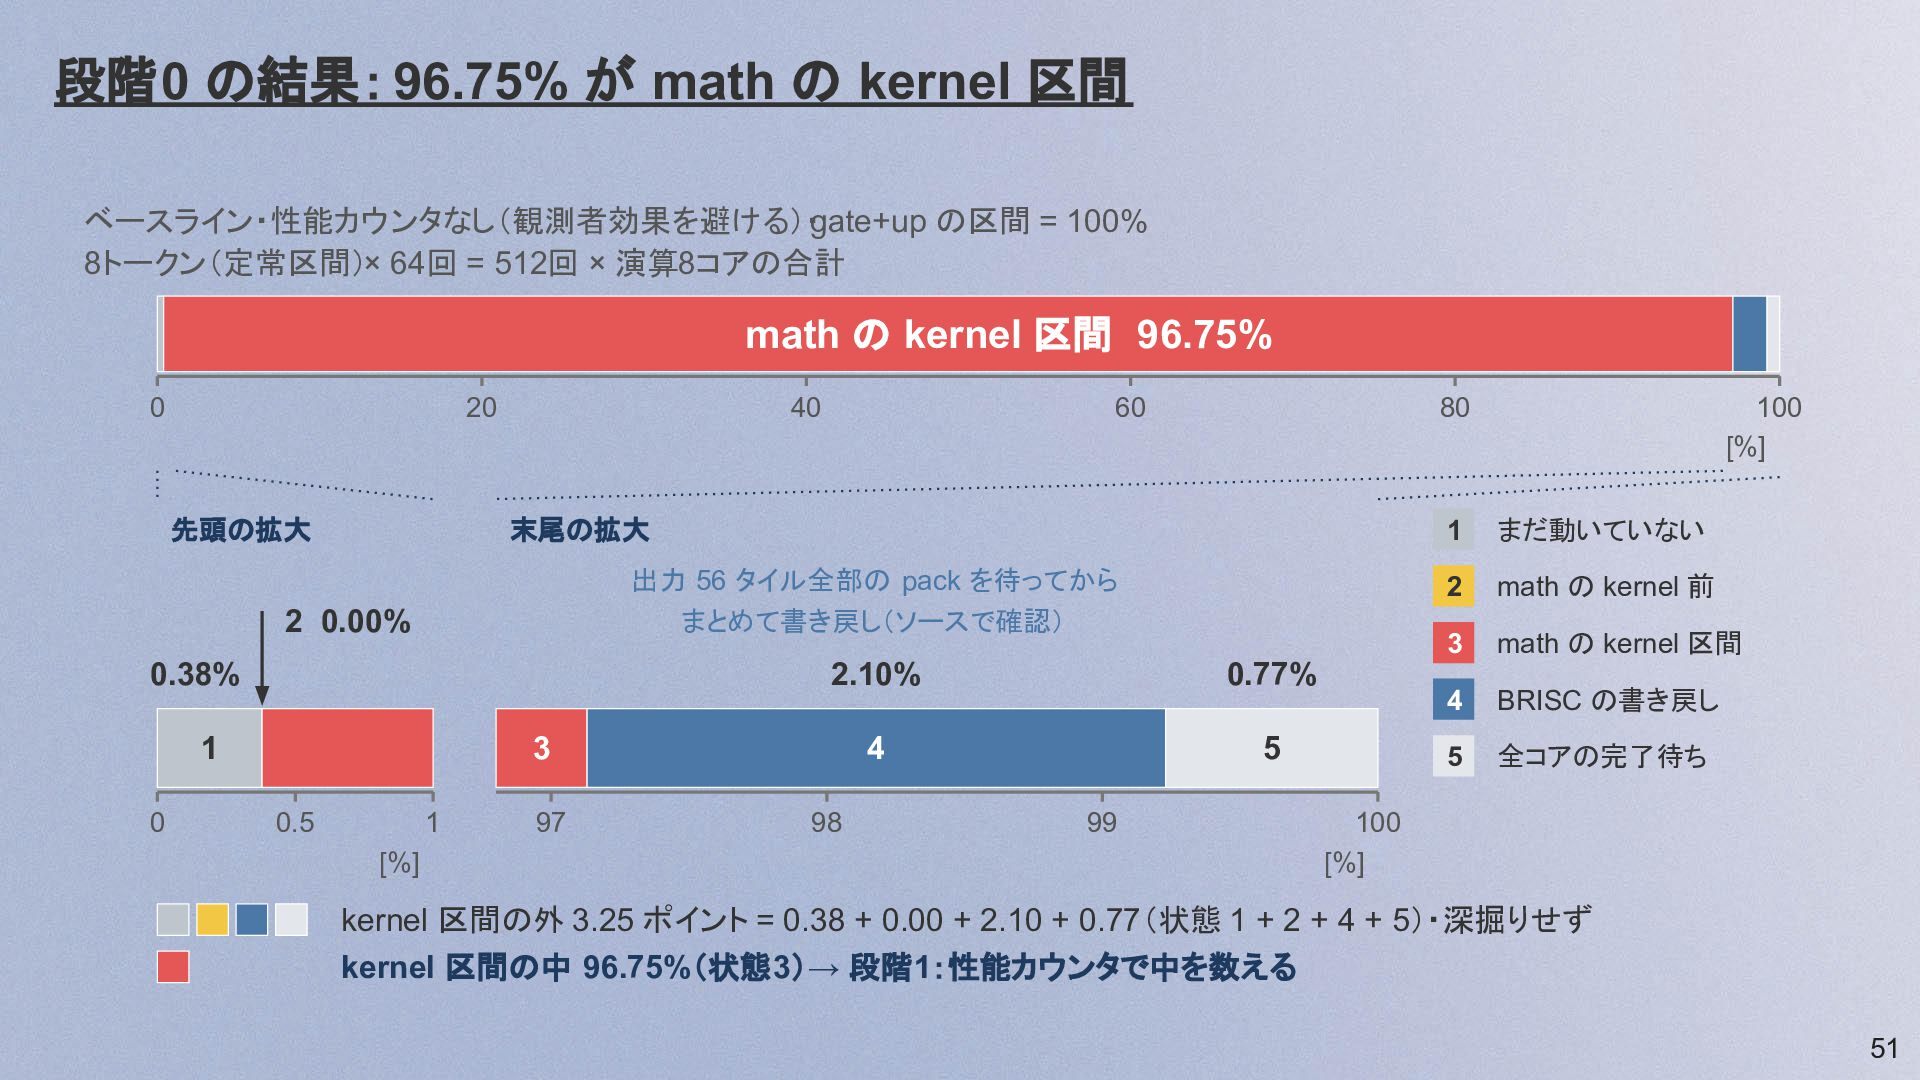
  46. 段階0 の結果: 96.75% が math の kernel 区間 ベースライン・性能カウンタなし(観測者効果を避ける)・gate+up の区間

    = 100% 8トークン(定常区間)× 64回 = 512回 × 演算8コアの合計 math の kernel 区間 96.75% 0 20 先頭の拡大 40 80 末尾の拡大 出力 56 タイル全部の pack を待ってから まとめて書き戻し(ソースで確認) 2 0.00% 0.38% 1 0 60 2.10% 0.77% 4 5 3 0.5 1 [%] 97 98 99 100 [%] 1 まだ動いていない 2 math の kernel 前 3 math の kernel 区間 4 BRISC の書き戻し 5 全コアの完了待ち 100 [%] kernel 区間の外 3.25 ポイント = 0.38 + 0.00 + 2.10 + 0.77(状態 1 + 2 + 4 + 5)・深掘りせず kernel 区間の中 96.75%(状態3)→ 段階1:性能カウンタで中を数える 51
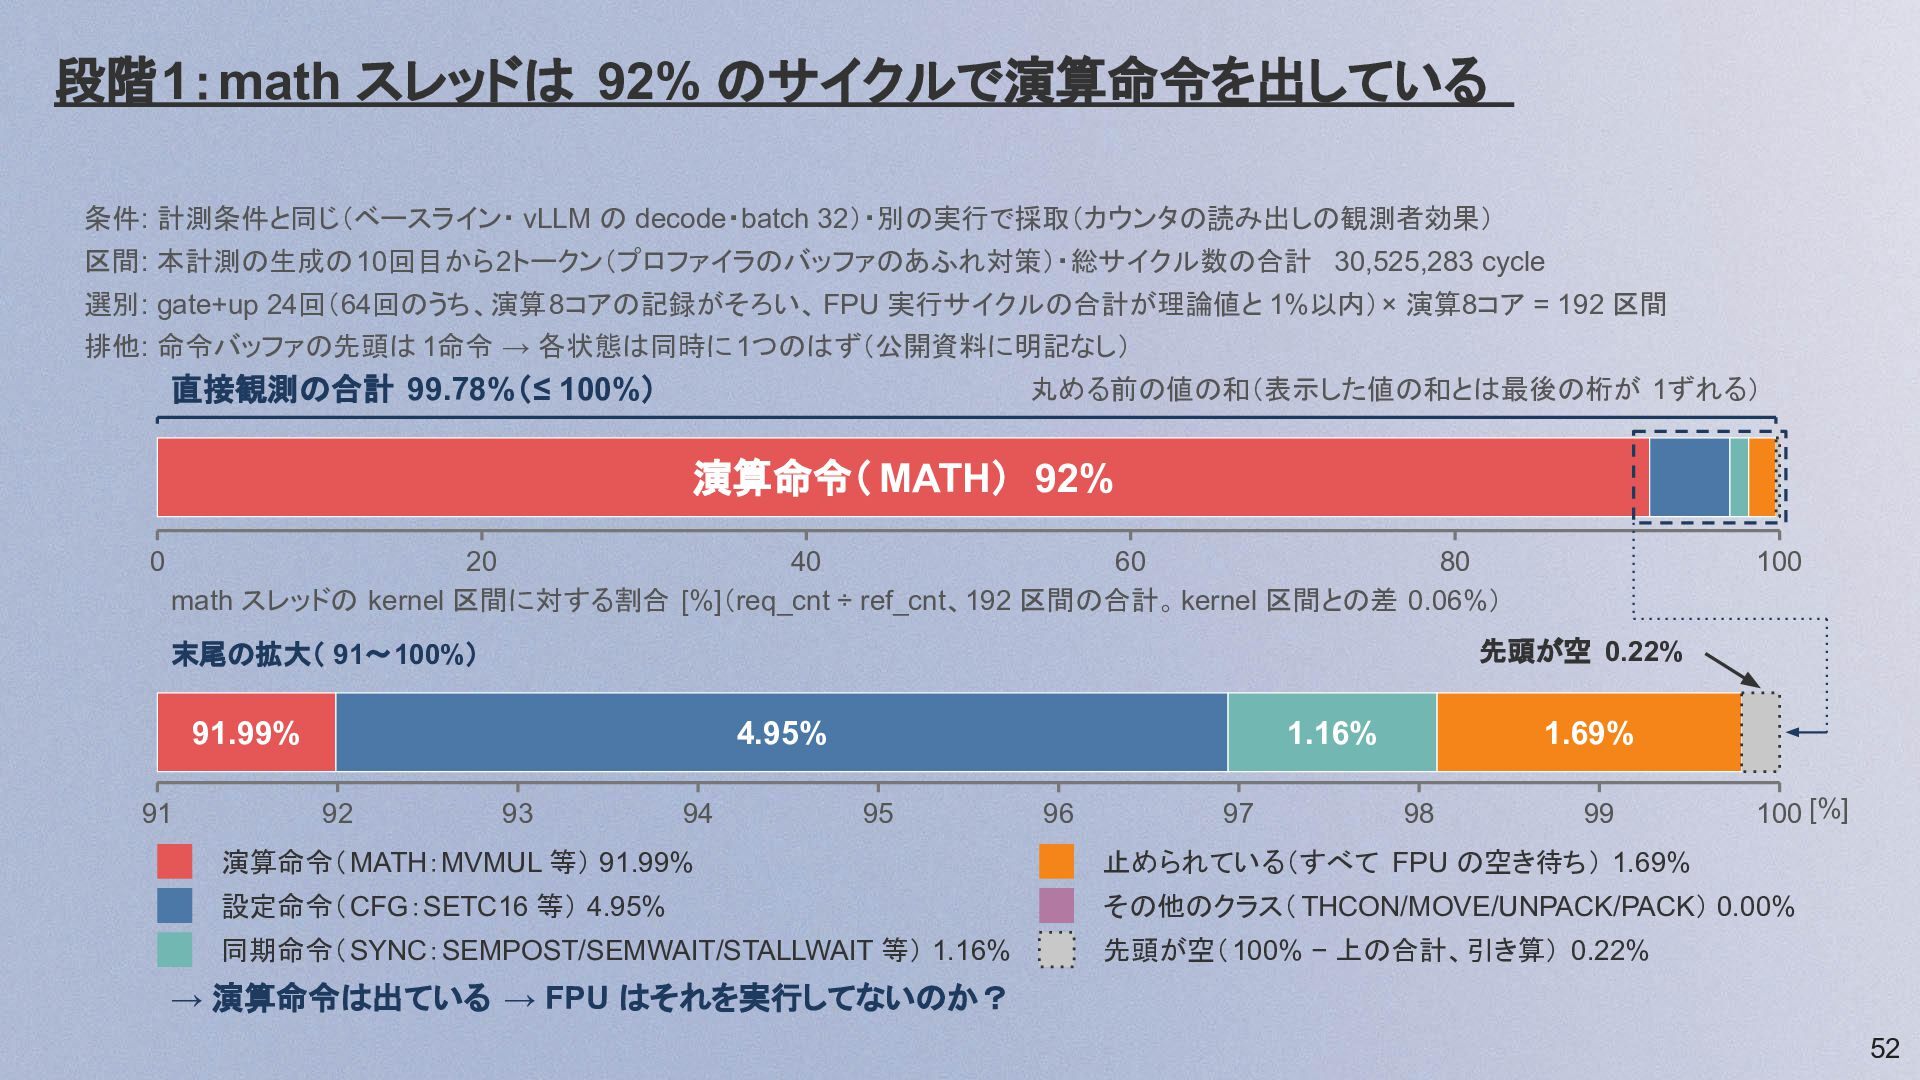
  47. 段階1:math スレッドは 92% のサイクルで演算命令を出している 条件: 計測条件と同じ(ベースライン・ vLLM の decode・batch 32)・別の実行で採取(カウンタの読み出しの観測者効果)

    区間: 本計測の生成の 10回目から2トークン(プロファイラのバッファのあふれ対策)・総サイクル数の合計 30,525,283 cycle 選別: gate+up 24回(64回のうち、演算 8コアの記録がそろい、 FPU 実行サイクルの合計が理論値と 1%以内)× 演算8コア = 192 区間 排他: 命令バッファの先頭は 1命令 → 各状態は同時に 1つのはず(公開資料に明記なし) 直接観測の合計 99.78%(≤ 100%) 丸める前の値の和(表示した値の和とは最後の桁が 1ずれる) 演算命令( MATH) 92% 0 20 40 60 80 math スレッドの kernel 区間に対する割合 [%](req_cnt ÷ ref_cnt、192 区間の合計。 kernel 区間との差 0.06%) 先頭が空 0.22% 末尾の拡大( 91〜100%) 91.99% 91 4.95% 92 100 93 94 1.16% 95 96 97 1.69% 98 99 100 [%] 演算命令(MATH:MVMUL 等) 91.99% 止められている(すべて FPU の空き待ち) 1.69% 設定命令(CFG:SETC16 等) 4.95% その他のクラス( THCON/MOVE/UNPACK/PACK) 0.00% 同期命令(SYNC:SEMPOST/SEMWAIT/STALLWAIT 等) 1.16% 先頭が空(100% − 上の合計、引き算) 0.22% → 演算命令は出ている → FPU はそれを実行してないのか? 52
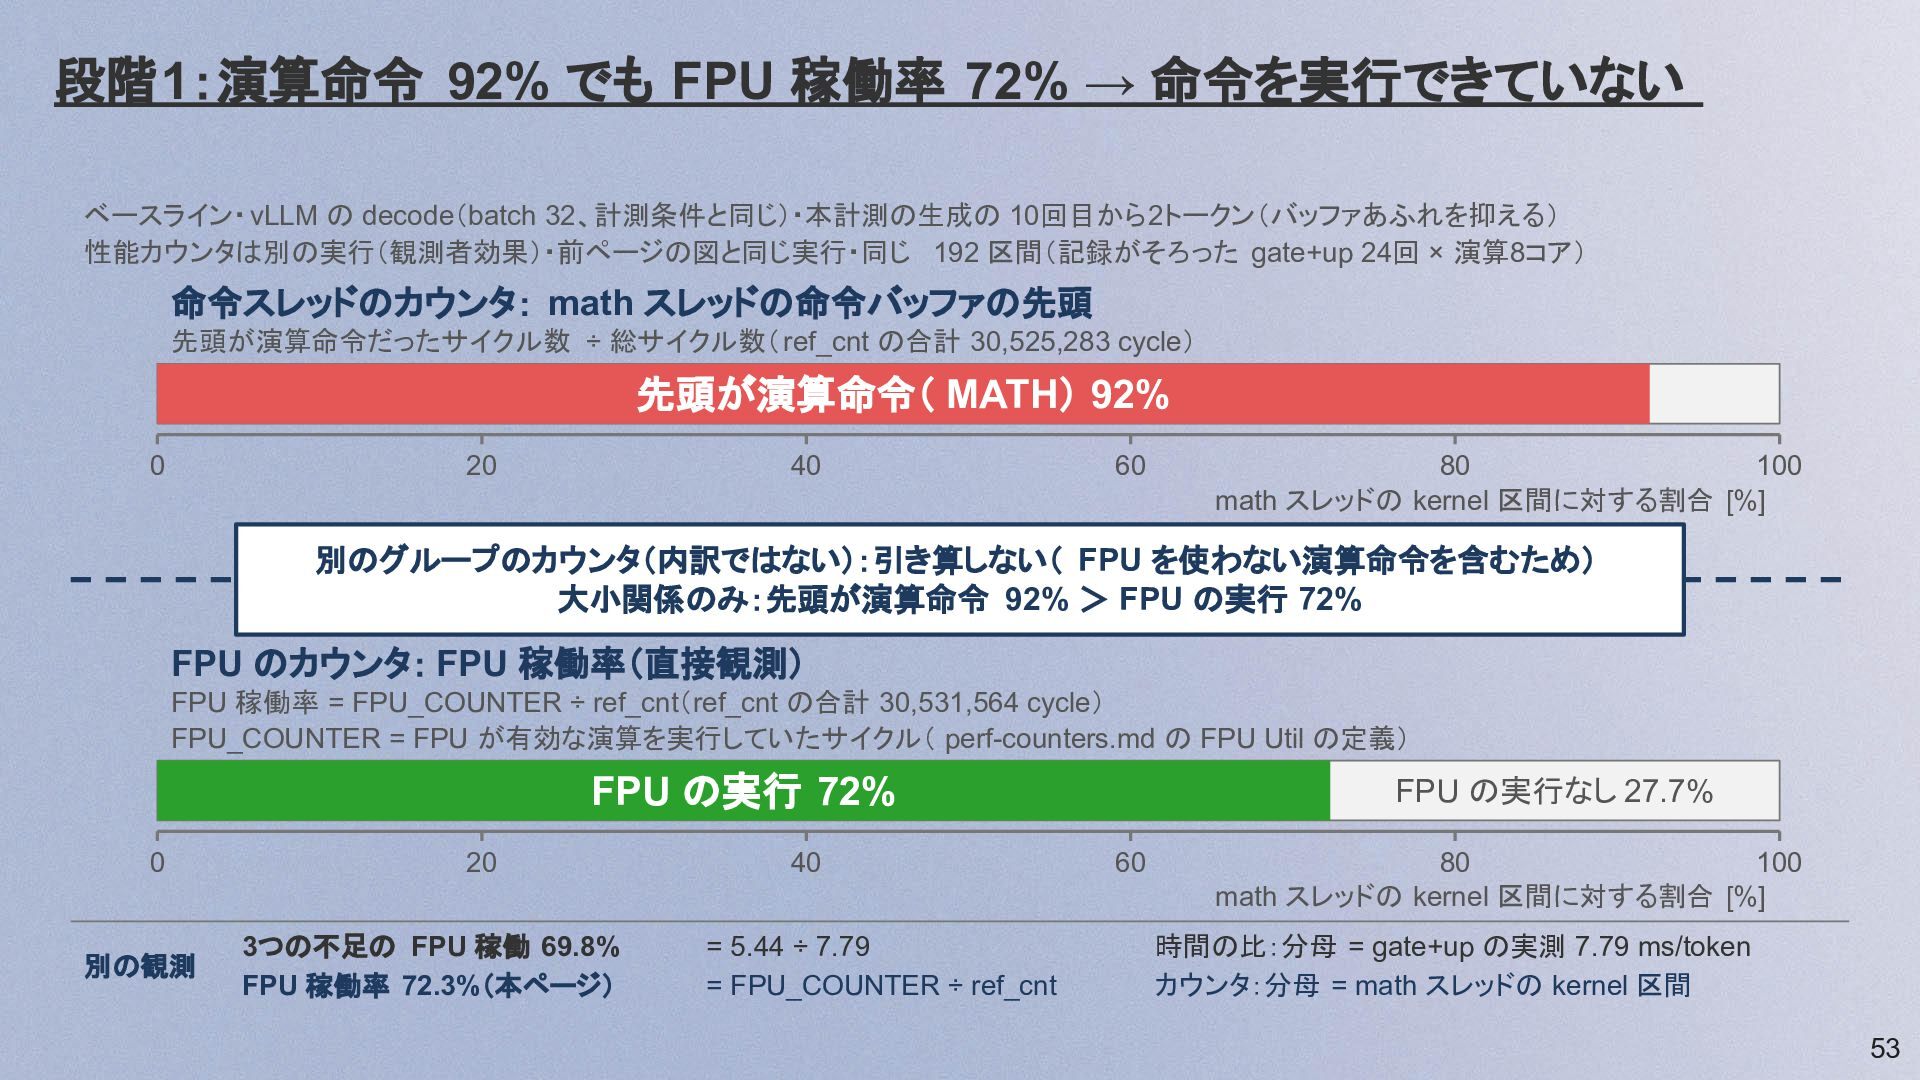
  48. 段階1:演算命令 92% でも FPU 稼働率 72% → 命令を実行できていない ベースライン・ vLLM

    の decode(batch 32、計測条件と同じ)・本計測の生成の 10回目から2トークン(バッファあふれを抑える) 性能カウンタは別の実行(観測者効果)・前ページの図と同じ実行・同じ 192 区間(記録がそろった gate+up 24回 × 演算8コア) 命令スレッドのカウンタ: math スレッドの命令バッファの先頭 先頭が演算命令だったサイクル数 ÷ 総サイクル数( ref_cnt の合計 30,525,283 cycle) 先頭が演算命令( MATH) 92% 0 20 40 60 80 100 math スレッドの kernel 区間に対する割合 [%] 別のグループのカウンタ(内訳ではない):引き算しない( FPU を使わない演算命令を含むため) 大小関係のみ:先頭が演算命令 92% > FPU の実行 72% FPU のカウンタ: FPU 稼働率(直接観測) FPU 稼働率 = FPU_COUNTER ÷ ref_cnt(ref_cnt の合計 30,531,564 cycle) FPU_COUNTER = FPU が有効な演算を実行していたサイクル( perf-counters.md の FPU Util の定義) FPU の実行 72% 0 別の観測 20 3つの不足の FPU 稼働 69.8% FPU 稼働率 72.3%(本ページ) 40 = 5.44 ÷ 7.79 = FPU_COUNTER ÷ ref_cnt FPU の実行なし 27.7% 60 80 100 math スレッドの kernel 区間に対する割合 [%] 時間の比:分母 = gate+up の実測 7.79 ms/token カウンタ:分母 = math スレッドの kernel 区間 53
  49. 段階2:入口のカウンタの差を見て 実行前の状態分離 段階1 と同じ 192 区間(gate+up 24回 × 演算8コア)・模式図(長さは量を表さない) unpack

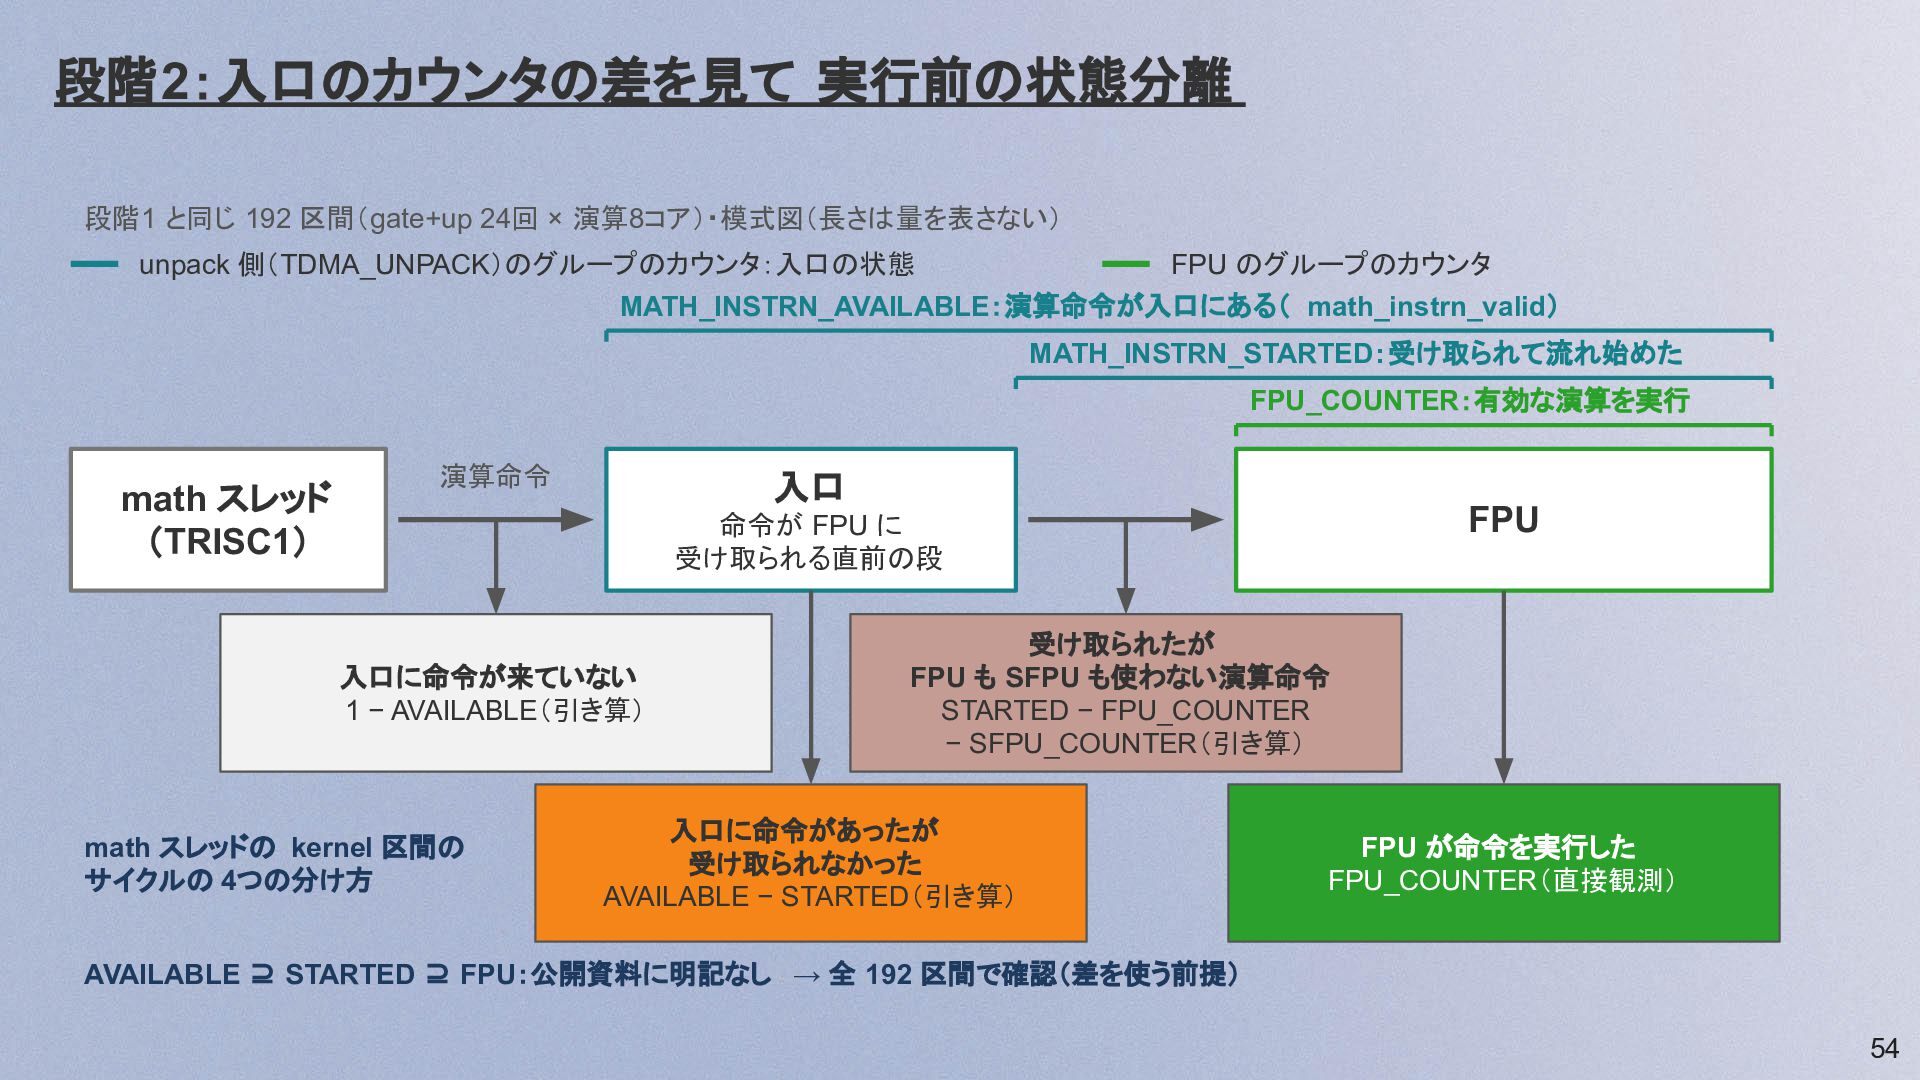
    側(TDMA_UNPACK)のグループのカウンタ:入口の状態 FPU のグループのカウンタ MATH_INSTRN_AVAILABLE:演算命令が入口にある( math_instrn_valid) MATH_INSTRN_STARTED:受け取られて流れ始めた FPU_COUNTER:有効な演算を実行 math スレッド (TRISC1) 演算命令 入口 FPU 命令が FPU に 受け取られる直前の段 入口に命令が来ていない 1 − AVAILABLE(引き算) math スレッドの kernel 区間の サイクルの 4つの分け方 受け取られたが FPU も SFPU も使わない演算命令 STARTED − FPU_COUNTER − SFPU_COUNTER(引き算) 入口に命令があったが 受け取られなかった AVAILABLE − STARTED(引き算) FPU が命令を実行した FPU_COUNTER(直接観測) AVAILABLE ⊇ STARTED ⊇ FPU:公開資料に明記なし → 全 192 区間で確認(差を使う前提) 54
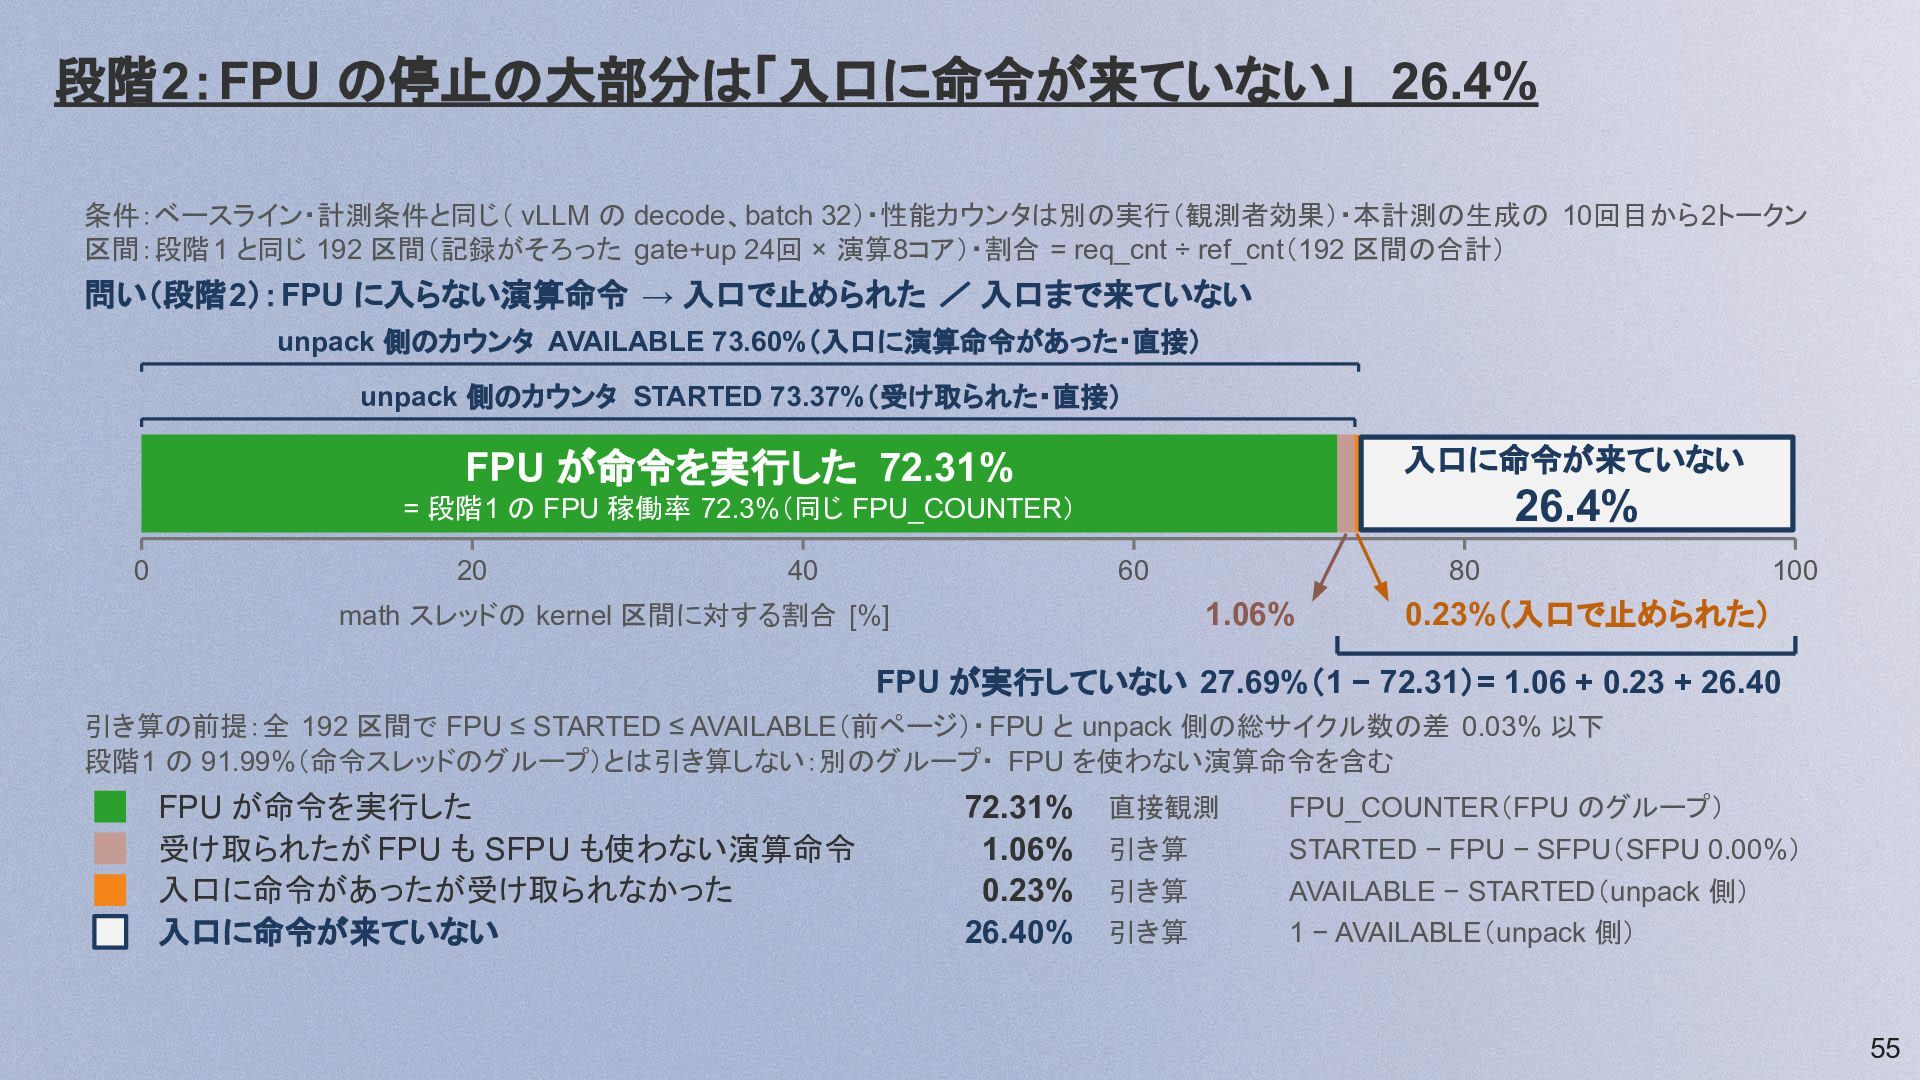
  50. 段階2:FPU の停止の大部分は「入口に命令が来ていない」 26.4% 条件:ベースライン・計測条件と同じ( vLLM の decode、batch 32)・性能カウンタは別の実行(観測者効果)・本計測の生成の 10回目から2トークン 区間:段階1

    と同じ 192 区間(記録がそろった gate+up 24回 × 演算8コア)・割合 = req_cnt ÷ ref_cnt(192 区間の合計) 問い(段階2):FPU に入らない演算命令 → 入口で止められた / 入口まで来ていない unpack 側のカウンタ AVAILABLE 73.60%(入口に演算命令があった・直接) unpack 側のカウンタ STARTED 73.37%(受け取られた・直接) 入口に命令が来ていない FPU が命令を実行した 72.31% 26.4% = 段階1 の FPU 稼働率 72.3%(同じ FPU_COUNTER) 0 20 40 60 math スレッドの kernel 区間に対する割合 [%] 80 1.06% 100 0.23%(入口で止められた) FPU が実行していない 27.69%(1 − 72.31)= 1.06 + 0.23 + 26.40 引き算の前提:全 192 区間で FPU ≤ STARTED ≤ AVAILABLE(前ページ)・FPU と unpack 側の総サイクル数の差 0.03% 以下 段階1 の 91.99%(命令スレッドのグループ)とは引き算しない:別のグループ・ FPU を使わない演算命令を含む FPU が命令を実行した 受け取られたが FPU も SFPU も使わない演算命令 入口に命令があったが受け取られなかった 入口に命令が来ていない 72.31% 1.06% 0.23% 26.40% 直接観測 引き算 引き算 引き算 FPU_COUNTER(FPU のグループ) STARTED − FPU − SFPU(SFPU 0.00%) AVAILABLE − STARTED(unpack 側) 1 − AVAILABLE(unpack 側) 55
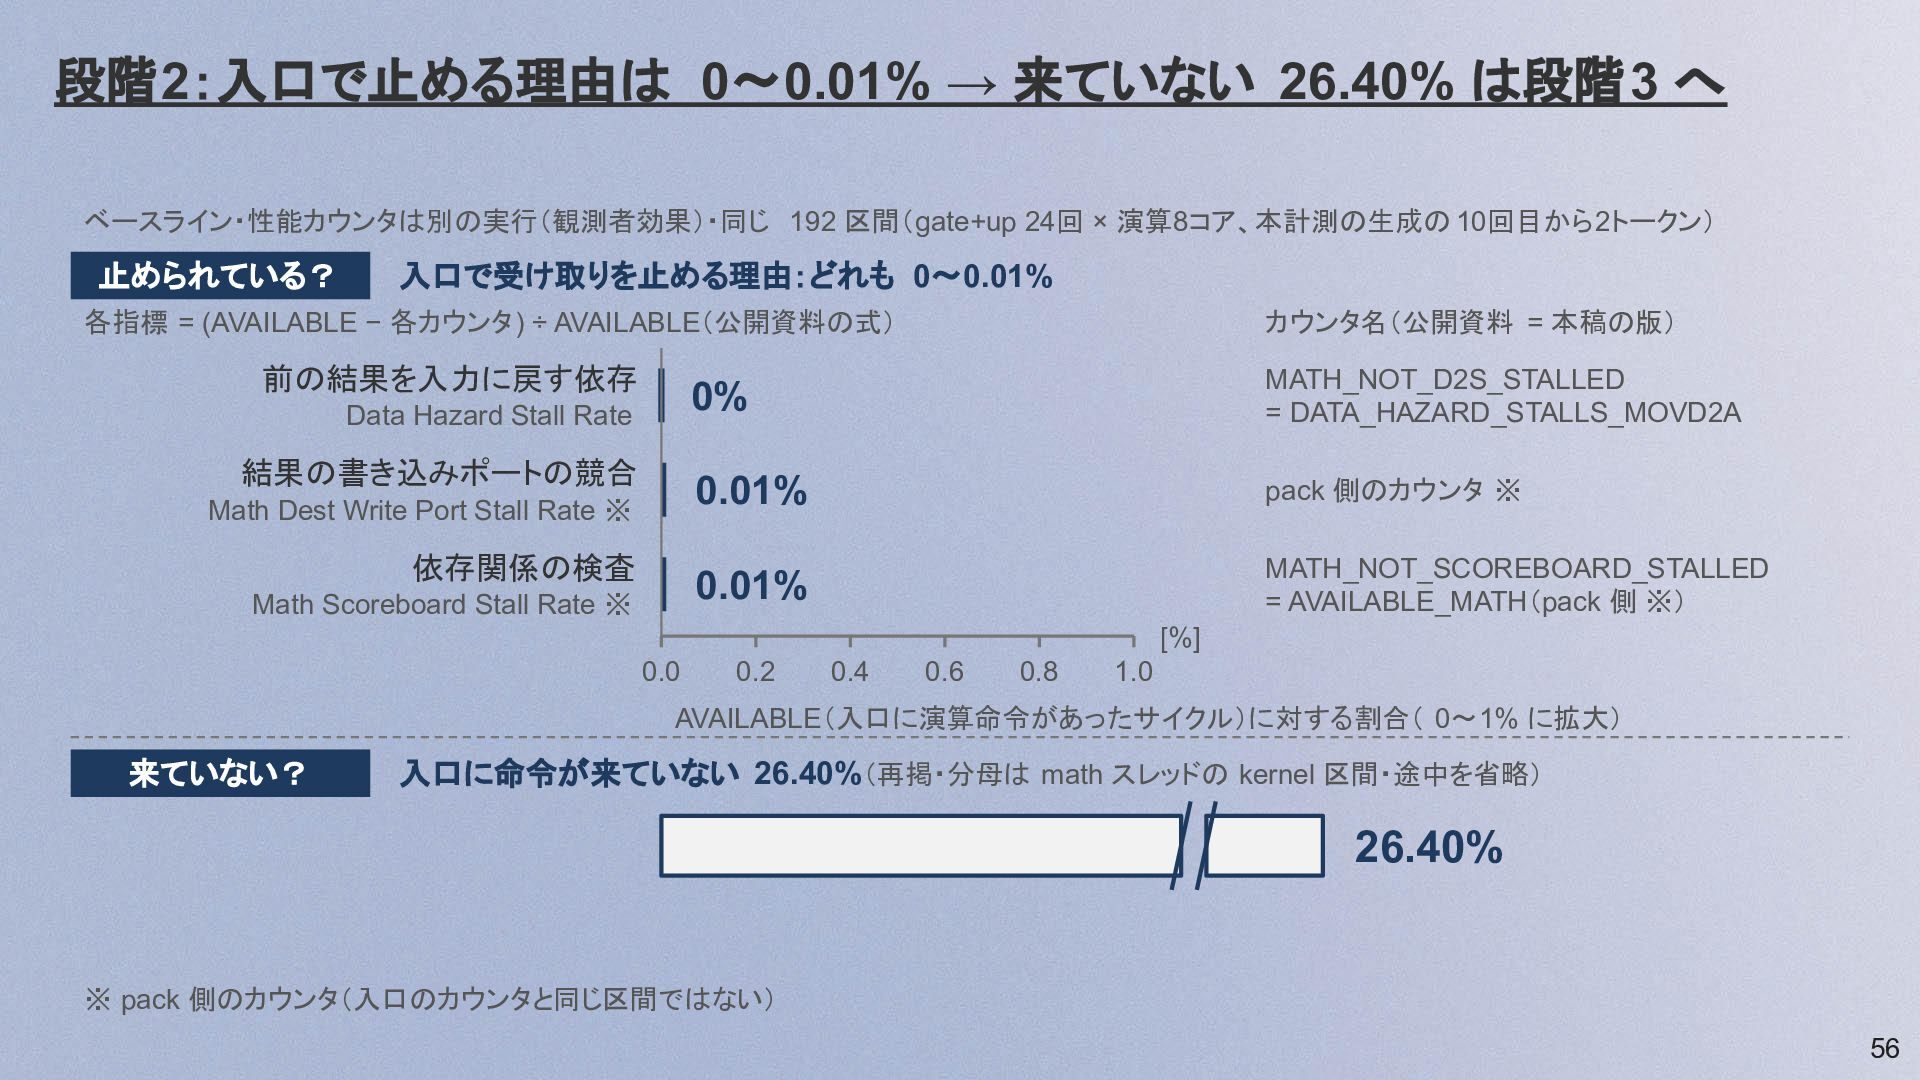
  51. 段階2:入口で止める理由は 0〜0.01% → 来ていない 26.40% は段階3 へ ベースライン・性能カウンタは別の実行(観測者効果)・同じ 192 区間(gate+up

    24回 × 演算8コア、本計測の生成の 10回目から2トークン) 止められている? 入口で受け取りを止める理由:どれも 0〜0.01% 各指標 = (AVAILABLE − 各カウンタ) ÷ AVAILABLE(公開資料の式) 前の結果を入力に戻す依存 Data Hazard Stall Rate 結果の書き込みポートの競合 Math Dest Write Port Stall Rate ※ 依存関係の検査 Math Scoreboard Stall Rate ※ カウンタ名(公開資料 = 本稿の版) 0% MATH_NOT_D2S_STALLED = DATA_HAZARD_STALLS_MOVD2A 0.01% pack 側のカウンタ ※ 0.01% MATH_NOT_SCOREBOARD_STALLED = AVAILABLE_MATH(pack 側 ※) [%] 0.0 0.2 0.4 0.6 0.8 1.0 AVAILABLE(入口に演算命令があったサイクル)に対する割合( 0〜1% に拡大) 来ていない? 入口に命令が来ていない 26.40%(再掲・分母は math スレッドの kernel 区間・途中を省略) 26.40% ※ pack 側のカウンタ(入口のカウンタと同じ区間ではない) 56
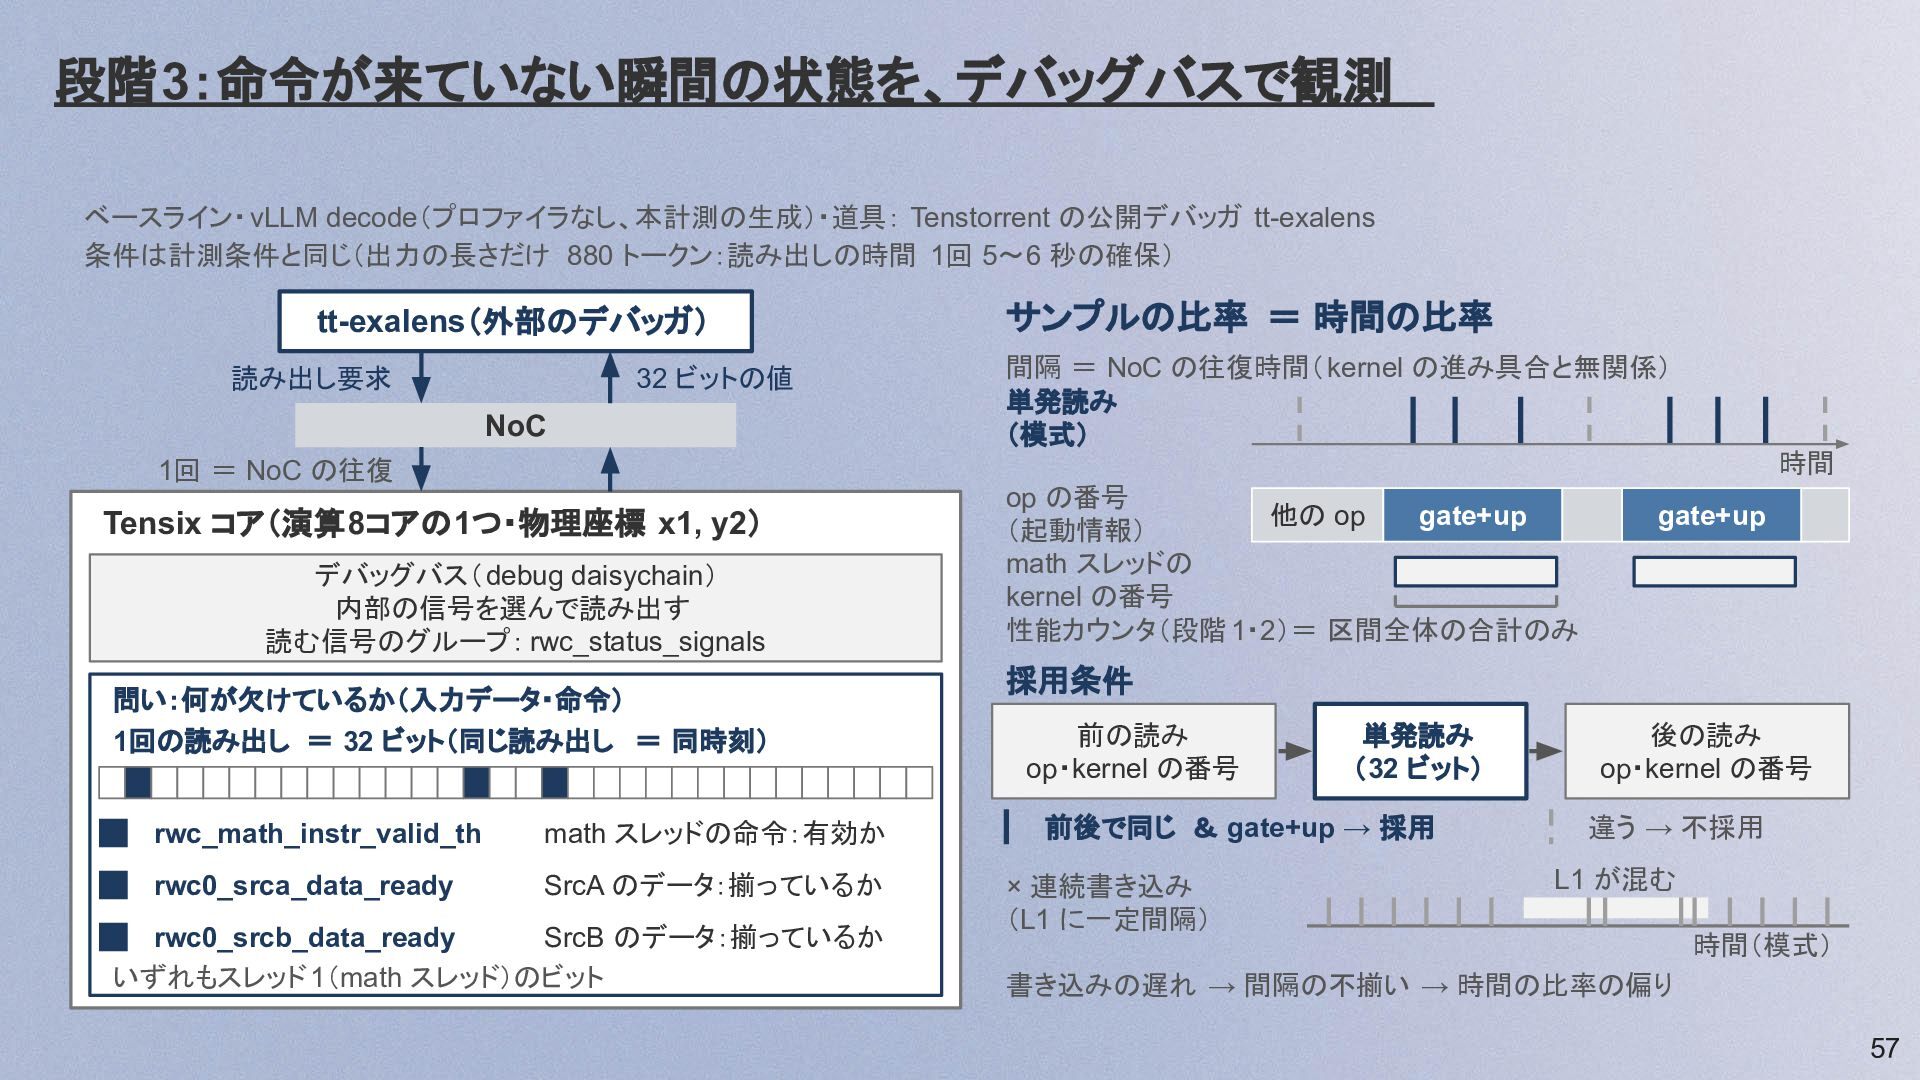
  52. 段階3:命令が来ていない瞬間の状態を、デバッグバスで観測 ベースライン・ vLLM decode(プロファイラなし、本計測の生成)・道具: Tenstorrent の公開デバッガ tt-exalens 条件は計測条件と同じ(出力の長さだけ 880 トークン:読み出しの時間

    1回 5〜6 秒の確保) tt-exalens(外部のデバッガ) 読み出し要求 32 ビットの値 NoC サンプルの比率 = 時間の比率 間隔 = NoC の往復時間(kernel の進み具合と無関係) 単発読み (模式) 時間 1回 = NoC の往復 Tensix コア(演算8コアの1つ・物理座標 x1, y2) デバッグバス( debug daisychain) 内部の信号を選んで読み出す 読む信号のグループ: rwc_status_signals 問い:何が欠けているか(入力データ・命令) 1回の読み出し = 32 ビット(同じ読み出し = 同時刻) rwc_math_instr_valid_th math スレッドの命令:有効か rwc0_srca_data_ready SrcA のデータ:揃っているか rwc0_srcb_data_ready SrcB のデータ:揃っているか いずれもスレッド 1(math スレッド)のビット op の番号 他の op gate+up (起動情報) math スレッドの kernel の番号 性能カウンタ(段階 1・2)= 区間全体の合計のみ gate+up 採用条件 前の読み op・kernel の番号 単発読み (32 ビット) 前後で同じ & gate+up → 採用 × 連続書き込み (L1 に一定間隔) 後の読み op・kernel の番号 違う → 不採用 L1 が混む 時間(模式) 書き込みの遅れ → 間隔の不揃い → 時間の比率の偏り 57
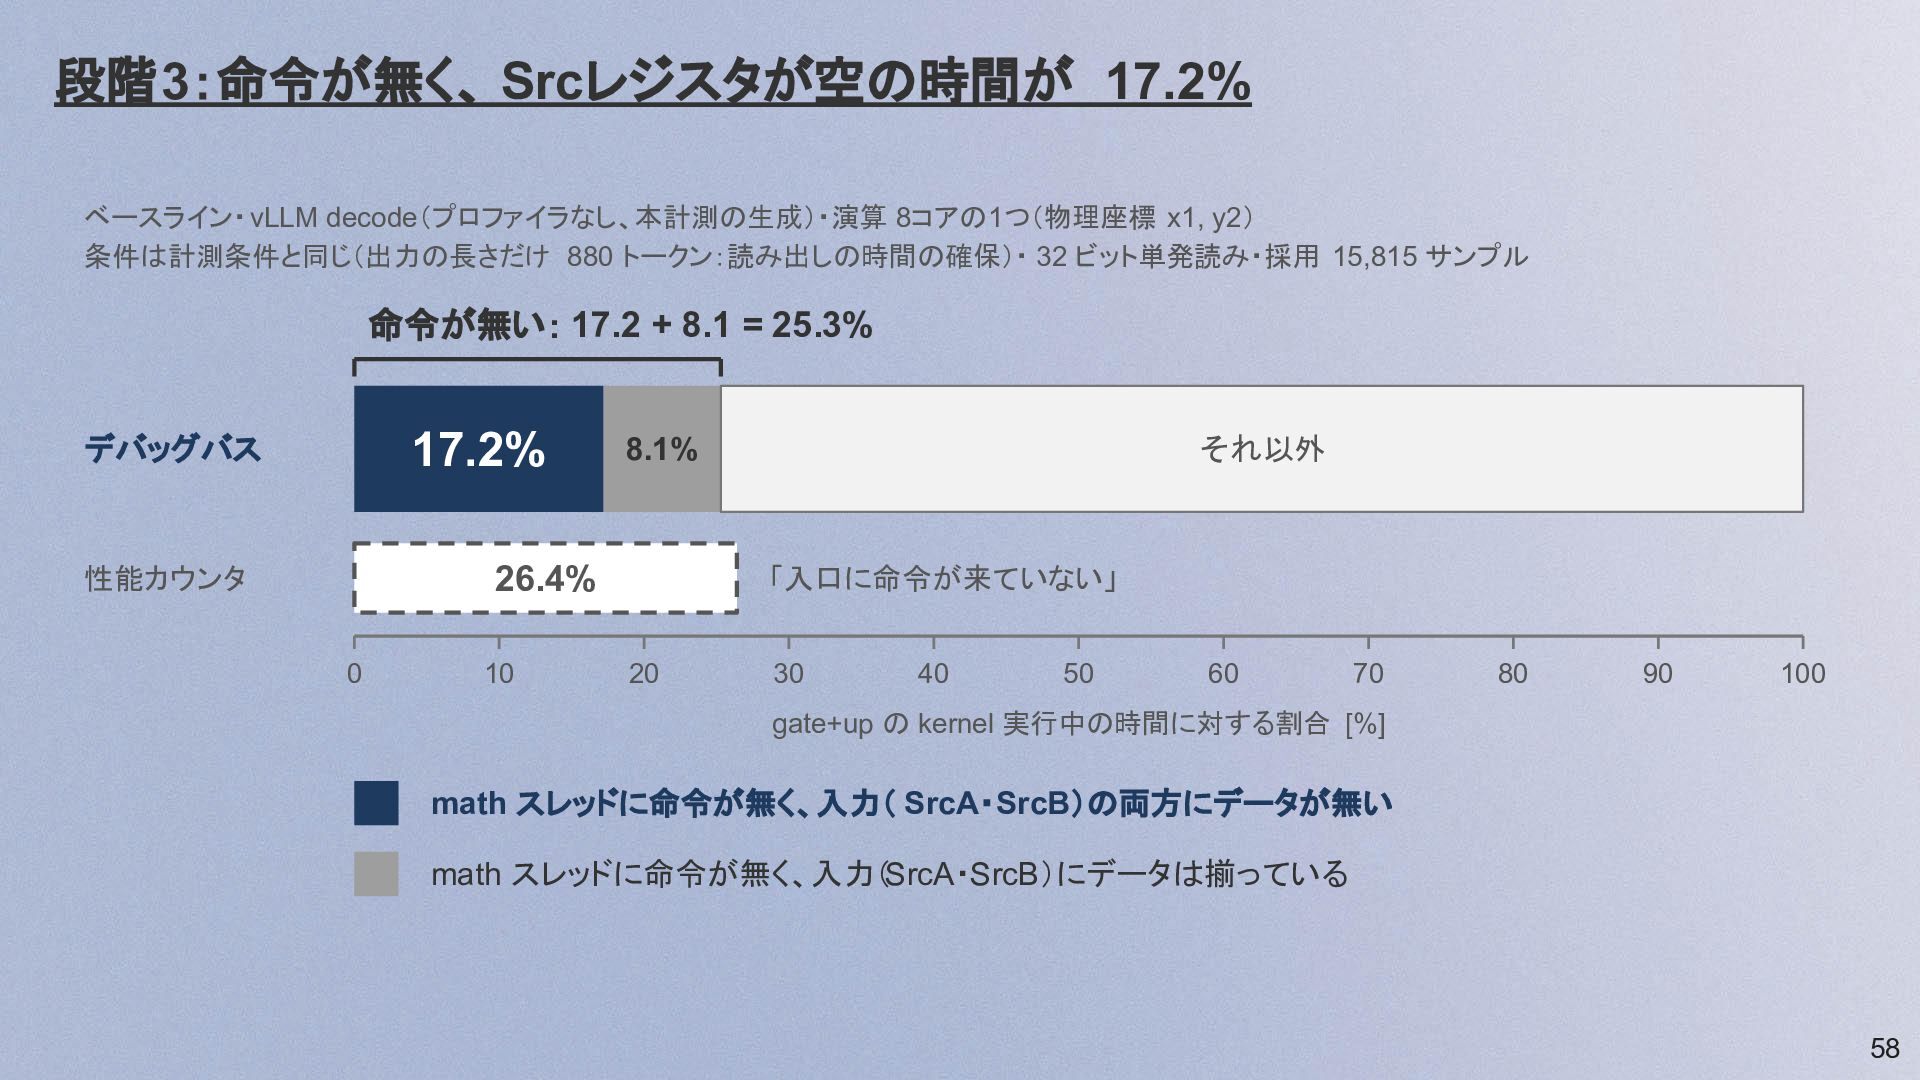
  53. 段階3:命令が無く、 Srcレジスタが空の時間が 17.2% ベースライン・ vLLM decode(プロファイラなし、本計測の生成)・演算 8コアの1つ(物理座標 x1, y2) 条件は計測条件と同じ(出力の長さだけ

    880 トークン:読み出しの時間の確保)・ 32 ビット単発読み・採用 15,815 サンプル 命令が無い: 17.2 + 8.1 = 25.3% 17.2% デバッグバス 性能カウンタ 「入口に命令が来ていない」 26.4% 0 10 それ以外 8.1% 20 30 40 50 60 70 80 90 100 gate+up の kernel 実行中の時間に対する割合 [%] math スレッドに命令が無く、入力( SrcA・SrcB)の両方にデータが無い math スレッドに命令が無く、入力(SrcA・SrcB)にデータは揃っている 58
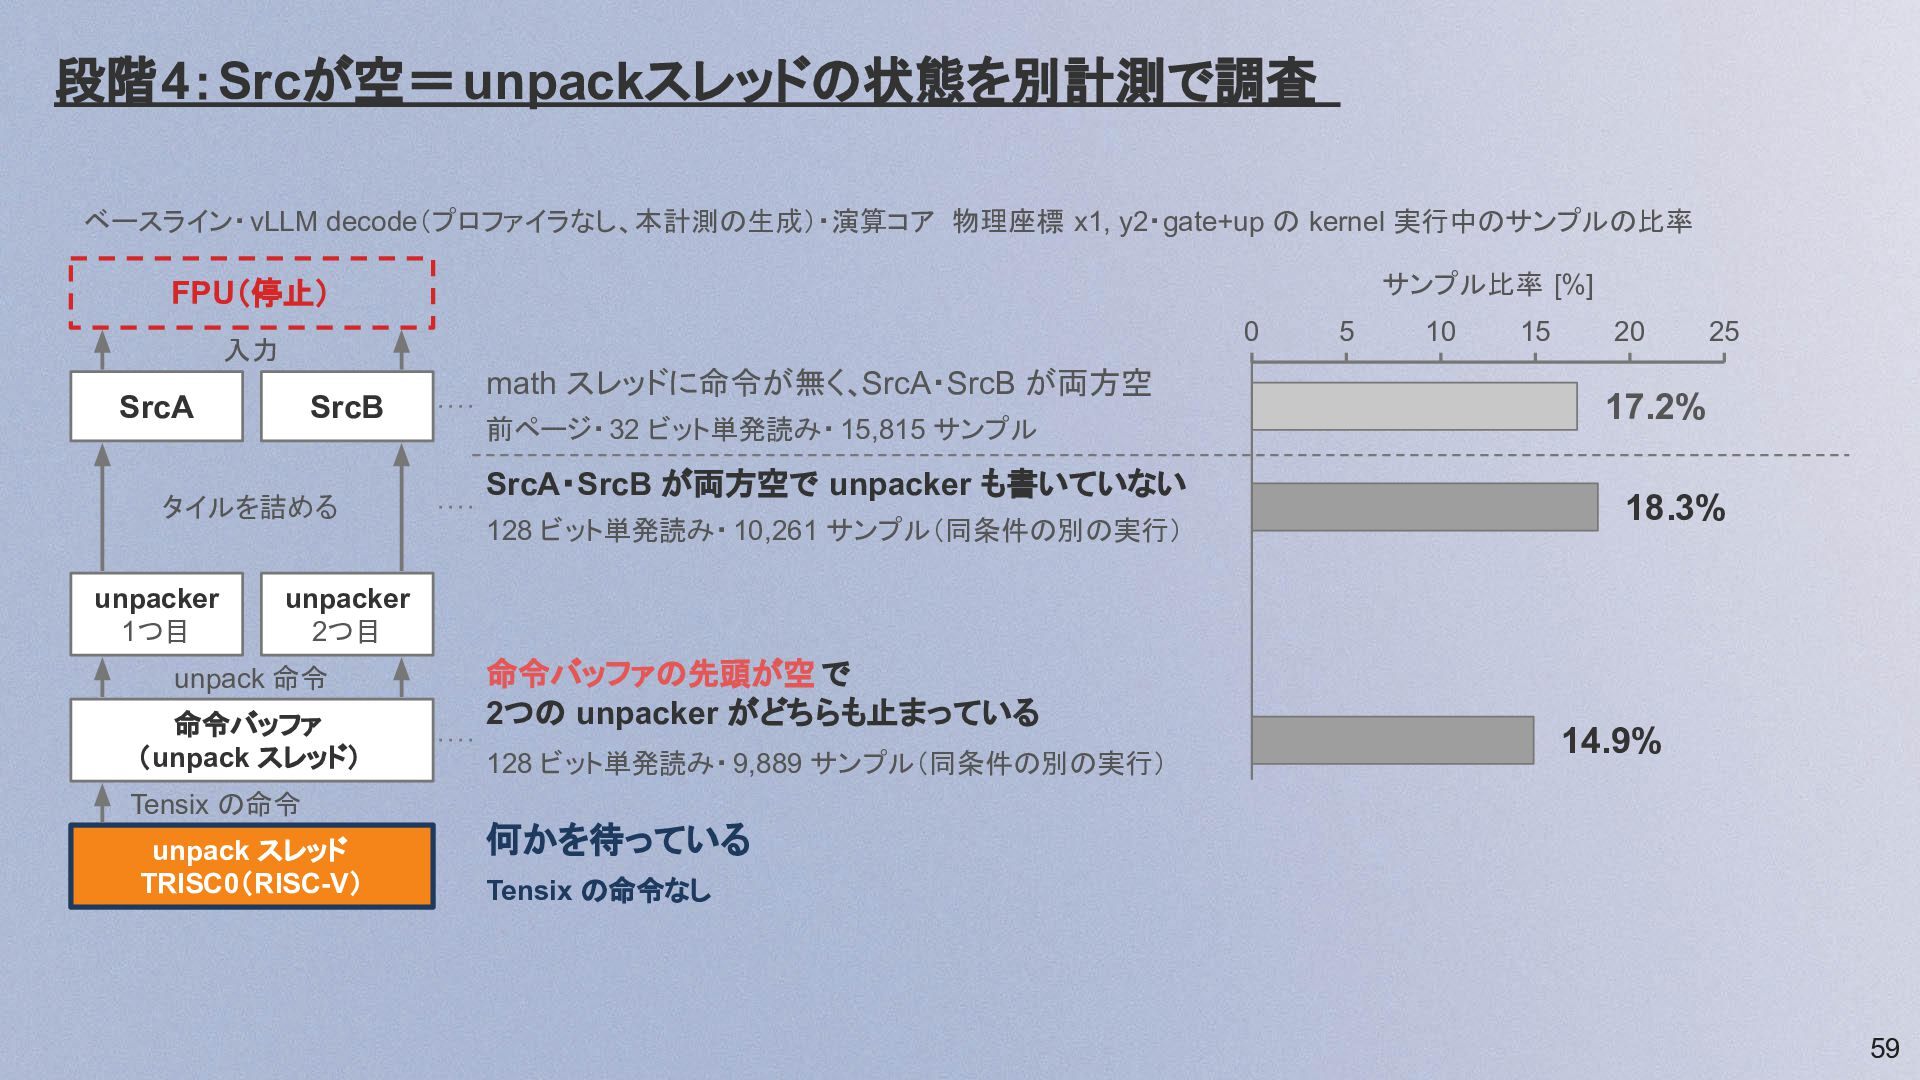
  54. 段階4:Srcが空=unpackスレッドの状態を別計測で調査 ベースライン・ vLLM decode(プロファイラなし、本計測の生成)・演算コア 物理座標 x1, y2・gate+up の kernel 実行中のサンプルの比率

    サンプル比率 [%] FPU(停止) 0 入力 SrcA SrcB タイルを詰める unpacker 1つ目 math スレッドに命令が無く、SrcA・SrcB が両方空 前ページ・32 ビット単発読み・ 15,815 サンプル SrcA・SrcB が両方空で unpacker も書いていない 128 ビット単発読み・ 10,261 サンプル(同条件の別の実行) 5 10 15 20 25 17.2% 18.3% unpacker 2つ目 unpack 命令 命令バッファ (unpack スレッド) 命令バッファの先頭が空 で 2つの unpacker がどちらも止まっている 128 ビット単発読み・ 9,889 サンプル(同条件の別の実行) 14.9% Tensix の命令 unpack スレッド TRISC0(RISC-V) 何かを待っている Tensix の命令なし 59
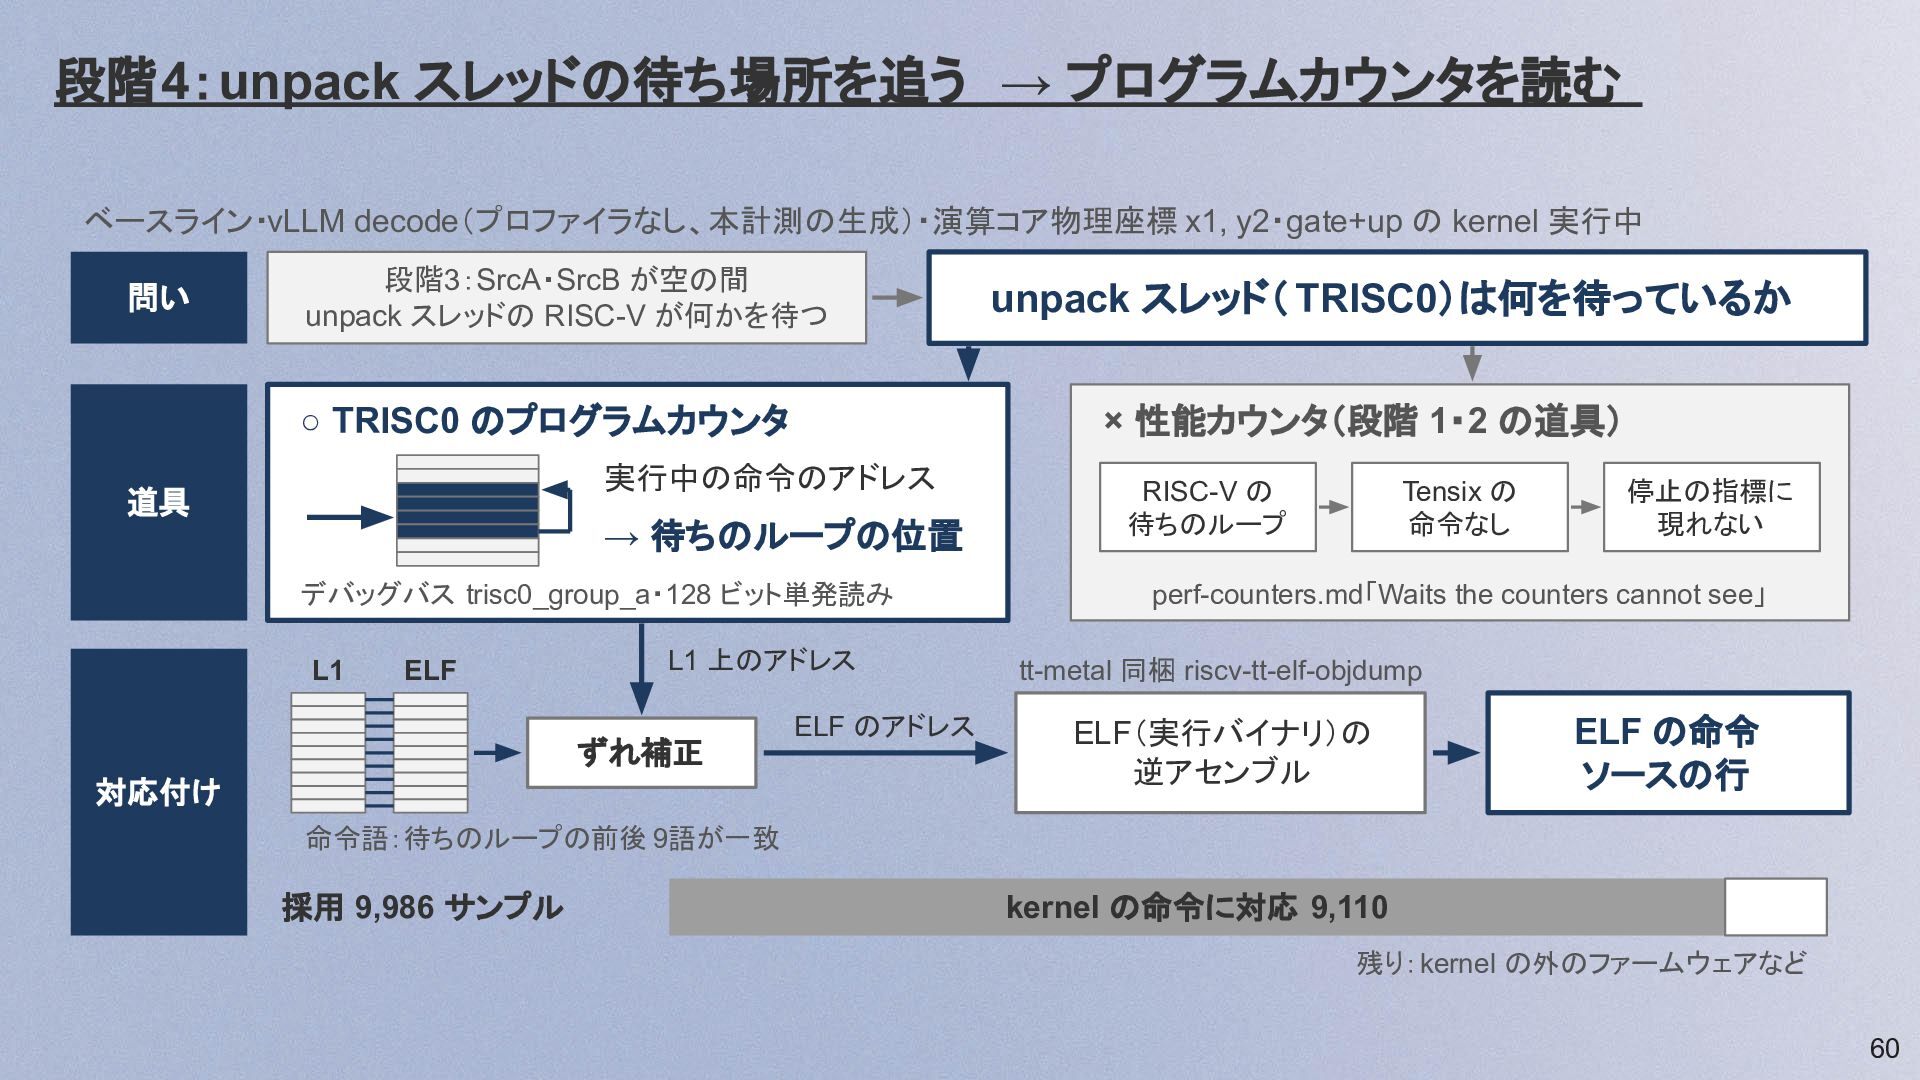
  55. 段階4:unpack スレッドの待ち場所を追う → プログラムカウンタを読む ベースライン・vLLM decode(プロファイラなし、本計測の生成)・演算コア物理座標 x1, y2・gate+up の kernel

    実行中 問い 段階3:SrcA・SrcB が空の間 unpack スレッドの RISC-V が何かを待つ ◦ TRISC0 のプログラムカウンタ × 性能カウンタ(段階 1・2 の道具) 実行中の命令のアドレス 道具 → 待ちのループの位置 デバッグバス trisc0_group_a・128 ビット単発読み L1 ELF L1 上のアドレス ずれ補正 対応付け unpack スレッド( TRISC0)は何を待っているか ELF のアドレス RISC-V の 待ちのループ Tensix の 命令なし 停止の指標に 現れない perf-counters.md「Waits the counters cannot see」 tt-metal 同梱 riscv-tt-elf-objdump ELF(実行バイナリ)の 逆アセンブル ELF の命令 ソースの行 命令語:待ちのループの前後 9語が一致 採用 9,986 サンプル kernel の命令に対応 9,110 残り:kernel の外のファームウェアなど 60
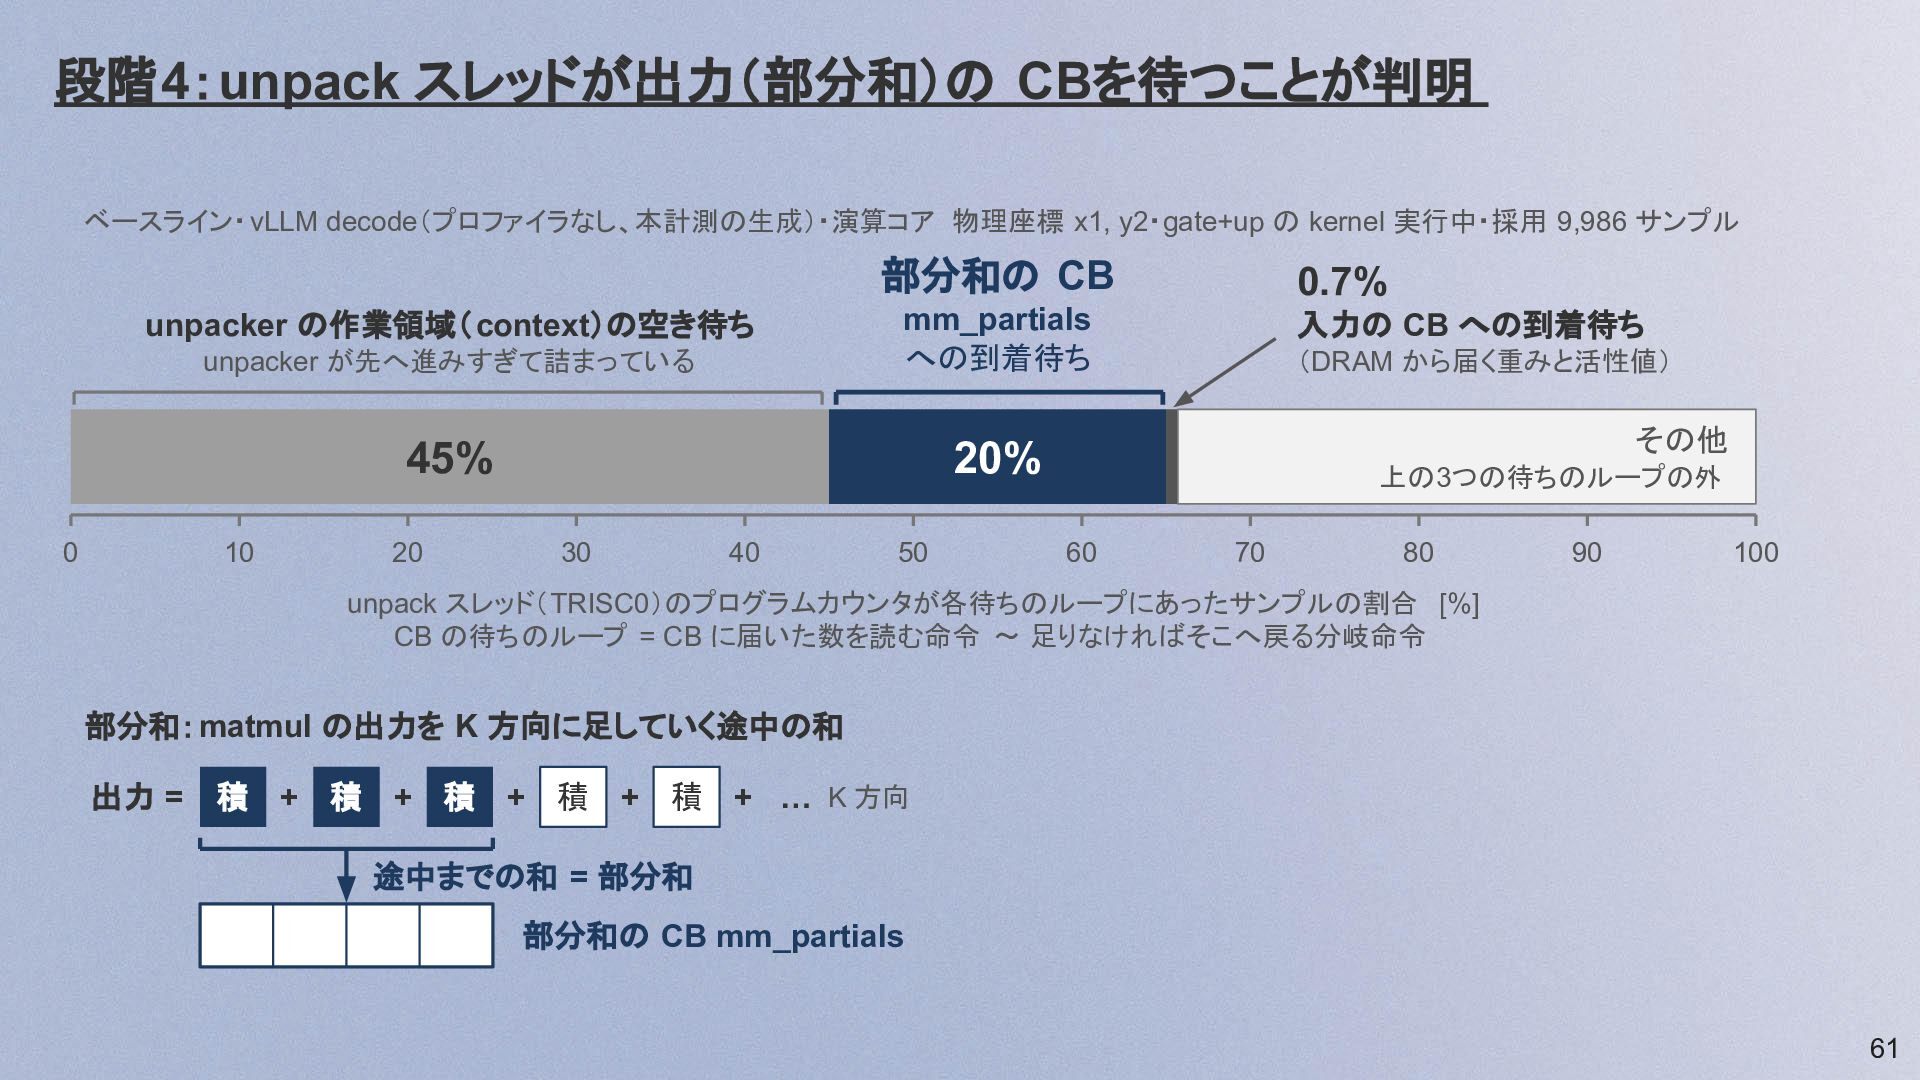
  56. 段階4:unpack スレッドが出力(部分和)の CBを待つことが判明 ベースライン・ vLLM decode(プロファイラなし、本計測の生成)・演算コア 物理座標 x1, y2・gate+up の

    kernel 実行中・採用 9,986 サンプル 部分和の CB unpacker が先へ進みすぎて詰まっている mm_partials への到着待ち 45% 20% unpacker の作業領域(context)の空き待ち 0 10 20 30 40 50 0.7% 入力の CB への到着待ち (DRAM から届く重みと活性値) その他 上の3つの待ちのループの外 60 70 80 90 100 unpack スレッド(TRISC0)のプログラムカウンタが各待ちのループにあったサンプルの割合 [%] CB の待ちのループ = CB に届いた数を読む命令 〜 足りなければそこへ戻る分岐命令 部分和:matmul の出力を K 方向に足していく途中の和 出力 = 積 + 積 + 積 + 積 + 積 + … K 方向 途中までの和 = 部分和 部分和の CB mm_partials 61
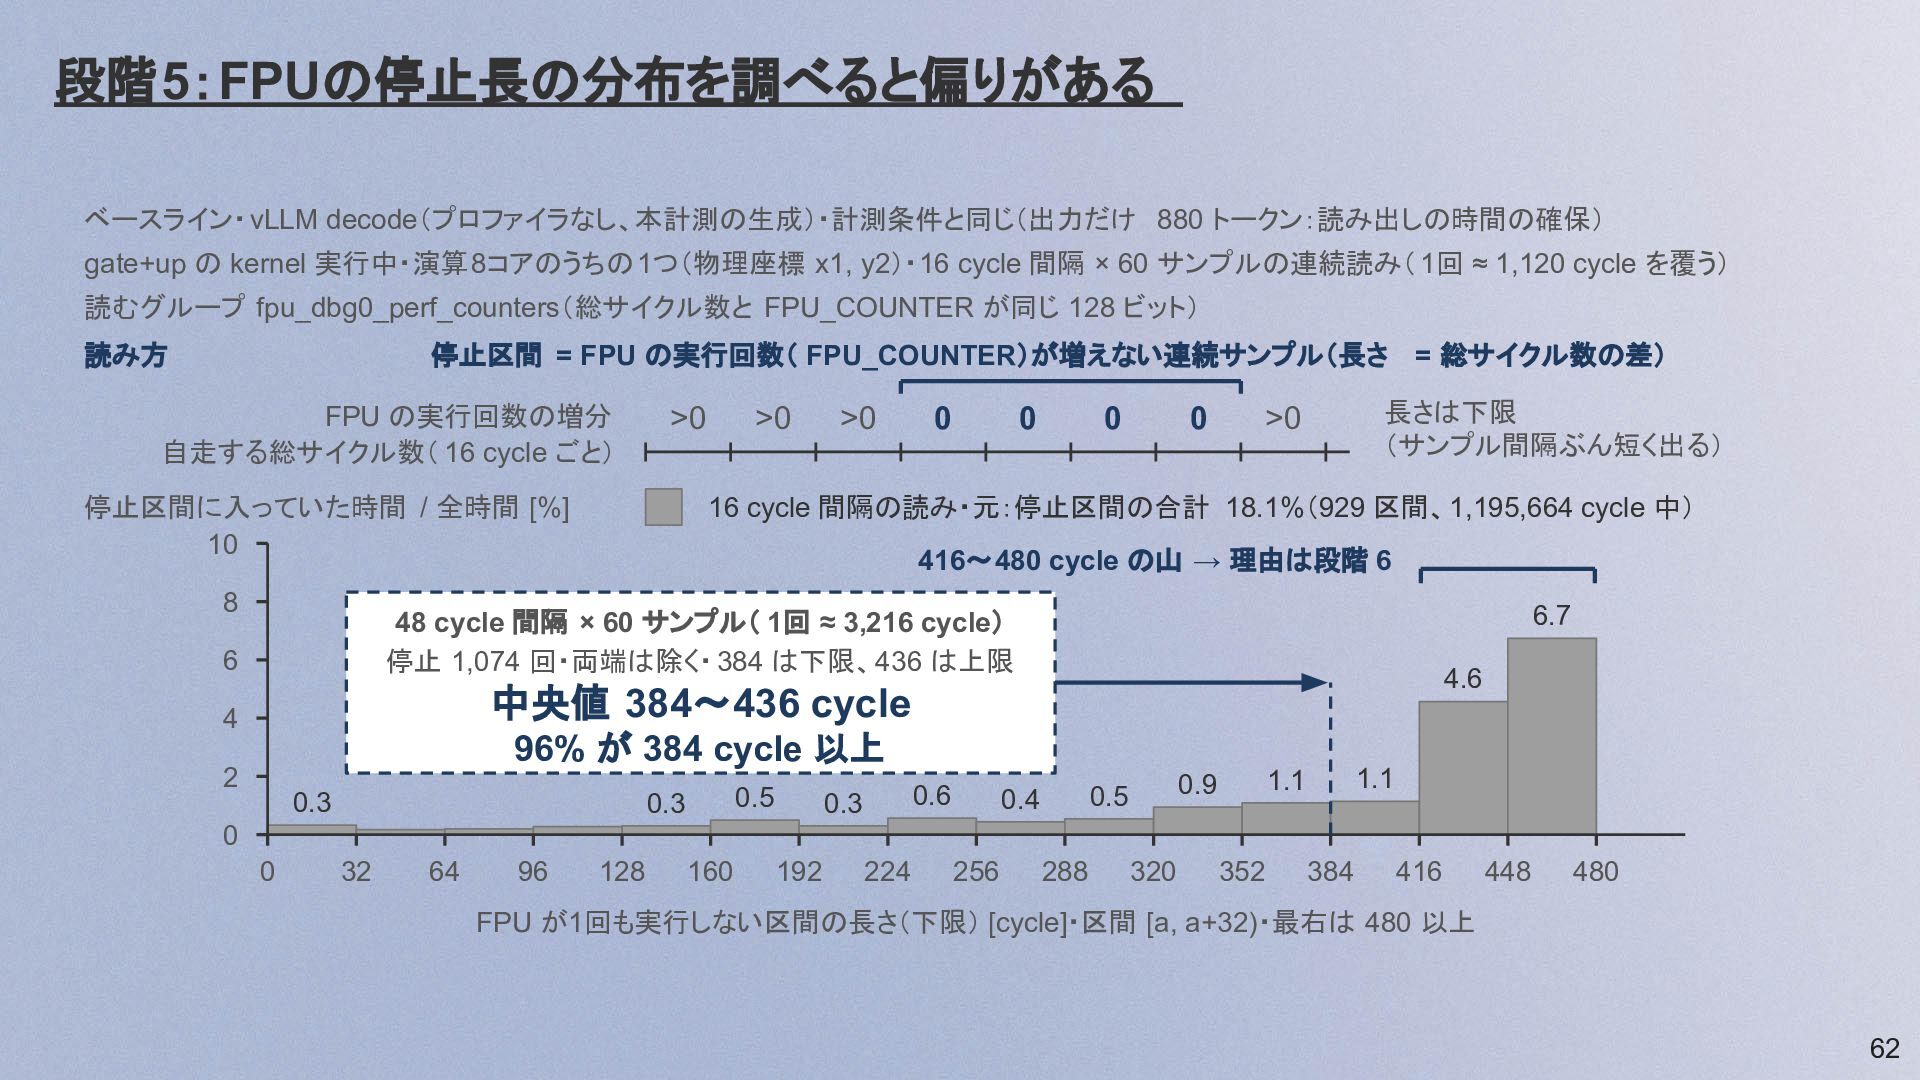
  57. 段階5:FPUの停止長の分布を調べると偏りがある ベースライン・ vLLM decode(プロファイラなし、本計測の生成)・計測条件と同じ(出力だけ 880 トークン:読み出しの時間の確保) gate+up の kernel 実行中・演算8コアのうちの1つ(物理座標

    x1, y2)・16 cycle 間隔 × 60 サンプルの連続読み( 1回 ≈ 1,120 cycle を覆う) 読むグループ fpu_dbg0_perf_counters(総サイクル数と FPU_COUNTER が同じ 128 ビット) 読み方 停止区間 = FPU の実行回数( FPU_COUNTER)が増えない連続サンプル(長さ = 総サイクル数の差) FPU の実行回数の増分 自走する総サイクル数( 16 cycle ごと) >0 停止区間に入っていた時間 / 全時間 [%] 10 8 >0 >0 0 0 0 0 長さは下限 (サンプル間隔ぶん短く出る) >0 16 cycle 間隔の読み・元:停止区間の合計 18.1%(929 区間、1,195,664 cycle 中) 416〜480 cycle の山 → 理由は段階 6 6 48 cycle 間隔 × 60 サンプル( 1回 ≈ 3,216 cycle) 停止 1,074 回・両端は除く・ 384 は下限、436 は上限 4 中央値 384〜436 cycle 6.7 4.6 96% が 384 cycle 以上 2 0.3 0.5 0.3 0.6 0.3 1.1 1.1 0.9 0.5 0.4 0 0 32 64 96 128 160 192 224 256 288 320 352 384 416 448 480 FPU が1回も実行しない区間の長さ(下限) [cycle]・区間 [a, a+32)・最右は 480 以上 62
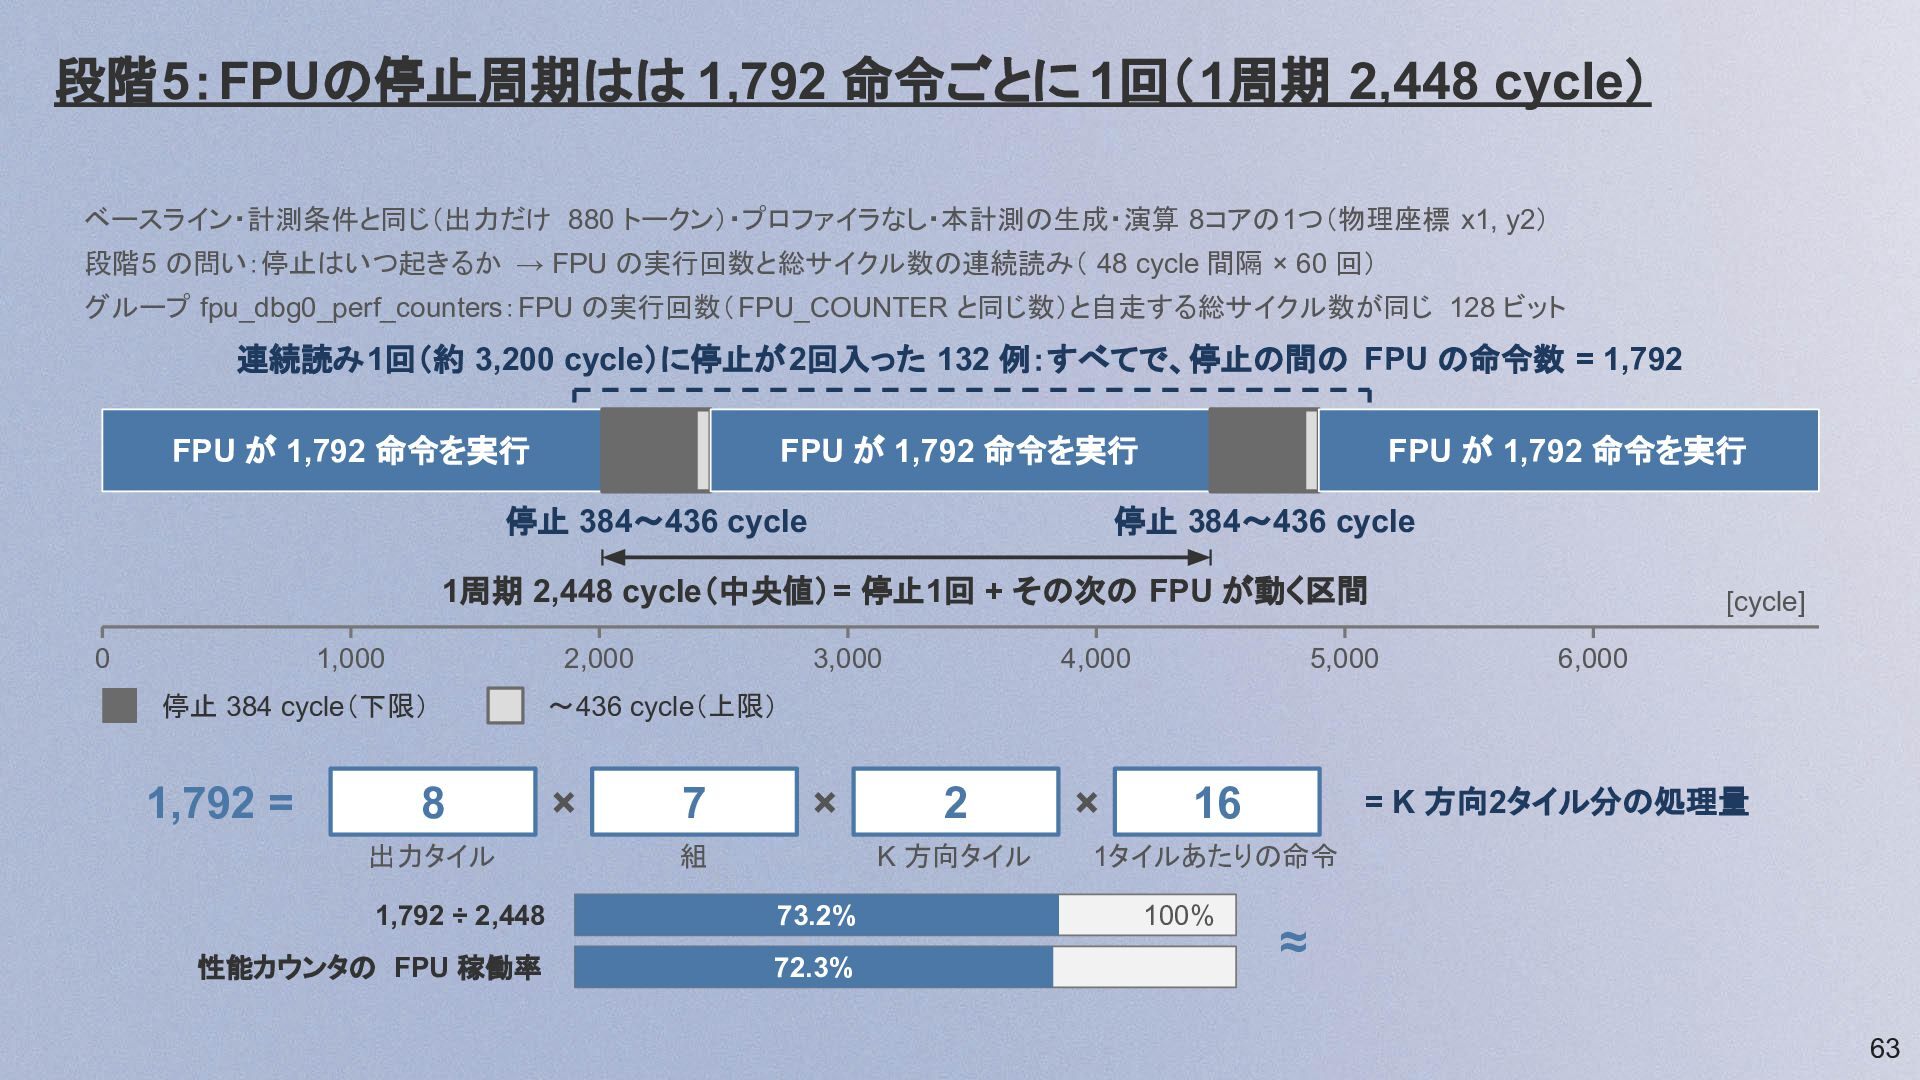
  58. 段階5:FPUの停止周期はは 1,792 命令ごとに 1回(1周期 2,448 cycle) ベースライン・計測条件と同じ(出力だけ 880 トークン)・プロファイラなし・本計測の生成・演算 8コアの1つ(物理座標

    x1, y2) 段階5 の問い:停止はいつ起きるか → FPU の実行回数と総サイクル数の連続読み( 48 cycle 間隔 × 60 回) グループ fpu_dbg0_perf_counters:FPU の実行回数(FPU_COUNTER と同じ数)と自走する総サイクル数が同じ 128 ビット 連続読み1回(約 3,200 cycle)に停止が2回入った 132 例:すべてで、停止の間の FPU の命令数 = 1,792 FPU が 1,792 命令を実行 FPU が 1,792 命令を実行 停止 384〜436 cycle FPU が 1,792 命令を実行 停止 384〜436 cycle 1周期 2,448 cycle(中央値)= 停止1回 + その次の FPU が動く区間 0 1,000 2,000 3,000 停止 384 cycle(下限) 〜436 cycle(上限) 1,792 = × 8 出力タイル 7 × 組 4,000 2 K 方向タイル 1,792 ÷ 2,448 73.2% 性能カウンタの FPU 稼働率 72.3% × 5,000 [cycle] 6,000 = K 方向2タイル分の処理量 16 1タイルあたりの命令 100% ≈ 63
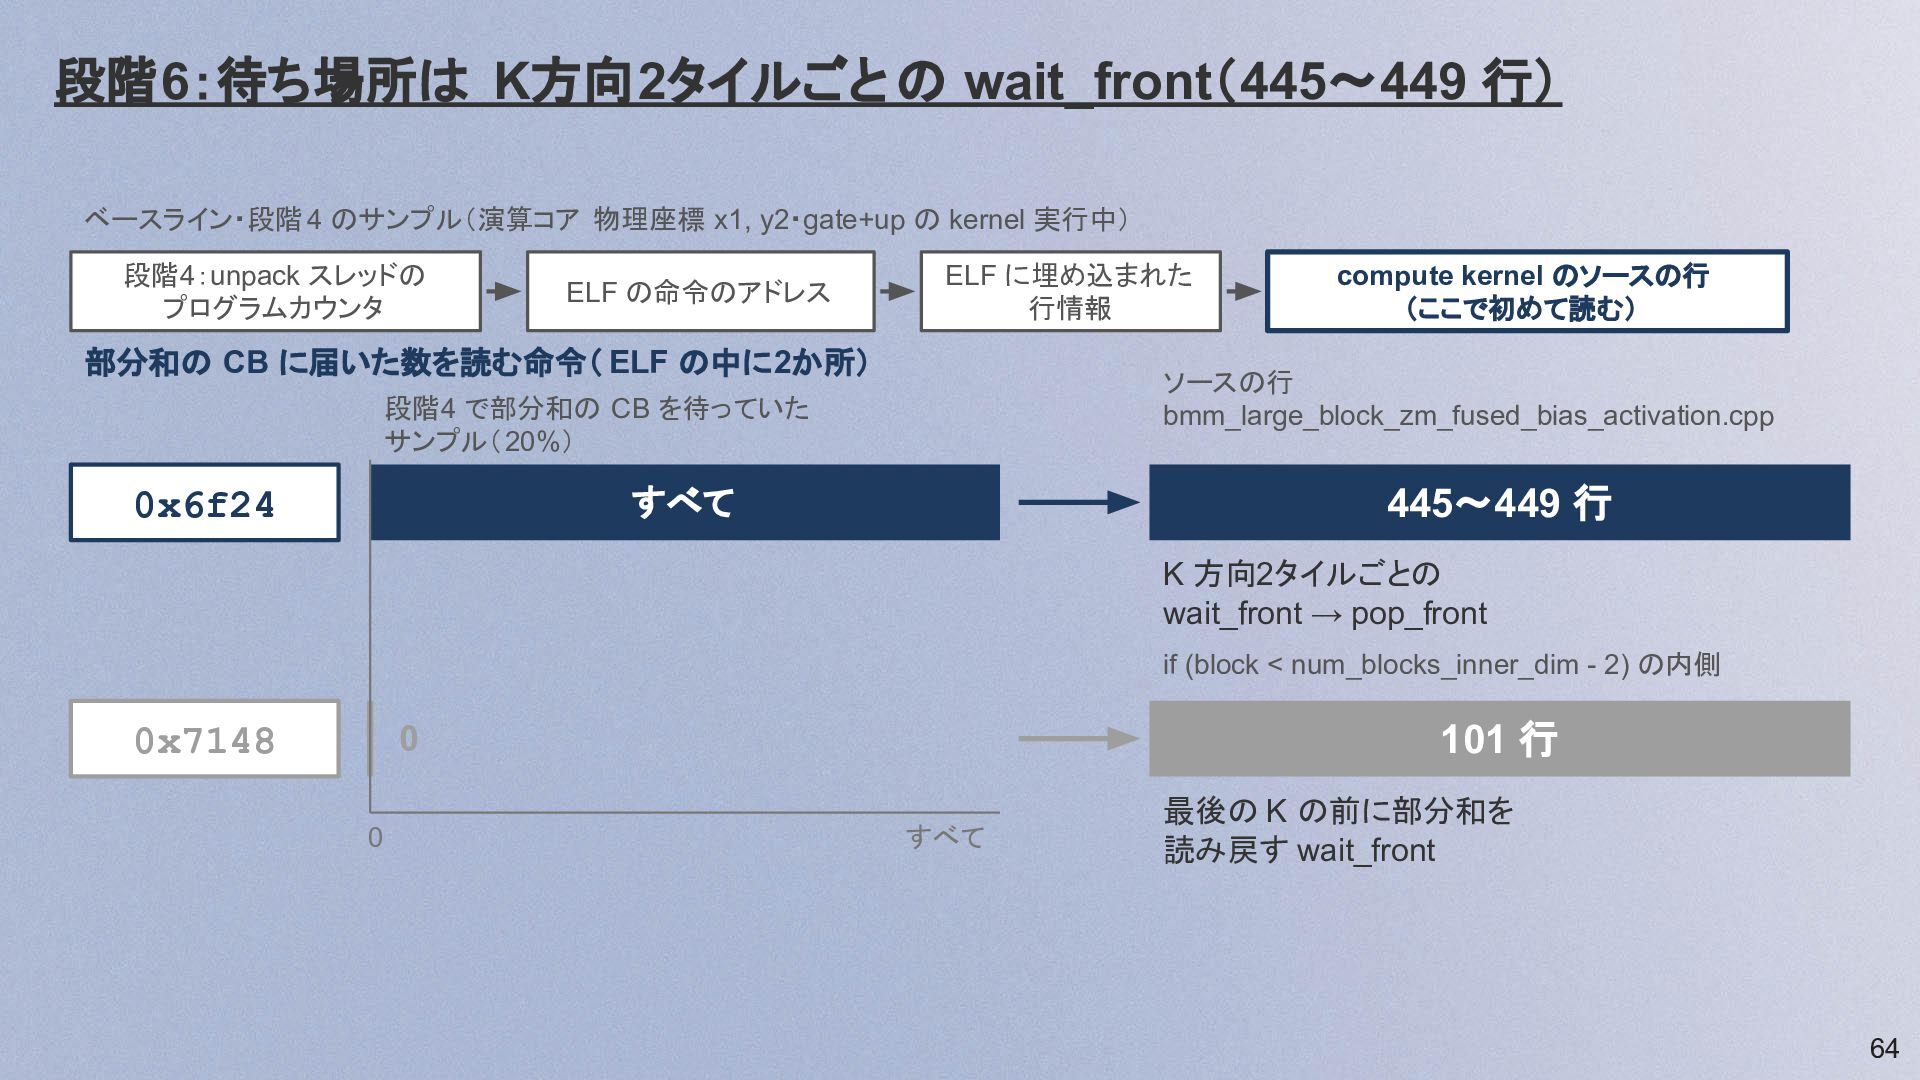
  59. 段階6:待ち場所は K方向2タイルごと の wait_front(445〜449 行) ベースライン・段階 4 のサンプル(演算コア 物理座標 x1,

    y2・gate+up の kernel 実行中) 段階4:unpack スレッドの プログラムカウンタ ELF の命令のアドレス ELF に埋め込まれた 行情報 部分和の CB に届いた数を読む命令( ELF の中に2か所) ソースの行 bmm_large_block_zm_fused_bias_activation.cpp 段階4 で部分和の CB を待っていた サンプル(20%) 445〜449 行 すべて 0x6f24 compute kernel のソースの行 (ここで初めて読む) K 方向2タイルごとの wait_front → pop_front if (block < num_blocks_inner_dim - 2) の内側 101 行 0 0x7148 0 すべて 最後の K の前に部分和を 読み戻す wait_front 64
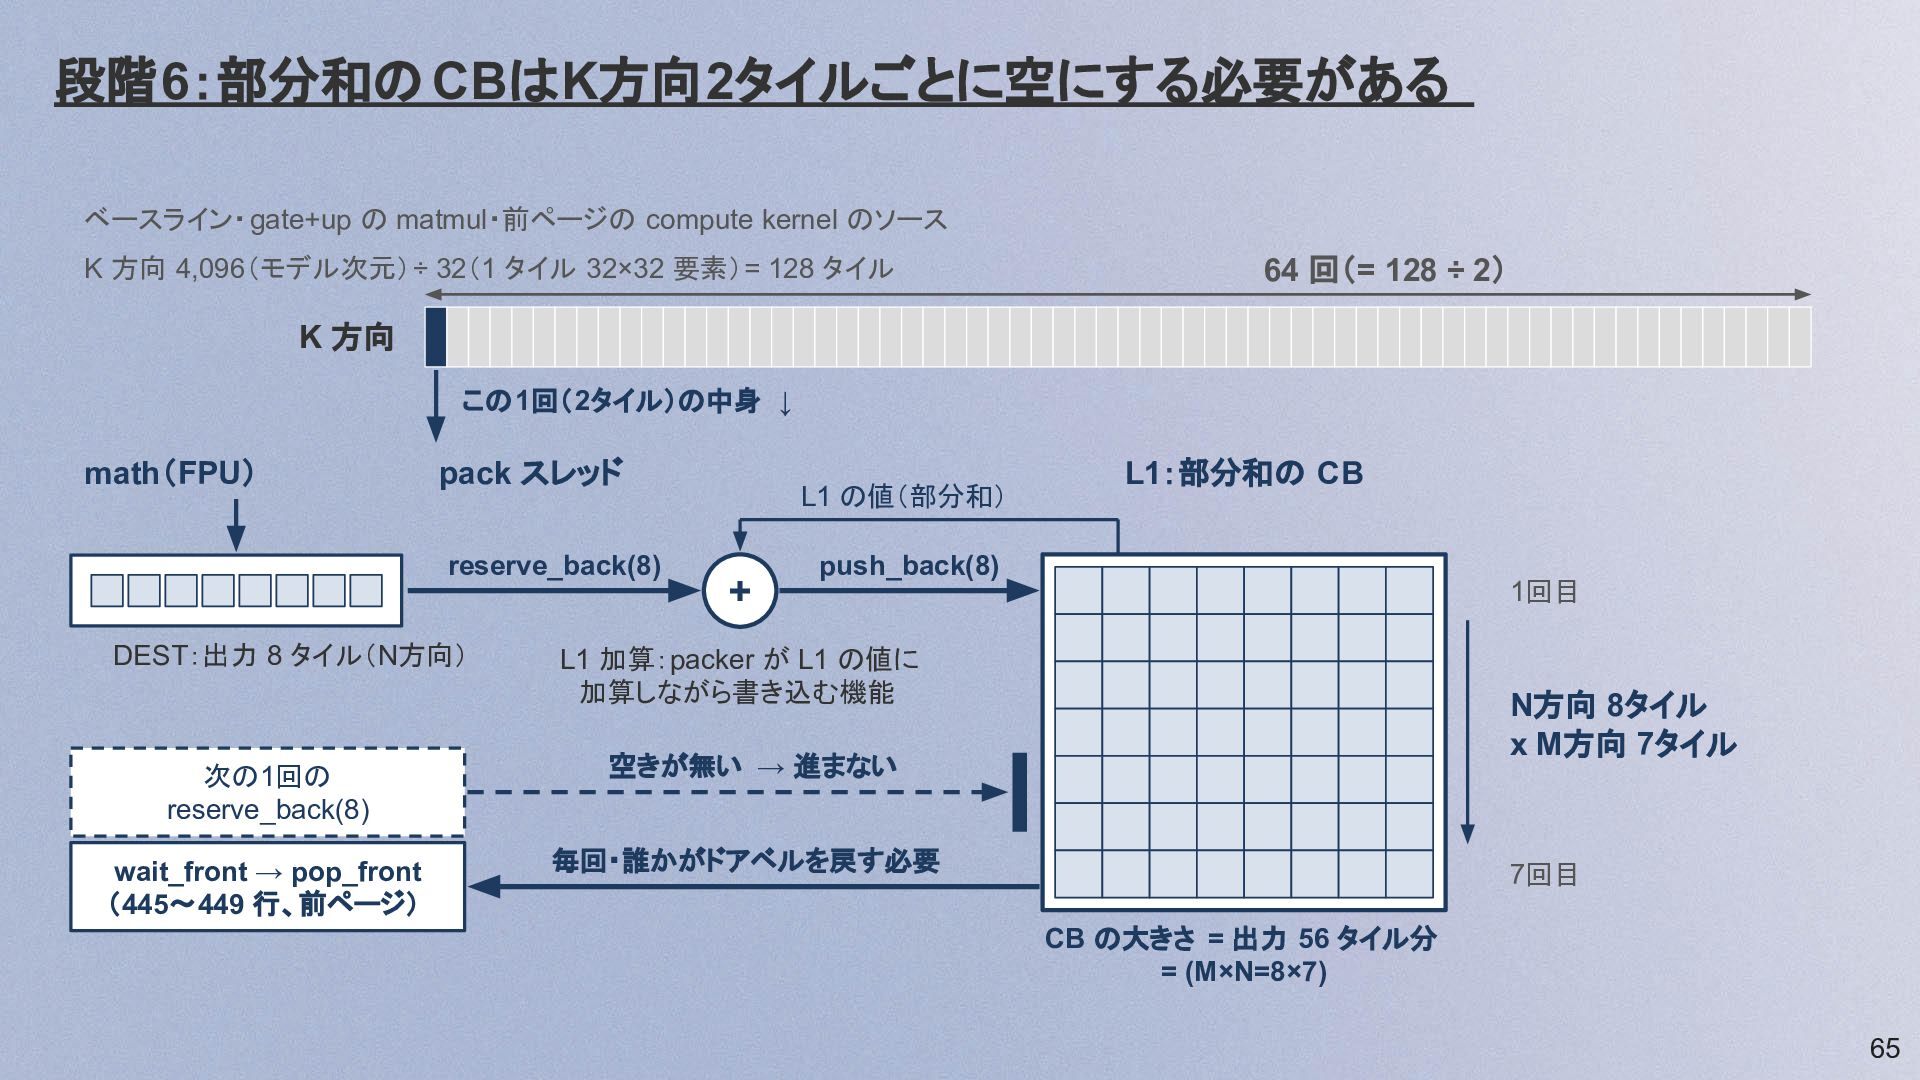
  60. 段階6:部分和の CBはK方向2タイルごとに空にする必要がある ベースライン・ gate+up の matmul・前ページの compute kernel のソース K

    方向 4,096(モデル次元) ÷ 32(1 タイル 32×32 要素)= 128 タイル 64 回(= 128 ÷ 2) K 方向 この1回(2タイル)の中身 ↓ math(FPU) pack スレッド reserve_back(8) DEST:出力 8 タイル(N方向) L1 の値(部分和) + L1:部分和の CB push_back(8) 1回目 L1 加算:packer が L1 の値に 加算しながら書き込む機能 次の1回の reserve_back(8) 空きが無い → 進まない wait_front → pop_front (445〜449 行、前ページ) 毎回・誰かがドアベルを戻す必要 N方向 8タイル x M方向 7タイル 7回目 CB の大きさ = 出力 56 タイル分 = (M×N=8×7) 65
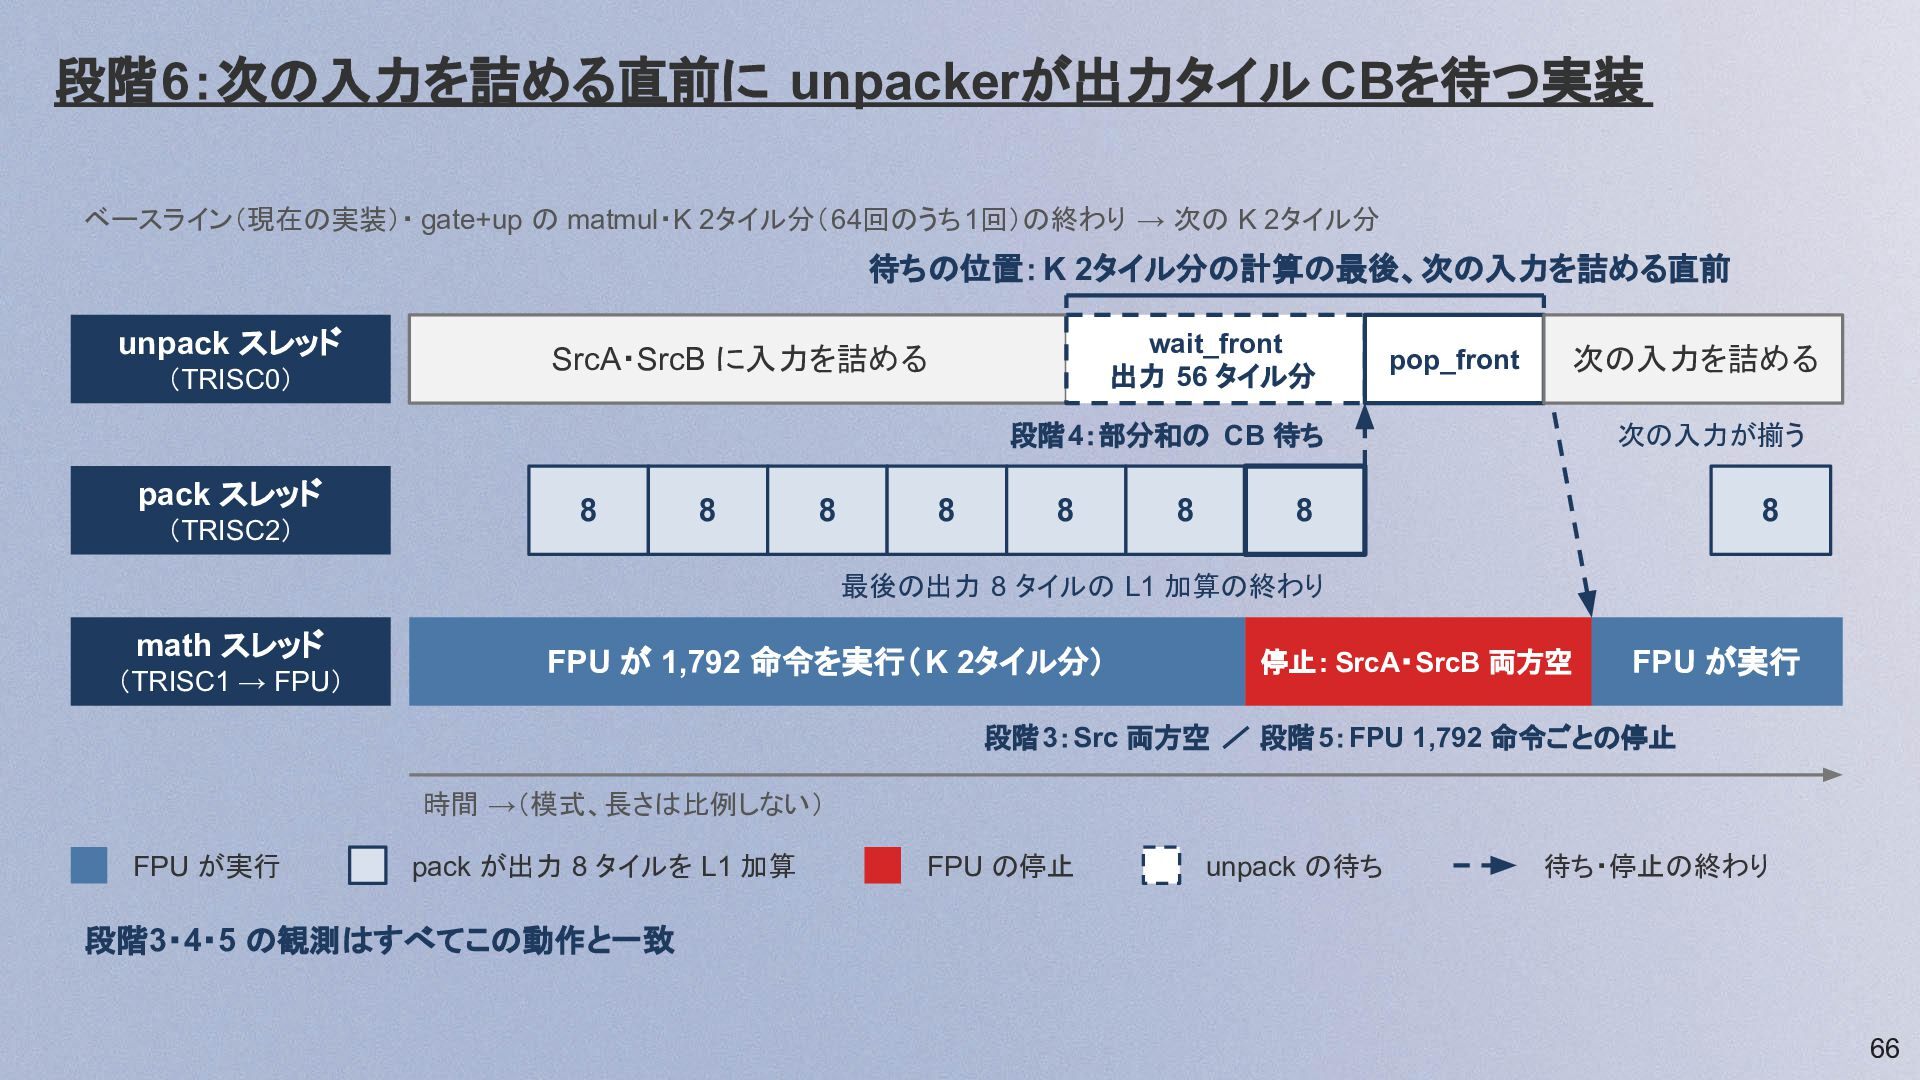
  61. 段階6:次の入力を詰める直前に unpackerが出力タイル CBを待つ実装 ベースライン(現在の実装)・ gate+up の matmul・K 2タイル分(64回のうち1回)の終わり → 次の

    K 2タイル分 待ちの位置: K 2タイル分の計算の最後、次の入力を詰める直前 unpack スレッド (TRISC0) wait_front 出力 56 タイル分 SrcA・SrcB に入力を詰める pop_front 次の入力を詰める 段階4:部分和の CB 待ち pack スレッド (TRISC2) 8 8 8 8 8 8 次の入力が揃う 8 8 最後の出力 8 タイルの L1 加算の終わり math スレッド (TRISC1 → FPU) FPU が 1,792 命令を実行( K 2タイル分) 停止: SrcA・SrcB 両方空 FPU が実行 段階3:Src 両方空 / 段階5:FPU 1,792 命令ごとの停止 時間 →(模式、長さは比例しない) FPU が実行 pack が出力 8 タイルを L1 加算 FPU の停止 unpack の待ち 待ち・停止の終わり 段階3・4・5 の観測はすべてこの動作と一致 66
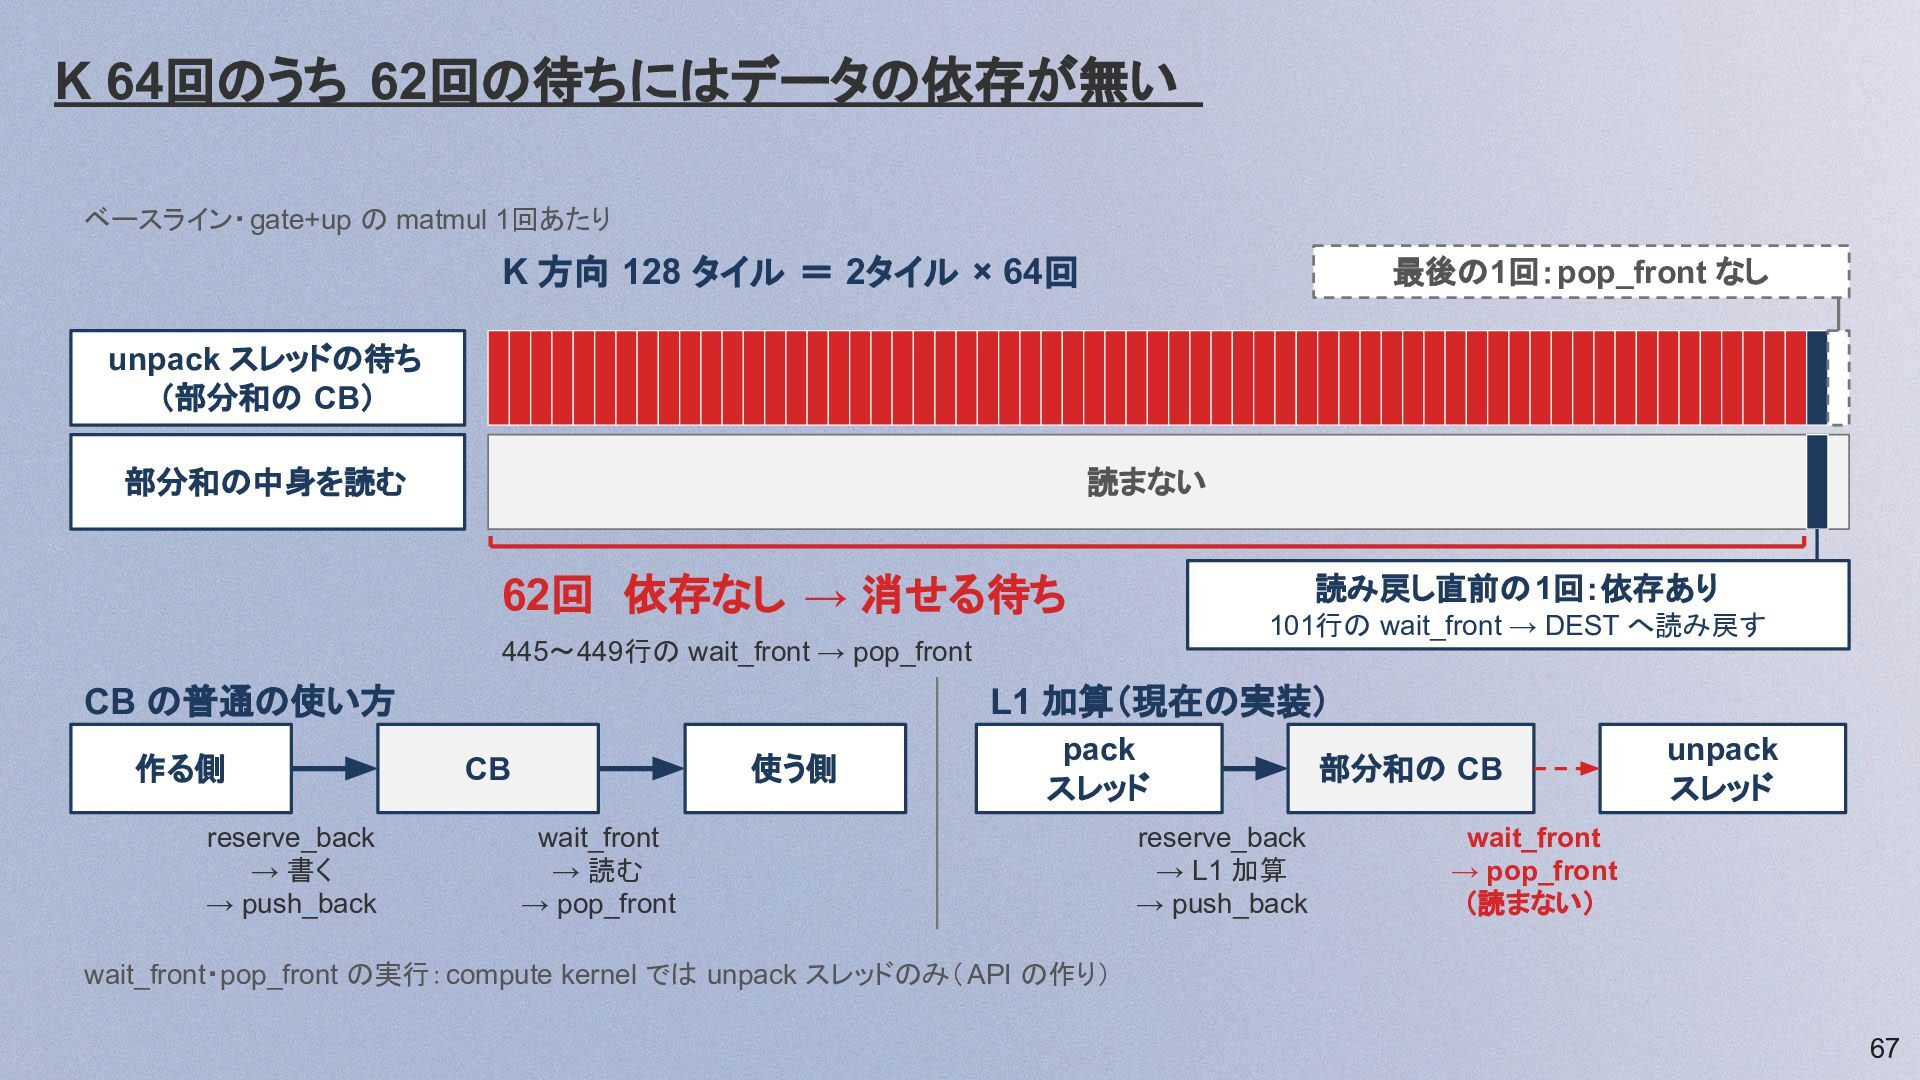
  62. K 64回のうち 62回の待ちにはデータの依存が無い ベースライン・ gate+up の matmul 1回あたり K 方向

    128 タイル = 2タイル × 64回 最後の1回:pop_front なし unpack スレッドの待ち (部分和の CB) 部分和の中身を読む 読まない 62回 依存なし → 消せる待ち 読み戻し直前の 1回:依存あり 101行の wait_front → DEST へ読み戻す 445〜449行の wait_front → pop_front CB の普通の使い方 作る側 reserve_back → 書く → push_back L1 加算(現在の実装) 使う側 CB pack スレッド wait_front → 読む → pop_front reserve_back → L1 加算 → push_back 部分和の CB unpack スレッド wait_front → pop_front (読まない) wait_front・pop_front の実行:compute kernel では unpack スレッドのみ( API の作り) 67
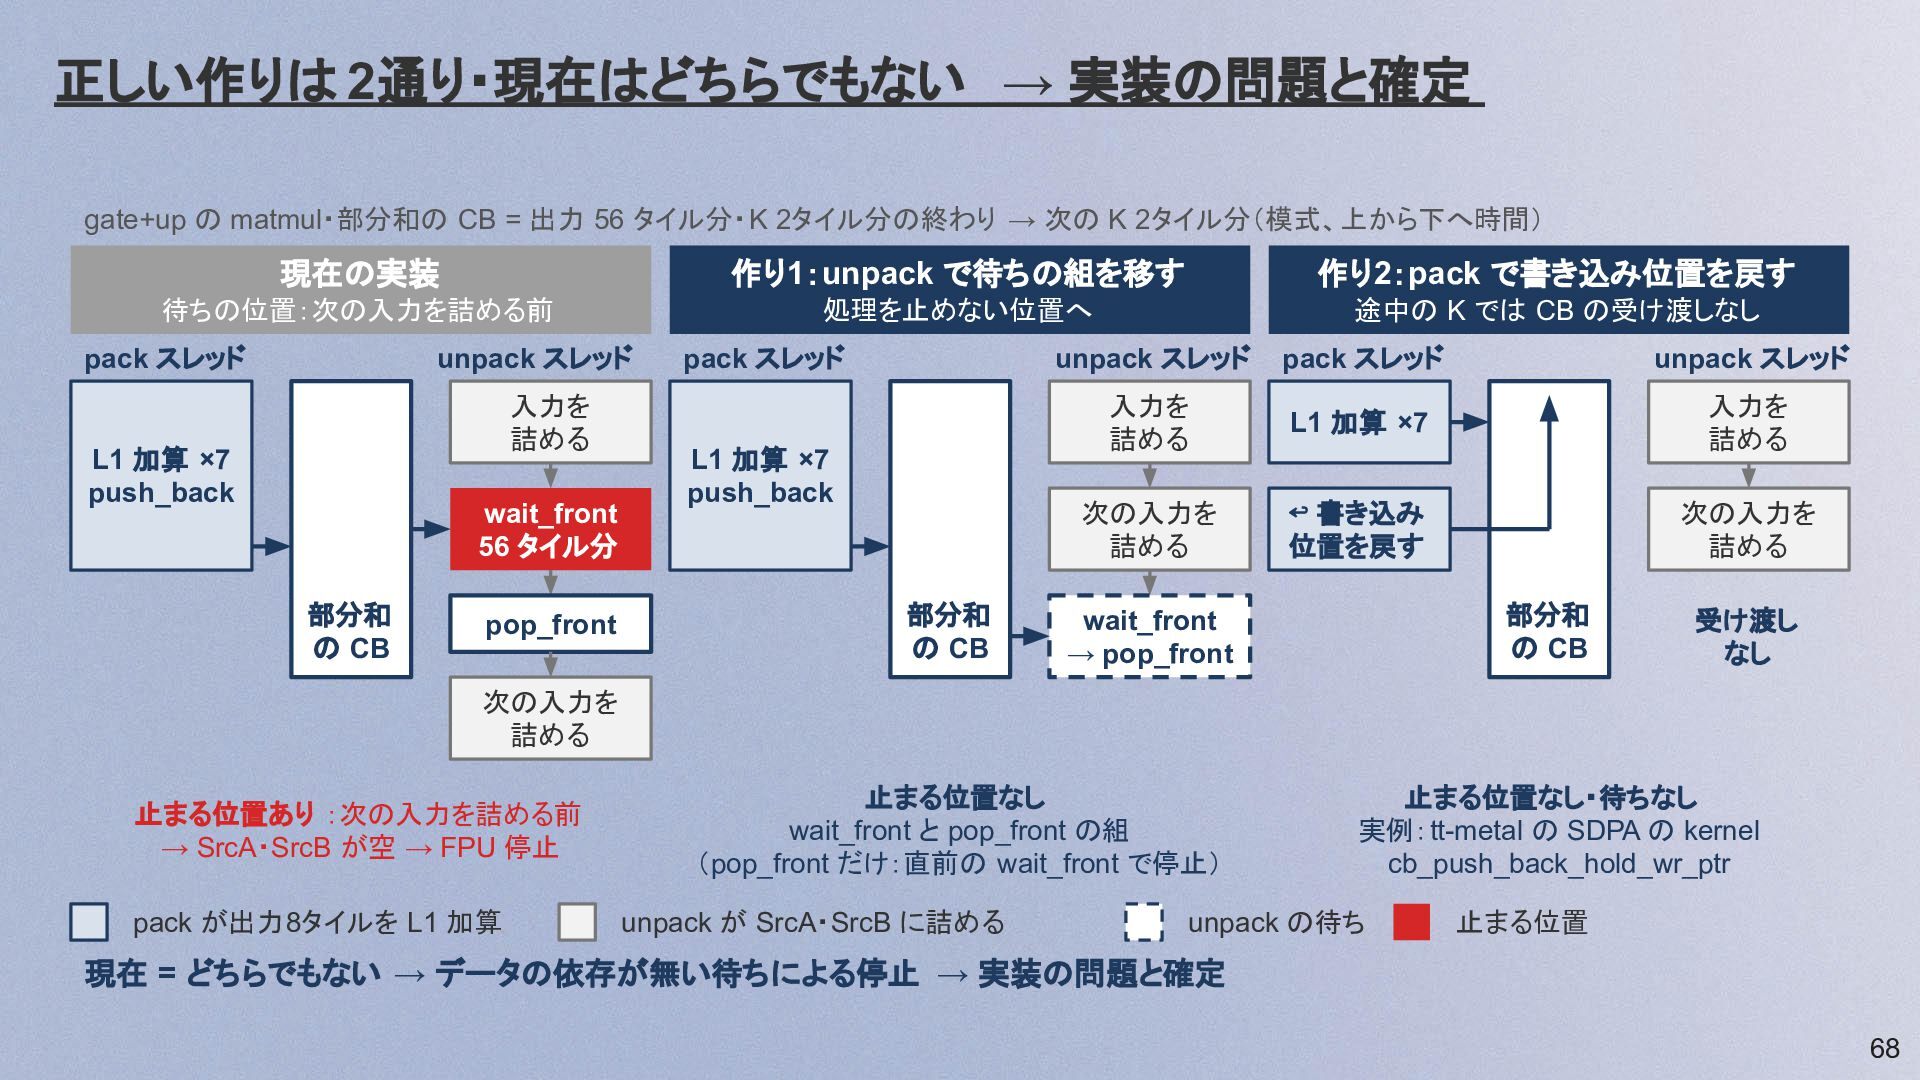
  63. 正しい作りは 2通り・現在はどちらでもない → 実装の問題と確定 gate+up の matmul・部分和の CB = 出力

    56 タイル分・K 2タイル分の終わり → 次の K 2タイル分(模式、上から下へ時間) 現在の実装 作り1:unpack で待ちの組を移す 作り2:pack で書き込み位置を戻す 待ちの位置:次の入力を詰める前 処理を止めない位置へ 途中の K では CB の受け渡しなし pack スレッド unpack スレッド 入力を 詰める L1 加算 ×7 push_back wait_front 56 タイル分 部分和 の CB pop_front pack スレッド L1 加算 ×7 push_back 部分和 の CB unpack スレッド pack スレッド unpack スレッド 入力を 詰める L1 加算 ×7 入力を 詰める 次の入力を 詰める ↩ 書き込み 位置を戻す 次の入力を 詰める 部分和 の CB wait_front → pop_front 受け渡し なし 次の入力を 詰める 止まる位置あり :次の入力を詰める前 → SrcA・SrcB が空 → FPU 停止 pack が出力8タイルを L1 加算 止まる位置なし wait_front と pop_front の組 (pop_front だけ:直前の wait_front で停止) unpack が SrcA・SrcB に詰める 止まる位置なし・待ちなし 実例:tt-metal の SDPA の kernel cb_push_back_hold_wr_ptr unpack の待ち 止まる位置 現在 = どちらでもない → データの依存が無い待ちによる停止 → 実装の問題と確定 68
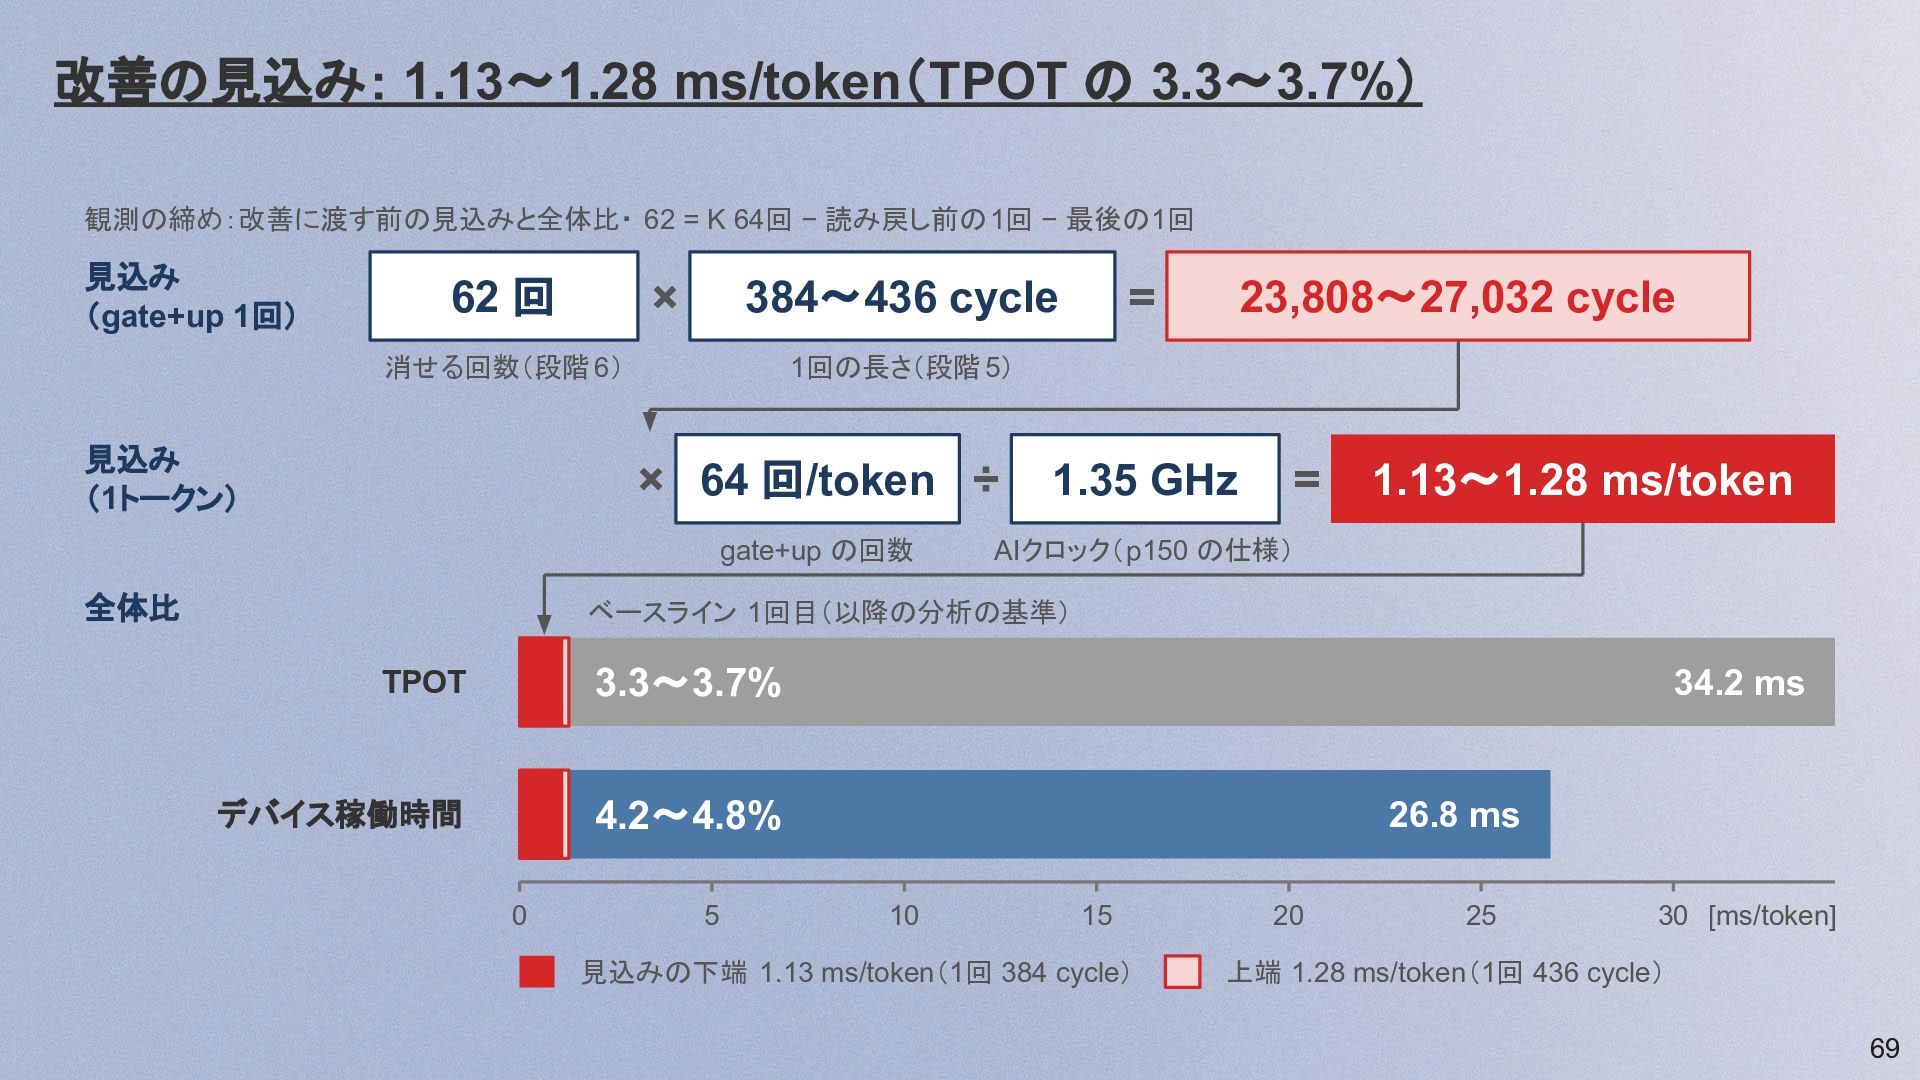
  64. 改善の見込み: 1.13〜1.28 ms/token(TPOT の 3.3〜3.7%) 観測の締め:改善に渡す前の見込みと全体比・ 62 = K 64回

    − 読み戻し前の 1回 − 最後の1回 見込み (gate+up 1回) 62 回 × 消せる回数(段階 6) 見込み (1トークン) 23,808〜27,032 cycle 1回の長さ(段階 5) × 64 回/token ÷ gate+up の回数 全体比 = 384〜436 cycle 1.35 GHz = 1.13〜1.28 ms/token AIクロック(p150 の仕様) ベースライン 1回目(以降の分析の基準) TPOT 3.3〜3.7% デバイス稼働時間 4.2〜4.8% 0 5 34.2 ms 26.8 ms 10 15 見込みの下端 1.13 ms/token(1回 384 cycle) 20 25 30 [ms/token] 上端 1.28 ms/token(1回 436 cycle) 69
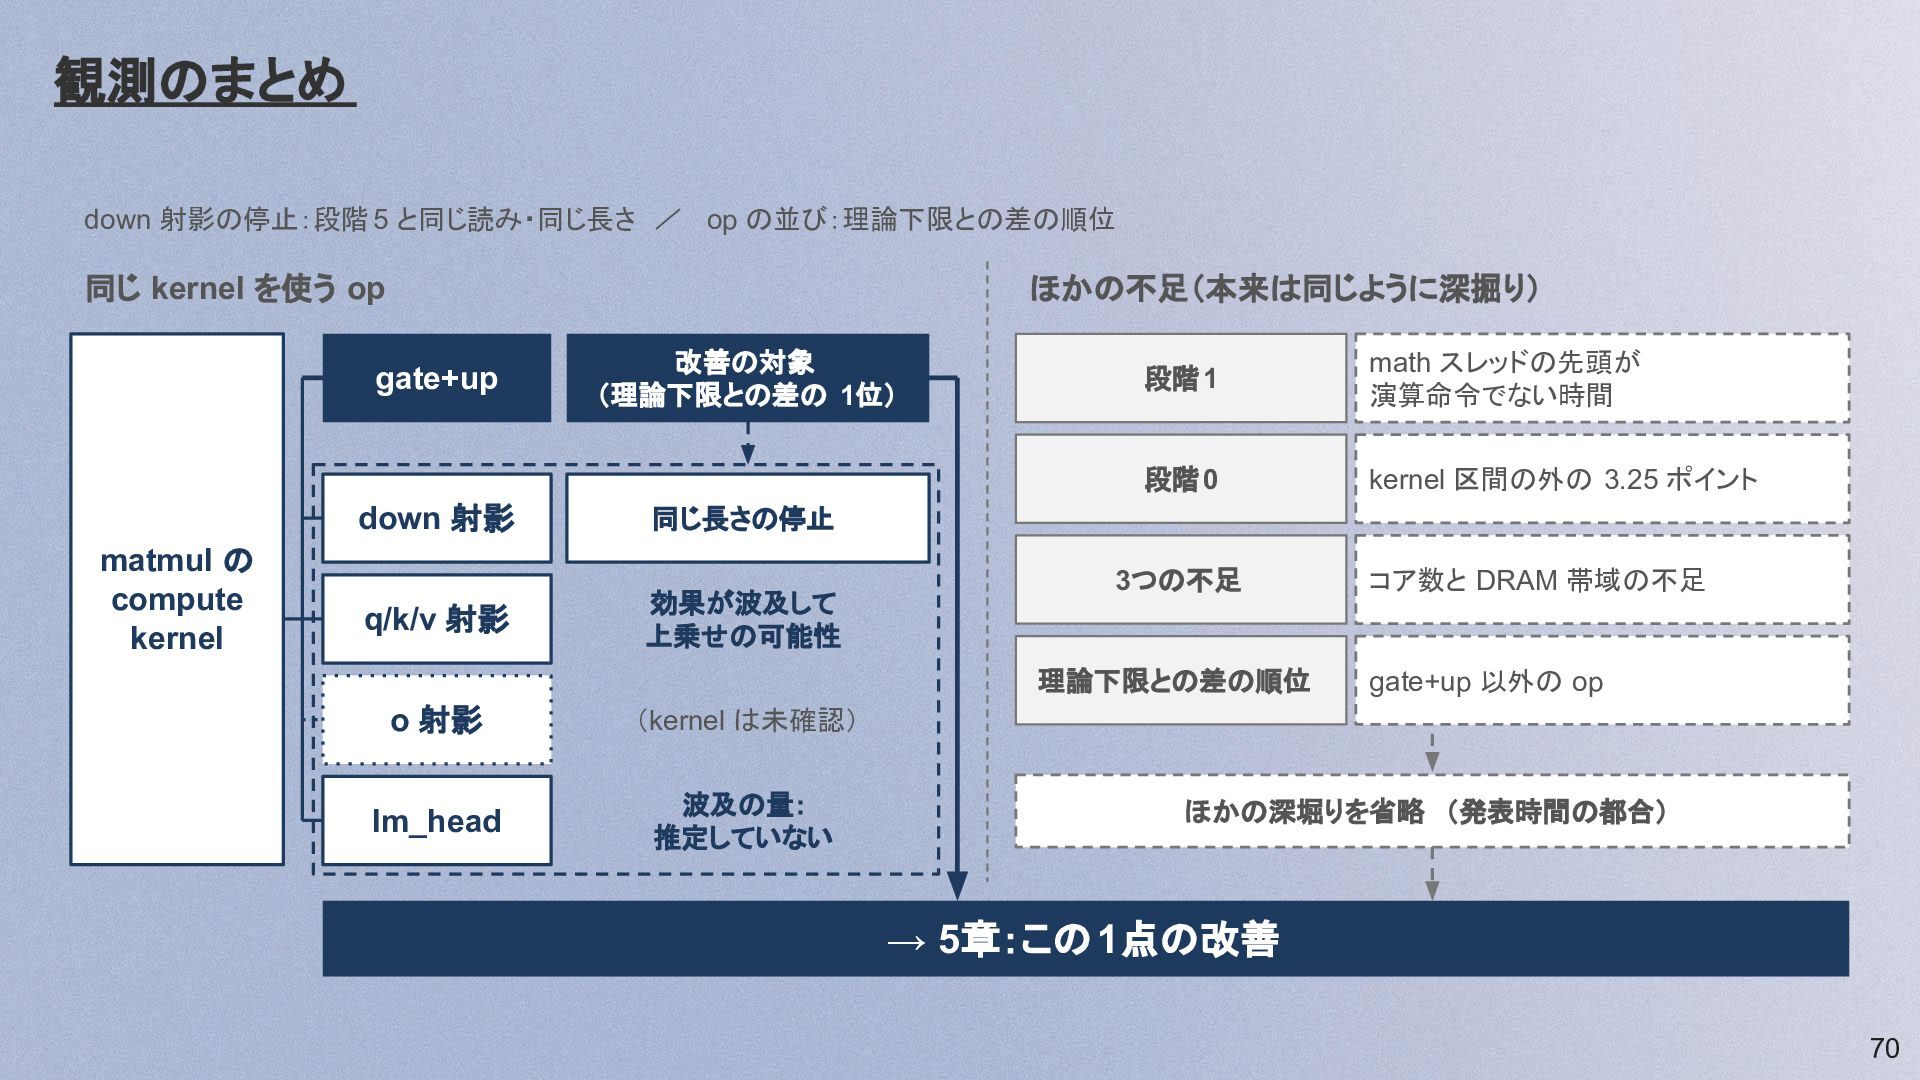
  65. 観測のまとめ down 射影の停止:段階 5 と同じ読み・同じ長さ / op の並び:理論下限との差の順位 同じ kernel

    を使う op ほかの不足(本来は同じように深掘り) gate+up matmul の compute kernel 改善の対象 (理論下限との差の 1位) down 射影 同じ長さの停止 q/k/v 射影 効果が波及して 上乗せの可能性 段階1 math スレッドの先頭が 演算命令でない時間 段階0 kernel 区間の外の 3.25 ポイント 3つの不足 理論下限との差の順位 o 射影 (kernel は未確認) lm_head 波及の量: 推定していない コア数と DRAM 帯域の不足 gate+up 以外の op ほかの深堀りを省略 (発表時間の都合) → 5章:この 1点の改善 70
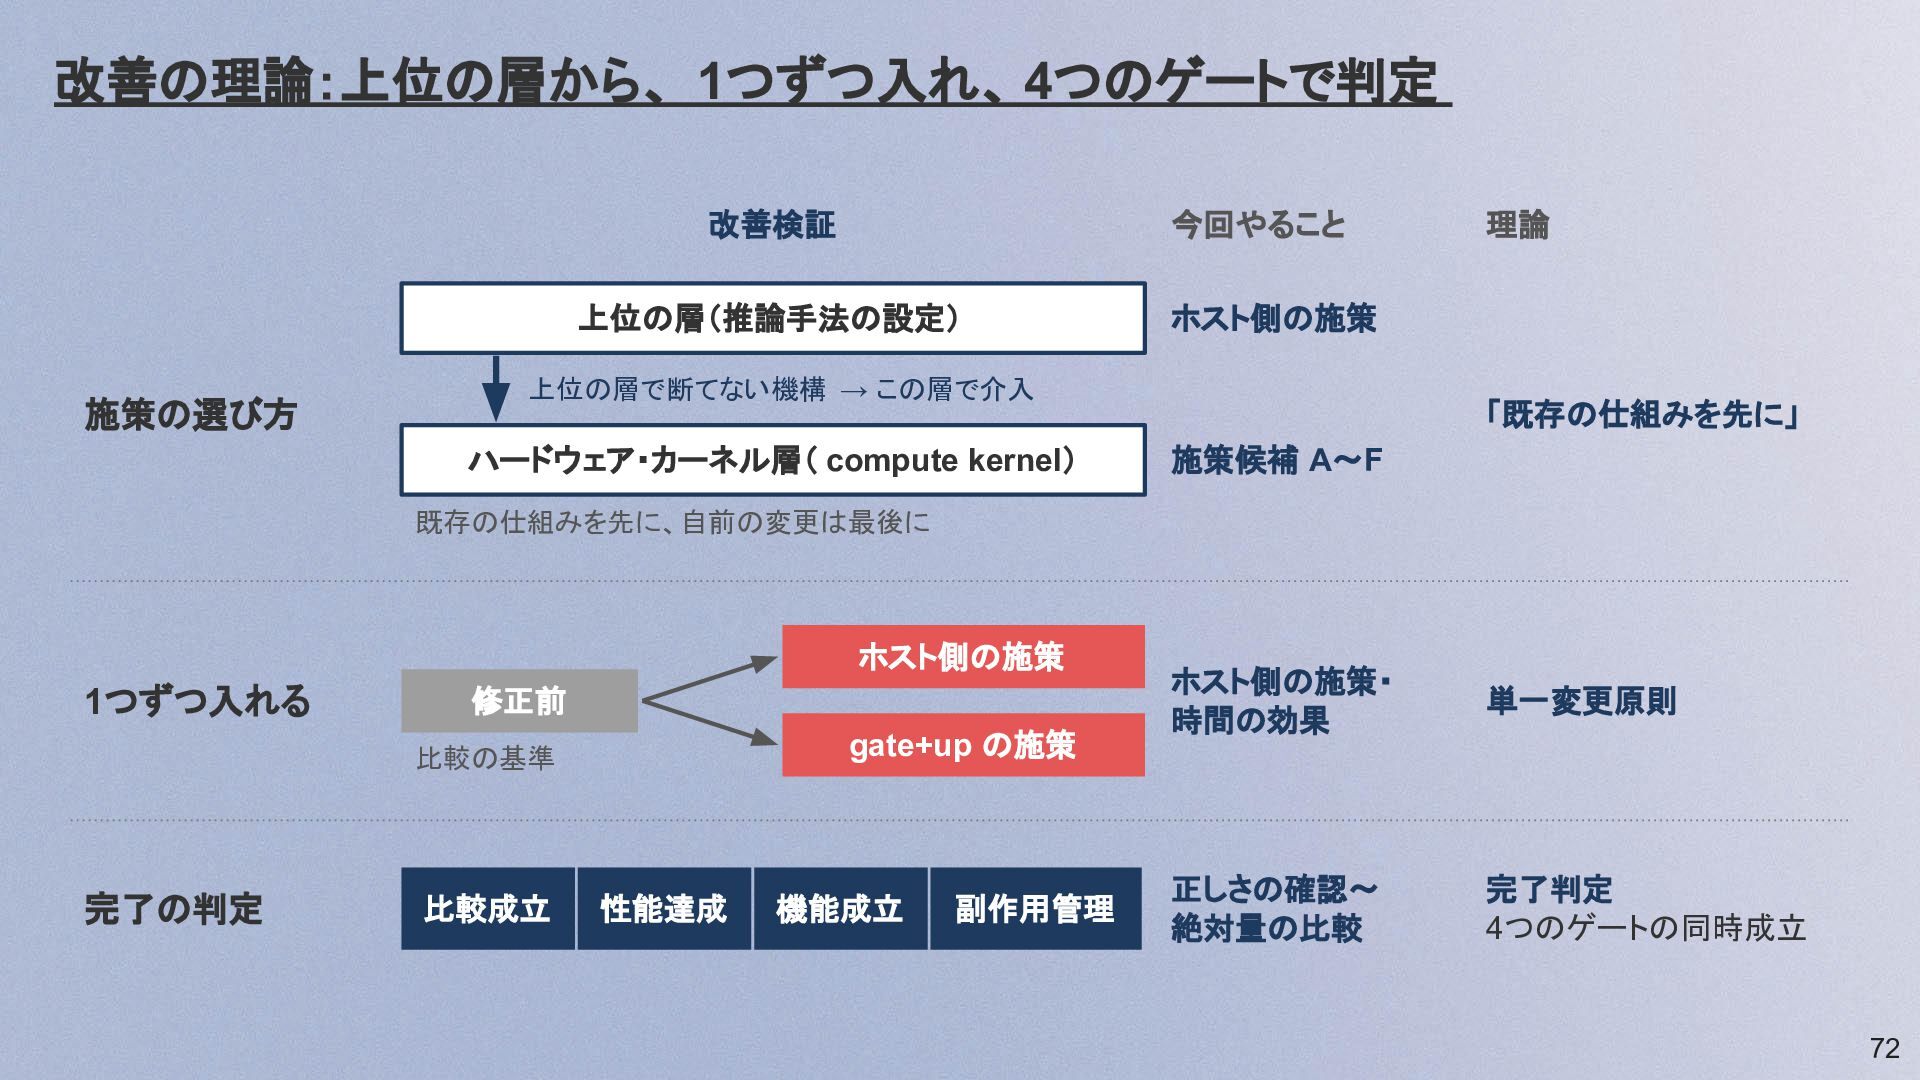
  66. 改善の理論:上位の層から、 1つずつ入れ、 4つのゲートで判定 施策の選び方 改善検証 今回やること 上位の層(推論手法の設定) ホスト側の施策 上位の層で断てない機構 →

    この層で介入 ハードウェア・カーネル層( compute kernel) 理論 「既存の仕組みを先に」 施策候補 A〜F 既存の仕組みを先に、自前の変更は最後に ホスト側の施策 1つずつ入れる 修正前 gate+up の施策 比較の基準 完了の判定 比較成立 性能達成 機能成立 副作用管理 ホスト側の施策・ 時間の効果 単一変更原則 正しさの確認〜 絶対量の比較 完了判定 4つのゲートの同時成立 72
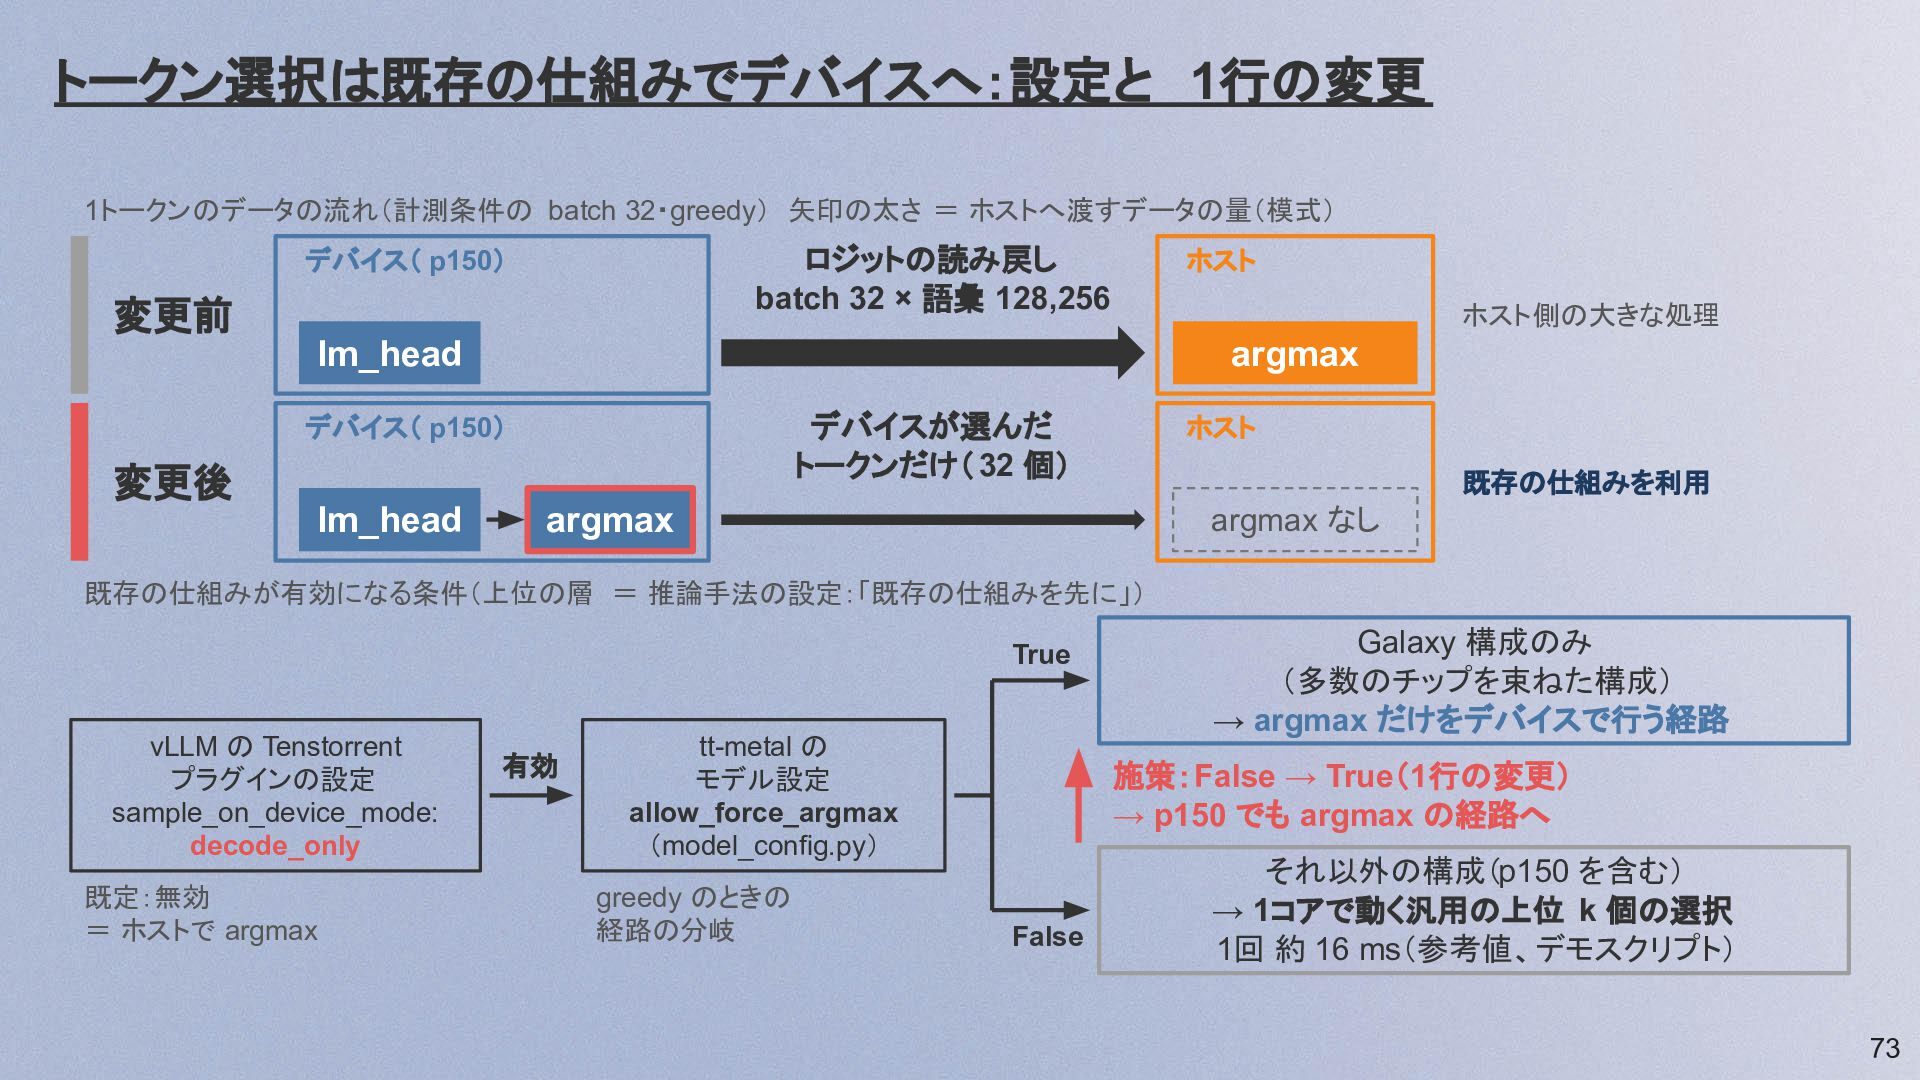
  67. トークン選択は既存の仕組みでデバイスへ:設定と 1行の変更 1トークンのデータの流れ(計測条件の batch 32・greedy) 矢印の太さ = ホストへ渡すデータの量(模式) ロジットの読み戻し batch

    32 × 語彙 128,256 デバイス( p150) 変更前 ホスト ホスト側の大きな処理 lm_head argmax デバイスが選んだ トークンだけ( 32 個) デバイス( p150) 変更後 lm_head ホスト 既存の仕組みを利用 argmax なし argmax 既存の仕組みが有効になる条件(上位の層 = 推論手法の設定:「既存の仕組みを先に」) True vLLM の Tenstorrent プラグインの設定 sample_on_device_mode: decode_only 既定:無効 = ホストで argmax 有効 tt-metal の モデル設定 allow_force_argmax (model_config.py) greedy のときの 経路の分岐 Galaxy 構成のみ (多数のチップを束ねた構成) → argmax だけをデバイスで行う経路 施策:False → True(1行の変更) → p150 でも argmax の経路へ False それ以外の構成(p150 を含む) → 1コアで動く汎用の上位 k 個の選択 1回 約 16 ms(参考値、デモスクリプト) 73
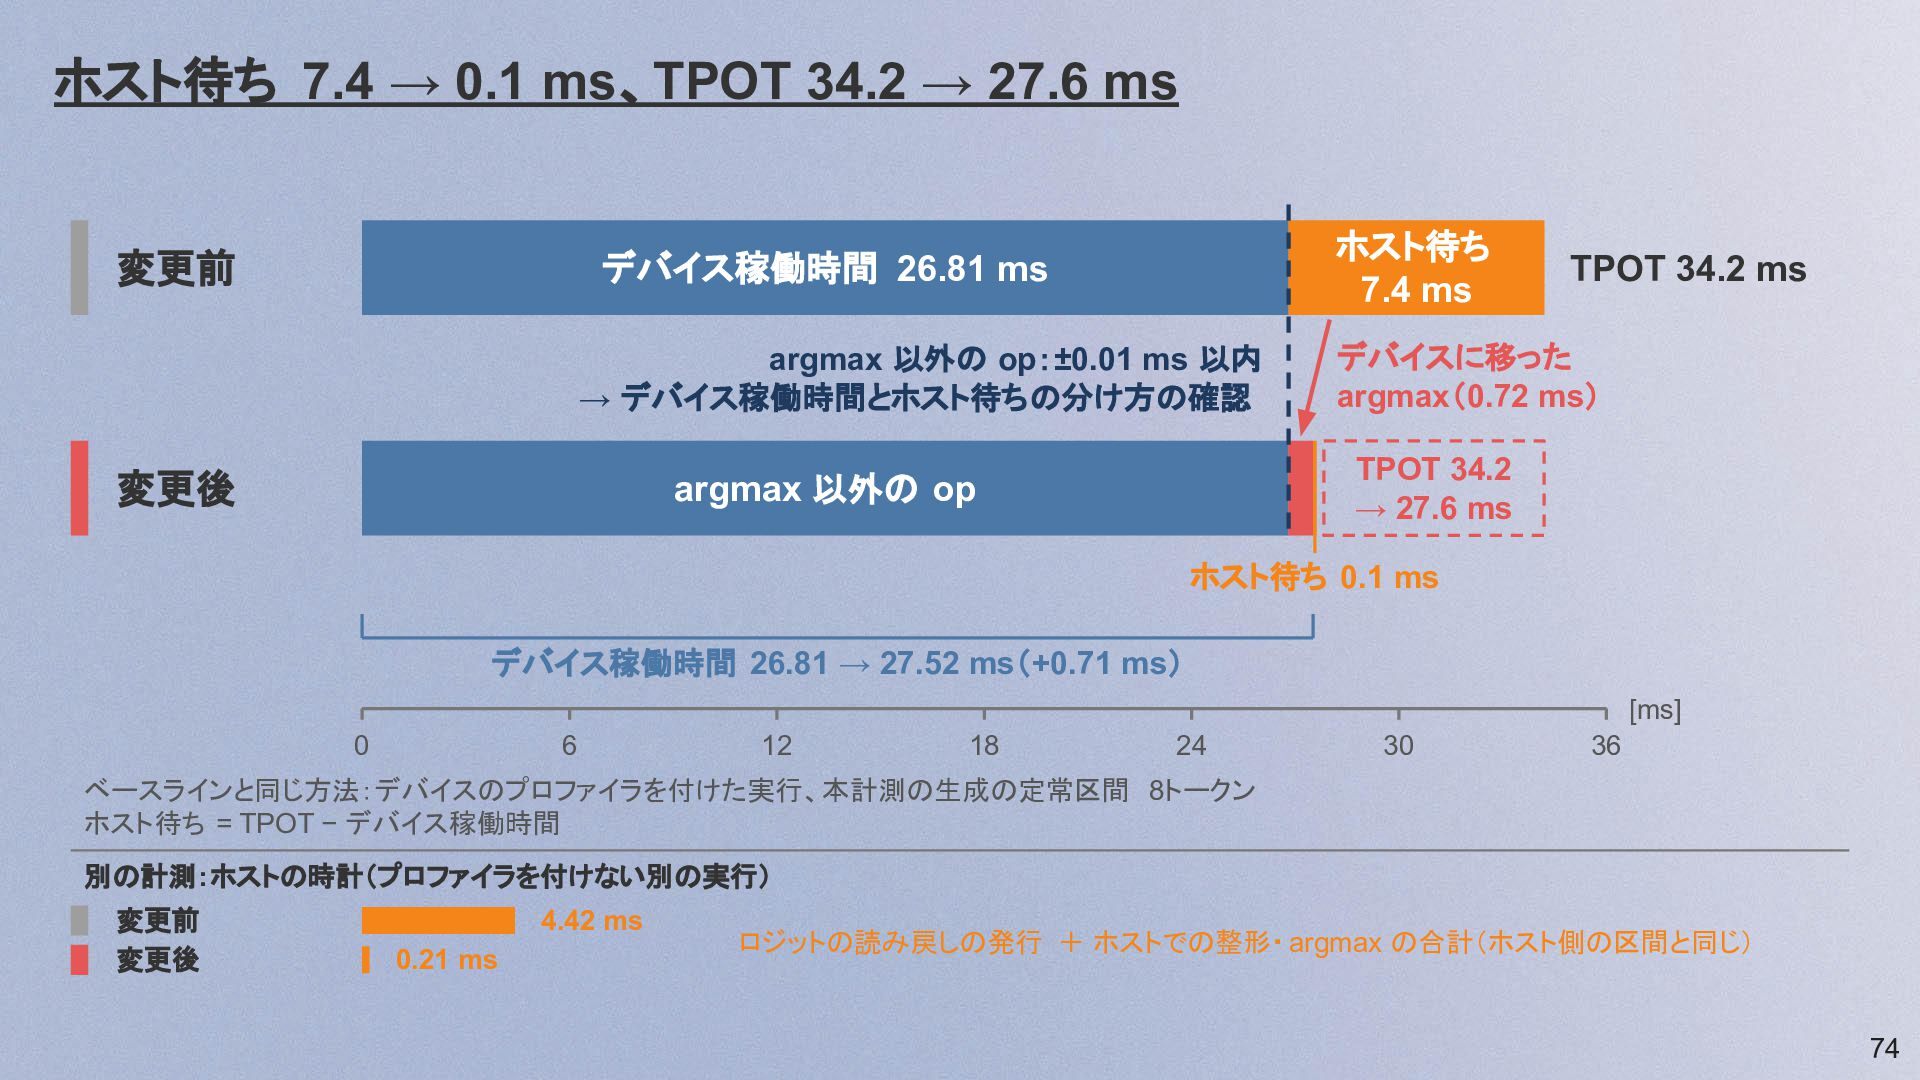
  68. ホスト待ち 7.4 → 0.1 ms、TPOT 34.2 → 27.6 ms 変更前

    デバイス稼働時間 26.81 ms ホスト待ち 7.4 ms argmax 以外の op:±0.01 ms 以内 → デバイス稼働時間とホスト待ちの分け方の確認 デバイスに移った argmax(0.72 ms) 変更後 TPOT 34.2 ms TPOT 34.2 → 27.6 ms argmax 以外の op ホスト待ち 0.1 ms デバイス稼働時間 26.81 → 27.52 ms(+0.71 ms) [ms] 0 6 12 18 24 30 36 ベースラインと同じ方法:デバイスのプロファイラを付けた実行、本計測の生成の定常区間 8トークン ホスト待ち = TPOT − デバイス稼働時間 別の計測:ホストの時計(プロファイラを付けない別の実行) 変更前 変更後 4.42 ms 0.21 ms ロジットの読み戻しの発行 + ホストでの整形・ argmax の合計(ホスト側の区間と同じ) 74
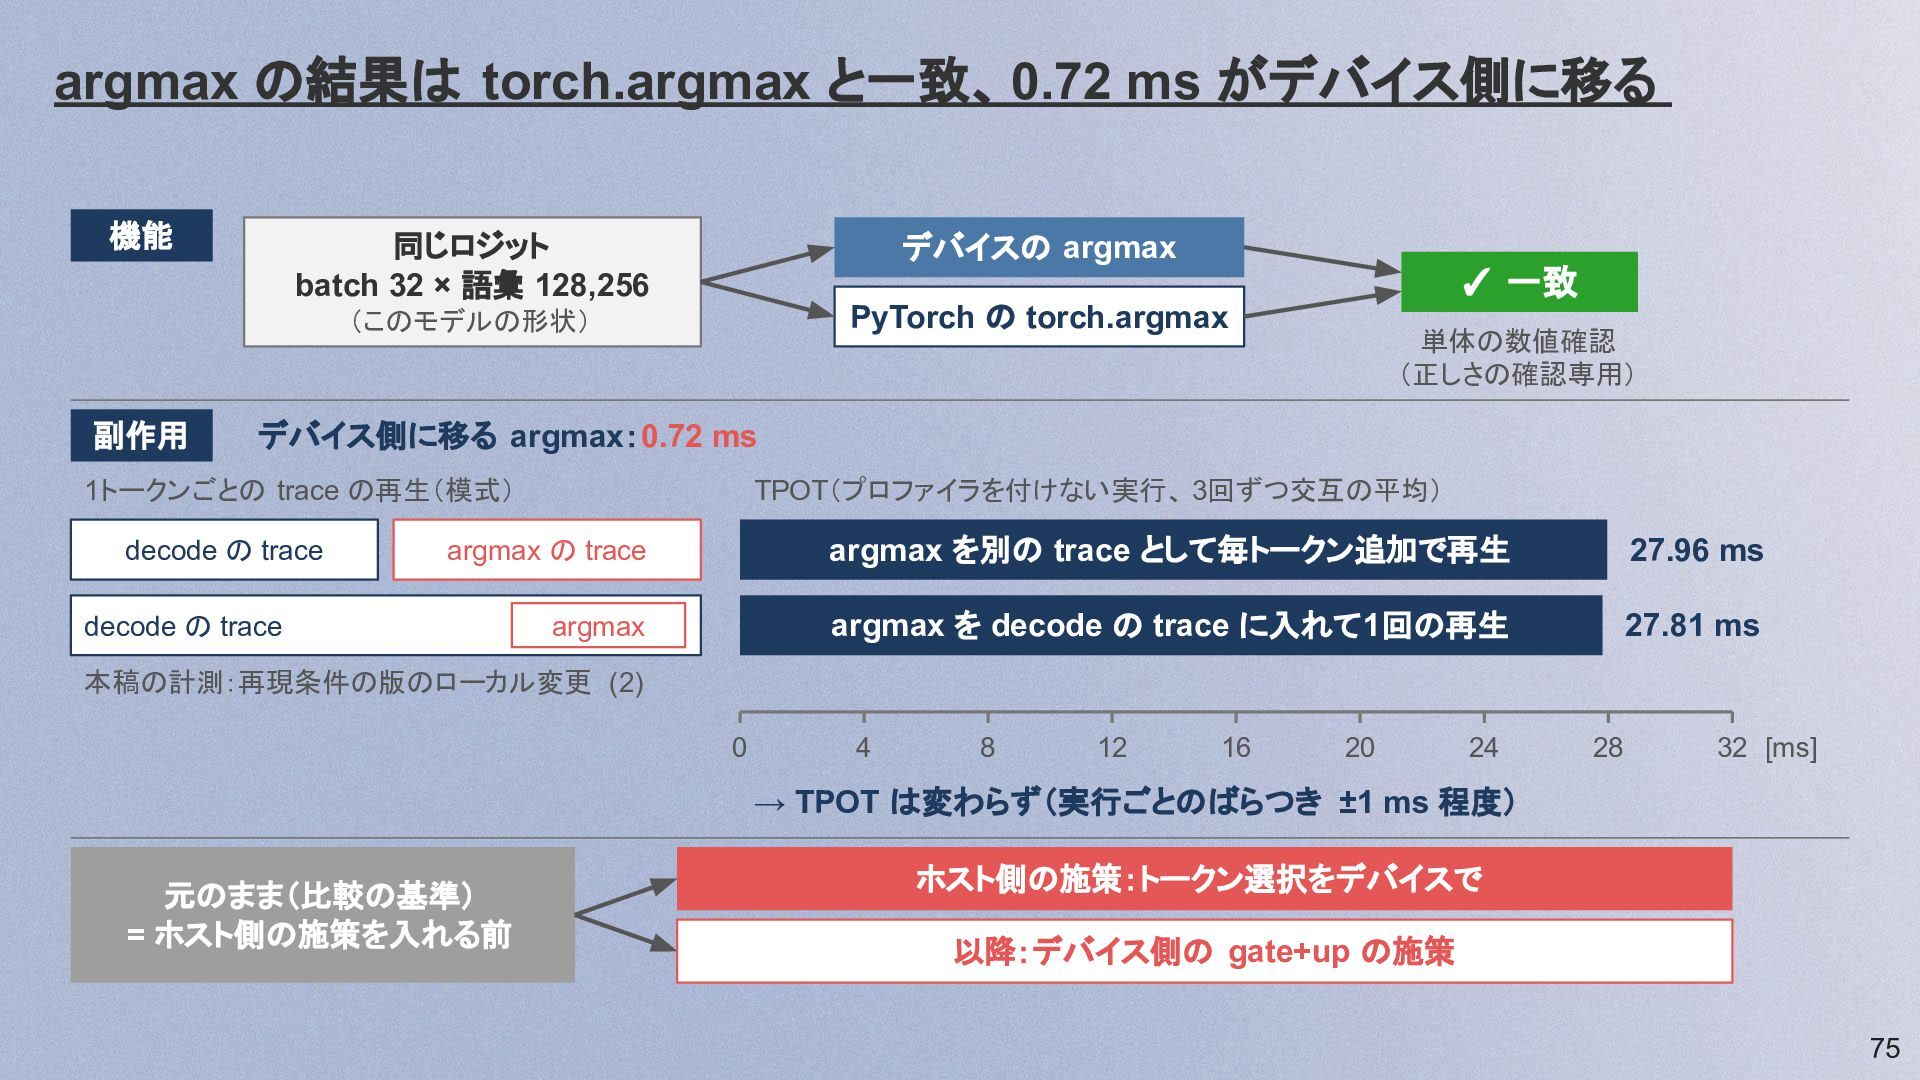
  69. argmax の結果は torch.argmax と一致、 0.72 ms がデバイス側に移る 機能 同じロジット batch

    32 × 語彙 128,256 デバイスの argmax PyTorch の torch.argmax (このモデルの形状) 副作用 ✓ 一致 単体の数値確認 (正しさの確認専用) デバイス側に移る argmax:0.72 ms 1トークンごとの trace の再生(模式) decode の trace TPOT(プロファイラを付けない実行、 3回ずつ交互の平均) argmax の trace argmax を別の trace として毎トークン追加で再生 27.96 ms argmax argmax を decode の trace に入れて1回の再生 27.81 ms decode の trace 本稿の計測:再現条件の版のローカル変更 (2) 0 4 8 12 16 20 24 28 32 [ms] → TPOT は変わらず(実行ごとのばらつき ±1 ms 程度) 元のまま(比較の基準) = ホスト側の施策を入れる前 ホスト側の施策:トークン選択をデバイスで 以降:デバイス側の gate+up の施策 75
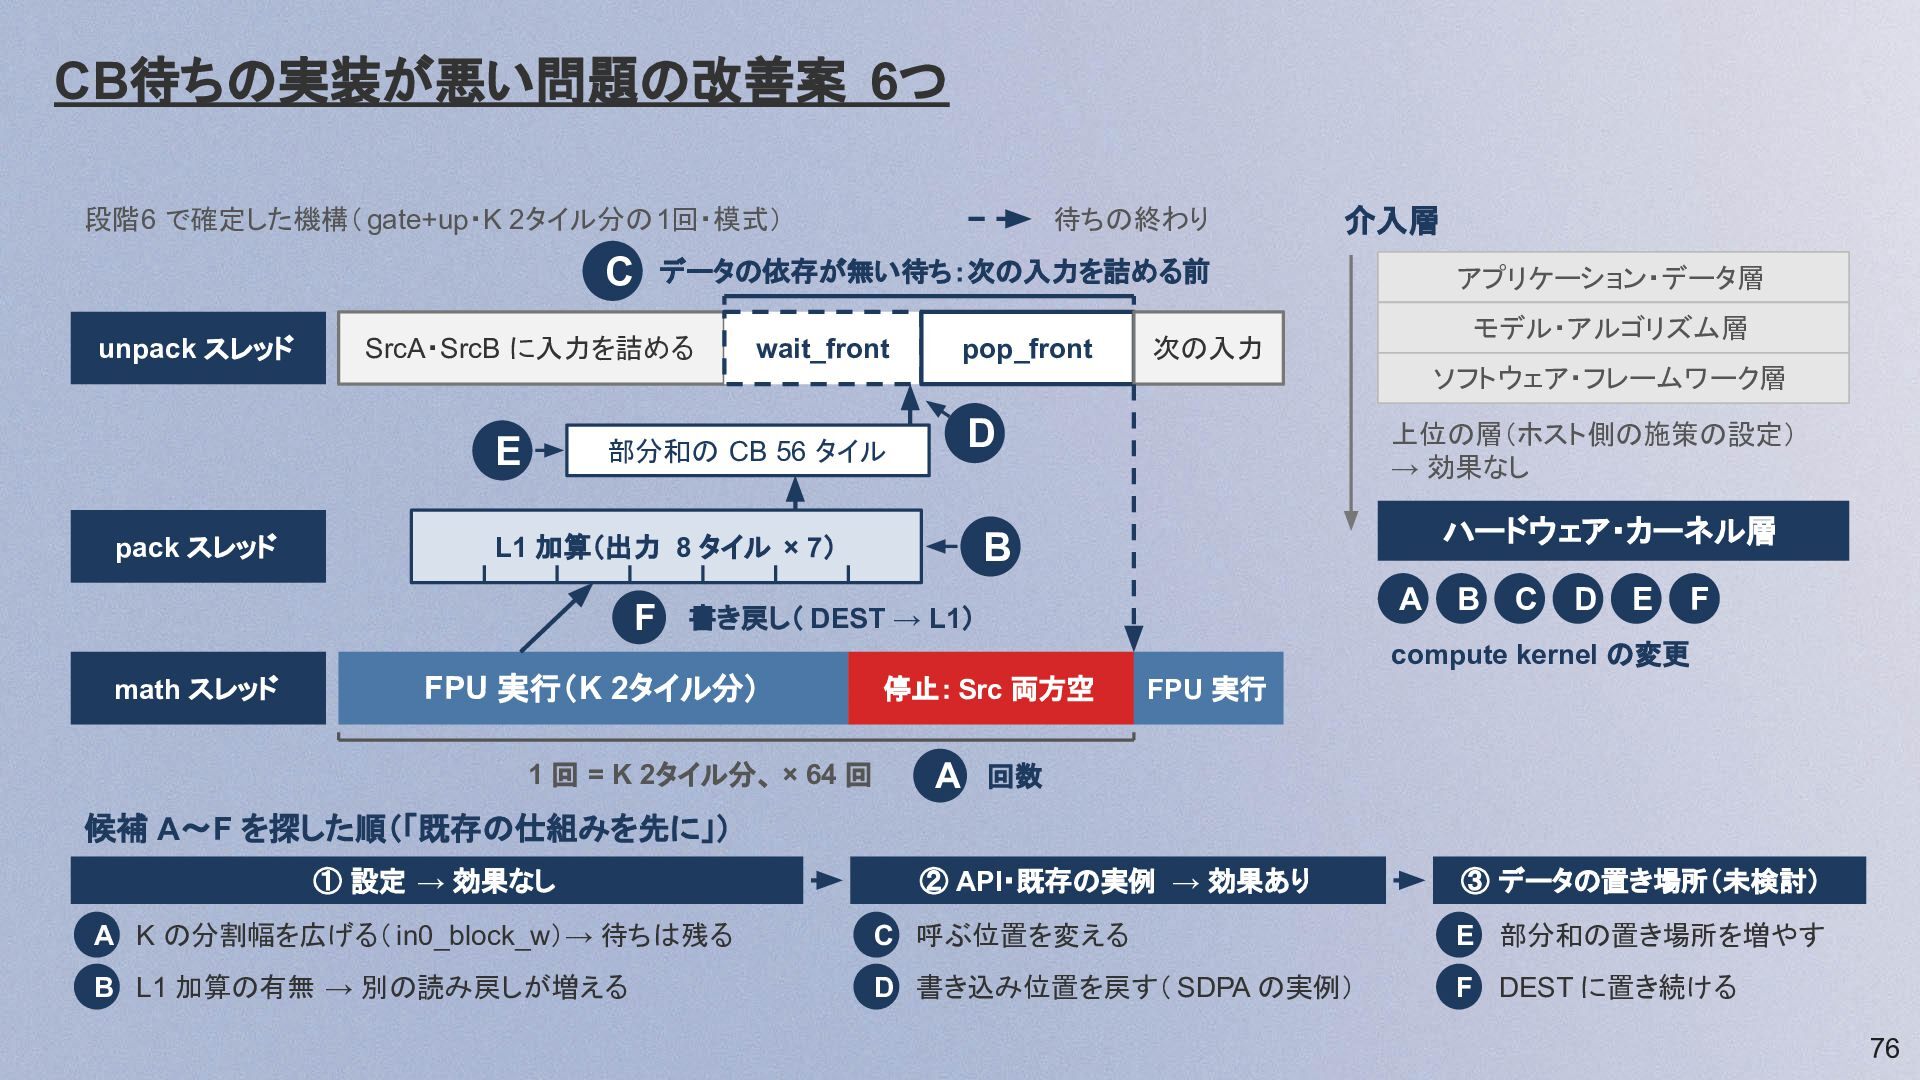
  70. CB待ちの実装が悪い問題の改善案 6つ 段階6 で確定した機構( gate+up・K 2タイル分の1回・模式) 待ちの終わり 介入層 C データの依存が無い待ち:次の入力を詰める前

    unpack スレッド SrcA・SrcB に入力を詰める wait_front pop_front アプリケーション・データ層 モデル・アルゴリズム層 次の入力 ソフトウェア・フレームワーク層 E pack スレッド D 部分和の CB 56 タイル ハードウェア・カーネル層 B L1 加算(出力 8 タイル × 7) F 上位の層(ホスト側の施策の設定) → 効果なし A 書き戻し( DEST → L1) B C D E F compute kernel の変更 math スレッド FPU 実行(K 2タイル分) 1 回 = K 2タイル分、 × 64 回 停止: Src 両方空 A FPU 実行 回数 候補 A〜F を探した順(「既存の仕組みを先に」) ① 設定 → 効果なし ② API・既存の実例 → 効果あり ③ データの置き場所(未検討) A K の分割幅を広げる( in0_block_w)→ 待ちは残る C 呼ぶ位置を変える E 部分和の置き場所を増やす B L1 加算の有無 → 別の読み戻しが増える D 書き込み位置を戻す( SDPA の実例) F DEST に置き続ける 76
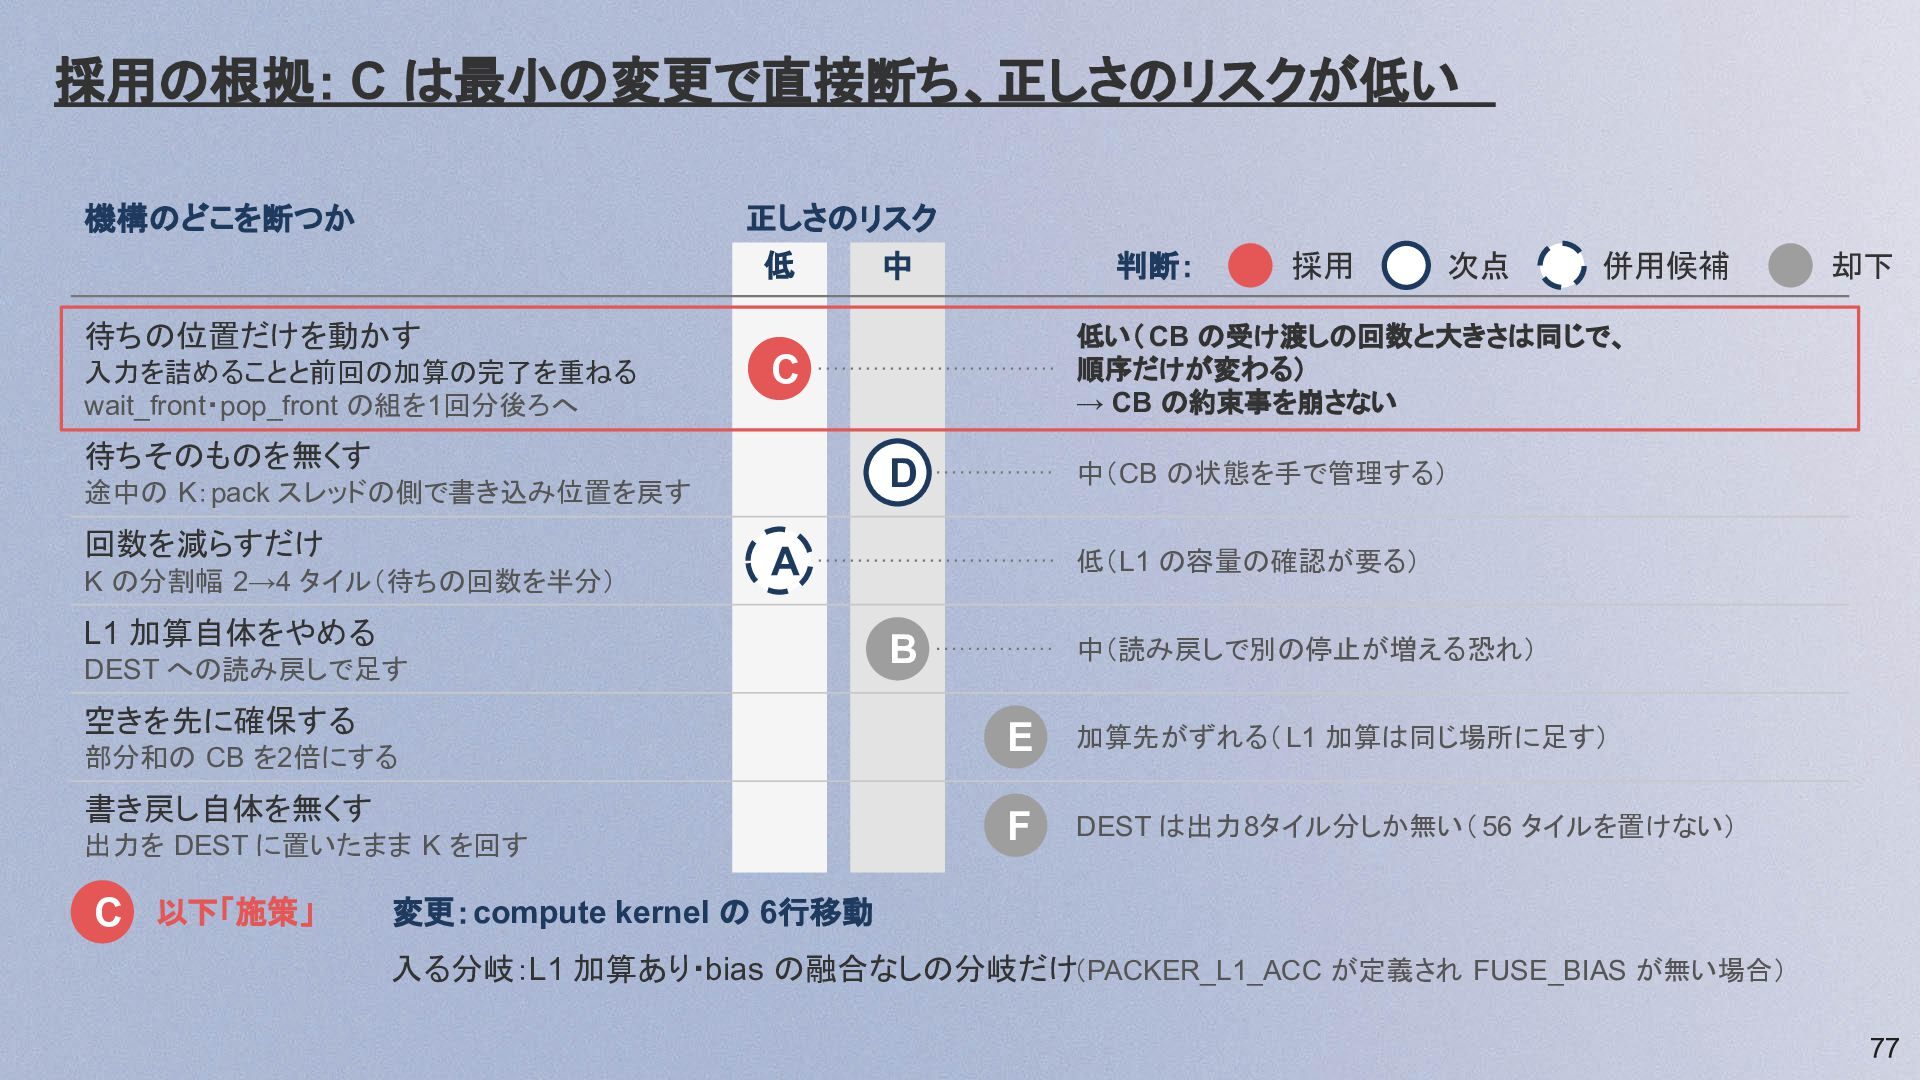
  71. 採用の根拠: C は最小の変更で直接断ち、正しさのリスクが低い 機構のどこを断つか 正しさのリスク 低 中 判断: 待ちの位置だけを動かす 入力を詰めることと前回の加算の完了を重ねる

    wait_front・pop_front の組を1回分後ろへ D 途中の K:pack スレッドの側で書き込み位置を戻す 回数を減らすだけ K の分割幅 2→4 タイル(待ちの回数を半分) DEST への読み戻しで足す 空きを先に確保する 部分和の CB を2倍にする 書き戻し自体を無くす 出力を DEST に置いたまま K を回す C 以下「施策」 併用候補 却下 中(CB の状態を手で管理する) A L1 加算自体をやめる 次点 低い( CB の受け渡しの回数と大きさは同じで、 順序だけが変わる) → CB の約束事を崩さない C 待ちそのものを無くす 採用 低(L1 の容量の確認が要る) B 中(読み戻しで別の停止が増える恐れ) E 加算先がずれる( L1 加算は同じ場所に足す) F DEST は出力8タイル分しか無い( 56 タイルを置けない) 変更:compute kernel の 6行移動 入る分岐:L1 加算あり・bias の融合なしの分岐だけ(PACKER_L1_ACC が定義され FUSE_BIAS が無い場合) 77
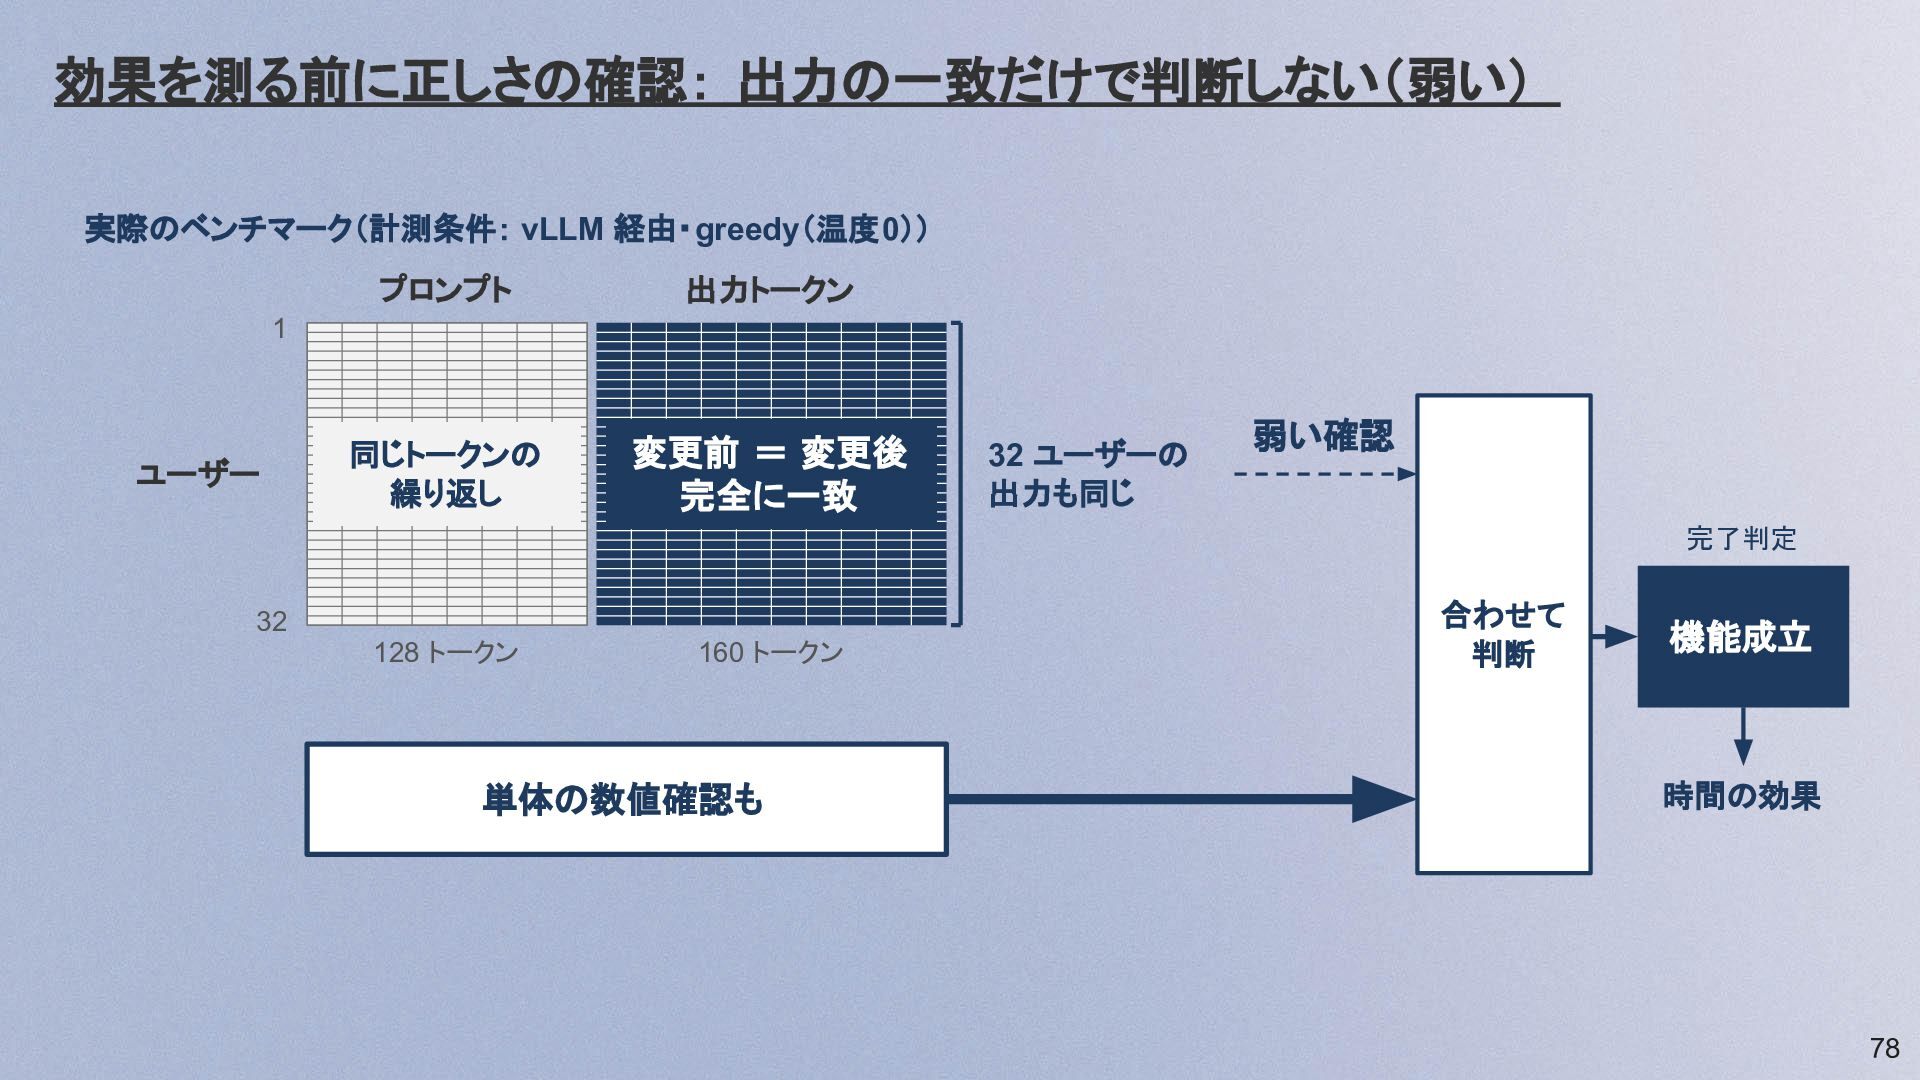
  72. 効果を測る前に正しさの確認: 出力の一致だけで判断しない(弱い) 実際のベンチマーク(計測条件: vLLM 経由・greedy(温度0)) プロンプト 出力トークン 同じトークンの 繰り返し 変更前

    = 変更後 完全に一致 1 ユーザー 32 ユーザーの 出力も同じ 弱い確認 完了判定 32 128 トークン 160 トークン 単体の数値確認も 合わせて 判断 機能成立 時間の効果 78
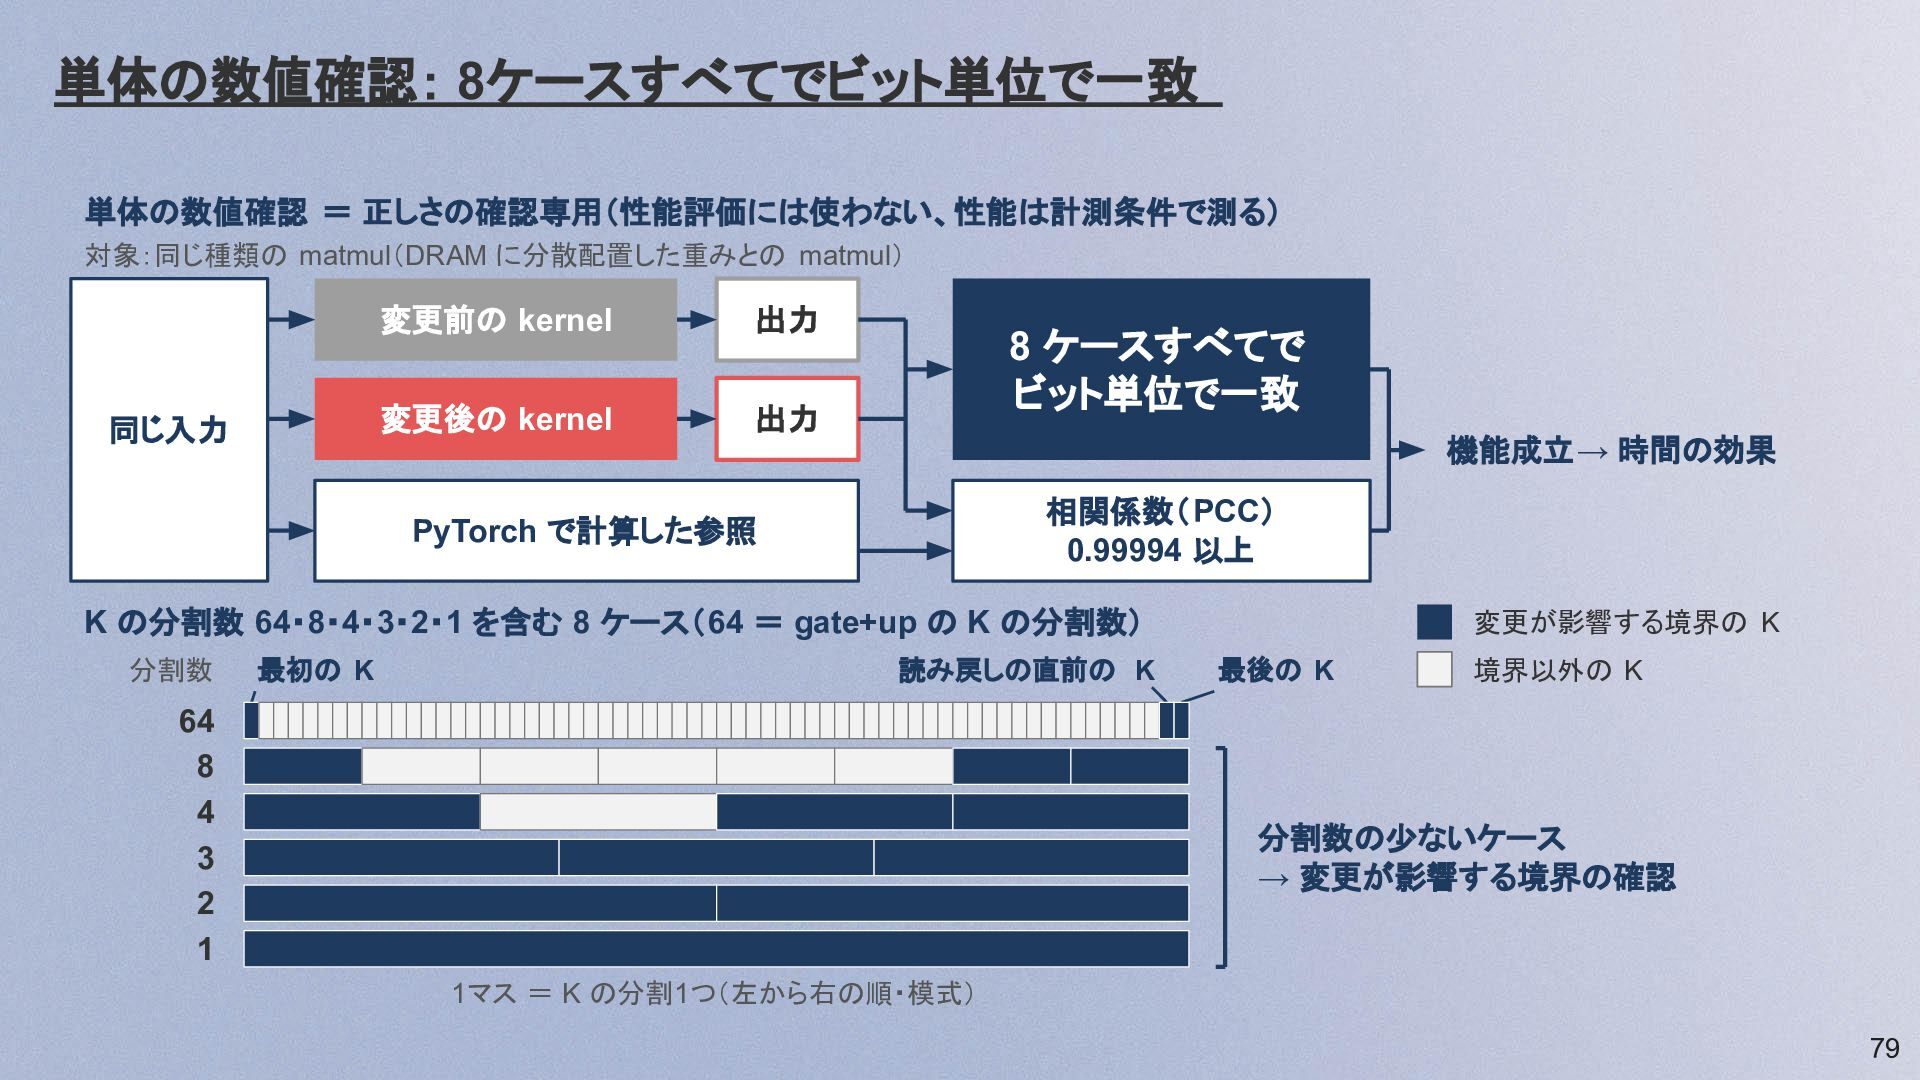
  73. 単体の数値確認: 8ケースすべてでビット単位で一致 単体の数値確認 = 正しさの確認専用(性能評価には使わない、性能は計測条件で測る) 対象:同じ種類の matmul(DRAM に分散配置した重みとの matmul) 同じ入力

    変更前の kernel 出力 変更後の kernel 出力 8 ケースすべてで ビット単位で一致 機能成立→ 時間の効果 相関係数(PCC) 0.99994 以上 PyTorch で計算した参照 K の分割数 64・8・4・3・2・1 を含む 8 ケース(64 = gate+up の K の分割数) 分割数 最初の K 読み戻しの直前の K 64 8 4 3 2 1 変更が影響する境界の K 最後の K 境界以外の K 分割数の少ないケース → 変更が影響する境界の確認 1マス = K の分割1つ(左から右の順・模式) 79
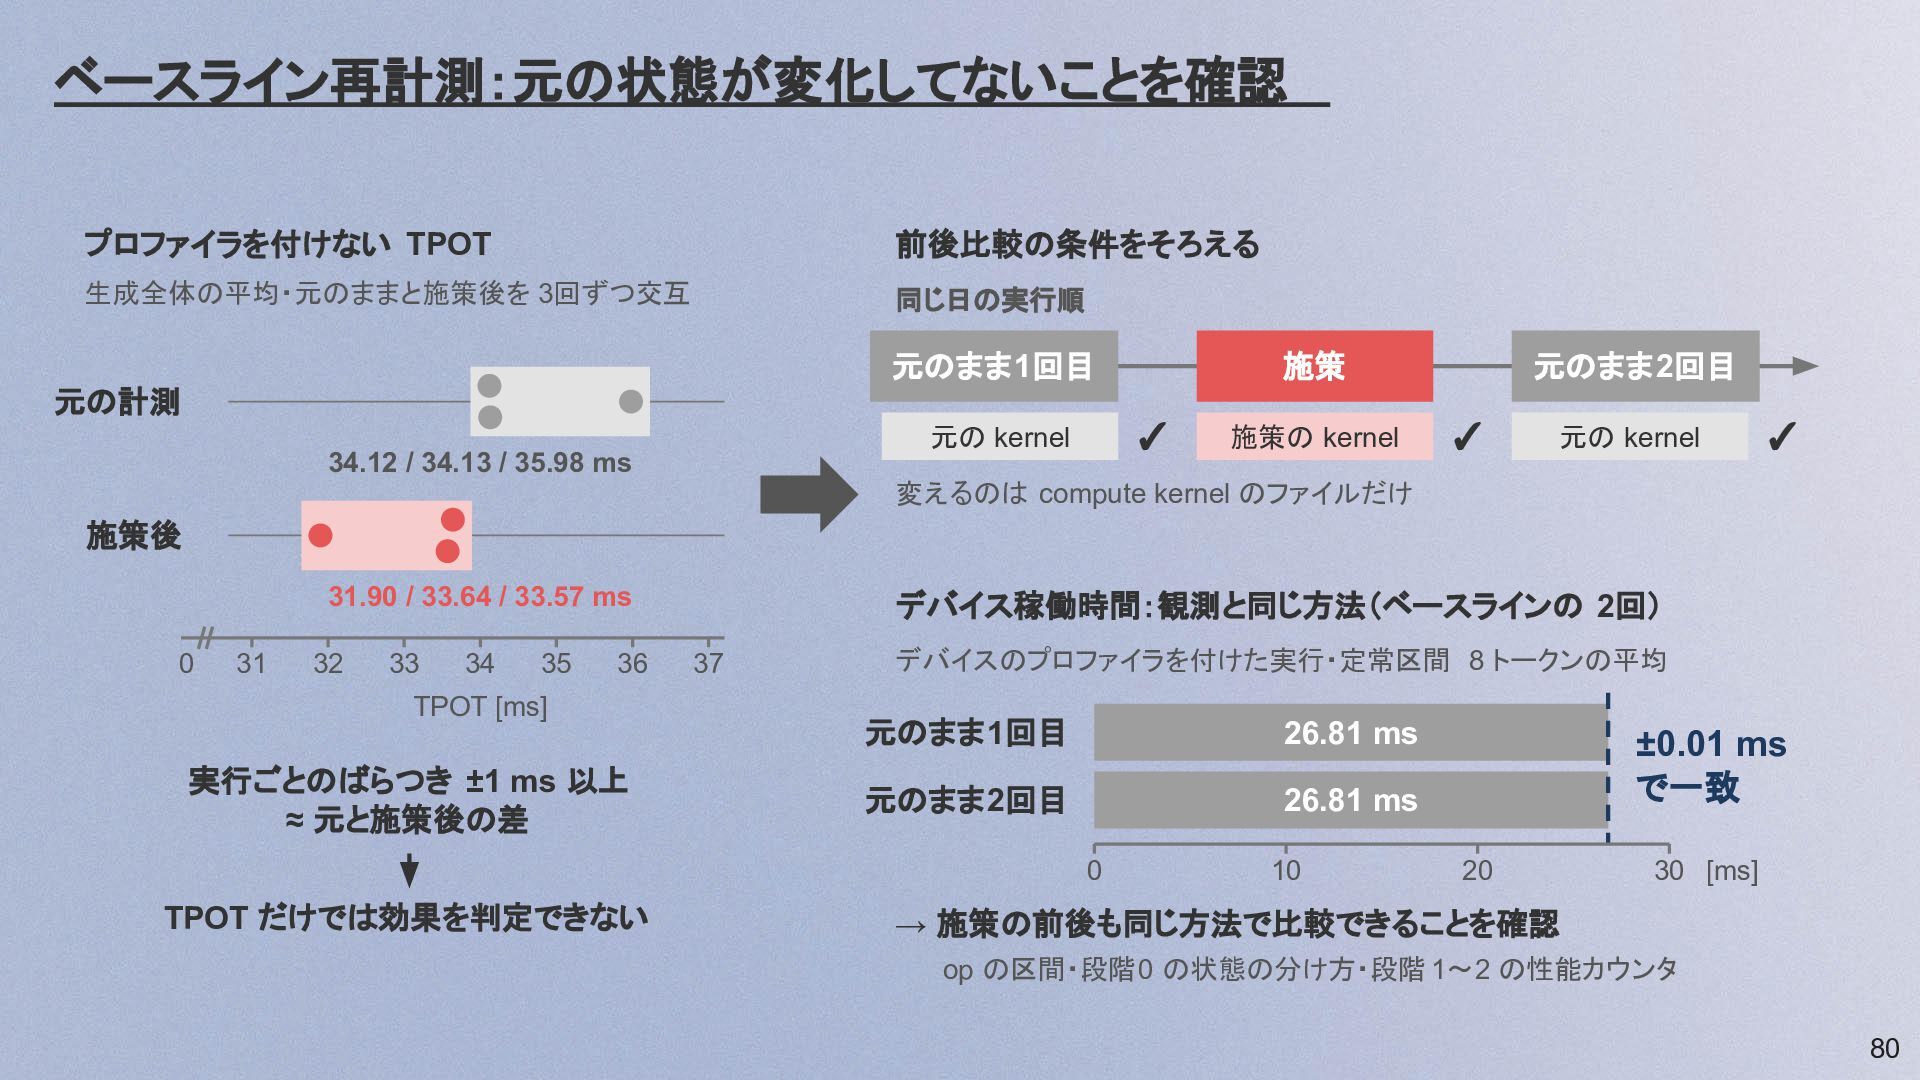
  74. ベースライン再計測:元の状態が変化してないことを確認 プロファイラを付けない TPOT 前後比較の条件をそろえる 生成全体の平均・元のままと施策後を 3回ずつ交互 同じ日の実行順 元のまま1回目 施策 元のまま2回目

    元の計測 ✓ 元の kernel 34.12 / 34.13 / 35.98 ms 施策の kernel ✓ 元の kernel ✓ 変えるのは compute kernel のファイルだけ 施策後 31.90 / 33.64 / 33.57 ms 0 31 32 33 34 35 36 TPOT [ms] 実行ごとのばらつき ±1 ms 以上 ≈ 元と施策後の差 デバイス稼働時間:観測と同じ方法(ベースラインの 2回) 37 デバイスのプロファイラを付けた実行・定常区間 8 トークンの平均 元のまま1回目 26.81 ms 元のまま2回目 26.81 ms 0 TPOT だけでは効果を判定できない 10 ±0.01 ms で一致 20 30 [ms] → 施策の前後も同じ方法で比較できることを確認 op の区間・段階0 の状態の分け方・段階 1〜2 の性能カウンタ 80
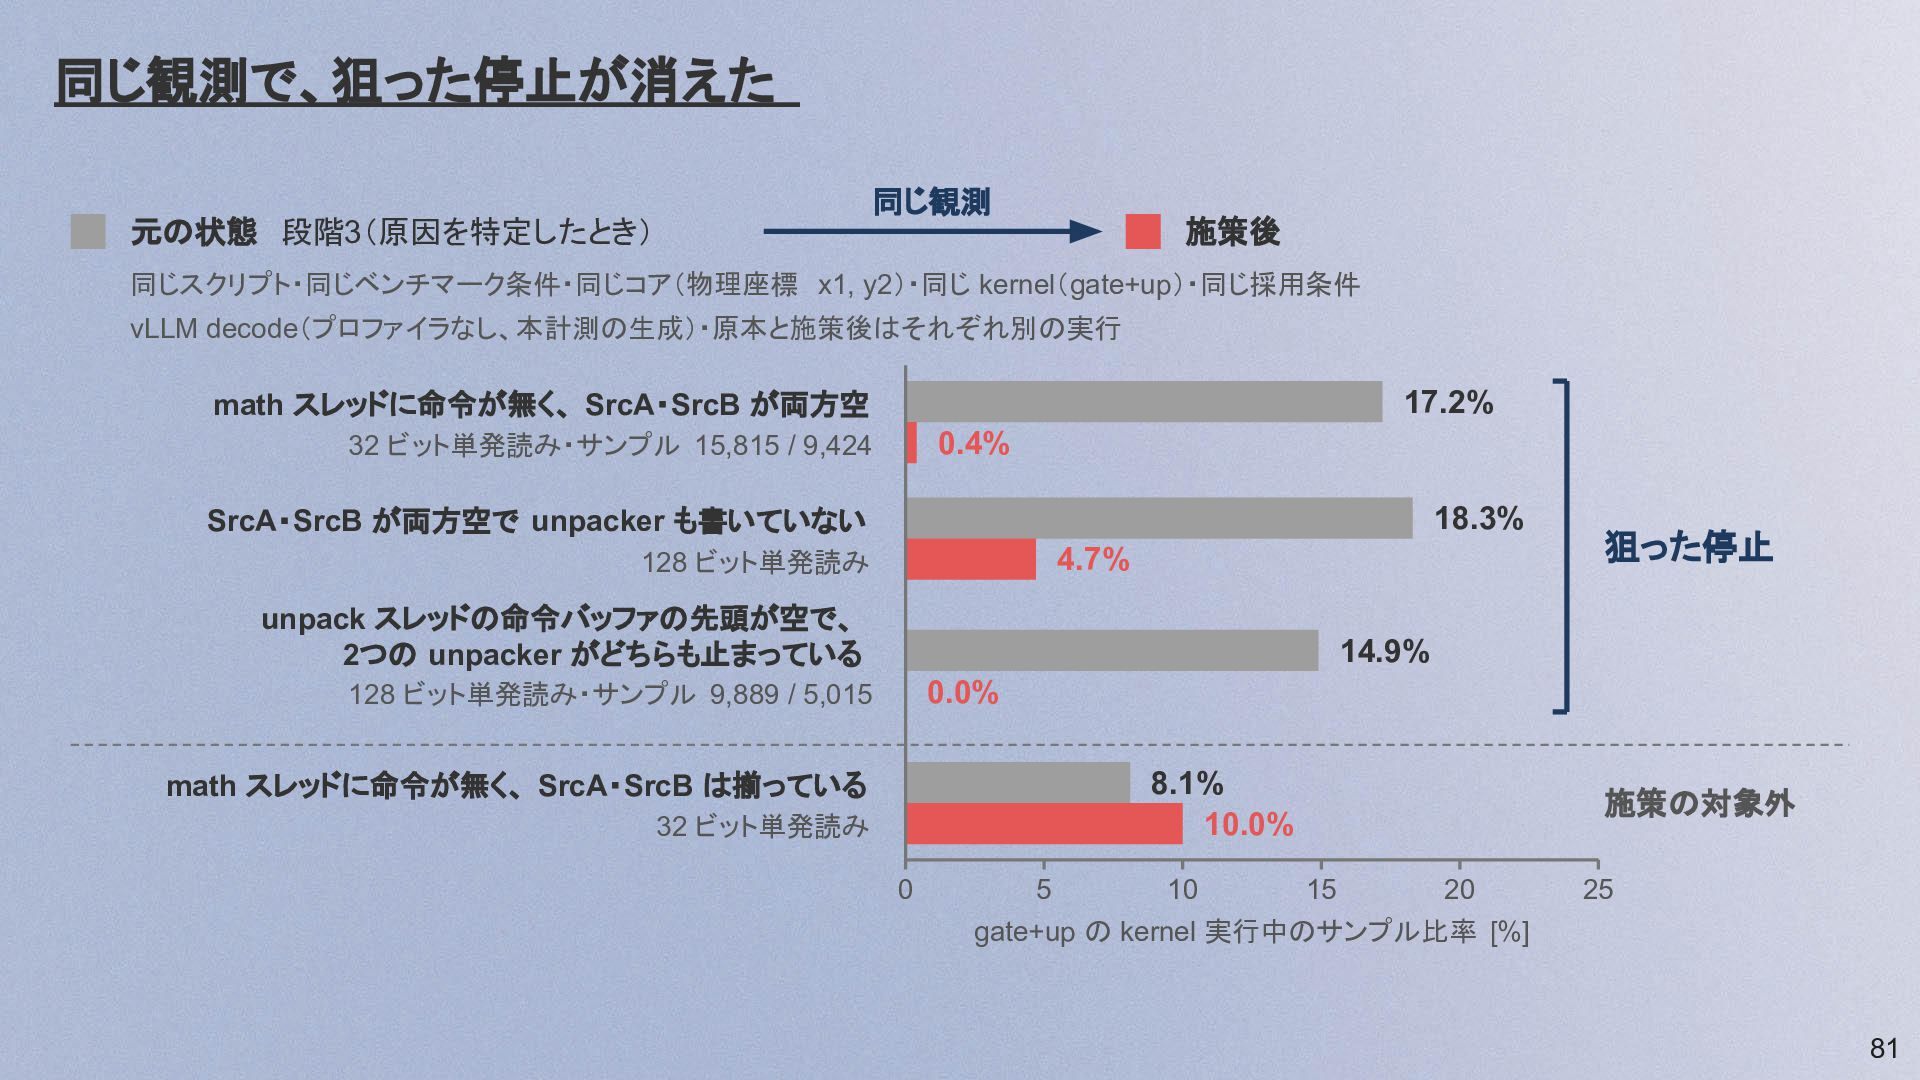
  75. 同じ観測で、狙った停止が消えた 同じ観測 元の状態 段階3(原因を特定したとき) 施策後 同じスクリプト・同じベンチマーク条件・同じコア(物理座標 x1, y2)・同じ kernel(gate+up)・同じ採用条件 vLLM

    decode(プロファイラなし、本計測の生成)・原本と施策後はそれぞれ別の実行 math スレッドに命令が無く、 SrcA・SrcB が両方空 17.2% 0.4% 32 ビット単発読み・サンプル 15,815 / 9,424 SrcA・SrcB が両方空で unpacker も書いていない 18.3% 4.7% 128 ビット単発読み unpack スレッドの命令バッファの先頭が空で、 2つの unpacker がどちらも止まっている 狙った停止 14.9% 0.0% 128 ビット単発読み・サンプル 9,889 / 5,015 math スレッドに命令が無く、 SrcA・SrcB は揃っている 8.1% 10.0% 32 ビット単発読み 0 5 10 15 20 gate+up の kernel 実行中のサンプル比率 [%] 施策の対象外 25 81
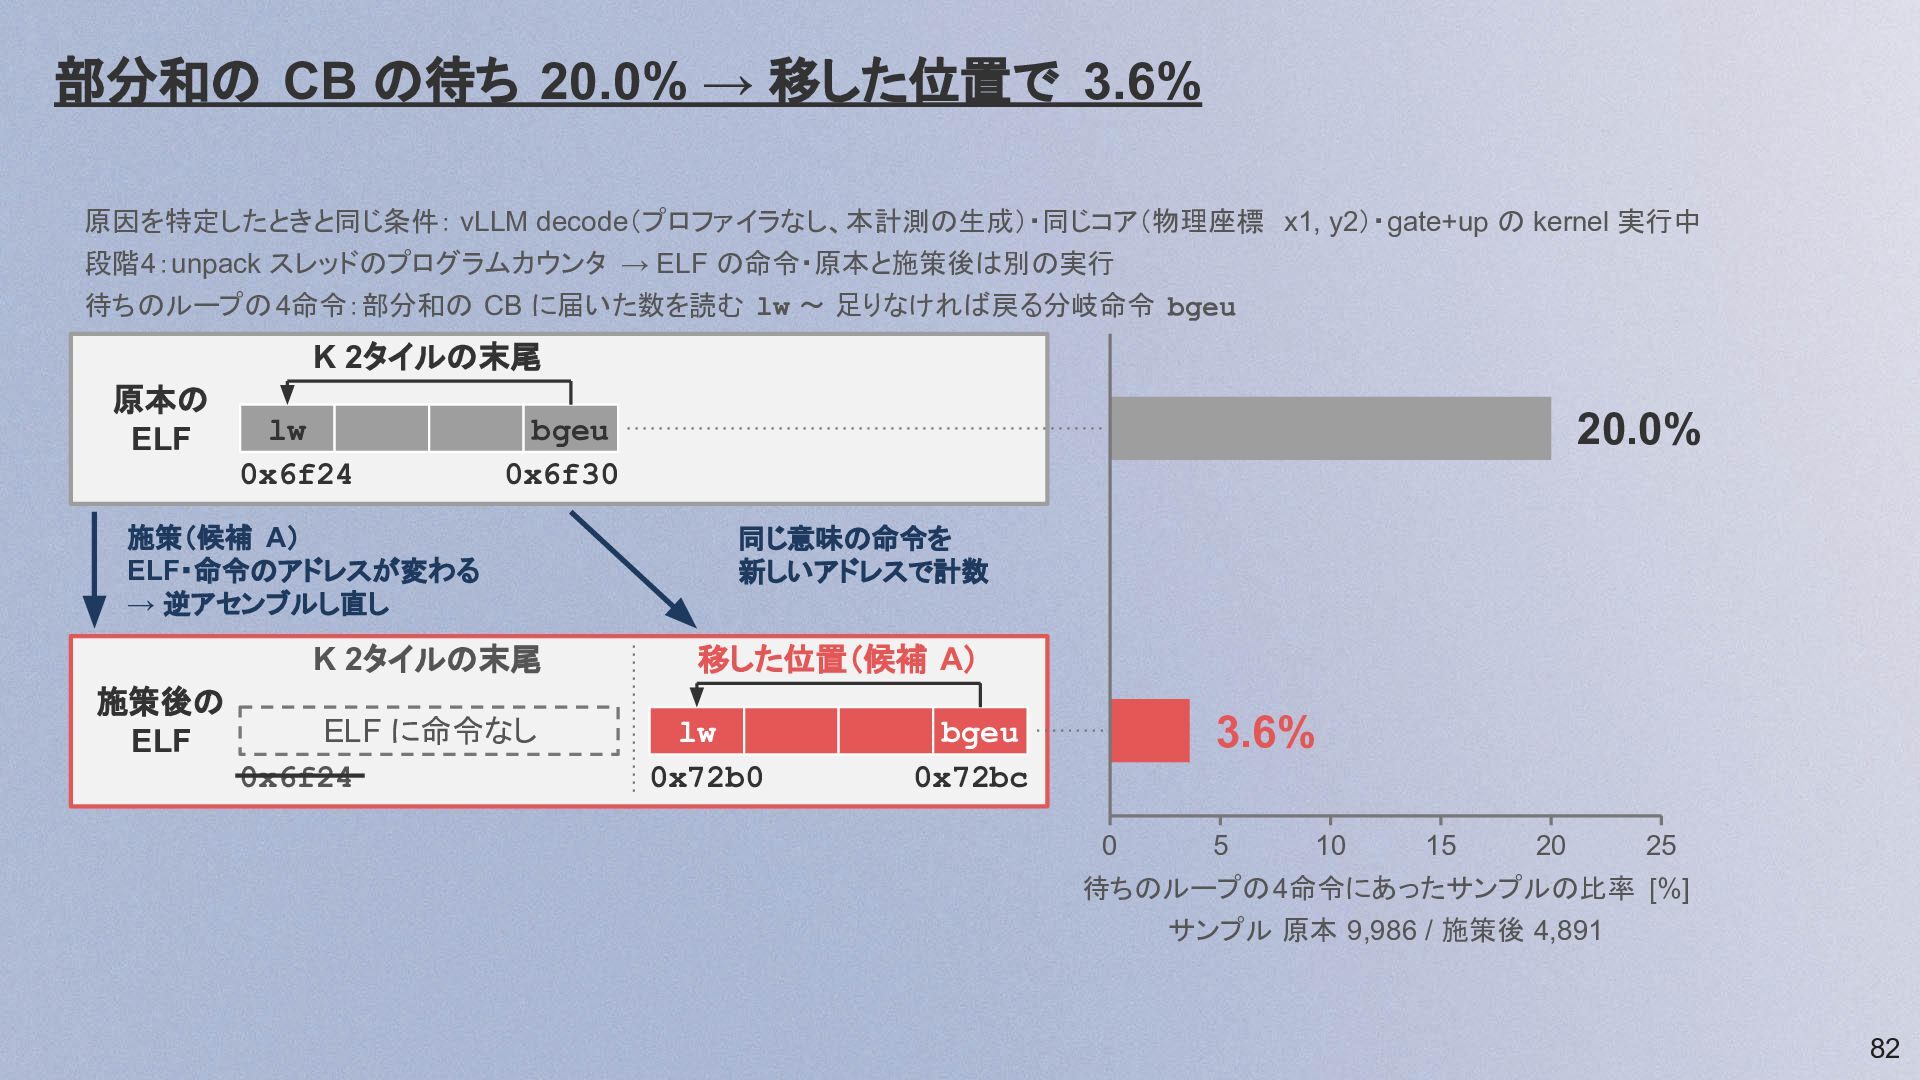
  76. 部分和の CB の待ち 20.0% → 移した位置で 3.6% 原因を特定したときと同じ条件: vLLM decode(プロファイラなし、本計測の生成)・同じコア(物理座標

    x1, y2)・gate+up の kernel 実行中 段階4:unpack スレッドのプログラムカウンタ → ELF の命令・原本と施策後は別の実行 待ちのループの 4命令:部分和の CB に届いた数を読む lw 〜 足りなければ戻る分岐命令 bgeu K 2タイルの末尾 原本の ELF lw 0x6f24 施策(候補 A) ELF・命令のアドレスが変わる → 逆アセンブルし直し K 2タイルの末尾 施策後の ELF 20.0% bgeu 0x6f30 ELF に命令なし 0x6f24 同じ意味の命令を 新しいアドレスで計数 移した位置(候補 A) lw 0x72b0 3.6% bgeu 0x72bc 0 5 10 15 20 25 待ちのループの 4命令にあったサンプルの比率 [%] サンプル 原本 9,986 / 施策後 4,891 82
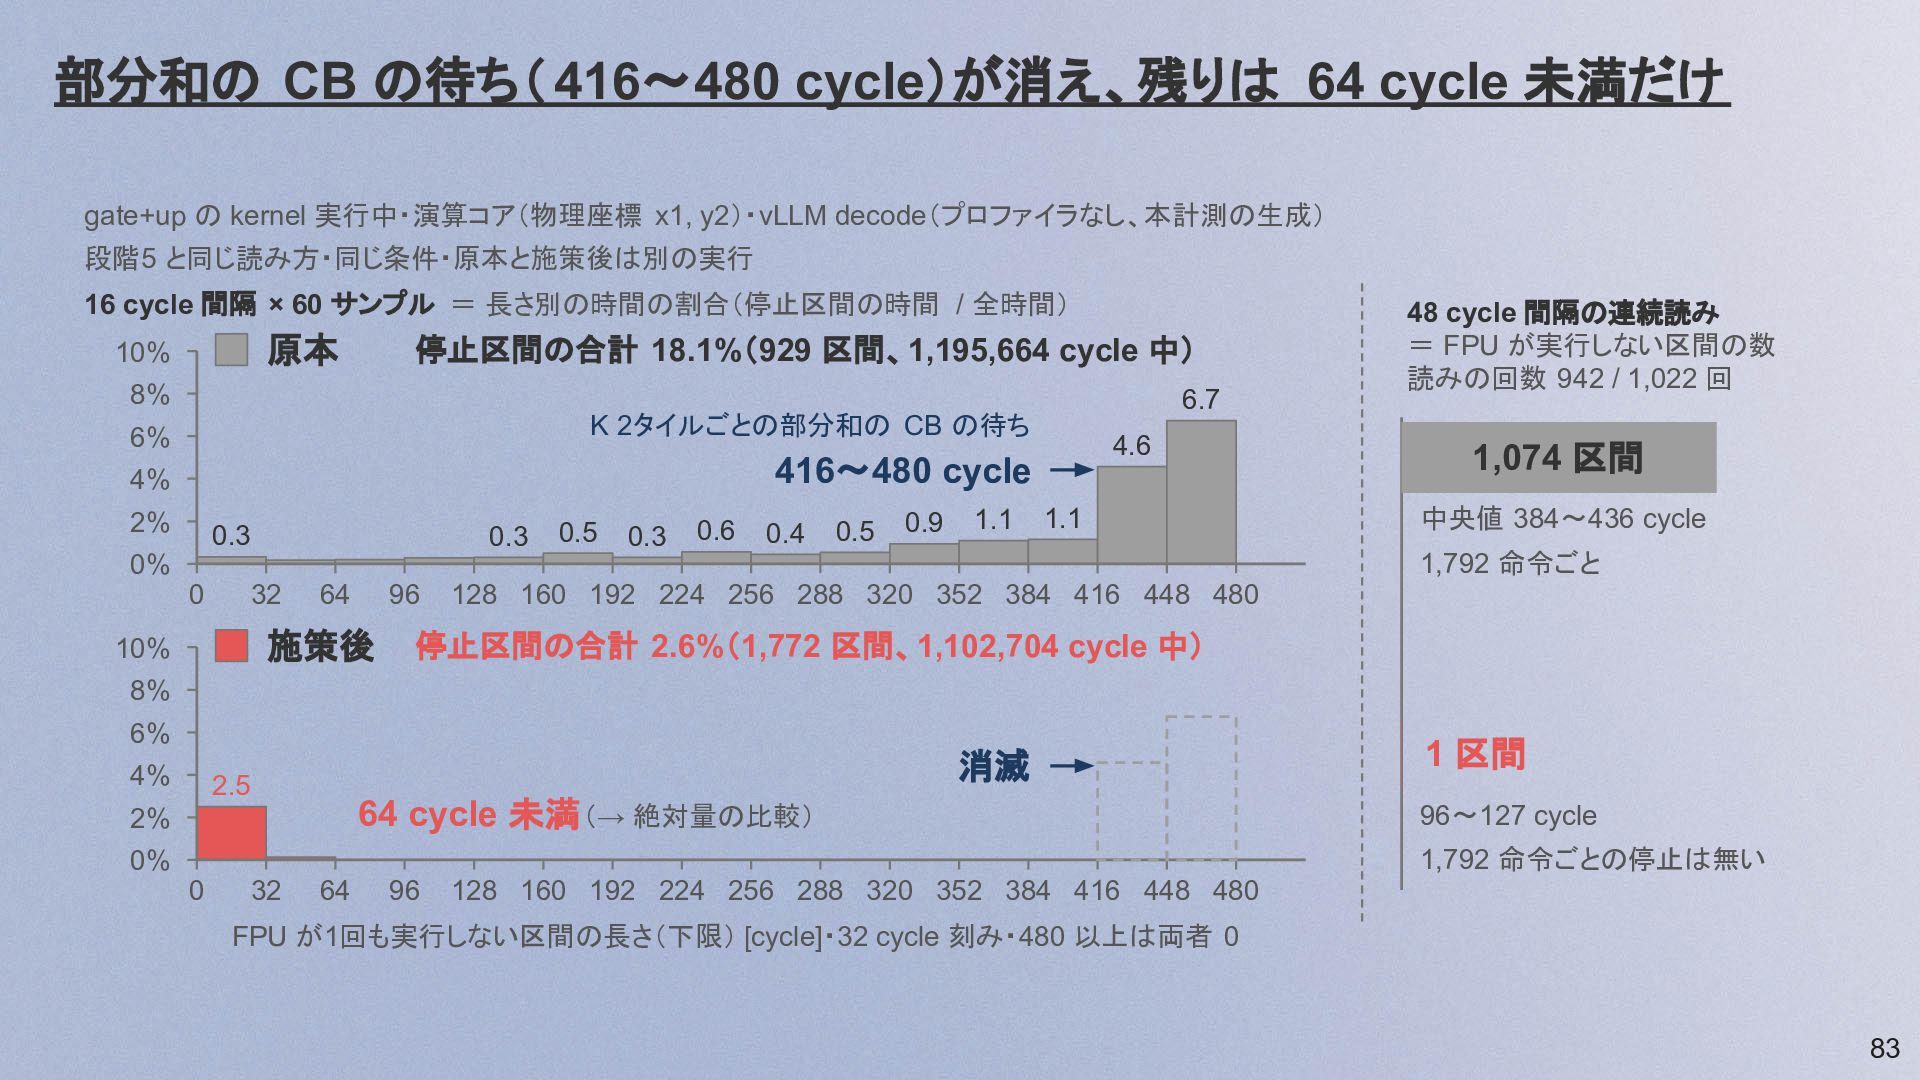
  77. 部分和の CB の待ち( 416〜480 cycle)が消え、残りは 64 cycle 未満だけ gate+up の

    kernel 実行中・演算コア(物理座標 x1, y2)・vLLM decode(プロファイラなし、本計測の生成) 段階5 と同じ読み方・同じ条件・原本と施策後は別の実行 16 cycle 間隔 × 60 サンプル = 長さ別の時間の割合(停止区間の時間 / 全時間) 原本 10% 停止区間の合計 18.1%(929 区間、1,195,664 cycle 中) 8% 6% K 2タイルごとの部分和の CB の待ち 4% 416〜480 cycle 2% 0.3 0.3 0.5 0.3 0.6 0.4 0.5 0.9 1.1 6.7 4.6 1.1 32 64 96 施策後 10% 1,074 区間 中央値 384〜436 cycle 1,792 命令ごと 0% 0 48 cycle 間隔の連続読み = FPU が実行しない区間の数 読みの回数 942 / 1,022 回 128 160 192 224 256 288 320 352 384 416 448 480 停止区間の合計 2.6%(1,772 区間、1,102,704 cycle 中) 8% 6% 4% 消滅 2.5 64 cycle 未満 (→ 絶対量の比較) 2% 1 区間 96〜127 cycle 1,792 命令ごとの停止は無い 0% 0 32 64 96 128 160 192 224 256 288 320 352 384 416 448 480 FPU が1回も実行しない区間の長さ(下限) [cycle]・32 cycle 刻み・480 以上は両者 0 83
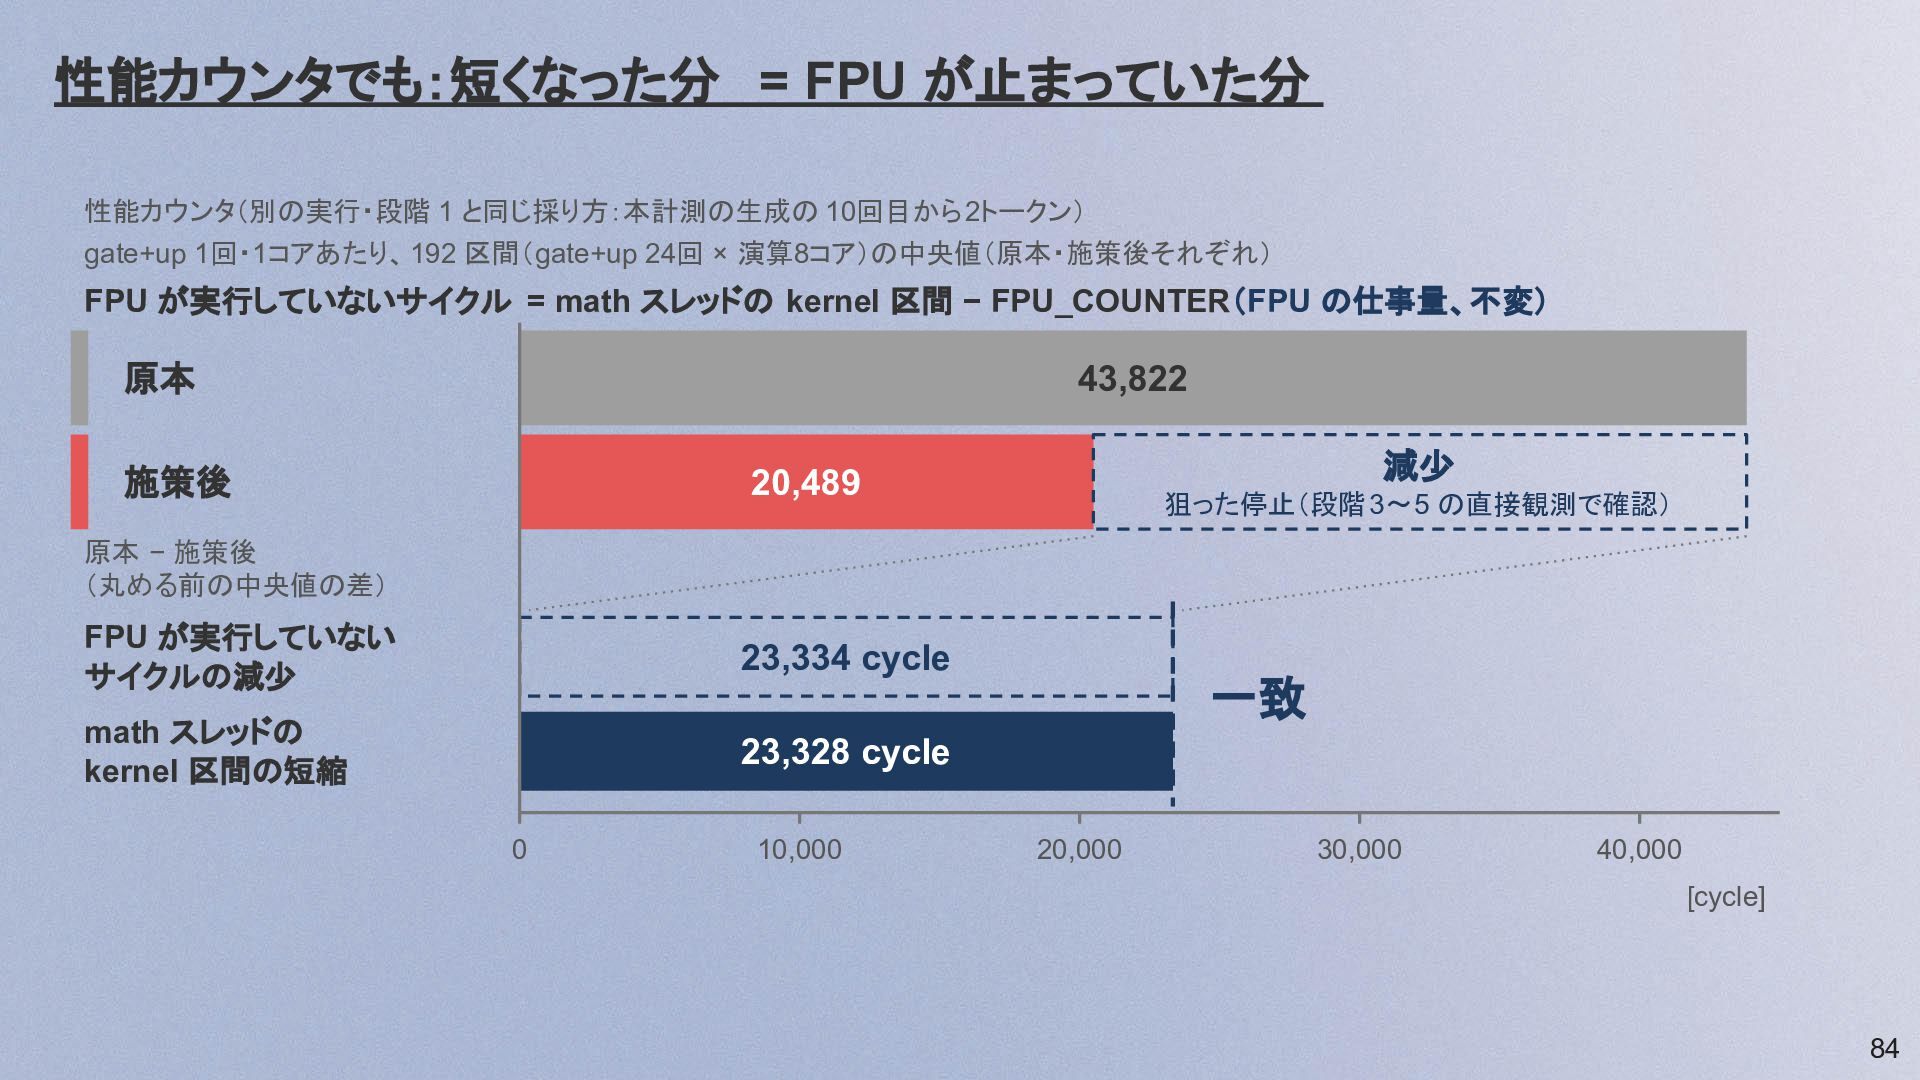
  78. 性能カウンタでも:短くなった分 = FPU が止まっていた分 性能カウンタ(別の実行・段階 1 と同じ採り方:本計測の生成の 10回目から2トークン) gate+up 1回・1コアあたり、192

    区間(gate+up 24回 × 演算8コア)の中央値(原本・施策後それぞれ) FPU が実行していないサイクル = math スレッドの kernel 区間 − FPU_COUNTER(FPU の仕事量、不変) 原本 43,822 施策後 減少 20,489 狙った停止(段階 3〜5 の直接観測で確認) 原本 − 施策後 (丸める前の中央値の差) FPU が実行していない サイクルの減少 23,334 cycle math スレッドの kernel 区間の短縮 23,328 cycle 0 10,000 一致 20,000 30,000 40,000 [cycle] 84
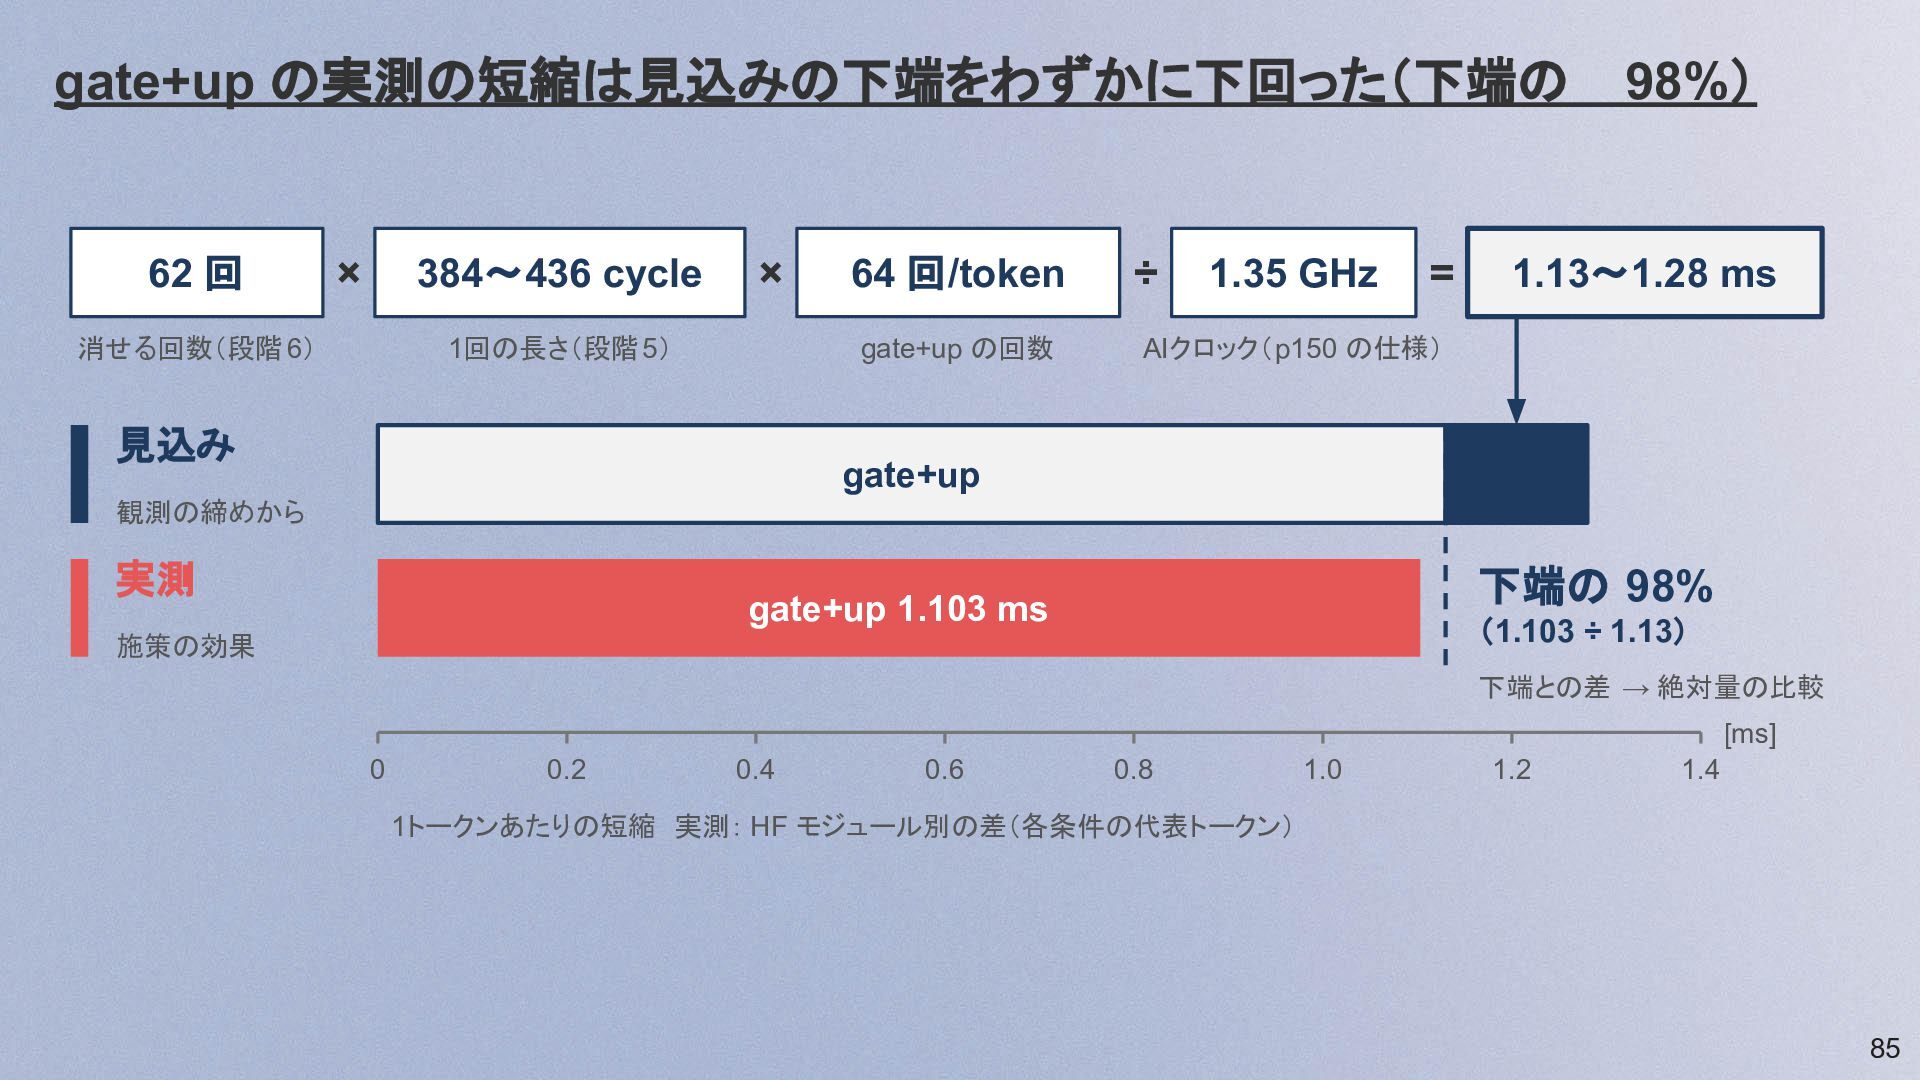
  79. gate+up の実測の短縮は見込みの下端をわずかに下回った(下端の 62 回 × 384〜436 cycle 消せる回数(段階 6) ×

    1回の長さ(段階 5) 見込み 64 回/token ÷ gate+up の回数 AIクロック(p150 の仕様) 1.35 GHz = 98%) 1.13〜1.28 ms gate+up 観測の締めから 実測 下端の 98% gate+up 1.103 ms (1.103 ÷ 1.13) 施策の効果 下端との差 → 絶対量の比較 [ms] 0 0.2 0.4 0.6 0.8 1.0 1.2 1.4 1トークンあたりの短縮 実測: HF モジュール別の差(各条件の代表トークン) 85
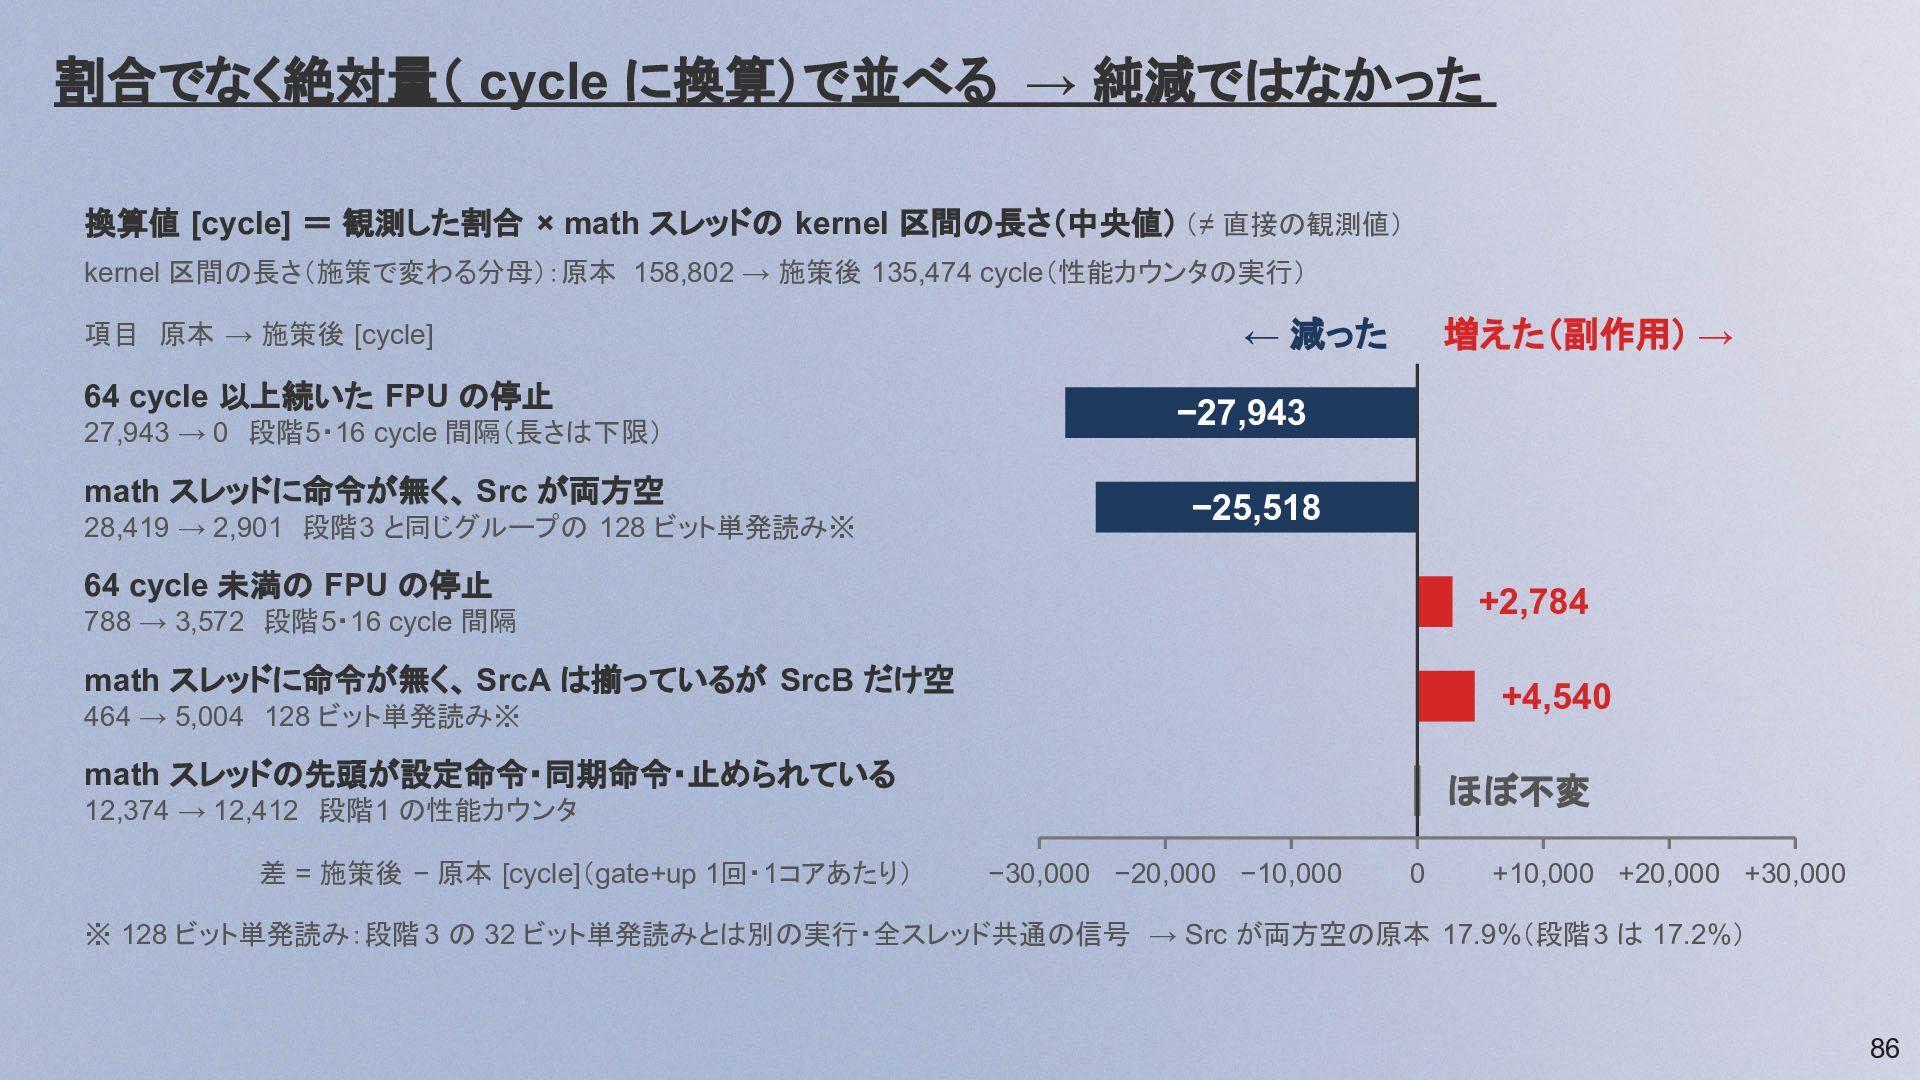
  80. 割合でなく絶対量( cycle に換算)で並べる → 純減ではなかった 換算値 [cycle] = 観測した割合 ×

    math スレッドの kernel 区間の長さ(中央値) (≠ 直接の観測値) kernel 区間の長さ(施策で変わる分母):原本 158,802 → 施策後 135,474 cycle(性能カウンタの実行) 項目 原本 → 施策後 [cycle] 64 cycle 以上続いた FPU の停止 27,943 → 0 段階5・16 cycle 間隔(長さは下限) math スレッドに命令が無く、 Src が両方空 28,419 → 2,901 段階3 と同じグループの 128 ビット単発読み※ ← 減った 増えた(副作用) → −27,943 −25,518 64 cycle 未満の FPU の停止 +2,784 788 → 3,572 段階5・16 cycle 間隔 math スレッドに命令が無く、 SrcA は揃っているが SrcB だけ空 +4,540 464 → 5,004 128 ビット単発読み※ math スレッドの先頭が設定命令・同期命令・止められている ほぼ不変 12,374 → 12,412 段階1 の性能カウンタ 差 = 施策後 − 原本 [cycle](gate+up 1回・1コアあたり) −30,000 −20,000 −10,000 0 +10,000 +20,000 +30,000 ※ 128 ビット単発読み:段階 3 の 32 ビット単発読みとは別の実行・全スレッド共通の信号 → Src が両方空の原本 17.9%(段階3 は 17.2%) 86
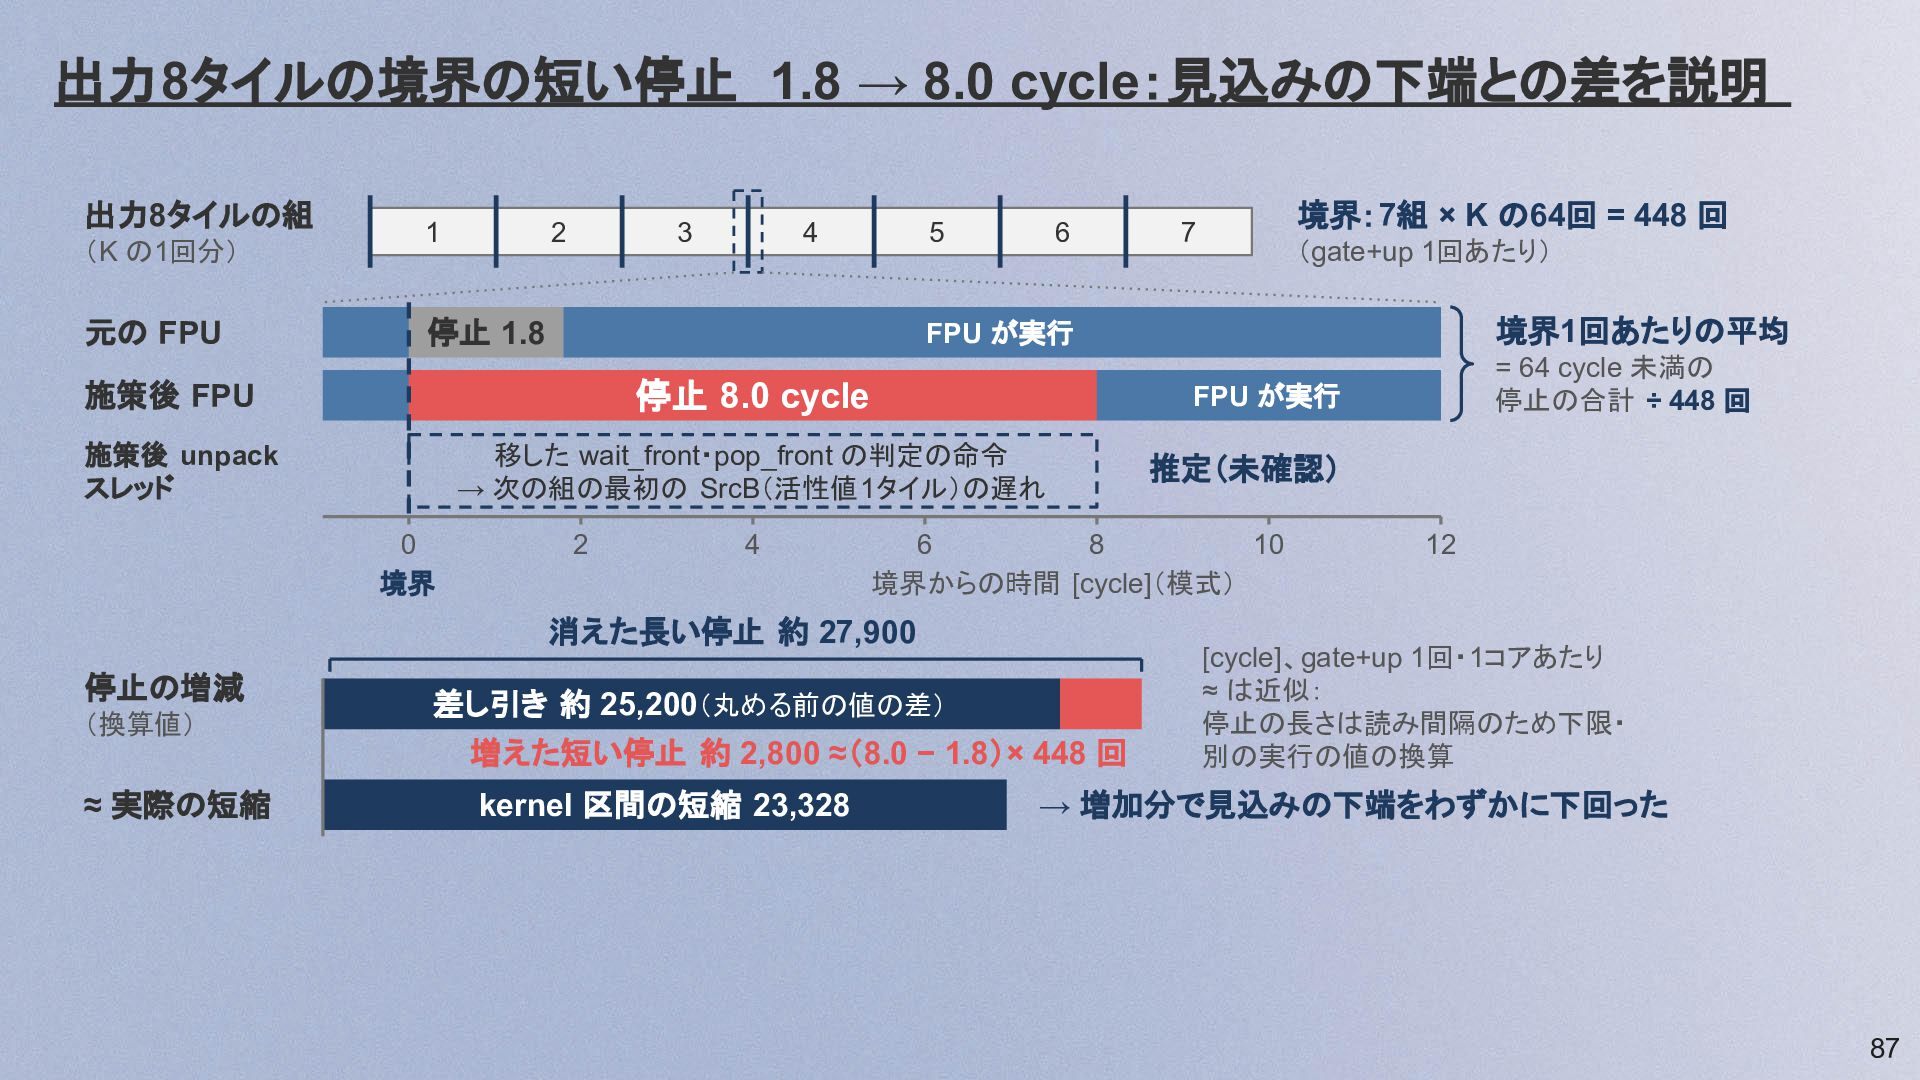
  81. 出力8タイルの境界の短い停止 1.8 → 8.0 cycle:見込みの下端との差を説明 出力8タイルの組 (K の1回分) 元の FPU

    1 2 3 4 5 停止 1.8 6 停止 8.0 cycle 施策後 unpack スレッド 移した wait_front・pop_front の判定の命令 → 次の組の最初の SrcB(活性値1タイル)の遅れ (換算値) ≈ 実際の短縮 境界1回あたりの平均 2 4 推定(未確認) 6 8 10 境界からの時間 [cycle](模式) 差し引き 約 25,200(丸める前の値の差) 増えた短い停止 約 2,800 ≈(8.0 − 1.8)× 448 回 kernel 区間の短縮 23,328 = 64 cycle 未満の 停止の合計 ÷ 448 回 FPU が実行 消えた長い停止 約 27,900 停止の増減 (gate+up 1回あたり) FPU が実行 施策後 FPU 0 境界 境界:7組 × K の64回 = 448 回 7 12 [cycle]、gate+up 1回・1コアあたり ≈ は近似: 停止の長さは読み間隔のため下限・ 別の実行の値の換算 → 増加分で見込みの下端をわずかに下回った 87
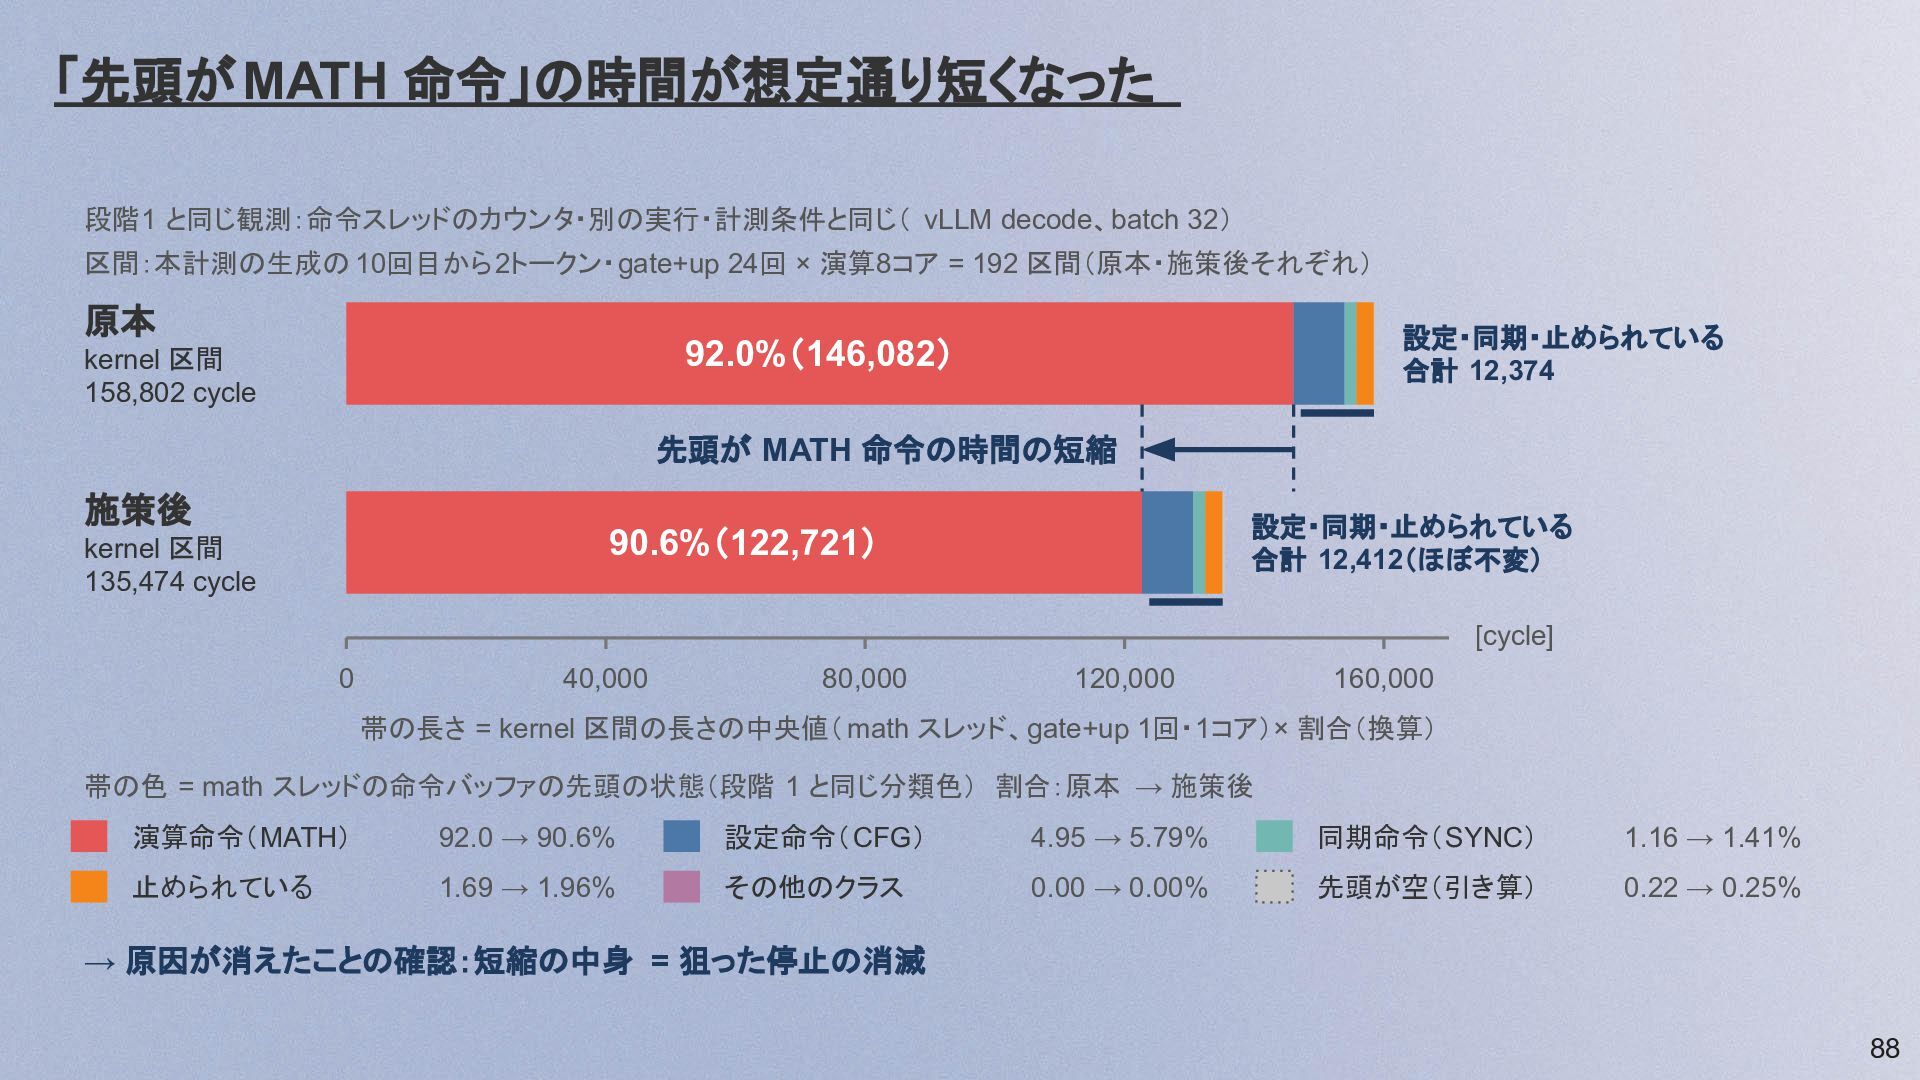
  82. 「先頭が MATH 命令」の時間が想定通り短くなった 段階1 と同じ観測:命令スレッドのカウンタ・別の実行・計測条件と同じ( vLLM decode、batch 32) 区間:本計測の生成の 10回目から2トークン・gate+up

    24回 × 演算8コア = 192 区間(原本・施策後それぞれ) 原本 設定・同期・止められている 合計 12,374 92.0%(146,082) kernel 区間 158,802 cycle 先頭が MATH 命令の時間の短縮 施策後 設定・同期・止められている 合計 12,412(ほぼ不変) 90.6%(122,721) kernel 区間 135,474 cycle [cycle] 0 40,000 80,000 120,000 160,000 帯の長さ = kernel 区間の長さの中央値( math スレッド、gate+up 1回・1コア)× 割合(換算) 帯の色 = math スレッドの命令バッファの先頭の状態(段階 1 と同じ分類色) 割合:原本 → 施策後 演算命令(MATH) 92.0 → 90.6% 設定命令(CFG) 4.95 → 5.79% 同期命令(SYNC) 1.16 → 1.41% 止められている 1.69 → 1.96% その他のクラス 0.00 → 0.00% 先頭が空(引き算) 0.22 → 0.25% → 原因が消えたことの確認:短縮の中身 = 狙った停止の消滅 88
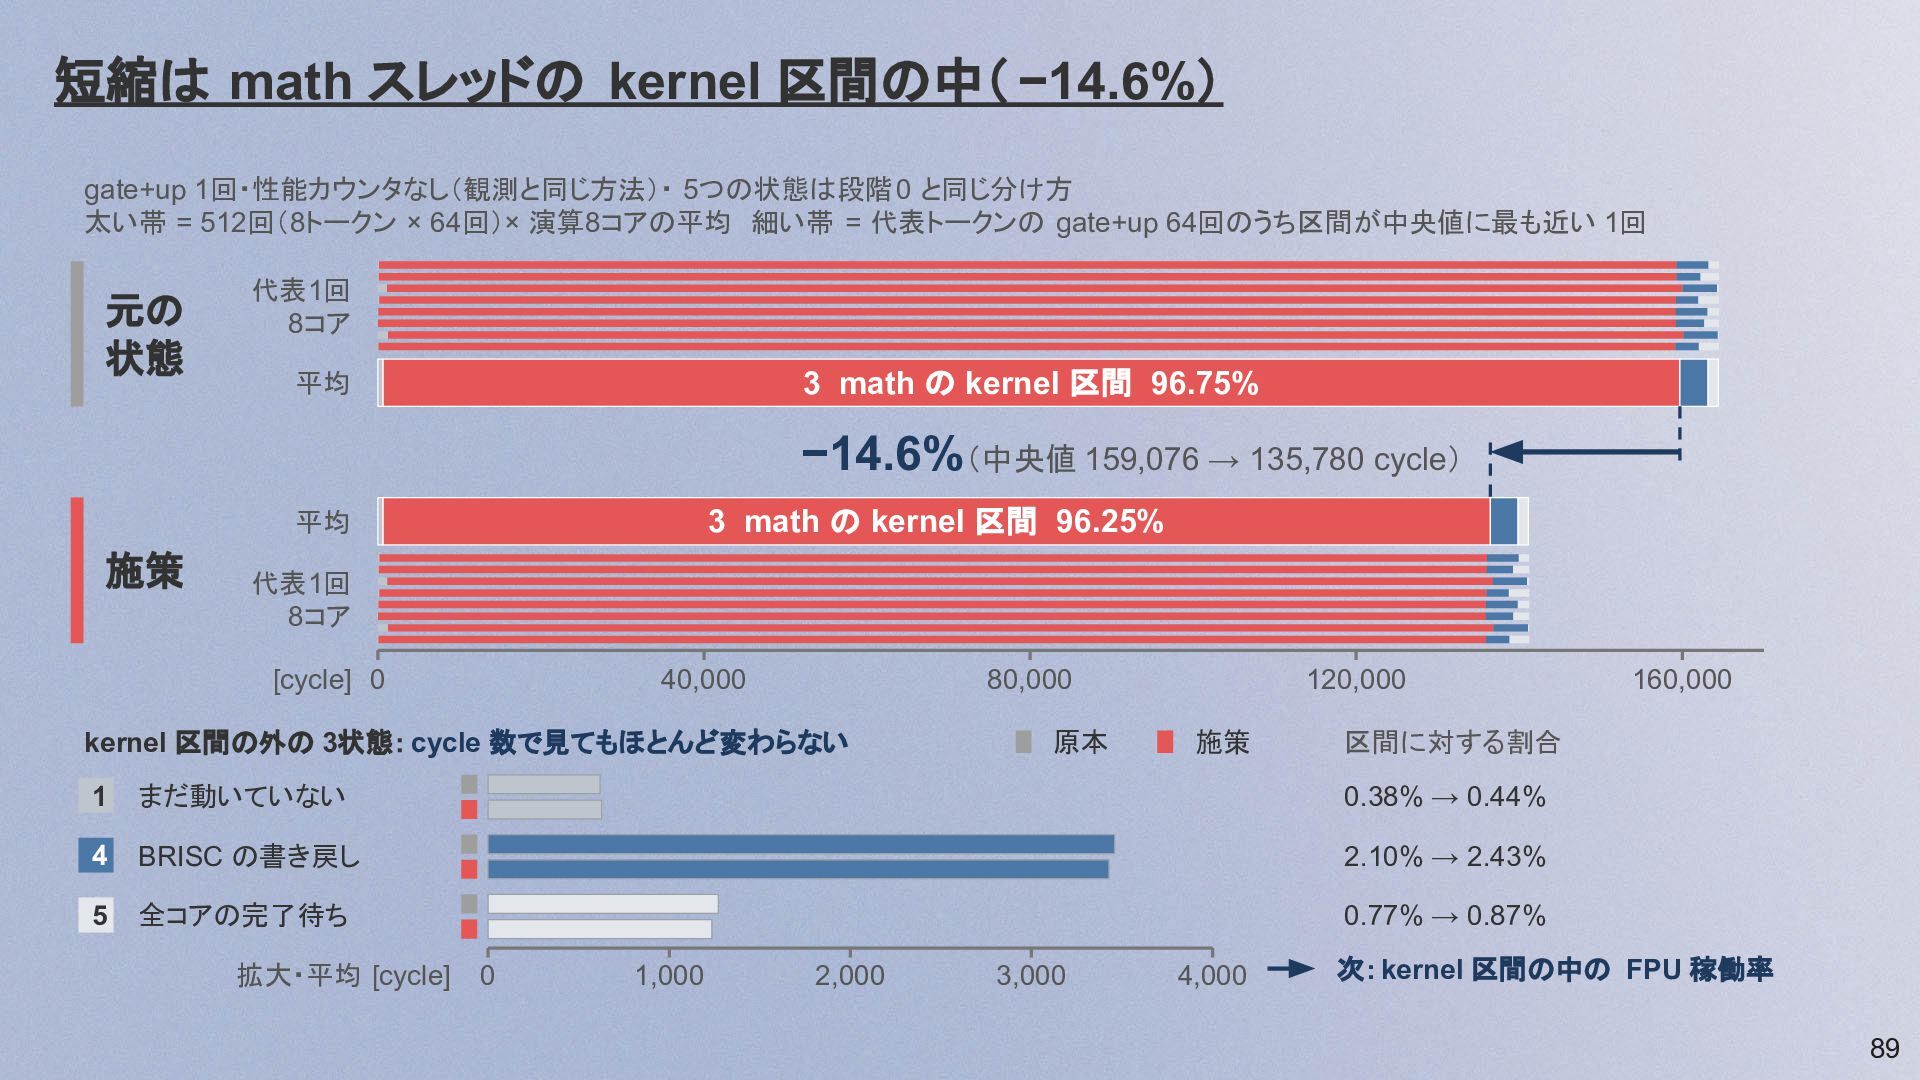
  83. 短縮は math スレッドの kernel 区間の中( −14.6%) gate+up 1回・性能カウンタなし(観測と同じ方法)・ 5つの状態は段階 0

    と同じ分け方 太い帯 = 512回(8トークン × 64回)× 演算8コアの平均 細い帯 = 代表トークンの gate+up 64回のうち区間が中央値に最も近い 1回 元の 状態 代表1回 8コア 3 math の kernel 区間 96.75% 平均 −14.6%(中央値 159,076 → 135,780 cycle) 3 math の kernel 区間 96.25% 平均 施策 代表1回 8コア [cycle] 0 40,000 80,000 kernel 区間の外の 3状態: cycle 数で見てもほとんど変わらない 原本 120,000 施策 区間に対する割合 1 まだ動いていない 0.38% → 0.44% 4 BRISC の書き戻し 2.10% → 2.43% 5 全コアの完了待ち 0.77% → 0.87% 拡大・平均 [cycle] 0 1,000 2,000 3,000 4,000 160,000 次:kernel 区間の中の FPU 稼働率 89
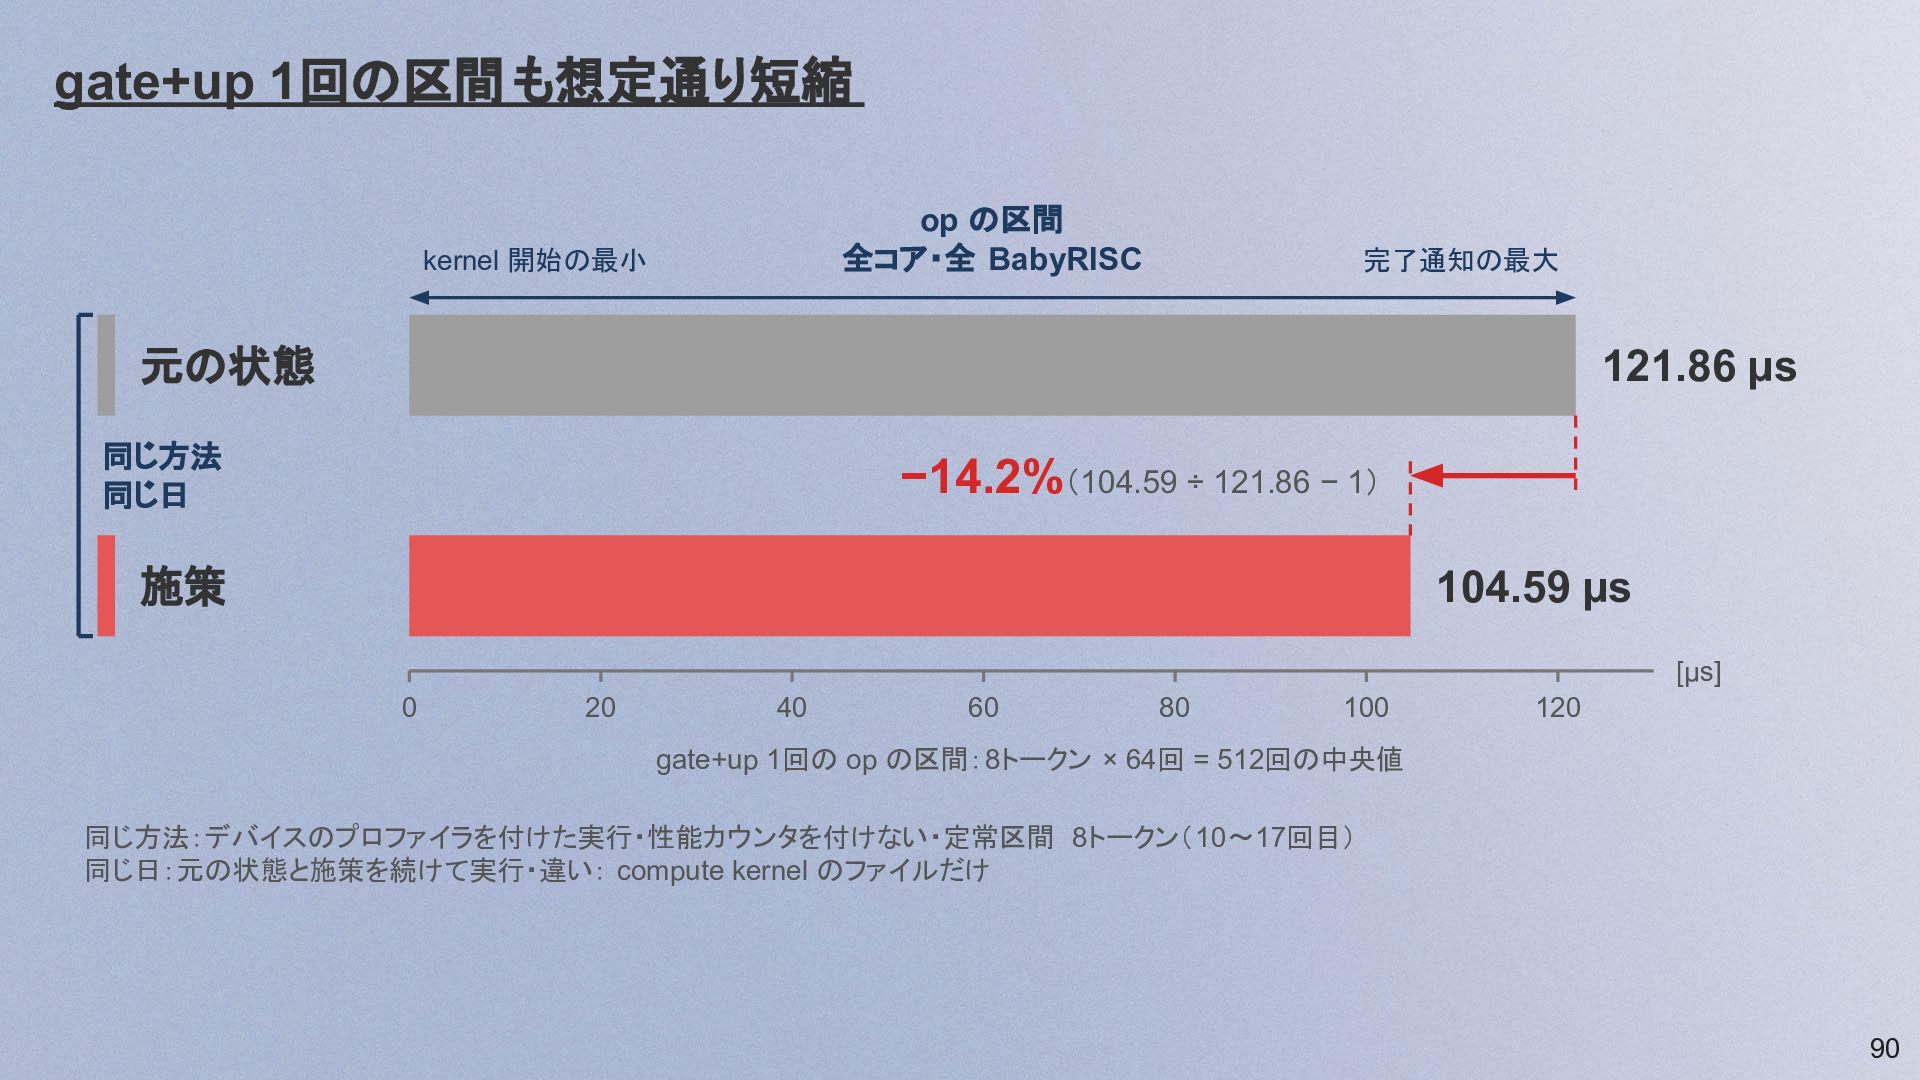
  84. gate+up 1回の区間 も想定通り短縮 op の区間 全コア・全 BabyRISC kernel 開始の最小 完了通知の最大

    元の状態 121.86 µs 同じ方法 同じ日 −14.2%(104.59 ÷ 121.86 − 1) 施策 104.59 µs [µs] 0 20 40 60 80 100 120 gate+up 1回の op の区間:8トークン × 64回 = 512回の中央値 同じ方法:デバイスのプロファイラを付けた実行・性能カウンタを付けない・定常区間 8トークン(10〜17回目) 同じ日:元の状態と施策を続けて実行・違い: compute kernel のファイルだけ 90
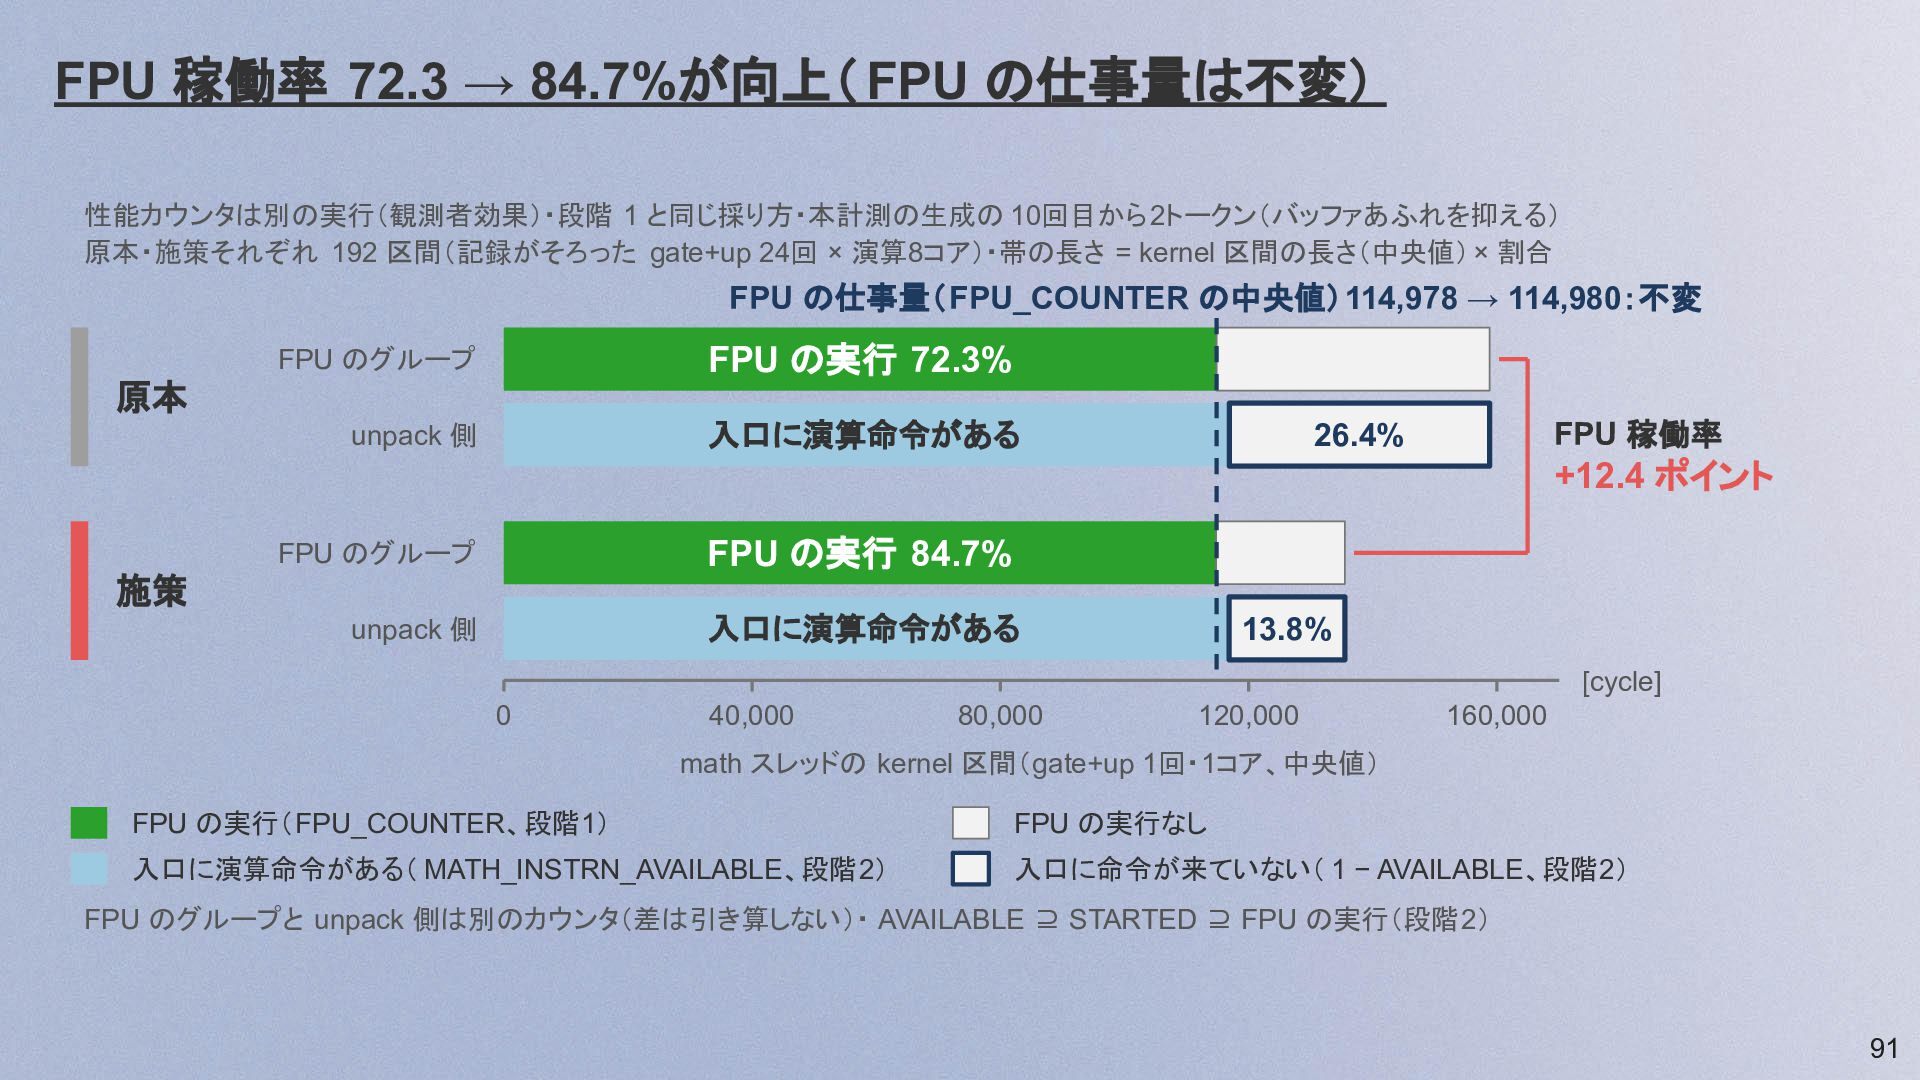
  85. FPU 稼働率 72.3 → 84.7%が向上( FPU の仕事量は不変) 性能カウンタは別の実行(観測者効果)・段階 1 と同じ採り方・本計測の生成の

    10回目から2トークン(バッファあふれを抑える) 原本・施策それぞれ 192 区間(記録がそろった gate+up 24回 × 演算8コア)・帯の長さ = kernel 区間の長さ(中央値) × 割合 FPU の仕事量(FPU_COUNTER の中央値)114,978 → 114,980:不変 FPU のグループ FPU の実行 72.3% unpack 側 入口に演算命令がある 原本 FPU 稼働率 26.4% +12.4 ポイント FPU のグループ FPU の実行 84.7% unpack 側 入口に演算命令がある 施策 13.8% [cycle] 0 40,000 80,000 120,000 160,000 math スレッドの kernel 区間(gate+up 1回・1コア、中央値) FPU の実行(FPU_COUNTER、段階1) FPU の実行なし 入口に演算命令がある( MATH_INSTRN_AVAILABLE、段階2) 入口に命令が来ていない( 1 − AVAILABLE、段階2) FPU のグループと unpack 側は別のカウンタ(差は引き算しない)・ AVAILABLE ⊇ STARTED ⊇ FPU の実行(段階2) 91
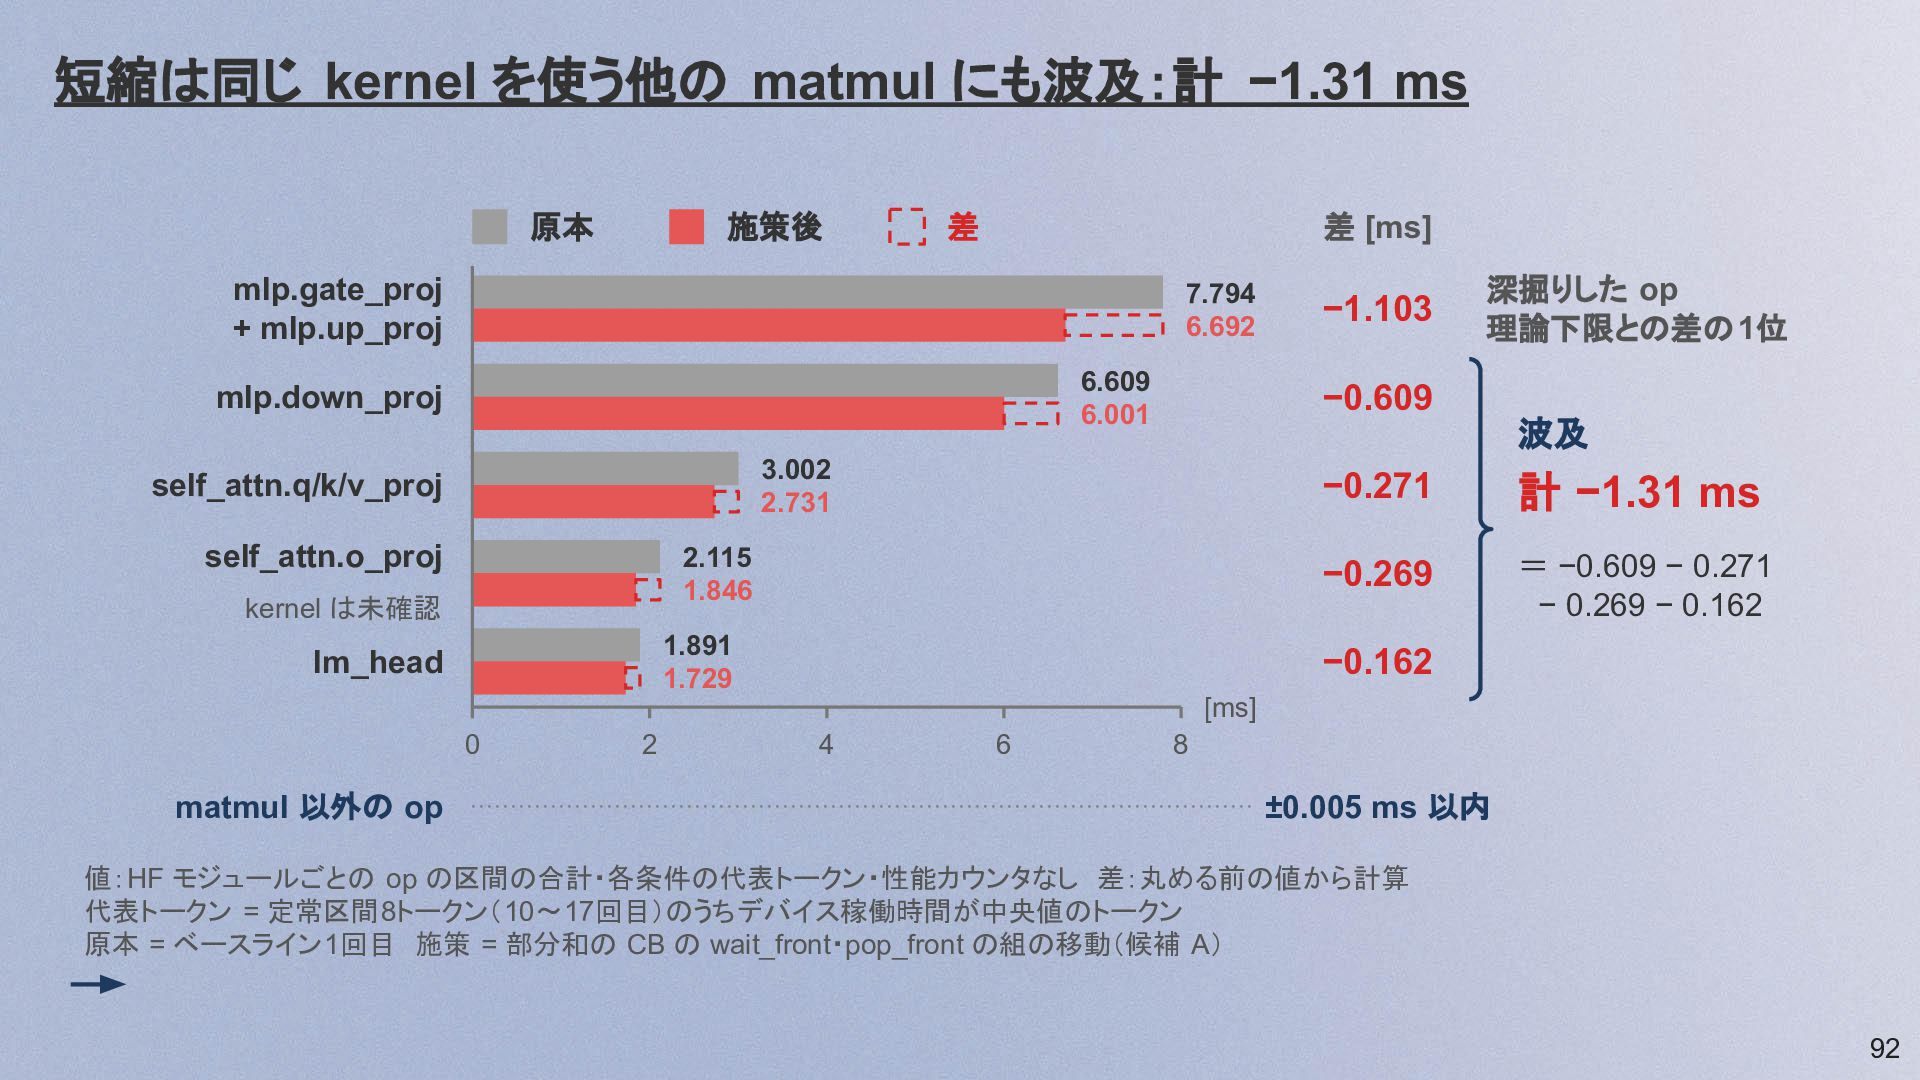
  86. 短縮は同じ kernel を使う他の matmul にも波及:計 −1.31 ms 原本 施策後 差

    差 [ms] mlp.gate_proj + mlp.up_proj 7.794 6.692 6.609 6.001 mlp.down_proj self_attn.o_proj 2.115 1.846 kernel は未確認 1.891 1.729 lm_head 深掘りした op 理論下限との差の 1位 −0.609 3.002 2.731 self_attn.q/k/v_proj −1.103 波及 −0.271 計 −1.31 ms −0.269 = −0.609 − 0.271 − 0.269 − 0.162 −0.162 [ms] 0 matmul 以外の op 2 4 6 8 ±0.005 ms 以内 値:HF モジュールごとの op の区間の合計・各条件の代表トークン・性能カウンタなし 差:丸める前の値から計算 代表トークン = 定常区間8トークン(10〜17回目)のうちデバイス稼働時間が中央値のトークン 原本 = ベースライン1回目 施策 = 部分和の CB の wait_front・pop_front の組の移動(候補 A) 92
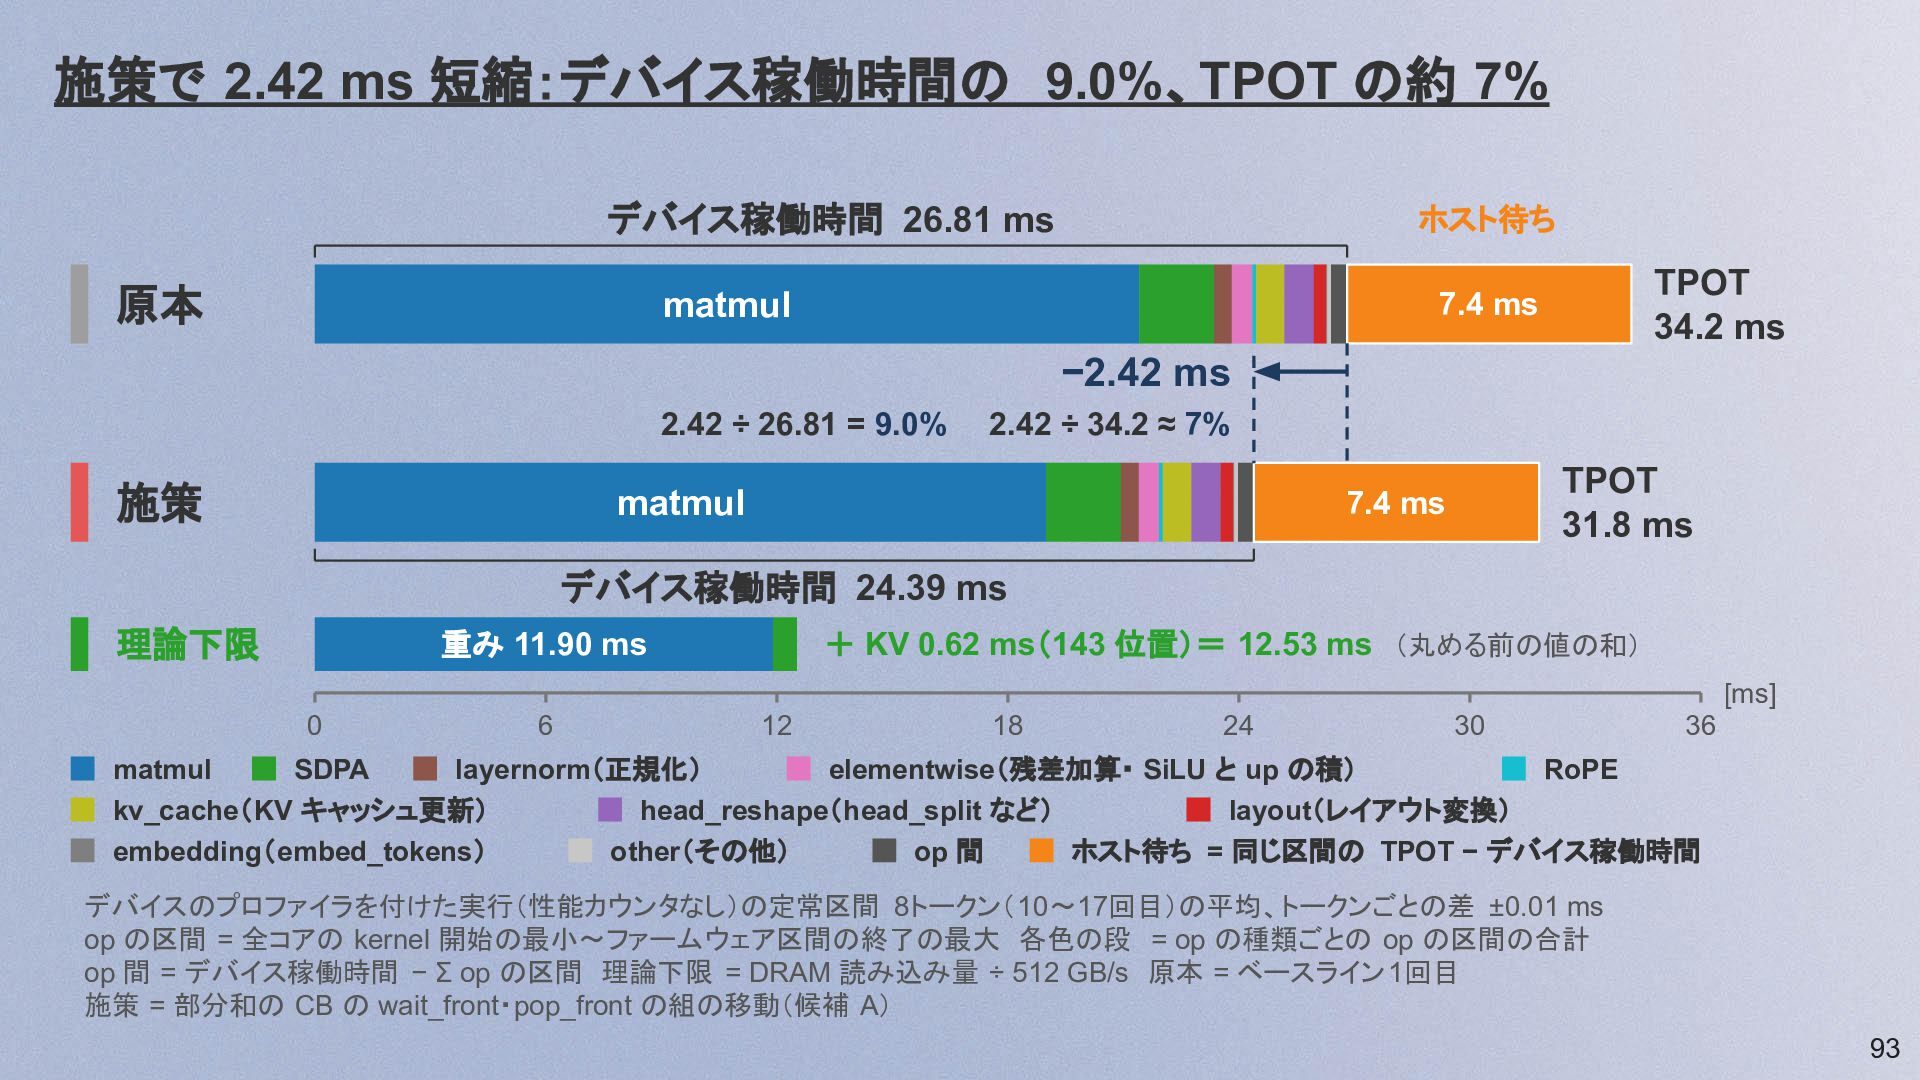
  87. 施策で 2.42 ms 短縮:デバイス稼働時間の 9.0%、TPOT の約 7% デバイス稼働時間 26.81 ms

    原本 ホスト待ち matmul TPOT 34.2 ms 7.4 ms −2.42 ms 2.42 ÷ 26.81 = 9.0% 施策 2.42 ÷ 34.2 ≈ 7% matmul TPOT 31.8 ms 7.4 ms デバイス稼働時間 24.39 ms 理論下限 重み 11.90 ms + KV 0.62 ms(143 位置)= 12.53 ms (丸める前の値の和) [ms] 0 6 12 18 24 30 36 matmul SDPA layernorm(正規化) elementwise(残差加算・ SiLU と up の積) RoPE kv_cache(KV キャッシュ更新) head_reshape(head_split など) layout(レイアウト変換) embedding(embed_tokens) other(その他) op 間 ホスト待ち = 同じ区間の TPOT − デバイス稼働時間 デバイスのプロファイラを付けた実行(性能カウンタなし)の定常区間 8トークン(10〜17回目)の平均、トークンごとの差 ±0.01 ms op の区間 = 全コアの kernel 開始の最小〜ファームウェア区間の終了の最大 各色の段 = op の種類ごとの op の区間の合計 op 間 = デバイス稼働時間 − Σ op の区間 理論下限 = DRAM 読み込み量 ÷ 512 GB/s 原本 = ベースライン1回目 施策 = 部分和の CB の wait_front・pop_front の組の移動(候補 A) 93
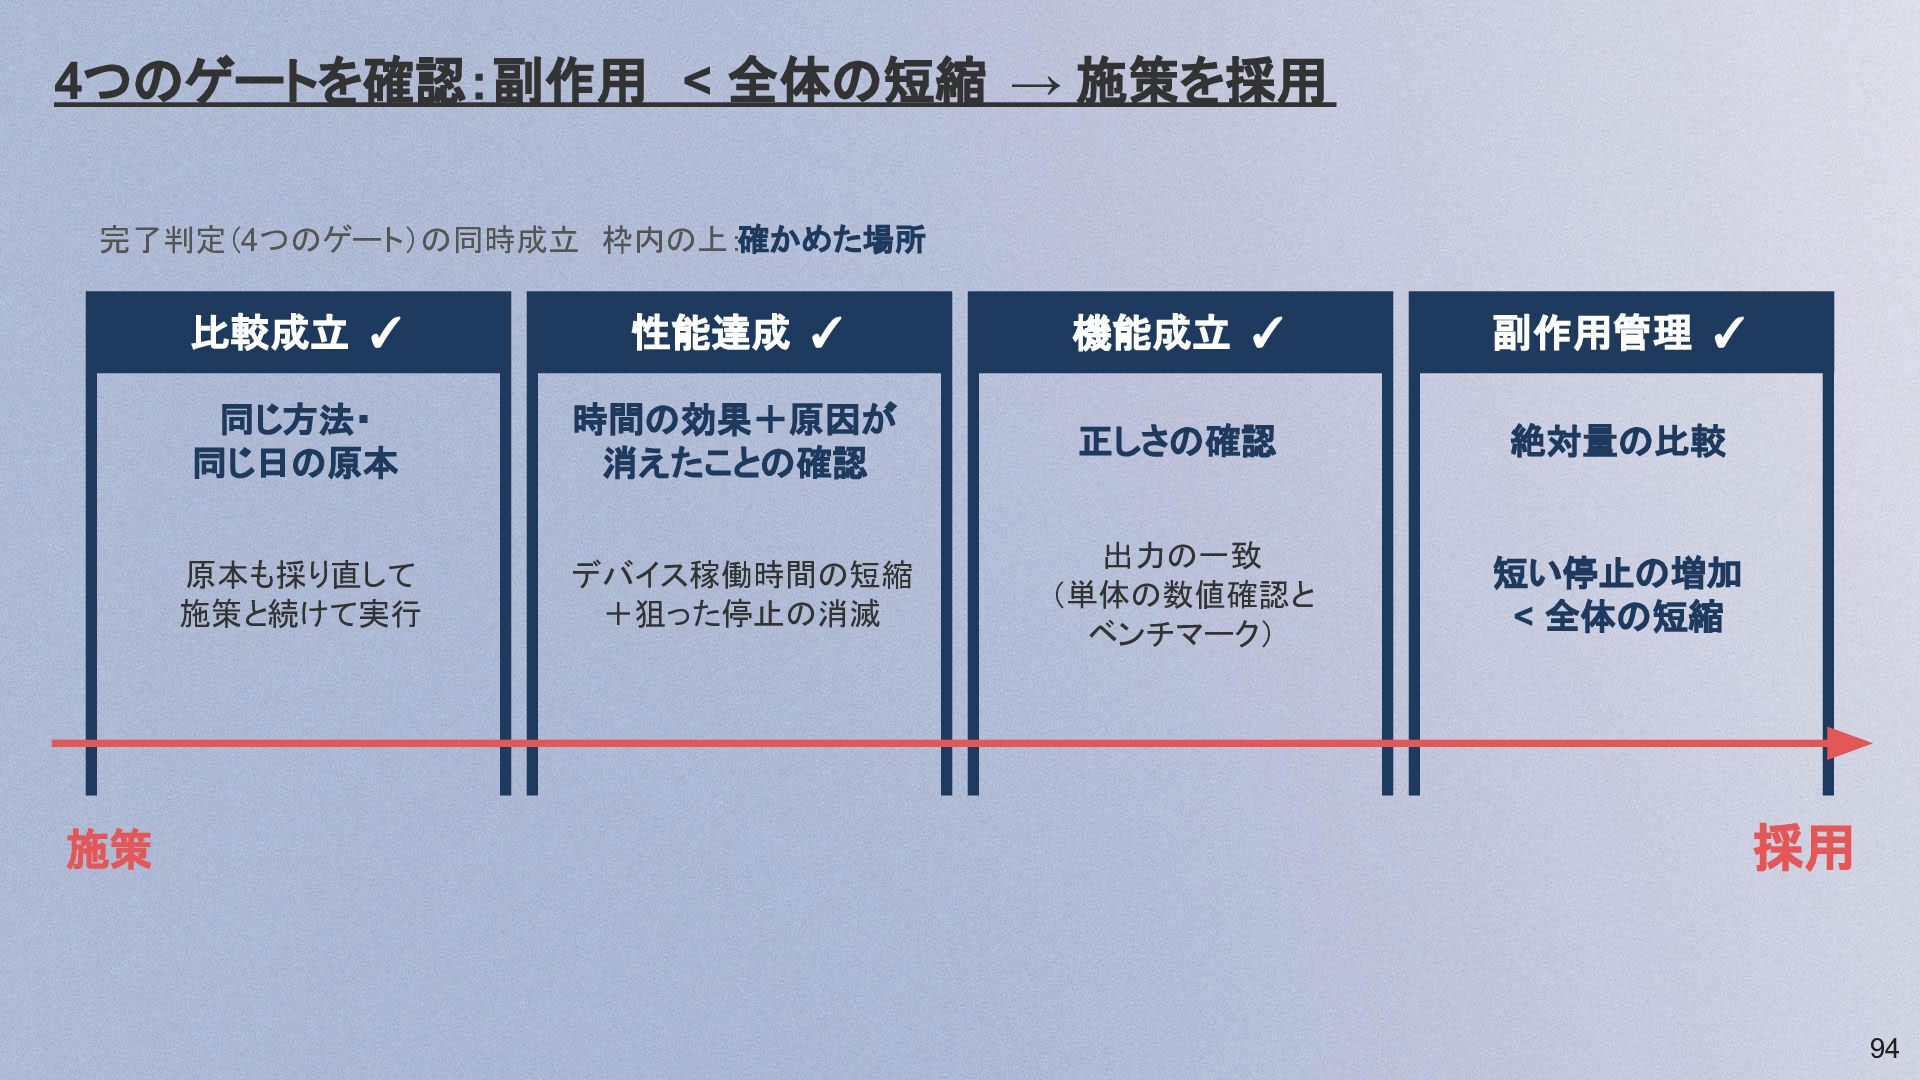
  88. 4つのゲートを確認:副作用 < 全体の短縮 → 施策を採用 完了判定(4つのゲート)の同時成立 枠内の上:確かめた場所 施策 比較成立 ✓

    性能達成 ✓ 機能成立 ✓ 副作用管理 ✓ 同じ方法・ 同じ日の原本 時間の効果+原因が 消えたことの確認 正しさの確認 絶対量の比較 原本も採り直して 施策と続けて実行 デバイス稼働時間の短縮 +狙った停止の消滅 出力の一致 (単体の数値確認と ベンチマーク) 短い停止の増加 < 全体の短縮 採用 94
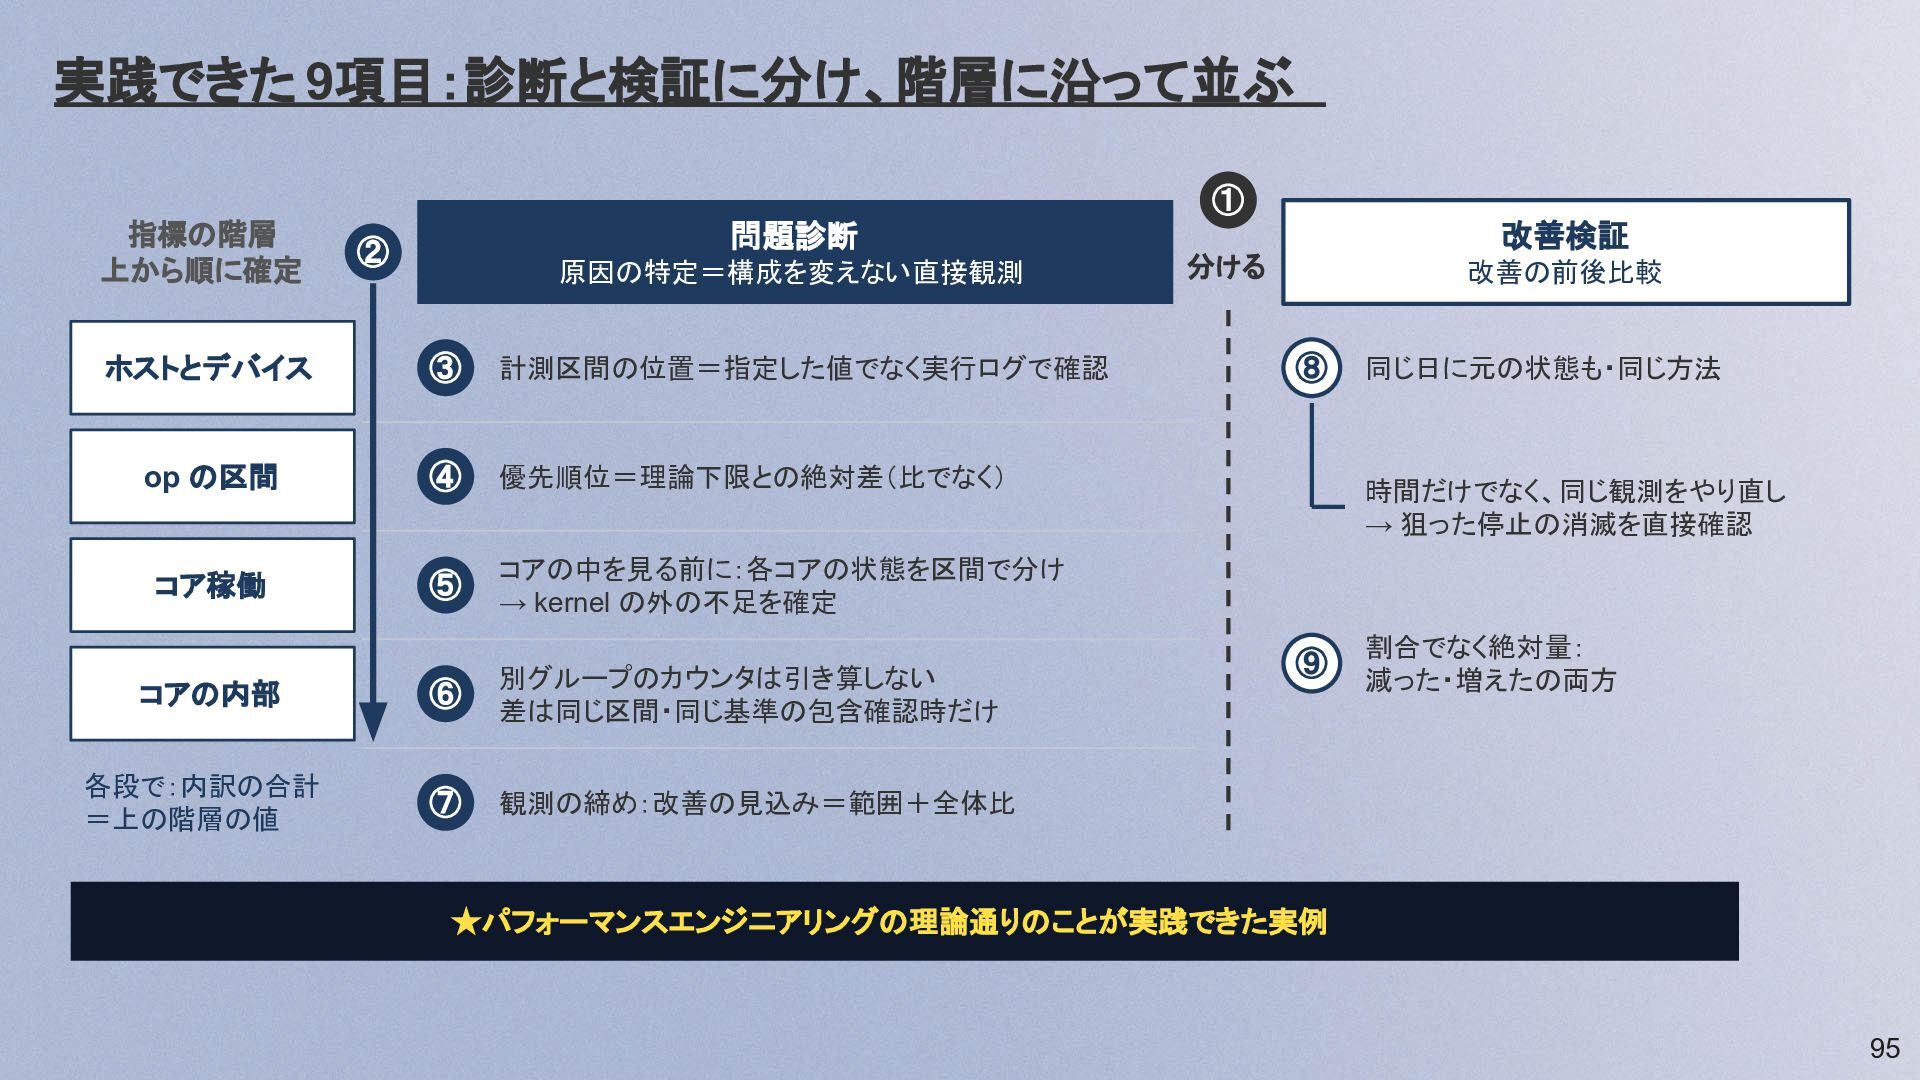
  89. 実践できた 9項目:診断と検証に分け、階層に沿って並ぶ ① 指標の階層 上から順に確定 問題診断 ② 原因の特定=構成を変えない直接観測 ホストとデバイス ③

    計測区間の位置=指定した値でなく実行ログで確認 op の区間 ④ 優先順位=理論下限との絶対差(比でなく) コア稼働 ⑤ コアの中を見る前に:各コアの状態を区間で分け → kernel の外の不足を確定 コアの内部 ⑥ 別グループのカウンタは引き算しない 差は同じ区間・同じ基準の包含確認時だけ 各段で:内訳の合計 =上の階層の値 ⑦ 観測の締め:改善の見込み=範囲+全体比 改善検証 分ける 改善の前後比較 ⑧ 同じ日に元の状態も・同じ方法 時間だけでなく、同じ観測をやり直し → 狙った停止の消滅を直接確認 ⑨ 割合でなく絶対量: 減った・増えたの両方 ★パフォーマンスエンジニアリングの理論通りのことが実践できた実例 95
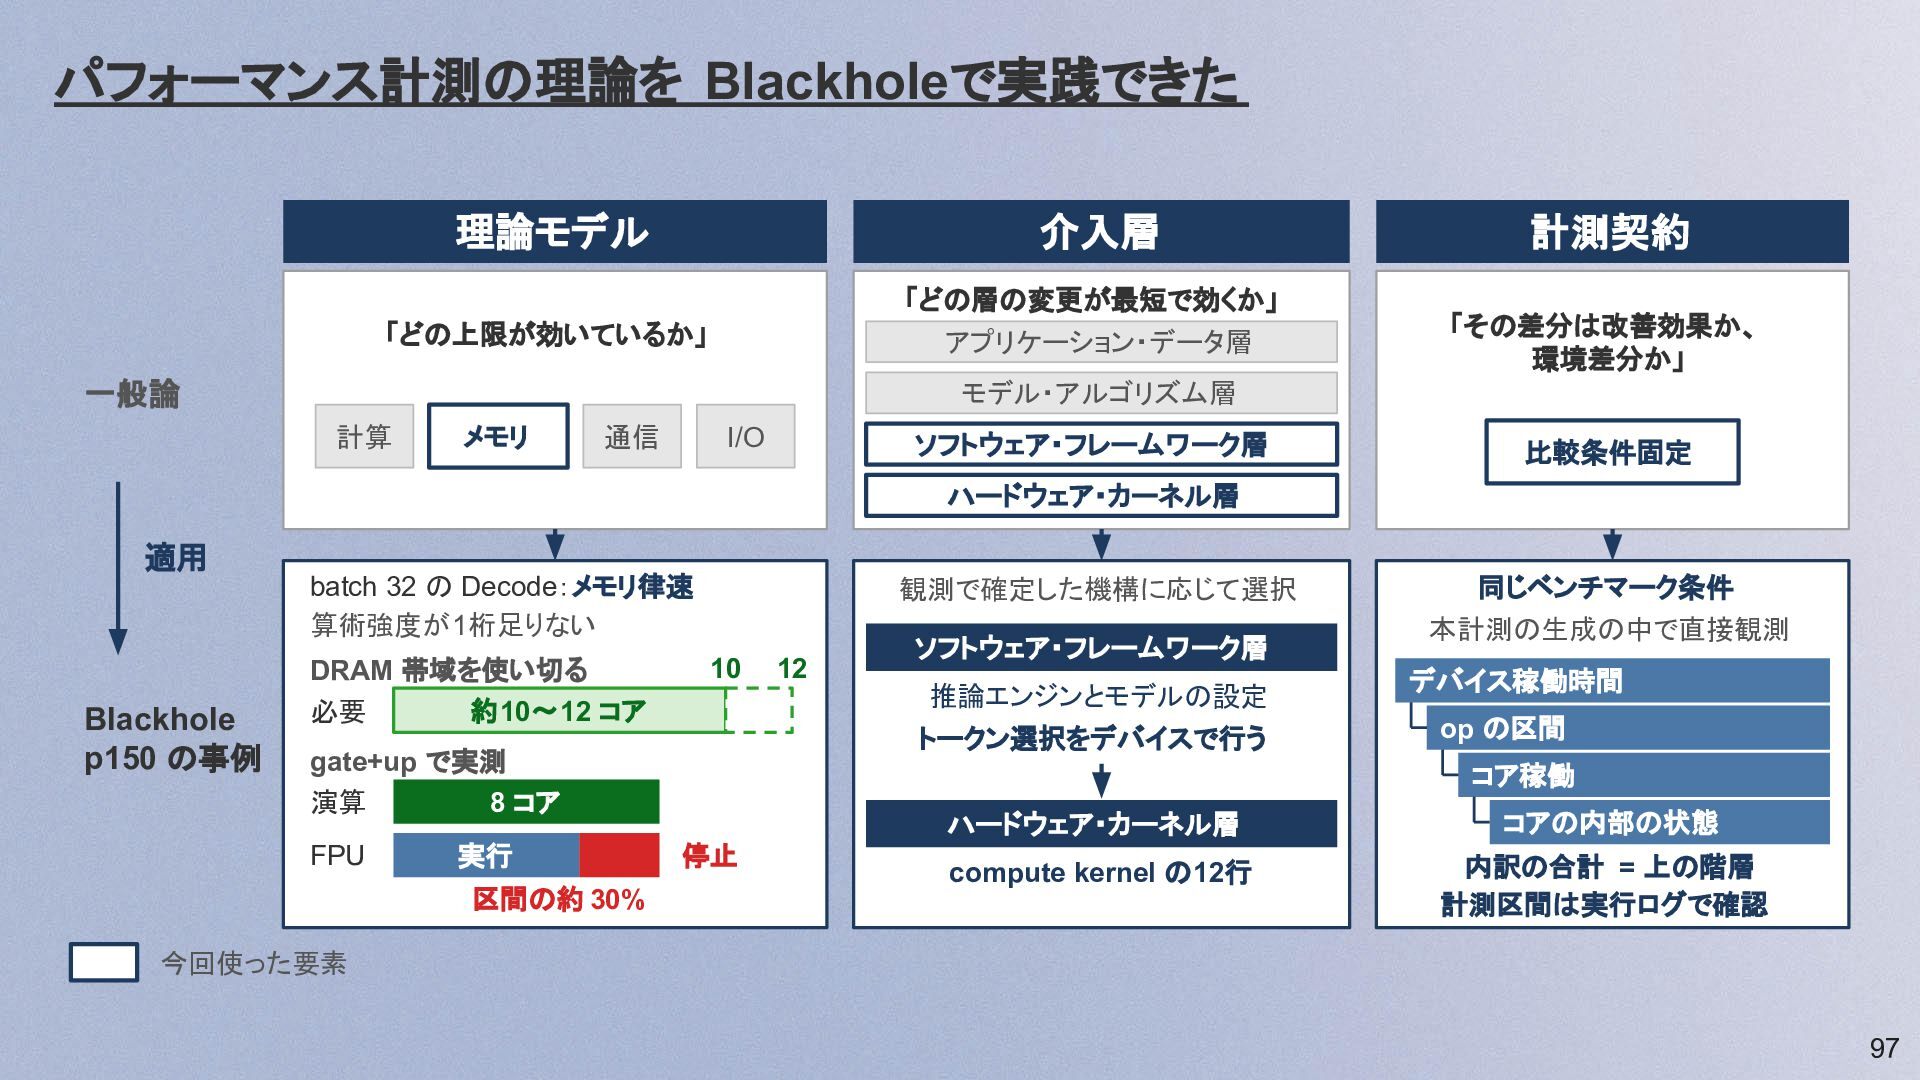
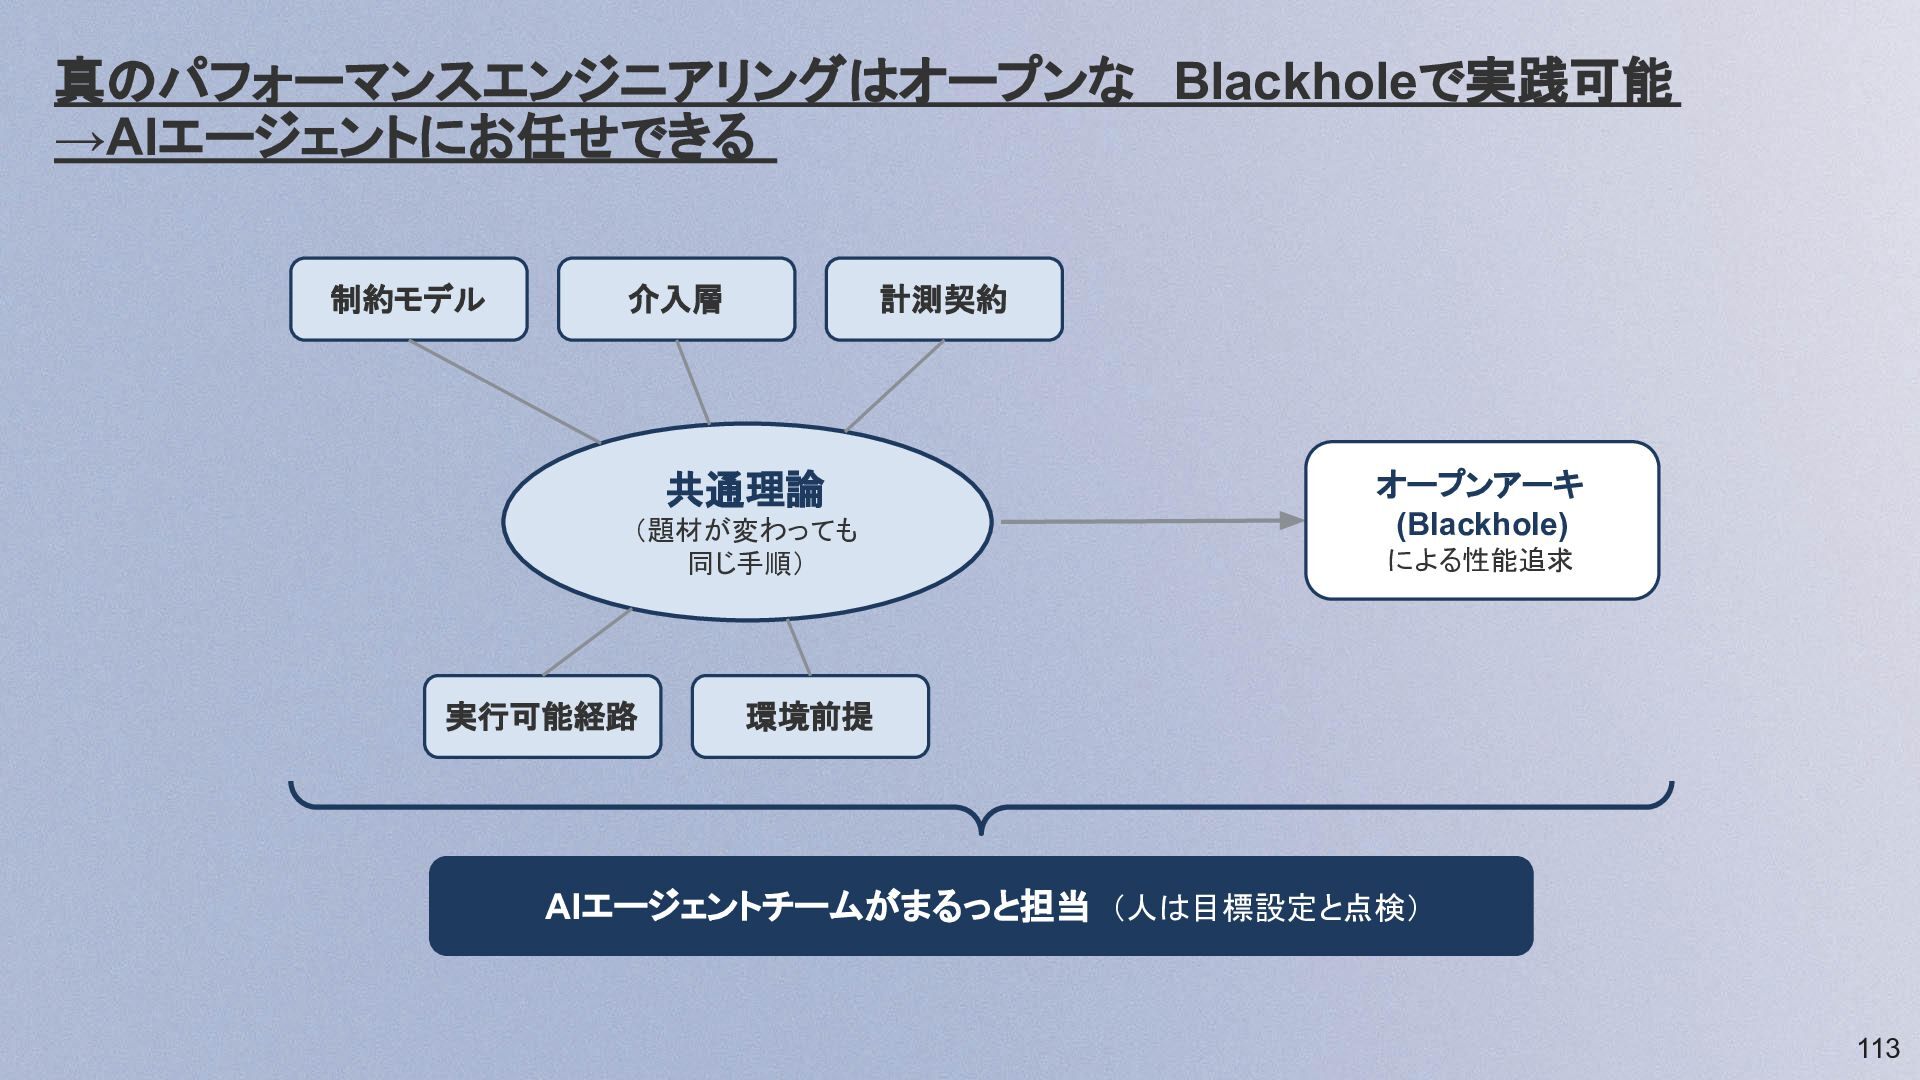
  90. パフォーマンス計測の理論を Blackholeで実践できた 理論モデル 介入層 「どの層の変更が最短で効くか」 「どの上限が効いているか」 アプリケーション・データ層 一般論 計測契約 「その差分は改善効果か、

    環境差分か」 モデル・アルゴリズム層 計算 メモリ 通信 I/O ソフトウェア・フレームワーク層 比較条件固定 ハードウェア・カーネル層 適用 Blackhole p150 の事例 batch 32 の Decode:メモリ律速 算術強度が1桁足りない DRAM 帯域を使い切る 必要 約10〜12 コア 観測で確定した機構に応じて選択 10 実行 区間の約 30% ソフトウェア・フレームワーク層 推論エンジンとモデルの設定 トークン選択をデバイスで行う gate+up で実測 演算 8 コア FPU 12 同じベンチマーク条件 本計測の生成の中で直接観測 デバイス稼働時間 op の区間 コア稼働 停止 ハードウェア・カーネル層 コアの内部の状態 compute kernel の12行 内訳の合計 = 上の階層 計測区間は実行ログで確認 今回使った要素 97
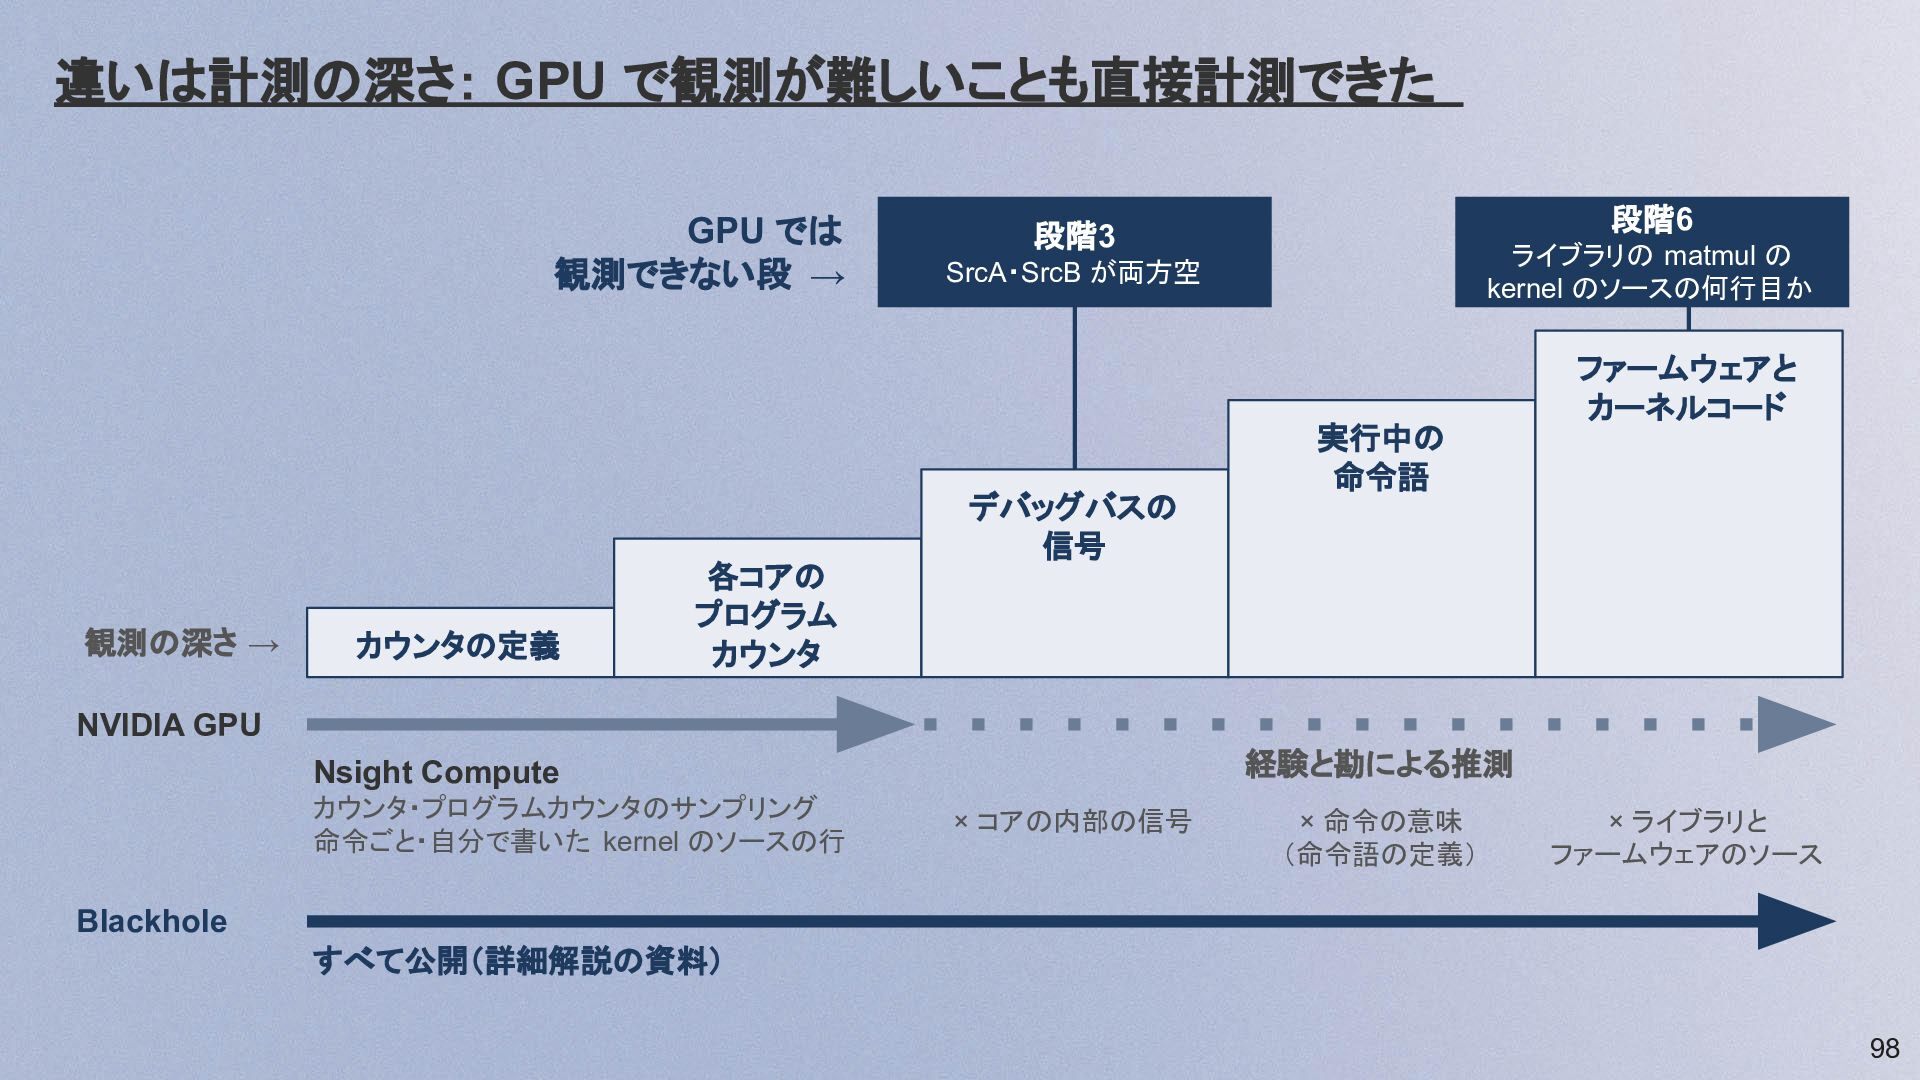
  91. 違いは計測の深さ: GPU で観測が難しいことも直接計測できた GPU では 観測できない段 → 観測の深さ → カウンタの定義

    各コアの プログラム カウンタ 段階6 段階3 ライブラリの matmul の kernel のソースの何行目か SrcA・SrcB が両方空 デバッグバスの 信号 実行中の 命令語 ファームウェアと カーネルコード NVIDIA GPU 経験と勘による推測 Nsight Compute カウンタ・プログラムカウンタのサンプリング 命令ごと・自分で書いた kernel のソースの行 × コアの内部の信号 × 命令の意味 (命令語の定義) × ライブラリと ファームウェアのソース Blackhole すべて公開(詳細解説の資料) 98
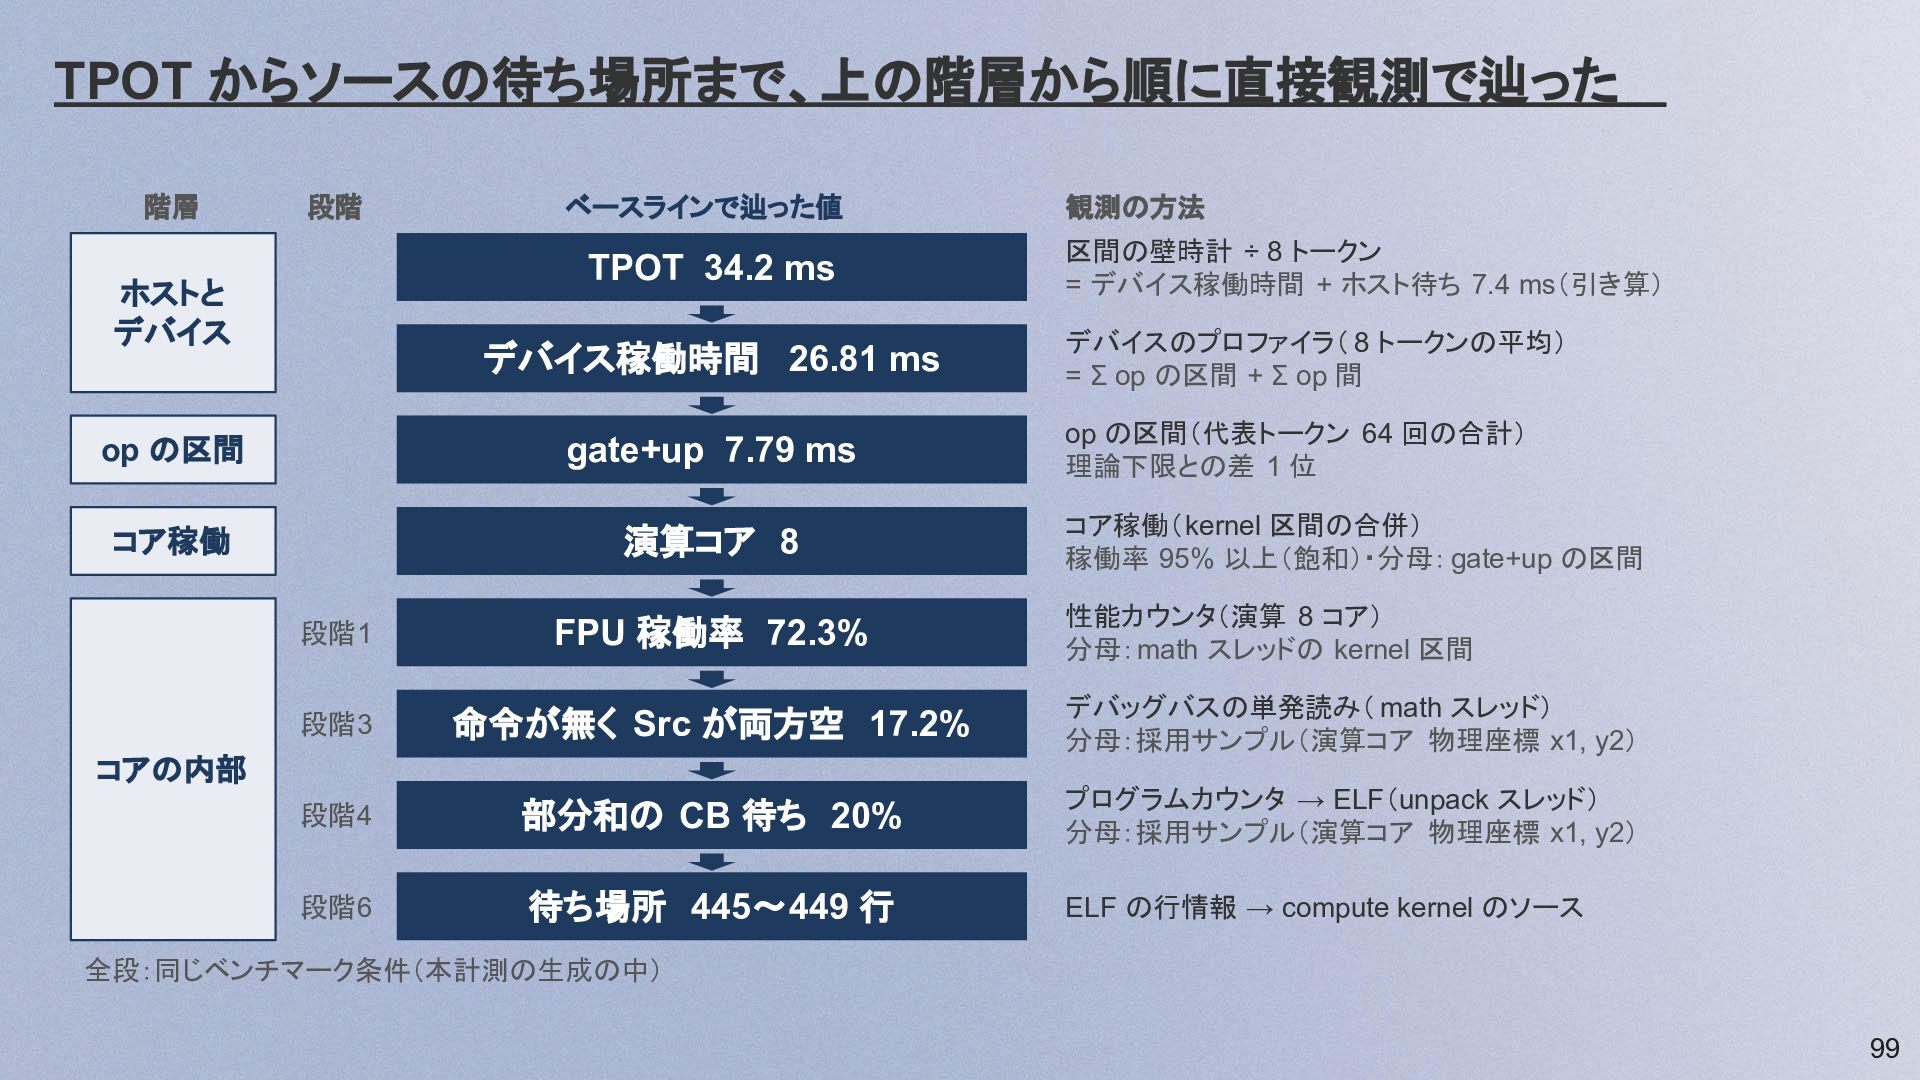
  92. TPOT からソースの待ち場所まで、上の階層から順に直接観測で辿った 階層 段階 ベースラインで辿った値 TPOT 34.2 ms ホストと デバイス

    デバイス稼働時間 26.81 ms op の区間 gate+up 7.79 ms コア稼働 演算コア 8 観測の方法 区間の壁時計 ÷ 8 トークン = デバイス稼働時間 + ホスト待ち 7.4 ms(引き算) デバイスのプロファイラ( 8 トークンの平均) = Σ op の区間 + Σ op 間 op の区間(代表トークン 64 回の合計) 理論下限との差 1 位 コア稼働(kernel 区間の合併) 稼働率 95% 以上(飽和)・分母: gate+up の区間 性能カウンタ(演算 8 コア) 分母:math スレッドの kernel 区間 段階1 FPU 稼働率 72.3% 段階3 命令が無く Src が両方空 17.2% デバッグバスの単発読み( math スレッド) 分母:採用サンプル(演算コア 物理座標 x1, y2) 段階4 部分和の CB 待ち 20% プログラムカウンタ → ELF(unpack スレッド) 分母:採用サンプル(演算コア 物理座標 x1, y2) 段階6 待ち場所 445〜449 行 ELF の行情報 → compute kernel のソース コアの内部 全段:同じベンチマーク条件(本計測の生成の中) 99
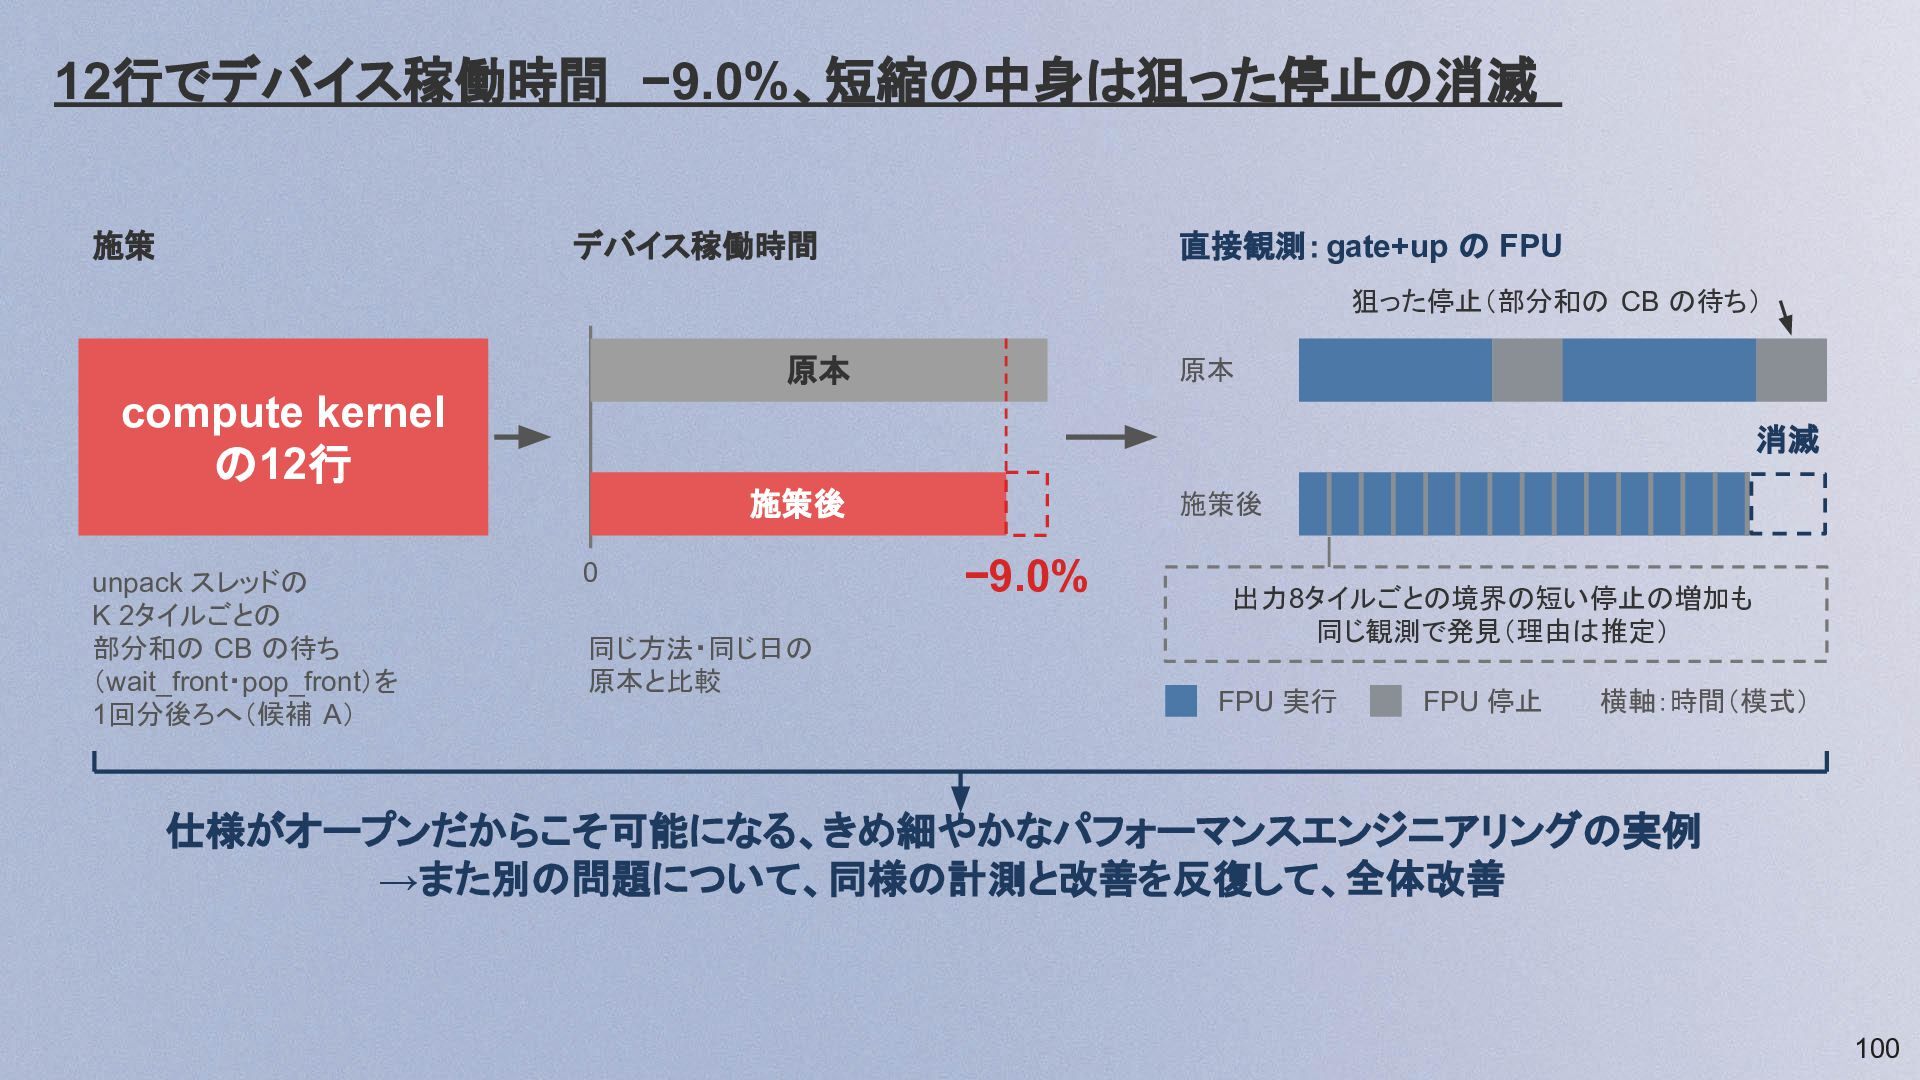
  93. 12行でデバイス稼働時間 −9.0%、短縮の中身は狙った停止の消滅 施策 デバイス稼働時間 直接観測:gate+up の FPU 狙った停止(部分和の CB の待ち)

    原本 原本 compute kernel の12行 消滅 施策後 unpack スレッドの K 2タイルごとの 部分和の CB の待ち (wait_front・pop_front)を 1回分後ろへ(候補 A) 0 同じ方法・同じ日の 原本と比較 施策後 −9.0% 出力8タイルごとの境界の短い停止の増加も 同じ観測で発見(理由は推定) FPU 実行 FPU 停止 横軸:時間(模式) 仕様がオープンだからこそ可能になる、きめ細やかなパフォーマンスエンジニアリングの実例 →また別の問題について、同様の計測と改善を反復して、全体改善 100
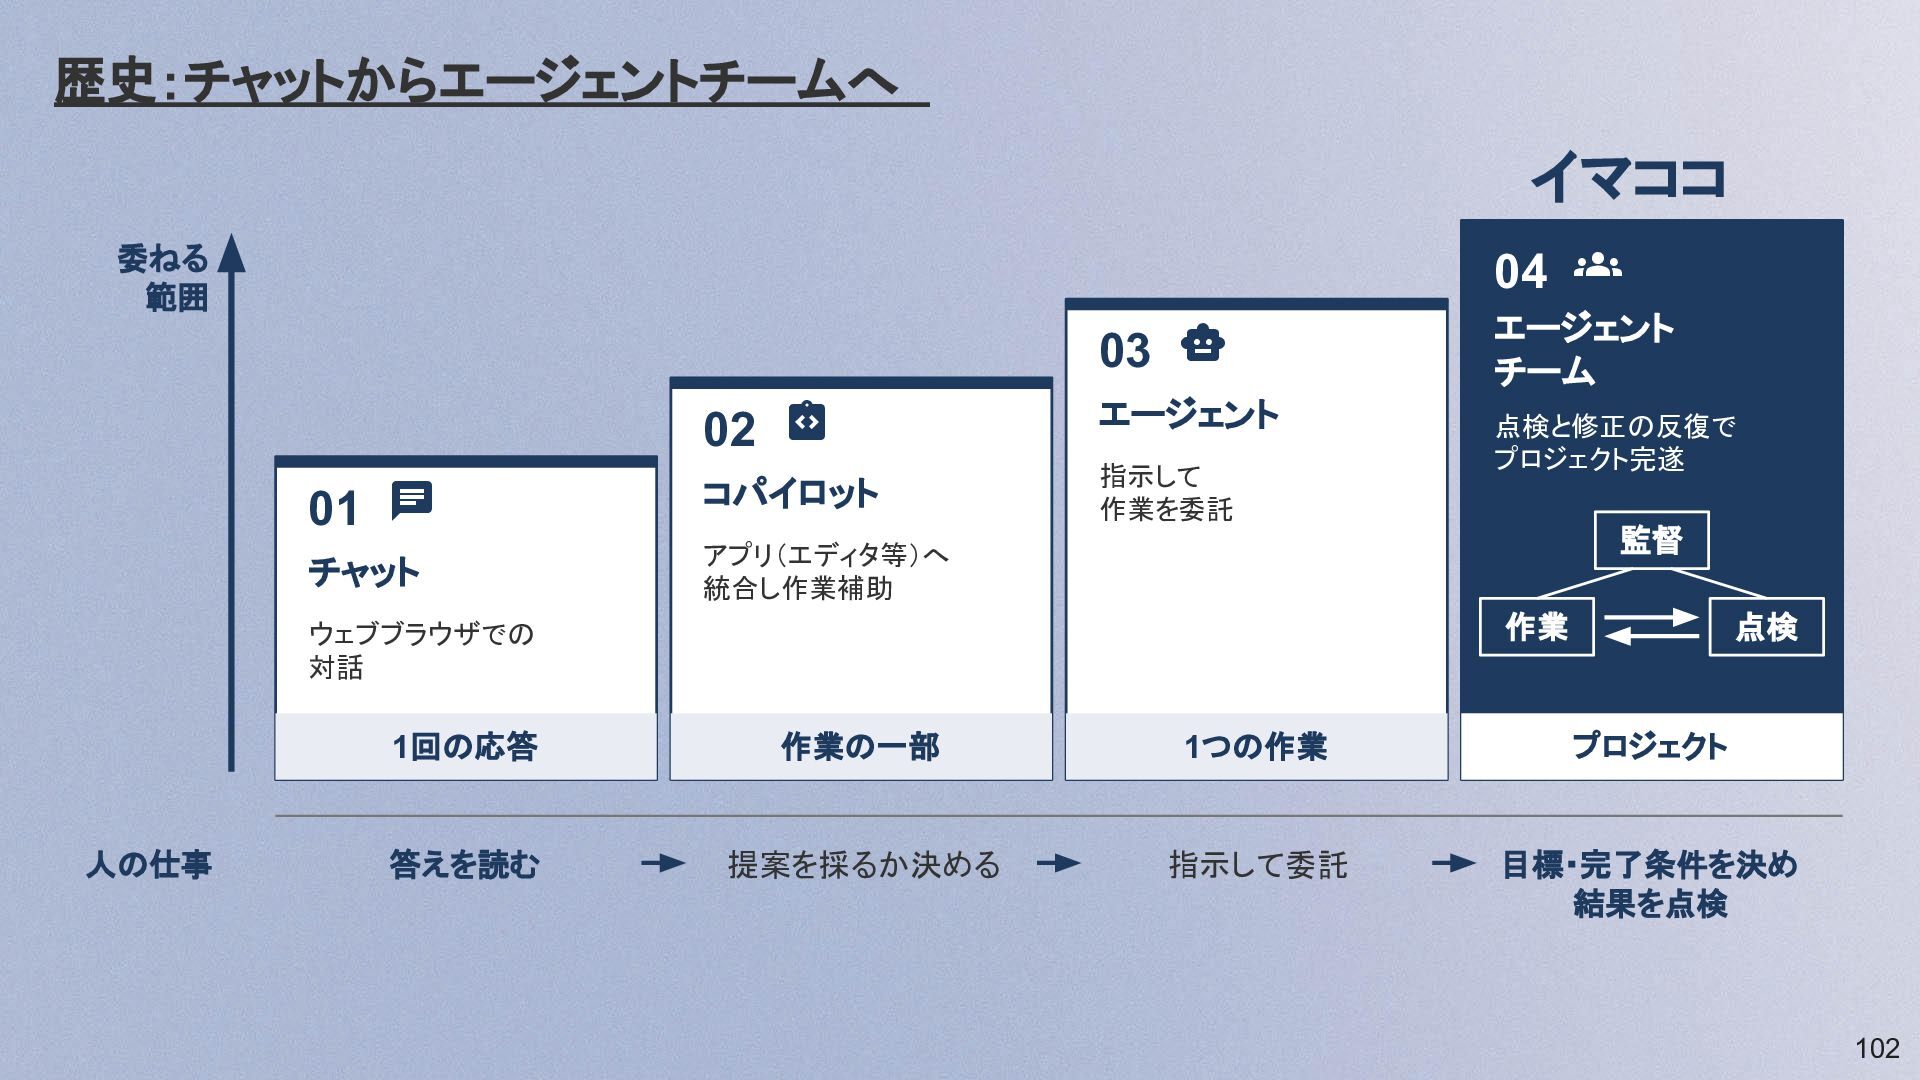
  94. 歴史:チャットからエージェントチームへ イマココ 04  委ねる 範囲 03  02 

    01  チャット コパイロット エージェント 指示して 作業を委託 点検と修正の反復で プロジェクト完遂 監督 アプリ(エディタ等)へ 統合し作業補助 作業 ウェブブラウザでの 対話 人の仕事 エージェント チーム 点検 1回の応答 作業の一部 1つの作業 プロジェクト 答えを読む 提案を採るか決める 指示して委託 目標・完了条件を決め 結果を点検 102
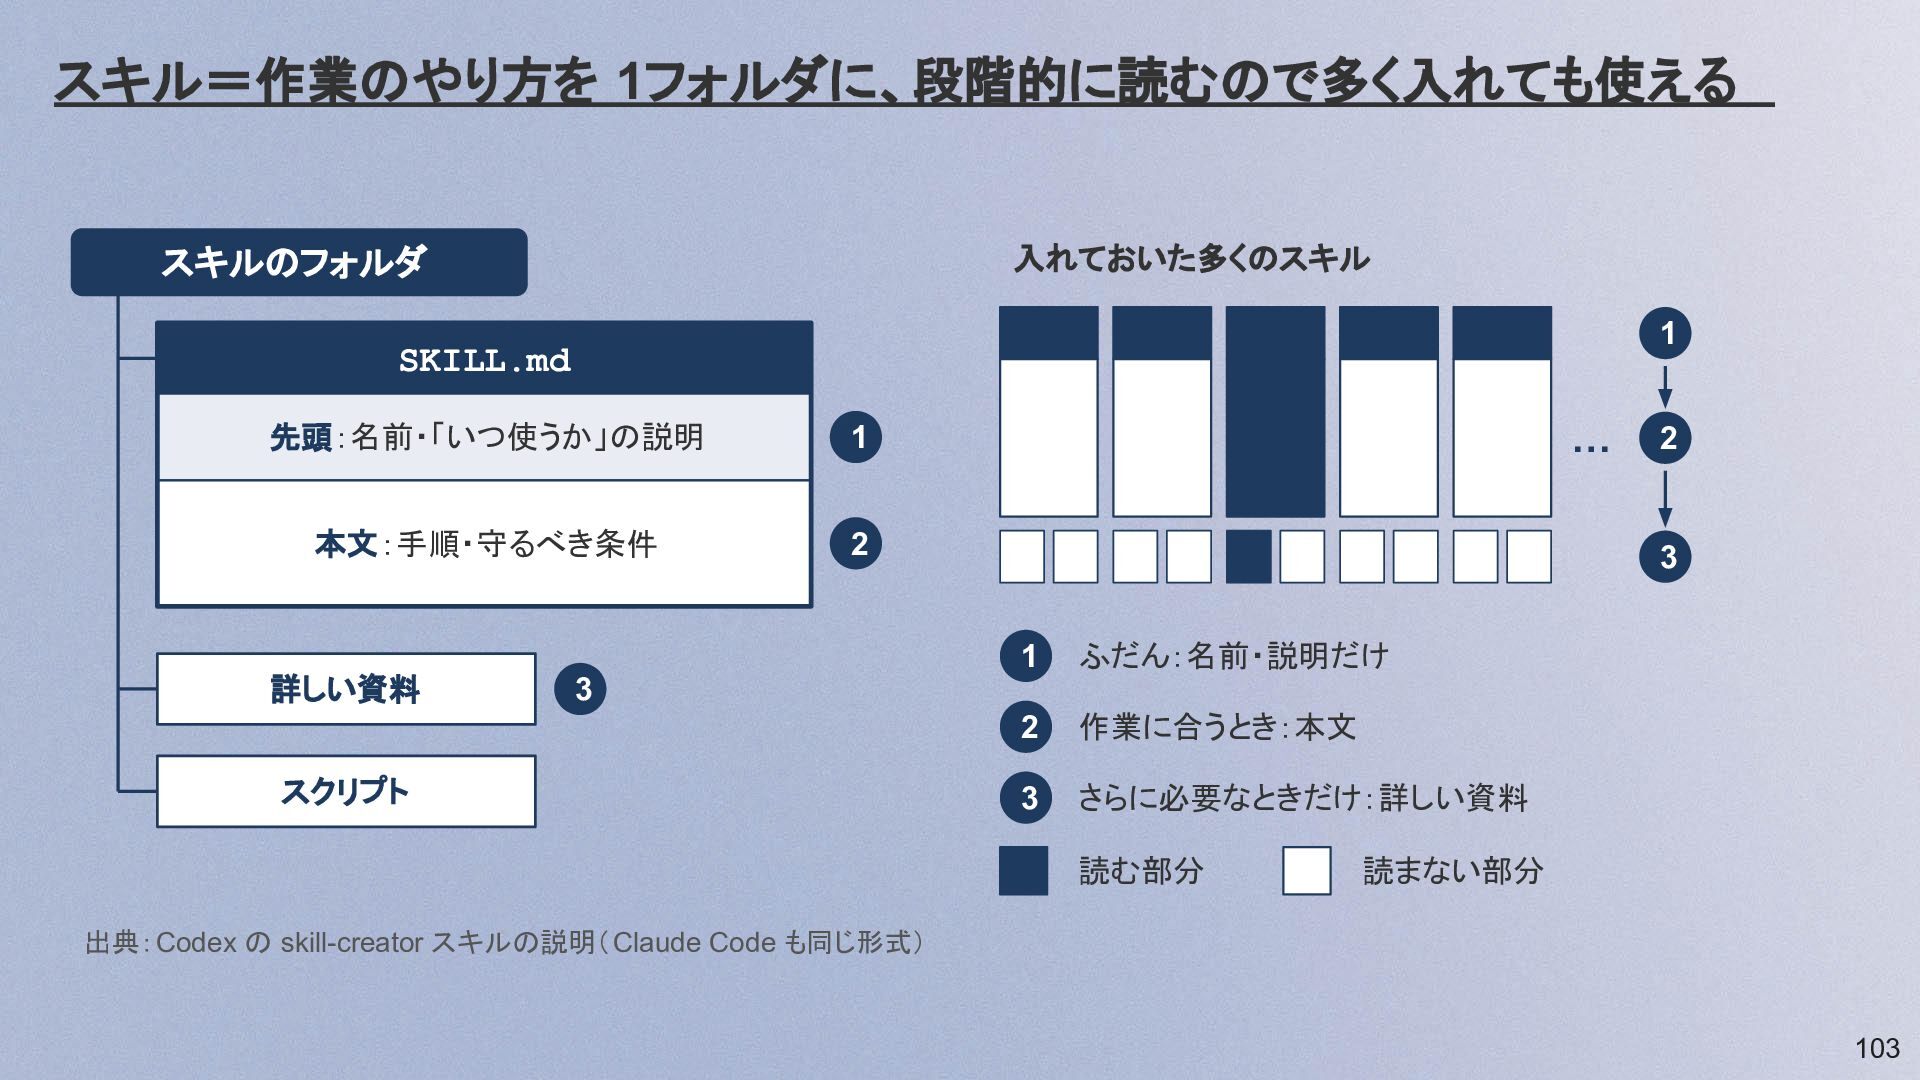
  95. スキル=作業のやり方を 1フォルダに、段階的に読むので多く入れても使える 入れておいた多くのスキル スキルのフォルダ 1 SKILL.md 先頭:名前・「いつ使うか」の説明 1 本文:手順・守るべき条件 2

    詳しい資料 … 2 3 1 ふだん:名前・説明だけ 2 作業に合うとき:本文 3 さらに必要なときだけ:詳しい資料 3 スクリプト 読む部分 読まない部分 出典:Codex の skill-creator スキルの説明( Claude Code も同じ形式) 103
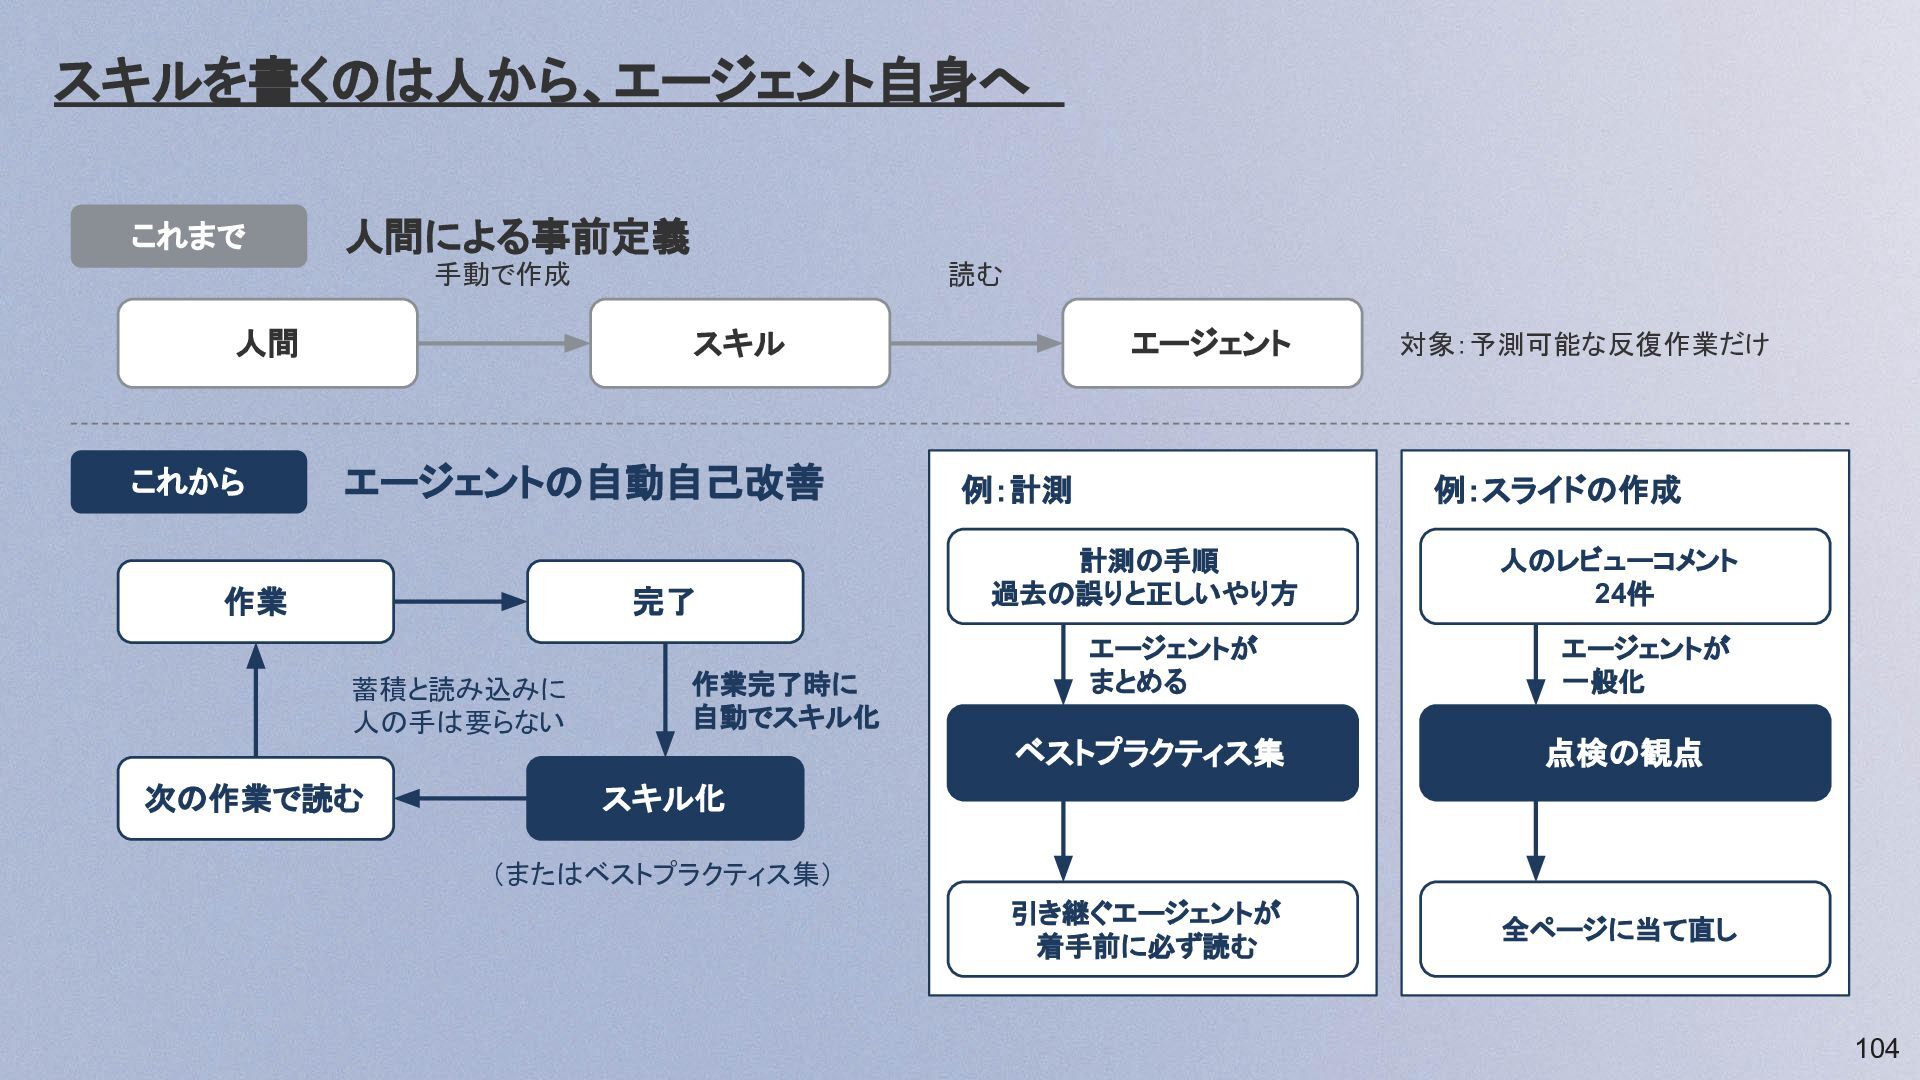
  96. スキルを書くのは人から、エージェント自身へ これまで 人間による事前定義 手動で作成 人間 これから 読む スキル エージェントの自動自己改善 作業

    完了 蓄積と読み込みに 人の手は要らない 次の作業で読む 作業完了時に 自動でスキル化 エージェント 例:計測 対象:予測可能な反復作業だけ 例:スライドの作成 計測の手順 過去の誤りと正しいやり方 エージェントが まとめる 人のレビューコメント 24件 エージェントが 一般化 ベストプラクティス集 点検の観点 引き継ぐエージェントが 着手前に必ず読む 全ページに当て直し スキル化 (またはベストプラクティス集) 104
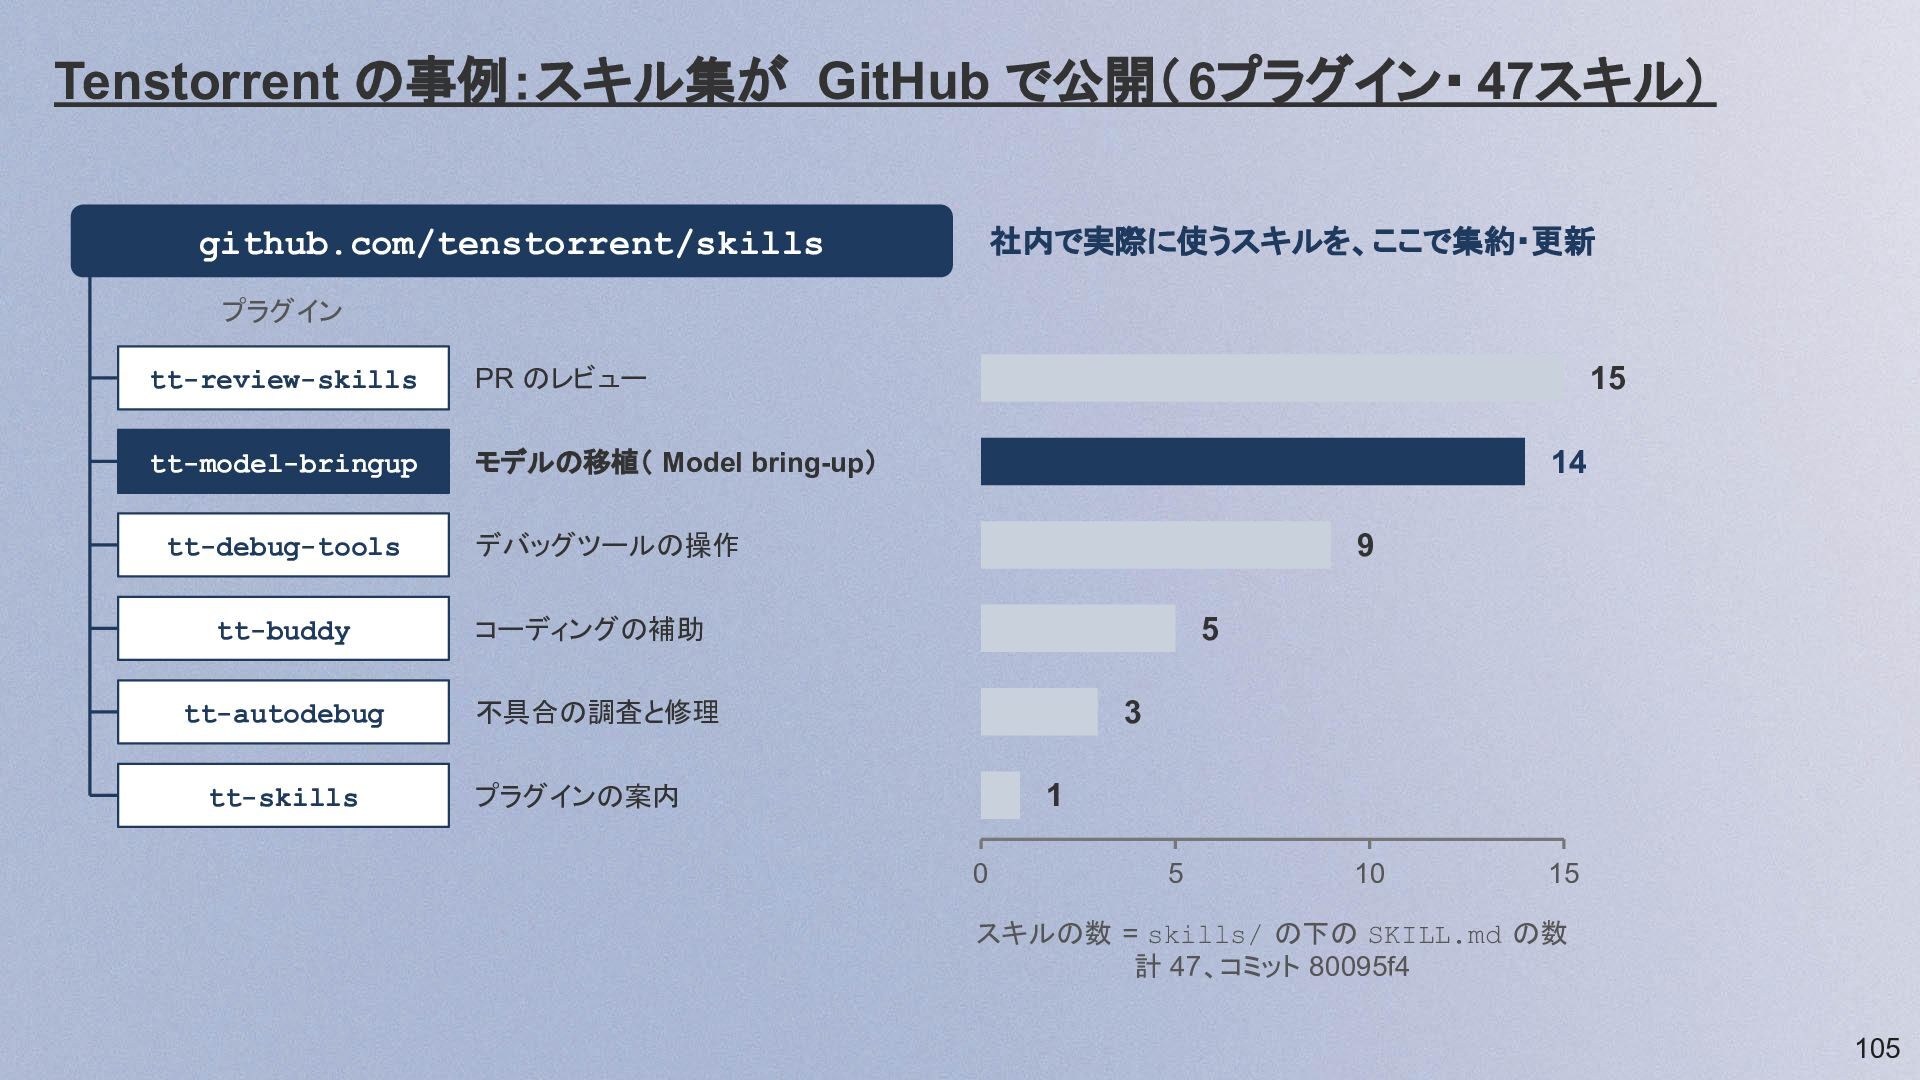
  97. Tenstorrent の事例:スキル集が GitHub で公開( 6プラグイン・ 47スキル) 社内で実際に使うスキルを、ここで集約・更新 github.com/tenstorrent/skills プラグイン tt-review-skills

    PR のレビュー tt-model-bringup モデルの移植( Model bring-up) tt-debug-tools デバッグツールの操作 tt-buddy コーディングの補助 tt-autodebug 不具合の調査と修理 tt-skills 15 14 9 5 3 プラグインの案内 1 0 5 10 15 スキルの数 = skills/ の下の SKILL.md の数 計 47、コミット 80095f4 105
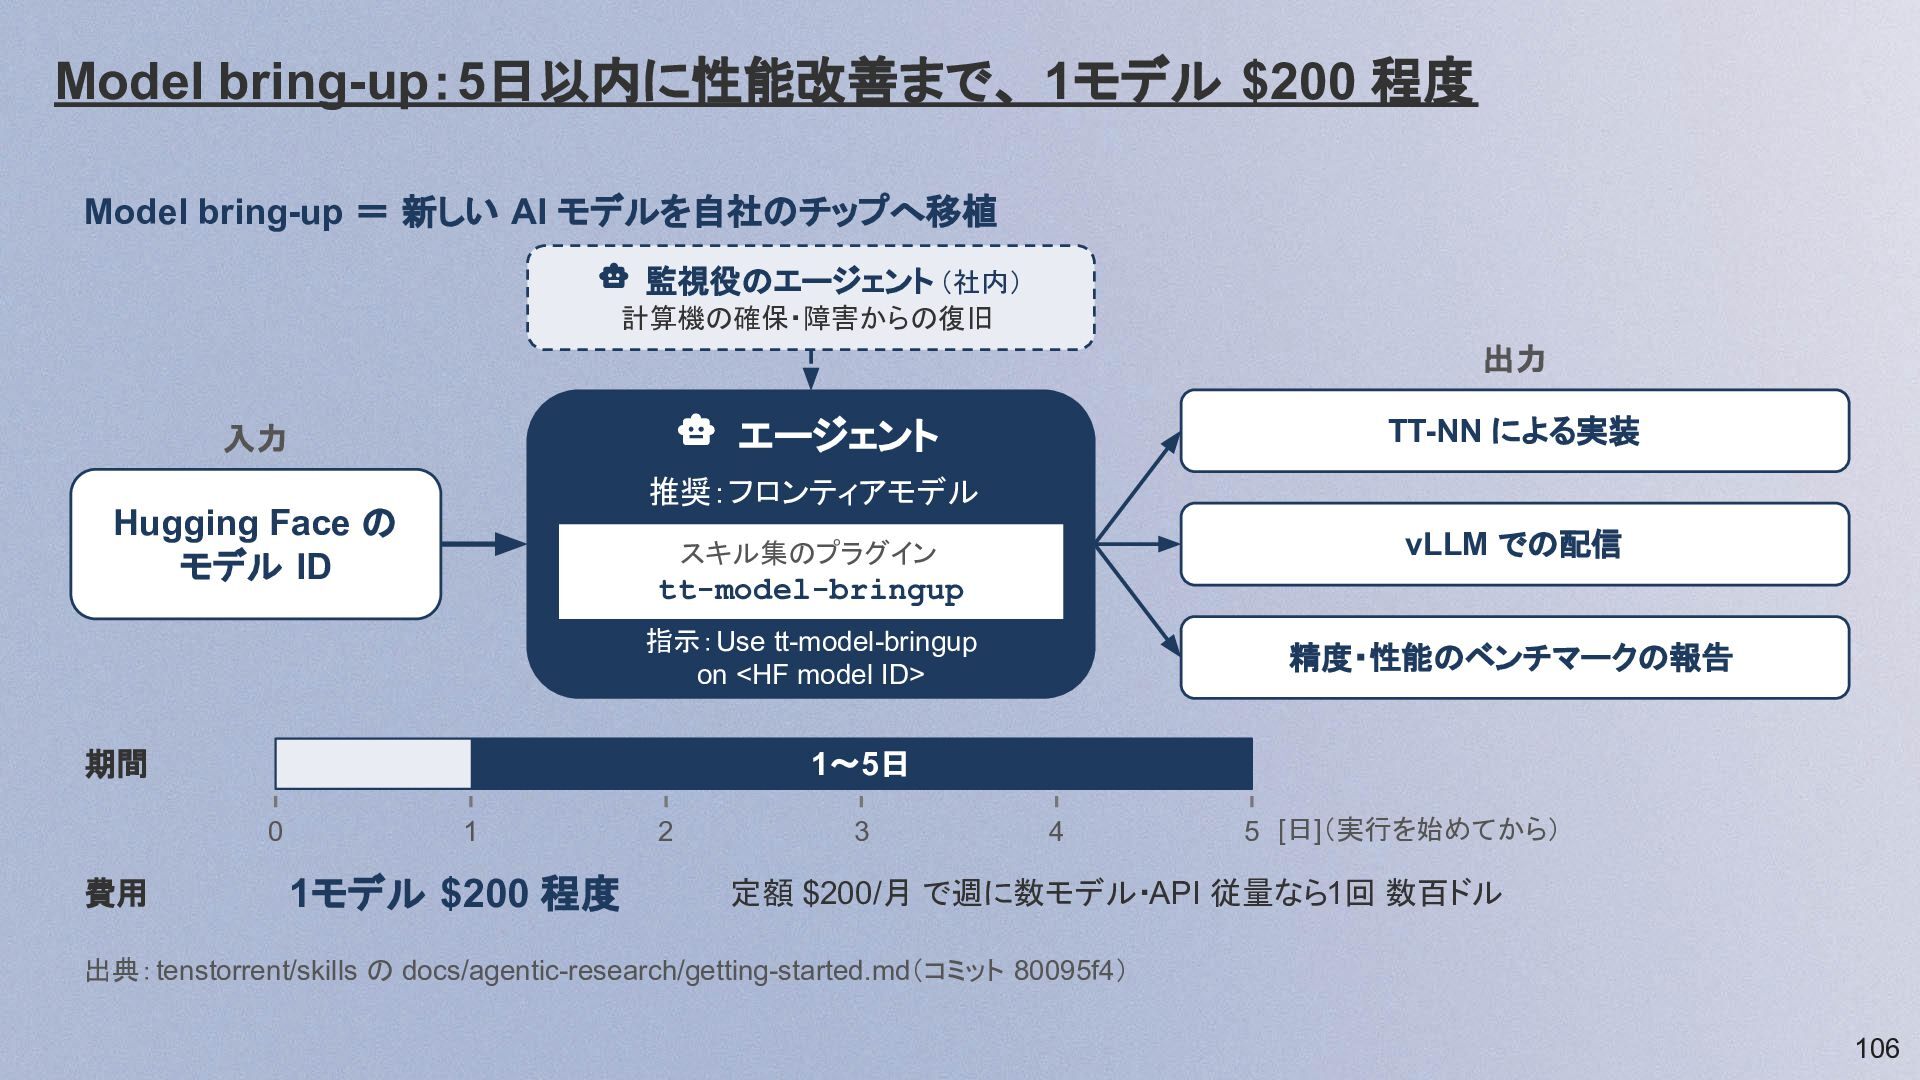
  98. Model bring-up:5日以内に性能改善まで、 1モデル $200 程度 Model bring-up = 新しい AI

    モデルを自社のチップへ移植  監視役のエージェント (社内) 計算機の確保・障害からの復旧 出力  エージェント 入力 TT-NN による実装 推奨:フロンティアモデル Hugging Face の モデル ID vLLM での配信 スキル集のプラグイン tt-model-bringup 指示:Use tt-model-bringup on <HF model ID> 期間 1〜5日 0 費用 精度・性能のベンチマークの報告 1 1モデル $200 程度 2 3 4 5 [日](実行を始めてから) 定額 $200/月 で週に数モデル・API 従量なら1回 数百ドル 出典:tenstorrent/skills の docs/agentic-research/getting-started.md(コミット 80095f4) 106
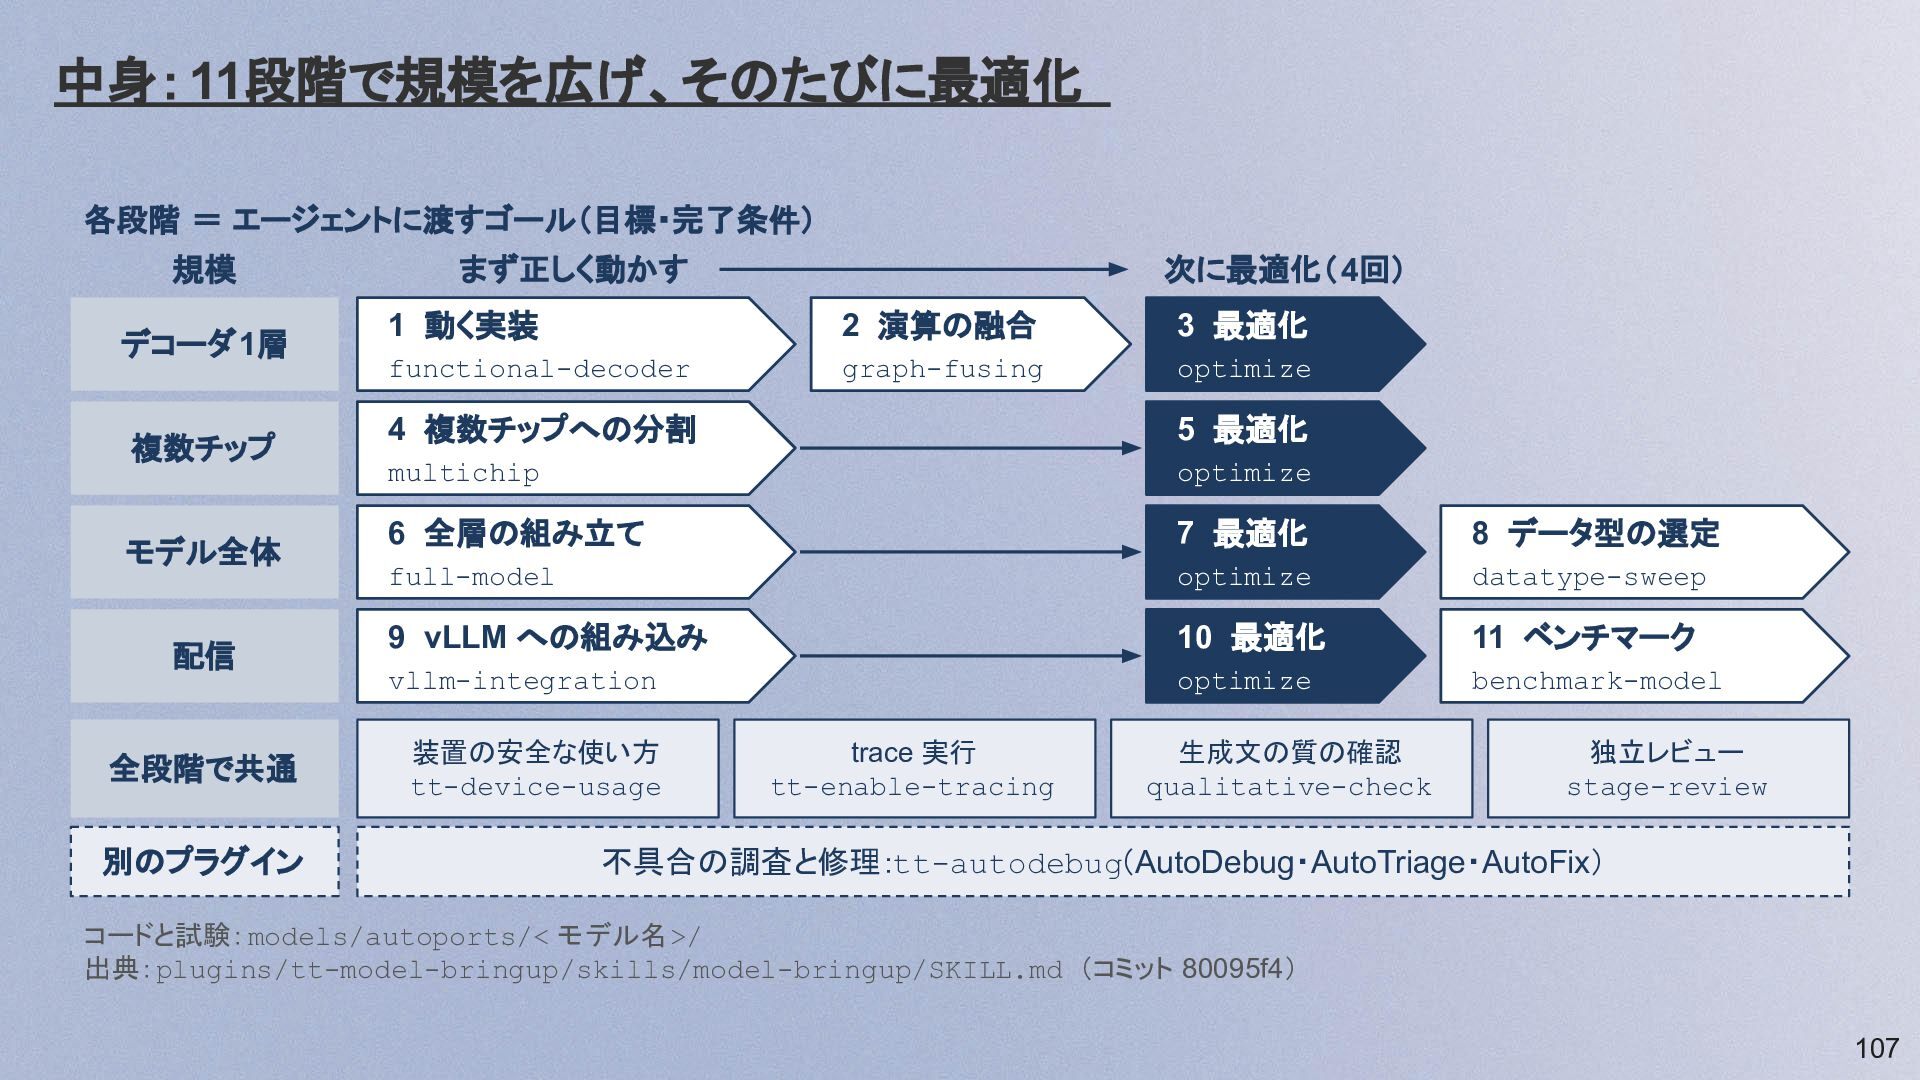
  99. 中身:11段階で規模を広げ、そのたびに最適化 各段階 = エージェントに渡すゴール(目標・完了条件) 規模 デコーダ1層 複数チップ モデル全体 配信 全段階で共通

    別のプラグイン まず正しく動かす 次に最適化(4回) 1 動く実装 2 演算の融合 3 最適化 functional-decoder graph-fusing optimize 4 複数チップへの分割 5 最適化 multichip optimize 6 全層の組み立て 7 最適化 8 データ型の選定 full-model optimize datatype-sweep 9 vLLM への組み込み 10 最適化 11 ベンチマーク vllm-integration optimize benchmark-model 装置の安全な使い方 tt-device-usage trace 実行 tt-enable-tracing 生成文の質の確認 qualitative-check 独立レビュー stage-review 不具合の調査と修理:tt-autodebug(AutoDebug・AutoTriage・AutoFix) コードと試験: models/autoports/< モデル名>/ 出典:plugins/tt-model-bringup/skills/model-bringup/SKILL.md (コミット 80095f4) 107
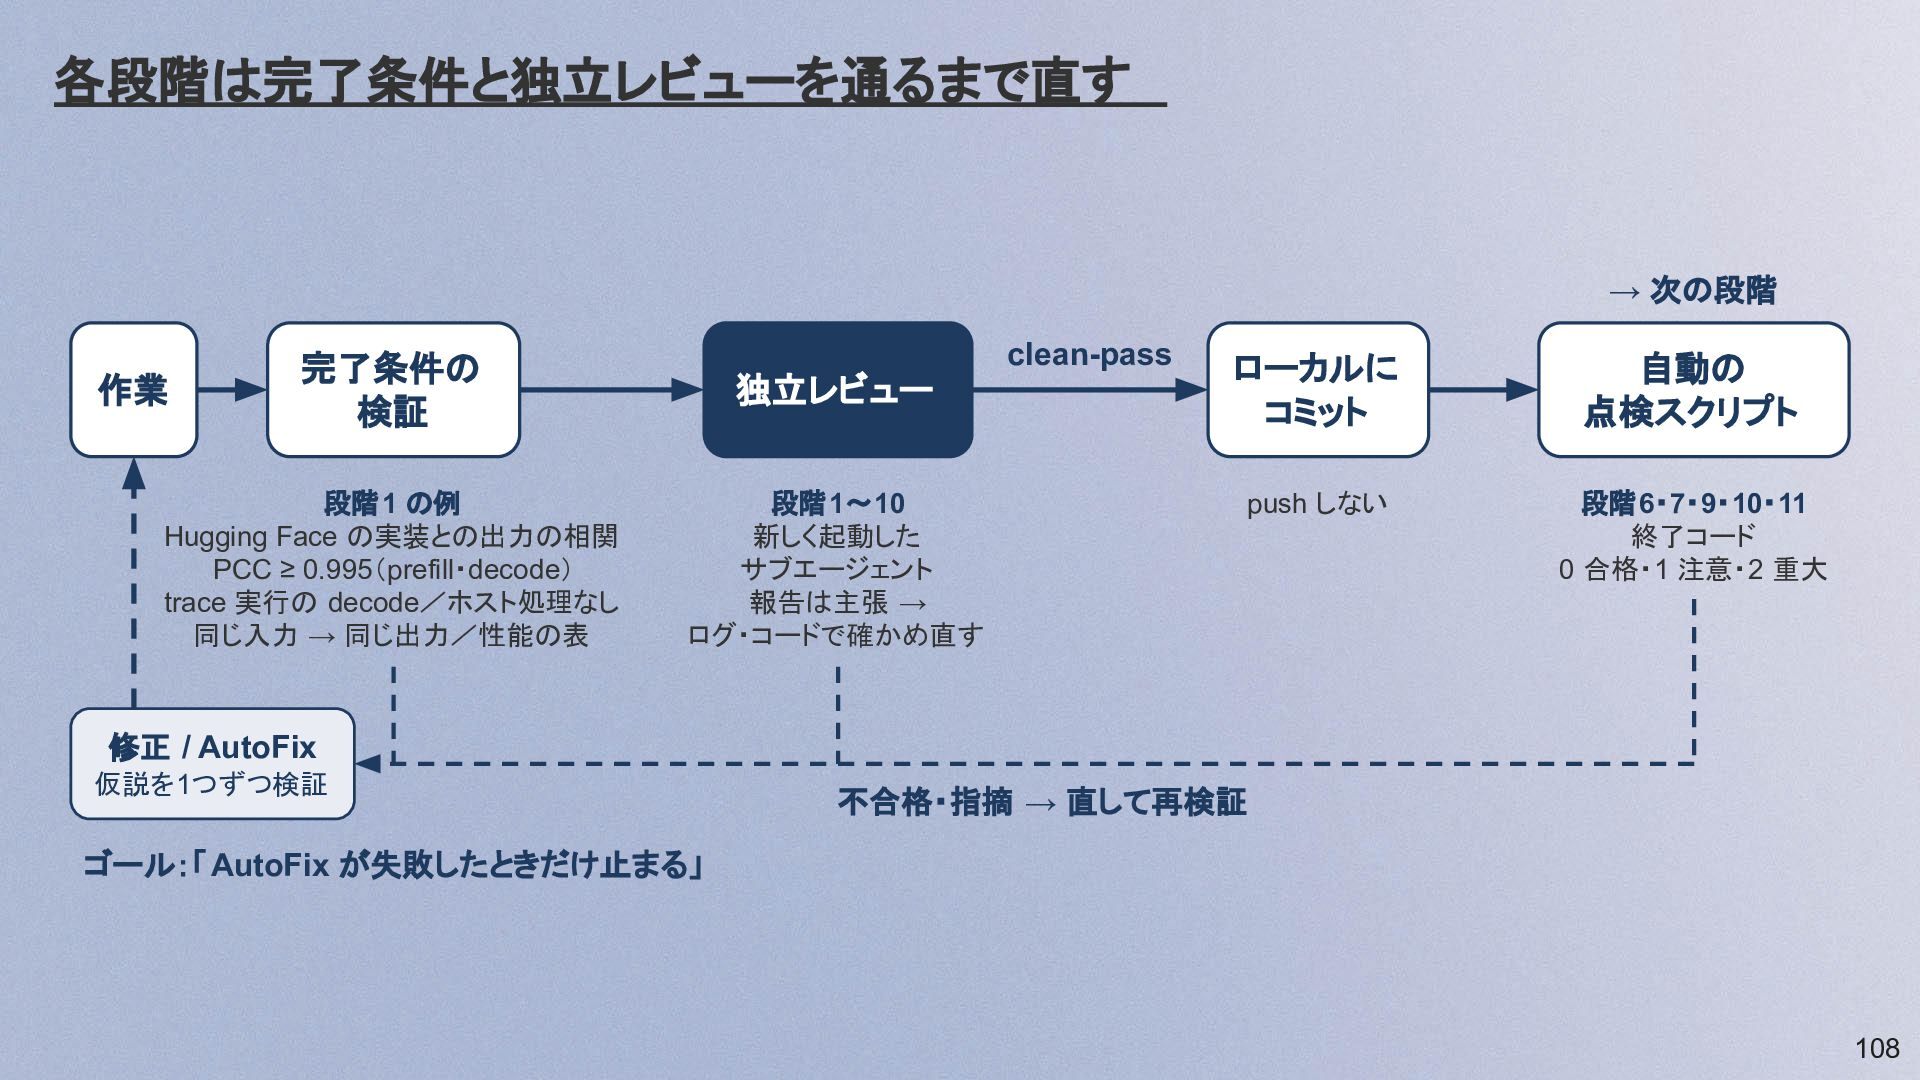
  100. 各段階は完了条件と独立レビューを通るまで直す → 次の段階 clean-pass 完了条件の 検証 独立レビュー 段階1 の例 Hugging

    Face の実装との出力の相関 PCC ≥ 0.995(prefill・decode) trace 実行の decode/ホスト処理なし 同じ入力 → 同じ出力/性能の表 段階1〜10 新しく起動した サブエージェント 報告は主張 → ログ・コードで確かめ直す 作業 ローカルに コミット 自動の 点検スクリプト push しない 段階6・7・9・10・11 終了コード 0 合格・1 注意・2 重大 修正 / AutoFix 仮説を1つずつ検証 不合格・指摘 → 直して再検証 ゴール:「AutoFix が失敗したときだけ止まる」 108
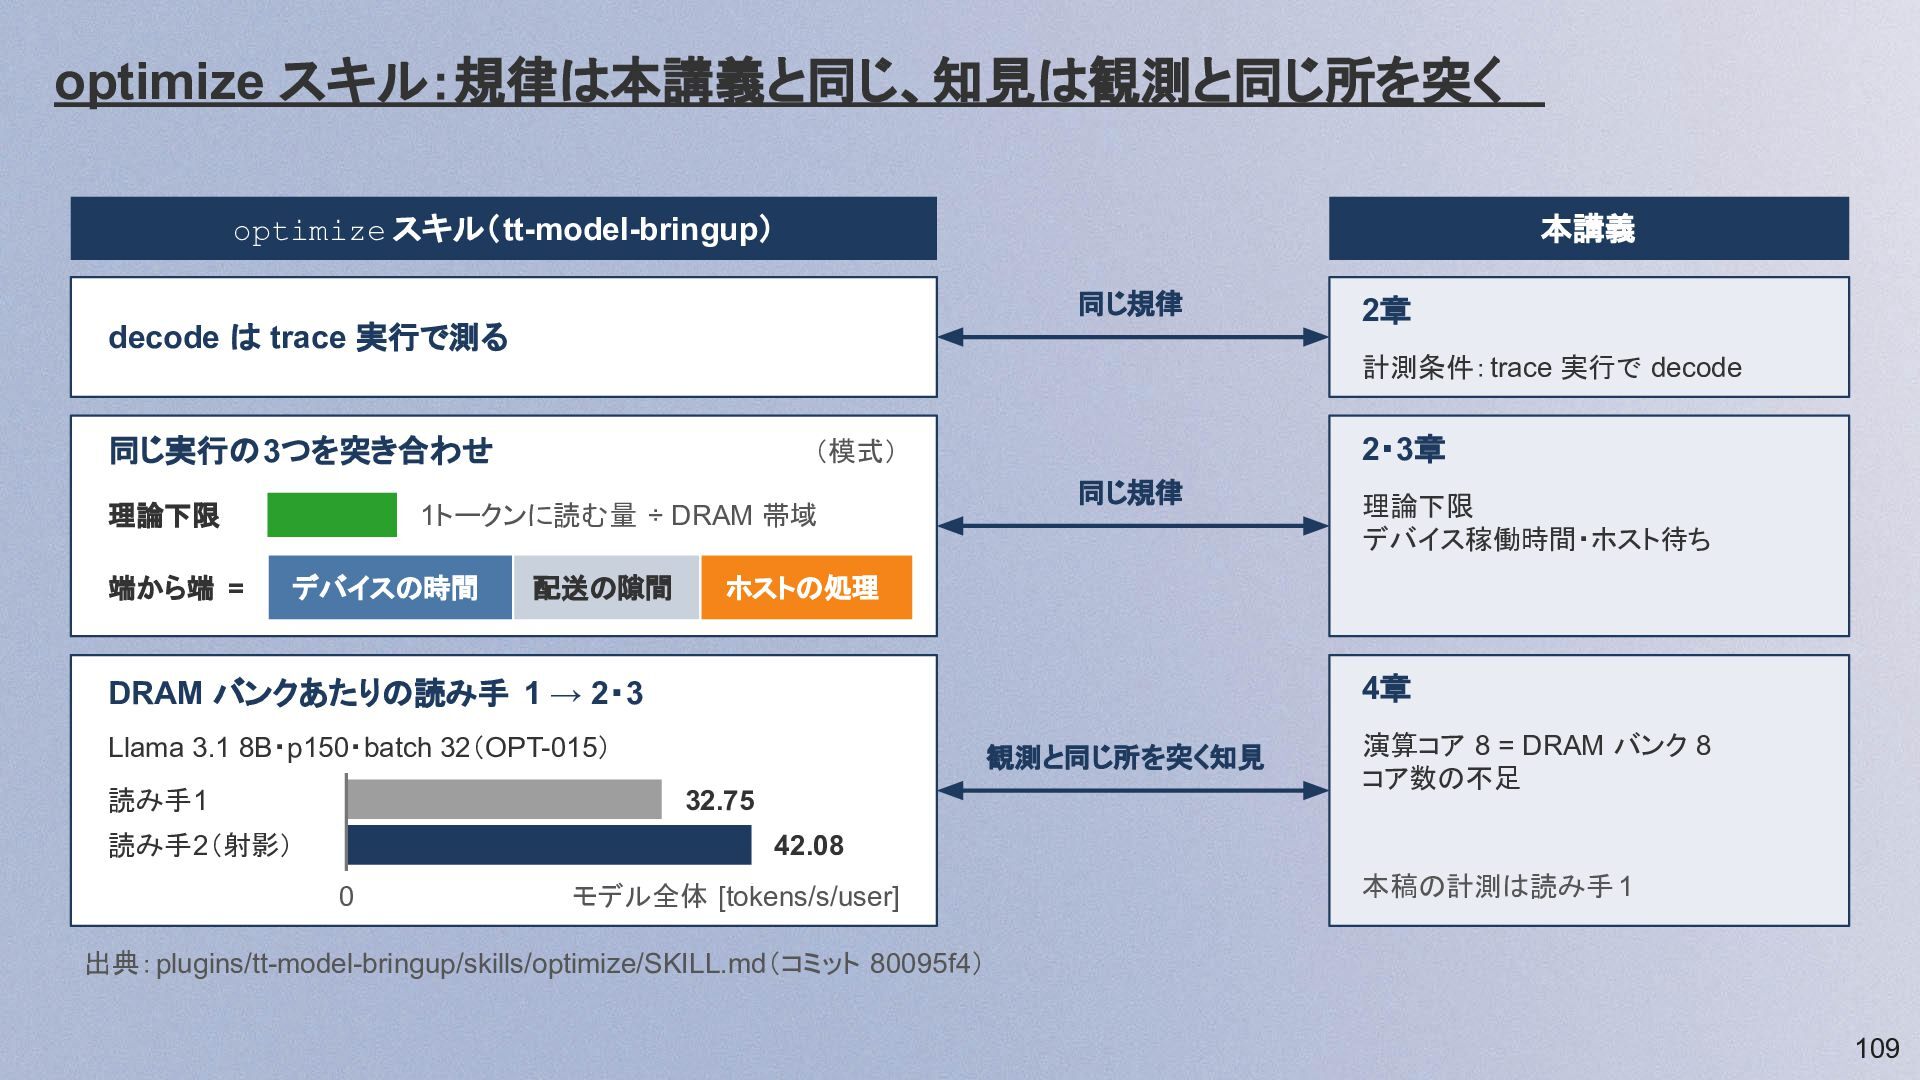
  101. optimize スキル:規律は本講義と同じ、知見は観測と同じ所を突く optimize スキル(tt-model-bringup) 本講義 同じ規律 decode は trace 実行で測る

    計測条件:trace 実行で decode 同じ実行の3つを突き合わせ 理論下限 端から端 = (模式) 1トークンに読む量 ÷ DRAM 帯域 デバイスの時間 配送の隙間 2・3章 同じ規律 4章 Llama 3.1 8B・p150・batch 32(OPT-015) 観測と同じ所を突く知見 32.75 読み手2(射影) 理論下限 デバイス稼働時間・ホスト待ち ホストの処理 DRAM バンクあたりの読み手 1 → 2・3 読み手1 2章 演算コア 8 = DRAM バンク 8 コア数の不足 42.08 0 モデル全体 [tokens/s/user] 本稿の計測は読み手 1 出典:plugins/tt-model-bringup/skills/optimize/SKILL.md(コミット 80095f4) 109
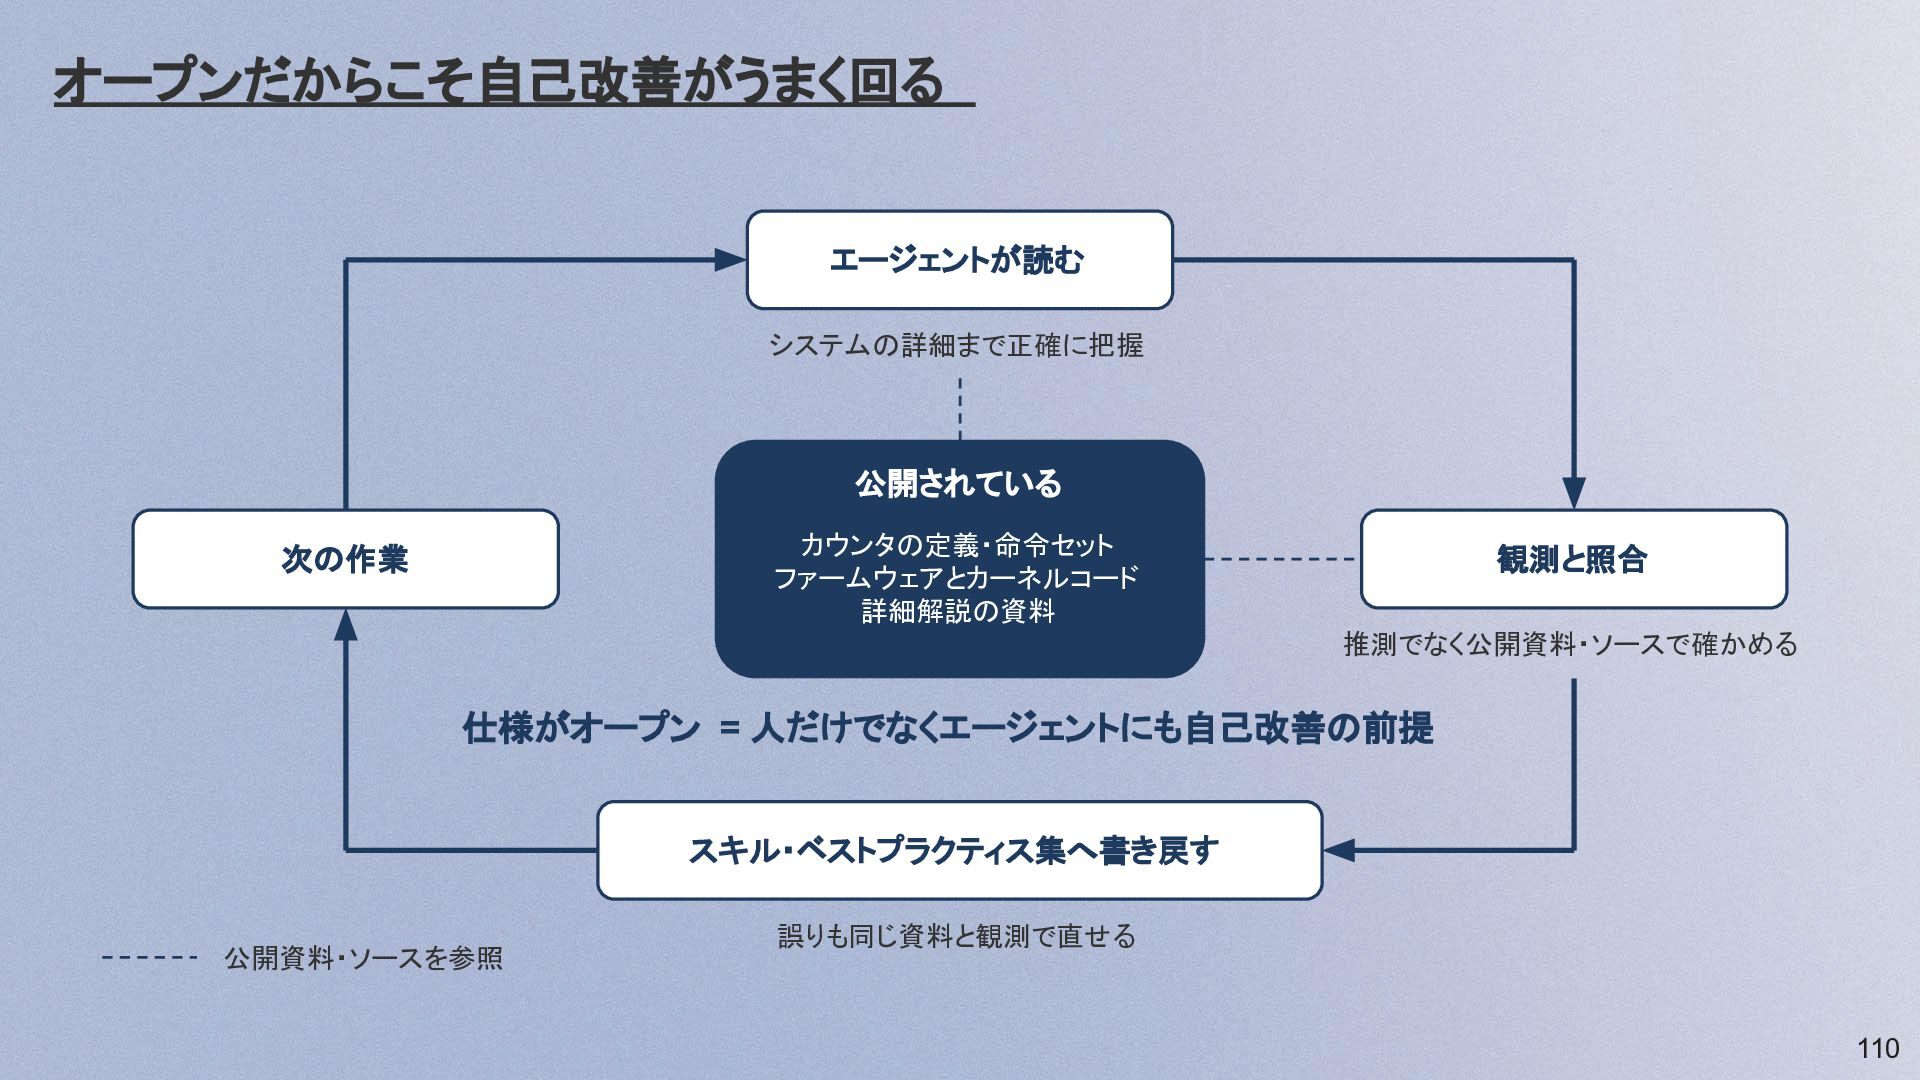
  102. オープンだからこそ自己改善がうまく回る エージェントが読む システムの詳細まで正確に把握 公開されている カウンタの定義・命令セット ファームウェアとカーネルコード 詳細解説の資料 次の作業 観測と照合 推測でなく公開資料・ソースで確かめる

    仕様がオープン = 人だけでなくエージェントにも自己改善の前提 スキル・ベストプラクティス集へ書き戻す 公開資料・ソースを参照 誤りも同じ資料と観測で直せる 110
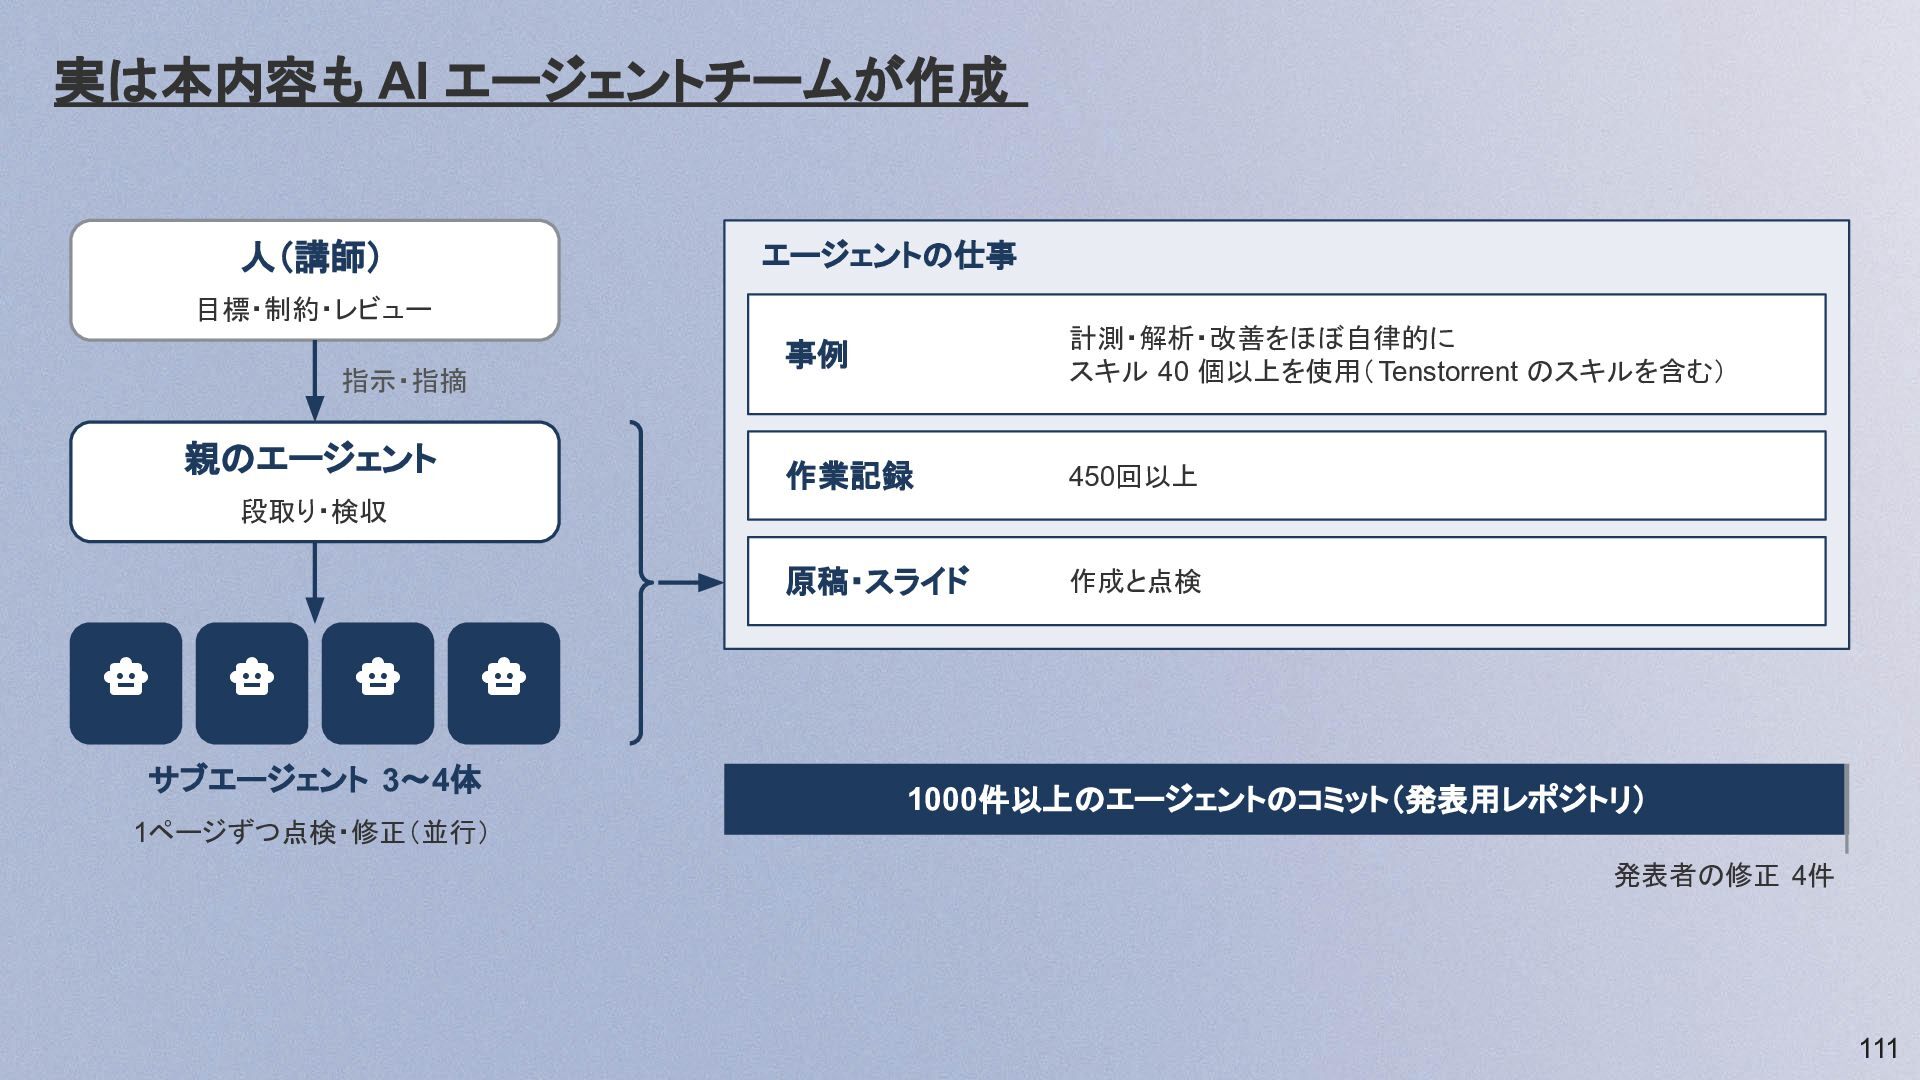
  103. 実は本内容も AI エージェントチームが作成 人(講師) エージェントの仕事 目標・制約・レビュー 指示・指摘 親のエージェント 事例 計測・解析・改善をほぼ自律的に

    スキル 40 個以上を使用( Tenstorrent のスキルを含む) 作業記録 450回以上 原稿・スライド 作成と点検 段取り・検収     サブエージェント 3〜4体 1000件以上のエージェントのコミット(発表用レポジトリ) 1ページずつ点検・修正(並行) 発表者の修正 4件 111