Share
Embed
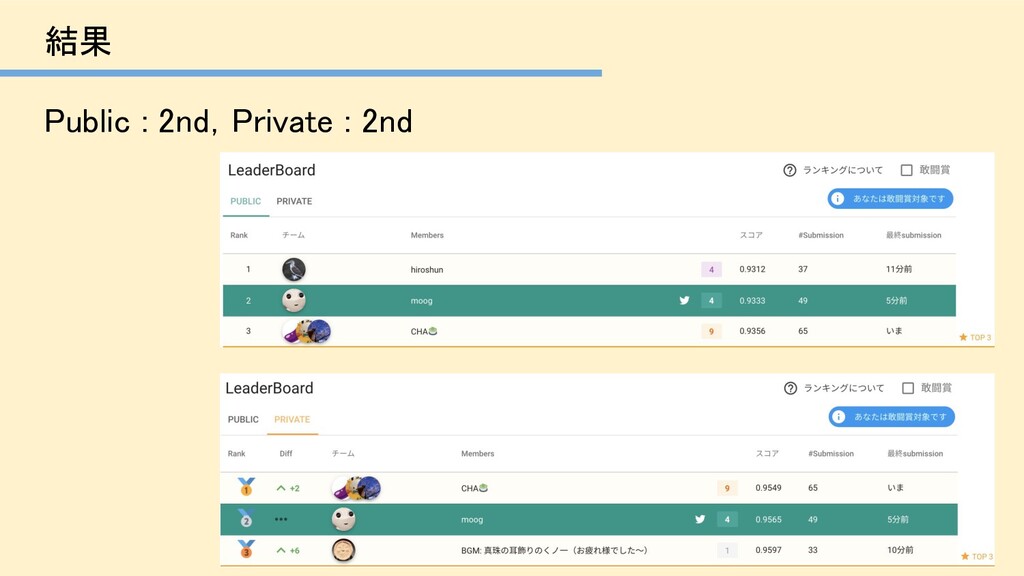
atmaCup#10 2nd place solution
atmaCup#10 振り返り会(https://www.youtube.com/watch?v=8k6A0IkGjwc&t=2863s)
のなかで発表したスライドです.
tellmoogry
March 31, 2021
Transcript
36 slides
-
自己紹介 機械工学専攻 M2 atma intern Kaggle : Expert SIGNATE :
Master コンペ歴 (≒プログラミング歴) 2年 atmaCup : 過去8回 (#7~#9以外) 参加 その他日本語コンペサイトいくつか 分析環境 : MacBookPro + Colab @tellmoogry -
コンペ概要 ・コンペの特徴 コンペ期間 : 8日間 (うち土日は3日間) サブミット回数 : 50 atmaCup
(日本語のコンペプラットフォーム, Discussionが超活発) 初心者歓迎 ・データの特徴 マルチモーダル (Table, Text, Image) 複数言語で構成されるデータ (Dutch, Englinsh...) 複数のメタデータ -
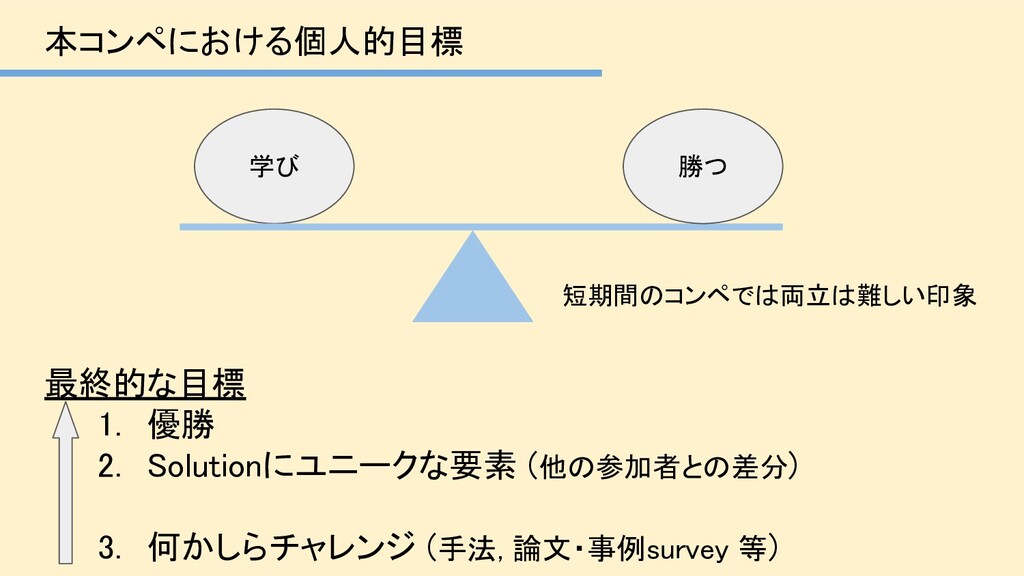
本コンペにおける個人的目標 最終的な目標 1. 優勝 2. Solutionにユニークな要素 (他の参加者との差分) 3. 何かしらチャレンジ
(手法, 論文・事例survey 等) 学び 勝つ 短期間のコンペでは両立は難しい印象 -
本コンペにおける個人的目標 目標達成のための方針 ・Discussionは全部みる ・時間と相談しつつ思いついたことは全部やりたい 早めに大事そうな要素に目星をつける 共有されにくそうな点 (Text, Image) を重点的に ・実装&Runningコスト
vs Score貢献 を意識 NaNの少ないカラムを重点的に ・心が折れないようにする 上位から離されすぎない 定期的に緑の画面を摂取 -
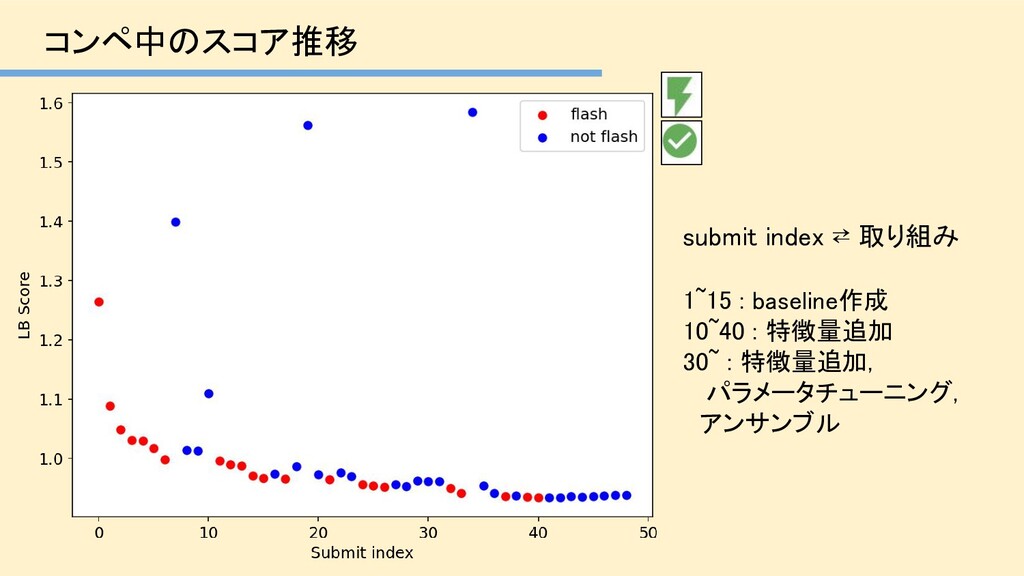
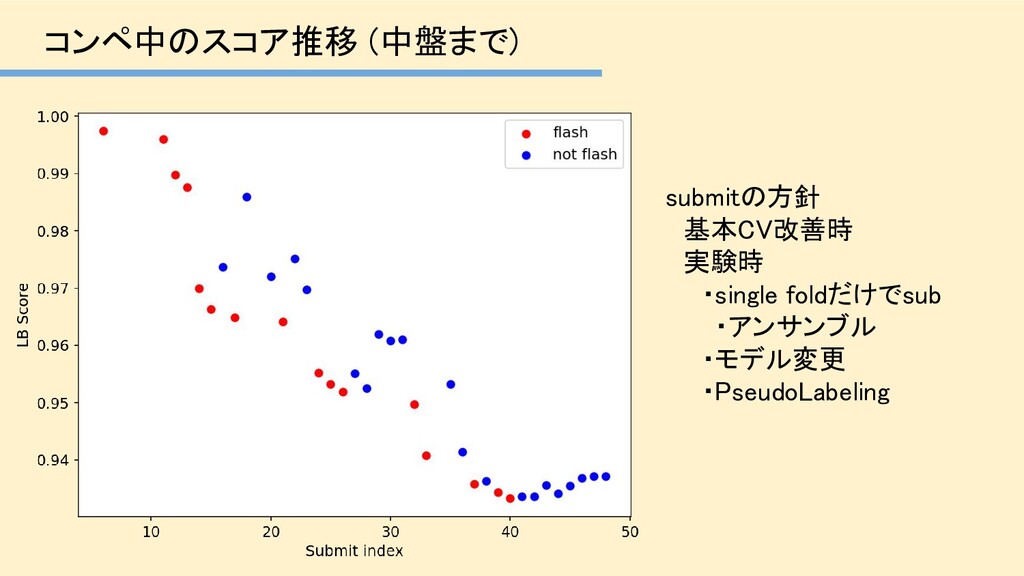
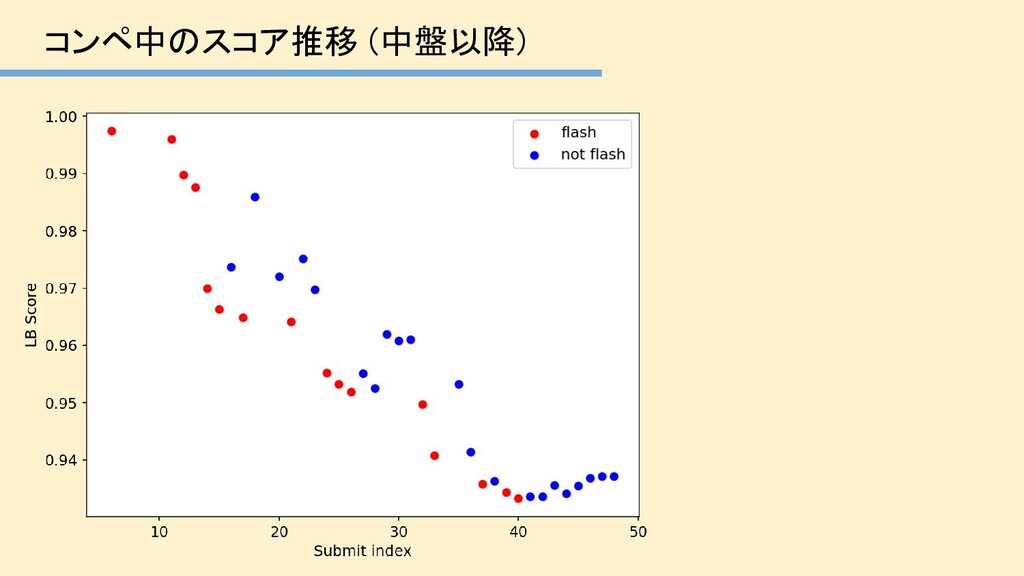
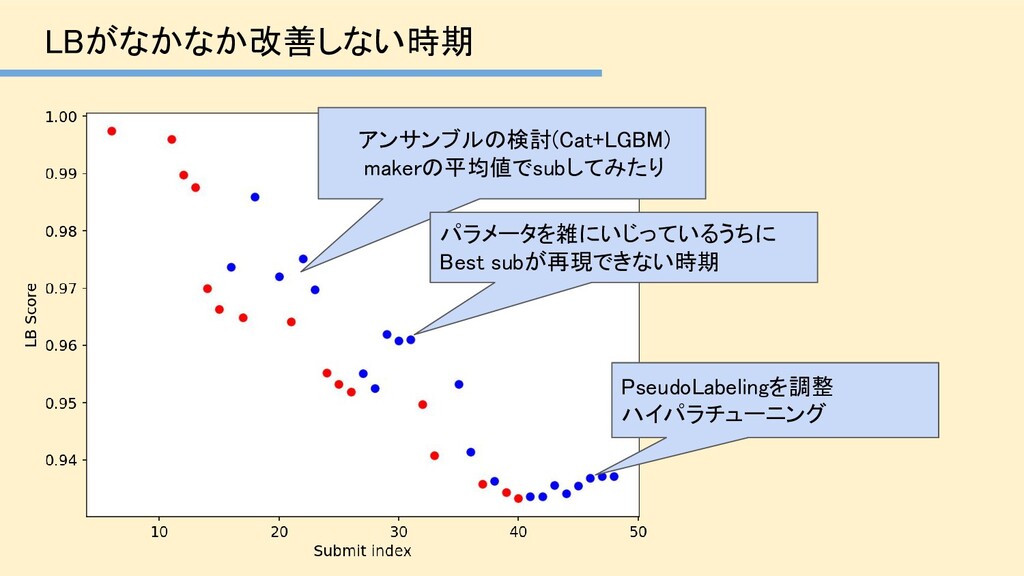
コンペ中のスコア推移 submit index ⇄ 取り組み 1~15 : baseline作成 10~40
: 特徴量追加 30~ : 特徴量追加, パラメータチューニング, アンサンブル -
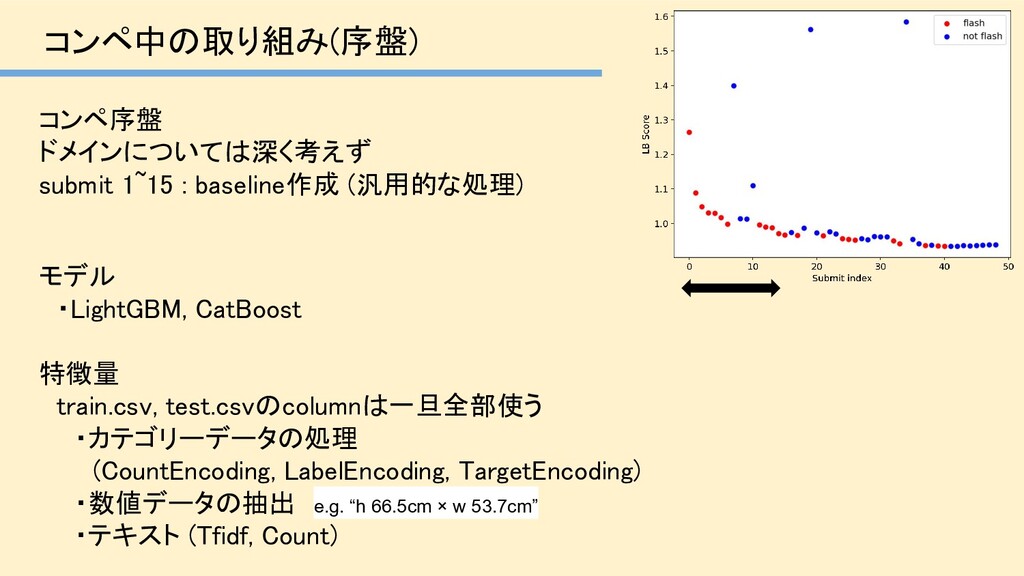
コンペ中の取り組み(序盤) コンペ序盤 ドメインについては深く考えず submit 1~15 : baseline作成 (汎用的な処理) モデル ・LightGBM,
CatBoost 特徴量 train.csv, test.csvのcolumnは一旦全部使う ・カテゴリーデータの処理 (CountEncoding, LabelEncoding, TargetEncoding) ・数値データの抽出 e.g. “h 66.5cm × w 53.7cm” ・テキスト (Tfidf, Count) -
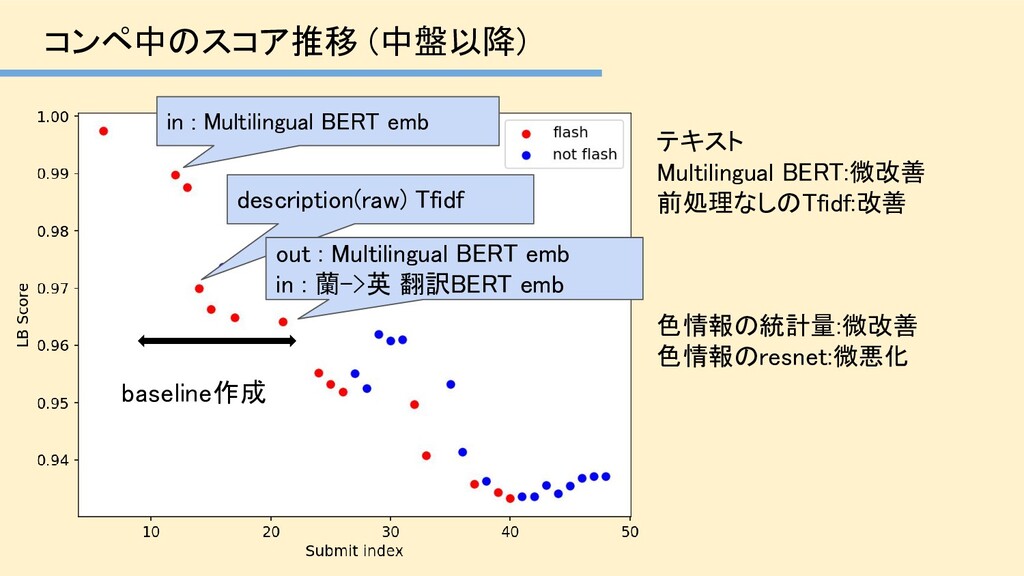
コンペ中のスコア推移 (中盤以降) baseline作成 description(raw) Tfidf in : Multilingual BERT emb
テキスト Multilingual BERT:微改善 前処理なしのTfidf:改善 色情報の統計量:微改善 色情報のresnet:微悪化 out : Multilingual BERT emb in : 蘭->英 翻訳BERT emb -
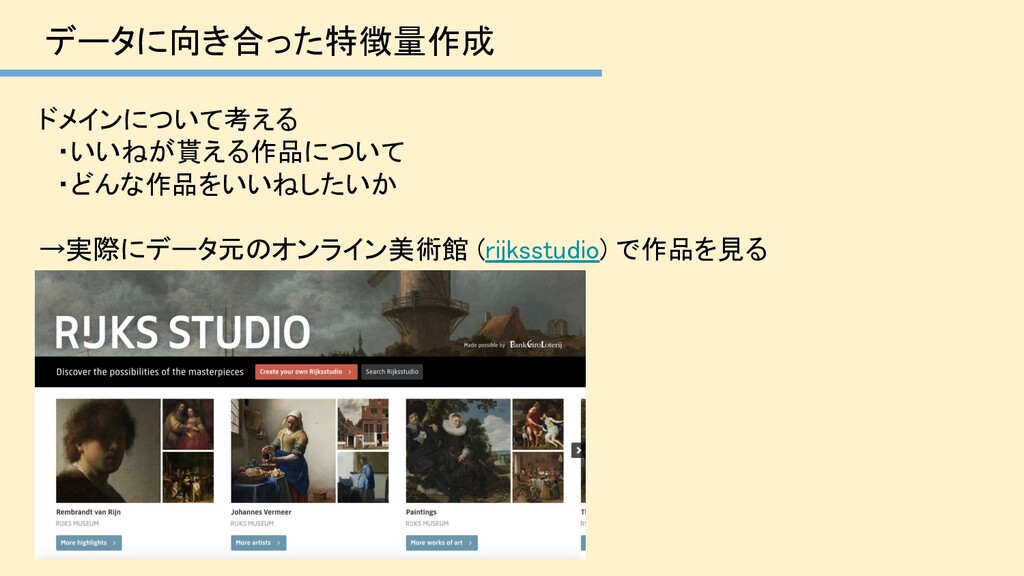
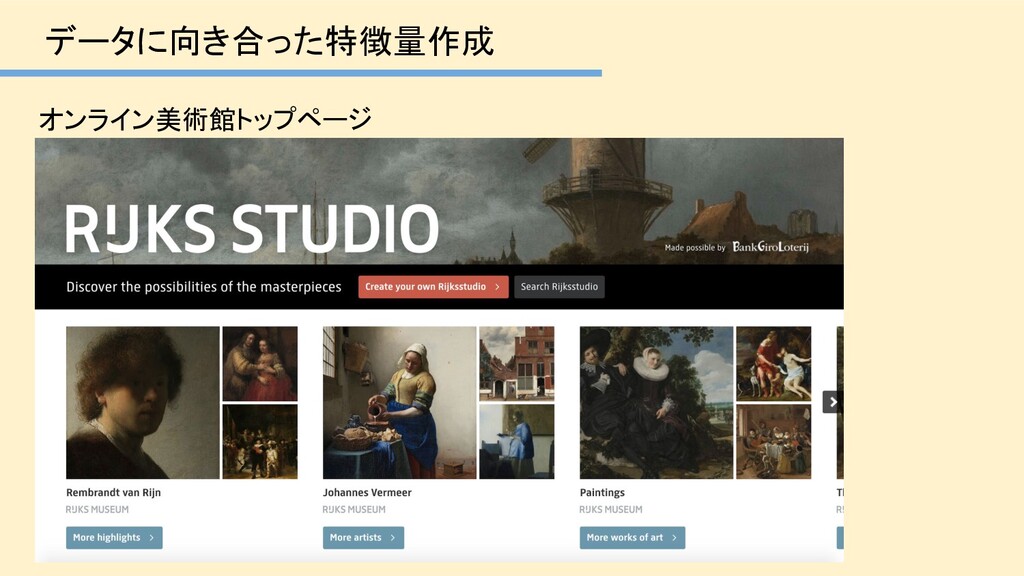
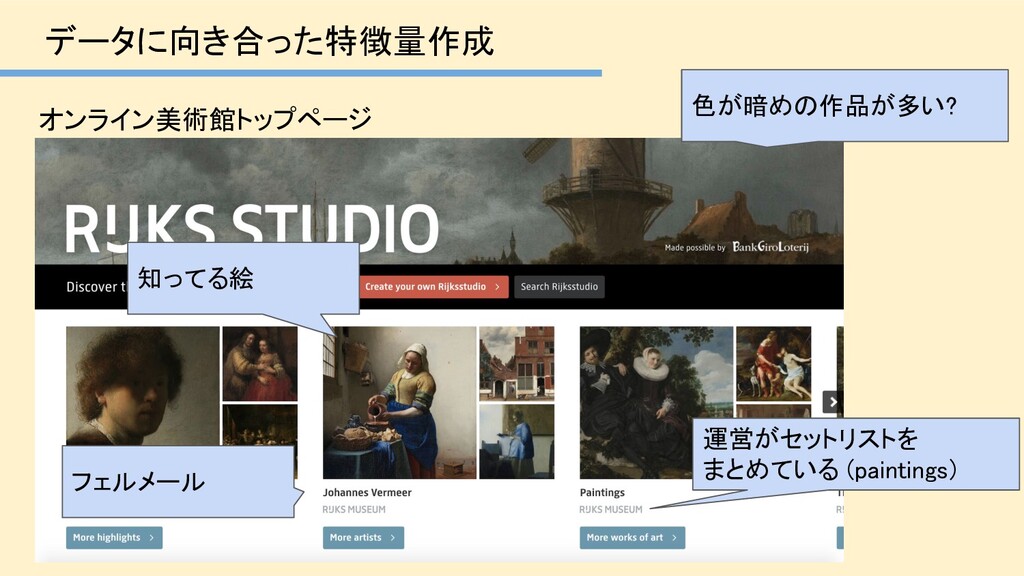
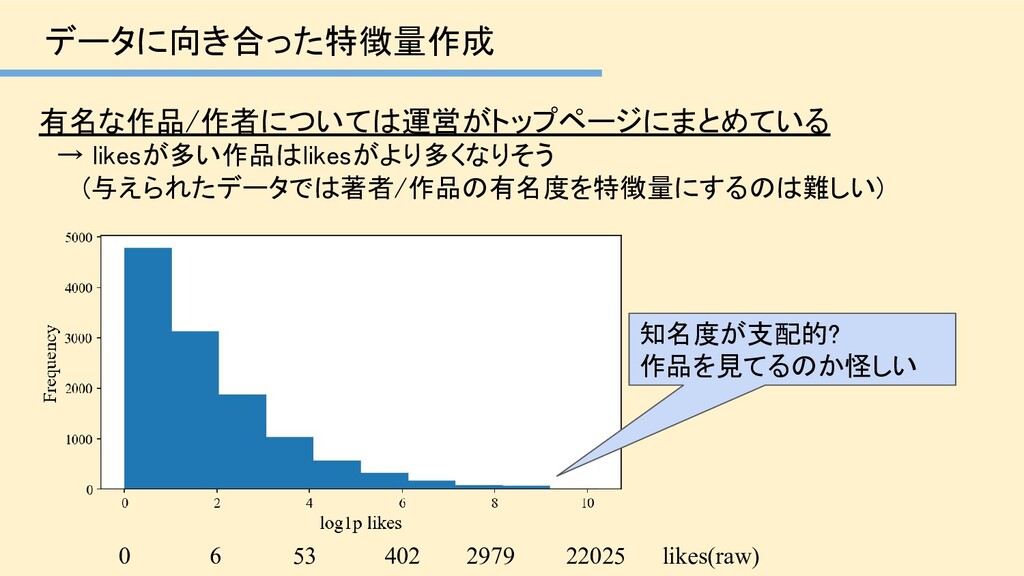
データに向き合った特徴量作成 有名な作品/作者については運営がトップページにまとめている → likesが多い作品はlikesがより多くなりそう (与えられたデータでは著者/作品の有名度を特徴量にするのは難しい) 0 6 53 402
2979 22025 likes(raw) 知名度が支配的? 作品を見てるのか怪しい -
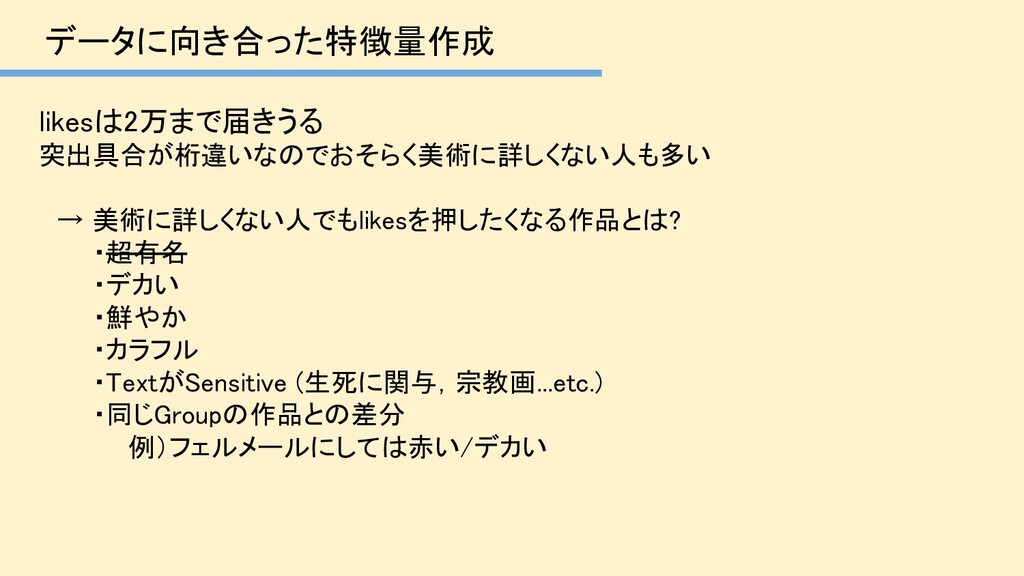
データに向き合った特徴量作成 likesは2万まで届きうる 突出具合が桁違いなのでおそらく美術に詳しくない人も多い → 美術に詳しくない人でもlikesを押したくなる作品とは? ・超有名 ・デカい ・鮮やか ・カラフル
・TextがSensitive (生死に関与,宗教画...etc.) ・同じGroupの作品との差分 例)フェルメールにしては赤い/デカい -
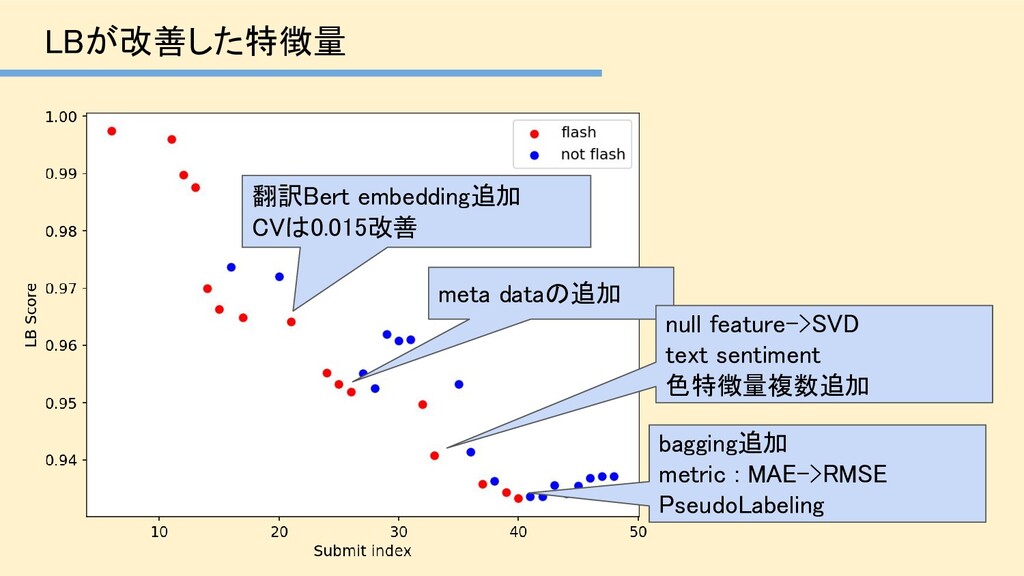
LBが改善した特徴量 翻訳Bert embedding追加 CVは0.015改善 bagging追加 metric : MAE->RMSE PseudoLabeling meta
dataの追加 null feature->SVD text sentiment 色特徴量複数追加 -
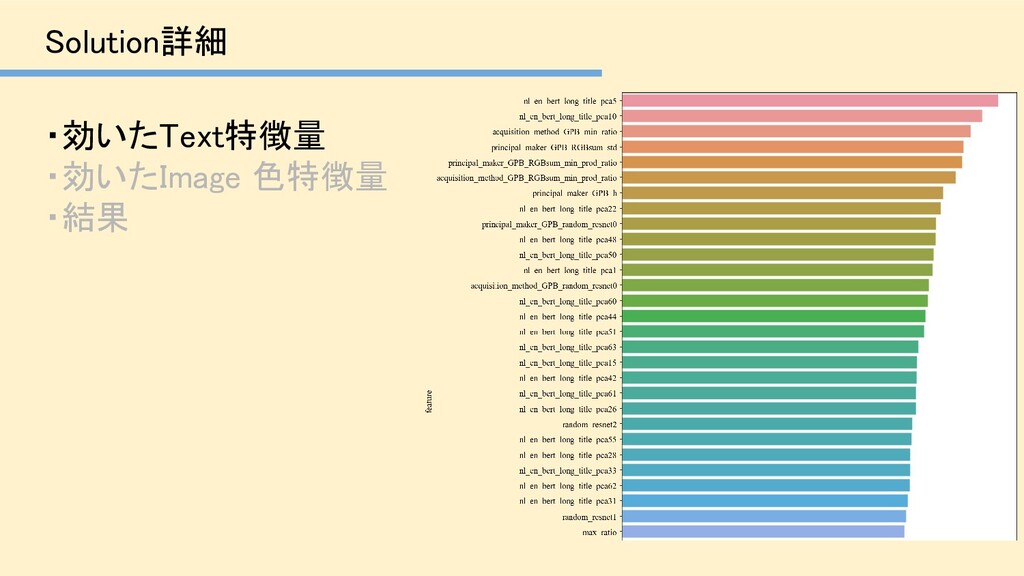
効いた特徴量 特徴量重要度Top ([Public 2nd/Private 2nd] LGBM single model solution)
・long_titleの翻訳後BERT embedding -> SVD ・long_titleの翻訳後 Sentiment Classification ・RGB値のsumのstd ・作品の大きさ (sub_title) ・paletteのratio統計量 ・NaNに関する特徴 -
複数言語を含んだTextカラムに対して事前学習済みBERTモデルから 文章の分散表現を得たい (<CLS> tokenのベクトル) [英] 'The Avenue of Birches, Jan
Hackaert, 1660 - 1685’ [蘭] 'Struik in bloei, Richard Tepe (attributed to), c. 1900 - c. 1930' 方法(3パターン) 1. 英に対して英のBERT, 蘭に対して蘭のBERT, ... 2. Multilingual BERT 3. 翻訳して言語を統一して統一先の言語でBERT 効いたText特徴量:翻訳 -
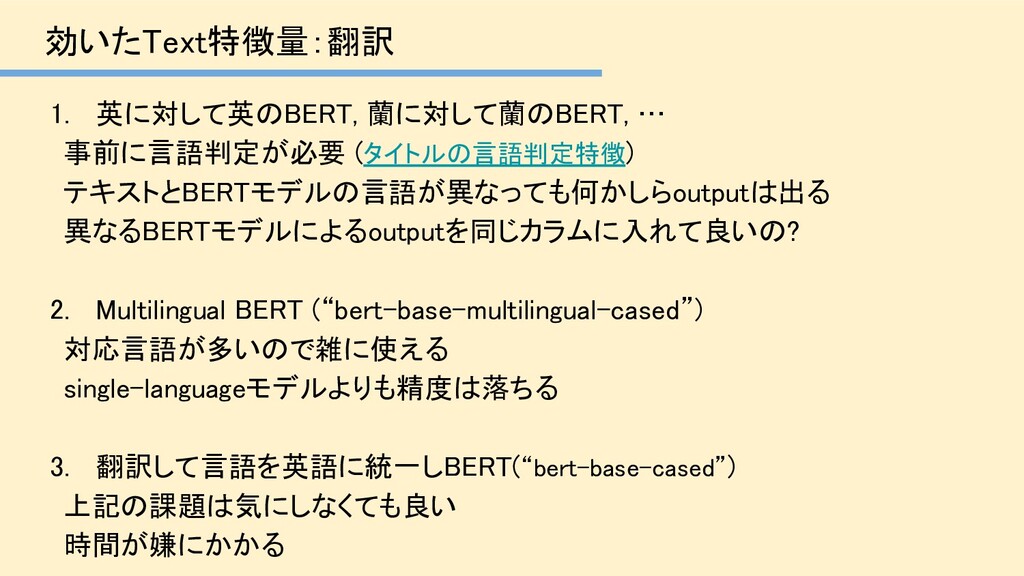
1. 英に対して英のBERT, 蘭に対して蘭のBERT, … 事前に言語判定が必要 (タイトルの言語判定特徴) テキストとBERTモデルの言語が異なっても何かしらoutputは出る 異なるBERTモデルによるoutputを同じカラムに入れて良いの? 2.
Multilingual BERT (“bert-base-multilingual-cased”) 対応言語が多いので雑に使える single-languageモデルよりも精度は落ちる 3. 翻訳して言語を英語に統一しBERT(“bert-base-cased”) 上記の課題は気にしなくても良い 時間が嫌にかかる 効いたText特徴量:翻訳 -
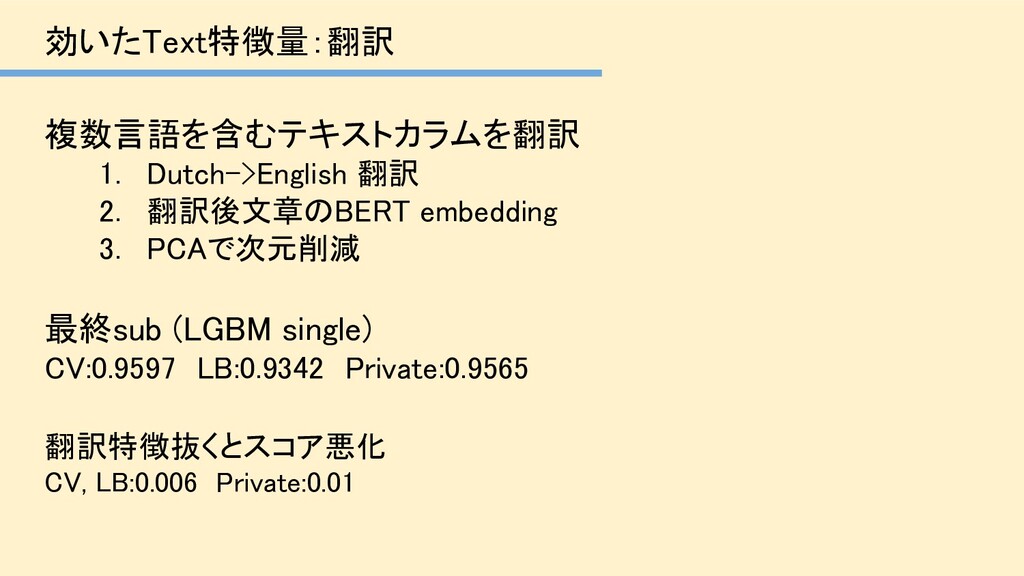
効いたText特徴量:翻訳 複数言語を含むテキストカラムを翻訳 1. Dutch->English 翻訳 2. 翻訳後文章のBERT embedding 3. PCAで次元削減
最終sub (LGBM single) CV:0.9597 LB:0.9342 Private:0.9565 翻訳特徴抜くとスコア悪化 CV, LB:0.006 Private:0.01 -
テキストの翻訳(蘭->英) Helsinki-NLP/opus-mt-nl-en · Hugging Face 例) long_titleの翻訳 [英]
'The Avenue of Birches, Jan Hackaert, 1660 - 1685’ ->[英] ’The Avenue of Birches, Jan Hackaert, 1660 - 1685’ [蘭] 'Struik in bloei, Richard Tepe (attributed to), c. 1900 - c. 1930' -> [英] ’Strike in bloom, Richard Tepe (attributed to), c. 1900 - c. 1930’ 英語を入力しても英語をそのまま返してくれるので雑に使える 効いたText特徴量:翻訳 -
テキストの翻訳はDataAugumentation目的で用いられることが多い [Toxic Comment Classification Challenge] A simple technique for extending
dataset 例) ・EN->FR->EN ・EN->DE->EN [英] 'The Avenue of Birches, Jan Hackaert, 1660 - 1685’ ->[仏] ’L'Avenue des Bouleaux, Jan Hackaert, 1660-1685 ’ ->[英] ‘Avenue des Bouleaux, Jan Hackaert, 1660-1685’ (ここではGoogle翻訳を使用) 効いたText特徴量:翻訳 (余談) -
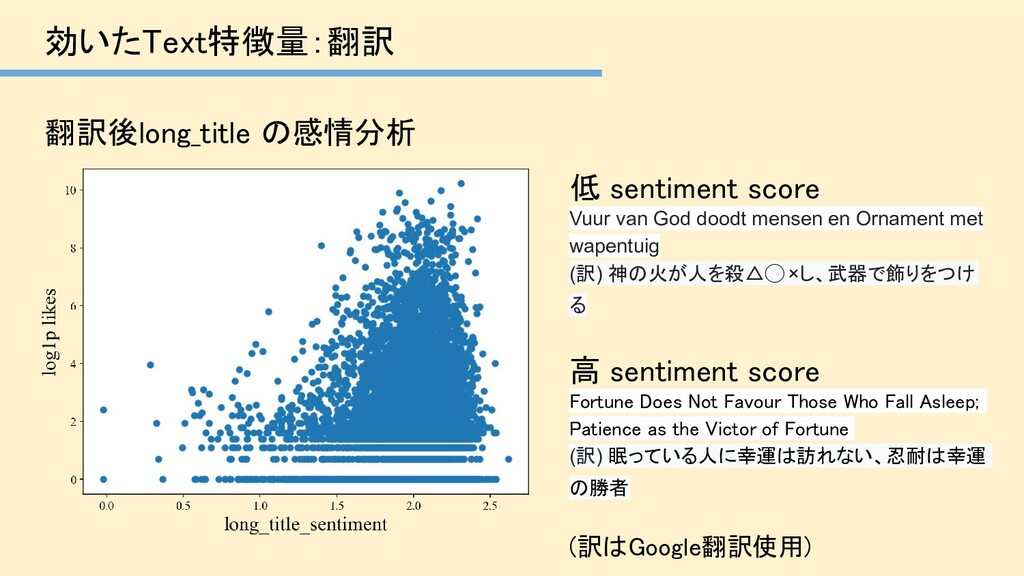
効いたText特徴量:翻訳 翻訳後long_title の感情分析 低 sentiment score Vuur van God doodt
mensen en Ornament met wapentuig (訳) 神の火が人を殺△◯ ×し、武器で飾りをつけ る 高 sentiment score Fortune Does Not Favour Those Who Fall Asleep; Patience as the Victor of Fortune (訳) 眠っている人に幸運は訪れない、忍耐は幸運 の勝者 (訳はGoogle翻訳使用) -
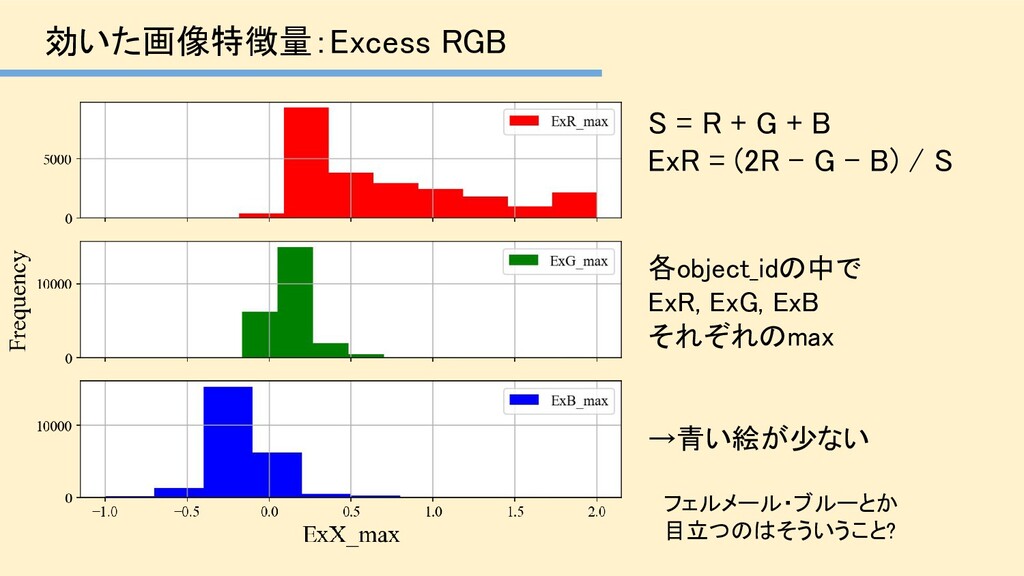
効いた画像特徴量:Excess RGB S = R + G + B ExR
= (2R - G - B) / S 各object_idの中で ExR, ExG, ExB それぞれのmax →青い絵が少ない フェルメール・ブルーとか 目立つのはそういうこと? -
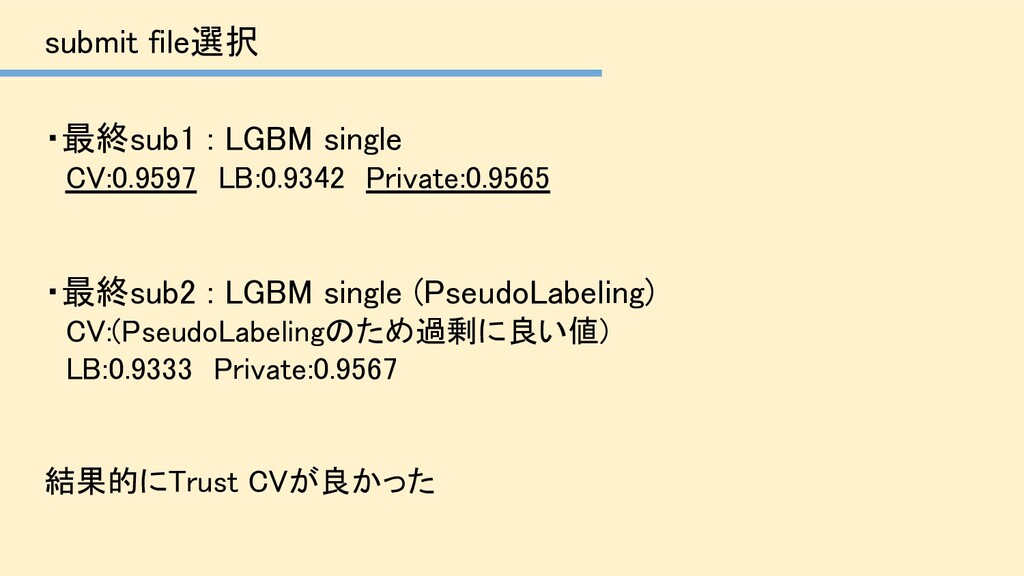
submit file選択 ・最終sub1 : LGBM single CV:0.9597 LB:0.9342 Private:0.9565 ・最終sub2
: LGBM single (PseudoLabeling) CV:(PseudoLabelingのため過剰に良い値) LB:0.9333 Private:0.9567 結果的にTrust CVが良かった