Share
Embed
Datadogで始める オブザーバビリティ入門
Uechi Shingo
November 20, 2026
Transcript
22 slides
-
自己紹介 上地 申吾 • • • • 2005/4 – 2022/2
メインフレーム運用監視 / 運用保守 2022/3 – 2023/5 クラウド テクニカルサポート職 2023/6 – 2025/9 クラウドソリューションアーキテクト 2025/10 - 現在 • 2023 - 2025 • 2025 - 2026 Datadog / Wiz 導入・運用支援、SRE 支援 Japan All AWS Certifications Engineers AWS Community Builders (AI Engineering) • JAWS-UG (AWS ユーザーグループ)沖縄支部運営 • JDDUG (Datadog ユーザーグループ)運営 -
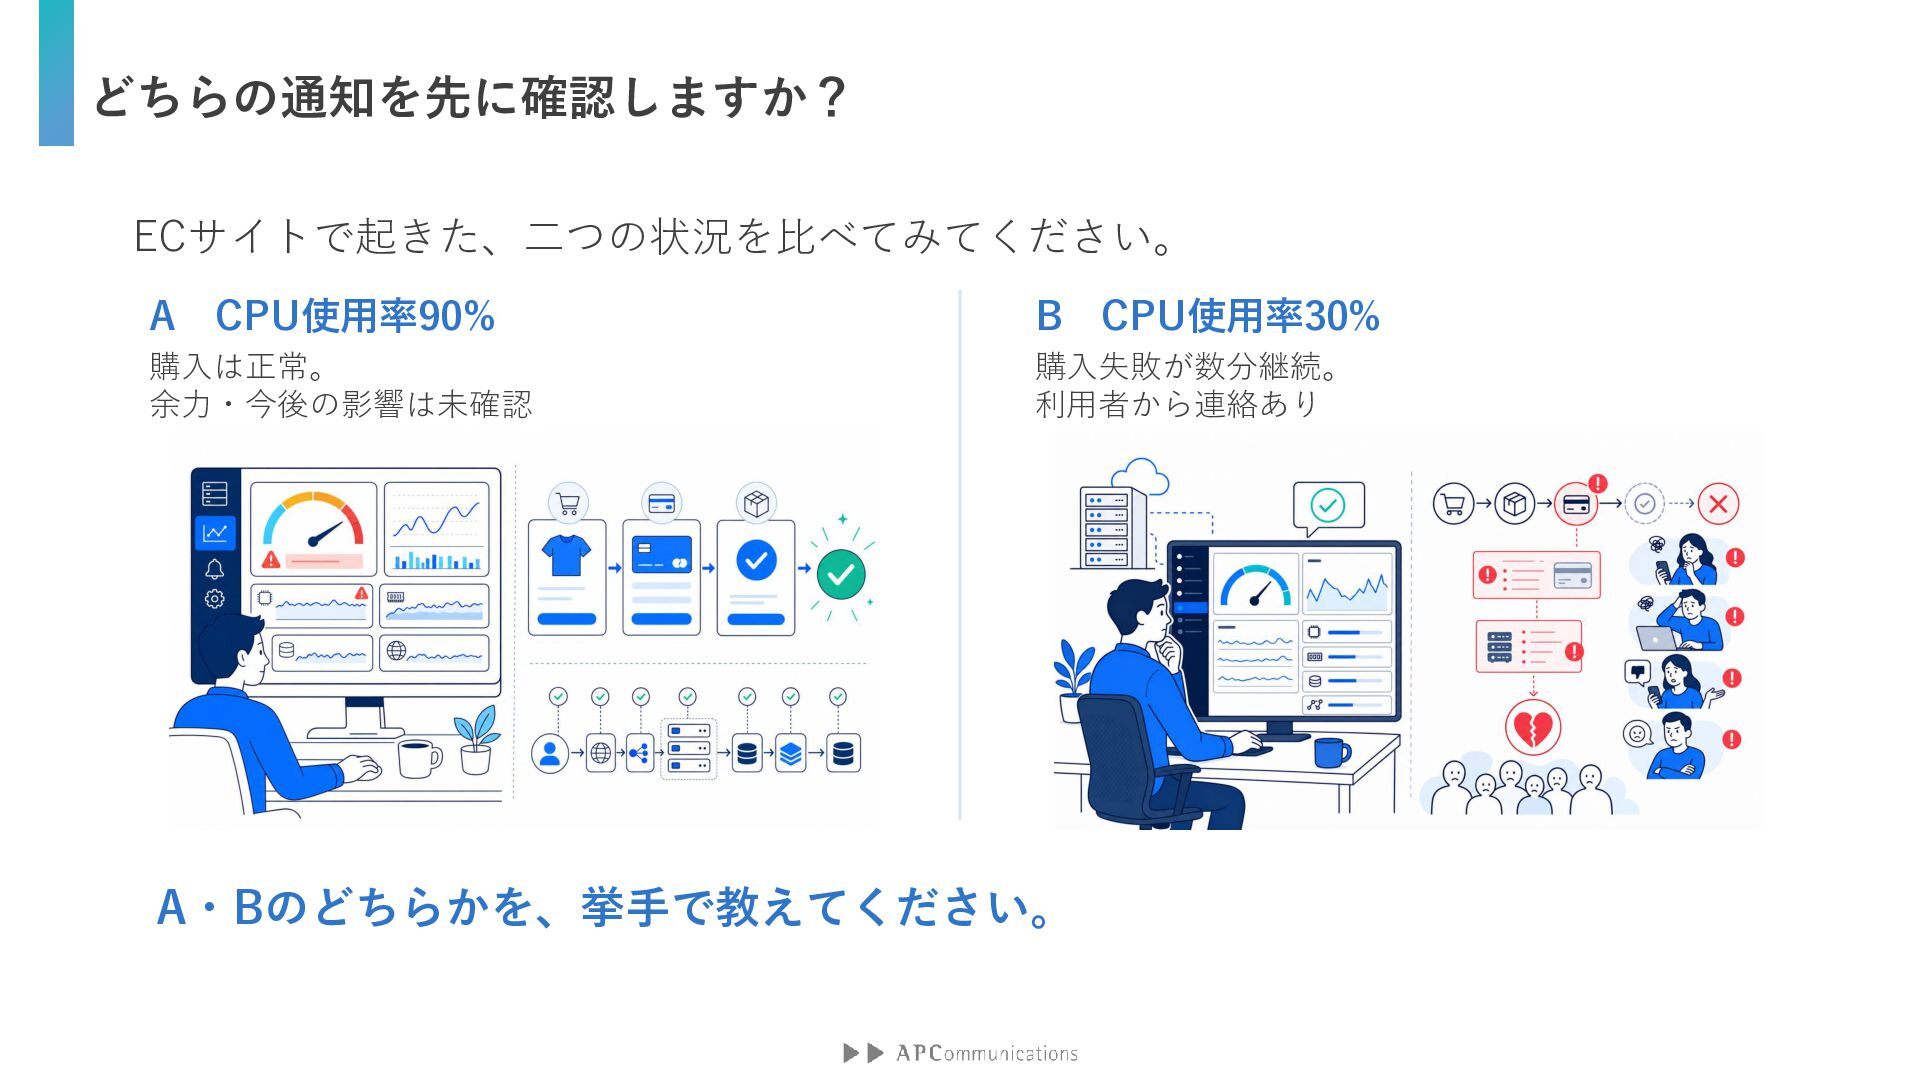
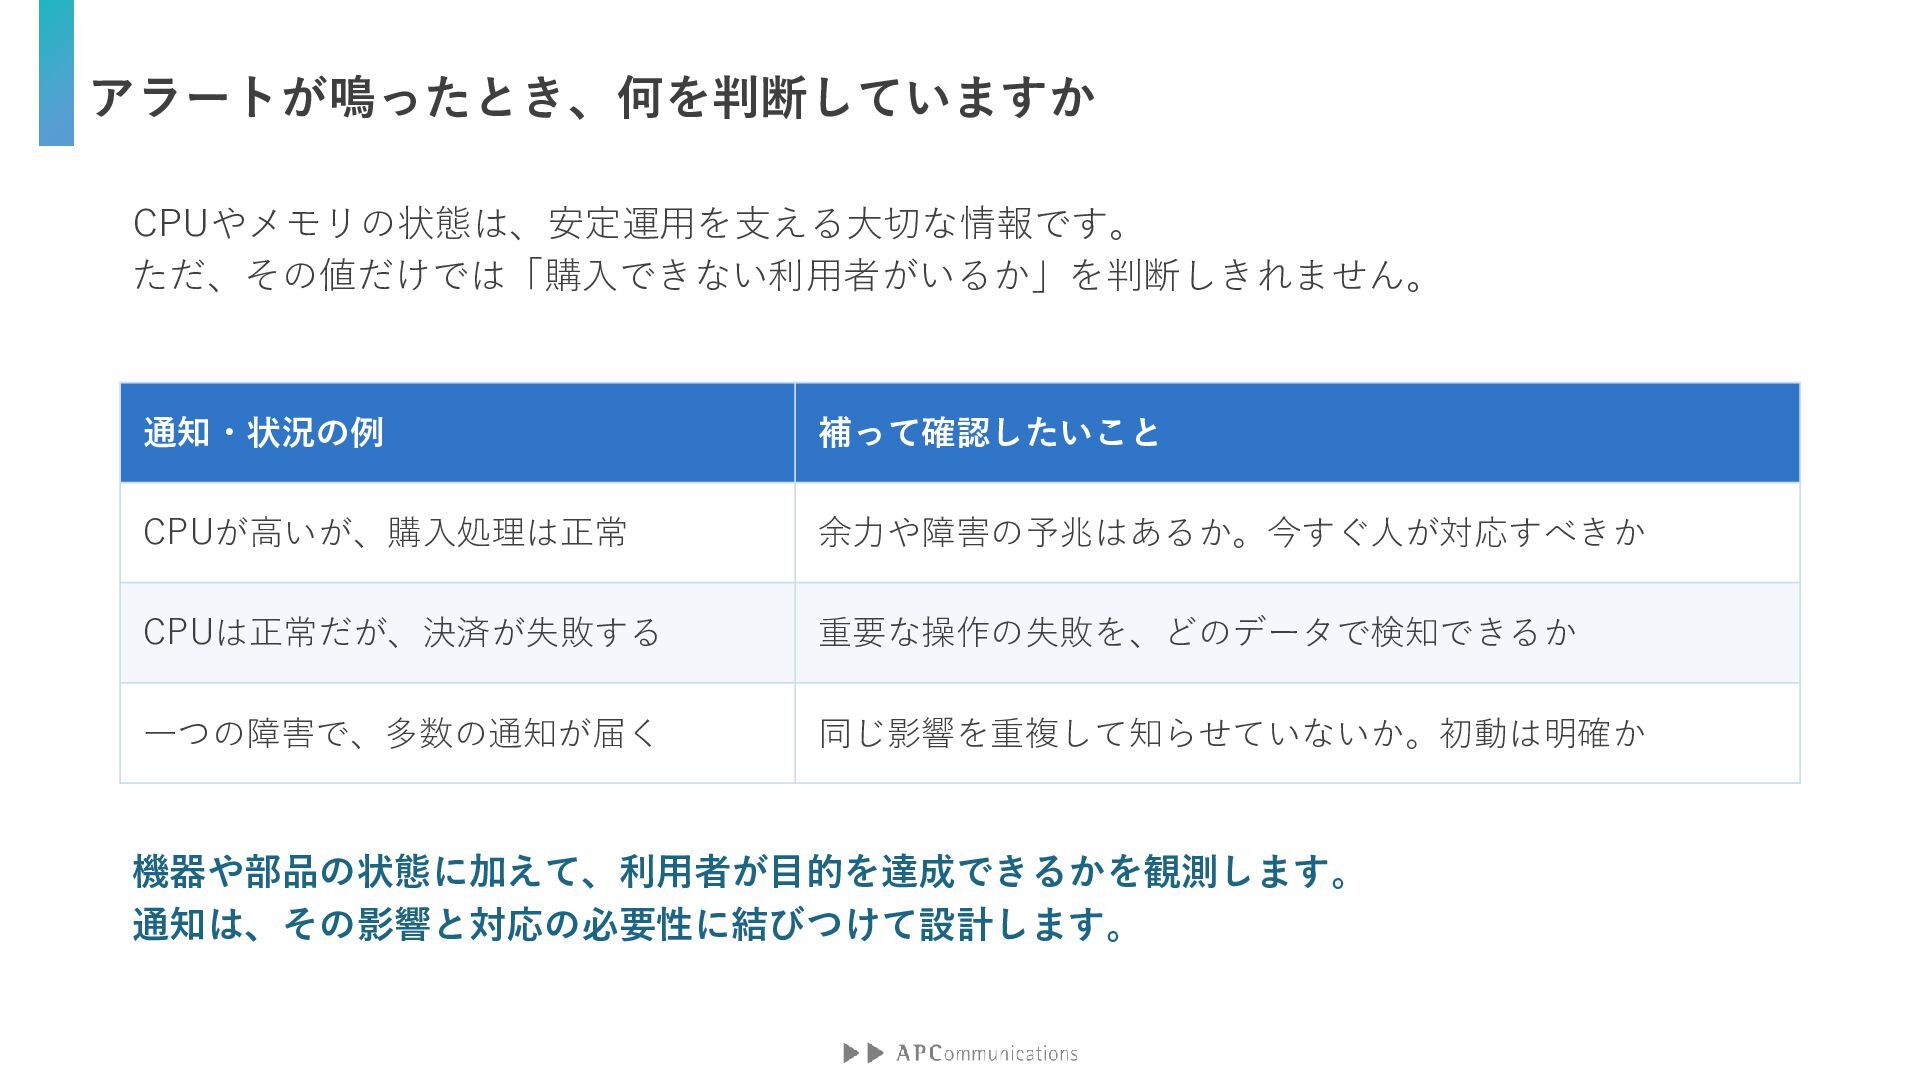
アラートが鳴ったとき、何を判断していますか CPUやメモリの状態は、安定運用を支える大切な情報です。 ただ、その値だけでは「購入できない利用者がいるか」を判断しきれません。 通知・状況の例 補って確認したいこと CPUが高いが、購入処理は正常 余力や障害の予兆はあるか。今すぐ人が対応すべきか CPUは正常だが、決済が失敗する 重要な操作の失敗を、どのデータで検知できるか 一つの障害で、多数の通知が届く
同じ影響を重複して知らせていないか。初動は明確か 機器や部品の状態に加えて、利用者が目的を達成できるかを観測します。 通知は、その影響と対応の必要性に結びつけて設計します。 -
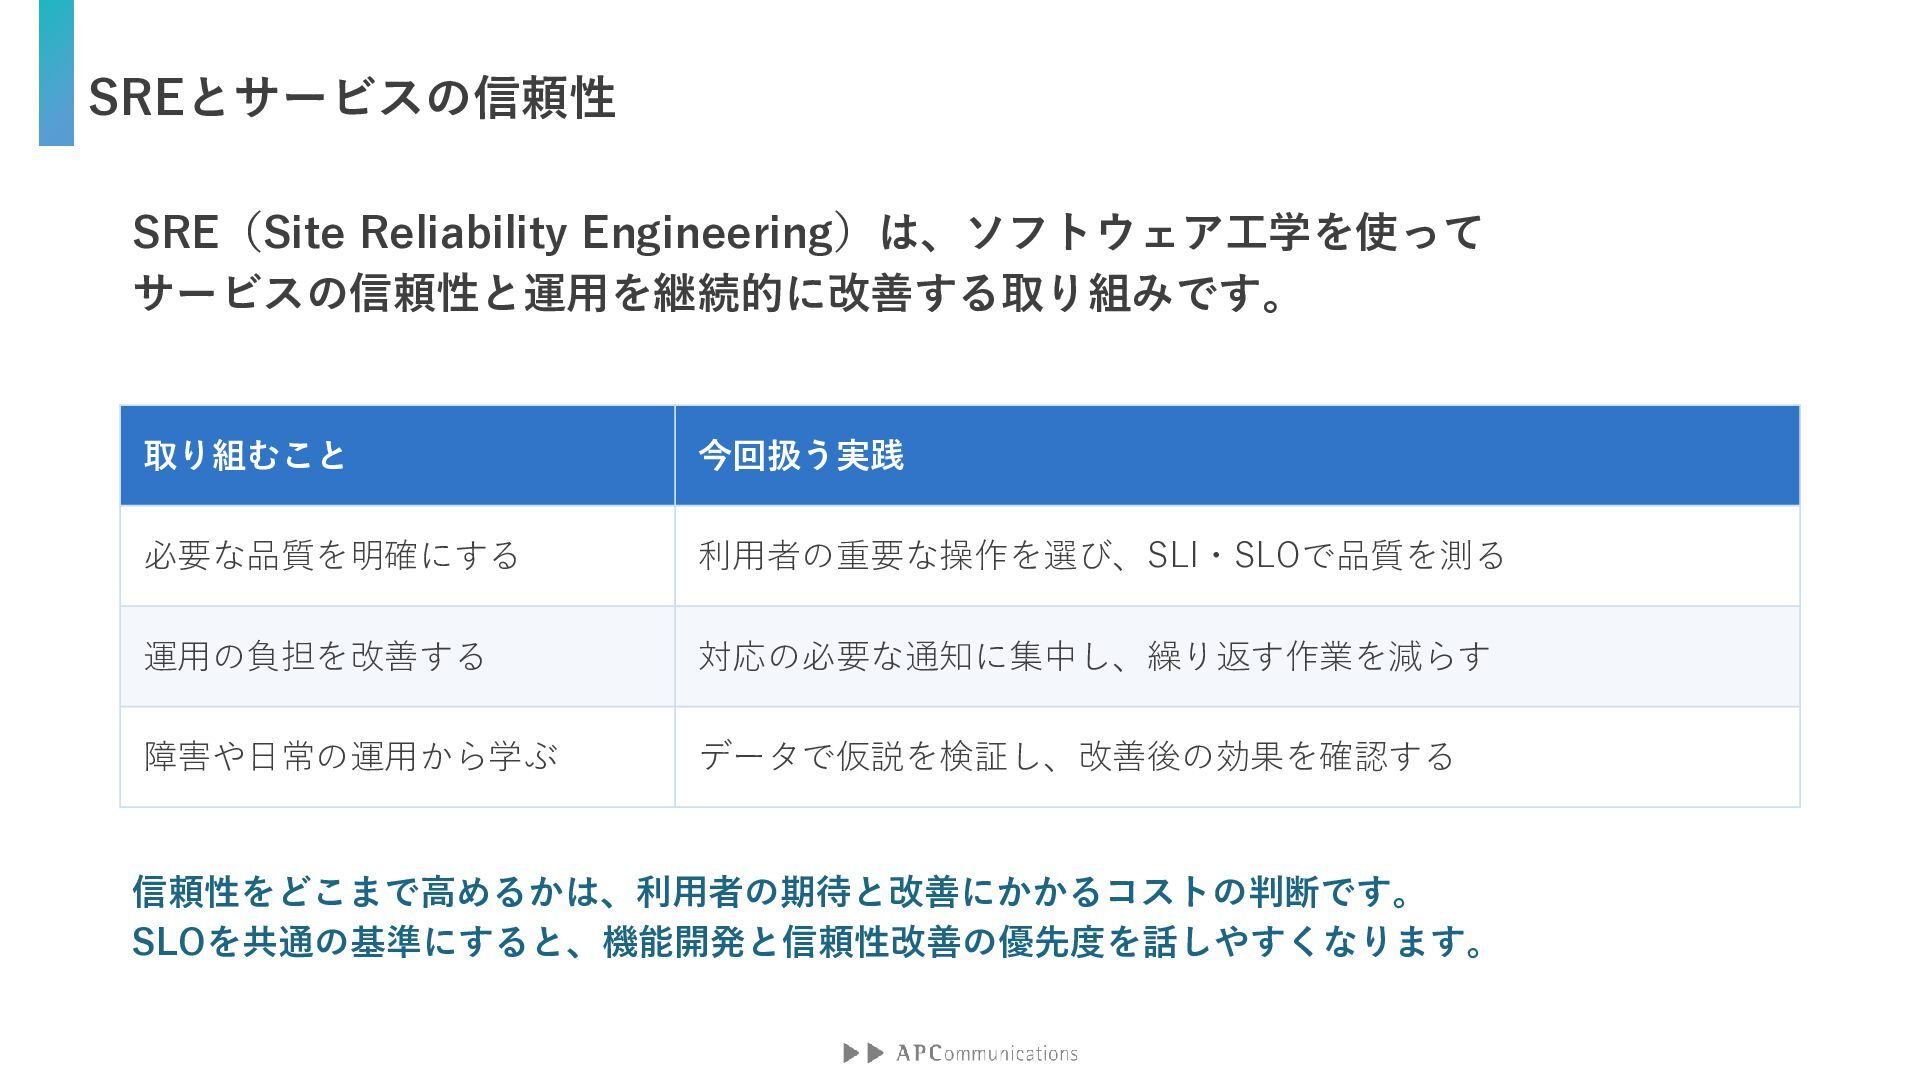
SREとサービスの信頼性 SRE(Site Reliability Engineering)は、ソフトウェア工学を使って サービスの信頼性と運用を継続的に改善する取り組みです。 取り組むこと 今回扱う実践 必要な品質を明確にする 利用者の重要な操作を選び、SLI・SLOで品質を測る 運用の負担を改善する
対応の必要な通知に集中し、繰り返す作業を減らす 障害や日常の運用から学ぶ データで仮説を検証し、改善後の効果を確認する 信頼性をどこまで高めるかは、利用者の期待と改善にかかるコストの判断です。 SLOを共通の基準にすると、機能開発と信頼性改善の優先度を話しやすくなります。 -
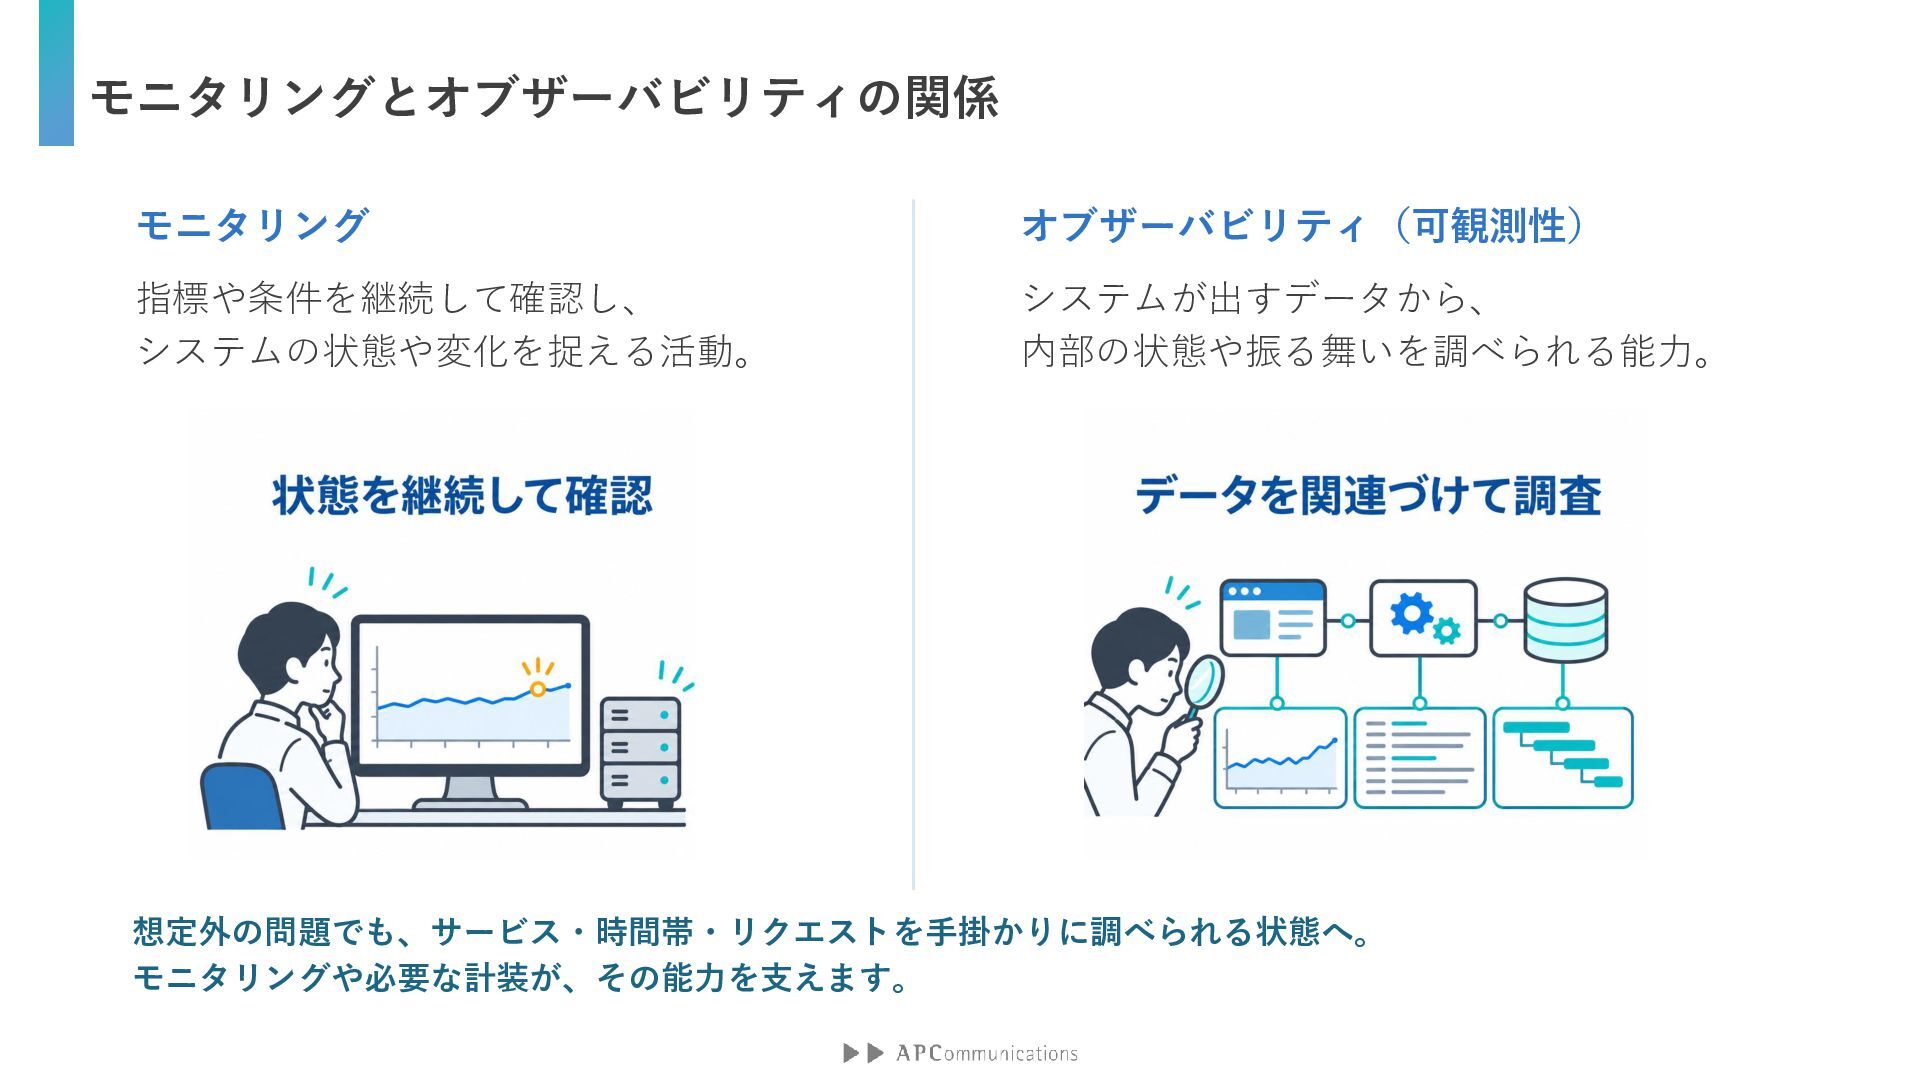
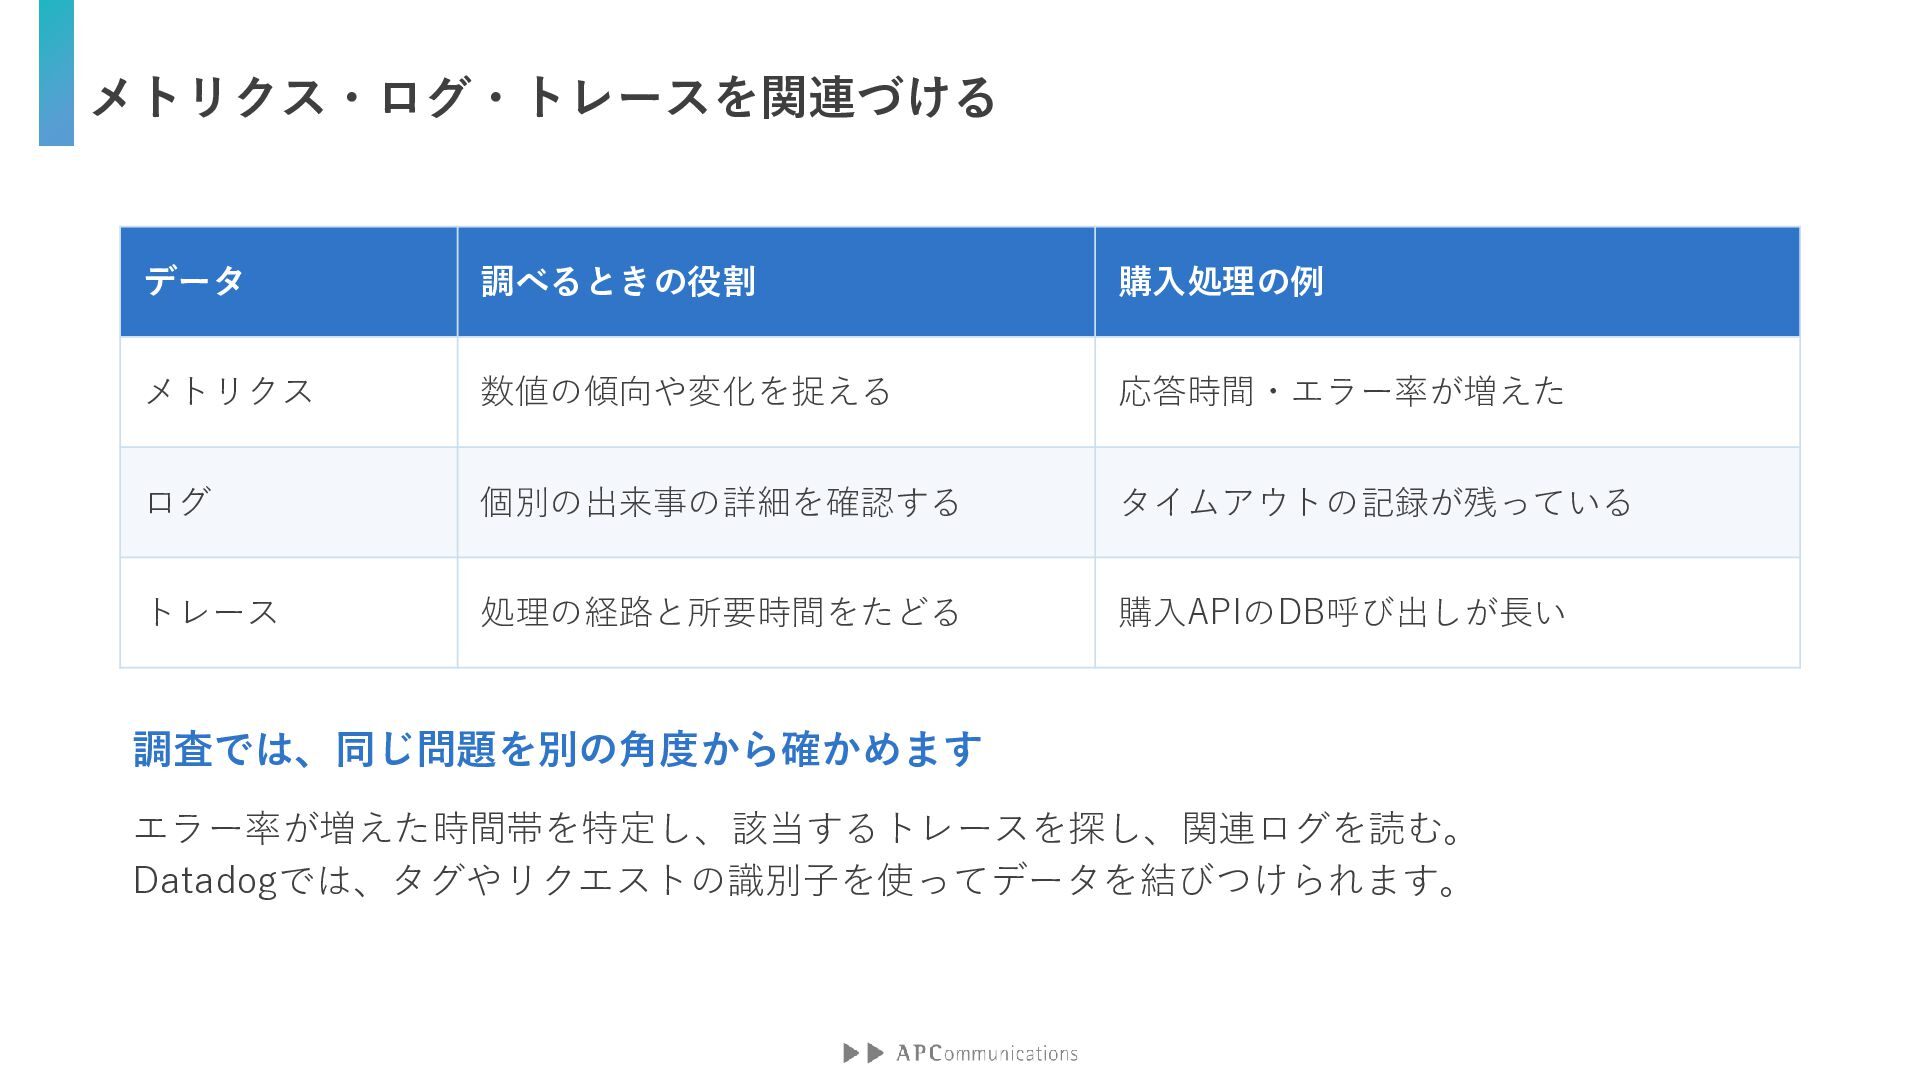
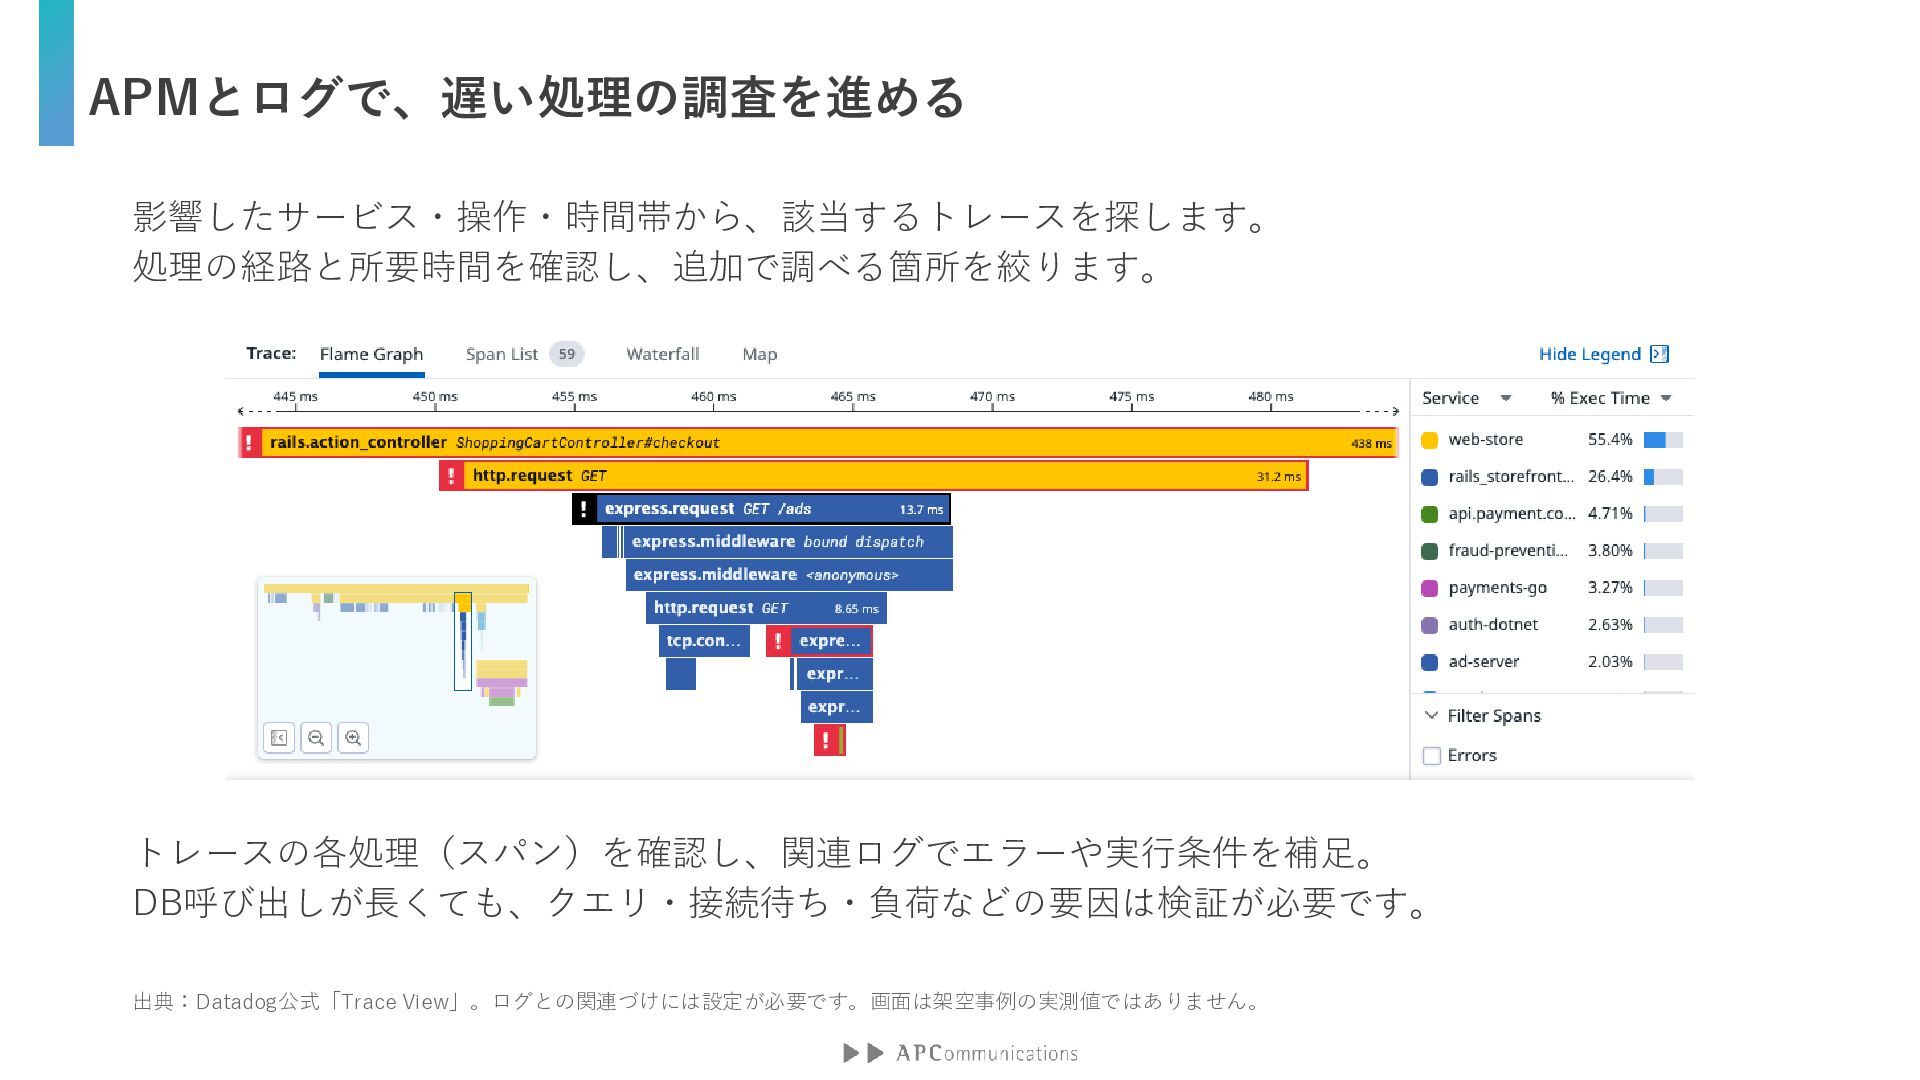
メトリクス・ログ・トレースを関連づける データ 調べるときの役割 購入処理の例 メトリクス 数値の傾向や変化を捉える 応答時間・エラー率が増えた ログ 個別の出来事の詳細を確認する タイムアウトの記録が残っている
トレース 処理の経路と所要時間をたどる 購入APIのDB呼び出しが長い 調査では、同じ問題を別の角度から確かめます エラー率が増えた時間帯を特定し、該当するトレースを探し、関連ログを読む。 Datadogでは、タグやリクエストの識別子を使ってデータを結びつけられます。 -
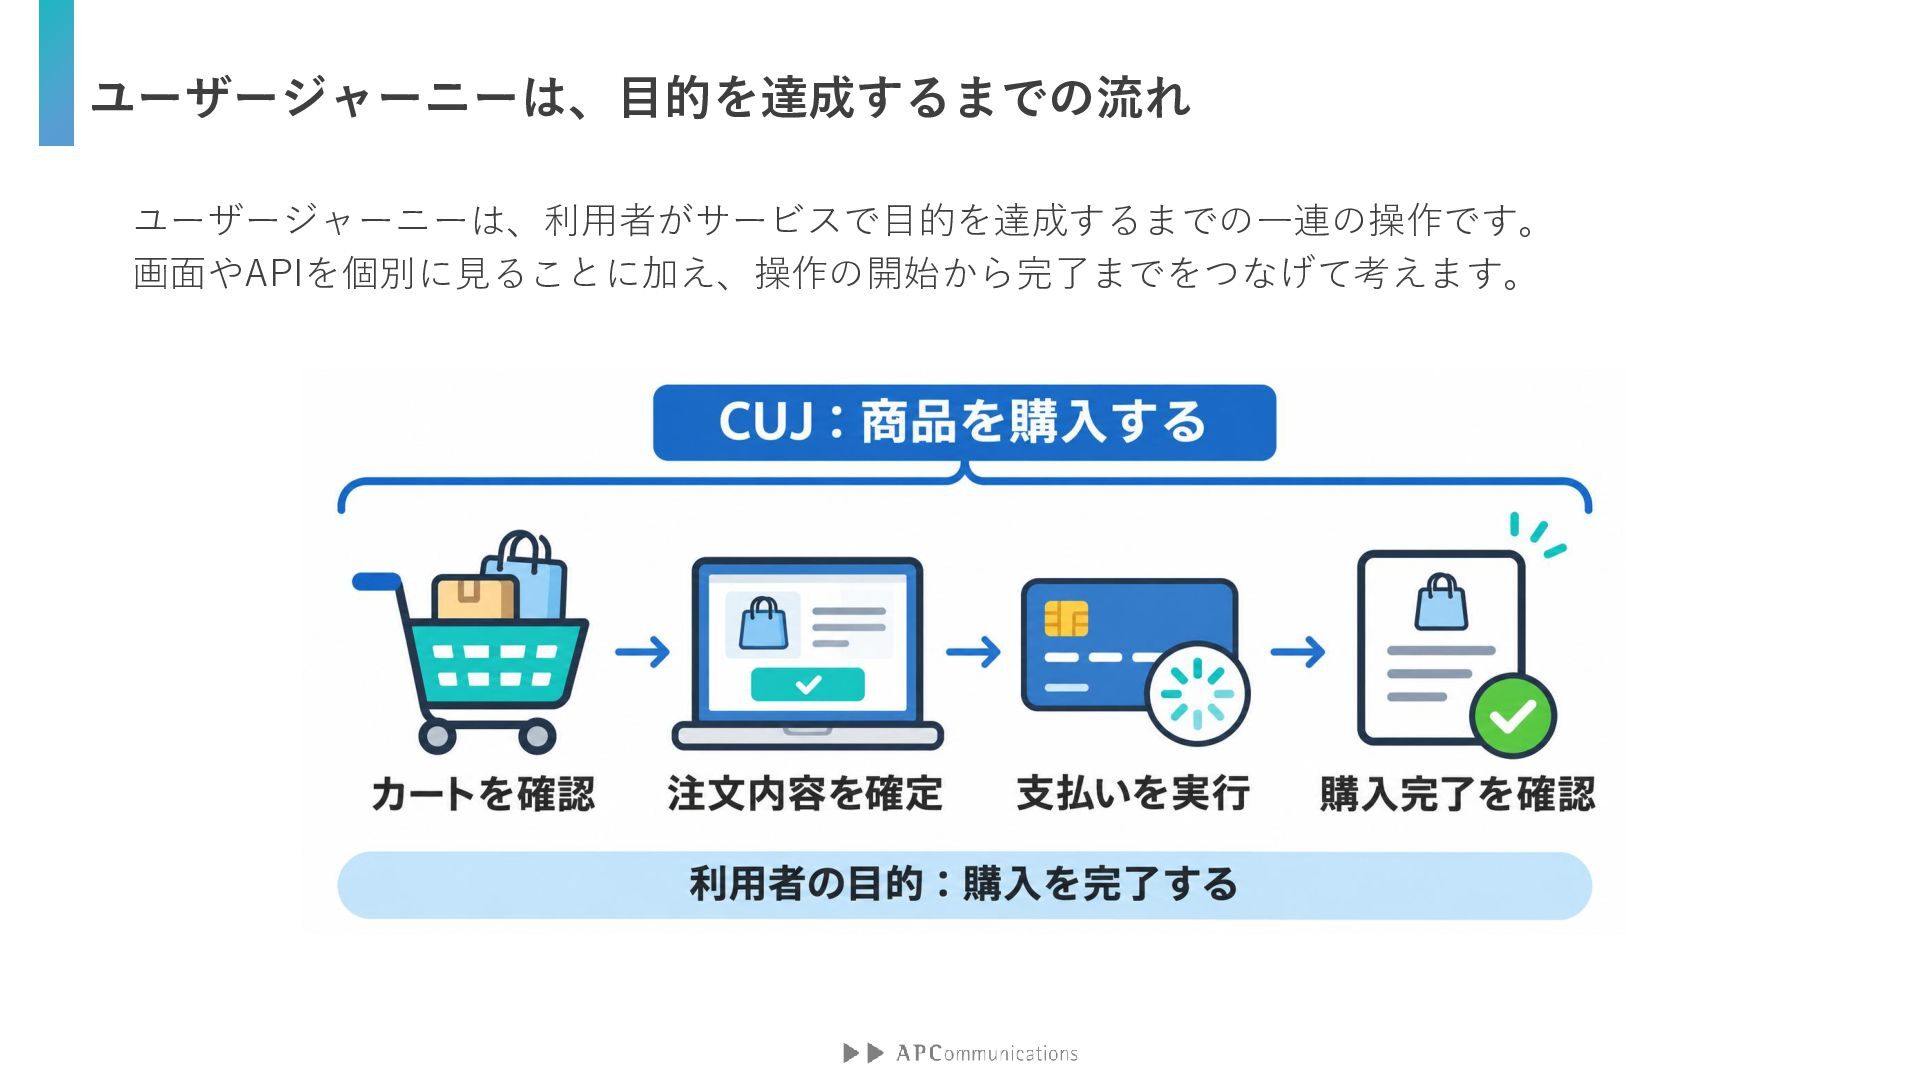
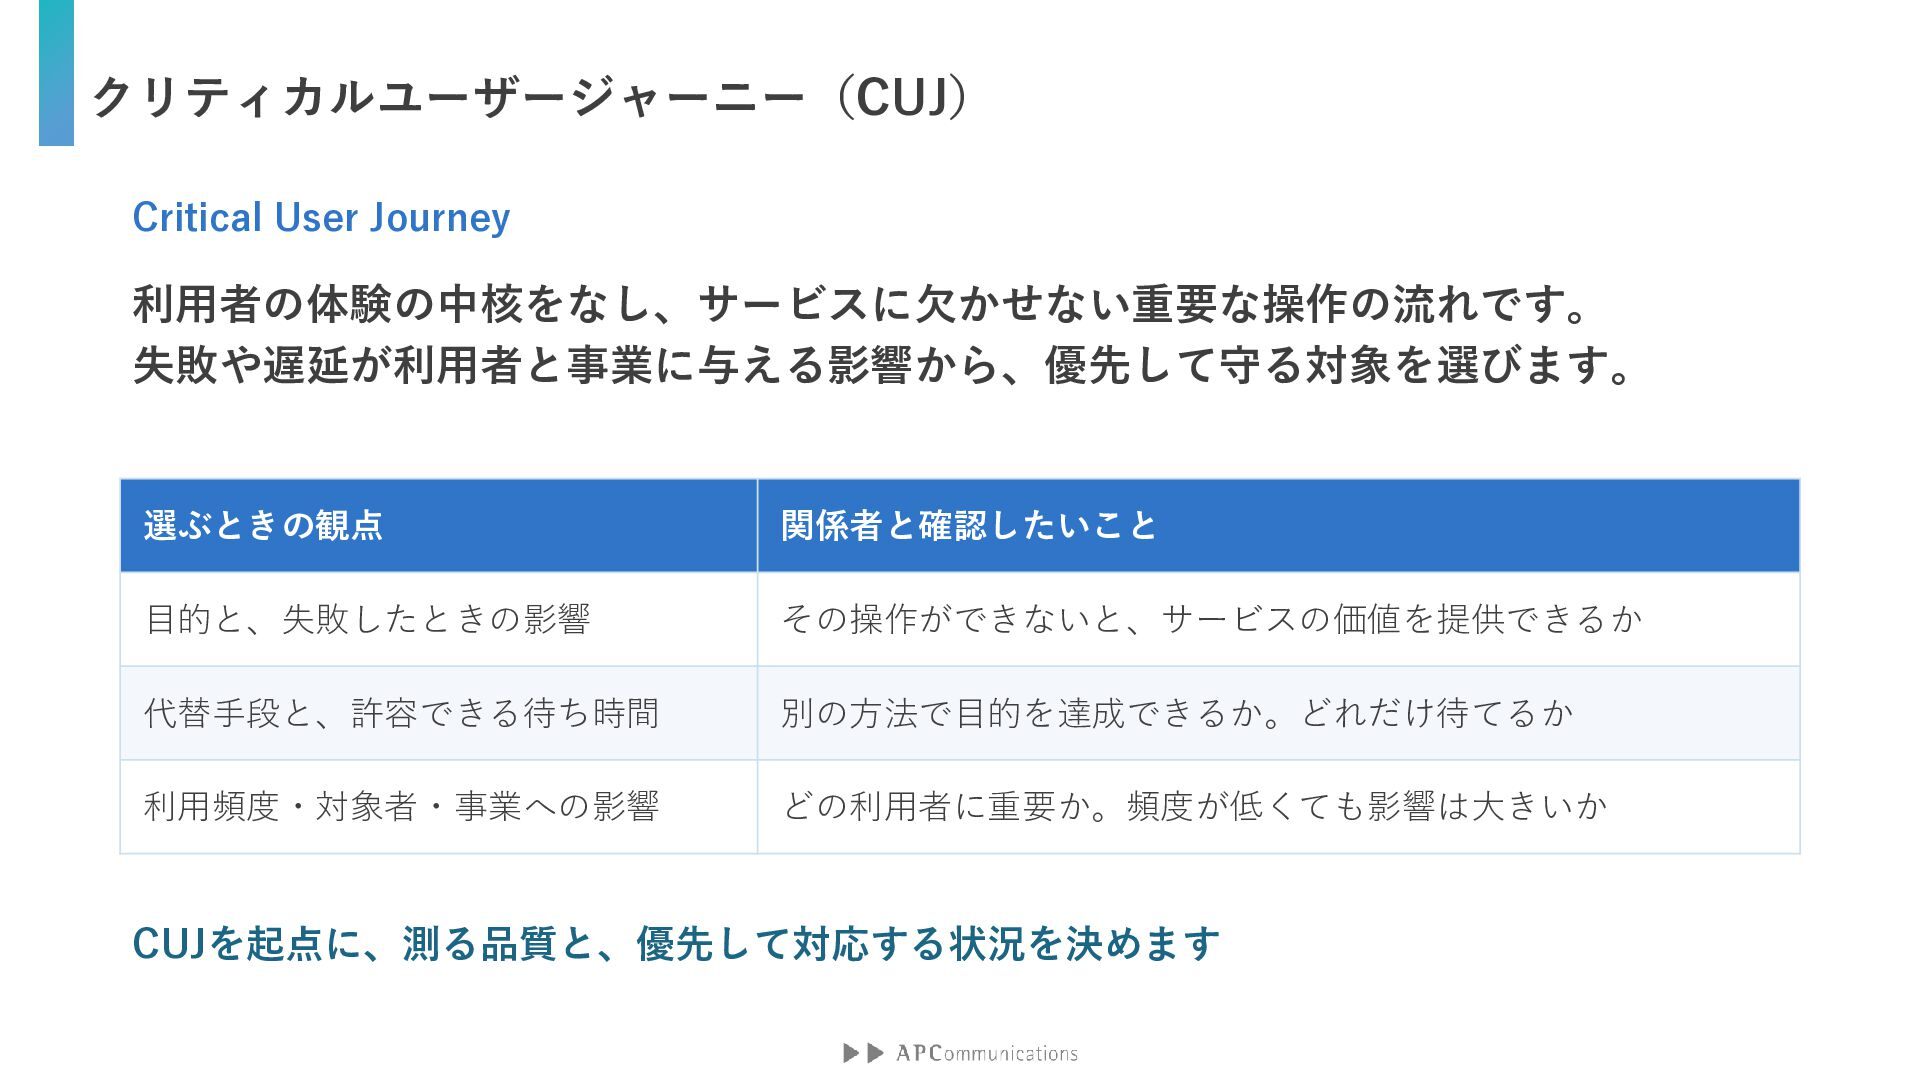
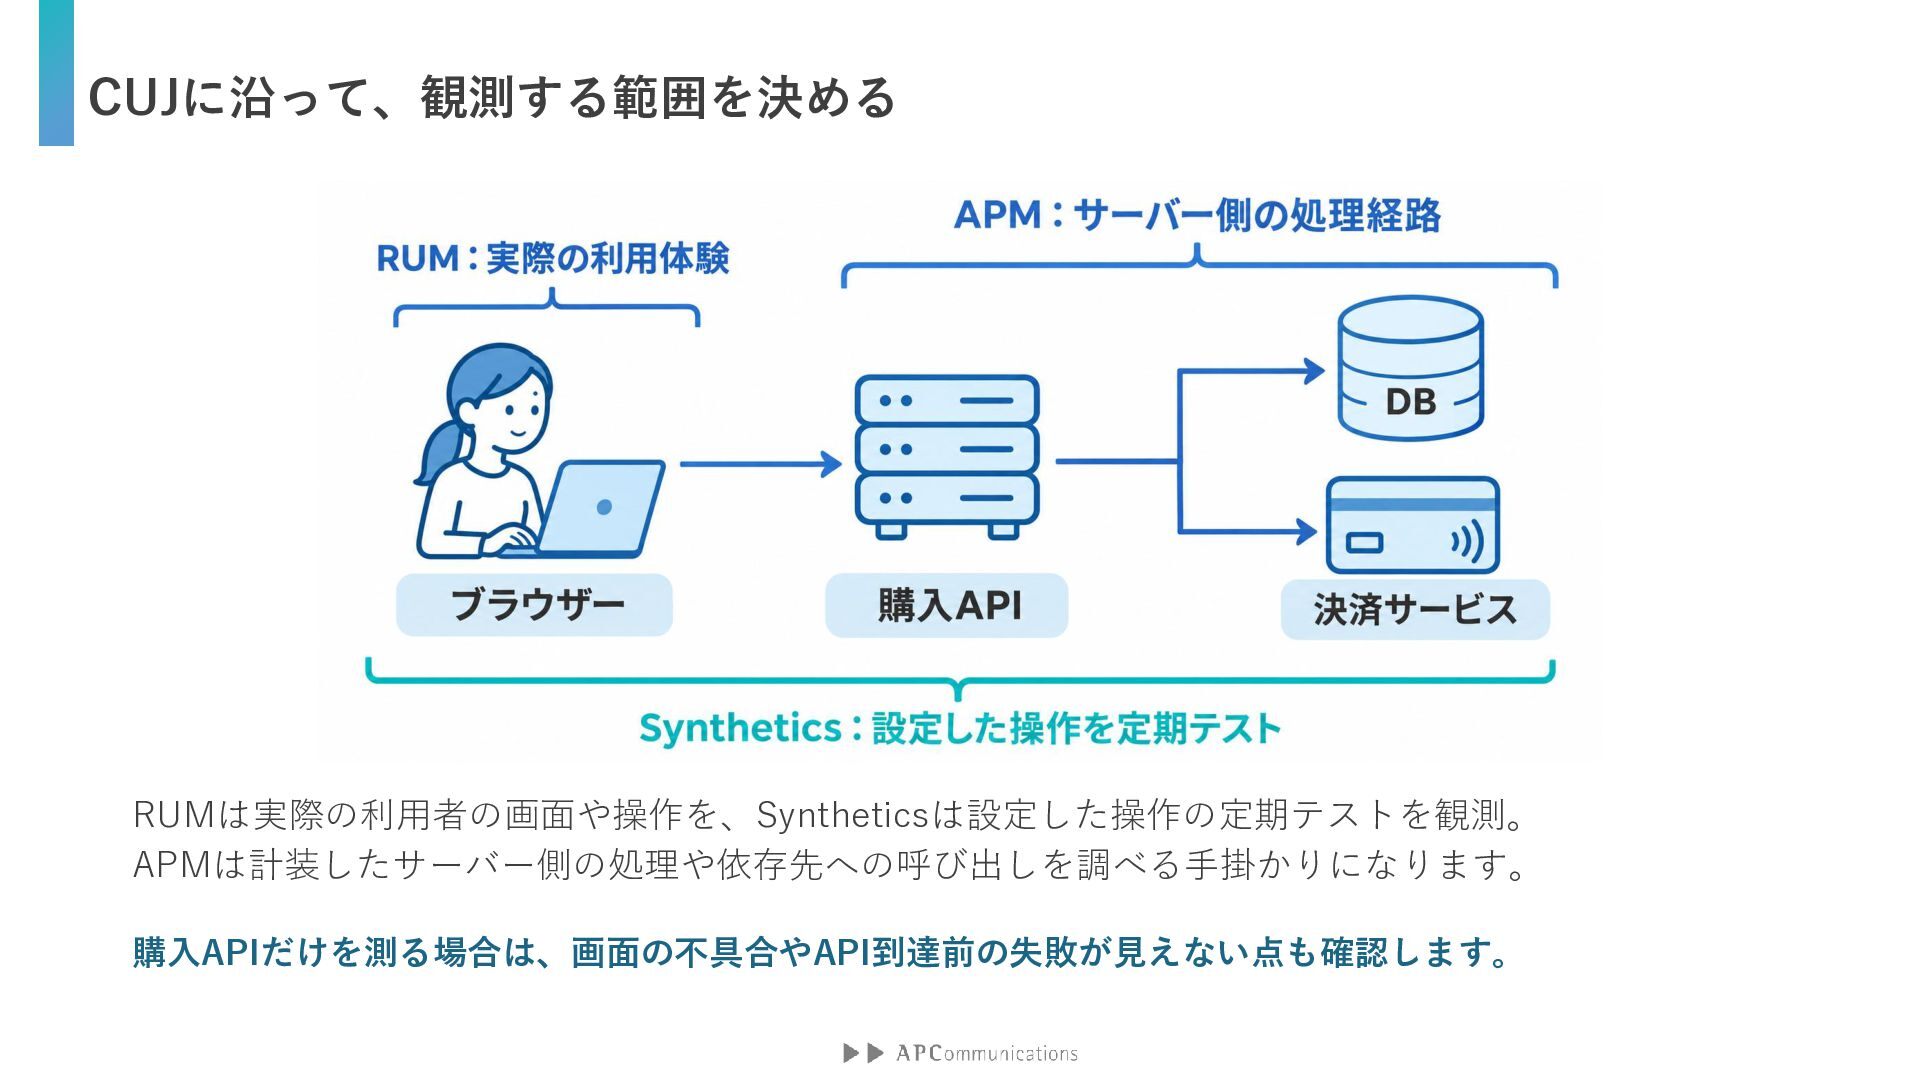
クリティカルユーザージャーニー(CUJ) Critical User Journey 利用者の体験の中核をなし、サービスに欠かせない重要な操作の流れです。 失敗や遅延が利用者と事業に与える影響から、優先して守る対象を選びます。 選ぶときの観点 関係者と確認したいこと 目的と、失敗したときの影響 その操作ができないと、サービスの価値を提供できるか
代替手段と、許容できる待ち時間 別の方法で目的を達成できるか。どれだけ待てるか 利用頻度・対象者・事業への影響 どの利用者に重要か。頻度が低くても影響は大きいか CUJを起点に、測る品質と、優先して対応する状況を決めます -
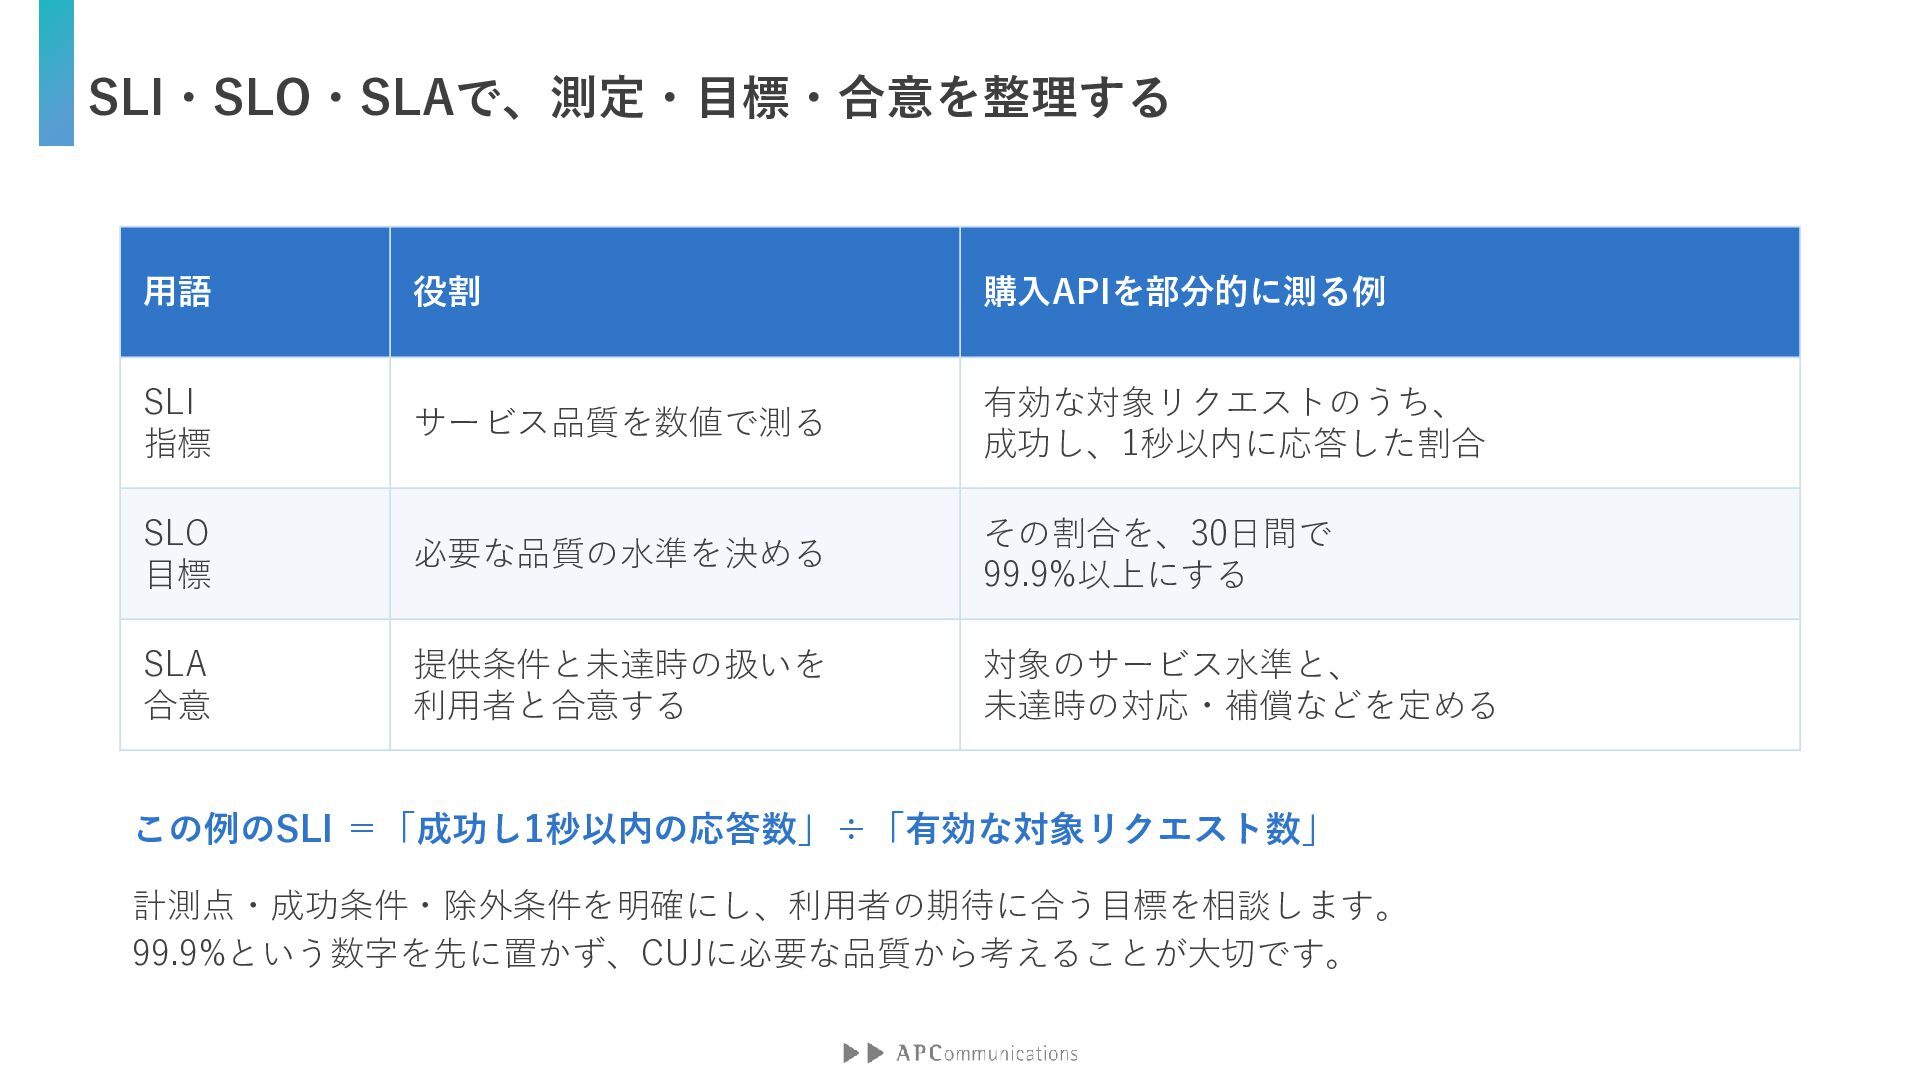
SLI・SLO・SLAで、測定・目標・合意を整理する 用語 役割 購入APIを部分的に測る例 SLI 指標 サービス品質を数値で測る 有効な対象リクエストのうち、 成功し、1秒以内に応答した割合 SLO
目標 必要な品質の水準を決める その割合を、30日間で 99.9%以上にする SLA 合意 提供条件と未達時の扱いを 利用者と合意する 対象のサービス水準と、 未達時の対応・補償などを定める この例のSLI =「成功し1秒以内の応答数」÷「有効な対象リクエスト数」 計測点・成功条件・除外条件を明確にし、利用者の期待に合う目標を相談します。 99.9%という数字を先に置かず、CUJに必要な品質から考えることが大切です。 -
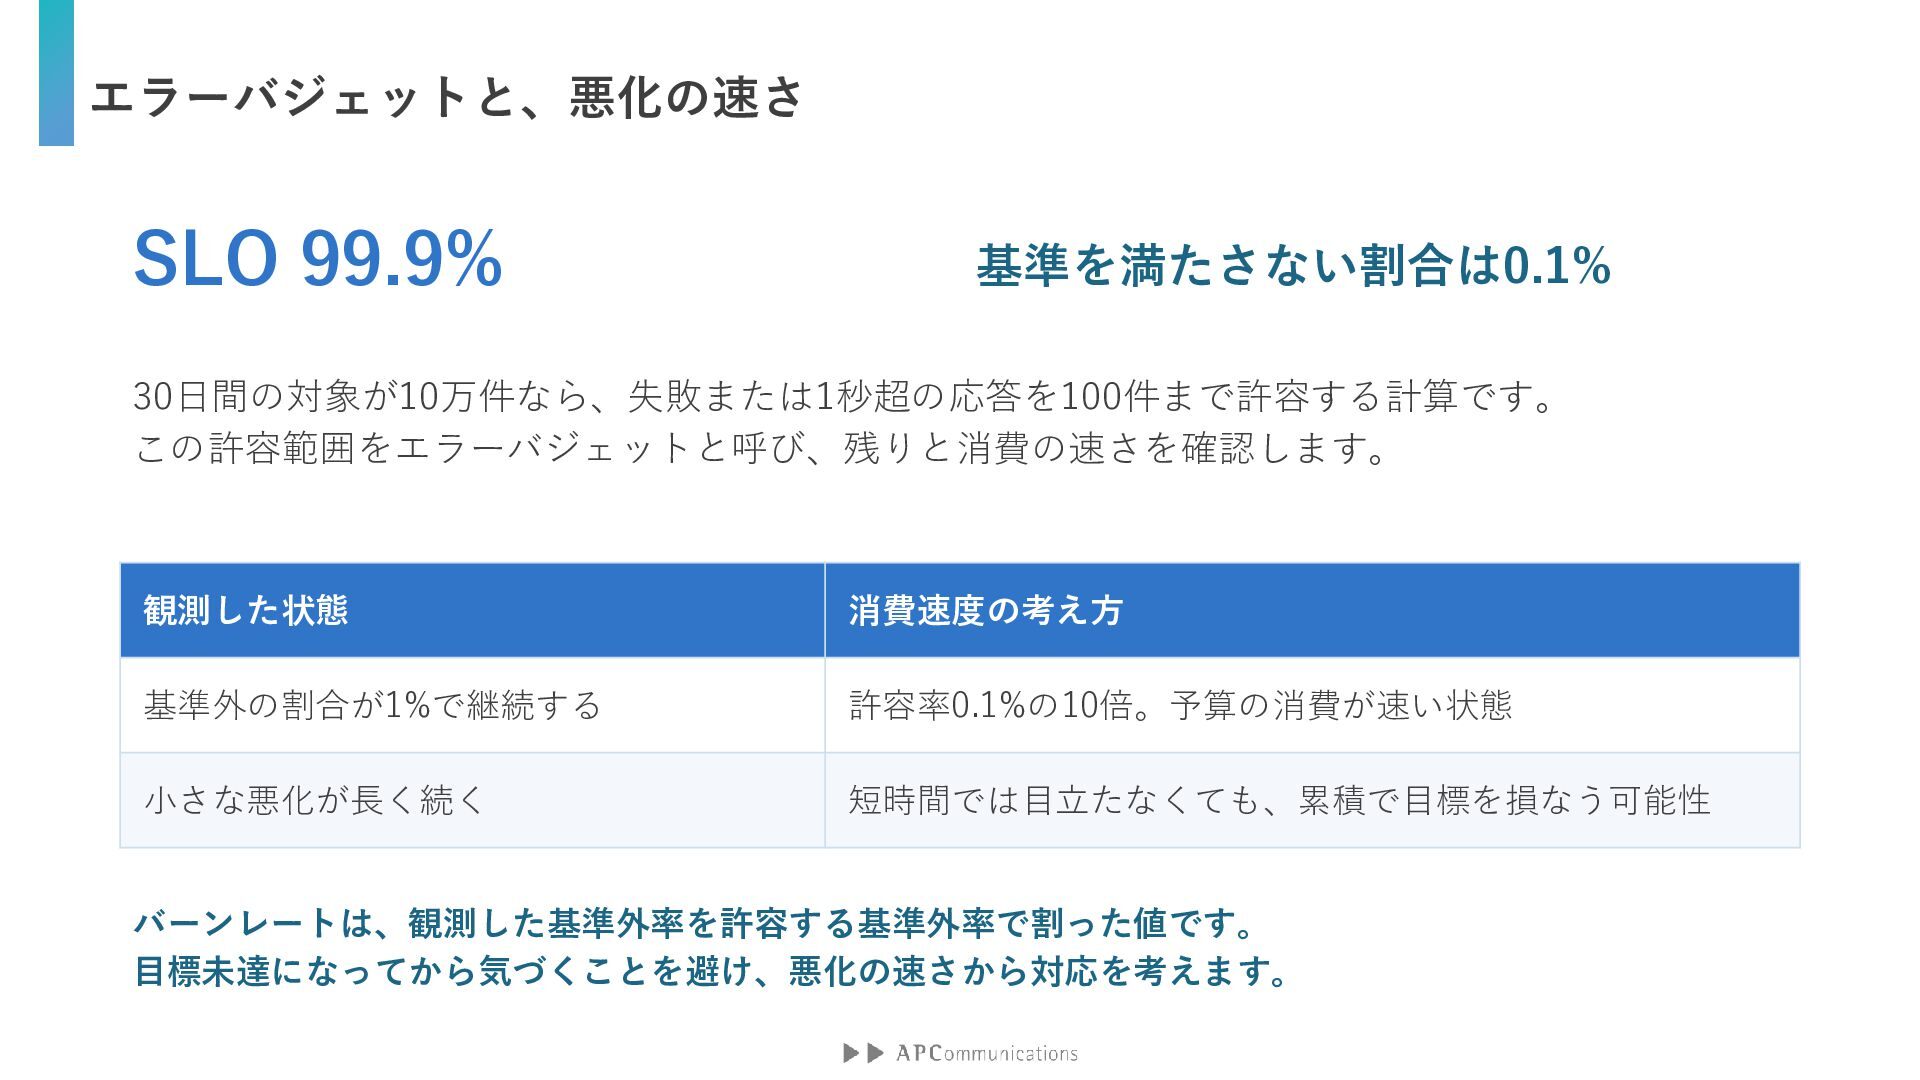
エラーバジェットと、悪化の速さ SLO 99.9% 基準を満たさない割合は0.1% 30日間の対象が10万件なら、失敗または1秒超の応答を100件まで許容する計算です。 この許容範囲をエラーバジェットと呼び、残りと消費の速さを確認します。 観測した状態 消費速度の考え方 基準外の割合が1%で継続する 許容率0.1%の10倍。予算の消費が速い状態
小さな悪化が長く続く 短時間では目立たなくても、累積で目標を損なう可能性 バーンレートは、観測した基準外率を許容する基準外率で割った値です。 目標未達になってから気づくことを避け、悪化の速さから対応を考えます。 -
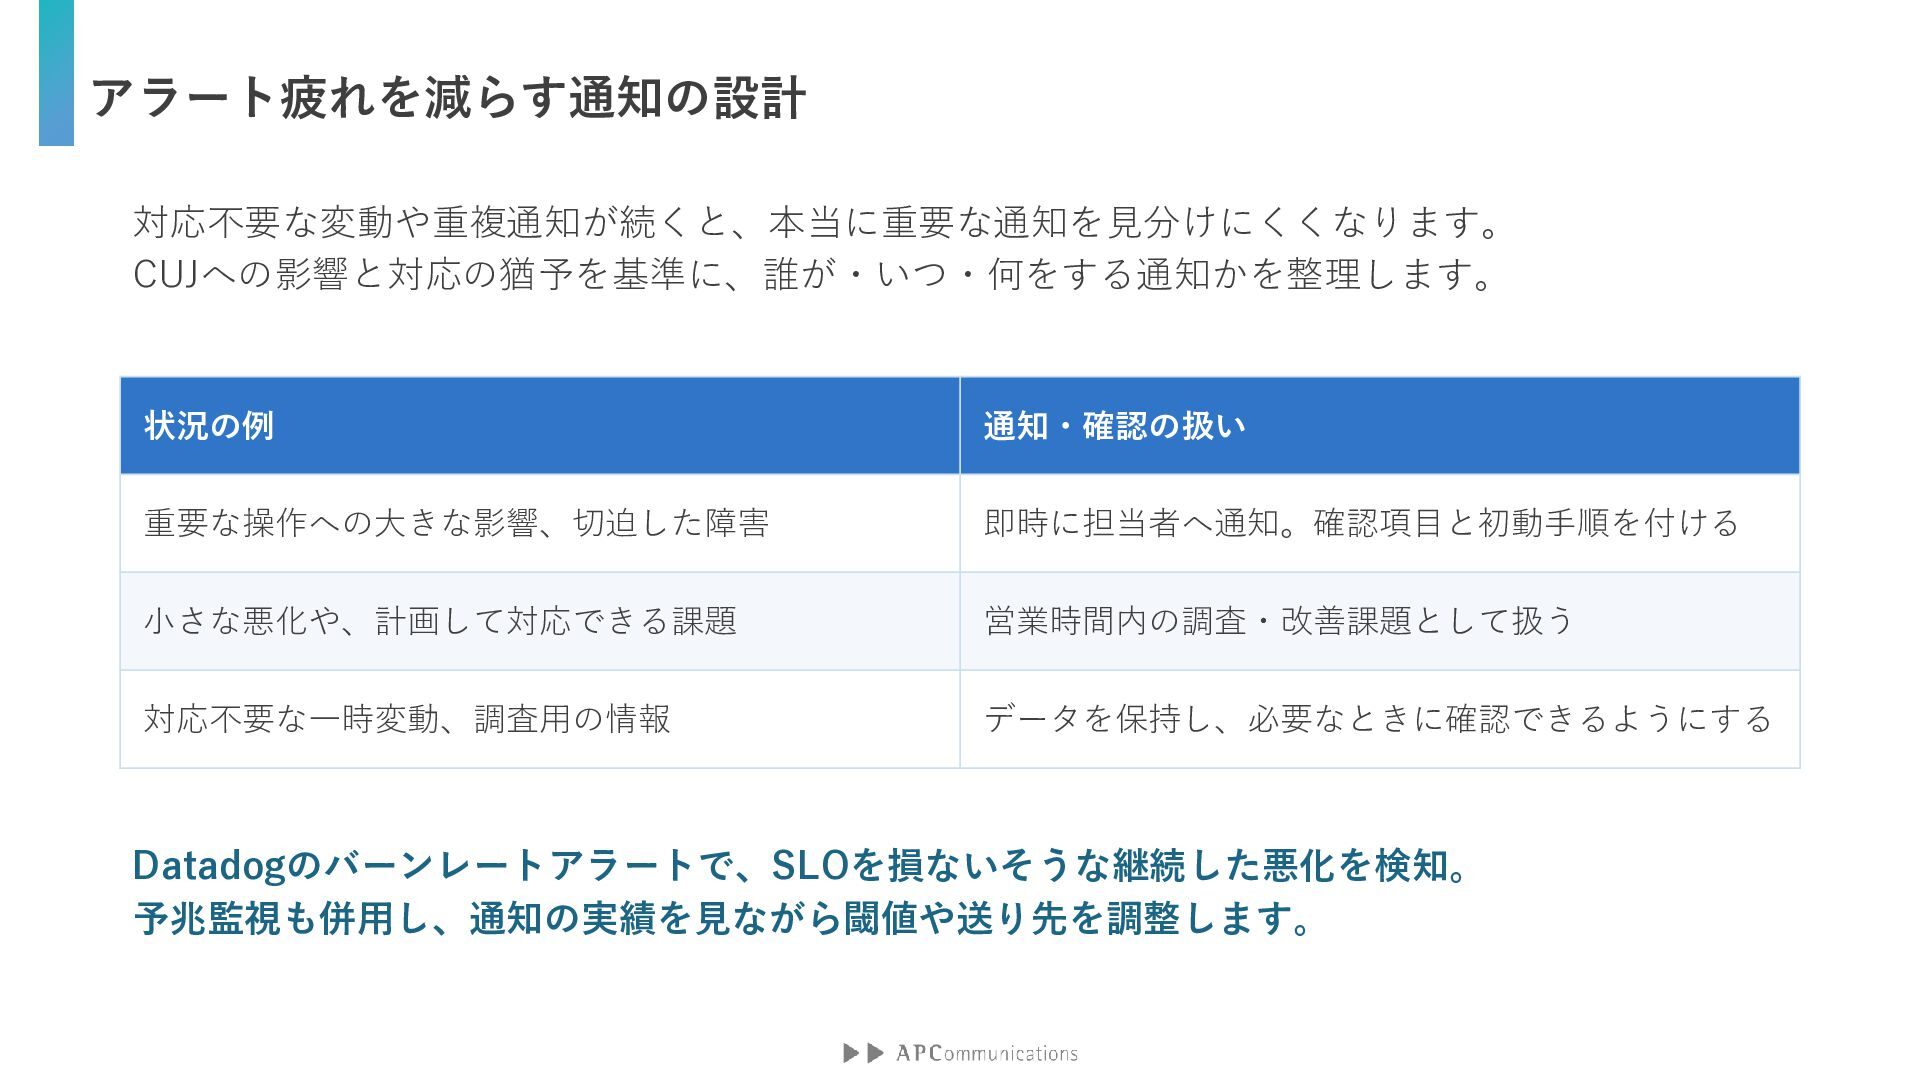
アラート疲れを減らす通知の設計 対応不要な変動や重複通知が続くと、本当に重要な通知を見分けにくくなります。 CUJへの影響と対応の猶予を基準に、誰が・いつ・何をする通知かを整理します。 状況の例 通知・確認の扱い 重要な操作への大きな影響、切迫した障害 即時に担当者へ通知。確認項目と初動手順を付ける 小さな悪化や、計画して対応できる課題 営業時間内の調査・改善課題として扱う 対応不要な一時変動、調査用の情報
データを保持し、必要なときに確認できるようにする Datadogのバーンレートアラートで、SLOを損ないそうな継続した悪化を検知。 予兆監視も併用し、通知の実績を見ながら閾値や送り先を調整します。 -
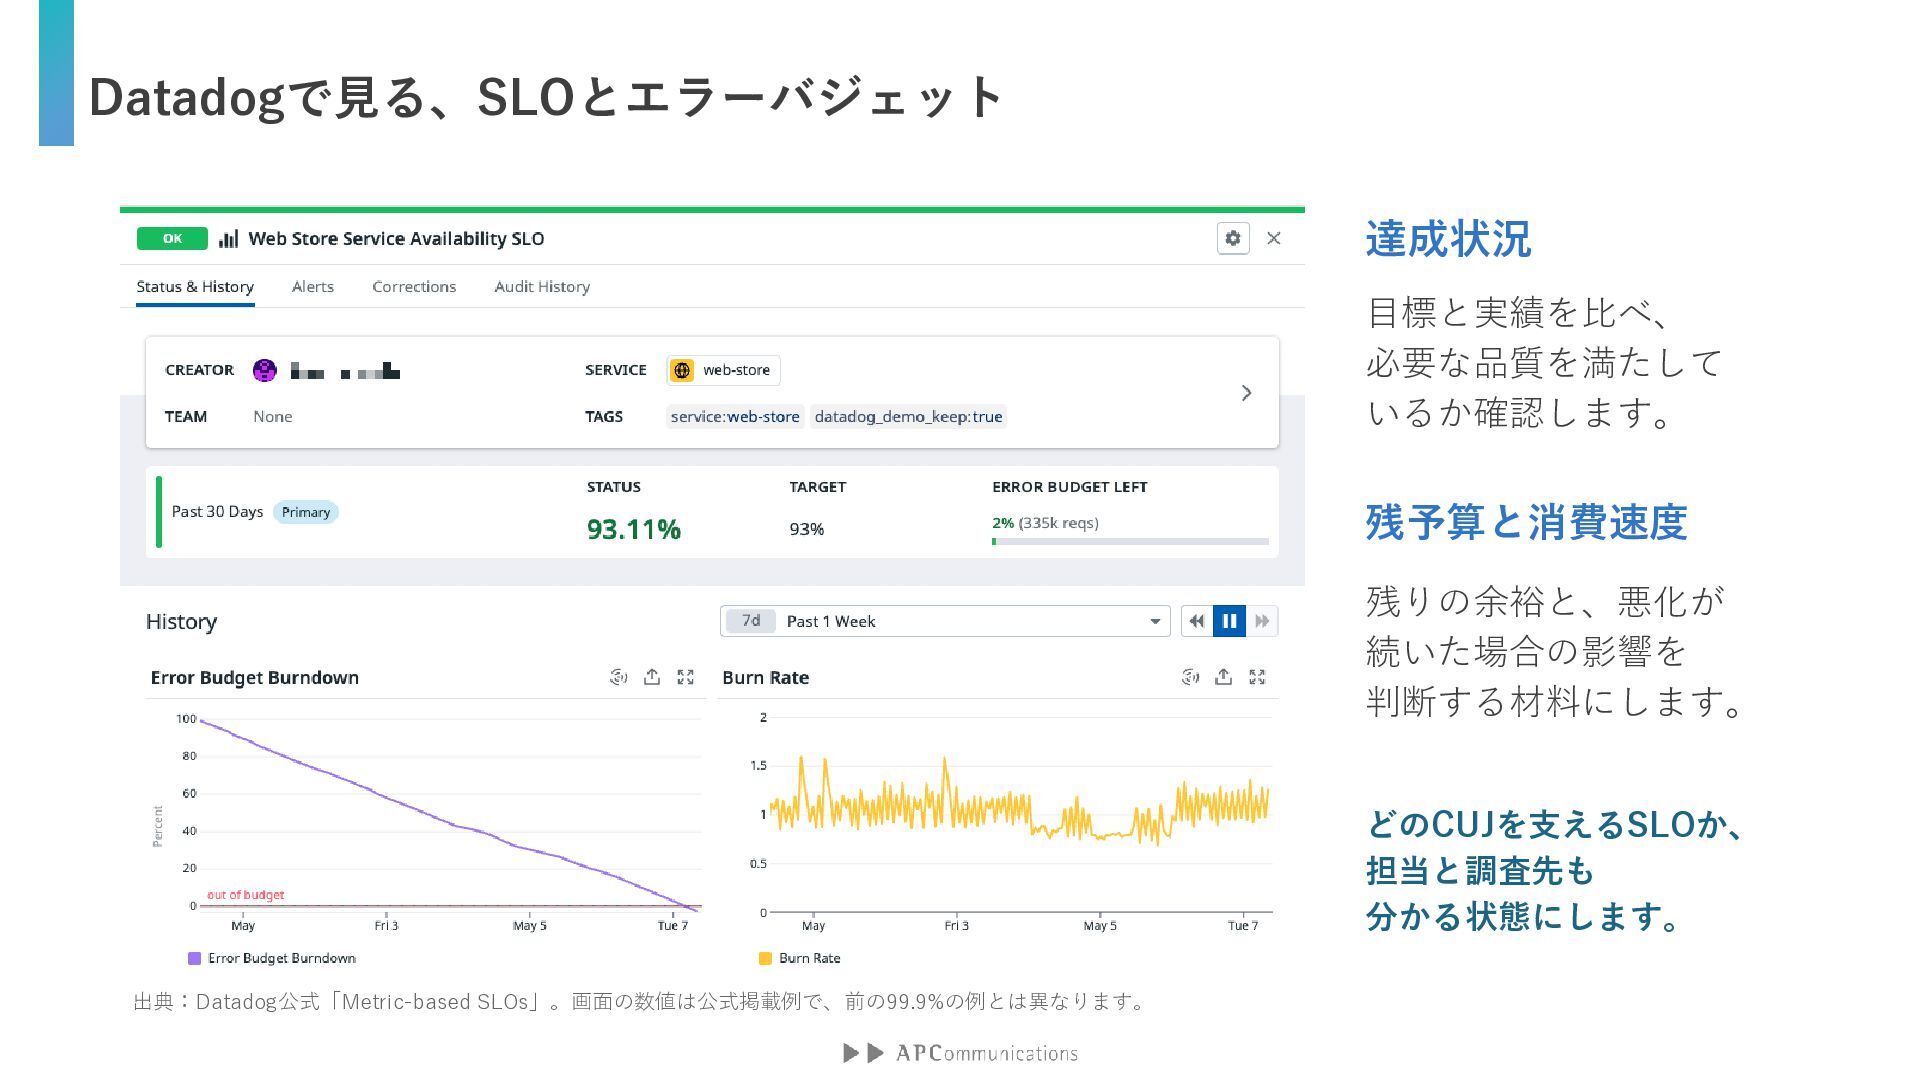
Datadogで見る、SLOとエラーバジェット 達成状況 目標と実績を比べ、 必要な品質を満たして いるか確認します。 残予算と消費速度 残りの余裕と、悪化が 続いた場合の影響を 判断する材料にします。 どのCUJを支えるSLOか、
担当と調査先も 分かる状態にします。 出典:Datadog公式「Metric-based SLOs」。画面の数値は公式掲載例で、前の99.9%の例とは異なります。 -
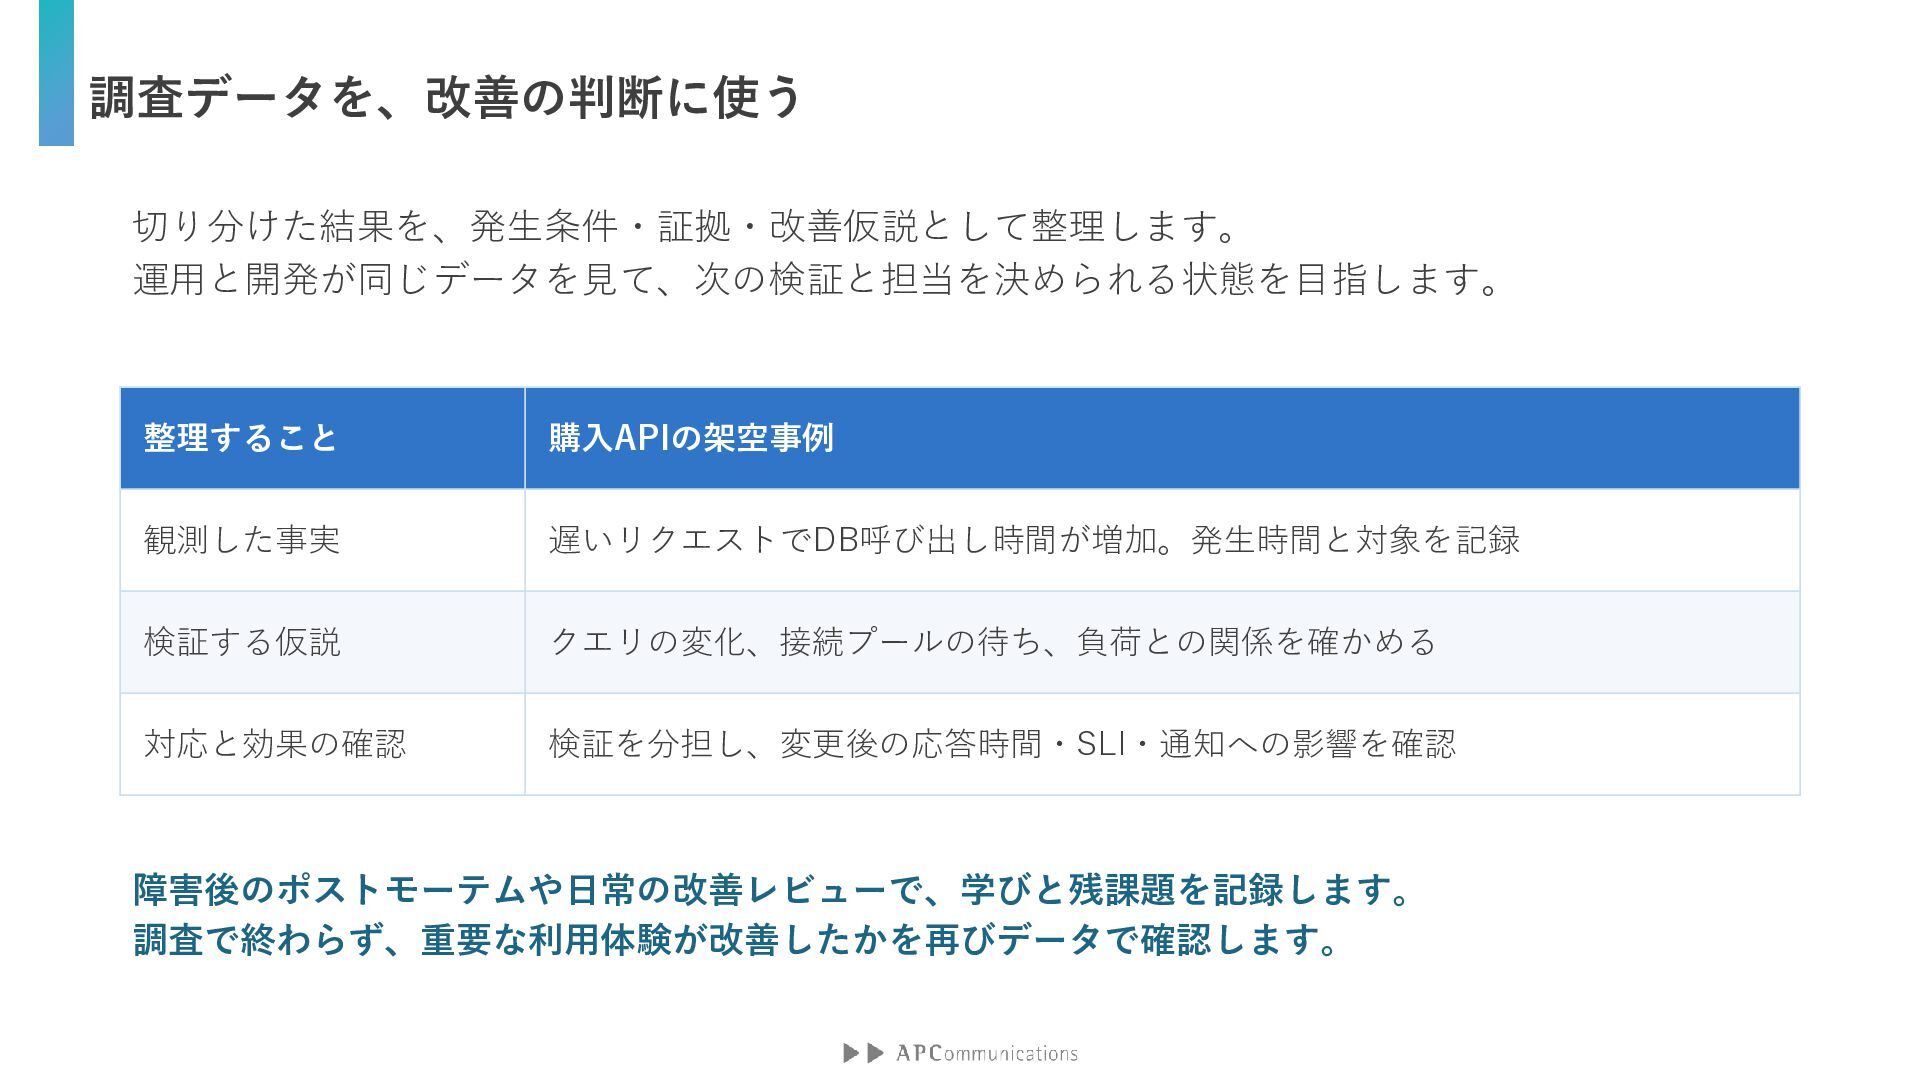
調査データを、改善の判断に使う 切り分けた結果を、発生条件・証拠・改善仮説として整理します。 運用と開発が同じデータを見て、次の検証と担当を決められる状態を目指します。 整理すること 購入APIの架空事例 観測した事実 遅いリクエストでDB呼び出し時間が増加。発生時間と対象を記録 検証する仮説 クエリの変化、接続プールの待ち、負荷との関係を確かめる 対応と効果の確認
検証を分担し、変更後の応答時間・SLI・通知への影響を確認 障害後のポストモーテムや日常の改善レビューで、学びと残課題を記録します。 調査で終わらず、重要な利用体験が改善したかを再びデータで確認します。 -
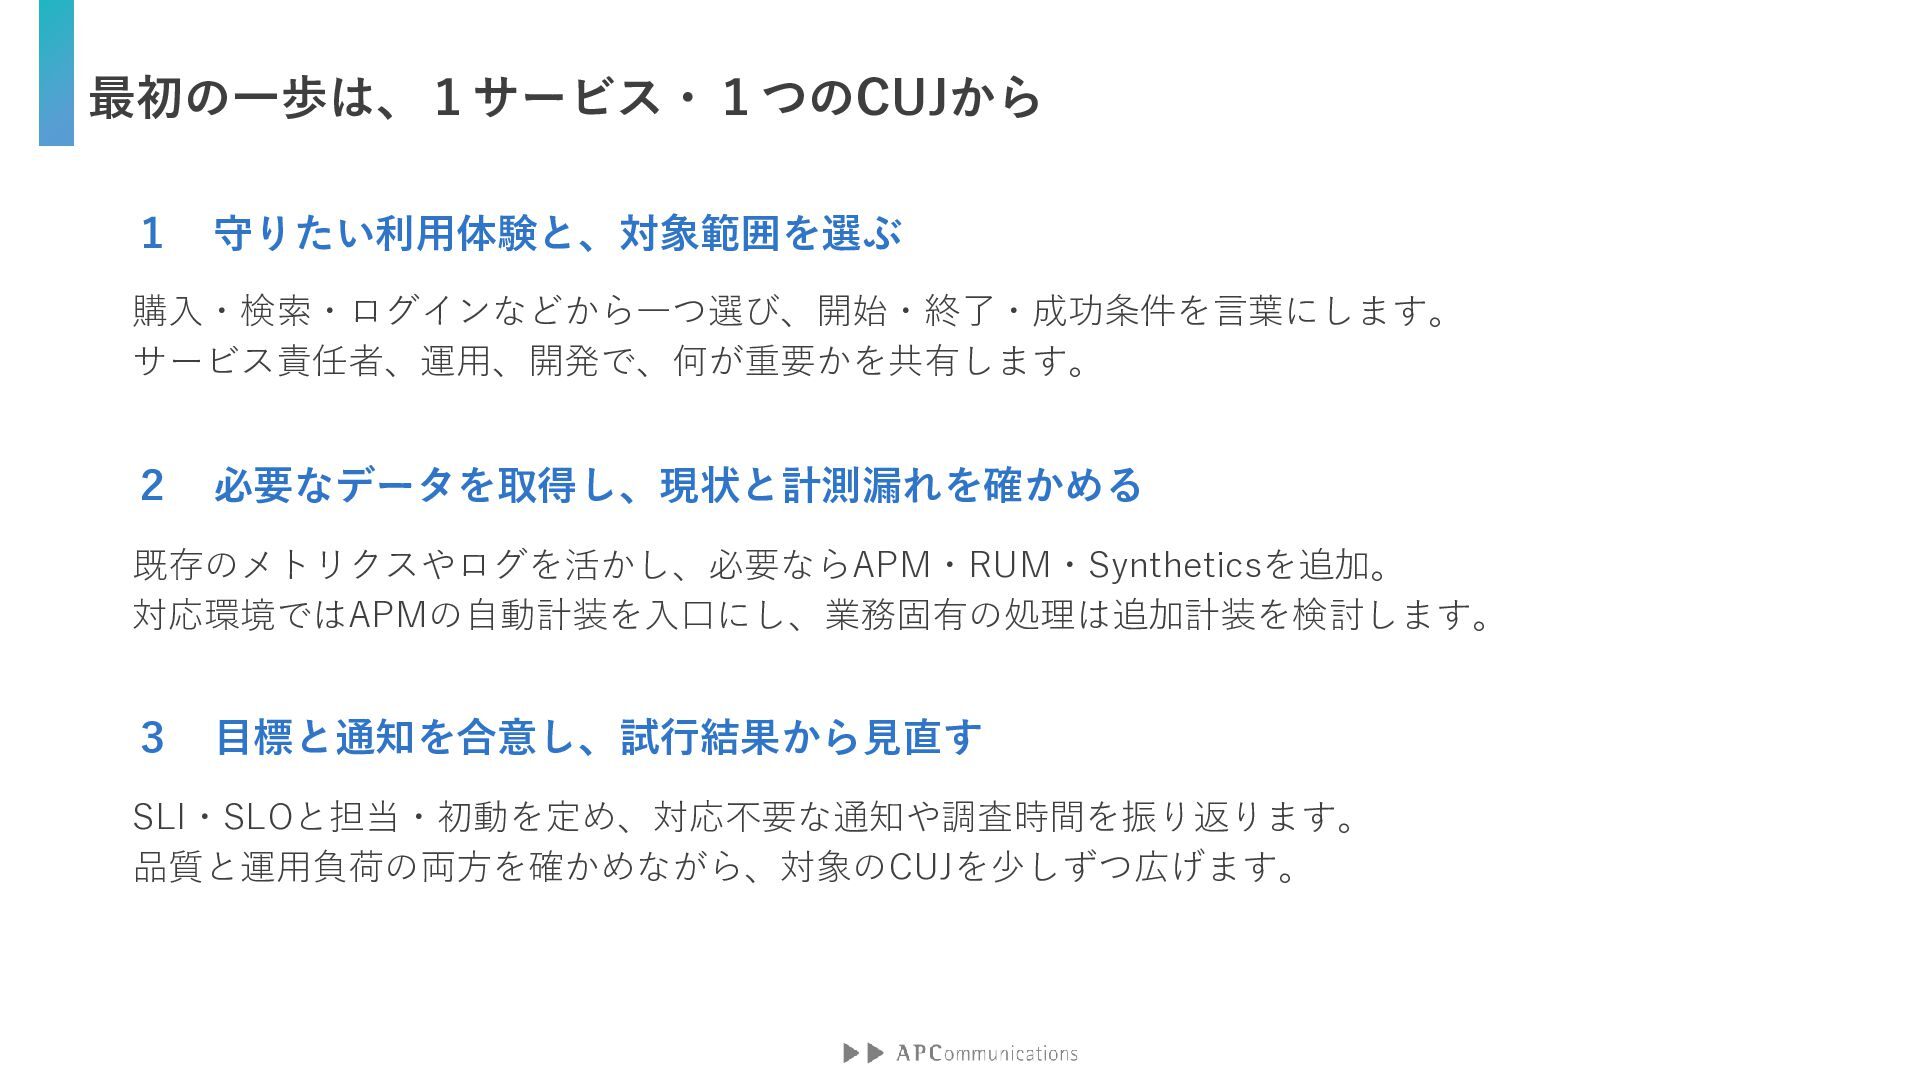
最初の一歩は、1サービス・1つのCUJから 1 守りたい利用体験と、対象範囲を選ぶ 購入・検索・ログインなどから一つ選び、開始・終了・成功条件を言葉にします。 サービス責任者、運用、開発で、何が重要かを共有します。 2 必要なデータを取得し、現状と計測漏れを確かめる 既存のメトリクスやログを活かし、必要ならAPM・RUM・Syntheticsを追加。 対応環境ではAPMの自動計装を入口にし、業務固有の処理は追加計装を検討します。 3
目標と通知を合意し、試行結果から見直す SLI・SLOと担当・初動を定め、対応不要な通知や調査時間を振り返ります。 品質と運用負荷の両方を確かめながら、対象のCUJを少しずつ広げます。