Share
Embed
機械に「聞く力」を——音声認識の基礎から最新トレンドまで / 2026 AI SPEECH RESEARCH TALK
2026年6月12日開催 Women in Data Science Tokyo @ IBM
AI SPEECH RESEARCH TALK 資料
Speaker: Sashi Novitasari (ノビタサリ サシ)
日本アイ・ビー・エム株式会社
東京基礎研究所 AIテクノロジーズ
スタッフ・リサーチ・サイエンティスト
https://widstokyoibm2026.pages.dev/
wids-tky-i
June 12, 2026
Transcript
26 slides
-
1 AI SPEECH RESEARCH TALK 機械に「聞く力」を ~音声認識の基礎から最新トレンドまで~ Sashi Novitasari (ノビタサリ
サシ) 日本アイ・ビー・エム株式会社 東京基礎研究所 -
自己紹介 趣味 :ゲーム、音楽鑑賞、旅行 2022年10月にIBM入社 専門領域:AI + 音声認識 • 2014~2018 (学士)情報工学専門
Bandung Institute of Technology, インドネシア • 2018~2020 (修士課程) データサイエンス専門 • 2018~2022 (博士課程)情報科学専門 奈良先端科学技術大学院大学 研究内容:フィードバック式音声認識と音声合成 • 2022〜 IBMの東京基礎研究・AIテクノロジーズチームに所属 研究開発:Watson STT, Granite Speech Sashi Novitasari (ノビタサリ サシ) 日本アイ・ビー・エム株式会社 東京基礎研究所 AIテクノロジーズ [email protected] 3 -
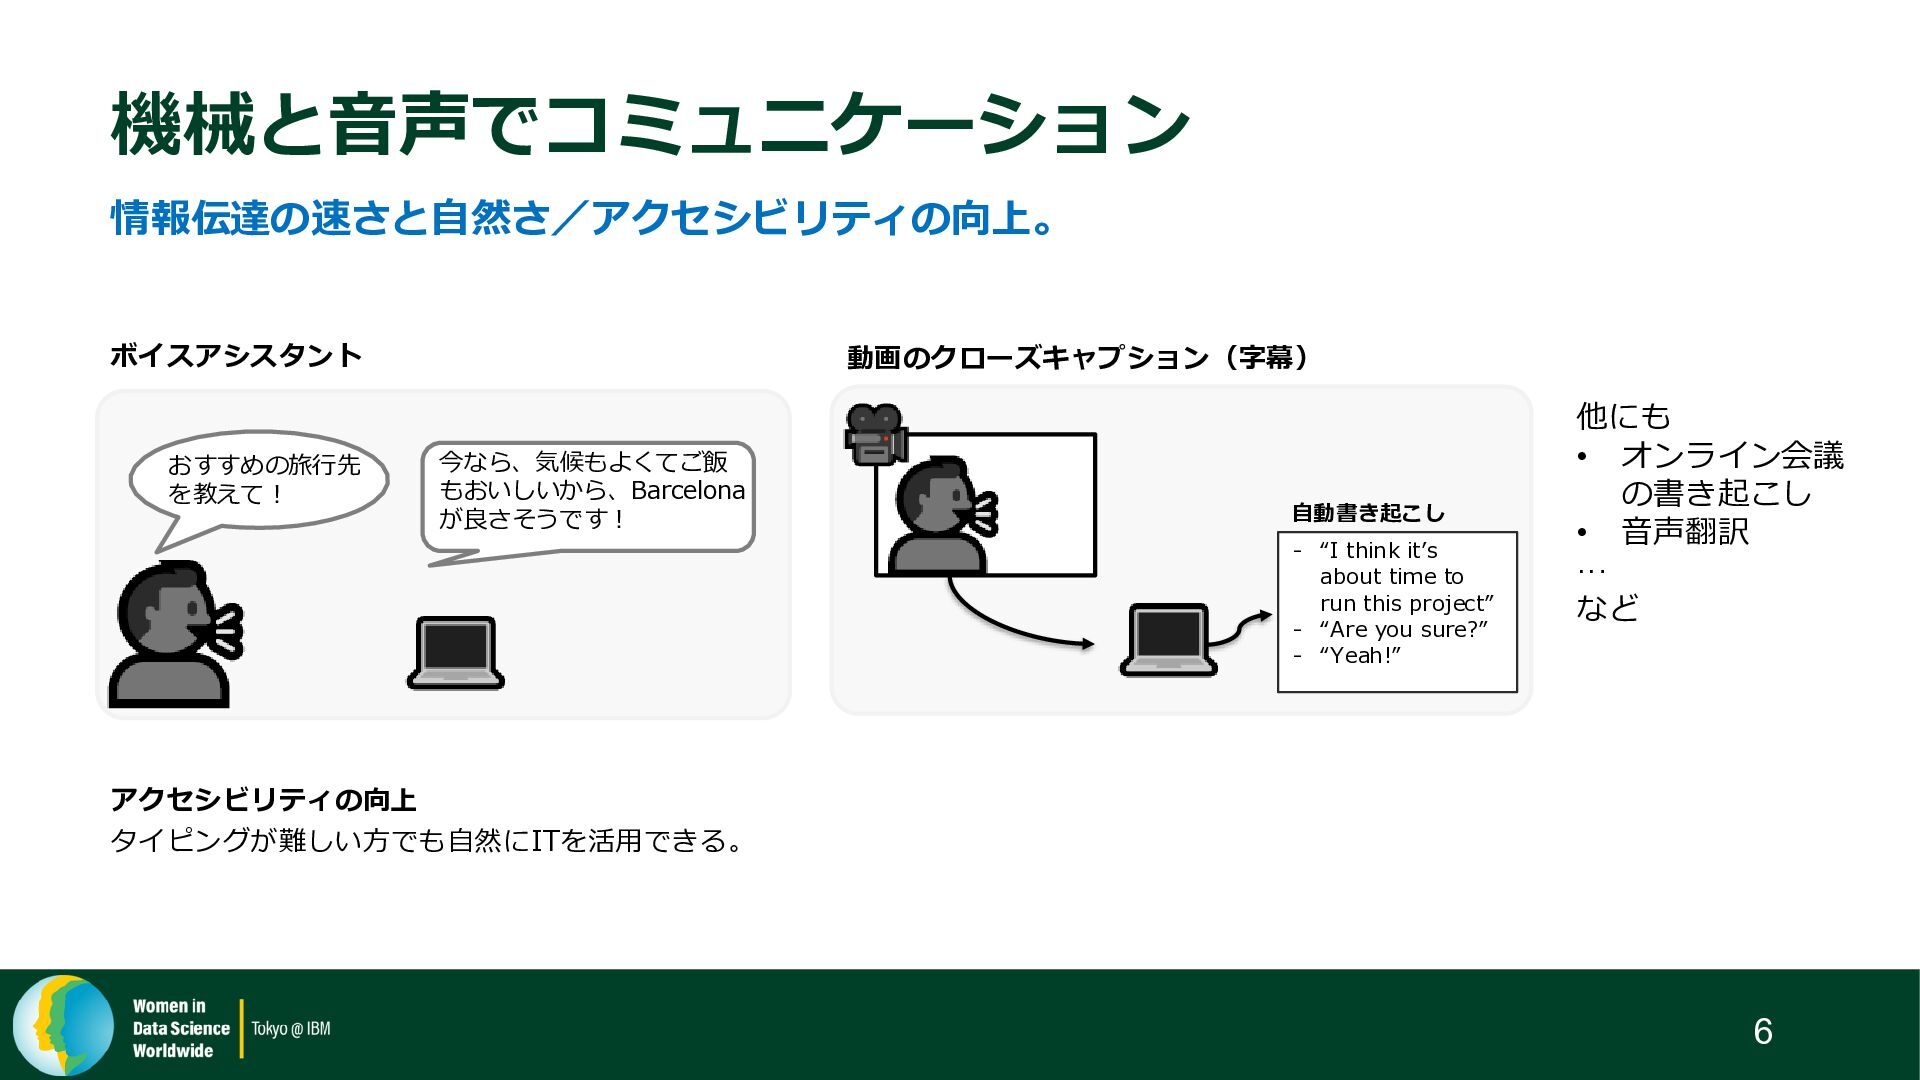
機械と音声でコミュニケーション おすすめの旅行先 を教えて! 今なら、気候もよくてご飯 もおいしいから、Barcelona が良さそうです! ボイスアシスタント - “I think
it’s about time to run this project” - “Are you sure?” - “Yeah!” 自動書き起こし 動画のクローズキャプション(字幕) 他にも • オンライン会議 の書き起こし • 音声翻訳 … など 情報伝達の速さと自然さ/アクセシビリティの向上。 アクセシビリティの向上 タイピングが難しい方でも自然にITを活用できる。 6 -
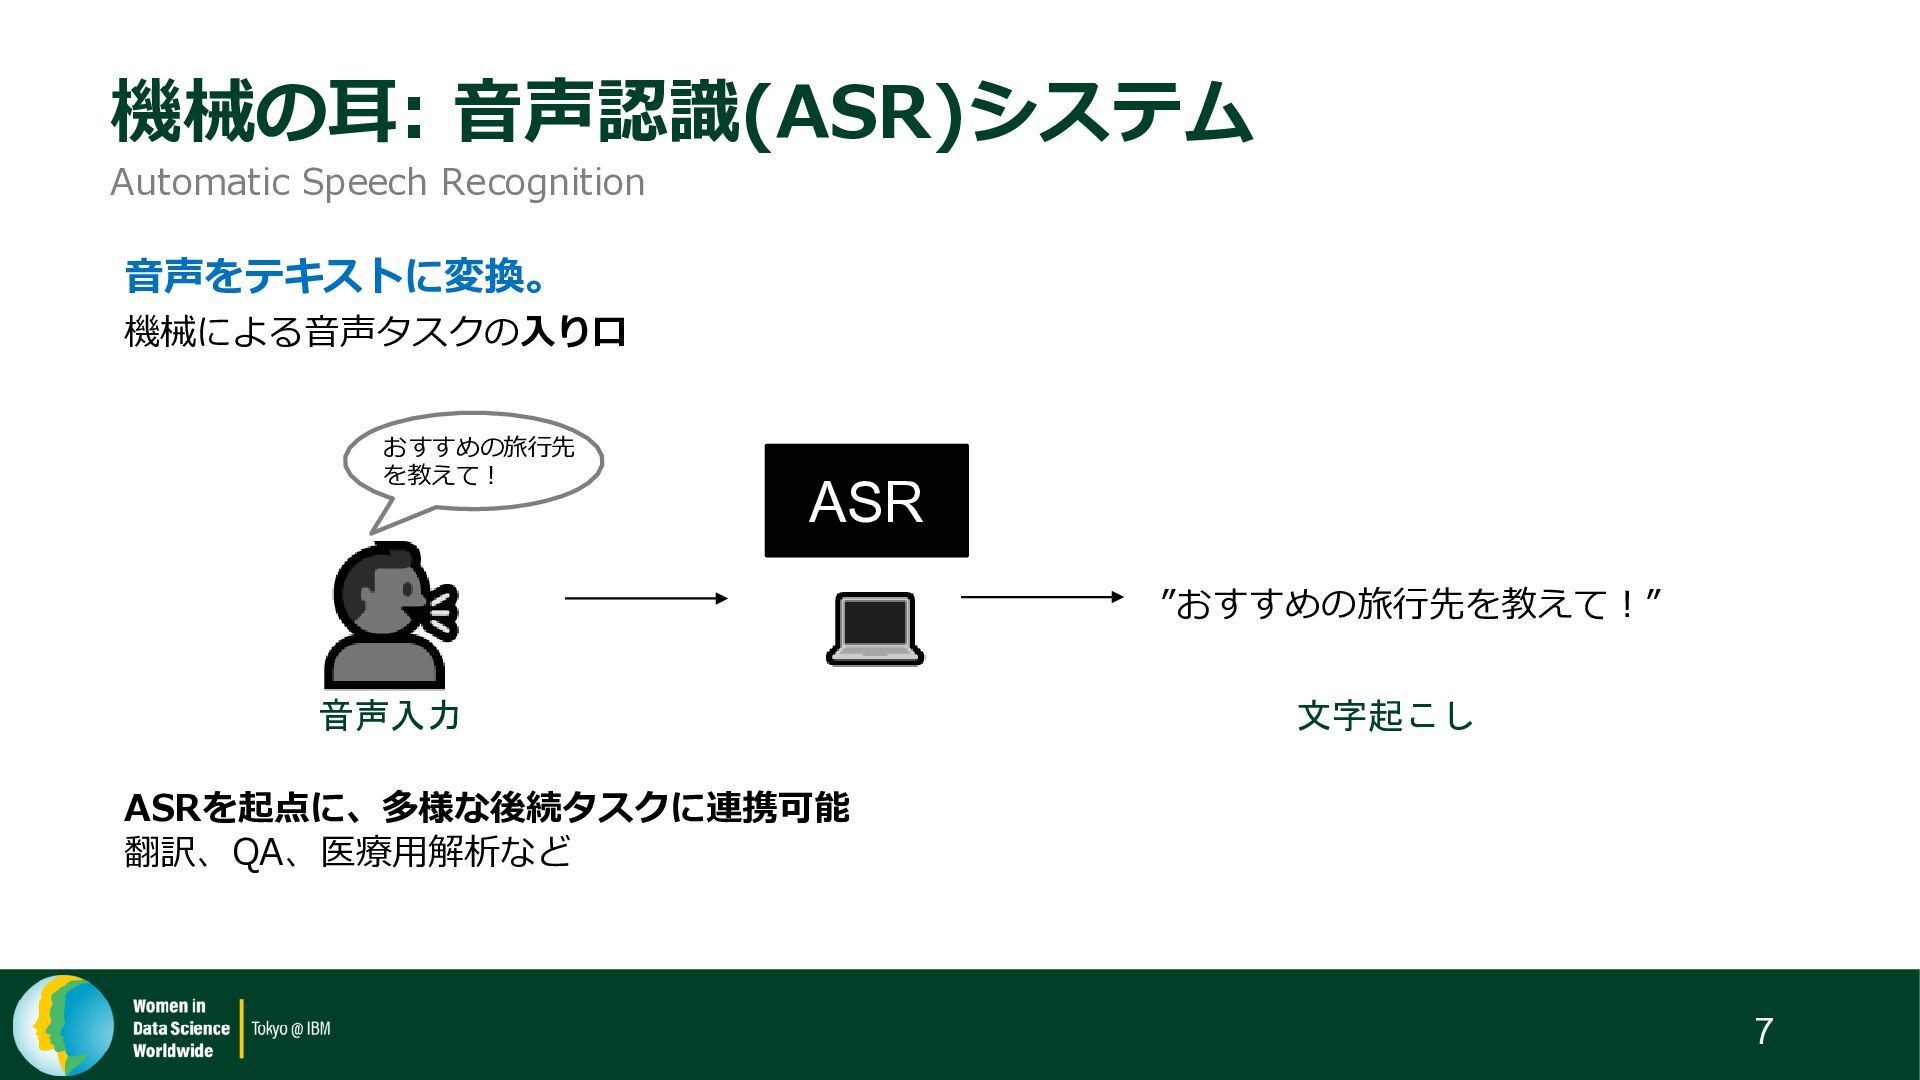
機械の耳: 音声認識(ASR)システム Automatic Speech Recognition 音声をテキストに変換。 機械による音声タスクの入り口 おすすめの旅行先 を教えて! ”おすすめの旅行先を教えて!”
ASR 文字起こし 音声入力 ASRを起点に、多様な後続タスクに連携可能 翻訳、QA、医療用解析など 7 -
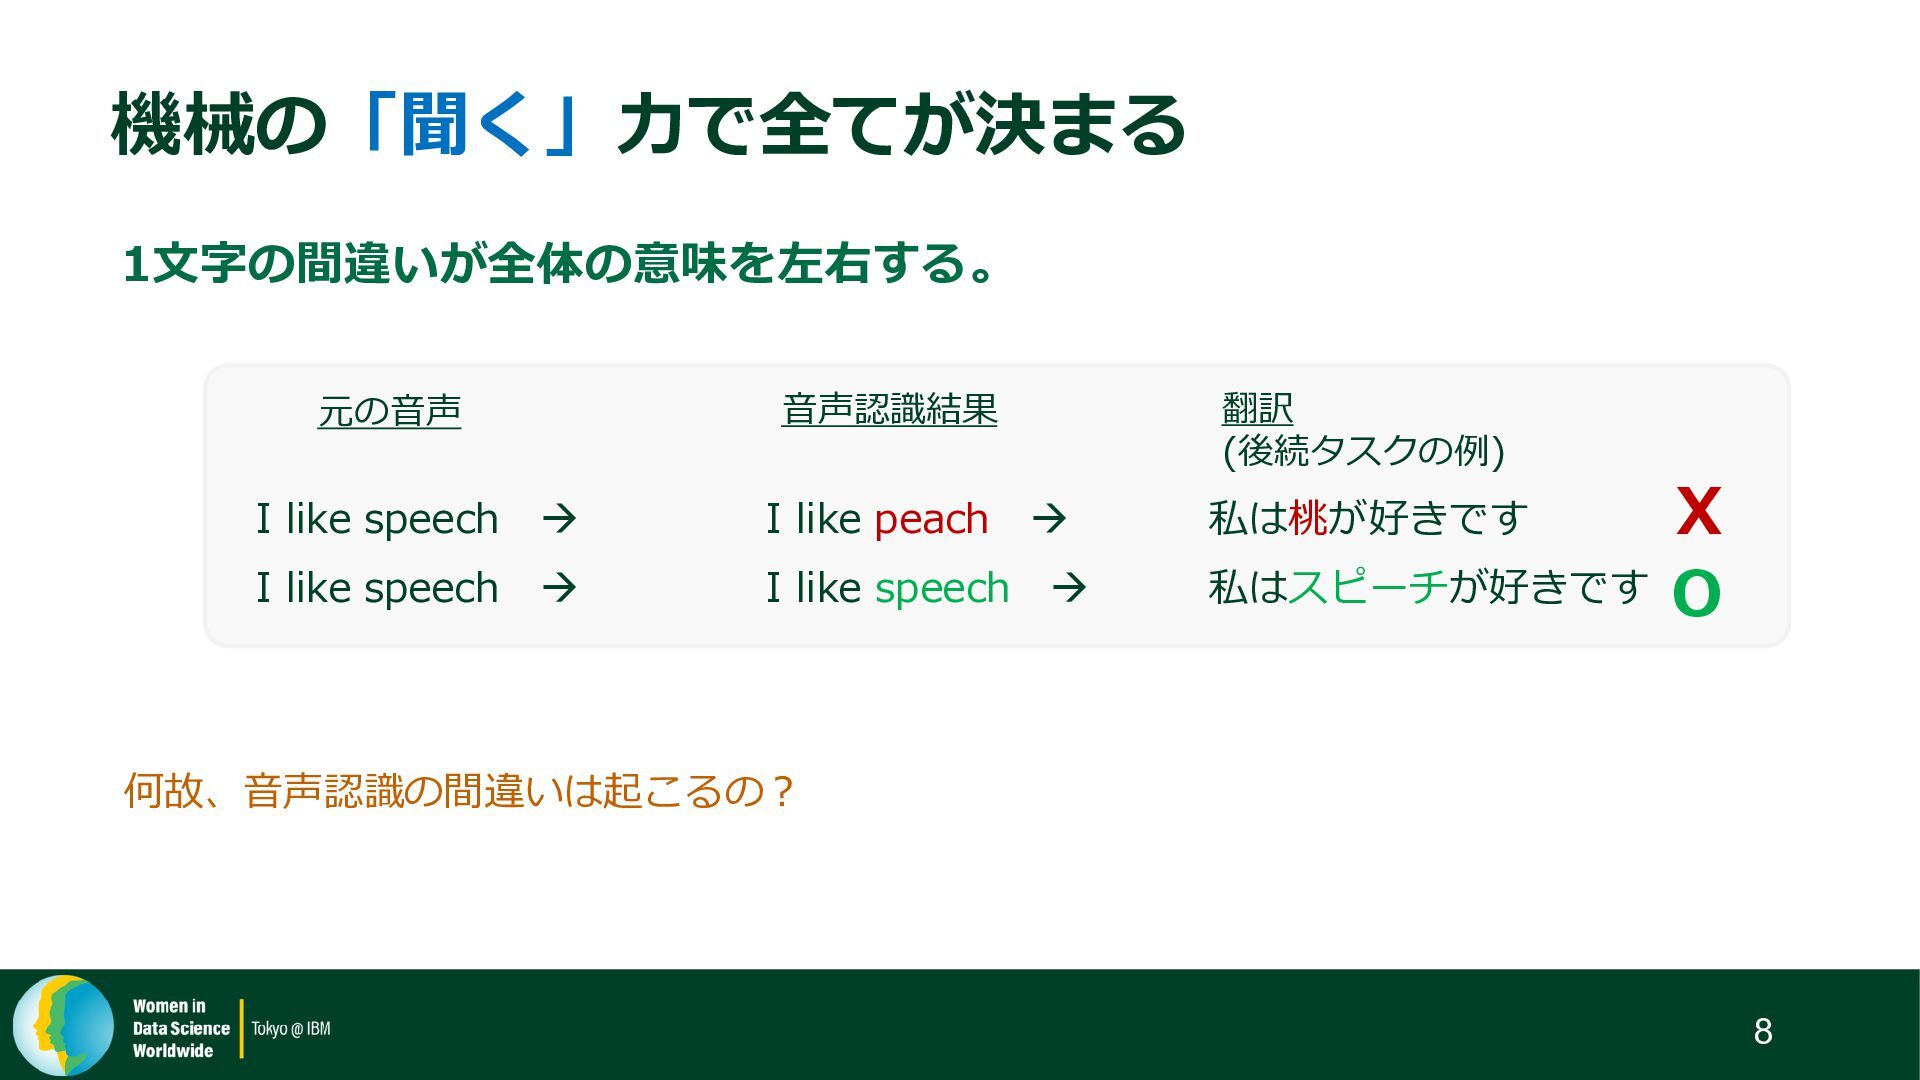
機械の「聞く」力で全てが決まる 1文字の間違いが全体の意味を左右する。 I like speech → I like peach →
私は桃が好きです I like speech → I like speech → 私はスピーチが好きです 元の音声 音声認識結果 翻訳 (後続タスクの例) X O 何故、音声認識の間違いは起こるの? 8 -
機械は音声を「数字」として「理解する」 おすすめの旅行先 を教えて! [0.130 2.455 …. 4.145] 話し方・環境によるもの • 言葉の区切りの違い・息の使い方
• 話者の性別 • 話す速度、音の大きさ • リズムや体調(風邪・感情) • ノイズ、など [0.040 0.234 …. 1.234] 人間は違う状況でも同じ言葉を 同じ言葉として認識 =パターン認識 ASRはパターン認識! データ上 (波形) 音声処理の難しい所:同じ「言葉」でも「数字」は変わる! おすすめ…の旅行先 を教えてぇ… 元気な時 疲れている時 9 -
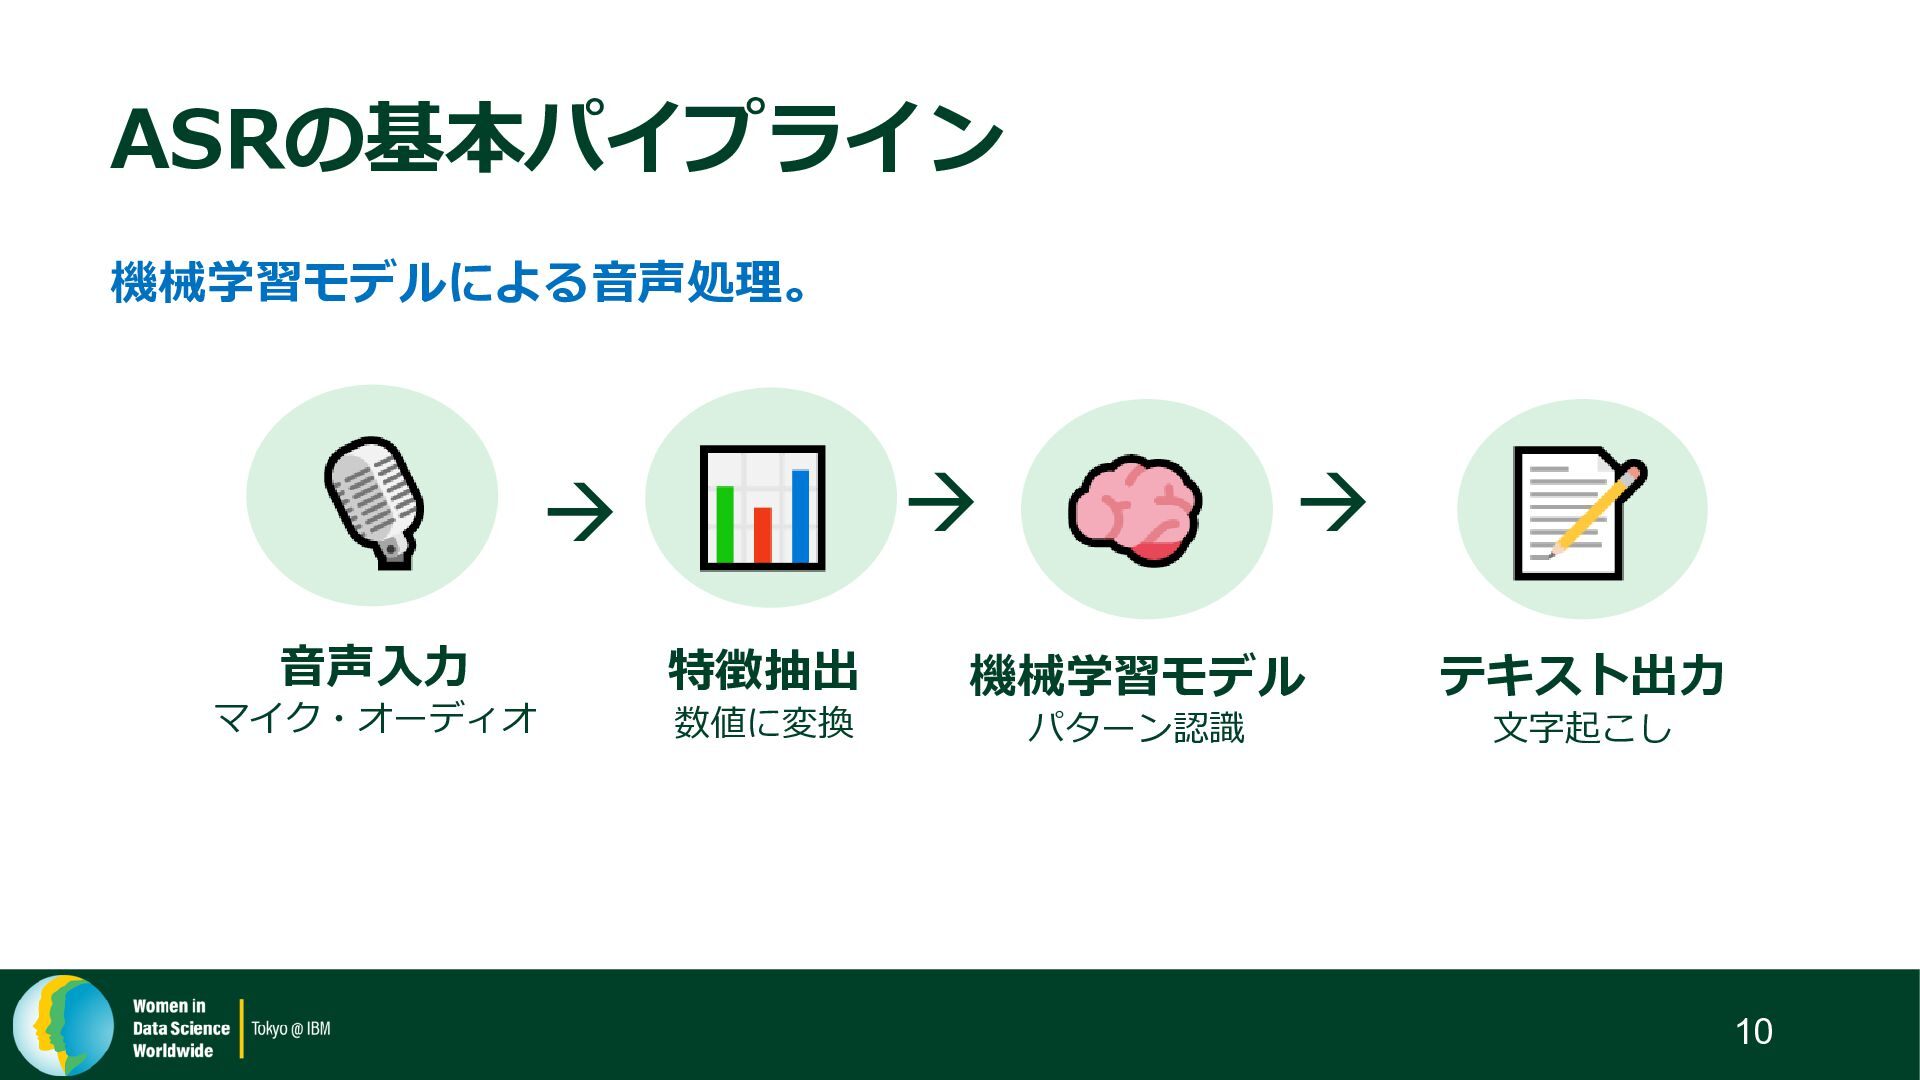
ASRの基本パイプライン 音声入力 マイク・オーディオ 特徴抽出 数値に変換 機械学習モデル パターン認識 テキスト出力 文字起こし →
→ → 機械学習モデルによる音声処理。 10 -
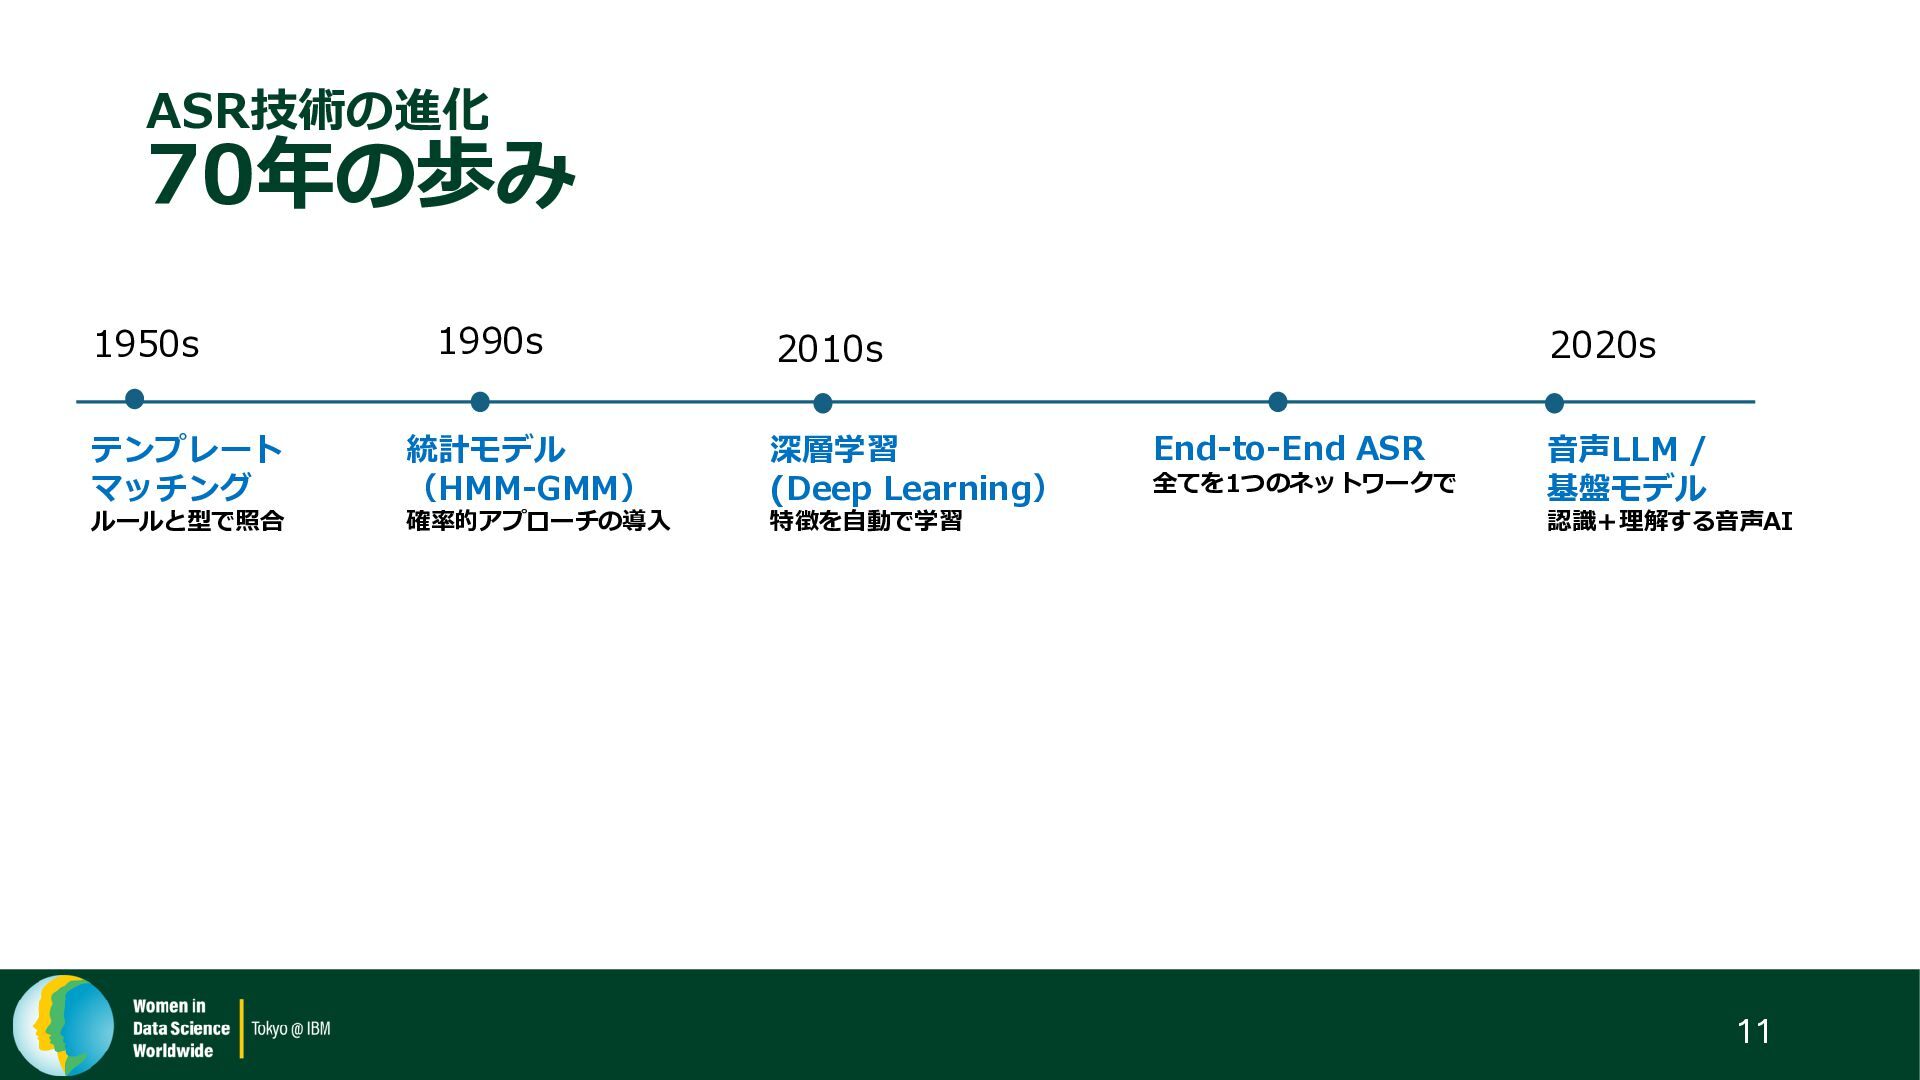
テンプレート マッチング ルールと型で照合 統計モデル (HMM-GMM) 確率的アプローチの導入 深層学習 (Deep Learning) 特徴を自動で学習
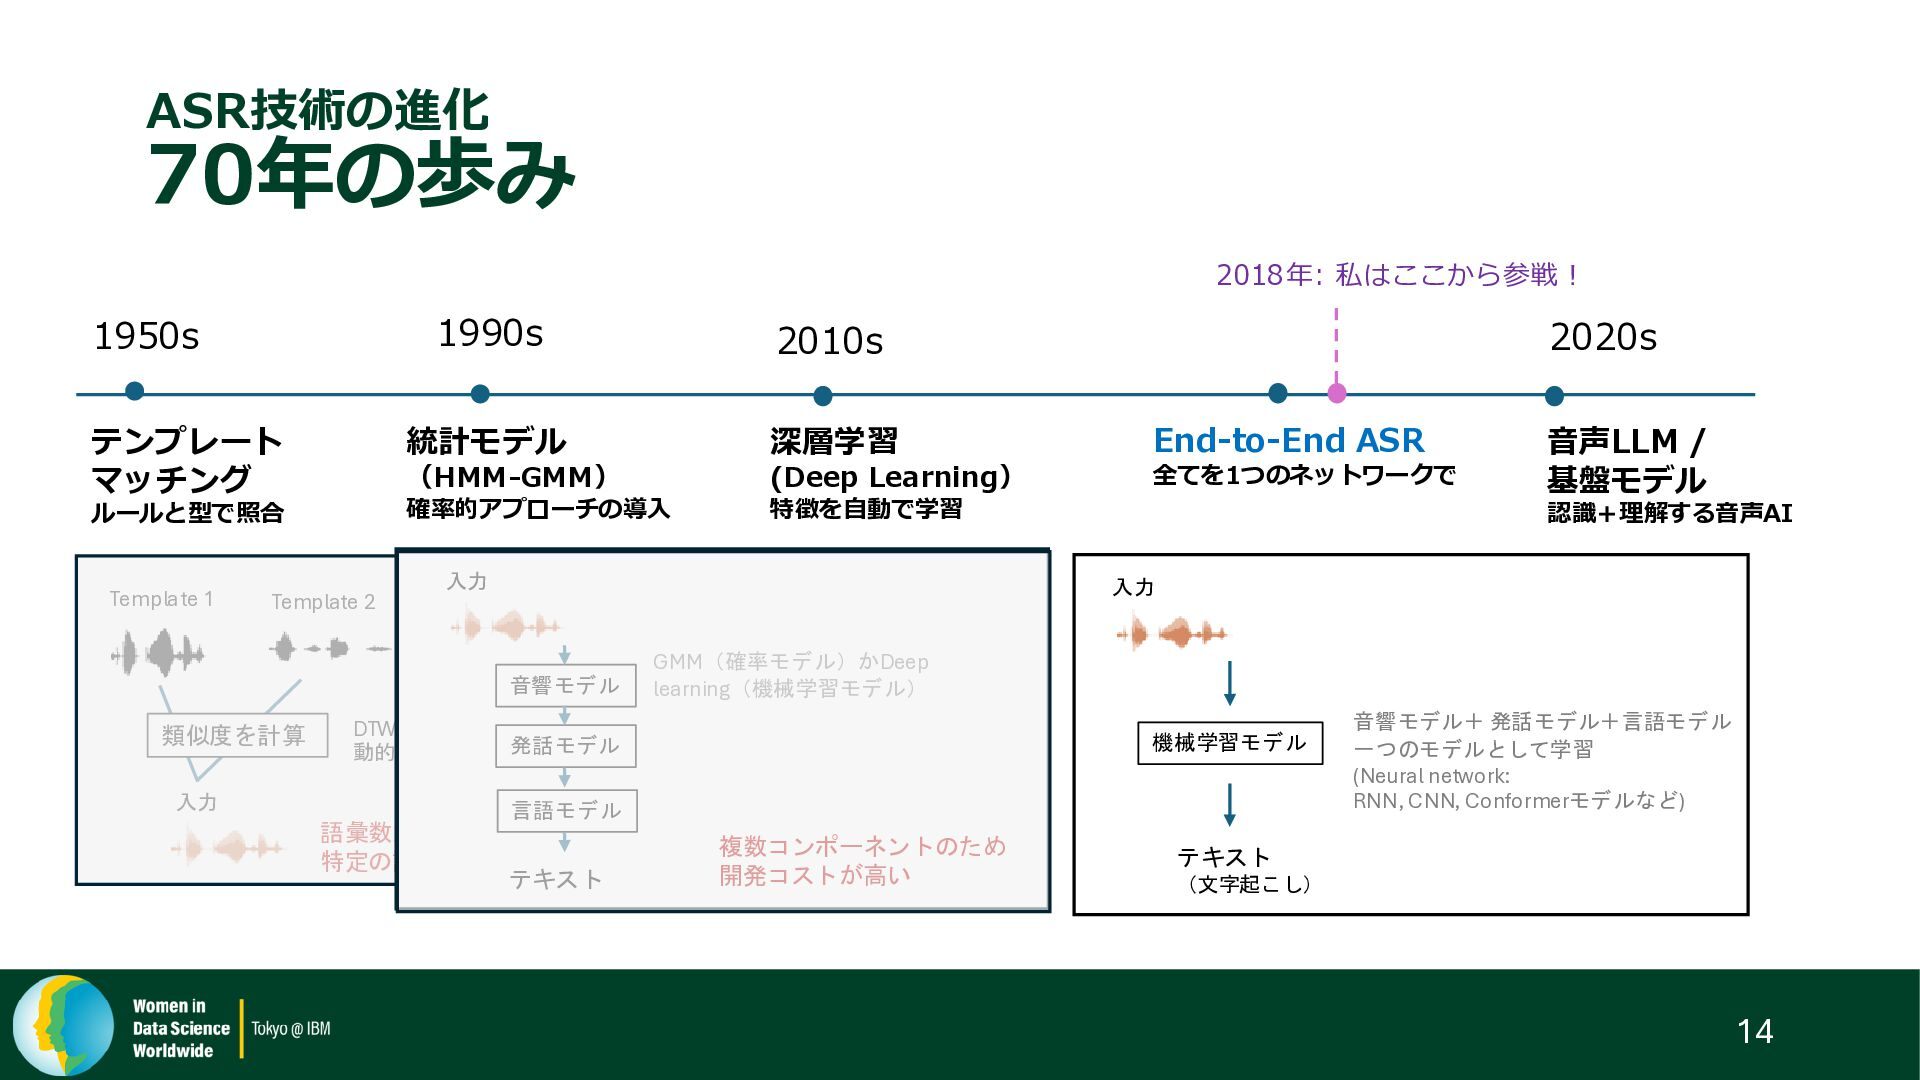
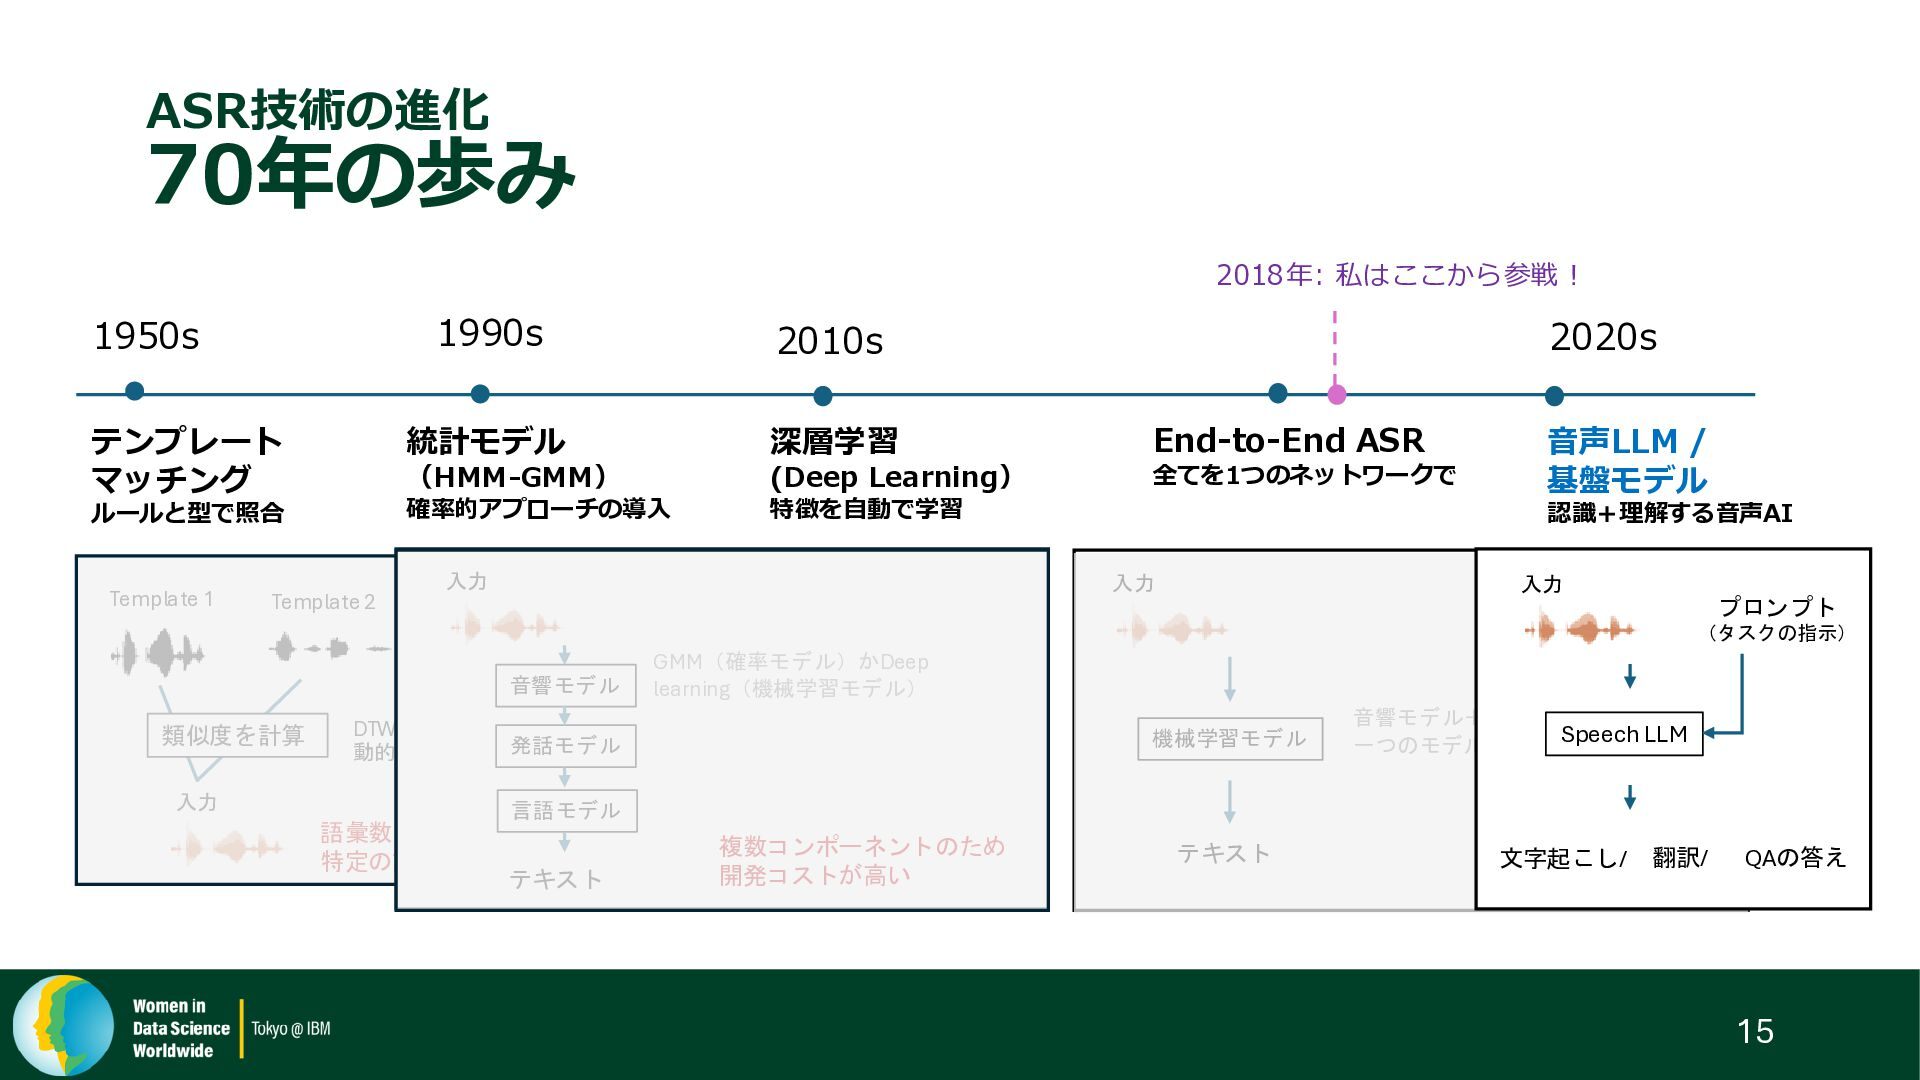
End-to-End ASR 全てを1つのネットワークで 音声LLM / 基盤モデル 認識+理解する音声AI 1950s 1990s 2010s 2020s ASR技術の進化 70年の歩み 11 -
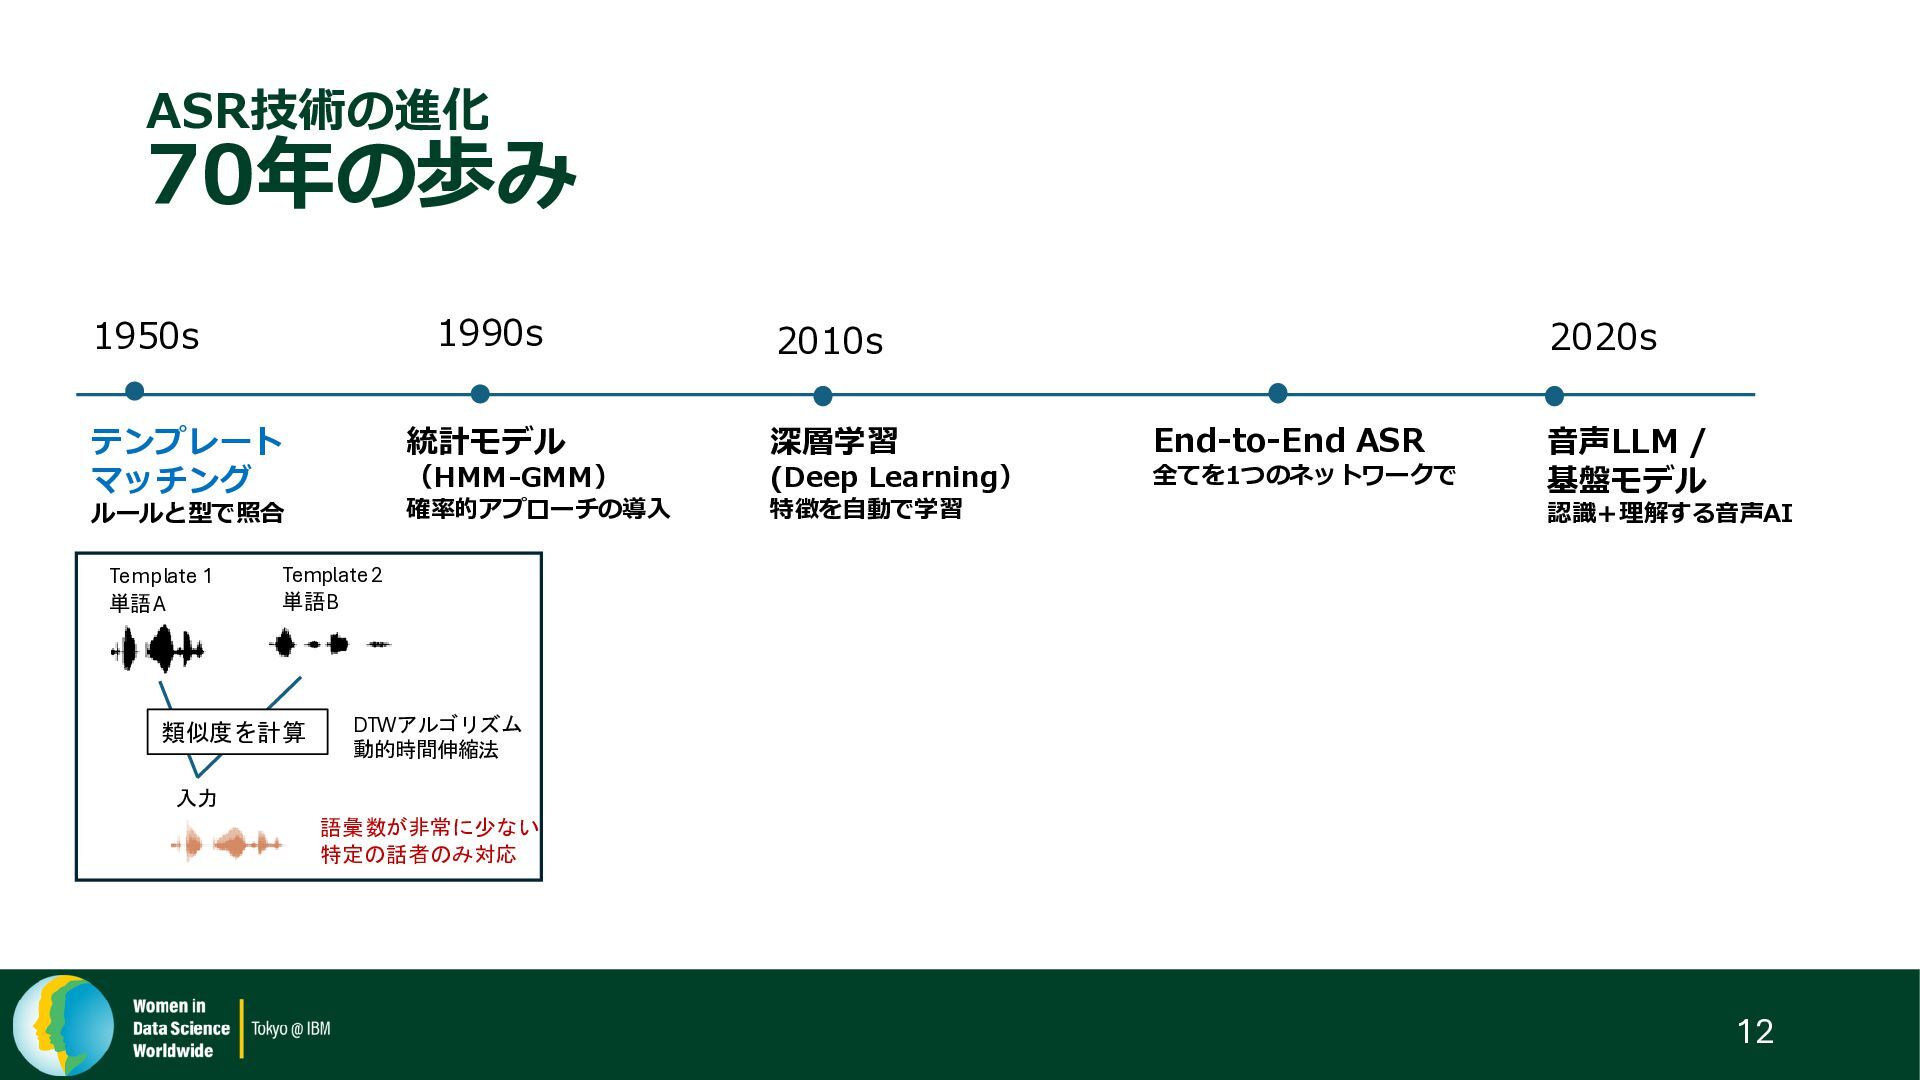
テンプレート マッチング ルールと型で照合 統計モデル (HMM-GMM) 確率的アプローチの導入 深層学習 (Deep Learning) 特徴を自動で学習
End-to-End ASR 全てを1つのネットワークで 音声LLM / 基盤モデル 認識+理解する音声AI 1950s 1990s 2010s 2020s Template 1 単語A Template 2 単語B 入力 類似度を計算 DTWアルゴリズム 動的時間伸縮法 語彙数が非常に少ない 特定の話者のみ対応 ASR技術の進化 70年の歩み 12 -
語彙数が非常に少い 特定の話者のみ対応 Template 1 Template 2 入力 類似度を計算 DTWアルゴリズム 動的時間伸縮法
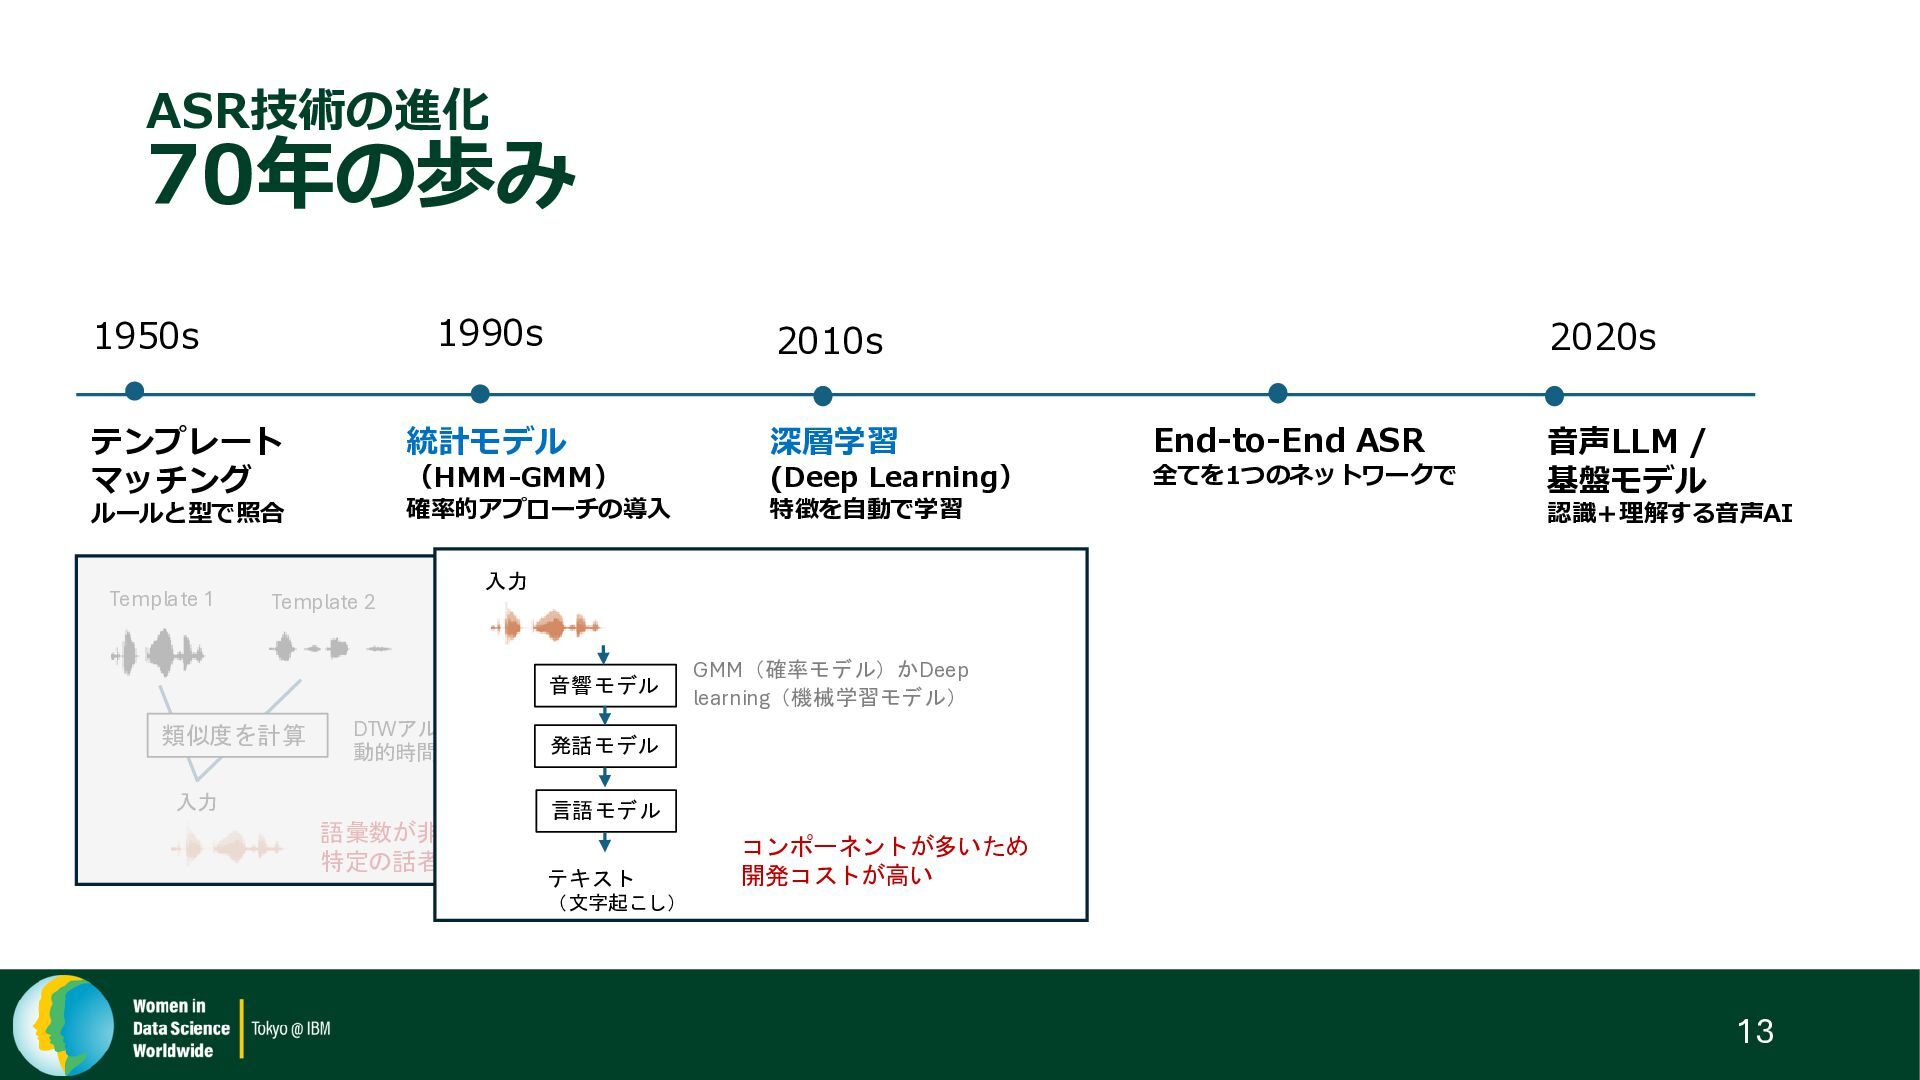
テンプレート マッチング ルールと型で照合 End-to-End ASR 全てを1つのネットワークで 音声LLM / 基盤モデル 認識+理解する音声AI 1950s 1990s 2010s 2020s 入力 音響モデル 発話モデル 言語モデル テキスト (文字起こし) GMM(確率モデル)かDeep learning(機械学習モデル) コンポーネントが多いため 開発コストが高い ASR技術の進化 70年の歩み 13 統計モデル (HMM-GMM) 確率的アプローチの導入 深層学習 (Deep Learning) 特徴を自動で学習 -
語彙数が非常に少い 特定の話者のみ対応 Template 1 Template 2 入力 類似度を計算 DTWアルゴリズム 動的時間伸縮法
テンプレート マッチング ルールと型で照合 統計モデル (HMM-GMM) 確率的アプローチの導入 深層学習 (Deep Learning) 特徴を自動で学習 End-to-End ASR 全てを1つのネットワークで 音声LLM / 基盤モデル 認識+理解する音声AI 1950s 1990s 2010s 2020s 入力 音響モデル 発話モデル 言語モデル テキスト GMM(確率モデル)かDeep learning(機械学習モデル) 複数コンポーネントのため 開発コストが高い 入力 機械学習モデル テキスト (文字起こし) 音響モデル+ 発話モデル+言語モデル 一つのモデルとして学習 (Neural network: RNN, CNN, Conformerモデルなど) 2018年: 私はここから参戦! ASR技術の進化 70年の歩み 14 -
語彙数が非常に少い 特定の話者のみ対応 Template 1 Template 2 入力 類似度を計算 DTWアルゴリズム 動的時間伸縮法
テンプレート マッチング ルールと型で照合 統計モデル (HMM-GMM) 確率的アプローチの導入 深層学習 (Deep Learning) 特徴を自動で学習 End-to-End ASR 全てを1つのネットワークで 音声LLM / 基盤モデル 認識+理解する音声AI 1950s 1990s 2010s 入力 音響モデル 発話モデル 言語モデル テキスト GMM(確率モデル)かDeep learning(機械学習モデル) 複数コンポーネントのため 開発コストが高い 入力 機械学習モデル テキスト 音響モデル+ 発話モデル+言語モデル 一つのモデルとして学習 2018年: 私はここから参戦! 文字起こし/ Speech LLM 翻訳/ QAの答え 入力 プロンプト (タスクの指示) ASR技術の進化 70年の歩み 15 2020s -
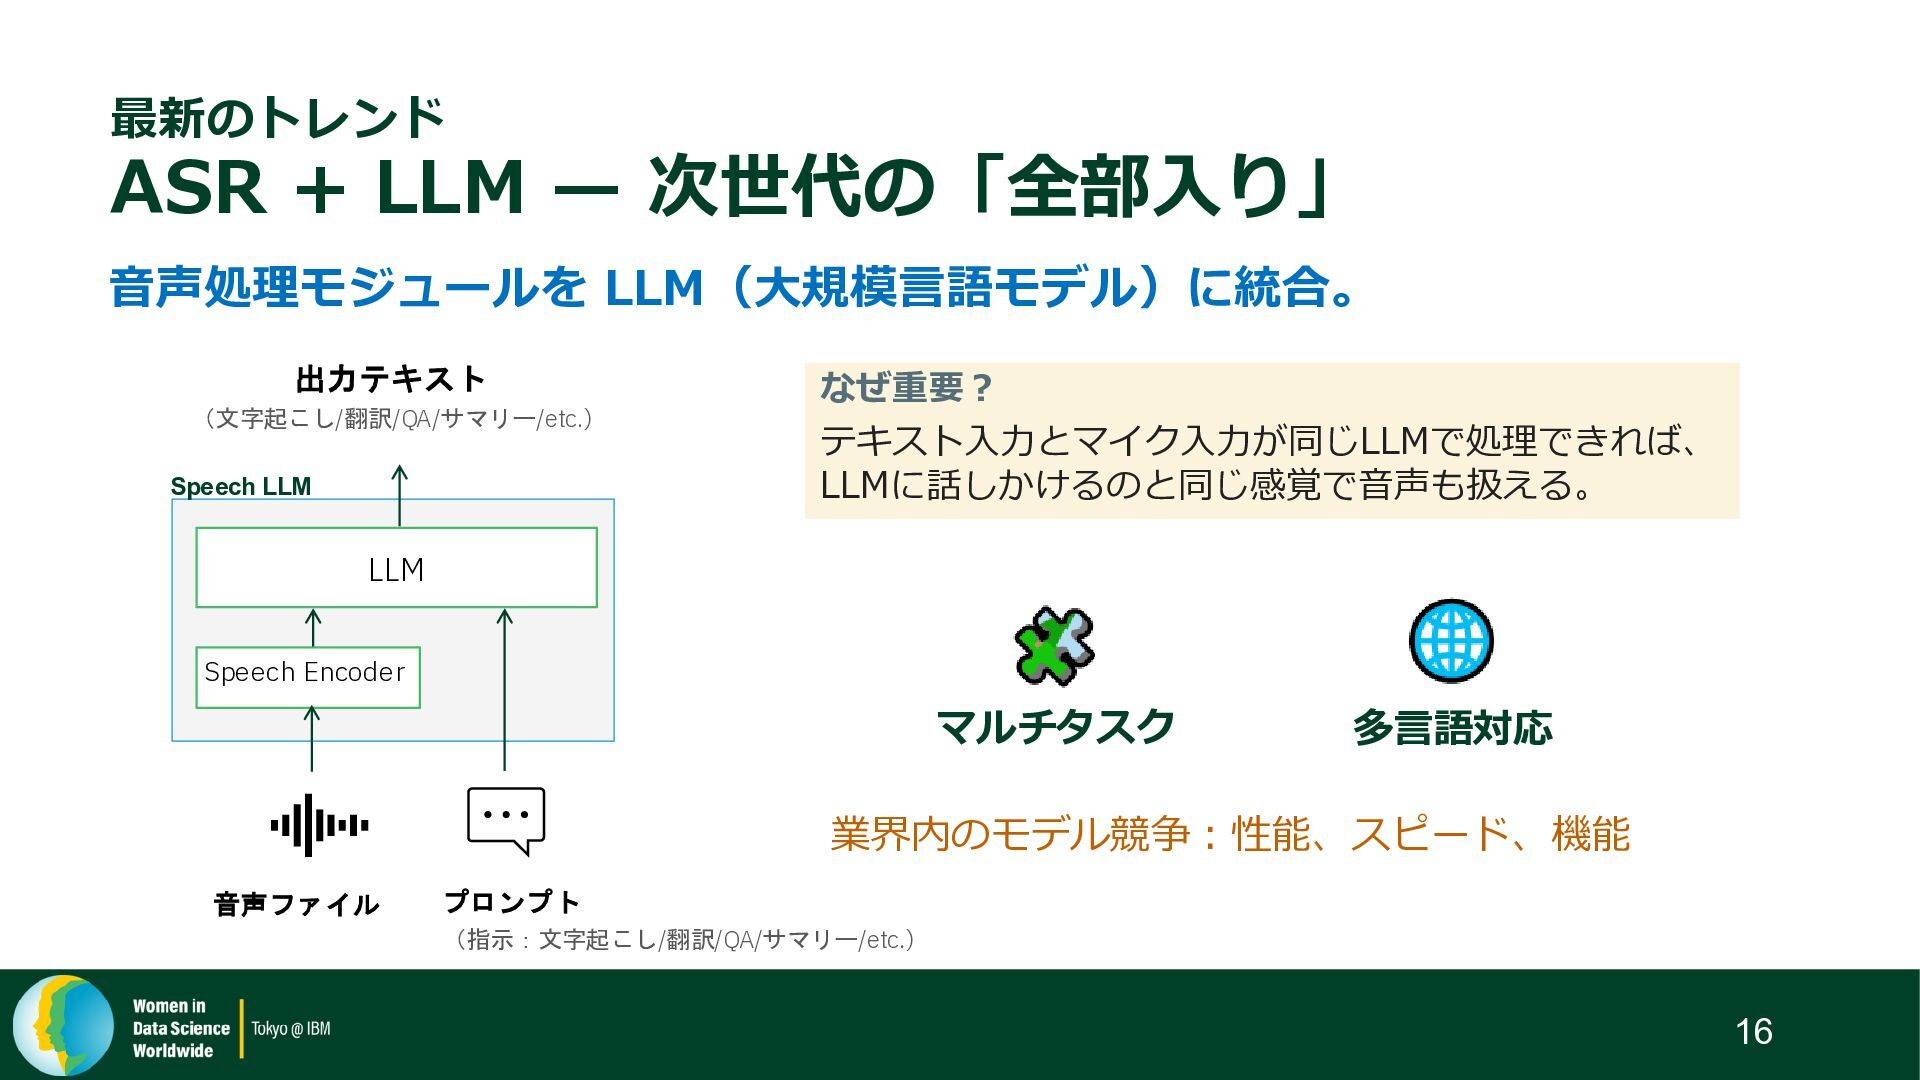
最新のトレンド ASR + LLM — 次世代の「全部入り」 多言語対応 マルチタスク なぜ重要? テキスト入力とマイク入力が同じLLMで処理できれば、
LLMに話しかけるのと同じ感覚で音声も扱える。 音声処理モジュールを LLM(大規模言語モデル)に統合。 16 LLM Speech Encoder プロンプト (指示:文字起こし/翻訳/QA/サマリー/etc.) 音声ファイル 出力テキスト (文字起こし/翻訳/QA/サマリー/etc.) 業界内のモデル競争:性能、スピード、機能 Speech LLM -
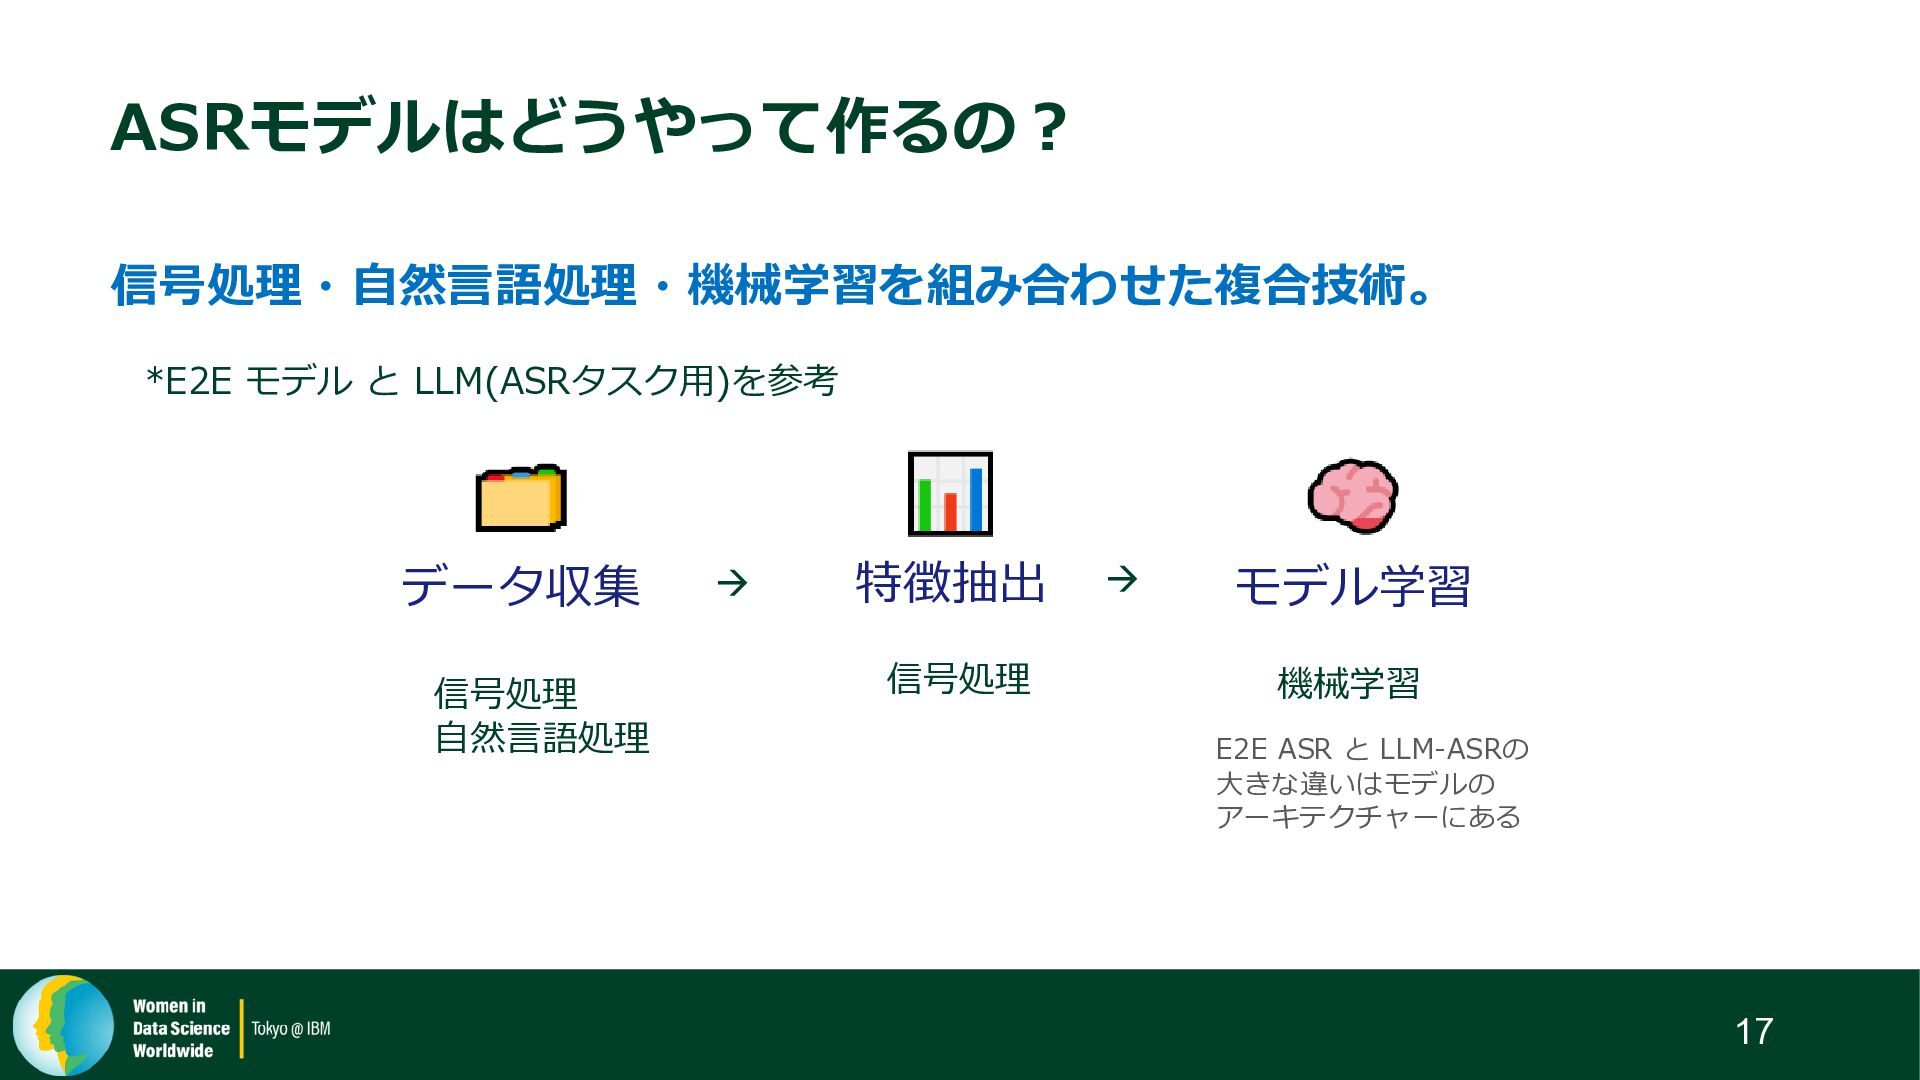
ASRモデルはどうやって作るの? 信号処理・自然言語処理・機械学習を組み合わせた複合技術。 データ収集 特徴抽出 モデル学習 信号処理 自然言語処理 信号処理 → →
機械学習 E2E ASR と LLM-ASRの 大きな違いはモデルの アーキテクチャーにある *E2E モデル と LLM(ASRタスク用)を参考 17 -
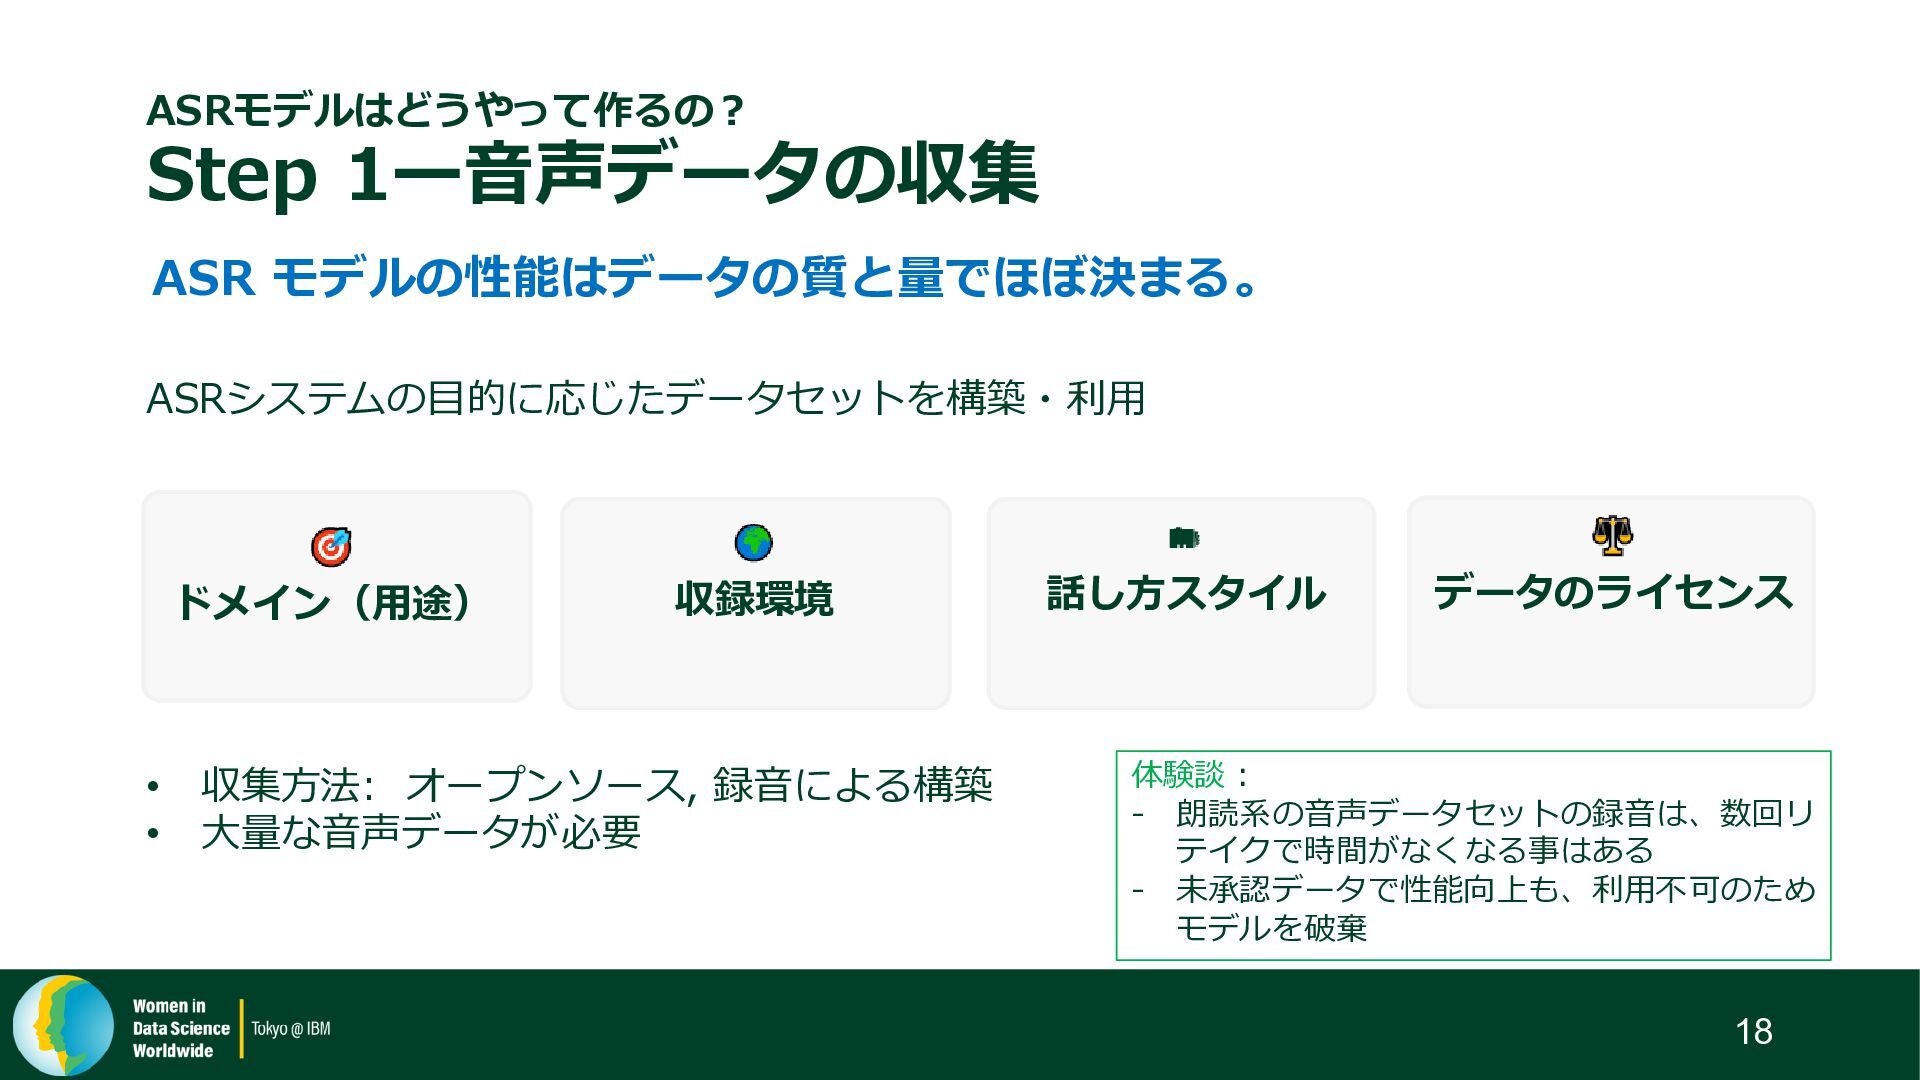
ASR モデルの性能はデータの質と量でほぼ決まる。 ドメイン(用途) 収録環境 話し方スタイル データのライセンス • 収集方法: オープンソース, 録音による構築
• 大量な音声データが必要 ASRモデルはどうやって作るの? Step 1ー音声データの収集 ASRシステムの目的に応じたデータセットを構築・利用 体験談: - 朗読系の音声データセットの録音は、数回リ テイクで時間がなくなる事はある - 未承認データで性能向上も、利用不可のため モデルを破棄 18 -
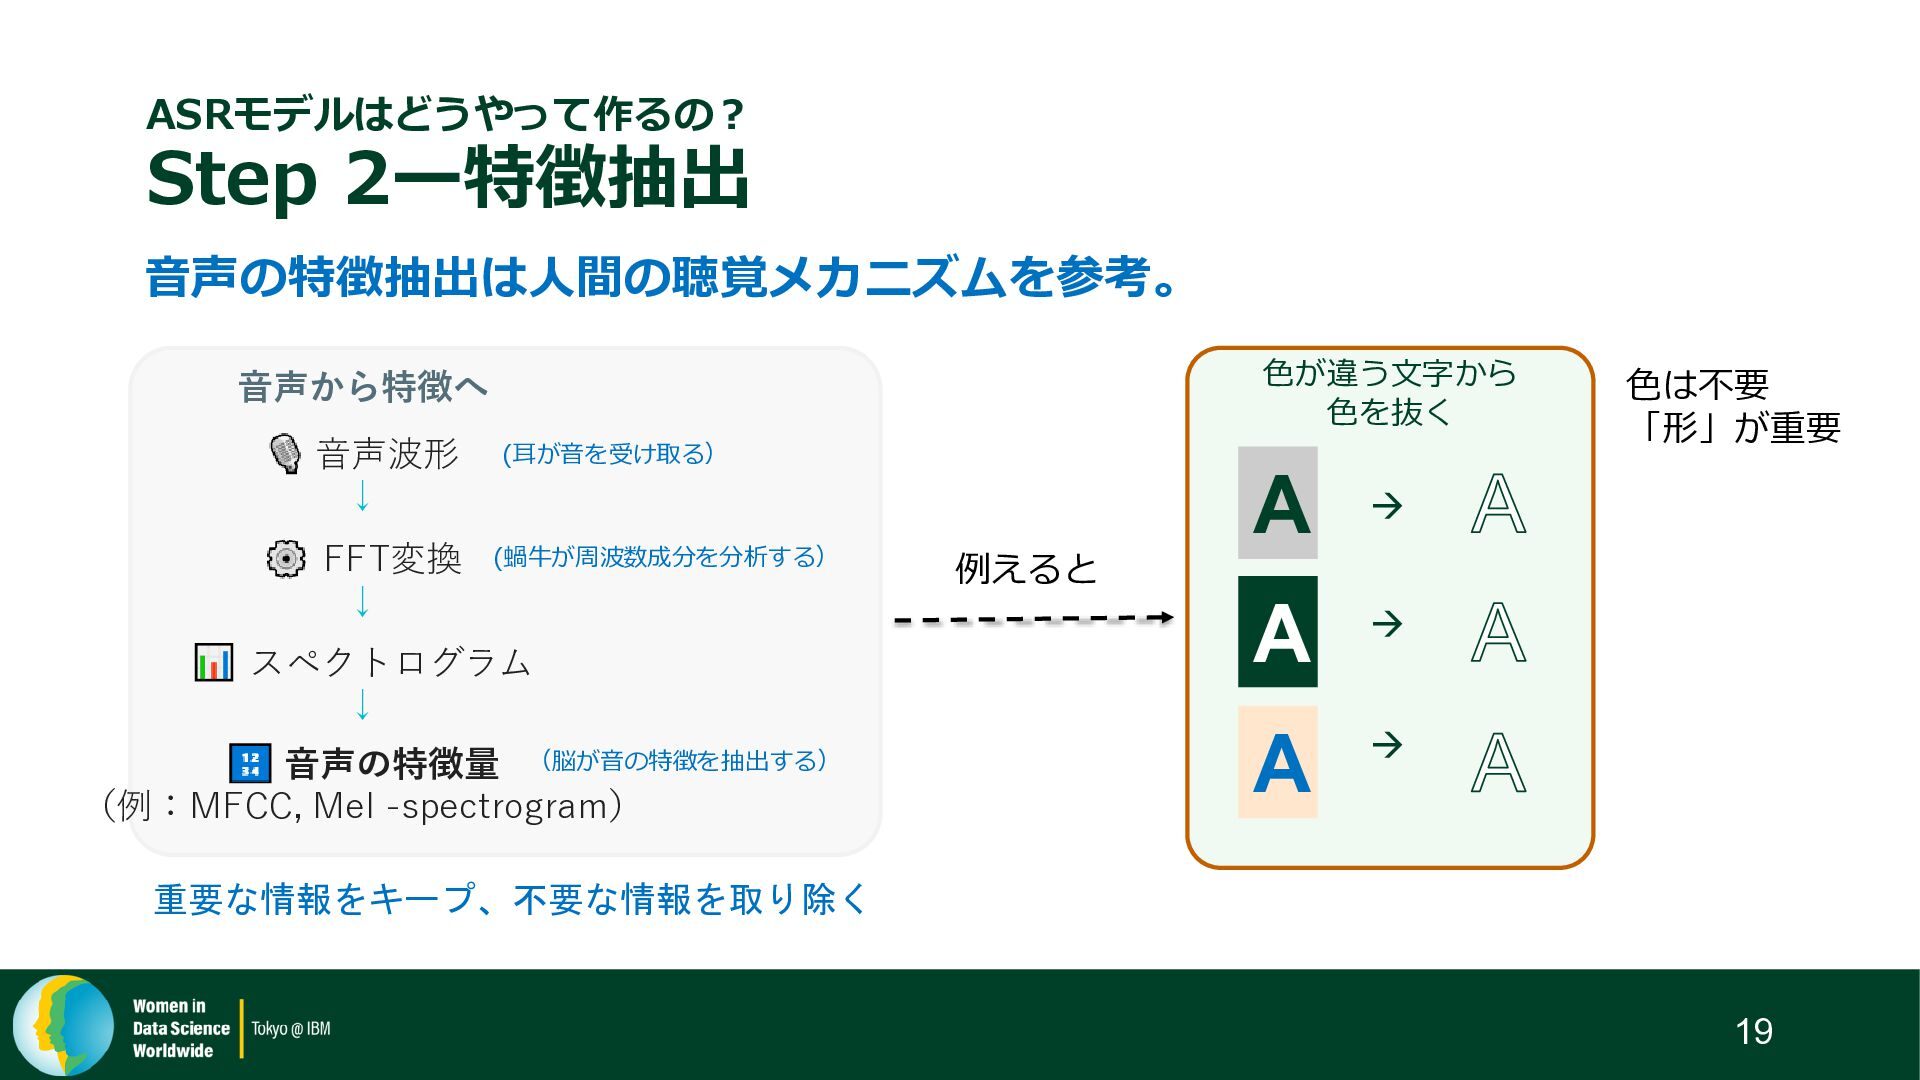
ASRモデルはどうやって作るの? Step 2ー特徴抽出 A A A A A A →
→ → 色が違う文字から 色を抜く 音声から特徴へ 音声波形 ↓ FFT変換 ↓ スペクトログラム ↓ 音声の特徴量 (例:MFCC, Mel -spectrogram) 例えると (耳が音を受け取る) (蝸牛が周波数成分を分析する) (脳が音の特徴を抽出する) 音声の特徴抽出は人間の聴覚メカニズムを参考。 19 重要な情報をキープ、不要な情報を取り除く 色は不要 「形」が重要 -
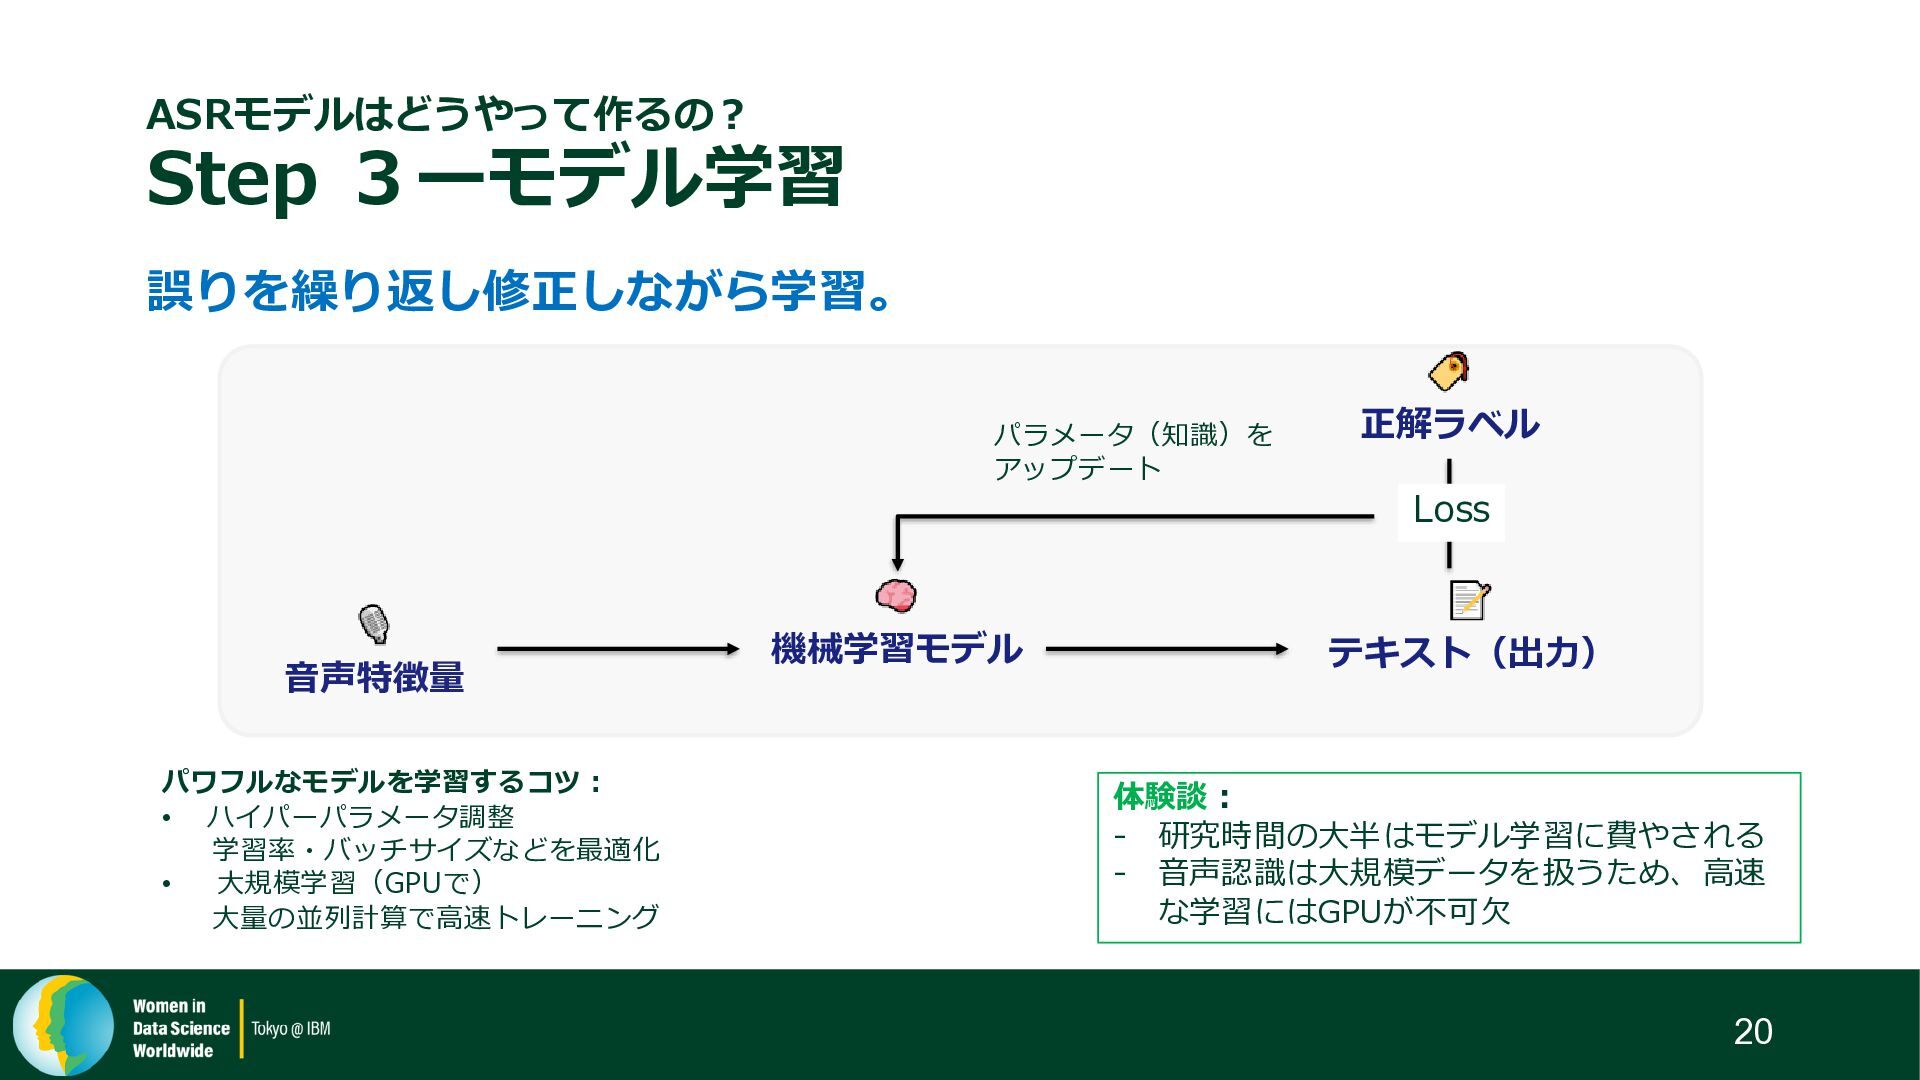
ASRモデルはどうやって作るの? Step 3ーモデル学習 誤りを繰り返し修正しながら学習。 音声特徴量 機械学習モデル テキスト(出力) 正解ラベル Loss パラメータ(知識)を
アップデート パワフルなモデルを学習するコツ: • ハイパーパラメータ調整 学習率・バッチサイズなどを最適化 • 大規模学習(GPUで) 大量の並列計算で高速トレーニング 体験談: - 研究時間の大半はモデル学習に費やされる - 音声認識は大規模データを扱うため、高速 な学習にはGPUが不可欠 20 -
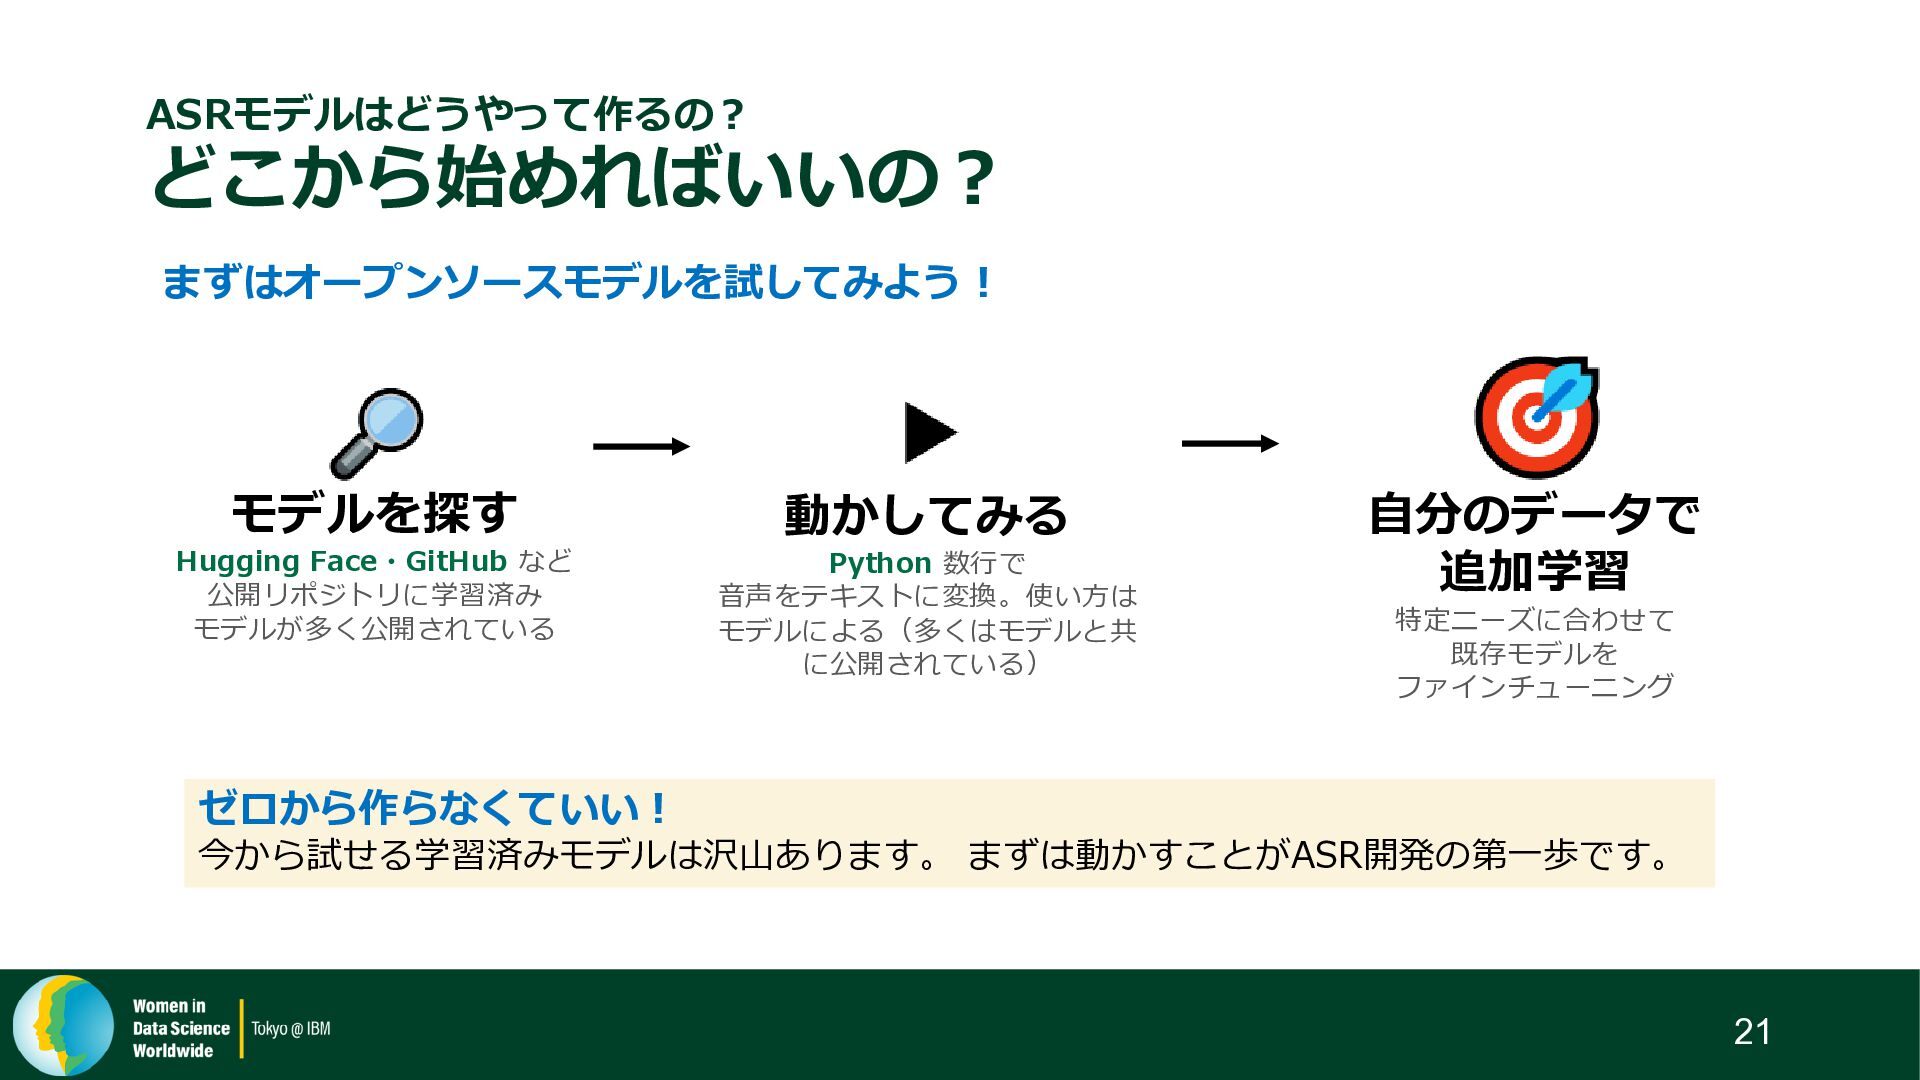
ASRモデルはどうやって作るの? どこから始めればいいの? 21 まずはオープンソースモデルを試してみよう! モデルを探す Hugging Face・GitHub など 公開リポジトリに学習済み モデルが多く公開されている
動かしてみる Python 数行で 音声をテキストに変換。使い方は モデルによる(多くはモデルと共 に公開されている) 自分のデータで 追加学習 特定ニーズに合わせて 既存モデルを ファインチューニング ゼロから作らなくていい! 今から試せる学習済みモデルは沢山あります。 まずは動かすことがASR開発の第一歩です。 -
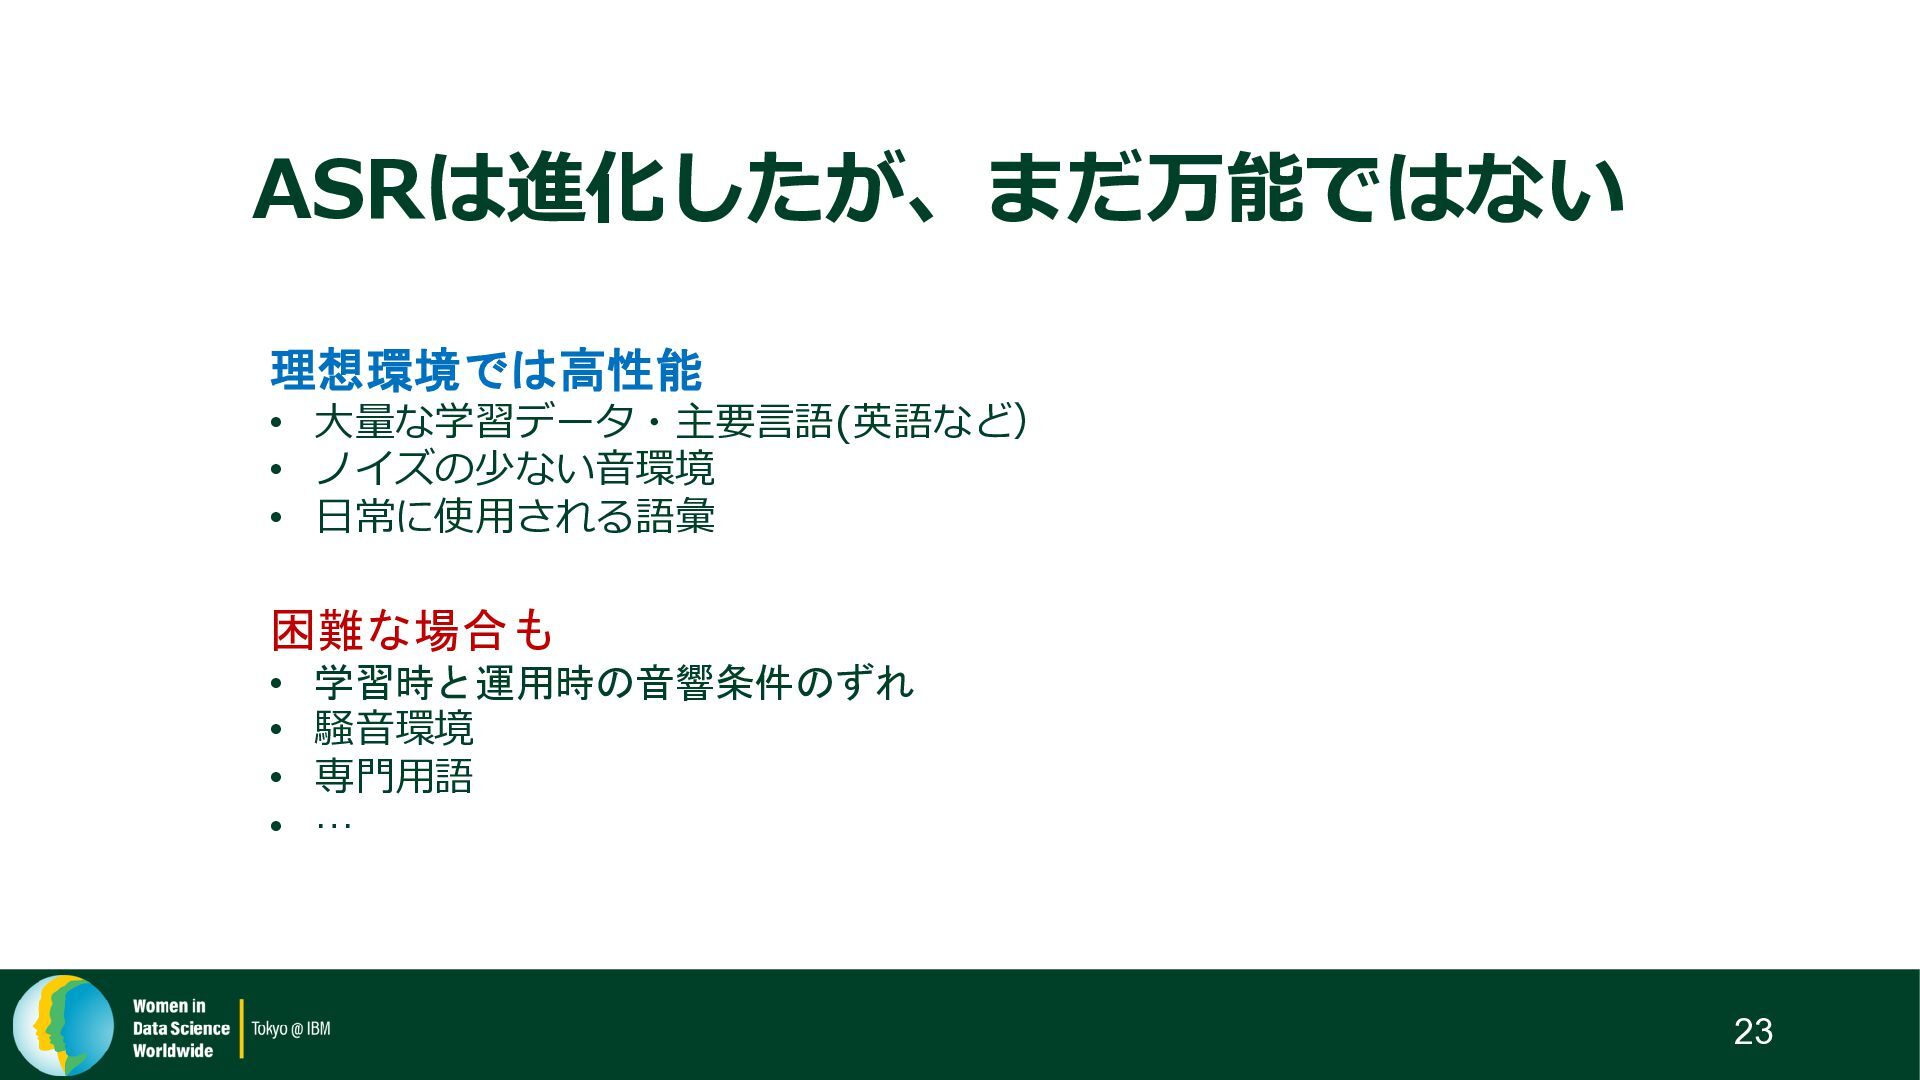
理想環境では高性能 • 大量な学習データ・主要言語(英語など) • ノイズの少ない音環境 • 日常に使用される語彙 困難な場合も • 学習時と運用時の音響条件のずれ
• 騒音環境 • 専門用語 • … ASRは進化したが、まだ万能ではない 23 -
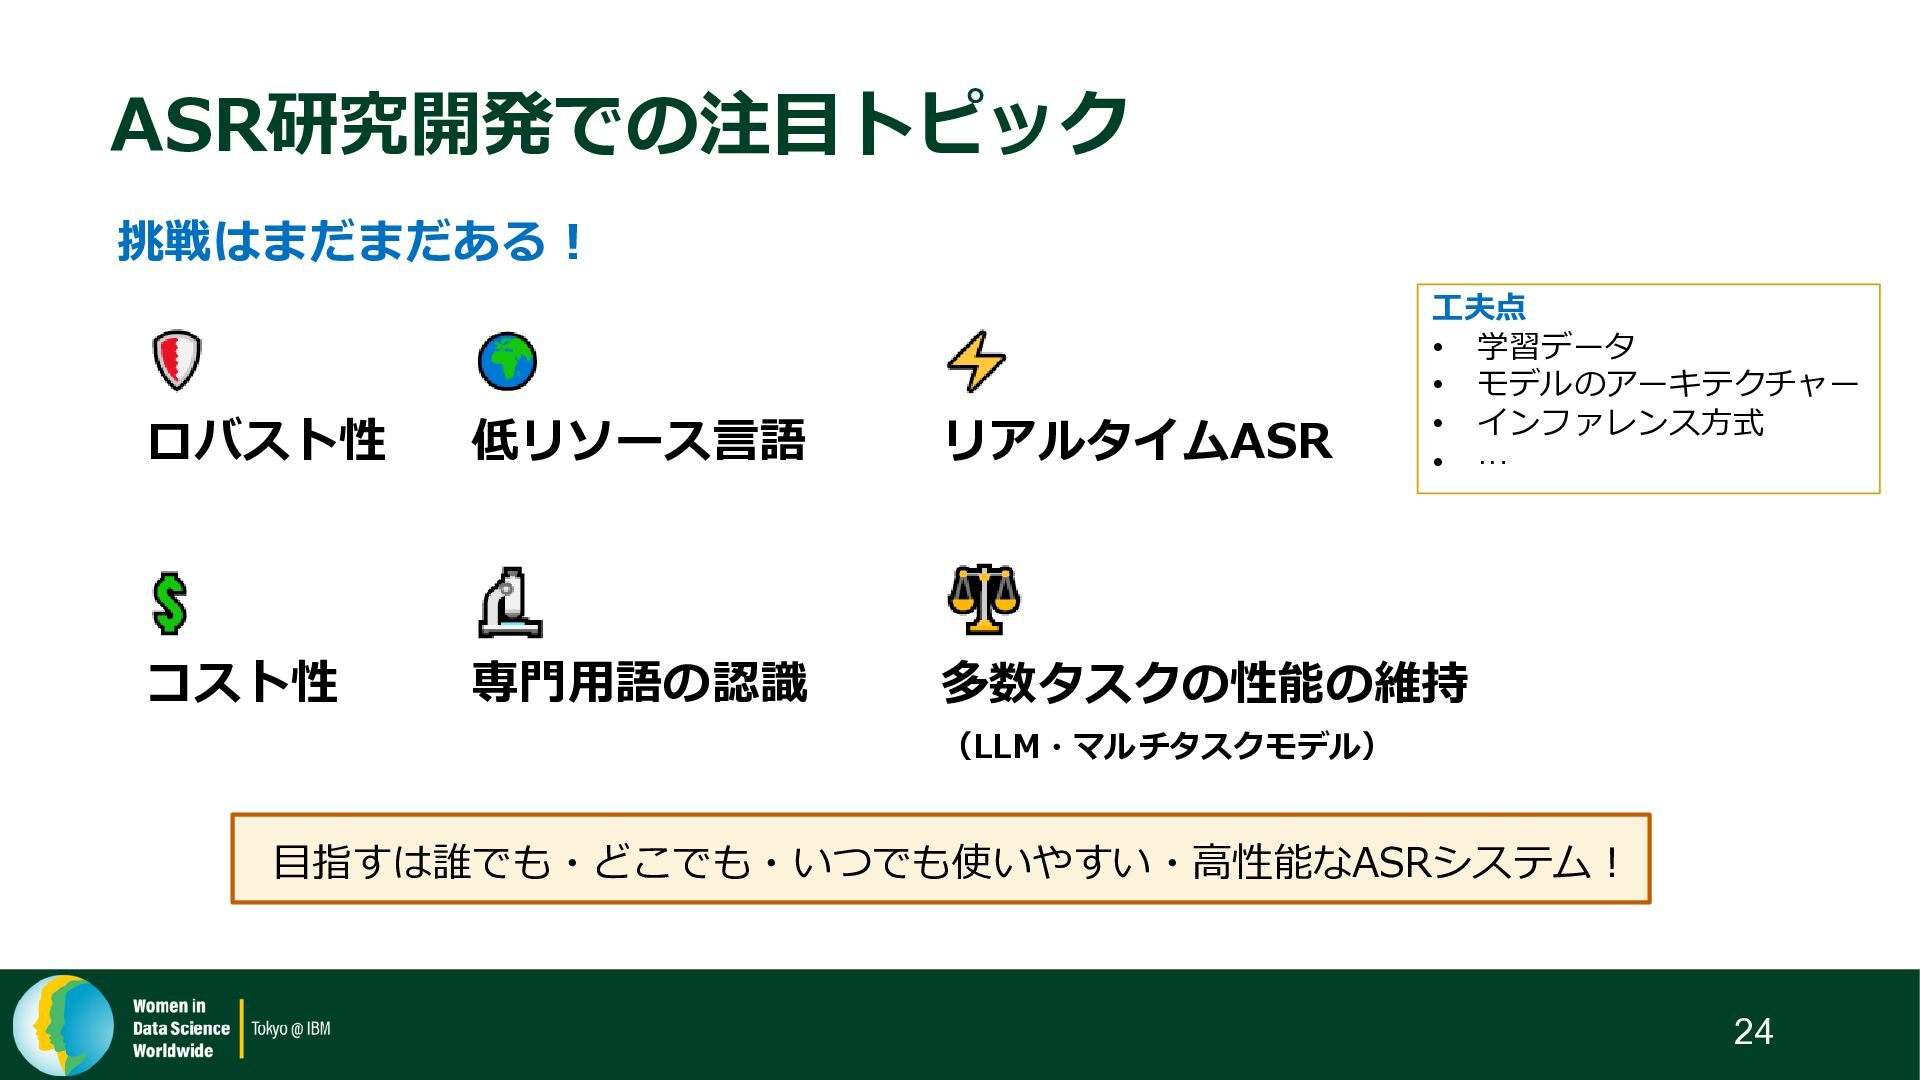
ASR研究開発での注目トピック 挑戦はまだまだある! ロバスト性 低リソース言語 リアルタイムASR コスト性 専門用語の認識 多数タスクの性能の維持 (LLM・マルチタスクモデル) 目指すは誰でも・どこでも・いつでも使いやすい・高性能なASRシステム!
24 工夫点 • 学習データ • モデルのアーキテクチャー • インファレンス方式 • … -
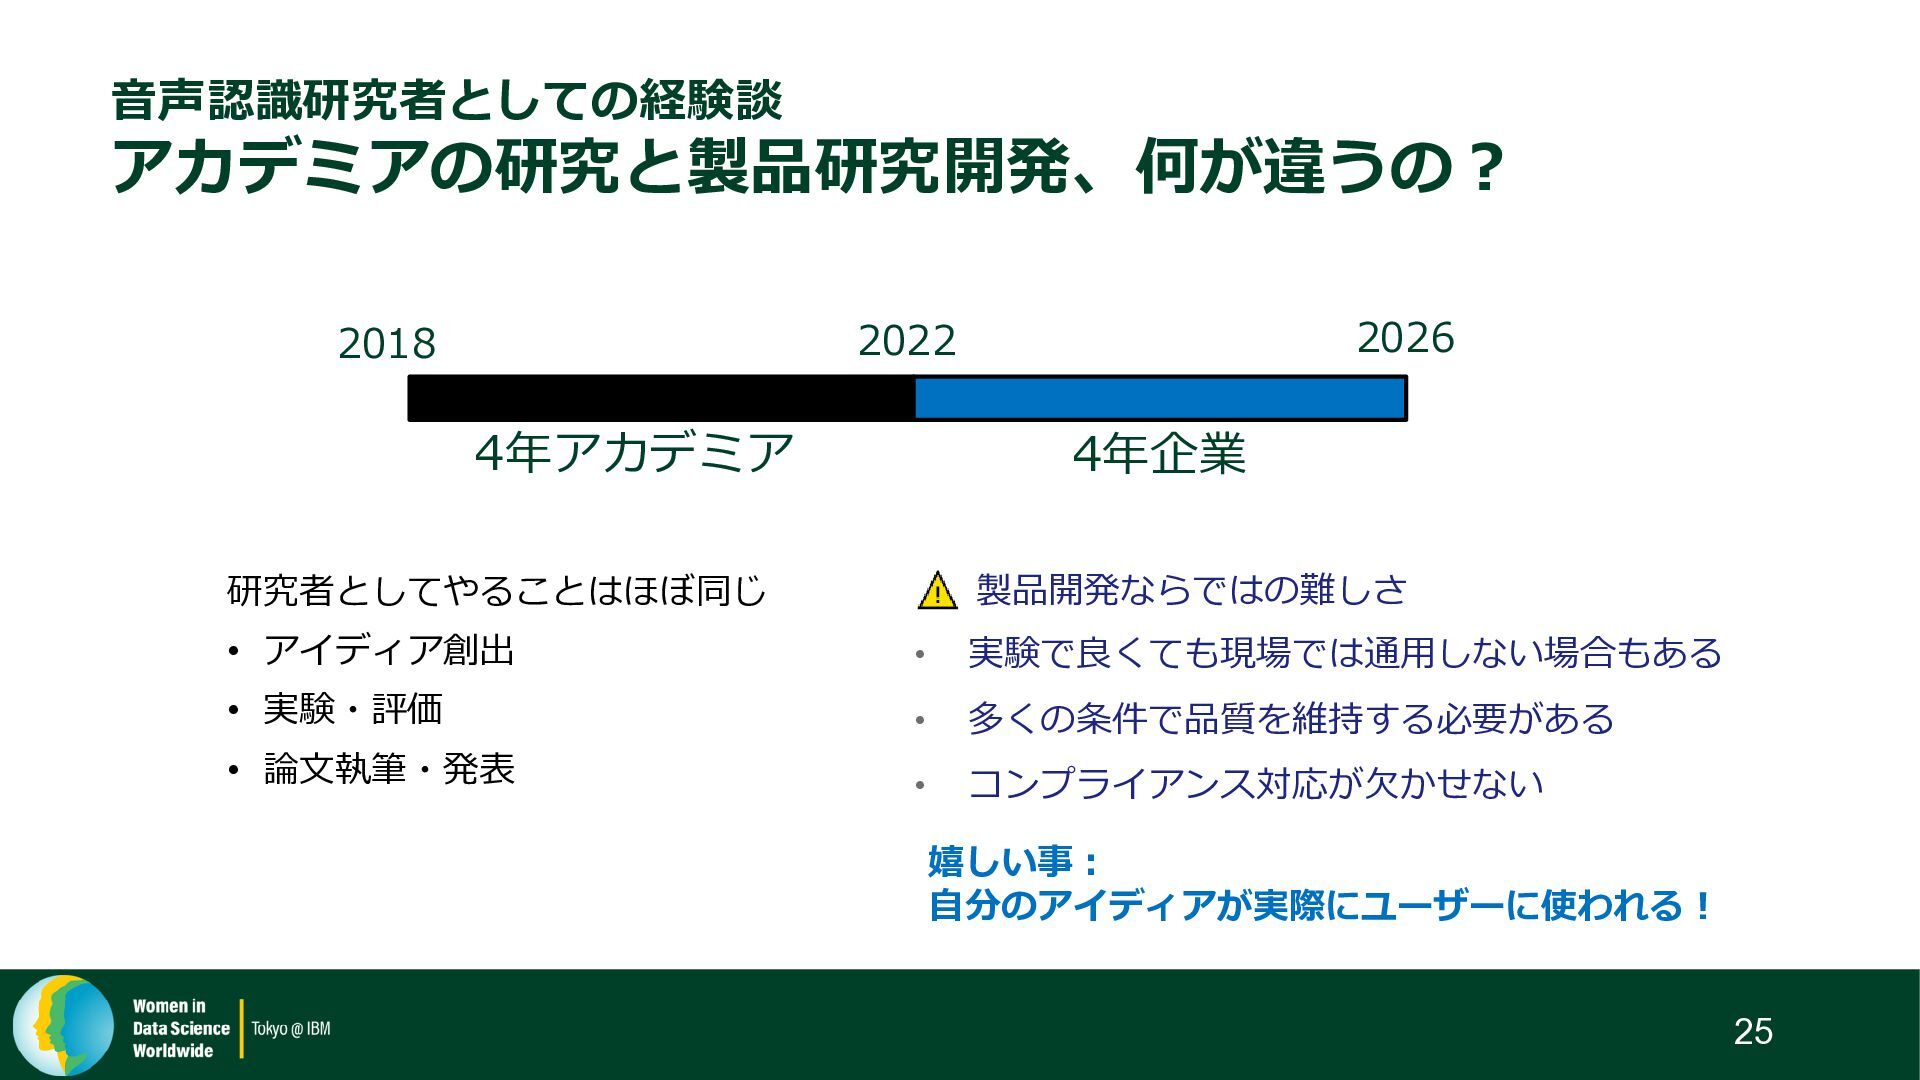
音声認識研究者としての経験談 アカデミアの研究と製品研究開発、何が違うの? 研究者としてやることはほぼ同じ • アイディア創出 • 実験・評価 • 論文執筆・発表 製品開発ならではの難しさ
• 実験で良くても現場では通用しない場合もある • 多くの条件で品質を維持する必要がある • コンプライアンス対応が欠かせない 4年アカデミア 4年企業 2018 2022 2026 嬉しい事: 自分のアイディアが実際にユーザーに使われる! 25 -
まとめ • ASR(音声認識)システムは機械の「耳」 • 機械学習モデルを敷いたパターン認識 o 半世紀以上の技術の進化 o 現代のモデル:高い性能+活用性 •
今のトレンド:ASR+LLM 「全部入り」モデル 26