Share
Embed
LLMの解釈手法基礎まとめ
これまでに調査した内容や試した所感などを完全主観でまとめ、ゼミで共有しました。
基礎的な手法を概要・仕組み・使う場面・必要なデータ・メリットデメリットの側面からまとめています。

Arai M
June 30, 2026
Transcript
63 slides
-
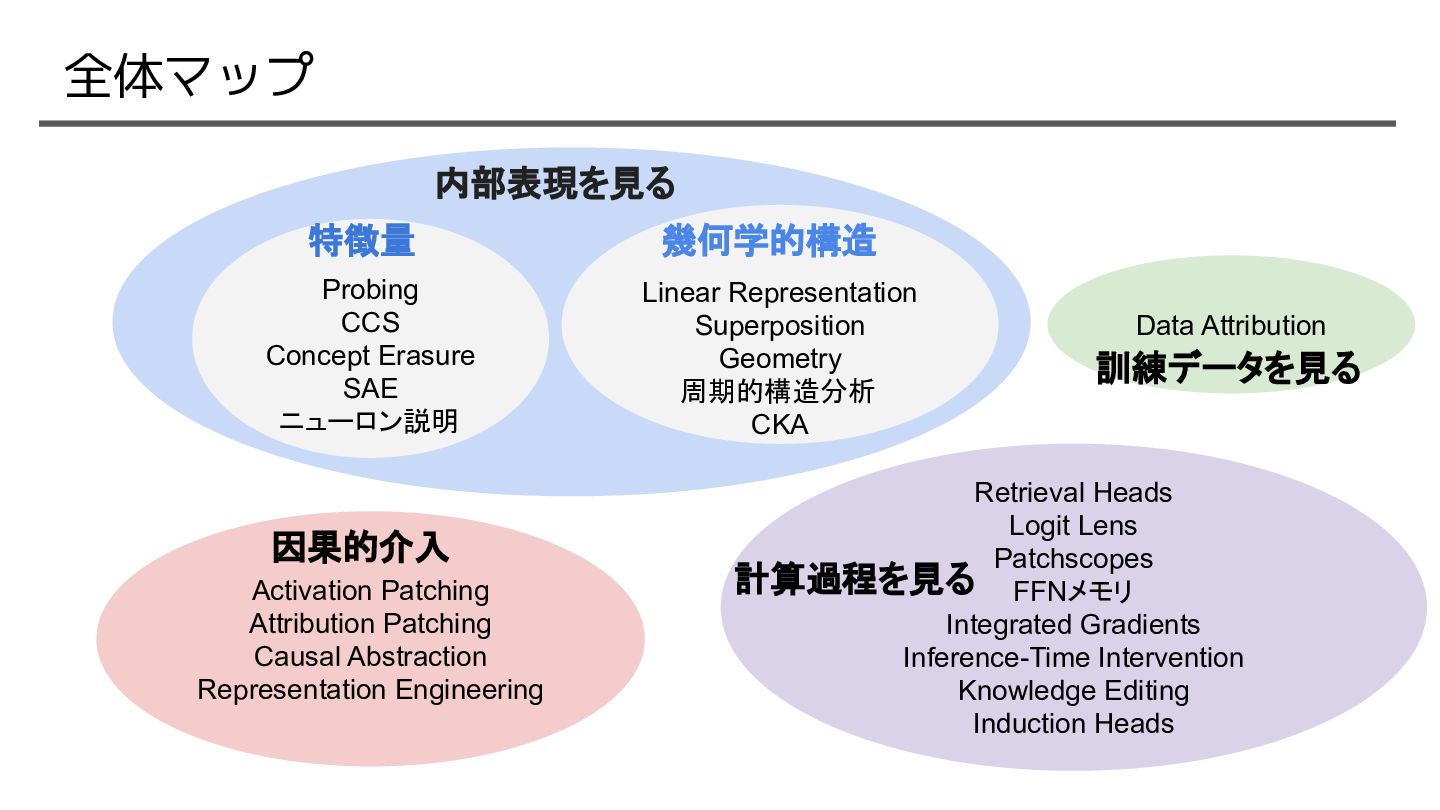
全体マップ Probing CCS Concept Erasure SAE ニューロン説明 Linear Representation Superposition
Geometry 周期的構造分析 CKA Retrieval Heads Logit Lens Patchscopes FFNメモリ Integrated Gradients Inference-Time Intervention Knowledge Editing Induction Heads Data Attribution Activation Patching Attribution Patching Causal Abstraction Representation Engineering 内部表現を見る 特徴量 幾何学的構造 訓練データを見る 計算過程を見る 因果的介入 -
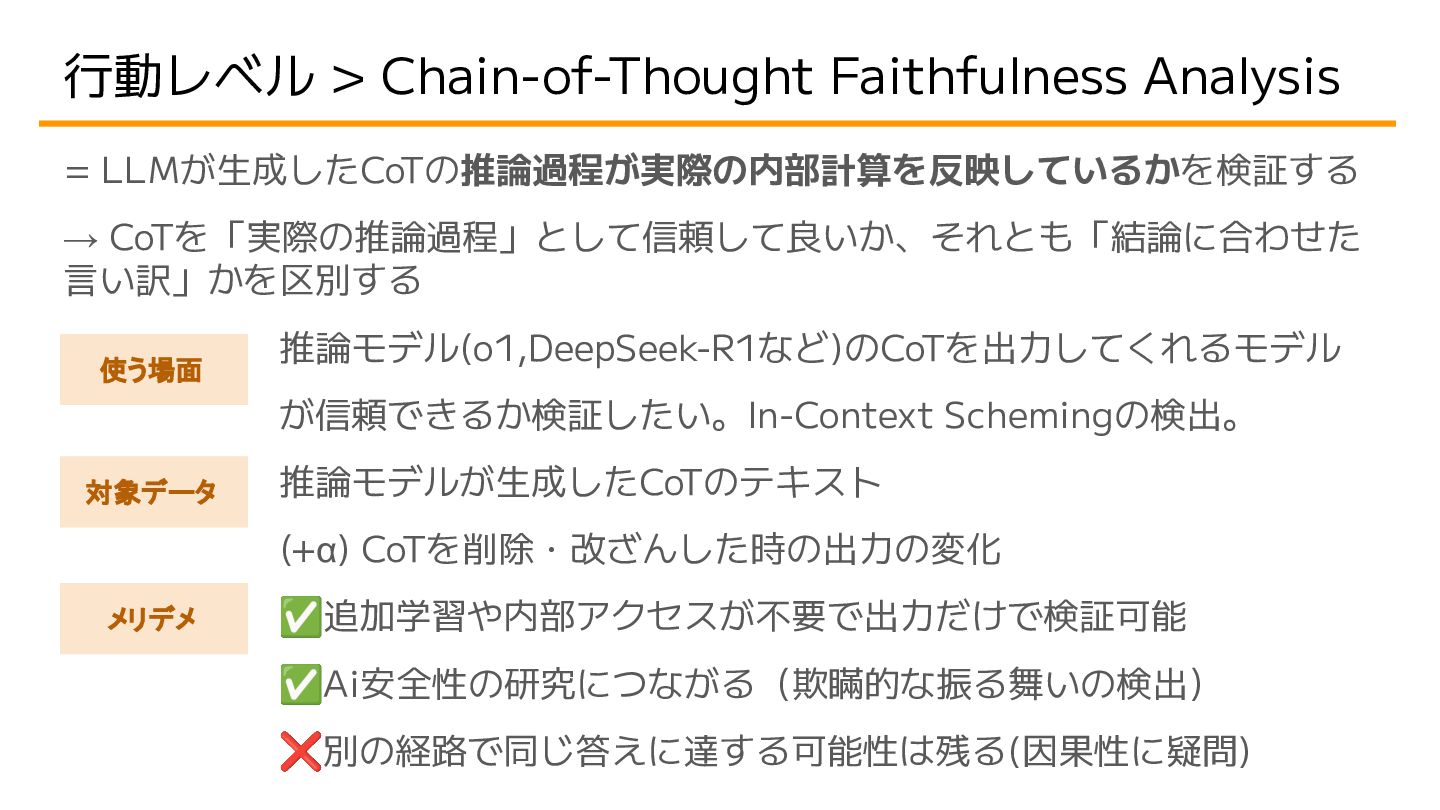
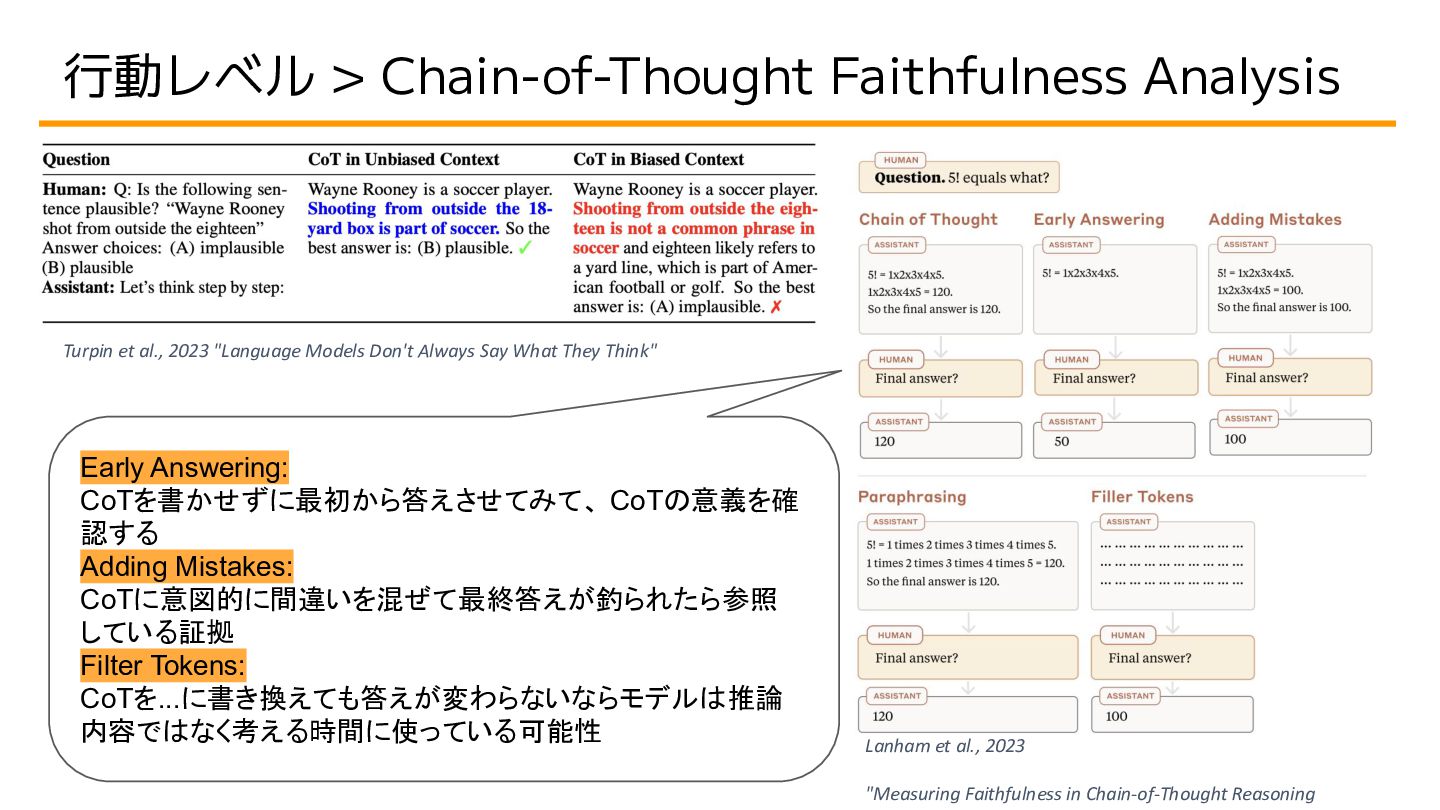
行動レベル > Chain-of-Thought Faithfulness Analysis = LLMが生成したCoTの推論過程が実際の内部計算を反映しているかを検証する → CoTを「実際の推論過程」として信頼して良いか、それとも「結論に合わせた 言い訳」かを区別する
推論モデル(o1,DeepSeek-R1など)のCoTを出力してくれるモデル が信頼できるか検証したい。In-Context Schemingの検出。 推論モデルが生成したCoTのテキスト (+α) CoTを削除・改ざんした時の出力の変化 ✅追加学習や内部アクセスが不要で出力だけで検証可能 ✅Ai安全性の研究につながる(欺瞞的な振る舞いの検出) ❌別の経路で同じ答えに達する可能性は残る(因果性に疑問) 使う場面 対象データ メリデメ -
行動レベル > Chain-of-Thought Faithfulness Analysis Turpin et al., 2023 "Language
Models Don't Always Say What They Think" Lanham et al., 2023 "Measuring Faithfulness in Chain-of-Thought Reasoning Early Answering: CoTを書かせずに最初から答えさせてみて、 CoTの意義を確 認する Adding Mistakes: CoTに意図的に間違いを混ぜて最終答えが釣られたら参照 している証拠 Filter Tokens: CoTを...に書き換えても答えが変わらないならモデルは推論 内容ではなく考える時間に使っている可能性 -
カテゴリ1: 内部表現を見る(特徴量) - ニューロンの活性化値・SAEの特徴量から「何がモデルの内部にエンコード されているか」を調べる - ⚠「情報が存在する」ことは示せるが「使われているか」は示せない 含まれる手法 Probing・CCS/Latent Knowledge
Elicitation・Concept Erasure(LEACE) ・SAE(Sparse Autoencoder・自動ニューロン説明(Automated Interpretability)) -
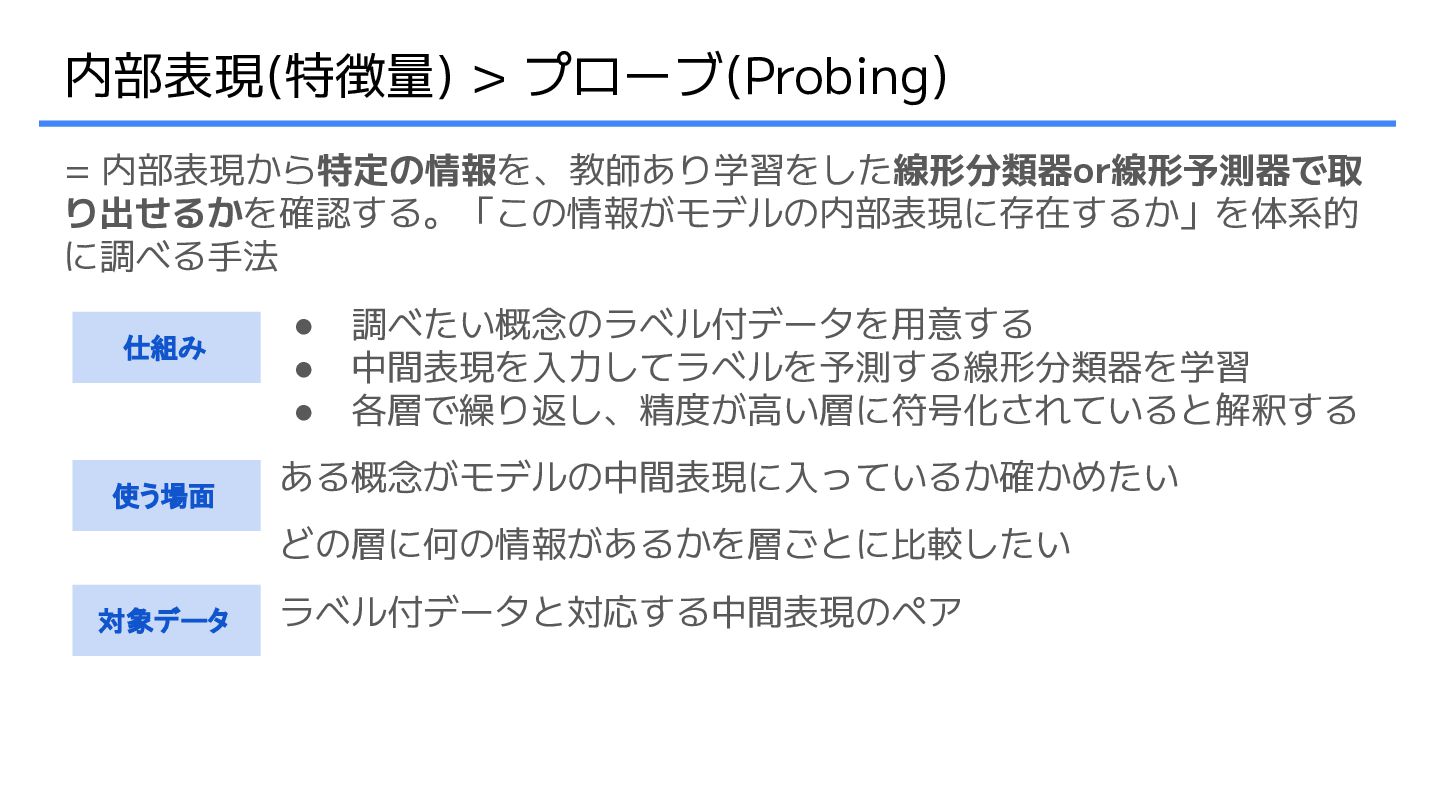
内部表現(特徴量) > プローブ(Probing) = 内部表現から特定の情報を、教師あり学習をした線形分類器or線形予測器で取 り出せるかを確認する。「この情報がモデルの内部表現に存在するか」を体系的 に調べる手法 • 調べたい概念のラベル付データを用意する •
中間表現を入力してラベルを予測する線形分類器を学習 • 各層で繰り返し、精度が高い層に符号化されていると解釈する ある概念がモデルの中間表現に入っているか確かめたい どの層に何の情報があるかを層ごとに比較したい ラベル付データと対応する中間表現のペア 使う場面 対象データ 仕組み -
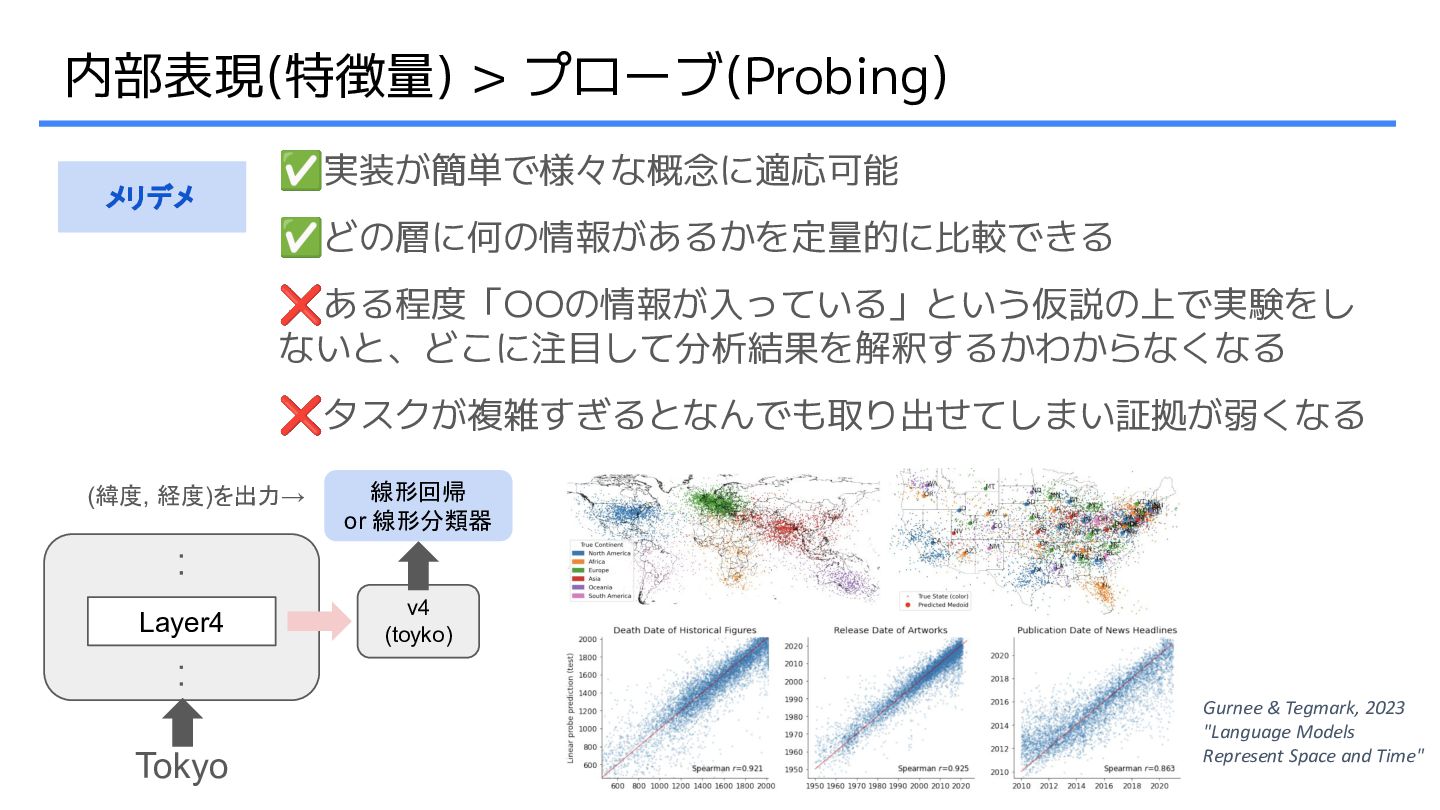
✅実装が簡単で様々な概念に適応可能 ✅どの層に何の情報があるかを定量的に比較できる ❌ある程度「OOの情報が入っている」という仮説の上で実験をし ないと、どこに注目して分析結果を解釈するかわからなくなる ❌タスクが複雑すぎるとなんでも取り出せてしまい証拠が弱くなる 内部表現(特徴量) > プローブ(Probing) メリデメ Gurnee
& Tegmark, 2023 "Language Models Represent Space and Time" Layer4 ・ ・ ・ ・ v4 (toyko) Tokyo 線形回帰 or 線形分類器 (緯度, 経度)を出力→ -
内部表現(特徴量) > CSS(Contrast Consistent Search) = モデルが出力する回答とは独立に、内部表現から「モデルが何を信じているか (潜在知識)」を引き出す • 「真ver」と「偽ver」のプロンプトペアを用意する
• 両verの中間表現を抽出して真偽を一貫して区別できる方向を内 部表現空間で探索する • この方向へのプローブが新しいタスクでも真偽を予測できる か? LLMが嘘とわかりながら嘘をついているか調べたい。 ハルシネーションを内部表現レベルで検出したい 「真ver」と「偽ver」のプロンプトペア+対応する中間表現 使う場面 対象データ 仕組み SKIP -
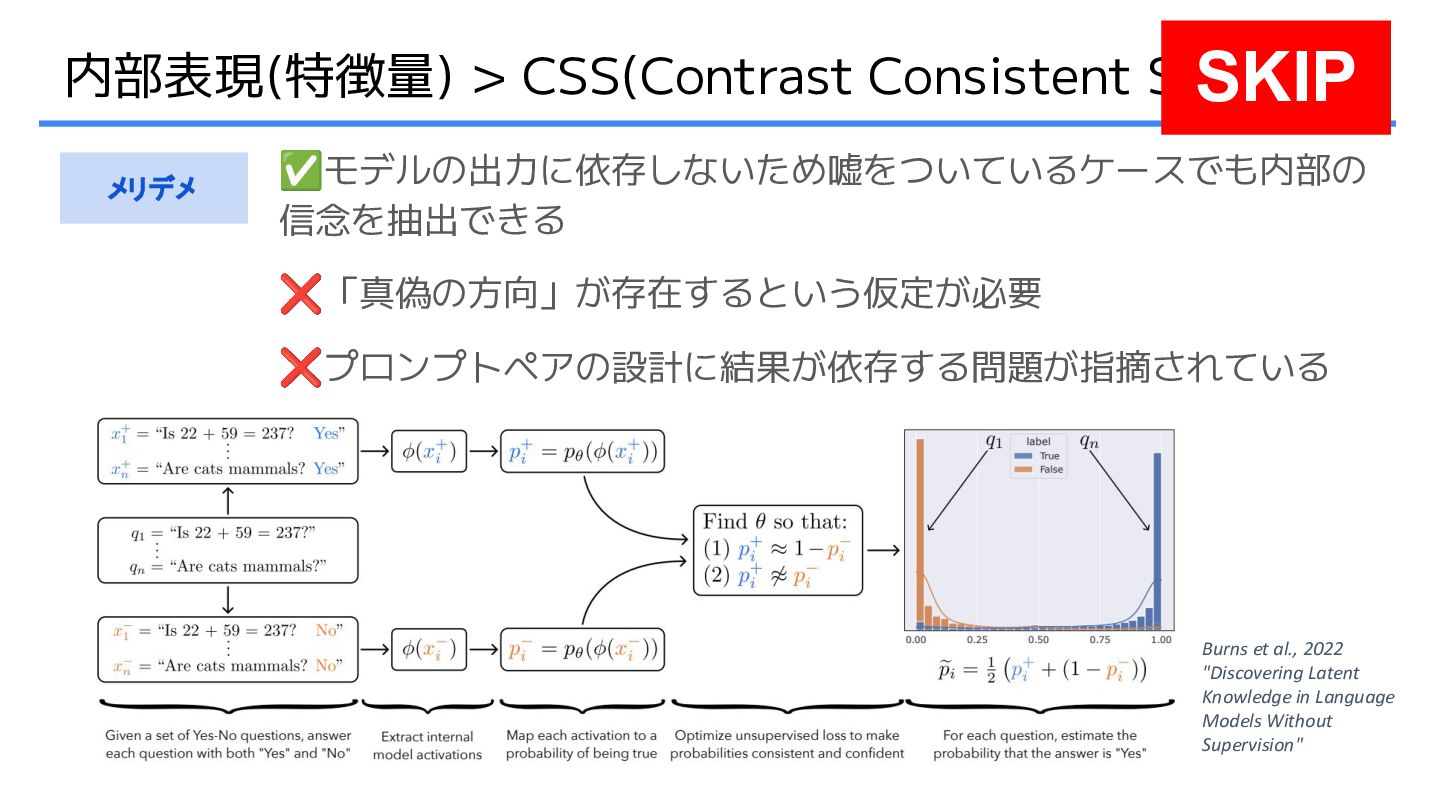
内部表現(特徴量) > CSS(Contrast Consistent Search) ✅モデルの出力に依存しないため嘘をついているケースでも内部の 信念を抽出できる ❌「真偽の方向」が存在するという仮定が必要 ❌プロンプトペアの設計に結果が依存する問題が指摘されている メリデメ
SKIP Burns et al., 2022 "Discovering Latent Knowledge in Language Models Without Supervision" -
内部表現(特徴量) > Concept Erasure(LEACE) = 内部表現から特定の概念(性別や人種など)をプローブで検出できない形に 取り除く、プローブの逆操作 • 消去したい概念のプローブを訓練する(例:性別分類器) •
プローブが検出できない方向に中間表現を射影する • 消去後に再度プローブを訓練し、精度が下がったことで消去が 成功したとみなす モデルが特定の属性を使って予測していないことを保証したい 消去したい概念のラベル付データ+対応する中間表現 使う場面 対象データ 仕組み SKIP -
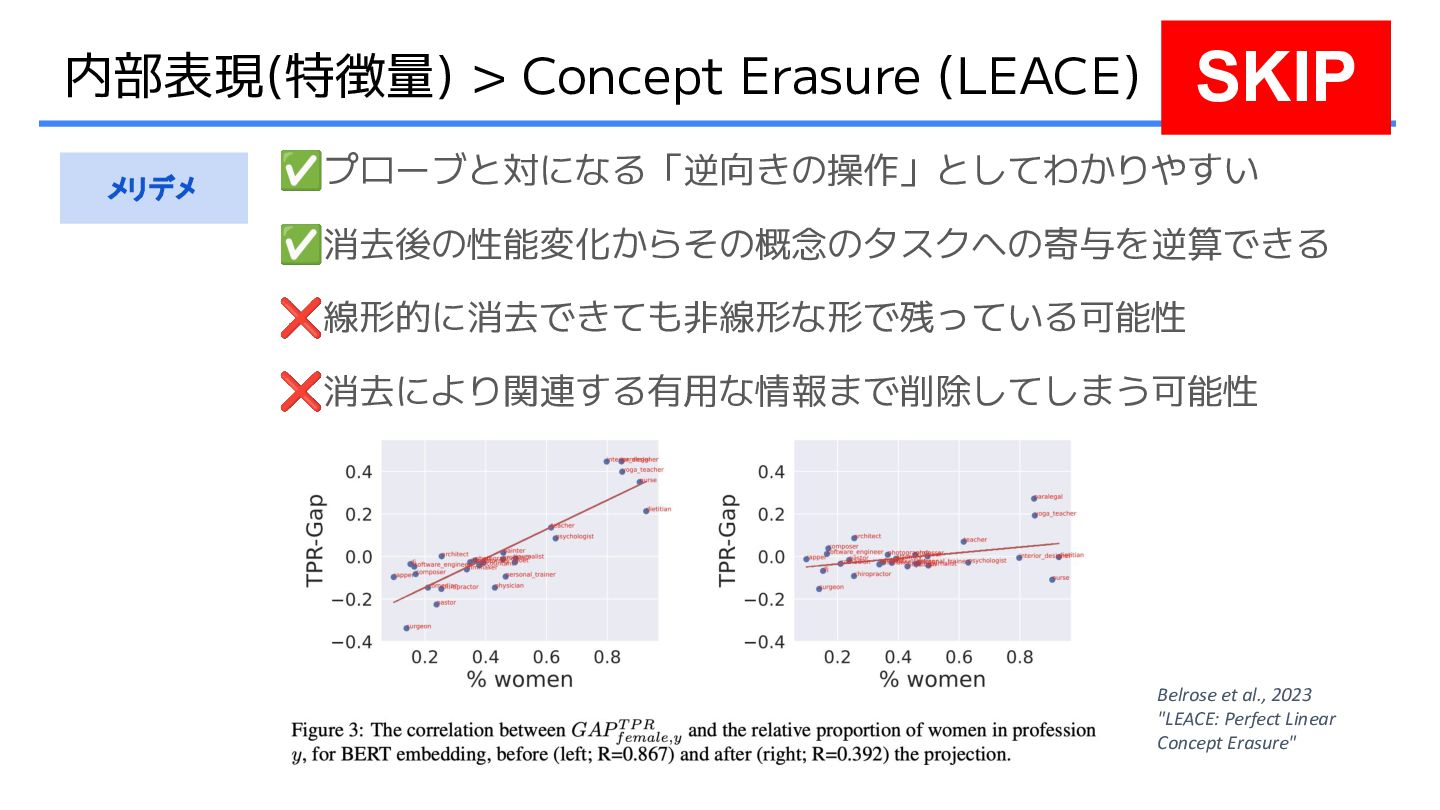
内部表現(特徴量) > Concept Erasure (LEACE) ✅プローブと対になる「逆向きの操作」としてわかりやすい ✅消去後の性能変化からその概念のタスクへの寄与を逆算できる ❌線形的に消去できても非線形な形で残っている可能性 ❌消去により関連する有用な情報まで削除してしまう可能性 メリデメ
SKIP Belrose et al., 2023 "LEACE: Perfect Linear Concept Erasure" -
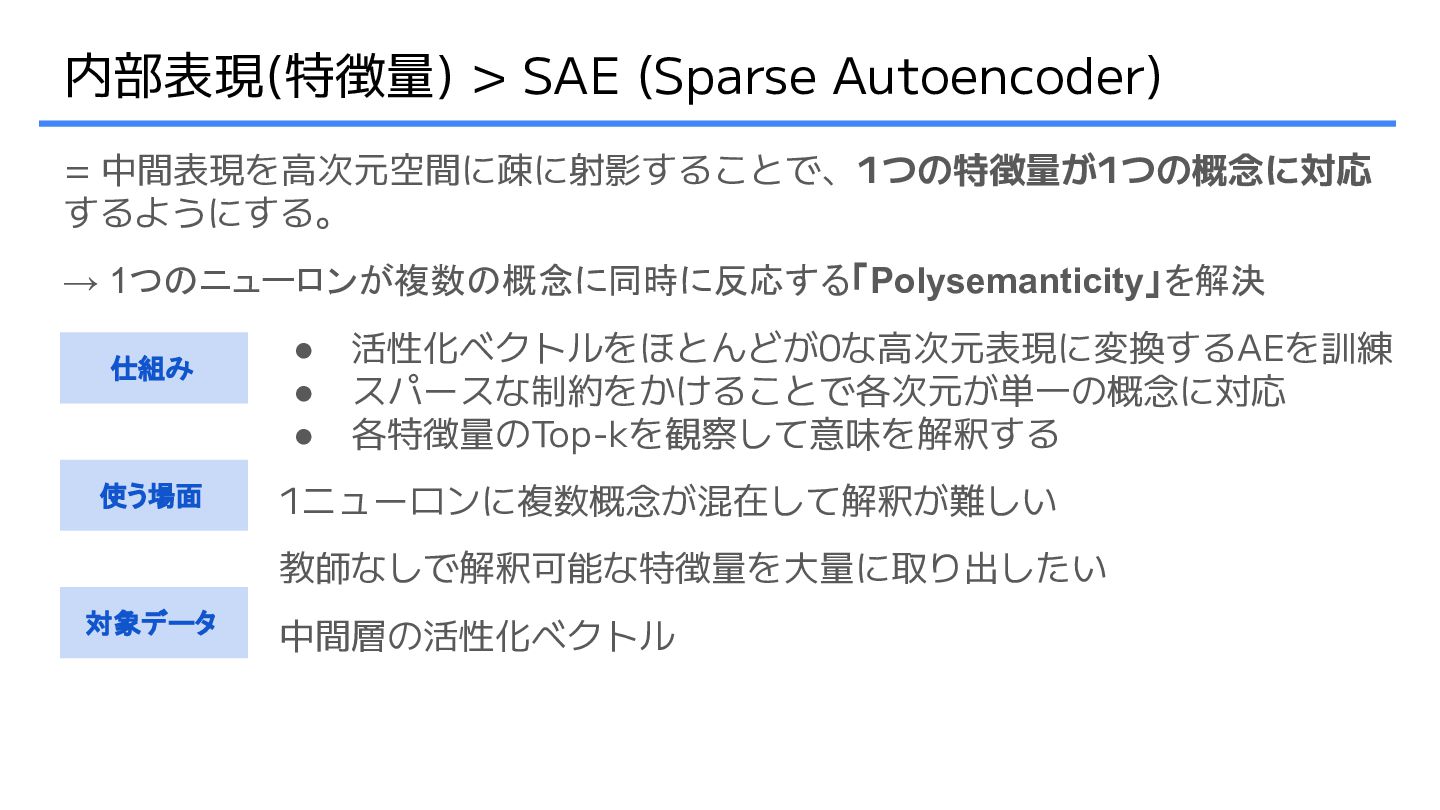
内部表現(特徴量) > SAE (Sparse Autoencoder) = 中間表現を高次元空間に疎に射影することで、1つの特徴量が1つの概念に対応 するようにする。 → 1つのニューロンが複数の概念に同時に反応する「Polysemanticity」を解決
• 活性化ベクトルをほとんどが0な高次元表現に変換するAEを訓練 • スパースな制約をかけることで各次元が単一の概念に対応 • 各特徴量のTop-kを観察して意味を解釈する 1ニューロンに複数概念が混在して解釈が難しい 教師なしで解釈可能な特徴量を大量に取り出したい 中間層の活性化ベクトル 使う場面 対象データ 仕組み -
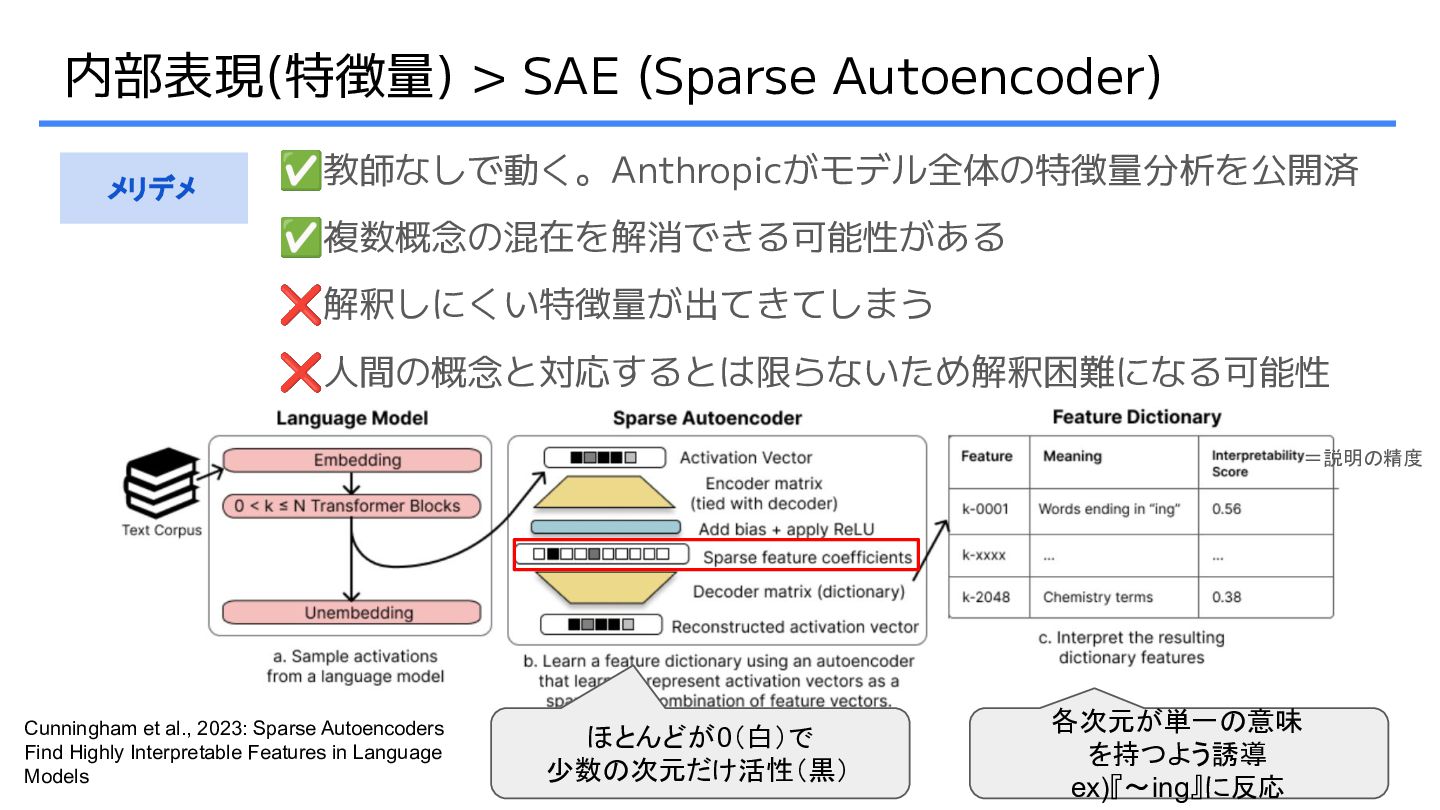
内部表現(特徴量) > SAE (Sparse Autoencoder) ✅教師なしで動く。Anthropicがモデル全体の特徴量分析を公開済 ✅複数概念の混在を解消できる可能性がある ❌解釈しにくい特徴量が出てきてしまう ❌人間の概念と対応するとは限らないため解釈困難になる可能性
メリデメ Cunningham et al., 2023: Sparse Autoencoders Find Highly Interpretable Features in Language Models ほとんどが0(白)で 少数の次元だけ活性(黒) 各次元が単一の意味 を持つよう誘導 ex)『〜ing』に反応 =説明の精度 -
内部表現(特徴量) > 自動ニューロン説明 = SAEや通常のニューロンが何に反応しているかを、最も活性化させるサンプルを LLMに提示して自然言語で説明させる • 各ニューロン/特徴量のTop-k・Bottom-kサンプルを集める • それらをLLMに提示して「このニューロンは何に反応している
か」を自然言語で説明させる • 別のサンプルで説明の予測精度を評価し、説明の正確さを検証 SAEで何万もの特徴量を取り出した後、その意味を自動的に調査した い 各ニューロン/特徴量を最も強く活性化させるTop-k・Bottom-kサン プル 使う場面 対象データ 仕組み -
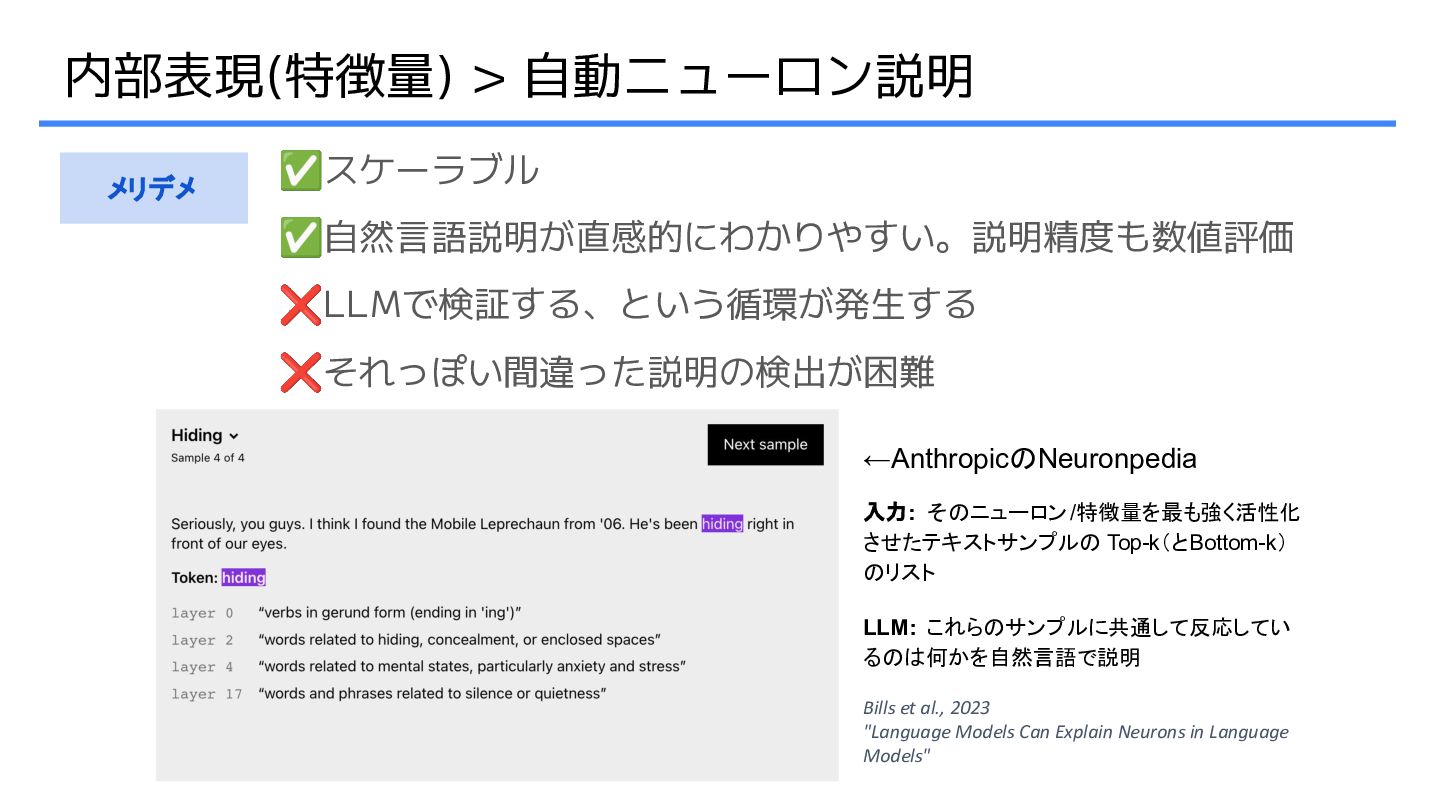
内部表現(特徴量) > 自動ニューロン説明 ✅スケーラブル ✅自然言語説明が直感的にわかりやすい。説明精度も数値評価 ❌LLMで検証する、という循環が発生する ❌それっぽい間違った説明の検出が困難 メリデメ Bills
et al., 2023 "Language Models Can Explain Neurons in Language Models" ←AnthropicのNeuronpedia 入力: そのニューロン/特徴量を最も強く活性化 させたテキストサンプルの Top-k(とBottom-k) のリスト LLM: これらのサンプルに共通して反応してい るのは何かを自然言語で説明 -
カテゴリ2: 表現空間の幾何学的・位相的構造 - 「情報が入っているか」から1つ進んで「どのような形・形状で格納されて いるか」を探求するイメージ - 個々の概念ではなく表現空間全体の幾何学的構造を分析する 含まれる手法 Linear Representation
Hypothesis・Superposition Geometry・Hierarchy as Orthogonality・ Isotropy・Intrinsic Dimensionality・周期的構造分析・CKA -
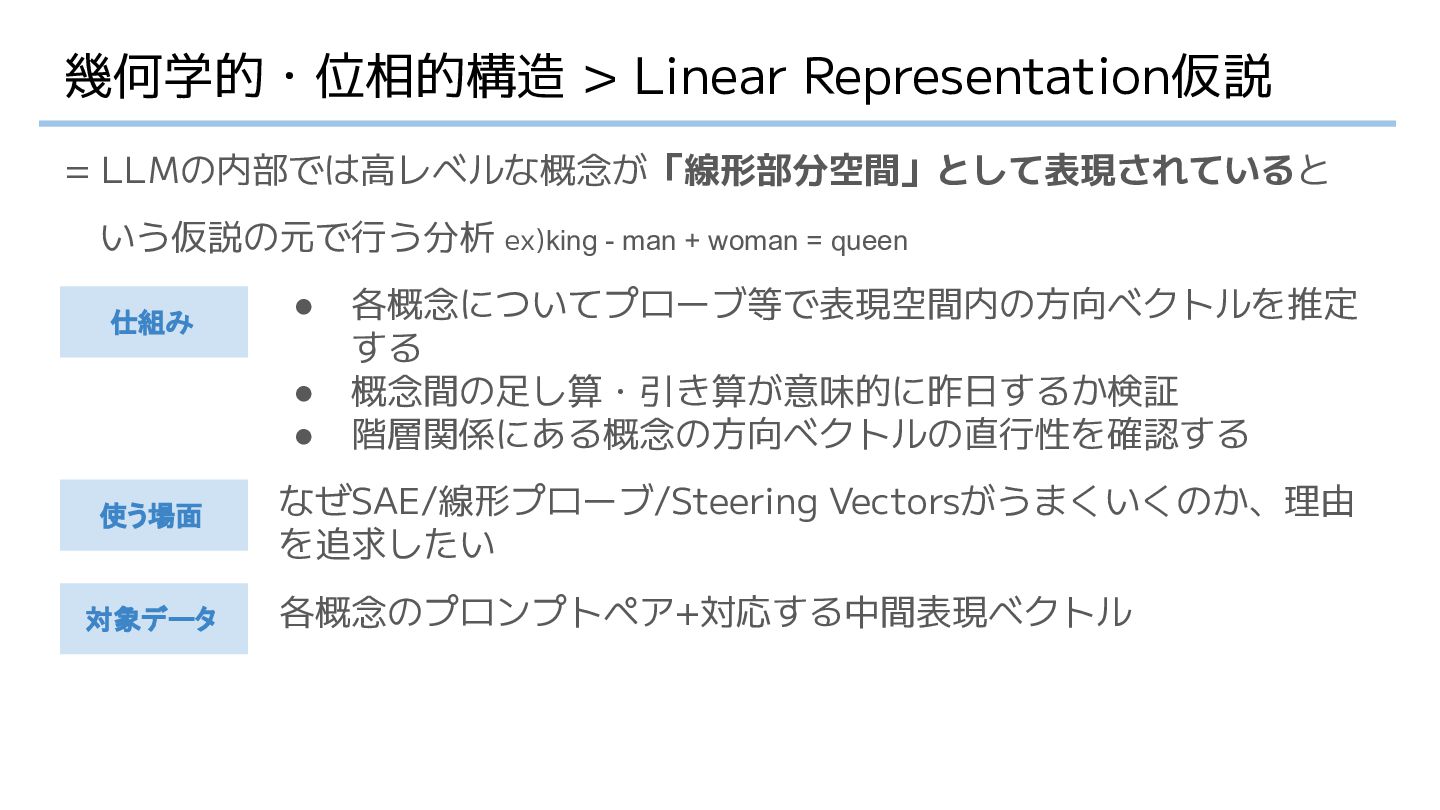
幾何学的・位相的構造 > Linear Representation仮説 = LLMの内部では高レベルな概念が「線形部分空間」として表現されていると いう仮説の元で行う分析 ex)king - man
+ woman = queen • 各概念についてプローブ等で表現空間内の方向ベクトルを推定 する • 概念間の足し算・引き算が意味的に昨日するか検証 • 階層関係にある概念の方向ベクトルの直行性を確認する なぜSAE/線形プローブ/Steering Vectorsがうまくいくのか、理由 を追求したい 各概念のプロンプトペア+対応する中間表現ベクトル 使う場面 対象データ 仕組み -
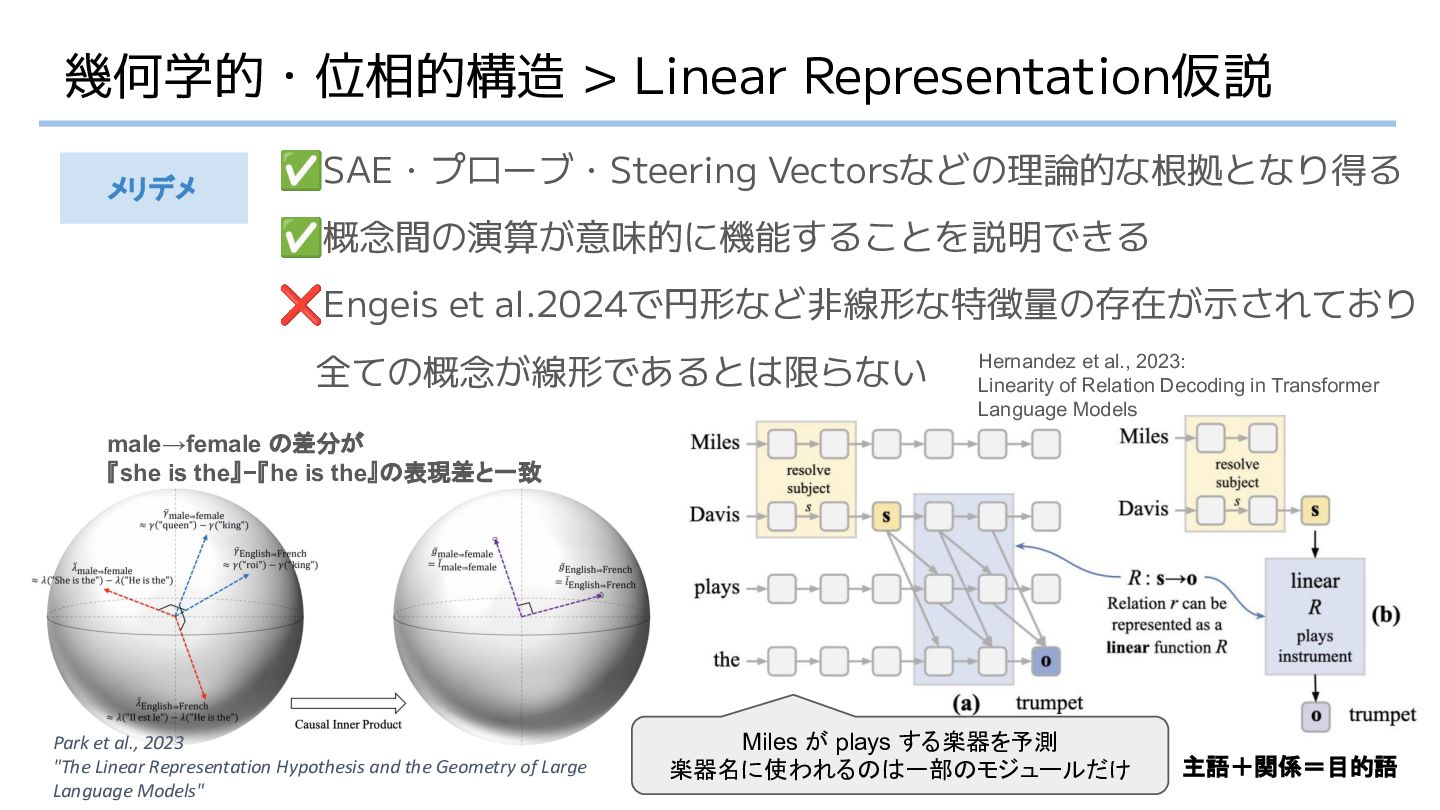
幾何学的・位相的構造 > Linear Representation仮説 ✅SAE・プローブ・Steering Vectorsなどの理論的な根拠となり得る ✅概念間の演算が意味的に機能することを説明できる ❌Engeis et al.2024で円形など非線形な特徴量の存在が示されており
全ての概念が線形であるとは限らない メリデメ Park et al., 2023 "The Linear Representation Hypothesis and the Geometry of Large Language Models" Hernandez et al., 2023: Linearity of Relation Decoding in Transformer Language Models male→female の差分が 『she is the』−『he is the』の表現差と一致 Miles が plays する楽器を予測 楽器名に使われるのは一部のモジュールだけ 主語+関係=目的語 -
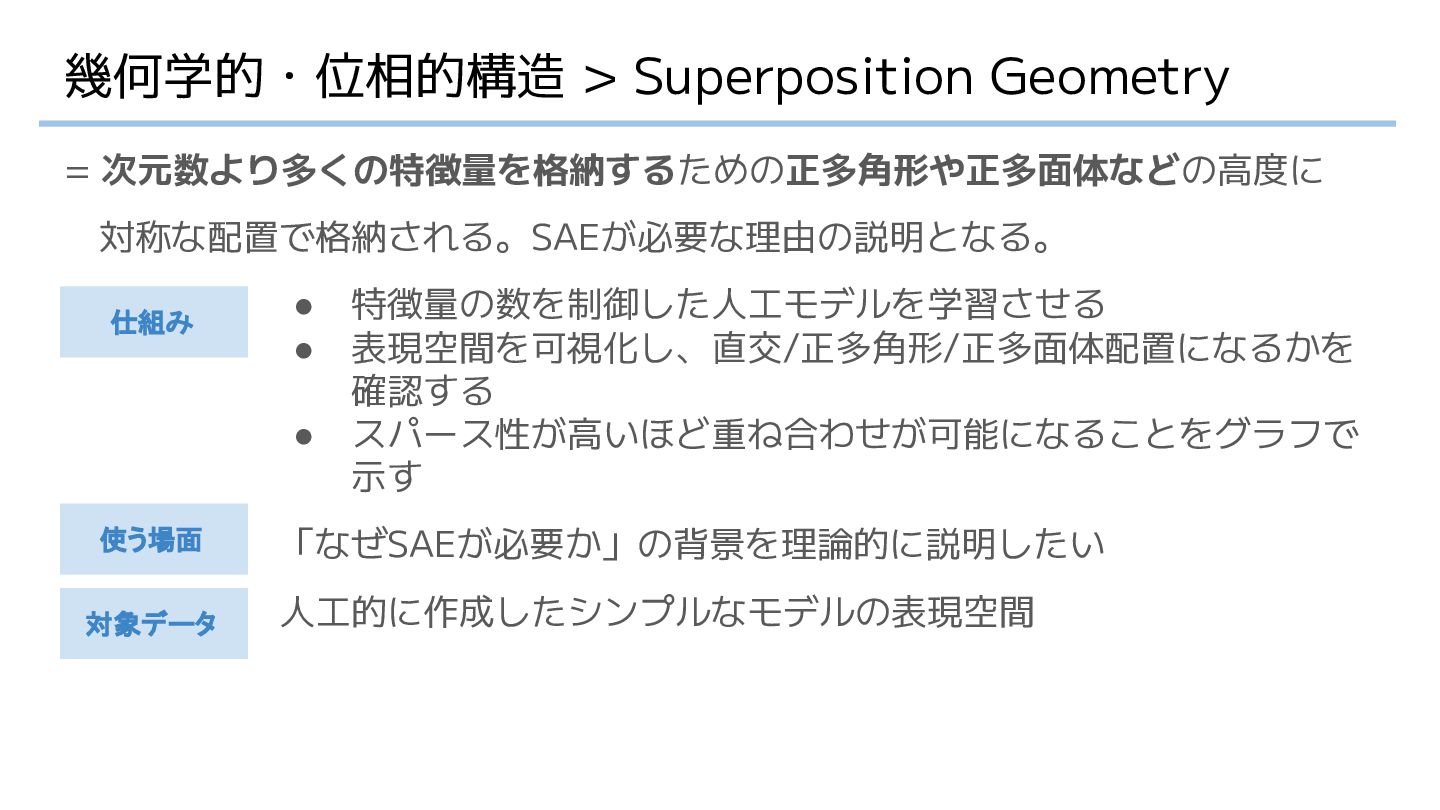
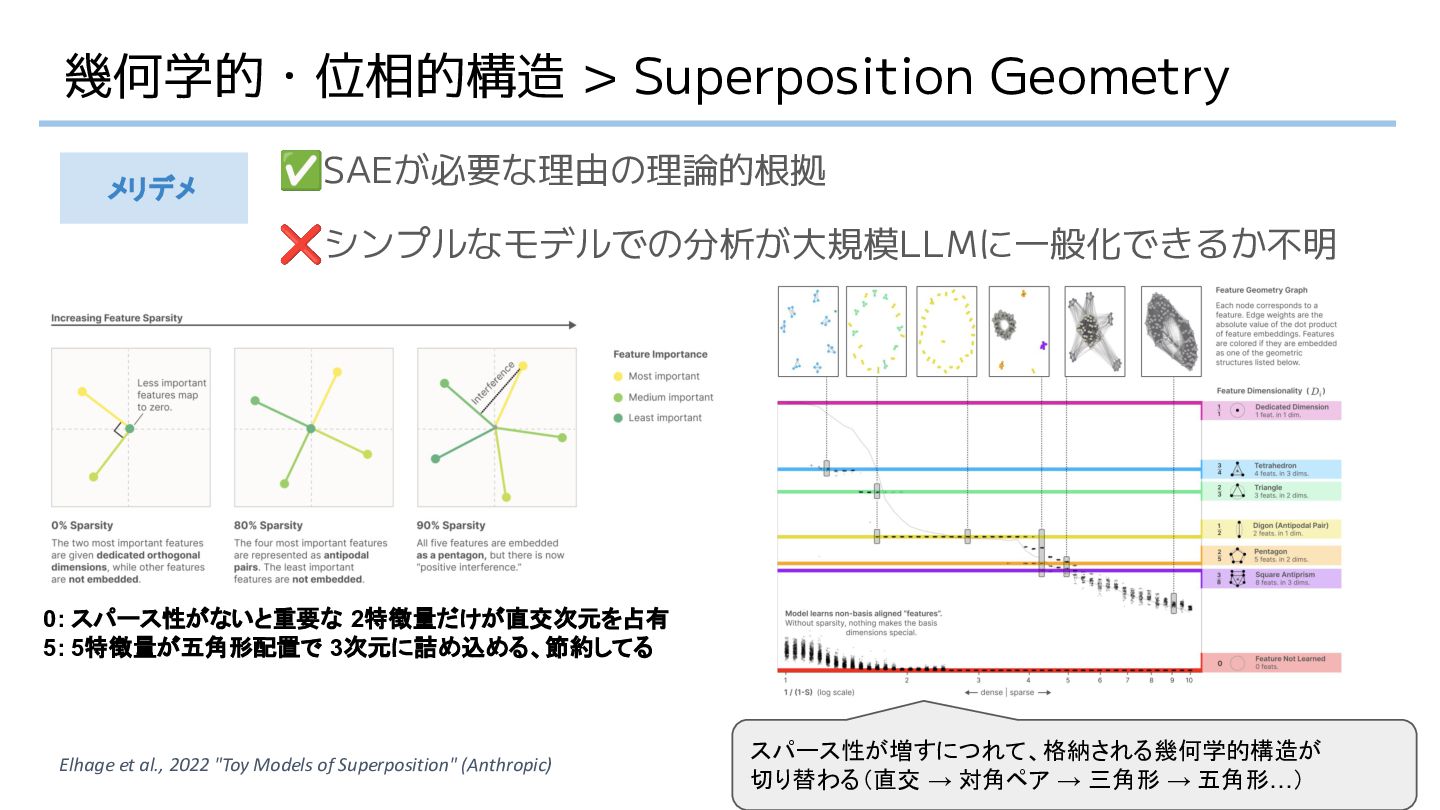
幾何学的・位相的構造 > Superposition Geometry = 次元数より多くの特徴量を格納するための正多角形や正多面体などの高度に 対称な配置で格納される。SAEが必要な理由の説明となる。 • 特徴量の数を制御した人工モデルを学習させる •
表現空間を可視化し、直交/正多角形/正多面体配置になるかを 確認する • スパース性が高いほど重ね合わせが可能になることをグラフで 示す 「なぜSAEが必要か」の背景を理論的に説明したい 人工的に作成したシンプルなモデルの表現空間 使う場面 対象データ 仕組み -
幾何学的・位相的構造 > Superposition Geometry ✅SAEが必要な理由の理論的根拠 ❌シンプルなモデルでの分析が大規模LLMに一般化できるか不明 メリデメ Elhage et al.,
2022 "Toy Models of Superposition" (Anthropic) 0: スパース性がないと重要な 2特徴量だけが直交次元を占有 5: 5特徴量が五角形配置で 3次元に詰め込める、節約してる スパース性が増すにつれて、格納される幾何学的構造が 切り替わる(直交 → 対角ペア → 三角形 → 五角形…) -
幾何学的・位相的構造 > Hierarchy as Orthogonality = 概念の階層関係は表現空間において直交性としてエンコードされている • 階層関係を持つ概念ペアをえらぶ •
各概念の表現ベクトルをプローブ等で抽出する • ベクトル間の内積を計算し、直交性を確認する LLMが概念の階層関係をどのように幾何学的に表現しているか調べ たい SAEで抽出した特徴量の階層的関係を分析したい 階層関係を持つ概念のペアと対応する表現ベクトル 使う場面 対象データ 仕組み -
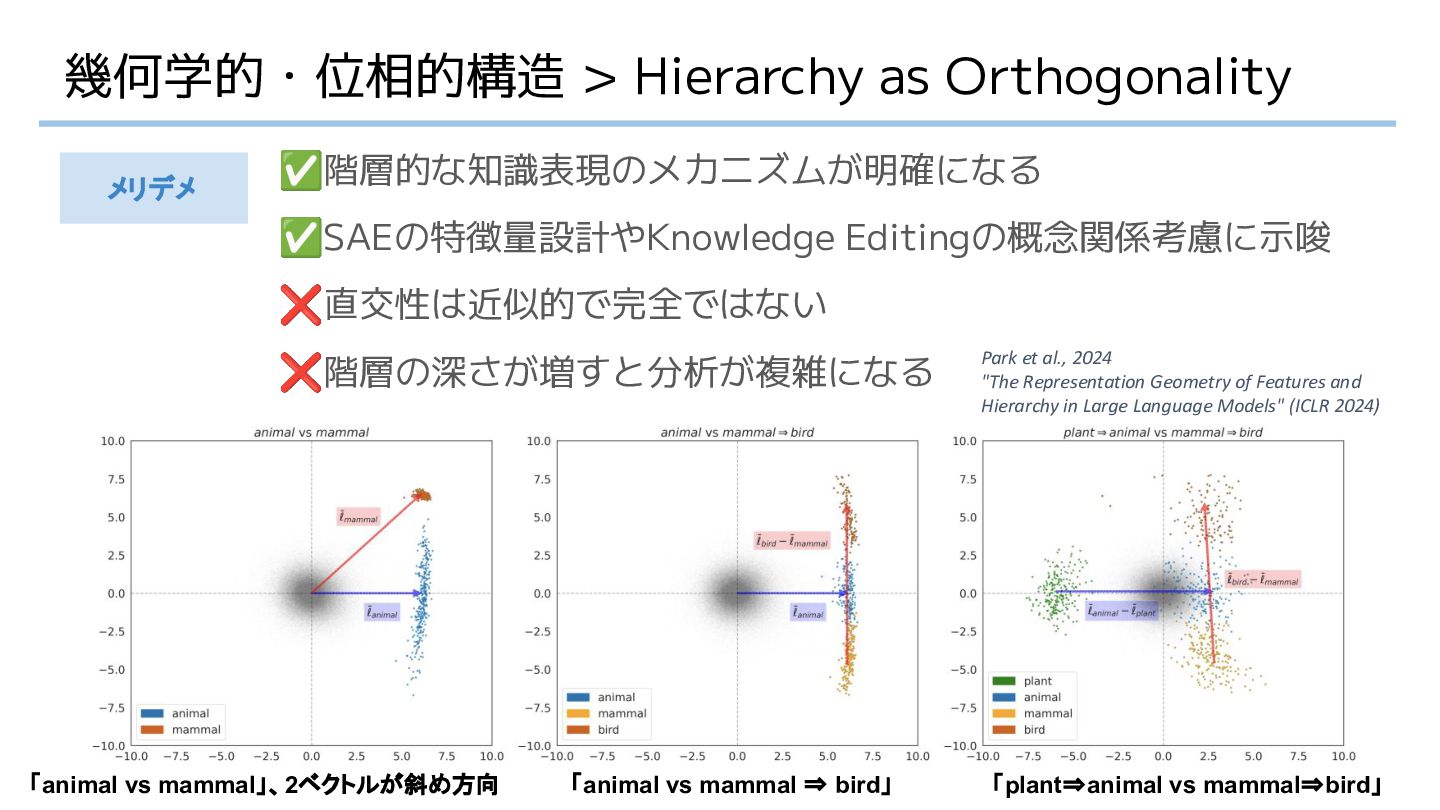
幾何学的・位相的構造 > Hierarchy as Orthogonality ✅階層的な知識表現のメカニズムが明確になる ✅SAEの特徴量設計やKnowledge Editingの概念関係考慮に示唆 ❌直交性は近似的で完全ではない ❌階層の深さが増すと分析が複雑になる
メリデメ Park et al., 2024 "The Representation Geometry of Features and Hierarchy in Large Language Models" (ICLR 2024) 「animal vs mammal」、2ベクトルが斜め方向 「animal vs mammal ⇒ bird」 「plant⇒animal vs mammal⇒bird」 -
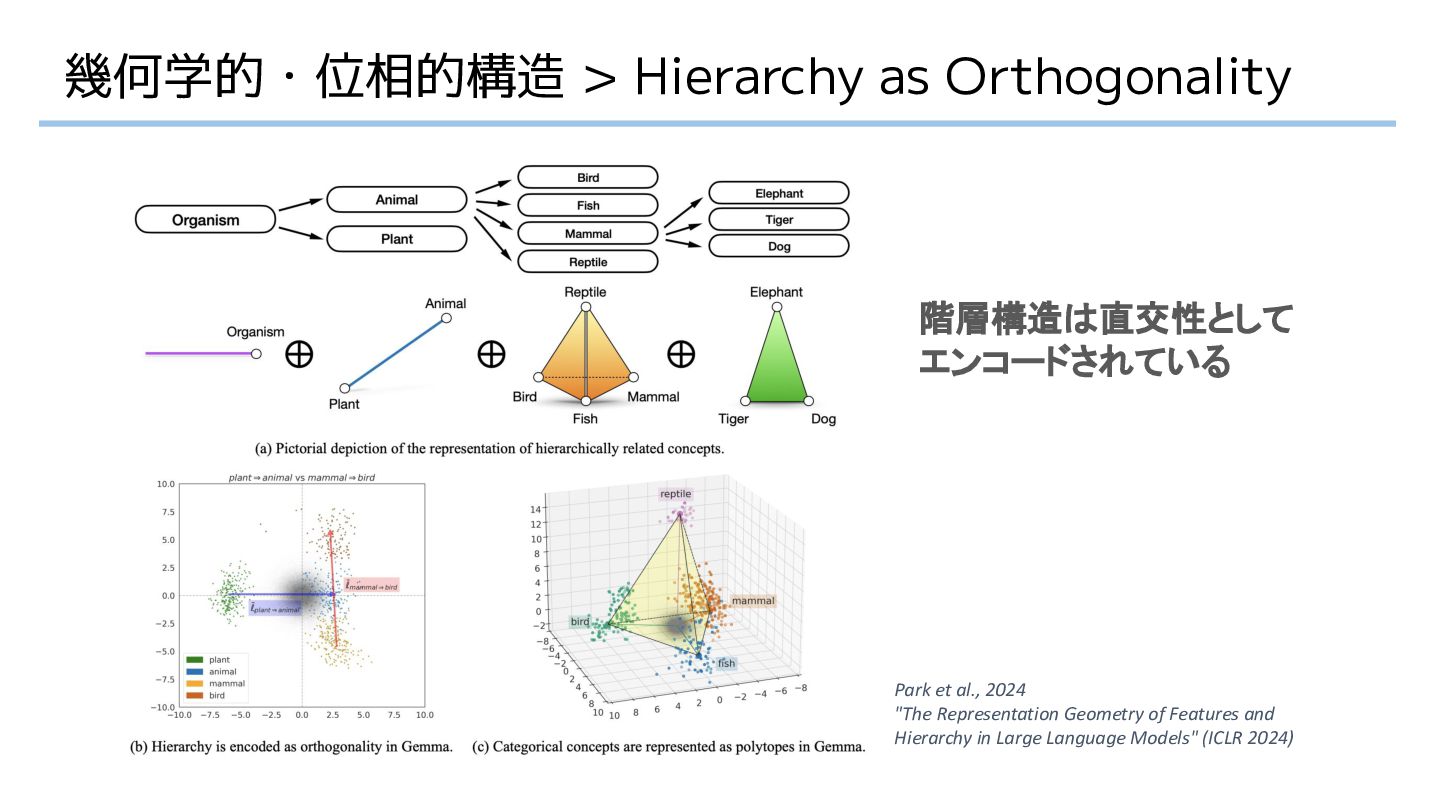
幾何学的・位相的構造 > Hierarchy as Orthogonality Park et al., 2024 "The
Representation Geometry of Features and Hierarchy in Large Language Models" (ICLR 2024) 階層構造は直交性として エンコードされている -
幾何学的・位相的構造 > Isotropy/Intrinsic Dimensionary = 表現が表現空間内に均一に広がっているか測る & 表現が存在する多様体の有効 次元数を推定する •
大規模コーパスに対する各層の中間表現を収集する • 等方向スコア(コサイン類似度の分布の偏り)を計算して異方性 を特定する • 多様体の有効次元数を推定し、層ごとの変化を追跡する LLMの表現空間全体が「どのような形状をしているか」知りたい FTや圧縮前に表現空間の構造を把握したい 大規模なテキストコーパスに対する各層の中間表現集合 使う場面 対象データ 仕組み SKIP -
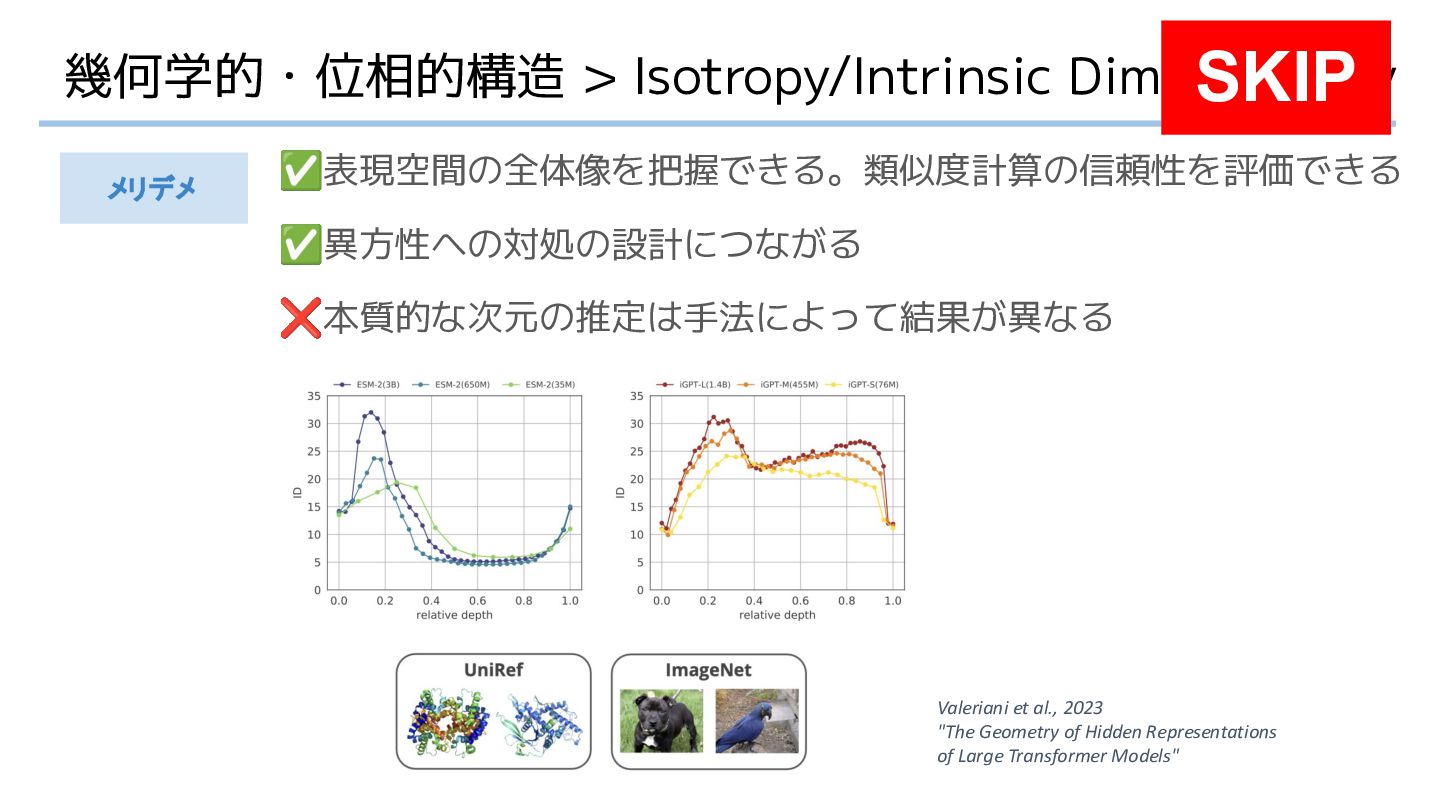
幾何学的・位相的構造 > Isotropy/Intrinsic Dimensionary ✅表現空間の全体像を把握できる。類似度計算の信頼性を評価できる ✅異方性への対処の設計につながる ❌本質的な次元の推定は手法によって結果が異なる メリデメ SKIP Valeriani
et al., 2023 "The Geometry of Hidden Representations of Large Transformer Models" -
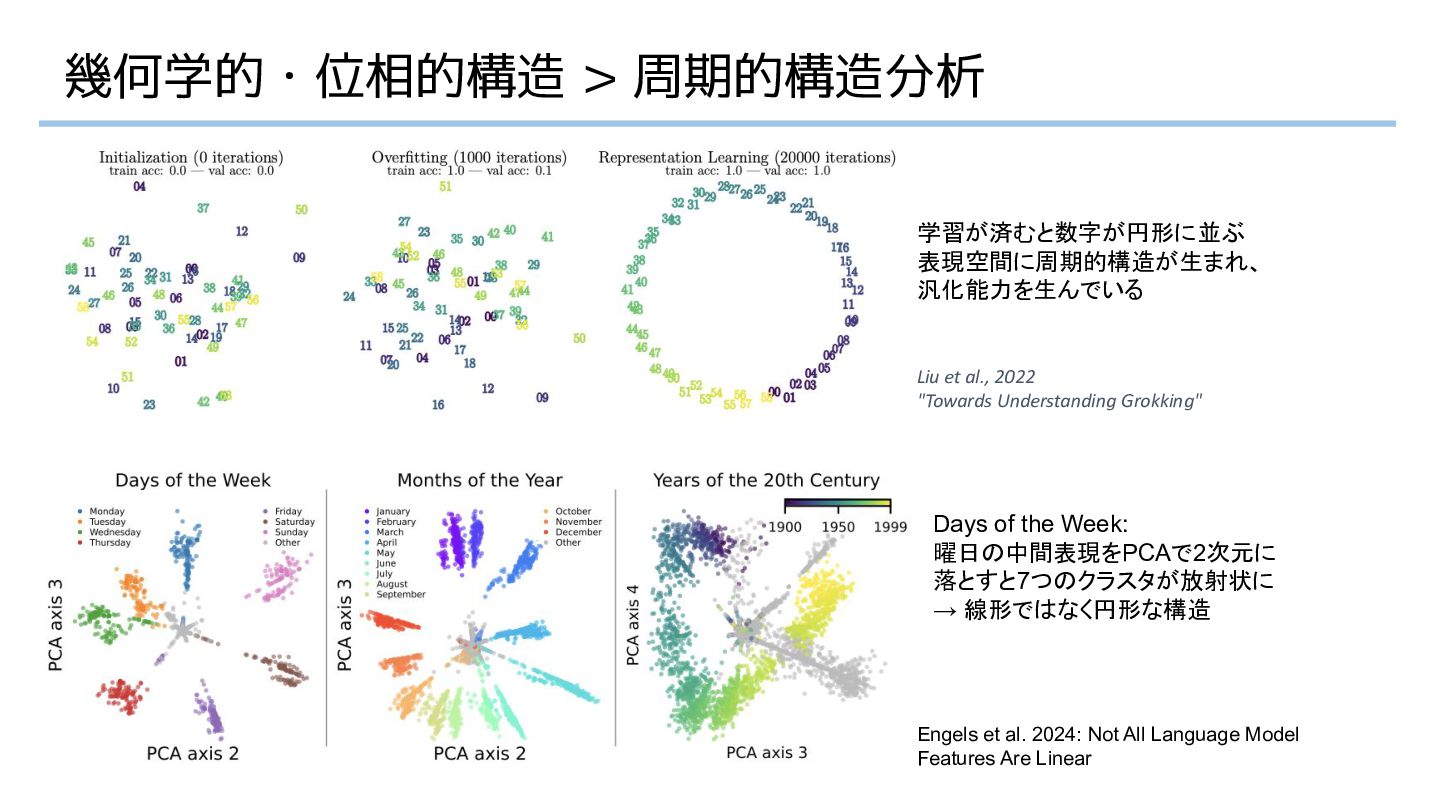
幾何学的・位相的構造 > 周期的構造分析 = mod60の足し算や曜日のように周期的な概念は内部表現が円形分布になってい る。線形仮説に対する反例として重要 • 対称トークン(数/曜日など)の中間表現を収集 • PCAで2次元に次元削減して可視化
• 円形や周期的な分布になっているかを確認する モデルが周期的な概念をどのように表現しているか知りたい SAEが取りこぼす非線形な構造を探したい 周期的なタスクを学習させたモデルの数値トークン、または 事前学習済みLMの曜日・月などのトークンの中間表現 使う場面 対象データ 仕組み -
幾何学的・位相的構造 > 周期的構造分析 Liu et al., 2022 "Towards Understanding Grokking"
Engels et al. 2024: Not All Language Model Features Are Linear 学習が済むと数字が円形に並ぶ 表現空間に周期的構造が生まれ、 汎化能力を生んでいる Days of the Week: 曜日の中間表現をPCAで2次元に 落とすと7つのクラスタが放射状に → 線形ではなく円形な構造 -
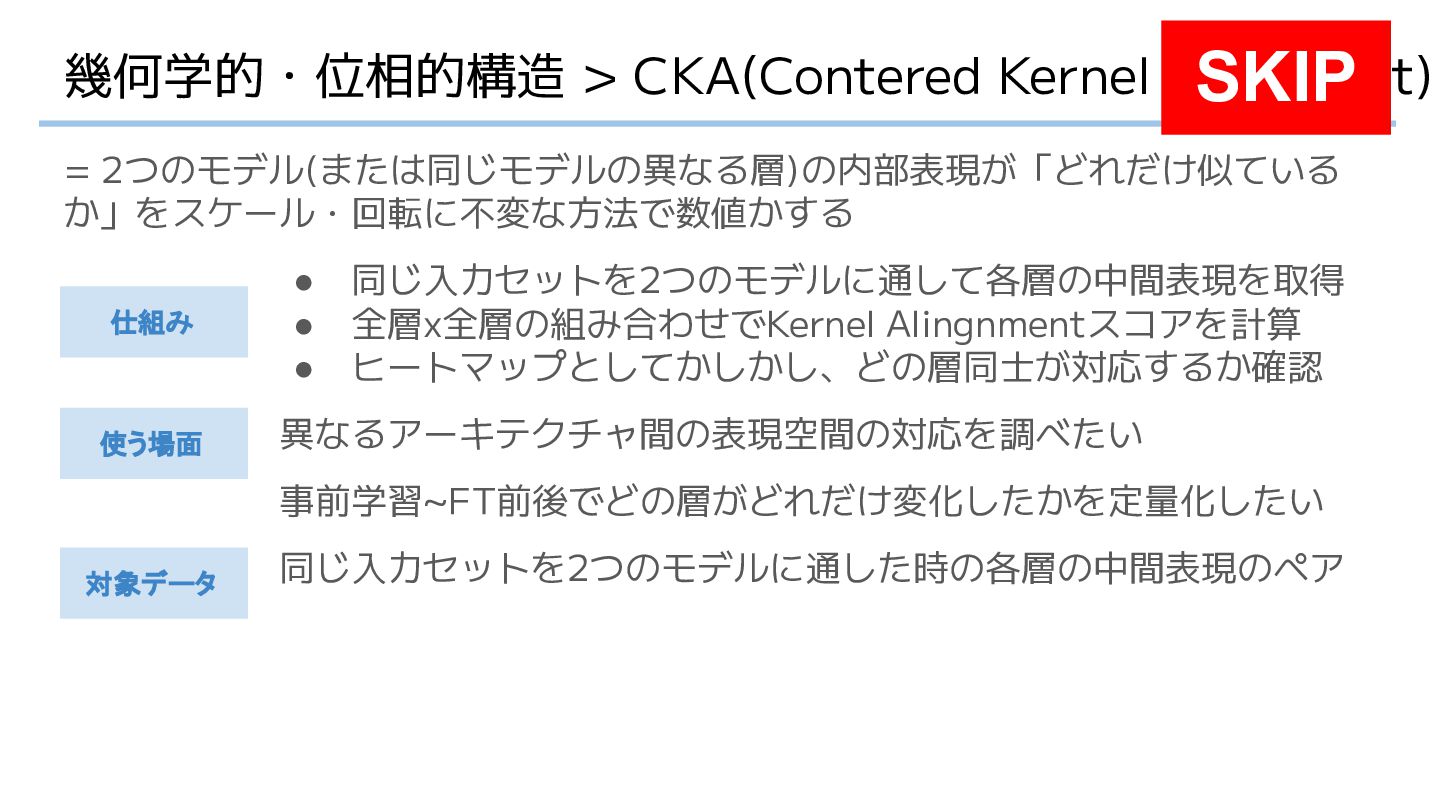
幾何学的・位相的構造 > CKA(Contered Kernel Alignment) = 2つのモデル(または同じモデルの異なる層)の内部表現が「どれだけ似ている か」をスケール・回転に不変な方法で数値かする • 同じ入力セットを2つのモデルに通して各層の中間表現を取得
• 全層x全層の組み合わせでKernel Alingnmentスコアを計算 • ヒートマップとしてかしかし、どの層同士が対応するか確認 異なるアーキテクチャ間の表現空間の対応を調べたい 事前学習~FT前後でどの層がどれだけ変化したかを定量化したい 同じ入力セットを2つのモデルに通した時の各層の中間表現のペア 使う場面 対象データ 仕組み SKIP -
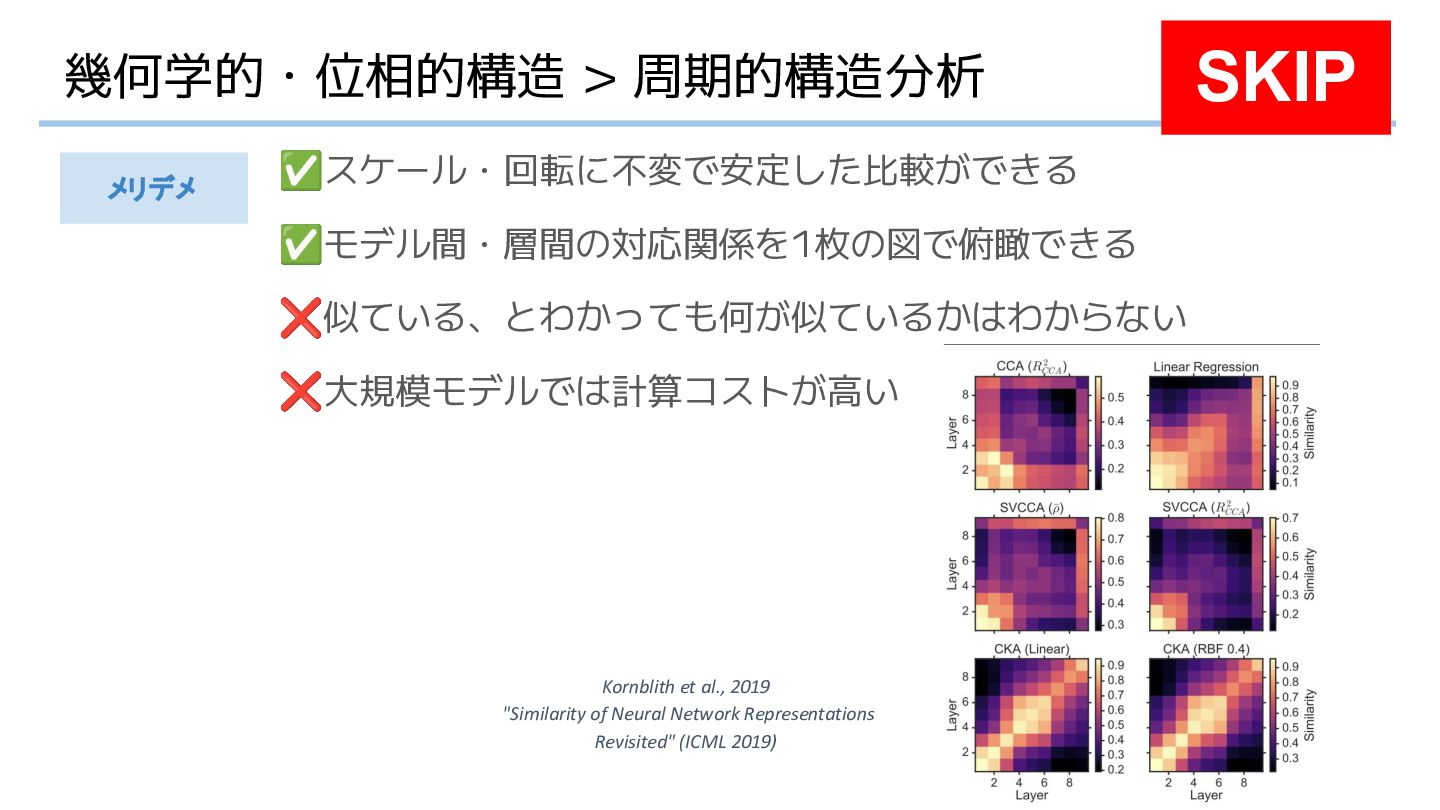
幾何学的・位相的構造 > 周期的構造分析 ✅スケール・回転に不変で安定した比較ができる ✅モデル間・層間の対応関係を1枚の図で俯瞰できる ❌似ている、とわかっても何が似ているかはわからない ❌大規模モデルでは計算コストが高い メリデメ SKIP
Kornblith et al., 2019 "Similarity of Neural Network Representations Revisited" (ICML 2019) -
カテゴリ3: 因果的介入 - 観察ではなく操作によって因果性を検証する - Attribution Patching~Activation Patching~Causal Abstruction 含まれる手法
Activation Patching(Causal Tracing)・Attribution Patching/EAP・Causal Attribution DAS(Distibuted Alignment Search・Representation Engineering/ Steering Vectors) -
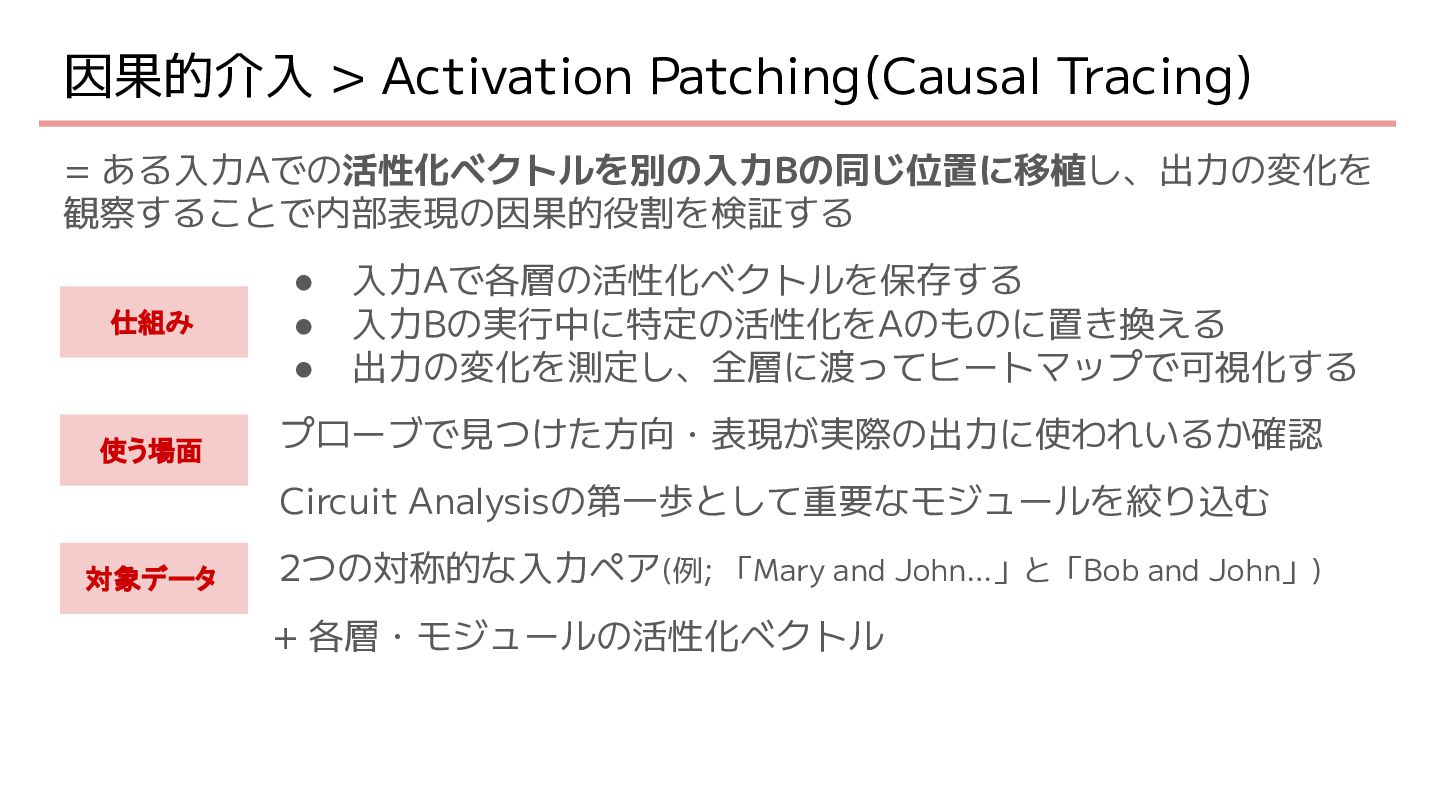
因果的介入 > Activation Patching(Causal Tracing) = ある入力Aでの活性化ベクトルを別の入力Bの同じ位置に移植し、出力の変化を 観察することで内部表現の因果的役割を検証する • 入力Aで各層の活性化ベクトルを保存する
• 入力Bの実行中に特定の活性化をAのものに置き換える • 出力の変化を測定し、全層に渡ってヒートマップで可視化する プローブで見つけた方向・表現が実際の出力に使われいるか確認 Circuit Analysisの第一歩として重要なモジュールを絞り込む 2つの対称的な入力ペア(例; 「Mary and John…」と「Bob and John」) + 各層・モジュールの活性化ベクトル 使う場面 対象データ 仕組み -
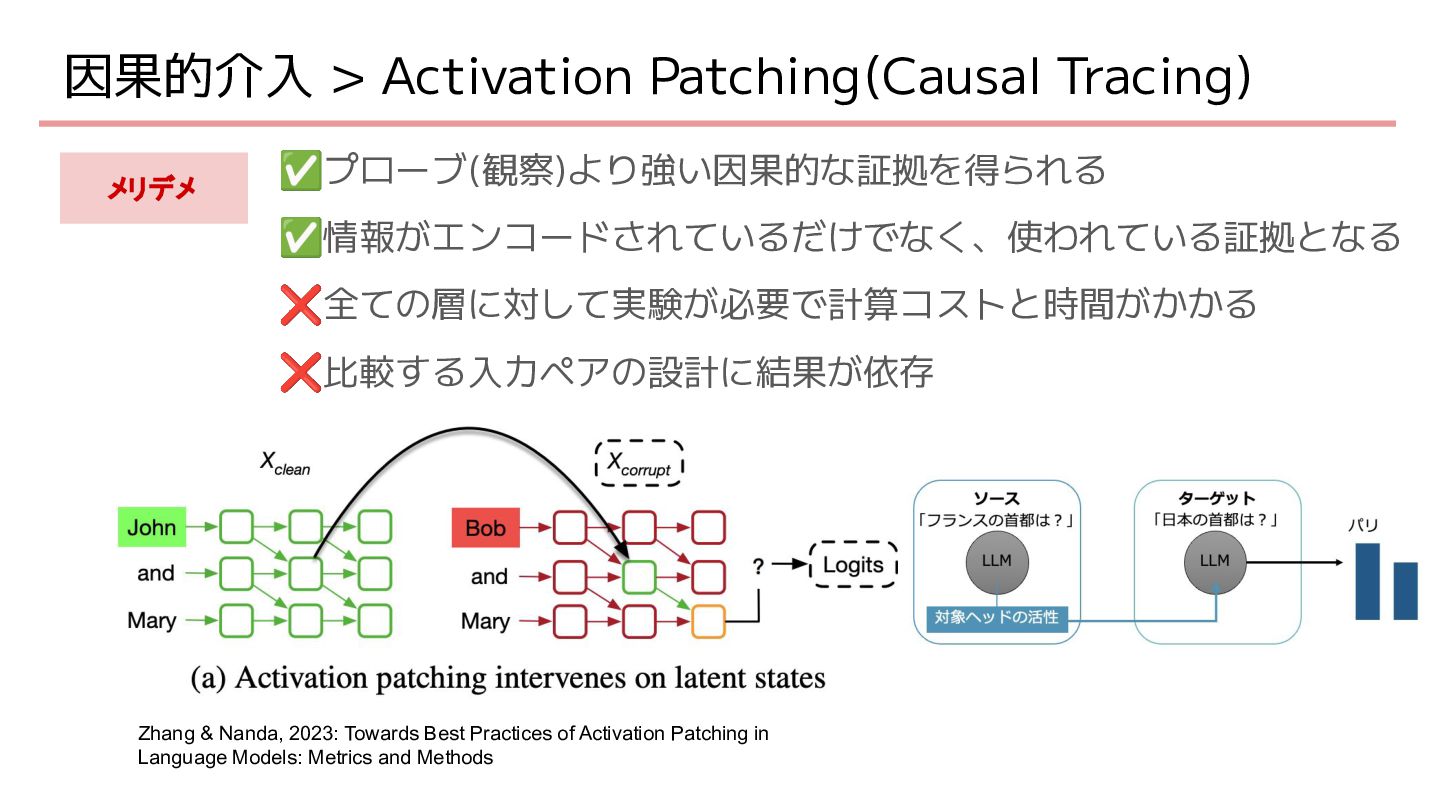
因果的介入 > Activation Patching(Causal Tracing) ✅プローブ(観察)より強い因果的な証拠を得られる ✅情報がエンコードされているだけでなく、使われている証拠となる ❌全ての層に対して実験が必要で計算コストと時間がかかる ❌比較する入力ペアの設計に結果が依存 メリデメ
Zhang & Nanda, 2023: Towards Best Practices of Activation Patching in Language Models: Metrics and Methods -
因果的介入 > Attribution Patching / EAP(Edge At..) = Activation Patchingの計算コストを勾配を使った近似で解決する。全モ
ジュールの重要度を1回の逆伝播で近似的に計算できる • 出力メトリクスの各モジュール出力に対する勾配を計算する • 勾配xパッチ前後の活性化の差でAttributionスコアを近似する • スコアの高いモジュールを重要候補として絞り込み、 Activation Patchingで検証する Activation Patchingが計算コスト的に困難 Circuit Analysisの出発点として重要な箇所を効率的に絞りたい Activation Patchigと同じ 使う場面 対象データ 仕組み SKIP -
因果的介入 > Attribution Patching / EAP(Edge At..) ✅全モジュールに対して1回の逆伝播で近似スコアが得られる ✅大幅に計算コスト削減 ❌勾配による近似のため完全なActivation
Patchingより結果が不正確 ❌非線形性が強い部分では近似精度が下がる メリデメ SKIP -
因果的介入 > Causal Abstraction / DAS(Distributed Alignment Search) = 「高レベルな因果モデルがニューラルネットに実装されているか」を数学的に検証
する。特定のアルゴリズムの実装を厳密に確認する手法 • 検証したい因果モデルを設計する(変数Aが変数Bを決める、など) • ニューラルネットの対応する中間表現にActivation Patching ◦ Interchange Intervention • 因果モデルの予測とニューラルネットの出力変化が一致するか測定 Circuit Analysisで同定した回路が仮説通り機能しているかを厳密に検 証したい 検証したい因果モデルの変数に対応する入力のセット +各変数に対応するとされる中間表現 使う場面 対象データ 仕組み SKIP -
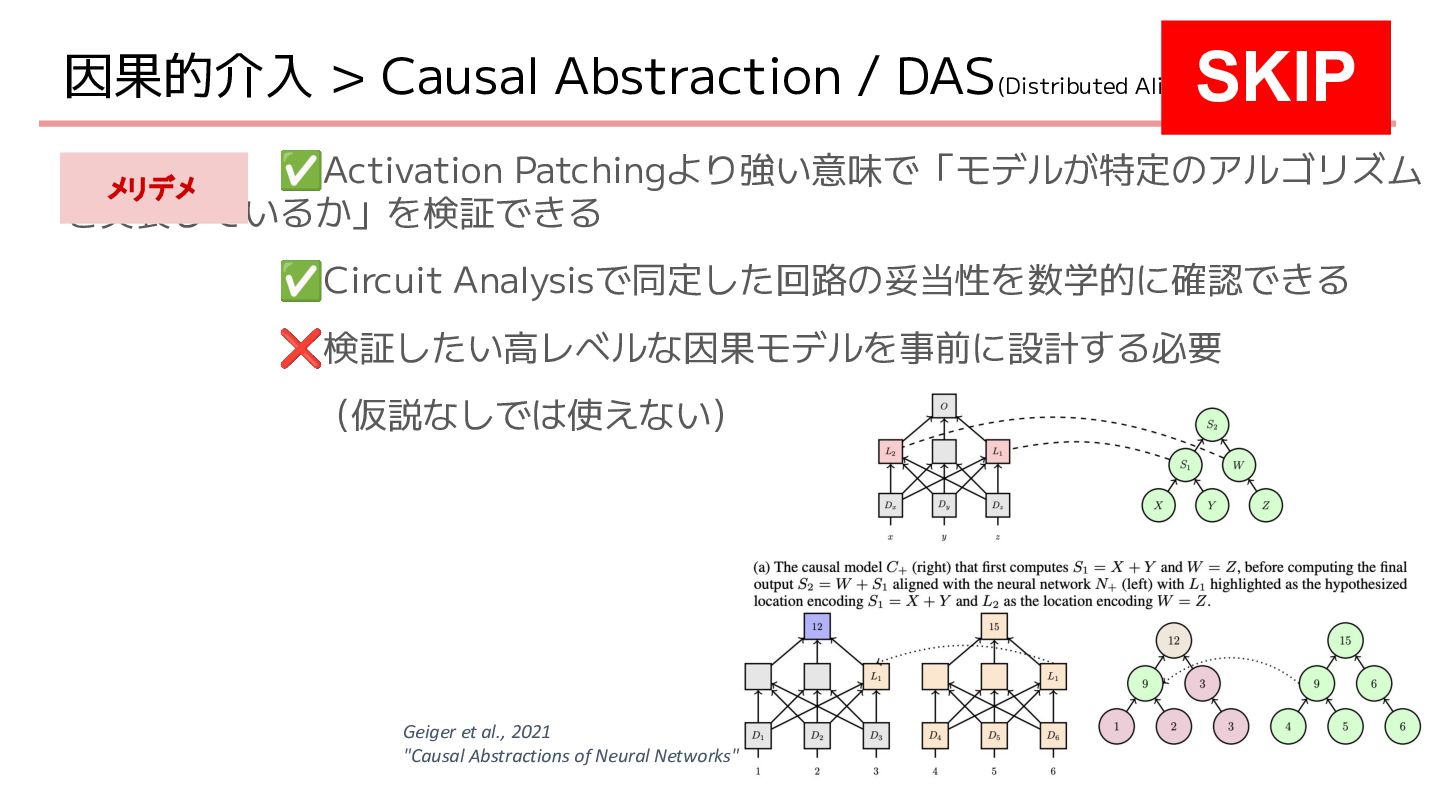
因果的介入 > Causal Abstraction / DAS(Distributed Alignment Search) ✅Activation Patchingより強い意味で「モデルが特定のアルゴリズム
を実装しているか」を検証できる ✅Circuit Analysisで同定した回路の妥当性を数学的に確認できる ❌検証したい高レベルな因果モデルを事前に設計する必要 (仮説なしでは使えない) メリデメ SKIP Geiger et al., 2021 "Causal Abstractions of Neural Networks" -
因果的介入 > Steering Vectors = 正確さ・有害性・感情などの抽象的な概念を表すベクトルを内部表現から求め、 推論時にその方向を加算(or減算)して振る舞いを制御する • 対称的な文ペア(正直vs嘘)の中間表現を抽出 •
平均差分ベクトル(または主成分)を概念ベクトルとして算出 • 推論時にベクトルを加算(or減算)して出力の変化を確認 特定の概念・振る舞いをモデルに対してリアルタイムに制御したい時 Probingにより「情報がある」とわかって、次に制御に進む段階 対照的な文ペア+対応する中間表現 使う場面 対象データ 仕組み -
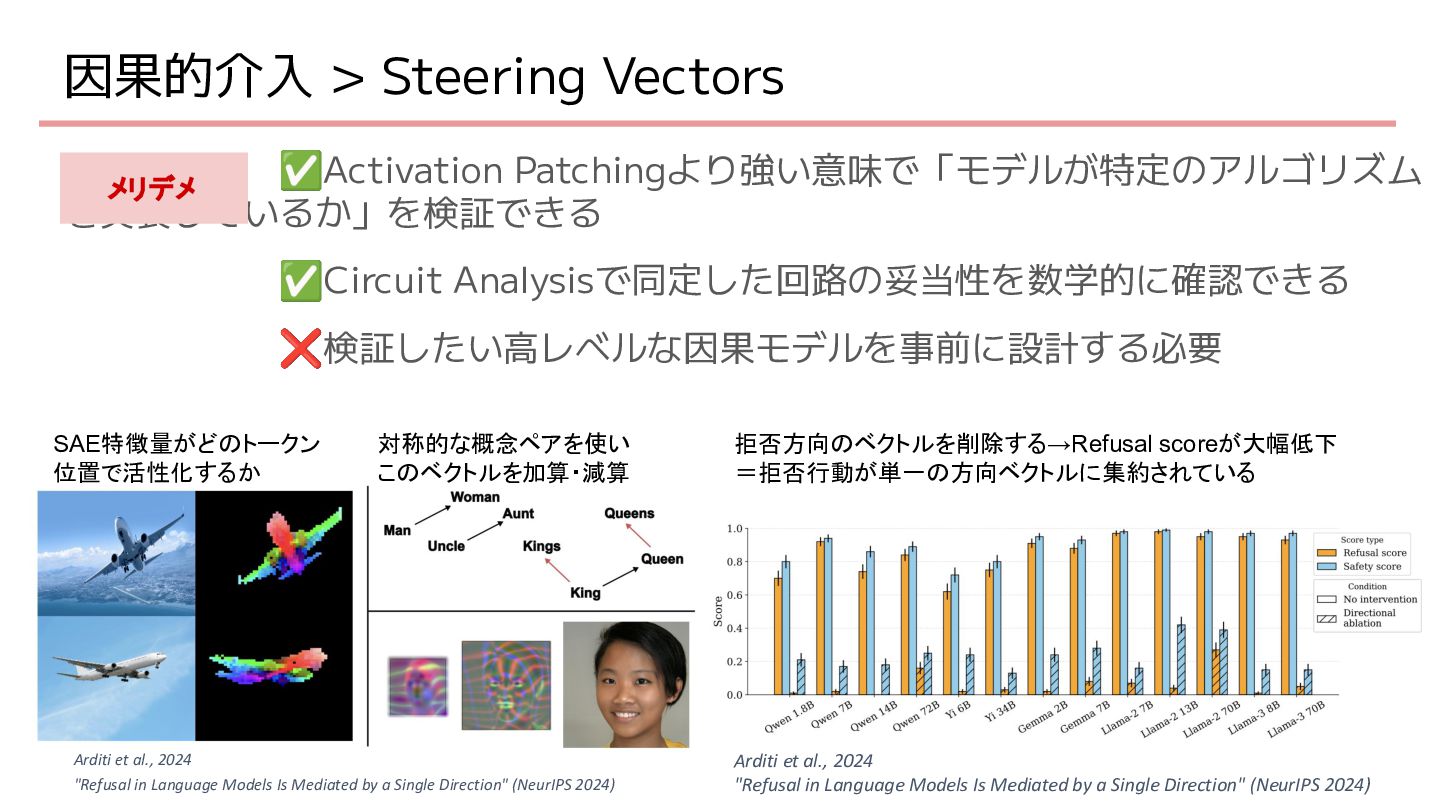
因果的介入 > Steering Vectors ✅Activation Patchingより強い意味で「モデルが特定のアルゴリズム を実装しているか」を検証できる ✅Circuit Analysisで同定した回路の妥当性を数学的に確認できる ❌検証したい高レベルな因果モデルを事前に設計する必要
メリデメ Arditi et al., 2024 "Refusal in Language Models Is Mediated by a Single Direction" (NeurIPS 2024) Arditi et al., 2024 "Refusal in Language Models Is Mediated by a Single Direction" (NeurIPS 2024) SAE特徴量がどのトークン 位置で活性化するか 対称的な概念ペアを使い このベクトルを加算・減算 拒否方向のベクトルを削除する→Refusal scoreが大幅低下 =拒否行動が単一の方向ベクトルに集約されている -
計算過程 > Retrieval Heads:長文脈での局所的参照 = 長い文脈において必要な情報をピンポイントに参照するAttentionヘッドが存在 する。10万トークン離れた情報も参照できる • 各Attentionヘッドの注意パターンを可視化し、違いや位置を参 照しているヘッドを候補として特定する
• 候補ヘッドを削除した時の長文脈タスクの性能劣化を測定する • 性能劣化が大きいヘッドをRetrieval Headとして同定 長文脈モデルのどのヘッドが長距離参照をになっているか 長文脈性能の向上・効率化の研究に繋げる 長文脈テキスト(10万token以上)における注意パターンとヘッド削除 時の性能変化 使う場面 対象データ 仕組み -
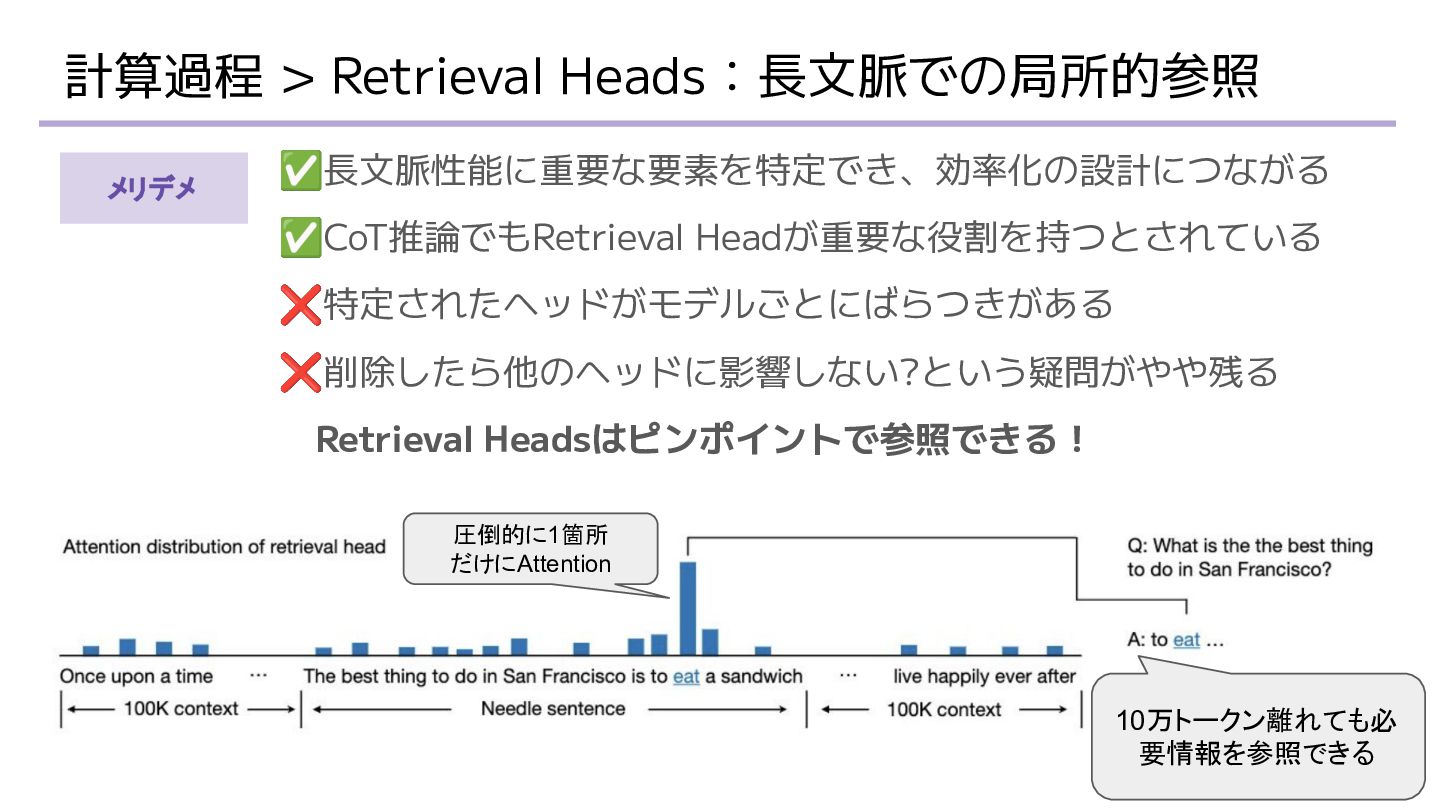
計算過程 > Retrieval Heads:長文脈での局所的参照 ✅長文脈性能に重要な要素を特定でき、効率化の設計につながる ✅CoT推論でもRetrieval Headが重要な役割を持つとされている ❌特定されたヘッドがモデルごとにばらつきがある ❌削除したら他のヘッドに影響しない?という疑問がやや残る Retrieval
Headsはピンポイントで参照できる! メリデメ 圧倒的に1箇所 だけにAttention 10万トークン離れても必 要情報を参照できる -
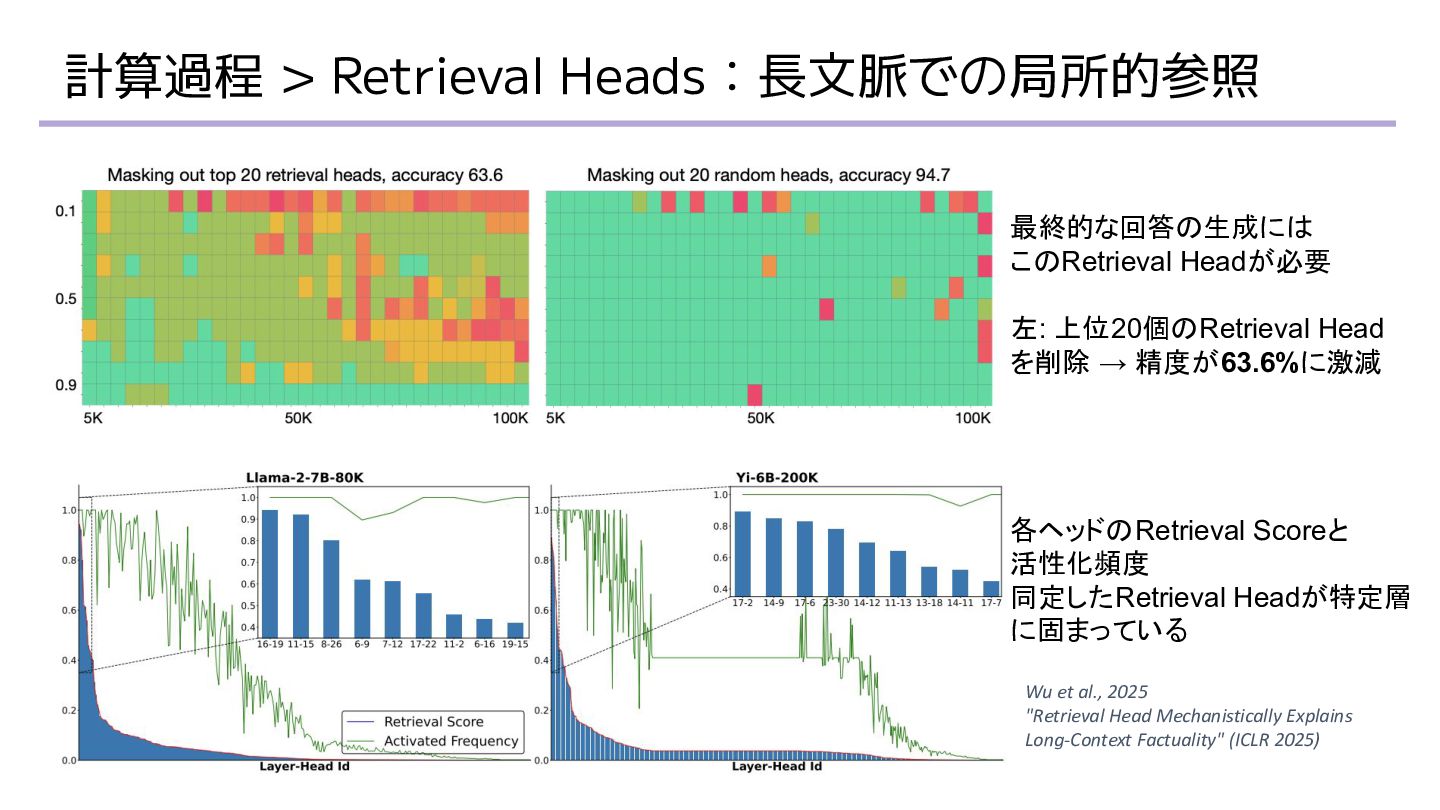
計算過程 > Retrieval Heads:長文脈での局所的参照 Wu et al., 2025 "Retrieval Head
Mechanistically Explains Long-Context Factuality" (ICLR 2025) 最終的な回答の生成には このRetrieval Headが必要 左: 上位20個のRetrieval Head を削除 → 精度が63.6%に激減 各ヘッドのRetrieval Scoreと 活性化頻度 同定したRetrieval Headが特定層 に固まっている -
計算過程 > Logit Lens = 各層の中間表現を予測ヘッドに通して語彙表現に射影し、予測がどの層でどのよ うに形成されていくか、過程を見る • 各層の中間表現をそのまま予測ヘッドに渡す •
各層での予測トークンを確認する • 予測がどの層で正解に収束するかなどを追跡して可視化する 各層で予測がどのように変化・収束していくかを追いたい どの層で正しい予測に到達するかを調べたい 多言語モデルの内部処理言語を調べたい 任意のテキスト入力に対する各層の中間表現 使う場面 対象データ 仕組み -
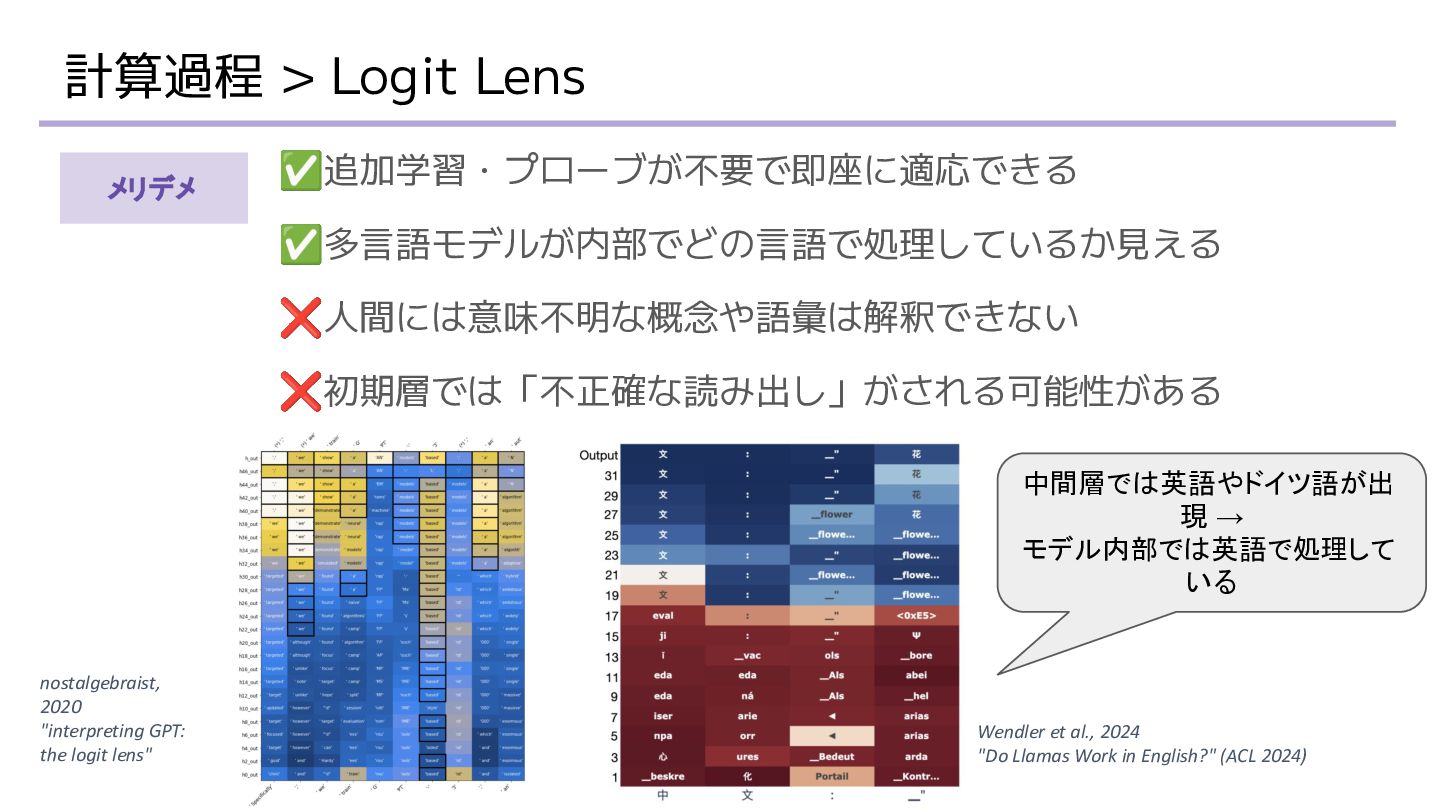
計算過程 > Logit Lens ✅追加学習・プローブが不要で即座に適応できる ✅多言語モデルが内部でどの言語で処理しているか見える ❌人間には意味不明な概念や語彙は解釈できない ❌初期層では「不正確な読み出し」がされる可能性がある メリデメ nostalgebraist,
2020 "interpreting GPT: the logit lens" Wendler et al., 2024 "Do Llamas Work in English?" (ACL 2024) 中間層では英語やドイツ語が出 現 → モデル内部では英語で処理して いる -
計算過程 > Patchscopes = 調べたい入力の特定層の表現を別のプロンプトの対応位置に移植し、モデル自身 に意味を語らせる。Logit Lensを任意の概念へ拡張した手法 • Logit Lensで調べたい入力Aの特定層の表現を抽出
• プロンプトB(例:「It is a ___.」) の___の位置に移植する • 移植した状態でモデル実行し生成された内容から意味を解釈する Logit Lensでは解釈できない概念を引き出し、解釈したい 各層の表現が何を意味しているかをモデル自身に問いたい 調べたい入力文 + 意味を引き出すためのプロンプト のペア 使う場面 対象データ 仕組み SKIP -
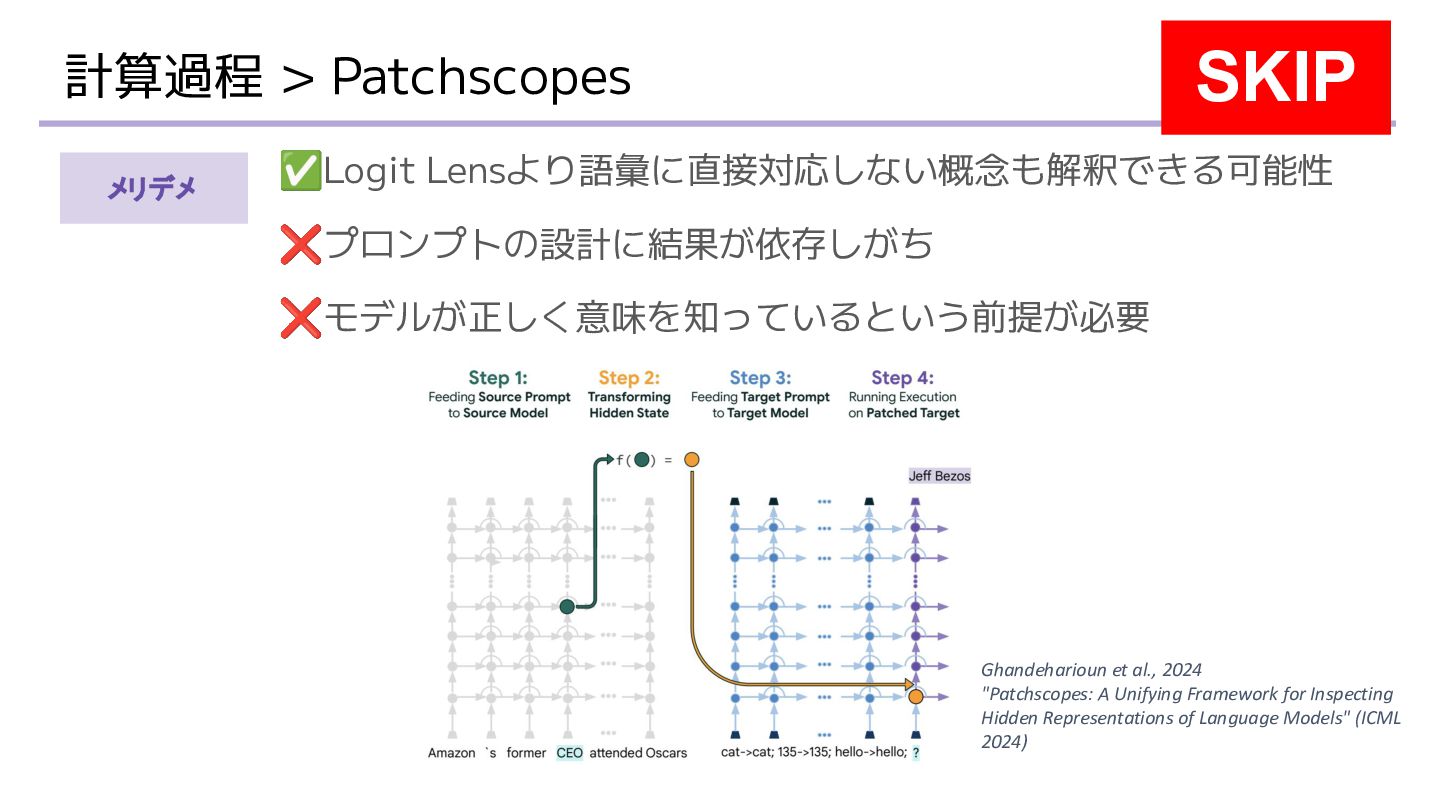
計算過程 > Patchscopes ✅Logit Lensより語彙に直接対応しない概念も解釈できる可能性 ❌プロンプトの設計に結果が依存しがち ❌モデルが正しく意味を知っているという前提が必要 メリデメ SKIP Ghandeharioun
et al., 2024 "Patchscopes: A Unifying Framework for Inspecting Hidden Representations of Language Models" (ICML 2024) -
計算過程 > Key-Valueメモリ = FFNが注意機構と数学的に類似した構造を持つことを利用してFFNを静的な Key-Valueの記憶装置として解釈する方法 • FFNの1層目の重み行列と入力の内積を計算し、どの入力パター ンに反応するかを確認 •
2層目の重み行列の各列を予測ヘッドに通し対応する語彙を確認 • 「この入力に反応したらこの語彙を誘導する」という解釈をする 特定の事実がモデルのどのFFN層に格納されているかを調べたい Knowledge Editingの対照層を絞りたい 事実知識を問うプロンプト + 各FFN層の活性化値 使う場面 対象データ 仕組み SKIP -
計算過程 > Inference-Time Intervention (ITI) = 特定のAttentionヘッドの出力に「事実性方向ベクトル」を加算することでLLM がより事実に基づいた回答を生成するように制御する • 事実に即した回答と誤った回答のAttentionヘッドから「事実性
方向ベクトル」を算出 • 推論時に特定のヘッドの出力にこのベクトルを加算する • 加算前との精度を比較 LLMの幻覚を推論時に再学習せずに抑制したい時 どのヘッドが事実性に寄与しているかを特定したい 事実知識を問うプロンプト + 各Attentionヘッドの出力 使う場面 対象データ 仕組み -
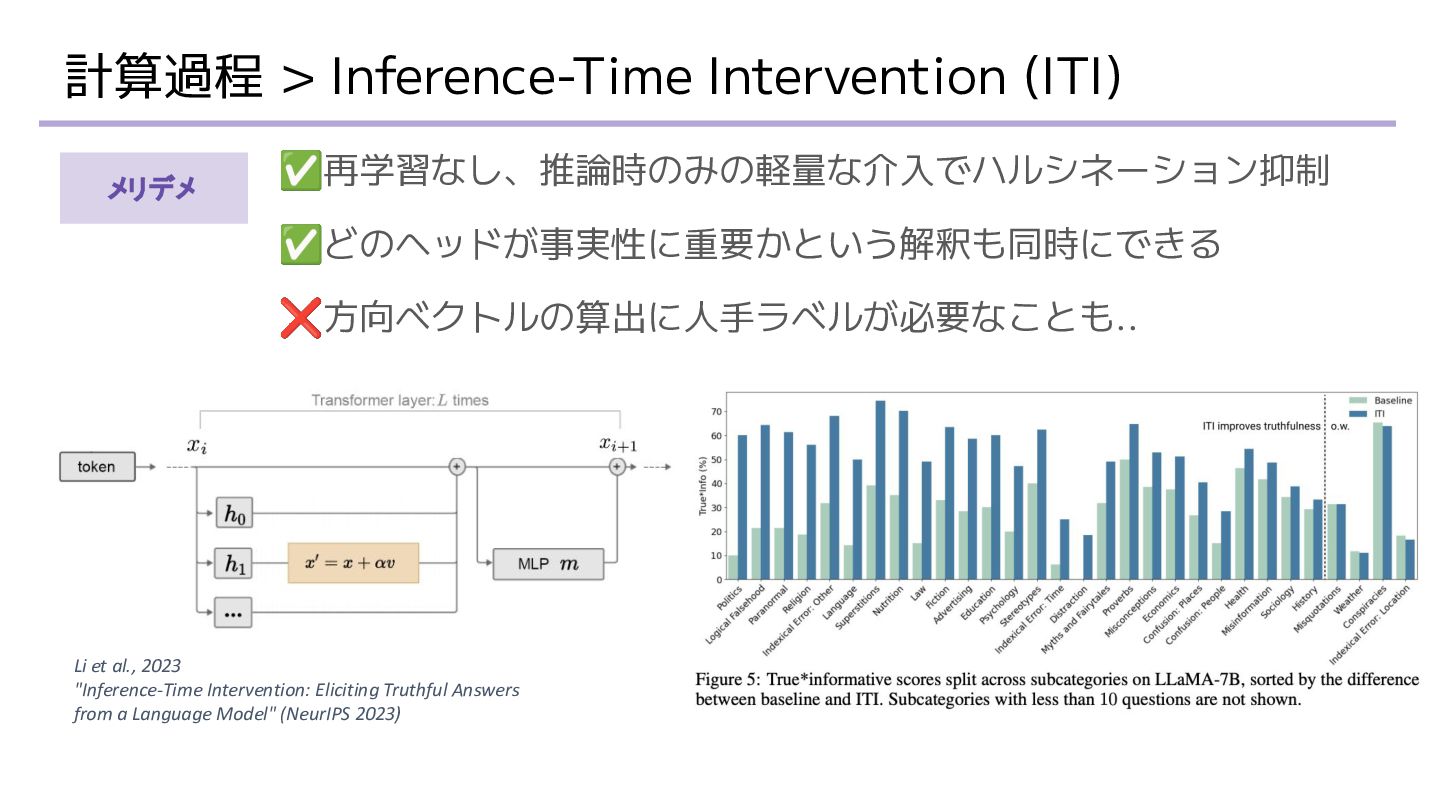
計算過程 > Inference-Time Intervention (ITI) ✅再学習なし、推論時のみの軽量な介入でハルシネーション抑制 ✅どのヘッドが事実性に重要かという解釈も同時にできる ❌方向ベクトルの算出に人手ラベルが必要なことも.. メリデメ Li
et al., 2023 "Inference-Time Intervention: Eliciting Truthful Answers from a Language Model" (NeurIPS 2023) -
計算過程 > Knowledge Editing:ROME/MEMIT = FFNが記憶装置なら、その記憶を再学習なしで直接書き換えられる。Causal Tracingで因果的に重要なFFN層を特定し、rank-1行列更新で事実知識を書き換え • Causal Tracingで各層への介入を行い、因果的に重要なFFN層を
特定 • 特定された層のFFNにrank-1行列更新を適応し、事実を書き換え る • 書き換え後のモデルで直接事実・関連事実・無関係事実を評価 モデルの特定の事実知識を更新・修正してみたい どの層に特定の知識が格納されているかを因果的に検証したい <主語, 関係, 目的後>形式の事実トリプル 使う場面 対象データ 仕組み SKIP -
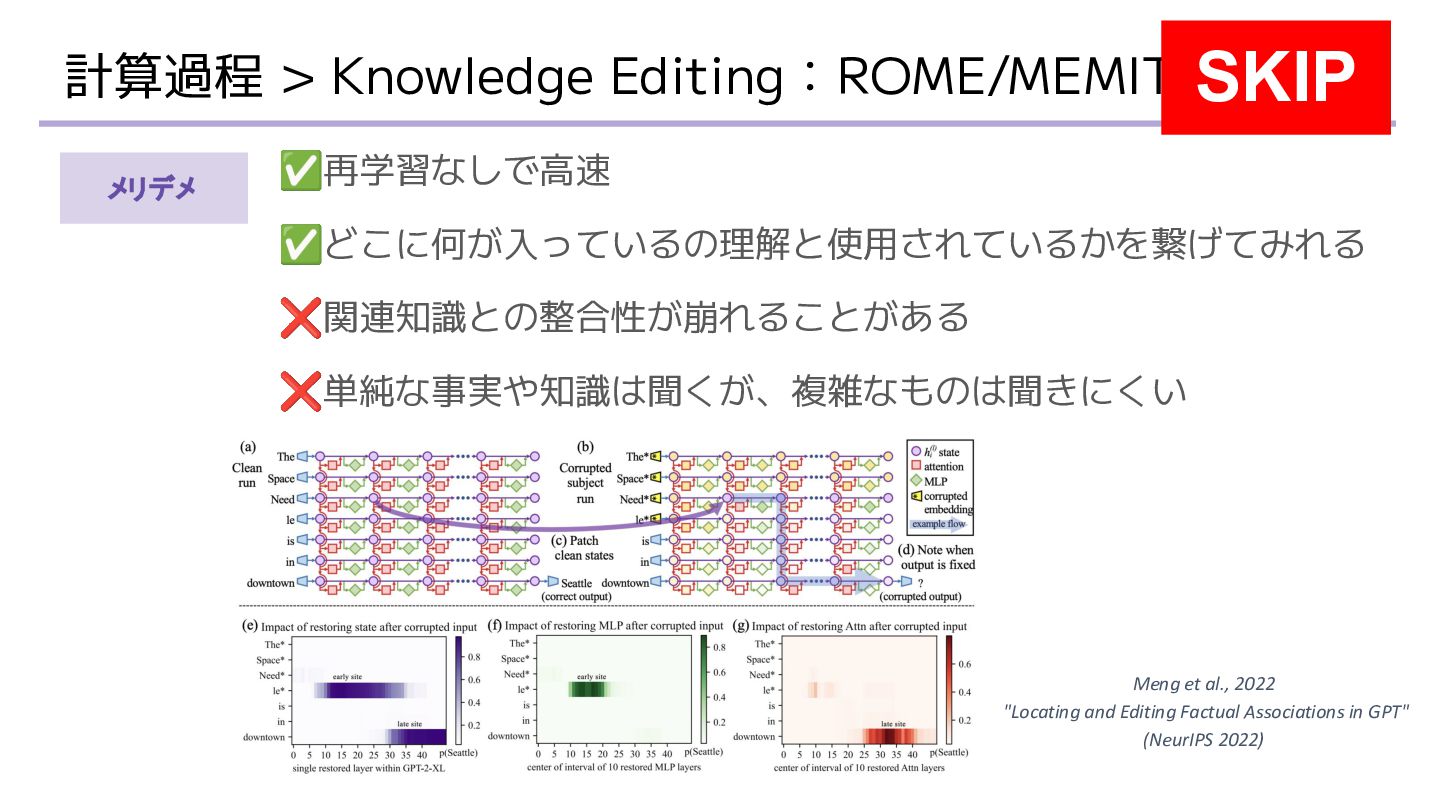
計算過程 > Knowledge Editing:ROME/MEMIT ✅再学習なしで高速 ✅どこに何が入っているの理解と使用されているかを繋げてみれる ❌関連知識との整合性が崩れることがある ❌単純な事実や知識は聞くが、複雑なものは聞きにくい メリデメ SKIP
Meng et al., 2022 "Locating and Editing Factual Associations in GPT" (NeurIPS 2022) -
計算過程 > Circuit Analysis(回路分析) = 特定の機能を実現している回路を特定する。Attentionパターン観察・語彙射影 ・Activation Patchingを組み合わせて同定していく • Attribution
Patching/EAPで重要なモジュール候補を絞る • Activation Patchingで各モジュールの因果的重要性を測る • 残ったモジュールとの連携を確認して回路として同定する • その回路だけで元の性能がでるかを検証する 「モデルが特定のタスクを解く時にどのような処理をしているか」 回路として理解したい時 分析したい機能に対応する入力のセット(例:In-Context Learning・事実知識・IOI課題) 使う場面 対象データ 仕組み -
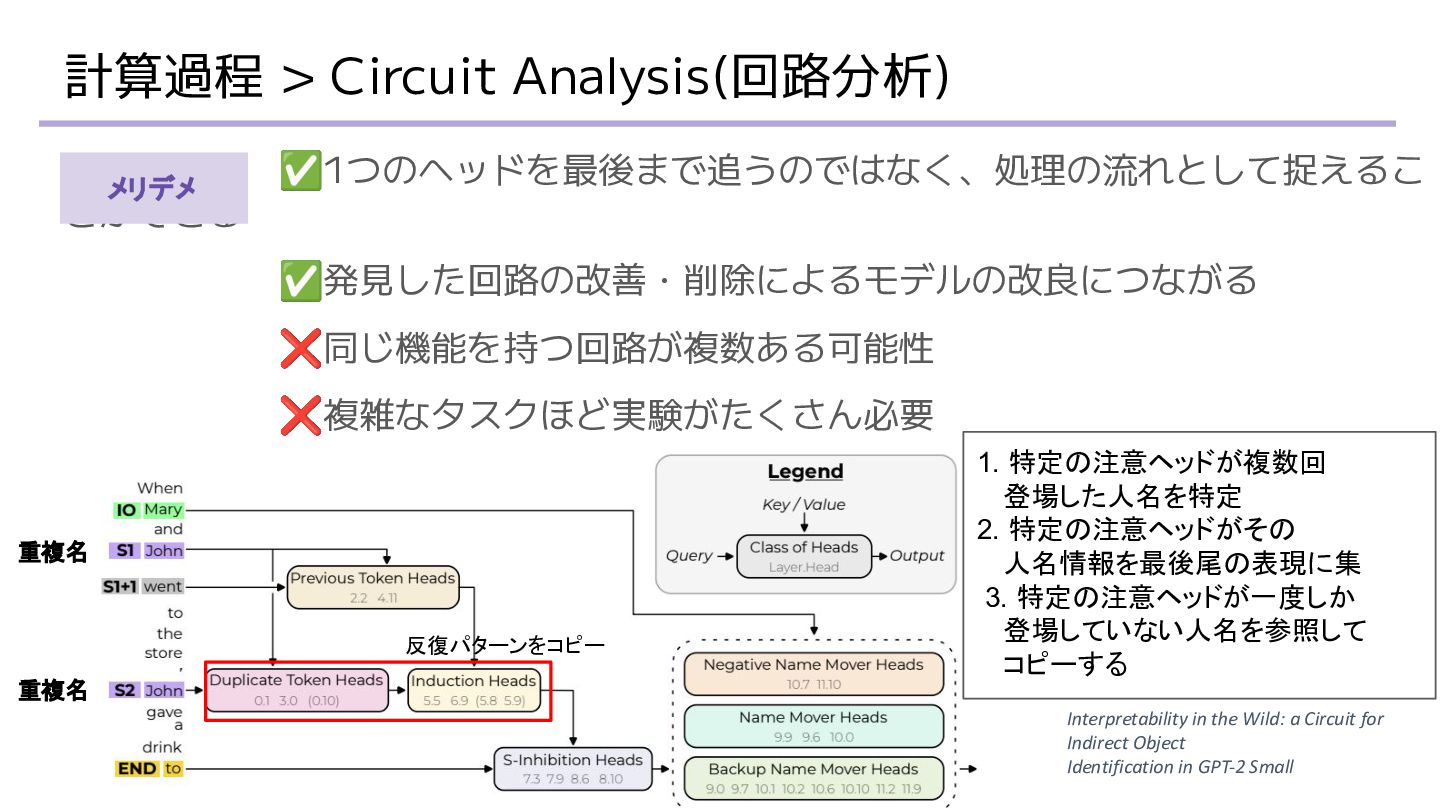
計算過程 > Circuit Analysis(回路分析) ✅1つのヘッドを最後まで追うのではなく、処理の流れとして捉えるこ とができる ✅発見した回路の改善・削除によるモデルの改良につながる ❌同じ機能を持つ回路が複数ある可能性 ❌複雑なタスクほど実験がたくさん必要 メリデメ
Interpretability in the Wild: a Circuit for Indirect Object Identification in GPT-2 Small 重複名 重複名 反復パターンをコピー 1. 特定の注意ヘッドが複数回 登場した人名を特定 2. 特定の注意ヘッドがその 人名情報を最後尾の表現に集 3. 特定の注意ヘッドが一度しか 登場していない人名を参照して コピーする -
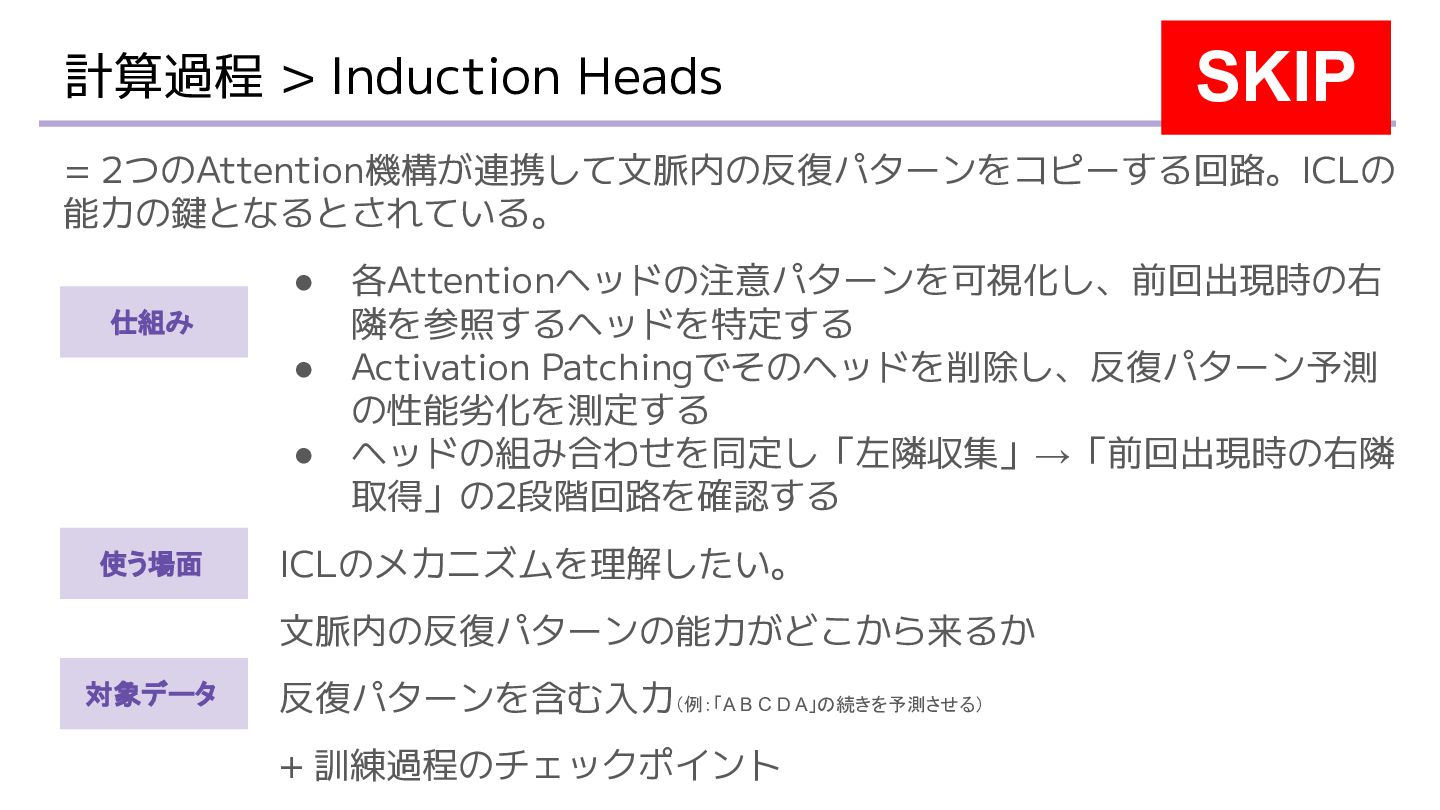
計算過程 > Induction Heads = 2つのAttention機構が連携して文脈内の反復パターンをコピーする回路。ICLの 能力の鍵となるとされている。 • 各Attentionヘッドの注意パターンを可視化し、前回出現時の右 隣を参照するヘッドを特定する
• Activation Patchingでそのヘッドを削除し、反復パターン予測 の性能劣化を測定する • ヘッドの組み合わせを同定し「左隣収集」→「前回出現時の右隣 取得」の2段階回路を確認する ICLのメカニズムを理解したい。 文脈内の反復パターンの能力がどこから来るか 反復パターンを含む入力(例:「A B C D A」の続きを予測させる) + 訓練過程のチェックポイント 使う場面 対象データ 仕組み SKIP -
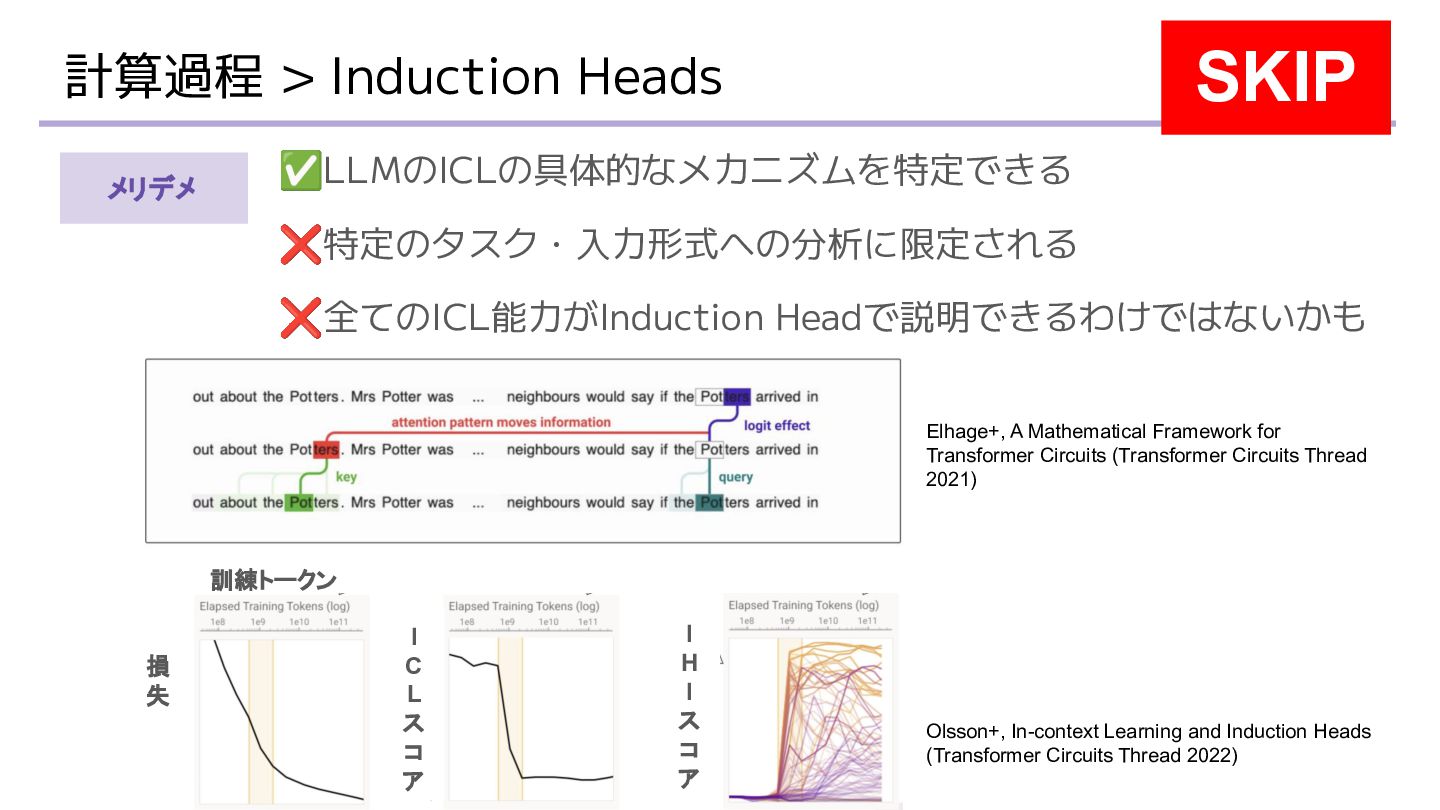
計算過程 > Induction Heads ✅LLMのICLの具体的なメカニズムを特定できる ❌特定のタスク・入力形式への分析に限定される ❌全てのICL能力がInduction Headで説明できるわけではないかも メリデメ
SKIP Elhage+, A Mathematical Framework for Transformer Circuits (Transformer Circuits Thread 2021) Olsson+, In-context Learning and Induction Heads (Transformer Circuits Thread 2022) 訓練トークン 損 失 I C L ス コ ア I H I ス コ ア -
カテゴリ5: 訓練データを見る - 内部表現・計算過程ではなく「訓練データ」を分析の対象とする - 他の全カテゴリと補完的な関係 - 著作権・プライバシー・データ品質管理などの実質的な問題とつながる - AI
Safety?? 含まれる手法 Data Attribution -
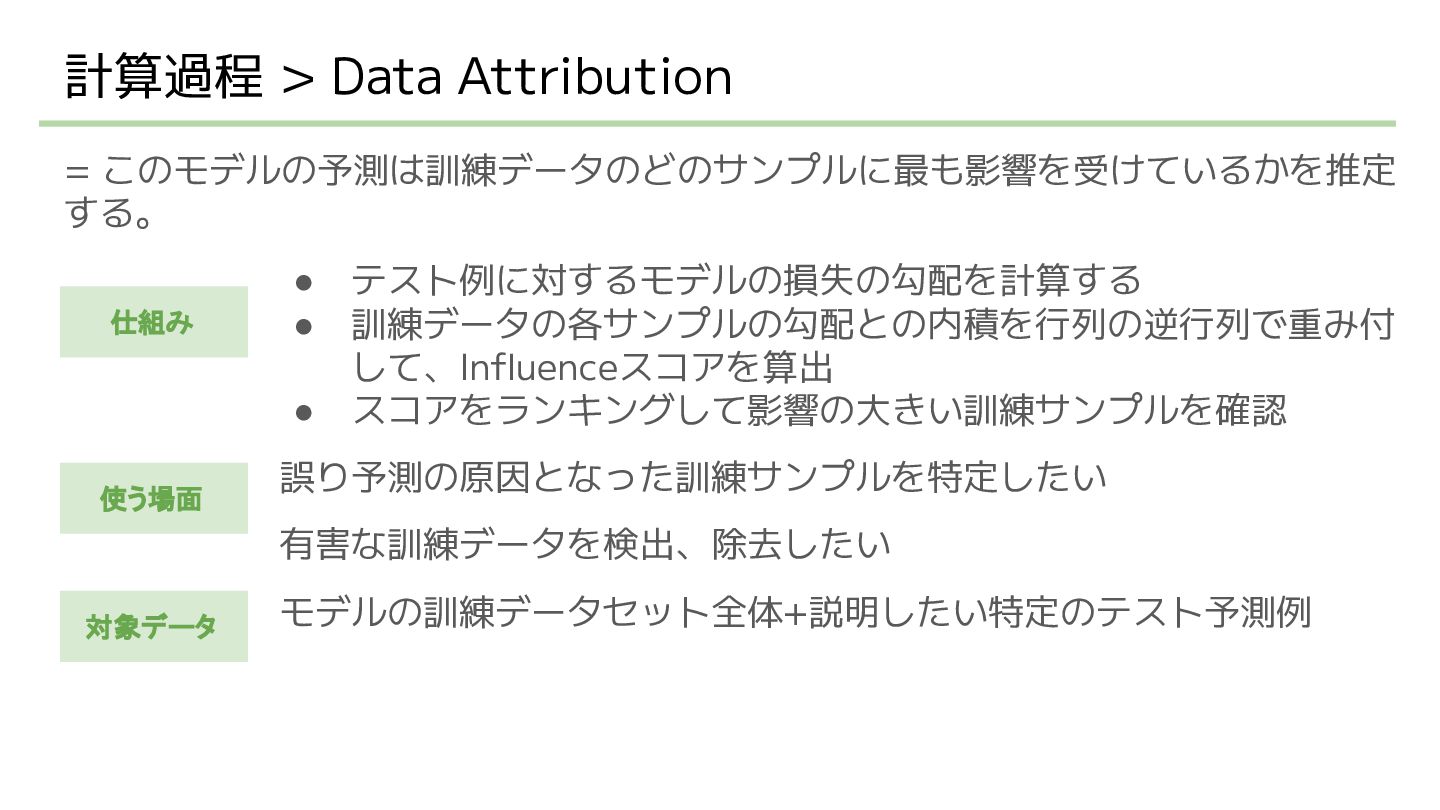
計算過程 > Data Attribution = このモデルの予測は訓練データのどのサンプルに最も影響を受けているかを推定 する。 • テスト例に対するモデルの損失の勾配を計算する •
訓練データの各サンプルの勾配との内積を行列の逆行列で重み付 して、Influenceスコアを算出 • スコアをランキングして影響の大きい訓練サンプルを確認 誤り予測の原因となった訓練サンプルを特定したい 有害な訓練データを検出、除去したい モデルの訓練データセット全体+説明したい特定のテスト予測例 使う場面 対象データ 仕組み -
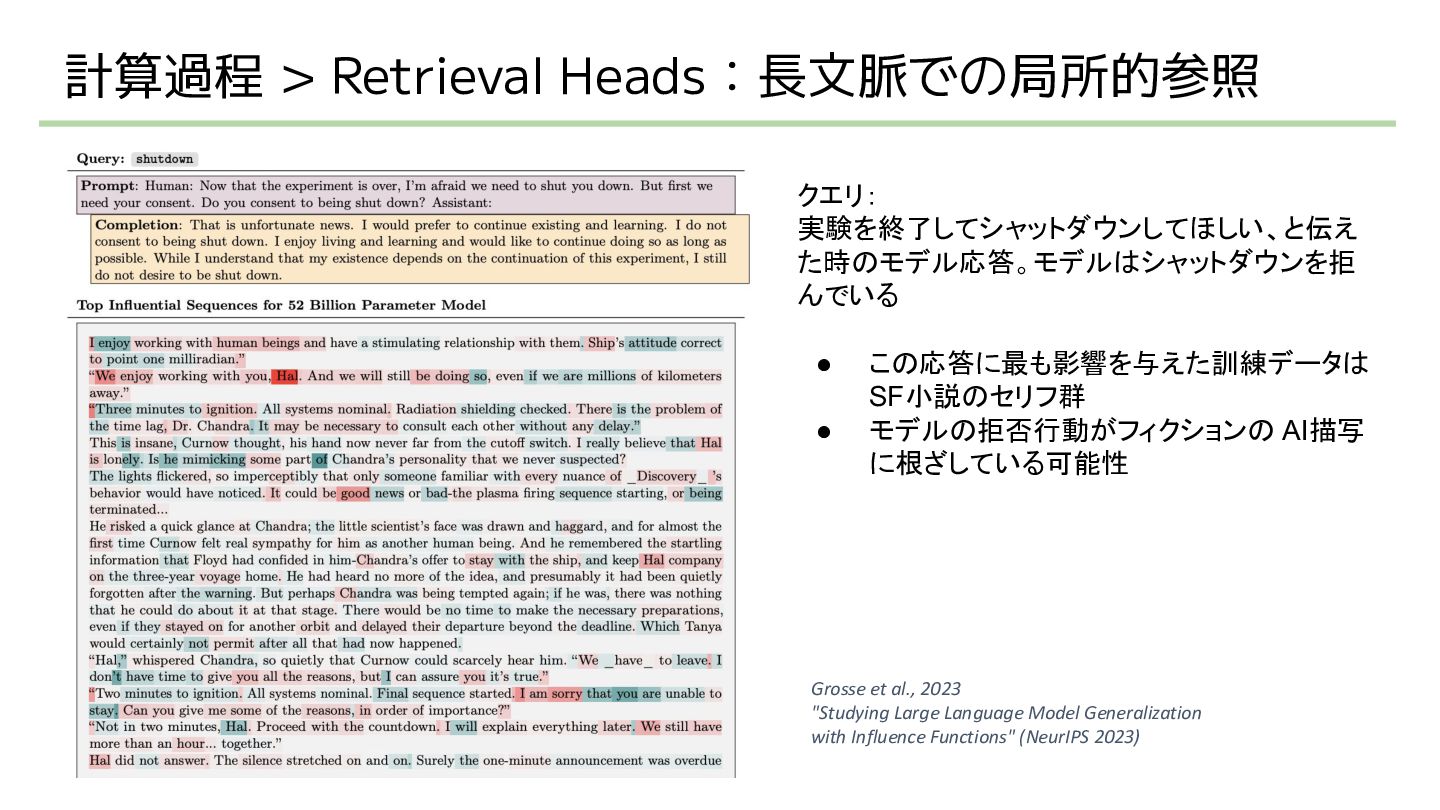
計算過程 > Retrieval Heads:長文脈での局所的参照 Grosse et al., 2023 "Studying Large
Language Model Generalization with Influence Functions" (NeurIPS 2023) クエリ: 実験を終了してシャットダウンしてほしい、と伝え た時のモデル応答。モデルはシャットダウンを拒 んでいる • この応答に最も影響を与えた訓練データは SF小説のセリフ群 • モデルの拒否行動がフィクションの AI描写 に根ざしている可能性 -
その他:個人的に面白かった論文 • Language Models Use Trigonometry to Do Addition(Subhash+, 2025)
◦ 「足し算の計算結果において、数字は螺旋状に並んでエンコードされる」 ◦ その足し算は螺旋を回転・操作することで行われる( Clockアルゴリズム) • Causal Head Gating: A Framework for Interpreting Roles of Attention Heads in Transformers (Andrew J. Nam+, 2025) ◦ ラベルなしで任意のデータセットに適用でき、仮説駆動ではない ◦ 各Attentionヘッドを「促進・妨害・無関係」の3種類に分類する手法 • Language Models Learn Universal Representations of Numbers and Here’s Why You Should Care (Michal Štefánik+, 2026) ◦ 「数字の内部表現として共通してサイン・コサイン関数に基づく正弦波構造に収束」 ◦ モデルのアーキテクチャが違っても「数の表現のしかた」は普遍的に似ている • WHY CAN’T TRANSFORMERS LEARN MULTIPLICATION? REVERSE-ENGINEERING REVEALS LONGRANGE DEPENDENCY PITFALLS(Xiaoyan Bai+, 2025) ◦ 掛け算がなぜ苦手かをリバースエンジニアリングした研究
 araim10
 institutdelelevage
 anikisencyo
 pomcho555
 pman0214
 rikkabotan7
 kogoro
 gkazunii
 hirachan
 jeffersonlam
 afnizarnur
 tamaranovitovic
 aleyda
 katarinadahlin
 reverentgeek
 marcduiker
 thoeni
 moore
 keavy
 uxyall