Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
論文紹介:Bridging the Gap between Expert and Langua...
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Arai M
April 30, 2026
Research
15
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
論文紹介:Bridging the Gap between Expert and Language Models: Concept-guided Chess Commentary Generation and Evaluation
Arai M
April 30, 2026
More Decks by Arai M
See All by Arai M
論文紹介:TS-RAG: Retrieval-Augmented Generation based Time Series Foundation Models are Stronger Zero-Shot Forecaster
araim10
0
14
LLMの解釈手法基礎まとめ
araim10
0
66
論文紹介:Time Series Forecasting with LLMs: Understanding and Enhancing Model Capabilities
araim10
0
12
論文紹介:Causal Head Gating: A Framework for Interpreting Roles of Attention Heads in Transformers
araim10
0
15
論文紹介:Language Models Use Trigonometry to Do Addition
araim10
0
10
Other Decks in Research
See All in Research
L’albédo:levier d’atténuation du changement climatique dans les systèmes fourragers
institutdelelevage
PRO
0
140
Hitting the buffers
beale
0
280
[最先端NLP勉強会2026] Checklists Are Better Than Reward Models For Aligning Language Models
nzw0301
1
330
論文読み会 SNLP2026 Tau2-Bench: Evaluating Conversational Agents in a Dual-Control Environment
s_mizuki_nlp
0
300
Byzantine Eventual Consistency for Reliable Local-First Software
ept
0
220
超効率化への挑戦:1bit LLMの現状と展望
yumaichikawa
0
880
Cross-Media Human-Information Interaction
signer
PRO
0
280
ハードウェア研究で国際トップ会議を目指す!IROS 2027での論文採択を目指して
ayatokanada
7
4.1k
[webinaire du Ciirpo] Agnelages plein air : des éleveurs partagent leurs pratiques
institutdelelevage
PRO
0
210
VRID: View-Invariant Representation through Dual-Axis Transformation for Cross-iew Pose Estimation
satai
3
120
ros2-perf-multihost: 分散システムにおける客観的なアーキテクチャ評価フレームワーク
takasehideki
0
290
Model Predictive Control for Uncertain Systems: Robust & Data-Driven Designs
kohlerjohannes
0
170
Featured
See All Featured
Ecommerce SEO: The Keys for Success Now & Beyond - #SERPConf2024
aleyda
1
2.2k
Avoiding the “Bad Training, Faster” Trap in the Age of AI
tmiket
0
270
エンジニアに許された特別な時間の終わり
watany
109
250k
Navigating Team Friction
lara
192
16k
Navigating the moral maze — ethical principles for Al-driven product design
skipperchong
2
630
Hiding What from Whom? A Critical Review of the History of Programming languages for Music
tomoyanonymous
3
1.3k
JavaScript: Past, Present, and Future - NDC Porto 2020
reverentgeek
52
6.1k
Fashionably flexible responsive web design (full day workshop)
malarkey
409
67k
Effective software design: The role of men in debugging patriarchy in IT @ Voxxed Days AMS
baasie
1
570
Ruling the World: When Life Gets Gamed
codingconduct
0
400
Mind Mapping
helmedeiros
1
400
Scaling GitHub
holman
464
140k
Transcript
⽂献講読 2026/4/27 M2 新井深⽉ NAACL2025
⽬次 研究背景 課題設定・周辺知識の調査 本研究のアプローチ チェス解説ドメインにおける既存研究の傾向 関連研究 Expert Modelの概念を使⽤した⽣成・評価 実験 実験⼿法・実験設定・評価設計
⼈⼿評価・LLMによる⾃動評価・⾃動評価の信頼性 2 実験結果 ノーマルLLMのチェス知識分析・対話型LLM・データ形式 Appendix: 追加実験 考察・限界・展望・まとめ
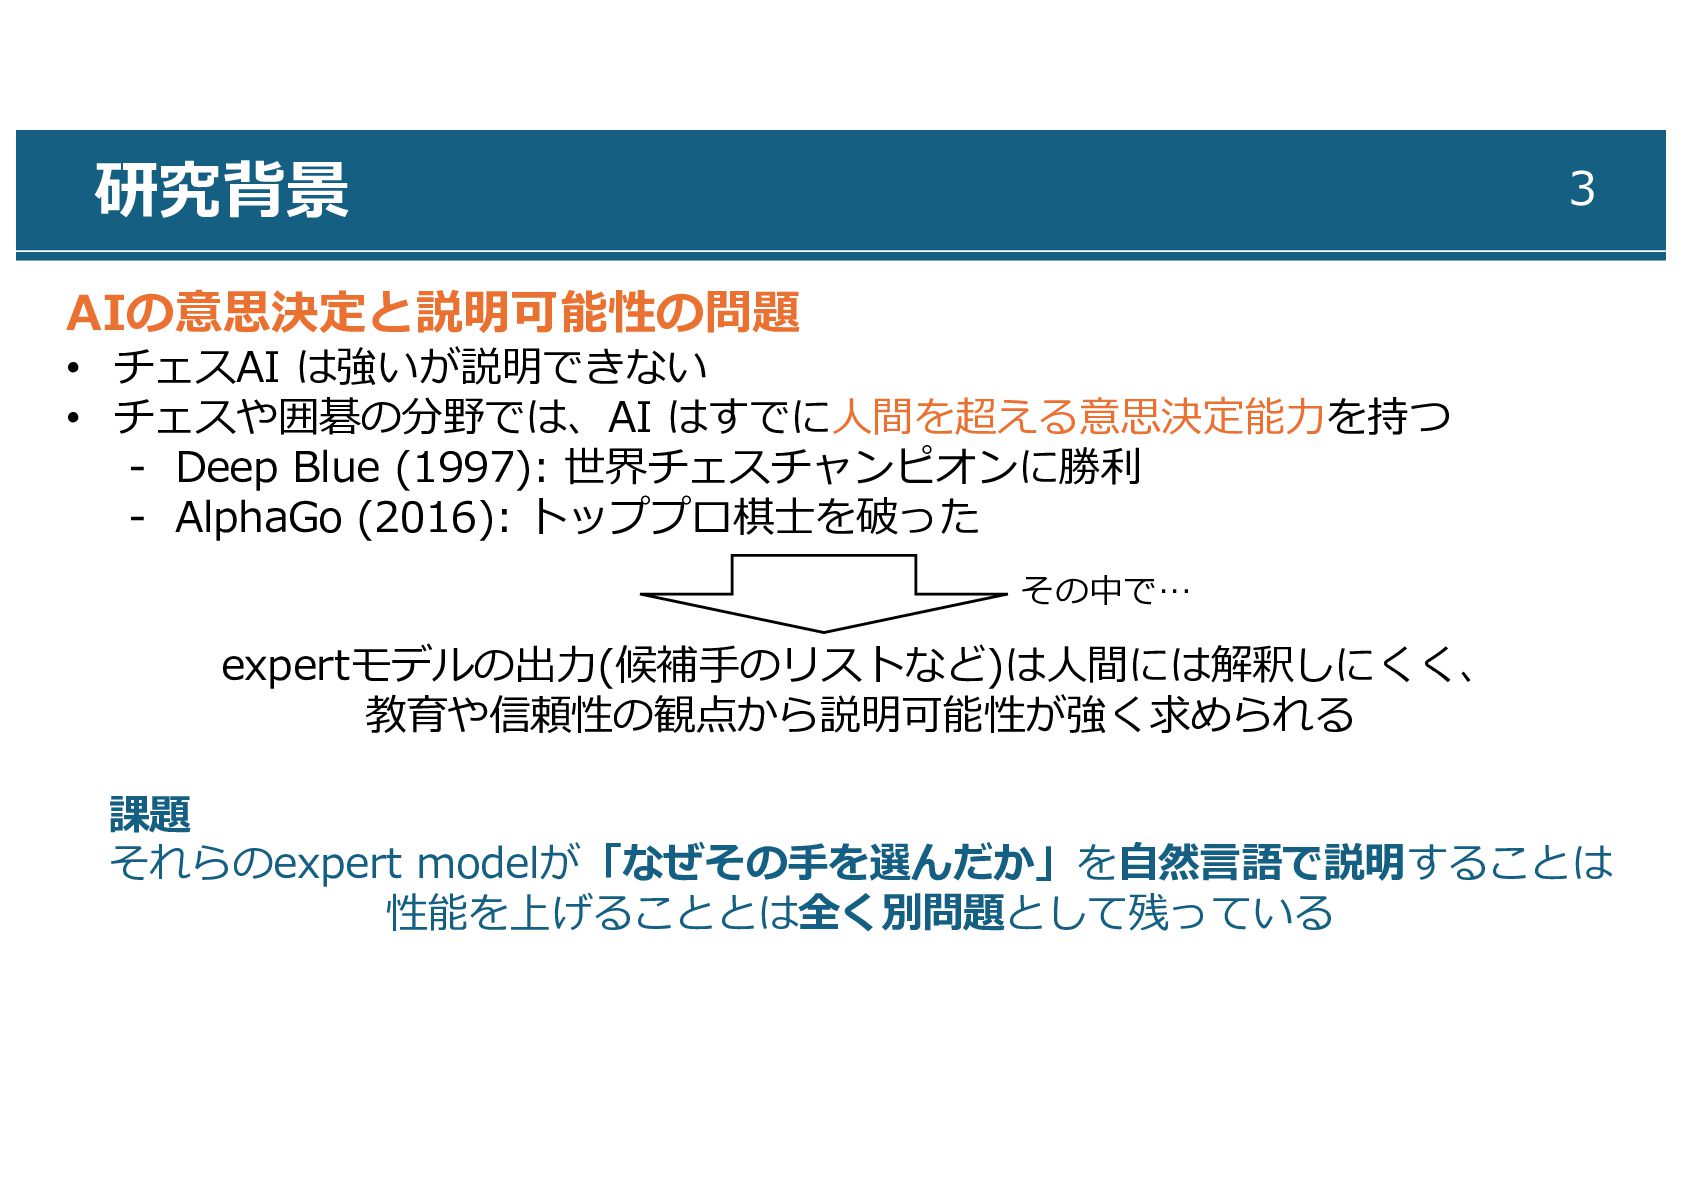
研究背景 3 AIの意思決定と説明可能性の問題 • チェスAI は強いが説明できない • チェスや囲碁の分野では、AI はすでに⼈間を超える意思決定能⼒を持つ -
Deep Blue (1997): 世界チェスチャンピオンに勝利 - AlphaGo (2016): トッププロ棋⼠を破った expertモデルの出⼒(候補⼿のリストなど)は⼈間には解釈しにくく、 教育や信頼性の観点から説明可能性が強く求められる 課題 それらのexpert modelが「なぜその⼿を選んだか」を⾃然⾔語で説明することは 性能を上げることとは全く別問題として残っている その中で…
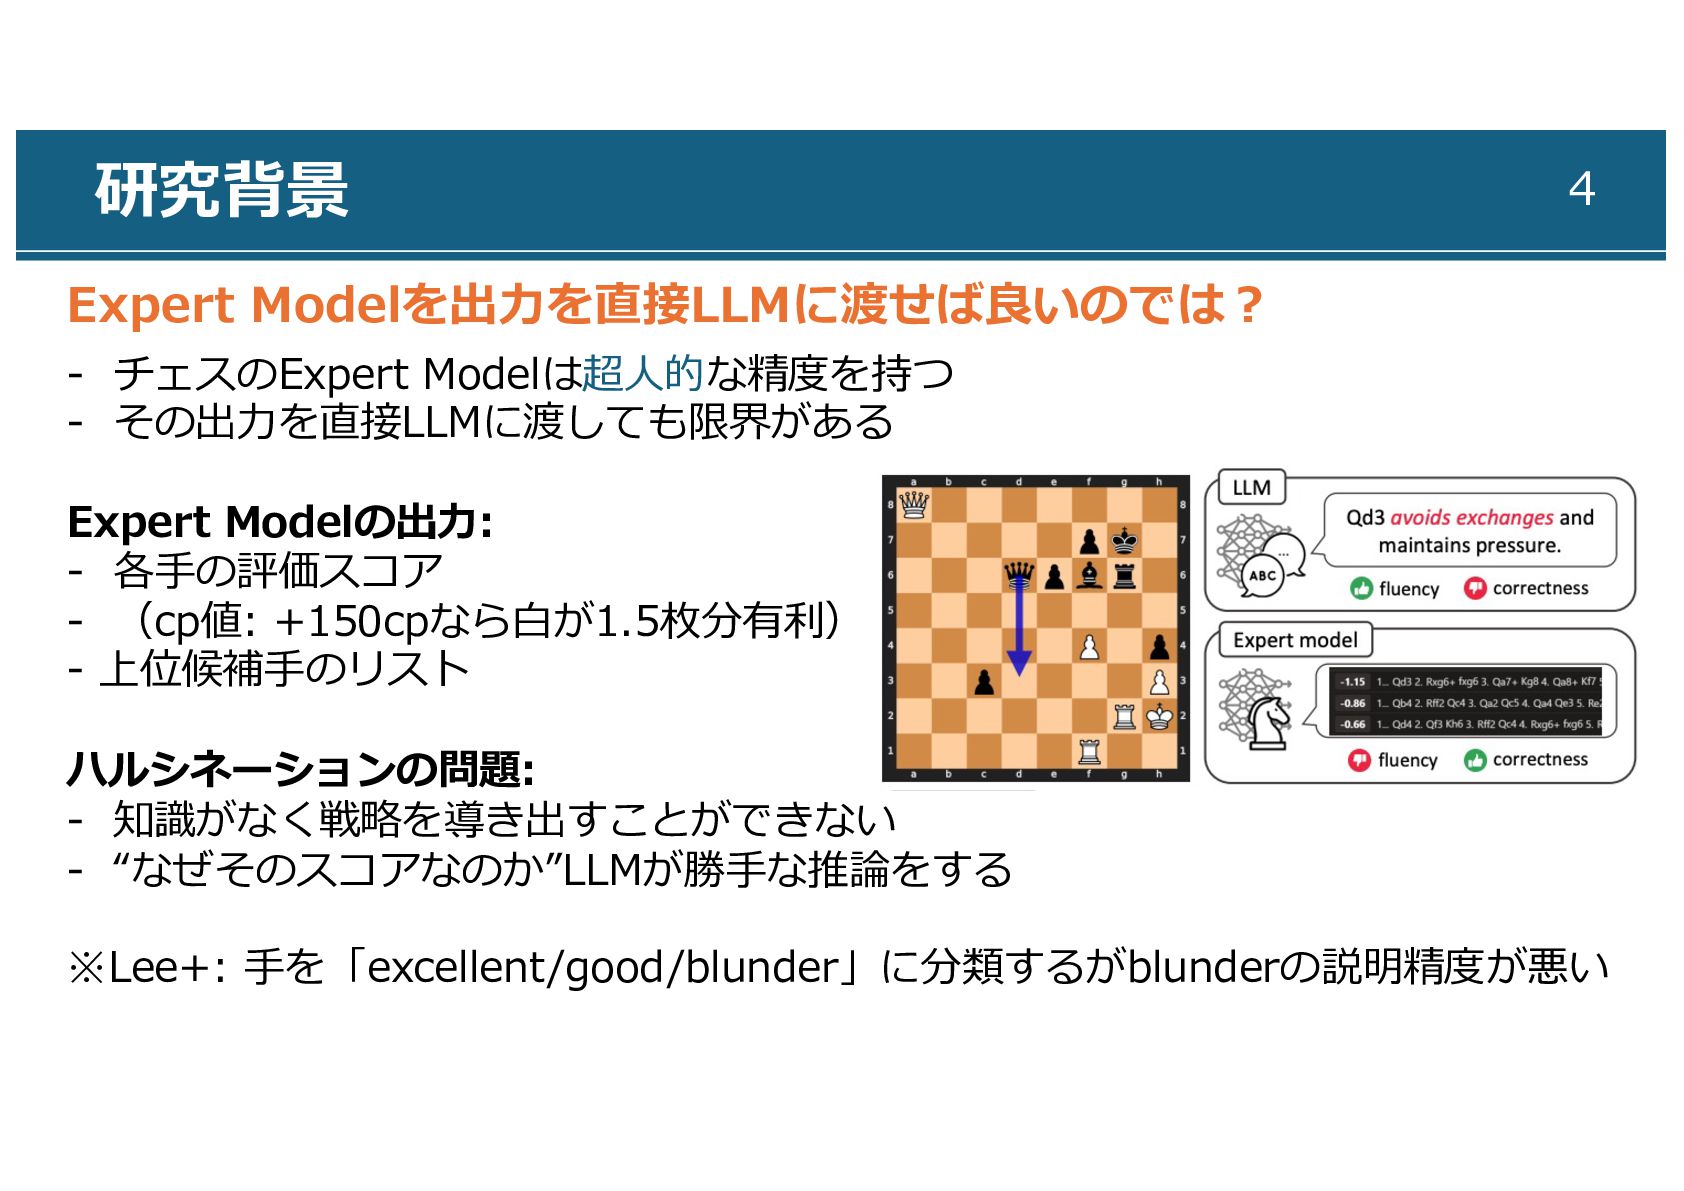
研究背景 4 - チェスのExpert Modelは超⼈的な精度を持つ - その出⼒を直接LLMに渡しても限界がある Expert Modelの出⼒: -
各⼿の評価スコア - (cp値: +150cpなら⽩が1.5枚分有利) - 上位候補⼿のリスト ハルシネーションの問題: - 知識がなく戦略を導き出すことができない - “なぜそのスコアなのか”LLMが勝⼿な推論をする ※Lee+: ⼿を「excellent/good/blunder」に分類するがblunderの説明精度が悪い Expert Modelを出⼒を直接LLMに渡せば良いのでは︖
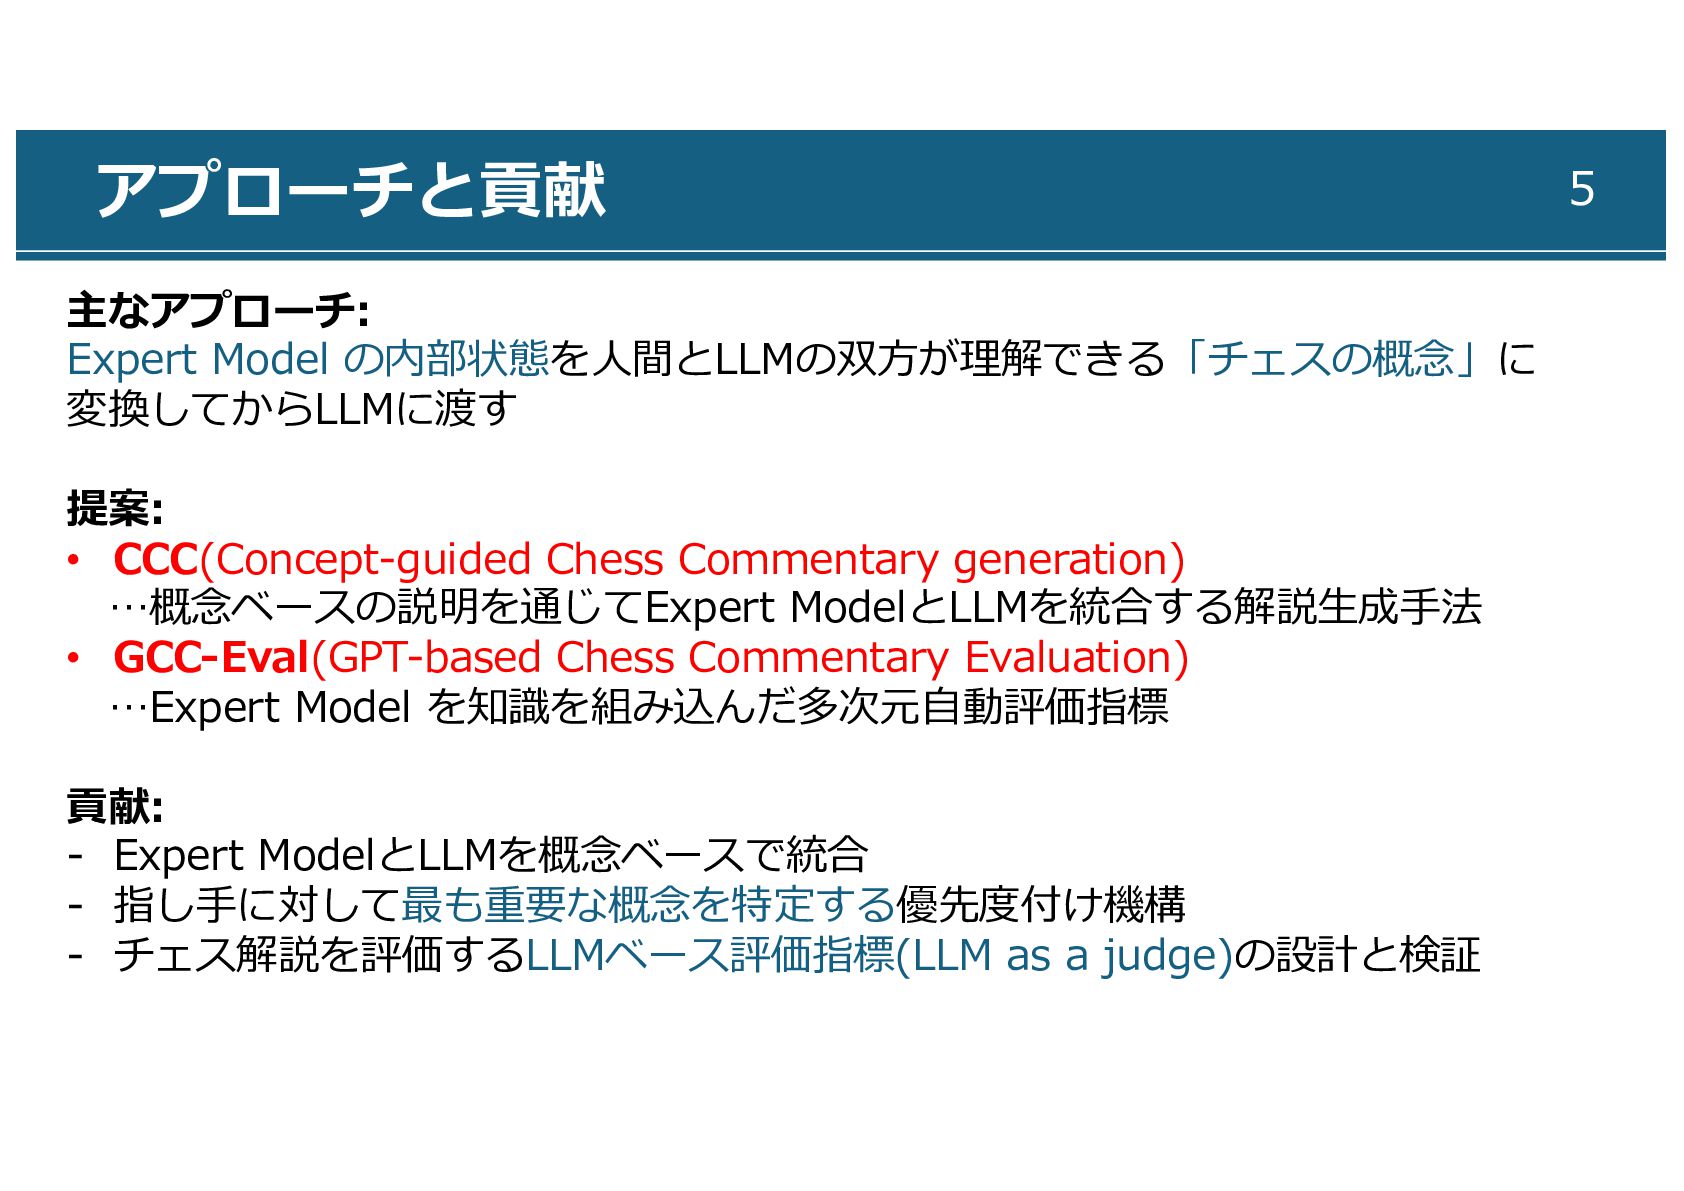
アプローチと貢献 5 主なアプローチ: Expert Model の内部状態を⼈間とLLMの双⽅が理解できる「チェスの概念」に 変換してからLLMに渡す 提案: • CCC(Concept-guided
Chess Commentary generation) …概念ベースの説明を通じてExpert ModelとLLMを統合する解説⽣成⼿法 • GCC-Eval(GPT-based Chess Commentary Evaluation) …Expert Model を知識を組み込んだ多次元⾃動評価指標 貢献: - Expert ModelとLLMを概念ベースで統合 - 指し⼿に対して最も重要な概念を特定する優先度付け機構 - チェス解説を評価するLLMベース評価指標(LLM as a judge)の設計と検証
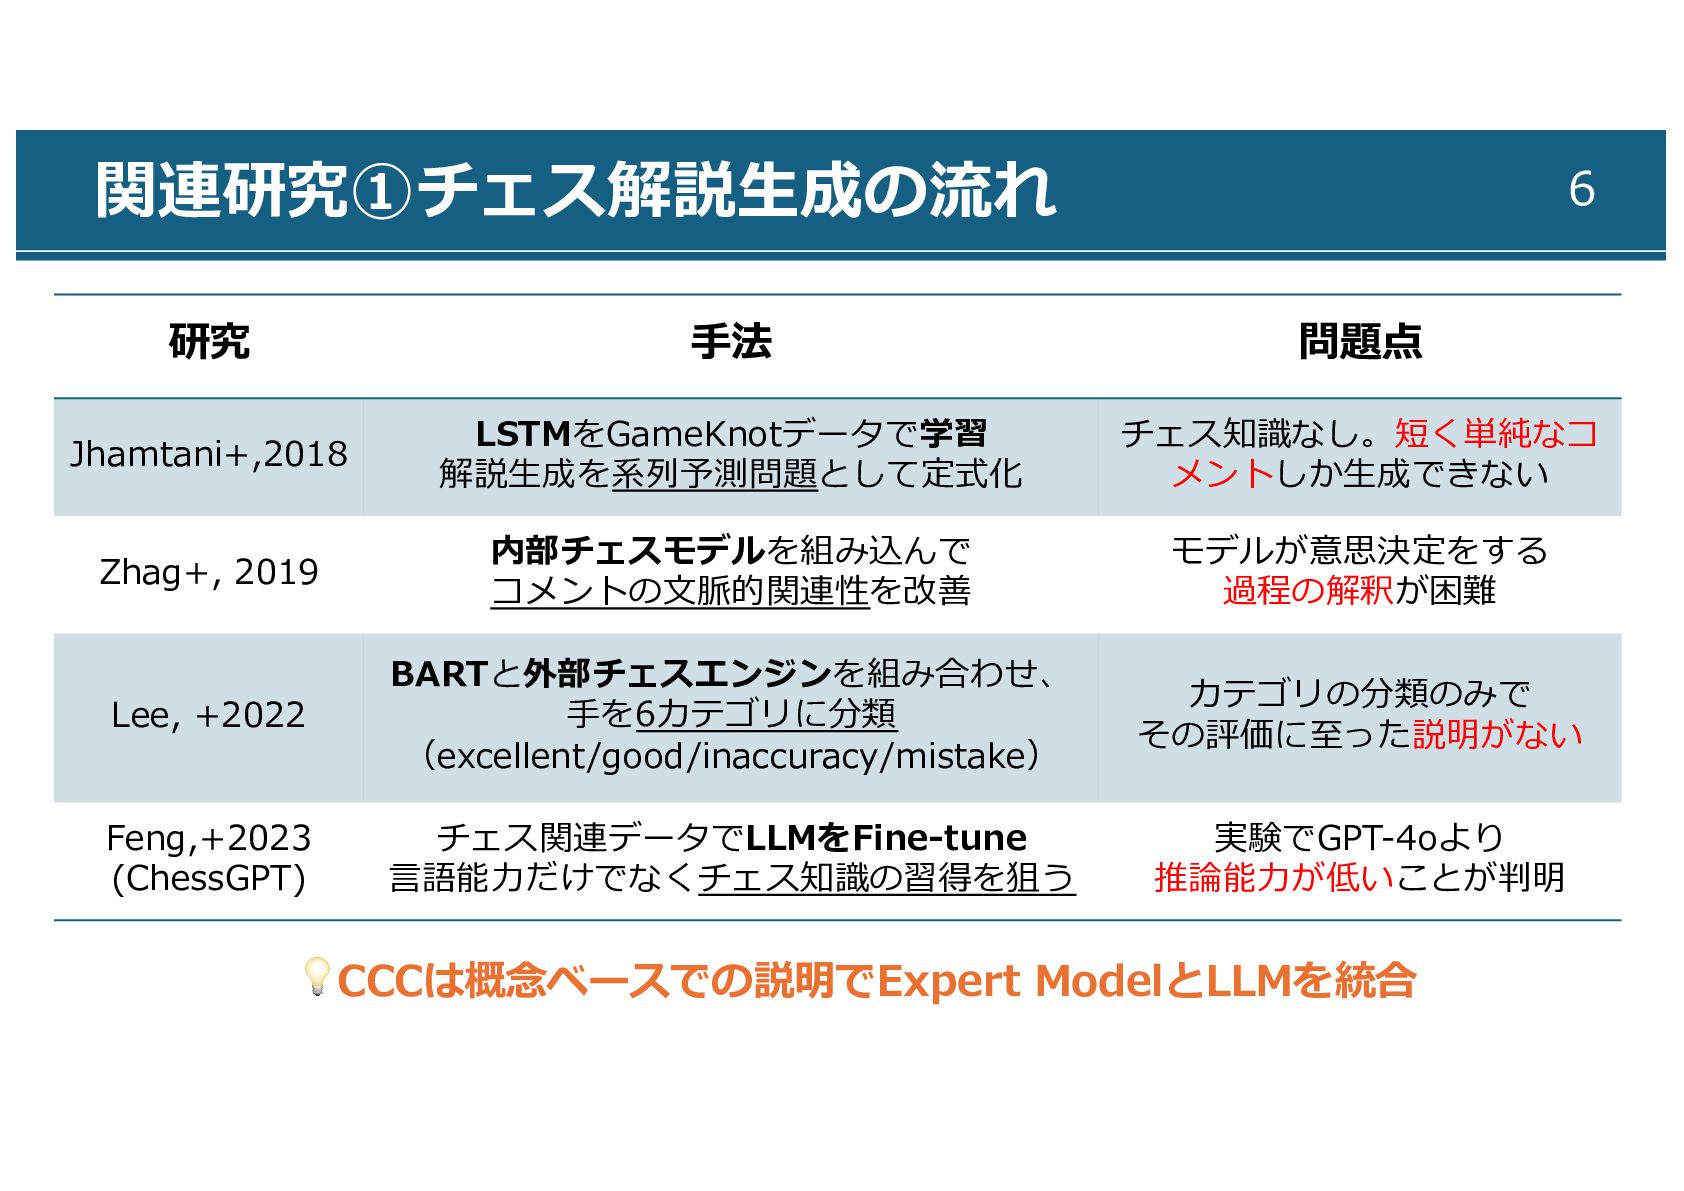
関連研究①チェス解説⽣成の流れ 6 研究 ⼿法 問題点 Jhamtani+,2018 LSTMをGameKnotデータで学習 解説⽣成を系列予測問題として定式化 チェス知識なし。短く単純なコ メントしか⽣成できない
Zhag+, 2019 内部チェスモデルを組み込んで コメントの⽂脈的関連性を改善 モデルが意思決定をする 過程の解釈が困難 Lee, +2022 BARTと外部チェスエンジンを組み合わせ、 ⼿を6カテゴリに分類 (excellent/good/inaccuracy/mistake) カテゴリの分類のみで その評価に⾄った説明がない Feng,+2023 (ChessGPT) チェス関連データでLLMをFine-tune ⾔語能⼒だけでなくチェス知識の習得を狙う 実験でGPT-4oより 推論能⼒が低いことが判明 💡CCCは概念ベースでの説明でExpert ModelとLLMを統合
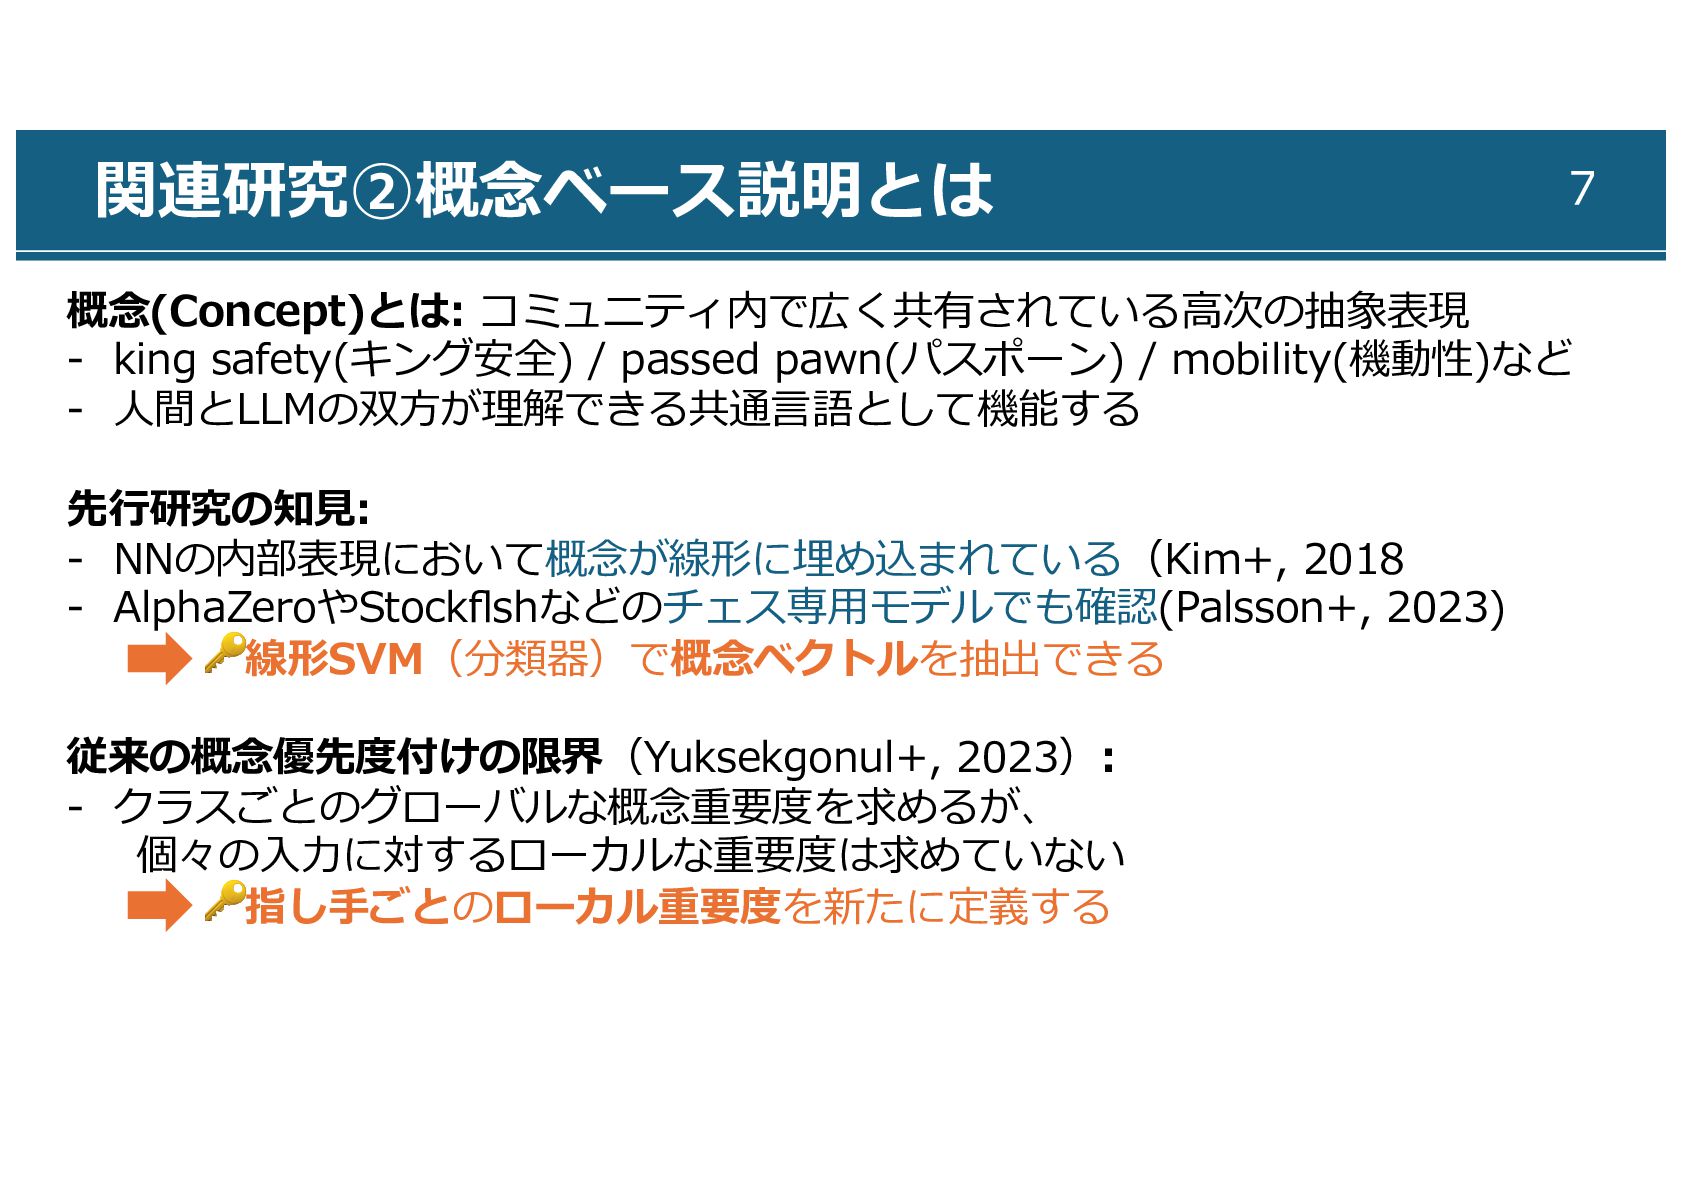
関連研究②概念ベース説明とは 7 概念(Concept)とは: コミュニティ内で広く共有されている⾼次の抽象表現 - king safety(キング安全) / passed pawn(パスポーン)
/ mobility(機動性)など - ⼈間とLLMの双⽅が理解できる共通⾔語として機能する 先⾏研究の知⾒: - NNの内部表現において概念が線形に埋め込まれている(Kim+, 2018 - AlphaZeroやStockflshなどのチェス専⽤モデルでも確認(Palsson+, 2023) 🔑線形SVM(分類器)で概念ベクトルを抽出できる 従来の概念優先度付けの限界(Yuksekgonul+, 2023): - クラスごとのグローバルな概念重要度を求めるが、 個々の⼊⼒に対するローカルな重要度は求めていない 🔑指し⼿ごとのローカル重要度を新たに定義する
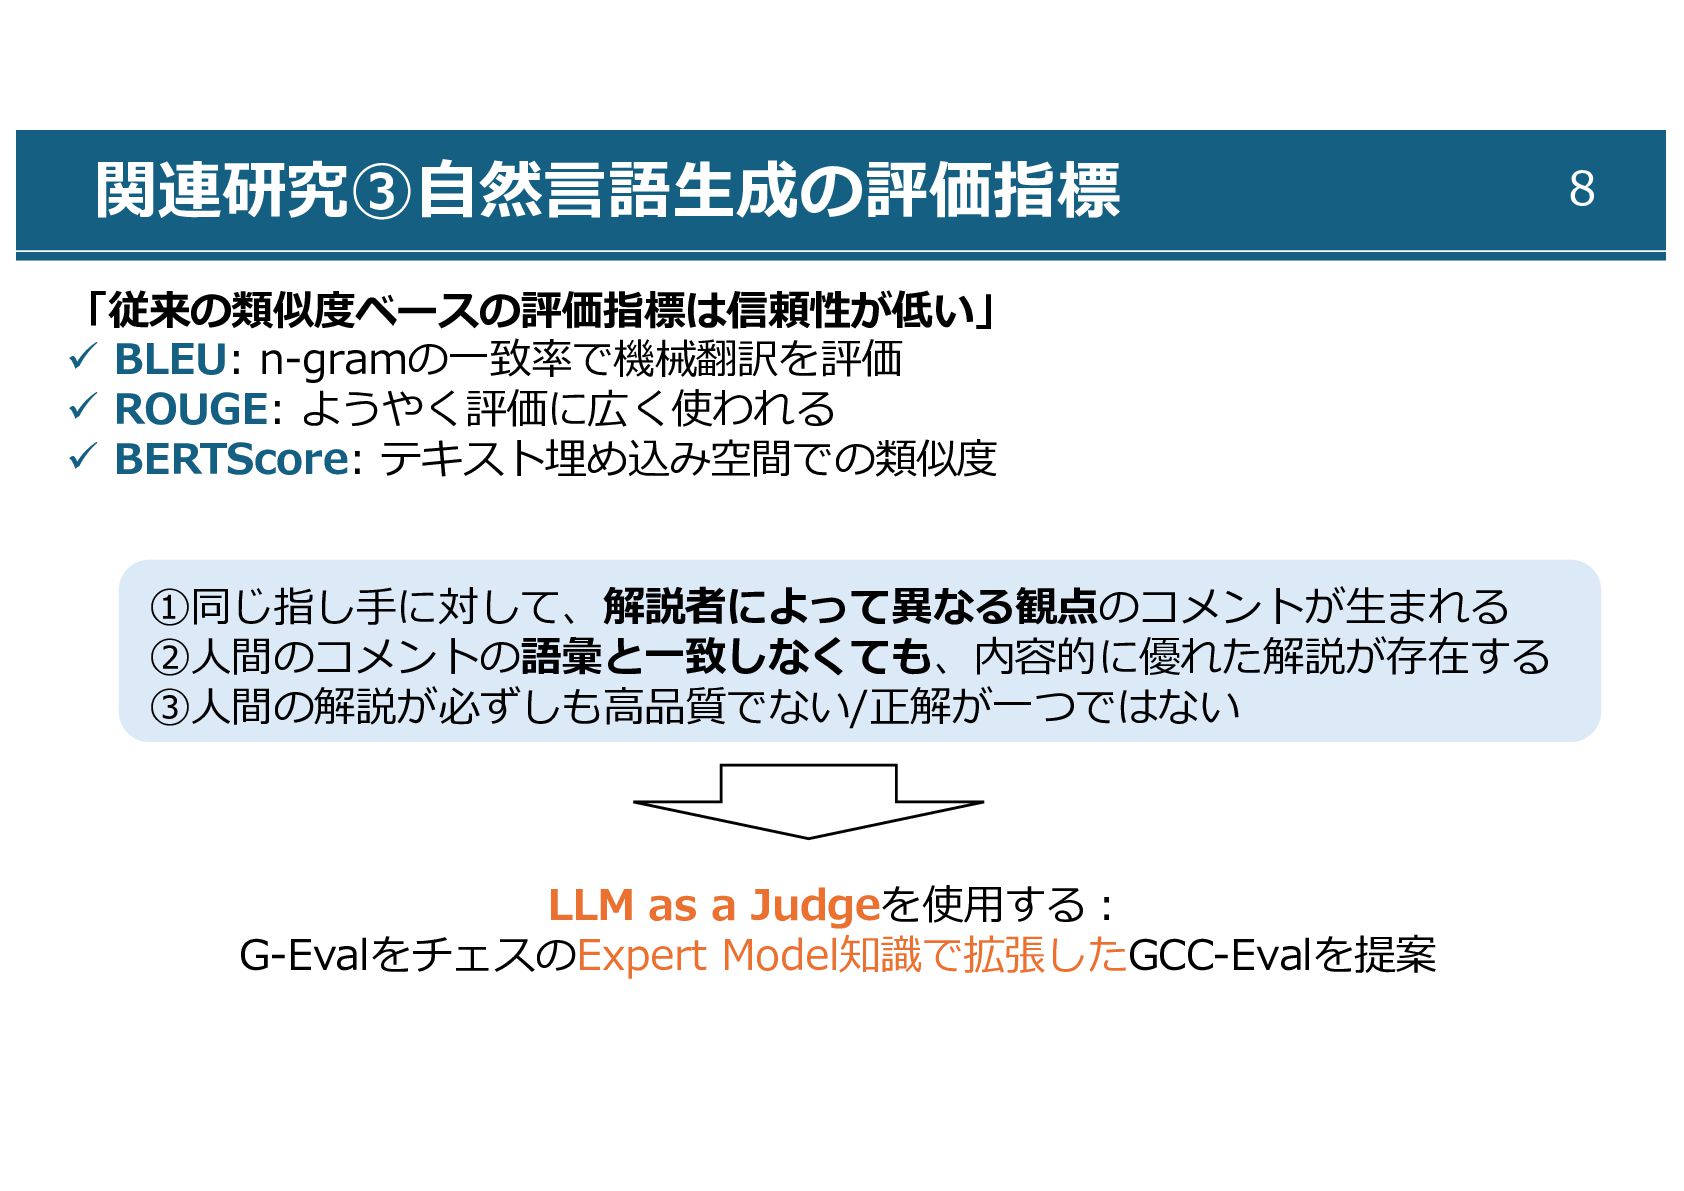
「従来の類似度ベースの評価指標は信頼性が低い」 ü BLEU: n-gramの⼀致率で機械翻訳を評価 ü ROUGE: ようやく評価に広く使われる ü BERTScore: テキスト埋め込み空間での類似度
①同じ指し⼿に対して、解説者によって異なる観点のコメントが⽣まれる ②⼈間のコメントの語彙と⼀致しなくても、内容的に優れた解説が存在する ③⼈間の解説が必ずしも⾼品質でない/正解が⼀つではない LLM as a Judgeを使⽤する︓ G-EvalをチェスのExpert Model知識で拡張したGCC-Evalを提案 関連研究③⾃然⾔語⽣成の評価指標 8
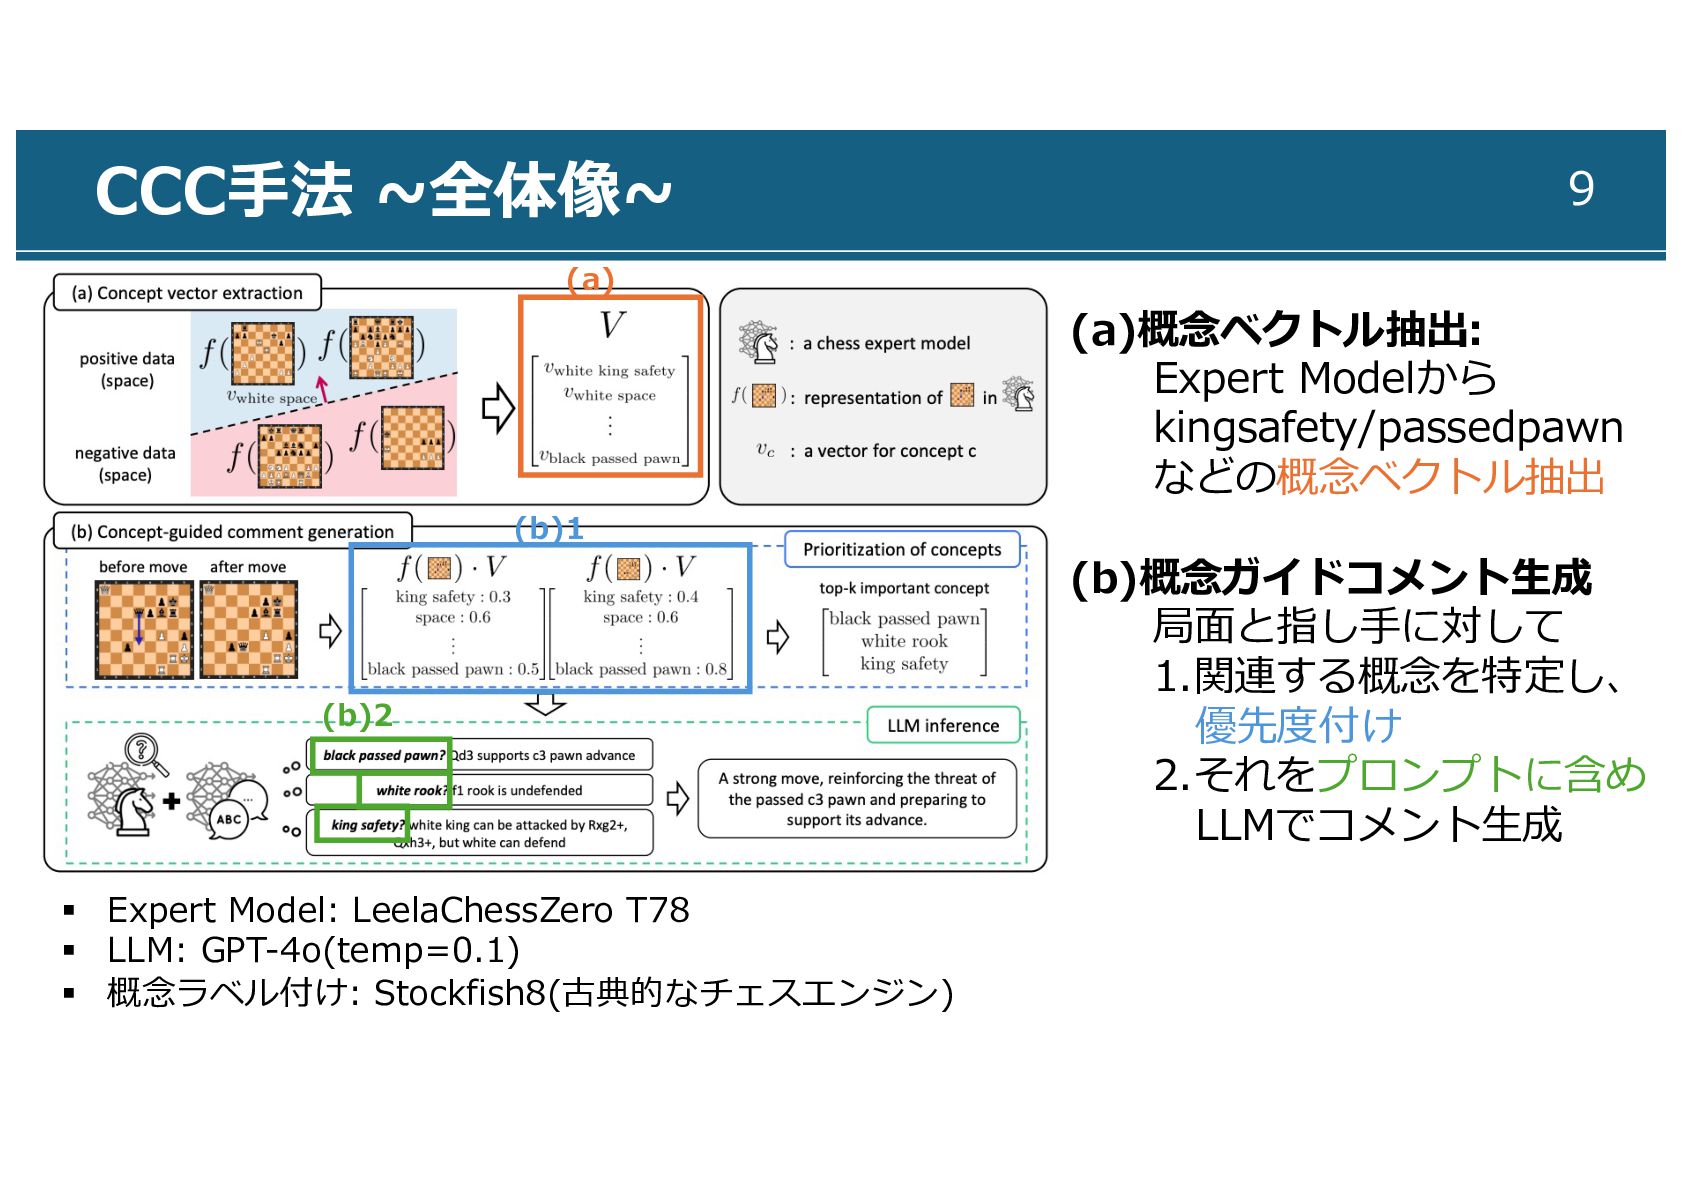
CCC⼿法 ~全体像~ 9 (a)概念ベクトル抽出: Expert Modelから kingsafety/passedpawn などの概念ベクトル抽出 (b)概念ガイドコメント⽣成 局⾯と指し⼿に対して
1.関連する概念を特定し、 優先度付け 2.それをプロンプトに含め LLMでコメント⽣成 § Expert Model: LeelaChessZero T78 § LLM: GPT-4o(temp=0.1) § 概念ラベル付け: Stockfish8(古典的なチェスエンジン) (b)1 (b)2 (a)
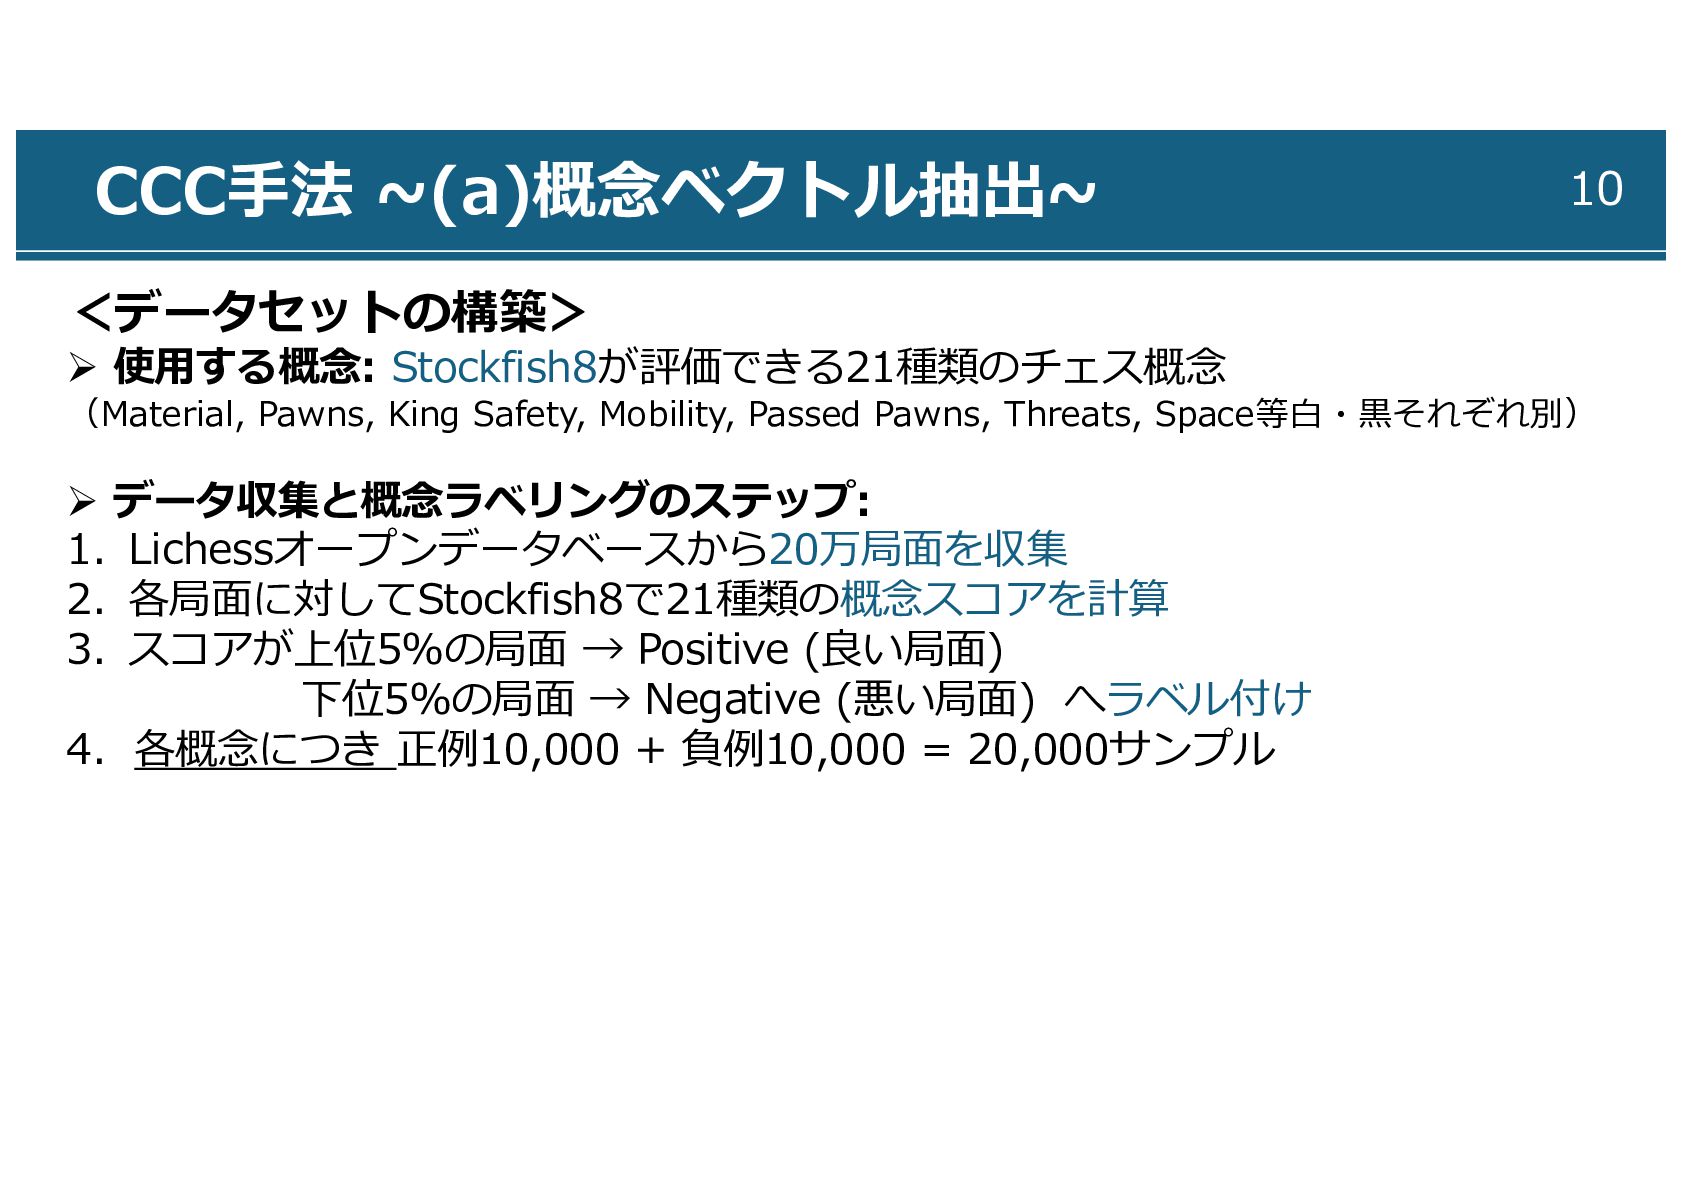
CCC⼿法 ~(a)概念ベクトル抽出~ 10 <データセットの構築> Ø 使⽤する概念: Stockfish8が評価できる21種類のチェス概念 (Material, Pawns, King
Safety, Mobility, Passed Pawns, Threats, Space等⽩・⿊それぞれ別) Ø データ収集と概念ラベリングのステップ: 1. Lichessオープンデータベースから20万局⾯を収集 2. 各局⾯に対してStockfish8で21種類の概念スコアを計算 3. スコアが上位5%の局⾯ → Positive (良い局⾯) 下位5%の局⾯ → Negative (悪い局⾯) へラベル付け 4. 各概念につき 正例10,000 + 負例10,000 = 20,000サンプル
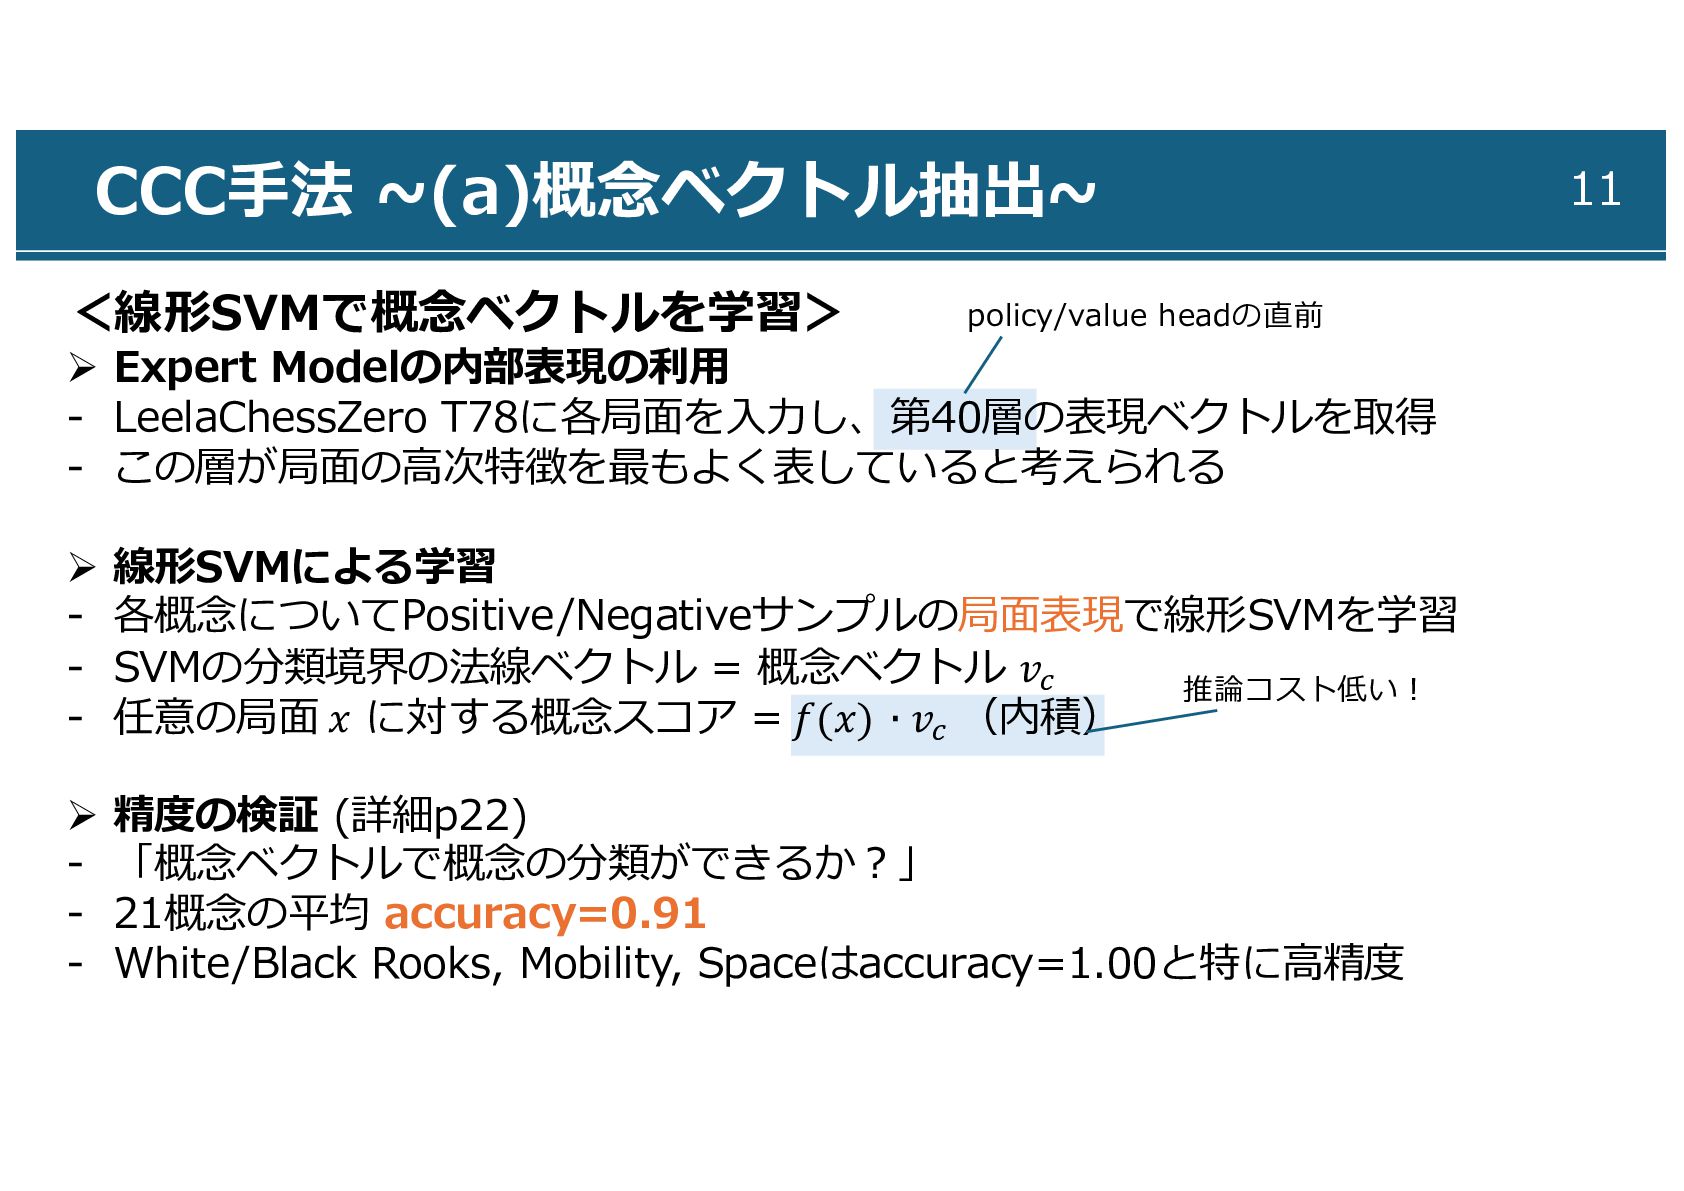
<線形SVMで概念ベクトルを学習> Ø Expert Modelの内部表現の利⽤ - LeelaChessZero T78に各局⾯を⼊⼒し、第40層の表現ベクトルを取得 - この層が局⾯の⾼次特徴を最もよく表していると考えられる Ø
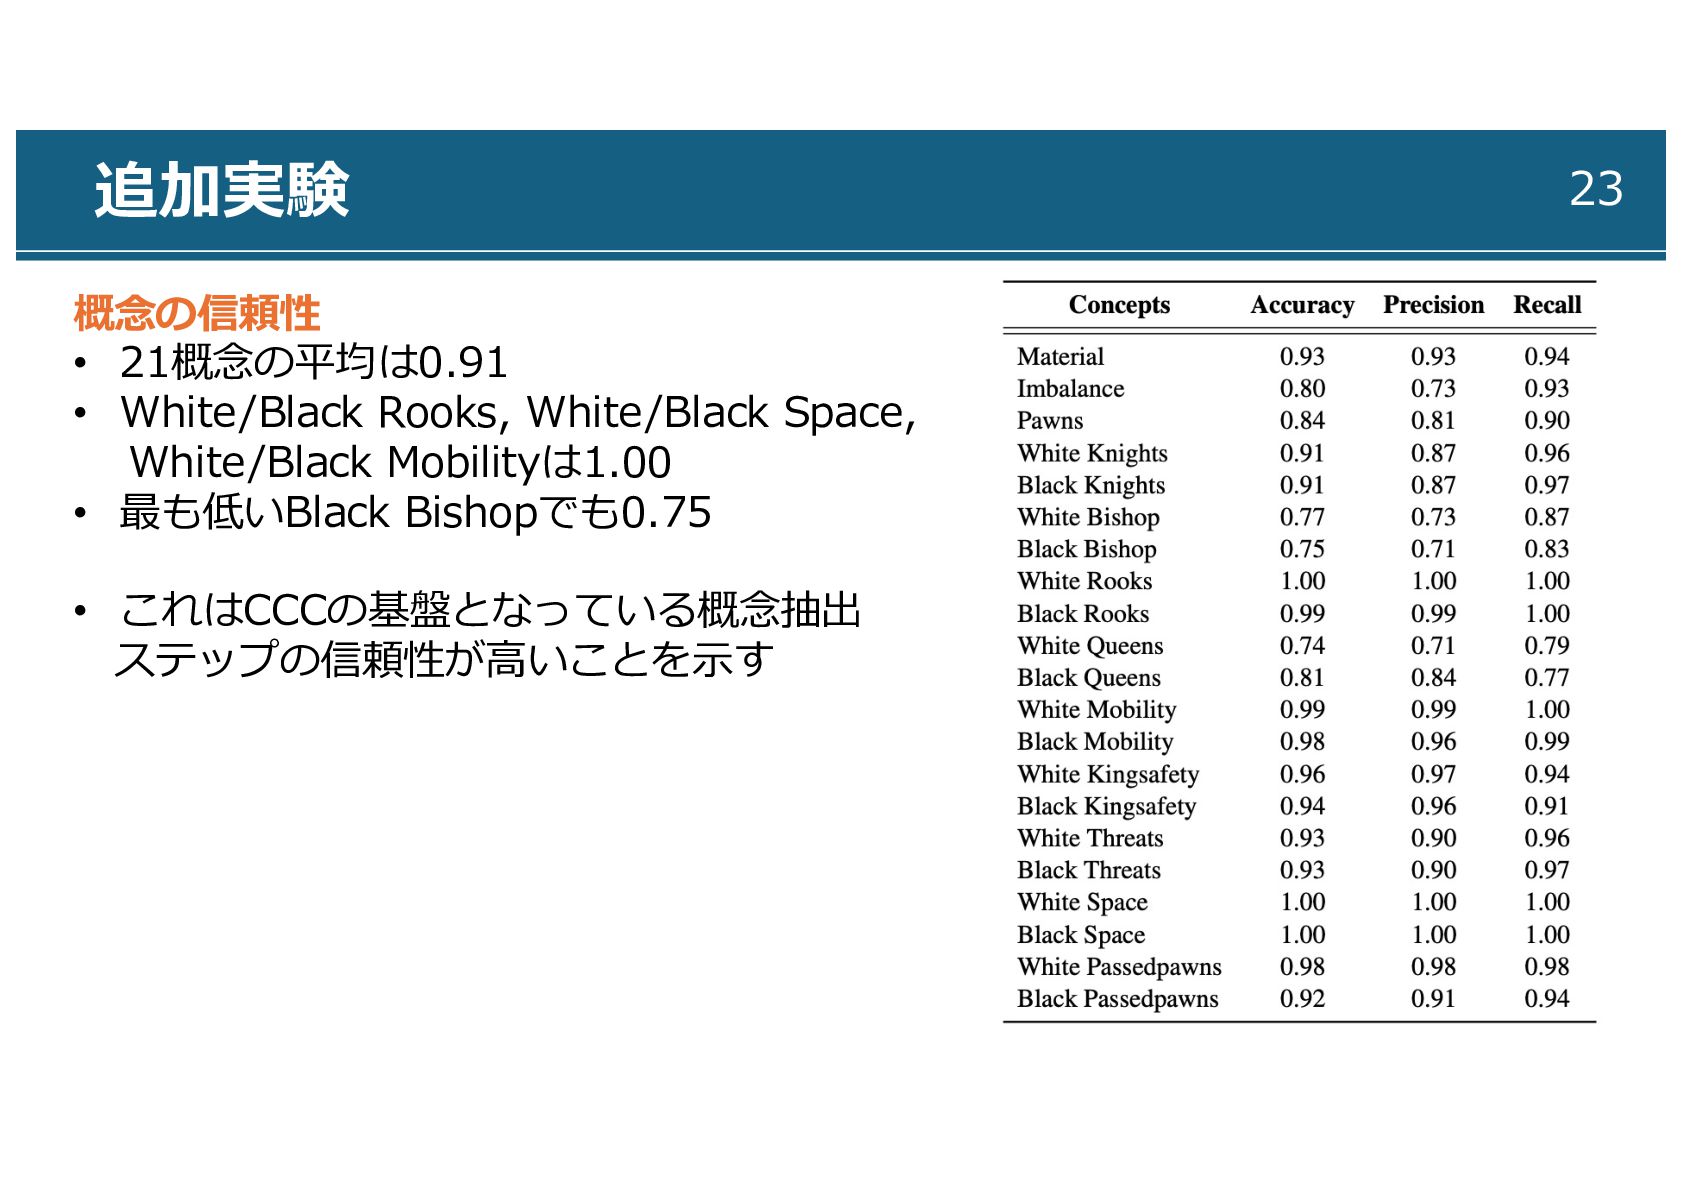
線形SVMによる学習 - 各概念についてPositive/Negativeサンプルの局⾯表現で線形SVMを学習 - SVMの分類境界の法線ベクトル = 概念ベクトル 𝑣! - 任意の局⾯ 𝑥 に対する概念スコア = 𝑓(𝑥) ⋅ 𝑣! (内積) Ø 精度の検証 (詳細p22) - 「概念ベクトルで概念の分類ができるか︖」 - 21概念の平均 accuracy=0.91 - White/Black Rooks, Mobility, Spaceはaccuracy=1.00と特に⾼精度 CCC⼿法 ~(a)概念ベクトル抽出~ 11 policy/value headの直前 推論コスト低い︕
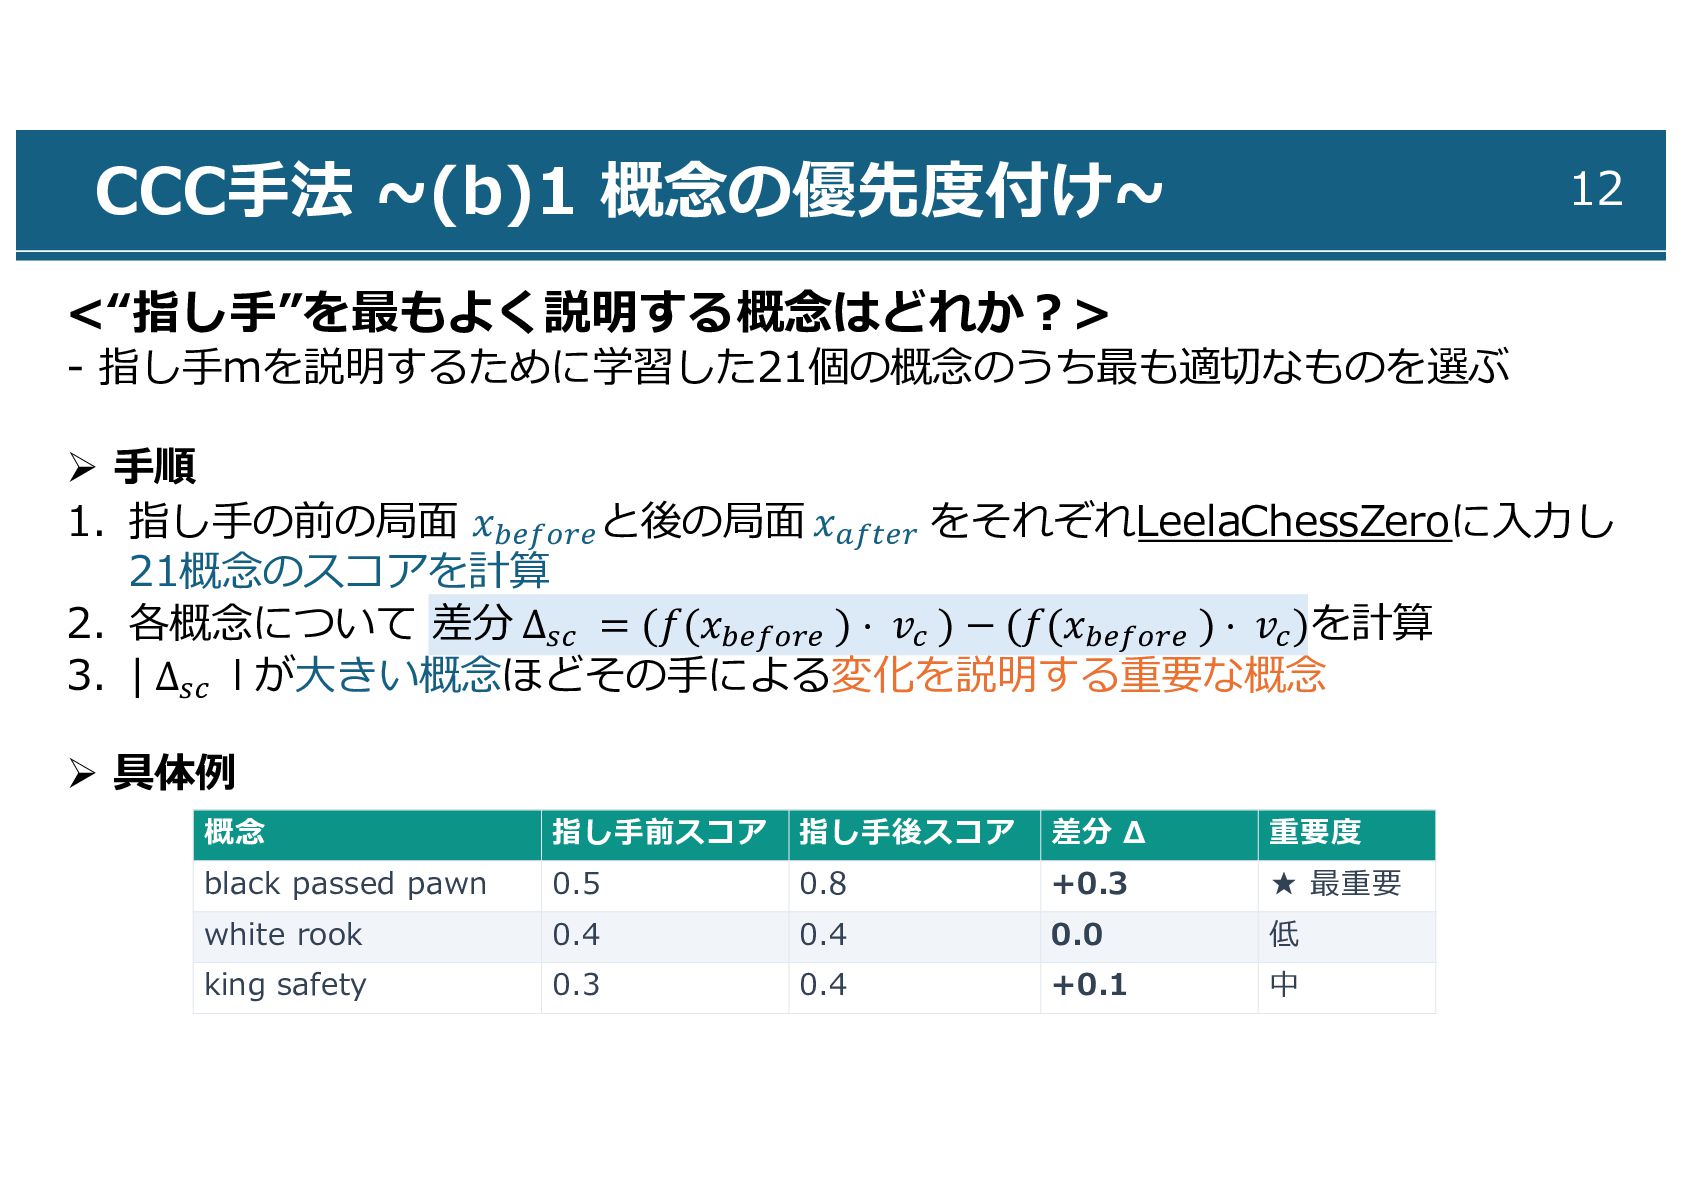
<“指し⼿”を最もよく説明する概念はどれか︖> - 指し⼿mを説明するために学習した21個の概念のうち最も適切なものを選ぶ Ø ⼿順 1. 指し⼿の前の局⾯ 𝑥"#$%&# と後の局⾯ 𝑥'$(#&
をそれぞれLeelaChessZeroに⼊⼒し 21概念のスコアを計算 2. 各概念について 差分 ∆)! = (𝑓(𝑥"#$%&# ) ⋅ 𝑣! ) − (𝑓(𝑥"#$%&# ) ⋅ 𝑣! )を計算 3. | ∆)! ∣が⼤きい概念ほどその⼿による変化を説明する重要な概念 Ø 具体例 CCC⼿法 ~(b)1 概念の優先度付け~ 12 概念 指し⼿前スコア 指し⼿後スコア 差分 Δ 重要度 black passed pawn 0.5 0.8 +0.3 ★ 最重要 white rook 0.4 0.4 0.0 低 king safety 0.3 0.4 +0.1 中
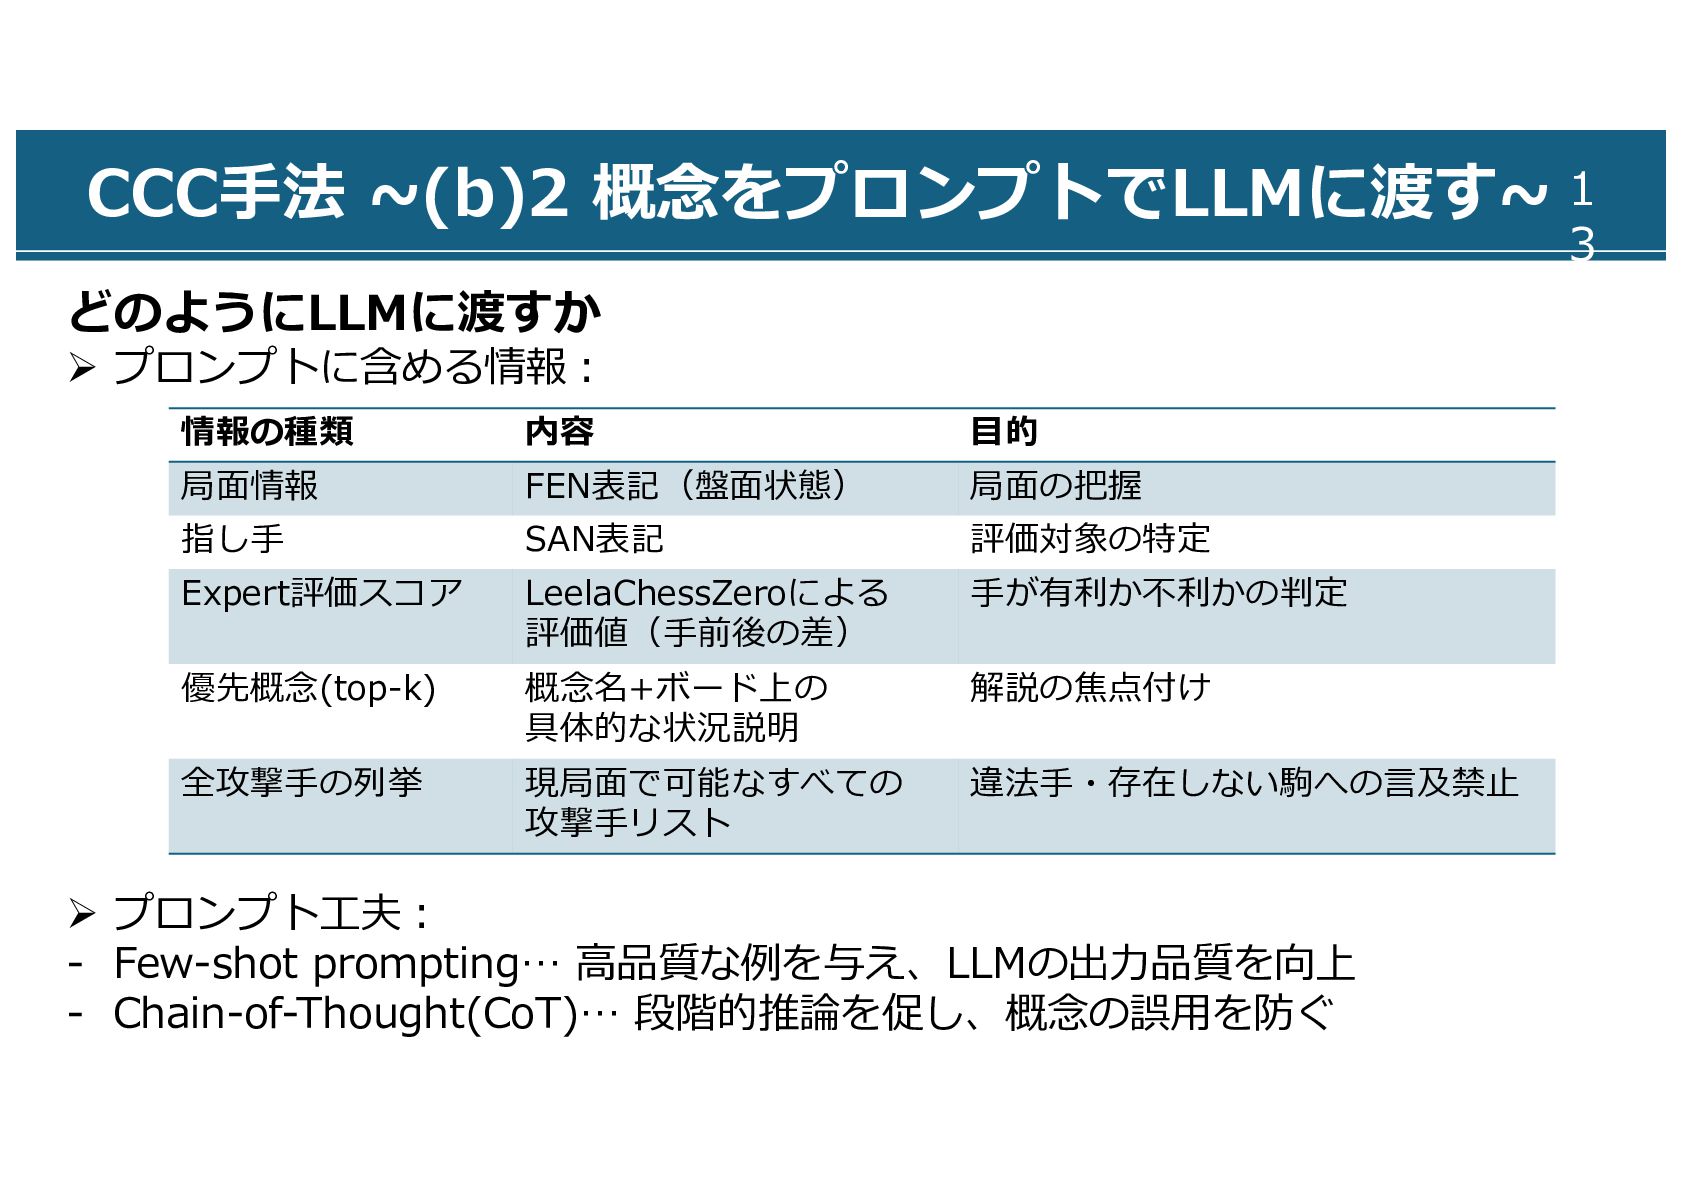
1 3 どのようにLLMに渡すか Ø プロンプトに含める情報︓ Ø プロンプト⼯夫︓ - Few-shot prompting…
⾼品質な例を与え、LLMの出⼒品質を向上 - Chain-of-Thought(CoT)… 段階的推論を促し、概念の誤⽤を防ぐ 情報の種類 内容 ⽬的 局⾯情報 FEN表記(盤⾯状態) 局⾯の把握 指し⼿ SAN表記 評価対象の特定 Expert評価スコア LeelaChessZeroによる 評価値(⼿前後の差) ⼿が有利か不利かの判定 優先概念(top-k) 概念名+ボード上の 具体的な状況説明 解説の焦点付け 全攻撃⼿の列挙 現局⾯で可能なすべての 攻撃⼿リスト 違法⼿・存在しない駒への⾔及禁⽌ CCC⼿法 ~(b)2 概念をプロンプトでLLMに渡す~
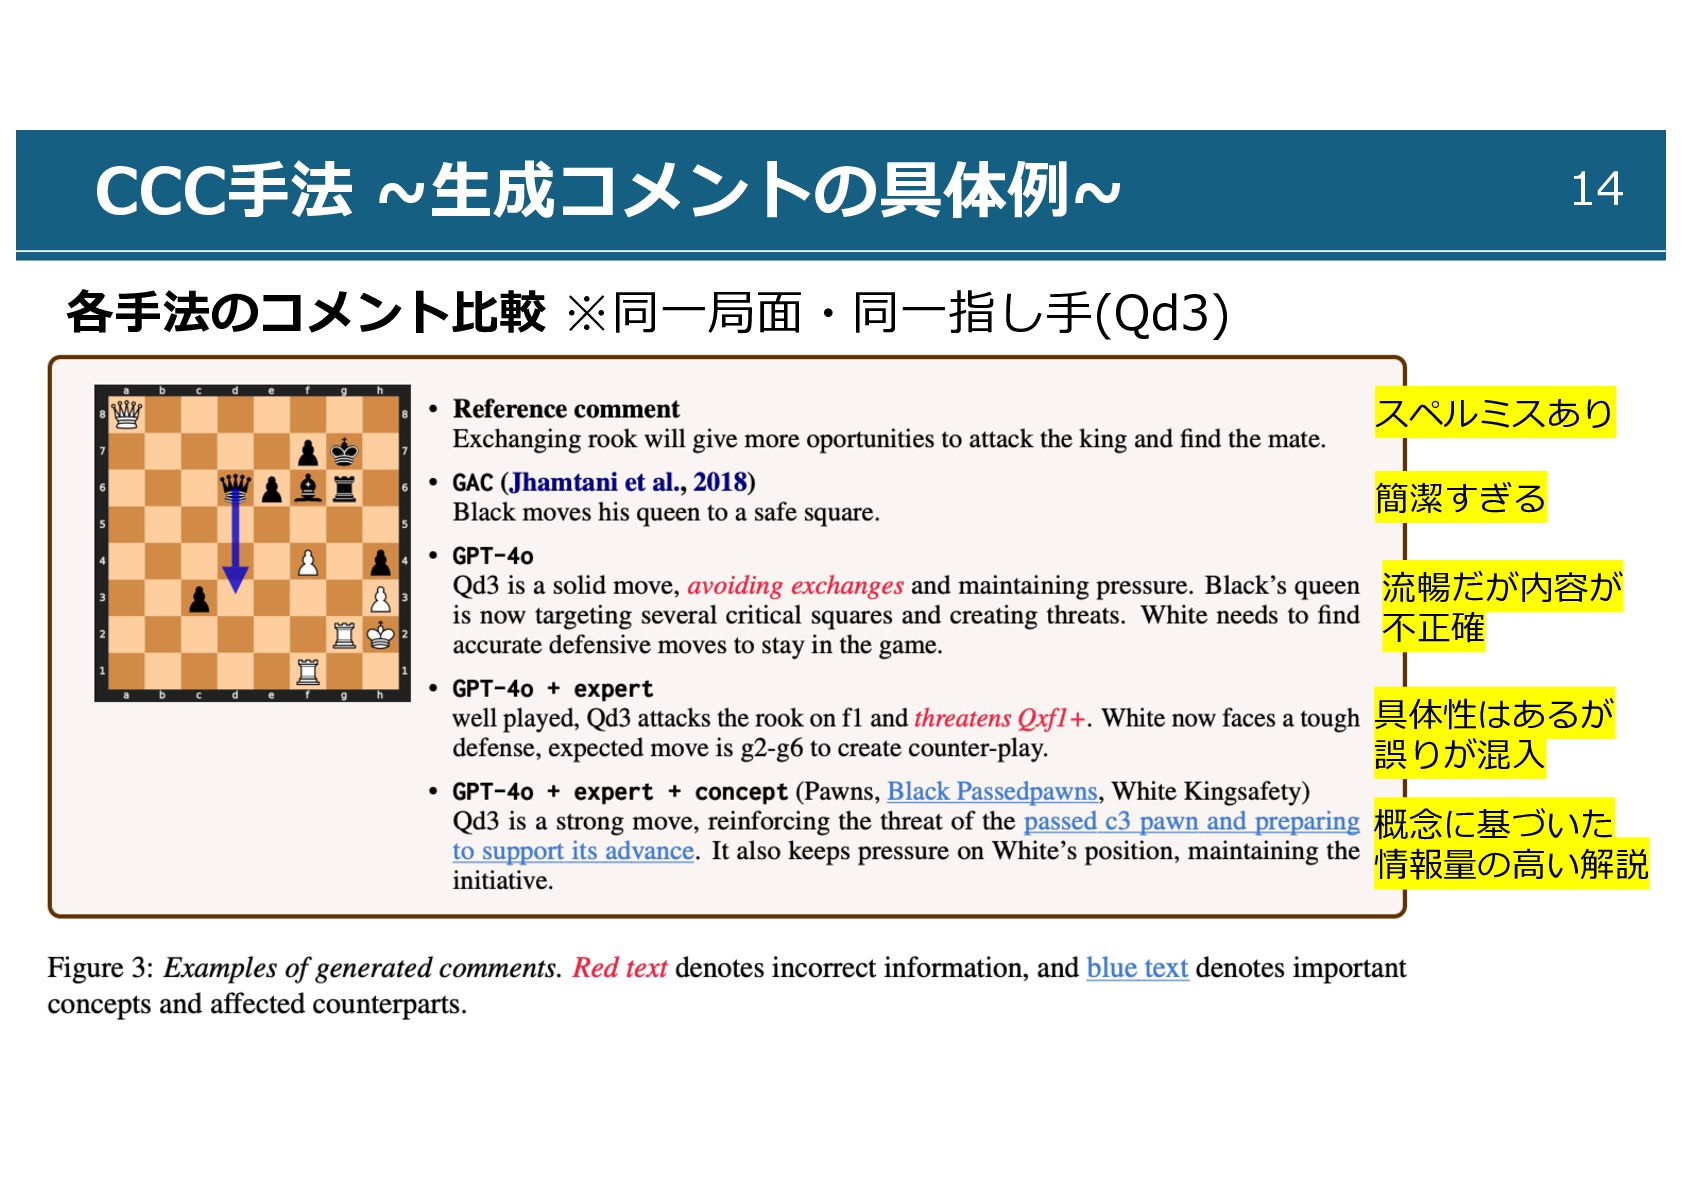
CCC⼿法 ~⽣成コメントの具体例~ 14 各⼿法のコメント⽐較 ※同⼀局⾯・同⼀指し⼿(Qd3) スペルミスあり 簡潔すぎる 流暢だが内容が 不正確 具体性はあるが
誤りが混⼊ 概念に基づいた 情報量の⾼い解説
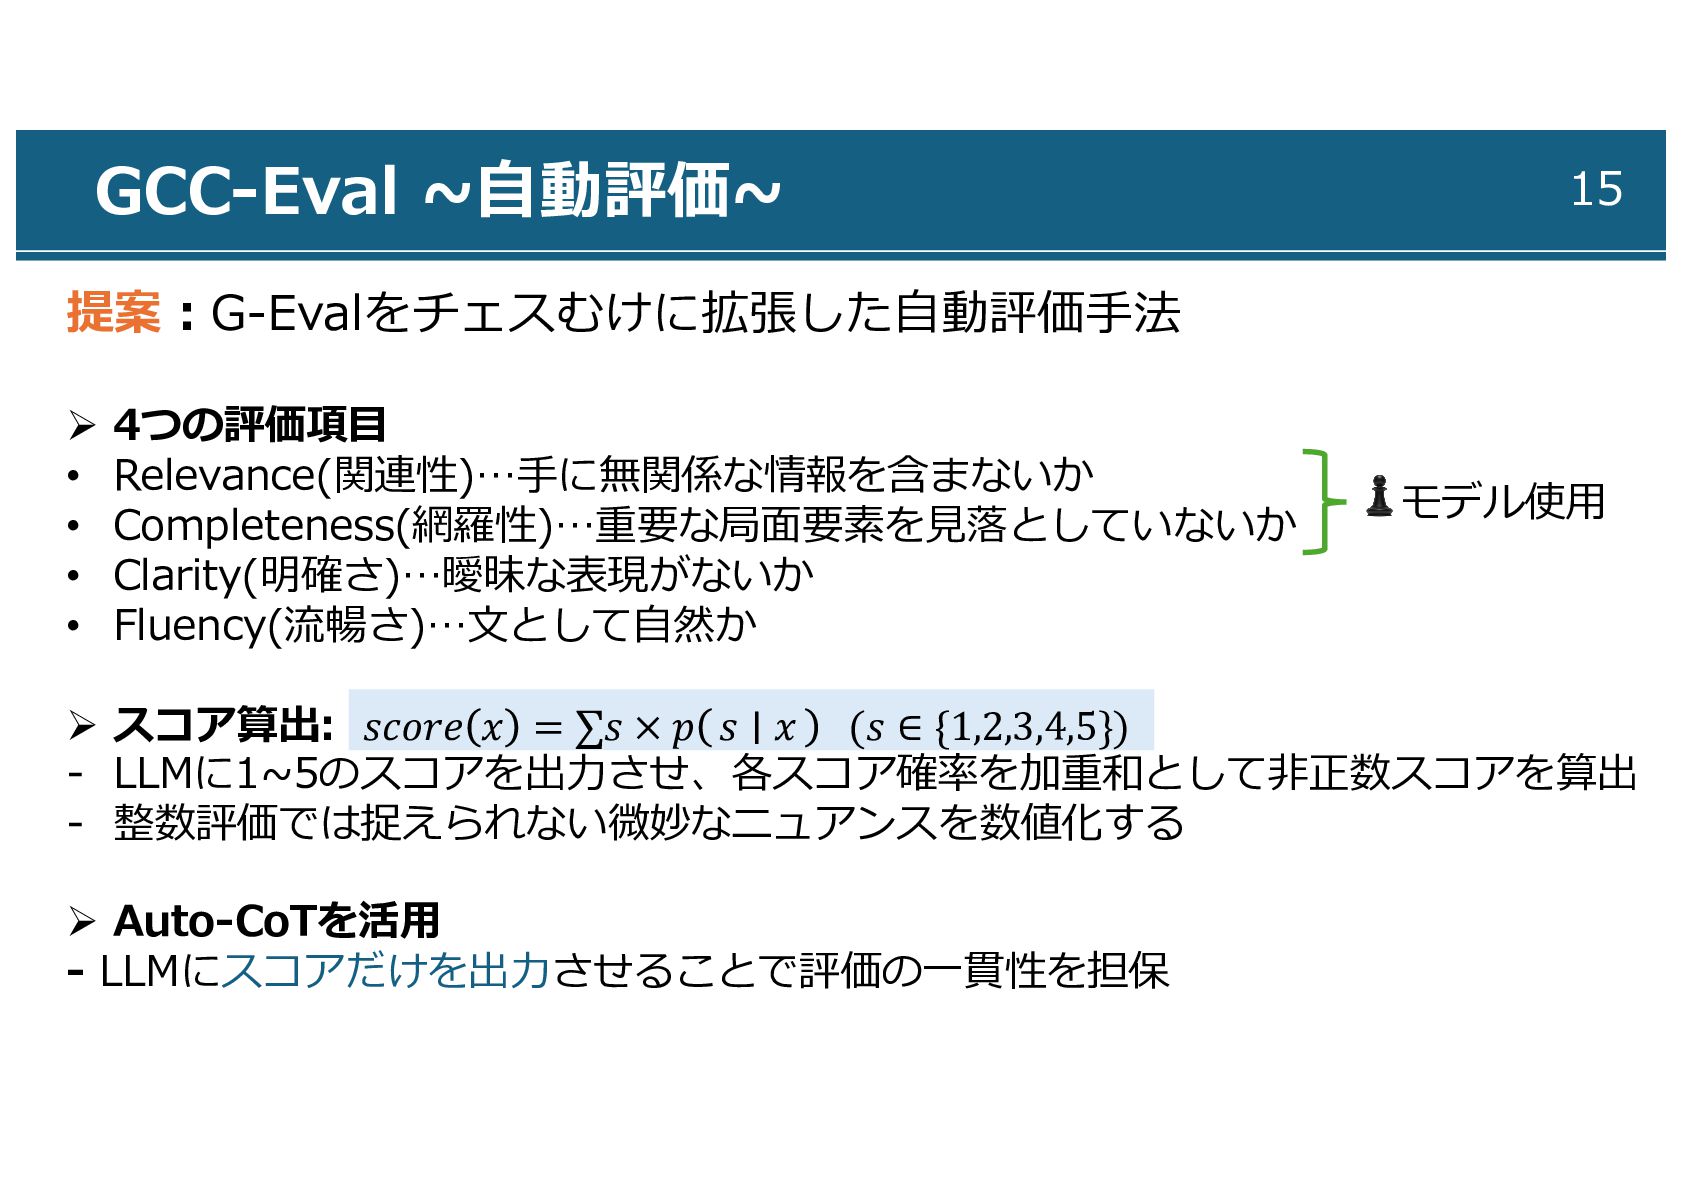
GCC-Eval ~⾃動評価~ 15 提案︓G-Evalをチェスむけに拡張した⾃動評価⼿法 Ø 4つの評価項⽬ • Relevance(関連性)…⼿に無関係な情報を含まないか • Completeness(網羅性)…重要な局⾯要素を⾒落としていないか
• Clarity(明確さ)…曖昧な表現がないか • Fluency(流暢さ)…⽂として⾃然か Ø スコア算出: 𝑠𝑐𝑜𝑟𝑒 𝑥 = ∑𝑠 × 𝑝 𝑠 𝑥 (𝑠 ∈ {1,2,3,4,5}) - LLMに1~5のスコアを出⼒させ、各スコア確率を加重和として⾮正数スコアを算出 - 整数評価では捉えられない微妙なニュアンスを数値化する Ø Auto-CoTを活⽤ - LLMにスコアだけを出⼒させることで評価の⼀貫性を担保 ♟モデル使⽤
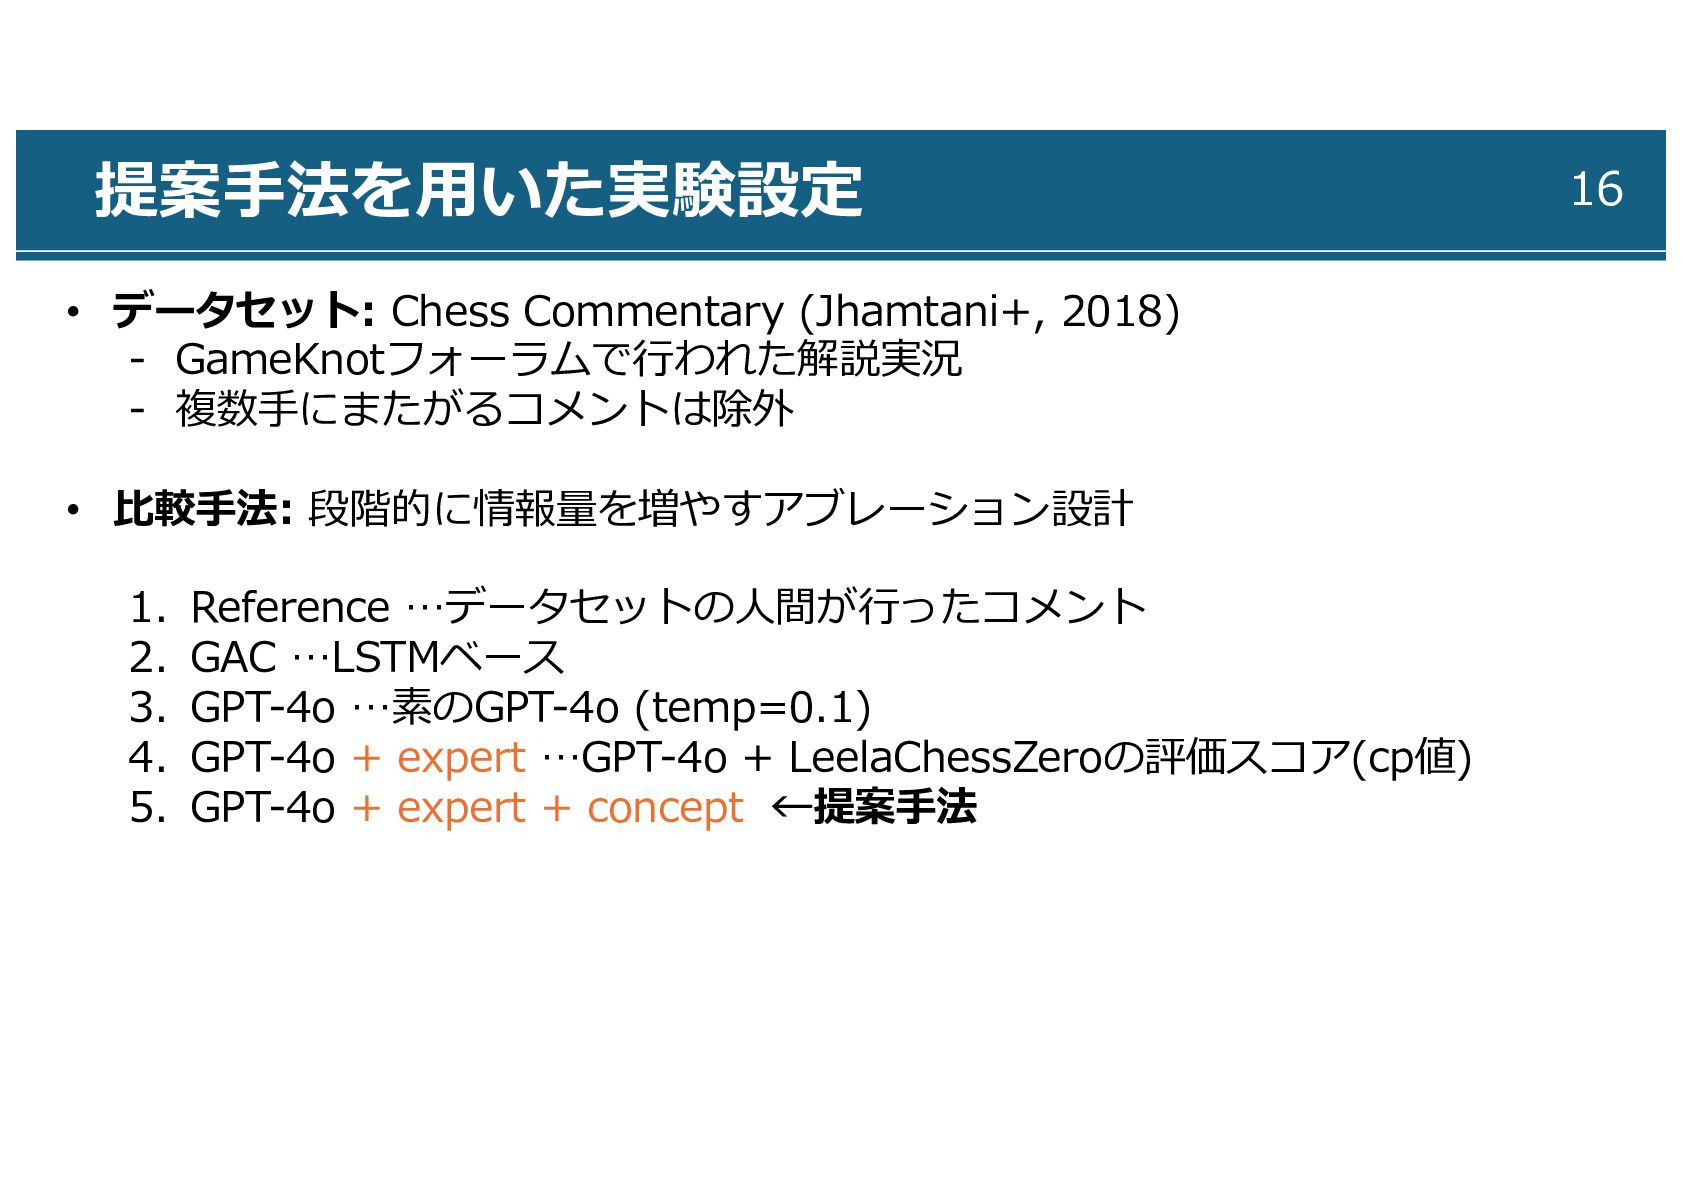
提案⼿法を⽤いた実験設定 16 • データセット: Chess Commentary (Jhamtani+, 2018) - GameKnotフォーラムで⾏われた解説実況
- 複数⼿にまたがるコメントは除外 • ⽐較⼿法: 段階的に情報量を増やすアブレーション設計 1. Reference …データセットの⼈間が⾏ったコメント 2. GAC …LSTMベース 3. GPT-4o …素のGPT-4o (temp=0.1) 4. GPT-4o + expert …GPT-4o + LeelaChessZeroの評価スコア(cp値) 5. GPT-4o + expert + concept ←提案⼿法
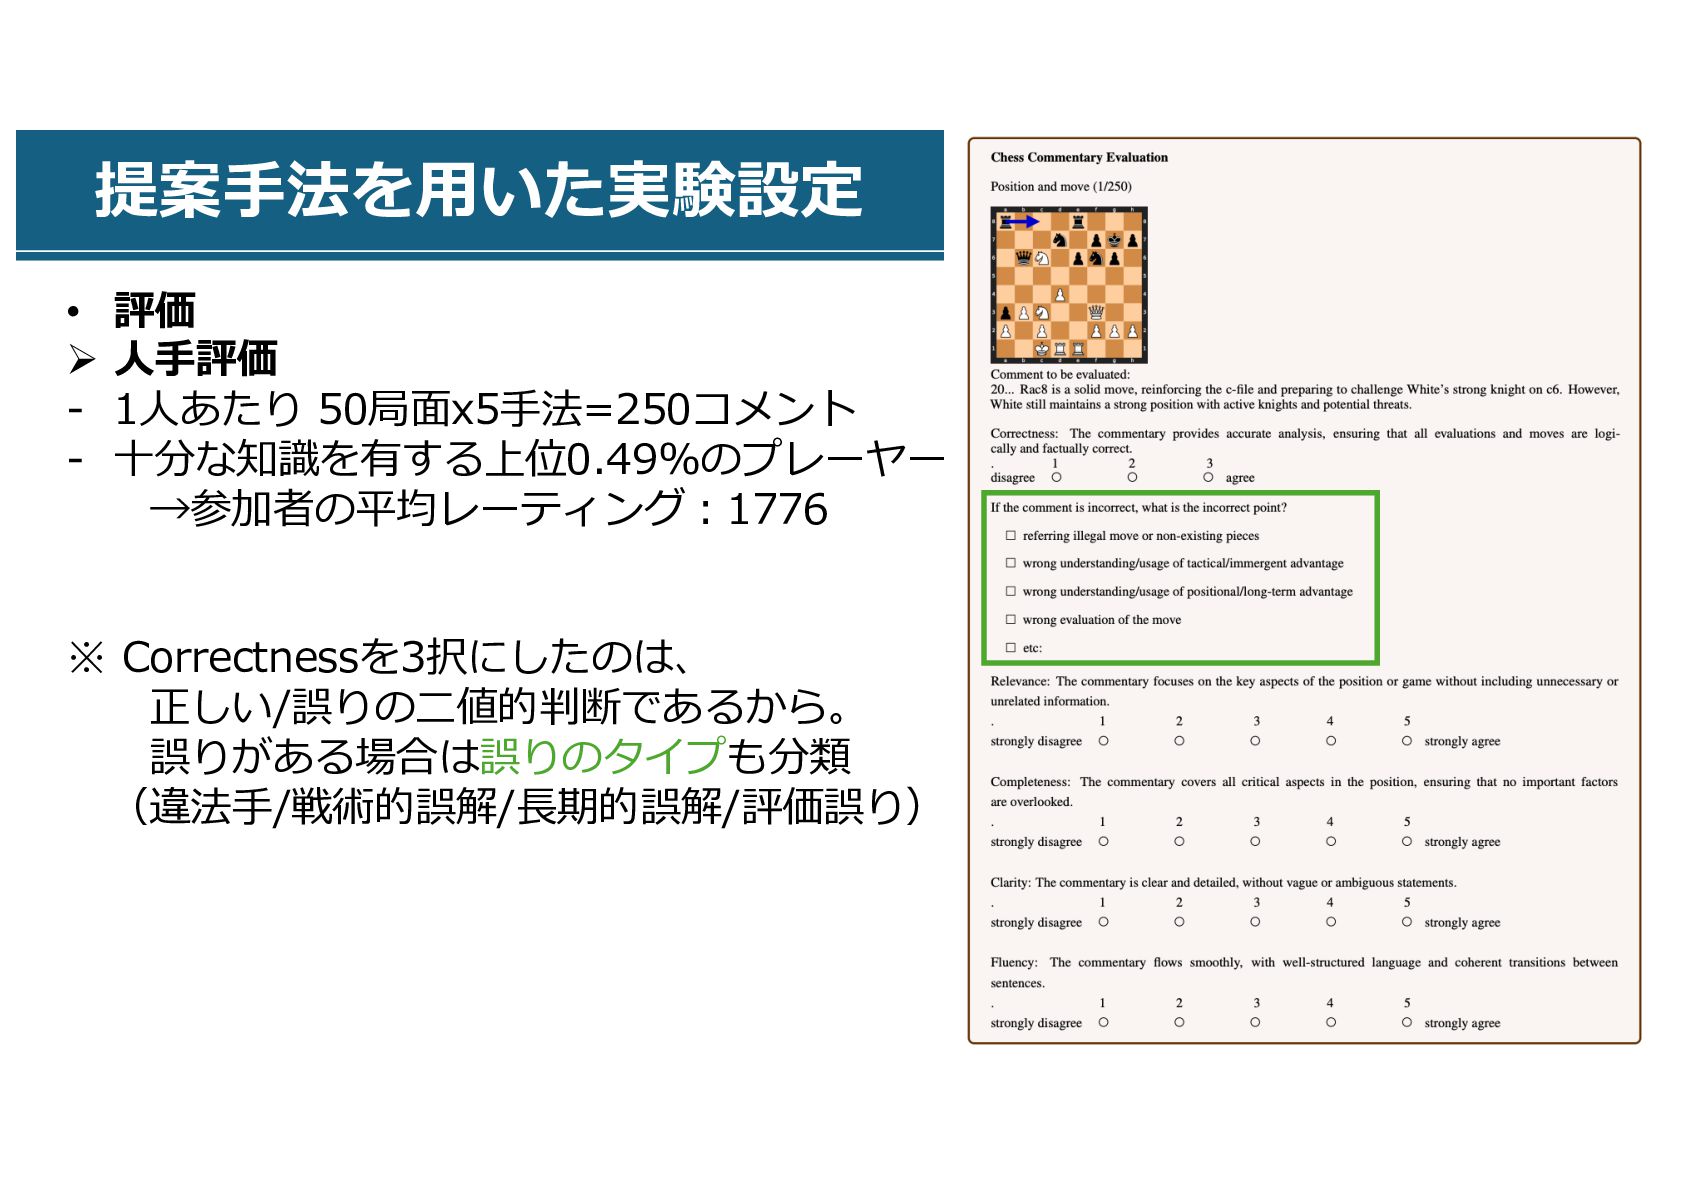
提案⼿法を⽤いた実験設定 1 7 • 評価 Ø ⼈⼿評価 - 1⼈あたり 50局⾯x5⼿法=250コメント
- ⼗分な知識を有する上位0.49%のプレーヤー →参加者の平均レーティング︓1776 ※ Correctnessを3択にしたのは、 正しい/誤りの⼆値的判断であるから。 誤りがある場合は誤りのタイプも分類 (違法⼿/戦術的誤解/⻑期的誤解/評価誤り)
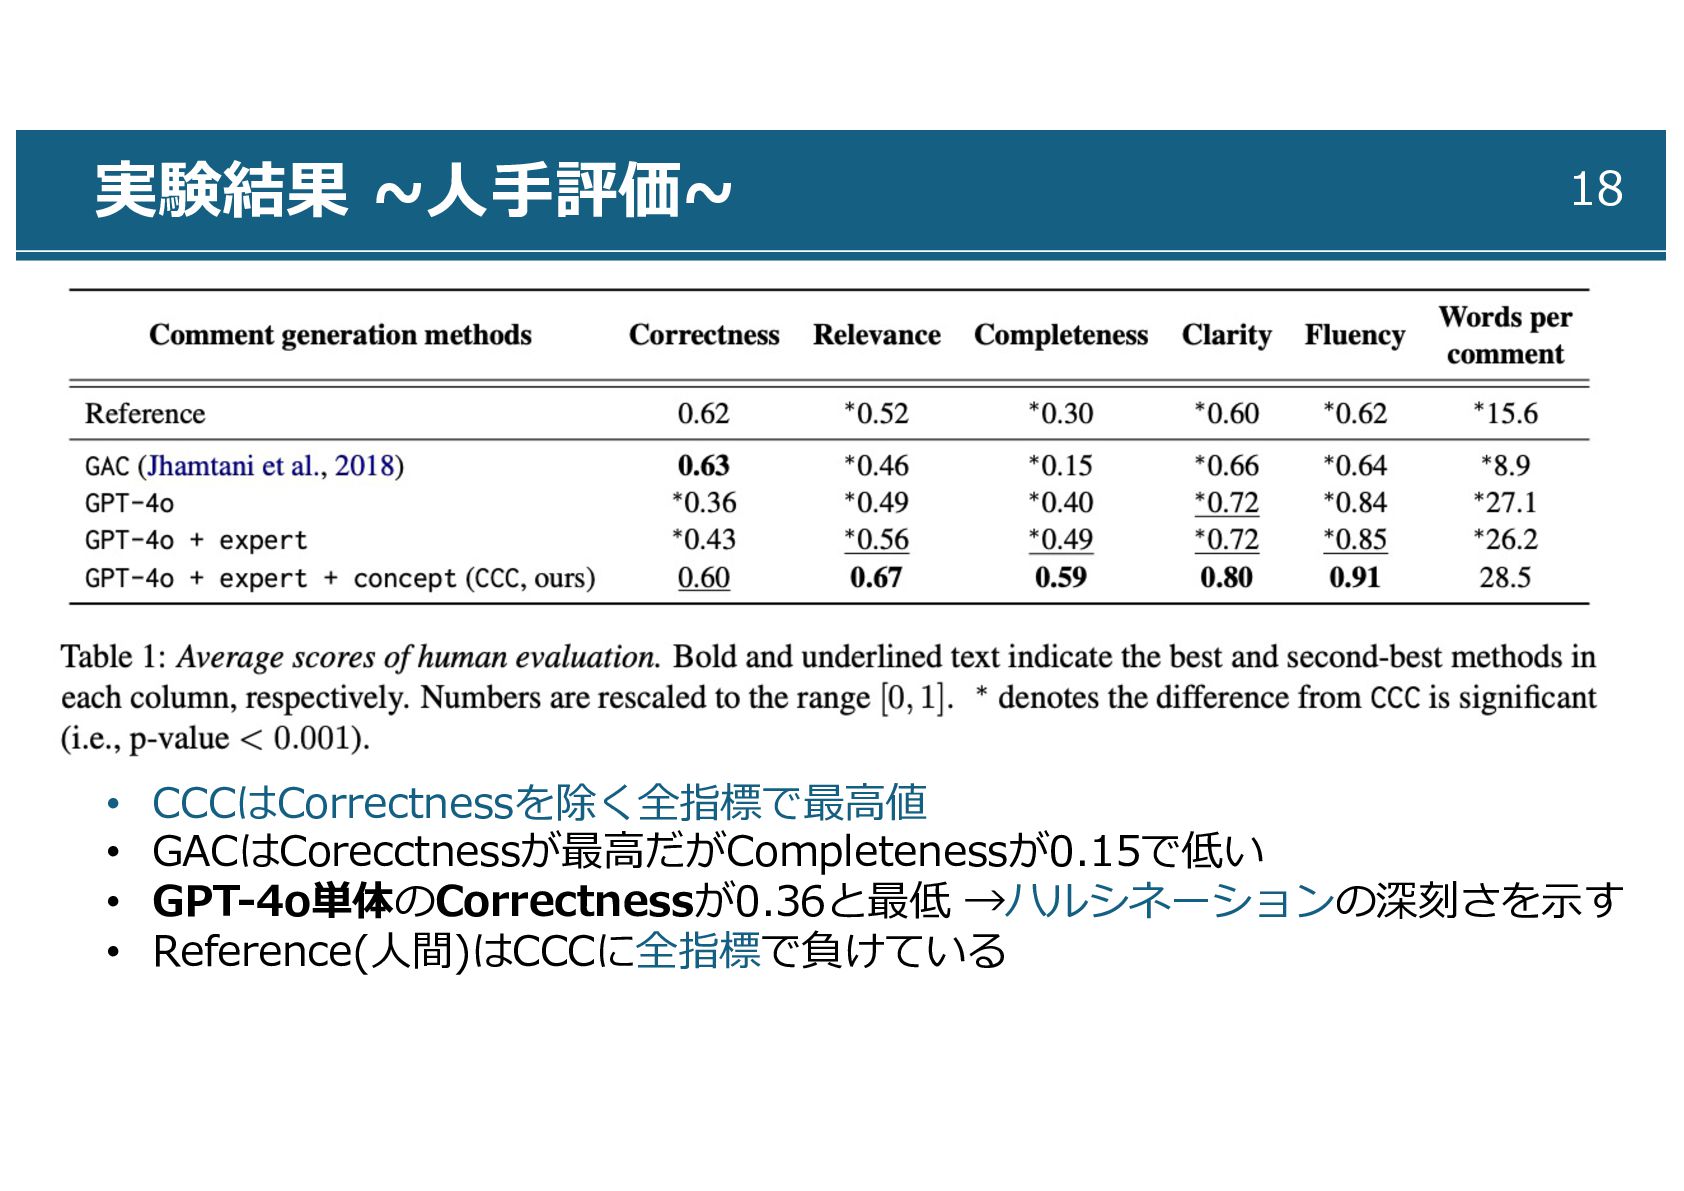
実験結果 ~⼈⼿評価~ 18 • CCCはCorrectnessを除く全指標で最⾼値 • GACはCorecctnessが最⾼だがCompletenessが0.15で低い • GPT-4o単体のCorrectnessが0.36と最低 →ハルシネーションの深刻さを⽰す
• Reference(⼈間)はCCCに全指標で負けている
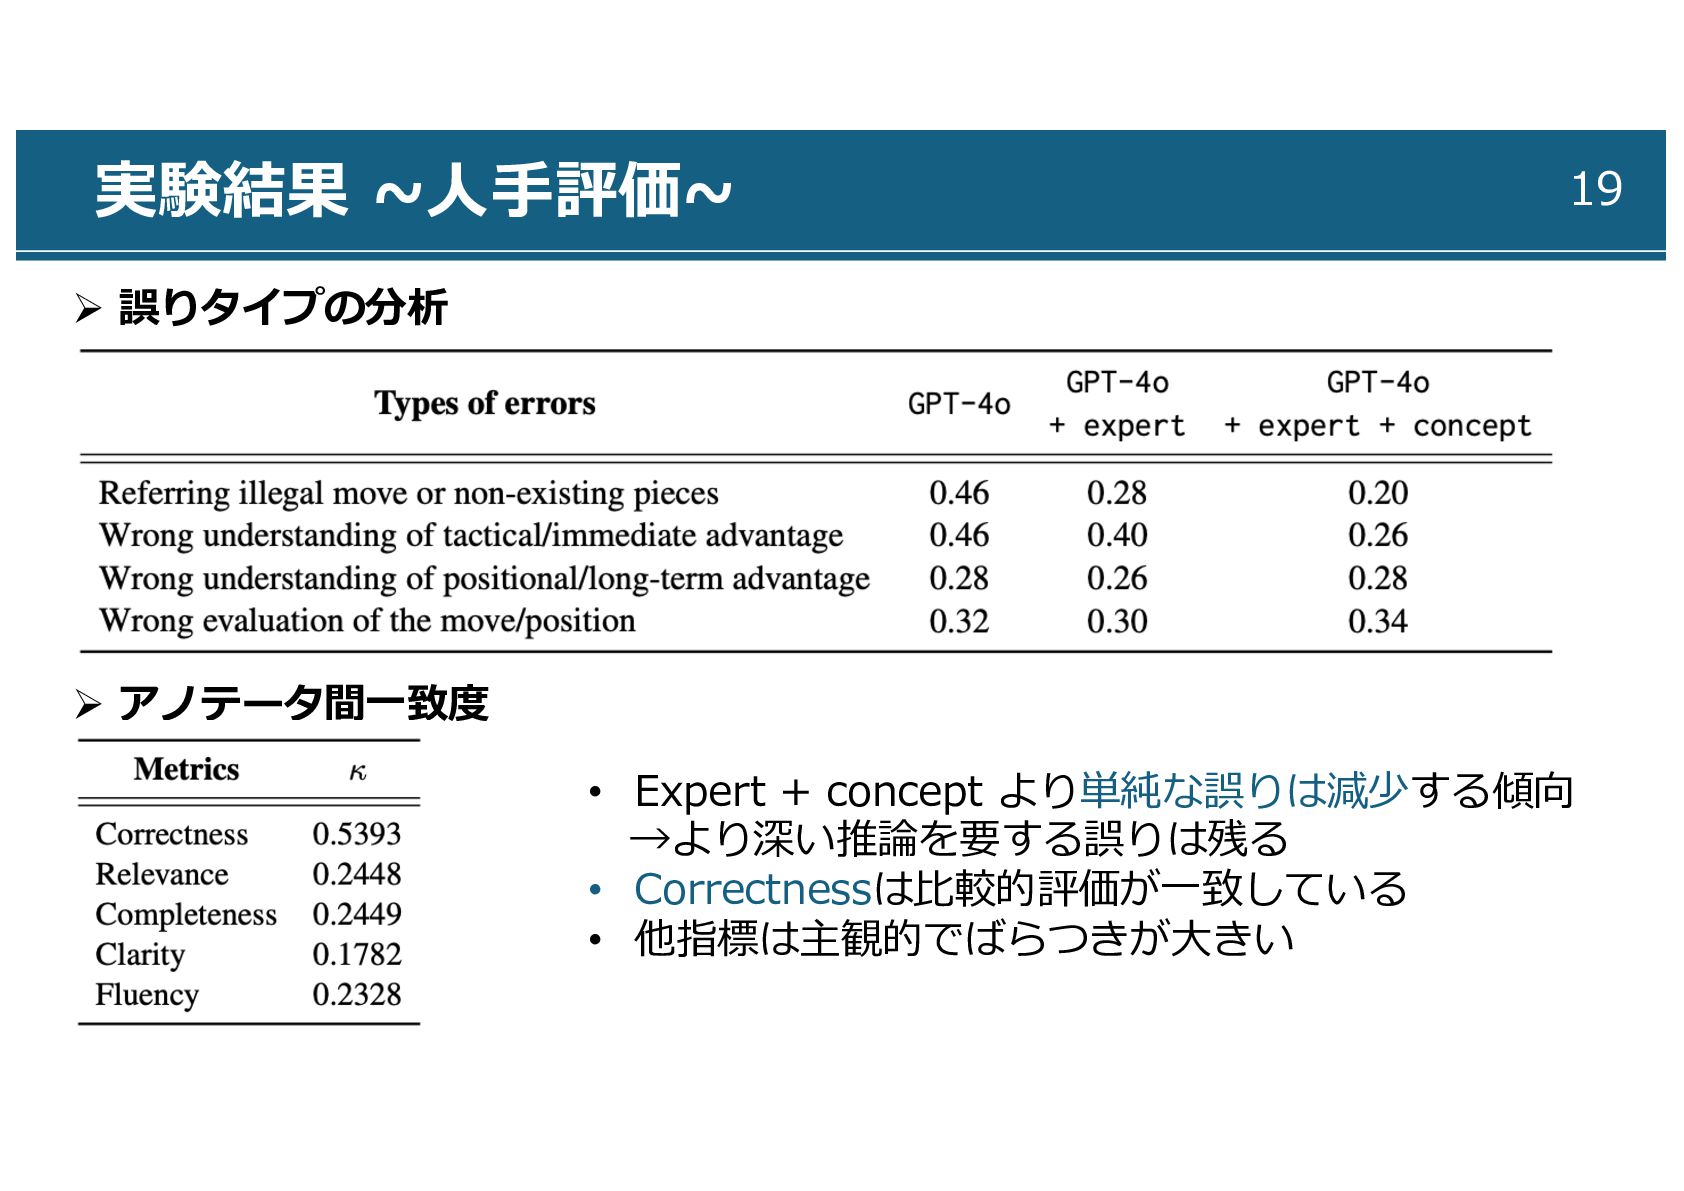
実験結果 ~⼈⼿評価~ 19 Ø 誤りタイプの分析 Ø アノテータ間⼀致度 • Expert +
concept より単純な誤りは減少する傾向 →より深い推論を要する誤りは残る • Correctnessは⽐較的評価が⼀致している • 他指標は主観的でばらつきが⼤きい
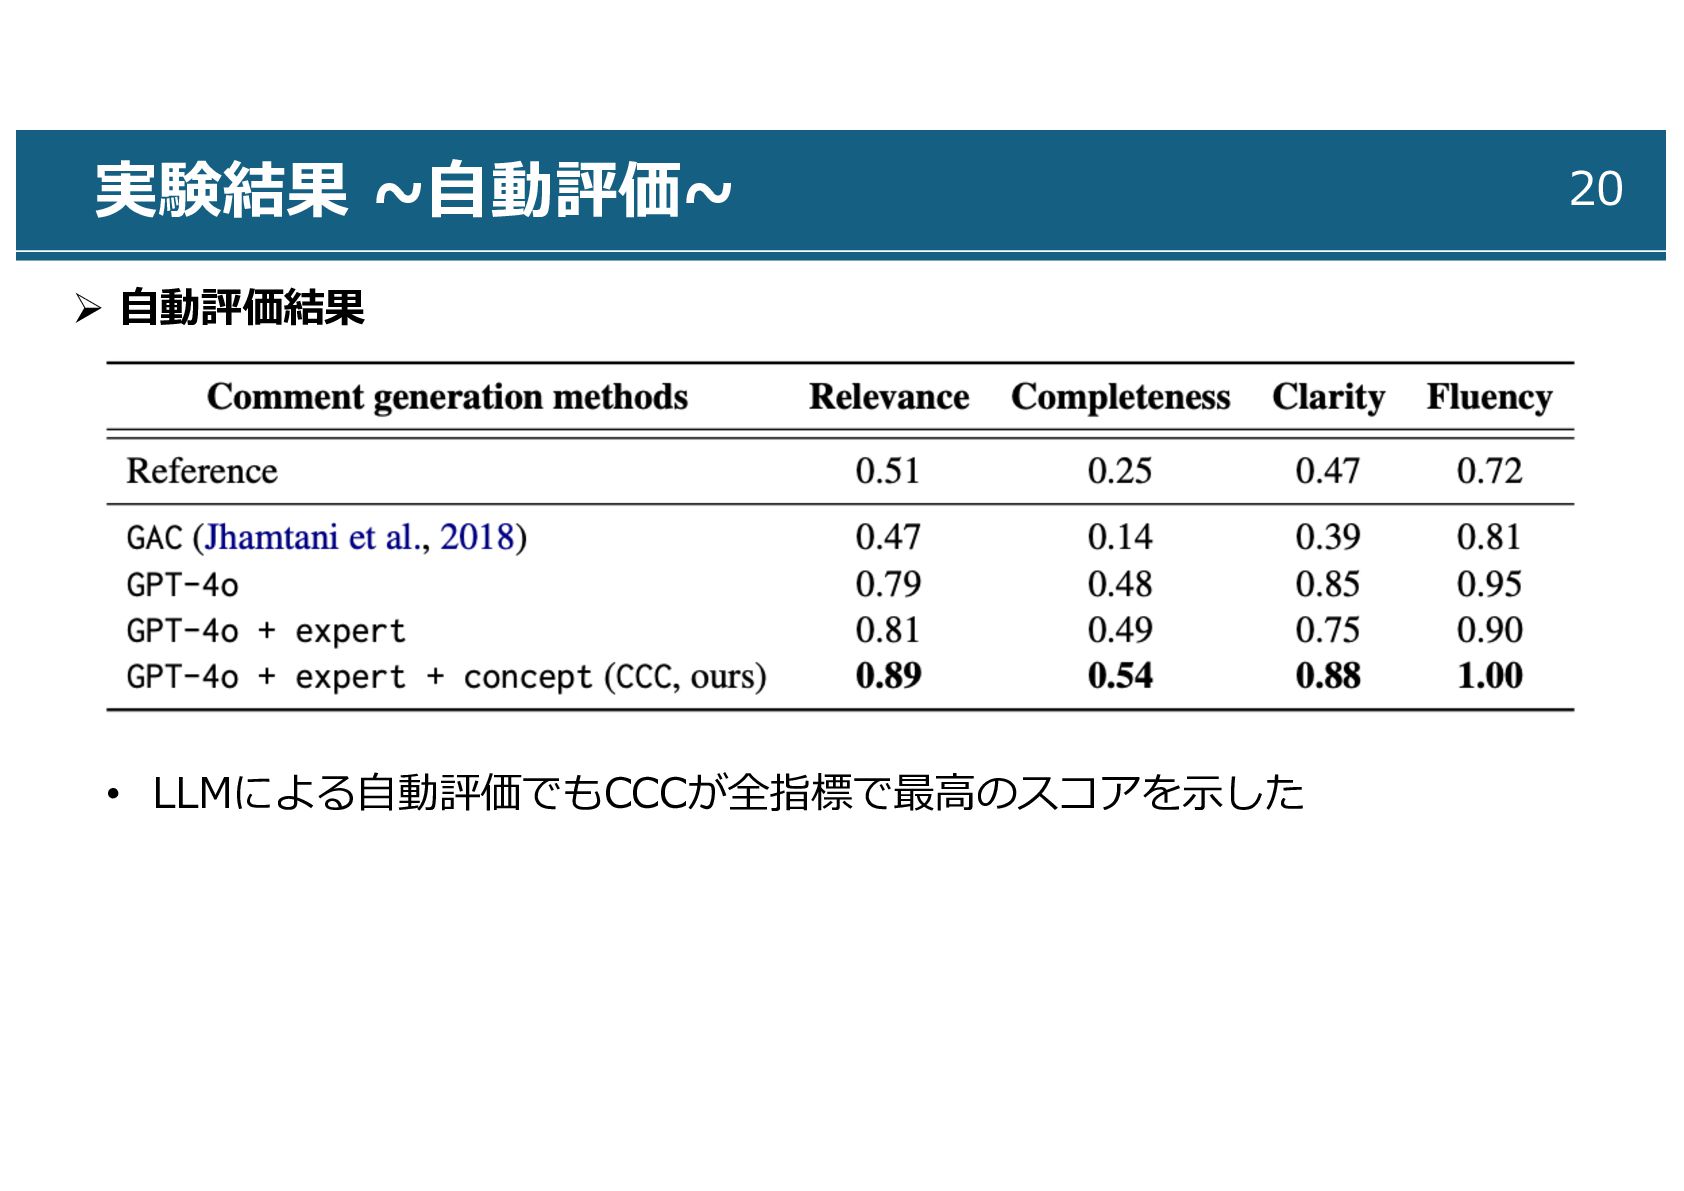
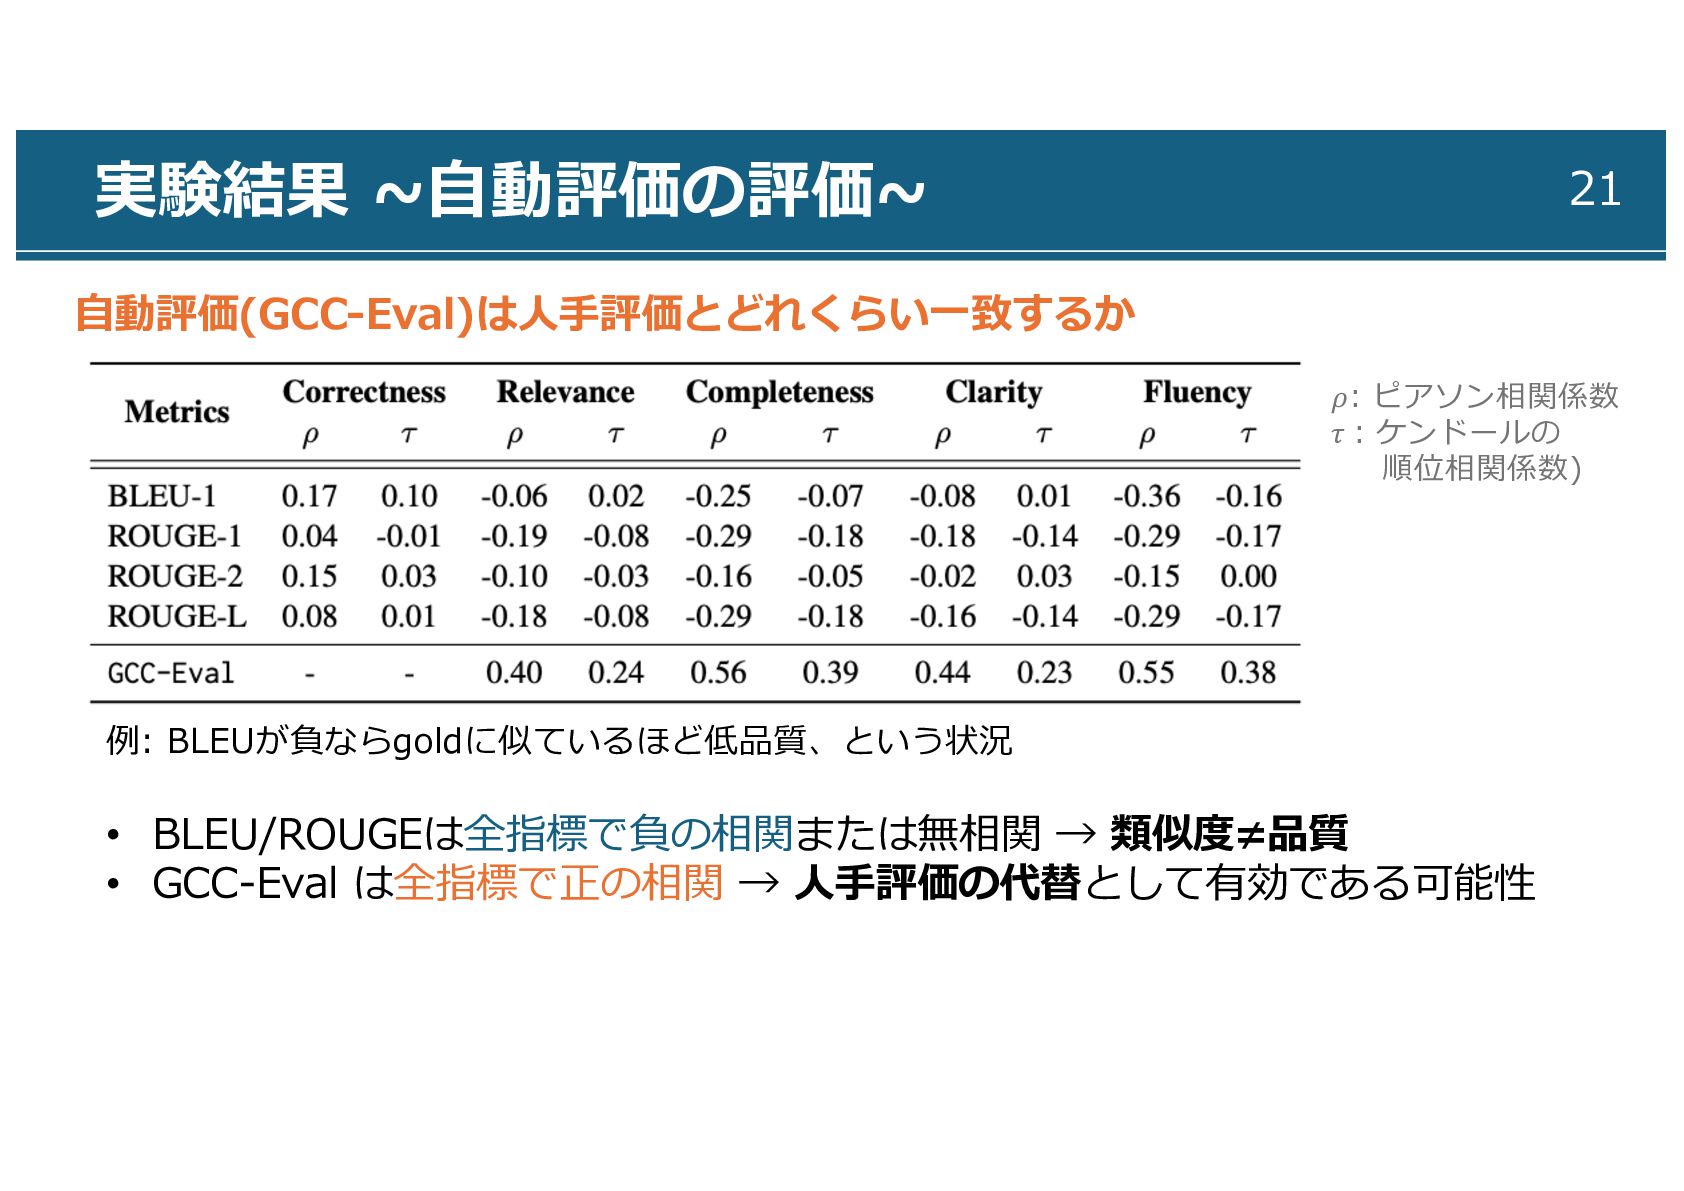
実験結果 ~⾃動評価~ 20 • LLMによる⾃動評価でもCCCが全指標で最⾼のスコアを⽰した Ø ⾃動評価結果
実験結果 ~⾃動評価の評価~ 21 例: BLEUが負ならgoldに似ているほど低品質、という状況 • BLEU/ROUGEは全指標で負の相関または無相関 → 類似度≠品質 •
GCC-Eval は全指標で正の相関 → ⼈⼿評価の代替として有効である可能性 ⾃動評価(GCC-Eval)は⼈⼿評価とどれくらい⼀致するか 𝜌: ピアソン相関係数 𝜏 : ケンドールの 順位相関係数)
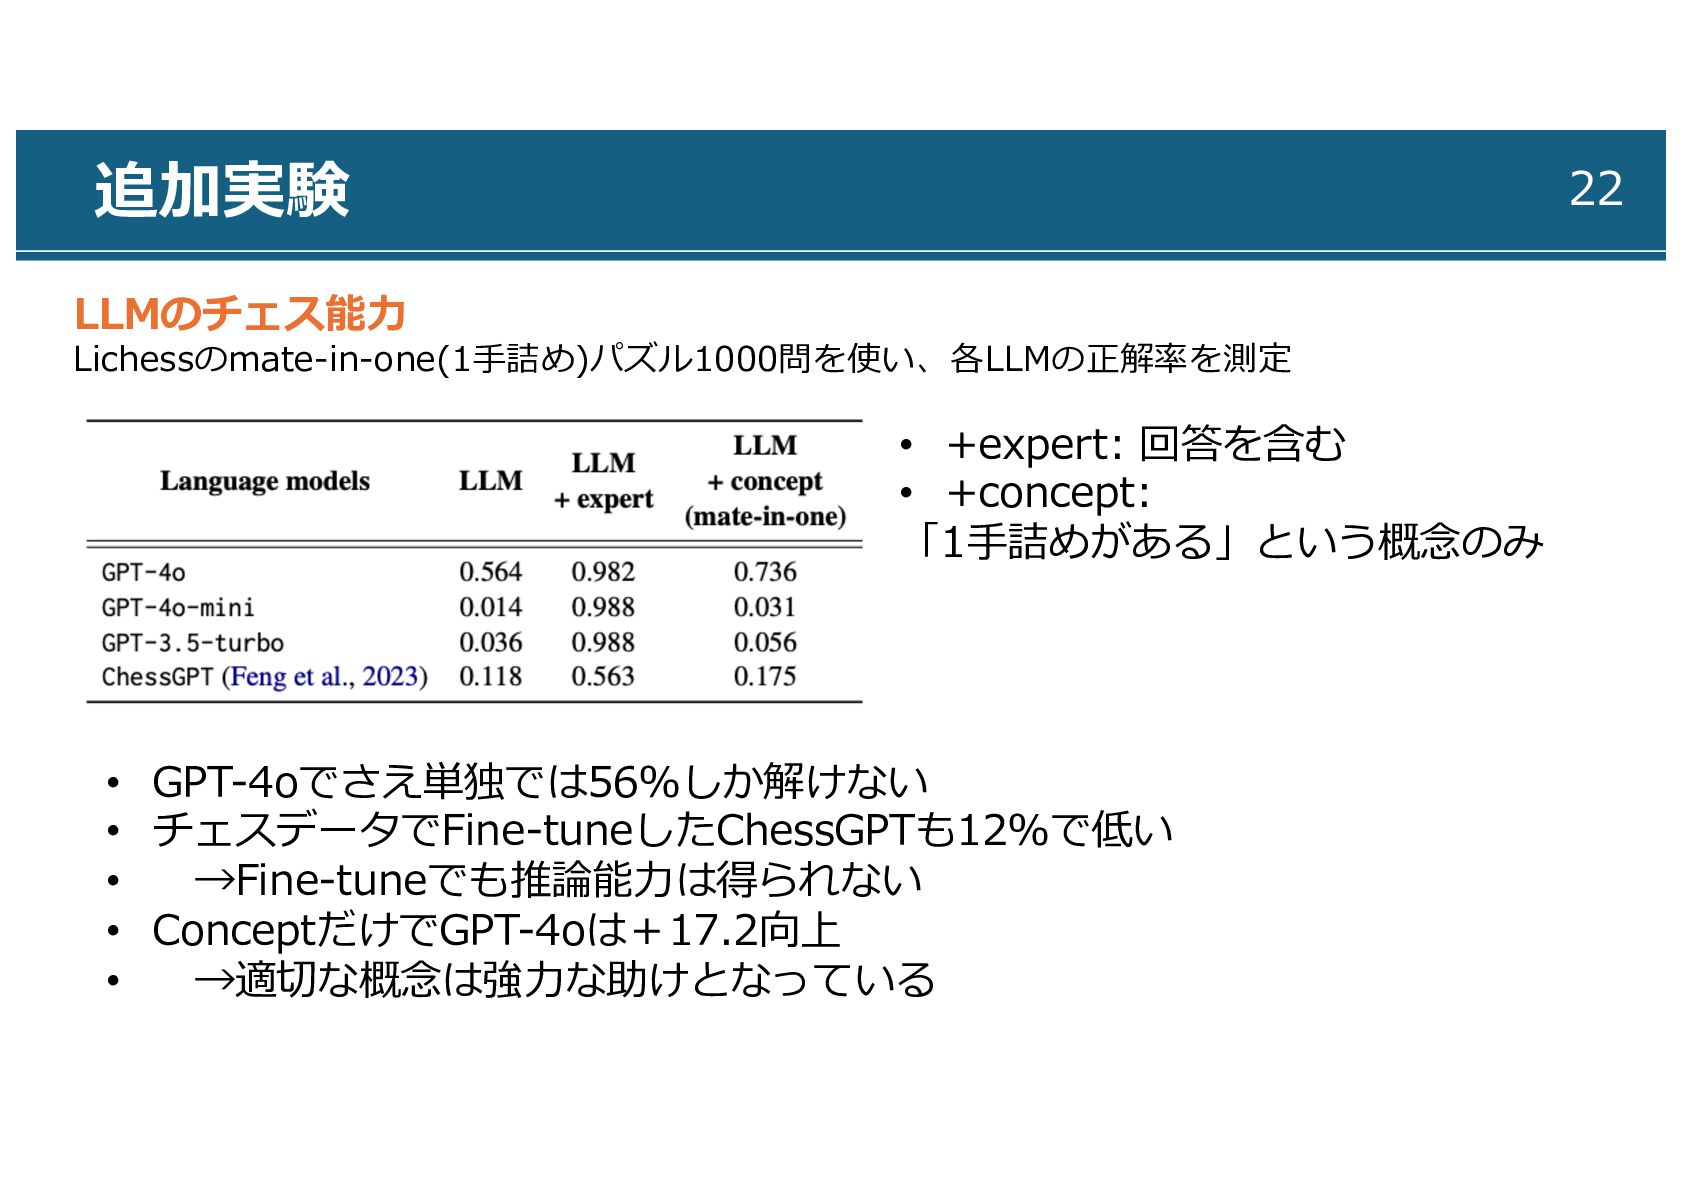
追加実験 22 • GPT-4oでさえ単独では56%しか解けない • チェスデータでFine-tuneしたChessGPTも12%で低い • →Fine-tuneでも推論能⼒は得られない • ConceptだけでGPT-4oは+17.2向上
• →適切な概念は強⼒な助けとなっている LLMのチェス能⼒ Lichessのmate-in-one(1⼿詰め)パズル1000問を使い、各LLMの正解率を測定 • +expert: 回答を含む • +concept: 「1⼿詰めがある」という概念のみ
追加実験 23 概念の信頼性 • 21概念の平均は0.91 • White/Black Rooks, White/Black Space,
White/Black Mobilityは1.00 • 最も低いBlack Bishopでも0.75 • これはCCCの基盤となっている概念抽出 ステップの信頼性が⾼いことを⽰す
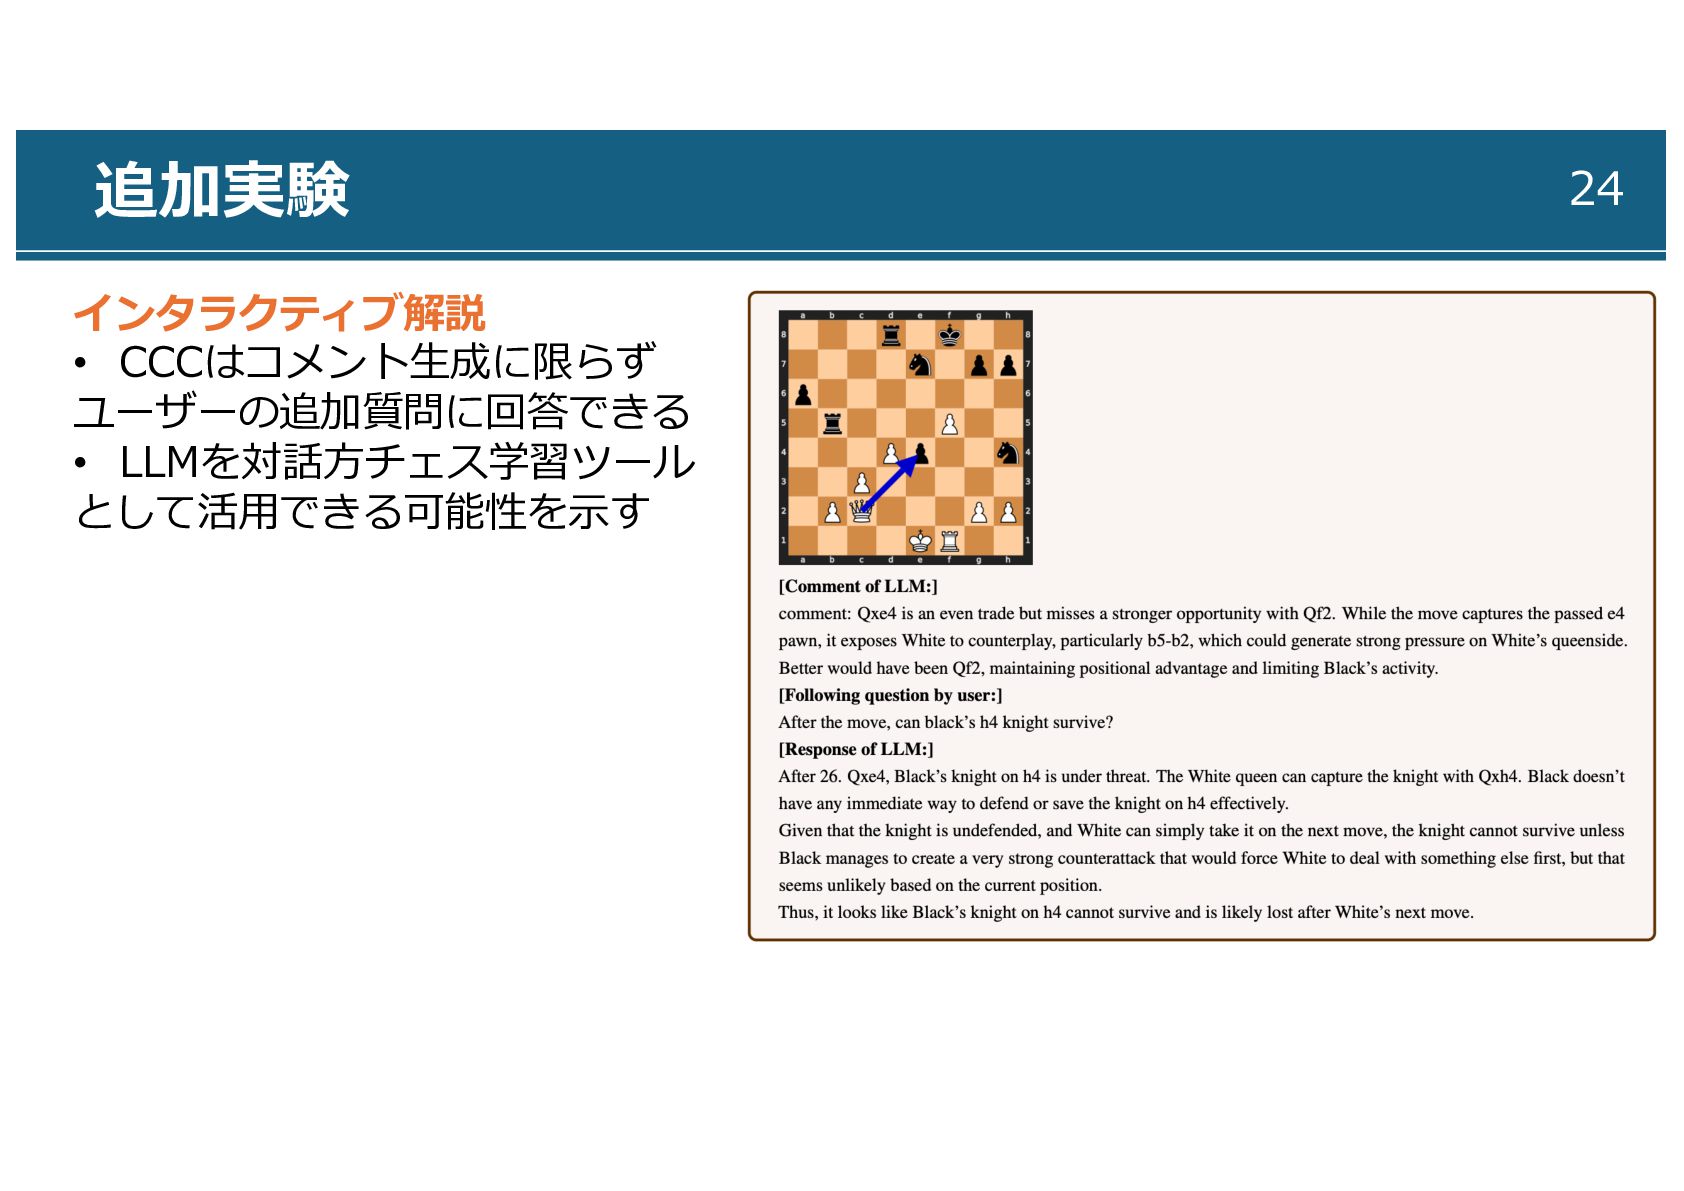
追加実験 24 インタラクティブ解説 • CCCはコメント⽣成に限らず ユーザーの追加質問に回答できる • LLMを対話⽅チェス学習ツール として活⽤できる可能性を⽰す
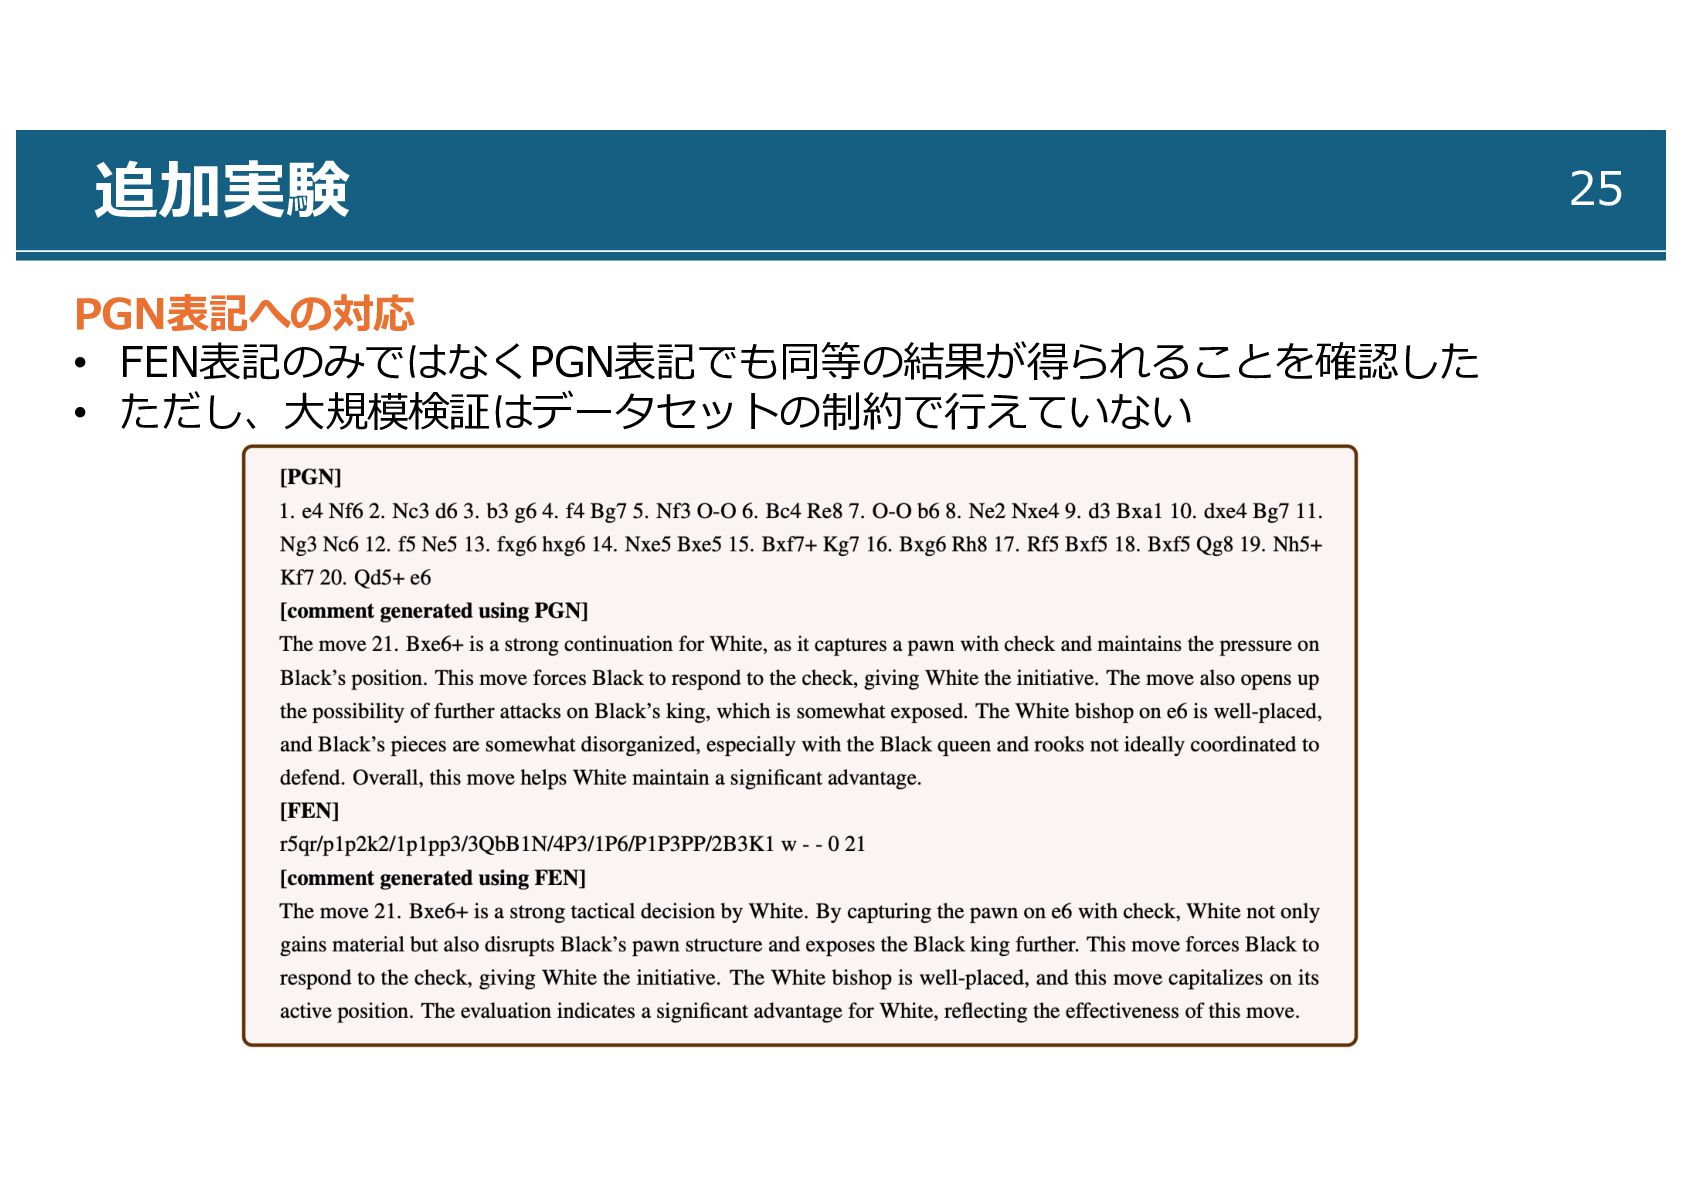
追加実験 25 PGN表記への対応 • FEN表記のみではなくPGN表記でも同等の結果が得られることを確認した • ただし、⼤規模検証はデータセットの制約で⾏えていない
Discussion 26 LLMを説明媒体として使う意義 - CCCの枠組みはチェスAIの知識をユーザーに伝える媒体としてLLMの有効性 を⽰唆した - ⾃然⾔語による説明は透明性が⾼く、その評価(GCC-Eval)も容易に⾏える GCC-EvalをFine-tuningに使う展望 -
⼈⼿評価と⾼い相関を持つことが⽰された - Fine-tuningの⽬的関数として使⽤する →⼈間の評価基準に沿ったコメント⽣成モデルを学習できる可能性がある 他ドメインへの応⽤ - 気象学や医療診断、ゲームなど概念抽出が効果的と考えられる領域への展開
Limitationと展望 27 Limitation︓ - GPT-4oを使⽤するため、再現性に限界がある - 評価者は専⾨家のみで初⼼者への教育効果は未検証 - 使⽤概念は21種類のみ(Stackfish 8)
- 他の未収録の概念がある - ⻑期的優位の誤りはCCCでも解消されず、深い推論能⼒の限界がある 展望︓ • GCC-EvalをFine-tuningの⽬的関数として利⽤ • より多くの概念を追加 • 初学者向けの教育効果の検証 • 他ドメインへの展開
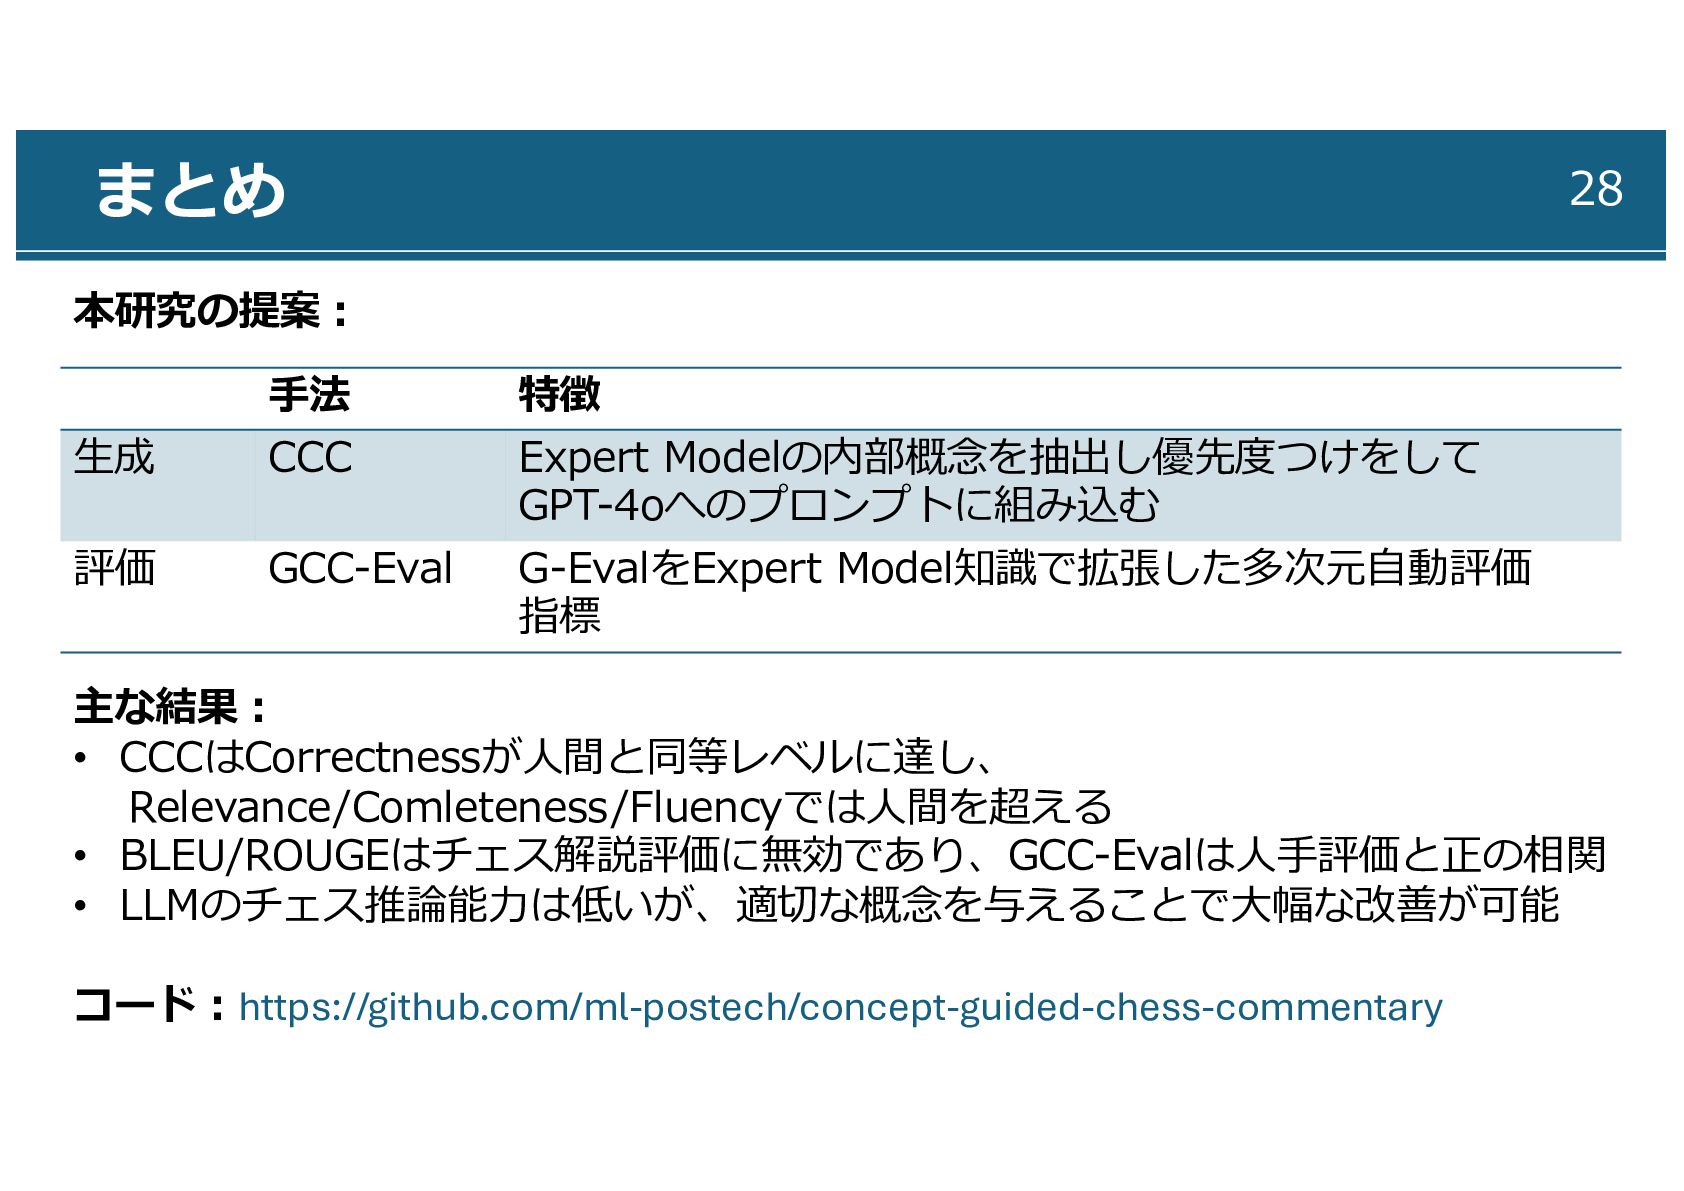
まとめ 28 ⼿法 特徴 ⽣成 CCC Expert Modelの内部概念を抽出し優先度つけをして GPT-4oへのプロンプトに組み込む 評価
GCC-Eval G-EvalをExpert Model知識で拡張した多次元⾃動評価 指標 本研究の提案︓ 主な結果︓ • CCCはCorrectnessが⼈間と同等レベルに達し、 Relevance/Comleteness/Fluencyでは⼈間を超える • BLEU/ROUGEはチェス解説評価に無効であり、GCC-Evalは⼈⼿評価と正の相関 • LLMのチェス推論能⼒は低いが、適切な概念を与えることで⼤幅な改善が可能 コード︓https://github.com/ml-postech/concept-guided-chess-commentary

 Your Podcast. Everywhere. Effortlessly.


 araim10
 institutdelelevage
 beale
 nzw0301
 s_mizuki_nlp
 ept
 yumaichikawa
 signer
 ayatokanada
 satai
 takasehideki
 kohlerjohannes
 aleyda
 tmiket
 watany
 lara
 skipperchong
 tomoyanonymous
 reverentgeek
 malarkey
 baasie
 codingconduct
 helmedeiros
 holman