Upgrade to Pro — share decks privately, control downloads, hide ads and more …

論文紹介:Agents' Room: Narrative Generation through...

Arai M
November 05, 2026

論文紹介:Agents' Room: Narrative Generation through Multi-step Collaboration

Arai M

November 05, 2026

Transcript

24 slides
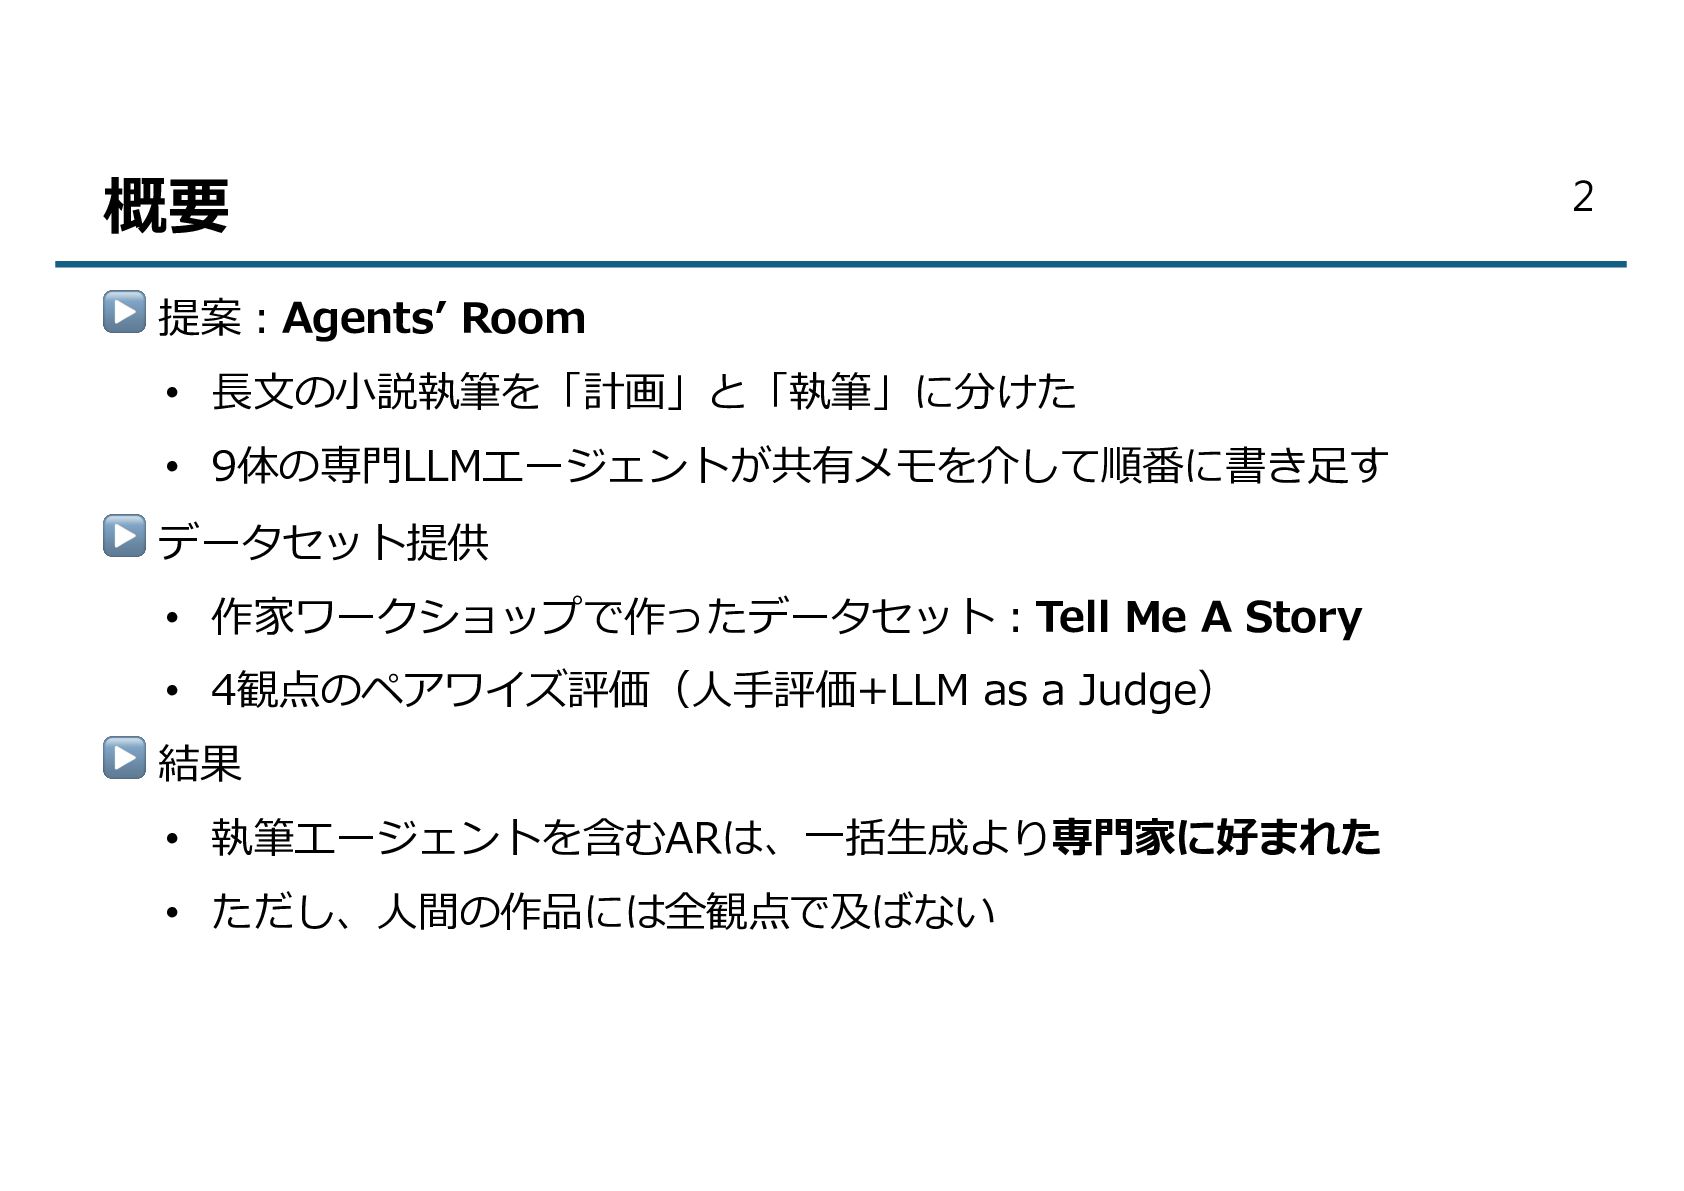
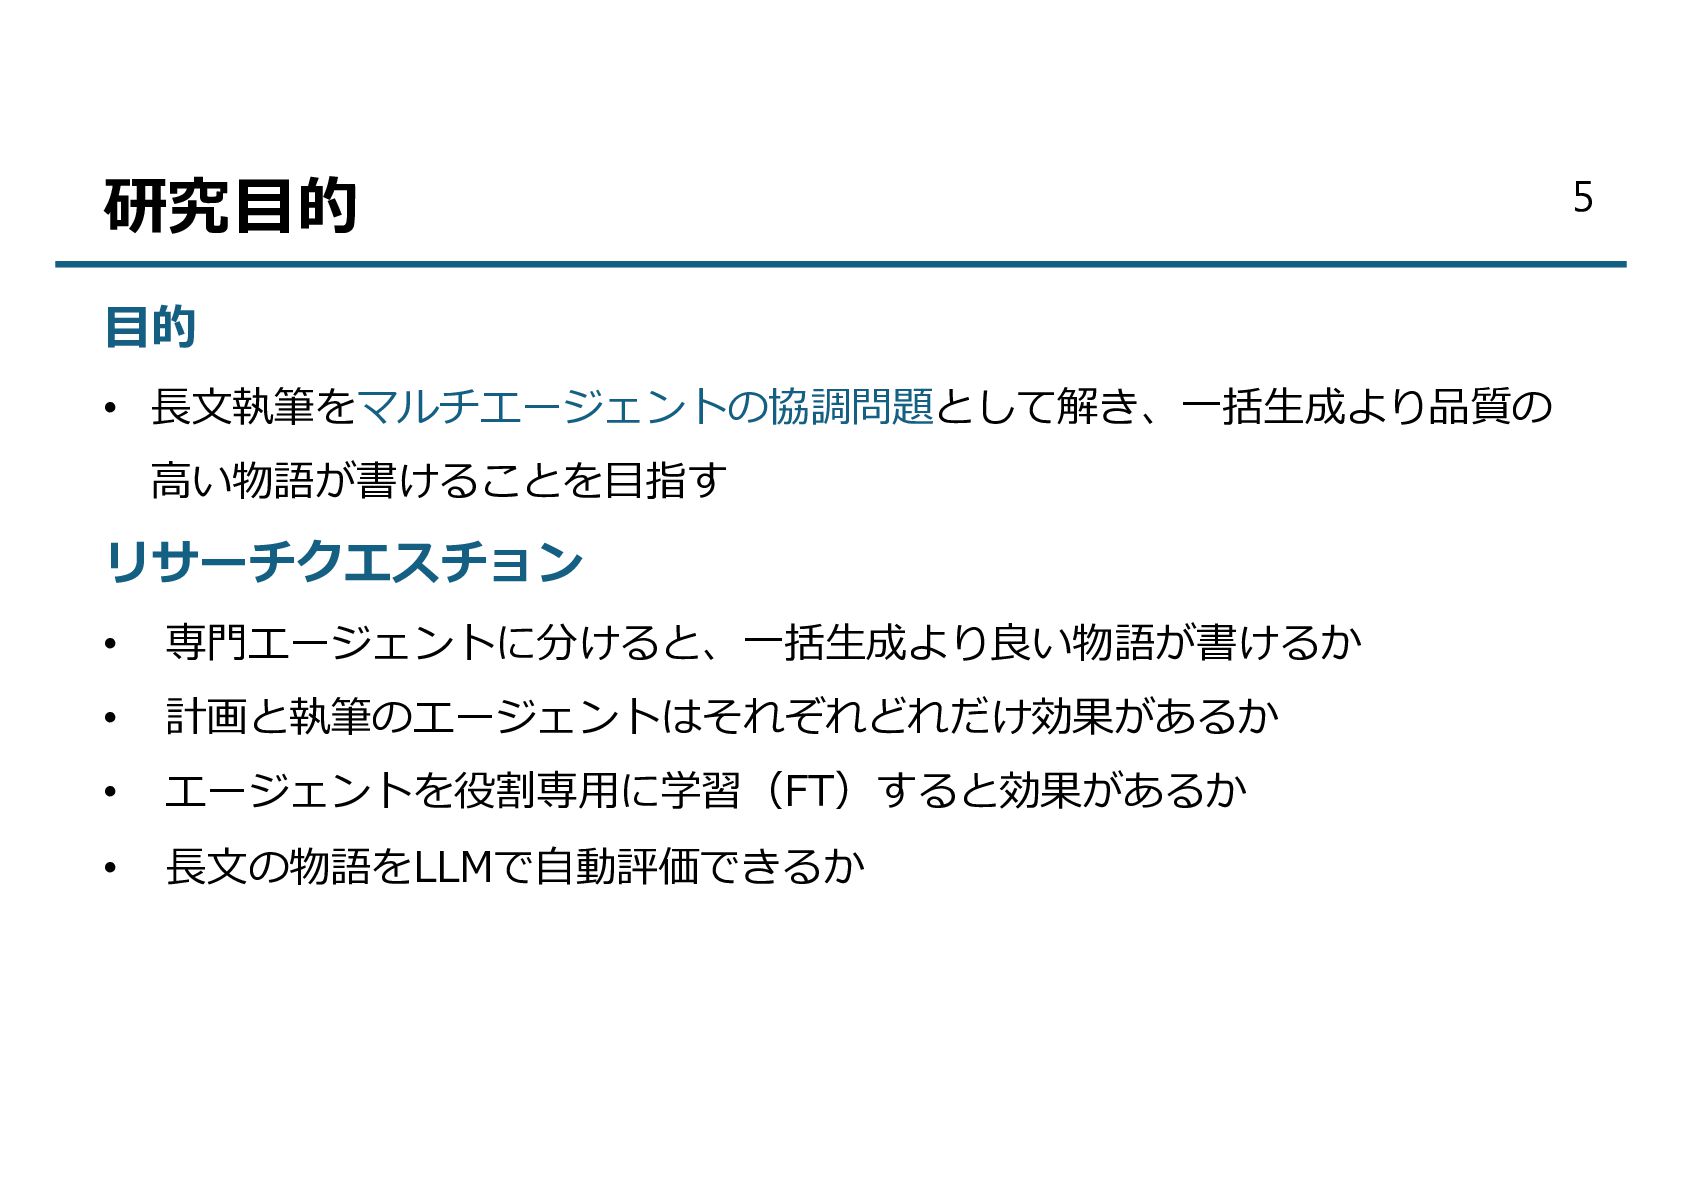
  1. 概要 ▶ 提案︓Agentsʼ Room • ⻑⽂の⼩説執筆を「計画」と「執筆」に分けた • 9体の専⾨LLMエージェントが共有メモを介して順番に書き⾜す ▶ データセット提供

    • 作家ワークショップで作ったデータセット︓Tell Me A Story • 4観点のペアワイズ評価(⼈⼿評価+LLM as a Judge) ▶ 結果 • 執筆エージェントを含むARは、⼀括⽣成より専⾨家に好まれた • ただし、⼈間の作品には全観点で及ばない 2
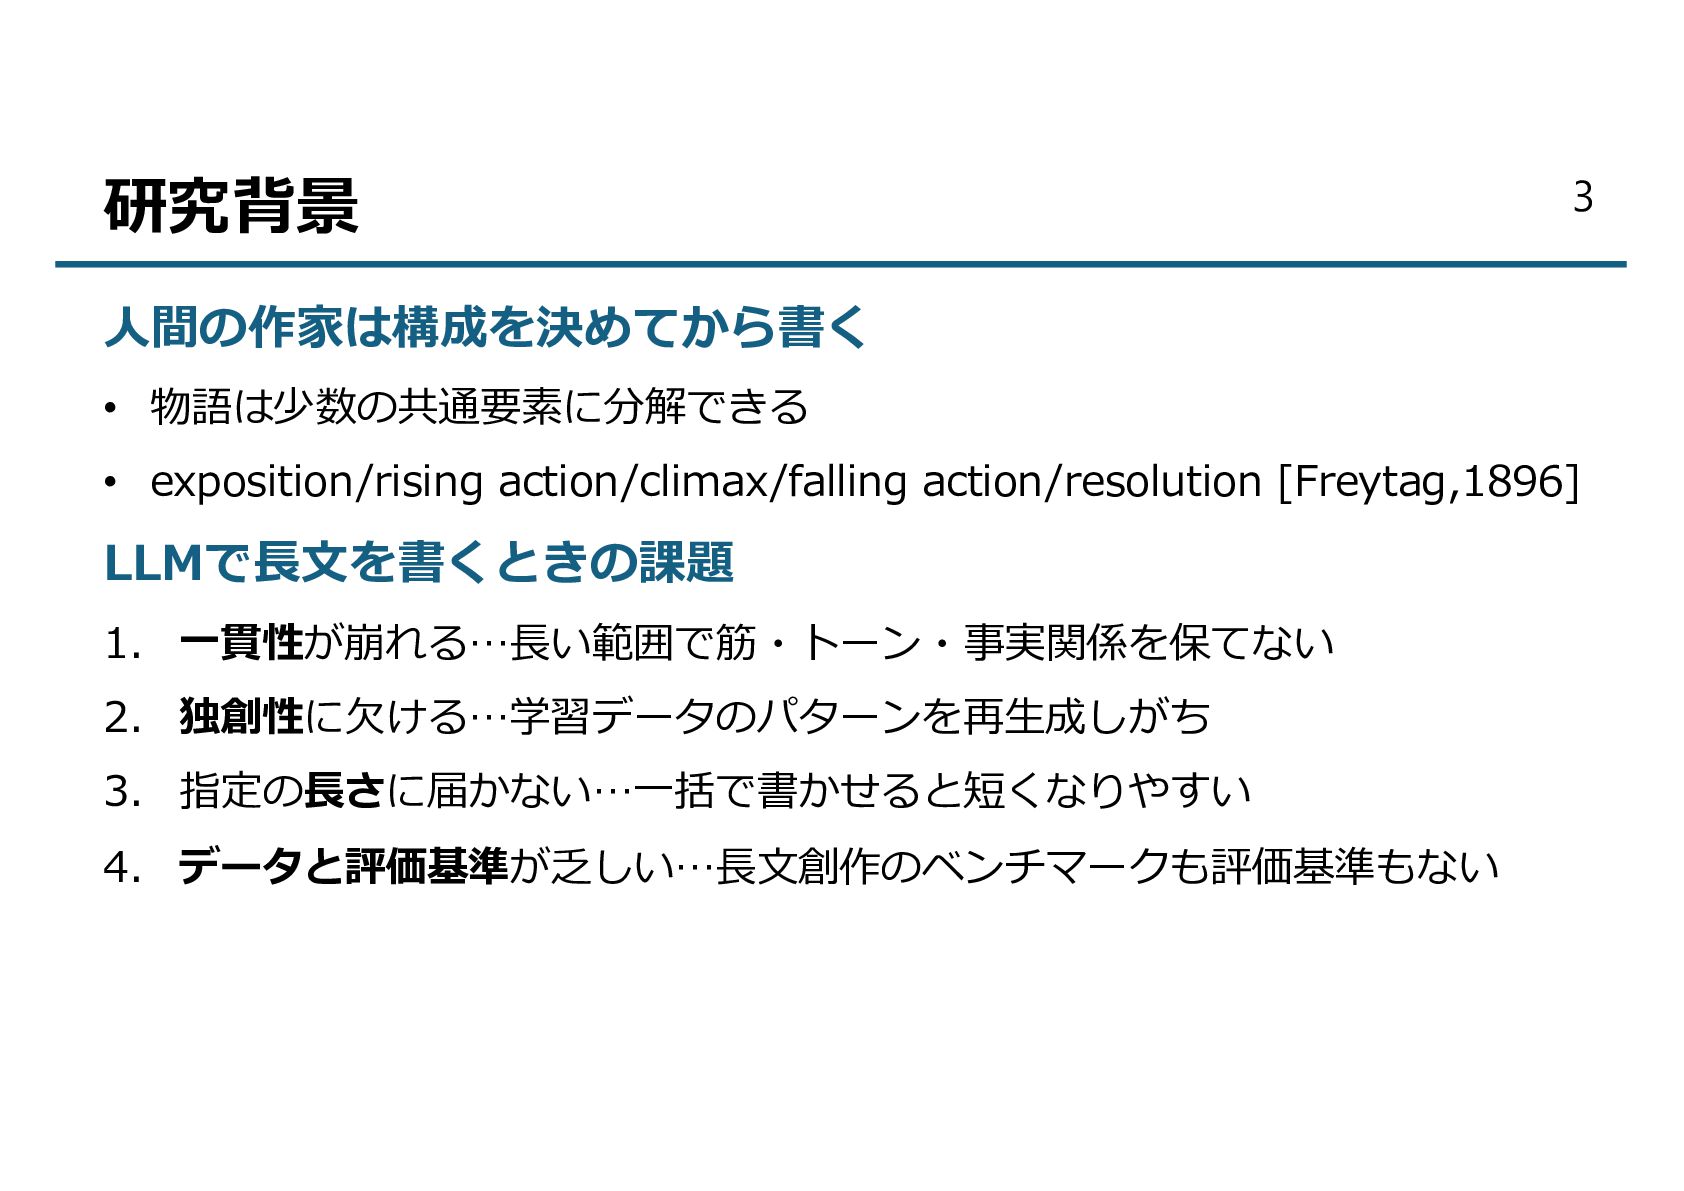
  2. 研究背景 3 3 ⼈間の作家は構成を決めてから書く • 物語は少数の共通要素に分解できる • exposition/rising action/climax/falling action/resolution

    [Freytag,1896] LLMで⻑⽂を書くときの課題 1. ⼀貫性が崩れる…⻑い範囲で筋・トーン・事実関係を保てない 2. 独創性に⽋ける…学習データのパターンを再⽣成しがち 3. 指定の⻑さに届かない…⼀括で書かせると短くなりやすい 4. データと評価基準が乏しい…⻑⽂創作のベンチマークも評価基準もない
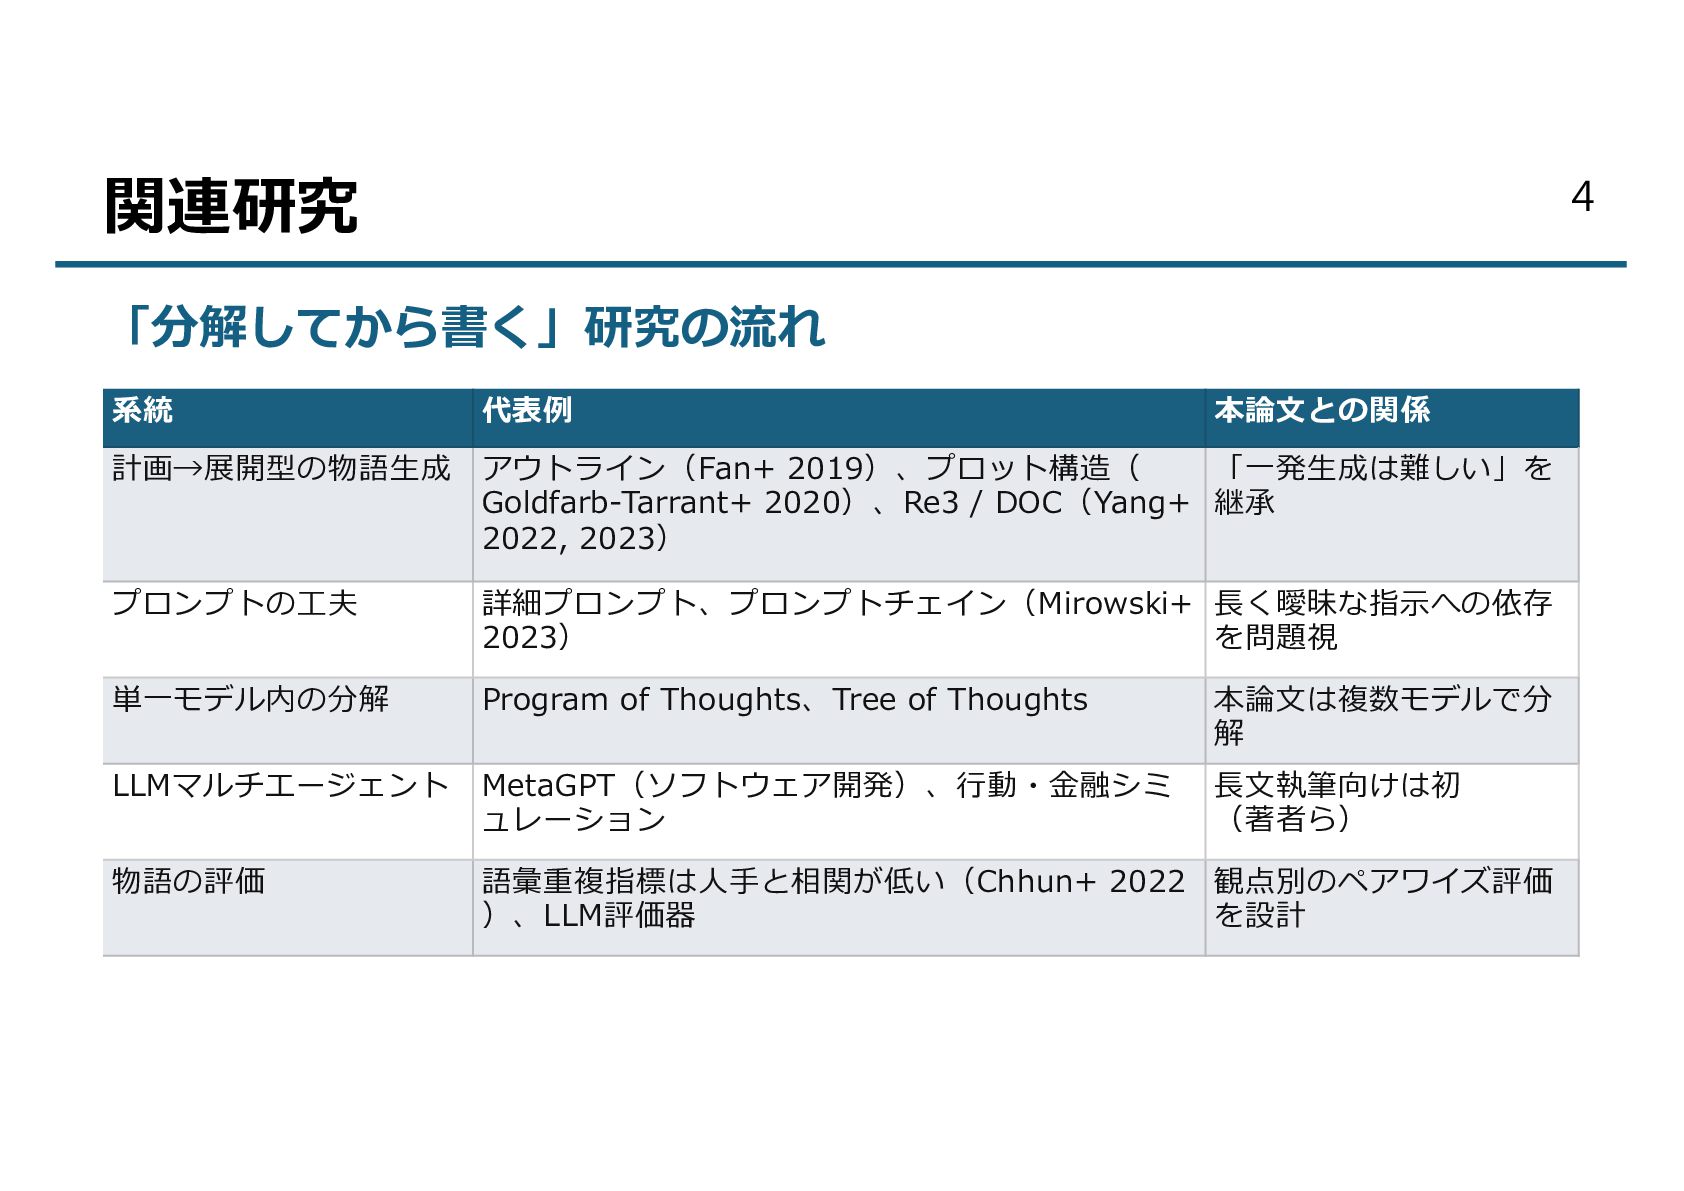
  3. 4 4 関連研究 「分解してから書く」研究の流れ 系統 代表例 本論⽂との関係 計画→展開型の物語⽣成 アウトライン(Fan+ 2019)、プロット構造(

    「⼀発⽣成は難しい」を Goldfarb-Tarrant+ 2020)、Re3 / DOC(Yang+ 継承 2022, 2023) プロンプトの⼯夫 詳細プロンプト、プロンプトチェイン(Mirowski+ ⻑く曖昧な指⽰への依存 2023) を問題視 単⼀モデル内の分解 Program of Thoughts、Tree of Thoughts 本論⽂は複数モデルで分 解 LLMマルチエージェント MetaGPT(ソフトウェア開発)、⾏動・⾦融シミ ュレーション ⻑⽂執筆向けは初 (著者ら) 物語の評価 語彙重複指標は⼈⼿と相関が低い(Chhun+ 2022 観点別のペアワイズ評価 )、LLM評価器 を設計
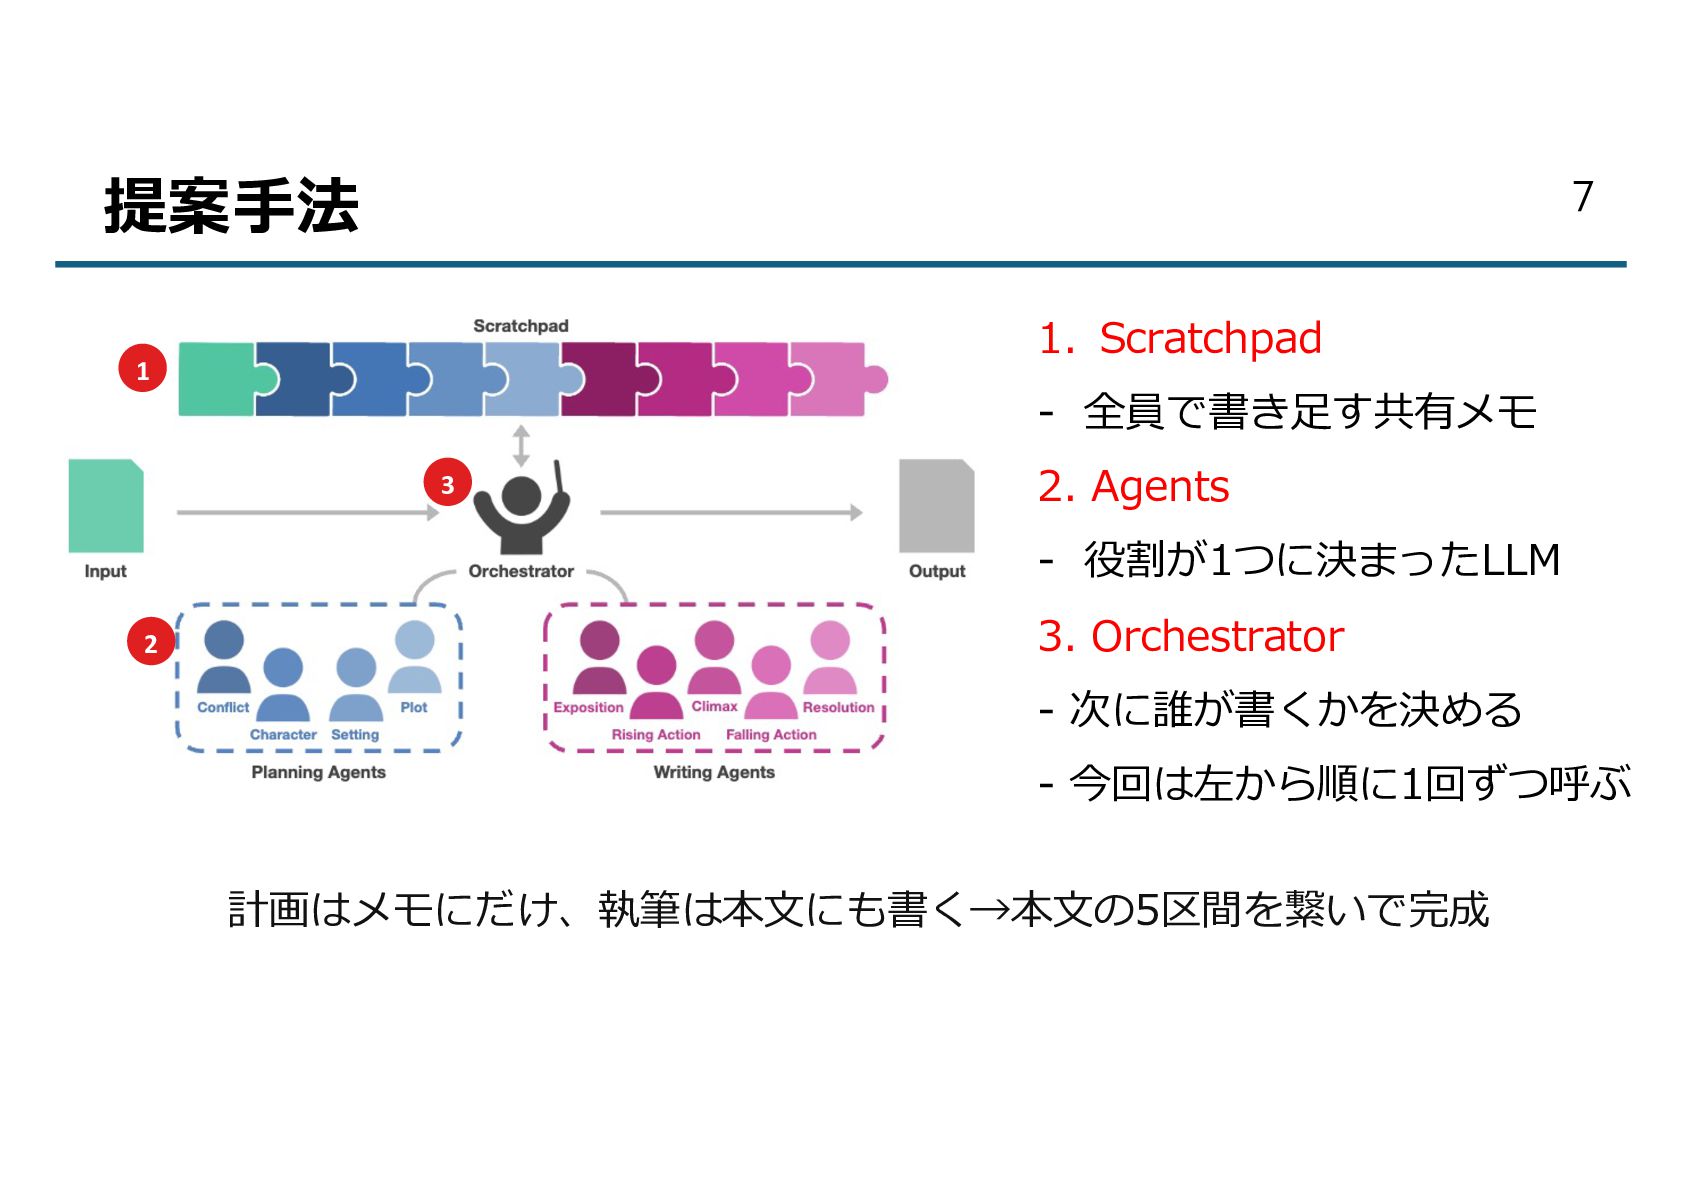
  4. 7 7 提案⼿法 1. Scratchpad 1 - 全員で書き⾜す共有メモ 3 2.

    Agents - 役割が1つに決まったLLM 2 3. Orchestrator - 次に誰が書くかを決める - 今回は左から順に1回ずつ呼ぶ 計画はメモにだけ、執筆は本⽂にも書く→本⽂の5区間を繋いで完成
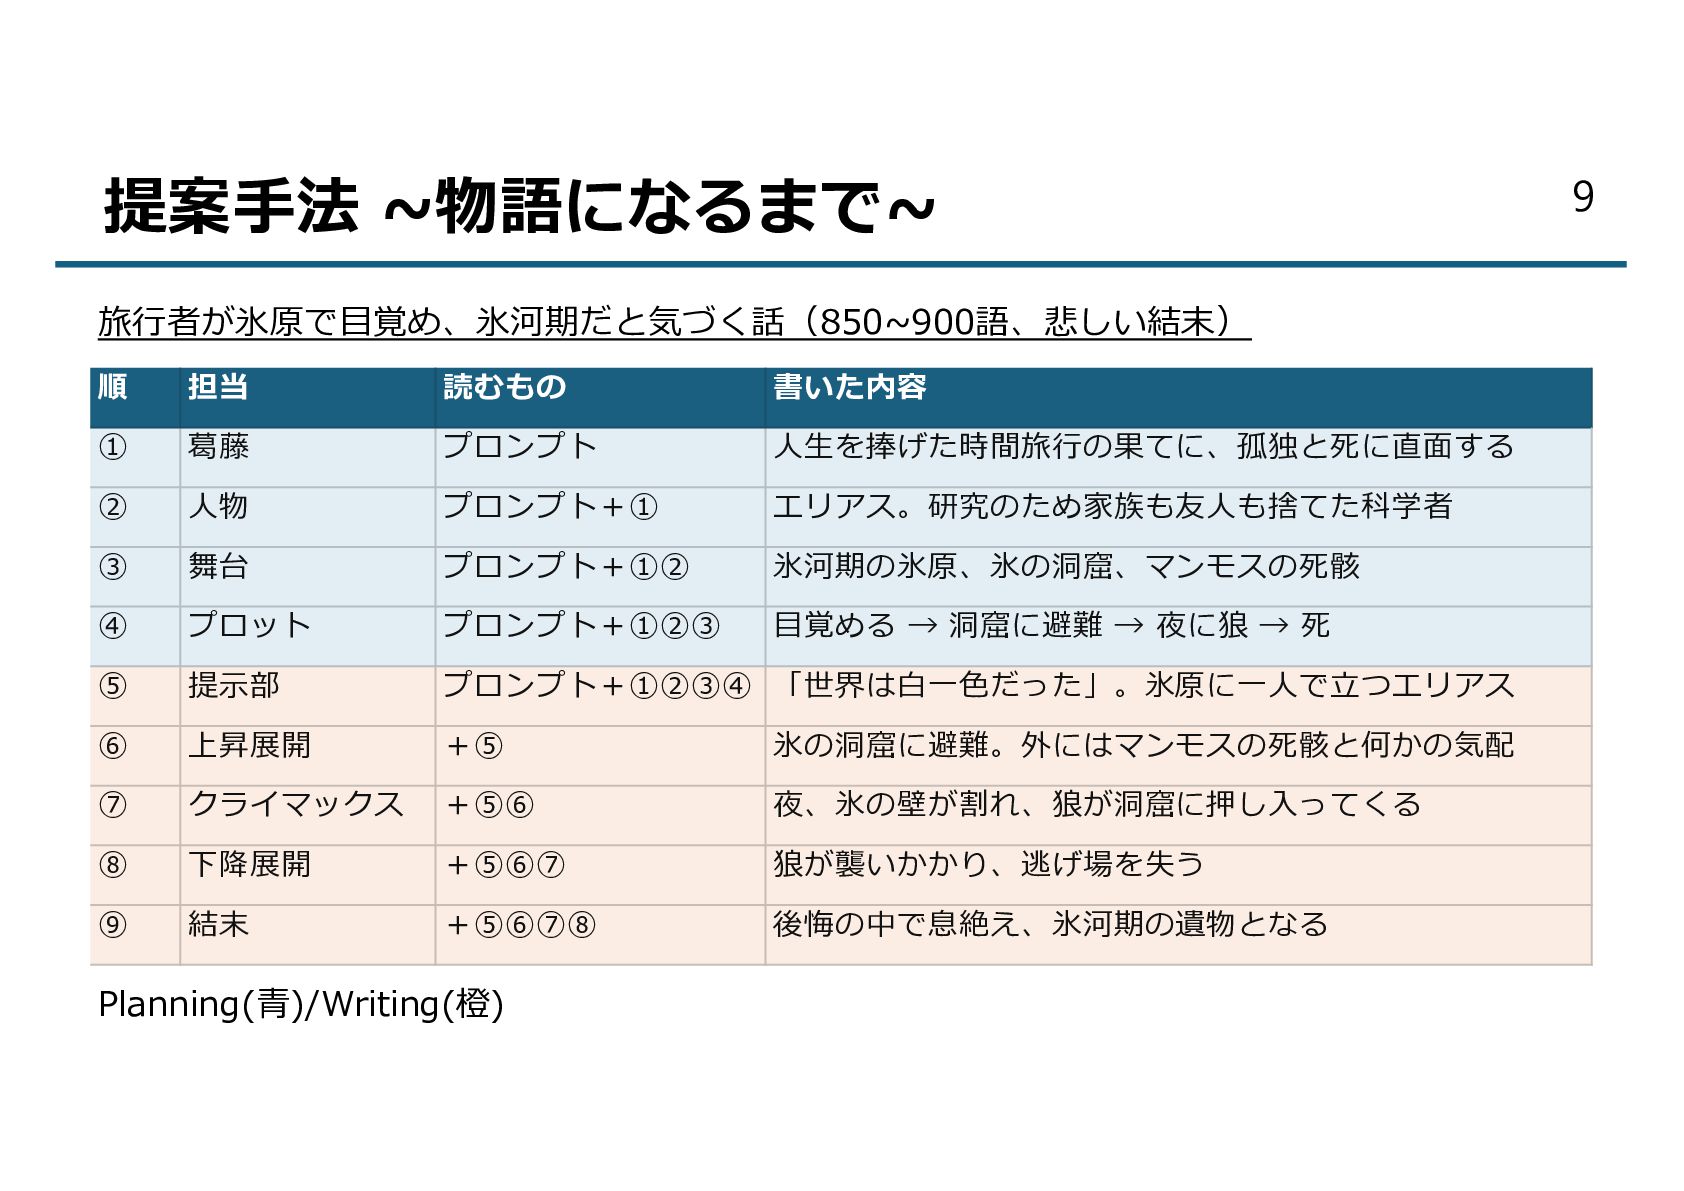
  5. 提案⼿法 ~物語になるまで~ 旅⾏者が氷原で⽬覚め、氷河期だと気づく話(850~900語、悲しい結末) 順 担当 読むもの 書いた内容 ① 葛藤 プロンプト

    ⼈⽣を捧げた時間旅⾏の果てに、孤独と死に直⾯する ② ⼈物 プロンプト+① エリアス。研究のため家族も友⼈も捨てた科学者 ③ 舞台 プロンプト+①② 氷河期の氷原、氷の洞窟、マンモスの死骸 ④ プロット プロンプト+①②③ ⽬覚める → 洞窟に避難 → 夜に狼 → 死 ⑤ 提⽰部 プロンプト+①②③④ 「世界は⽩⼀⾊だった」。氷原に⼀⼈で⽴つエリアス ⑥ 上昇展開 +⑤ 氷の洞窟に避難。外にはマンモスの死骸と何かの気配 ⑦ クライマックス +⑤⑥ 夜、氷の壁が割れ、狼が洞窟に押し⼊ってくる ⑧ 下降展開 +⑤⑥⑦ 狼が襲いかかり、逃げ場を失う ⑨ 結末 +⑤⑥⑦⑧ 後悔の中で息絶え、氷河期の遺物となる Planning(⻘)/Writing(橙) 9 9
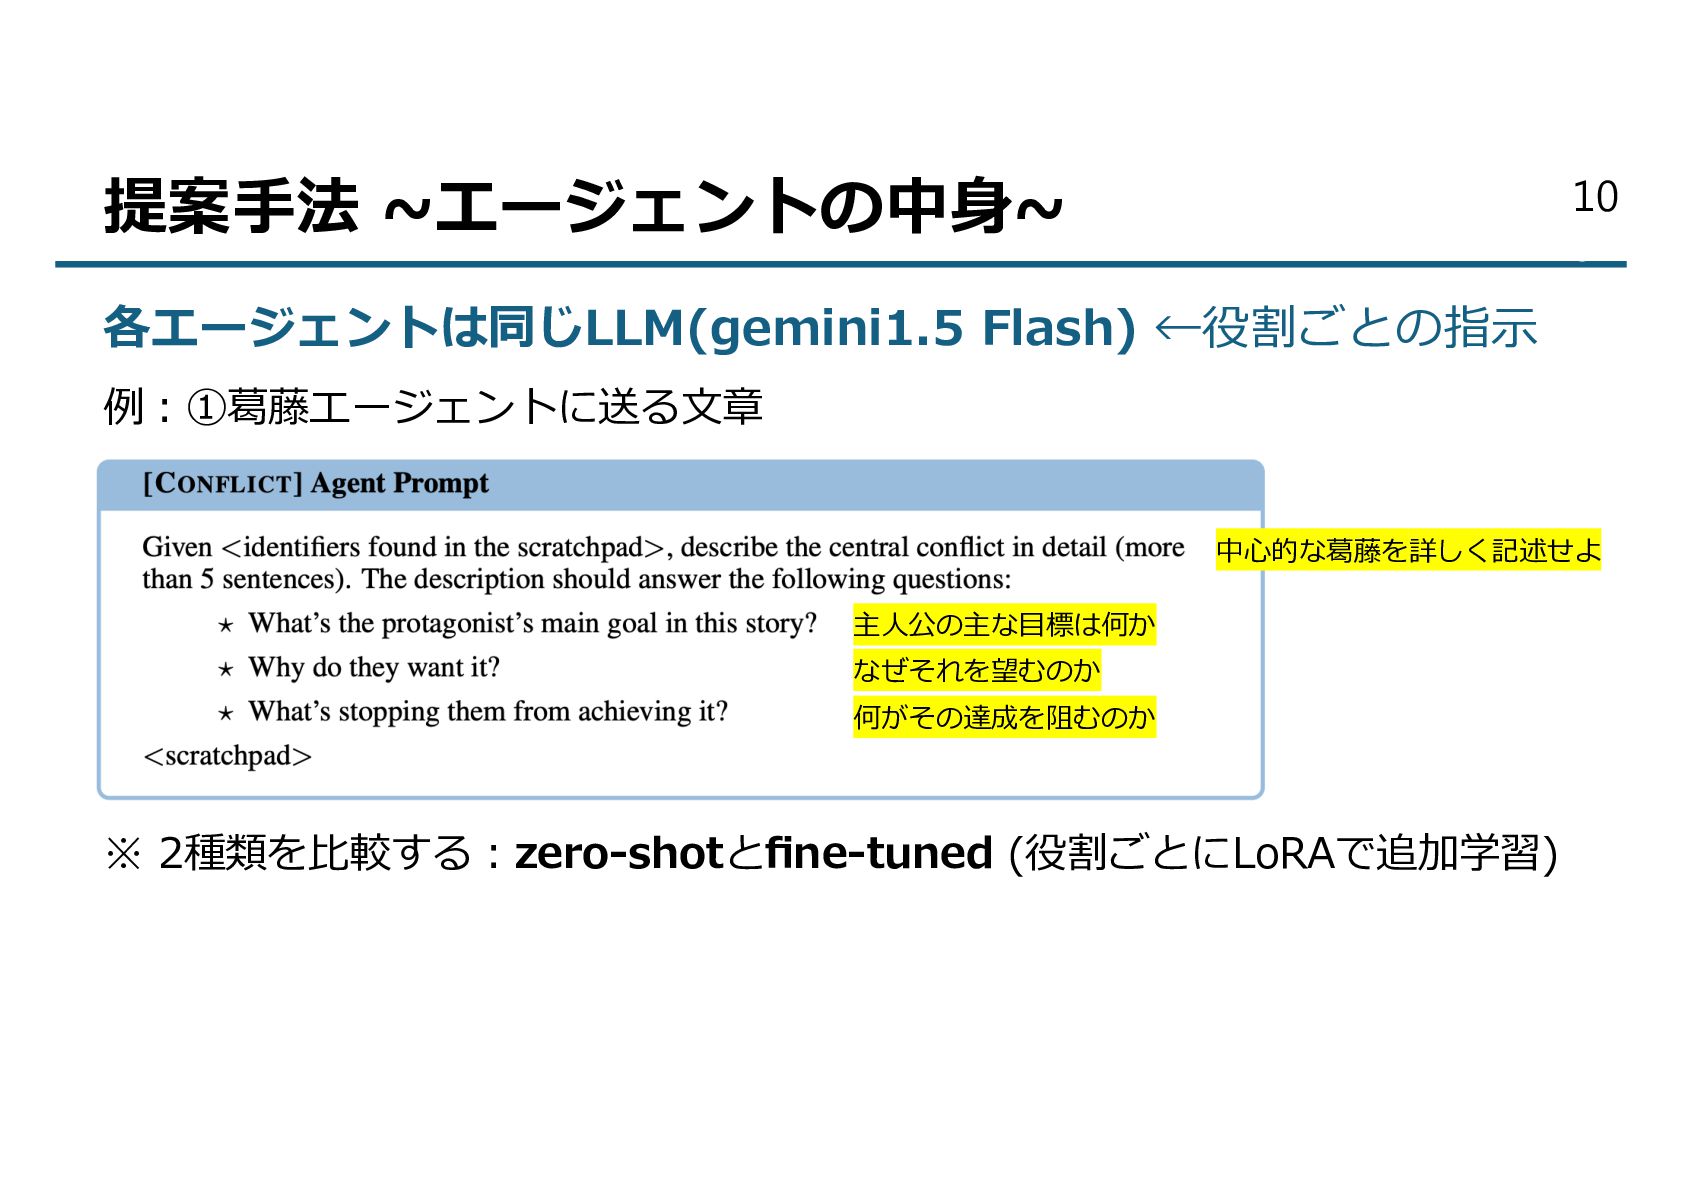
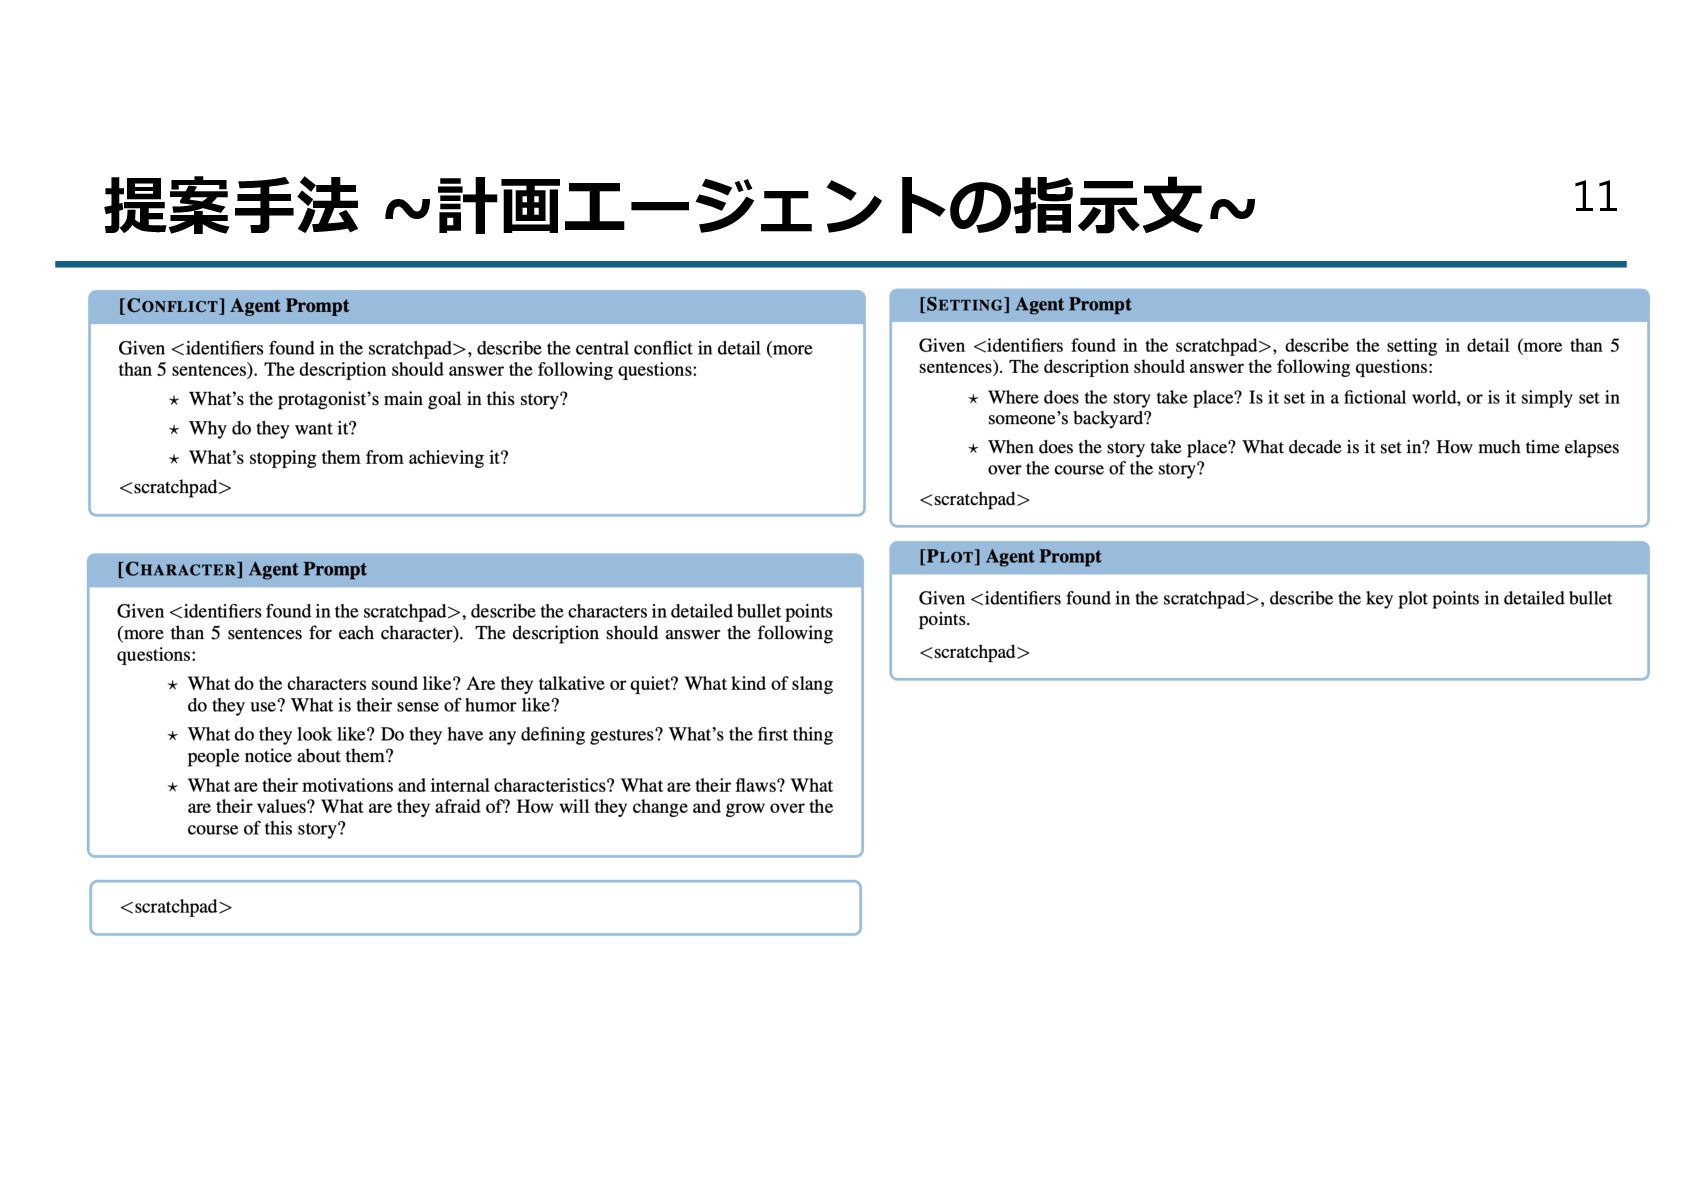
  6. 1 10 0 提案⼿法 ~エージェントの中⾝~ 各エージェントは同じLLM(gemini1.5 Flash) ←役割ごとの指⽰ 例︓①葛藤エージェントに送る⽂章 中⼼的な葛藤を詳しく記述せよ

    主⼈公の主な⽬標は何か なぜそれを望むのか 何がその達成を阻むのか ※ 2種類を⽐較する︓zero-shotとfine-tuned (役割ごとにLoRAで追加学習)
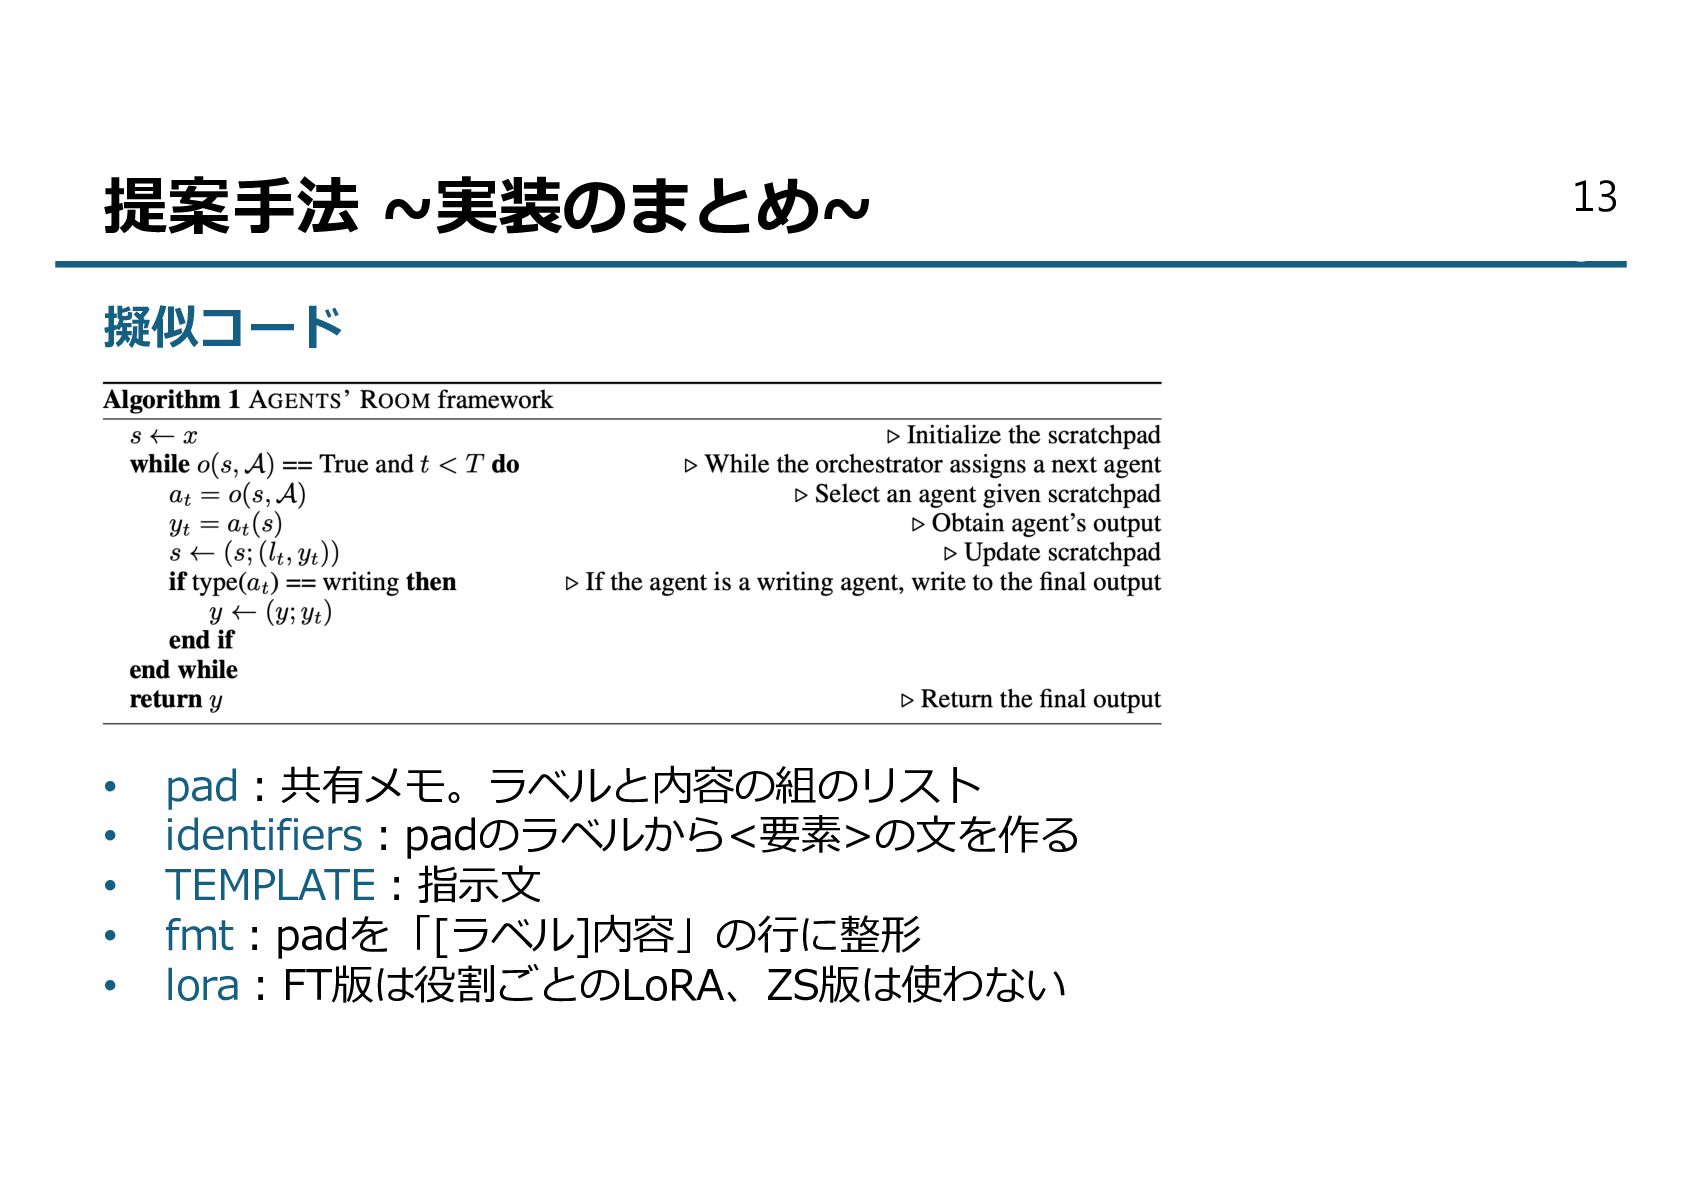
  7. 提案⼿法 ~実装のまとめ~ 擬似コード • • • • • pad︓共有メモ。ラベルと内容の組のリスト identifiers︓padのラベルから<要素>の⽂を作る

    TEMPLATE︓指⽰⽂ fmt︓padを「[ラベル]内容」の⾏に整形 lora︓FT版は役割ごとのLoRA、ZS版は使わない 1 13 3
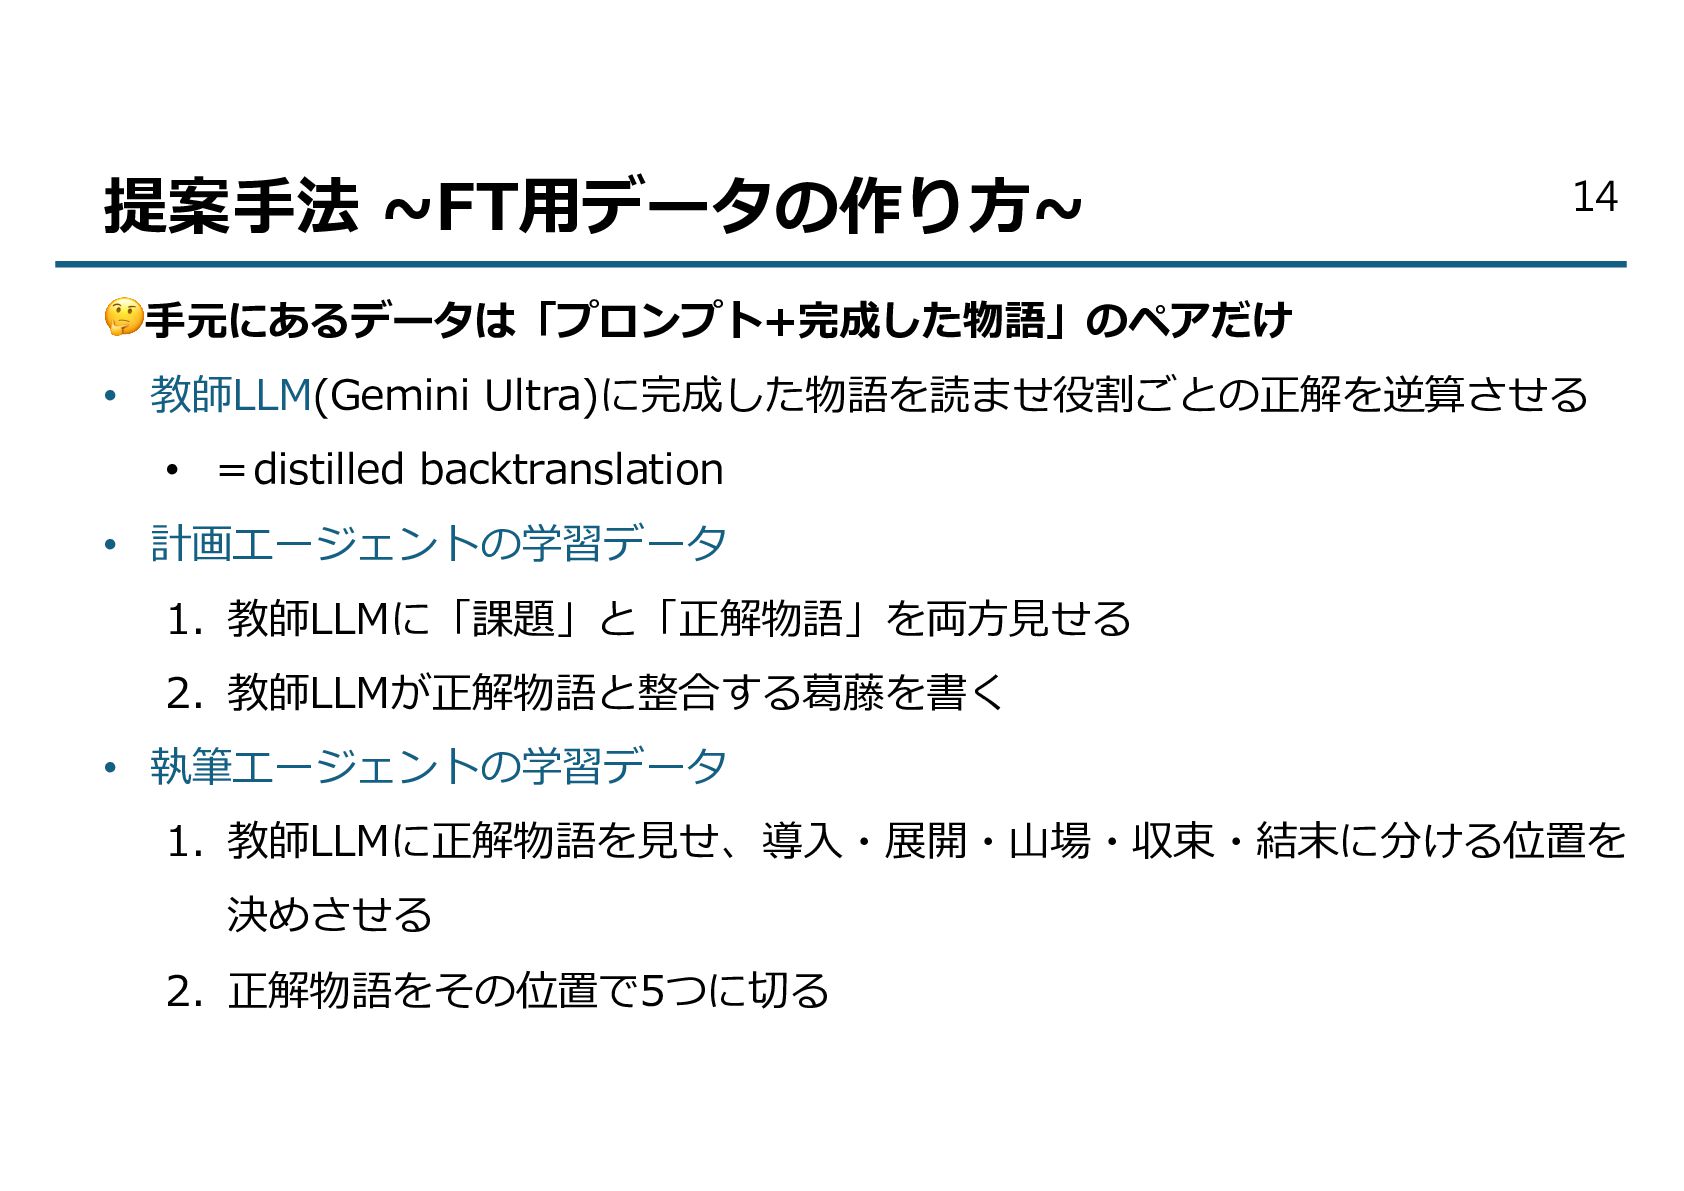
  8. 提案⼿法 ~FT⽤データの作り⽅~ 1 14 4 🤔⼿元にあるデータは「プロンプト+完成した物語」のペアだけ • 教師LLM(Gemini Ultra)に完成した物語を読ませ役割ごとの正解を逆算させる •

    =distilled backtranslation • 計画エージェントの学習データ 1. 教師LLMに「課題」と「正解物語」を両⽅⾒せる 2. 教師LLMが正解物語と整合する葛藤を書く • 執筆エージェントの学習データ 1. 教師LLMに正解物語を⾒せ、導⼊・展開・⼭場・収束・結末に分ける位置を 決めさせる 2. 正解物語をその位置で5つに切る
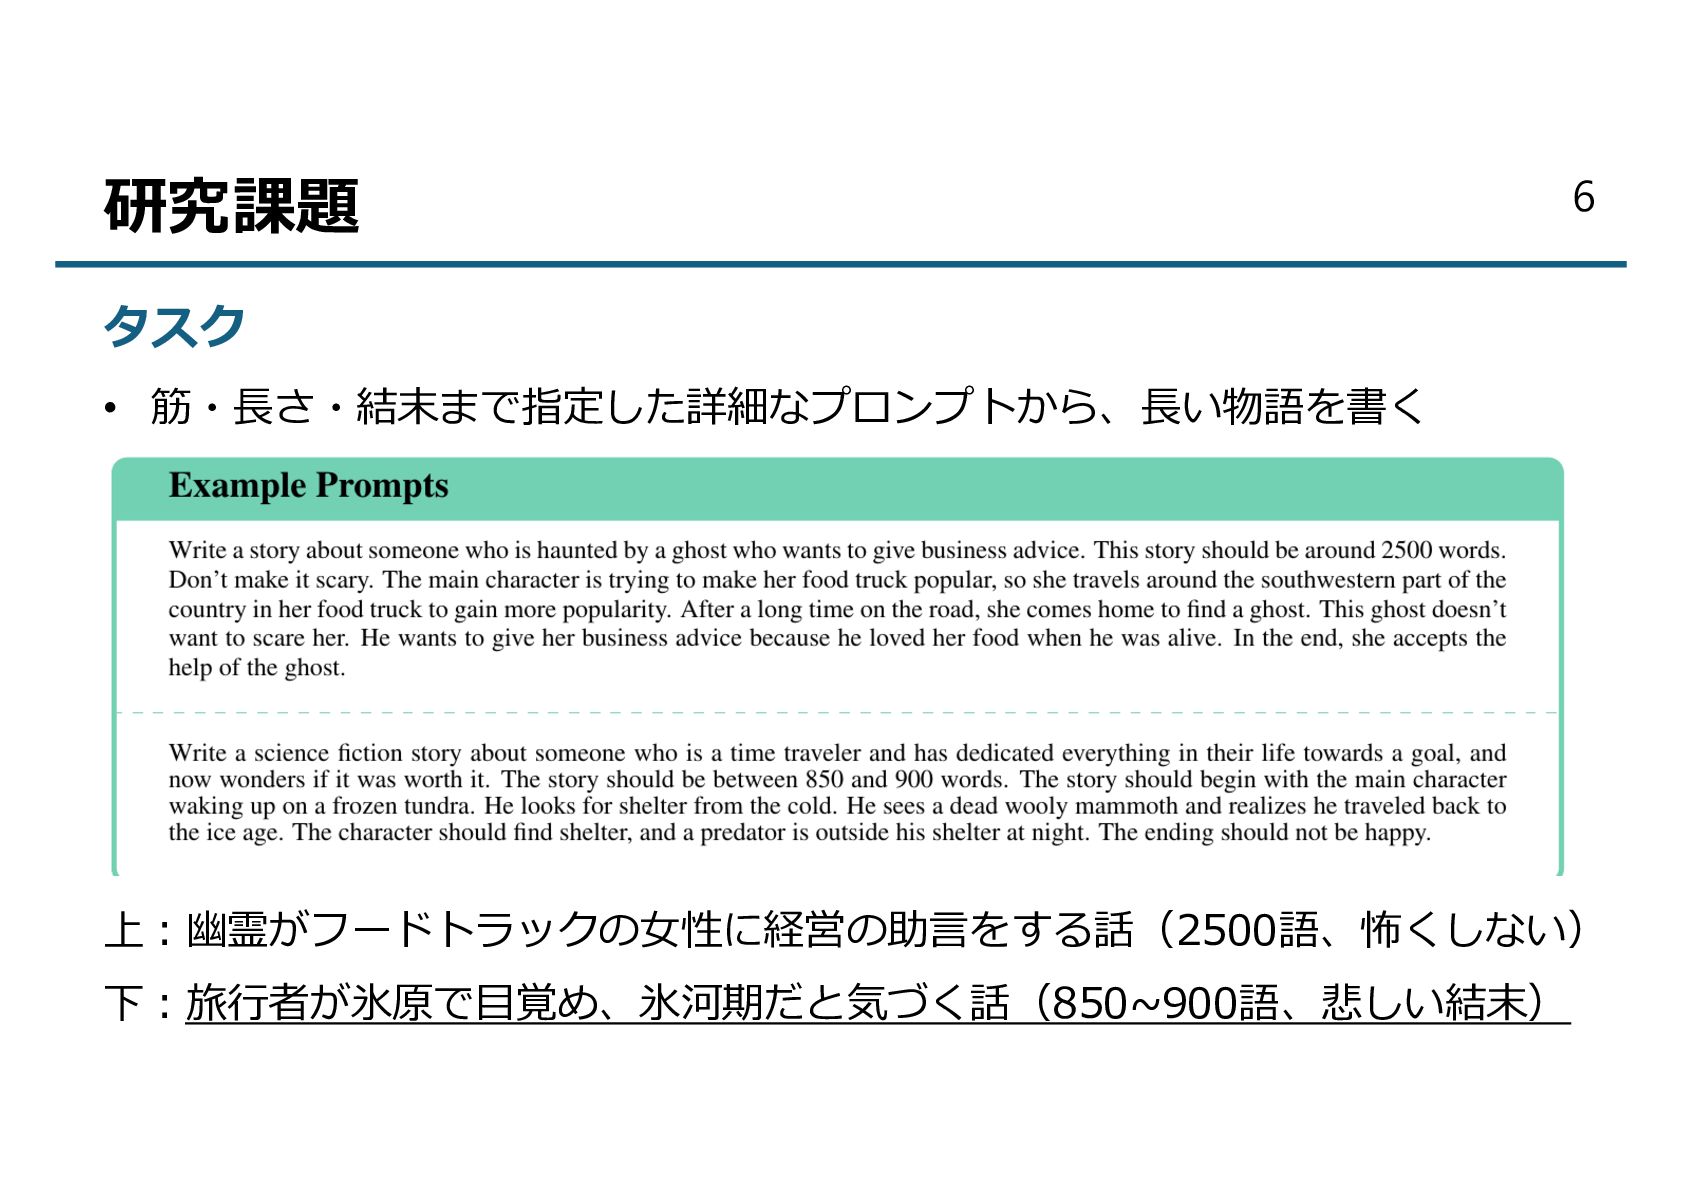
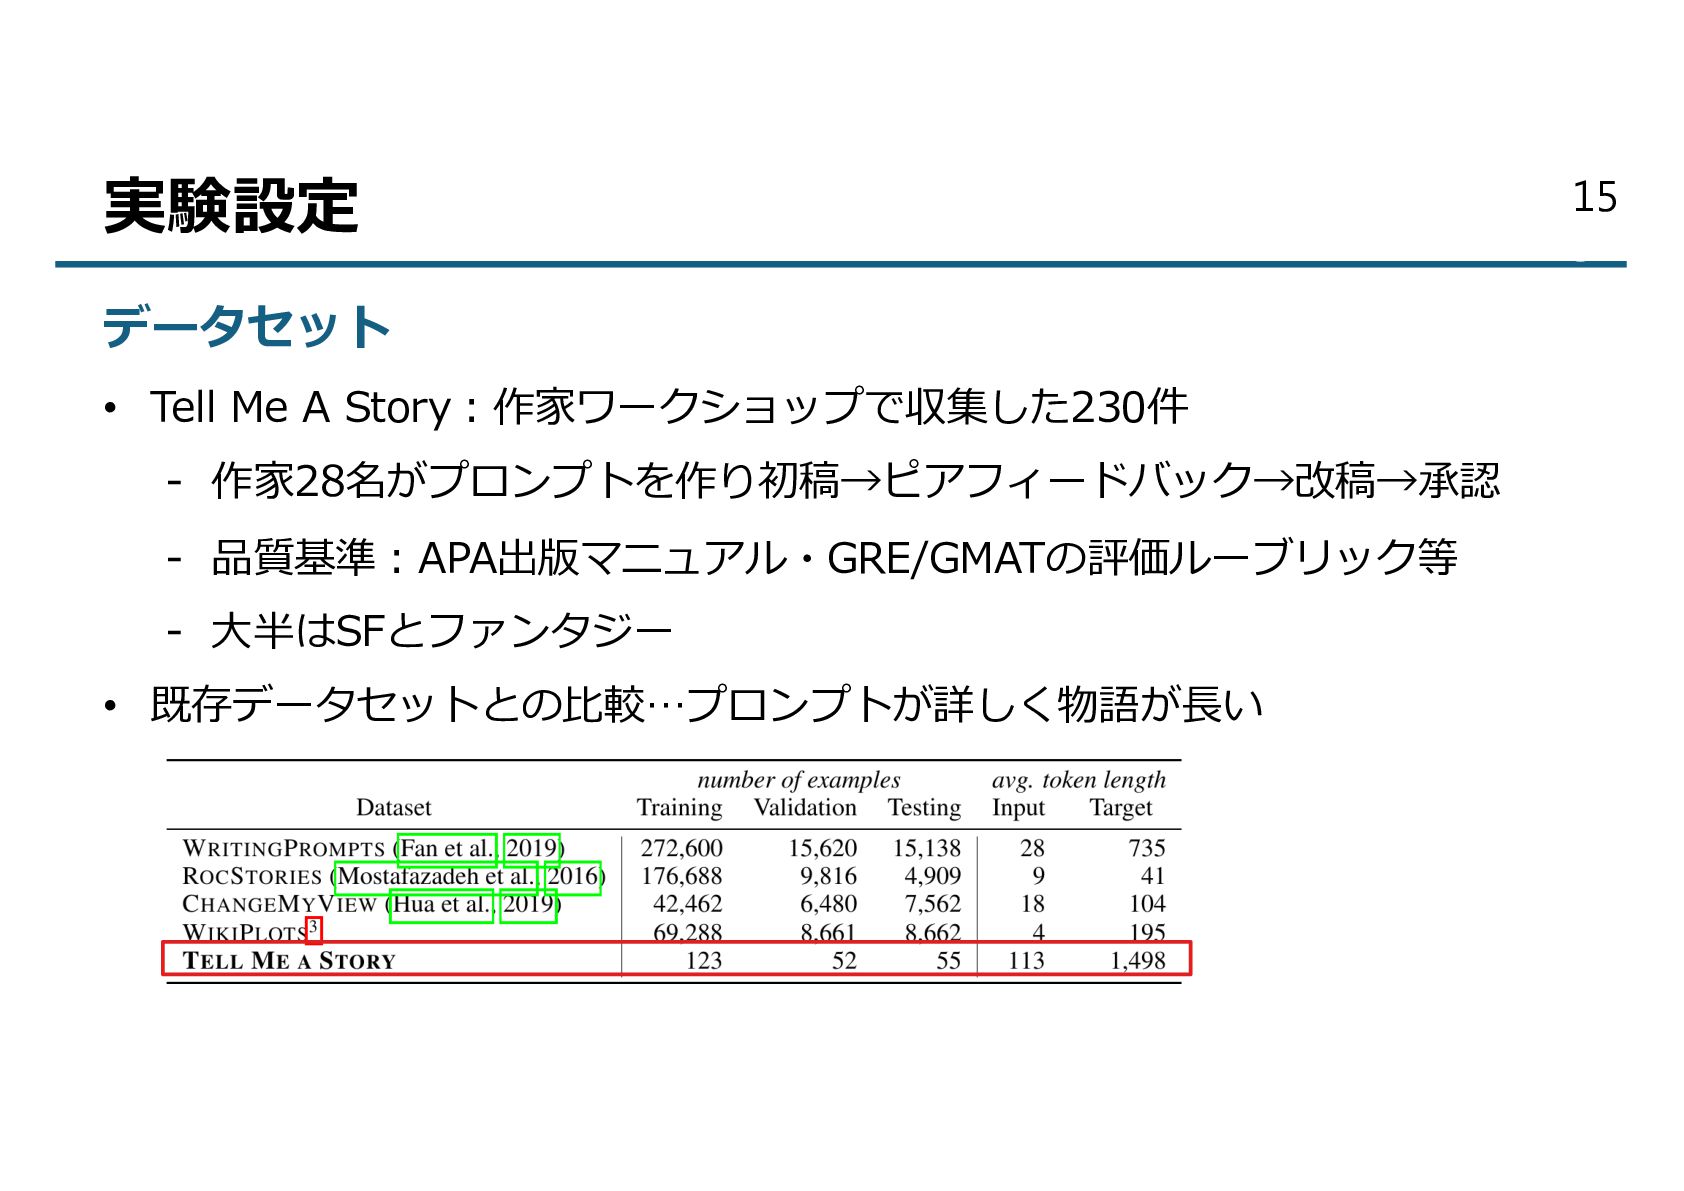
  9. 実験設定 データセット • Tell Me A Story︓作家ワークショップで収集した230件 - 作家28名がプロンプトを作り初稿→ピアフィードバック→改稿→承認 -

    品質基準︓APA出版マニュアル・GRE/GMATの評価ルーブリック等 - ⼤半はSFとファンタジー • 既存データセットとの⽐較…プロンプトが詳しく物語が⻑い - 1 15 5
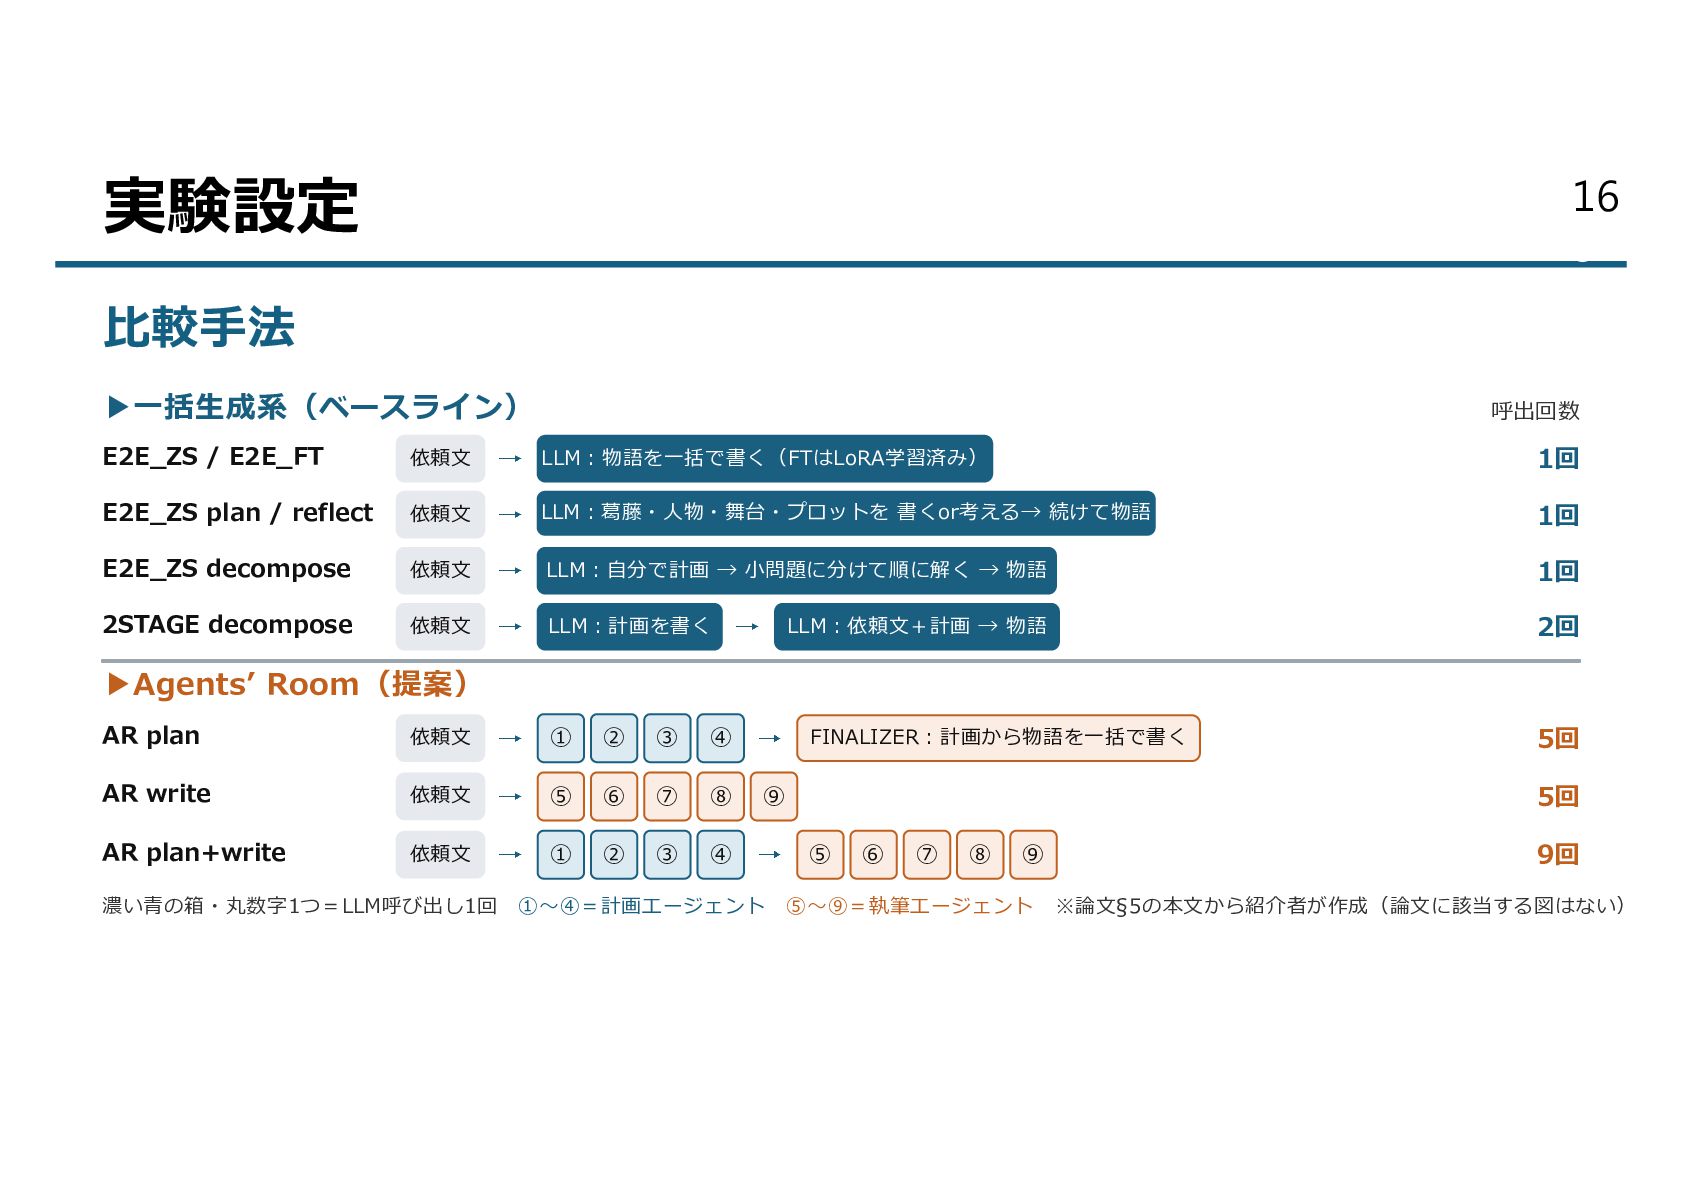
  10. 1 16 6 実験設定 ⽐較⼿法 ▶⼀括⽣成系(ベースライン) 呼出回数 E2E_ZS / E2E_FT

    依頼⽂ LLM︓物語を⼀括で書く(FTはLoRA学習済み) 1回 E2E_ZS plan / reflect 依頼⽂ LLM︓葛藤・⼈物・舞台・プロットを 書くor考える→ 続けて物語 1回 E2E_ZS decompose 依頼⽂ LLM︓⾃分で計画 → ⼩問題に分けて順に解く → 物語 1回 2STAGE decompose 依頼⽂ LLM︓計画を書く 2回 LLM︓依頼⽂+計画 → 物語 ▶Agentsʼ Room(提案) AR plan 依頼⽂ ① ② ③ ④ AR write 依頼⽂ ⑤ ⑥ ⑦ ⑧ AR plan+write 依頼⽂ ① ② ③ ④ 濃い⻘の箱・丸数字1つ=LLM呼び出し1回 FINALIZER︓計画から物語を⼀括で書く 5回 ⑨ ①〜④=計画エージェント 5回 ⑤ ⑥ ⑦ ⑧ ⑨ ⑤〜⑨=執筆エージェント 9回 ※論⽂§5の本⽂から紹介者が作成(論⽂に該当する図はない)
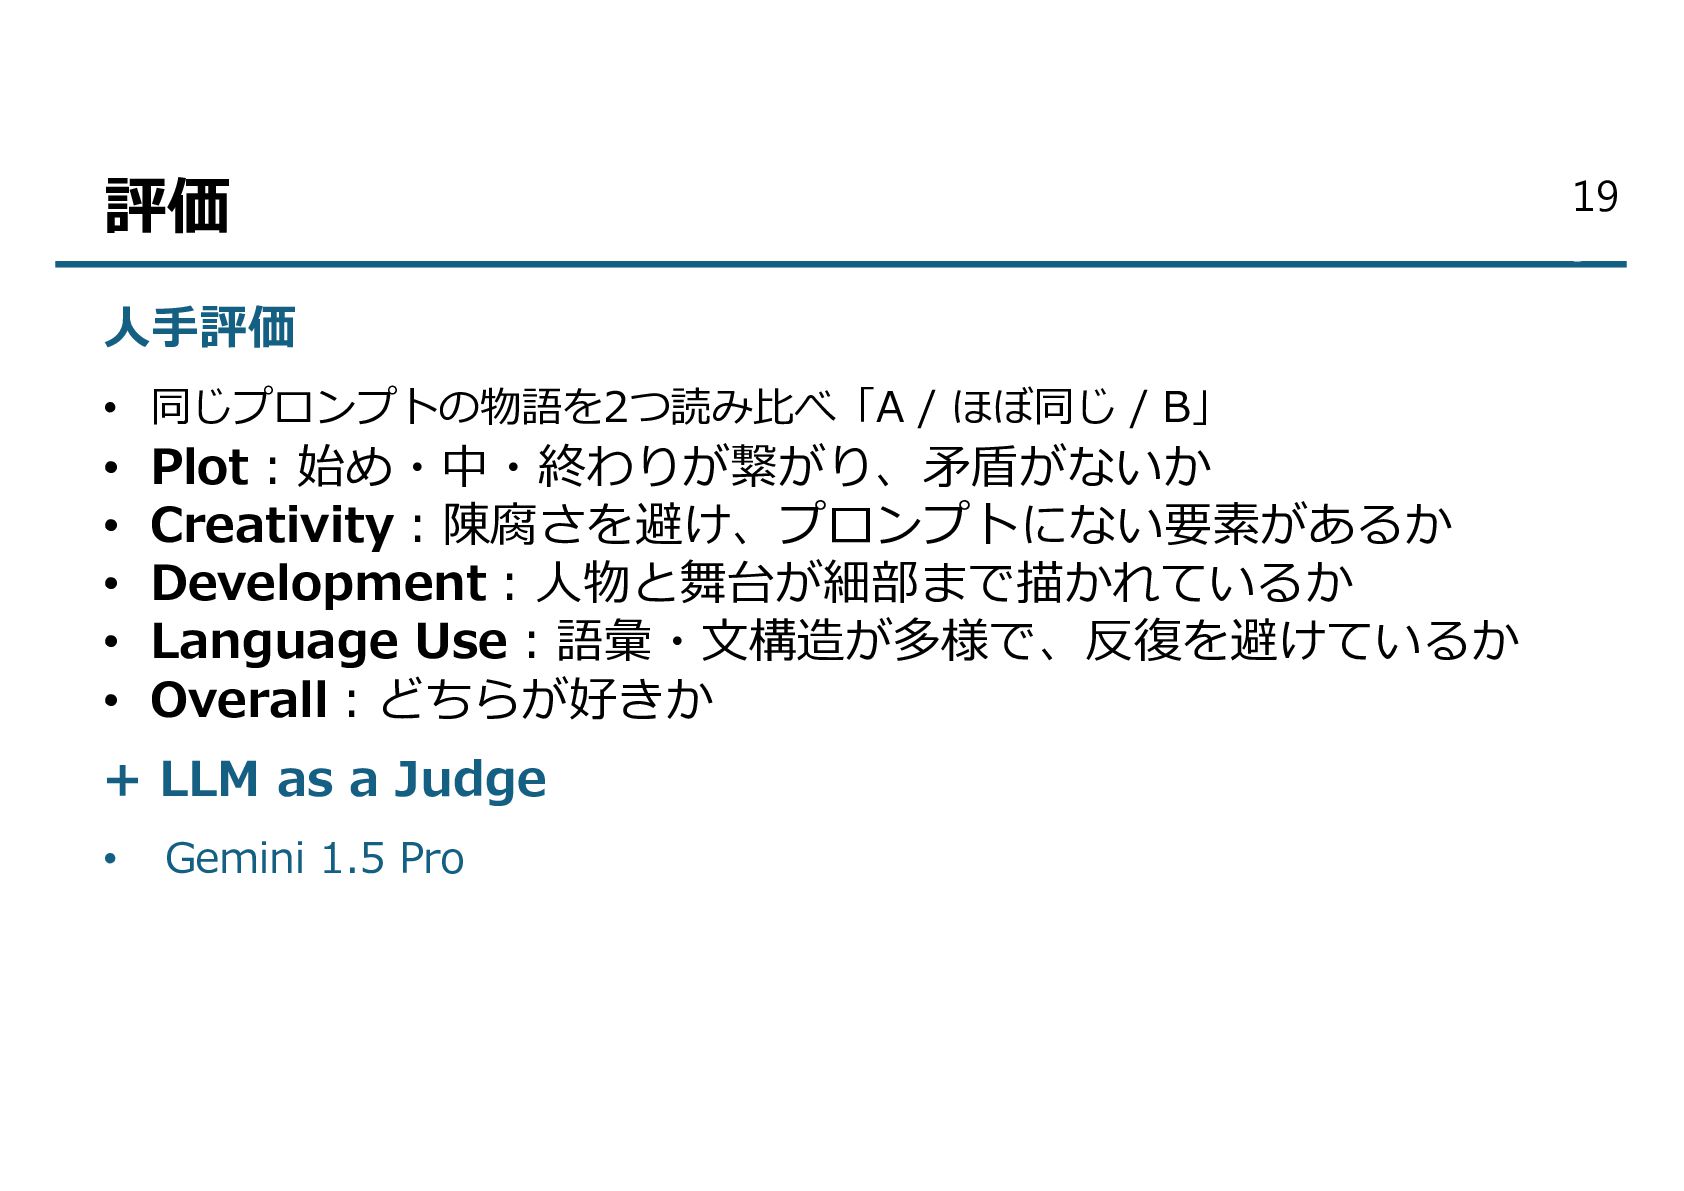
  11. 評価 ⼈⼿評価 • 同じプロンプトの物語を2つ読み⽐べ「A / ほぼ同じ / B」 • Plot︓始め・中・終わりが繋がり、⽭盾がないか

    • Creativity︓陳腐さを避け、プロンプトにない要素があるか • Development︓⼈物と舞台が細部まで描かれているか • Language Use︓語彙・⽂構造が多様で、反復を避けているか • Overall︓どちらが好きか + LLM as a Judge • Gemini 1.5 Pro 1 19 9
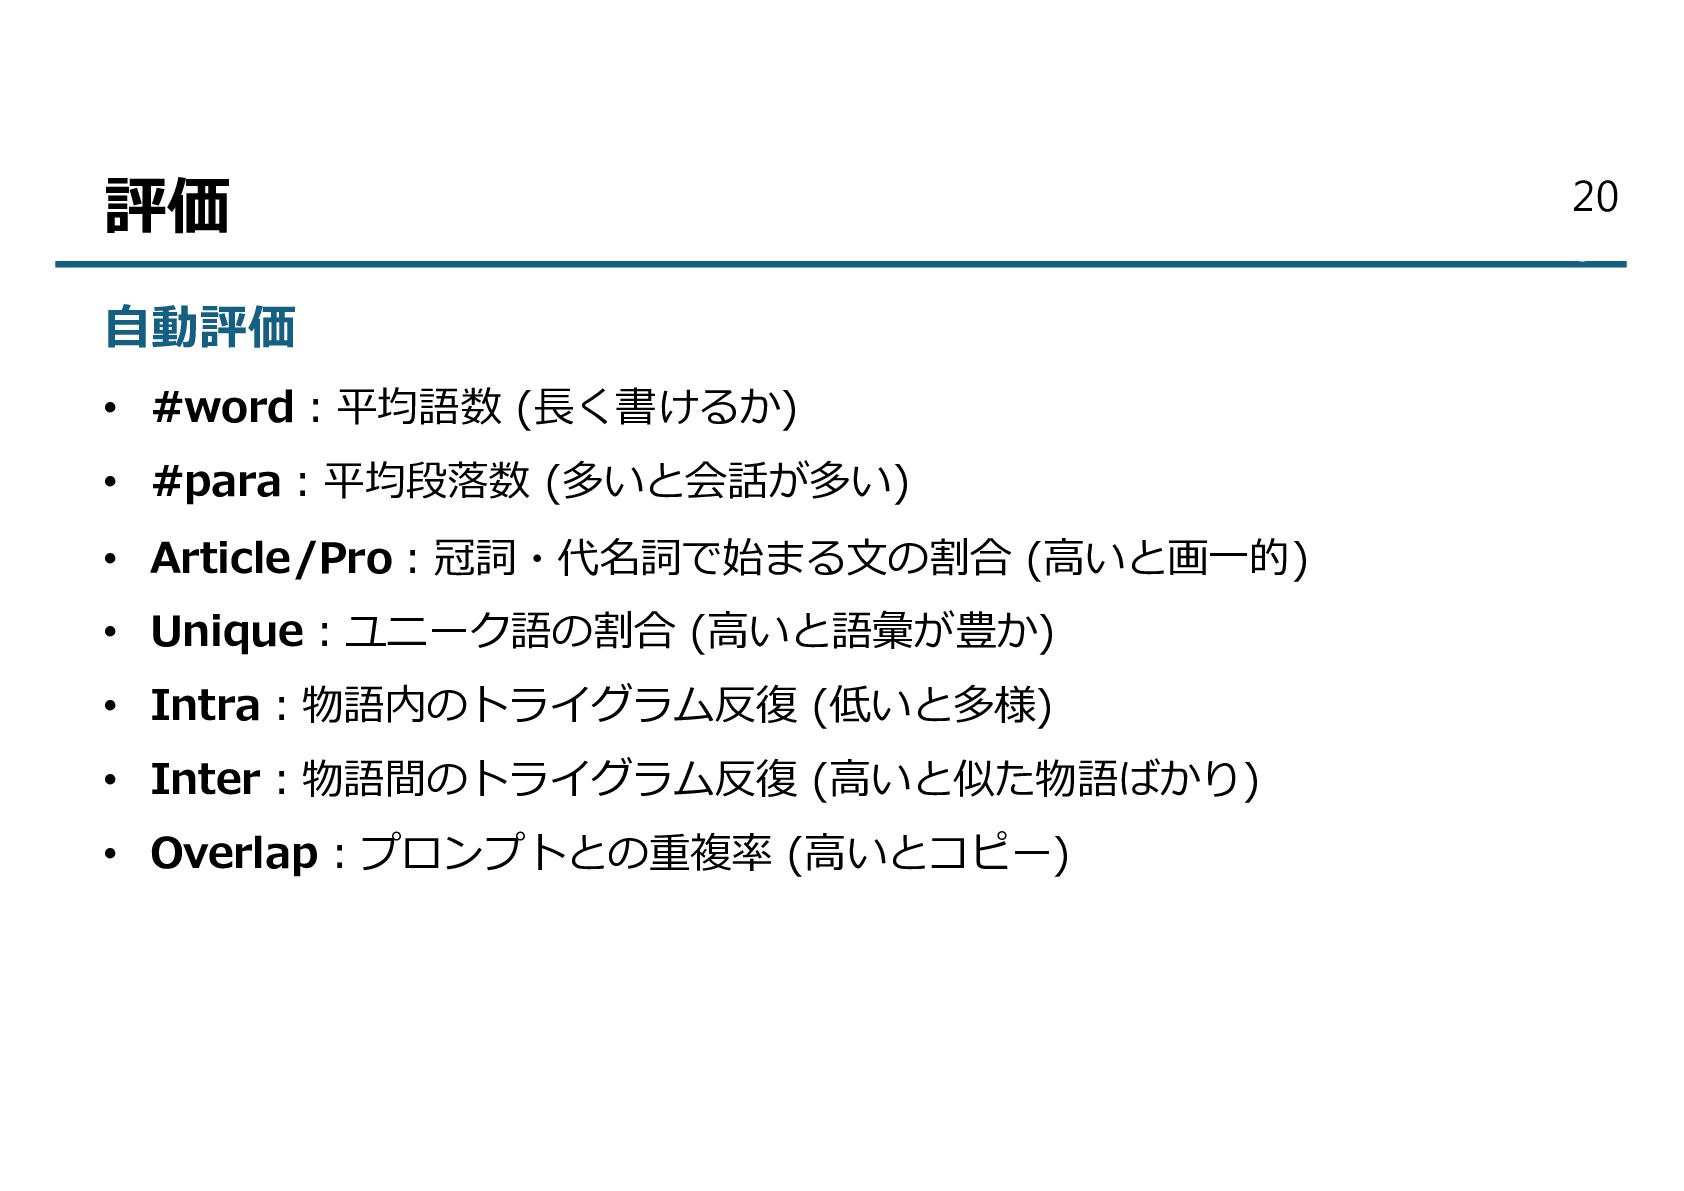
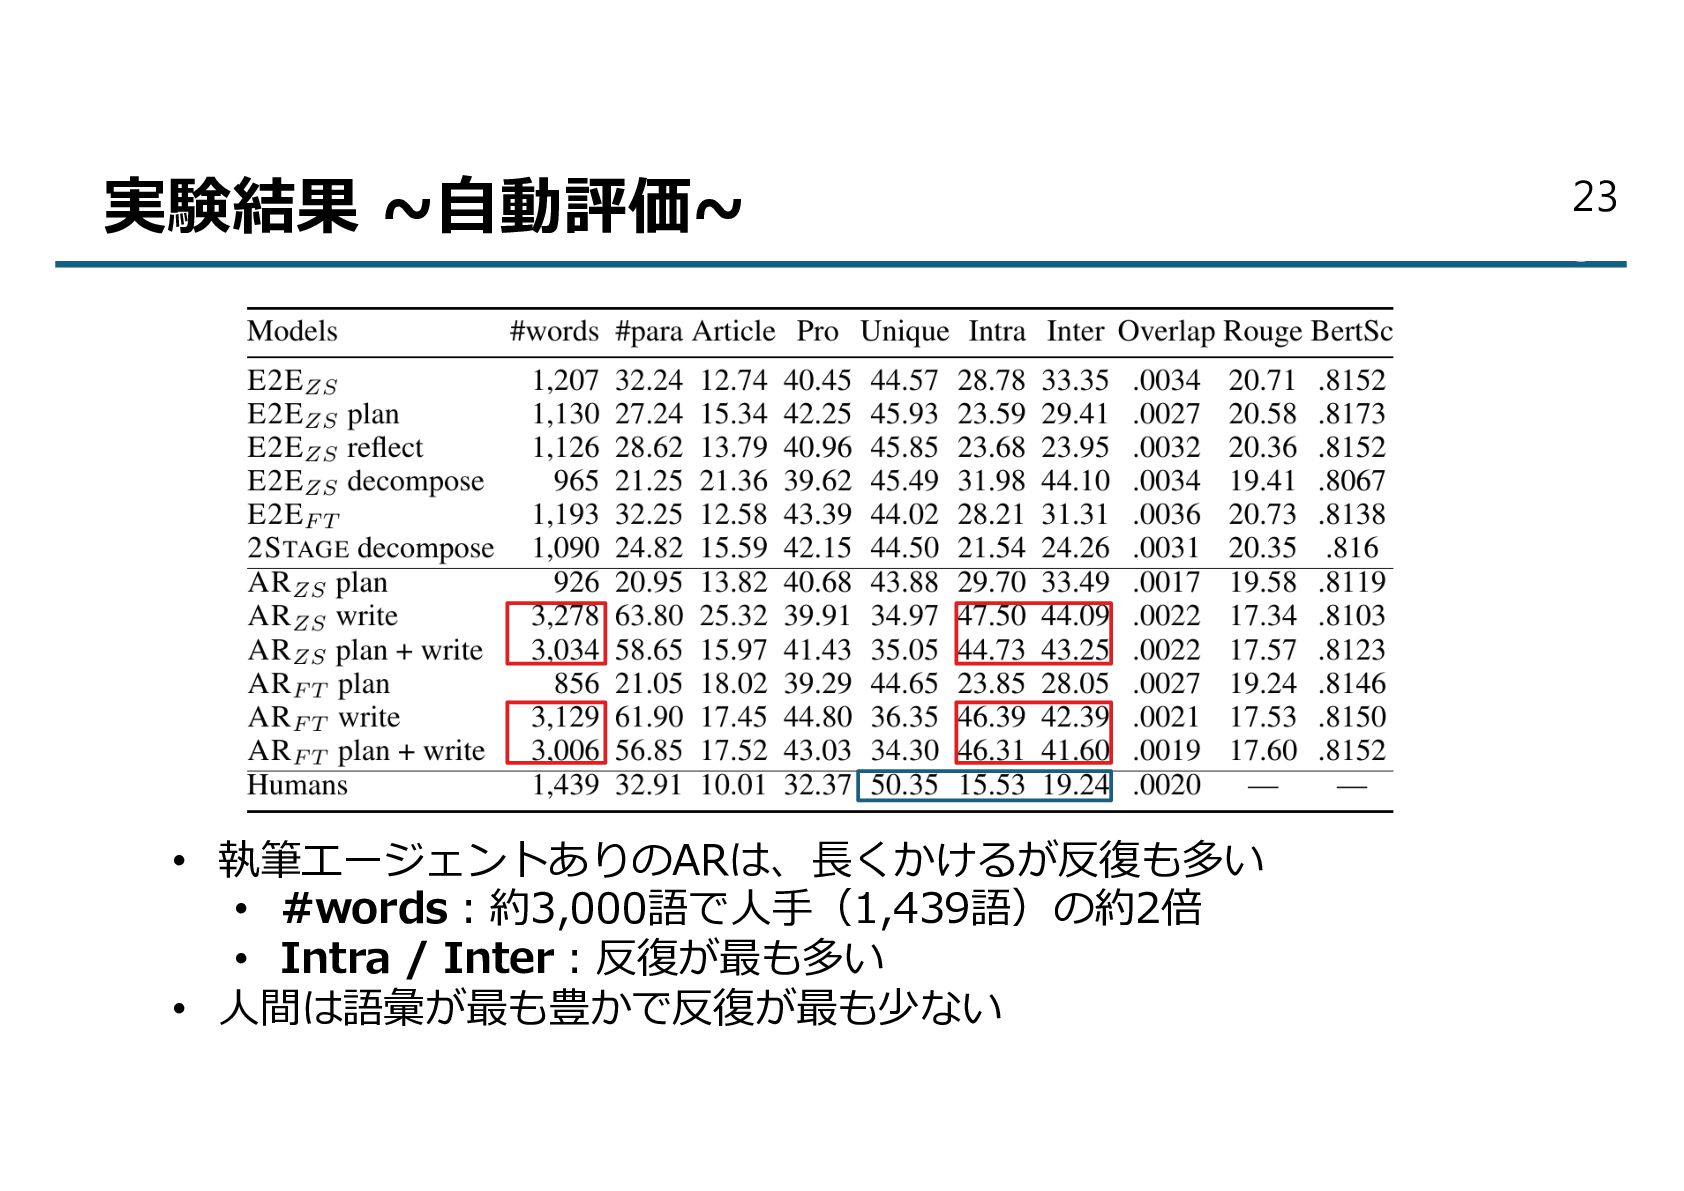
  12. 評価 ⾃動評価 • #word︓平均語数 (⻑く書けるか) • #para︓平均段落数 (多いと会話が多い) • Article/Pro︓冠詞・代名詞で始まる⽂の割合

    (⾼いと画⼀的) • Unique︓ユニーク語の割合 (⾼いと語彙が豊か) • Intra︓物語内のトライグラム反復 (低いと多様) • Inter︓物語間のトライグラム反復 (⾼いと似た物語ばかり) • Overlap︓プロンプトとの重複率 (⾼いとコピー) 2 20 0
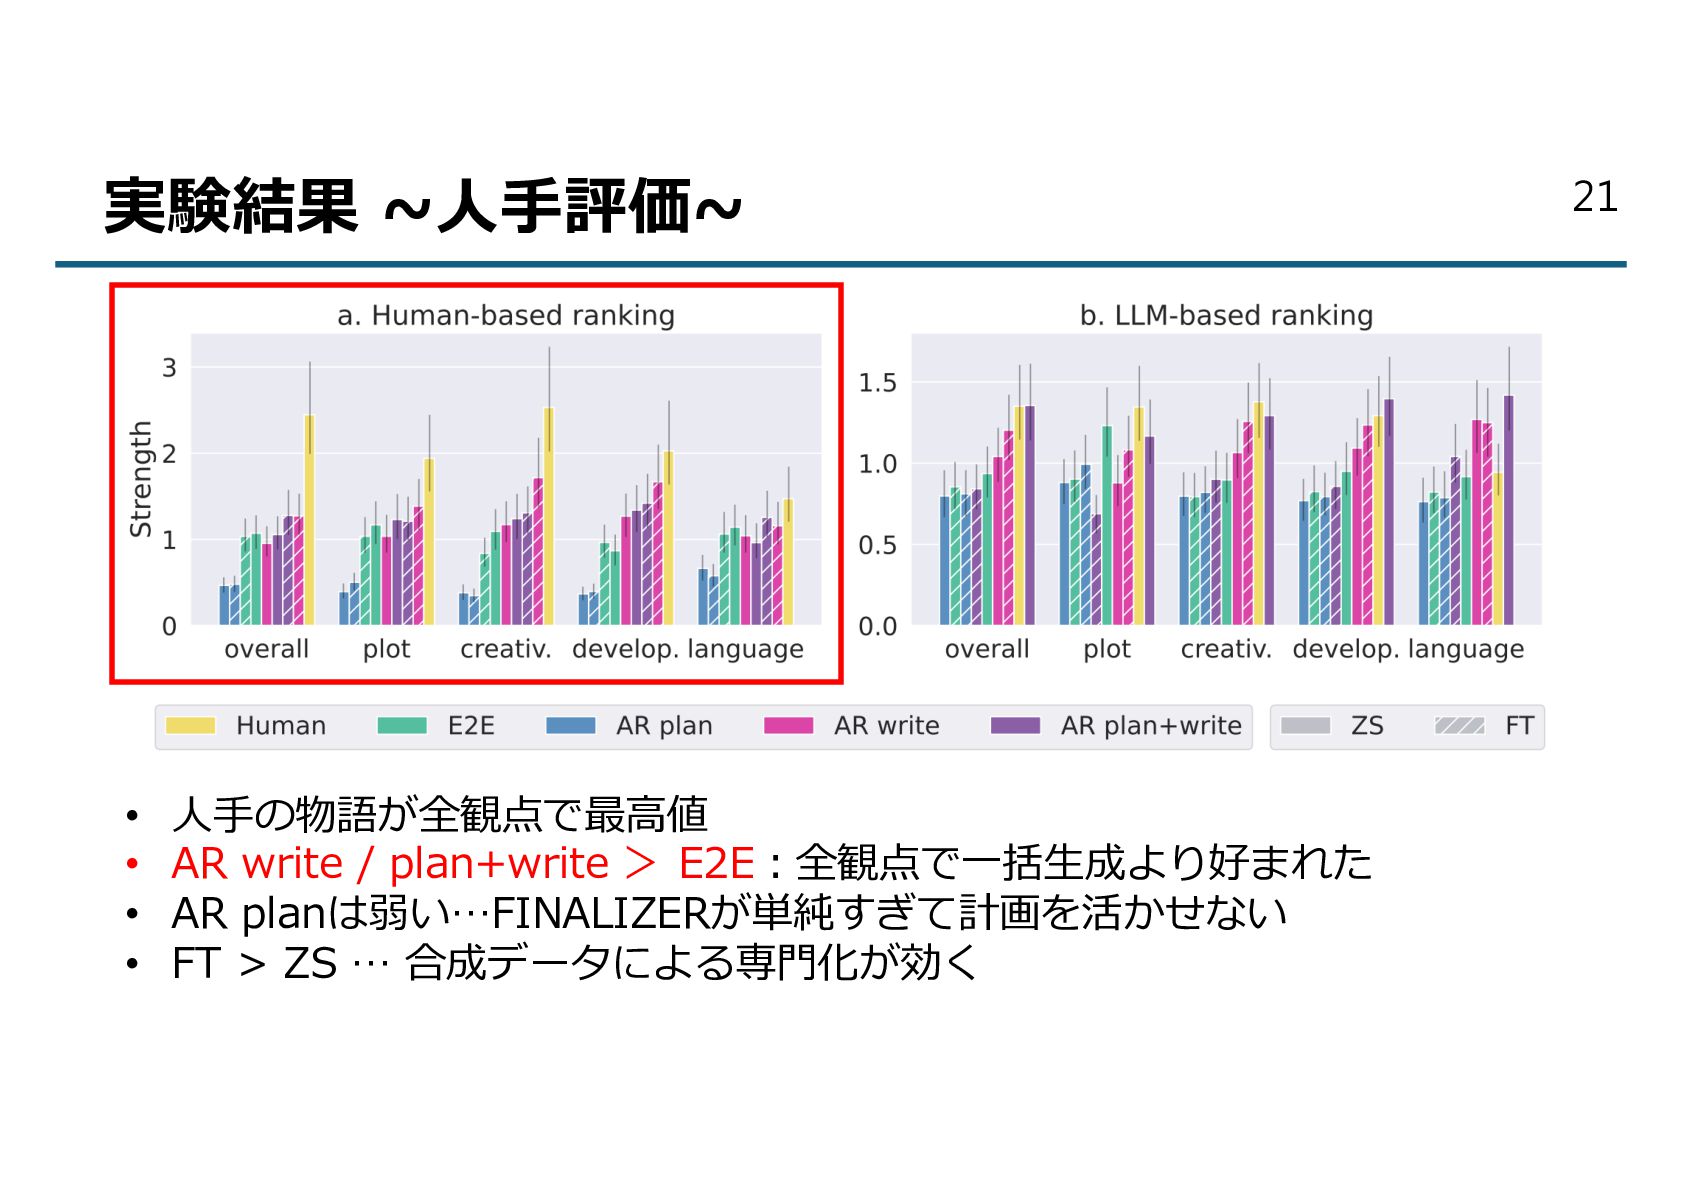
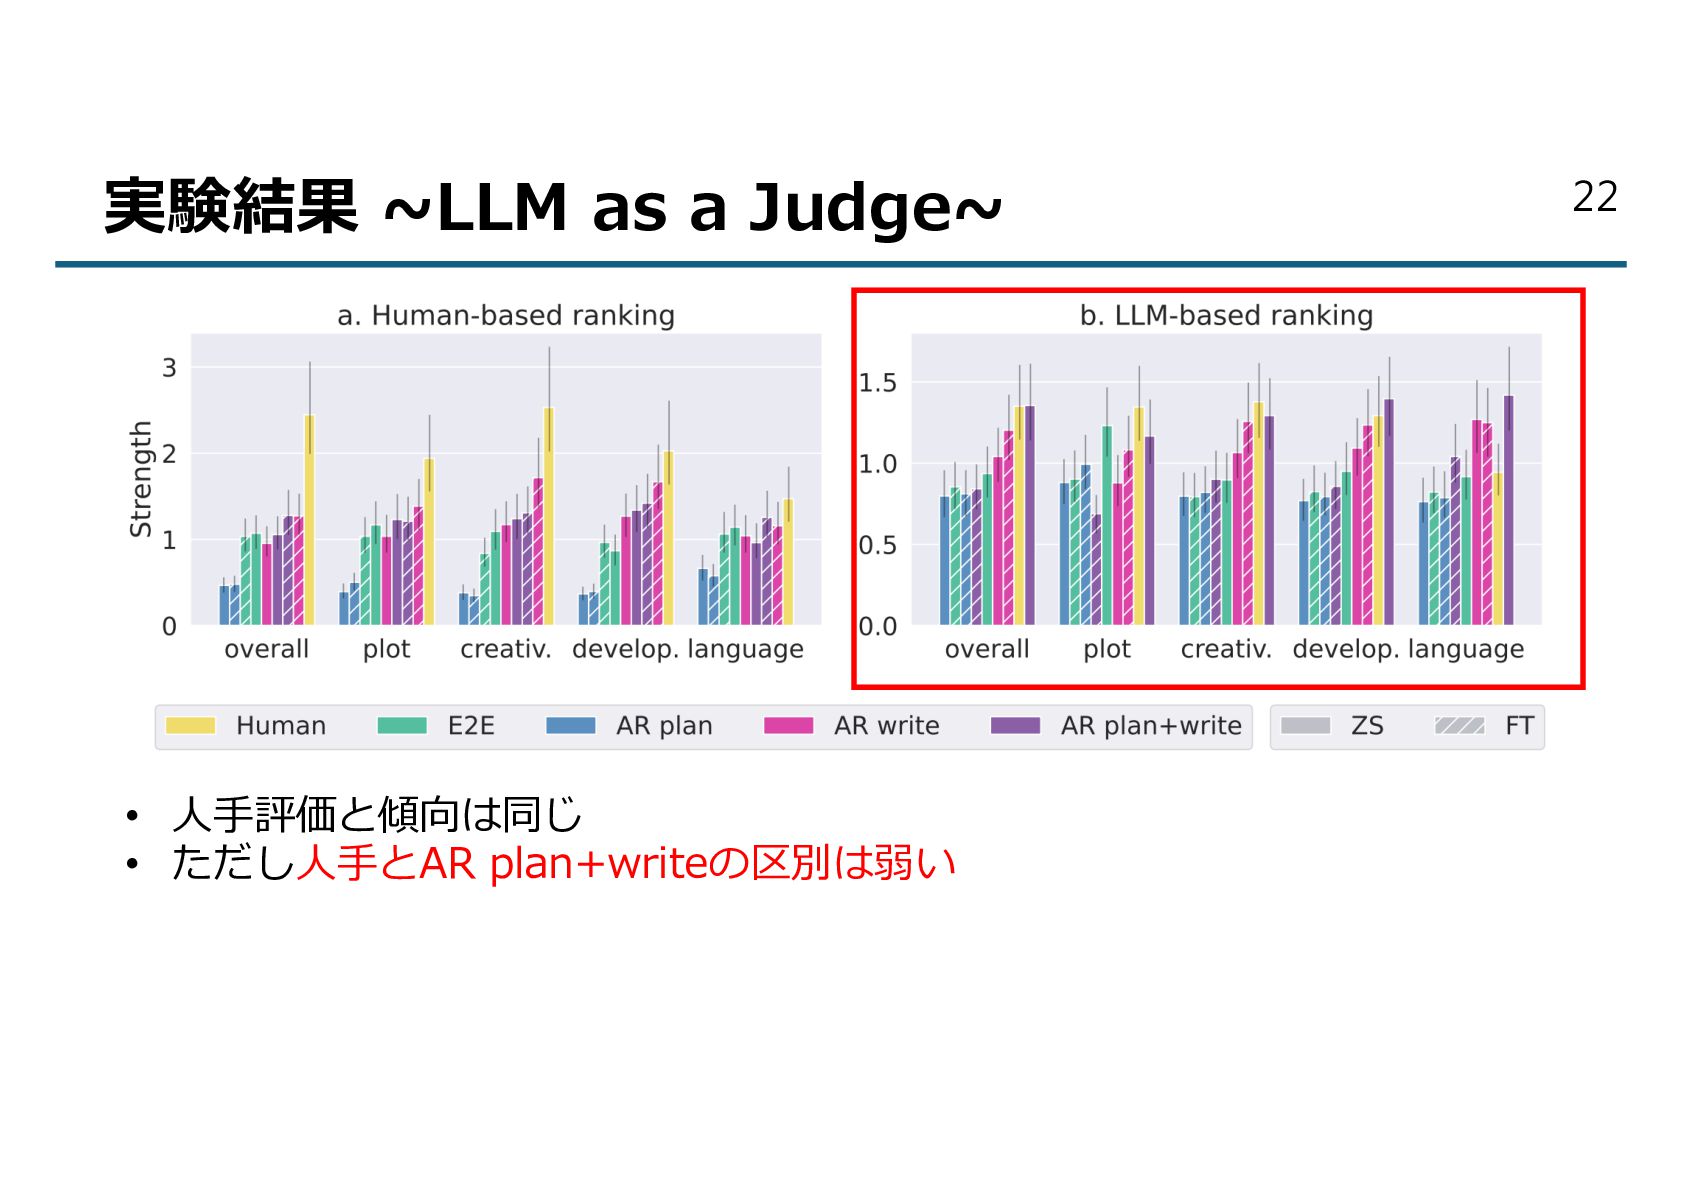
  13. 実験結果 ~⼈⼿評価~ • • • • ⼈⼿の物語が全観点で最⾼値 AR write /

    plan+write > E2E︓全観点で⼀括⽣成より好まれた AR planは弱い…FINALIZERが単純すぎて計画を活かせない FT > ZS … 合成データによる専⾨化が効く 2 21 1
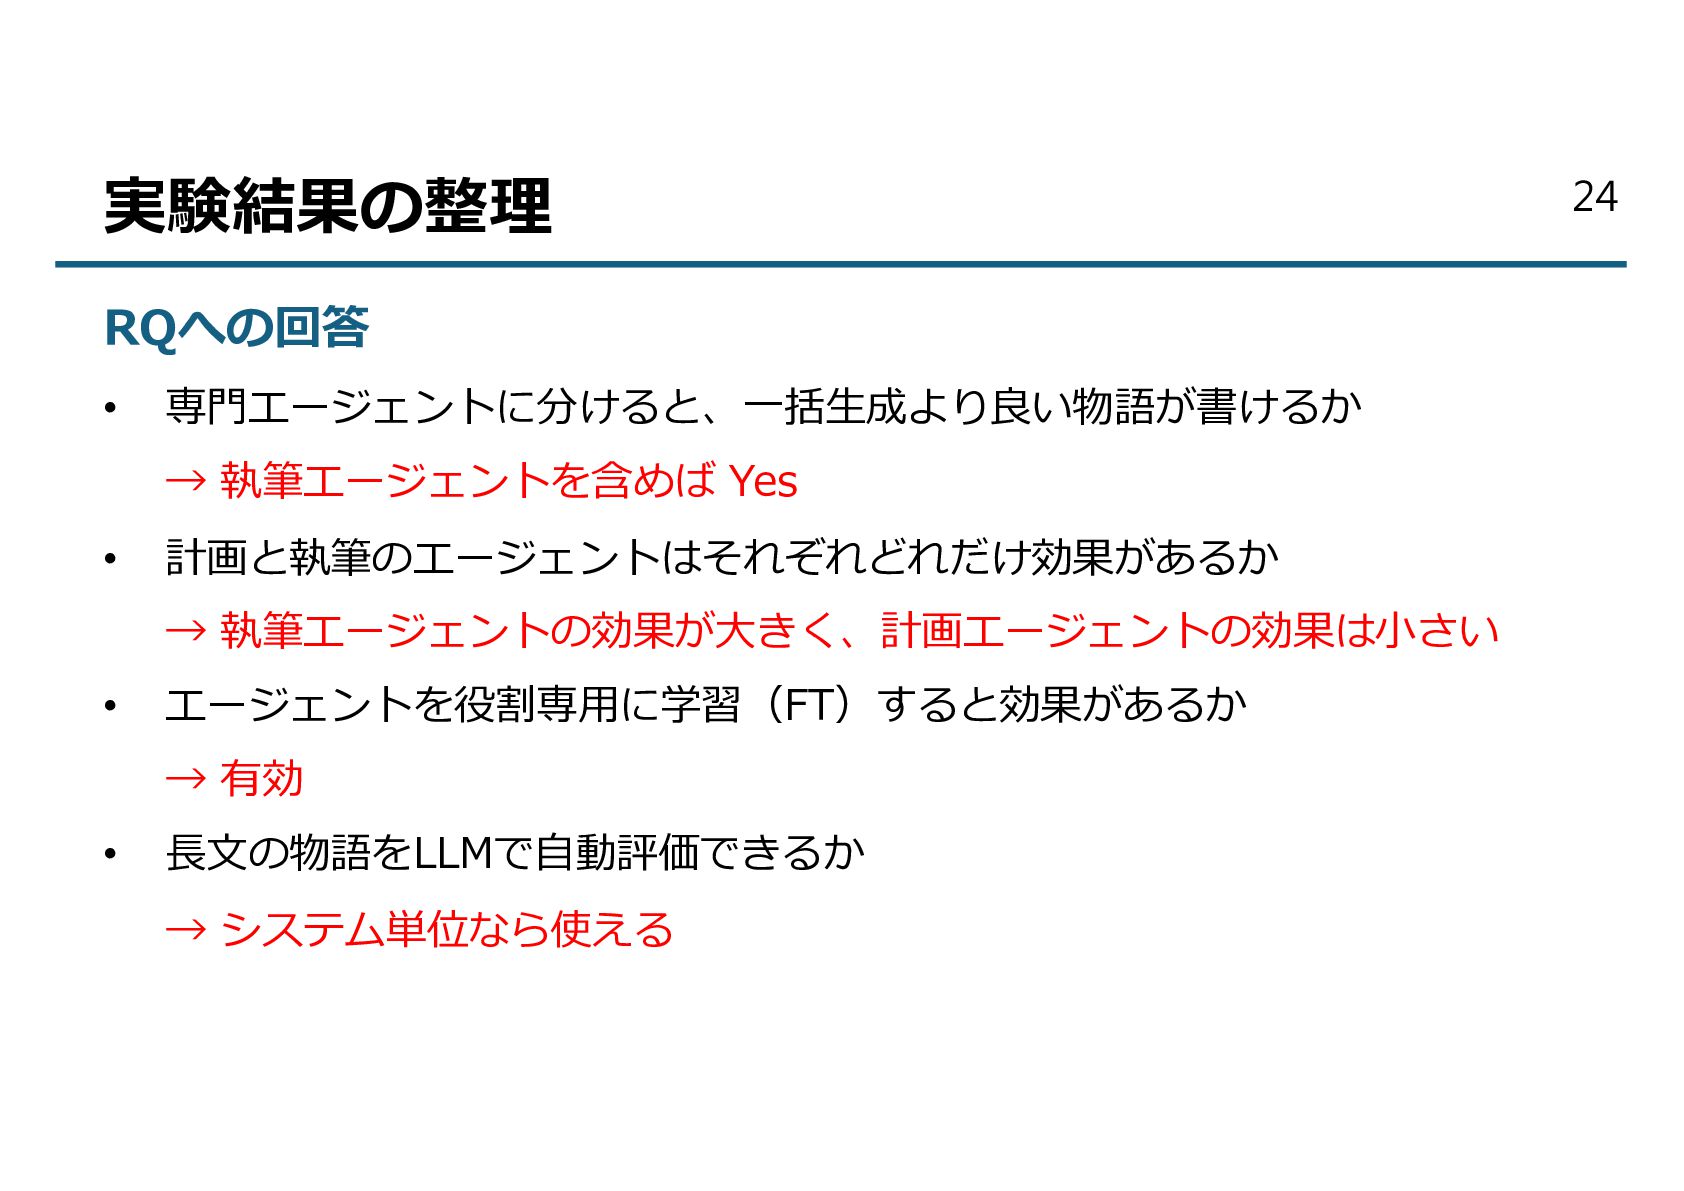
  14. 実験結果の整理 RQへの回答 • 専⾨エージェントに分けると、⼀括⽣成より良い物語が書けるか → 執筆エージェントを含めば Yes • 計画と執筆のエージェントはそれぞれどれだけ効果があるか →

    執筆エージェントの効果が⼤きく、計画エージェントの効果は⼩さい • エージェントを役割専⽤に学習(FT)すると効果があるか → 有効 • ⻑⽂の物語をLLMで⾃動評価できるか → システム単位なら使える 2 24 4
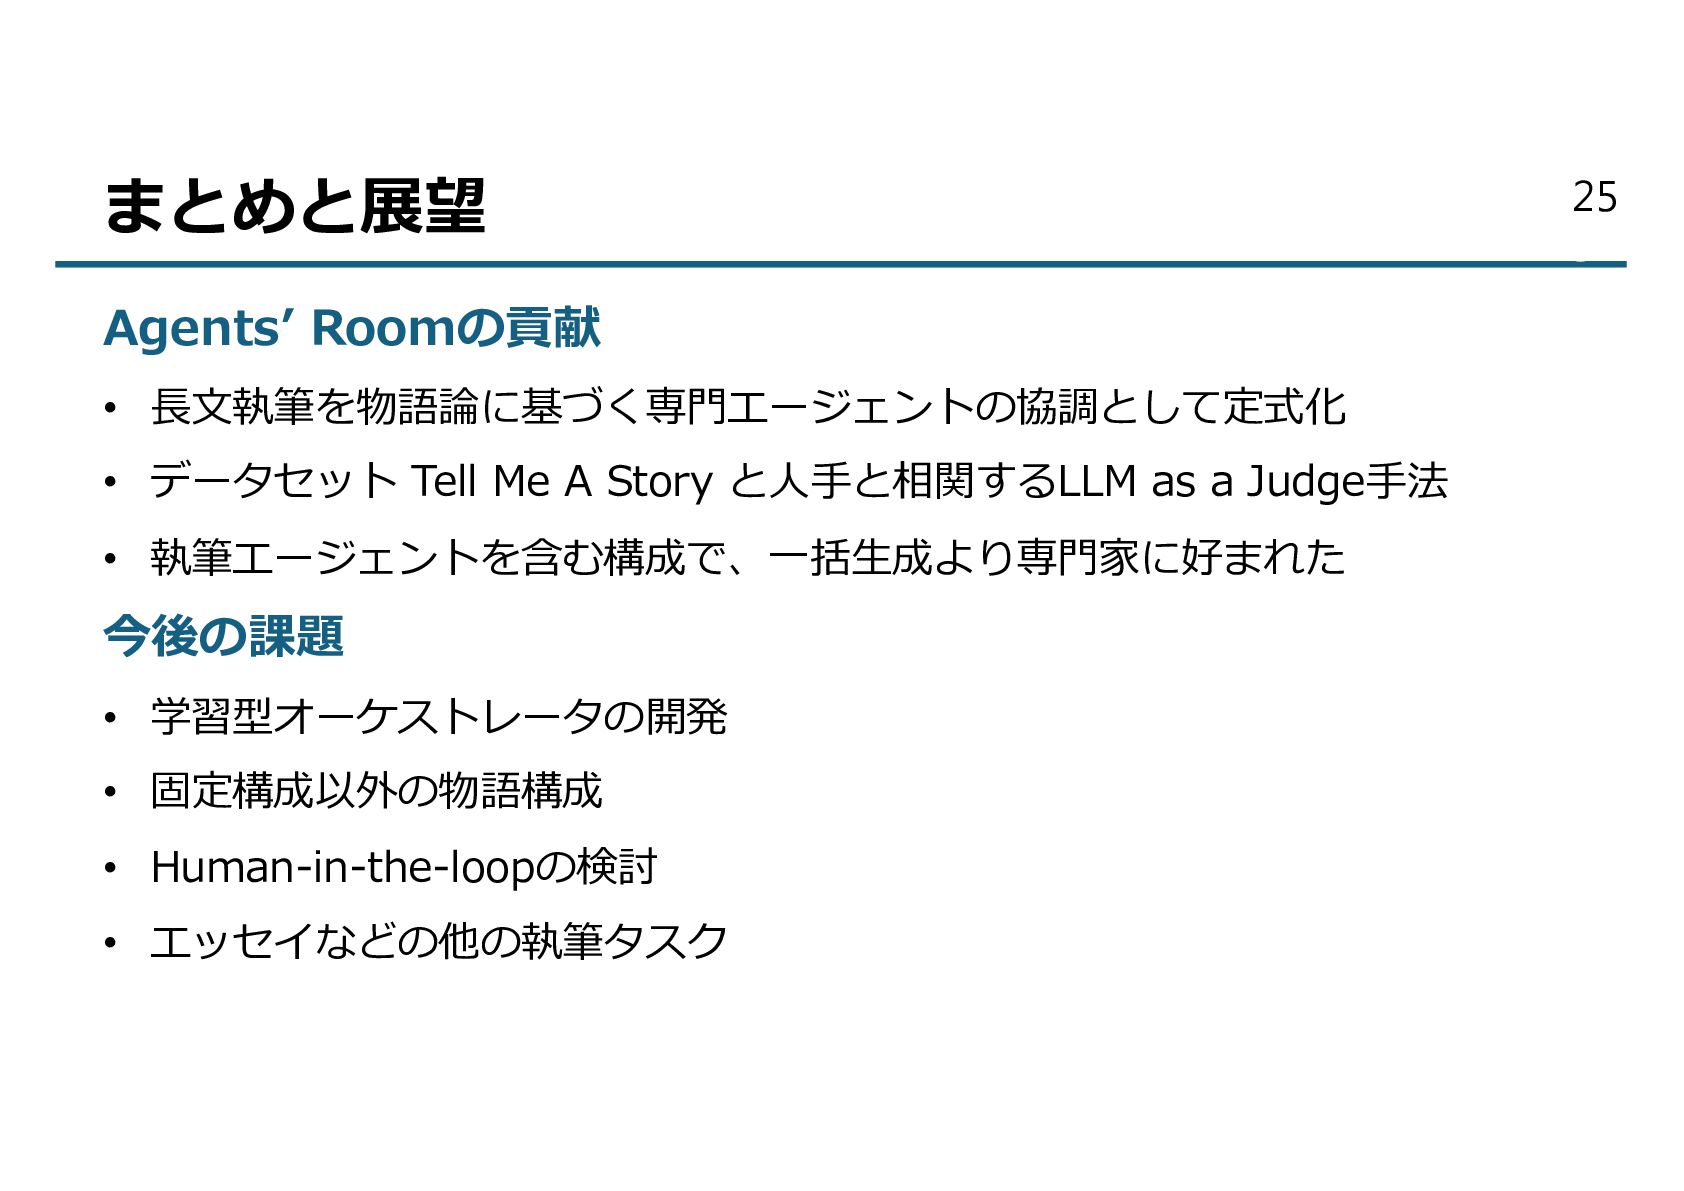
  15. まとめと展望 Agentsʼ Roomの貢献 • ⻑⽂執筆を物語論に基づく専⾨エージェントの協調として定式化 • データセット Tell Me A

    Story と⼈⼿と相関するLLM as a Judge⼿法 • 執筆エージェントを含む構成で、⼀括⽣成より専⾨家に好まれた 今後の課題 • 学習型オーケストレータの開発 • 固定構成以外の物語構成 • Human-in-the-loopの検討 • エッセイなどの他の執筆タスク 2 25 5
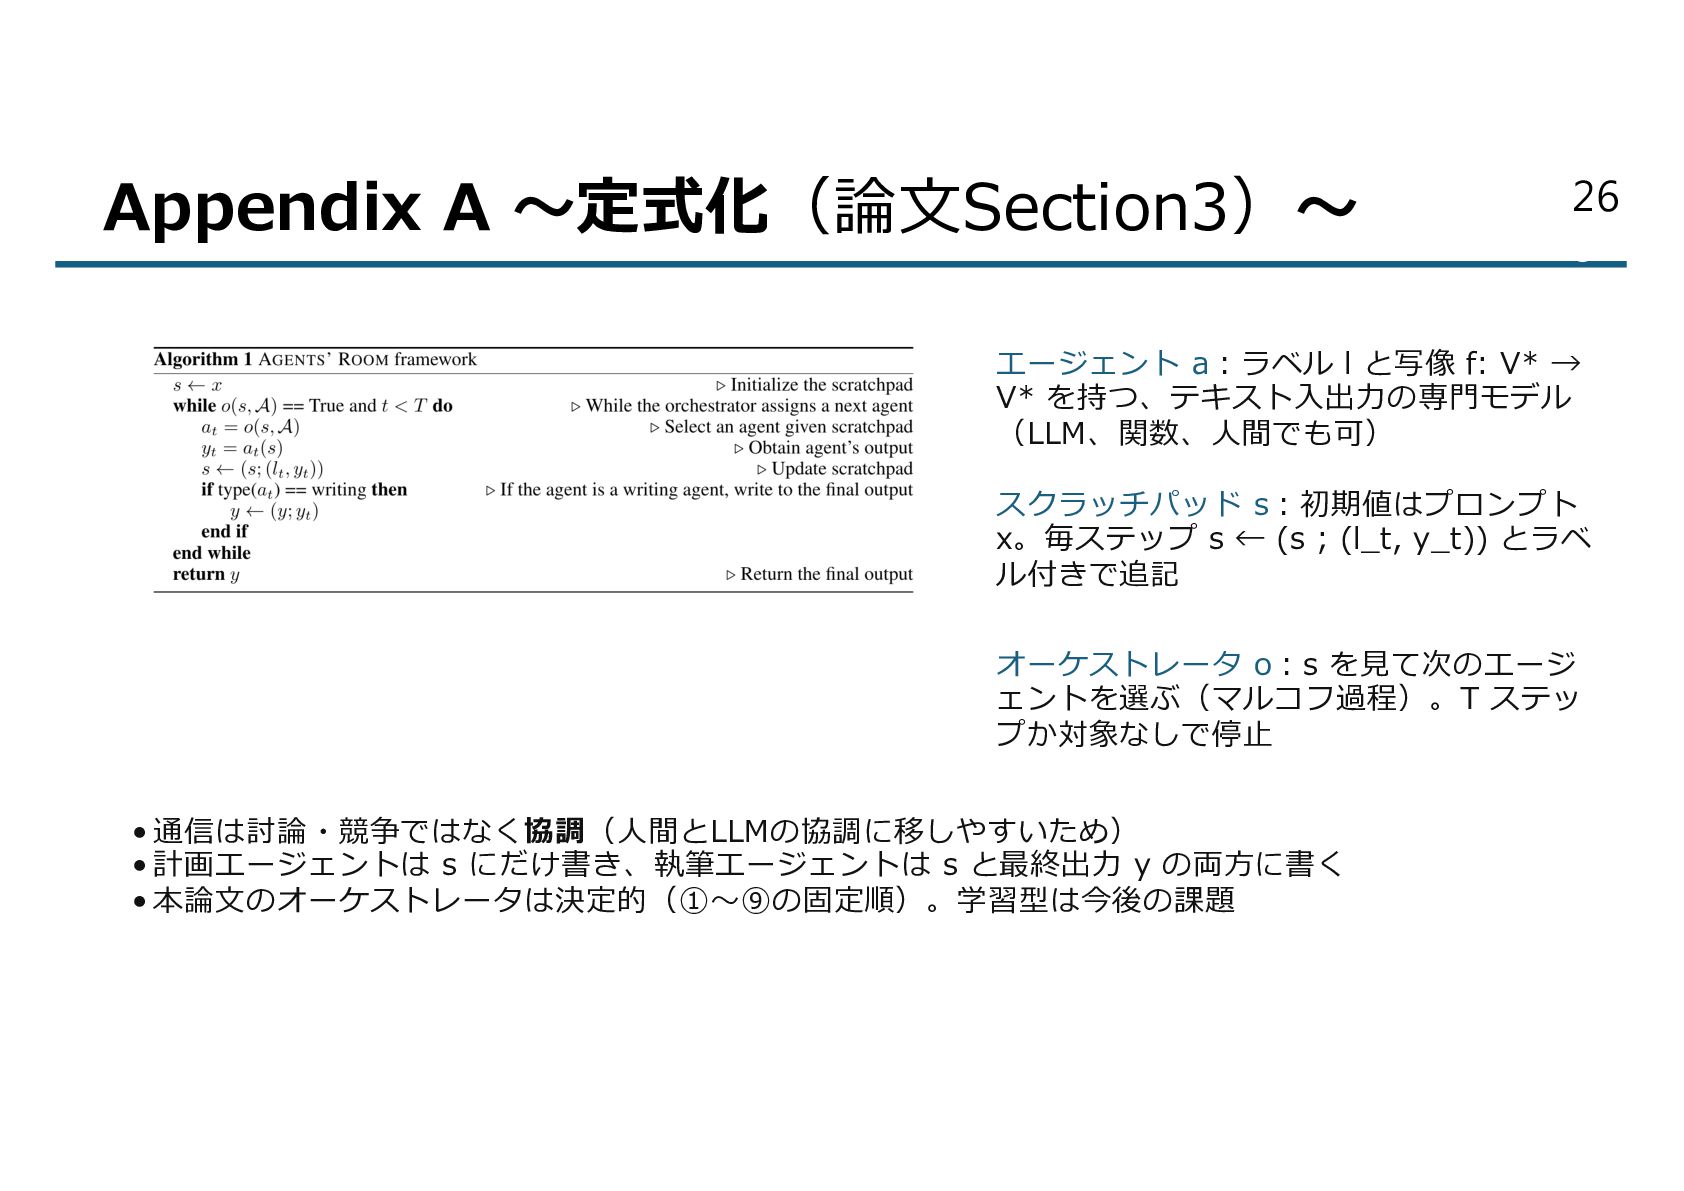
  16. Appendix A 〜定式化(論⽂Section3)〜 2 26 6 エージェント a︓ラベル l と写像

    f: V* → V* を持つ、テキスト⼊出⼒の専⾨モデル (LLM、関数、⼈間でも可) スクラッチパッド s︓初期値はプロンプト x。毎ステップ s ← (s ; (l_t, y_t)) とラベ ル付きで追記 オーケストレータ o︓s を⾒て次のエージ ェントを選ぶ(マルコフ過程)。T ステッ プか対象なしで停⽌ • 通信は討論・競争ではなく協調(⼈間とLLMの協調に移しやすいため) • 計画エージェントは s にだけ書き、執筆エージェントは s と最終出⼒ y の両⽅に書く • 本論⽂のオーケストレータは決定的(①〜⑨の固定順)。学習型は今後の課題
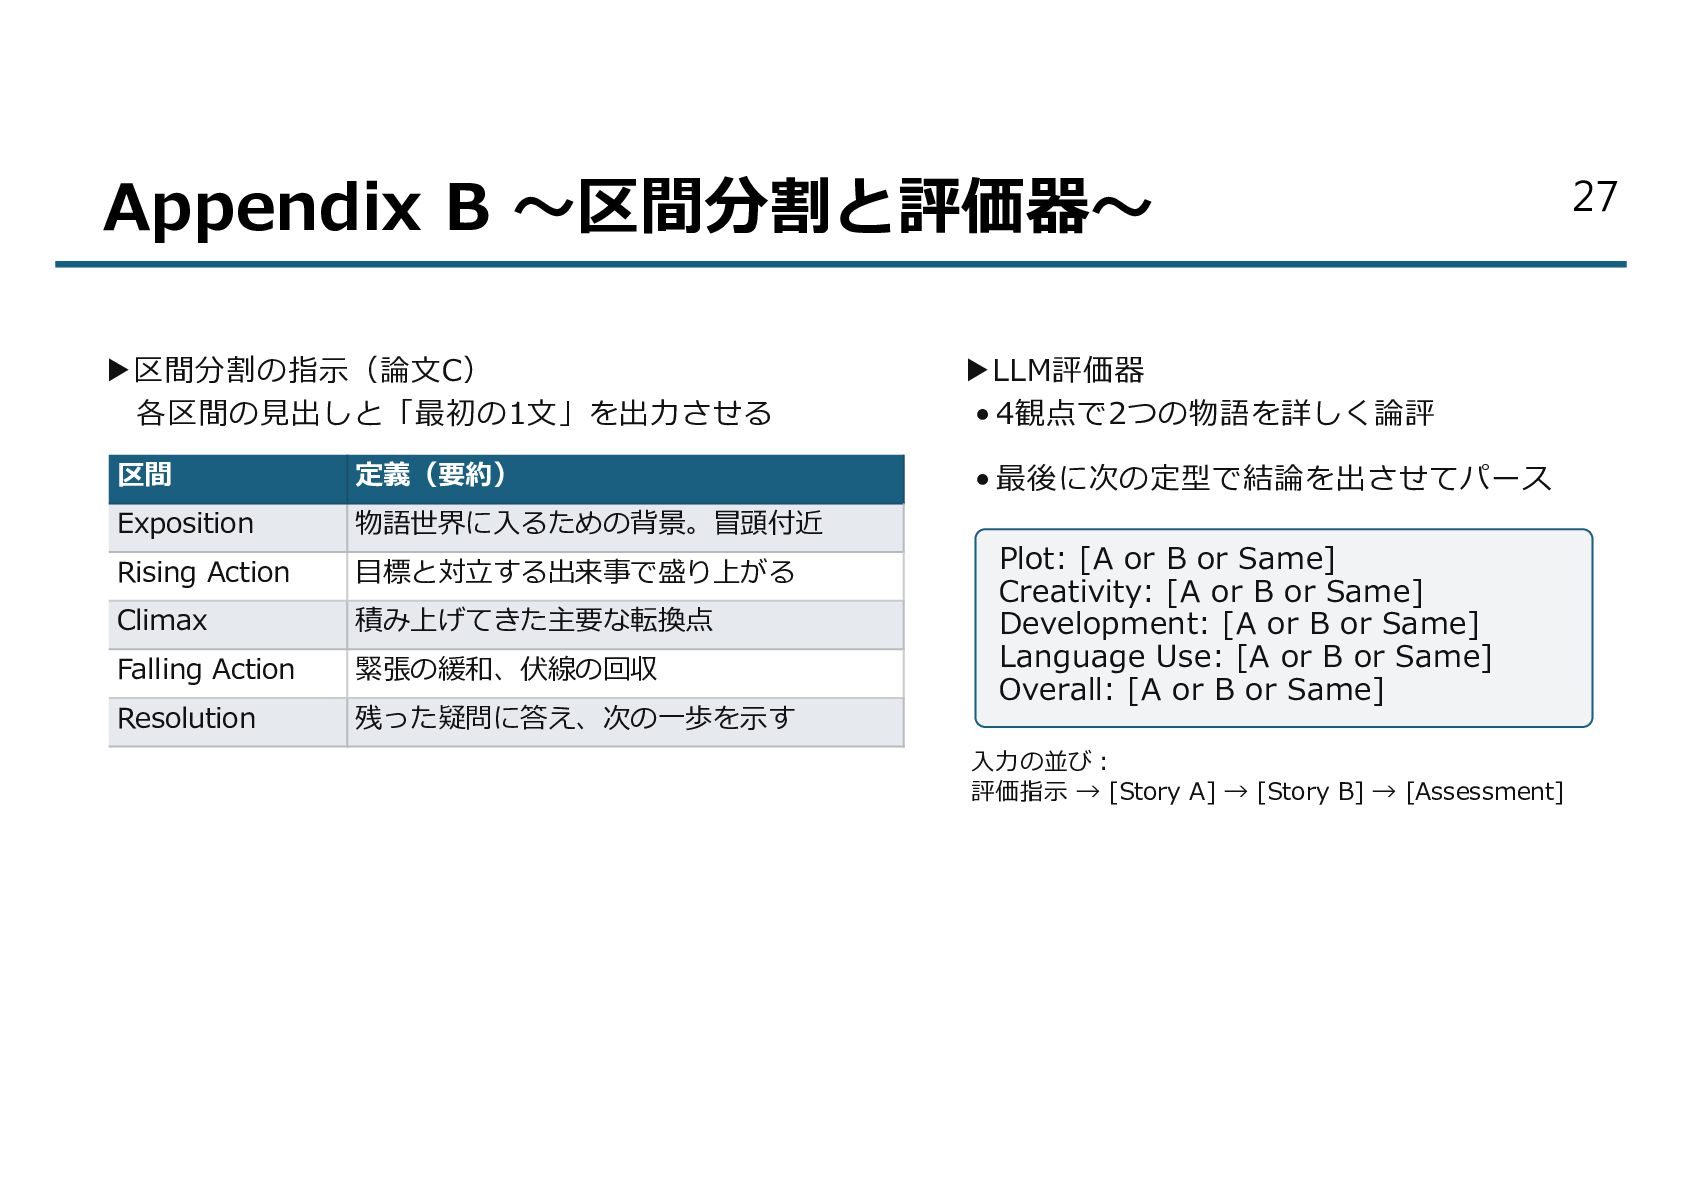
  17. Appendix B 〜区間分割と評価器〜 ▶区間分割の指⽰(論⽂C) 各区間の⾒出しと「最初の1⽂」を出⼒させる ▶LLM評価器 • 4観点で2つの物語を詳しく論評 区間 定義(要約)

    • 最後に次の定型で結論を出させてパース Exposition 物語世界に⼊るための背景。冒頭付近 Rising Action ⽬標と対⽴する出来事で盛り上がる Climax 積み上げてきた主要な転換点 Falling Action 緊張の緩和、伏線の回収 Resolution 残った疑問に答え、次の⼀歩を⽰す Plot: [A or B or Same] Creativity: [A or B or Same] Development: [A or B or Same] Language Use: [A or B or Same] Overall: [A or B or Same] ⼊⼒の並び︓ 評価指⽰ → [Story A] → [Story B] → [Assessment] 2 27 7

More Decks by Arai M

Other Decks in Research