Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
在庫の最適化を実現する SaaSデータ基盤の裏側
Search
Atsushi Yokota
December 12, 2023
Programming
260
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
在庫の最適化を実現する SaaSデータ基盤の裏側
[大阪オフィス現地開催] 目指せ日本の西海岸!関西スタートアップの AWS 活用事例 登壇資料
Atsushi Yokota
December 12, 2023
More Decks by Atsushi Yokota
See All by Atsushi Yokota
Athenaで実現する時系列データのパフォーマンス改善
atsuyokota
0
250
Rust on Lambda 大きめCSV生成
atsuyokota
3
1.6k
Other Decks in Programming
See All in Programming
iOSDCのペンライトを自動制御したい!
akkeylab
0
140
Turning Architecture into Unit Tests in the AI Era (NSSpain XIV)
steliosf
PRO
1
120
[ハンズオン]AIへの指示だけで「五目並べ」を作ってみよう
satoshi256kbyte
1
290
Intent as Code
shoppingjaws
6
1.1k
Go × SIMDで高速化するベクトル検索 ~ルーフラインモデルでSIMDが効く境界を探れ! ~
po3rin
1
4.8k
速習iPhone Duo対応
yuukiw00w
2
880
Are APIs Still Relevant in the AI Era?
soyuka
0
360
難しいけど、読めた。- OSSの入口に立った話。
sts11142
0
130
モデルのリファクタリングが難しいと思ったら、そもそも複雑だったのはビジネス仕様だった ? / is-the-business-domain-the-real-complexity
hatsu38
0
420
JAWS-UG 東京支部が始める、JAWS-UG支部コラボ / JAWS-UG lunchtime LT Collaboration
y0hgi
0
170
TiDB Cloudのカスタムコントローラーによるオートスケール対応
takaidohigasi
0
140
AGENTS.md Is Not Enough: Build Skills, Don't Download Them
lx_t
0
130
Featured
See All Featured
Helping Users Find Their Own Way: Creating Modern Search Experiences
danielanewman
31
3.4k
DBのスキルで生き残る技術 - AI時代におけるテーブル設計の勘所
soudai
PRO
68
58k
CoffeeScript is Beautiful & I Never Want to Write Plain JavaScript Again
sstephenson
162
16k
The Psychology of Web Performance [Beyond Tellerrand 2023]
tammyeverts
49
3.6k
The Cost Of JavaScript in 2023
addyosmani
55
10k
Marketing to machines
jonoalderson
1
5.8k
Reality Check: Gamification 10 Years Later
codingconduct
0
2.3k
Code Reviewing Like a Champion
maltzj
528
40k
Heart Work Chapter 1 - Part 1
lfama
PRO
10
36k
Practical Tips for Bootstrapping Information Extraction Pipelines
honnibal
25
2.1k
Prompt Engineering for Job Search
mfonobong
0
460
Become a Pro
speakerdeck
PRO
31
6.3k
Transcript
在庫の最適化を実現する SaaSデータ基盤の裏側 フルカイテン株式会社 横田
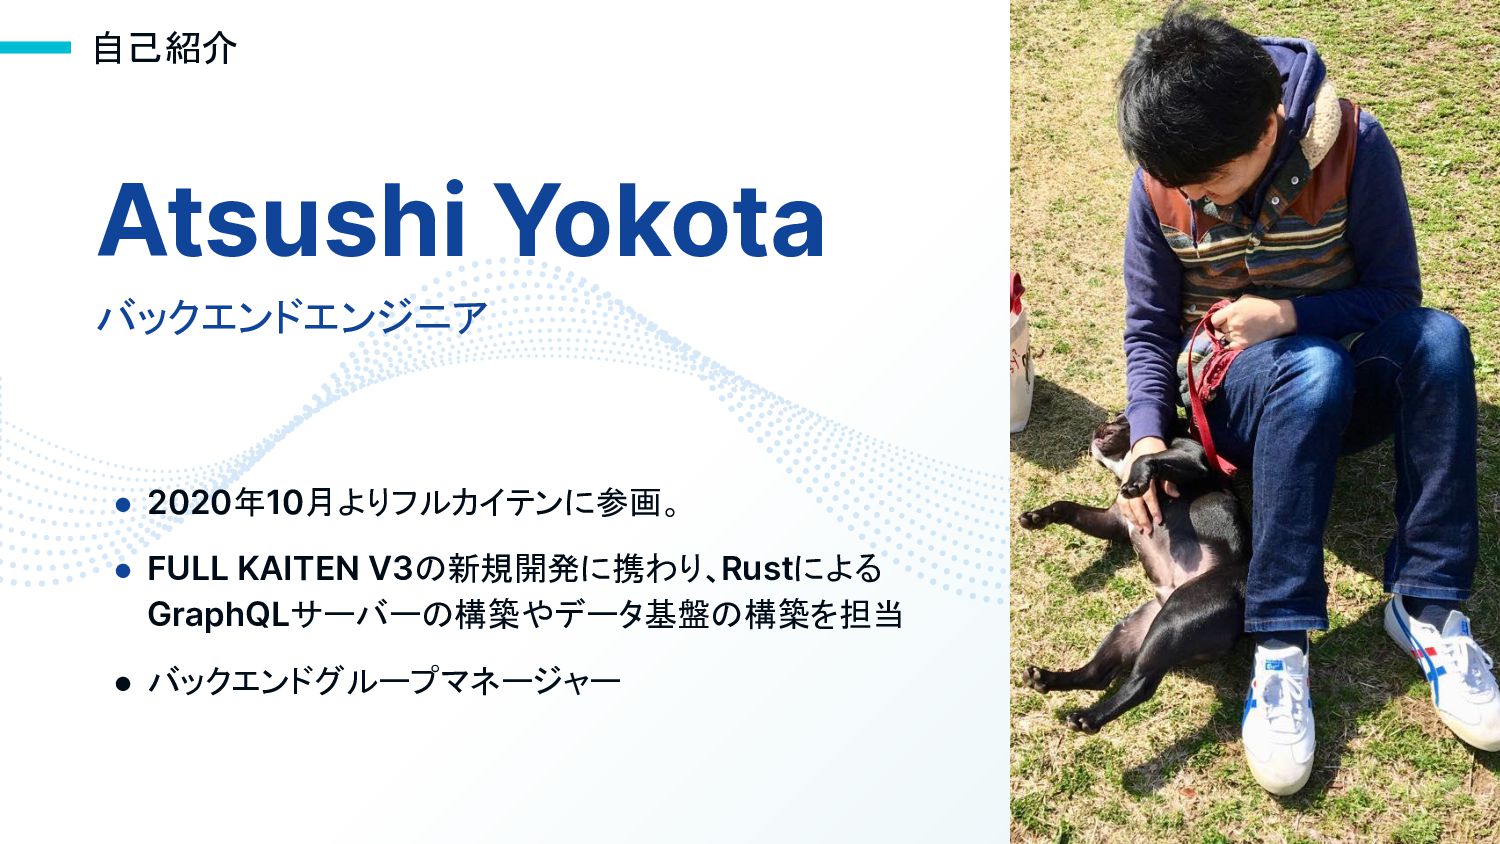
Atsushi Yokota バックエンドエンジニア 2 • 2020年10月よりフルカイテンに参画。 • FULL KAITEN V3の新規開発に携わり、Rustによる
GraphQLサーバーの構築やデータ基盤の構築を担当 • バックエンドグループマネージャー 自己紹介
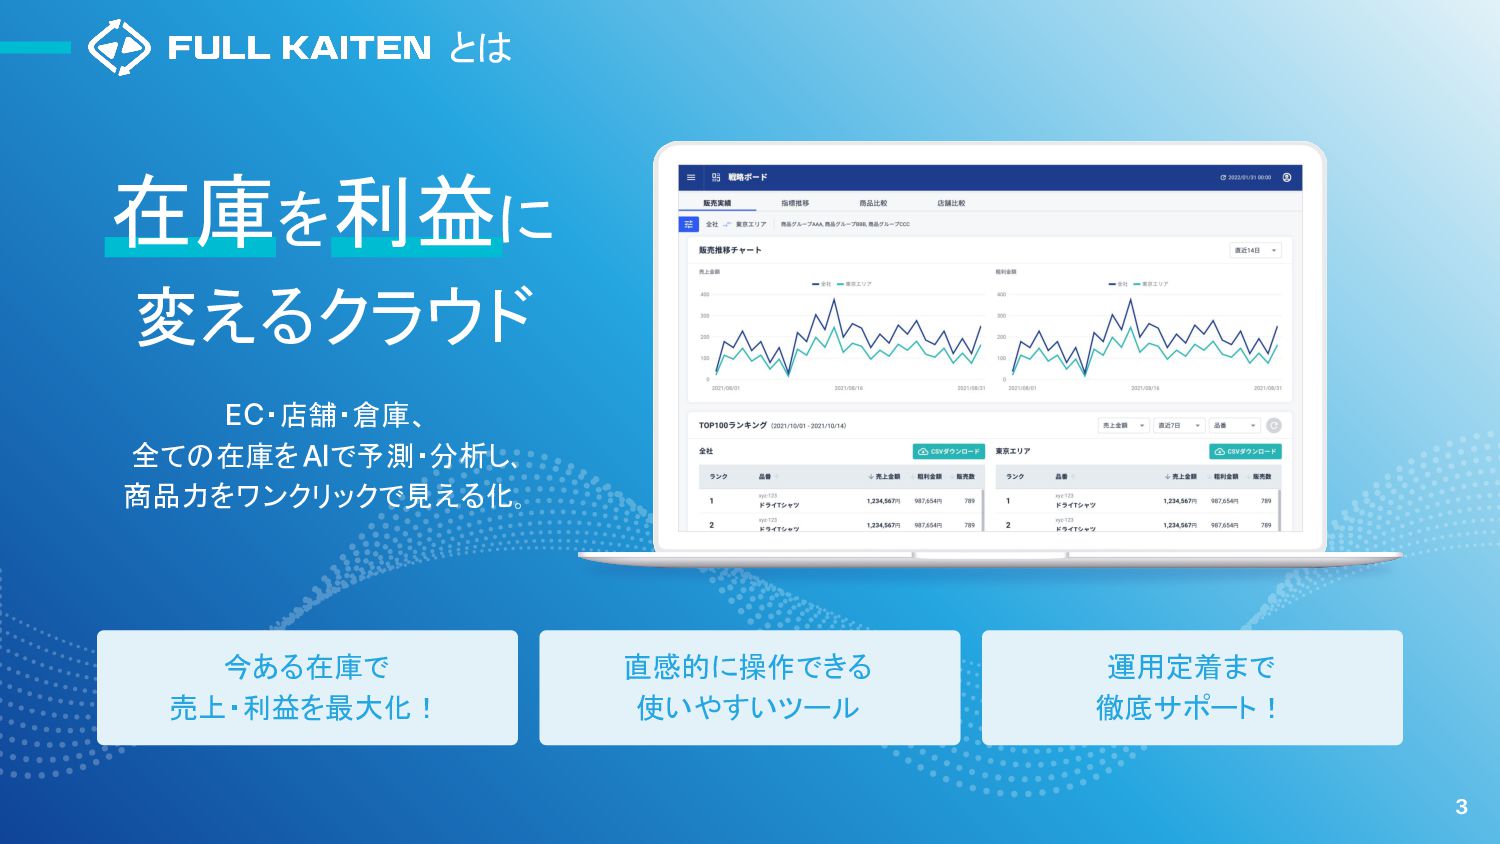
3 在庫を利益に 変えるクラウド 今ある在庫で 売上・利益を最大化! 直感的に操作できる 使いやすいツール 運用定着まで 徹底サポート! EC・店舗・倉庫、
全ての在庫をAIで予測・分析し、 商品力をワンクリックで見える化。 とは
4 導入実績 ※一部抜粋/順不同 ※2023年10月時点
1. データ基盤の重要ポイント 2. リリース当初のアーキテクチャー 3. 刷新後のアーキテクチャー 4. 刷新の結果 5. 今後の展望
Agenda
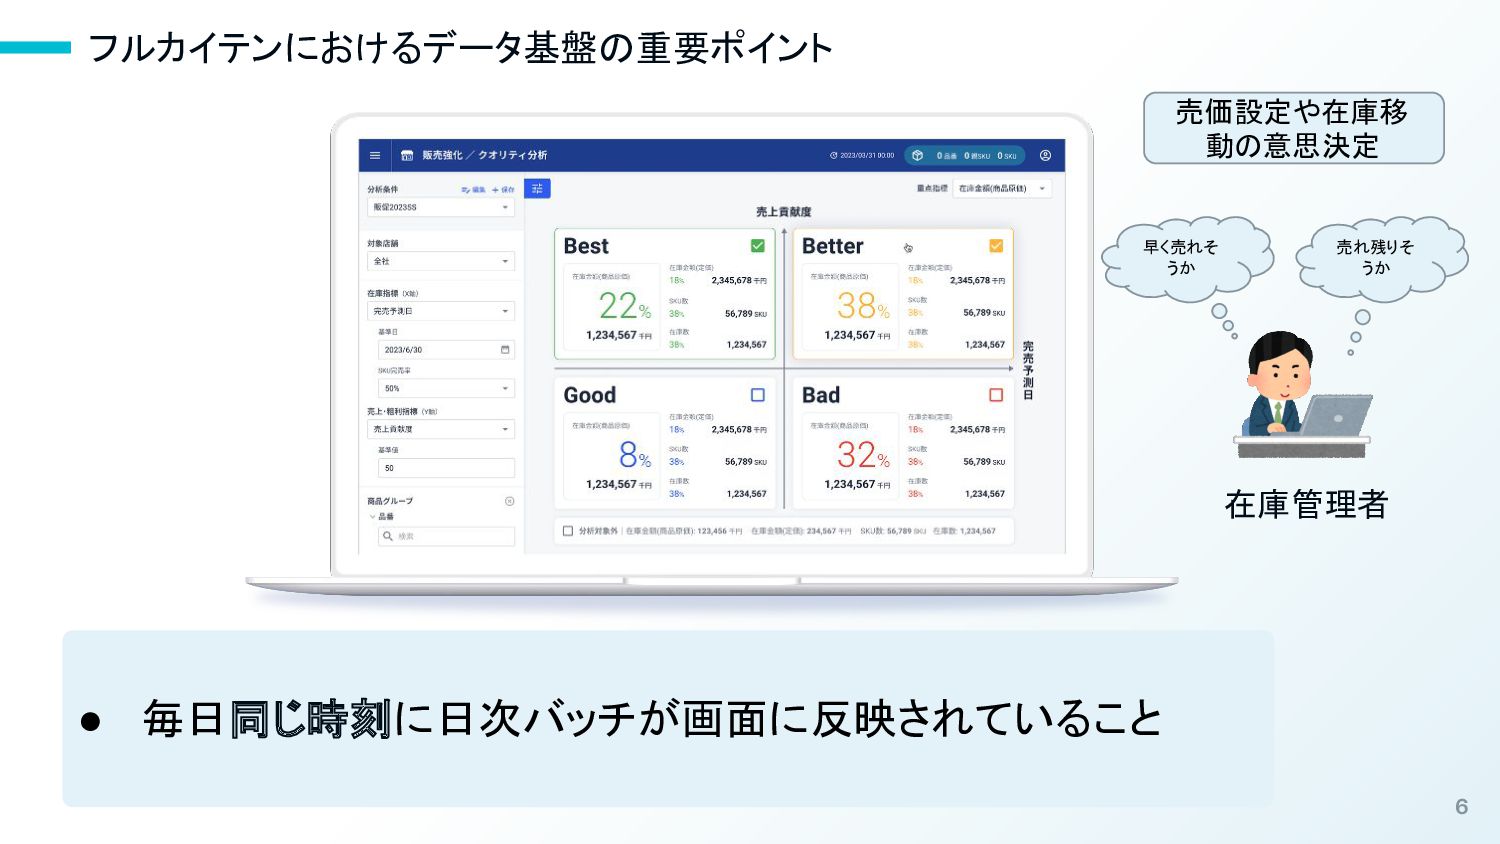
6 フルカイテンにおけるデータ基盤の重要ポイント • 毎日同じ時刻に日次バッチが画面に反映されていること 在庫管理者 売価設定や在庫移 動の意思決定 早く売れそ うか 売れ残りそ
うか
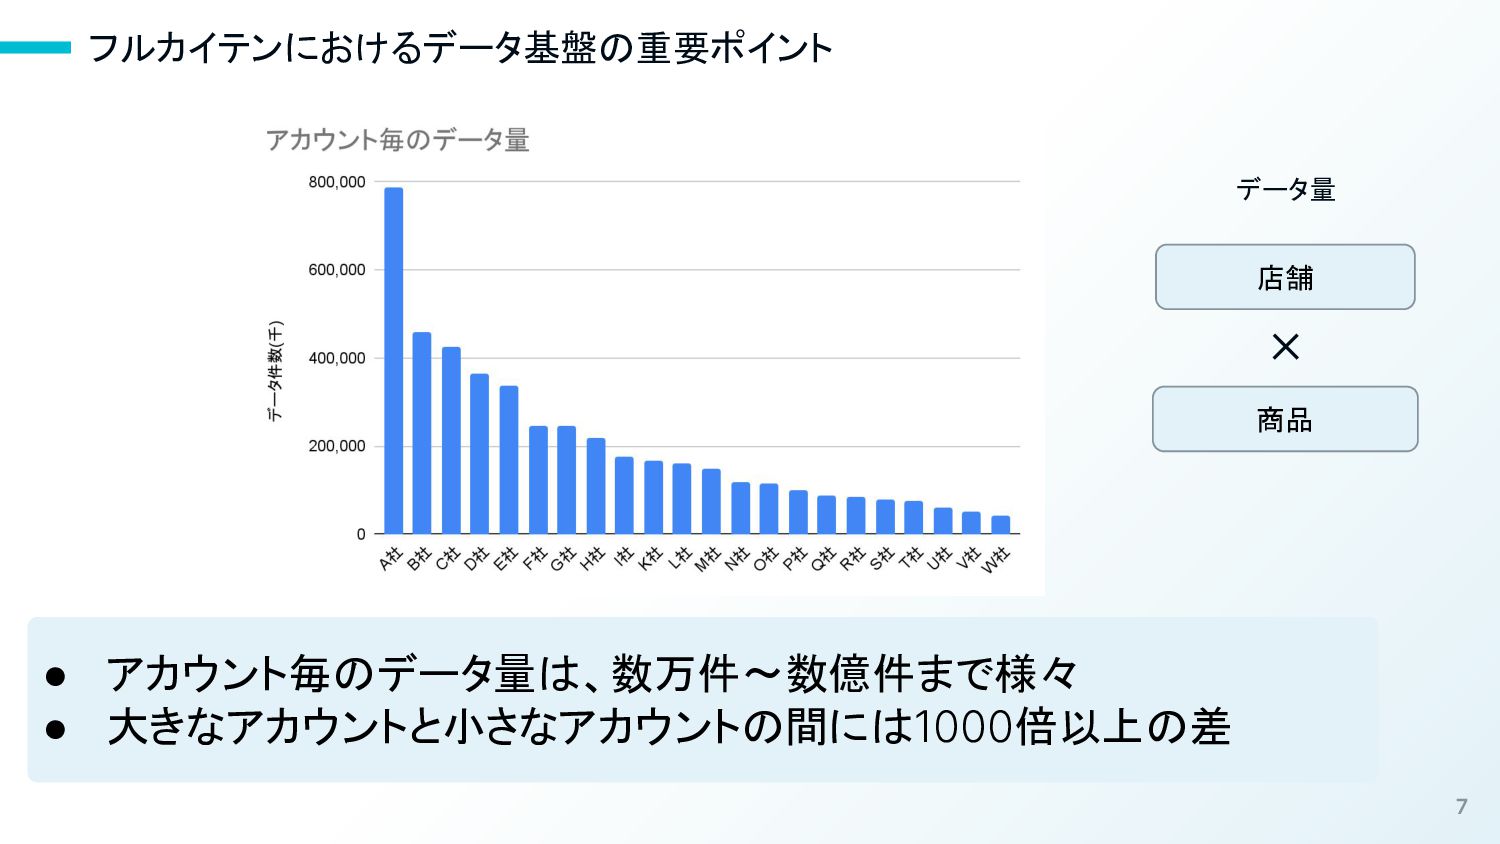
7 フルカイテンにおけるデータ基盤の重要ポイント • アカウント毎のデータ量は、数万件〜数億件まで様々 • 大きなアカウントと小さなアカウントの間には1000倍以上の差 店舗 商品 ✕ データ量
8 リリース当初のデータ基盤概要(2021年5月〜)
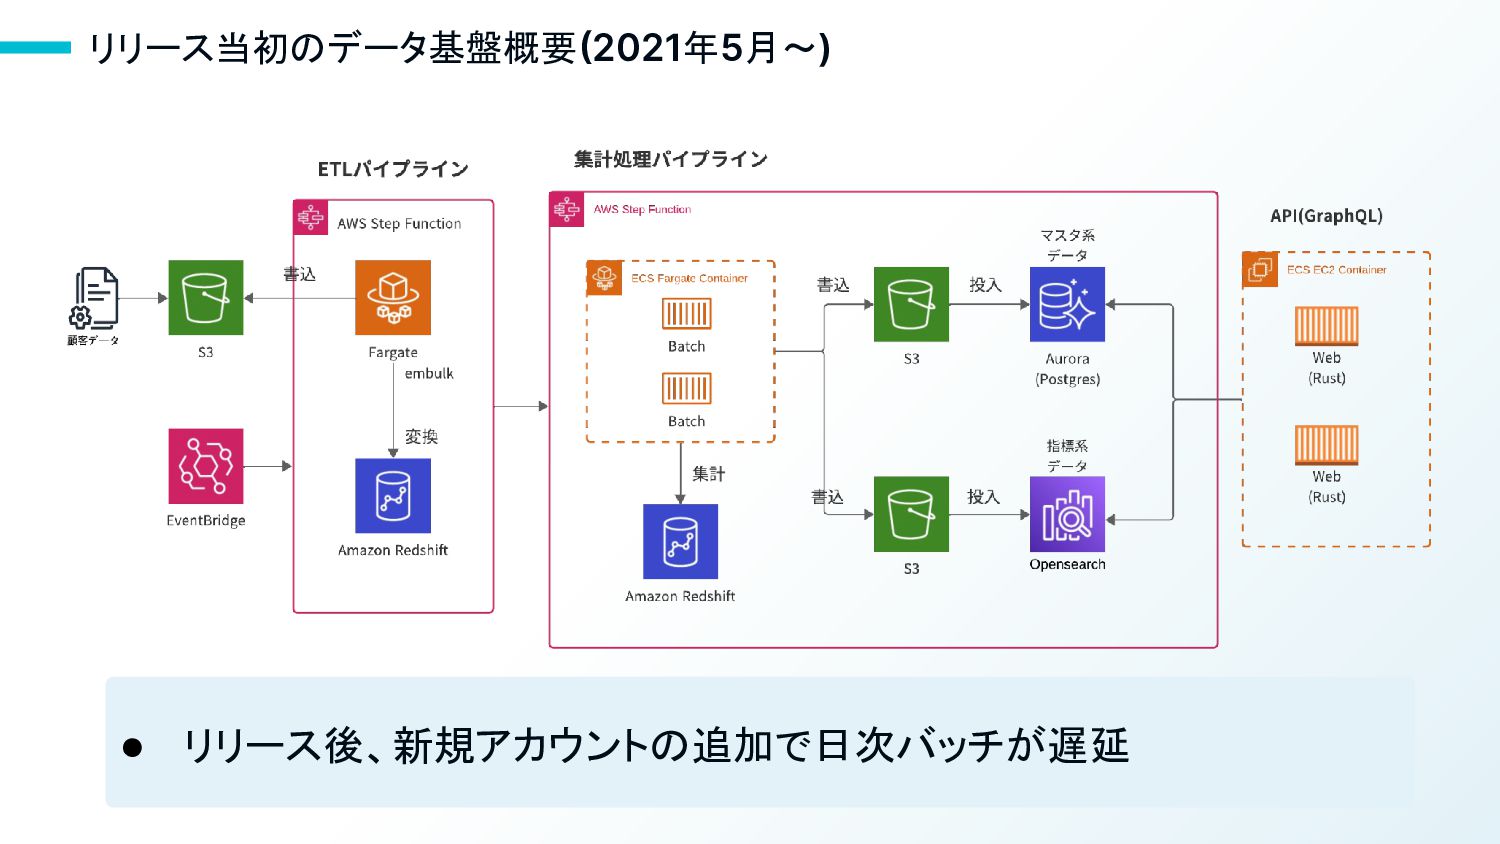
リリース当初のデータ基盤概要(2021年5月〜) • リリース後、新規アカウントの追加で日次バッチが遅延
日次バッチが遅延した原因(1) Redshiftの集計処理でクエリ遅延が発生
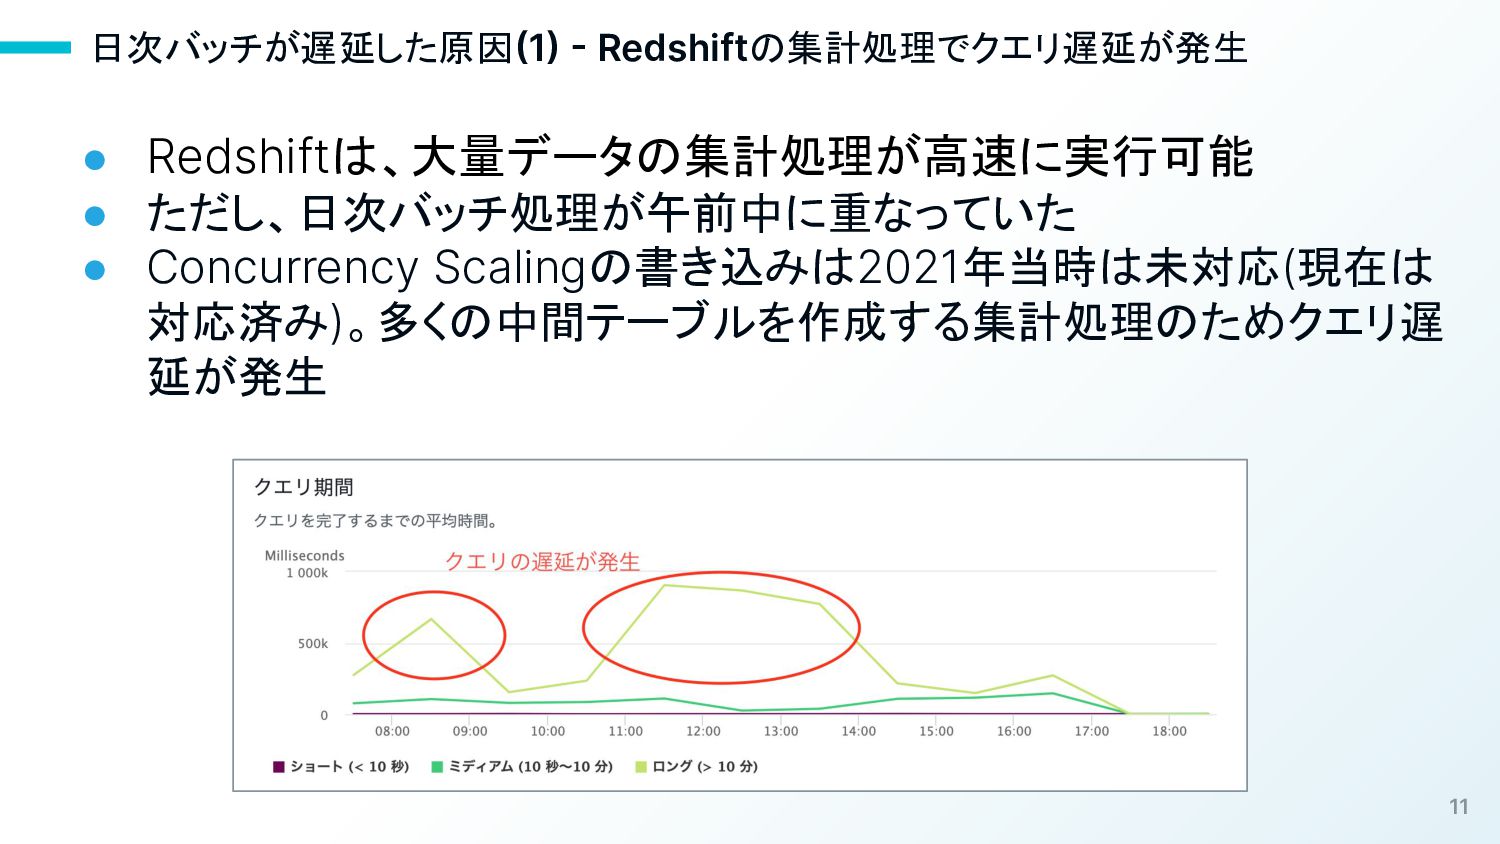
11 日次バッチが遅延した原因(1) - Redshiftの集計処理でクエリ遅延が発生 • Redshiftは、大量データの集計処理が高速に実行可能 • ただし、日次バッチ処理が午前中に重なっていた • Concurrency
Scalingの書き込みは2021年当時は未対応(現在は 対応済み)。多くの中間テーブルを作成する集計処理のためクエリ遅 延が発生
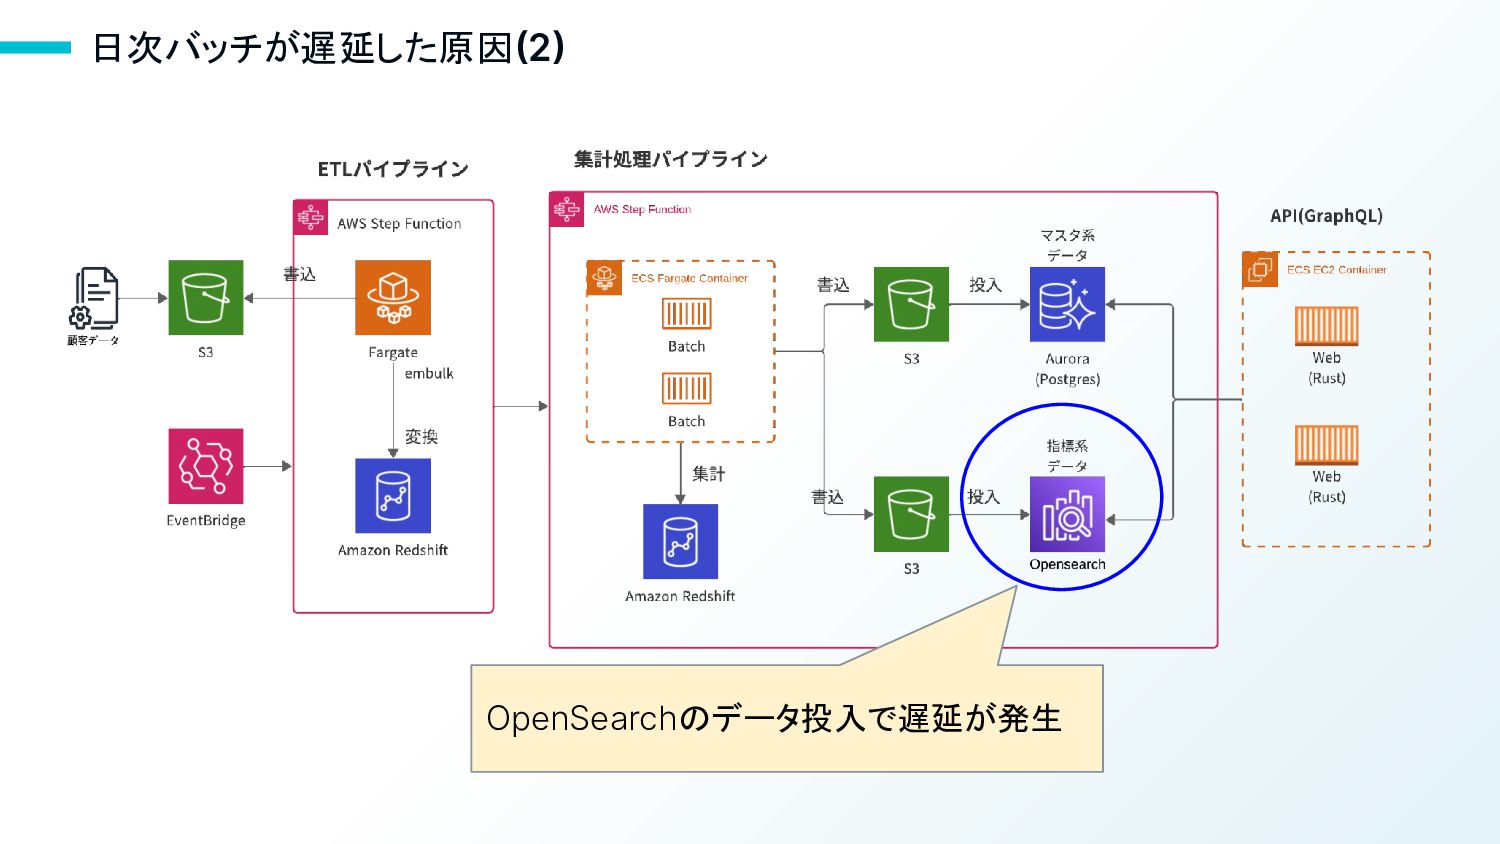
日次バッチが遅延した原因(2) OpenSearchのデータ投入で遅延が発生
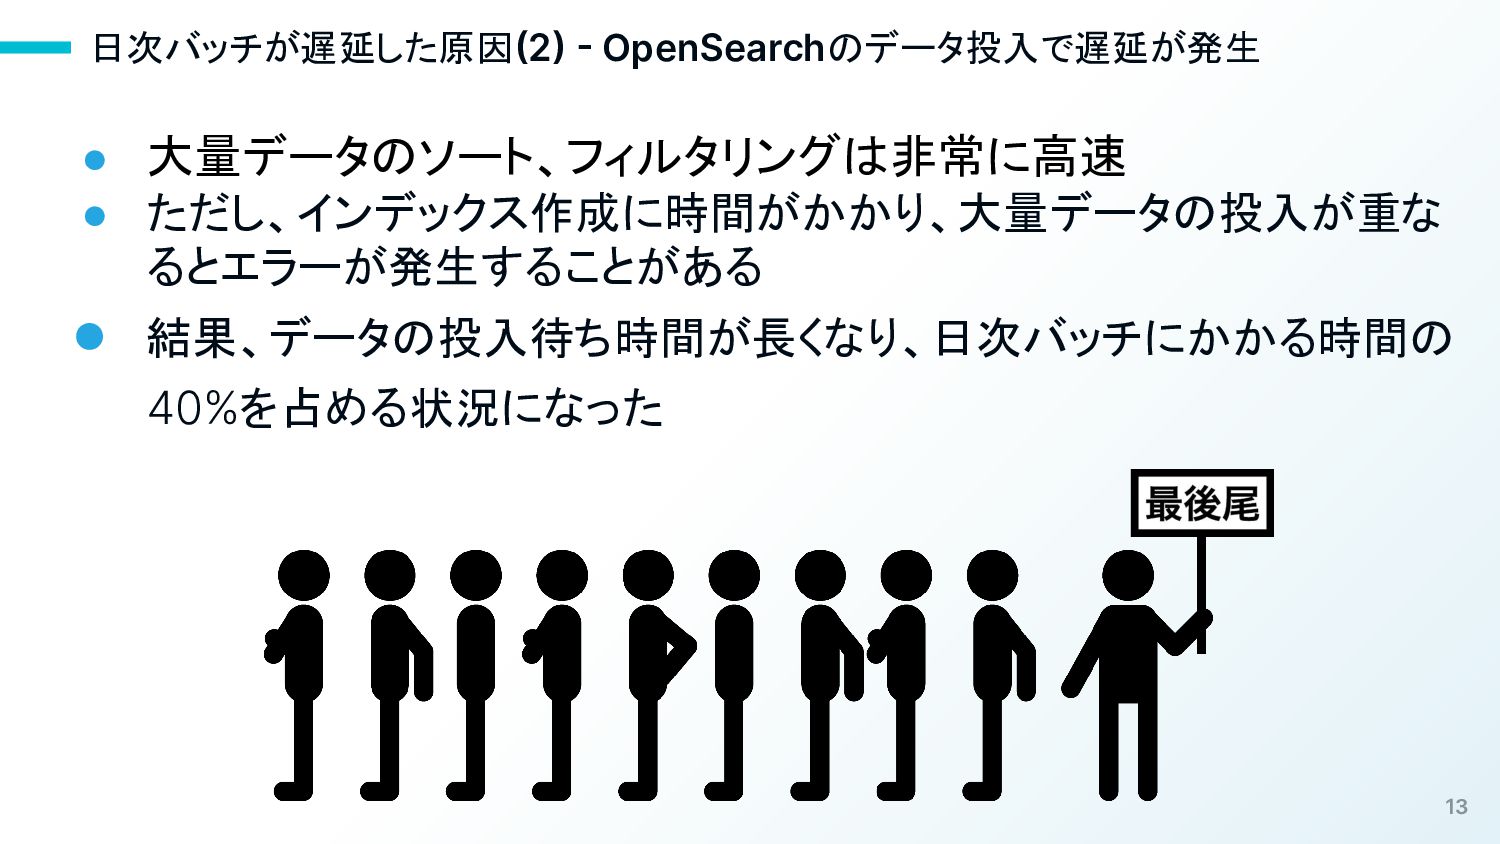
13 日次バッチが遅延した原因(2) - OpenSearchのデータ投入で遅延が発生 • 大量データのソート、フィルタリングは非常に高速 • ただし、インデックス作成に時間がかかり、大量データの投入が重な るとエラーが発生することがある •
結果、データの投入待ち時間が長くなり、日次バッチにかかる時間の 40%を占める状況になった
14 問題点のまとめ • 新規アカウントが増加するにつれて、リソースの奪い合いが発生 • 大きめのアカウント(約3.5億件)で画面反映まで、毎日15時間もかかる 状態 • データ量の小さなお客様もバッチ処理の反映が遅くなるようになっ た。。
15 刷新後のデータ基盤概要(2022年11月〜現在)
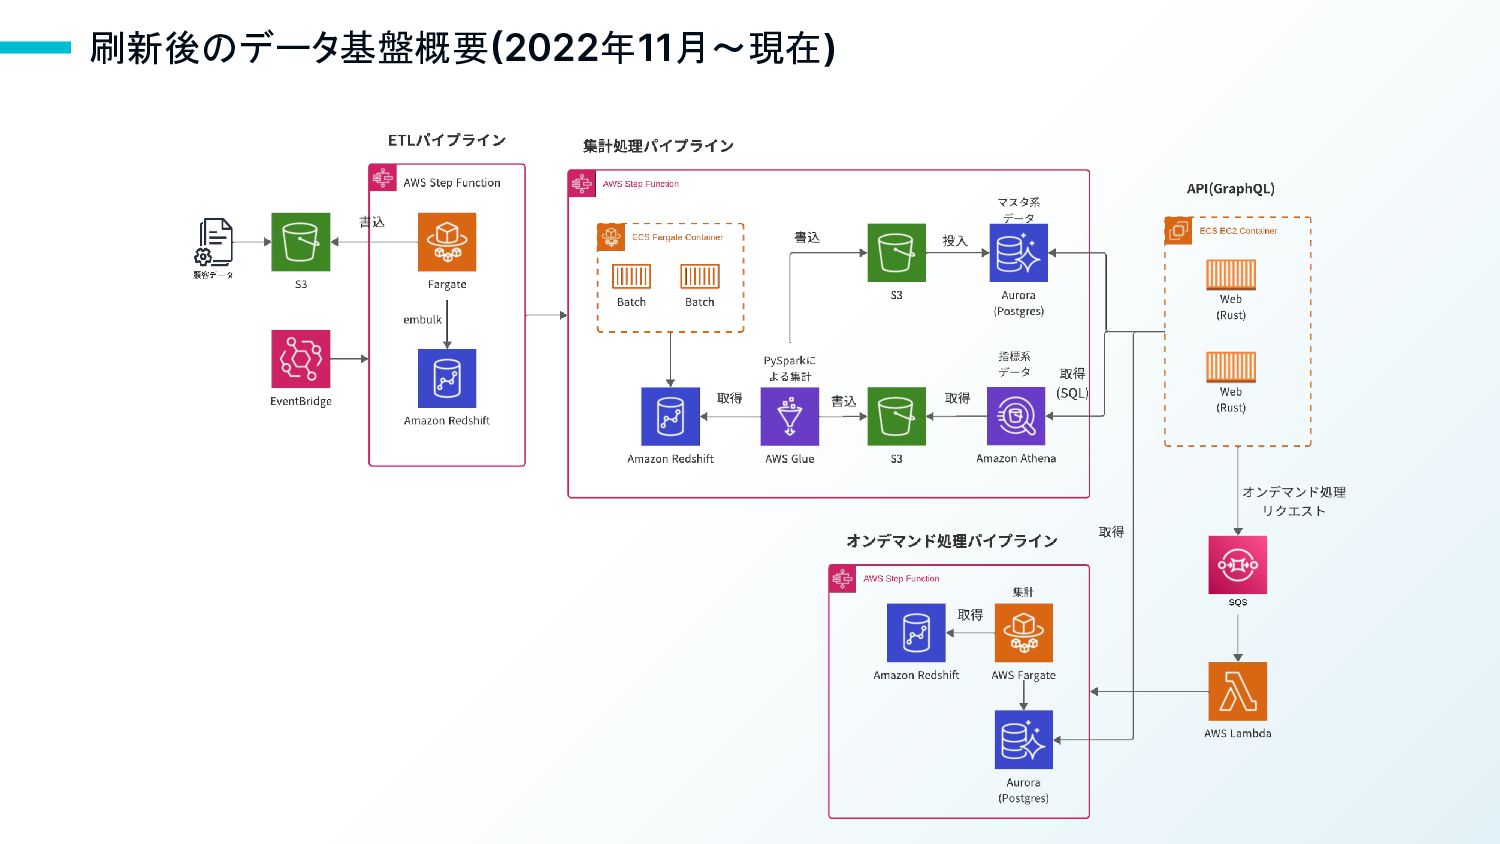
刷新後のデータ基盤概要(2022年11月〜現在)
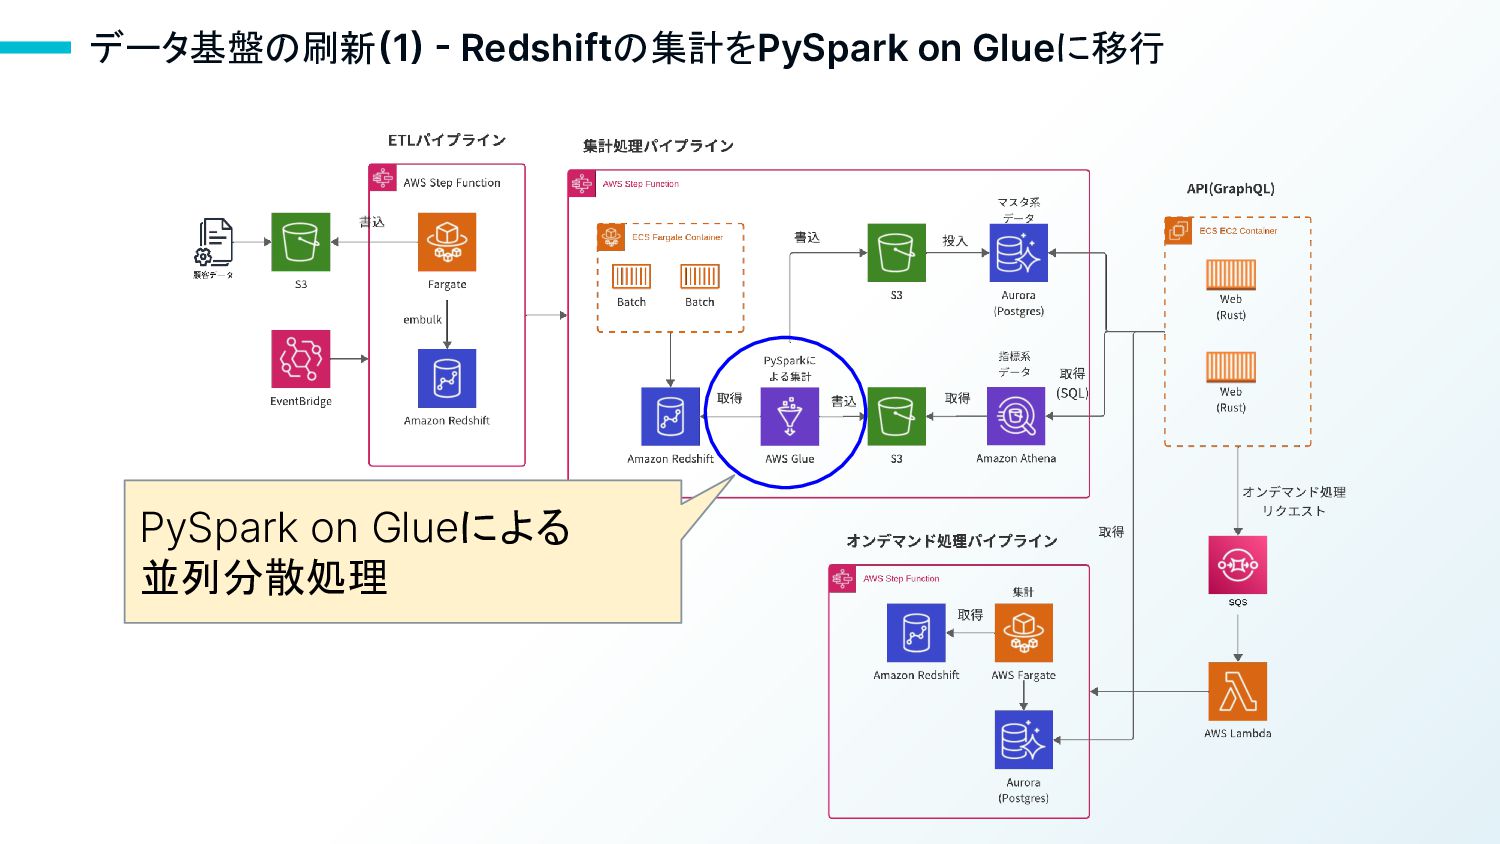
データ基盤の刷新(1) - Redshiftの集計をPySpark on Glueに移行 PySpark on Glueによる 並列分散処理
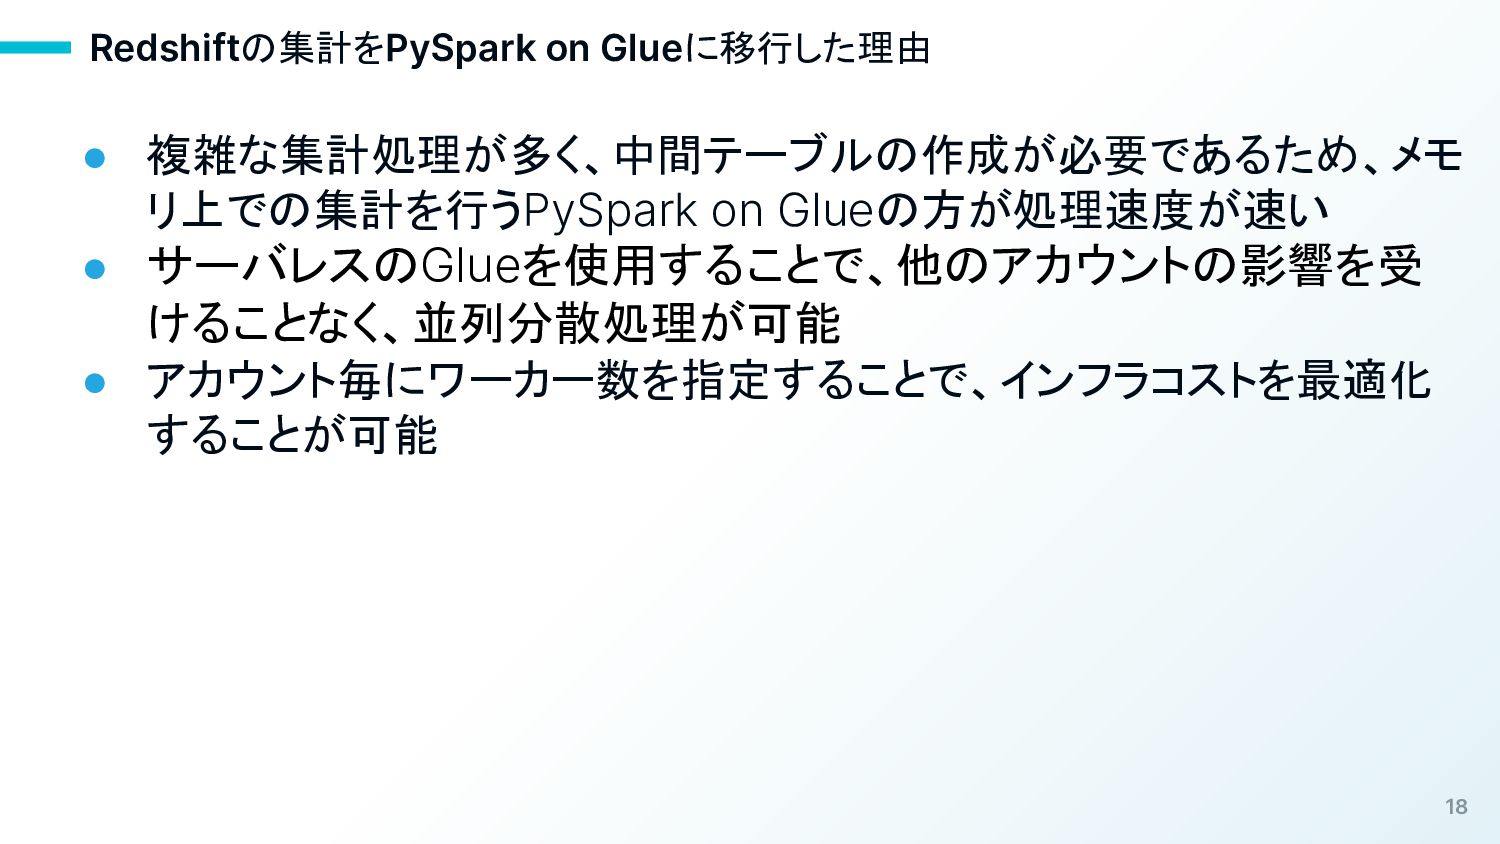
18 Redshiftの集計をPySpark on Glueに移行した理由 • 複雑な集計処理が多く、中間テーブルの作成が必要であるため、メモ リ上での集計を行うPySpark on Glueの方が処理速度が速い •
サーバレスのGlueを使用することで、他のアカウントの影響を受 けることなく、並列分散処理が可能 • アカウント毎にワーカー数を指定することで、インフラコストを最適化 することが可能
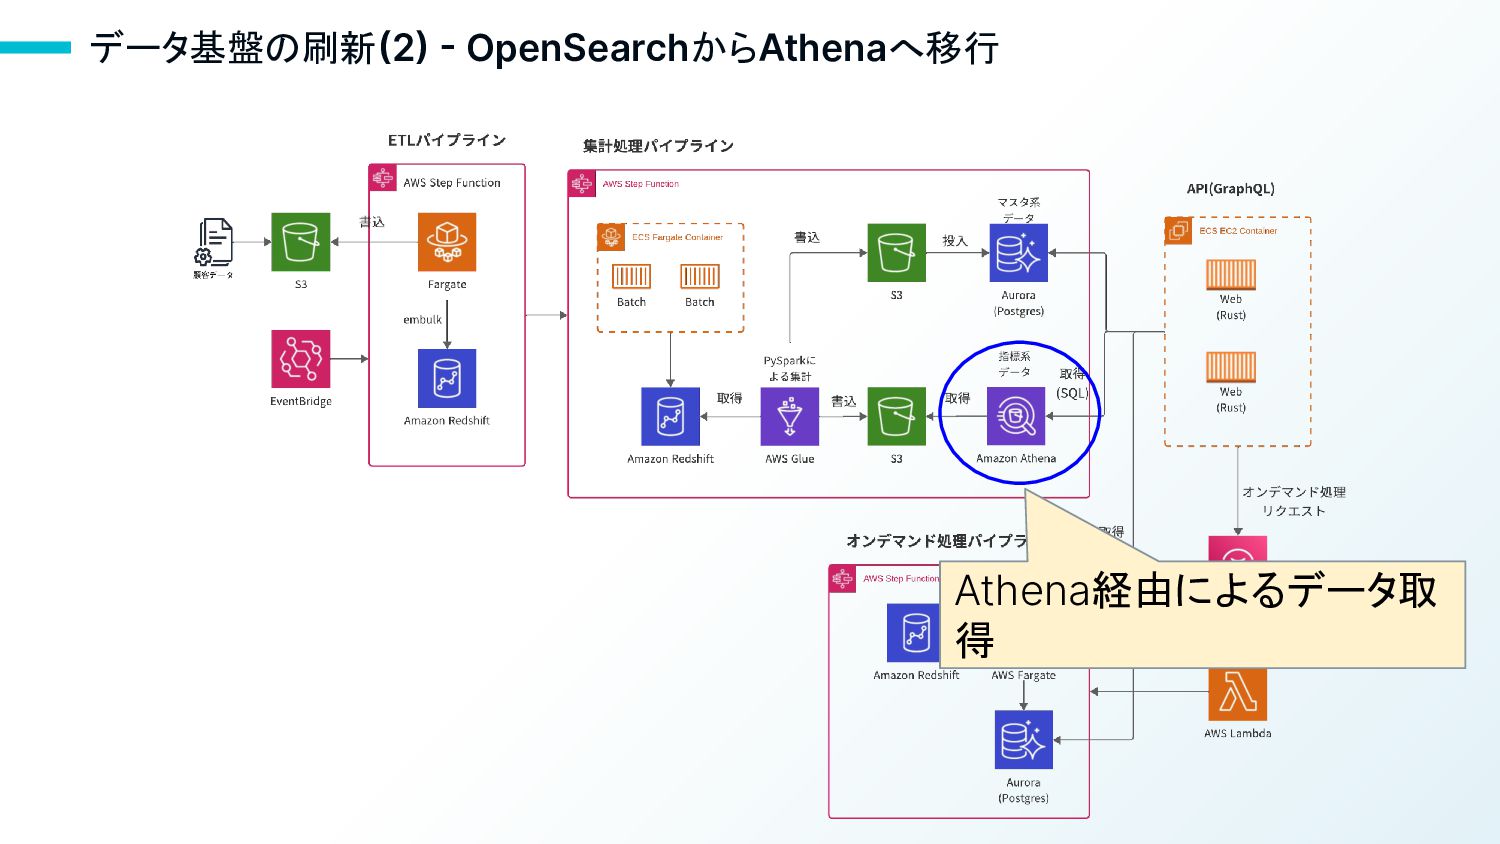
データ基盤の刷新(2) - OpenSearchからAthenaへ移行 Athena経由によるデータ取 得
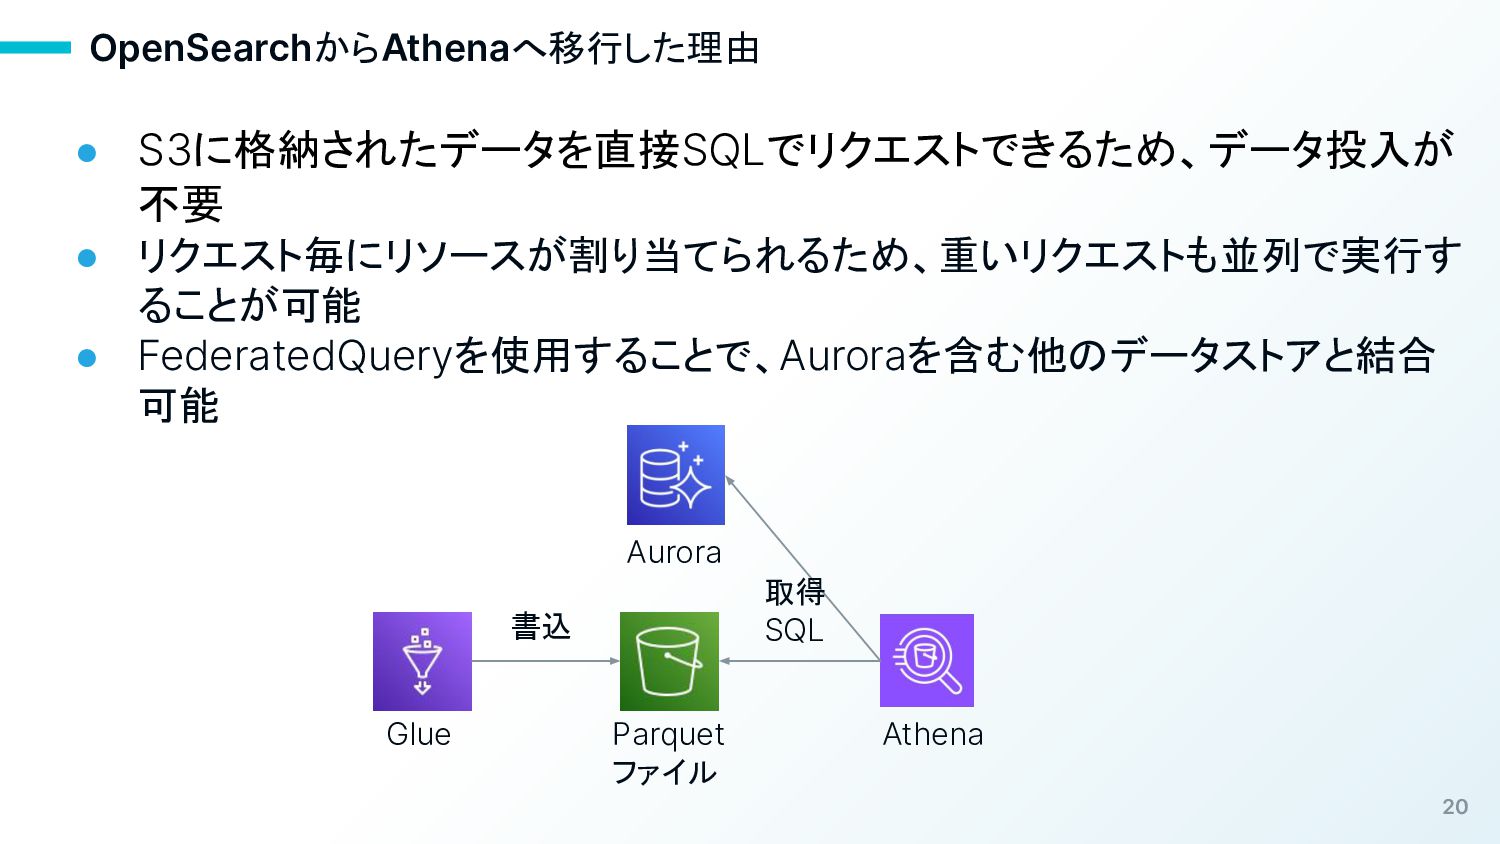
20 OpenSearchからAthenaへ移行した理由 • S3に格納されたデータを直接SQLでリクエストできるため、データ投入が 不要 • リクエスト毎にリソースが割り当てられるため、重いリクエストも並列で実行す ることが可能 • FederatedQueryを使用することで、Auroraを含む他のデータストアと結合
可能 書込 Parquet ファイル Glue Athena 取得 SQL Aurora
Athena導入の注意点 • ソートやフィルタリング処理は、OpenSearchの方が速いことが多い • 少量のデータに対してもレスポンス時間がかかる ◦ S3のExpress One Zoneで早くなるらしい トレードオフがあるので、
ユースケースに合わせた検討が必要
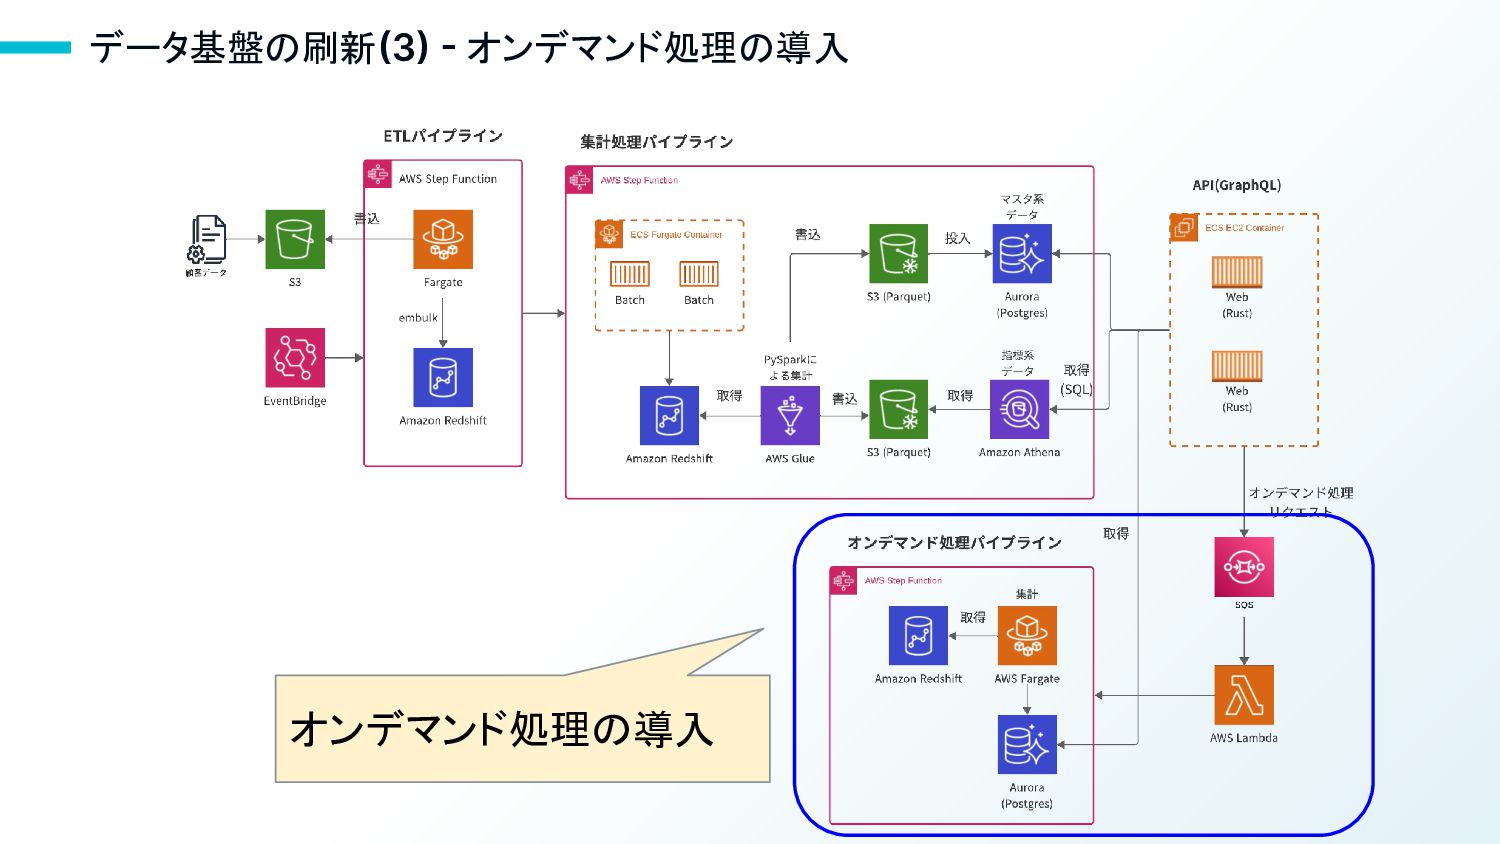
データ基盤の刷新(3) - オンデマンド処理の導入 オンデマンド処理の導入
23 オンデマンド処理の導入理由 • ユーザーからのリクエストに応じて、必要な集計処理を行うオンデマ ンド処理に対応 • 日次バッチを待たずにアドホックな分析が可能になり、ユーザー体験 が向上した • 参照頻度の低い日次集計をオンデマンド処理に移行
• Fargateの最大vCPU16個、メモリ128GiBに大幅拡張(2022年9 月)。これにより、ある程度のデータ量でもPandasで処理できるように なった。
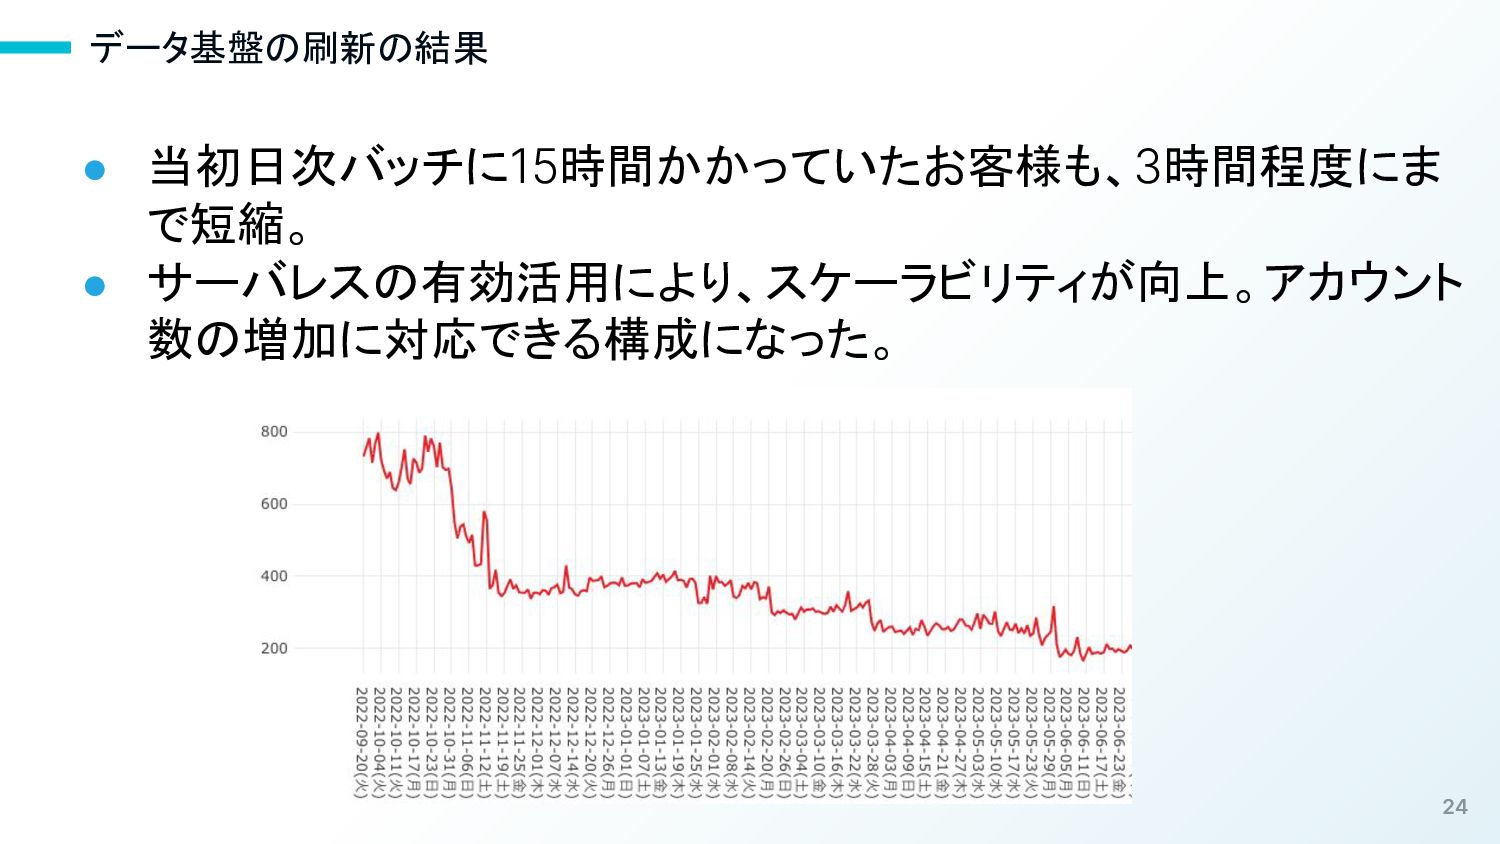
24 データ基盤の刷新の結果 • 当初日次バッチに15時間かかっていたお客様も、3時間程度にま で短縮。 • サーバレスの有効活用により、スケーラビリティが向上。アカウント 数の増加に対応できる構成になった。
25 今後の展望 • アーキテクチャーの再編 ◦ オンデマンド処理への移行 ◦ Glueジョブの分割 • パフォーマンス・チューニング
◦ データ構造の見直し ◦ Glueのworkerの自動設定 • 機械学習のライフサイクル管理 • サービスとして横断的なデータ解析 プロダクトの状況は日々変化する データ基盤の作り替えも積極的に行う
エンジニア募集中! 一緒に世界の大量廃棄問題を解決しましょう! https://note.com/fullkaiten_re フルカイテン公式note


 atsuyokota
 akkeylab
 steliosf
 satoshi256kbyte
 shoppingjaws
 po3rin
 yuukiw00w
 soyuka
 sts11142
 hatsu38
 y0hgi
 takaidohigasi
 lx_t
 danielanewman
 soudai
 sstephenson
 tammyeverts
 addyosmani
 jonoalderson
 codingconduct
 maltzj
 lfama
 honnibal
 mfonobong
 speakerdeck