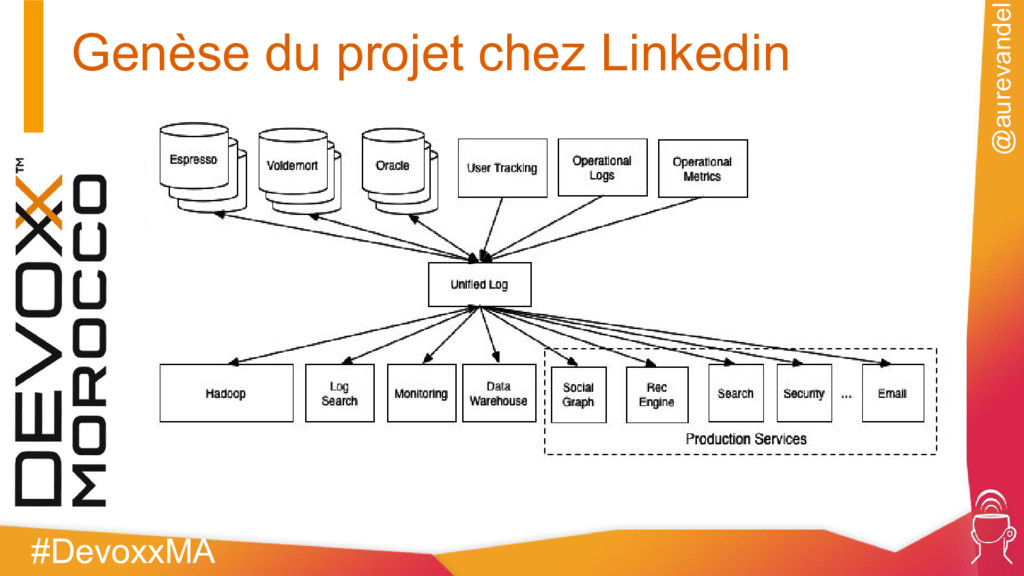
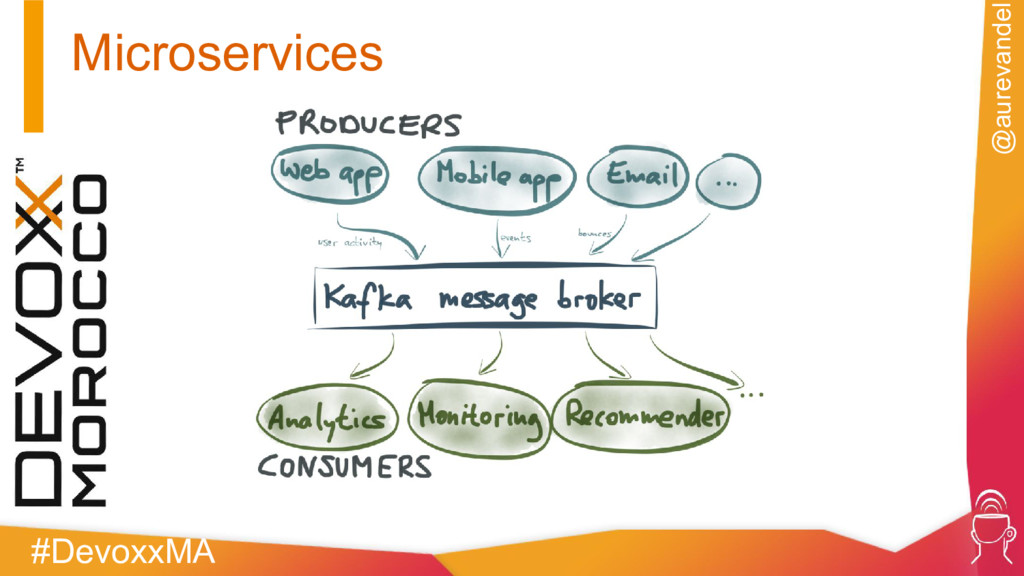
messagerie distribué open source, haut débit en mode publish-subscribe modélisé comme un commit log distribué. Il est tolérant aux pannes, efficace et performant. Il permet de prendre en charge l'ingestion de gros volume données avec des longues périodes de rétention. @aurevandel
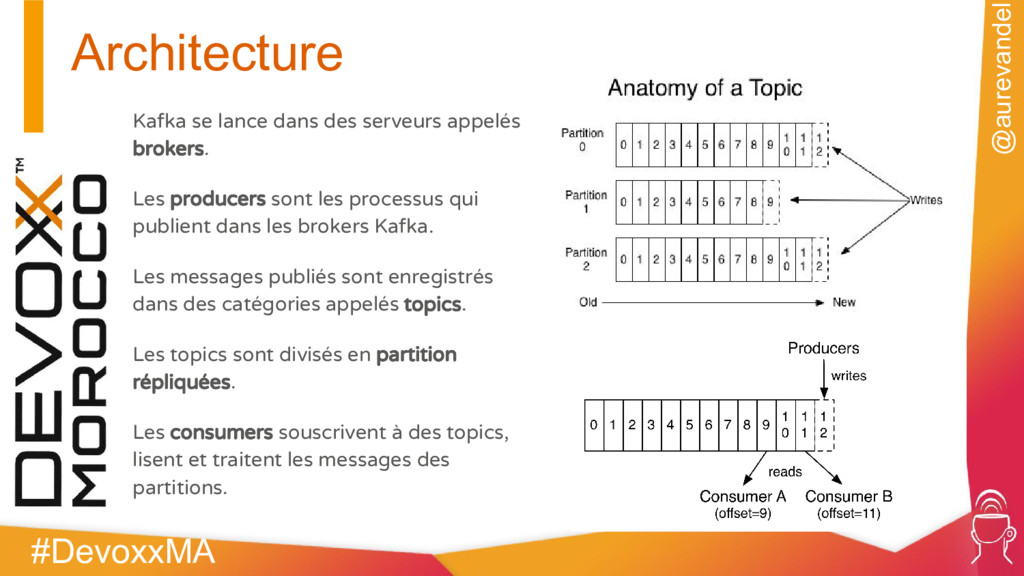
brokers. Les producers sont les processus qui publient dans les brokers Kafka. Les messages publiés sont enregistrés dans des catégories appelés topics. Les topics sont divisés en partition répliquées. Les consumers souscrivent à des topics, lisent et traitent les messages des partitions.
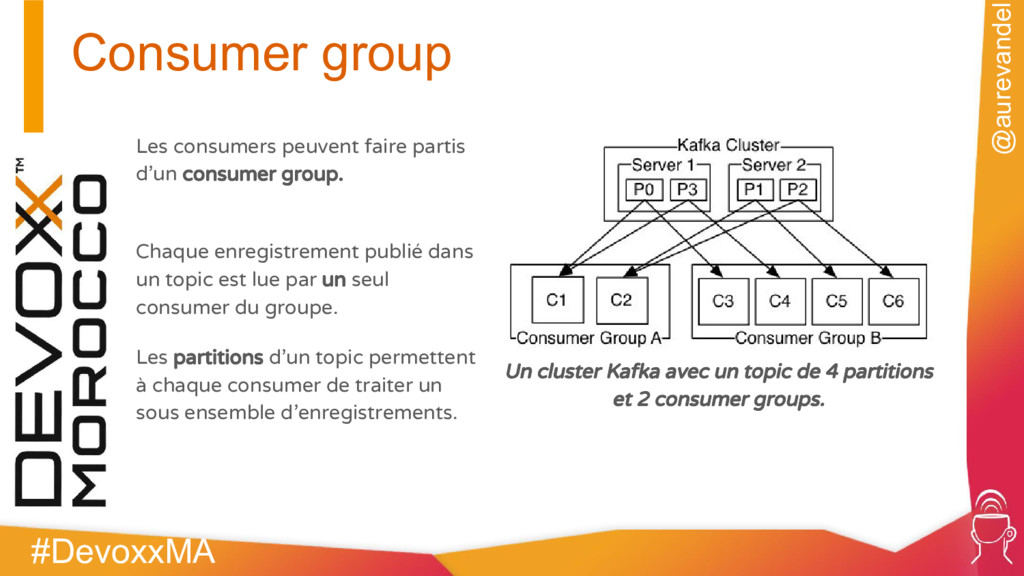
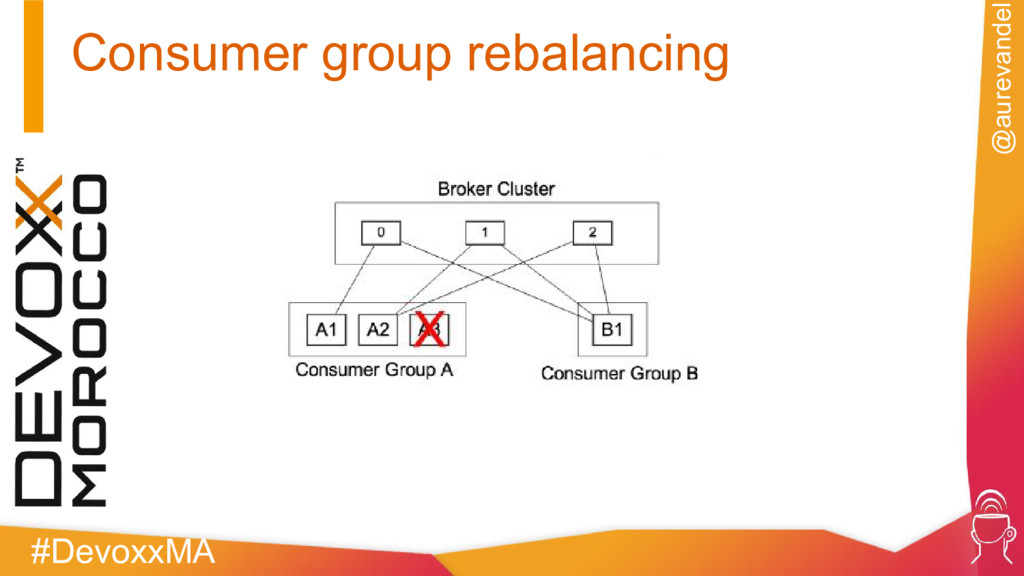
consumer group. Chaque enregistrement publié dans un topic est lue par un seul consumer du groupe. Les partitions d’un topic permettent à chaque consumer de traiter un sous ensemble d’enregistrements. Un cluster Kafka avec un topic de 4 partitions et 2 consumer groups.
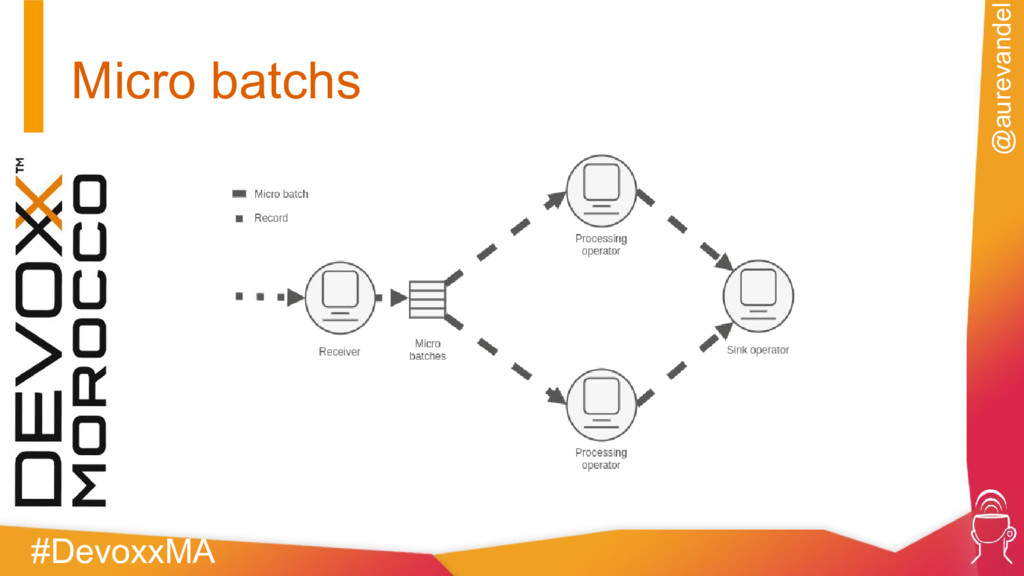
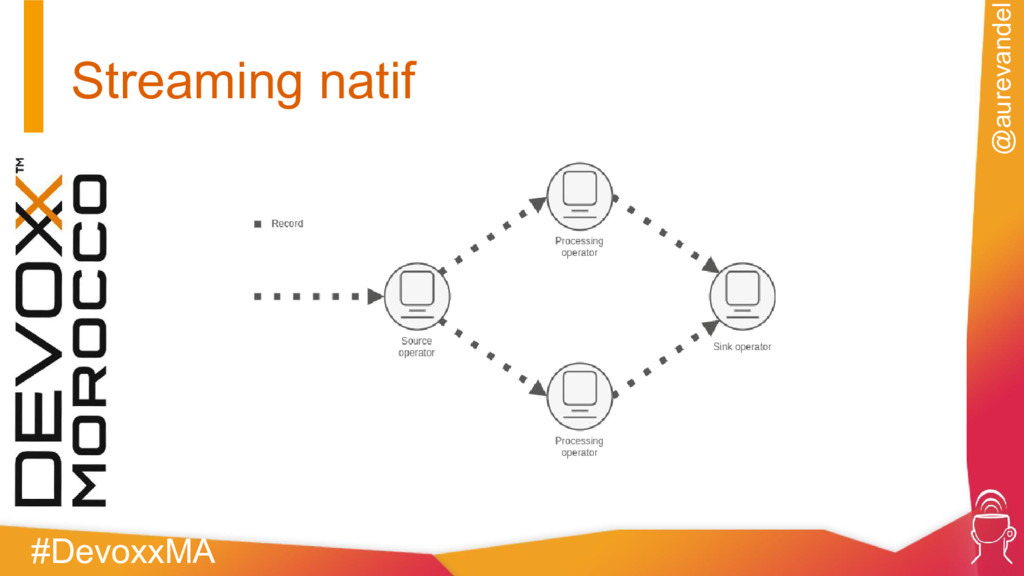
plus en plus rapidement afin de réduire la latence. Traiter des données de plus en plus massives et illimités. Répartir le travail plus uniformément et au fil du temps pour une meilleure gestion des ressources. #DevoxxMA @aurevandel
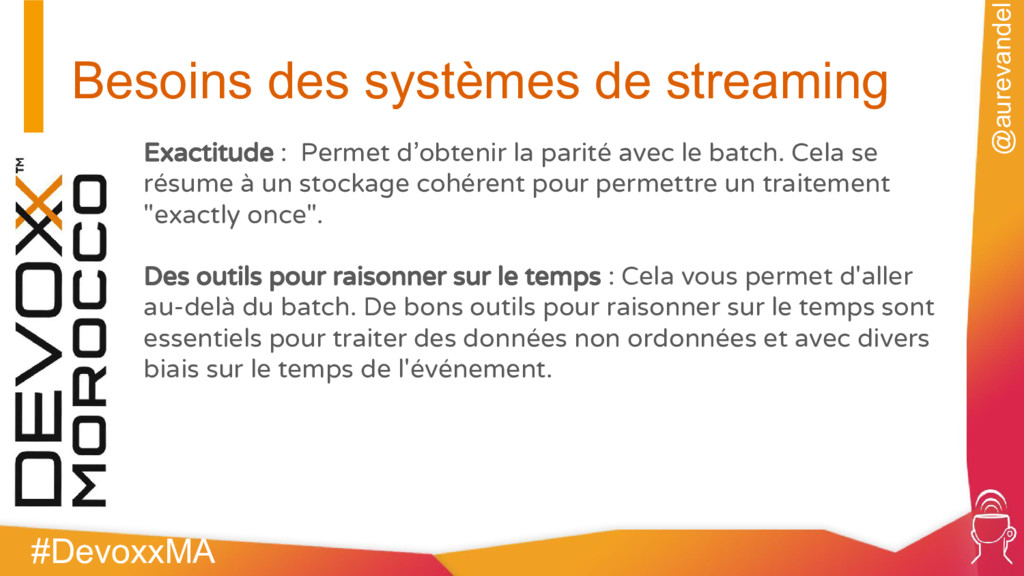
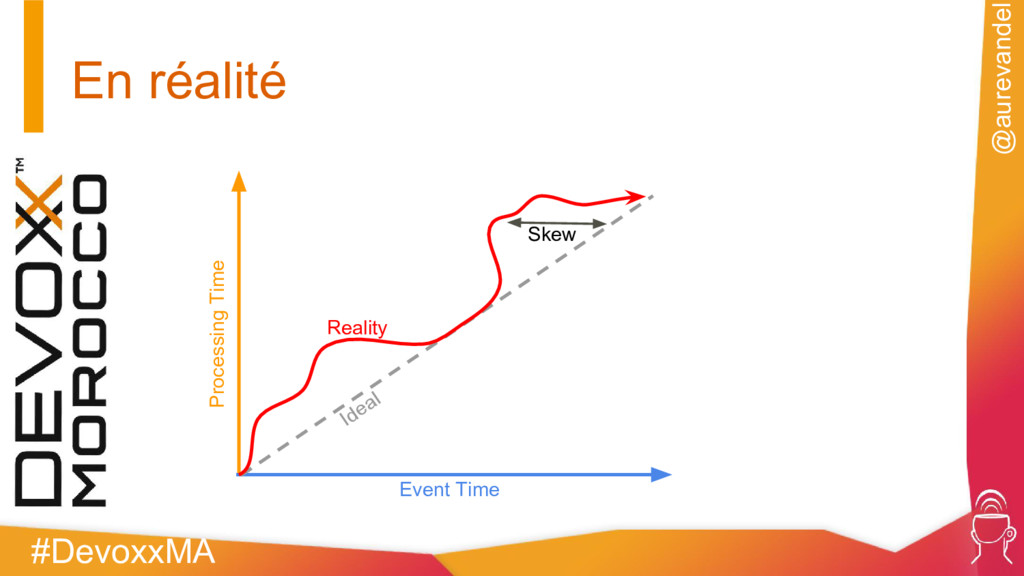
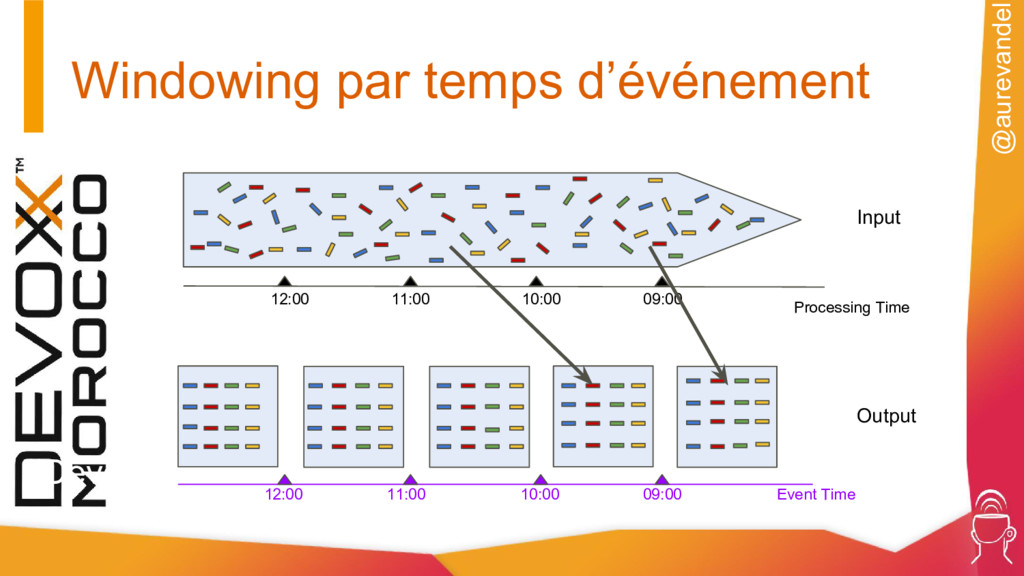
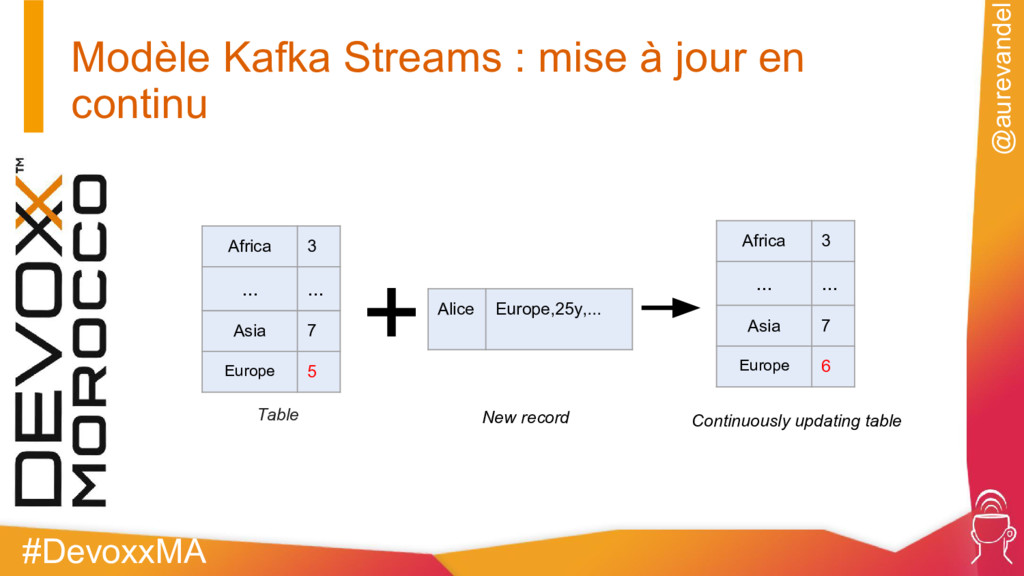
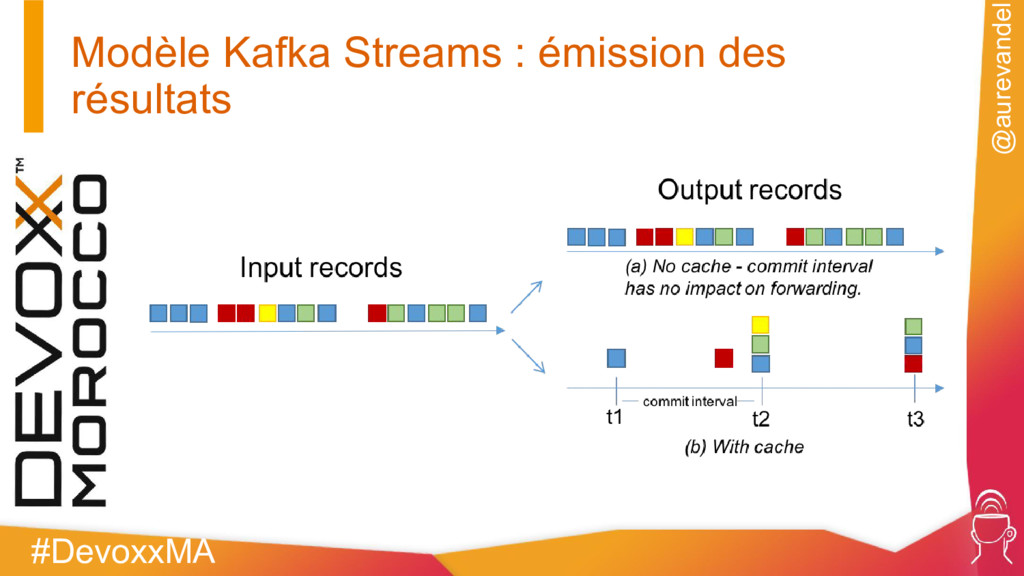
d’obtenir la parité avec le batch. Cela se résume à un stockage cohérent pour permettre un traitement "exactly once". Des outils pour raisonner sur le temps : Cela vous permet d'aller au-delà du batch. De bons outils pour raisonner sur le temps sont essentiels pour traiter des données non ordonnées et avec divers biais sur le temps de l'événement.
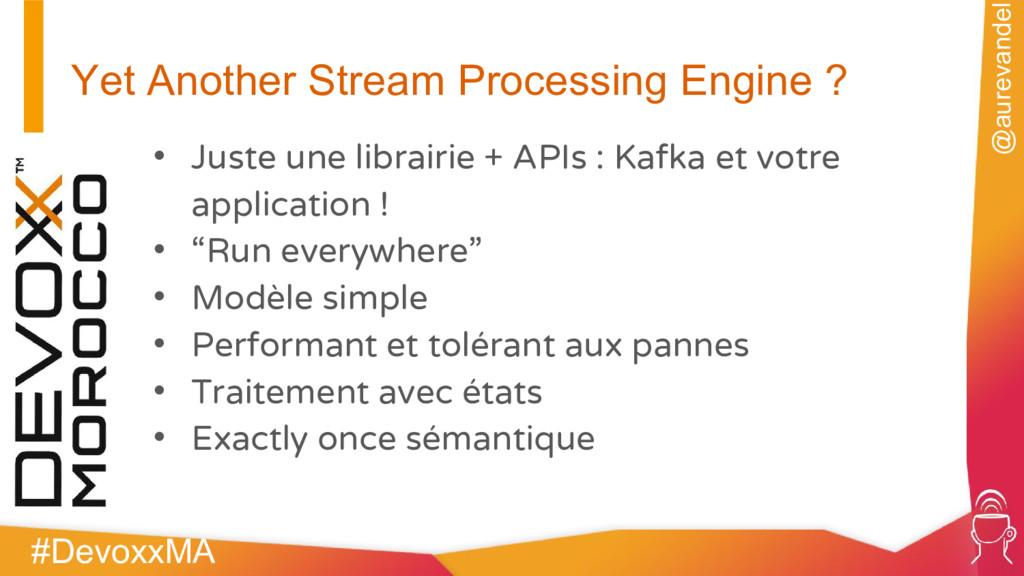
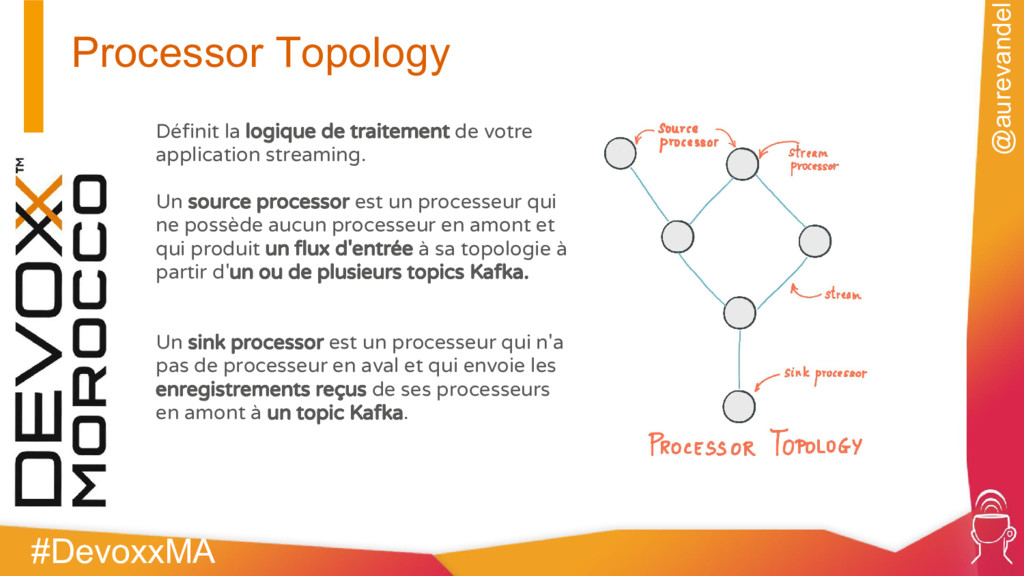
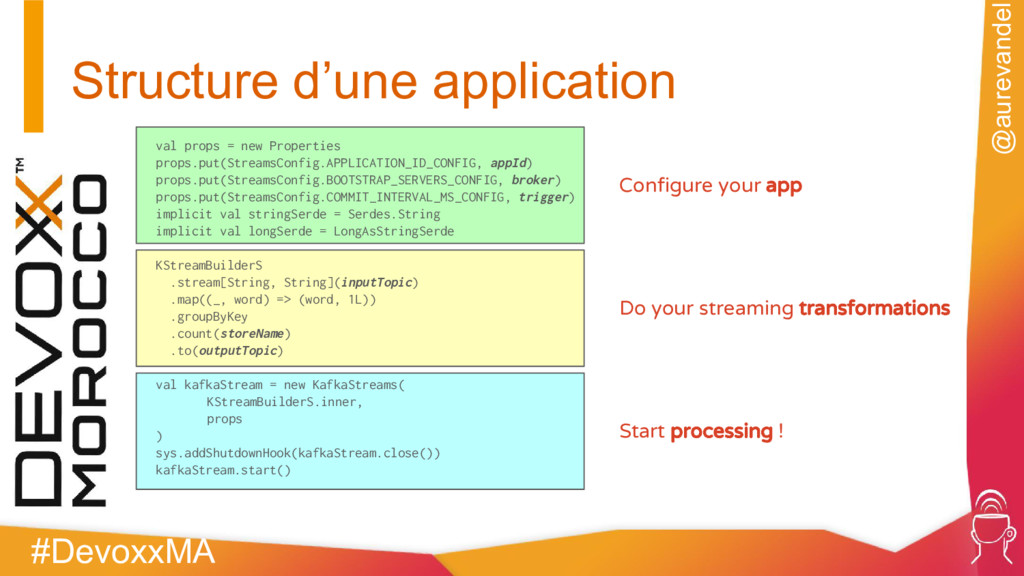
votre application streaming. Un source processor est un processeur qui ne possède aucun processeur en amont et qui produit un flux d'entrée à sa topologie à partir d'un ou de plusieurs topics Kafka. Un sink processor est un processeur qui n'a pas de processeur en aval et qui envoie les enregistrements reçus de ses processeurs en amont à un topic Kafka.
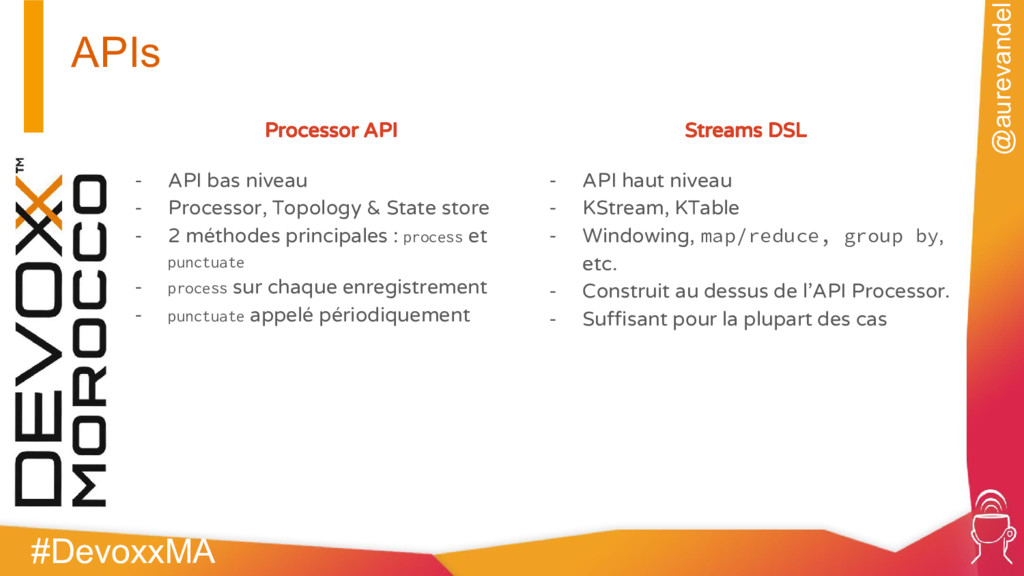
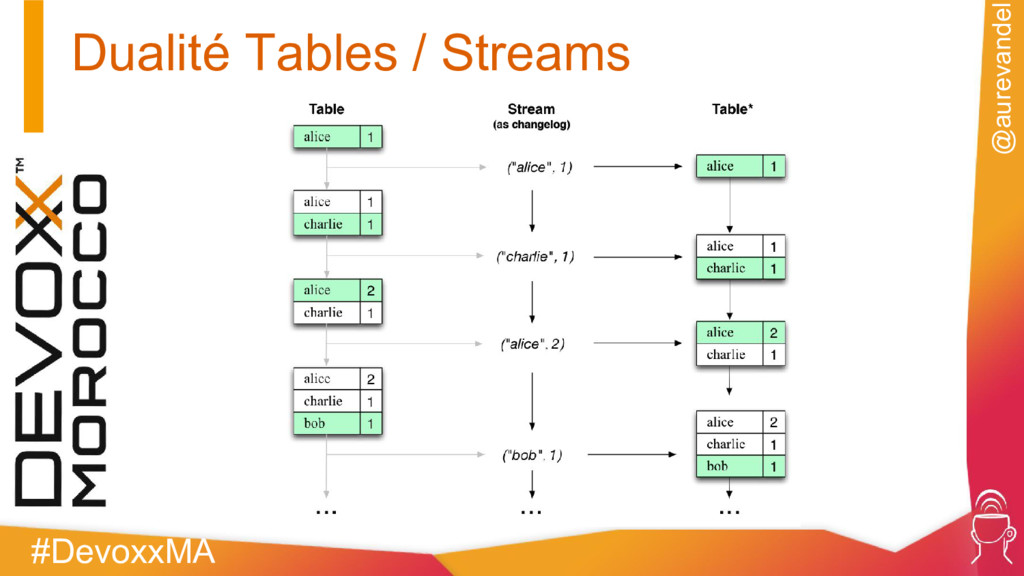
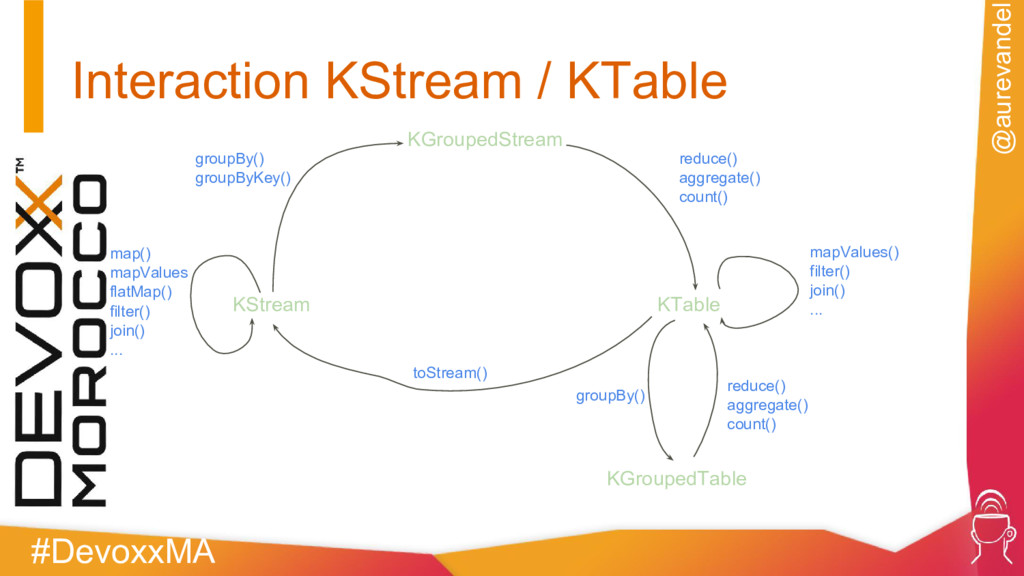
Processor, Topology & State store - 2 méthodes principales : process et punctuate - process sur chaque enregistrement - punctuate appelé périodiquement Streams DSL - API haut niveau - KStream, KTable - Windowing, map/reduce, group by, etc. - Construit au dessus de l’API Processor. - Suffisant pour la plupart des cas
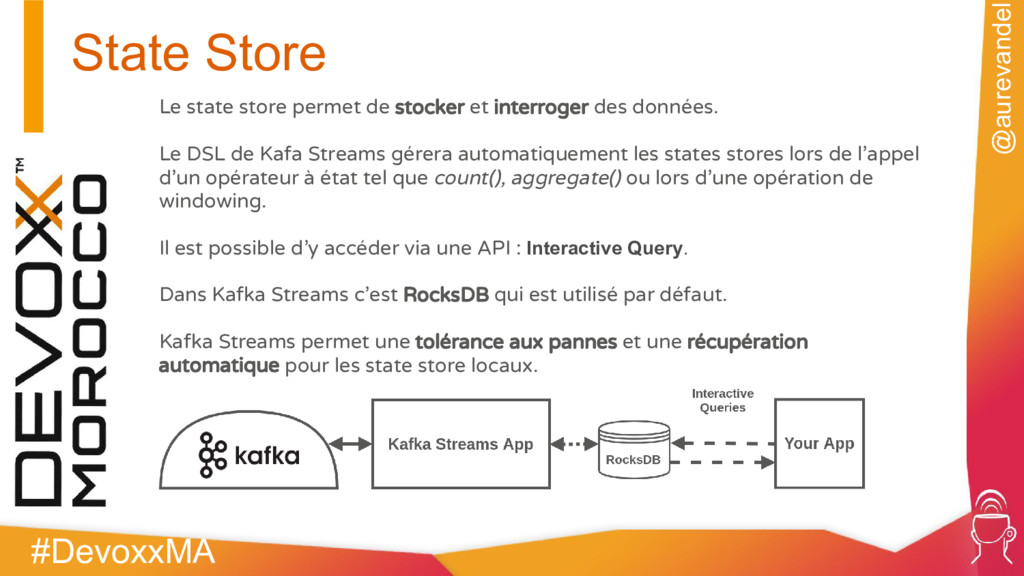
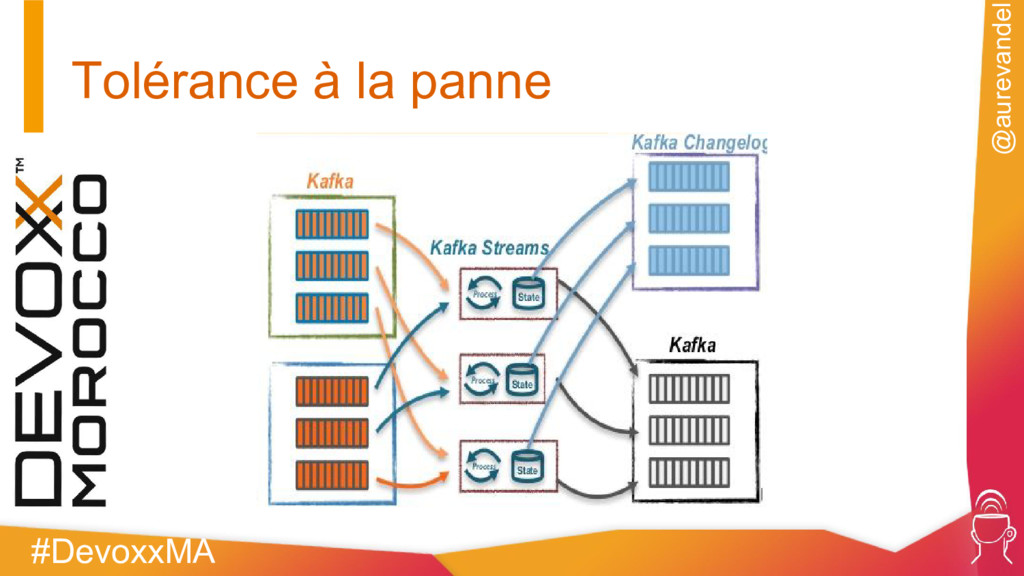
et interroger des données. Le DSL de Kafa Streams gérera automatiquement les states stores lors de l’appel d’un opérateur à état tel que count(), aggregate() ou lors d’une opération de windowing. Il est possible d’y accéder via une API : Interactive Query. Dans Kafka Streams c’est RocksDB qui est utilisé par défaut. Kafka Streams permet une tolérance aux pannes et une récupération automatique pour les state store locaux.
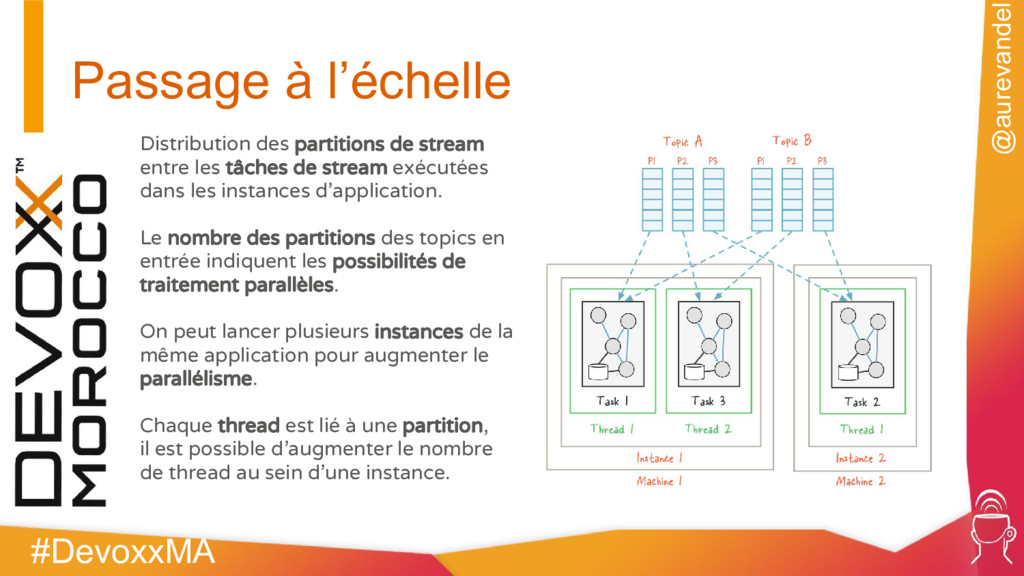
entre les tâches de stream exécutées dans les instances d’application. Le nombre des partitions des topics en entrée indiquent les possibilités de traitement parallèles. On peut lancer plusieurs instances de la même application pour augmenter le parallélisme. Chaque thread est lié à une partition, il est possible d’augmenter le nombre de thread au sein d’une instance.
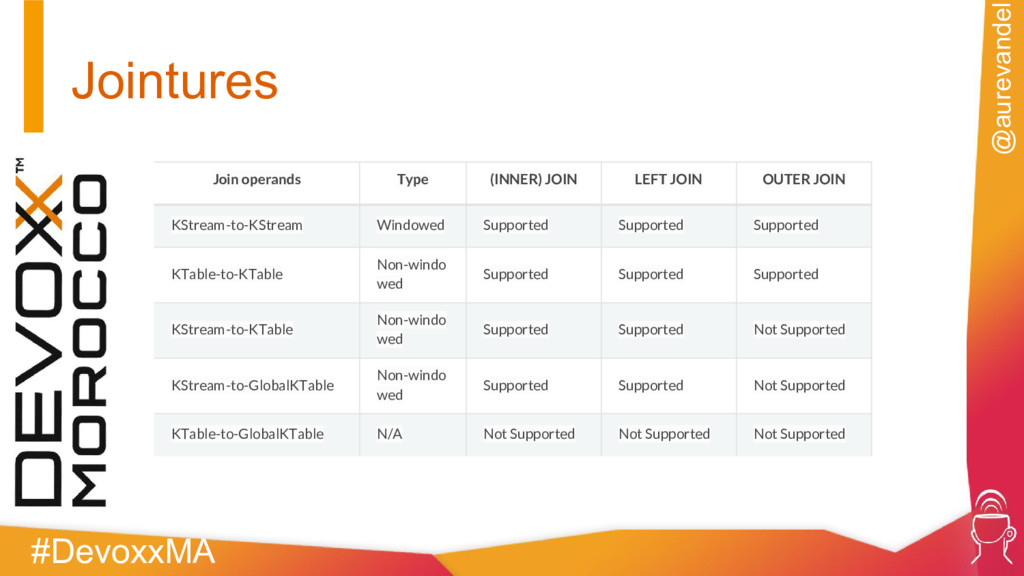
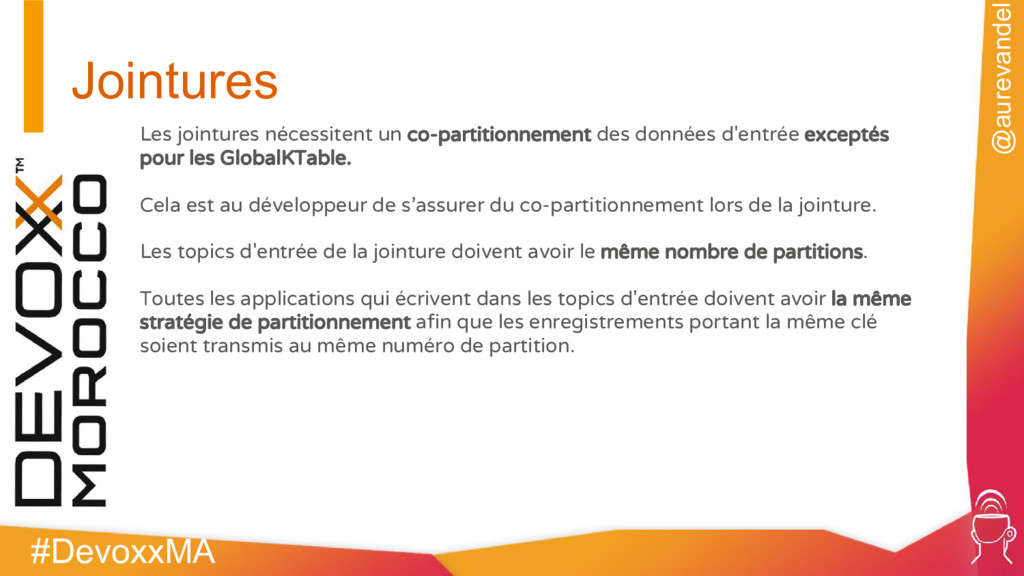
d'entrée exceptés pour les GlobalKTable. Cela est au développeur de s’assurer du co-partitionnement lors de la jointure. Les topics d'entrée de la jointure doivent avoir le même nombre de partitions. Toutes les applications qui écrivent dans les topics d'entrée doivent avoir la même stratégie de partitionnement afin que les enregistrements portant la même clé soient transmis au même numéro de partition.
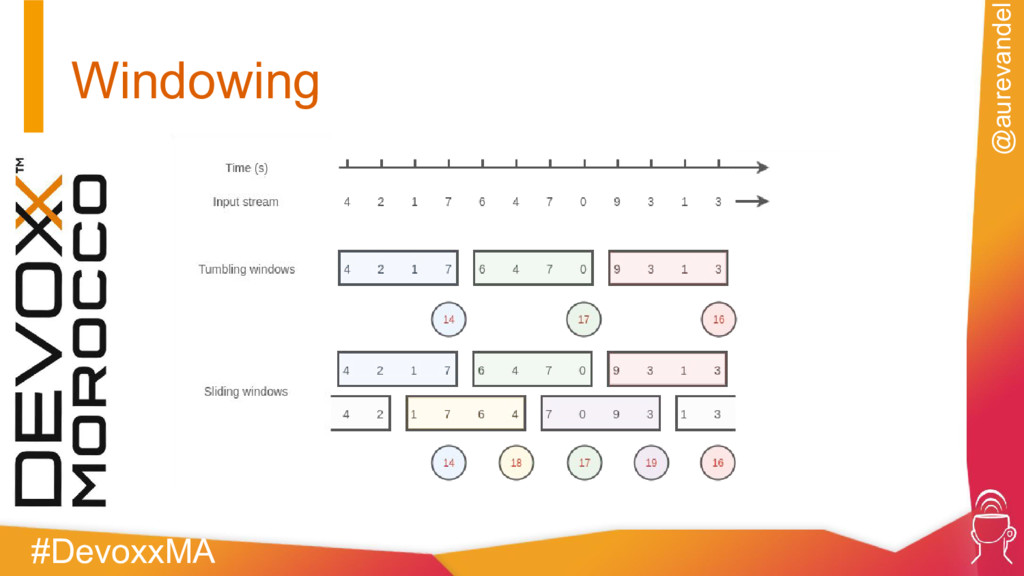
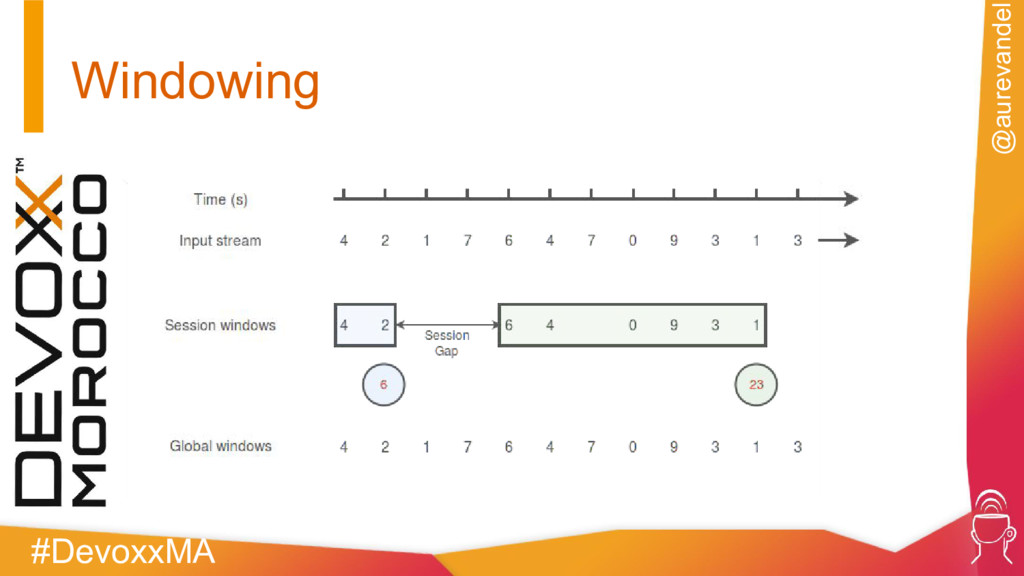
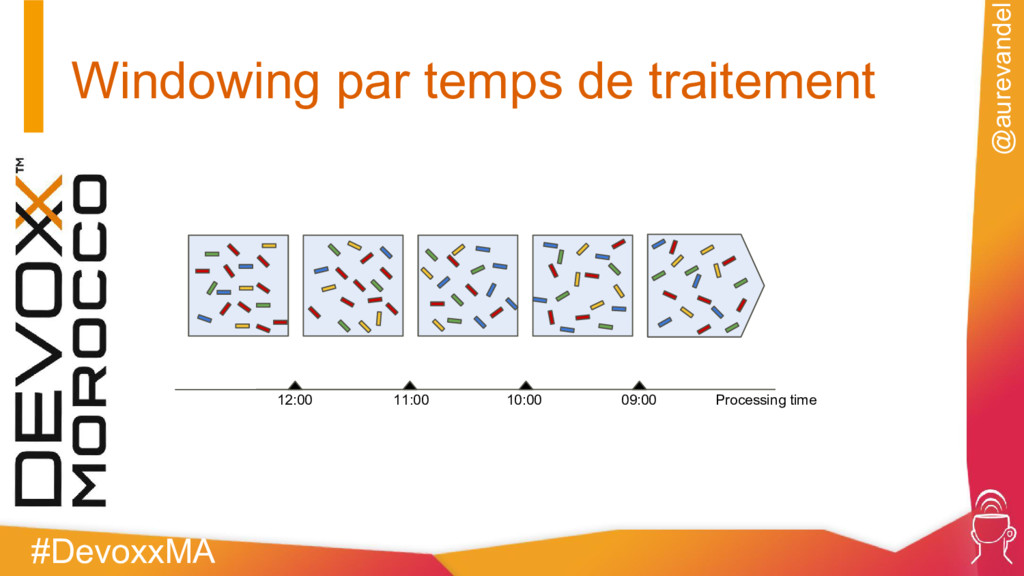
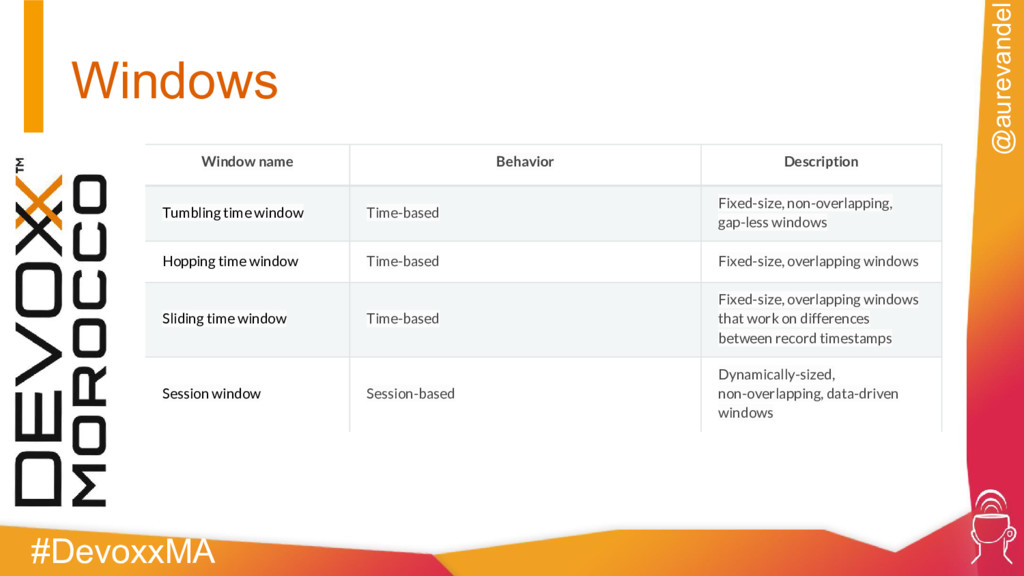
Time-based Fixed-size, non-overlapping, gap-less windows Hopping time window Time-based Fixed-size, overlapping windows Sliding time window Time-based Fixed-size, overlapping windows that work on differences between record timestamps Session window Session-based Dynamically-sized, non-overlapping, data-driven windows


 palkan
 sylph01
 uyuki234
 optim
 oku053
 lynnswap
 ___akari11
 o0h
 tosite
 minodriven
 y0hgi
 nokomoro3
 mfonobong
 kristinabergwall1
 chriscoyier
 axbom
 jnunemaker
 ryanjones
 sarafernandez
 cassininazir
 gr2m
 lindahogenes
 auna
 mraible