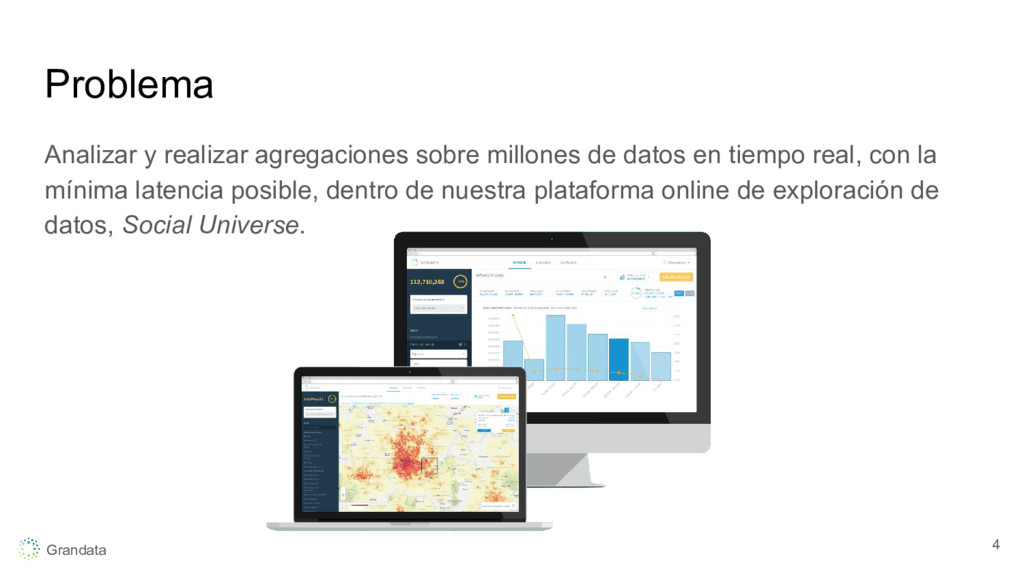
y bancos. Unimos ambas partes, generamos un grafo social y analizamos dichos datos aplicando diferentes algoritmos de Machine Learning. Luego nuestros clientes pueden explorar estos datos y utilizarlos para generar campañas. Grandata 2
(OLAP). Características de MySQL • Row-oriented storage. • Inserts y Selects simples, rápidos. • Set de agregaciones (Limitado). 5 Para agregaciones sobre millones de filas es lento
una base de datos columnar embebida, con generación y compilación de queries online por medio LLVM y utiliza SQL como interface. El objetivo principal es minimizar los tiempos de respuestas de las queries (< 1s) Basado en el paper Efficiently Compiling Efficient Query Plans for Modern Hardware de Thomas Neumann. 6
• Minimizar el acceso a memoria dejando los datos el mayor tiempo posible en los registros del CPU. (Mem-Read ~100ns, CPU Reg-Read ~1ns). • Explotar la localidad de los datos (temporal y espacial). • Mejorar la predicción de branching. • No romper el pipeline de ejecución del CPU (Minimizar CPU Hazards). • Reducir la cantidad de function calls (Method dispatch). 7 Muy rápido y eficiente
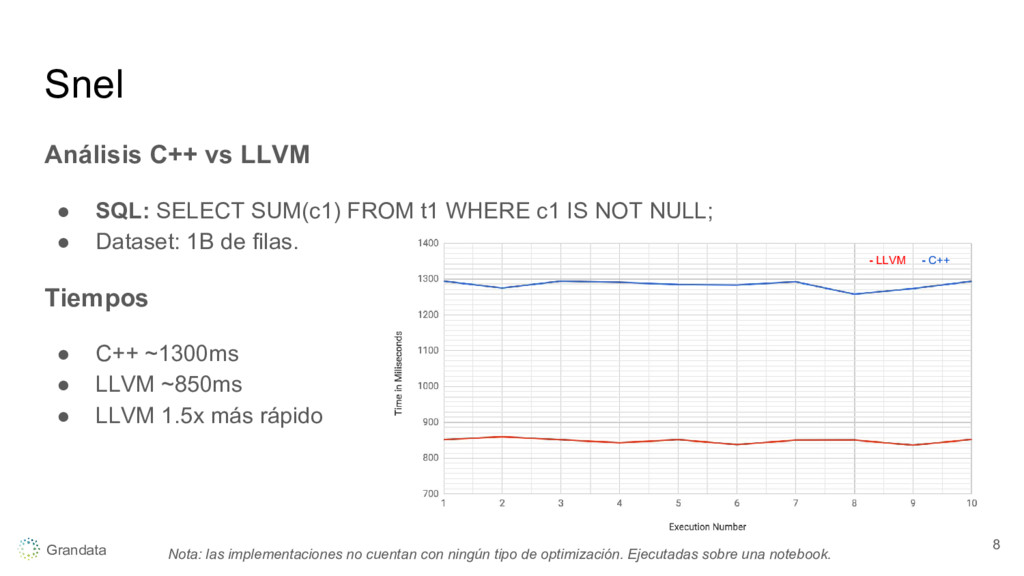
FROM t1 WHERE c1 IS NOT NULL; • Dataset: 1B de filas. Tiempos • C++ ~1300ms • LLVM ~850ms • LLVM 1.5x más rápido 8 - LLVM - C++ Nota: las implementaciones no cuentan con ningún tipo de optimización. Ejecutadas sobre una notebook.
con agregaciones extras. • Predicate pushdown evaluation. • Storage columnar. • Generación y compilación de queries online utilizando LLVM. • Interface SQL por medio de SQLite CLI y driver JDBC. • Integración con Apache Spark. 9
ANDs y ORs, y sub-queries. • JOIN, GROUP BY, ORDER BY y LIMIT. • Agregaciones: COUNT, COUNT(DISTINCT), SUM, AVG, MIN y MAX. Agregaciones extras: • Histogramas e Histogramas de rango fijo. • Histogramas en dos dimensiones. • Cálculo de percentiles. 10
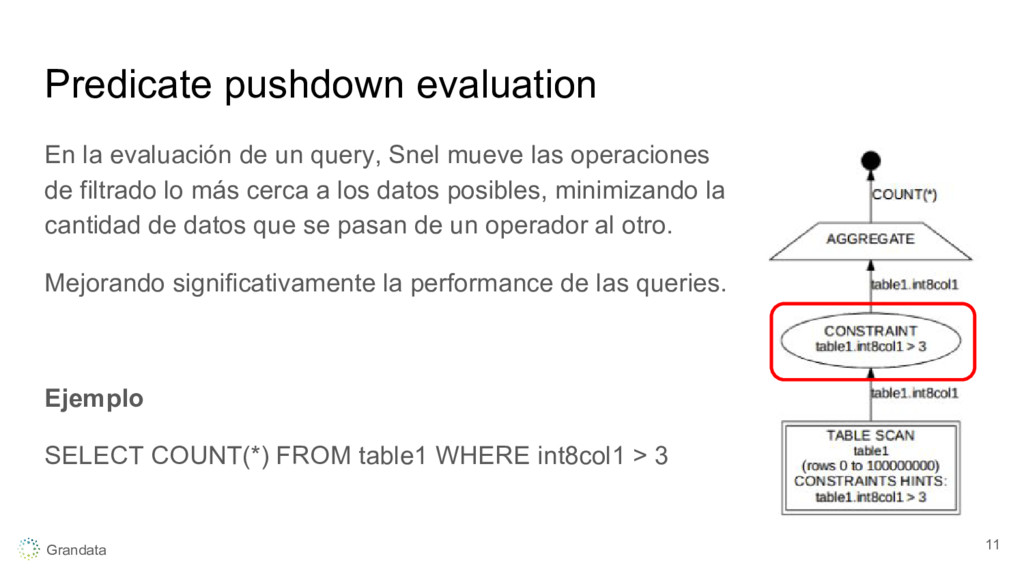
Snel mueve las operaciones de filtrado lo más cerca a los datos posibles, minimizando la cantidad de datos que se pasan de un operador al otro. Mejorando significativamente la performance de las queries. Ejemplo SELECT COUNT(*) FROM table1 WHERE int8col1 > 3 11
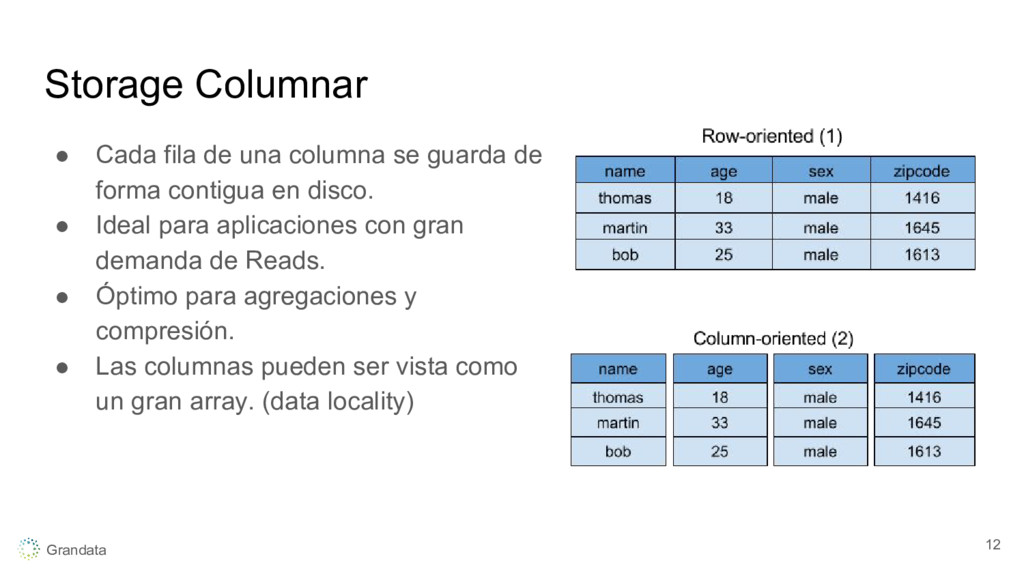
guarda de forma contigua en disco. • Ideal para aplicaciones con gran demanda de Reads. • Óptimo para agregaciones y compresión. • Las columnas pueden ser vista como un gran array. (data locality) 12
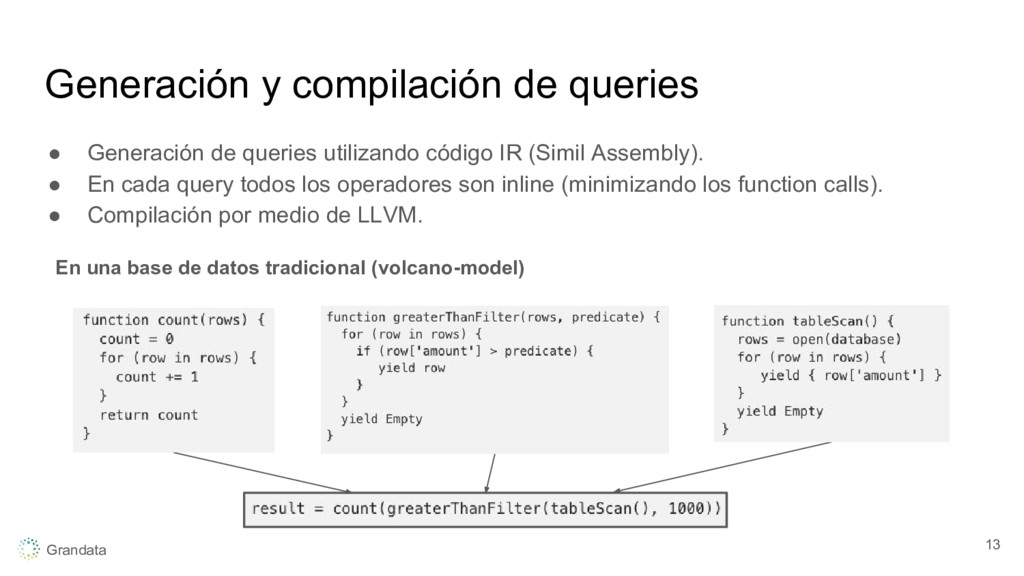
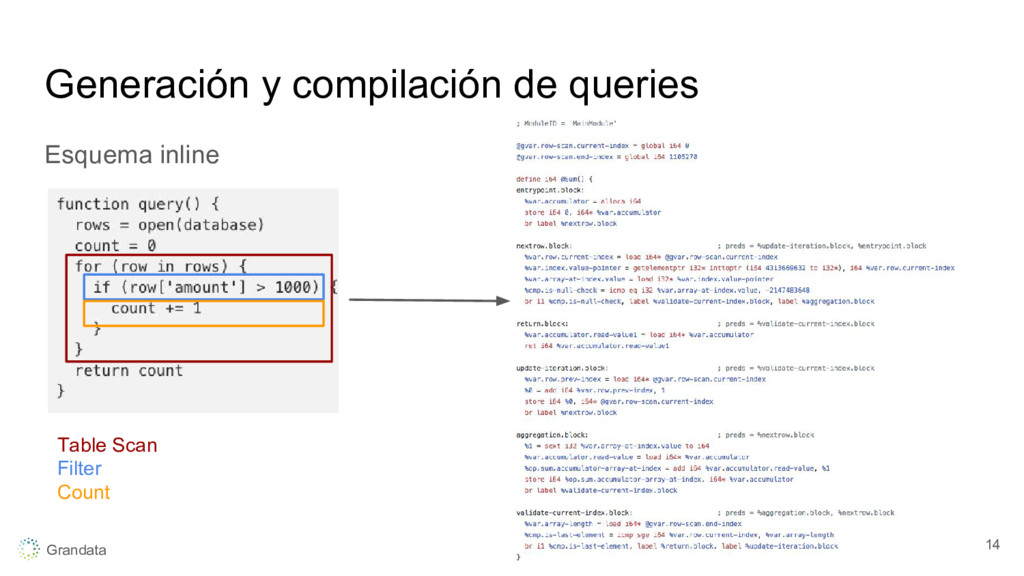
utilizando código IR (Simil Assembly). • En cada query todos los operadores son inline (minimizando los function calls). • Compilación por medio de LLVM. 13 En una base de datos tradicional (volcano-model)
resulta en un sistema performante y eficiente para el tipo de workloads que tenemos. Próximos pasos • Soporte para compresión de columnas. • Setup como sistema distribuído. • Aplicar otras técnicas de optimización. • Open-source. 15


 y0hgi
 bgpat
 bitkey
 carta_engineering
 riyaamemiya
 shuta13
 endonanana
 iktakahiro
 nealle
 ezaki
 teamlab
 occhi
 helenjbeal
 orderedlist
 moore
 davidcarrasco
 badams
 jct
 brettharned
 mayatellez
 danielanewman
 ryanjones
 techseoconnect
 akosma