Share
Embed
Transcript
41 slides
-
自己紹介 経歴 ・2008年にモバイルコンテンツプロバイダに入社 ・2012年クルーズ株式会社に入社 入社後は技術統括部門の責任者として全社の開発平準化や採用技術選定、 アーキテクト業務に従事のほか、品質管理部門やCS部門、人材育成部門 の運営に携わる。 ・2015年に執行役員就任 最高技術責任者CTO グループのIT技術・セキュリティ分野全般を担当する。
鈴木 優一 クルーズ 株式会社 執行役員 CTO 兼 CROOZ SHOPLIST株式会社 技術統括部長 #TECHHILLS -
・CROOZについて ・当社でのインフラの変遷 ・コンテナ化推進の背景 ・Fargateでの構築事例 事例① Laravel環境 事例② デプロイ回り 事例③ gRPC
Proxyサービス ・技術的に苦労した点 ・ぶちゃけどうなの?手間とかコストとか ・まとめ 本日のAgenda #TECHHILLS -
CROOZ について CROOZは、ファッション通販サイト『SHOPLIST.com by CROOZ』を軸に ショッピングやゲームなどのエンターテイメント領域を中心に、 常に時代の変化に合わせて幅広くインターネットサービスを展開しています モバイル コンテンツ 受託開発事業
IT業界に 特化した 人材派遣事業 2001年 検索エンジン CROOZを 活用した ネットワーク 事業 2002~ 2009年 事業売却 コンテンツ ブロバイダ 事業 ソーシャル ゲーム事業 2003年 2007年 Mobage 参入 2007年 ネイティブ ゲーム市場 参入 2014年~ モバイル コマース 事業 2008年 2016年~ 事業撤退 ファッションEC SHOPLIST 2016年~ 10業種20社を超 えるグループ経営 で1兆円を目指す 時代の流れに合わせメイン事業を 5回変更 #TECHHILLS -
当社でのインフラの変遷 ▪オンプレミス #TECHHILLS ・その他事業(モバイルコンテンツ受託、コンテンツプロバイダ、ゲームなど) 2012年 サービスイン ・shop-list.com by CROOZ 2001年~
2014年 AWS利用開始(EC2,ELB, ElastiCacheがメイン) ▪クラウド ・その他事業 2012年 AWS USリージョンにて運用開始 ・shop-list.com by CROOZ USリージョンにてサービス終了 新規サービスより 逐次運用開始 クラウドに移行 運用中サービスについて クラウドに移行 Cognite利用開始 ASG運用開始 Container運用開始 オンプレ運用 の時代 クラウド 検証の時代 クラウドでの運用の時代 (IaaSとしての使い方がメインだった時代) クラウド 活用の時代 -
当社でのインフラの変遷 ・創業1年目よりさくらインターネットで1/4ラックを契約し自前でサーバを立て コンテンツ運営。 ・はじめてクラウドを利用したのは海外にゲームコンテンツを提供するためで 2012年。この際初めてAWSを利用開始。 ・2012年にshop-list.com by CROOZ をサービスイン。リリース時はほかのコンテ ンツと同様に、データセンター内に自前で立てたサーバでコンテンツ運営。
・2014年にshop-list.com by CROOZをAWS移行。当時は仮想サーバとしての利用 傾向のほうが強かった。 ・2016年以降、原則として新規コンテンツはクラウドサービス上で構築する方針と し、既存コンテンツについても逐次移行し、2019年にはオンプレ運用廃止。 ・2020年以降、オートスケーリングの導入など仮想サーバ以上のクラウドの使い方 を徐々に取り入れ現在へ至る。 #TECHHILLS -
コンテナ化推進の背景 #TECHHILLS 1.柔軟なスケーリングの実現 予測できない事態への対処が後手に ・プロモーション施策で想定していたリクエスト数よりも 多く来てしまいアクセス遅延する。 ・特に施策としては計画していないものの、出品している 商品に想定外に ユーザが一斉に集まってしまいアクセス遅延する。 ・仮想サーバが予期せぬ不具合で再起動し、サービス維持に必要な台数が担保できず
アクセス遅延する。 など。 また、CPU利用率やコネクション数などでインスタンス台数のAuto Scaling ができても、インスタンス起動開始からBalancerに入るまでの時間が長ければ その間サービスが不安定な状況となってしまい、柔軟なスケーリング実現できな いことが課題だった -
コンテナ化推進の背景 #TECHHILLS 2.Infrastructure as Codeの推進 ヒトが介在するインフラオペレーションによって生まれる問題 ・作業手順が残っていない。 特に緊急対応時は、手順を残すよりもサービス復旧優先のためこの傾向が強い。 後々不具合が発生した際に「なんでこのインスタンスだけこの設定入ってるんだろう?」 みたいな会話が生まれる。
・自動でスケーリングできない ちょっと前まではインスタンスのイメージやスナップショットを復元し、インスタンスを 生成していた。一定の手続きなので半自動化は出ていたものの人の手が介在していて、 作業の即時性に問題があった。 など。 柔軟なスケーリングの実現のためにも、環境差異を極限までなくすためにも 構築の自動化は必須。 -
コンテナ化推進の背景 #TECHHILLS 3.オンプレ思想に依存したクラウドインフラからの脱却 当時のクラウドの使い方上の問題 ・主要部分はほぼIaaS。 ・ハイスペックインスタンスに依存しがち。 ・オンデマンド契約 / RI /Saving
Plansなどの購入が多い。 ・Spot Instanceは最近まで未活用。 など。 オンプレから比べると柔軟には運用できるようにはなったものの、 物理サーバ→仮想サーバになっただけの「なんちゃってクラウド感」満載 なのは否めない。もっとクラウドの恩恵を受けたい。 -
コンテナ化推進の背景 #TECHHILLS 4.コスト削減 コストは少ないほうがいいに決まっている! 当社のコスト削減の取り組みとしては ・インスタンスサイズ、タイプ、世代の見直し。 ・Spot Instanceの活用。 ・定額料金制(RI)やSaving Plansの導入。
・複数ベンダーとの渉外。 ・為替予約取引での購入検討。 など様々。 Container化により柔軟なスケーリングが実現できれば、不要なときにリソース を極限まで下げれるので、コスト削減にも貢献するはず。 -
Fargate選定の背景 1.インフラ管理の範囲を減らせる ・Containerを実行させるためのNodeインスタンスの管理が外出しできる。 #TECHHILLS 2.導入対象のサービスがAWSで稼働していた ・既にAWSのVPC内に連携するサーバやDBなどが存在。 ・原則VPC内のインターナル通信で完結したかった。 以下3点が大きなポイント 3.ほかのAWS上の選択肢と比較すると学習、構築コストが少ない ・Container化に取り組みだしたのが、ここ2年と後発だった。
・導入対象サービスのリリースまでの期間は3か月とタイトだった。 ・AWS上のほかのContainerの選択肢と比較すると圧倒的に学習および構築コストが 少なく済みそうだった。 -
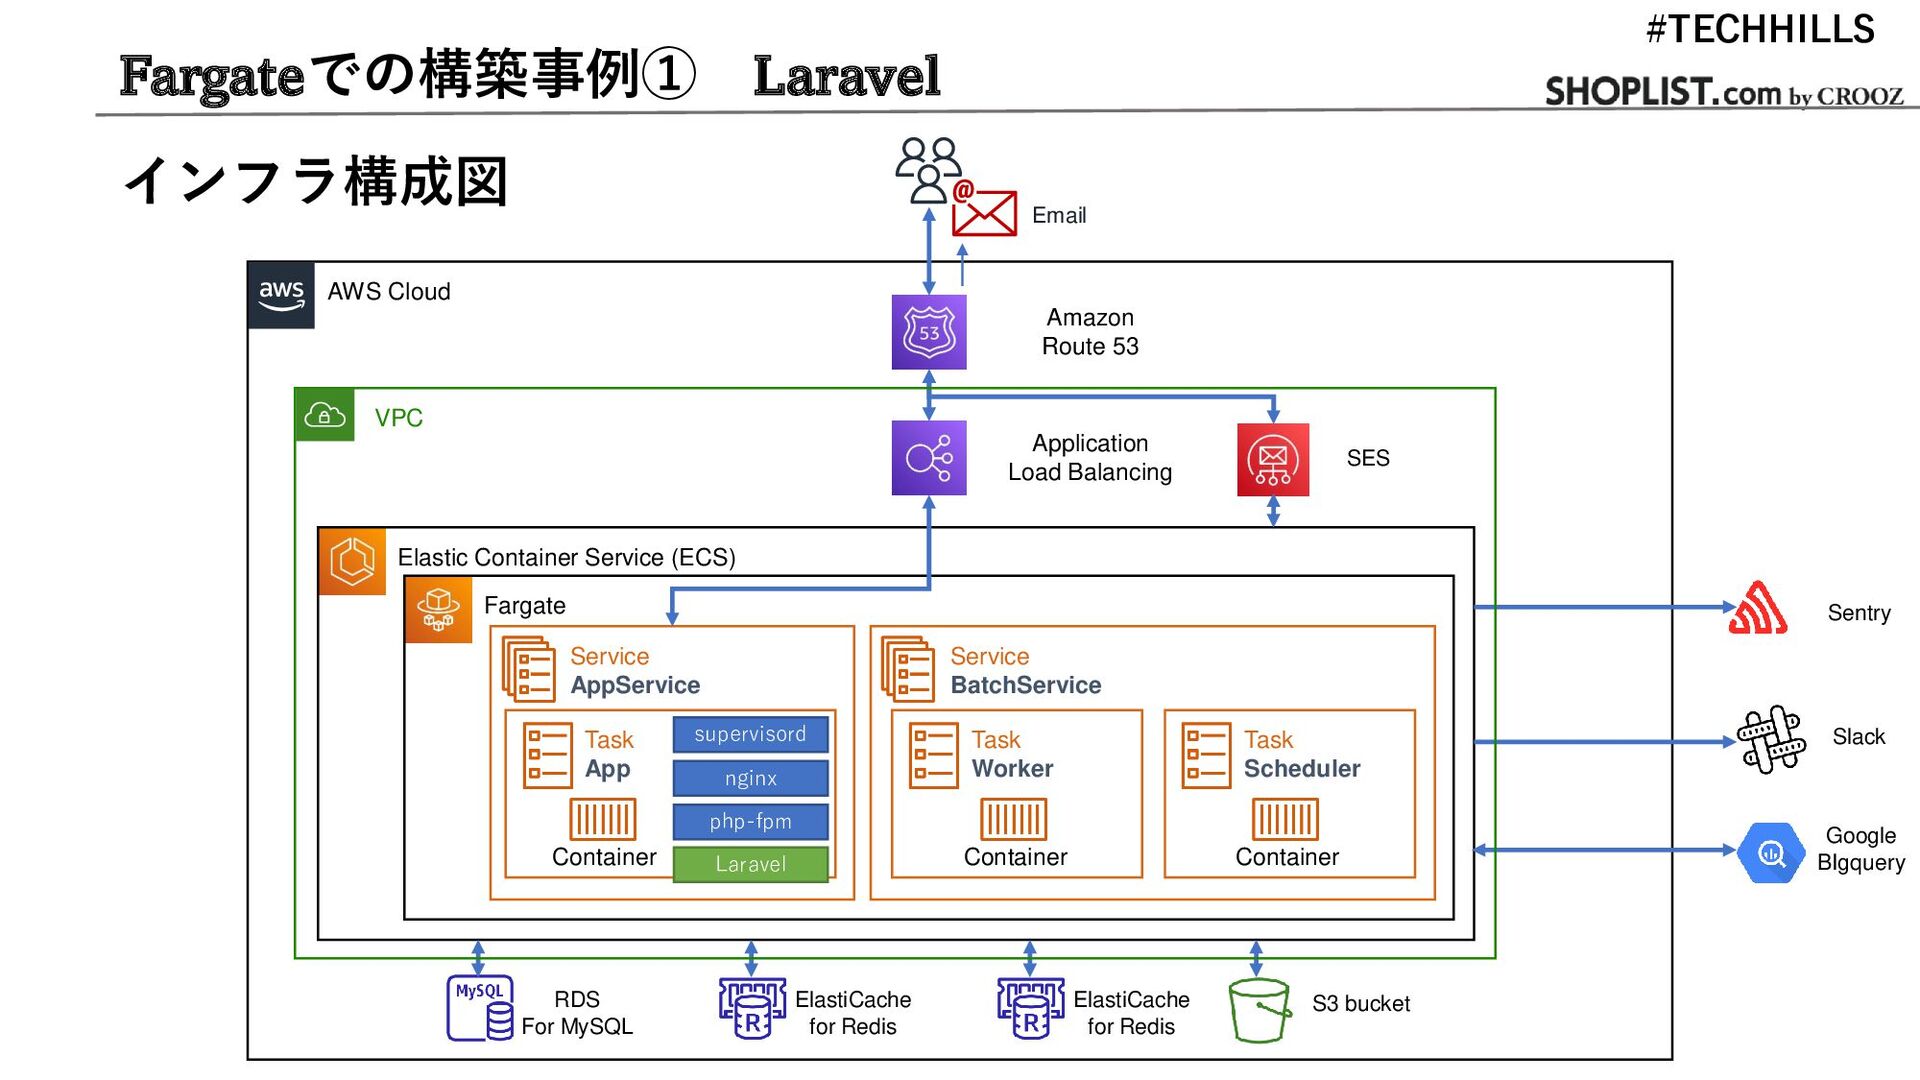
Fargateでの構築事例① Laravel #TECHHILLS インフラ構成図 AWS Cloud Container Amazon Route 53
Application Load Balancing Elastic Container Service (ECS) Fargate Service AppService Service BatchService Task App Task Worker Task Scheduler Container Container RDS For MySQL ElastiCache for Redis SES Email Slack S3 bucket Google BIgquery ElastiCache for Redis Sentry VPC supervisord nginx php-fpm Laravel -
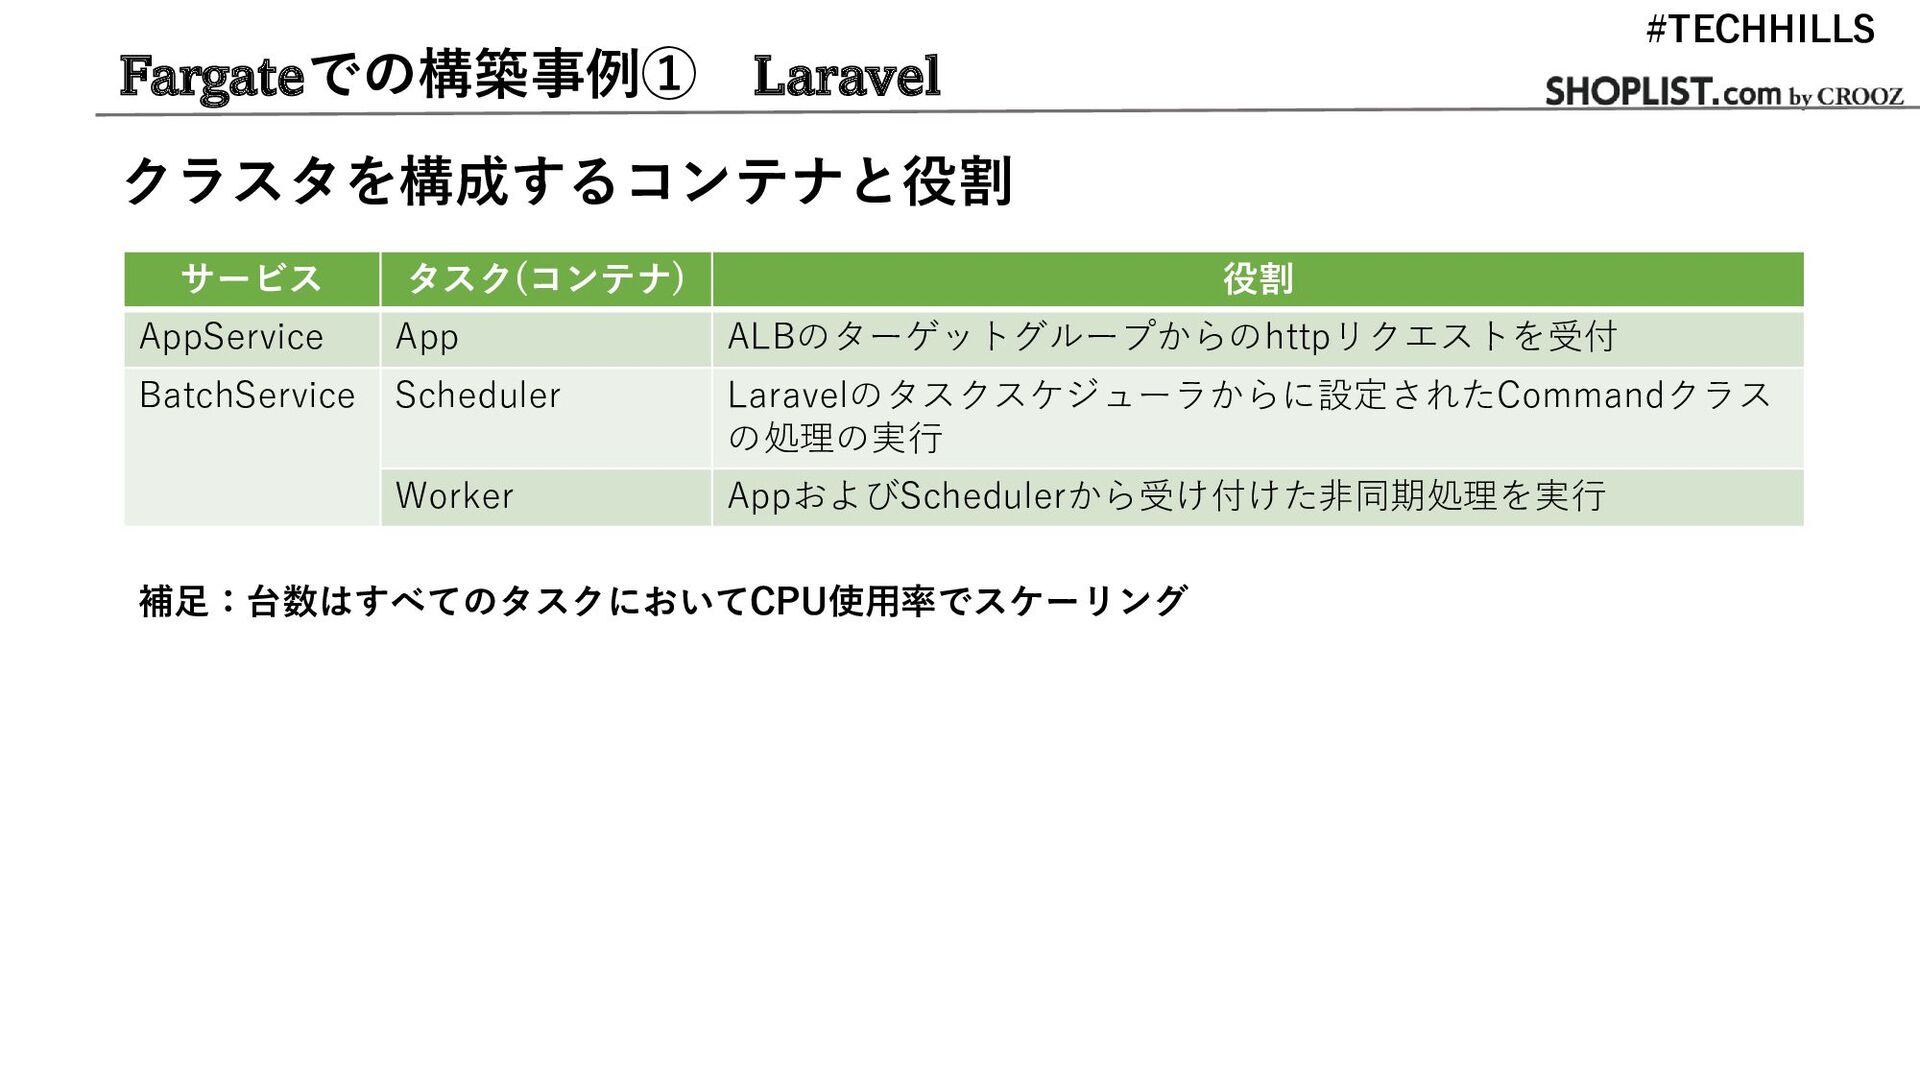
Fargateでの構築事例① Laravel #TECHHILLS クラスタを構成するコンテナと役割 サービス タスク(コンテナ) 役割 AppService App ALBのターゲットグループからのhttpリクエストを受付
BatchService Scheduler Laravelのタスクスケジューラからに設定されたCommandクラス の処理の実行 Worker AppおよびSchedulerから受け付けた非同期処理を実行 補足:台数はすべてのタスクにおいてCPU使用率でスケーリング -
Fargateでの構築事例① Laravel #TECHHILLS クラスタを構成するコンテナのentrypoint サービス タスク(コンテナ) entrypoint AppService App supervisord
1コンテナ1プロセスにすべきではあるものの、コンテナ間の連携 がうまくいかなかっため、暫定でsupervisordを起動ポイントとし て、nginxとphp-fpmの2プロセスを起動してsocketファイル経由 で連携。 BatchService Scheduler bashにて以下コマンドを引数として指定 while sleep $((60 - `date +%s` % 60)); do php artisan schedule:run; done ※コマンドの絶対パスは省略 Worker php artisan queue:listen ※コマンドの絶対パスは省略 -
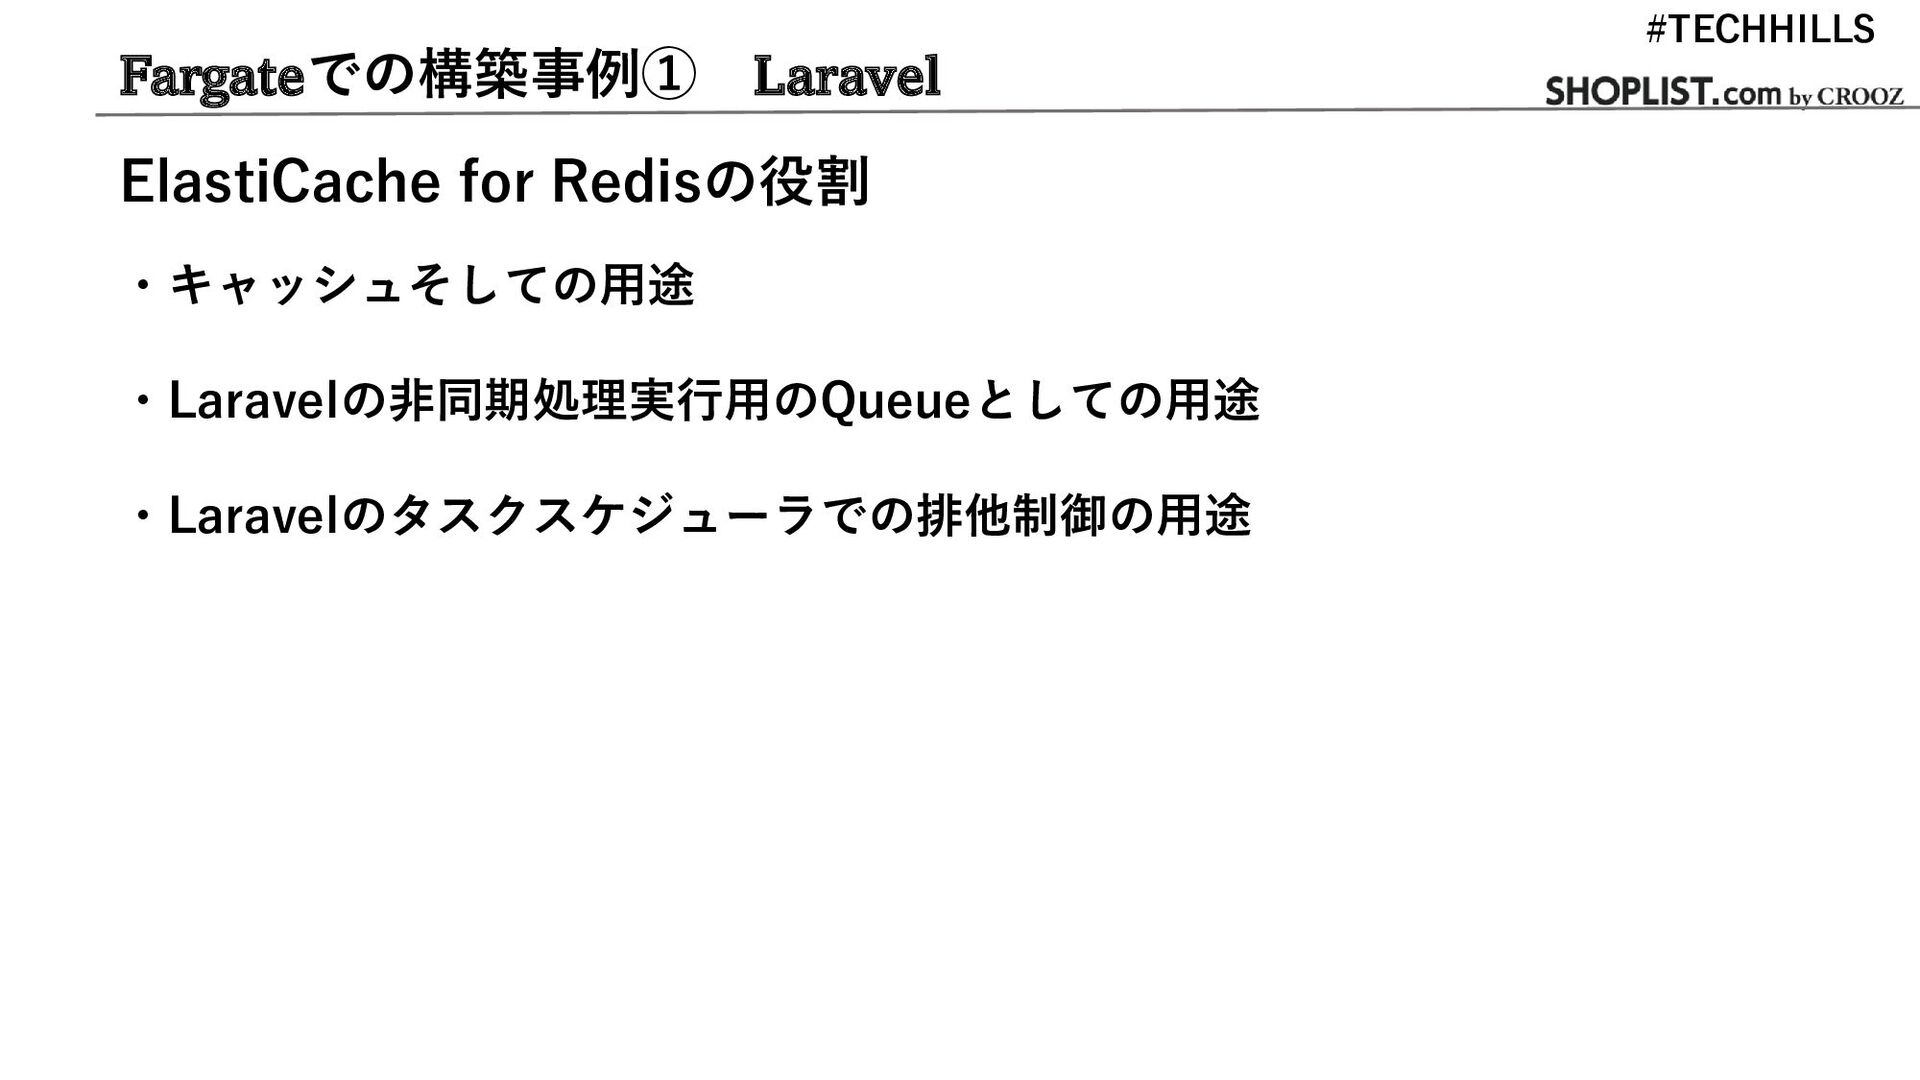
Fargateでの構築事例① Laravel #TECHHILLS ログ及び監視回り ・コンテナ周り → Fargate の標準の仕組みを使う ・Cloudwatch Metrix
・アプリケーションログ → composerにてインストールされた各種パッケージ経由でAPIで送信 思想としてはPHPの例外処理としてキャッチしてHandlerで送信する考え方 ・sentry/sentry-Laravel ・maxbanton/cwh -
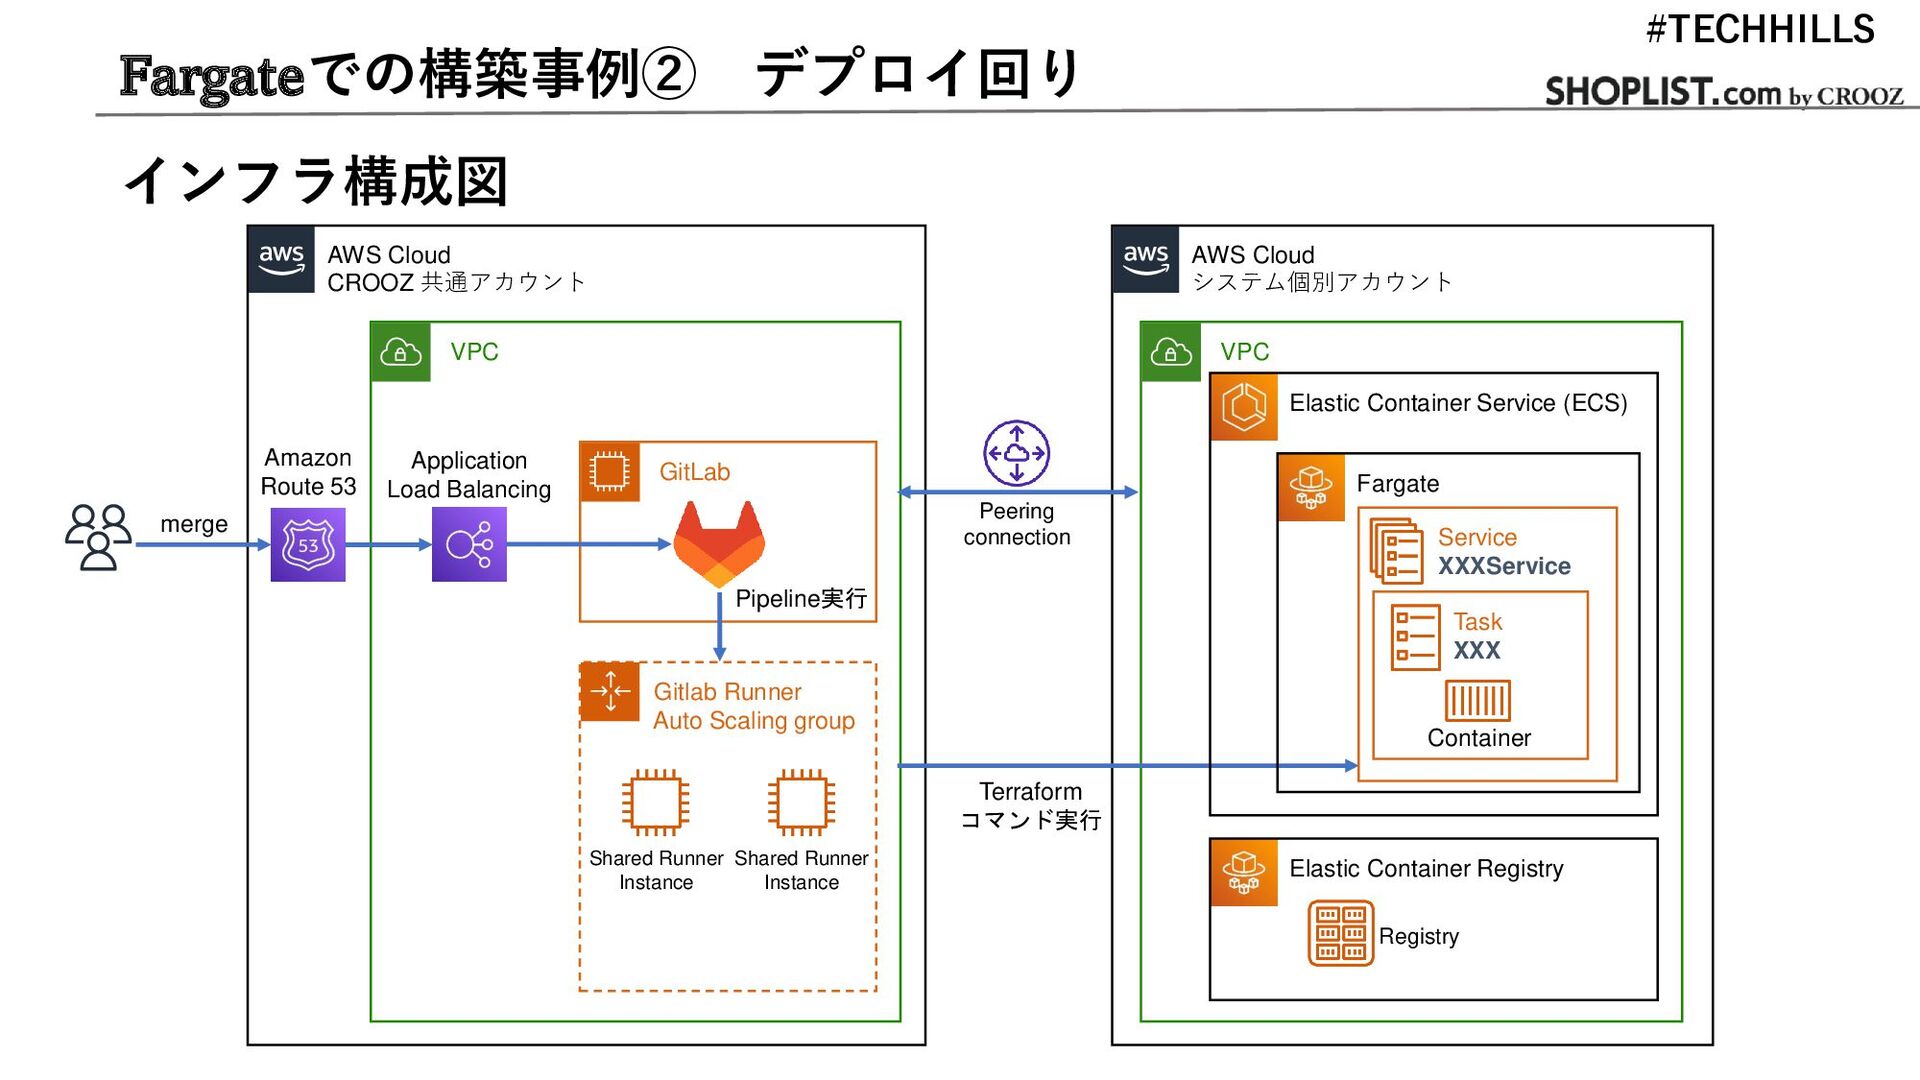
Fargateでの構築事例② デプロイ回り #TECHHILLS インフラ構成図 AWS Cloud CROOZ 共通アカウント VPC Amazon
Route 53 Application Load Balancing GitLab Gitlab Runner Auto Scaling group Shared Runner Instance Shared Runner Instance merge Pipeline実行 AWS Cloud システム個別アカウント VPC Peering connection Terraform コマンド実行 Container Elastic Container Service (ECS) Fargate Service XXXService Task XXX Elastic Container Registry Registry -
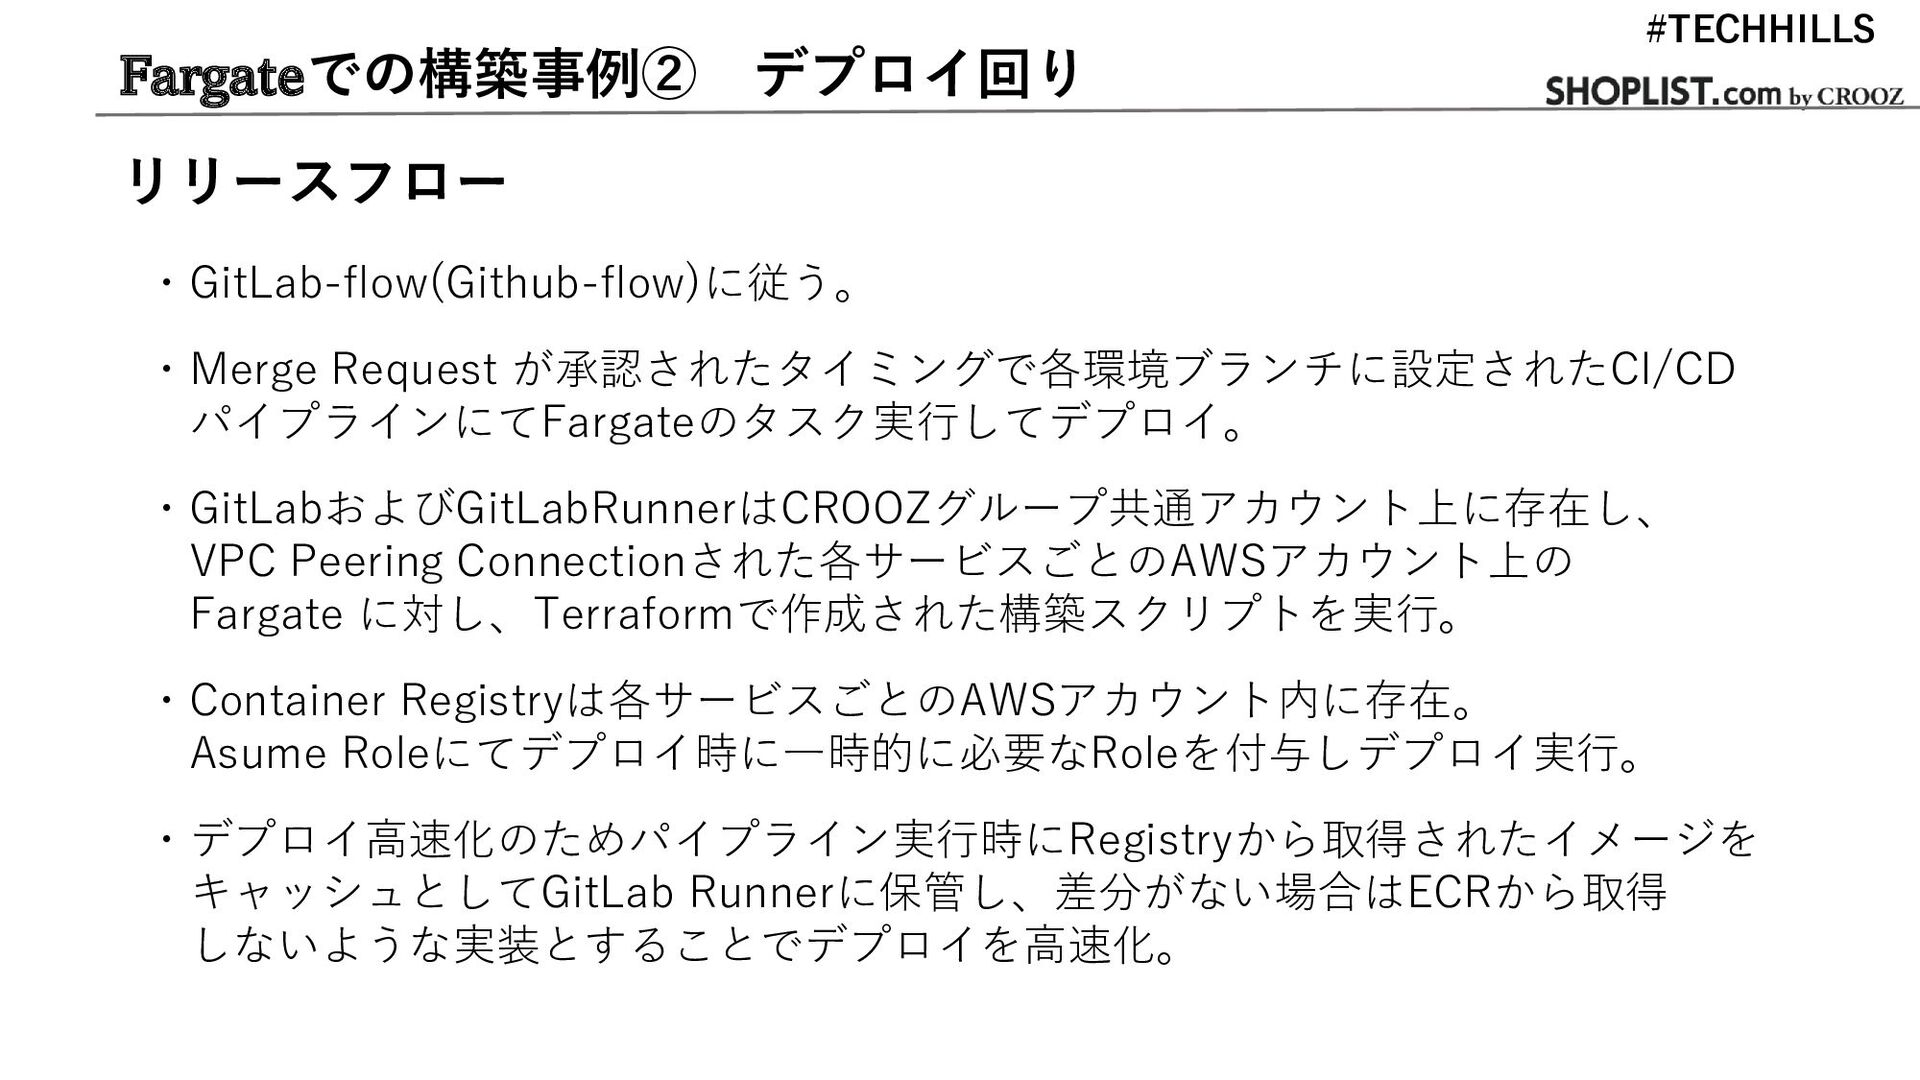
Fargateでの構築事例② デプロイ回り #TECHHILLS リリースフロー ・GitLab-flow(Github-flow)に従う。 ・Merge Request が承認されたタイミングで各環境ブランチに設定されたCI/CD パイプラインにてFargateのタスク実行してデプロイ。 ・GitLabおよびGitLabRunnerはCROOZグループ共通アカウント上に存在し、
VPC Peering Connectionされた各サービスごとのAWSアカウント上の Fargate に対し、Terraformで作成された構築スクリプトを実行。 ・Container Registryは各サービスごとのAWSアカウント内に存在。 Asume Roleにてデプロイ時に一時的に必要なRoleを付与しデプロイ実行。 ・デプロイ高速化のためパイプライン実行時にRegistryから取得されたイメージを キャッシュとしてGitLab Runnerに保管し、差分がない場合はECRから取得 しないような実装とすることでデプロイを高速化。 -
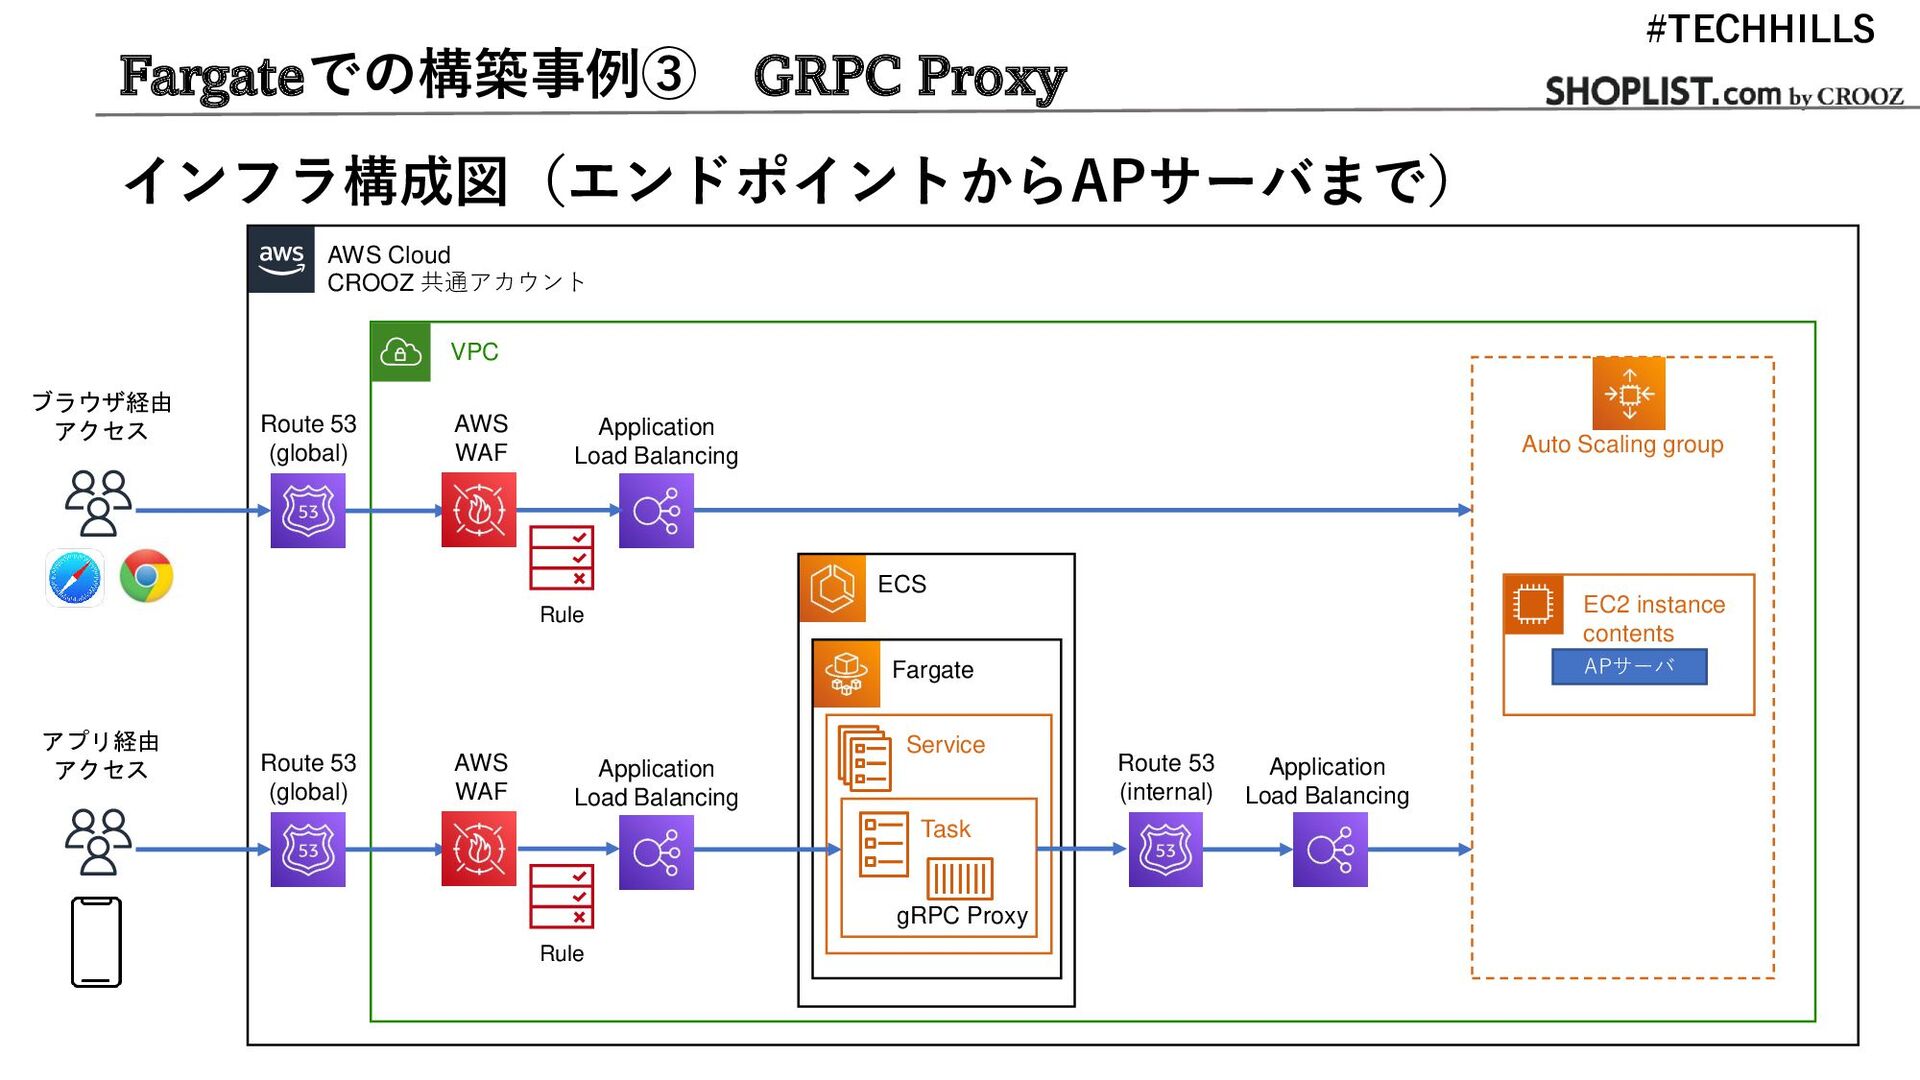
Fargateでの構築事例③ GRPC Proxy #TECHHILLS インフラ構成図(エンドポイントからAPサーバまで) AWS Cloud CROOZ 共通アカウント VPC
Route 53 (global) Application Load Balancing ブラウザ経由 アクセス AWS WAF Rule Auto Scaling group EC2 instance contents APサーバ Route 53 (global) アプリ経由 アクセス AWS WAF Rule Application Load Balancing gRPC Proxy ECS Fargate Service Task Route 53 (internal) Application Load Balancing -
Fargateでの構築事例③ GRPC Proxy ・ALB RuleによりFargate内のコンテナに転送 ・コンテナ内に構築されたgRPC ProxyがgRPC ProtocolをHTTP Protcolに変換 し、バックエンドのインターナルドメインに対してHTTPリクエスト送出
・インターナルDNS(Route 53)はインターナルのALBに転送し、対象のEC2 インスタンスにリクエスト送出 #TECHHILLS アプリからの通信経路 -
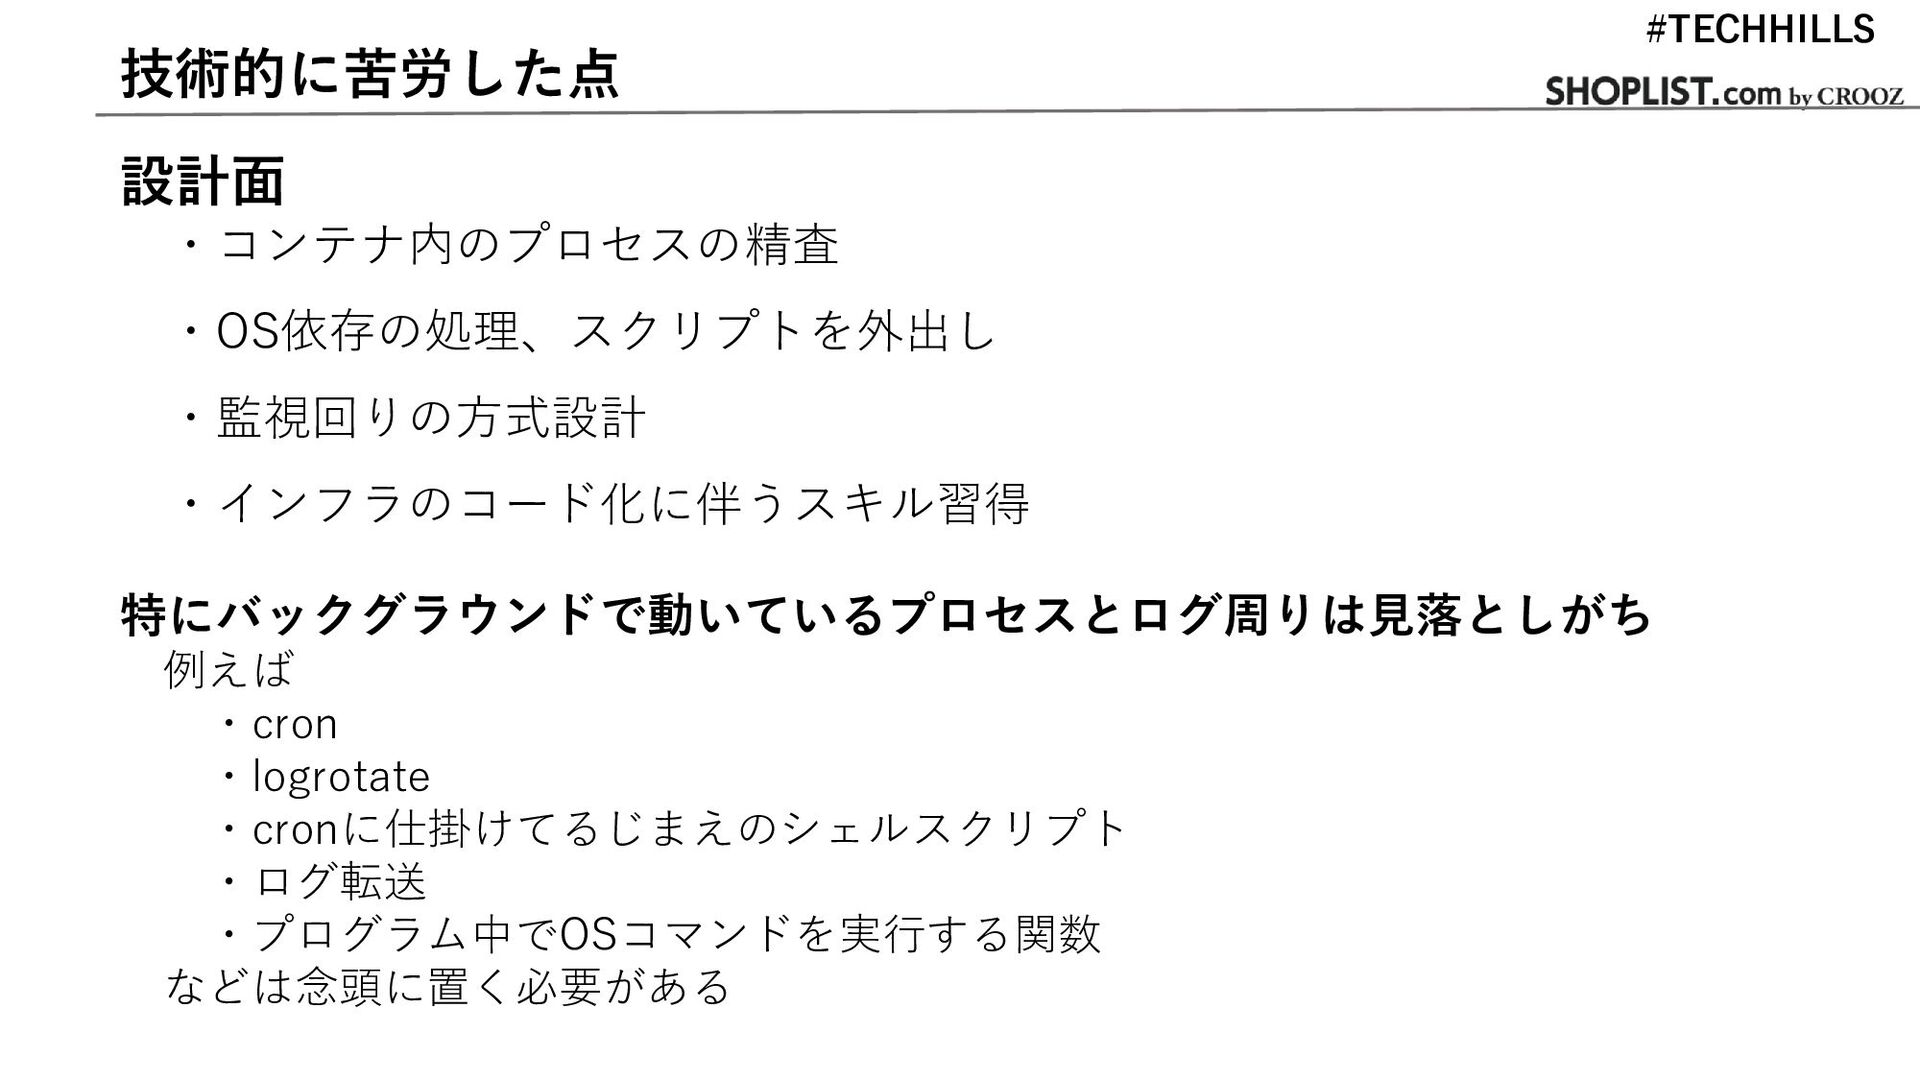
技術的に苦労した点 設計面 ・コンテナ内のプロセスの精査 ・OS依存の処理、スクリプトを外出し ・監視回りの方式設計 ・インフラのコード化に伴うスキル習得 #TECHHILLS 特にバックグラウンドで動いているプロセスとログ周りは見落としがち 例えば ・cron
・logrotate ・cronに仕掛けてるじまえのシェルスクリプト ・ログ転送 ・プログラム中でOSコマンドを実行する関数 などは念頭に置く必要がある -
技術的に苦労した点 デバッグ、運用面 ・SSHでOSに入れない Managedなんで当たり前なんだけど恐ろしくデバッグしづらい。 ECS EXECでFargateに入るのも恐ろしく手間。 ・そんなん絶対入ってるでしょ!!というコマンドがない vimがない… まあ、いまvimの時代ではないのは理解してるのですが、基本的に我々がOSコマンド として認識しているものの多くは都度追加インストールが必要。
そして、再デプロイすると無くなってしまうのでデバッグ都度インストールが必要… ・権限で怒られることが多い IAM / IAM Roleにアタッチするポリシーやコンテナ内のディレクトリの パーミッションでとにかく怒られる #TECHHILLS -
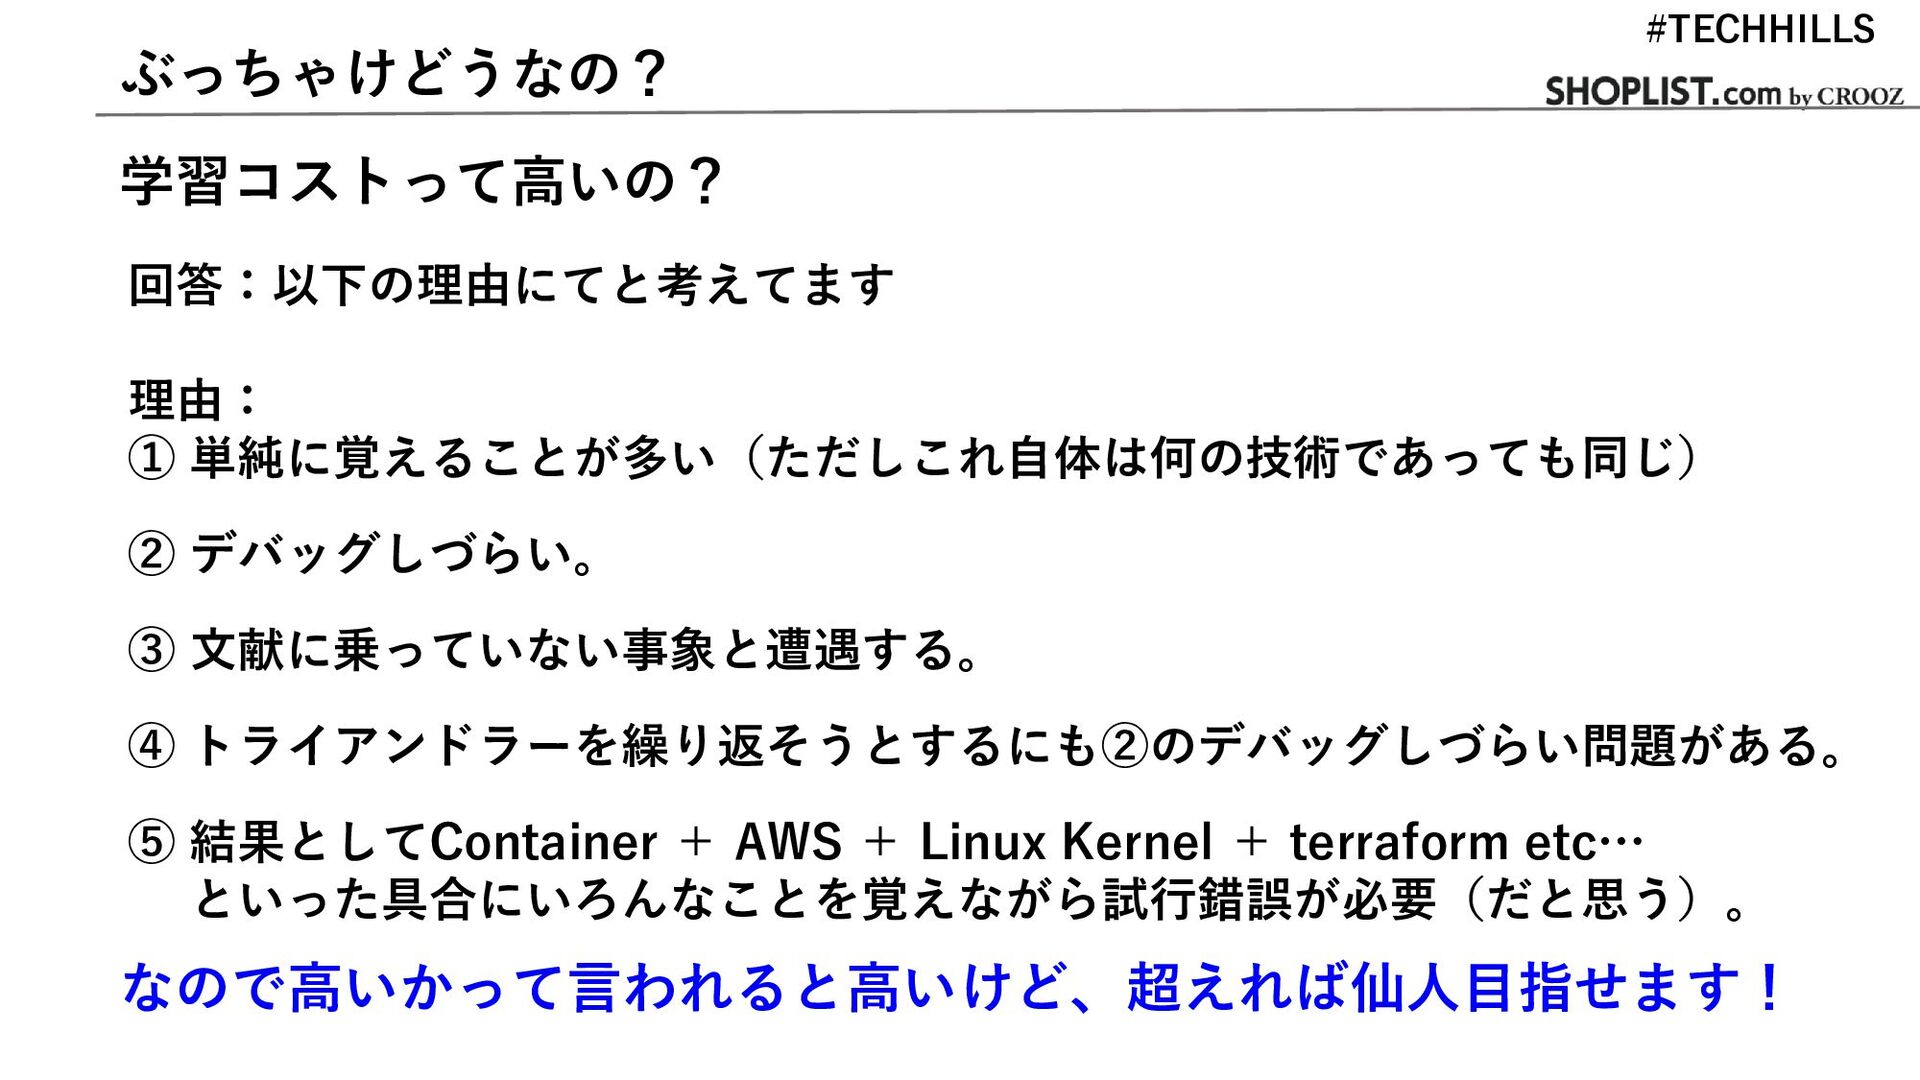
ぶっちゃけどうなの? 学習コストって高いの? 回答:以下の理由にてと考えてます 理由: ① 単純に覚えることが多い(ただしこれ自体は何の技術であっても同じ) ② デバッグしづらい。 ③ 文献に乗っていない事象と遭遇する。
④ トライアンドラーを繰り返そうとするにも②のデバッグしづらい問題がある。 ⑤ 結果としてContainer + AWS + Linux Kernel + terraform etc… といった具合にいろんなことを覚えながら試行錯誤が必要(だと思う)。 #TECHHILLS なので高いかって言われると高いけど、超えれば仙人目指せます! -
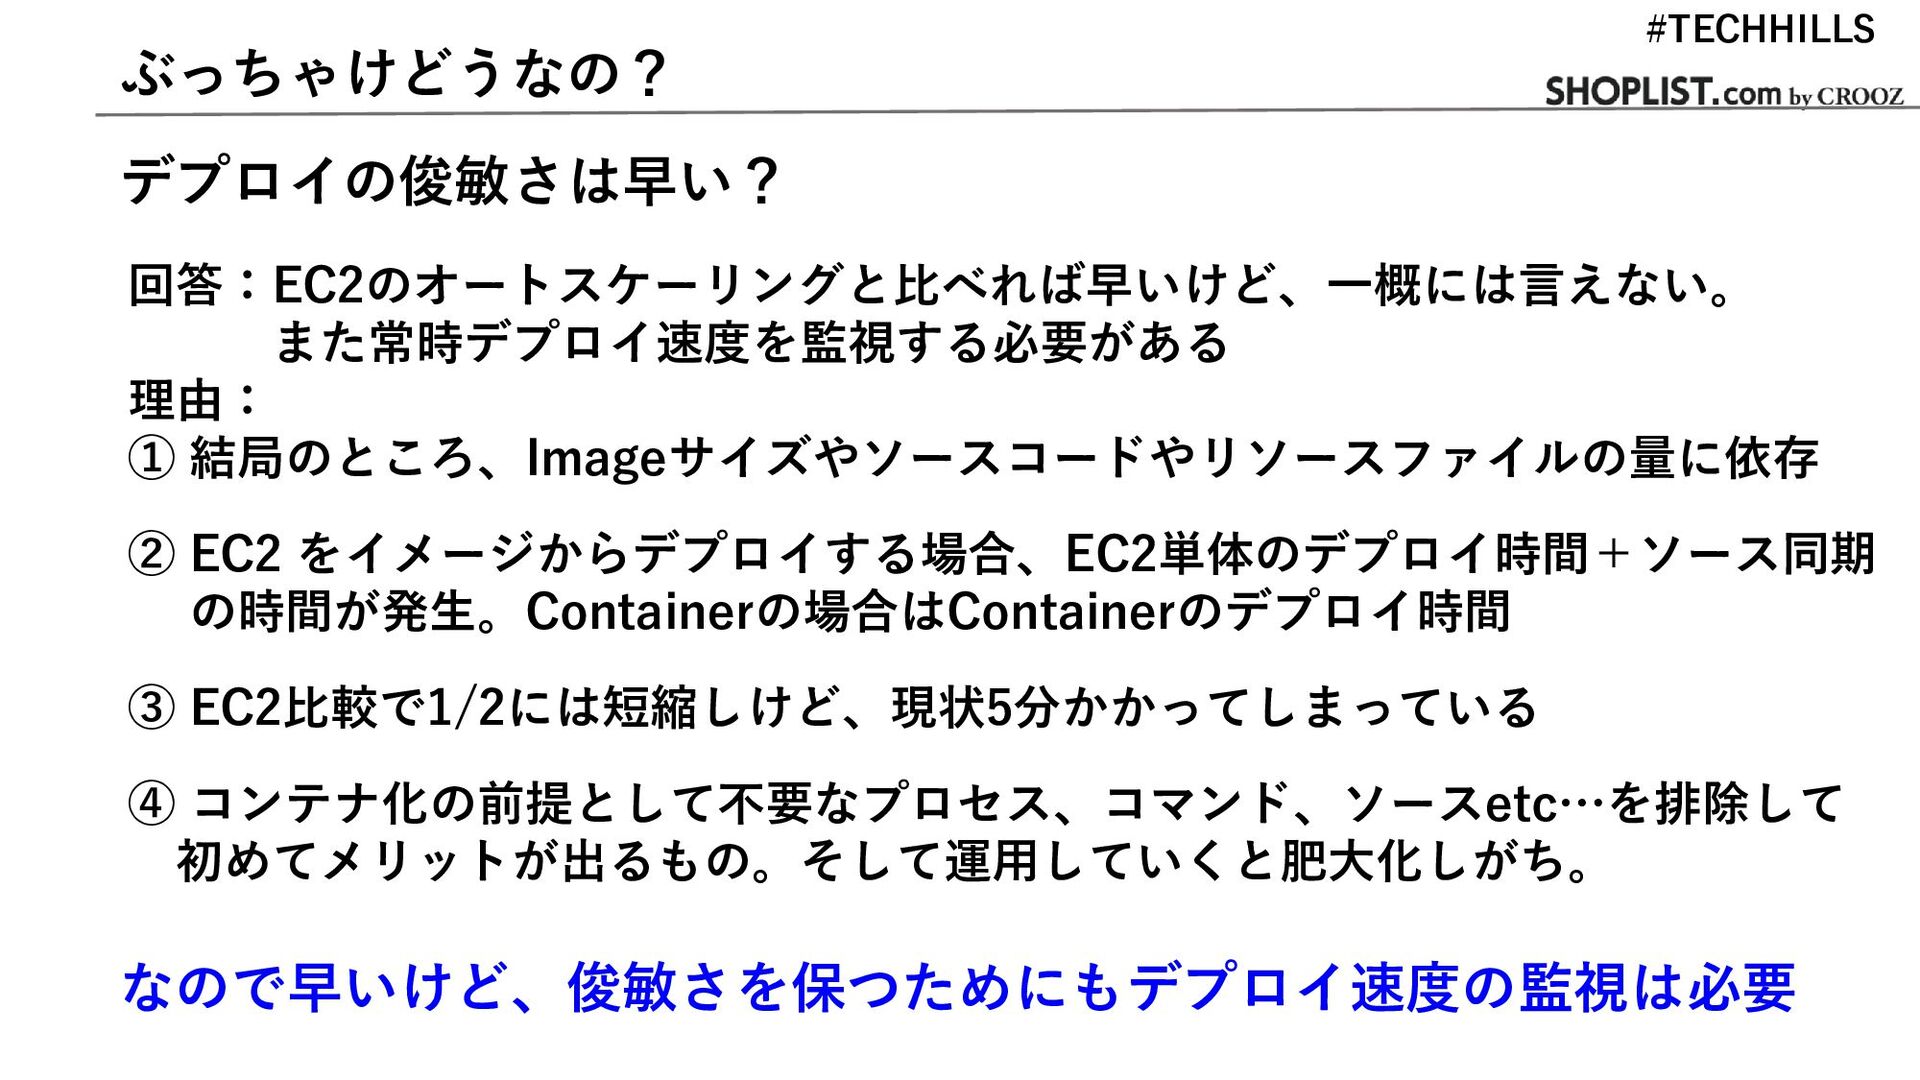
ぶっちゃけどうなの? デプロイの俊敏さは早い? 回答:EC2のオートスケーリングと比べれば早いけど、一概には言えない。 また常時デプロイ速度を監視する必要がある 理由: ① 結局のところ、Imageサイズやソースコードやリソースファイルの量に依存 ② EC2 をイメージからデプロイする場合、EC2単体のデプロイ時間+ソース同期
の時間が発生。Containerの場合はContainerのデプロイ時間 ③ EC2比較で1/2には短縮しけど、現状5分かかってしまっている ④ コンテナ化の前提として不要なプロセス、コマンド、ソースetc…を排除して 初めてメリットが出るもの。そして運用していくと肥大化しがち。 #TECHHILLS なので早いけど、俊敏さを保つためにもデプロイ速度の監視は必要 -
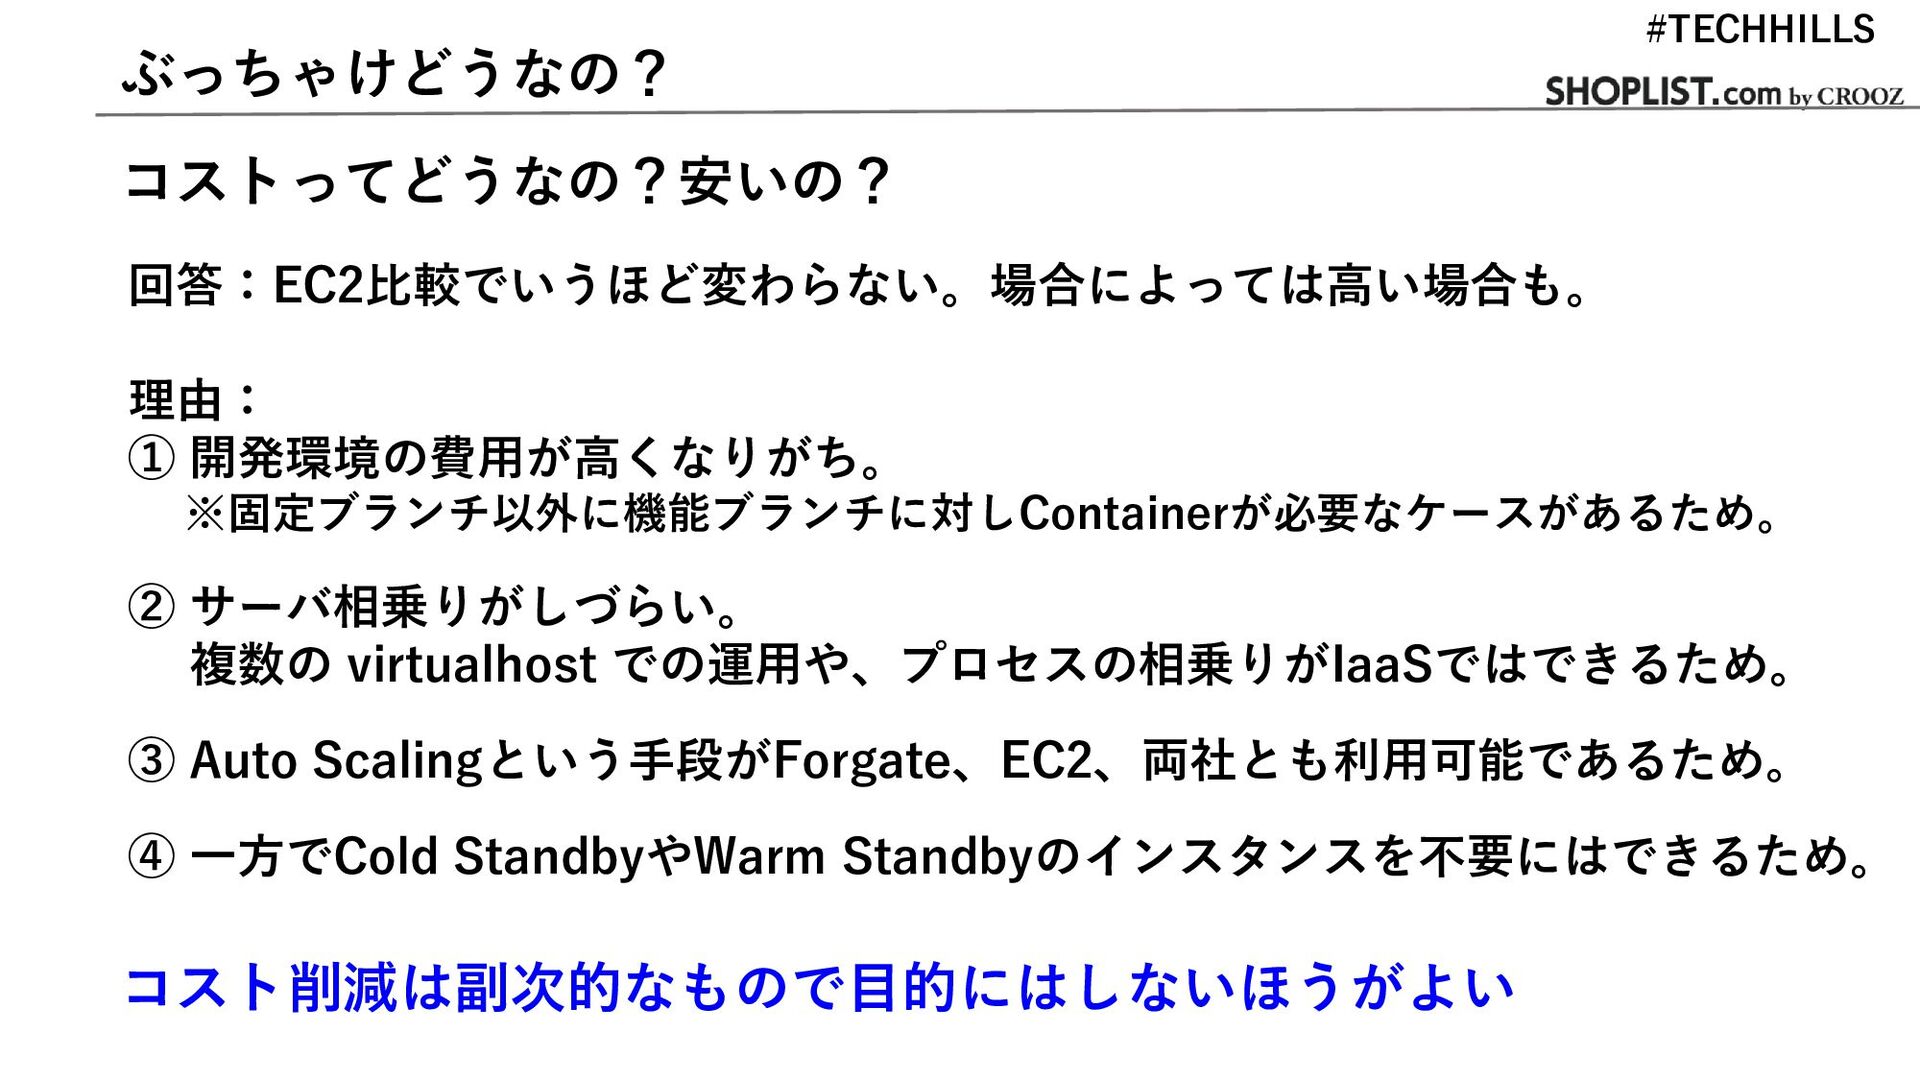
ぶっちゃけどうなの? コストってどうなの?安いの? 回答:EC2比較でいうほど変わらない。場合によっては高い場合も。 理由: ① 開発環境の費用が高くなりがち。 ※固定ブランチ以外に機能ブランチに対しContainerが必要なケースがあるため。 ② サーバ相乗りがしづらい。 複数の
virtualhost での運用や、プロセスの相乗りがIaaSではできるため。 ③ Auto Scalingという手段がForgate、EC2、両社とも利用可能であるため。 ④ 一方でCold StandbyやWarm Standbyのインスタンスを不要にはできるため。 #TECHHILLS コスト削減は副次的なもので目的にはしないほうがよい -
ぶっちゃけどうなの? インフラのコード化によってどんないいことがあった? 回答: ・Fargateに限らず、Ansible / Terraform の活用により自動でできる範囲が 広がり、ヒトが管理する範囲を少なくできた。 → 予測できない負荷に対してもサービスダウンリスクの排除。
→ 定常オペレーションの簡素化。 → 少人数&兼務でのインフラ管理の実現。 ・品質を下げる要素を減らせた。 → Git上での管理、Merge Requestでの複数名でのレビュー。 → 流れるコマンドが固定化されることによる環境差異要因の減少。 #TECHHILLS