Share
Embed
Transcript
61 slides
-
Кто говорит • Очень долго работал админом • Руководил эксплуатацией
в hh.ru • Основал и работаю в okmeter.io – сервис мониторинга -
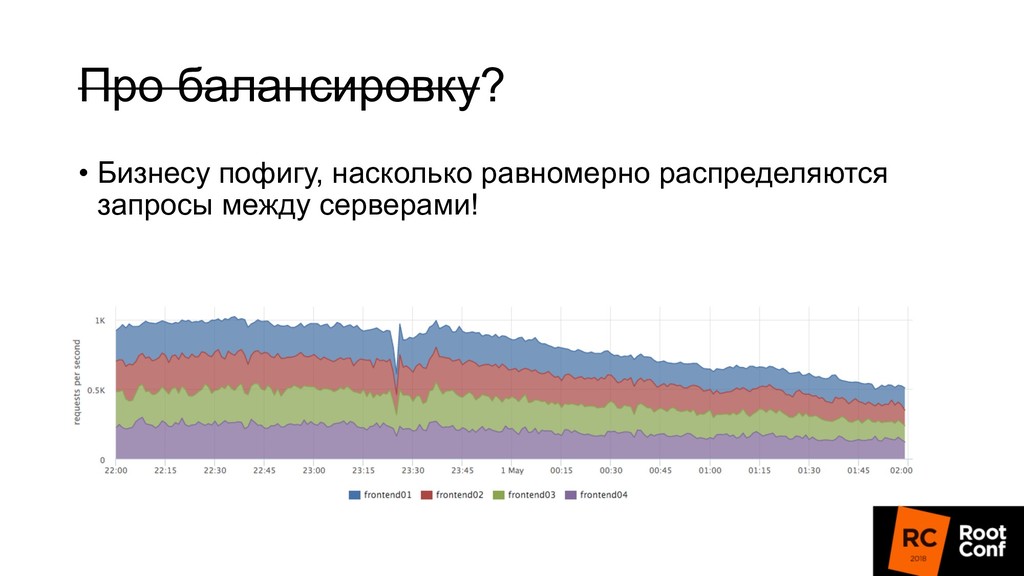
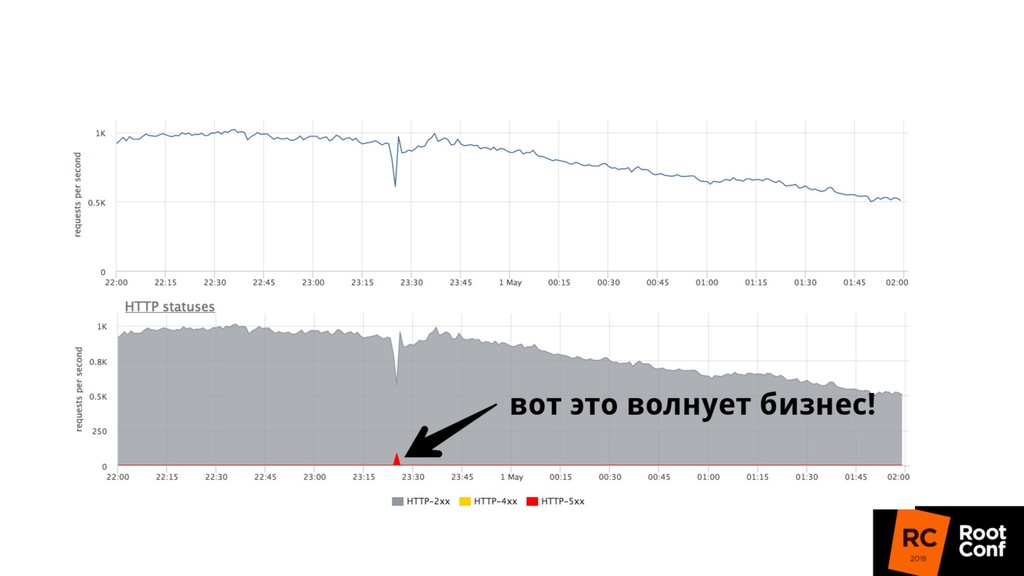
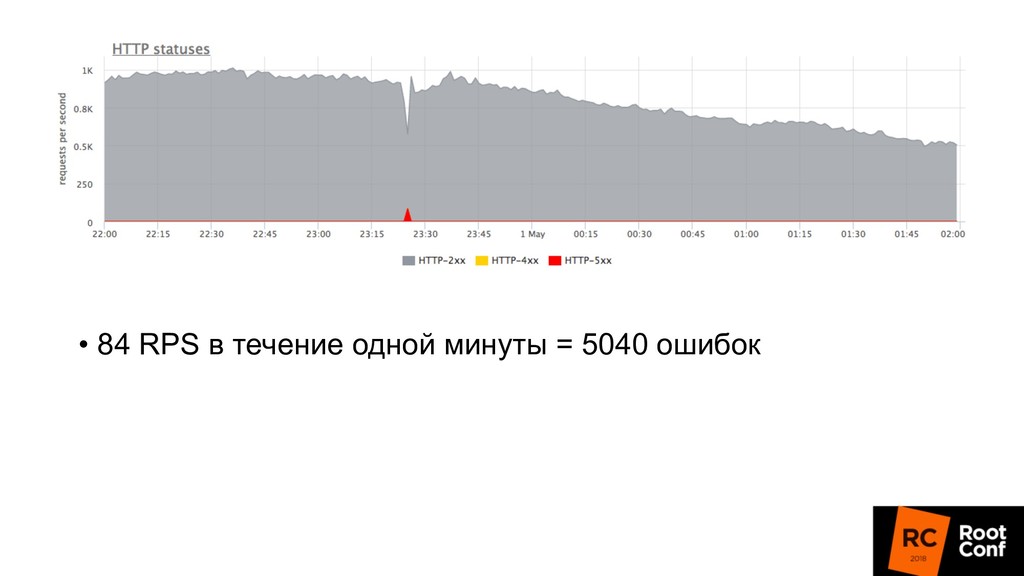
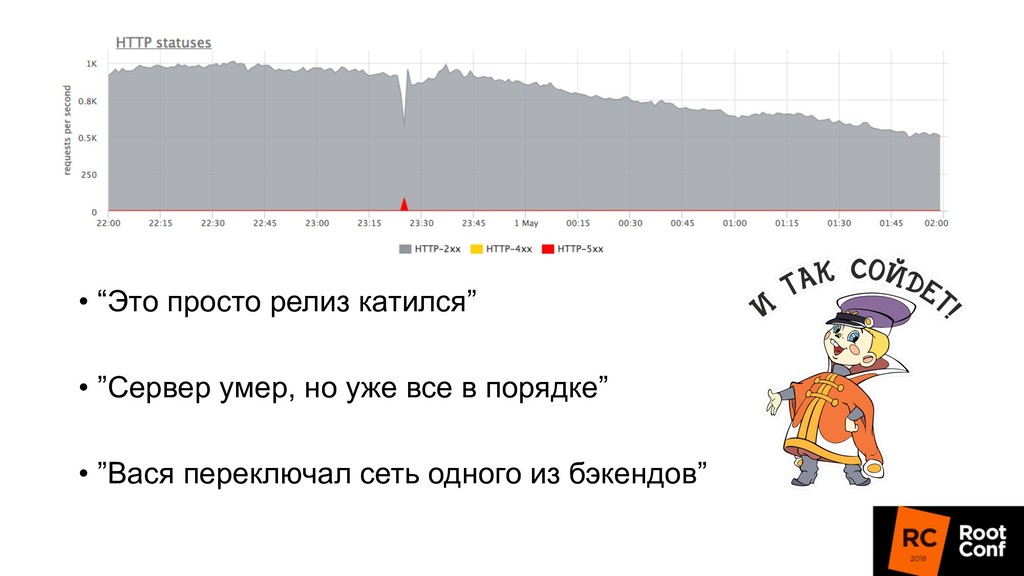
• “Это просто релиз катился” • ”Сервер умер, но уже
все в порядке” • ”Вася переключал сеть одного из бэкендов” -
Почему ”тонкая” настройка? • До этой задачи не все добираются:
очень важна при факапах, но в нормальной ситуации не видна • Нужно много думать • Цепляет нижележащие уровни = взаимодействие с разработкой -
Почему пора заниматься этой задачей? • Говорят, что теперь правильно
релизиться 100 раз в день • Kubernetes rollout с точки зрения балансировщика — это как в новую школу перевестись (все апстримы новые) • Микросервисы: теперь все общаются по сети, нужно делать это надежно -
Тестовый стенд для наглядности • Golang app: • отдает http-200
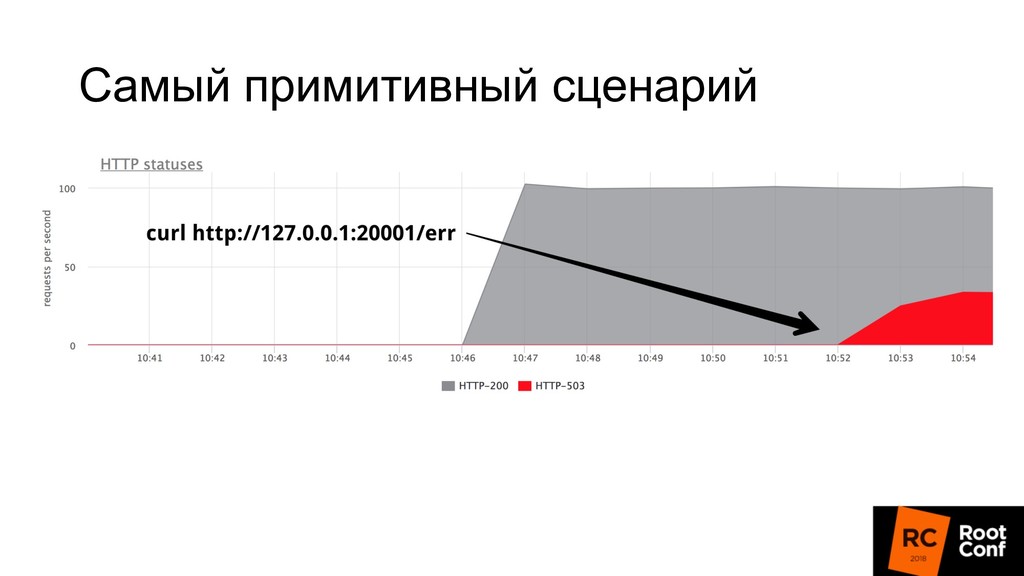
• GET /err – переключатель в режим http-503 • GET /ok – опять http-200 • Запускаем 3 инстанса: • 127.0.0.1:20001 • 127.0.0.1:20002 • 127.0.0.1:20003 • Подаем 100rps через yandex.tank через nginx -
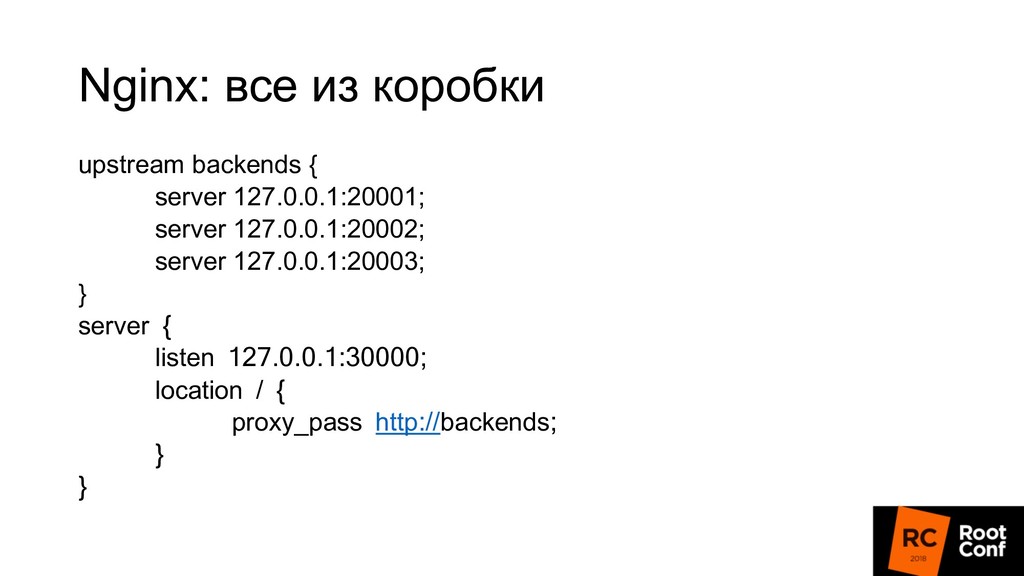
Nginx: все из коробки upstream backends { server 127.0.0.1:20001; server
127.0.0.1:20002; server 127.0.0.1:20003; } server { listen 127.0.0.1:30000; location / { proxy_pass http://backends; } } -
Что произошло? • Nginx default: proxy_next_upstream error timeout; • Нет
повторной попытки при получении любого ответа от сервера -
Retries: вводные • Пользовательский запрос — святое, расшибись, но ответь
VS • Лучше ответить ошибкой, чем перегруз серверов VS • Целостность данных (при неидемпотентных запросах) -
Retries: вводные • Пользовательский запрос — святое, расшибись, но ответь
VS • Лучше ответить ошибкой, чем перегруз серверов VS • Целостность данных (при неидемпотентных запросах) Истина, как обычно, где-то между -
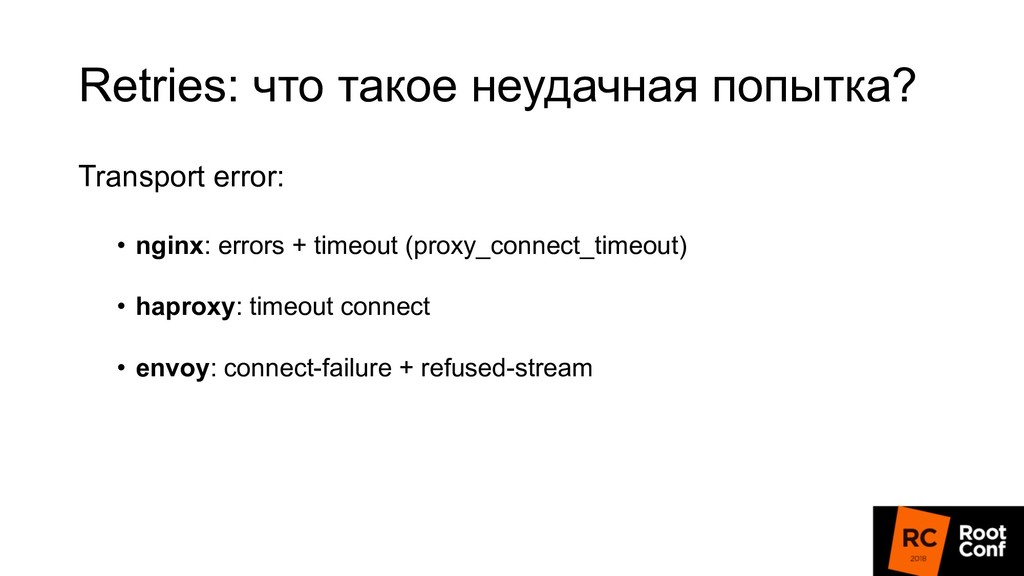
Retries: что такое неудачная попытка? Transport error: • nginx: errors
+ timeout (proxy_connect_timeout) • haproxy: timeout connect • envoy: connect-failure + refused-stream -
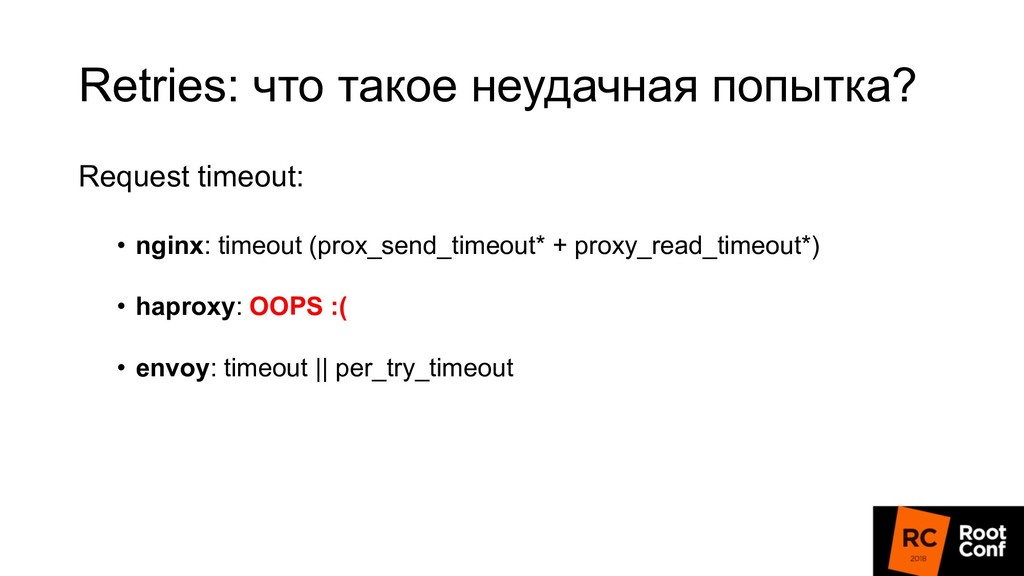
Retries: что такое неудачная попытка? Request timeout: • nginx: timeout
(prox_send_timeout* + proxy_read_timeout*) • haproxy: OOPS :( • envoy: timeout || per_try_timeout -
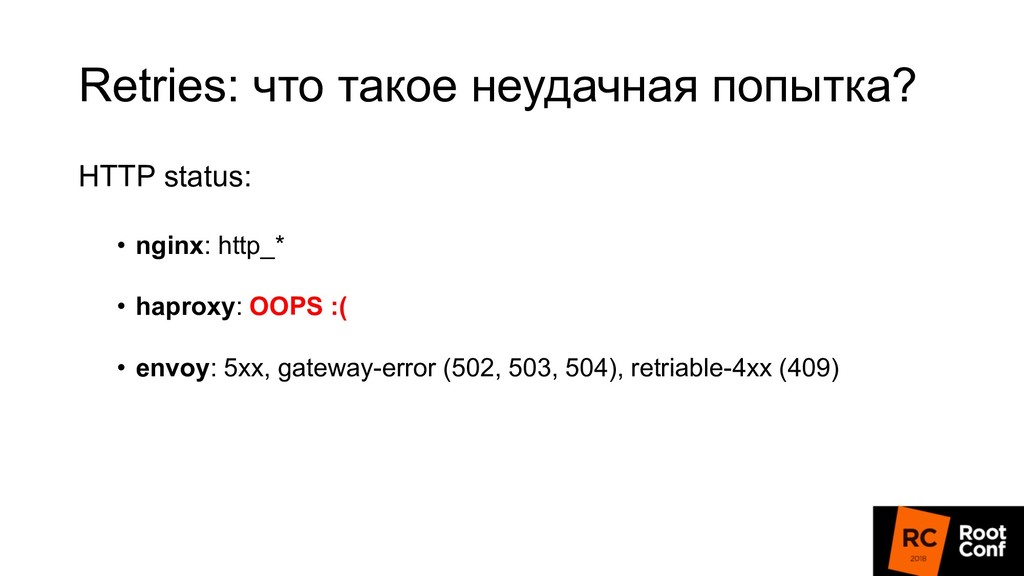
Retries: что такое неудачная попытка? HTTP status: • nginx: http_*
• haproxy: OOPS :( • envoy: 5xx, gateway-error (502, 503, 504), retriable-4xx (409) -
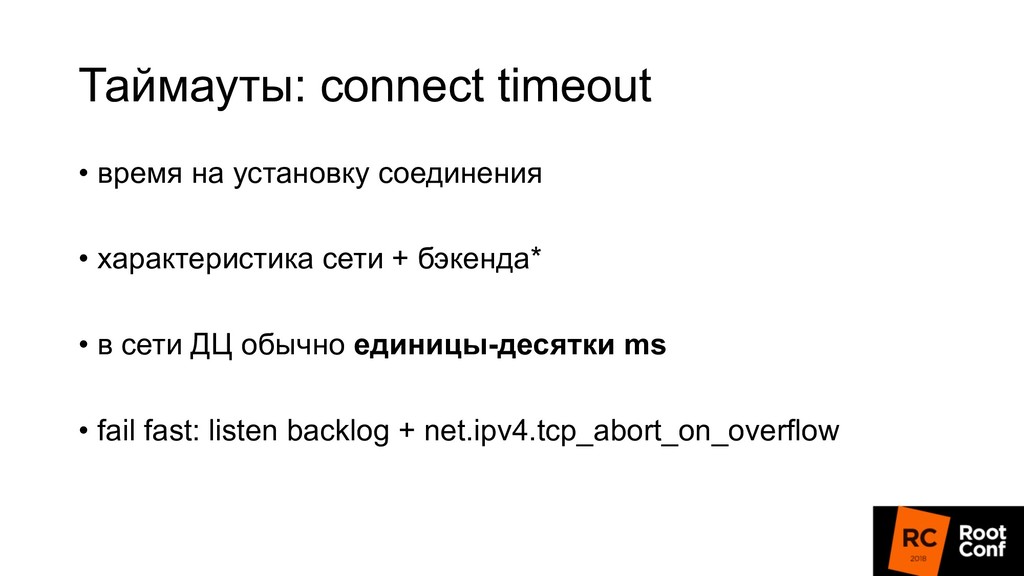
Таймауты: connect timeout • время на установку соединения • характеристика
сети + бэкенда* • в сети ДЦ обычно единицы-десятки ms • fail fast: listen backlog + net.ipv4.tcp_abort_on_overflow -
Таймауты: request timeout • Request timeout – характеристика группы запросов
(handler) • Nginx: нет таймаута на весь запрос • proxy_send_timeout: время между 2 успешными вызовами write() • proxy_read_timeout: время между 2 успешными вызовами read() • c допущением, что в сети нет slow loris, proxy_read_timeout прокатит за request_timeout • Envoy: timeout || per_try_timeout -
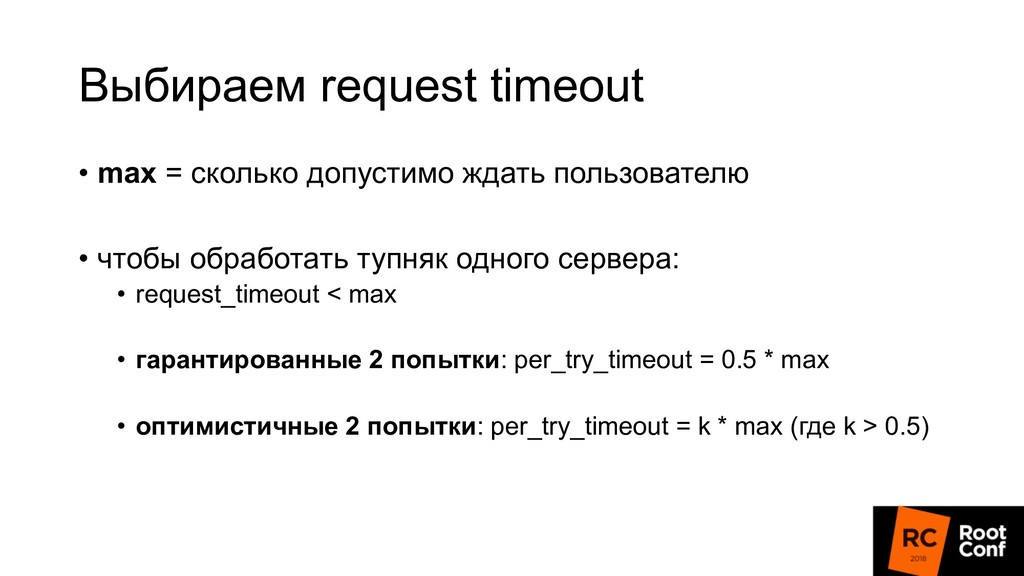
Выбираем request timeout • max = сколько допустимо ждать пользователю
• чтобы обработать тупняк одного сервера: • request_timeout < max • гарантированные 2 попытки: per_try_timeout = 0.5 * max • оптимистичные 2 попытки: per_try_timeout = k * max (где k > 0.5) -
Выбираем request timeout • СЛОЖНО • Всегда найдутся краевые случаи:
• пользователи с большим количеством связей • поиск по большому количеству критериев • … -
Выбираем request timeout • Так появляется paging там, где его
не было • Отделяем OLTP от статистики • Оптимизация запросов, которые должны работать быстро, но тупят • Сложный переход: тупящий запрос –> ошибка -
Speculative retries #нифигасечобывает • Сейчас не реализованы ни в одном
известном мне прокси • Как сделано в cassandra (rapid read protection): • speculative_retry = N ms | Mth percentile • при достижении условия отправляем второй запрос • первый не прерываем • берем ответ того, кто быстрее ответил • Надежность VS лишние запросы -
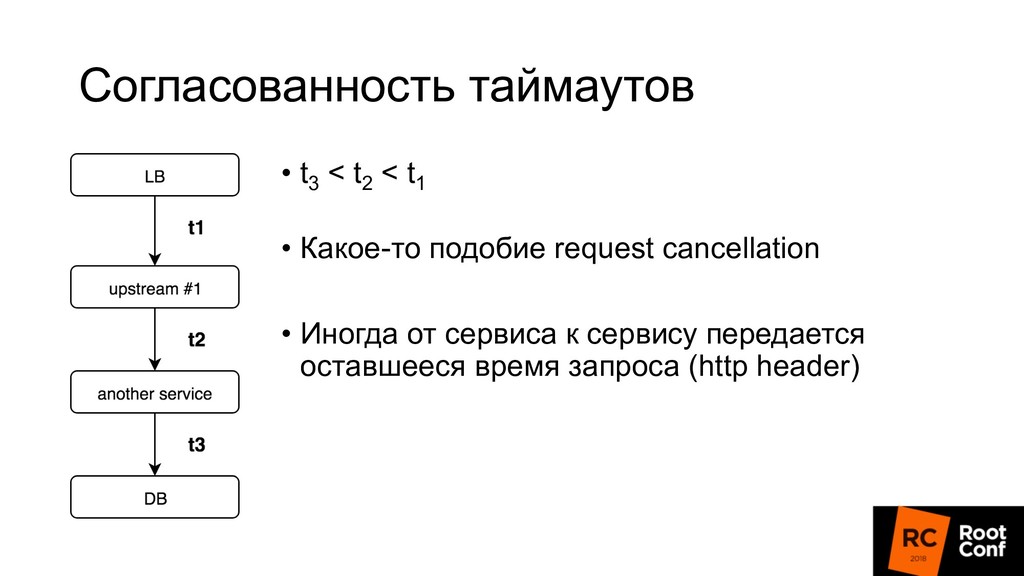
Согласованность таймаутов • t3 < t2 < t1 • Какое-то
подобие request cancellation • Иногда от сервиса к сервису передается оставшееся время запроса (http header) -
Retries: точка невозврата (V1) • Если мы начали передавать ответ
клиенту, никакие ошибки исправить уже нельзя • Уменьшаем вероятность: graceful shutdown при выкладке • Если у нас “умный клиент”: повторная попытка из клиента -
Retries: точка невозврата [envoy] • Если в envoy срабатывал per_try_timeout,
а ответ уже начал отдаваться клиенту, ответ прерывался • Мы сделали патч, который уже в master и будет в 1.7 https://github.com/envoyproxy/envoy/pull/3221 by Pavel Trukhanov • Теперь, если ответ начали передавать, сработает только global timeout -
Retries: нужно ограничивать • Запрос-убийца: тяжелый запрос, который часто не
укладывается в per_try_timeout + • Отсутствие request cancellation в 99.9% сервисов: • первая попытка начала грузить базу; балансер бросил запрос • вторая попытка начала грузить базу, которую грузит первая попытка, так как не умеет понимать, что ответ уже никому не нужен • … -
Retries: нужно ограничивать • Nginx: • proxy_next_upstream_timeout (global) • proxt_read_timeout**
в качестве per_try_timeout • proxy_next_upstream_tries • Envoy: • timeout (global) • per_try_timeout • num_retries -
Retries: применяем [nginx] upstream backends { server 127.0.0.1:20001; server 127.0.0.1:20002;
server 127.0.0.1:20003; } server { listen 127.0.0.1:30000; proxy_next_upstream error timeout http_503; proxy_next_upstream_tries 2; location / { proxy_pass http://backends; } } -
Что произошло? • proxy_next_upstream_tries = 2 • получаем HTTP-503 в
случае обеих попыток на “плохие” серверы • их мало, так как nginx “банит” бэкенды на fail_timeout -
Что с этим делать? • Увеличивать proxy_next_upstream_tries? • Уменьшить вероятность
попадания запроса на “плохой” сервер: health checks -
Health checks • Это всего лишь оптимизация процесса выбора живого
сервера • Не расходуем ценные ”попытки” в ходе пользовательского запроса • Периодические проверяем каждый upstream, выкидываем заведомо ”дохлые” -
Health checks: с точки зрения бэкенда • Проверяем свое состояние
и нижележащие подсистемы • Если балансер не особо интеллектуальный, можно понаписать разной логики: • последние N запросов закончились ошибкой, забаню сам себя на M секунд • Должен быть легким, так как дергаться будет часто -
Health checks: имплементации • У всех всё +/- одинаково: •
Request • Timeout • Interval + jitter • Healthy threshold • Unhealthy threshold • Check status + body • nginx: только в nginx+ ($) • envoy: есть panic mode, если > N% хостов unhealthy — игнорируем результаты health checks -
Собираем все воедино • Либо nginx+ • Либо nginx+что-то еще:)
• Очень часто nginx+haproxy • У нас nginx+envoy, но если заморочиться, можно только envoy* -
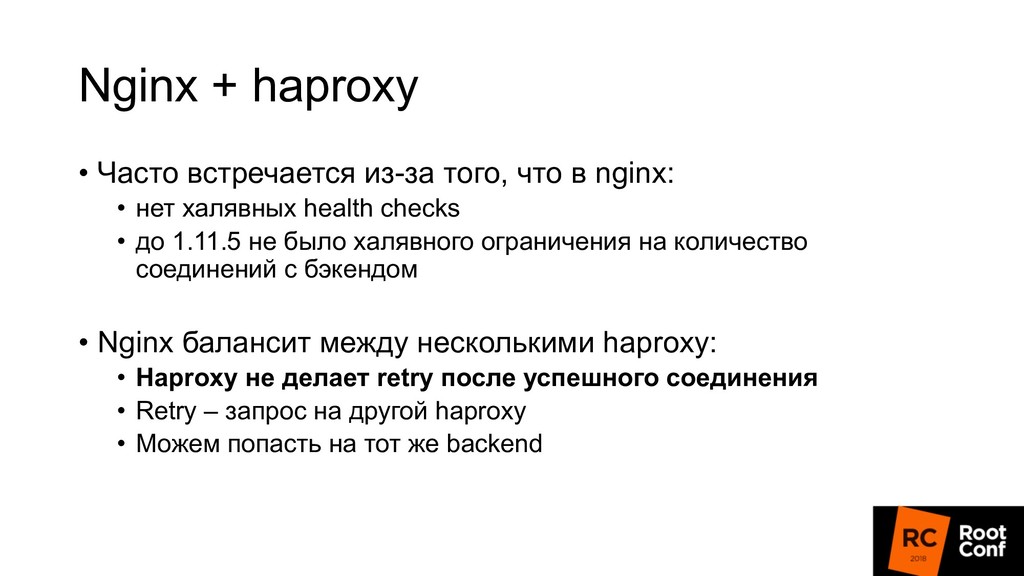
Nginx + haproxy • Часто встречается из-за того, что в
nginx: • нет халявных health checks • до 1.11.5 не было халявного ограничения на количество соединений с бэкендом • Nginx балансит между несколькими haproxy: • Haproxу не делает retry после успешного соединения • Retry – запрос на другой haproxy • Можем попасть на тот же backend -
Какой-такой envoy? • Envoy is an open source edge and
service proxy, designed for cloud-native applications • Изначально разрабатывался в Lyft (С++) • Обычно service mesh = envoy + примочки (istio, contour, ambassador) • Из коробки умеет кучу плюшек по нашей сегодняшней теме -
Backoff for retries [envoy] • Между попытками envoy делает паузы
• Случайное значение в возрастающем интервале • Первый retry через 0-24ms • Второй через 0-74ms • … -
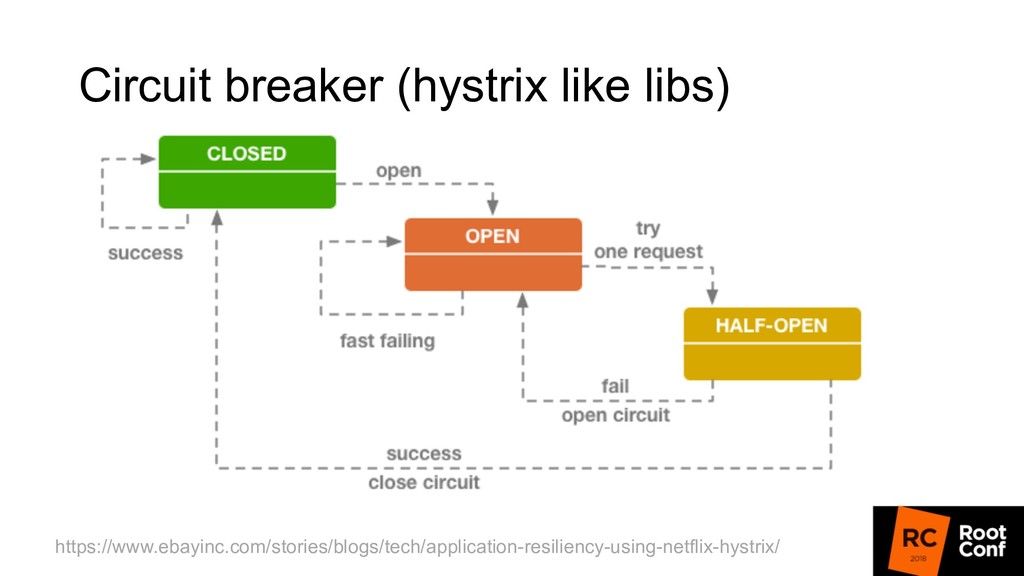
Circuit breaking • В момент проблем приложение начинает отвечать медленнее,
но при этом получает больше нагрузки: • F5/⌘-R от пользователей • Retries от балансировщика • Circuit breaker позволяет определить, что мы в таком состоянии, быстро отстрелить ошибку и дать бэкендам “отдышаться” -
Circuit breaking [envoy] • Cluster (upstream group) max connections •
Cluster max pending requests • Cluster max requests • Cluster max active retries -
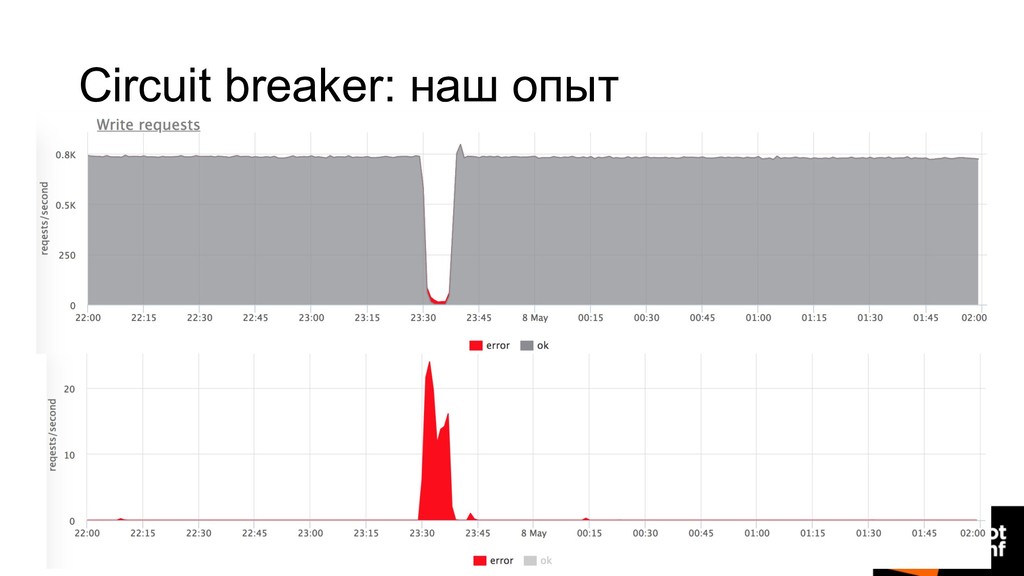
Circuit breaker: наш опыт • Раньше у нас коллектор метрик
работал по http • В момент проблем агенты получали ошибки и делали повторные попытки (метрики уже были в spool на диске) • Агентов много, они не расстраиваются и не уходят:) • При проблемах мы зажимали входящий поток записи через nginx limit req -
Circuit breaker: наш опыт • В нормальной ситуации коллектор способен
записывать гораздо больше, чем кризисный limit req • Из-за других причин мы перешли на свой протокол поверх TCP и потеряли возможность использовать nginx limit req • К тому же больше не хотелось менять limit req руками -
Circuit breaker: наш опыт • Мы сделали программный CB и
в клиенте, и в сервере • Клиент: получил N ошибок подряд -> open + exp backoff • Сервер: CB на походы к сервисам + request cancellation (где возможно) -
Самые сложные ошибки • Сервер, который просто выключился и не
включается – это просто подарок судьбы • Самый сложный вариант – “сервер Шредингера” -
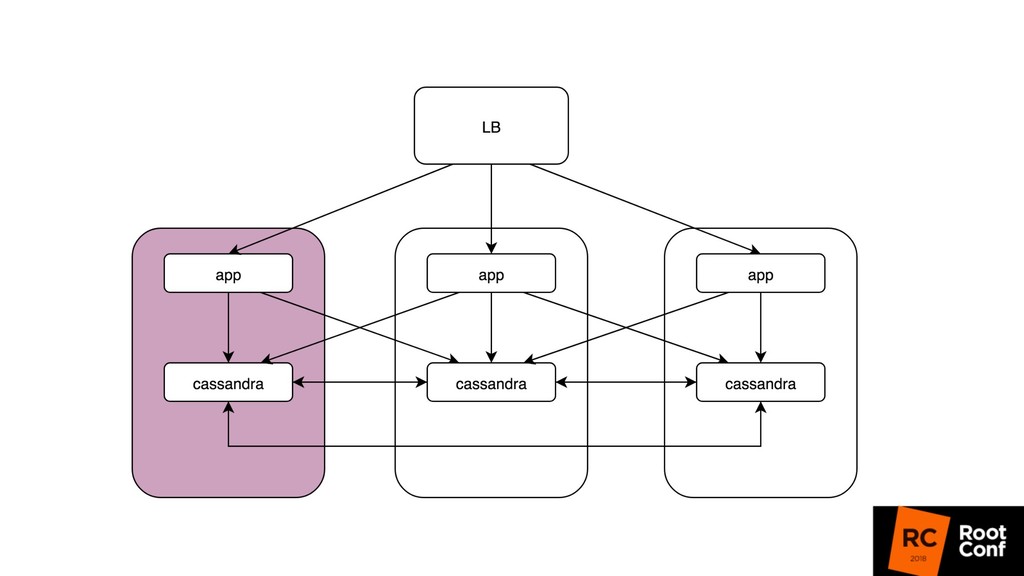
Сервер Шредингера kernel: NETDEV WATCHDOG: eth0 (ixgbe): transmit queue 3
timed out • ! " исходящих фреймов не отправляется • Ситуация сама не исправляется -
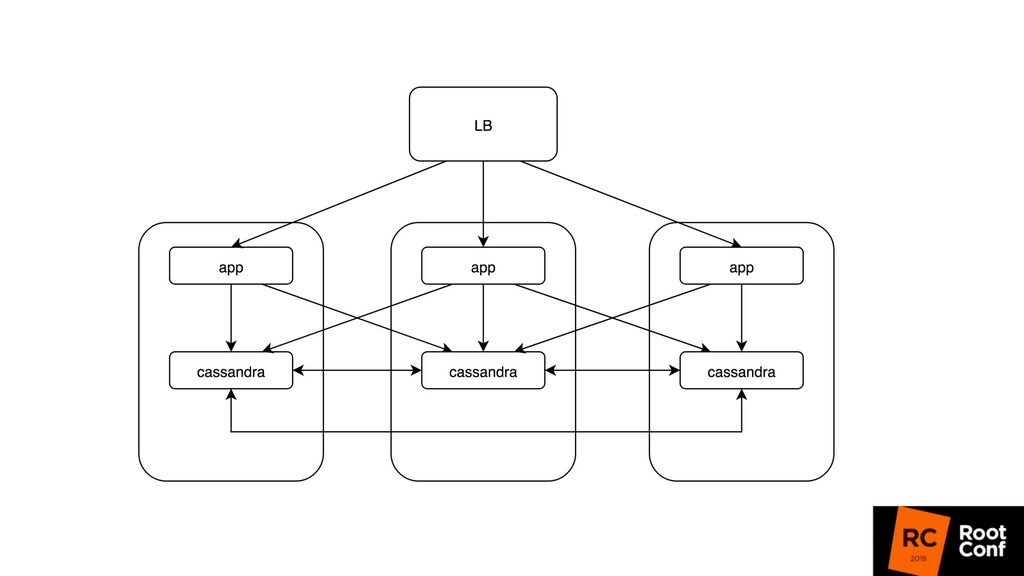
Cassandra: coordinator -> nodes • Rapid read protection (speculative retries)
прекрасно справляется с задачей • Есть небольшое повышение latency, но в целом все работает -
App -> cassandra coordinator • Из коробки ничего не работает
• Но cassandra client (gocql) достаточно навороченный • HostSelectionPolicy -> bitly/go-hostpool -> epsilon greedy -
Epsilon-greedy • Один из простейших подходов решения задачи ”multi- armed
bandit” • Фаза “explore” (10 - 30% запросов): запросы распределяем на все серверы, собираем статистику (время ответа + ошибки) • Фаза “exploit” (70 - 90% запросов): выбираем “лучший” сервер и обновляем статистику http://stevehanov.ca/blog/index.php?id=132 -
Host-pool • Каждый сервер оцениваем по количеству успешных ответов и
времени ответа • Время ответа – взвешенное среднее (свежие замеры более значимые) • Периодически сбрасываем старые замеры https://github.com/bitly/go-hostpool -
Промежуточный итог • Мы добавили ”бронебойности” на уровне app –
cassandra • При попадании запроса на app ”плохого” сервера в любом случае получим проблемы -
Outlier detection [envoy] • Может найти outlier по: • Consecutive
http-5xx • Consecutive gateway errors (502,503,504) • Success rate • Outlier баним на N ms • С ростом количества банов, N растет • max_ejection_percent -
Итого #1 • Бороться с выбросами ошибок и latency определенно
стоит для того, чтобы: • релизиться нужное количество раз в день • спать спокойно по ночам, а проблемные серверы чинить в рабочее время -
Итого #2 • Из коробки ничего не работает, примите этот
факт • Для 99% проблем хватает стандартных возможностей nginx/haproxy/envoy • Дело не в конкретном proxy (если это не haproxy:), а в том, как вы его настроили