Share
Embed
Эксплуатация container based инфраструктур
Слайды с доклада на highload++ 2017
Nikolay Sivko
November 21, 2017
Transcript
82 slides
-
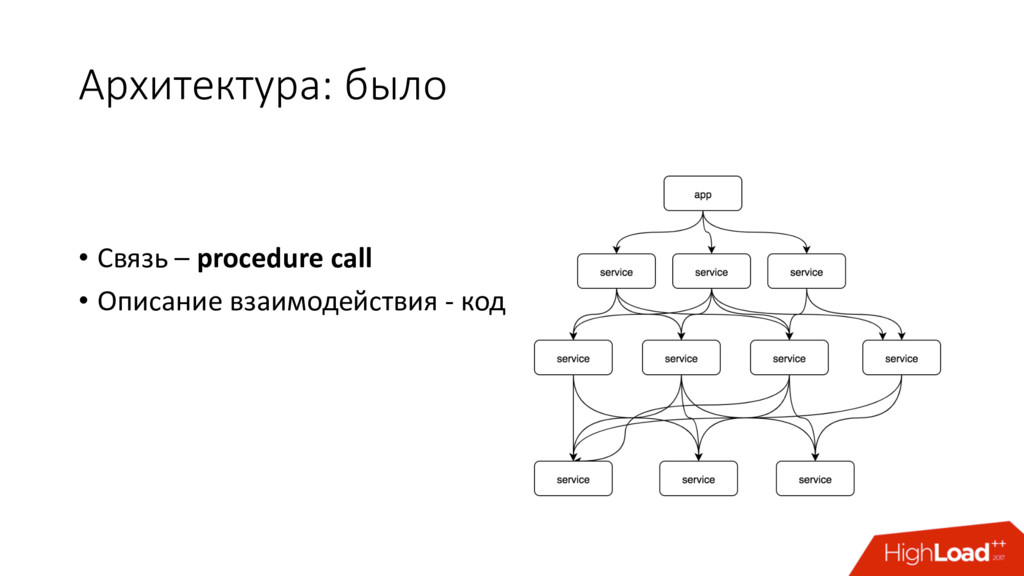
Было • Монолитное приложение, работающее в гордом одиночестве на сервере
или виртуалке • БД на отдельных серверах • Фронтенды • Вспомогательные инфраструктурные сервисы -
Dev: есть проблемы • Монолит сложно разрабатывать толпой разработчиков! •
Сложно управлять зависимостями! • Сложно релизить! • Сложно траблшутить! -
Dev: микросервисы! • Разделим монолит, каждый сервис будет простой! •
Зависимости больше не проблема! • Для релизов что-нибудь придумаем! • Траблшутить каждый сервис просто, они все простые! -
Сложность системы снизилась?! “Ежели где-то что-то убыло, то где-то что-то
прибыть должно непременно” М. Ломоносов -
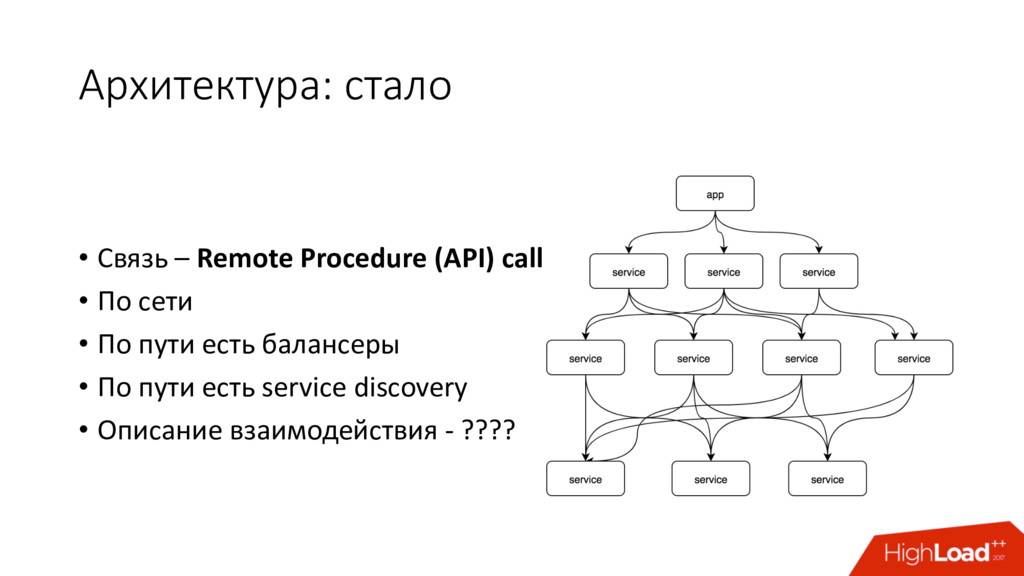
Архитектура: стало • Связь – Remote Procedure (API) call •
По сети • По пути есть балансеры • По пути есть service discovery • Описание взаимодействия - ???? -
Микросервисы: решения • Infrastructure is a code: если не зафиксируем
архитектуру – не выживем • Docker: удобная упаковка • Оркестрация -
Docker • Решили проблему упаковки — было сложно собирать rpm/deb
пакеты • Чтобы не думать про коллизии портов итд – намудрили с сетью • Linux namespaces + cgroups + layered fs + TOOLING + … -
Docker и друзья: следствие • Контейнер легко собрать и запустить
• Контейнер легче VM, можно плотнее деплоить -
Docker и друзья: следствие • Контейнер легко собрать и запустить
• Контейнер легче VM, можно плотнее деплоить • Убрали барьеры в порождении микросервисов -
Счастливое облачное будущее • Не хотим думать про ДЦ, серверы,
сеть — всё это облако, мы запускаем там контейнеры • Масштабировать будем просто докидывая ресурсы (серверов/ инстансов) -
Облачное настоящее: под нагрузкой • Есть серверы docker-*, kube-* на
каждом из них 20-50 контейнеров • Базы работают на отдельных железках и как правило общие • Resource-intensive сервисы на отдельных железках • Latency-sensitive сервисы на отдельных железках -
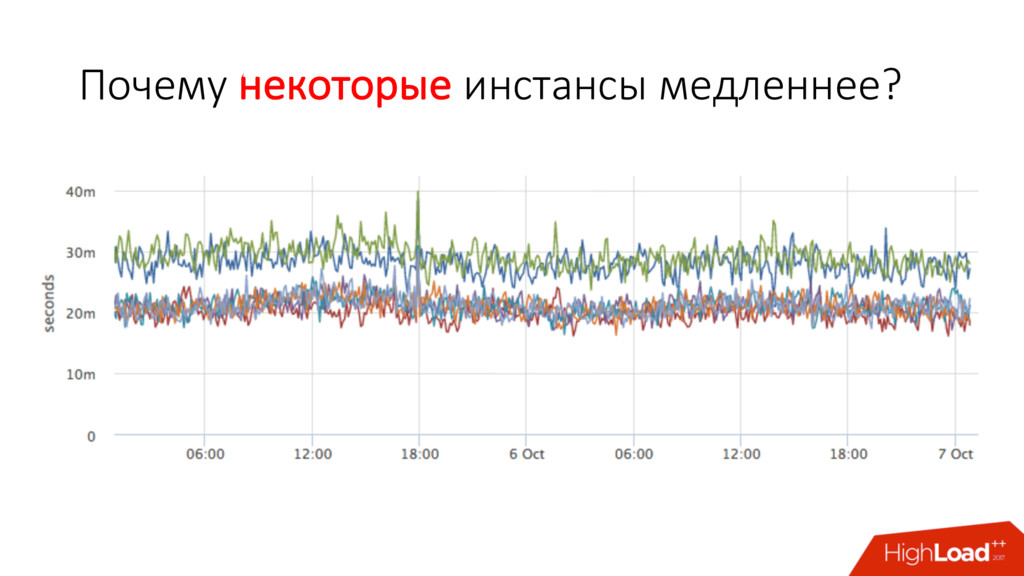
Почему некоторые инстансы медленнее? • Может там серверы слабее? •
Может кто-то ресурсы съел? • Нужно найти, на каких серверах работают инстансы • dc1d9748-30b6-4acb-9a5f-d5054cfb29bd • 7a1c47cb-6388-4016-bef0-4876c240ccd6 и посмотреть там на соседние контейнеры и потребление ресурсов -
Почему некоторые инстансы медленнее? • Как оказалось, мы хотим знать
топологию! • Следующим шагом мы захотим управлять топологией! -
Почему некоторые инстансы медленнее? • Как оказалось, мы хотим знать
топологию! • Следующим шагом мы захотим управлять топологией! • Есть ли способ не думать про это??? -
Попробуем подсмотреть Google Container Engine, Amazon EC2 Container Service: •
Это всего лишь dedicated k8s поверх купленных вами VM • Никаких готовых рецептов они не предлагают -
Попробуем подсмотреть Google Container Engine, Amazon EC2 Container Service: •
Это всего лишь dedicated k8s поверх купленных вами VM • Никаких готовых рецептов они не предлагают Google App Engine: • Вы выбираете класс инстанса • Класс = CPU (Mhz) + Memory • Mhz = CPU Shares • Платим за instance/hour -
Лимиты ресурсов • Ресурсы нужно ограничивать – вводить классы как
в GAE • Docker, k8s и аналоги поддерживают лимиты, но не настаивают на их настройке -
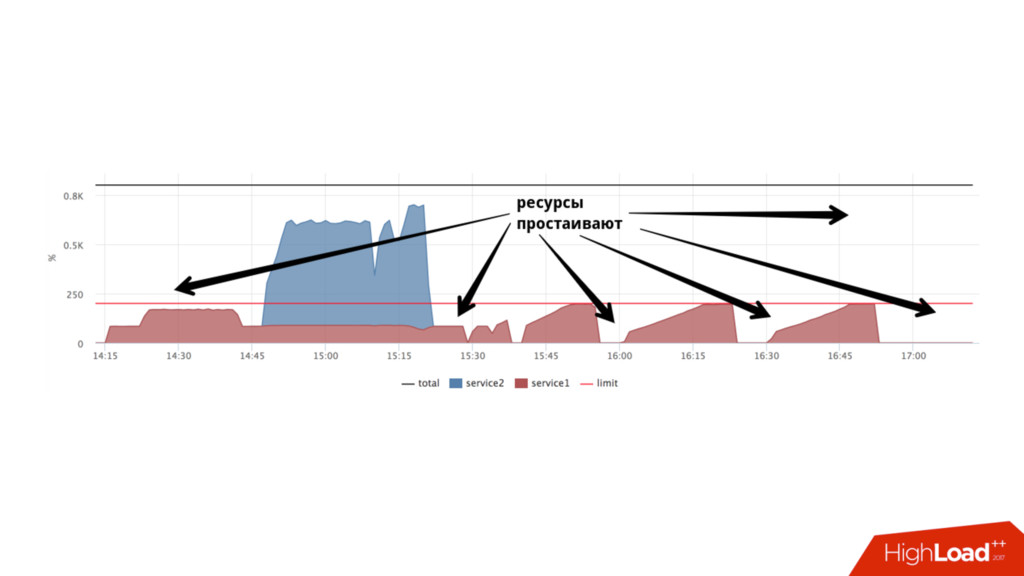
Формулируем задачу • Хотим распределить ресурсы между сервисами • Нагрузка
на соседние сервисы не должна влиять • Хотим понимать, сколько ресурсов осталось, когда пора добавлять • Не хотим, чтобы ресурсы простаивали -
Cgroups — control groups • Начали разработку в google (2006)
• Первый merge в ядро 2.6.24 (2008) • Cобираем процессы в группу, на неё навешиваем ограничения ресурсов • Все потомки автоматически включаются в группу родителя • Запущенный docker* контейнер = всегда отдельная cgroup, даже если ресурсы не ограничивали -
Cgroups: CPU • Shares: пропорции выделения процессорного времени • Quota:
жесткое ограничение количества процессорного времени в единицу реального времени • Cpusets: привязка процессов к конкретным cpu (+NUMA) -
Попробуем разобраться на тестах • Тестовый сервер 8 ядер/32Gb (hyper-threading
выключен для простоты) • Сервис: 50:50% cpu:wait • Нагрузку подает yandex.tank • Задержки будем оценивать по гистограмме -
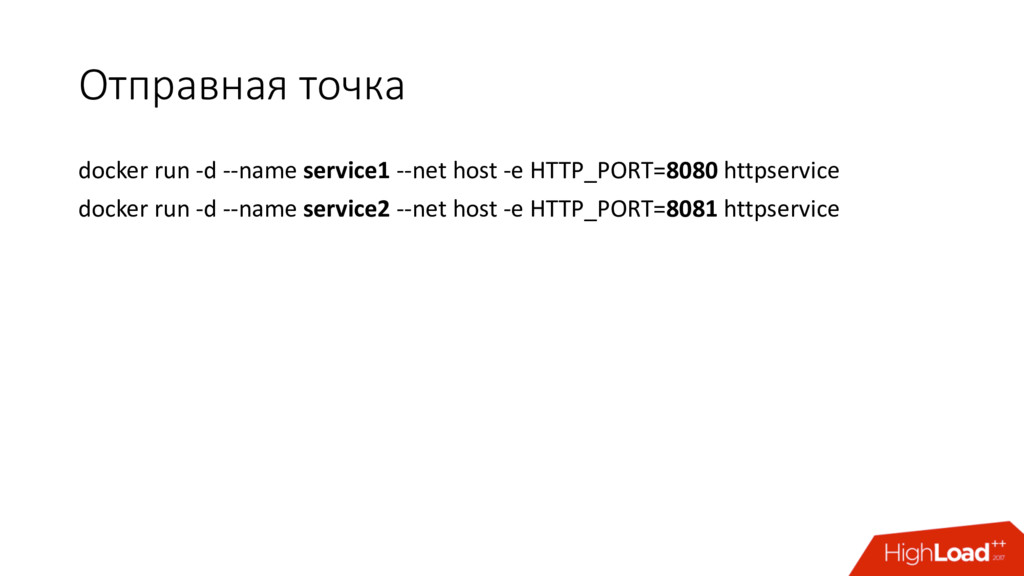
Отправная точка docker run -d --name service1 --net host -e
HTTP_PORT=8080 httpservice docker run -d --name service2 --net host -e HTTP_PORT=8081 httpservice -
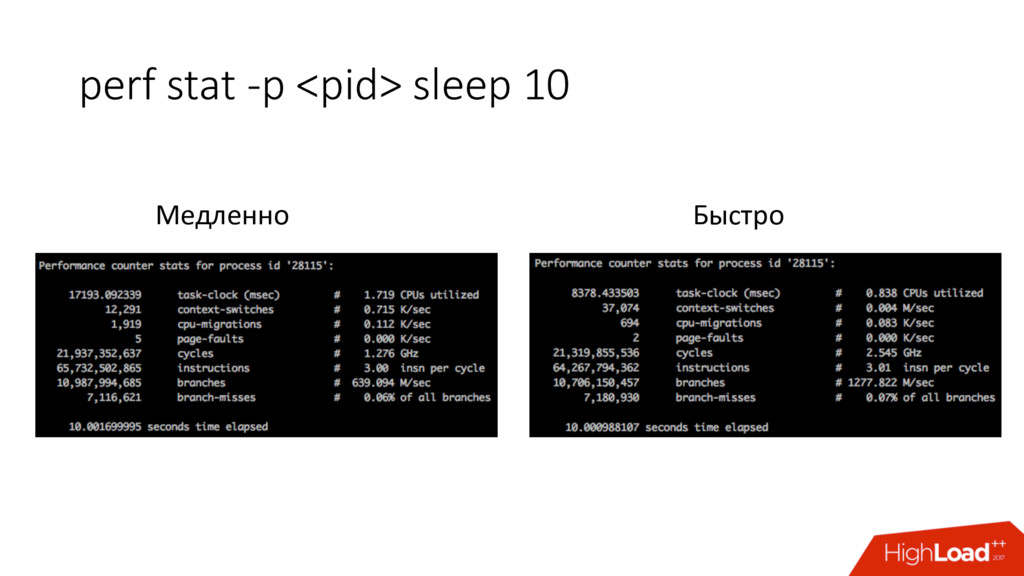
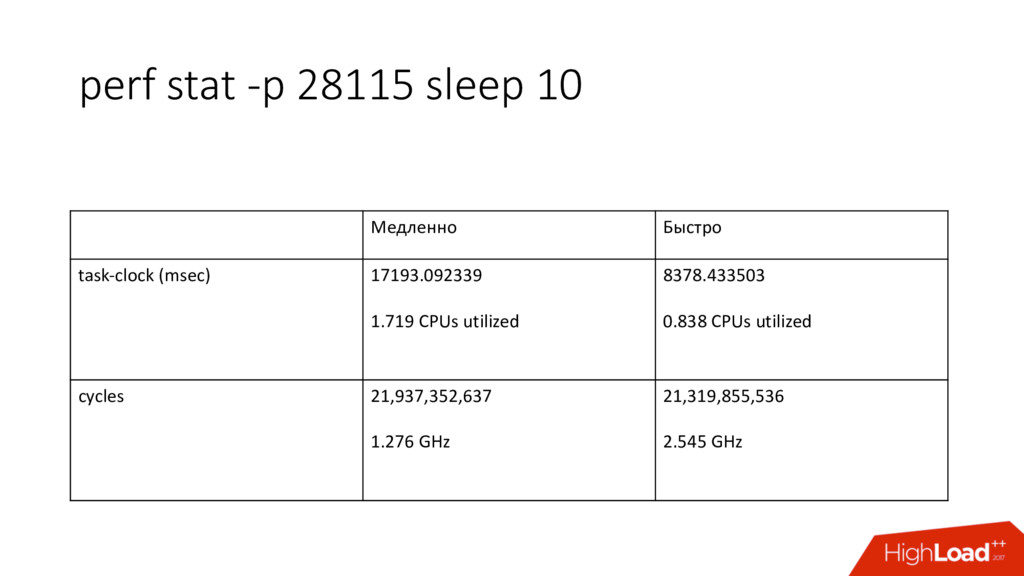
perf stat -p 28115 sleep 10 Медленно Быстро task-clock (msec)
17193.092339 1.719 CPUs utilized 8378.433503 0.838 CPUs utilized cycles 21,937,352,637 1.276 GHz 21,319,855,536 2.545 GHz -
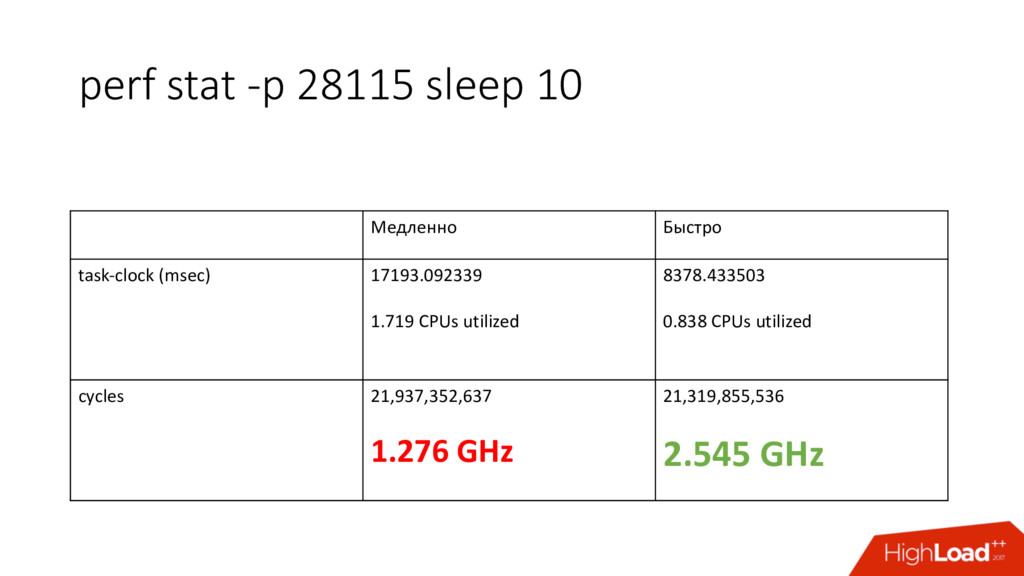
perf stat -p 28115 sleep 10 Медленно Быстро task-clock (msec)
17193.092339 1.719 CPUs utilized 8378.433503 0.838 CPUs utilized cycles 21,937,352,637 1.276 GHz 21,319,855,536 2.545 GHz -
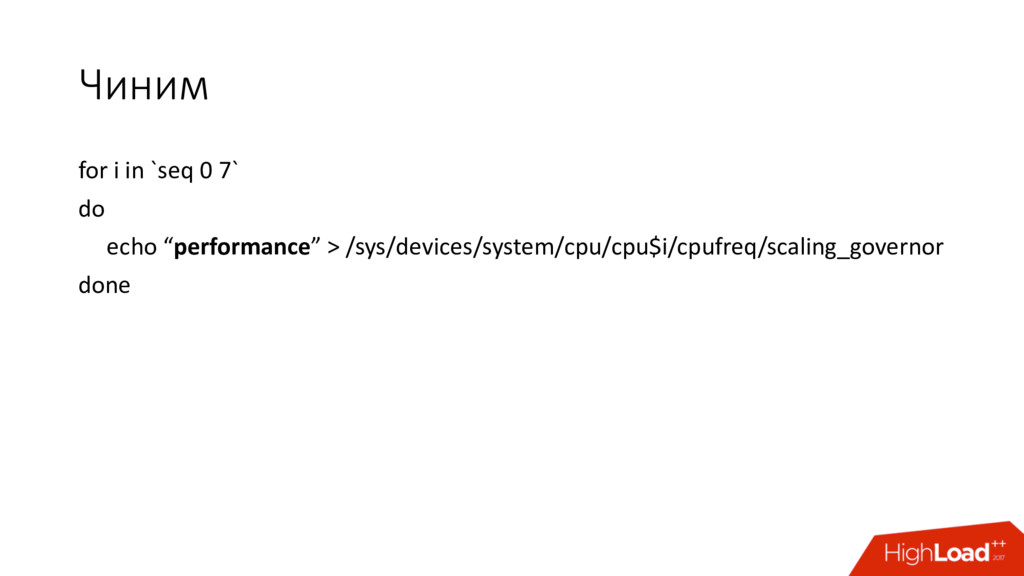
Чиним for i in `seq 0 7` do echo “performance”
> /sys/devices/system/cpu/cpu$i/cpufreq/scaling_governor done -
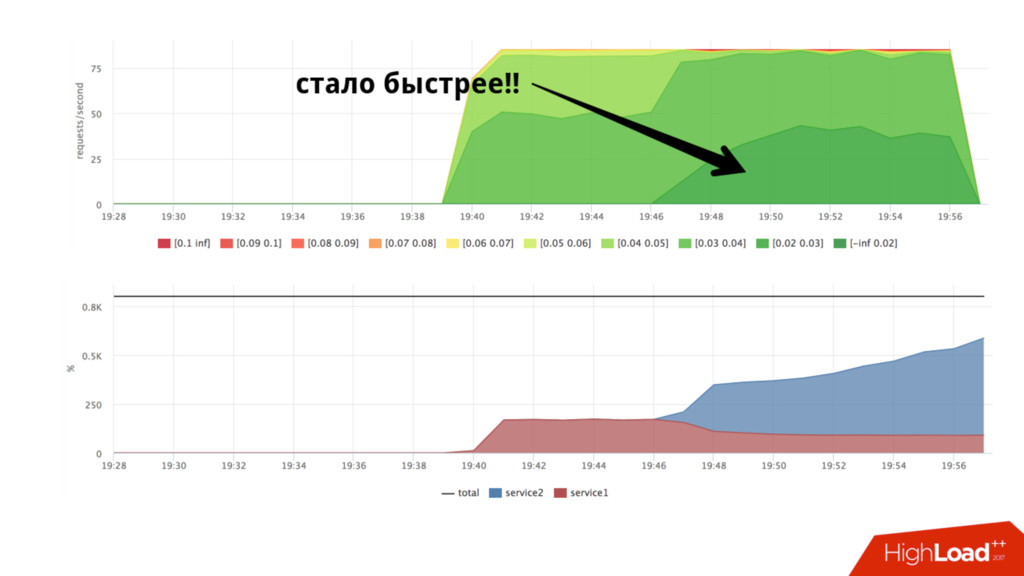
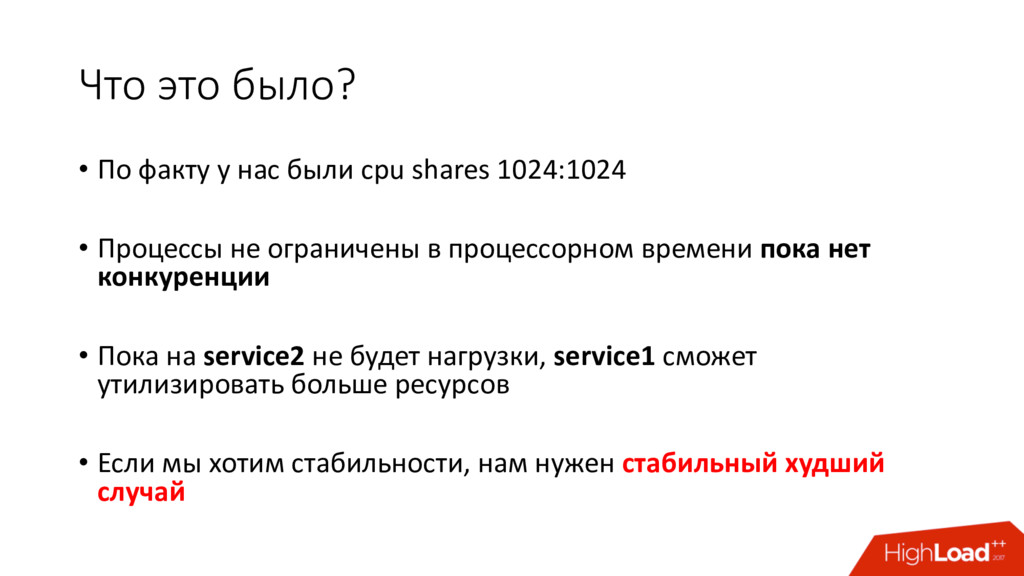
Что это было? • По факту у нас были cpu
shares 1024:1024 • Процессы не ограничены в процессорном времени пока нет конкуренции • Пока на service2 не будет нагрузки, service1 сможет утилизировать больше ресурсов • Если мы хотим стабильности, нам нужен стабильный худший случай -
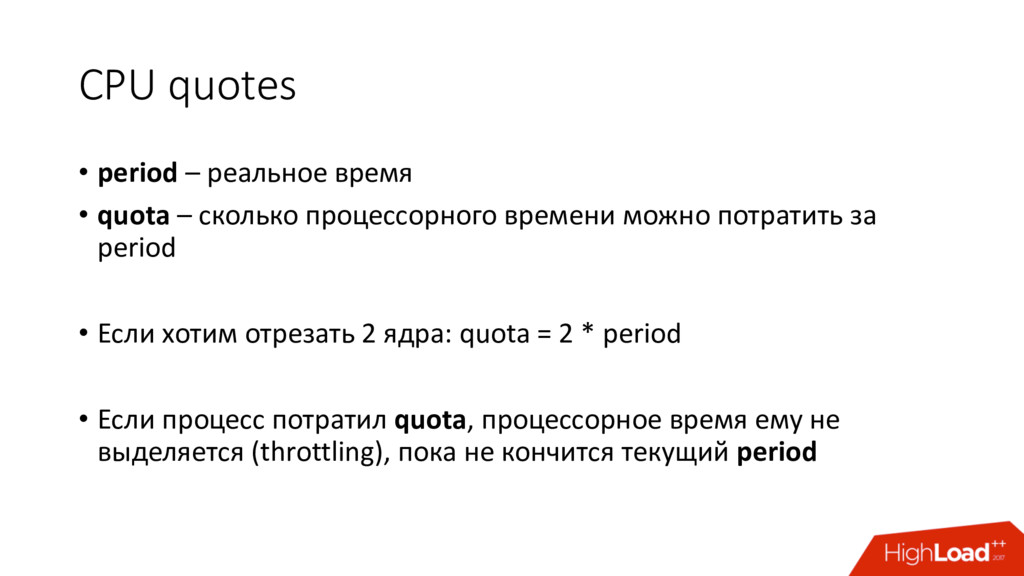
CPU quotes • period – реальное время • quota –
сколько процессорного времени можно потратить за period • Если хотим отрезать 2 ядра: quota = 2 * period • Если процесс потратил quota, процессорное время ему не выделяется (throttling), пока не кончится текущий period -
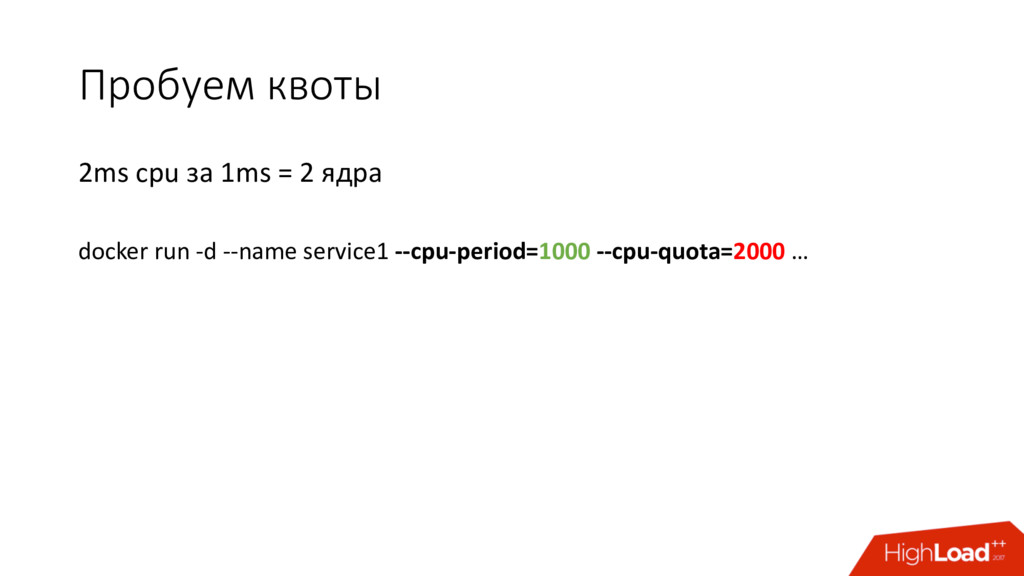
Пробуем квоты 2ms cpu за 1ms = 2 ядра docker
run -d --name service1 --cpu-period=1000 --cpu-quota=2000 … -
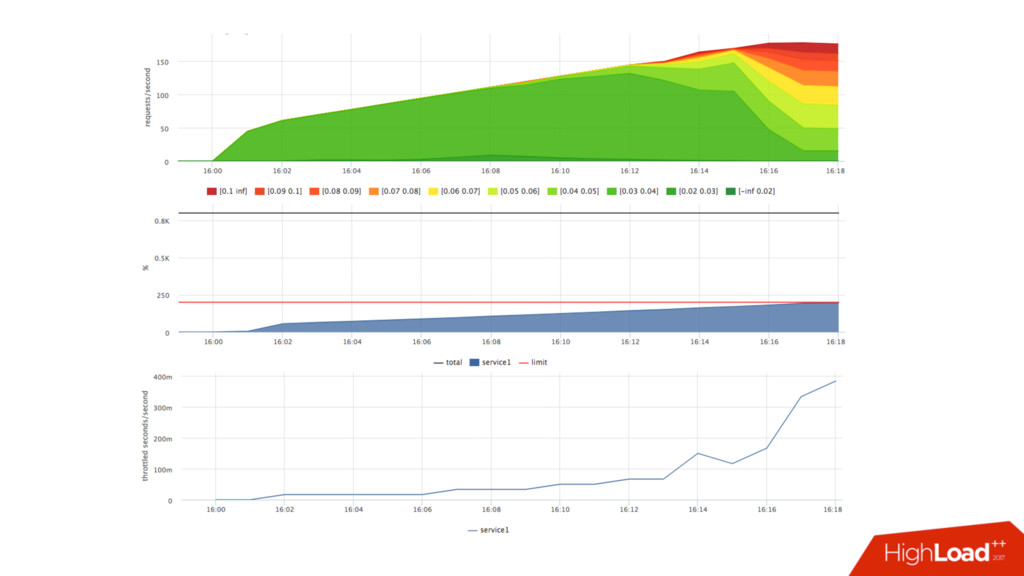
Стабильность с квотами • Знаем предел производительности сервиса при квоте
• Можем посчитать в % утилизацию cpu сервисом: • Факт: /sys/fs/cgroup/cpu/docker/<id>/cpuacct.usage • Лимит: period/quota • Триггер: [service1] cpu usage > 90% • Если уперлись в quota — растёт nr_throttled и throttled_time из • /sys/fs/cgroup/cpu/docker/<id>/cpu.stat -
Распределяем ресурсы • Делим машину на ”слоты” без overselling для
latency-sensitive сервисов (quota) • Если готовимся к повышению нагрузки – запускаем каждого сервиса столько, чтобы потребление было < N % • Если есть умный оркестратор и желание – делаем это динамически • Количество свободных слотов – наш запас, держим его на комфортном уровне -
Добиваем машины фоновой нагрузкой • Слотам проставляем максимальный --cpu-shares •
Свободное процессорное время “отдаем” (ставим минимальный --cpu-shares) некритичным сервисам: второстепенные сервисы, обработка фоновых задач, аналитика, … -
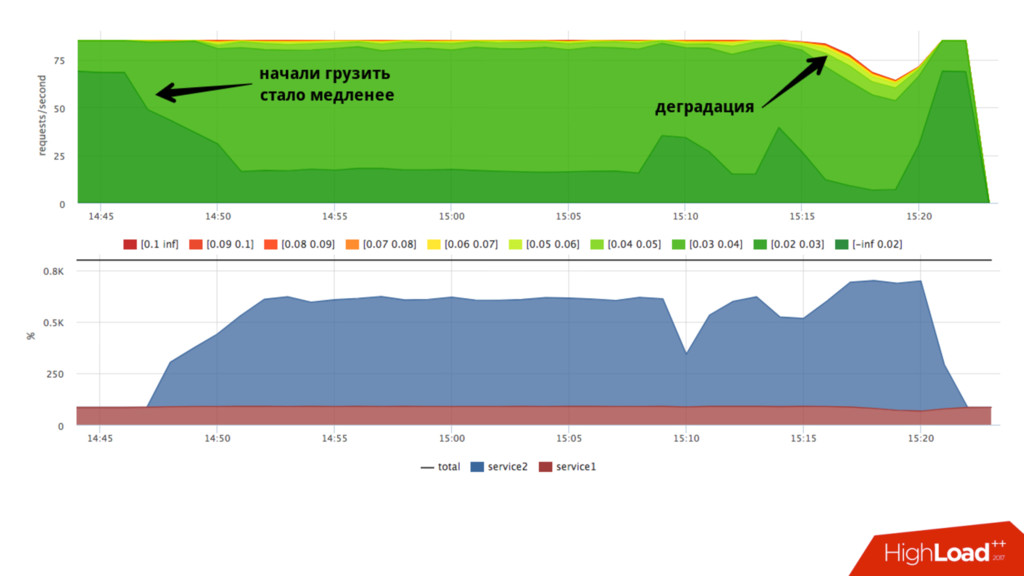
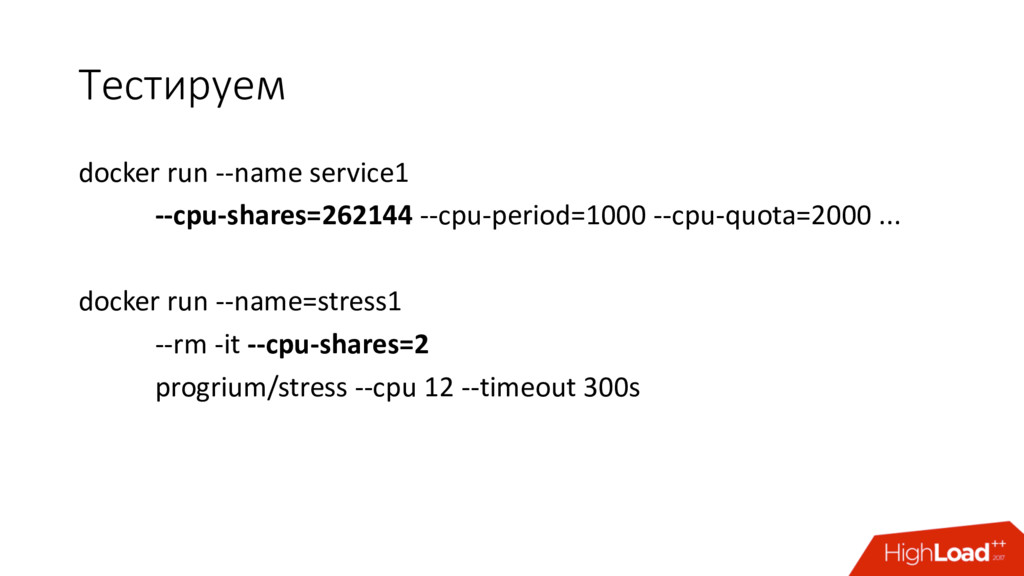
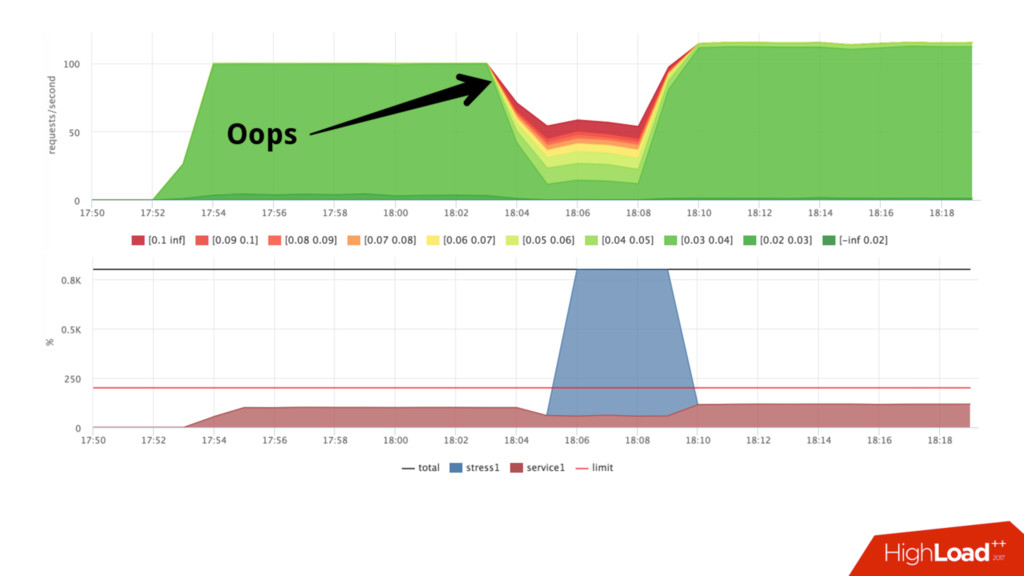
Тестируем docker run --name service1 --cpu-shares=262144 --cpu-period=1000 --cpu-quota=2000 ... docker
run --name=stress1 --rm -it --cpu-shares=2 progrium/stress --cpu 12 --timeout 300s -
CFS — completely fair scheduler • Достаточно дискретен, процессорное время
выделяется слотами (slices) • Можно крутить разные ручки: sysctl –a |grep kernel.sched_ • Я все тестировал на дефолтовых настройках и крутить не было желания -
CFS — completely fair scheduler • Достаточно дискретен, процессорное время
выделяется слотами (slices) • Можно крутить разные ручки: sysctl –a |grep kernel.sched_ • Я все тестировал на дефолтовых настройках и крутить не было желания • Мы поставили квоту 2ms/1ms, это уменьшило размер слота, который может потратить наш сервис -
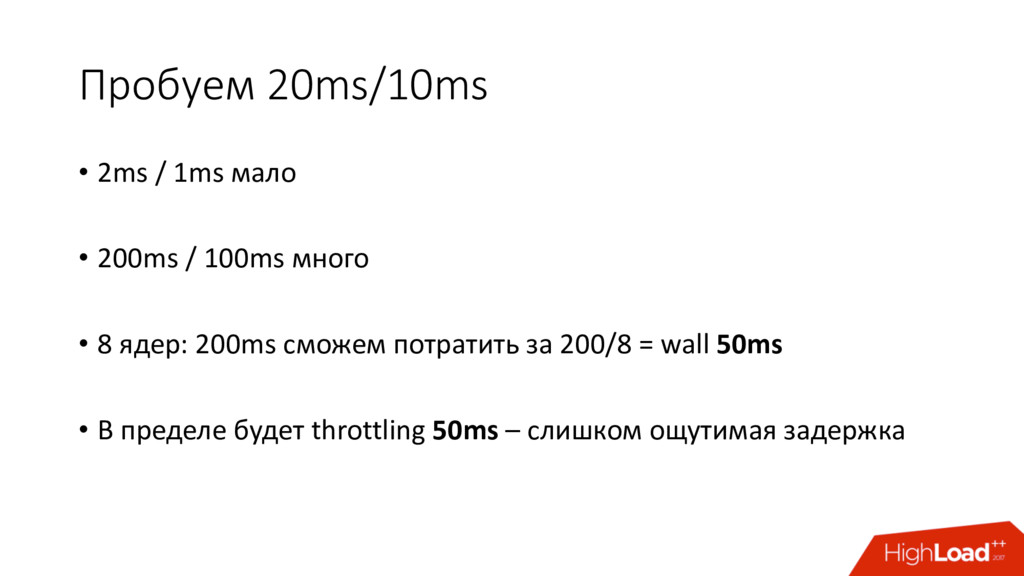
Пробуем 20ms/10ms • 2ms / 1ms мало • 200ms /
100ms много • 8 ядер: 200ms сможем потратить за 200/8 = wall 50ms • В пределе будет throttling 50ms – слишком ощутимая задержка -
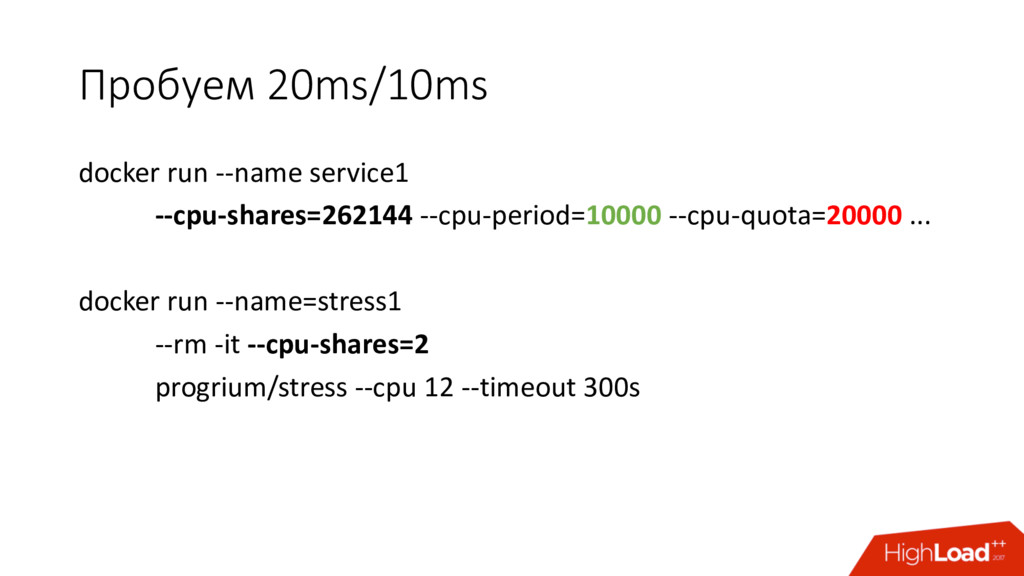
Пробуем 20ms/10ms docker run --name service1 --cpu-shares=262144 --cpu-period=10000 --cpu-quota=20000 ...
docker run --name=stress1 --rm -it --cpu-shares=2 progrium/stress --cpu 12 --timeout 300s -
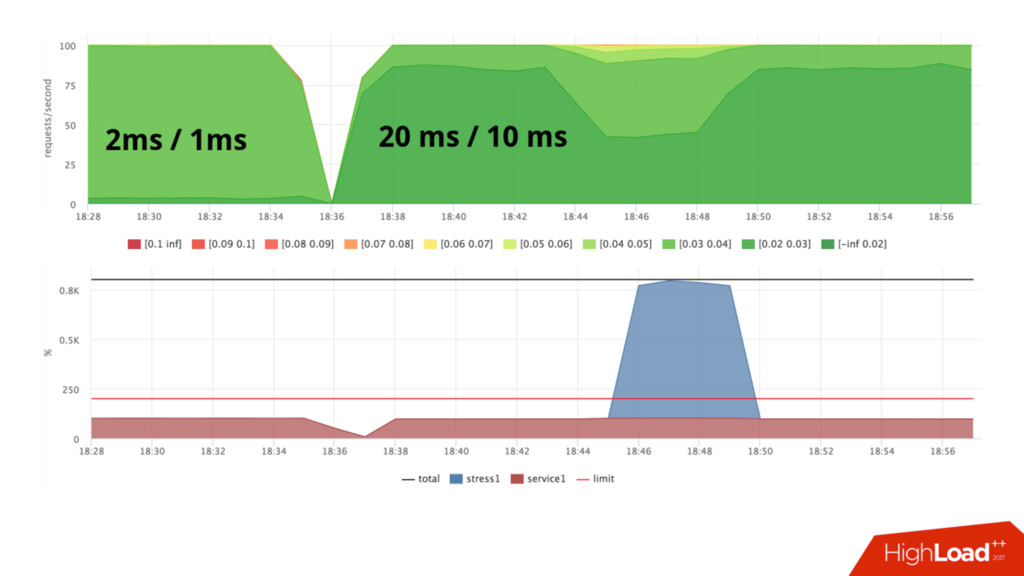
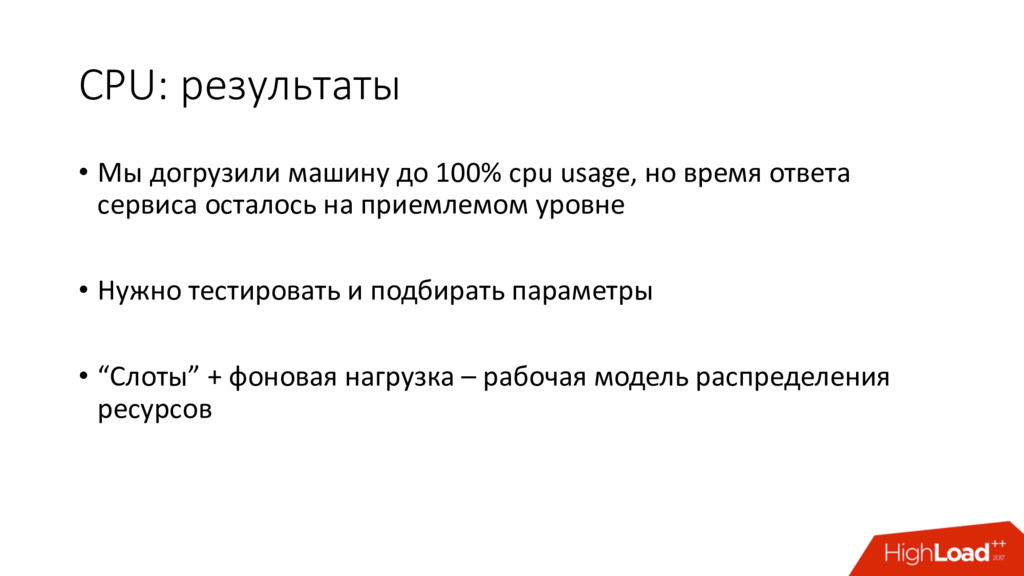
CPU: результаты • Мы догрузили машину до 100% cpu usage,
но время ответа сервиса осталось на приемлемом уровне • Нужно тестировать и подбирать параметры • “Слоты” + фоновая нагрузка – рабочая модель распределения ресурсов -
Cgroups: memory • Можем ограничить размер суммарной памяти, используемой группой
• Получаем статистику /sys/fs/cgroup/memory/<cgroup>/memory.stat -
Cgroups: memory • Можем ограничить размер суммарной памяти, используемой группой
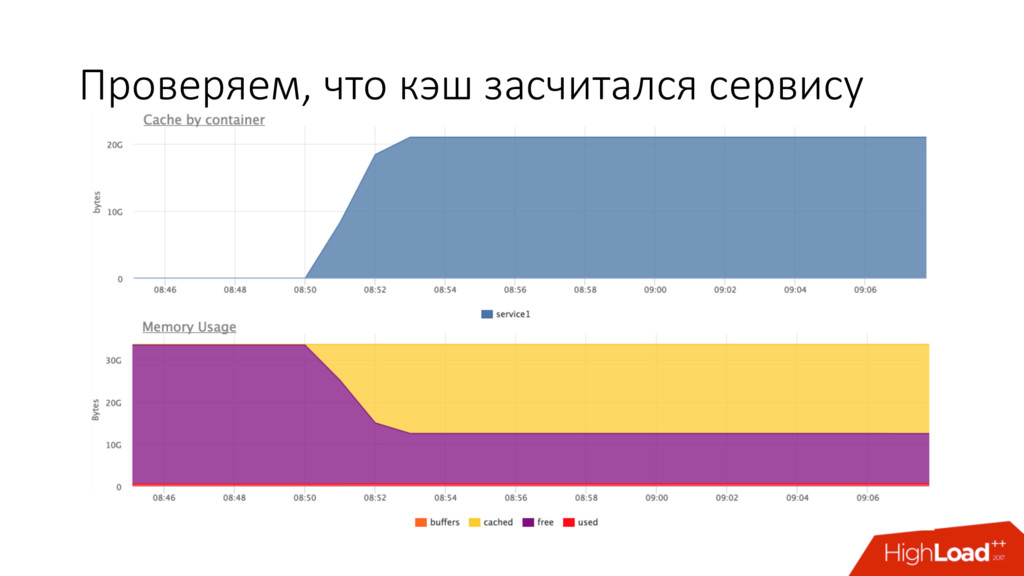
• Получаем статистику /sys/fs/cgroup/memory/<cgroup>/memory.stat • Самое крутое — можем узнать, кто сколько page cache съел (засчитывается той группе, которая первая использовала страницу) -
Зачем ограничивать память? • Сервис с утечкой может съесть всю
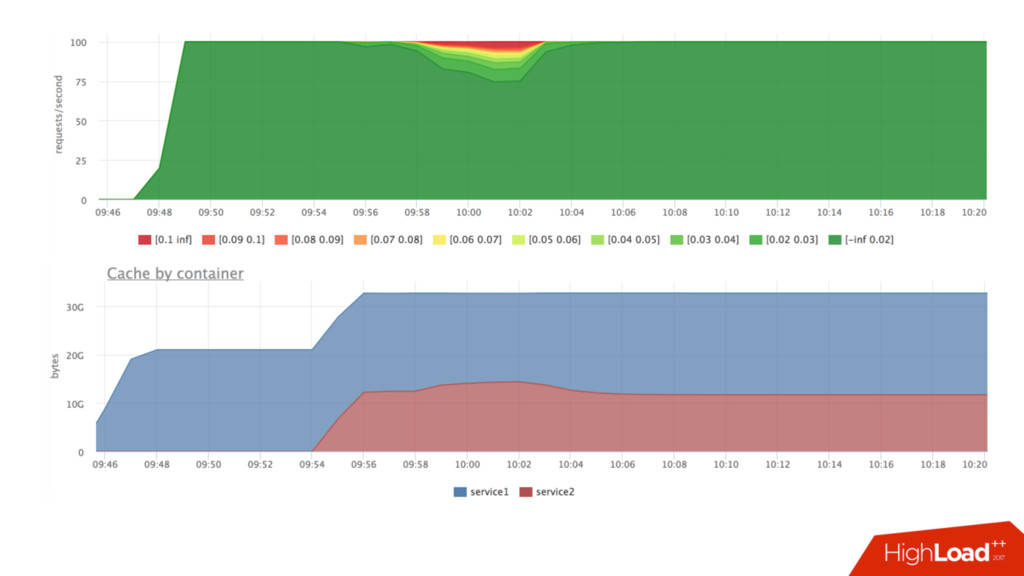
память, а OOM killer может прибить не его, а соседа • Сервис с утечкой или активно читающий с диска может вымыть кэш соседнего сервиса -
Тестируем Создаем файл 20Gb: dd if=/dev/zero of=datafile count=20024 bs=1048576 #
20GB Запускаем сервис: docker run -d --name service1 .. DATAFILE_PATH=/datadir/datafile … На каждый запрос читаем N байт со случайного offset -
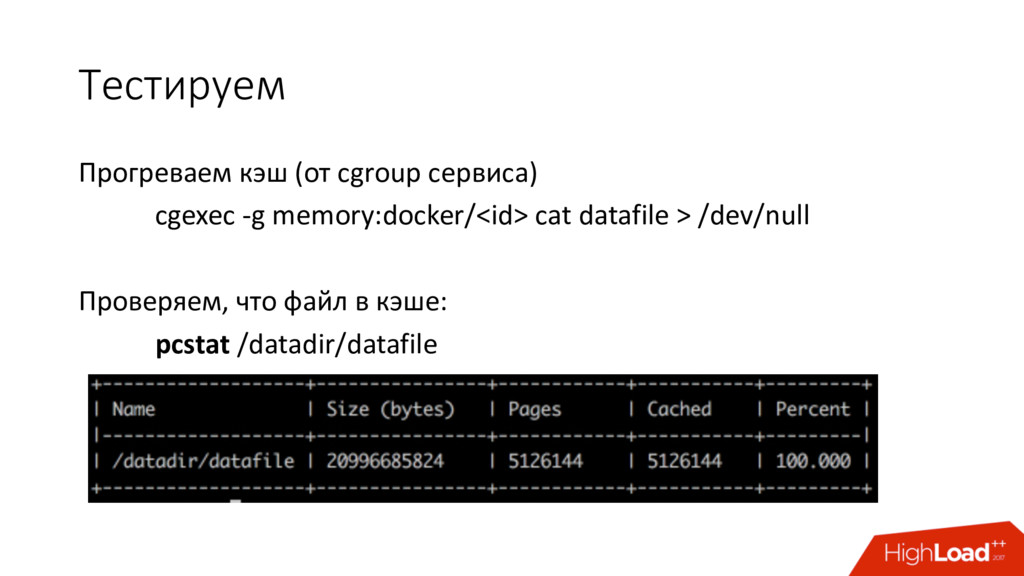
Тестируем Прогреваем кэш (от cgroup сервиса) cgexec -g memory:docker/<id> cat
datafile > /dev/null Проверяем, что файл в кэше: pcstat /datadir/datafile -
Вымывание кэша • docker run --rm -ti --name service2 ubuntu
cat datafile1 > /dev/null -
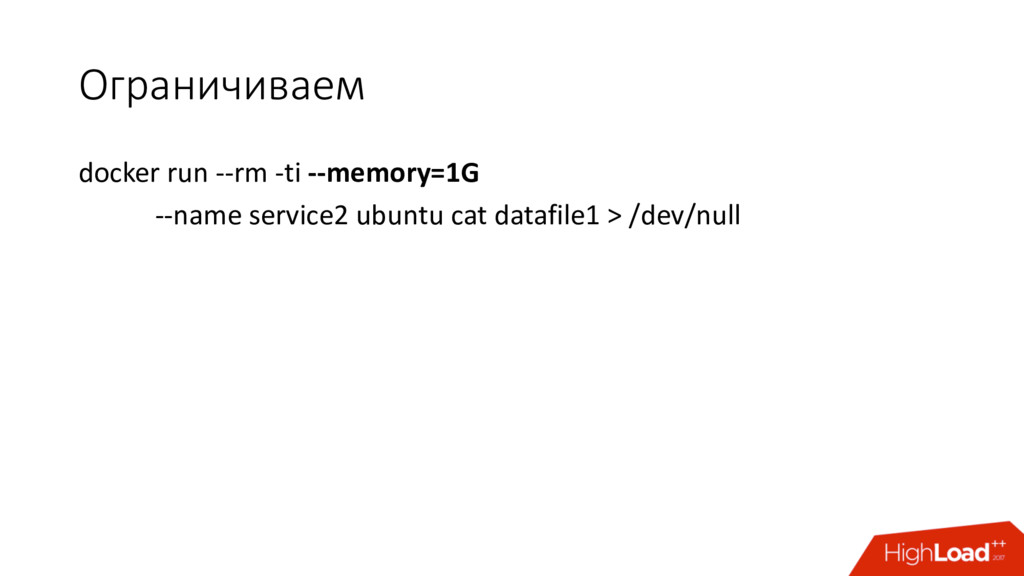
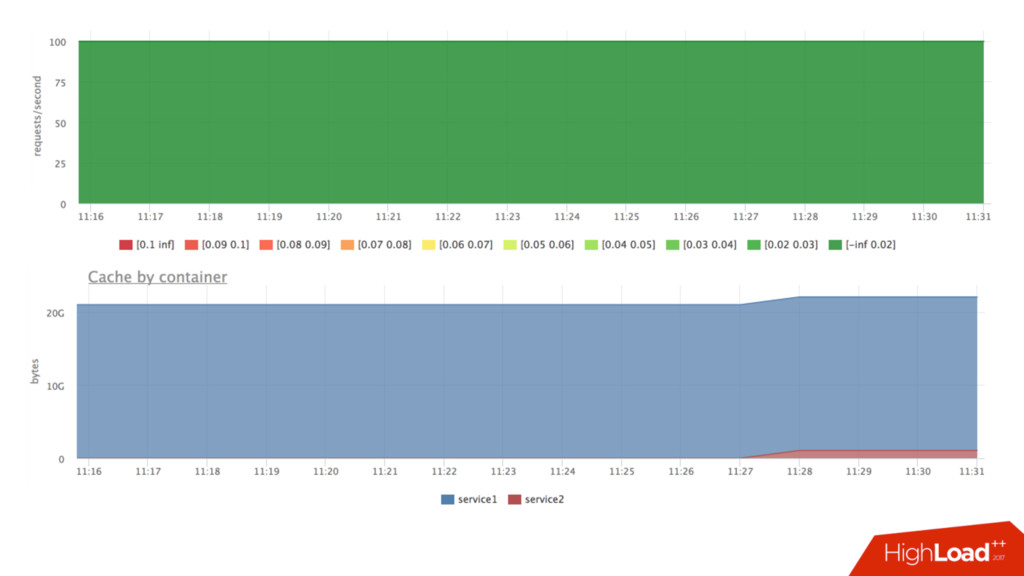
Ограничиваем docker run --rm -ti --memory=1G --name service2 ubuntu cat
datafile1 > /dev/null -
Memory: результаты • Ограничения работают • Отличный способ не вымывать
кэш у критичных сервисов (можно использовать при обслуживании) • Метрики cgroups:mem более детальны, чем метрики процессов (cache usage) -
Cgroups: blkio • Все по аналогии с CPU • Есть
возможность задать вес (приоритет) • Лимиты по iops/traffic на чтение/запись • Можно настроить для конкретных дисков -
Подход • Поступим так же, как с CPU • Отрезаем
квоту по iops критичным сервисам, но ставим большой приоритет • Фоновые процессы запускаем с минимальным приоритетом -
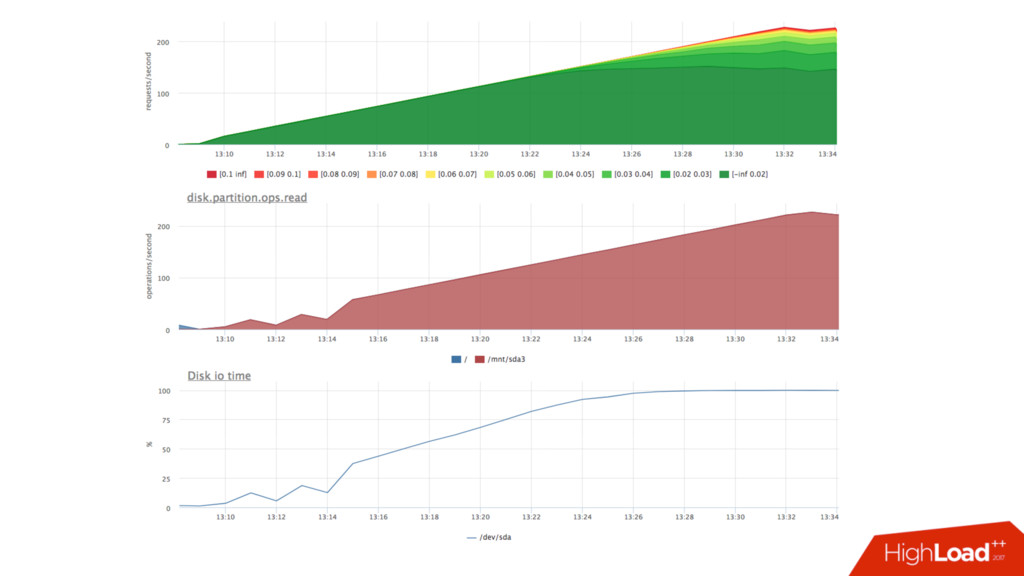
Лимиты • В случае с CPU есть понятный предел –
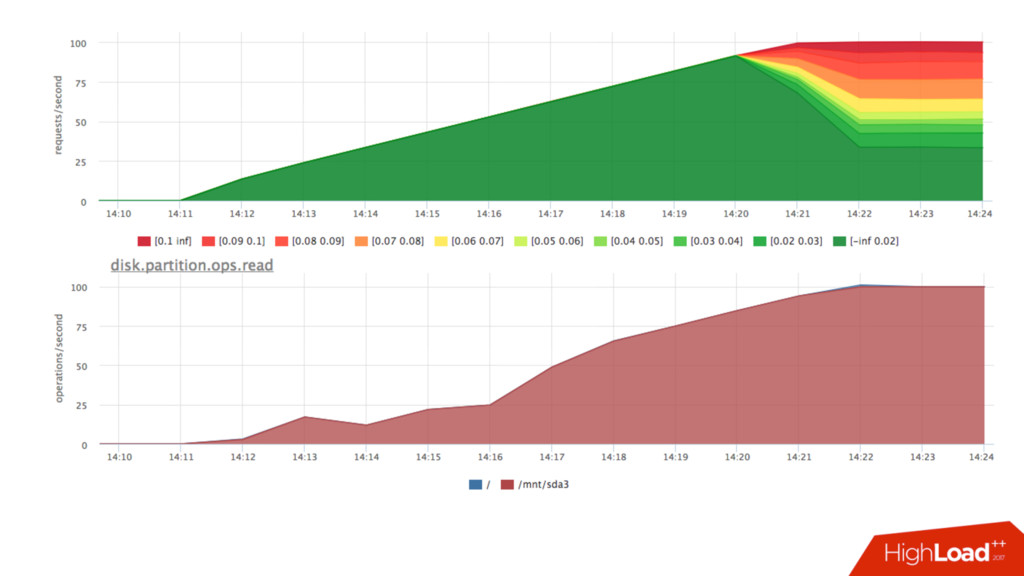
100% времени всех ядер • Нагрузим диск и посмотрим примерный предел по iops на чтение -
Ограничим 100 iops на чтение docker run -d --name service1
-m 10M --device-read-iops /dev/sda:100 … -
Мониторинг • Знаем лимит каждой cgroup для каждого device •
Можем снять факт из • /sys/fs/cgroup/blkio/<id>/blkio.throttle.io_serviced • Триггер вида: • [service1] /dev/sda read iops > 90% -
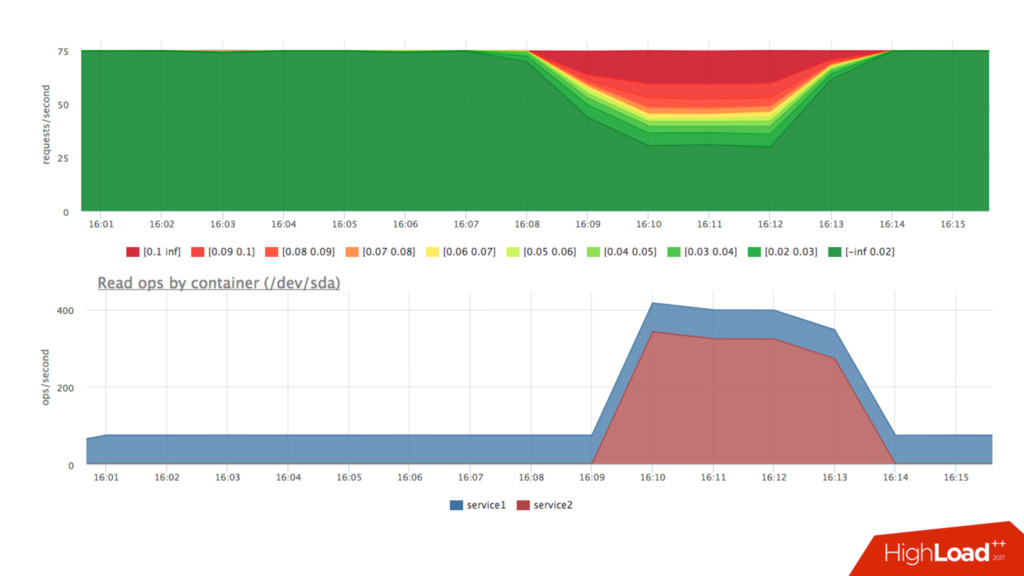
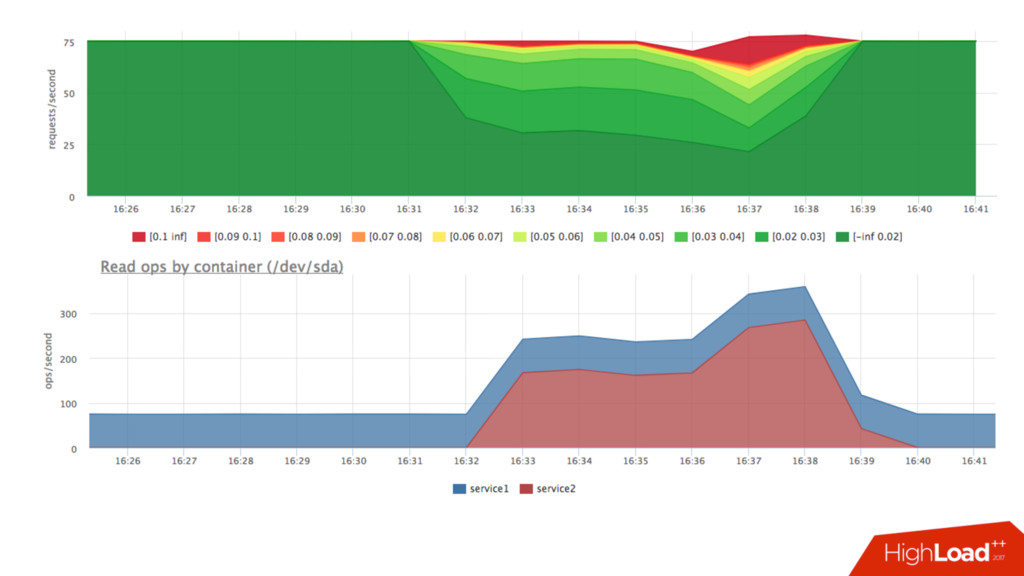
Нагрузим диск фоновой задачей docker run -d --name service1 -m
10M … docker run -d --name service2 -m 10M ubuntu cat datafile1 > /dev/null -
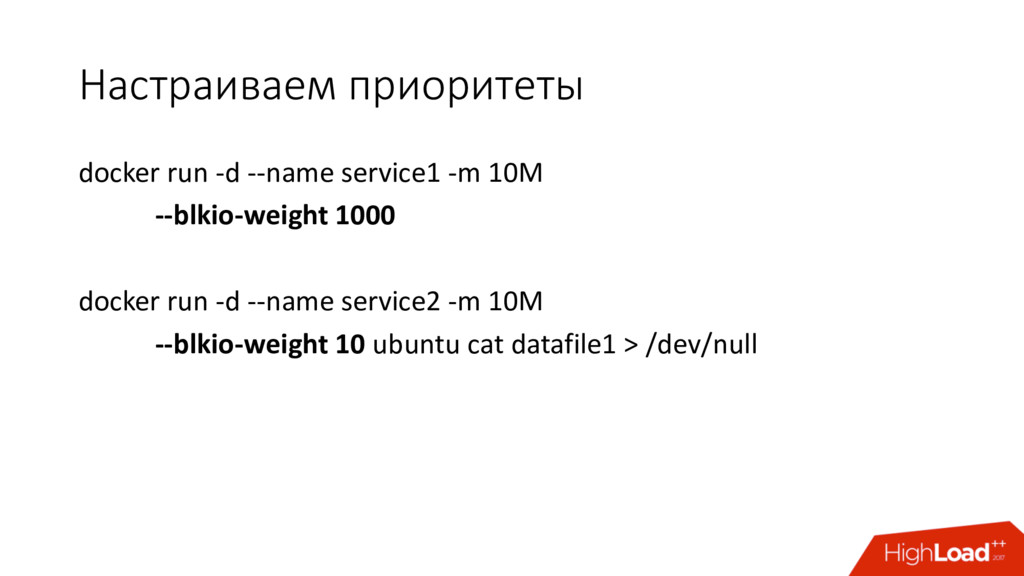
Настраиваем приоритеты docker run -d --name service1 -m 10M --blkio-weight
1000 docker run -d --name service2 -m 10M --blkio-weight 10 ubuntu cat datafile1 > /dev/null -
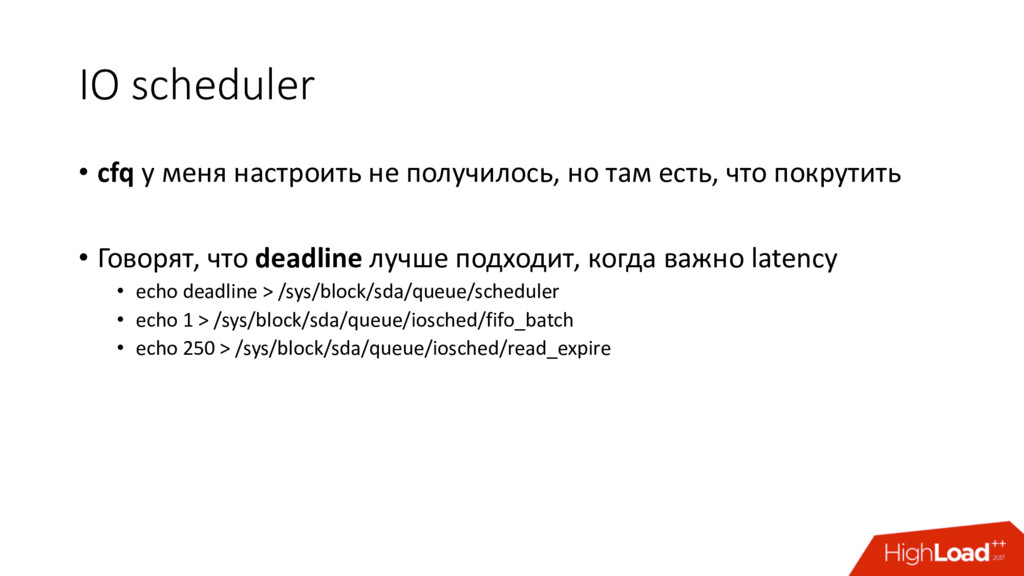
IO scheduler • cfq у меня настроить не получилось, но
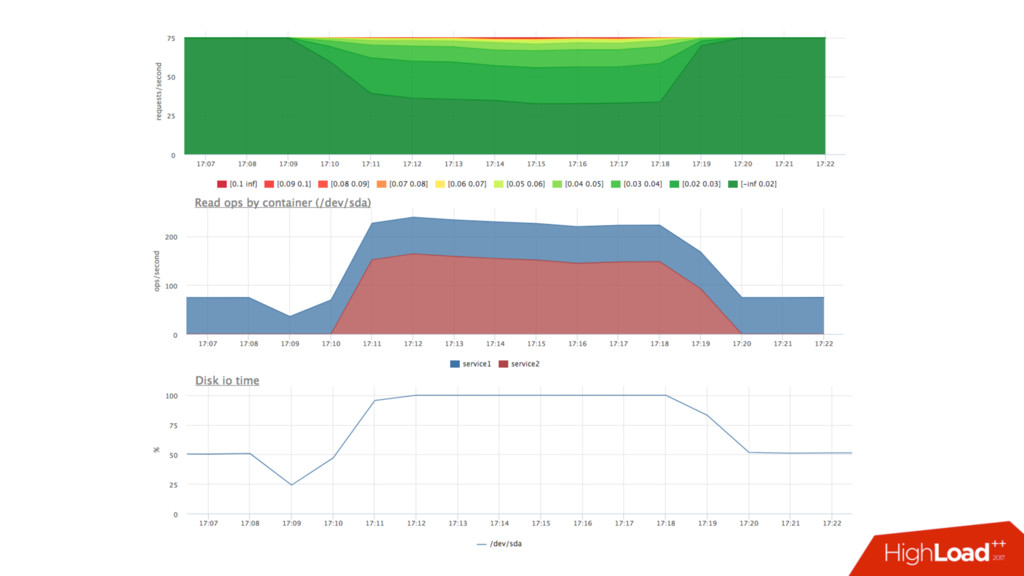
там есть, что покрутить • Говорят, что deadline лучше подходит, когда важно latency • echo deadline > /sys/block/sda/queue/scheduler • echo 1 > /sys/block/sda/queue/iosched/fifo_batch • echo 250 > /sys/block/sda/queue/iosched/read_expire -
Blkio: результаты • Лимиты работают достаточно точно • Работа приоритетов
сильно зависит от планировщика io и его настроек • Можно добиться приемлемого уровня latency -
Выводы (филосовские) • DevOps придумали разработчики, чтобы админы больше работали
:) • Работы еще много! -
Выводы (технические) • В linux все достаточно хорошо с планировщиками
(cpu, io), можно добиться приемлемых показателей -
Выводы (технические) • В linux все достаточно хорошо с планировщиками
(cpu, io), можно добиться приемлемых показателей • Есть достаточно много экспериментальных патчей с более точными* планировщиками (нужно следить) -
Выводы (главные) • Бенчмаркать сложно, долго, муторно, но очень интересно
• Perf очень крутой :) -
Выводы (главные) • Бенчмаркать сложно, долго, муторно, но очень интересно
• Perf очень крутой :) • Если очень захотеть, можно запускать hadoop рядом с боевой БД в prime time -
Выводы (главные) • Бенчмаркать сложно, долго, муторно, но очень интересно
• Perf очень крутой :) • Если очень захотеть, можно запускать hadoop рядом с боевой БД в prime time • Доклад был не про docker :)