Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Inetl NPU でローカル LLM
Search
desigrammer
May 21, 2026
Programming
23
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Inetl NPU でローカル LLM
Intel NPU で LLM が動くことを再現できる形で見せます
- NPU とはなにか
- Docker を使って NPU 利用
- モデルの準備と利用方法
desigrammer
May 21, 2026
More Decks by desigrammer
See All by desigrammer
Sakana Fugu でこの先生きのこるには
desigrammer
0
29
Other Decks in Programming
See All in Programming
残高管理から台帳サービスへの進化
artoy
1
200
AWSに止められる覚悟してますか?
morizo_1984
2
530
自サークルのIdPからログアウトできるようになるまで
taiseiue
1
140
IBM Bob Dojo #1 仕様駆動開発入門
oniak3ibm
PRO
0
390
Starting & Sustaining Code-Based E2E Testing for Non-Coding QA Teams( #jasstniigata )
teyamagu
PRO
1
1k
SalesForceを内製化!? ~ HR事業を支える顧客管理基盤のインフラを大公開 ~
oku053
0
180
AIで開発が速くなった先で、開発チームは何を目指すか
shihochan
0
920
コードで差別化できない時代の ソフトウェアエンジニアリング / Software Engineering in an Era Where Code Doesn’t Differentiate
kishida
2
180
FactoryBotをやめればRSpecは速くなるのか?
yuta_onishi_97
0
290
Verilogで学ぶCPU自作入門
uyuki234
8
4.1k
iOS 27でニュースアプリはどう変わる!? 〜日経電子版の新機能対応と、開発事例から〜
lynnswap
7
13k
When benchmarks go bad - what I learned from measuring performance wrong
hollycummins
0
220
Featured
See All Featured
How Fast Is Fast Enough? [PerfNow 2025]
tammyeverts
3
940
From Legacy to Launchpad: Building Startup-Ready Communities
dugsong
0
360
Accessibility Awareness
sabderemane
1
250
My Coaching Mixtape
mlcsv
0
360
Reflections from 52 weeks, 52 projects
jeffersonlam
356
22k
The Pragmatic Product Professional
lauravandoore
37
7.5k
It's Worth the Effort
3n
188
29k
Pawsitive SEO: Lessons from My Dog (and Many Mistakes) on Thriving as a Consultant in the Age of AI
davidcarrasco
0
260
State of Search Keynote: SEO is Dead Long Live SEO
ryanjones
0
320
Building Experiences: Design Systems, User Experience, and Full Site Editing
marktimemedia
1
630
技術選定の審美眼(2025年版) / Understanding the Spiral of Technologies 2025 edition
twada
PRO
120
120k
Highjacked: Video Game Concept Design
rkendrick25
PRO
1
480
Transcript
Intel NPU でローカル LLM 1 1
今日のゴール Intel NPU で LLM が動くことを 再現できる形で見せる NPU とは何か Docker
でどう NPU に接続するか モデルをどう準備して動かすか 2 2
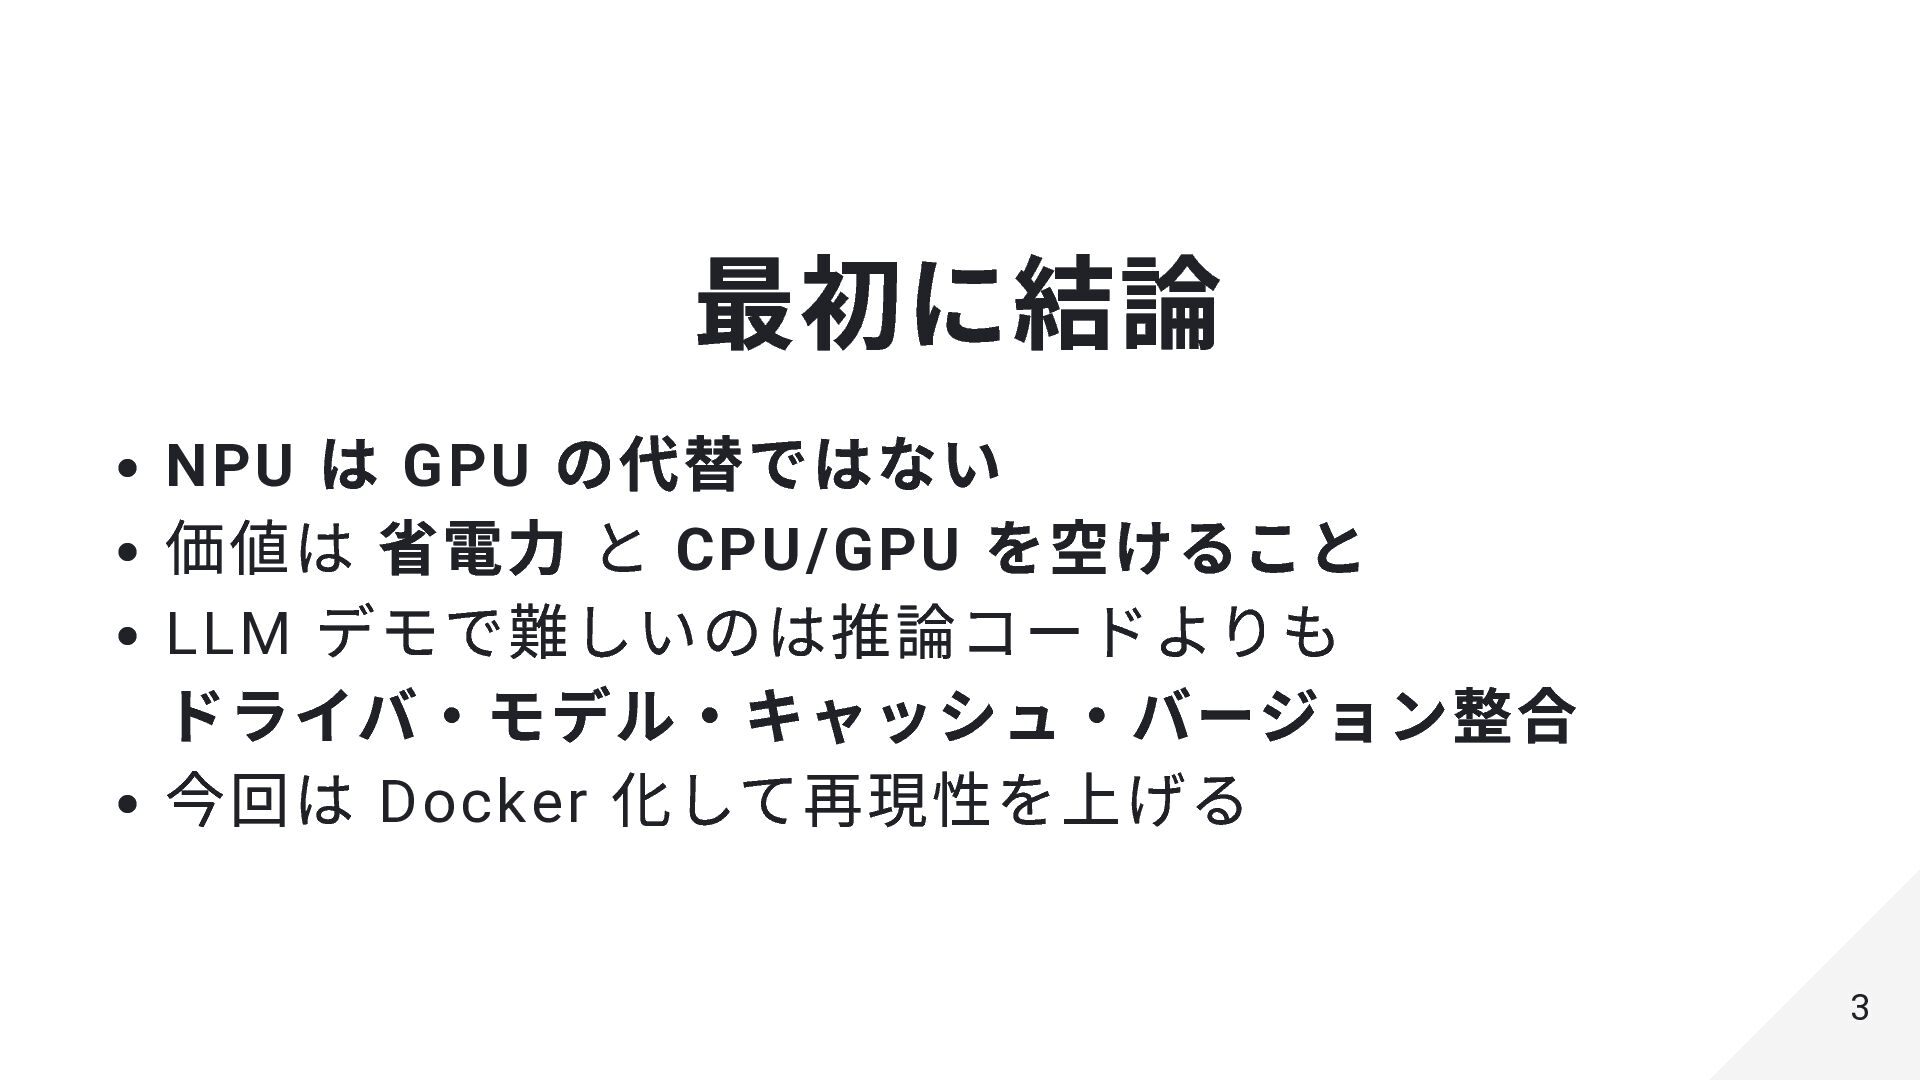
最初に結論 NPU は GPU の代替ではない 価値は 省電力 と CPU/GPU を空けること
LLM デモで難しいのは推論コードよりも ドライバ・モデル・キャッシュ・バージョン整合 今回は Docker 化して再現性を上げる 3 3
NPU とは 4 4
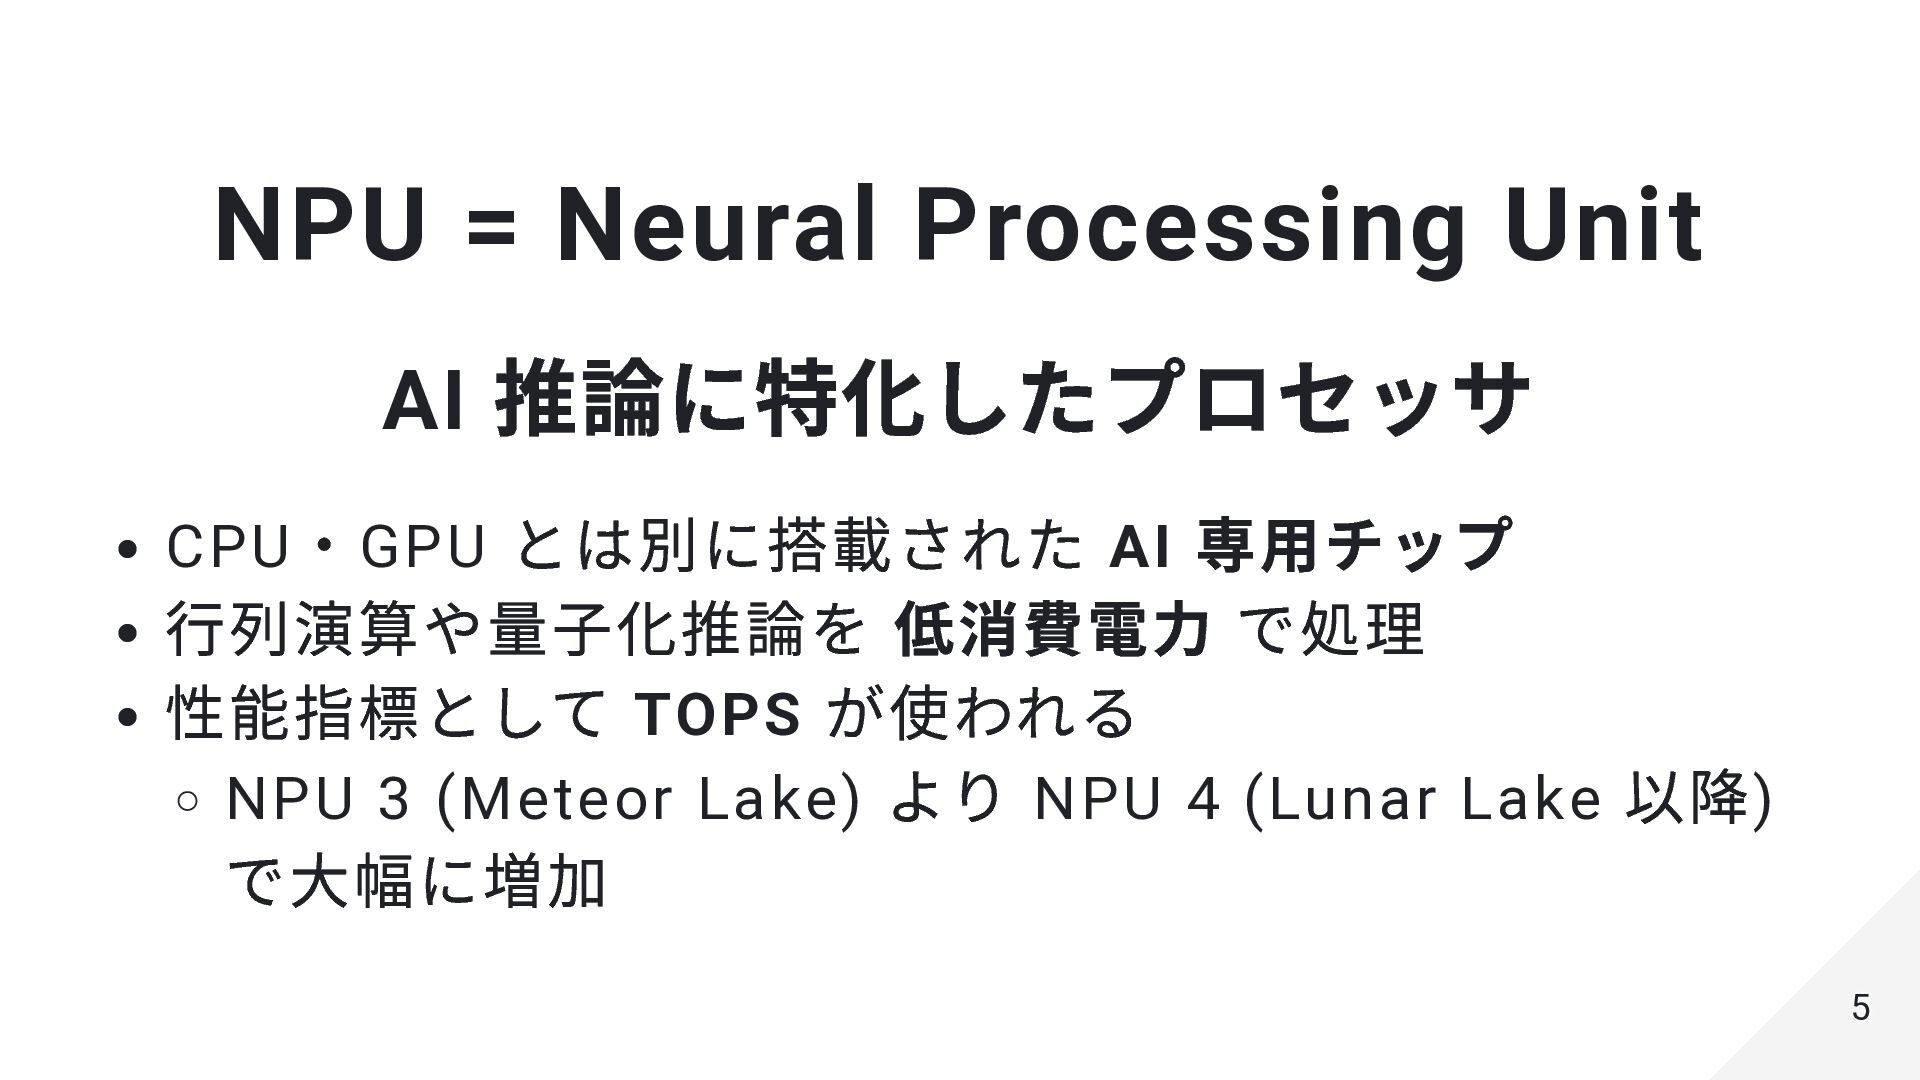
NPU = Neural Processing Unit AI 推論に特化したプロセッサ CPU ・GPU とは別に搭載された
AI 専用チップ 行列演算や量子化推論を 低消費電力 で処理 性能指標として TOPS が使われる NPU 3 (Meteor Lake) より NPU 4 (Lunar Lake 以降) で大幅に増加 5 5
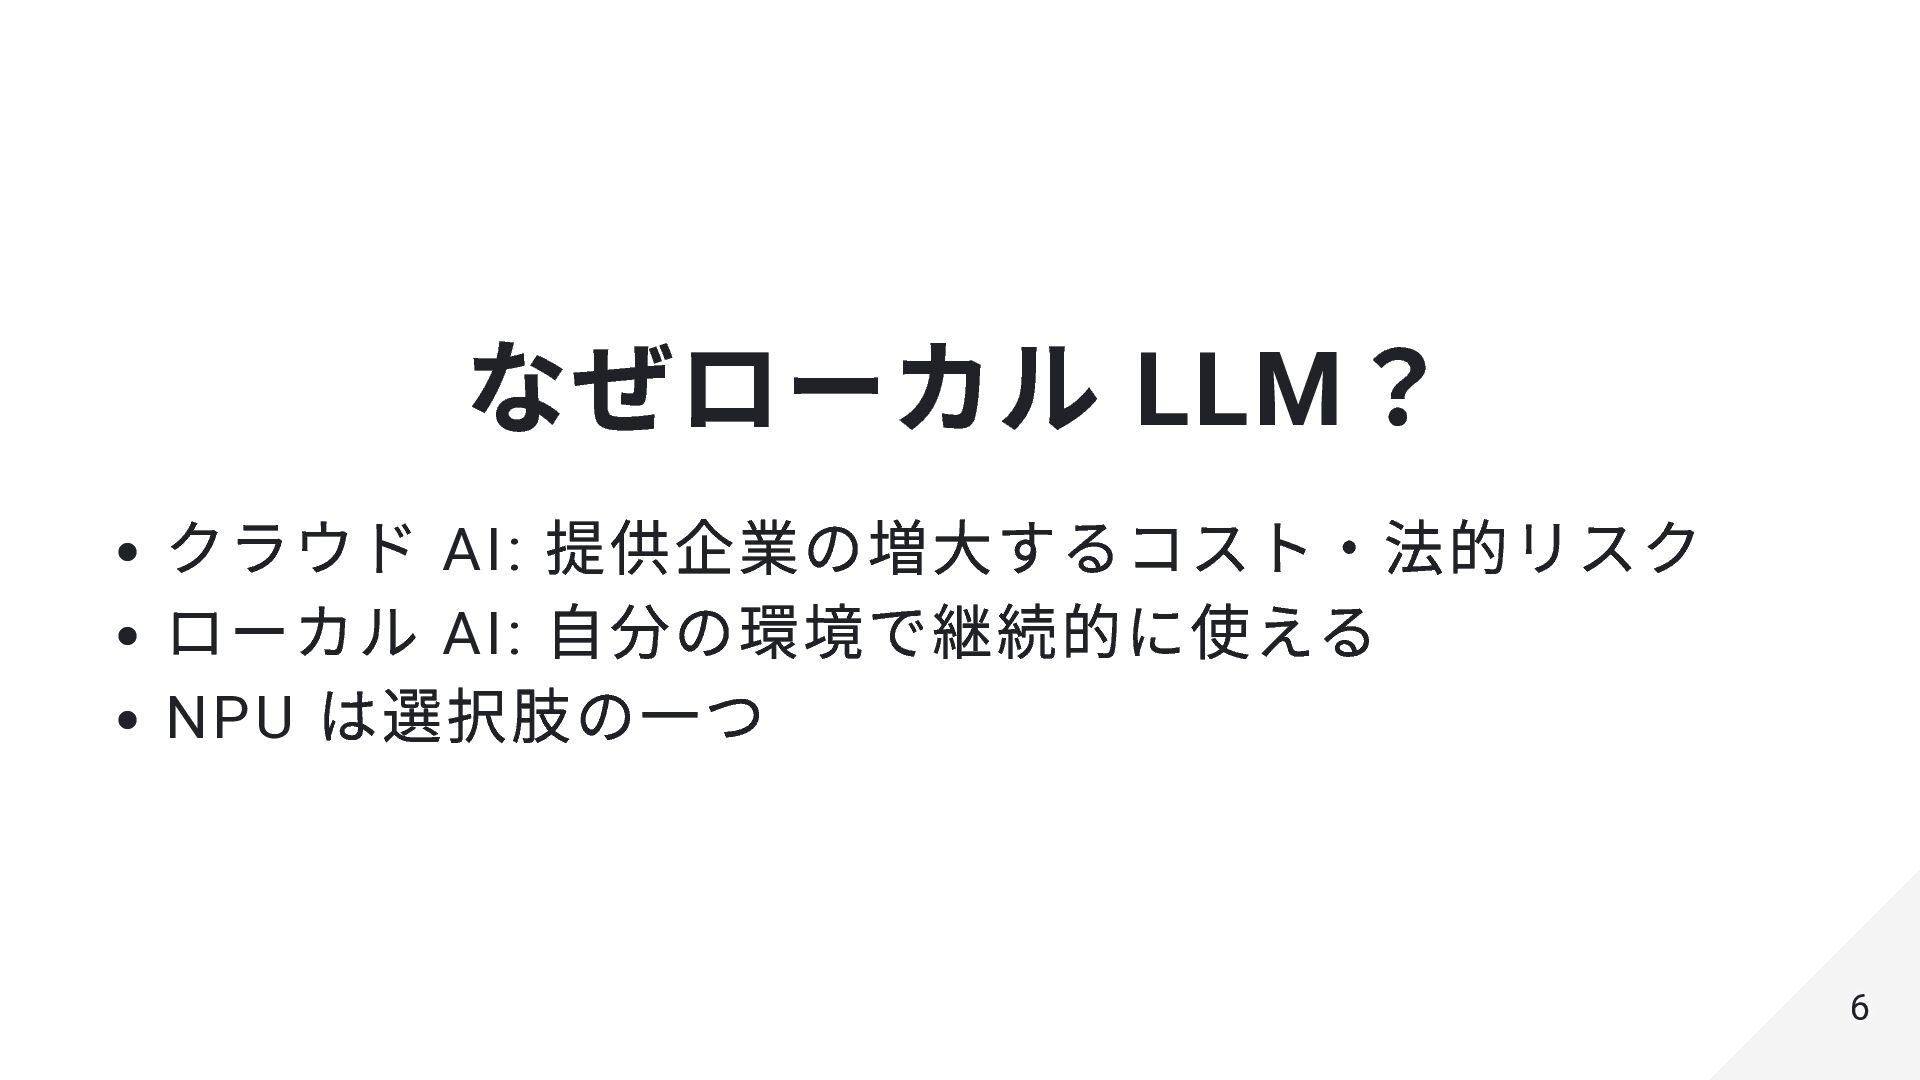
なぜローカル LLM ? クラウド AI: 提供企業の増大するコスト・法的リスク ローカル AI: 自分の環境で継続的に使える NPU
は選択肢の一つ 6 6
今回のデモ構成 7 7
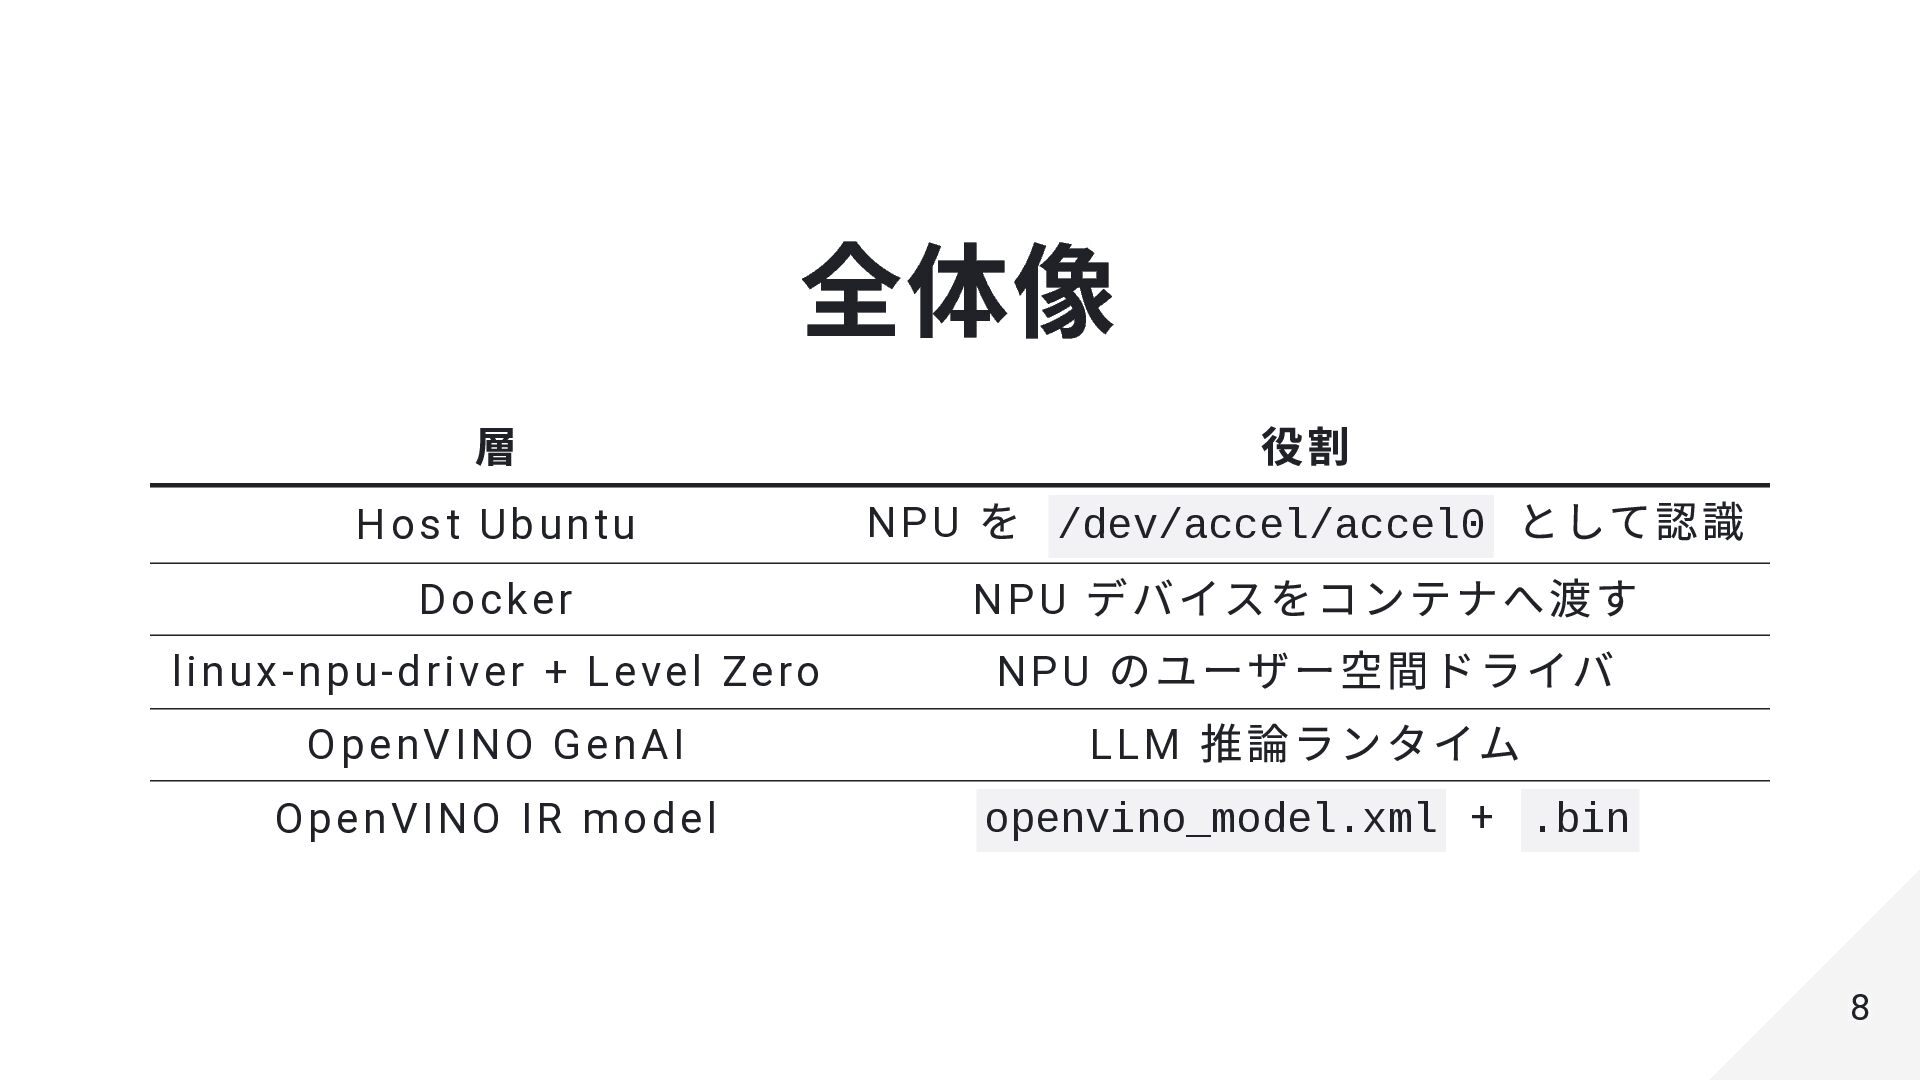
全体像 層 役割 Host Ubuntu NPU を /dev/accel/accel0 として認識 Docker
NPU デバイスをコンテナへ渡す linux-npu-driver + Level Zero NPU のユーザー空間ドライバ OpenVINO GenAI LLM 推論ランタイム OpenVINO IR model openvino_model.xml + .bin 8 8
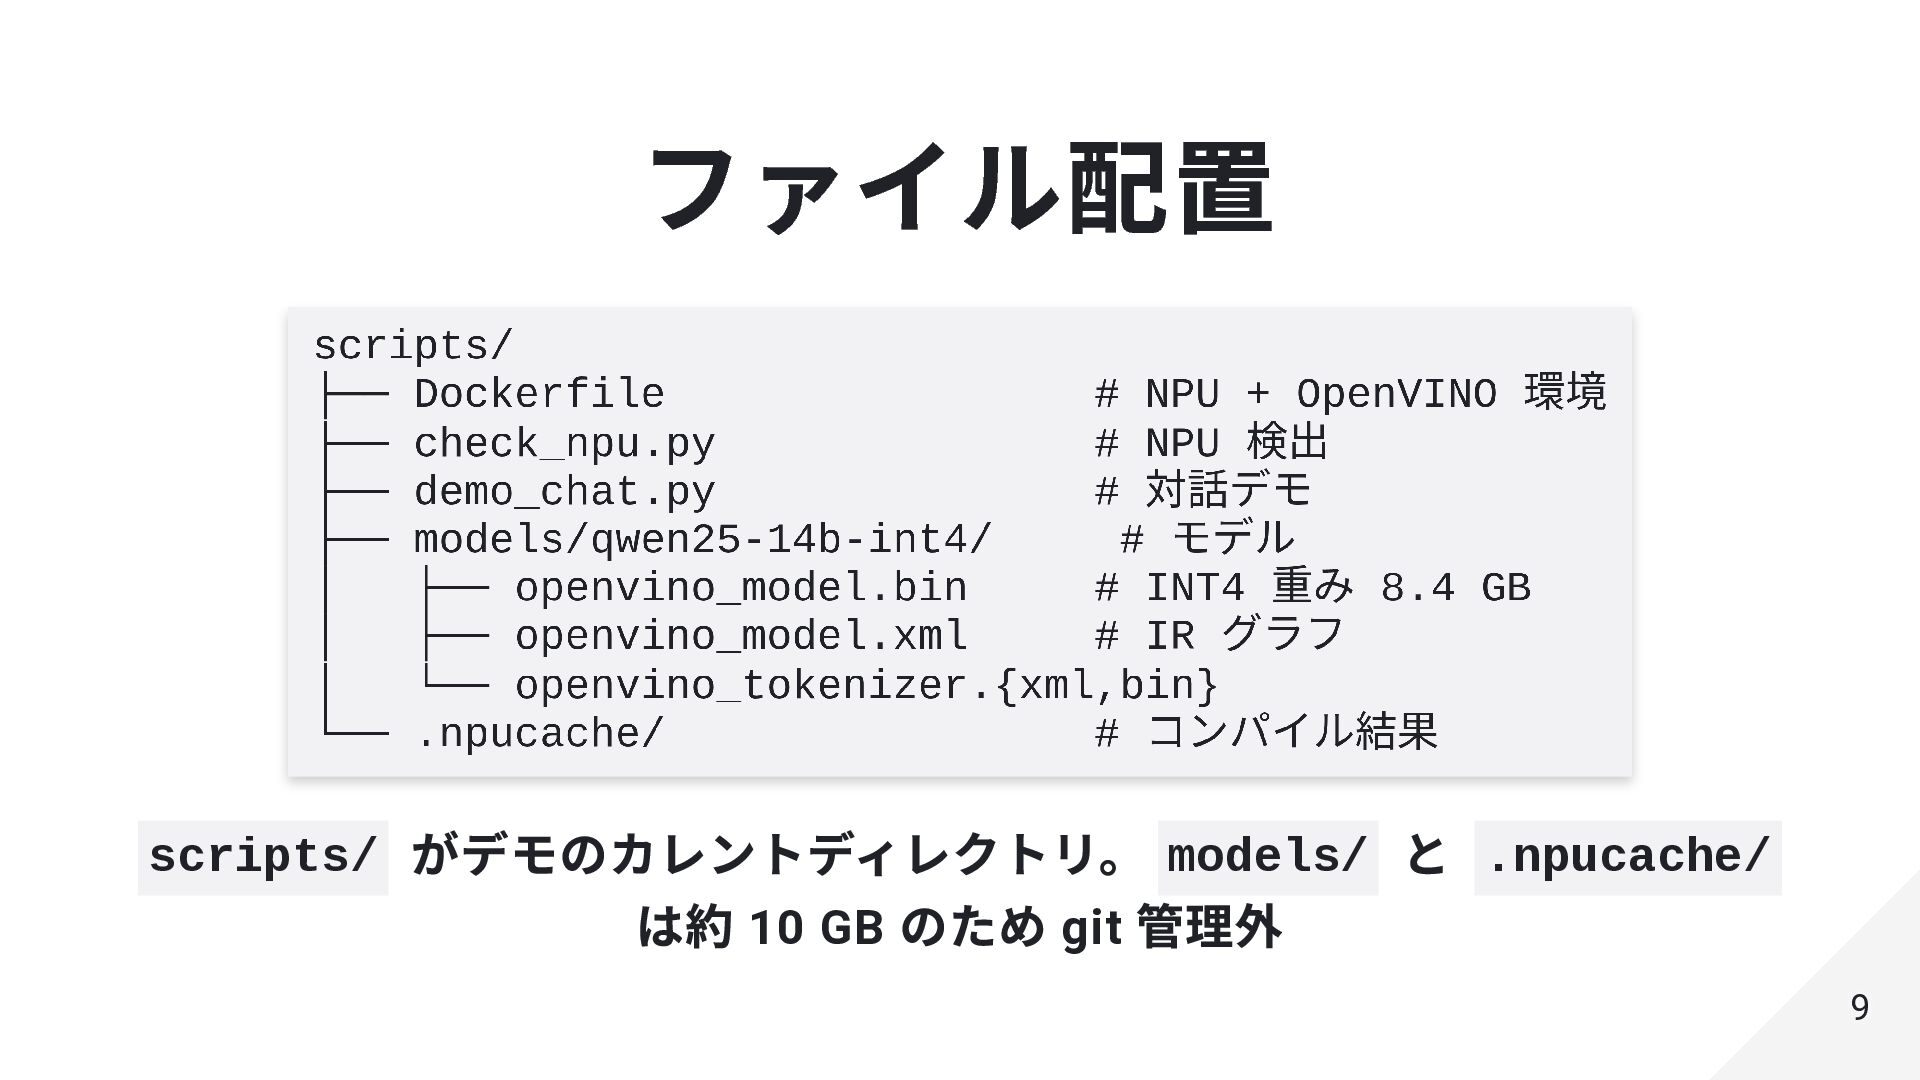
ファイル配置 scripts/ がデモのカレントディレクトリ。 models/ と .npucache/ は約 10 GB のため
git 管理外 9 9
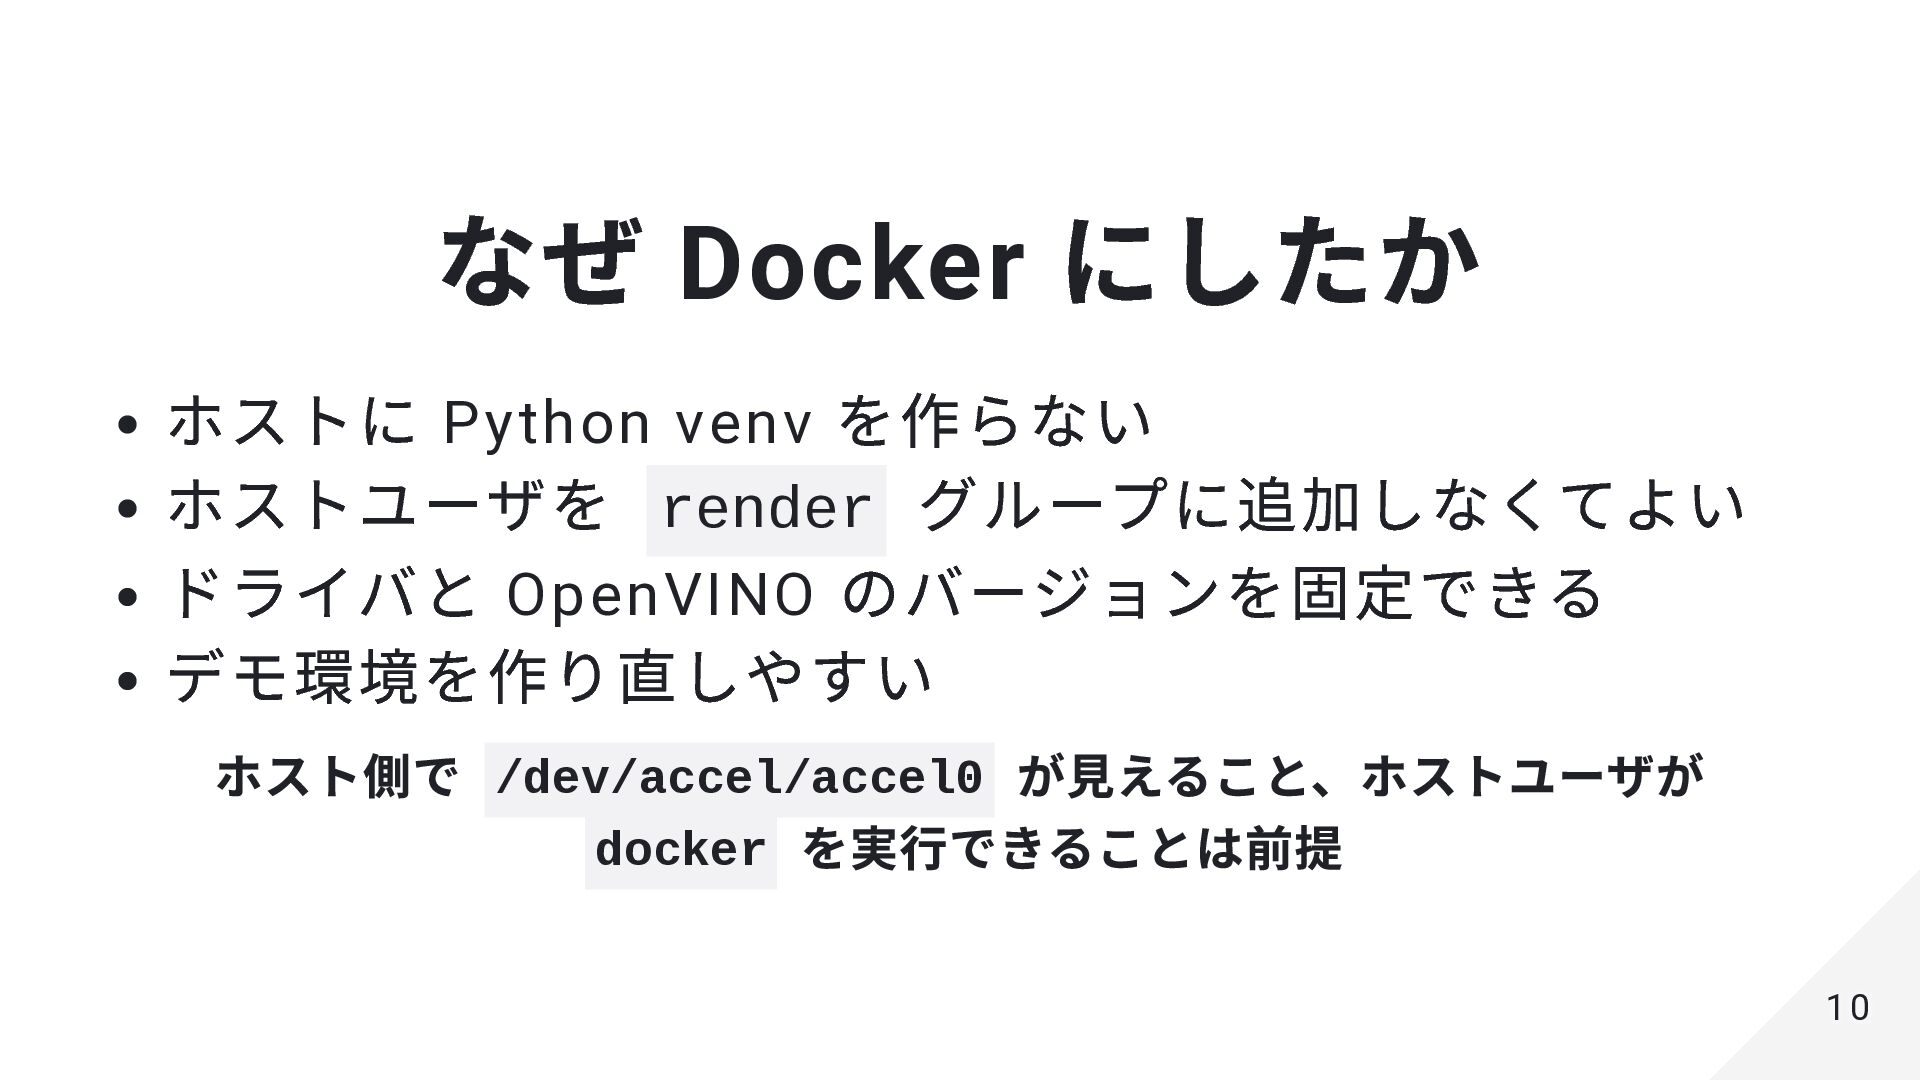
なぜ Docker にしたか ホストに Python venv を作らない ホストユーザを render グループに追加しなくてよい
ドライバと OpenVINO のバージョンを固定できる デモ環境を作り直しやすい ホスト側で /dev/accel/accel0 が見えること、ホストユーザが docker を実行できることは前提 10 10
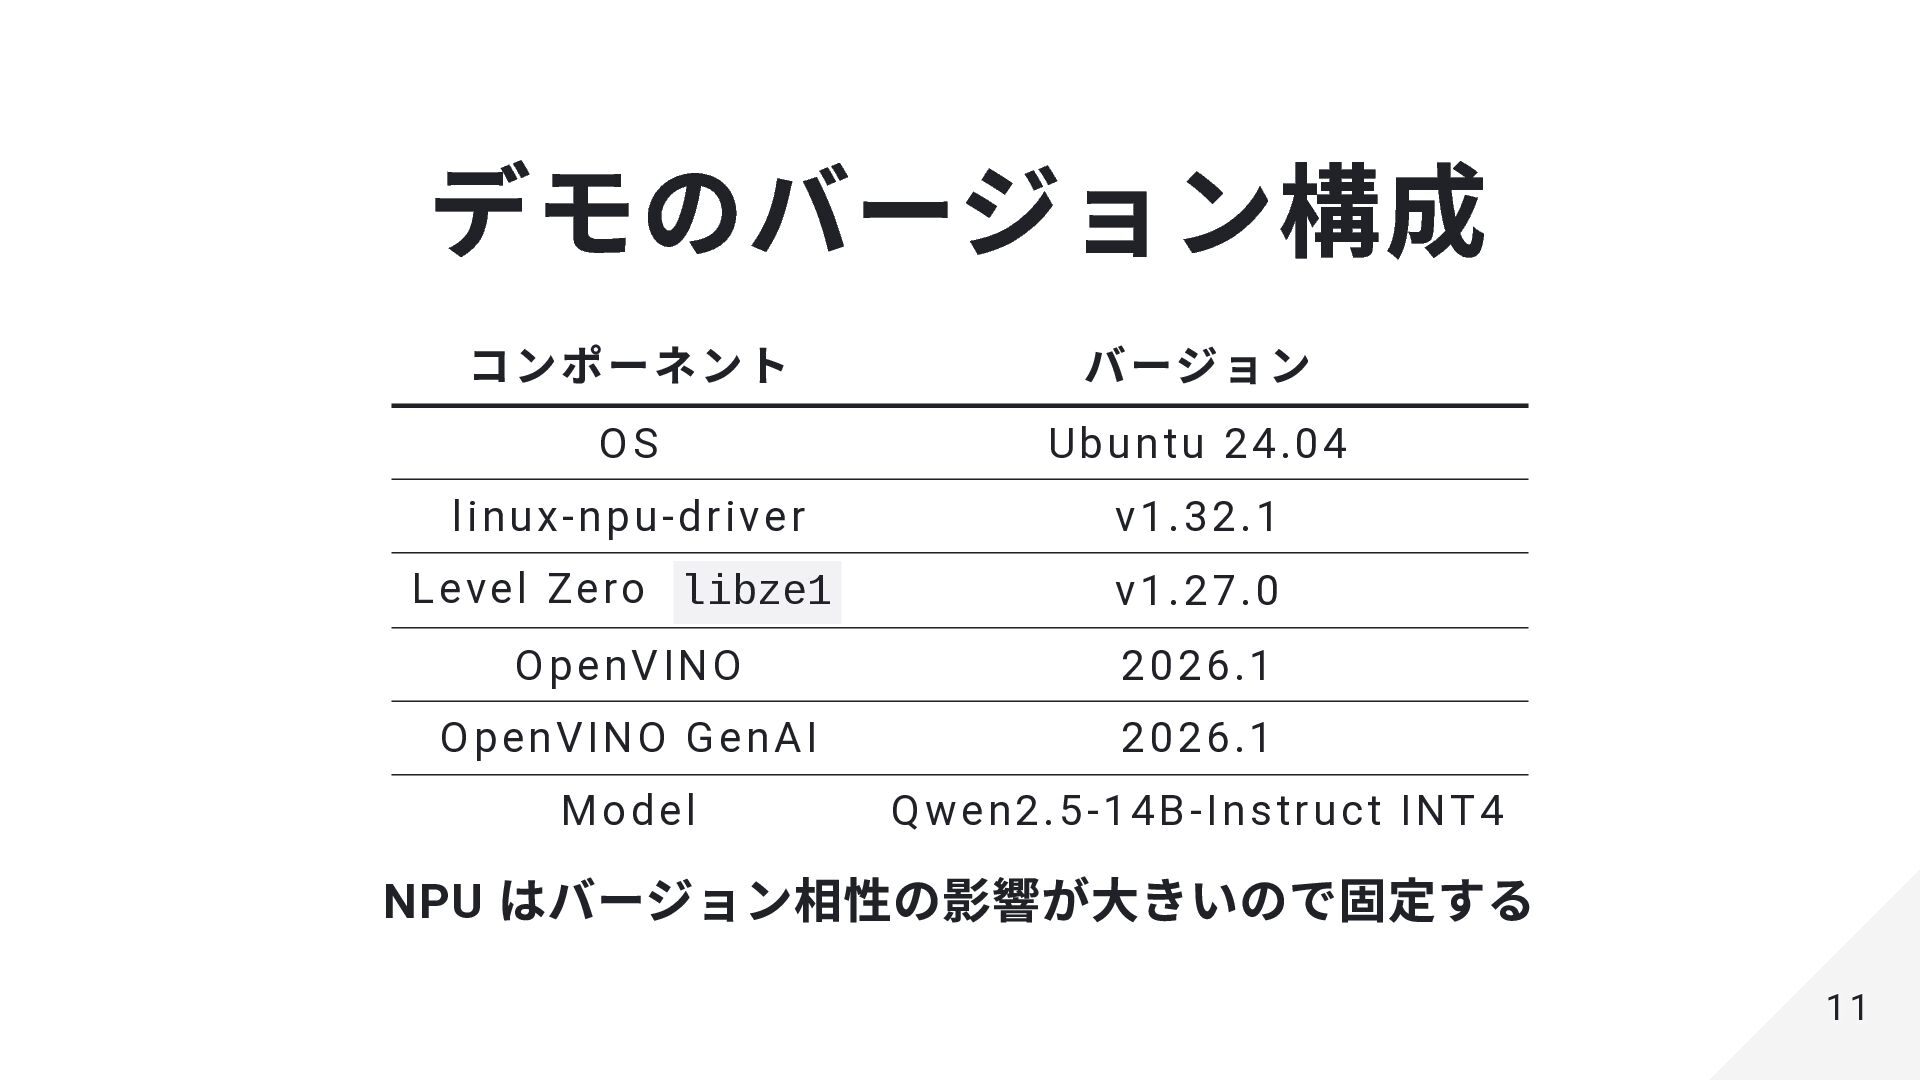
デモのバージョン構成 コンポーネント バージョン OS Ubuntu 24.04 linux-npu-driver v1.32.1 Level Zero
libze1 v1.27.0 OpenVINO 2026.1 OpenVINO GenAI 2026.1 Model Qwen2.5-14B-Instruct INT4 NPU はバージョン相性の影響が大きいので固定する 11 11
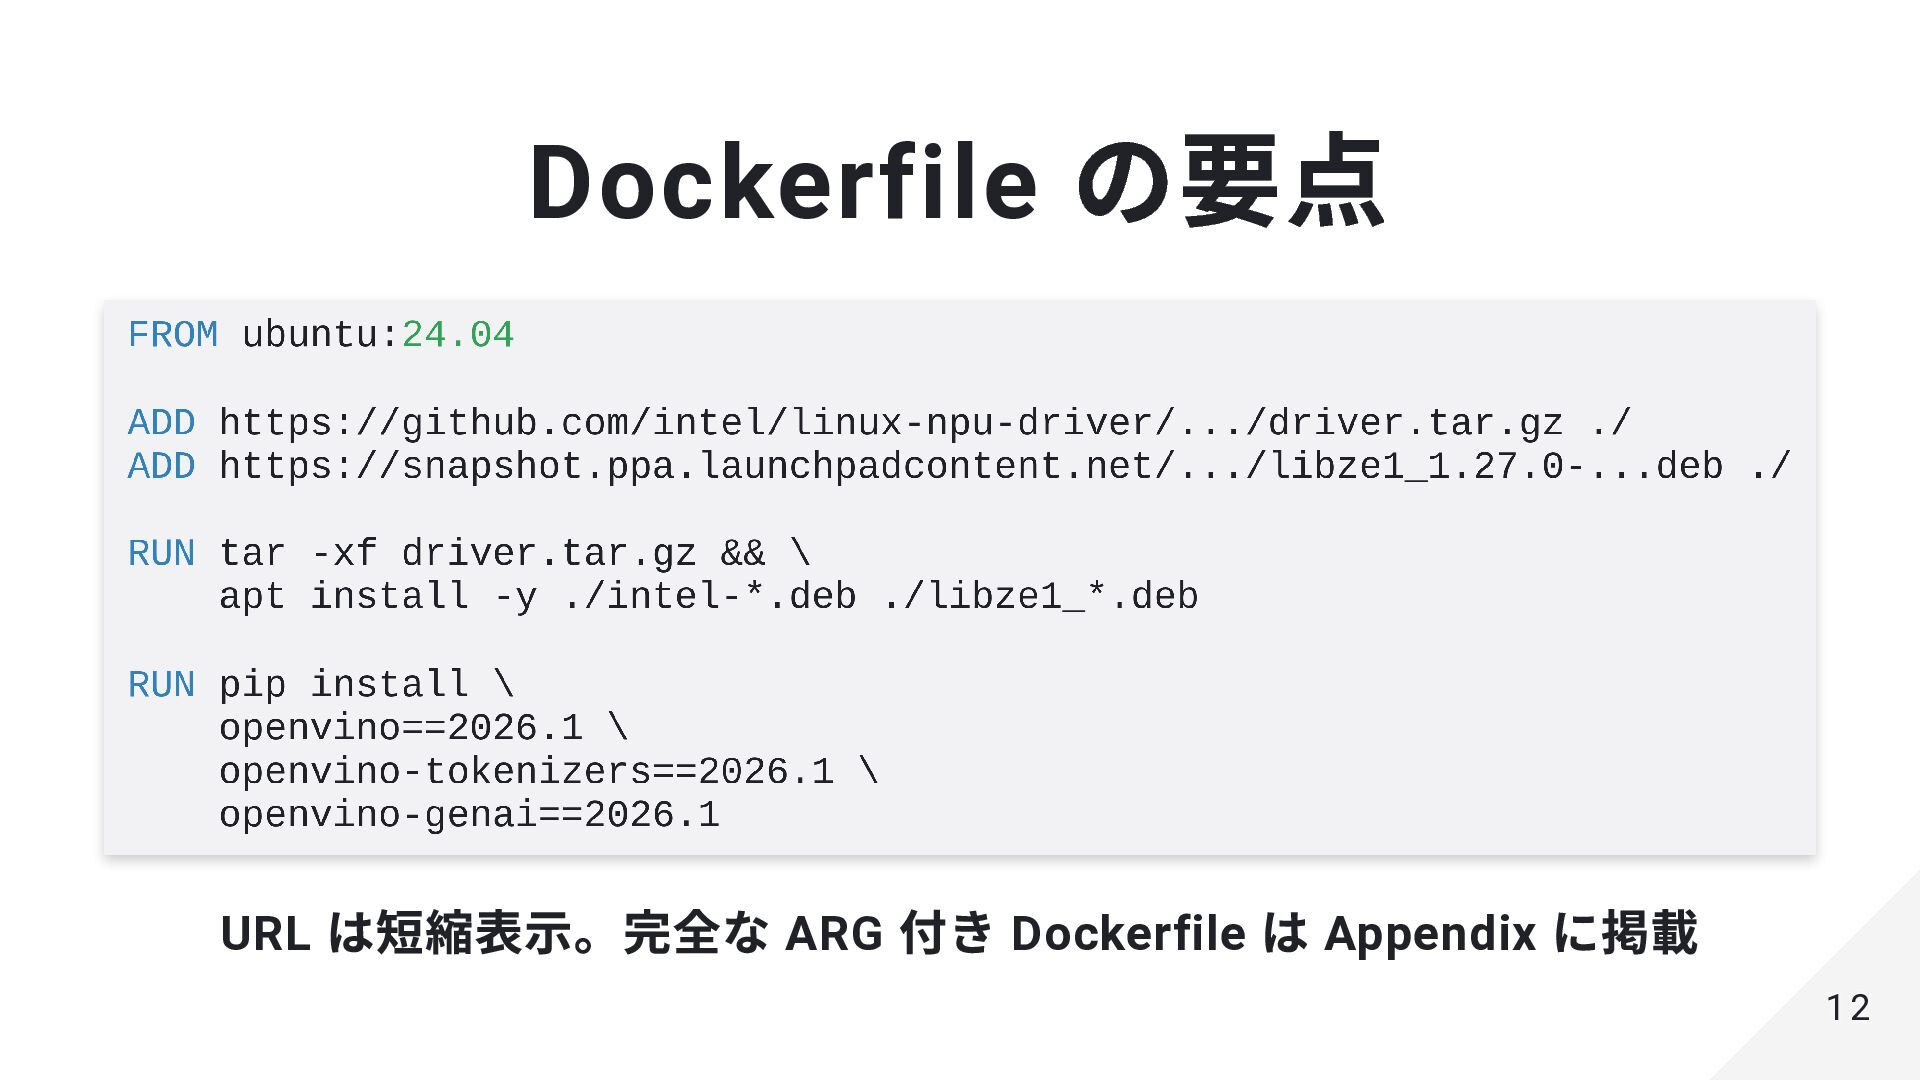
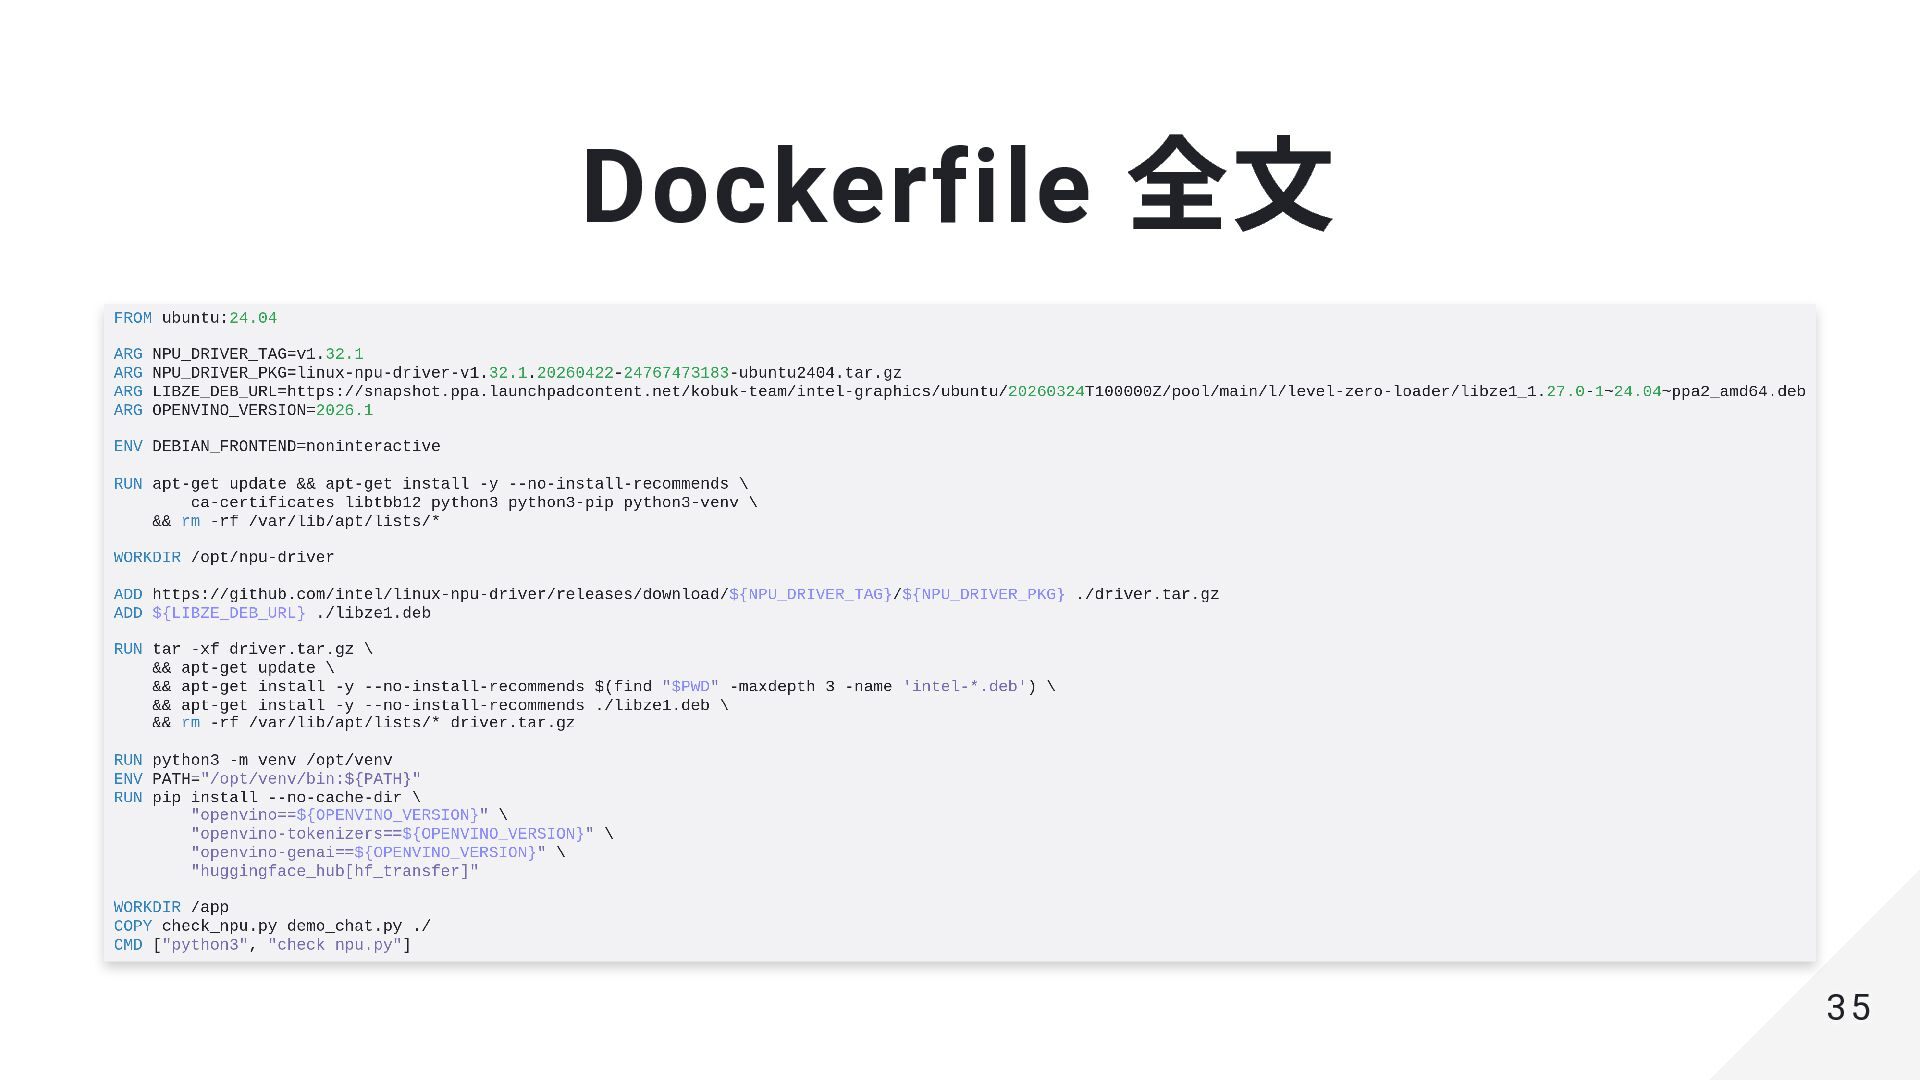
Dockerfile の要点 URL は短縮表示。完全な ARG 付き Dockerfile は Appendix に掲載
12 12
OpenVINO の仕組み 13 13
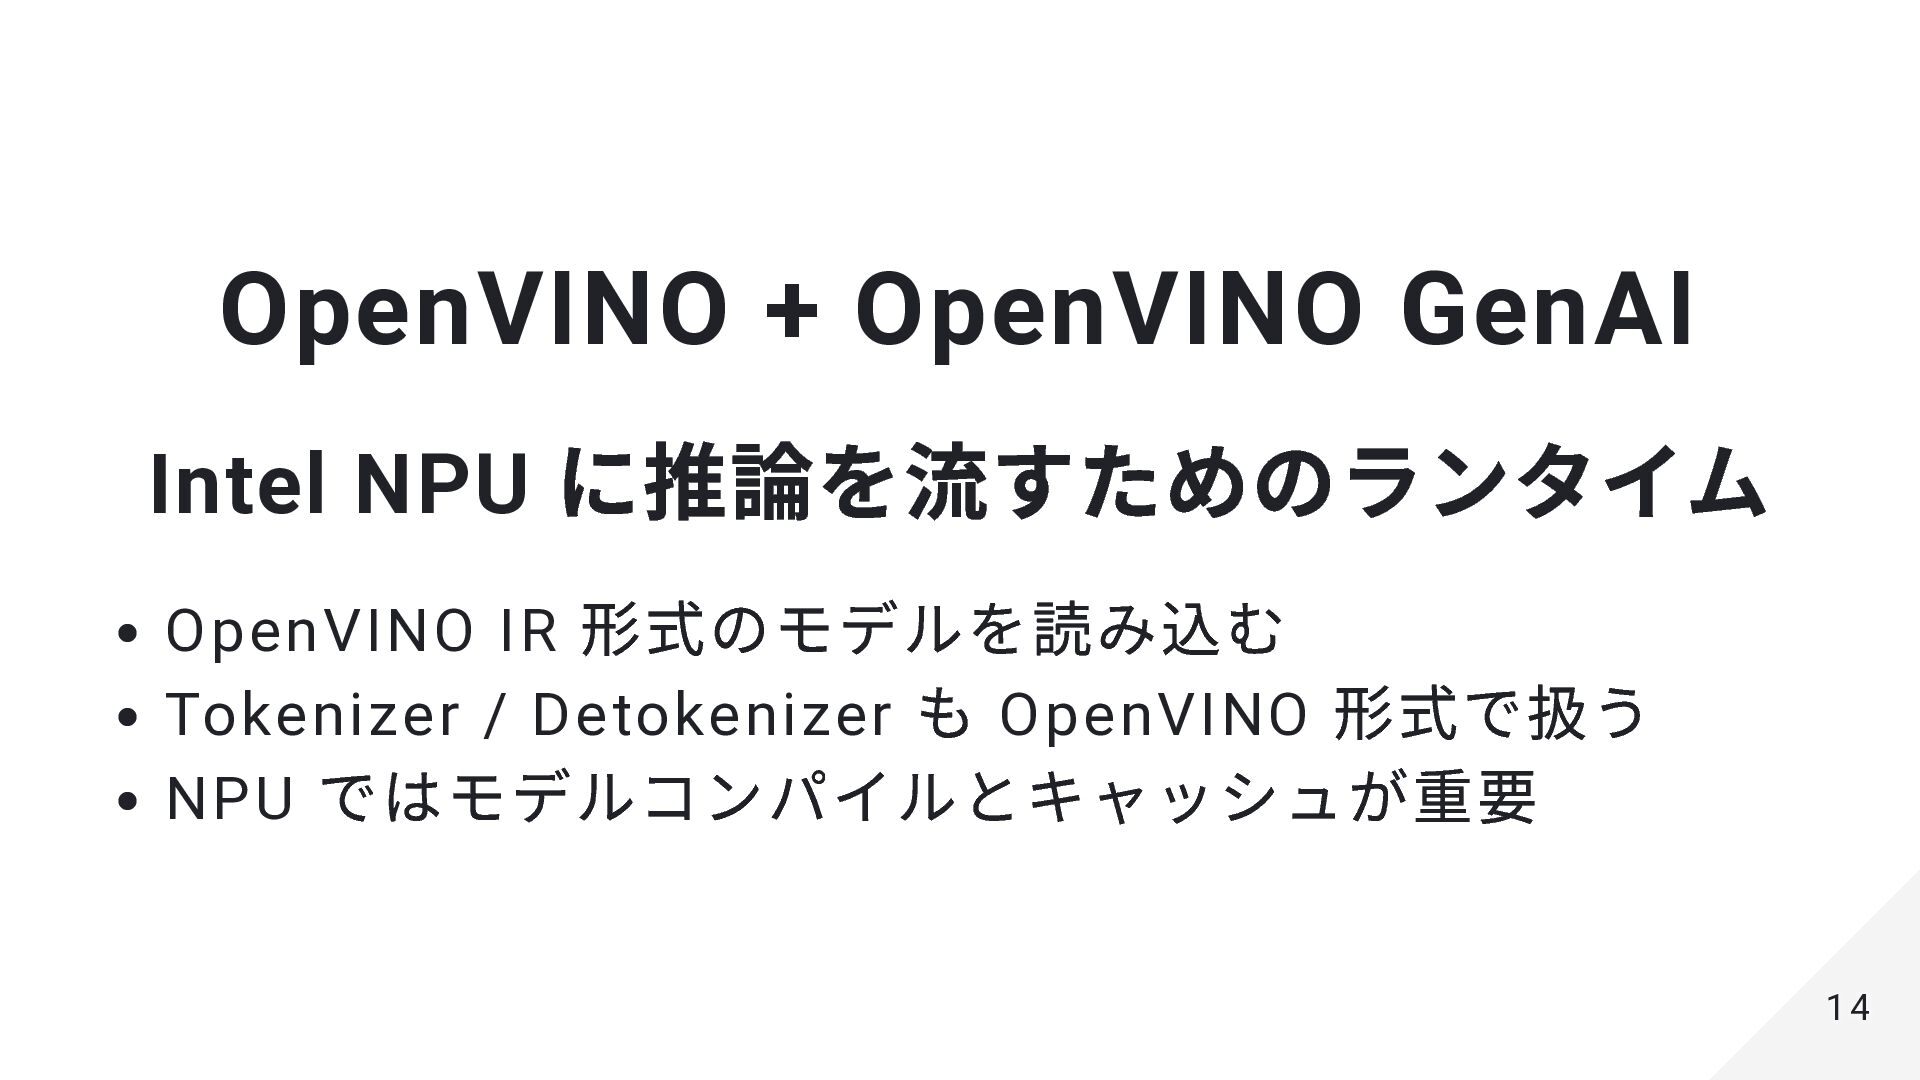
OpenVINO + OpenVINO GenAI Intel NPU に推論を流すためのランタイム OpenVINO IR 形式のモデルを読み込む
Tokenizer / Detokenizer も OpenVINO 形式で扱う NPU ではモデルコンパイルとキャッシュが重要 14 14
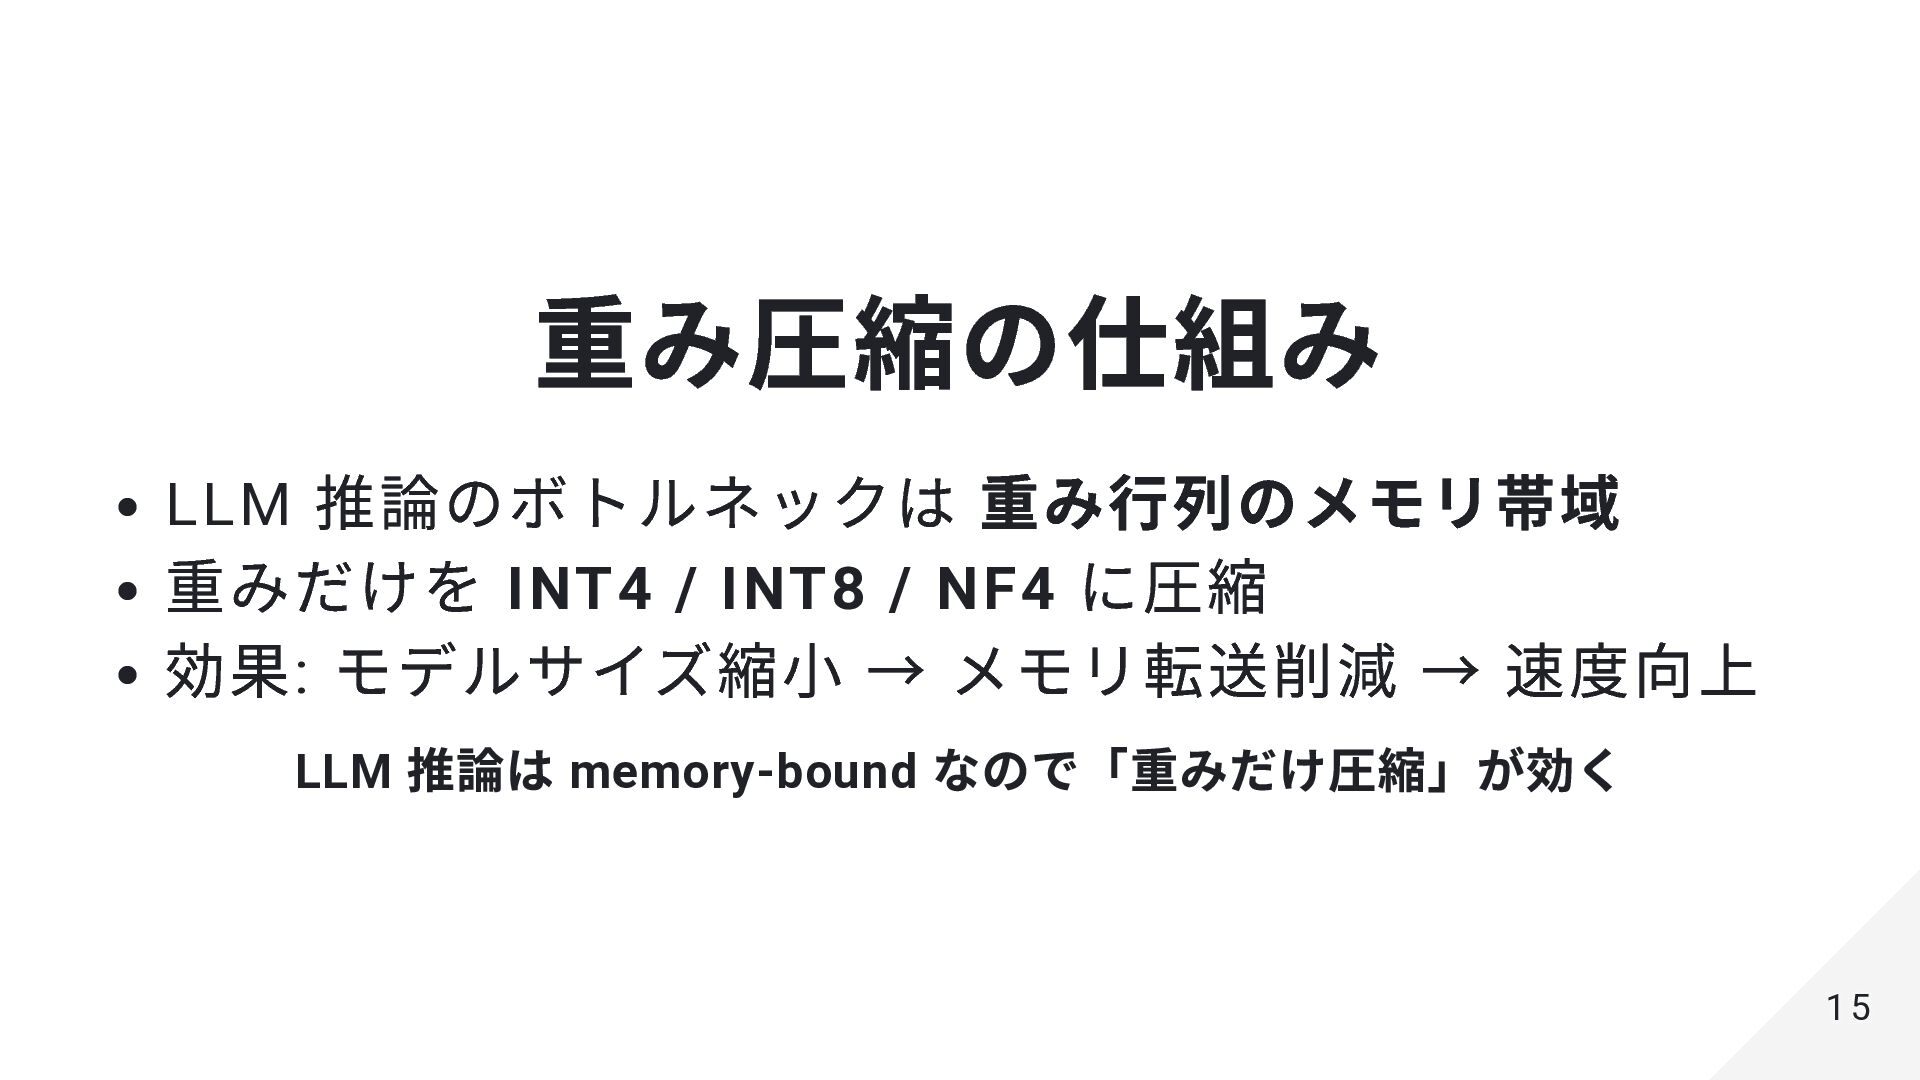
重み圧縮の仕組み LLM 推論のボトルネックは 重み行列のメモリ帯域 重みだけを INT4 / INT8 / NF4
に圧縮 効果: モデルサイズ縮小 → メモリ転送削減 → 速度向上 LLM 推論は memory-bound なので「重みだけ圧縮」が効く 15 15
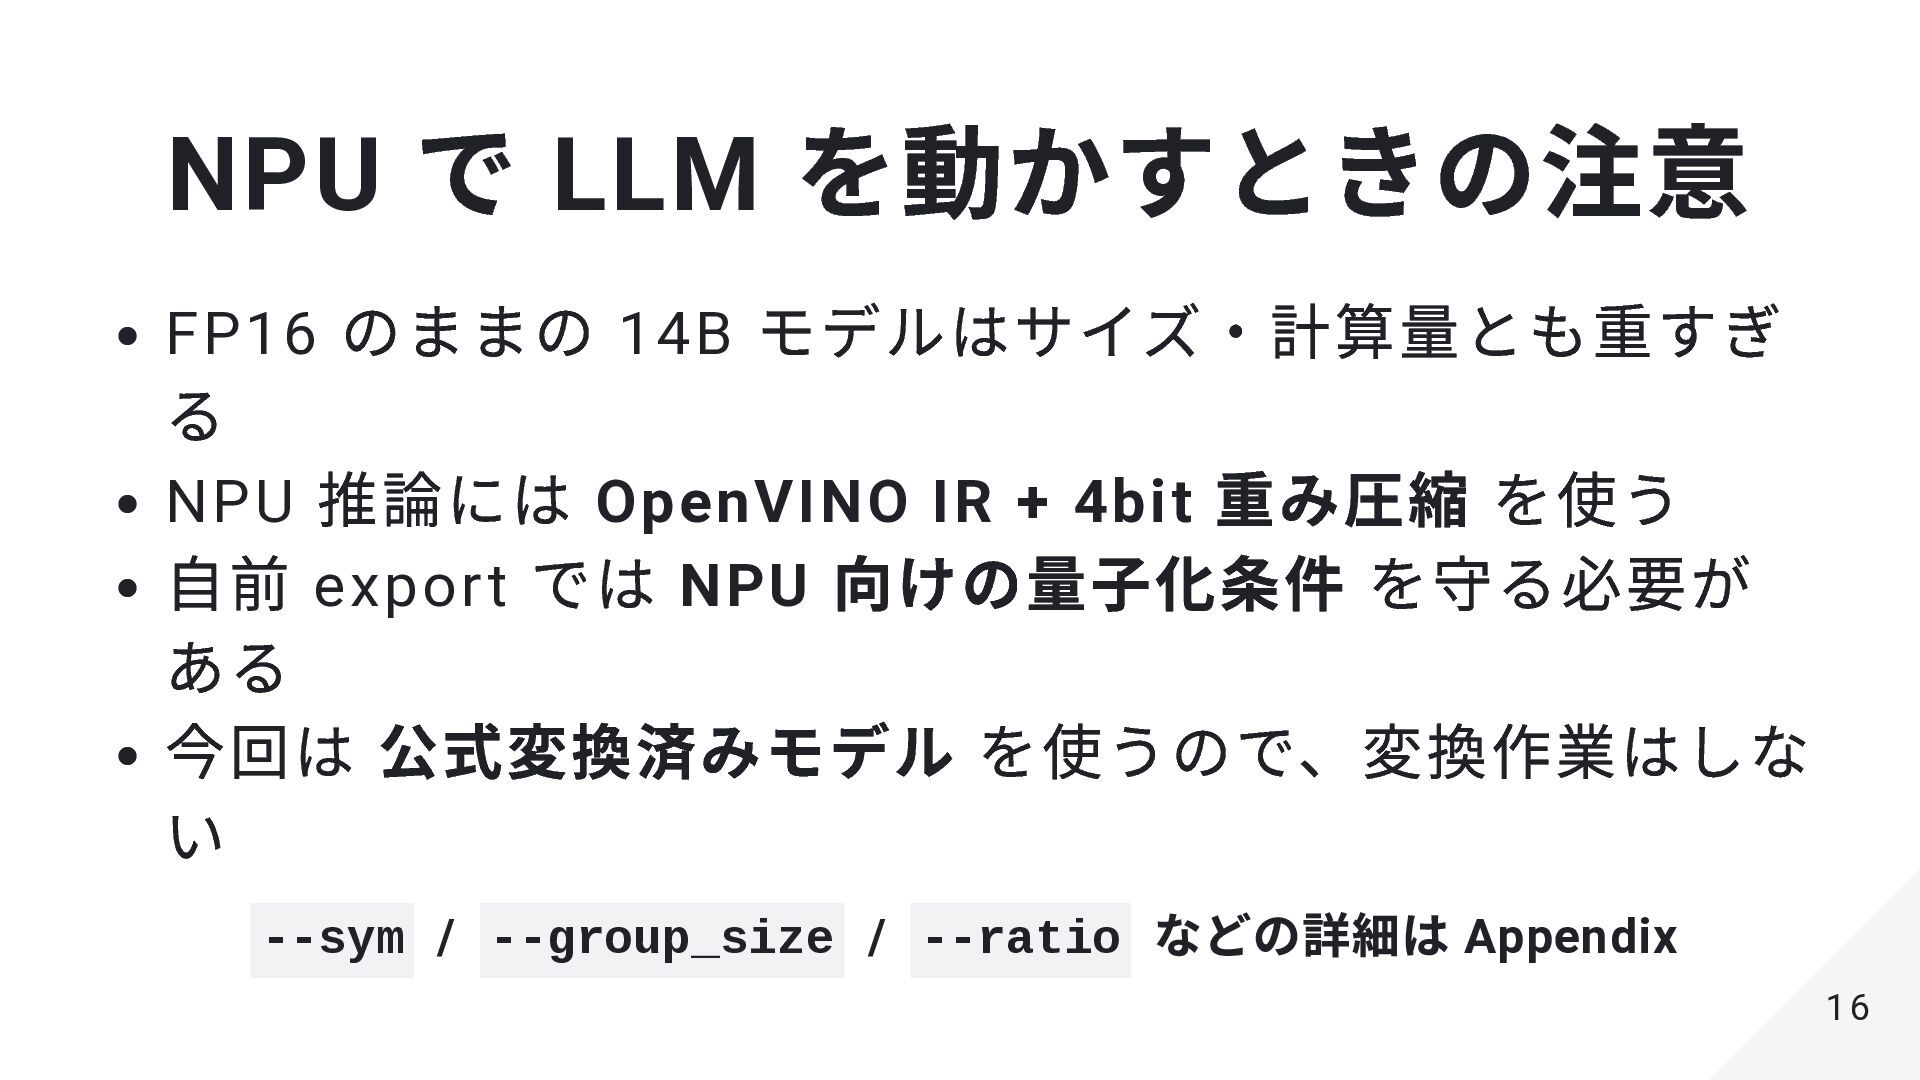
NPU で LLM を動かすときの注意 FP16 のままの 14B モデルはサイズ・計算量とも重すぎ る NPU
推論には OpenVINO IR + 4bit 重み圧縮 を使う 自前 export では NPU 向けの量子化条件 を守る必要が ある 今回は 公式変換済みモデル を使うので、変換作業はしな い --sym / --group_size / --ratio などの詳細は Appendix 16 16
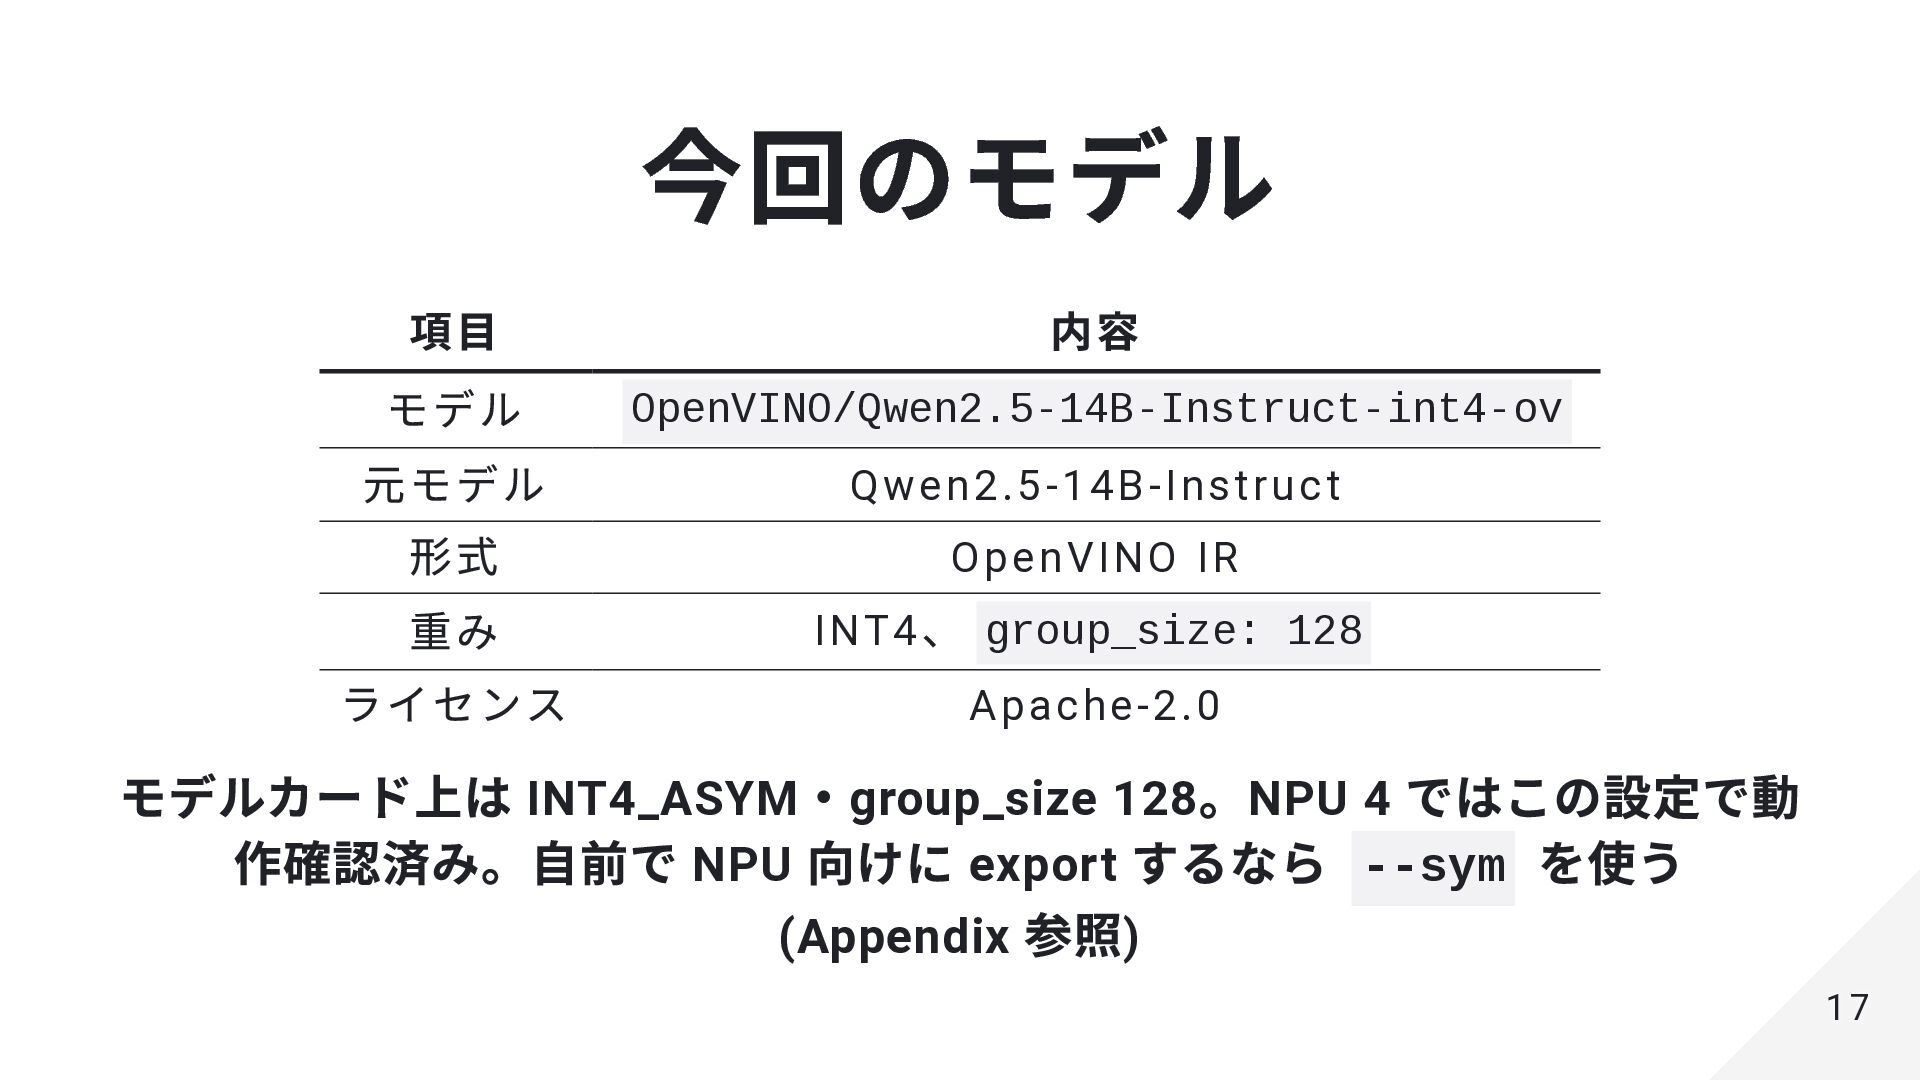
今回のモデル 項目 内容 モデル OpenVINO/Qwen2.5-14B-Instruct-int4-ov 元モデル Qwen2.5-14B-Instruct 形式 OpenVINO IR
重み INT4 、 group_size: 128 ライセンス Apache-2.0 モデルカード上は INT4_ASYM ・group_size 128 。NPU 4 ではこの設定で動 作確認済み。自前で NPU 向けに export するなら --sym を使う (Appendix 参照) 17 17
実行までの流れ 18 18
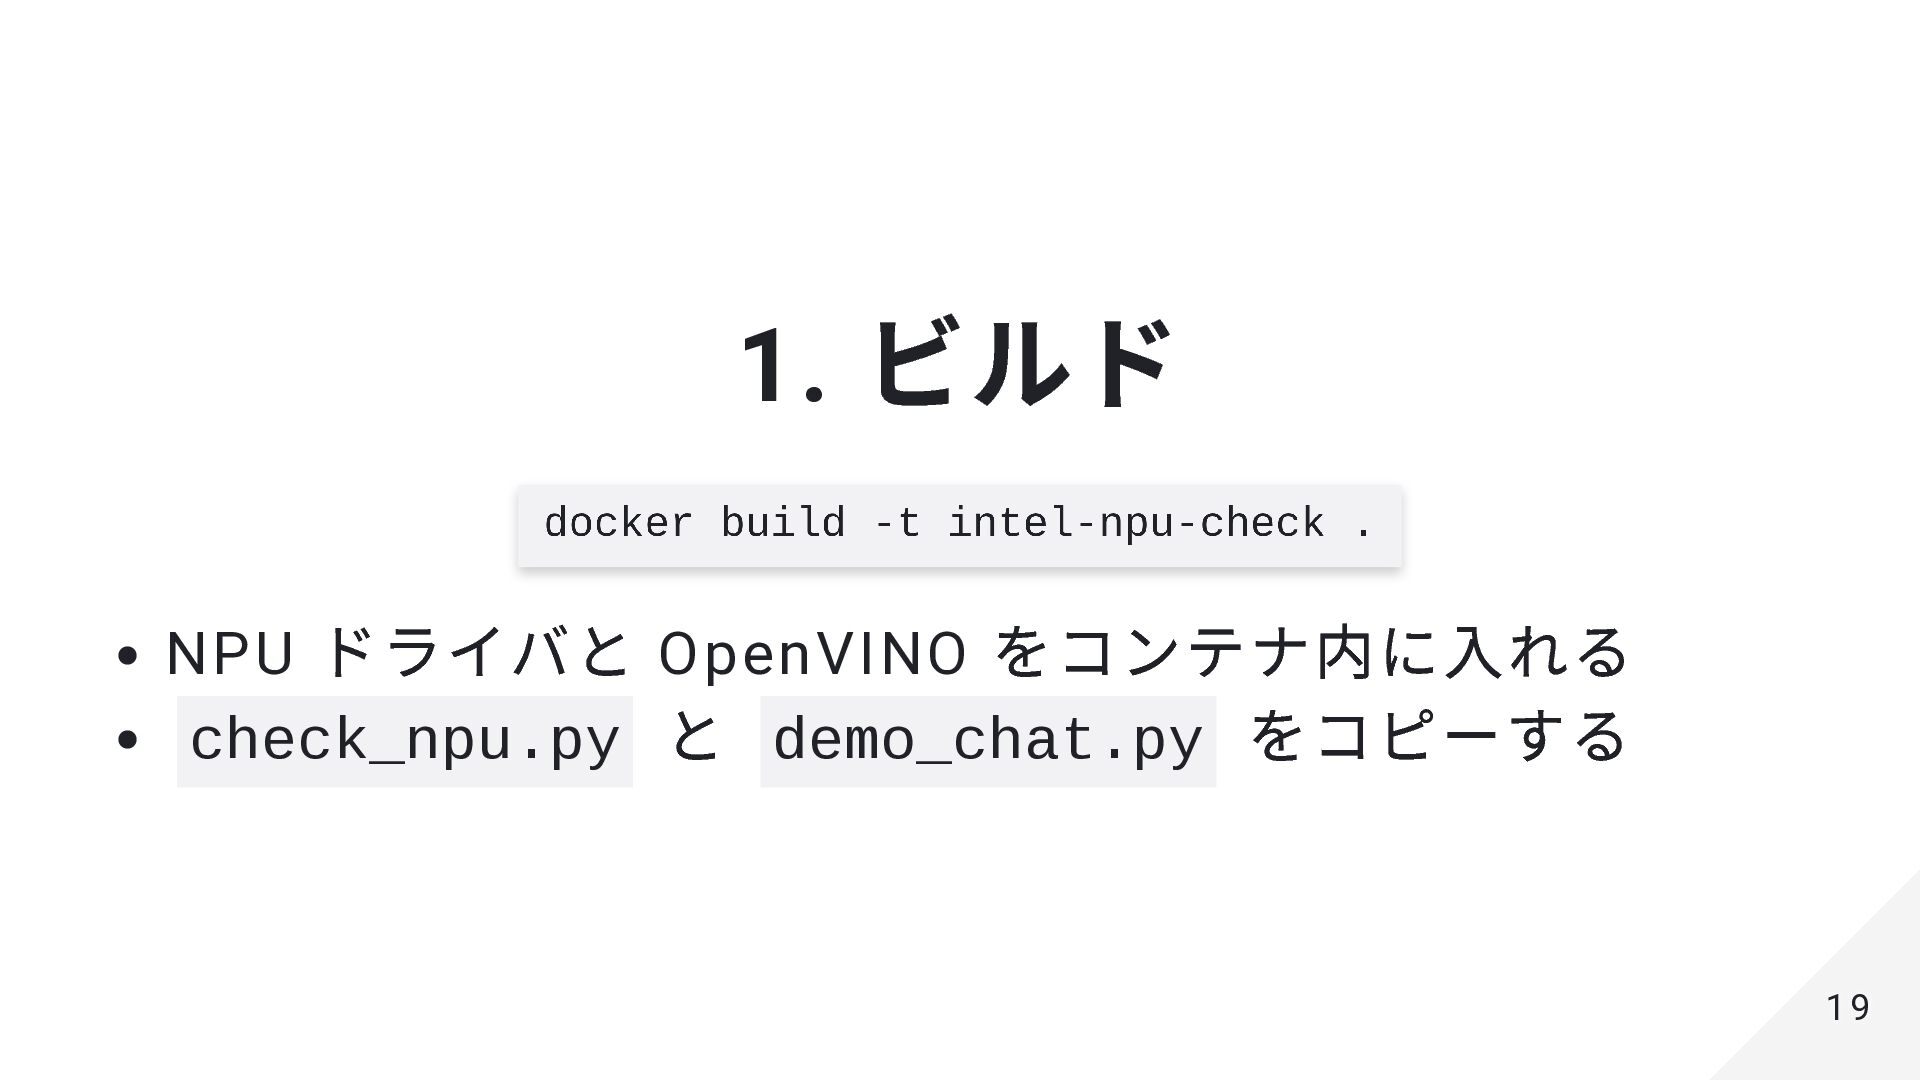
1. ビルド NPU ドライバと OpenVINO をコンテナ内に入れる check_npu.py と demo_chat.py をコピーする
19 19
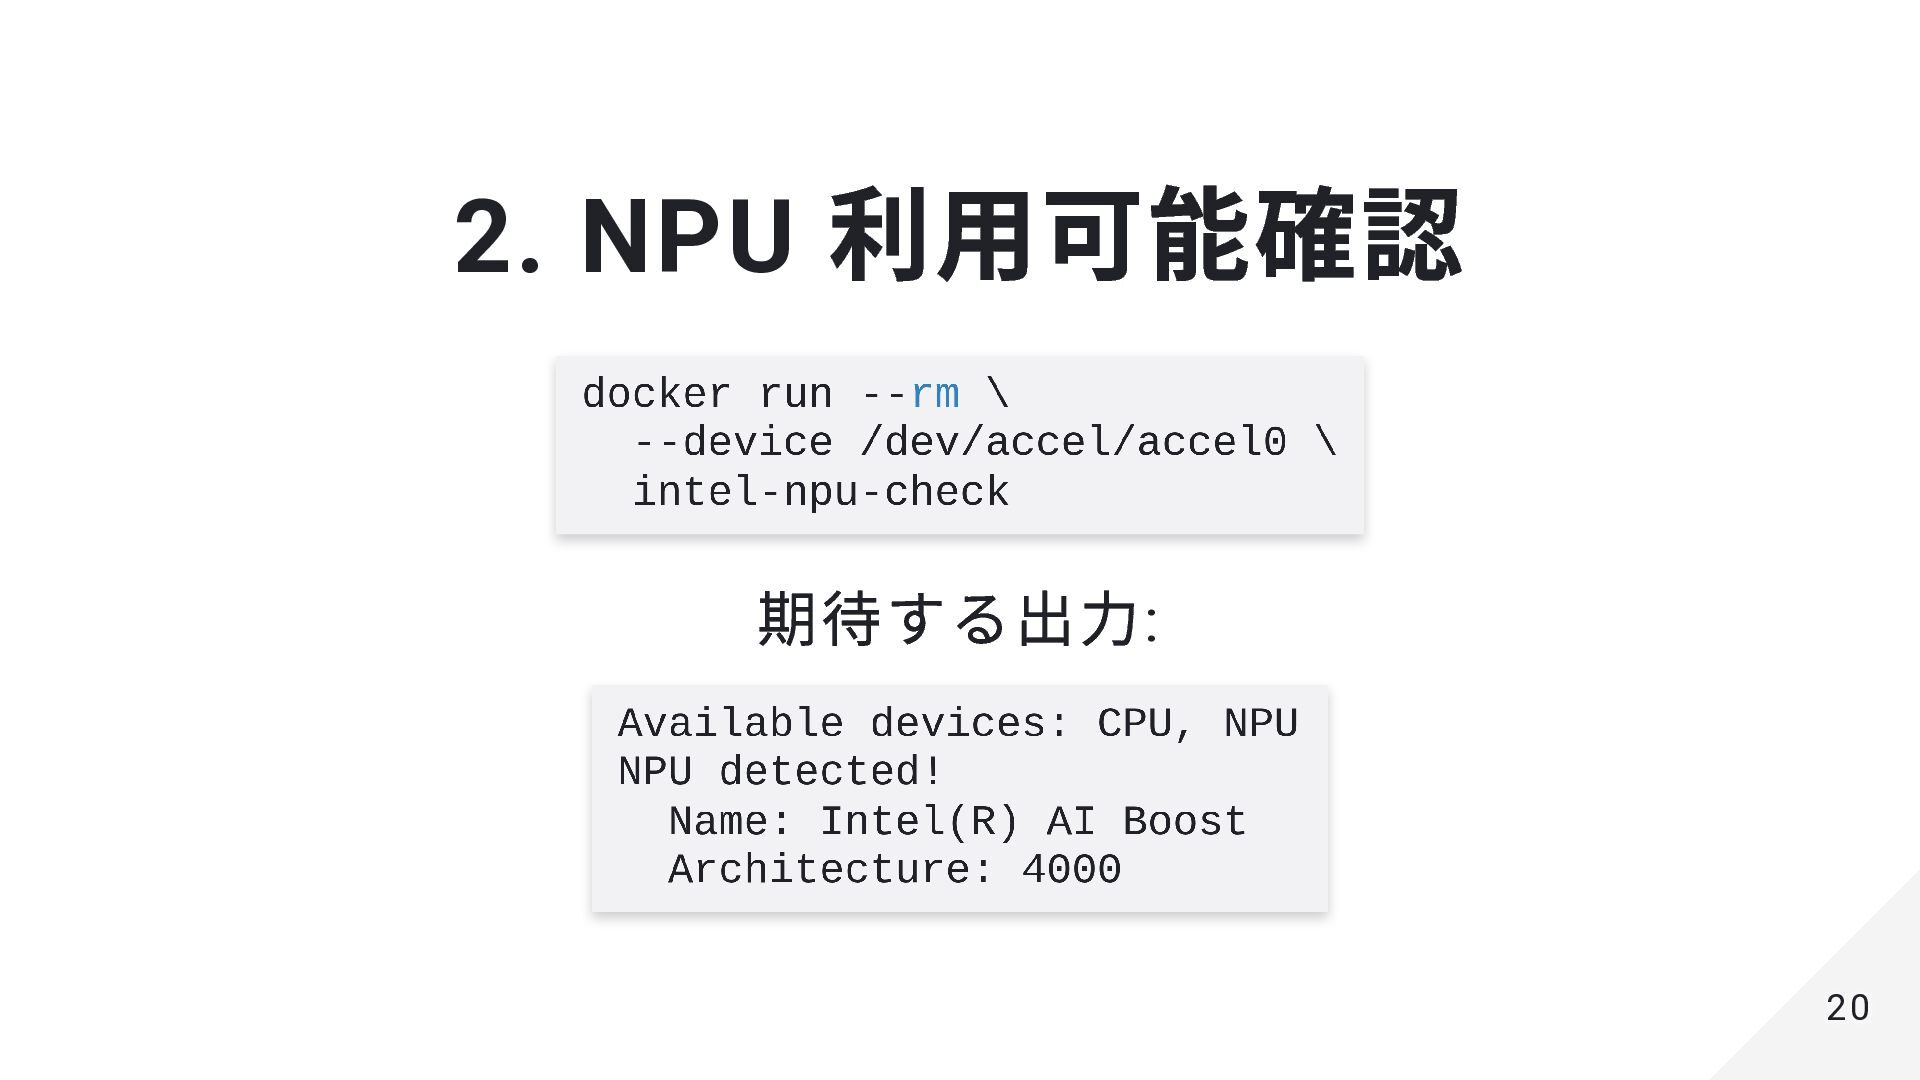
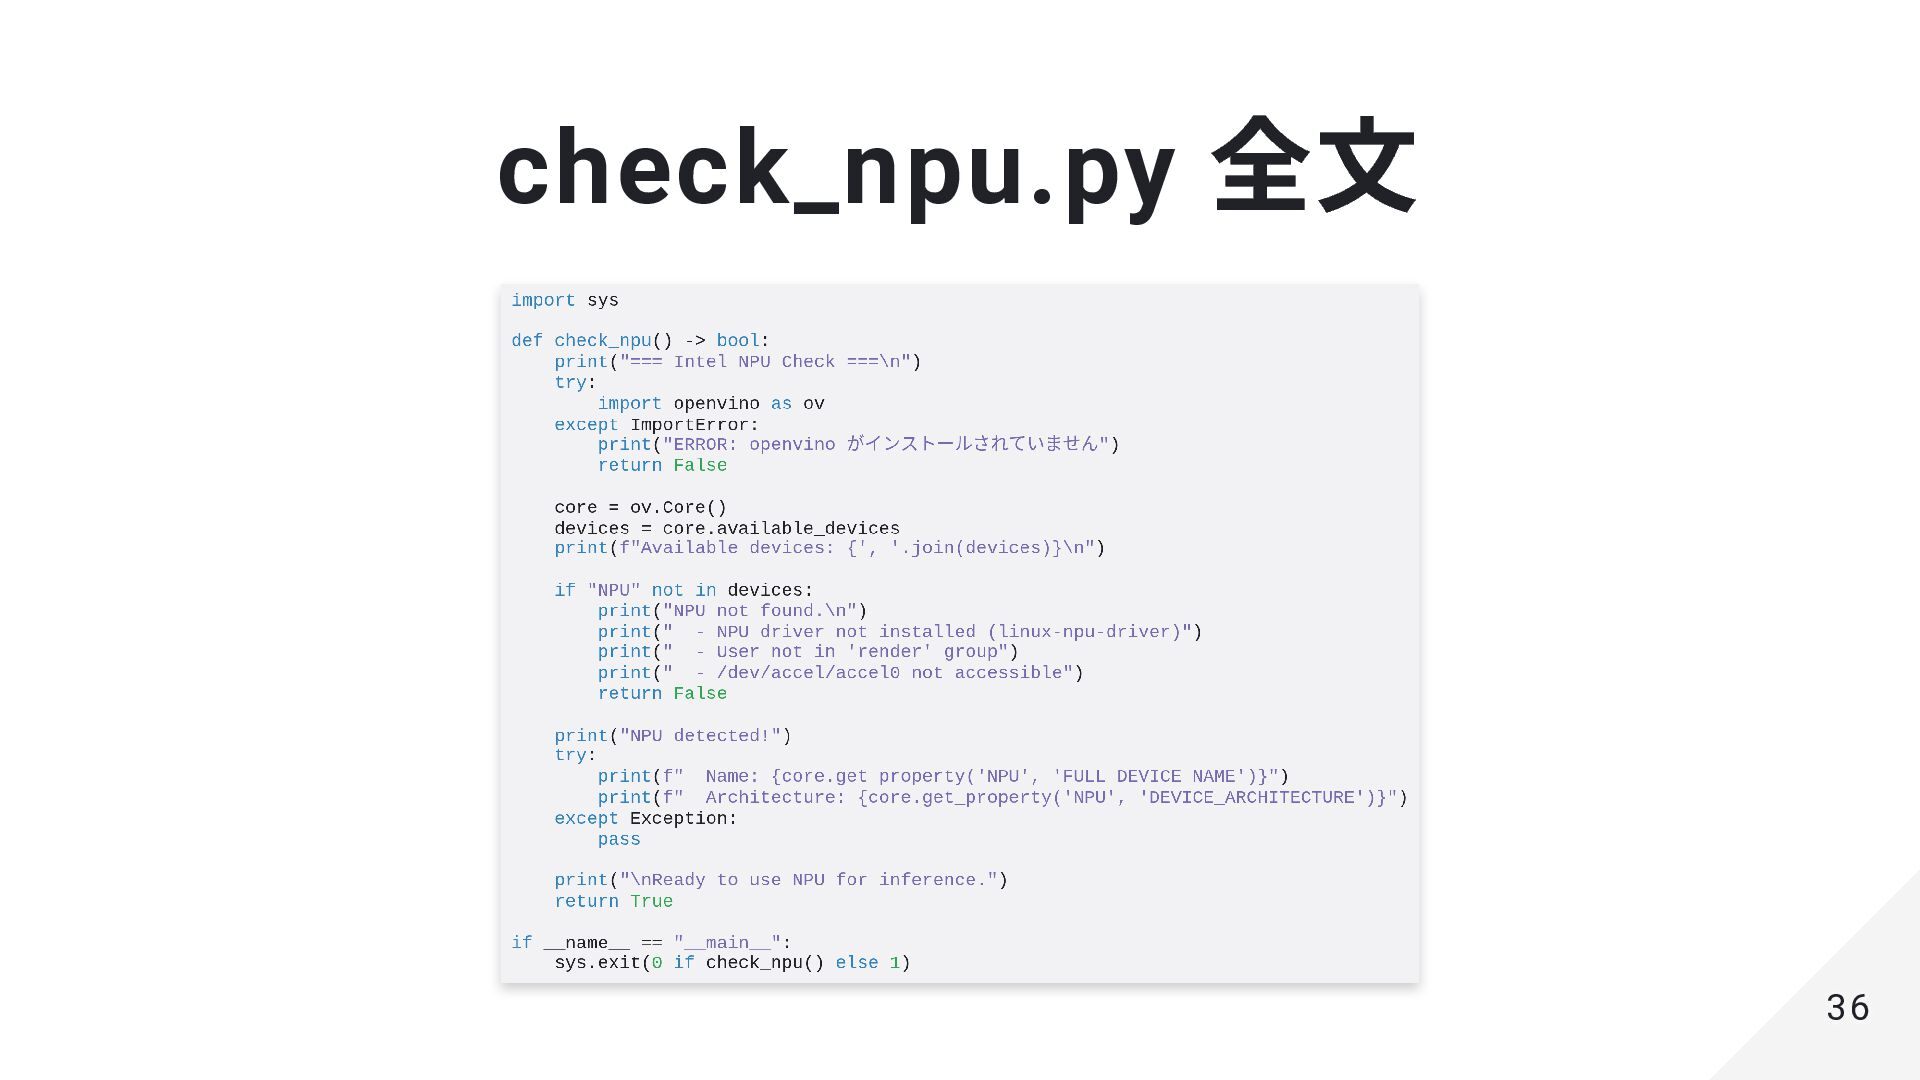
2. NPU 利用可能確認 期待する出力: 20 20
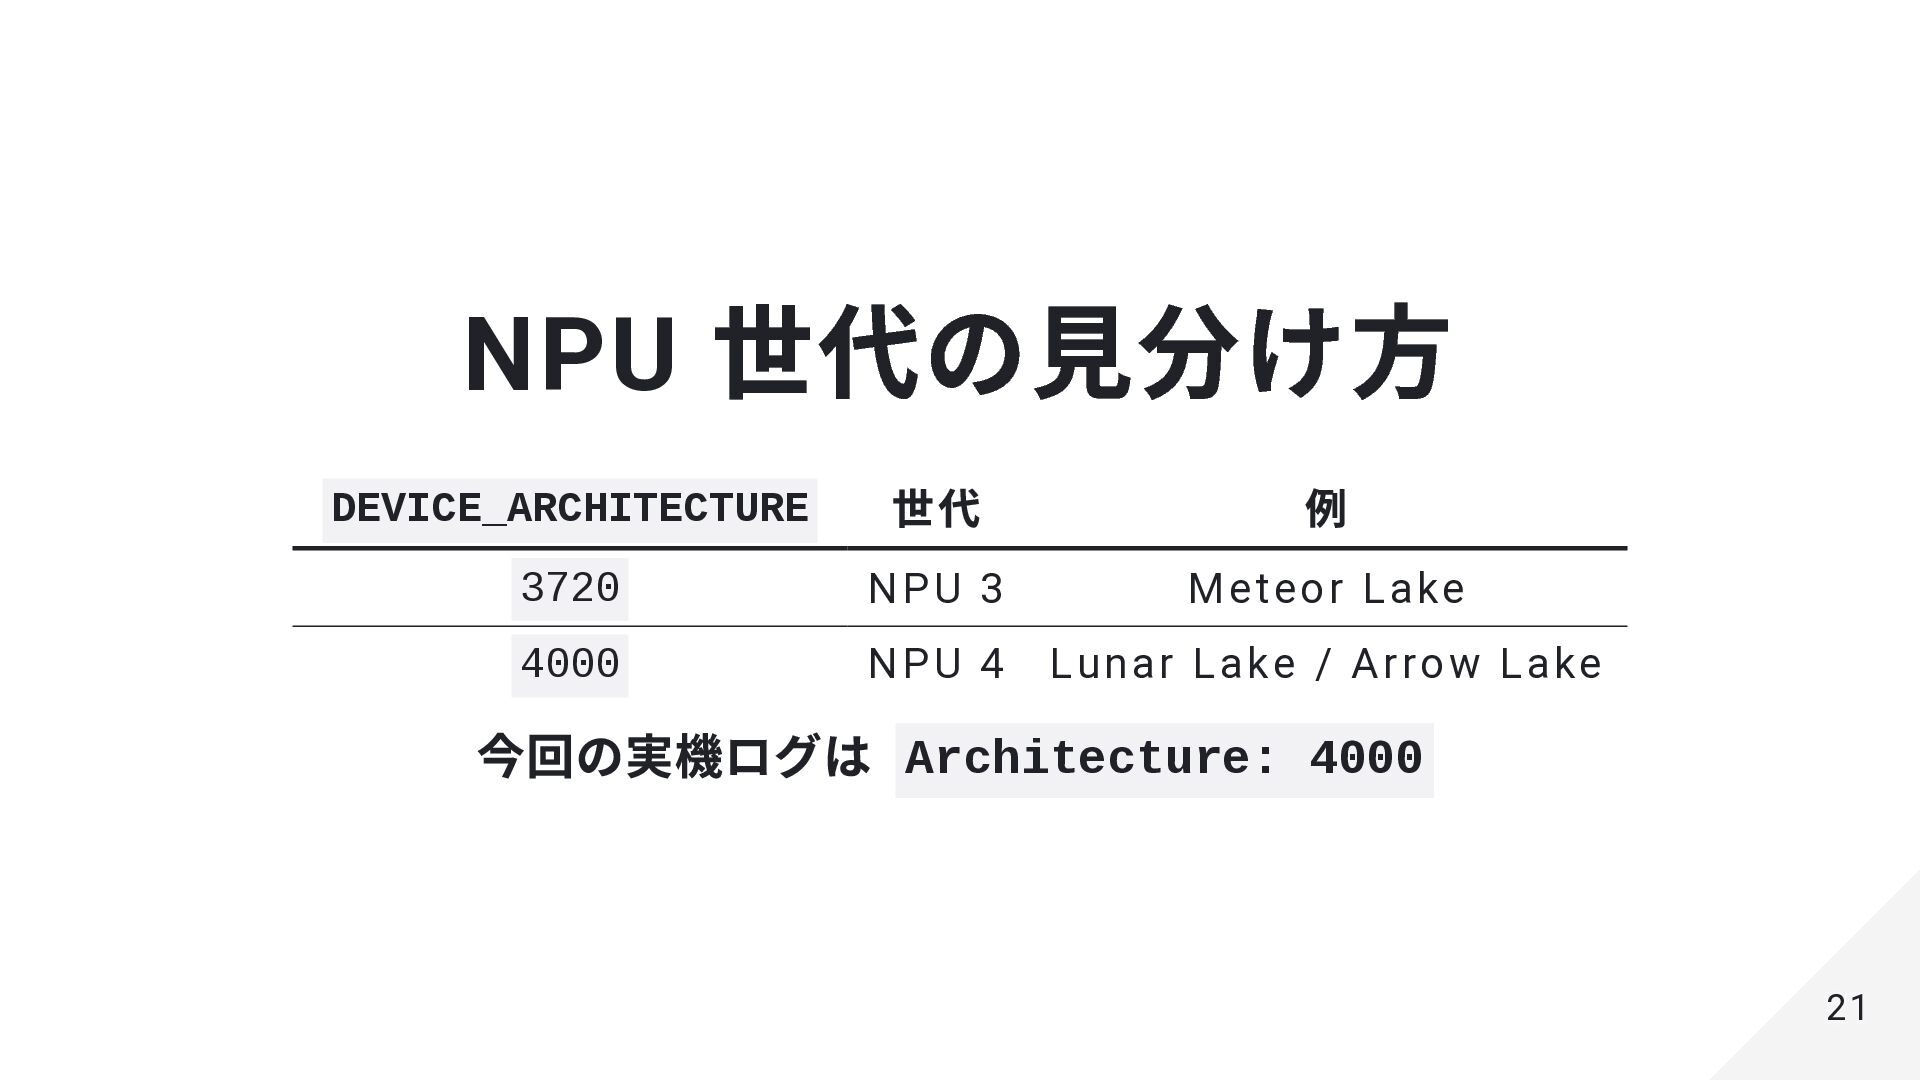
NPU 世代の見分け方 DEVICE_ARCHITECTURE 世代 例 3720 NPU 3 Meteor Lake
4000 NPU 4 Lunar Lake / Arrow Lake 今回の実機ログは Architecture: 4000 21 21
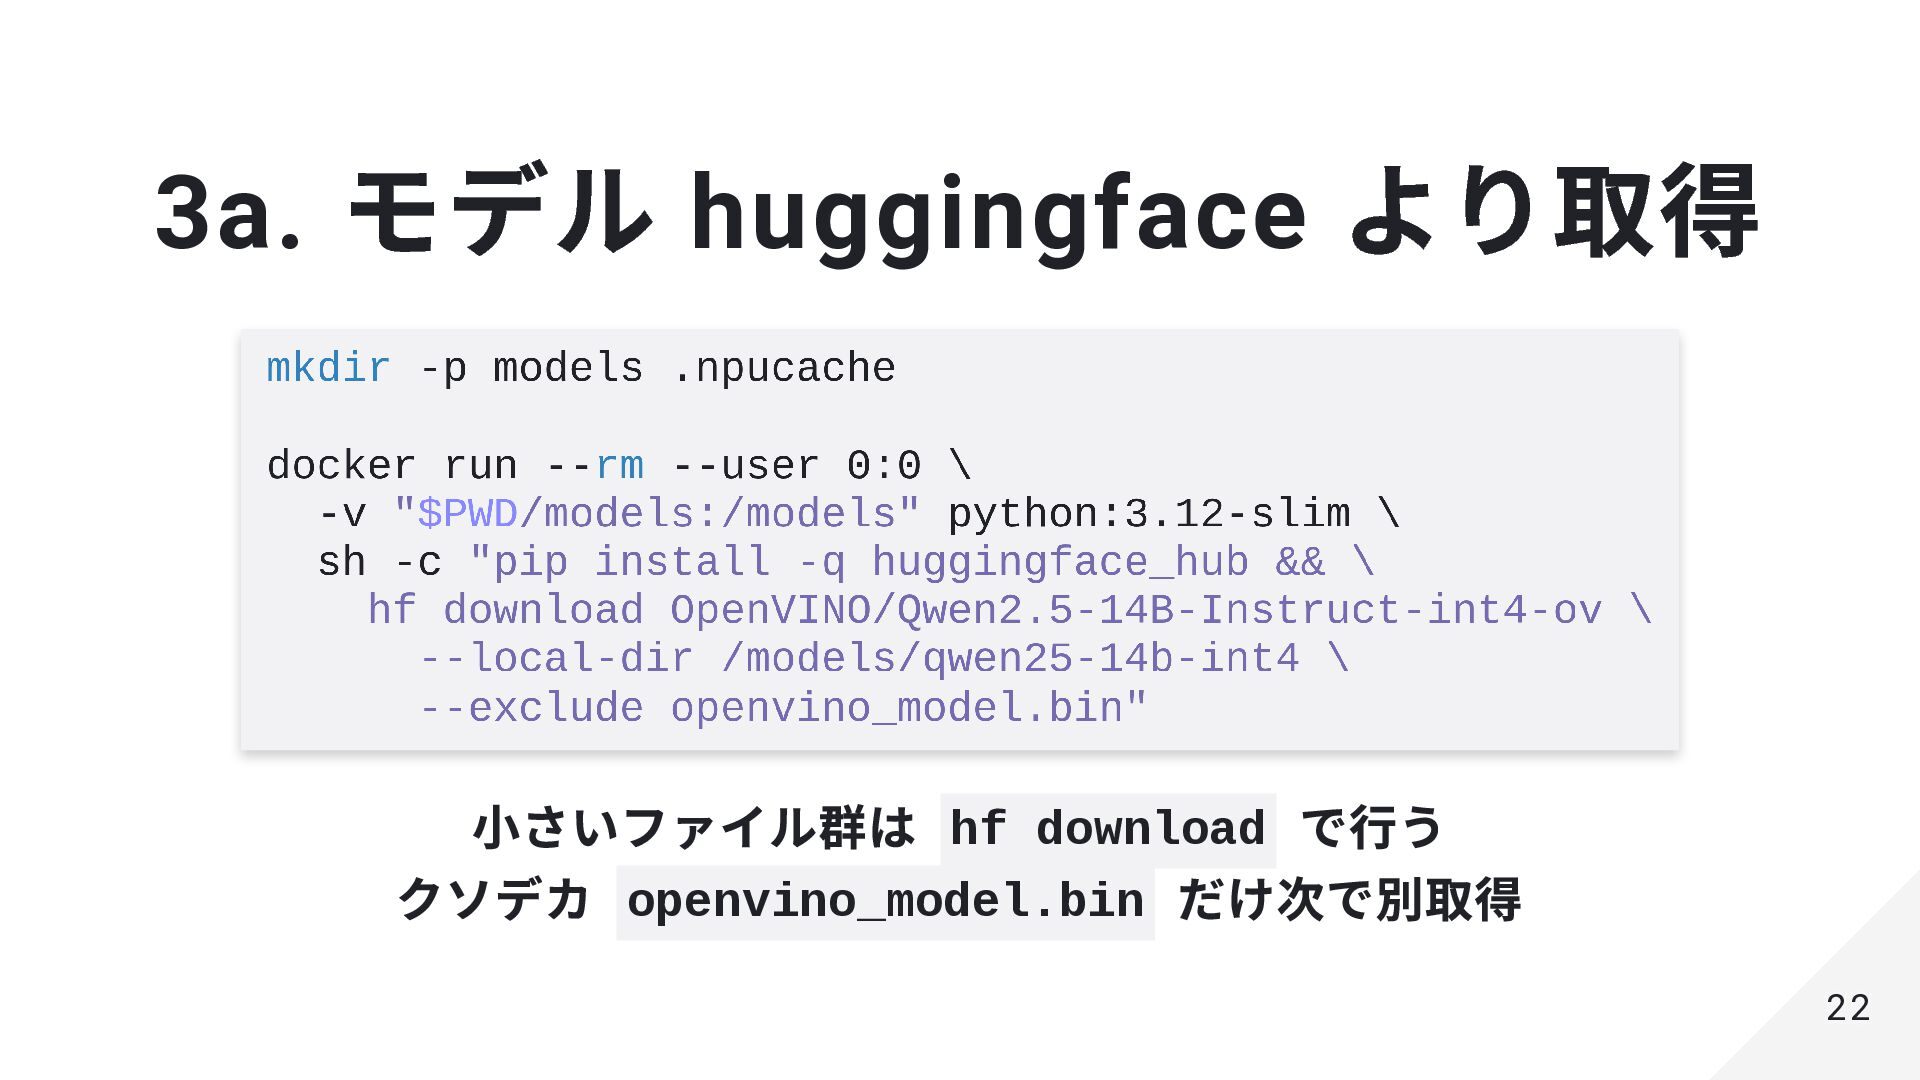
3a. モデル huggingface より取得 小さいファイル群は hf download で行う クソデカ openvino_model.bin
だけ次で別取得 22 22
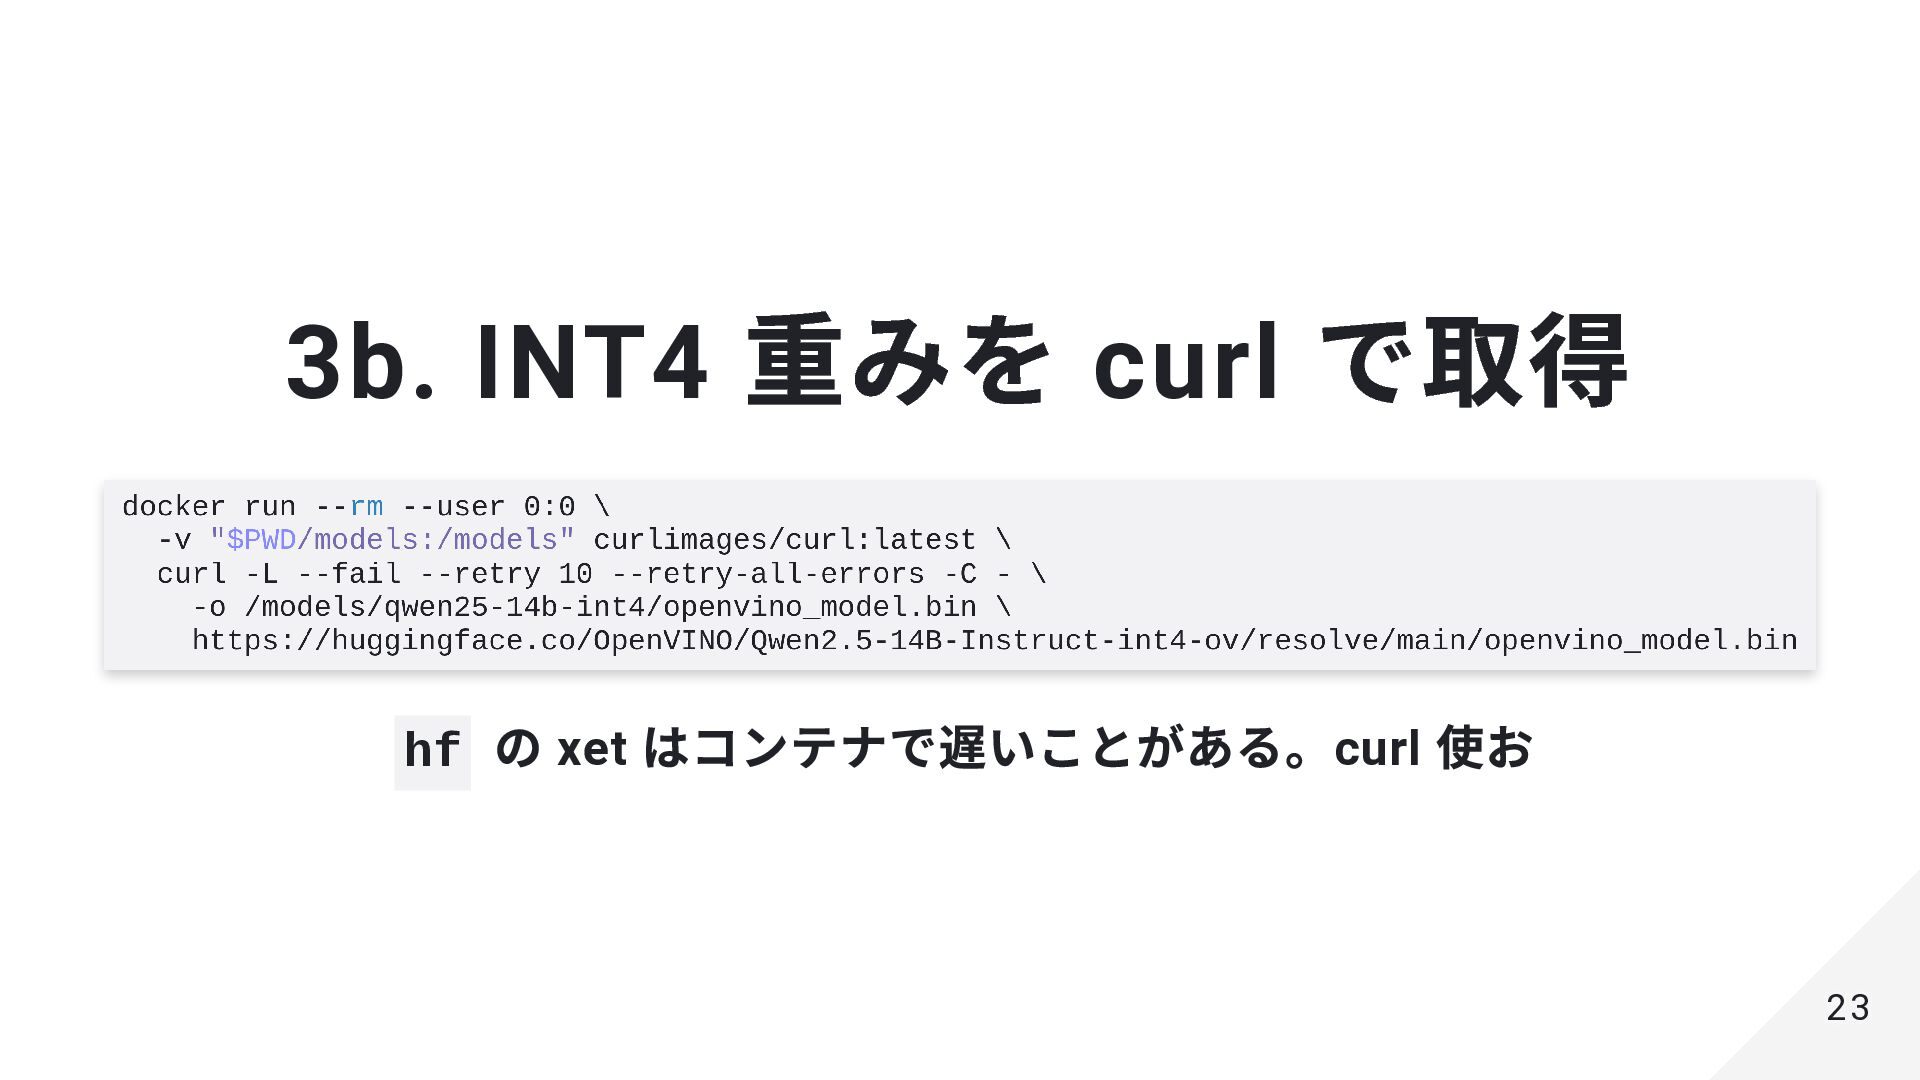
3b. INT4 重みを curl で取得 hf の xet はコンテナで遅いことがある。curl 使お
23 23
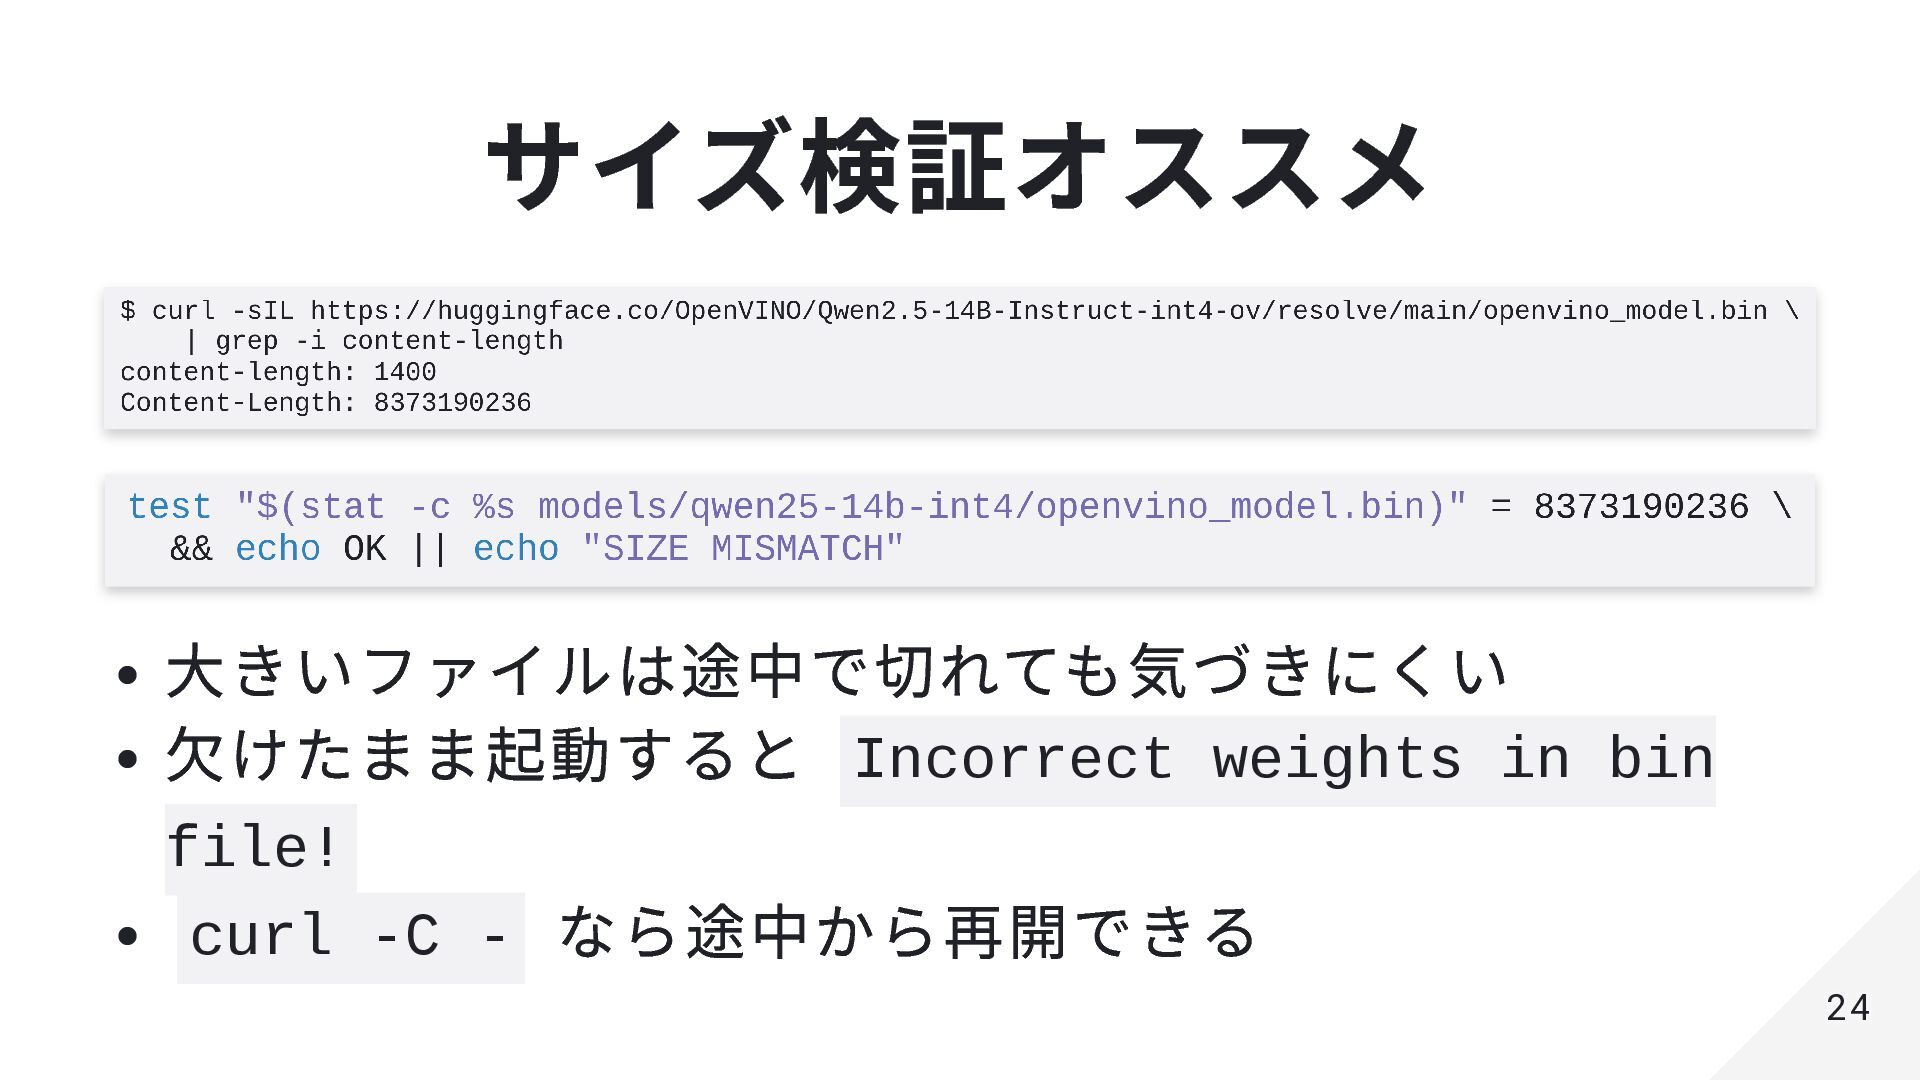
サイズ検証オススメ 大きいファイルは途中で切れても気づきにくい 欠けたまま起動すると Incorrect weights in bin file! curl -C
- なら途中から再開できる 24 24
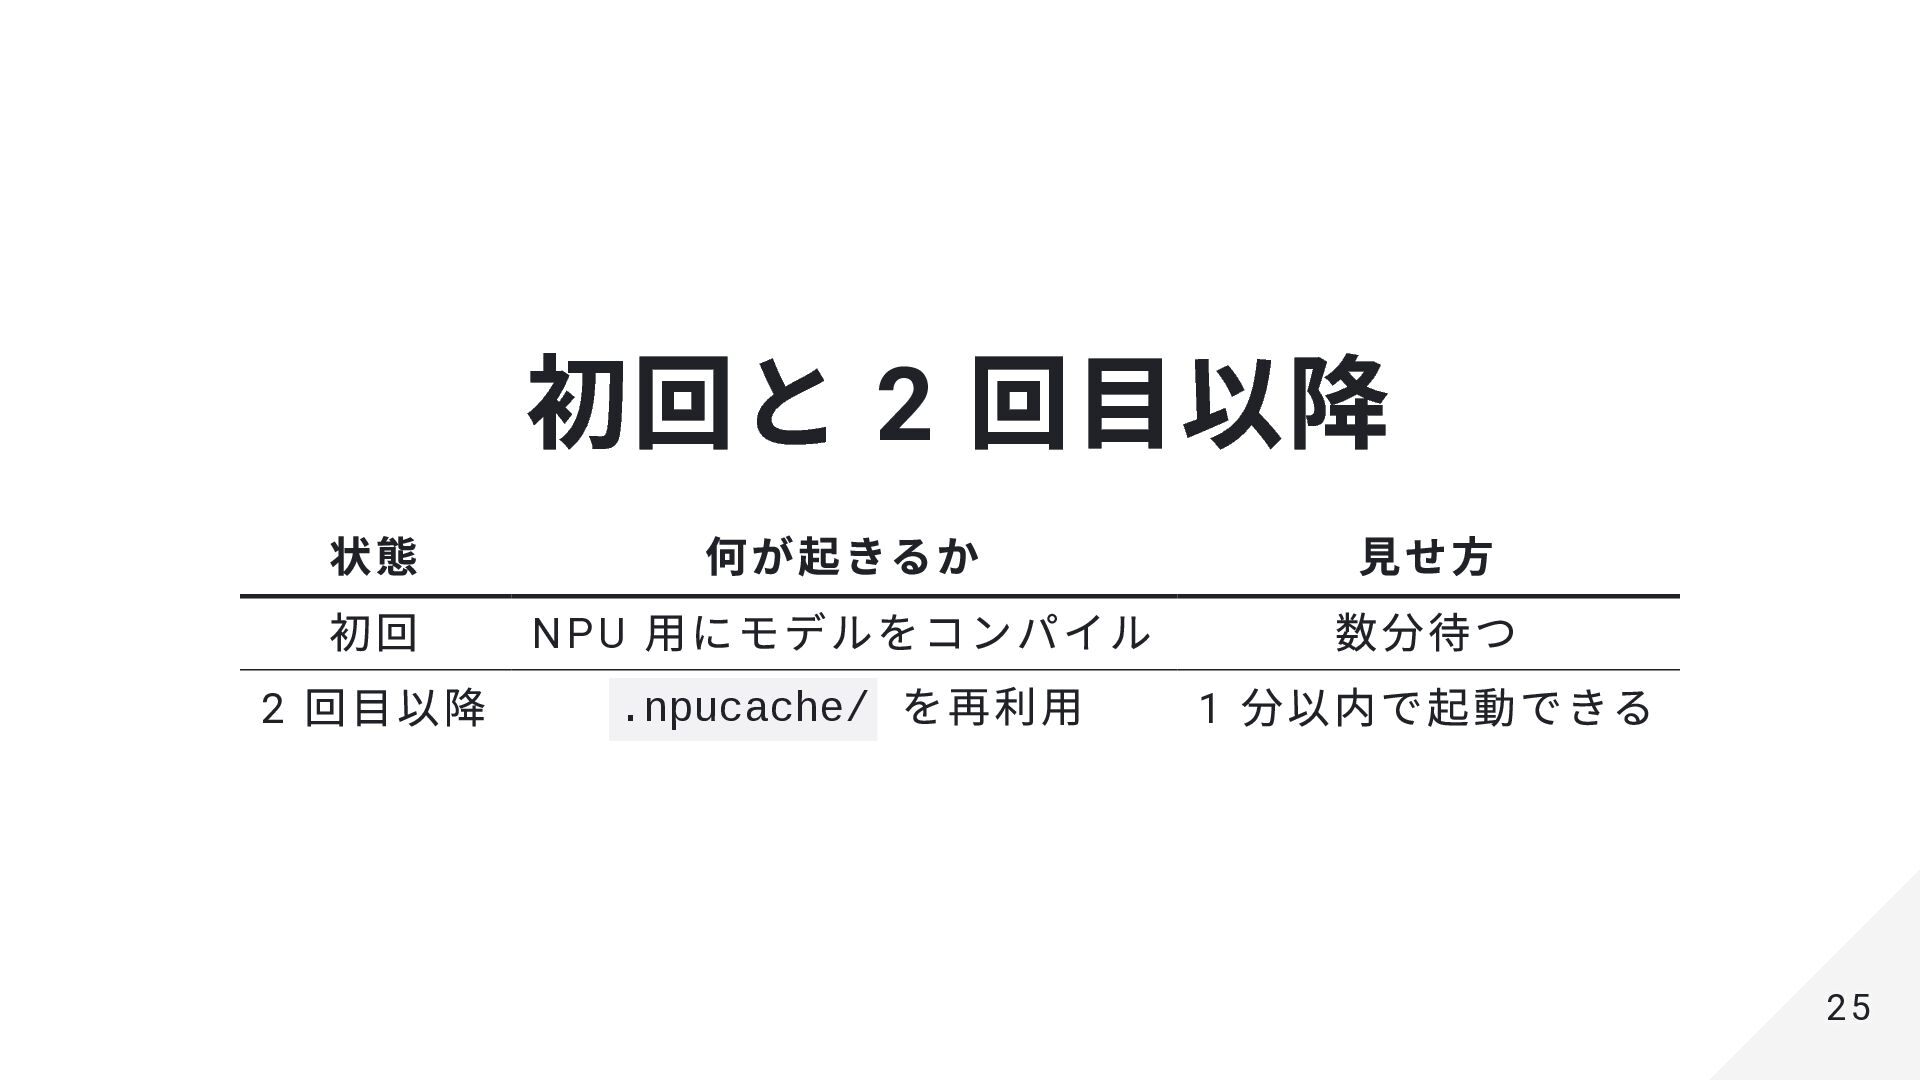
初回と 2 回目以降 状態 何が起きるか 見せ方 初回 NPU 用にモデルをコンパイル 数分待つ
2 回目以降 .npucache/ を再利用 1 分以内で起動できる 25 25
デモ 26 26
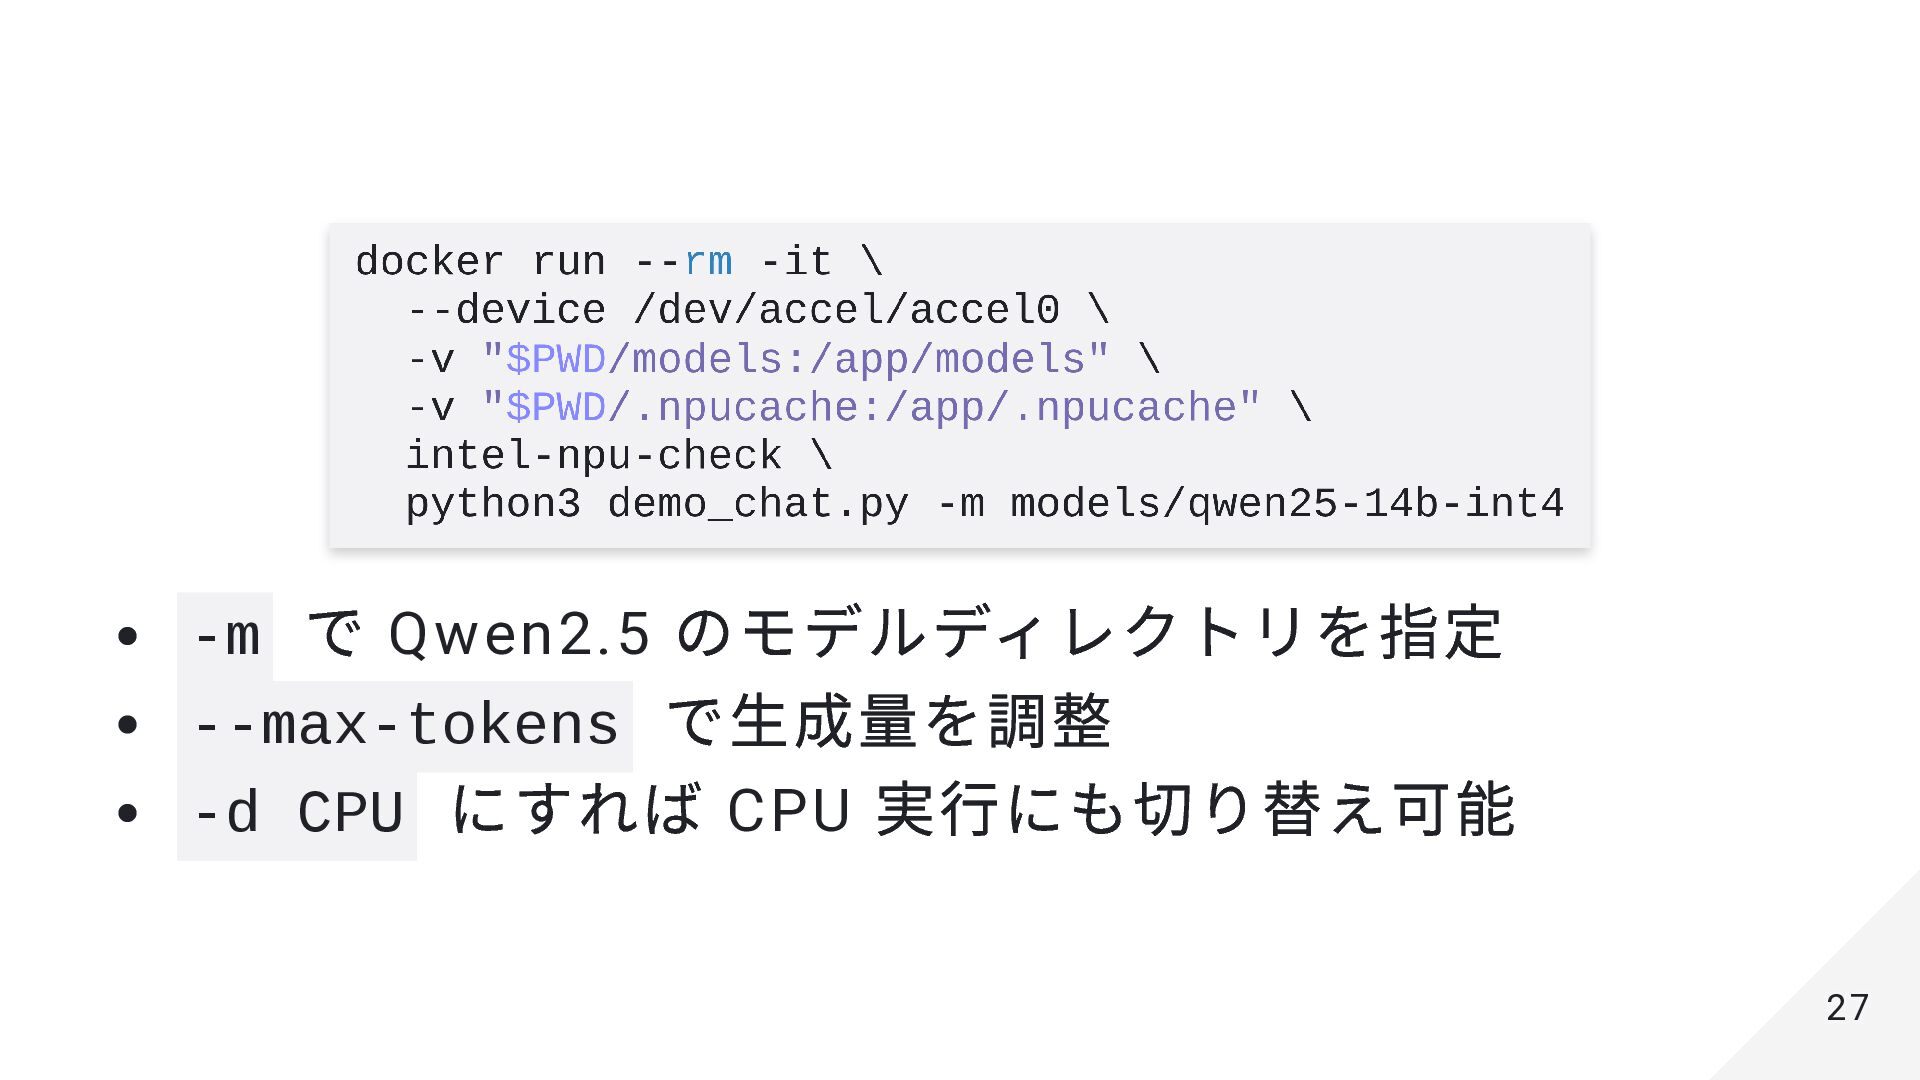
-m で Qwen2.5 のモデルディレクトリを指定 --max-tokens で生成量を調整 -d CPU にすれば CPU
実行にも切り替え可能 27 27
ありがとうございました 28 28
Appendix 29 29
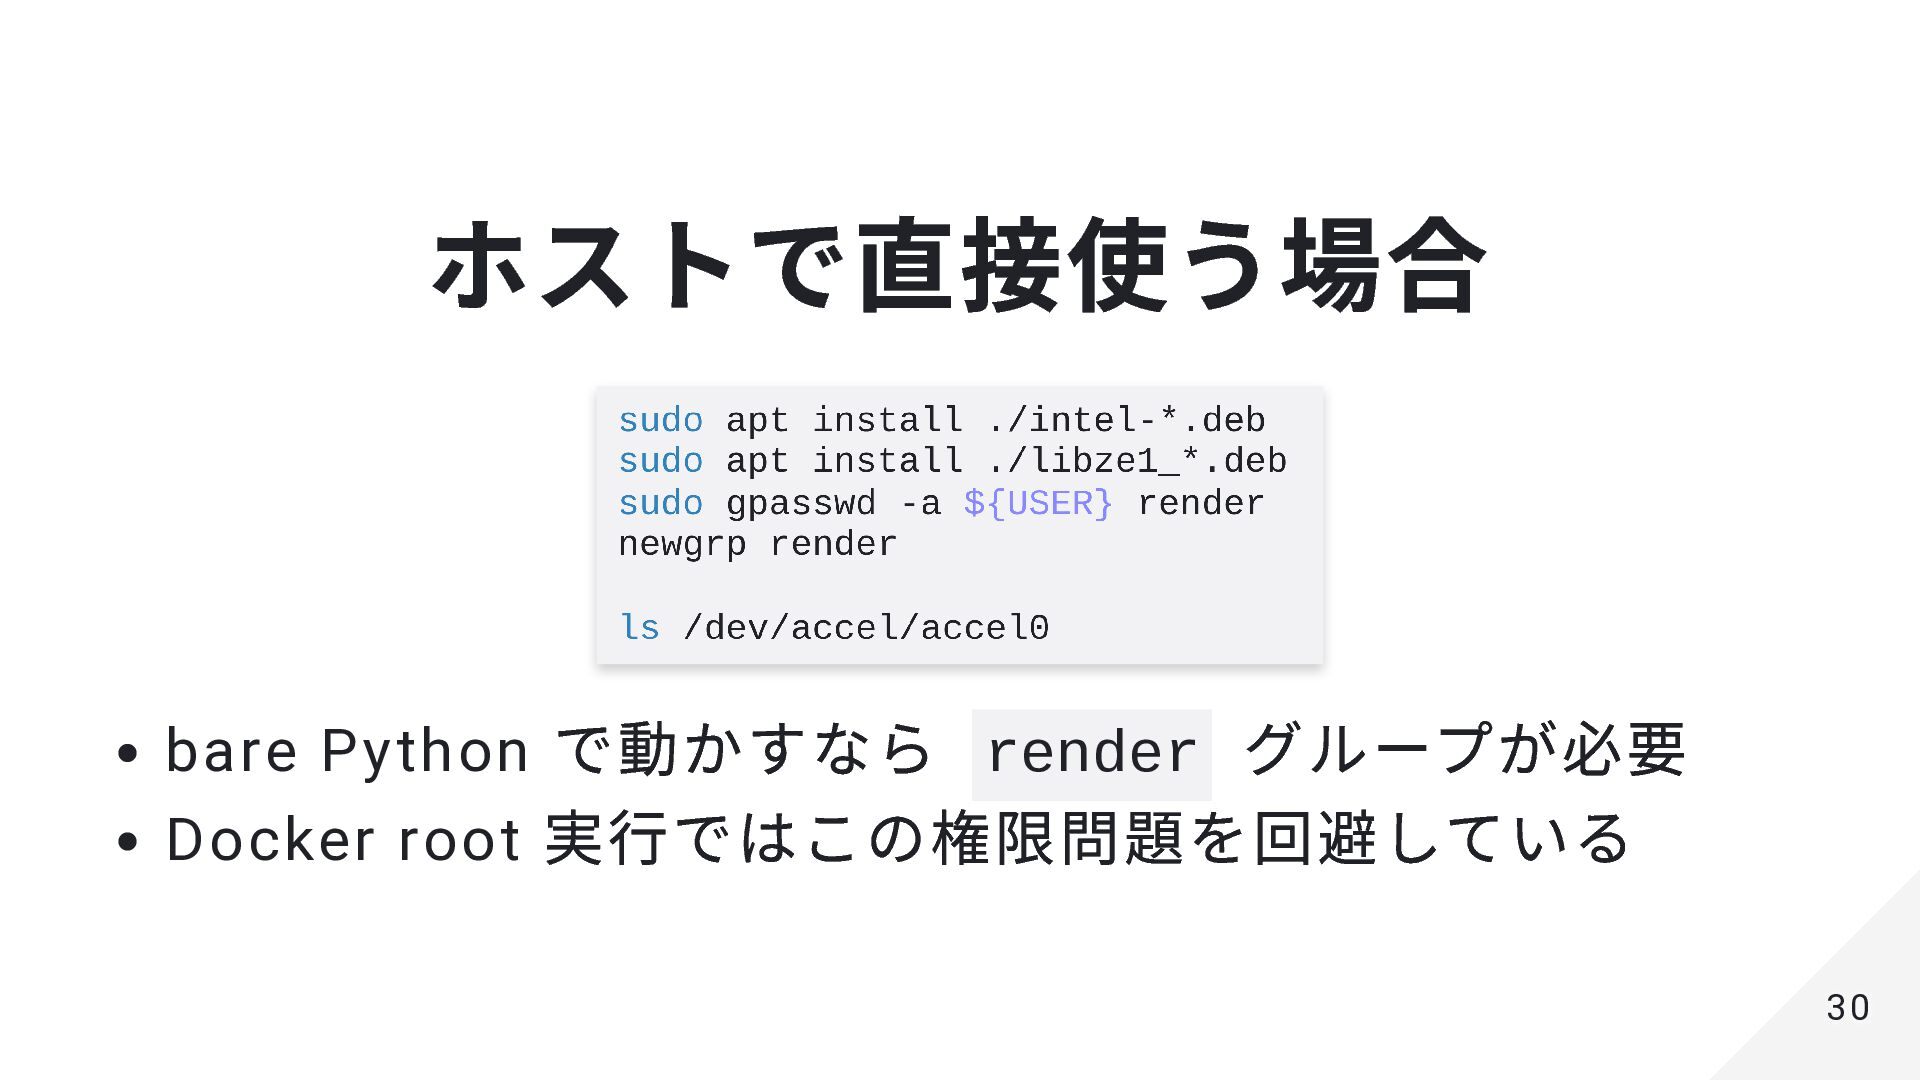
ホストで直接使う場合 bare Python で動かすなら render グループが必要 Docker root 実行ではこの権限問題を回避している 30
30
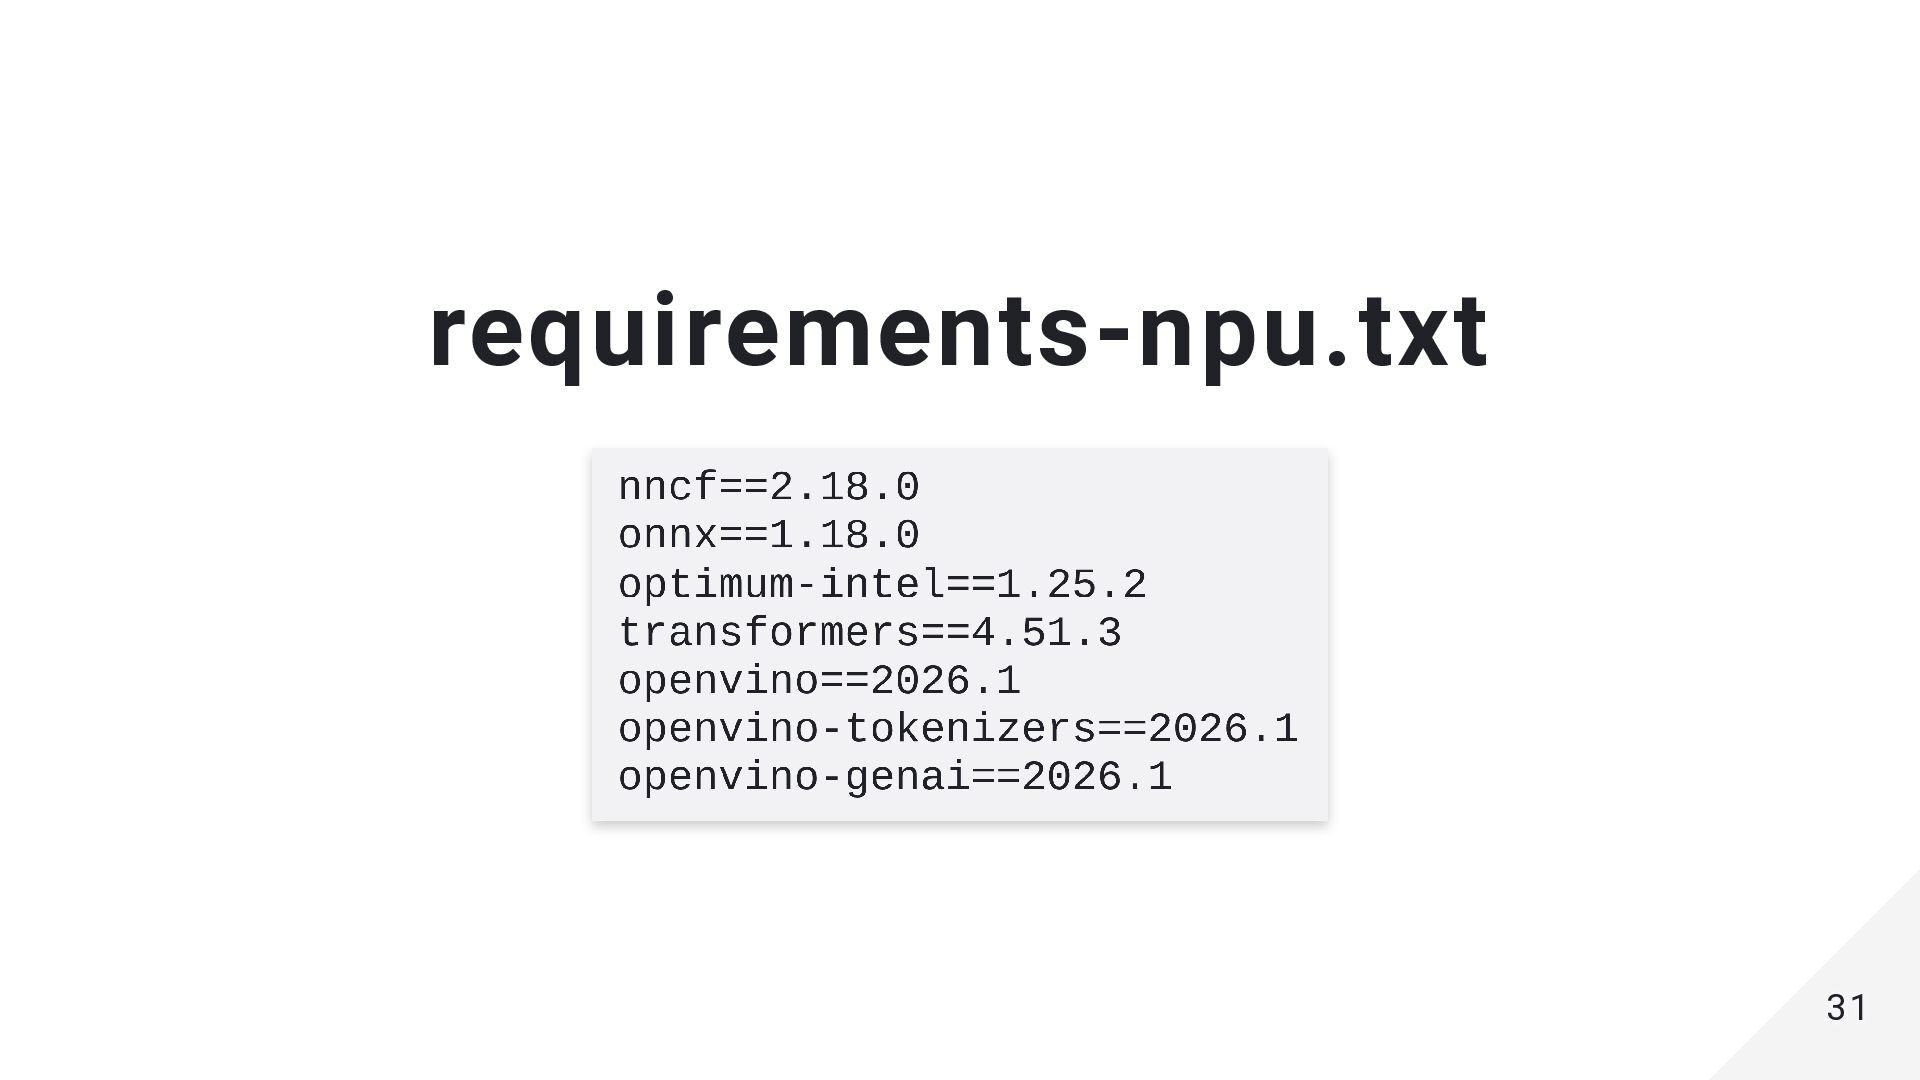
requirements-npu.txt 31 31
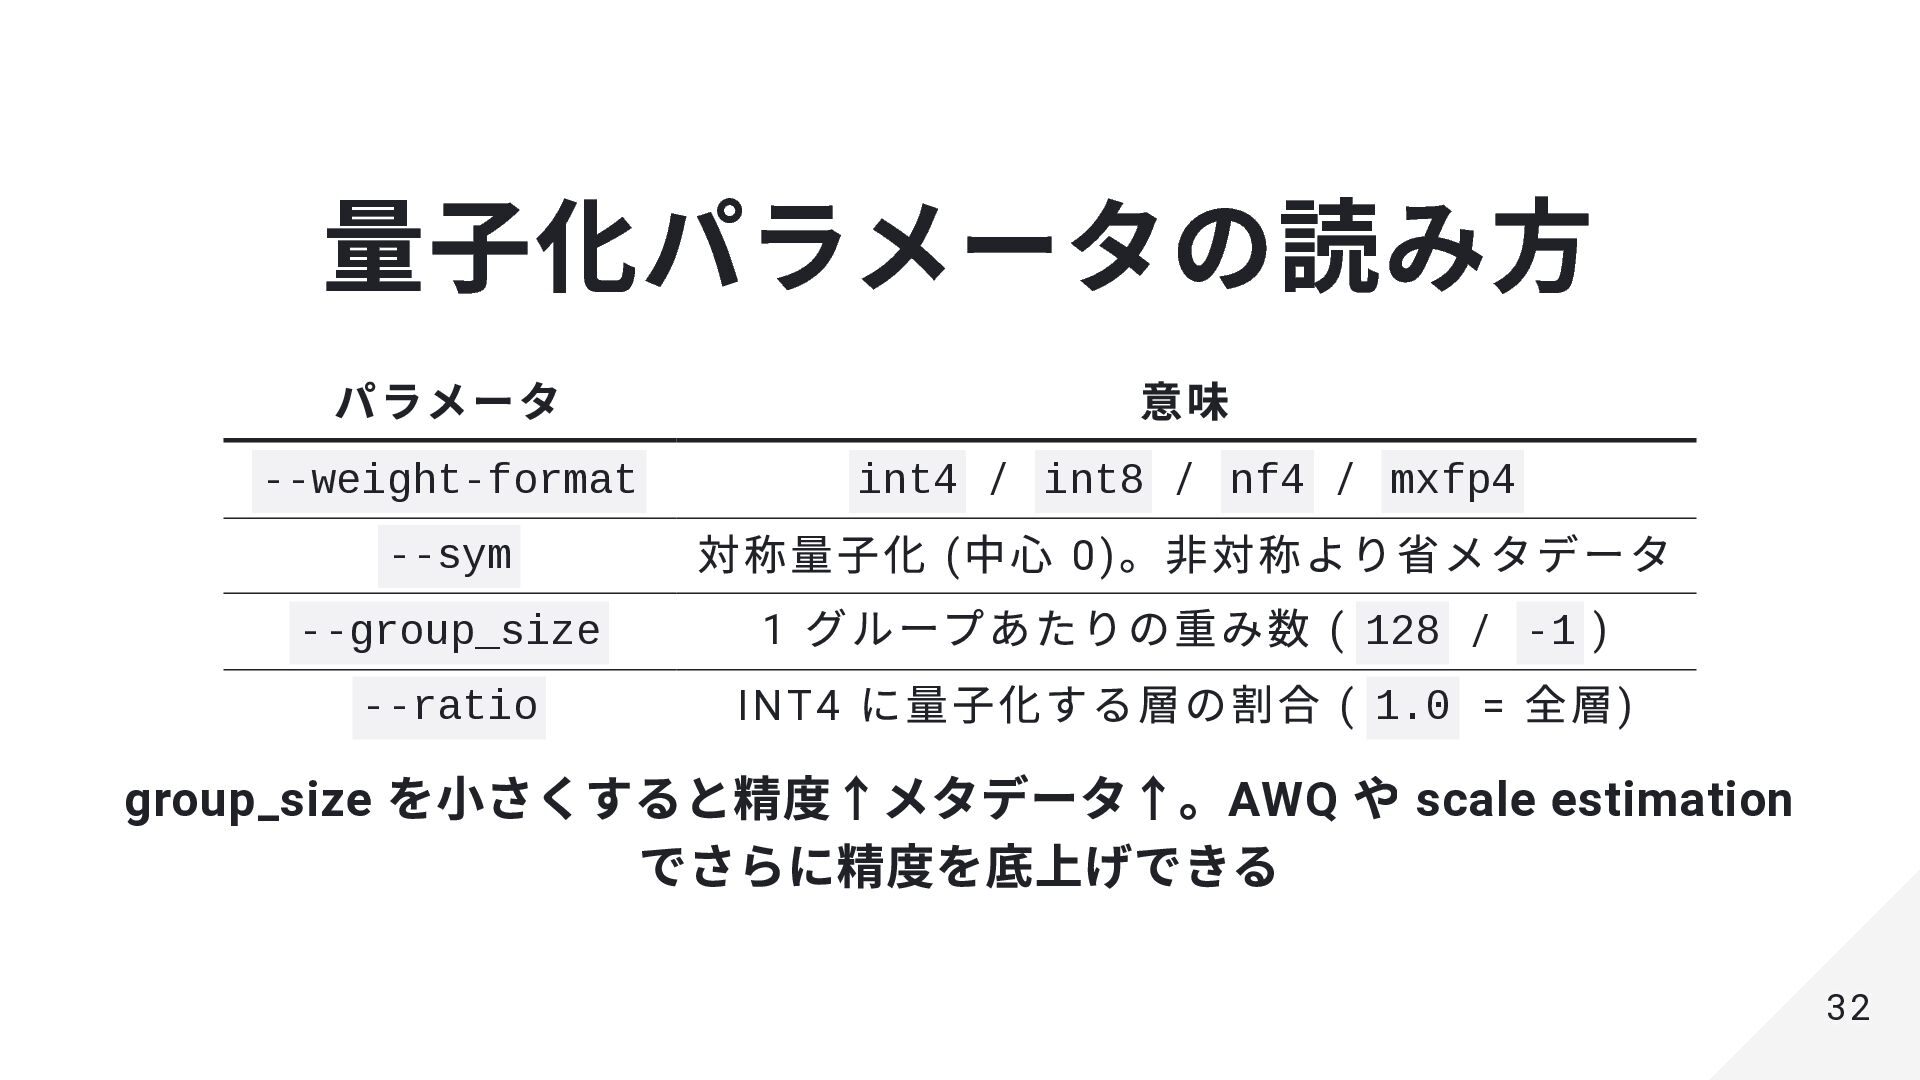
量子化パラメータの読み方 パラメータ 意味 --weight-format int4 / int8 / nf4 /
mxfp4 --sym 対称量子化 ( 中心 0) 。非対称より省メタデータ --group_size 1 グループあたりの重み数 ( 128 / -1 ) --ratio INT4 に量子化する層の割合 ( 1.0 = 全層) group_size を小さくすると精度↑メタデータ↑。AWQ や scale estimation でさらに精度を底上げできる 32 32
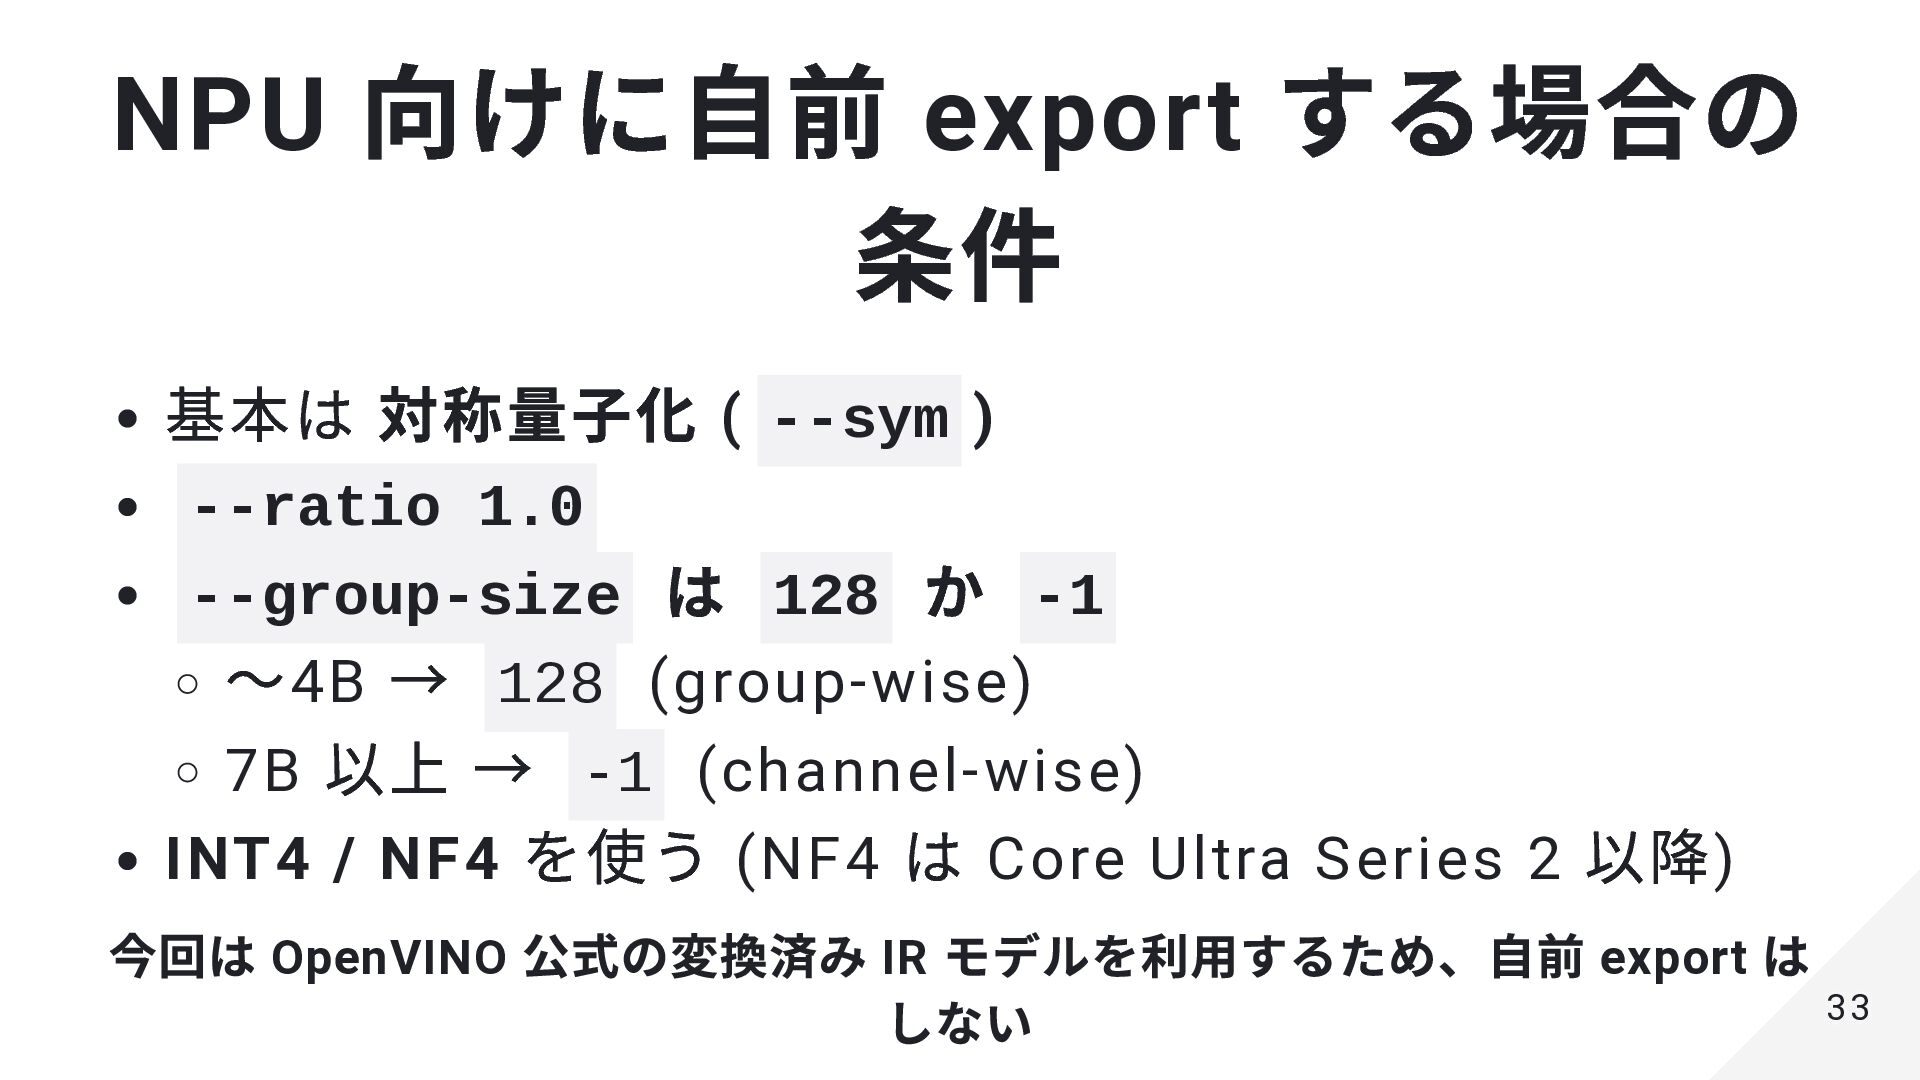
NPU 向けに自前 export する場合の 条件 基本は 対称量子化 ( --sym )
--ratio 1.0 --group-size は 128 か -1 〜4B → 128 (group-wise) 7B 以上 → -1 (channel-wise) INT4 / NF4 を使う (NF4 は Core Ultra Series 2 以降) 今回は OpenVINO 公式の変換済み IR モデルを利用するため、自前 export は しない 33 33
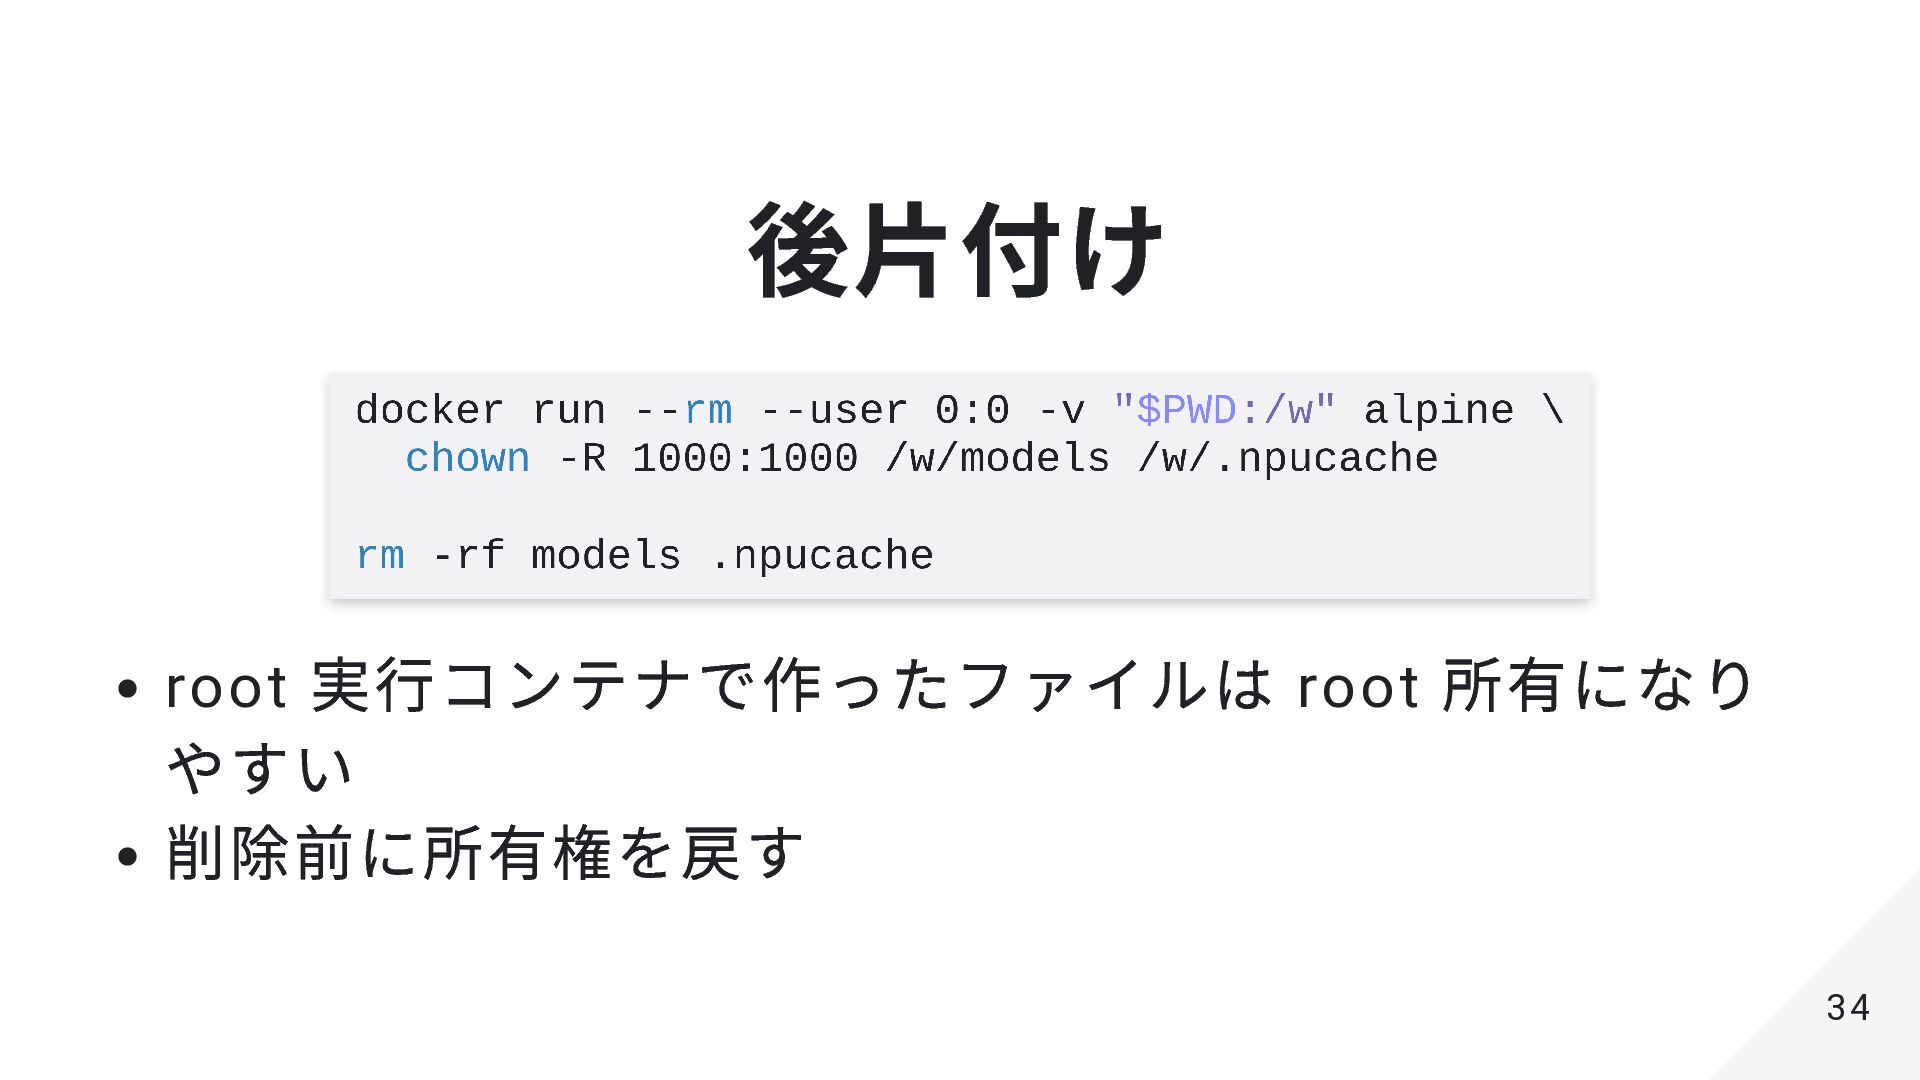
後片付け root 実行コンテナで作ったファイルは root 所有になり やすい 削除前に所有権を戻す 34 34
Dockerfile 全文 35 35
check_npu.py 全文 36 36
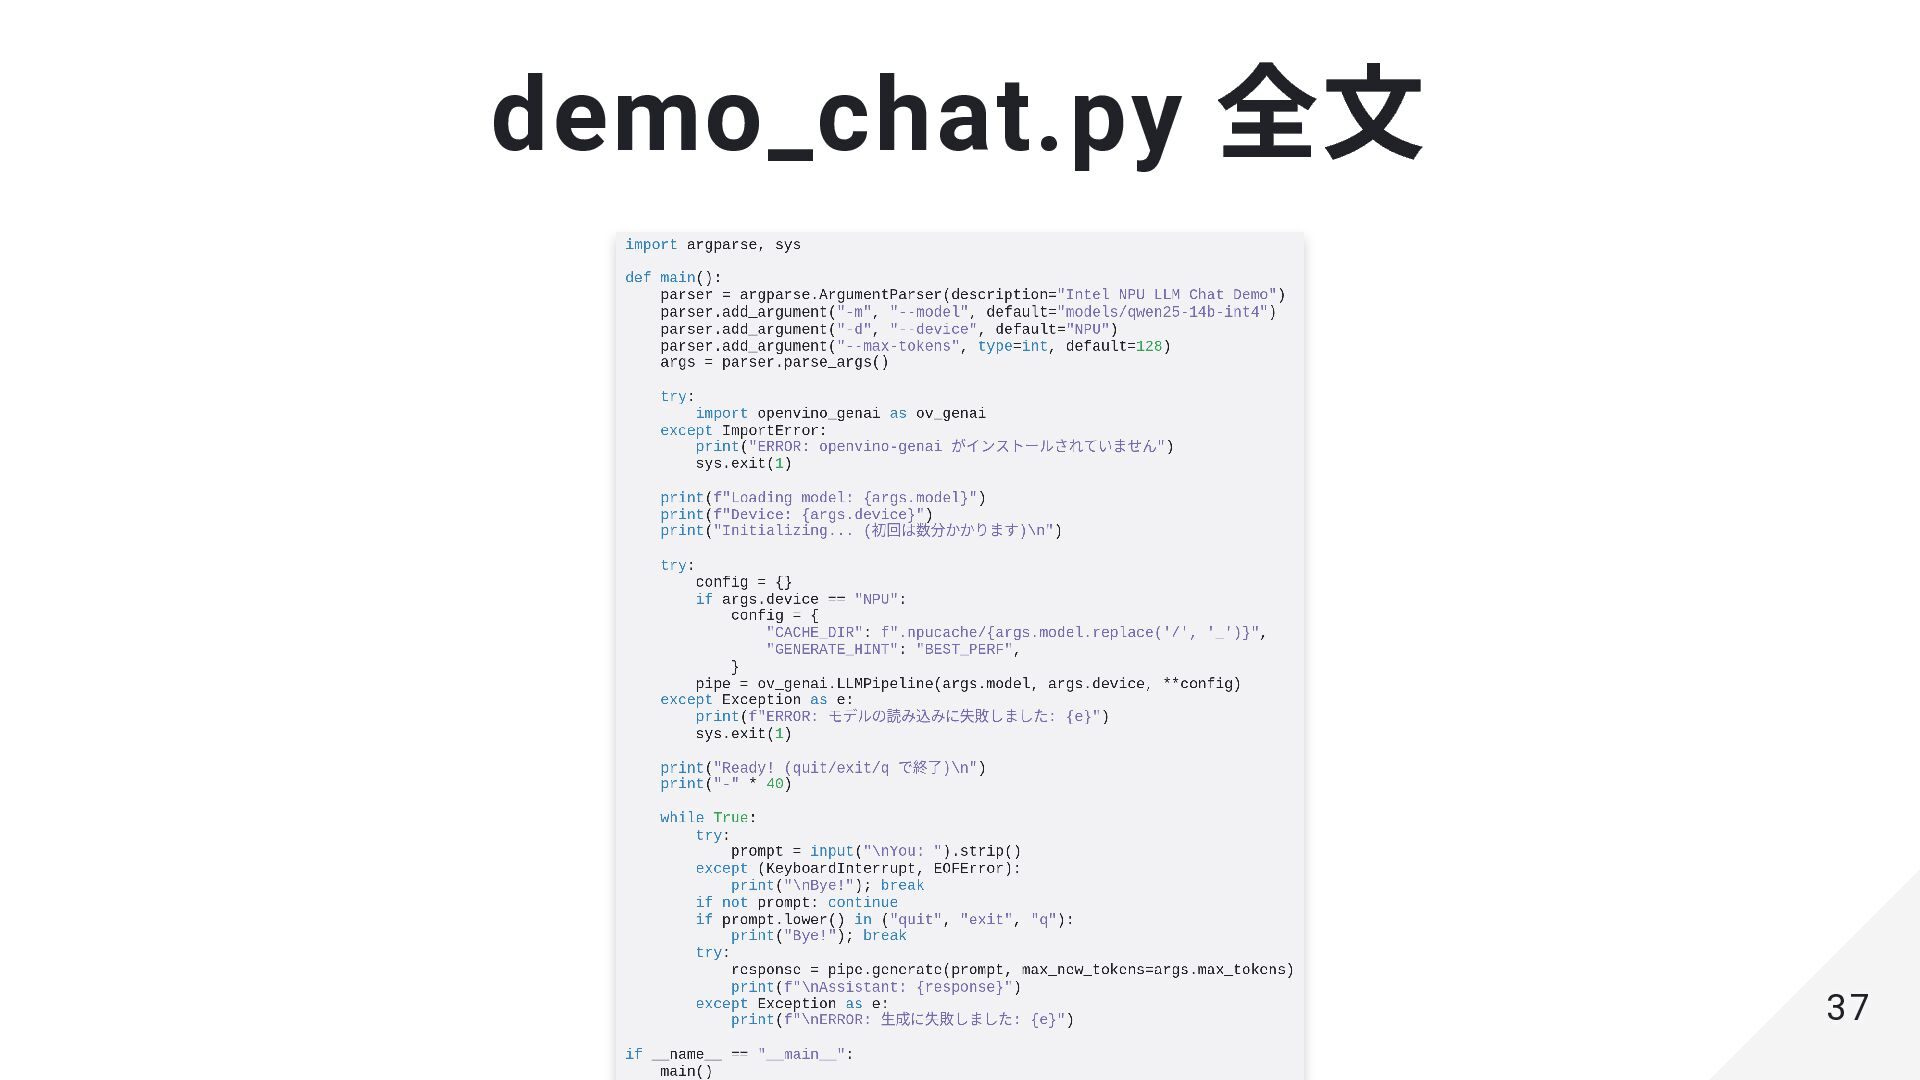
demo_chat.py 全文 37 37
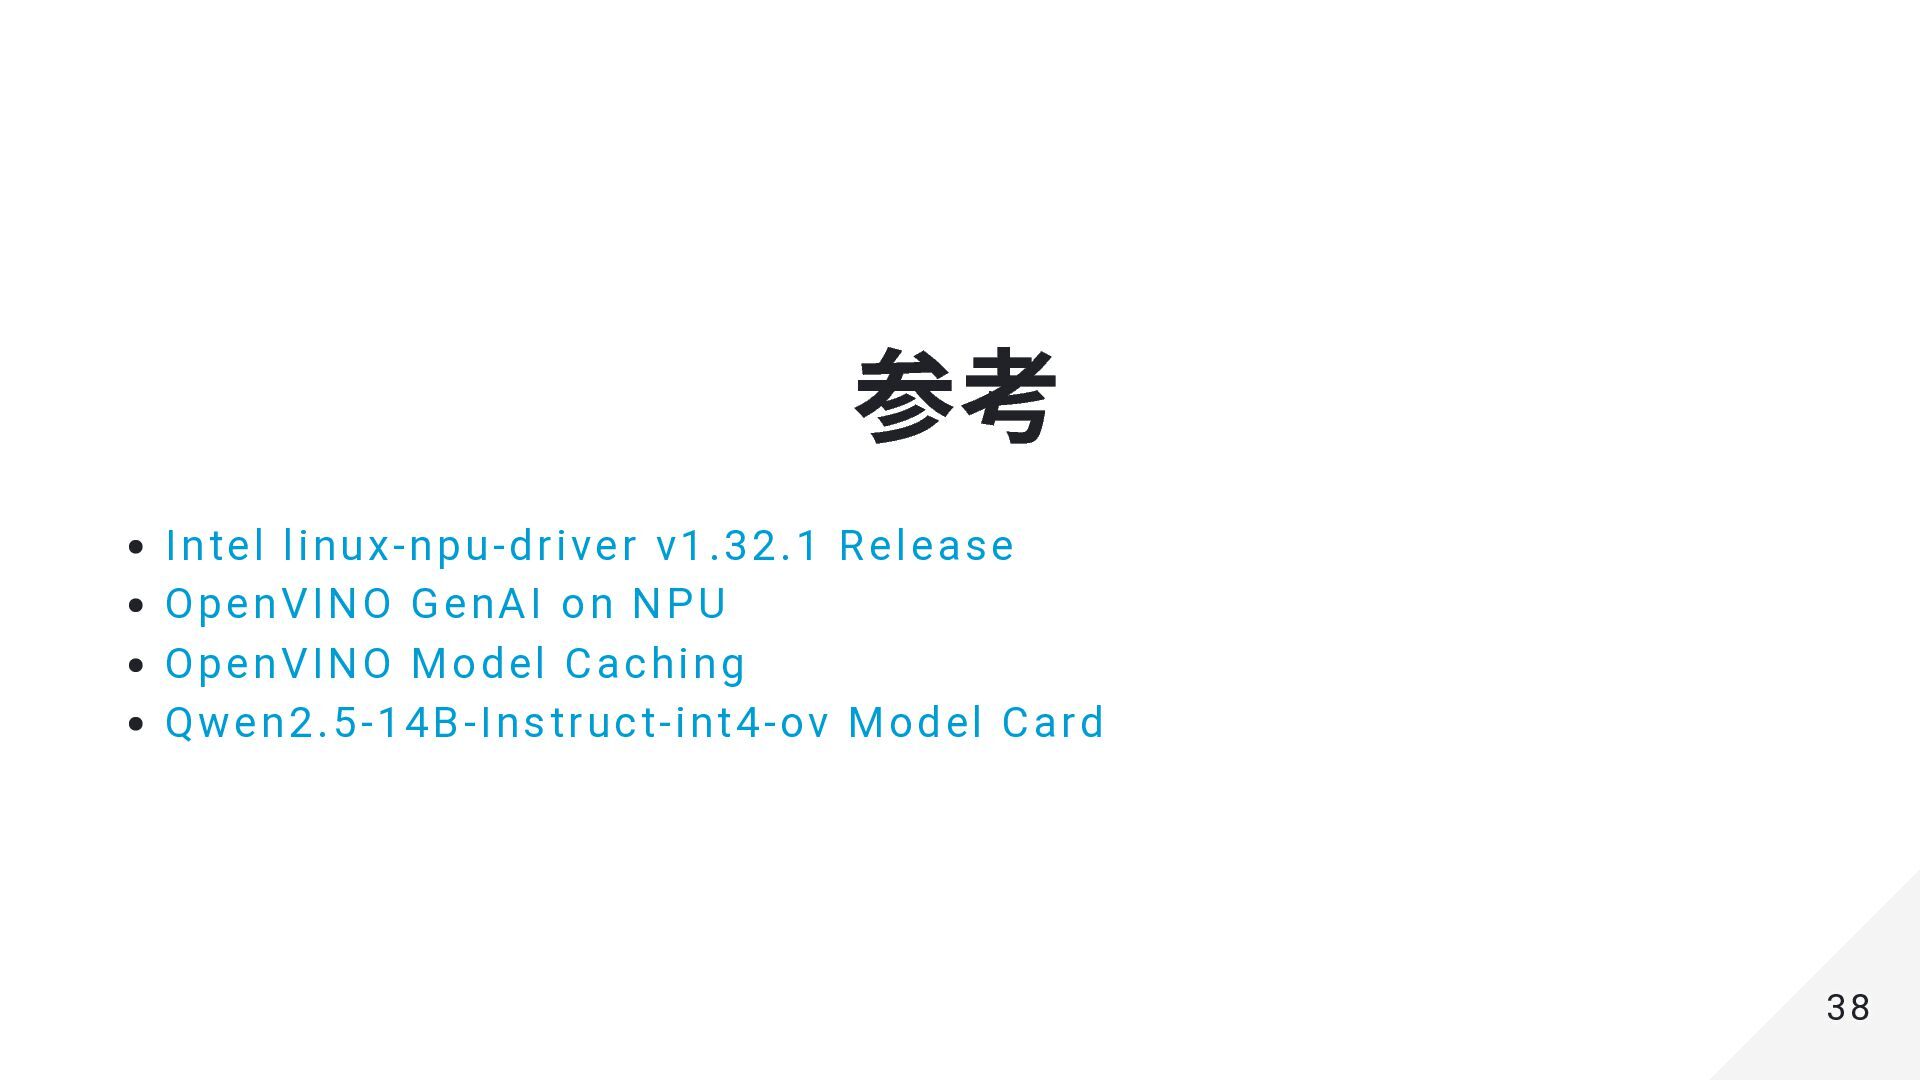
参考 Intel linux-npu-driver v1.32.1 Release OpenVINO GenAI on NPU OpenVINO
Model Caching Qwen2.5-14B-Instruct-int4-ov Model Card 38 38


 desigrammer
 artoy
 morizo_1984
 taiseiue
 oniak3ibm
 teyamagu
 oku053
 shihochan
 kishida
 yuta_onishi_97
 uyuki234
 lynnswap
 hollycummins
 tammyeverts
 dugsong
 sabderemane
 mlcsv
 jeffersonlam
 lauravandoore
 3n
 davidcarrasco
 ryanjones
 marktimemedia
 twada
 rkendrick25