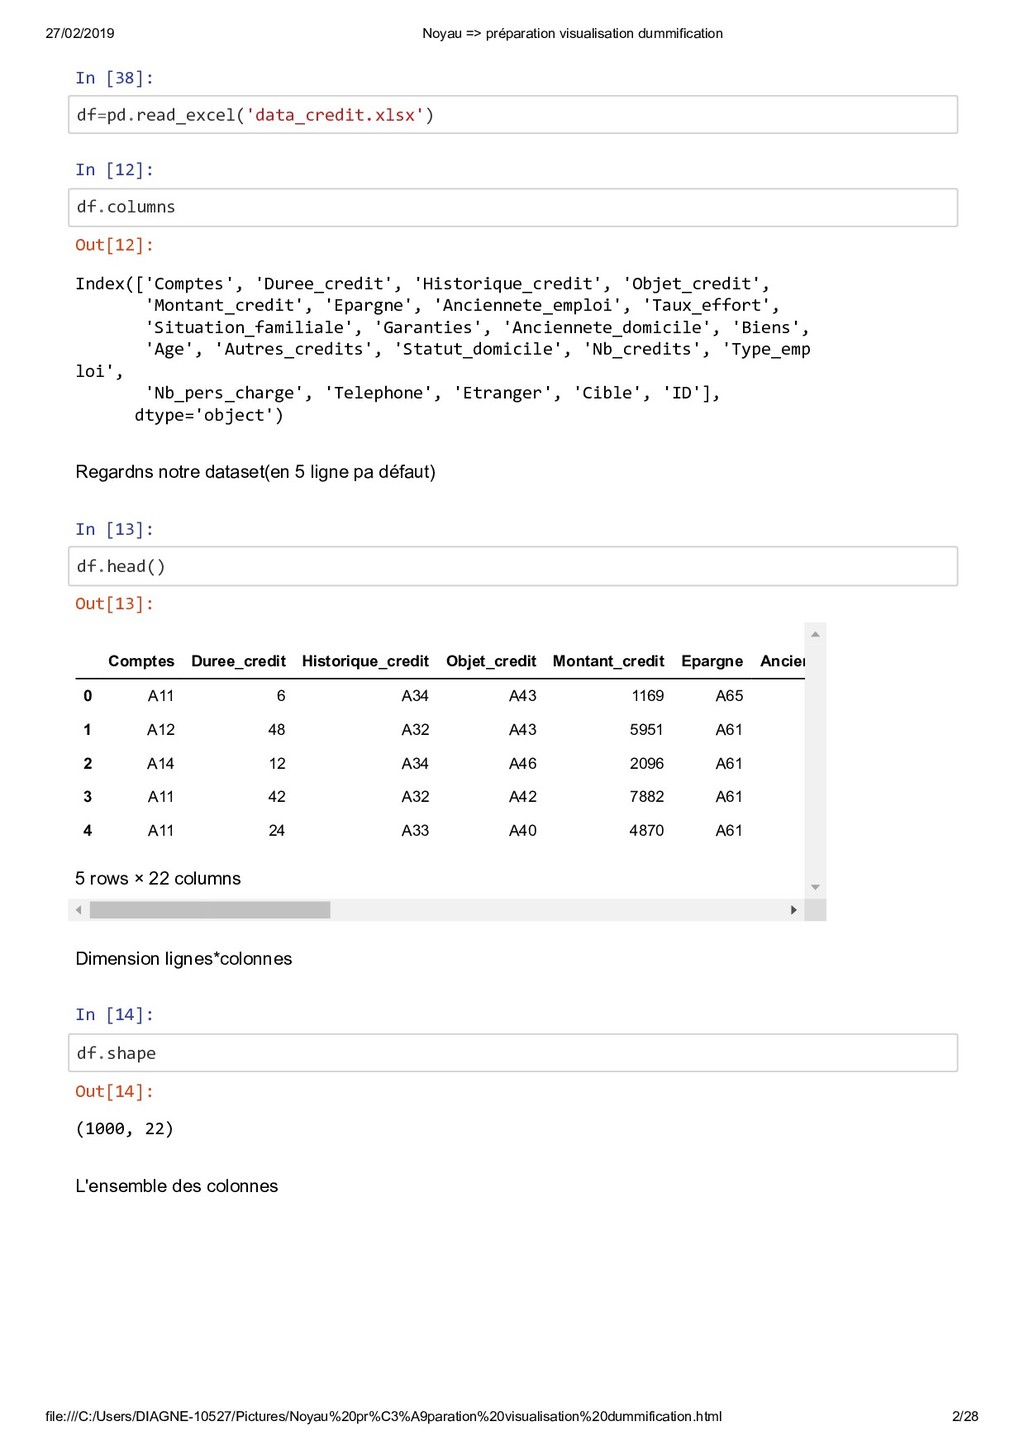
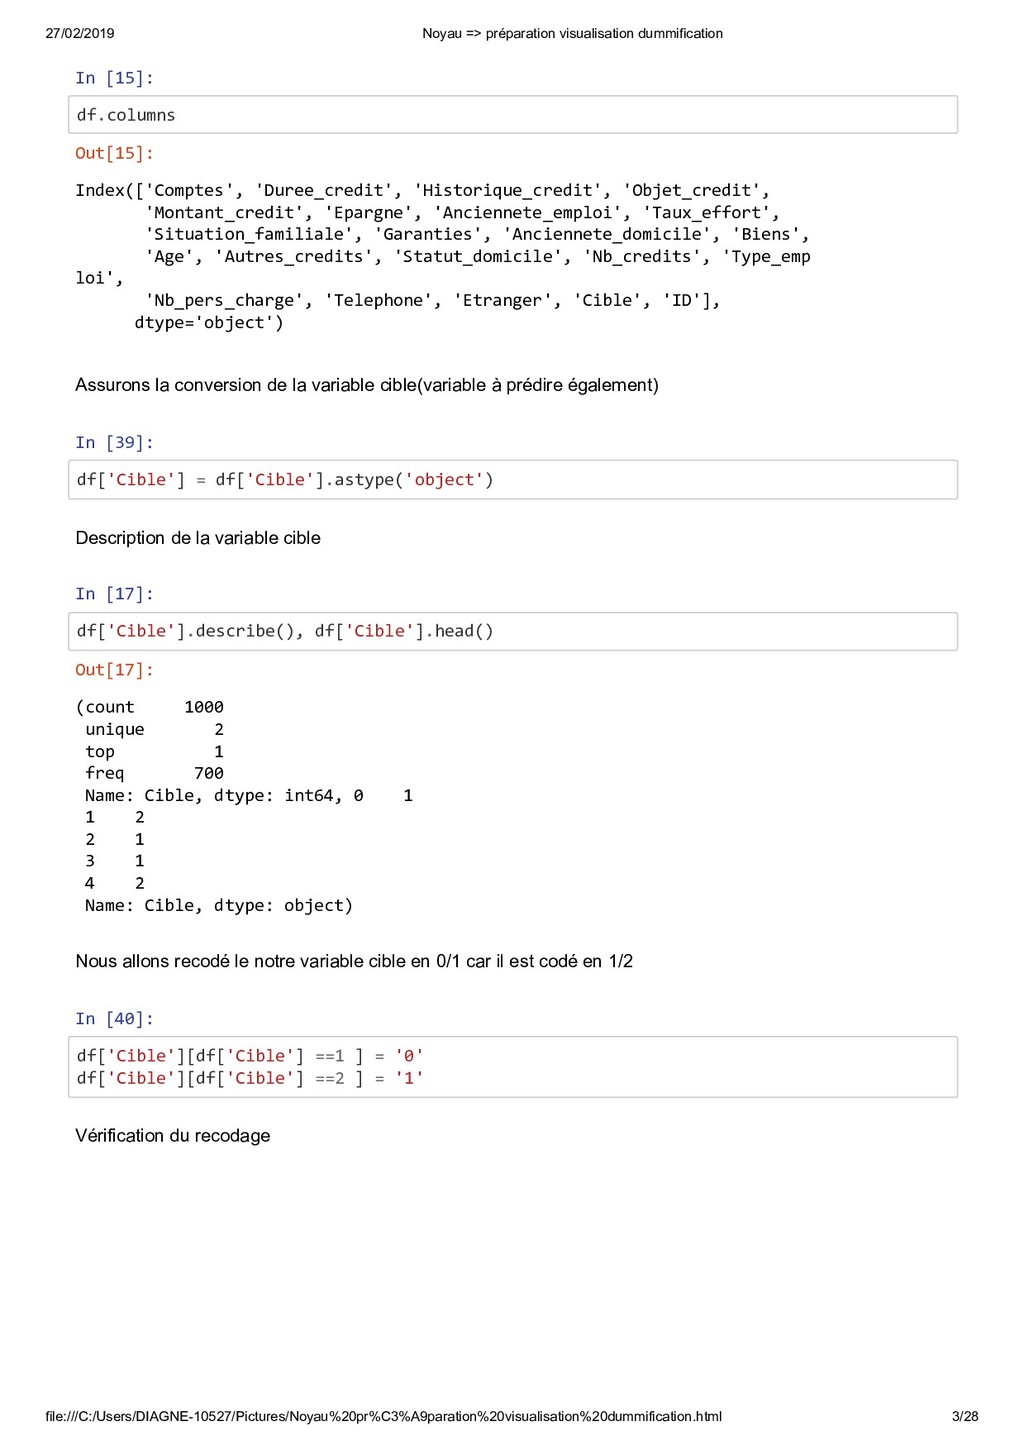
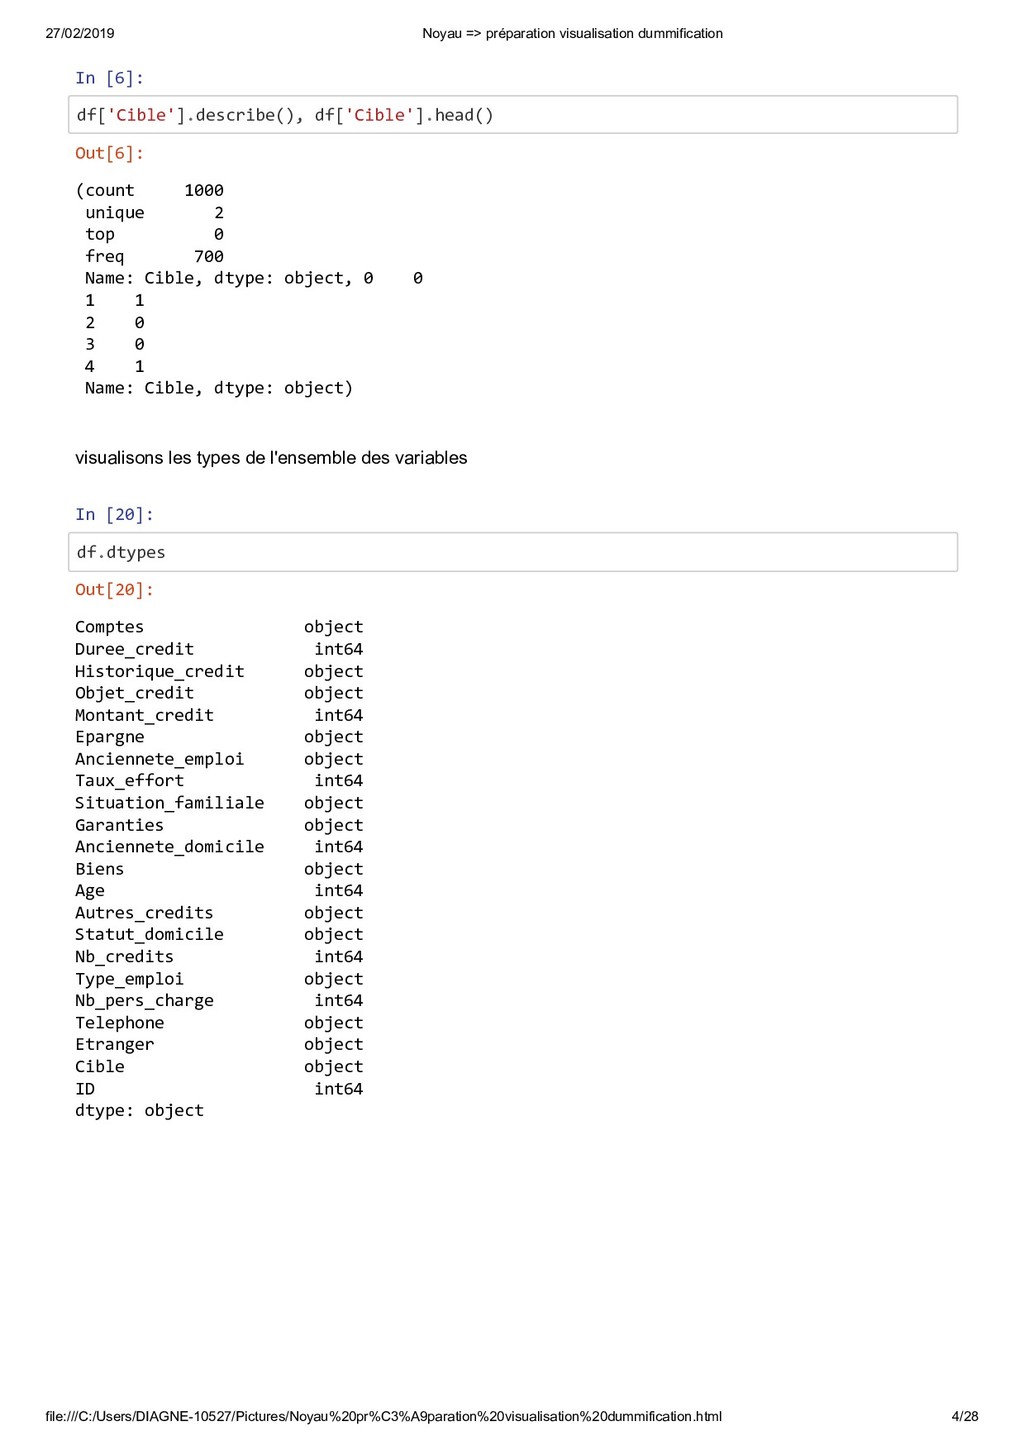
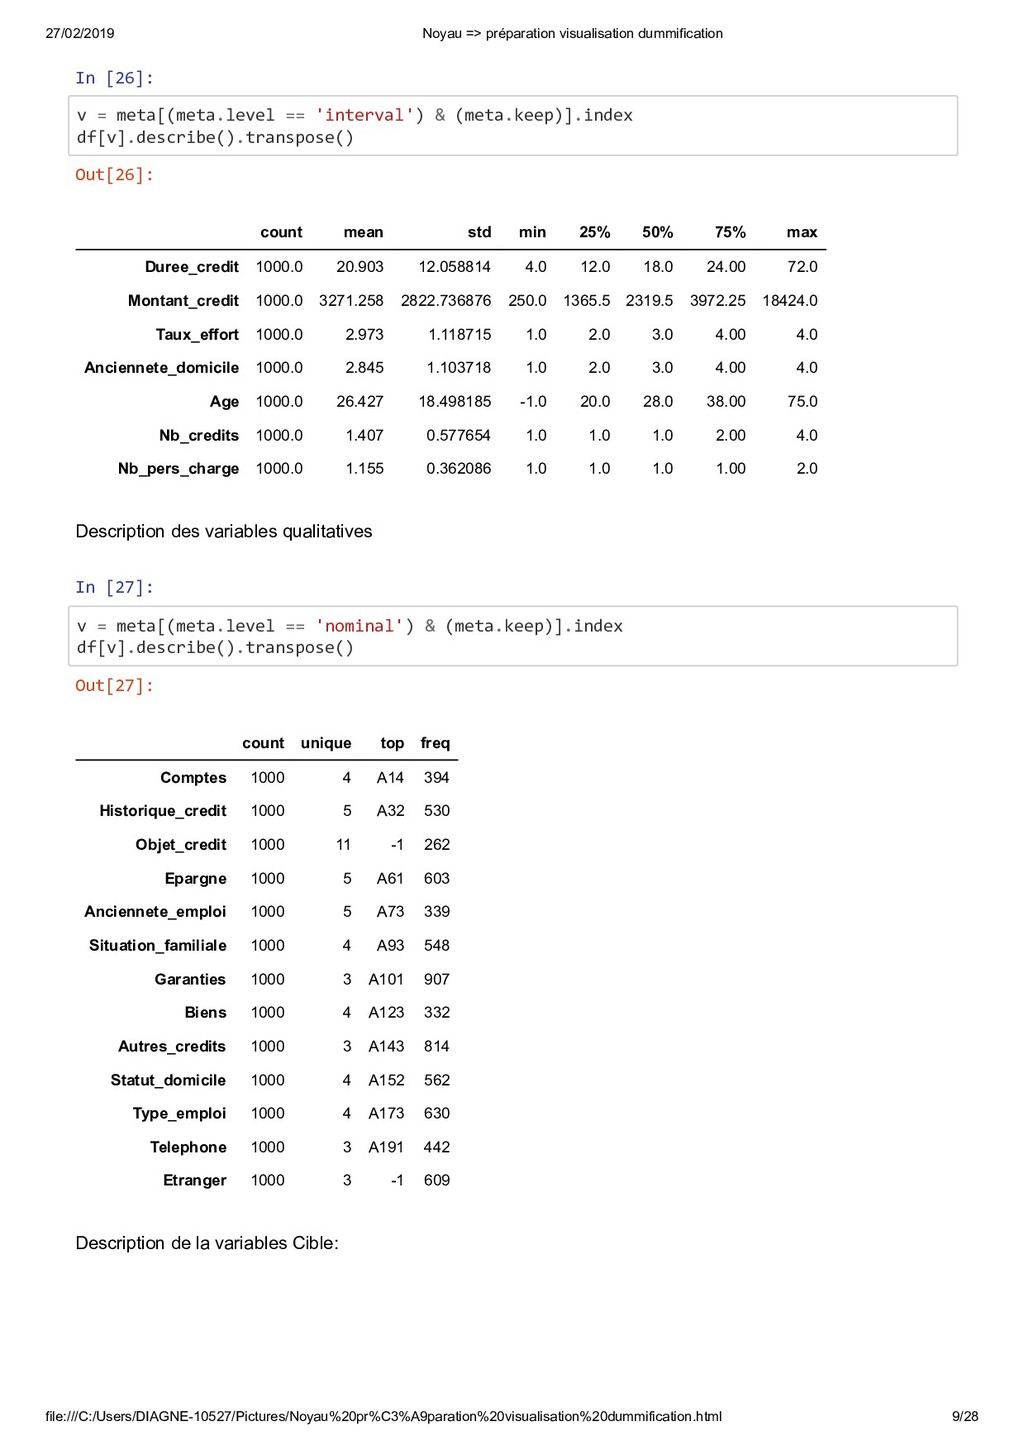
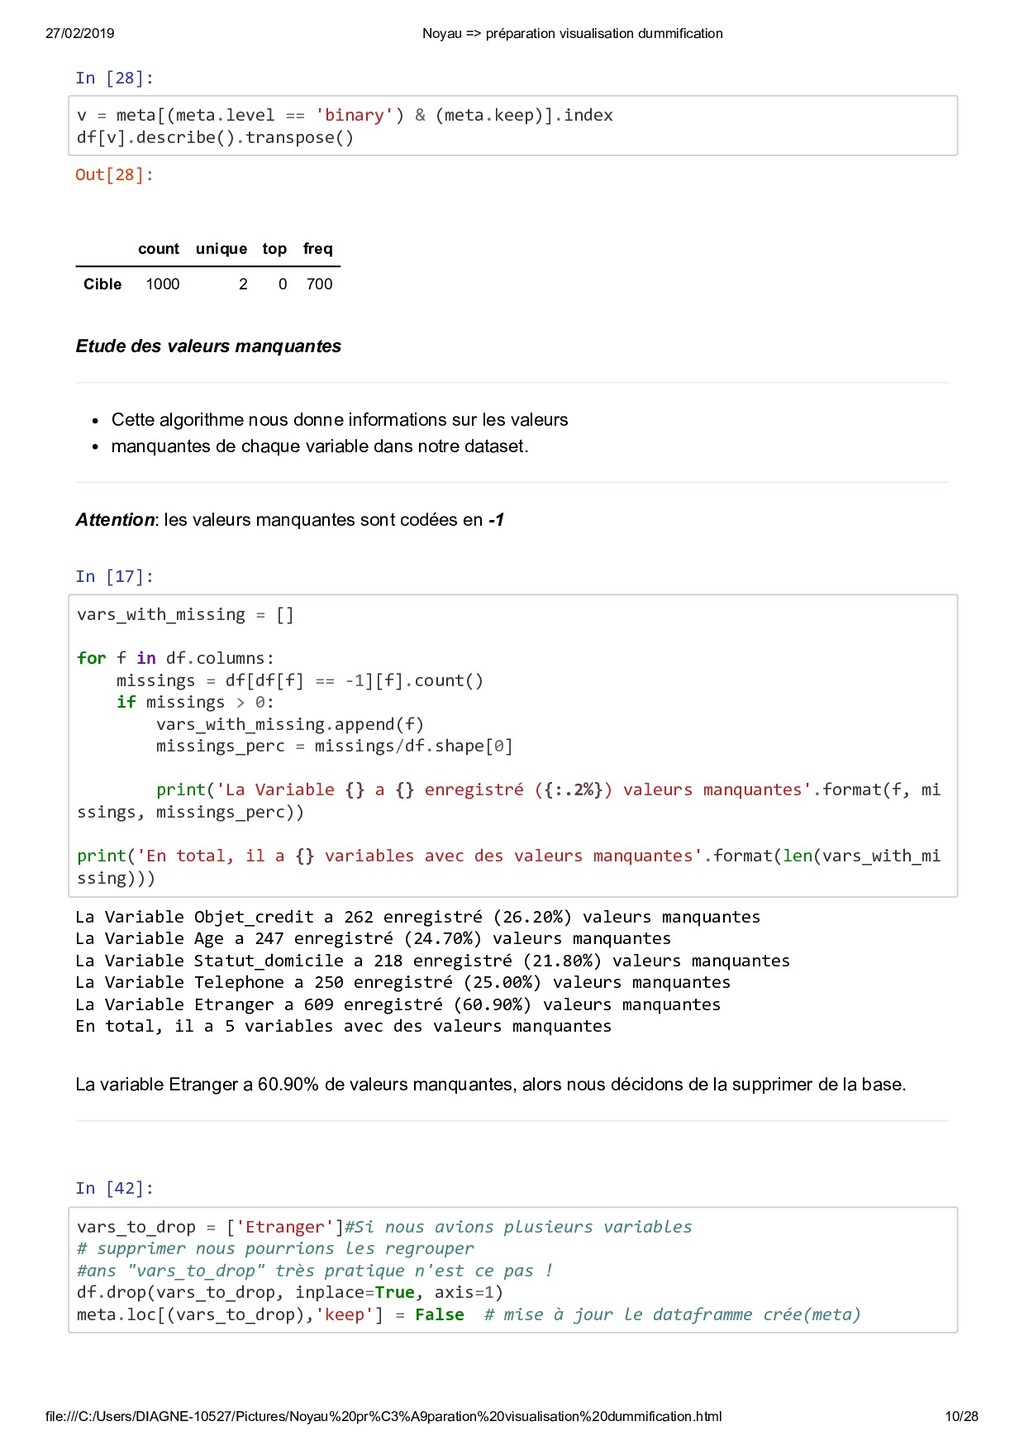
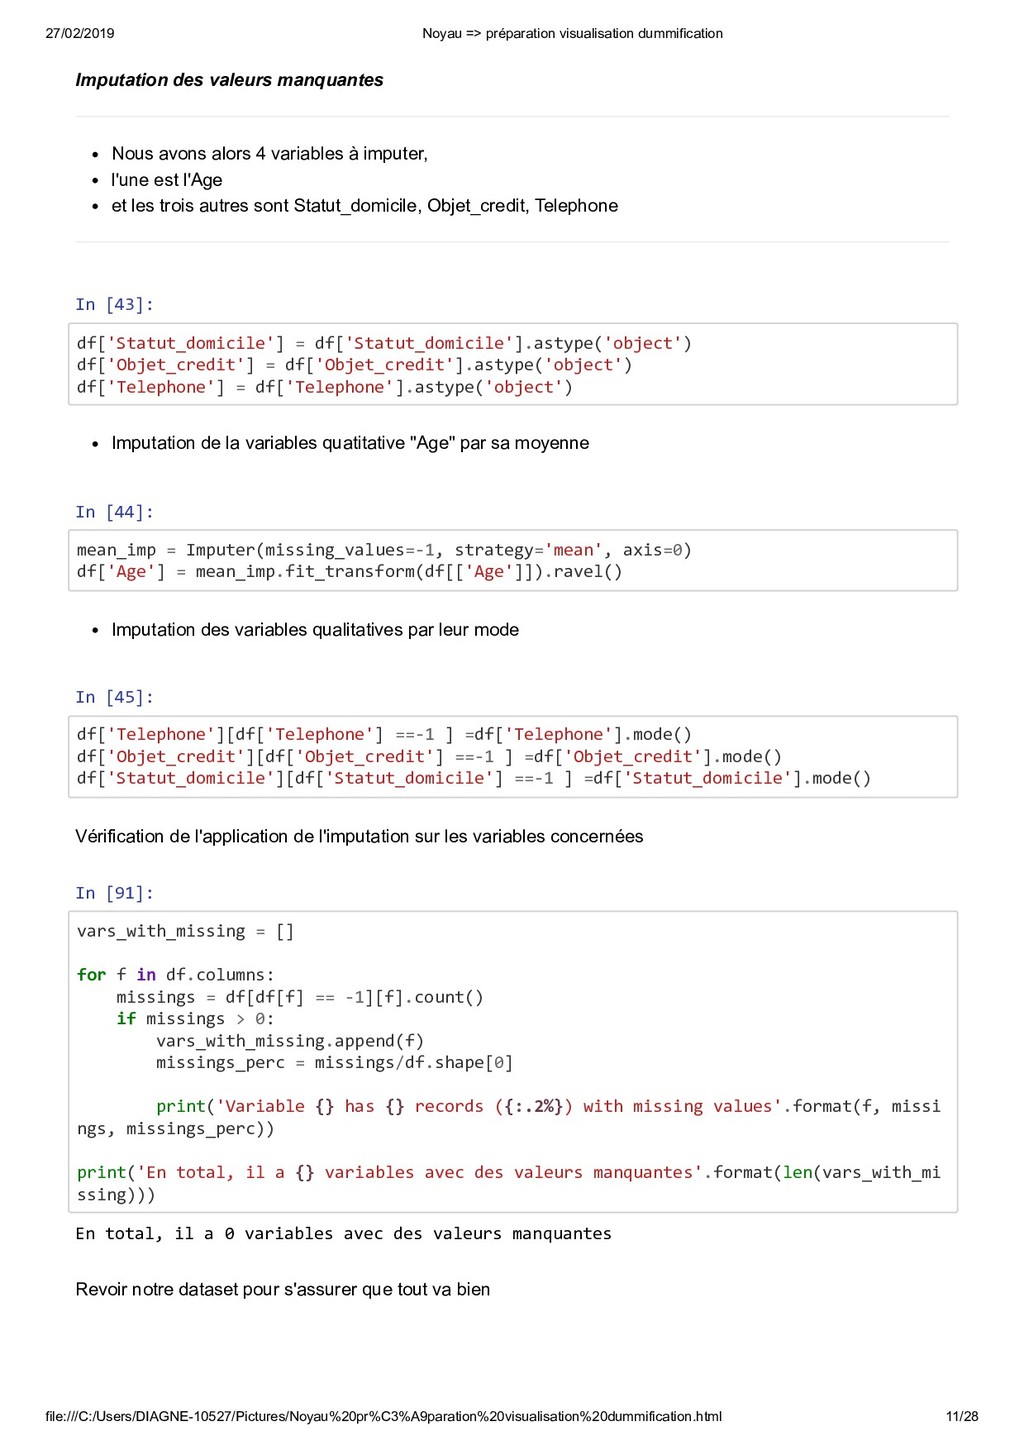
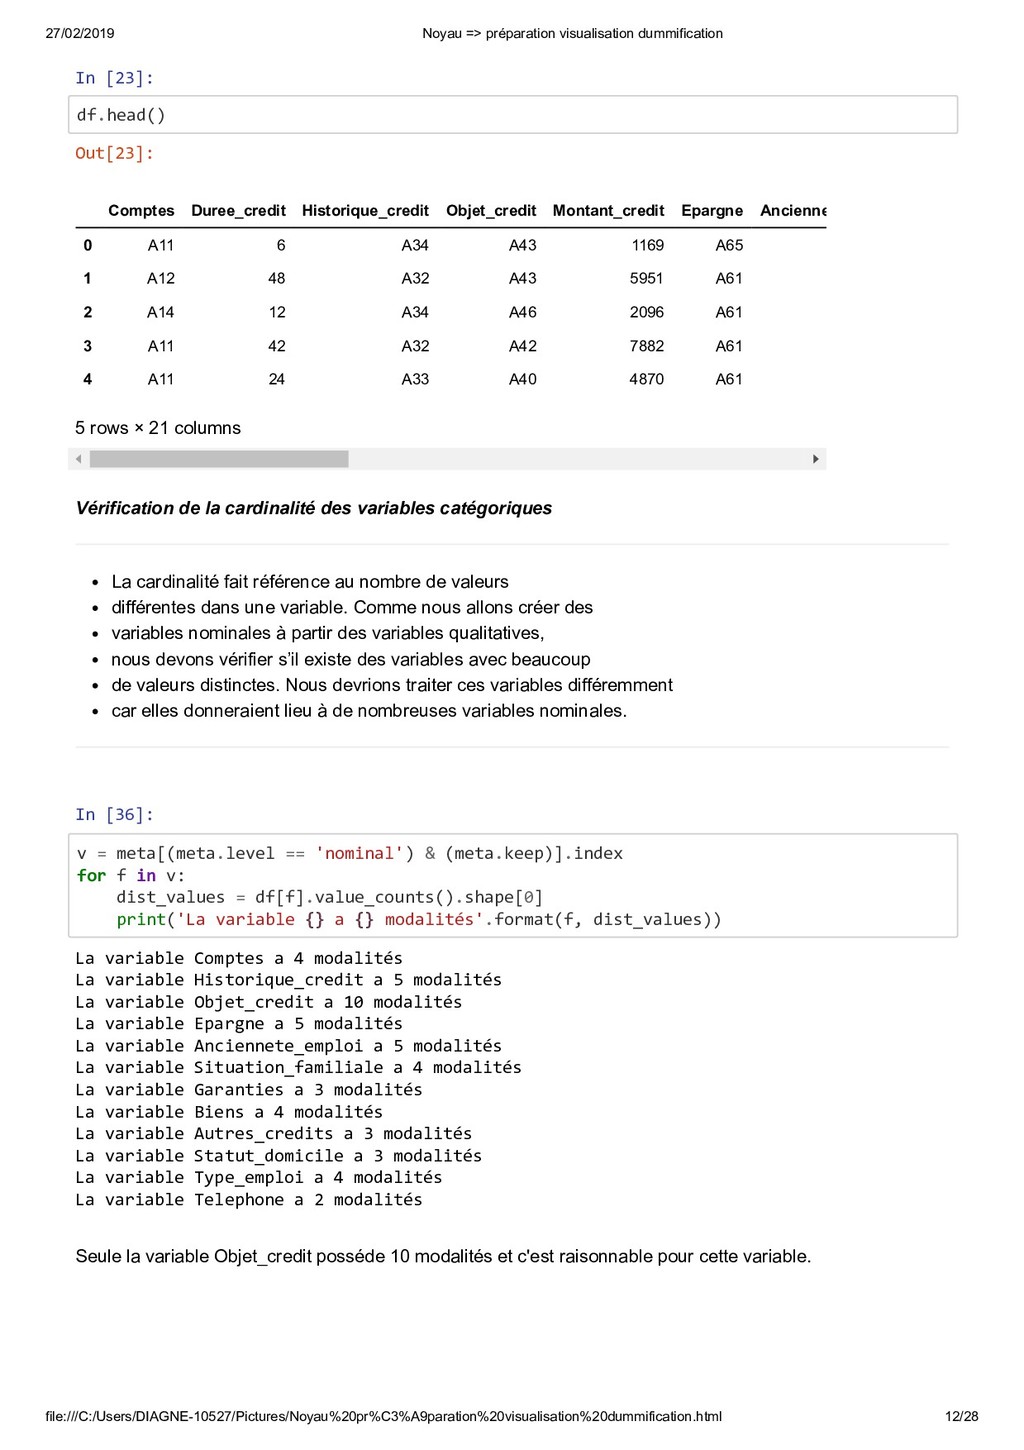
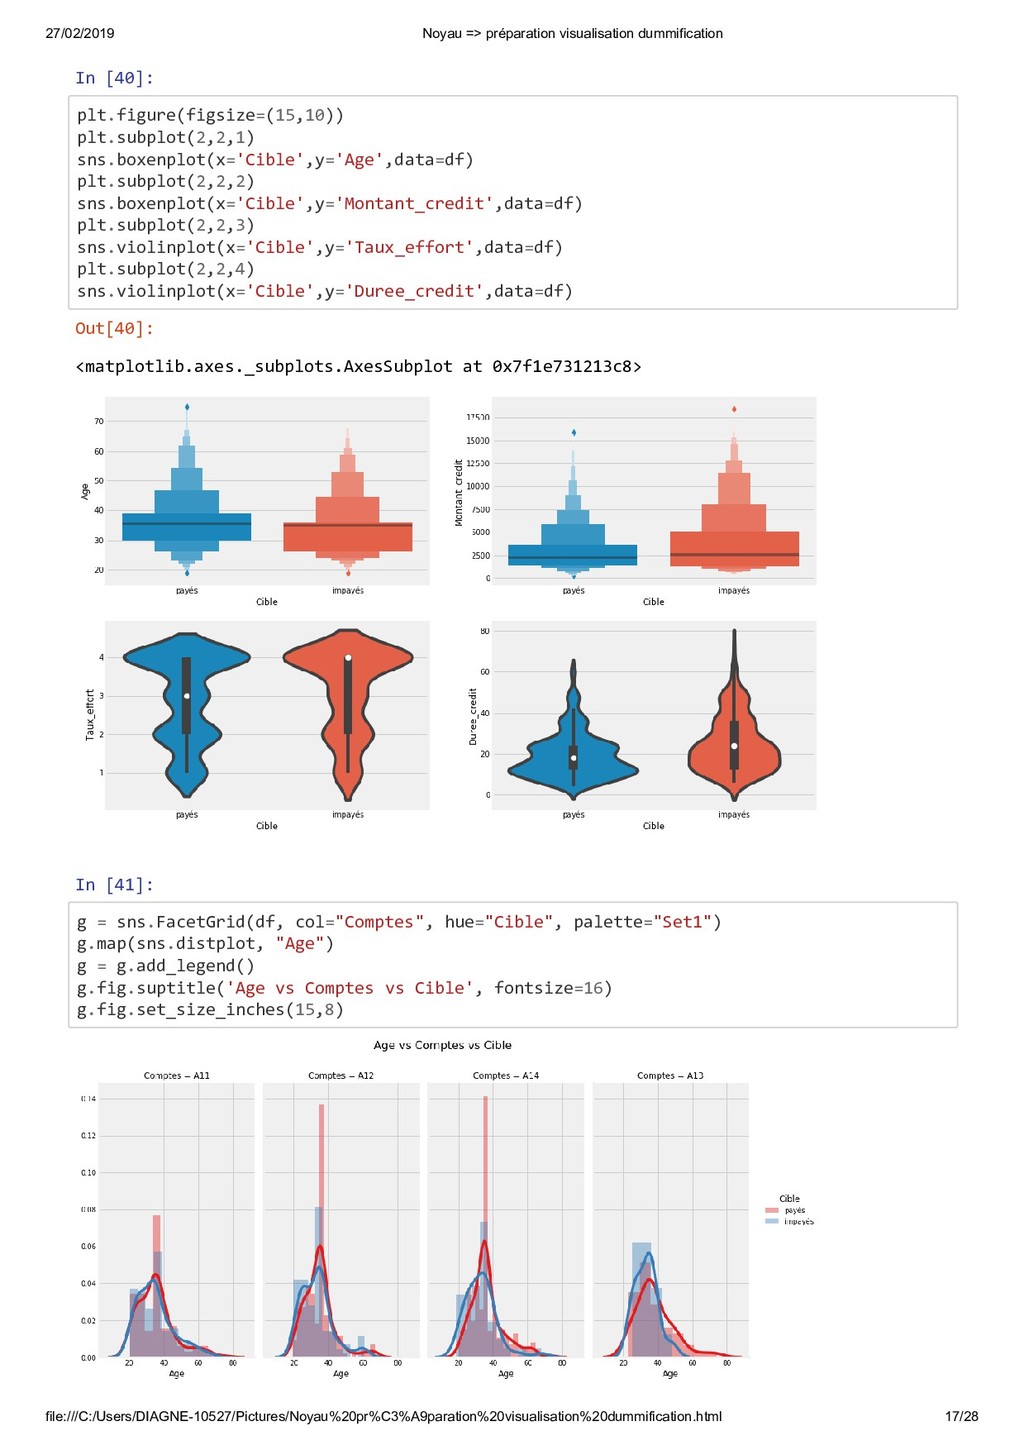
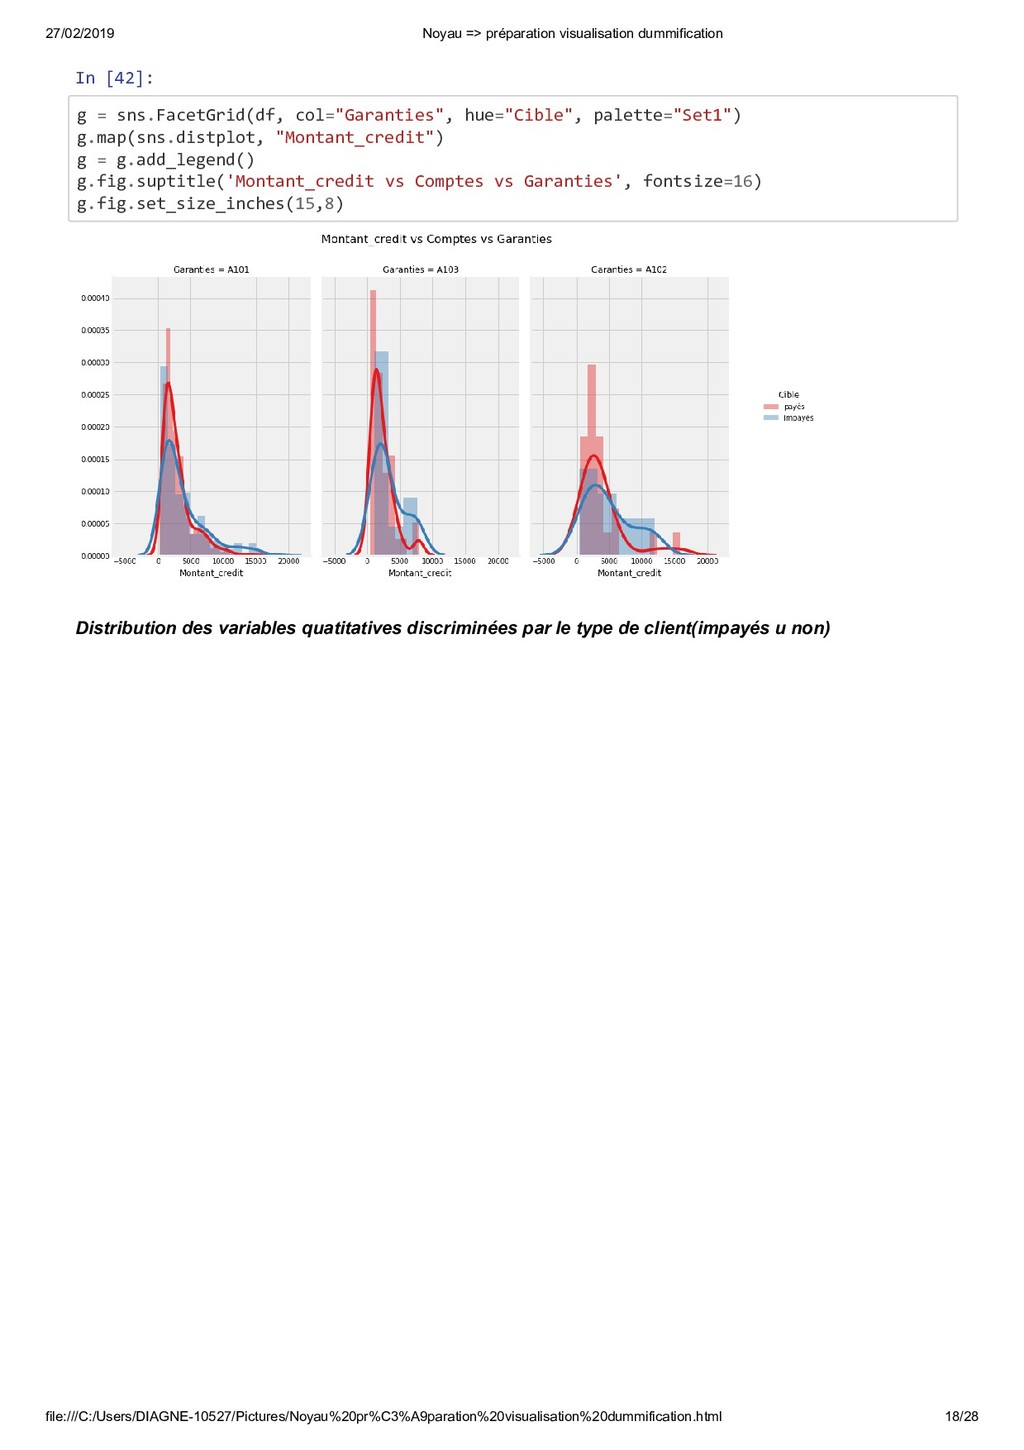
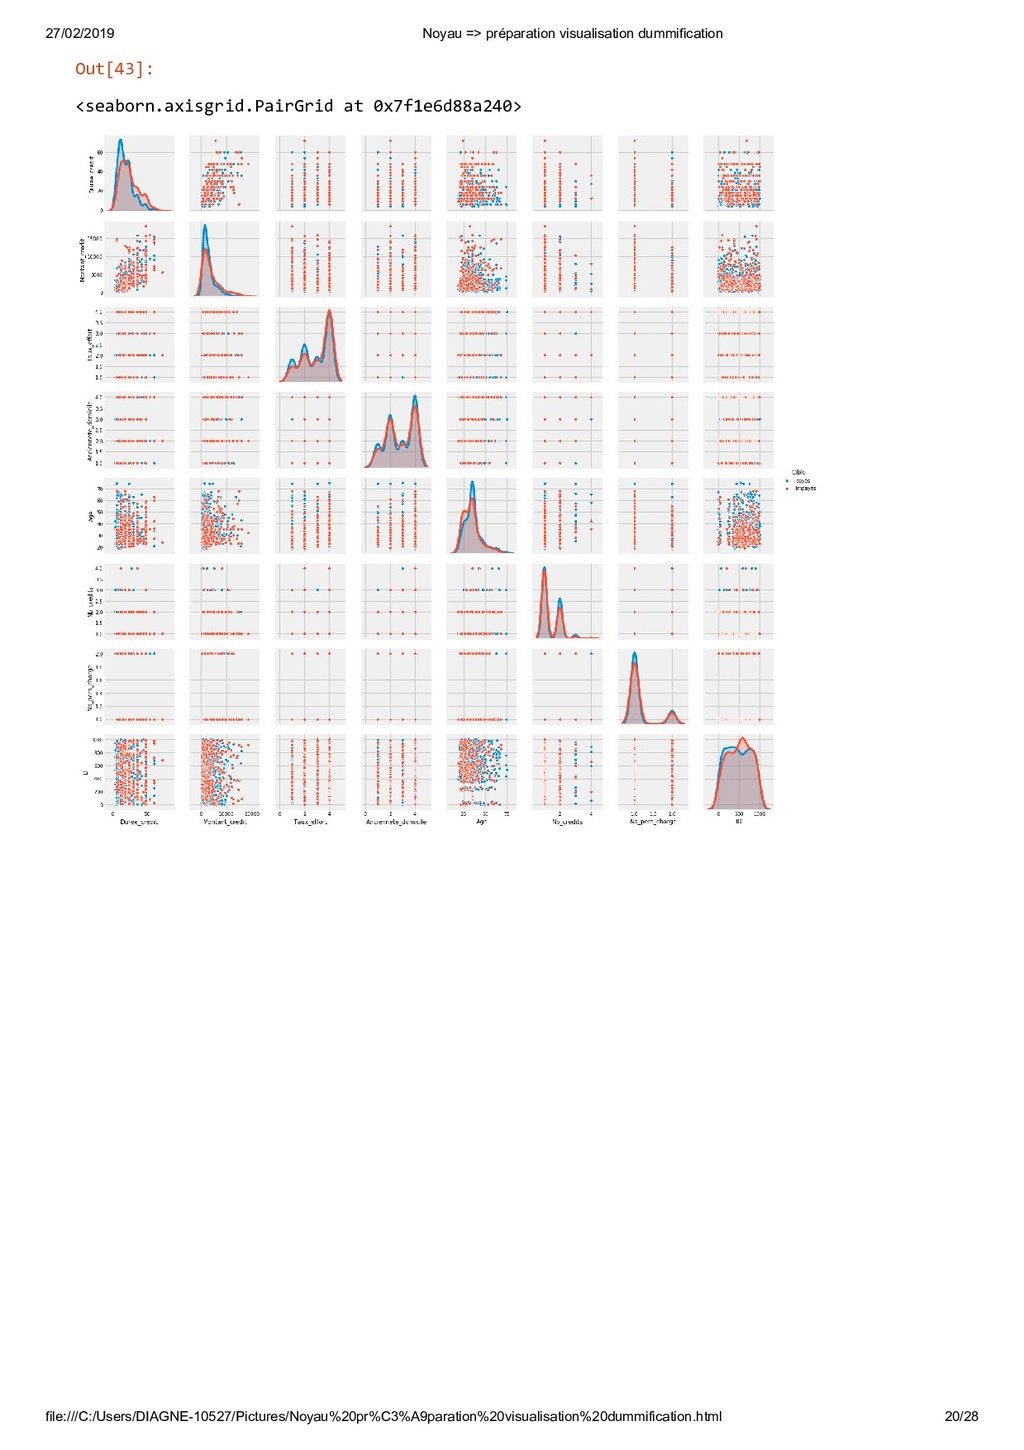
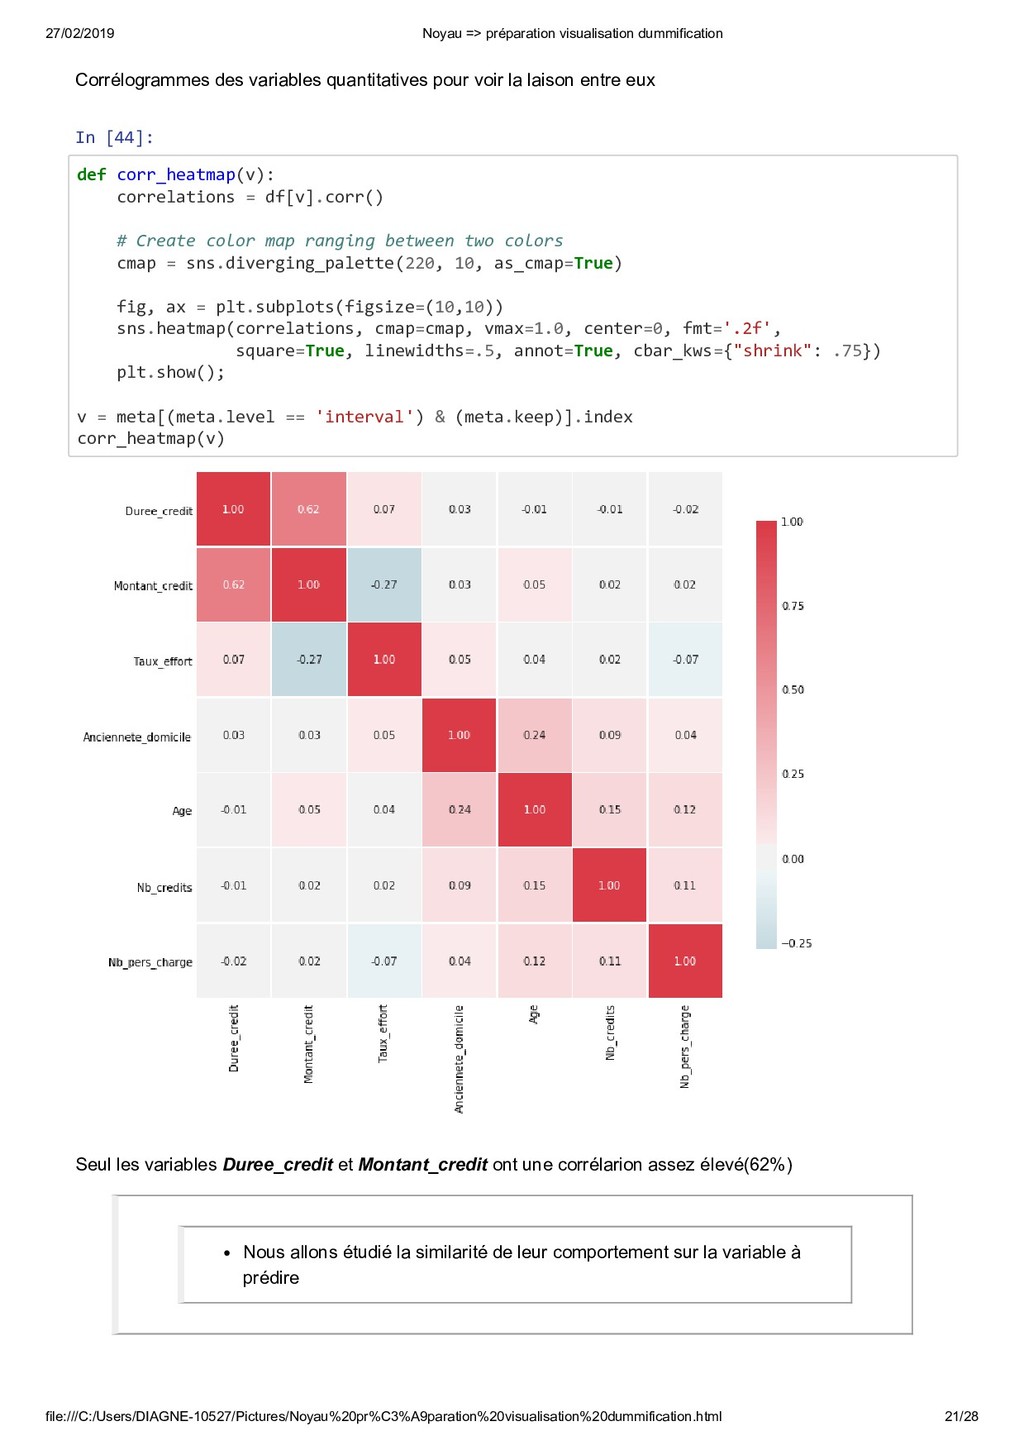
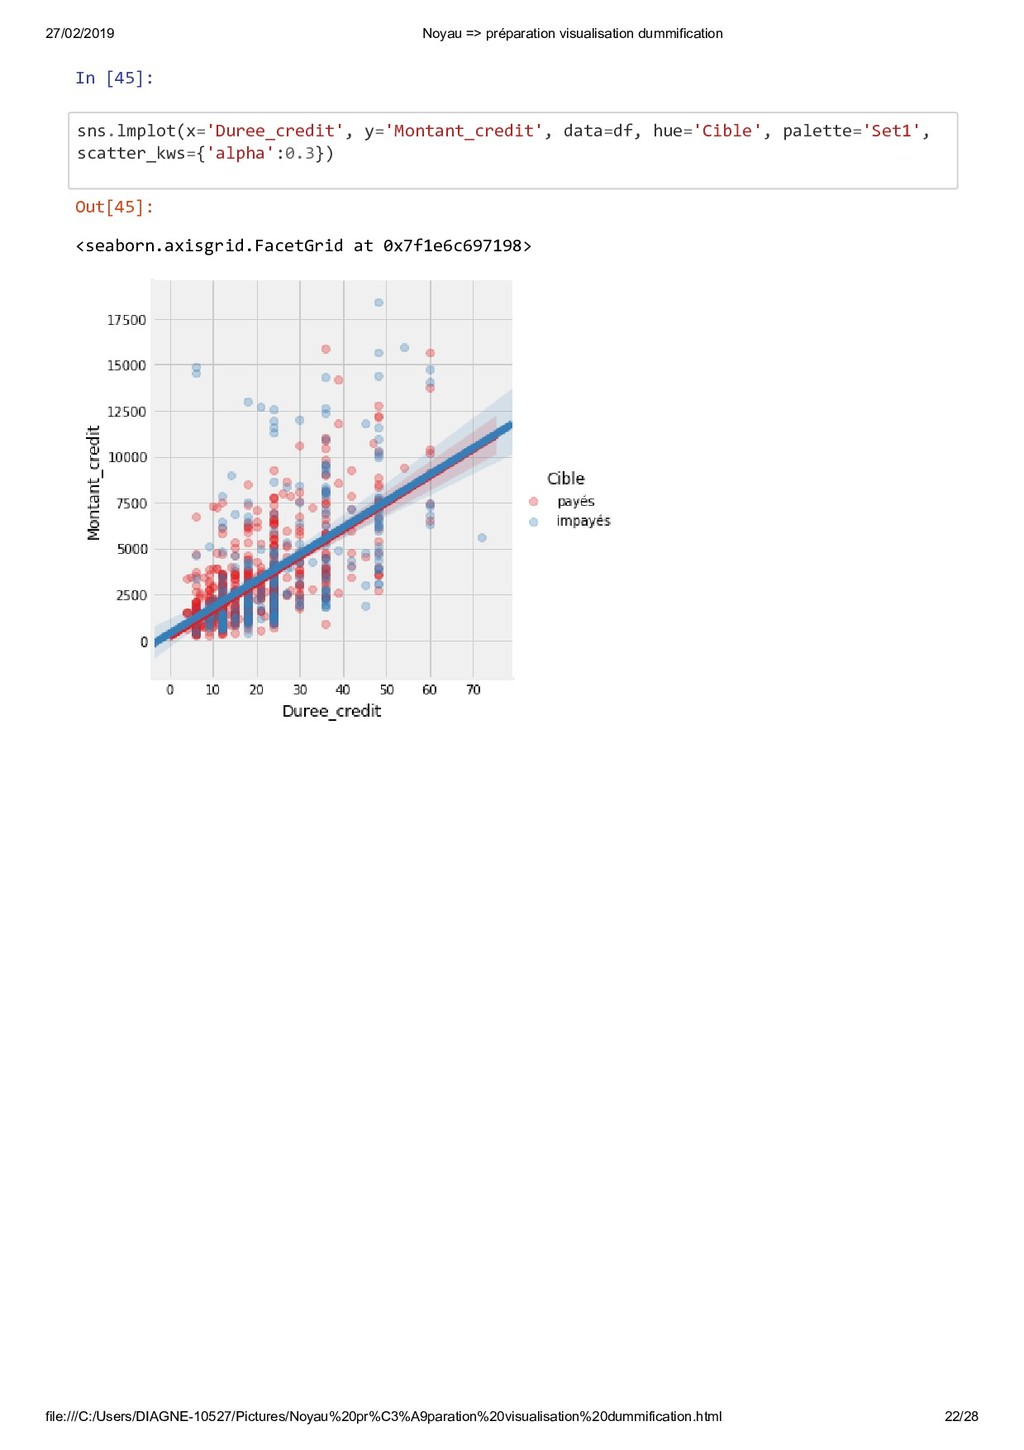
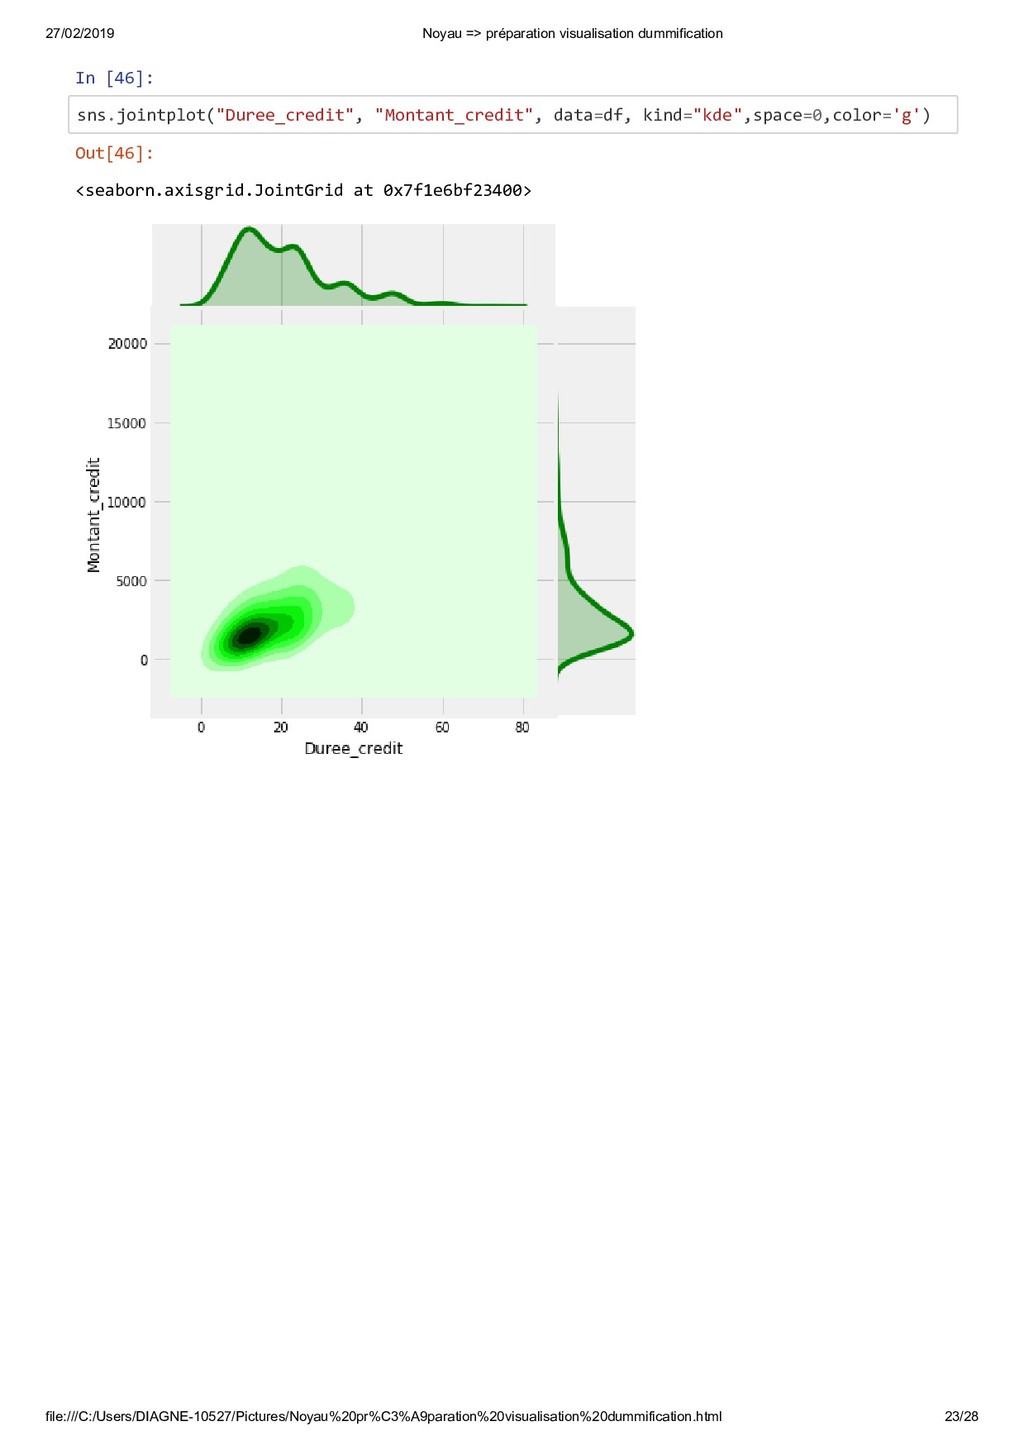
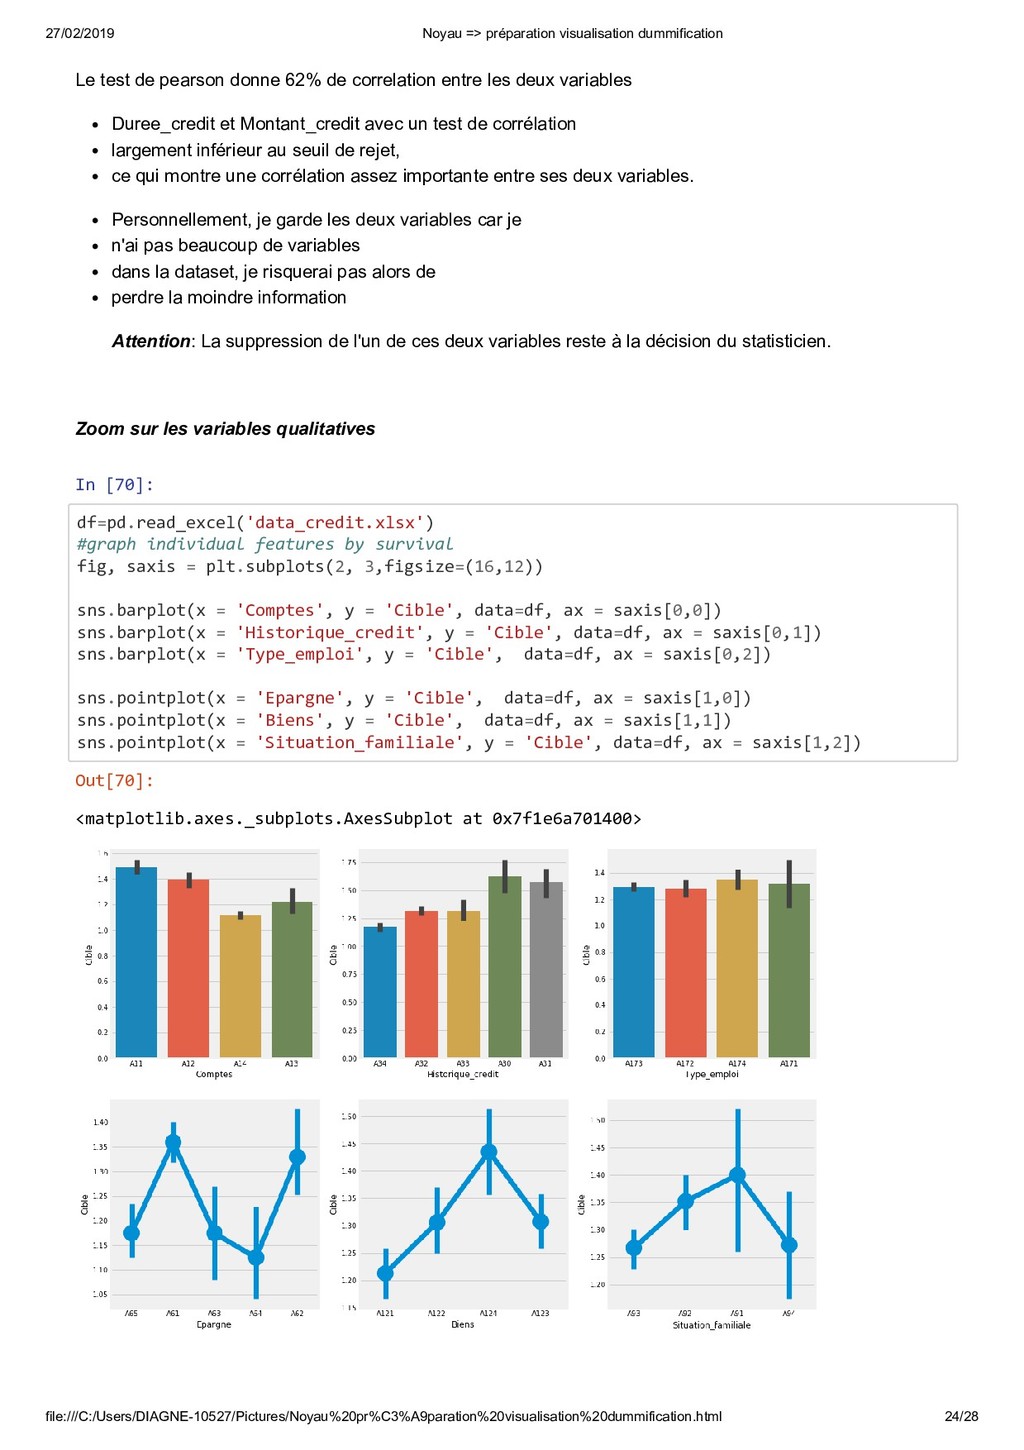
de pearson donne 62% de correlation entre les deux variables Duree_credit et Montant_credit avec un test de corrélation largement inférieur au seuil de rejet, ce qui montre une corrélation assez importante entre ses deux variables. Personnellement, je garde les deux variables car je n'ai pas beaucoup de variables dans la dataset, je risquerai pas alors de perdre la moindre information Attention: La suppression de l'un de ces deux variables reste à la décision du statisticien. Zoom sur les variables qualitatives In [70]: df=pd.read_excel('data_credit.xlsx') #graph individual features by survival fig, saxis = plt.subplots(2, 3,figsize=(16,12)) sns.barplot(x = 'Comptes', y = 'Cible', data=df, ax = saxis[0,0]) sns.barplot(x = 'Historique_credit', y = 'Cible', data=df, ax = saxis[0,1]) sns.barplot(x = 'Type_emploi', y = 'Cible', data=df, ax = saxis[0,2]) sns.pointplot(x = 'Epargne', y = 'Cible', data=df, ax = saxis[1,0]) sns.pointplot(x = 'Biens', y = 'Cible', data=df, ax = saxis[1,1]) sns.pointplot(x = 'Situation_familiale', y = 'Cible', data=df, ax = saxis[1,2]) Out[70]: <matplotlib.axes._subplots.AxesSubplot at 0x7f1e6a701400>


 fullkaiten
 sasukefinanciallab
 ikuodanaka
 ozakiomumkj
 infcurion
 kinsofficial
 layerx
 yasslab
 so_kotani
 yoshikikonishi_
 stanby_inc
 reiwatravel_0405
 kimpetersen
 addyosmani
 matthewcrist
 bcantrill
 tmiket
 helenjbeal
 chriscoyier
 elsirapls
 aleyda
 jacobian
 stephaniewalter