Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
データ基盤を Athena _ Glue から Databricks へ移行しました - 第4...
Search
スタンバイ
October 01, 2026
Business
280
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
データ基盤を Athena _ Glue から Databricks へ移行しました - 第4回 Youは何しにDatabricksへ!?
スタンバイ
October 01, 2026
Transcript
26 slides
データ基盤を Athena / Glue から Databricks へ移行しました 株式会社スタンバイ 権藤 尚樹
2026.09.29 第4回 Youは何しにDatabricksへ!? © Stanby, Inc. 1
目次 1. 会社紹介 2. 背景と課題 3. 解決方針と Databricks の選定 4.
移行後のアーキテクチャと効果 5. まとめ © Stanby, Inc. 2
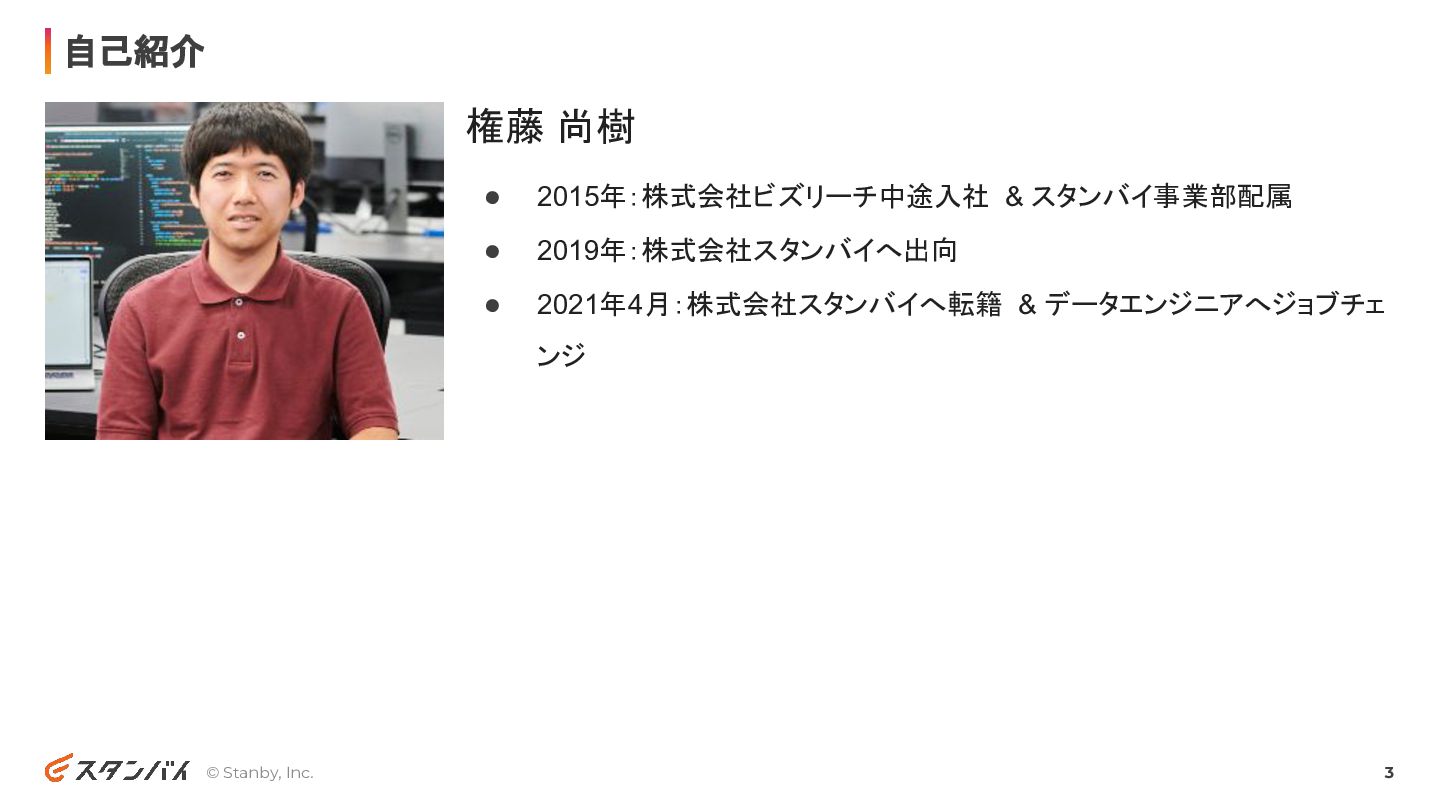
自己紹介 権藤 尚樹 • 2015年:株式会社ビズリーチ中途入社 & スタンバイ事業部配属 • 2019年:株式会社スタンバイへ出向 •
2021年4月:株式会社スタンバイへ転籍 & データエンジニアへジョブチェ ンジ © Stanby, Inc. 3
会社紹介 © Stanby, Inc. 4
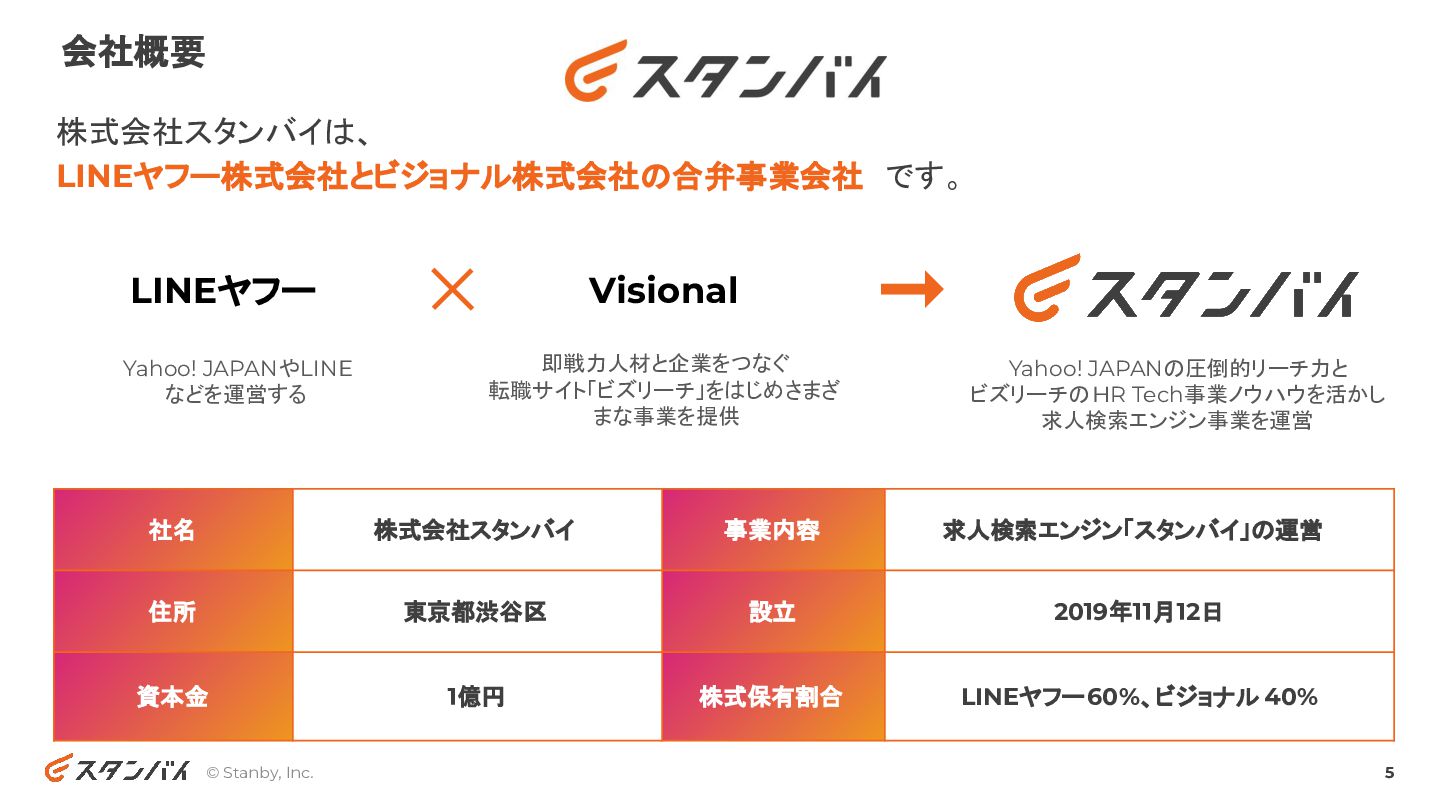
会社概要 株式会社スタンバイは、 LINEヤフー株式会社とビジョナル株式会社の合弁事業会社 です。 LINEヤフー Visional Yahoo! JAPANやLINE などを運営する 即戦力人材と企業をつなぐ
転職サイト「ビズリーチ」をはじめさまざ まな事業を提供 Yahoo! JAPANの圧倒的リーチ力と ビズリーチの HR Tech事業ノウハウを活かし 求人検索エンジン事業を運営 社名 株式会社スタンバイ 事業内容 求人検索エンジン「スタンバイ」の運営 住所 東京都渋谷区 設立 2019年11月12日 資本金 1億円 株式保有割合 LINEヤフー60%、ビジョナル 40% © Stanby, Inc. 5
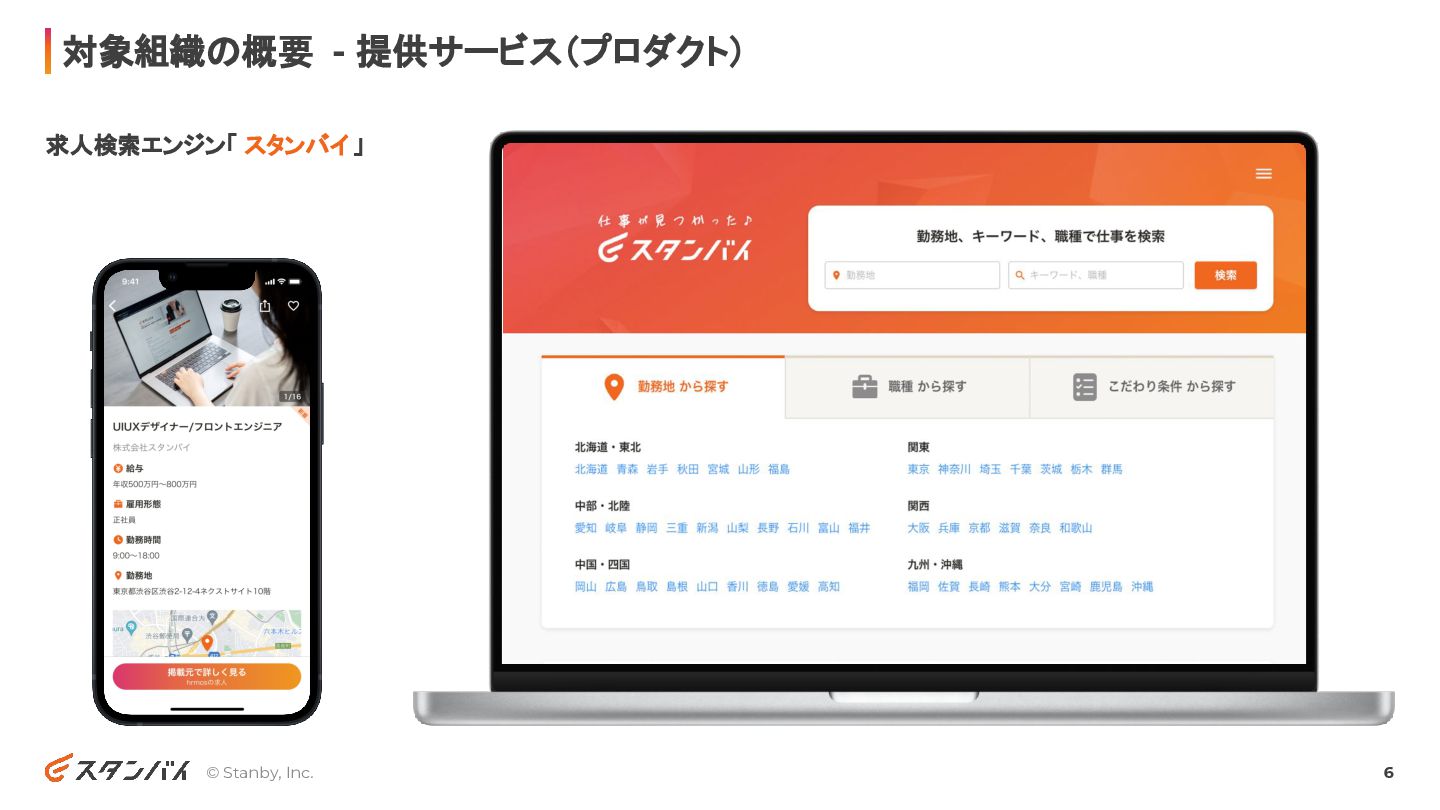
対象組織の概要 - 提供サービス(プロダクト) 求人検索エンジン「 スタンバイ 」 © Stanby, Inc. 6
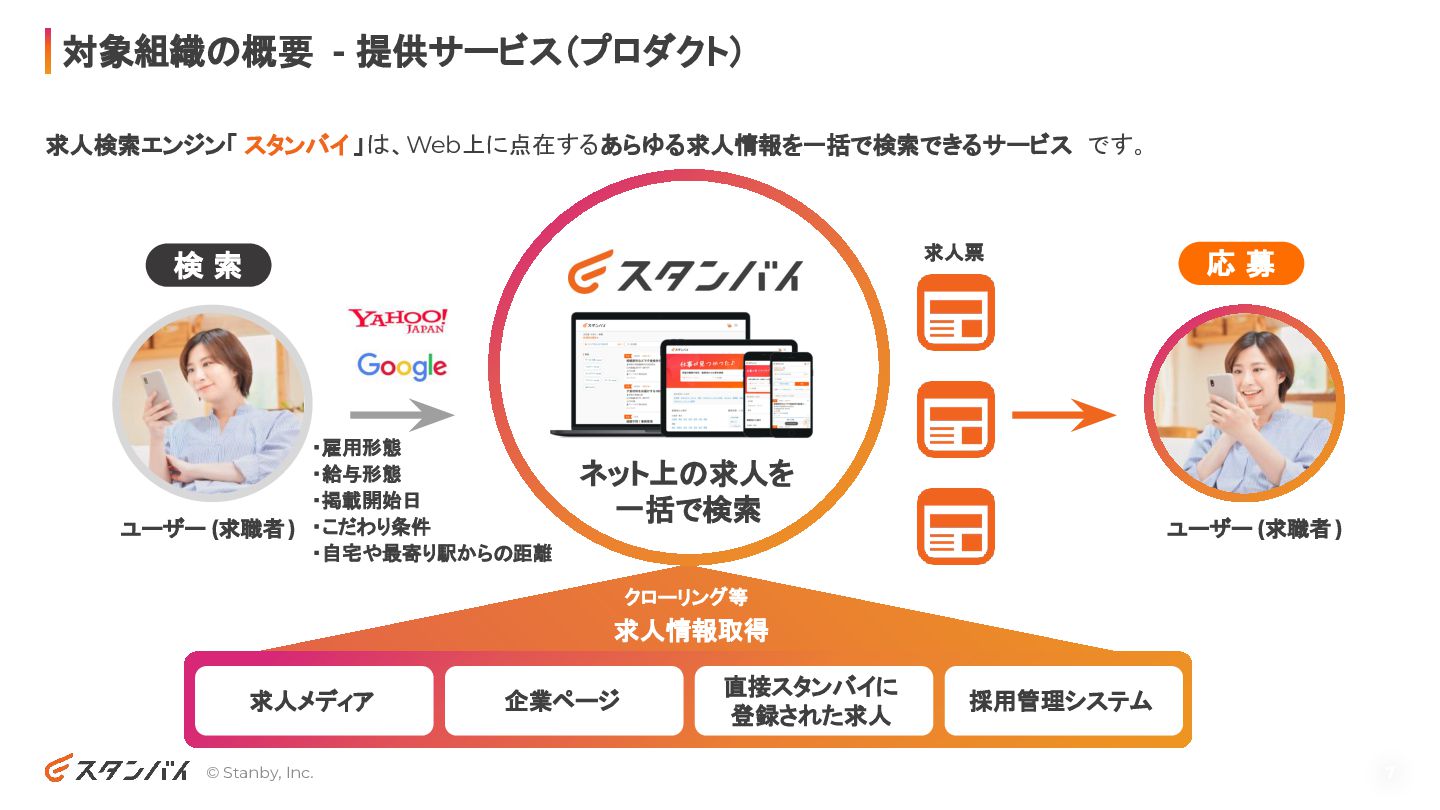
対象組織の概要 - 提供サービス(プロダクト) 求人検索エンジン「 スタンバイ 」は、Web上に点在するあらゆる求人情報を一括で検索できるサービス です。 求人票 検索 ・雇用形態
・給与形態 ・掲載開始日 ユーザー (求職者 ) ・こだわり条件 ・自宅や最寄り駅からの距離 ネット上の求人を 一括で検索 応募 ユーザー (求職者 ) クローリング等 求人情報取得 求人メディア © Stanby, Inc. 企業ページ 直接スタンバイに 登録された求人 採用管理システム 7
背景と課題 © Stanby, Inc. 8
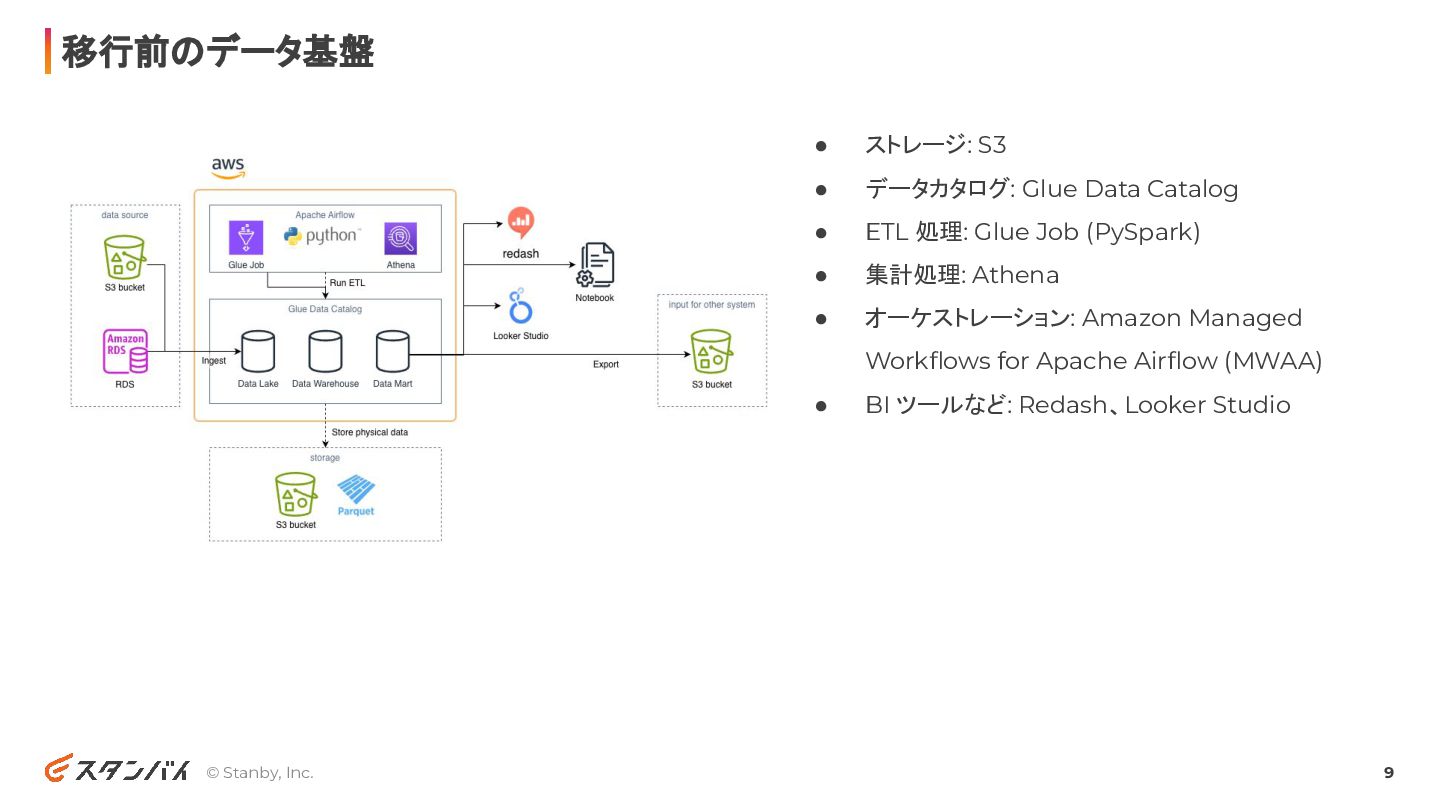
移行前のデータ基盤 • ストレージ: S3 • データカタログ: Glue Data Catalog •
ETL 処理: Glue Job (PySpark) • 集計処理: Athena • オーケストレーション: Amazon Managed Workflows for Apache Airflow (MWAA) • © Stanby, Inc. BI ツールなど: Redash、Looker Studio 9
課題に対するアプローチを検討 • データエンジニアの主観だけで進めるのは危険 ◦ • 今のデータ基盤はどこが良い/悪いといった診断を行う ◦ • モダンデータスタックで構築したい、といったソリューションが先行するとうまく行かない 改善の前後でどう変わったか?を定量的に測定したい
データ基盤は利用者に使ってもらってなんぼのもの ◦ 利用者の声も聞いて認識を合わせながら進めるべき © Stanby, Inc. 10
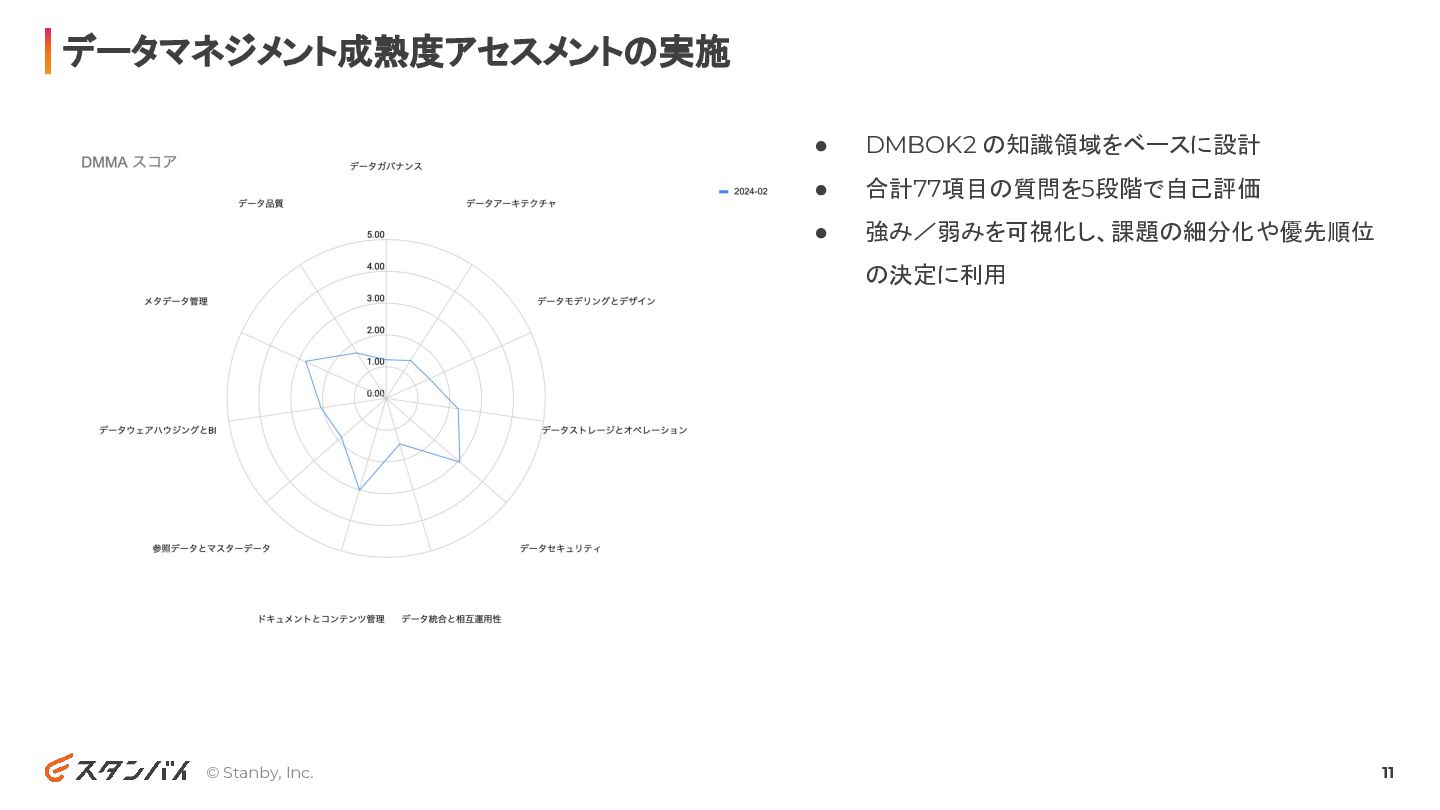
データマネジメント成熟度アセスメントの実施 • DMBOK2 の知識領域をベースに設計 • 合計77項目の質問を5段階で自己評価 • 強み/弱みを可視化し、課題の細分化や優先順位 の決定に利用 ©
Stanby, Inc. 11
データ基盤利用者へのアンケートの実施 • 以下のような質問を選択式の回答とセットで用意 ◦ 主な利用目的は? ◦ よく利用する周辺ツールは? ◦ よく利用するデータは? ◦
現在のデータ基盤に対する満足度は? ◦ データ基盤について現在直面している問題は? • 自由記述形式の質問も用意 • 実施の結果、以下のような要望が多かった ◦ 様々なデータを同じデータ基盤上で扱いたい (複数のデータを統一の SQL で参照したい) ◦ データの関係性がわかりにくい (データリネージュ・メタデータの不足) ◦ KPI の計算式を統一したい (分析者によって SQL の記述方法が異なるため統一したい) ◦ データの欠損が一部あり、分析がしづらい (データ品質の不足) © Stanby, Inc. 12
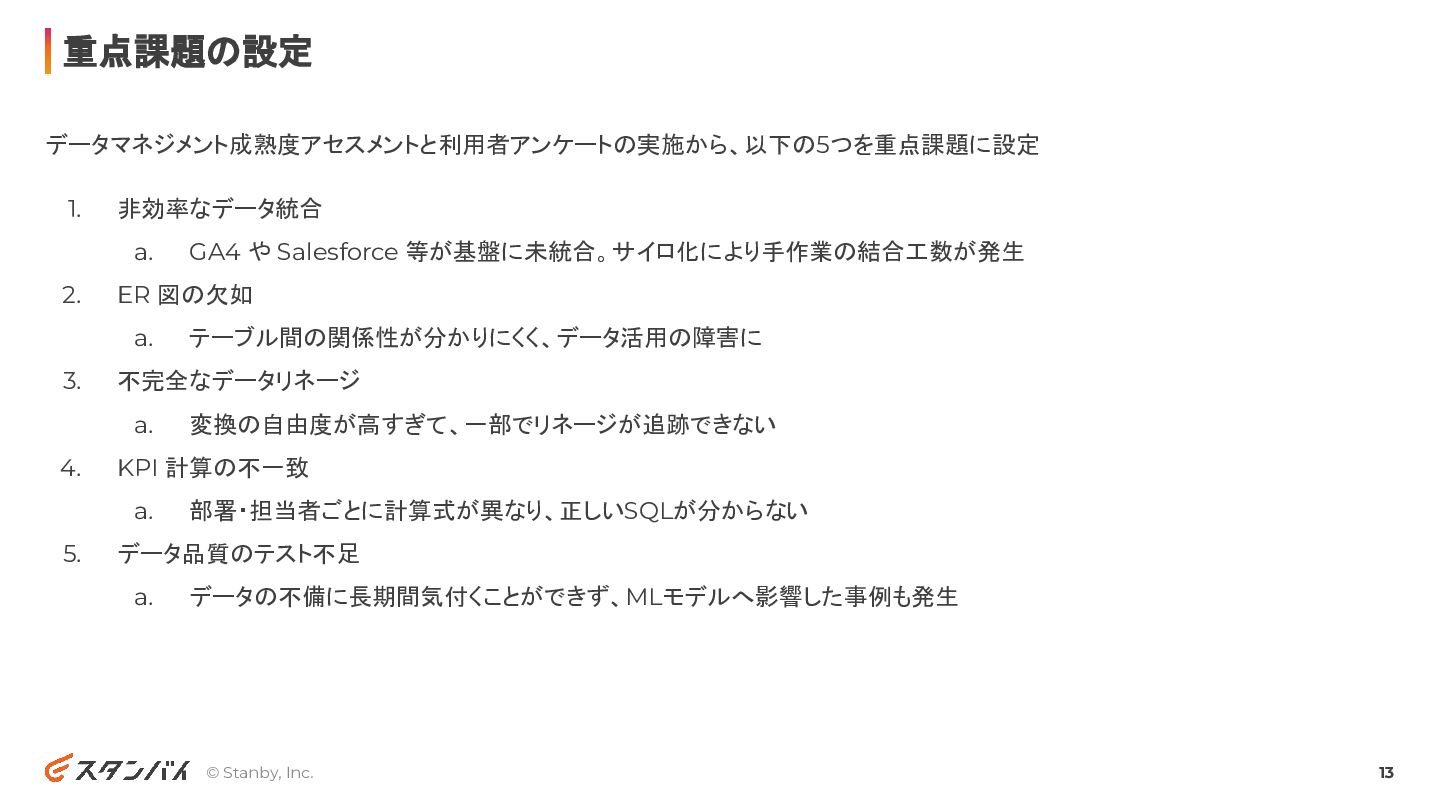
重点課題の設定 データマネジメント成熟度アセスメントと利用者アンケートの実施から、以下の5つを重点課題に設定 1. 非効率なデータ統合 a. 2. ER 図の欠如 a. 3.
変換の自由度が高すぎて、一部でリネージが追跡できない KPI 計算の不一致 a. 5. テーブル間の関係性が分かりにくく、データ活用の障害に 不完全なデータリネージ a. 4. GA4 や Salesforce 等が基盤に未統合。サイロ化により手作業の結合工数が発生 部署・担当者ごとに計算式が異なり、正しいSQLが分からない データ品質のテスト不足 a. データの不備に長期間気付くことができず、MLモデルへ影響した事例も発生 © Stanby, Inc. 13
解決方針と Databricks の選定 © Stanby, Inc. 14
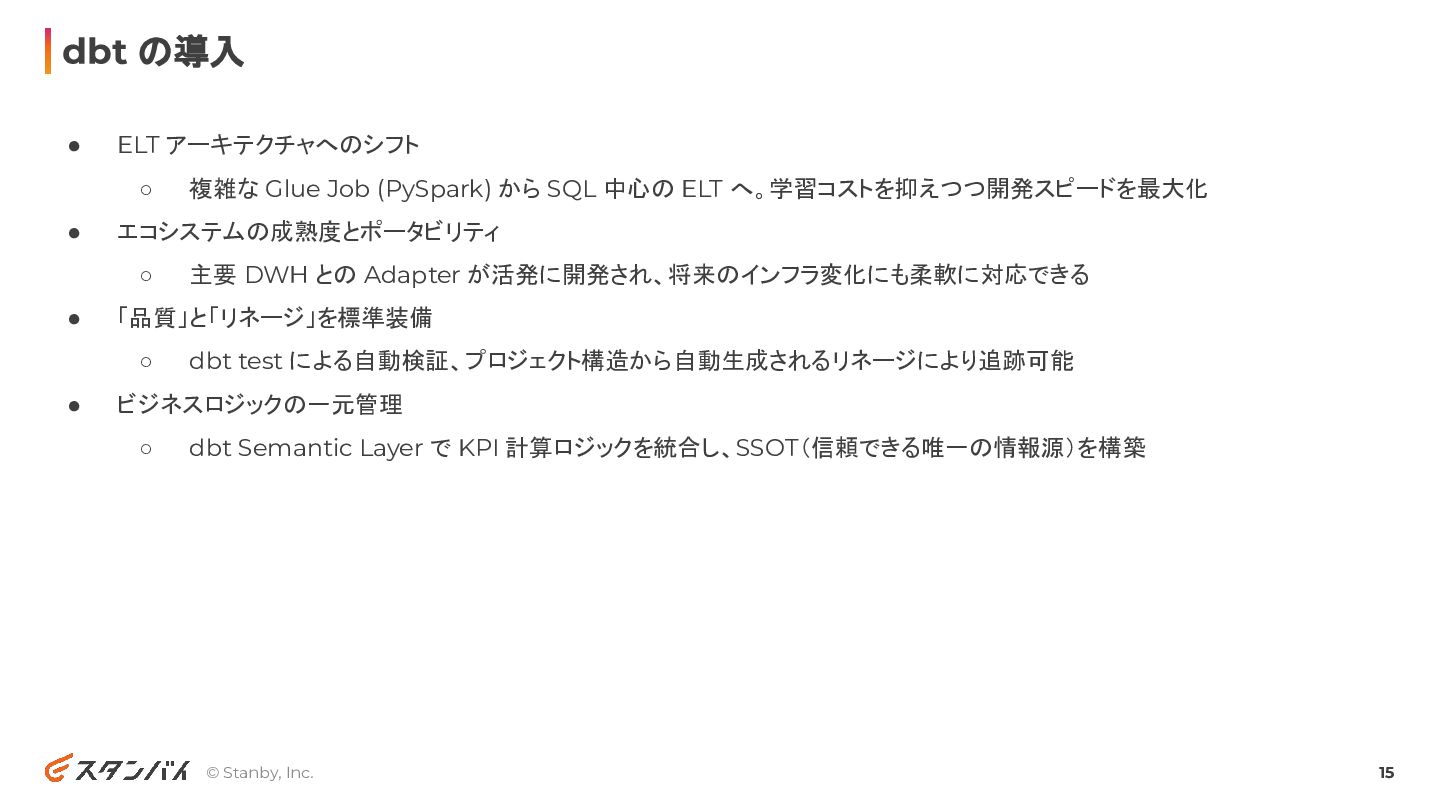
dbt の導入 • ELT アーキテクチャへのシフト ◦ • エコシステムの成熟度とポータビリティ ◦ •
主要 DWH との Adapter が活発に開発され、将来のインフラ変化にも柔軟に対応できる 「品質」と「リネージ」を標準装備 ◦ • 複雑な Glue Job (PySpark) から SQL 中心の ELT へ。学習コストを抑えつつ開発スピードを最大化 dbt test による自動検証、プロジェクト構造から自動生成されるリネージにより追跡可能 ビジネスロジックの一元管理 ◦ dbt Semantic Layer で KPI 計算ロジックを統合し、SSOT(信頼できる唯一の情報源)を構築 © Stanby, Inc. 15
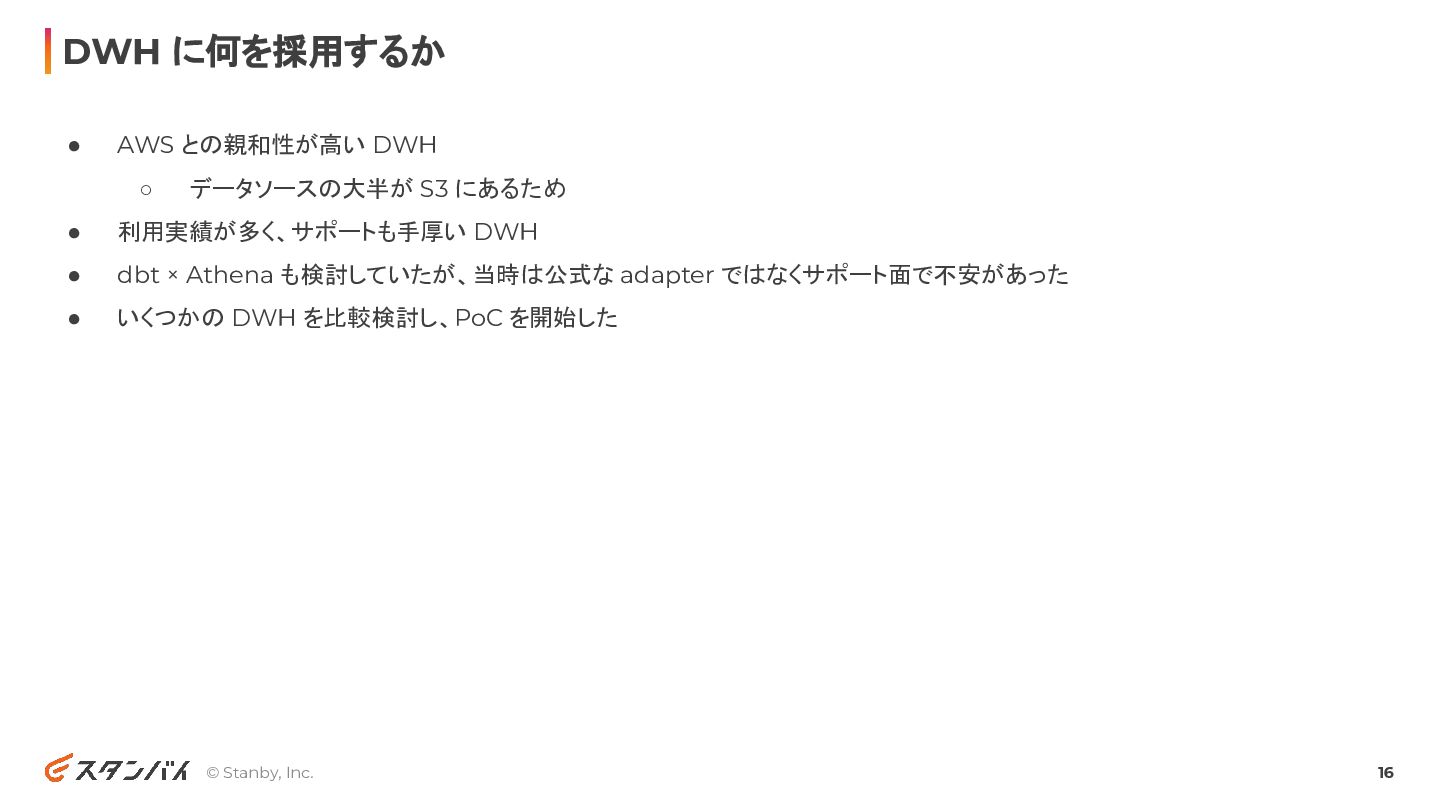
DWH に何を採用するか • AWS との親和性が高い DWH ◦ データソースの大半が S3 にあるため
• 利用実績が多く、サポートも手厚い DWH • dbt × Athena も検討していたが、当時は公式な adapter ではなくサポート面で不安があった • いくつかの DWH を比較検討し、PoC を開始した © Stanby, Inc. 16
PoC での検証項目 • コスト ◦ • データロード ◦ • dbt
連携の安定性、周辺ツールとの接続 ガバナンス ◦ • SQL / Python の記述、デバッグのしやすさ エコシステム ◦ • S3 からのデータロード・外部テーブル参照 開発体験 ◦ • クエリ実行、インスタンス起動の費用 カタログ、権限管理、リネージの自動化 AI / 機械学習 ◦ 生成 AI 連携、ノートブックの AI 補助 © Stanby, Inc. 17
Databricks の優位性 • • オープンなデータ管理とポータビリティ ◦ Delta Lake 形式で S3
に保存されており、他の AWS サービスからも利用可能 ◦ ベンダーロックインにならない コストパフォーマンスの良さ ◦ • 3 割ほどコンピューティングコストを抑えられる AI 活用とデータ活用の民主化 ◦ Genie を中心とした AI 機能の充実 ◦ メタデータを整備することで AI が賢くなるという相乗効果 © Stanby, Inc. 18
移行後のアーキテクチャと効果 © Stanby, Inc. 19
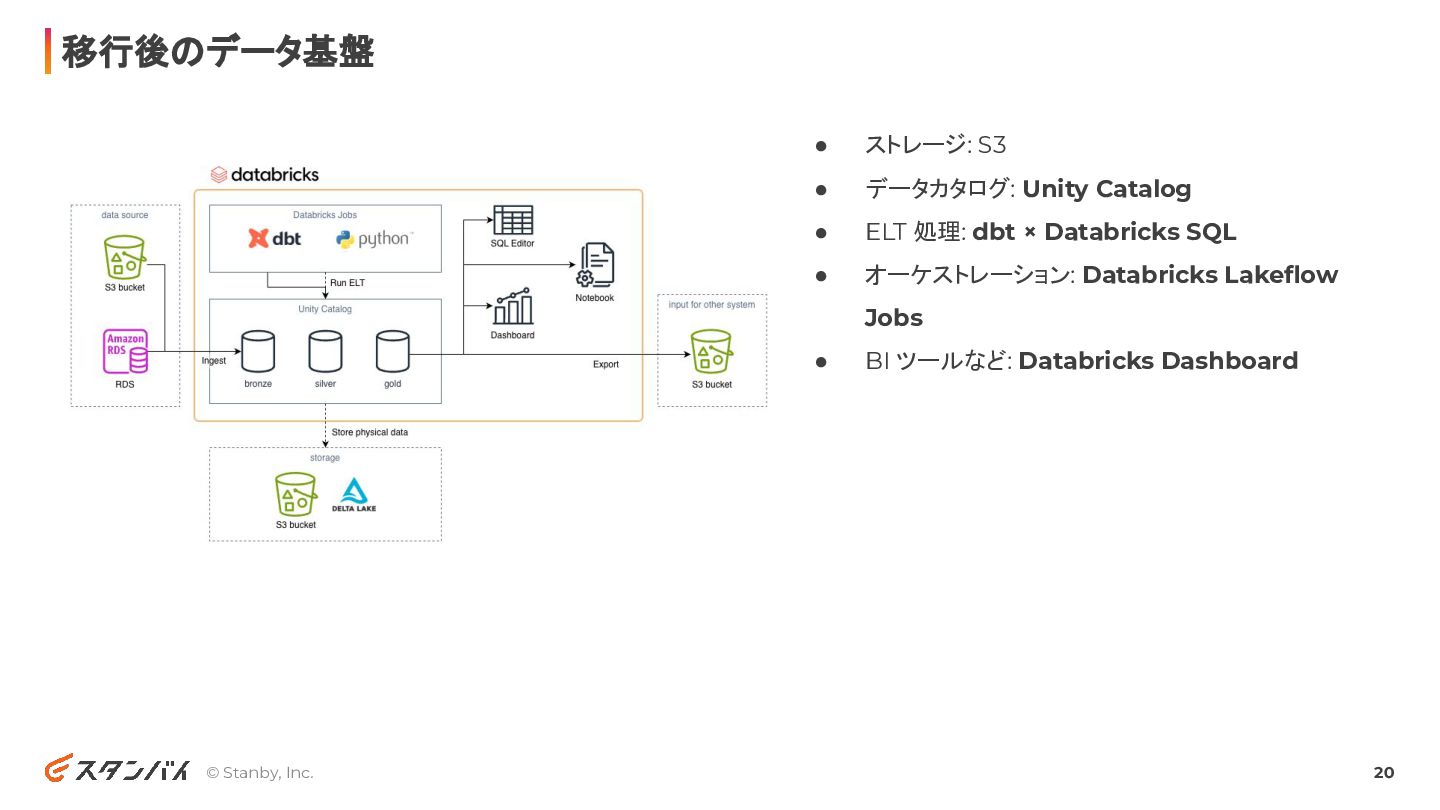
移行後のデータ基盤 • ストレージ: S3 • データカタログ: Unity Catalog • ELT
処理: dbt × Databricks SQL • オーケストレーション: Databricks Lakeflow Jobs • © Stanby, Inc. BI ツールなど: Databricks Dashboard 20
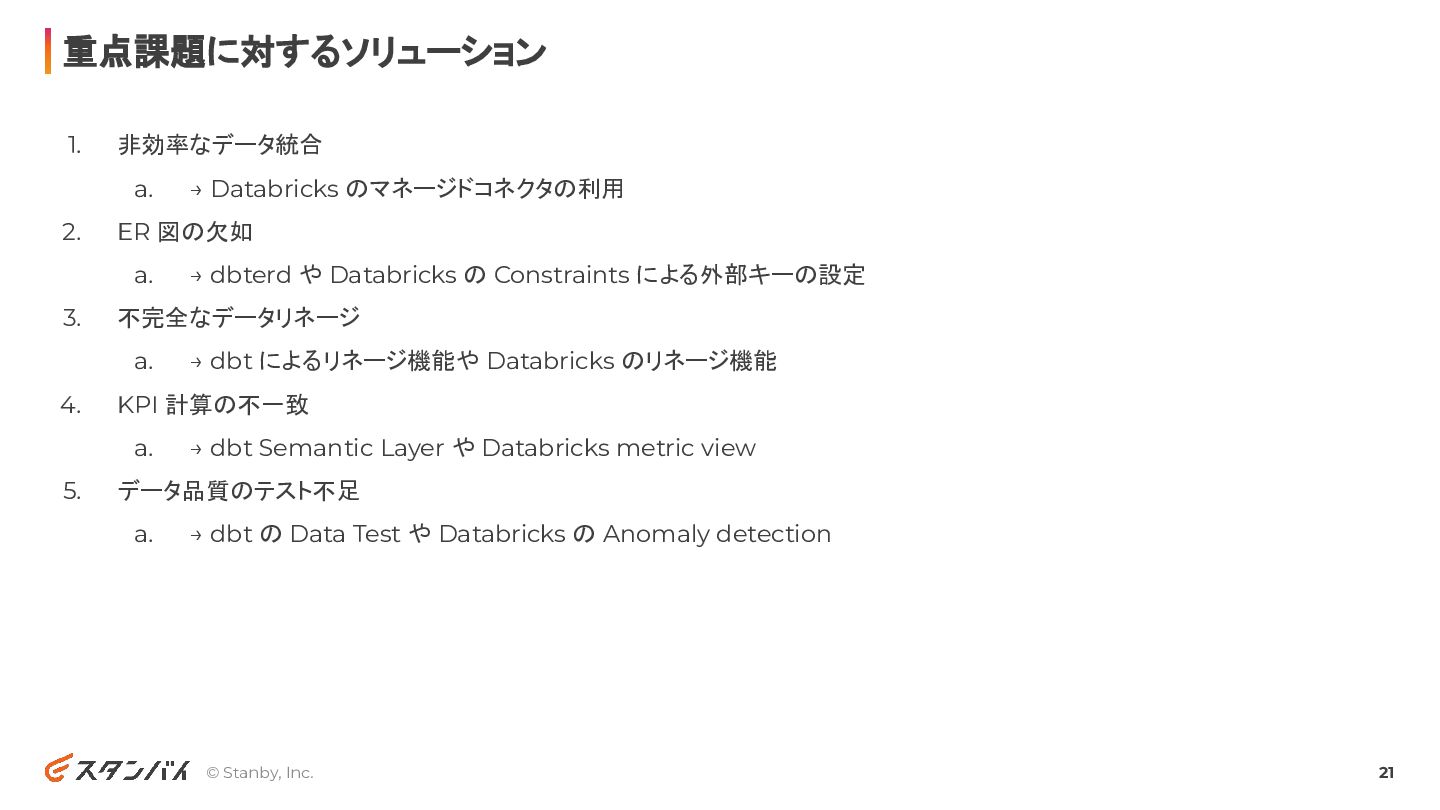
重点課題に対するソリューション 1. 非効率なデータ統合 a. 2. ER 図の欠如 a. 3. →
dbt によるリネージ機能や Databricks のリネージ機能 KPI 計算の不一致 a. 5. → dbterd や Databricks の Constraints による外部キーの設定 不完全なデータリネージ a. 4. → Databricks のマネージドコネクタの利用 → dbt Semantic Layer や Databricks metric view データ品質のテスト不足 a. → dbt の Data Test や Databricks の Anomaly detection © Stanby, Inc. 21
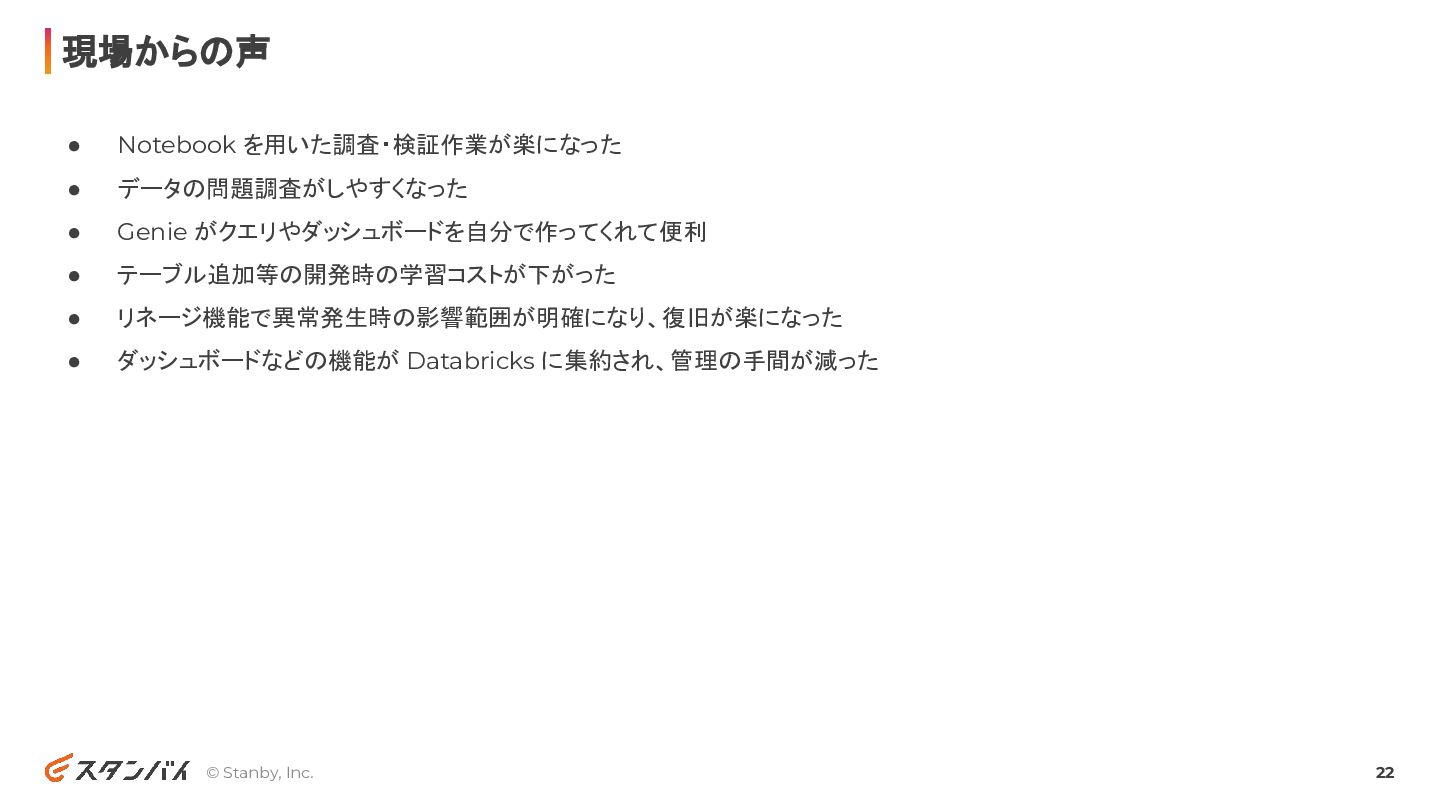
現場からの声 • Notebook を用いた調査・検証作業が楽になった • データの問題調査がしやすくなった • Genie がクエリやダッシュボードを自分で作ってくれて便利 •
テーブル追加等の開発時の学習コストが下がった • リネージ機能で異常発生時の影響範囲が明確になり、復旧が楽になった • ダッシュボードなどの機能が Databricks に集約され、管理の手間が減った © Stanby, Inc. 22
まとめ © Stanby, Inc. 23
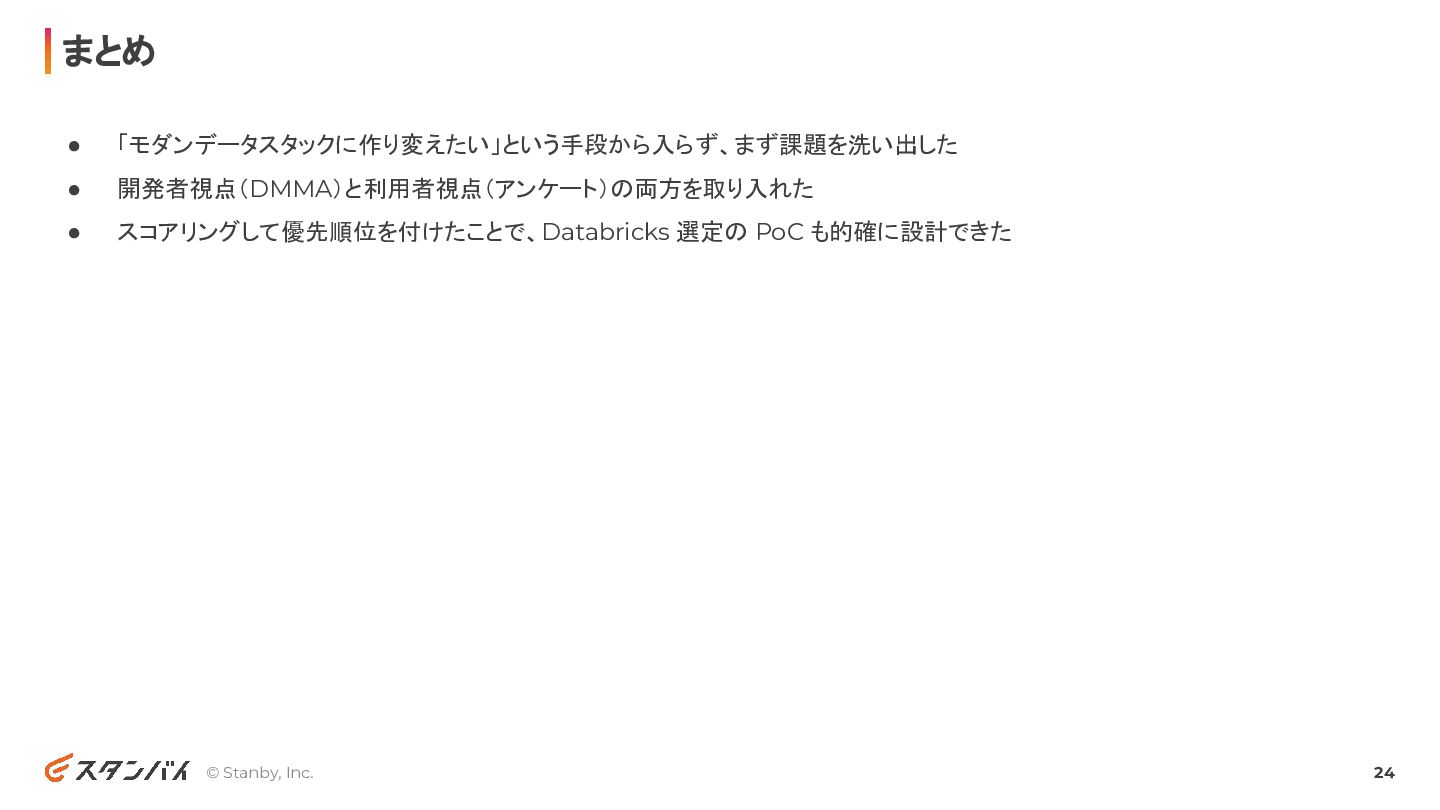
まとめ • 「モダンデータスタックに作り変えたい」という手段から入らず、まず課題を洗い出した • 開発者視点(DMMA)と利用者視点(アンケート)の両方を取り入れた • スコアリングして優先順位を付けたことで、Databricks 選定の PoC も的確に設計できた
© Stanby, Inc. 24
より詳しい内容 弊社テックブログに掲載していますので、読んでいだけると嬉しいです! https://techblog.stanby.co.jp/entry/databricks_migration © Stanby, Inc. 25
ご清聴ありがとうございました © Stanby, Inc. 26
More Decks by スタンバイ
See All by スタンバイ
自立を加速させる神器 - EMOasis #11
stanby_inc
0
370
TypeScript ASTとJSDocで実現するコードの自動削除 / Auto remove code with TypeScript AST and JSDoc
stanby_inc
3
470
スタンバイ会社紹介資料
stanby_inc
0
11k
プロダクト部門のマネージャー全員でマネジメントポリシーを宣言した記録_-_EMConf_JP_2025.2.27.pdf
stanby_inc
1
5.3k
スタンバイ会社紹介資料
stanby_inc
0
95k
Amazon Aurora のインフラコストを55%削減した話
stanby_inc
0
5.1k
スタンバイQAのテスト自動化導入
stanby_inc
0
1.4k
検索エンジンをVespaへ移行しています
stanby_inc
0
1.4k
どうするLeSS - スクラムフェス三河2023.9.16
stanby_inc
1
2.3k
Other Decks in Business
See All in Business
ピリカ 採用候補者向け資料(スマホ版)2026.11
pirika_info
0
240
KOWRO / IDOL CAST 会社・サービス紹介
kuni29
0
660
THE Impact Report 2026 /THE株式会社 2026年10月公開(訂正版)
yusukiwashita
0
240
納品して終わり、を事業会社でやった話
tamosan01
2
290
【UMed】Company Deck_261026
ryushu
0
350
小さく早く作る って 本当に正しいの?— GTMの観点から見るアジャイル開発
ryu1013
0
210
Session 5 - Teknik Lobby dan Negosiasi
adeputra13
0
460
株式会社ユビレジ_採用ピッチ資料 / Ubiregi_CompanyProfile
ubiregi_saiyo
1
12k
株式会社アドバンテッジリスクマネジメント会社紹介資料
arm0020
0
76k
入社4ヶ月で 2つのプロダクトの撤退判断
tkt42u19421
3
5.5k
アカウント営業_候補者様向け資料
mayu1001
0
580
会社説明資料 | 株式会社Swish
takumi4327
0
180
Featured
See All Featured
Evolution of real-time – Irina Nazarova, EuRuKo, 2024
irinanazarova
9
1.7k
Designing for humans not robots
tammielis
254
26k
The SEO Collaboration Effect
kristinabergwall1
1
620
Code Reviewing Like a Champion
maltzj
529
40k
DevOps and Value Stream Thinking: Enabling flow, efficiency and business value
helenjbeal
2
440
Effective software design: The role of men in debugging patriarchy in IT @ Voxxed Days AMS
baasie
1
610
How Software Deployment tools have changed in the past 20 years
geshan
3
35k
Build The Right Thing And Hit Your Dates
maggiecrowley
39
3.5k
Believing is Seeing
oripsolob
1
280
From π to Pie charts
rasagy
1
450
Odyssey Design
rkendrick25
PRO
3
940
Navigating the Design Leadership Dip - Product Design Week Design Leaders+ Conference 2024
apolaine
2
520


 stanby_inc
 pirika_info
 kuni29
 yusukiwashita
 tamosan01
 ryushu
 ryu1013
 adeputra13
 ubiregi_saiyo
 arm0020
 tkt42u19421
 mayu1001
 takumi4327
 irinanazarova
 tammielis
 kristinabergwall1
 maltzj
 helenjbeal
 baasie
 geshan
 maggiecrowley
 oripsolob
 rasagy
 rkendrick25
 apolaine