Introduction au Traitement Automatique du Langa...
Sponsored
·
 Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→

Share
Embed
Introduction au Traitement Automatique du Langage Naturel

Entrepreneurs d'intérêt général
March 13, 2019
Transcript
80 slides
-
Session EIG III du LLL Introduction au Traitement Automatique du
Langage Naturel Valentin Barriere 13/03/19 -
Outline : R´ esum´ e des diff´ erentes tˆ aches
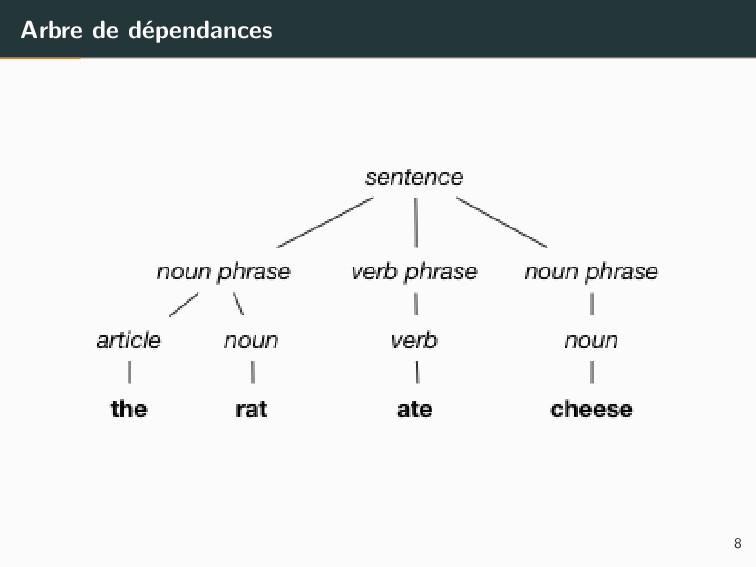
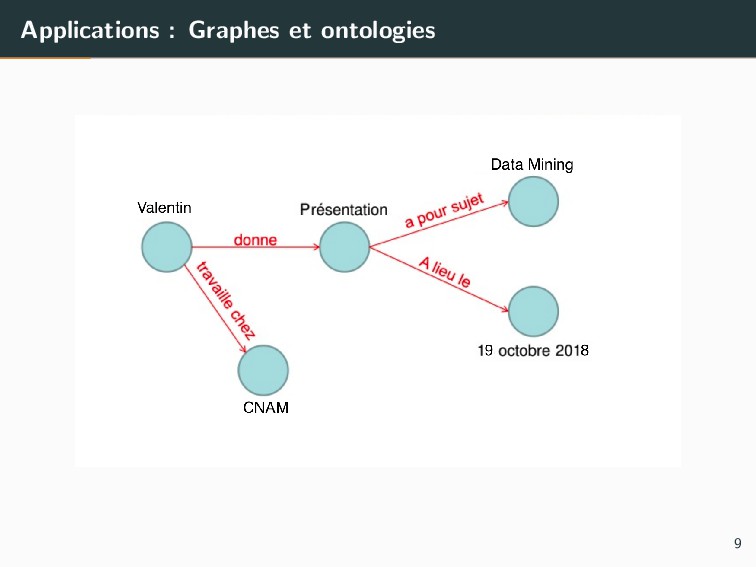
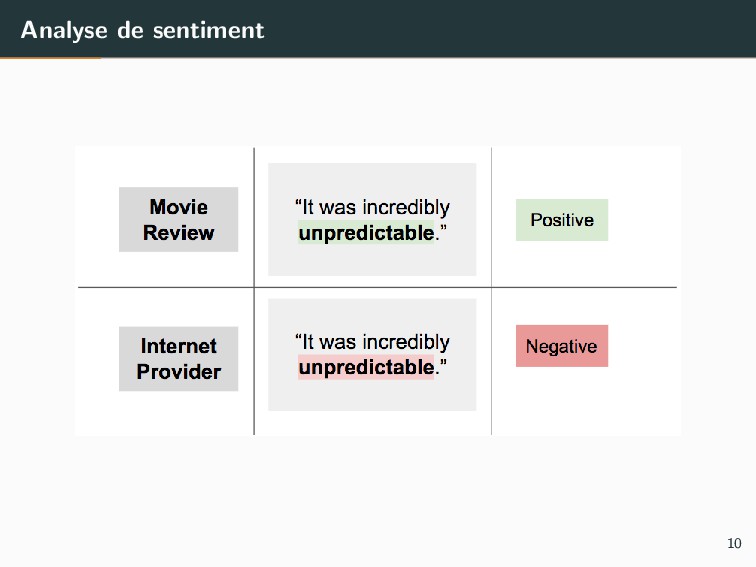
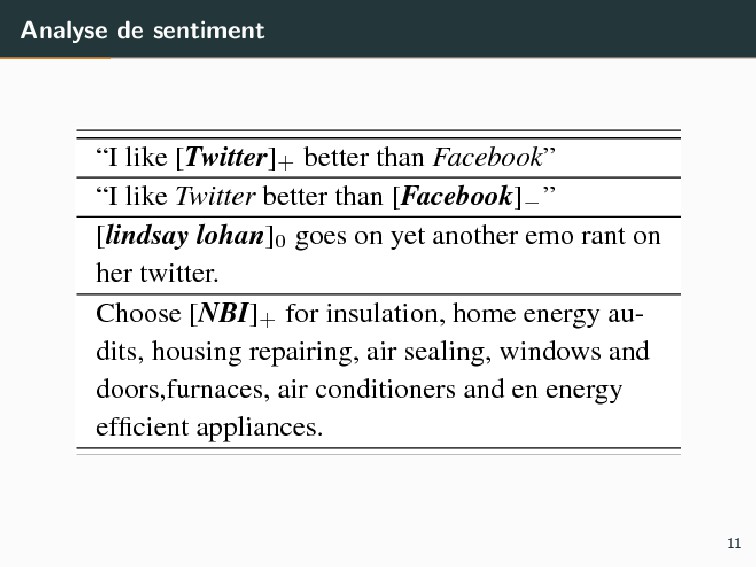
Diff´ erentes tˆ aches R´ esum´ e des diff´ erentes tˆ aches Tokenisation POS-tagging NER Arbre de d´ ependances Analyse de sentiment Question Answering Similarit´ e Mod` eles disponibles Mod` eles simples R´ eseaux R´ ecurrents Encodeurs et embeddings TP : Text-mining Ressources disponibles API Corpus disponibles 2 -
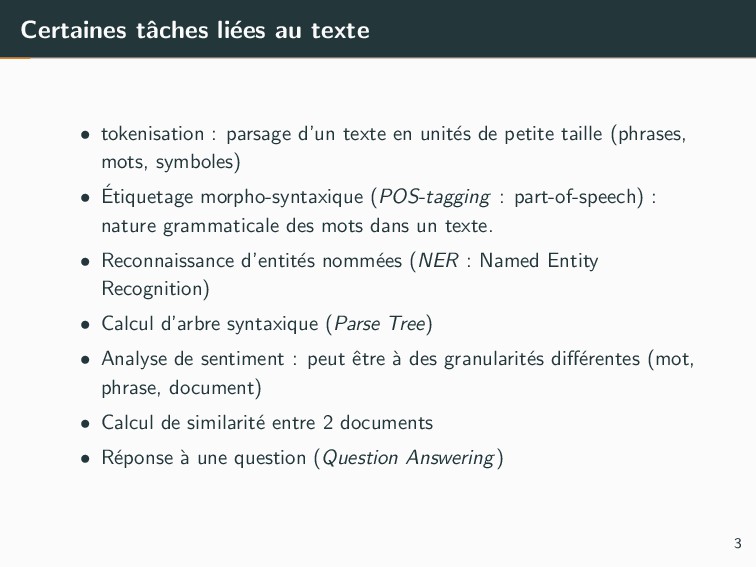
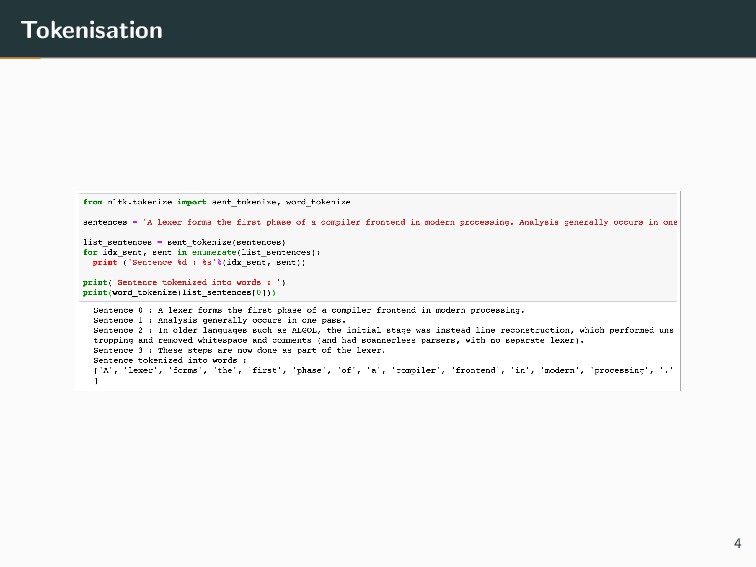
Certaines tˆ aches li´ ees au texte • tokenisation :
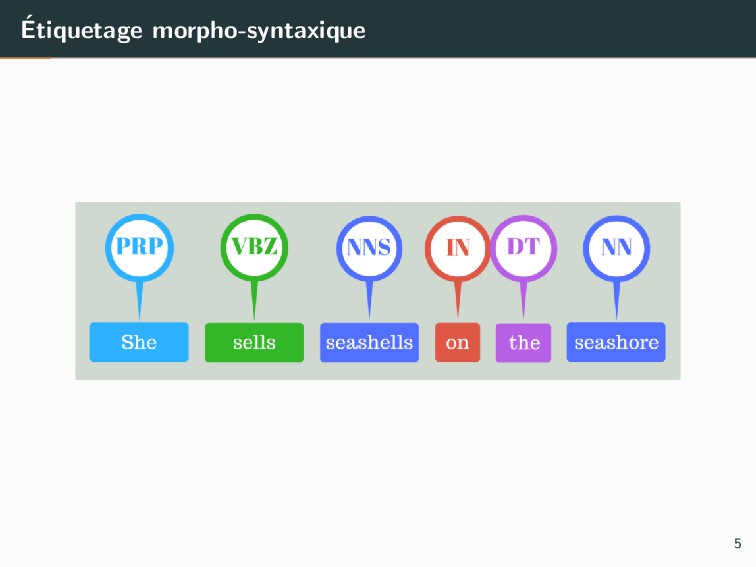
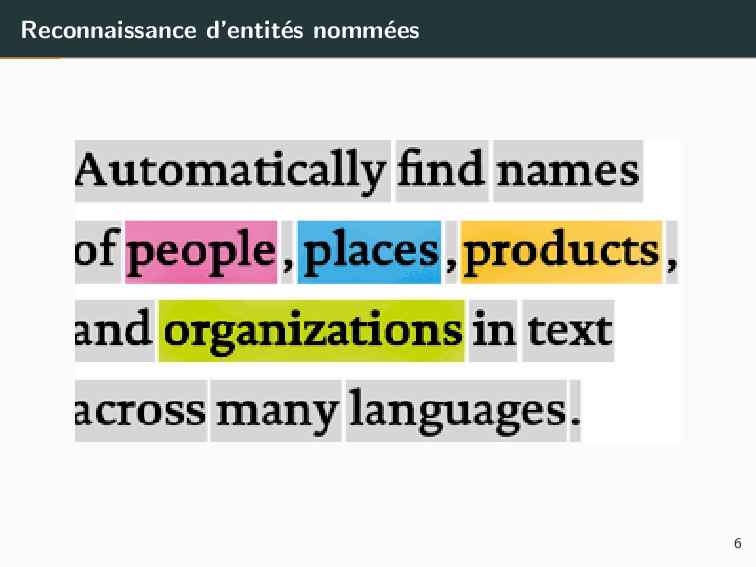
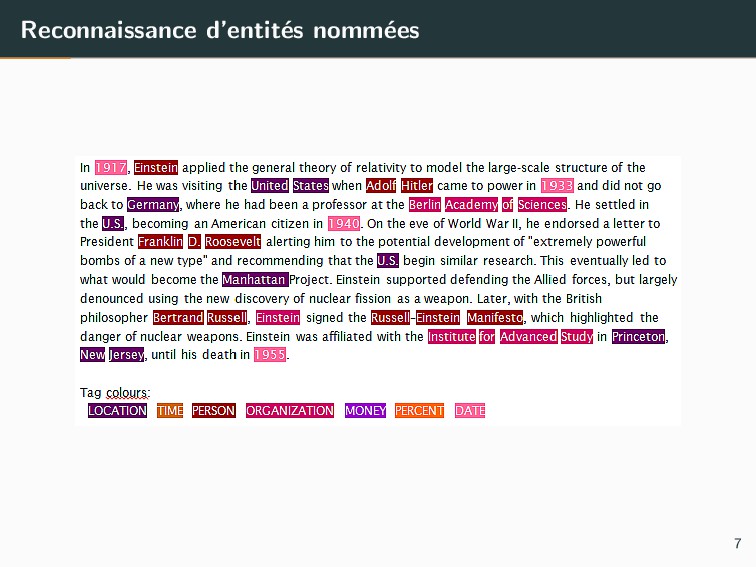
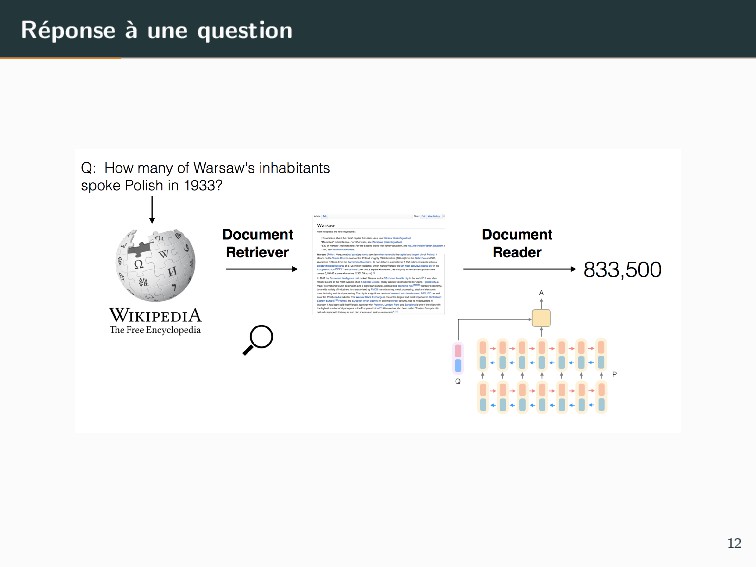
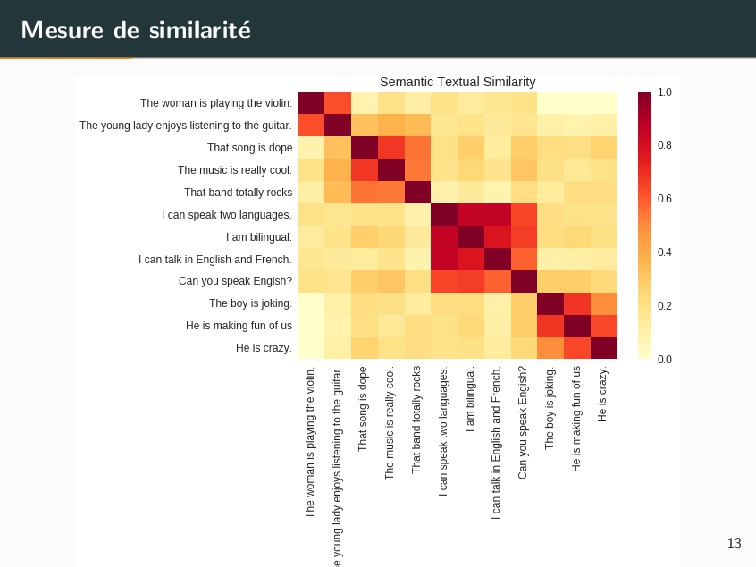
parsage d’un texte en unit´ es de petite taille (phrases, mots, symboles) • ´ Etiquetage morpho-syntaxique (POS-tagging : part-of-speech) : nature grammaticale des mots dans un texte. • Reconnaissance d’entit´ es nomm´ ees (NER : Named Entity Recognition) • Calcul d’arbre syntaxique (Parse Tree) • Analyse de sentiment : peut ˆ etre ` a des granularit´ es diff´ erentes (mot, phrase, document) • Calcul de similarit´ e entre 2 documents • R´ eponse ` a une question (Question Answering) 3 -
Outline : Mod` eles simples Diff´ erentes tˆ aches R´
esum´ e des diff´ erentes tˆ aches Mod` eles disponibles Mod` eles simples CRF R´ eseaux R´ ecurrents Encodeurs et embeddings TP : Text-mining Ressources disponibles API Corpus disponibles 15 -
Champs al´ eatoires conditionnels : S´ equence ´ Etiquetage de
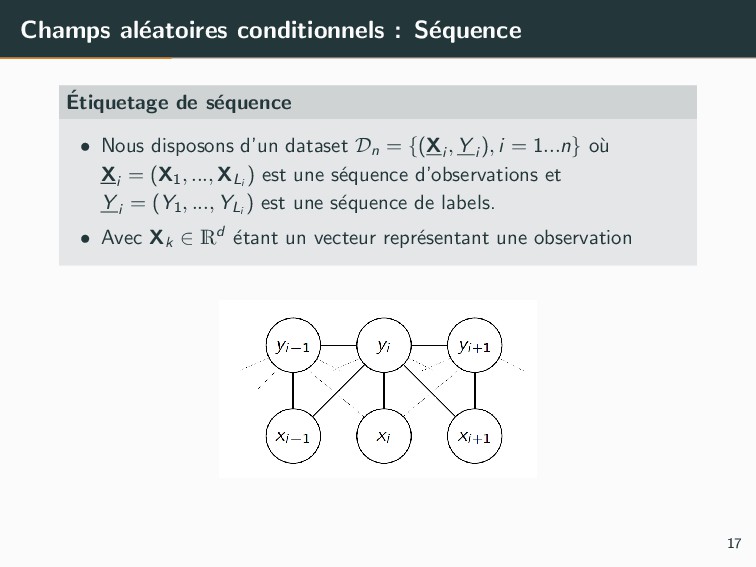
s´ equence • Nous disposons d’un dataset Dn = {(Xi , Y i ), i = 1...n} o` u Xi = (X1, ..., XLi ) est une s´ equence d’observations et Y i = (Y1, ..., YLi ) est une s´ equence de labels. • Avec Xk ∈ Rd ´ etant un vecteur repr´ esentant une observation 17 -
Champs al´ eatoires conditionnels : D´ efinition D´ efinition du
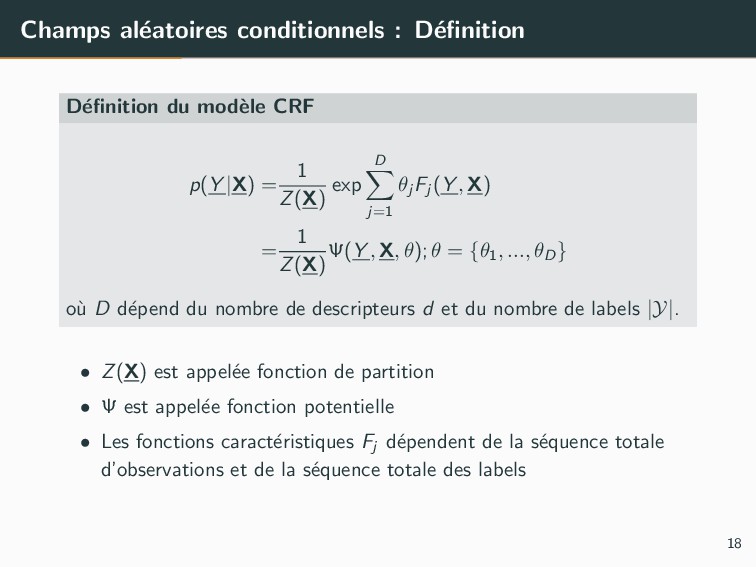
mod` ele CRF p(Y |X) = 1 Z(X) exp D j=1 θj Fj (Y , X) = 1 Z(X) Ψ(Y , X, θ); θ = {θ1, ..., θD} o` u D d´ epend du nombre de descripteurs d et du nombre de labels |Y|. • Z(X) est appel´ ee fonction de partition • Ψ est appel´ ee fonction potentielle • Les fonctions caract´ eristiques Fj d´ ependent de la s´ equence totale d’observations et de la s´ equence totale des labels 18 -
Champs al´ eatoires conditionnels : En pratique Linear-Chain CRF En
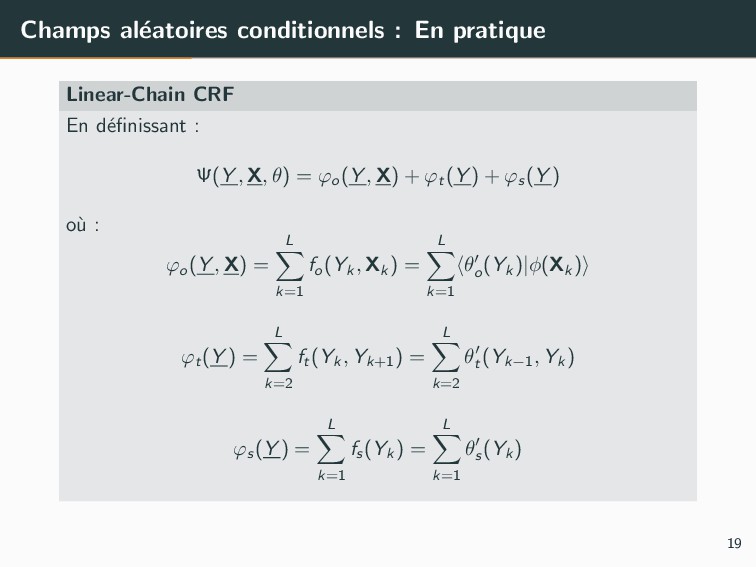
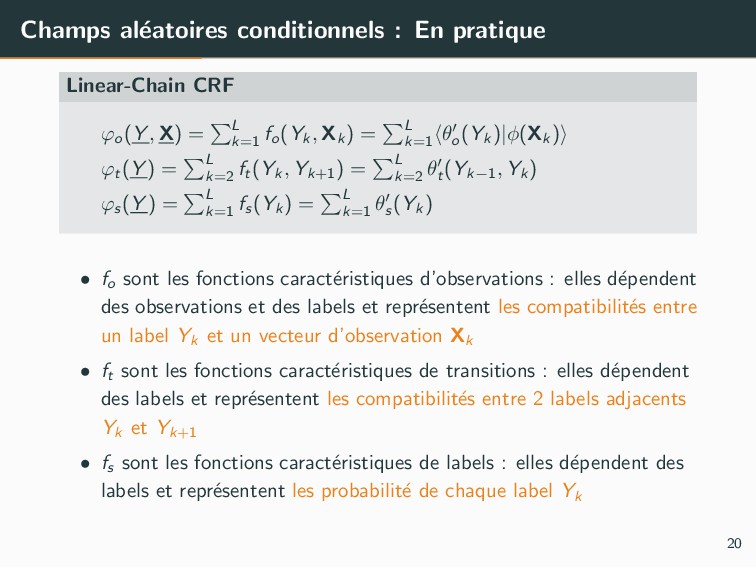
d´ efinissant : Ψ(Y , X, θ) = ϕo (Y , X) + ϕt (Y ) + ϕs (Y ) o` u : ϕo (Y , X) = L k=1 fo (Yk , Xk ) = L k=1 θo (Yk )|φ(Xk ) ϕt (Y ) = L k=2 ft (Yk , Yk+1 ) = L k=2 θt (Yk−1, Yk ) ϕs (Y ) = L k=1 fs (Yk ) = L k=1 θs (Yk ) 19 -
Champs al´ eatoires conditionnels : En pratique Linear-Chain CRF ϕo
(Y , X) = L k=1 fo (Yk , Xk ) = L k=1 θo (Yk )|φ(Xk ) ϕt (Y ) = L k=2 ft (Yk , Yk+1 ) = L k=2 θt (Yk−1, Yk ) ϕs (Y ) = L k=1 fs (Yk ) = L k=1 θs (Yk ) • fo sont les fonctions caract´ eristiques d’observations : elles d´ ependent des observations et des labels et repr´ esentent les compatibilit´ es entre un label Yk et un vecteur d’observation Xk • ft sont les fonctions caract´ eristiques de transitions : elles d´ ependent des labels et repr´ esentent les compatibilit´ es entre 2 labels adjacents Yk et Yk+1 • fs sont les fonctions caract´ eristiques de labels : elles d´ ependent des labels et repr´ esentent les probabilit´ e de chaque label Yk 20 -
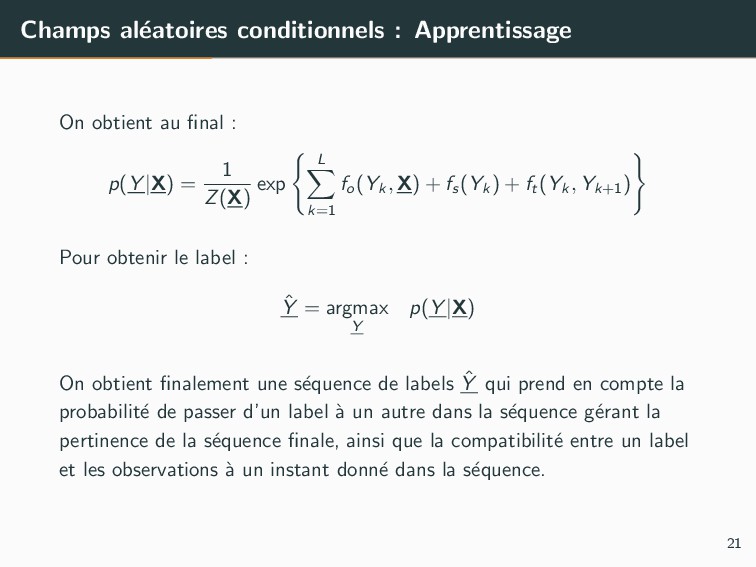
Champs al´ eatoires conditionnels : Apprentissage On obtient au final
: p(Y |X) = 1 Z(X) exp L k=1 fo (Yk , X) + fs (Yk ) + ft (Yk , Yk+1 ) Pour obtenir le label : ˆ Y = argmax Y p(Y |X) On obtient finalement une s´ equence de labels ˆ Y qui prend en compte la probabilit´ e de passer d’un label ` a un autre dans la s´ equence g´ erant la pertinence de la s´ equence finale, ainsi que la compatibilit´ e entre un label et les observations ` a un instant donn´ e dans la s´ equence. 21 -
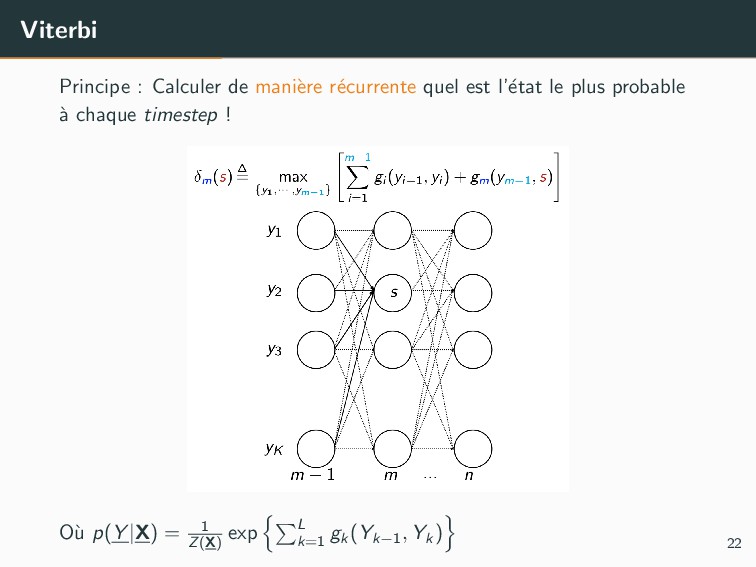
Viterbi Principe : Calculer de mani` ere r´ ecurrente quel
est l’´ etat le plus probable ` a chaque timestep ! O` u p(Y |X) = 1 Z(X) exp L k=1 gk (Yk−1, Yk ) 22 -
Outline : R´ eseaux R´ ecurrents Diff´ erentes tˆ aches
R´ esum´ e des diff´ erentes tˆ aches Mod` eles disponibles Mod` eles simples R´ eseaux R´ ecurrents RNN LSTM Encodeurs et embeddings TP : Text-mining Ressources disponibles API Corpus disponibles 23 -
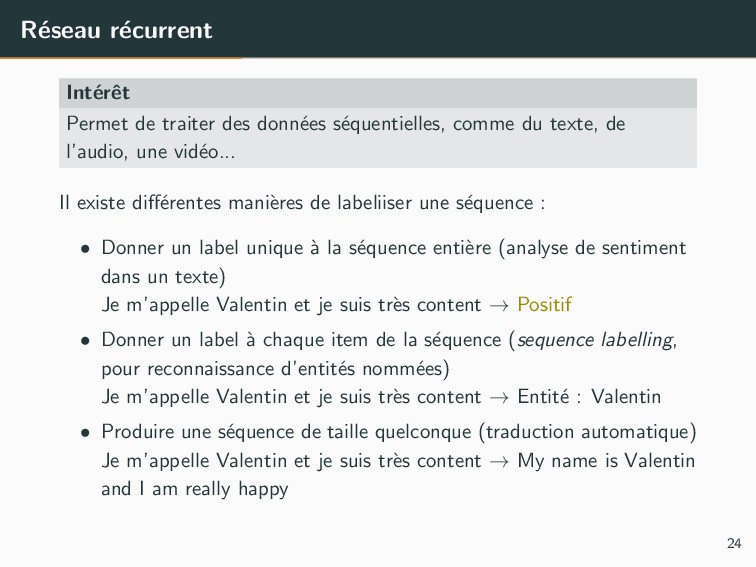
R´ eseau r´ ecurrent Int´ erˆ et Permet de traiter
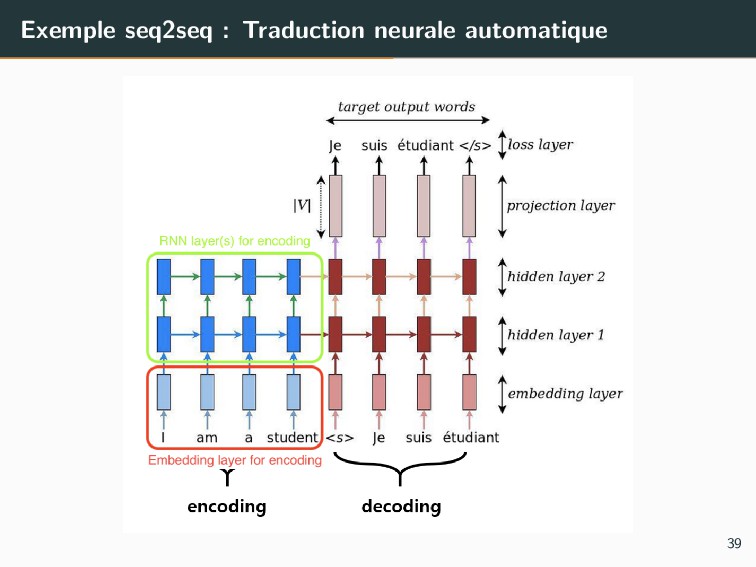
des donn´ ees s´ equentielles, comme du texte, de l’audio, une vid´ eo... Il existe diff´ erentes mani` eres de labeliiser une s´ equence : • Donner un label unique ` a la s´ equence enti` ere (analyse de sentiment dans un texte) Je m’appelle Valentin et je suis tr` es content → Positif • Donner un label ` a chaque item de la s´ equence (sequence labelling, pour reconnaissance d’entit´ es nomm´ ees) Je m’appelle Valentin et je suis tr` es content → Entit´ e : Valentin • Produire une s´ equence de taille quelconque (traduction automatique) Je m’appelle Valentin et je suis tr` es content → My name is Valentin and I am really happy 24 -
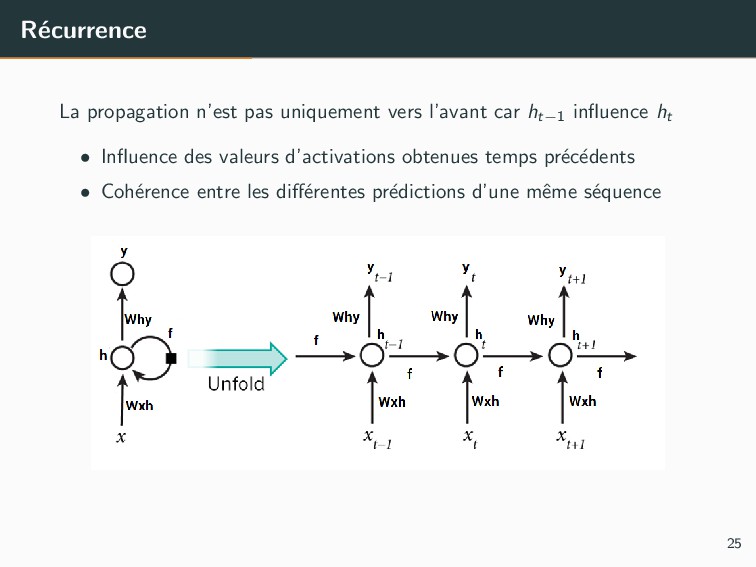
R´ ecurrence La propagation n’est pas uniquement vers l’avant car
ht−1 influence ht • Influence des valeurs d’activations obtenues temps pr´ ec´ edents • Coh´ erence entre les diff´ erentes pr´ edictions d’une mˆ eme s´ equence 25 -
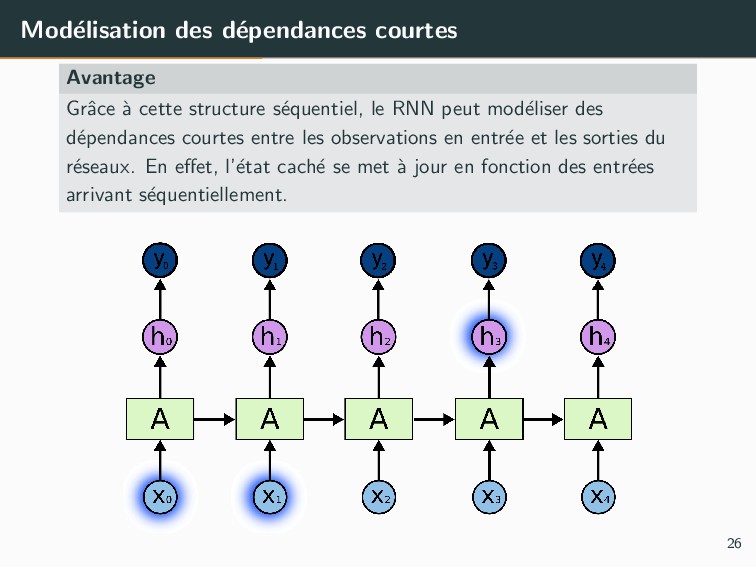
Mod´ elisation des d´ ependances courtes Avantage Grˆ ace `
a cette structure s´ equentiel, le RNN peut mod´ eliser des d´ ependances courtes entre les observations en entr´ ee et les sorties du r´ eseaux. En effet, l’´ etat cach´ e se met ` a jour en fonction des entr´ ees arrivant s´ equentiellement. 26 -
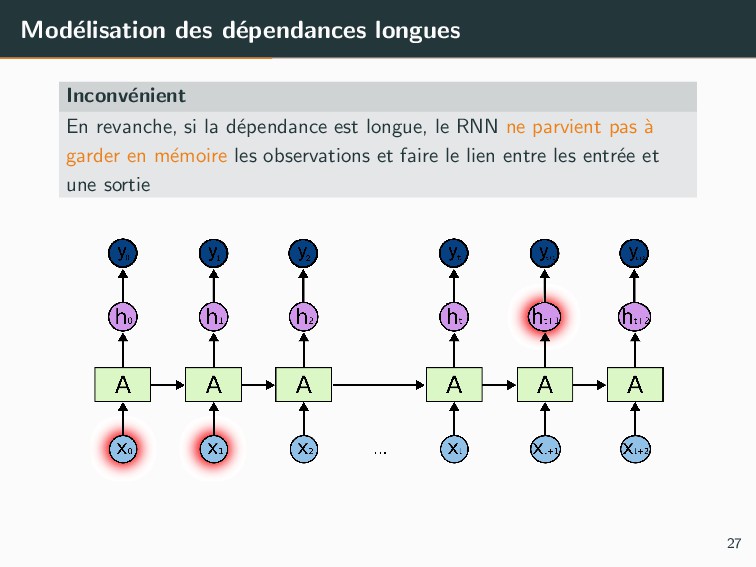
Mod´ elisation des d´ ependances longues Inconv´ enient En revanche,
si la d´ ependance est longue, le RNN ne parvient pas ` a garder en m´ emoire les observations et faire le lien entre les entr´ ee et une sortie 27 -
´ Evanescence du gradient et d´ ependances longues Probl` eme
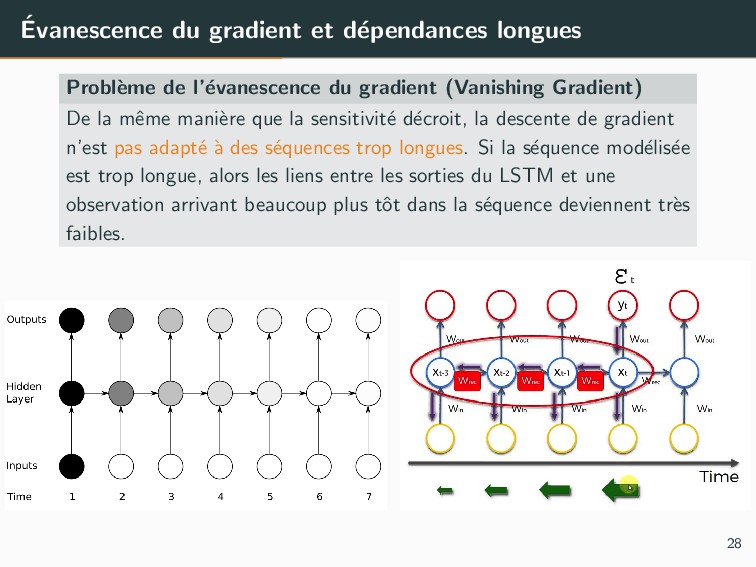
de l’´ evanescence du gradient (Vanishing Gradient) De la mˆ eme mani` ere que la sensitivit´ e d´ ecroit, la descente de gradient n’est pas adapt´ e ` a des s´ equences trop longues. Si la s´ equence mod´ elis´ ee est trop longue, alors les liens entre les sorties du LSTM et une observation arrivant beaucoup plus tˆ ot dans la s´ equence deviennent tr` es faibles. 28 -
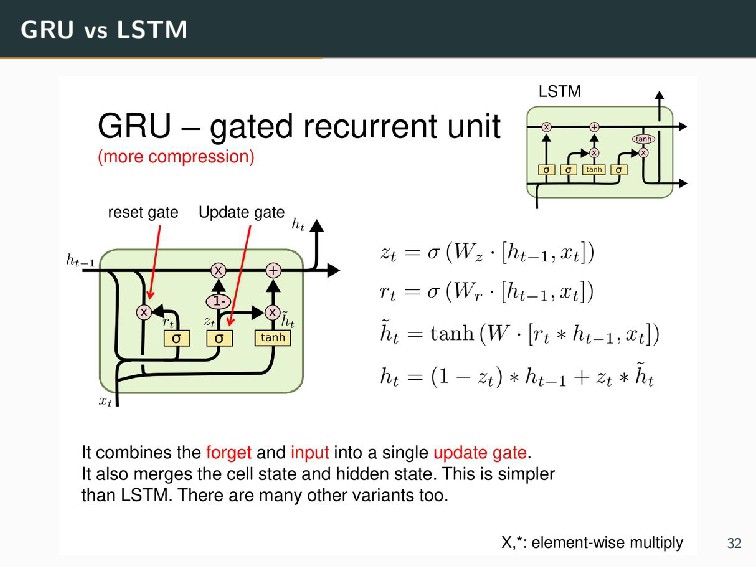
´ Evanescence du gradient : LSTM Solution ces probl` emes:
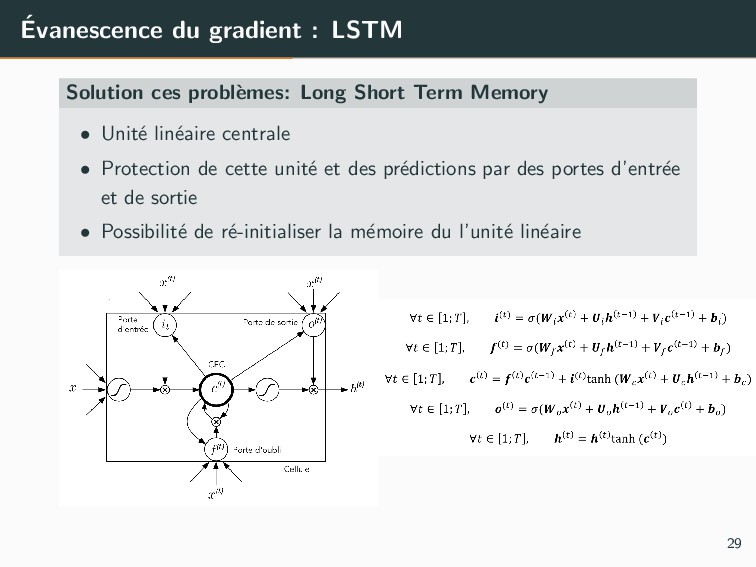
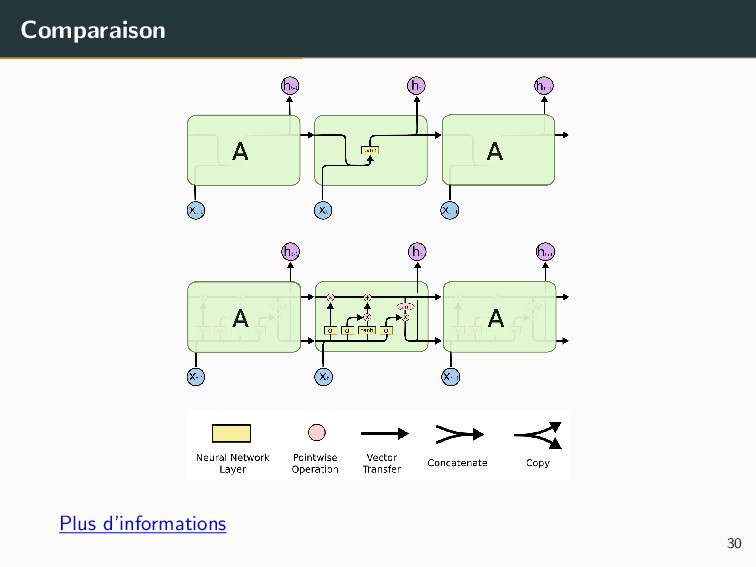
Long Short Term Memory • Unit´ e lin´ eaire centrale • Protection de cette unit´ e et des pr´ edictions par des portes d’entr´ ee et de sortie • Possibilit´ e de r´ e-initialiser la m´ emoire du l’unit´ e lin´ eaire 29 -
Outline : Encodeurs et embeddings Diff´ erentes tˆ aches R´
esum´ e des diff´ erentes tˆ aches Mod` eles disponibles Mod` eles simples R´ eseaux R´ ecurrents Encodeurs et embeddings AE Encodeur-D´ ecodeur s´ equentiel : Seq2Seq Context Embeddings Transfer learning et embedding r´ ecents TP : Text-mining Ressources disponibles API Corpus disponibles 33 -
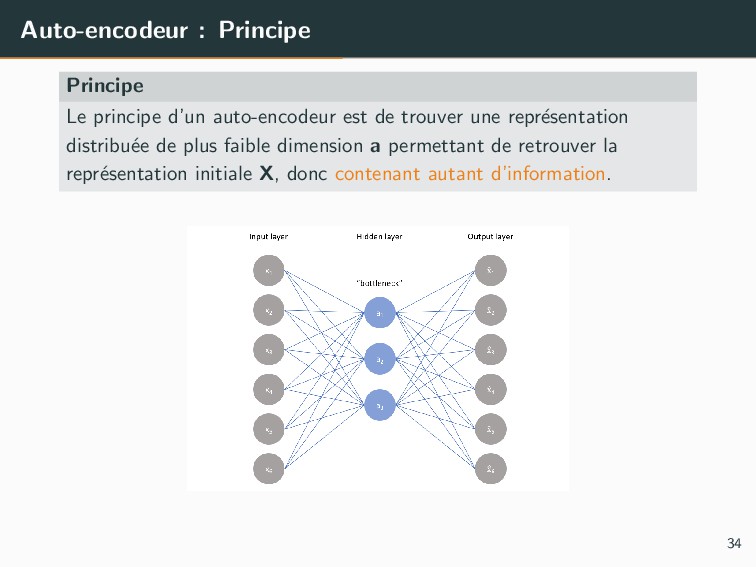
Auto-encodeur : Principe Principe Le principe d’un auto-encodeur est de
trouver une repr´ esentation distribu´ ee de plus faible dimension a permettant de retrouver la repr´ esentation initiale X, donc contenant autant d’information. 34 -
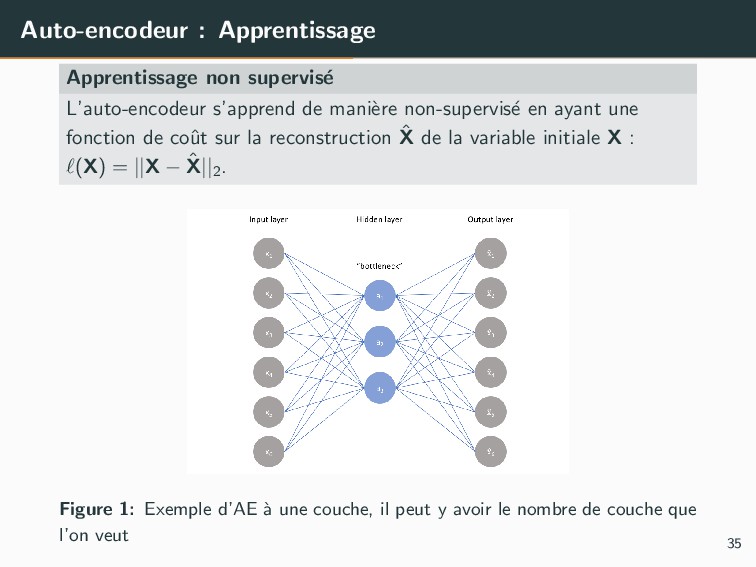
Auto-encodeur : Apprentissage Apprentissage non supervis´ e L’auto-encodeur s’apprend de
mani` ere non-supervis´ e en ayant une fonction de coˆ ut sur la reconstruction ˆ X de la variable initiale X : (X) = ||X − ˆ X||2 . Figure 1: Exemple d’AE ` a une couche, il peut y avoir le nombre de couche que l’on veut 35 -
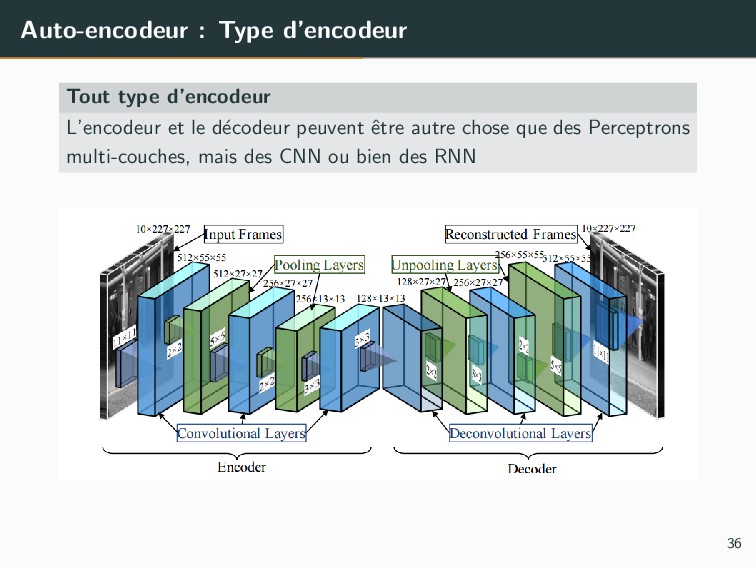
Auto-encodeur : Type d’encodeur Tout type d’encodeur L’encodeur et le
d´ ecodeur peuvent ˆ etre autre chose que des Perceptrons multi-couches, mais des CNN ou bien des RNN 36 -
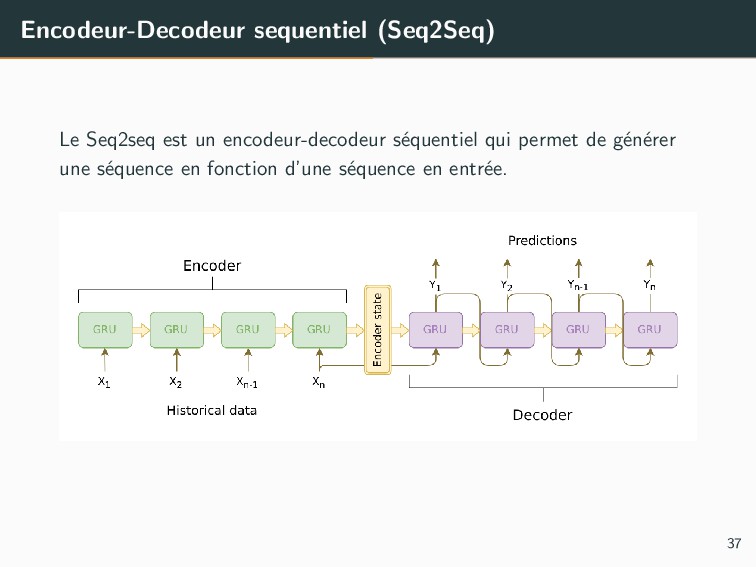
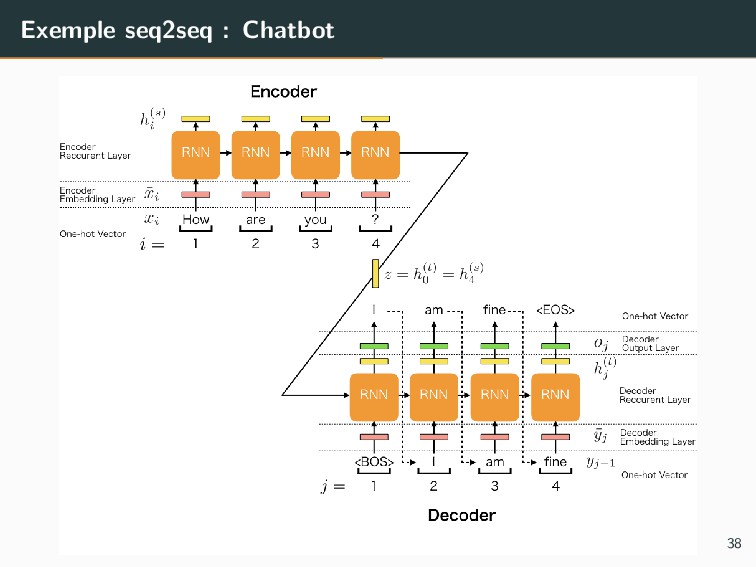
Encodeur-Decodeur sequentiel (Seq2Seq) Le Seq2seq est un encodeur-decodeur s´ equentiel
qui permet de g´ en´ erer une s´ equence en fonction d’une s´ equence en entr´ ee. 37 -
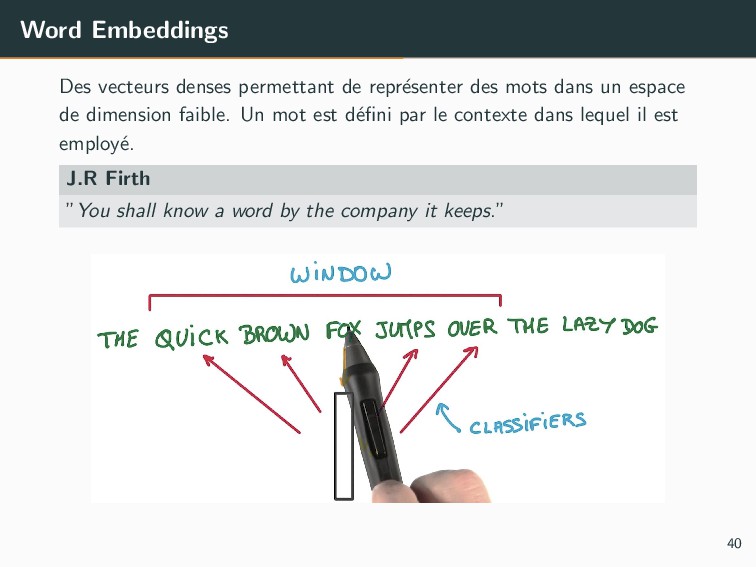
Word Embeddings Des vecteurs denses permettant de repr´ esenter des
mots dans un espace de dimension faible. Un mot est d´ efini par le contexte dans lequel il est employ´ e. J.R Firth ”You shall know a word by the company it keeps.” 40 -
Word Embeddings Deux techniques d’apprentissage • Skip-Gram : knowing a
context window, you find representations useful to find the central word • CBOW : knowing the word, you find representations useful to find the words of the context 41 -
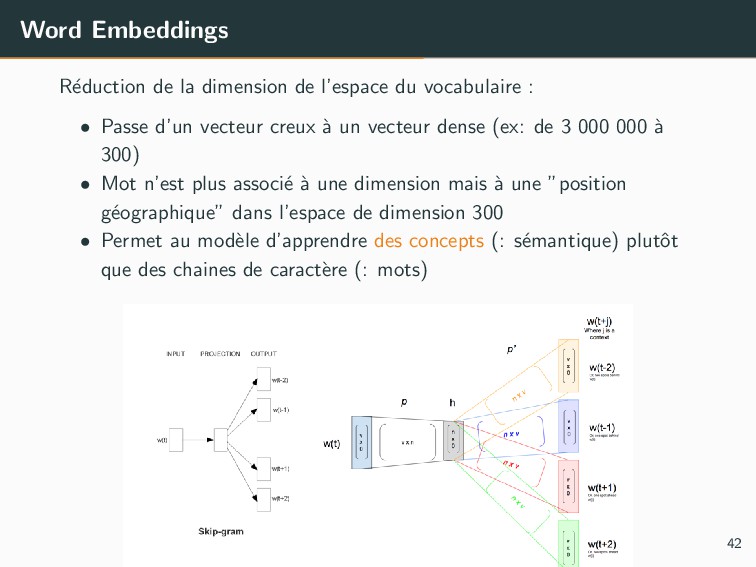
Word Embeddings R´ eduction de la dimension de l’espace du
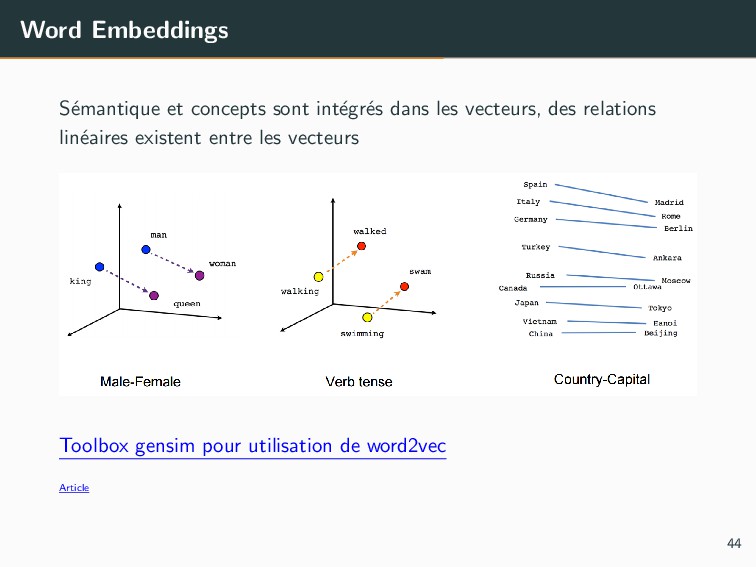
vocabulaire : • Passe d’un vecteur creux ` a un vecteur dense (ex: de 3 000 000 ` a 300) • Mot n’est plus associ´ e ` a une dimension mais ` a une ”position g´ eographique” dans l’espace de dimension 300 • Permet au mod` ele d’apprendre des concepts (: s´ emantique) plutˆ ot que des chaines de caract` ere (: mots) 42 -
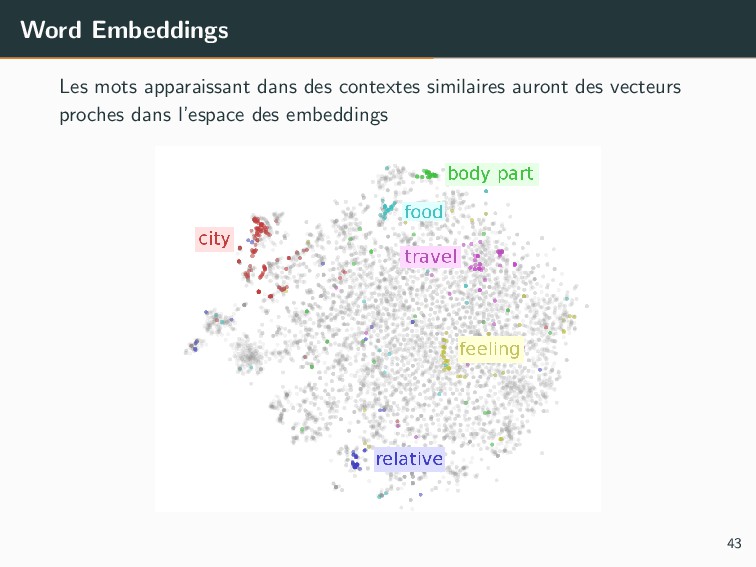
Word Embeddings Les mots apparaissant dans des contextes similaires auront
des vecteurs proches dans l’espace des embeddings 43 -
Word Embeddings S´ emantique et concepts sont int´ egr´ es
dans les vecteurs, des relations lin´ eaires existent entre les vecteurs Toolbox gensim pour utilisation de word2vec Article 44 -
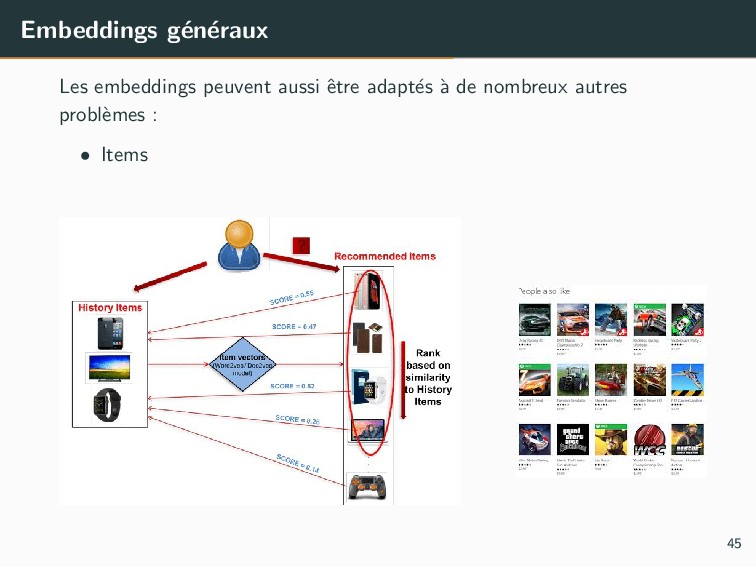
Embeddings g´ en´ eraux Les embeddings peuvent aussi ˆ etre
adapt´ es ` a de nombreux autres probl` emes : • Items 45 -
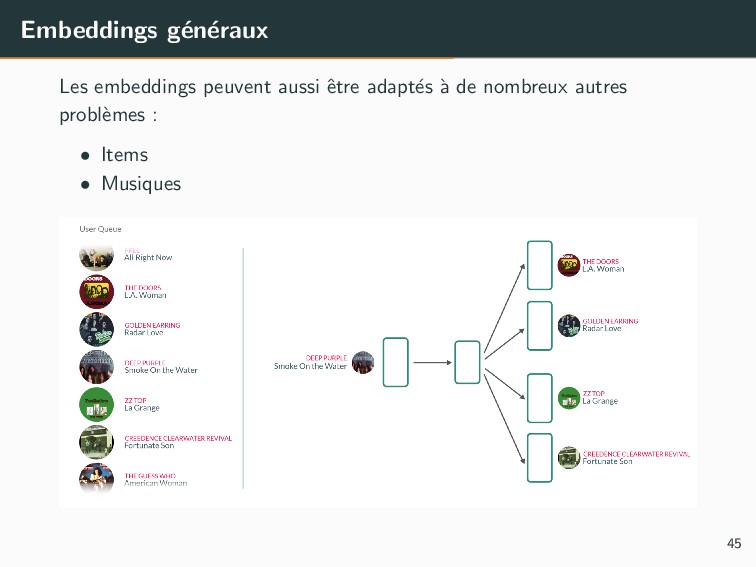
Embeddings g´ en´ eraux Les embeddings peuvent aussi ˆ etre
adapt´ es ` a de nombreux autres probl` emes : • Items • Musiques 45 -
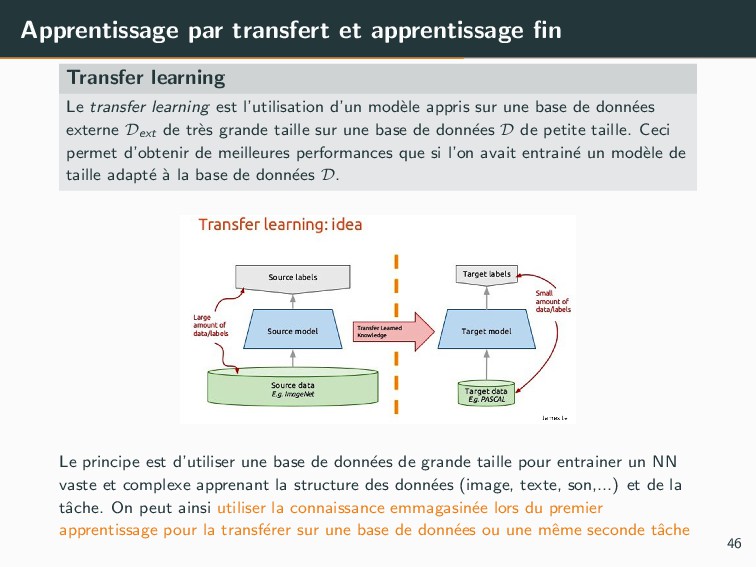
Apprentissage par transfert et apprentissage fin Transfer learning Le transfer
learning est l’utilisation d’un mod` ele appris sur une base de donn´ ees externe Dext de tr` es grande taille sur une base de donn´ ees D de petite taille. Ceci permet d’obtenir de meilleures performances que si l’on avait entrain´ e un mod` ele de taille adapt´ e ` a la base de donn´ ees D. Le principe est d’utiliser une base de donn´ ees de grande taille pour entrainer un NN vaste et complexe apprenant la structure des donn´ ees (image, texte, son,...) et de la tˆ ache. On peut ainsi utiliser la connaissance emmagasin´ ee lors du premier apprentissage pour la transf´ erer sur une base de donn´ ees ou une mˆ eme seconde tˆ ache 46 -
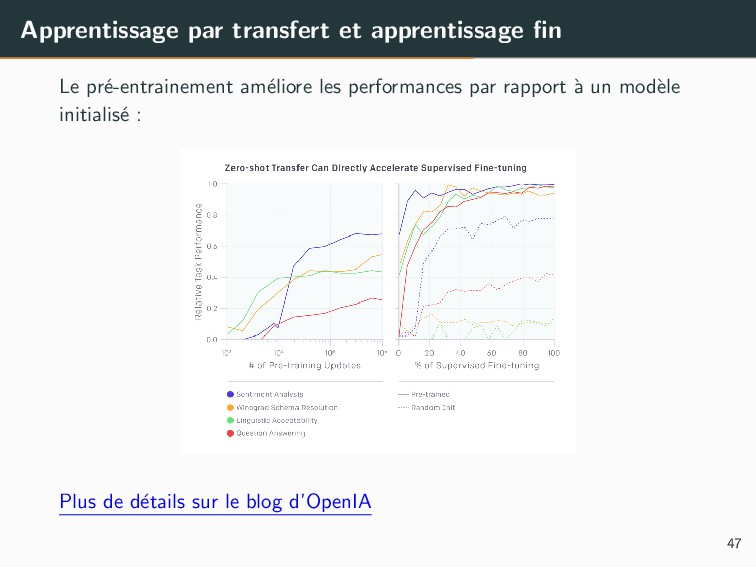
Apprentissage par transfert et apprentissage fin Le pr´ e-entrainement am´
eliore les performances par rapport ` a un mod` ele initialis´ e : Plus de d´ etails sur le blog d’OpenIA 47 -
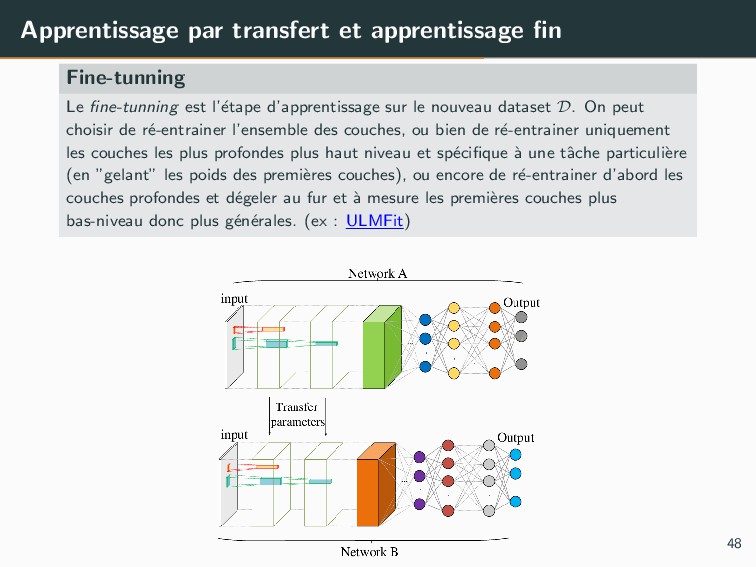
Apprentissage par transfert et apprentissage fin Fine-tunning Le fine-tunning est
l’´ etape d’apprentissage sur le nouveau dataset D. On peut choisir de r´ e-entrainer l’ensemble des couches, ou bien de r´ e-entrainer uniquement les couches les plus profondes plus haut niveau et sp´ ecifique ` a une tˆ ache particuli` ere (en ”gelant” les poids des premi` eres couches), ou encore de r´ e-entrainer d’abord les couches profondes et d´ egeler au fur et ` a mesure les premi` eres couches plus bas-niveau donc plus g´ en´ erales. (ex : ULMFit) 48 -
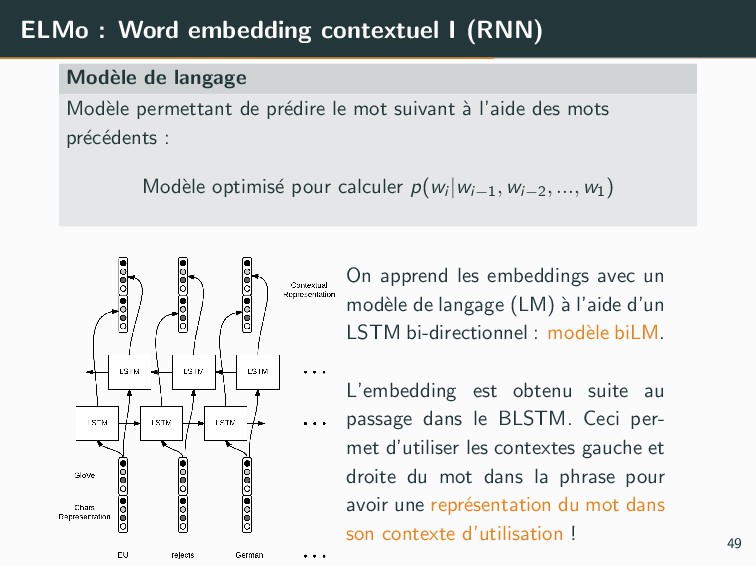
ELMo : Word embedding contextuel I (RNN) Mod` ele de
langage Mod` ele permettant de pr´ edire le mot suivant ` a l’aide des mots pr´ ec´ edents : Mod` ele optimis´ e pour calculer p(wi |wi−1, wi−2, ..., w1 ) On apprend les embeddings avec un mod` ele de langage (LM) ` a l’aide d’un LSTM bi-directionnel : mod` ele biLM. L’embedding est obtenu suite au passage dans le BLSTM. Ceci per- met d’utiliser les contextes gauche et droite du mot dans la phrase pour avoir une repr´ esentation du mot dans son contexte d’utilisation ! 49 -
ELMo : Word embedding contextuel II (RNN) • On utilise
les repr´ esentations des diff´ erentes couches pour cr´ eer l’embedding final du mot : permet d’utiliser les diff´ erentes sp´ ecialisations de chaque couche. • On utilise le contexte phrastique pour cr´ eer l’embedding d’un mot afin de d´ esambigu¨ ıser le sens d’un mot. Par exemple, dans ”Santiago submitted a new paper”, Santiago est une personne et non un lieu. Repr´ esentations ` a chaque couches sont +/- bonnes pour diff´ erentes tˆ aches ayant des aspects diff´ erents ` a chaque couche • Word embedding layer: morphology, syntactic analogies • Bottom layer: syntax, POS tagging • Middle layer(s): syntax, constituents • Top layer: Word Sens Desambiguisation, coreference Explications plus compl` etes du mod` ele ELMo ; Article 50 -
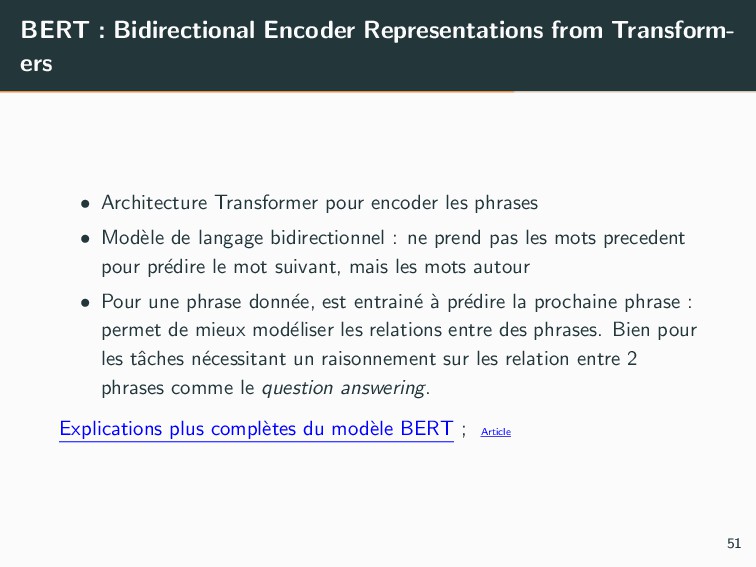
BERT : Bidirectional Encoder Representations from Transform- ers • Architecture
Transformer pour encoder les phrases • Mod` ele de langage bidirectionnel : ne prend pas les mots precedent pour pr´ edire le mot suivant, mais les mots autour • Pour une phrase donn´ ee, est entrain´ e ` a pr´ edire la prochaine phrase : permet de mieux mod´ eliser les relations entre des phrases. Bien pour les tˆ aches n´ ecessitant un raisonnement sur les relation entre 2 phrases comme le question answering. Explications plus compl` etes du mod` ele BERT ; Article 51 -
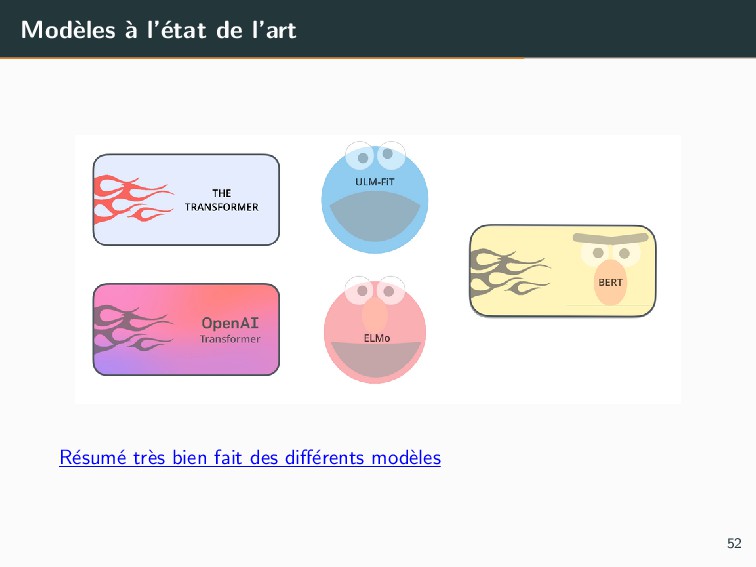
Mod` eles ` a l’´ etat de l’art R´ esum´
e tr` es bien fait des diff´ erents mod` eles 52 -
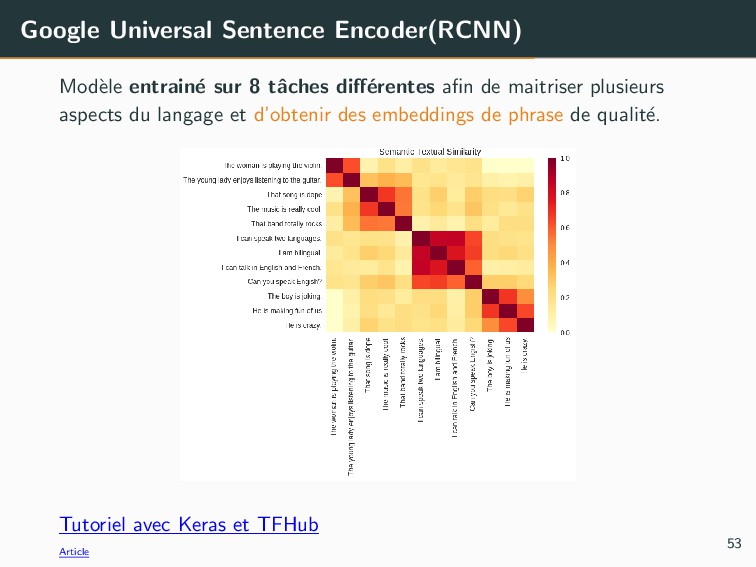
Google Universal Sentence Encoder(RCNN) Mod` ele entrain´ e sur 8
tˆ aches diff´ erentes afin de maitriser plusieurs aspects du langage et d’obtenir des embeddings de phrase de qualit´ e. Tutoriel avec Keras et TFHub Article 53 -
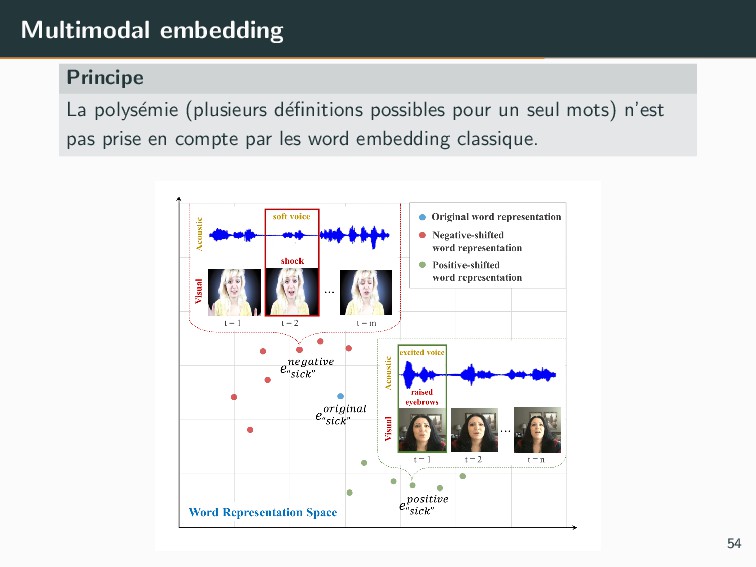
Multimodal embedding Principe La polys´ emie (plusieurs d´ efinitions possibles
pour un seul mots) n’est pas prise en compte par les word embedding classique. 54 -
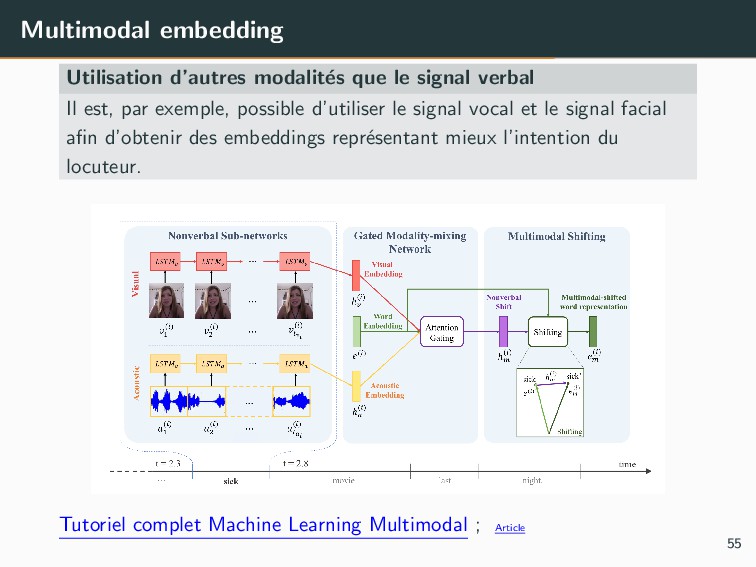
Multimodal embedding Utilisation d’autres modalit´ es que le signal verbal
Il est, par exemple, possible d’utiliser le signal vocal et le signal facial afin d’obtenir des embeddings repr´ esentant mieux l’intention du locuteur. Tutoriel complet Machine Learning Multimodal ; Article 55 -
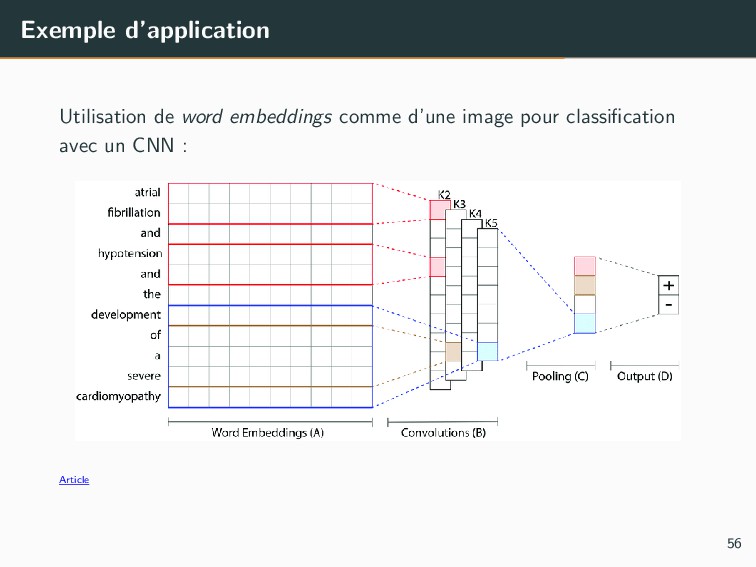
Exemple d’application Utilisation de word embeddings comme d’une image pour
classification avec un CNN : Article 56 -
Outline : TP : Text-mining Diff´ erentes tˆ aches R´
esum´ e des diff´ erentes tˆ aches Mod` eles disponibles Mod` eles simples R´ eseaux R´ ecurrents Encodeurs et embeddings TP : Text-mining Ressources disponibles API Corpus disponibles 57 -
Keras Librairie Python permettant de faire du Deep Learning (R´
eseaux de neurones profonds) 58 -
Outline : API Diff´ erentes tˆ aches R´ esum´ e
des diff´ erentes tˆ aches Mod` eles disponibles Mod` eles simples R´ eseaux R´ ecurrents Encodeurs et embeddings TP : Text-mining Ressources disponibles API API : Scikit-learn Natural Language Toolkit Spacy CoreNLP AllenNLP Flair Corpus disponibles 60 -
Scikit-learn : librairie Python Librairie de Machine Learning tr` es
simple d’utilisation : https://scikit-learn.org/ 61 -
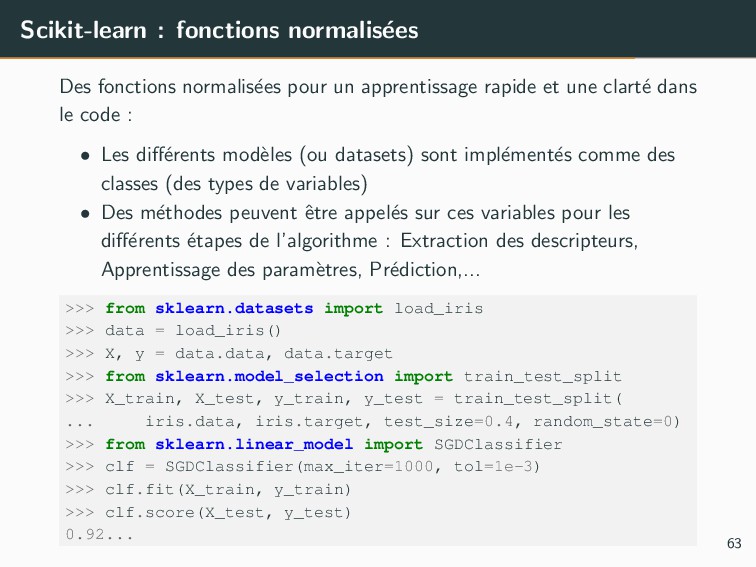
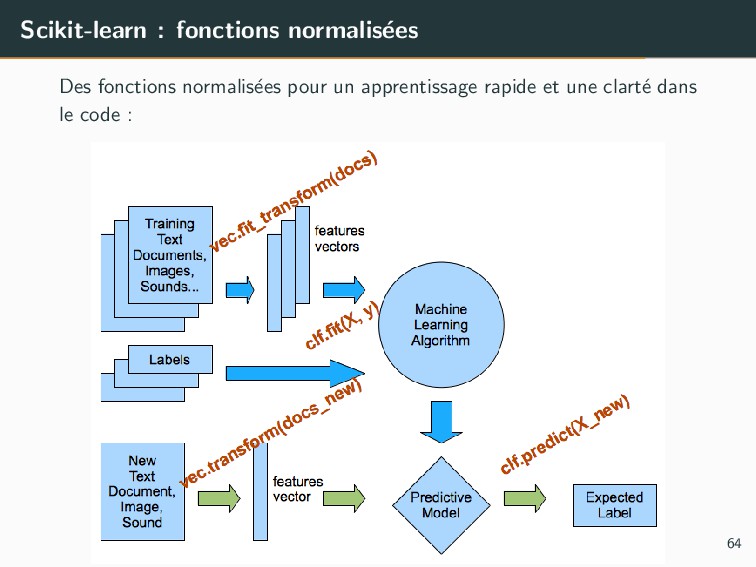
Scikit-learn : fonctions normalis´ ees Des fonctions normalis´ ees pour
un apprentissage rapide et une clart´ e dans le code : • Les diff´ erents mod` eles (ou datasets) sont impl´ ement´ es comme des classes (des types de variables) • Des m´ ethodes peuvent ˆ etre appel´ es sur ces variables pour les diff´ erents ´ etapes de l’algorithme : Extraction des descripteurs, Apprentissage des param` etres, Pr´ ediction,... >>> from sklearn.datasets import load_iris >>> data = load_iris() >>> X, y = data.data, data.target >>> from sklearn.model_selection import train_test_split >>> X_train, X_test, y_train, y_test = train_test_split( ... iris.data, iris.target, test_size=0.4, random_state=0) >>> from sklearn.linear_model import SGDClassifier >>> clf = SGDClassifier(max_iter=1000, tol=1e-3) >>> clf.fit(X_train, y_train) >>> clf.score(X_test, y_test) 0.92... 63 -
Scikit-learn : fonctions normalis´ ees Des fonctions normalis´ ees pour
un apprentissage rapide et une clart´ e dans le code : 64 -
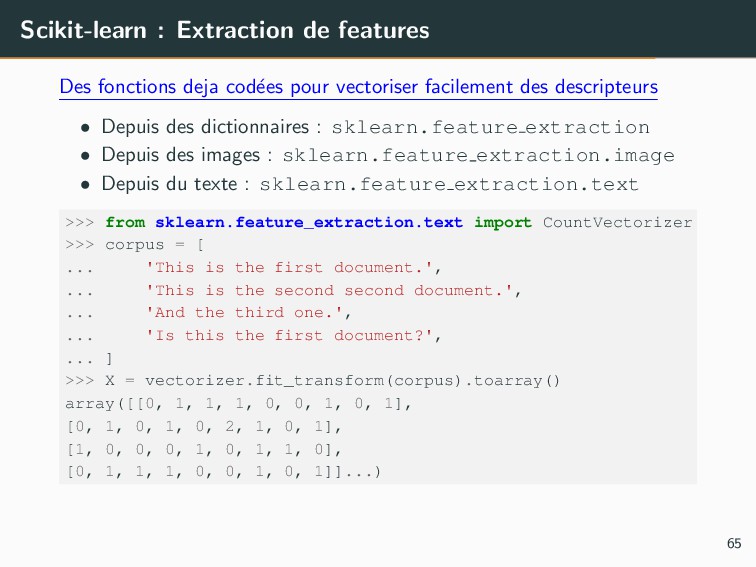
Scikit-learn : Extraction de features Des fonctions deja cod´ ees
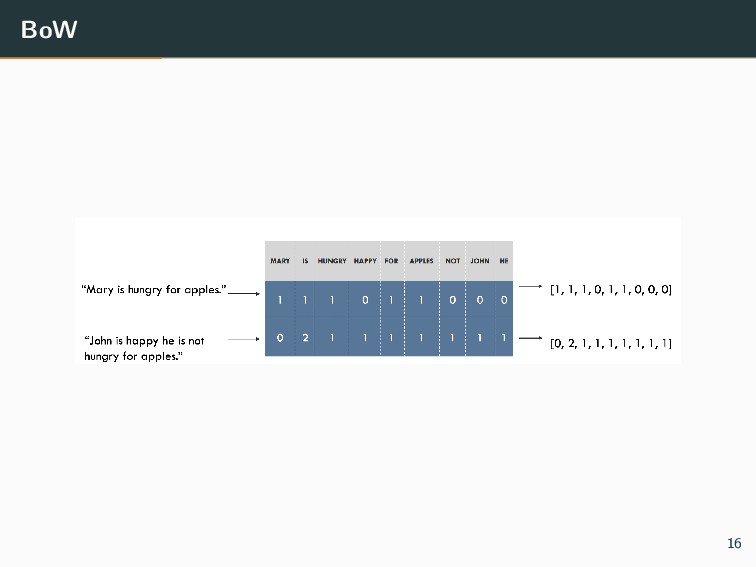
pour vectoriser facilement des descripteurs • Depuis des dictionnaires : sklearn.feature extraction • Depuis des images : sklearn.feature extraction.image • Depuis du texte : sklearn.feature extraction.text >>> from sklearn.feature_extraction.text import CountVectorizer >>> corpus = [ ... 'This is the first document.', ... 'This is the second second document.', ... 'And the third one.', ... 'Is this the first document?', ... ] >>> X = vectorizer.fit_transform(corpus).toarray() array([[0, 1, 1, 1, 0, 0, 1, 0, 1], [0, 1, 0, 1, 0, 2, 1, 0, 1], [1, 0, 0, 0, 1, 0, 1, 1, 0], [0, 1, 1, 1, 0, 0, 1, 0, 1]]...) 65 -
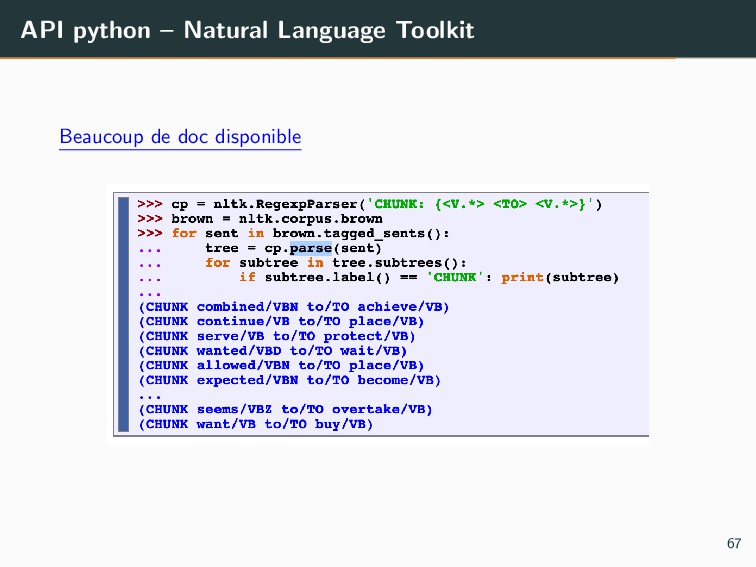
API python – Natural Language Toolkit Librairie gratuite disponible •
API plutˆ ot simple d’utilisation • Tokenisation, NER, POS-tagging, Arbre de d´ ependance, reconnaissance de structures • Un grand nombre de corpus disponibles pour de nombreuses tˆ aches • Vieux et pas de mots-vecteurs 66 -
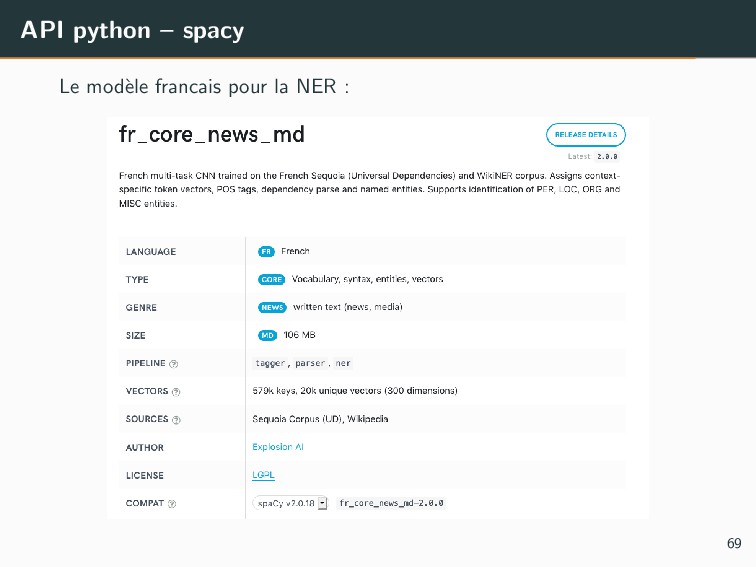
API python – spacy Librairie gratuite disponible • API simple
d’utilisation • Mod` eles tr` es rapides • Tokenisation, NER, POS-tagging • mots-vecteurs pr´ e-entrain´ es 68 -
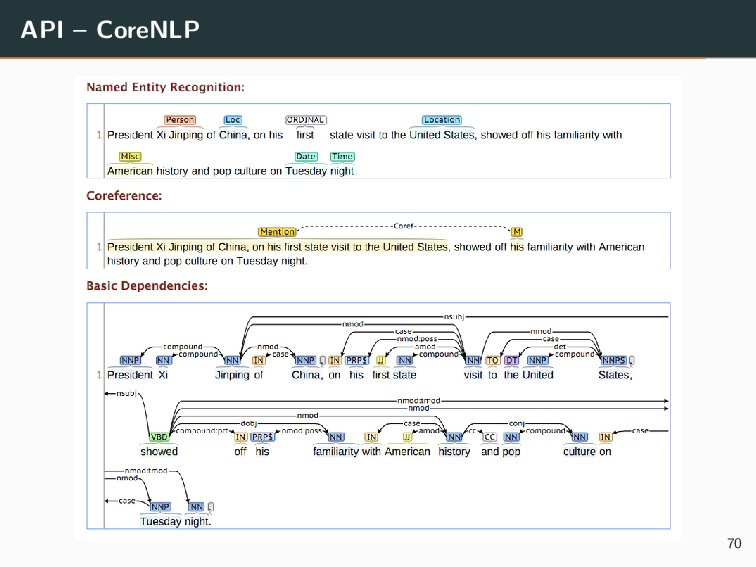
API – CoreNLP API disponible gratuitement sur le web permettant
d’utiliser des mod` eles entrain´ ees sur de multiples tˆ aches. • Version Java (lancer puis communiquer via un port) • Facile d’utilisation avec la nouvelle version python • POS-tagging, NER, Arbres syntaxiques • Coreferences • Analyse de sentiment • autres... Outils qui ne s’imbriquent pas tr` es bien les un avec les autres, et librairie plutˆ ot lente et pas tr` es bien document´ e. Donne n´ eanmoins de bons r´ esultats. 71 -
API – CoreNLP • Simple d’utilisation • Beaucoup plus flexible
mais moins rapide que spacy • NER, Textual Entailment, Machine Reading Comprehension, Semantic Role Labeling, Coreference, ... Tuto AllenNLP 72 -
API – Flair API python d´ evelopp´ e par Zalando,
orient´ e pour la NER, permettant : • d’utiliser divers mots-vecteurs : GloVe, Flair Embeddings (ELMo-like), character embeddings, BERT • principalement d’utiliser des BLSTM-CRF avec diff´ erents embeddings (donc principalement de sequential tagging) Disponible gratuitement sur github Autre tutoriel sur medium avec un notebook 73 -
Outline : Corpus disponibles Diff´ erentes tˆ aches R´ esum´
e des diff´ erentes tˆ aches Mod` eles disponibles Mod` eles simples R´ eseaux R´ ecurrents Encodeurs et embeddings TP : Text-mining Ressources disponibles API Corpus disponibles 74 -
NER • Corpus arbor´ e de Paris 7 (French Treebank)
: entit´ es nomm´ ees et POS article • WIkiNER : article t´ el´ echargement • QAERO : • Sequoia : article scientifique • Gallica : corpus ’articles de journaux en fran¸ cais, t´ el´ echargeable ici Une liste de corpus NER disponibles pour plusieurs langues 75 -
Texte pur Pour l’entrainement de mots-vecteurs g´ en´ eraux. •
Wikipedia : 660M de tokens, 11M de tokens unique t´ el´ echargeable 76
 eig2020
 dayeon
 dalinaum
 ivargrimstad
 naruogram
 seosoft
 youto
 takehaya
 j5ik2o
 kinakomoti321
 t45k
 ktombow
 akihisaikeda
 wjessup
 retrage
 jct
 yeseniaperezcruz
 sferik
 tamaranovitovic
 szymonslowik
 aki_iinuma
 signer
 csswizardry
 codingconduct
 bcantrill