Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
第2回ディープラーニング勉強会~画像処理編~
Search
iwanaga
November 27, 2021
Science
310
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
第2回ディープラーニング勉強会~画像処理編~
iwanaga
November 27, 2021
More Decks by iwanaga
See All by iwanaga
第1回ディープラーニング勉強会~画像処理編~
ganchan11
0
280
第0回ディープラーニング勉強会(演習問題、訂正)
ganchan11
0
450
第0回ディープラーニング勉強会~画像処理編~資料
ganchan11
1
800
第3回python勉強会(解答)
ganchan11
0
360
第3回python勉強会~基礎編~
ganchan11
0
490
第2回python勉強会(解答編)
ganchan11
0
440
第2回python勉強会~基礎編~
ganchan11
0
620
第1回python勉強会~インストール編~
ganchan11
0
680
Other Decks in Science
See All in Science
社内で活躍できるデータサイエンティストになるために
aikinohara
1
160
データベース14: B+木 & ハッシュ索引
trycycle
PRO
0
910
機械学習 - pandas入門
trycycle
PRO
0
710
機械学習 - K近傍法 & 機械学習のお作法
trycycle
PRO
1
1.6k
From Prediction to Understanding: Causal Discovery for Data Science and AI Applications
sshimizu2006
0
300
データベース02: データベースの概念
trycycle
PRO
2
1.4k
第67回コンピュータビジョン勉強会論文紹介「RoboWheel: A Data Engine from Real-World Human Demonstrations for Cross-Embodiment Robotic Learning」
x_ttyszk
0
200
[TMLR 2026, Featured Certification] Double Bounded α-Divergence Optimization for Density Estimation
gkazunii
1
120
Where does the rigor go? Research software and the future of trustworthy science.
arfon
0
160
AI bij literatuuronderzoek in de wetenschap
voginip
0
250
Van Dare naar Durf
voginip
0
300
GKE上でオセロの強化学習やってみた
akasan
0
110
Featured
See All Featured
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
560
Chrome DevTools: State of the Union 2024 - Debugging React & Beyond
addyosmani
10
1.3k
How STYLIGHT went responsive
nonsquared
100
6.3k
職位にかかわらず全員がリーダーシップを発揮するチーム作り / Building a team where everyone can demonstrate leadership regardless of position
madoxten
69
65k
Paper Plane
katiecoart
PRO
3
53k
Gemini Prompt Engineering: Practical Techniques for Tangible AI Outcomes
mfonobong
2
520
Exploring the Power of Turbo Streams & Action Cable | RailsConf2023
kevinliebholz
37
6.6k
New Earth Scene 8
popppiees
3
2.5k
Rails Girls Zürich Keynote
gr2m
96
14k
GitHub's CSS Performance
jonrohan
1033
470k
技術選定の審美眼(2025年版) / Understanding the Spiral of Technologies 2025 edition
twada
PRO
120
120k
RailsConf 2023
tenderlove
30
1.5k
Transcript
第2回ディープラーニング 勉強会 ~画像処理編~
⽬次 ▪ ⾃⼰紹介 ▪ 本の紹介 ▪ ResNetとは ▪ VGGとは ▪
画像分類のディープラーニングにおい て ▪ Loss関数とOptimizer ▪ VGGの実装 ▪ 汎化性能 ▪ 学習⽤データと評価⽤データ ▪ オンライン学習 ▪ 混同⾏列 ▪ バッチ学習の利⽤ ▪ 過学習 ▪ 最後にやってみて
⾃⼰紹介 ▪ 岩永拓也 ▪ 九州⼯業⼤学 情報⼯学部 4年 ▪ 藤原研究室 アルゴリズム
▪ 趣味︓ゲーム、読書、ボードゲーム ▪ エディタ︓Atom
本の紹介 ▪ 即戦⼒になるための ディープラーニング開発実践ハンズオン ▪ [著]井上⼤樹、佐藤峻 ▪ 価格︓3280円(税抜) ▪ リンク︓
https://gihyo.jp/book/2021/978-4-297-11942-3
ResNetとは ▪ 2015年のLISVRC(ImageNet Large Scale Visual Recognition Challenge)で1位に なったモデル。以前の優勝したモデルの層の数が約20なのに対し、ResNetは 152層
▪ ⼀般的に層が多くなるほど複雑になっていき、勾配消失問題などが出てくるた め学習が進まない。 →その解決法として残差ブロックを置くこと
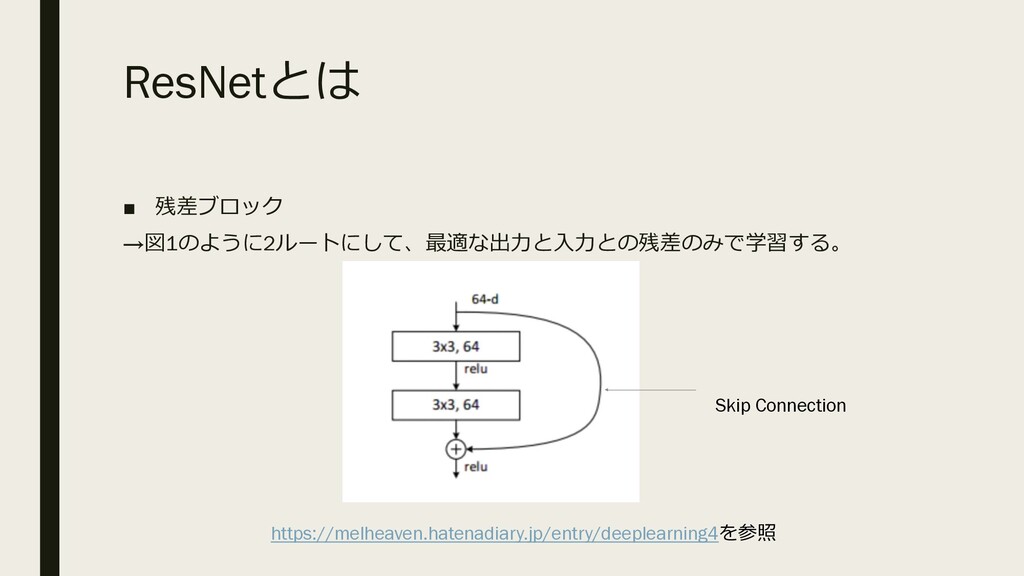
ResNetとは ▪ 残差ブロック →図1のように2ルートにして、最適な出⼒と⼊⼒との残差のみで学習する。 https://melheaven.hatenadiary.jp/entry/deeplearning4を参照 Skip Connection
VGGとは ▪ 2014年のILSVRCでローカリゼーション(画像の中の物体の検出)の分野にて1位、 画像分類の分野で2位になったアルゴリズム。 ▪ 前年のILSVRCの画像分野で1位だったZFNetが8層に対し、VGGは最⼤で19層。
画像分類のディープラーニングにお いて ▪ メリット →⼯場での製品の検査などにおいて従来は前からのものに限定していたのに対し、 ディープラーニングを取り⼊れることで横からや斜めに撮影した映像や写真といっ た場合でも特徴を抽出し、検出が可能 ▪ デメリット →実装には莫⼤なコストがかかる。
例︓データの質と量の確保、学習にかかる時間
画像分類のディープラーニングにお いて ▪ アルゴリズムの選定⽅法 →ディープラーニングのアルゴリズムは毎年数多く発表されている。⾼い制度を持 つからといって、実際の事業などで有⽤とは限らない。 ⾼い処理速度を要するものにとっては、コンピュータのメモリが⼗分に搭載されて いなかったり、ハードウェアを容易に拡張できない場合があるため慎重に選ぶ必要 がある。
Loss関数とOptimizer 今まで受け取った画像を処理する⼿順のみ定義してた →学習を進めるためLoss関数(損失関数)とOptimizer(最適化関数)が必要になる ▪ Loss関数 →理想とする結果から現在の処理結果がどれだけの誤差があるか表現した関数 主に平均⼆乗誤差かクロスエントロピーに使⽤。
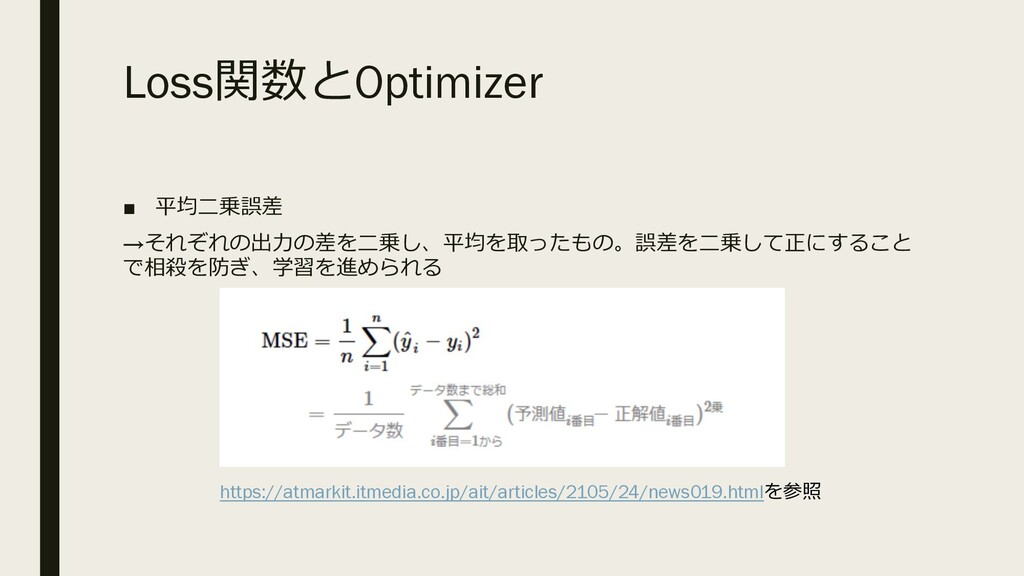
Loss関数とOptimizer ▪ 平均⼆乗誤差 →それぞれの出⼒の差を⼆乗し、平均を取ったもの。誤差を⼆乗して正にすること で相殺を防ぎ、学習を進められる https://atmarkit.itmedia.co.jp/ait/articles/2105/24/news019.htmlを参照
Loss関数とOptimizer ▪ クロスエントロピー →分類タスクで⽤いられ、分類時の確率が100%になるような出⼒になり、正解ク ラスの確率が1に近いほど良いことからLogを⽤いてその誤差を表現する。 ※今回はクロスエントロピーを⽤いる →「categorical_crossentropy」を使⽤
Loss関数とOptimizer ▪ Optimizer →Loss関数によって求めた誤差をどのような⽅針で修正するか表現する関数。 ディープラーニングでは⼤量の変数を取り扱うので、ただ求めた結果の通り修正し ているだけでは誤差が⼩さくなりません。 →⽅法としてLearningRate(学習率)で修正する量を⼩さくする。
Loss関数とOptimizer ▪ SGD(Stochastic Gradient Descent : 確率的勾配降下法) →Loss関数で求めた修正量に学習率をかけて修正するOptimizer。 学習率は1e-3~1e-5あたりの数が⽤いられる。 ▪
他にもMomentumSGD、AdamGrad、RMSprop、Adam、Eveなど数多くのOptimizerが 存在する。 ※参考リンク︓https://qiita.com/omiita/items/1735c1d048fe5f611f80 今回はMomentumSGDを使⽤。学習率は1e-2に学習率減衰は5e-4にモーメンタムは0.9
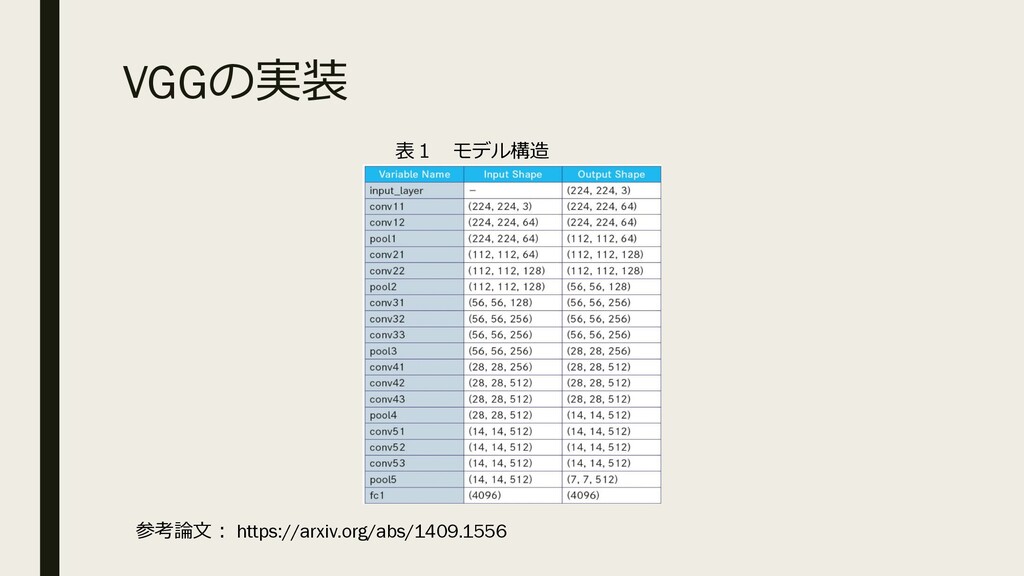
VGGの実装 参考論⽂︓ https://arxiv.org/abs/1409.1556 表1 モデル構造
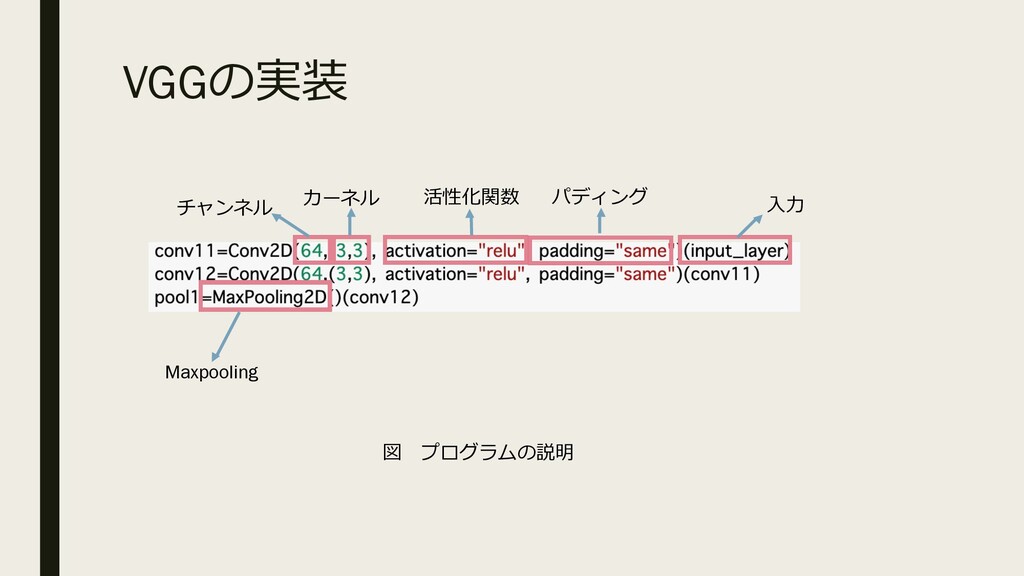
VGGの実装 チャンネル カーネル 活性化関数 パディング ⼊⼒ Maxpooling 図 プログラムの説明
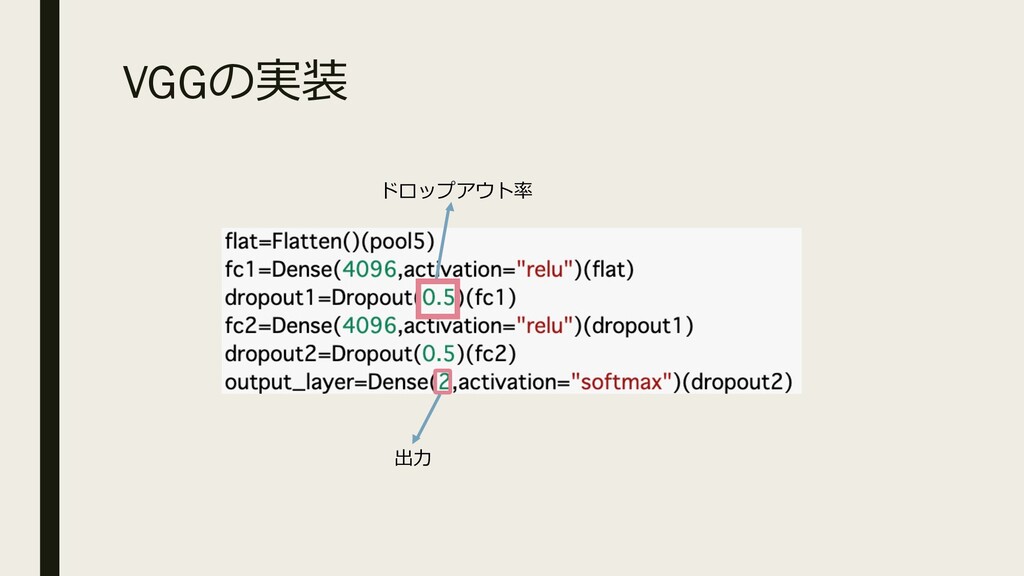
VGGの実装 出⼒ ドロップアウト率
汎化性能 ▪ 汎化性能 →1つのモデルがどれだけ幅広いデータに適応できるかを⽰すもの。⾼いほど学習 してないデータに対して適応できる可能性が⾼い。精度とはトレードオフの関係に あることが多く、どちらかを⾼くするかはプロジェクトの要件によって異なる。
学習⽤データと評価⽤データ ▪ ディープラーニングは⽤意したデータ全てをモデルに学習させるわけではなく、 その⼀部を使って学習したモデルの性能を学習の際に与えなかった残りのデー タで評価する。これにより、実際にそのモデルを使⽤する状況に近い状態で精 度評価を⾏える。この時学習⽤データと評価⽤データは7:3の⽐率でランダムに 分割することが多い。
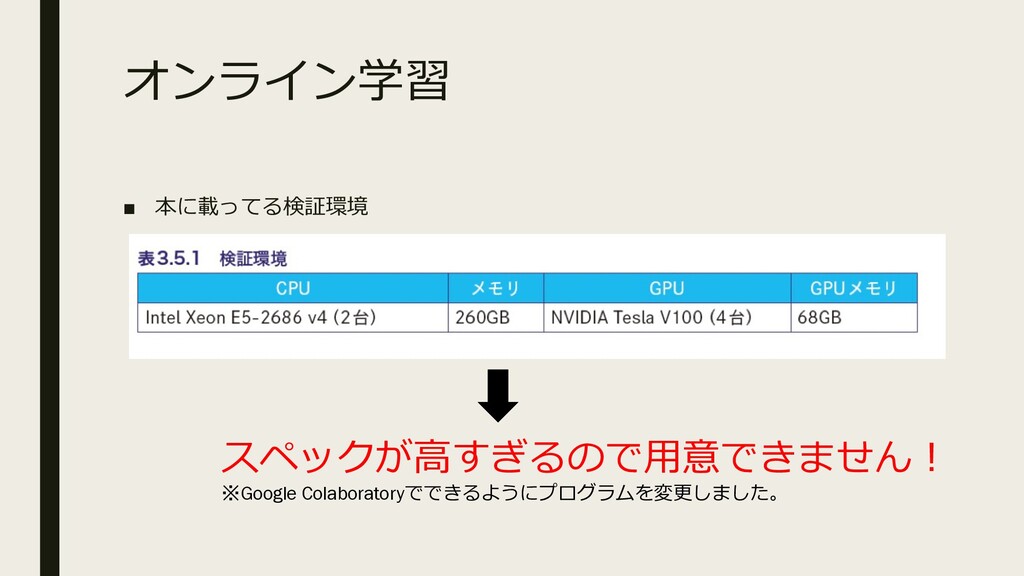
オンライン学習 ▪ 本に載ってる検証環境 スペックが⾼すぎるので⽤意できません︕ ※Google Colaboratoryでできるようにプログラムを変更しました。
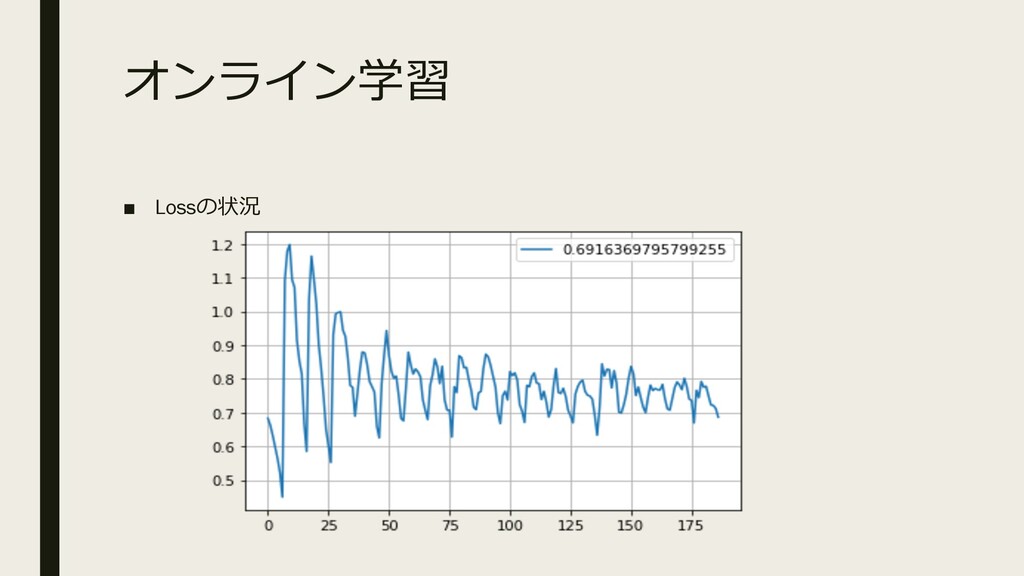
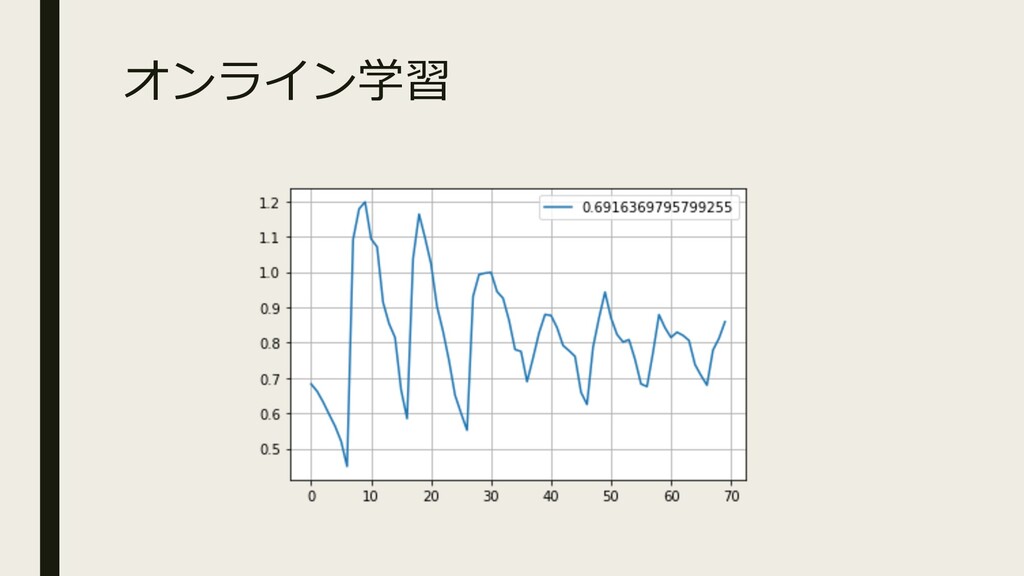
オンライン学習 ▪ Lossの状況
オンライン学習
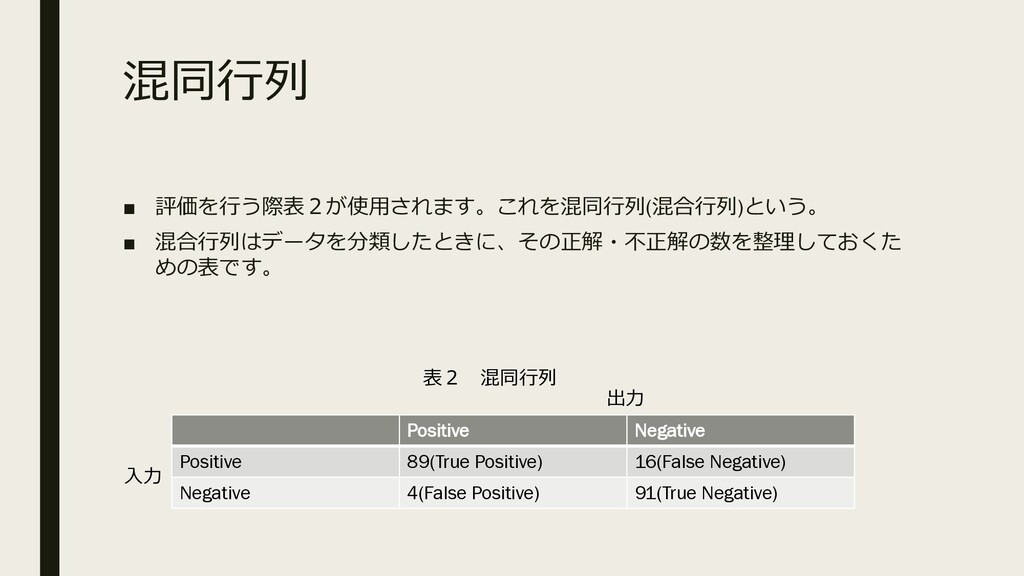
混同⾏列 ▪ 評価を⾏う際表2が使⽤されます。これを混同⾏列(混合⾏列)という。 ▪ 混合⾏列はデータを分類したときに、その正解・不正解の数を整理しておくた めの表です。 Positive Negative Positive 89(True
Positive) 16(False Negative) Negative 4(False Positive) 91(True Negative) ⼊⼒ 出⼒ 表2 混同⾏列
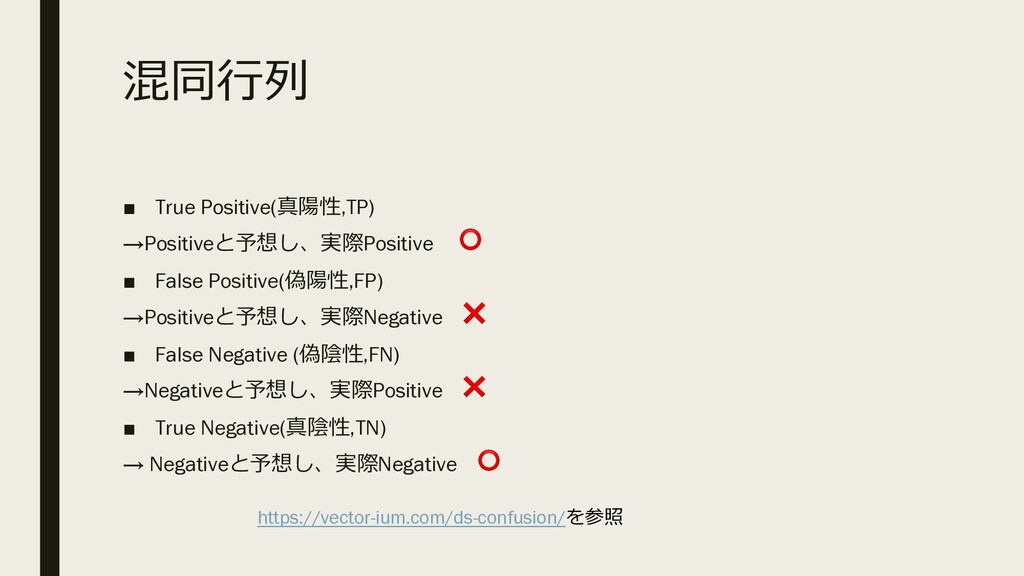
混同⾏列 ▪ True Positive(真陽性,TP) →Positiveと予想し、実際Positive ⭕ ▪ False Positive(偽陽性,FP) →Positiveと予想し、実際Negative
❌ ▪ False Negative (偽陰性,FN) →Negativeと予想し、実際Positive ❌ ▪ True Negative(真陰性,TN) → Negativeと予想し、実際Negative ⭕ https://vector-ium.com/ds-confusion/を参照
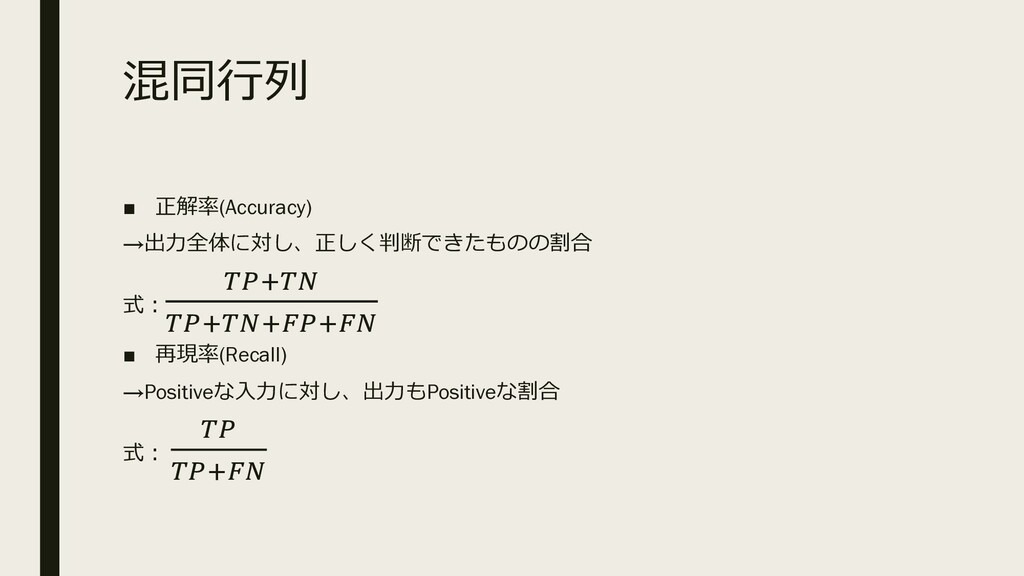
混同⾏列 ▪ 正解率(Accuracy) →出⼒全体に対し、正しく判断できたものの割合 式︓ !"#!$ !"#!$#%"#%$ ▪ 再現率(Recall) →Positiveな⼊⼒に対し、出⼒もPositiveな割合
式︓ !" !"#%$
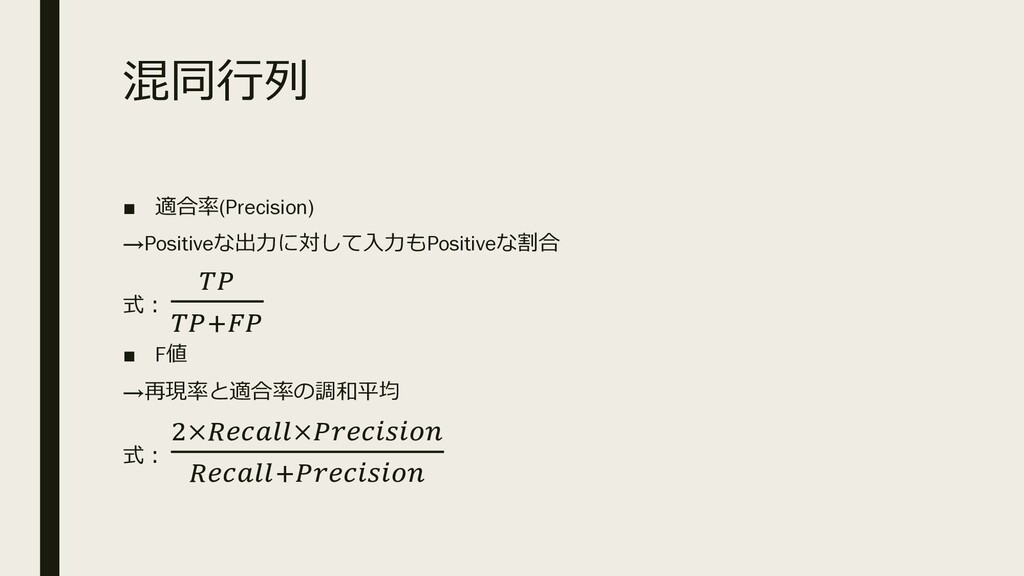
混同⾏列 ▪ 適合率(Precision) →Positiveな出⼒に対して⼊⼒もPositiveな割合 式︓ !" !"#%" ▪ F値 →再現率と適合率の調和平均
式︓ &×()*+,,×"-)*./.01 ()*+,,#"-)*./.01
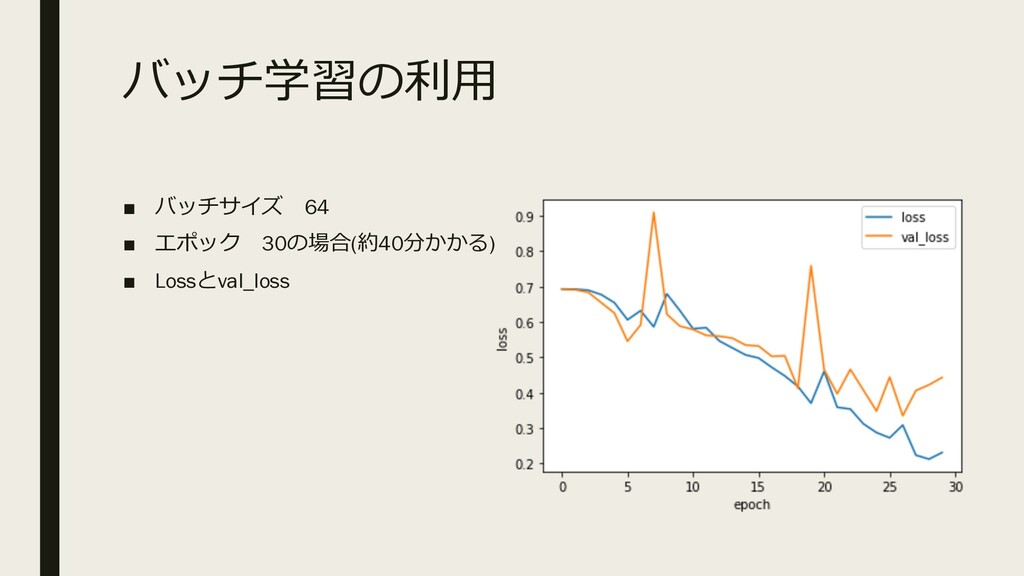
バッチ学習の利⽤ ▪ バッチサイズ 64 ▪ エポック 30の場合(約40分かかる) ▪ Lossとval_loss
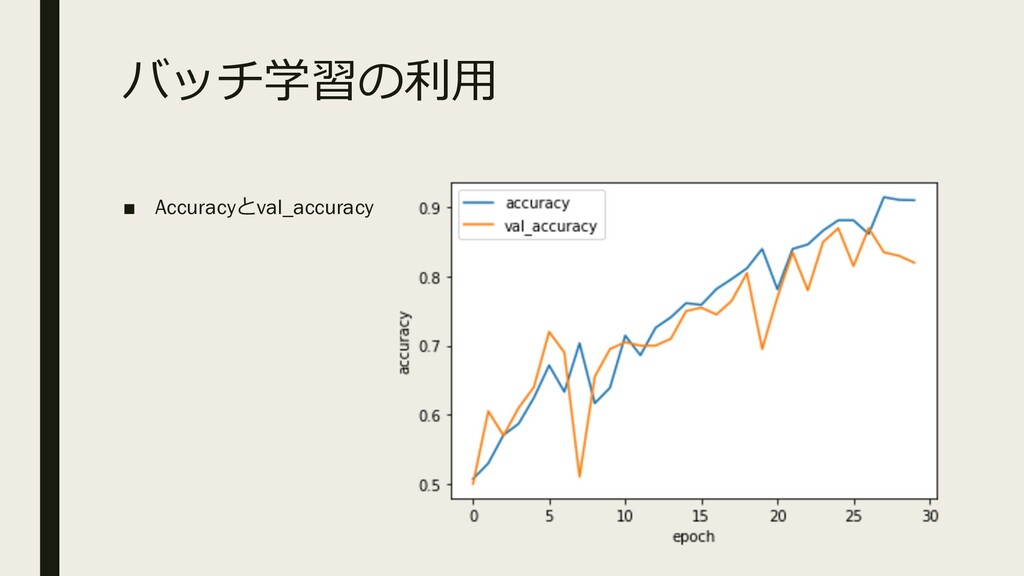
バッチ学習の利⽤ ▪ Accuracyとval_accuracy
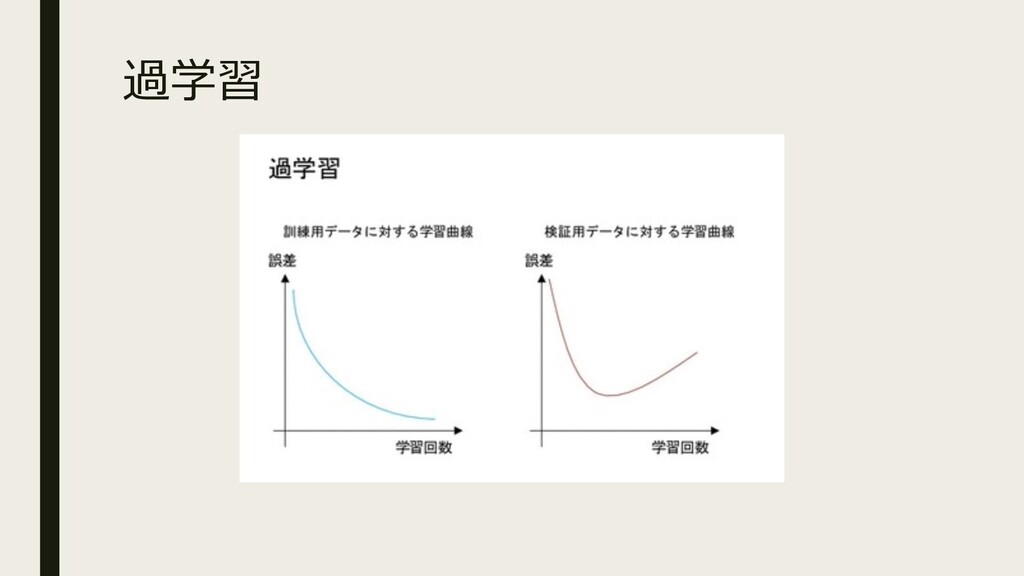
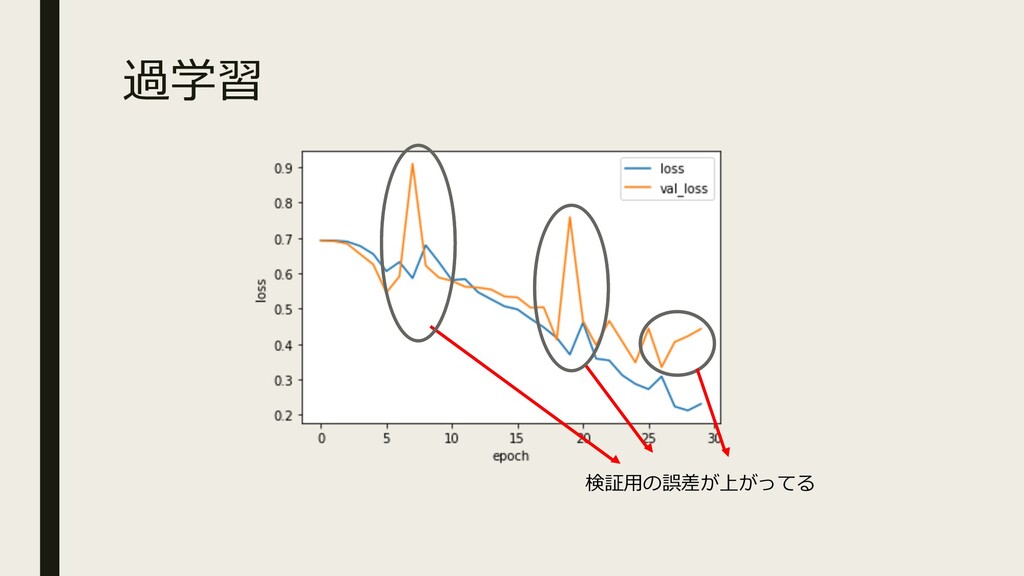
過学習
過学習 検証⽤の誤差が上がってる
改善点 ▪ しっかりしたデータを使⽤ ▪ バッチサイズ、エポックの変更 ▪ SDGの変更 ▪ 画像処理の追加や削減 など…
最後にやってみて ▪ 今回は猫と⼈の識別を⾏いましたが、他にも⽝のデータが存在しますのでそれ も⽤いての識別 ▪ 先程のプログラムを改良して精度を上げる⼯夫 ▪ VGG以外のモデルの調査


 ganchan11
 aikinohara
 trycycle
 sshimizu2006
 x_ttyszk
 gkazunii
 arfon
 voginip
 akasan
 reverentgeek
 addyosmani
 nonsquared
 madoxten
 katiecoart
 mfonobong
 kevinliebholz
 popppiees
 gr2m
 jonrohan
 twada
 tenderlove