Share
Embed
【マケデコ】JPX Kaggleコンペ5位解法共有
2023/01/26のマケデコのイベントで共有した、JPX Kaggleコンペ5位解法紹介の資料です。
ghtaro
January 29, 2023
Transcript
43 slides
-
自己紹介 • 大学で、物理 • 新卒で証券会社で、セルサイドクオンツ • 中途でフィンテックの会社で、データサイエンティスト • Kaggleは新参者 •
暗号資産コンペで銅 • 本コンペ(JPX Kaggle)ではエラー敗退 • 個別株とシストレの初心者です。的外れな解釈やアウトプット も多々あると思います。ツッコミ・ご意見いただけると、有難 いです。 -
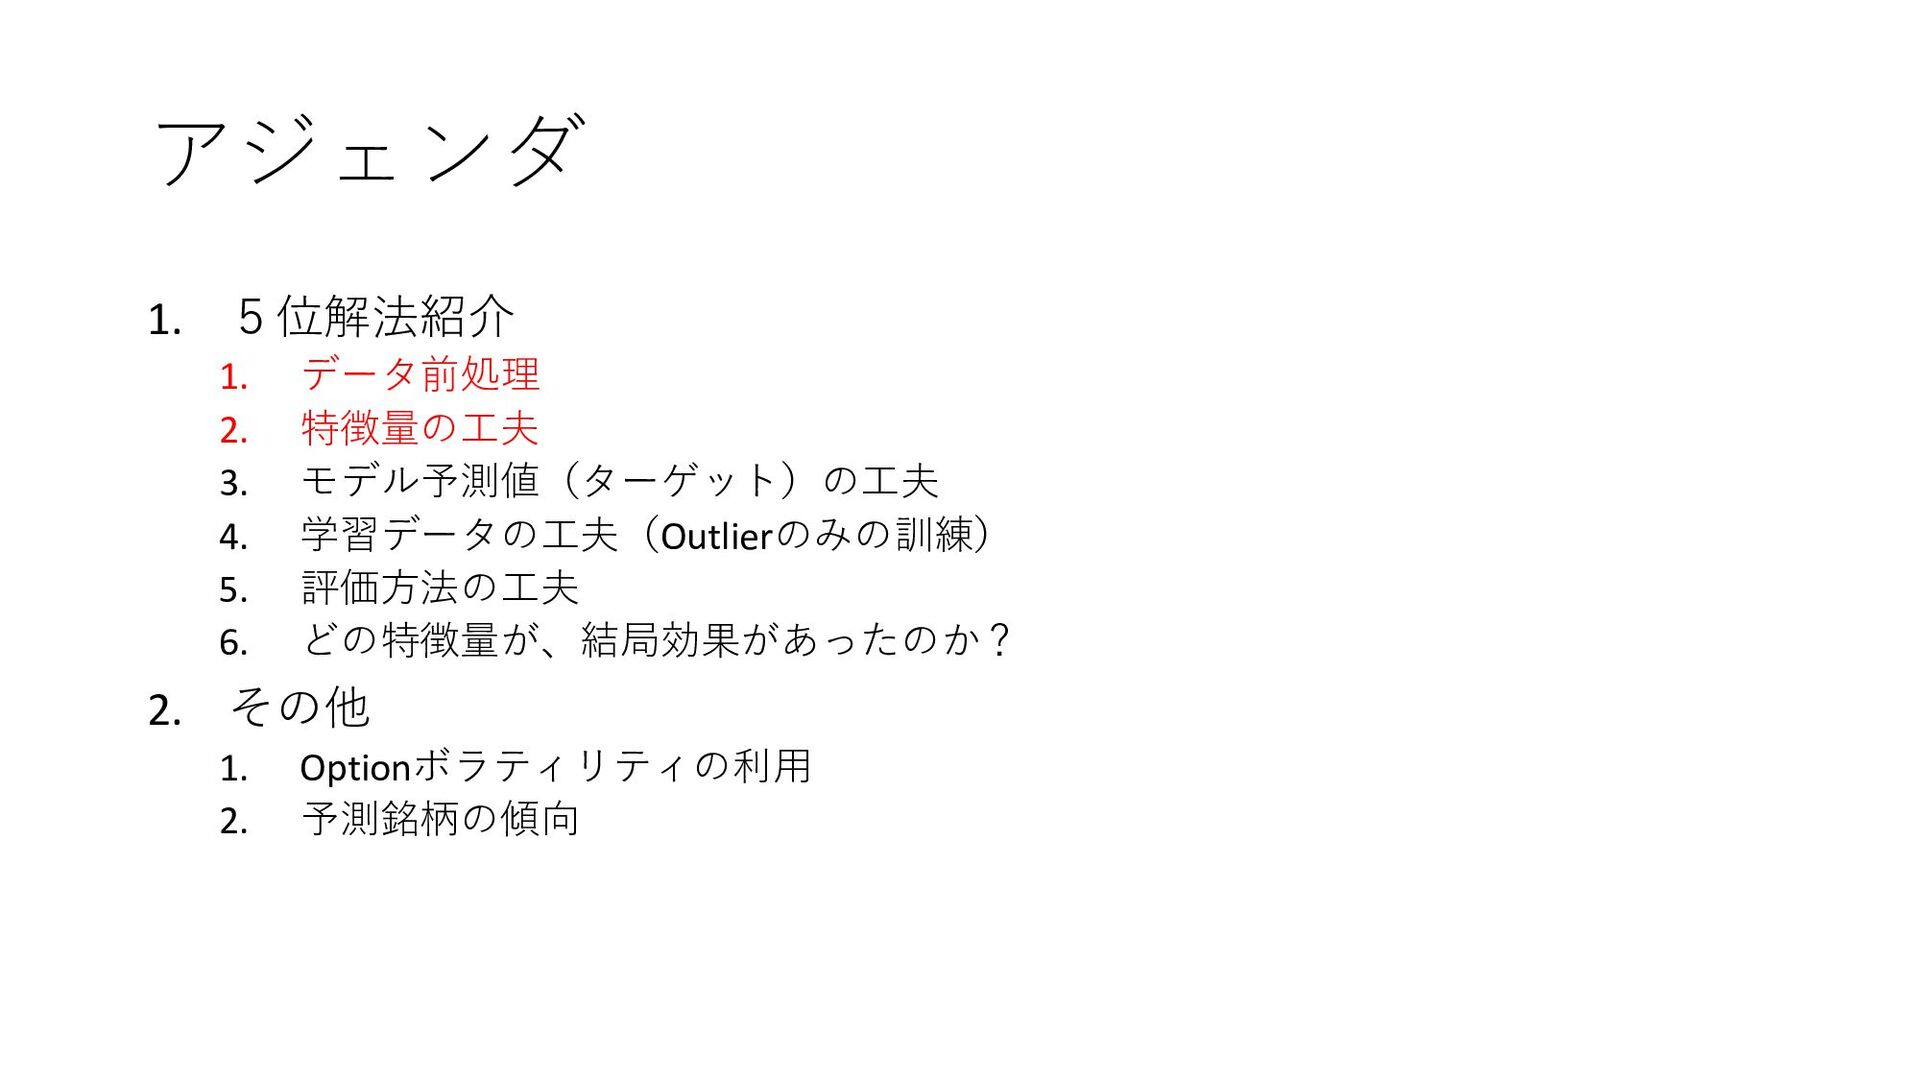
アジェンダ 1. 5位解法紹介 1. データ前処理 2. 特徴量の工夫 3. モデル予測値(ターゲット)の工夫 4.
学習データの工夫(Outlierのみの訓練) 5. 評価方法の工夫 6. どの特徴量が、結局効果があったのか? 2. その他 1. Optionボラティリティの利用 2. 予測銘柄の傾向 -
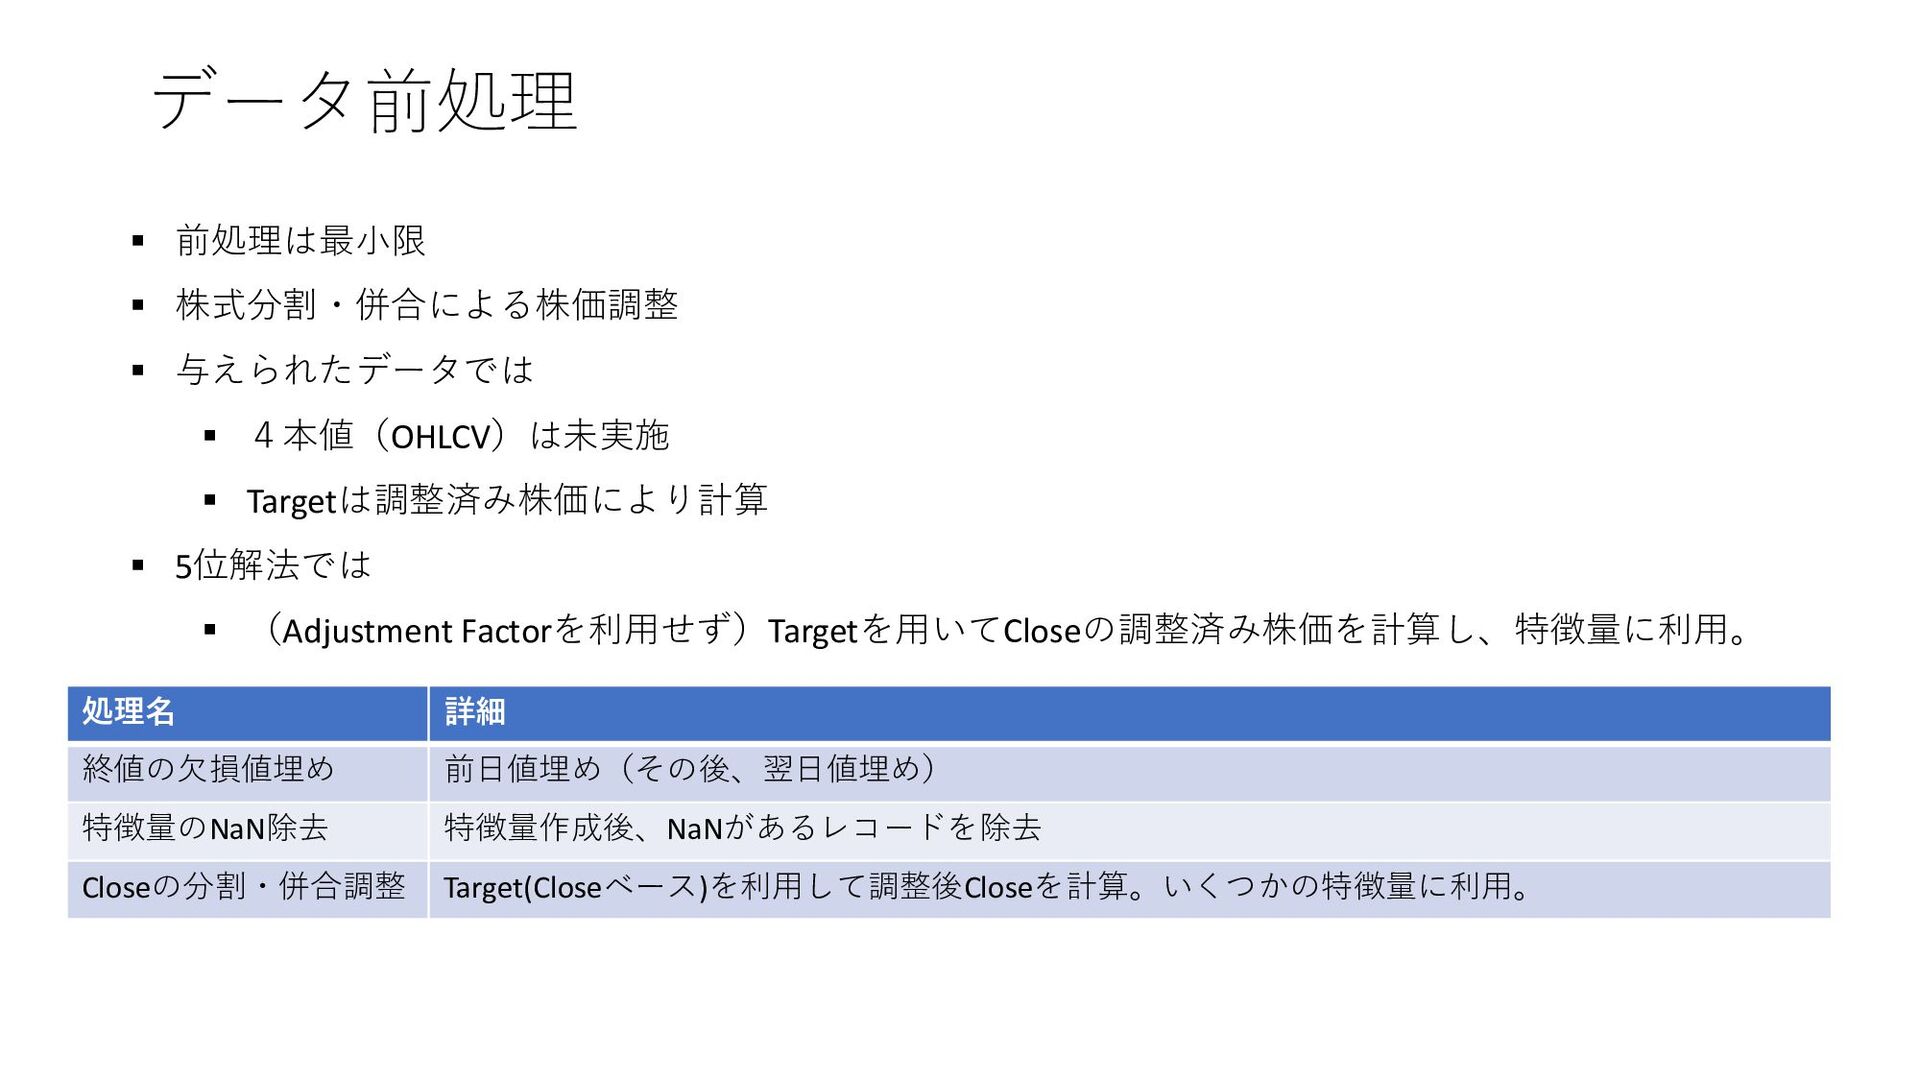
データ前処理 処理名 詳細 終値の欠損値埋め 前日値埋め(その後、翌日値埋め) 特徴量のNaN除去 特徴量作成後、NaNがあるレコードを除去 Closeの分割・併合調整 Target(Closeベース)を利用して調整後Closeを計算。いくつかの特徴量に利用。 ▪
前処理は最小限 ▪ 株式分割・併合による株価調整 ▪ 与えられたデータでは ▪ 4本値(OHLCV)は未実施 ▪ Targetは調整済み株価により計算 ▪ 5位解法では ▪ (Adjustment Factorを利用せず)Targetを用いてCloseの調整済み株価を計算し、特徴量に利用。 -
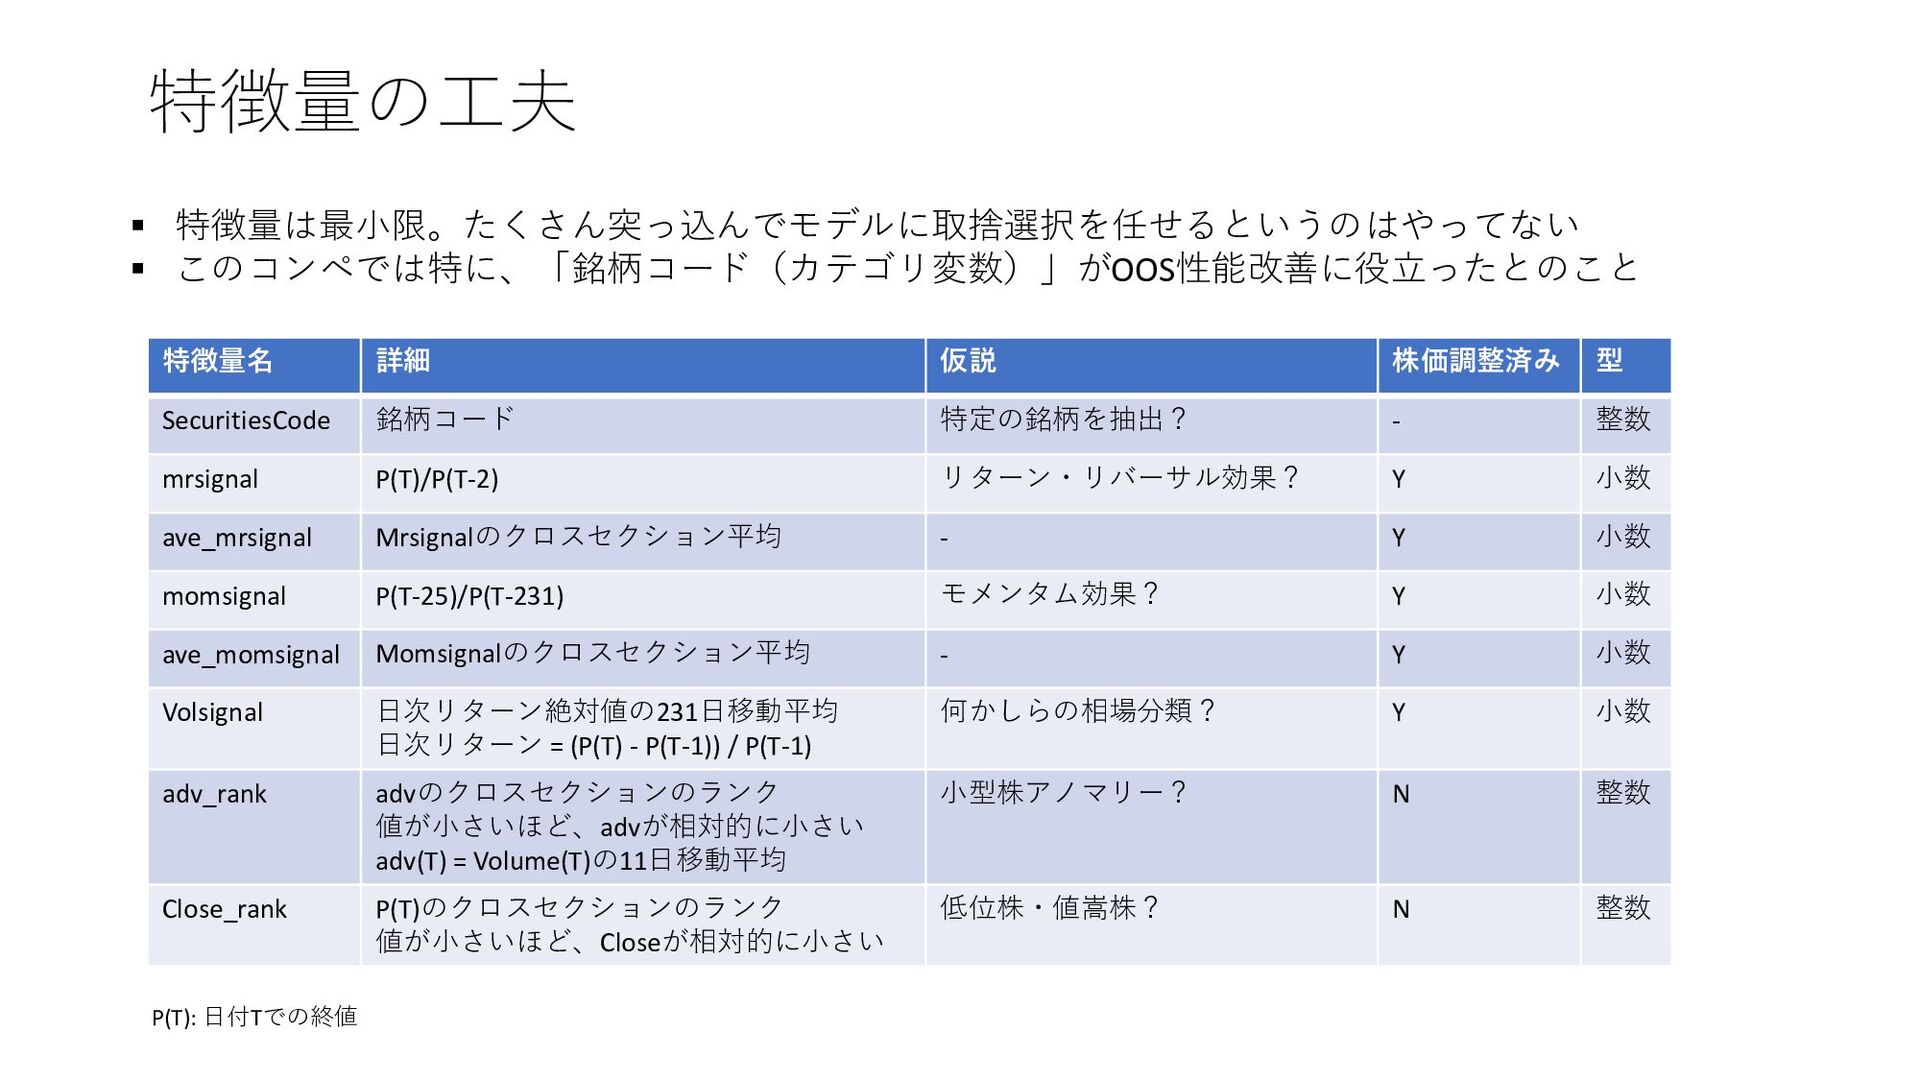
特徴量の工夫 特徴量名 詳細 仮説 株価調整済み 型 SecuritiesCode 銘柄コード 特定の銘柄を抽出? -
整数 mrsignal P(T)/P(T-2) リターン・リバーサル効果? Y 小数 ave_mrsignal Mrsignalのクロスセクション平均 - Y 小数 momsignal P(T-25)/P(T-231) モメンタム効果? Y 小数 ave_momsignal Momsignalのクロスセクション平均 - Y 小数 Volsignal 日次リターン絶対値の231日移動平均 日次リターン = (P(T) - P(T-1)) / P(T-1) 何かしらの相場分類? Y 小数 adv_rank advのクロスセクションのランク 値が小さいほど、advが相対的に小さい adv(T) = Volume(T)の11日移動平均 小型株アノマリー? N 整数 Close_rank P(T)のクロスセクションのランク 値が小さいほど、Closeが相対的に小さい 低位株・値嵩株? N 整数 P(T): 日付Tでの終値 ▪ 特徴量は最小限。たくさん突っ込んでモデルに取捨選択を任せるというのはやってない ▪ このコンペでは特に、「銘柄コード(カテゴリ変数)」がOOS性能改善に役立ったとのこと -
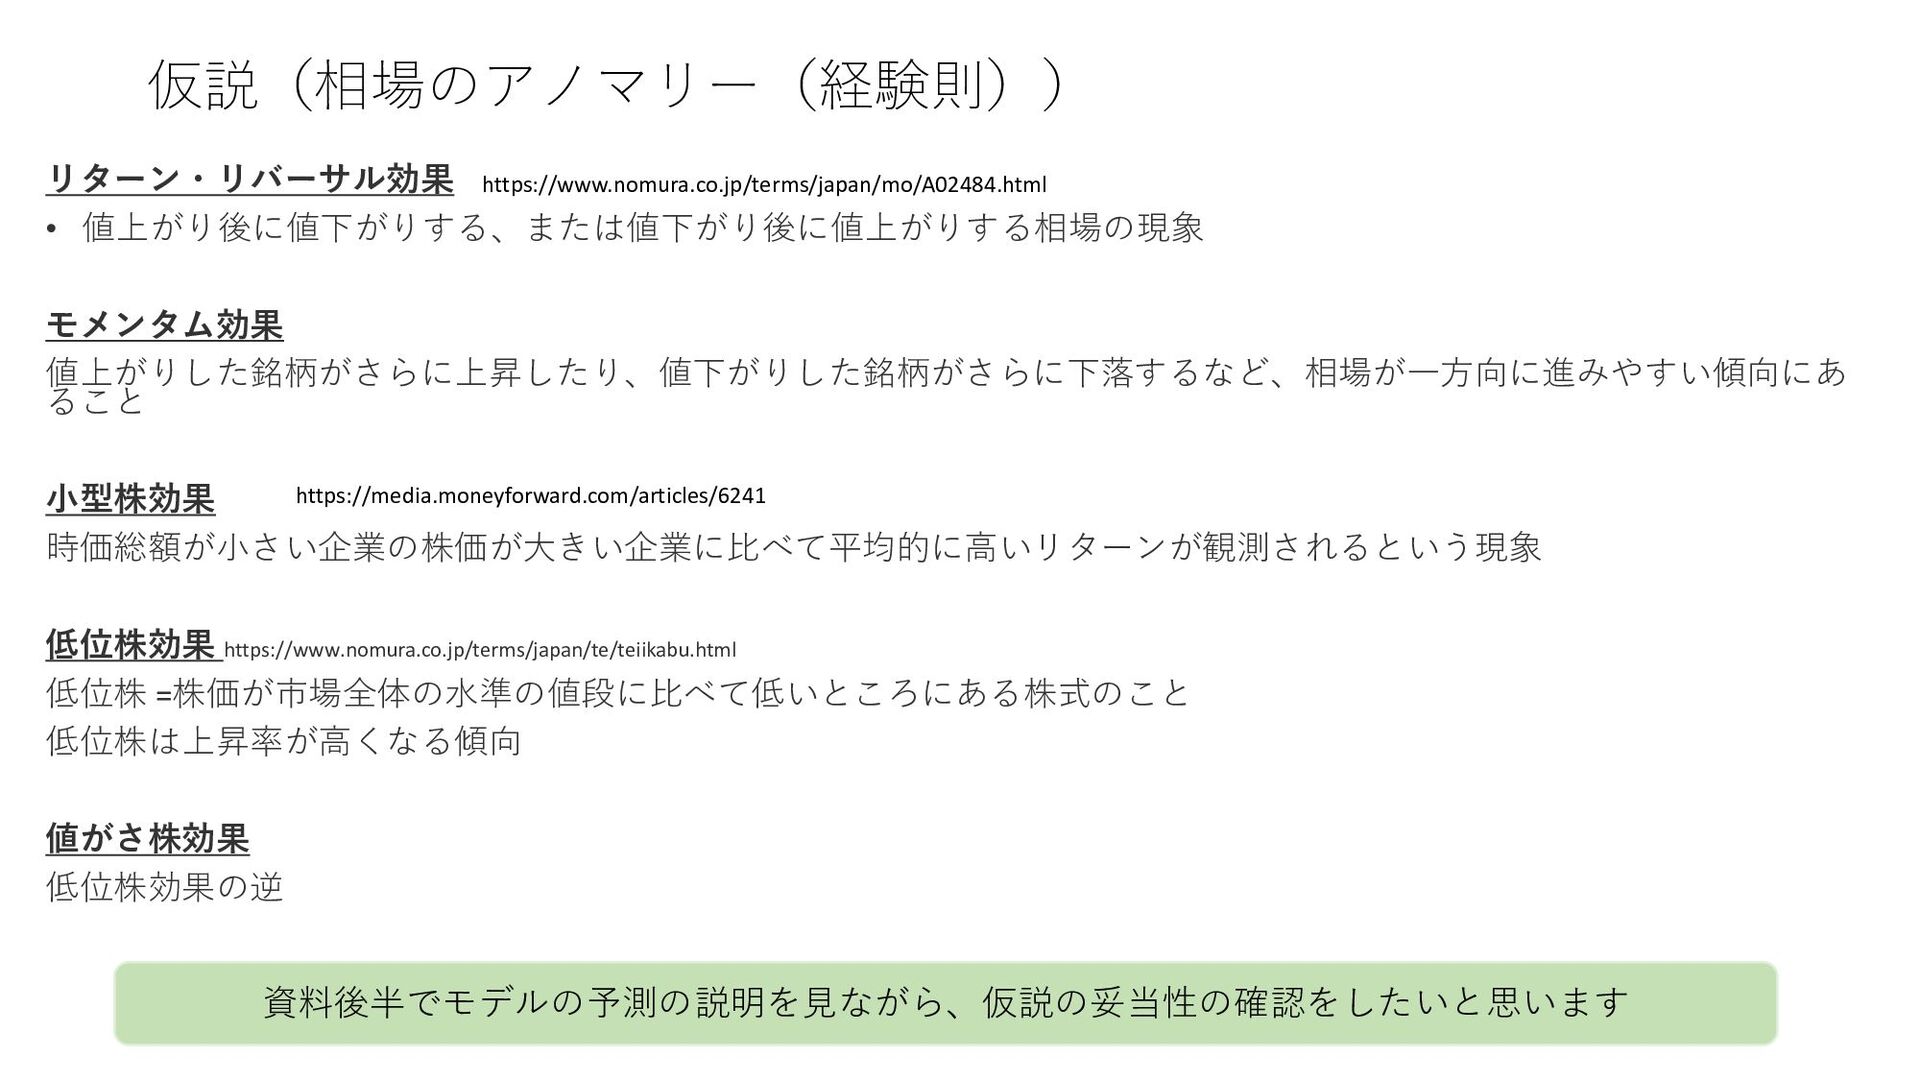
仮説(相場のアノマリー(経験則)) リターン・リバーサル効果 • 値上がり後に値下がりする、または値下がり後に値上がりする相場の現象 モメンタム効果 値上がりした銘柄がさらに上昇したり、値下がりした銘柄がさらに下落するなど、相場が一方向に進みやすい傾向にあ ること 小型株効果 時価総額が小さい企業の株価が大きい企業に比べて平均的に高いリターンが観測されるという現象 低位株効果
https://www.nomura.co.jp/terms/japan/te/teiikabu.html 低位株 =株価が市場全体の水準の値段に比べて低いところにある株式のこと 低位株は上昇率が高くなる傾向 値がさ株効果 低位株効果の逆 https://media.moneyforward.com/articles/6241 https://www.nomura.co.jp/terms/japan/mo/A02484.html 資料後半でモデルの予測の説明を見ながら、仮説の妥当性の確認をしたいと思います -
アジェンダ 1. 5位解法紹介 1. データ前処理 2. 特徴量の工夫 3. モデル予測値(ターゲット)の工夫 4.
学習データの工夫(Outlierのみの訓練) 5. 評価方法の工夫 6. どの特徴量が、結局効果があったのか? 2. その他 1. Optionボラティリティの利用 2. 予測銘柄の傾向 -
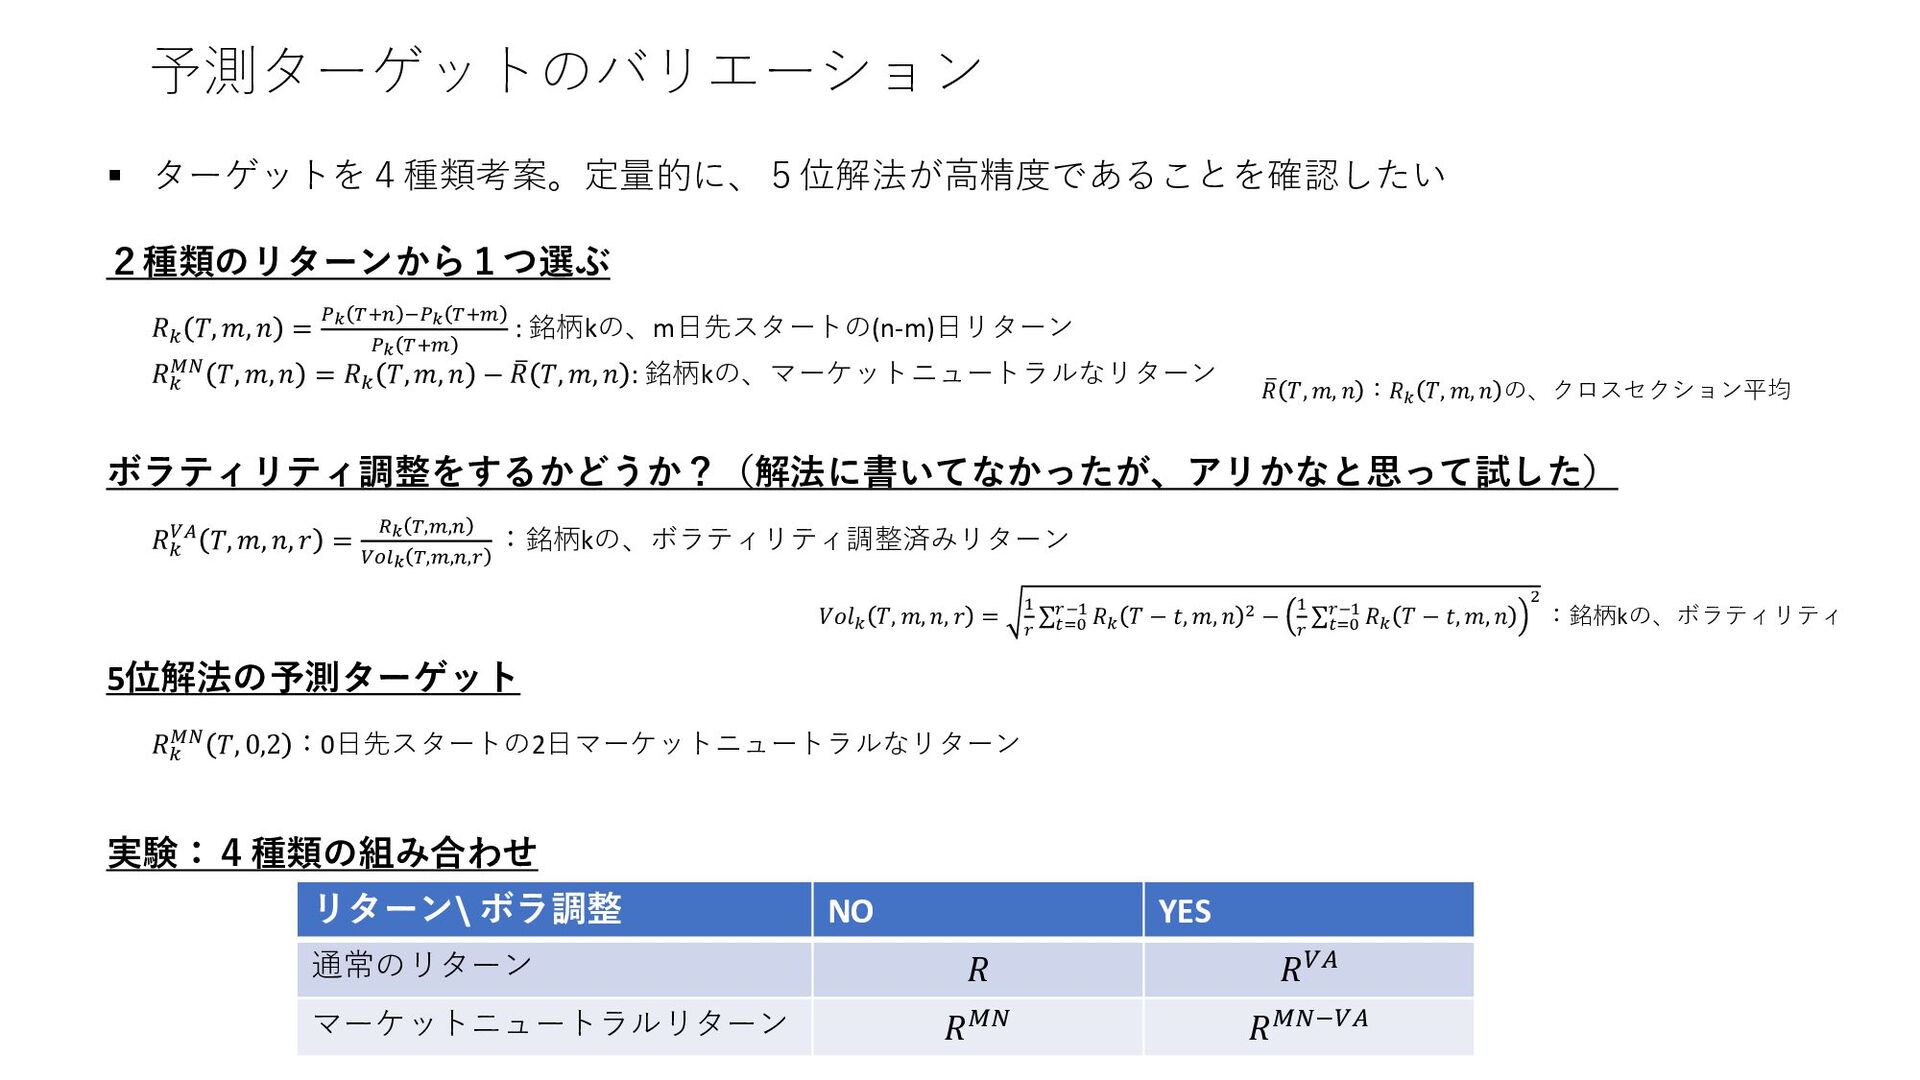
予測ターゲットのバリエーション リターン\ ボラ調整 NO YES 通常のリターン 𝑅 𝑅𝑉𝐴 マーケットニュートラルリターン 𝑅𝑀𝑁
𝑅𝑀𝑁−𝑉𝐴 𝑅𝑘 𝑇, 𝑚, 𝑛 = 𝑃𝑘 𝑇+𝑛 −𝑃𝑘 𝑇+𝑚 𝑃𝑘 𝑇+𝑚 : 銘柄kの、m日先スタートの(n-m)日リターン 𝑅𝑘 𝑀𝑁 𝑇, 𝑚, 𝑛 = 𝑅𝑘 𝑇, 𝑚, 𝑛 − ത 𝑅 𝑇, 𝑚, 𝑛 : 銘柄kの、マーケットニュートラルなリターン 𝑅𝑘 𝑉𝐴 𝑇, 𝑚, 𝑛, 𝑟 = 𝑅𝑘 𝑇,𝑚,𝑛 𝑉𝑜𝑙𝑘 𝑇,𝑚,𝑛,𝑟 :銘柄kの、ボラティリティ調整済みリターン 𝑉𝑜𝑙𝑘 𝑇, 𝑚, 𝑛, 𝑟 = 1 𝑟 σ 𝑡=0 𝑟−1 𝑅𝑘 𝑇 − 𝑡, 𝑚, 𝑛 2 − 1 𝑟 σ 𝑡=0 𝑟−1 𝑅𝑘 𝑇 − 𝑡, 𝑚, 𝑛 2 :銘柄kの、ボラティリティ ത 𝑅 𝑇, 𝑚, 𝑛 :𝑅𝑘 𝑇, 𝑚, 𝑛 の、クロスセクション平均 2種類のリターンから1つ選ぶ ボラティリティ調整をするかどうか?(解法に書いてなかったが、アリかなと思って試した) 実験:4種類の組み合わせ 5位解法の予測ターゲット 𝑅𝑘 𝑀𝑁 𝑇, 0,2 :0日先スタートの2日マーケットニュートラルなリターン ▪ ターゲットを4種類考案。定量的に、5位解法が高精度であることを確認したい -
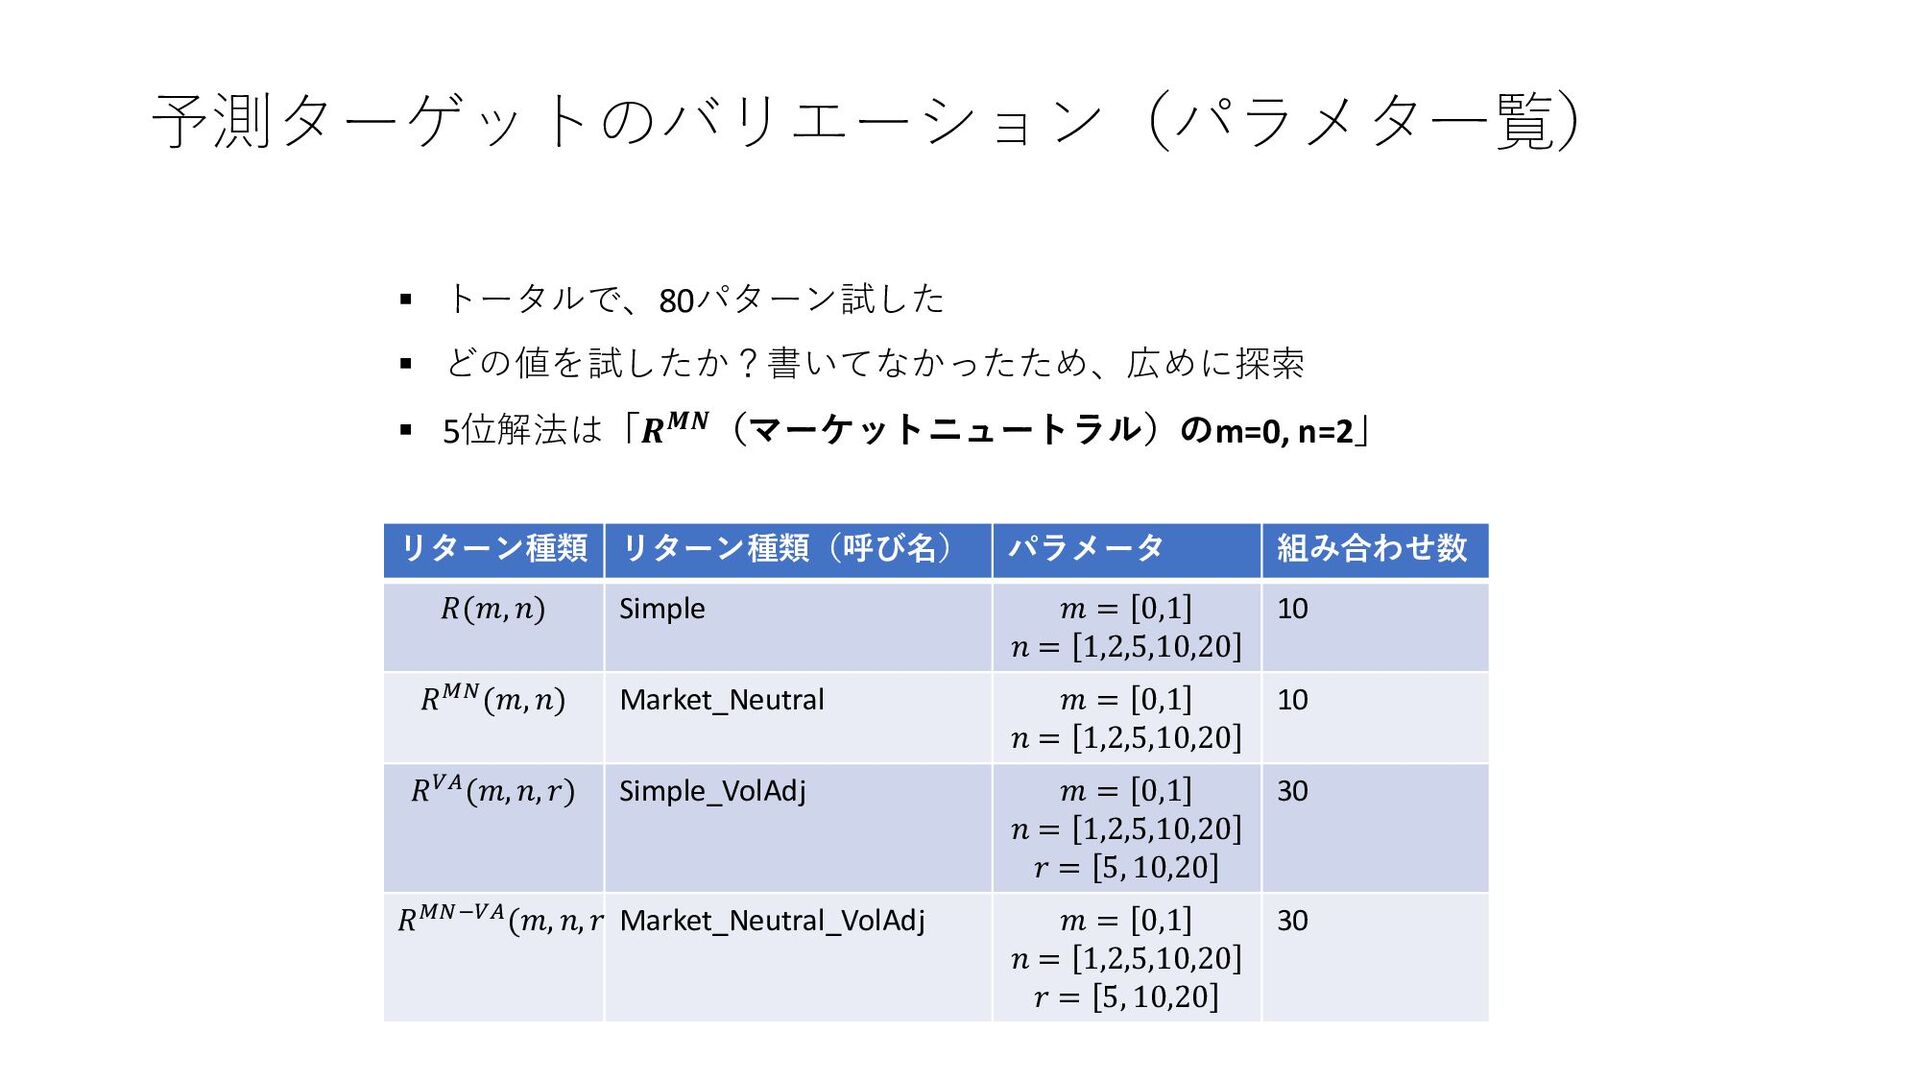
リターン種類 リターン種類(呼び名) パラメータ 組み合わせ数 𝑅(𝑚, 𝑛) Simple 𝑚 = 0,1
𝑛 = 1,2,5,10,20 10 𝑅𝑀𝑁(𝑚, 𝑛) Market_Neutral 𝑚 = 0,1 𝑛 = 1,2,5,10,20 10 𝑅𝑉𝐴(𝑚, 𝑛, 𝑟) Simple_VolAdj 𝑚 = 0,1 𝑛 = 1,2,5,10,20 𝑟 = 5, 10,20 30 𝑅𝑀𝑁−𝑉𝐴(𝑚, 𝑛, 𝑟)Market_Neutral_VolAdj 𝑚 = 0,1 𝑛 = 1,2,5,10,20 𝑟 = 5, 10,20 30 予測ターゲットのバリエーション(パラメタ一覧) ▪ トータルで、80パターン試した ▪ どの値を試したか?書いてなかったため、広めに探索 ▪ 5位解法は「𝑹𝑴𝑵(マーケットニュートラル)のm=0, n=2」 -
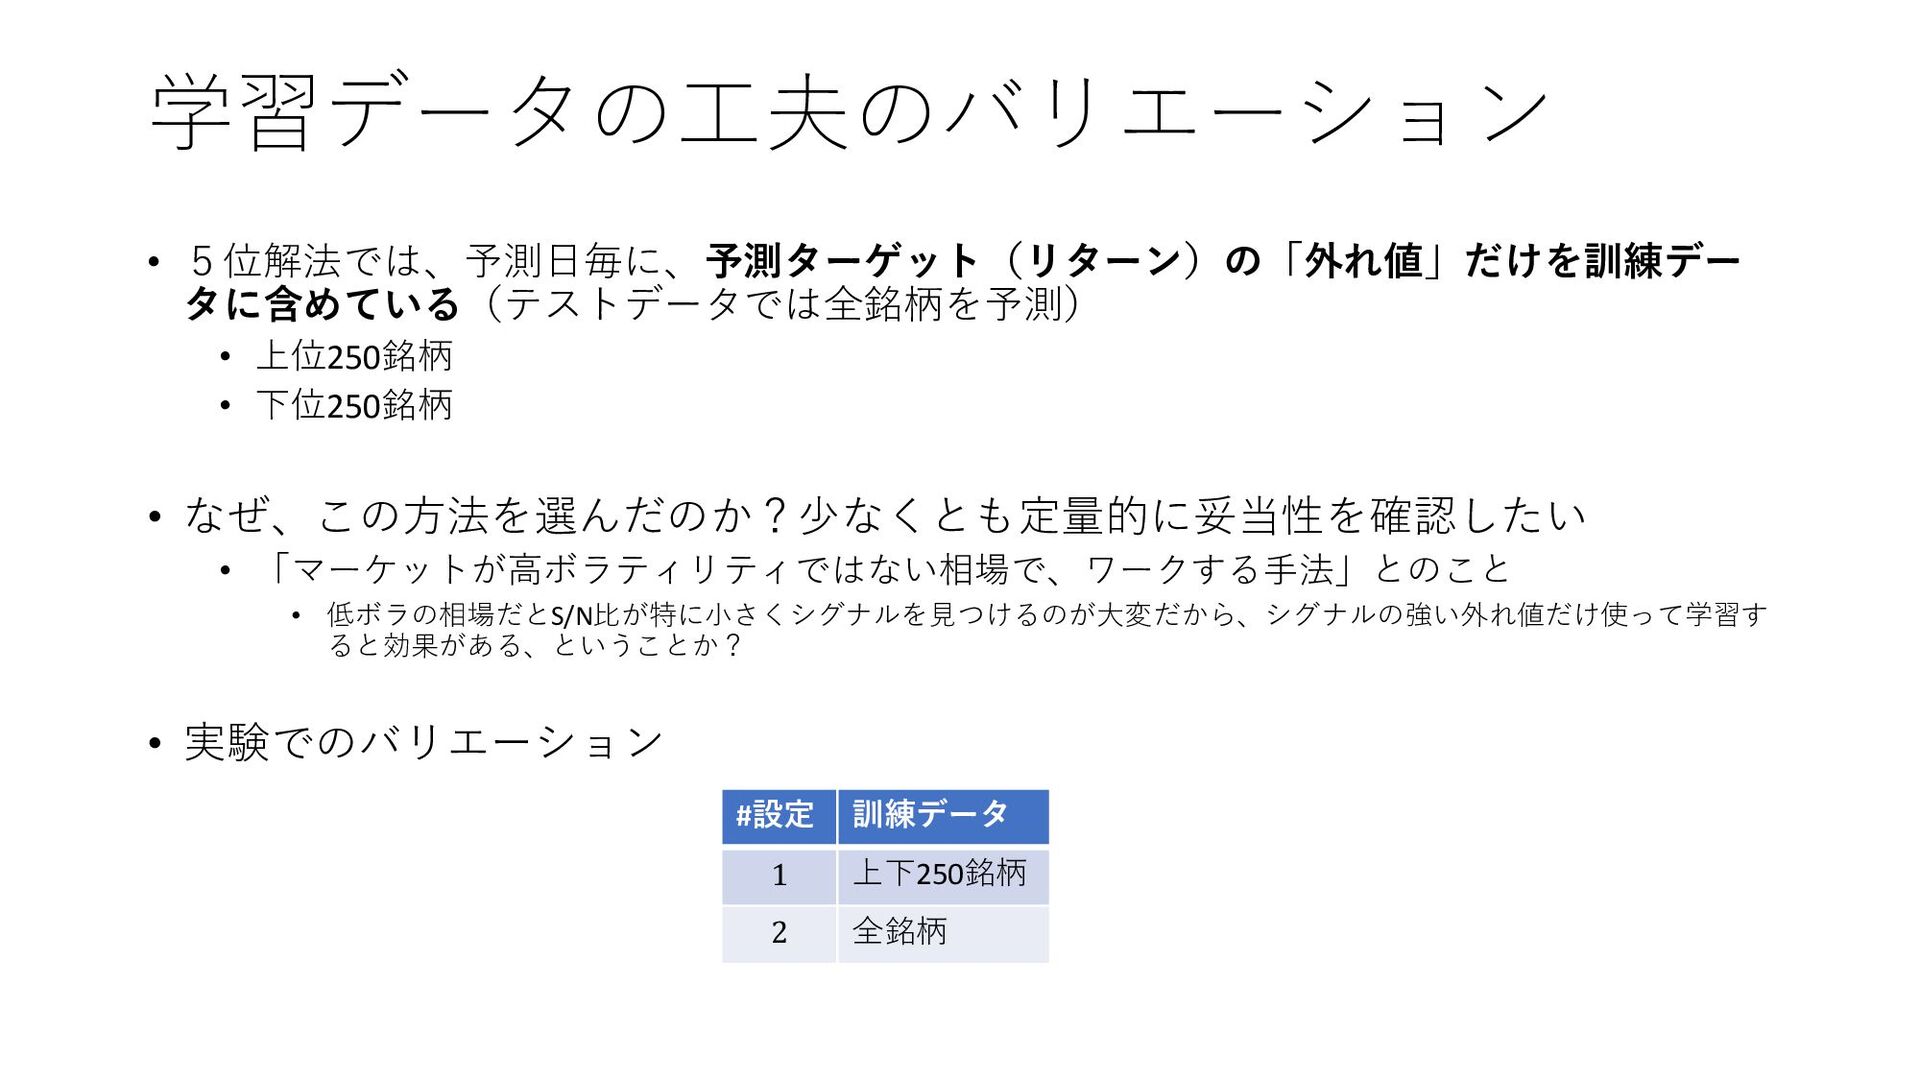
学習データの工夫のバリエーション • 5位解法では、予測日毎に、予測ターゲット(リターン)の「外れ値」だけを訓練デー タに含めている(テストデータでは全銘柄を予測) • 上位250銘柄 • 下位250銘柄 • なぜ、この方法を選んだのか?少なくとも定量的に妥当性を確認したい
• 「マーケットが高ボラティリティではない相場で、ワークする手法」とのこと • 低ボラの相場だとS/N比が特に小さくシグナルを見つけるのが大変だから、シグナルの強い外れ値だけ使って学習す ると効果がある、ということか? • 実験でのバリエーション #設定 訓練データ 1 上下250銘柄 2 全銘柄 -
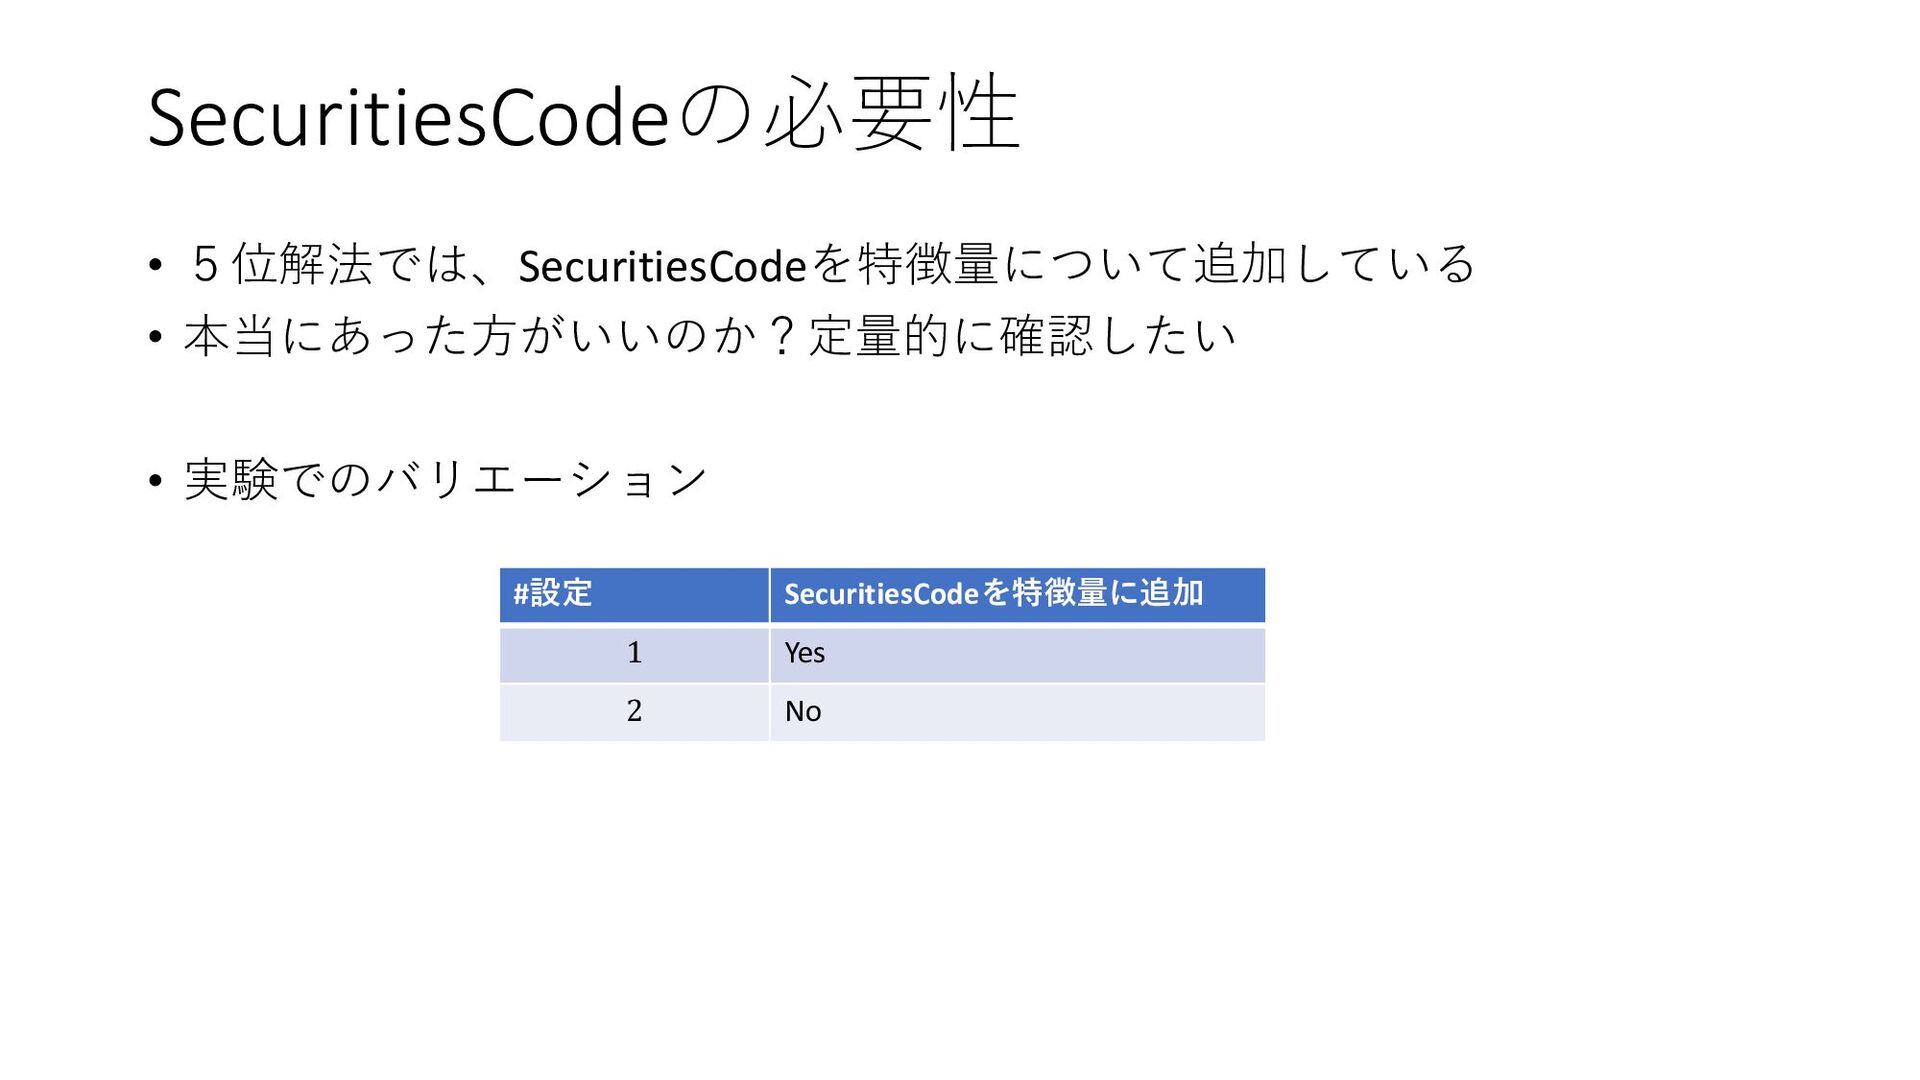
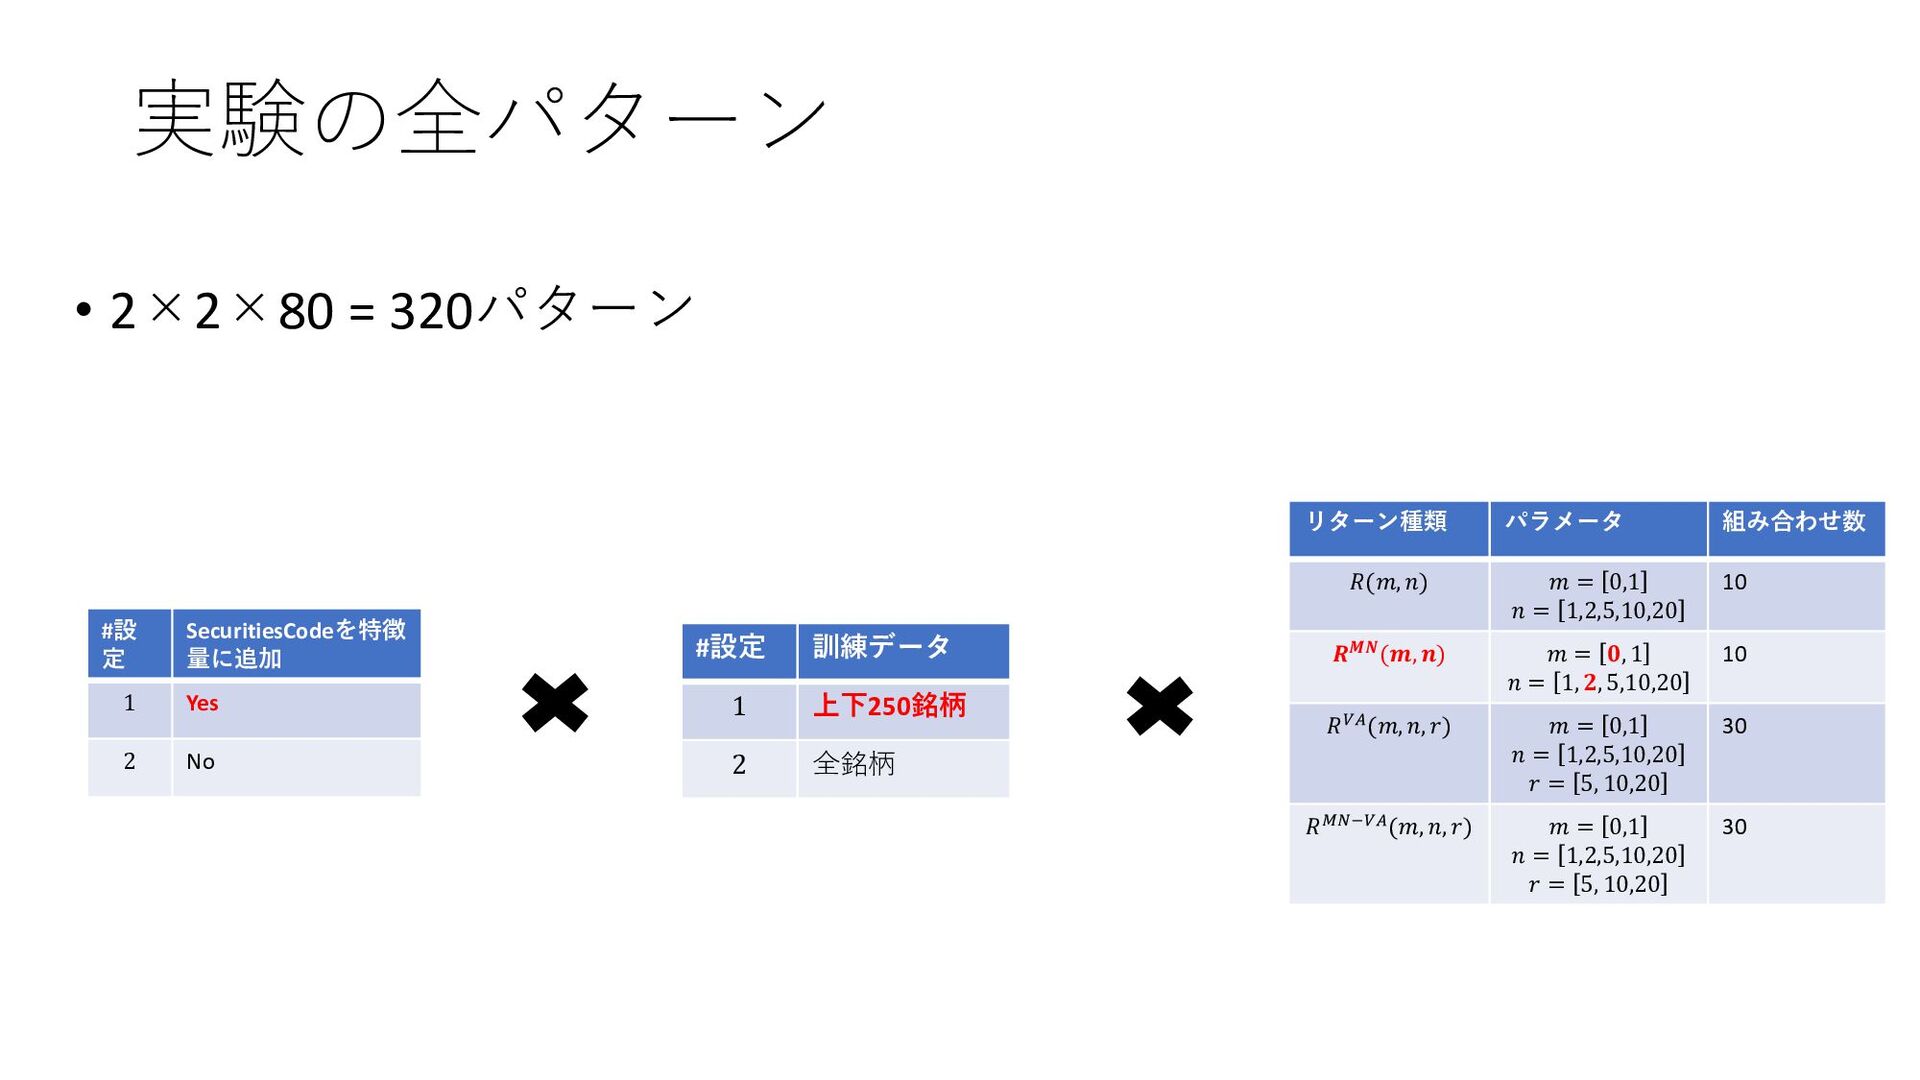
実験の全パターン • 2×2×80 = 320パターン リターン種類 パラメータ 組み合わせ数 𝑅(𝑚, 𝑛)
𝑚 = 0,1 𝑛 = 1,2,5,10,20 10 𝑹𝑴𝑵(𝒎, 𝒏) 𝑚 = 𝟎, 1 𝑛 = 1, 𝟐, 5,10,20 10 𝑅𝑉𝐴(𝑚, 𝑛, 𝑟) 𝑚 = 0,1 𝑛 = 1,2,5,10,20 𝑟 = 5, 10,20 30 𝑅𝑀𝑁−𝑉𝐴(𝑚, 𝑛, 𝑟) 𝑚 = 0,1 𝑛 = 1,2,5,10,20 𝑟 = 5, 10,20 30 #設 定 SecuritiesCodeを特徴 量に追加 1 Yes 2 No #設定 訓練データ 1 上下250銘柄 2 全銘柄 -
最適化の指標(評価方法) 1M 訓練データ テストデータ 1M 1M データ全期間 1M ・ ・
・ 𝑆𝑅1 𝑆𝑅2 𝑆𝑅3 𝑆𝑅𝑁 ▪ Expanding Windowで訓練期間を延ばしながら(最短1年)、先1か月間を予測。 ▪ 各月でSR(シャープレシオ)を計算し平均を取る(平均SR)。 ▪ 5位解法では、平均SRを最大化する、予測ターゲットを選んだとのこと。 -
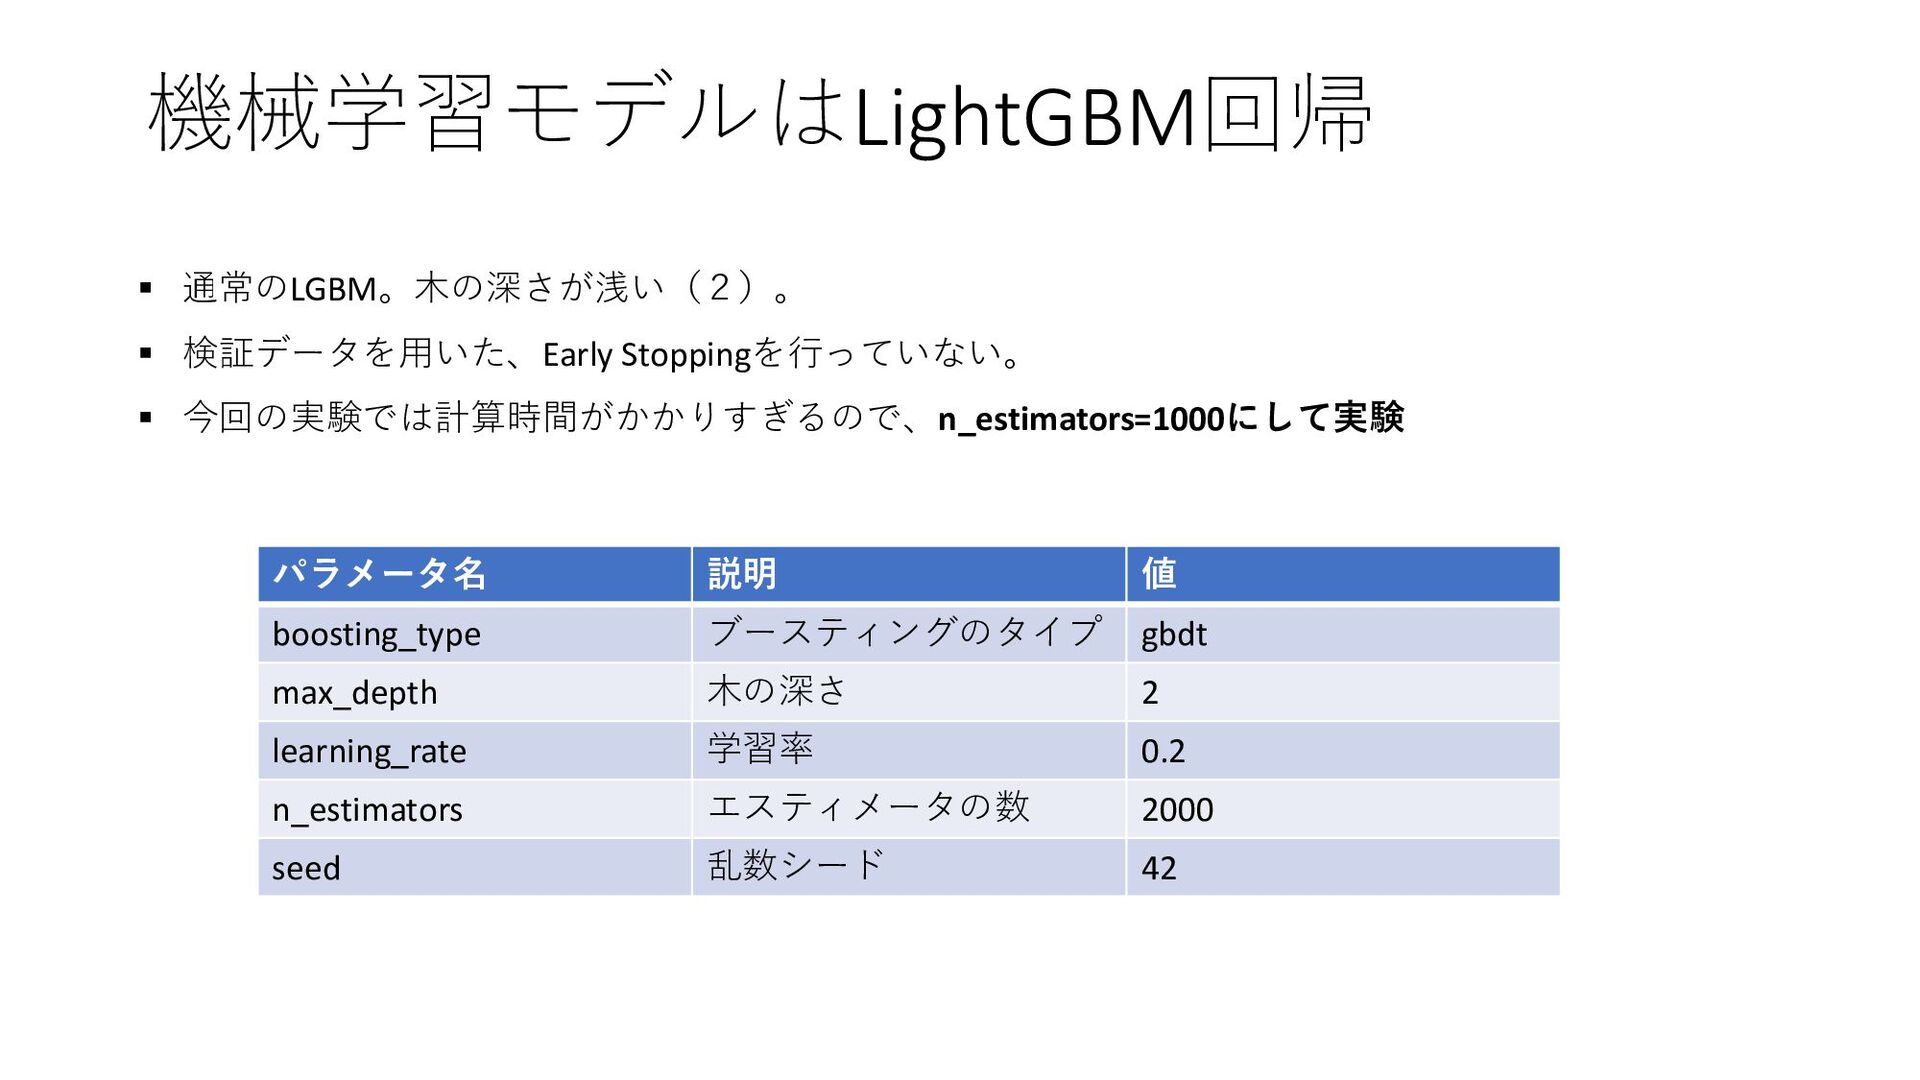
機械学習モデルはLightGBM回帰 パラメータ名 説明 値 boosting_type ブースティングのタイプ gbdt max_depth 木の深さ 2
learning_rate 学習率 0.2 n_estimators エスティメータの数 2000 seed 乱数シード 42 ▪ 通常のLGBM。木の深さが浅い(2)。 ▪ 検証データを用いた、Early Stoppingを行っていない。 ▪ 今回の実験では計算時間がかかりすぎるので、n_estimators=1000にして実験 -
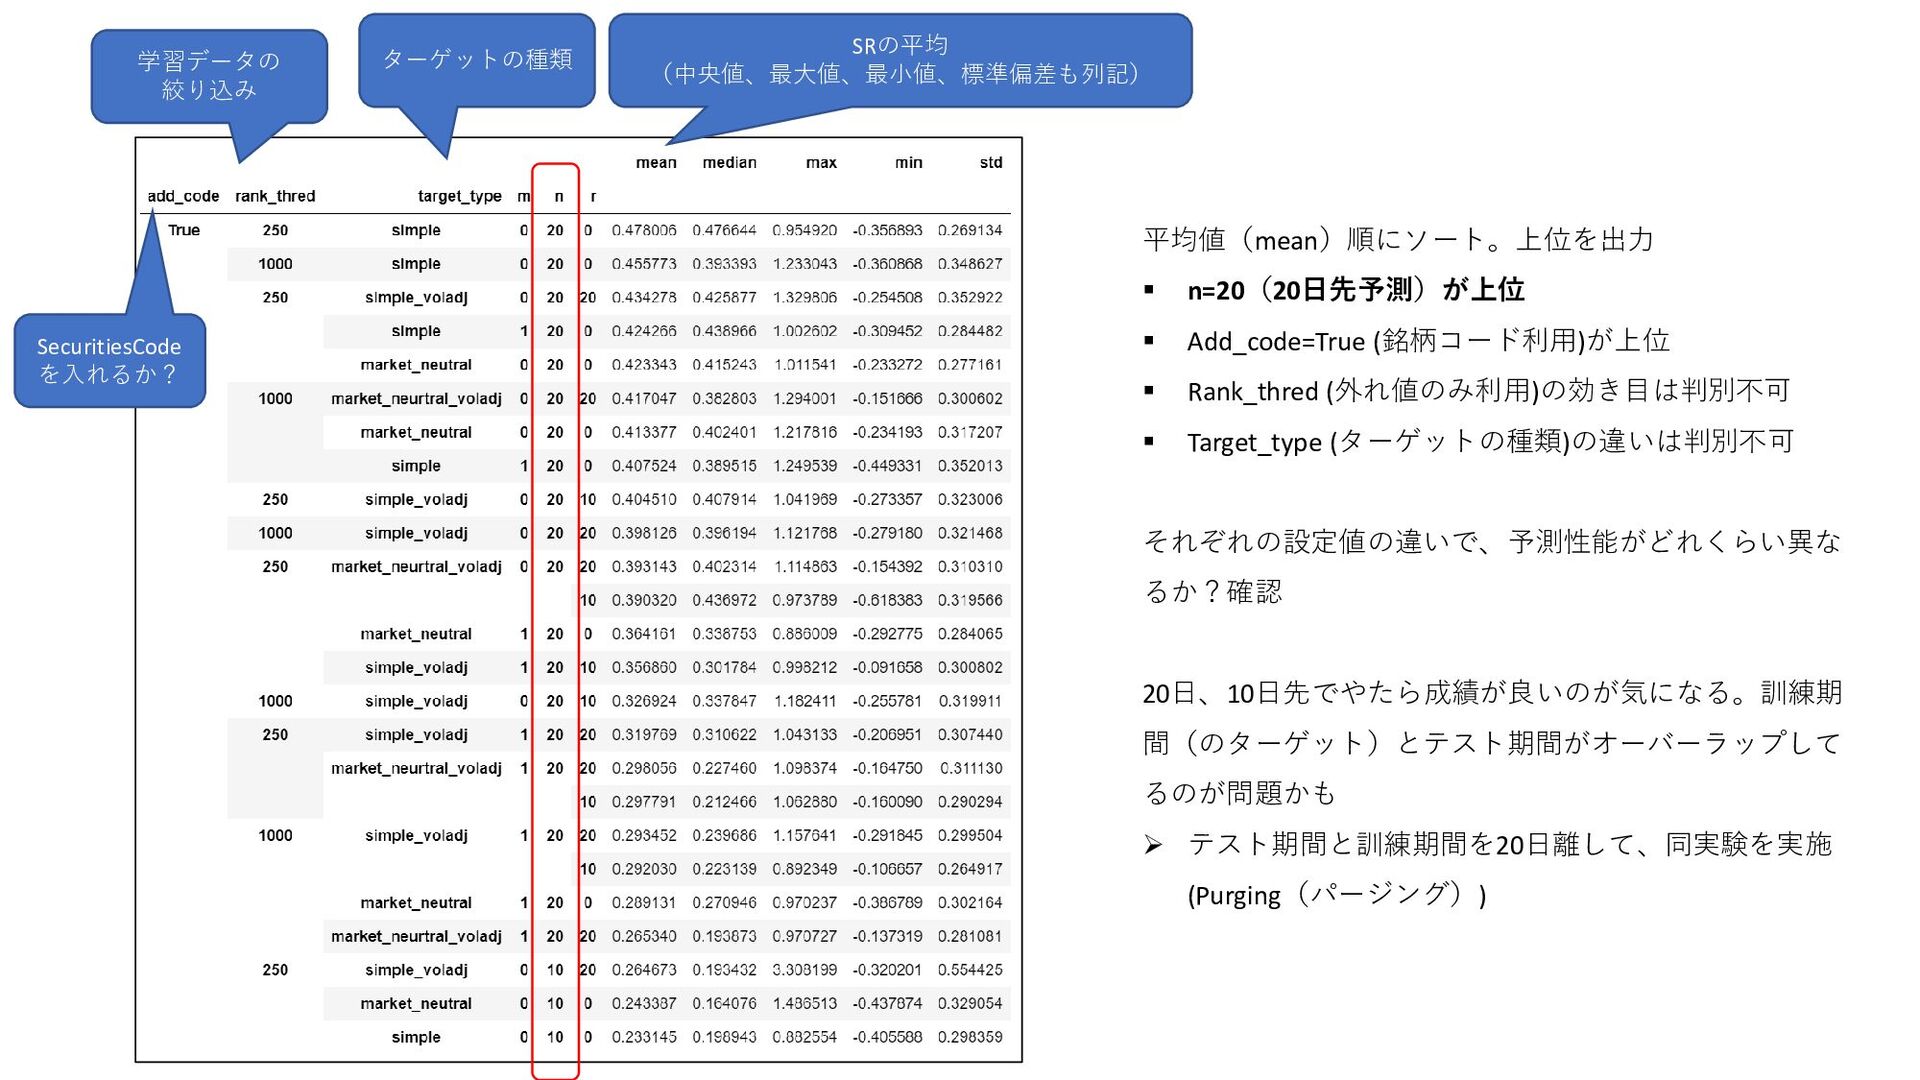
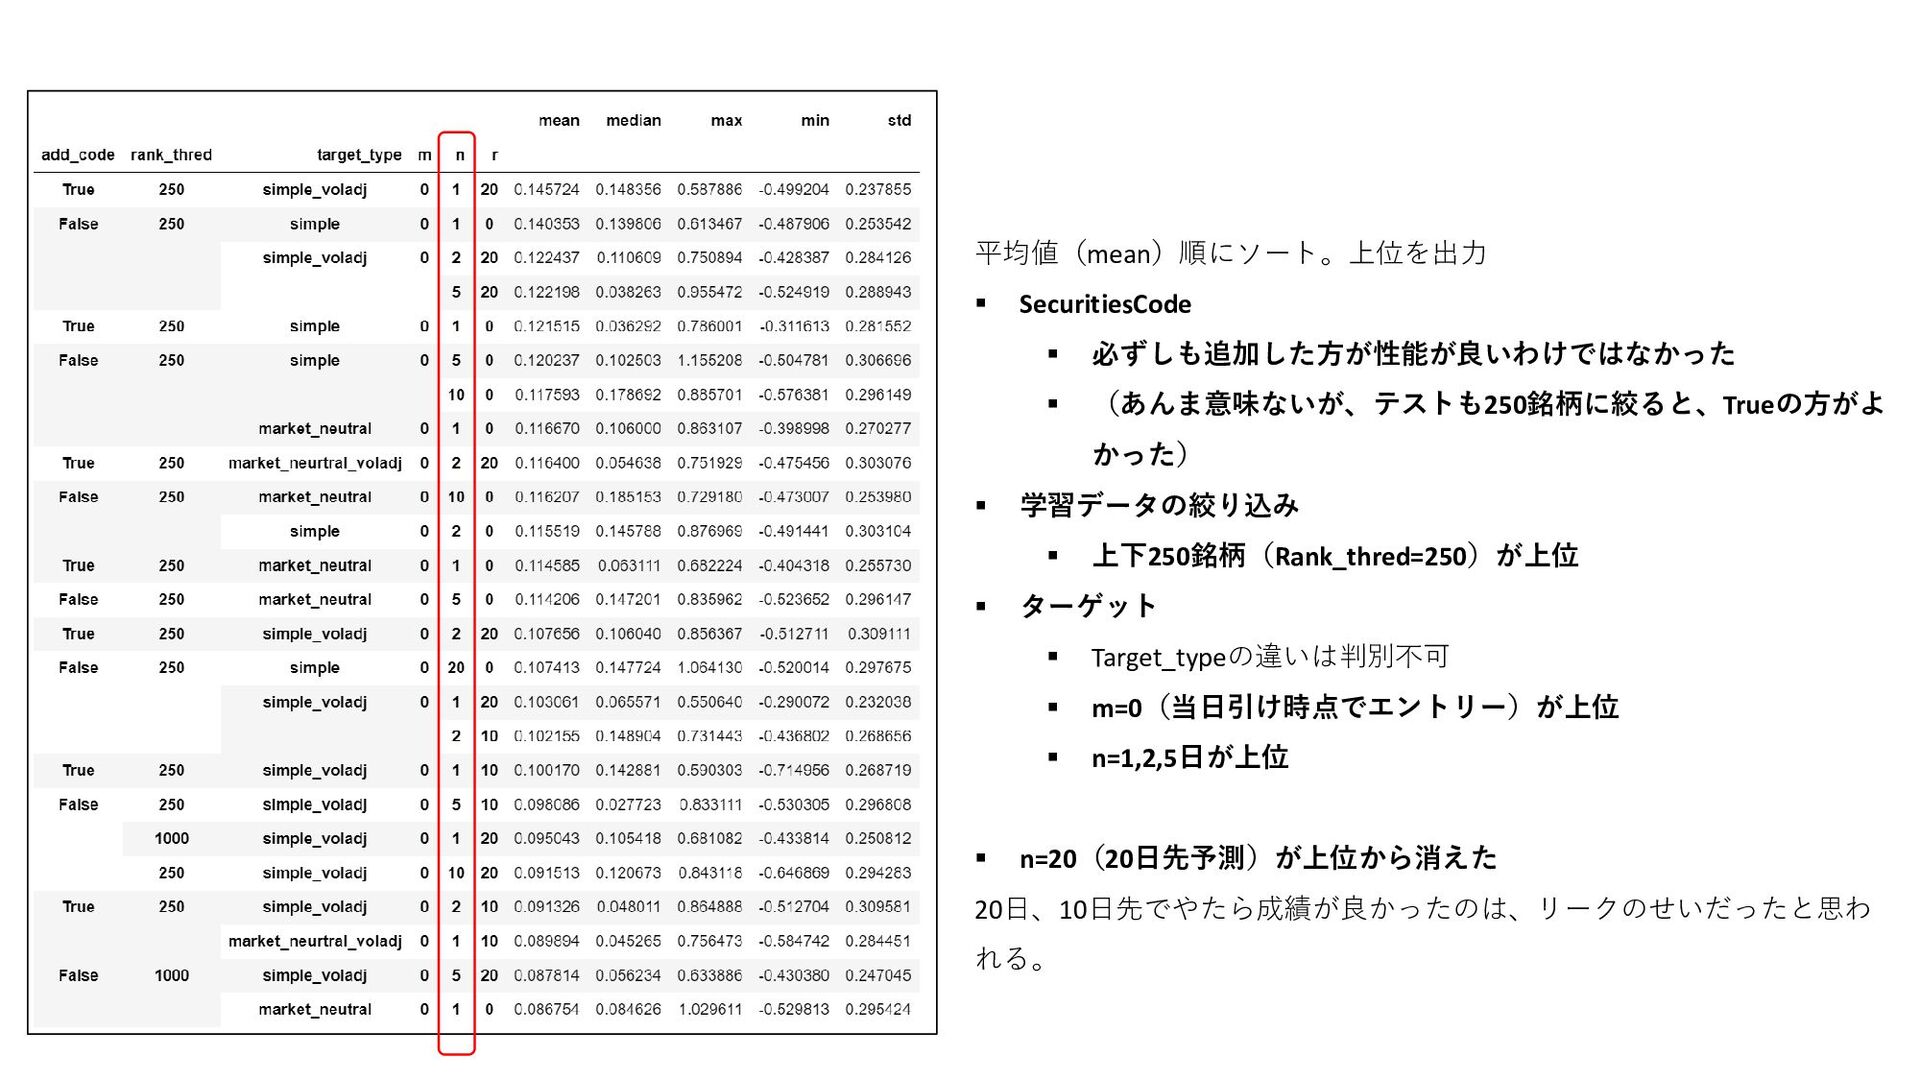
平均値(mean)順にソート。上位を出力 ▪ n=20(20日先予測)が上位 ▪ Add_code=True (銘柄コード利用)が上位 ▪ Rank_thred (外れ値のみ利用)の効き目は判別不可 ▪
Target_type (ターゲットの種類)の違いは判別不可 それぞれの設定値の違いで、予測性能がどれくらい異な るか?確認 20日、10日先でやたら成績が良いのが気になる。訓練期 間(のターゲット)とテスト期間がオーバーラップして るのが問題かも ➢ テスト期間と訓練期間を20日離して、同実験を実施 (Purging(パージング)) SecuritiesCode を入れるか? 学習データの 絞り込み ターゲットの種類 SRの平均 (中央値、最大値、最小値、標準偏差も列記) -
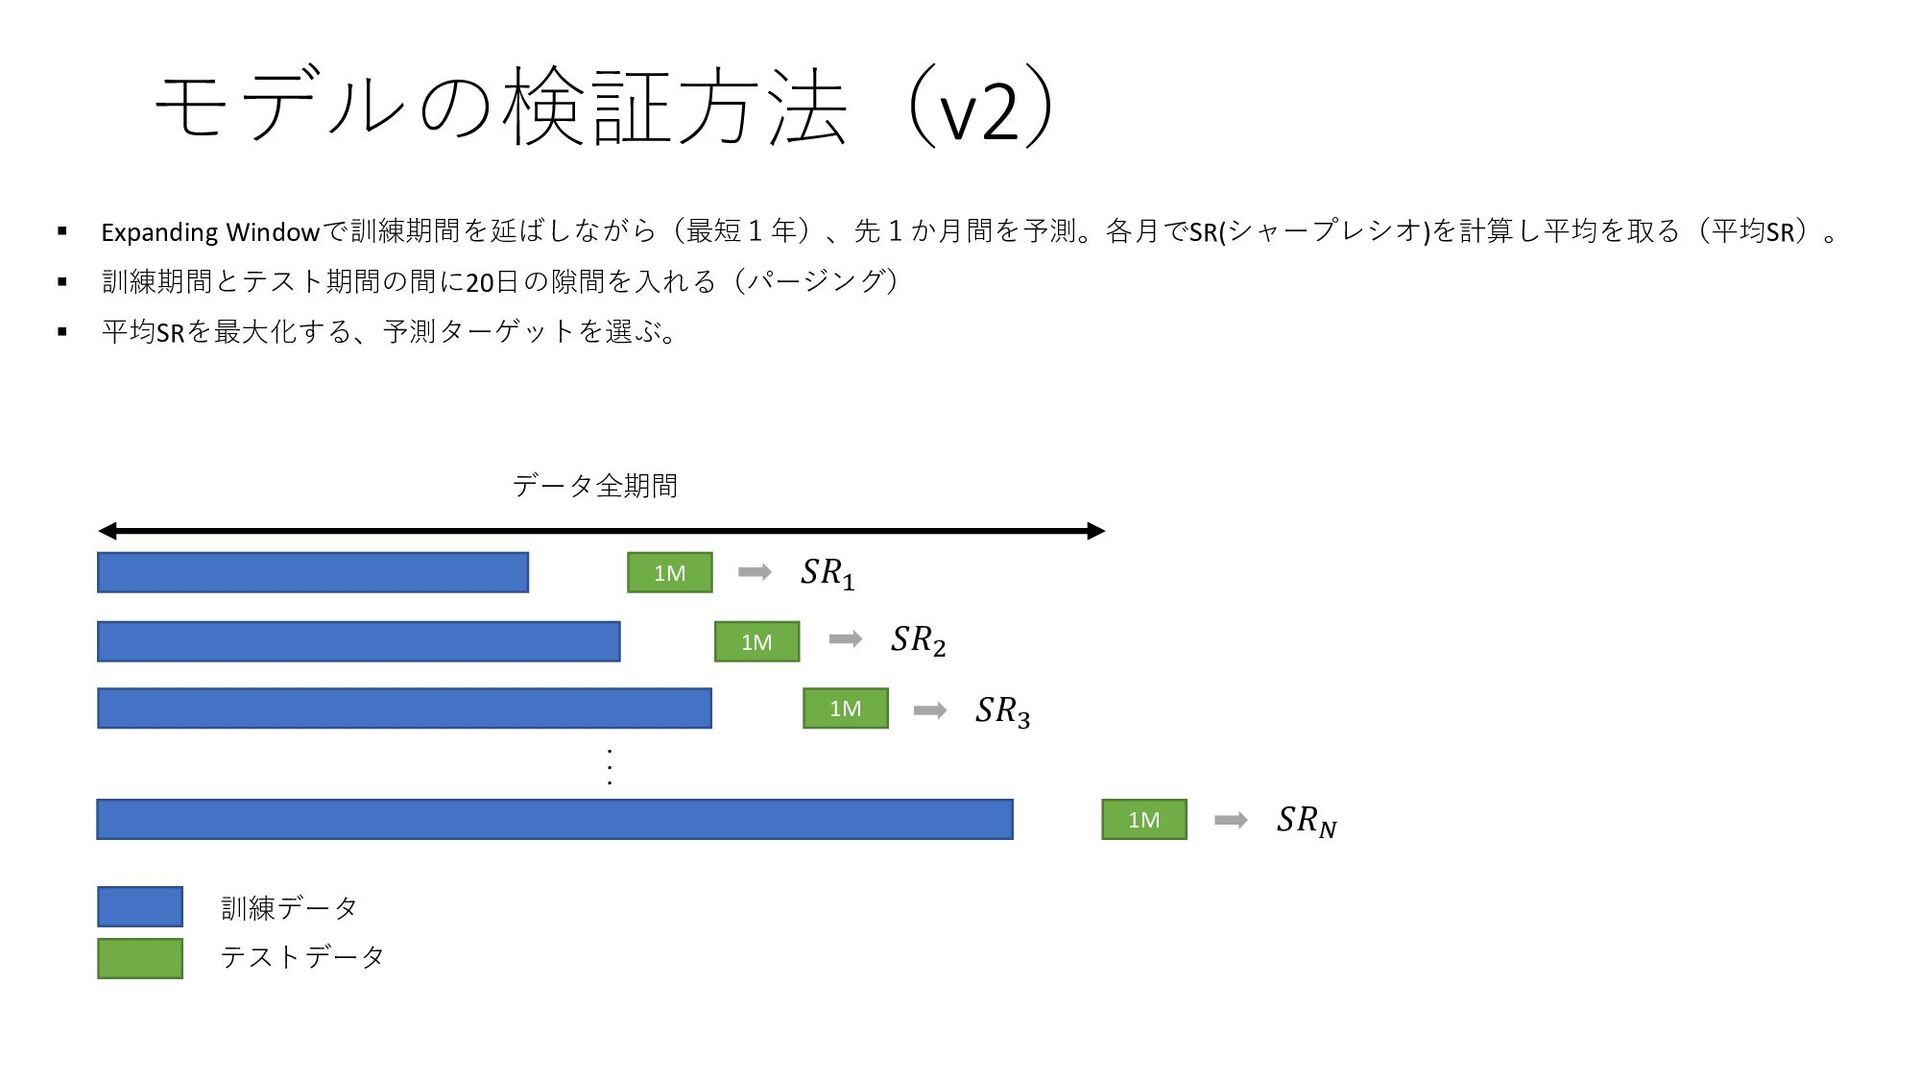
モデルの検証方法(v2) 1M 訓練データ テストデータ 1M 1M データ全期間 1M ・ ・
・ 𝑆𝑅1 𝑆𝑅2 𝑆𝑅3 𝑆𝑅𝑁 ▪ Expanding Windowで訓練期間を延ばしながら(最短1年)、先1か月間を予測。各月でSR(シャープレシオ)を計算し平均を取る(平均SR)。 ▪ 訓練期間とテスト期間の間に20日の隙間を入れる(パージング) ▪ 平均SRを最大化する、予測ターゲットを選ぶ。 -
平均値(mean)順にソート。上位を出力 ▪ SecuritiesCode ▪ 必ずしも追加した方が性能が良いわけではなかった ▪ (あんま意味ないが、テストも250銘柄に絞ると、Trueの方がよ かった) ▪ 学習データの絞り込み
▪ 上下250銘柄(Rank_thred=250)が上位 ▪ ターゲット ▪ Target_typeの違いは判別不可 ▪ m=0(当日引け時点でエントリー)が上位 ▪ n=1,2,5日が上位 ▪ n=20(20日先予測)が上位から消えた 20日、10日先でやたら成績が良かったのは、リークのせいだったと思わ れる。 -
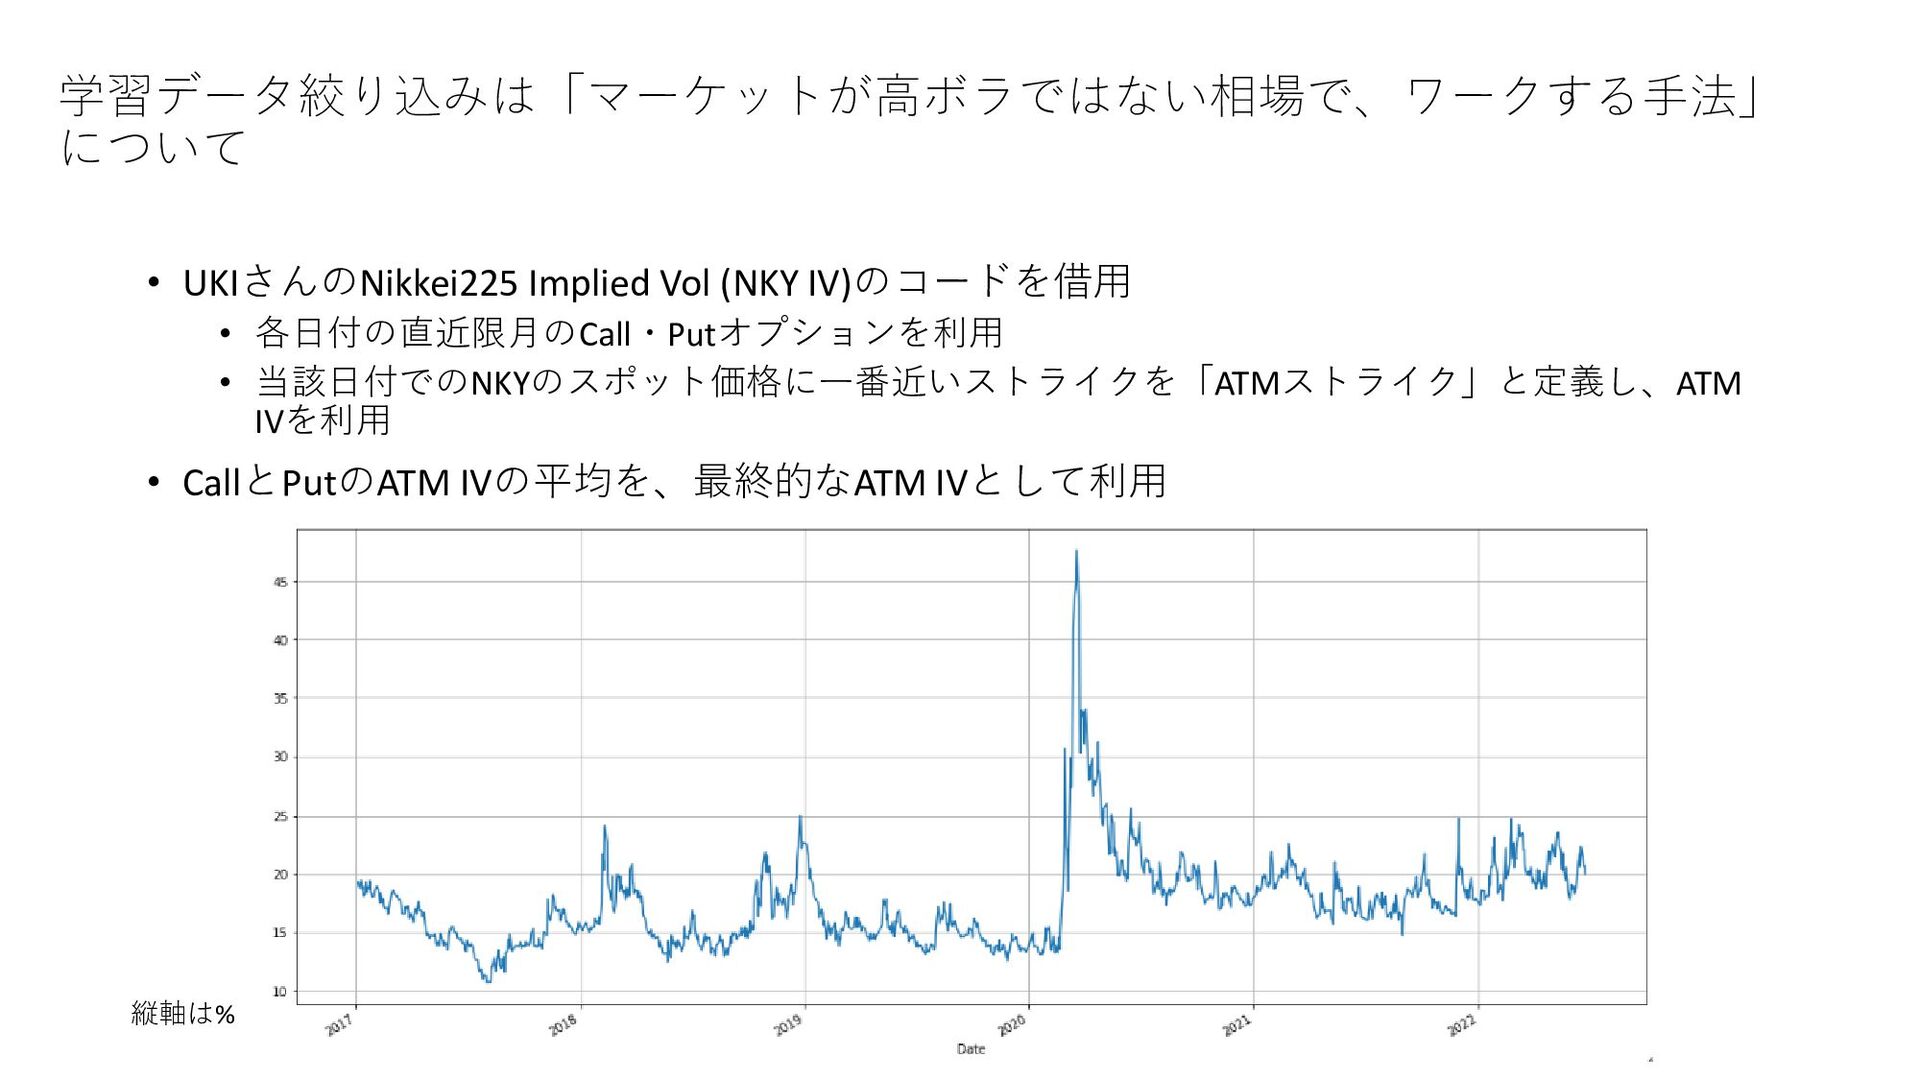
学習データ絞り込みは「マーケットが高ボラではない相場で、ワークする手法」 について • UKIさんのNikkei225 Implied Vol (NKY IV)のコードを借用 • 各日付の直近限月のCall・Putオプションを利用
• 当該日付でのNKYのスポット価格に一番近いストライクを「ATMストライク」と定義し、ATM IVを利用 • CallとPutのATM IVの平均を、最終的なATM IVとして利用 縦軸は% -
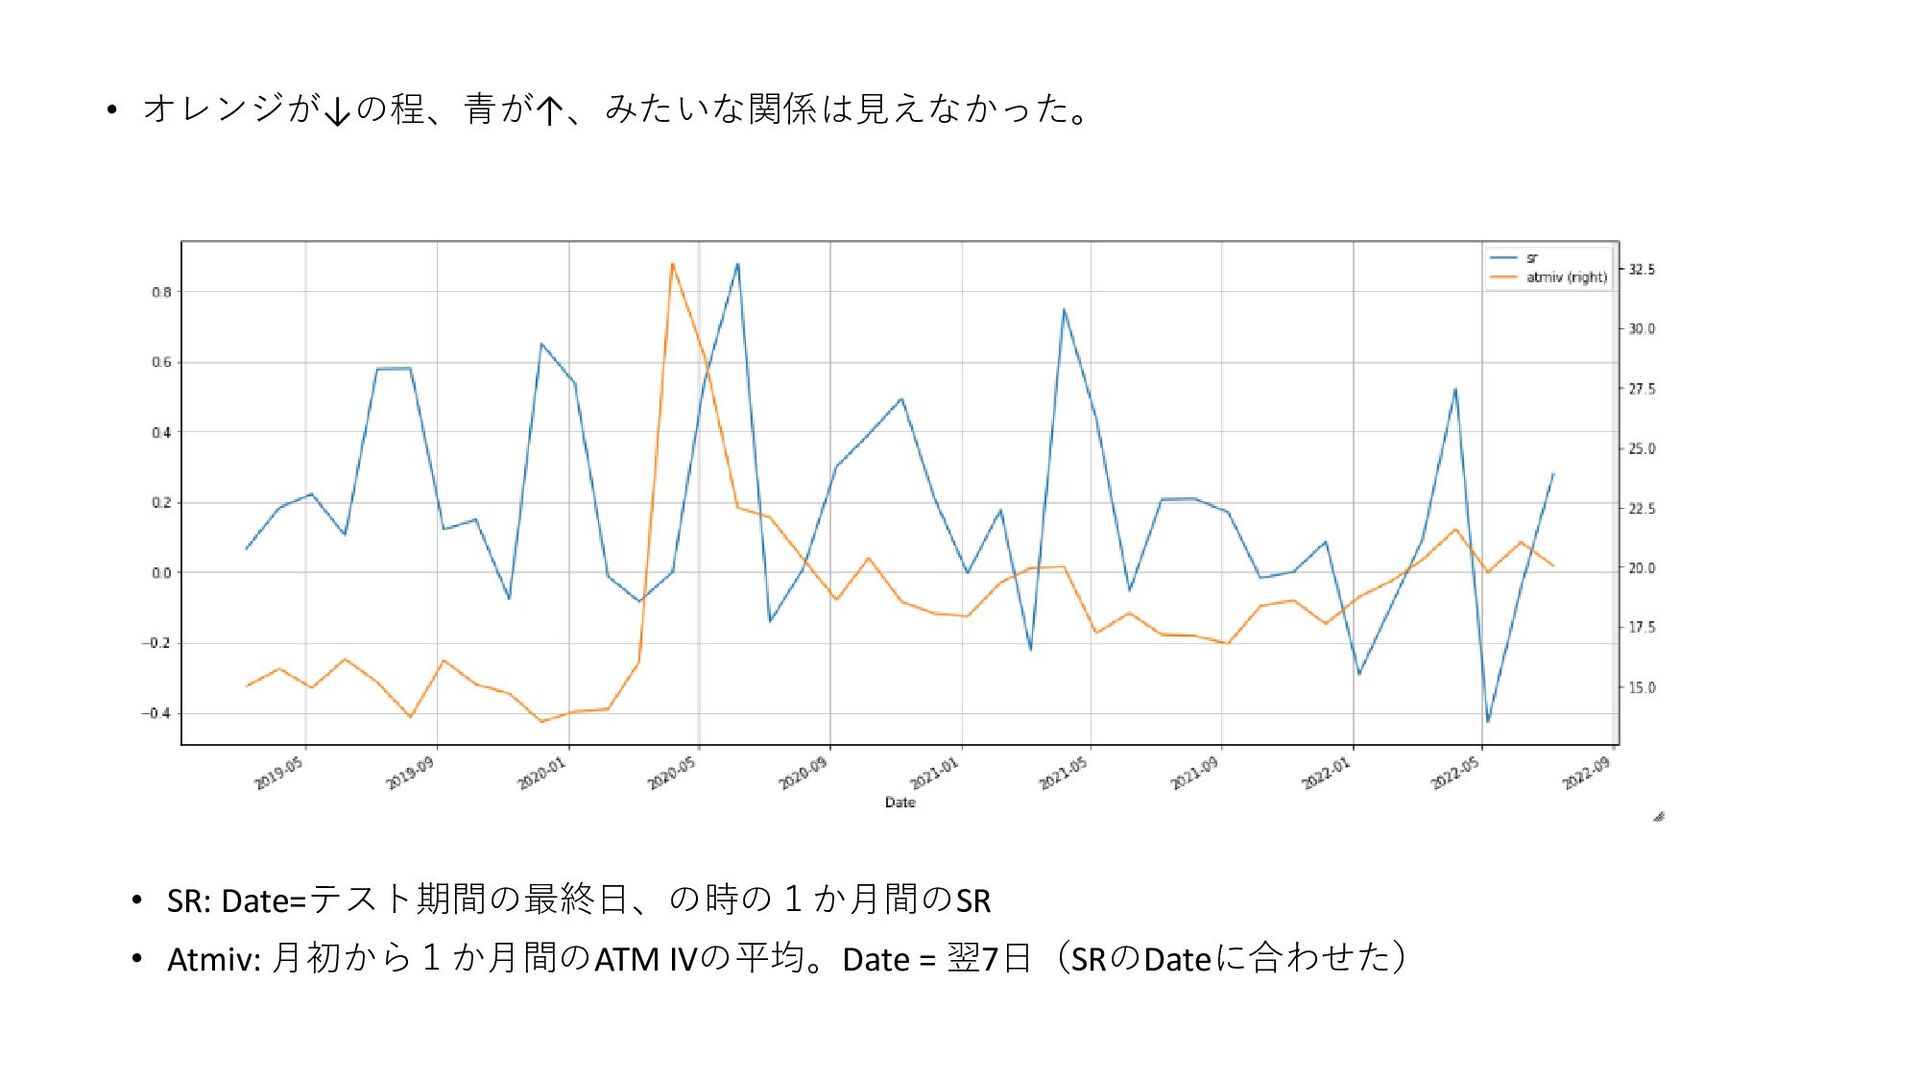
• SR: Date=テスト期間の最終日、の時の1か月間のSR • Atmiv: 月初から1か月間のATM IVの平均。Date = 翌7日(SRのDateに合わせた) •
オレンジが↓の程、青が↑、みたいな関係は見えなかった。 -
ここまでのまとめ ✓ データ前処理 ✓ 特徴量設計 ➢ その特徴量が効く要因の仮説を考えてみた。未検証 ✓ モデル予測値(ターゲット)と、学習データについて、5位解法の設定の妥当性を検証した。 ✓
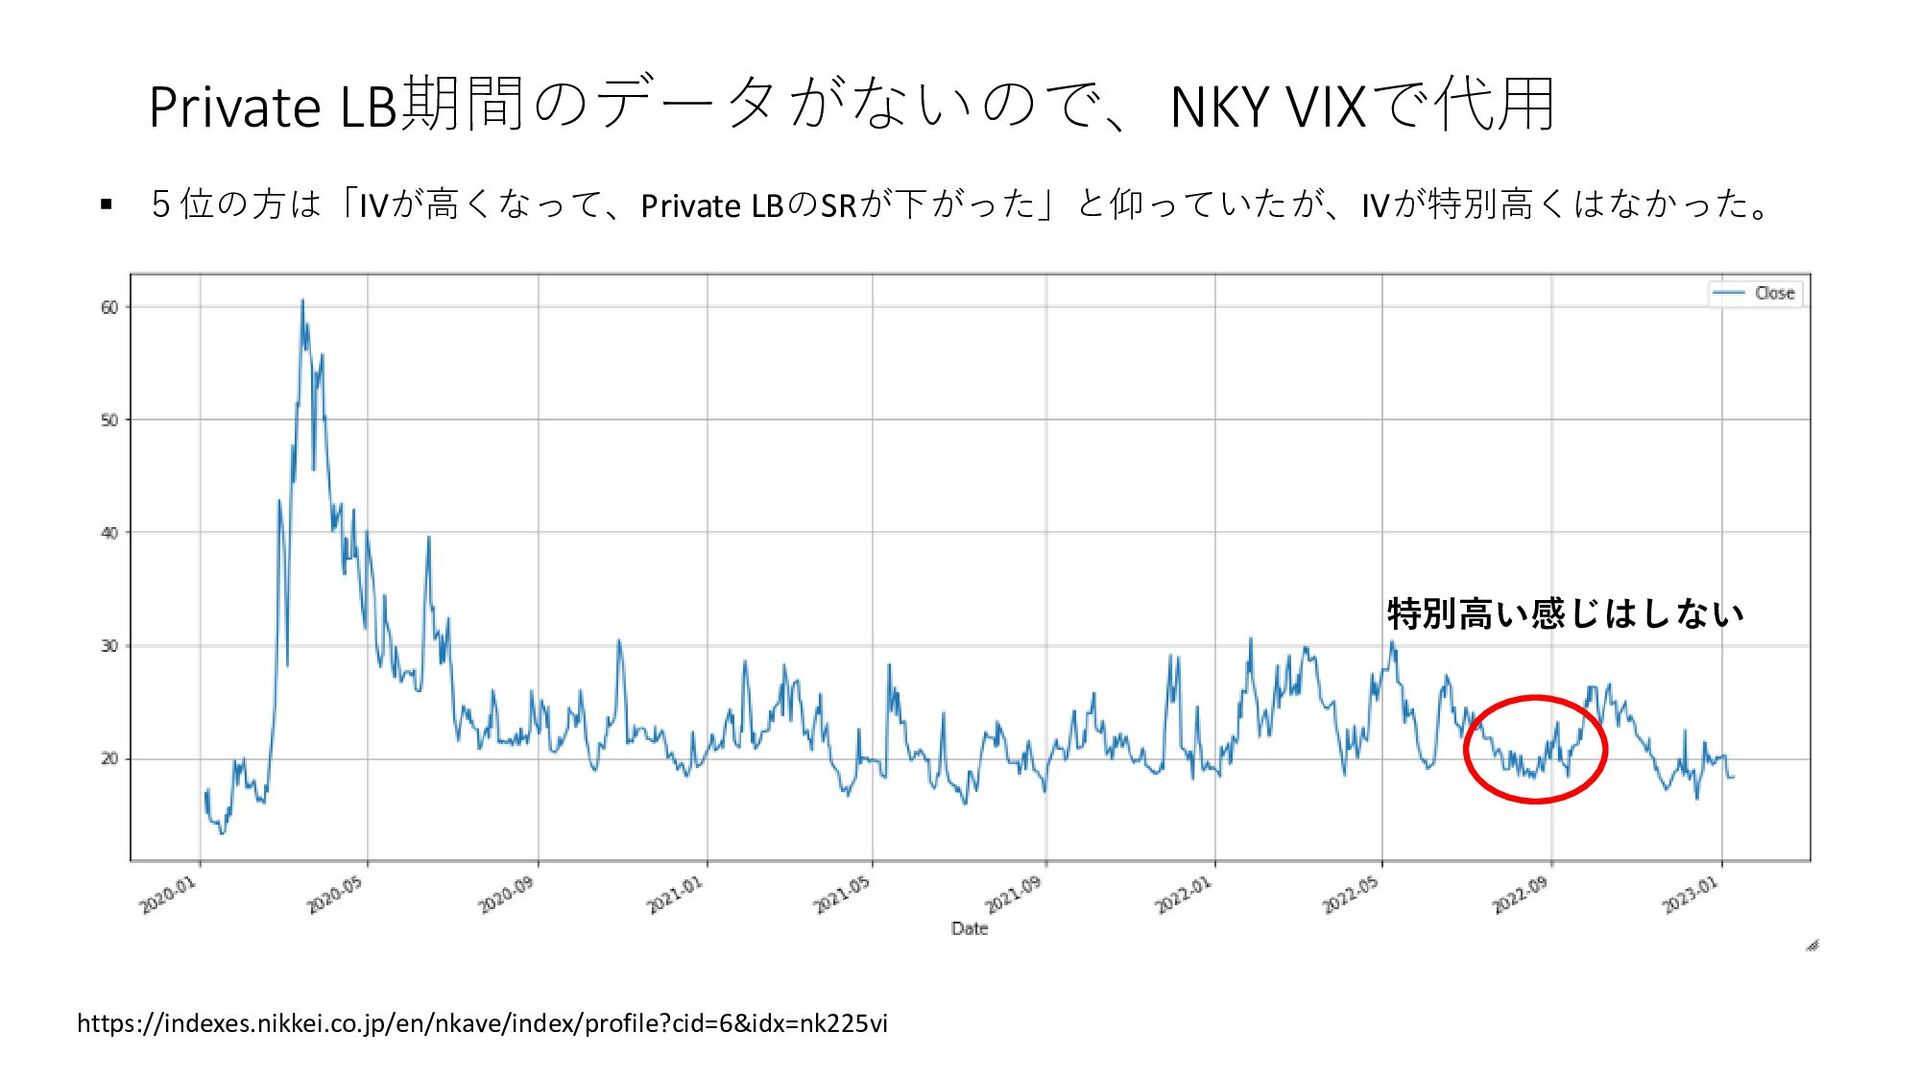
SecuritiesCodeを特徴量として入れた方がはっきり良い、という結果を得られなかった。 ✓ 学習データの絞り込みをする方がよい。 ✓ M=0の方が良さそう。N=2より1の方がよい? ✓ Market_Neutralが必ずしもベストかわからなかった。 ✓ 5位の方の評価方法には工夫があった。リークが怖かったためパージしたバージョンで比較した。 ✓ 「マーケットが高ボラティリティではない相場で、ワークする手法」を確認したが、学習データではっきりとし た関係は見えなかった。また、Private LBのIVもそんなに高くなかった。 -
アジェンダ 1. 5位解法紹介 1. データ前処理 2. 特徴量の工夫 3. モデル予測値(ターゲット)の工夫 4.
学習データの工夫(Outlierのみの訓練) 5. 評価方法の工夫 6. どの特徴量が、結局効果があったのか? 2. その他 1. Optionボラティリティの利用 2. 予測銘柄の傾向 -
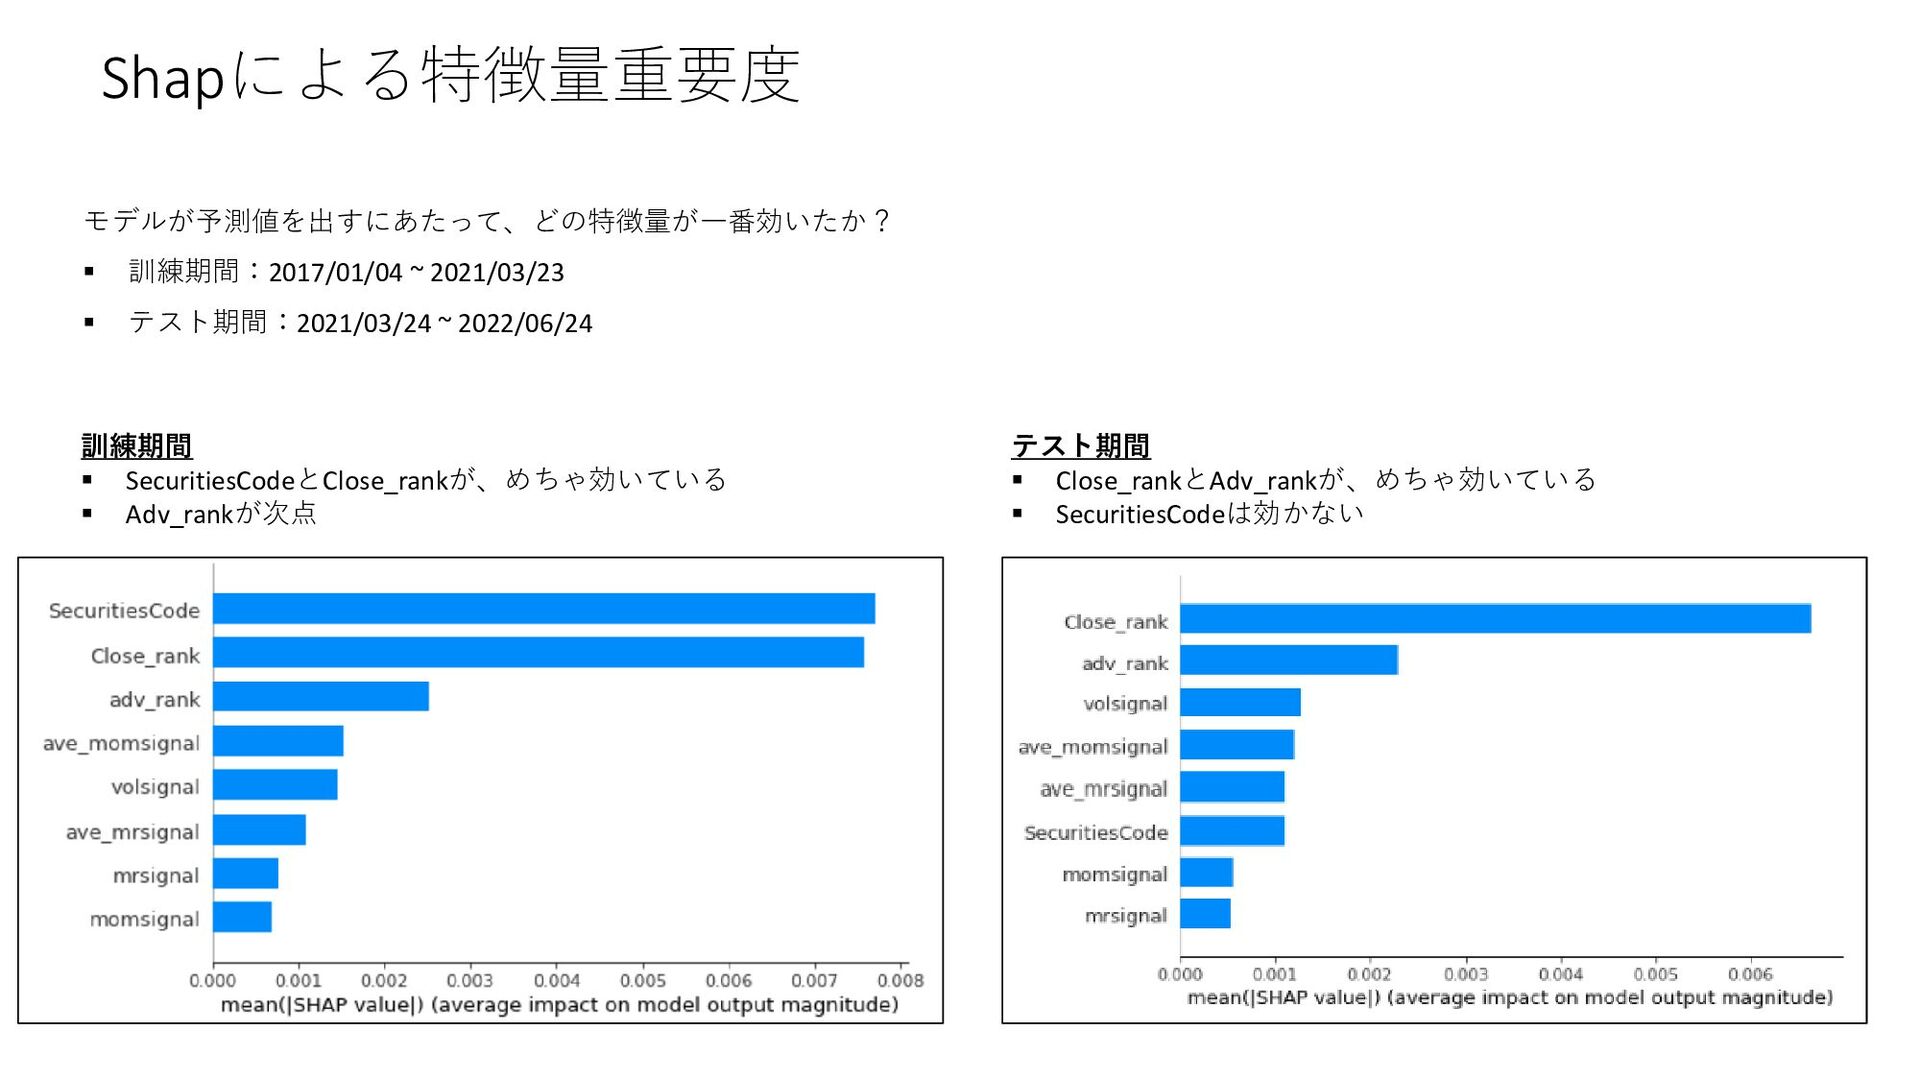
Shapによる特徴量重要度 モデルが予測値を出すにあたって、どの特徴量が一番効いたか? ▪ 訓練期間:2017/01/04 ~ 2021/03/23 ▪ テスト期間:2021/03/24 ~ 2022/06/24
テスト期間 ▪ Close_rankとAdv_rankが、めちゃ効いている ▪ SecuritiesCodeは効かない 訓練期間 ▪ SecuritiesCodeとClose_rankが、めちゃ効いている ▪ Adv_rankが次点 -
Shapによる特徴量重要度 各特徴量は、予測リターンを「正の方向に押し上げた」のか、それとも「負の方向に押し下げた」のか? ▪ SecuritiesCode ▪ 良く分からない(コードの数値の大小にあまり意味がない) ▪ Close_rank ▪ Closeが相対的に小さい→リターンを正に押し上げる
▪ Closeが相対的に大きい→リターンを負に押し下げる ▪ adv_rank ▪ 出来高が相対的に小さい→リターンを正に押し上げる ▪ 出来高が相対的に大きい→リターンを負に押し下げる 訓練期間 テスト期間 -
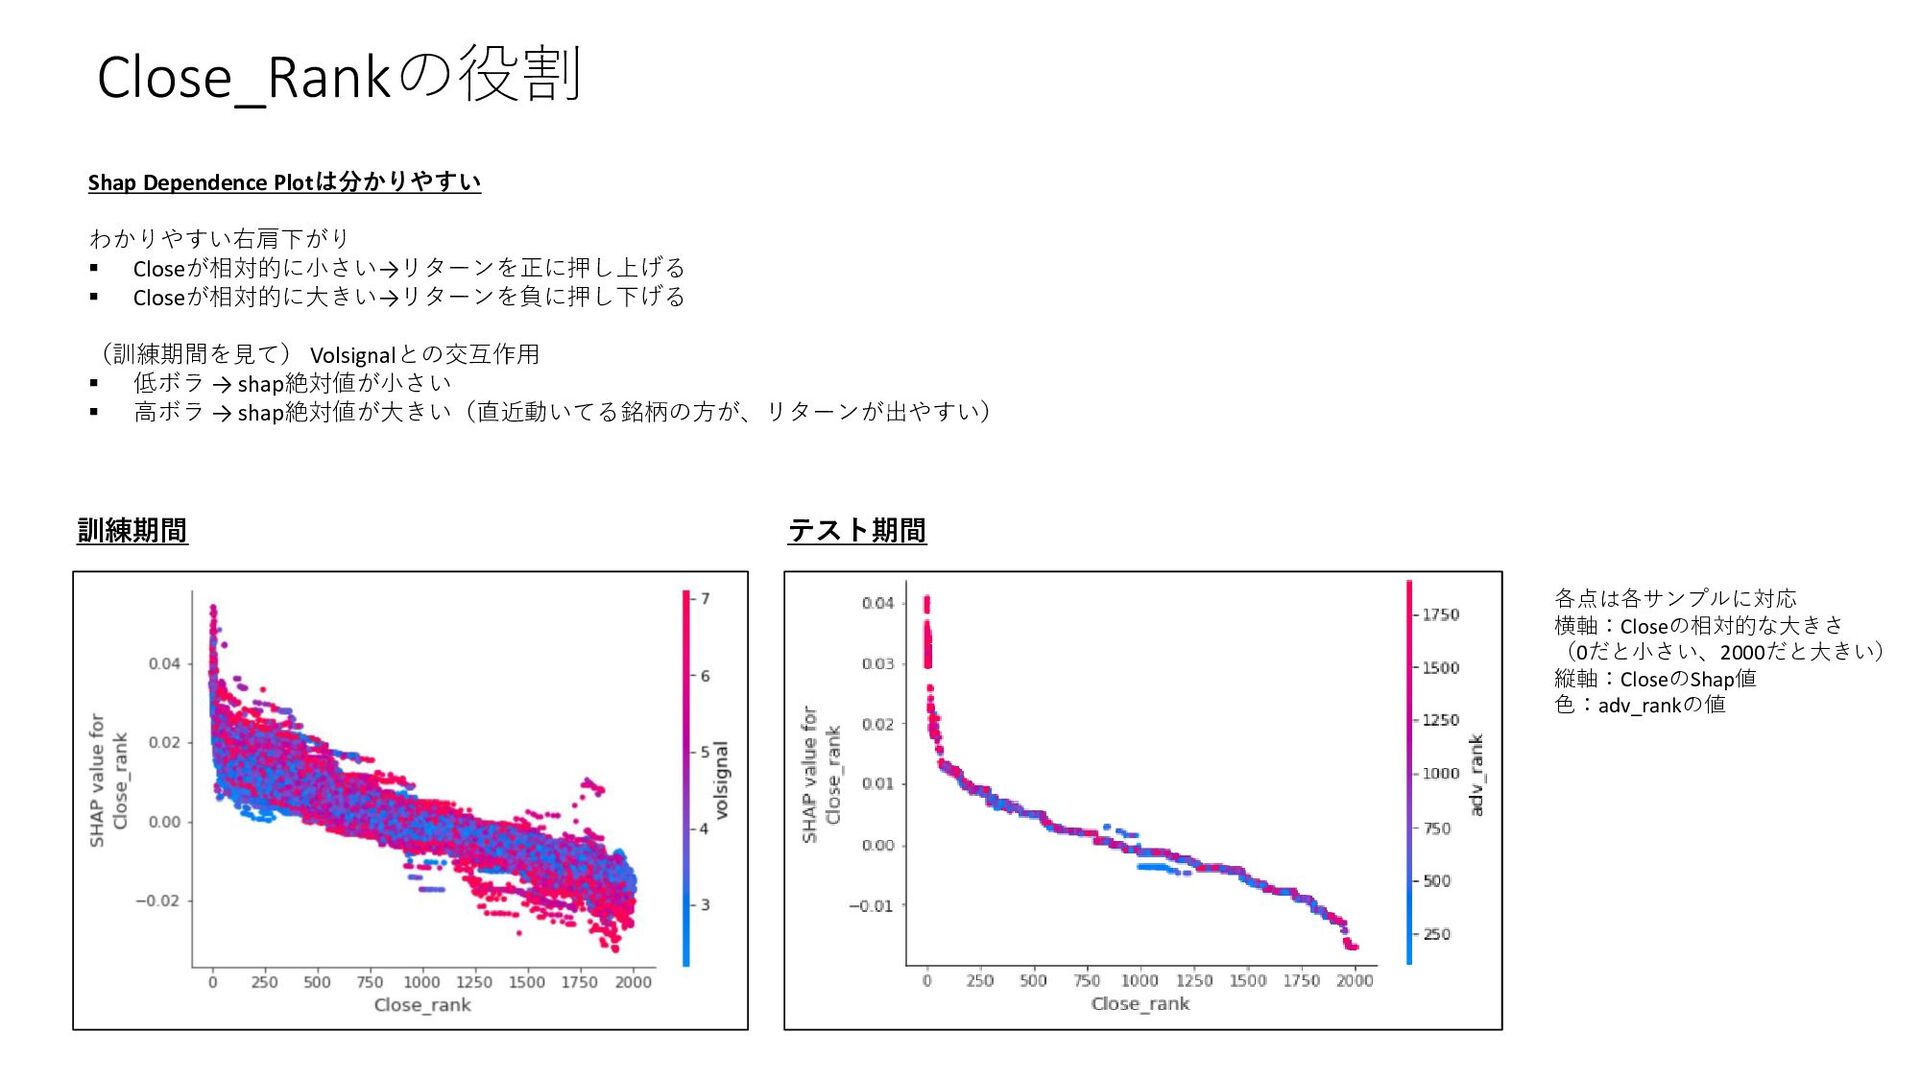
Close_Rankの役割 Shap Dependence Plotは分かりやすい わかりやすい右肩下がり ▪ Closeが相対的に小さい→リターンを正に押し上げる ▪ Closeが相対的に大きい→リターンを負に押し下げる (訓練期間を見て)
Volsignalとの交互作用 ▪ 低ボラ → shap絶対値が小さい ▪ 高ボラ → shap絶対値が大きい(直近動いてる銘柄の方が、リターンが出やすい) 各点は各サンプルに対応 横軸:Closeの相対的な大きさ (0だと小さい、2000だと大きい) 縦軸:CloseのShap値 色:adv_rankの値 訓練期間 テスト期間 -
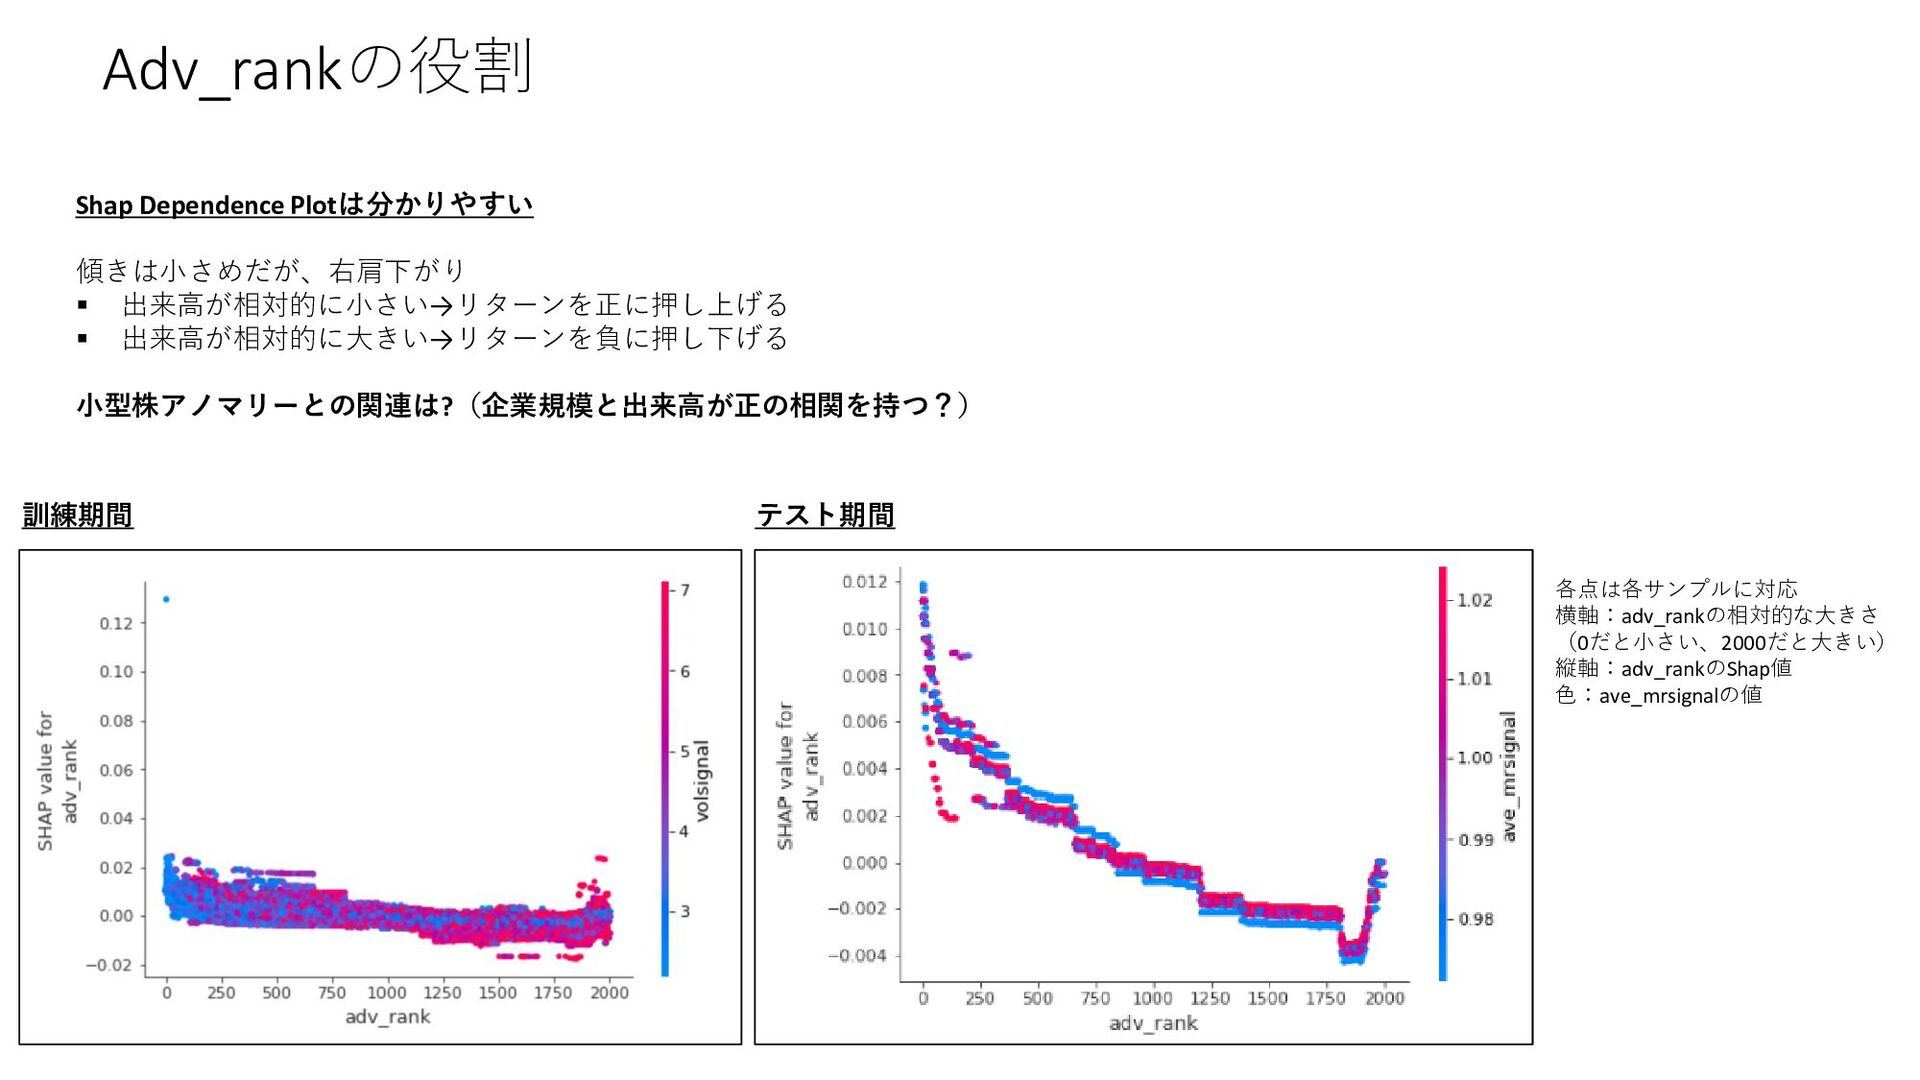
Adv_rankの役割 Shap Dependence Plotは分かりやすい 傾きは小さめだが、右肩下がり ▪ 出来高が相対的に小さい→リターンを正に押し上げる ▪ 出来高が相対的に大きい→リターンを負に押し下げる 小型株アノマリーとの関連は?(企業規模と出来高が正の相関を持つ?)
各点は各サンプルに対応 横軸:adv_rankの相対的な大きさ (0だと小さい、2000だと大きい) 縦軸:adv_rankのShap値 色:ave_mrsignalの値 訓練期間 テスト期間 -
出来高と企業規模(時価総額)の関係 各点は各銘柄を表す ▪ x軸:stock_list.csvのMarket Capitalization(時価総額) ▪ y軸:adv(Volumeの11日移動平均)の全期間の平均値 ▪ x軸、y軸ともに対数で表示 観察できること
▪ 一応、正の相関が見える ▪ 出来高↑ ↔ 企業規模↑ → リターン↓で、一応、小型株アノマリー の説明がつくのかな、、、 -
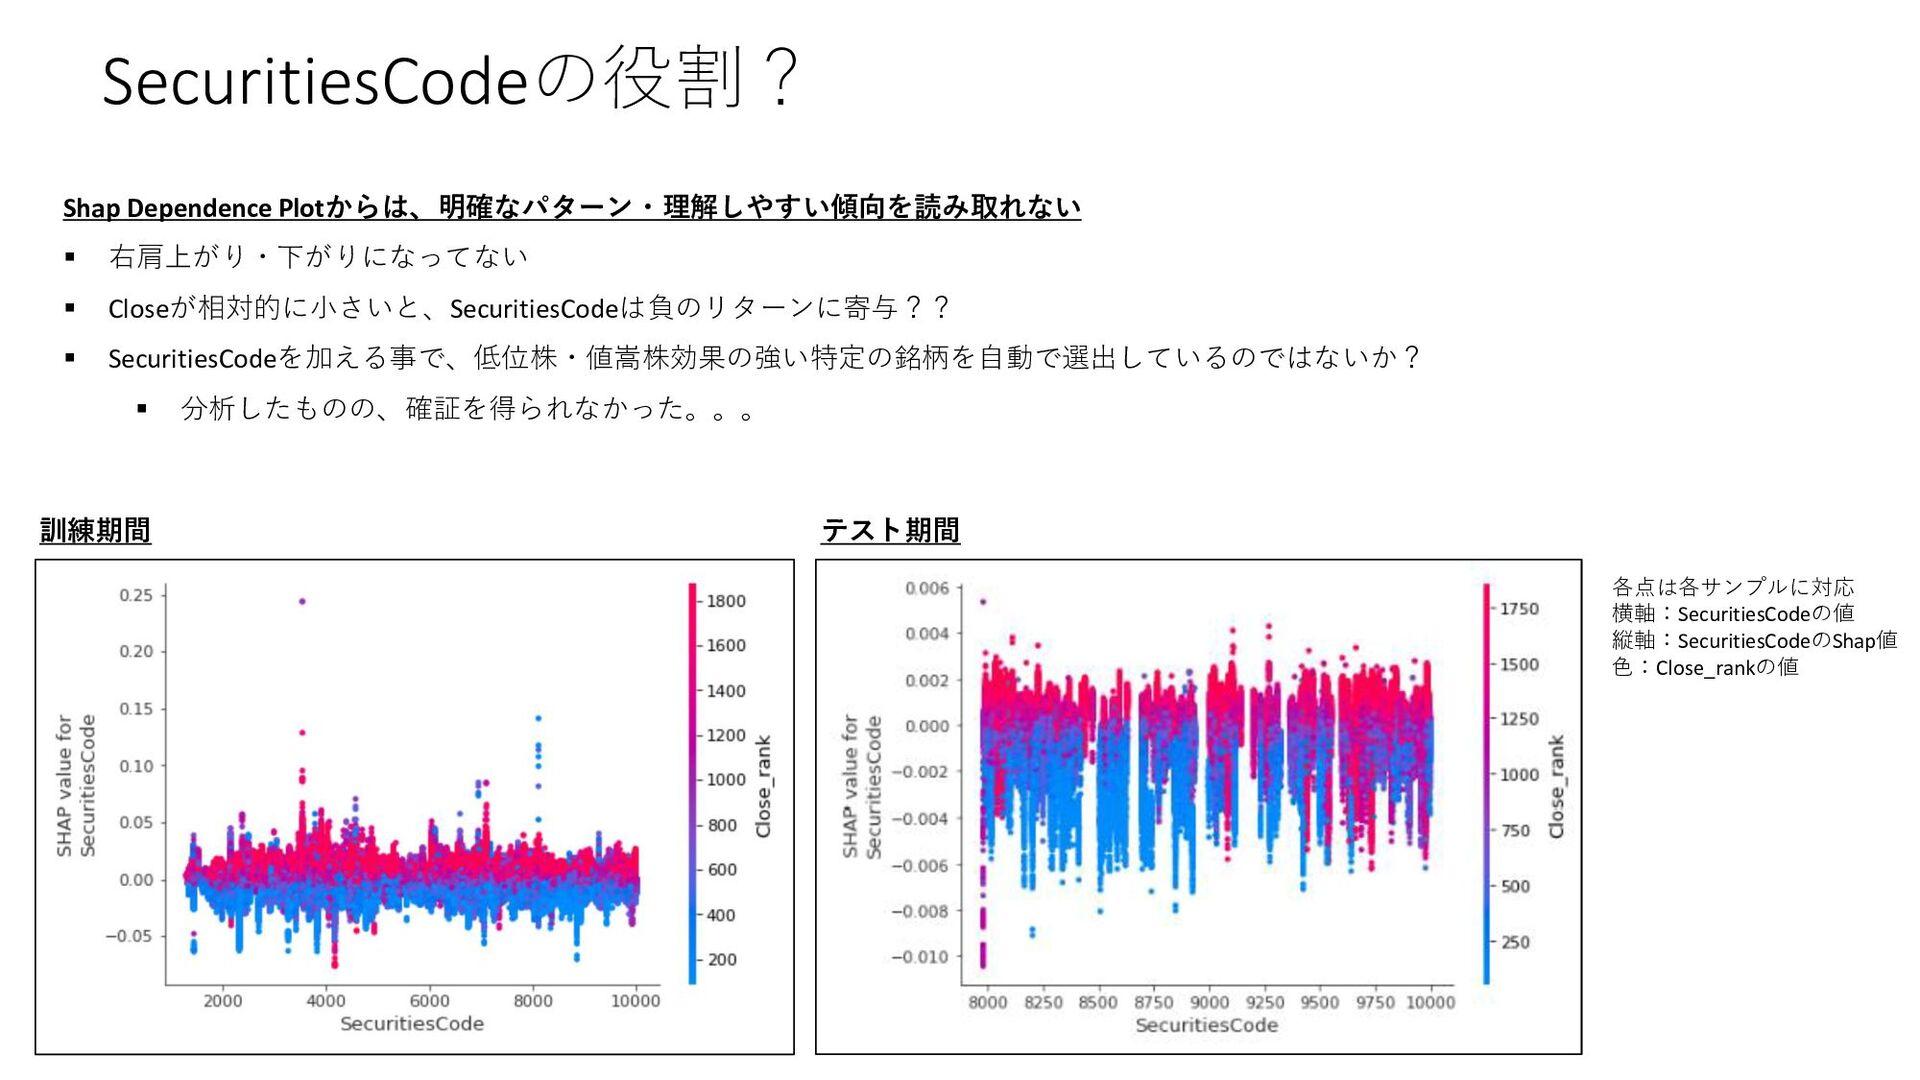
SecuritiesCodeの役割? Shap Dependence Plotからは、明確なパターン・理解しやすい傾向を読み取れない ▪ 右肩上がり・下がりになってない ▪ Closeが相対的に小さいと、SecuritiesCodeは負のリターンに寄与?? ▪ SecuritiesCodeを加える事で、低位株・値嵩株効果の強い特定の銘柄を自動で選出しているのではないか?
▪ 分析したものの、確証を得られなかった。。。 訓練期間 テスト期間 各点は各サンプルに対応 横軸:SecuritiesCodeの値 縦軸:SecuritiesCodeのShap値 色:Close_rankの値 -
アジェンダ 1. 5位解法紹介 1. データ前処理 2. 特徴量の工夫 3. モデル予測値(ターゲット)の工夫 4.
学習データの工夫(Outlierのみの訓練) 5. 評価方法の工夫 6. どの特徴量が、結局効果があったのか? 2. その他 1. Optionボラティリティの利用 2. 予測銘柄の傾向 -
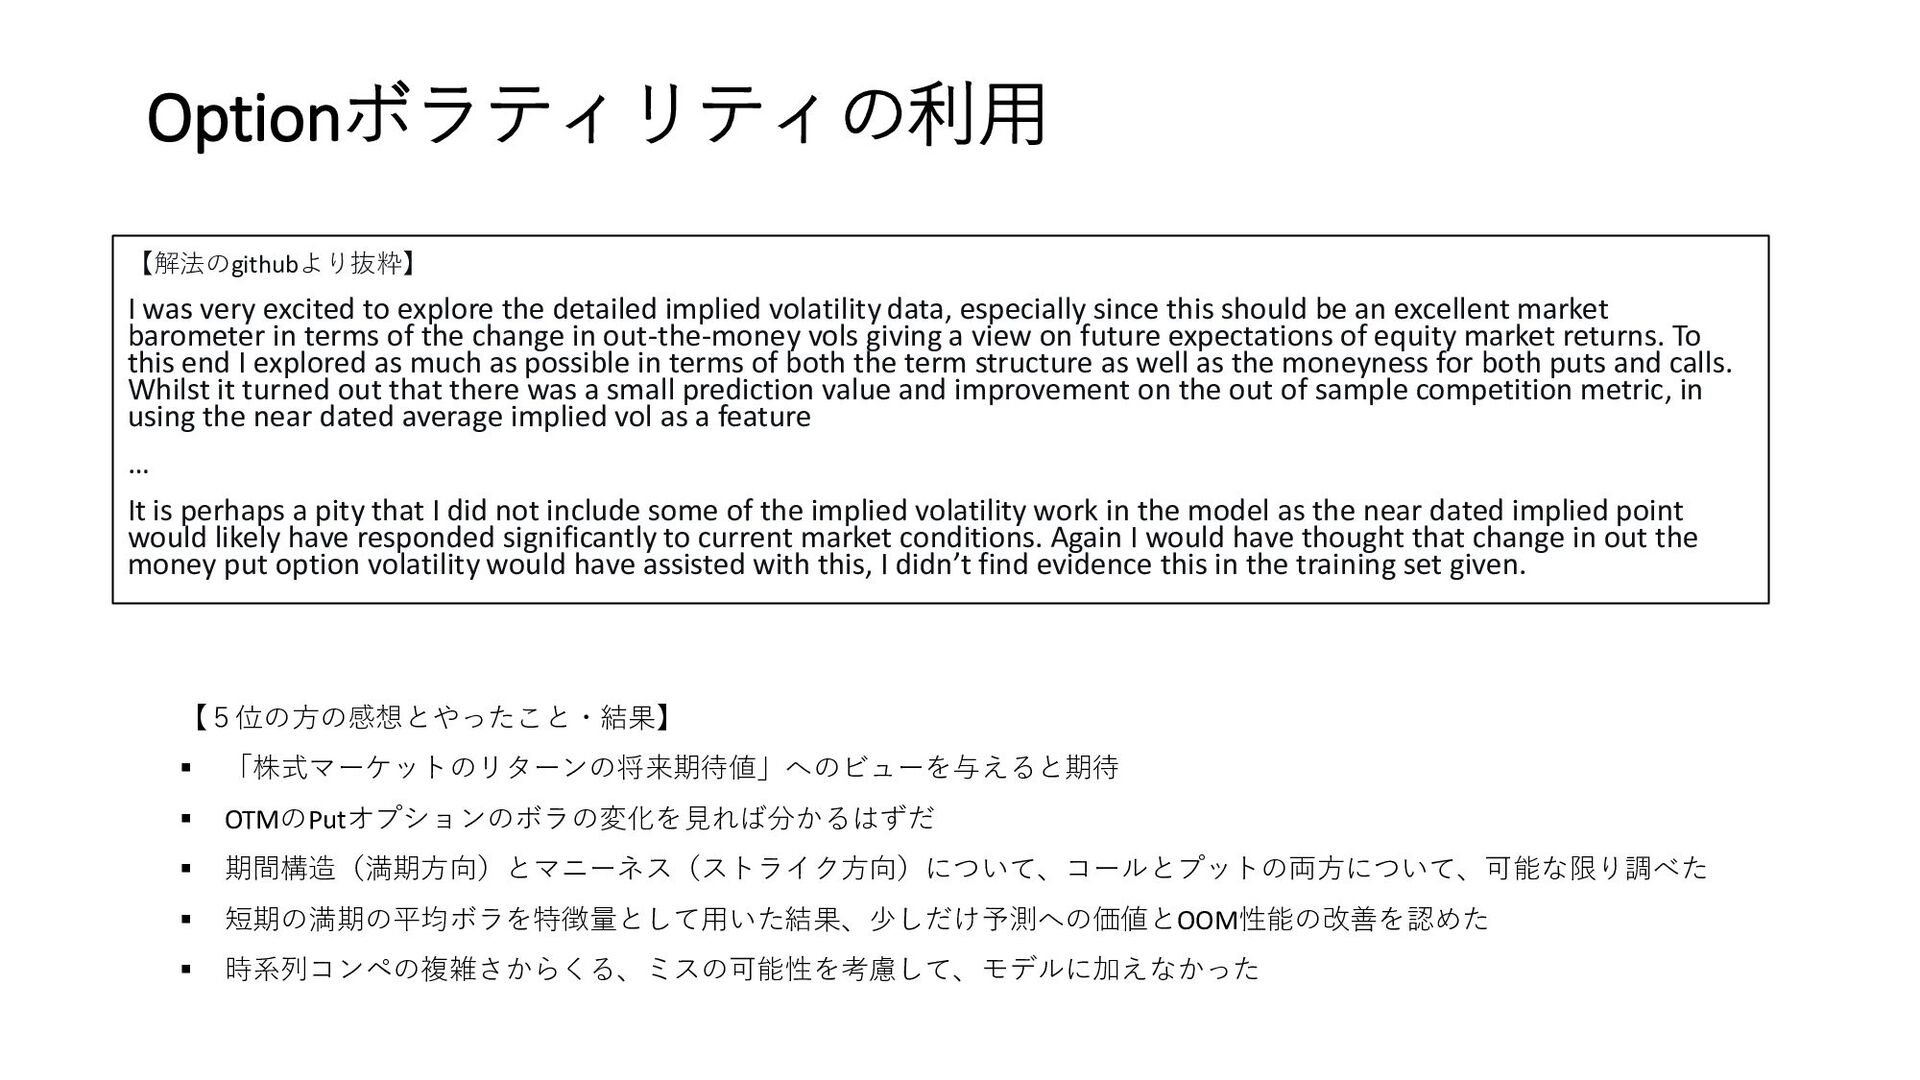
Optionボラティリティの利用 【解法のgithubより抜粋】 I was very excited to explore the detailed
implied volatility data, especially since this should be an excellent market barometer in terms of the change in out-the-money vols giving a view on future expectations of equity market returns. To this end I explored as much as possible in terms of both the term structure as well as the moneyness for both puts and calls. Whilst it turned out that there was a small prediction value and improvement on the out of sample competition metric, in using the near dated average implied vol as a feature … It is perhaps a pity that I did not include some of the implied volatility work in the model as the near dated implied point would likely have responded significantly to current market conditions. Again I would have thought that change in out the money put option volatility would have assisted with this, I didn’t find evidence this in the training set given. 【5位の方の感想とやったこと・結果】 ▪ 「株式マーケットのリターンの将来期待値」へのビューを与えると期待 ▪ OTMのPutオプションのボラの変化を見れば分かるはずだ ▪ 期間構造(満期方向)とマニーネス(ストライク方向)について、コールとプットの両方について、可能な限り調べた ▪ 短期の満期の平均ボラを特徴量として用いた結果、少しだけ予測への価値とOOM性能の改善を認めた ▪ 時系列コンペの複雑さからくる、ミスの可能性を考慮して、モデルに加えなかった -
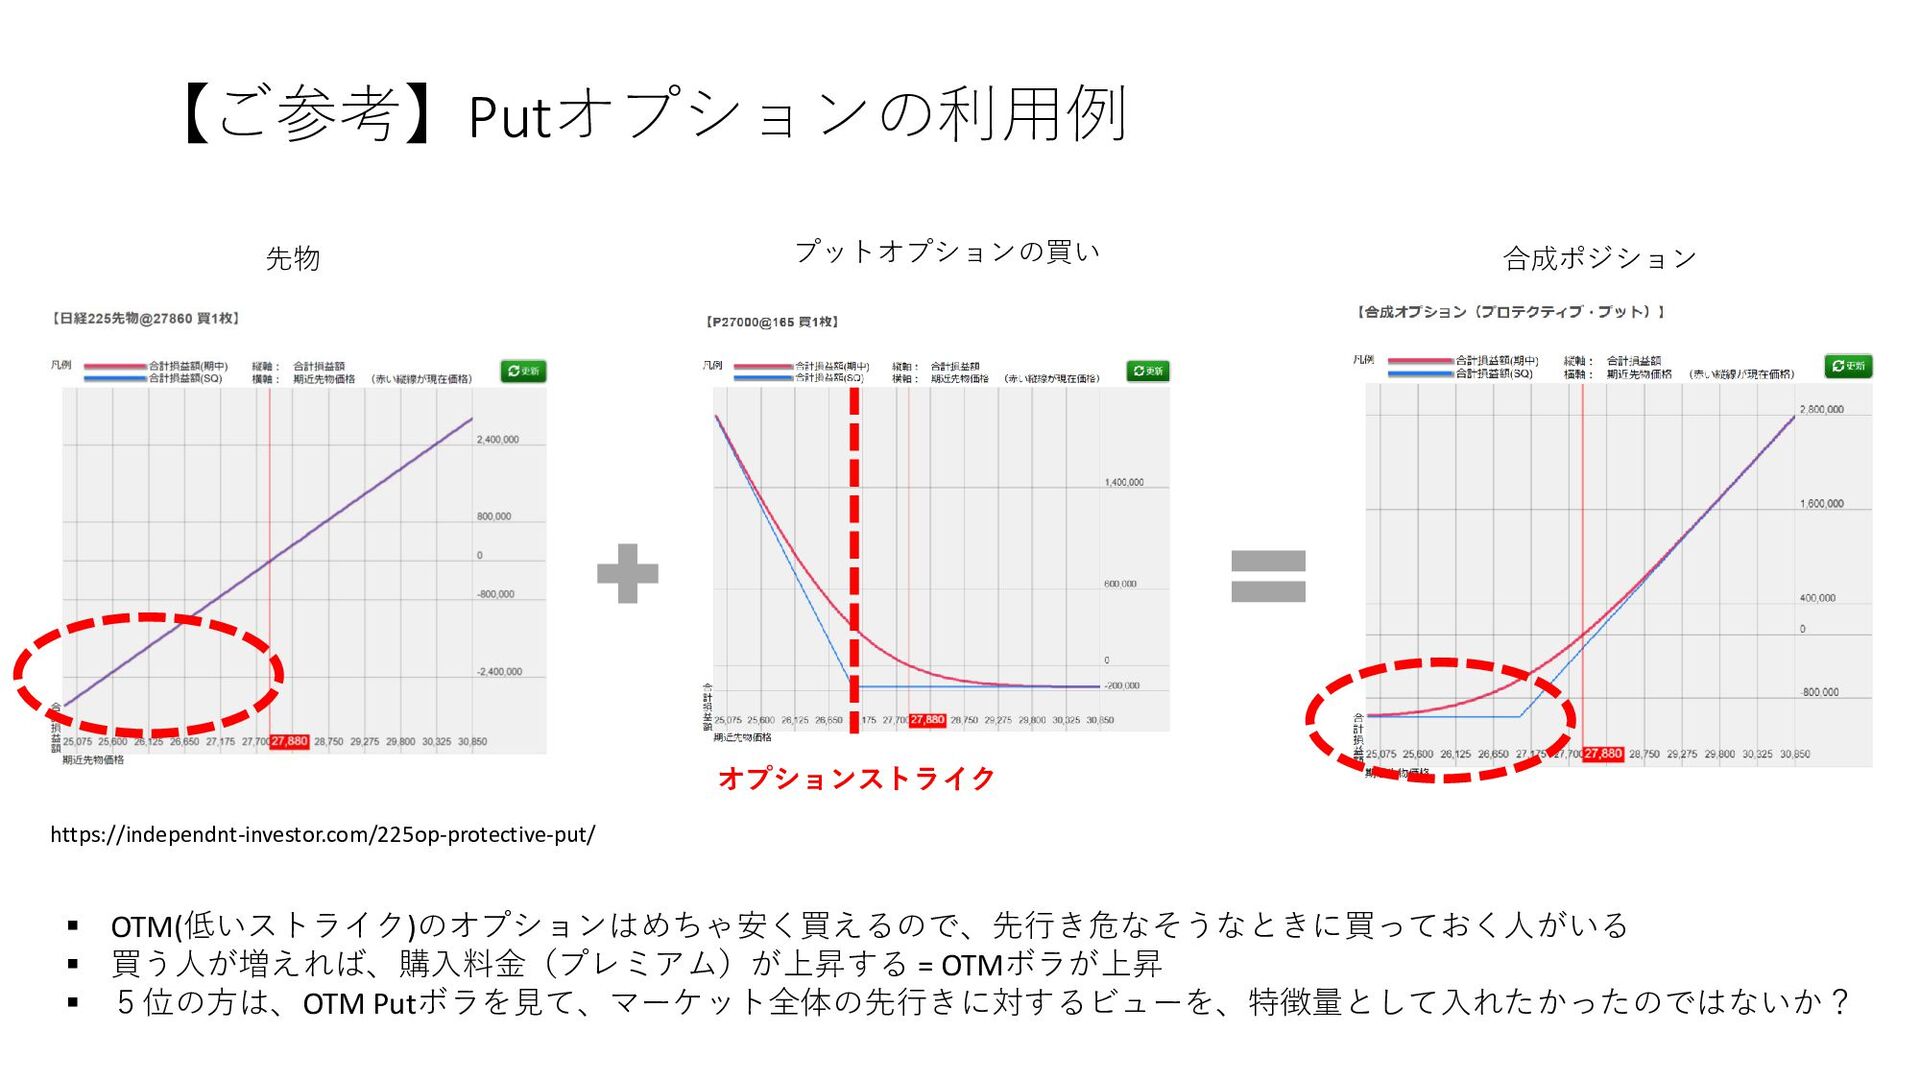
【ご参考】Putオプションの利用例 https://independnt-investor.com/225op-protective-put/ 先物 合成ポジション プットオプションの買い ▪ OTM(低いストライク)のオプションはめちゃ安く買えるので、先行き危なそうなときに買っておく人がいる ▪ 買う人が増えれば、購入料金(プレミアム)が上昇する =
OTMボラが上昇 ▪ 5位の方は、OTM Putボラを見て、マーケット全体の先行きに対するビューを、特徴量として入れたかったのではないか? オプションストライク -
アジェンダ 1. 5位解法紹介 1. データ前処理 2. 特徴量の工夫 3. モデル予測値(ターゲット)の工夫 4.
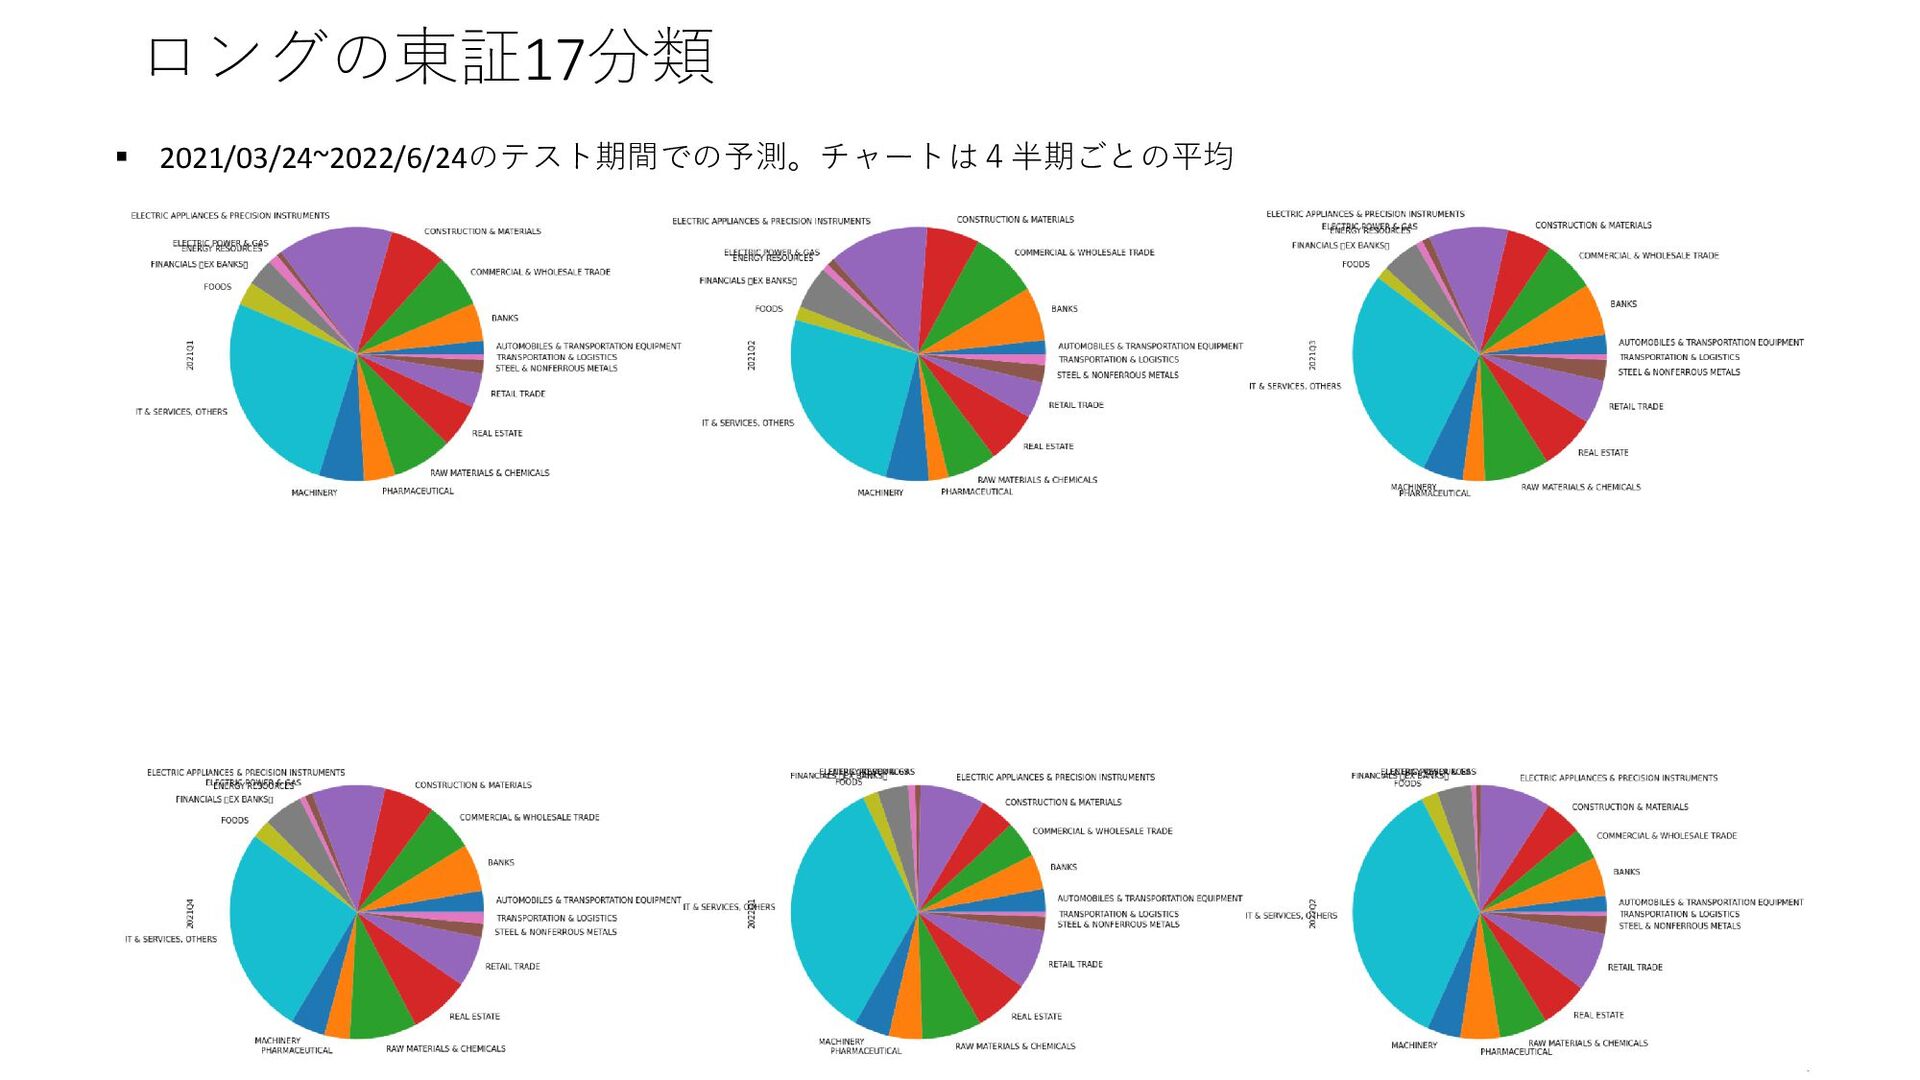
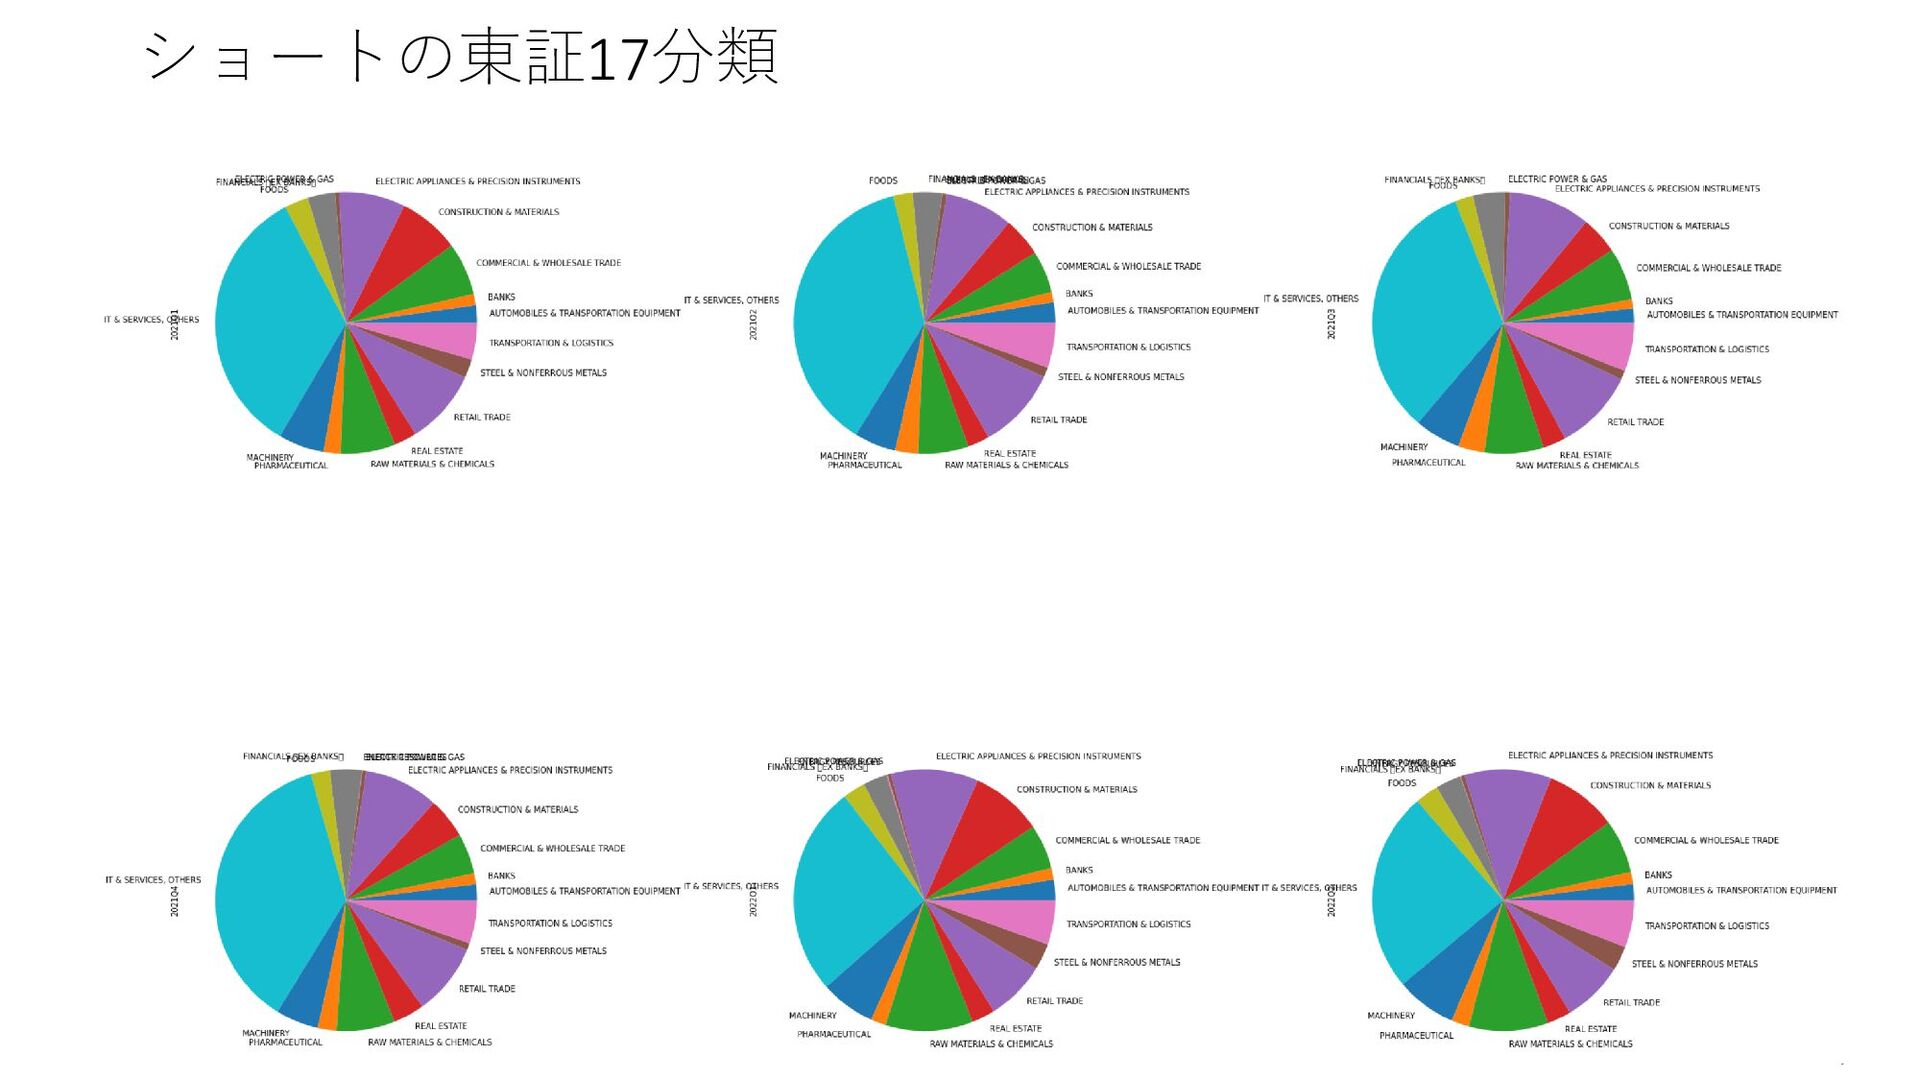
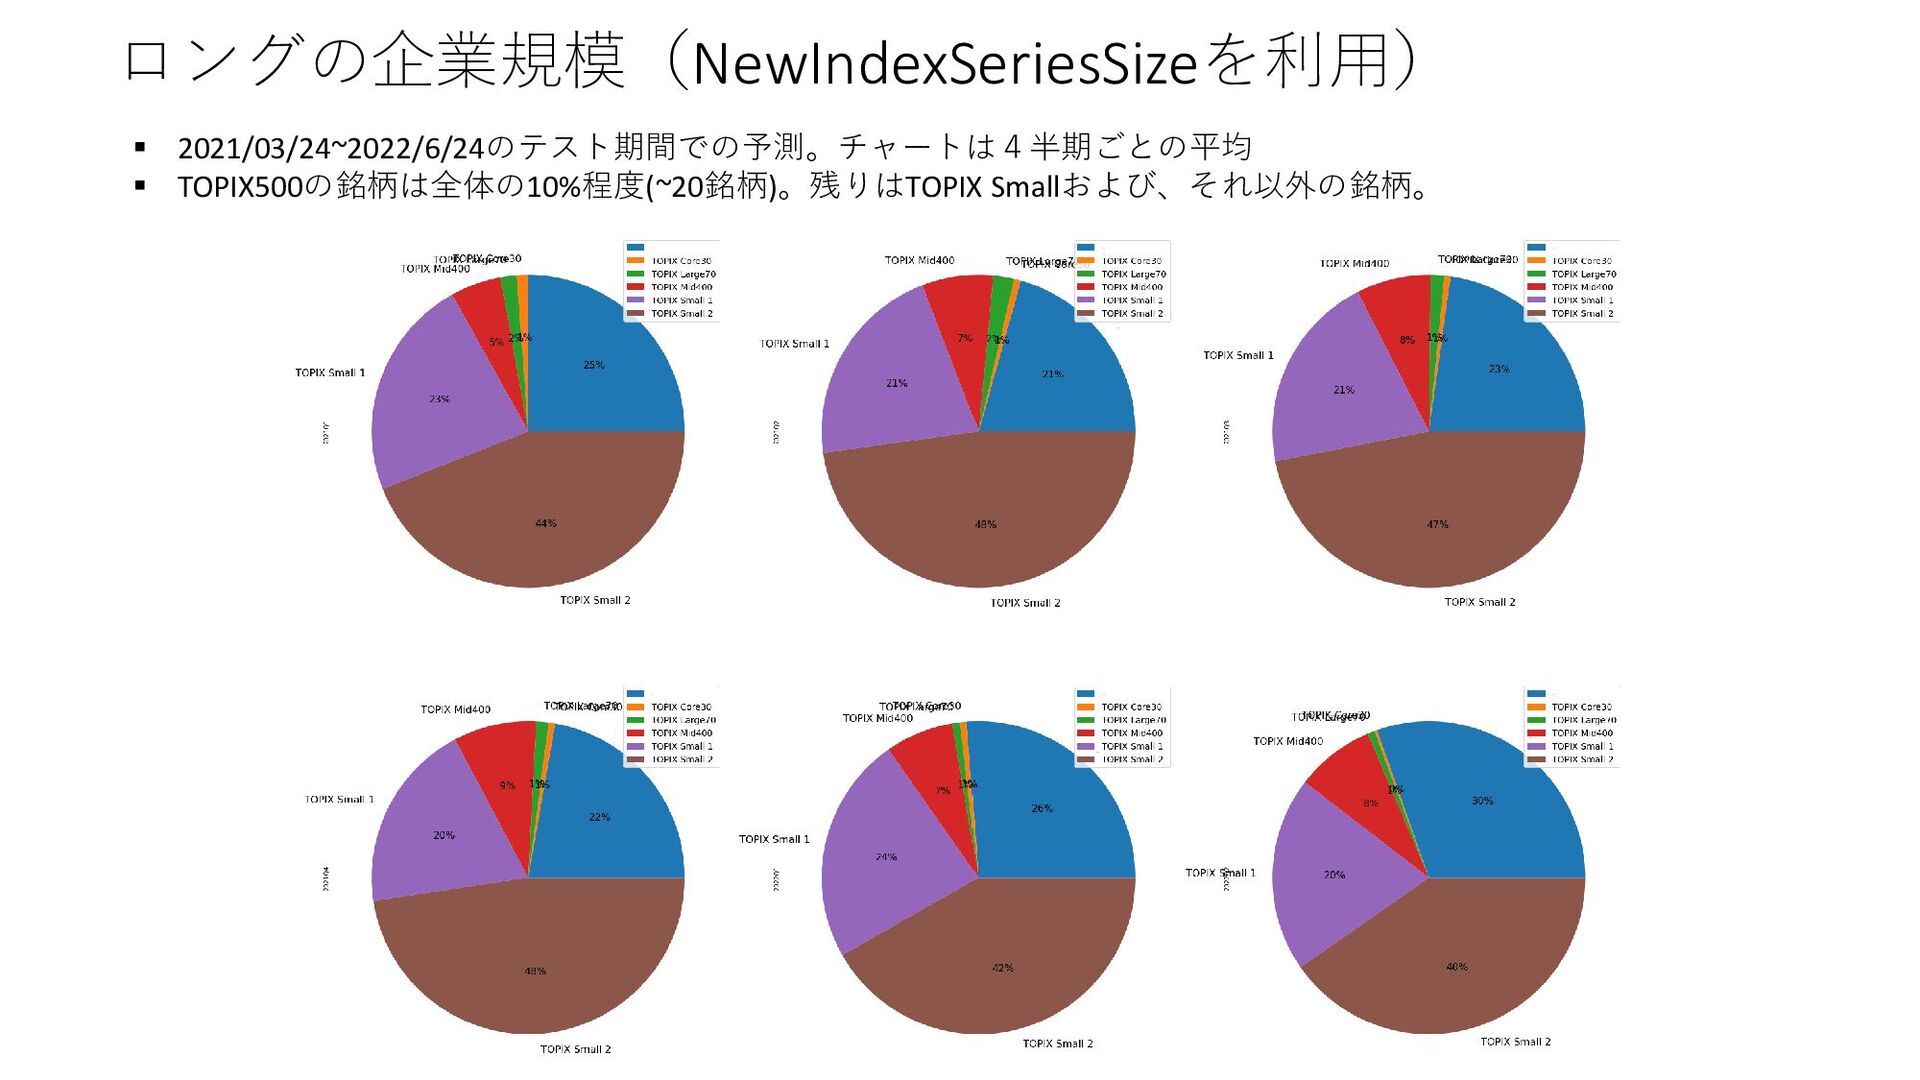
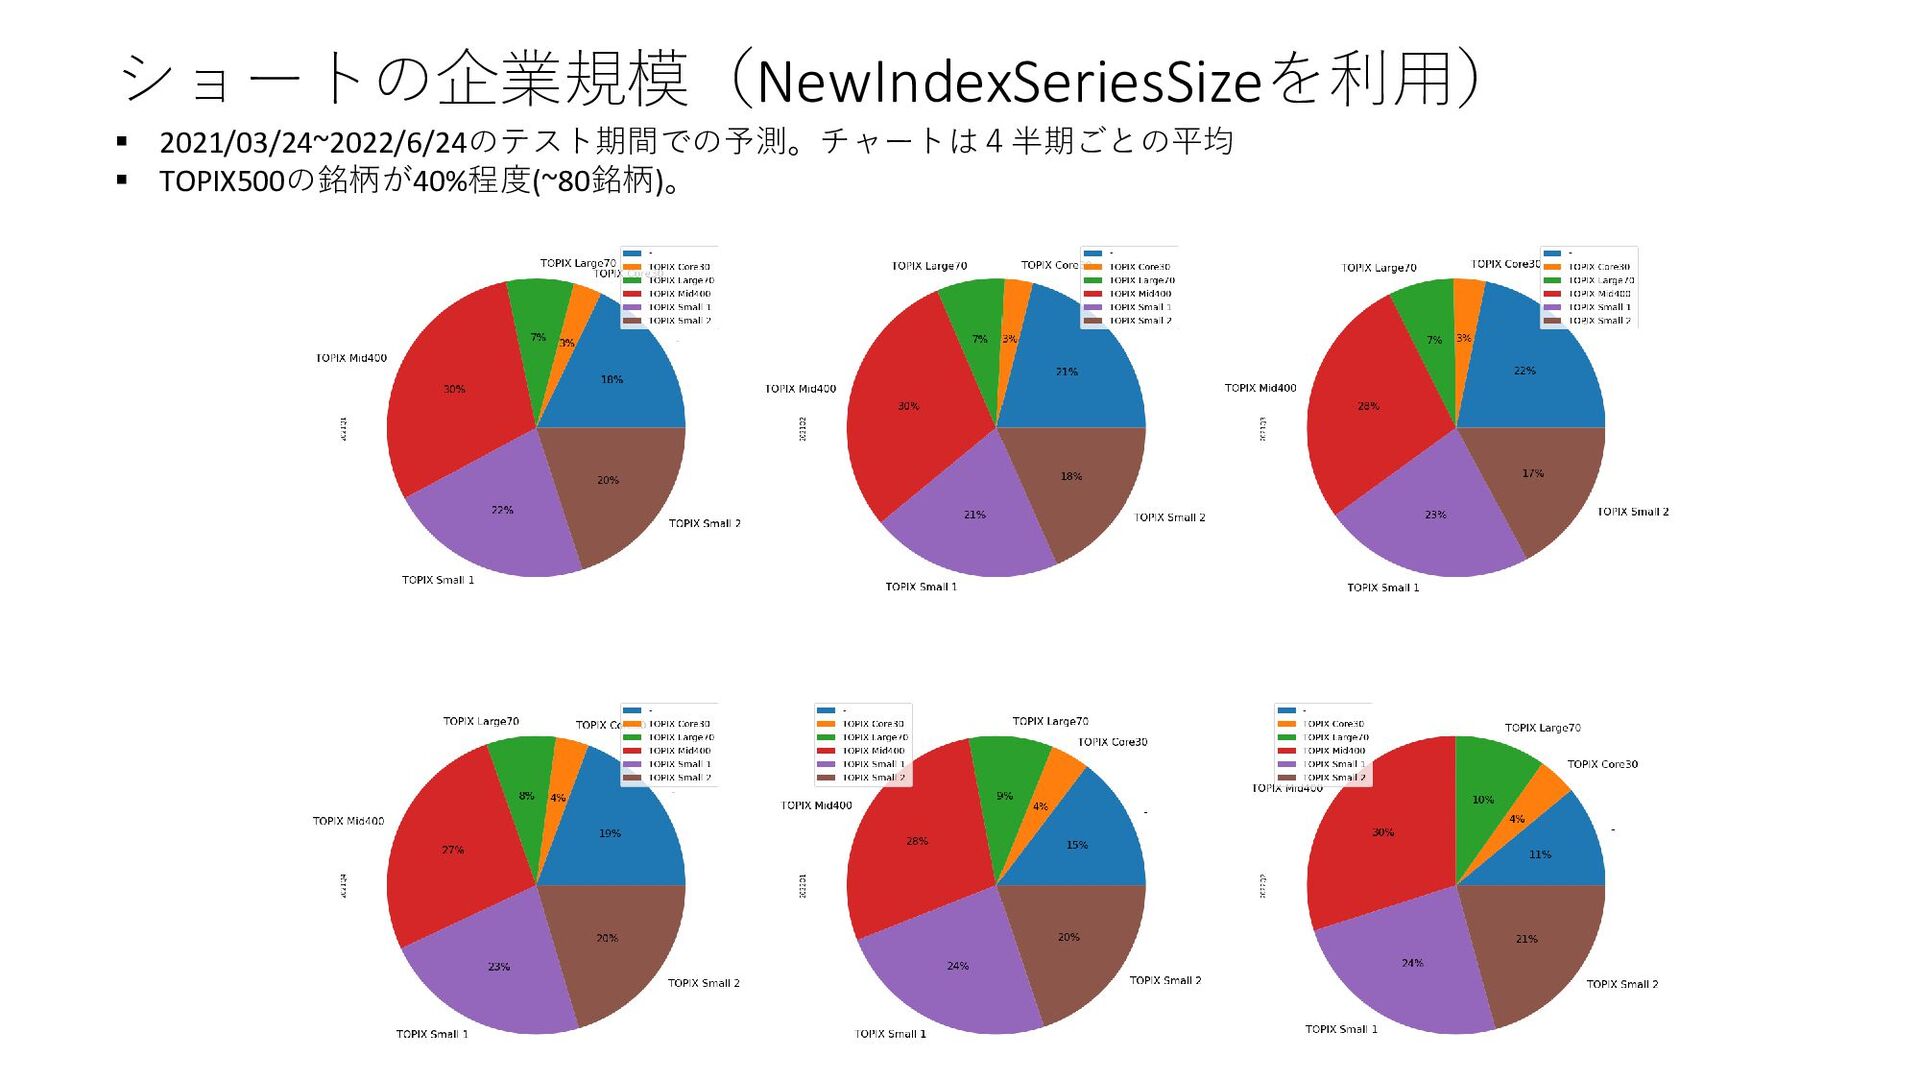
学習データの工夫(Outlierのみの訓練) 5. 評価方法の工夫 6. どの特徴量が、結局効果があったのか? 2. その他 1. Optionボラティリティの利用 2. 予測銘柄の傾向(5位解法の説明、ではないのですが、気になったので調査) -
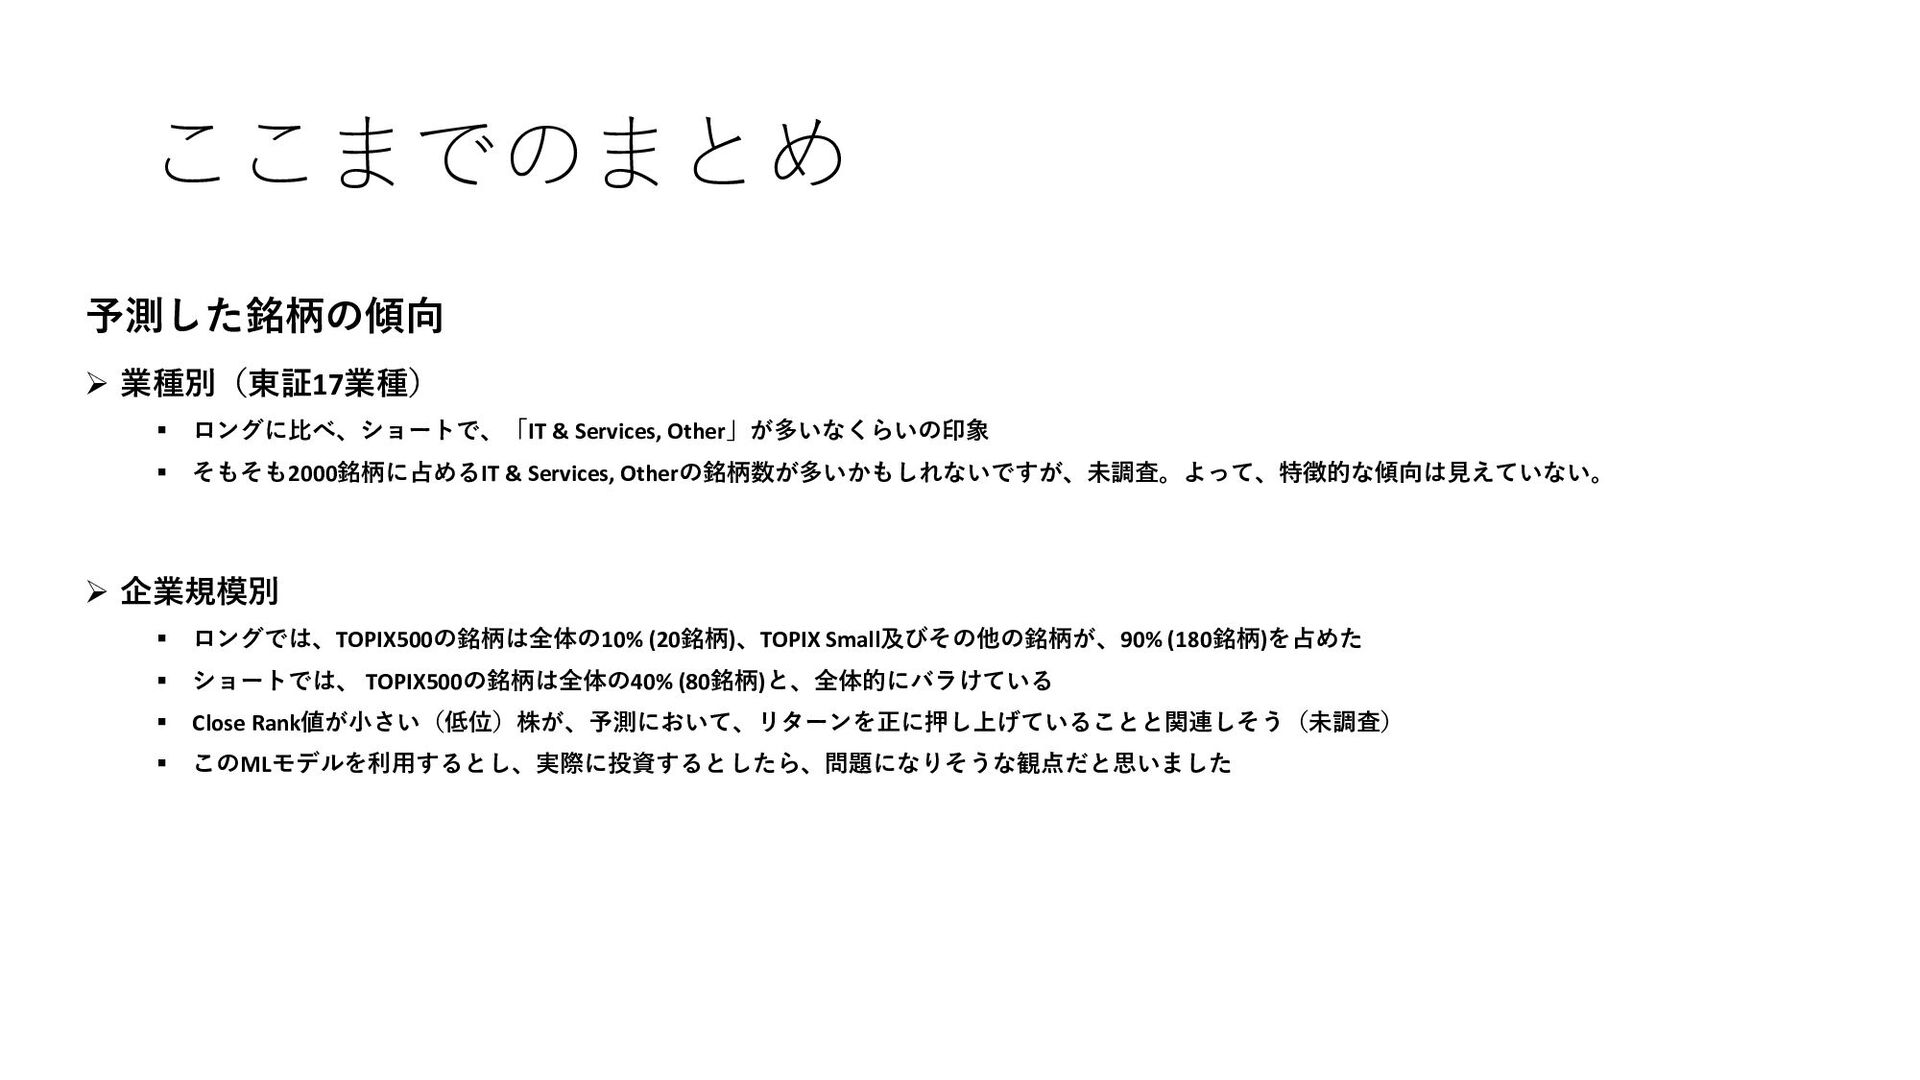
ここまでのまとめ 予測した銘柄の傾向 ➢ 業種別(東証17業種) ▪ ロングに比べ、ショートで、「IT & Services, Other」が多いなくらいの印象 ▪
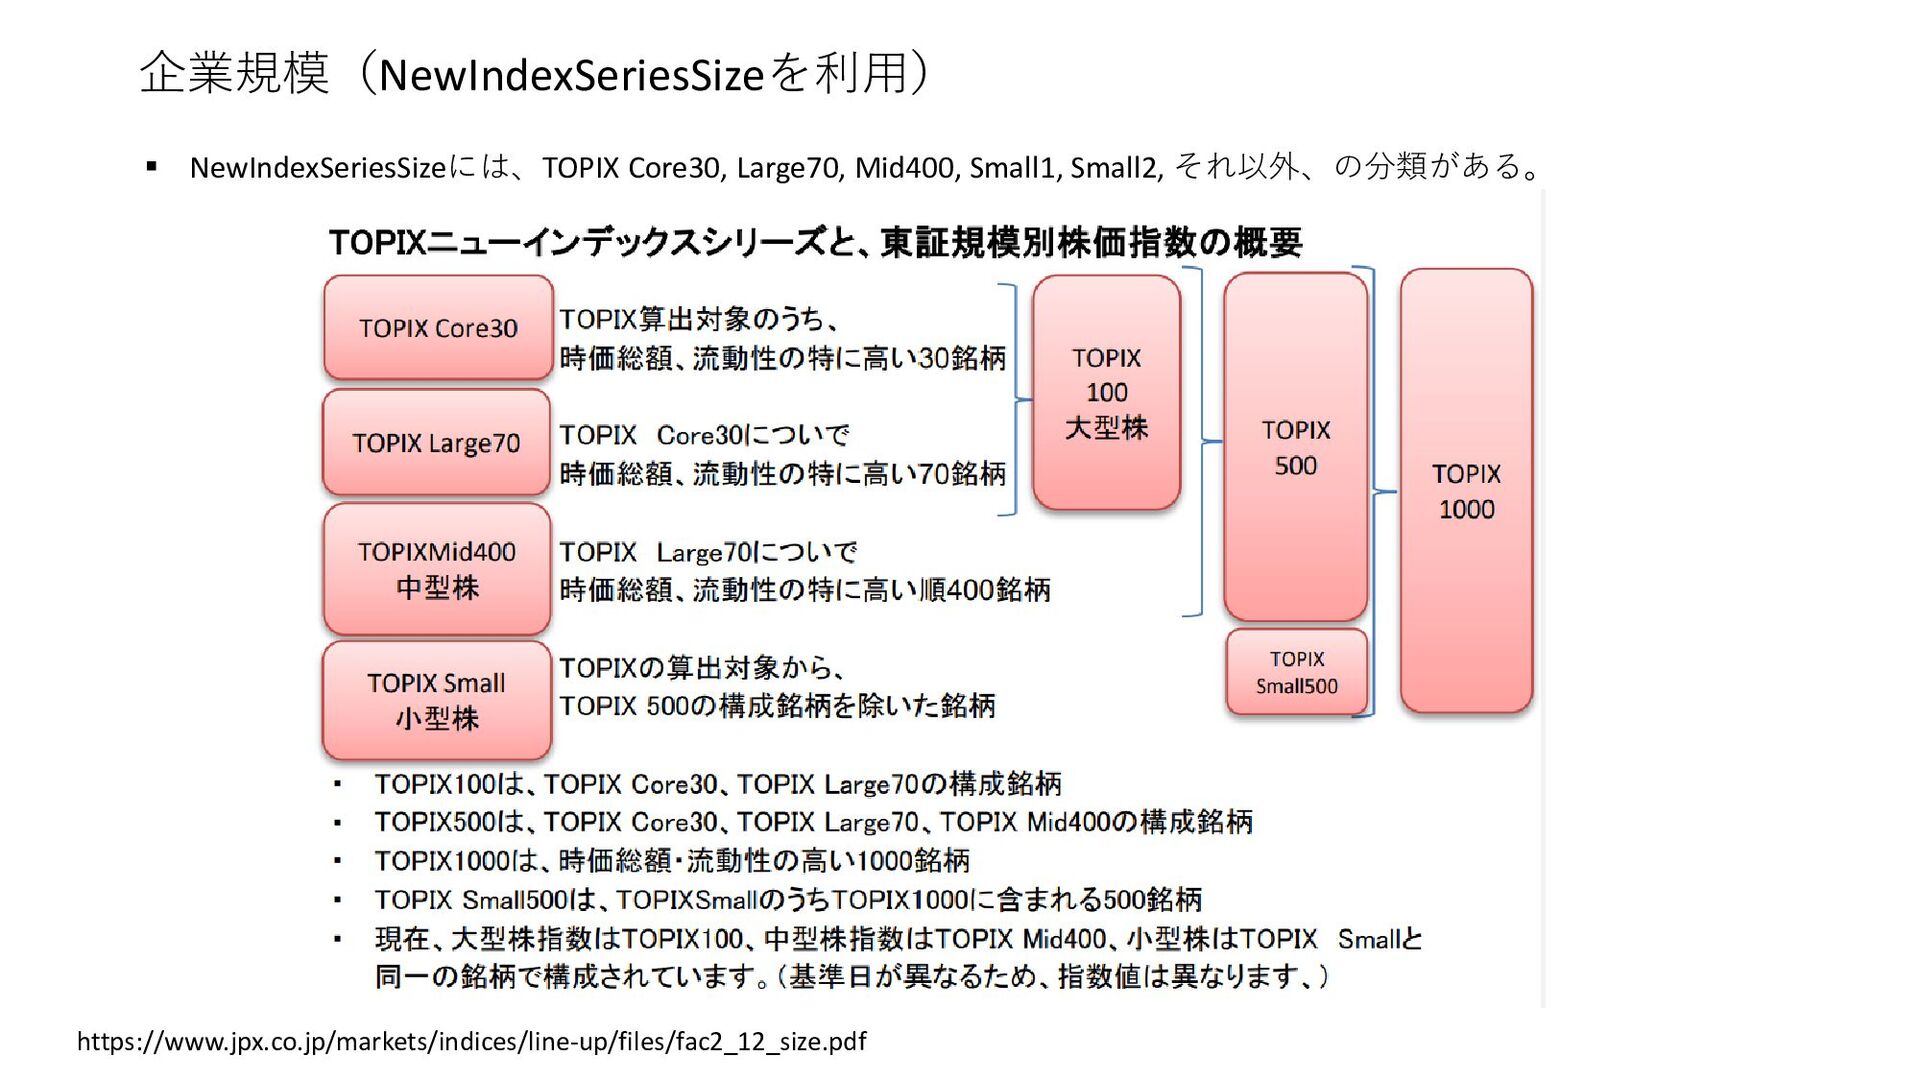
そもそも2000銘柄に占めるIT & Services, Otherの銘柄数が多いかもしれないですが、未調査。よって、特徴的な傾向は見えていない。 ➢ 企業規模別 ▪ ロングでは、TOPIX500の銘柄は全体の10% (20銘柄)、TOPIX Small及びその他の銘柄が、90% (180銘柄)を占めた ▪ ショートでは、 TOPIX500の銘柄は全体の40% (80銘柄)と、全体的にバラけている ▪ Close Rank値が小さい(低位)株が、予測において、リターンを正に押し上げていることと関連しそう(未調査) ▪ このMLモデルを利用するとし、実際に投資するとしたら、問題になりそうな観点だと思いました