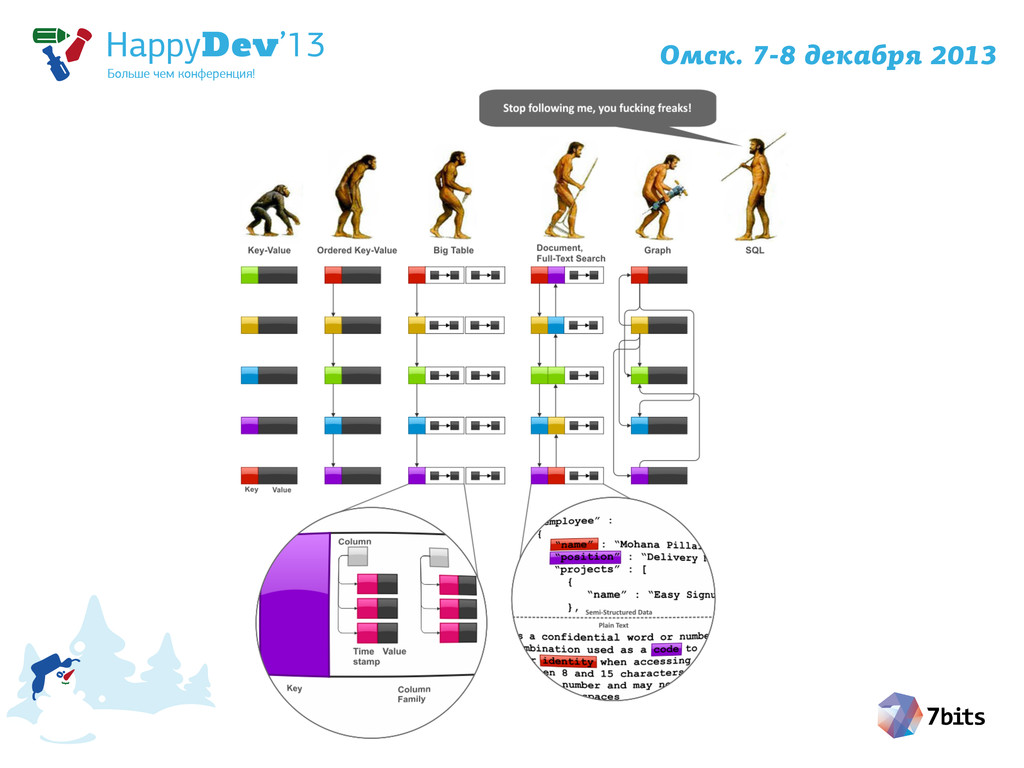
в чем-то своем. А в чем именно? На чем основываться, выбирая NoSQL решение для своего проекта? Может быть на предпочтениях бабушки вашего ведущего программиста или на основе забрасывания сапога за ворота в ночь перед Рождеством? Давайте попробуем разобраться в критериях оценки и выявить различия между самыми популярными вариантами. Нас ждет увлекательный полет над гладью болот MongoDB, Cassandra, Riak, Hbase, Neo4j, CouchDB. А в тихом омуте, как известно, и черти водятся.
и тренд • Протест и компромисс • Запечатление и эффект якоря влияют на нас не меньше чем умные статьи • Через это должен пройти каждый и этот этап не стоит откладывать
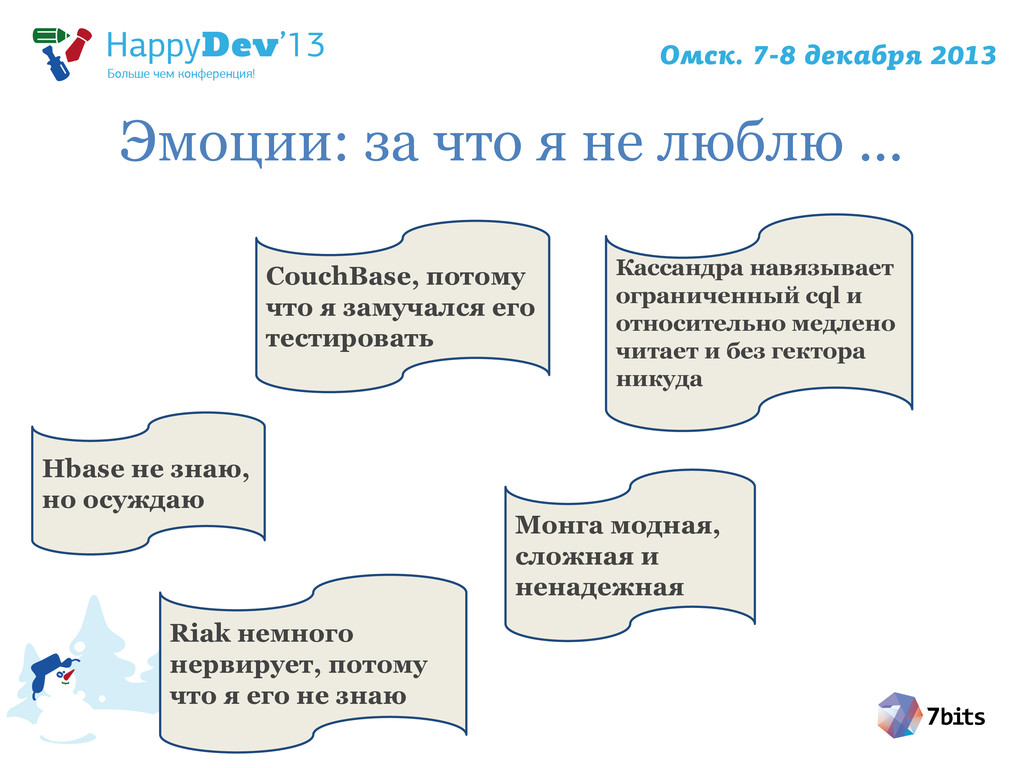
но осуждаю Riak немного нервирует, потому что я его не знаю CouchBase, потому что я замучался его тестировать Кассандра навязывает ограниченный cql и относительно медлено читает и без гектора никуда Монга модная, сложная и ненадежная
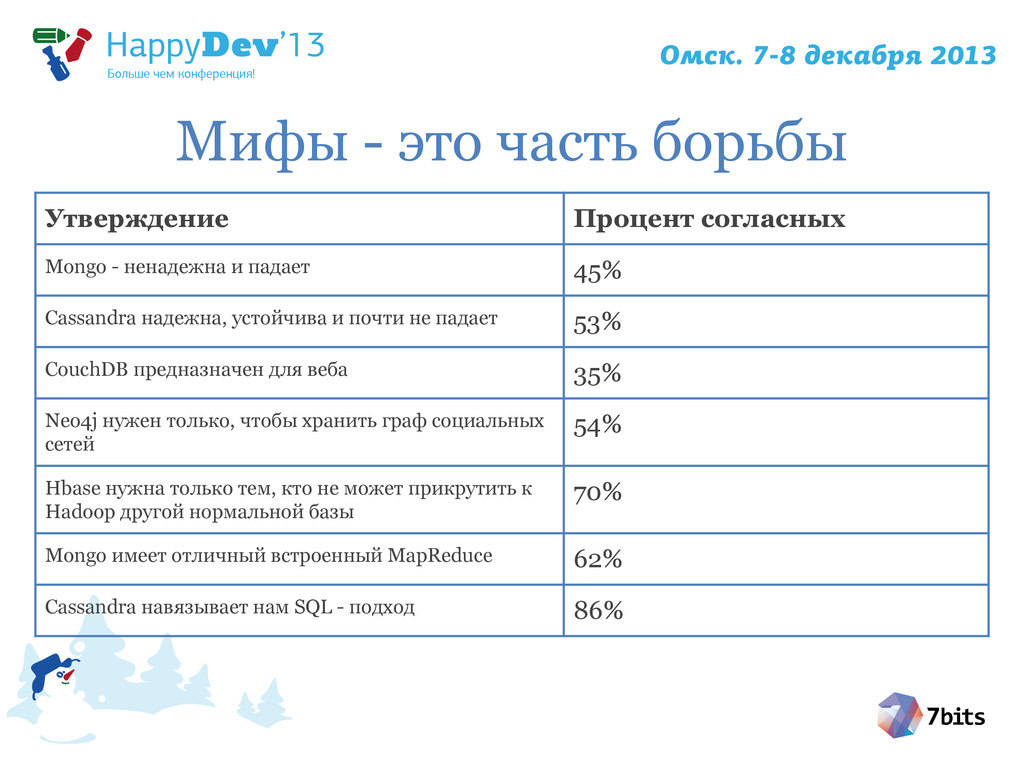
ненадежна и падает 45% Cassandra надежна, устойчива и почти не падает 53% CouchDB предназначен для веба 35% Neo4j нужен только, чтобы хранить граф социальных сетей 54% Hbase нужна только тем, кто не может прикрутить к Hadoop другой нормальной базы 70% Mongo имеет отличный встроенный MapReduce 62% Cassandra навязывает нам SQL - подход 86%
задачи, необходимо знакомство с основными парадигмами и их воплощениями • Если вы будете, вопреки голосу разума, цепляться за первую любовь - вас ждет поражение
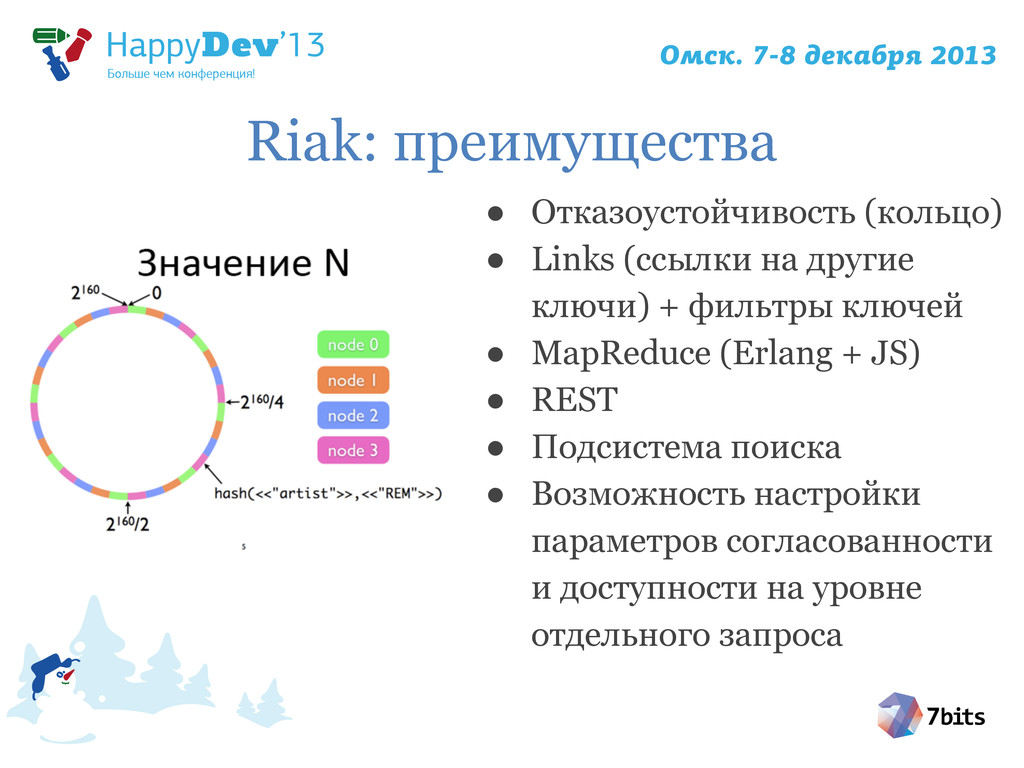
нескольких датацентров • Возможность добавлять прозрачно новые сервера • Собственная, отличная от реляционной, модель данных • Согласованность в конечном счете
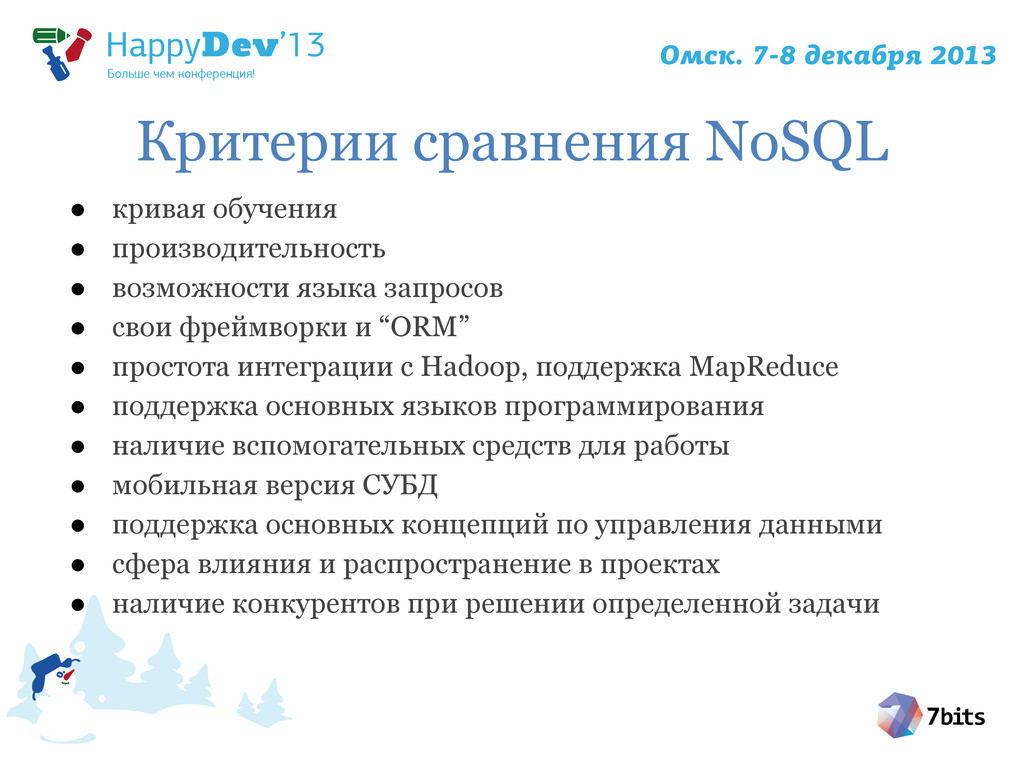
языка запросов • свои фреймворки и “ORM” • простота интеграции с Hadoop, поддержка MapReduce • поддержка основных языков программирования • наличие вспомогательных средств для работы • мобильная версия СУБД • поддержка основных концепций по управления данными • сфера влияния и распространение в проектах • наличие конкурентов при решении определенной задачи
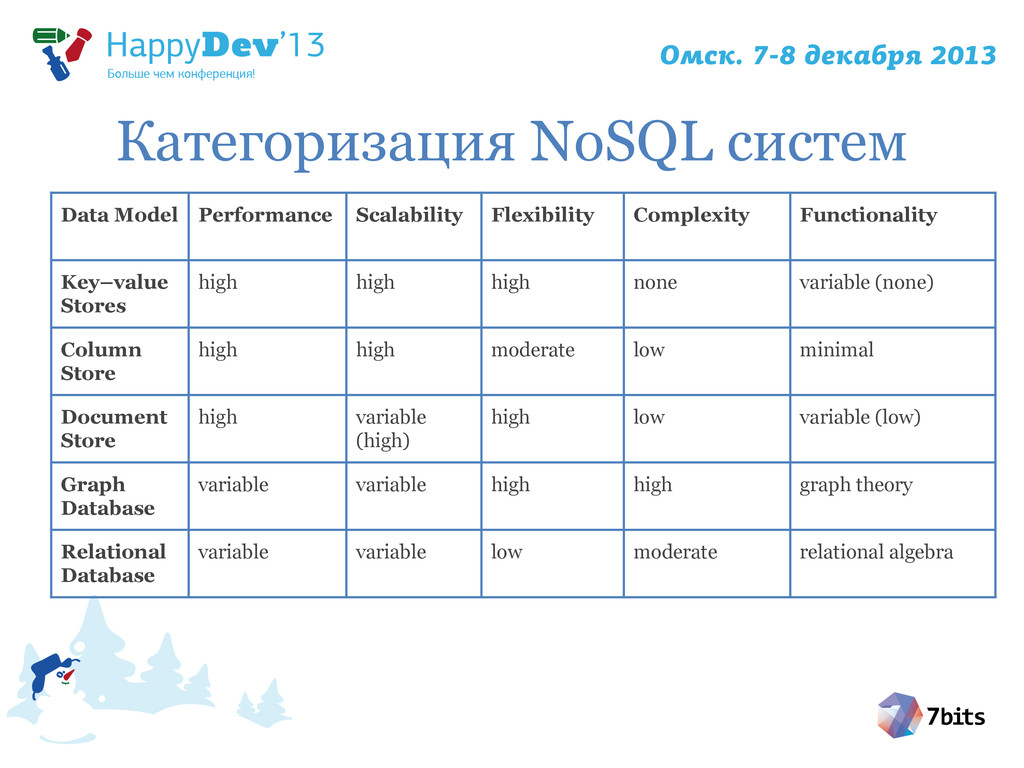
Key–value Stores high high high none variable (none) Column Store high high moderate low minimal Document Store high variable (high) high low variable (low) Graph Database variable variable high high graph theory Relational Database variable variable low moderate relational algebra
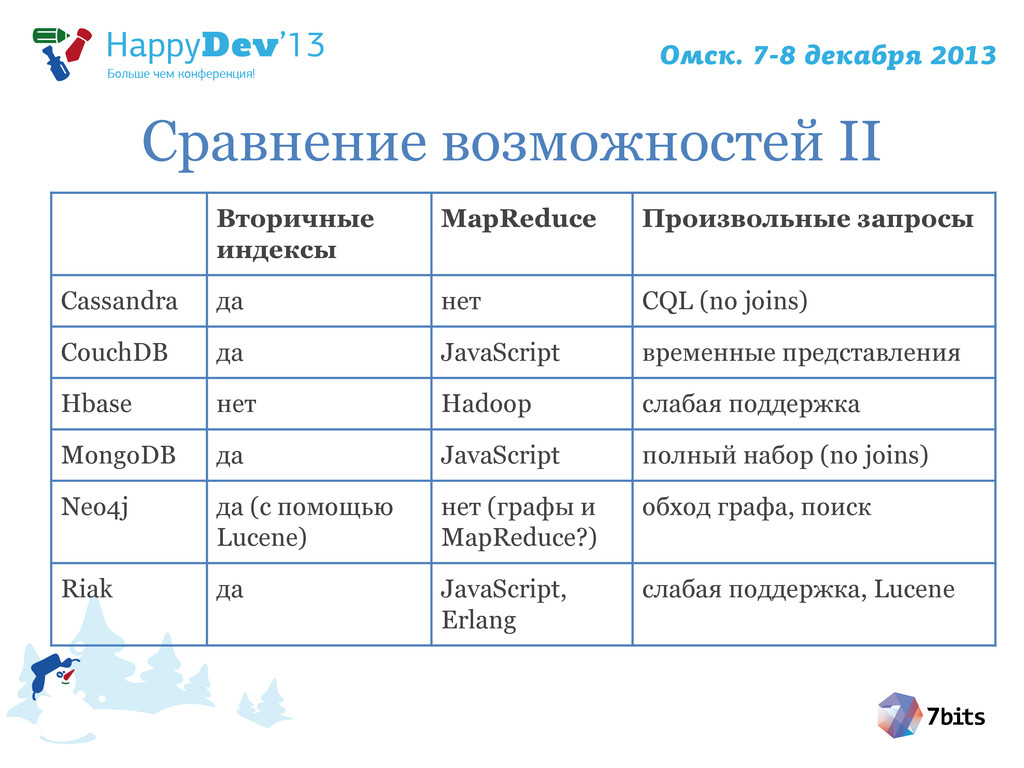
нет CQL (no joins) CouchDB да JavaScript временные представления Hbase нет Hadoop слабая поддержка MongoDB да JavaScript полный набор (no joins) Neo4j да (с помощью Lucene) нет (графы и MapReduce?) обход графа, поиск Riak да JavaScript, Erlang слабая поддержка, Lucene
Mongo + Node.js + JS • Хранение сложных денормализованных документов • Большой выбор индексов (B- tree, 2d, 3d • Репликация данных и сегментирование коллекций • Community
Проблема четного числа узлов и сложные выборы • Опечатка стоит дорого • Над планированием кластера надо думать • Иногда навязывает воспроизведение схемы в коде (проверка типов и т.д.)
версия • Простота встраивания и резервного копирования • Функции-валидаторы, функции-представления, функции-фильтры сохраняются в текстовом виде в самой базе данных
Заимствованная терминология из мира SQL скорее мешает • Надо не менее 5 узлов • Нет средств сортировки и индексирования • Строгая согласованность без возможности изменений
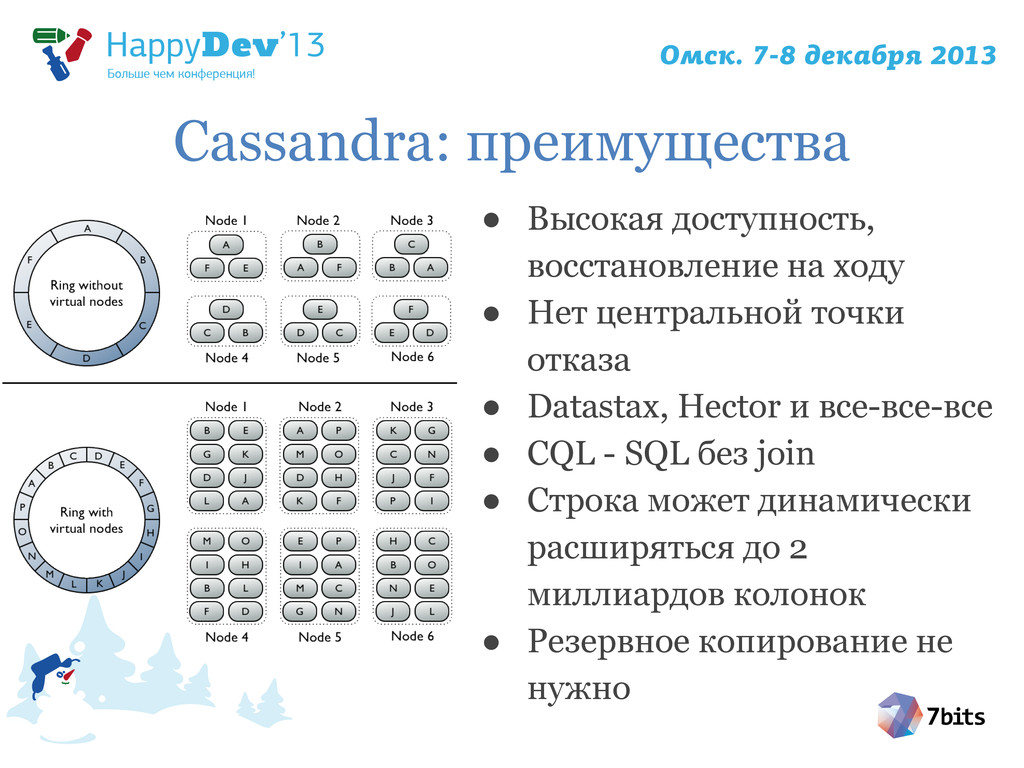
центральной точки отказа • Datastax, Hector и все-все-все • CQL - SQL без join • Строка может динамически раcширяться до 2 миллиардов колонок • Резервное копирование не нужно
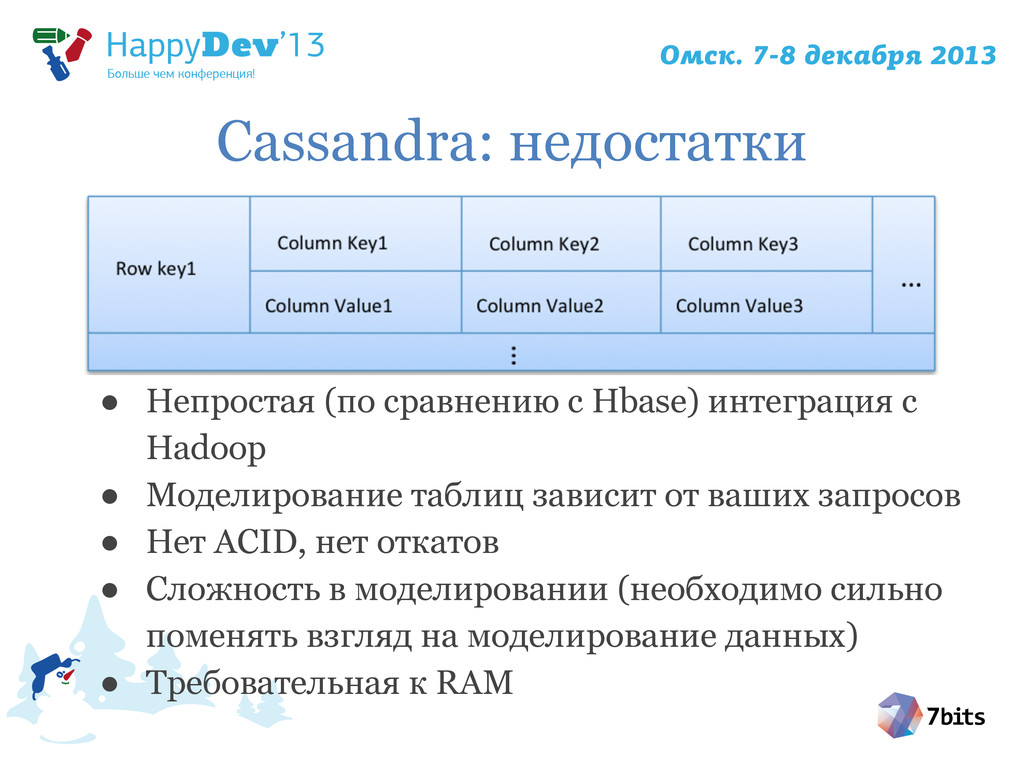
Hadoop • Моделирование таблиц зависит от ваших запросов • Нет ACID, нет откатов • Сложность в моделировании (необходимо сильно поменять взгляд на моделирование данных) • Требовательная к RAM
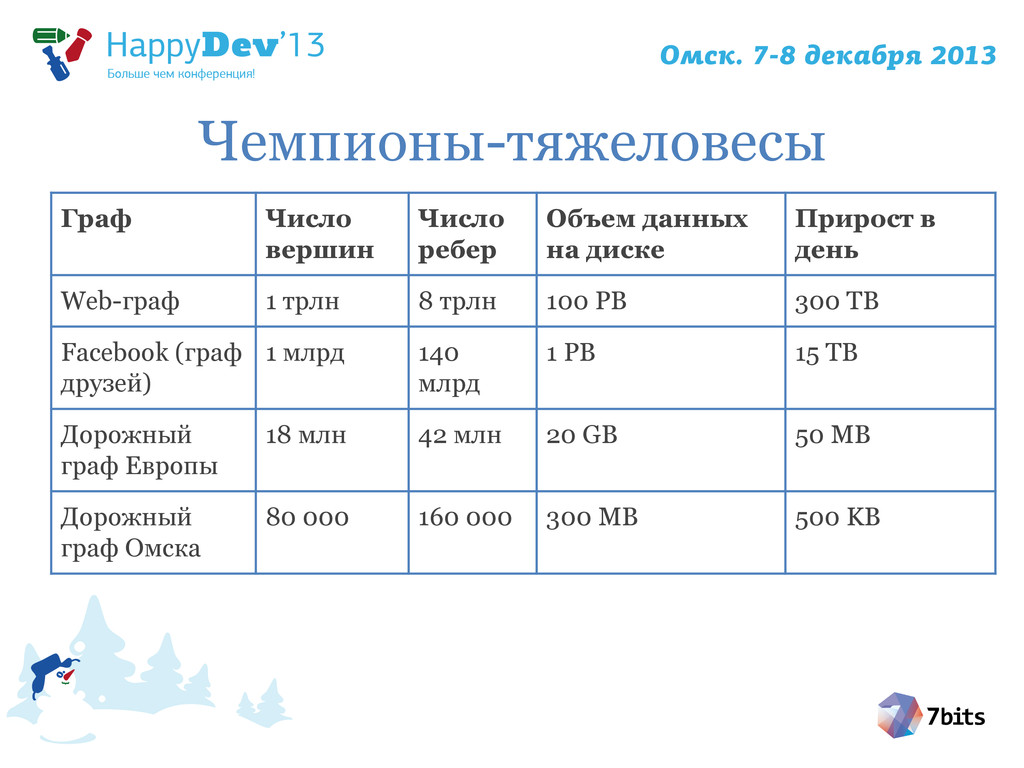
Прирост в день Web-граф 1 трлн 8 трлн 100 PB 300 TB Facebook (граф друзей) 1 млрд 140 млрд 1 PB 15 TB Дорожный граф Европы 18 млн 42 млн 20 GB 50 MB Дорожный граф Омска 80 000 160 000 300 MB 500 KB
фаза, которая позволяет вам экономить деньги. До ее начала необходимо ответить себе на вопросы о характере ваших данных и сформулировать требования по их использованию.
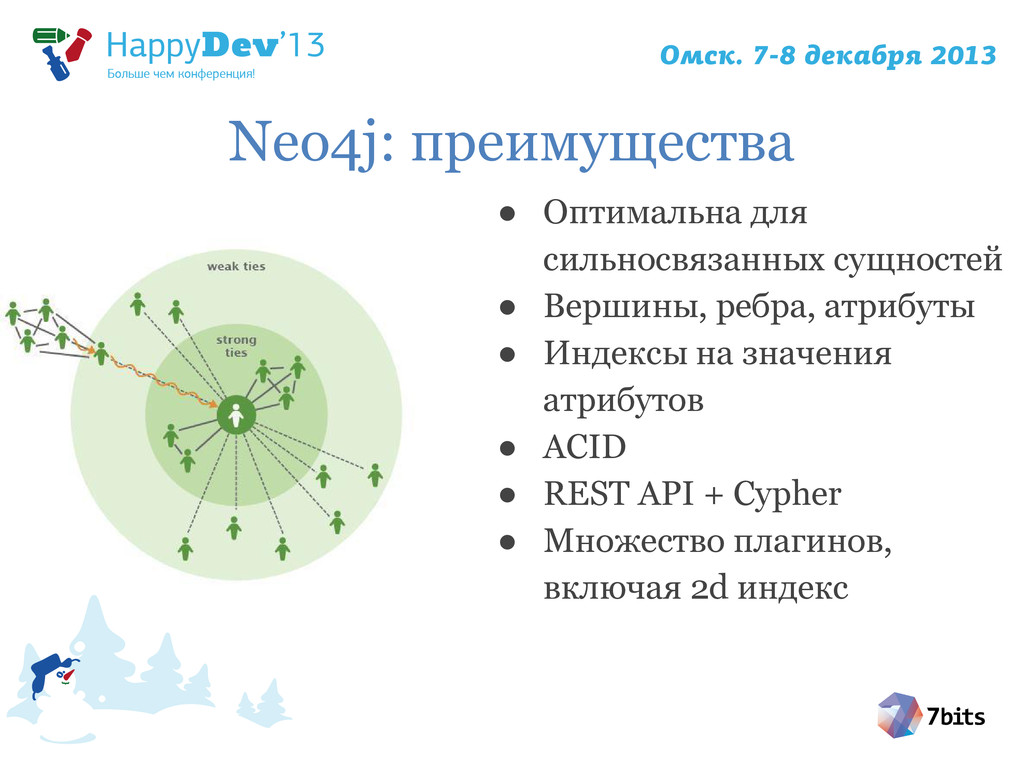
знаний, а самый популярный запрос связан с обходом сложной иерархии объектов? Вы готовы отказаться размещения на нескольких машинах? Neo4j спешит на помощь!
морских существ • Но пока они не выловлены, пользы от никакой • Средство лова: удочку, сеть, глушить гранатой или вычерпывать кастрюлей, выбираем мы сами
данных за семь недель” 2. “A generic intro to NoSQL” by Ben Scofield. 3. http://nosql-database.org/ 4. Исследования компании Тамтэк 5. Собственные исследования


 happydev
 makun
 curekoshimizu
 reimaru
 nogu66
 ryu1013
 high_g_engineer
 kajitack
 f2lk
 ktcryomm
 murabayashi
 colorful12
 kaseken
 kevinliebholz
 samanthasiow
 matthewcrist
 bcantrill
 rkendrick25
 inesmontani
 bkeepers
 keavy
 watany
 jdejongh
 tammyeverts
 livdayseo