Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
VideoMAE V2: Scaling Video Masked Autoencoders ...
Search
Jundai Inoue
December 21, 2024
800
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
VideoMAE V2: Scaling Video Masked Autoencoders with Dual Masking
Jundai Inoue
December 21, 2024
Transcript
9 slides
e 井上 純大
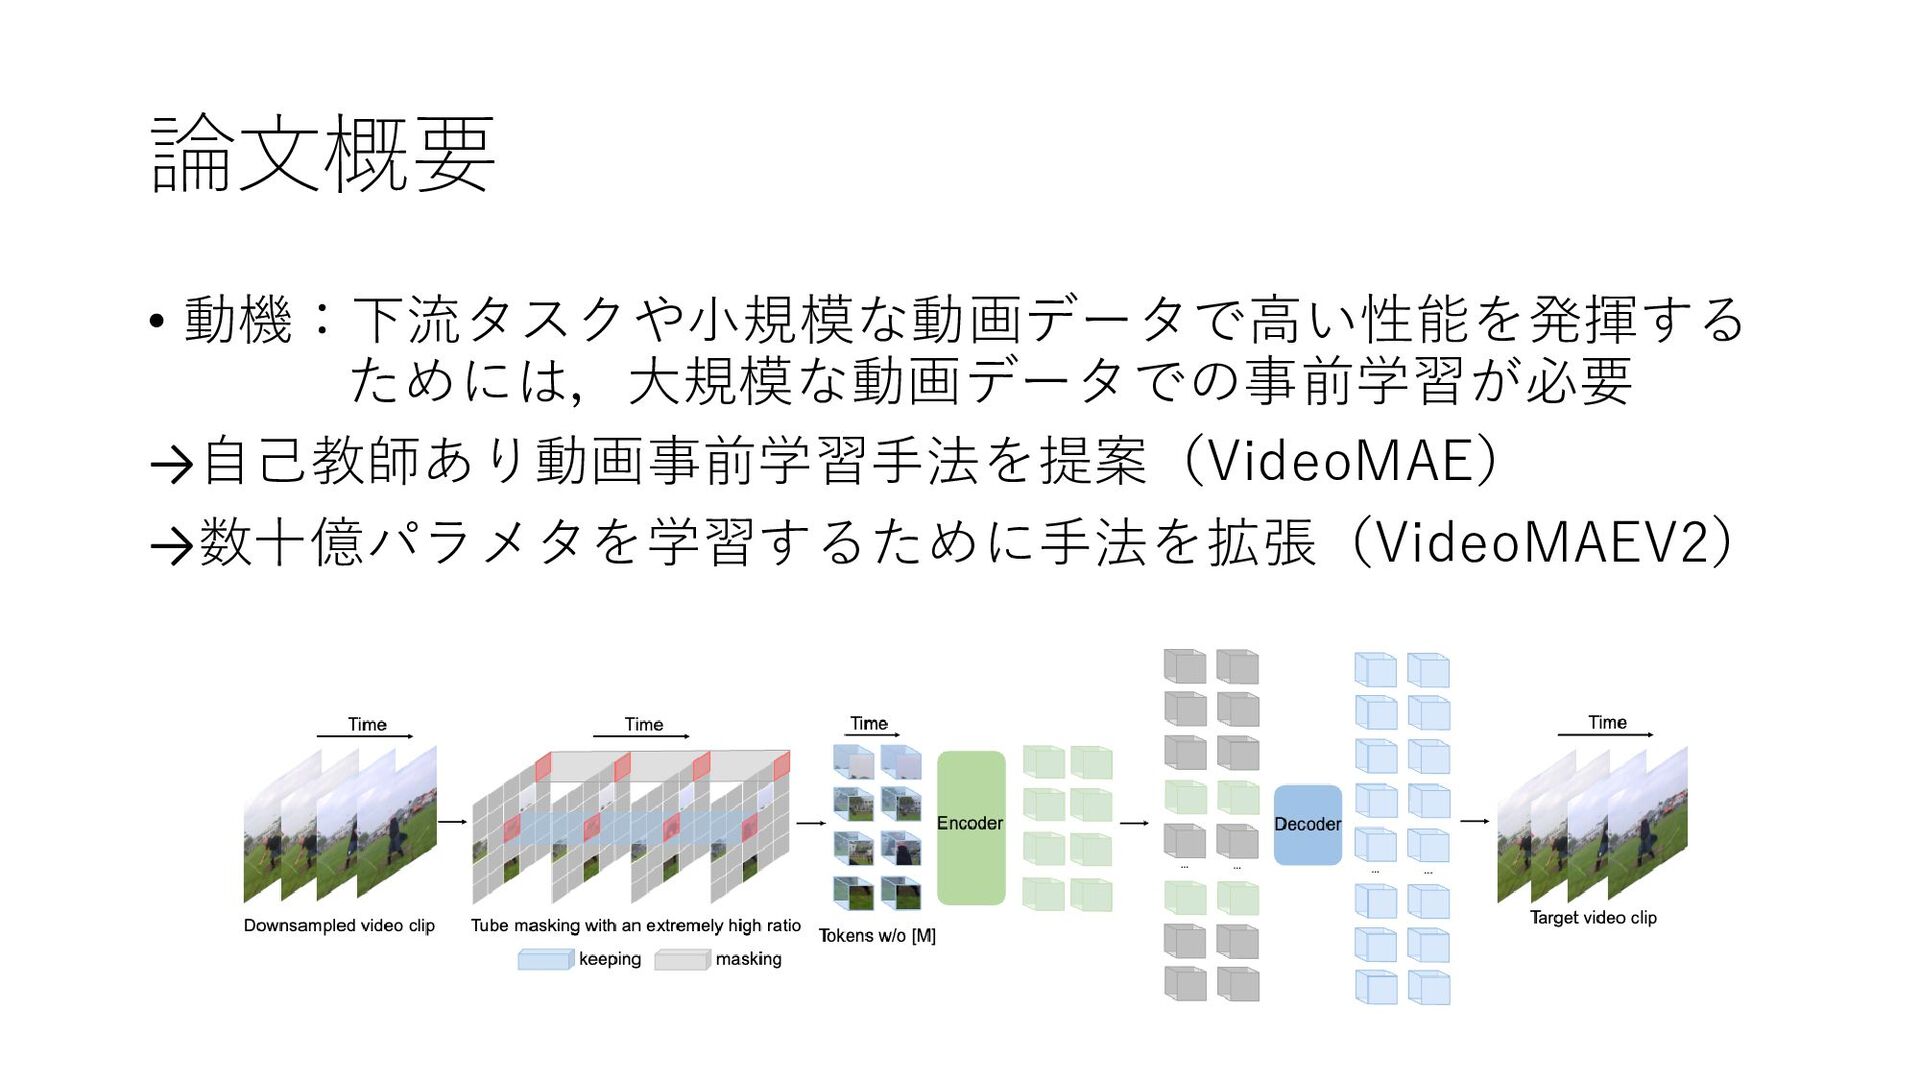
論文概要 • 動機:下流タスクや小規模な動画データで高い性能を発揮する ためには,大規模な動画データでの事前学習が必要 →自己教師あり動画事前学習手法を提案(VideoMAE) →数十億パラメタを学習するために手法を拡張(VideoMAEV2)
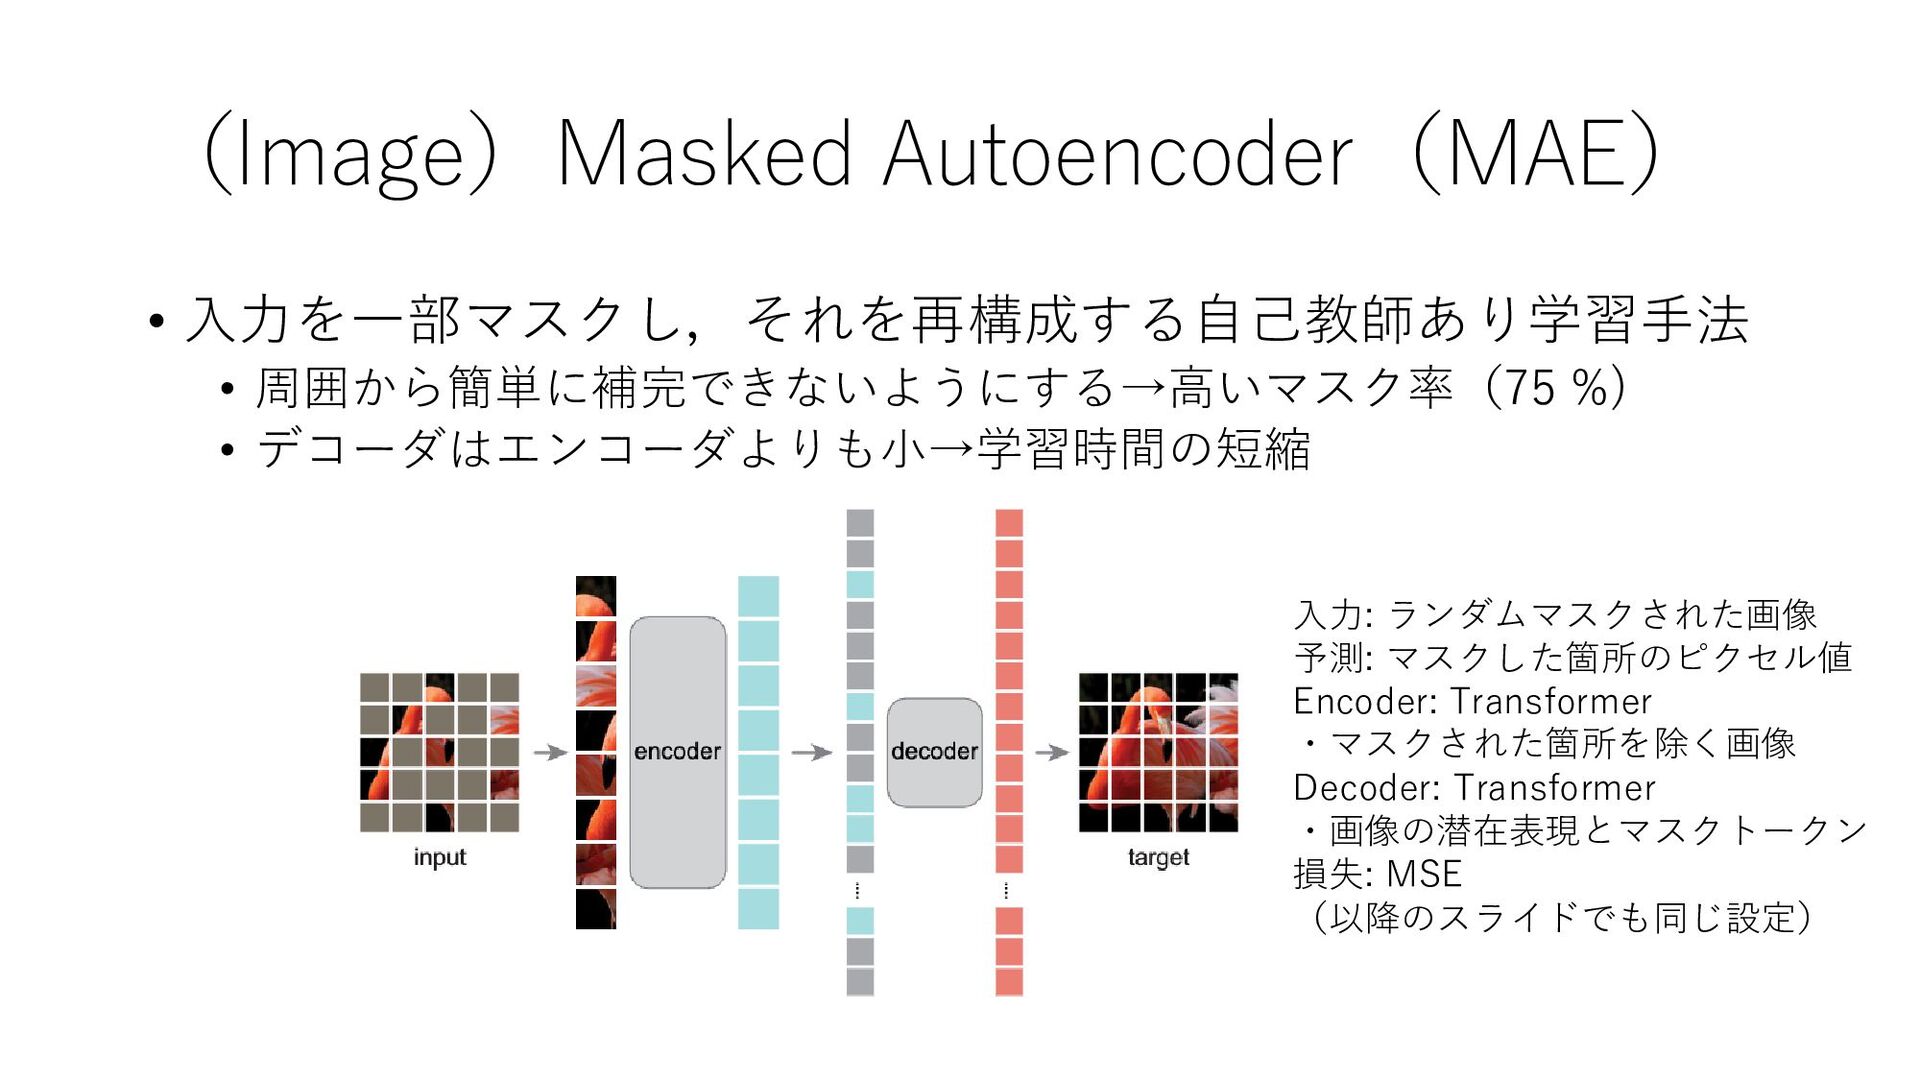
(Image)Masked Autoencoder(MAE) • 入力を一部マスクし,それを再構成する自己教師あり学習手法 • 周囲から簡単に補完できないようにする→高いマスク率(75 %) • デコーダはエンコーダよりも小→学習時間の短縮 入力:
ランダムマスクされた画像 予測: マスクした箇所のピクセル値 Encoder: Transformer ・マスクされた箇所を除く画像 Decoder: Transformer ・画像の潜在表現とマスクトークン 損失: MSE (以降のスライドでも同じ設定)
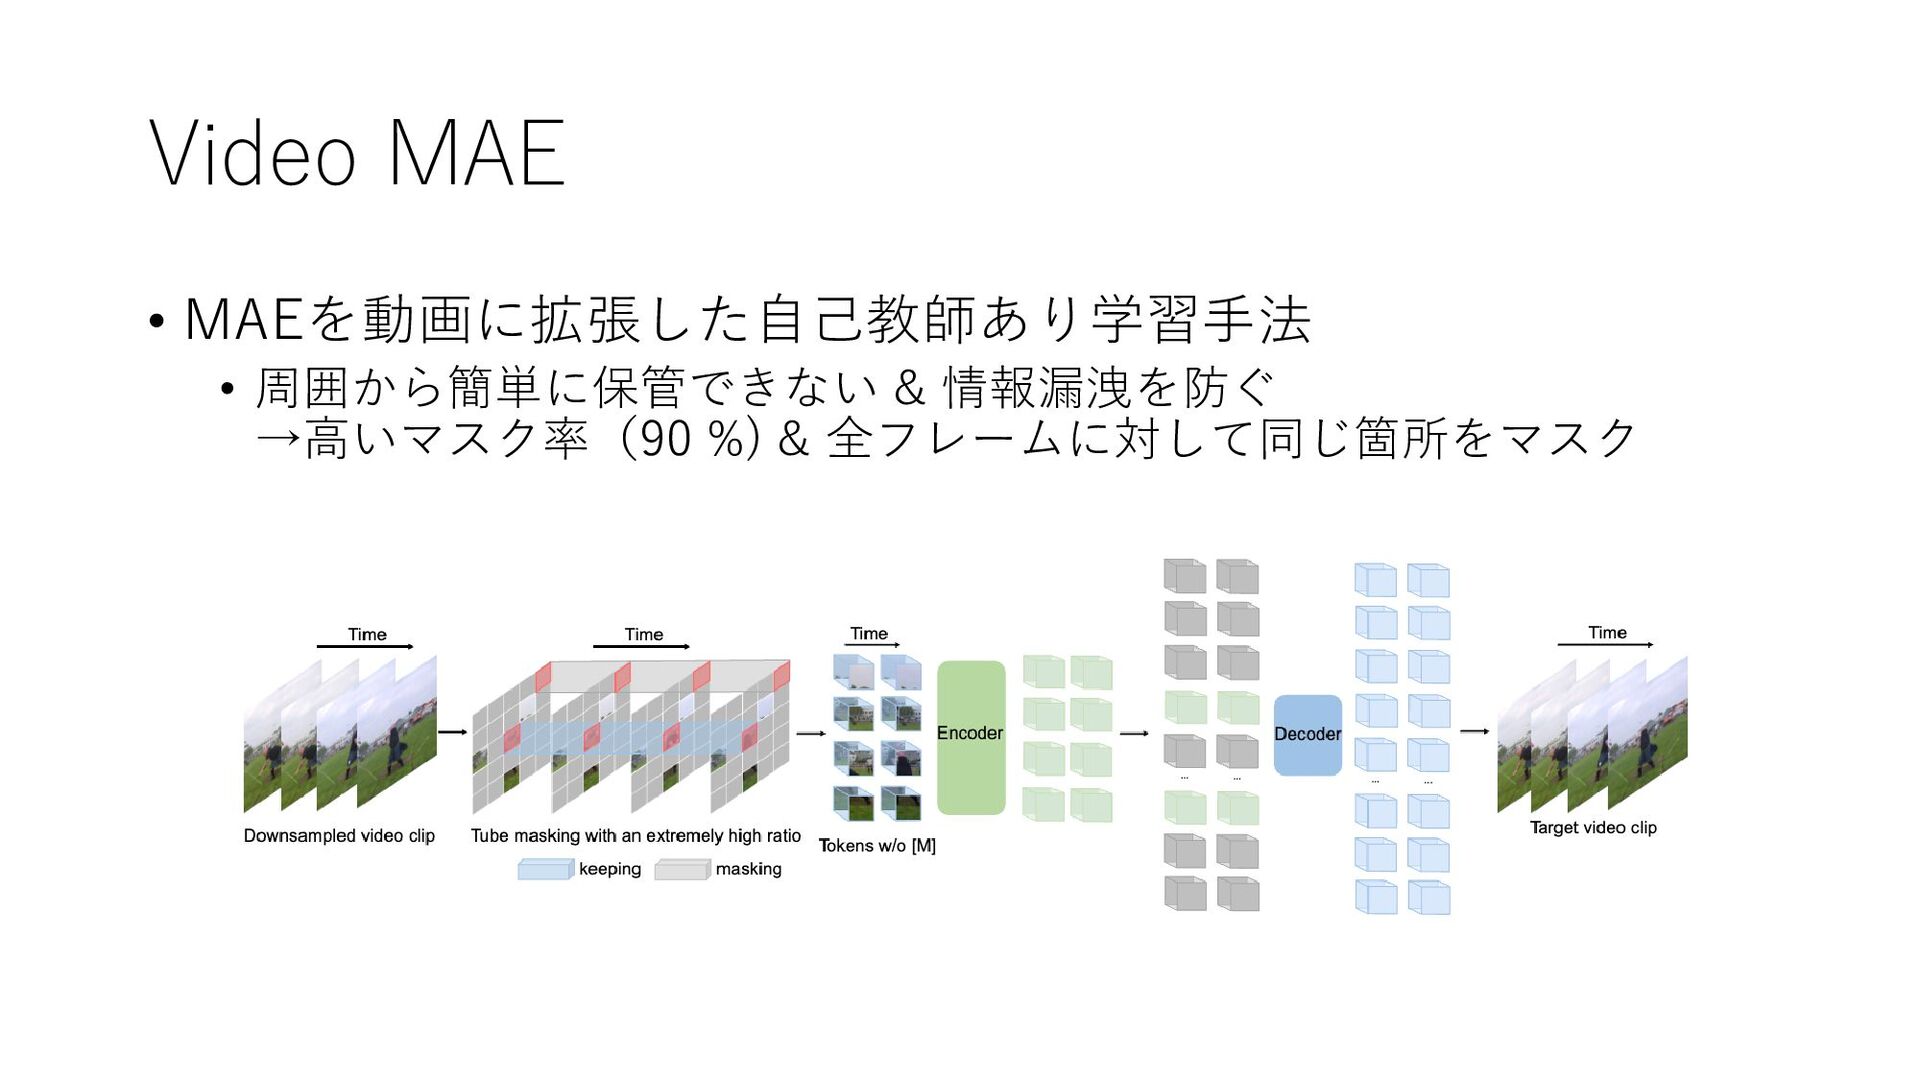
Video MAE • MAEを動画に拡張した自己教師あり学習手法 • 周囲から簡単に保管できない & 情報漏洩を防ぐ →高いマスク率(90 %)
& 全フレームに対して同じ箇所をマスク
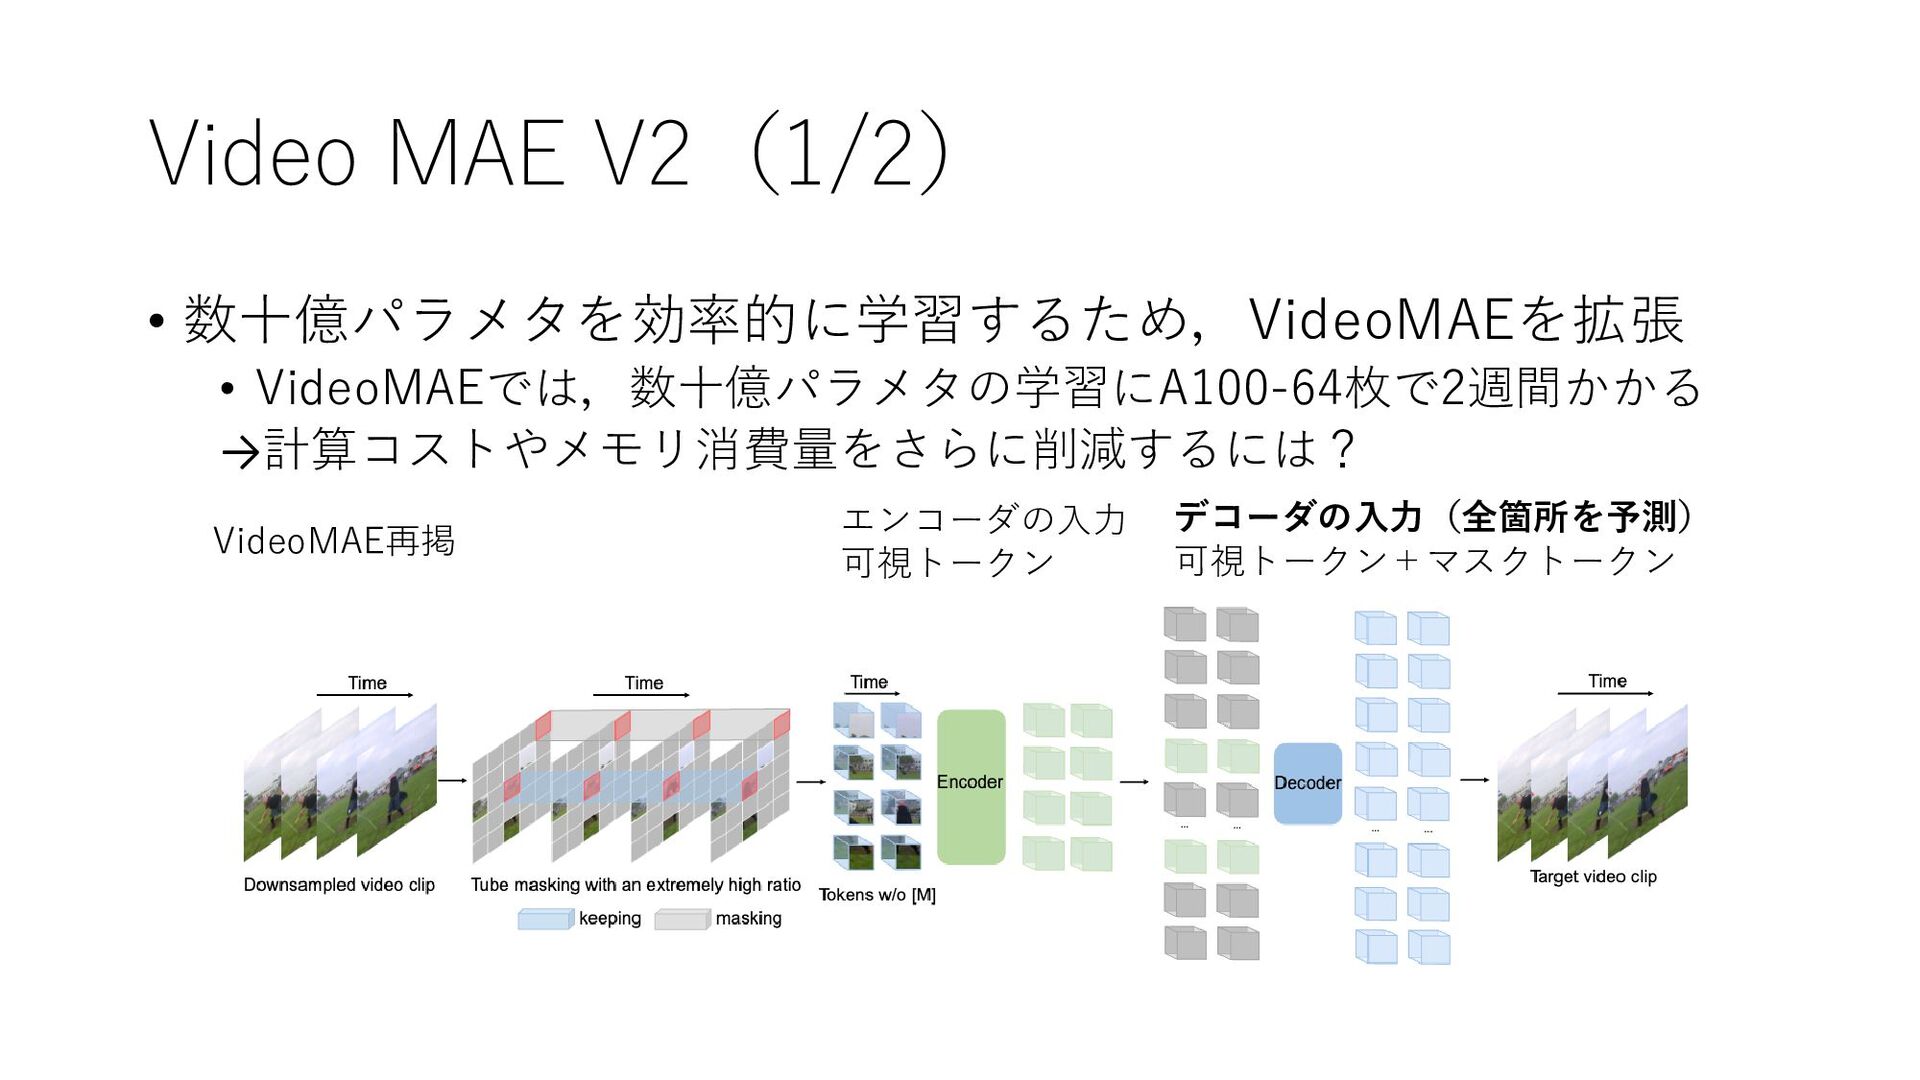
Video MAE V2(1/2) • 数十億パラメタを効率的に学習するため,VideoMAEを拡張 • VideoMAEでは,数十億パラメタの学習にA100-64枚で2週間かかる →計算コストやメモリ消費量をさらに削減するには? エンコーダの入力 可視トークン
デコーダの入力(全箇所を予測) 可視トークン+マスクトークン VideoMAE再掲
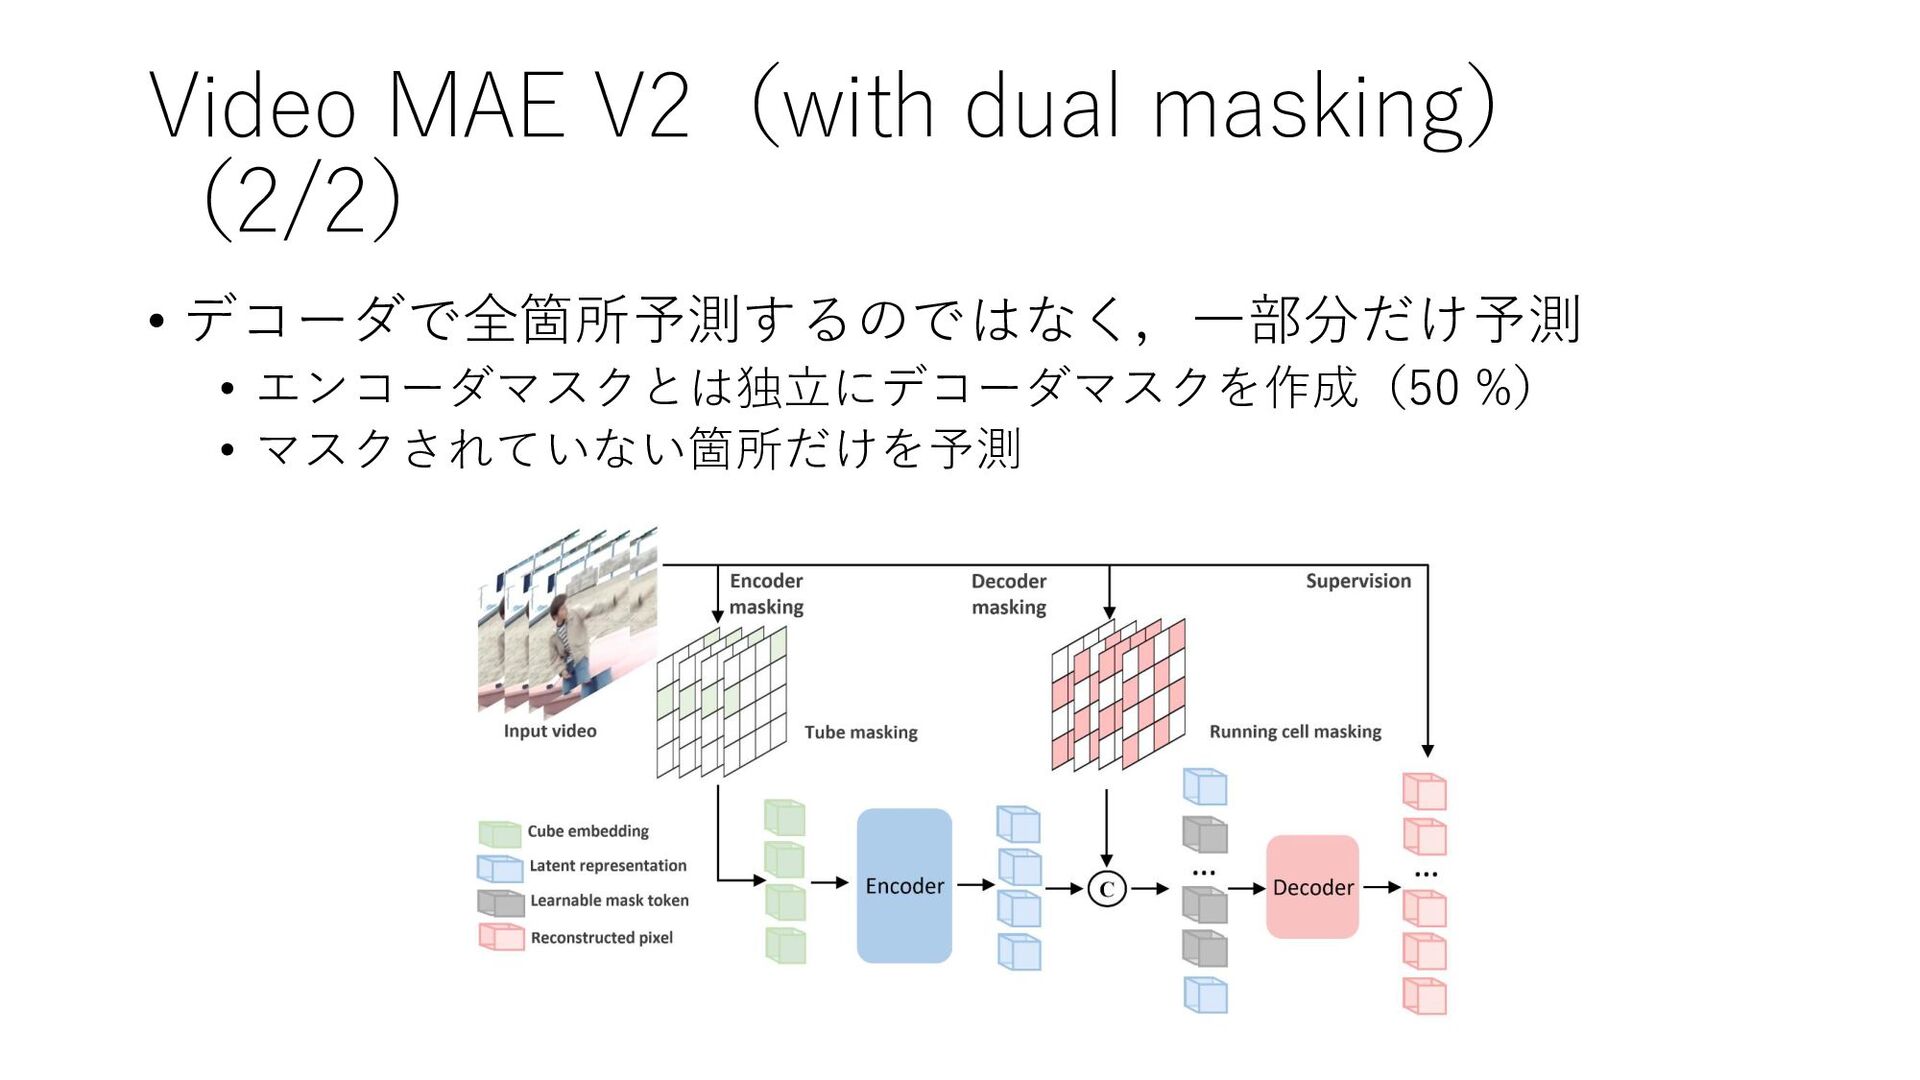
Video MAE V2(with dual masking) (2/2) • デコーダで全箇所予測するのではなく,一部分だけ予測 • エンコーダマスクとは独立にデコーダマスクを作成(50
%) • マスクされていない箇所だけを予測
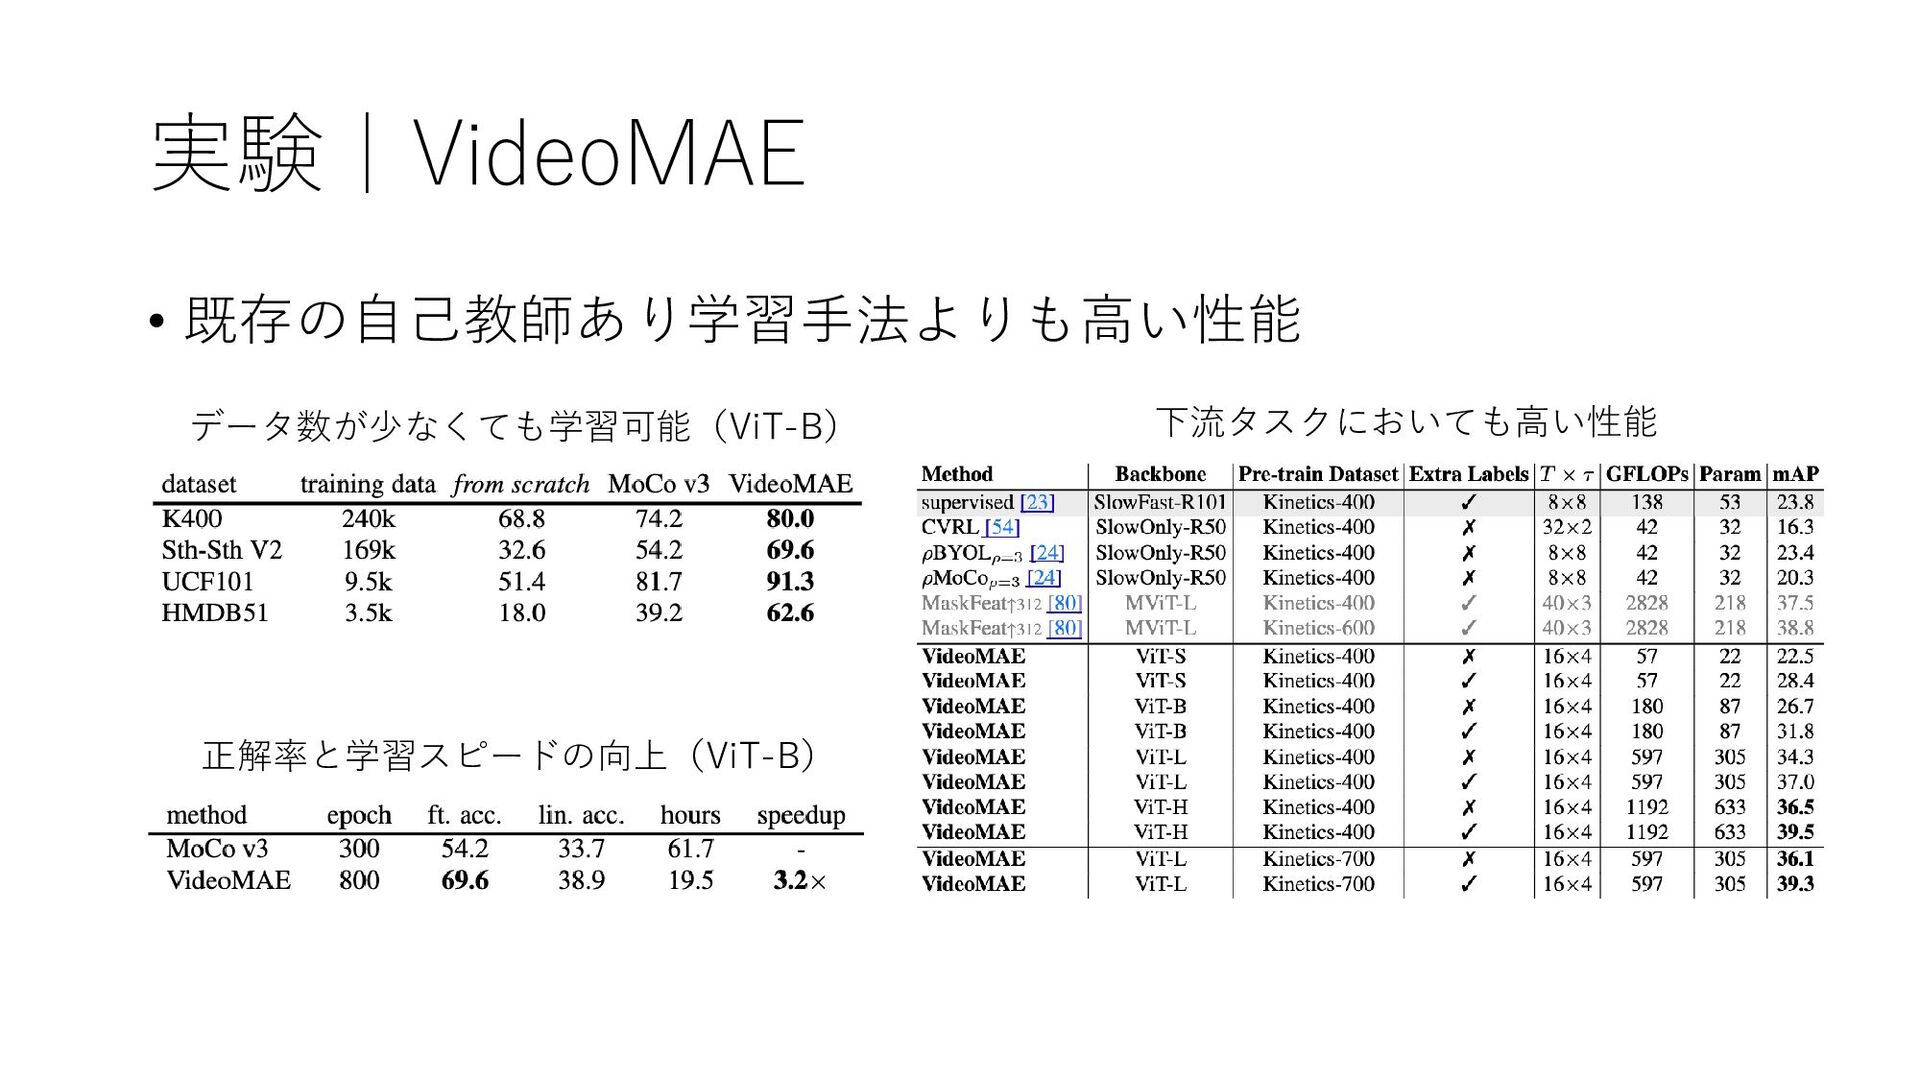
実験|VideoMAE • 既存の自己教師あり学習手法よりも高い性能 データ数が少なくても学習可能(ViT-B) 下流タスクにおいても高い性能 正解率と学習スピードの向上(ViT-B)
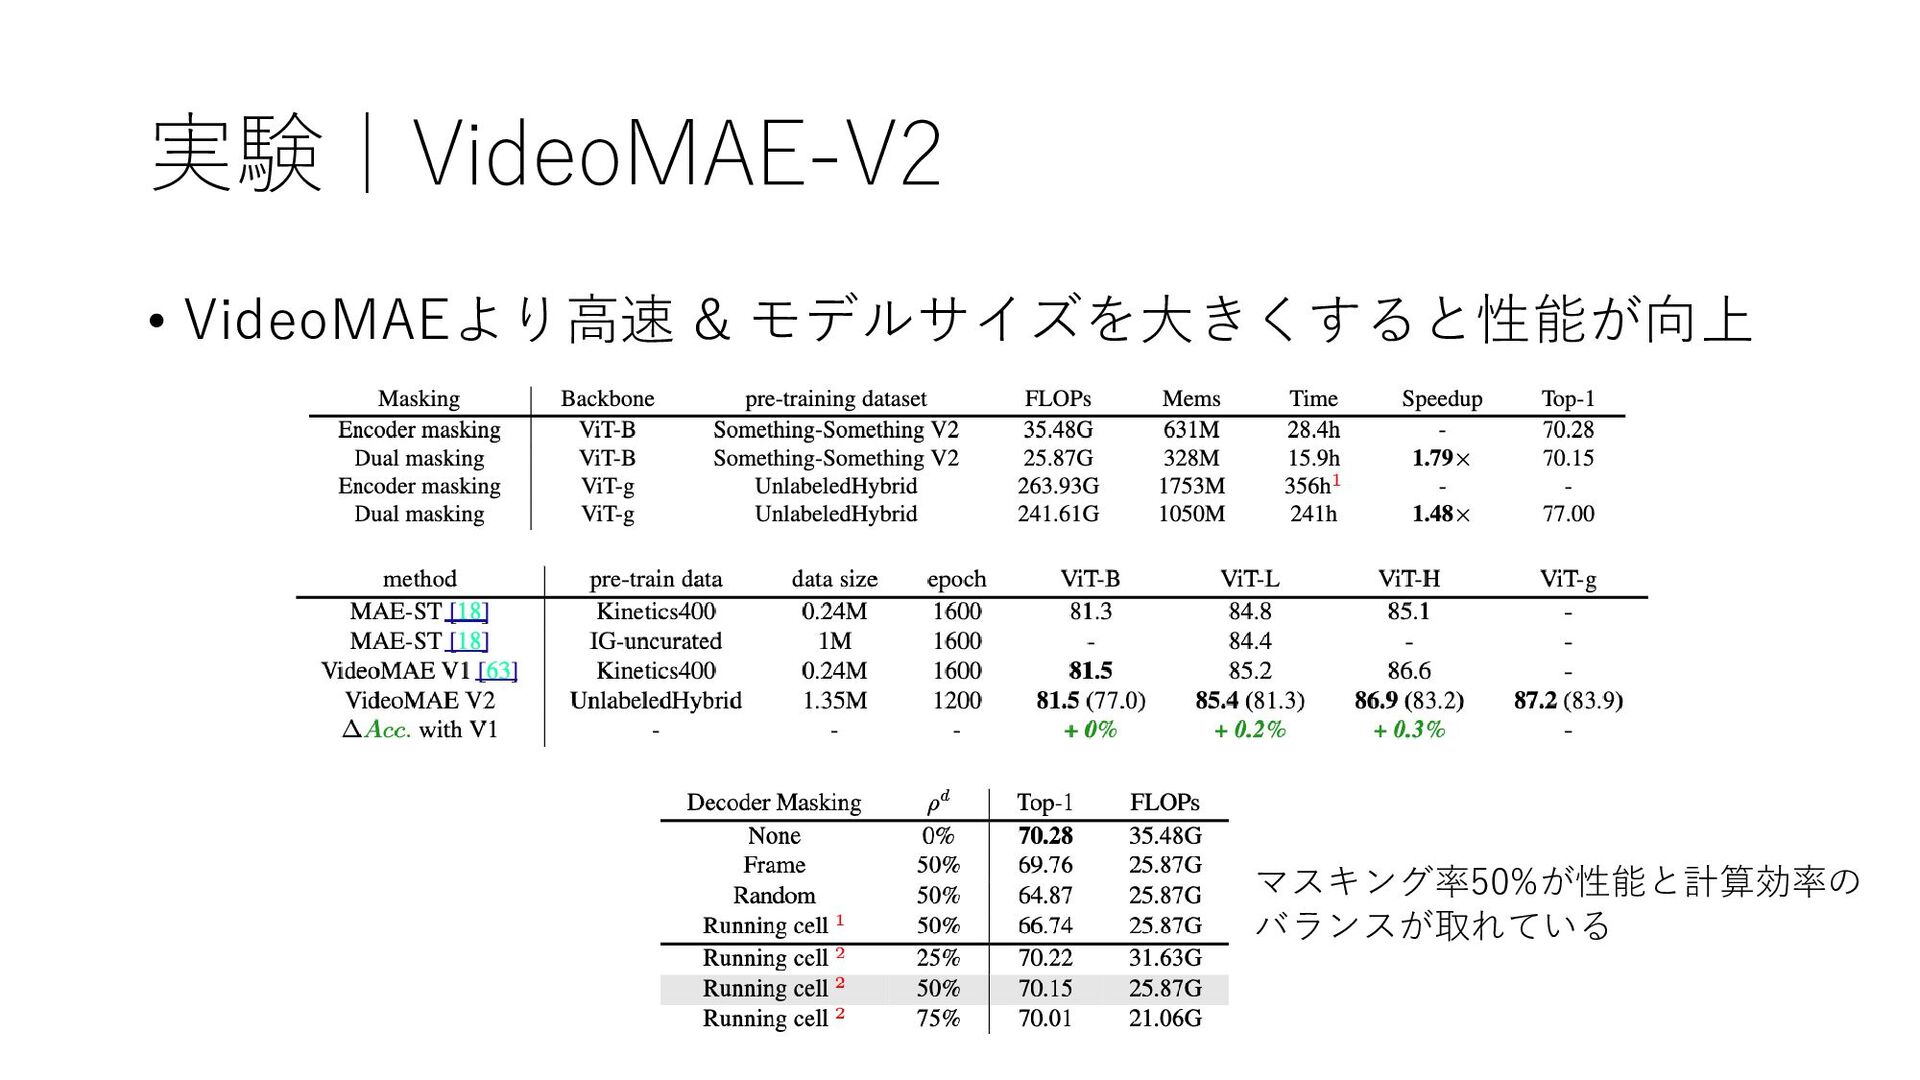
実験|VideoMAE-V2 • VideoMAEより高速 & モデルサイズを大きくすると性能が向上 マスキング率50%が性能と計算効率の バランスが取れている
まとめ • 自己教師あり動画事前学習手法を提案(VideoMAE) • Image MAEを拡張 • 大規模なモデルで学習するために効率化(VideoMAE-V2) • デコーダで全箇所予測するのではなく,一部分だけ予測
• 結果 • 既存手法よりも高い性能 • 下流タスクでも性能を発揮
More Decks by Jundai Inoue
See All by Jundai Inoue
500xCompressor: Generalized Prompt Compression for Large Language Models
jkmt
0
120
輪講資料:UNI-SIGN: TOWARD UNIFIED SIGN LANGUAGE UN- DERSTANDING AT SCALE
jkmt
0
23
T2S-GPT: Dynamic Vector Quantization for Autoregressive Sign Language Production from Text
jkmt
0
130
Featured
See All Featured
CoffeeScript is Beautiful & I Never Want to Write Plain JavaScript Again
sstephenson
162
16k
The AI Search Optimization Roadmap by Aleyda Solis
aleyda
2
6.4k
Joys of Absence: A Defence of Solitary Play
codingconduct
1
580
Optimising Largest Contentful Paint
csswizardry
37
4k
Producing Creativity
orderedlist
PRO
348
41k
"I'm Feeling Lucky" - Building Great Search Experiences for Today's Users (#IAC19)
danielanewman
230
23k
The Spectacular Lies of Maps
axbom
PRO
1
1.1k
KATA
mclloyd
PRO
35
16k
Git: the NoSQL Database
bkeepers
PRO
433
67k
Evolving SEO for Evolving Search Engines
ryanjones
0
360
BBQ
matthewcrist
90
10k
Creating an realtime collaboration tool: Agile Flush - .NET Oxford
marcduiker
35
2.6k


 jkmt
 sstephenson
 aleyda
 codingconduct
 csswizardry
 orderedlist
 danielanewman
 axbom
 mclloyd
 bkeepers
 ryanjones
 matthewcrist
 marcduiker