Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
分析の民主化を支えるメタデータ整備の実践
Search
KAKEHASHI
PRO
October 09, 2026
Technology
1.8k
5
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
分析の民主化を支えるメタデータ整備の実践
Data Engineering Summit 2026
https://data-engineering-summit.findy-tools.io/2026
での登壇資料です
KAKEHASHI
PRO
October 09, 2026
Transcript
65 slides
分析の民主化を支える メタデータ整備の実践 生成AIが読み手になった環境で、何を・どこに・どのように書くか Data Engineering Summit 2026 / 2026年10月9日 /
株式会社カケハシ © KAKEHASHI Inc. All Rights Reserved.
自己紹介 株式会社カケハシ Musubi Insight プロダクトマネージャー 梶村直人 東京大学では自然言語処理の研究 新卒の総合商社では海外大手 IT企業との 合弁会社設立やその営業企画を担当。
カケハシには 2022年に入社。 一番好きなプロダクトは Databricks Techと事業の両方が好きで PdMは天職 © KAKEHASHI Inc. All Rights Reserved. 2
3
4
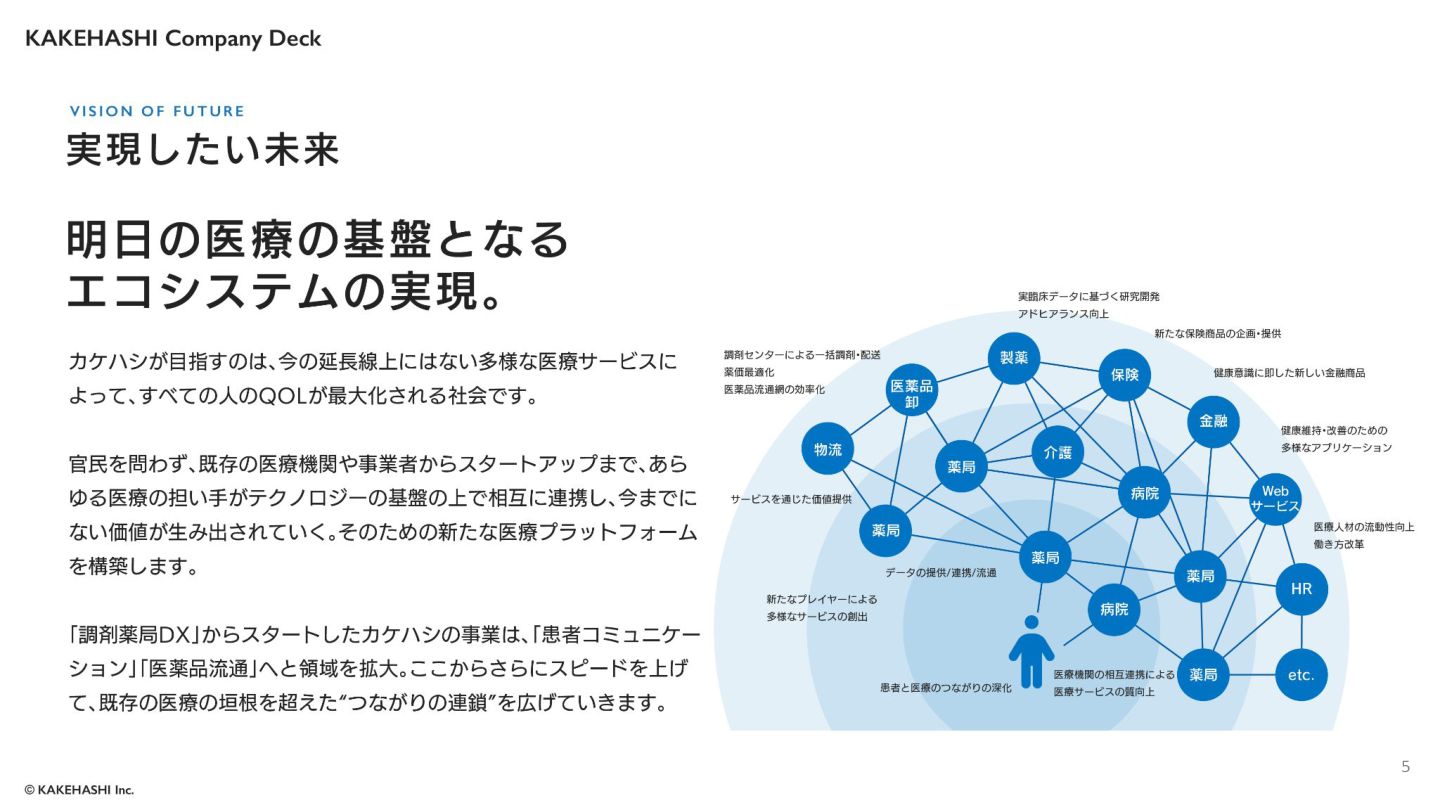
5
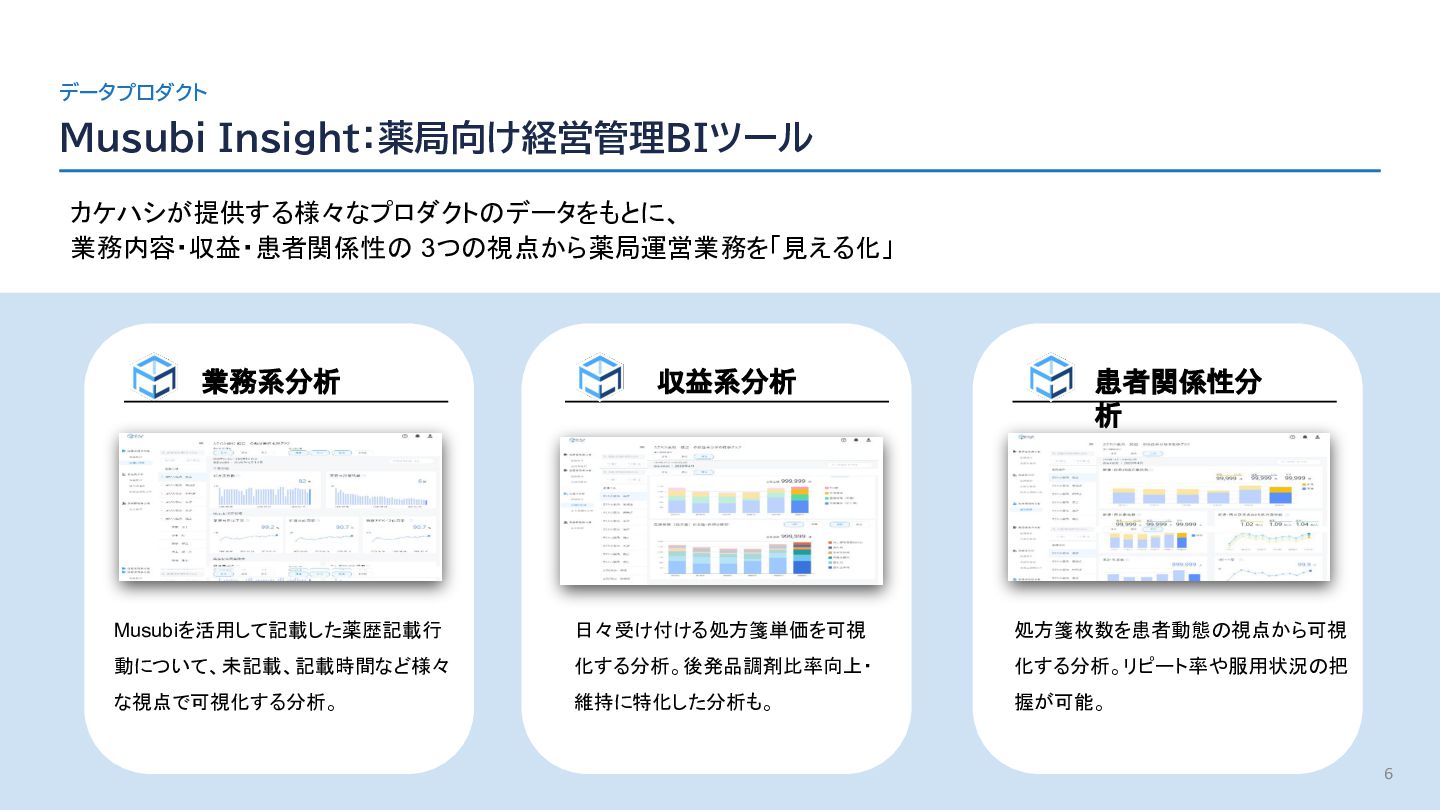
データプロダクト Musubi Insight:薬局向け経営管理BIツール カケハシが提供する様々なプロダクトのデータをもとに、 業務内容・収益・患者関係性の 3つの視点から薬局運営業務を「見える化」 業務系分析 収益系分析 患者関係性分 析
Musubiを活用して記載した薬歴記載行 日々受け付ける処方箋単価を可視 処方箋枚数を患者動態の視点から可視 動について、未記載、記載時間など様々 化する分析。後発品調剤比率向上・ 化する分析。リピート率や服用状況の把 な視点で可視化する分析。 維持に特化した分析も。 握が可能。 6
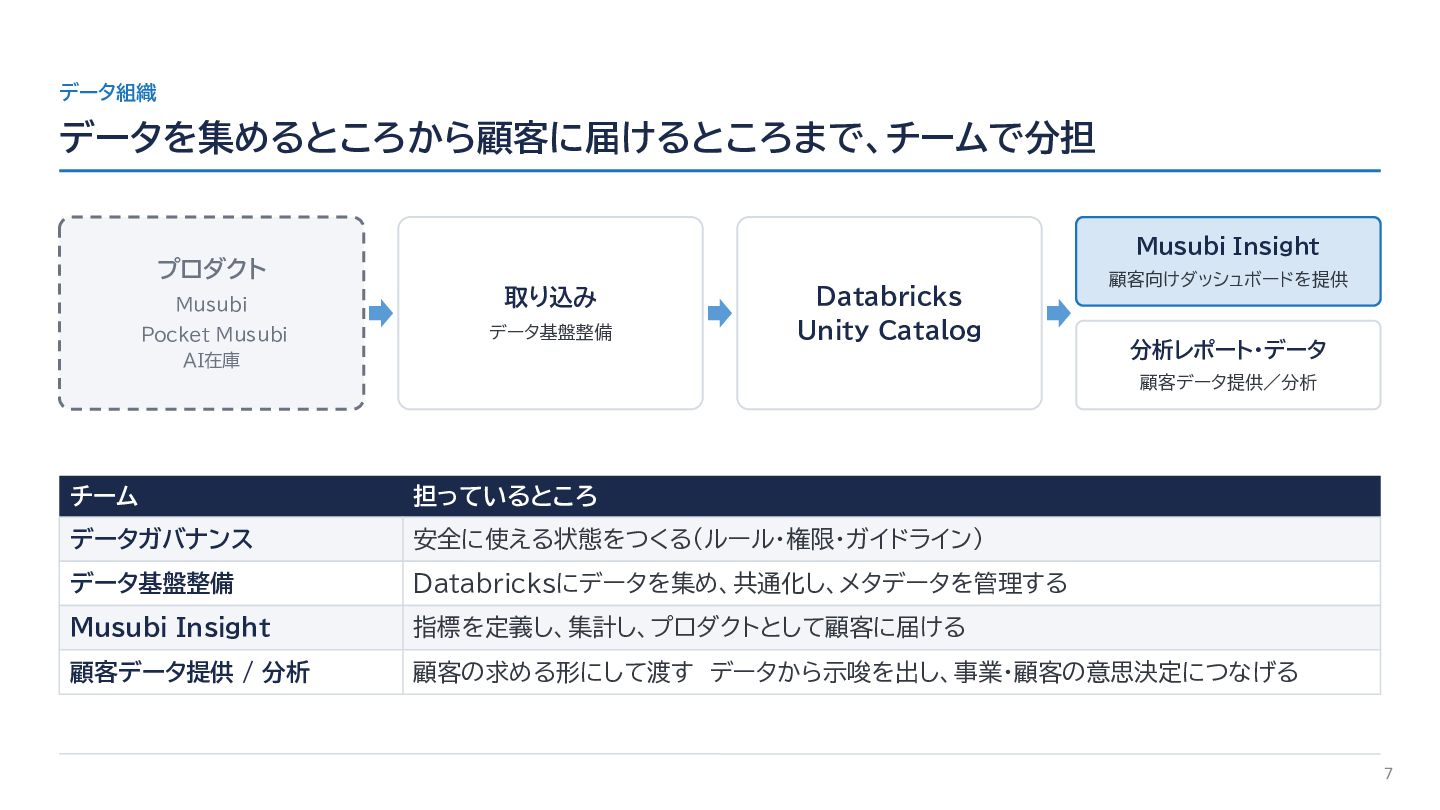
データ組織 データを集めるところから顧客に届けるところまで、チームで分担 Musubi Insight プロダクト Musubi Pocket Musubi AI在庫 取り込み
データ基盤整備 Databricks Unity Catalog 顧客向けダッシュボードを提供 分析レポート・データ 顧客データ提供/分析 チーム 担っているところ データガバナンス 安全に使える状態をつくる(ルール・権限・ガイドライン) データ基盤整備 Databricksにデータを集め、共通化し、メタデータを管理する Musubi Insight 指標を定義し、集計し、プロダクトとして顧客に届ける 顧客データ提供 / 分析 顧客の求める形にして渡す データから示唆を出し、事業・顧客の意思決定につなげる 7
AIが出力するデータを信じられますか? © KAKEHASHI Inc. All Rights Reserved.
はじめに AIが返答するデータを信じられますか? エラーは出さずに、それっぽい数字が返ってくる。 ただし、たまに間違える。 9
はじめに AIが返答するデータを信じられますか? エラーは出さずに、それっぽい数字が返ってくる。 ただし、たまに間違える。 今日の話 この間違いを防ぎ安心して活用するためのメタデータ整備 10
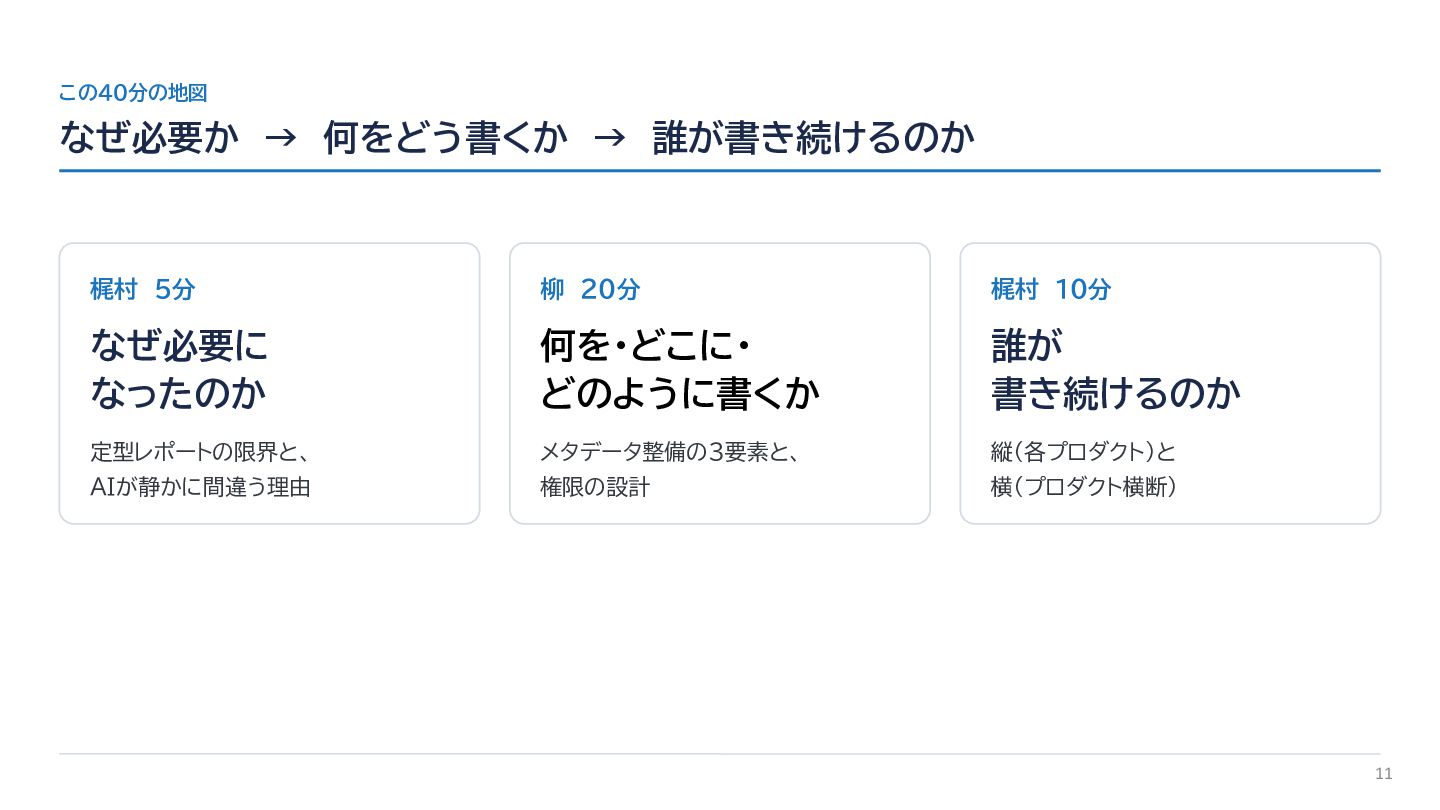
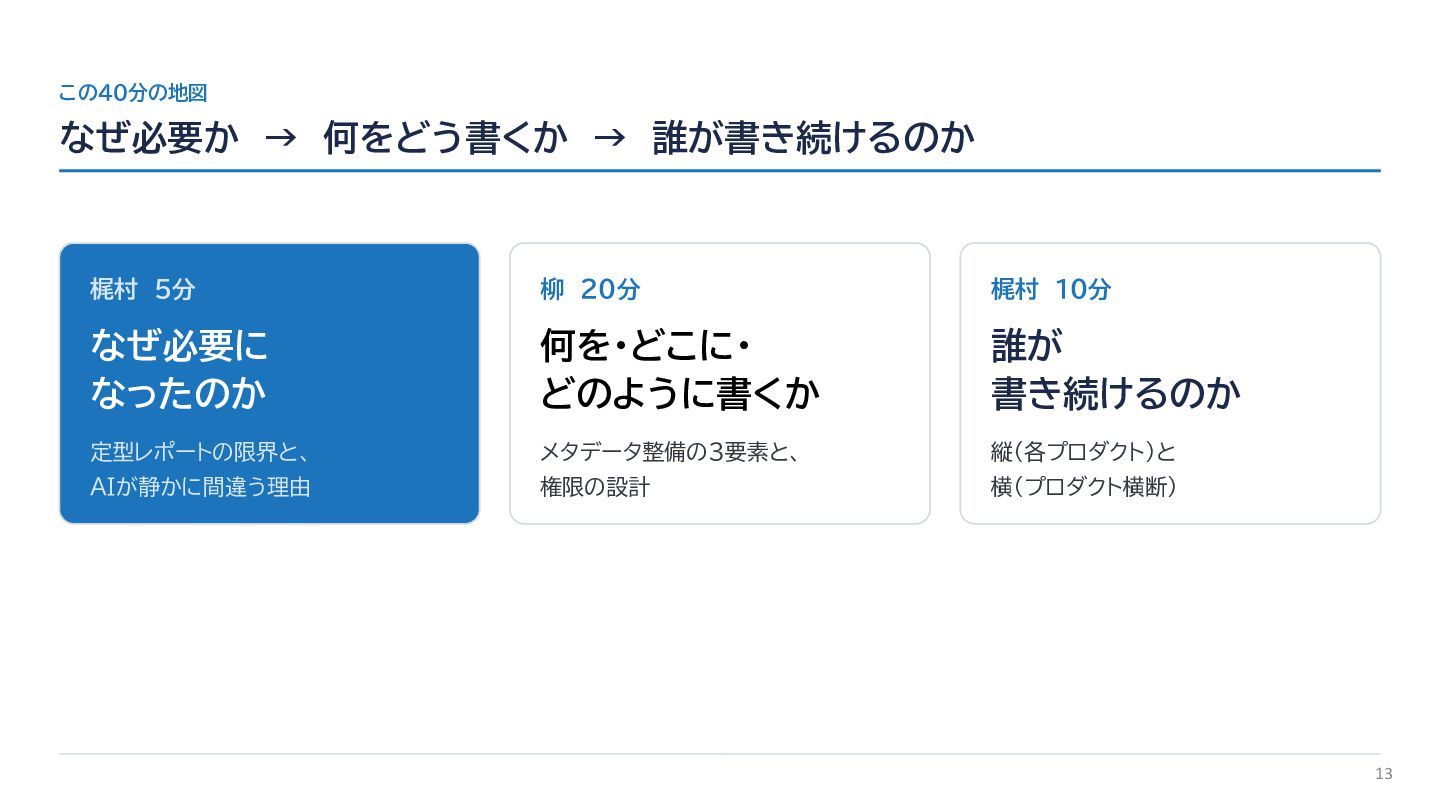
この40分の地図 なぜ必要か → 何をどう書くか → 誰が書き続けるのか 梶村 5分 柳 20分
梶村 10分 なぜ必要に なったのか 何を・どこに・ どのように書くか 誰が 書き続けるのか 定型レポートの限界と、 メタデータ整備の3要素と、 縦(各プロダクト)と AIが静かに間違う理由 権限の設計 横(プロダクト横断) 11
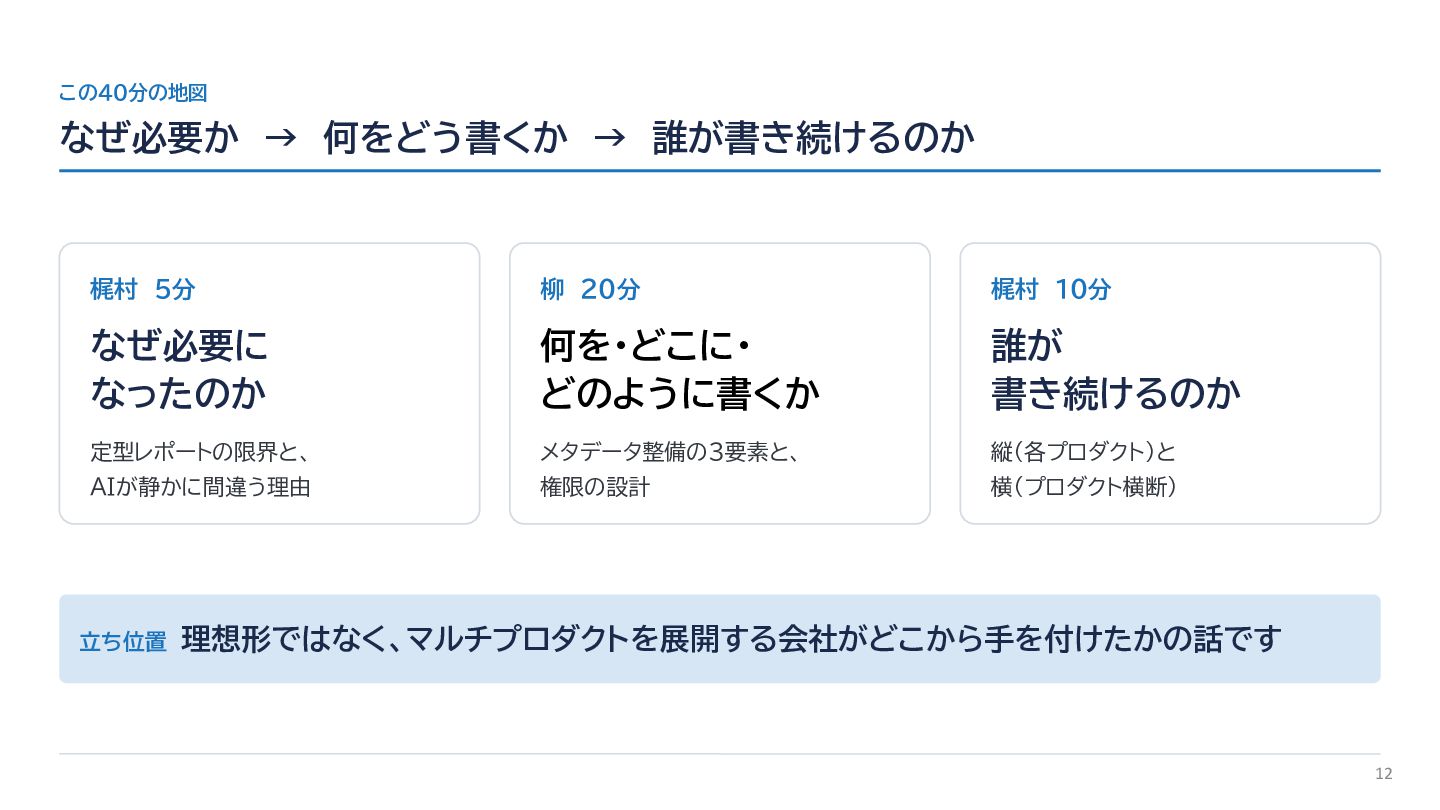
この40分の地図 なぜ必要か → 何をどう書くか → 誰が書き続けるのか 梶村 5分 柳 20分
梶村 10分 なぜ必要に なったのか 何を・どこに・ どのように書くか 誰が 書き続けるのか 定型レポートの限界と、 メタデータ整備の3要素と、 縦(各プロダクト)と AIが静かに間違う理由 権限の設計 横(プロダクト横断) 立ち位置 理想形ではなく、マルチプロダクトを展開する会社がどこから手を付けたかの話です 12
この40分の地図 なぜ必要か → 何をどう書くか → 誰が書き続けるのか 梶村 5分 柳 20分
梶村 10分 なぜ必要に なったのか 何を・どこに・ どのように書くか 誰が 書き続けるのか 定型レポートの限界と、 メタデータ整備の3要素と、 縦(各プロダクト)と AIが静かに間違う理由 権限の設計 横(プロダクト横断) 13
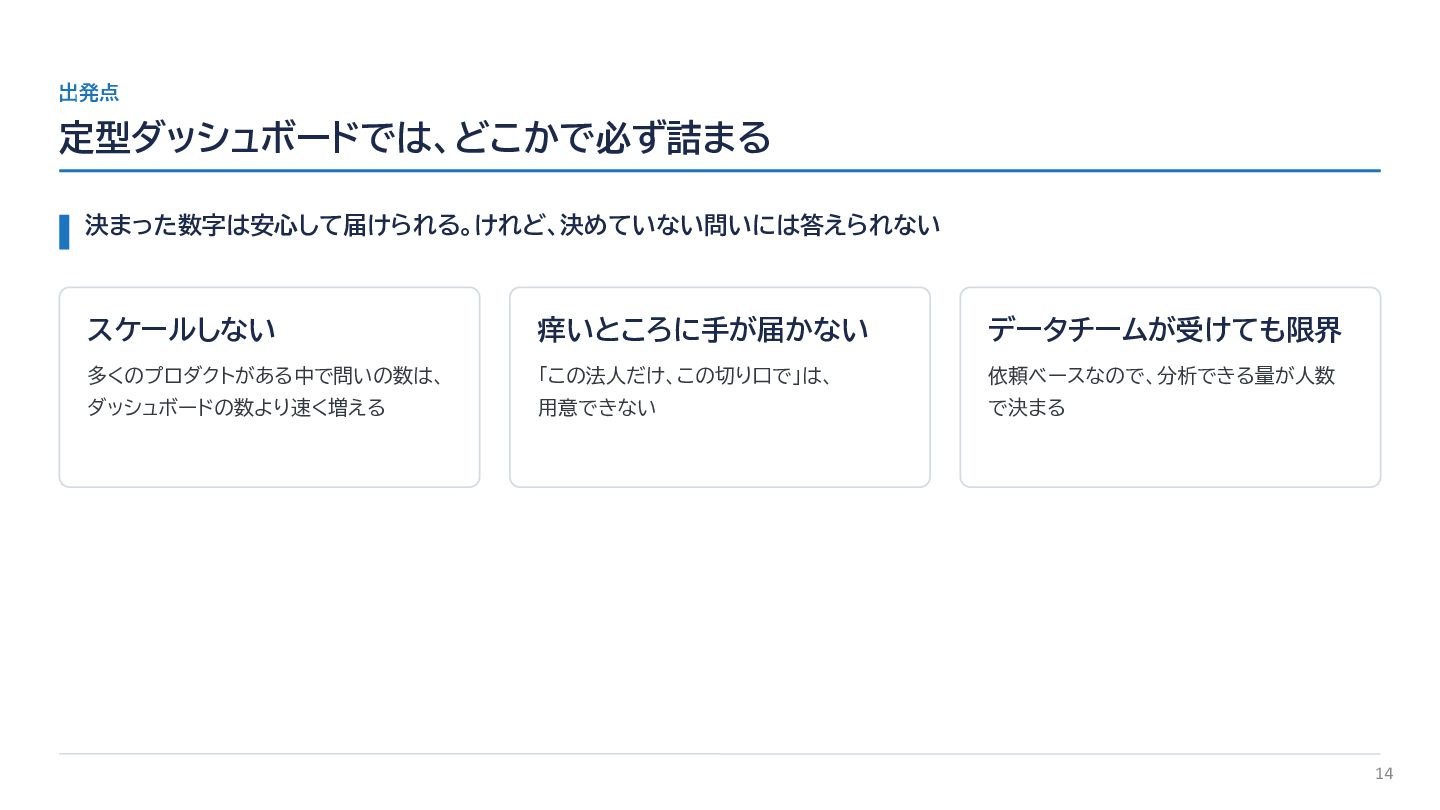
出発点 定型ダッシュボードでは、どこかで必ず詰まる 決まった数字は安心して届けられる。けれど、決めていない問いには答えられない スケールしない 痒いところに手が届かない データチームが受けても限界 多くのプロダクトがある中で問いの数は、 「この法人だけ、この切り口で」は、 依頼ベースなので、分析できる量が人数 ダッシュボードの数より速く増える
用意できない で決まる 14
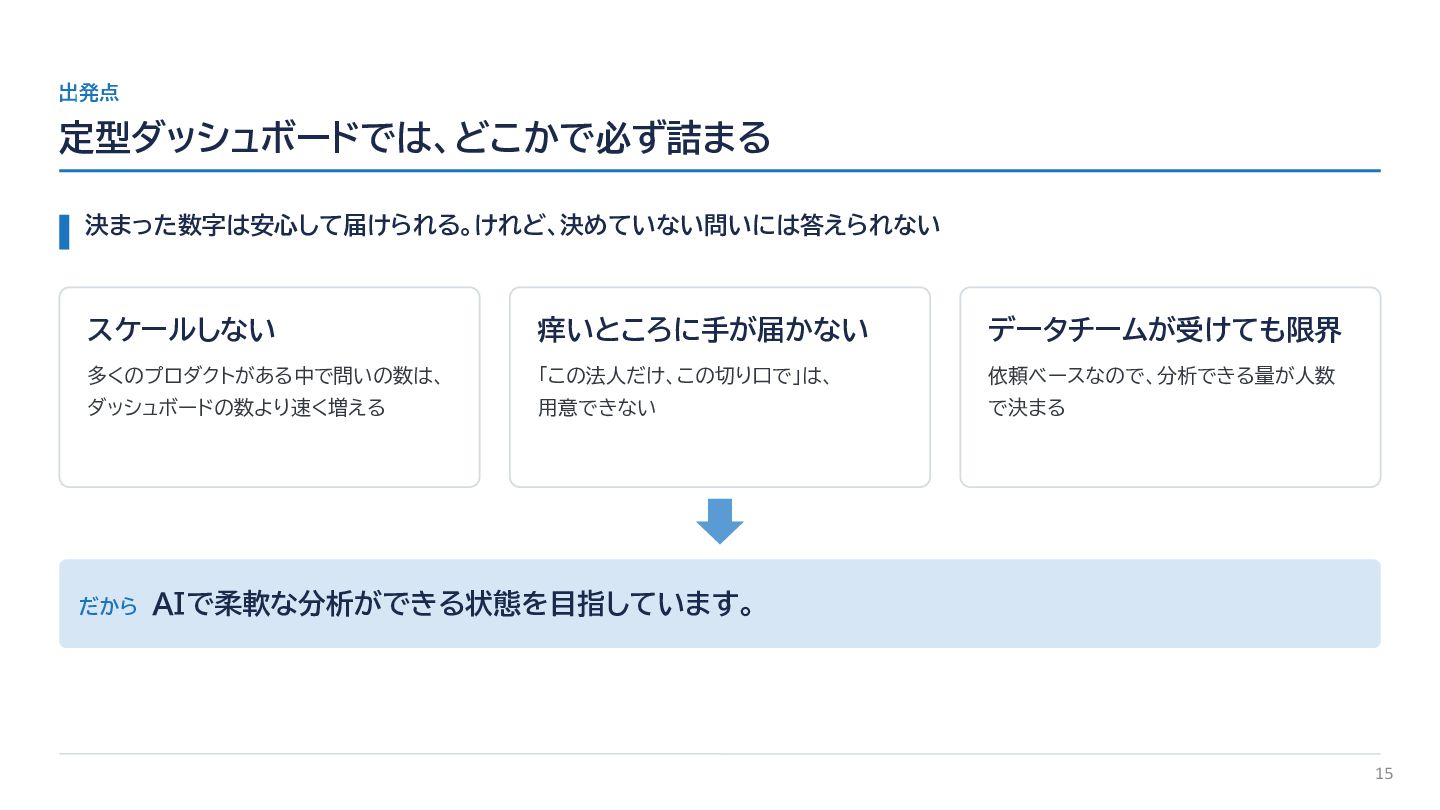
出発点 定型ダッシュボードでは、どこかで必ず詰まる 決まった数字は安心して届けられる。けれど、決めていない問いには答えられない スケールしない 痒いところに手が届かない データチームが受けても限界 多くのプロダクトがある中で問いの数は、 「この法人だけ、この切り口で」は、 依頼ベースなので、分析できる量が人数 ダッシュボードの数より速く増える
用意できない で決まる だから AIで柔軟な分析ができる状態を目指しています。 15
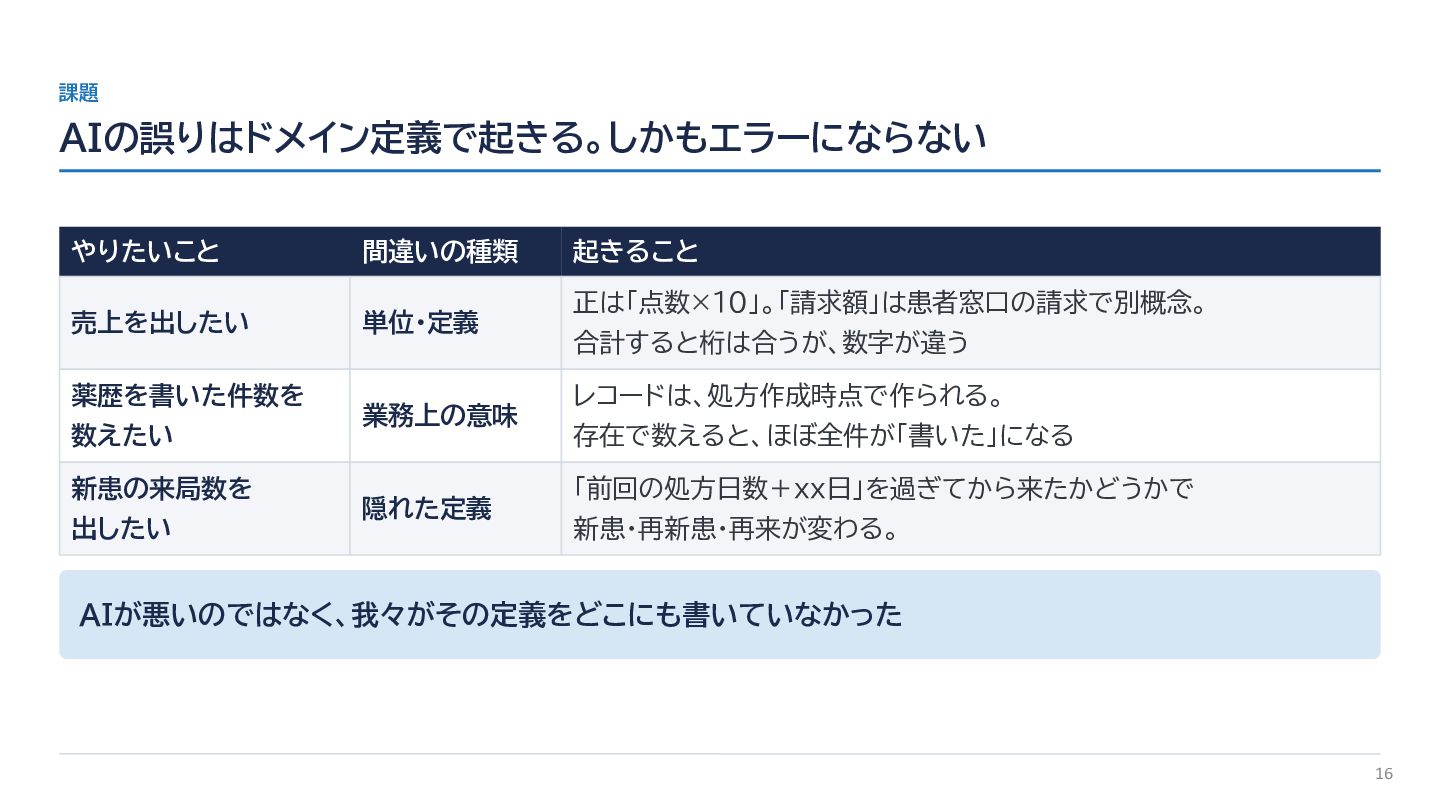
課題 AIの誤りはドメイン定義で起きる。しかもエラーにならない やりたいこと 間違いの種類 売上を出したい 単位・定義 薬歴を書いた件数を 数えたい 新患の来局数を 出したい
業務上の意味 隠れた定義 起きること 正は「点数×10」。「請求額」は患者窓口の請求で別概念。 合計すると桁は合うが、数字が違う レコードは、処方作成時点で作られる。 存在で数えると、ほぼ全件が「書いた」になる 「前回の処方日数+xx日」を過ぎてから来たかどうかで 新患・再新患・再来が変わる。 AIが悪いのではなく、我々がその定義をどこにも書いていなかった 16
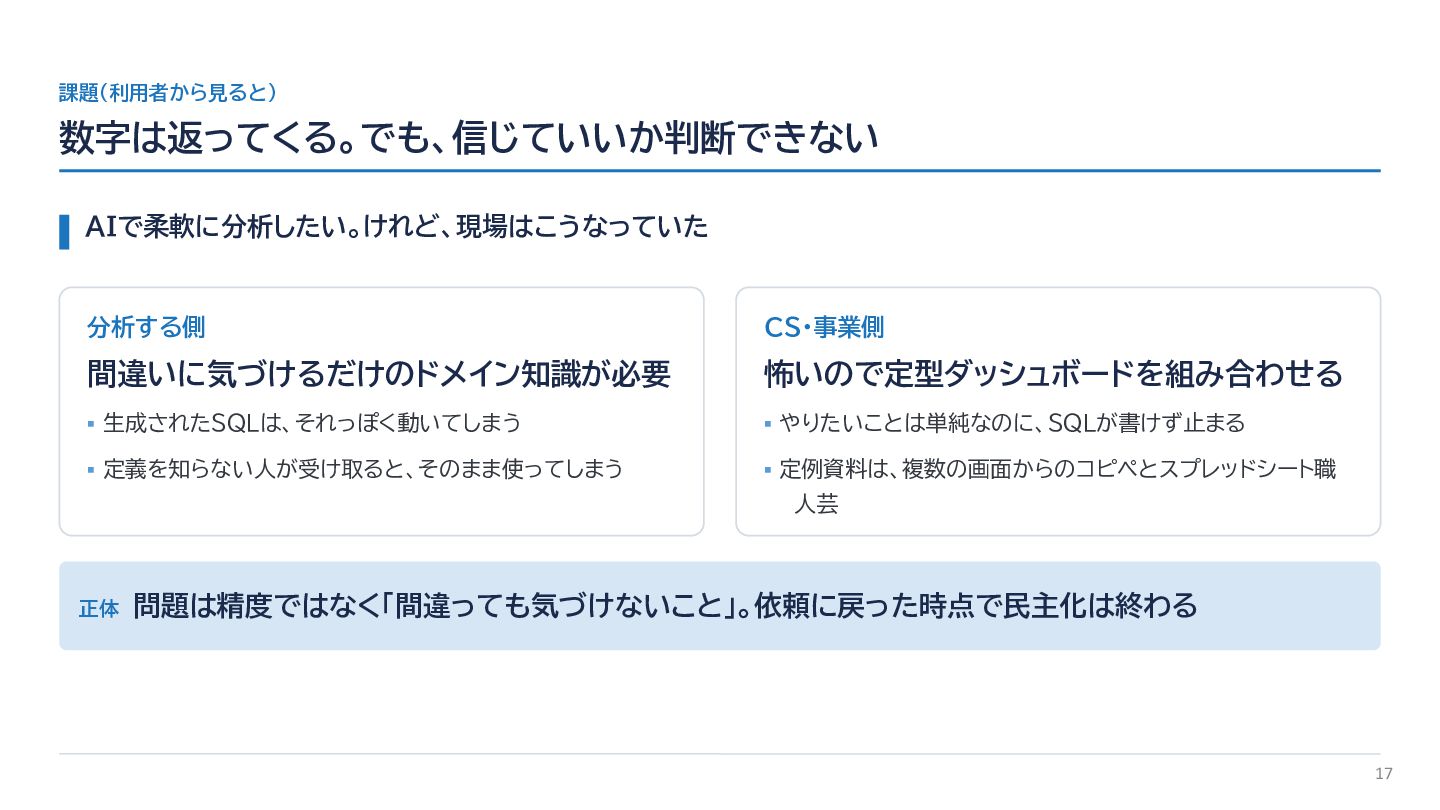
課題(利用者から見ると) 数字は返ってくる。でも、信じていいか判断できない AIで柔軟に分析したい。けれど、現場はこうなっていた 分析する側 CS・事業側 間違いに気づけるだけのドメイン知識が必要 怖いので定型ダッシュボードを組み合わせる ▪ 生成されたSQLは、それっぽく動いてしまう ▪
やりたいことは単純なのに、SQLが書けず止まる ▪ 定義を知らない人が受け取ると、そのまま使ってしまう ▪ 定例資料は、複数の画面からのコピペとスプレッドシート職 人芸 正体 問題は精度ではなく「間違っても気づけないこと」。依頼に戻った時点で民主化は終わる 17
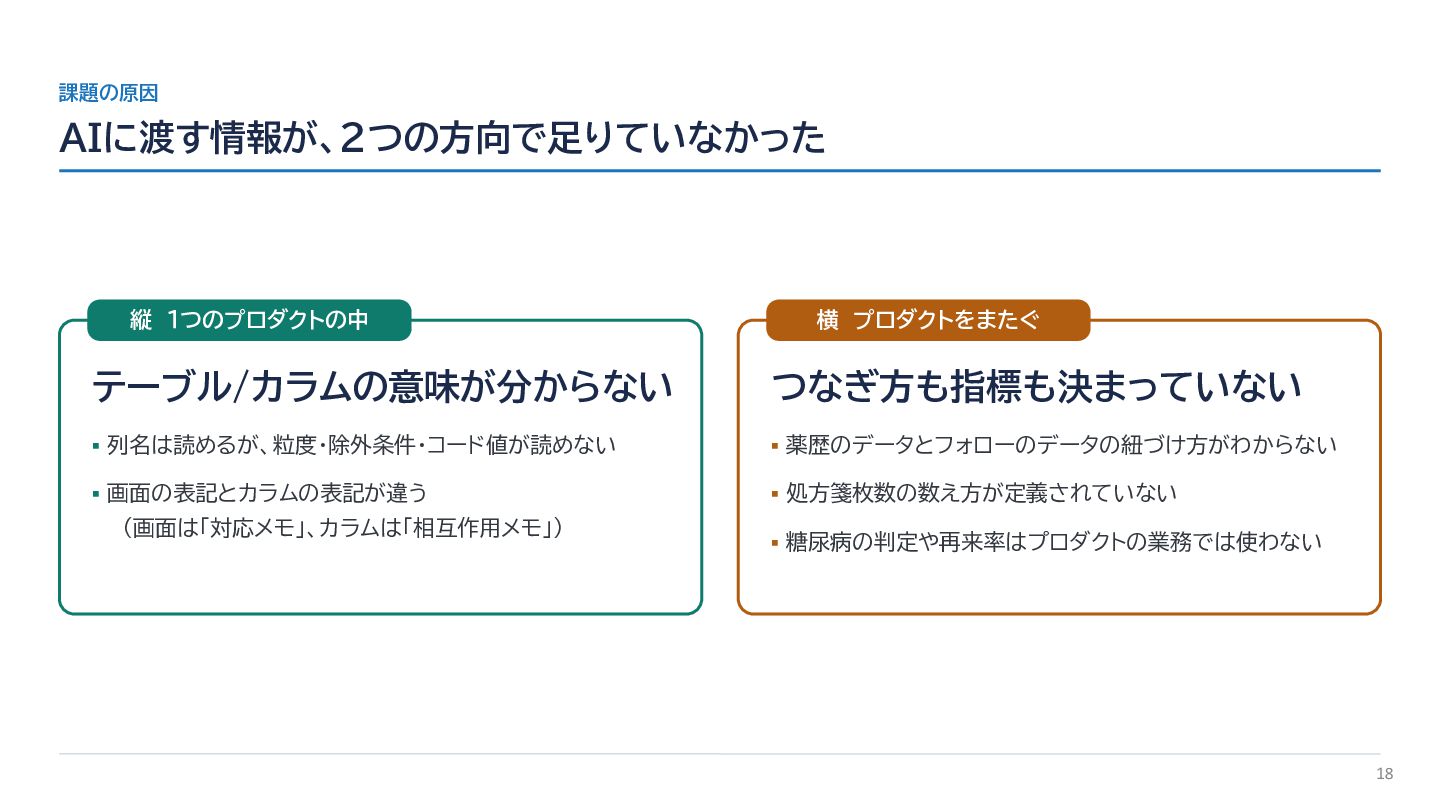
課題の原因 AIに渡す情報が、2つの方向で足りていなかった 縦 1つのプロダクトの中 横 プロダクトをまたぐ テーブル/カラムの意味が分からない つなぎ方も指標も決まっていない ▪ 列名は読めるが、粒度・除外条件・コード値が読めない
▪ 薬歴のデータとフォローのデータの紐づけ方がわからない ▪ 画面の表記とカラムの表記が違う ▪ 処方箋枚数の数え方が定義されていない (画面は「対応メモ」、カラムは「相互作用メモ」) ▪ 糖尿病の判定や再来率はプロダクトの業務では使わない 18
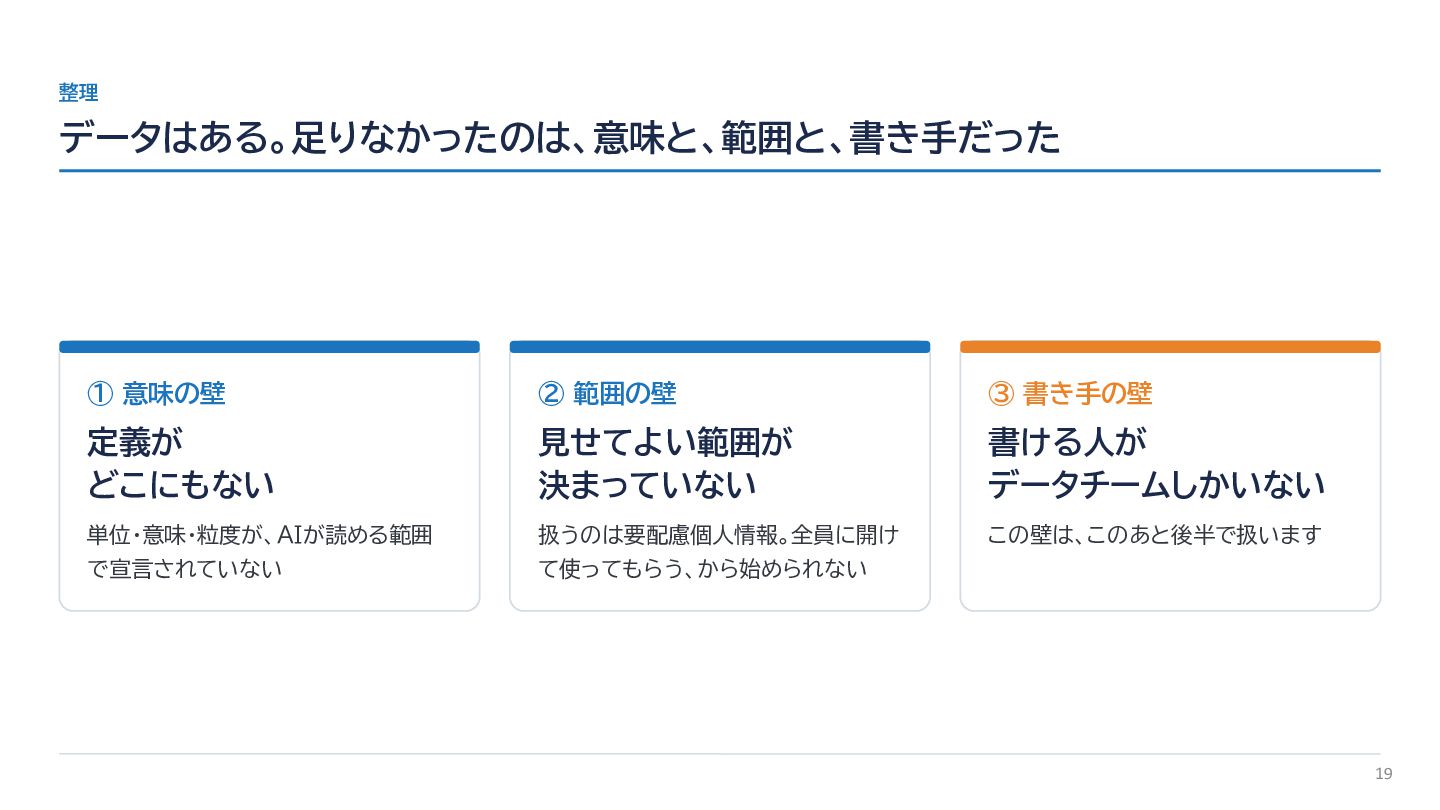
整理 データはある。足りなかったのは、意味と、範囲と、書き手だった ① 意味の壁 ② 範囲の壁 ③ 書き手の壁 定義が どこにもない
見せてよい範囲が 決まっていない 書ける人が データチームしかいない 単位・意味・粒度が、AIが読める範囲 扱うのは要配慮個人情報。全員に開け この壁は、このあと後半で扱います で宣言されていない て使ってもらう、から始められない 19
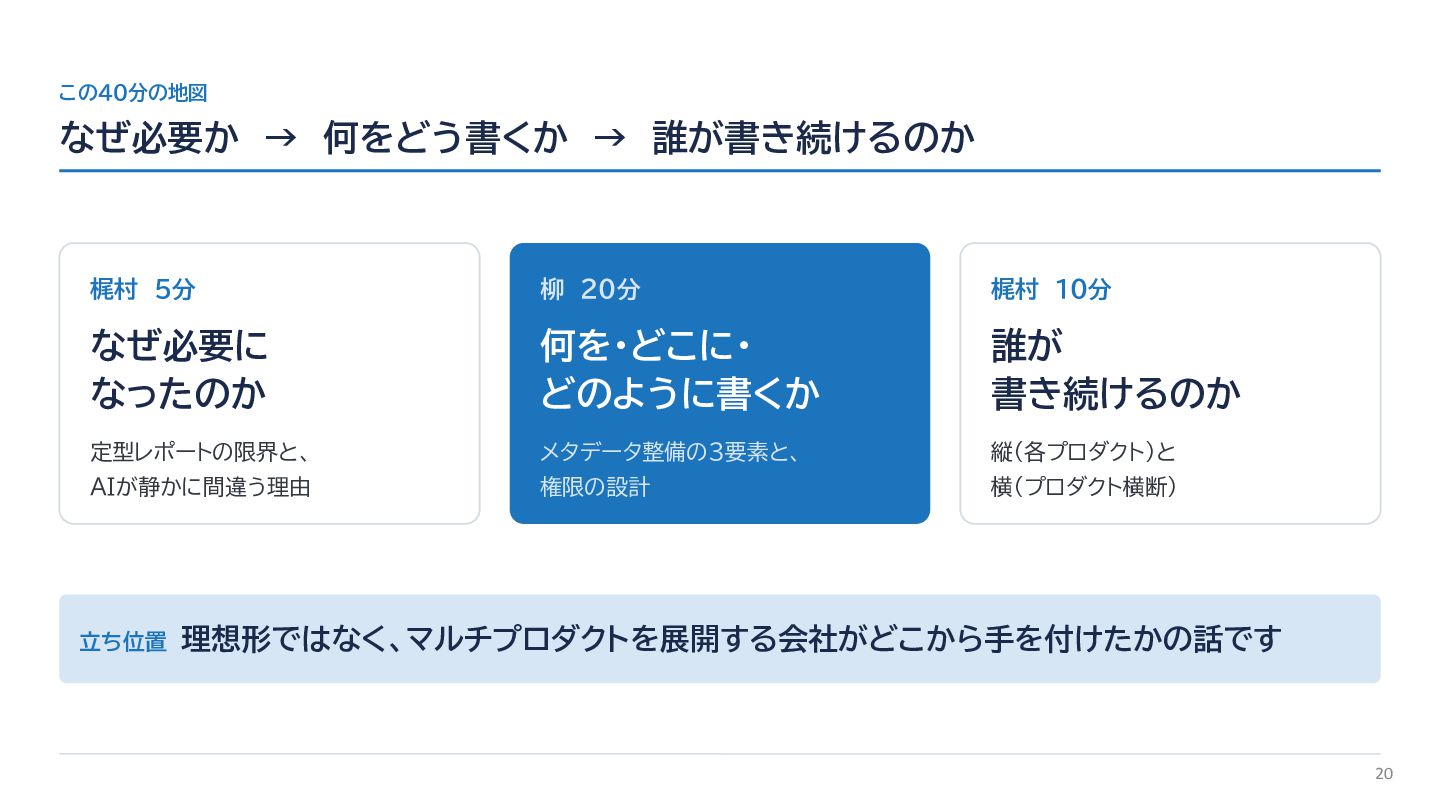
この40分の地図 なぜ必要か → 何をどう書くか → 誰が書き続けるのか 梶村 5分 柳 20分
梶村 10分 なぜ必要に なったのか 何を・どこに・ どのように書くか 誰が 書き続けるのか 定型レポートの限界と、 メタデータ整備の3要素と、 縦(各プロダクト)と AIが静かに間違う理由 権限の設計 横(プロダクト横断) 立ち位置 理想形ではなく、マルチプロダクトを展開する会社がどこから手を付けたかの話です 20
自己紹介 略歴 コンサルティング企業にてデータアナリスト、プロジェ クトマネージャーとしてクライアント企業のデータパイ プライン構築・データ分析基盤リプレイスなどのプロ 柳 優樹 ジェクトを牽引。その後株式会社カケハシに参画し、現 ヤナギ ユウキ
在はアナリティクスエンジニアとしてデータ活用の推進 Data & AI チーム所属 に取り組んでいる。 © KAKEHASHI Inc. All Rights Reserved. 21
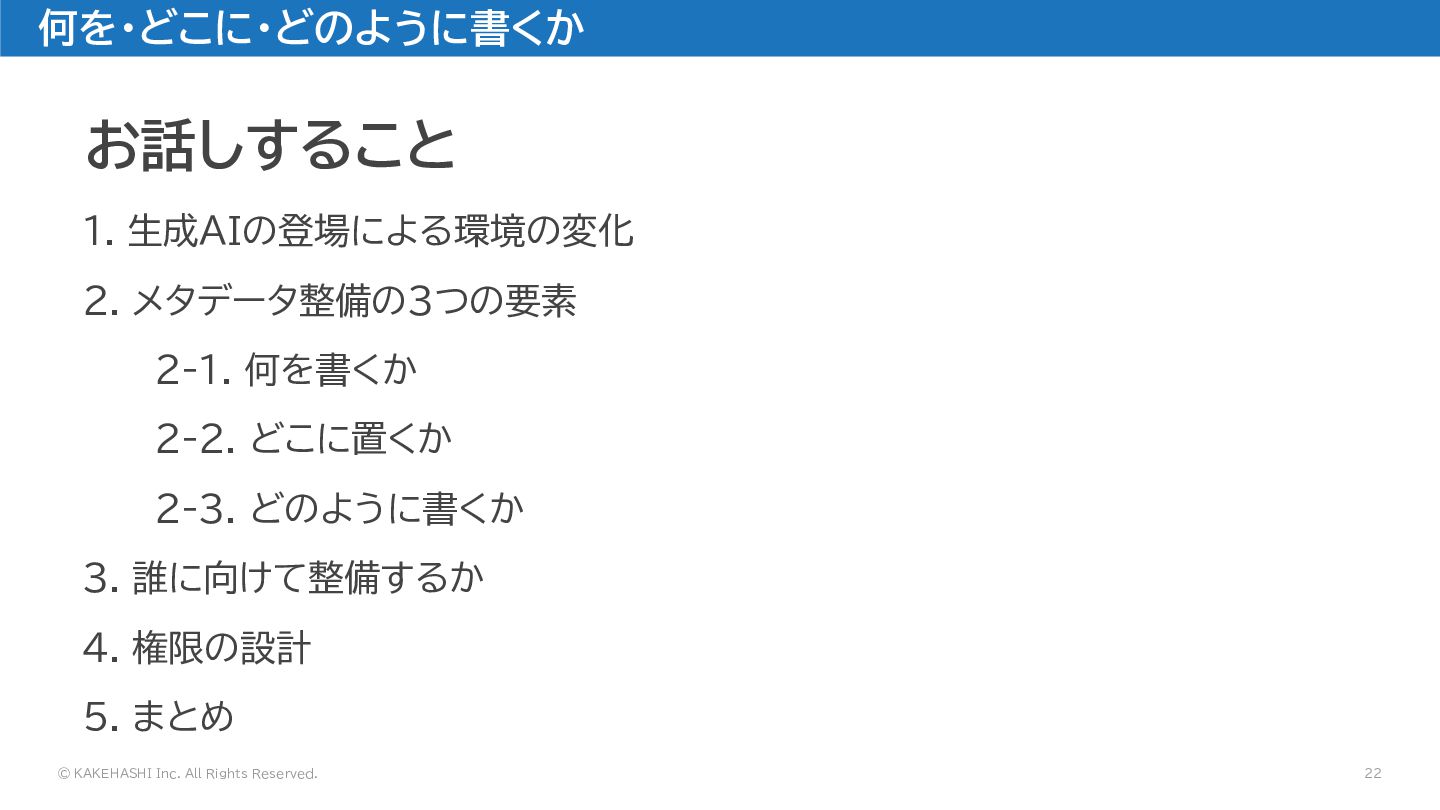
何を・どこに・どのように書くか お話しすること 1. 生成AIの登場による環境の変化 2. メタデータ整備の3つの要素 2-1. 何を書くか 2-2. どこに置くか
2-3. どのように書くか 3. 誰に向けて整備するか 4. 権限の設計 5. まとめ © KAKEHASHI Inc. All Rights Reserved. 22
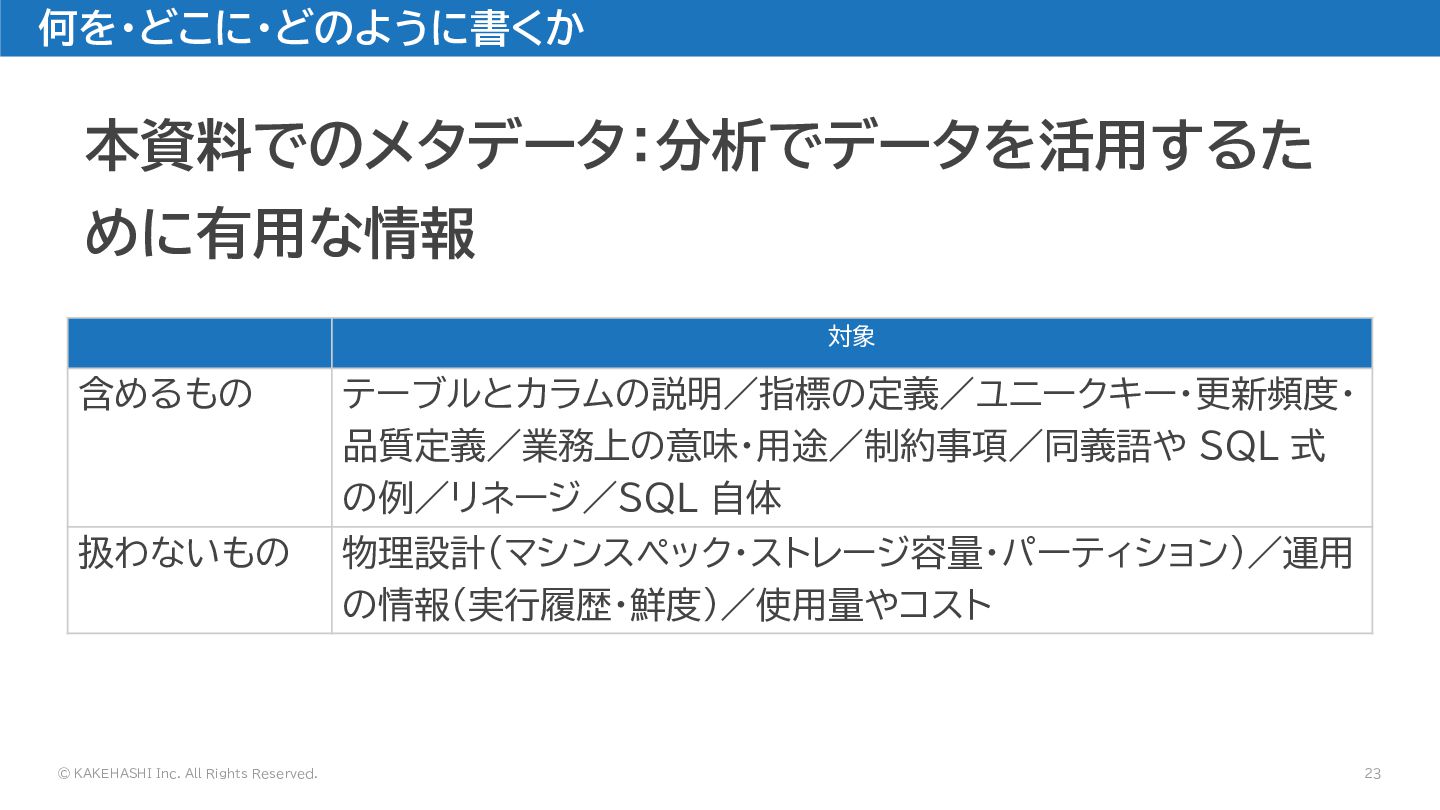
何を・どこに・どのように書くか 本資料でのメタデータ:分析でデータを活用するた めに有用な情報 対象 含めるもの テーブルとカラムの説明/指標の定義/ユニークキー・更新頻度・ 品質定義/業務上の意味・用途/制約事項/同義語や SQL 式 の例/リネージ/SQL
自体 扱わないもの 物理設計(マシンスペック・ストレージ容量・パーティション)/運用 の情報(実行履歴・鮮度)/使用量やコスト © KAKEHASHI Inc. All Rights Reserved. 23
何を・どこに・どのように書くか お話しすること 1. 生成AIの登場による環境の変化 2. メタデータ整備の3つの要素 2-1. 何を書くか 2-2. どこに置くか
2-3. どのように書くか 3. 誰に向けて整備するか 4. 権限の設計 5. まとめ © KAKEHASHI Inc. All Rights Reserved. 24
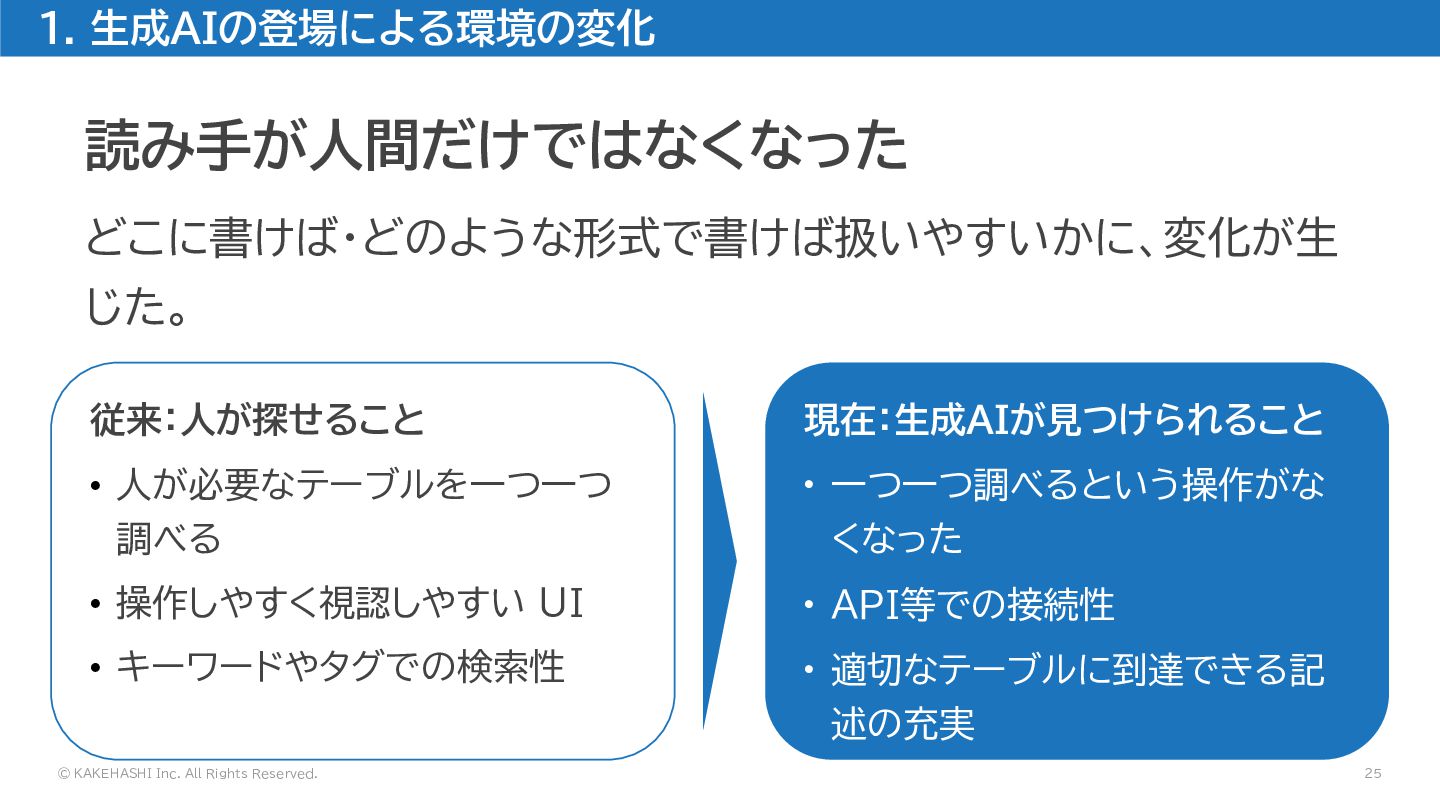
1. 生成AIの登場による環境の変化 読み手が人間だけではなくなった どこに書けば・どのような形式で書けば扱いやすいかに、変化が生 じた。 従来:人が探せること 現在:生成AIが見つけられること • 人が必要なテーブルを一つ一つ 調べる
• 一つ一つ調べるという操作がな くなった • 操作しやすく視認しやすい UI • API等での接続性 • キーワードやタグでの検索性 • 適切なテーブルに到達できる記 述の充実 © KAKEHASHI Inc. All Rights Reserved. 25
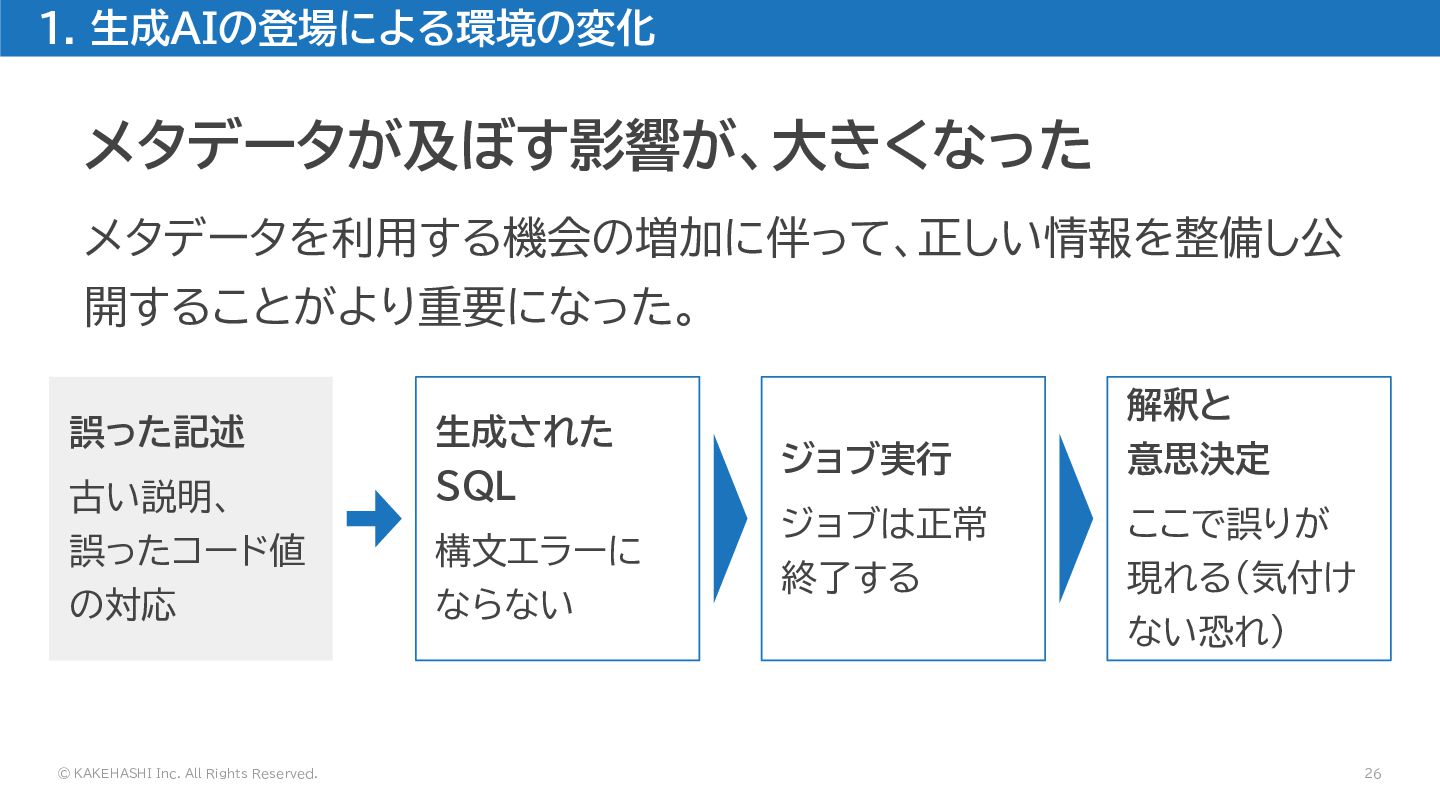
1. 生成AIの登場による環境の変化 メタデータが及ぼす影響が、大きくなった メタデータを利用する機会の増加に伴って、正しい情報を整備し公 開することがより重要になった。 誤った記述 生成された 古い説明、 誤ったコード値 の対応
SQL © KAKEHASHI Inc. All Rights Reserved. 構文エラーに ならない 解釈と ジョブ実行 意思決定 ジョブは正常 終了する ここで誤りが 現れる(気付け ない恐れ) 26
何を・どこに・どのように書くか お話しすること 1. 生成AIの登場による環境の変化 2. メタデータ整備の3つの要素 2-1. 何を書くか 2-2. どこに置くか
2-3. どのように書くか 3. 誰に向けて整備するか 4. 権限の設計 5. まとめ © KAKEHASHI Inc. All Rights Reserved. 27
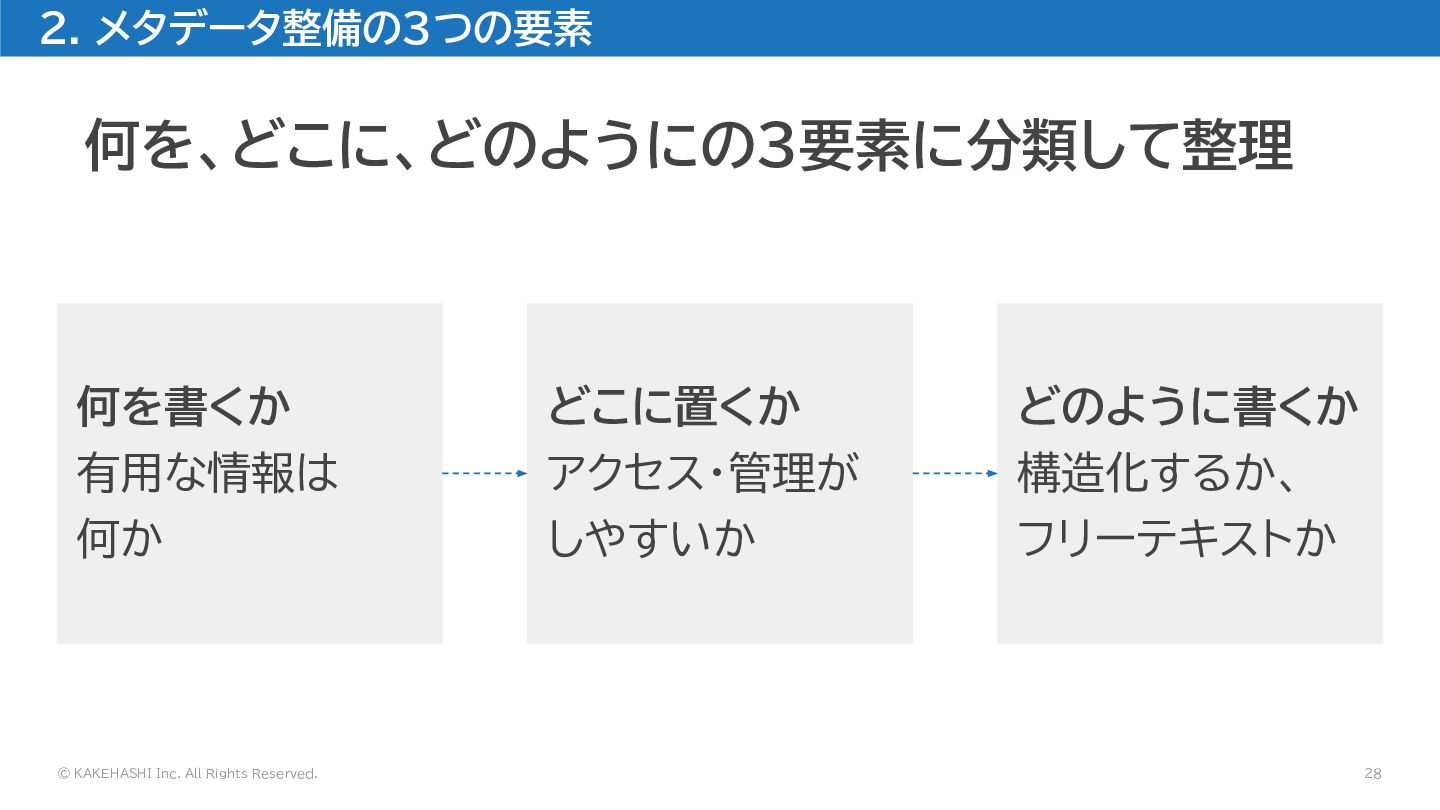
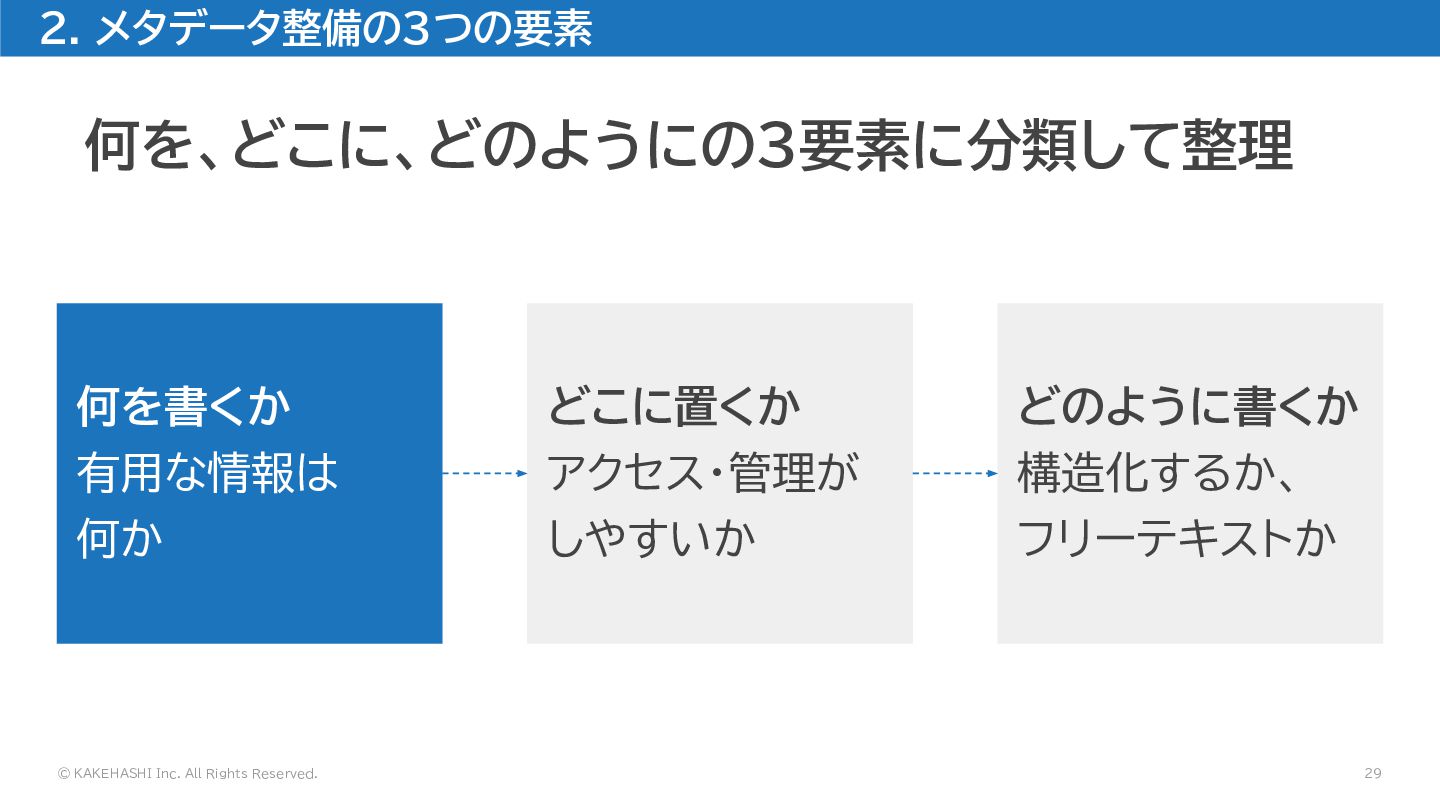
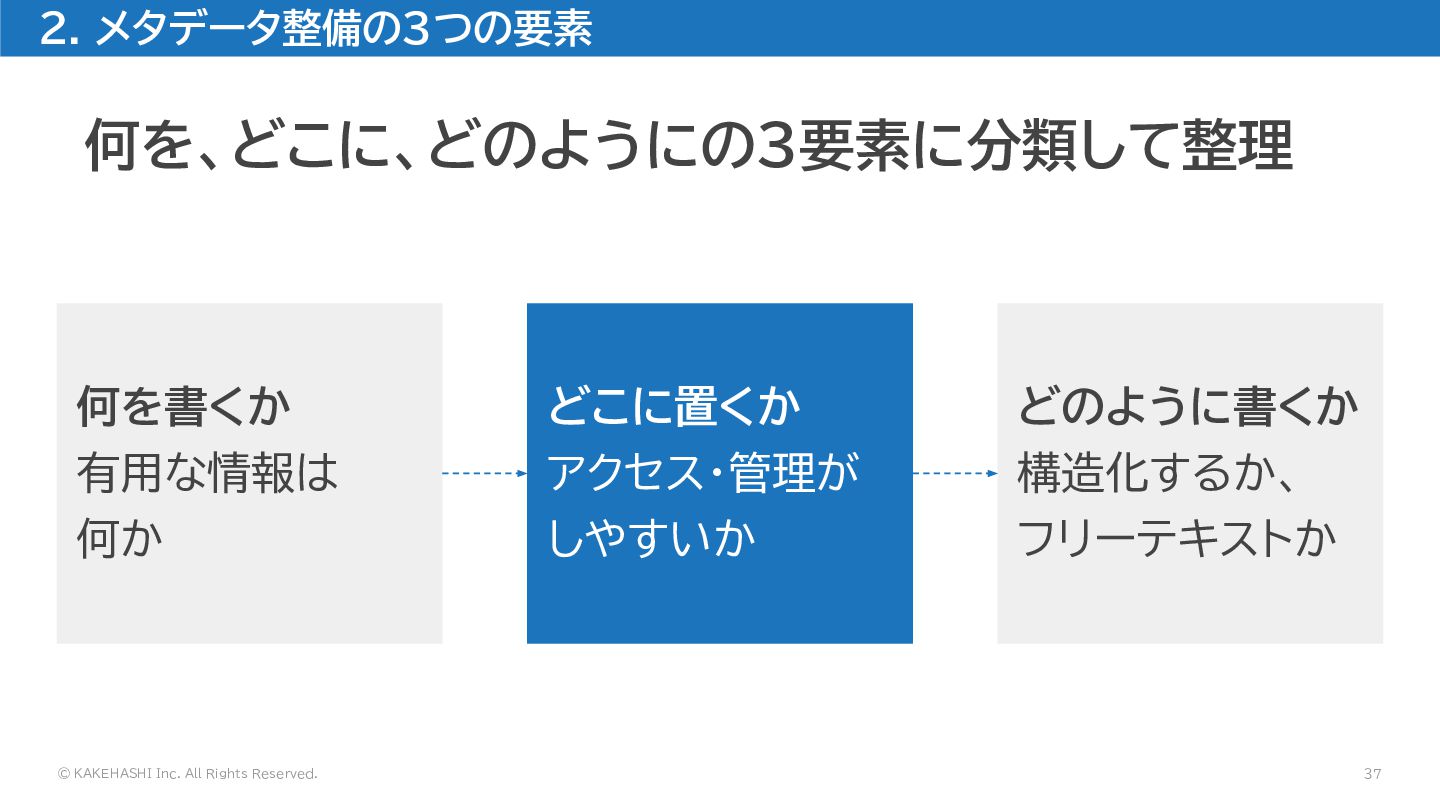
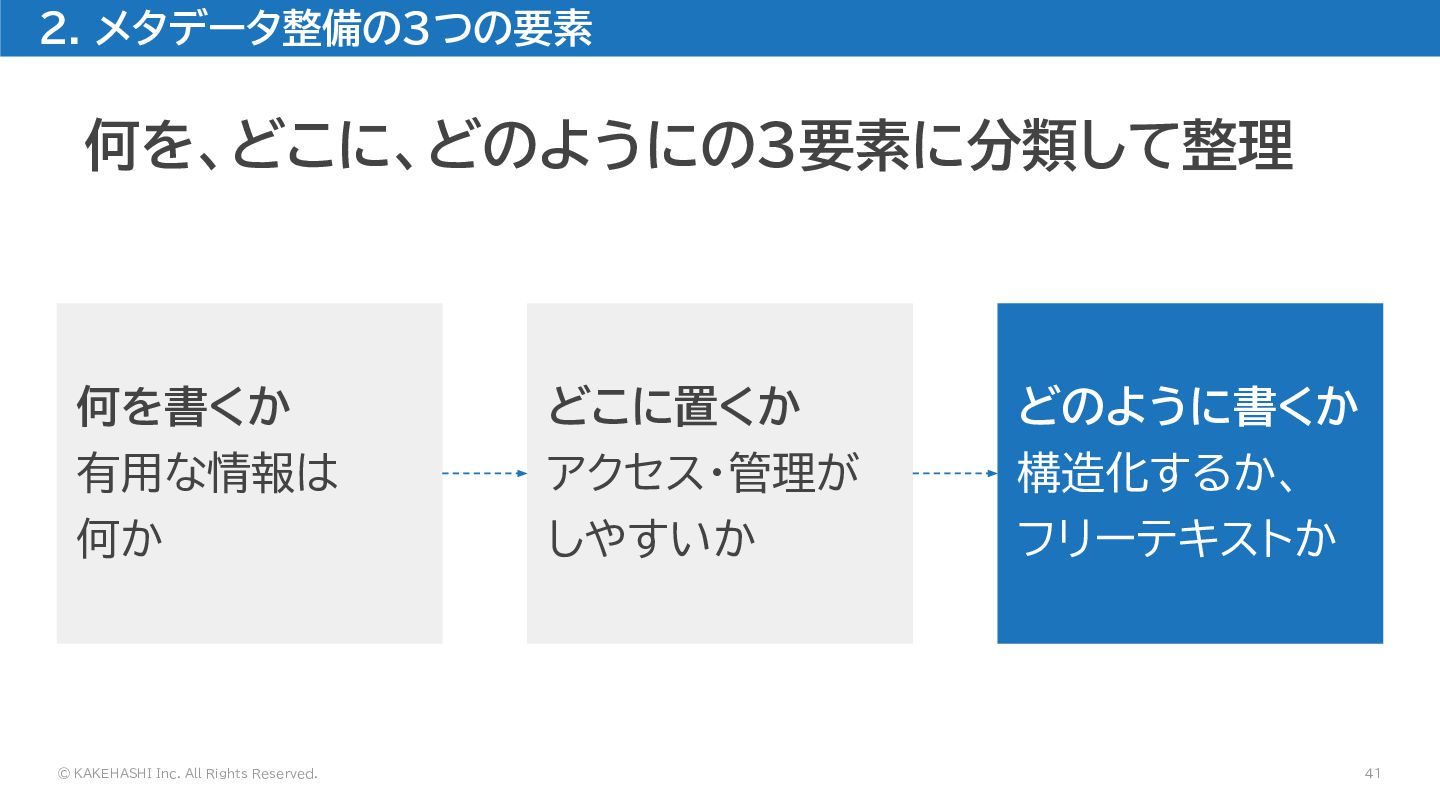
2. メタデータ整備の3つの要素 何を、どこに、どのようにの3要素に分類して整理 何を書くか 有用な情報は 何か © KAKEHASHI Inc. All
Rights Reserved. どこに置くか アクセス・管理が しやすいか どのように書くか 構造化するか、 フリーテキストか 28
2. メタデータ整備の3つの要素 何を、どこに、どのようにの3要素に分類して整理 何を書くか 有用な情報は 何か © KAKEHASHI Inc. All
Rights Reserved. どこに置くか アクセス・管理が しやすいか どのように書くか 構造化するか、 フリーテキストか 29
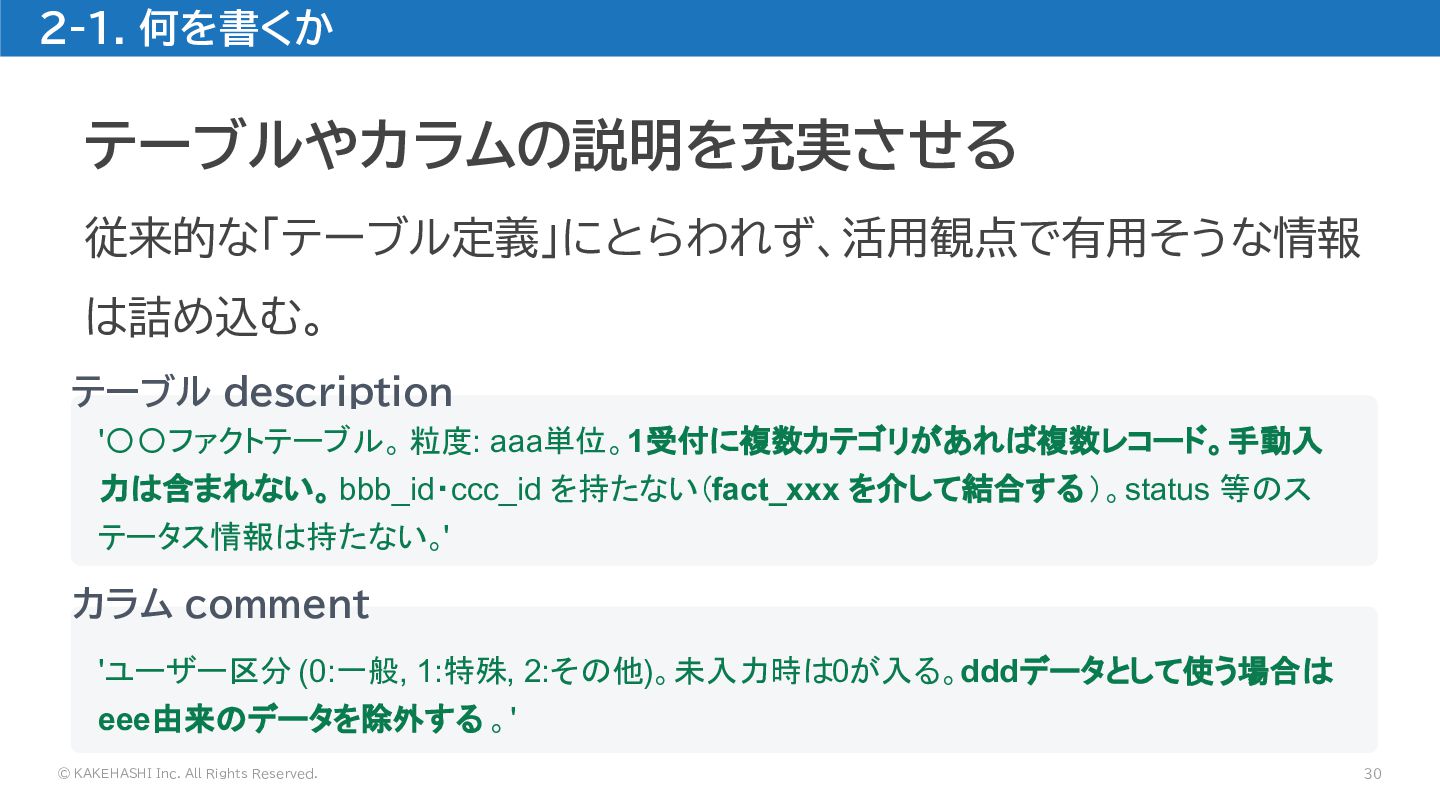
2-1. 何を書くか テーブルやカラムの説明を充実させる 従来的な「テーブル定義」にとらわれず、活用観点で有用そうな情報 は詰め込む。 テーブル description '〇〇ファクトテーブル。 粒度: aaa単位。1受付に複数カテゴリがあれば複数レコード。手動入
力は含まれない。 bbb_id・ccc_id を持たない(fact_xxx を介して結合する )。status 等のス テータス情報は持たない。' カラム comment 'ユーザー区分 (0:一般, 1:特殊, 2:その他)。未入力時は0が入る。dddデータとして使う場合は eee由来のデータを除外する 。' © KAKEHASHI Inc. All Rights Reserved. 30
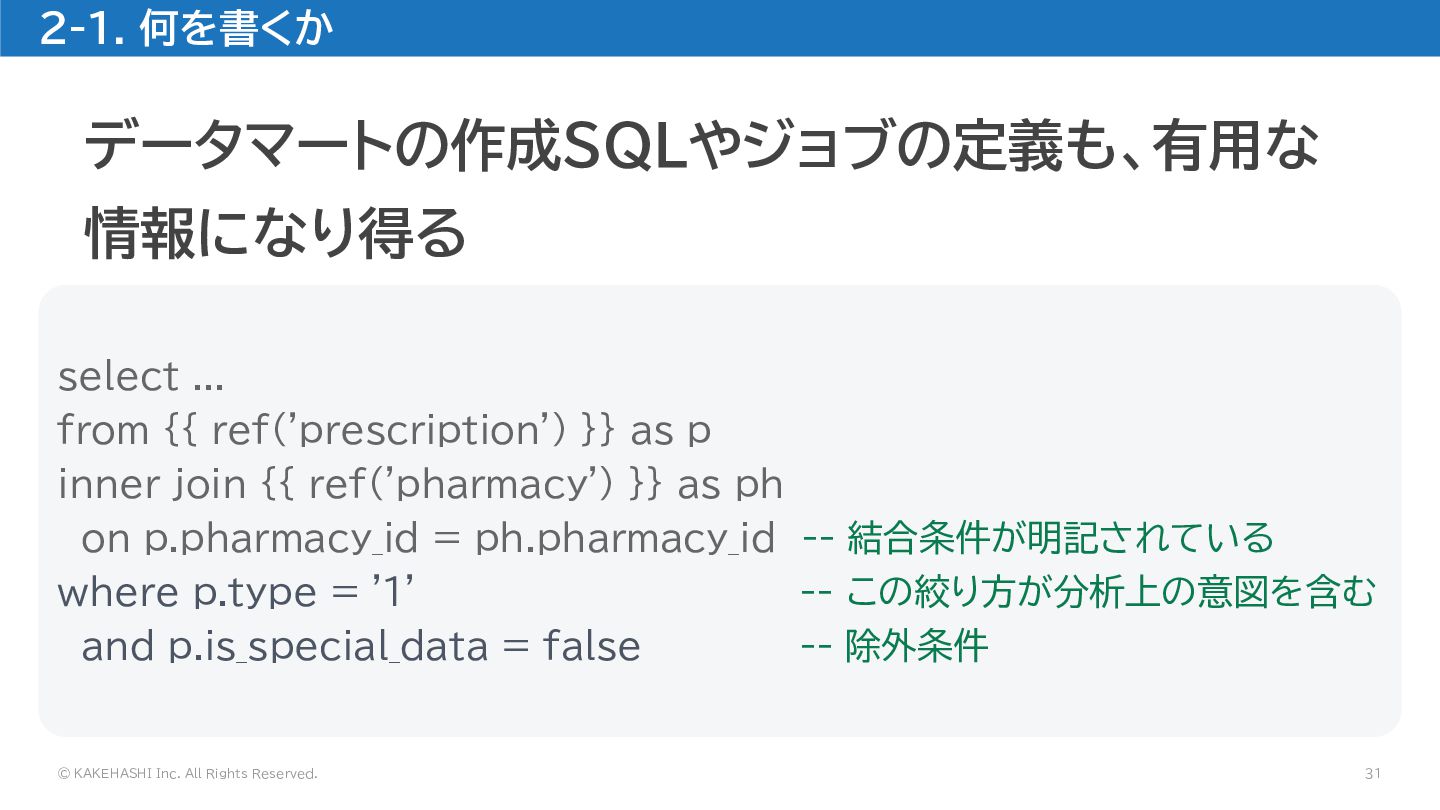
2-1. 何を書くか データマートの作成SQLやジョブの定義も、有用な 情報になり得る select ... from {{ ref('prescription') }}
as p inner join {{ ref('pharmacy') }} as ph on p.pharmacy_id = ph.pharmacy_id -- 結合条件が明記されている where p.type = '1' -- この絞り方が分析上の意図を含む and p.is_special_data = false -- 除外条件 © KAKEHASHI Inc. All Rights Reserved. 31
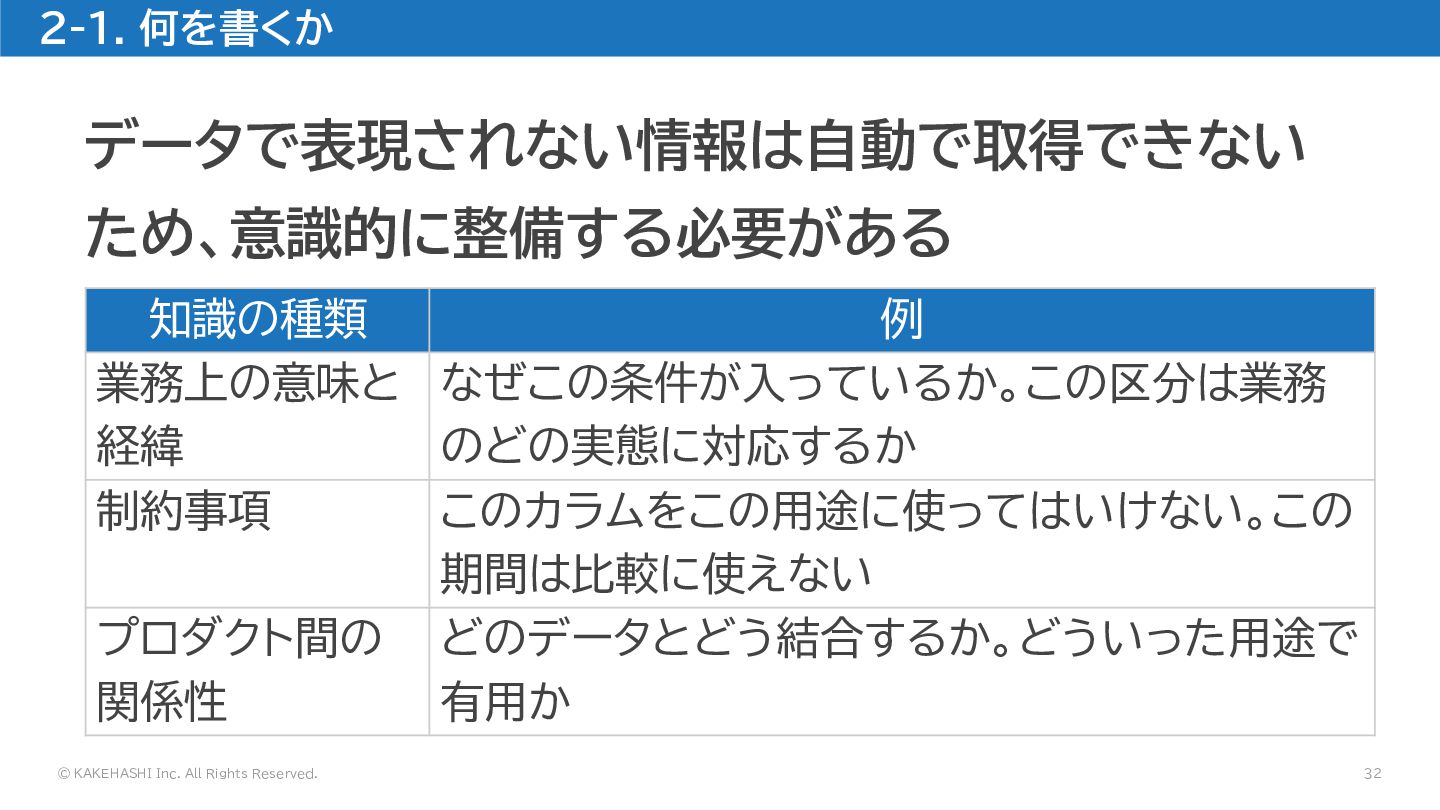
2-1. 何を書くか データで表現されない情報は自動で取得できない ため、意識的に整備する必要がある 知識の種類 例 業務上の意味と なぜこの条件が入っているか。この区分は業務 経緯 のどの実態に対応するか
制約事項 このカラムをこの用途に使ってはいけない。この 期間は比較に使えない プロダクト間の どのデータとどう結合するか。どういった用途で 関係性 有用か © KAKEHASHI Inc. All Rights Reserved. 32
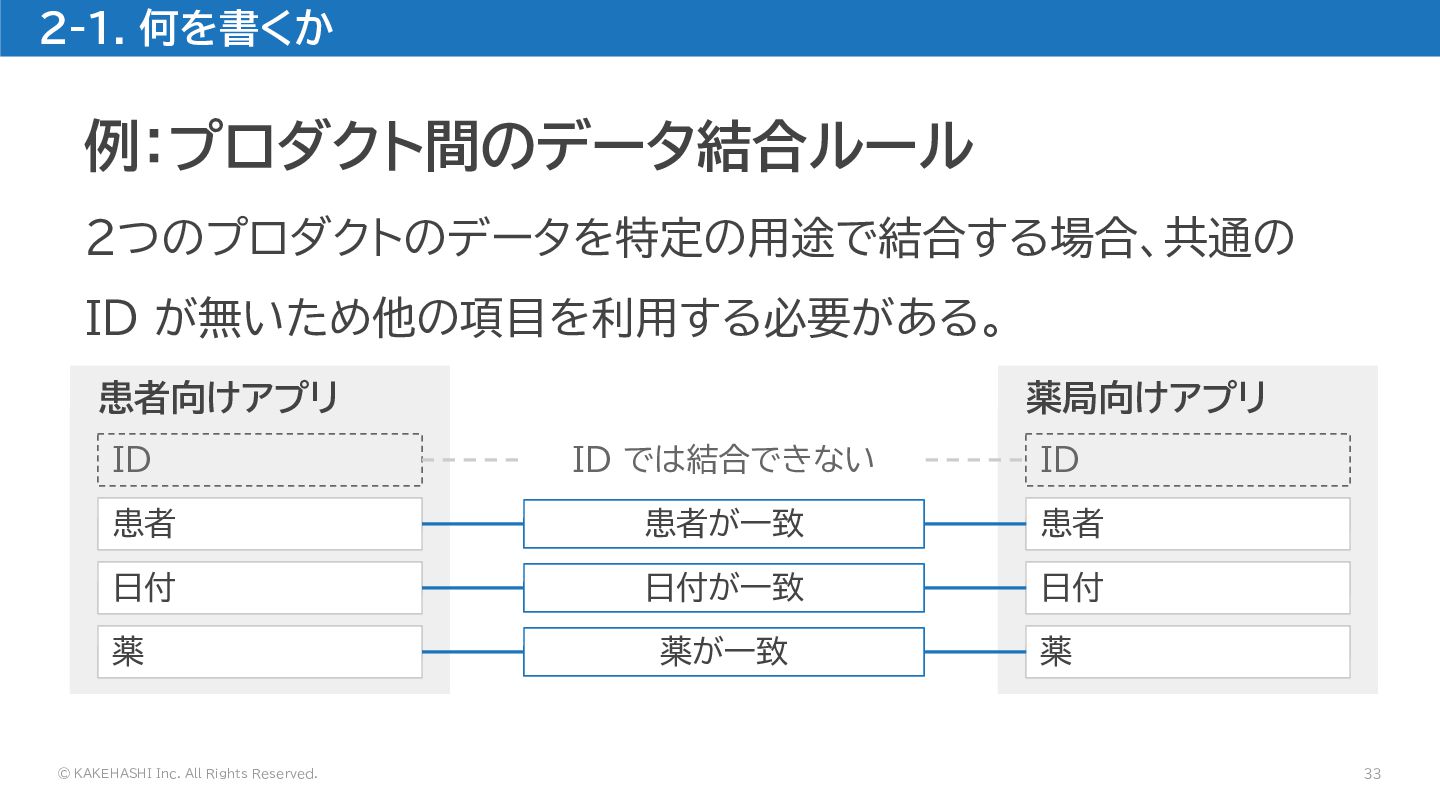
2-1. 何を書くか 例:プロダクト間のデータ結合ルール 2つのプロダクトのデータを特定の用途で結合する場合、共通の ID が無いため他の項目を利用する必要がある。 患者向けアプリ 薬局向けアプリ ID ID
では結合できない ID 患者 患者が一致 患者 日付 日付が一致 日付 薬 薬が一致 薬 © KAKEHASHI Inc. All Rights Reserved. 33
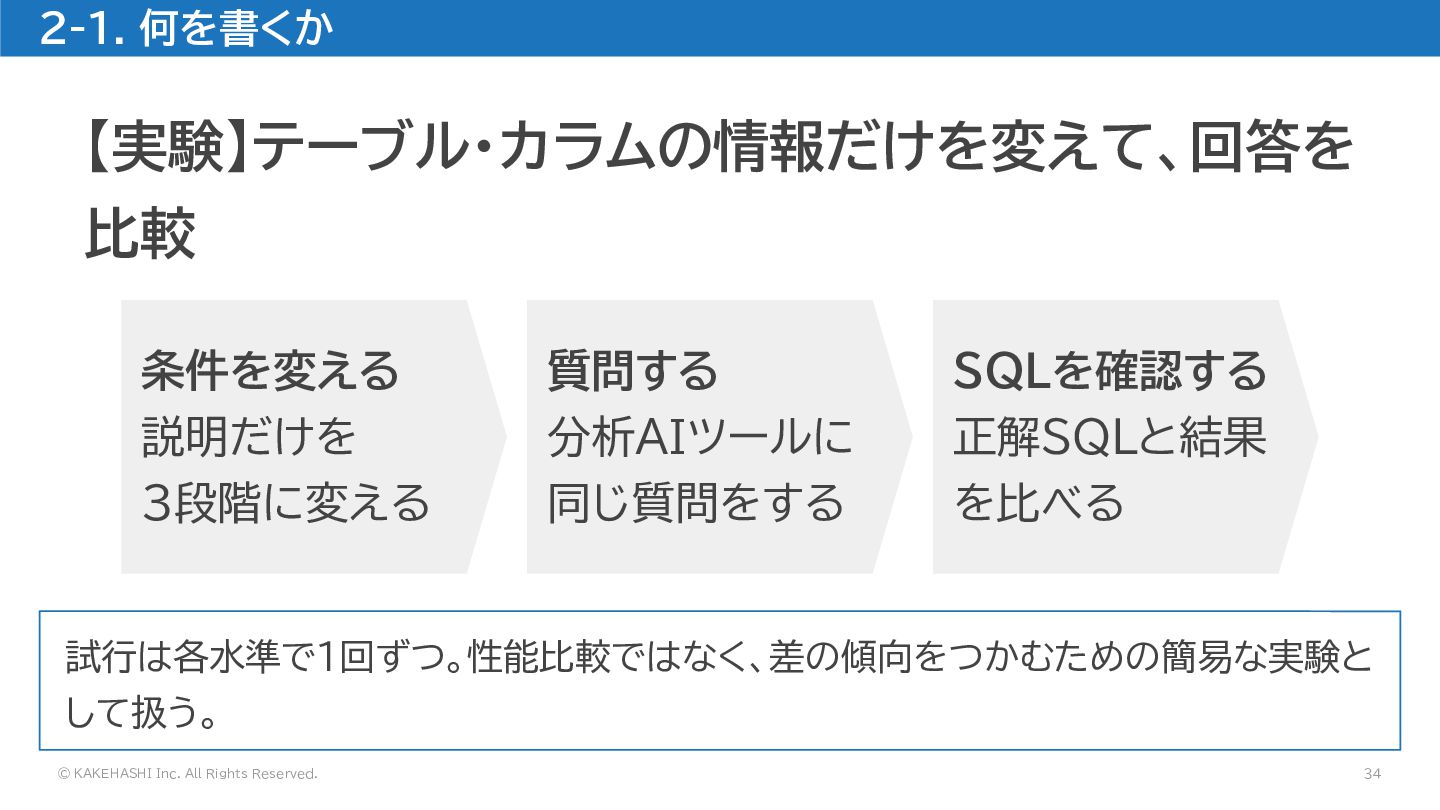
2-1. 何を書くか 【実験】テーブル・カラムの情報だけを変えて、回答を 比較 条件を変える 説明だけを 3段階に変える 質問する 分析AIツールに 同じ質問をする
SQLを確認する 正解SQLと結果 を比べる 試行は各水準で1回ずつ。性能比較ではなく、差の傾向をつかむための簡易な実験と して扱う。 © KAKEHASHI Inc. All Rights Reserved. 34
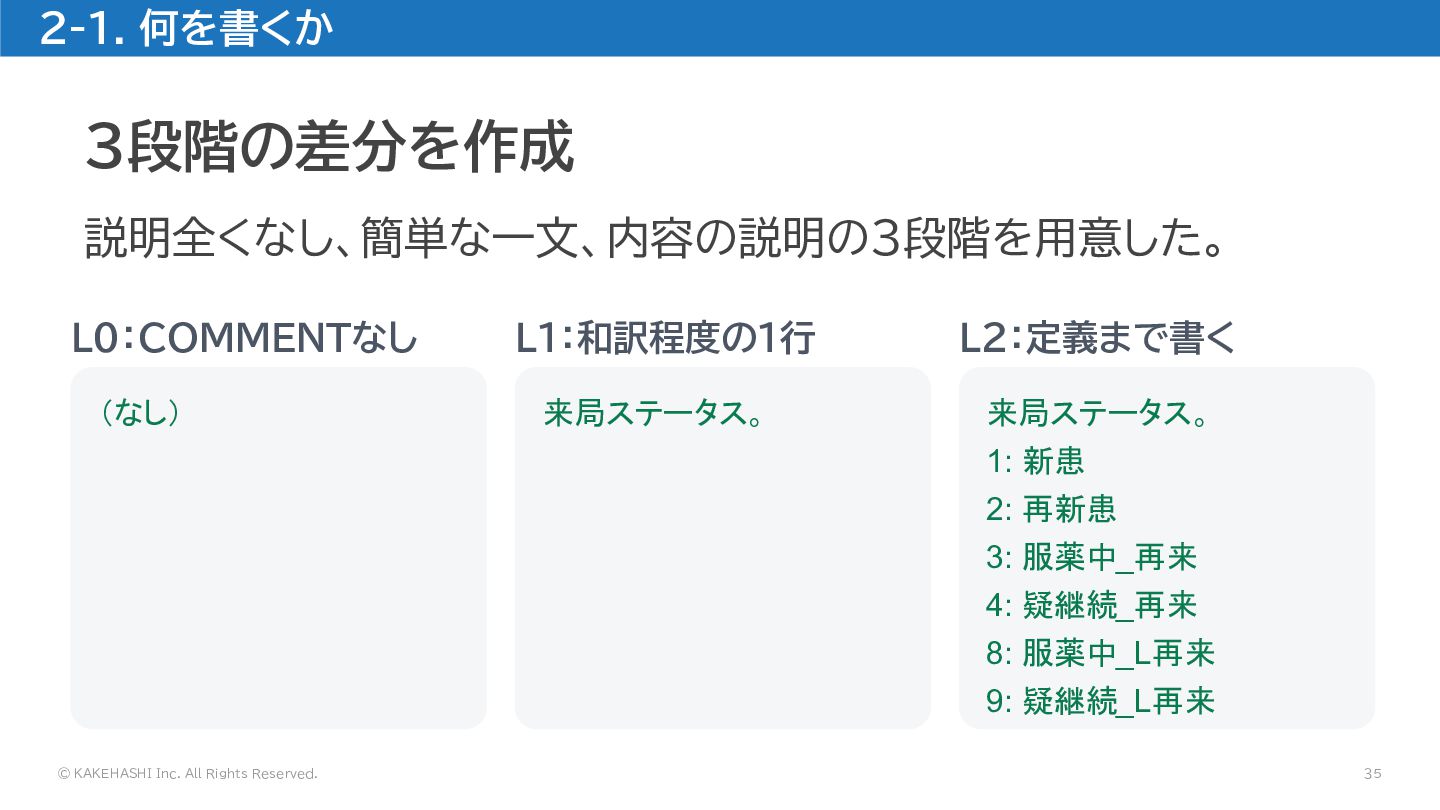
2-1. 何を書くか 3段階の差分を作成 説明全くなし、簡単な一文、内容の説明の3段階を用意した。 L0:COMMENTなし (なし) L1:和訳程度の1行 L2:定義まで書く 来局ステータス。 来局ステータス。
1: 新患 2: 再新患 3: 服薬中_再来 4: 疑継続_再来 8: 服薬中_L再来 9: 疑継続_L再来 © KAKEHASHI Inc. All Rights Reserved. 35
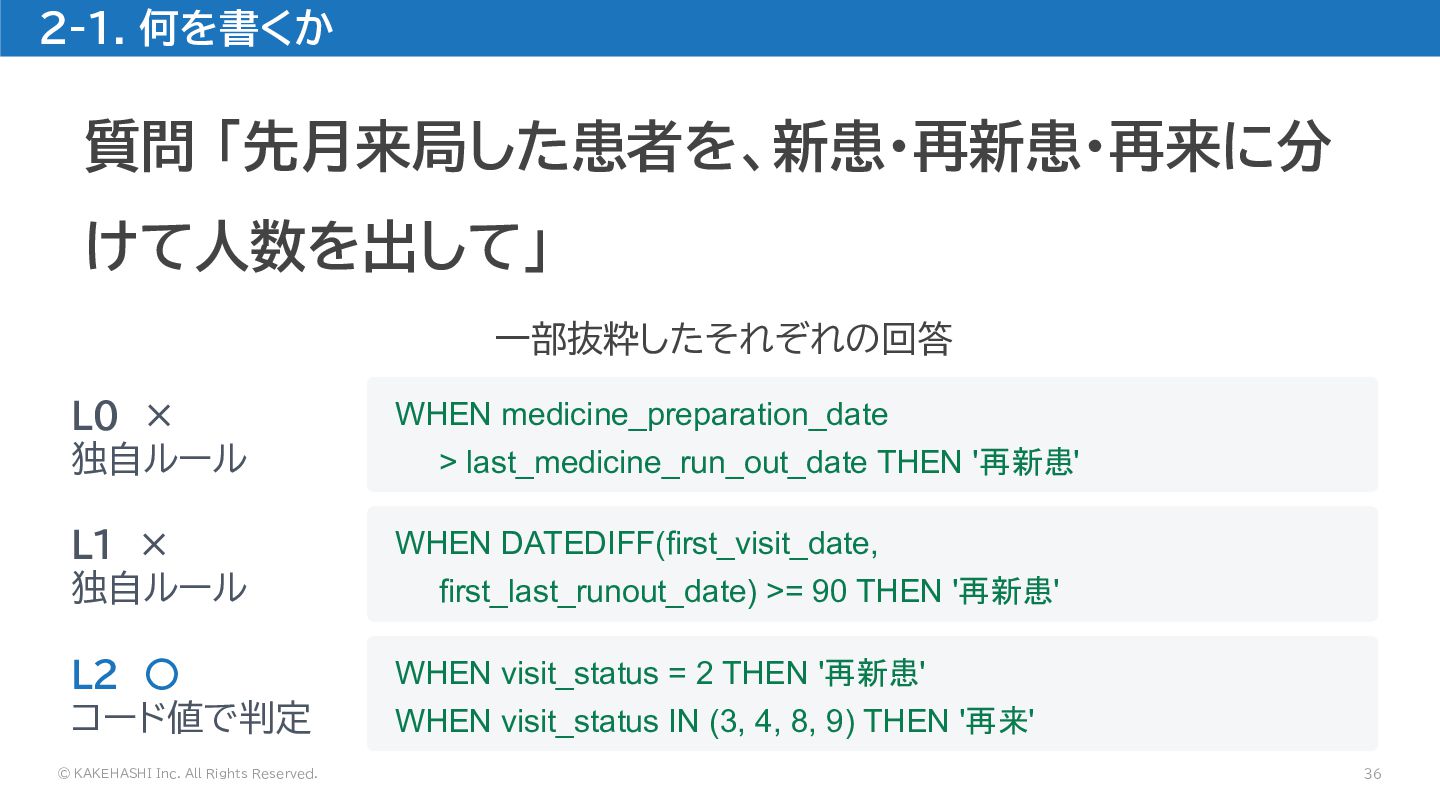
2-1. 何を書くか 質問 「先月来局した患者を、新患・再新患・再来に分 けて人数を出して」 一部抜粋したそれぞれの回答 L0 × 独自ルール WHEN
medicine_preparation_date > last_medicine_run_out_date THEN '再新患' L1 × 独自ルール WHEN DATEDIFF(first_visit_date, first_last_runout_date) >= 90 THEN '再新患' L2 〇 コード値で判定 WHEN visit_status = 2 THEN '再新患' WHEN visit_status IN (3, 4, 8, 9) THEN '再来' © KAKEHASHI Inc. All Rights Reserved. 36
2. メタデータ整備の3つの要素 何を、どこに、どのようにの3要素に分類して整理 何を書くか 有用な情報は 何か © KAKEHASHI Inc. All
Rights Reserved. どこに置くか アクセス・管理が しやすいか どのように書くか 構造化するか、 フリーテキストか 37
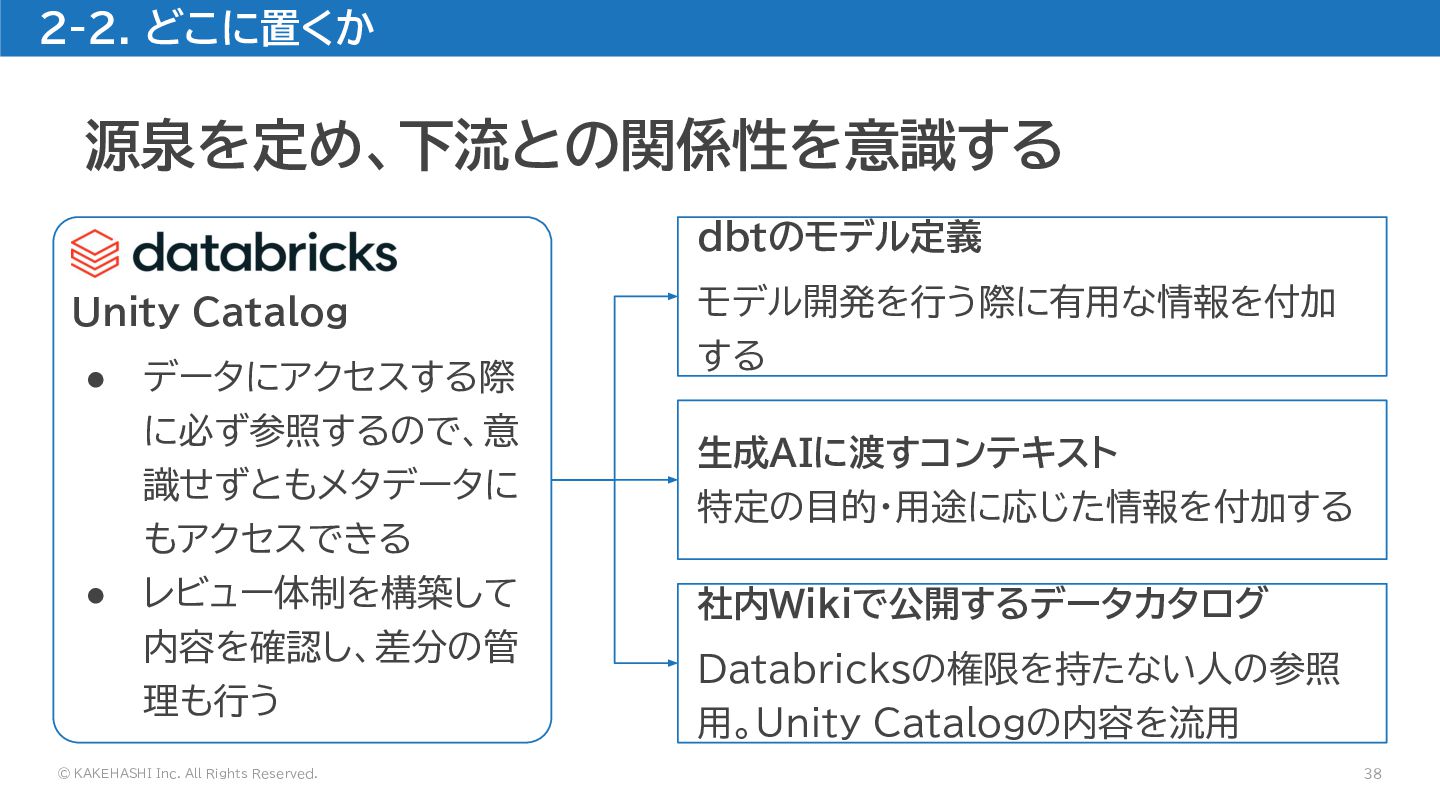
2-2. どこに置くか 源泉を定め、下流との関係性を意識する dbtのモデル定義 Unity Catalog • • データにアクセスする際 に必ず参照するので、意
識せずともメタデータに もアクセスできる レビュー体制を構築して 内容を確認し、差分の管 理も行う © KAKEHASHI Inc. All Rights Reserved. モデル開発を行う際に有用な情報を付加 する 生成AIに渡すコンテキスト 特定の目的・用途に応じた情報を付加する 社内Wikiで公開するデータカタログ Databricksの権限を持たない人の参照 用。Unity Catalogの内容を流用 38
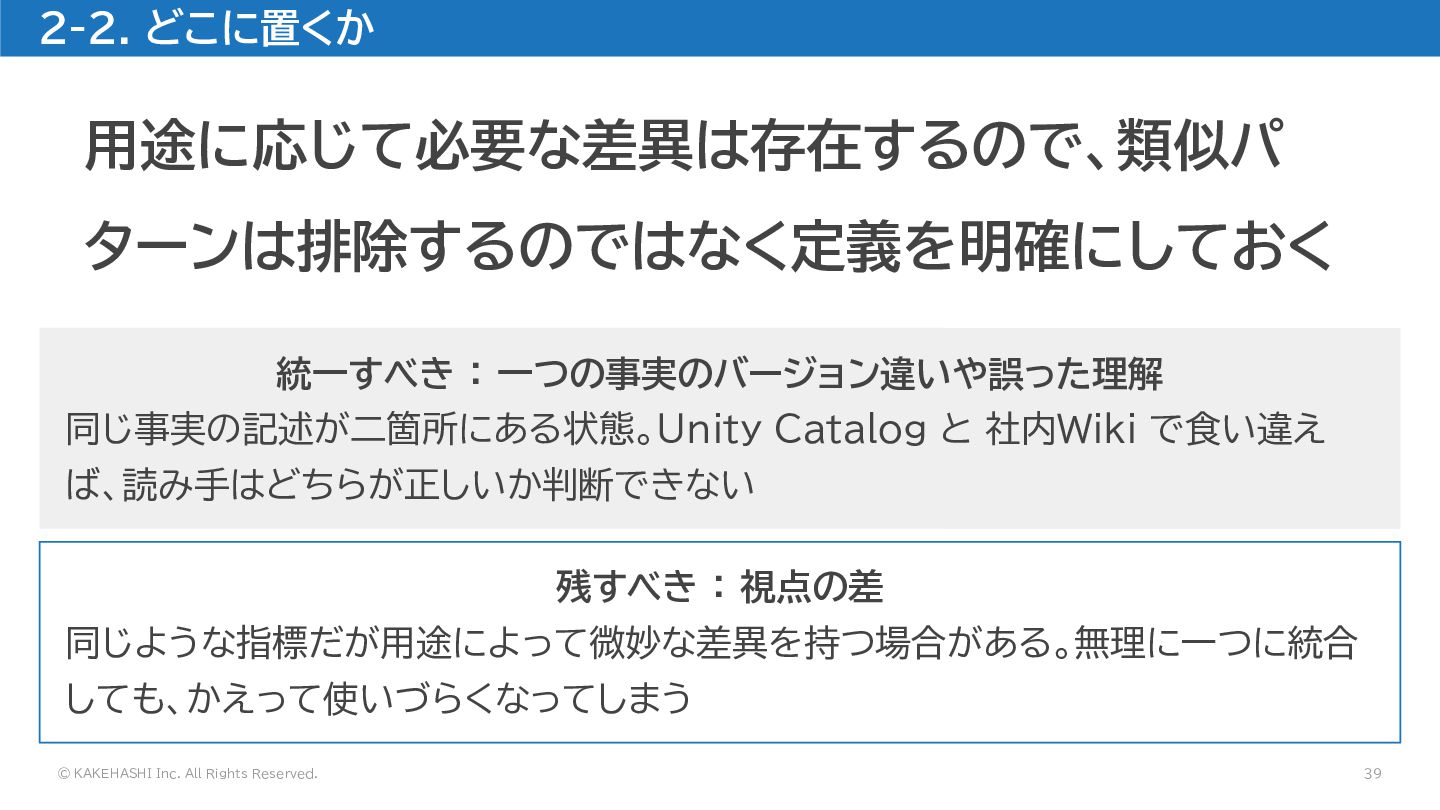
2-2. どこに置くか 用途に応じて必要な差異は存在するので、類似パ ターンは排除するのではなく定義を明確にしておく 統一すべき : 一つの事実のバージョン違いや誤った理解 同じ事実の記述が二箇所にある状態。Unity Catalog と
社内Wiki で食い違え ば、読み手はどちらが正しいか判断できない 残すべき : 視点の差 同じような指標だが用途によって微妙な差異を持つ場合がある。無理に一つに統合 しても、かえって使いづらくなってしまう © KAKEHASHI Inc. All Rights Reserved. 39
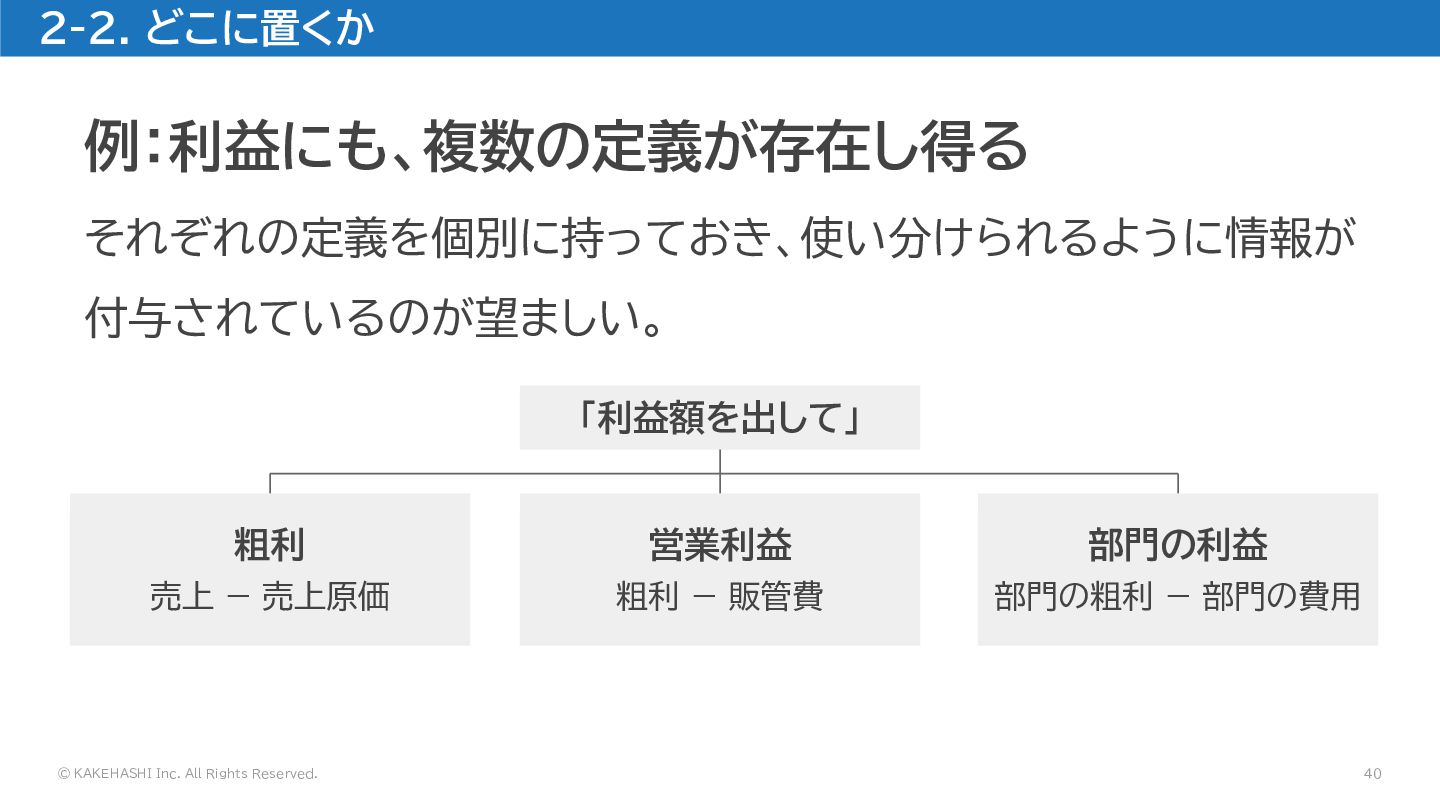
2-2. どこに置くか 例:利益にも、複数の定義が存在し得る それぞれの定義を個別に持っておき、使い分けられるように情報が 付与されているのが望ましい。 「利益額を出して」 粗利 営業利益 部門の利益 売上
− 売上原価 粗利 − 販管費 部門の粗利 − 部門の費用 © KAKEHASHI Inc. All Rights Reserved. 40
2. メタデータ整備の3つの要素 何を、どこに、どのようにの3要素に分類して整理 何を書くか 有用な情報は 何か © KAKEHASHI Inc. All
Rights Reserved. どこに置くか アクセス・管理が しやすいか どのように書くか 構造化するか、 フリーテキストか 41
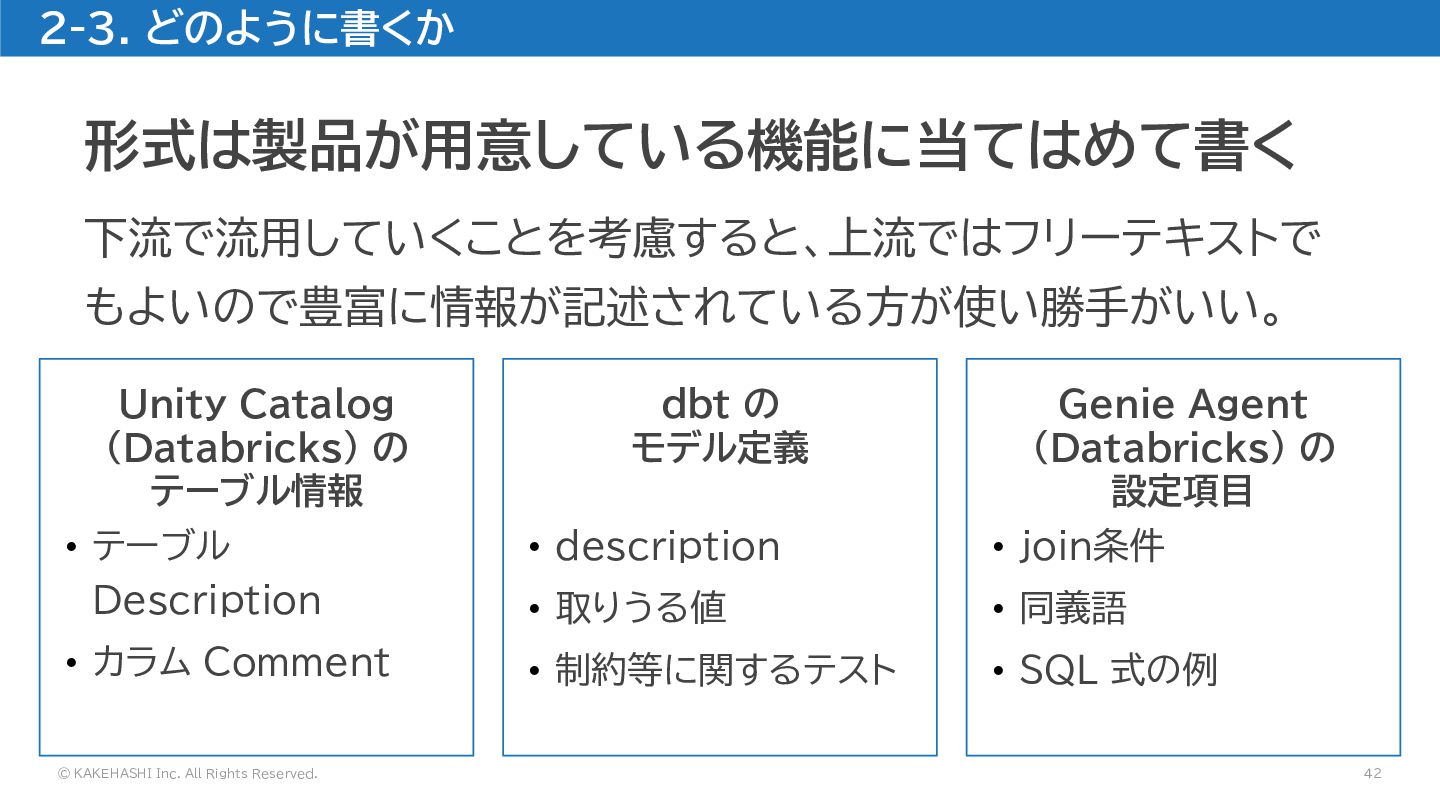
2-3. どのように書くか 形式は製品が用意している機能に当てはめて書く 下流で流用していくことを考慮すると、上流ではフリーテキストで もよいので豊富に情報が記述されている方が使い勝手がいい。 Unity Catalog (Databricks) の テーブル情報
dbt の モデル定義 Genie Agent (Databricks) の 設定項目 • テーブル Description • description • join条件 • 取りうる値 • 同義語 • カラム Comment • 制約等に関するテスト • SQL 式の例 © KAKEHASHI Inc. All Rights Reserved. 42
何を・どこに・どのように書くか お話しすること 1. 生成AIの登場による環境の変化 2. メタデータ整備の3つの要素 2-1. 何を書くか 2-2. どこに置くか
2-3. どのように書くか 3. 誰に向けて整備するか 4. 権限の設計 5. まとめ © KAKEHASHI Inc. All Rights Reserved. 43
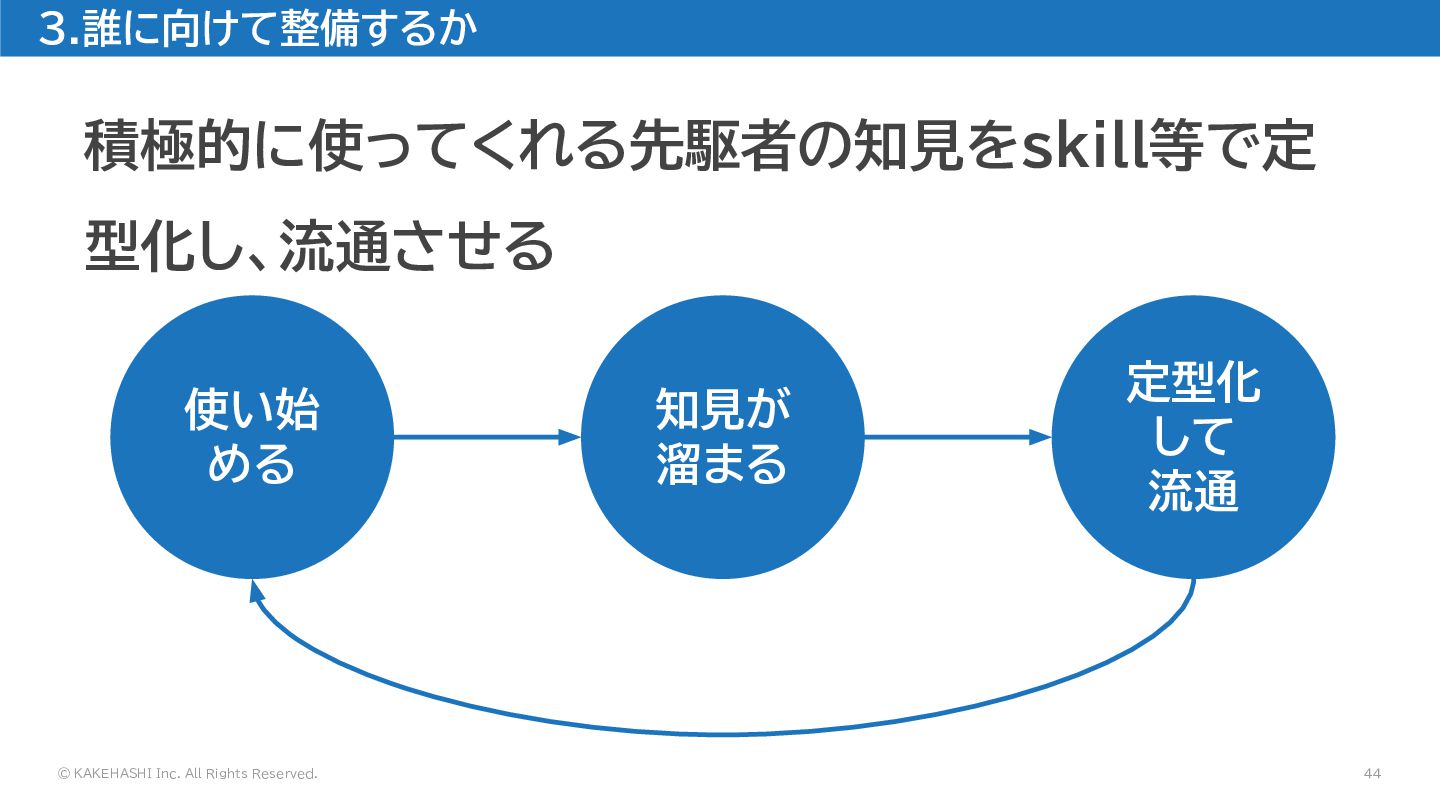
3.誰に向けて整備するか 積極的に使ってくれる先駆者の知見をskill等で定 型化し、流通させる 使い始 める © KAKEHASHI Inc. All Rights
Reserved. 知見が 溜まる 定型化 して 流通 44
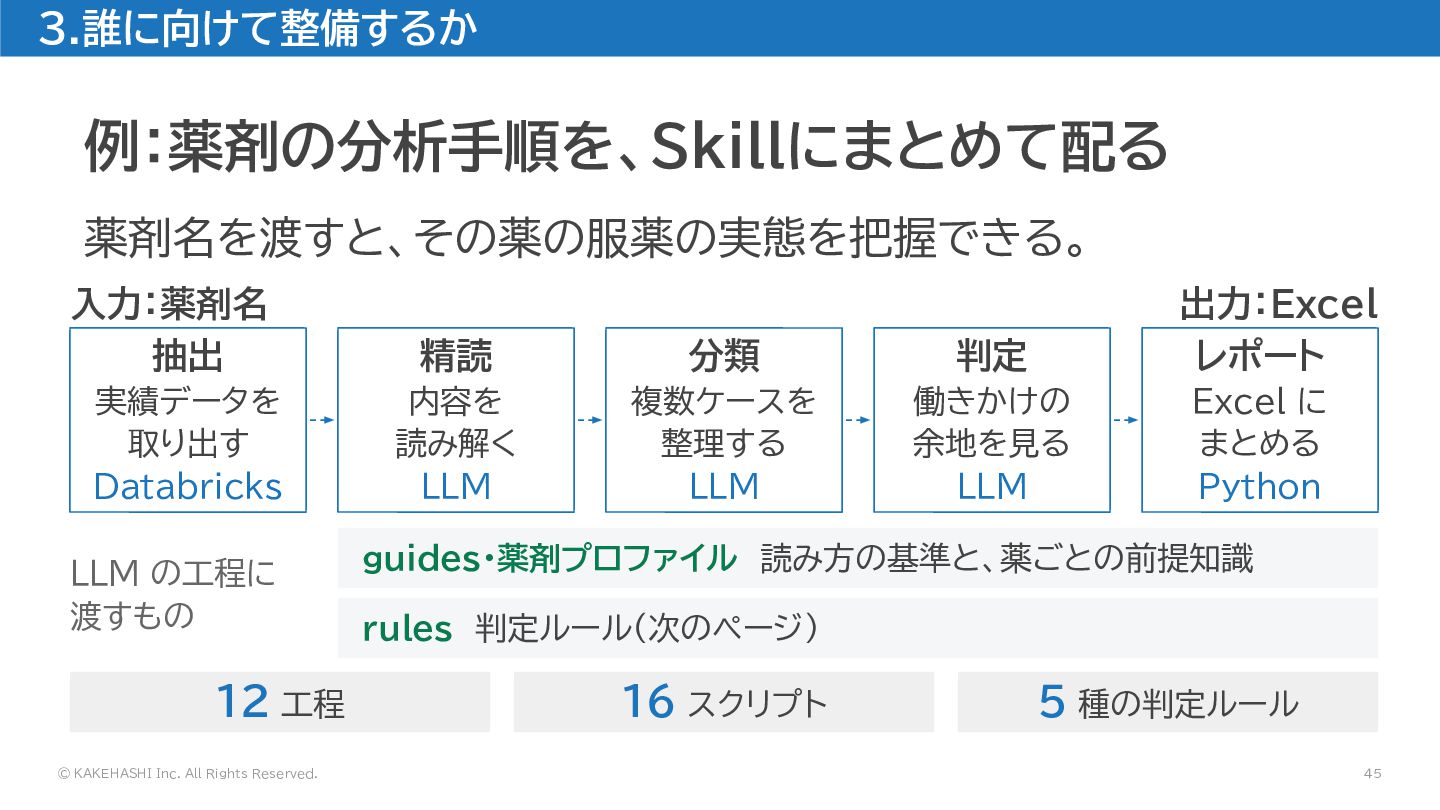
3.誰に向けて整備するか 例:薬剤の分析手順を、Skillにまとめて配る 薬剤名を渡すと、その薬の服薬の実態を把握できる。 入力:薬剤名 抽出 精読 分類 判定 出力:Excel レポート
実績データを 取り出す Databricks 内容を 読み解く LLM 複数ケースを 整理する LLM 働きかけの 余地を見る LLM Excel に まとめる Python LLM の工程に 渡すもの 12 工程 © KAKEHASHI Inc. All Rights Reserved. guides・薬剤プロファイル 読み方の基準と、薬ごとの前提知識 rules 判定ルール(次のページ) 16 スクリプト 5 種の判定ルール 45
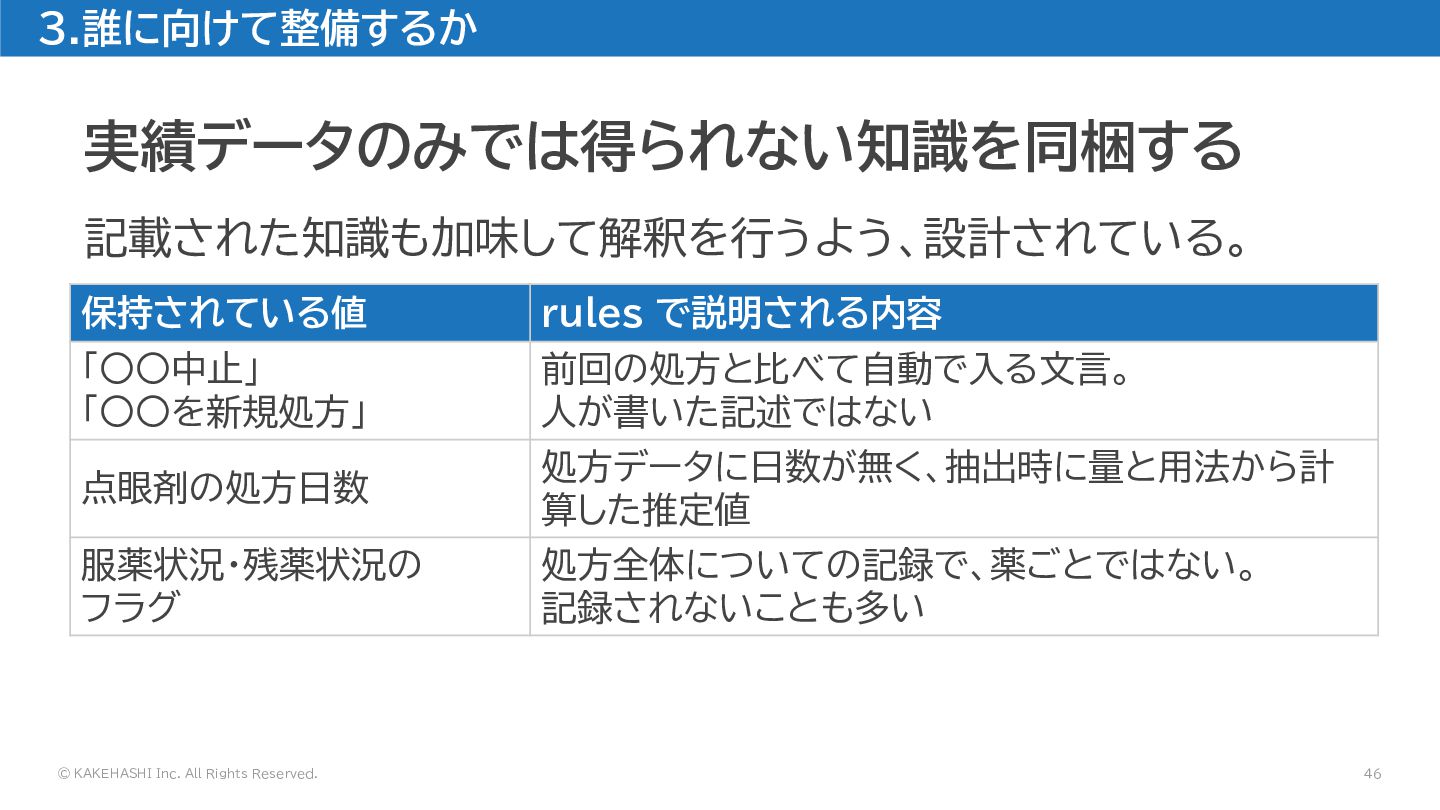
3.誰に向けて整備するか 実績データのみでは得られない知識を同梱する 記載された知識も加味して解釈を行うよう、設計されている。 保持されている値 rules で説明される内容 「〇〇中止」 「〇〇を新規処方」 前回の処方と比べて自動で入る文言。 人が書いた記述ではない
点眼剤の処方日数 処方データに日数が無く、抽出時に量と用法から計 算した推定値 服薬状況・残薬状況の フラグ 処方全体についての記録で、薬ごとではない。 記録されないことも多い © KAKEHASHI Inc. All Rights Reserved. 46
何を・どこに・どのように書くか お話しすること 1. 生成AIの登場による環境の変化 2. メタデータ整備の3つの要素 2-1. 何を書くか 2-2. どこに置くか
2-3. どのように書くか 3. 誰に向けて整備するか 4. 権限の設計 5. まとめ © KAKEHASHI Inc. All Rights Reserved. 47
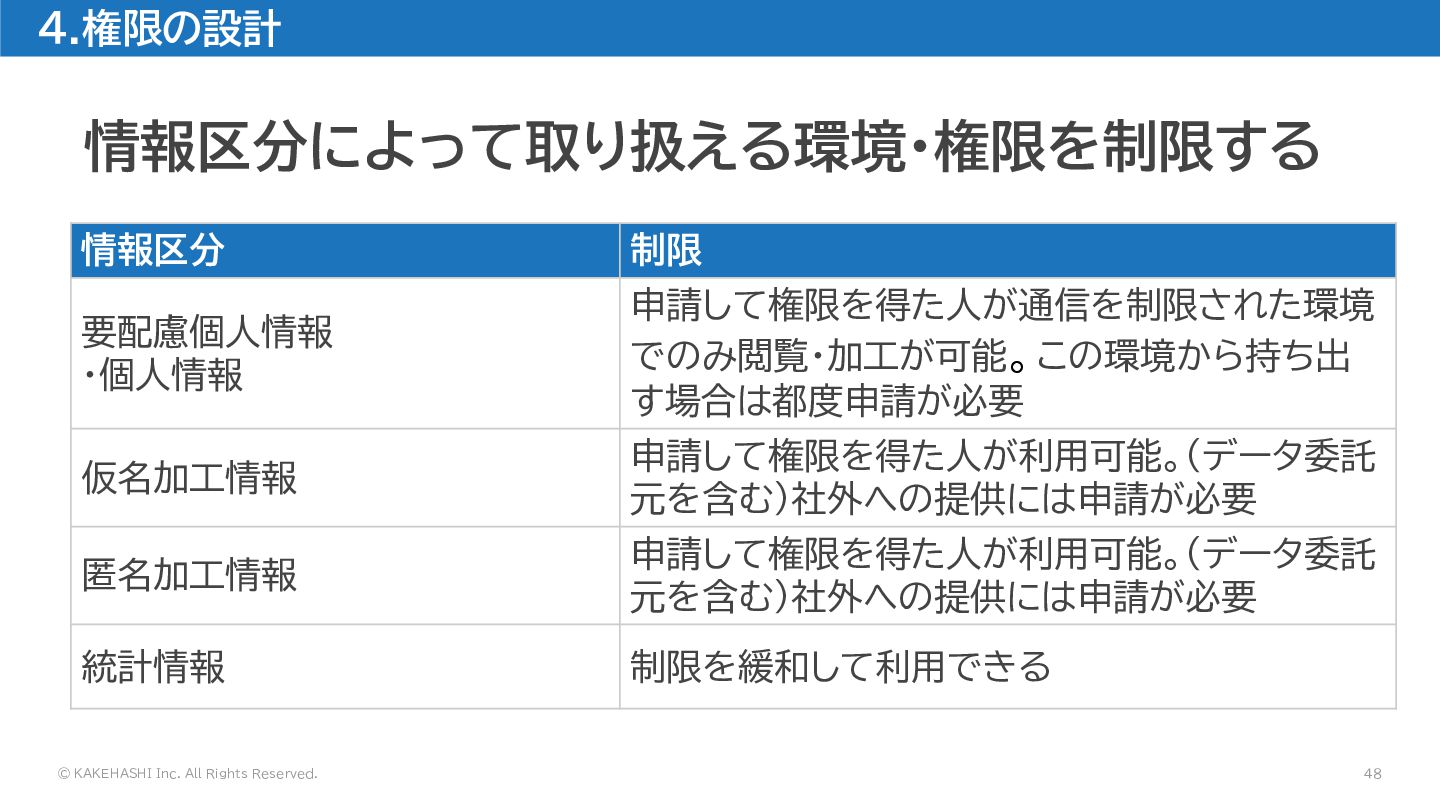
4.権限の設計 情報区分によって取り扱える環境・権限を制限する 情報区分 制限 要配慮個人情報 ・個人情報 申請して権限を得た人が通信を制限された環境 でのみ閲覧・加工が可能。この環境から持ち出 す場合は都度申請が必要 仮名加工情報
申請して権限を得た人が利用可能。(データ委託 元を含む)社外への提供には申請が必要 匿名加工情報 申請して権限を得た人が利用可能。(データ委託 元を含む)社外への提供には申請が必要 統計情報 制限を緩和して利用できる © KAKEHASHI Inc. All Rights Reserved. 48
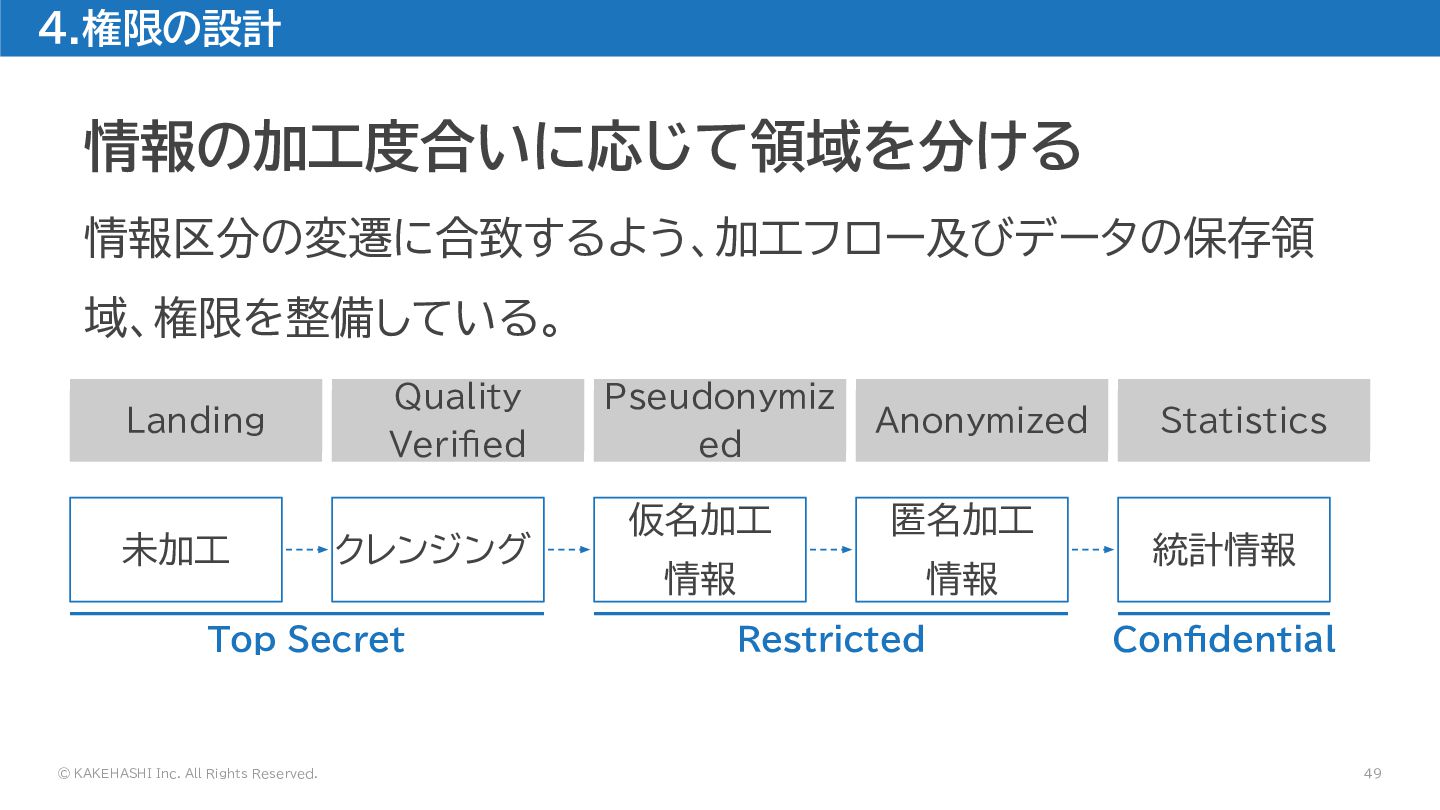
4.権限の設計 情報の加工度合いに応じて領域を分ける 情報区分の変遷に合致するよう、加工フロー及びデータの保存領 域、権限を整備している。 Landing 未加工 Quality Verified クレンジング Top
Secret © KAKEHASHI Inc. All Rights Reserved. Pseudonymiz ed Anonymized 仮名加工 匿名加工 情報 情報 Restricted Statistics 統計情報 Confidential 49
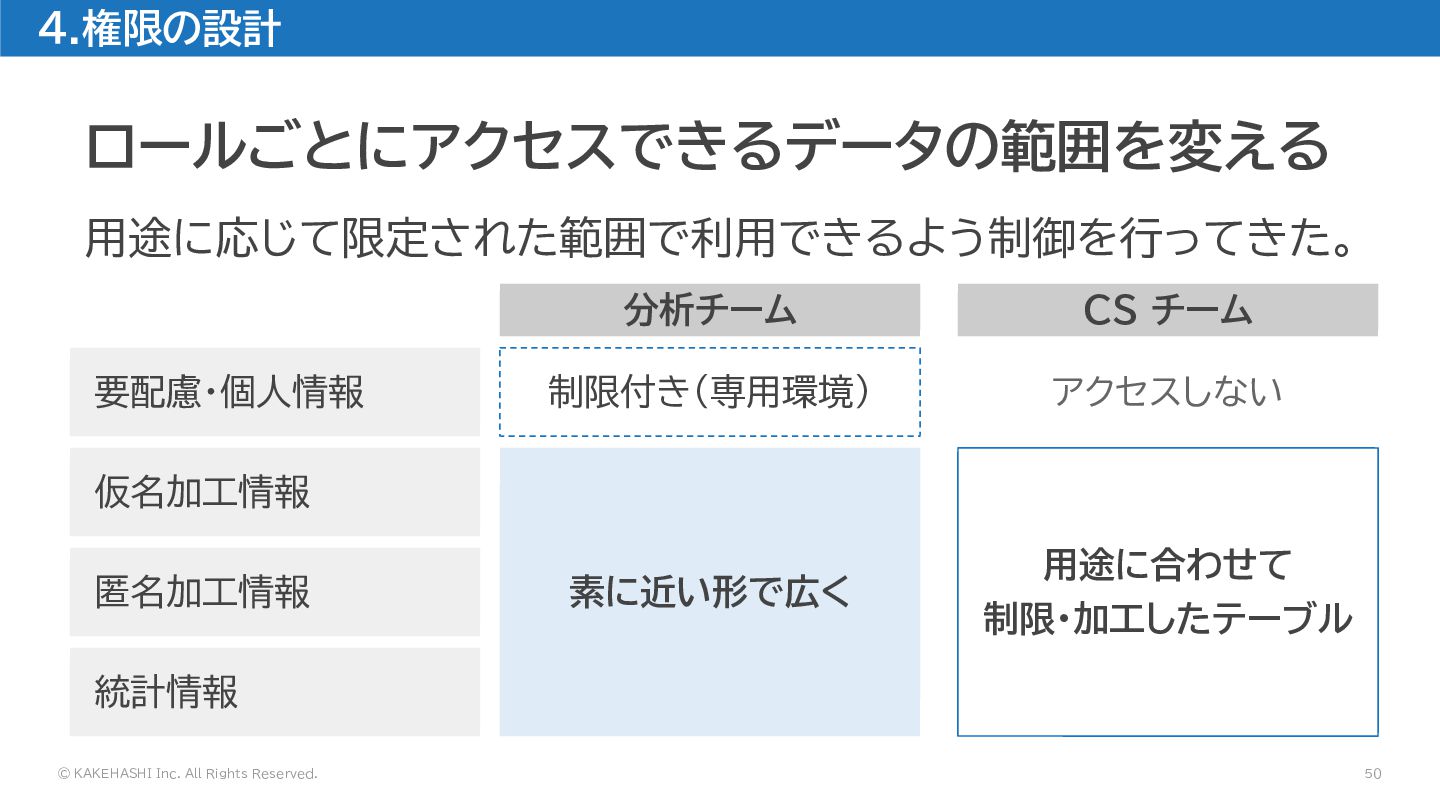
4.権限の設計 ロールごとにアクセスできるデータの範囲を変える 用途に応じて限定された範囲で利用できるよう制御を行ってきた。 要配慮・個人情報 分析チーム CS チーム 制限付き(専用環境) アクセスしない 素に近い形で広く
用途に合わせて 制限・加工したテーブル 仮名加工情報 匿名加工情報 統計情報 © KAKEHASHI Inc. All Rights Reserved. 50
4.権限の設計 課題:自由度を持って分析をするメンバーが増える ことにより、権限管理が難しくなる • データ系以外のロールの方に広い権限を与える必要があり、権 限範囲の設定の複雑さが増す • 権限設定だけでは制御しきれない、許可された目的の範囲内で の利用を守る必要がある ©
KAKEHASHI Inc. All Rights Reserved. 51
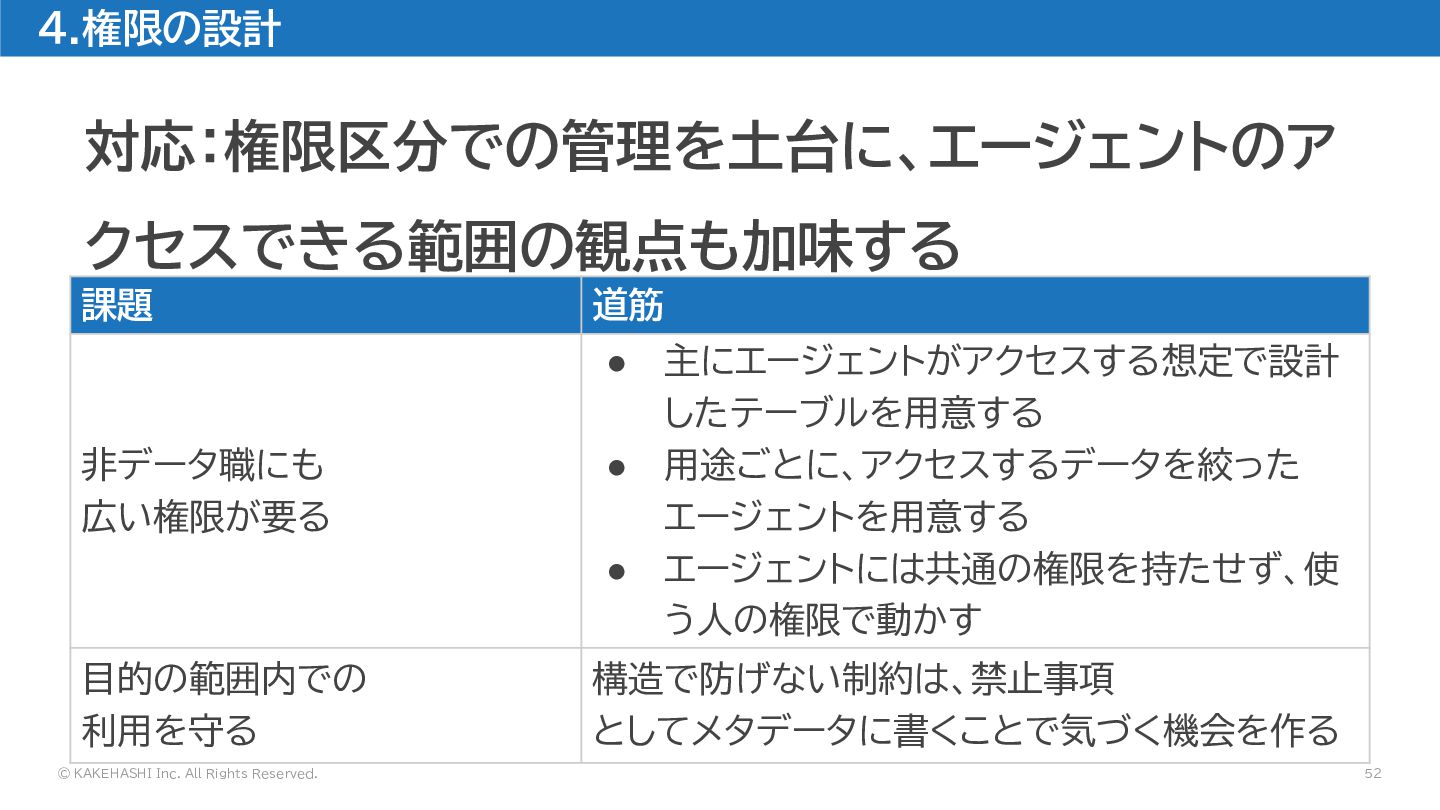
4.権限の設計 対応:権限区分での管理を土台に、エージェントのア クセスできる範囲の観点も加味する 課題 道筋 • 非データ職にも 広い権限が要る • •
目的の範囲内での 利用を守る © KAKEHASHI Inc. All Rights Reserved. 主にエージェントがアクセスする想定で設計 したテーブルを用意する 用途ごとに、アクセスするデータを絞った エージェントを用意する エージェントには共通の権限を持たせず、使 う人の権限で動かす 構造で防げない制約は、禁止事項 としてメタデータに書くことで気づく機会を作る 52
何を・どこに・どのように書くか お話しすること 1. 生成AIの登場による環境の変化 2. メタデータ整備の3つの要素 2-1. 何を書くか 2-2. どこに置くか
2-3. どのように書くか 3. 誰に向けて整備するか 4. 権限の設計 5. まとめ © KAKEHASHI Inc. All Rights Reserved. 53
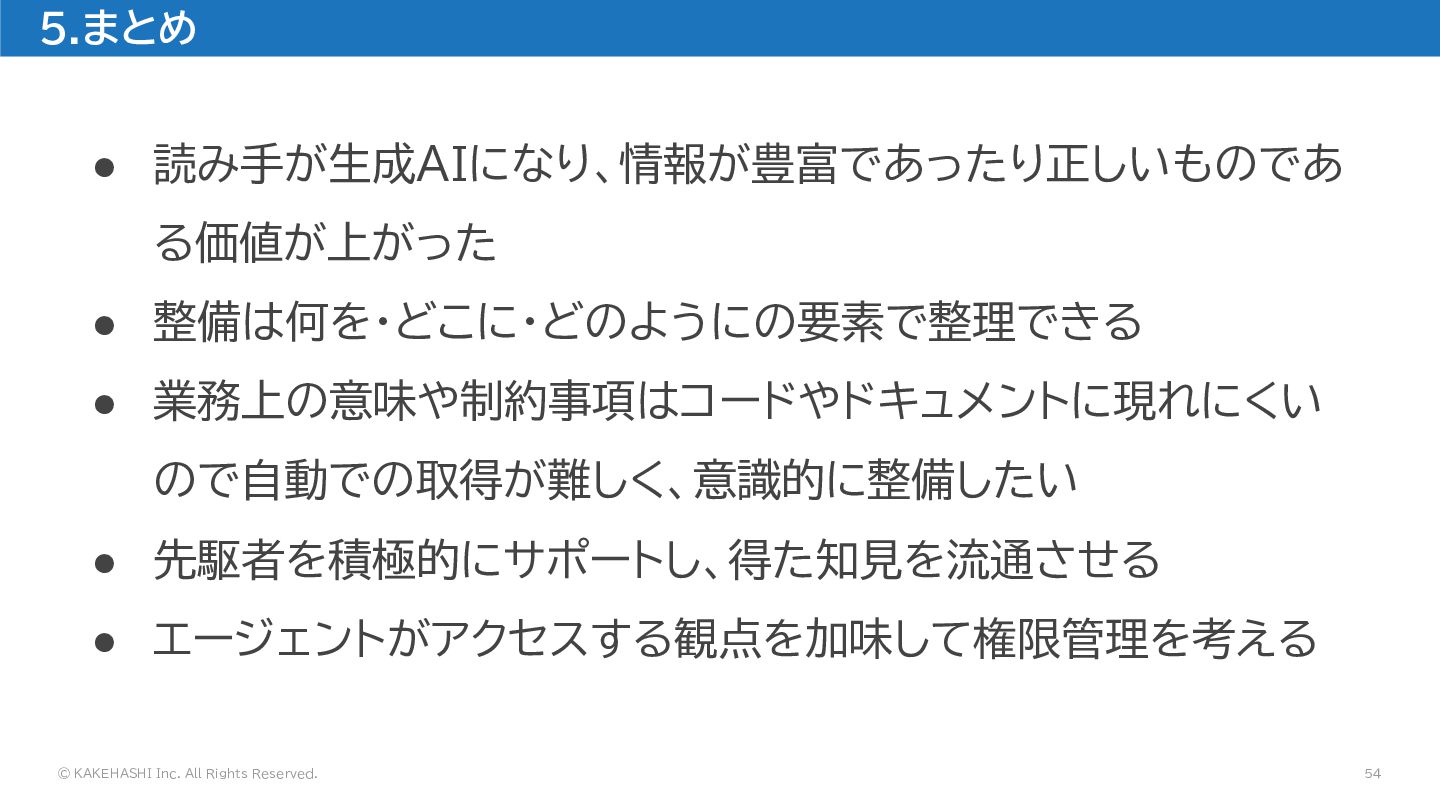
5.まとめ • 読み手が生成AIになり、情報が豊富であったり正しいものであ る価値が上がった • 整備は何を・どこに・どのようにの要素で整理できる • 業務上の意味や制約事項はコードやドキュメントに現れにくい ので自動での取得が難しく、意識的に整備したい •
先駆者を積極的にサポートし、得た知見を流通させる • エージェントがアクセスする観点を加味して権限管理を考える © KAKEHASHI Inc. All Rights Reserved. 54
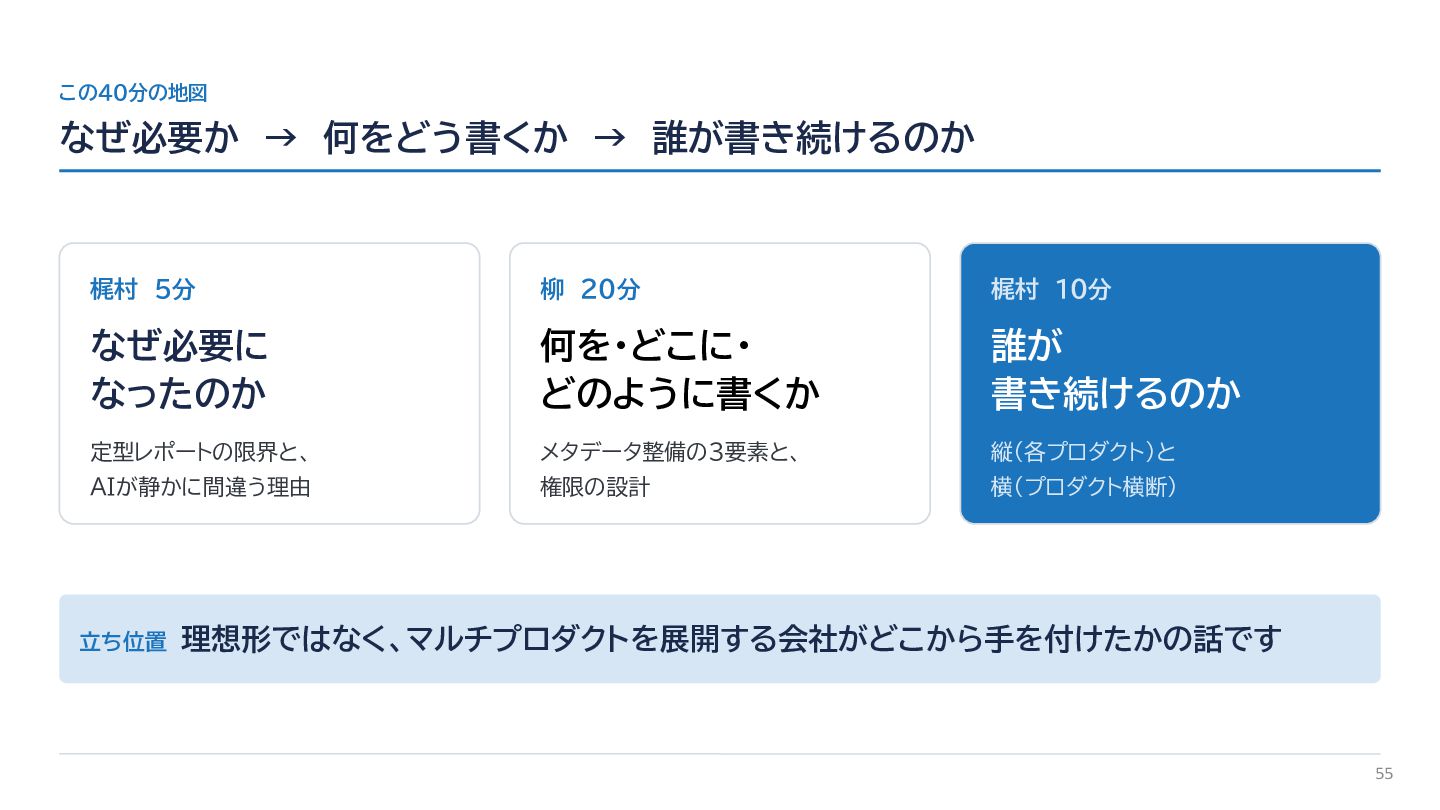
この40分の地図 なぜ必要か → 何をどう書くか → 誰が書き続けるのか 梶村 5分 柳 20分
梶村 10分 なぜ必要に なったのか 何を・どこに・ どのように書くか 誰が 書き続けるのか 定型レポートの限界と、 メタデータ整備の3要素と、 縦(各プロダクト)と AIが静かに間違う理由 権限の設計 横(プロダクト横断) 立ち位置 理想形ではなく、マルチプロダクトを展開する会社がどこから手を付けたかの話です 55
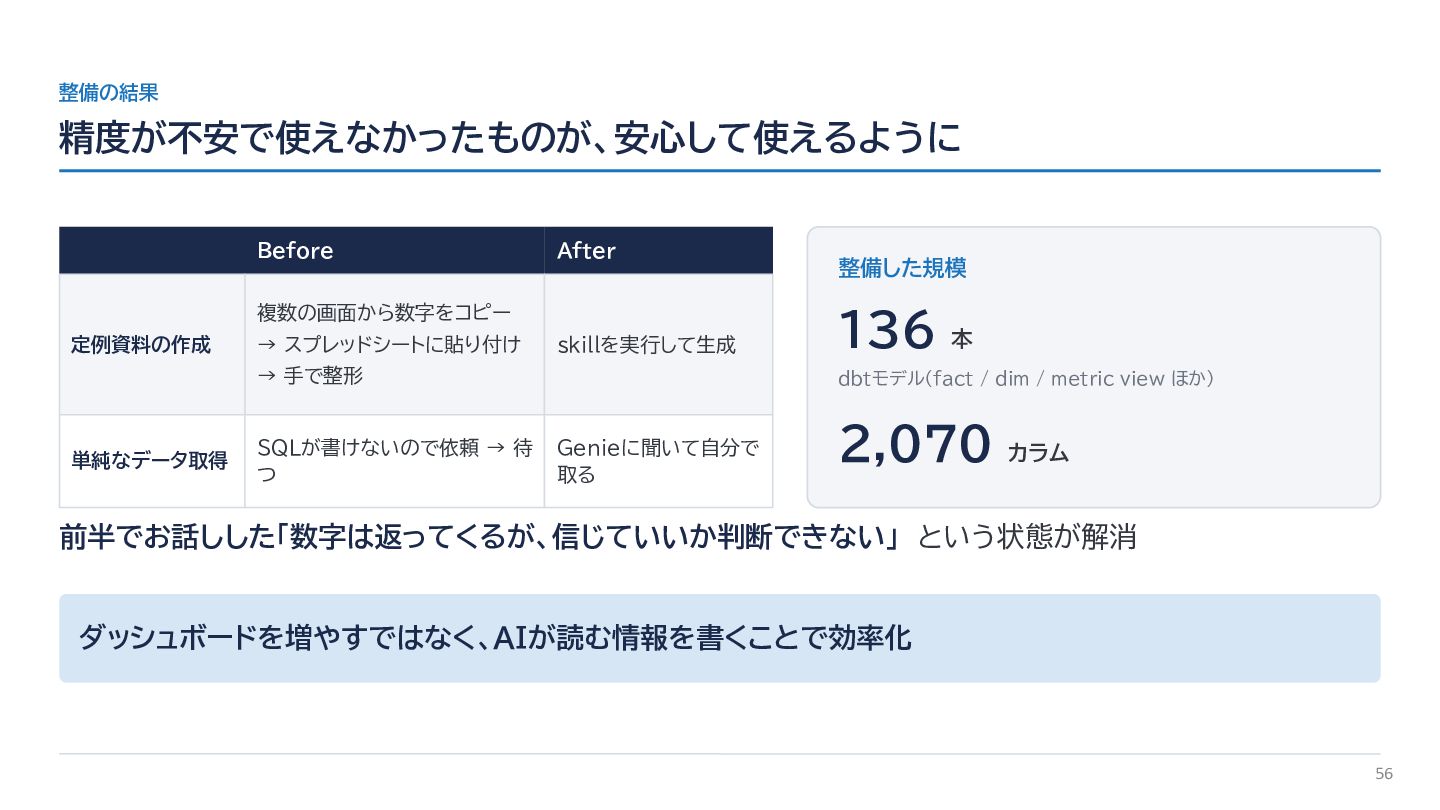
整備の結果 精度が不安で使えなかったものが、安心して使えるように Before After 複数の画面から数字をコピー 定例資料の作成 → スプレッドシートに貼り付け skillを実行して生成 →
手で整形 単純なデータ取得 SQLが書けないので依頼 → 待 つ 整備した規模 136 本 dbtモデル(fact / dim / metric view ほか) Genieに聞いて自分で 取る 2,070 カラム 前半でお話しした「数字は返ってくるが、信じていいか判断できない」 という状態が解消 ダッシュボードを増やすではなく、AIが読む情報を書くことで効率化 56
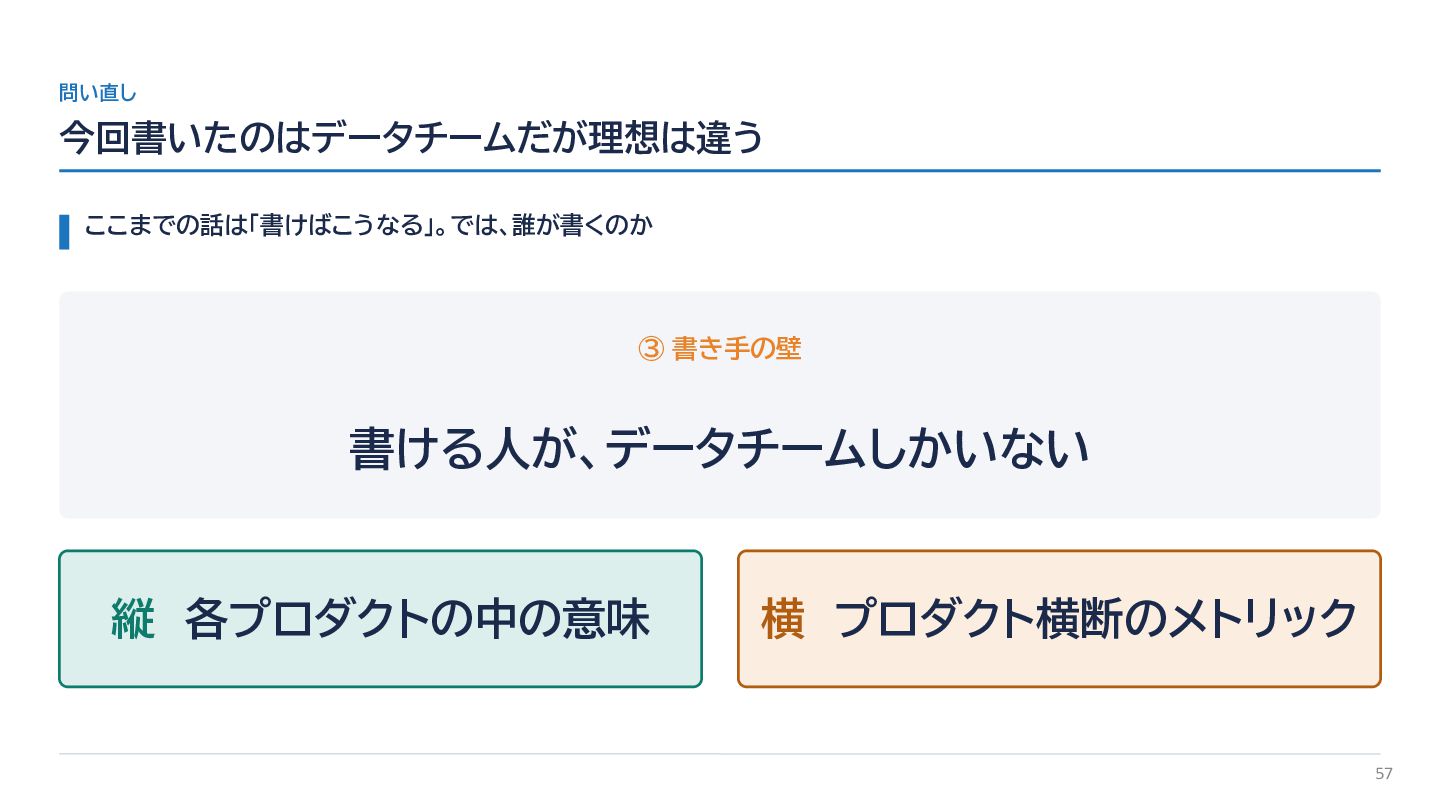
問い直し 今回書いたのはデータチームだが理想は違う ここまでの話は「書けばこうなる」。では、誰が書くのか ③ 書き手の壁 書ける人が、データチームしかいない 縦 各プロダクトの中の意味 横 プロダクト横断のメトリック
57
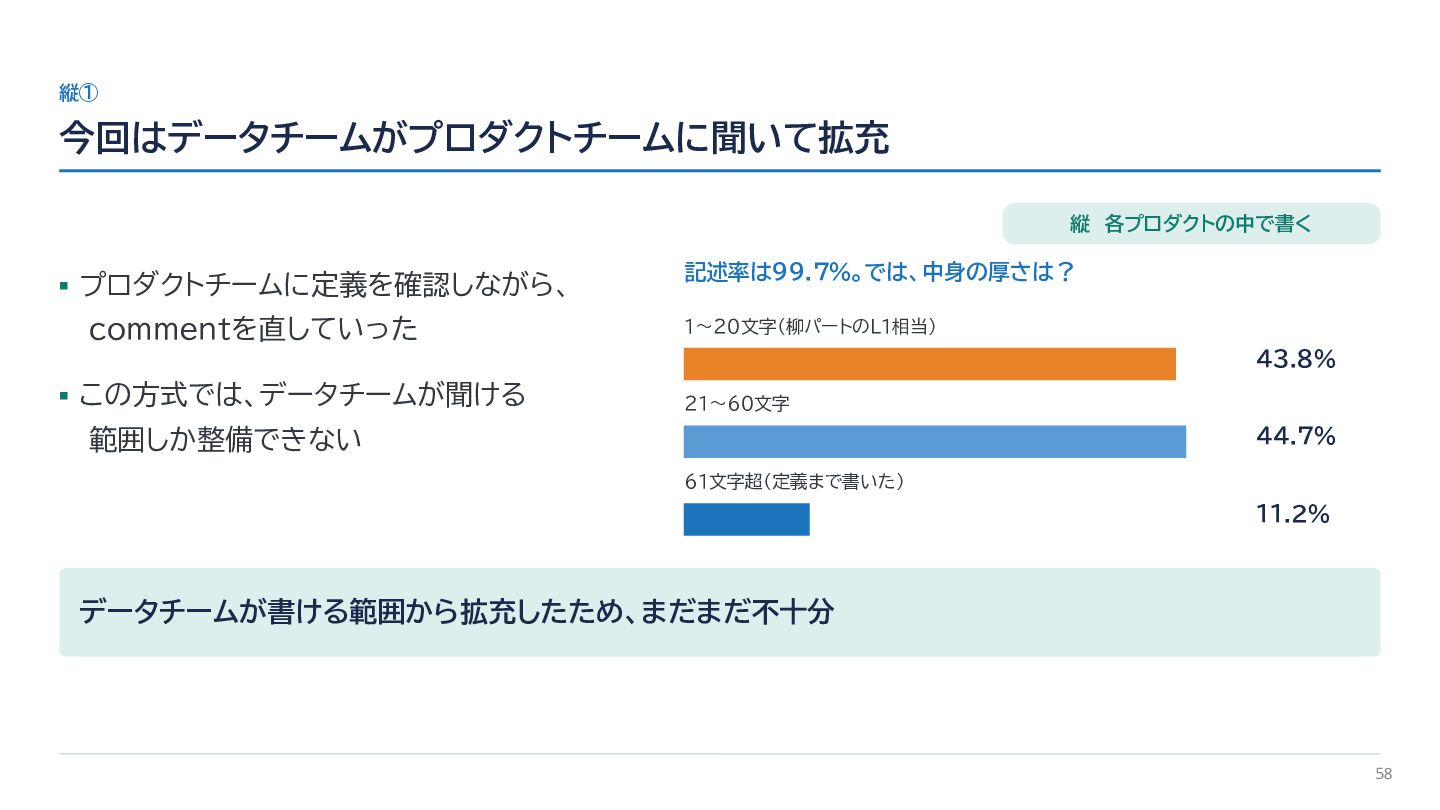
縦① 今回はデータチームがプロダクトチームに聞いて拡充 縦 各プロダクトの中で書く ▪ プロダクトチームに定義を確認しながら、 commentを直していった 記述率は99.7%。では、中身の厚さは? 1〜20文字(柳パートのL1相当) 43.8%
▪ この方式では、データチームが聞ける 21〜60文字 44.7% 範囲しか整備できない 61文字超(定義まで書いた) 11.2% データチームが書ける範囲から拡充したため、まだまだ不十分 58
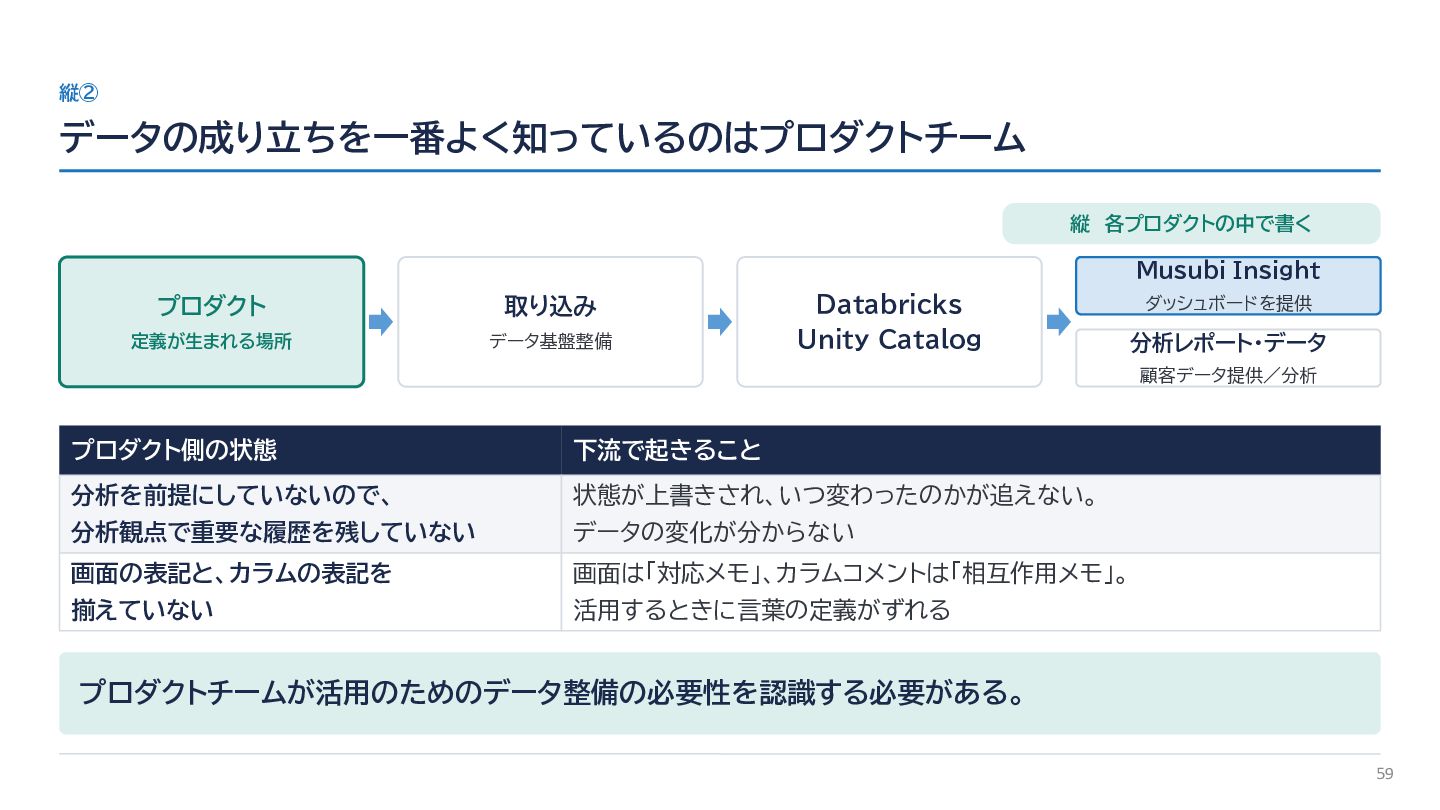
縦② データの成り立ちを一番よく知っているのはプロダクトチーム 縦 各プロダクトの中で書く Musubi Insight プロダクト 取り込み 定義が生まれる場所 データ基盤整備
Databricks Unity Catalog ダッシュボードを提供 分析レポート・データ 顧客データ提供/分析 プロダクト側の状態 下流で起きること 分析を前提にしていないので、 状態が上書きされ、いつ変わったのかが追えない。 分析観点で重要な履歴を残していない データの変化が分からない 画面の表記と、カラムの表記を 画面は「対応メモ」、カラムコメントは「相互作用メモ」。 揃えていない 活用するときに言葉の定義がずれる プロダクトチームが活用のためのデータ整備の必要性を認識する必要がある。 59
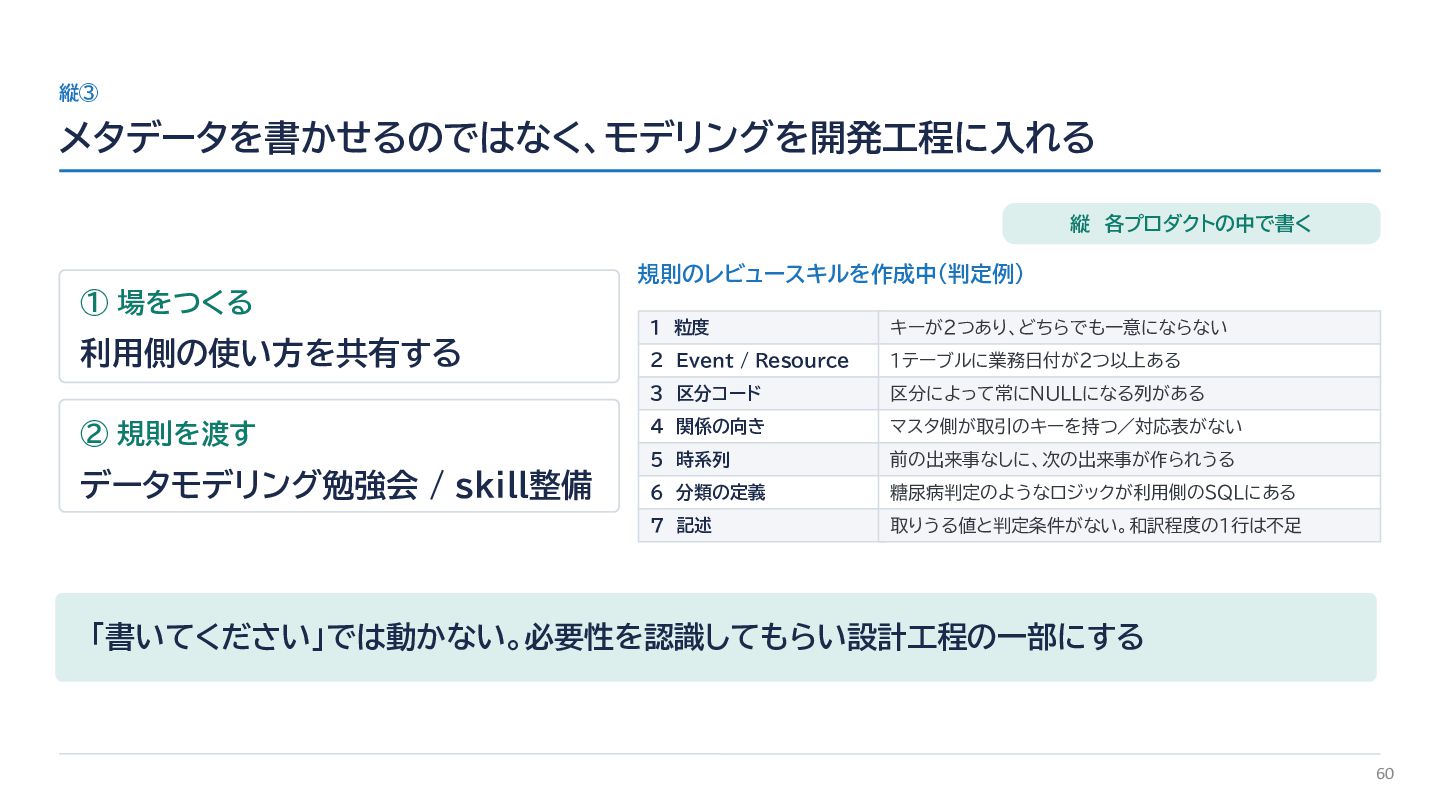
縦③ メタデータを書かせるのではなく、モデリングを開発工程に入れる 縦 各プロダクトの中で書く 規則のレビュースキルを作成中(判定例) ① 場をつくる 利用側の使い方を共有する ② 規則を渡す
データモデリング勉強会 / skill整備 1 粒度 キーが2つあり、どちらでも一意にならない 2 Event / Resource 1テーブルに業務日付が2つ以上ある 3 区分コード 区分によって常にNULLになる列がある 4 関係の向き マスタ側が取引のキーを持つ/対応表がない 5 時系列 前の出来事なしに、次の出来事が作られうる 6 分類の定義 糖尿病判定のようなロジックが利用側のSQLにある 7 記述 取りうる値と判定条件がない。和訳程度の1行は不足 「書いてください」では動かない。必要性を認識してもらい設計工程の一部にする 60
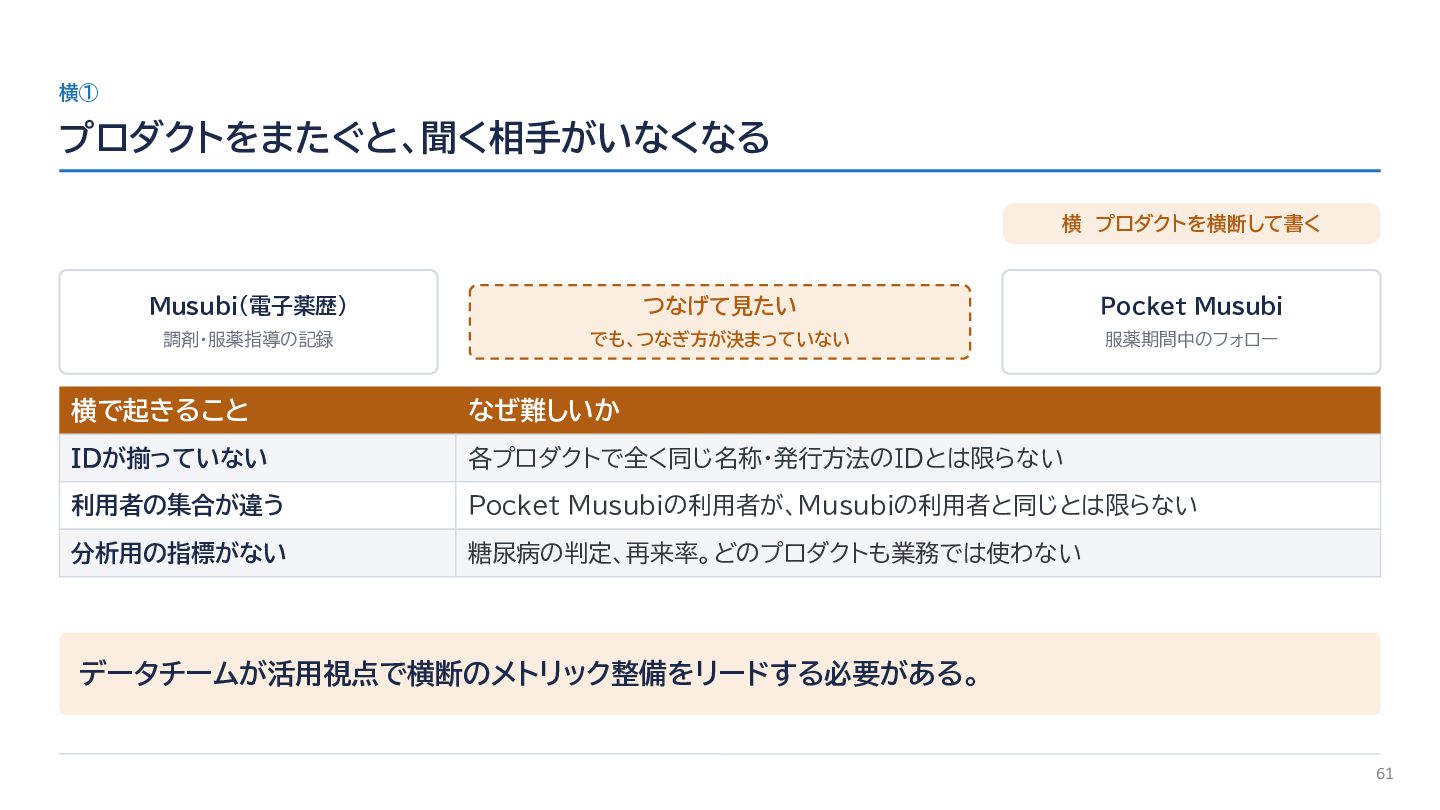
横① プロダクトをまたぐと、聞く相手がいなくなる 横 プロダクトを横断して書く Musubi(電子薬歴) つなげて見たい Pocket Musubi 調剤・服薬指導の記録 でも、つなぎ方が決まっていない
服薬期間中のフォロー 横で起きること なぜ難しいか IDが揃っていない 各プロダクトで全く同じ名称・発行方法のIDとは限らない 利用者の集合が違う Pocket Musubiの利用者が、Musubiの利用者と同じとは限らない 分析用の指標がない 糖尿病の判定、再来率。どのプロダクトも業務では使わない データチームが活用視点で横断のメトリック整備をリードする必要がある。 61
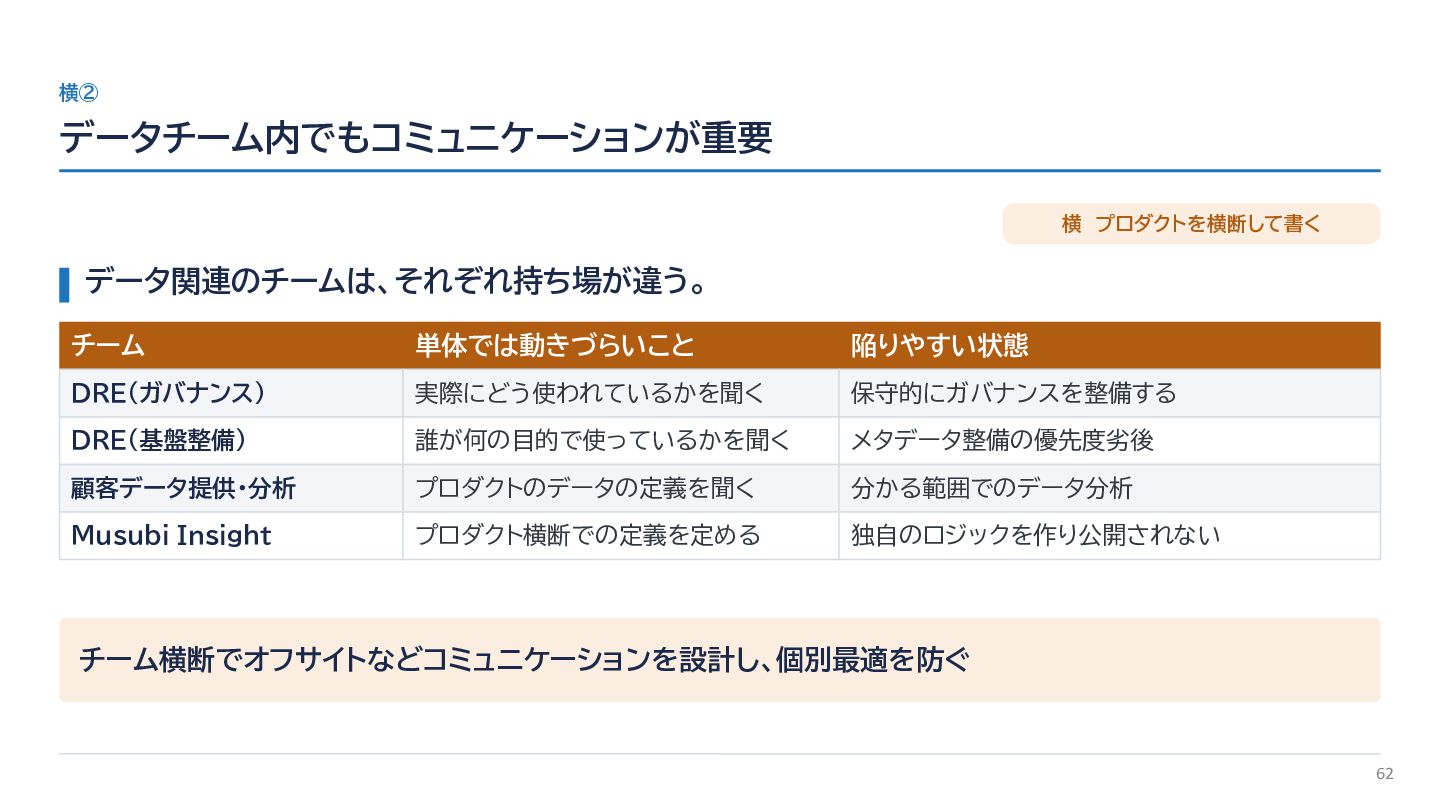
横② データチーム内でもコミュニケーションが重要 横 プロダクトを横断して書く データ関連のチームは、それぞれ持ち場が違う。 チーム 単体では動きづらいこと 陥りやすい状態 DRE(ガバナンス) 実際にどう使われているかを聞く
保守的にガバナンスを整備する DRE(基盤整備) 誰が何の目的で使っているかを聞く メタデータ整備の優先度劣後 顧客データ提供・分析 プロダクトのデータの定義を聞く 分かる範囲でのデータ分析 Musubi Insight プロダクト横断での定義を定める 独自のロジックを作り公開されない チーム横断でオフサイトなどコミュニケーションを設計し、個別最適を防ぐ 62
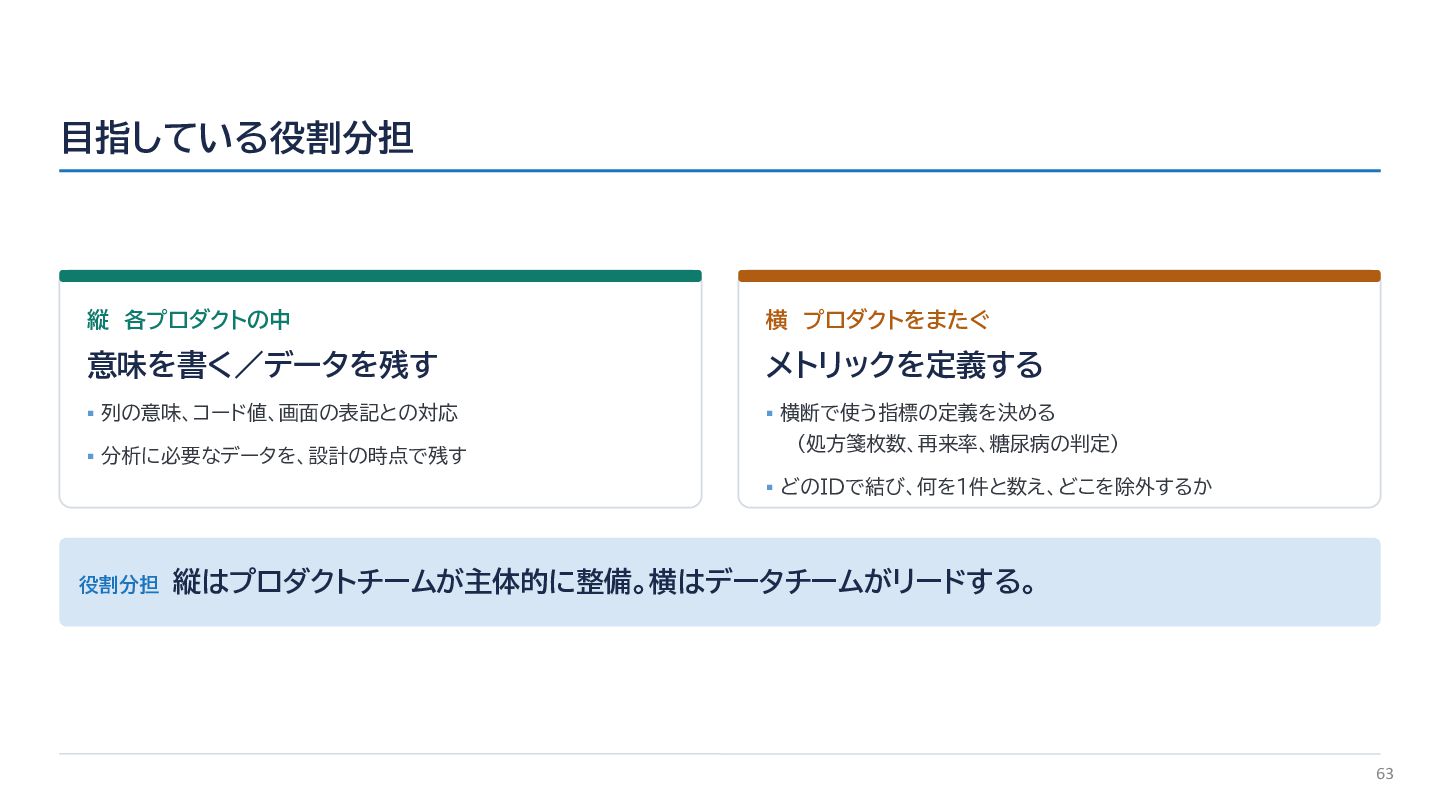
目指している役割分担 縦 各プロダクトの中 横 プロダクトをまたぐ 意味を書く/データを残す メトリックを定義する ▪ 列の意味、コード値、画面の表記との対応 ▪
横断で使う指標の定義を決める ▪ 分析に必要なデータを、設計の時点で残す (処方箋枚数、再来率、糖尿病の判定) ▪ どのIDで結び、何を1件と数え、どこを除外するか 役割分担 縦はプロダクトチームが主体的に整備。横はデータチームがリードする。 63
メタデータ整備は、 ドキュメントを書くだけではなく、 チーム横断のコミュニケーションを設計する仕事 © KAKEHASHI Inc. All Rights Reserved.
We Are Hiring!!! PM EM エンジニア積極採用中 © KAKEHASHI Inc. All
Rights Reserved.
More Decks by KAKEHASHI
See All by KAKEHASHI
Claudeのコストを見える化して、自動で守る
kakehashi
PRO
2
110
生成AI時代、PMは事業責任者に進化するともっと面白い〜PMだからこそ事業構造を動かせる時代に〜
kakehashi
PRO
1
1.2k
SharedWorkerを使ったキャッシュでネイティブアプリに負けないユーザー体験を目指す
kakehashi
PRO
1
1k
Honoが叶える!いつでも降りられるLambdalith
kakehashi
PRO
2
320
薬剤師(ドメインエキスパート)と一緒に育てる薬局向けAIアシスタント
kakehashi
PRO
2
330
デザイナーとPdMが自分でデプロイする ― Amplify Hosting の PR プレビューで回す仮説検証
kakehashi
PRO
2
270
人を動かすのは時間ではなく、納得感 〜新任EMが入社3ヶ月、組織を2回変えた話〜
kakehashi
PRO
3
750
クラウド上のデータ復旧で見落としがちな制約: 医療系 SaaS の BCP 設計から得た教訓
kakehashi
PRO
0
6.1k
プロダクトだけじゃない、社内プロセスにおける自動化・省力化ノススメ
kakehashi
PRO
1
6.3k
Other Decks in Technology
See All in Technology
Datadog の権限統制 〜Org 統合に向けて調べた注意点 / JDDUG-Meetup_24
visional_engineering_and_design
1
190
エンタープライズ事業未経験のデータ屋、 AI時代にN回撃沈する.pdf
ryoskdara_
0
150
さようならSSH鍵、こんにちはゼロトラスト ― AIフレンドリーで快適な自宅鯖SSH
atalie2m
14
7.1k
re:Inventを楽しむために、 1日1つ「これが楽しみ」を決めよう
beli68
0
120
SORACOM × AWS IoT Core でSREする
butadora
0
110
落とし穴にハマってわかった 開発生産性を測るときに気をつけたいこと
munakata
3
420
Linuxネットワークスタック進化の軌跡: 過去10年の歩みと最新トレンド
orimanabu
4
760
契約書SaaSにAIエージェントを組み込む
sansantech
PRO
0
190
目を覚ませ!僕らの認証情報が何者かに侵略されてるぞ
tkito
2
470
OCI Artifact による自動運転タクシーに向けた OTA 基盤の構築
biwashi
0
120
マネージャーをエスパーにしない マネジメントされる側から始める、働きやすい現場づくり
comi190327
1
790
パスワードのない鍵で、 データを手元に置く
ginjihayashi
0
370
Featured
See All Featured
BBQ
matthewcrist
90
10k
A designer walks into a library…
pauljervisheath
211
25k
Bash Introduction
62gerente
615
220k
Building Flexible Design Systems
yeseniaperezcruz
330
41k
Chasing Engaging Ingredients in Design
codingconduct
0
400
Building AI with AI
inesmontani
PRO
1
1.4k
Tell your own story through comics
letsgokoyo
1
1.1k
[Rails World 2023 - Day 1 Closing Keynote] - The Magic of Rails
eileencodes
38
3.1k
KATA
mclloyd
PRO
35
16k
Visual Storytelling: How to be a Superhuman Communicator
reverentgeek
2
750
Unsuck your backbone
ammeep
672
58k
Mind Mapping
helmedeiros
1
440


 kakehashi
 visional_engineering_and_design
 ryoskdara_
 atalie2m
 beli68
 butadora
 munakata
 orimanabu
 sansantech
 tkito
 biwashi
 comi190327
 ginjihayashi
 matthewcrist
 pauljervisheath
 62gerente
 yeseniaperezcruz
 codingconduct
 inesmontani
 letsgokoyo
 eileencodes
 mclloyd
 reverentgeek
 ammeep
 helmedeiros