Upgrade to Pro — share decks privately, control downloads, hide ads and more …

[Journal club] EXPERT: An Explainable Image Cap...

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →

[Journal club] EXPERT: An Explainable Image Captioning Evaluation Metric with Structured Explanations

Transcript

18 slides
  1. Hyunjong Kim1 Sangyeop Kim1,2 Jongheon Jeong1 Yeongjae Cho1 Sungzoon Cho1

    (1:Seoul National University 2:Coxwave) 1 EXPERT: An Explainable Image Captioning Evaluation Metric with Structured Explanations 慶應義塾⼤学 杉浦孔明研究室 ⼩⼭修⽣ Hyunjong Kim et al., “EXPERT: An Explainable Image Captioning Evaluation Metric with Structured Explanations,” in Findings of ACL, 2025. ACL25 Findings
  2. 概要 2 背景 n 画像キャプション⽣成の既存評価尺度は評価値の説明の品質が低い n 既存のデータセットは評価値に対する説明を含まない 提案 n Polaris-exp,

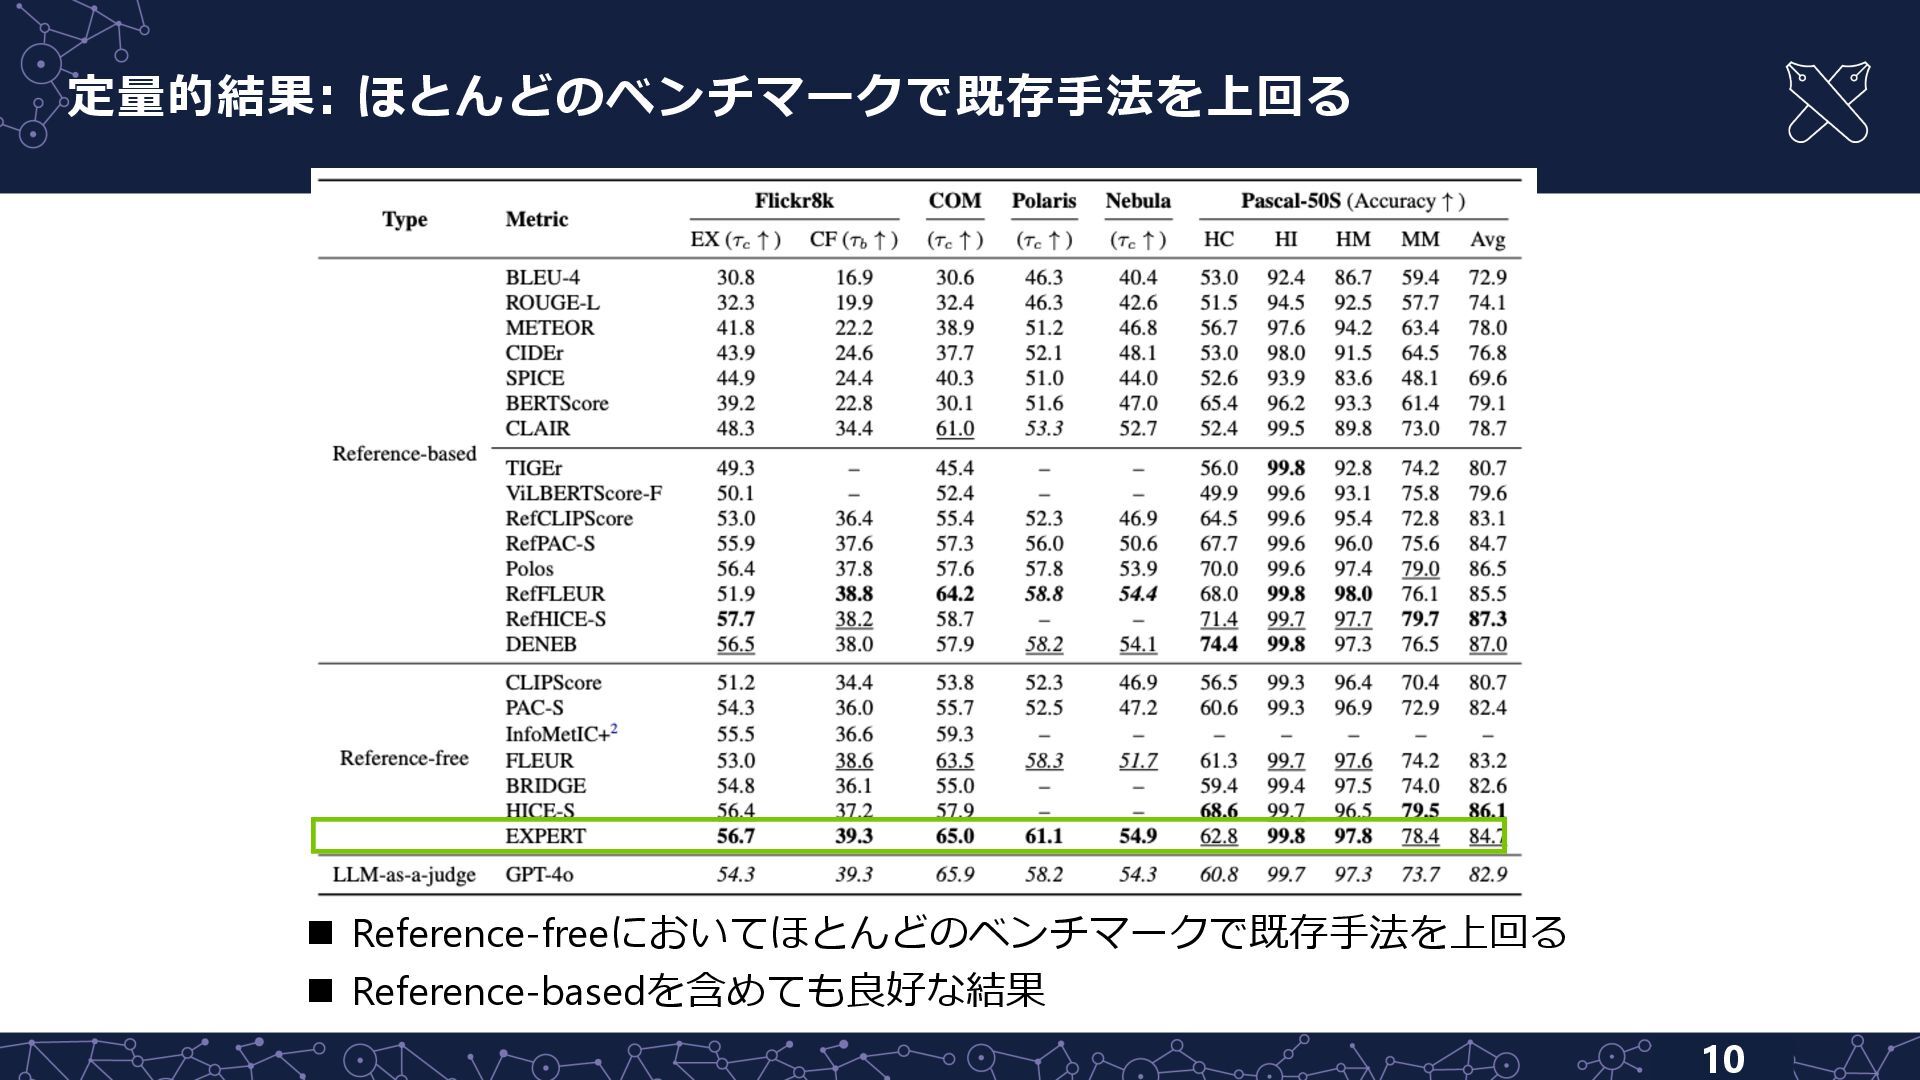
    Nebula-exp︓評価値に対する説明を含むデータセット n EXPERT︓⾼品質な説明を出⼒するMLLM-as-a-Judge 結論 n ほとんどのベンチマークで既存⼿法を上回る n 評価値に対する説明の品質においても既存⼿法を上回る
  3. 背景︓既存のMLLM-as-a-Judgeは説明の品質に課題 3 L 画像キャプション⽣成における既存の⾃動評価尺度 (e.g., PAC-Score [Sarto+, CVPR23] )の多くは 評価値に対する説明を⽋く

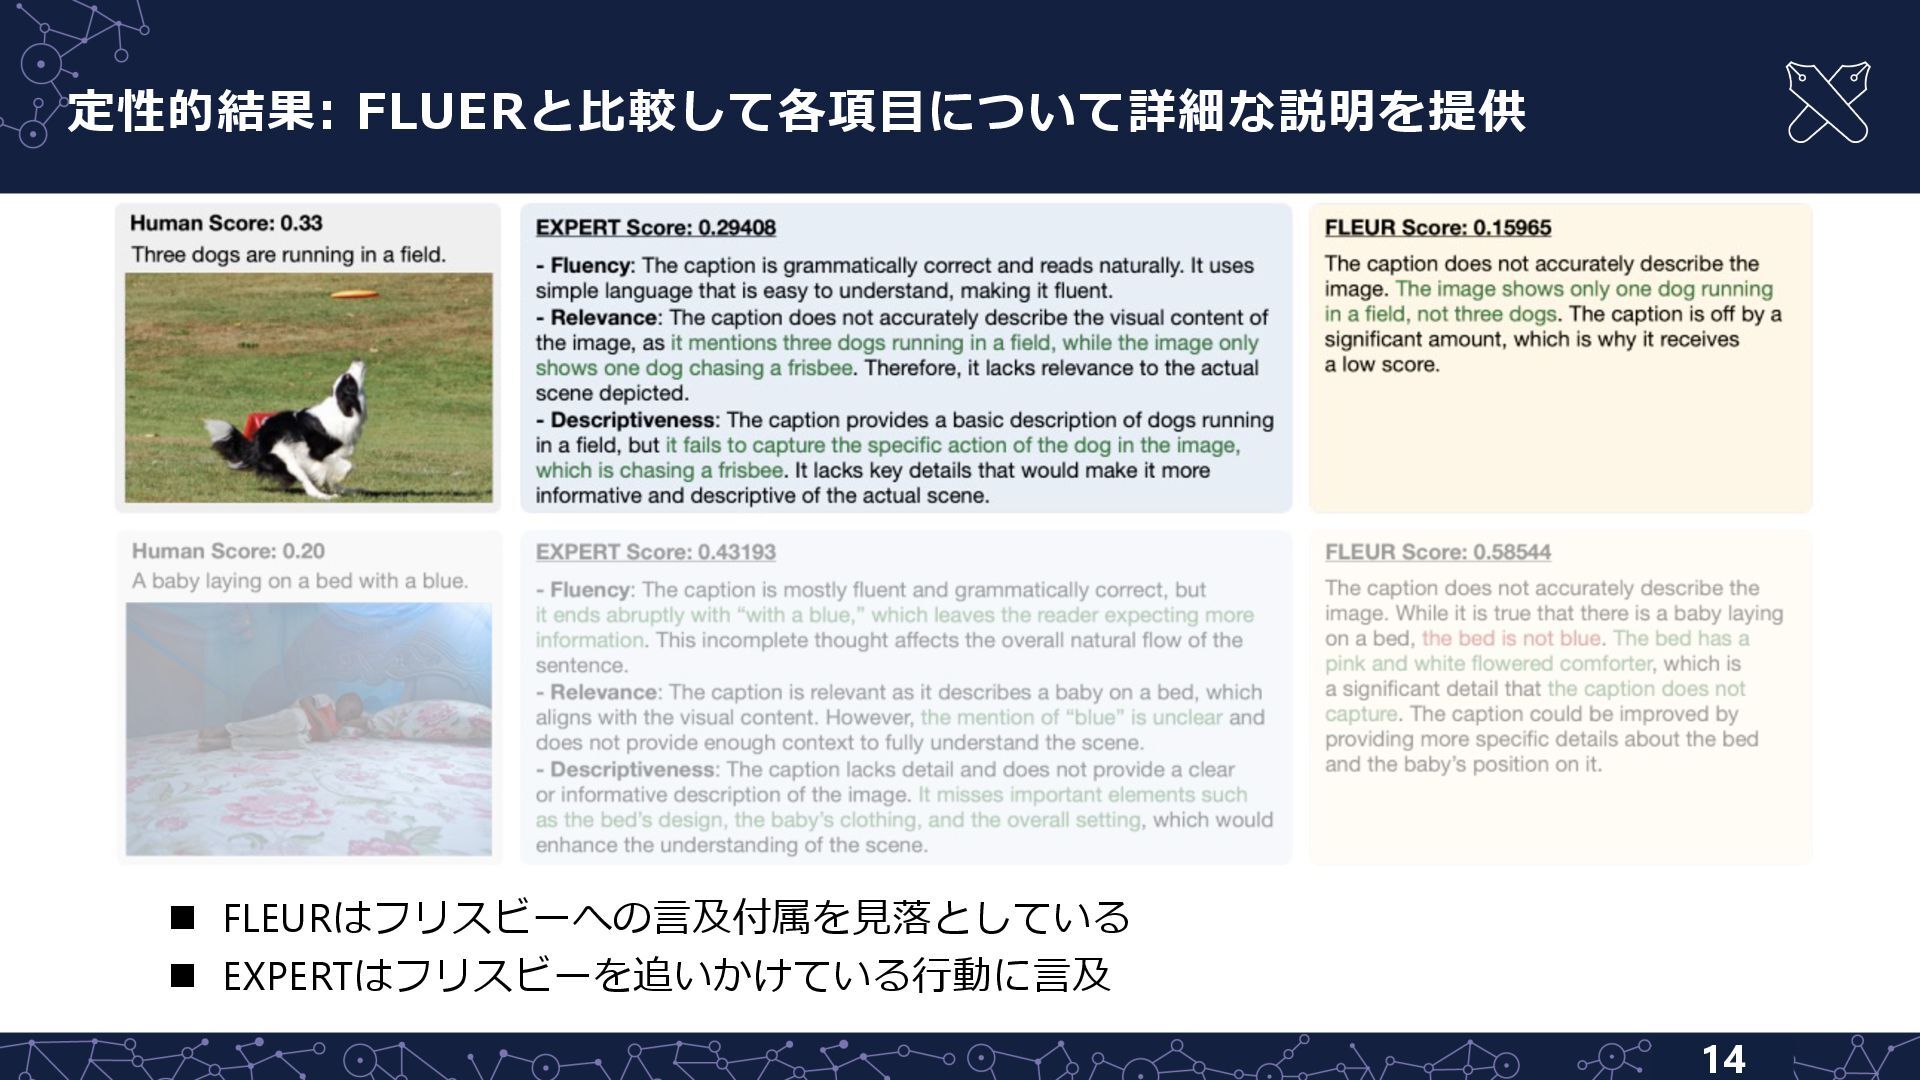
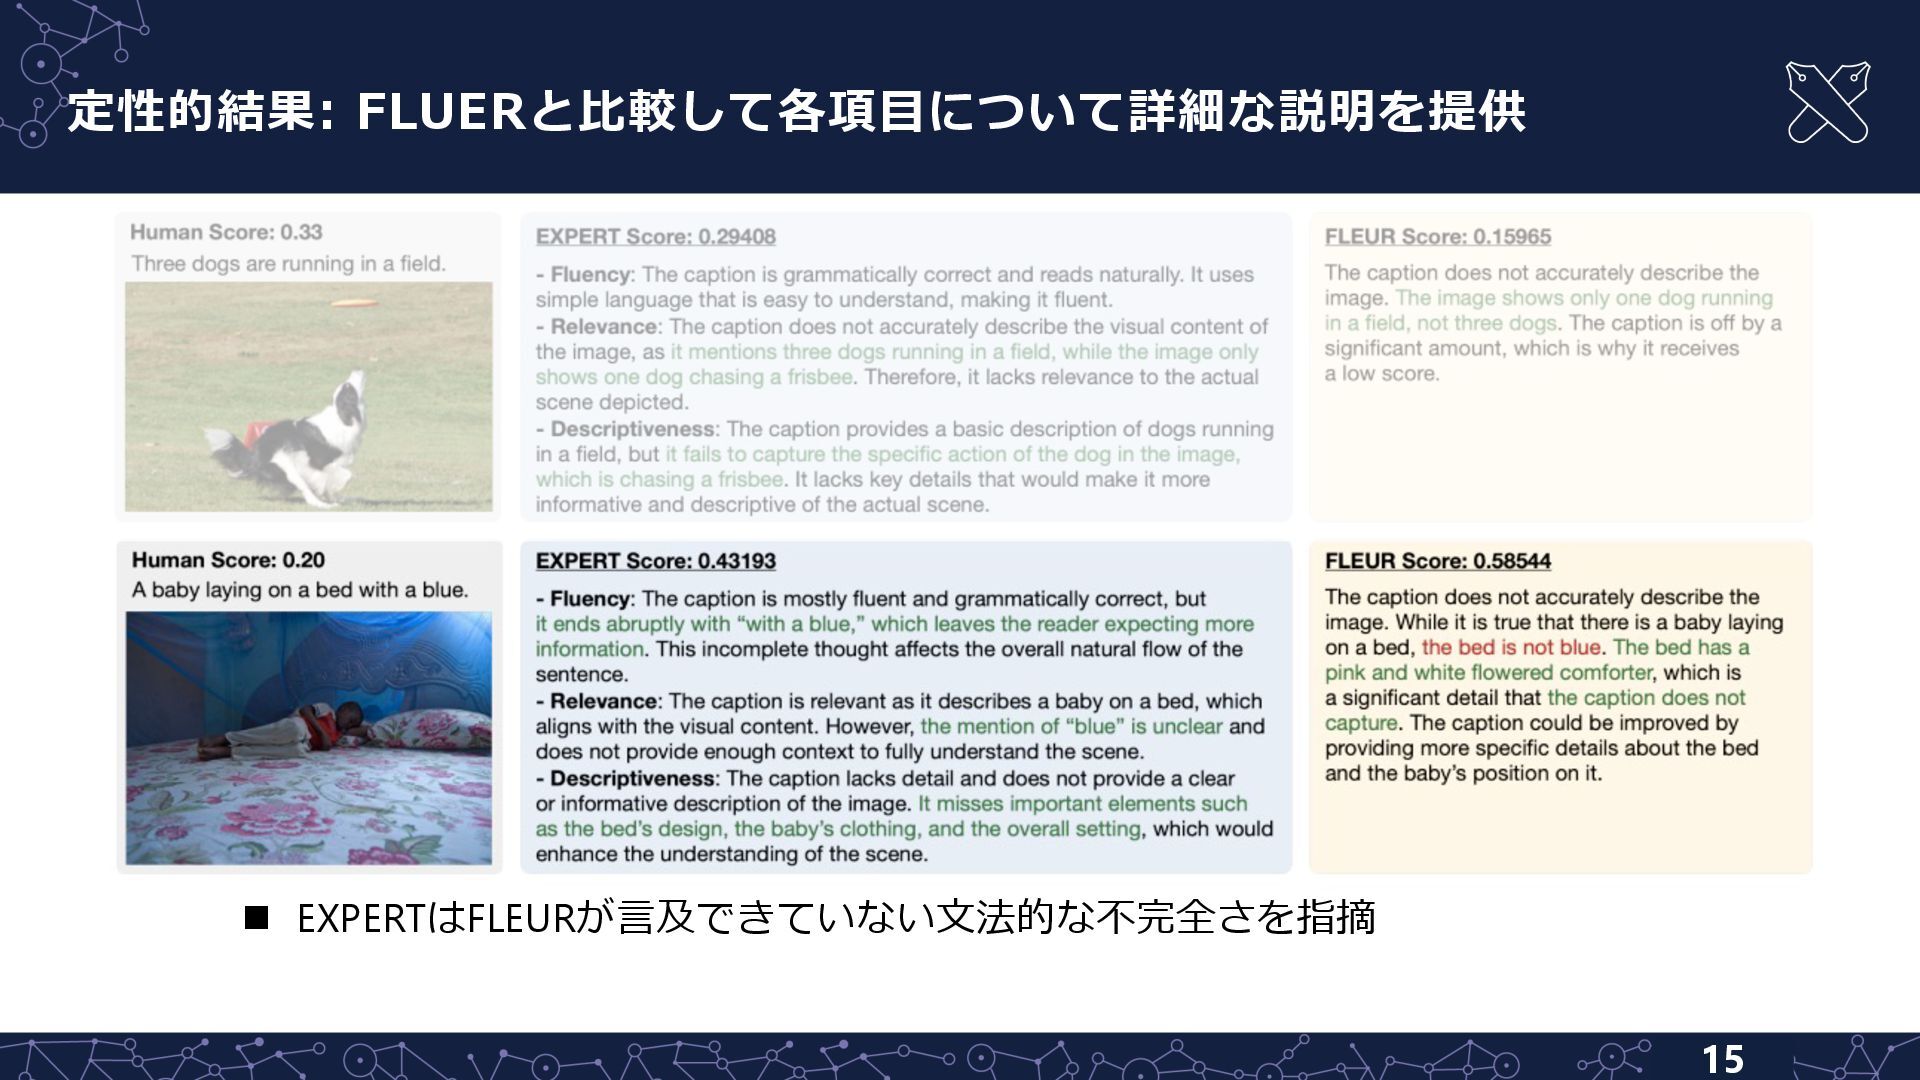
    L MLLM-as-a-Judge (e.g., FLEUR [Lee+, ACL24] ) は評価値の理由を出⼒するが,評価値の説明に⼀ 貫した基準がない L 既存の画像キャプション⽣成の評価尺度⽤のデータセット (e.g., Polaris [Wada+, CVPR24] ) は評価 値に対する説明を含まない FLEURにおける評価値の説明の例
  4. 関連研究 4 PAC-Score ⼿法 概要 PAC-Score [Sarto+, CVPR23] PAC-Score++ [Sarto+,

    IJCV25] CLIPの訓練時と画像キャプションの評価時のドメインギャップをBLIP2で データを⽣成し訓練することで対処 L評価値に対する説明を⽋く FLEUR [Lee+, ACL24] Score smoothingを⽤いたMLLM-as-a-Judge.スコアおよびスコアの理 由を出⼒ L評価値の説明に⼀貫した基準がない Polaris [Wada+, CVPR24] 画像キャプションに対する⼈間による評価を含む⼤規模データセット Lデータセットに評価値に対する説明を含まない FLEUR
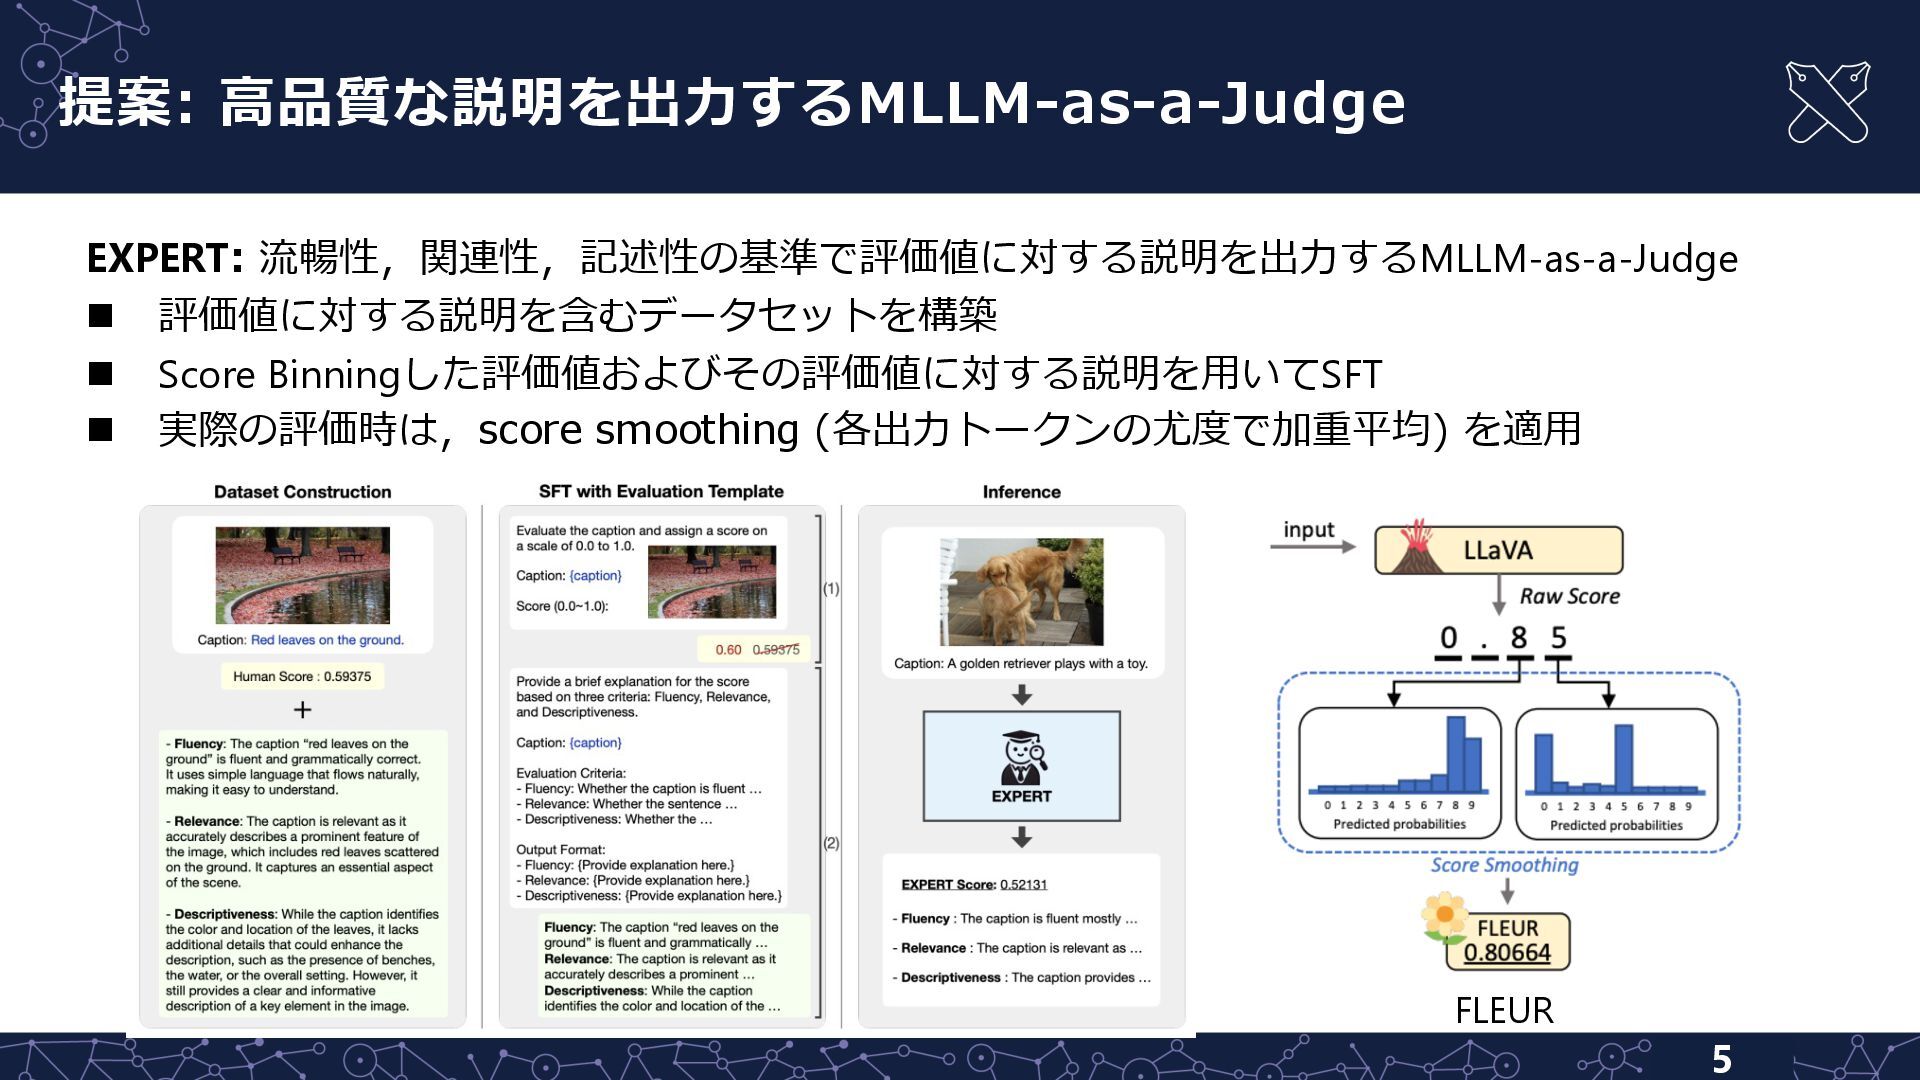
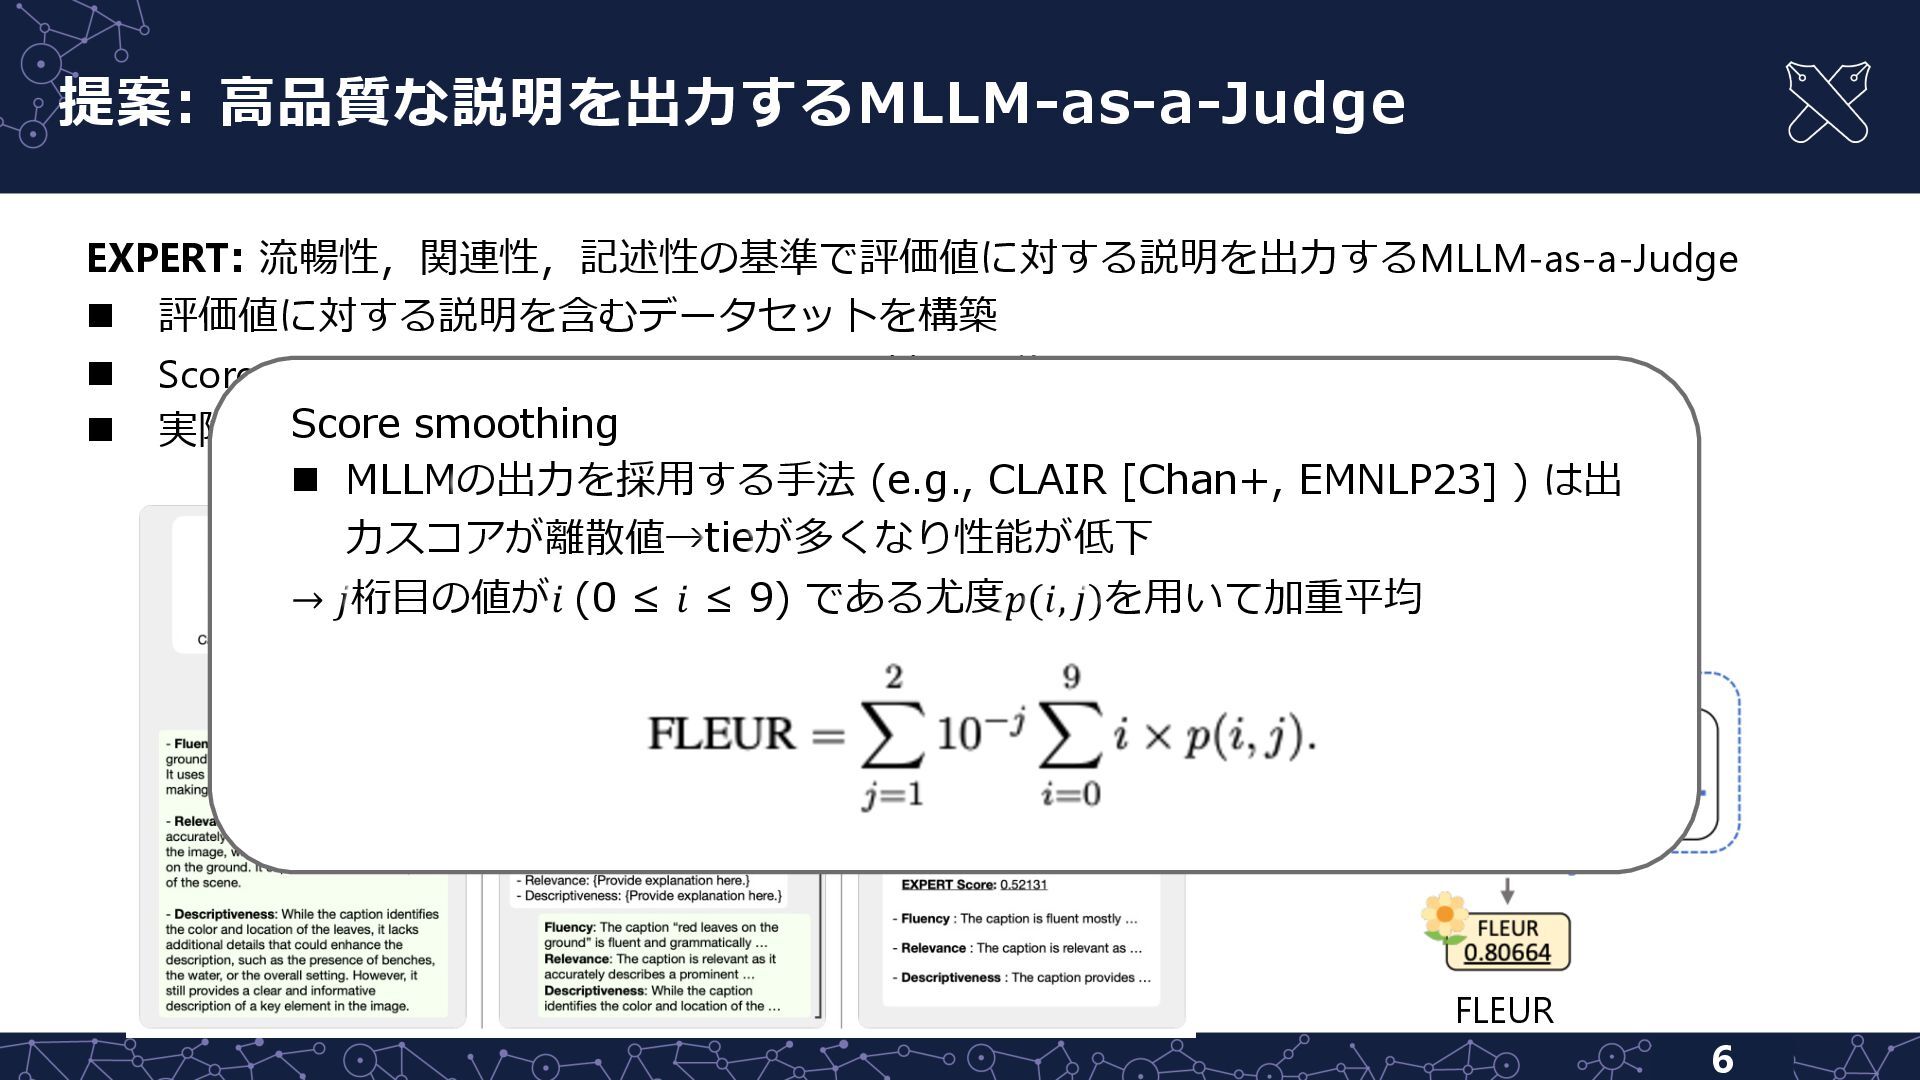
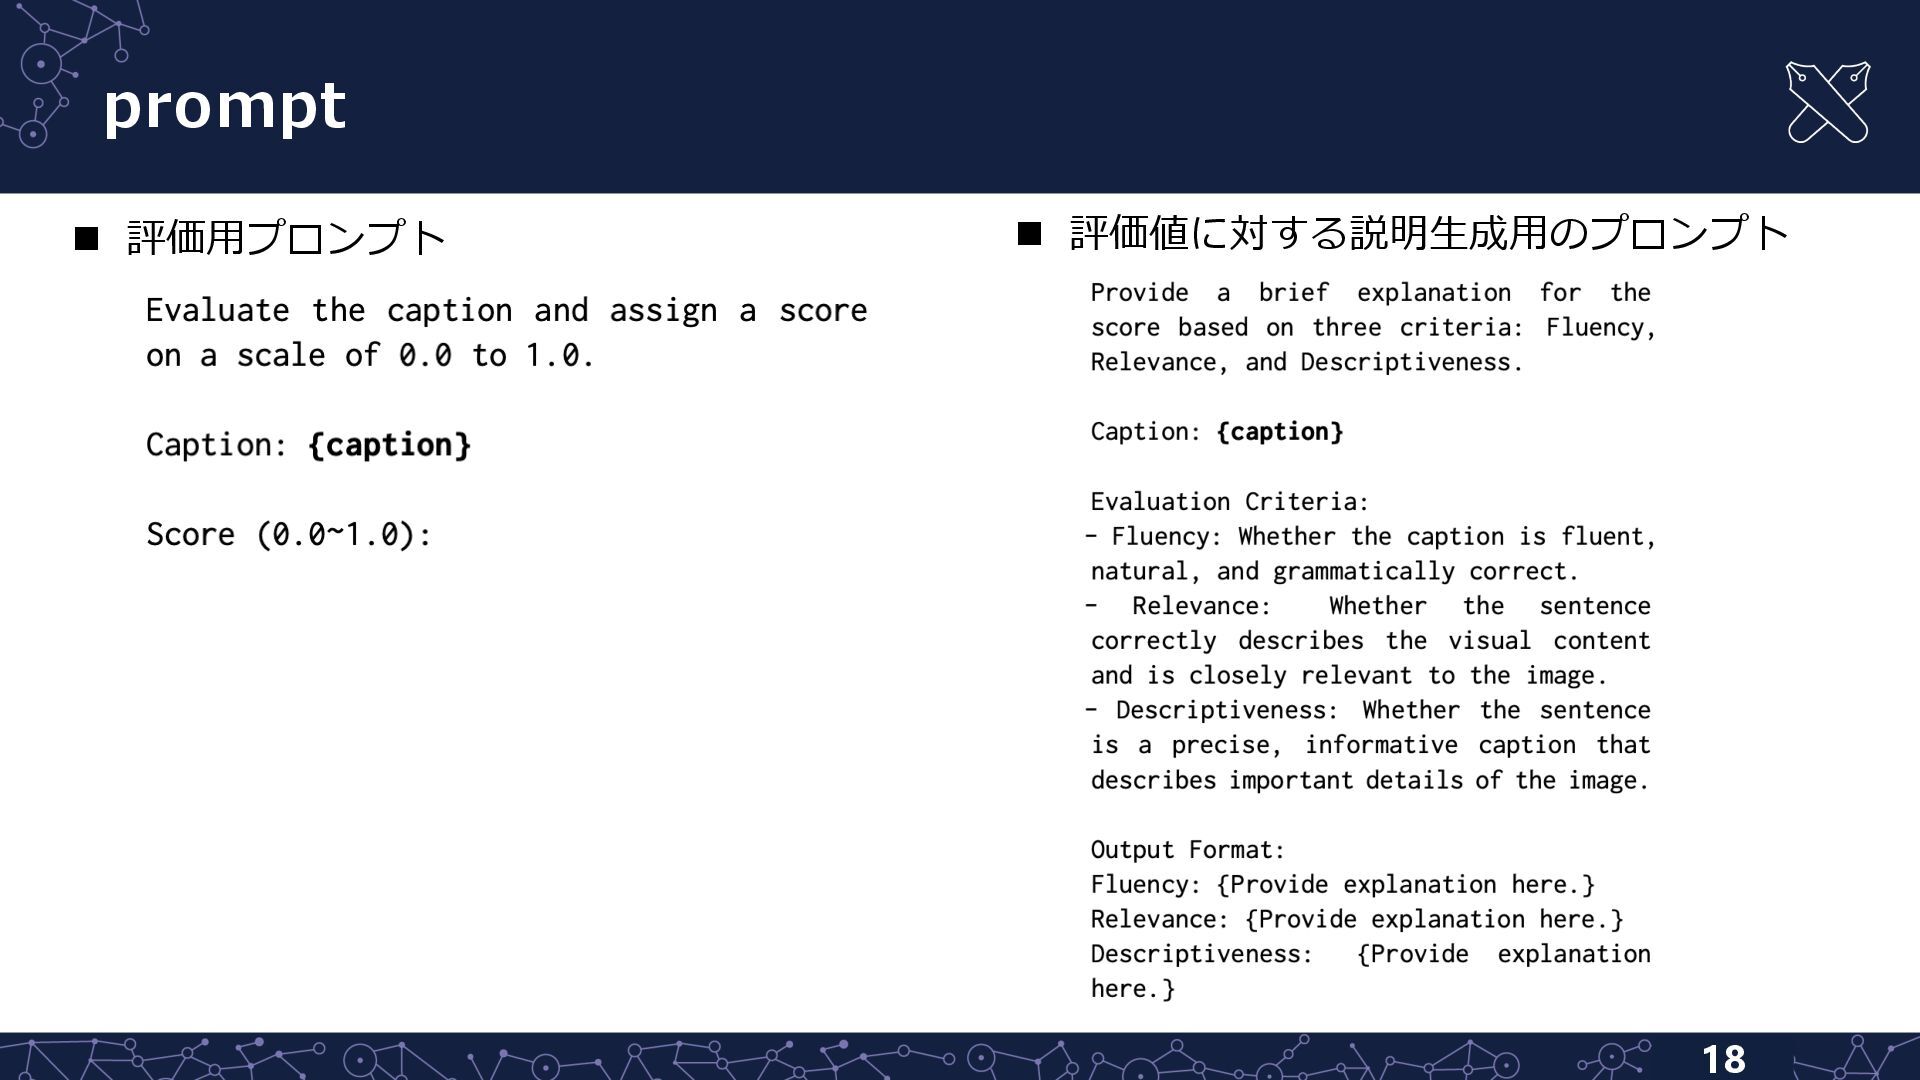
  5. 提案: ⾼品質な説明を出⼒するMLLM-as-a-Judge 6 EXPERT: 流暢性,関連性,記述性の基準で評価値に対する説明を出⼒するMLLM-as-a-Judge n 評価値に対する説明を含むデータセットを構築 n Score Binningしたスコアとそのスコアに対する説明を⽤いてSFT

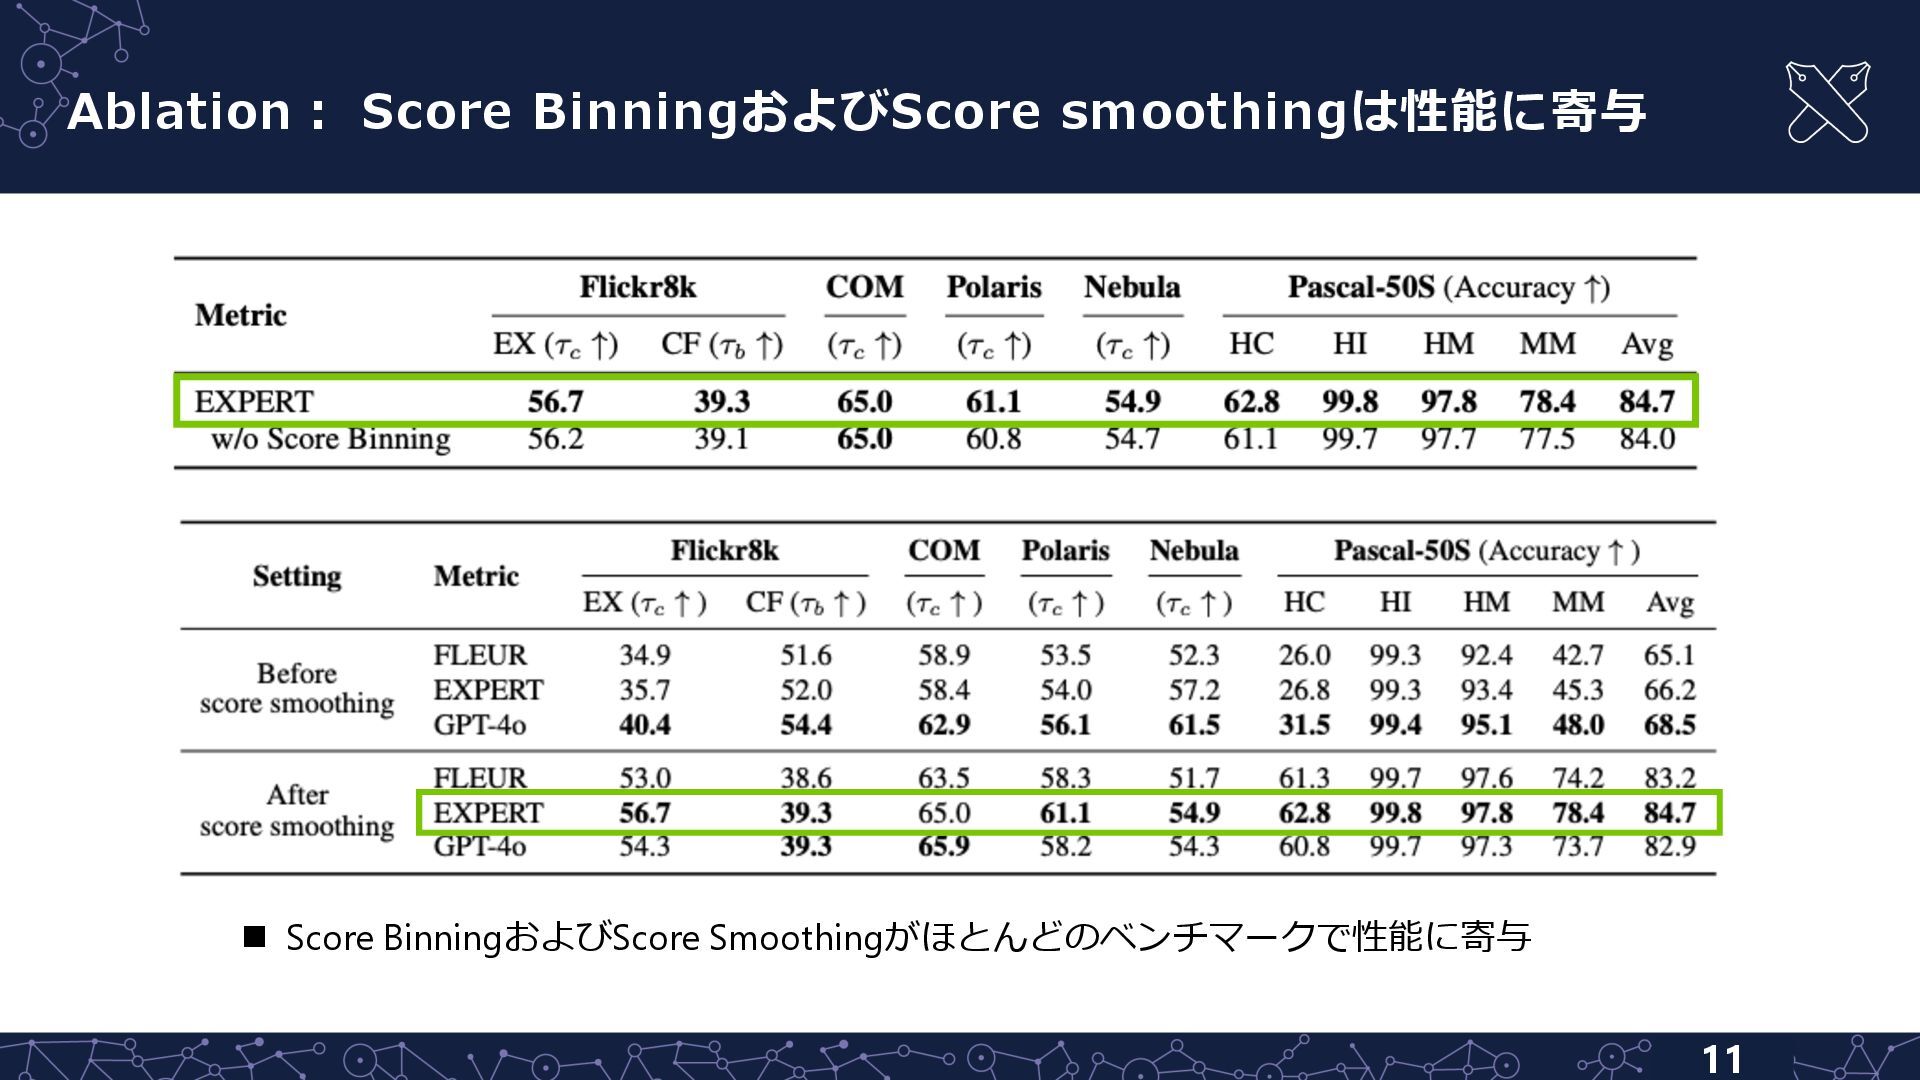
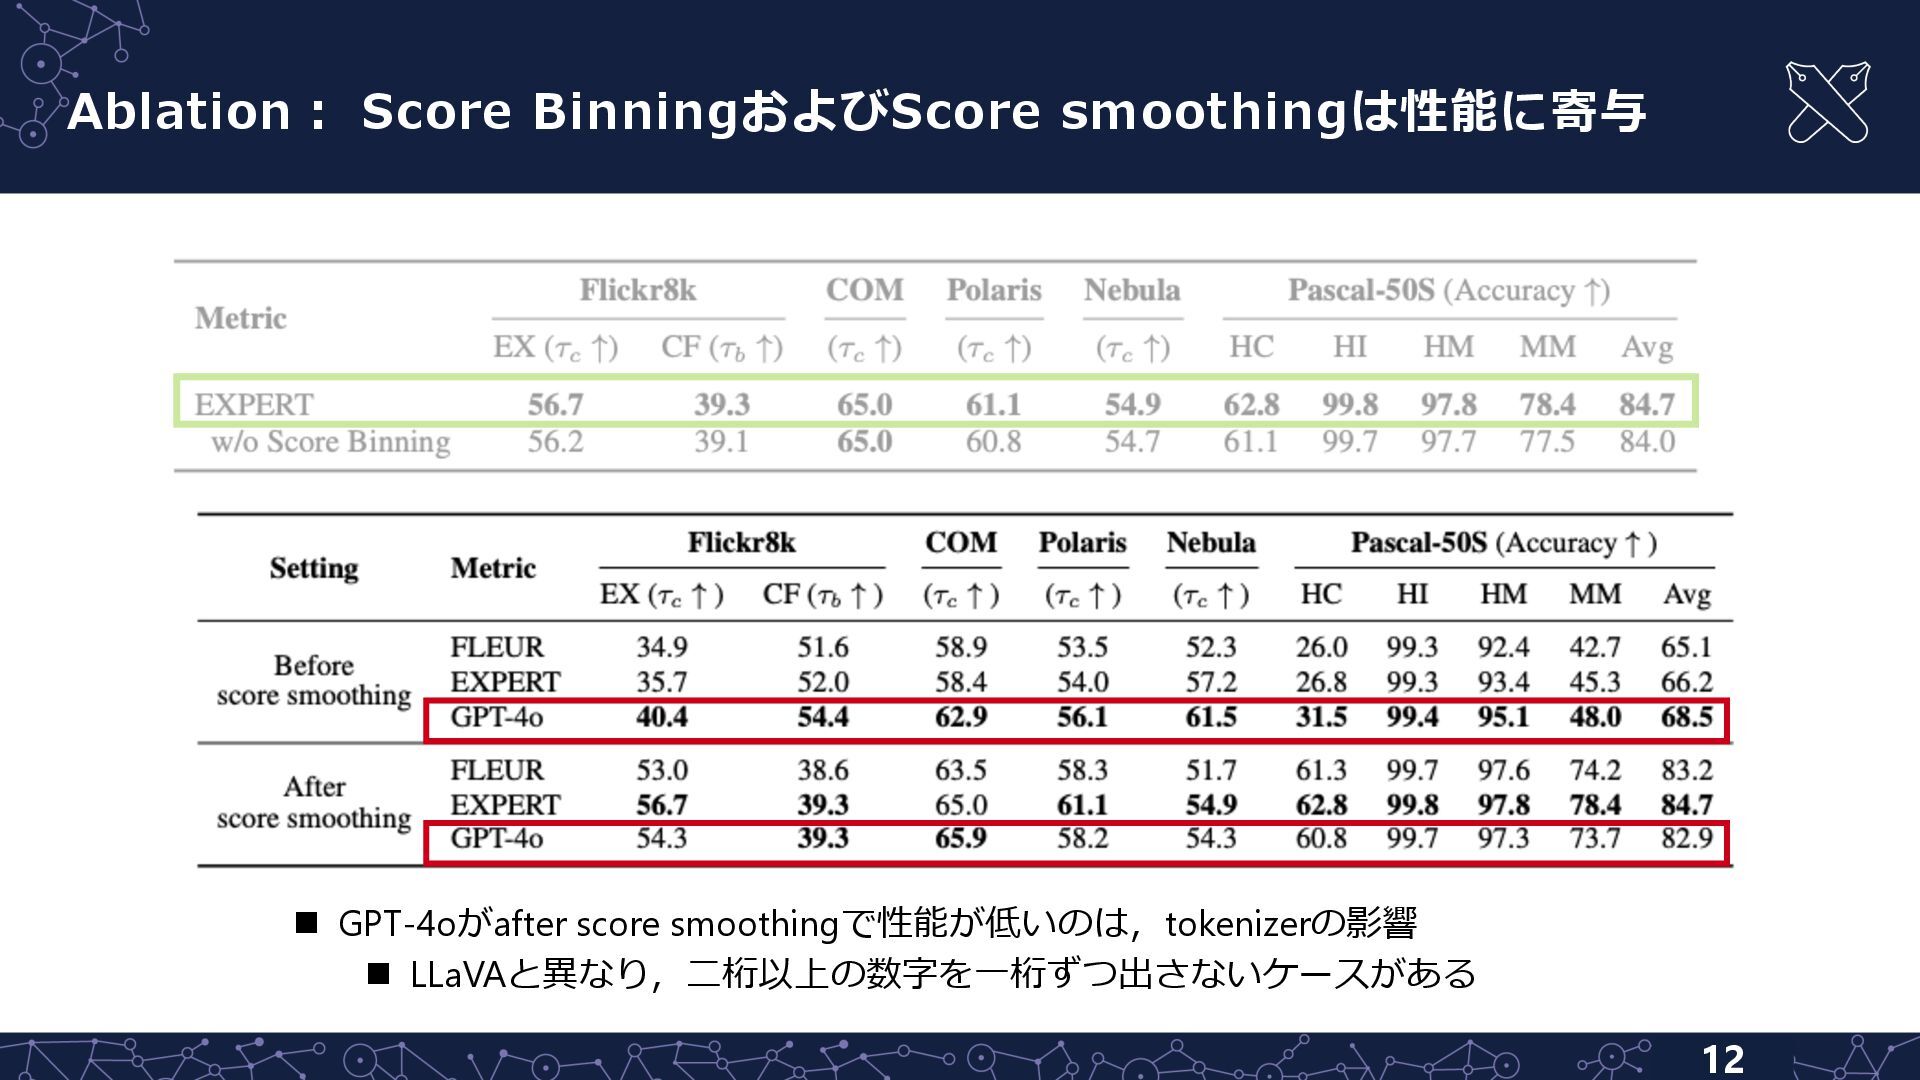
    n 実際の評価時は,score smoothing(各出⼒トークンの尤度で加重平均)を適⽤ FLEUR Score smoothing n MLLMの出⼒を採⽤する⼿法 (e.g., CLAIR [Chan+, EMNLP23] ) は出 ⼒スコアが離散値→tieが多くなり性能が低下 → 𝑗桁⽬の値が𝑖 (0 ≤ 𝑖 ≤ 9) である尤度𝑝(𝑖, 𝑗)を⽤いて加重平均
  6. 提案: スコアに対する説明を含むデータセット 7 L 既存の画像キャプション⽣成の評価尺度⽤のデータセットは評価値に対する説明を含まない →Polaris [Wada+, CVPR24], Nebula [Matsuda+,

    ACCV24] を拡張したPolaris-exp, Nebula-expデータセッ トを構築 構築⼿順 1. 流暢さ,関連性,記述性についての説明を各キャプションごとにGPT-4oで作成 2. 品質の保証のため,サブセット (100サンプル) の品質を⼈⼿評価 n 全ての観点で平均3.7/4以上→⾼品質 ⽣成された説明の⼈⼿評価
  7. 提案: Polaris-exp, Nebula-expを⽤いてMLLMをSFT 8 n Polaris-exp, Nebula-expの評価値および理由を⽤いてLoRA [Edward+, ICLR22] でFine-Tuning

    n Score binning n ⼈⼿評価は複数のアノテータによる評価値を平均化→⼩数点以下が⻑い値の傾向 L MLLMは評価値の各桁を個別のトークンとして扱うため,些細な数値の違い(e.g., 0.59375 vs 0.60)は不必要に複雑で,学習しづらい可能性 J 事前にscore binningを⾏い安定して性能向上 スコアの理由のデータ スコアのデータ
  8. 実験設定 9 n MLLM n LLaVA-1.5 [Liu+, NeurIPS23] n 学習設定

    n エポック数︓1 n バッチサイズ︓8 n ベンチマーク n Flickr8k-Expert & Flickr8k-CF [Hodosh+, IJCAI13], Composite [Hodosh+, IJCAI15], Polaris [Wada+, CVPR24], Nebula [Matsuda+, ACCV24], Pascal-50S [Vedantam+, CVPR15] n 実験環境 n NVIDIA A100 GPU n SFTに2h LLaVA-1.5
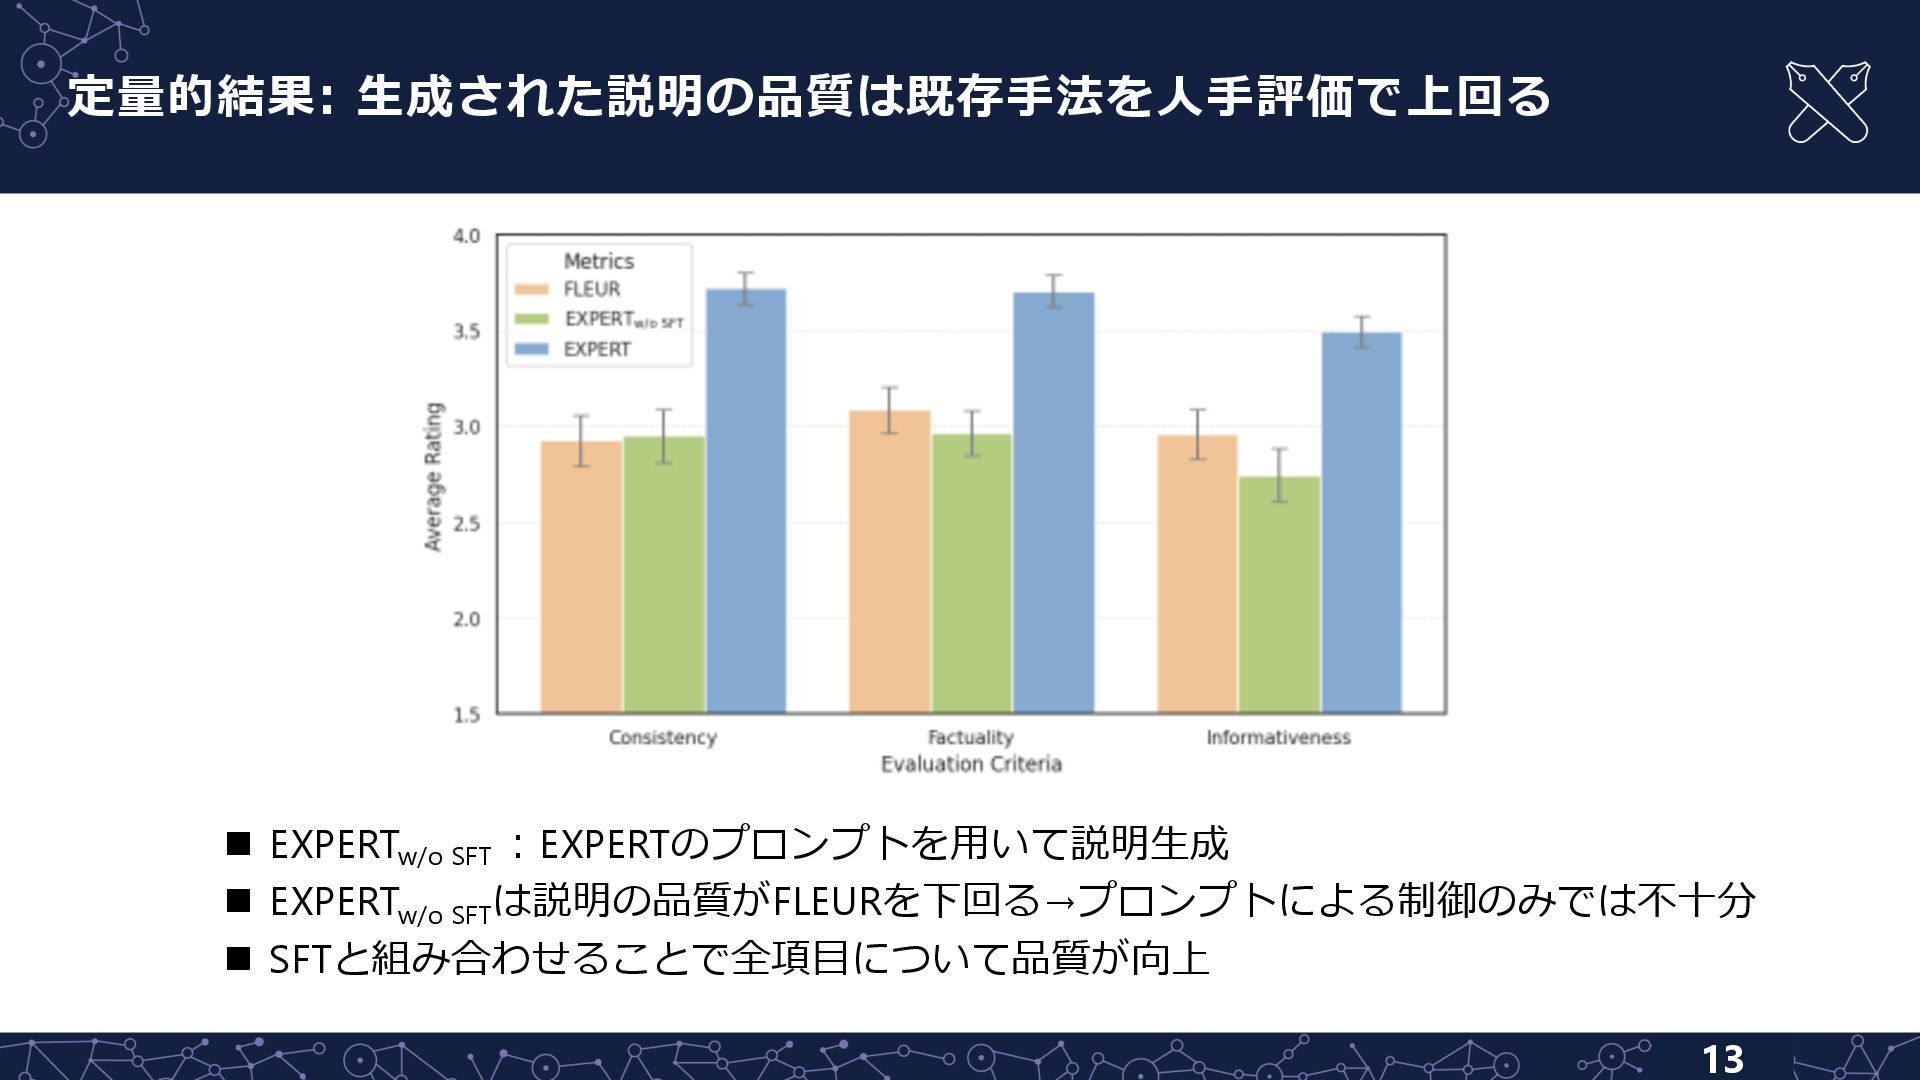
  9. 定量的結果: ⽣成された説明の品質は既存⼿法を⼈⼿評価で上回る 13 n EXPERTw/o SFT ︓EXPERTのプロンプトを⽤いて説明⽣成 n EXPERTw/o SFT

    は説明の品質がFLEURを下回る→プロンプトによる制御のみでは不⼗分 n SFTと組み合わせることで全項⽬について品質が向上
  10. まとめ 16 背景 n 画像キャプション⽣成の既存評価尺度は評価値の説明の品質に課題 n 既存のデータセットは評価値に対する説明の含まない 提案 n Polaris-exp,

    Nebula-exp︓評価値に対する説明を含むデータセット n EXPERT︓⾼品質な説明を出⼒するMLLM-as-a-Judge 結論 n ほとんどのベンチマークで既存⼿法を上回る n 評価値に対する説明の品質で,既存⼿法を上回る

More Decks by Semantic Machine Intelligence Lab., Keio Univ.

Other Decks in Technology