Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
[Journal club] Parallel Vertex Diffusion for Un...
Search
Sponsored
·
SiteGround - Reliable hosting with speed, security, and support you can count on.
→
Semantic Machine Intelligence Lab., Keio Univ.
PRO
March 07, 2024
Technology
1.5k
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
[Journal club] Parallel Vertex Diffusion for Unified Visual Grounding
Semantic Machine Intelligence Lab., Keio Univ.
PRO
March 07, 2024
More Decks by Semantic Machine Intelligence Lab., Keio Univ.
See All by Semantic Machine Intelligence Lab., Keio Univ.
[EMNLP26] RIGEL: Self-Distilled Score Adaptation for Image and Video Captioning Evaluation
keio_smilab
PRO
0
65
[RSJ26] Building a VLA Model Based on Self-Distilled Classification
keio_smilab
PRO
0
210
[RSJ26] AnoleVLA: Lightweight Vision-Language-Action Model with Deep State Space Models for Mobile Manipulation
keio_smilab
PRO
0
180
[RSJ26] NarrativeFlow: Flow-Based Vision-Language-Action Model Using Robot Velocity Fields
keio_smilab
PRO
0
250
[RSJ26] Flow as Flow: Modeling Robot Velocity Fields as Probability Velocity Fields
keio_smilab
PRO
1
240
[RSJ26] Hierarchy-Aware Multimodal Retrieval-Augmented Generation for Embodied Question Answering
keio_smilab
PRO
1
200
[MIRU26] Open-Vocabulary Intention-Guided Object Detection in Diverse Scenes
keio_smilab
PRO
0
250
[Journal club] Evo-1: Lightweight Vision-Language-Action Model with Preserved Semantic Alignment
keio_smilab
PRO
0
74
[MIRU26] To What Extent Does MLLM-as-a-Judge Exhibit Cross-Model Preference Bias?
keio_smilab
PRO
0
330
Other Decks in Technology
See All in Technology
Refining Active Record
shugo
0
160
Railsで挑む大量データ永続化 〜600億件を永続化するための設計とボトルネックとの戦い〜
occhi
1
750
トークン化預金DCJPYの取り組みと活用ユースケース
finengine
0
150
AI コーディングと人間の認知スループット / CTO Night & Day 2026 Morning Session / AI Coding and Human Cognitive Throughput
prog893
5
1.3k
コンテナ運用におけるネットワーク・コンテナコストの削減方法/How to Reduce Network and Container Costs in Container Operations
masakiokuda
2
300
PagerDuty Tech Hub-鳴らすけれど、人は動かない
ezaki
0
180
Conditional PED-ANOVA: Hyperparameter Importance in Hierarchical & Dynamic Search Spaces
pfn
PRO
0
140
V8のArray.prototype.flatを最大約20倍速くするまでと、巨大OSSへの大規模コミットの道のり
riyaamemiya
0
300
スキマバイトという雇用形態は存在しないので、雇用期間1日のアルバイト契約を事業者とワーカーが結ぶ手続きを支えるのがタイミーなんです
akitoshiga
0
210
実体験から学ぶ分析エージェントの開発と運⽤
recruitengineers
PRO
8
2.4k
Post AI時代のリファクタリング実践記 / Refactoring in the post AI era
kaminashi
1
280
"優秀な誰か"の下位互換にならないために
yut0naga1_fa
1
1.8k
Featured
See All Featured
Measuring Dark Social's Impact On Conversion and Attribution
stephenakadiri
2
310
How To Stay Up To Date on Web Technology
chriscoyier
790
250k
Optimizing for Happiness
mojombo
378
71k
How STYLIGHT went responsive
nonsquared
100
6.3k
DBのスキルで生き残る技術 - AI時代におけるテーブル設計の勘所
soudai
PRO
68
58k
Done Done
chrislema
187
17k
Build The Right Thing And Hit Your Dates
maggiecrowley
39
3.5k
Statistics for Hackers
jakevdp
799
230k
The untapped power of vector embeddings
frankvandijk
2
1.9k
A better future with KSS
kneath
240
18k
Learning to Love Humans: Emotional Interface Design
aarron
275
41k
Crafting Experiences
bethany
1
380
Transcript
Parallel Vertex Diffusion for Unified Visual Grounding 慶應義塾大学 杉浦孔明研究室 畑中駿平
Cheng, Z. et al. "Parallel Vertex Diffusion for Unified Visual Grounding." AAAI, 2024. Zesen Cheng1 Kehan Li1 Peng Jin1 Xiangyang Ji3 Li Yuan1,2 Chang Liu3† Jie Chen1,2† 1 School of Electronic and Computer Engineering, Peking University 2 Peng Cheng Laboratoy 3 Tsinghua Universiy † Corresponding author AAAI2024
▸ Visual grounding:与えられた参照表現を画像に接地させること ▹ 画像とテキスト間の細かい対応を確立することが可能 [Li+, CVPR22] ▸ Visual groundingは2つのサブタスクに分類
▹ Referring Expression Comprehension (REC) [Hu+, CVPR16]:bboxで予測 ▹ Referring Expression Segmentation (RES) [Hu+, ECCV16]:マスクで予測 2 背景:Visual groundingはvision-language分野のタスクで 重要なタスクである [Hu+, CVPR16] [Hu+, ECCV16]
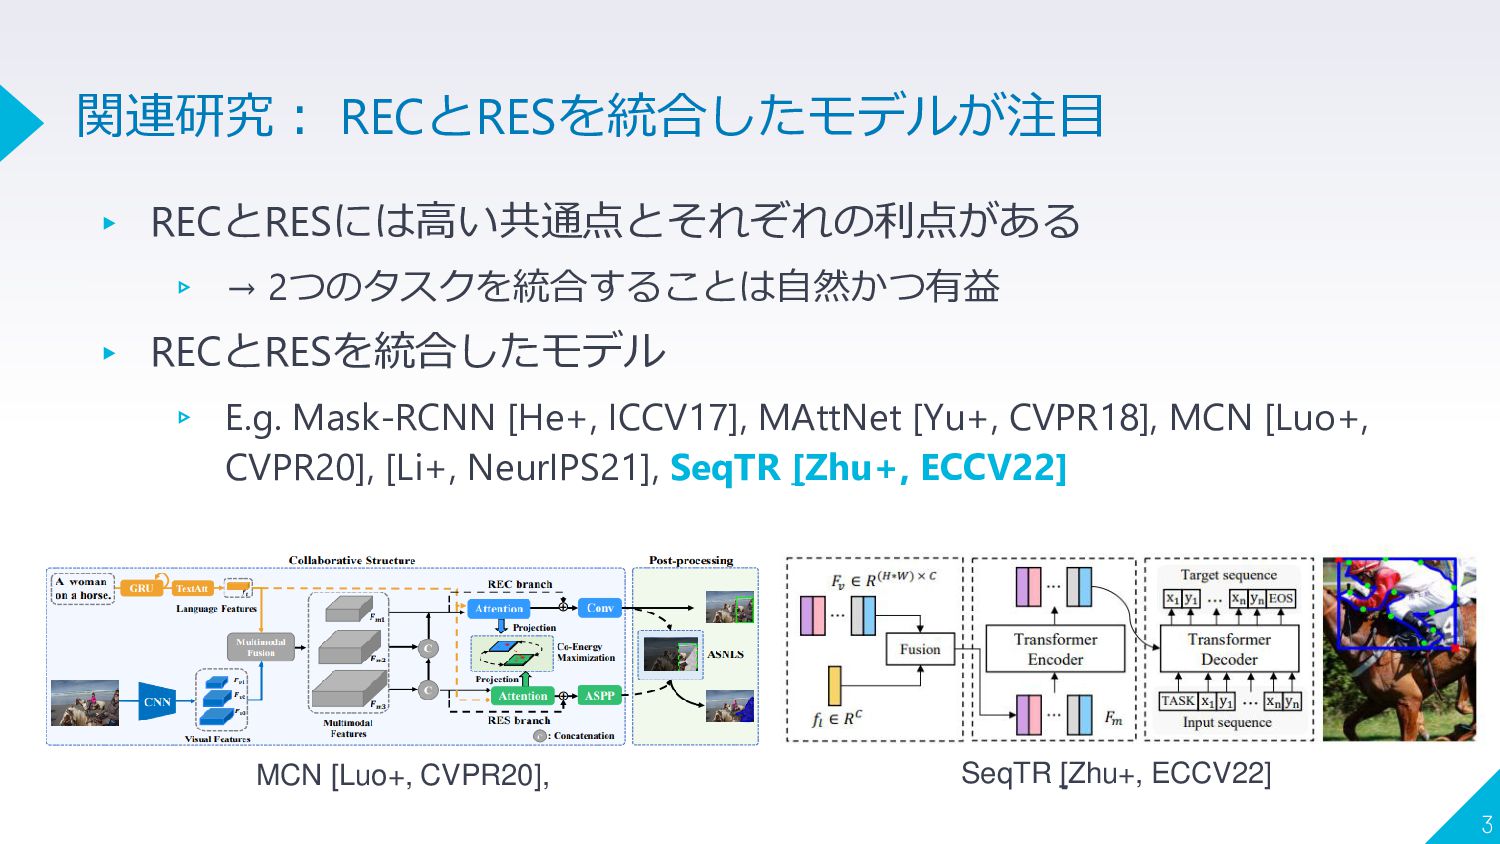
▸ RECとRESには高い共通点とそれぞれの利点がある ▹ → 2つのタスクを統合することは自然かつ有益 ▸ RECとRESを統合したモデル ▹ E.g. Mask-RCNN
[He+, ICCV17], MAttNet [Yu+, CVPR18], MCN [Luo+, CVPR20], [Li+, NeurIPS21], SeqTR [Zhu+, ECCV22] 3 関連研究: RECとRESを統合したモデルが注目 MCN [Luo+, CVPR20], SeqTR [Zhu+, ECCV22]
▸ SeqTR [Zhu+, ECCV22]:自己回帰モデル (Pix2Seq [Chen+, ICLR21]) によってRECとRESを同時に自己回帰頂点生成問題としてモデル化 ▸ SeqTRの問題点
▹ 頂点列の上流の精度が十分でない場合,誤差が増大する ▹ 高次元になると生成のための反復回数が増加し推論に時間がかかる 4 既存手法の問題点:自己回帰モデルの逐次頂点生成は性能 の上限に制限がある テキスト:“center baseman”
▸ SeqTR [Zhu+, ECCV22]:自己回帰モデル (Pix2Seq [Chen+, ICLR21]) によってRECとRESを同時に自己回帰頂点生成問題としてモデル化 ▸ SeqTRの問題点
▹ 頂点列の上流の精度が十分でない場合,誤差が増大する ▹ 高次元になると生成のための反復回数が増加し推論に時間がかかる 5 既存手法の問題点:自己回帰モデルの逐次頂点生成は性能 の上限に制限がある テキスト:“center baseman” 最初の頂点が右側の野球選手に予測 するとその後のリカバリーが困難
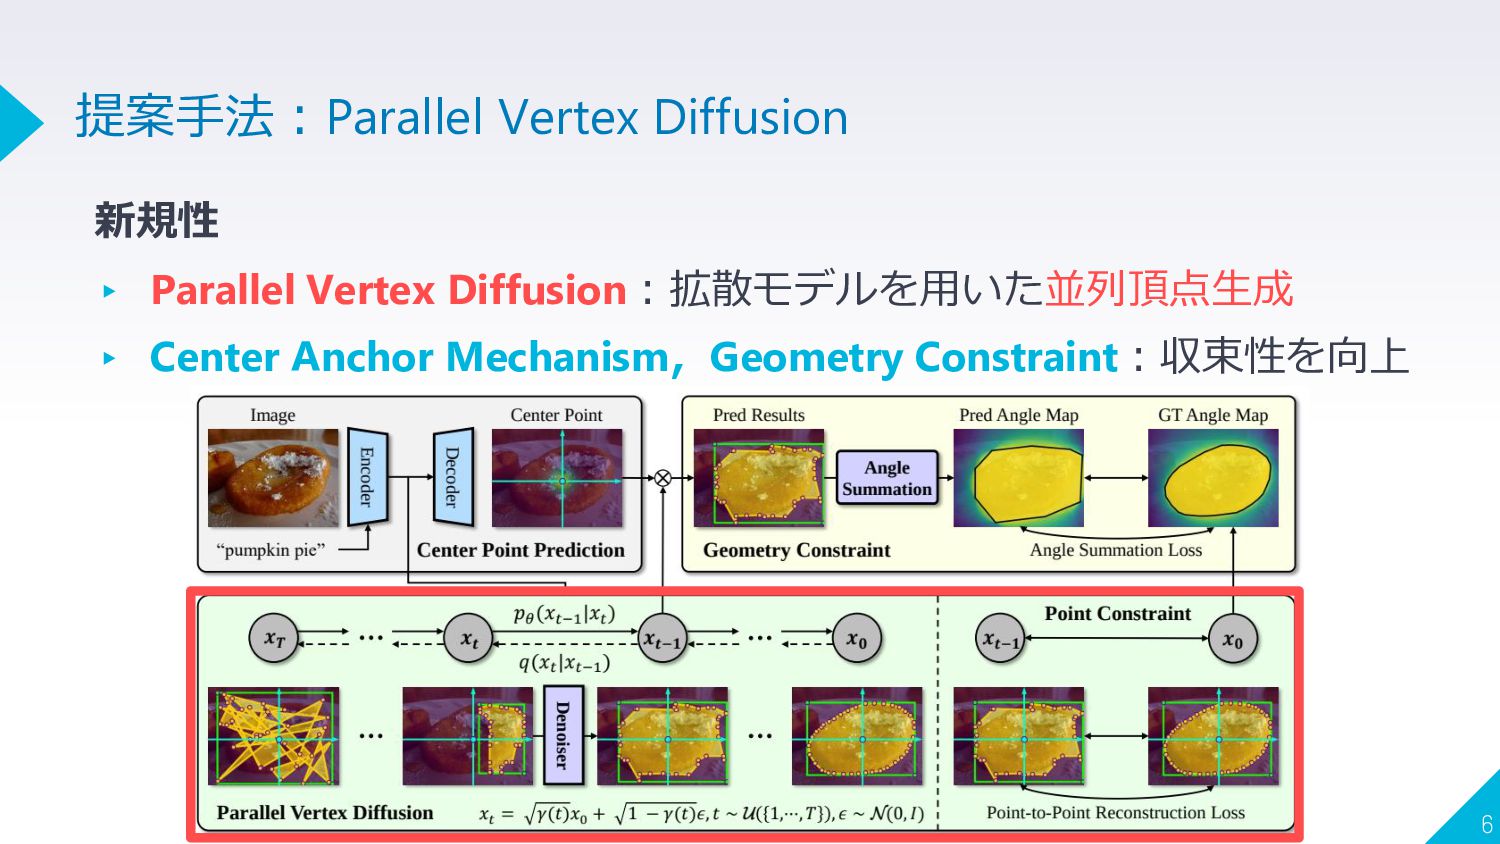
新規性 ▸ Parallel Vertex Diffusion:拡散モデルを用いた並列頂点生成 ▸ Center Anchor Mechanism,Geometry Constraint:収束性を向上
6 提案手法:Parallel Vertex Diffusion
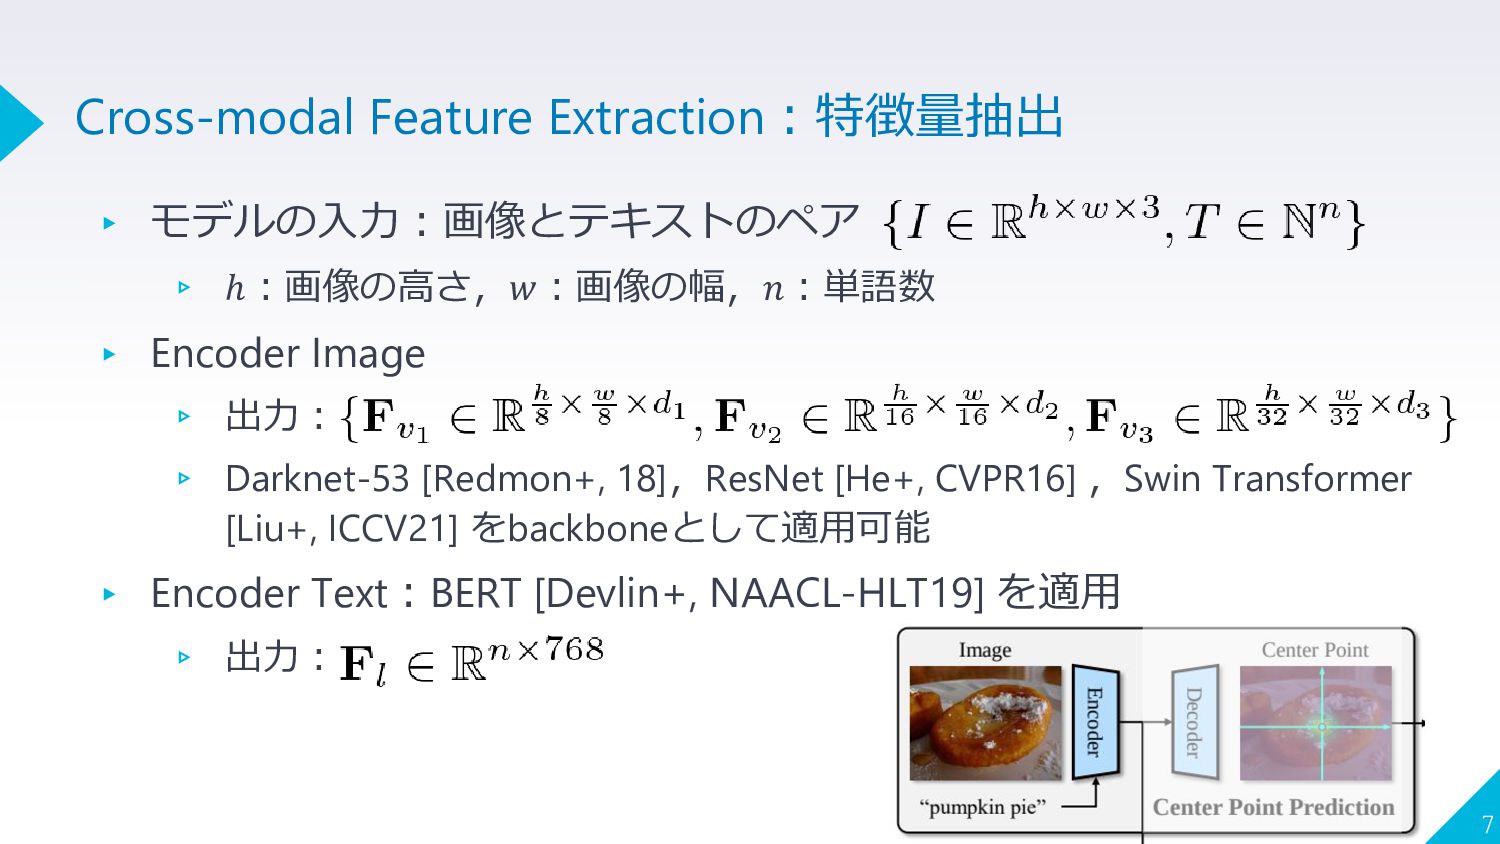
▸ モデルの入力:画像とテキストのペア ▹ ℎ:画像の高さ,𝑤:画像の幅,𝑛:単語数 ▸ Encoder Image ▹ 出力: ▹
Darknet-53 [Redmon+, 18],ResNet [He+, CVPR16] ,Swin Transformer [Liu+, ICCV21] をbackboneとして適用可能 ▸ Encoder Text:BERT [Devlin+, NAACL-HLT19] を適用 ▹ 出力: 7 Cross-modal Feature Extraction:特徴量抽出
▸ 𝑖層目の画像特徴量 と をSeqTRとMSDeformAttn [Zhu+, ICLR21] をベースに融合し を得る ▸ ▹
MLP:全結合層 ▹ 𝜎:活性化関数 ▹ ⨀:アダマール積 8 Cross-modal Feature Extraction:特徴量抽出 SeqTRとおなじ形
▸ CAMの動機:中心点を基準に正規化することで座標回帰の難易度が 下がることが期待される [Tian+, ICCV19] ▸ Center Point Prediction:物体の中央点をヒートマップ で予測
▹ : 正解の中心点の座標(正規化済み) ▹ 𝜎:画像サイズに適した標準偏差 9 Center Anchor Mechanism (CAM) :物体の中心点を予測
▸ CAMの動機:中心点を基準に正規化することで座標回帰の難易度が 下がることが期待される [Tian+, ICCV19] ▸ 正解 および予測されたヒートマップ に対してfocal loss
[Lin+, ICCV17] を用いて学習 10 Center Anchor Mechanism (CAM) :物体の中心点を予測
▸ 拡散モデルは効果的なスケーラブルなモデルとして活用 ▹ E.g. 画像生成タスク [Ramesh+, 22],識別タスク [Chen+, ICCV23] ▹
☺ ノイズの次元を変更するだけで,高次元設定の拡張可能 ▸ 拡散モデルを用いて頂点生成をより高次元かつ並列に行う Parallel Vertex Diffusionの提案 ▹ ※ Pix2Seq-D [Chen+, ICCV23] に基づいて構築(以降Denoiserと称す) 11 Parallel Vertex Diffusion:拡散モデルを用いて頂点を洗練
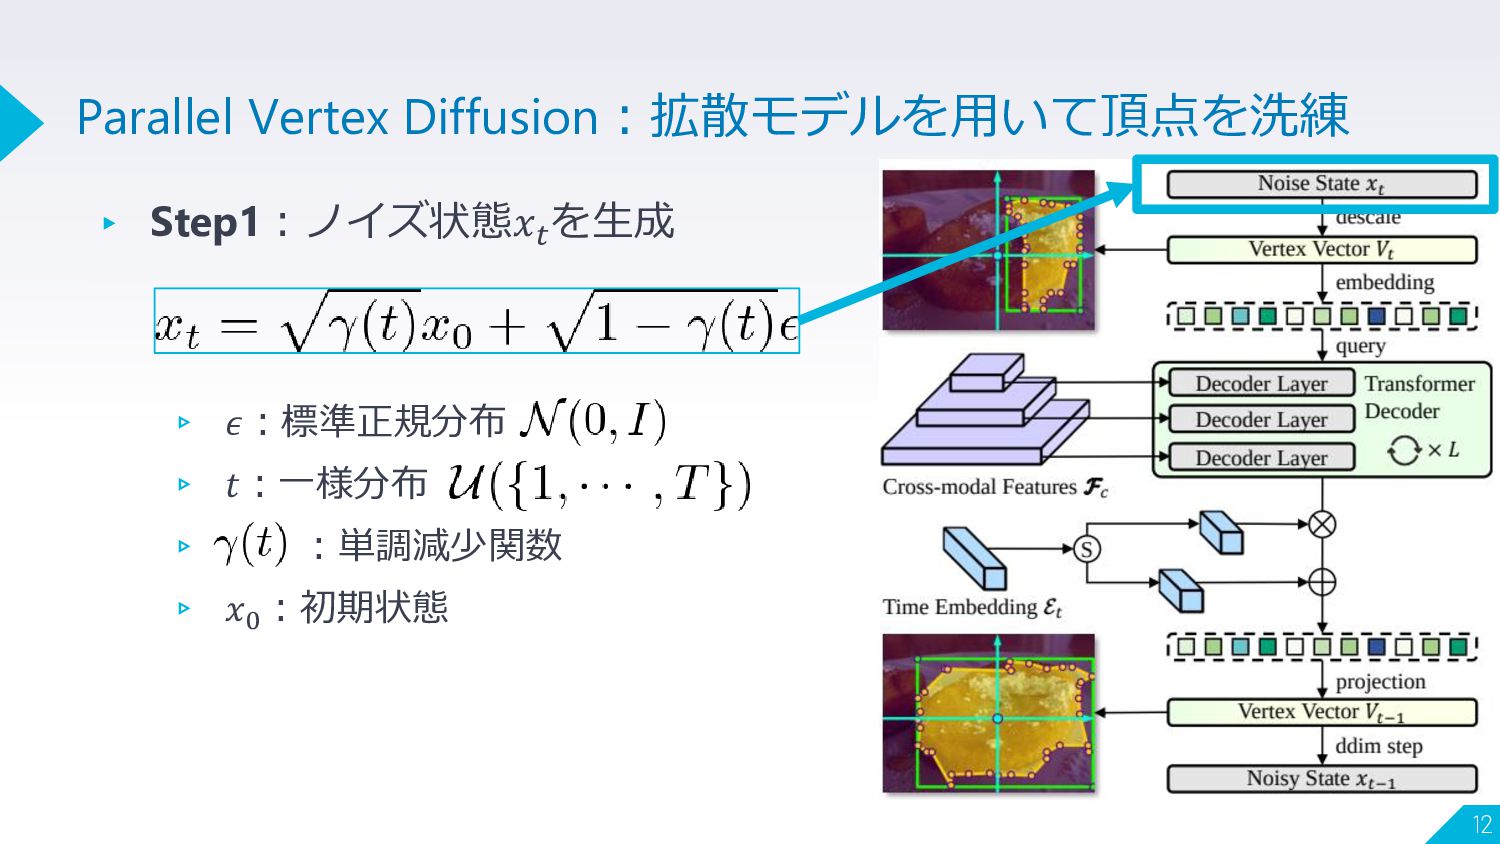
▸ Step1:ノイズ状態𝑥𝑡 を生成 ▹ 𝜖:標準正規分布 ▹ 𝑡:一様分布 ▹ :単調減少関数 ▹
𝑥0 :初期状態 12 Parallel Vertex Diffusion:拡散モデルを用いて頂点を洗練
▸ Step2:𝑥𝑡 を頂点ベクトル𝑉𝑡 に変換 ▸ Denoiserの頂点の正規化座標が [0, 1] のため[-1, 1]→[0,
1]にスケールダウン ▸ 𝑉𝑡 の次元数は(4 + 2𝑁)である ▹ 𝑁:ポリゴンの頂点数 13 Parallel Vertex Diffusion:拡散モデルを用いて頂点を洗練
▸ Step3:𝑉𝑡 を2次元座標埋め込みにより 𝑄𝑡 に変換 [Meng+, ICCV21] 14 Parallel Vertex
Diffusion:拡散モデルを用いて頂点を洗練
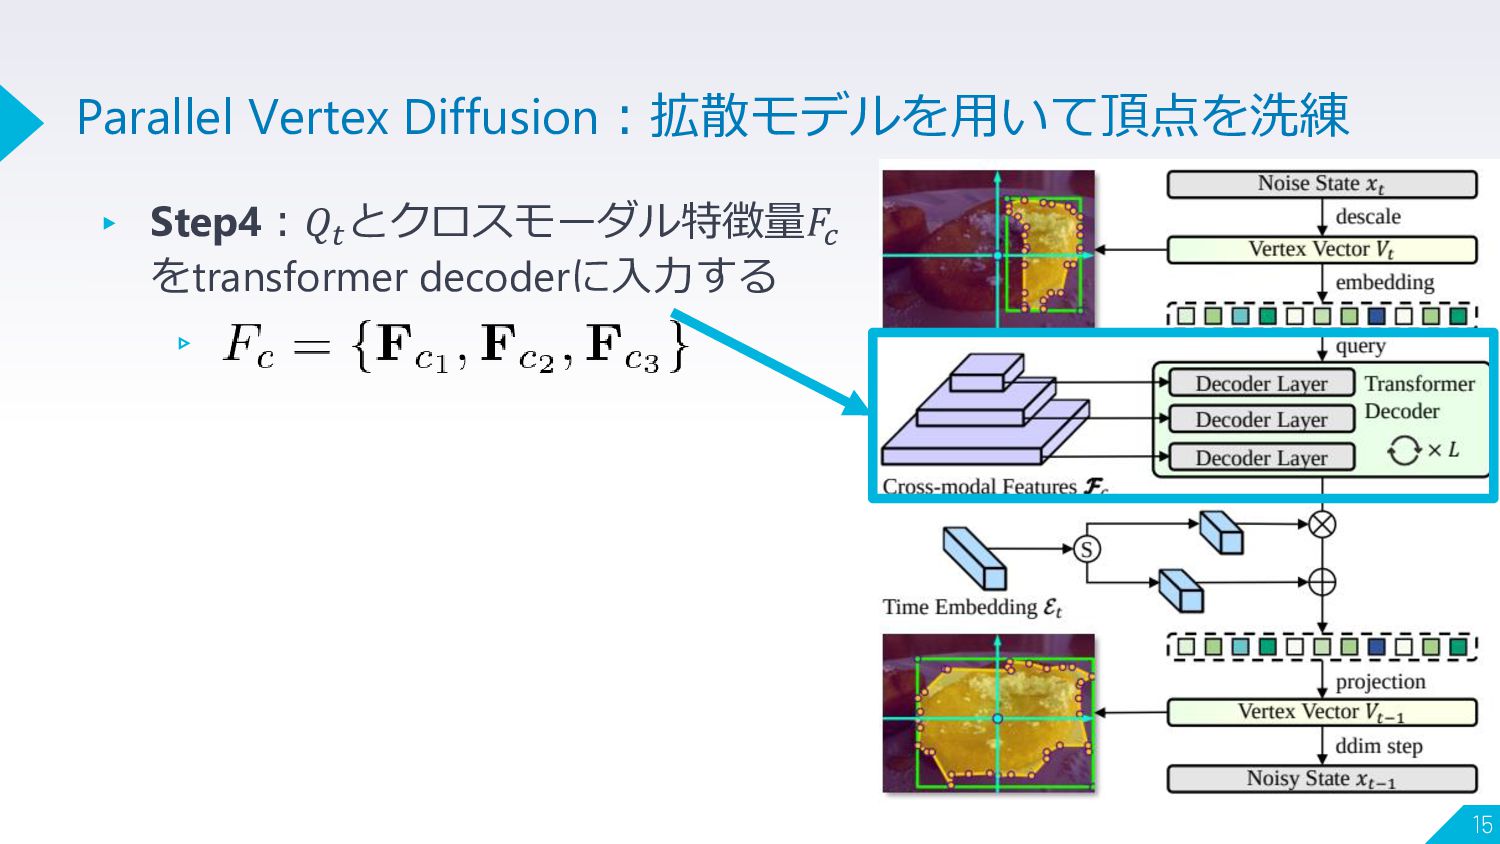
▸ Step4:𝑄𝑡 とクロスモーダル特徴量𝐹𝑐 をtransformer decoderに入力する ▹ 15 Parallel Vertex Diffusion:拡散モデルを用いて頂点を洗練
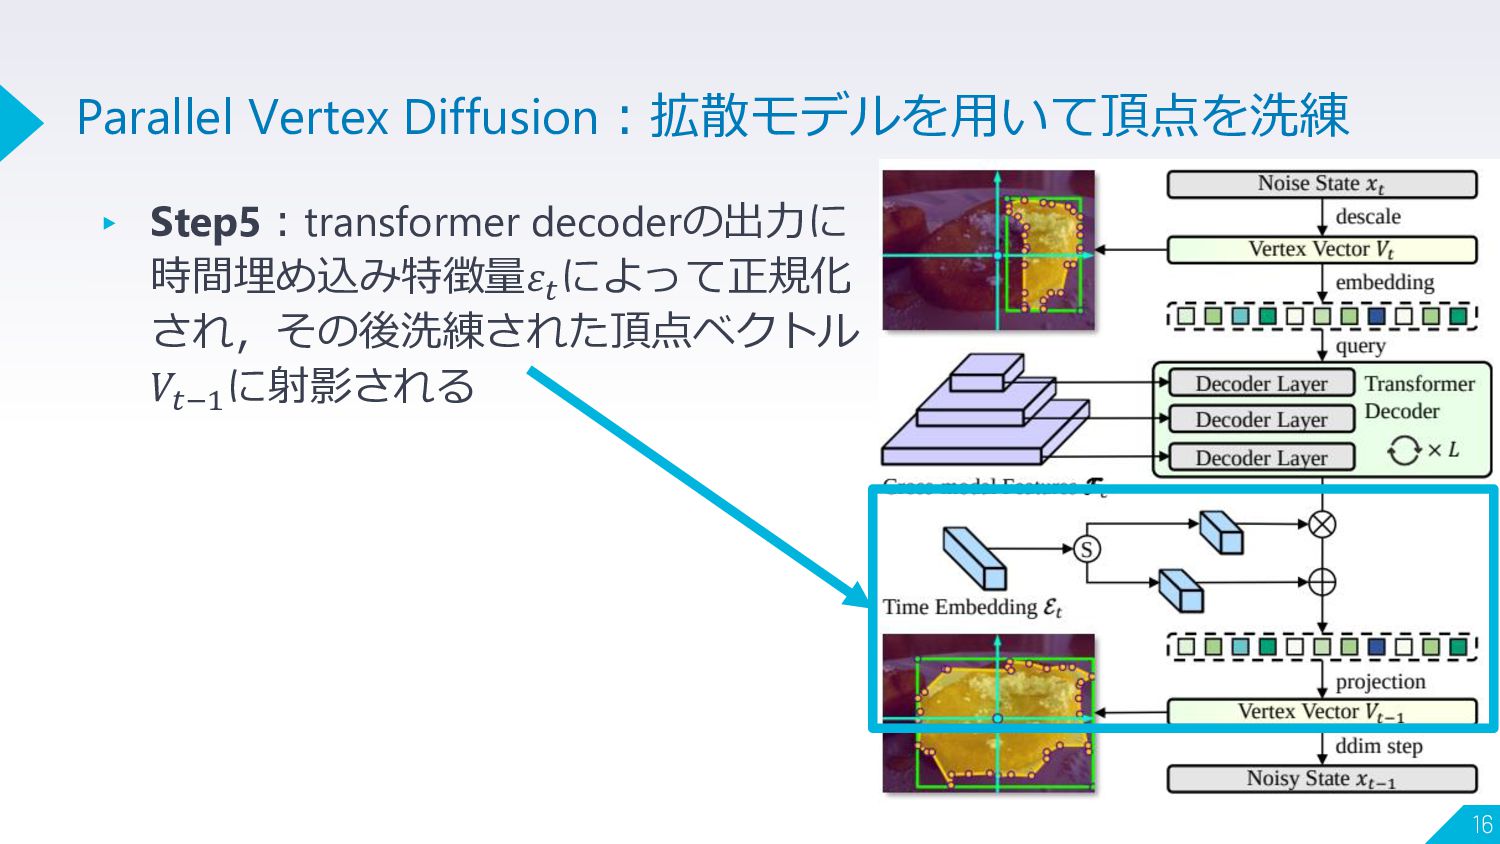
▸ Step5:transformer decoderの出力に 時間埋め込み特徴量𝜀𝑡 によって正規化 され,その後洗練された頂点ベクトル 𝑉𝑡−1 に射影される 16 Parallel
Vertex Diffusion:拡散モデルを用いて頂点を洗練
▸ Step6:次のノイズ状態𝑥𝑡−1 を取得 するために,DDIMステップ [Song+, ICLR21] によって処理される 17 Parallel Vertex
Diffusion:拡散モデルを用いて頂点を洗練
▸ Point Constraintの損失関数 [Chen+, ICLR23] ▹ :パラメータ化されたDenoiser ▹ 各ノイズ状態𝑥𝑡 は初期状態𝑥0
に近づくこと が求められる 18 Parallel Vertex Diffusion:拡散モデルを用いて頂点を洗練
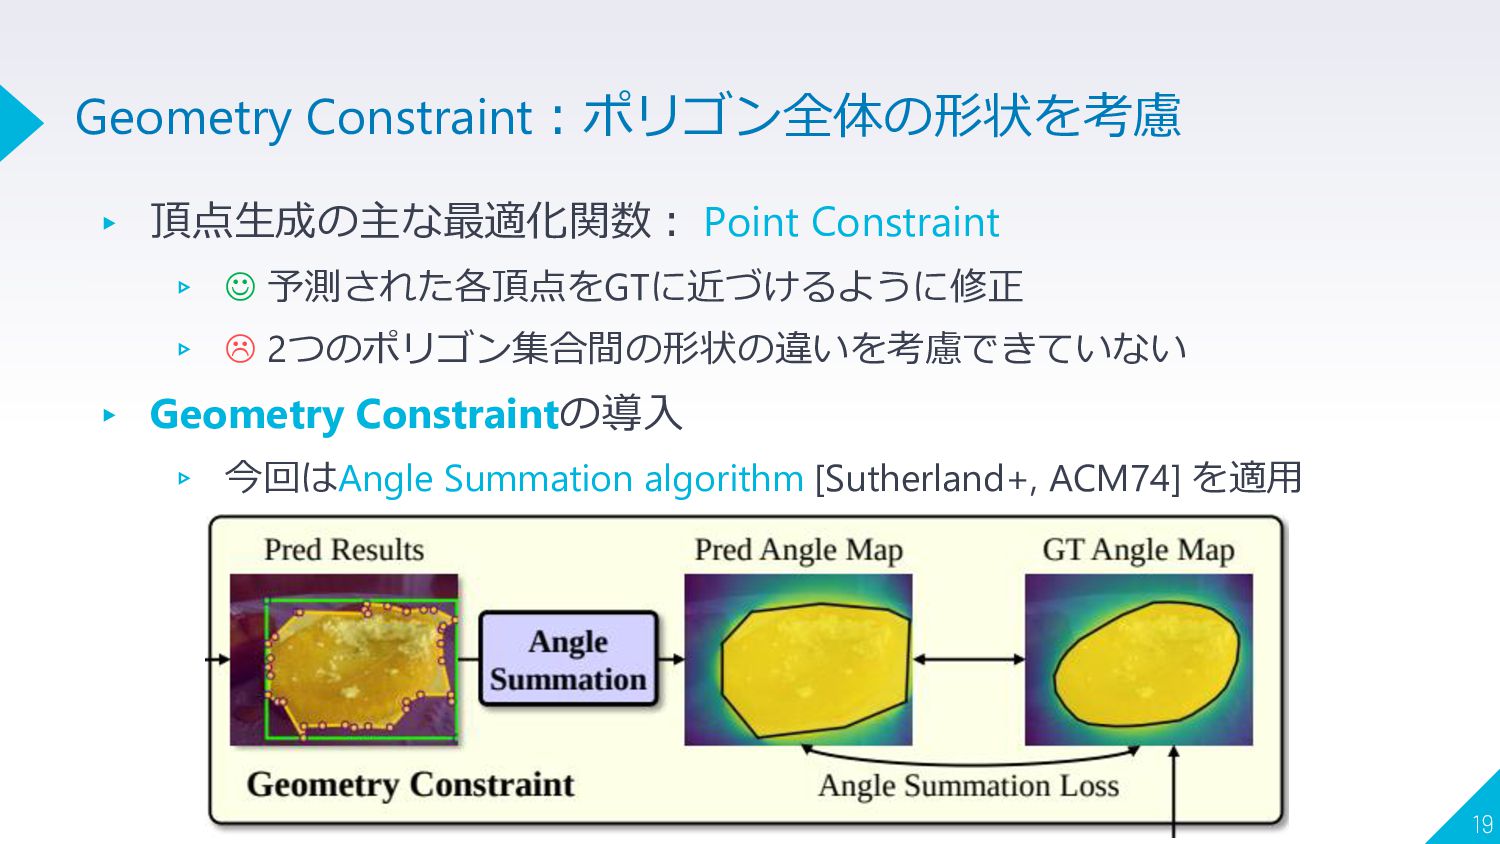
▸ 頂点生成の主な最適化関数: Point Constraint ▹ ☺ 予測された各頂点をGTに近づけるように修正 ▹ 2つのポリゴン集合間の形状の違いを考慮できていない
▸ Geometry Constraintの導入 ▹ 今回はAngle Summation algorithm [Sutherland+, ACM74] を適用 19 Geometry Constraint:ポリゴン全体の形状を考慮
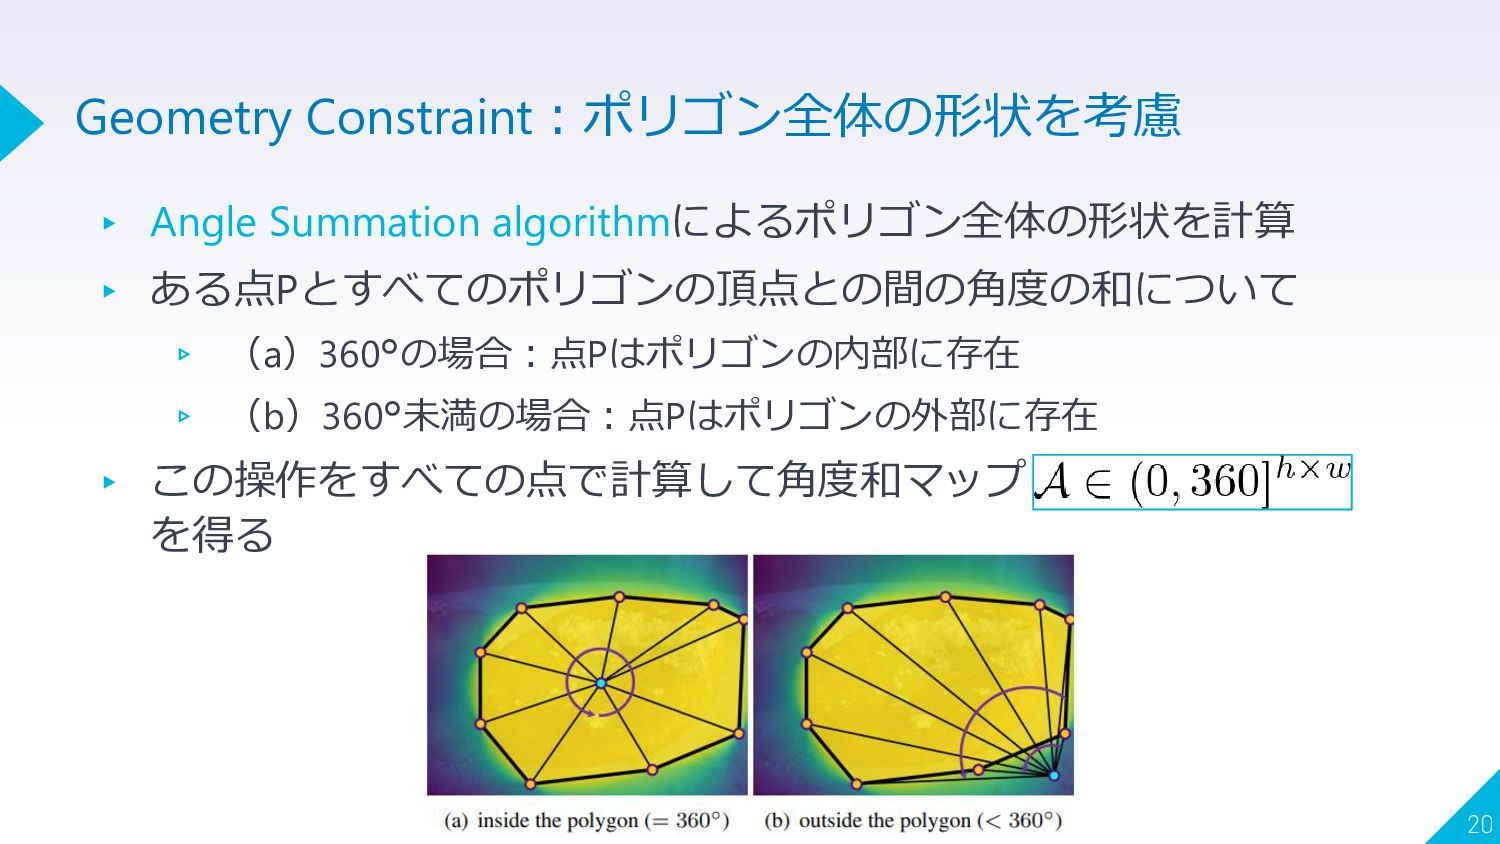
▸ Angle Summation algorithmによるポリゴン全体の形状を計算 ▸ ある点Pとすべてのポリゴンの頂点との間の角度の和について ▹ (a)360°の場合:点Pはポリゴンの内部に存在 ▹ (b)360°未満の場合:点Pはポリゴンの外部に存在
▸ この操作をすべての点で計算して角度和マップ を得る 20 Geometry Constraint:ポリゴン全体の形状を考慮
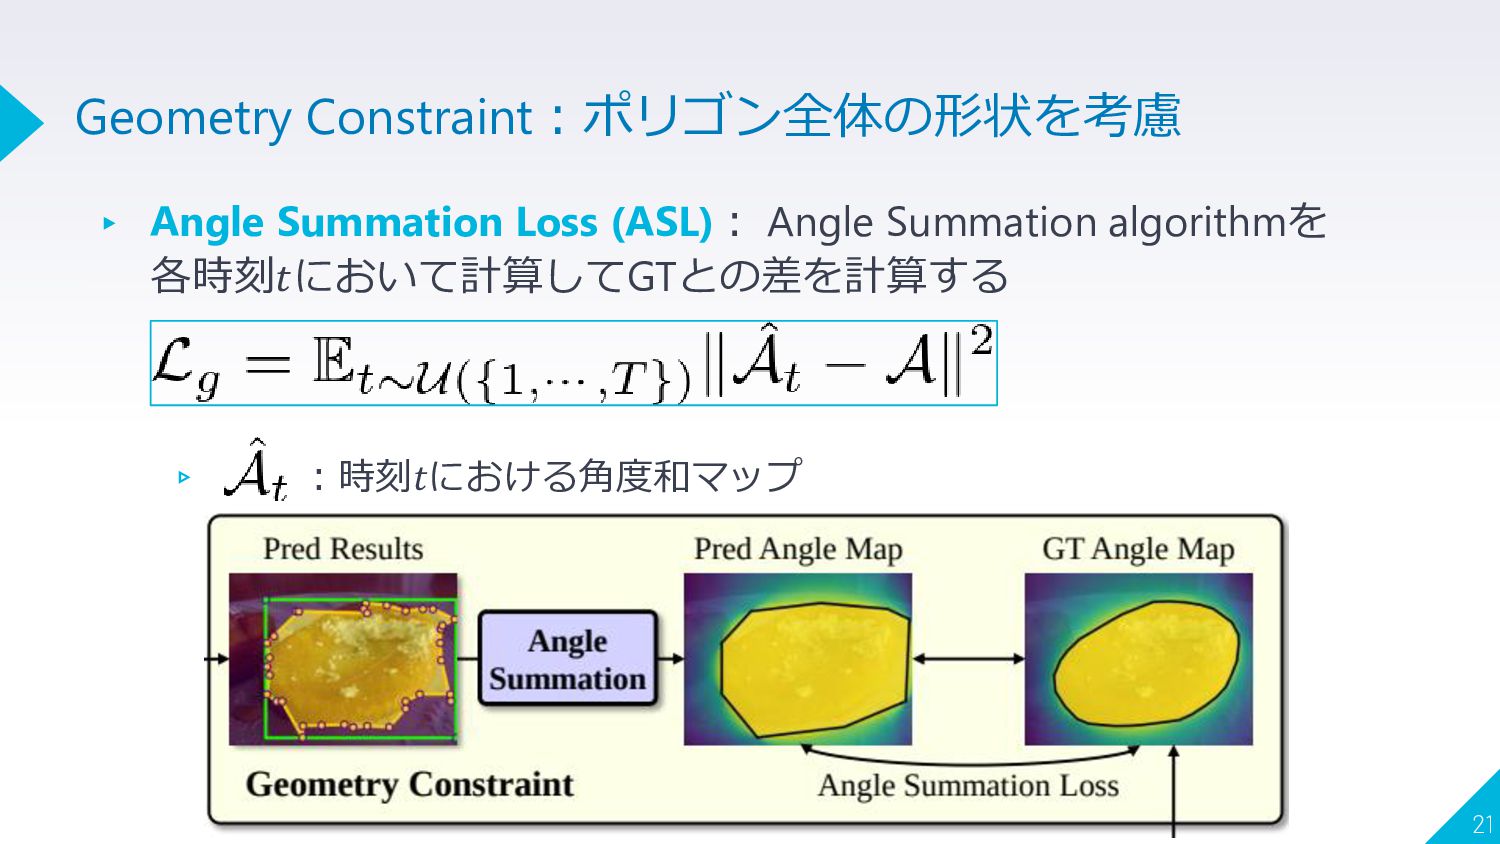
▸ Angle Summation Loss (ASL): Angle Summation algorithmを 各時刻𝑡において計算してGTとの差を計算する ▹
:時刻𝑡における角度和マップ 21 Geometry Constraint:ポリゴン全体の形状を考慮
▸ REC・RESタスクの標準データセット ▹ RefCOCO [Yu+, ECCV16],RefCOCO+ [Yu+, ECCV16], RefCOCOg [Mao+,
CVPR16] ▸ 評価尺度 ▹ REC:
[email protected]
▹ RES:overall IoU ▸ 学習設定等 ▹ GPU:4つのNVIDIA V100 ▹ デフォルトの頂点数𝑁 = 36 ▹ バッチサイズ 64,エポック数 100 22 実験設定:3種類の標準データセットで実験
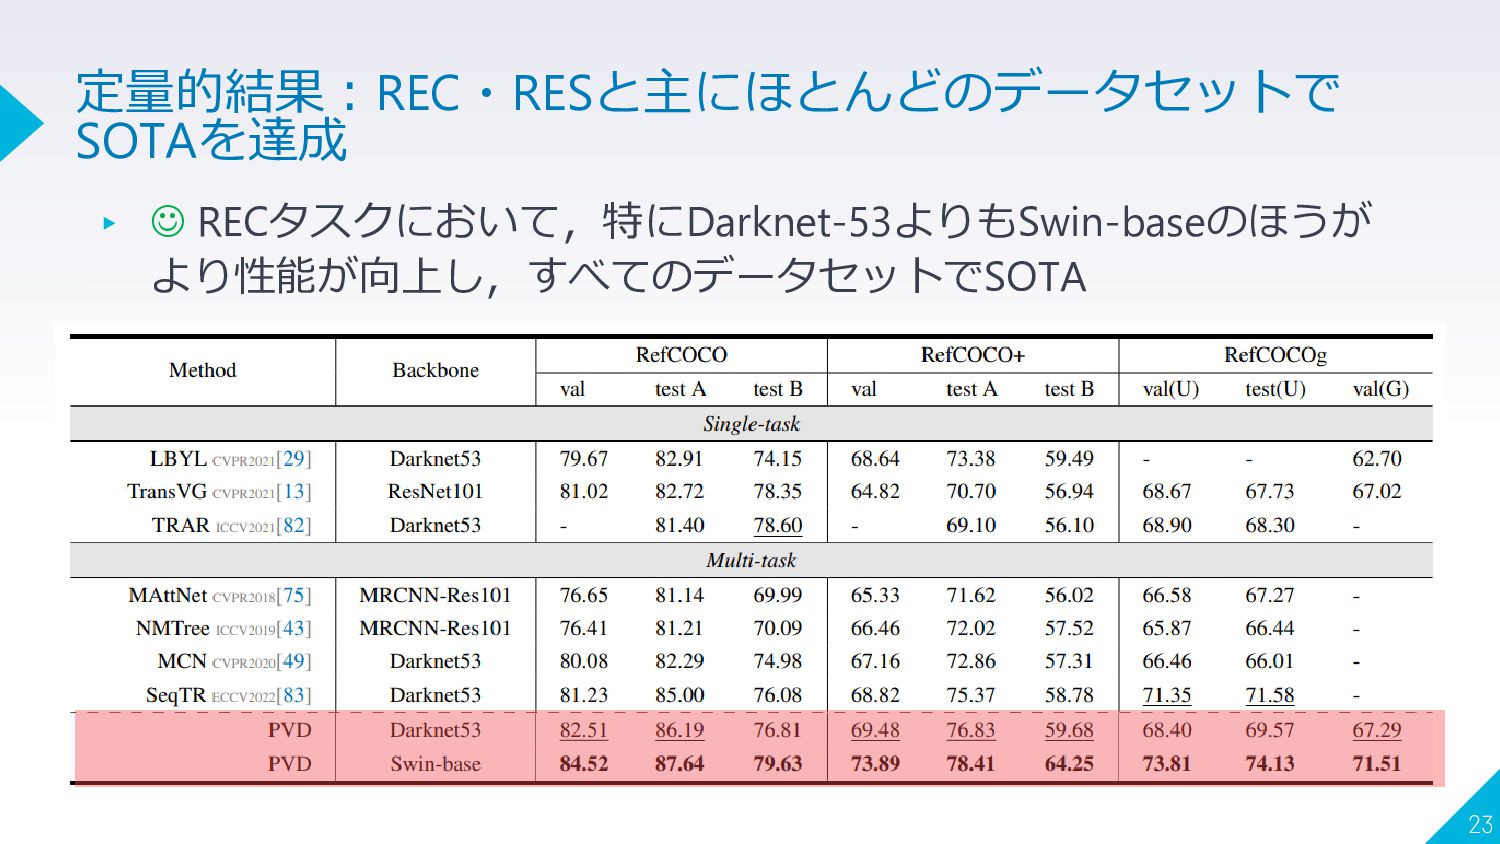
▸ ☺ RECタスクにおいて,特にDarknet-53よりもSwin-baseのほうが より性能が向上し,すべてのデータセットでSOTA 23 定量的結果:REC・RESと主にほとんどのデータセットで SOTAを達成
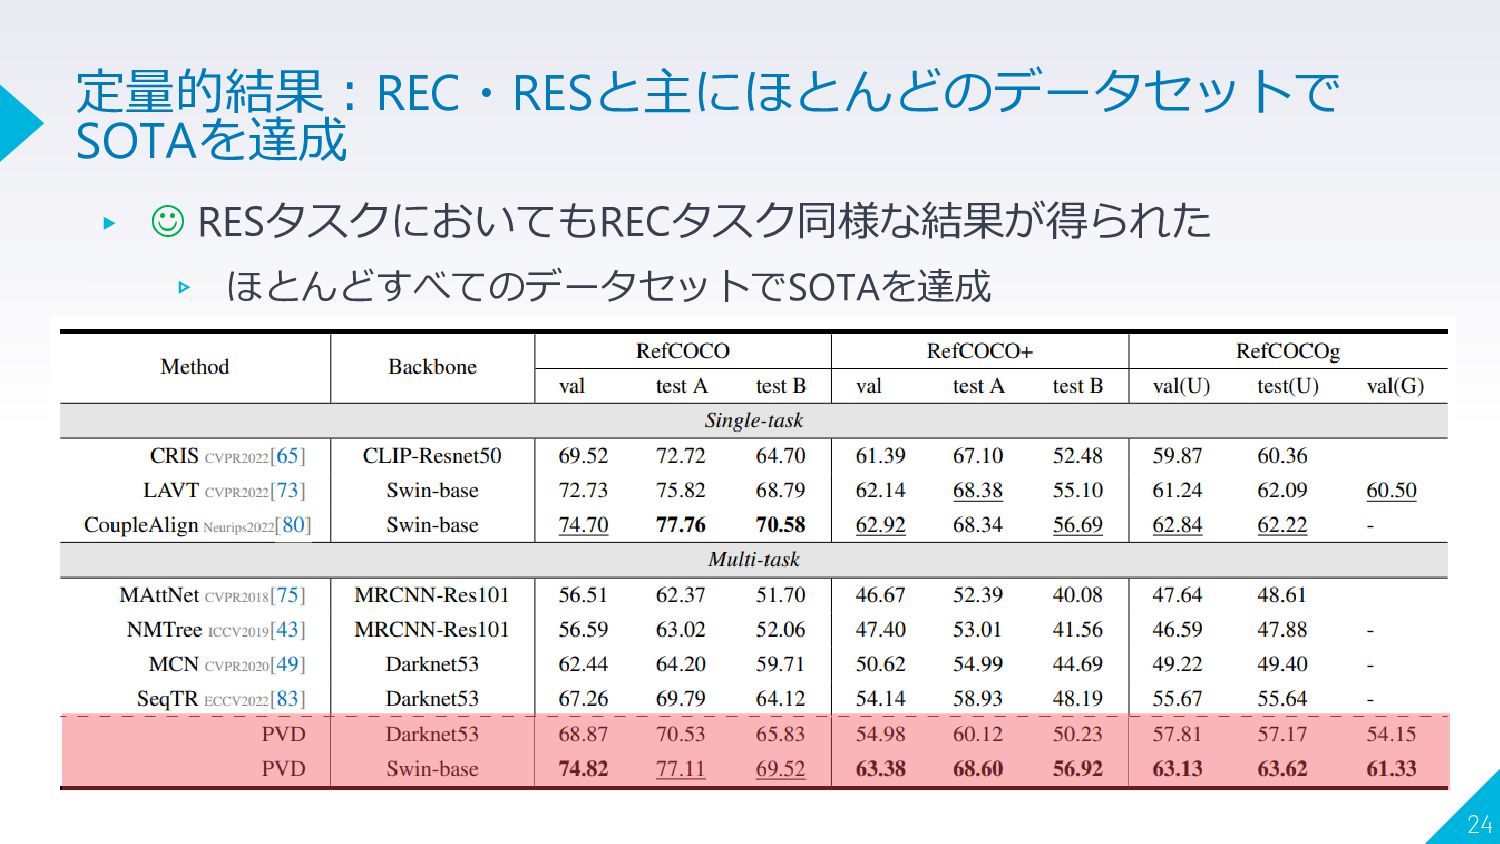
▸ ☺ RESタスクにおいてもRECタスク同様な結果が得られた ▹ ほとんどすべてのデータセットでSOTAを達成 24 定量的結果:REC・RESと主にほとんどのデータセットで SOTAを達成
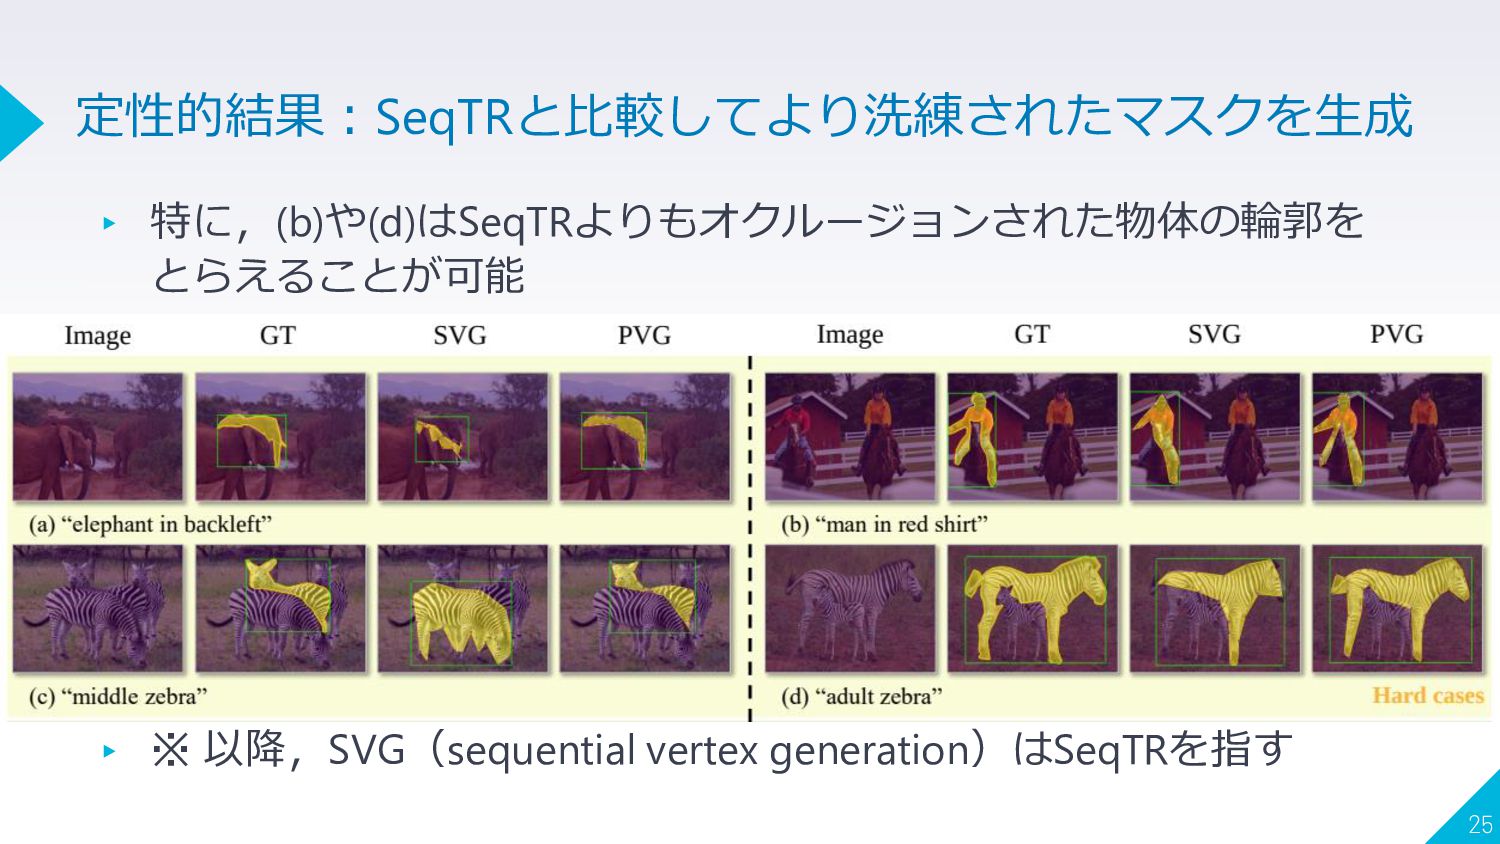
▸ 特に,(b)や(d)はSeqTRよりもオクルージョンされた物体の輪郭を とらえることが可能 ▸ ※ 以降,SVG(sequential vertex generation)はSeqTRを指す 25 定性的結果:SeqTRと比較してより洗練されたマスクを生成
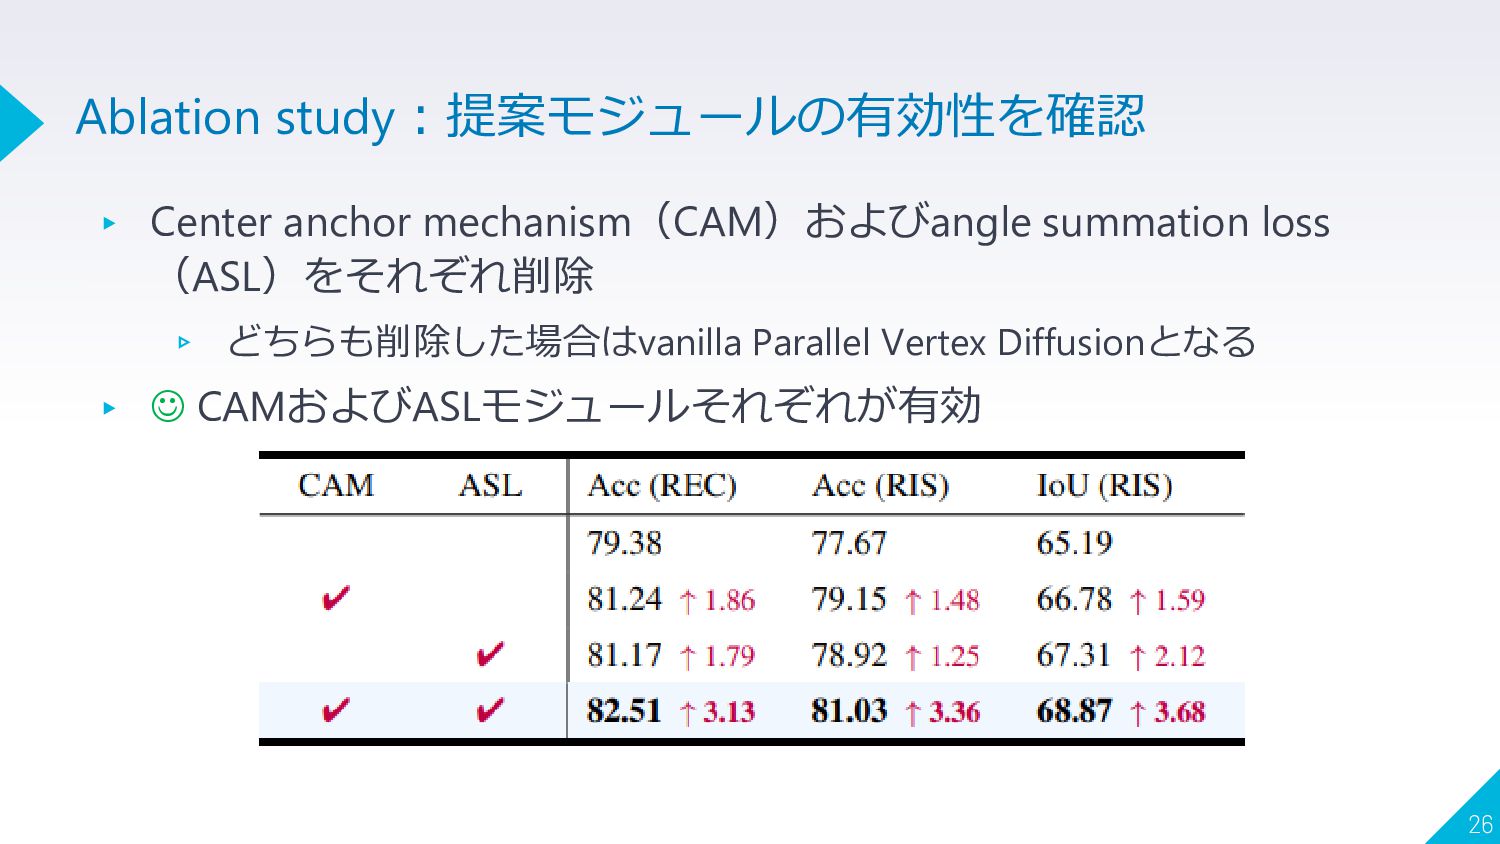
▸ Center anchor mechanism(CAM)およびangle summation loss (ASL)をそれぞれ削除 ▹ どちらも削除した場合はvanilla Parallel
Vertex Diffusionとなる ▸ ☺ CAMおよびASLモジュールそれぞれが有効 26 Ablation study:提案モジュールの有効性を確認
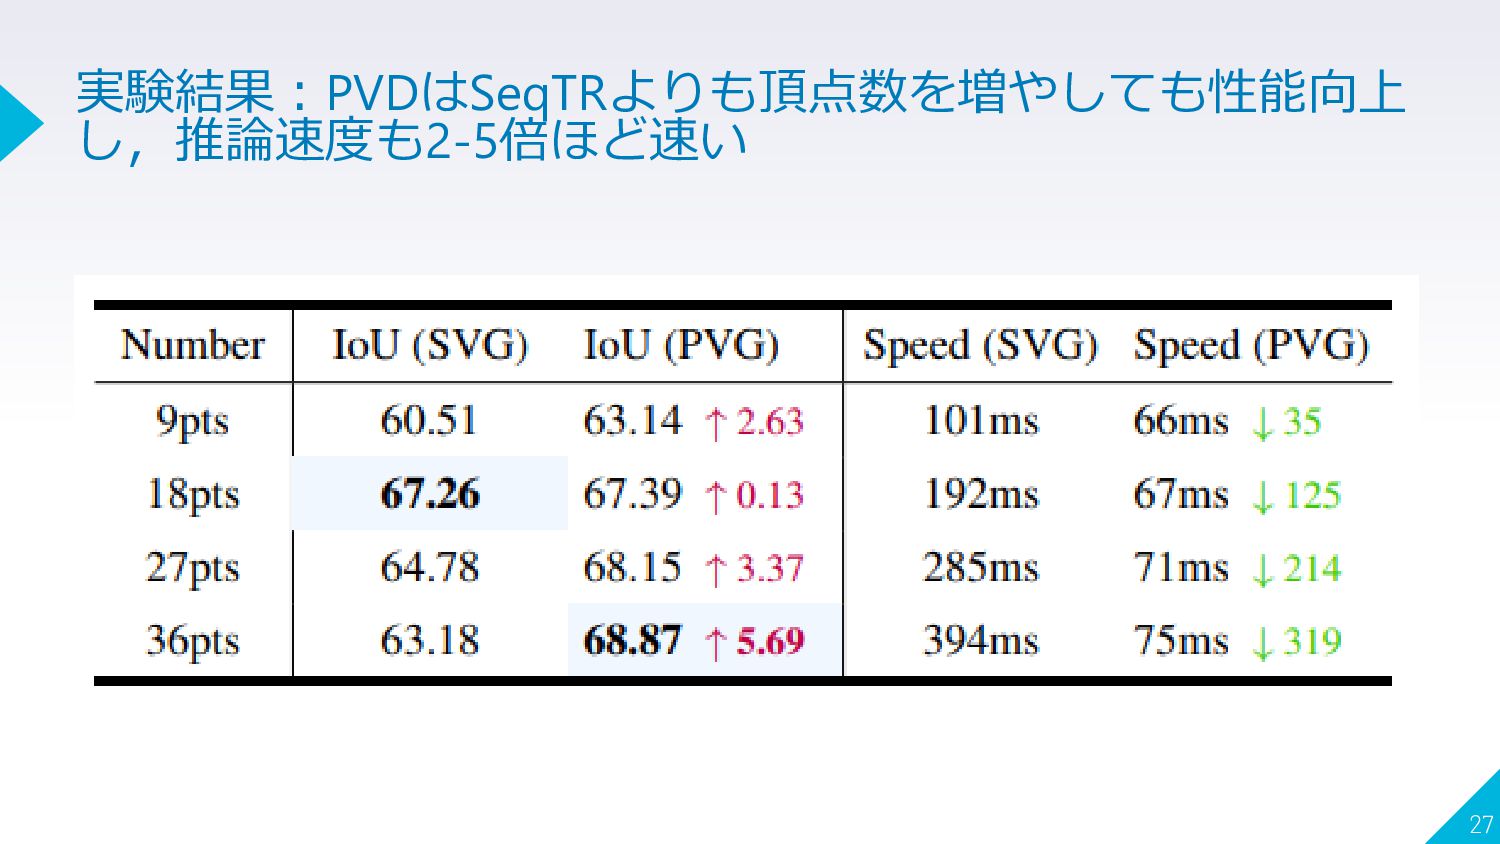
27 実験結果:PVDはSeqTRよりも頂点数を増やしても性能向上 し,推論速度も2-5倍ほど速い
Strengths ▸ 要所で図や新規性のmotivationが明記されていて理解しやすい ▸ 拡散モデルの特徴を活かして,スケーラビリティおよび推論速度の向上を実現 ▸ 実験設定が適切かつ豊富で提案手法の有効性を確認している Weaknesses ▸ SeqTRよりも頂点数の増やしているが(最大で2倍の36点),オクルージョンには依然として対応
できていない ▸ 表のキャプションが下側にある・typoが随所見られた(最新版は修正されているかもしれない) Others ▸ SeqTRによる後続研究が活発的である(e.g. PolyFormer [Liu+, CVPR23],Partial-RES [Qu+, CVPR23],PORTER [九曜+, NLP24]) ▸ ベースライン手法も含めて2020年以降のREC/RESモデルのbackboneにDarknet-53 [Redmon+, 18] を適用している手法が多い印象 28 所感
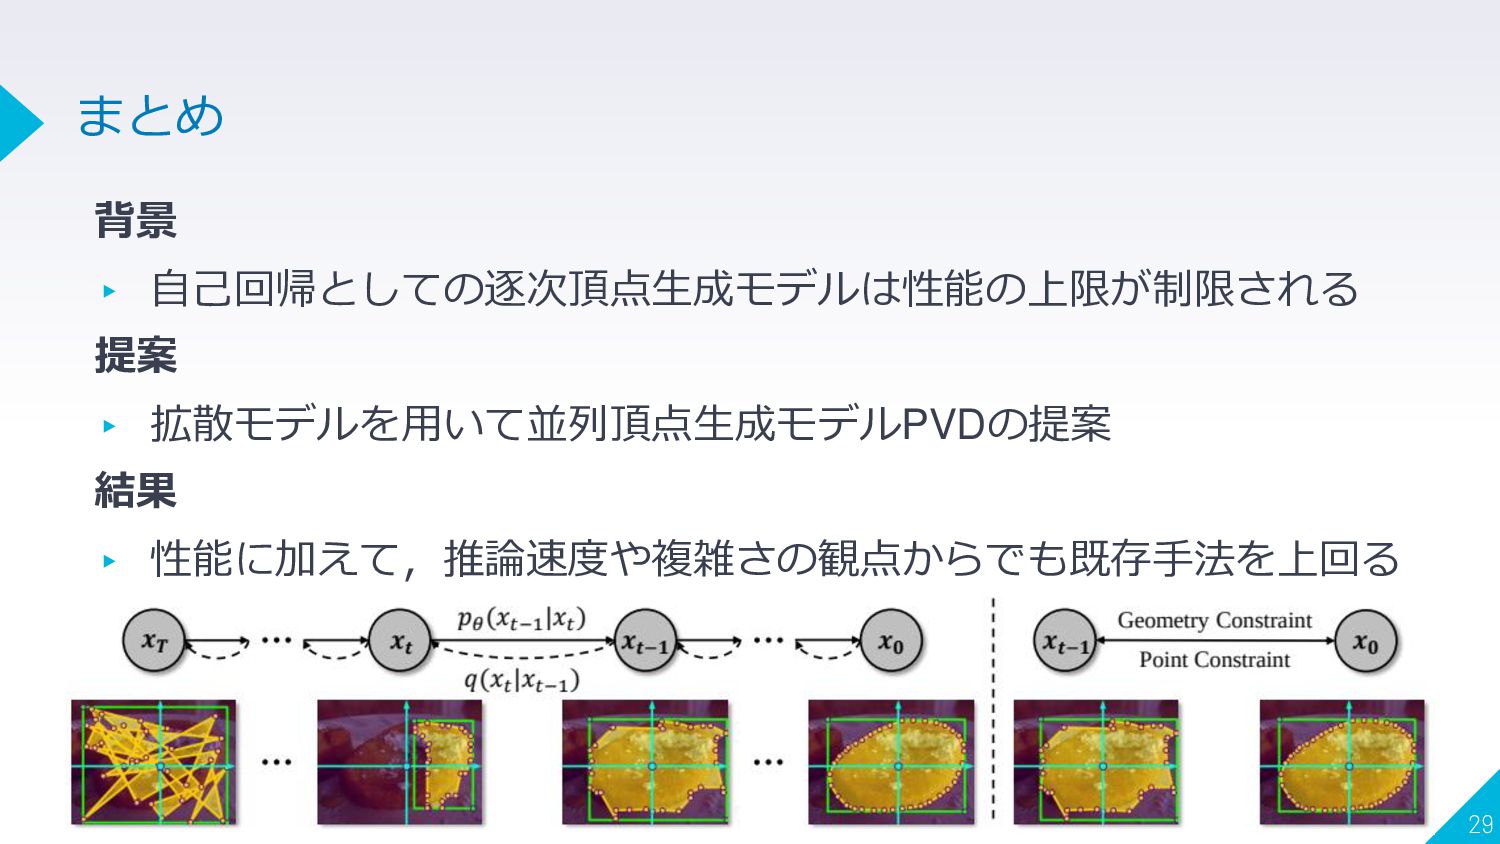
背景 ▸ 自己回帰としての逐次頂点生成モデルは性能の上限が制限される 提案 ▸ 拡散モデルを用いて並列頂点生成モデルPVDの提案 結果 ▸ 性能に加えて,推論速度や複雑さの観点からでも既存手法を上回る 29
まとめ

 SiteGround - Reliable hosting with speed, security, and support you can count on.


 keio_smilab
 shugo
 occhi
 finengine
 prog893
 masakiokuda
 ezaki
 pfn
 riyaamemiya
 akitoshiga
 recruitengineers
 kaminashi
 yut0naga1_fa
 stephenakadiri
 chriscoyier
 mojombo
 nonsquared
 soudai
 chrislema
 maggiecrowley
 jakevdp
 frankvandijk
 kneath
 aarron
 bethany