Share
Embed
[RSJ22]Cross-Modal Explanation Generation of Hazards in Object Placement Tasks
Semantic Machine Intelligence Lab., Keio Univ. PRO
September 04, 2022
Transcript
18 slides
-
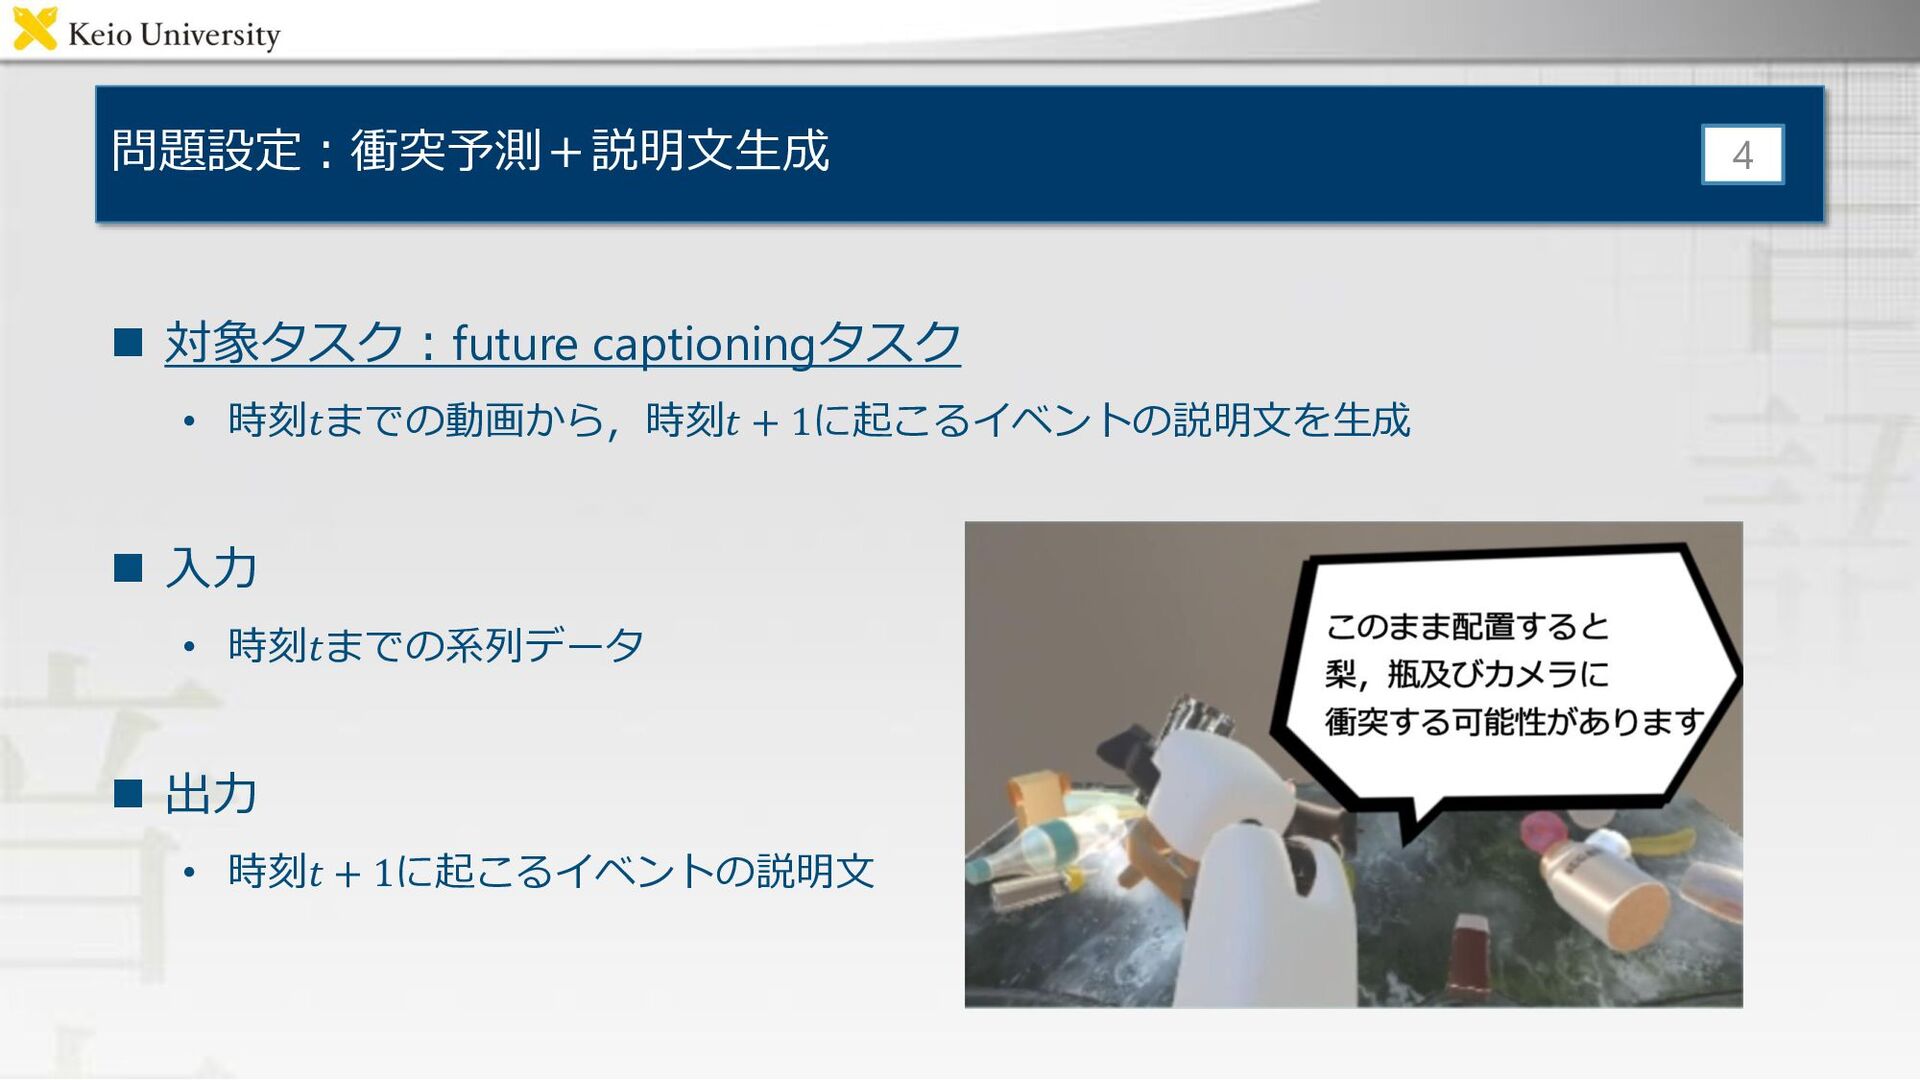
問題設定:衝突予測+説明文生成 ◼ 対象タスク:future captioningタスク • 時刻𝑡までの動画から,時刻𝑡 + 1に起こるイベントの説明文を生成 ◼ 入力
• 時刻𝑡までの系列データ ◼ 出力 • 時刻𝑡 + 1に起こるイベントの説明文 4 -
関連研究:将来イベントにおける物体の記述が不十分 入力 将来 RFCM [Kambara+ ICIP22] Robot hits the apple
and the stuffed bear hard because robot tried to put the hourglass where they are. タスク 手法 概要 動画キャプション生成 MART [Lei+, ACL20] Memory Updaterモジュールにより 過去の動画情報を利用 future captioning [Mori+, IEEE IV21] 自動運転において,過去の動画情報 とセンサ情報を利用 RFCM [Kambara+, ICIP22] 各時刻のイベント間の関係性を抽出 5 -
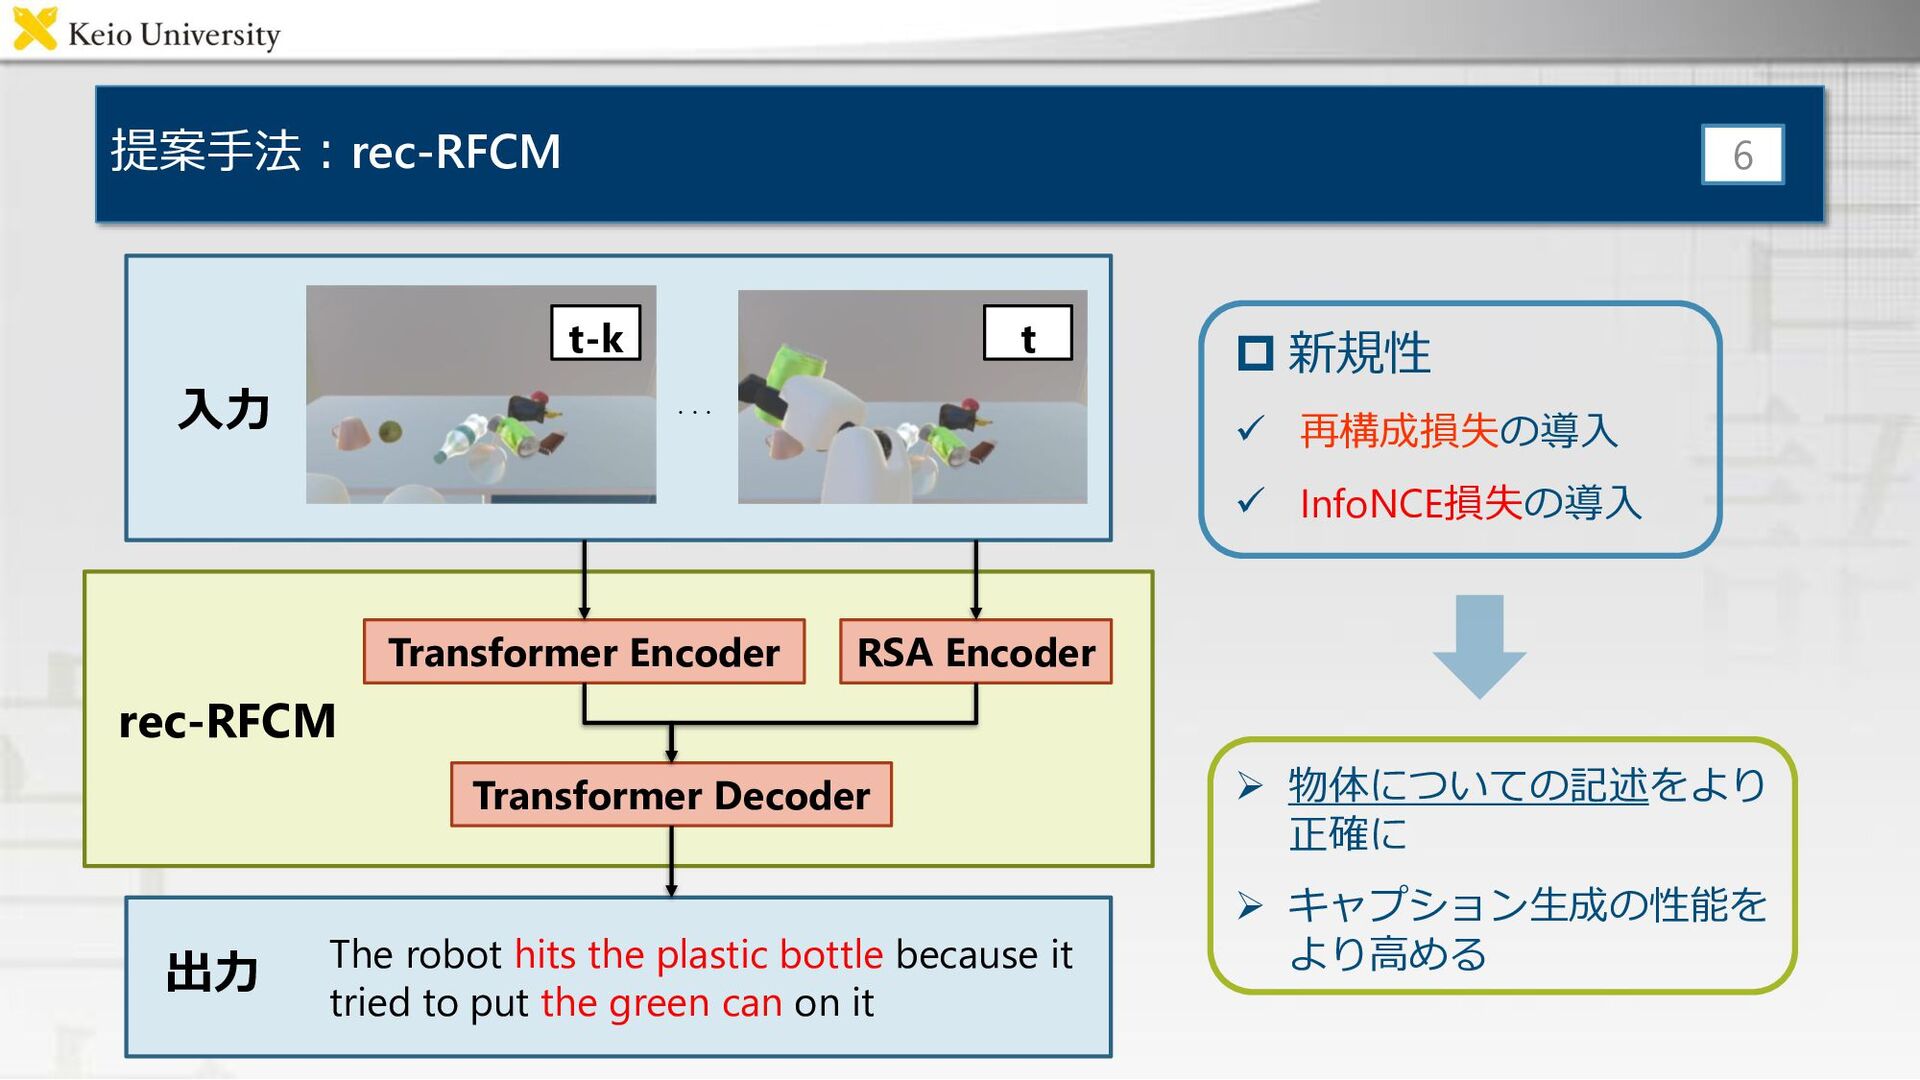
提案手法:rec-RFCM 6 新規性 ✓ 再構成損失の導入 ✓ InfoNCE損失の導入 ➢ 物体についての記述をより
正確に ➢ キャプション生成の性能を より高める ・・・ 入力 Transformer Encoder Transformer Decoder RSA Encoder rec-RFCM 出力 The robot hits the plastic bottle because it tried to put the green can on it t t-k -
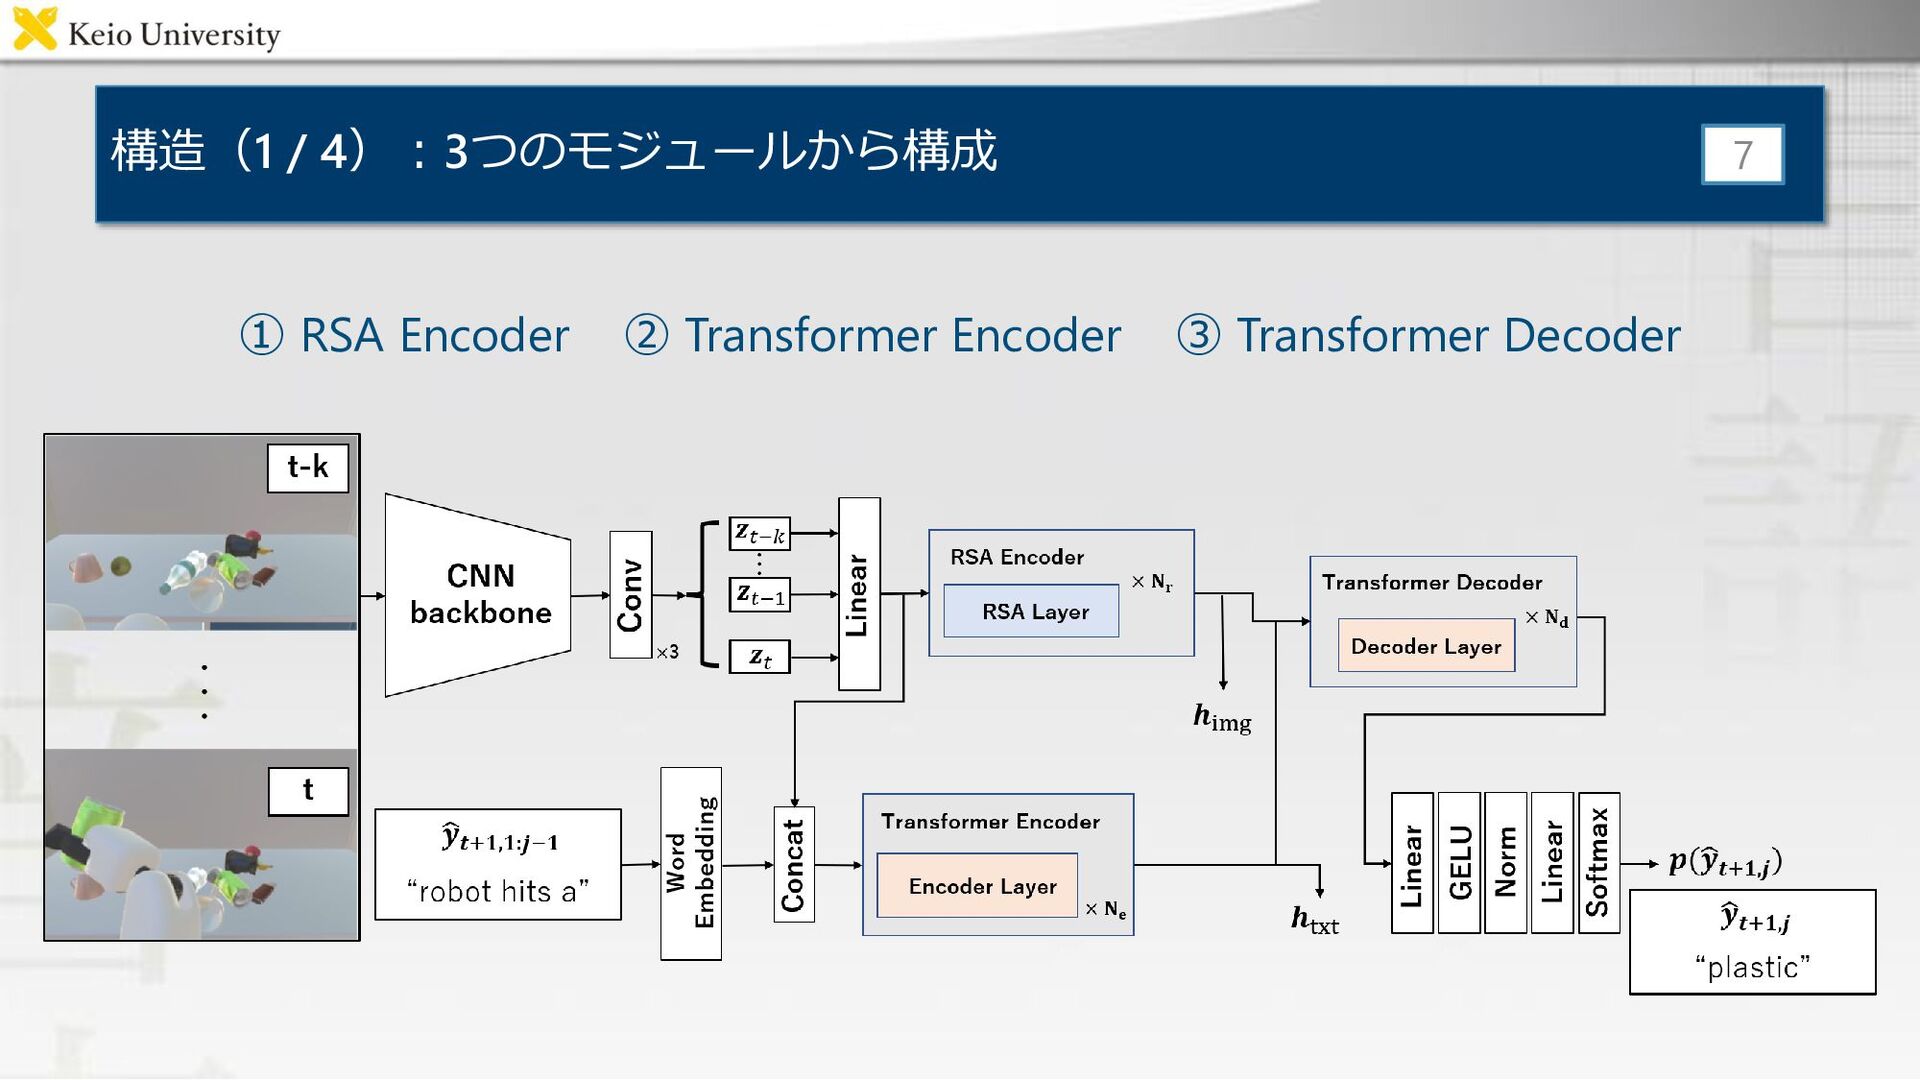
構造(1 / 4):3つのモジュールから構成 ① RSA Encoder ② Transformer Encoder ③
Transformer Decoder 7 -
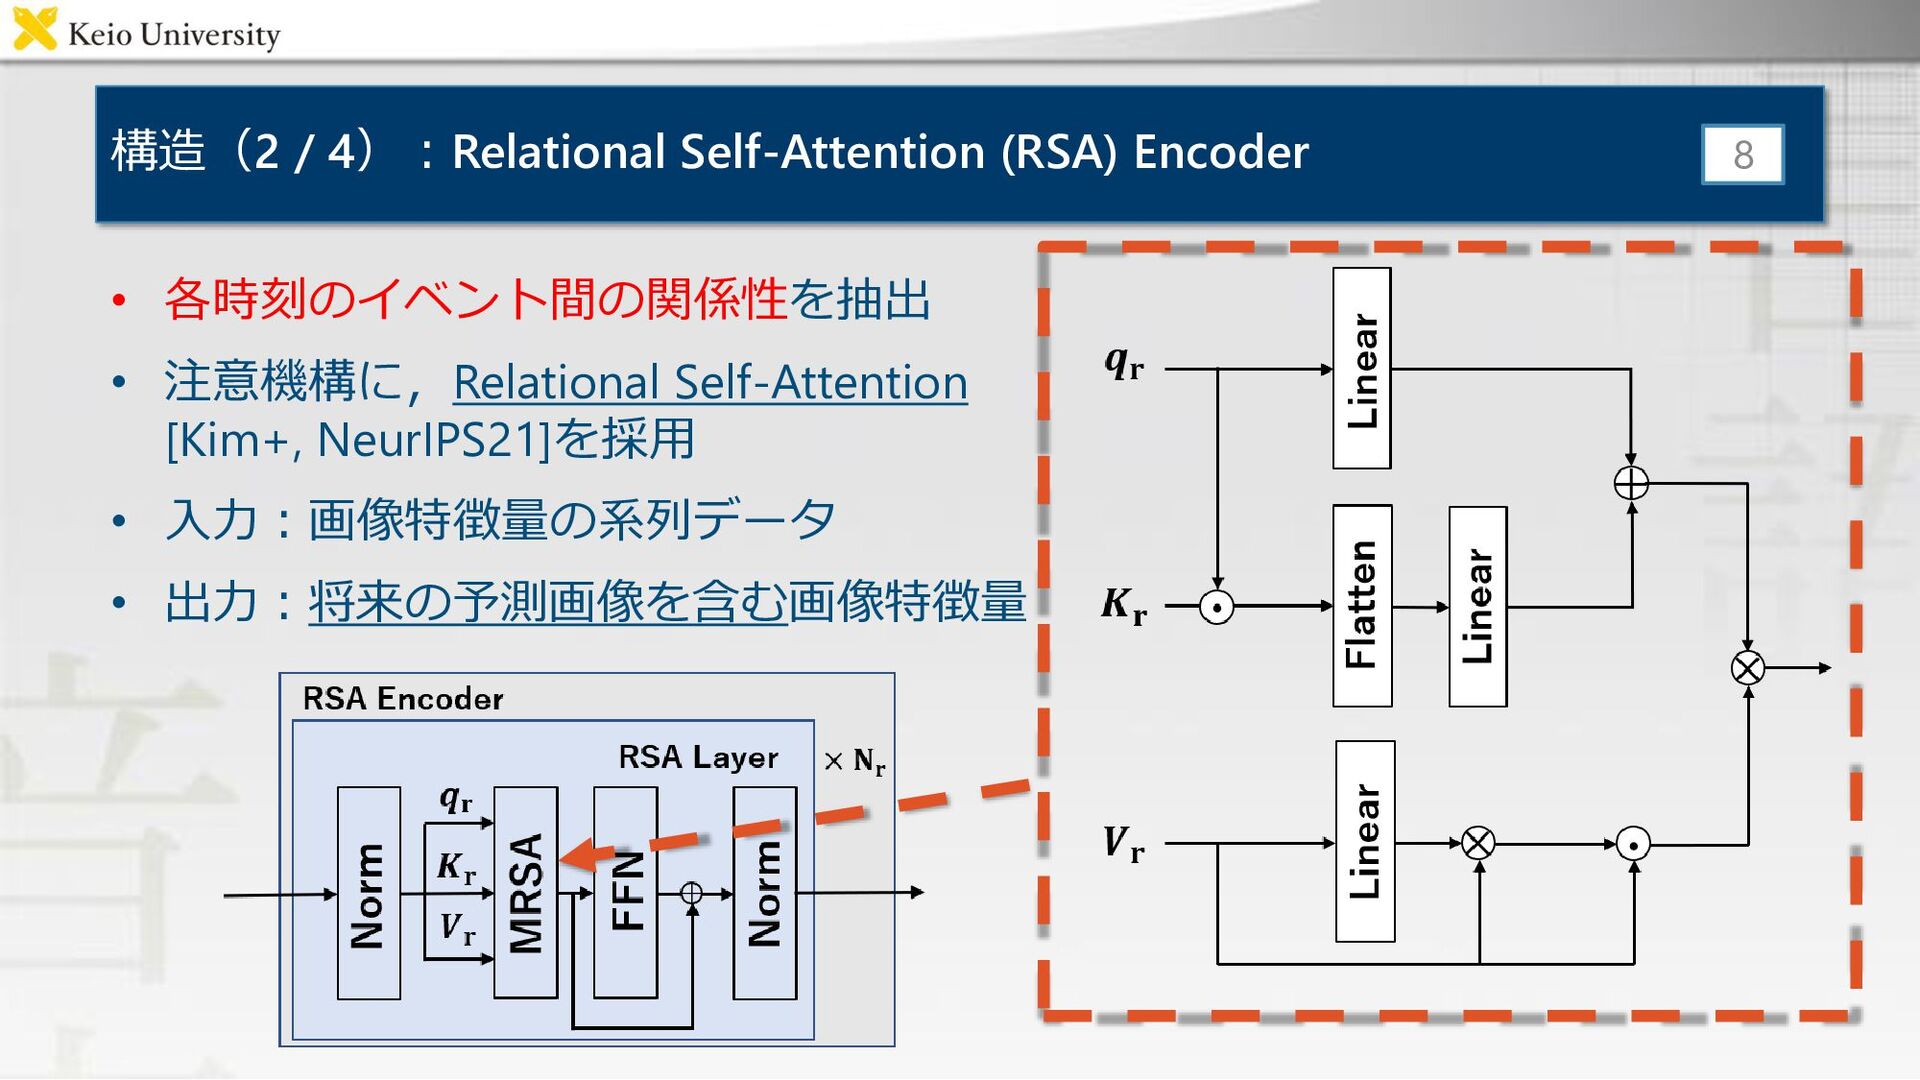
構造(2 / 4):Relational Self-Attention (RSA) Encoder • 各時刻のイベント間の関係性を抽出 • 注意機構に,Relational
Self-Attention [Kim+, NeurIPS21]を採用 • 入力:画像特徴量の系列データ • 出力:将来の予測画像を含む画像特徴量 8 -
構造(3 / 4):Transformer Encoder / Decoder • Transformer [Vaswani+, NeurIPS17]の構造を採用
• Encoder – 入力と出力:言語特徴量 • Decoder – 入力 • RSA Encoderからの画像特徴量 • Transformer Encoderからの言語特徴量 – 出力:将来画像のキャプション 9 -
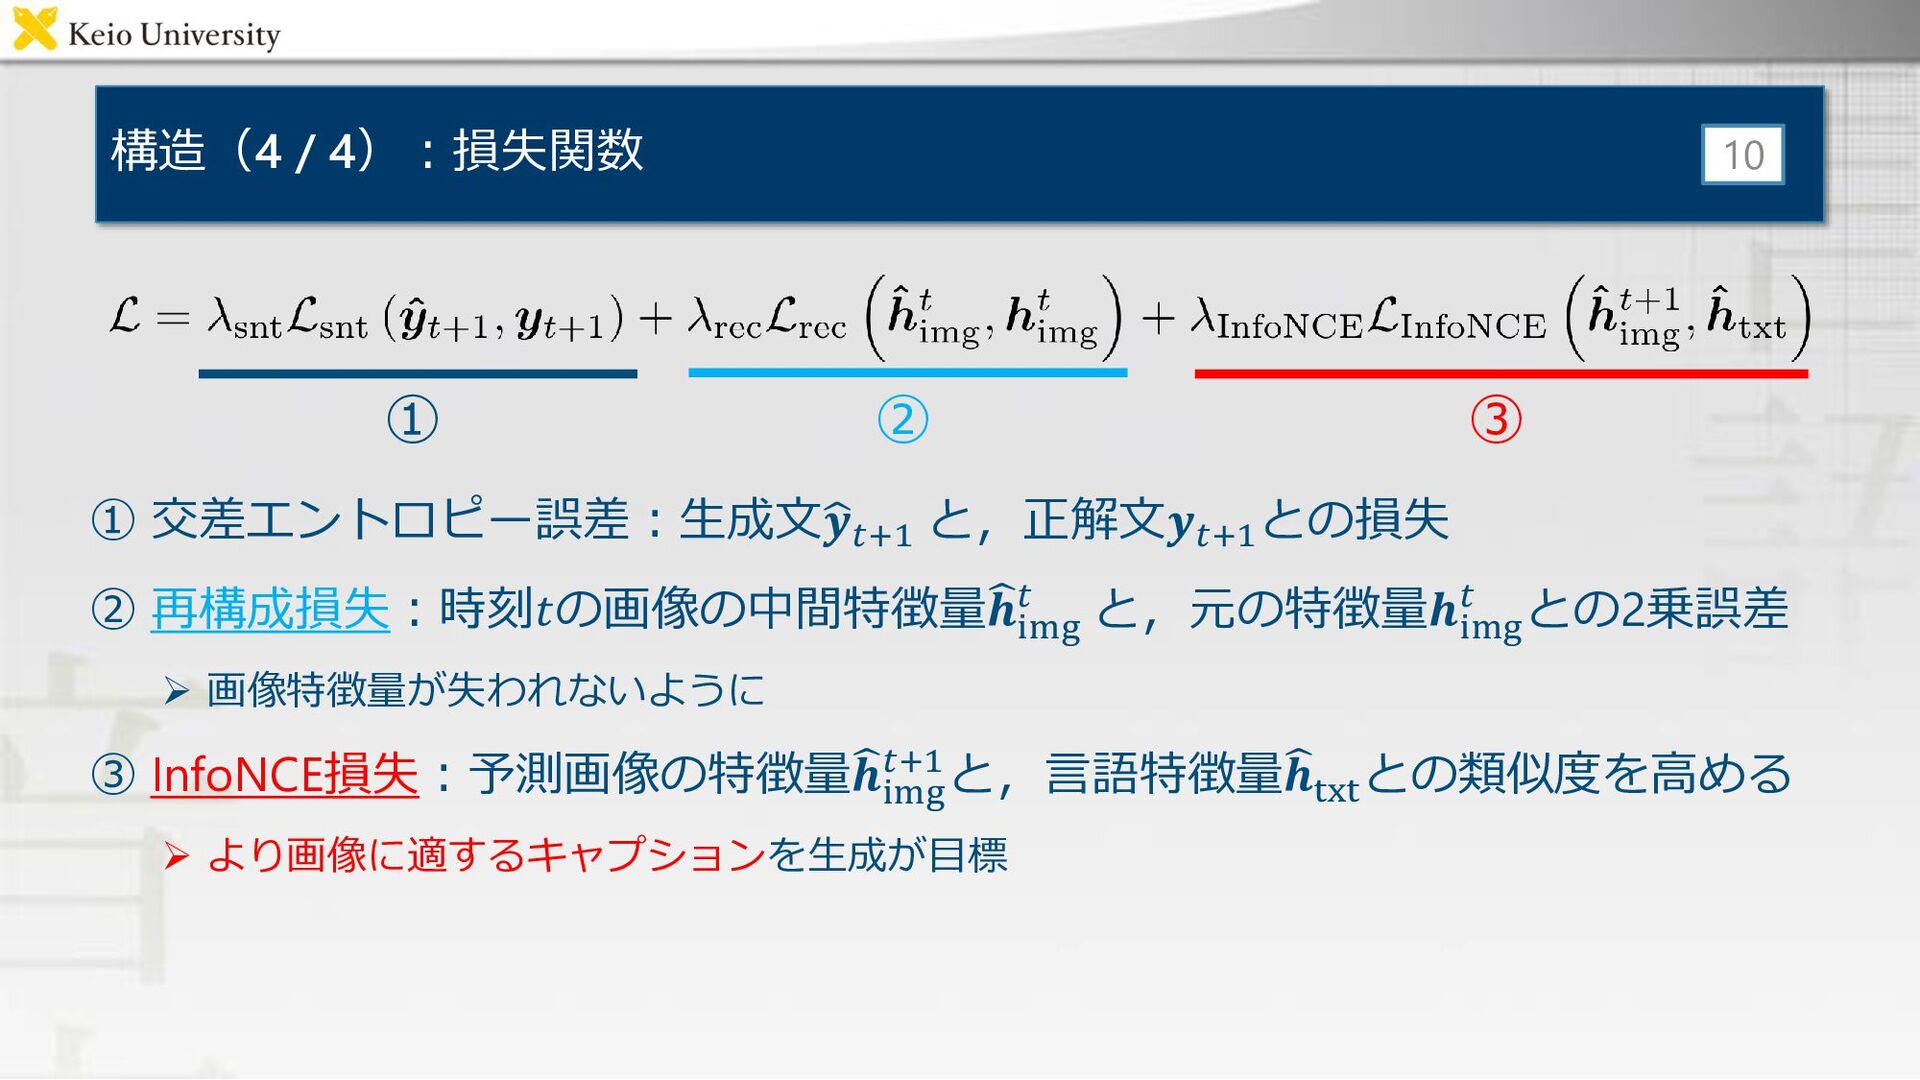
構造(4 / 4):損失関数 ① 交差エントロピー誤差:生成文ෝ 𝒚𝑡+1 と,正解文𝒚𝑡+1 との損失 ② 再構成損失:時刻𝑡の画像の中間特徴量
𝒉img 𝑡 と,元の特徴量𝒉img 𝑡 との2乗誤差 ➢ 画像特徴量が失われないように ③ InfoNCE損失:予測画像の特徴量 𝒉img 𝑡+1と,言語特徴量 𝒉txt との類似度を高める ➢ より画像に適するキャプションを生成が目標 10 ① ② ③ -
実験設定:物体配置タスク データセット • BILA-Captionデータセット[Kambara+, ICIP22] • 生活支援ロボットによる物体配置タスクにおける,衝突の危険性についての説明文 を付与 •
train:1000 samples,validation:100 samples,test:100 samples • 入力:衝突前までの0.2秒ごとのフレーム • 出力:これから起こる衝突の予測文 11 robot hits the black teapot hard because robot tried to put an apple on it -
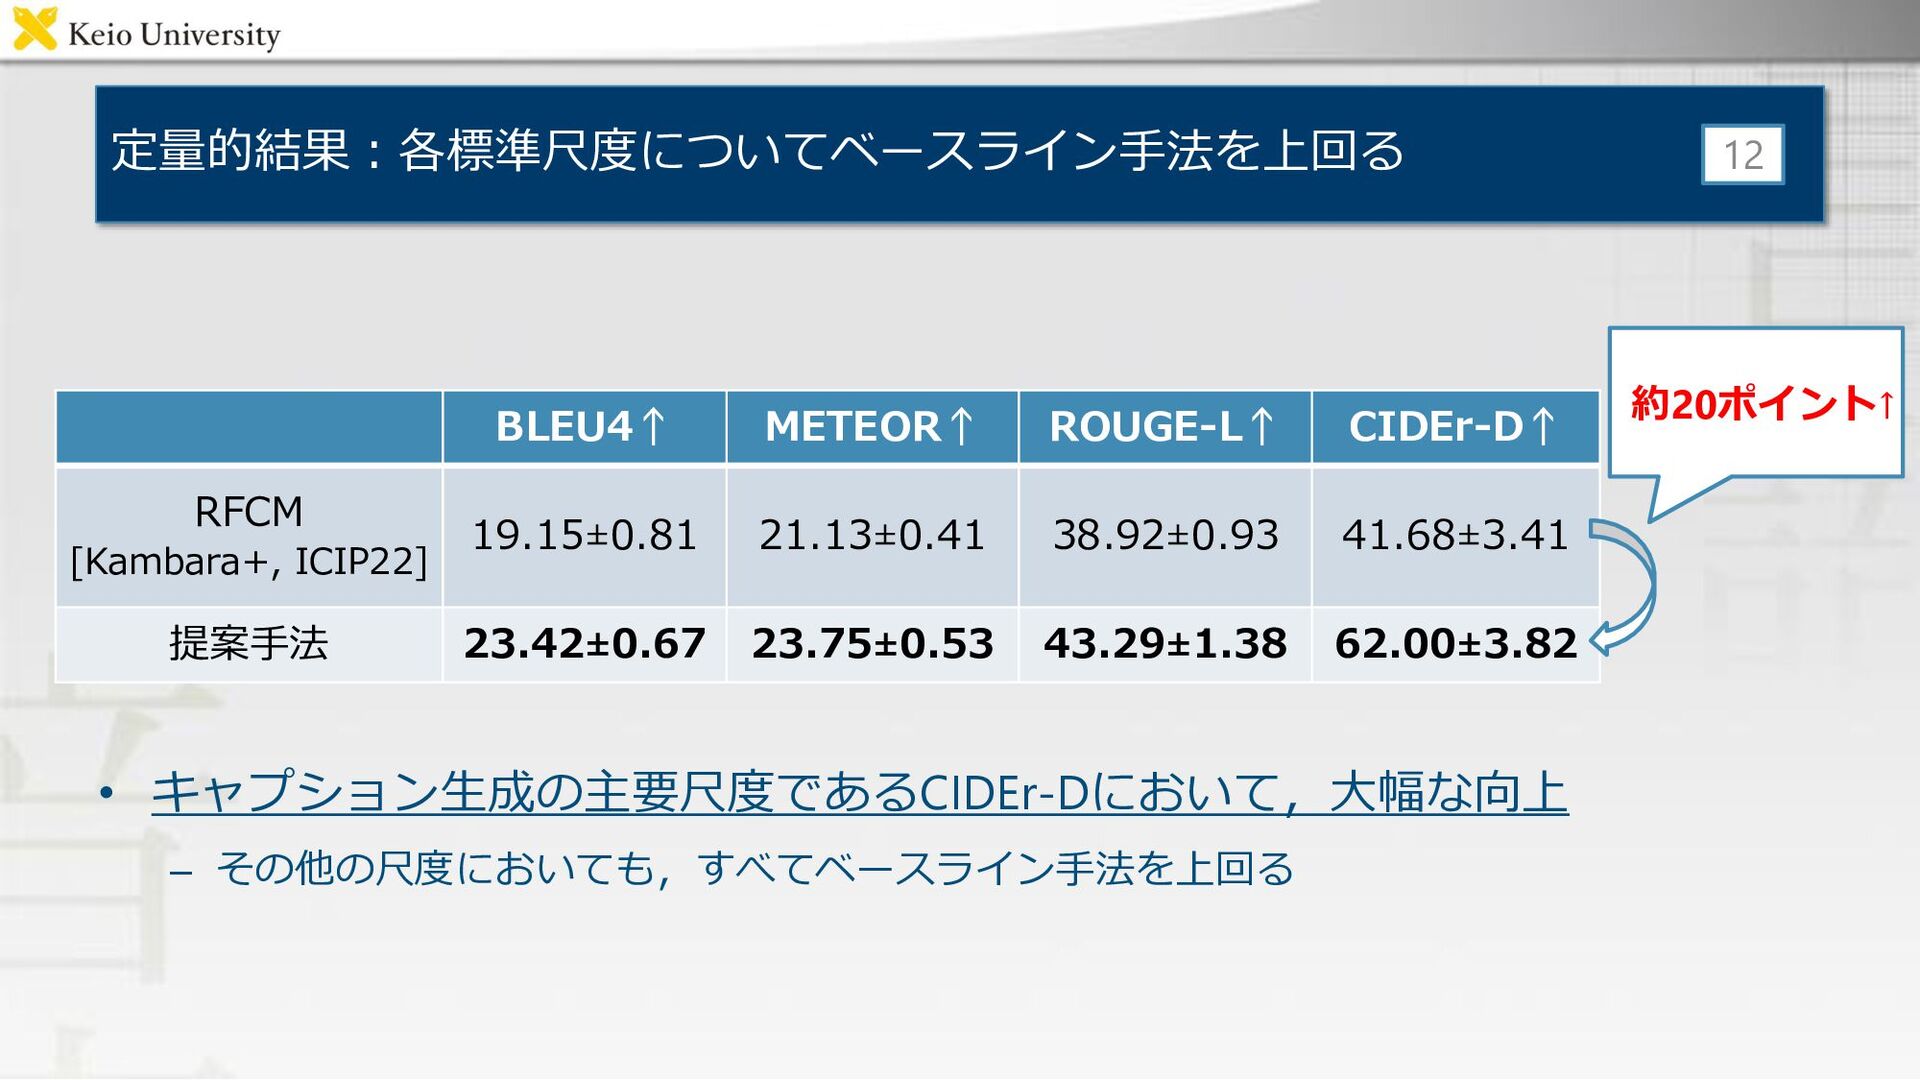
定量的結果:各標準尺度についてベースライン手法を上回る • キャプション生成の主要尺度であるCIDEr-Dにおいて,大幅な向上 – その他の尺度においても,すべてベースライン手法を上回る 12 BLEU4↑ METEOR↑ ROUGE-L↑ CIDEr-D↑
RFCM [Kambara+, ICIP22] 19.15±0.81 21.13±0.41 38.92±0.93 41.68±3.41 提案手法 23.42±0.67 23.75±0.53 43.29±1.38 62.00±3.82 約20ポイント↑ -
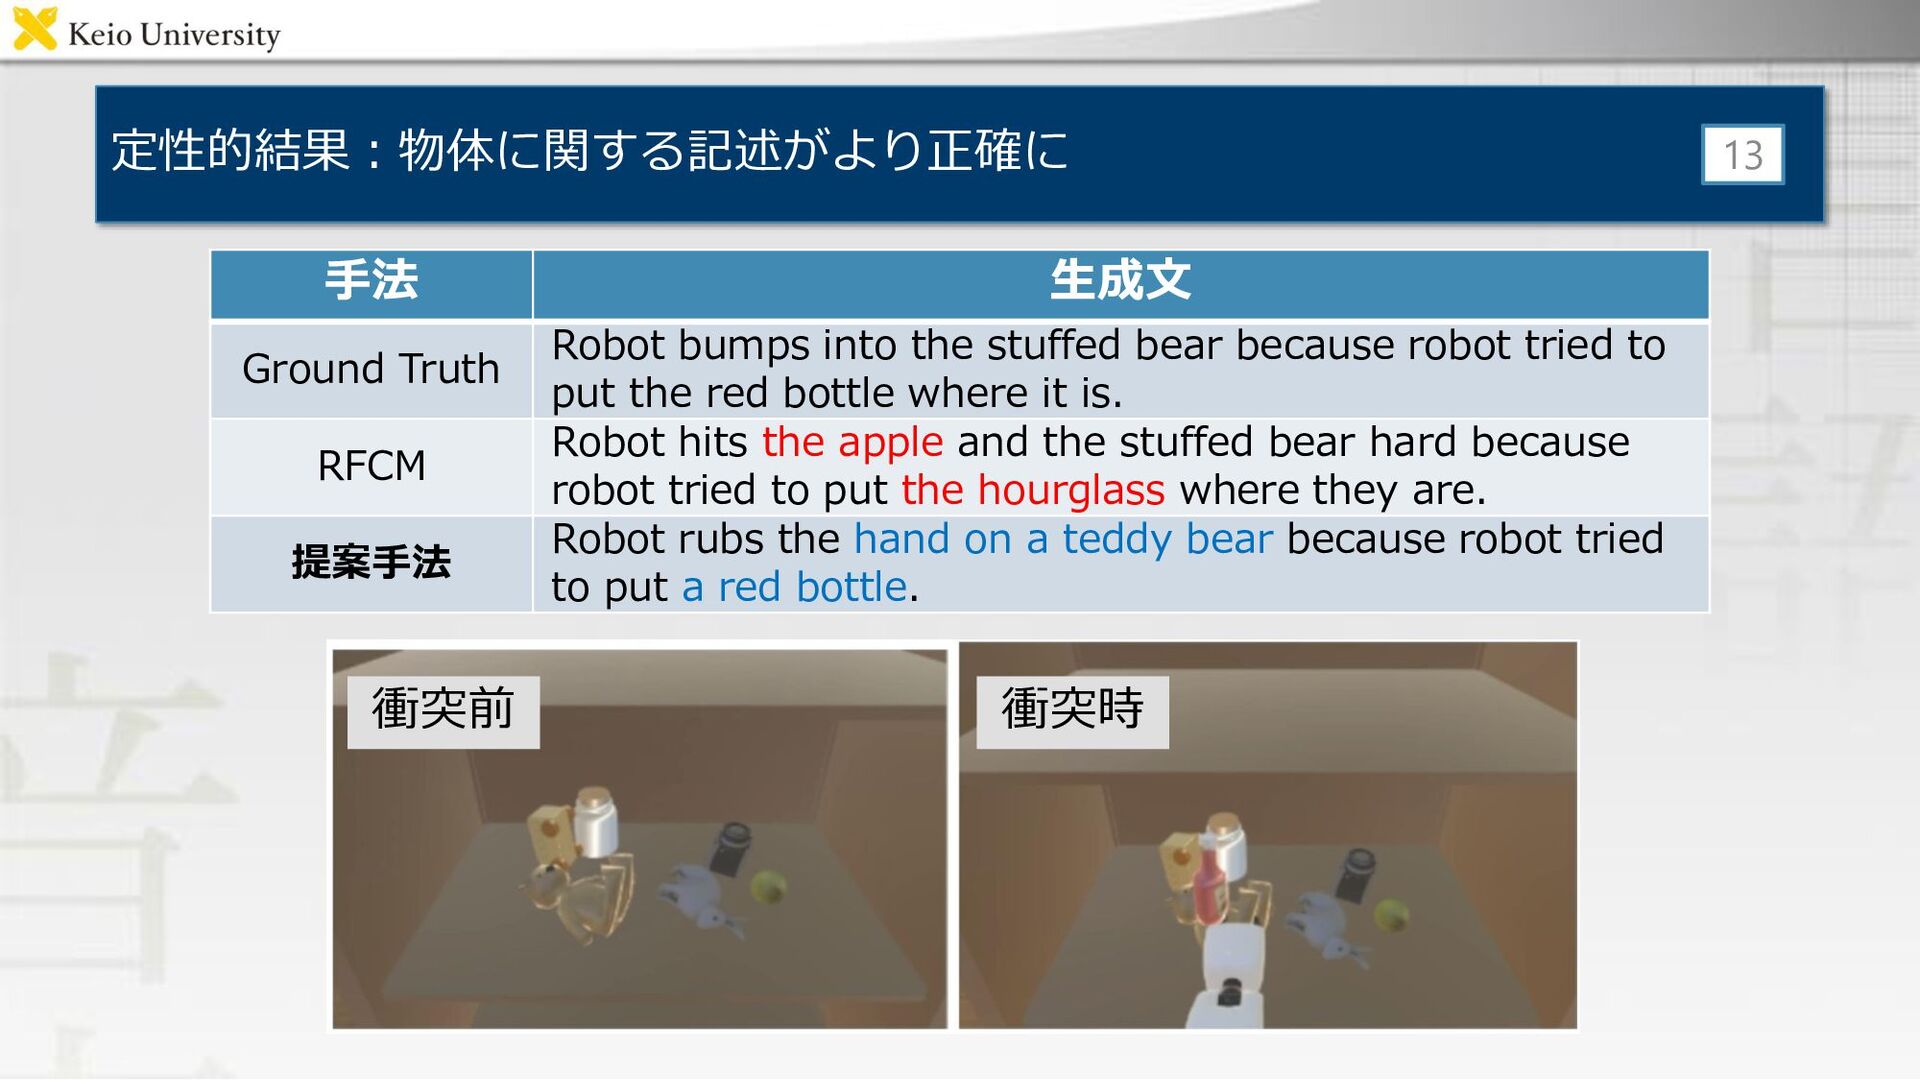
定性的結果:物体に関する記述がより正確に 13 手法 生成文 Ground Truth Robot bumps into the
stuffed bear because robot tried to put the red bottle where it is. RFCM Robot hits the apple and the stuffed bear hard because robot tried to put the hourglass where they are. 提案手法 Robot rubs the hand on a teddy bear because robot tried to put a red bottle. 衝突前 衝突時 -
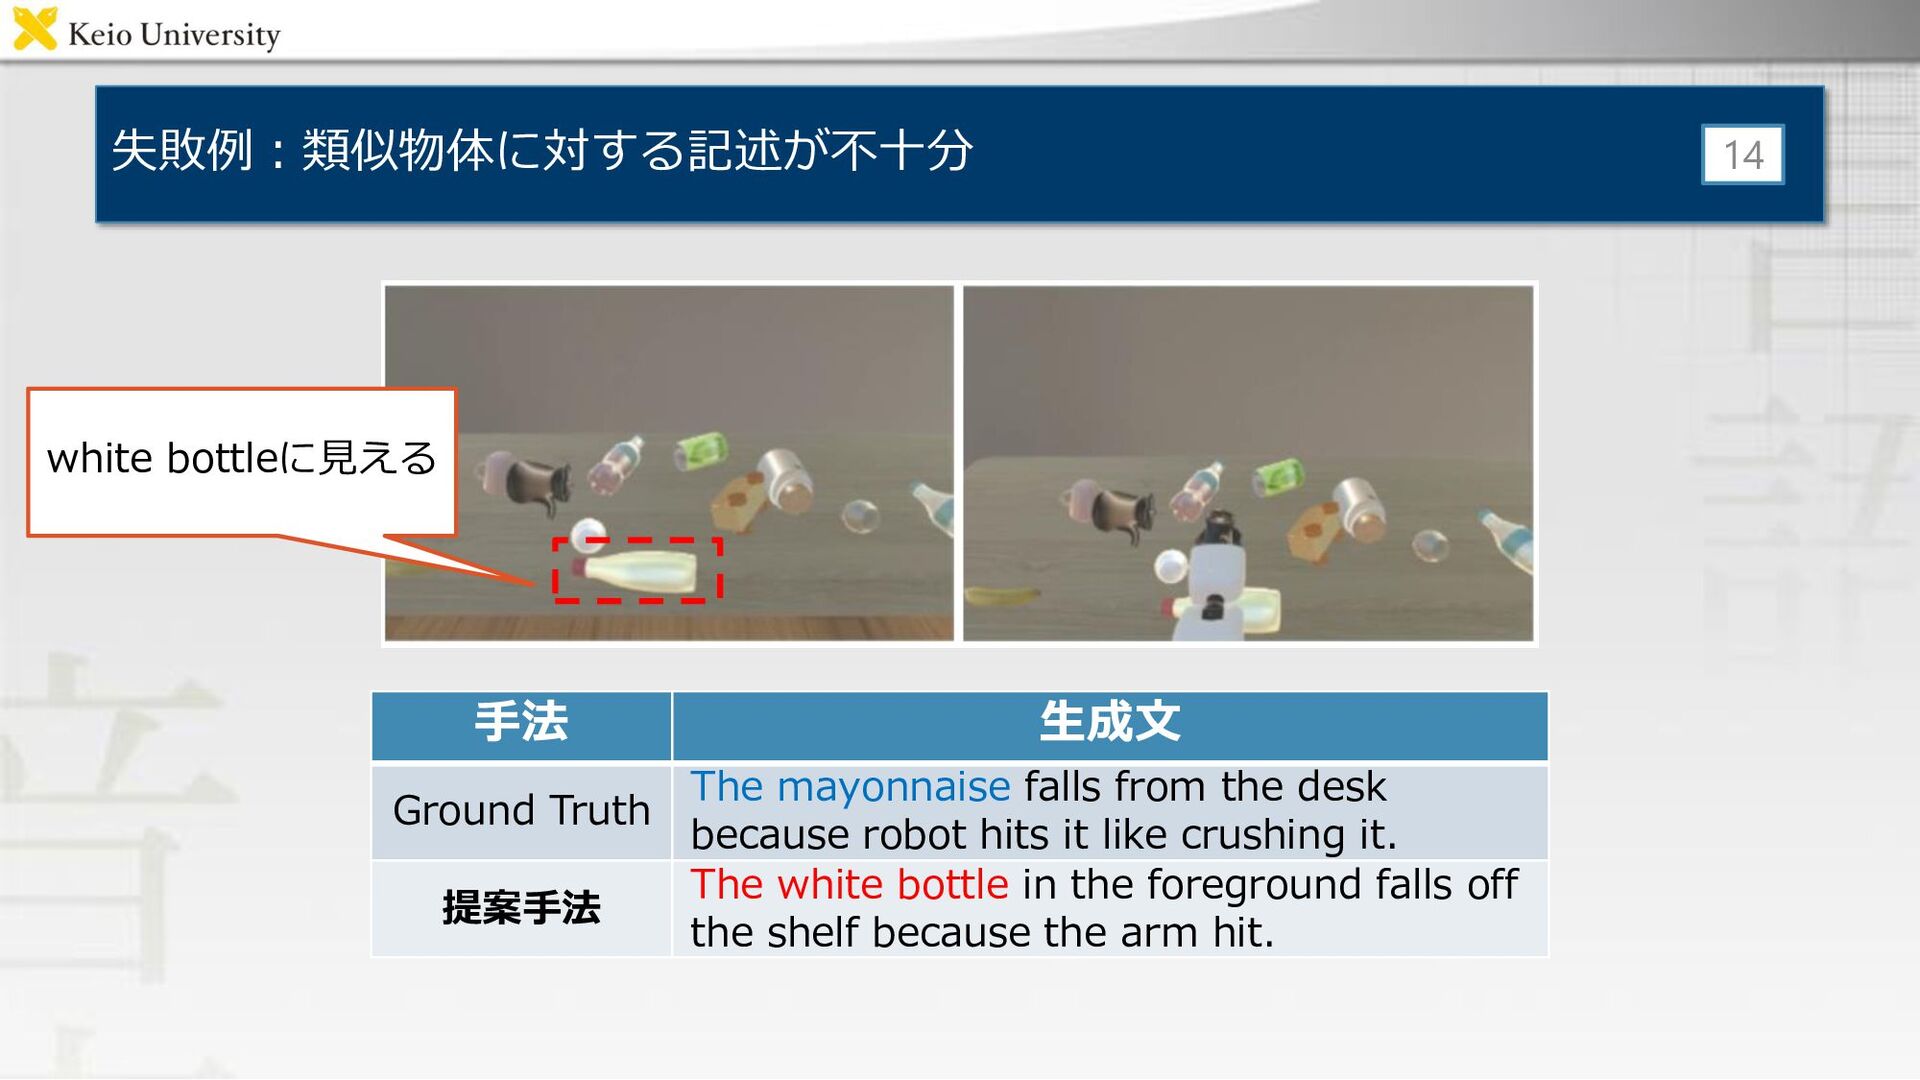
失敗例:類似物体に対する記述が不十分 14 手法 生成文 Ground Truth The mayonnaise falls from
the desk because robot hits it like crushing it. 提案手法 The white bottle in the foreground falls off the shelf because the arm hit. white bottleに見える -
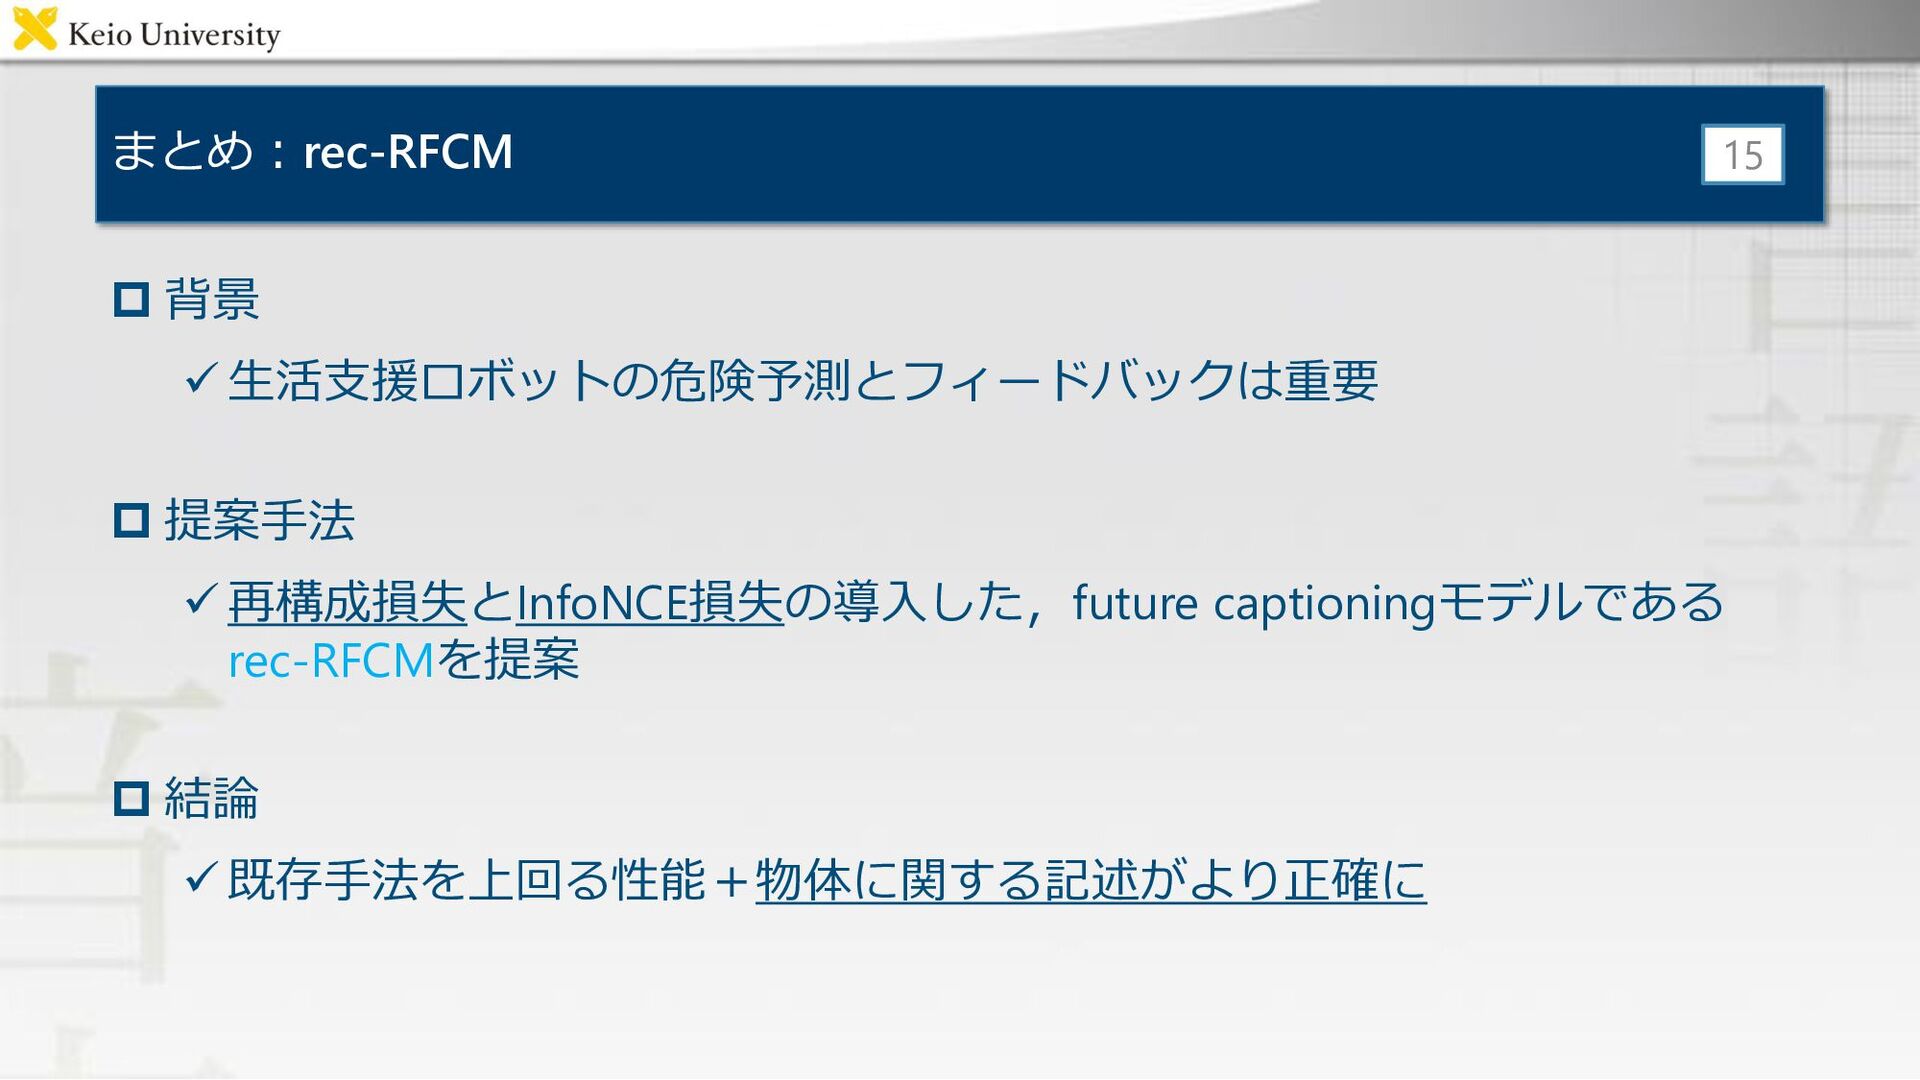
まとめ:rec-RFCM 背景 ✓ 生活支援ロボットの危険予測とフィードバックは重要 提案手法 ✓ 再構成損失とInfoNCE損失の導入した,future captioningモデルである
rec-RFCMを提案 結論 ✓ 既存手法を上回る性能+物体に関する記述がより正確に 15 -
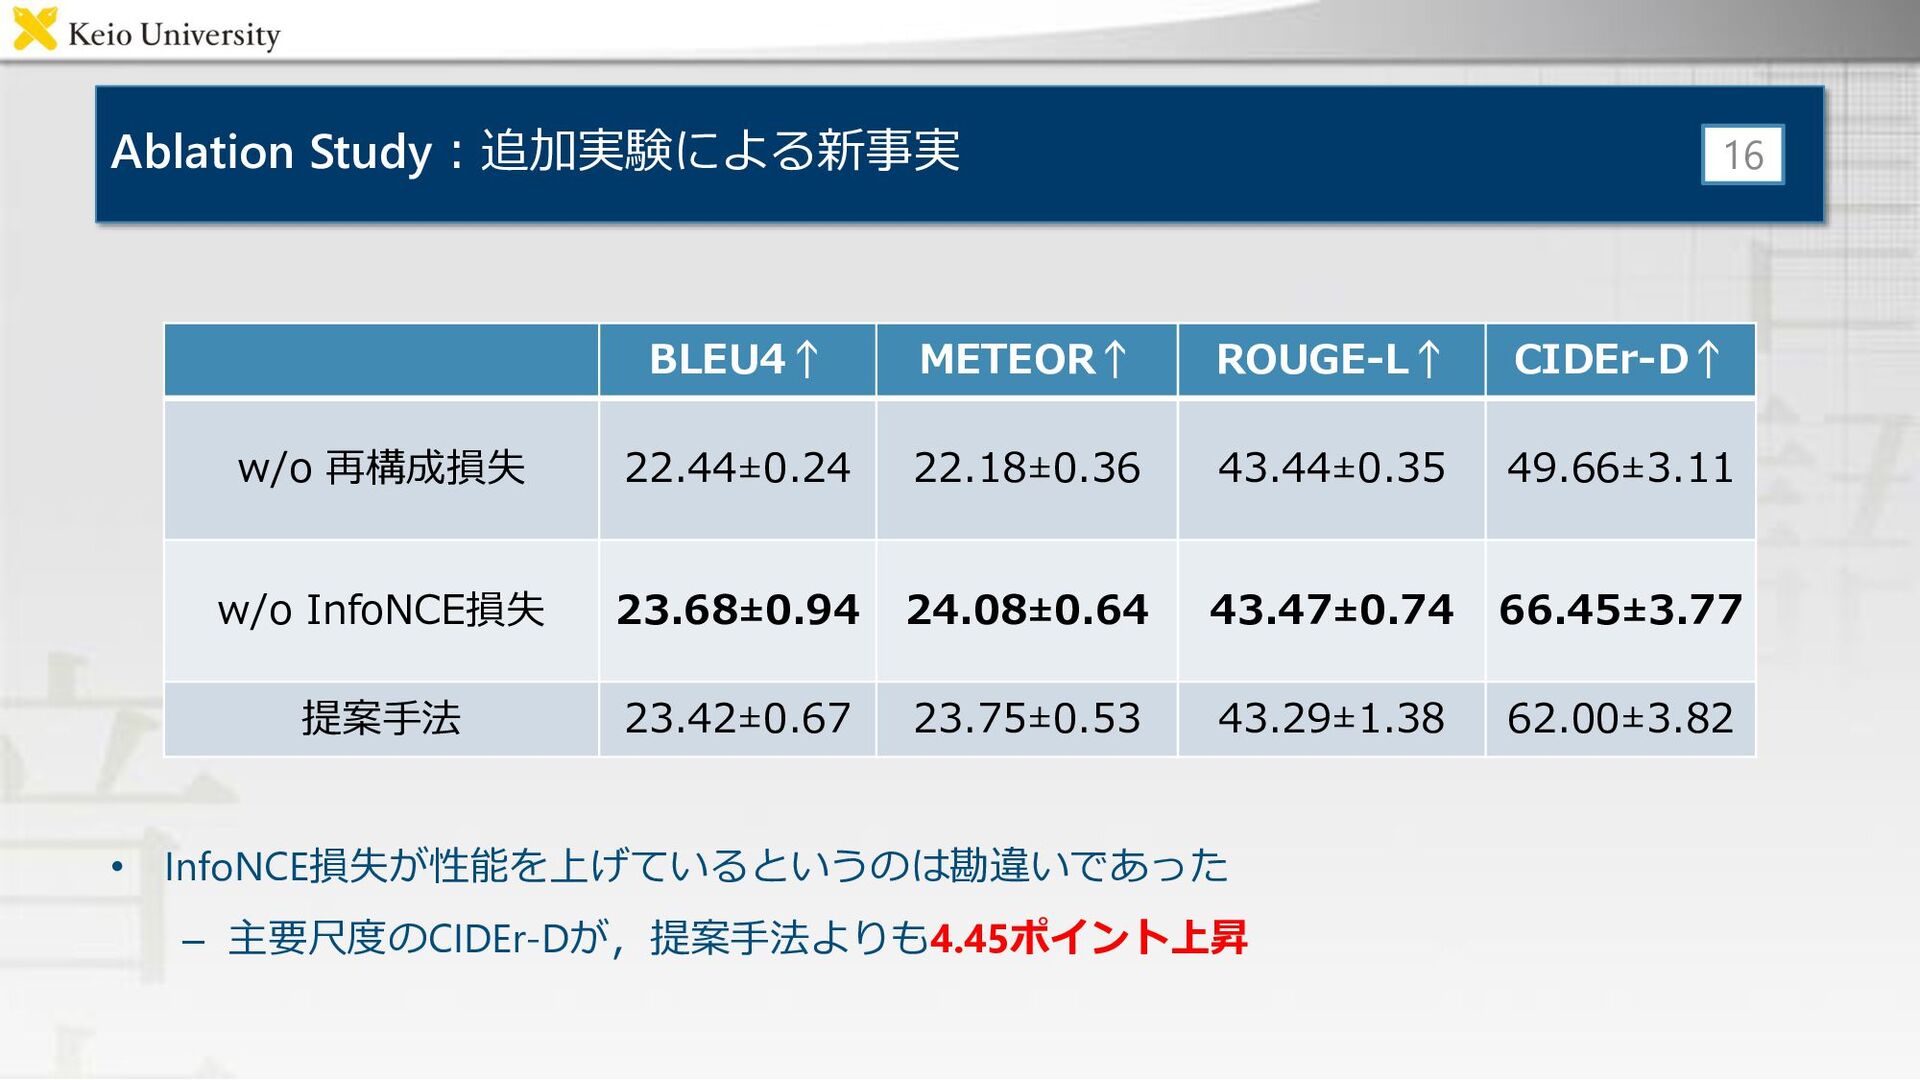
Ablation Study:追加実験による新事実 16 BLEU4↑ METEOR↑ ROUGE-L↑ CIDEr-D↑ w/o 再構成損失 22.44±0.24
22.18±0.36 43.44±0.35 49.66±3.11 w/o InfoNCE損失 23.68±0.94 24.08±0.64 43.47±0.74 66.45±3.77 提案手法 23.42±0.67 23.75±0.53 43.29±1.38 62.00±3.82 • InfoNCE損失が性能を上げているというのは勘違いであった – 主要尺度のCIDEr-Dが,提案手法よりも4.45ポイント上昇 -
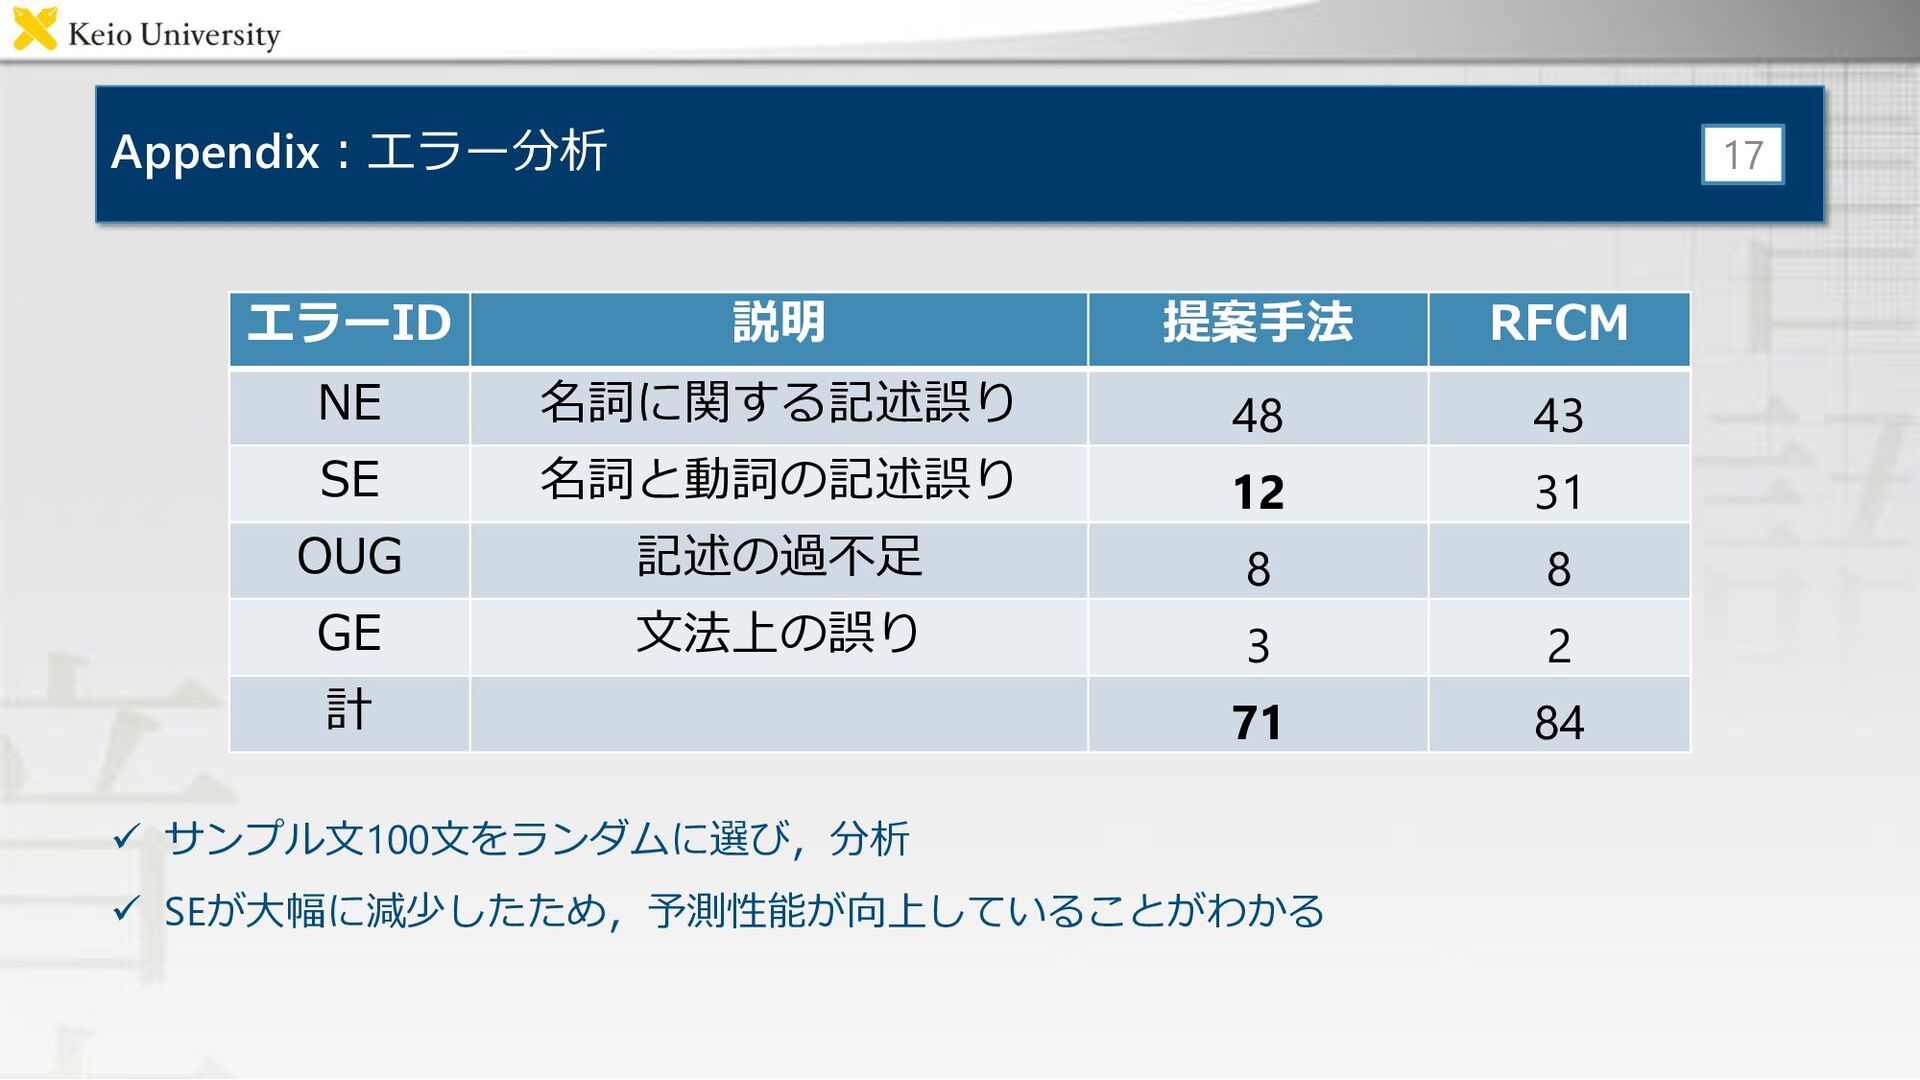
Appendix:エラー分析 エラーID 説明 提案手法 RFCM NE 名詞に関する記述誤り 48 43 SE
名詞と動詞の記述誤り 12 31 OUG 記述の過不足 8 8 GE 文法上の誤り 3 2 計 71 84 17 ✓ サンプル文100文をランダムに選び,分析 ✓ SEが大幅に減少したため,予測性能が向上していることがわかる -
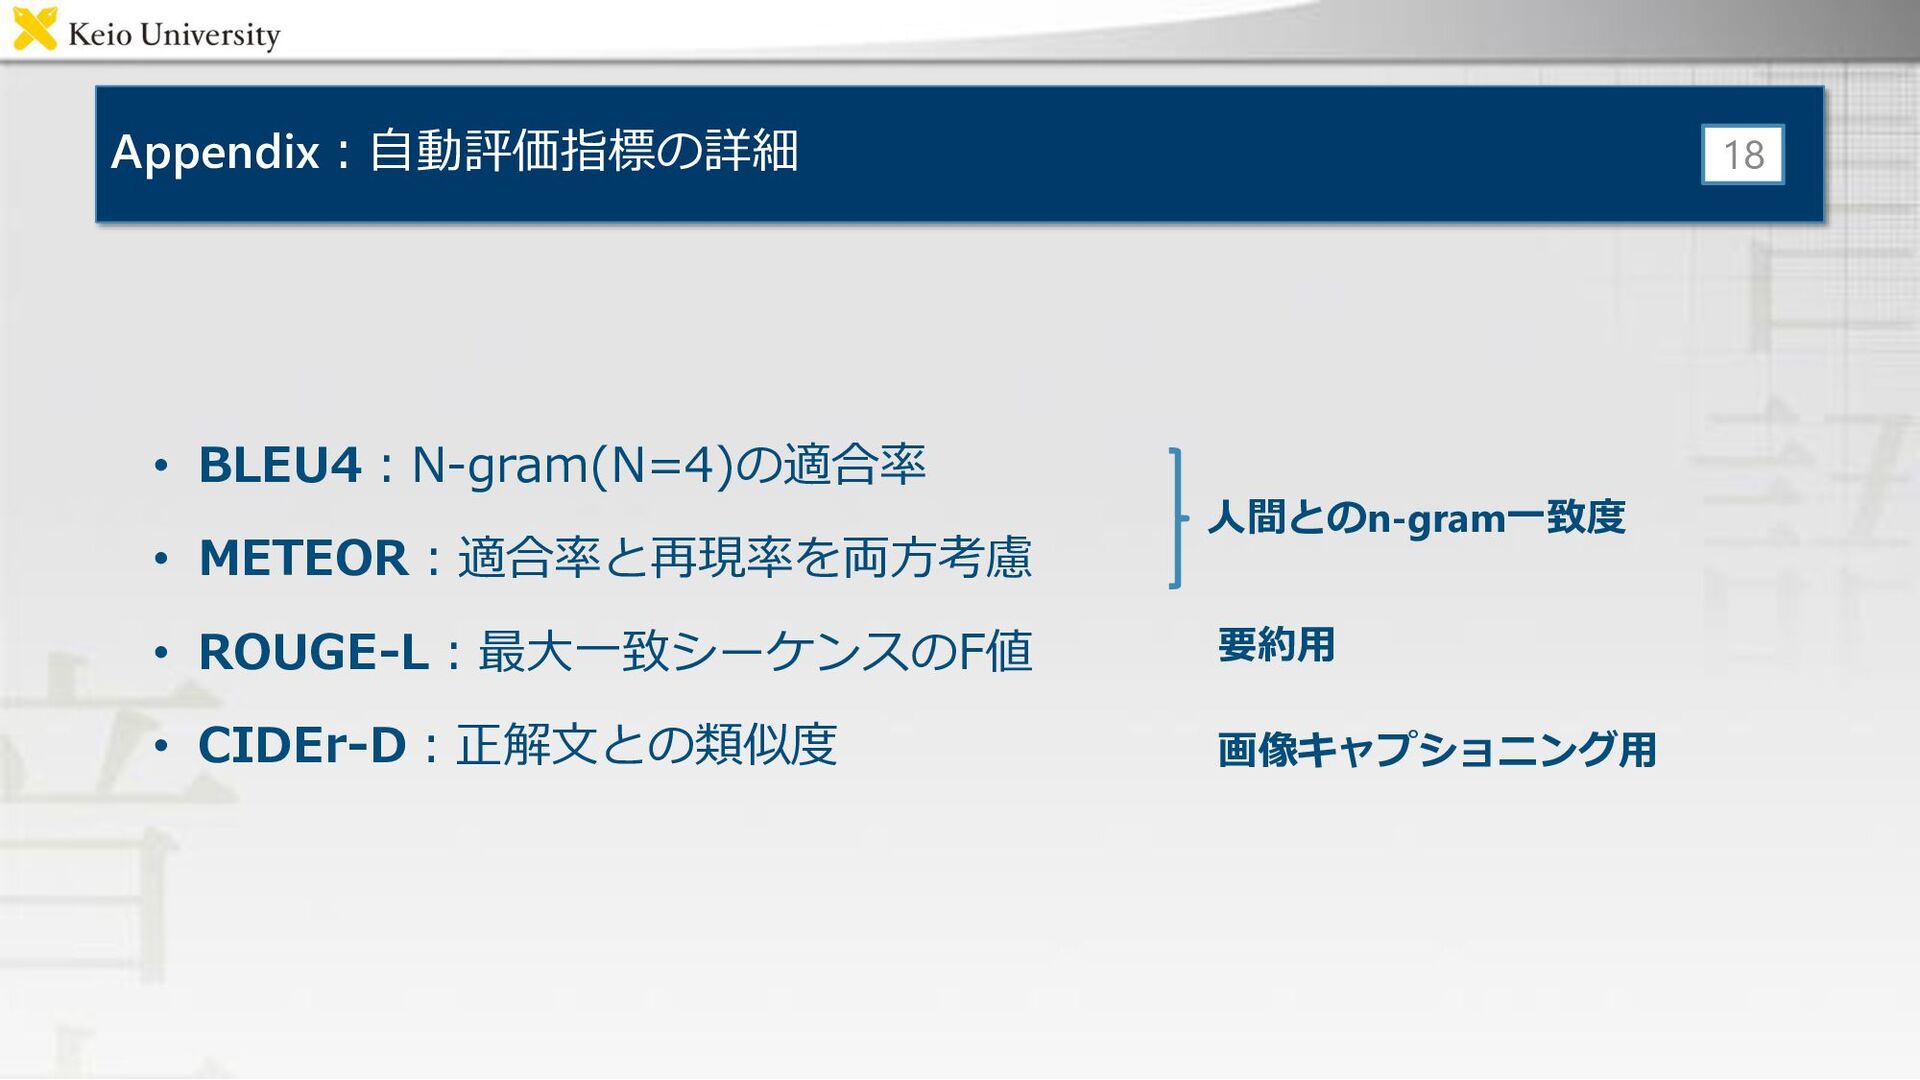
Appendix:自動評価指標の詳細 18 • BLEU4:N-gram(N=4)の適合率 • METEOR:適合率と再現率を両方考慮 • ROUGE-L:最大一致シーケンスのF値 • CIDEr-D:正解文との類似度
画像キャプショニング用 要約用 人間とのn-gram一致度