Share
Embed
[SIG-KBS22] Target Position Prediction Using UNITER Regressor for Understanding Navigation Instructions in Urban Areas
Semantic Machine Intelligence Lab., Keio Univ. PRO
August 26, 2022
Transcript
26 slides
-
背景:モビリティが移動指示を理解することができれば便利 • 人とモビリティの関係性 – 現状:人がモビリティを操作 – 将来:モビリティに指示を与え, 自動化技術が命令を遂行 • モビリティが移動指示を理解し,
目標位置で止まることができれば 便利 – 例)「ポストの前で止まって」 https://www.youtube.com/watch?v=LSAg6bzlf1Q • 車などの自動化技術の進展とともに人とモビリティの相互作用の変化に期待 2 -
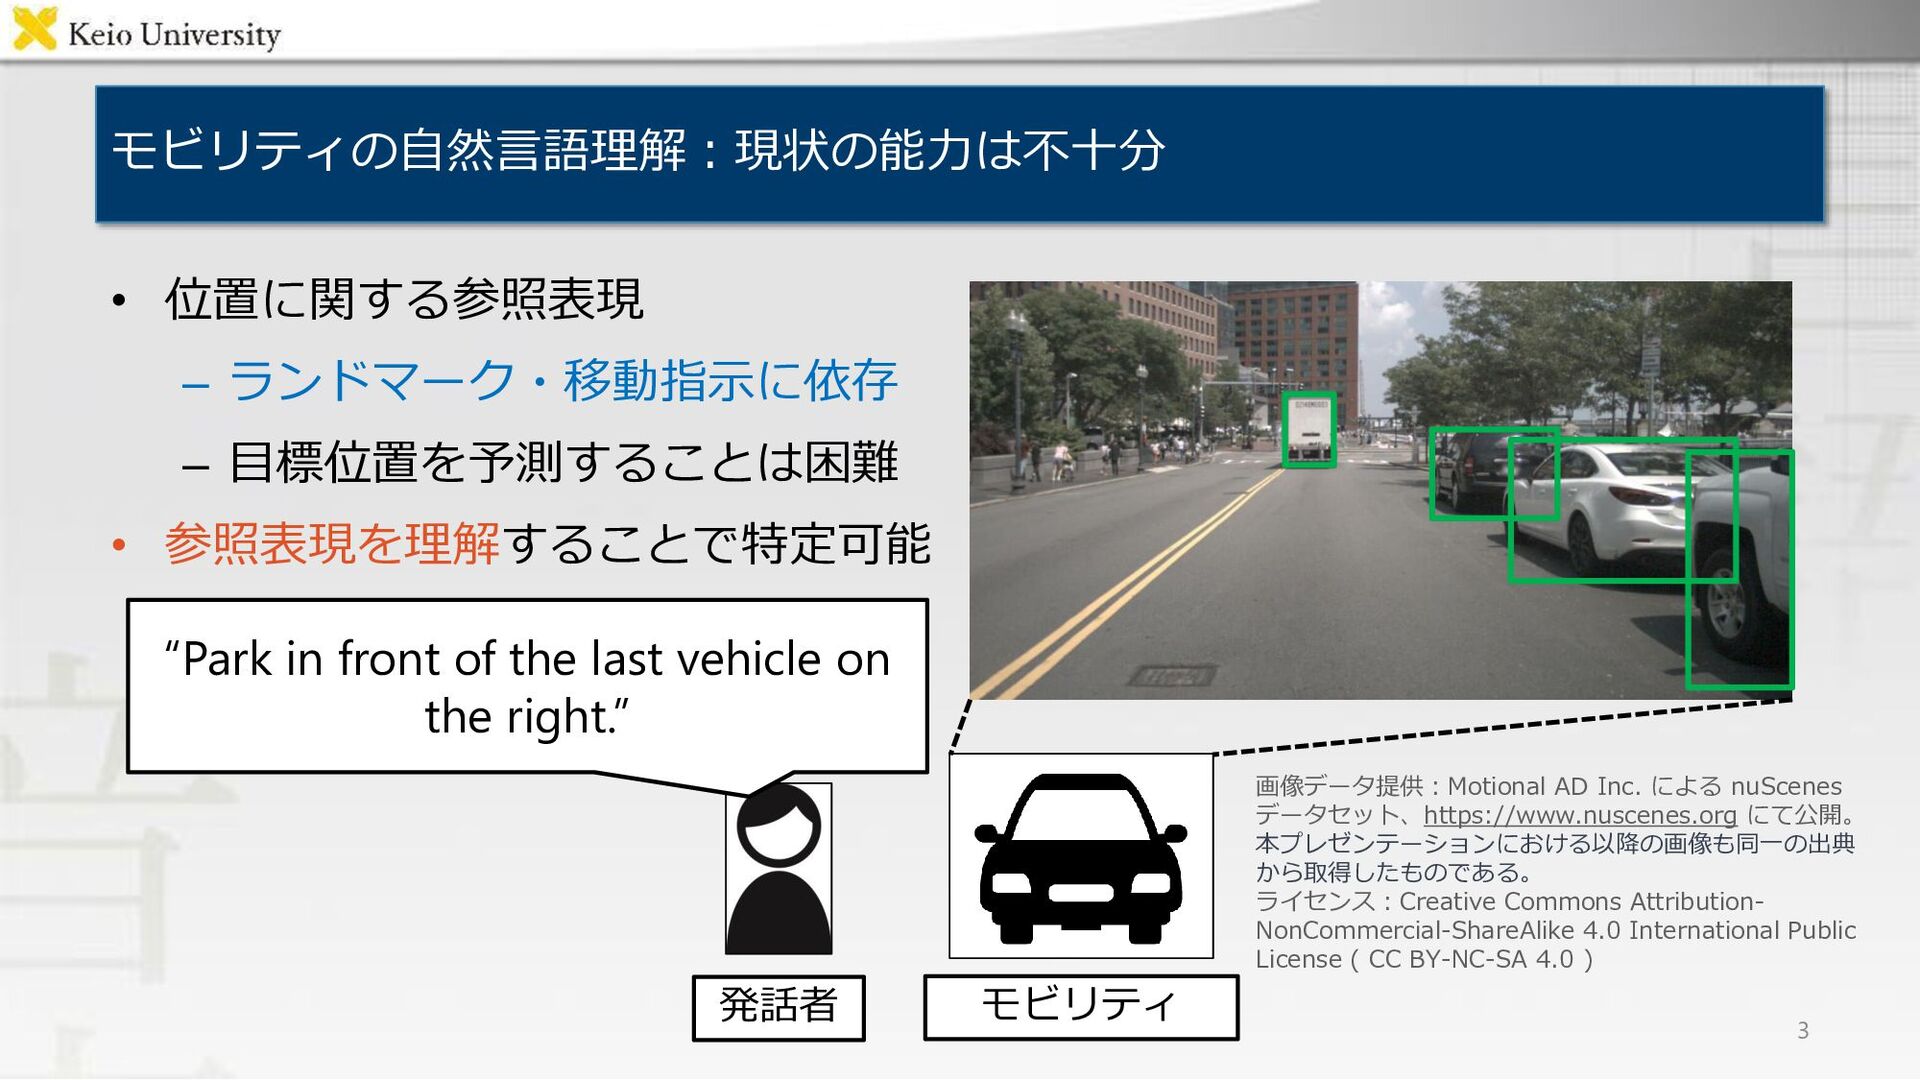
モビリティの自然言語理解:現状の能力は不十分 • 位置に関する参照表現 – ランドマーク・移動指示に依存 – 目標位置を予測することは困難 • 参照表現を理解することで特定可能 モビリティ
発話者 “Park in front of the last vehicle on the right.” 3 画像データ提供:Motional AD Inc. による nuScenes データセット、https://www.nuscenes.org にて公開。 本プレゼンテーションにおける以降の画像も同一の出典 から取得したものである。 ライセンス:Creative Commons Attribution- NonCommercial-ShareAlike 4.0 International Public License ( CC BY-NC-SA 4.0 ) -
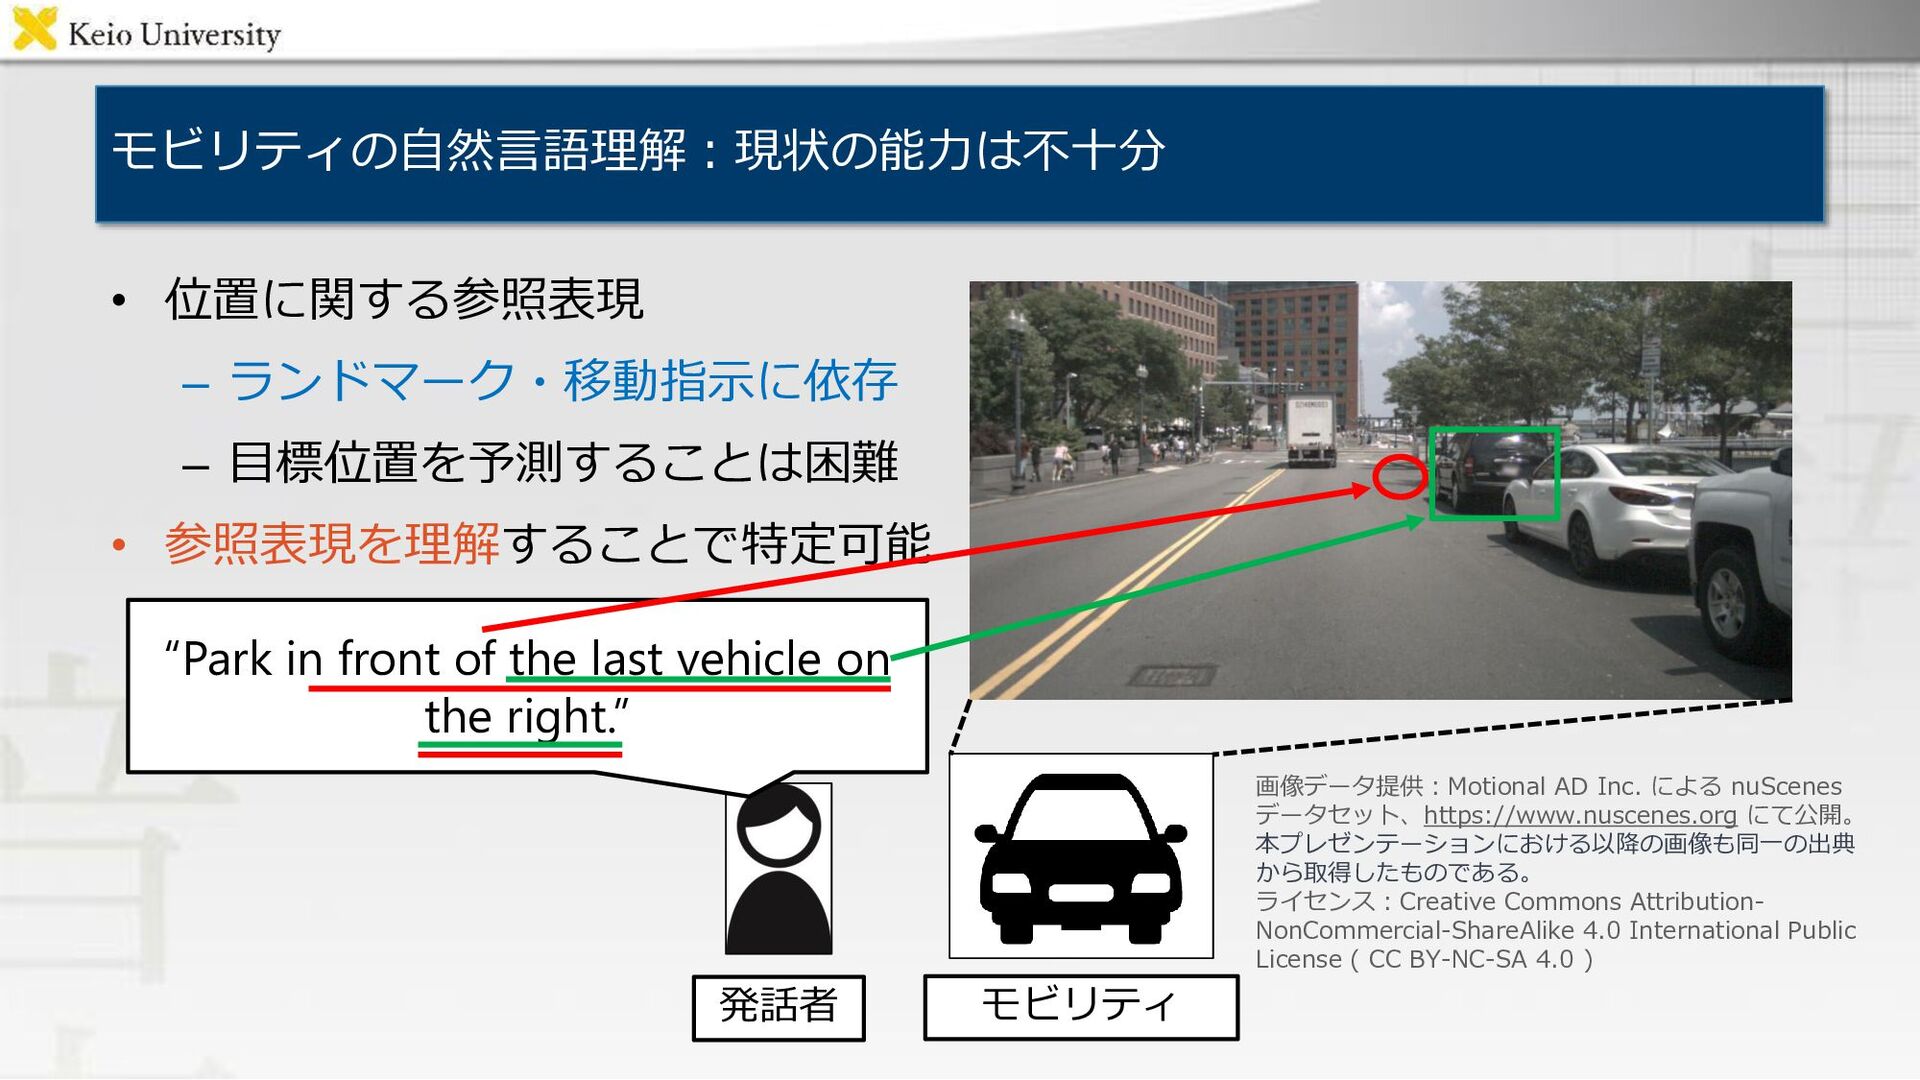
モビリティの自然言語理解:現状の能力は不十分 • 位置に関する参照表現 – ランドマーク・移動指示に依存 – 目標位置を予測することは困難 • 参照表現を理解することで特定可能 モビリティ
発話者 “Park in front of the last vehicle on the right.” 画像データ提供:Motional AD Inc. による nuScenes データセット、https://www.nuscenes.org にて公開。 本プレゼンテーションにおける以降の画像も同一の出典 から取得したものである。 ライセンス:Creative Commons Attribution- NonCommercial-ShareAlike 4.0 International Public License ( CC BY-NC-SA 4.0 ) -
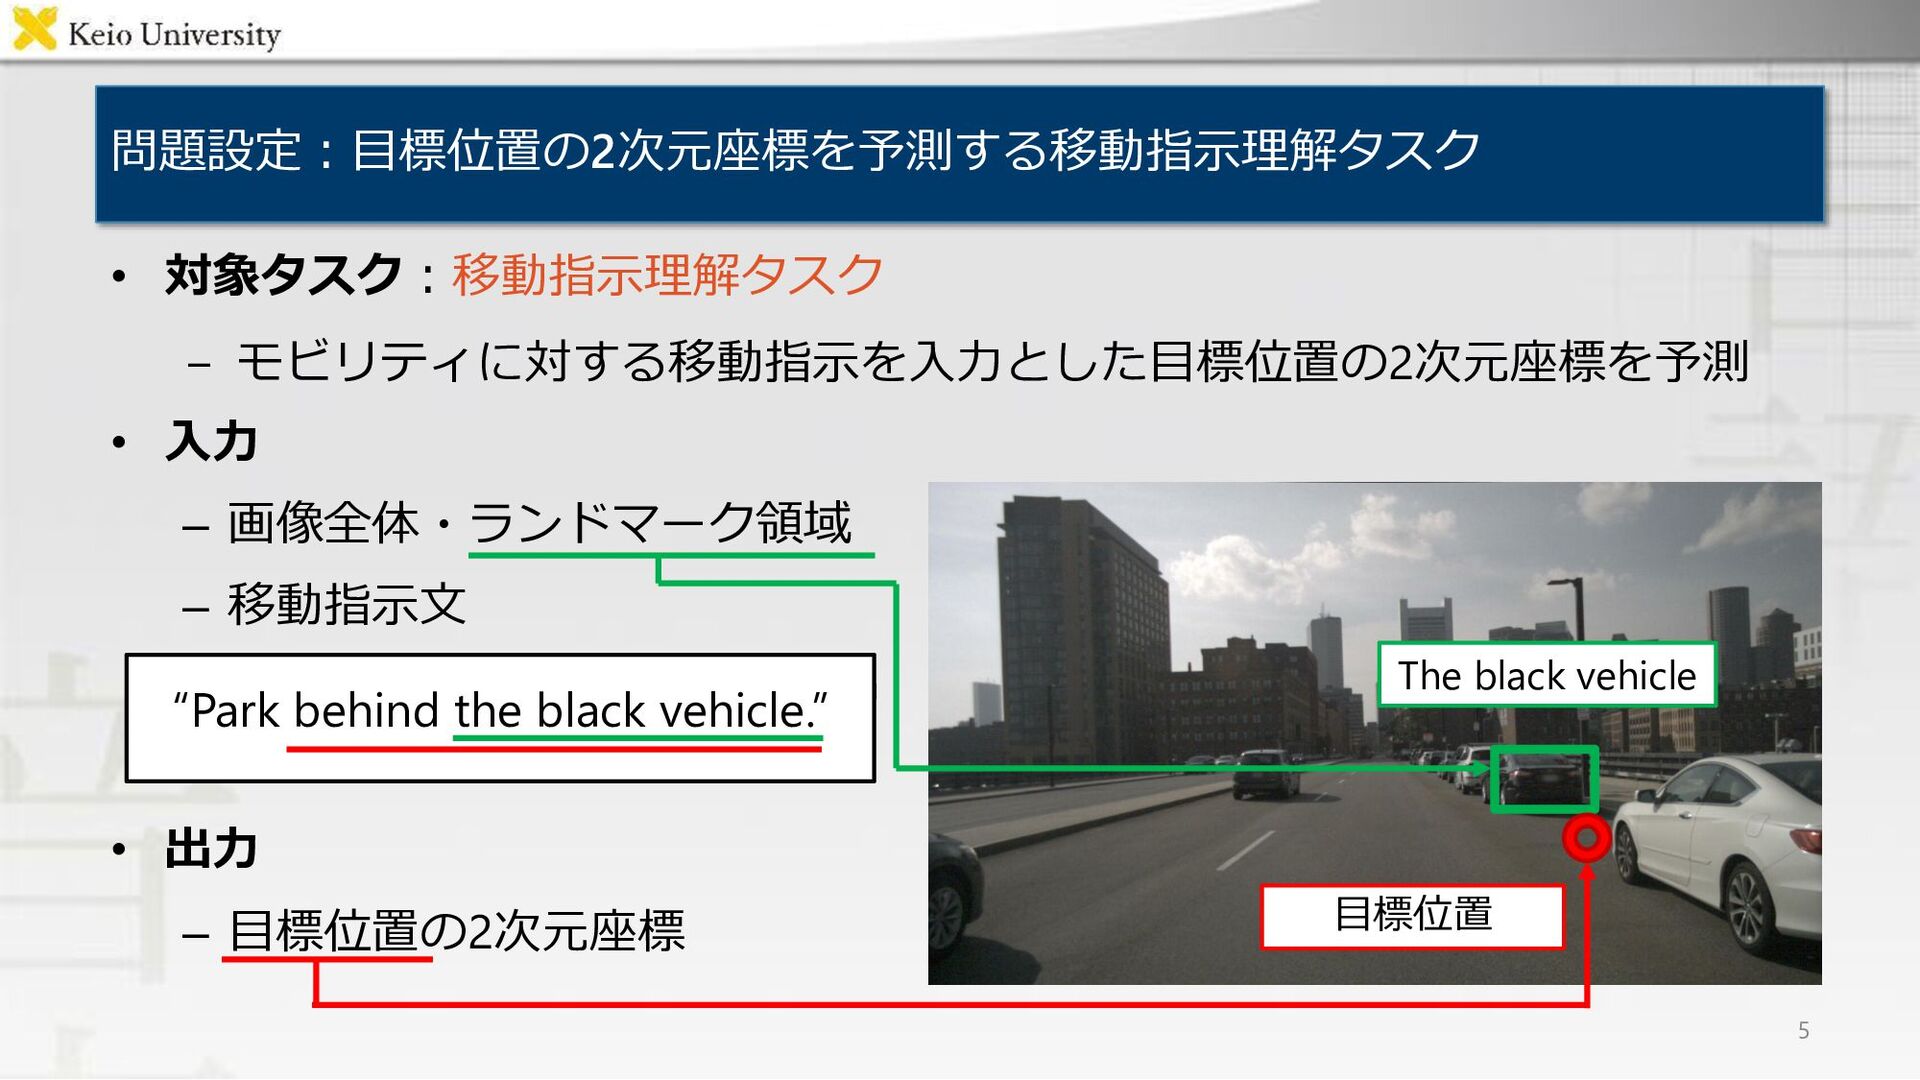
問題設定:目標位置の2次元座標を予測する移動指示理解タスク • 入力 – 画像全体・ランドマーク領域 – 移動指示文 • 出力 –
目標位置の2次元座標 5 “Park behind the black vehicle.” The black vehicle 目標位置 • 対象タスク:移動指示理解タスク − モビリティに対する移動指示を入力とした目標位置の2次元座標を予測 -
既存手法(1/2):関連分野としてマルチモーダルなRECモデルと屋外でのVLN モデルの研究 タスク 手法 概要 REC ViLBERT [Lu+, NeurIPS2019] 画像と自然言語の相互表現を学習
MDETER [Kamath+, ICCV2021] End-to-Endのテキスト条件付き 物体検出モデル VLN MTST [Zhu+, EACL2021] マルチモーダルなテキストスタイルの transformerモデル ORAR [Schumann+, ACL2022] 未知の屋外にも対応した双方向 LSTMモデル MTST [Zhu+ EACL 2021] ViLBERT [Lu+, NeurIPS2019] 6 -
既存手法(2/2):関連手法は目標領域をマスクで予測するが,依然として目標領域の 曖昧さが残る タスク 手法 概要 RES [Rufus+, IROS2021] DETR [Carion+,
ECCV2020] を適用し セグメンテーションマスクとして モビリティの目標領域を予測 PDPC [Grujicic+, AAAI2022] 上空視点画像の情報も入力に加えて 目標領域をガウス混合分布として予測 PDPC [Grujicic+ AAAI2022] [Rufus+, IROS2021] 7 -
Text Embedder:移動指示文の埋め込み処理を行う • 移動指示文 𝑿inst に対して,WordPiece [Wu+, 16] によってトークン化を行う –
𝒙inst :学習済み BERT [Devlin+, 2018] に基づく埋め込み処理 – 𝒙pos :命令文中の各トークンの位置を表すone-hotベクトル集合 9 -
Text Embedder:移動指示文の埋め込み処理を行う • 移動指示文 𝑿inst に対して,WordPiece [Wu+, 16] によってトークン化を行う –
𝒙inst :学習済み BERT [Devlin+, 2018] に基づく埋め込み処理 – 𝒙pos :命令文中の各トークンの位置を表すone-hotベクトル集合 10 𝒉txtemb = 𝑓𝐿𝑁 { 𝑾inst 𝒙inst , 𝑾pos 𝒙pos } 𝑾inst, 𝑾pos :学習可能パラメータ 𝑓𝐿𝑁 :Layer Normalization -
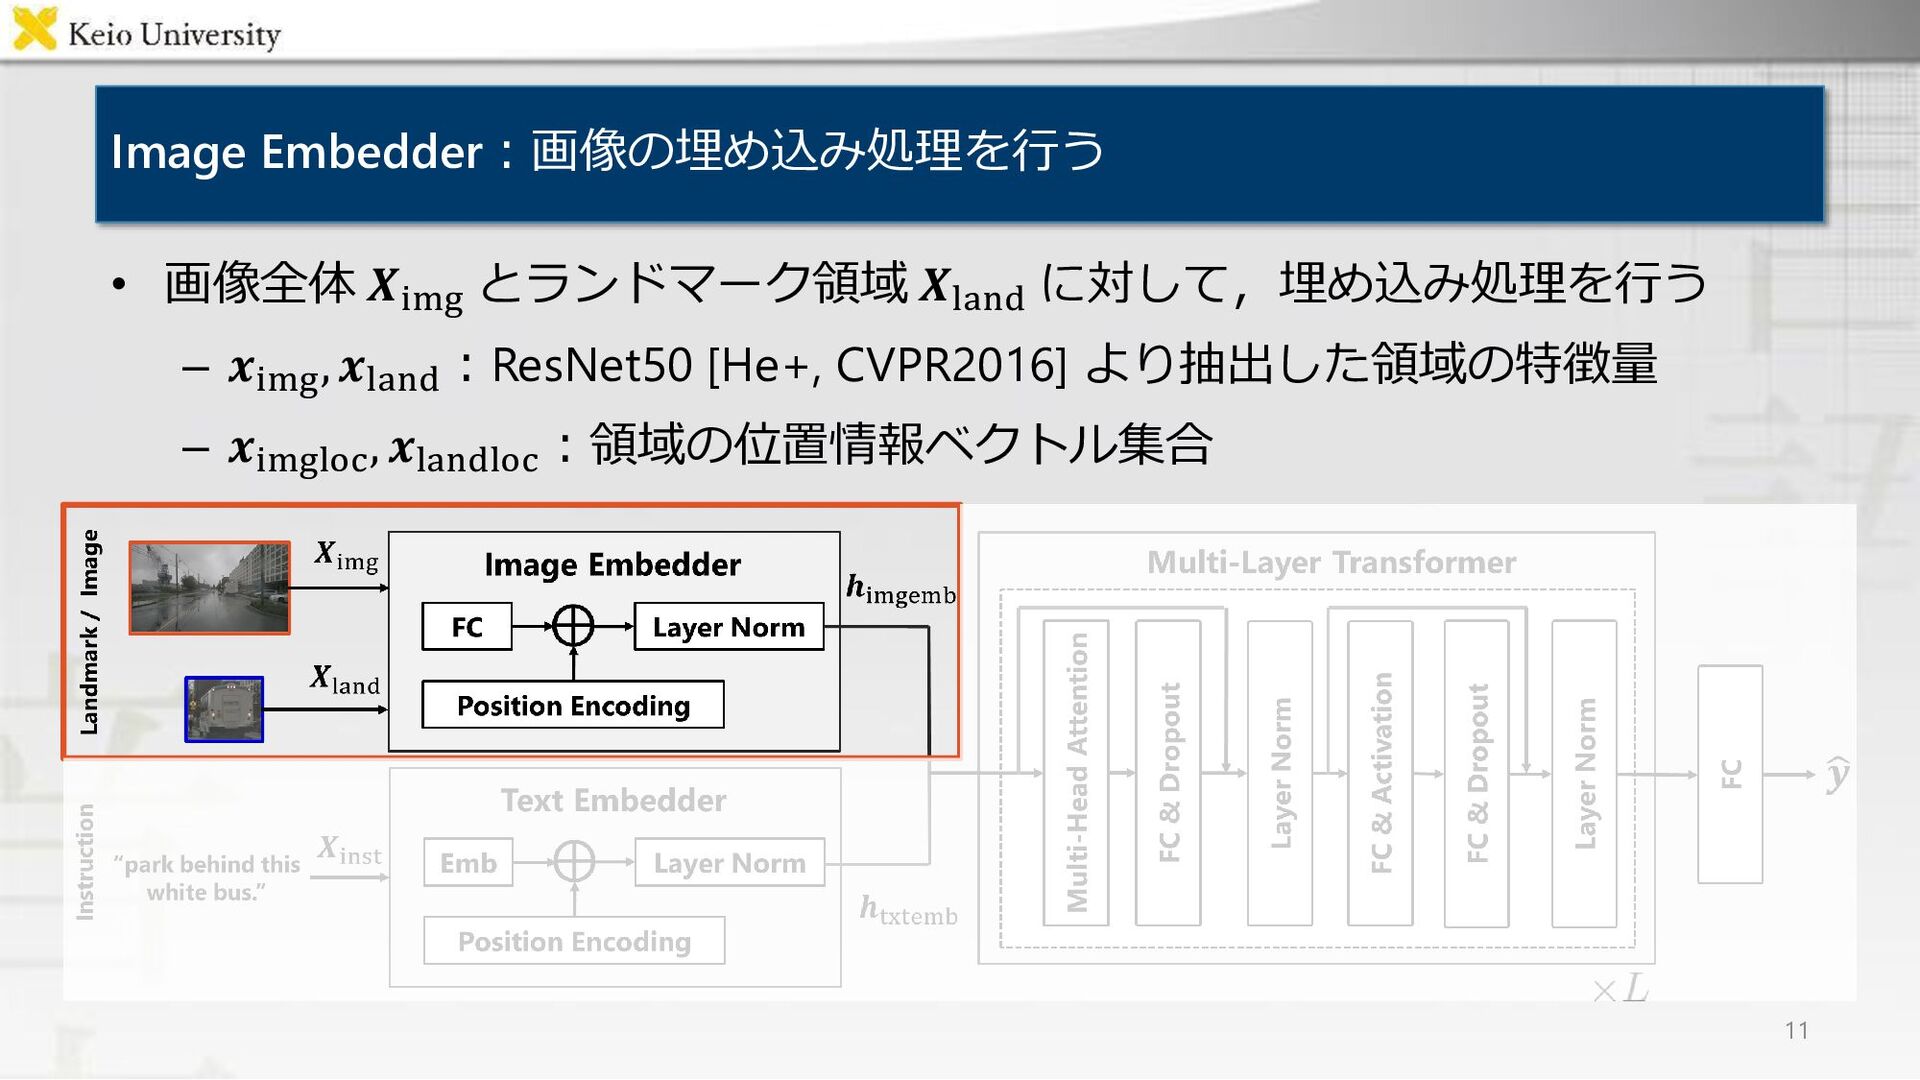
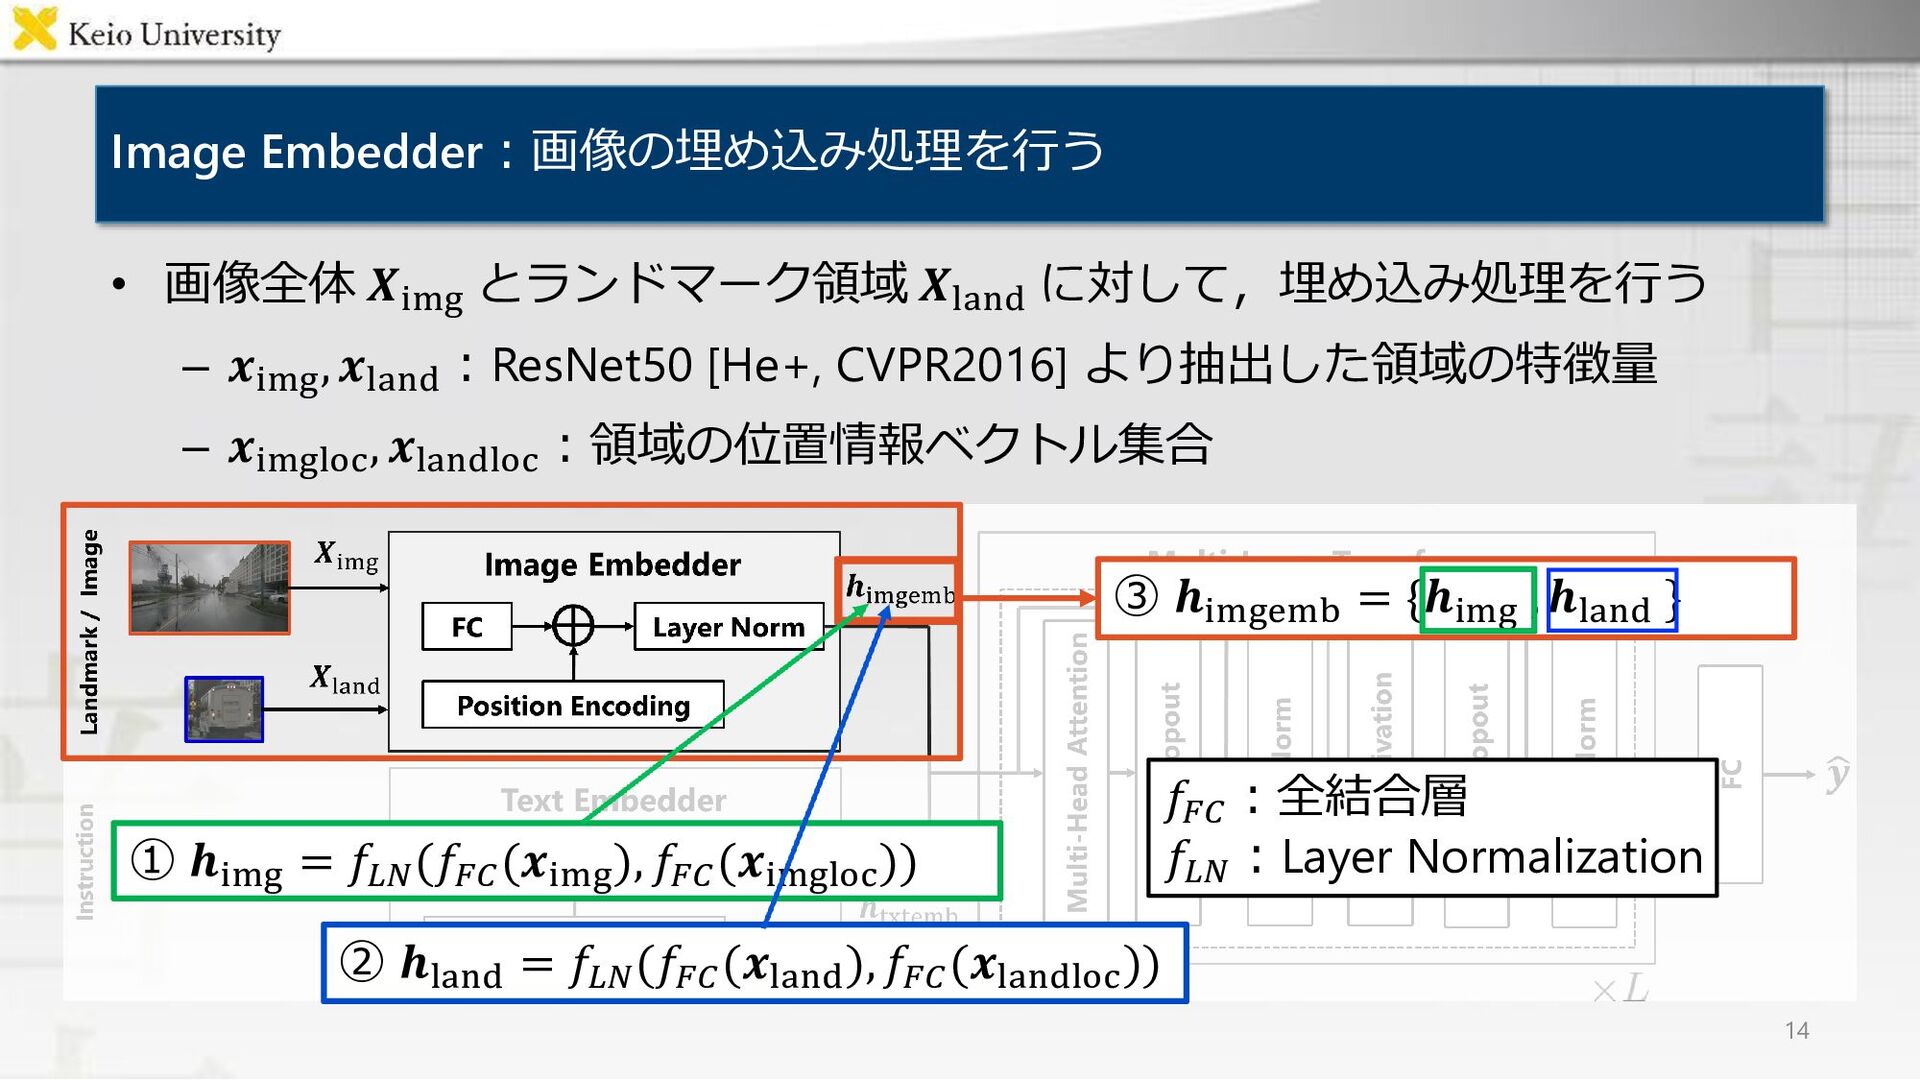
Image Embedder:画像の埋め込み処理を行う • 画像全体 𝑿img とランドマーク領域 𝑿land に対して,埋め込み処理を行う – 𝒙img
, 𝒙land :ResNet50 [He+, CVPR2016] より抽出した領域の特徴量 – 𝒙imgloc , 𝒙landloc :領域の位置情報ベクトル集合 11 -
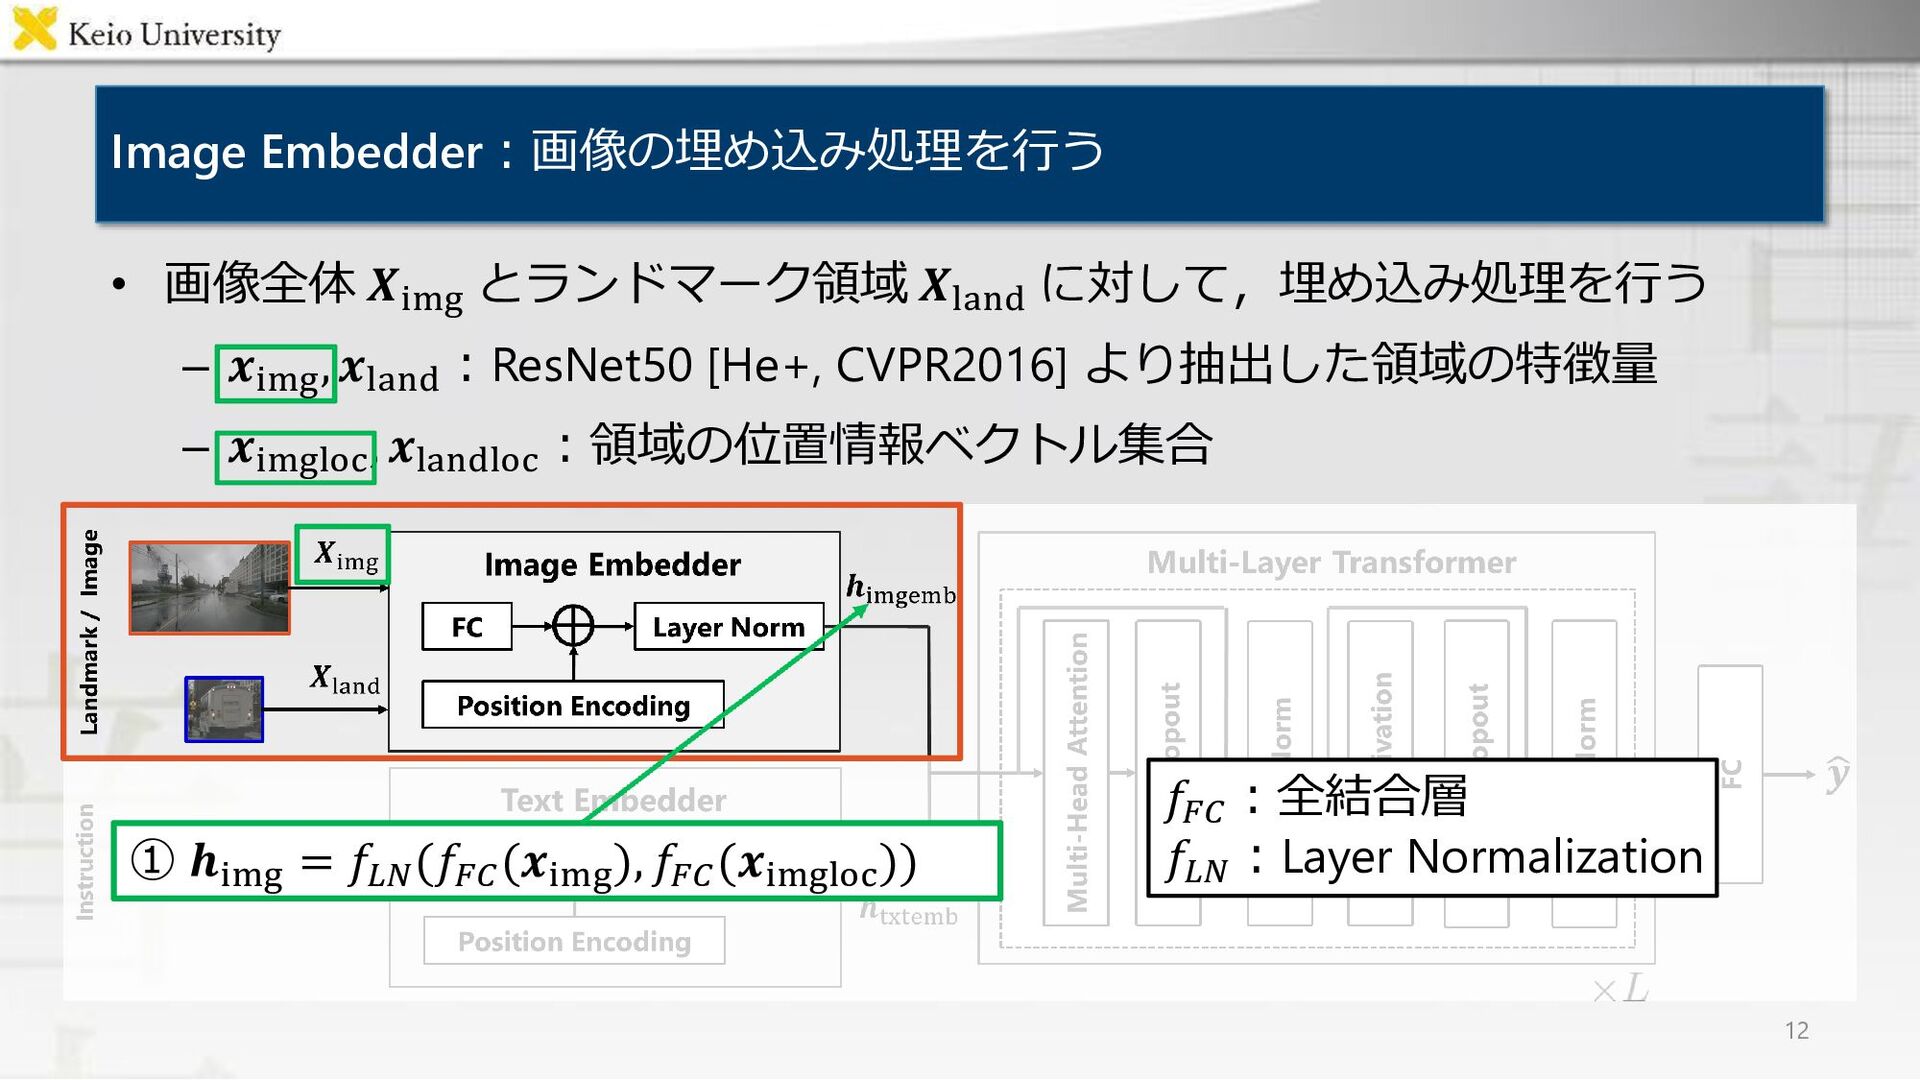
Image Embedder:画像の埋め込み処理を行う • 画像全体 𝑿img とランドマーク領域 𝑿land に対して,埋め込み処理を行う – 𝒙img
, 𝒙land :ResNet50 [He+, CVPR2016] より抽出した領域の特徴量 – 𝒙imgloc , 𝒙landloc :領域の位置情報ベクトル集合 12 ① 𝒉img = 𝑓𝐿𝑁 (𝑓𝐹𝐶 (𝒙img ), 𝑓𝐹𝐶 (𝒙imgloc )) 𝑓𝐹𝐶 :全結合層 𝑓𝐿𝑁 :Layer Normalization -
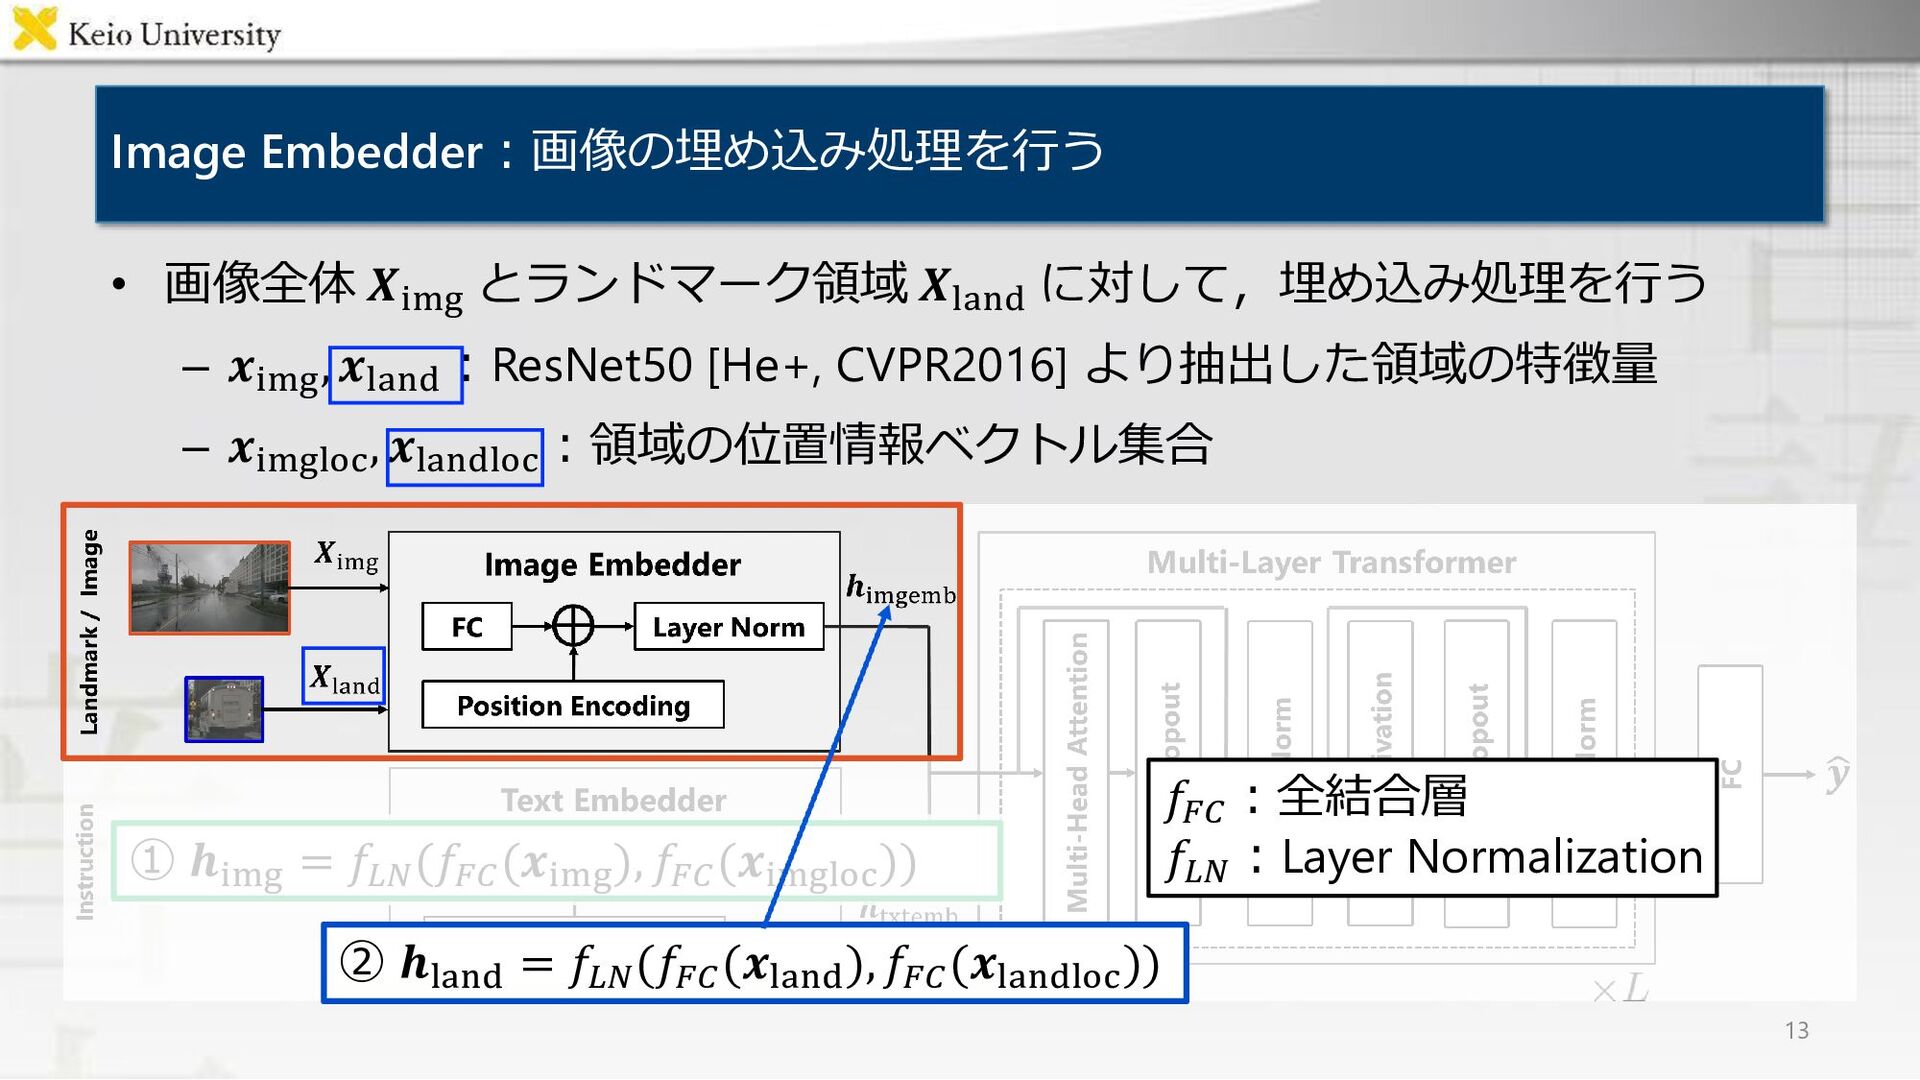
• 画像全体 𝑿img とランドマーク領域 𝑿land に対して,埋め込み処理を行う – 𝒙img , 𝒙land
:ResNet50 [He+, CVPR2016] より抽出した領域の特徴量 – 𝒙imgloc , 𝒙landloc :領域の位置情報ベクトル集合 Image Embedder:画像の埋め込み処理を行う 13 ① 𝒉img = 𝑓𝐿𝑁 (𝑓𝐹𝐶 (𝒙img ), 𝑓𝐹𝐶 (𝒙imgloc )) ② 𝒉land = 𝑓𝐿𝑁 (𝑓𝐹𝐶 (𝒙land ), 𝑓𝐹𝐶 (𝒙landloc )) 𝑓𝐹𝐶 :全結合層 𝑓𝐿𝑁 :Layer Normalization -
• 画像全体 𝑿img とランドマーク領域 𝑿land に対して,埋め込み処理を行う – 𝒙img , 𝒙land
:ResNet50 [He+, CVPR2016] より抽出した領域の特徴量 – 𝒙imgloc , 𝒙landloc :領域の位置情報ベクトル集合 Image Embedder:画像の埋め込み処理を行う 14 𝑓𝐹𝐶 :全結合層 𝑓𝐿𝑁 :Layer Normalization ② 𝒉land = 𝑓𝐿𝑁 (𝑓𝐹𝐶 (𝒙land ), 𝑓𝐹𝐶 (𝒙landloc )) ① 𝒉img = 𝑓𝐿𝑁 (𝑓𝐹𝐶 (𝒙img ), 𝑓𝐹𝐶 (𝒙imgloc )) ③ 𝒉imgemb = {𝒉img , 𝒉land } -
Multi-Layer Transformer:画像とテキストの関係性を学習 15 • 𝐿層の Transformer [Vaswani+, NeurIPS17] で構成 •
Image EmbedderとText Embedderの出力を結合 – 第1層の入力とする ① 𝒉 in 𝑖 = {𝒉imgemb , 𝒉txtemb } -
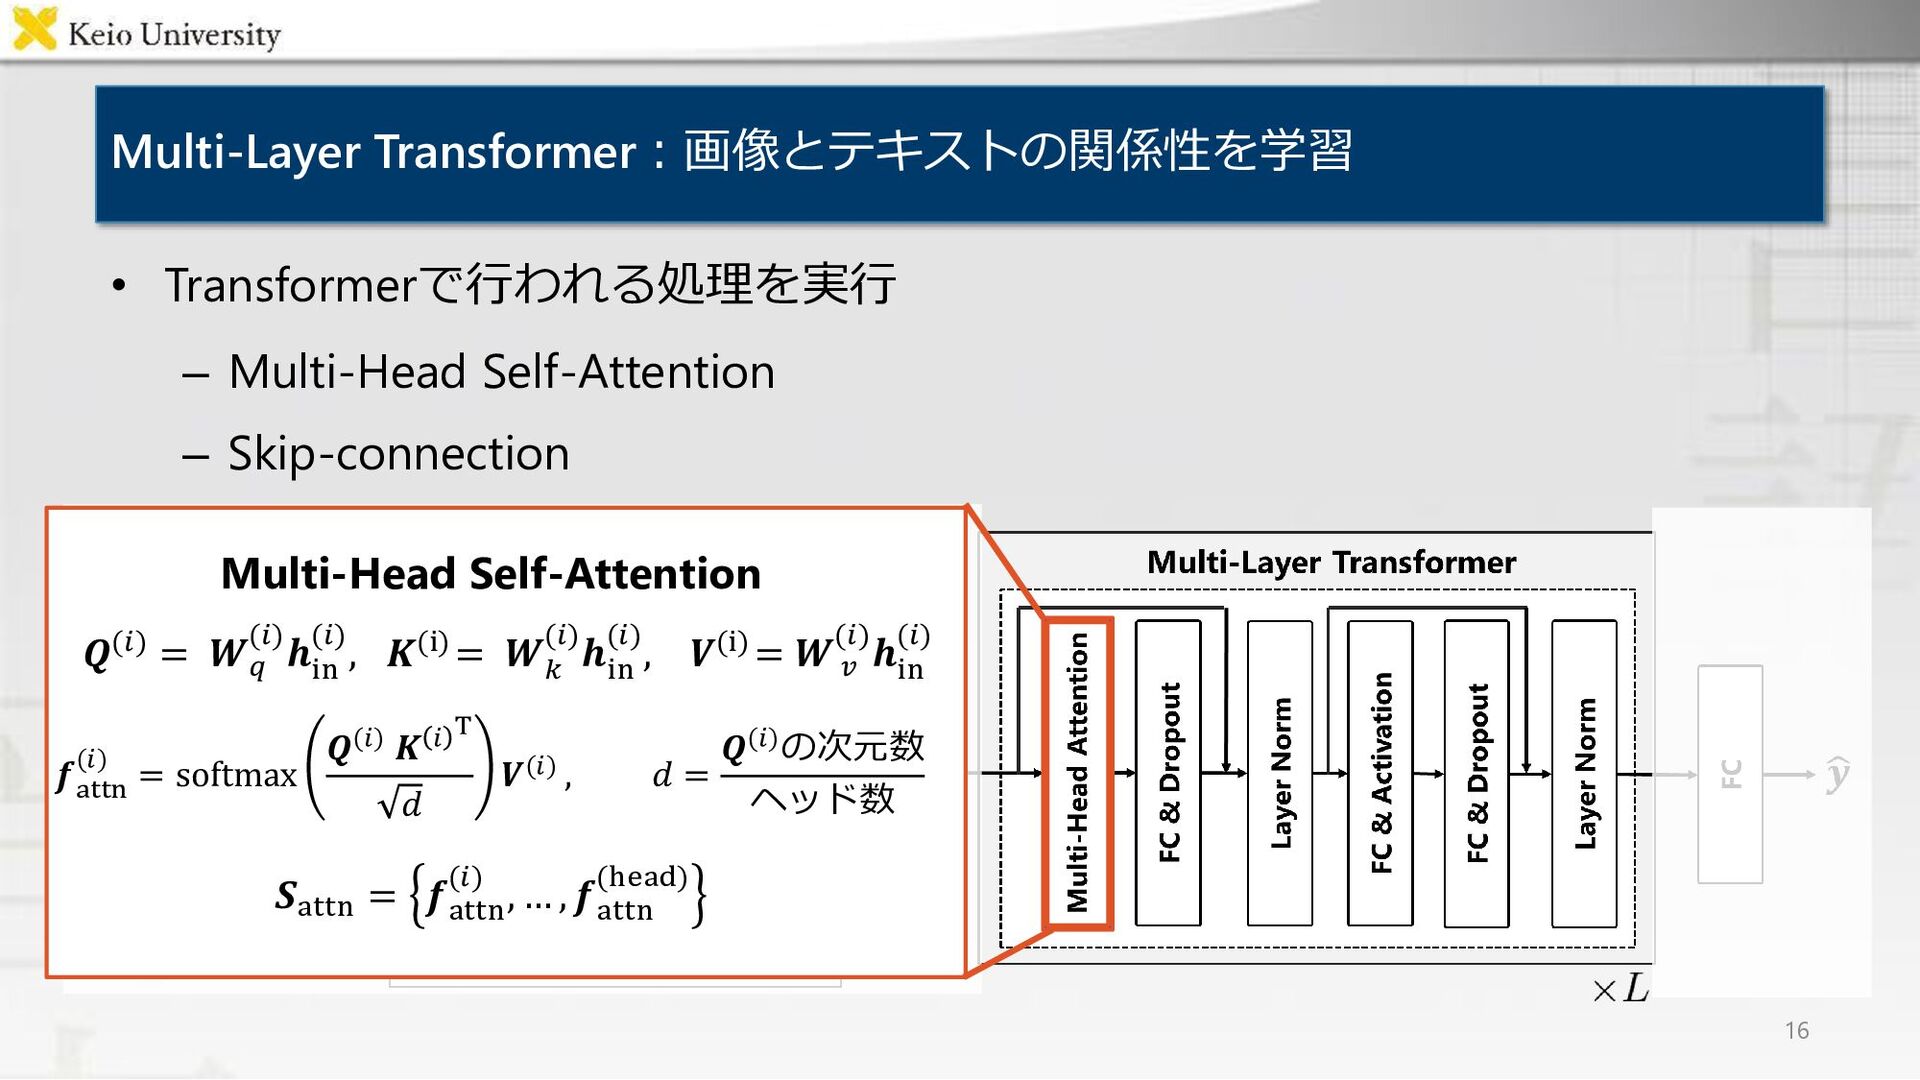
Multi-Layer Transformer:画像とテキストの関係性を学習 16 • Transformerで行われる処理を実行 – Multi-Head Self-Attention – Skip-connection
𝑸(𝑖) = 𝑾𝑞 (𝑖)𝒉 in (𝑖), 𝑲(i) = 𝑾 𝑘 (𝑖)𝒉 in (𝑖), 𝑽(i) = 𝑾 𝑣 (𝑖)𝒉 in (𝑖) Multi-Head Self-Attention 𝑺attn = 𝒇 attn (𝑖) , … , 𝒇 attn (head) 𝒇 attn (𝑖) = softmax 𝑸(𝑖) 𝑲 𝑖 T 𝑑 𝑽(𝑖) , 𝑑 = 𝑸(𝑖)の次元数 ヘッド数 -
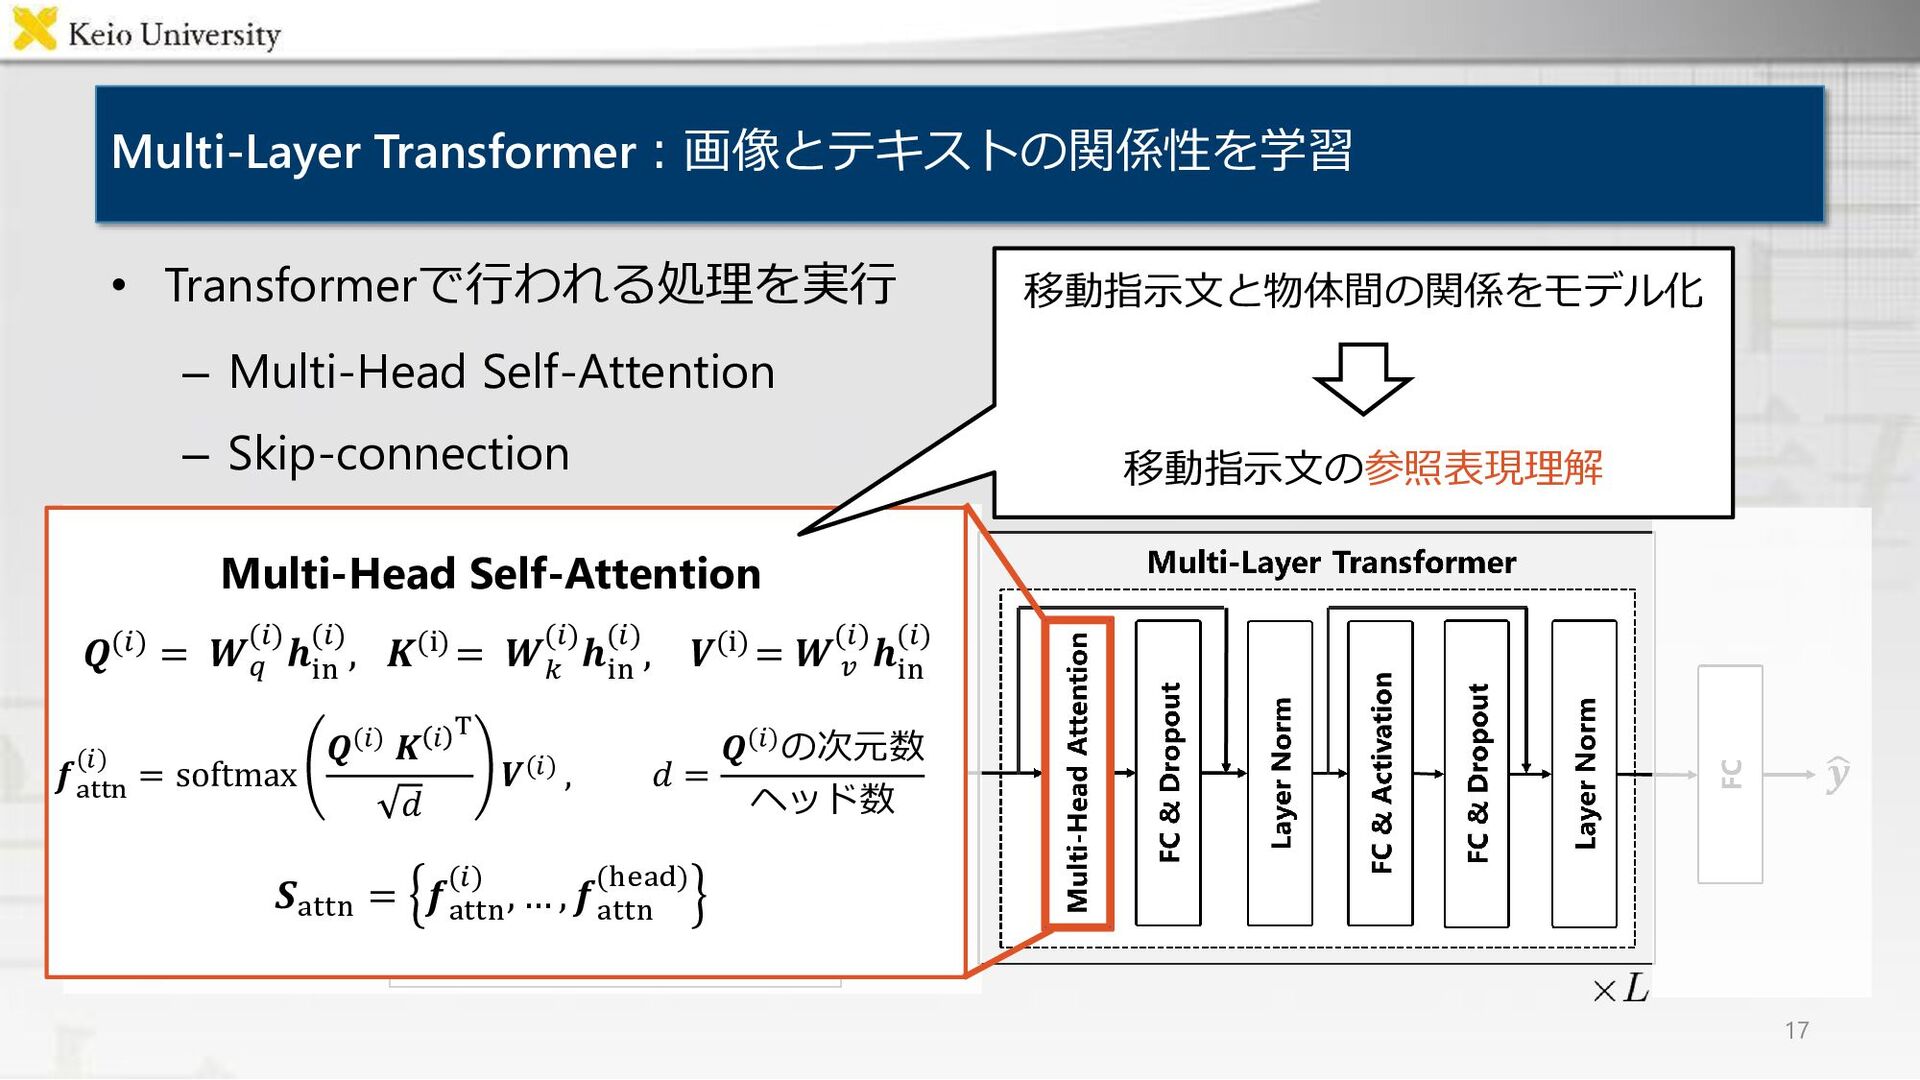
Multi-Layer Transformer:画像とテキストの関係性を学習 17 • Transformerで行われる処理を実行 – Multi-Head Self-Attention – Skip-connection
𝑸(𝑖) = 𝑾𝑞 (𝑖)𝒉 in (𝑖), 𝑲(i) = 𝑾 𝑘 (𝑖)𝒉 in (𝑖), 𝑽(i) = 𝑾 𝑣 (𝑖)𝒉 in (𝑖) Multi-Head Self-Attention 𝑺attn = 𝒇 attn (𝑖) , … , 𝒇 attn (head) 𝒇 attn (𝑖) = softmax 𝑸(𝑖) 𝑲 𝑖 T 𝑑 𝑽(𝑖) , 𝑑 = 𝑸(𝑖)の次元数 ヘッド数 移動指示文と物体間の関係をモデル化 移動指示文の参照表現理解 -
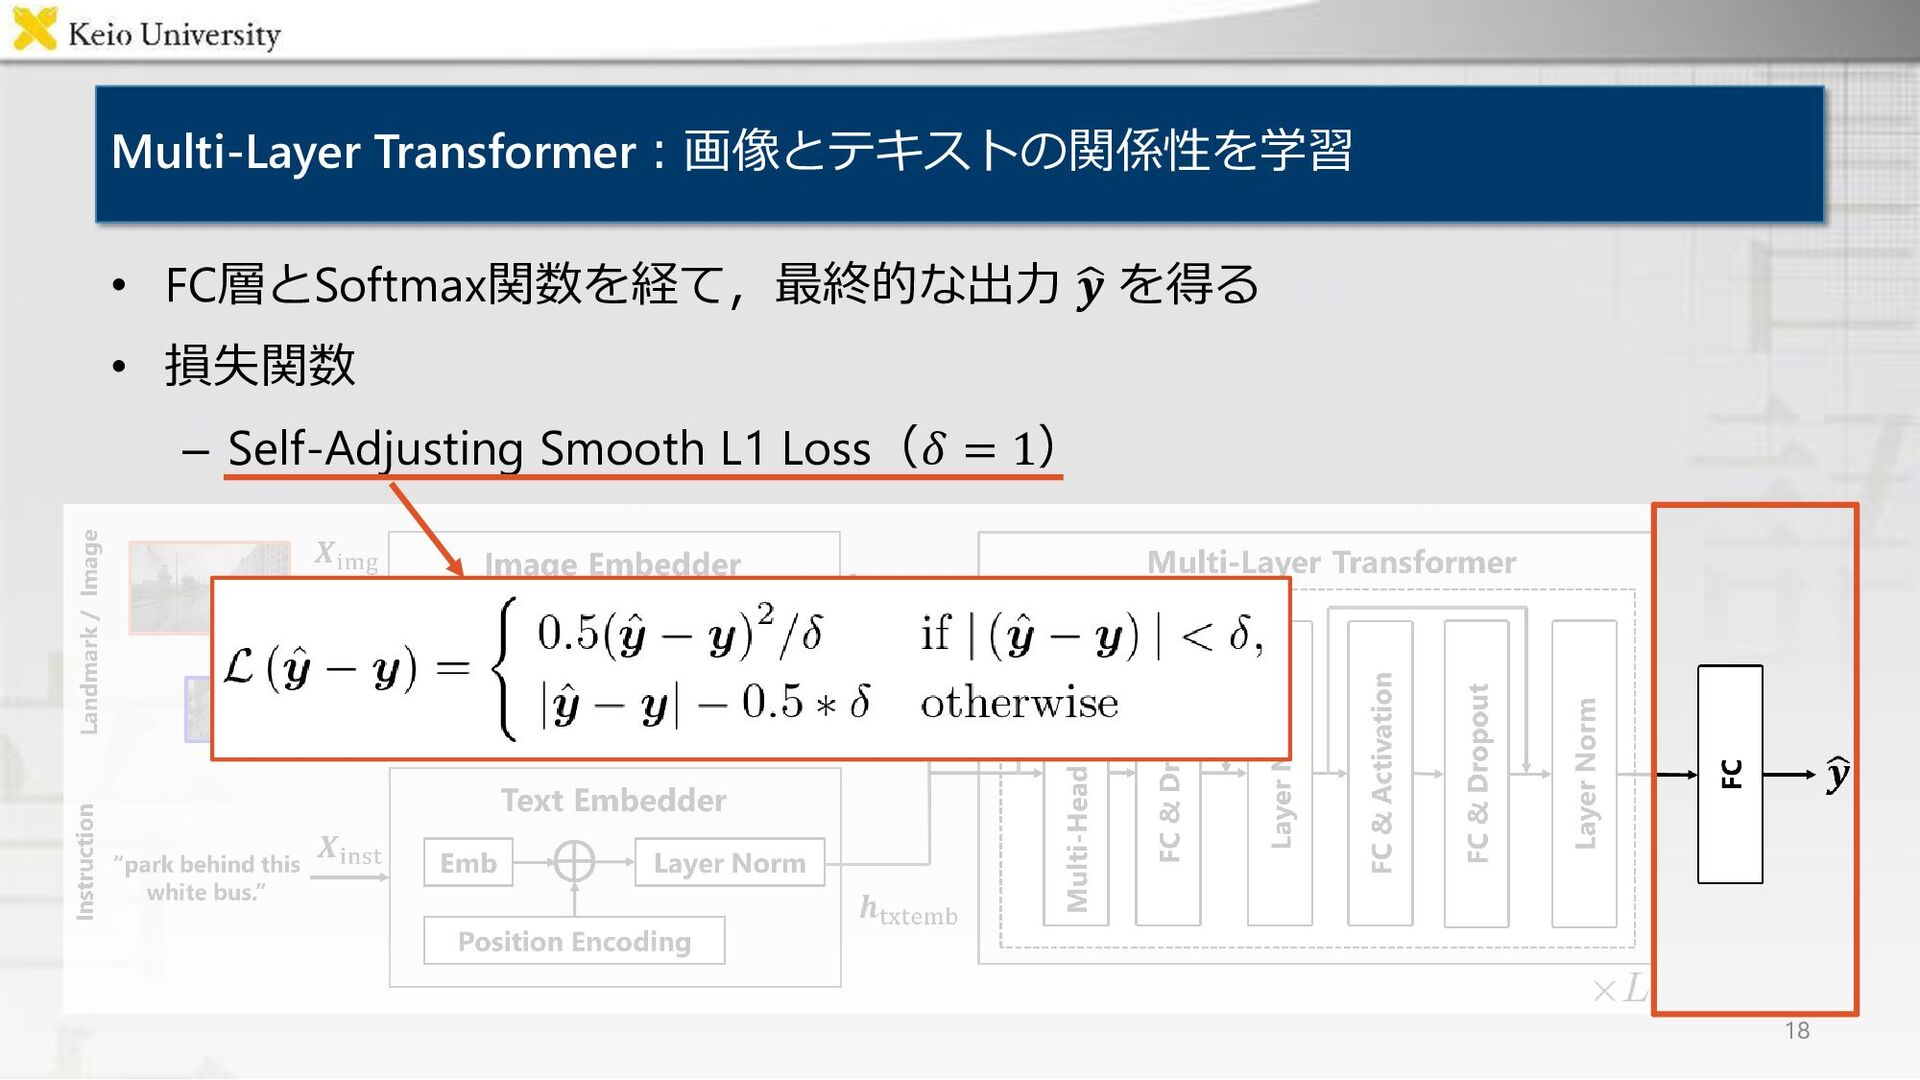
Multi-Layer Transformer:画像とテキストの関係性を学習 18 • FC層とSoftmax関数を経て,最終的な出力 ෝ 𝒚 を得る • 損失関数
– Self-Adjusting Smooth L1 Loss(𝛿 = 1) -
Talk2Carデータセットの問題点:目標位置の正解データが与えられていない • Talk2Car [Deruyttere+, 2019] – 自動運転における実世界の 自然言語理解データセット – 発話内容からランドマーク領域
を推定 • 問題点 – 目標位置の正解データがない – 発話内容が停止するものでない ものが存在する https://www.youtube.com/watch?v=G6fRK3xoAYk 19 -
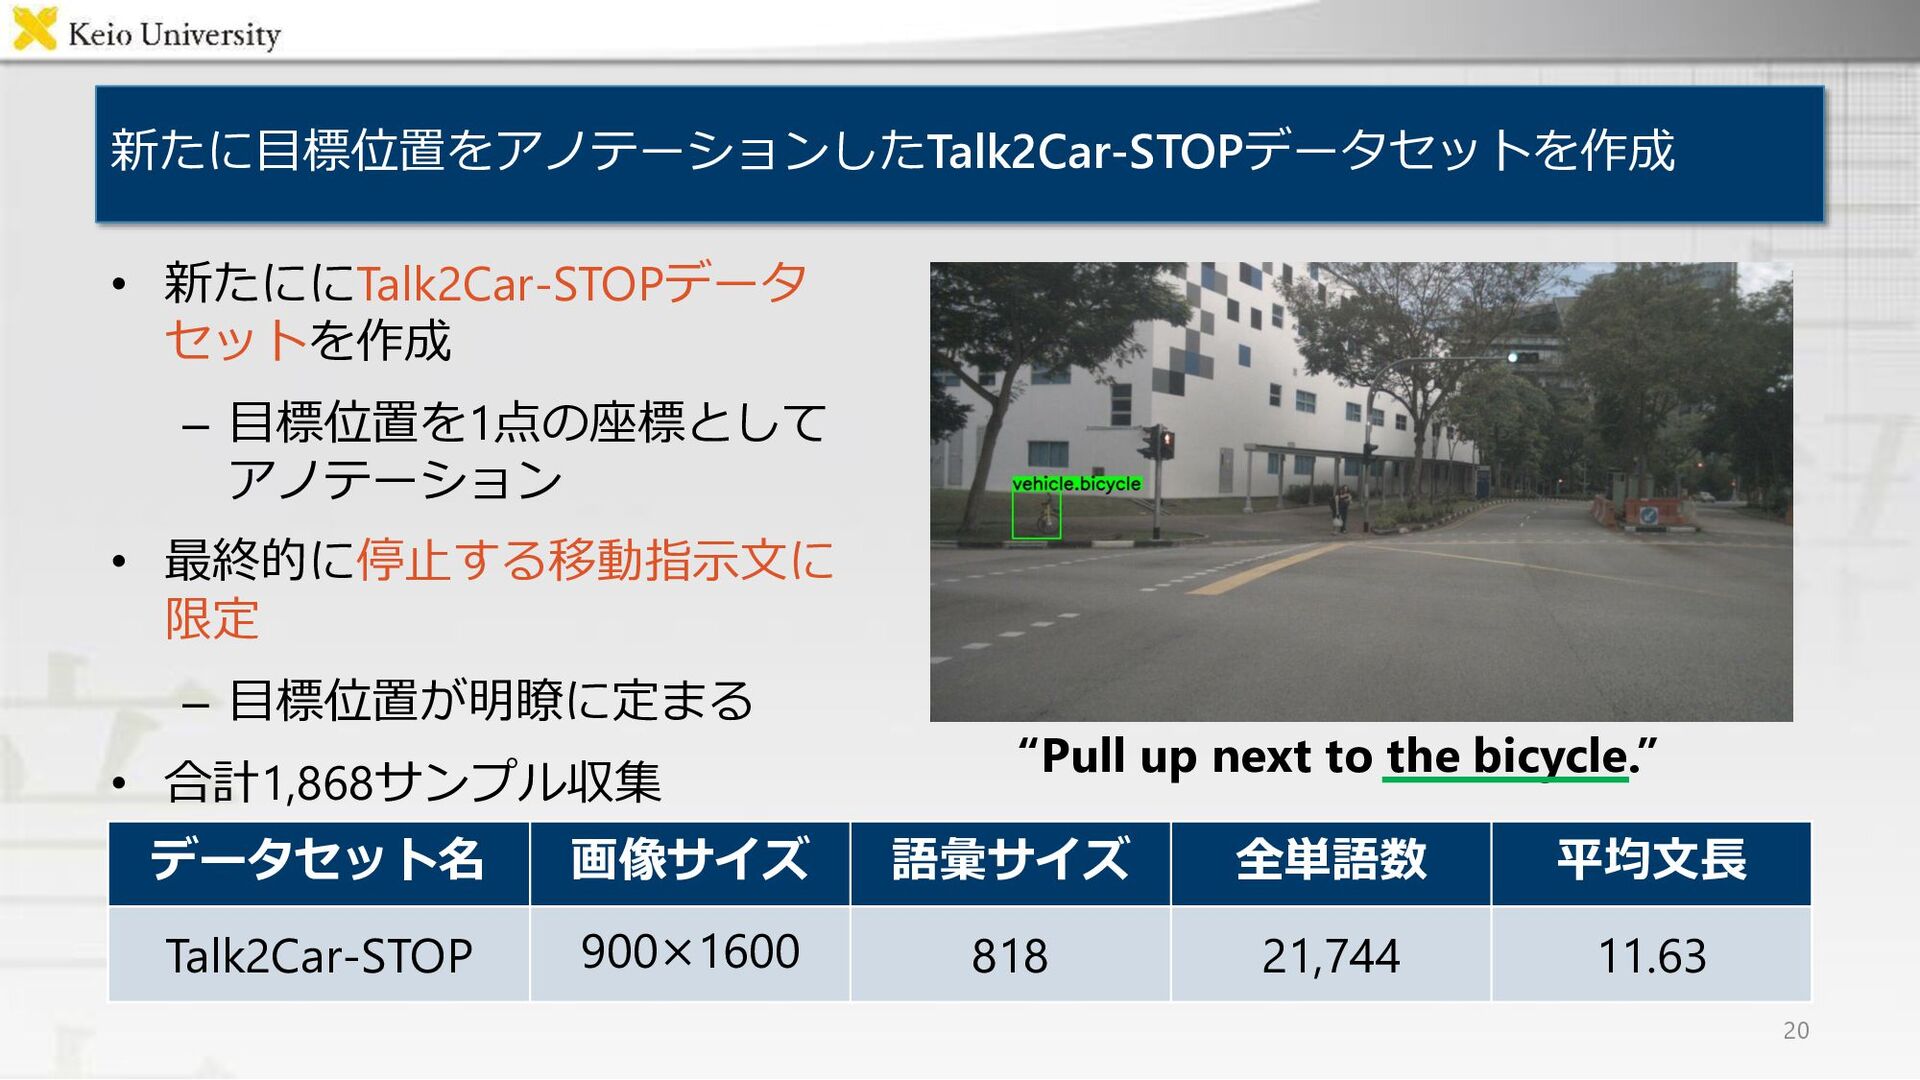
新たに目標位置をアノテーションしたTalk2Car-STOPデータセットを作成 20 “Pull up next to the bicycle.” • 新たににTalk2Car-STOPデータ
セットを作成 – 目標位置を1点の座標として アノテーション • 最終的に停止する移動指示文に 限定 – 目標位置が明瞭に定まる • 合計1,868サンプル収集 データセット名 画像サイズ 語彙サイズ 全単語数 平均文長 Talk2Car-STOP 900×1600 818 21,744 11.63 -
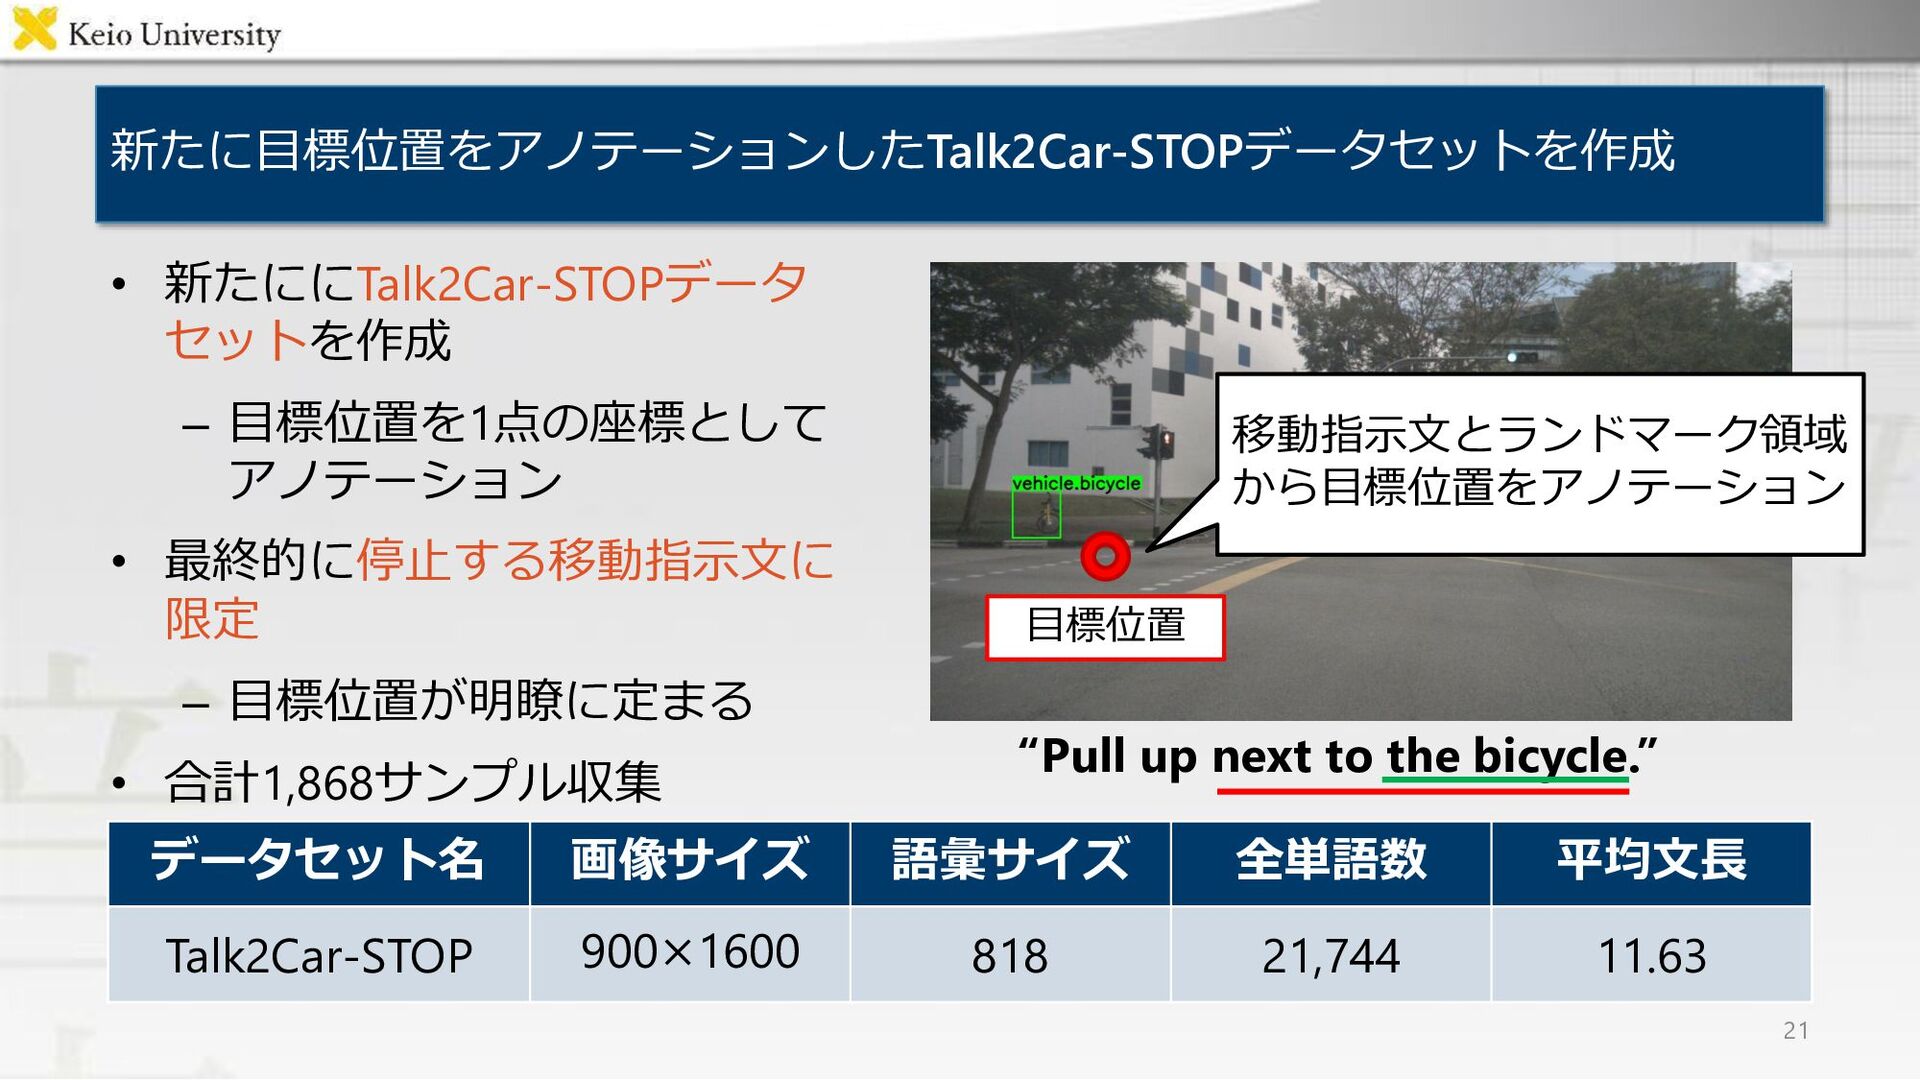
“Pull up next to the bicycle.” 新たに目標位置をアノテーションしたTalk2Car-STOPデータセットを作成 • 新たににTalk2Car-STOPデータ セットを作成
– 目標位置を1点の座標として アノテーション • 最終的に停止する移動指示文に 限定 – 目標位置が明瞭に定まる • 合計1,868サンプル収集 データセット名 画像サイズ 語彙サイズ 全単語数 平均文長 Talk2Car-STOP 900×1600 818 21,744 11.63 21 目標位置 移動指示文とランドマーク領域 から目標位置をアノテーション -
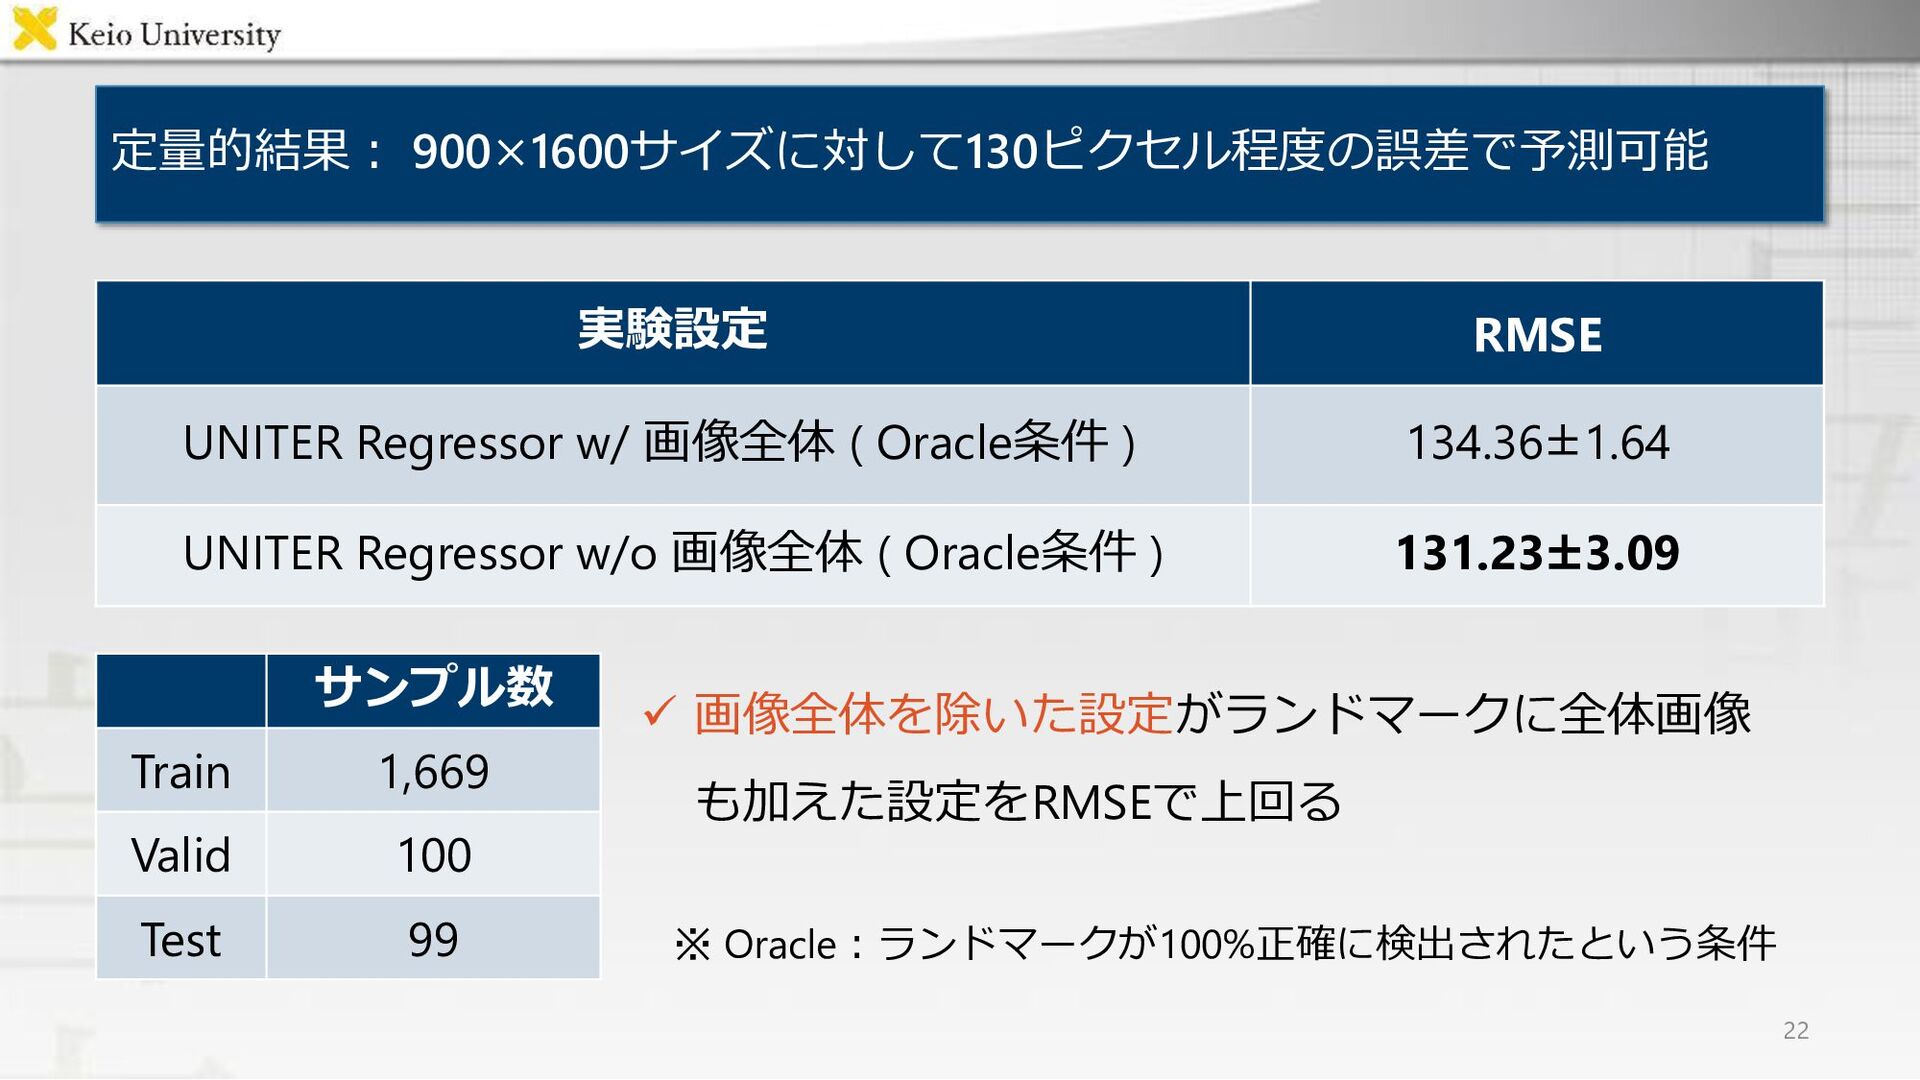
定量的結果: 900×1600サイズに対して130ピクセル程度の誤差で予測可能 実験設定 RMSE UNITER Regressor w/ 画像全体 ( Oracle条件
) 134.36±1.64 UNITER Regressor w/o 画像全体 ( Oracle条件 ) 131.23±3.09 ✓ 画像全体を除いた設定がランドマークに全体画像 も加えた設定をRMSEで上回る ※ Oracle:ランドマークが100%正確に検出されたという条件 22 サンプル数 Train 1,669 Valid 100 Test 99 -
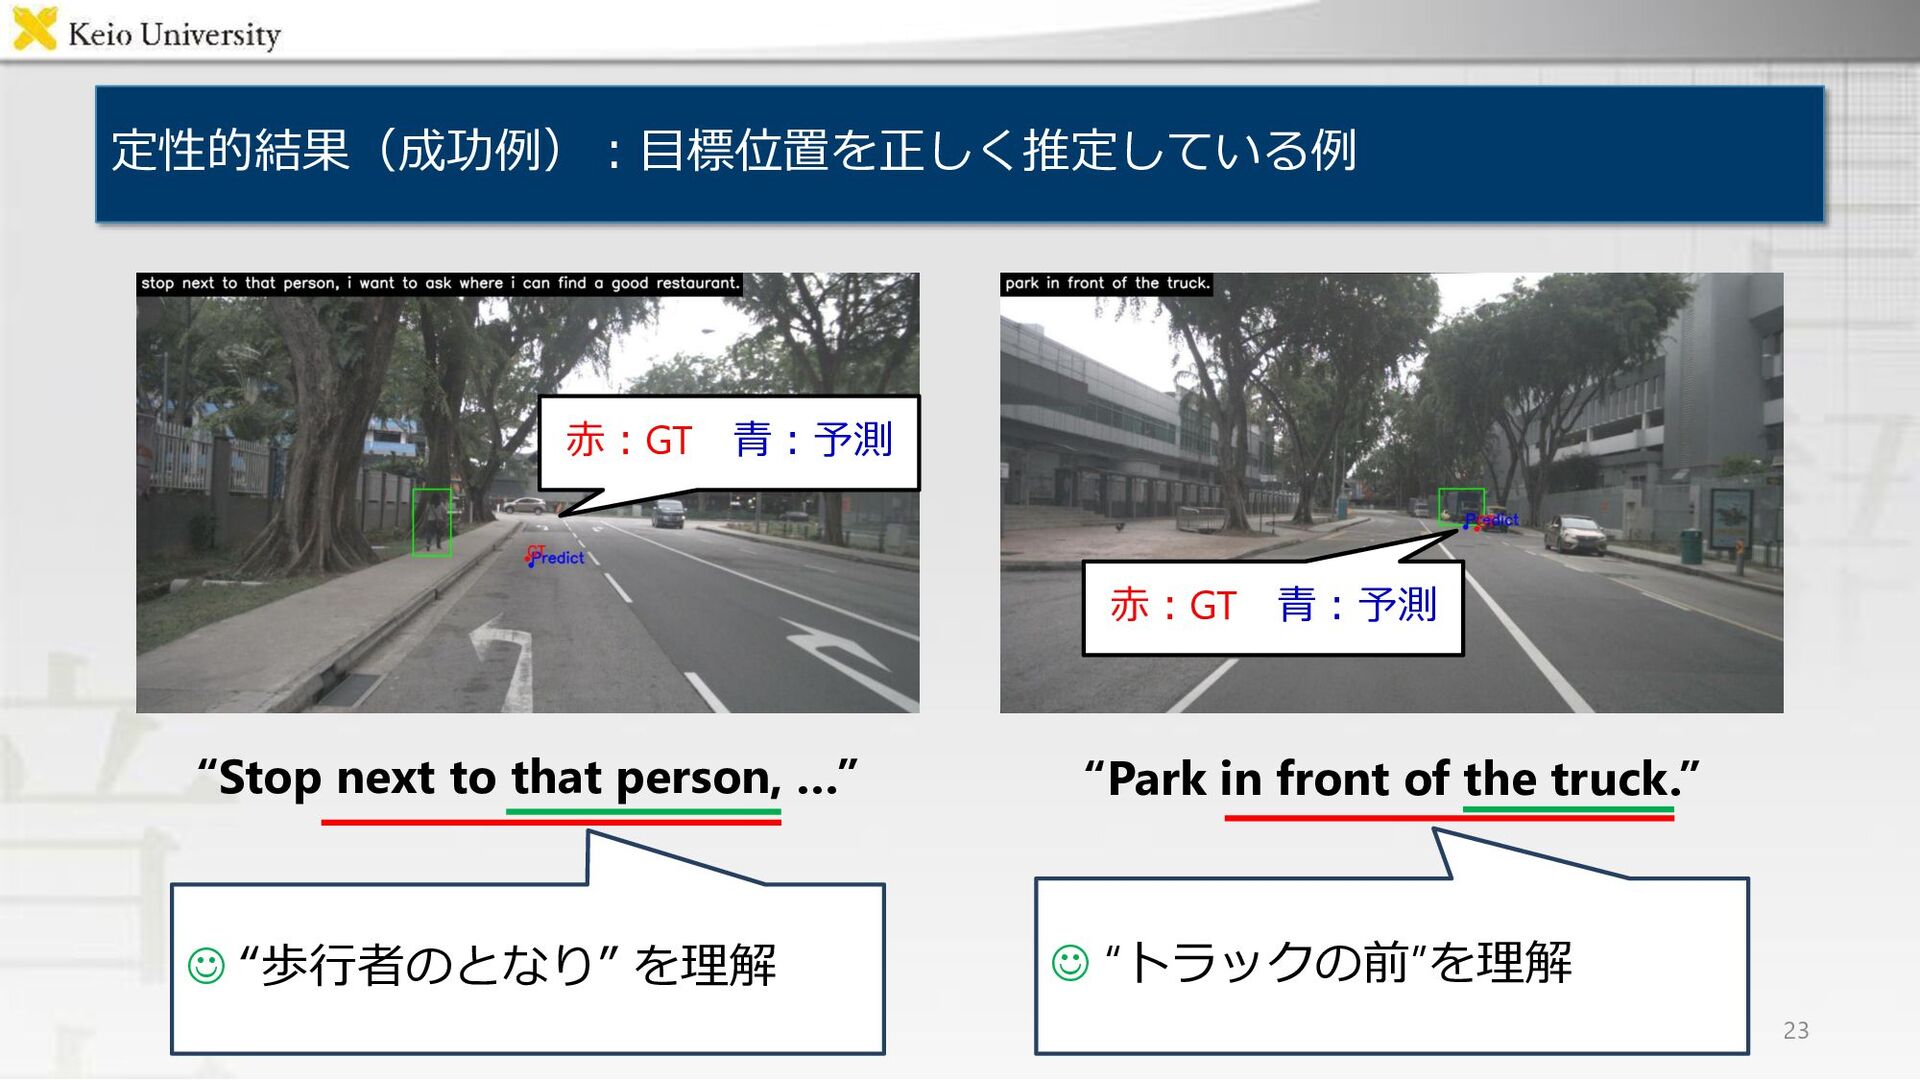
定性的結果(成功例):目標位置を正しく推定している例 ☺ “歩行者のとなり” を理解 ☺ “トラックの前”を理解 “Stop next to that
person, …” “Park in front of the truck.” 赤:GT 青:予測 23 赤:GT 青:予測 -
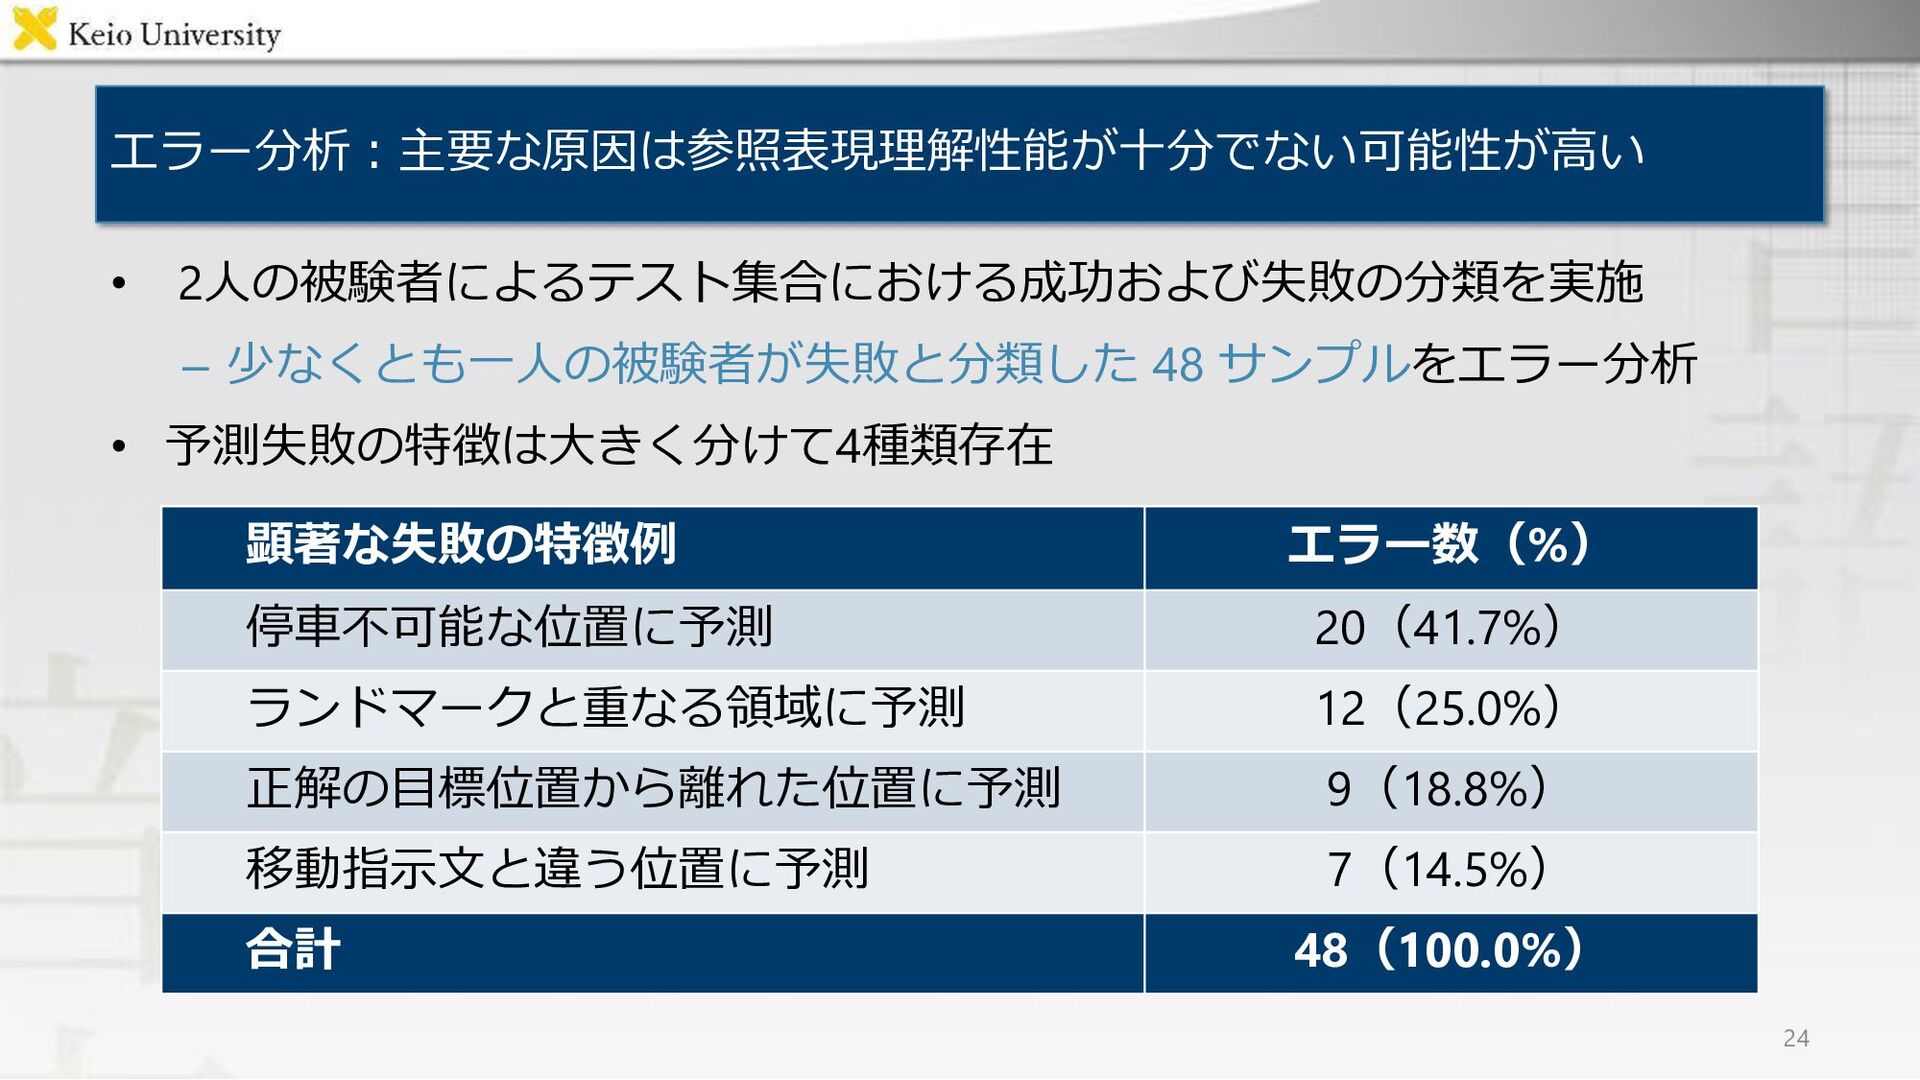
エラー分析:主要な原因は参照表現理解性能が十分でない可能性が高い • 2人の被験者によるテスト集合における成功および失敗の分類を実施 – 少なくとも一人の被験者が失敗と分類した 48 サンプルをエラー分析 • 予測失敗の特徴は大きく分けて4種類存在 24
顕著な失敗の特徴例 エラー数(%) 停車不可能な位置に予測 20(41.7%) ランドマークと重なる領域に予測 12(25.0%) 正解の目標位置から離れた位置に予測 9(18.8%) 移動指示文と違う位置に予測 7(14.5%) 合計 48(100.0%) -
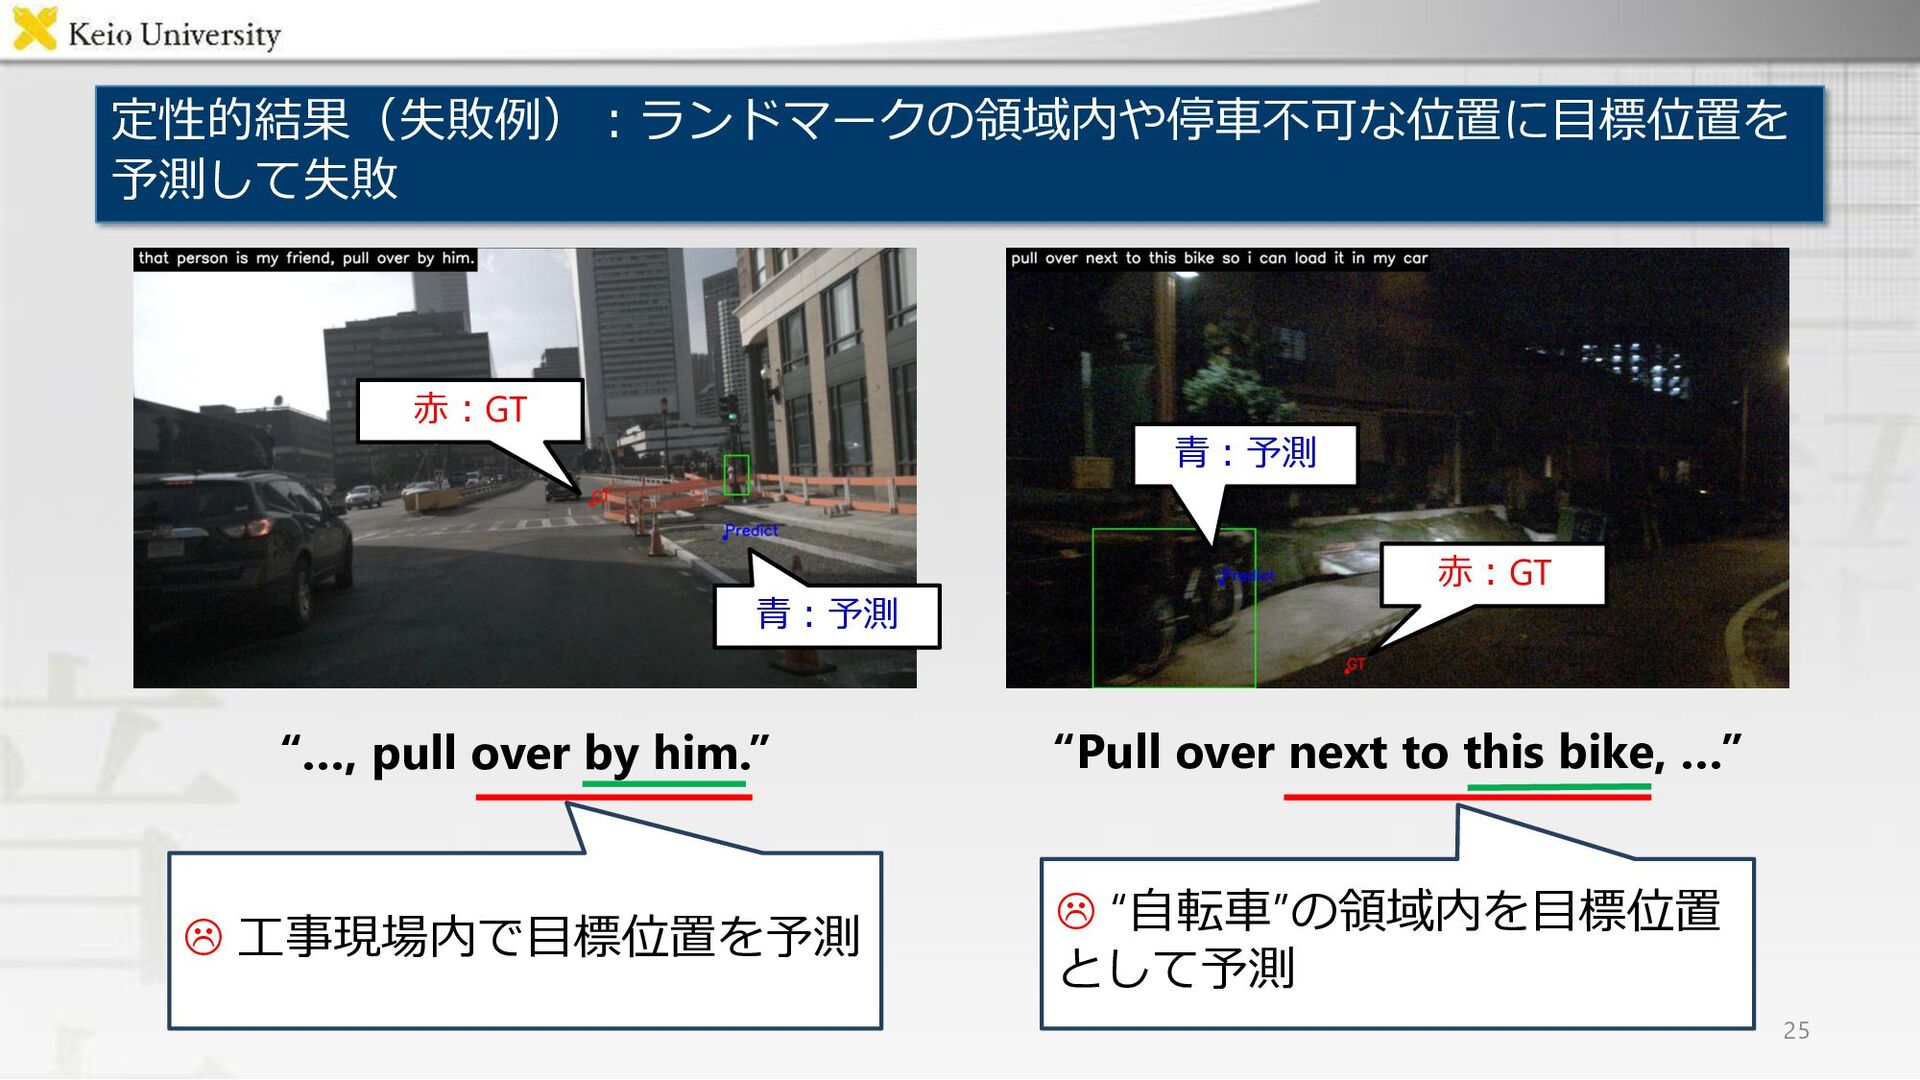
定性的結果(失敗例):ランドマークの領域内や停車不可な位置に目標位置を 予測して失敗 工事現場内で目標位置を予測 “…, pull over by him.” 赤:GT
青:予測 “自転車”の領域内を目標位置 として予測 “Pull over next to this bike, …” 青:予測 赤:GT 25 -
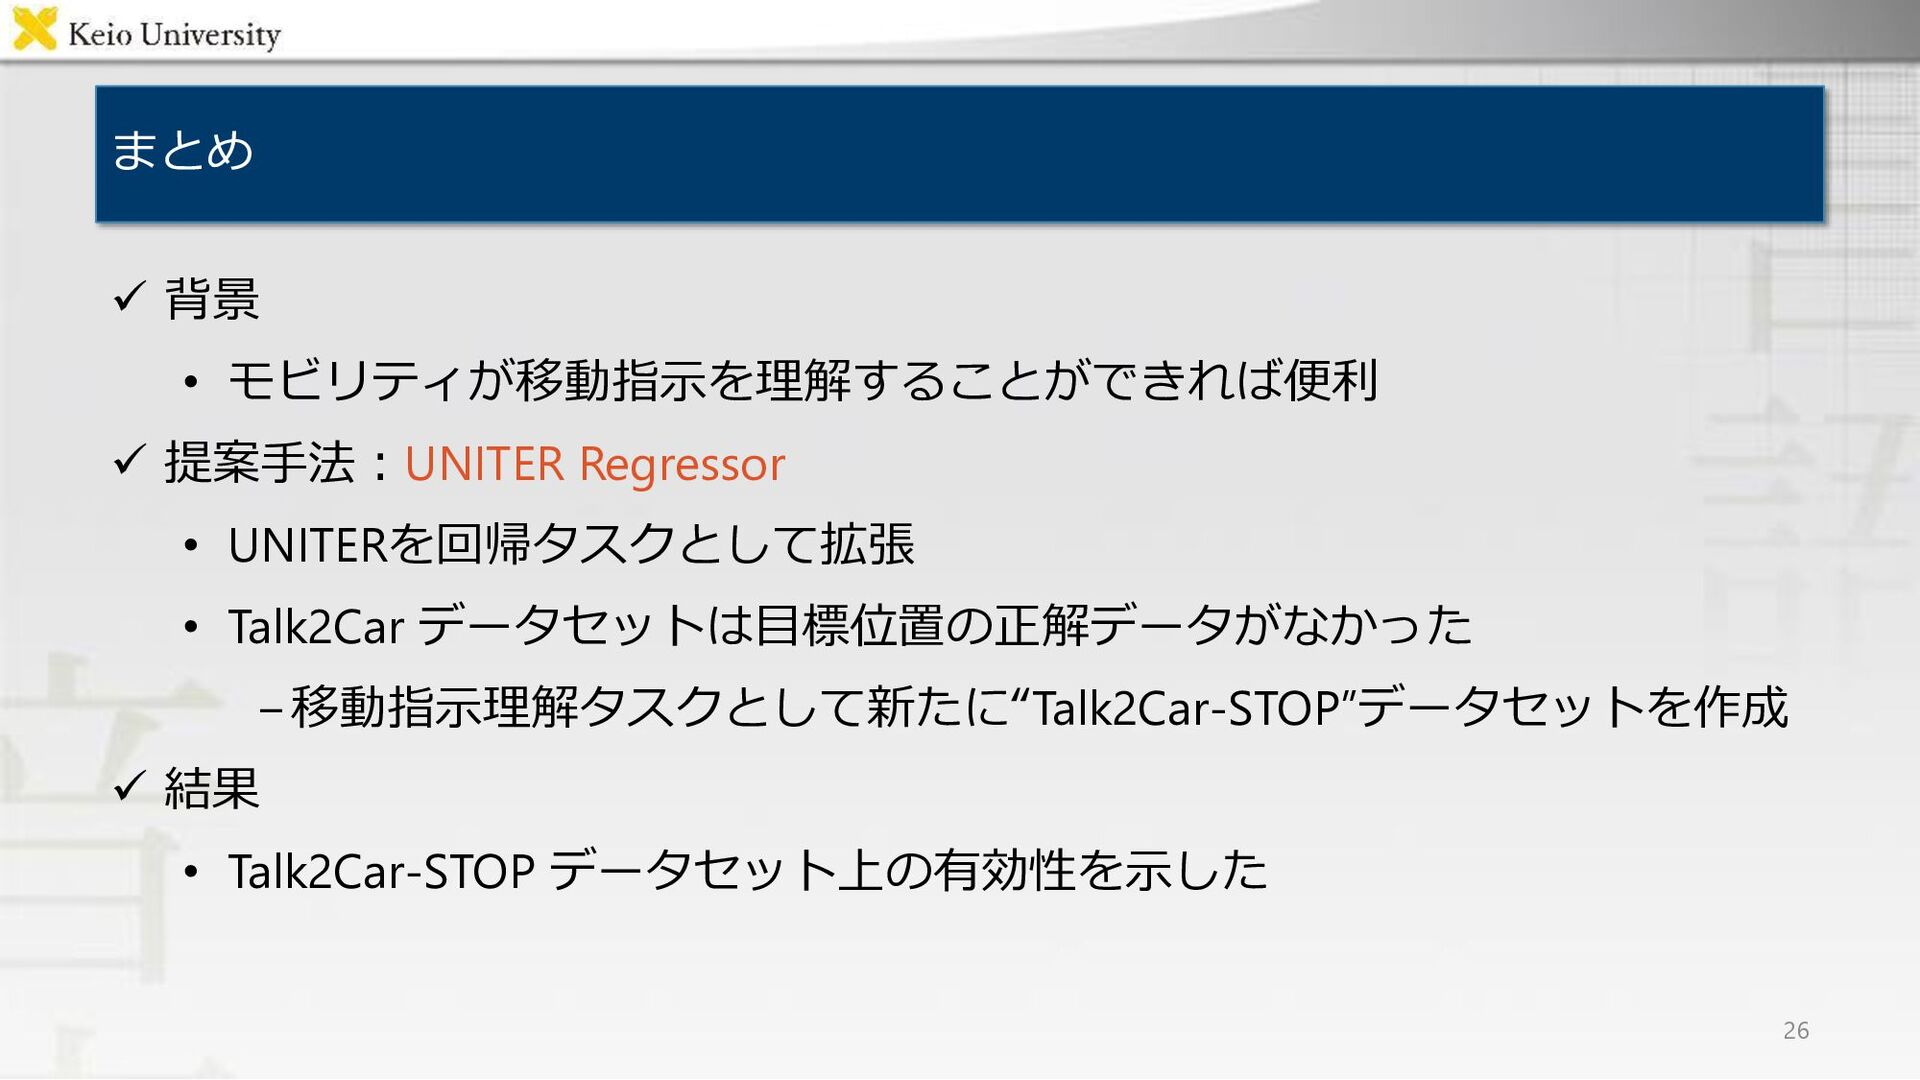
まとめ ✓ 背景 • モビリティが移動指示を理解することができれば便利 ✓ 提案手法:UNITER Regressor • UNITERを回帰タスクとして拡張
• Talk2Car データセットは目標位置の正解データがなかった −移動指示理解タスクとして新たに“Talk2Car-STOP”データセットを作成 ✓ 結果 • Talk2Car-STOP データセット上の有効性を示した 26