Share
Embed
生活支援ロボットによる物体配置タスクにおけるTransformer PonNetに基づく危険性予測および可視化/Transformer PonNet
Presented at JSAI2021
Semantic Machine Intelligence Lab., Keio Univ. PRO
June 09, 2021
Transcript
19 slides
-
生活支援ロボットによる物体配置タスクにおける Transformer PonNet に基づく危険性予測および可視化 植田有咲 1, Aly Magassouba 2, 平川
翼 3 , 山下 隆義 3, 藤吉 弘亘 3, 杉浦 孔明 1 1 慶應義塾大学 2 NICT 3 中部大学 -
概要 2 RGBD画像からロボットが物体配置を行う際の衝突確率を予測し, 可視化するモデル 「Transformer PonNet 」の提案 本研究のポイント
Attention Branch Network [Fukui+, CVPR19] の branch構造をTransformer に導入 実機実験による検証を行い85%を超える精度 -
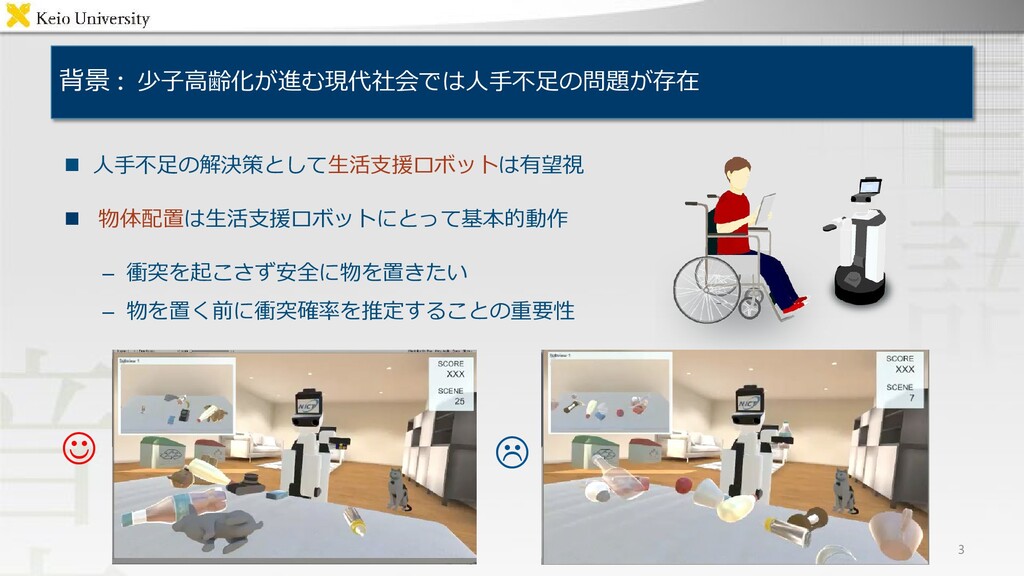
背景 : 少子高齢化が進む現代社会では人手不足の問題が存在 人手不足の解決策として生活支援ロボットは有望視 物体配置は生活支援ロボットにとって基本的動作 – 衝突を起こさず安全に物を置きたい –
物を置く前に衝突確率を推定することの重要性 3 -
既存研究と問題点 Object manipulation survey [Wang+, Artif Intell Rev20]
multi-task robot manipulation learning [Rouhollah+, ICRA18] picking, 配置タスクにおいて画像入力からロボットアームの軌道を生成 Attention Branch Network (ABN) [ Fukui+ , CVPR19] 画像内のどの領域に注目してモデルが学習を行なっているかの領域を 示すAttention mapを可視化 PonNet [Magassouba+, 20] ABN を用いて画像から物体配置における衝突確率を推定 5 -
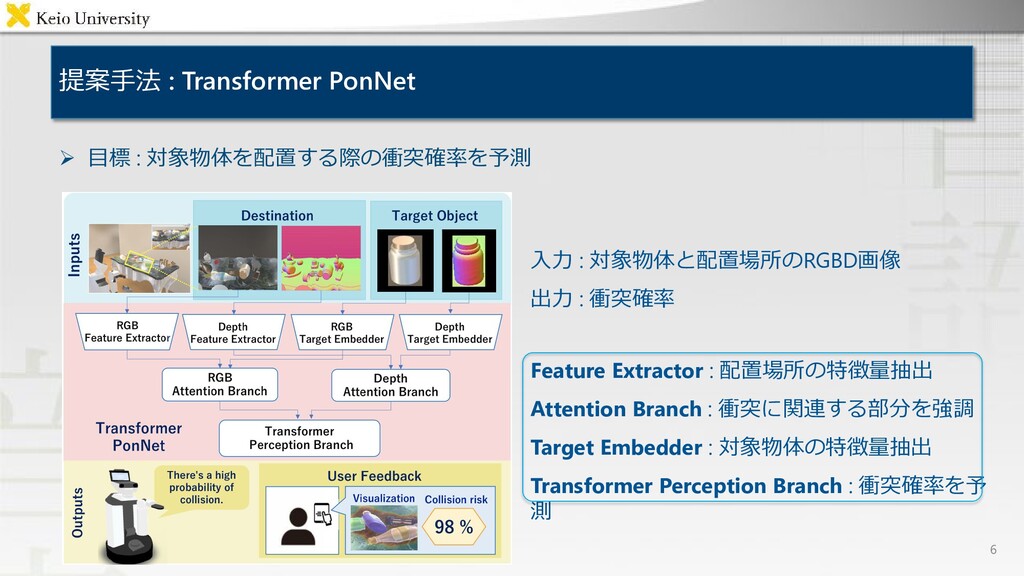
目標 : 対象物体を配置する際の衝突確率を予測 入力 : 対象物体と配置場所のRGBD画像 出力 : 衝突確率
Feature Extractor : 配置場所の特徴量抽出 Attention Branch : 衝突に関連する部分を強調 Target Embedder : 対象物体の特徴量抽出 Transformer Perception Branch : 衝突確率を予 測 提案手法 : Transformer PonNet 6 -
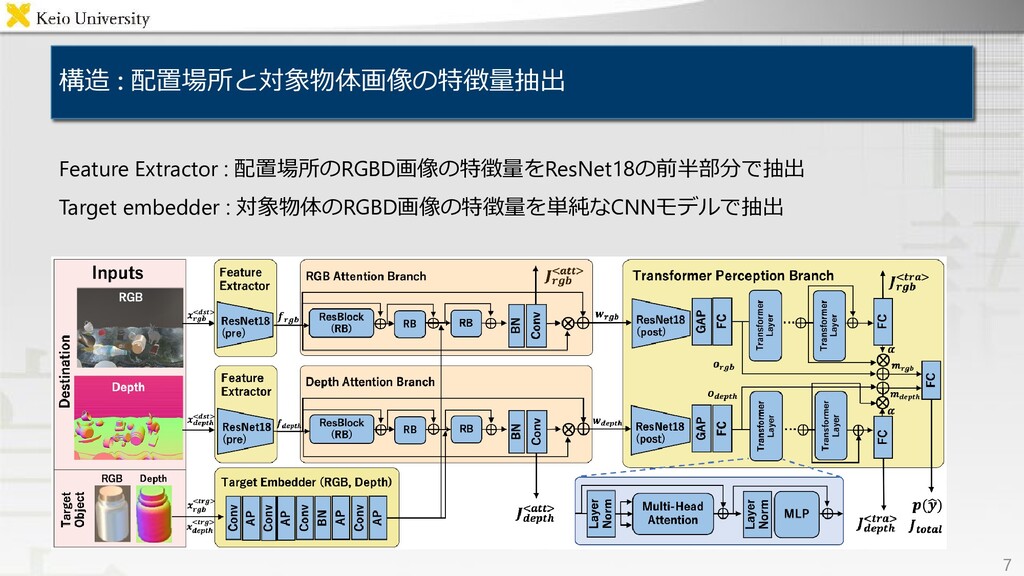
7 Feature Extractor : 配置場所のRGBD画像の特徴量をResNet18の前半部分で抽出 Target embedder : 対象物体のRGBD画像の特徴量を単純なCNNモデルで抽出 提案手法
Transformer PonNet 構造 : 配置場所と対象物体画像の特徴量抽出 -
8 Attention Branch Network (ABN) 𝑤𝑤𝑟𝑟𝑟𝑟𝑟𝑟 = 1 +
𝑎𝑎𝑟𝑟𝑟𝑟𝑟𝑟 ⨀ 𝑓𝑓𝑟𝑟𝑟𝑟𝑟𝑟 𝑤𝑤𝑑𝑑𝑑𝑑𝑑𝑑𝑑𝑑𝑑 = 1 + 𝑎𝑎𝑑𝑑𝑑𝑑𝑑𝑑𝑑𝑑𝑑 ⨀ 𝑓𝑓𝑑𝑑𝑑𝑑𝑑𝑑𝑑𝑑𝑑 提案手法 Transformer PonNet 構造 : Attention Branch (衝突に関連する部分に注目) Attention Map 𝑎𝑎𝑘𝑘 -
9 𝑸𝑸(i)= 𝑊𝑊 𝑞𝑞 (𝑖𝑖)𝑜𝑜𝑘𝑘 (𝑖𝑖), 𝑲𝑲(i) = 𝑊𝑊 𝑘𝑘
(𝑖𝑖)𝑜𝑜𝑘𝑘 (𝑖𝑖), 𝑽𝑽(i) = 𝑊𝑊𝑣𝑣 (𝑖𝑖)𝑜𝑜𝑘𝑘 (𝑖𝑖) 𝜔𝜔𝑘𝑘 = 𝑽𝑽(𝑖𝑖) softmax 𝑸𝑸(i) 𝑲𝑲 𝑖𝑖 T 𝑑𝑑𝑘𝑘 , 𝑑𝑑𝑘𝑘 = 𝐻𝐻 𝐴𝐴 𝑚𝑚𝑘𝑘 = 𝑸𝑸(i) + 𝛼𝛼 ⨀ 𝒉𝒉(i) ABNのbranch構造をTransformerに初めて導入 - Transformer の skip connection の一部を Attention Branch 化し, Attention map を生成 提案手法 Transformer PonNet : Transformer Perception Branch 構造 : Transformer Perception Branch (RGBとdepthの特徴量を融合して衝突確率を予 測) Hは入力𝑜𝑜𝑘𝑘 (𝑖𝑖)の次元数 Aはヘッド数を表す -
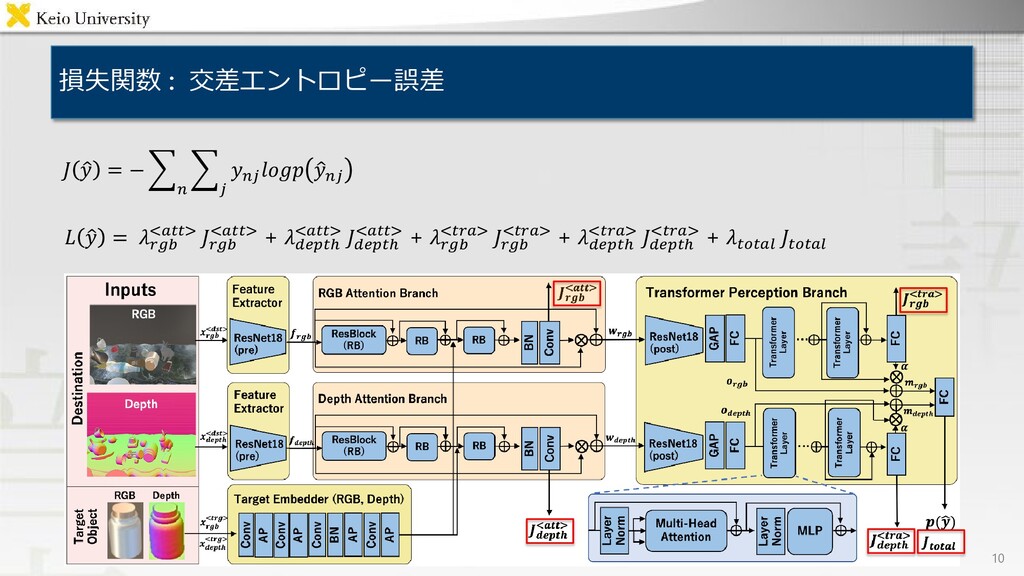
損失関数 : 交差エントロピー誤差 10 𝐽𝐽 � 𝑦𝑦 = − �
𝑛𝑛 � 𝑗𝑗 𝑦𝑦𝑛𝑛𝑛𝑛 𝑙𝑙𝑙𝑙𝑙𝑙𝑙𝑙 � 𝑦𝑦𝑛𝑛𝑛𝑛 𝐿𝐿 � 𝑦𝑦 = 𝜆𝜆𝑟𝑟𝑟𝑟𝑟𝑟 <𝑎𝑎𝑎𝑎𝑎𝑎> 𝐽𝐽𝑟𝑟𝑟𝑟𝑟𝑟 <𝑎𝑎𝑎𝑎𝑎𝑎> + 𝜆𝜆𝑑𝑑𝑑𝑑𝑑𝑑𝑑𝑑𝑑 <𝑎𝑎𝑎𝑎𝑎𝑎> 𝐽𝐽𝑑𝑑𝑑𝑑𝑑𝑑𝑑𝑑𝑑 <𝑎𝑎𝑎𝑎𝑎𝑎> + 𝜆𝜆𝑟𝑟𝑟𝑟𝑟𝑟 <𝑡𝑡𝑡𝑡𝑎𝑎> 𝐽𝐽𝑟𝑟𝑟𝑟𝑟𝑟 <𝑡𝑡𝑡𝑡𝑡𝑡> + 𝜆𝜆𝑑𝑑𝑑𝑑𝑑𝑑𝑑𝑑𝑑 <𝑡𝑡𝑡𝑡𝑡𝑡> 𝐽𝐽𝑑𝑑𝑑𝑑𝑑𝑑𝑑𝑑𝑑 <𝑡𝑡𝑡𝑡𝑡𝑡> + 𝜆𝜆𝑡𝑡𝑡𝑡𝑡𝑡𝑡𝑡𝑡𝑡 𝐽𝐽𝑡𝑡𝑡𝑡𝑡𝑡𝑡𝑡𝑡𝑡 -
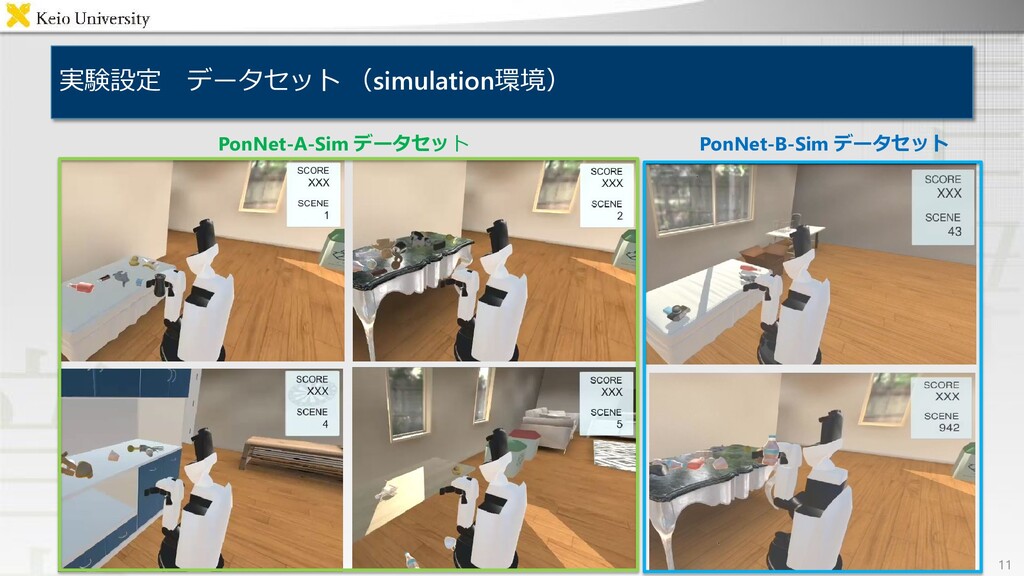
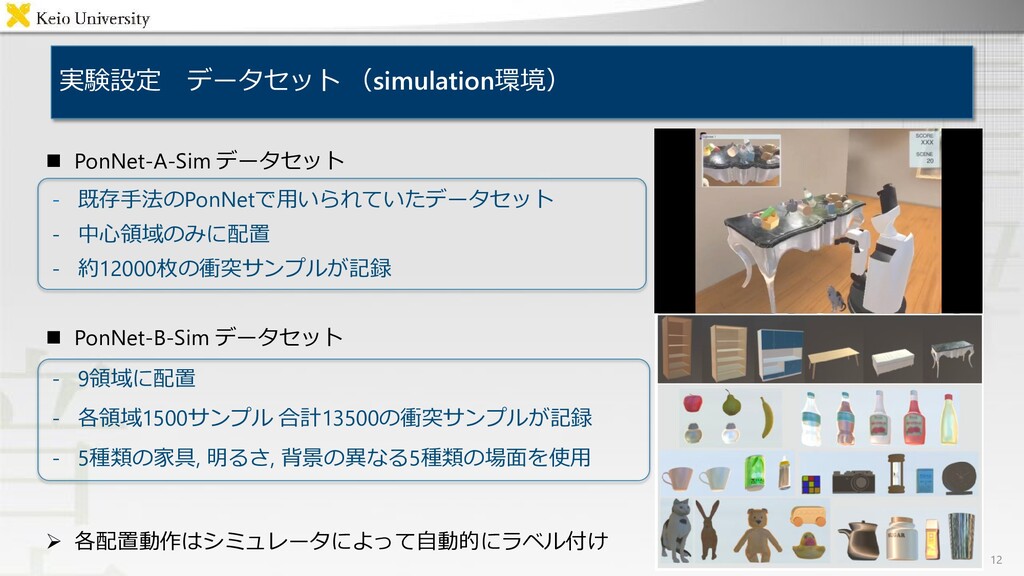
PonNet-A-Sim データセット - 既存手法のPonNetで用いられていたデータセット - 中心領域のみに配置 - 約12000枚の衝突サンプルが記録
PonNet-B-Sim データセット - 9領域に配置 - 各領域1500サンプル 合計13500の衝突サンプルが記録 - 5種類の家具, 明るさ, 背景の異なる5種類の場面を使用 各配置動作はシミュレータによって自動的にラベル付け 12 実験設定 データセット (simulation環境) -
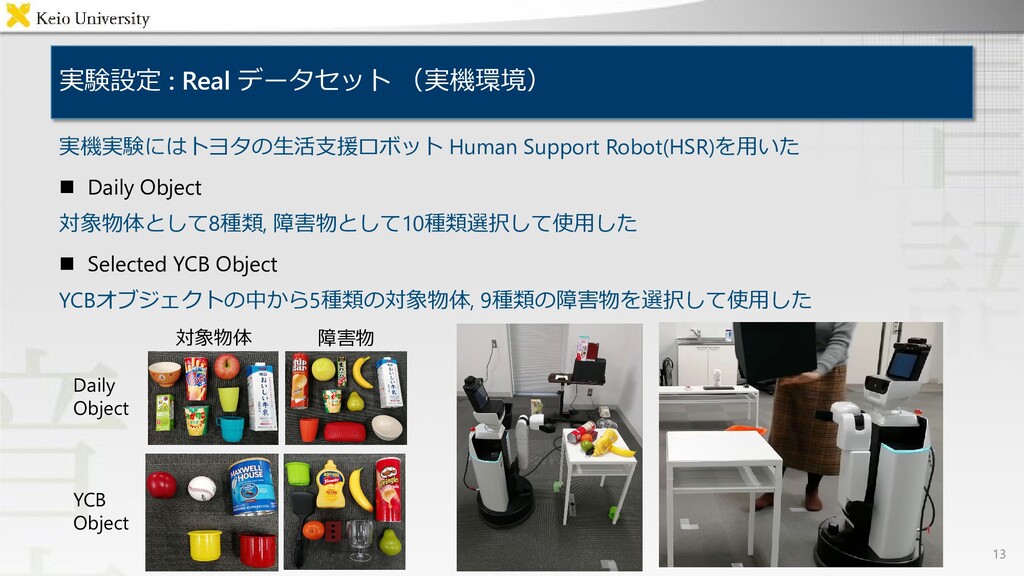
実験設定 : Real データセット (実機環境) 実機実験にはトヨタの生活支援ロボット Human Support Robot(HSR)を用いた
Daily Object 対象物体として8種類, 障害物として10種類選択して使用した Selected YCB Object YCBオブジェクトの中から5種類の対象物体, 9種類の障害物を選択して使用した 13 Daily Object YCB Object 対象物体 障害物 -
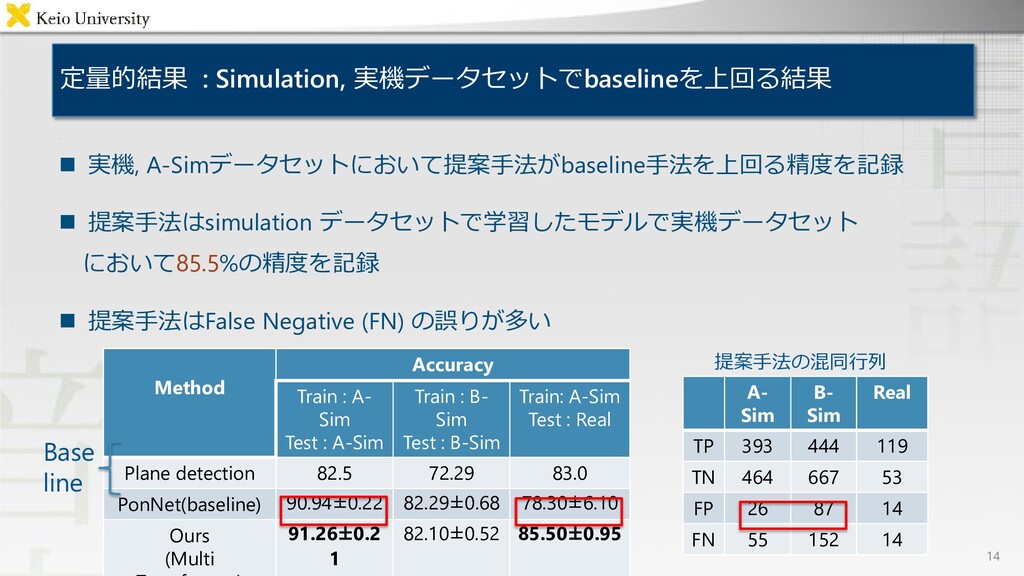
定量的結果 : Simulation, 実機データセットでbaselineを上回る結果 T 実機, A-Simデータセットにおいて提案手法がbaseline手法を上回る精度を記録
提案手法はsimulation データセットで学習したモデルで実機データセット において85.5%の精度を記録 提案手法はFalse Negative (FN) の誤りが多い 14 Method Accuracy Train : A- Sim Test : A-Sim Train : B- Sim Test : B-Sim Train: A-Sim Test : Real Plane detection 82.5 72.29 83.0 PonNet(baseline) 90.94±0.22 82.29±0.68 78.30±6.10 Ours (Multi 91.26±0.2 1 82.10±0.52 85.50±0.95 Base line A- Sim B- Sim Real TP 393 444 119 TN 464 667 53 FP 26 87 14 FN 55 152 14 提案手法の混同行列 -
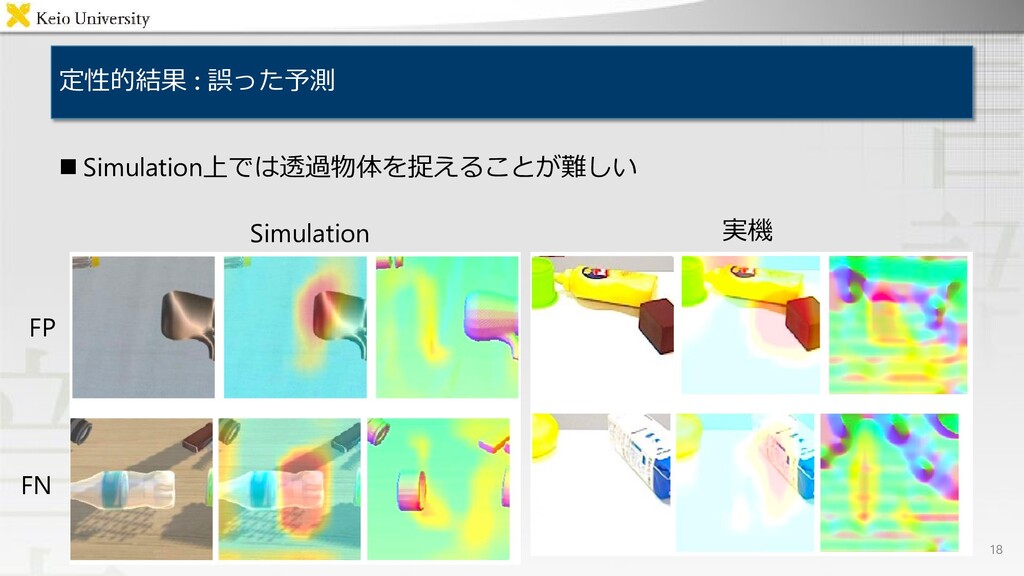
障害物の熊やケチャップに注目 できている RGBでは主に障害物にDepthで は安全に配置できる領域に注目 RGB 画像 Attention RGB
Attention Depth 15 定性的結果 : 正しい予測例 定性的結果 シミュレーションデータの成功例 TP TN -
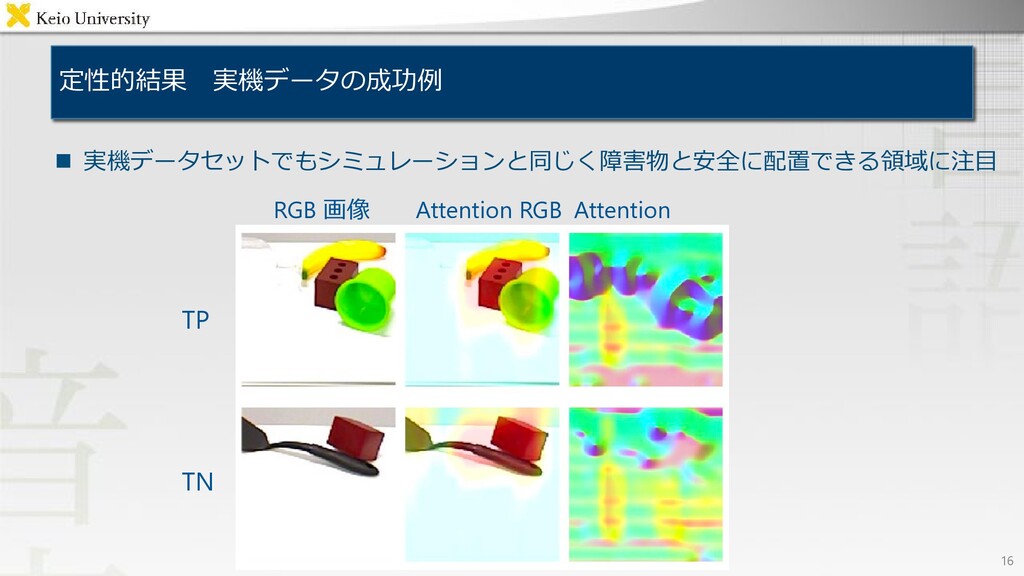
実機データセットでもシミュレーションと同じく障害物と安全に配置できる領域に注目 RGB 画像 Attention RGB Attention Depth 16 定性的結果
: 正しい予測例 定性的結果 実機データの成功例 TP TN -
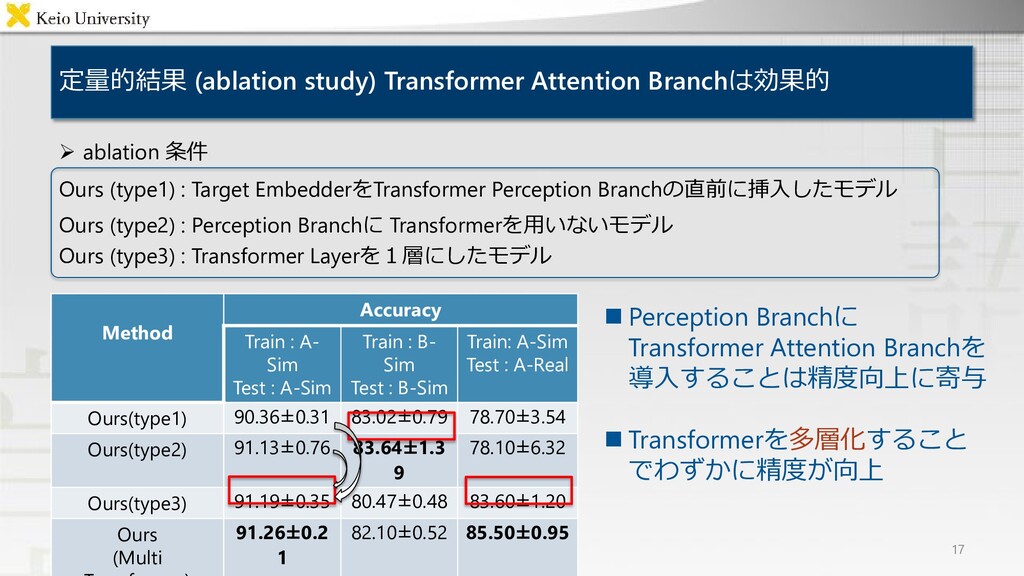
定量的結果 (ablation study) Transformer Attention Branchは効果的 17 Method Accuracy Train
: A- Sim Test : A-Sim Train : B- Sim Test : B-Sim Train: A-Sim Test : A-Real Ours(type1) 90.36±0.31 83.02±0.79 78.70±3.54 Ours(type2) 91.13±0.76 83.64±1.3 9 78.10±6.32 Ours(type3) 91.19±0.35 80.47±0.48 83.60±1.20 Ours (Multi 91.26±0.2 1 82.10±0.52 85.50±0.95 ablation 条件 Ours (type1) : Target EmbedderをTransformer Perception Branchの直前に挿入したモデル Ours (type2) : Perception Branchに Transformerを用いないモデル Ours (type3) : Transformer Layerを1層にしたモデル Perception Branchに Transformer Attention Branchを 導入することは精度向上に寄与 Transformerを多層化すること でわずかに精度が向上 -
結論 19 RGBD画像からロボットが物体配置を行う際の衝突確率を予測し, 可視化するモデル 「Transformer PonNet 」の提案 本研究のポイント
Target Embedderを追加導入して対象物体の大きさ を仮定する必要がなくなった Perception BranchにTransformer Attention Branchを 導入し, 精度を向上 実機実験による検証を行い85%を超える精度