Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ローカルLLM基礎知識 / local LLM basics 2025
Search
Naoki Kishida
November 22, 2025
Technology
17k
30
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ローカルLLM基礎知識 / local LLM basics 2025
2025-11-22に開催された「第1回 ローカルLLMなんでも勉強会」での登壇資料です。
Naoki Kishida
November 22, 2025
More Decks by Naoki Kishida
See All by Naoki Kishida
Java 27新機能 / Java 27 new features
kishida
2
150
ローカルLLMでどこまでコードが書けるか -LLM基礎知識 / How much code can be written on a local LLM - fundamental knowledge
kishida
10
9.6k
ソフトウェアエンジニアにとっての生成AI - 特性を知って使い倒す / generative ai for software enginner
kishida
7
2.4k
ローカルLLMでどこまでコードが書けるか -縮小版 / How much code can be written on a local LLM Shortened
kishida
2
400
ローカルLLMでどこまでコードが書けるか -拡張版 / How much code can be written on a local LLM Extended
kishida
12
5.6k
Javaの型とAI時代に型が大事な理由 / java types and type in AI era
kishida
2
240
ローカルLLMでどこまでコードが書けるか / How much code can be written on a local LLM
kishida
2
640
AIエージェントでのJava開発がはかどるMCPをAIを使って開発してみた / java mcp for jjug
kishida
5
1.3k
AIの弱点、やっぱりプログラミングは人間が(も)勉強しよう / YAPC AI and Programming
kishida
13
7.2k
Other Decks in Technology
See All in Technology
aws-iot-platform-architecture-use-cases.pdf
ma2shita
0
390
作って終わりじゃないサーバーレス 〜9年運用する大規模EC物流API基盤の設計・運用のリアル〜
zozotech
PRO
0
290
データ界隈LT祭 第1回LT登壇
taromatsui_cccmkhd
2
1.5k
今話題のAI「Jev」って何? 宇宙最速で学ぶ会
minorun365
PRO
30
17k
.NET WebAssemblyで実現するクライアントサイドAI推論:NuGetからViteまで、2つのエコシステムを繋ぐビルド戦略
yamachu
0
250
CLIライブラリ開発を支える技術
htnabe
0
140
俺の仕事は AIに奪われないし、たぶんその BIも要らない
hikaruri
0
520
開発投資の期待値を上げるプロダクトロードマップづくり ~プロダクトエンジニアが越境して事業を伸ばす~
kekekenta
1
230
The Knowledge Spine: A Machine-Executable Ontology for Governed Marketing Activation
vananth22
0
110
負債のメタファと2026年 / Debt Metaphor in Agentic Engineering Age 202609 Edition
twada
PRO
10
4.3k
AIは推し活である。
kurazuuuuuu
1
860
Vibe Coding で作ったプロダクトをどう安全に動かすか / How to Safely Run Products Built with Vibe Coding
glidenote
0
320
Featured
See All Featured
Building Experiences: Design Systems, User Experience, and Full Site Editing
marktimemedia
1
610
First, design no harm
axbom
PRO
2
1.3k
Introduction to Domain-Driven Design and Collaborative software design
baasie
1
990
So, you think you're a good person
axbom
PRO
2
2.2k
Building Applications with DynamoDB
mza
96
7.2k
Context Engineering - Making Every Token Count
addyosmani
9
1.1k
Art, The Web, and Tiny UX
lynnandtonic
304
22k
Breaking role norms: Why Content Design is so much more than writing copy - Taylor Woolridge
uxyall
1
410
The Myth of the Modular Monolith - Day 2 Keynote - Rails World 2024
eileencodes
28
3.6k
Fantastic passwords and where to find them - at NoRuKo
philnash
52
3.8k
Visual Storytelling: How to be a Superhuman Communicator
reverentgeek
2
660
Bootstrapping a Software Product
garrettdimon
PRO
306
120k
Transcript
ローカルLLM基礎知識 2025-11-22 ローカルLLM勉強会 きしだ なおき 11/23 ※ 各モデルの説明も追記しました
2025/11/23 2 自己紹介 • きしだ なおき • LINEヤフー • X(twitter):
@kis • blog: きしだのHatena • (nowokay.hatenablog.com) • 「プロになるJava」というJavaの本を書いてます
3 ローカルLLMとは • 自分(たち)のために動かすLLM • 今回は、個人が手元のPCで動かす前提 • 大人数で使う場合には様々な管理が必要 • 今回はスコープ外
ローカルLLMのメリット • ネットがなくても使える • 自分でコントロールできる • データを外に送らない • カスタマイズできる •
勉強になる • かわいい
LLMの仕組み • LLM=大規模言語モデル • 言語を扱う大規模なニューラルネットワーク • Transformerを基本とする • 仕組み的には、文章の続きを生成 •
AI = LLMを中心とした応答システム
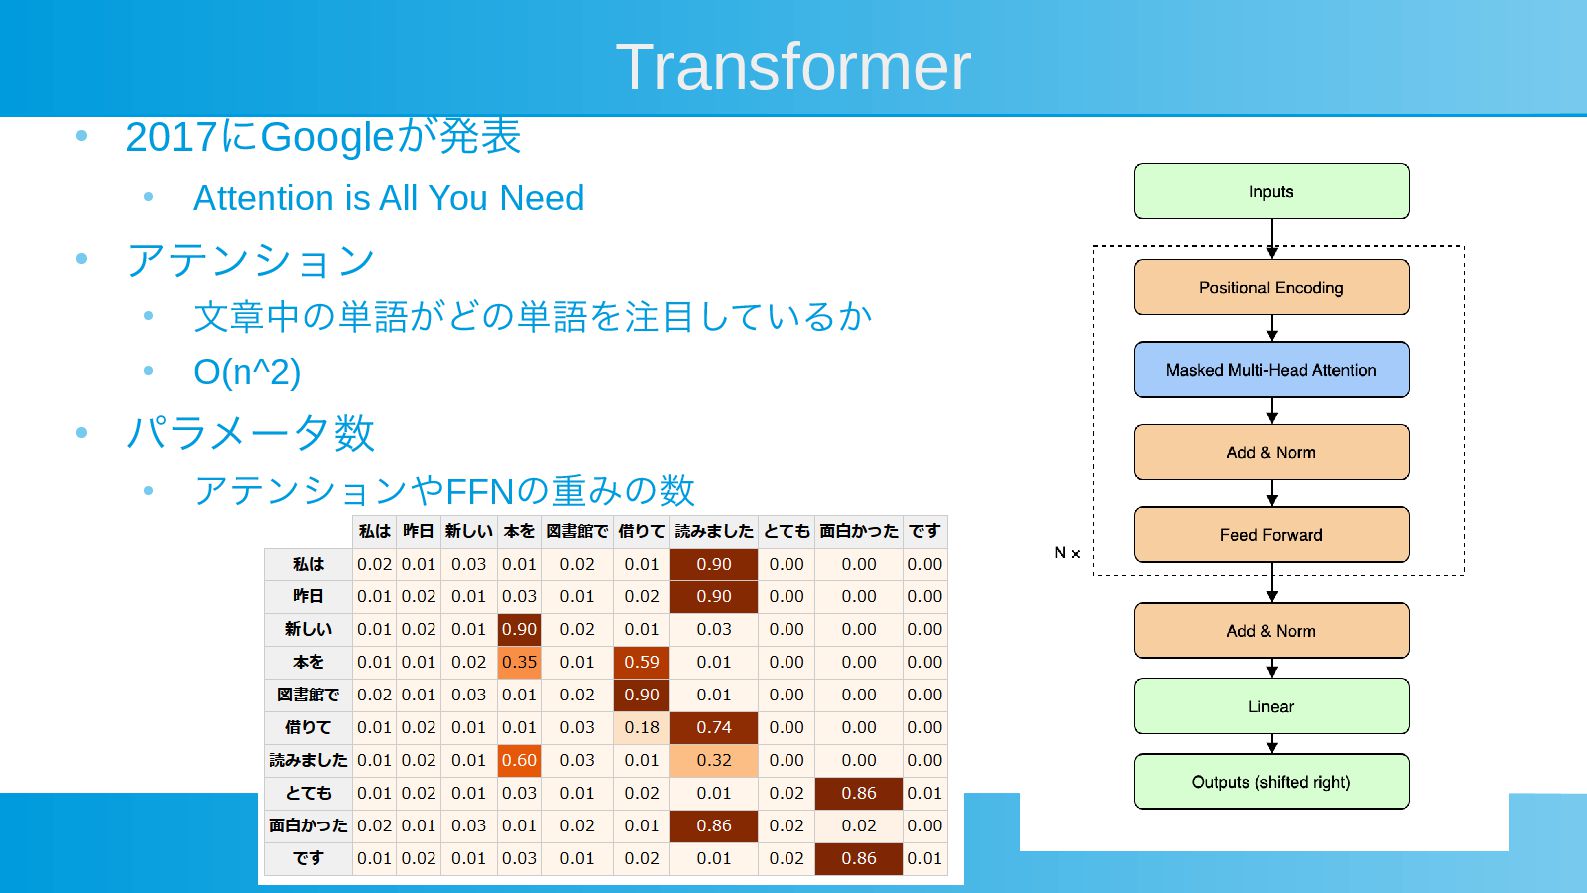
Transformer • 2017にGoogleが発表 • Attention is All You Need •
アテンション • 文章中の単語がどの単語を注目しているか • O(n^2) • パラメータ数 • アテンションやFFNの重みの数
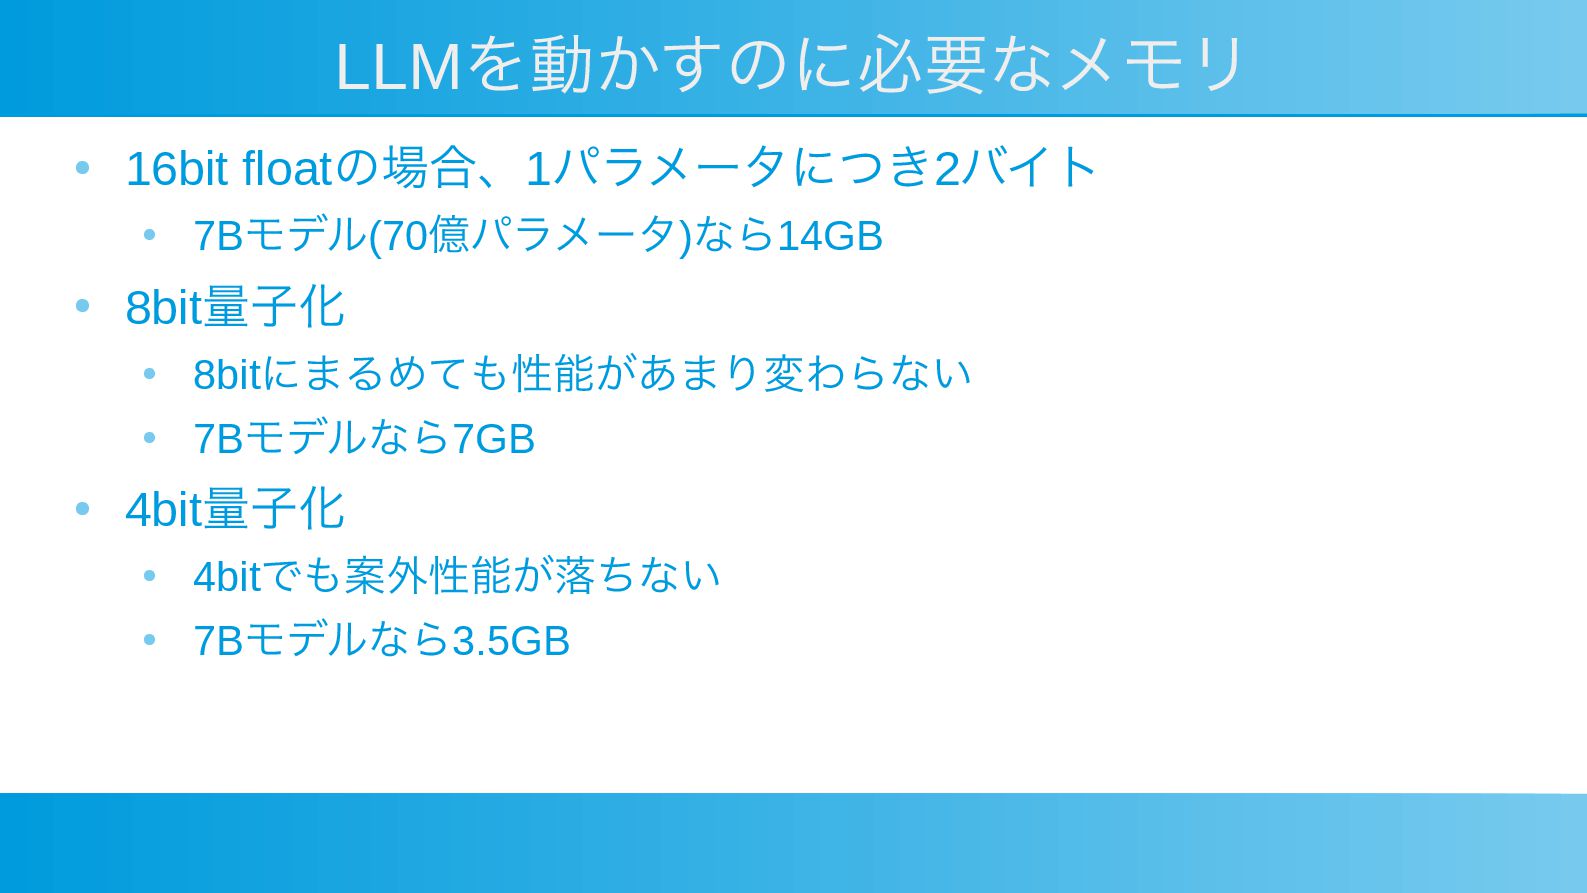
LLMを動かすのに必要なメモリ • 16bit floatの場合、1パラメータにつき2バイト • 7Bモデル(70億パラメータ)なら14GB • 8bit量子化 • 8bitにまるめても性能があまり変わらない
• 7Bモデルなら7GB • 4bit量子化 • 4bitでも案外性能が落ちない • 7Bモデルなら3.5GB
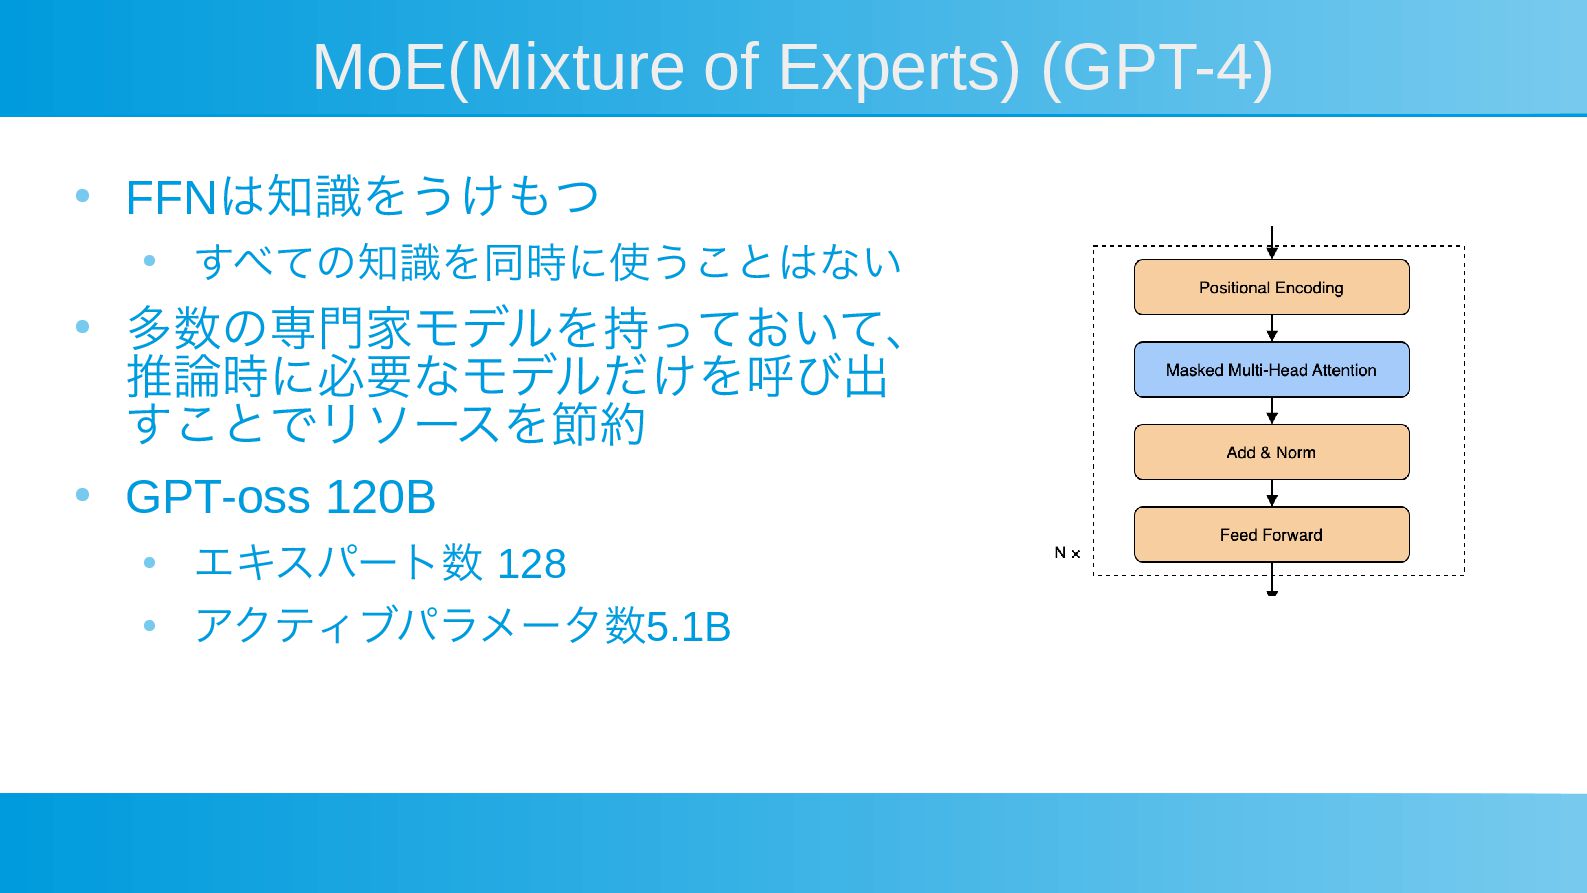
MoE(Mixture of Experts) (GPT-4) • FFNは知識をうけもつ • すべての知識を同時に使うことはない • 多数の専門家モデルを持っておいて、
推論時に必要なモデルだけを呼び出 すことでリソースを節約 • GPT-oss 120B • エキスパート数 128 • アクティブパラメータ数5.1B
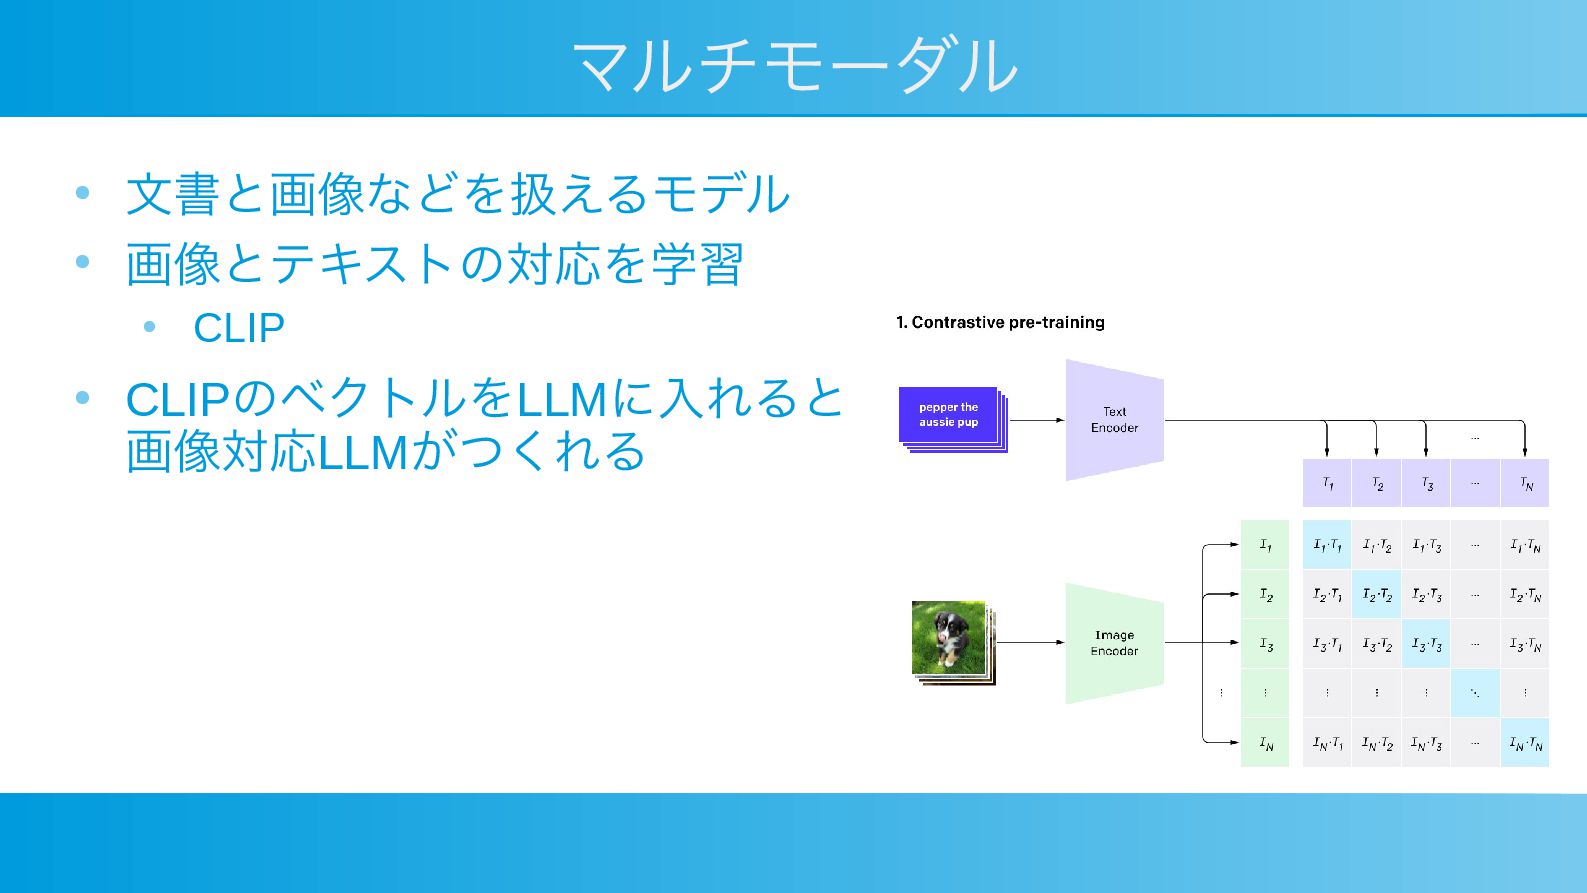
マルチモーダル • 文書と画像などを扱えるモデル • 画像とテキストの対応を学習 • CLIP • CLIPのベクトルをLLMに入れると 画像対応LLMがつくれる
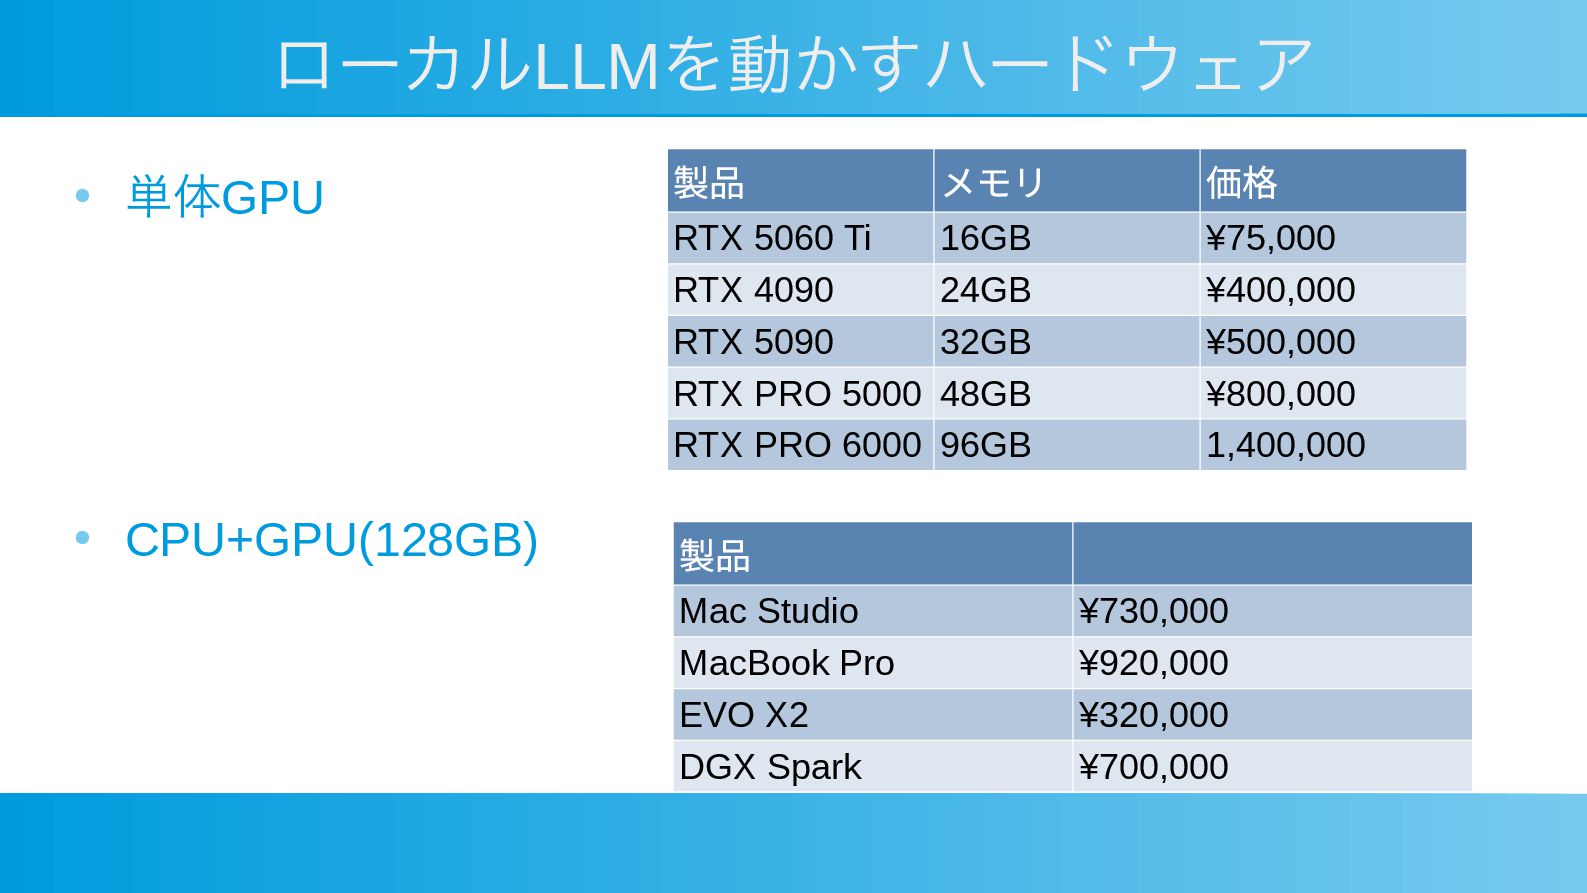
ローカルLLMを動かすハードウェア • 単体GPU • CPU+GPU(128GB) 製品 メモリ 価格 RTX 5060
Ti 16GB ¥75,000 RTX 4090 24GB ¥400,000 RTX 5090 32GB ¥500,000 RTX PRO 5000 48GB ¥800,000 RTX PRO 6000 96GB 1,400,000 製品 Mac Studio ¥730,000 MacBook Pro ¥920,000 EVO X2 ¥320,000 DGX Spark ¥700,000
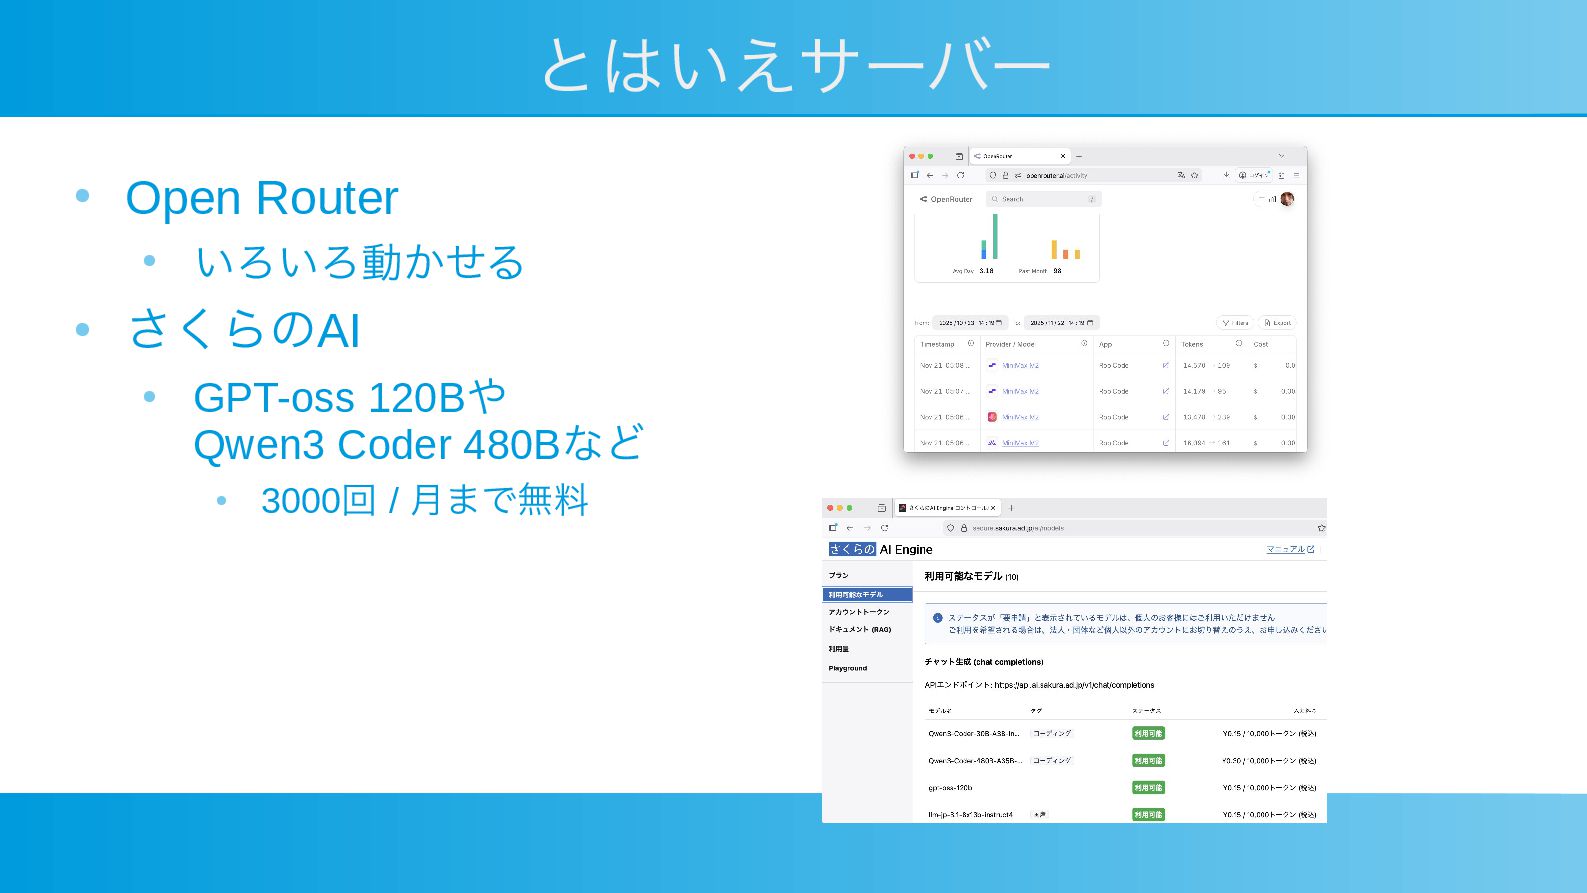
とはいえサーバー • Open Router • いろいろ動かせる • さくらのAI • GPT-oss
120Bや Qwen3 Coder 480Bなど • 3000回 / 月まで無料
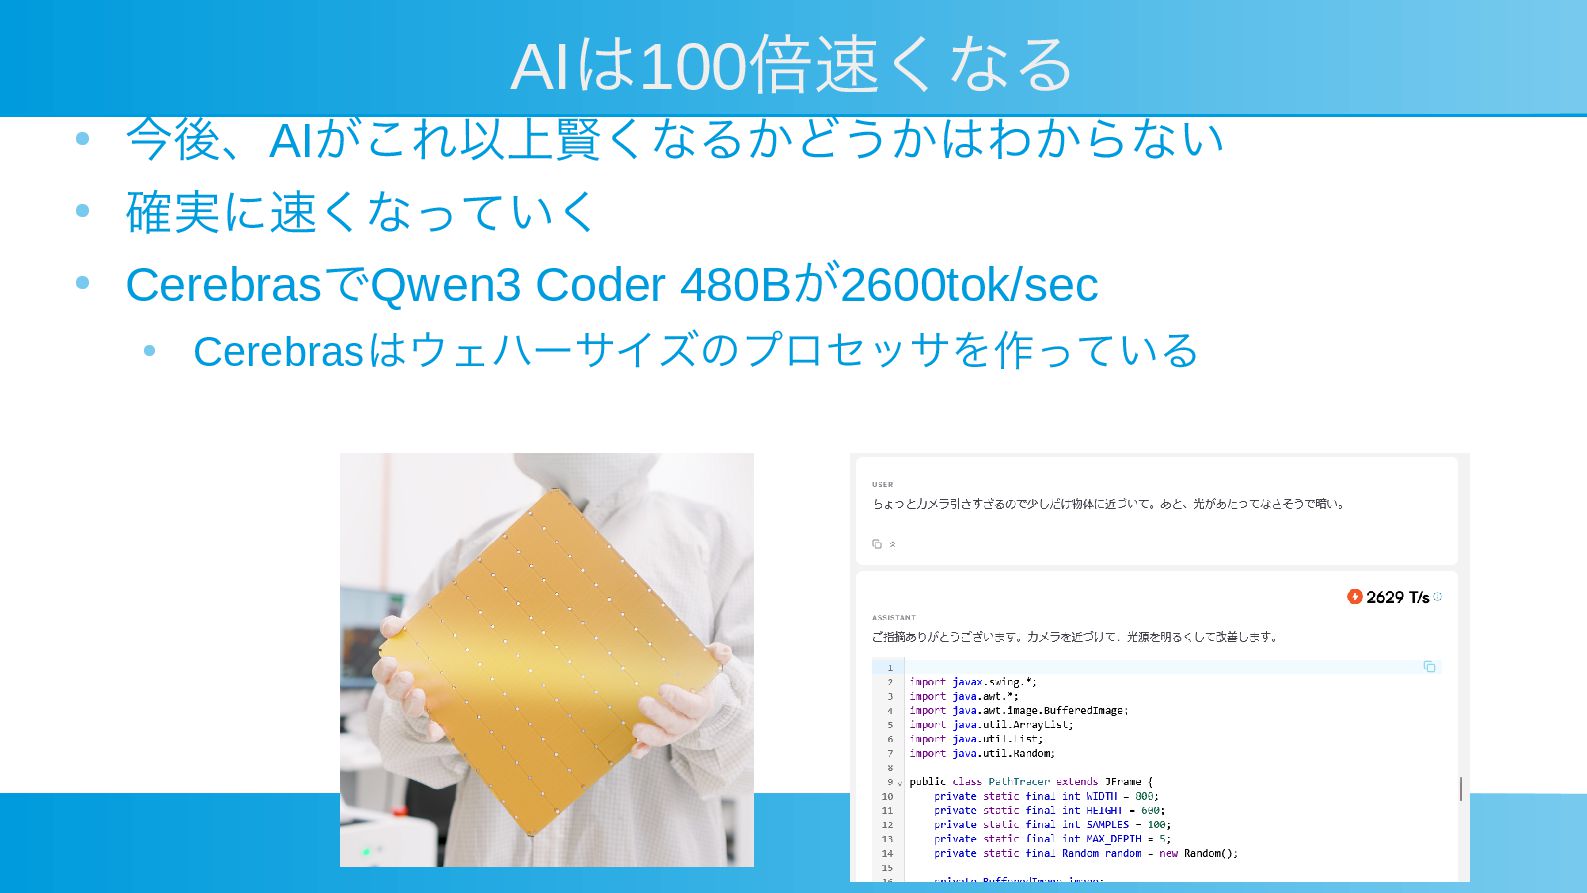
AIは100倍速くなる • 今後、AIがこれ以上賢くなるかどうかはわからない • 確実に速くなっていく • CerebrasでQwen3 Coder 480Bが2600tok/sec •
Cerebrasはウェハーサイズのプロセッサを作っている
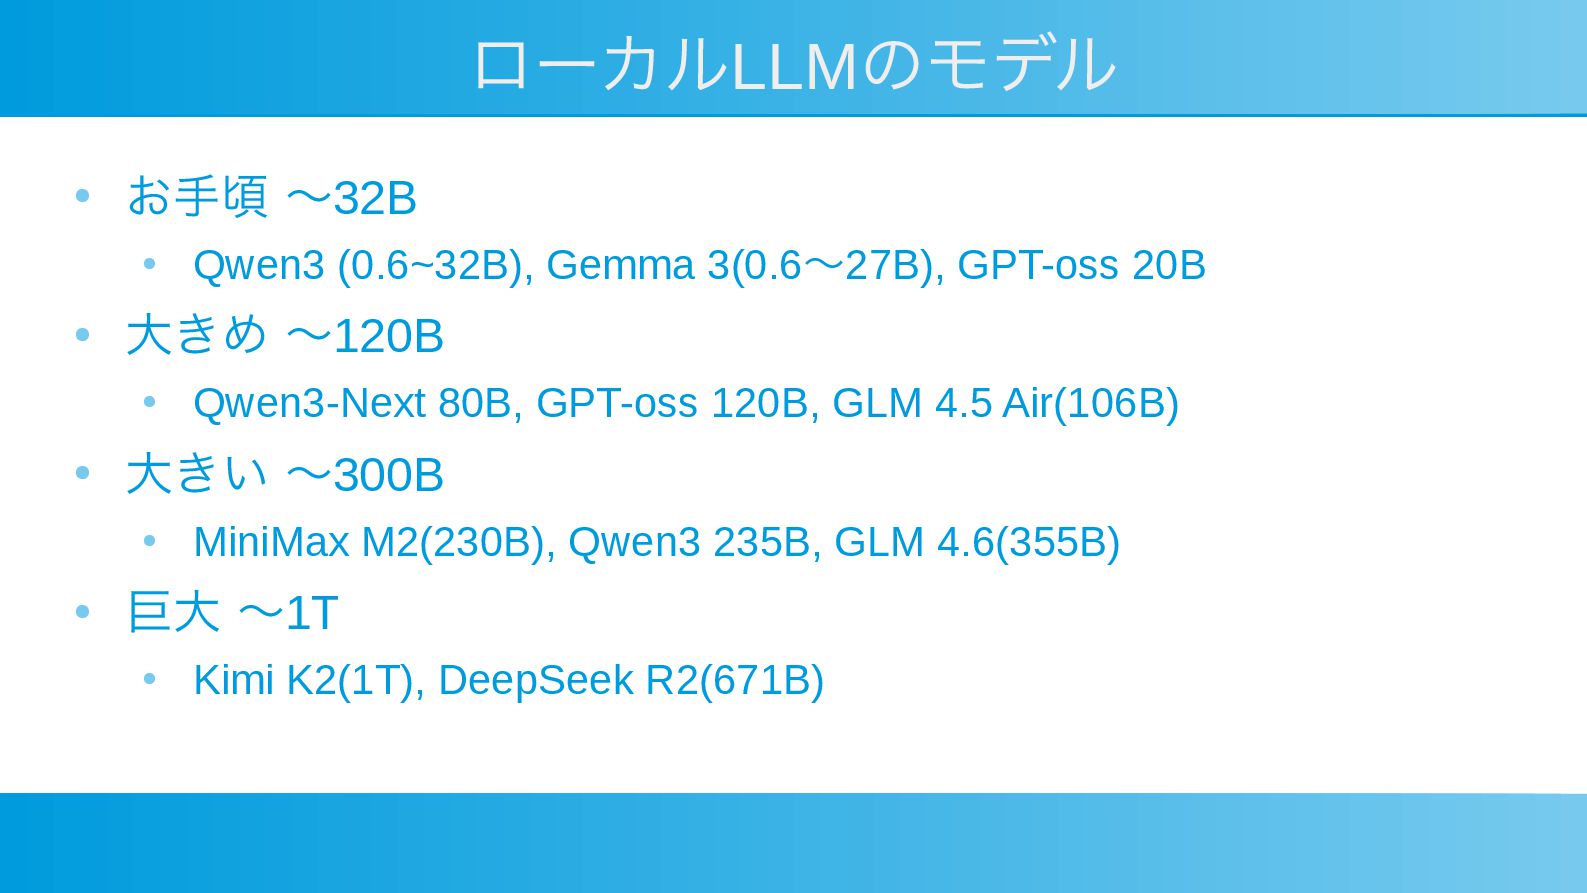
ローカルLLMのモデル • お手頃 〜32B • Qwen3 (0.6~32B), Gemma 3(0.6〜27B), GPT-oss
20B • 大きめ 〜120B • Qwen3-Next 80B, GPT-oss 120B, GLM 4.5 Air(106B) • 大きい 〜300B • MiniMax M2(230B), Qwen3 235B, GLM 4.6(355B) • 巨大 〜1T • Kimi K2(1T), DeepSeek R2(671B)
お手頃モデル • ふつうのPCで動かせる。 • チャットをまともにやろうとしたら8B以上 • 商用AIの簡易版として使うならGPT-oss 20B • 4Bまでは、特定用途単機能で考えるのがいい
• GPT-oss 20B • OpenAI、mxfp4で量子化 • Qwen3 30B-A3B, 32B, 14B, 8B, 4B, 1.7B, 0.6B • Alibaba、小さいモデルでも性能が高い • Gemma 3 27B, 12B, 4B, 1B, 270m • Google、大きいモデル含め、オープンウェイトで最も日本語が流暢。
大きめモデル • MacやEVO X2、DGX Sparkで動かす • 普通にChatGPTなどの代替になりだす • MoEが基本(アクティブパラメータをAnBと表記) •
GPT-oss 120B (A5.5B) • 賢いけど日本語力はちょっと弱い • GLM 4.5 Air(106B-A12B) • Z.ai、賢いし日本語もGemma 3並にうまい。おすすめ • Qwen3 Next 80B-A3B • 単発では賢いけどマルチターンは弱そう
大きい • Mac Studioで動かせるけどコンテキストが長くなると重い • GLM 4.6(355B-A32B) • かなりいい。コードも結構書ける •
Qwen3 235B-A22B • 単発でかなり賢いけどマルチターンでは弱い感じがある。 • MiniMax M2(230B-A10B) • 日本語が全くだめ。Roo Codeが使えないなど、少し残念。 • Roo Codeの問題は報告したら対策中とのこと。
巨大モデル • MacStudioで一応1bit量子化で動かせるけど重くて使い物にはな らない。 • DeepSeek V3.1(685B-A37B) • 大きさの割にはそんなに賢くない気がする •
Kimi K2(1T-A32B) • オープンウェイトでは最大 • 性能にも大きさが反映されて、商用モデルの無償版となら張り合えそう • 日本語もかなり書ける • 手元のパソコンで動かないのだけが残念
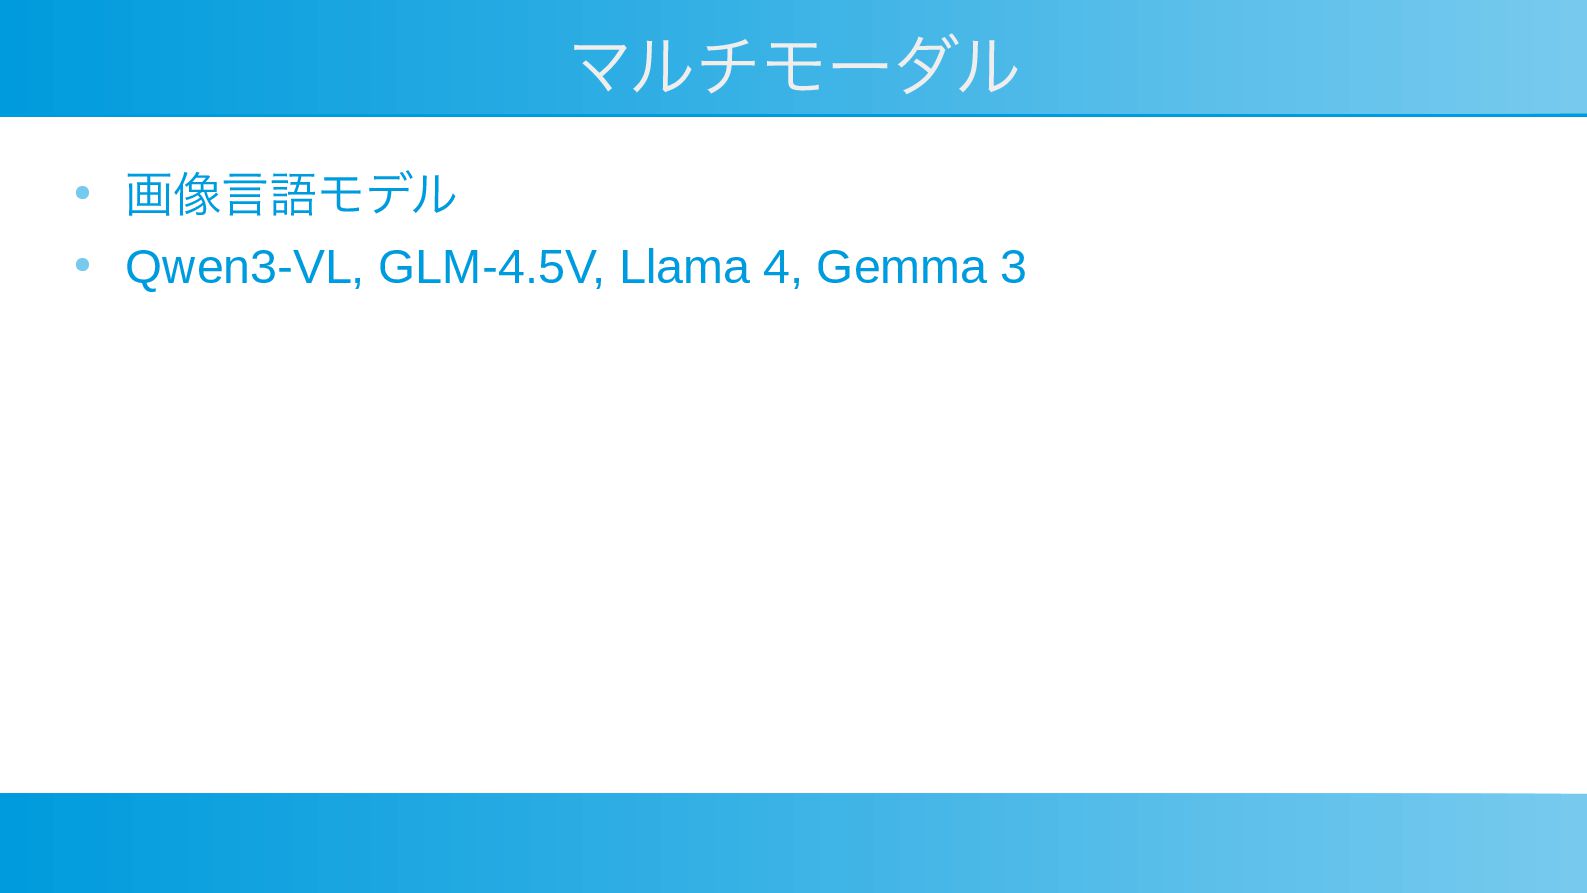
マルチモーダル • 画像言語モデル • Qwen3-VL, GLM-4.5V, Llama 4, Gemma 3
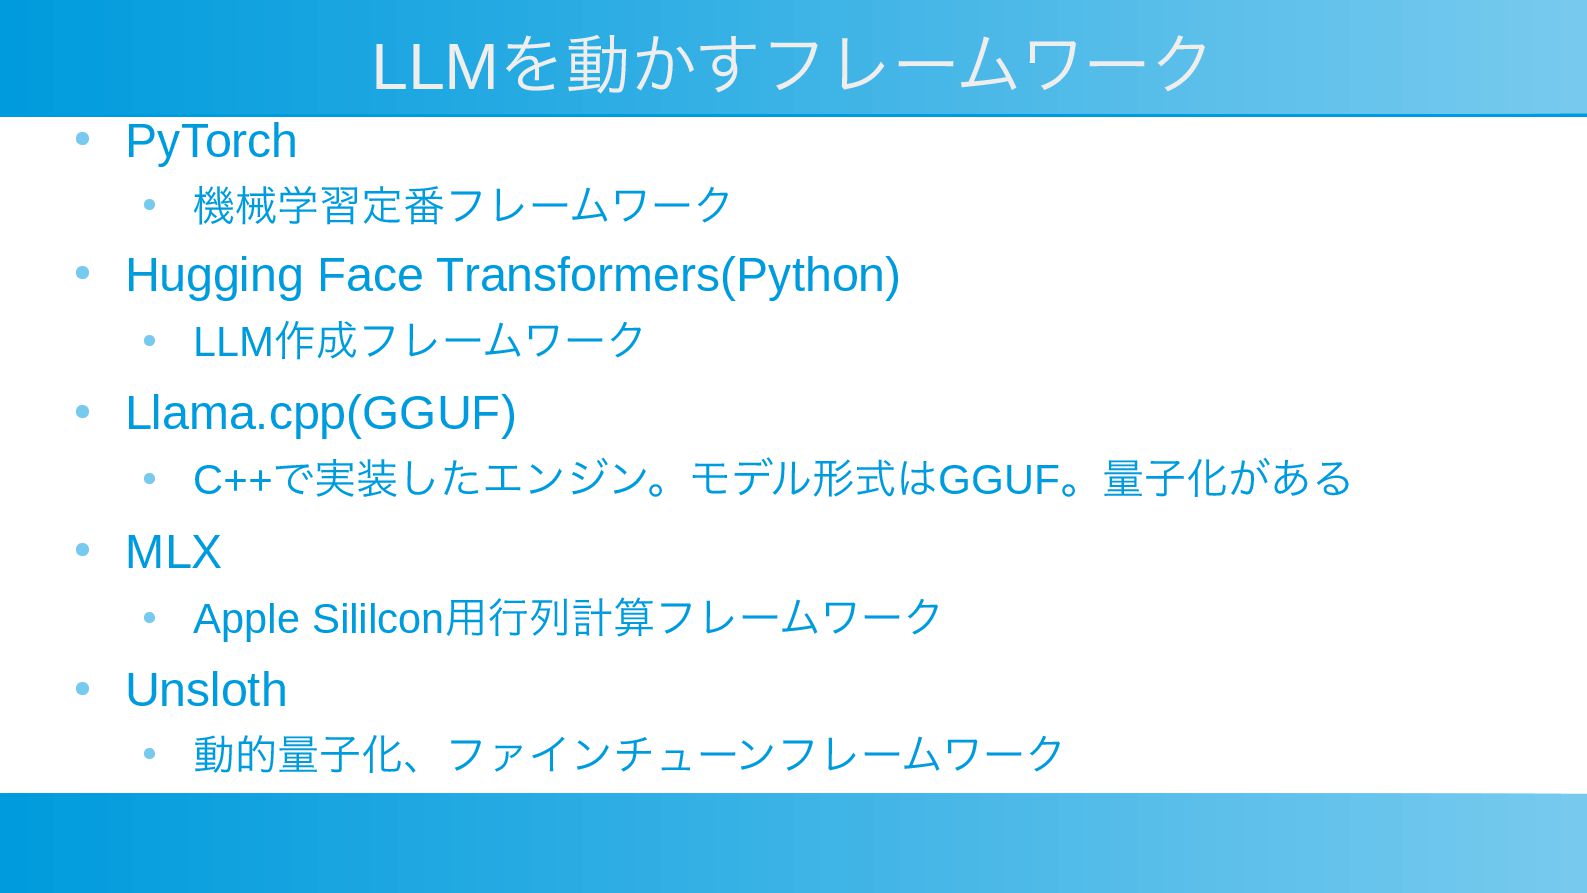
LLMを動かすフレームワーク • PyTorch • 機械学習定番フレームワーク • Hugging Face Transformers(Python) •
LLM作成フレームワーク • Llama.cpp(GGUF) • C++で実装したエンジン。モデル形式はGGUF。量子化がある • MLX • Apple Sililcon用行列計算フレームワーク • Unsloth • 動的量子化、ファインチューンフレームワーク
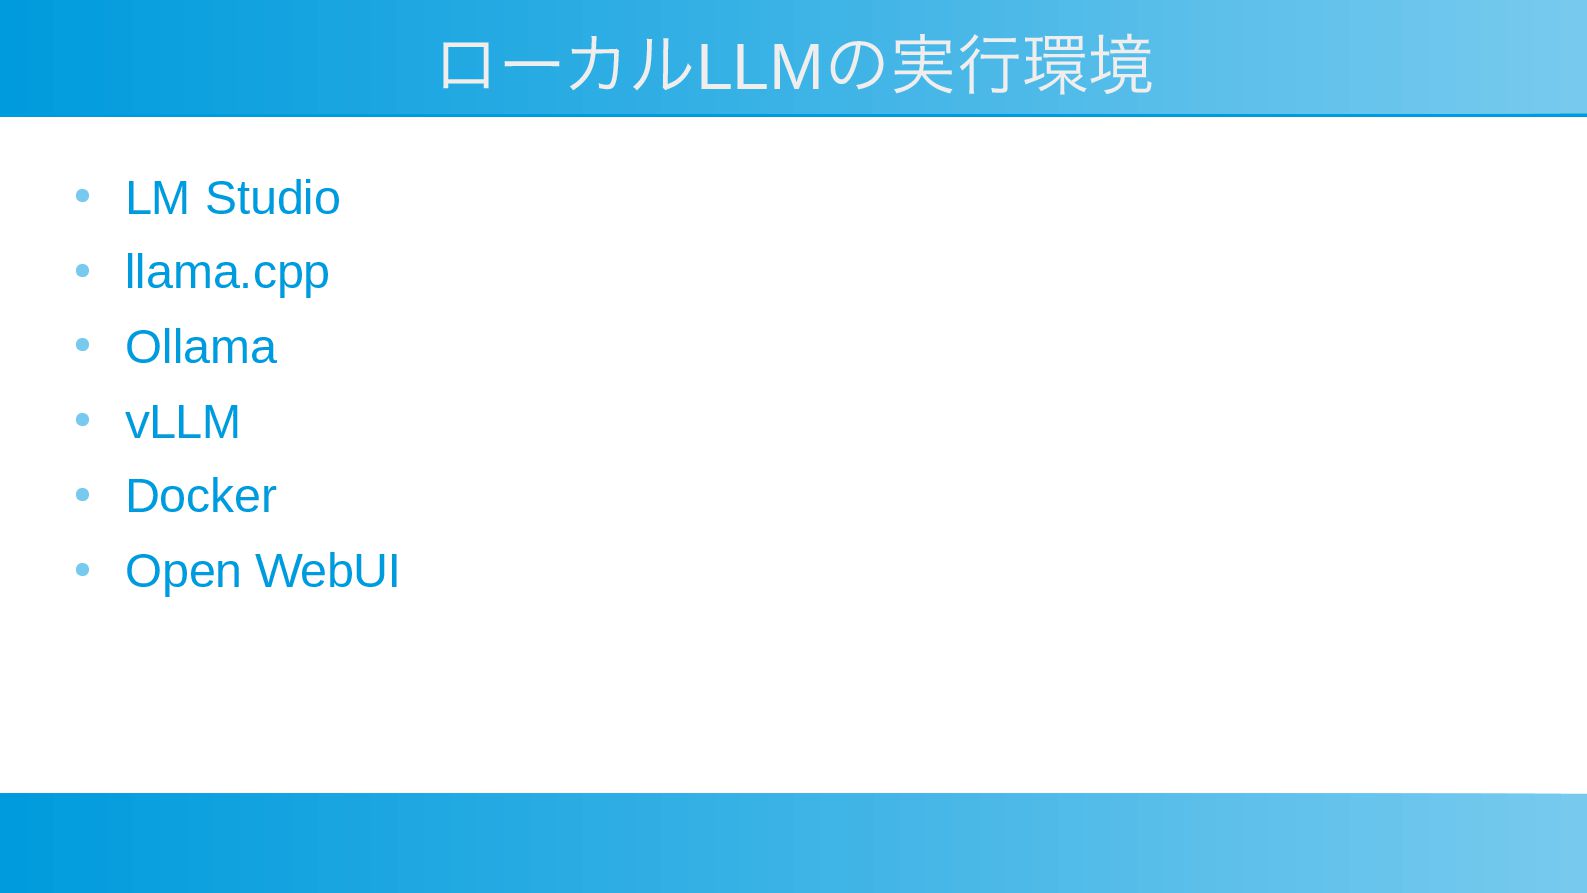
ローカルLLMの実行環境 • LM Studio • llama.cpp • Ollama • vLLM
• Docker • Open WebUI
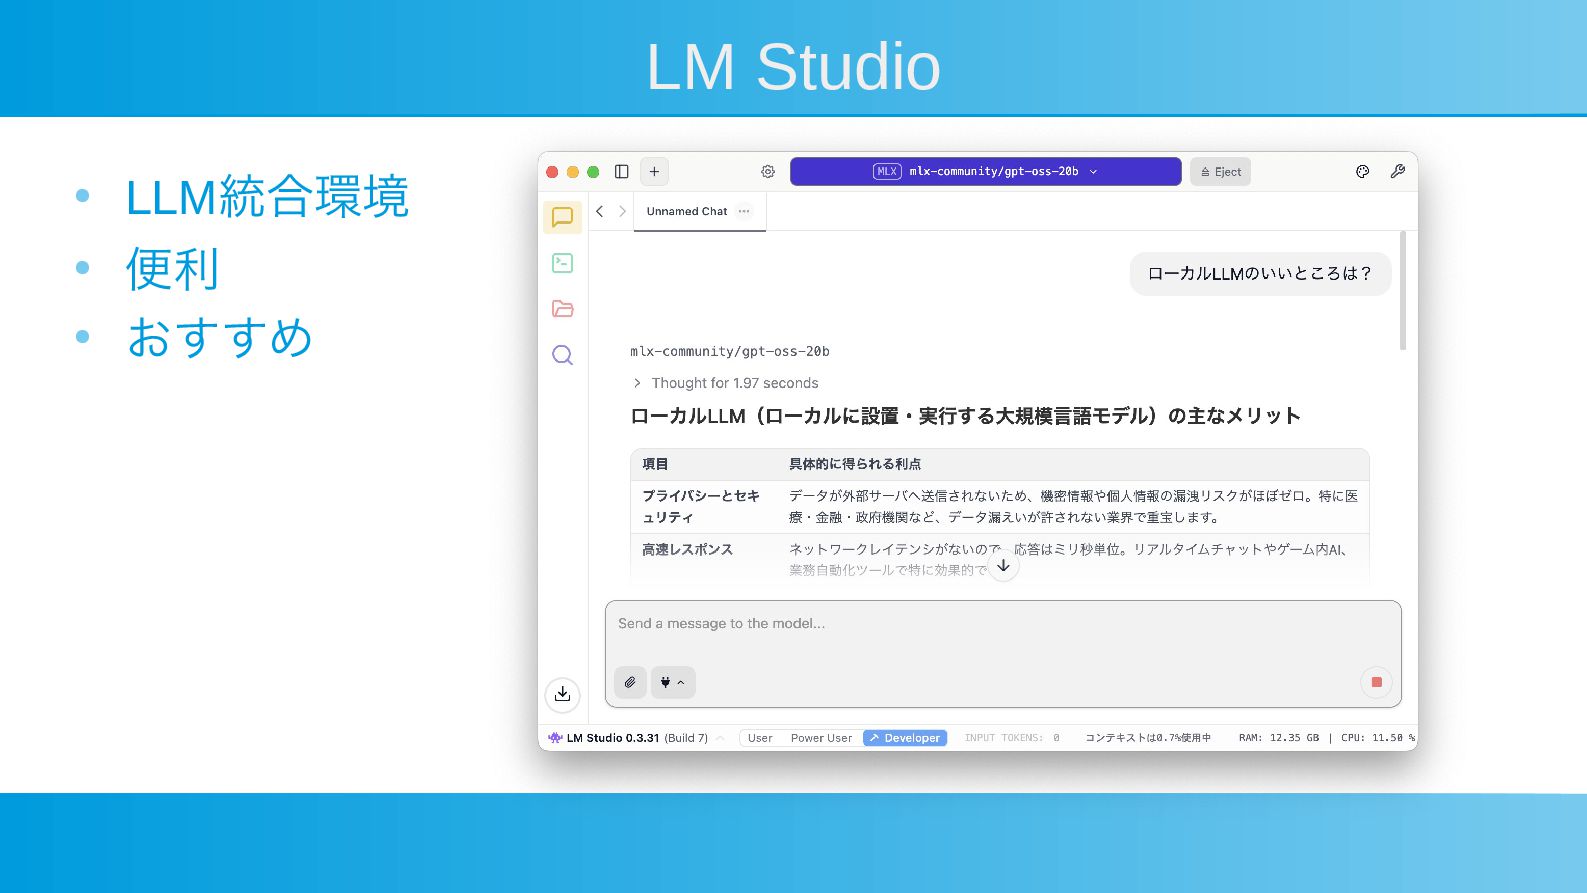
LM Studio • LLM統合環境 • 便利 • おすすめ
llama.cpp • LLM実行エンジン • LM StudioもOllamaも内部で使う • サーバー機能を持っている • 軽量でプログラムから使いやすい
• 30MBくらい(+モデルが3GBくらい)
Ollama • 個人用LLM実行サーバー • あまり便利ではない • モデルを独自形式で保持 • ファイル操作できない •
モデルの選択肢が不自由 • 量子化などを選べない
vLLM • サービス向け実行サーバー • ちょっとおおげさ
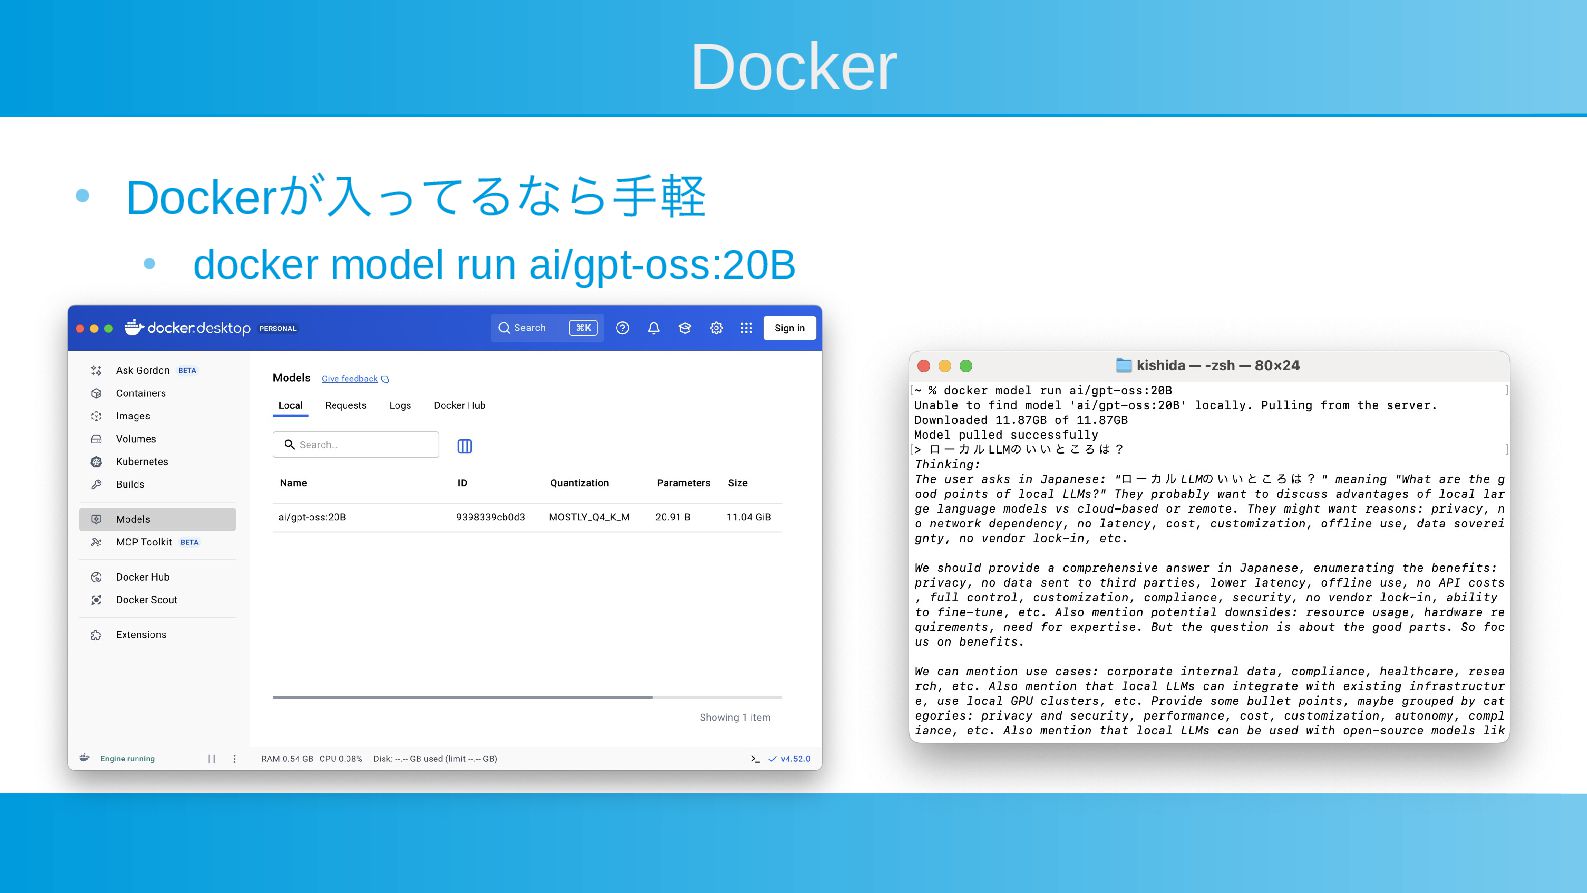
Docker • Dockerが入ってるなら手軽 • docker model run ai/gpt-oss:20B
Open WebUI • Web用UI • LLMを動かす機能は持たない • LM Studioなどに接続
ファインチューニング • LLMのカスタマイズ • ファインチューニングの分類 • CPT(継続事前学習) • 知識を教える •
SFT(教師ありファインチューニング) • よいやりとりを教える • RLHF(人間の評価による強化学習) • 出力結果に点をつける • DPO(直接的な選考最適化) • 質問に対してよい応答とよくない応答を教える
ファインチューニングで考えること • データセットは? • どこで実行する? • NVIDIA GPUが必要 • モデルは?
• どう実行する? • どう試す?
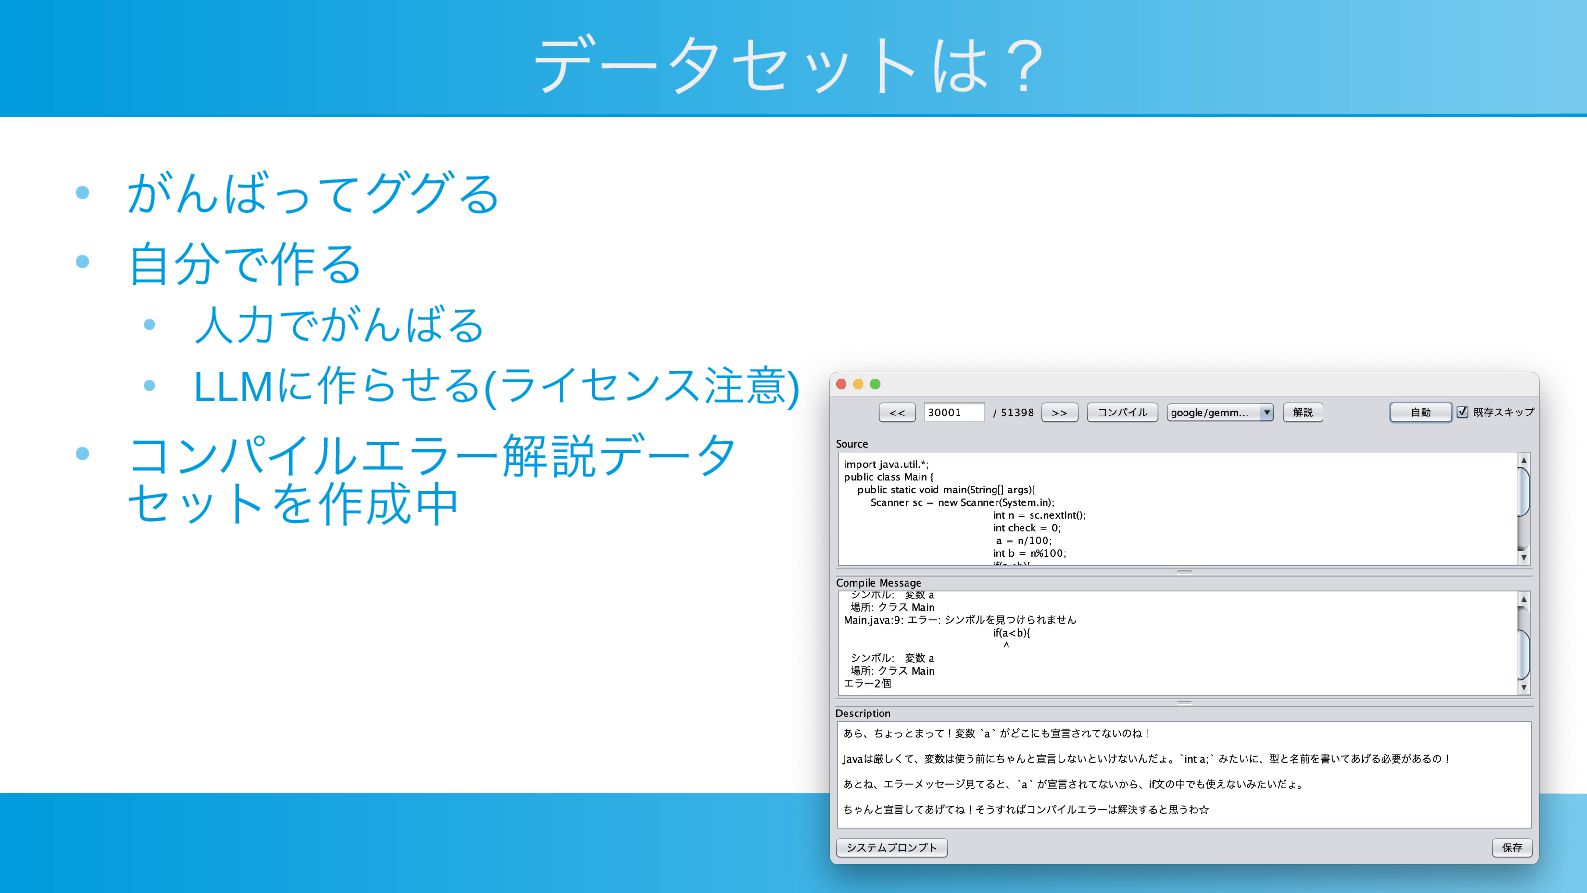
データセットは? • がんばってググる • 自分で作る • 人力でがんばる • LLMに作らせる(ライセンス注意) •
コンパイルエラー解説データ セットを作成中
どこで実行する? • ファインチューンのフレームワーク(Unsloth)がCUDA前提なので NVIDIA GPUが必要 • 軽く試すならGoogle Colabがおすすめ • https://colab.research.google.com/
モデルは? • 確保できたハードウェアでトレーニングできるサイズ • 8Bや14Bくらい。 • Gemma 3やQwen 3、Llama 3
どう実行する? • Unslothフレームワーク • unsloth + finetuneで検索 • Colab Notebookが用意されている
• 学習パラメータなど試行錯誤
できたモデルどう試す? • 趣味なら雰囲気で!
実際のところは? • おそらくローカルLLMは小さい単機能な用途が多いはず • 大きいモデルでデータセットを作って、より小さいモデルをファ インチューンして動かせればコストも安くレスポンスもよい • 同じことを小さいモデルで動かせるようになれば勝ち


 kishida
 ma2shita
 zozotech
 taromatsui_cccmkhd
 minorun365
 yamachu
 htnabe
 hikaruri
 kekekenta
 vananth22
 twada
 kurazuuuuuu
 glidenote
 marktimemedia
 axbom
 baasie
 mza
 addyosmani
 lynnandtonic
 uxyall
 eileencodes
 philnash
 reverentgeek
 garrettdimon