Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Apache Icebergを"正しく"選ぶ - スタートアップのためのデータ基盤設計の思考法
Search
Kouki Kishida
July 28, 2026
Technology
92
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Apache Icebergを"正しく"選ぶ - スタートアップのためのデータ基盤設計の思考法
AWS Summit Japan 2026 で登壇した資料です。
Kouki Kishida
July 28, 2026
More Decks by Kouki Kishida
See All by Kouki Kishida
TROCCO®︎とAmazon S3で始める コスト安なデータ分析ジャーニーの実現方法
kishidak
0
43
Kiroで学ぶ仕様駆動開発入門
kishidak
0
27
ビジネスを加速するSnowflake×AWSの活用のすゝめ
kishidak
0
230
~スタートアップから学ぶ~ ビジネスを成長させるQuickSightの賢い使い方
kishidak
0
210
シード期のスタートアップに知ってほしい技術のこと
kishidak
0
80
Startupゼミ よくある課題シリーズ 2022秋期講習編
kishidak
0
110
Other Decks in Technology
See All in Technology
専門領域のAIをどう評価するか
bengo4com
2
300
Classmethod Company Deck
satoshi7
1
740
Active Record Connection Adaptersにおける長年の課題に再び取り組む
yahonda
0
200
AI駆動で「他アプリの音を加工できる」アプリを作った
satomasahiro2005
0
170
How to Design Configuration for Rails Applications
willnet
1
840
Metadata - Section 1: HTML Basics
mohab1
0
120
Railsで挑む大量データ永続化 〜600億件を永続化するための設計とボトルネックとの戦い〜
occhi
1
780
DevelopersIO 2026 知識の地図を描く ─ オントロジーとは何か?
ishikawa_satoru
1
1.7k
Benchmarking Disaggregated Serving on vLLM + Dynamo with a Real Coding-Agent Workload
nttcom
1
200
10年後、Engineering 行為を剥奪されるとして、わたしたちは、どう、何を創ればいいだろうか。 / If Engineering Is Taken Away in 10 Years, How and What Should We Create?
bitkey
PRO
1
200
Optunaの最新リリースv5.0について
pfn
PRO
0
120
Persisting Massive Data with Rails ~Designing for 60 billion rows, and fighting the bottlenecks~ Railsで挑む大量データ永続化 〜600億件を永続化するための設計とボトルネックとの戦い〜
occhi
0
740
Featured
See All Featured
Building a A Zero-Code AI SEO Workflow
portentint
PRO
0
780
Digital Ethics as a Driver of Design Innovation
axbom
PRO
1
460
<Decoding/> the Language of Devs - We Love SEO 2024
nikkihalliwell
1
360
AI: The stuff that nobody shows you
jnunemaker
PRO
10
1.2k
How Software Deployment tools have changed in the past 20 years
geshan
2
35k
jQuery: Nuts, Bolts and Bling
dougneiner
66
8.6k
Are puppies a ranking factor?
jonoalderson
2
4.1k
Deep Space Network (abreviated)
tonyrice
0
380
Code Reviewing Like a Champion
maltzj
529
40k
Marketing to machines
jonoalderson
1
5.9k
4 Signs Your Business is Dying
shpigford
187
23k
For a Future-Friendly Web
brad_frost
184
10k
Transcript
Apache Iceberg を"正しく"選ぶ ─ スタートアッ プのためのデータ基盤設計の思考法 Kouki Kishida Startup Solutions
Architect アマゾンウェブサービスジャパン合同会社 © 2026, Amazon W eb Services, © 2026, Inc. Amazon or itsW affil ebiates. Services, All riInc. ghtsorreserv its affil ed.iates. All ri ghts reserv ed.
はじめに • 想定聴講者 • Apache Iceberg(※)に興味があるが、実際に採用するべきか悩んでいる人 • Apache Icebergの特徴はなんとなく知っているがどういうケースで有用かよ くわからない人
• このセッションのゴール • 自分の分析基盤にApache Icebergを入れるべきかの判断の仕方がわかる • Apache Icebergの特徴からどういうユースケースが実現できるかわかる (※) 以降 Icebergと記載します © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
昨今の分析基盤トレンド © 2026, Amazon W eb Services, Inc. or its
affil iates. All ri ghts reserv ed.
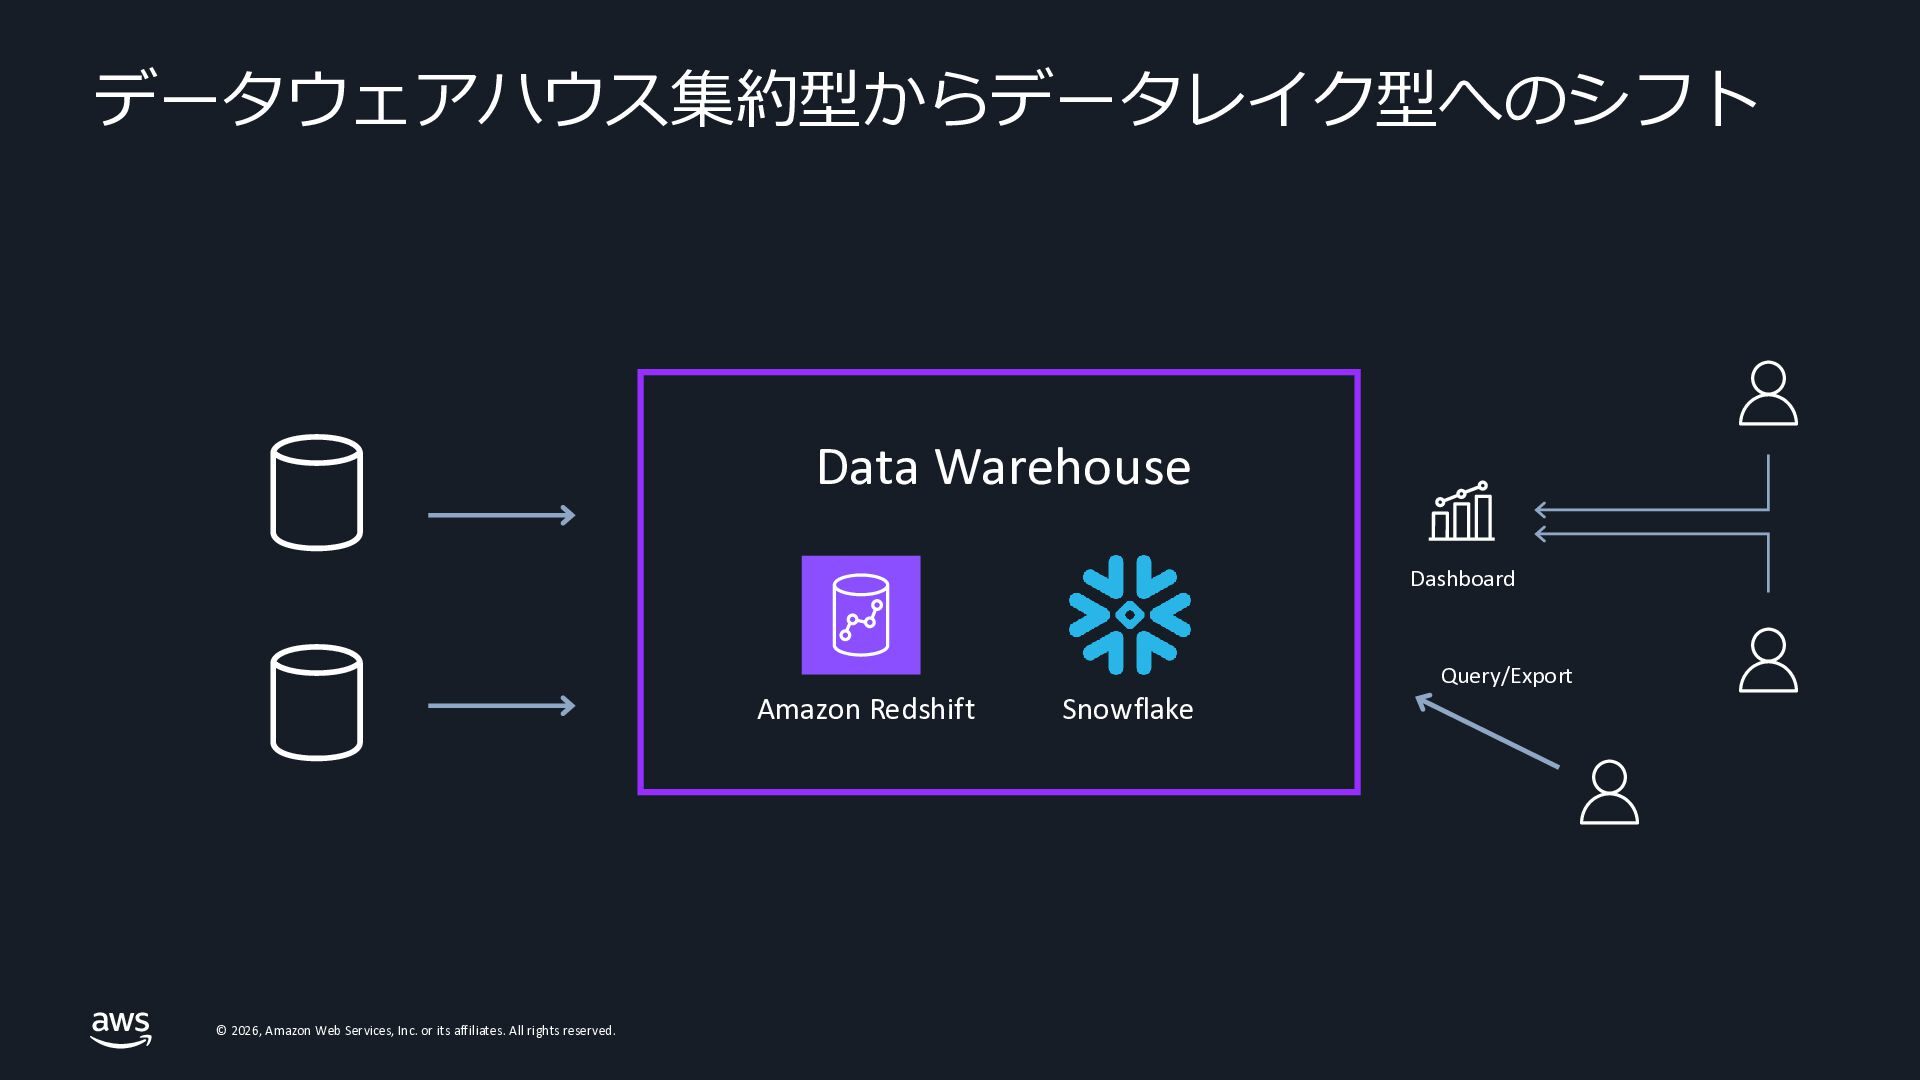
データウェアハウス集約型からデータレイク型へのシフト Data Warehouse Dashboard Query/Export Amazon Redshift © 2026, Amazon
W eb Services, Inc. or its affil iates. All ri ghts reserv ed. Snowflake
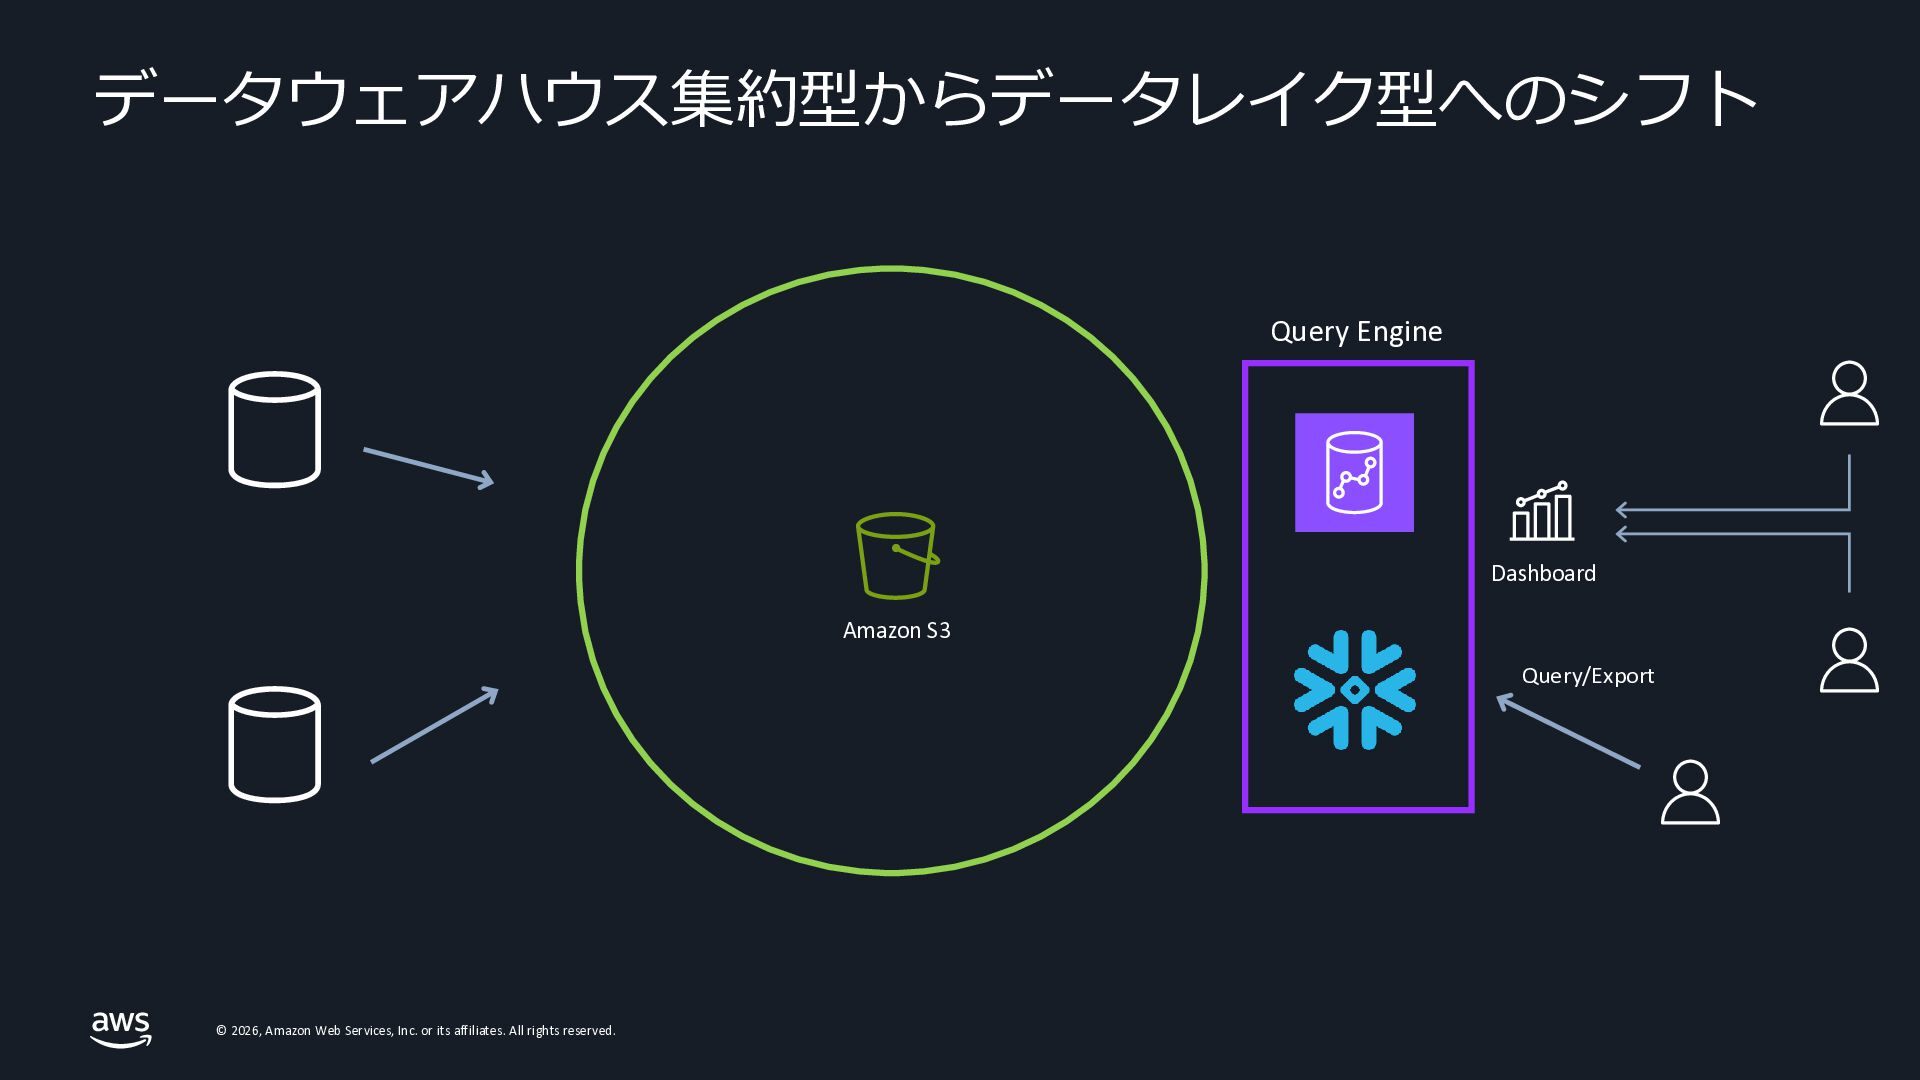
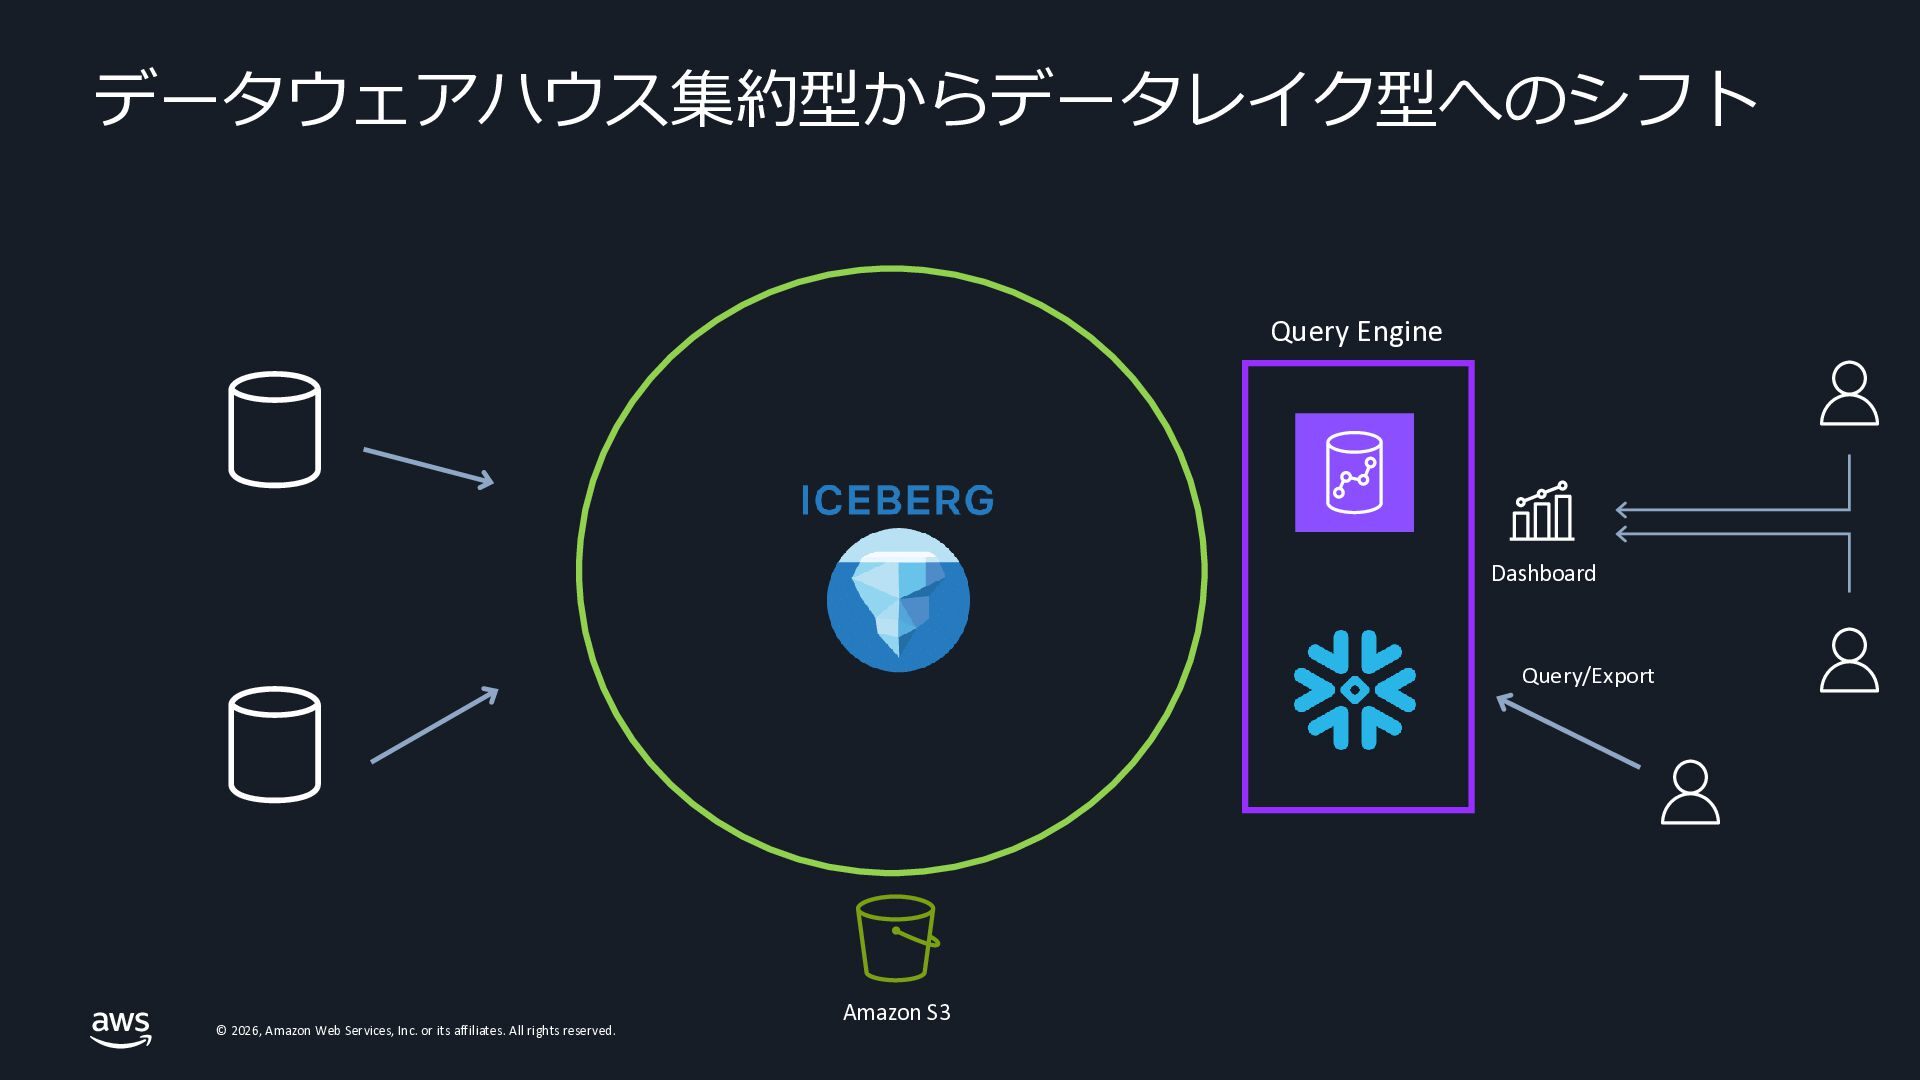
データウェアハウス集約型からデータレイク型へのシフト Query Engine Dashboard Amazon S3 Query/Export © 2026, Amazon
W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
データウェアハウス集約型からデータレイク型へのシフト Query Engine Dashboard Query/Export © 2026, Amazon W eb
Services, Inc. or its affil iates. All ri ghts reserv ed. Amazon S3
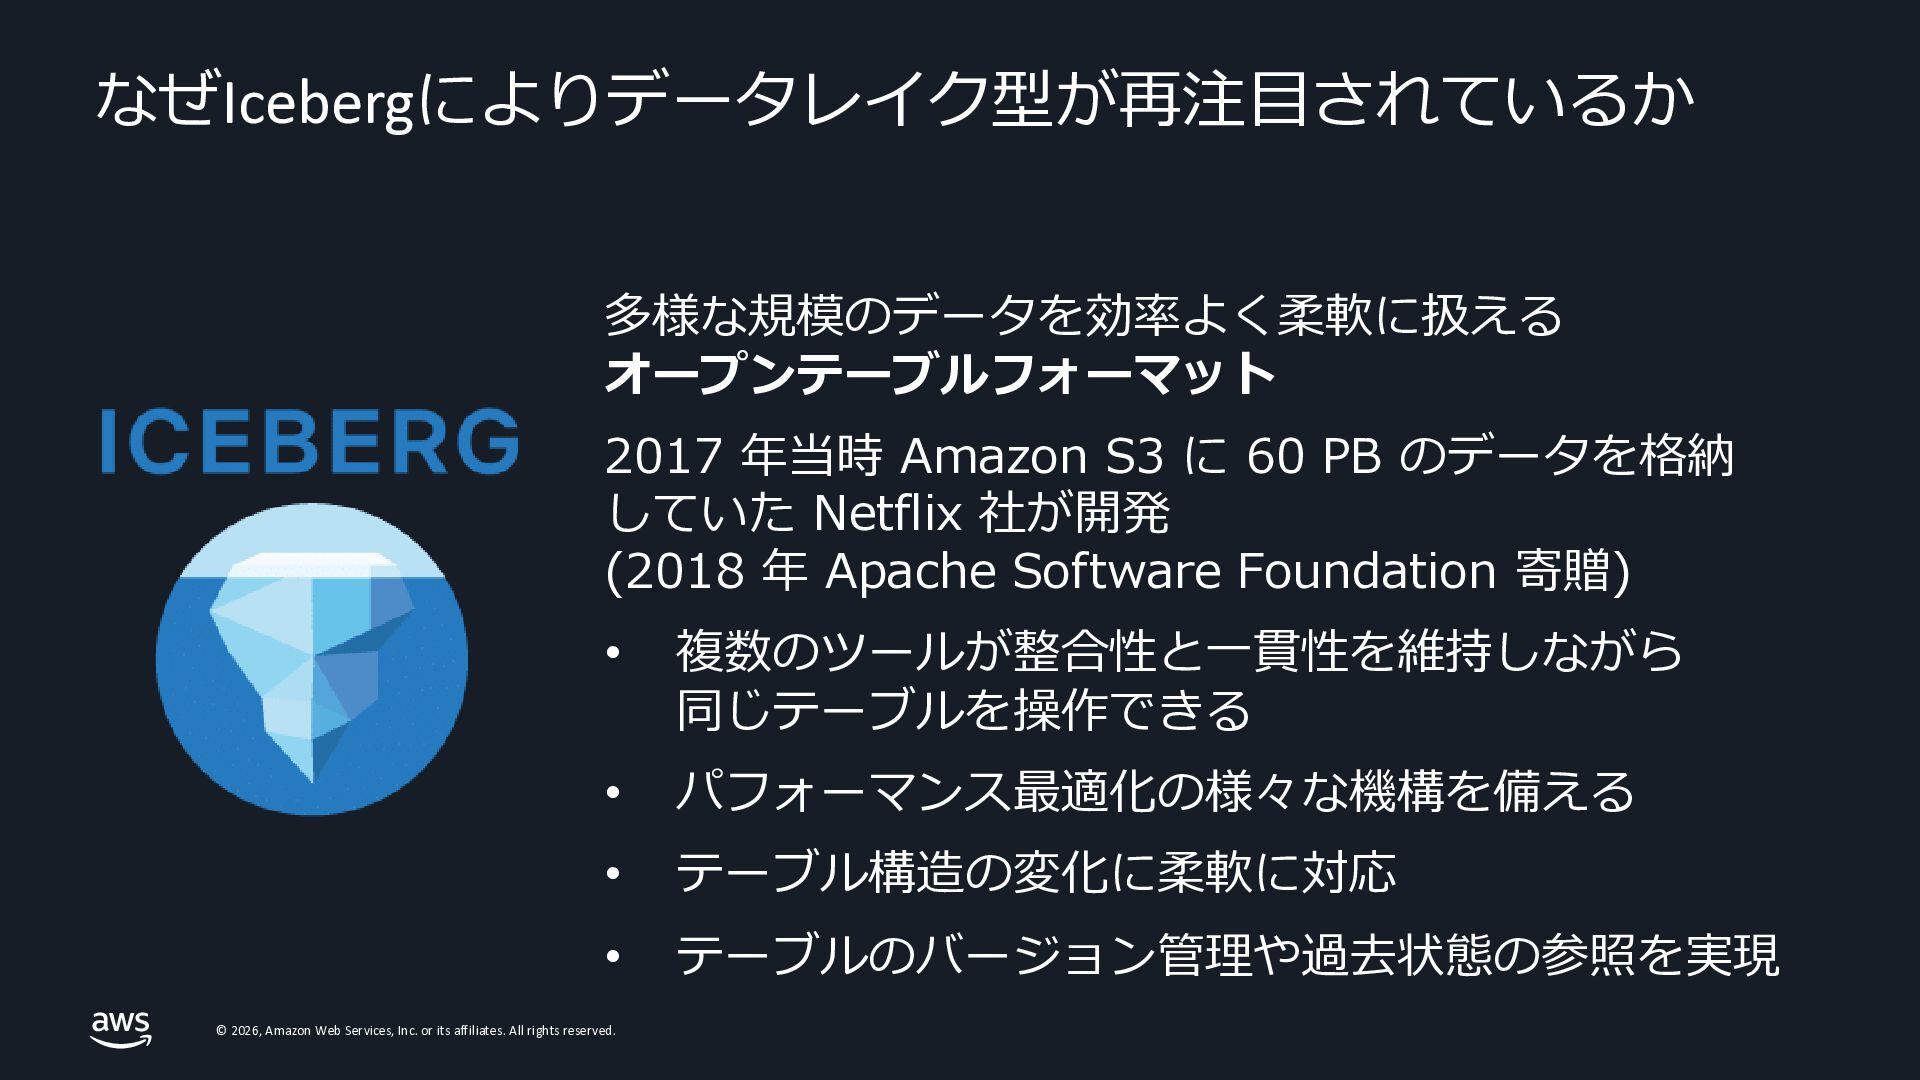
なぜIcebergによりデータレイク型が再注目されているか 多様な規模のデータを効率よく柔軟に扱える オープンテーブルフォーマット 2017 年当時 Amazon S3 に 60 PB
のデータを格納 していた Netflix 社が開発 (2018 年 Apache Software Foundation 寄贈) • 複数のツールが整合性と一貫性を維持しながら 同じテーブルを操作できる • パフォーマンス最適化の様々な機構を備える • テーブル構造の変化に柔軟に対応 • テーブルのバージョン管理や過去状態の参照を実現 © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
Icebergの技術選定での悩み • Icebergは対応ツールが多く、迷う • Apache SparkやApache FlinkなどのオープンソースやSnowflakeやDatabricksなどの商用製品が続 々対応 • さらに、Icebergは幅広いユースケースに対応する
• データウェアハウスに負けず劣らずの性能のイメージ • 大容量のデータ更新ワークロードにも対応 • とはいえ、コンパクション計画など運用面を考慮する必要があり初期から安易に入れていいものか よくわからない なぜデータウェアハウスで完結せず、Icebergを採用するのか?その考え方を紐解いていきます © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
アーキテクチャの考え方 © 2026, Amazon W eb Services, Inc. or its
affil iates. All ri ghts reserv ed.
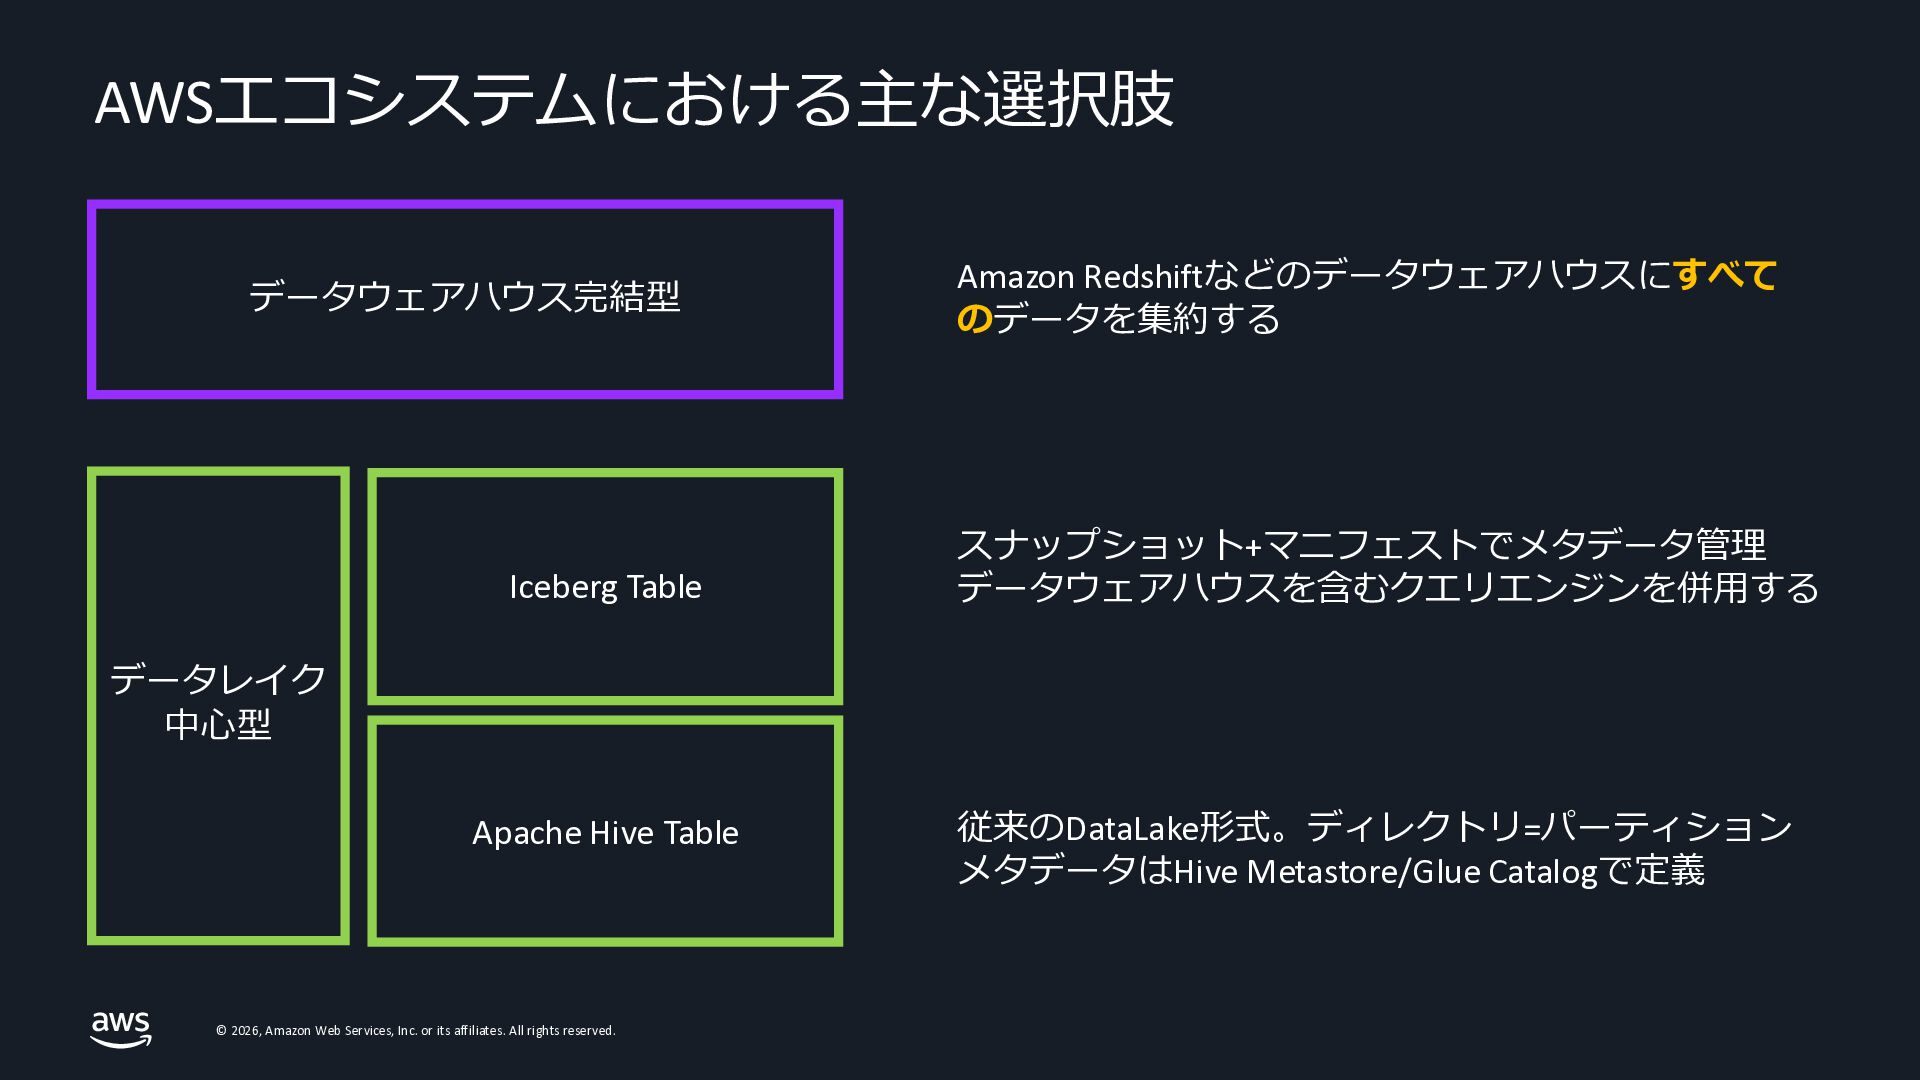
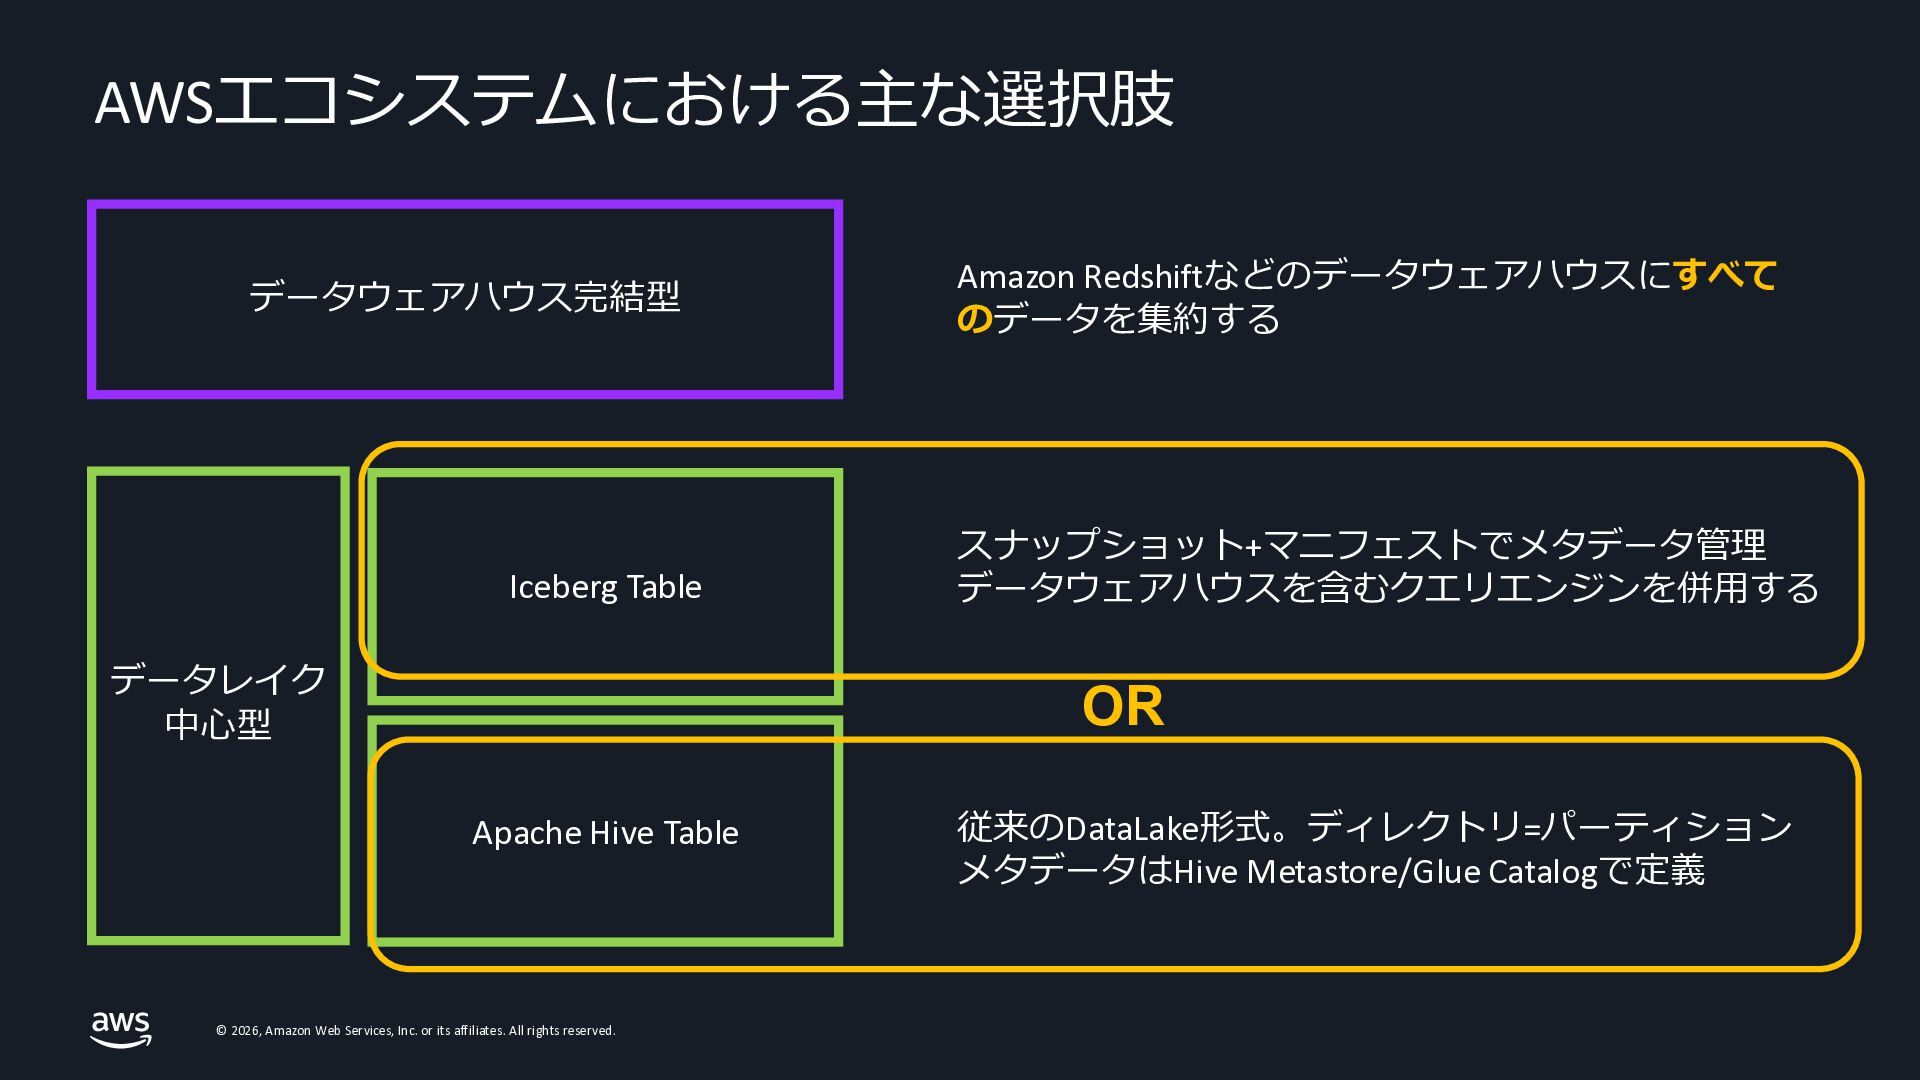
AWSエコシステムにおける主な選択肢 データウェアハウス完結型 Iceberg Table Amazon Redshiftなどのデータウェアハウスにすべて のデータを集約する スナップショット+マニフェストでメタデータ管理 データウェアハウスを含むクエリエンジンを併用する データレイク
中心型 Apache Hive Table © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed. 従来のDataLake形式。ディレクトリ=パーティション メタデータはHive Metastore/Glue Catalogで定義
選択肢の補足:いずれも併用可能な点を考慮する • データレイク基盤にデータウェアハウスのクエリエンジンを利用することはポ ピュラーなアーキテクチャ • データによってはデータレイクとデータウェアハウス双方にデータを持たせて おくのも一つの選択肢 データのワークロード(分析業務からETLやスキーマ管理など)によって 適材適所で採用を決めることが重要 ©
2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
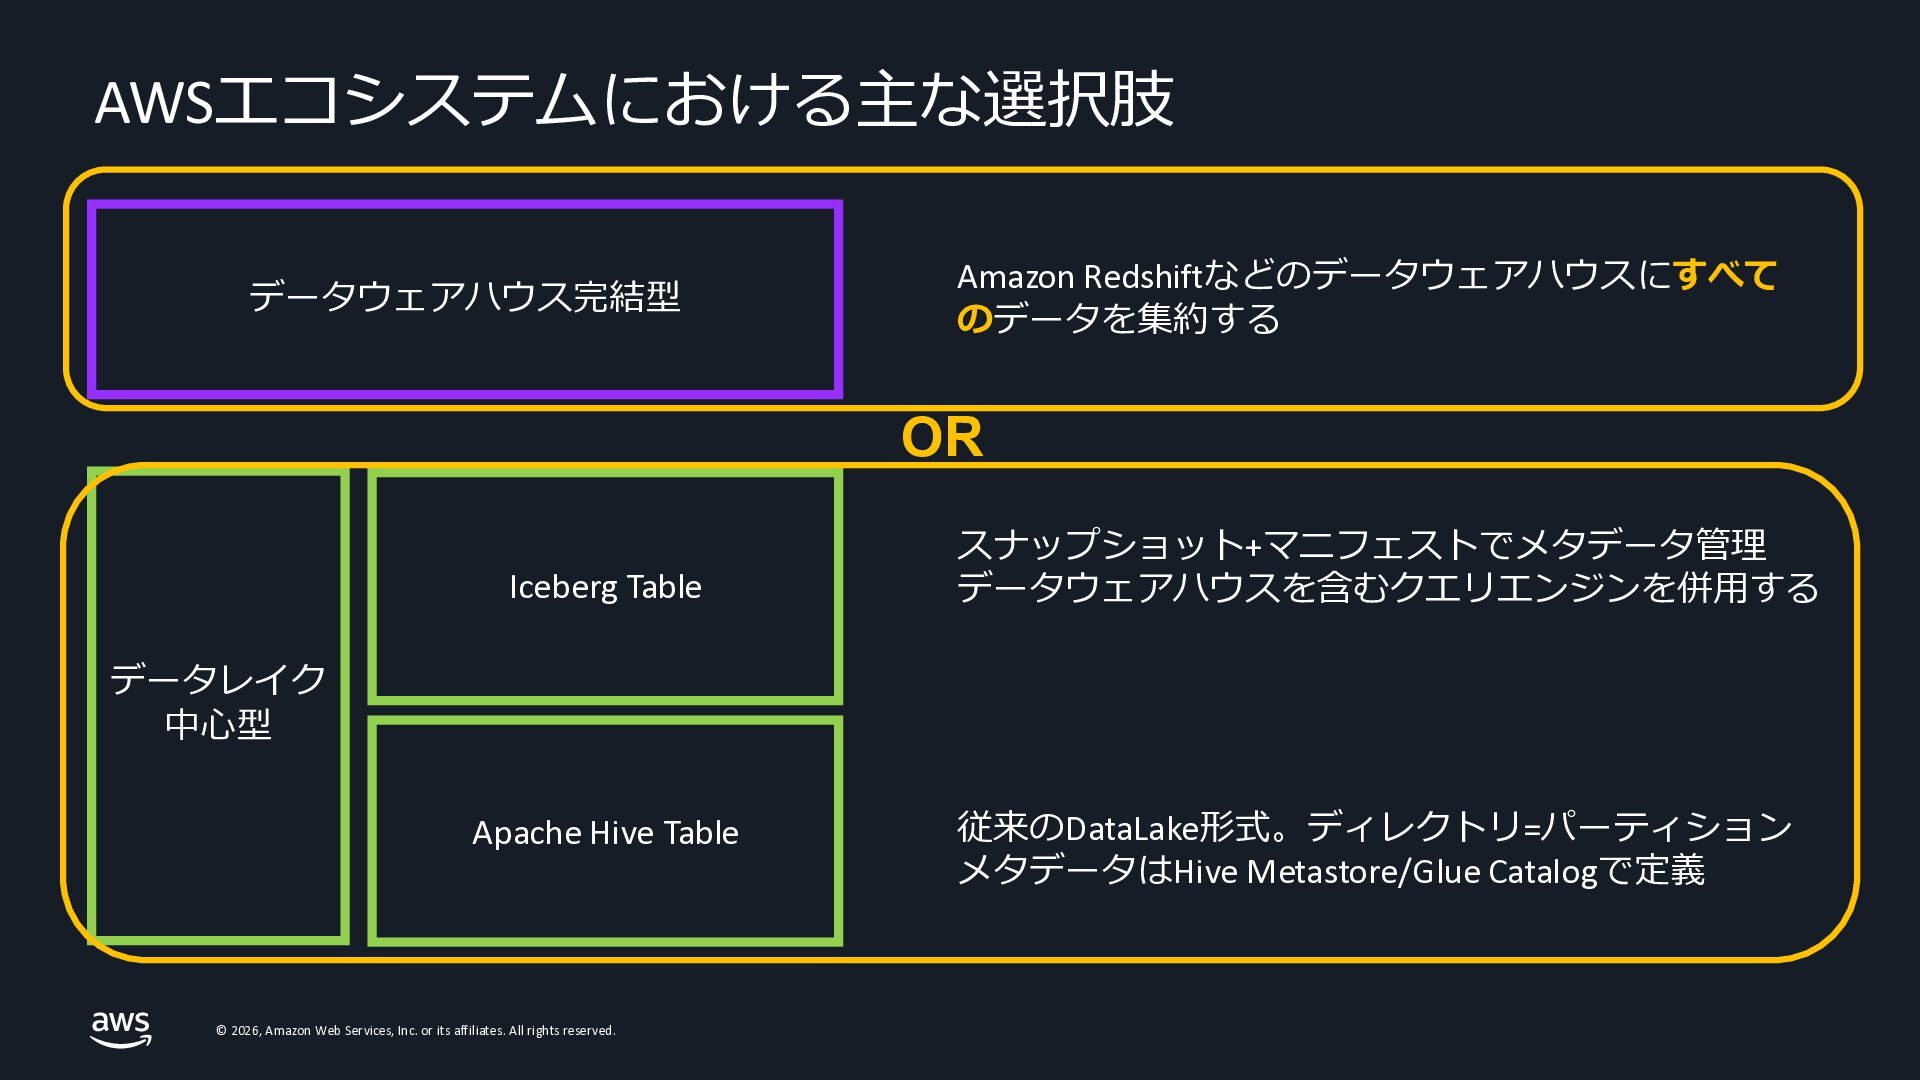
AWSエコシステムにおける主な選択肢 データウェアハウス完結型 Amazon Redshiftなどのデータウェアハウスにすべて のデータを集約する OR Iceberg Table スナップショット+マニフェストでメタデータ管理 データウェアハウスを含むクエリエンジンを併用する
データレイク 中心型 Apache Hive Table © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed. 従来のDataLake形式。ディレクトリ=パーティション メタデータはHive Metastore/Glue Catalogで定義
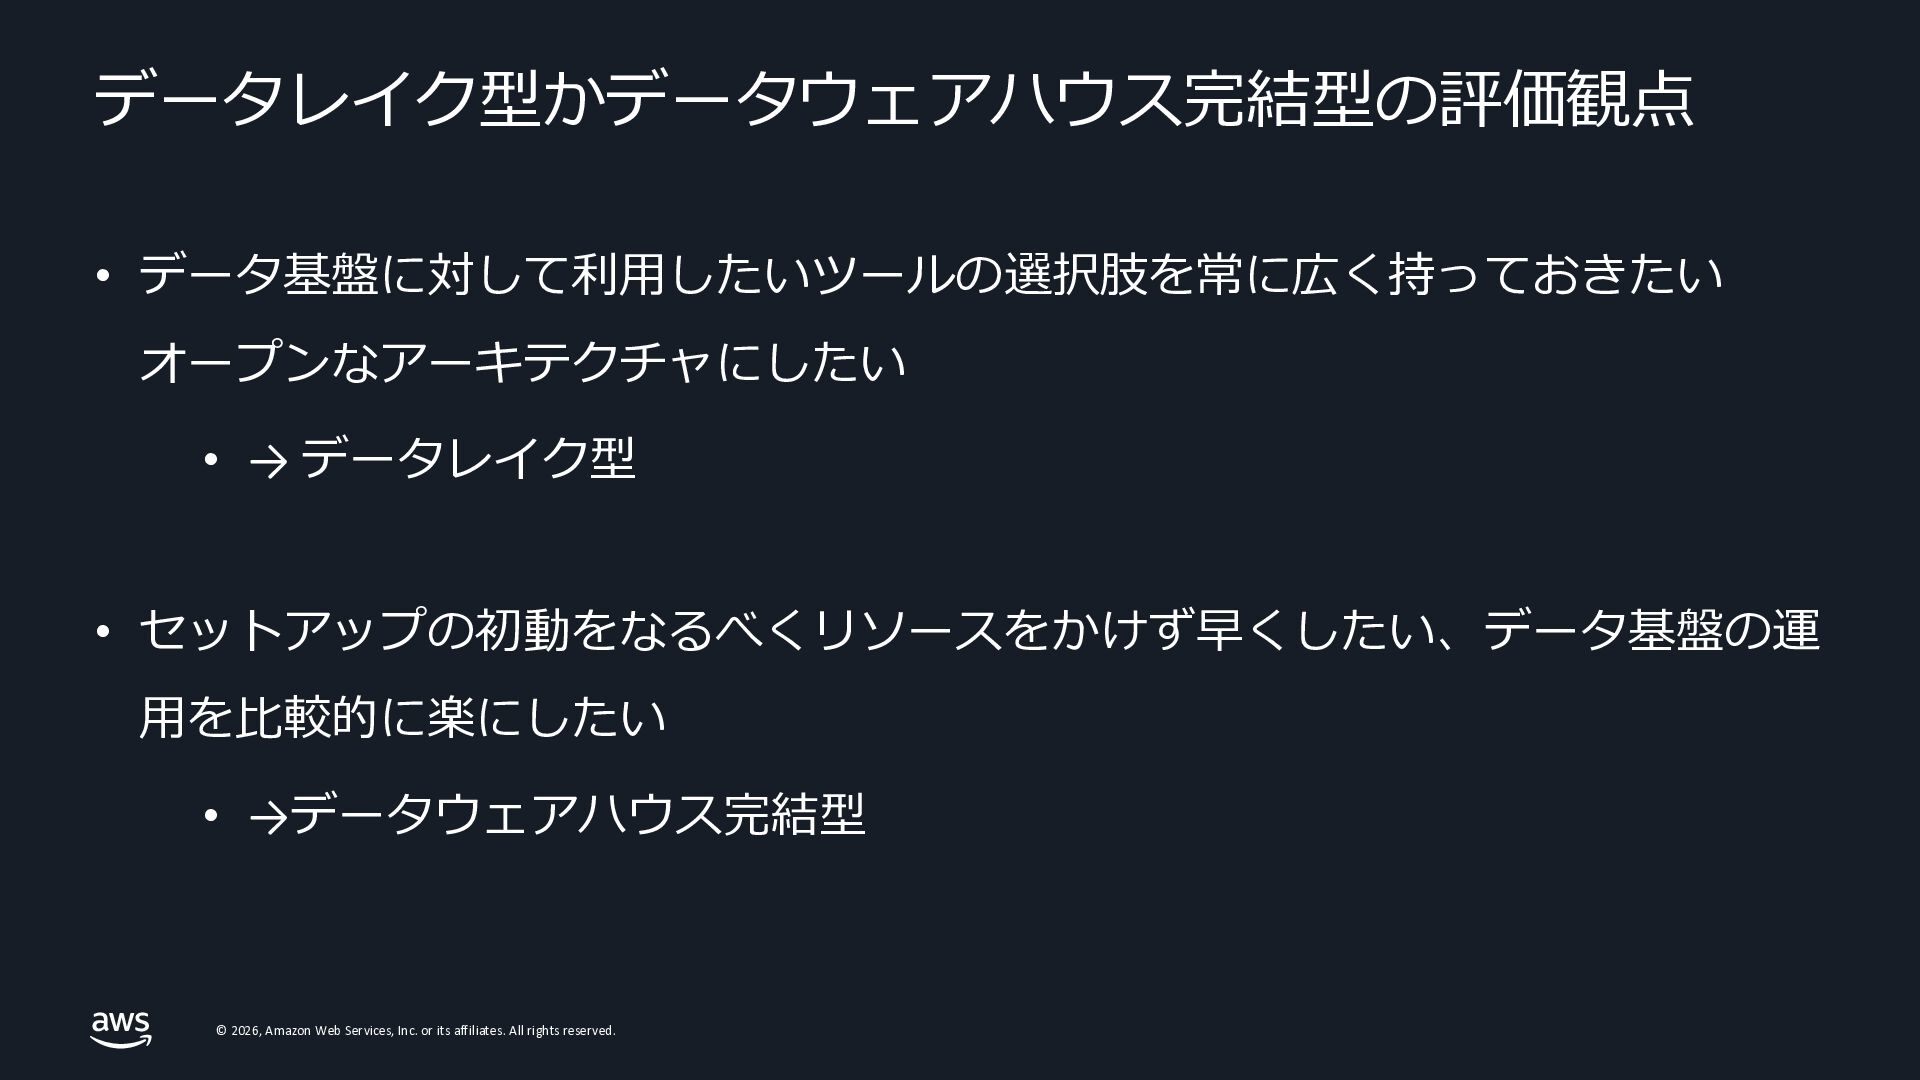
データレイク型かデータウェアハウス完結型の評価観点 • データ基盤に対して利用したいツールの選択肢を常に広く持っておきたい オープンなアーキテクチャにしたい • → データレイク型 • セットアップの初動をなるべくリソースをかけず早くしたい、データ基盤の運 用を比較的に楽にしたい
• →データウェアハウス完結型 © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
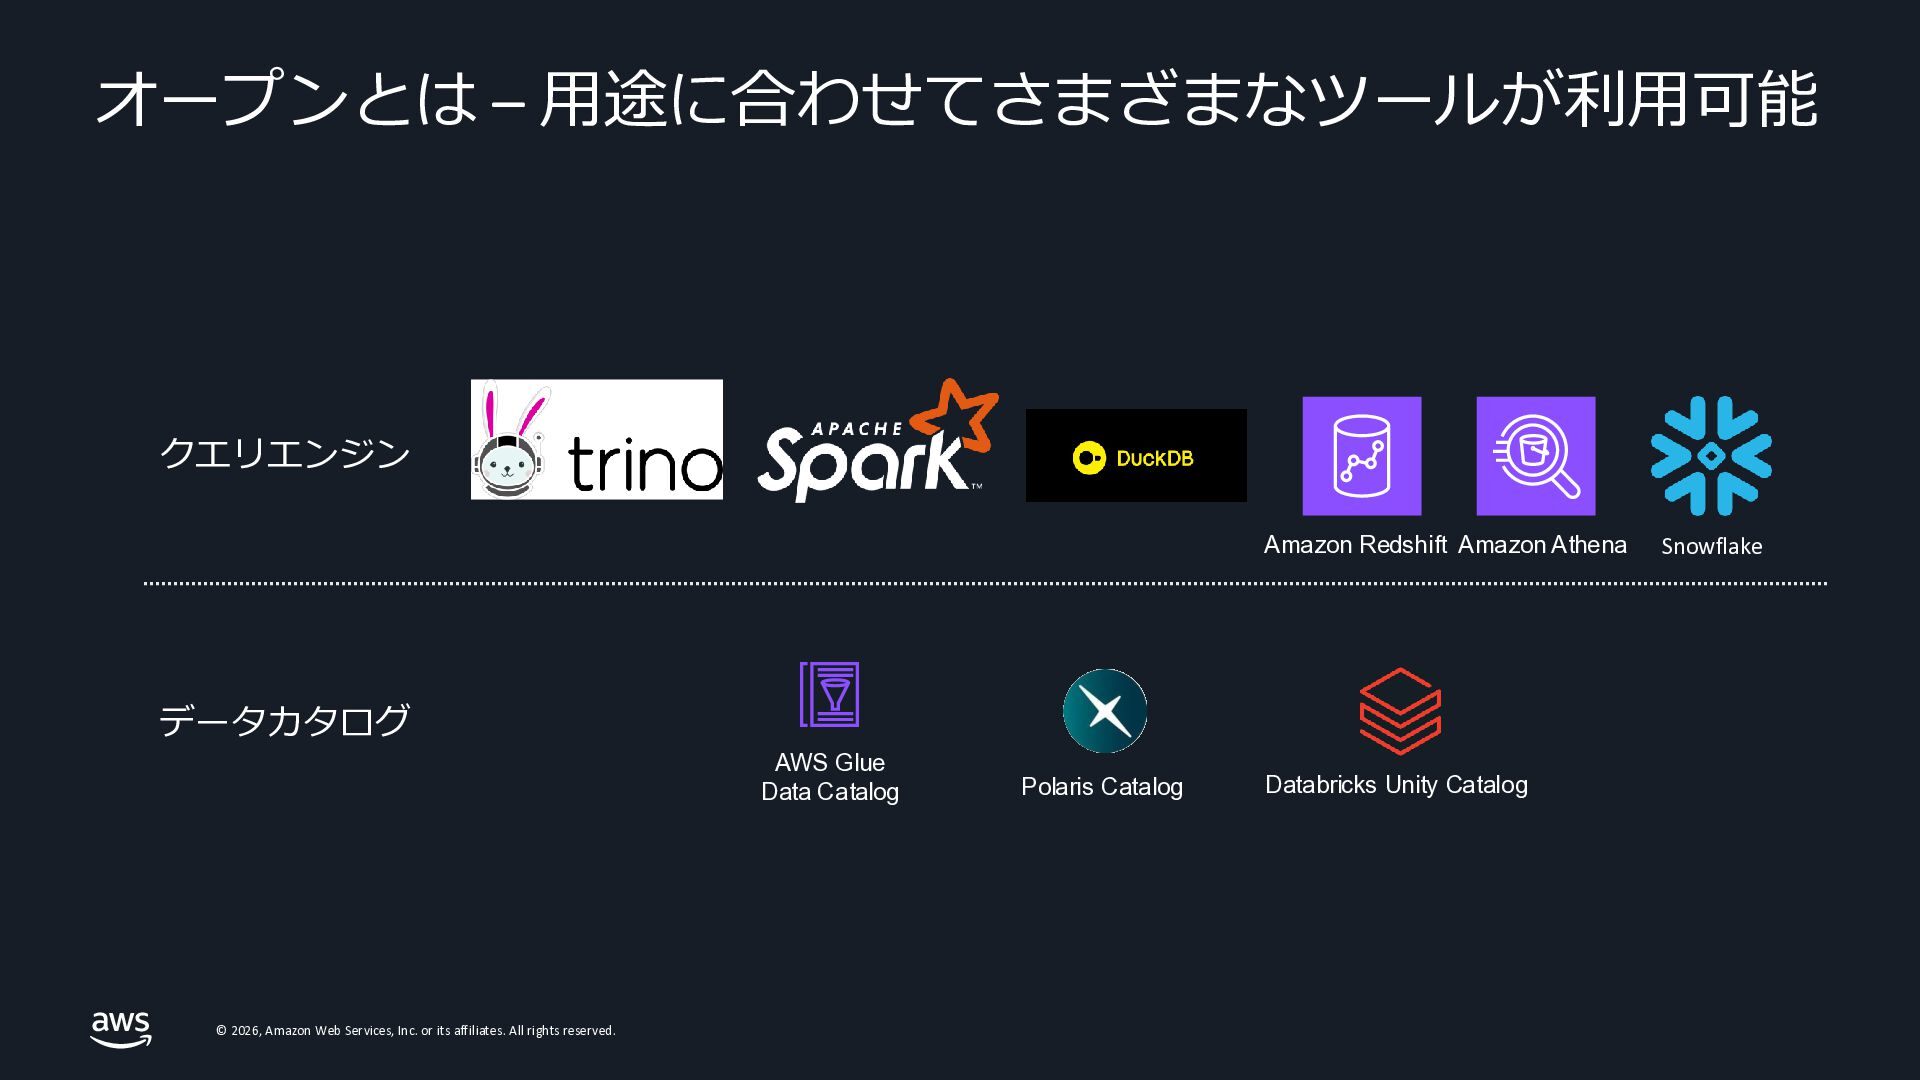
オープンとは – 用途に合わせてさまざまなツールが利用可能 クエリエンジン Amazon Redshift Amazon Athena データカタログ AWS
Glue Data Catalog © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed. Polaris Catalog Databricks Unity Catalog Snowflake
AWSエコシステムにおける主な選択肢 データウェアハウス完結型 Iceberg Table データレイク 中心型 Amazon Redshiftなどのデータウェアハウスにすべて のデータを集約する スナップショット+マニフェストでメタデータ管理
データウェアハウスを含むクエリエンジンを併用する OR Apache Hive Table © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed. 従来のDataLake形式。ディレクトリ=パーティション メタデータはHive Metastore/Glue Catalogで定義
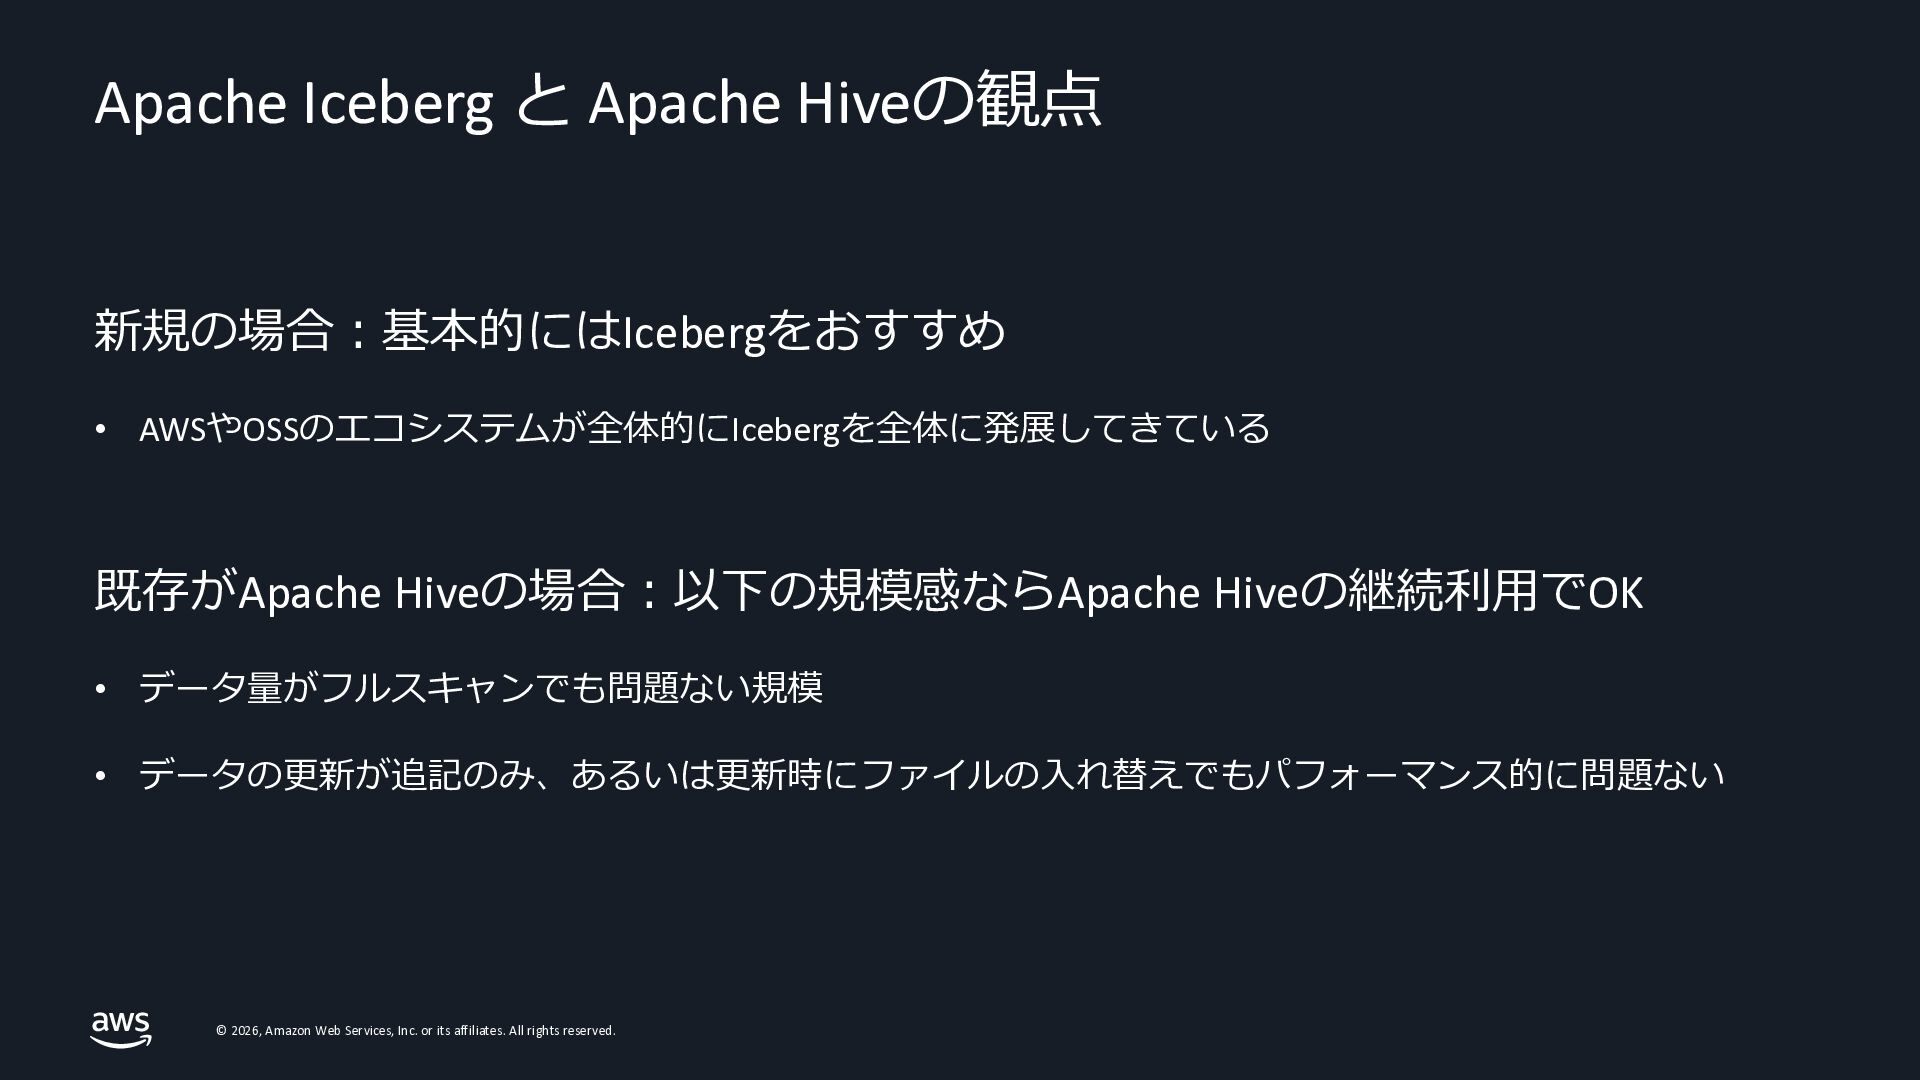
Apache Iceberg と Apache Hiveの観点 新規の場合:基本的にはIcebergをおすすめ • AWSやOSSのエコシステムが全体的にIcebergを全体に発展してきている 既存がApache Hiveの場合:以下の規模感ならApache
Hiveの継続利用でOK • データ量がフルスキャンでも問題ない規模 • データの更新が追記のみ、あるいは更新時にファイルの入れ替えでもパフォーマンス的に問題ない © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
事例から学ぶApache Iceberg活用 © 2026, Amazon W eb Services, Inc. or
its affil iates. All ri ghts reserv ed.
Case1 © 2026, Amazon W eb Services, Inc. or its
affil iates. All ri ghts reserv ed.
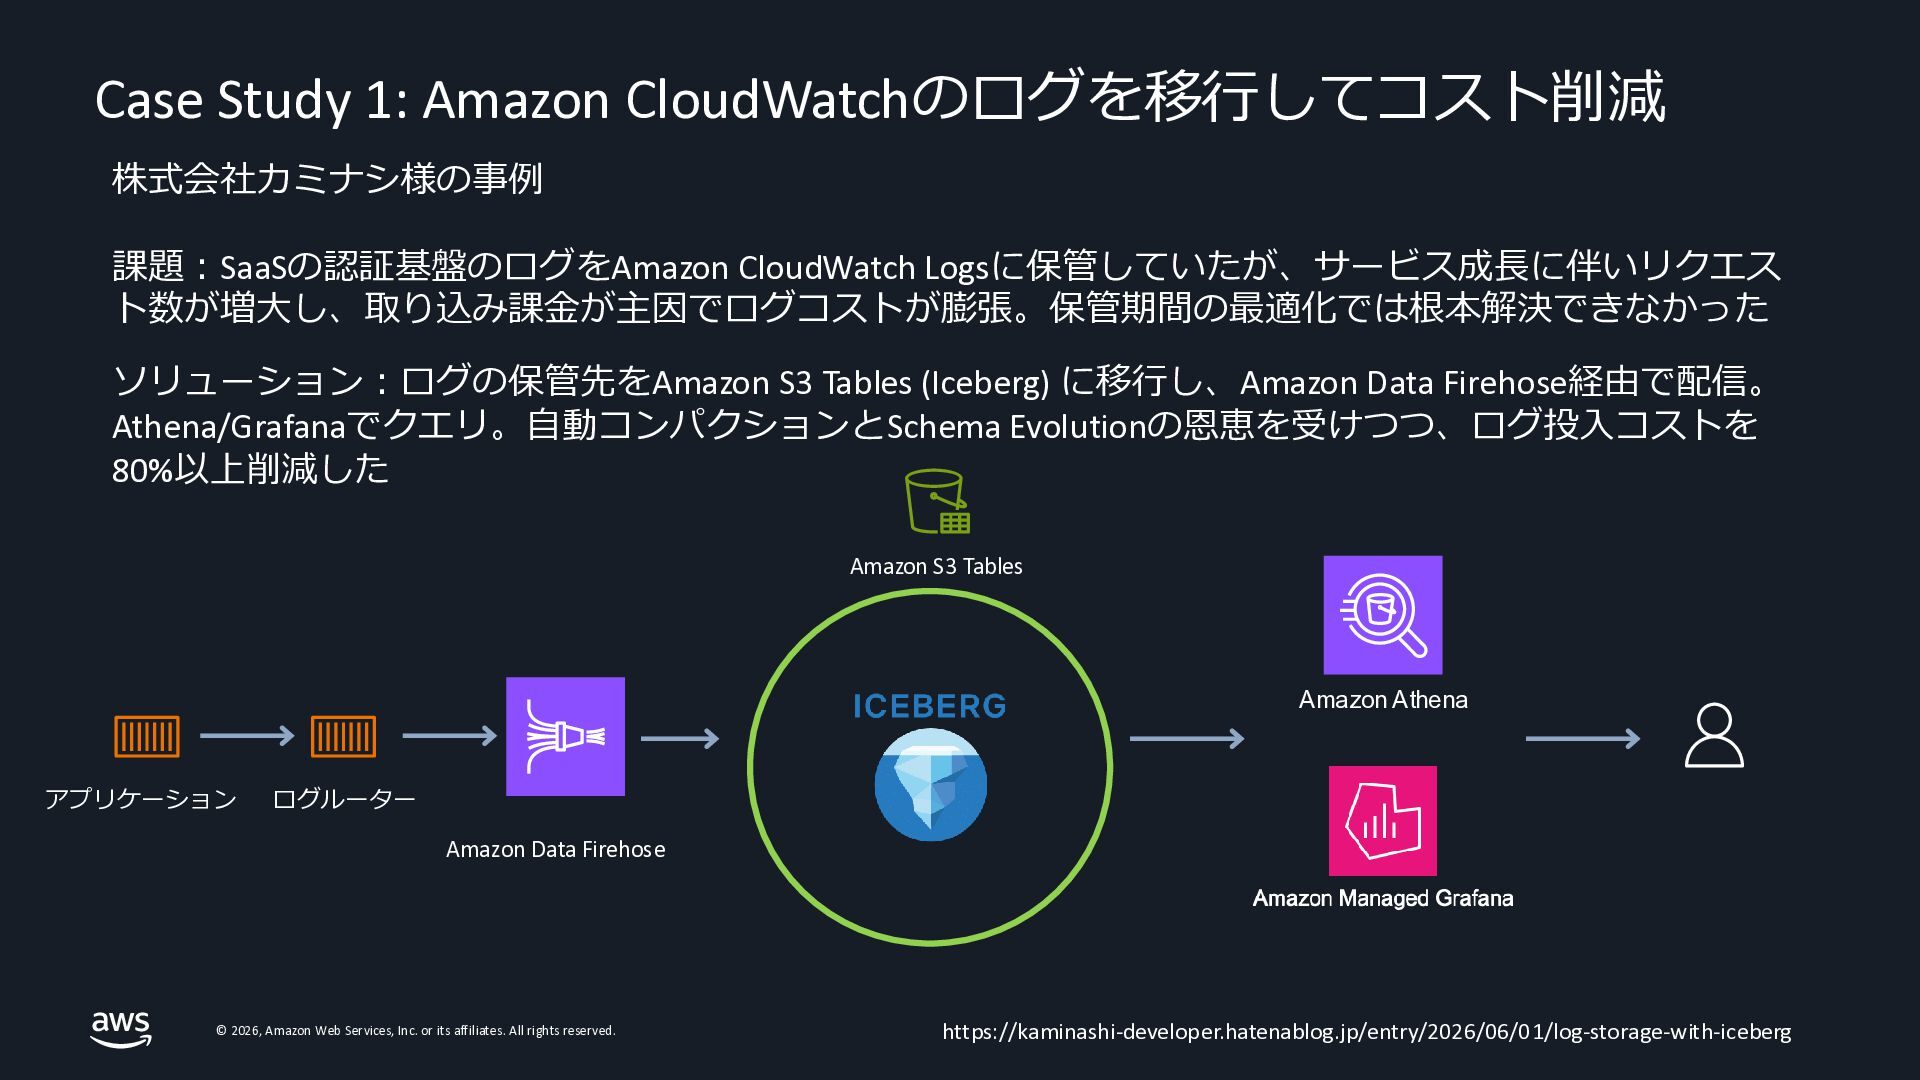
Case Study 1: Amazon CloudWatchのログを移行してコスト削減 株式会社カミナシ様の事例 課題:SaaSの認証基盤のログをAmazon CloudWatch Logsに保管していたが、サービス成長に伴いリクエス ト数が増大し、取り込み課金が主因でログコストが膨張。保管期間の最適化では根本解決できなかった
ソリューション:ログの保管先をAmazon S3 Tables (Iceberg) に移行し、Amazon Data Firehose経由で配信。 Athena/Grafanaでクエリ。自動コンパクションとSchema Evolutionの恩恵を受けつつ、ログ投入コストを 80%以上削減した Amazon S3 Tables Amazon Athena アプリケーション ログルーター Amazon Data Firehose © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed. https://kaminashi-developer.hatenablog.jp/entry/2026/06/01/log-storage-with-iceberg
このケースでのIceberg導入のポイント • データウェアハウス完結型かデータレイク型か • Apache Icebergのオープン特性を利用しAmazon Athenaという従来よりコス ト効率の高い分析ツールを利用 • Hive
か Iceberg か • 馴染みのあるSQLを利用してパーティションやカラムなどのテーブルスキー マの変更したいのでIcebergに • さらにAmazon S3 Intelligent Tieringによりコストを最適化しながら、コンパ クションなどの日々の運用をAmazon S3 Tablesのマネージドサービスに委任 する © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
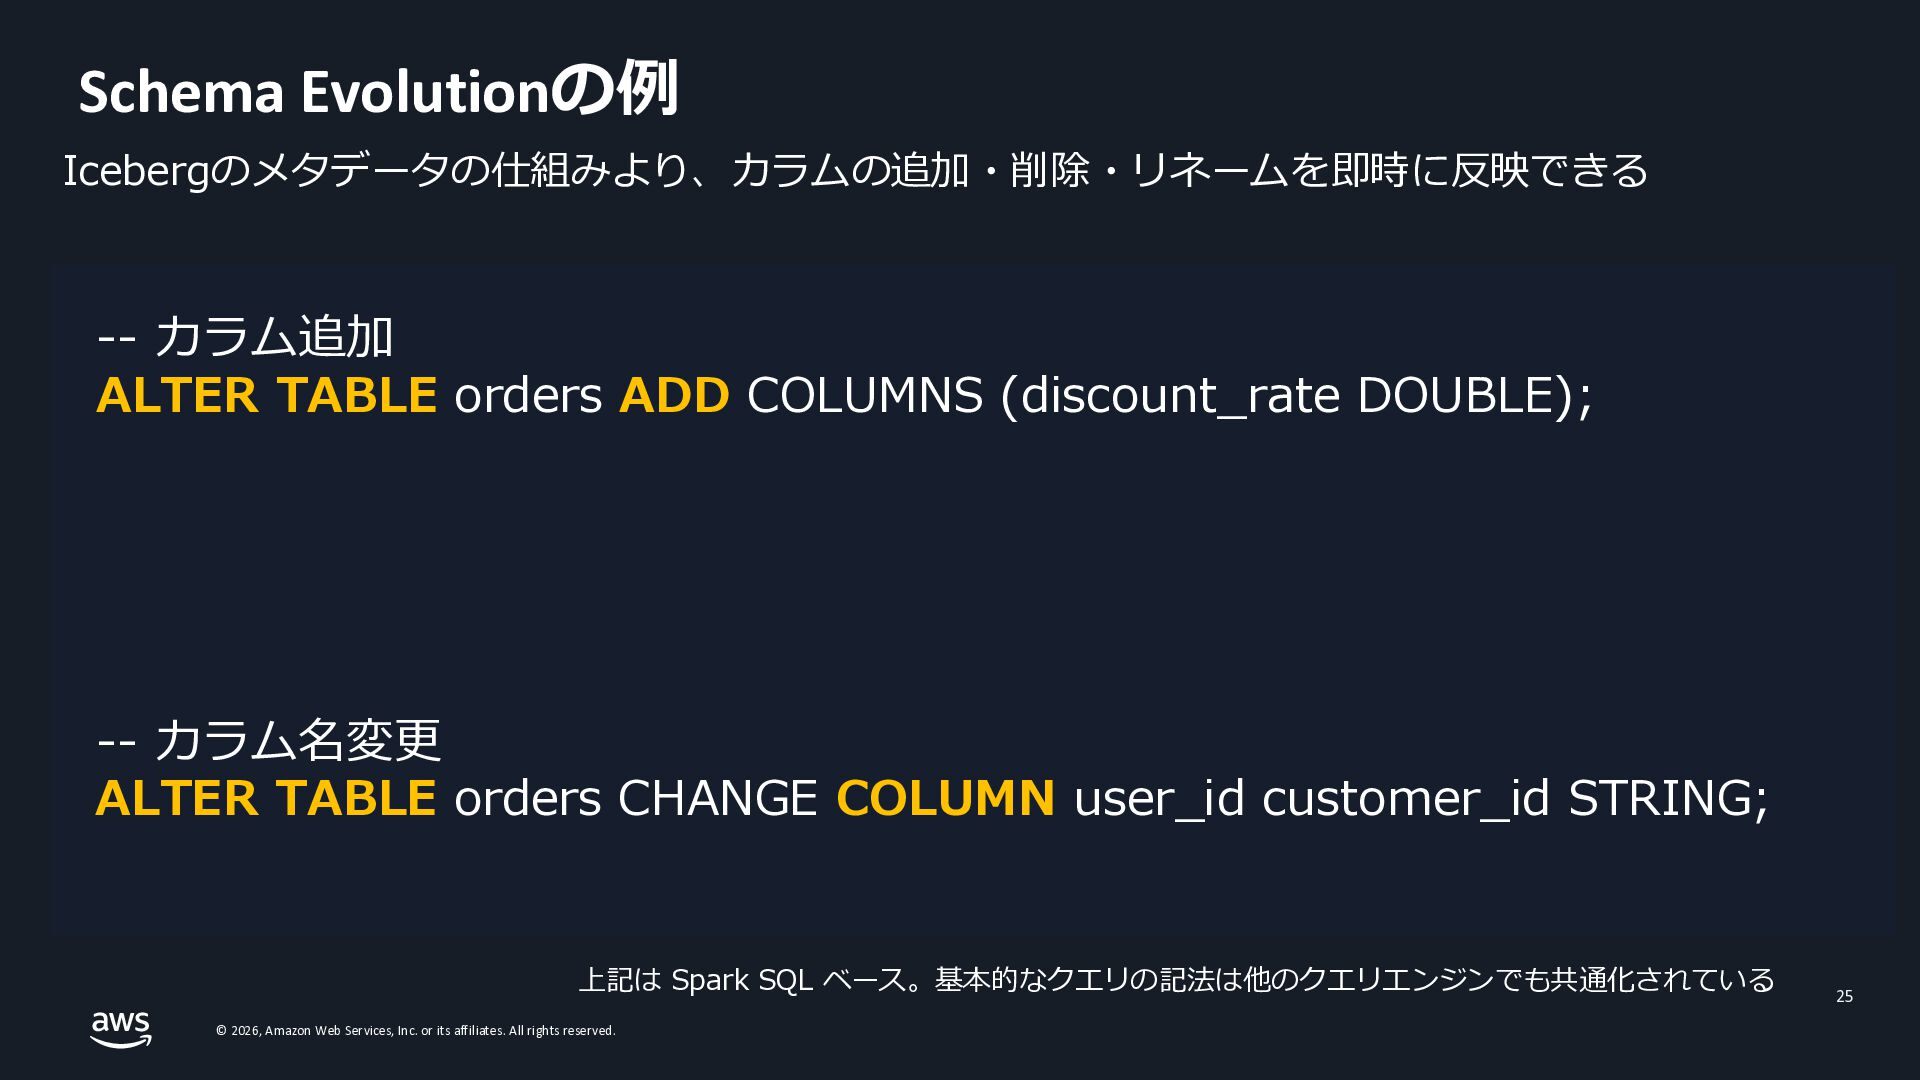
Schema Evolutionの例 Icebergのメタデータの仕組みより、カラムの追加・削除・リネームを即時に反映できる -- カラム追加 ALTER TABLE orders ADD COLUMNS
(discount_rate DOUBLE); -- カラム名変更 ALTER TABLE orders CHANGE COLUMN user_id customer_id STRING; 上記は Spark SQL ベース。基本的なクエリの記法は他のクエリエンジンでも共通化されている © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed. 25
このケースでのIceberg導入のポイント • データウェアハウス完結型かデータレイク型か • Apache Icebergのオープン特性を利用しAmazon Athenaという従来よりコス ト効率の高い分析ツールを利用 • Hive
か Iceberg か • 馴染みのあるSQLを利用してパーティションやカラムなどのテーブルスキー マの変更したいのでIcebergに • さらにAmazon S3 Intelligent Tieringによりコストを最適化しながら、コンパ クションなどの日々の運用をAmazon S3 Tablesのマネージドサービスに委任 する © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
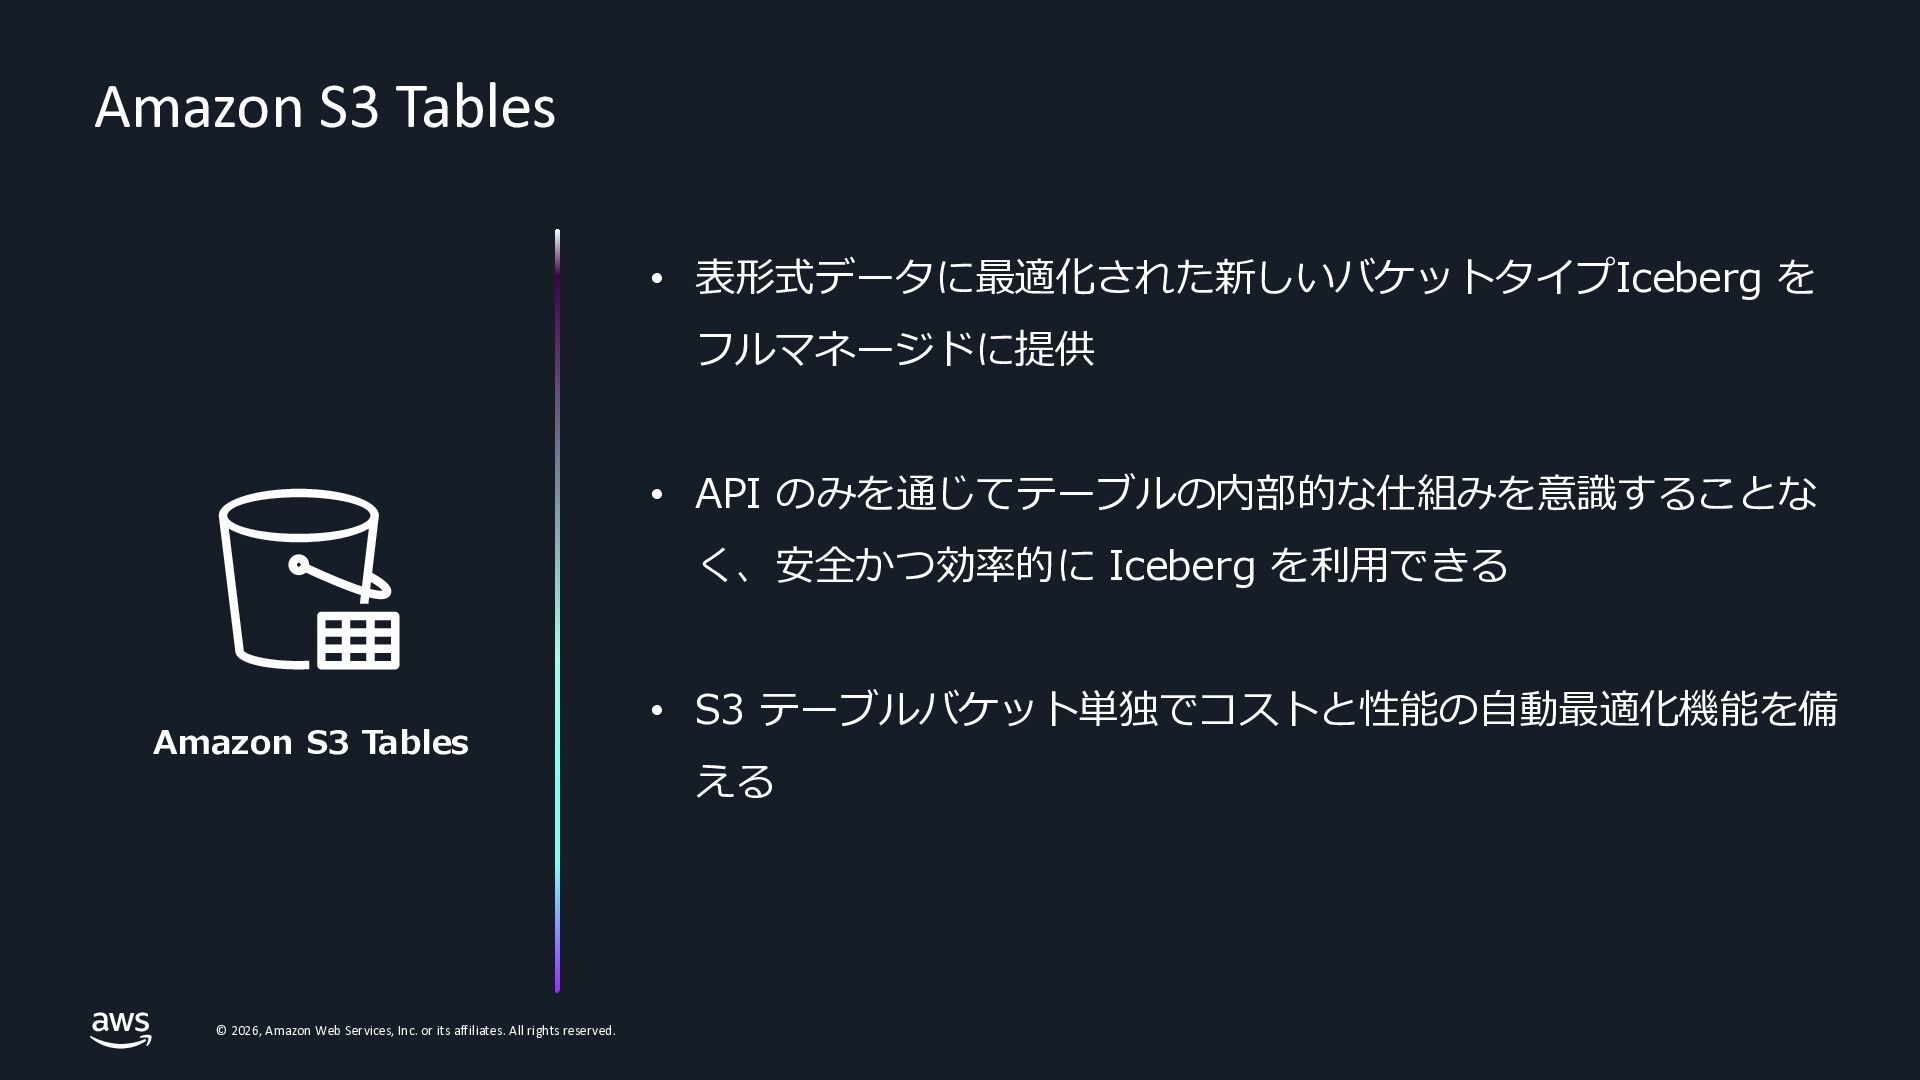
Amazon S3 Tables • 表形式データに最適化された新しいバケットタイプIceberg を フルマネージドに提供 • API のみを通じてテーブルの内部的な仕組みを意識することな
く、安全かつ効率的に Iceberg を利用できる Amazon S3 Tables © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed. • S3 テーブルバケット単独でコストと性能の自動最適化機能を備 える
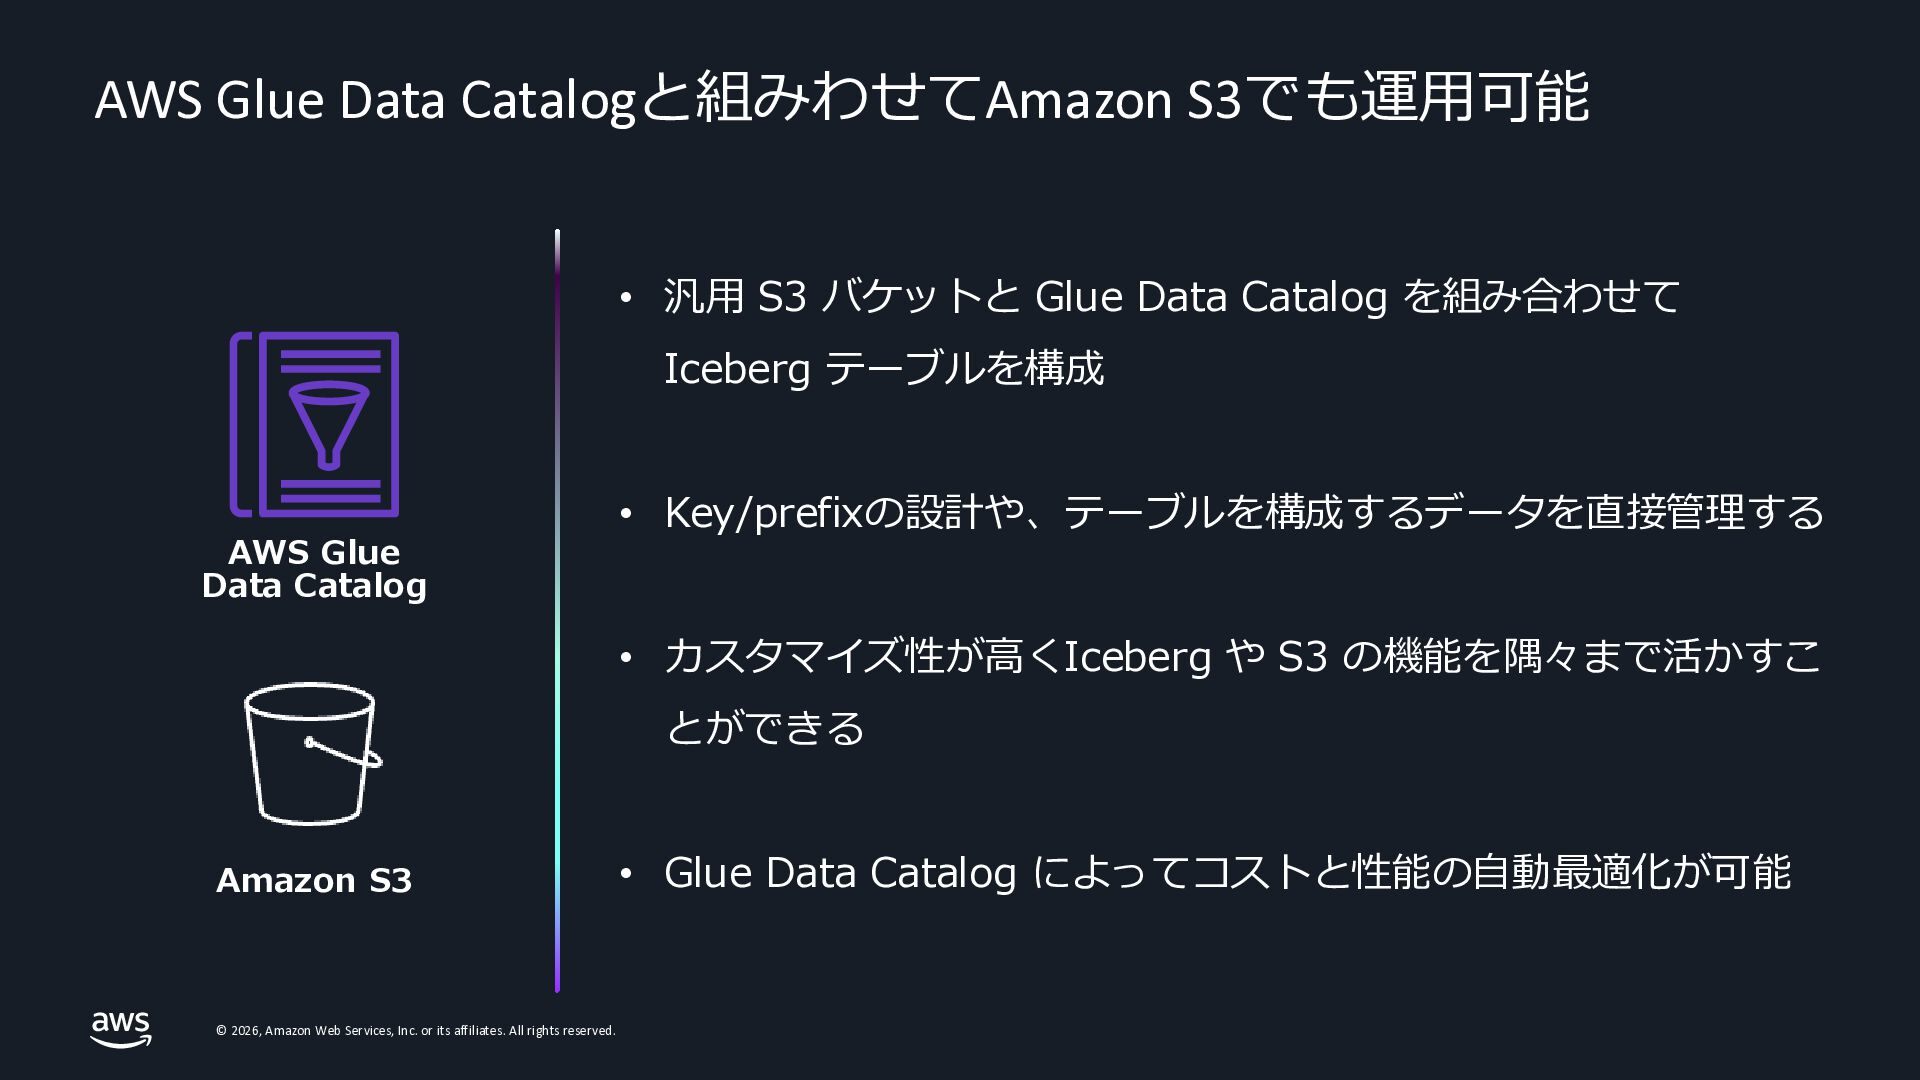
AWS Glue Data Catalogと組みわせてAmazon S3でも運用可能 • 汎用 S3 バケットと Glue
Data Catalog を組み合わせて Iceberg テーブルを構成 AWS Glue Data Catalog • Key/prefixの設計や、テーブルを構成するデータを直接管理する • カスタマイズ性が高くIceberg や S3 の機能を隅々まで活かすこ とができる Amazon S3 © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed. • Glue Data Catalog によってコストと性能の自動最適化が可能
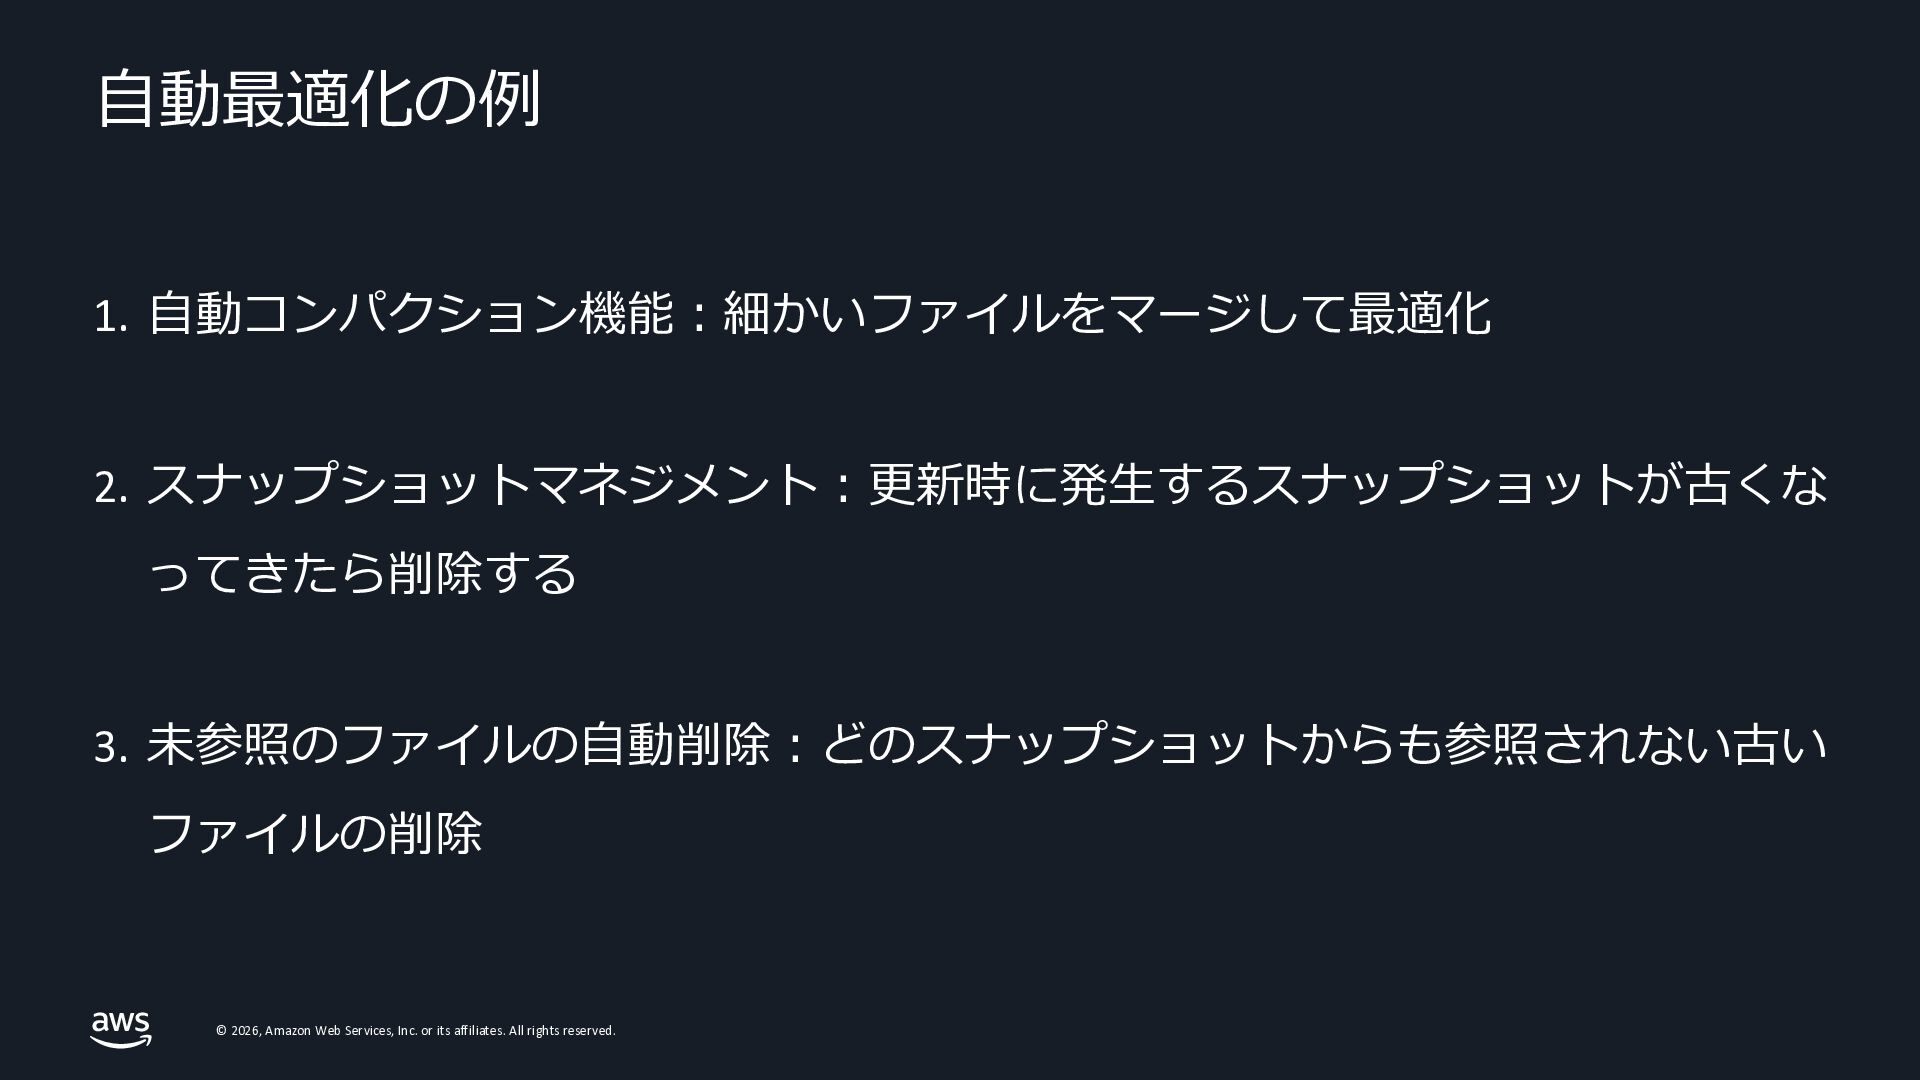
自動最適化の例 1. 自動コンパクション機能:細かいファイルをマージして最適化 2. スナップショットマネジメント:更新時に発生するスナップショットが古くな ってきたら削除する 3. 未参照のファイルの自動削除:どのスナップショットからも参照されない古い ファイルの削除 ©
2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
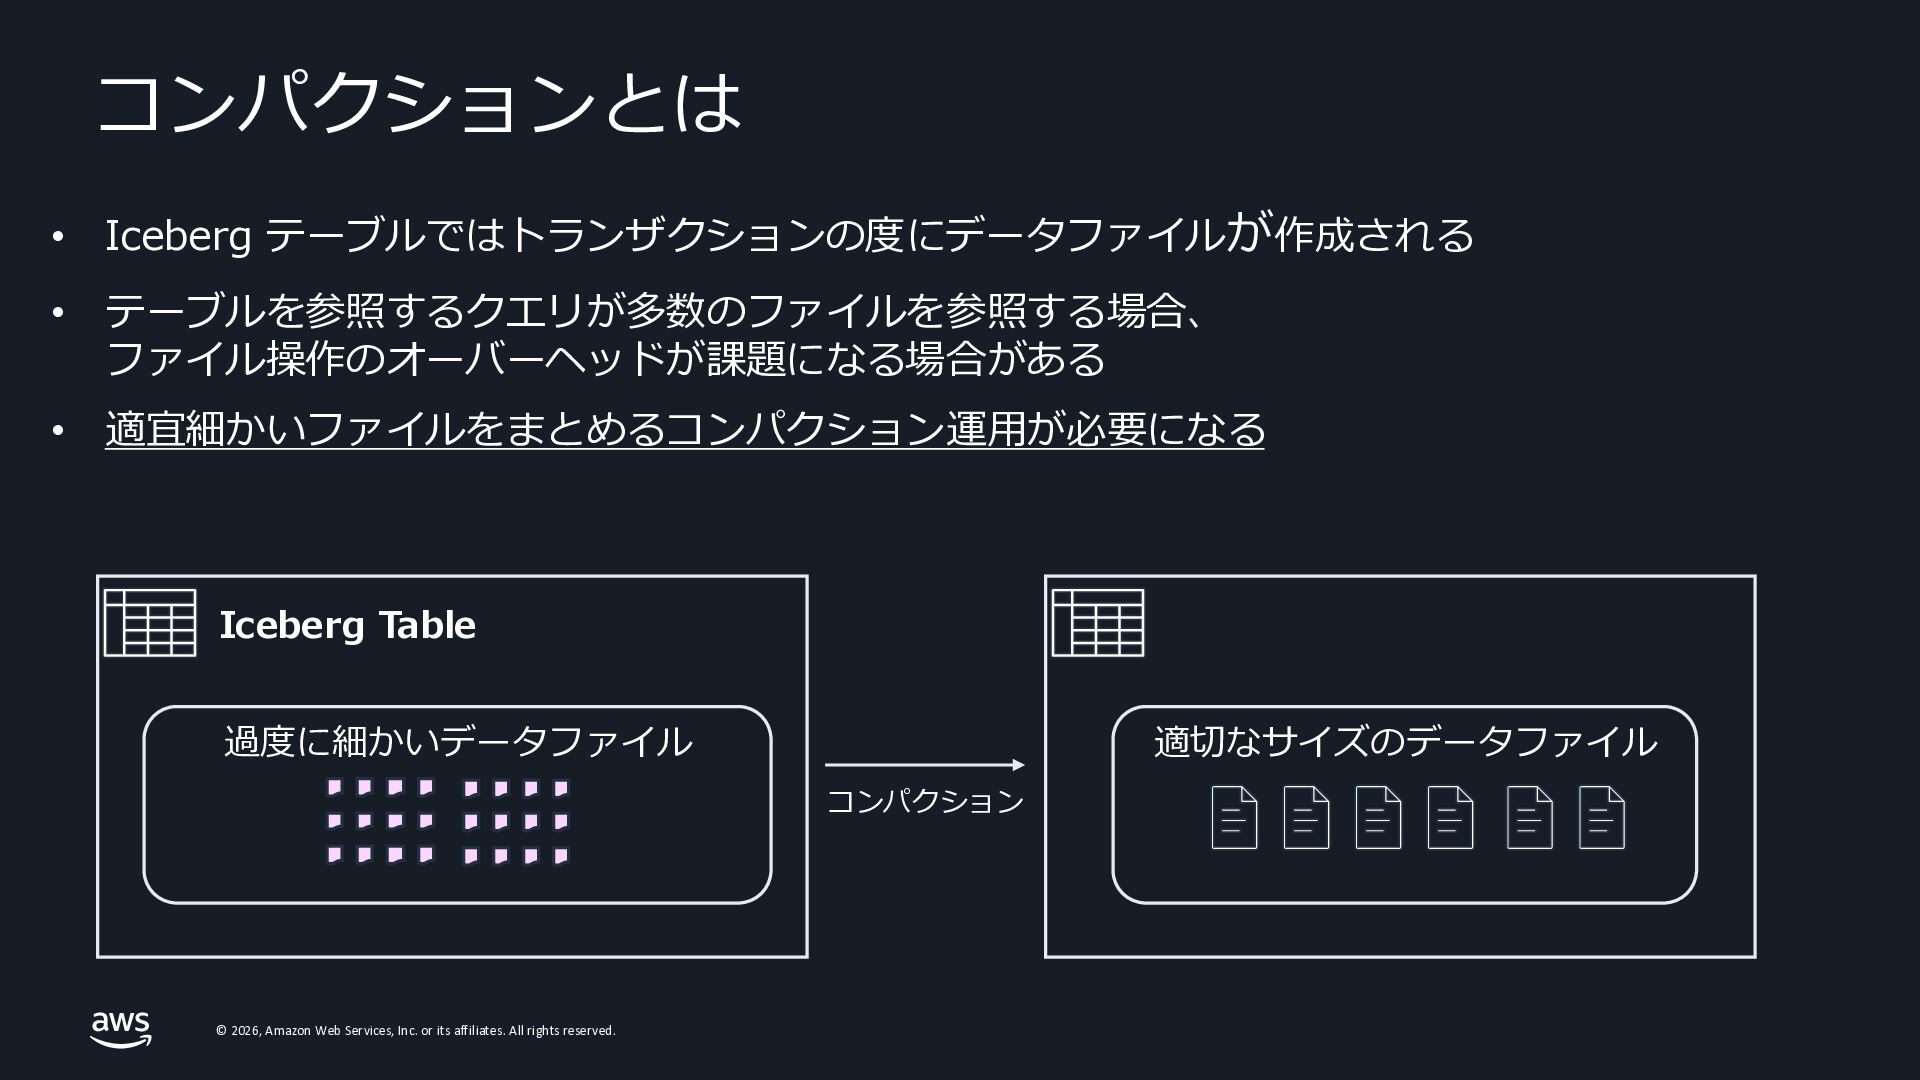
コンパクションとは • Iceberg テーブルではトランザクションの度にデータファイルが作成される • テーブルを参照するクエリが多数のファイルを参照する場合、 ファイル操作のオーバーヘッドが課題になる場合がある • 適宜細かいファイルをまとめるコンパクション運用が必要になる Iceberg
Table 過度に細かいデータファイル 適切なサイズのデータファイル コンパクション © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
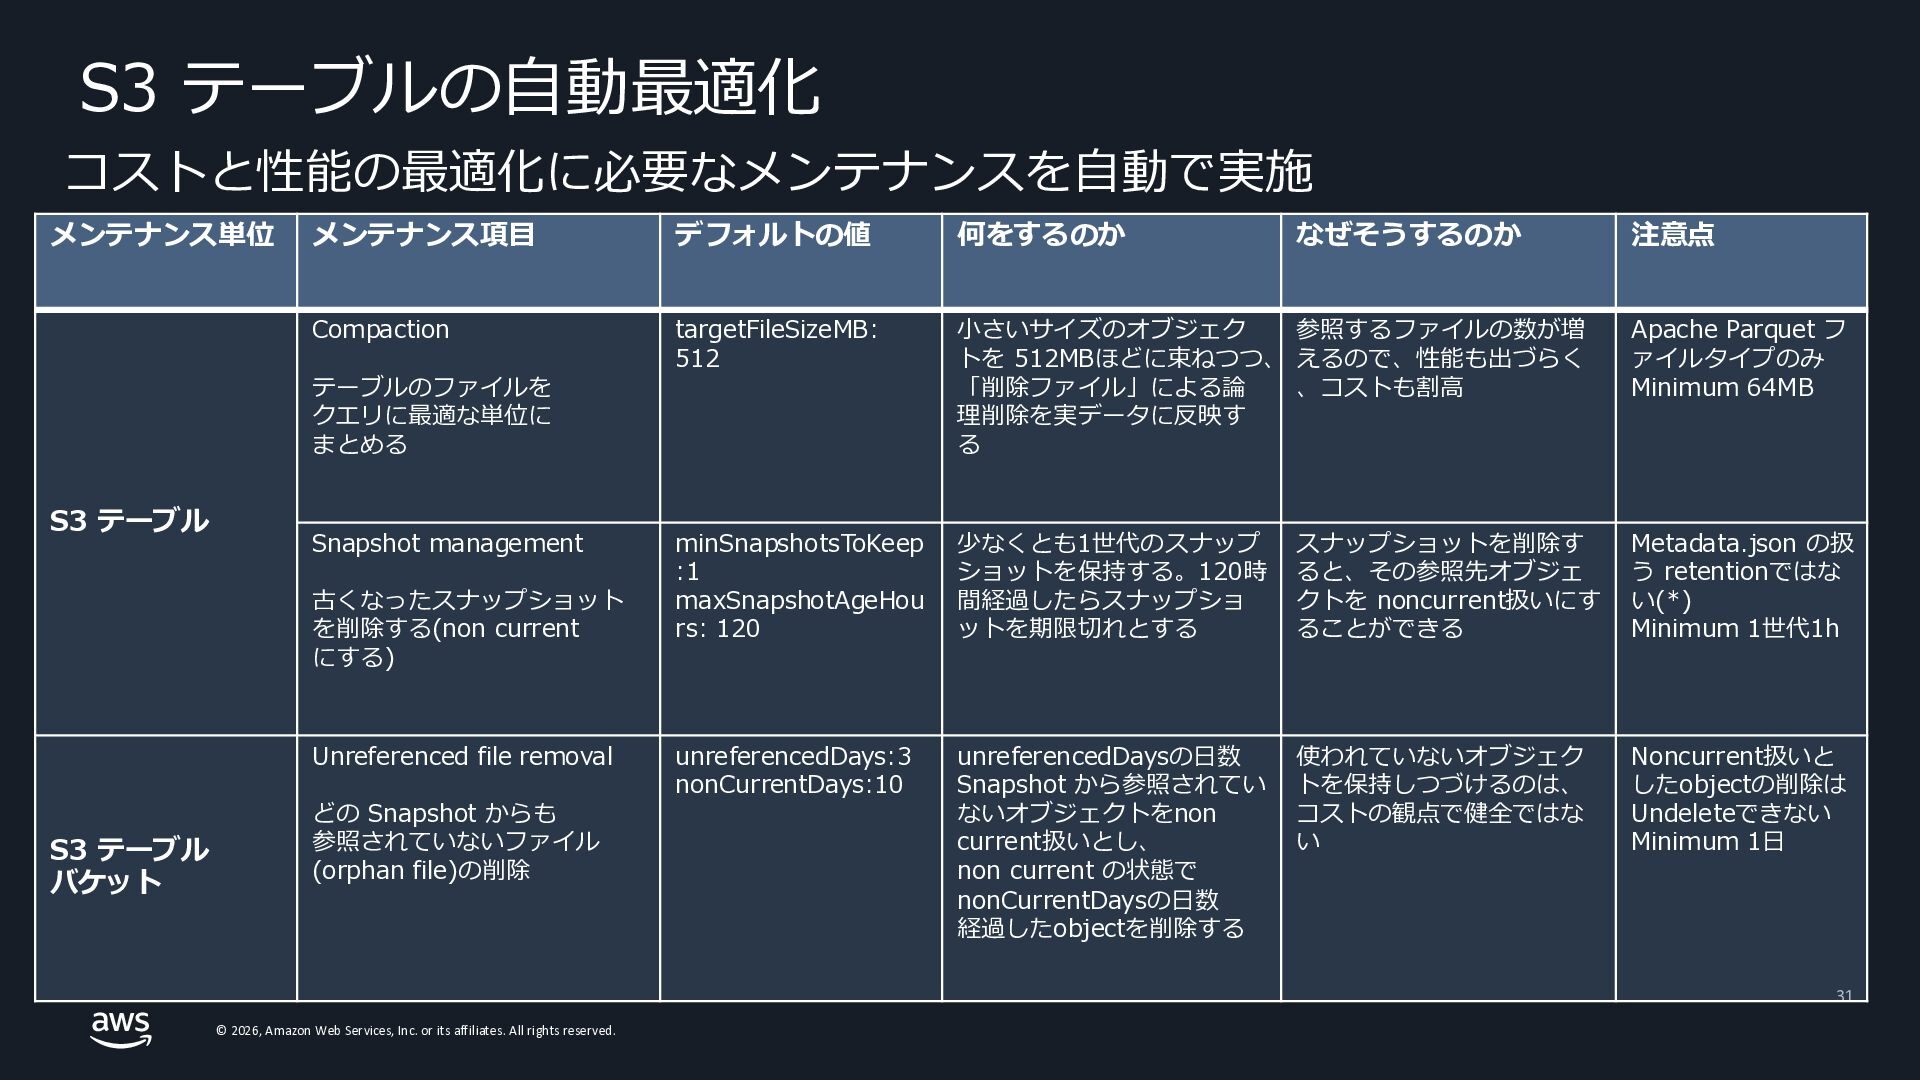
S3 テーブルの自動最適化 コストと性能の最適化に必要なメンテナンスを自動で実施 メンテナンス単位 メンテナンス項目 デフォルトの値 何をするのか Compaction targetFileSizeMB: 512
小さいサイズのオブジェク 参照するファイルの数が増 トを 512MBほどに束ねつつ、 えるので、性能も出づらく 「削除ファイル」による論 、コストも割高 理削除を実データに反映す る Apache Parquet フ ァイルタイプのみ Minimum 64MB minSnapshotsToKeep :1 maxSnapshotAgeHou rs: 120 少なくとも1世代のスナップ ショットを保持する。120時 間経過したらスナップショ ットを期限切れとする スナップショットを削除す ると、その参照先オブジェ クトを noncurrent扱いにす ることができる Metadata.json の扱 う retentionではな い(*) Minimum 1世代1h unreferencedDays:3 nonCurrentDays:10 unreferencedDaysの日数 Snapshot から参照されてい ないオブジェクトをnon current扱いとし、 non current の状態で nonCurrentDaysの日数 経過したobjectを削除する 使われていないオブジェク トを保持しつづけるのは、 コストの観点で健全ではな い Noncurrent扱いと したobjectの削除は Undeleteできない Minimum 1日 テーブルのファイルを クエリに最適な単位に まとめる S3 テーブル Snapshot management 古くなったスナップショット を削除する(non current にする) Unreferenced file removal S3 テーブル バケット どの Snapshot からも 参照されていないファイル (orphan file)の削除 なぜそうするのか 注意点 31 © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
Case2 © 2026, Amazon W eb Services, Inc. or its
affil iates. All ri ghts reserv ed.
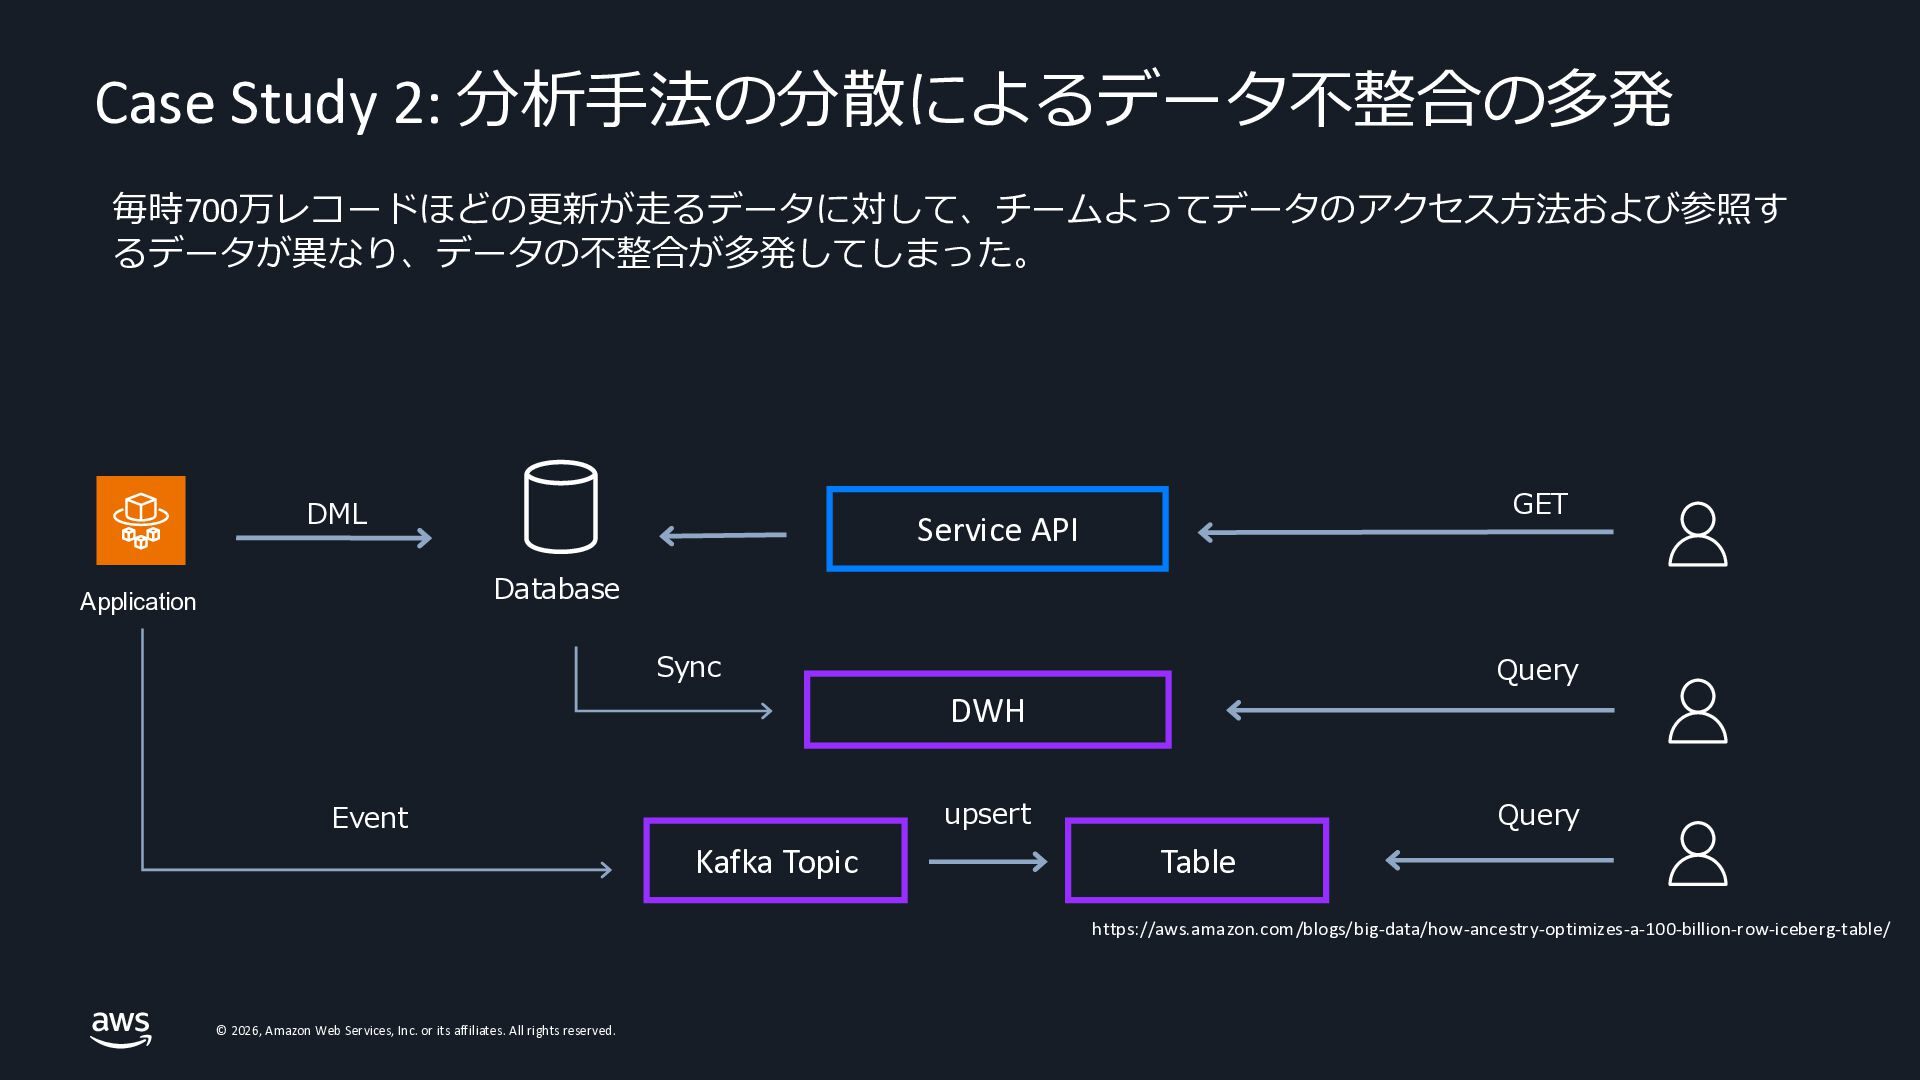
Case Study 2: 分析手法の分散によるデータ不整合の多発 毎時700万レコードほどの更新が走るデータに対して、チームよってデータのアクセス方法および参照す るデータが異なり、データの不整合が多発してしまった。 DML GET Service API
Database Application Sync Query DWH upsert Event Kafka Topic Query Table https://aws.amazon.com/blogs/big-data/how-ancestry-optimizes-a-100-billion-row-iceberg-table/ © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
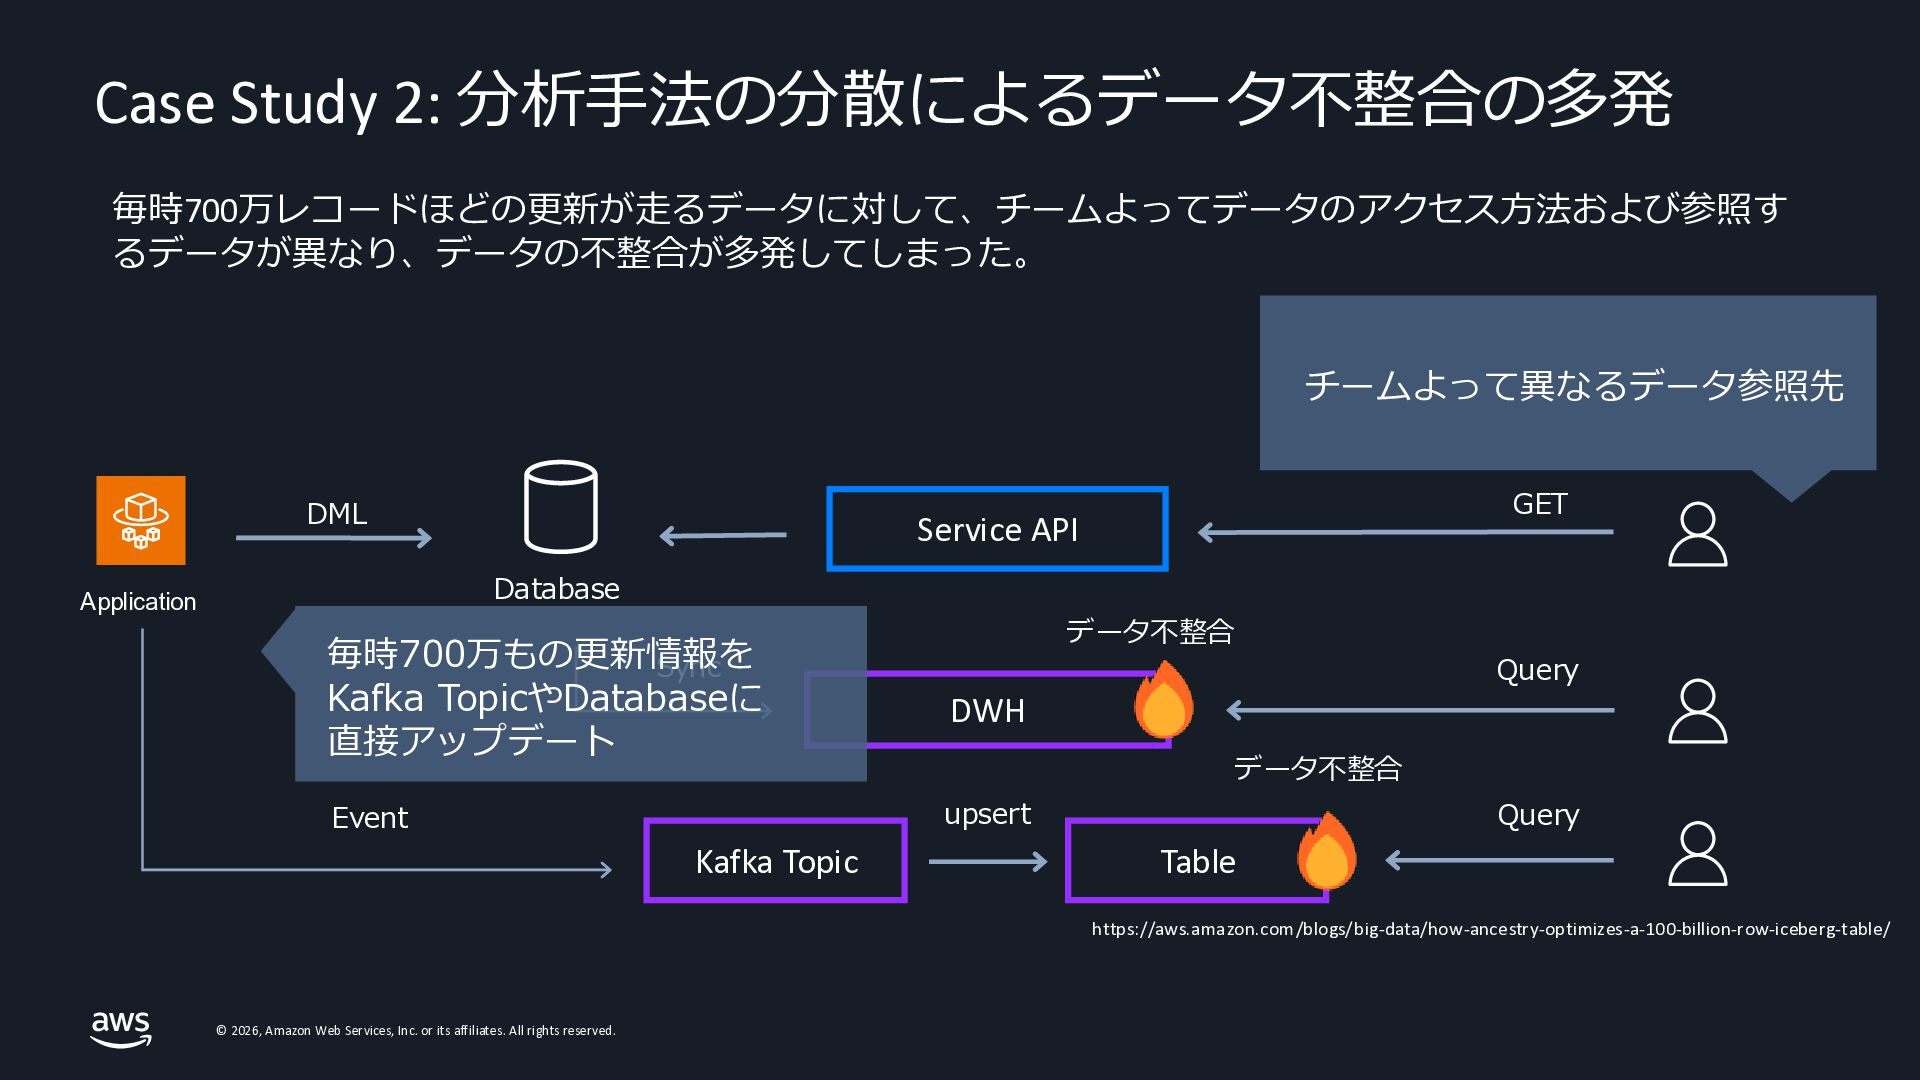
Case Study 2: 分析手法の分散によるデータ不整合の多発 毎時700万レコードほどの更新が走るデータに対して、チームよってデータのアクセス方法および参照す るデータが異なり、データの不整合が多発してしまった。 チームよって異なるデータ参照先 DML GET Service
API Database Application 毎時700万もの更新情報を Sync Kafka TopicやDatabaseに 直接アップデート データ不整合 Query DWH データ不整合 upsert Event Kafka Topic Query Table https://aws.amazon.com/blogs/big-data/how-ancestry-optimizes-a-100-billion-row-iceberg-table/ © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
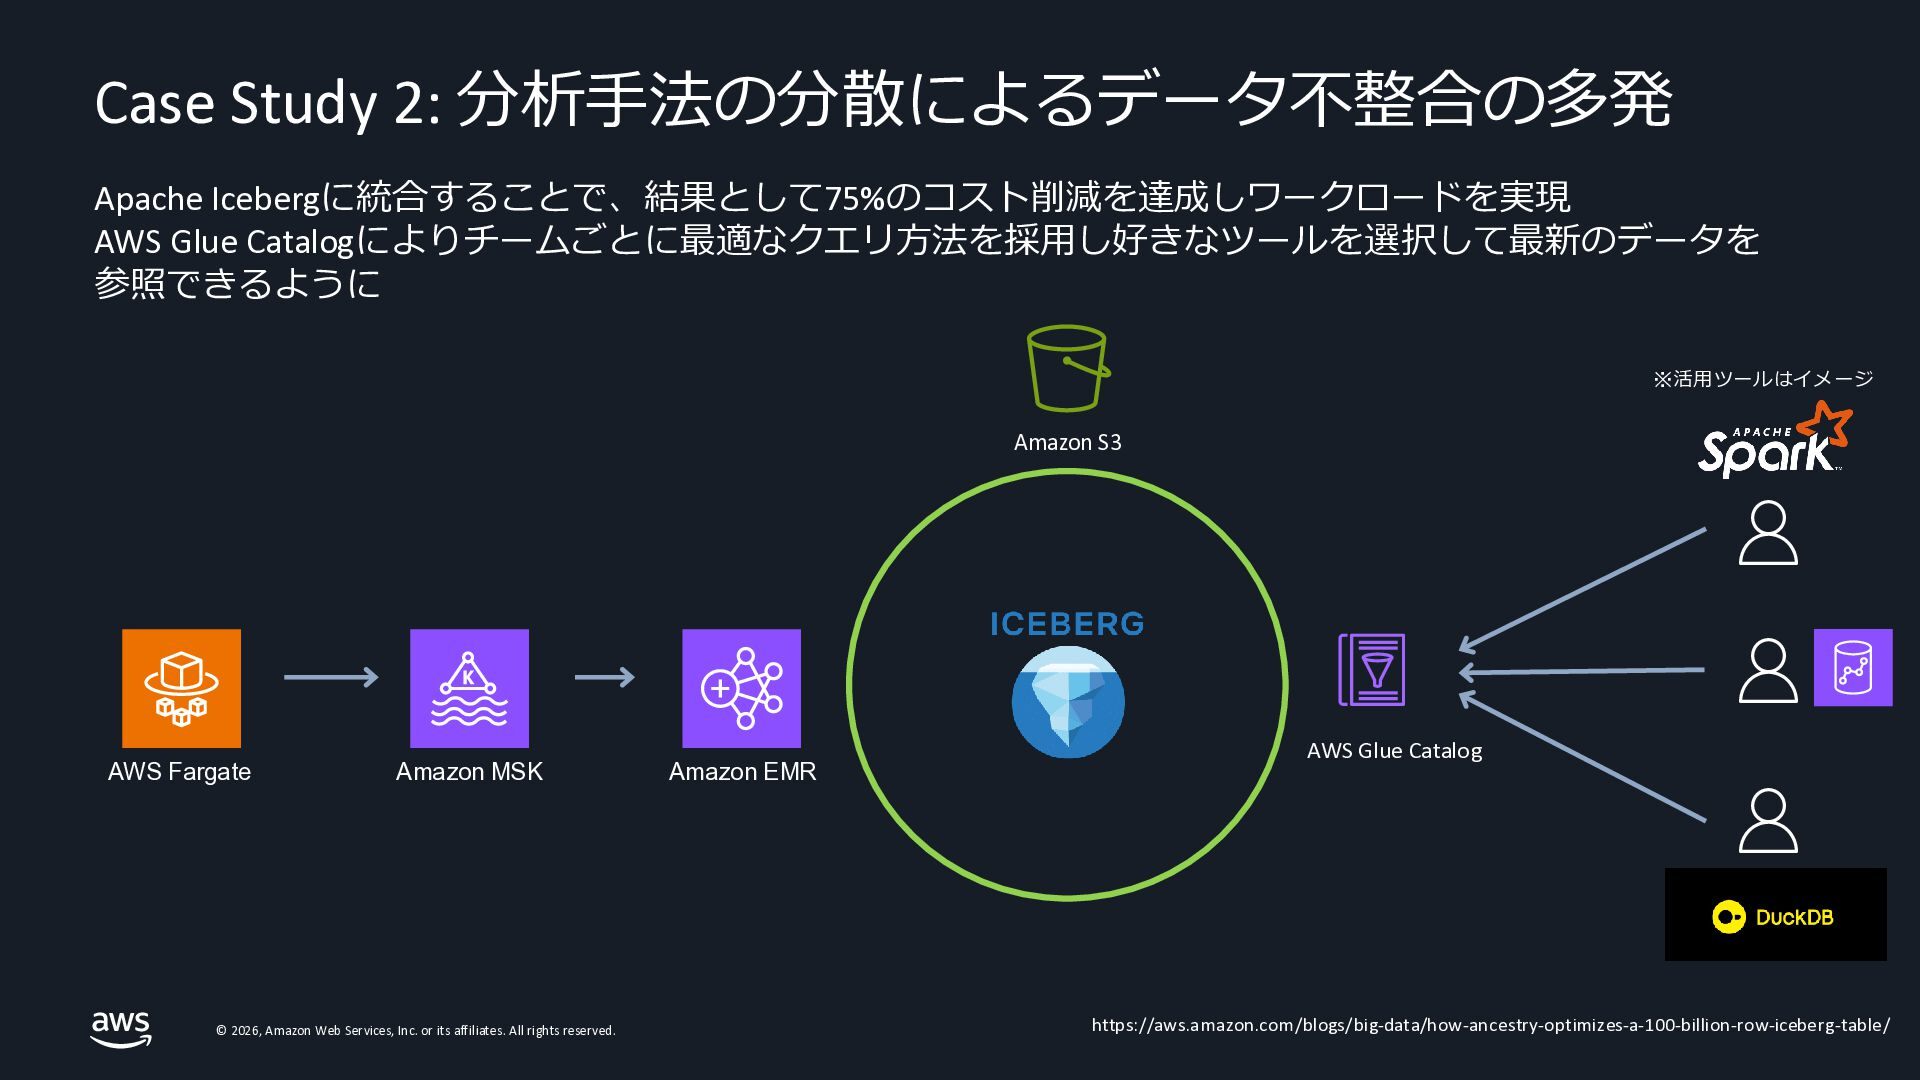
Case Study 2: 分析手法の分散によるデータ不整合の多発 Apache Icebergに統合することで、結果として75%のコスト削減を達成しワークロードを実現 AWS Glue Catalogによりチームごとに最適なクエリ方法を採用し好きなツールを選択して最新のデータを 参照できるように
※活用ツールはイメージ Amazon S3 AWS Fargate Amazon MSK © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed. Amazon EMR AWS Glue Catalog https://aws.amazon.com/blogs/big-data/how-ancestry-optimizes-a-100-billion-row-iceberg-table/
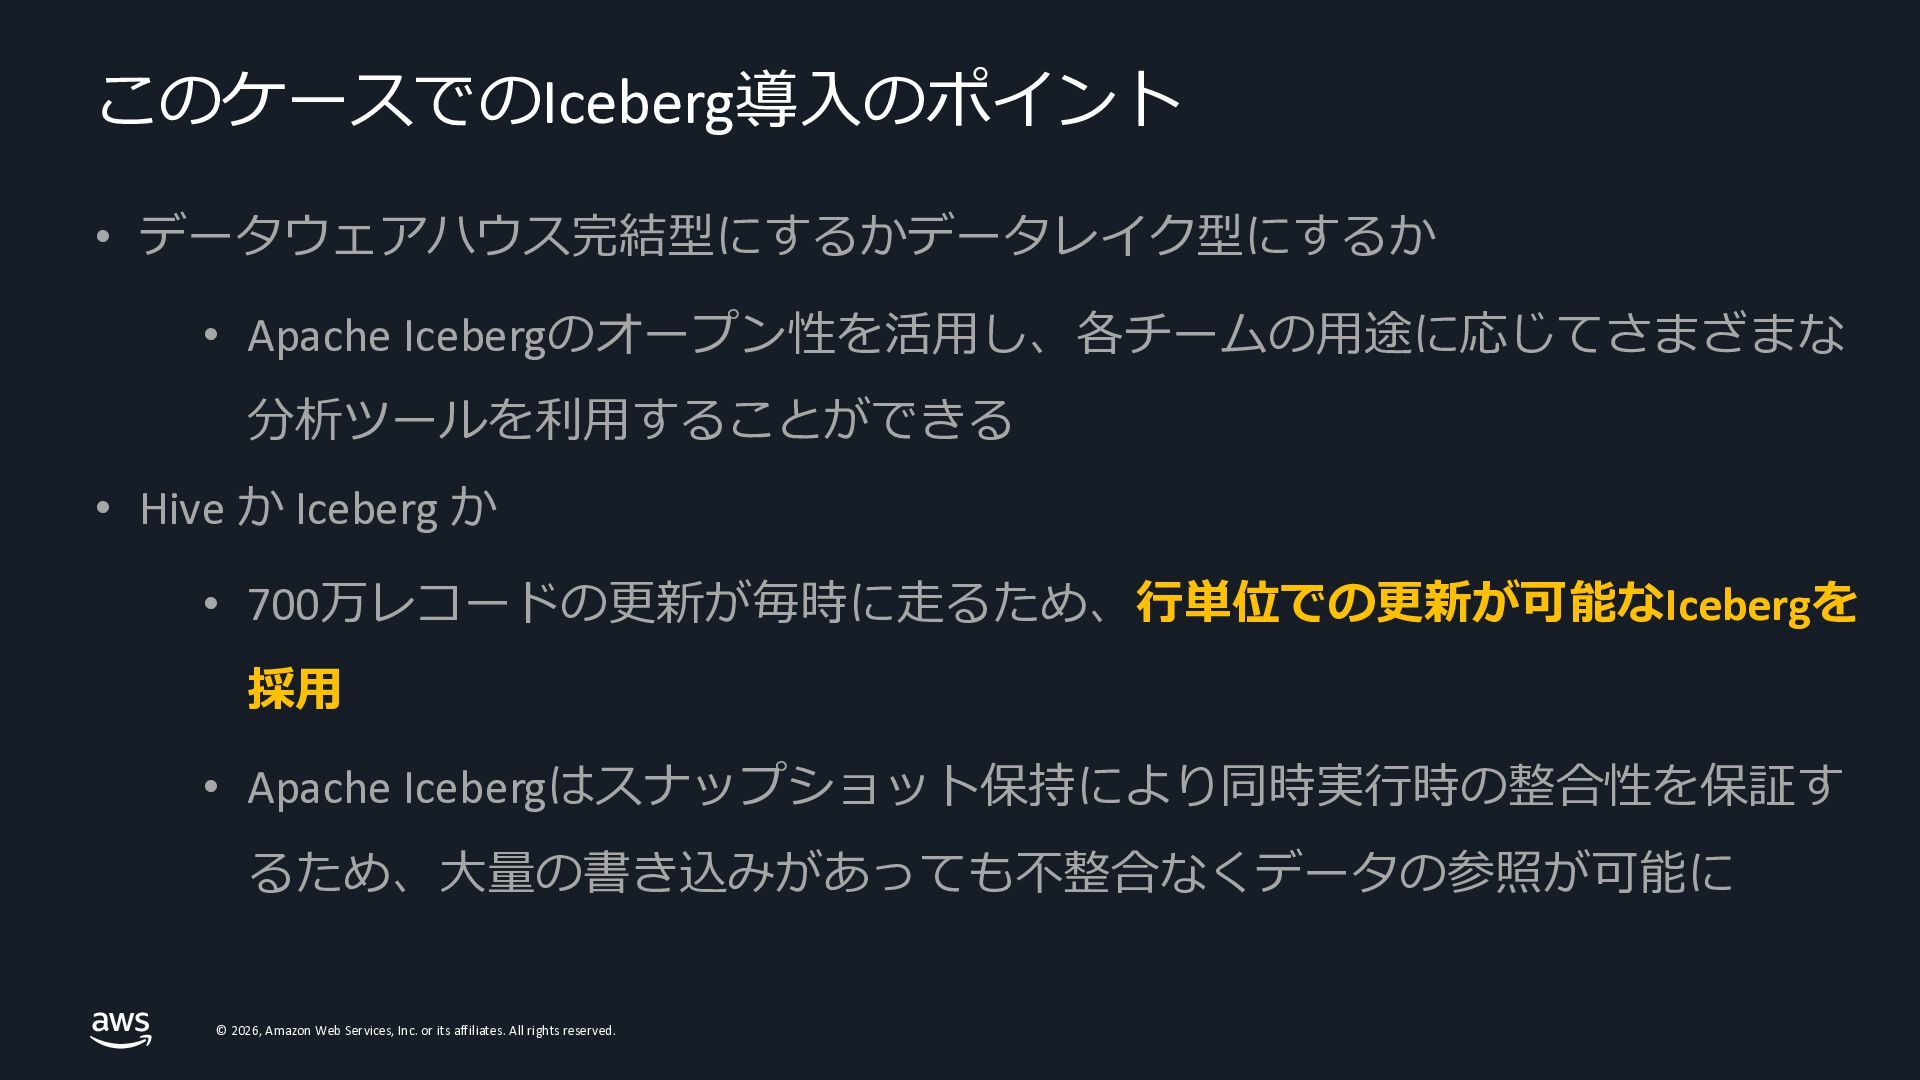
このケースでのIceberg導入のポイント • データウェアハウス完結型にするかデータレイク型にするか • Apache Icebergのオープン性を活用し、各チームの用途に応じてさまざまな 分析ツールを利用することができる • Hive か
Iceberg か • 700万レコードの更新が毎時に走るため、行単位での更新が可能なIcebergを 採用 • Icebergはスナップショット保持により同時実行時の整合性を保証するため 、大量の書き込みがあっても不整合なくデータの参照が可能に © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
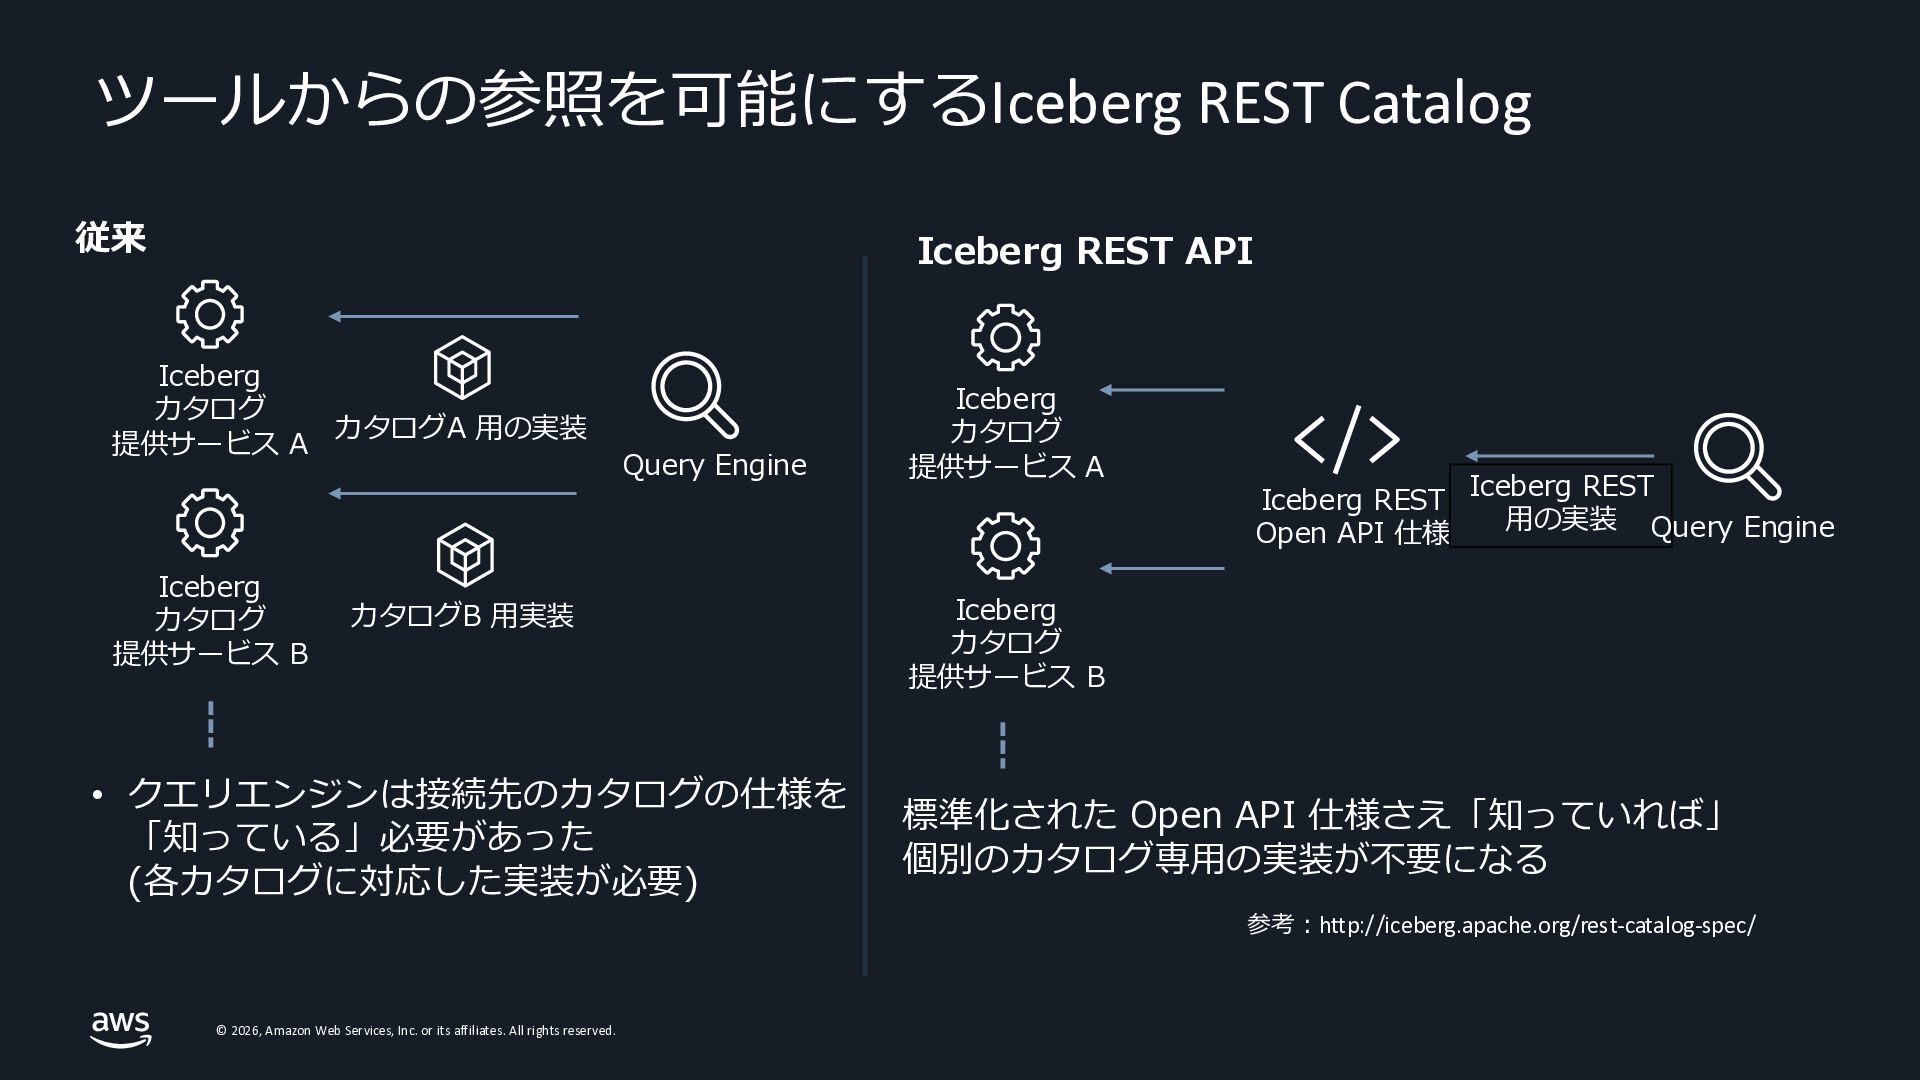
ツールからの参照を可能にするIceberg REST Catalog 従来 Iceberg REST API Iceberg カタログ カタログA
用の実装 提供サービス A Iceberg カタログ 提供サービス B Query Engine カタログB 用実装 • クエリエンジンは接続先のカタログの仕様を 「知っている」必要があった (各カタログに対応した実装が必要) Iceberg カタログ 提供サービス A Iceberg REST Open API 仕様 Iceberg REST 用の実装 Query Engine Iceberg カタログ 提供サービス B 標準化された Open API 仕様さえ「知っていれば」 個別のカタログ専用の実装が不要になる 参考:http://iceberg.apache.org/rest-catalog-spec/ © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
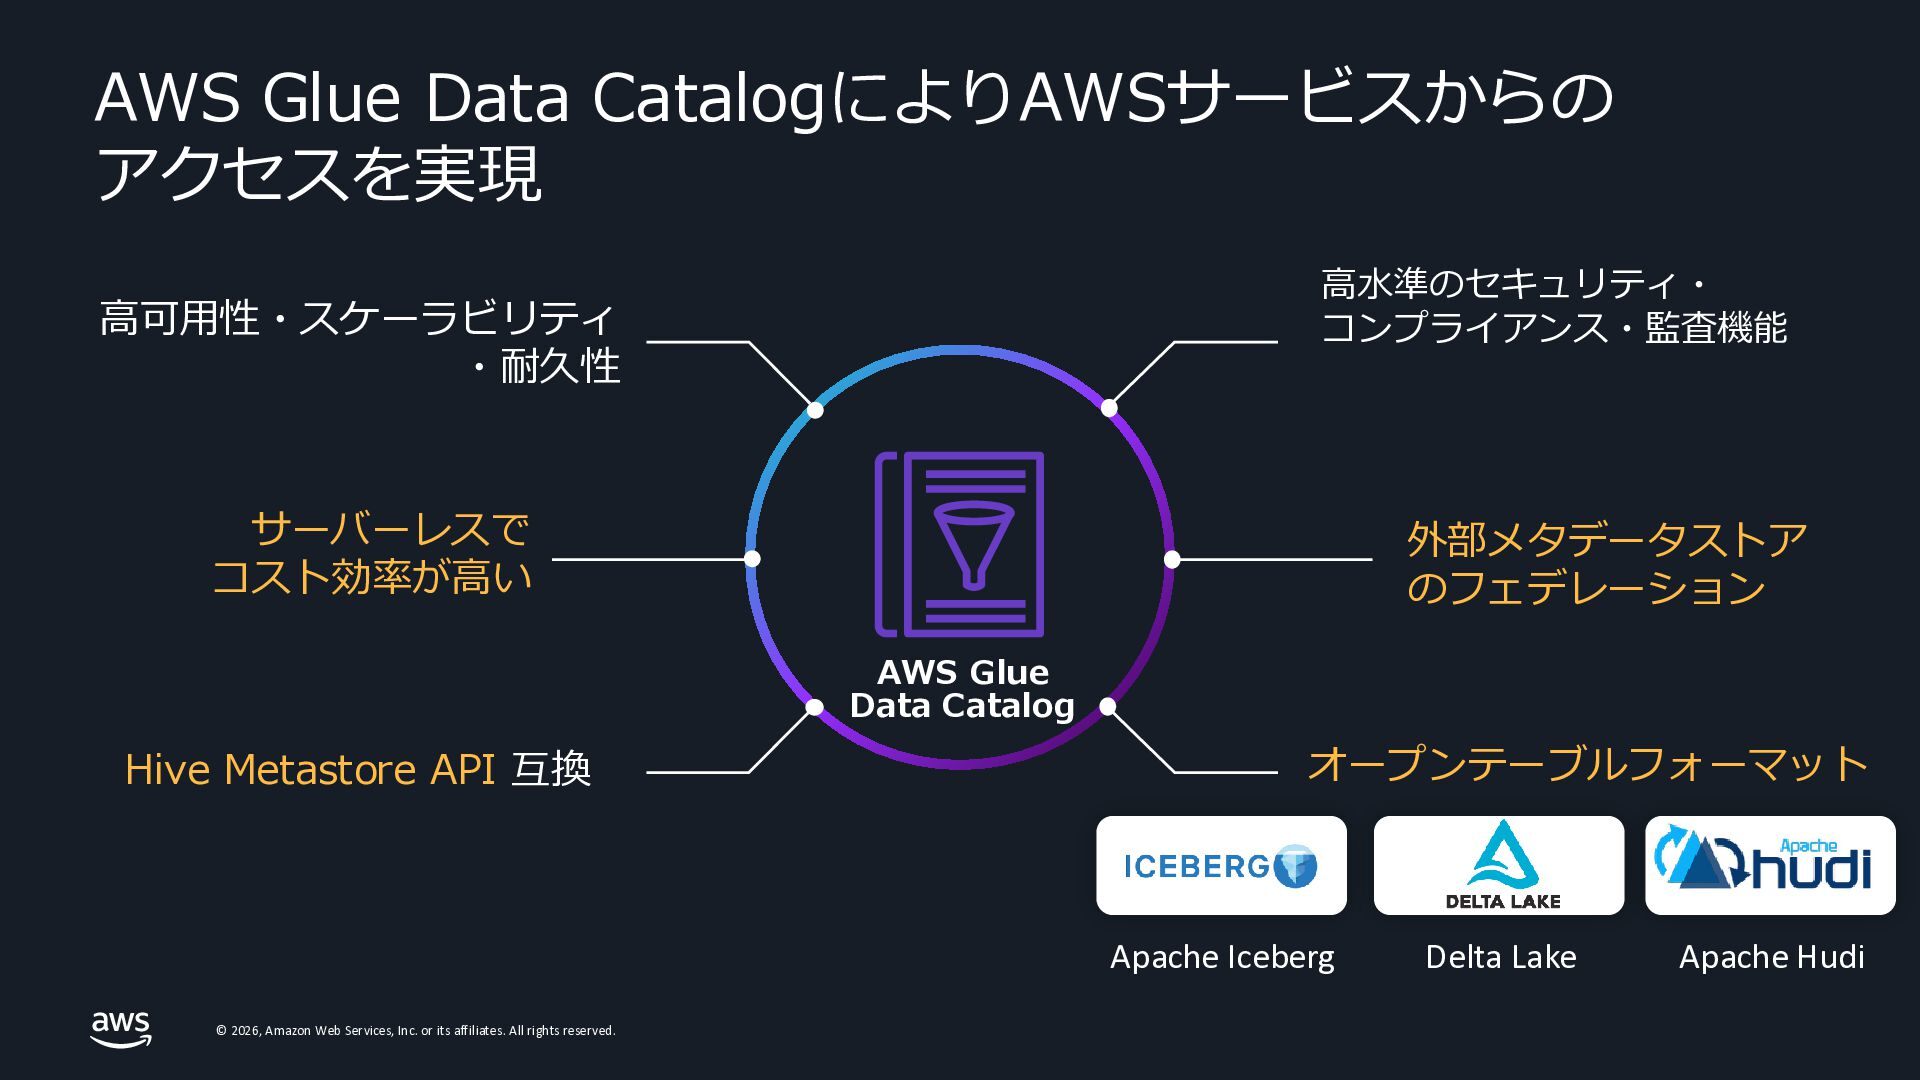
AWS Glue Data CatalogによりAWSサービスからの アクセスを実現 高水準のセキュリティ・ コンプライアンス・監査機能 高可用性・スケーラビリティ ・耐久性 サーバーレスで
コスト効率が高い 外部メタデータストア のフェデレーション AWS Glue Data Catalog Hive Metastore API 互換 オープンテーブルフォーマット Apache Iceberg © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed. Delta Lake Apache Hudi
このケースでのIceberg導入のポイント • データウェアハウス完結型にするかデータレイク型にするか • Apache Icebergのオープン性を活用し、各チームの用途に応じてさまざまな 分析ツールを利用することができる • Hive か
Iceberg か • 700万レコードの更新が毎時に走るため、行単位での更新が可能なIcebergを 採用 • Apache Icebergはスナップショット保持により同時実行時の整合性を保証す るため、大量の書き込みがあっても不整合なくデータの参照が可能に © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
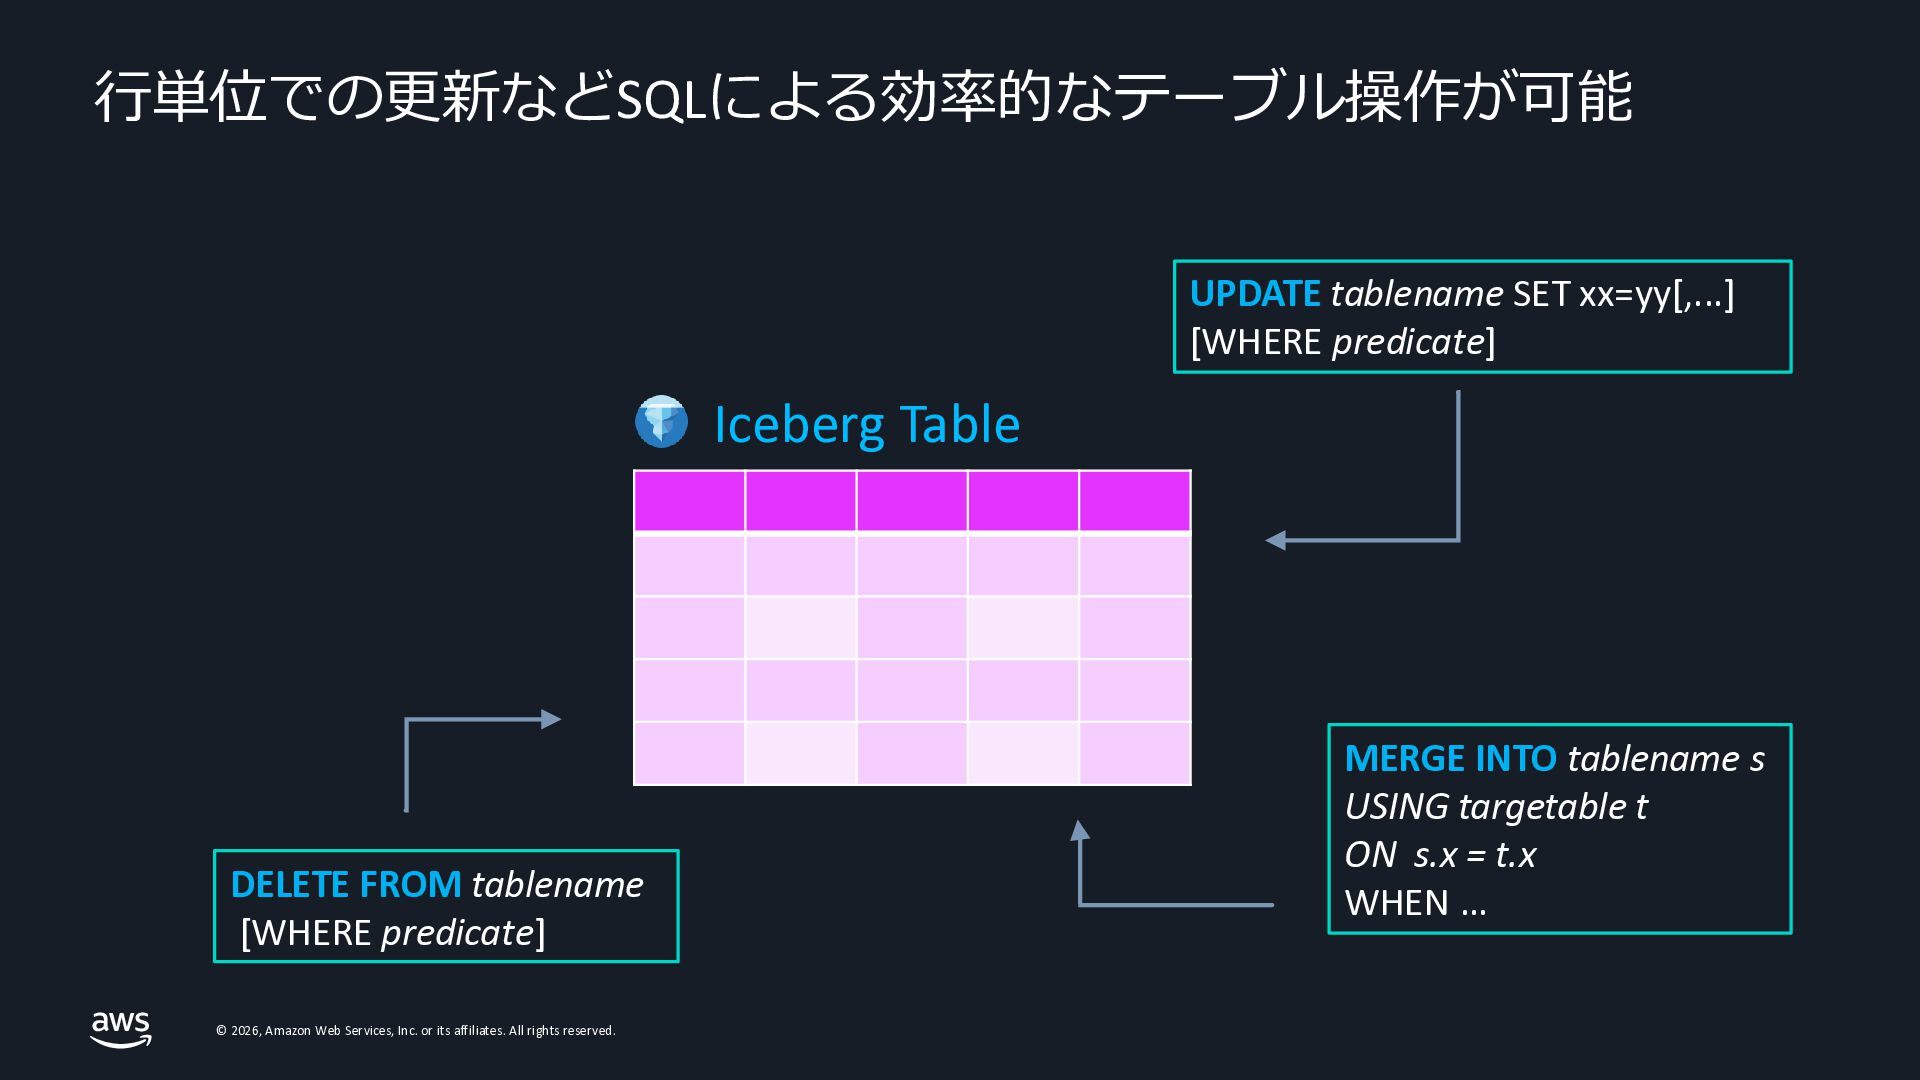
行単位での更新などSQLによる効率的なテーブル操作が可能 UPDATE tablename SET xx=yy[,...] [WHERE predicate] Iceberg Table DELETE
FROM tablename [WHERE predicate] © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed. MERGE INTO tablename s USING targetable t ON s.x = t.x WHEN …
まとめ © 2026, Amazon W eb Services, Inc. or its
affil iates. All ri ghts reserv ed.
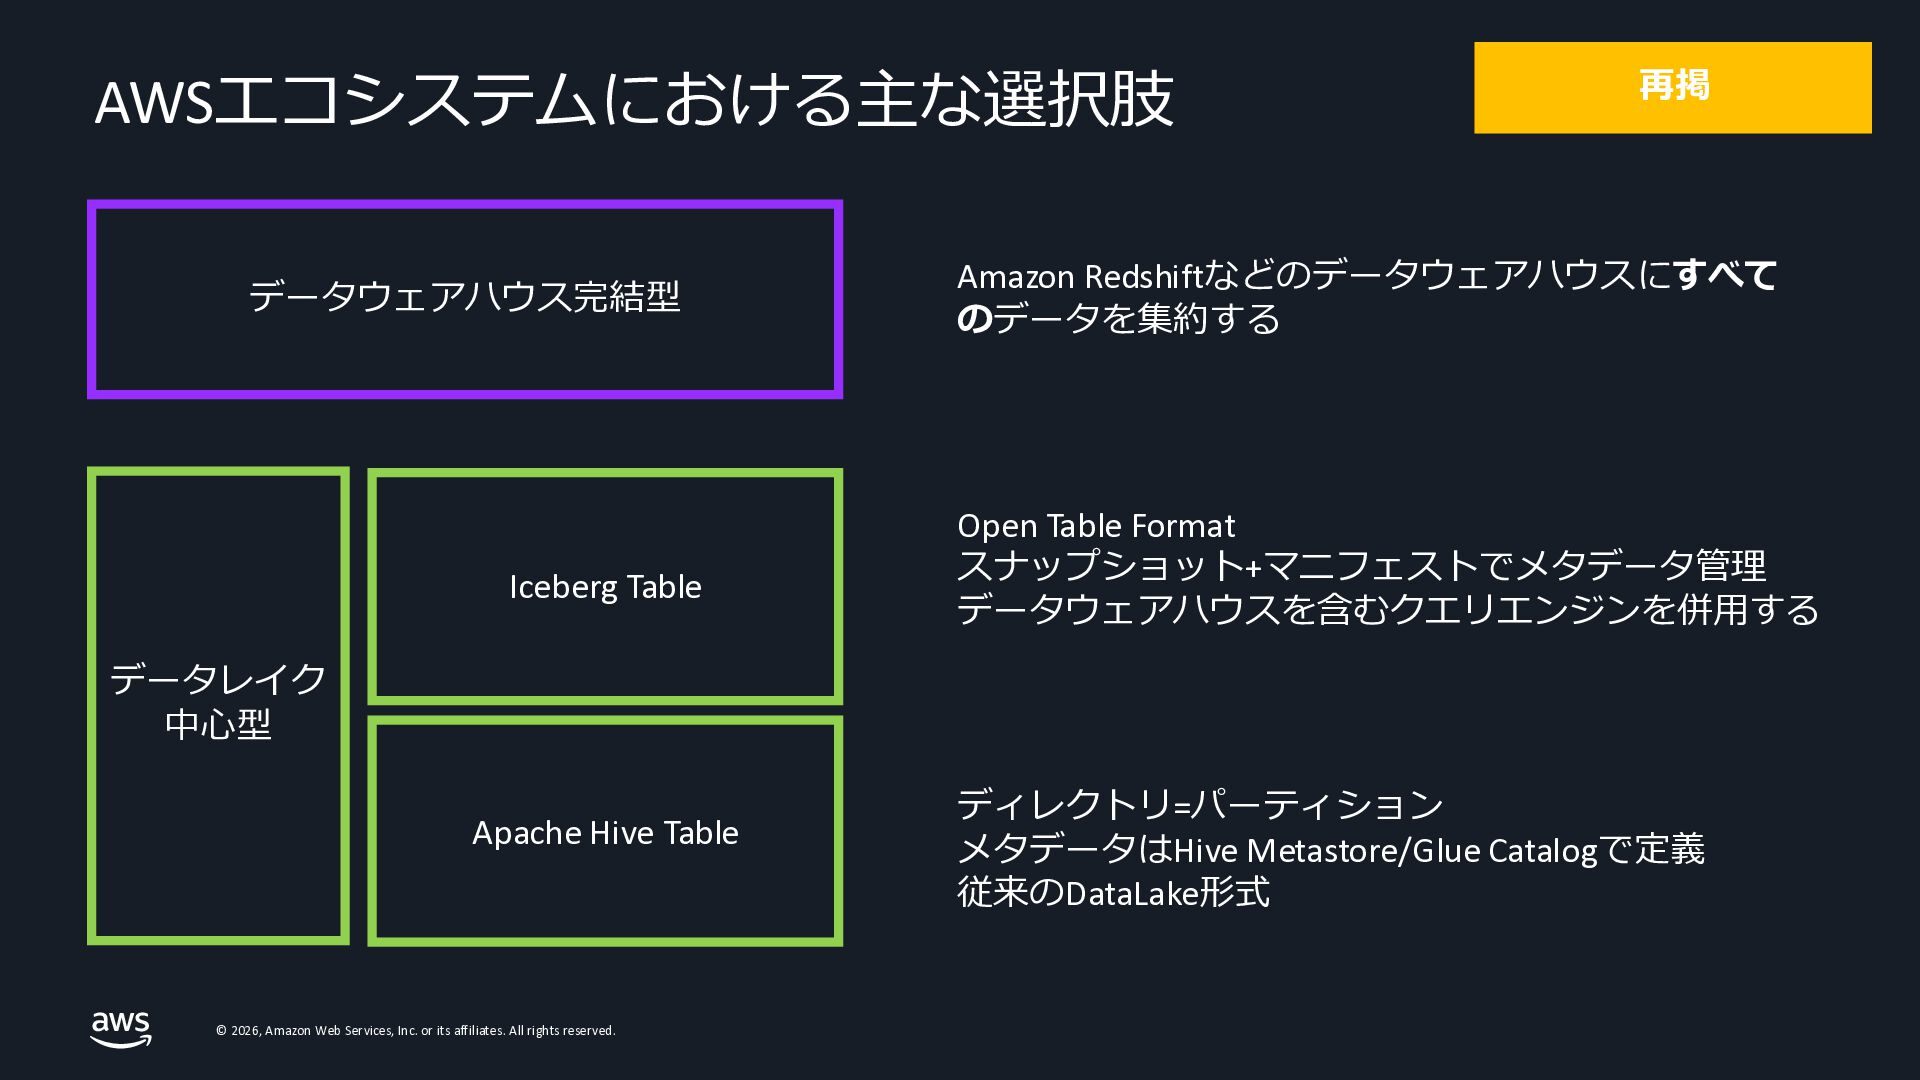
AWSエコシステムにおける主な選択肢 データウェアハウス完結型 Iceberg Table 再掲 Amazon Redshiftなどのデータウェアハウスにすべて のデータを集約する Open Table
Format スナップショット+マニフェストでメタデータ管理 データウェアハウスを含むクエリエンジンを併用する データレイク 中心型 Apache Hive Table © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed. ディレクトリ=パーティション メタデータはHive Metastore/Glue Catalogで定義 従来のDataLake形式
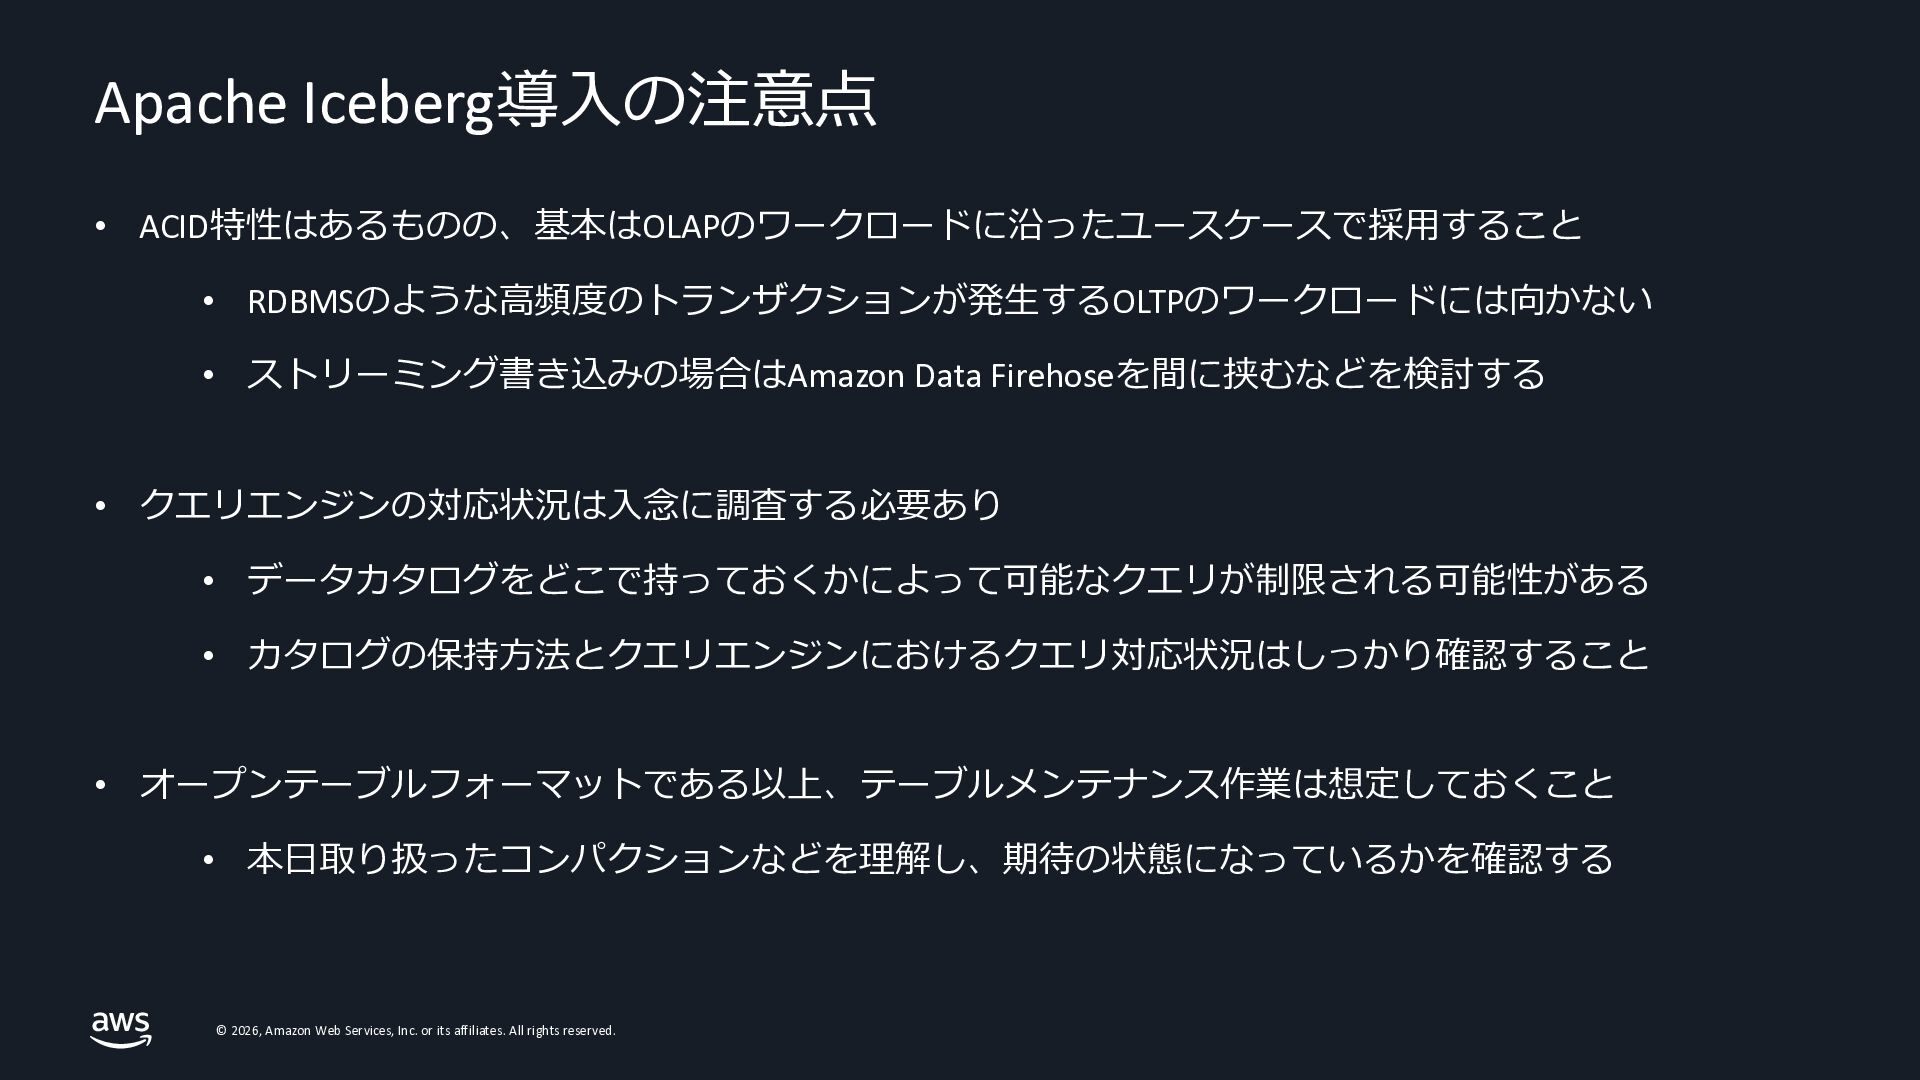
Apache Iceberg導入の注意点 • ACID特性はあるものの、基本はOLAPのワークロードに沿ったユースケースで採用すること • RDBMSのような高頻度のトランザクションが発生するOLTPのワークロードには向かない • ストリーミング書き込みの場合はAmazon Data Firehoseを間に挟むなどを検討する
• クエリエンジンの対応状況は入念に調査する必要あり • データカタログをどこで持っておくかによって可能なクエリが制限される可能性がある • カタログの保持方法とクエリエンジンにおけるクエリ対応状況はしっかり確認すること • オープンテーブルフォーマットである以上、テーブルメンテナンス作業は想定しておくこと • 本日取り扱ったコンパクションなどを理解し、期待の状態になっているかを確認する © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
まとめ • Apache Icebergはデータ統合を目的とし、大規模データに対してマルチク エリエンジンや書き込み処理が発生するワークロードに適する • Apache Icebergを利用することで、コストを抑えながら柔軟な基盤アーキ テクチャを構築できる •
Glue Data CatalogやS3 Tablesを利用することで、Apache Icebergの機能を便 利に活用することができる © 2026, Amazon W eb Services, Inc. or its affil iates. All ri ghts reserv ed.
Thank you! Please complete the session survey © 2026, Amazon
W eb Services, © 2026, Inc. Amazon or itsW affil ebiates. Services, All riInc. ghtsorreserv its affil ed.iates. All ri ghts reserv ed.


 kishidak
 bengo4com
 satoshi7
 yahonda
 satomasahiro2005
 willnet
 mohab1
 occhi
 ishikawa_satoru
 nttcom
 bitkey
 pfn
 portentint
 axbom
 nikkihalliwell
 jnunemaker
 geshan
 dougneiner
 jonoalderson
 tonyrice
 maltzj
 shpigford
 brad_frost