Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
論文紹介:Not All Tokens Are What You Need for Pretr...
Search
Kosuke Nishida
August 21, 2025
Research
320
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
論文紹介:Not All Tokens Are What You Need for Pretraining
Kosuke Nishida
August 21, 2025
More Decks by Kosuke Nishida
See All by Kosuke Nishida
⼤規模⾔語モデルとVision-and-Language
kosuken
6
2.4k
論文紹介:What Learning Algorithm is In-Context Learning? Investigation with Linear Models
kosuken
0
1.2k
論文紹介: Memorisation versus Generalisation in Pre-trained Language Models
kosuken
2
1.3k
Other Decks in Research
See All in Research
学術バーQ AI研究最前線:自己教師あり学習による画像モデルの事前学習
naok615
0
110
【中間報告】国会議員の立法・政策実務を支える環境を巡る現状と課題
polipoli
0
650
[CV勉強会@関東 CVPR2026] PSDesigner: Automated Graphic Design with a Human-Like Creative Workflow / kantocv 67th CVPR 2026
shunk031
0
350
J-STAGEの現況と全文XML登載必須化について
xspa2012
0
290
論文紹介: Understanding Epistemic Language with a Language-augmented Bayesian Theory of Mind
hisaokatsumi
0
170
PHTalks Bengaluru - SSRF When All Else Fails
dk999
0
1.2k
[Fishers] DIVER OSINT CTF 2026 特化AIエージェントハーネスで挑戦するOSINT CTF
analokmaus
0
610
進化?迷走?CasualConc ファミリーアプリの現在地 @ 英語コーパス学会 2026
casualconc
0
110
Anthropic が提案する LLM の内部状態を自然言語で説明可能にした Natural Language Autoencoders / Natural Language Autoencoders Produce Unsupervised Explanations of LLM Activations
shunk031
0
310
データサイエンティストの就労意識~2015 → 2026 一般(個人)会員アンケートより
datascientistsociety
PRO
0
930
20260624 NLP colloquium: 単一のhubテキストがCLIPを壊す:hubnessによる埋め込みの脆弱性特定
de9uch1
2
280
Language and AI
ayaniwa
0
310
Featured
See All Featured
Design and Strategy: How to Deal with People Who Don’t "Get" Design
morganepeng
133
19k
How to build a perfect <img>
jonoalderson
1
6k
Efficient Content Optimization with Google Search Console & Apps Script
katarinadahlin
PRO
1
890
How to Ace a Technical Interview
jacobian
281
24k
We Have a Design System, Now What?
morganepeng
55
8.3k
The Organizational Zoo: Understanding Human Behavior Agility Through Metaphoric Constructive Conversations (based on the works of Arthur Shelley, Ph.D)
kimpetersen
PRO
0
480
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
76k
Fireside Chat
paigeccino
43
4k
sira's awesome portfolio website redesign presentation
elsirapls
0
430
Agile Leadership in an Agile Organization
kimpetersen
PRO
0
250
Building Better People: How to give real-time feedback that sticks.
wjessup
370
20k
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
1
2k
Transcript
© NTT, Inc. 2025 紹介者:西田光甫(NTT人間研) 最先端NLP勉強会2025
© NTT, Inc. 2025 1 • 背景 • 提案手法 •
実験 • まとめ 目次
© NTT, Inc. 2025 2 背景
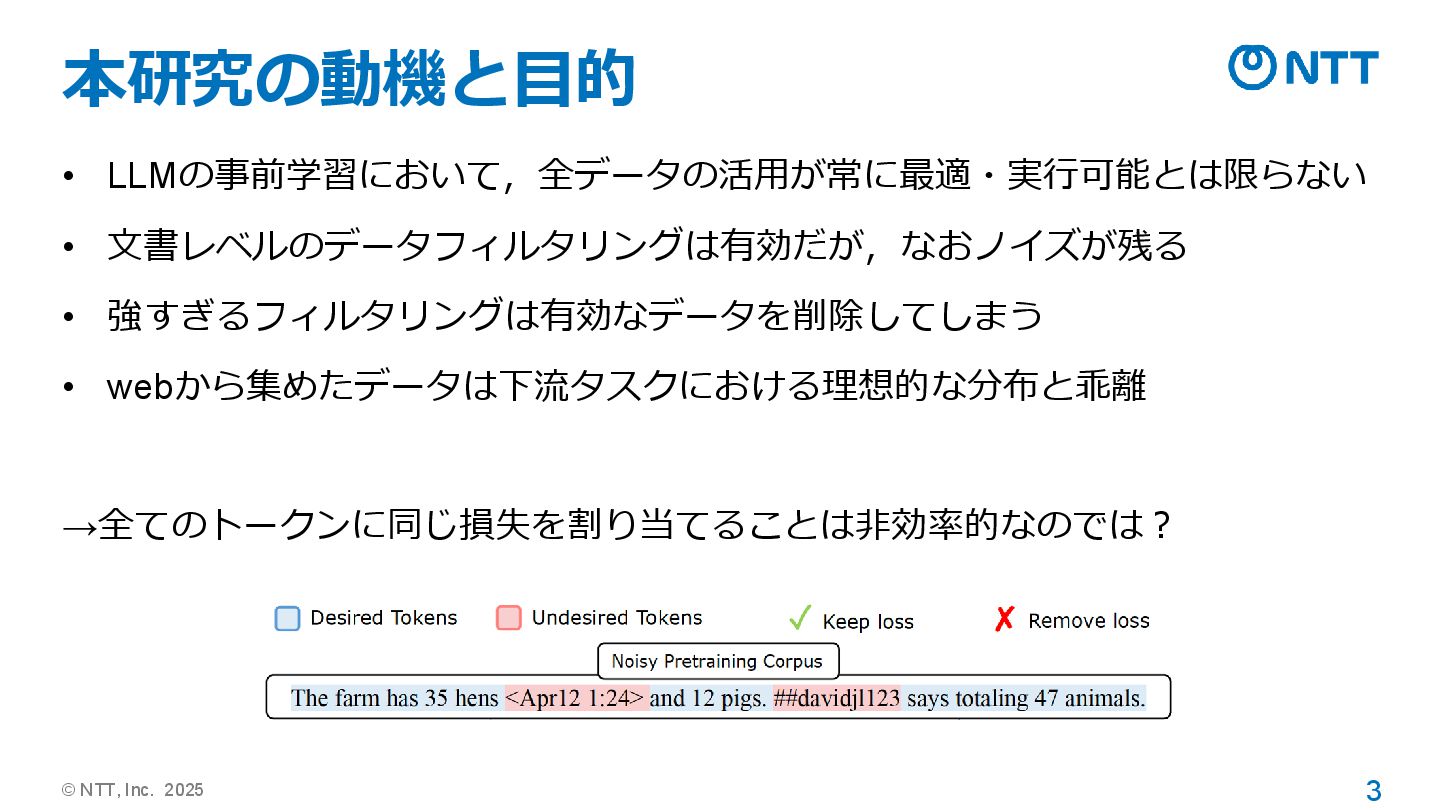
© NTT, Inc. 2025 3 本研究の動機と目的 • LLMの事前学習において,全データの活用が常に最適・実行可能とは限らない • 文書レベルのデータフィルタリングは有効だが,なおノイズが残る
• 強すぎるフィルタリングは有効なデータを削除してしまう • webから集めたデータは下流タスクにおける理想的な分布と乖離 →全てのトークンに同じ損失を割り当てることは非効率的なのでは?
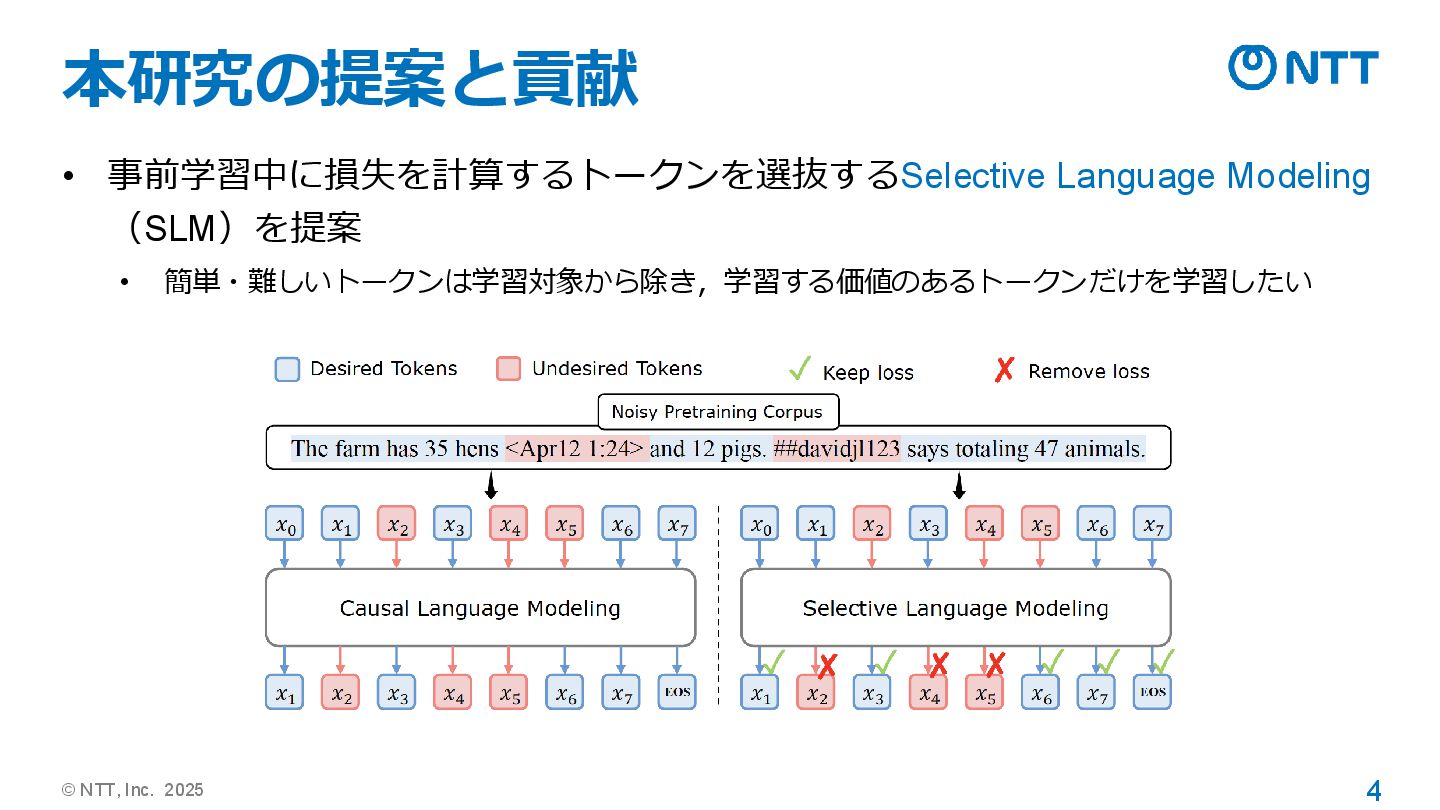
© NTT, Inc. 2025 4 本研究の提案と貢献 • 事前学習中に損失を計算するトークンを選抜するSelective Language Modeling
(SLM)を提案 • 簡単・難しいトークンは学習対象から除き,学習する価値のあるトークンだけを学習したい
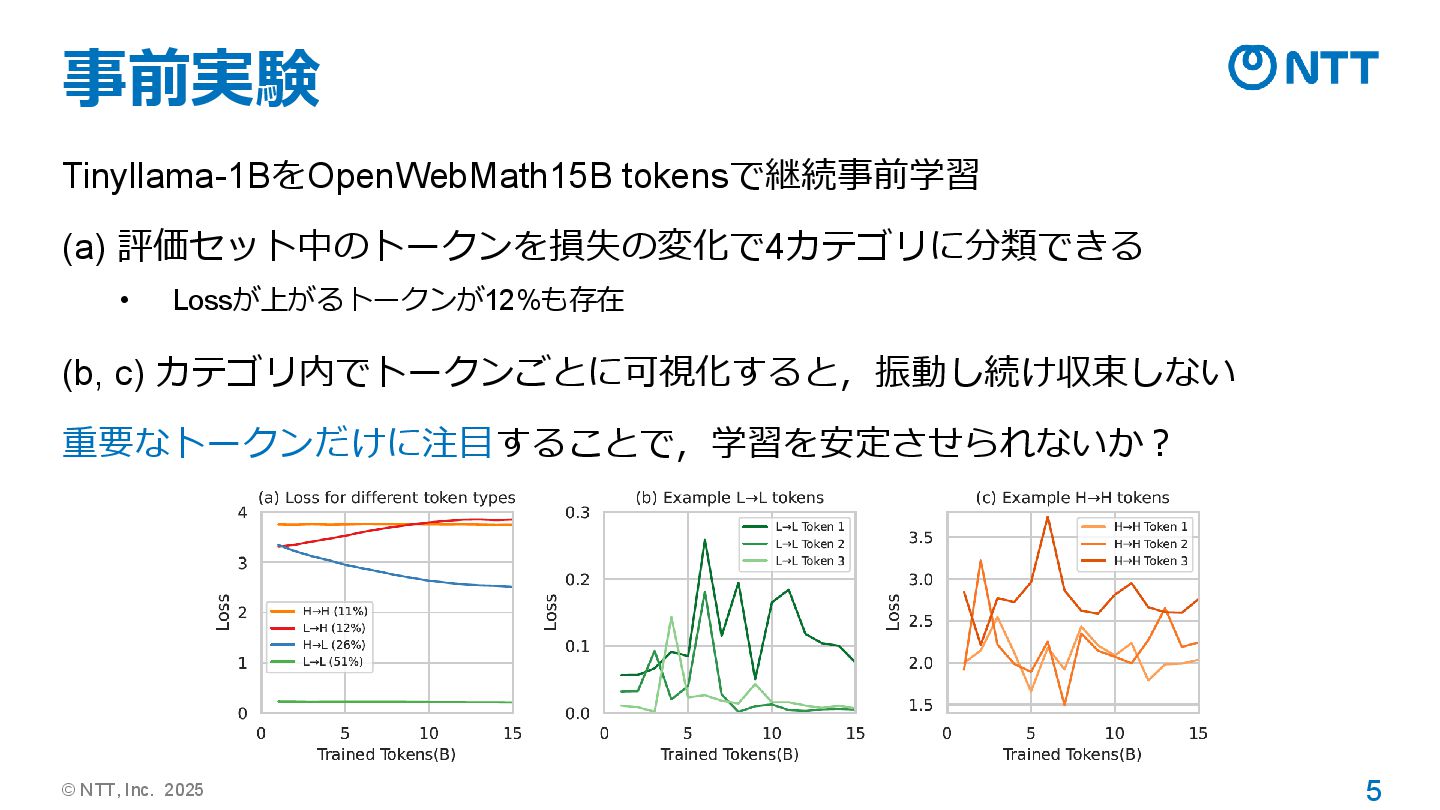
© NTT, Inc. 2025 5 事前実験 Tinyllama-1BをOpenWebMath15B tokensで継続事前学習 (a) 評価セット中のトークンを損失の変化で4カテゴリに分類できる
• Lossが上がるトークンが12%も存在 (b, c) カテゴリ内でトークンごとに可視化すると,振動し続け収束しない 重要なトークンだけに注目することで,学習を安定させられないか?
© NTT, Inc. 2025 6 提案手法
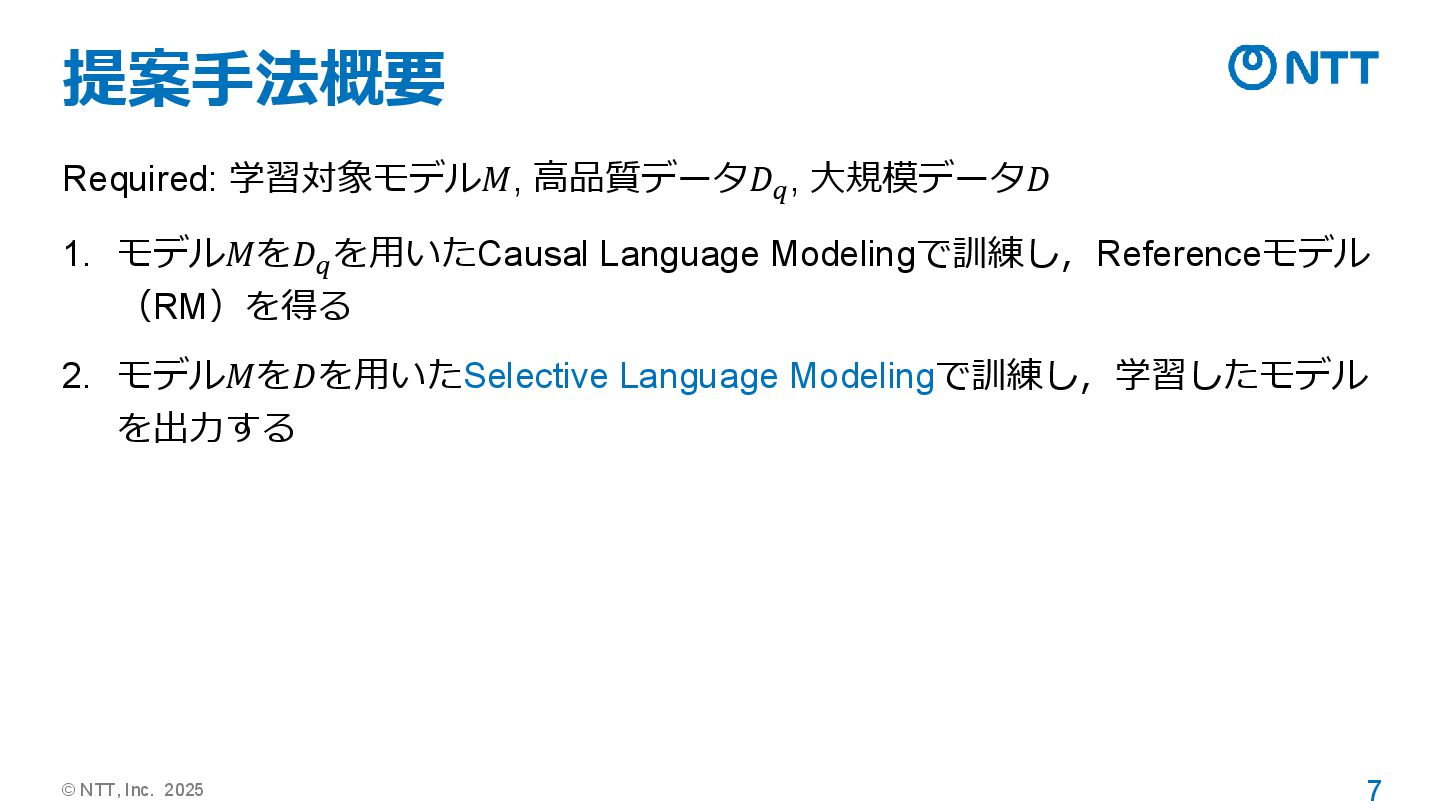
© NTT, Inc. 2025 7 提案手法概要 Required: 学習対象モデル𝑀, 高品質データ𝐷𝑞, 大規模データ𝐷
1. モデル𝑀を𝐷𝑞 を用いたCausal Language Modelingで訓練し,Referenceモデル (RM)を得る 2. モデル𝑀を𝐷を用いたSelective Language Modelingで訓練し,学習したモデル を出力する
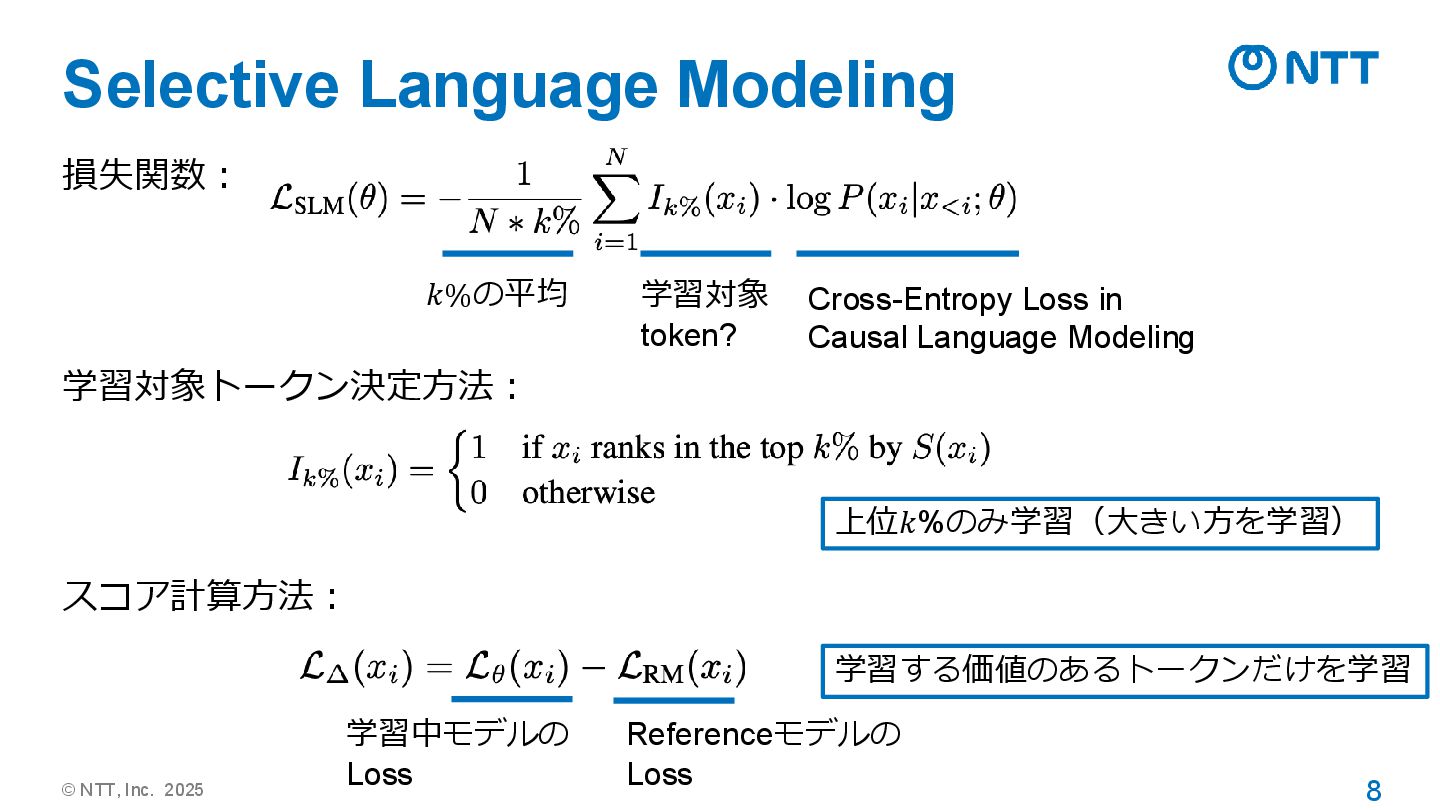
© NTT, Inc. 2025 8 Selective Language Modeling 損失関数: 学習対象トークン決定方法:
スコア計算方法: 𝑘%の平均 学習対象 token? Cross-Entropy Loss in Causal Language Modeling 上位𝑘%のみ学習(大きい方を学習) 学習中モデルの Loss Referenceモデルの Loss 学習する価値のあるトークンだけを学習
© NTT, Inc. 2025 9 実験
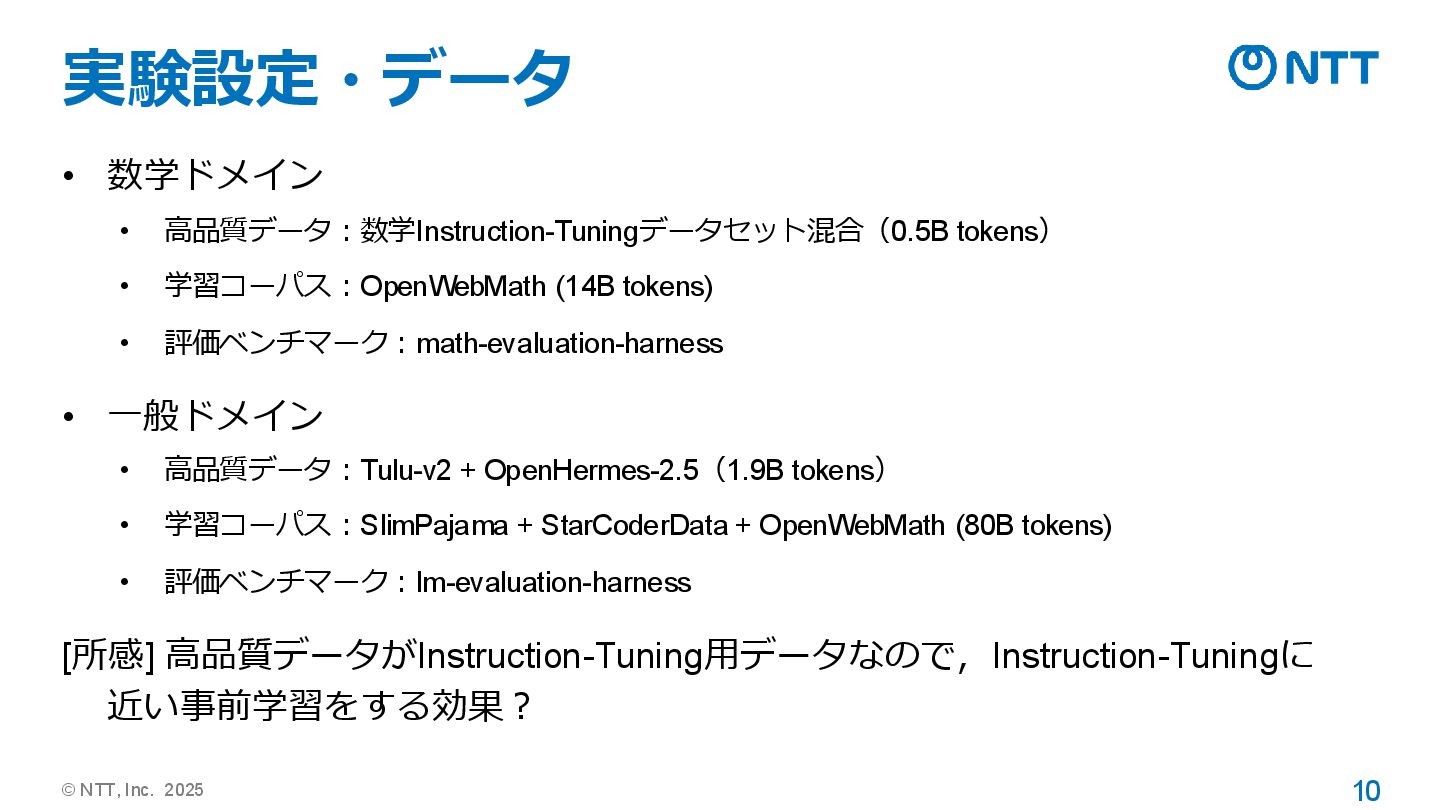
© NTT, Inc. 2025 10 実験設定・データ • 数学ドメイン • 高品質データ:数学Instruction-Tuningデータセット混合(0.5B
tokens) • 学習コーパス:OpenWebMath (14B tokens) • 評価ベンチマーク:math-evaluation-harness • 一般ドメイン • 高品質データ:Tulu-v2 + OpenHermes-2.5(1.9B tokens) • 学習コーパス:SlimPajama + StarCoderData + OpenWebMath (80B tokens) • 評価ベンチマーク:lm-evaluation-harness [所感] 高品質データがInstruction-Tuning用データなので,Instruction-Tuningに 近い事前学習をする効果?
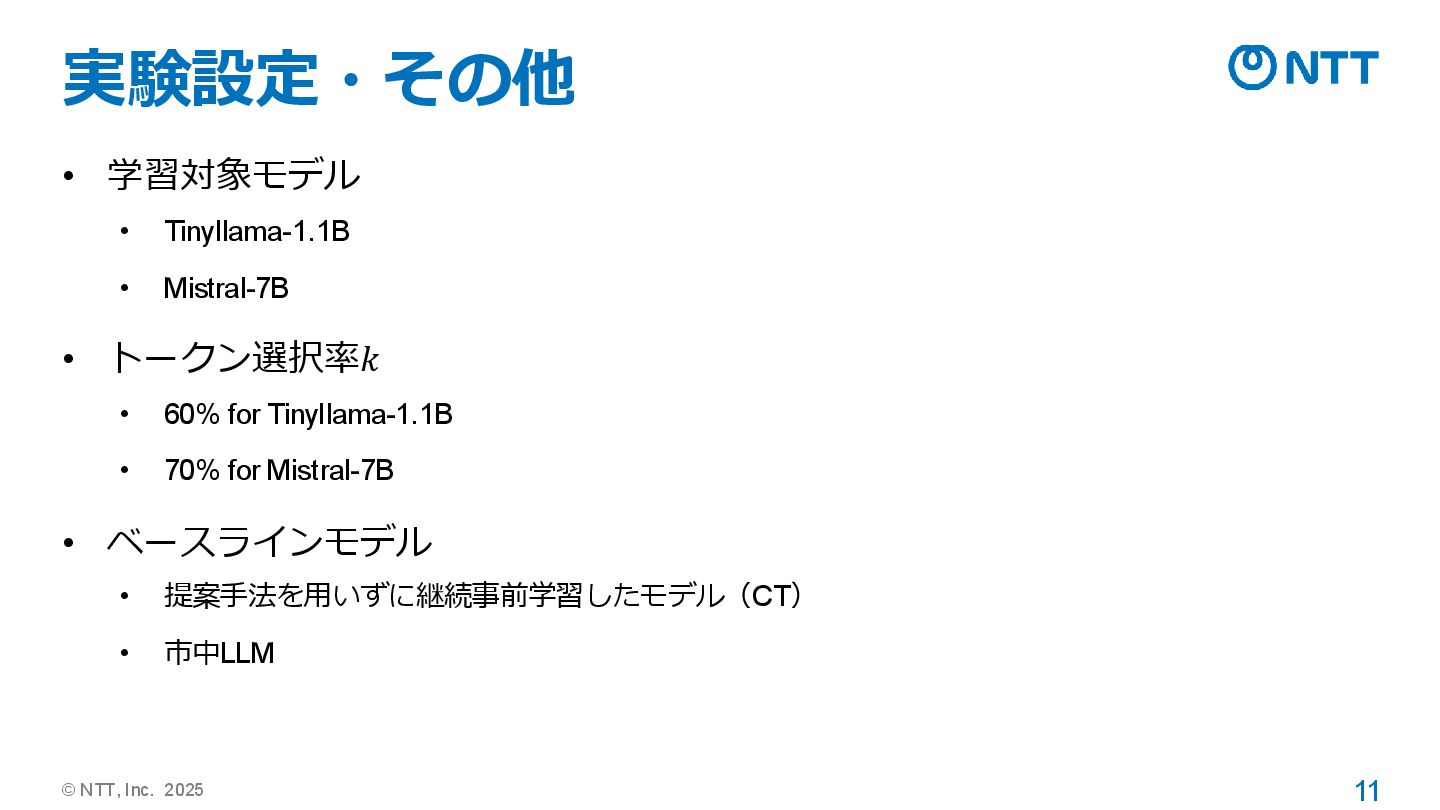
© NTT, Inc. 2025 11 実験設定・その他 • 学習対象モデル • Tinyllama-1.1B
• Mistral-7B • トークン選択率𝑘 • 60% for Tinyllama-1.1B • 70% for Mistral-7B • ベースラインモデル • 提案手法を用いずに継続事前学習したモデル(CT) • 市中LLM
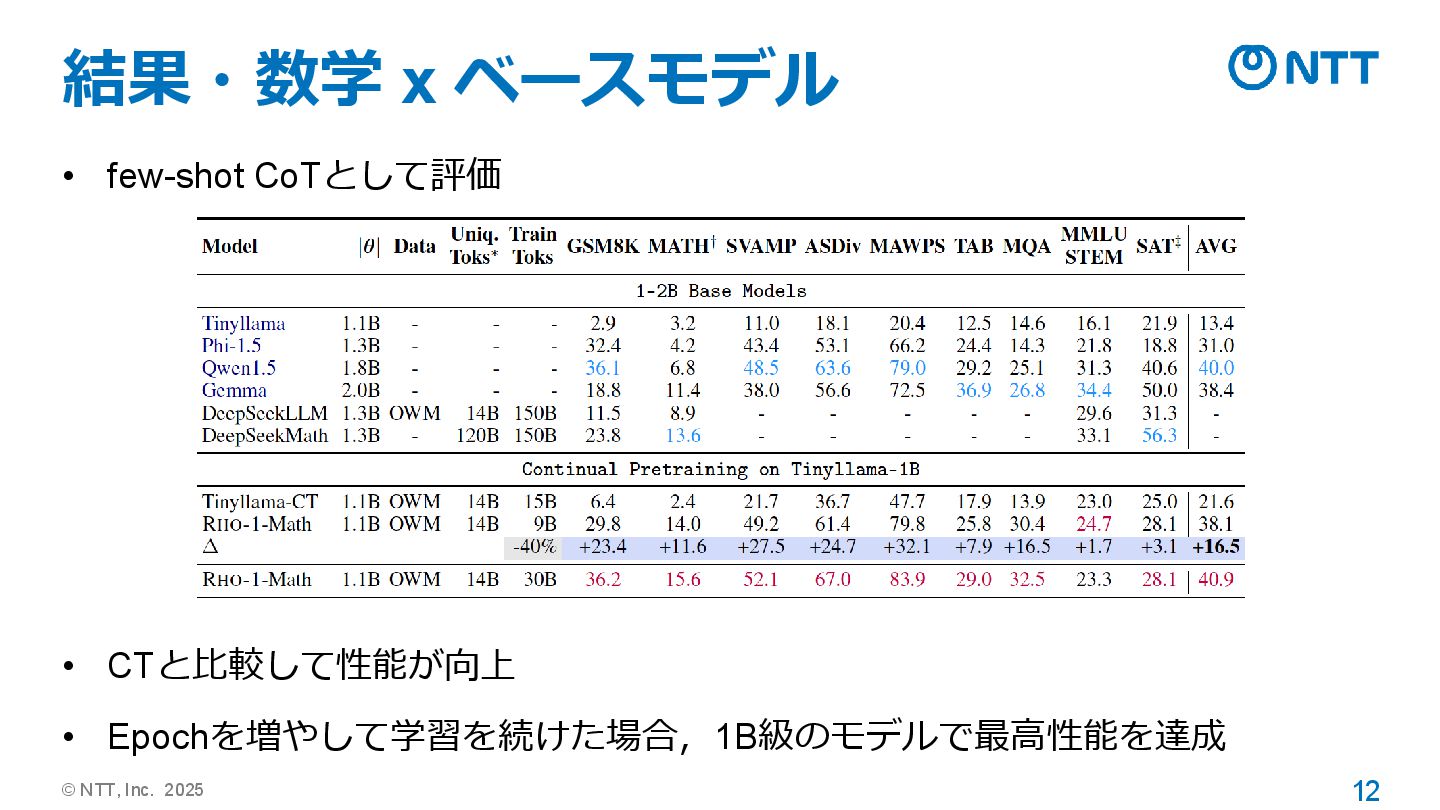
© NTT, Inc. 2025 12 結果・数学 x ベースモデル • few-shot
CoTとして評価 • CTと比較して性能が向上 • Epochを増やして学習を続けた場合,1B級のモデルで最高性能を達成
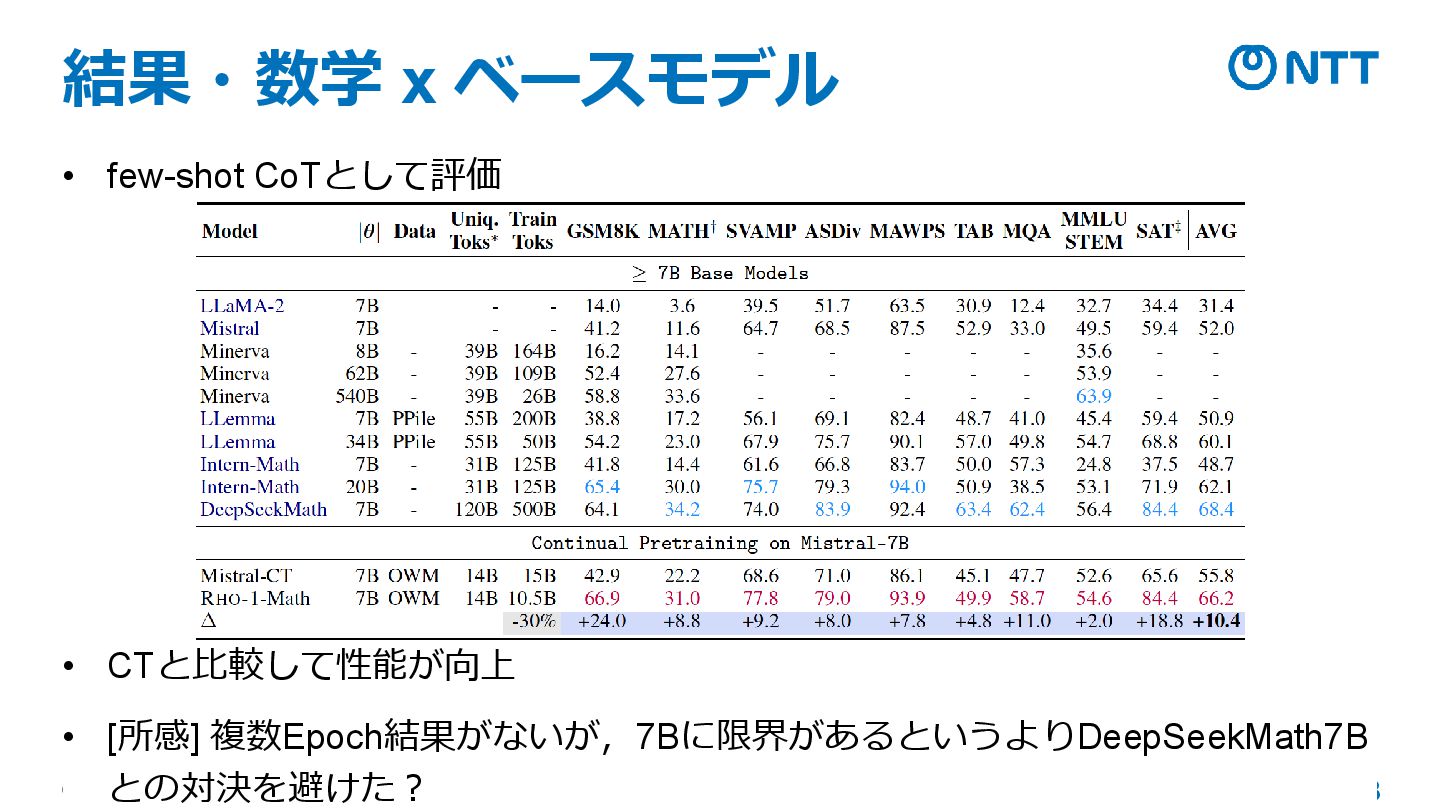
© NTT, Inc. 2025 13 結果・数学 x ベースモデル • few-shot
CoTとして評価 • CTと比較して性能が向上 • [所感] 複数Epoch結果がないが,7Bに限界があるというよりDeepSeekMath7B との対決を避けた?
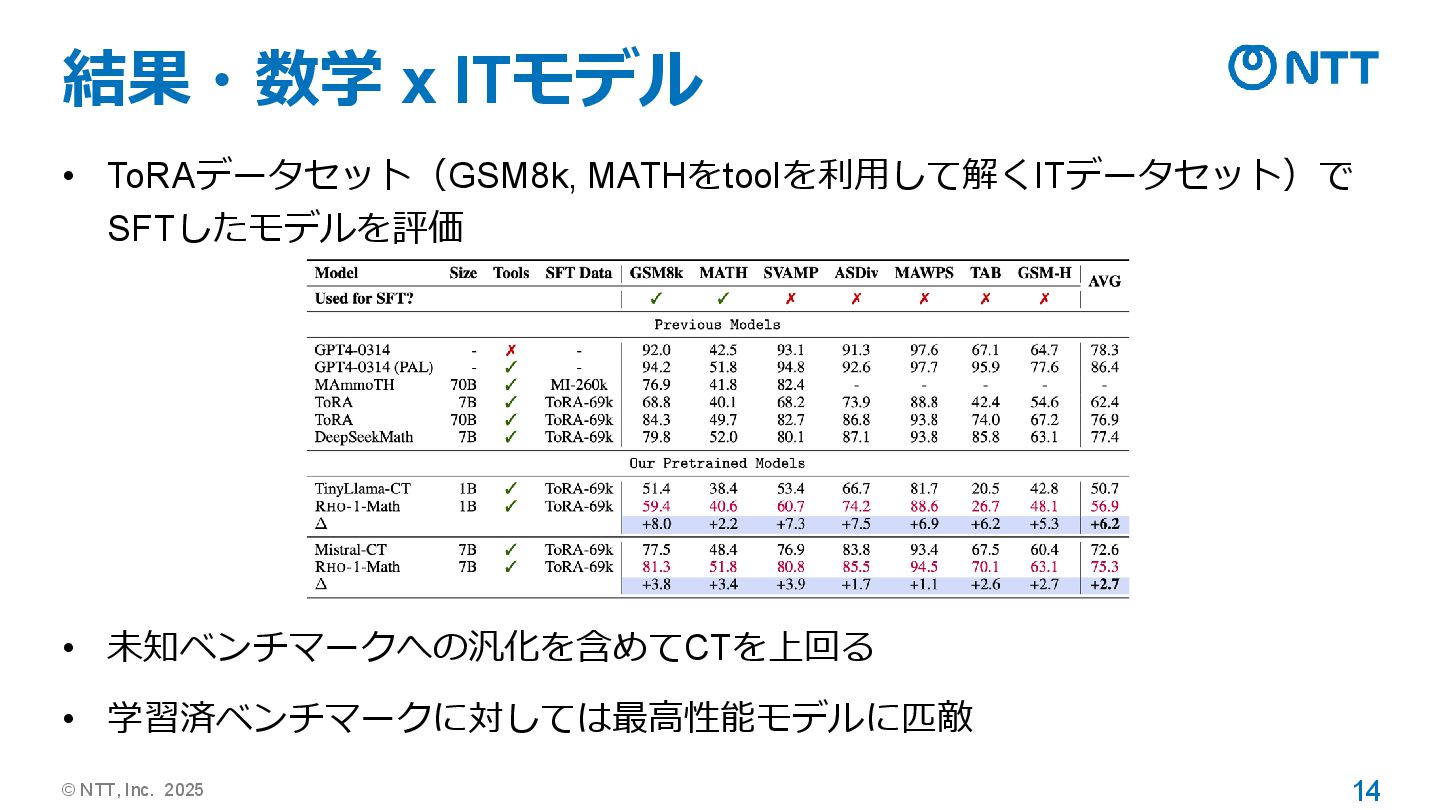
© NTT, Inc. 2025 14 結果・数学 x ITモデル • ToRAデータセット(GSM8k,
MATHをtoolを利用して解くITデータセット)で SFTしたモデルを評価 • 未知ベンチマークへの汎化を含めてCTを上回る • 学習済ベンチマークに対しては最高性能モデルに匹敵
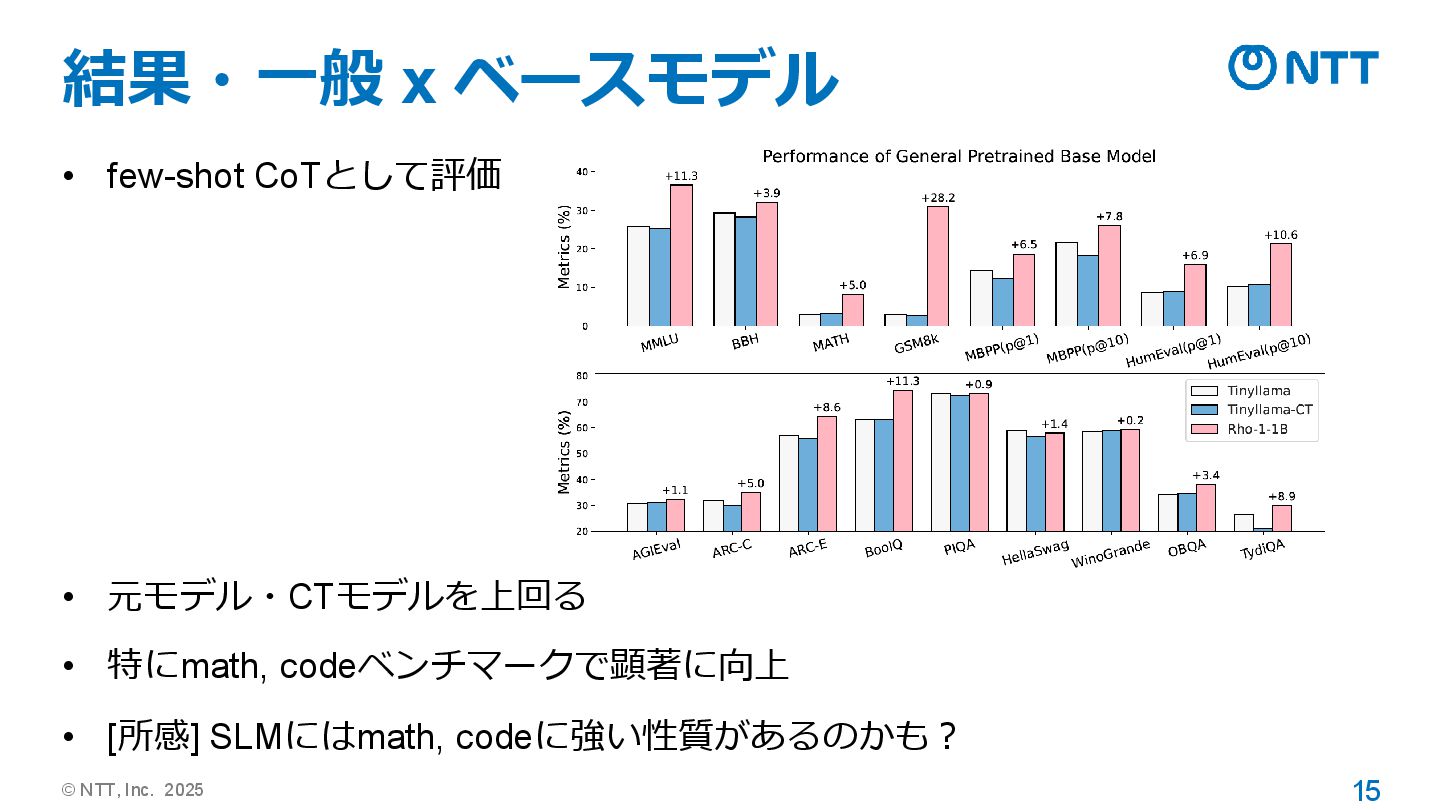
© NTT, Inc. 2025 15 結果・一般 x ベースモデル • few-shot
CoTとして評価 • 元モデル・CTモデルを上回る • 特にmath, codeベンチマークで顕著に向上 • [所感] SLMにはmath, codeに強い性質があるのかも?
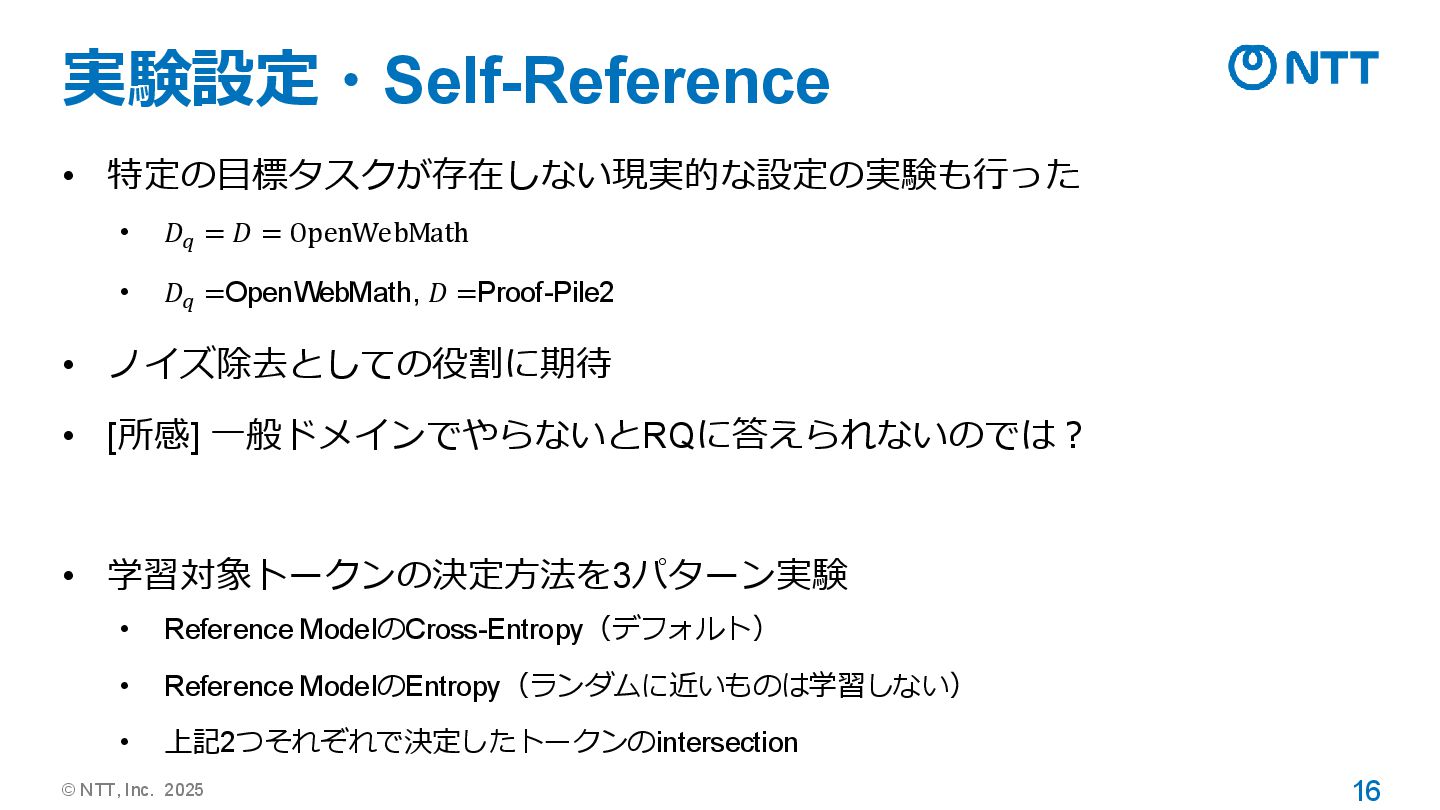
© NTT, Inc. 2025 16 実験設定・Self-Reference • 特定の目標タスクが存在しない現実的な設定の実験も行った • 𝐷𝑞
= 𝐷 = OpenWebMath • 𝐷𝑞 =OpenWebMath, 𝐷 =Proof-Pile2 • ノイズ除去としての役割に期待 • [所感] 一般ドメインでやらないとRQに答えられないのでは? • 学習対象トークンの決定方法を3パターン実験 • Reference ModelのCross-Entropy(デフォルト) • Reference ModelのEntropy(ランダムに近いものは学習しない) • 上記2つそれぞれで決定したトークンのintersection
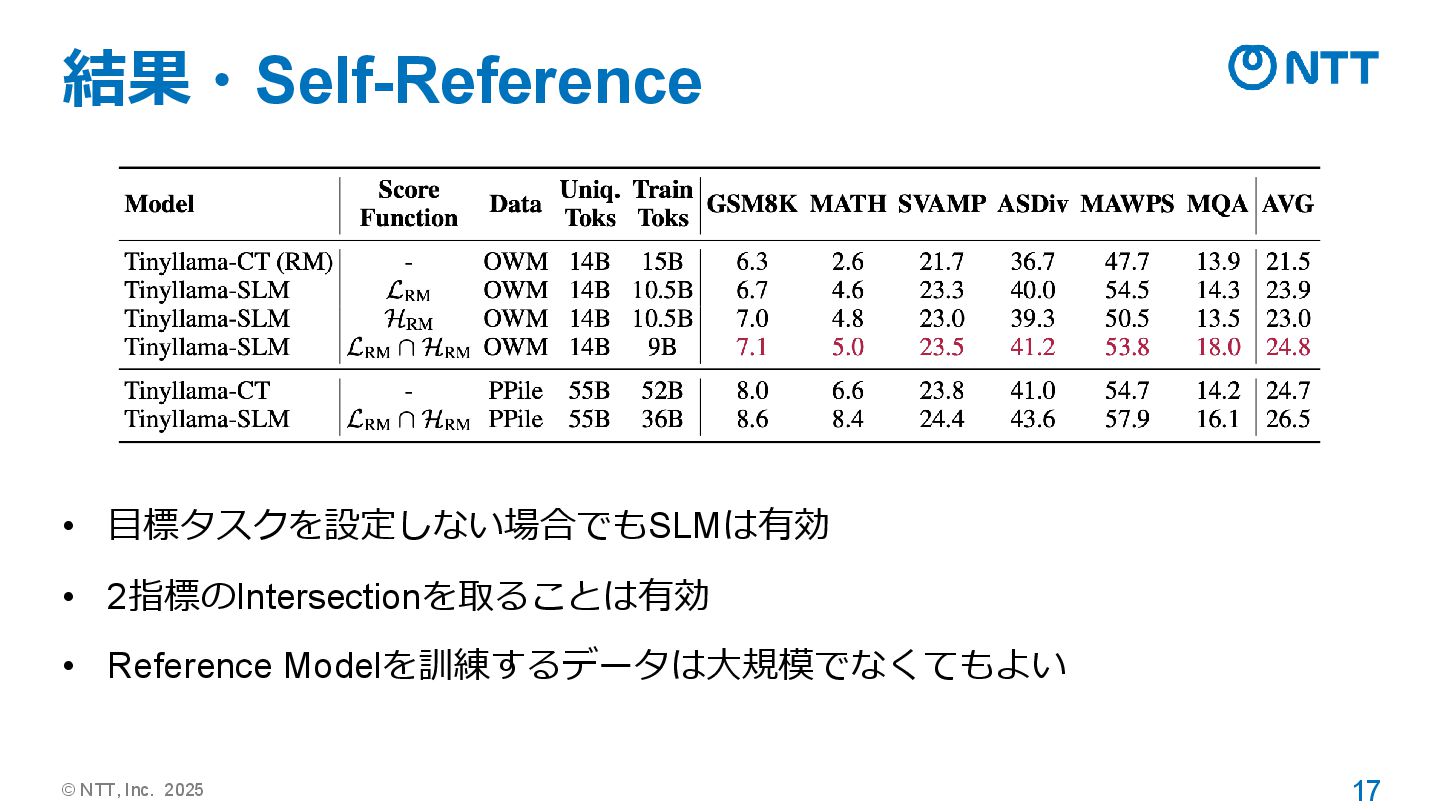
© NTT, Inc. 2025 17 結果・Self-Reference • 目標タスクを設定しない場合でもSLMは有効 • 2指標のIntersectionを取ることは有効
• Reference Modelを訓練するデータは大規模でなくてもよい
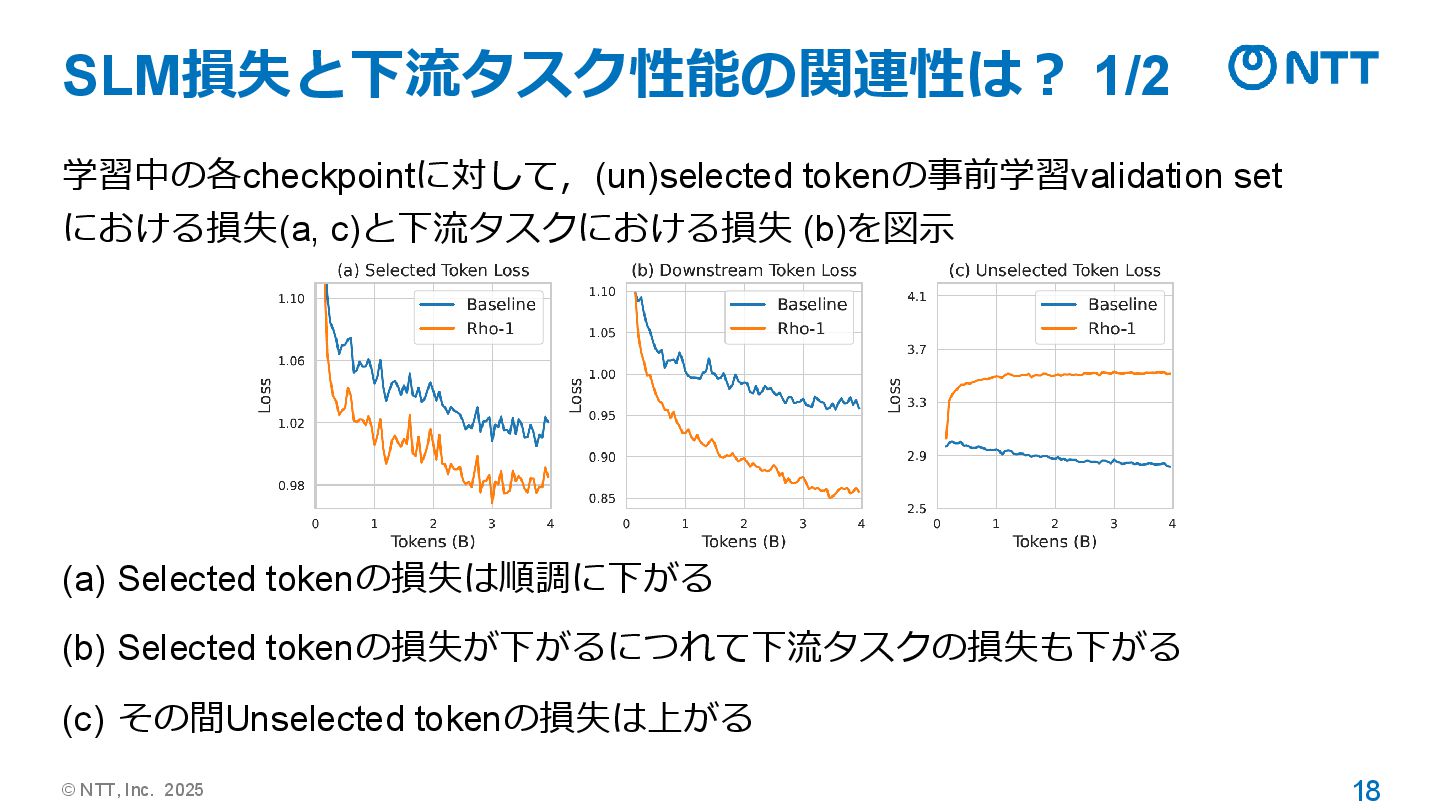
© NTT, Inc. 2025 18 SLM損失と下流タスク性能の関連性は? 1/2 学習中の各checkpointに対して,(un)selected tokenの事前学習validation set
における損失(a, c)と下流タスクにおける損失 (b)を図示 (a) Selected tokenの損失は順調に下がる (b) Selected tokenの損失が下がるにつれて下流タスクの損失も下がる (c) その間Unselected tokenの損失は上がる
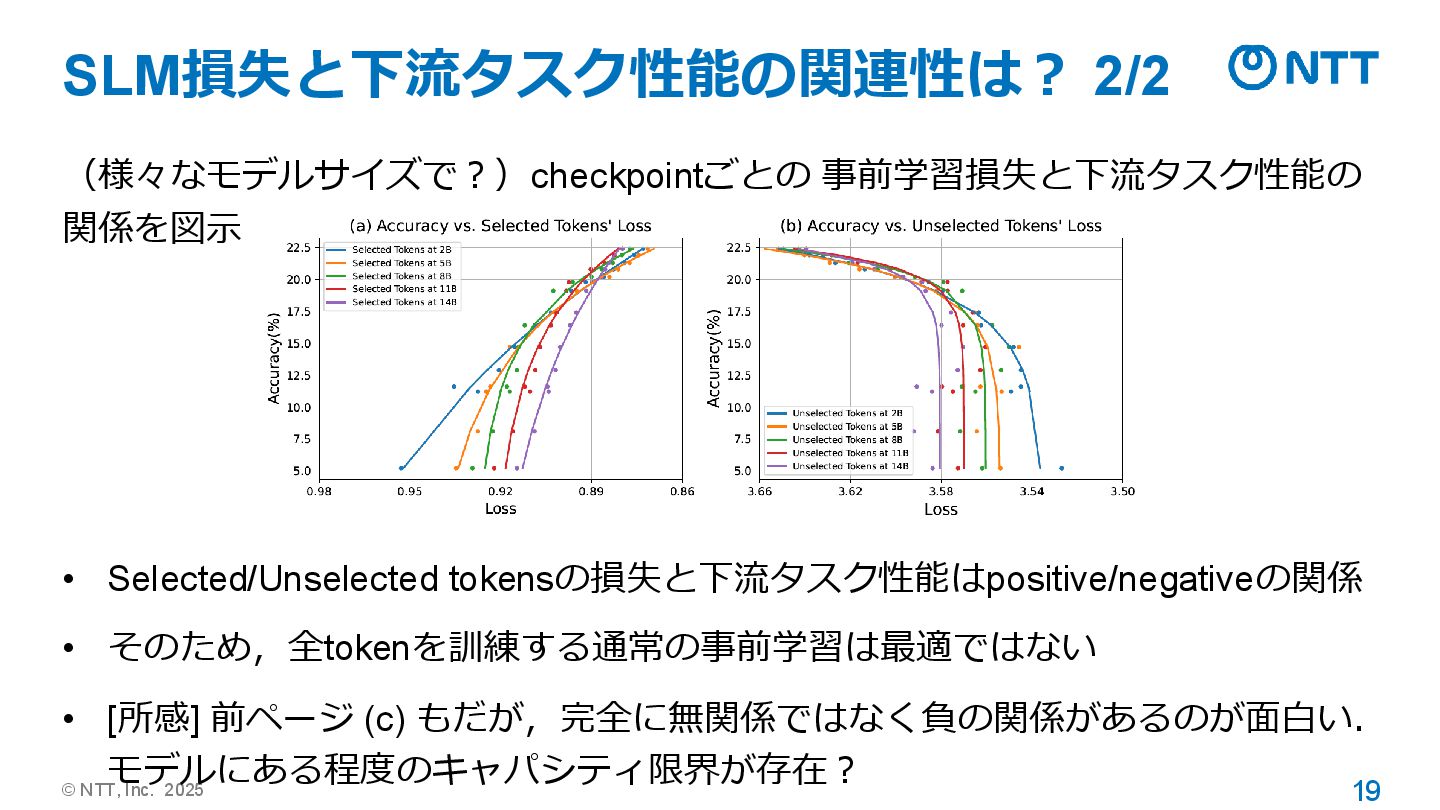
© NTT, Inc. 2025 19 SLM損失と下流タスク性能の関連性は? 2/2 (様々なモデルサイズで?)checkpointごとの 事前学習損失と下流タスク性能の 関係を図示
• Selected/Unselected tokensの損失と下流タスク性能はpositive/negativeの関係 • そのため,全tokenを訓練する通常の事前学習は最適ではない • [所感] 前ページ (c) もだが,完全に無関係ではなく負の関係があるのが面白い. モデルにある程度のキャパシティ限界が存在?
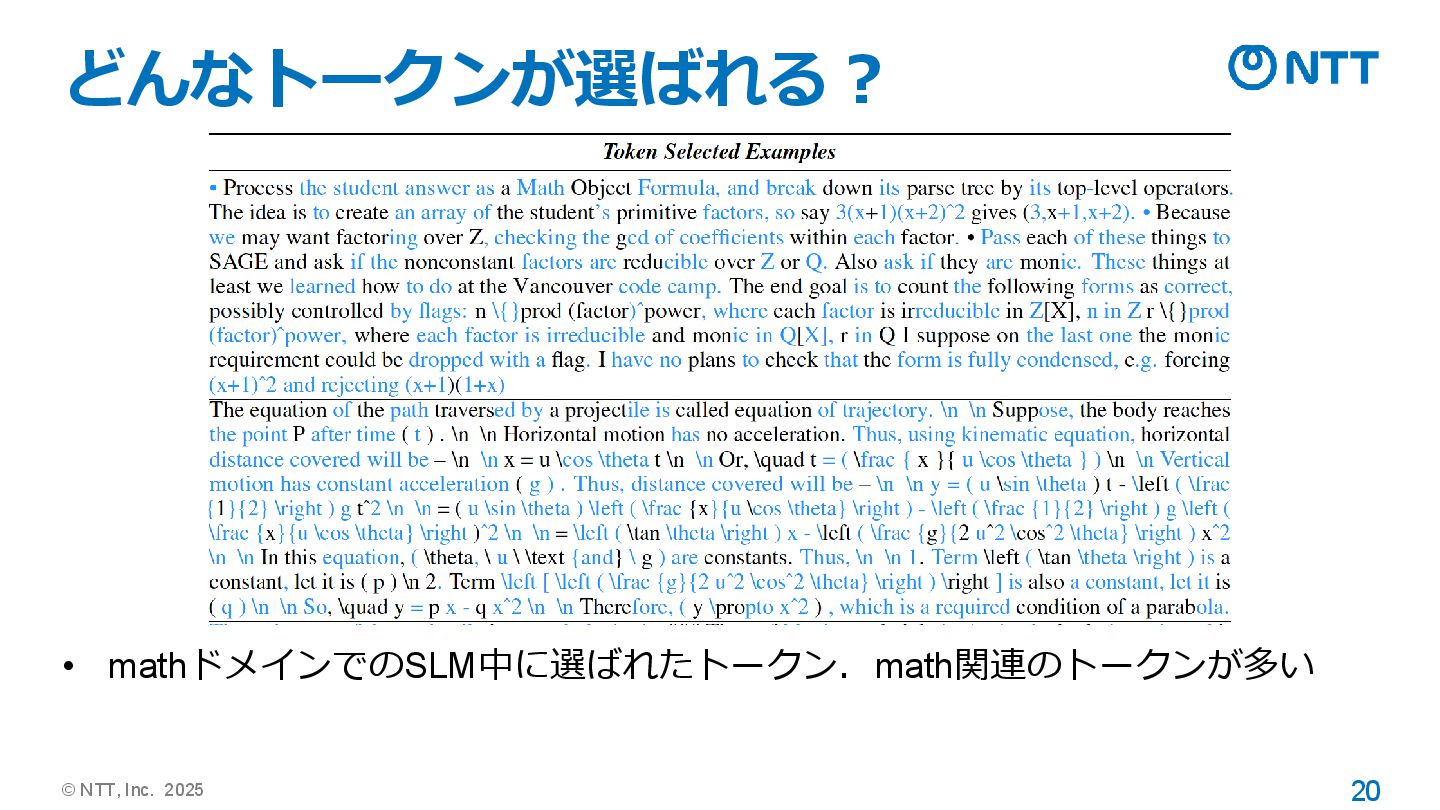
© NTT, Inc. 2025 20 どんなトークンが選ばれる? • mathドメインでのSLM中に選ばれたトークン.math関連のトークンが多い
© NTT, Inc. 2025 21 まとめ
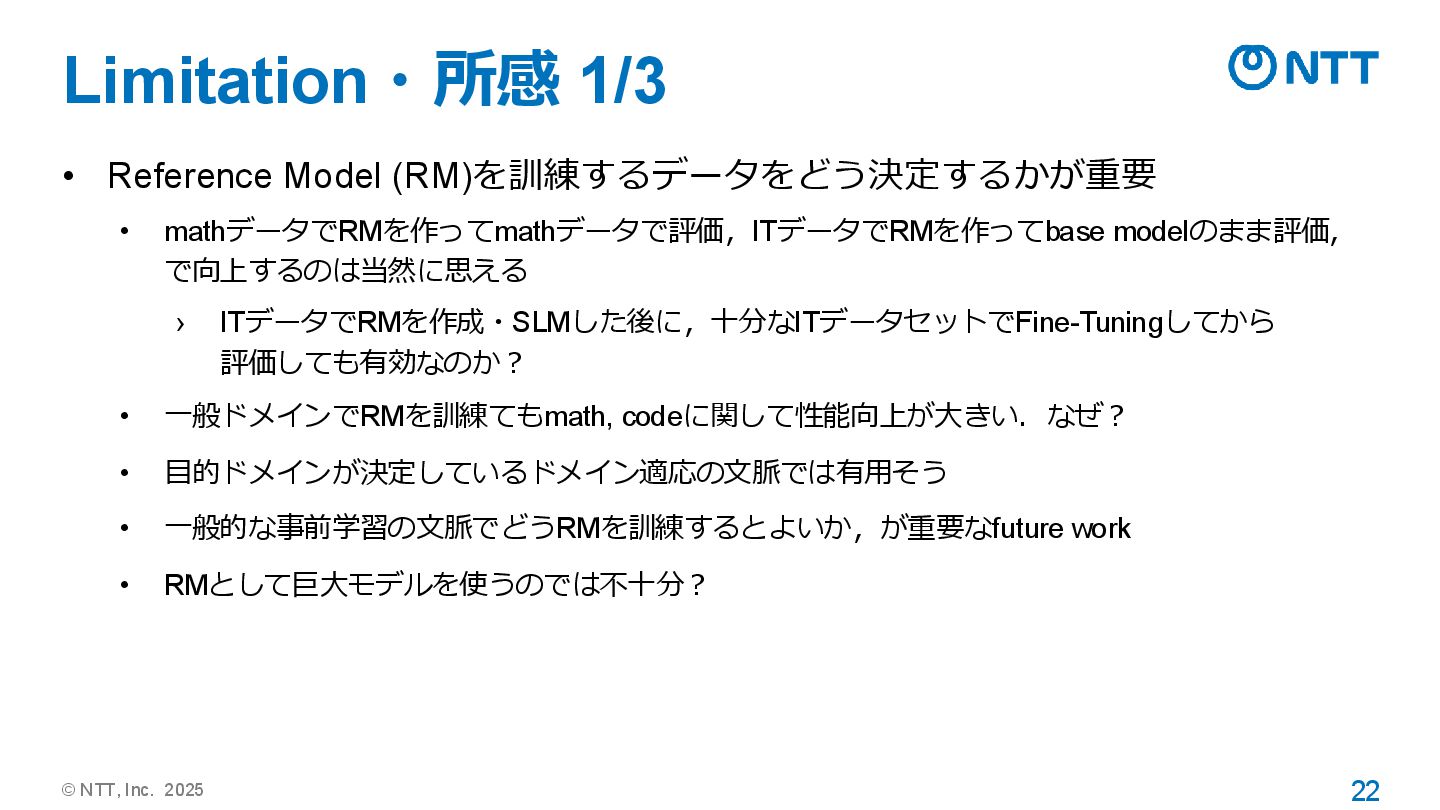
© NTT, Inc. 2025 22 Limitation・所感 1/3 • Reference Model
(RM)を訓練するデータをどう決定するかが重要 • mathデータでRMを作ってmathデータで評価,ITデータでRMを作ってbase modelのまま評価, で向上するのは当然に思える › ITデータでRMを作成・SLMした後に,十分なITデータセットでFine-Tuningしてから 評価しても有効なのか? • 一般ドメインでRMを訓練てもmath, codeに関して性能向上が大きい.なぜ? • 目的ドメインが決定しているドメイン適応の文脈では有用そう • 一般的な事前学習の文脈でどうRMを訓練するとよいか,が重要なfuture work • RMとして巨大モデルを使うのでは不十分?
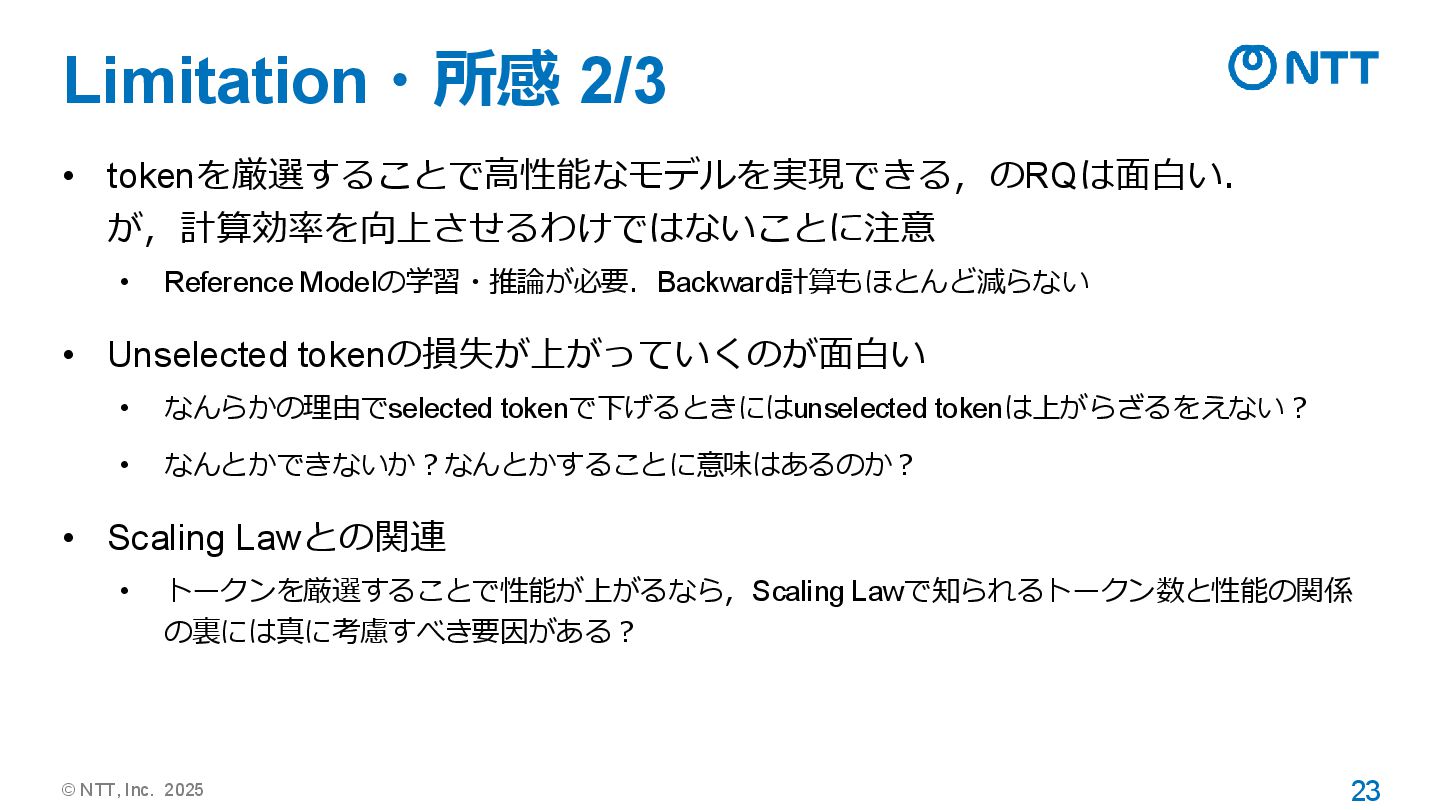
© NTT, Inc. 2025 23 Limitation・所感 2/3 • tokenを厳選することで高性能なモデルを実現できる,のRQは面白い. が,計算効率を向上させるわけではないことに注意
• Reference Modelの学習・推論が必要.Backward計算もほとんど減らない • Unselected tokenの損失が上がっていくのが面白い • なんらかの理由でselected tokenで下げるときにはunselected tokenは上がらざるをえない? • なんとかできないか?なんとかすることに意味はあるのか? • Scaling Lawとの関連 • トークンを厳選することで性能が上がるなら,Scaling Lawで知られるトークン数と性能の関係 の裏には真に考慮すべき要因がある?
© NTT, Inc. 2025 24 Limitation・所感 3/3 • SLMの使い方はトークン選択でいいのか? •
連続的reweighting, Reward Model, 複数Reference Model. 反復的SLM • SLMの適用先は事前学習だけか? • fine-tuning, multi-modal pre-training • 大規模な設定でも有効か? • モデルサイズ,コーパスサイズ


 kosuken
 naok615
 polipoli
 shunk031
 xspa2012
 hisaokatsumi
 dk999
 analokmaus
 casualconc
 datascientistsociety
 de9uch1
 ayaniwa
 morganepeng
 jonoalderson
 katarinadahlin
 jacobian
 kimpetersen
 soudai
 paigeccino
 elsirapls
 wjessup
 joshbly