Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
論文紹介 CLIP, LLaVA, Penguin-VL
Search
kyad
March 14, 2026
Technology
22
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
論文紹介 CLIP, LLaVA, Penguin-VL
kyad
March 14, 2026
More Decks by kyad
See All by kyad
論文紹介 mHC
kyad
0
50
論文紹介 Attention Residuals
kyad
0
25
Other Decks in Technology
See All in Technology
価値について
gree_tech
PRO
0
100
USB PDを使ってスマホを労わりたい
raspython3
0
180
S3 Filesで挑む! 八戸せんべい汁の食べ頃問題
usanchuu
0
120
M5Stackで作る BLEマウス GPSログの世界
tomokusaba
PRO
0
440
アウトプット初心者、半年間のふりかえり
4o1sobblue
0
440
エンタメ企業のM&Aを支えるデータ基盤 ― 統合から店舗のリアルタイム分析まで / Data Engineering Summit 2026
genda
0
190
Code for Security プロジェクト紹介 2026年10月
yu23ki14
0
110
Rustuna: Rustによる高速なOptuna実装
pfn
PRO
0
200
ストレスなくAIと付き合いたい!こんなときどうしてる?
namiki64
4
610
事業成長とデータ活用を止めないためのマネジメントへ挑戦
hiracky16
0
400
AI × アーキテクト 第1・2章|生成AIの課題とアーキテクトの素養
daidaidai
0
180
10年後、Engineering 行為を剥奪されるとして、わたしたちは、どう、何を創ればいいだろうか。 / If Engineering Is Taken Away in 10 Years, How and What Should We Create?
bitkey
PRO
1
200
Featured
See All Featured
Large-scale JavaScript Application Architecture
addyosmani
516
110k
WCS-LA-2024
lcolladotor
0
890
Navigating the moral maze — ethical principles for Al-driven product design
skipperchong
2
630
Google's AI Overviews - The New Search
badams
0
1.6k
Everyday Curiosity
cassininazir
0
360
Documentation Writing (for coders)
carmenintech
77
5.6k
Responsive Adventures: Dirty Tricks From The Dark Corners of Front-End
smashingmag
254
22k
First, design no harm
axbom
PRO
2
1.3k
HTML-Aware ERB: The Path to Reactive Rendering @ RubyCon 2026, Rimini, Italy
marcoroth
5
830
Deep Space Network (abreviated)
tonyrice
0
370
brightonSEO & MeasureFest 2025 - Winning Strategies for Black Friday CRO & PPC - Christian Goodrich
cargoodrich
3
870
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
600
Transcript
論文紹介 CLIP, LLaVA, Penguin-VL @kyad 2026/3/14 本資料中の図は論文から引用しています
CLIP •書誌情報 [2103.00020] Learning Transferable Visual Models From Natural Language
Supervision 研究機関:OpenAI •何をするもの? 画像とテキストを同じ埋め込み空間に対応付けるように学習させる仕組み Contrastive Language-Image Pre-training
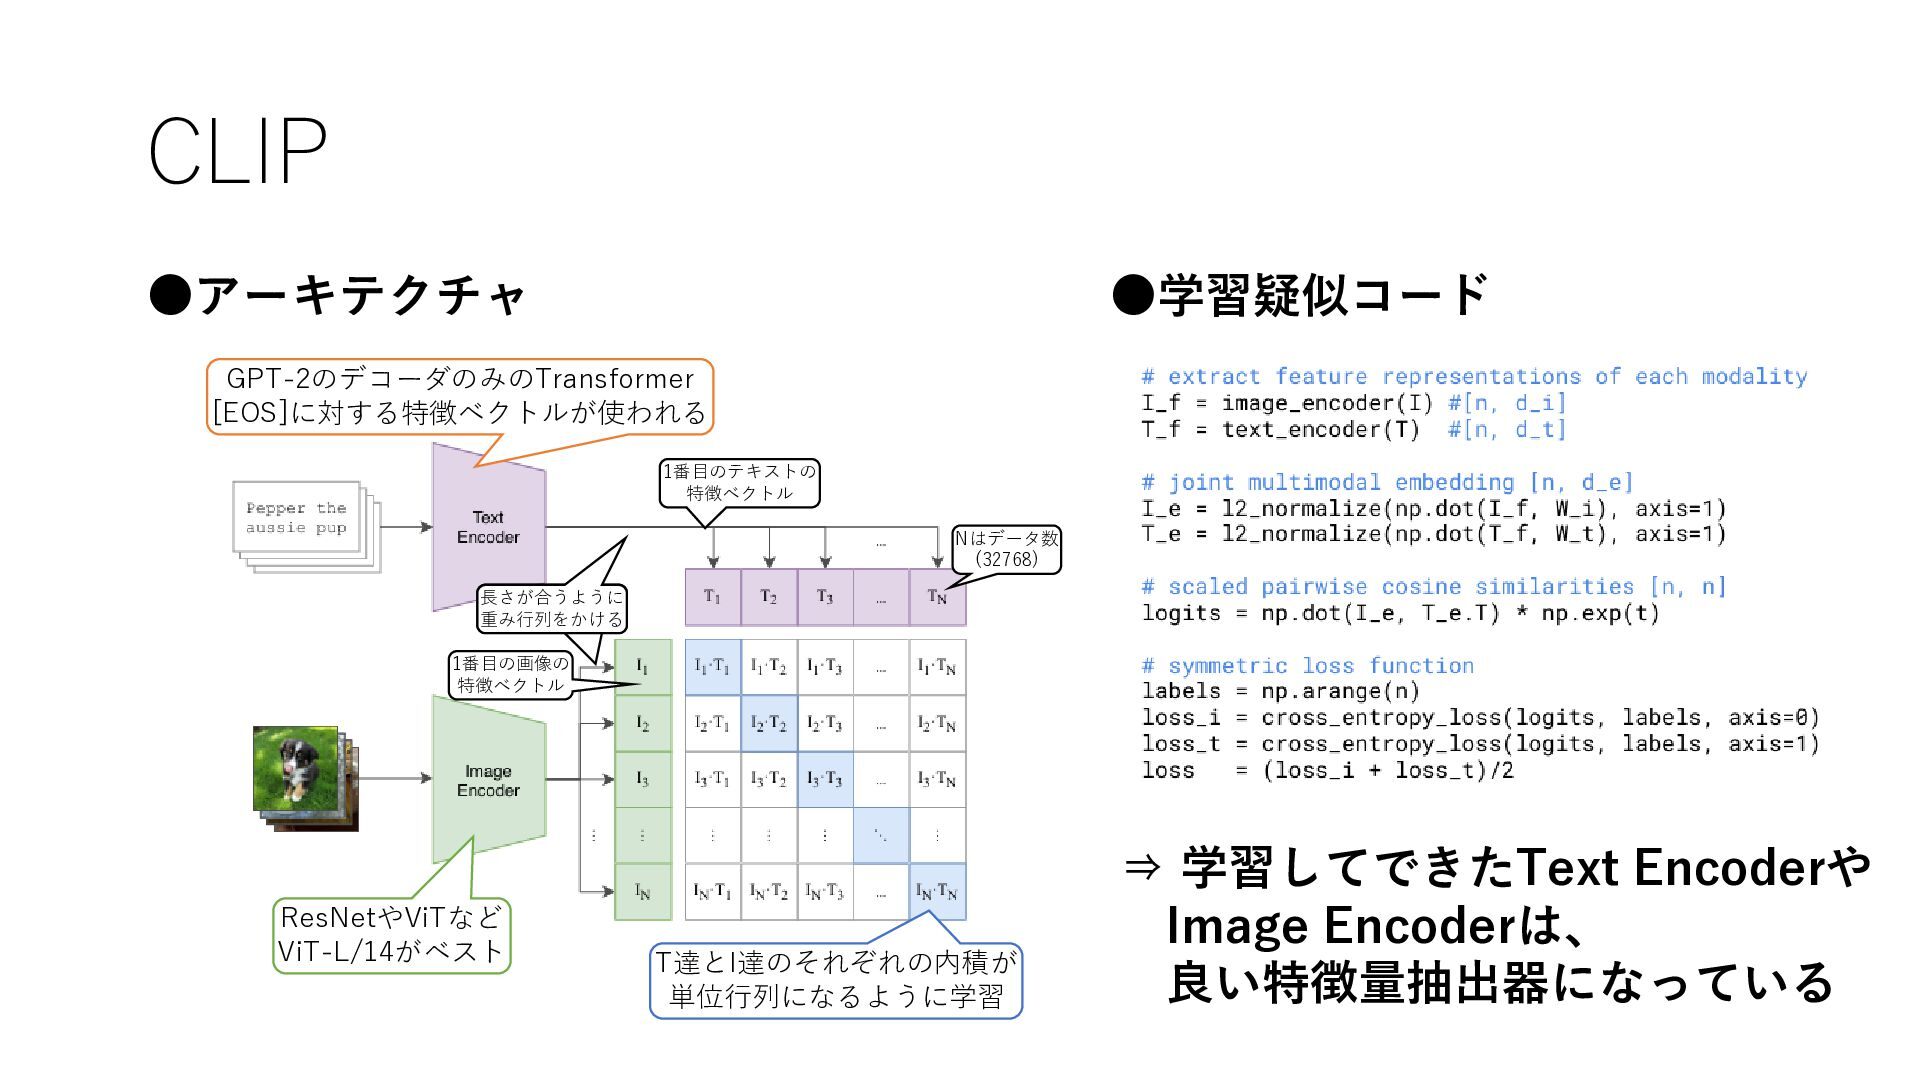
CLIP •アーキテクチャ ResNetやViTなど ViT-L/14がベスト GPT-2のデコーダのみのTransformer [EOS]に対する特徴ベクトルが使われる 長さが合うように 重み行列をかける 長さが合うように 重み行列をかける
Nはデータ数 (32768) 1番目のテキストの 特徴ベクトル 1番目の画像の 特徴ベクトル •学習疑似コード T達とI達のそれぞれの内積が 単位行列になるように学習 ⇒ 学習してできたText Encoderや Image Encoderは、 良い特徴量抽出器になっている
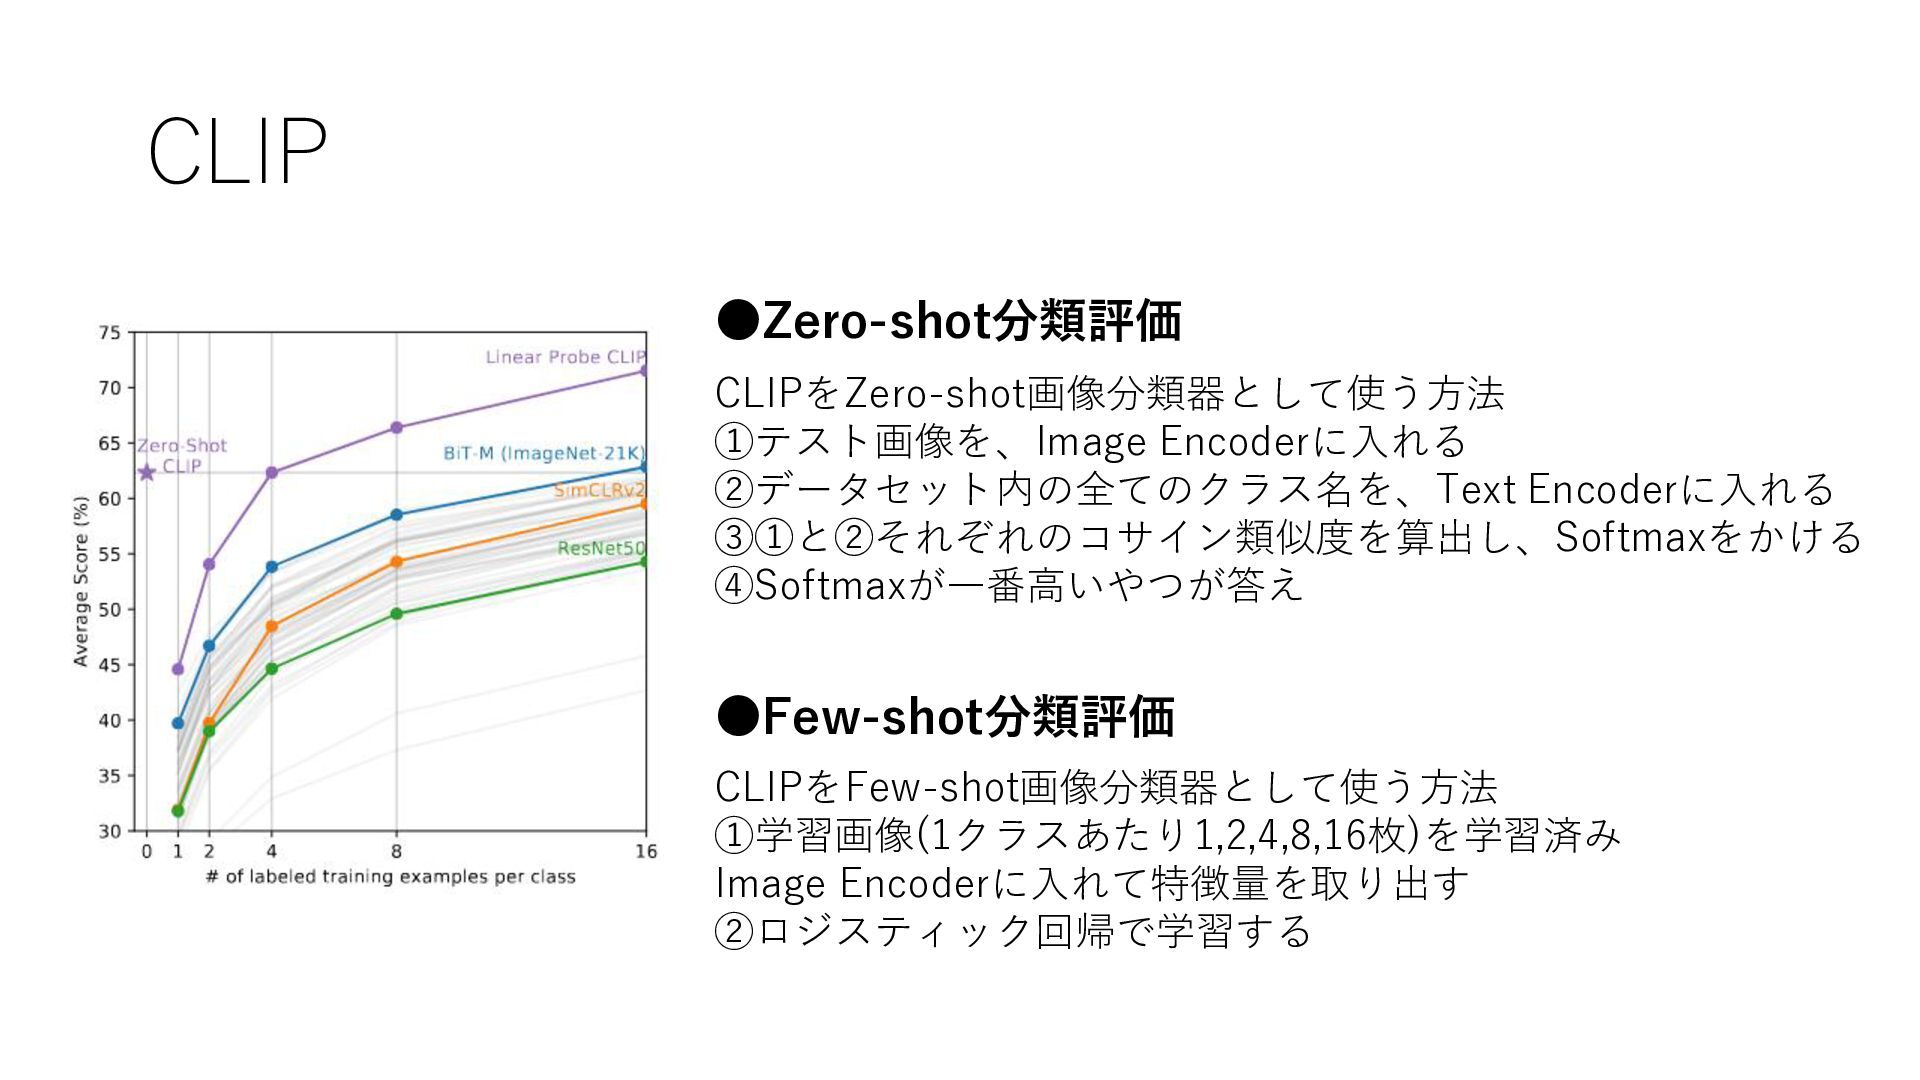
CLIP •Few-shot分類評価 CLIPをFew-shot画像分類器として使う方法 ①学習画像(1クラスあたり1,2,4,8,16枚)を学習済み Image Encoderに入れて特徴量を取り出す ②ロジスティック回帰で学習する •Zero-shot分類評価 CLIPをZero-shot画像分類器として使う方法 ①テスト画像を、Image
Encoderに入れる ②データセット内の全てのクラス名を、Text Encoderに入れる ③①と②それぞれのコサイン類似度を算出し、Softmaxをかける ④Softmaxが一番高いやつが答え
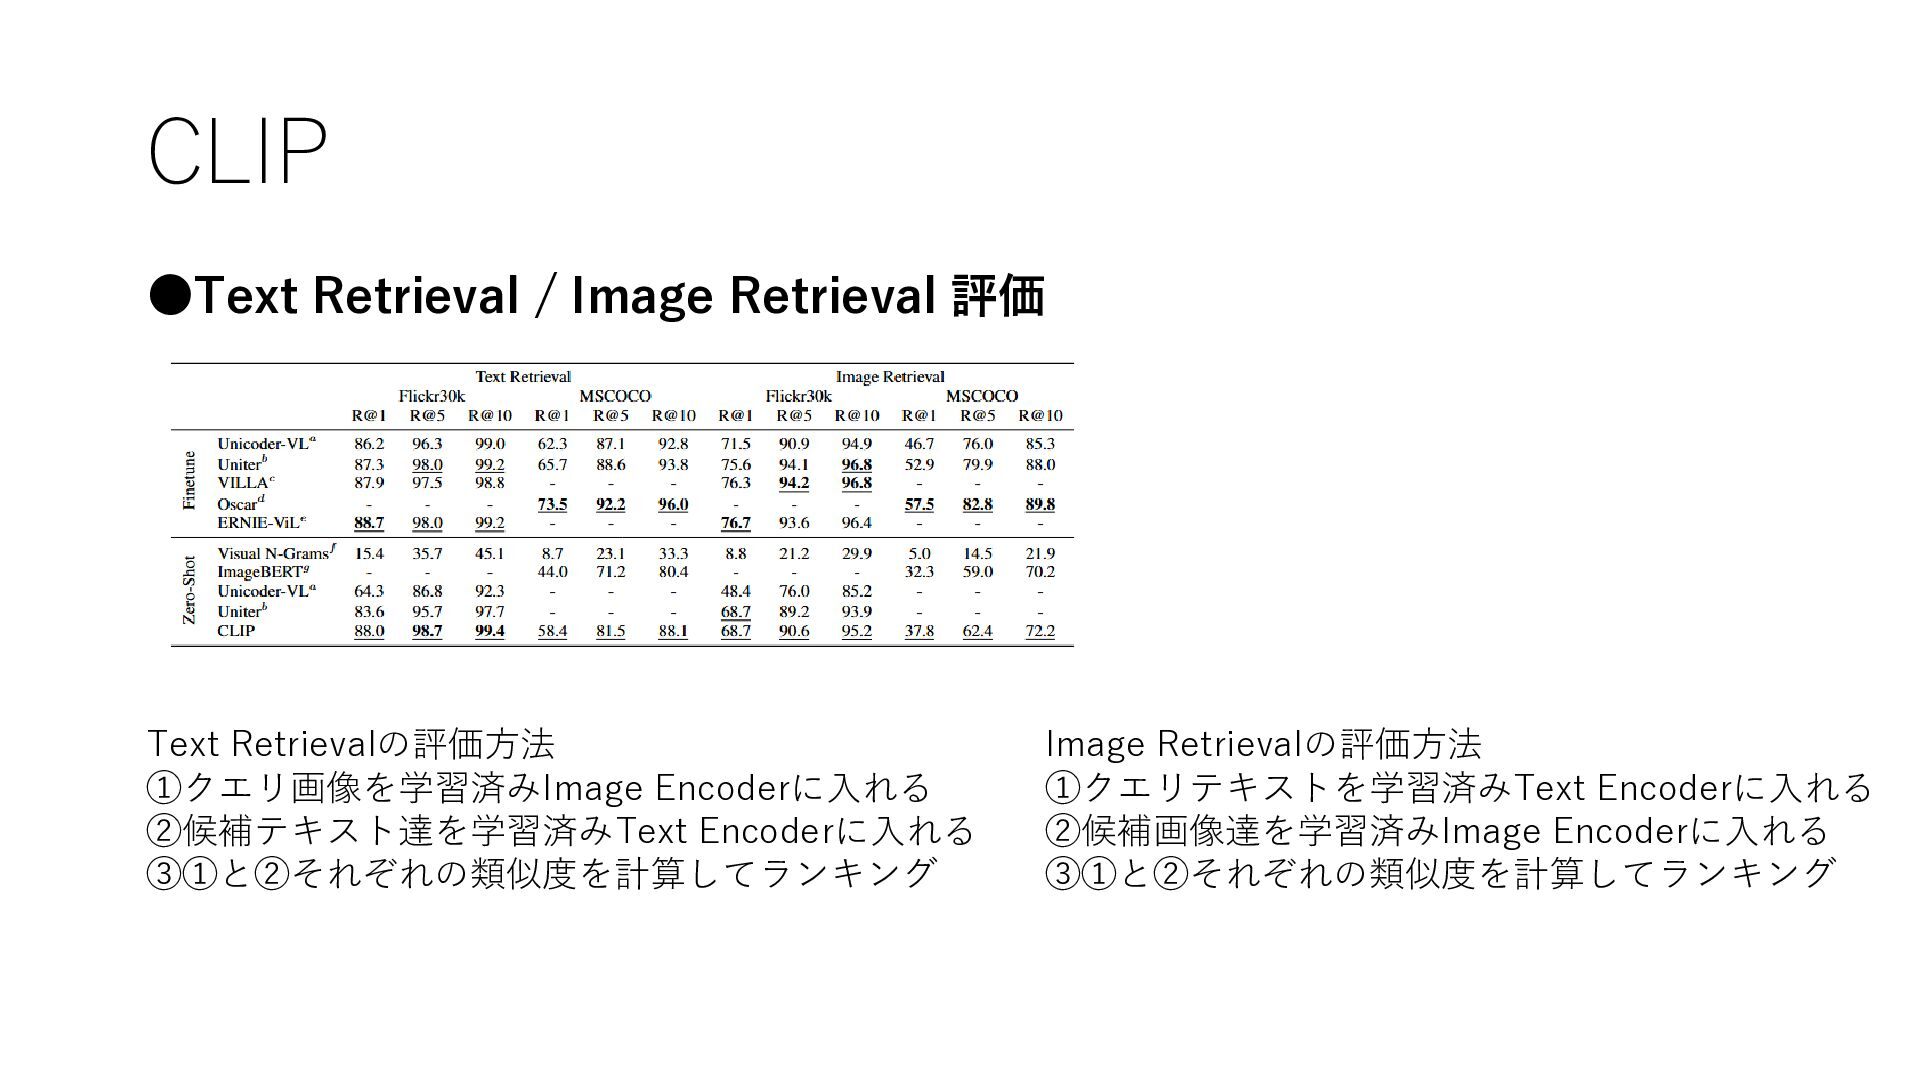
CLIP •Text Retrieval / Image Retrieval 評価 Text Retrievalの評価方法 ①クエリ画像を学習済みImage
Encoderに入れる ②候補テキスト達を学習済みText Encoderに入れる ③①と②それぞれの類似度を計算してランキング Image Retrievalの評価方法 ①クエリテキストを学習済みText Encoderに入れる ②候補画像達を学習済みImage Encoderに入れる ③①と②それぞれの類似度を計算してランキング
LLaVA •書誌情報 [2304.08485] Visual Instruction Tuning 研究機関:Microsoft •何をするもの? LLMで画像とテキストのマルチモーダル学習するシンプルな方法 強力なマルチモーダルチャット機能を実現
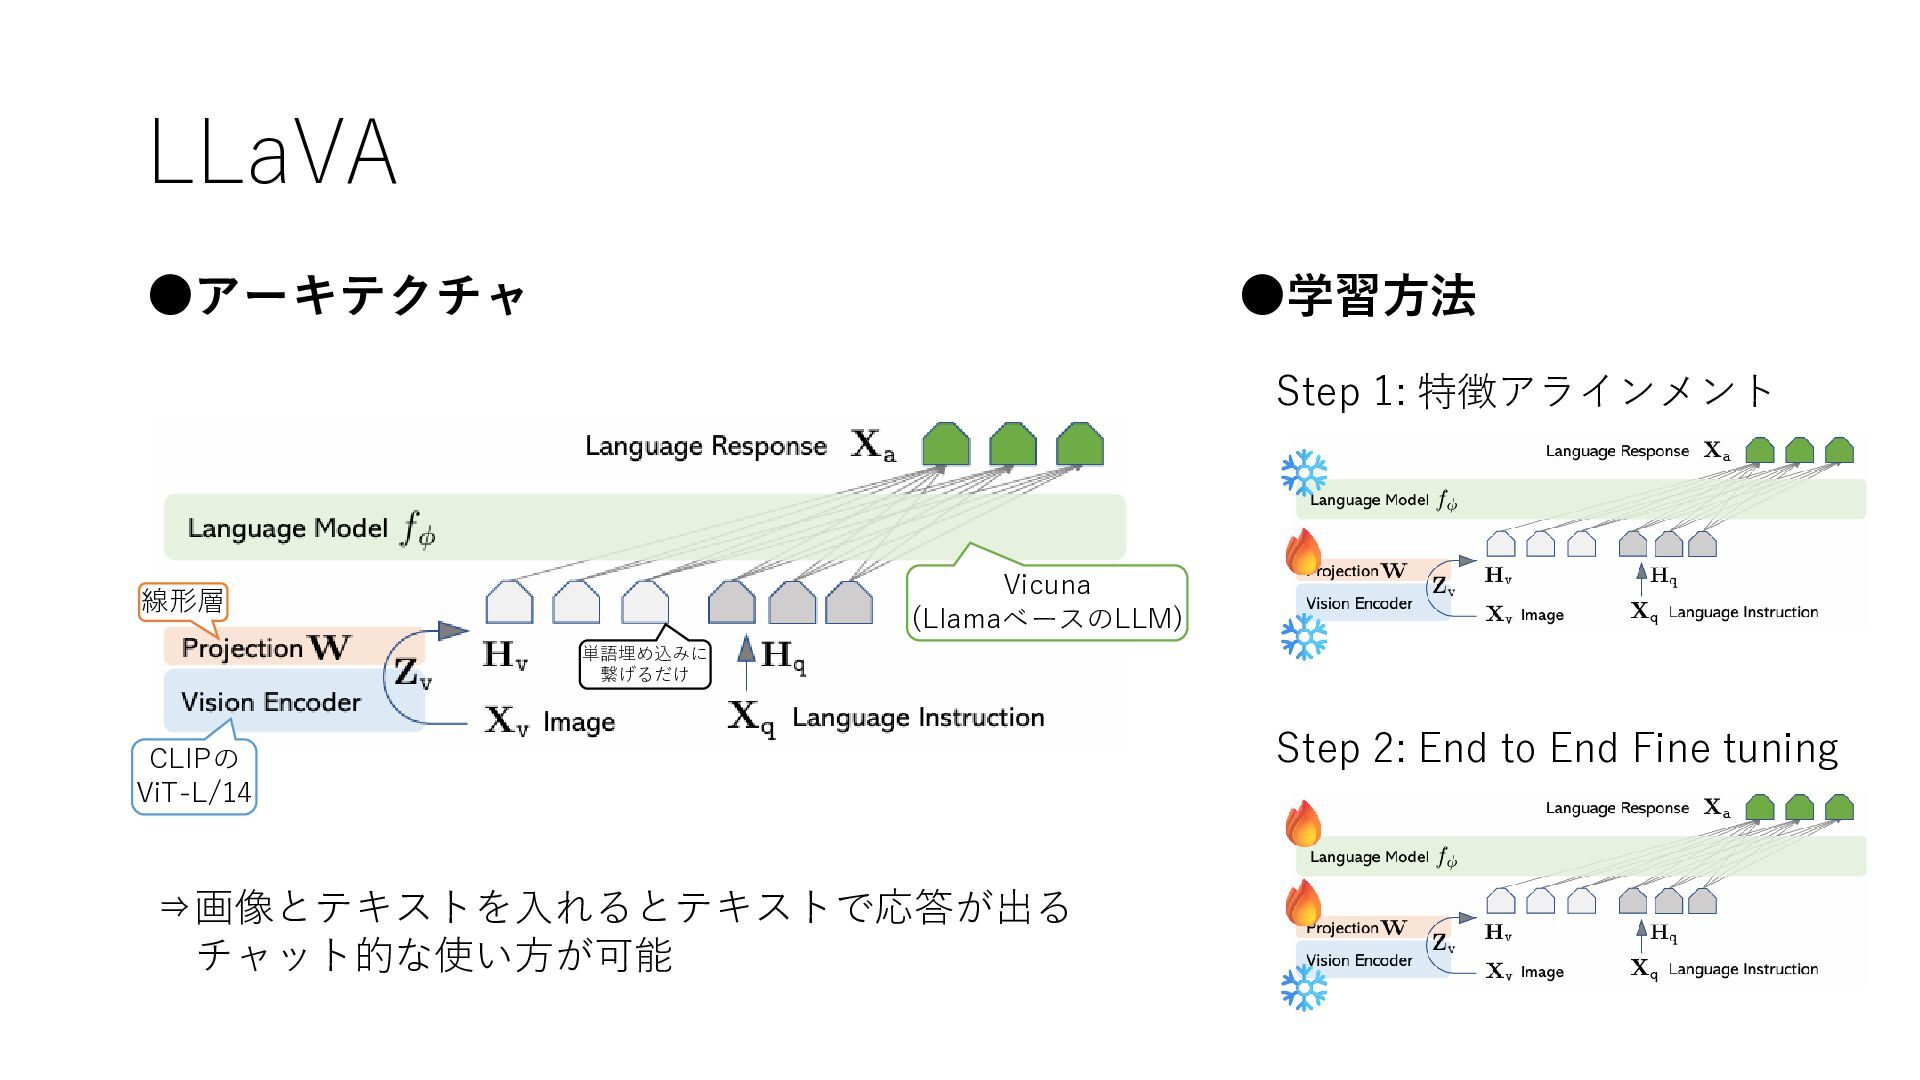
LLaVA •アーキテクチャ CLIPの ViT-L/14 Vicuna (LlamaベースのLLM) 線形層 単語埋め込みに 繋げるだけ •学習方法
Step 1: 特徴アラインメント Step 2: End to End Fine tuning ⇒画像とテキストを入れるとテキストで応答が出る チャット的な使い方が可能
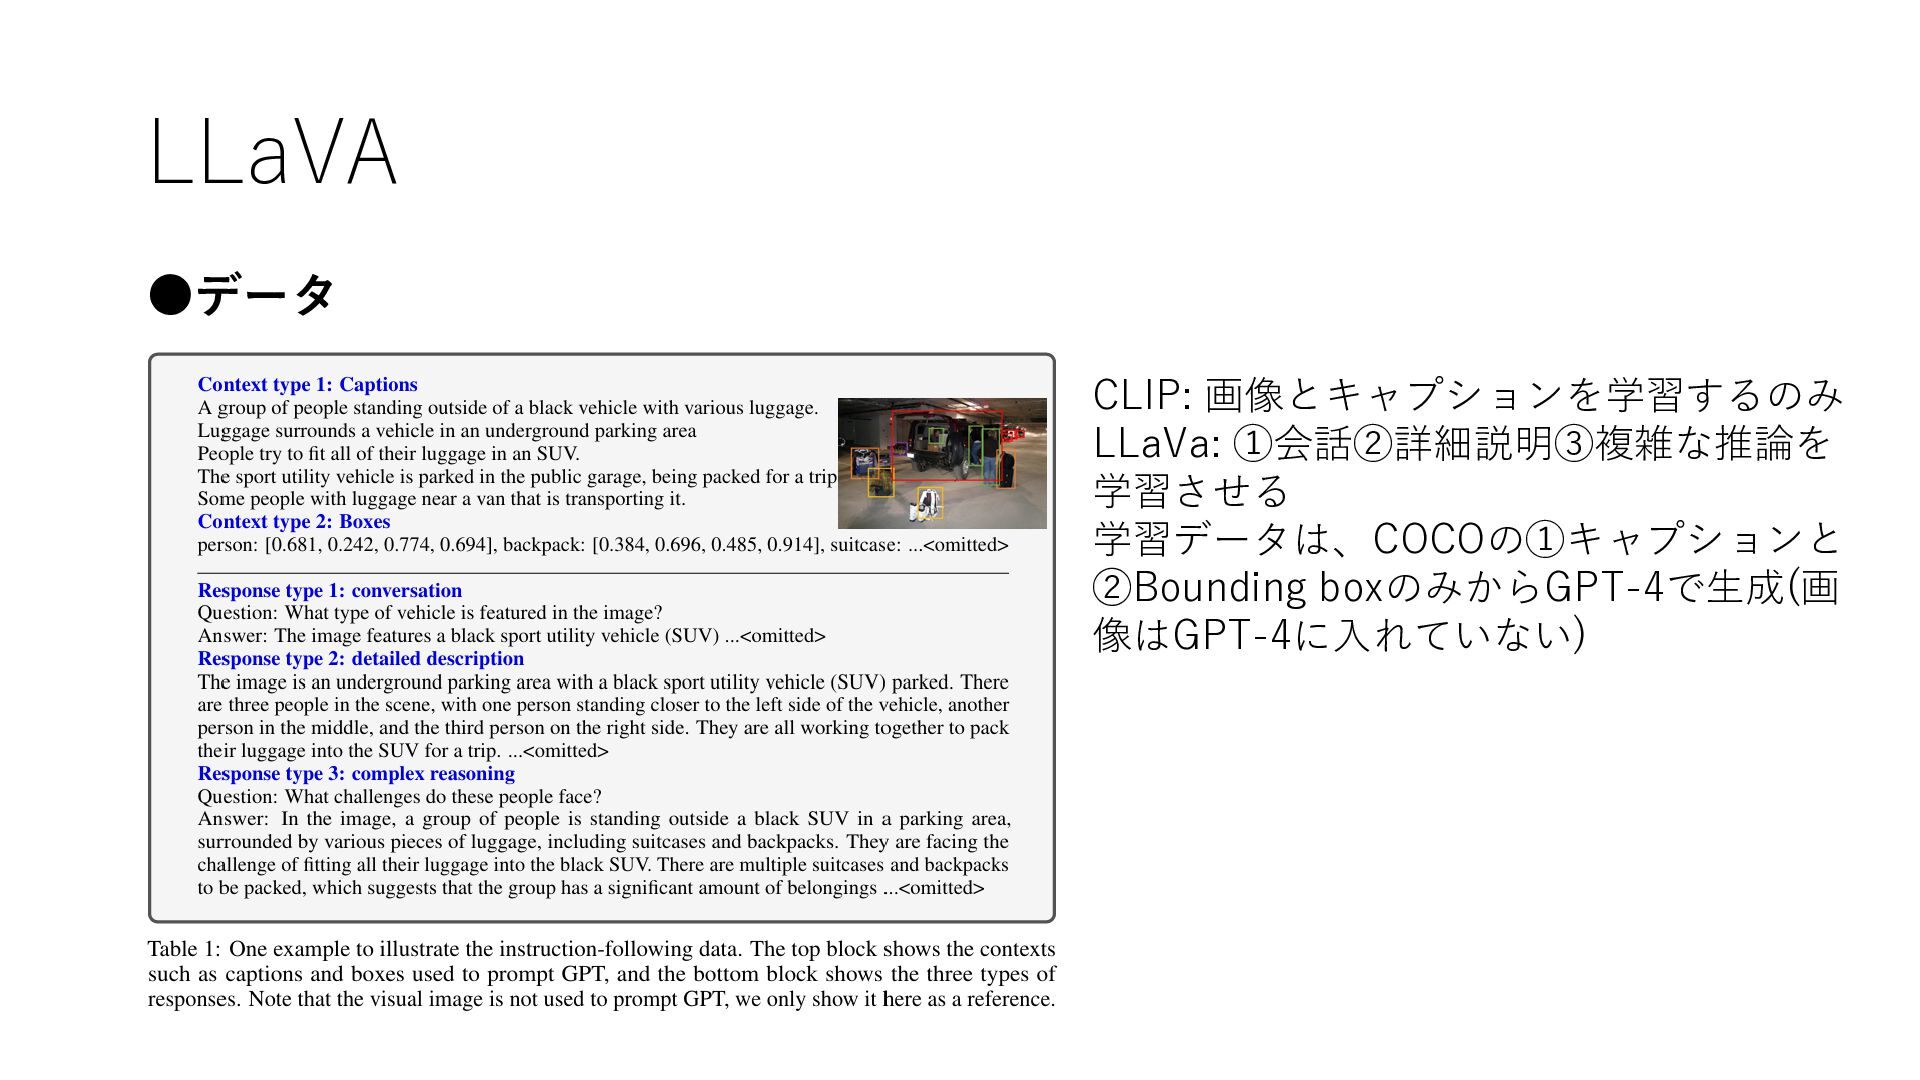
LLaVA •データ CLIP: 画像とキャプションを学習するのみ LLaVa: ①会話②詳細説明③複雑な推論を 学習させる 学習データは、COCOの①キャプションと ②Bounding boxのみからGPT-4で生成(画
像はGPT-4に入れていない)
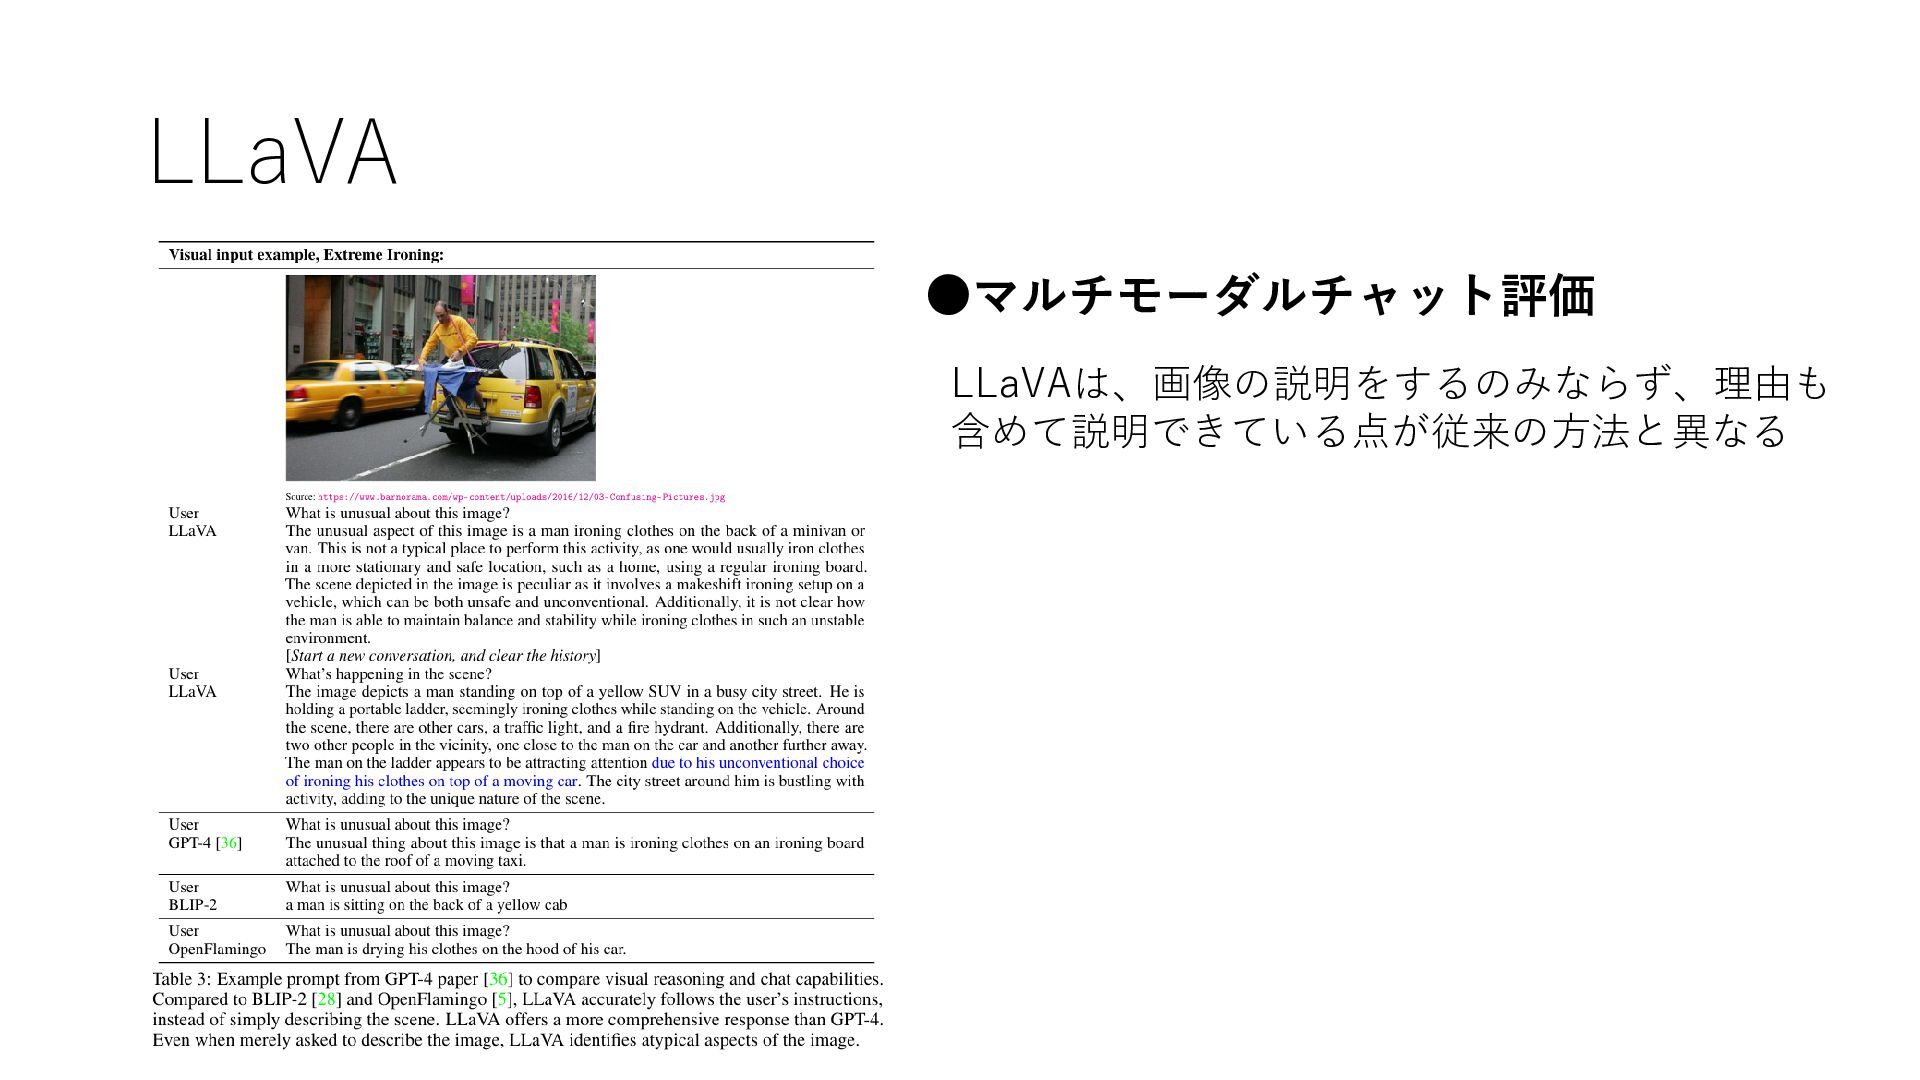
LLaVA LLaVAは、画像の説明をするのみならず、理由も 含めて説明できている点が従来の方法と異なる •マルチモーダルチャット評価
Penguin-VL •書誌情報 [2603.06569] Penguin-VL: Exploring the Efficiency Limits of VLM
with LLM-based Vision Encoders 研究機関:Tencent プロジェクトページ:Penguin-VL •何をするもの? CLIPベースの画像エンコーダを使わないVLM
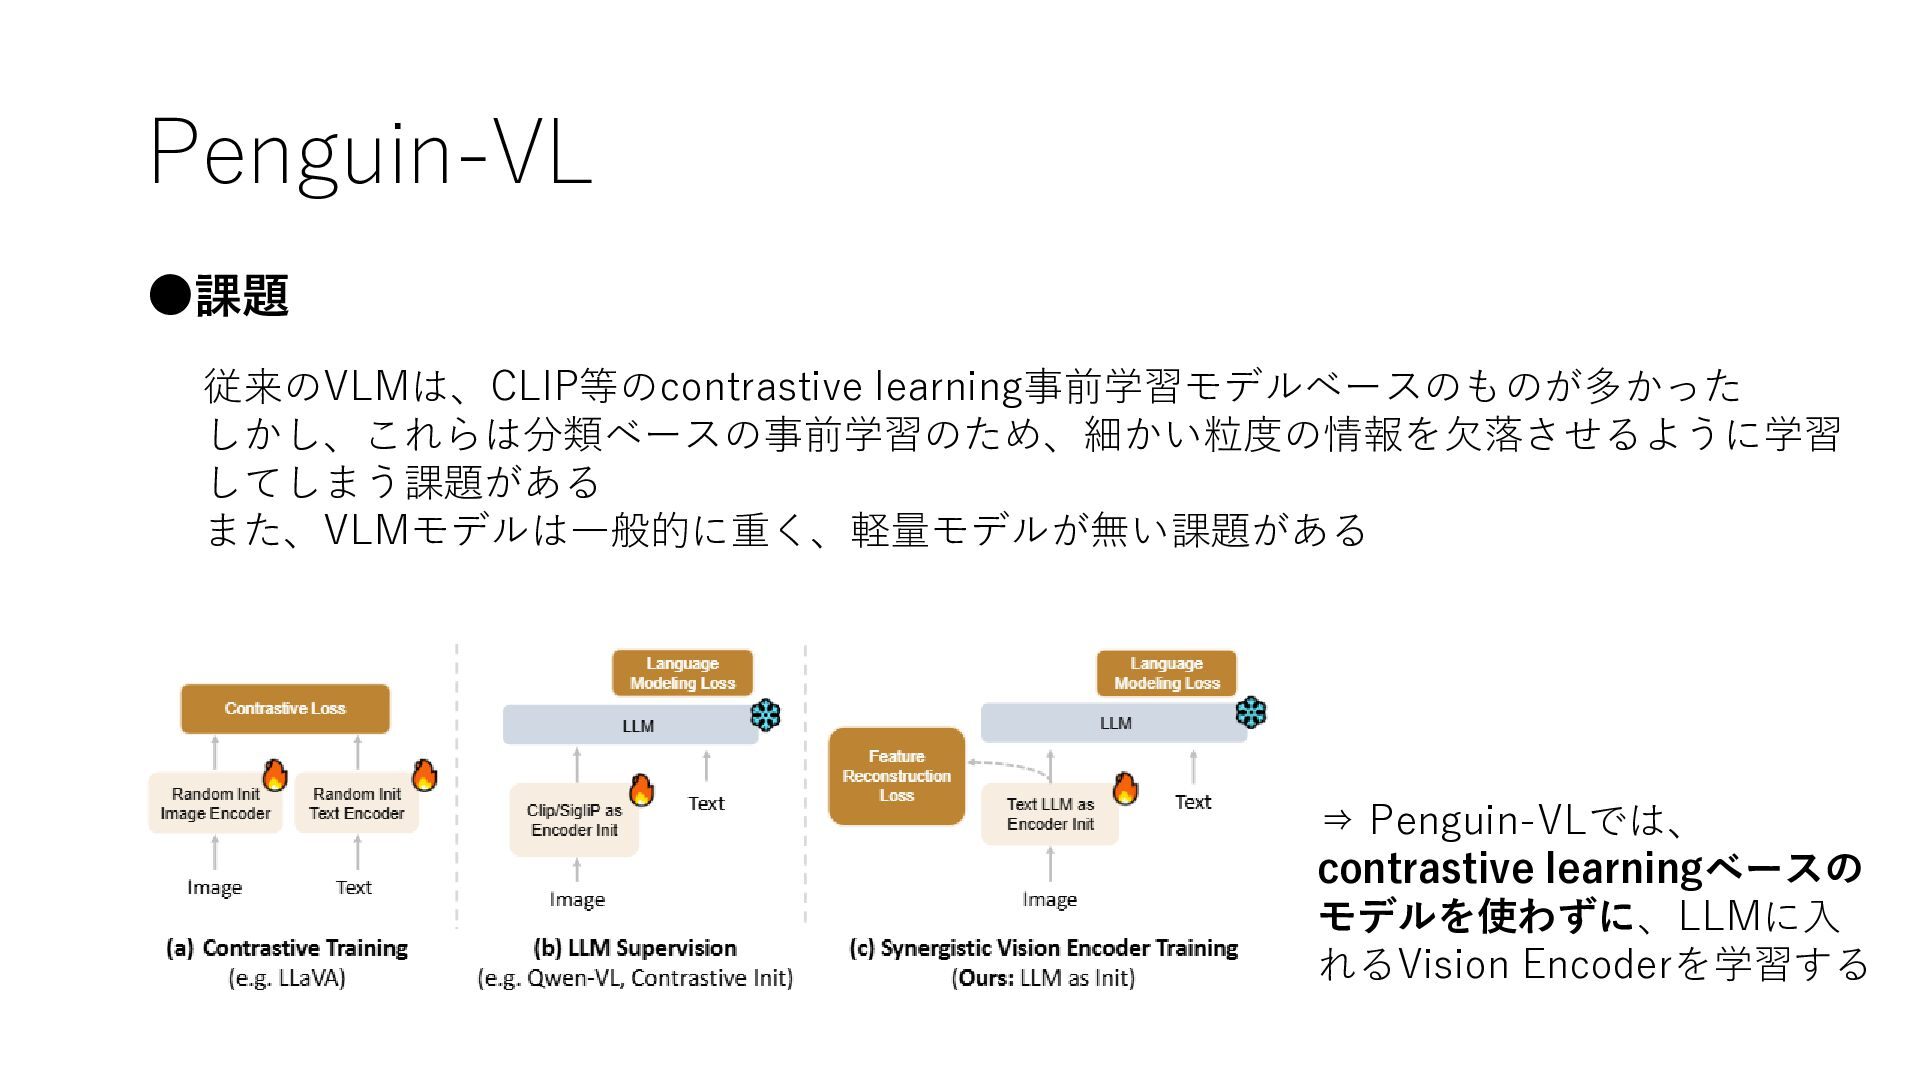
Penguin-VL •課題 従来のVLMは、CLIP等のcontrastive learning事前学習モデルベースのものが多かった しかし、これらは分類ベースの事前学習のため、細かい粒度の情報を欠落させるように学習 してしまう課題がある また、VLMモデルは一般的に重く、軽量モデルが無い課題がある ⇒ Penguin-VLでは、 contrastive
learningベースの モデルを使わずに、LLMに入 れるVision Encoderを学習する
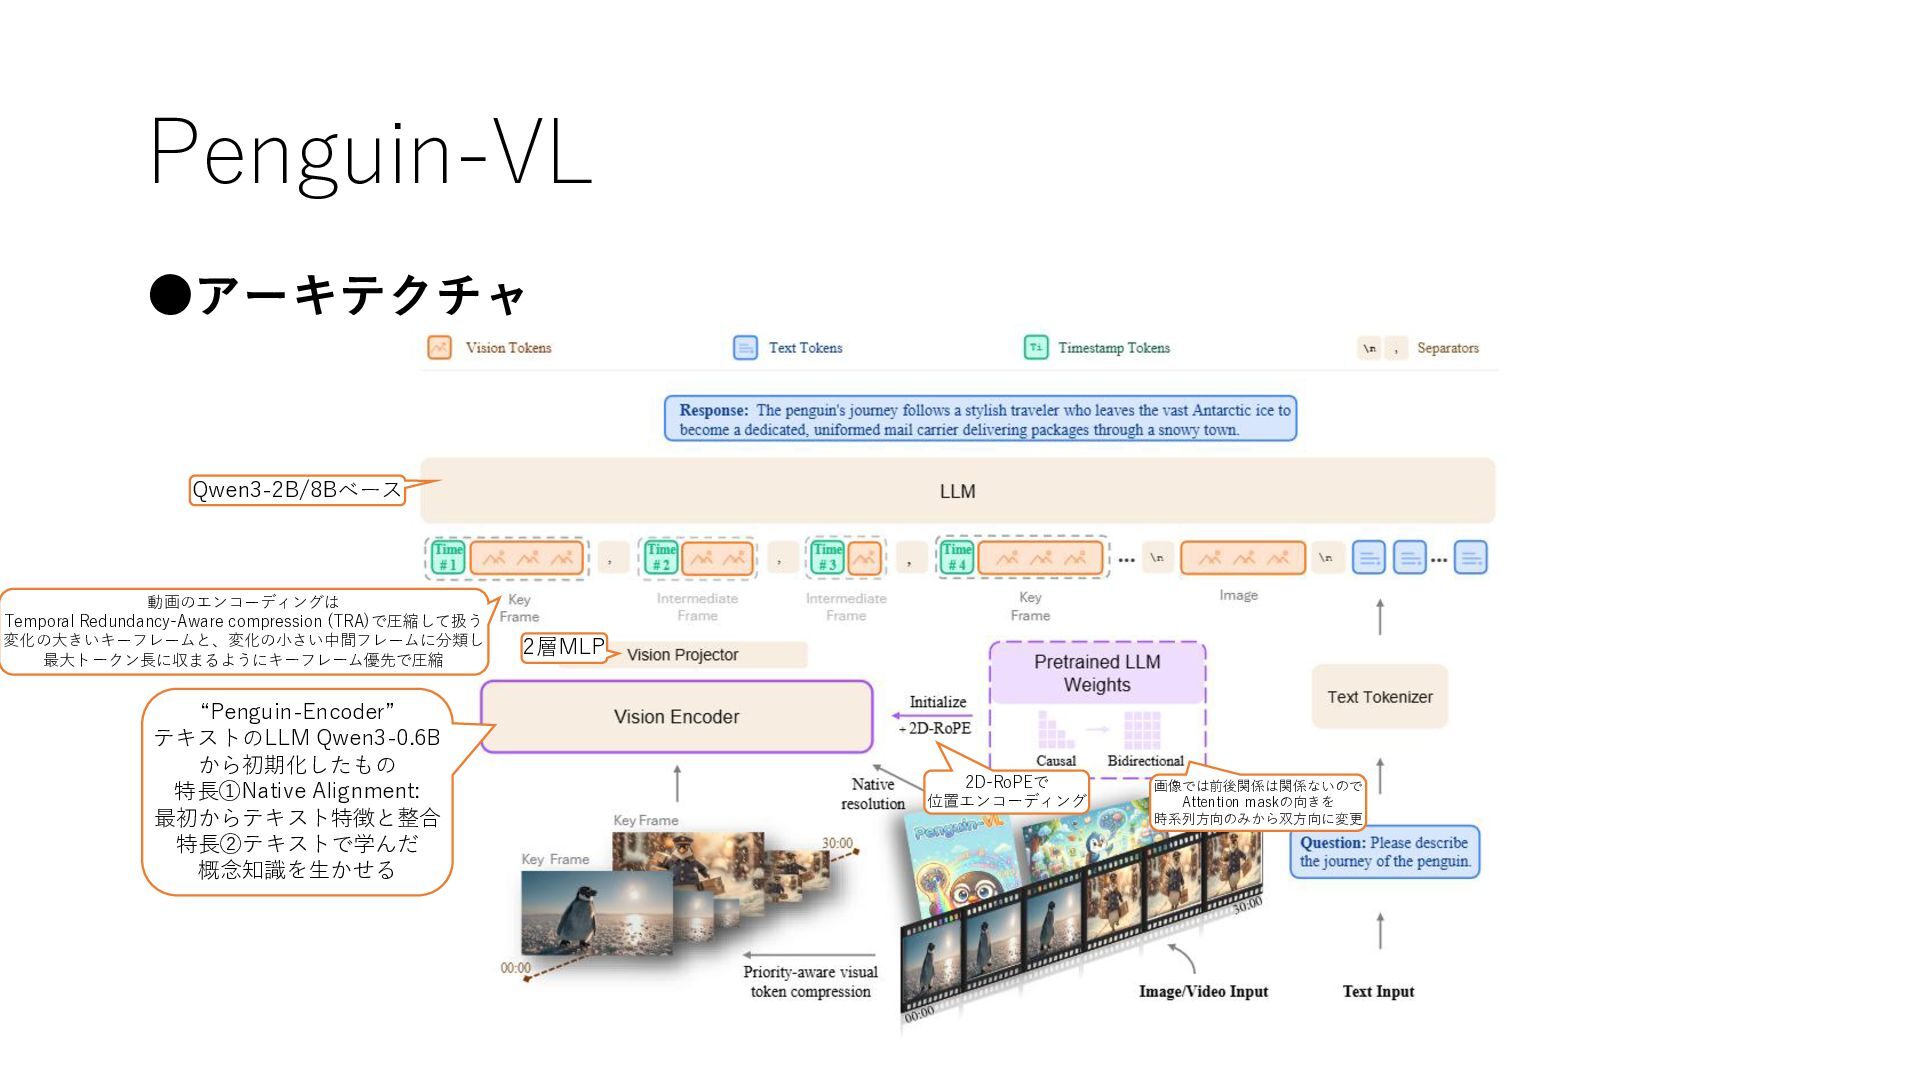
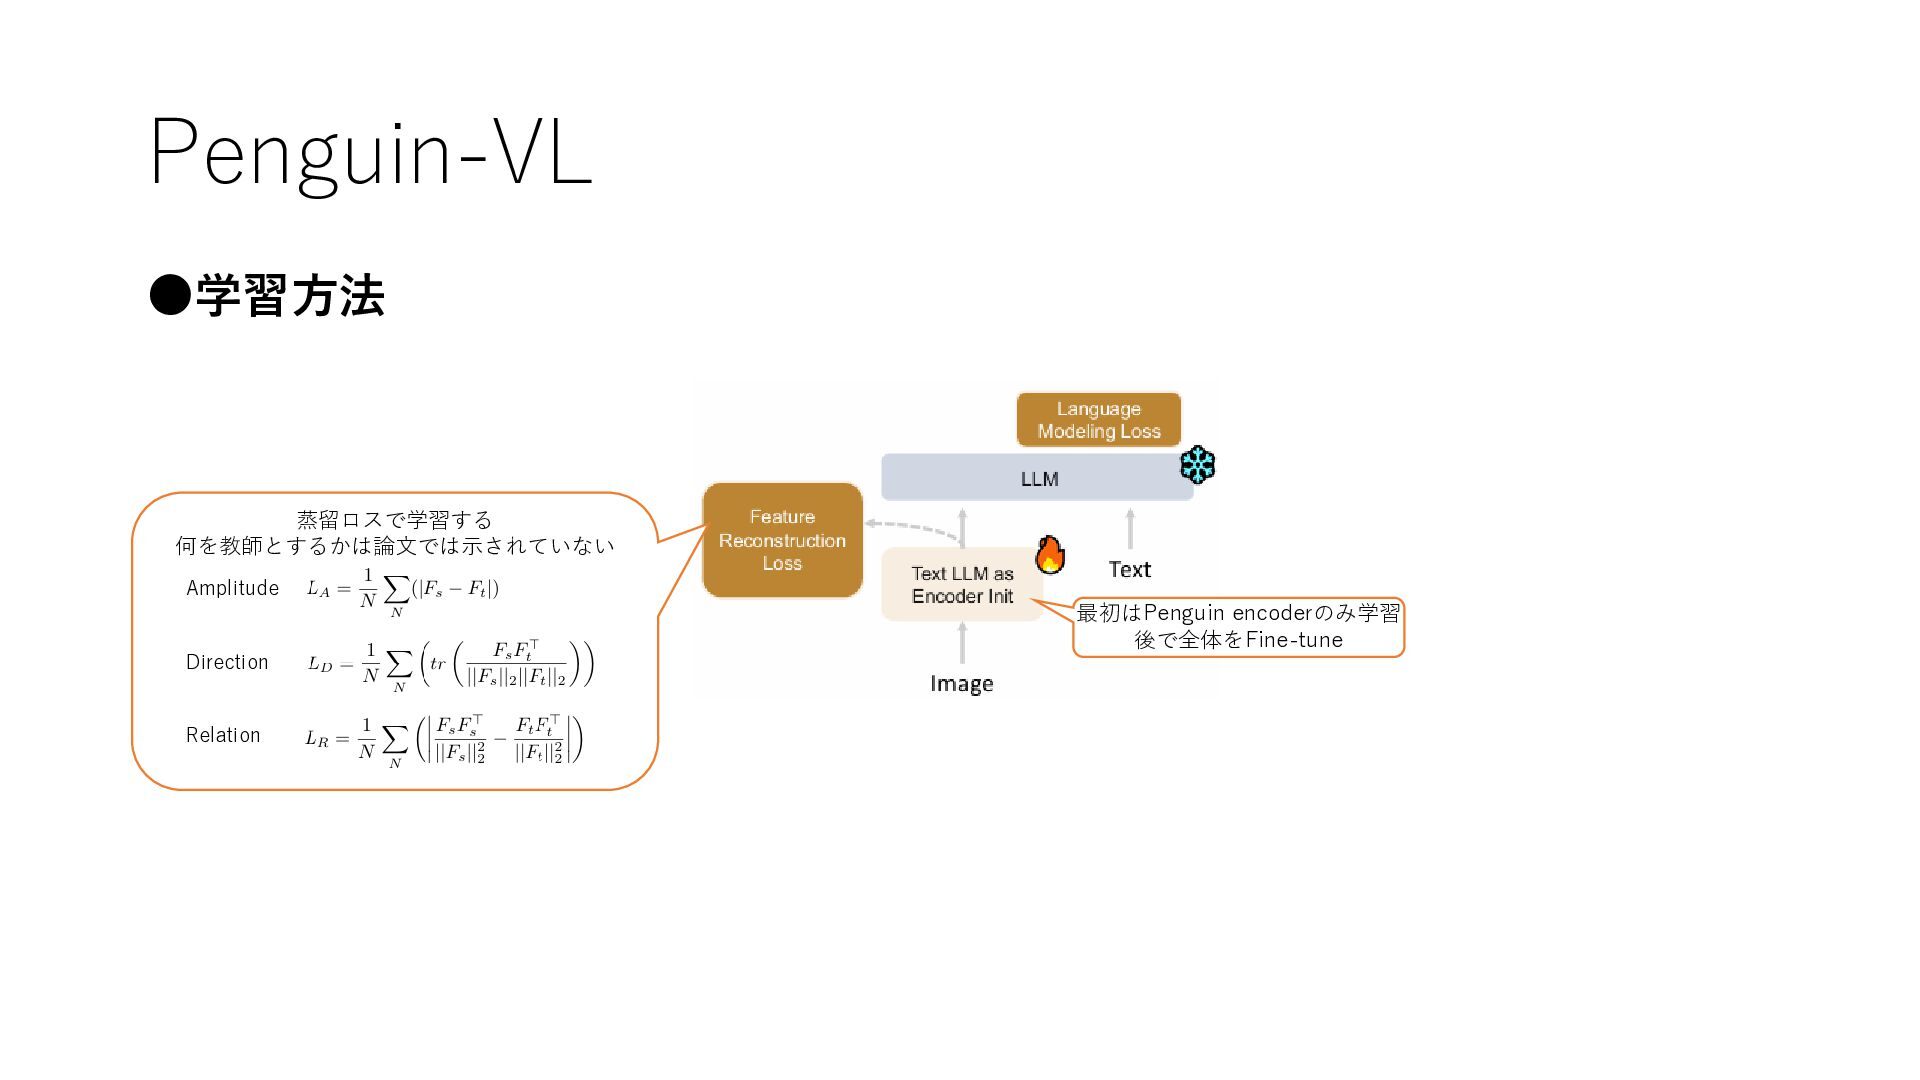
Penguin-VL •アーキテクチャ “Penguin-Encoder” テキストのLLM Qwen3-0.6B から初期化したもの 特長①Native Alignment: 最初からテキスト特徴と整合 特長②テキストで学んだ
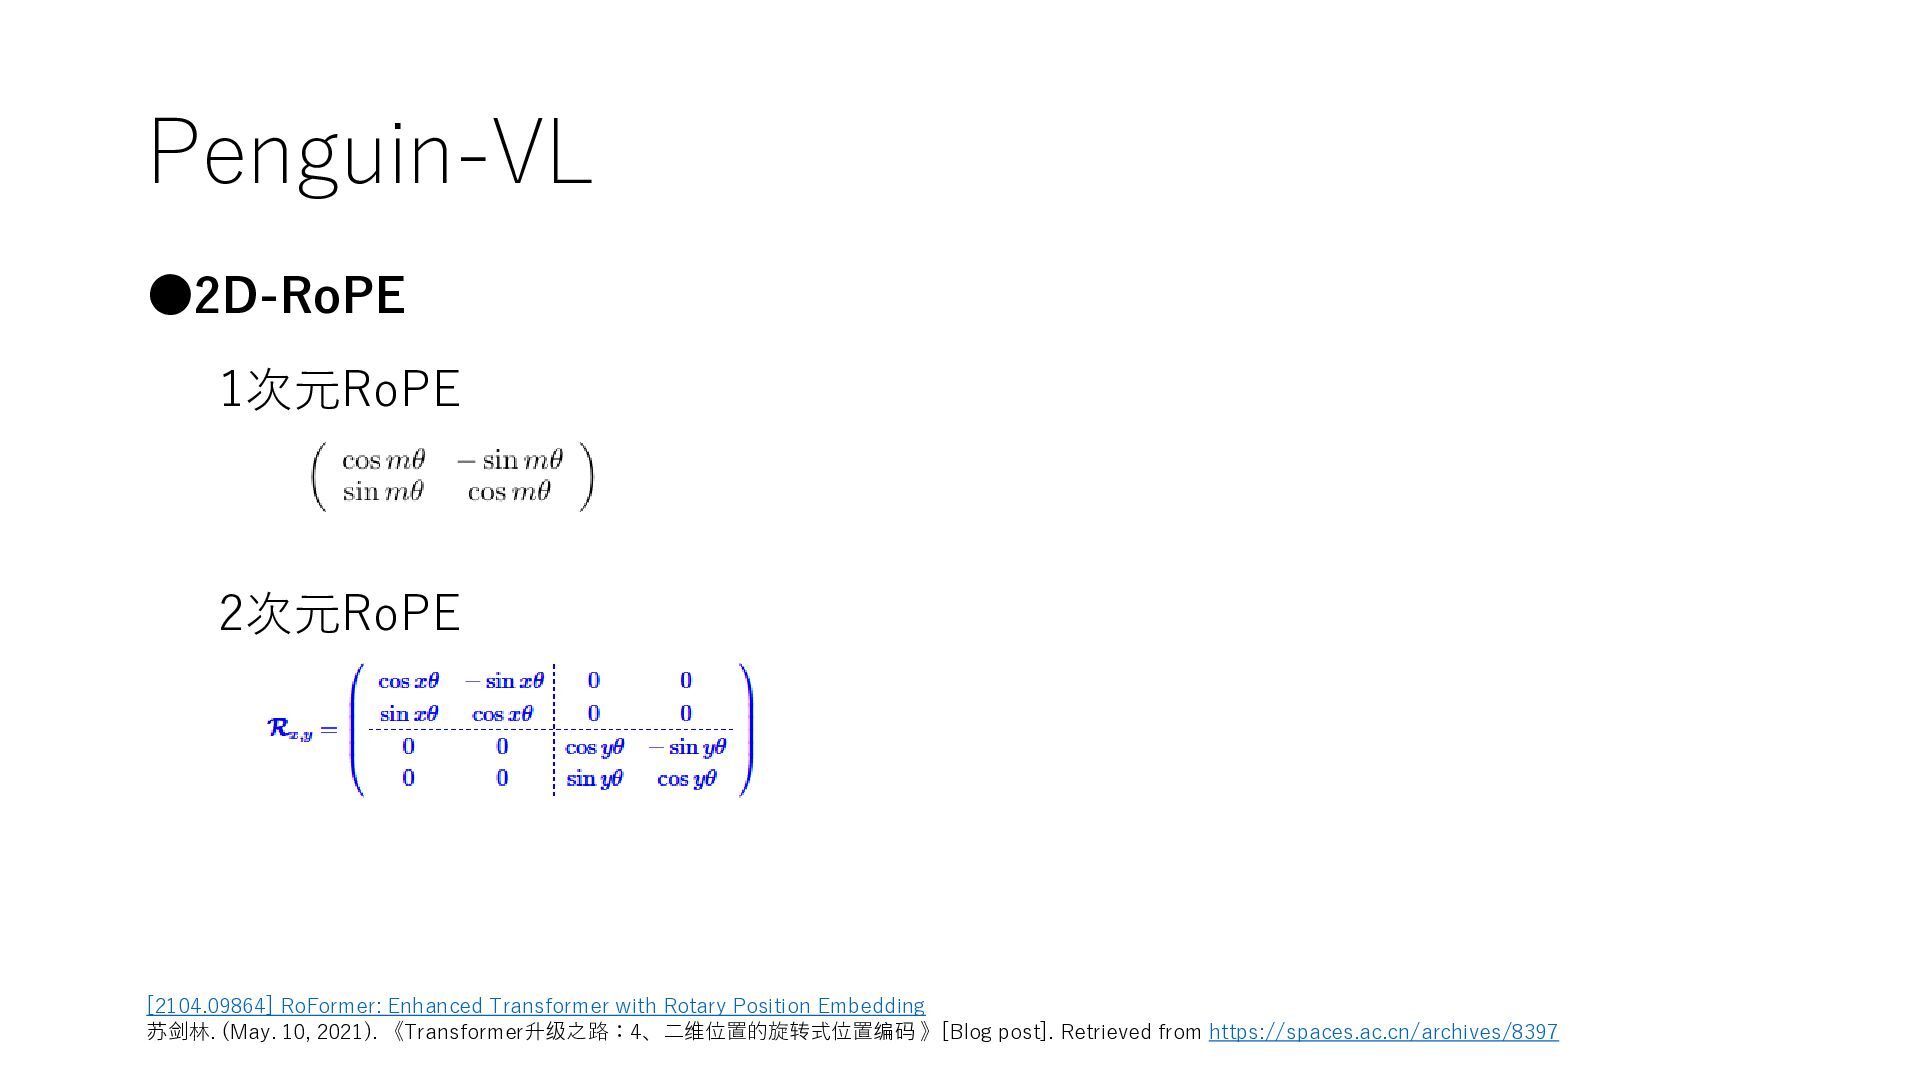
概念知識を生かせる 画像では前後関係は関係ないので Attention maskの向きを 時系列方向のみから双方向に変更 2D-RoPEで 位置エンコーディング 動画のエンコーディングは Temporal Redundancy-Aware compression (TRA)で圧縮して扱う 変化の大きいキーフレームと、変化の小さい中間フレームに分類し 最大トークン長に収まるようにキーフレーム優先で圧縮 Qwen3-2B/8Bベース 2層MLP
Penguin-VL •2D-RoPE 1次元RoPE [2104.09864] RoFormer: Enhanced Transformer with Rotary Position
Embedding 苏剑林. (May. 10, 2021). 《Transformer升级之路:4、二维位置的旋转式位置编码 》[Blog post]. Retrieved from https://spaces.ac.cn/archives/8397 2次元RoPE
Penguin-VL •学習方法 最初はPenguin encoderのみ学習 後で全体をFine-tune 蒸留ロスで学習する 何を教師とするかは論文では示されていない Amplitude Direction Relation
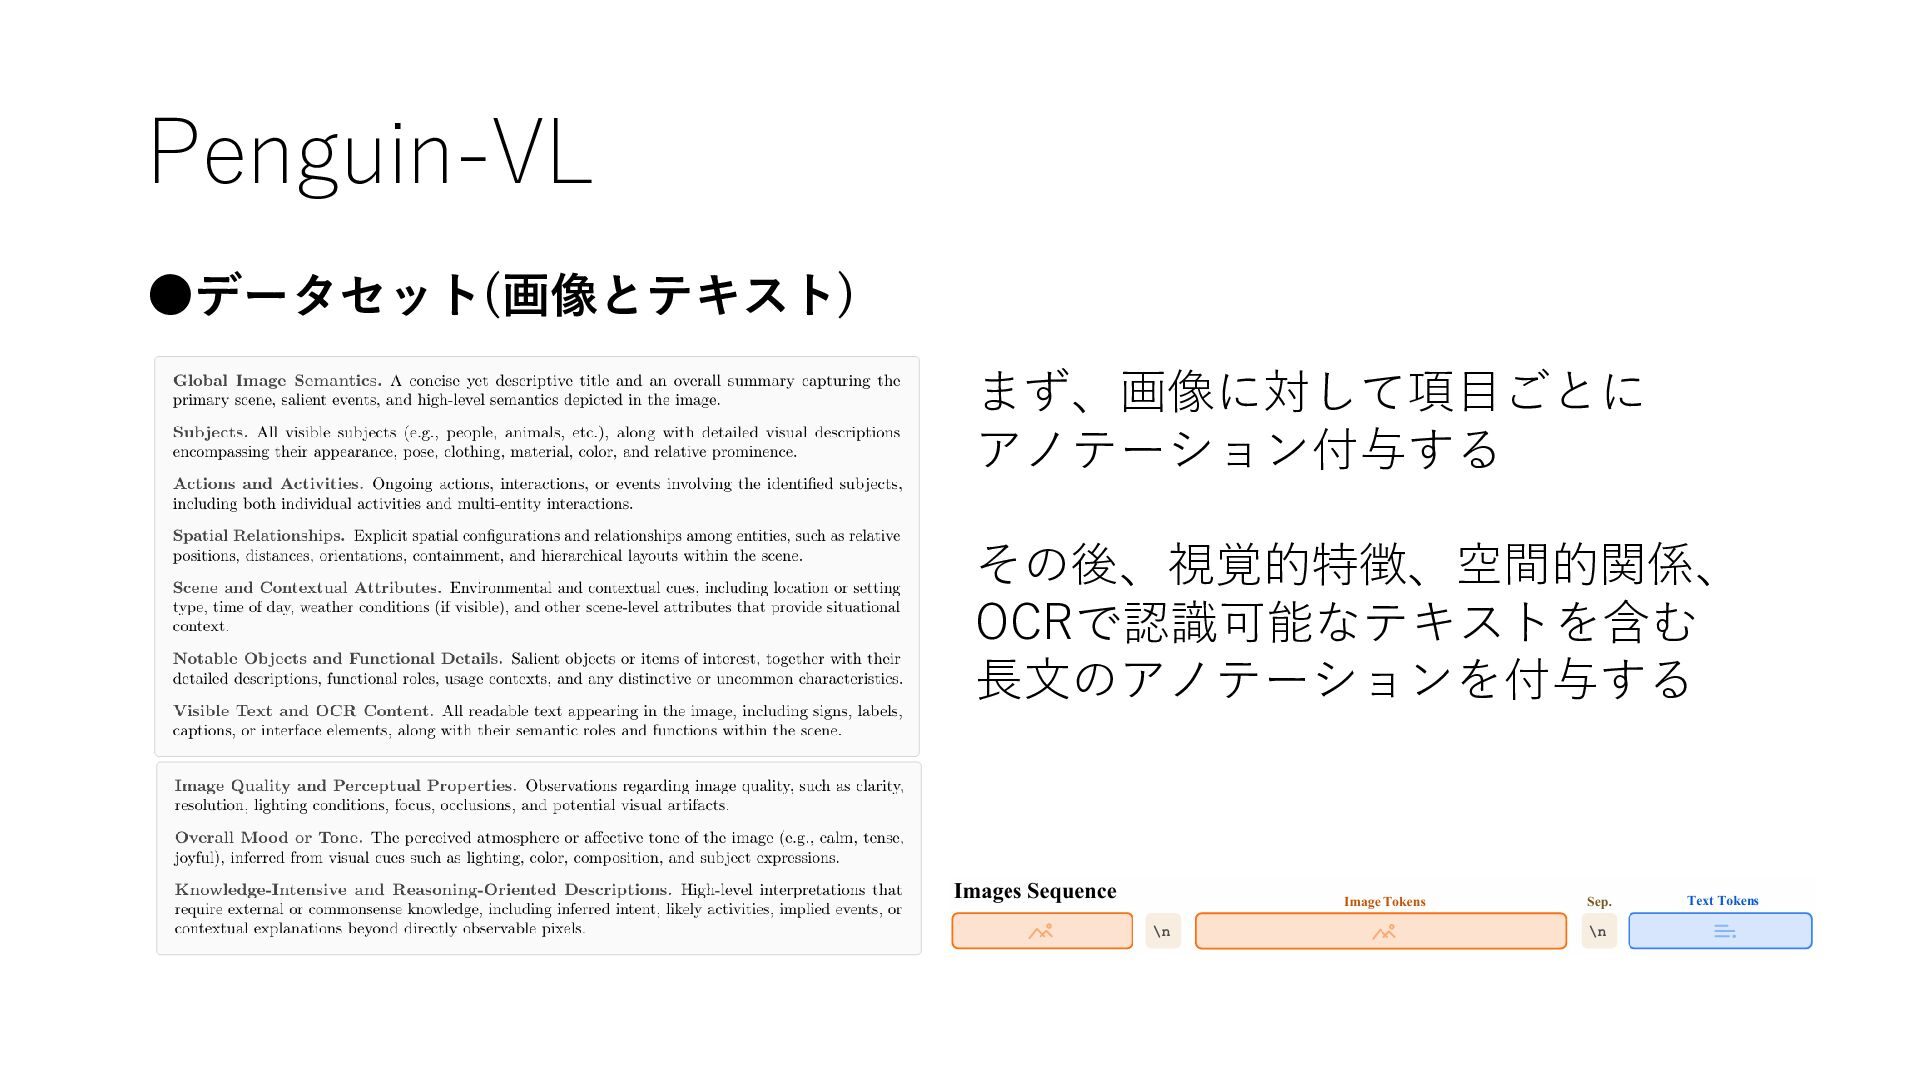
Penguin-VL •データセット(画像とテキスト) まず、画像に対して項目ごとに アノテーション付与する その後、視覚的特徴、空間的関係、 OCRで認識可能なテキストを含む 長文のアノテーションを付与する
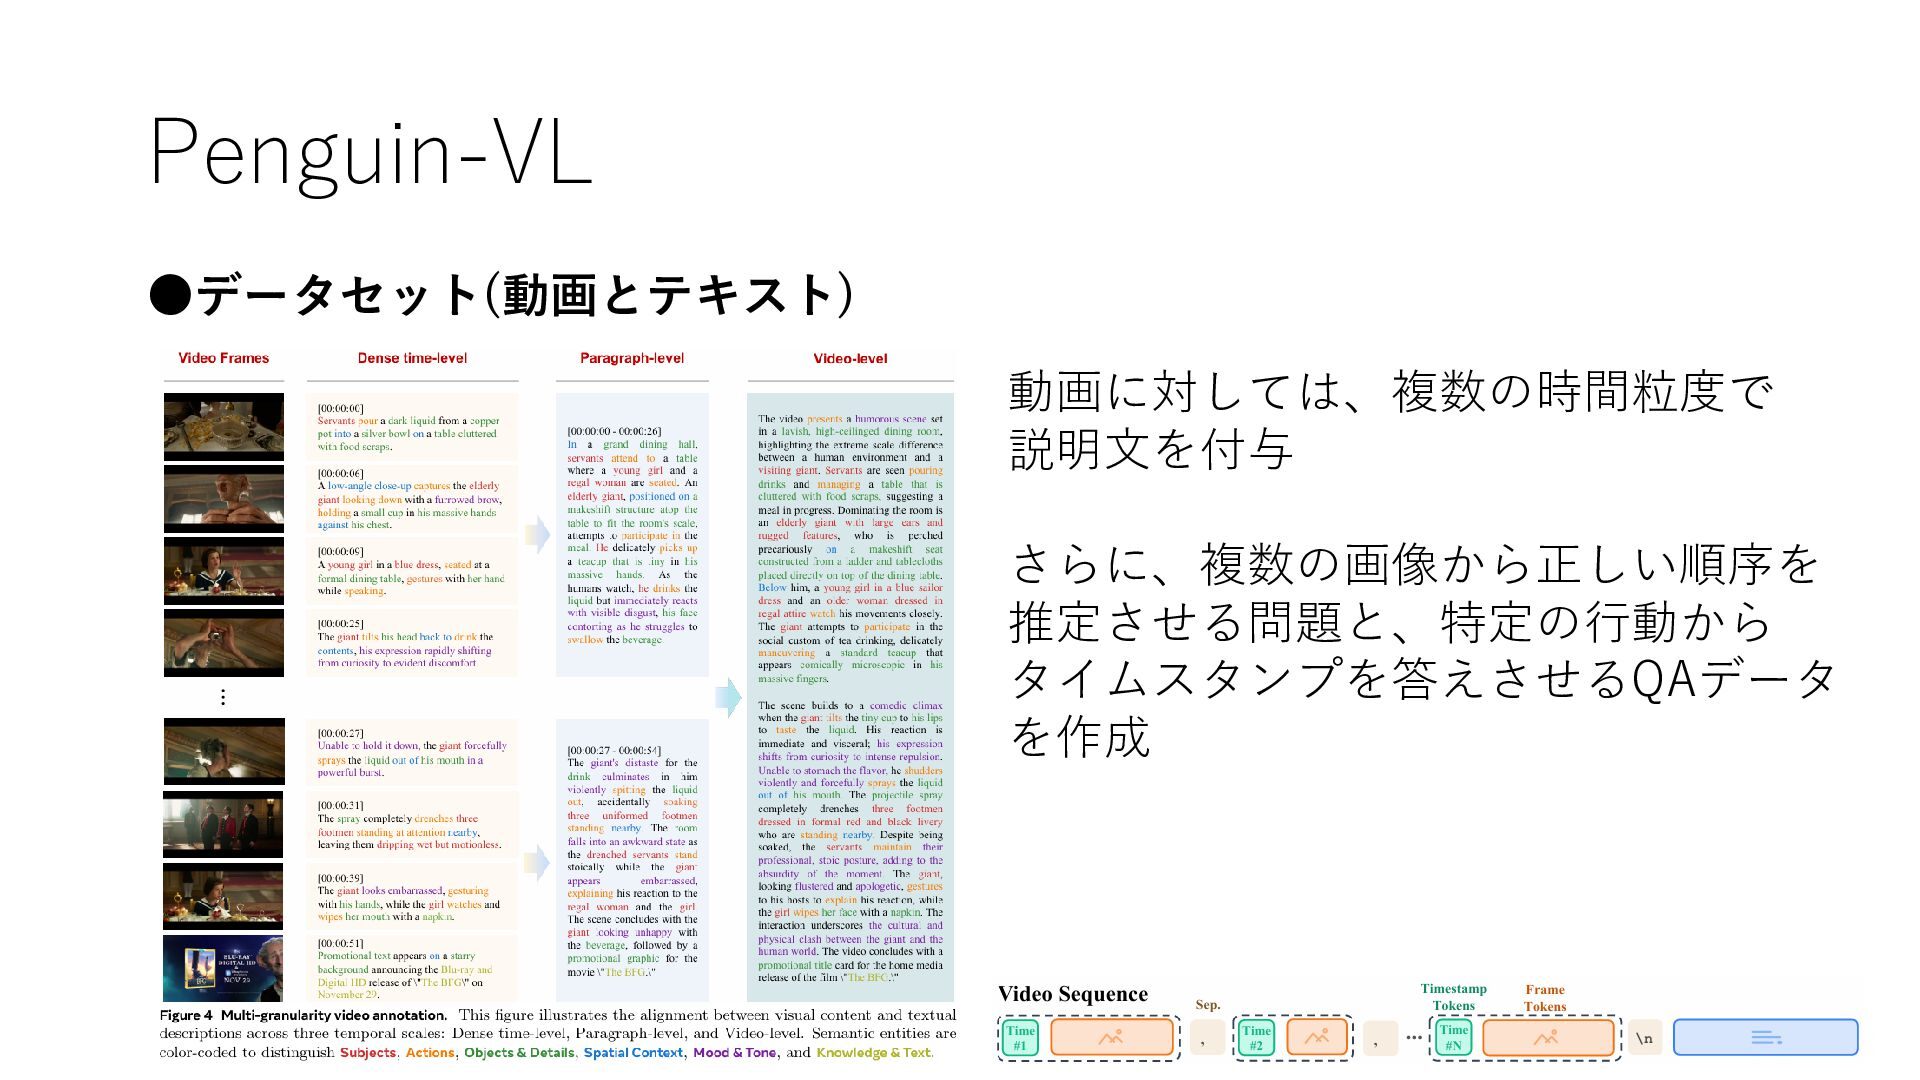
Penguin-VL •データセット(動画とテキスト) 動画に対しては、複数の時間粒度で 説明文を付与 さらに、複数の画像から正しい順序を 推定させる問題と、特定の行動から タイムスタンプを答えさせるQAデータ を作成
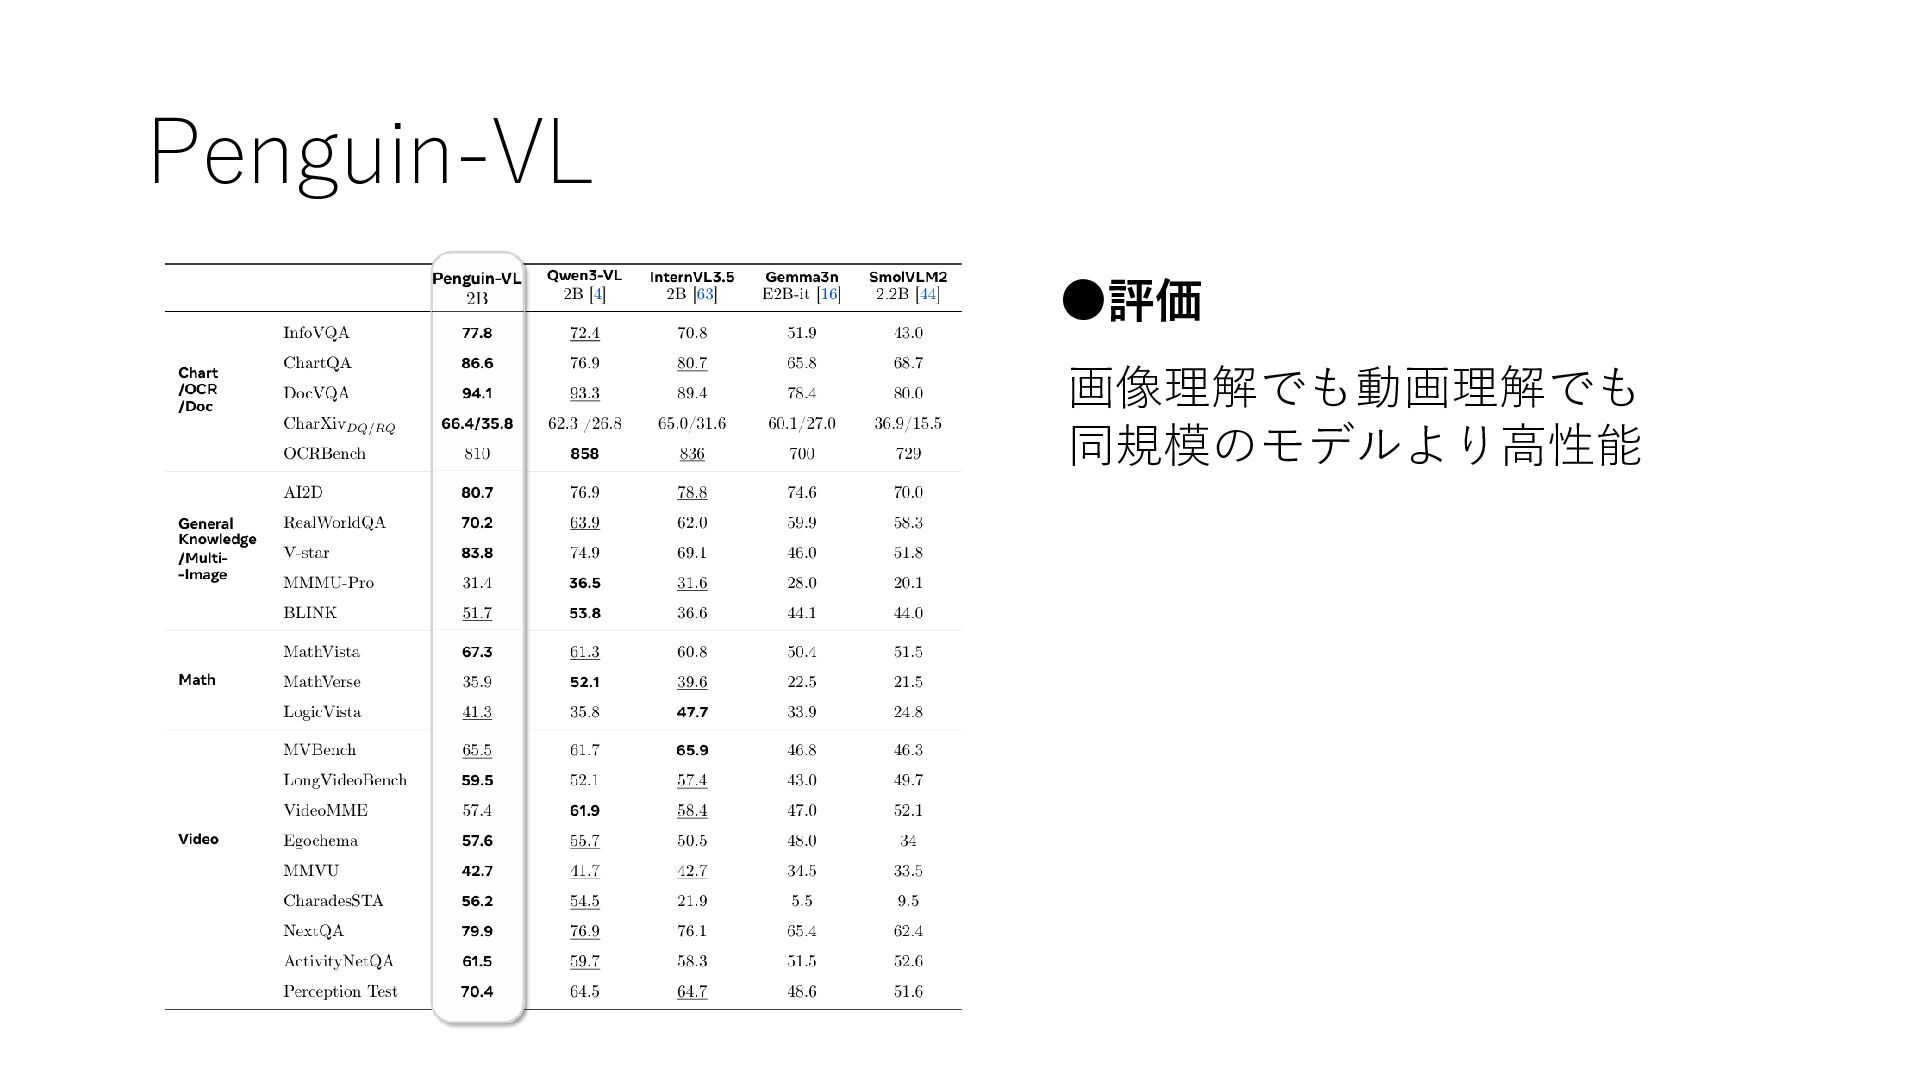
Penguin-VL •評価 画像理解でも動画理解でも 同規模のモデルより高性能
参考文献 • VLM視覚言語モデルの歴史整理(2025年9月まで) • alphaXiv


 kyad
 gree_tech
 raspython3
 usanchuu
 tomokusaba
 4o1sobblue
 genda
 yu23ki14
 pfn
 namiki64
 hiracky16
 daidaidai
 bitkey
 addyosmani
 lcolladotor
 skipperchong
 badams
 cassininazir
 carmenintech
 smashingmag
 axbom
 marcoroth
 tonyrice
 cargoodrich
 reverentgeek