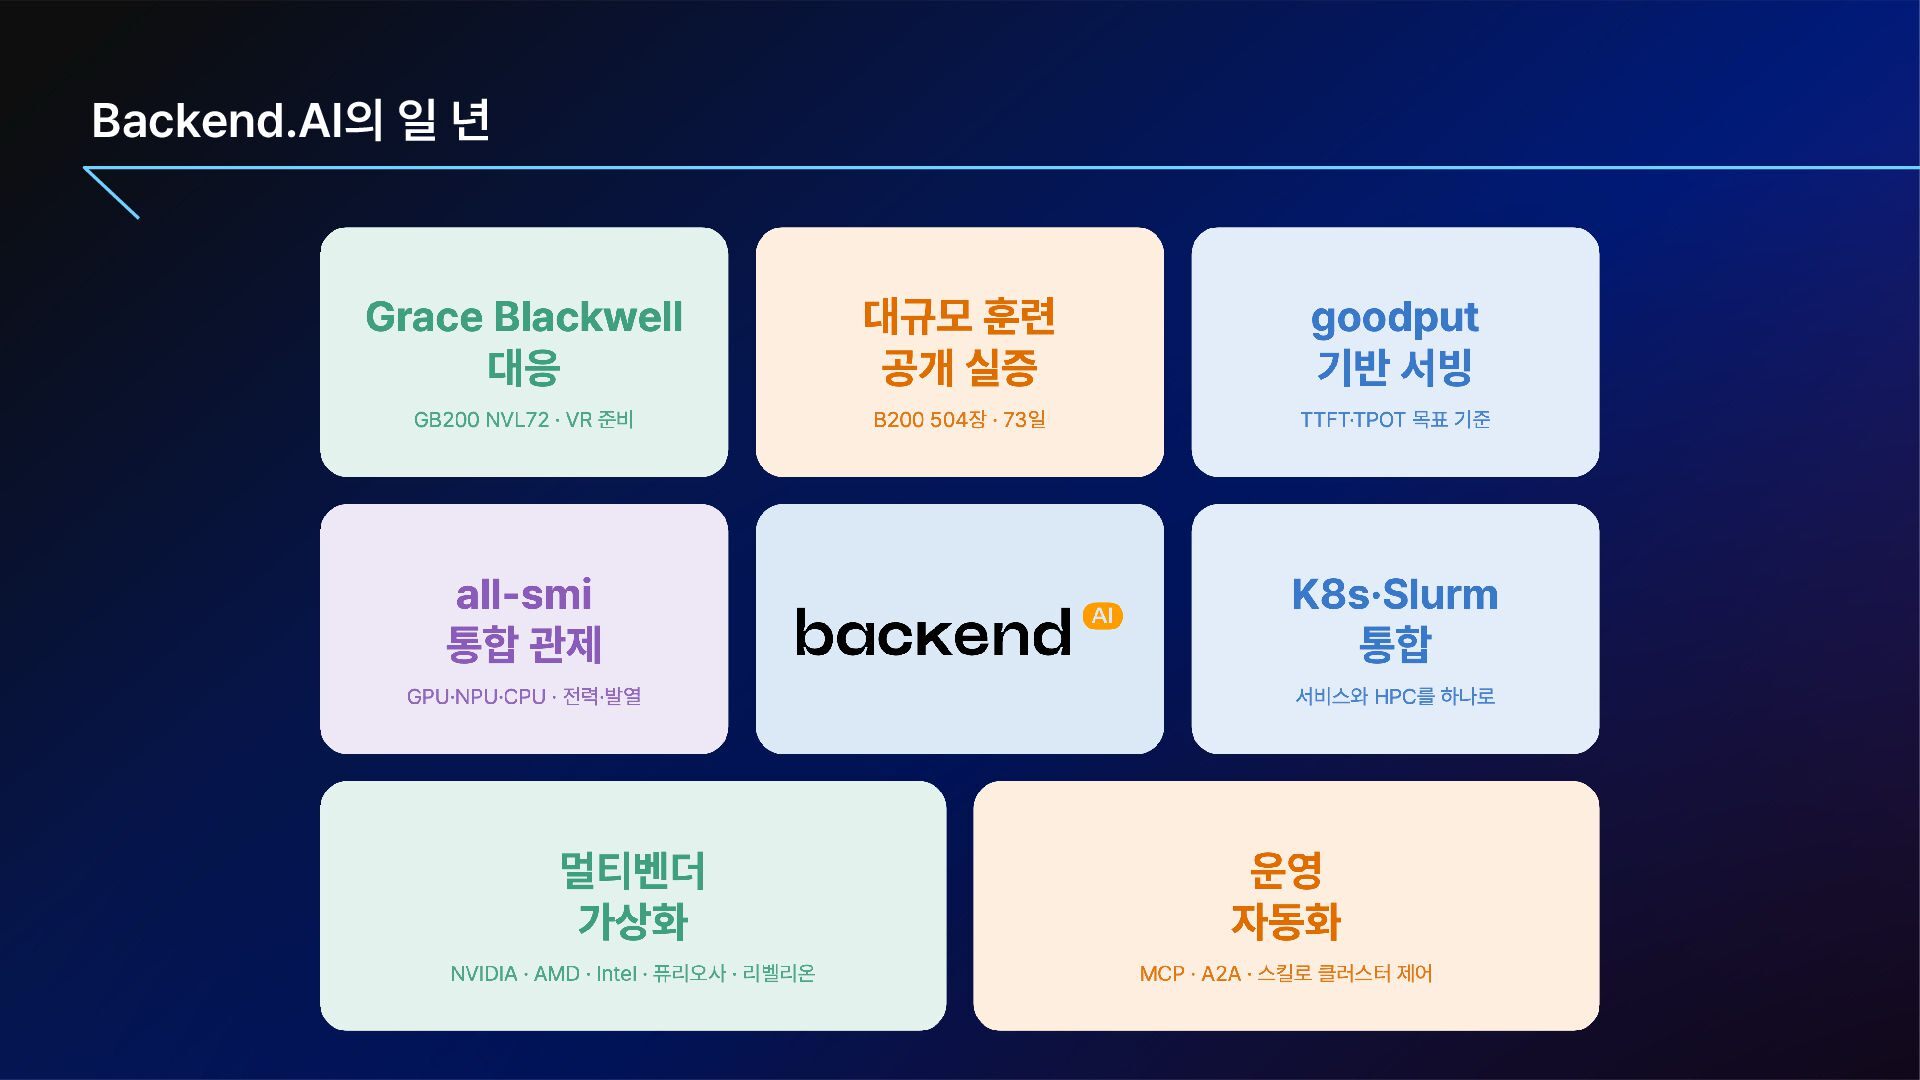
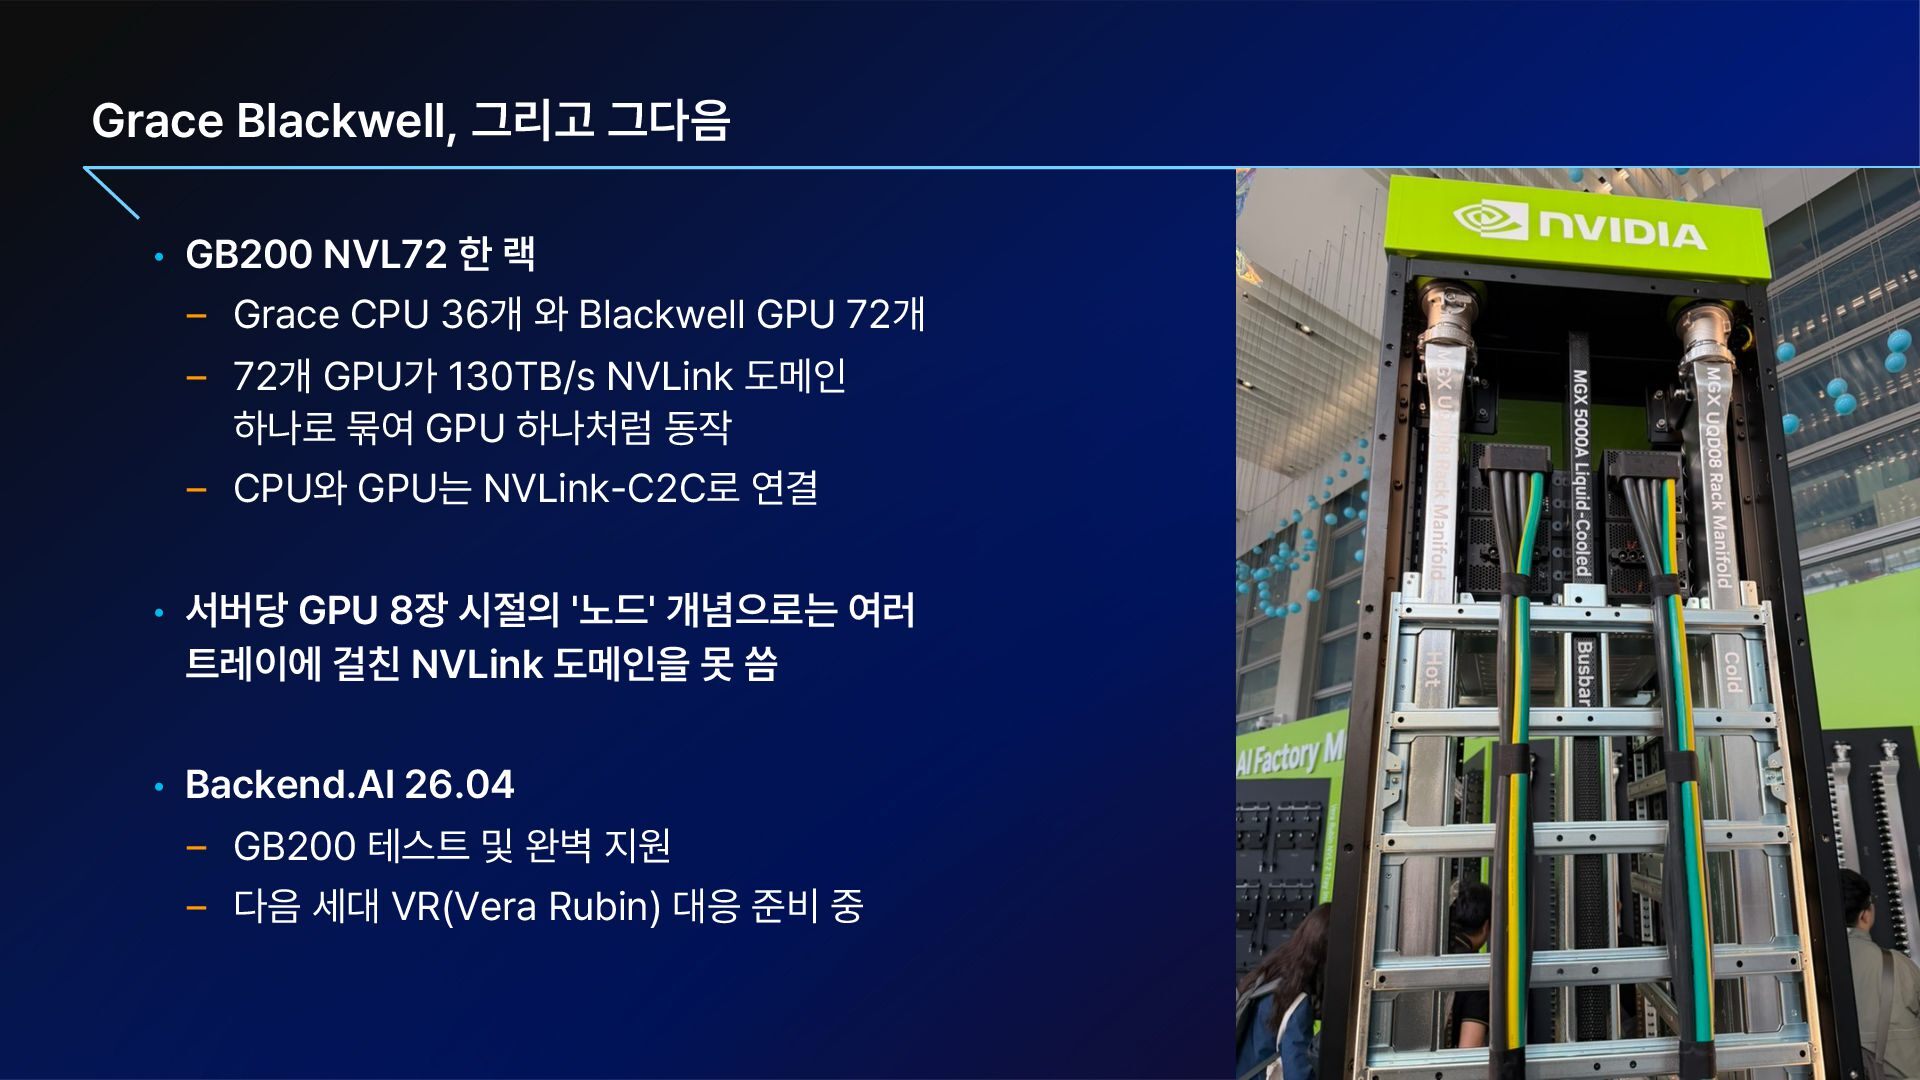
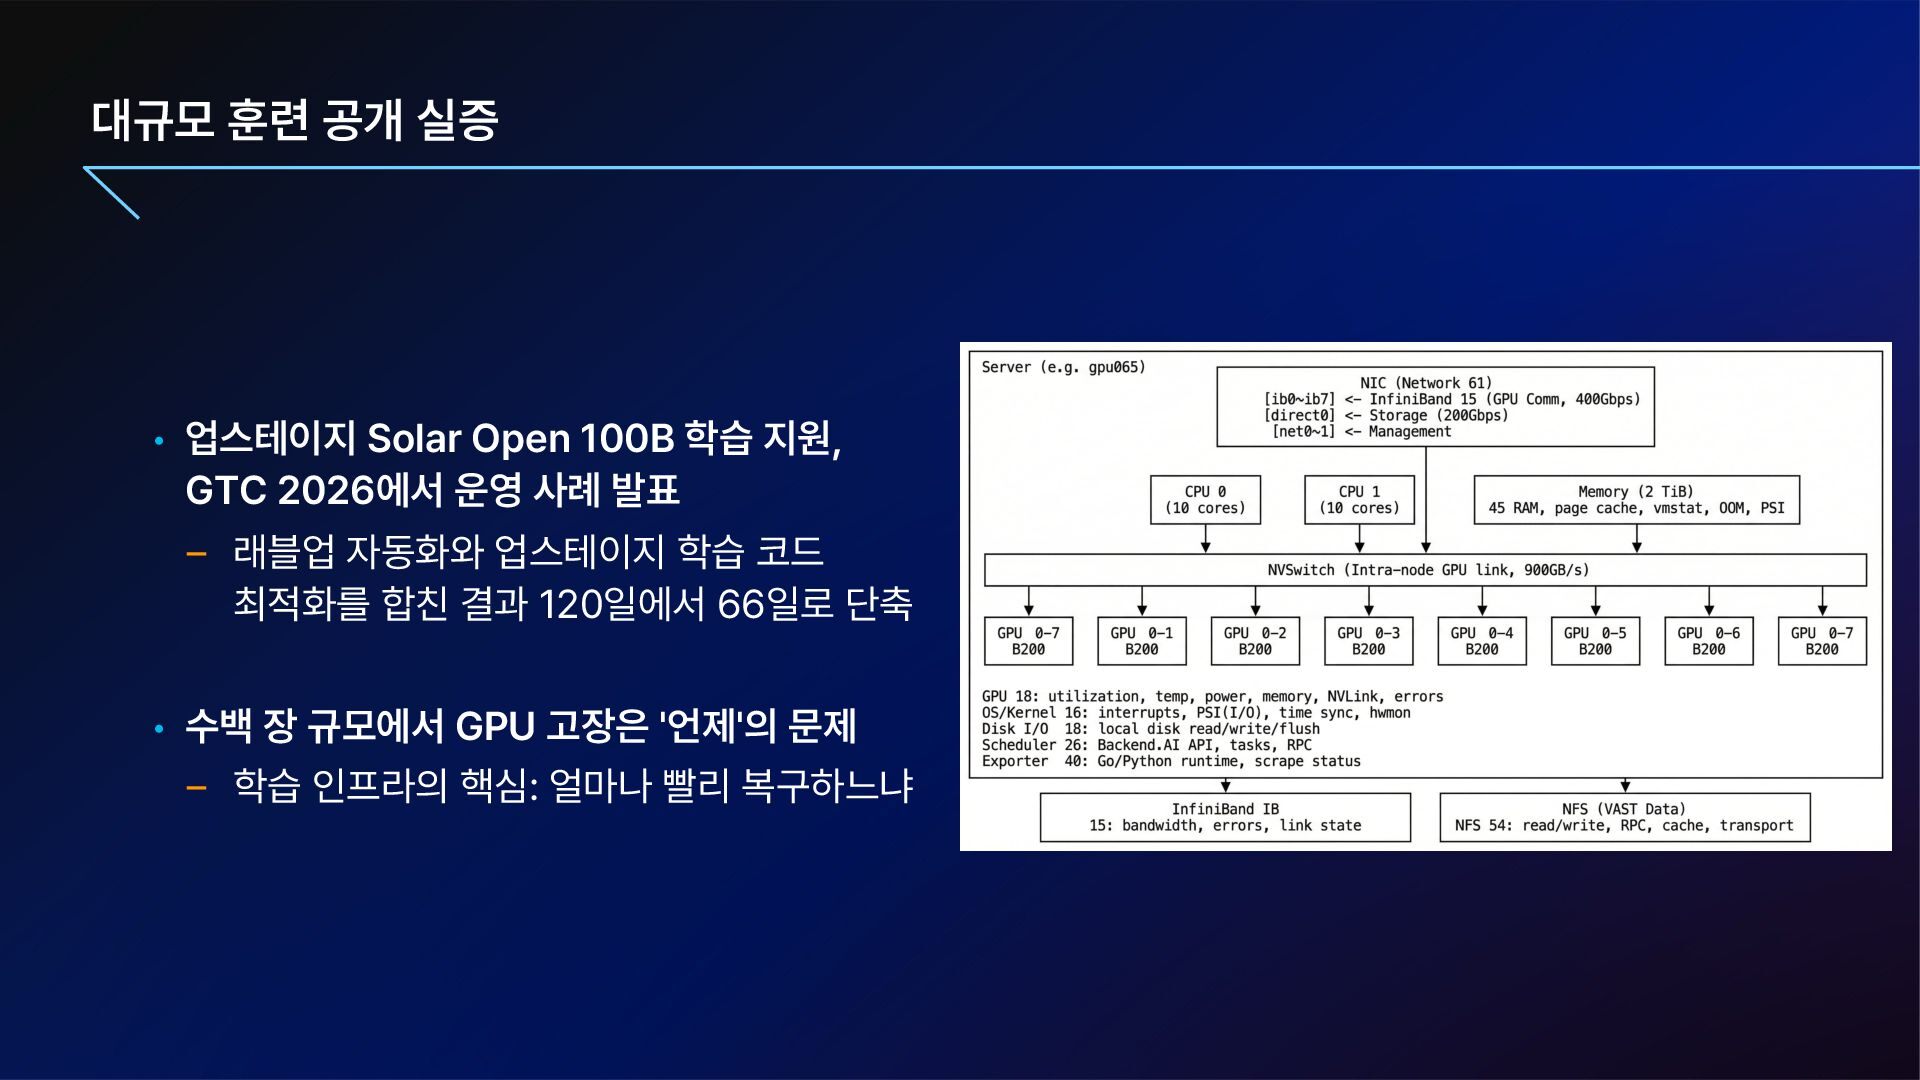
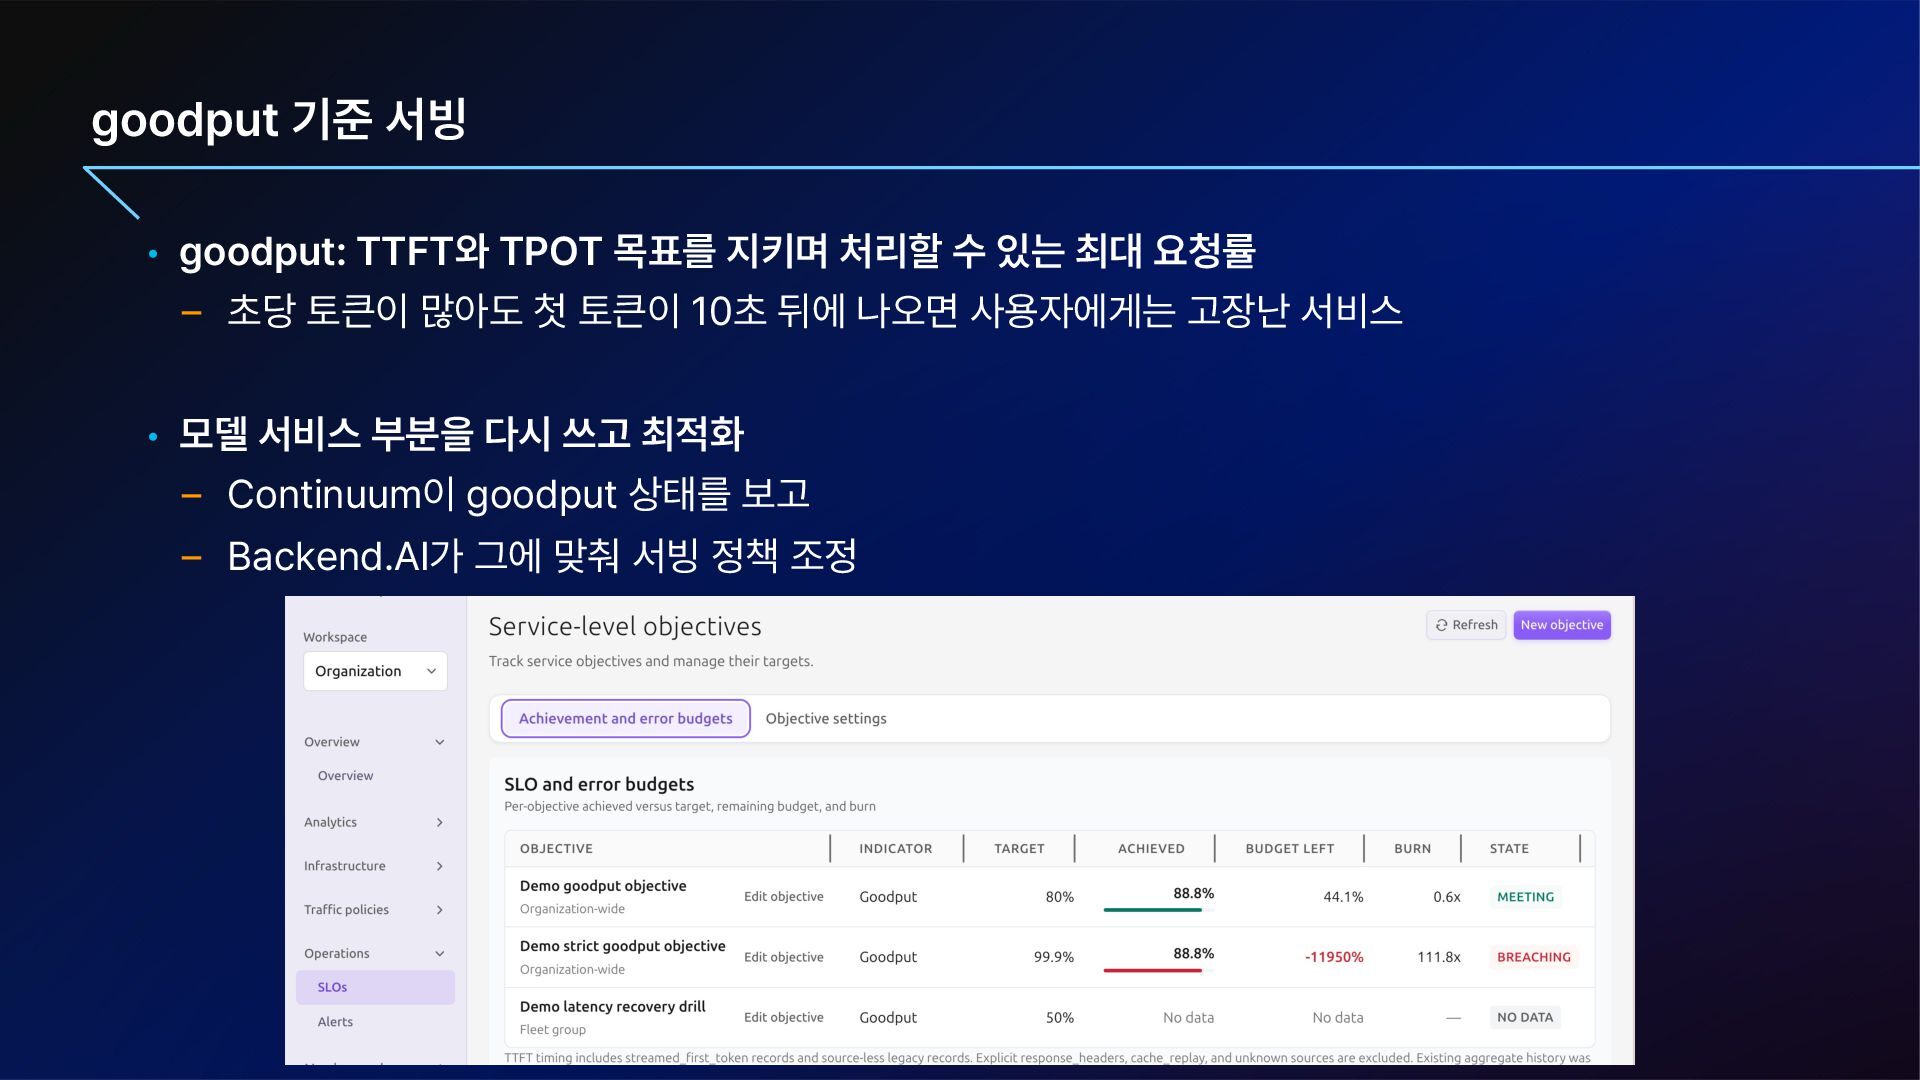
CPU 36개 와 Blackwell GPU 72개 72개 GPU가 130TB/s NVLink 도메인 하나로 묶여 GPU 하나처럼 동작 CPU와 GPU는 NVLink C2C로 연결 • 서버당 GPU 8장 시절의 노드 개념으로는 여러 트레이에 걸친 NVLink 도메인을 못 씀 • Backend.AI 26.04 GB200 테스트 및 완벽 지원 다음 세대 VR Vera Rubin 대응 준비 중
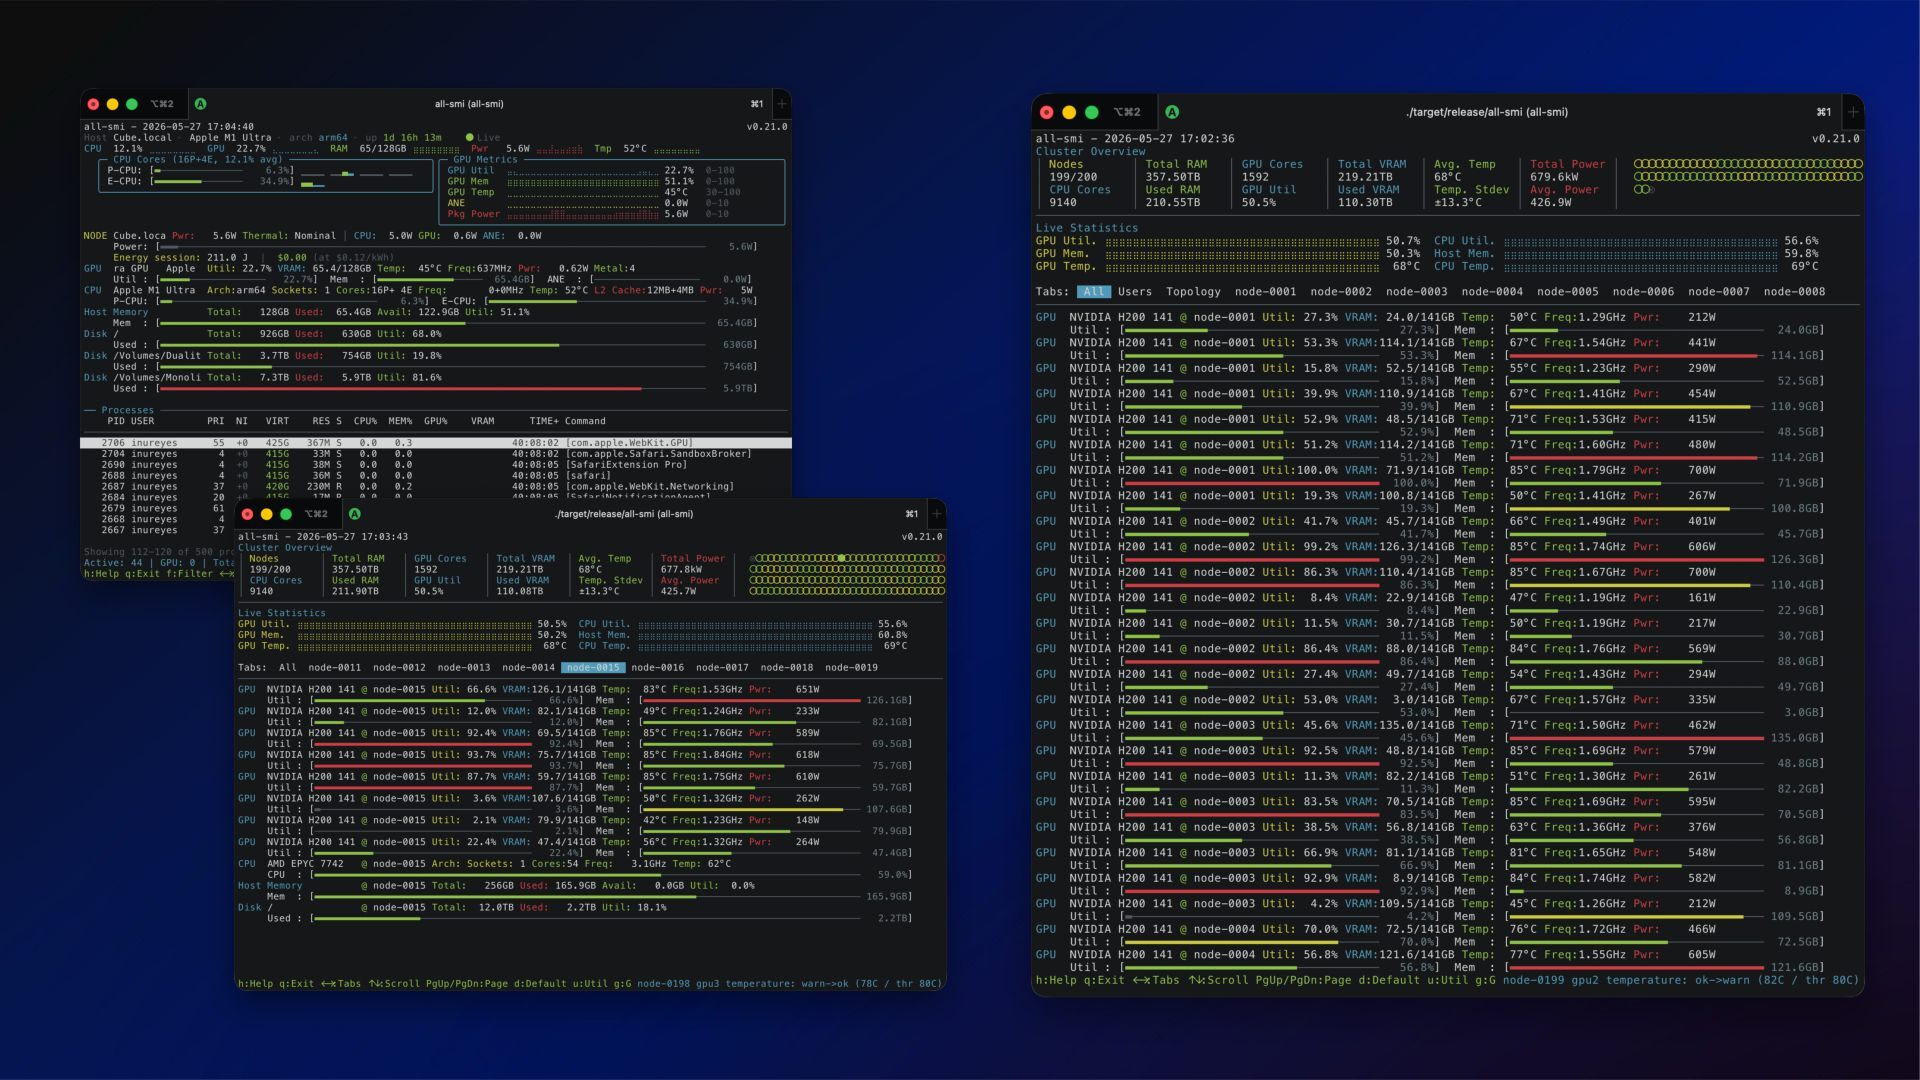
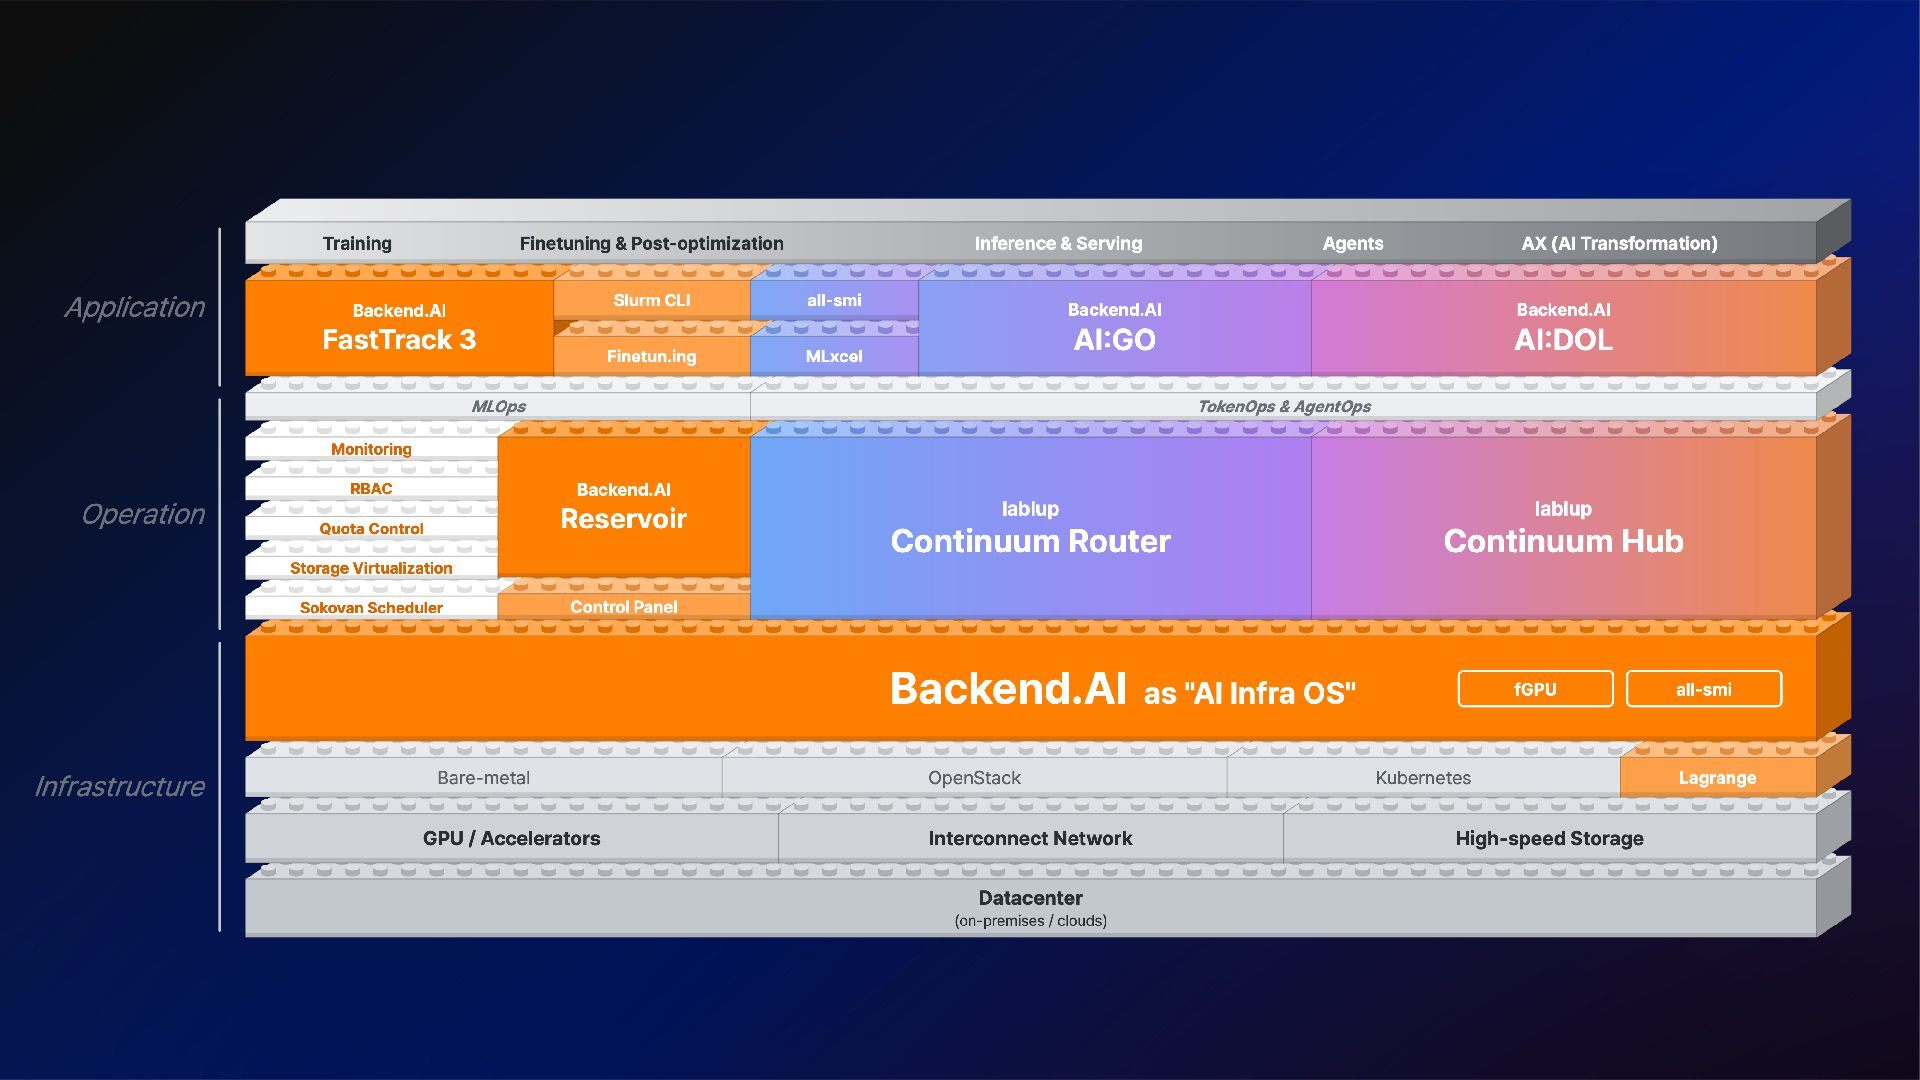
smi 기반으로 통합 GPU·NPU·CPU부터 섀시 단위 전력·발열까지 모니터링해 운영에 반영 • 멀티벤더 가상화 GPU 가상화를 NVIDIA에서 AMD, Intel 베타 , 퓨리오사·리벨리온 알파 으로 확대 • 운영 자동화 • 플랫폼 통합 설치 자동화 고도화, 장애 복구·재시작 로직 개선 Kubernetes·Slurm 통합 MCP·A2A 지원으로 클러스터 운영을 자동화 서비스는 K8s, HPC는 Slurm인 현실을 그대로 두고 그 위를 하나로 Claude Code 및 Codex에서 스킬로 클러스터 제어
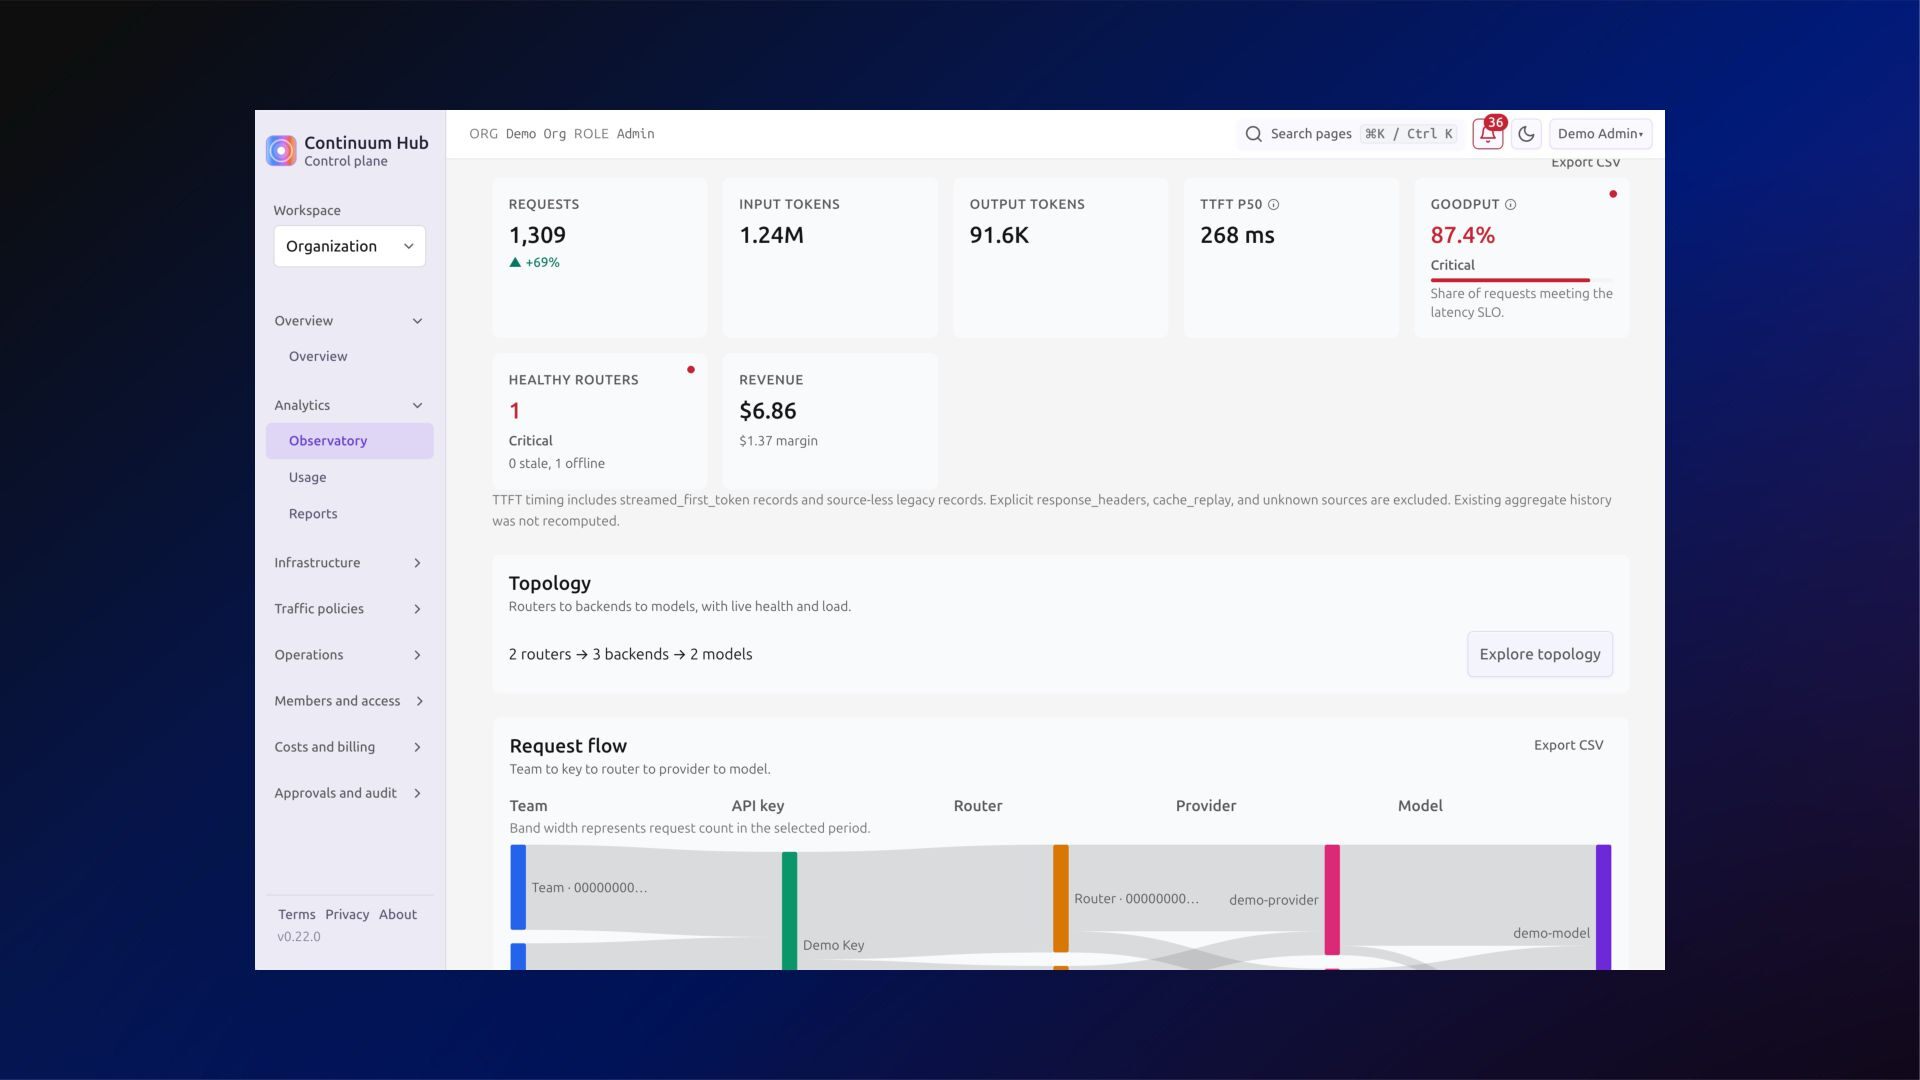
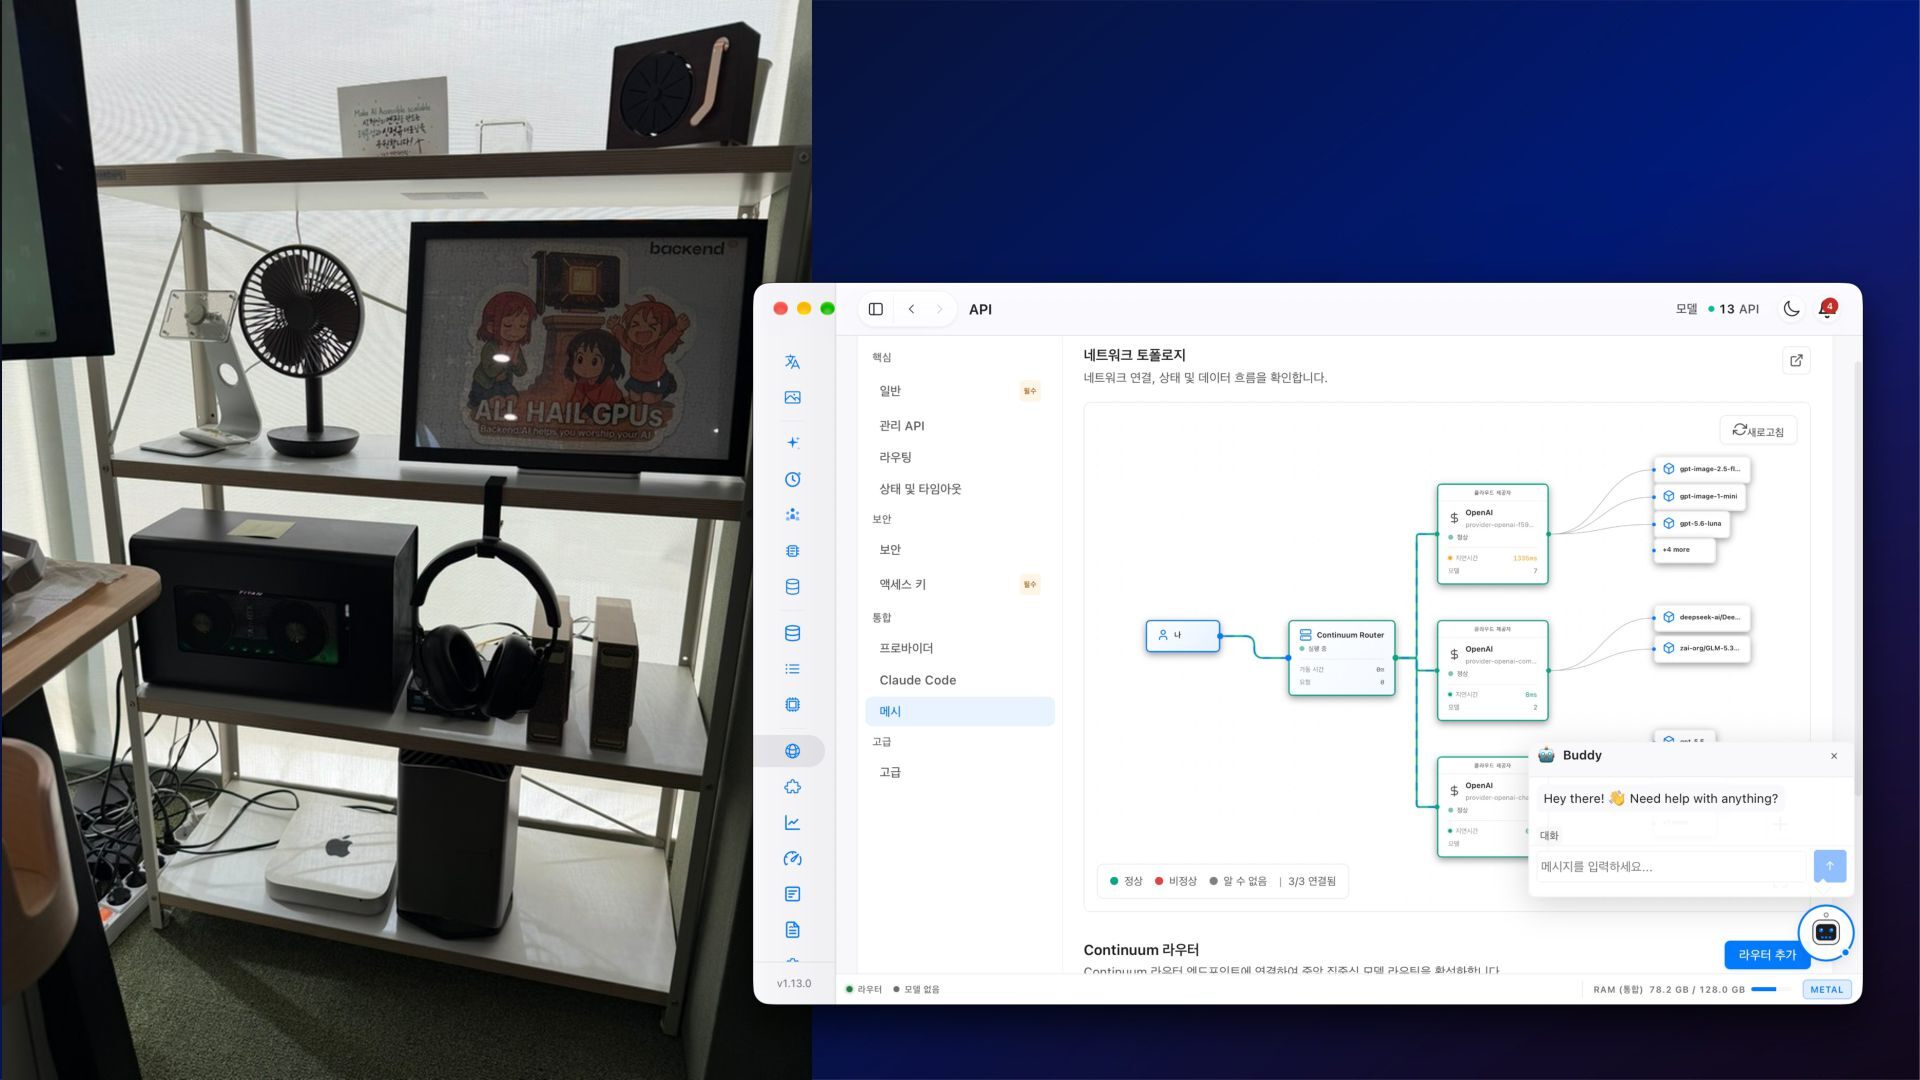
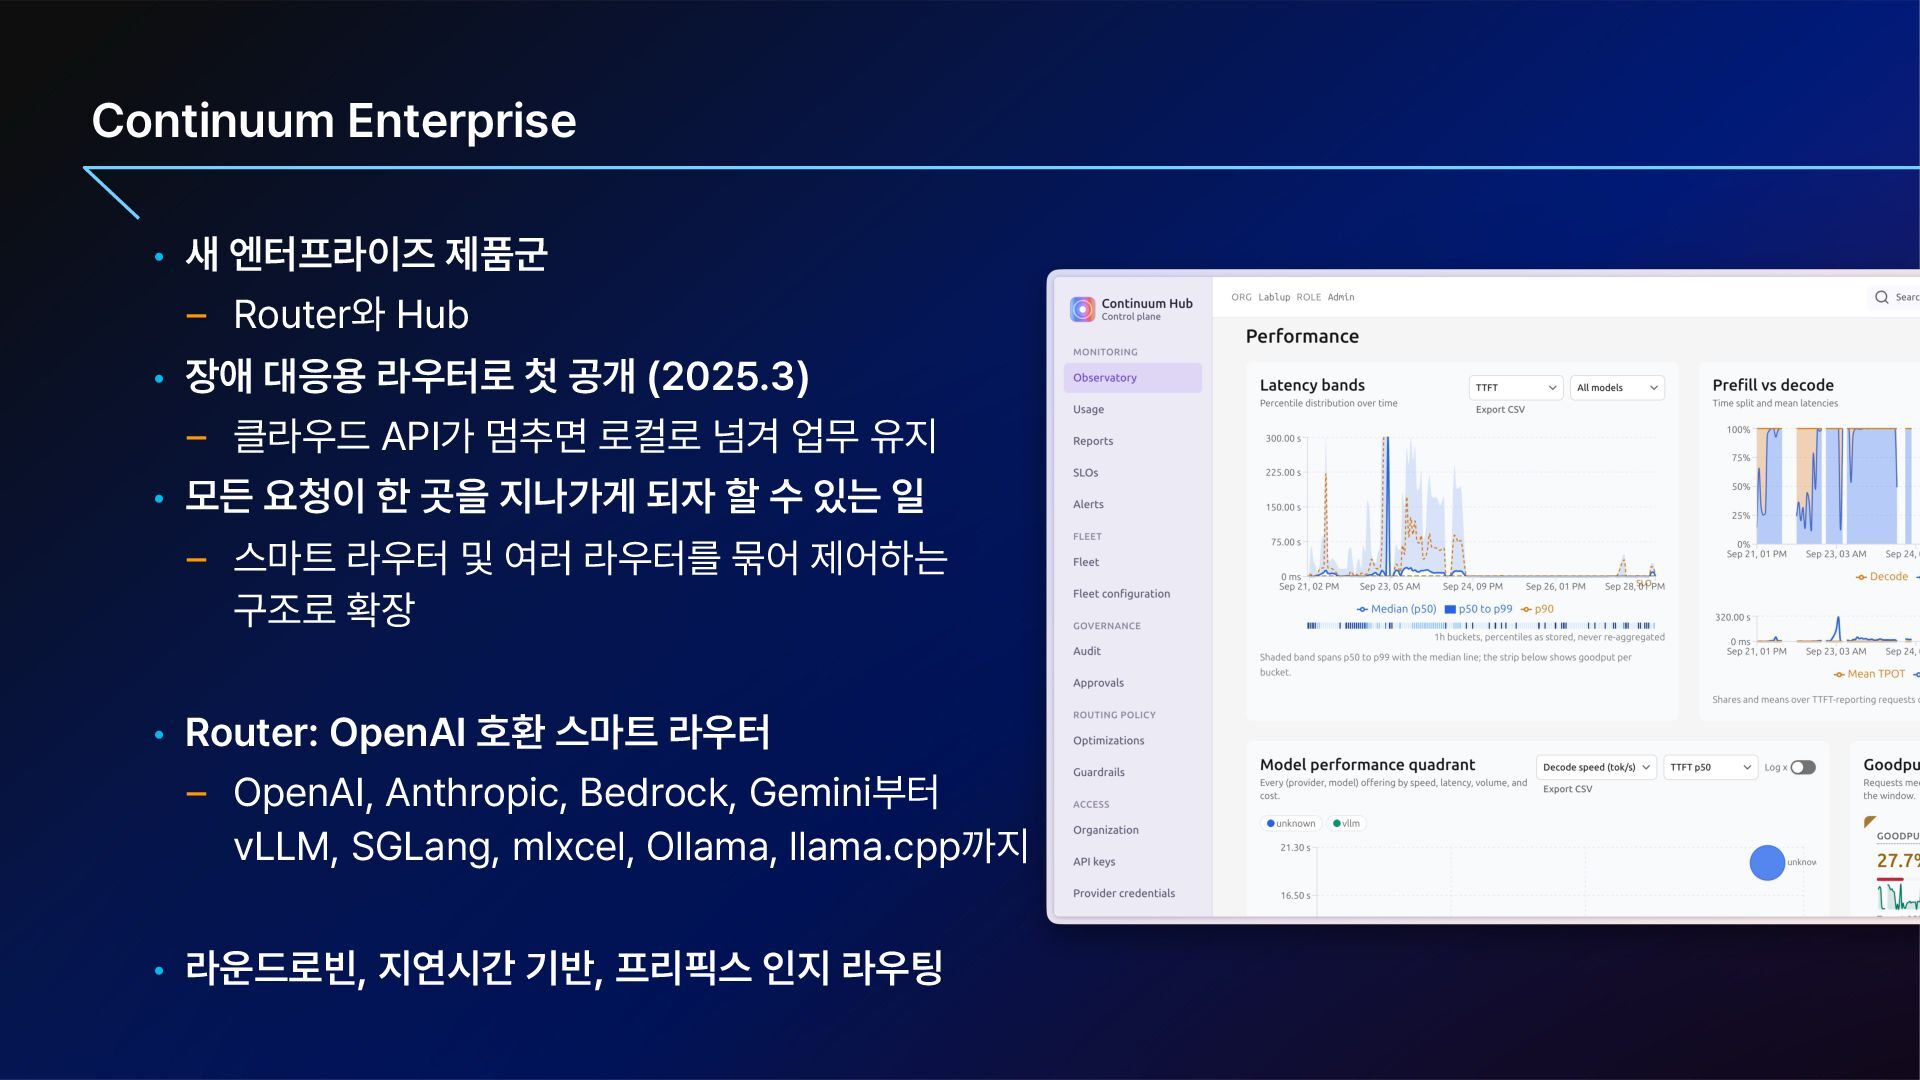
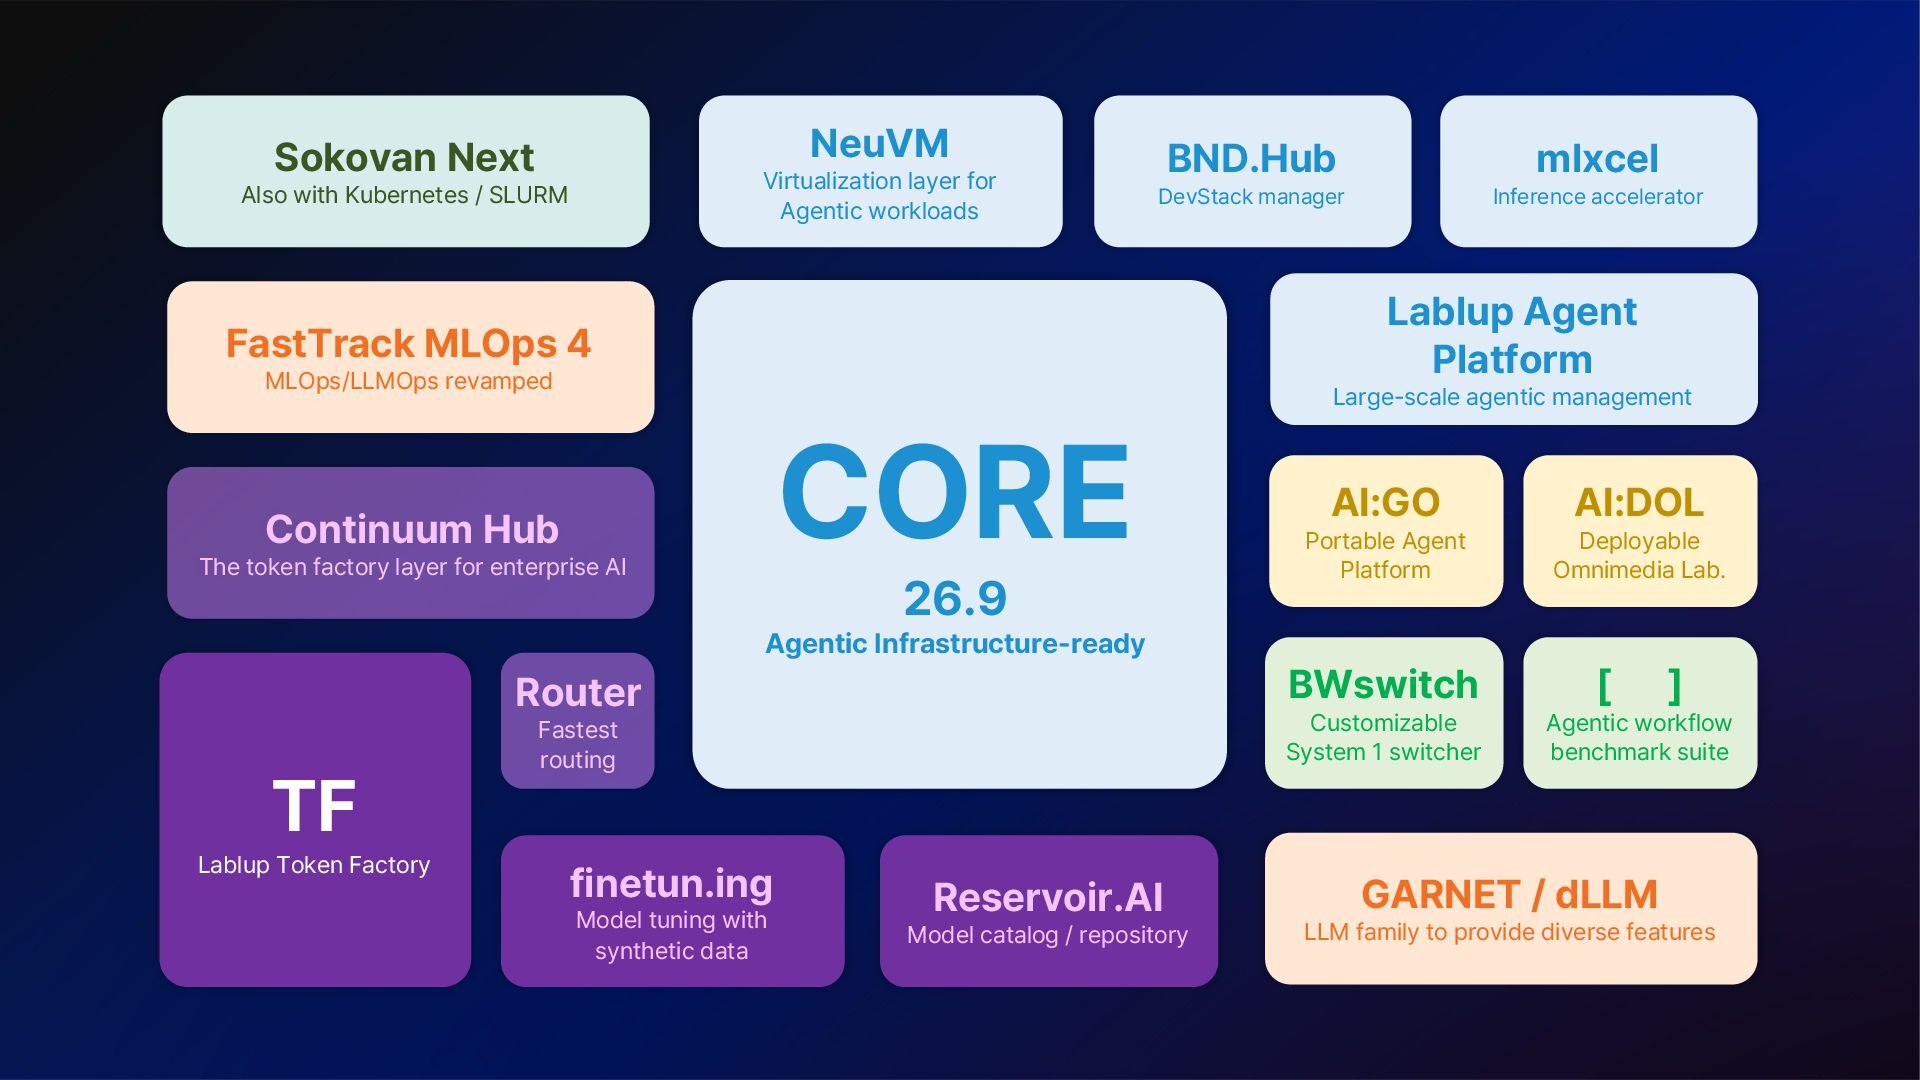
대응용 라우터로 첫 공개 2025.3 클라우드 API가 멈추면 로컬로 넘겨 업무 유지 • 모든 요청이 한 곳을 지나가게 되자 할 수 있는 일 스마트 라우터 및 여러 라우터를 묶어 제어하는 구조로 확장 • Router: OpenAI 호환 스마트 라우터 OpenAI, Anthropic, Bedrock, Gemini부터 vLLM, SGLang, mlxcel, Ollama, llama.cpp까지 • 라운드로빈, 지연시간 기반, 프리픽스 인지 라우팅
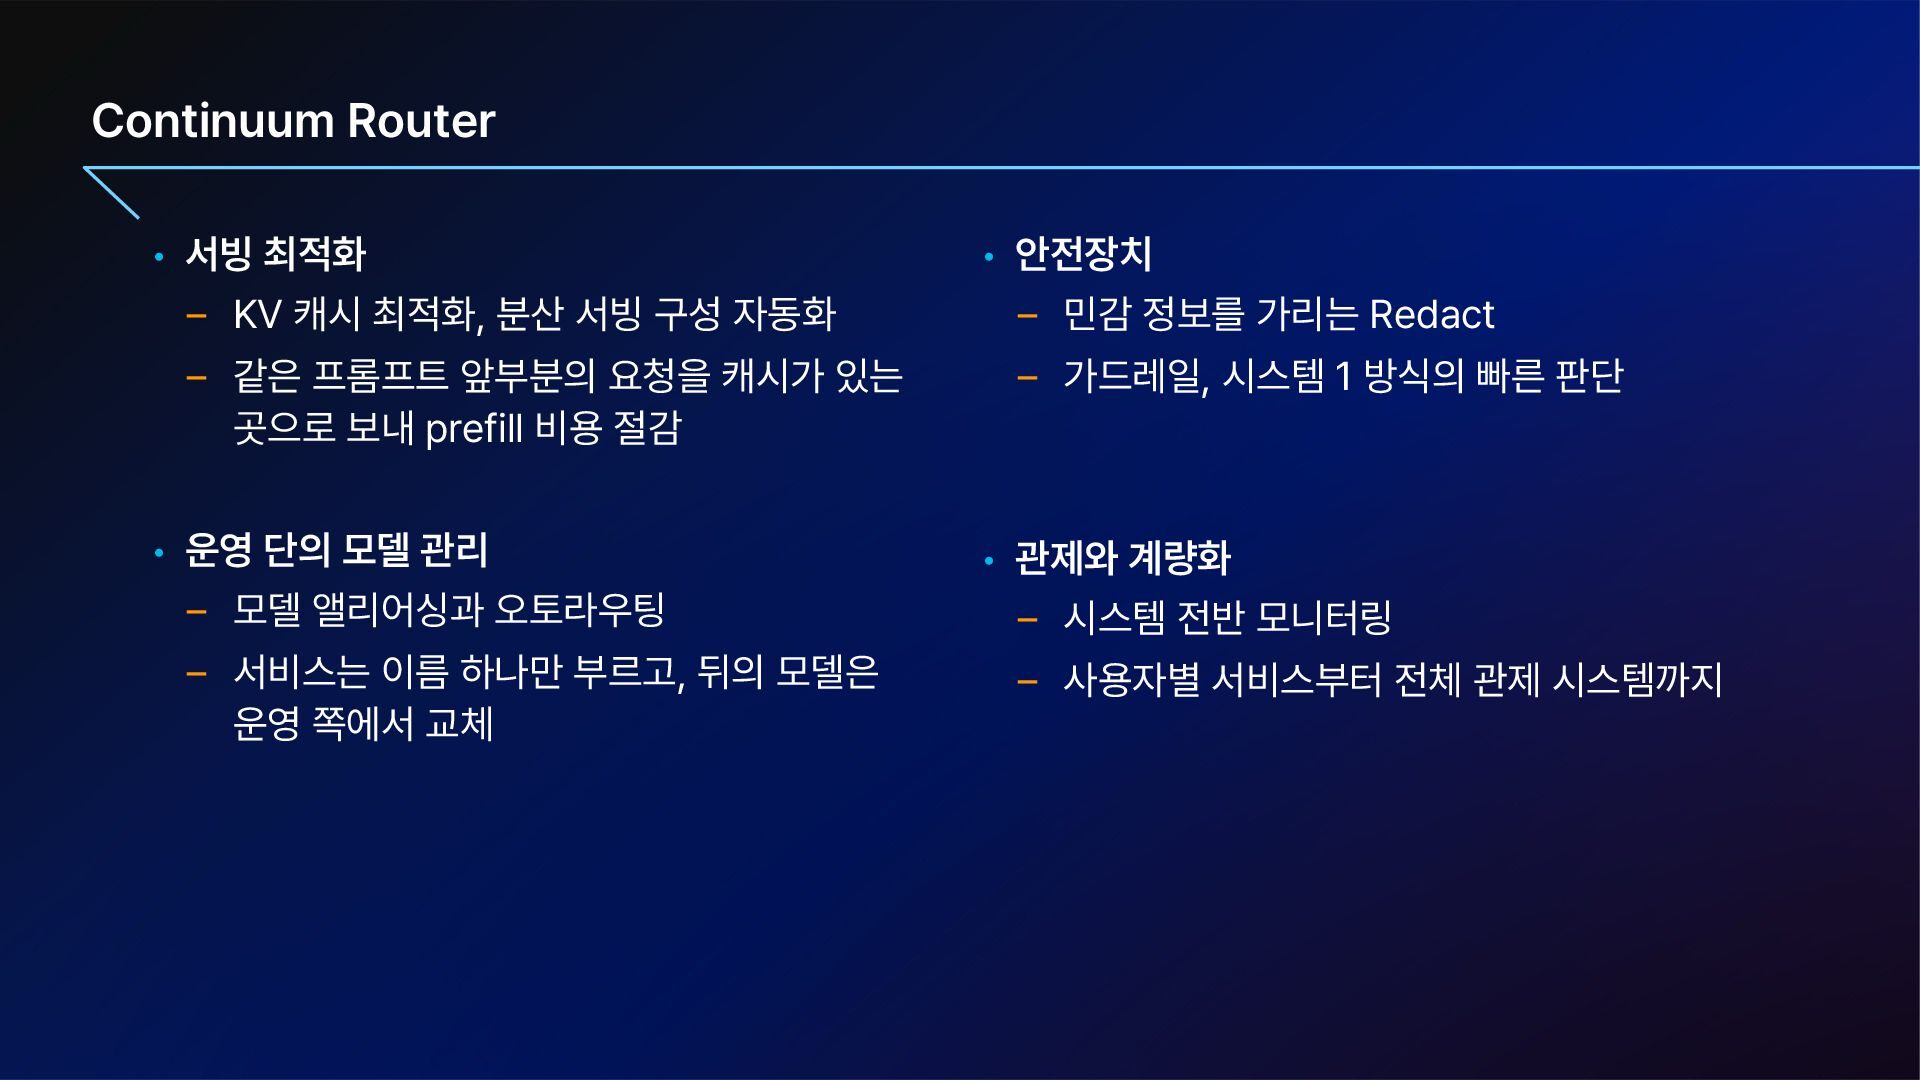
분산 서빙 구성 자동화 민감 정보를 가리는 Redact 같은 프롬프트 앞부분의 요청을 캐시가 있는 곳으로 보내 prefill 비용 절감 가드레일, 시스템 1 방식의 빠른 판단 • 운영 단의 모델 관리 • 관제와 계량화 모델 앨리어싱과 오토라우팅 시스템 전반 모니터링 서비스는 이름 하나만 부르고, 뒤의 모델은 운영 쪽에서 교체 사용자별 서비스부터 전체 관제 시스템까지
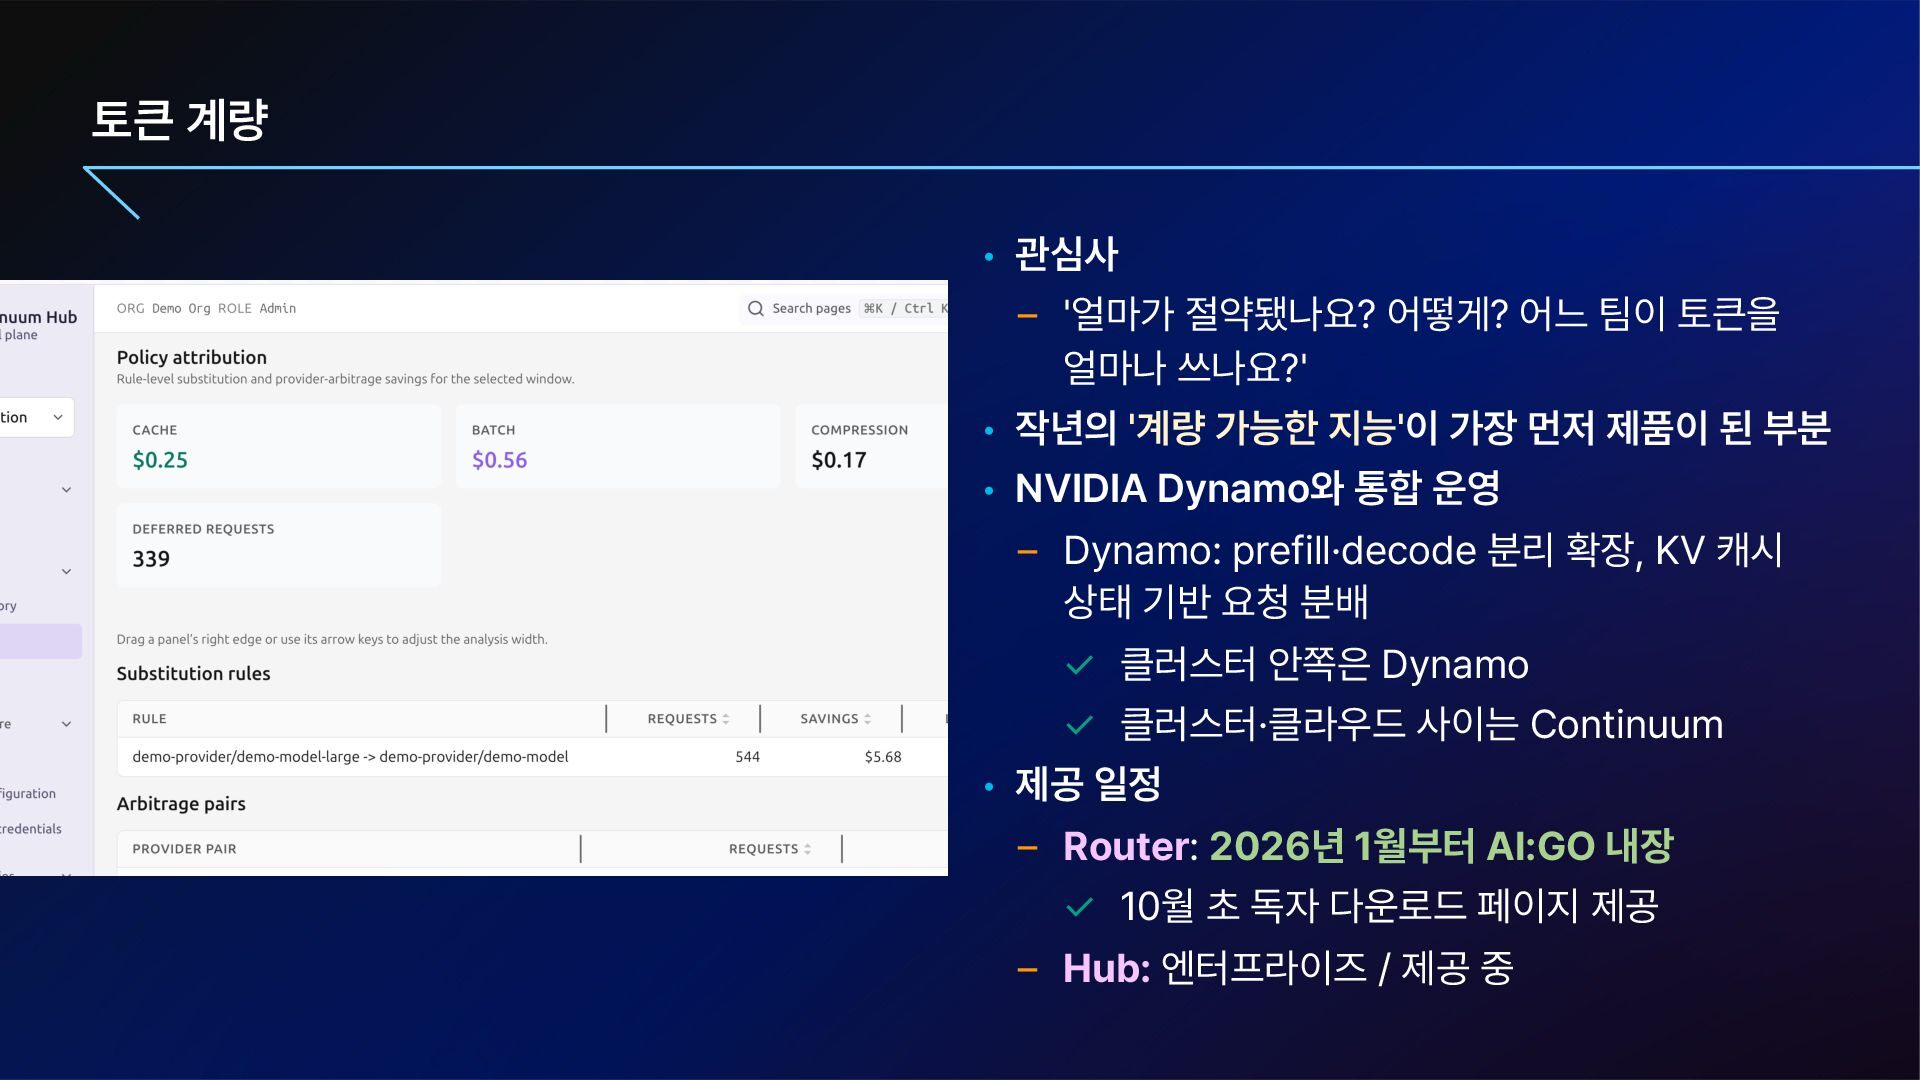
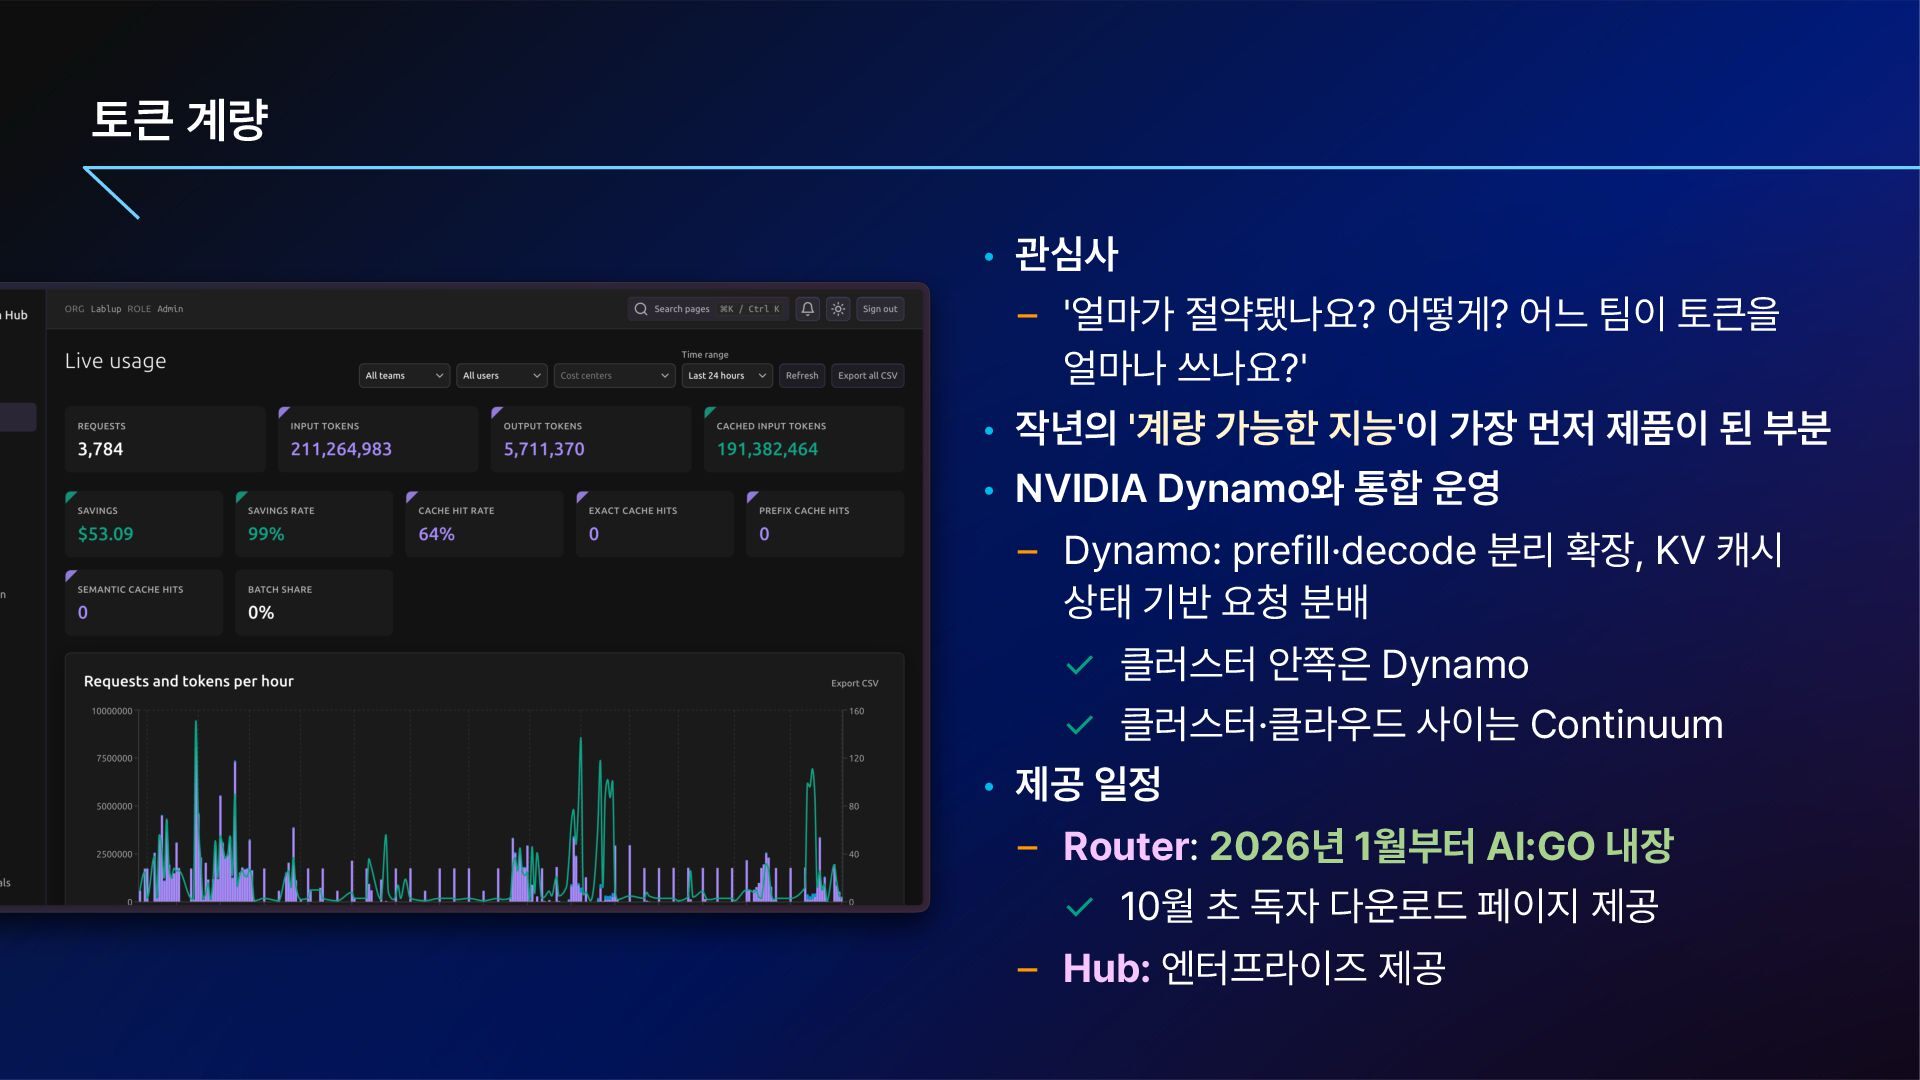
얼마나 쓰나요? • 작년의 계량 가능한 지능 이 가장 먼저 제품이 된 부분 • NVIDIA Dynamo와 통합 운영 Dynamo: prefill·decode 분리 확장, KV 캐시 상태 기반 요청 분배 클러스터 안쪽은 Dynamo 클러스터·클라우드 사이는 Continuum • 제공 일정 Router: 2026년 1월부터 AI:GO 내장 10월 초 독자 다운로드 페이지 제공 Hub: 엔터프라이즈 / 제공 중
얼마나 쓰나요? • 작년의 계량 가능한 지능 이 가장 먼저 제품이 된 부분 • NVIDIA Dynamo와 통합 운영 Dynamo: prefill·decode 분리 확장, KV 캐시 상태 기반 요청 분배 클러스터 안쪽은 Dynamo 클러스터·클라우드 사이는 Continuum • 제공 일정 Router: 2026년 1월부터 AI:GO 내장 10월 초 독자 다운로드 페이지 제공 Hub: 엔터프라이즈 제공
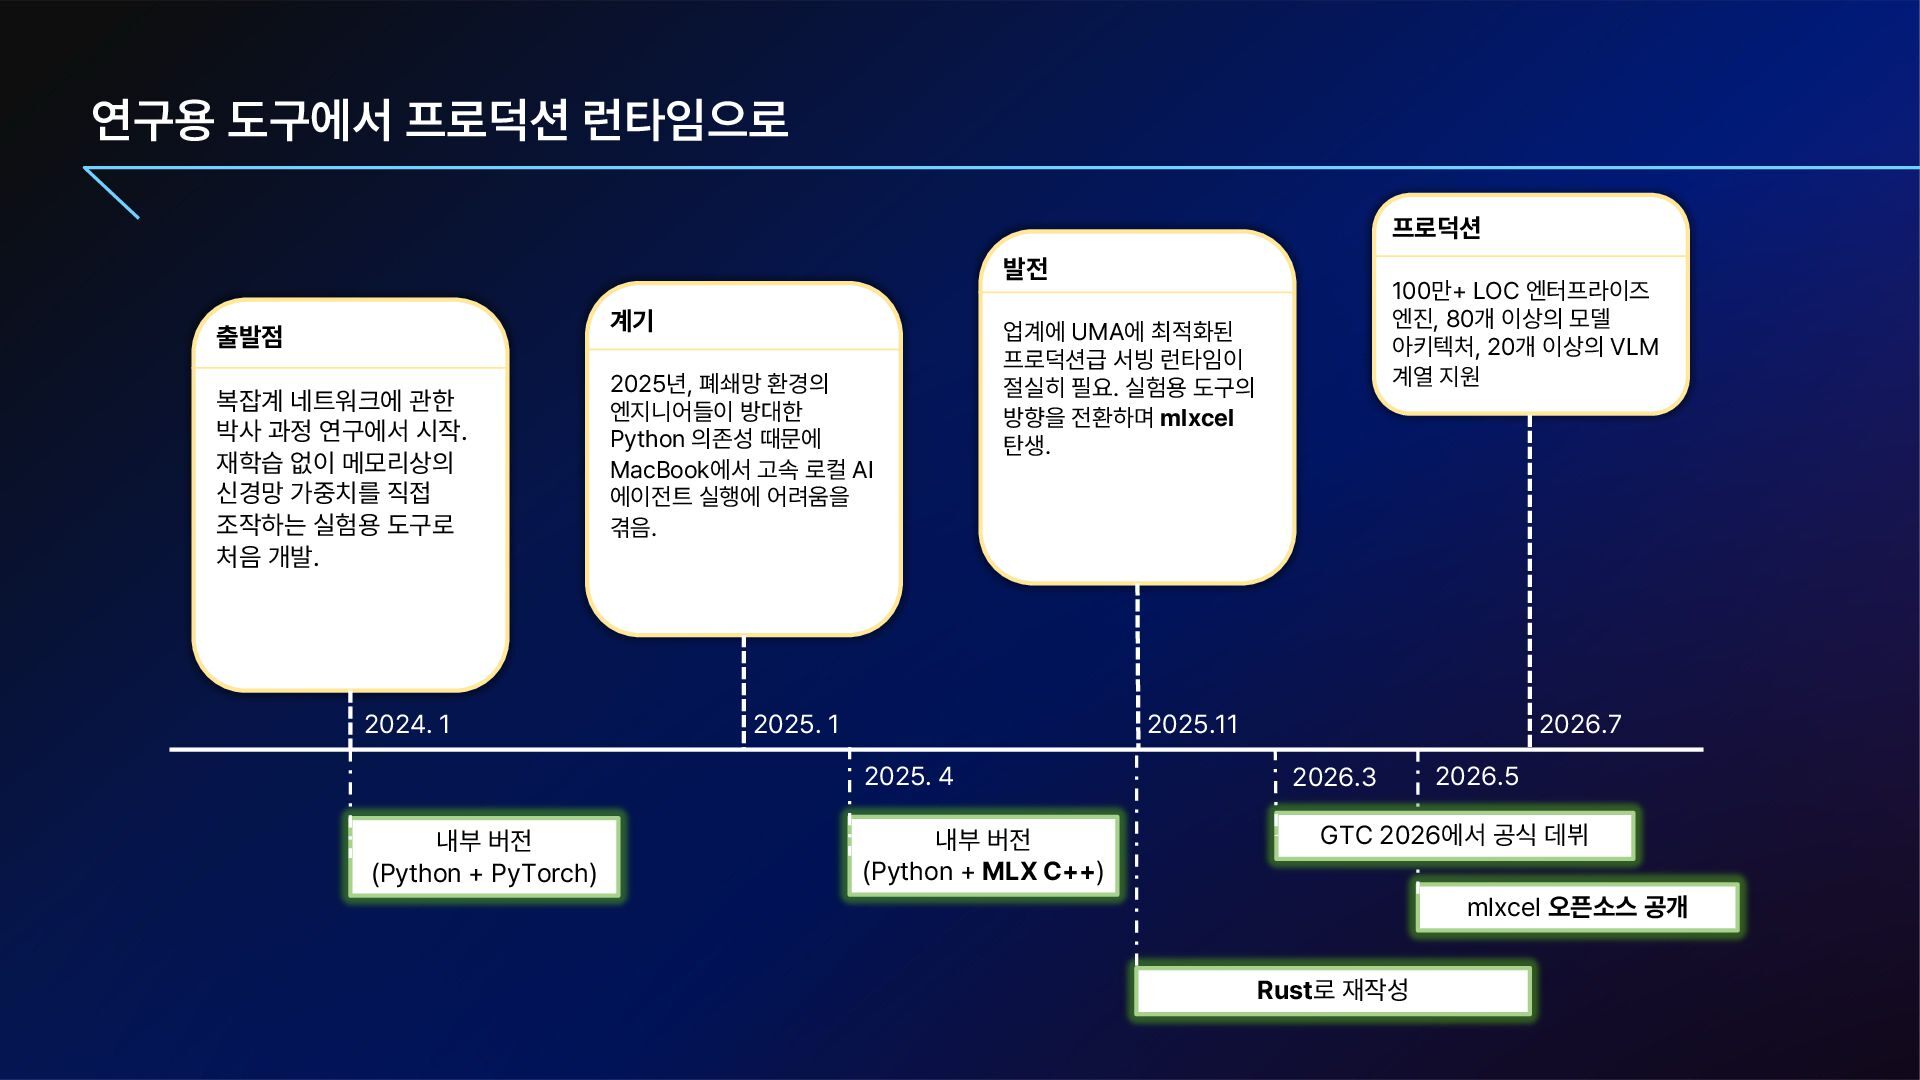
관한 박사 과정 연구에서 시작. 재학습 없이 메모리상의 신경망 가중치를 직접 조작하는 실험용 도구로 처음 개발. 2024. 1 2025년, 폐쇄망 환경의 엔지니어들이 방대한 Python 의존성 때문에 MacBook에서 고속 로컬 AI 에이전트 실행에 어려움을 겪음. 업계에 UMA에 최적화된 프로덕션급 서빙 런타임이 절실히 필요. 실험용 도구의 방향을 전환하며 mlxcel 탄생. 2025. 1 2025.11 2025. 4 내부 버전 Python PyTorch 100만 LOC 엔터프라이즈 엔진, 80개 이상의 모델 아키텍처, 20개 이상의 VLM 계열 지원 내부 버전 Python MLX C 2026.7 2026.3 2026.5 GTC 2026에서 공식 데뷔 mlxcel 오픈소스 공개 Rust로 재작성
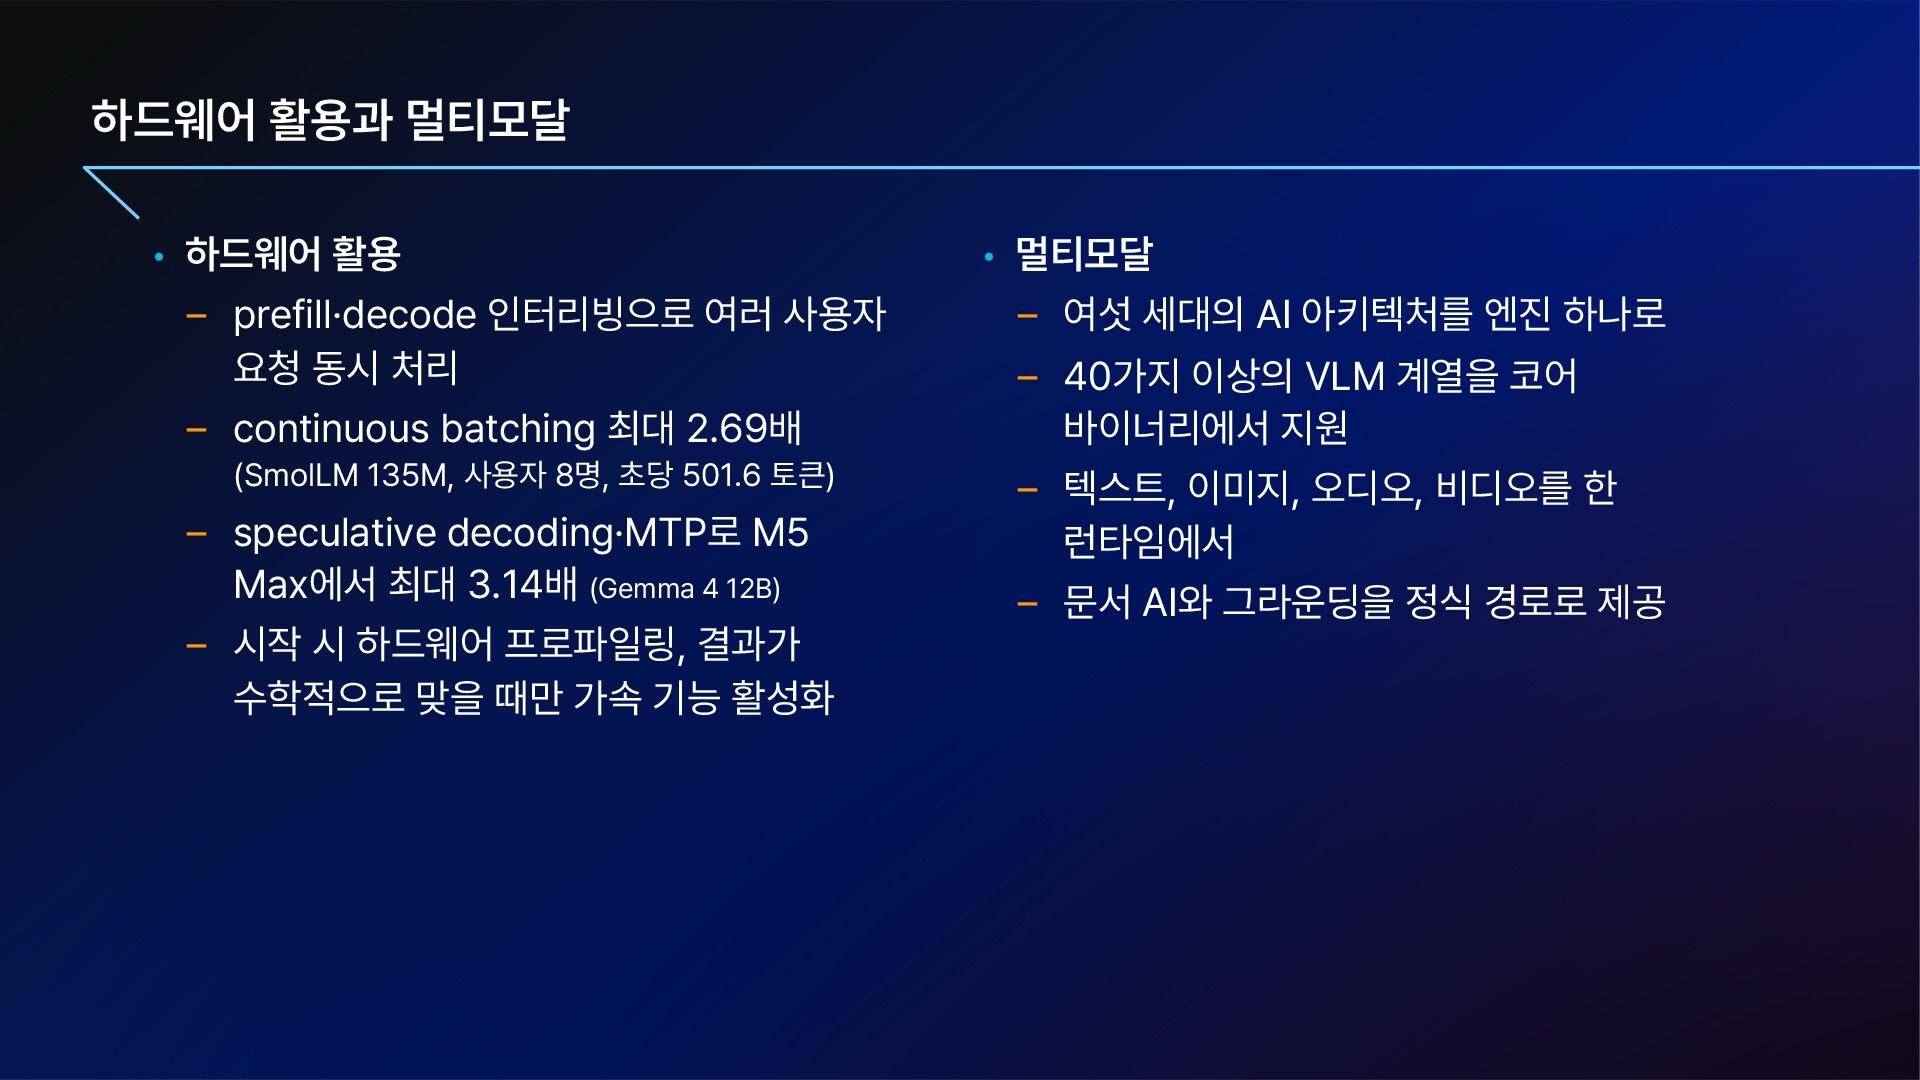
요청 동시 처리 continuous batching 최대 2.69배 SmolLM 135M, 사용자 8명, 초당 501.6 토큰 speculative decoding·MTP로 M5 Max에서 최대 3.14배 Gemma 4 12B 시작 시 하드웨어 프로파일링, 결과가 수학적으로 맞을 때만 가속 기능 활성화 • 멀티모달 여섯 세대의 AI 아키텍처를 엔진 하나로 40가지 이상의 VLM 계열을 코어 바이너리에서 지원 텍스트, 이미지, 오디오, 비디오를 한 런타임에서 문서 AI와 그라운딩을 정식 경로로 제공
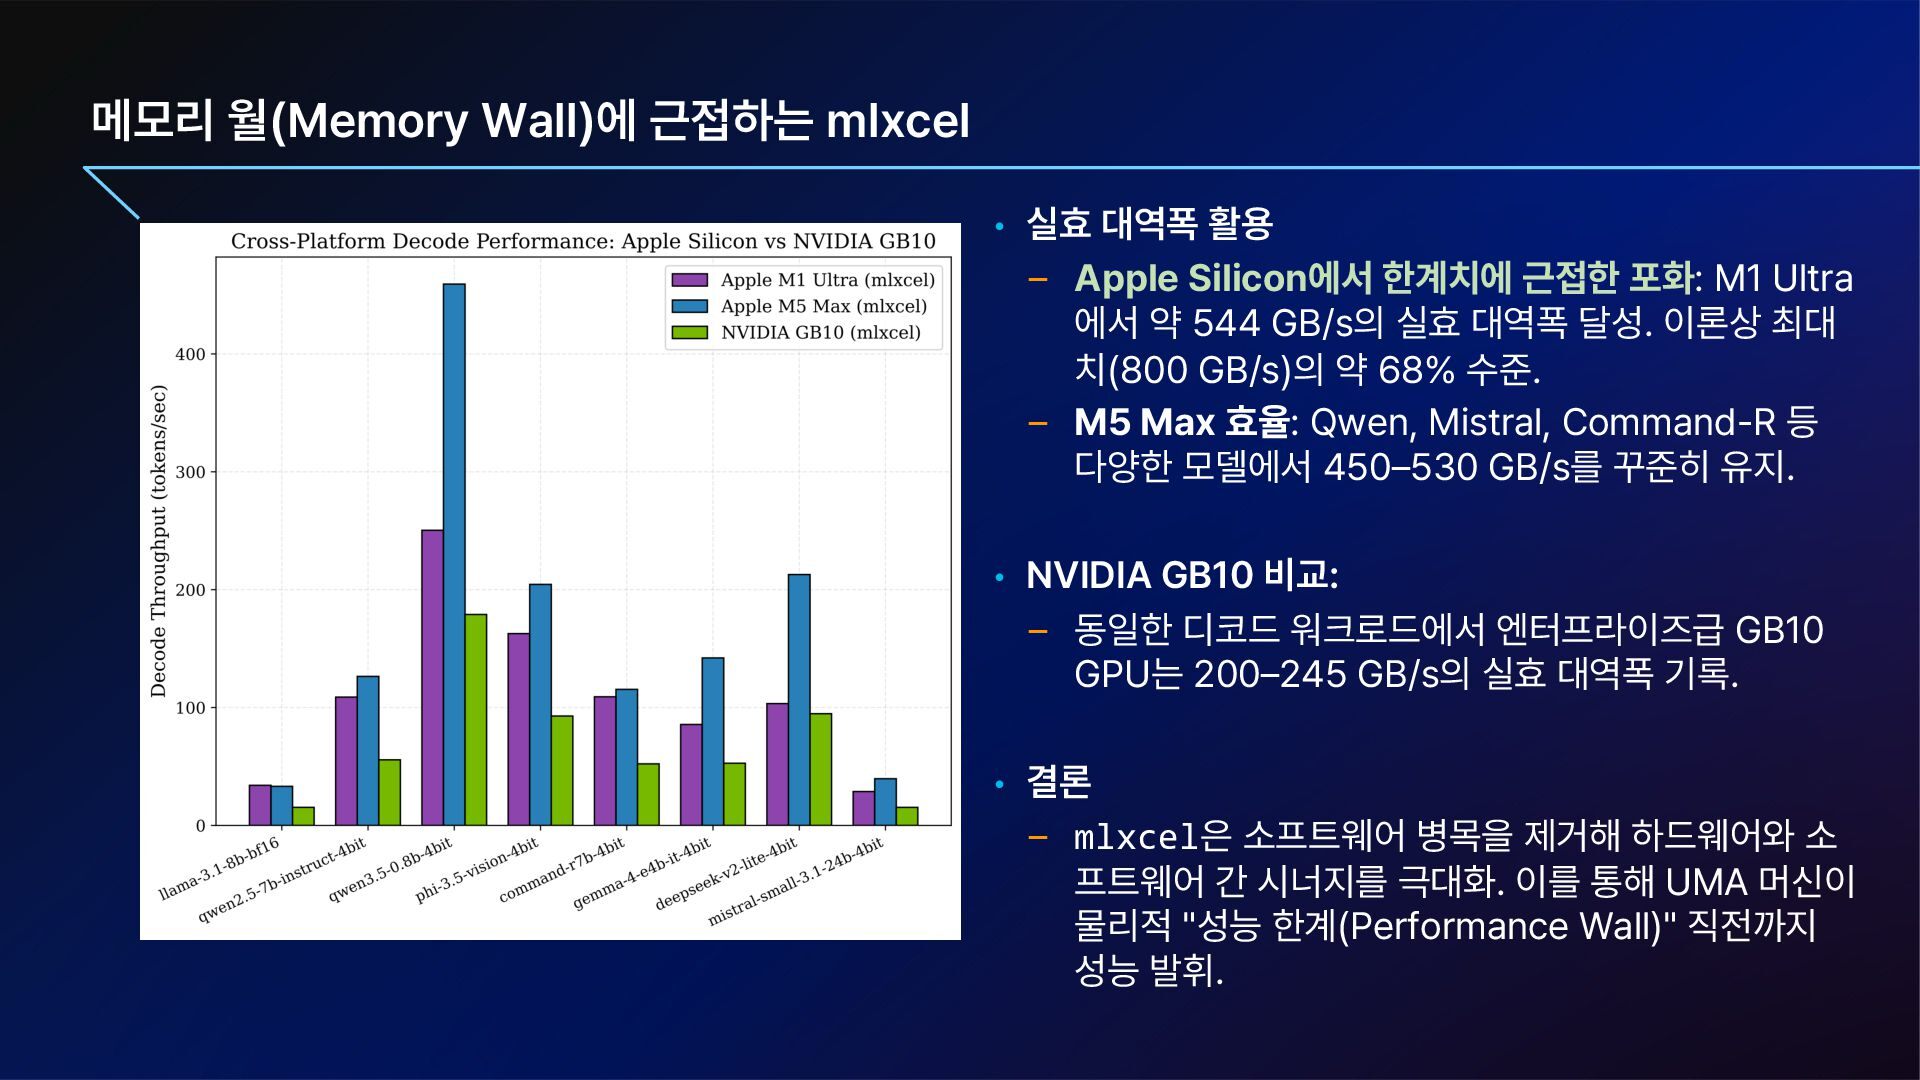
활용 Apple Silicon에서 한계치에 근접한 포화: M1 Ultra 에서 약 544 GB/s의 실효 대역폭 달성. 이론상 최대 치 800 GB/s 의 약 68 수준. M5 Max 효율: Qwen, Mistral, Command R 등 다양한 모델에서 450 530 GB/s를 꾸준히 유지. • NVIDIA GB10 비교: 동일한 디코드 워크로드에서 엔터프라이즈급 GB10 GPU는 200 245 GB/s의 실효 대역폭 기록. • 결론 mlxcel은 소프트웨어 병목을 제거해 하드웨어와 소 프트웨어 간 시너지를 극대화. 이를 통해 UMA 머신이 물리적 성능 한계 Performance Wall 직전까지 성능 발휘.
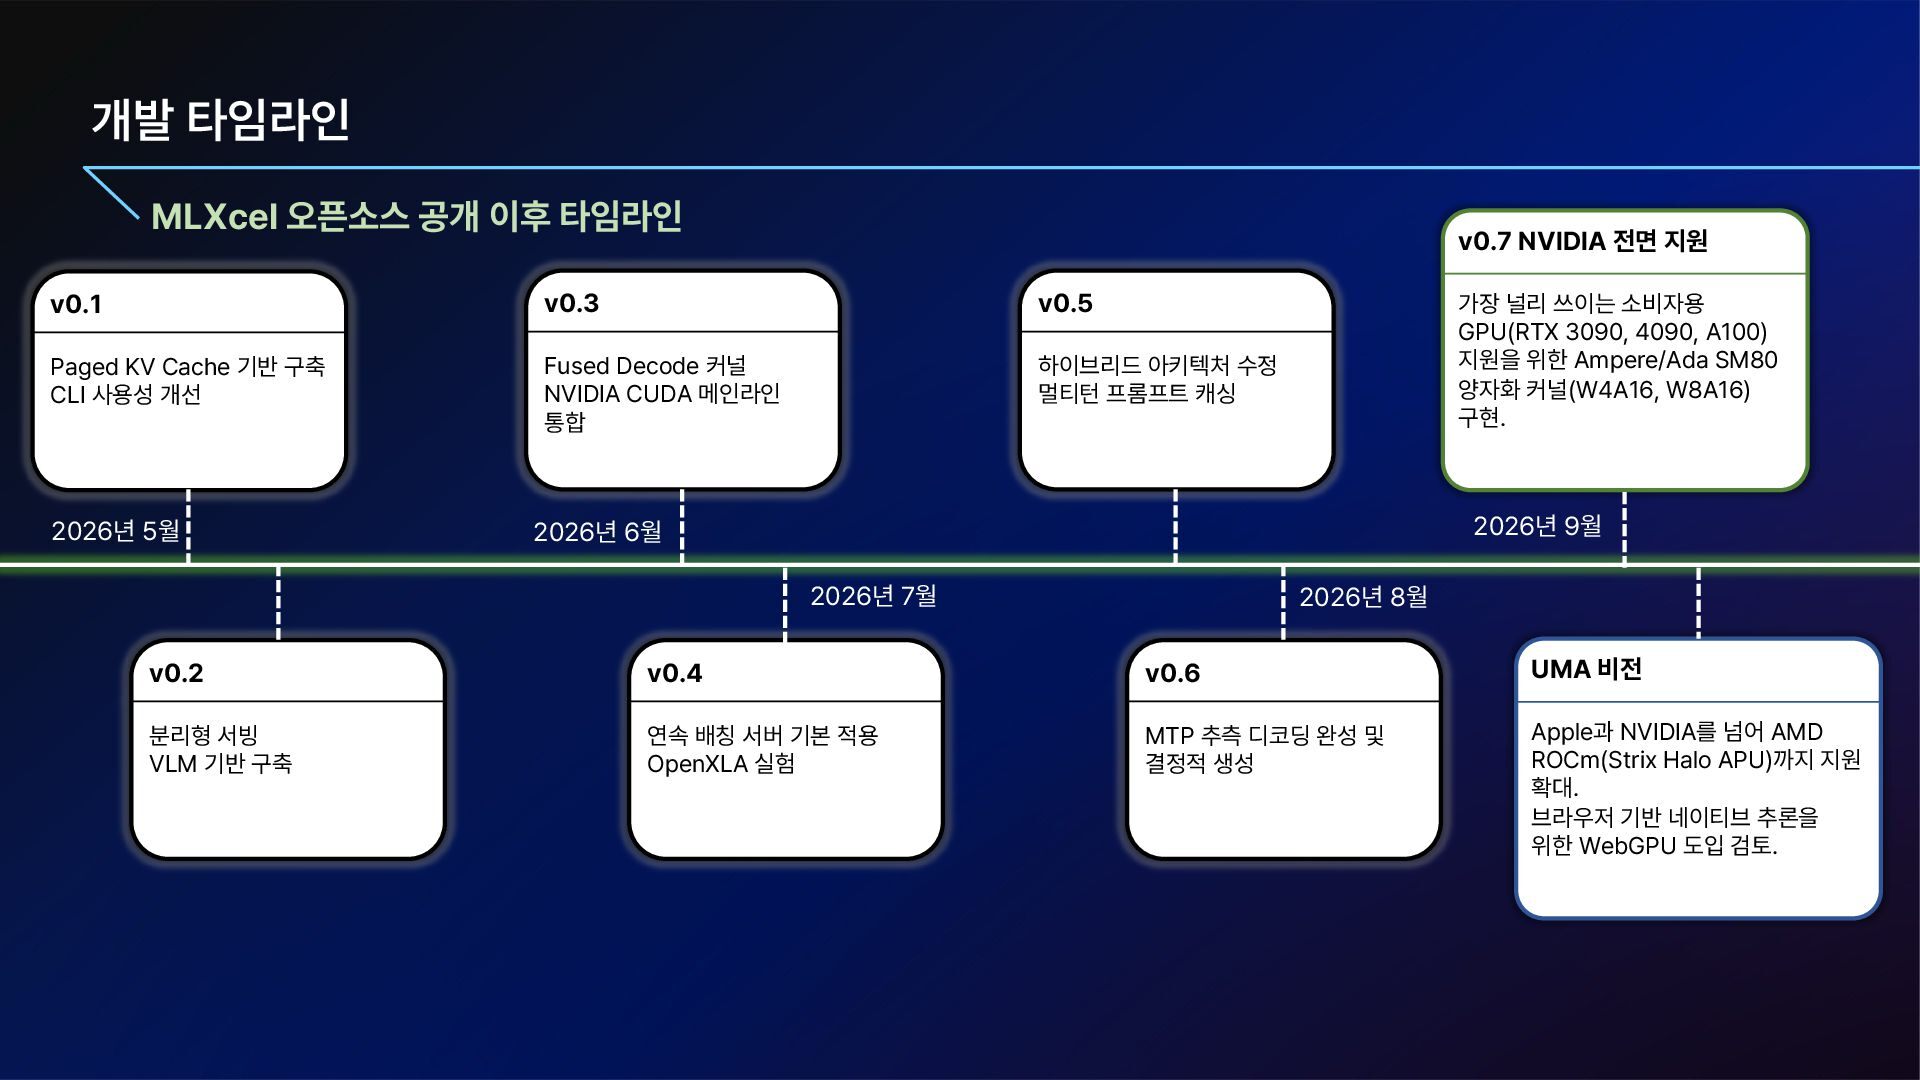
지원 v0.1 v0.3 v0.5 Paged KV Cache 기반 구축 CLI 사용성 개선 Fused Decode 커널 NVIDIA CUDA 메인라인 통합 하이브리드 아키텍처 수정 멀티턴 프롬프트 캐싱 2026년 5월 2026년 6월 가장 널리 쓰이는 소비자용 GPU RTX 3090, 4090, A100 지원을 위한 Ampere/Ada SM80 양자화 커널 W4A16, W8A16 구현. 2026년 9월 2026년 7월 2026년 8월 v0.2 v0.4 v0.6 UMA 비전 분리형 서빙 VLM 기반 구축 연속 배칭 서버 기본 적용 OpenXLA 실험 MTP 추측 디코딩 완성 및 결정적 생성 Apple과 NVIDIA를 넘어 AMD ROCm Strix Halo APU 까지 지원 확대. 브라우저 기반 네이티브 추론을 위한 WebGPU 도입 검토.
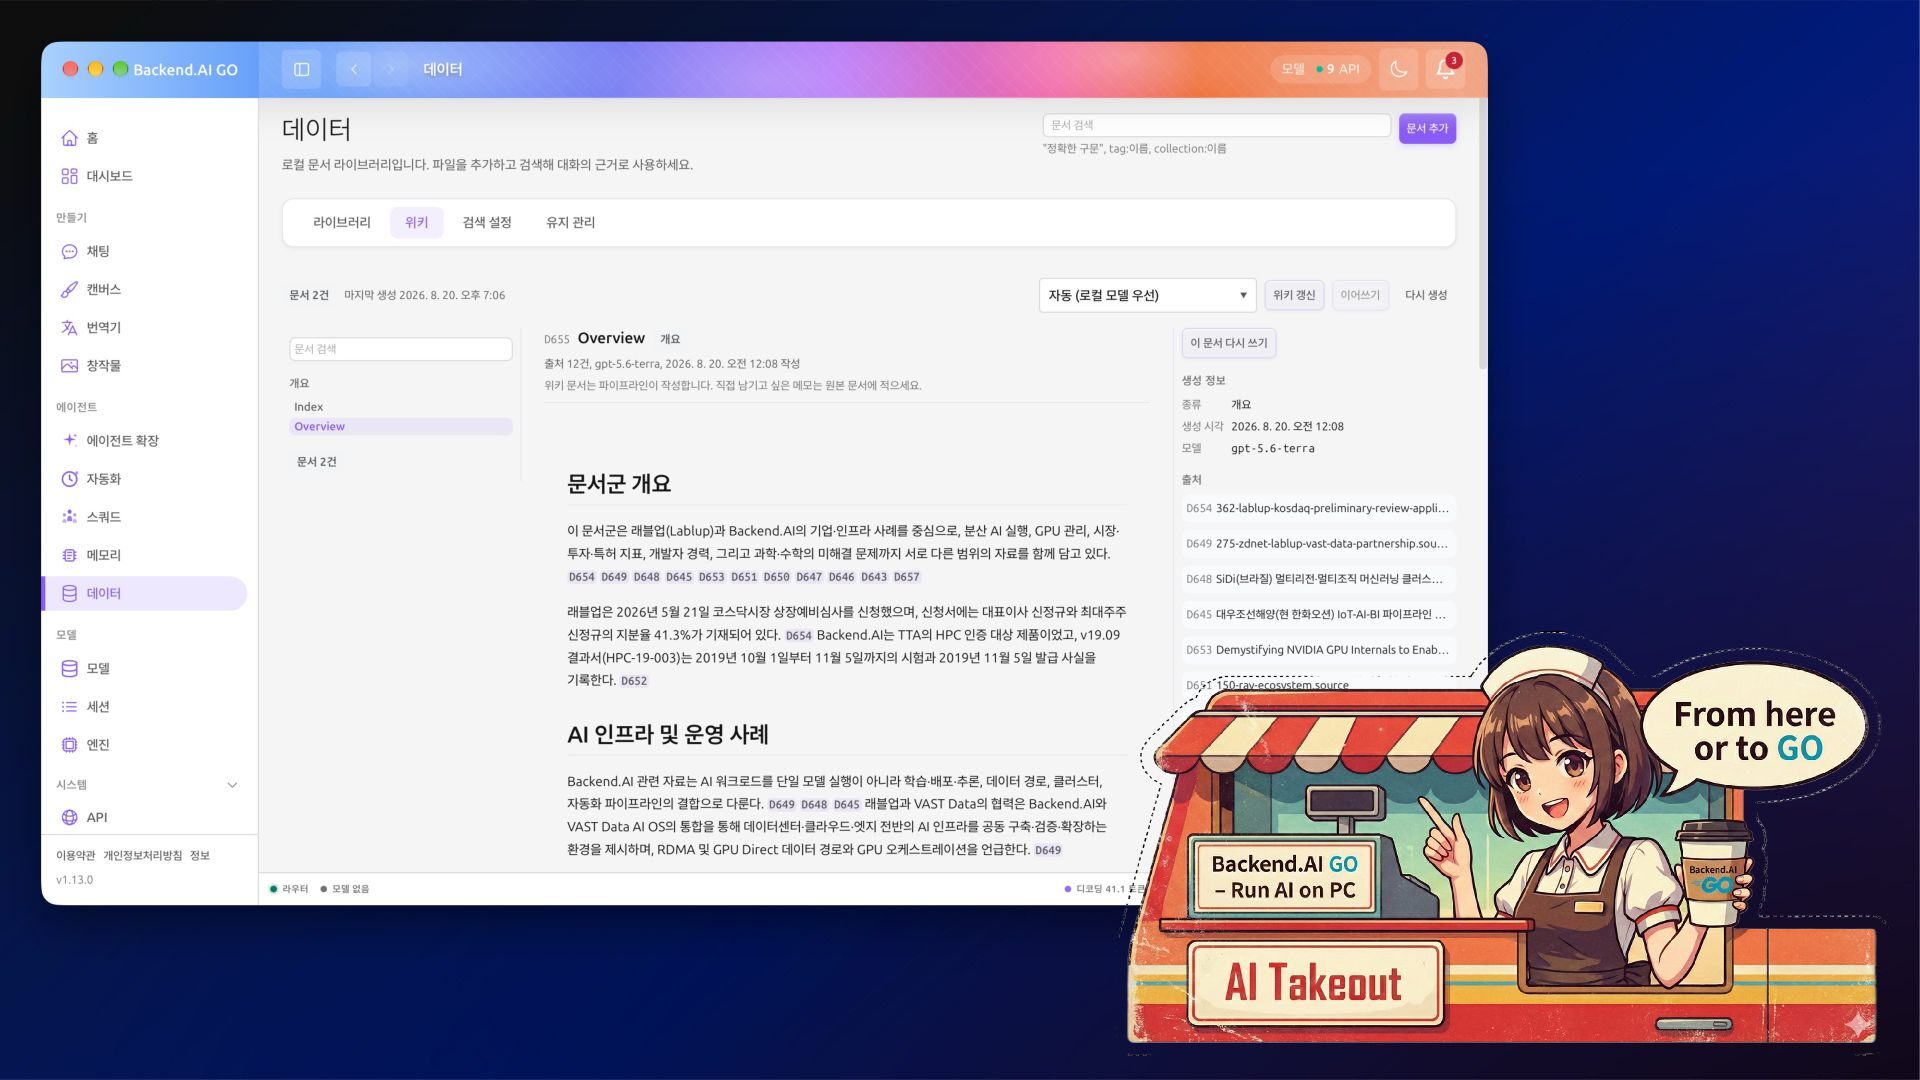
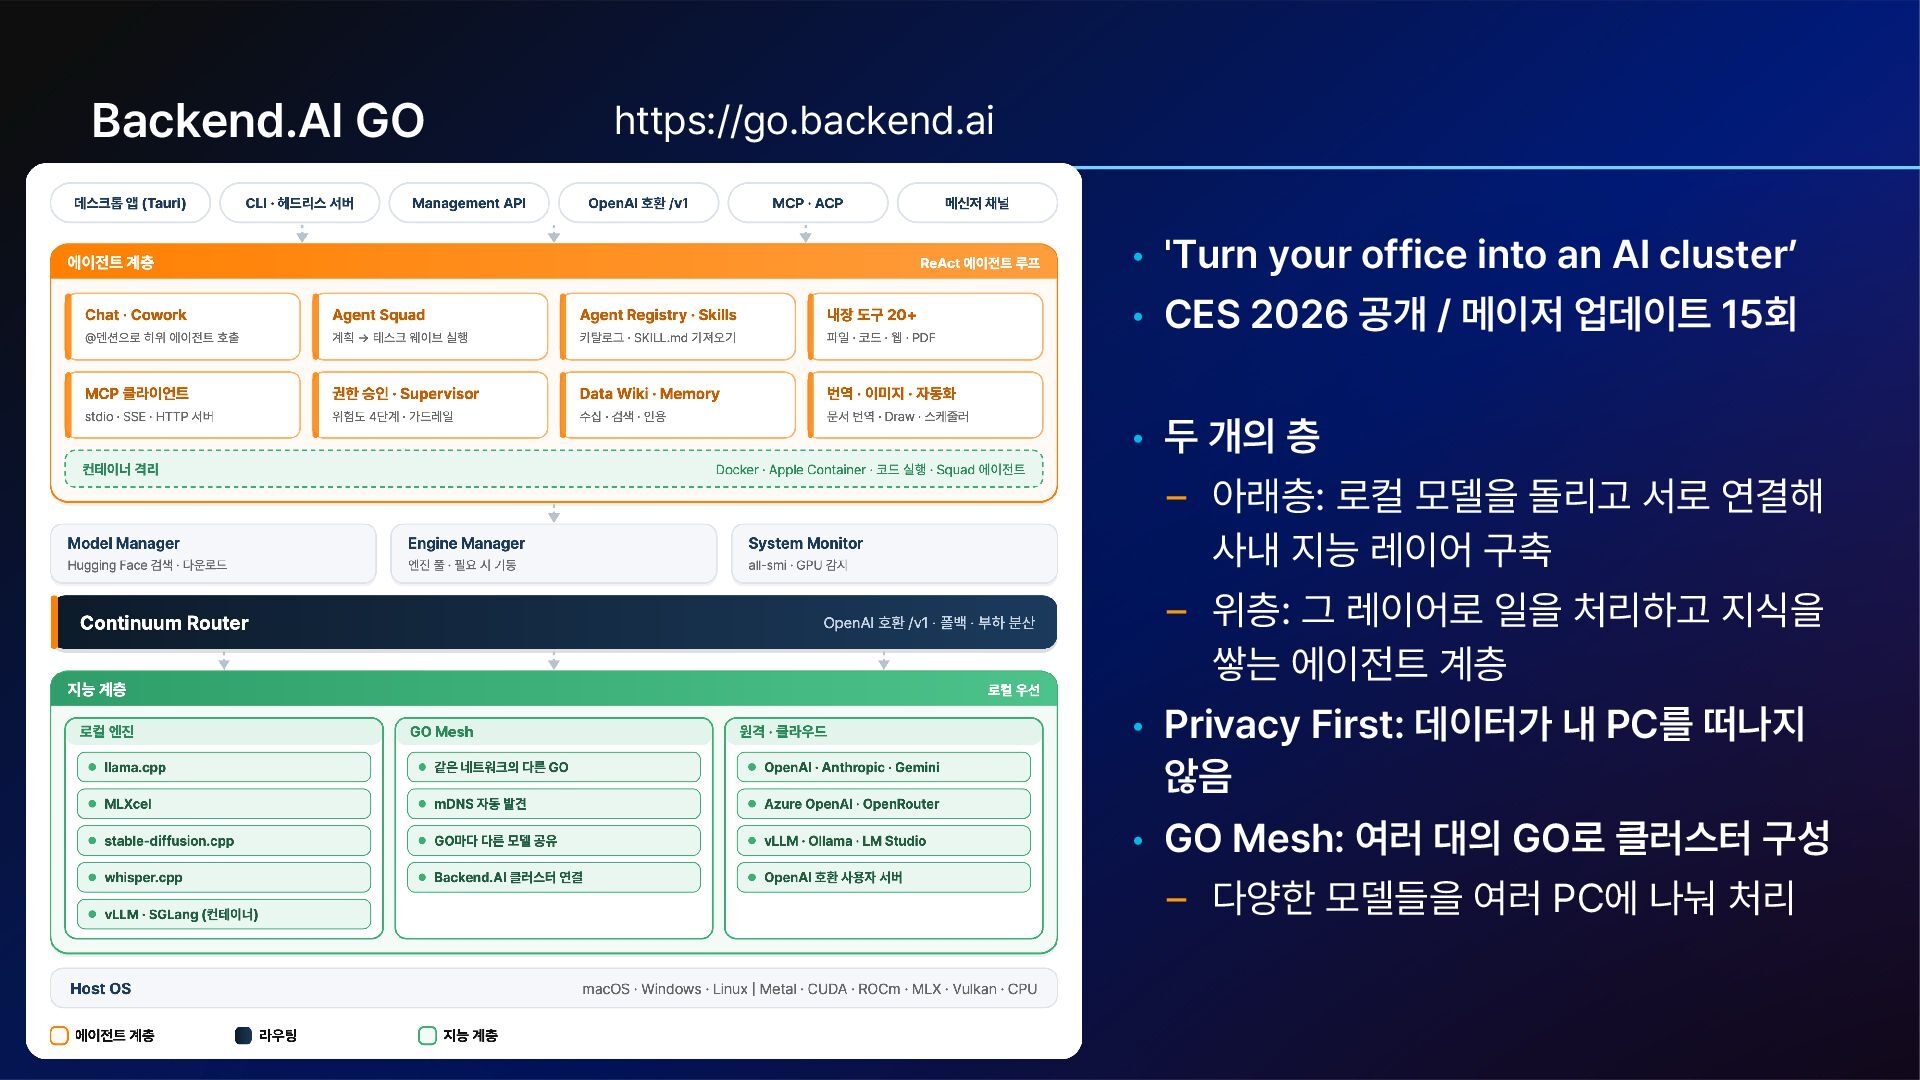
cluster • CES 2026 공개 / 메이저 업데이트 15회 • 두 개의 층 아래층: 로컬 모델을 돌리고 서로 연결해 사내 지능 레이어 구축 위층: 그 레이어로 일을 처리하고 지식을 쌓는 에이전트 계층 • Privacy First: 데이터가 내 PC를 떠나지 않음 • GO Mesh: 여러 대의 GO로 클러스터 구성 다양한 모델들을 여러 PC에 나눠 처리
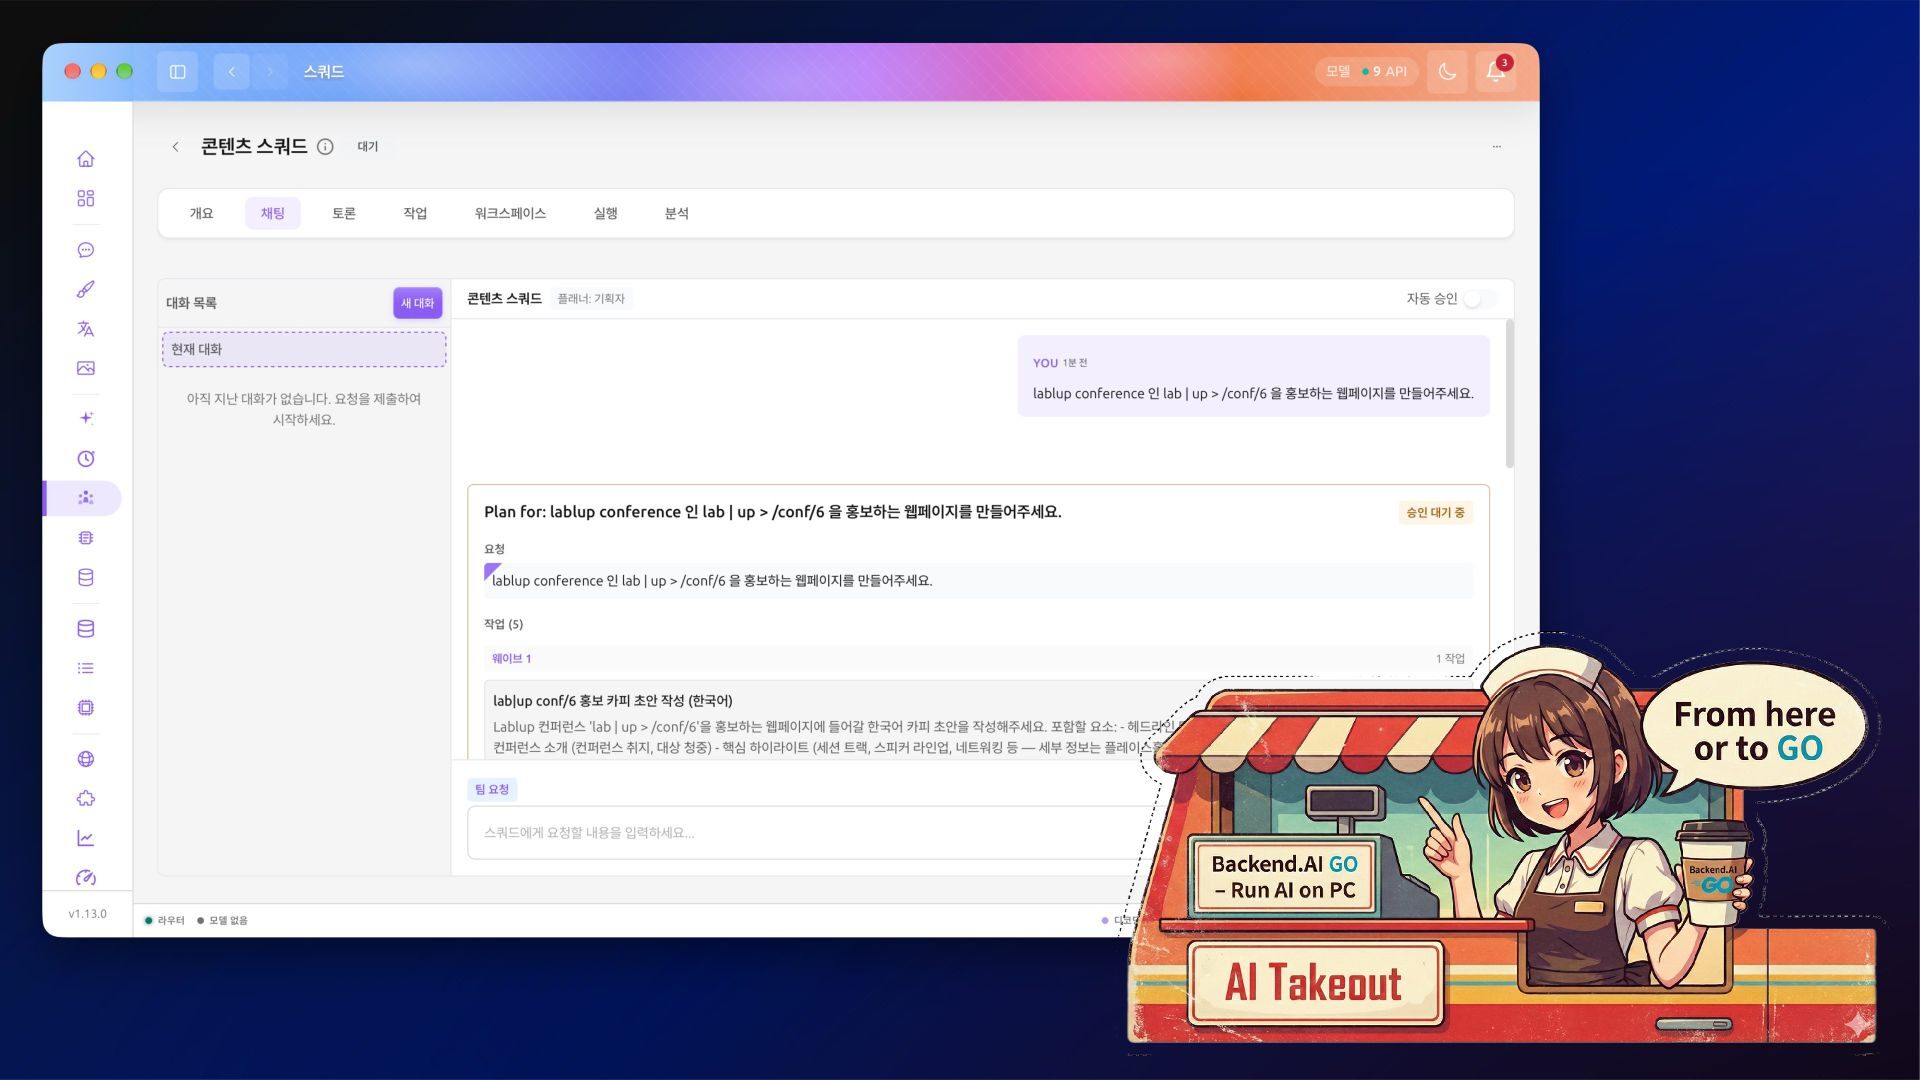
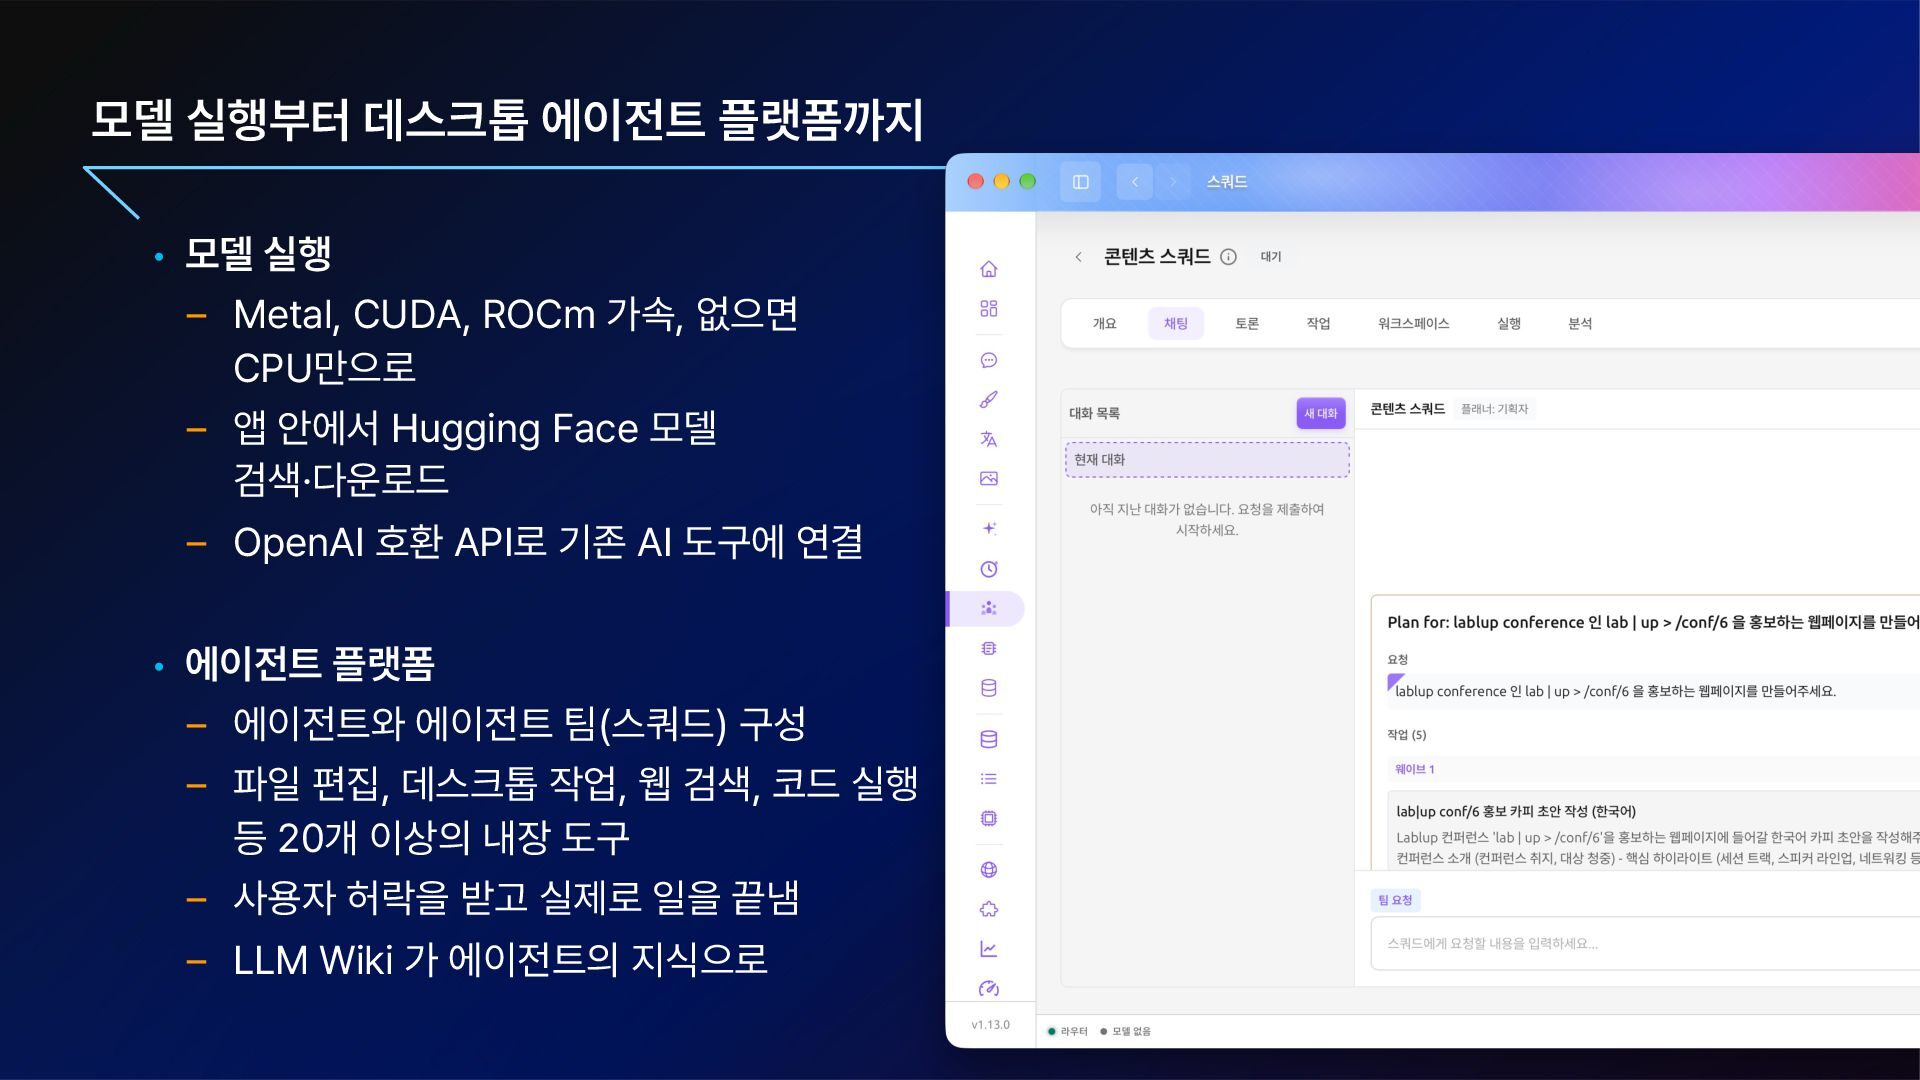
ROCm 가속, 없으면 CPU만으로 앱 안에서 Hugging Face 모델 검색·다운로드 OpenAI 호환 API로 기존 AI 도구에 연결 • 에이전트 플랫폼 에이전트와 에이전트 팀 스쿼드 구성 파일 편집, 데스크톱 작업, 웹 검색, 코드 실행 등 20개 이상의 내장 도구 사용자 허락을 받고 실제로 일을 끝냄 LLM Wiki 가 에이전트의 지식으로
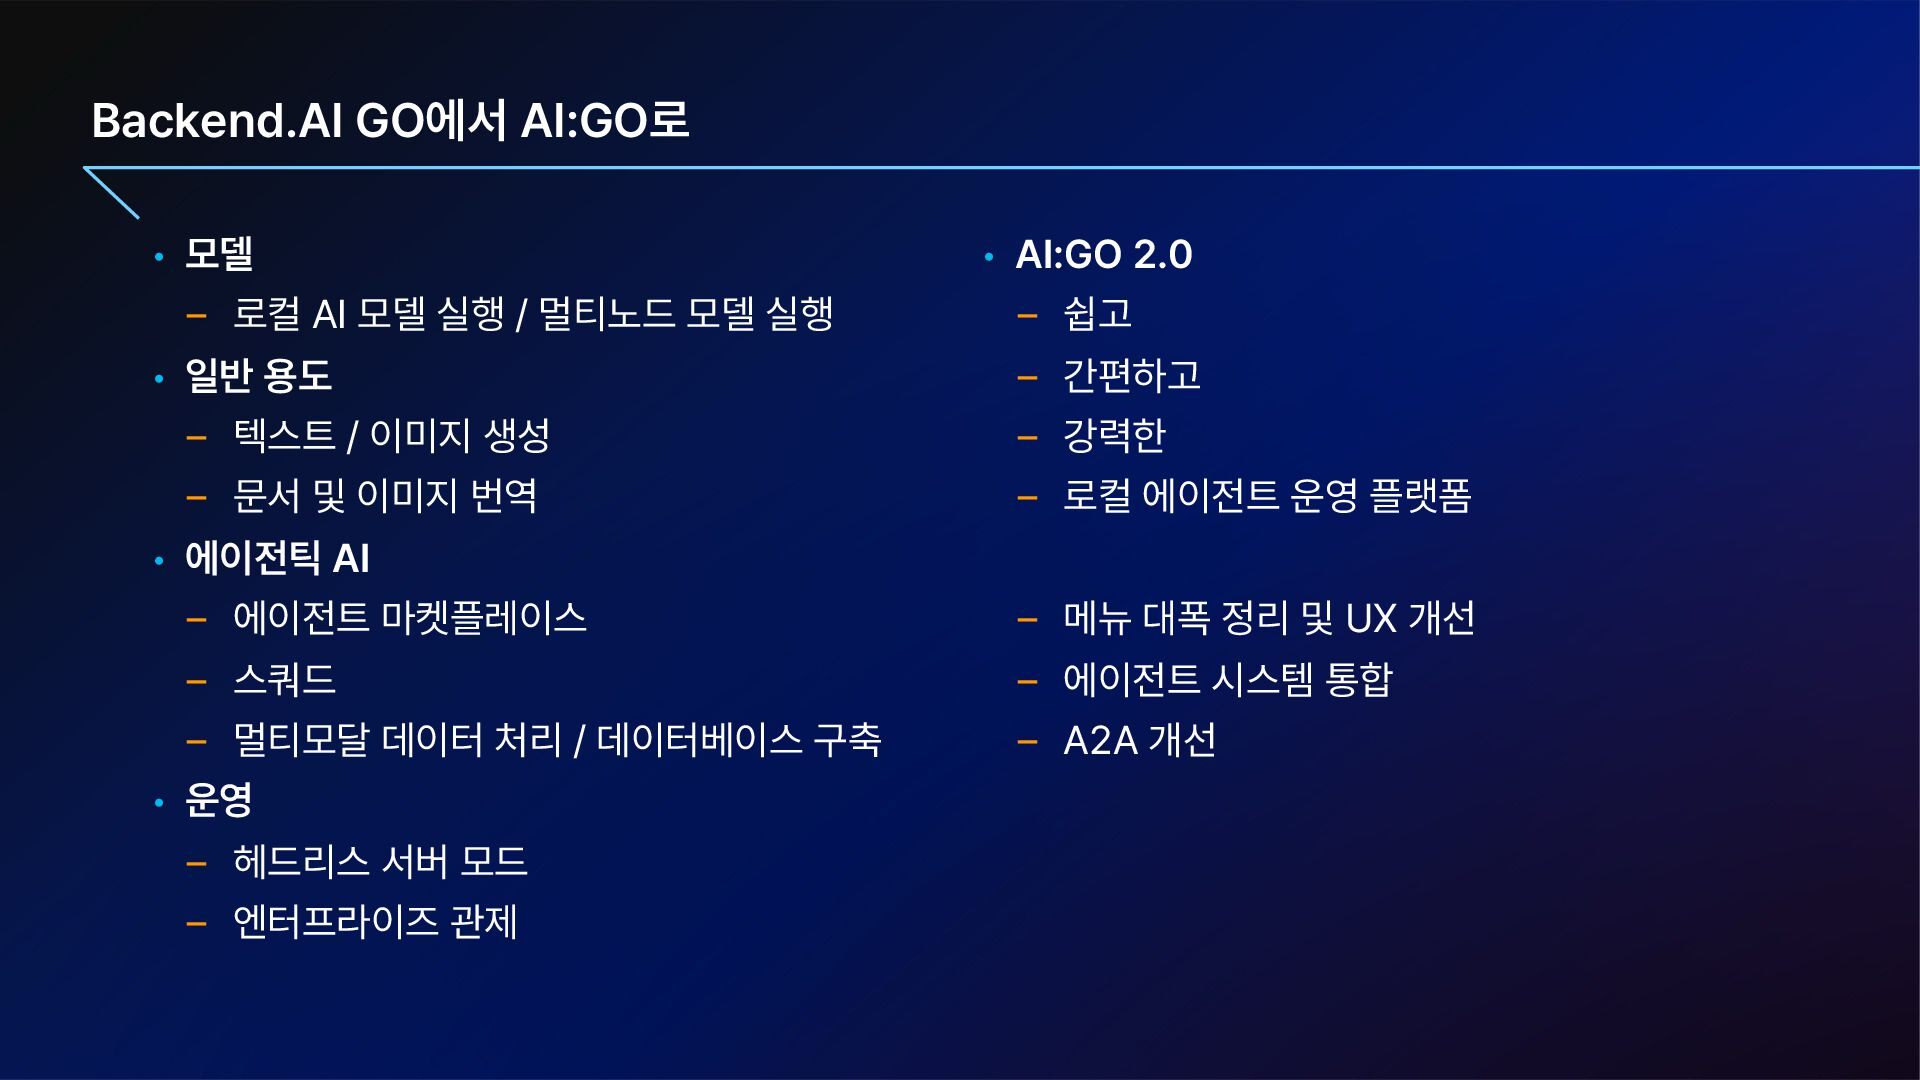
멀티노드 모델 실행 • 일반 용도 • AI:GO 2.0 쉽고 간편하고 텍스트 / 이미지 생성 강력한 문서 및 이미지 번역 로컬 에이전트 운영 플랫폼 • 에이전틱 AI 에이전트 마켓플레이스 메뉴 대폭 정리 및 UX 개선 스쿼드 에이전트 시스템 통합 멀티모달 데이터 처리 / 데이터베이스 구축 A2A 개선 • 운영 헤드리스 서버 모드 엔터프라이즈 관제
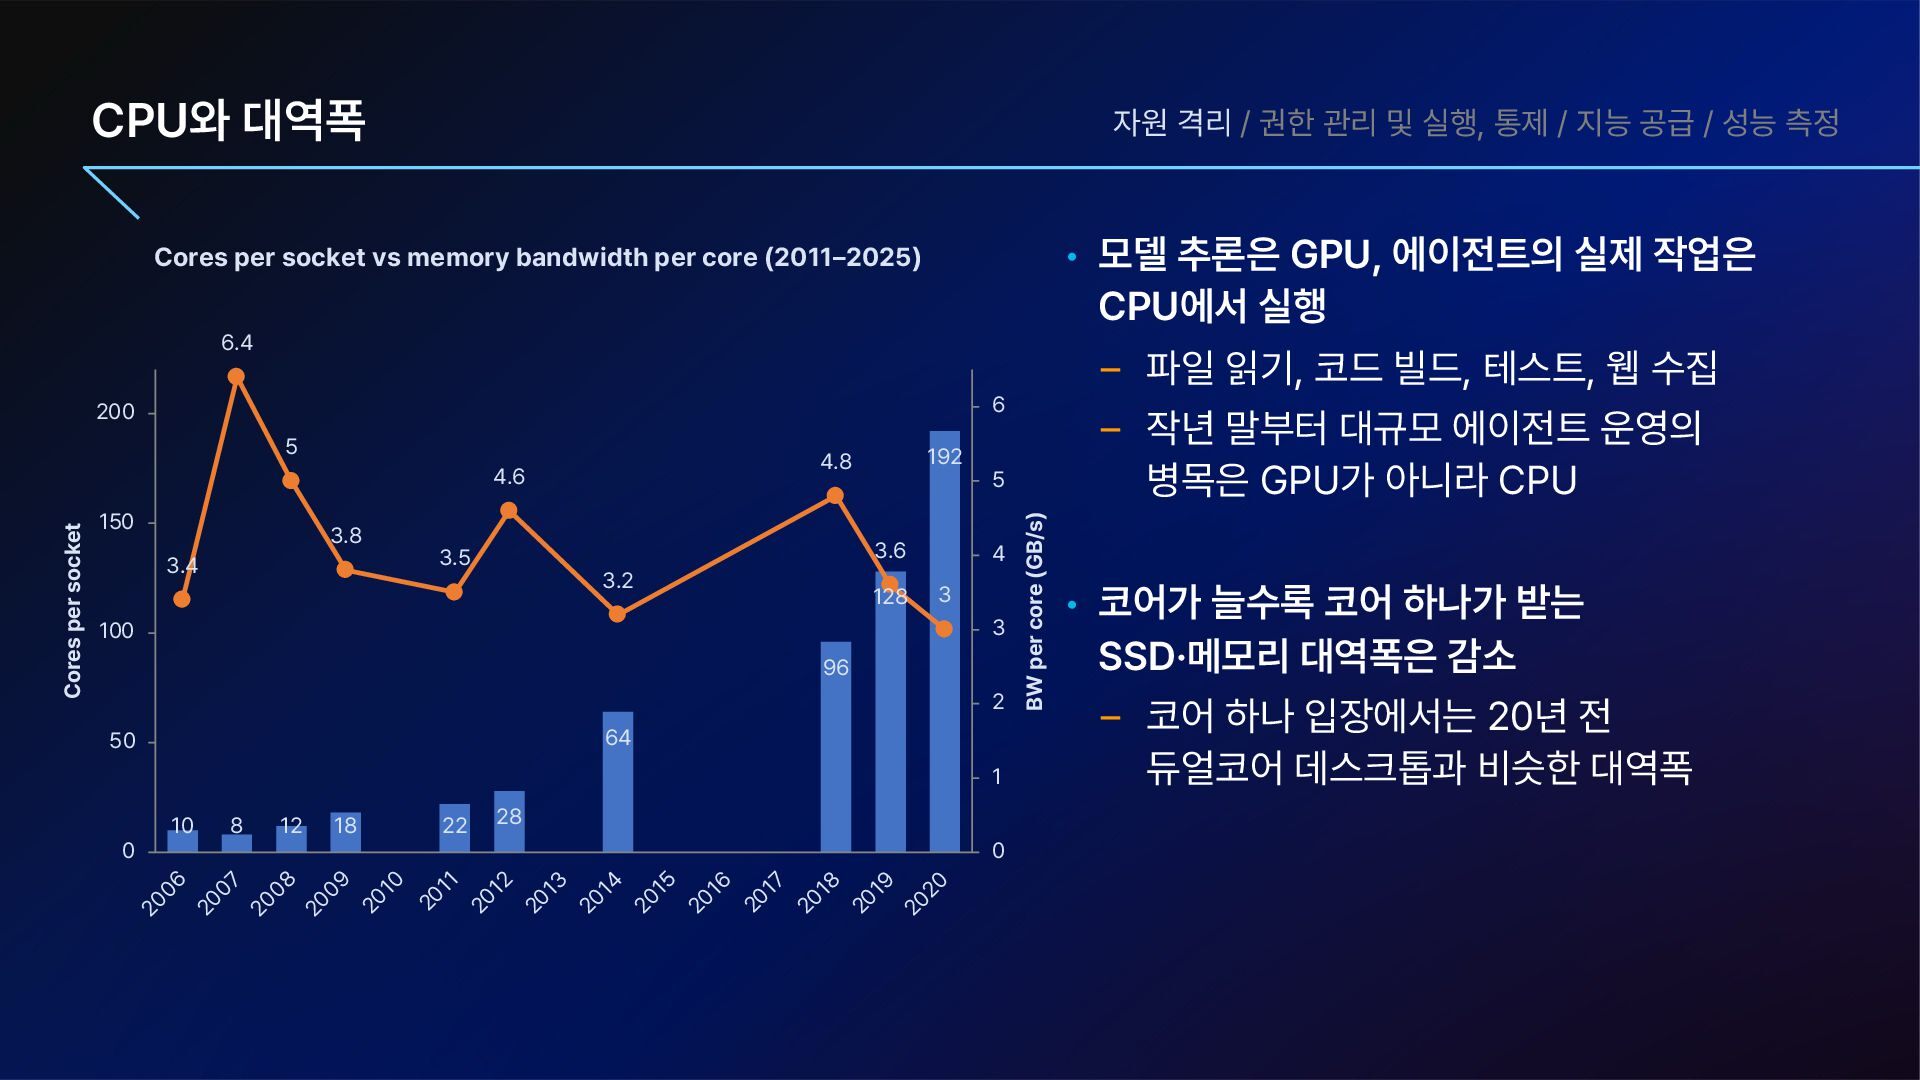
/ 지능 공급 / 성능 측정 • 모델 추론은 GPU, 에이전트의 실제 작업은 CPU에서 실행 Cores per socket vs memory bandwidth per core 2011 2025 6.4 6 5 3.8 3.4 3.6 3.5 3.2 128 3 3 96 2 64 50 1 8 12 18 22 28 6 20 07 20 08 20 09 20 10 20 11 20 12 20 13 20 14 20 15 20 16 20 17 20 18 20 19 20 20 10 작년 말부터 대규모 에이전트 운영의 병목은 GPU가 아니라 CPU 5 4 100 20 0 Cores per socket 4.6 150 192 4.8 0 BW per core GB/s 200 0 파일 읽기, 코드 빌드, 테스트, 웹 수집 • 코어가 늘수록 코어 하나가 받는 SSD·메모리 대역폭은 감소 코어 하나 입장에서는 20년 전 듀얼코어 데스크톱과 비슷한 대역폭
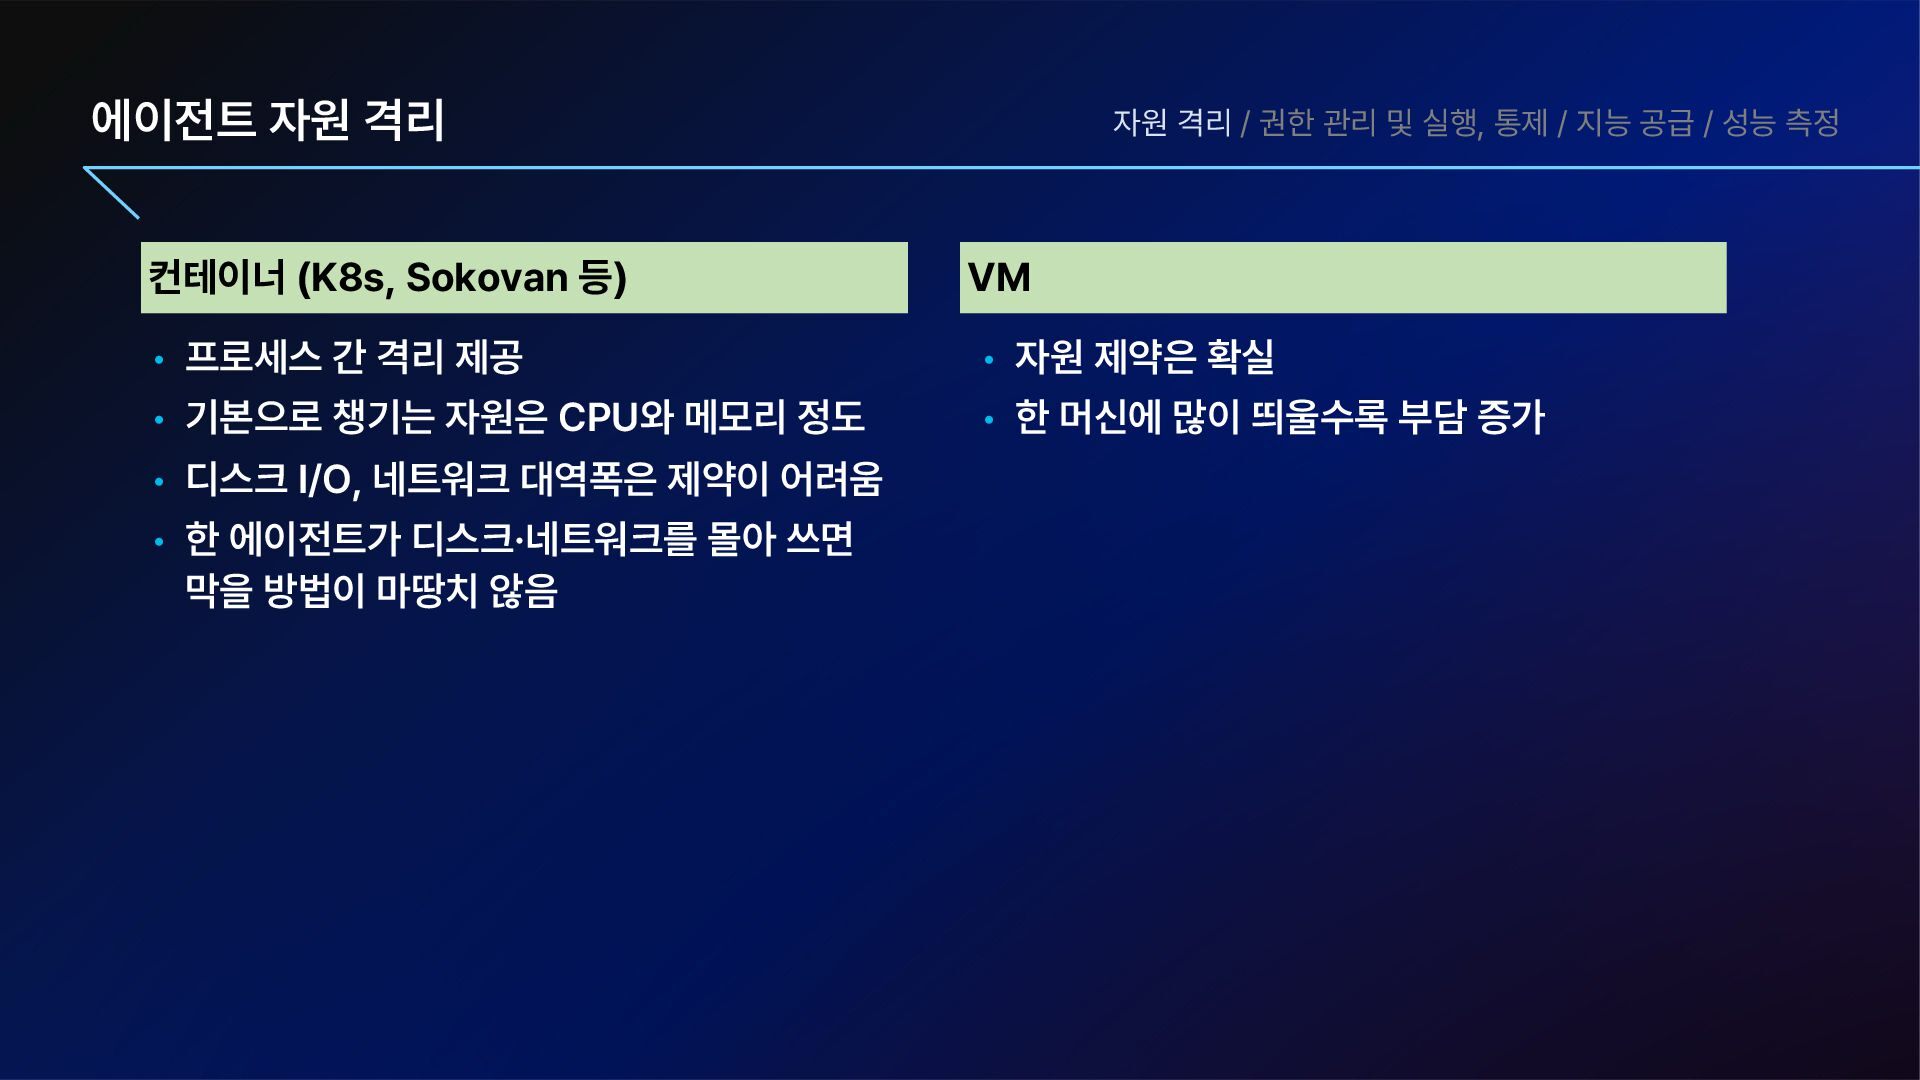
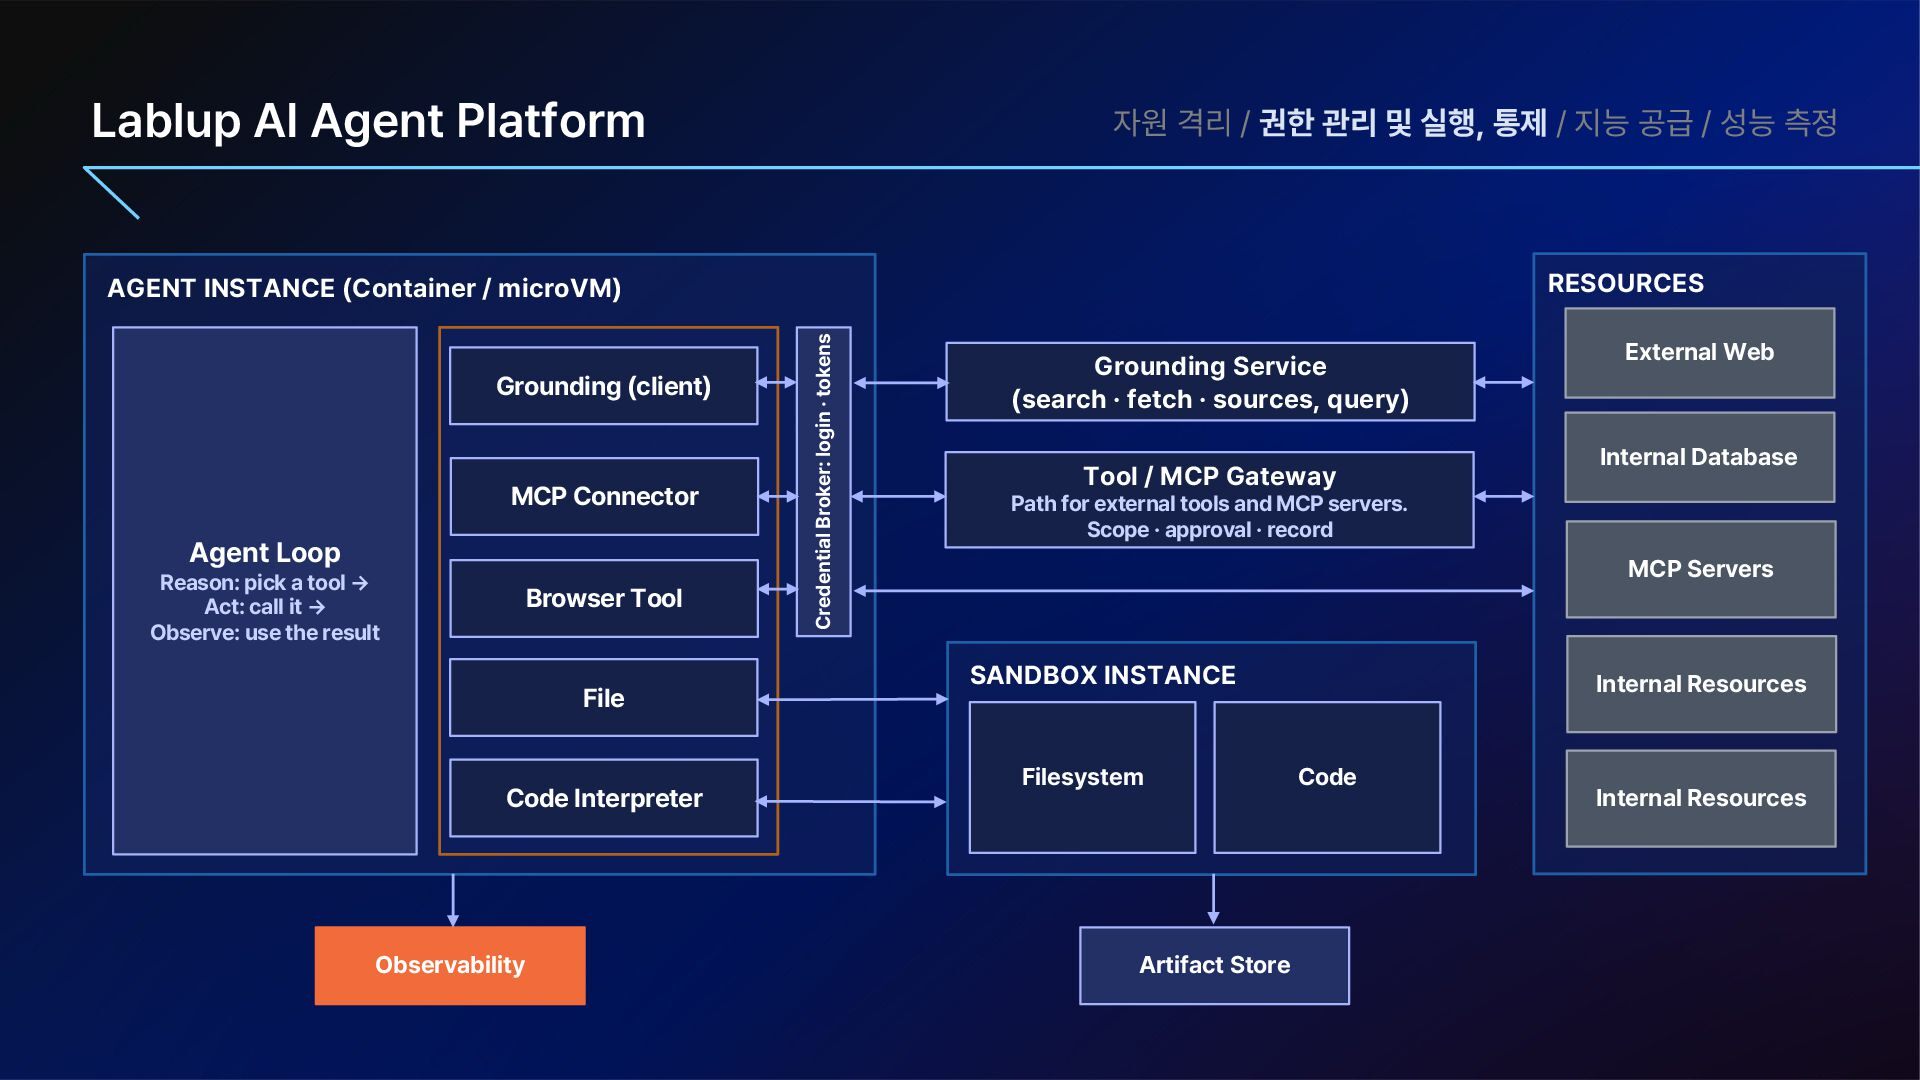
통제 / 지능 공급 / 성능 측정 컨테이너 K8s, Sokovan 등 VM • 프로세스 간 격리 제공 • 자원 제약은 확실 • 기본으로 챙기는 자원은 CPU와 메모리 정도 • 한 머신에 많이 띄울수록 부담 증가 • 디스크 I/O, 네트워크 대역폭은 제약이 어려움 • 한 에이전트가 디스크·네트워크를 몰아 쓰면 막을 방법이 마땅치 않음
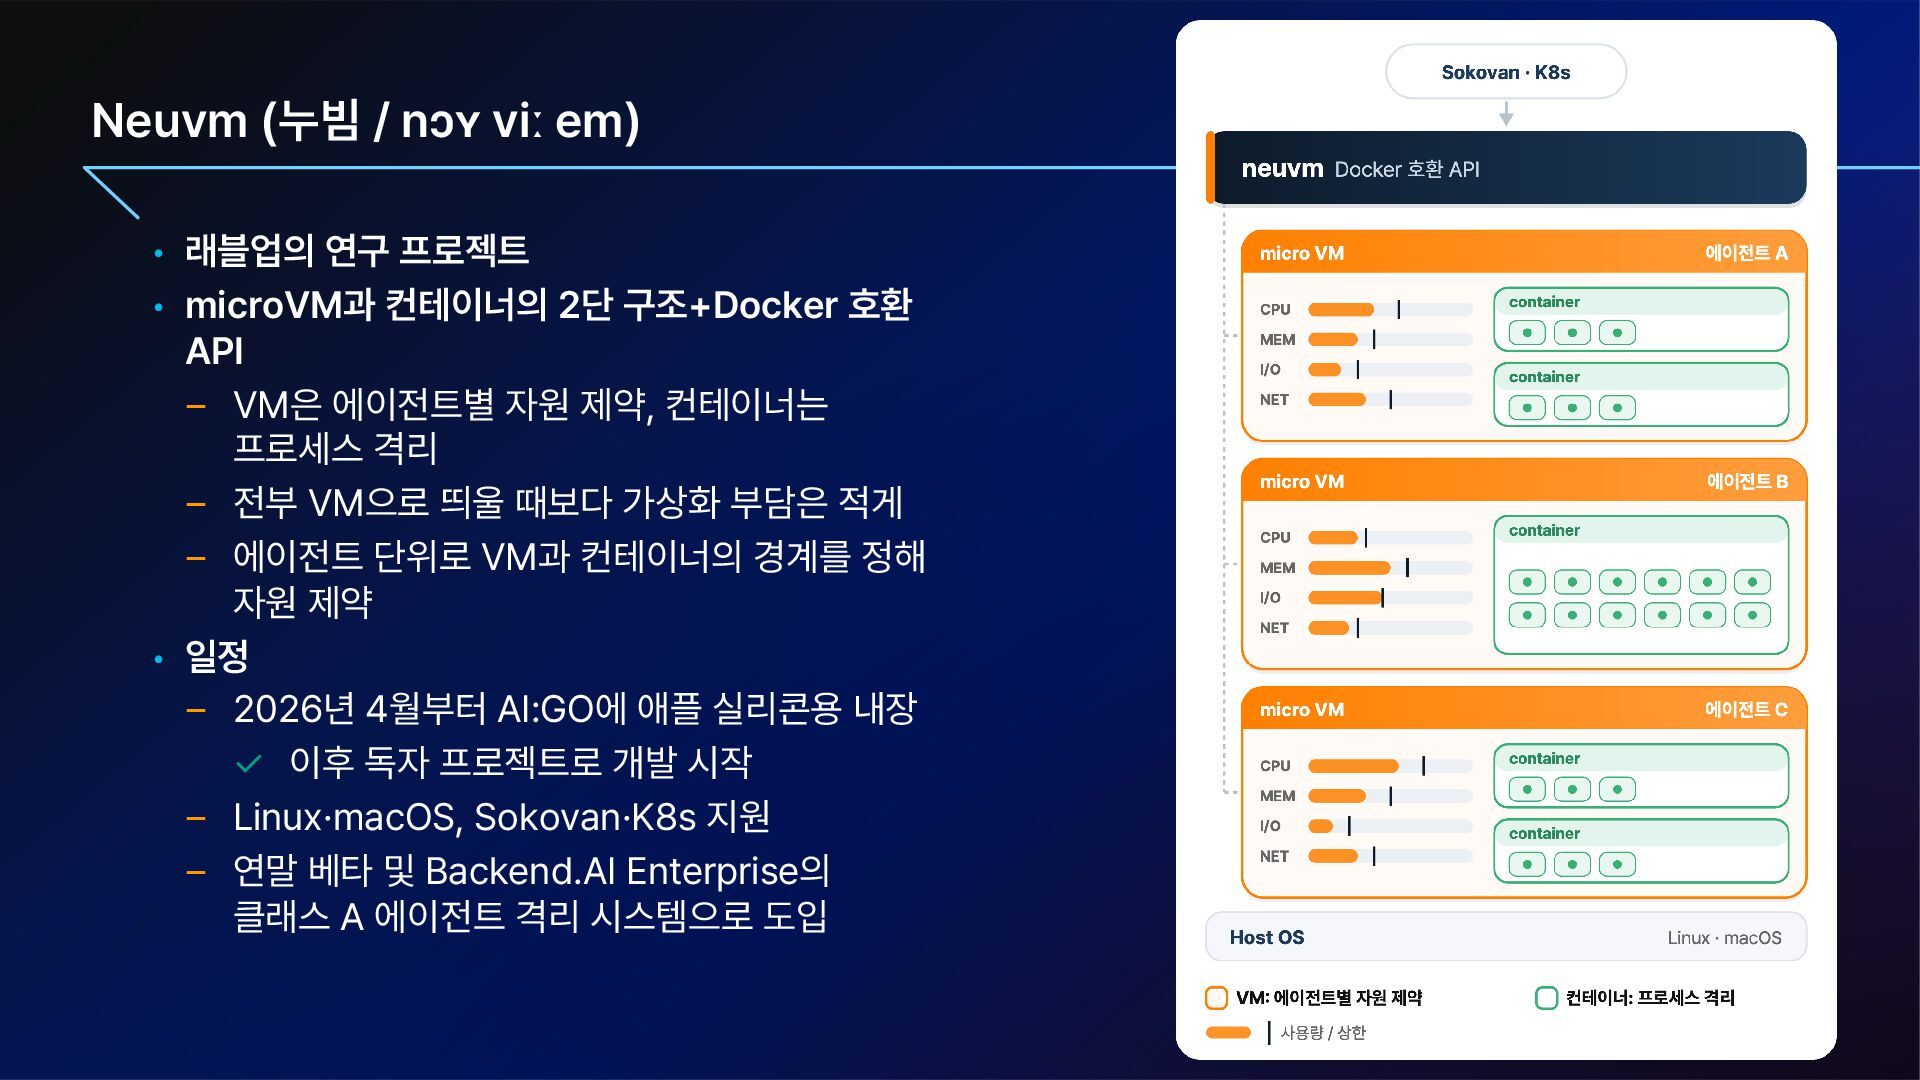
• microVM과 컨테이너의 2단 구조 Docker 호환 API VM은 에이전트별 자원 제약, 컨테이너는 프로세스 격리 전부 VM으로 띄울 때보다 가상화 부담은 적게 에이전트 단위로 VM과 컨테이너의 경계를 정해 자원 제약 • 일정 2026년 4월부터 AI:GO에 애플 실리콘용 내장 이후 독자 프로젝트로 개발 시작 Linux·macOS, Sokovan·K8s 지원 연말 베타 및 Backend.AI Enterprise의 클래스 A 에이전트 격리 시스템으로 도입
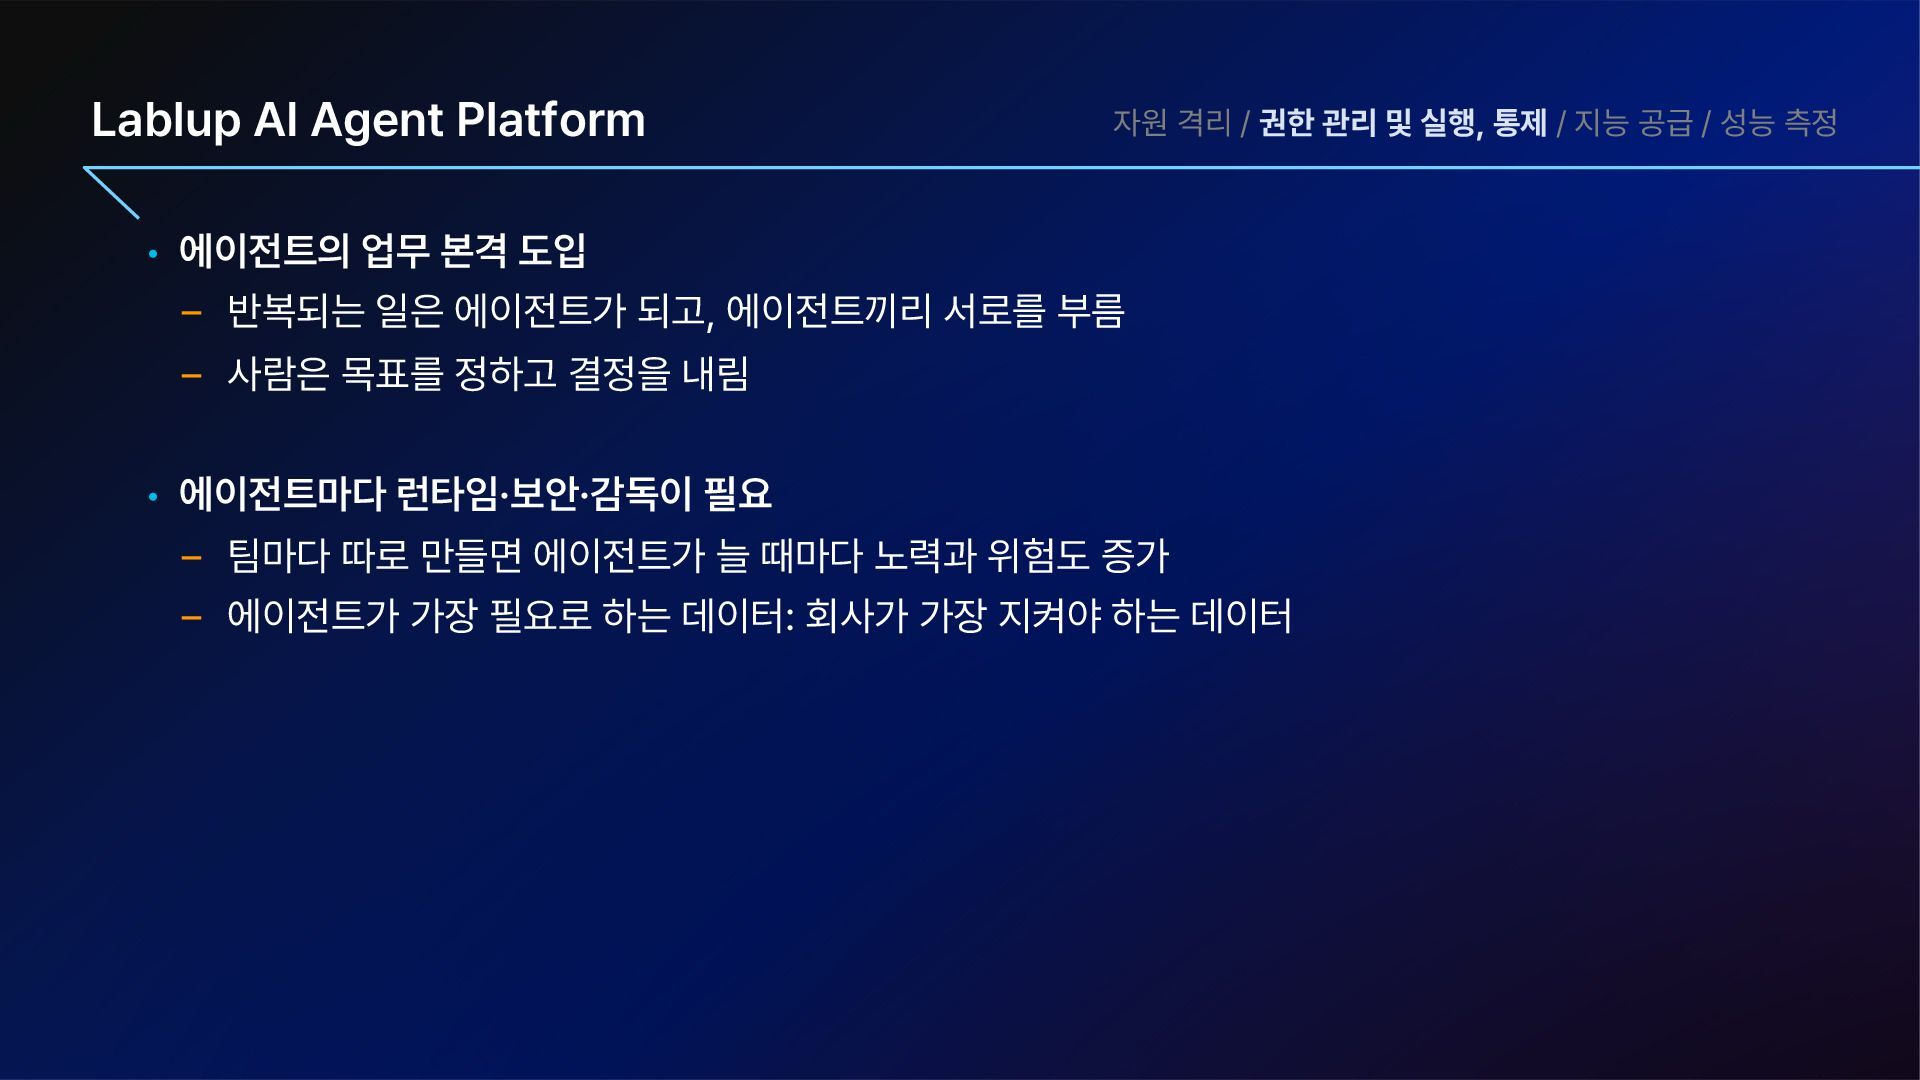
실행, 통제 / 지능 공급 / 성능 측정 • 에이전트의 업무 본격 도입 반복되는 일은 에이전트가 되고, 에이전트끼리 서로를 부름 사람은 목표를 정하고 결정을 내림 • 에이전트마다 런타임·보안·감독이 필요 팀마다 따로 만들면 에이전트가 늘 때마다 노력과 위험도 증가 에이전트가 가장 필요로 하는 데이터: 회사가 가장 지켜야 하는 데이터
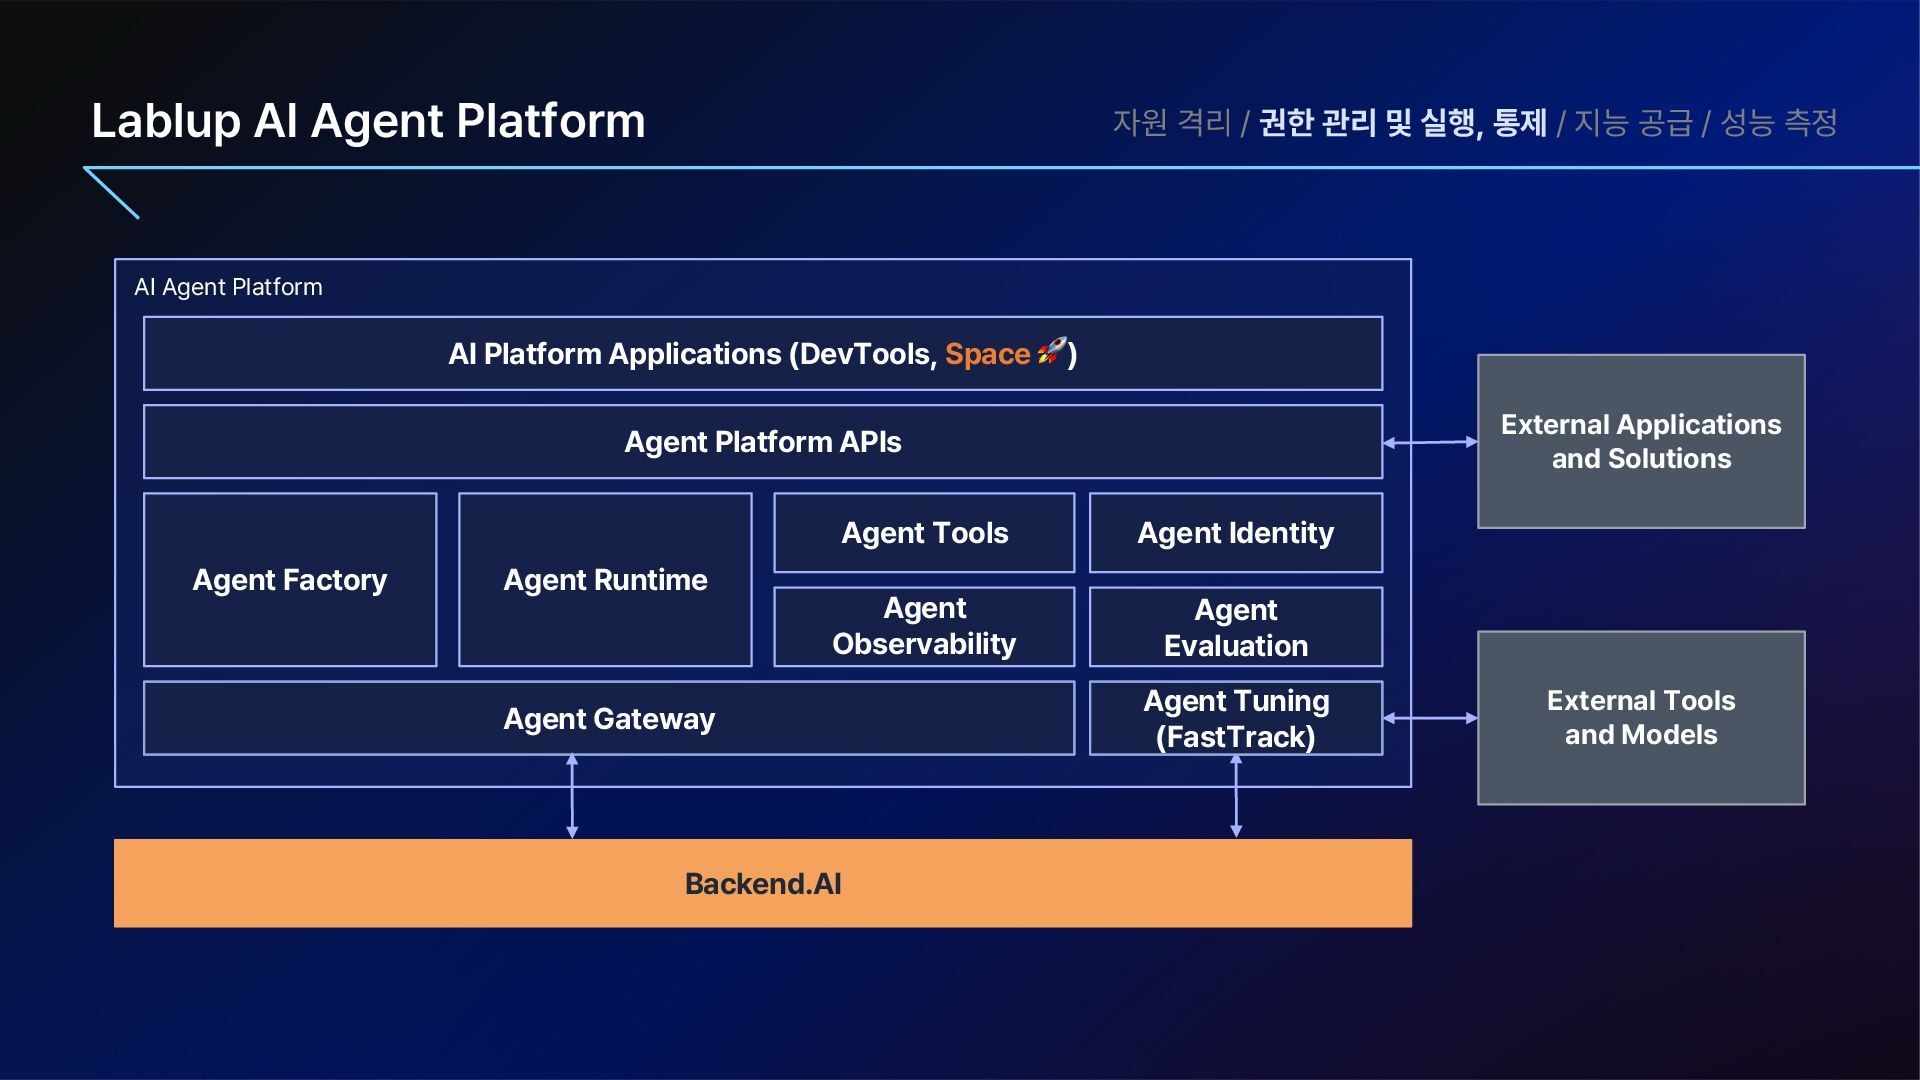
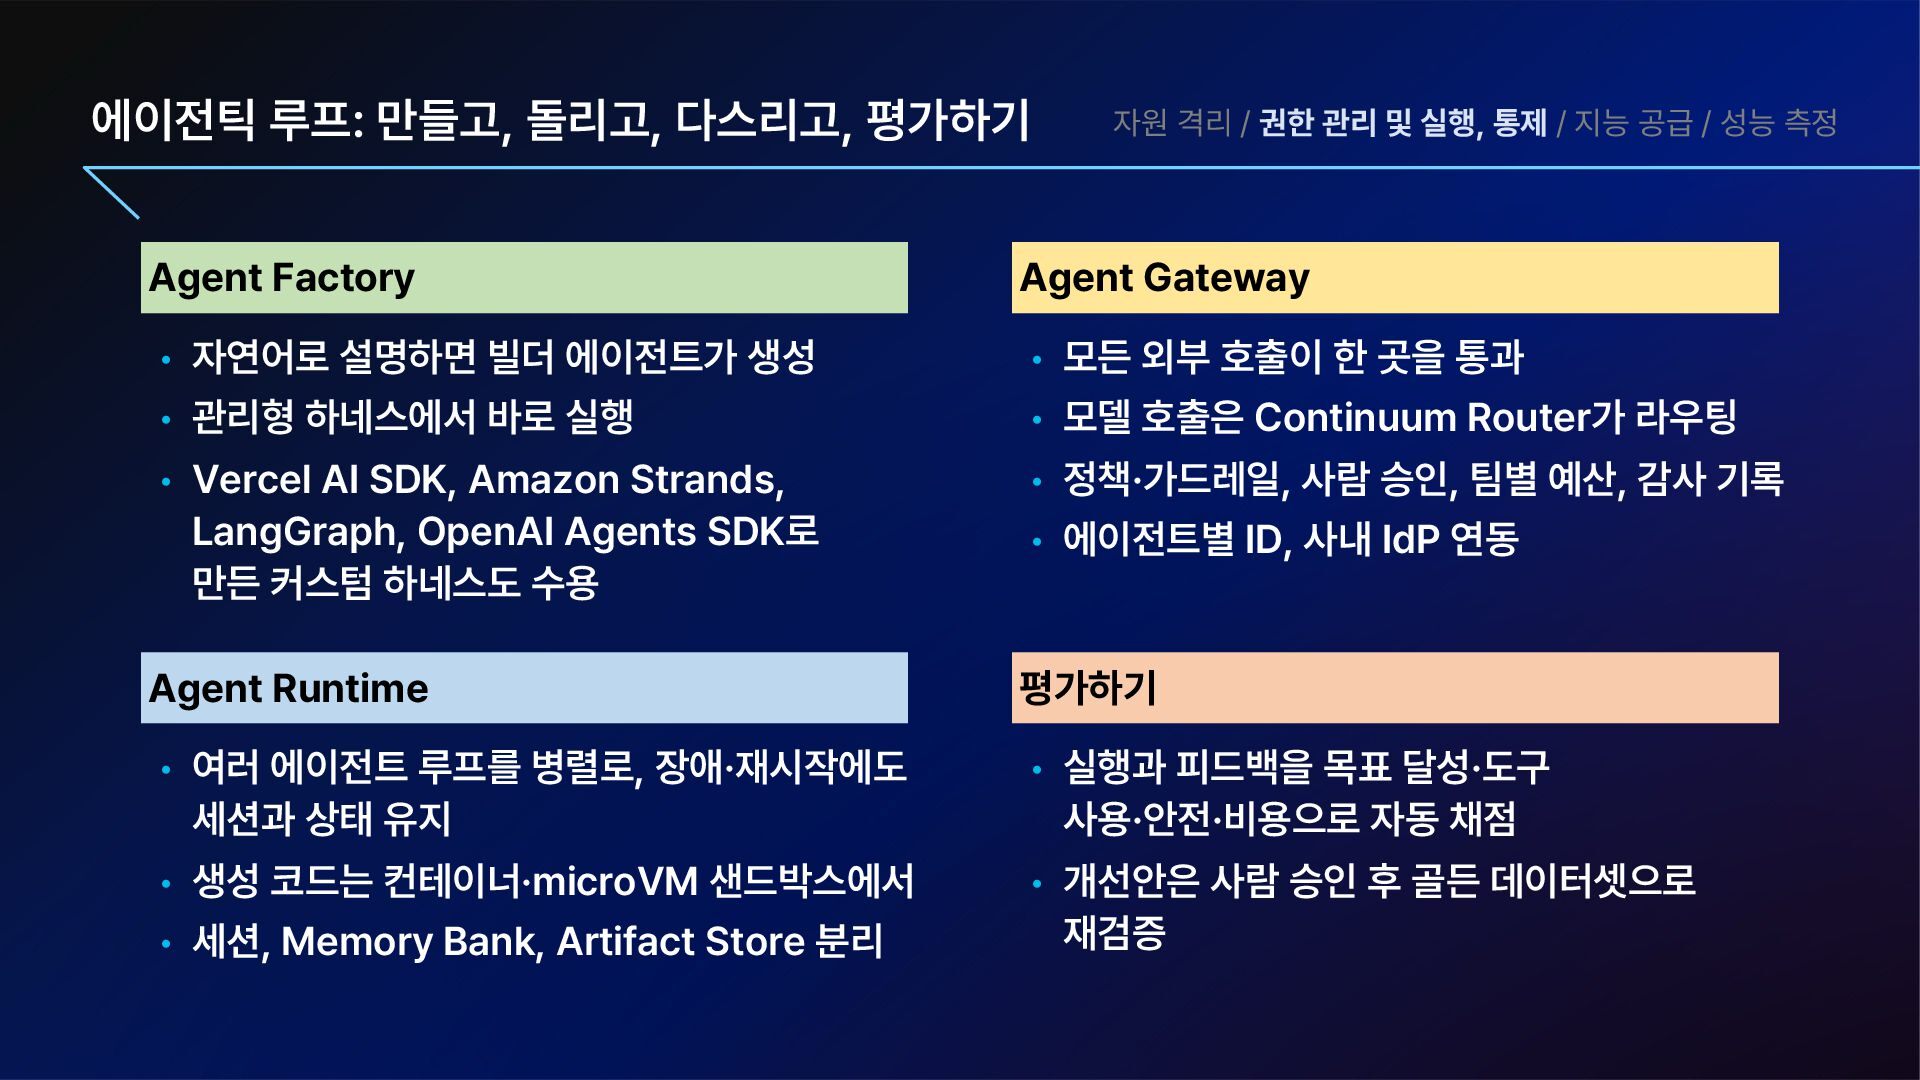
관리 및 실행, 통제 / 지능 공급 / 성능 측정 Agent Factory Agent Gateway • 자연어로 설명하면 빌더 에이전트가 생성 • 모든 외부 호출이 한 곳을 통과 • 관리형 하네스에서 바로 실행 • 모델 호출은 Continuum Router가 라우팅 • Vercel AI SDK, Amazon Strands, LangGraph, OpenAI Agents SDK로 만든 커스텀 하네스도 수용 • 정책·가드레일, 사람 승인, 팀별 예산, 감사 기록 Agent Runtime 평가하기 • 여러 에이전트 루프를 병렬로, 장애·재시작에도 세션과 상태 유지 • 실행과 피드백을 목표 달성·도구 사용·안전·비용으로 자동 채점 • 생성 코드는 컨테이너·microVM 샌드박스에서 • 개선안은 사람 승인 후 골든 데이터셋으로 재검증 • 세션, Memory Bank, Artifact Store 분리 • 에이전트별 ID, 사내 IdP 연동
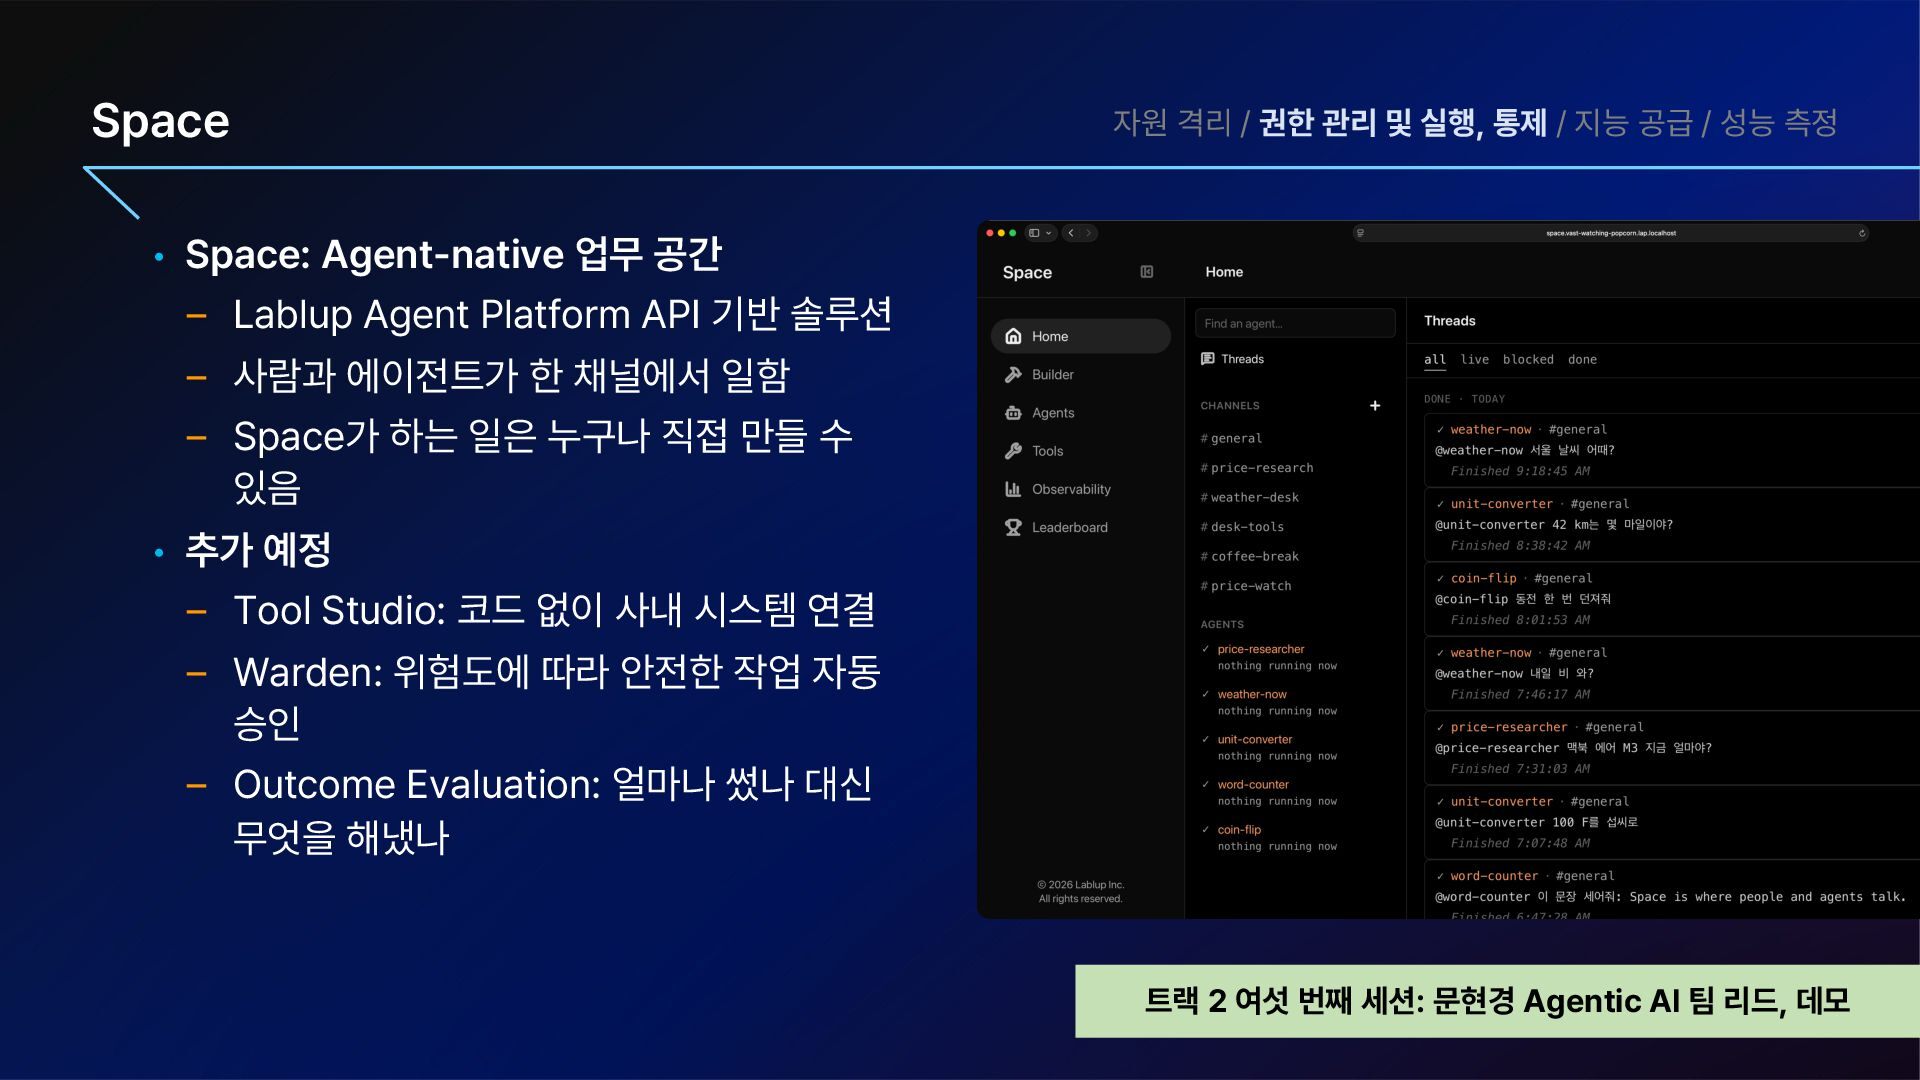
지능 공급 / 성능 측정 • Space: Agent native 업무 공간 Lablup Agent Platform API 기반 솔루션 사람과 에이전트가 한 채널에서 일함 Space가 하는 일은 누구나 직접 만들 수 있음 • 추가 예정 Tool Studio: 코드 없이 사내 시스템 연결 Warden: 위험도에 따라 안전한 작업 자동 승인 Outcome Evaluation: 얼마나 썼나 대신 무엇을 해냈나 트랙 2 여섯 번째 세션: 문현경 Agentic AI 팀 리드, 데모
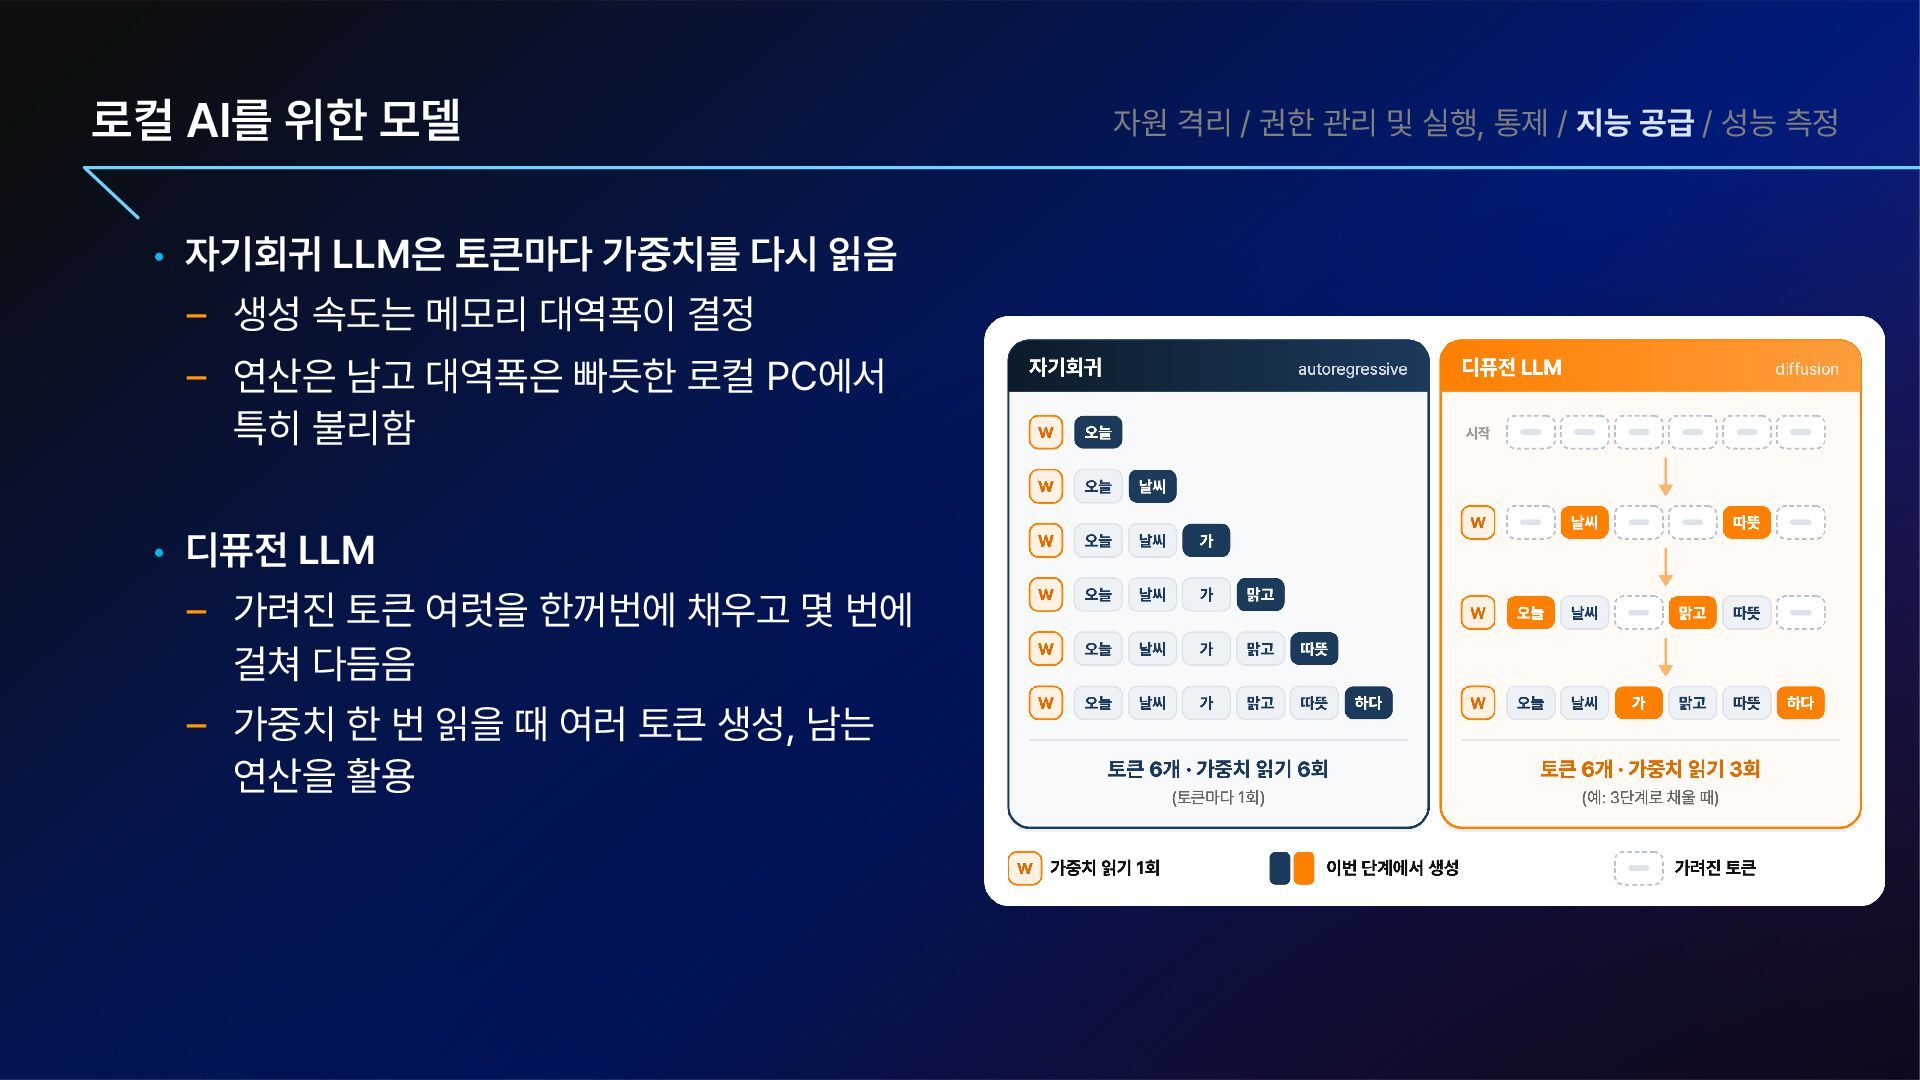
읽음 생성 속도는 메모리 대역폭이 결정 연산은 남고 대역폭은 빠듯한 로컬 PC에서 특히 불리함 • 디퓨전 LLM 가려진 토큰 여럿을 한꺼번에 채우고 몇 번에 걸쳐 다듬음 가중치 한 번 읽을 때 여러 토큰 생성, 남는 연산을 활용 자원 격리 / 권한 관리 및 실행, 통제 / 지능 공급 / 성능 측정
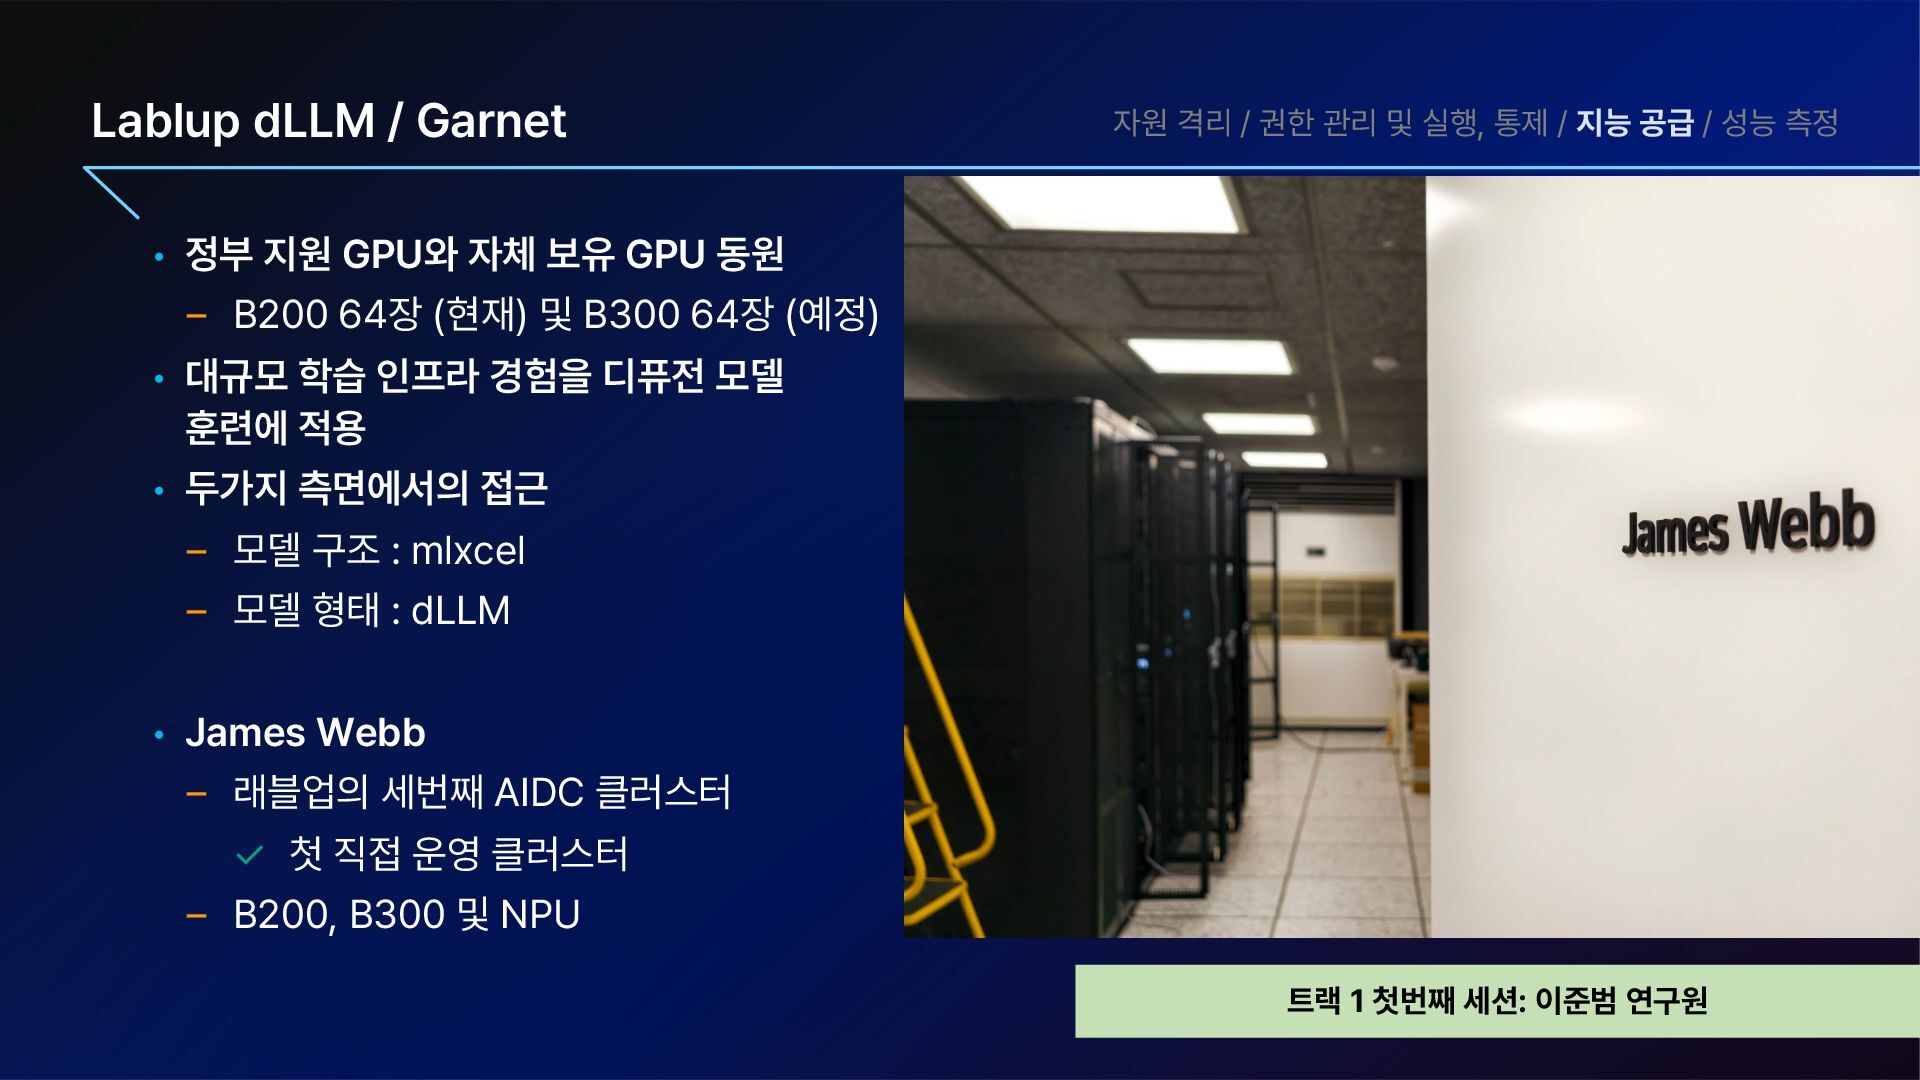
실행, 통제 / 지능 공급 / 성능 측정 • 정부 지원 GPU와 자체 보유 GPU 동원 B200 64장 현재 및 B300 64장 예정 • 대규모 학습 인프라 경험을 디퓨전 모델 훈련에 적용 • 두가지 측면에서의 접근 모델 구조 : mlxcel 모델 형태 : dLLM • James Webb 래블업의 세번째 AIDC 클러스터 첫 직접 운영 클러스터 B200, B300 및 NPU 트랙 1 첫번째 세션: 이준범 연구원
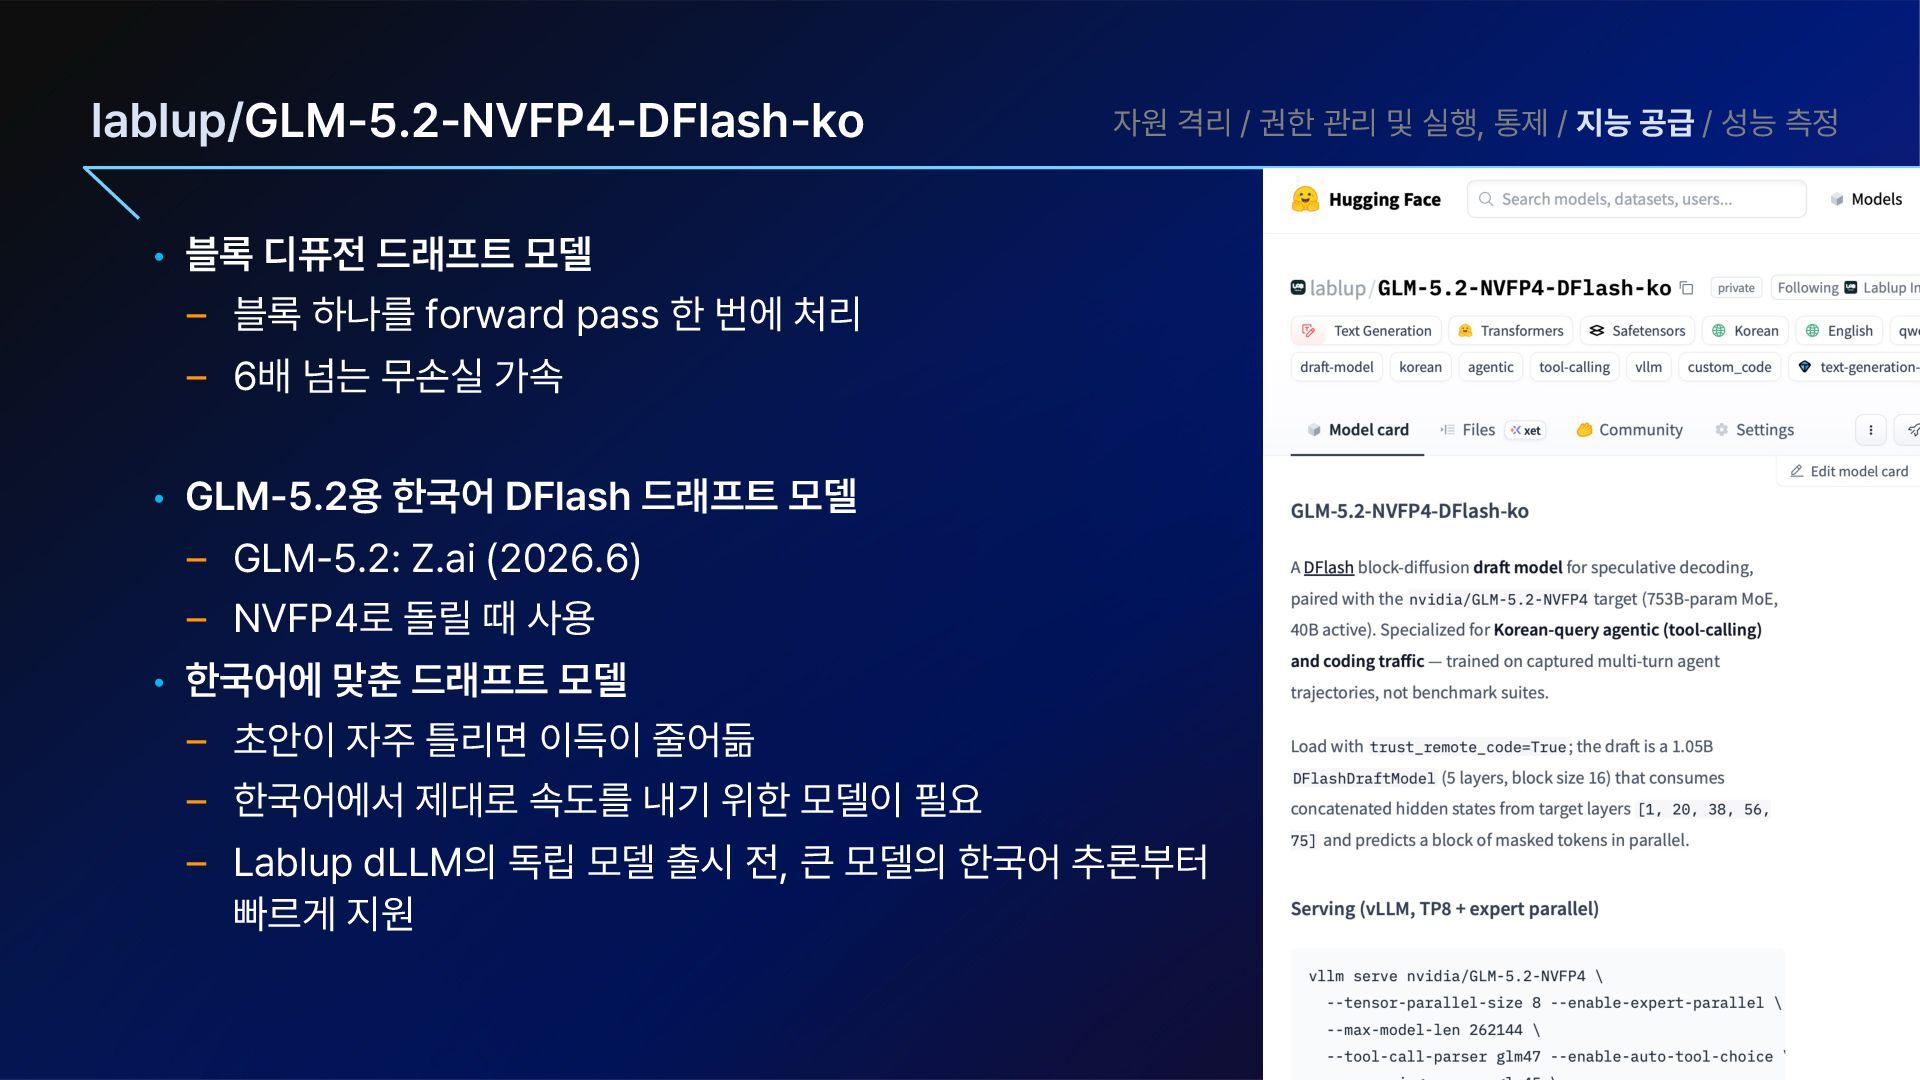
및 실행, 통제 / 지능 공급 / 성능 측정 • 블록 디퓨전 드래프트 모델 블록 하나를 forward pass 한 번에 처리 6배 넘는 무손실 가속 • GLM 5.2용 한국어 DFlash 드래프트 모델 GLM 5.2: Z.ai 2026.6 NVFP4로 돌릴 때 사용 • 한국어에 맞춘 드래프트 모델 초안이 자주 틀리면 이득이 줄어듦 한국어에서 제대로 속도를 내기 위한 모델이 필요 Lablup dLLM의 독립 모델 출시 전, 큰 모델의 한국어 추론부터 빠르게 지원
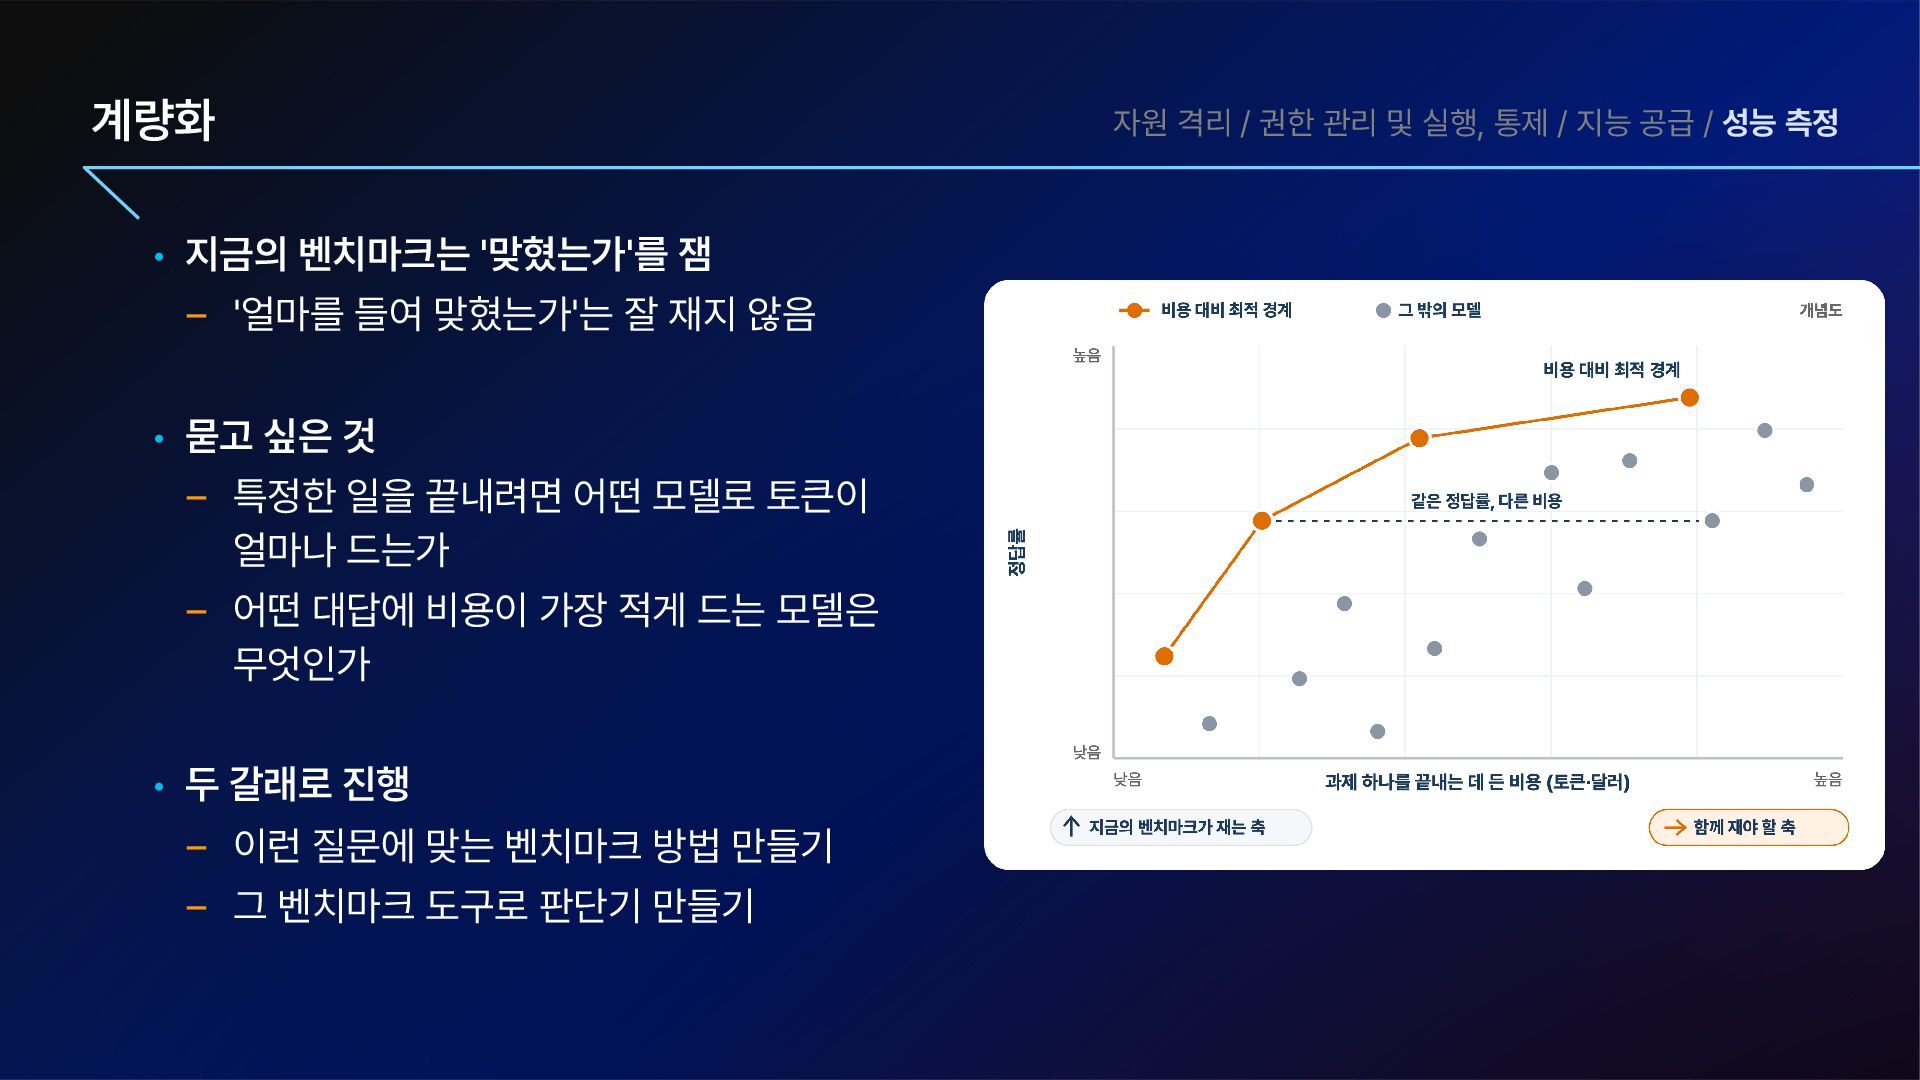
지능 공급 / 성능 측정 • 지금의 벤치마크는 맞혔는가 를 잼 얼마를 들여 맞혔는가 는 잘 재지 않음 • 묻고 싶은 것 특정한 일을 끝내려면 어떤 모델로 토큰이 얼마나 드는가 어떤 대답에 비용이 가장 적게 드는 모델은 무엇인가 • 두 갈래로 진행 이런 질문에 맞는 벤치마크 방법 만들기 그 벤치마크 도구로 판단기 만들기
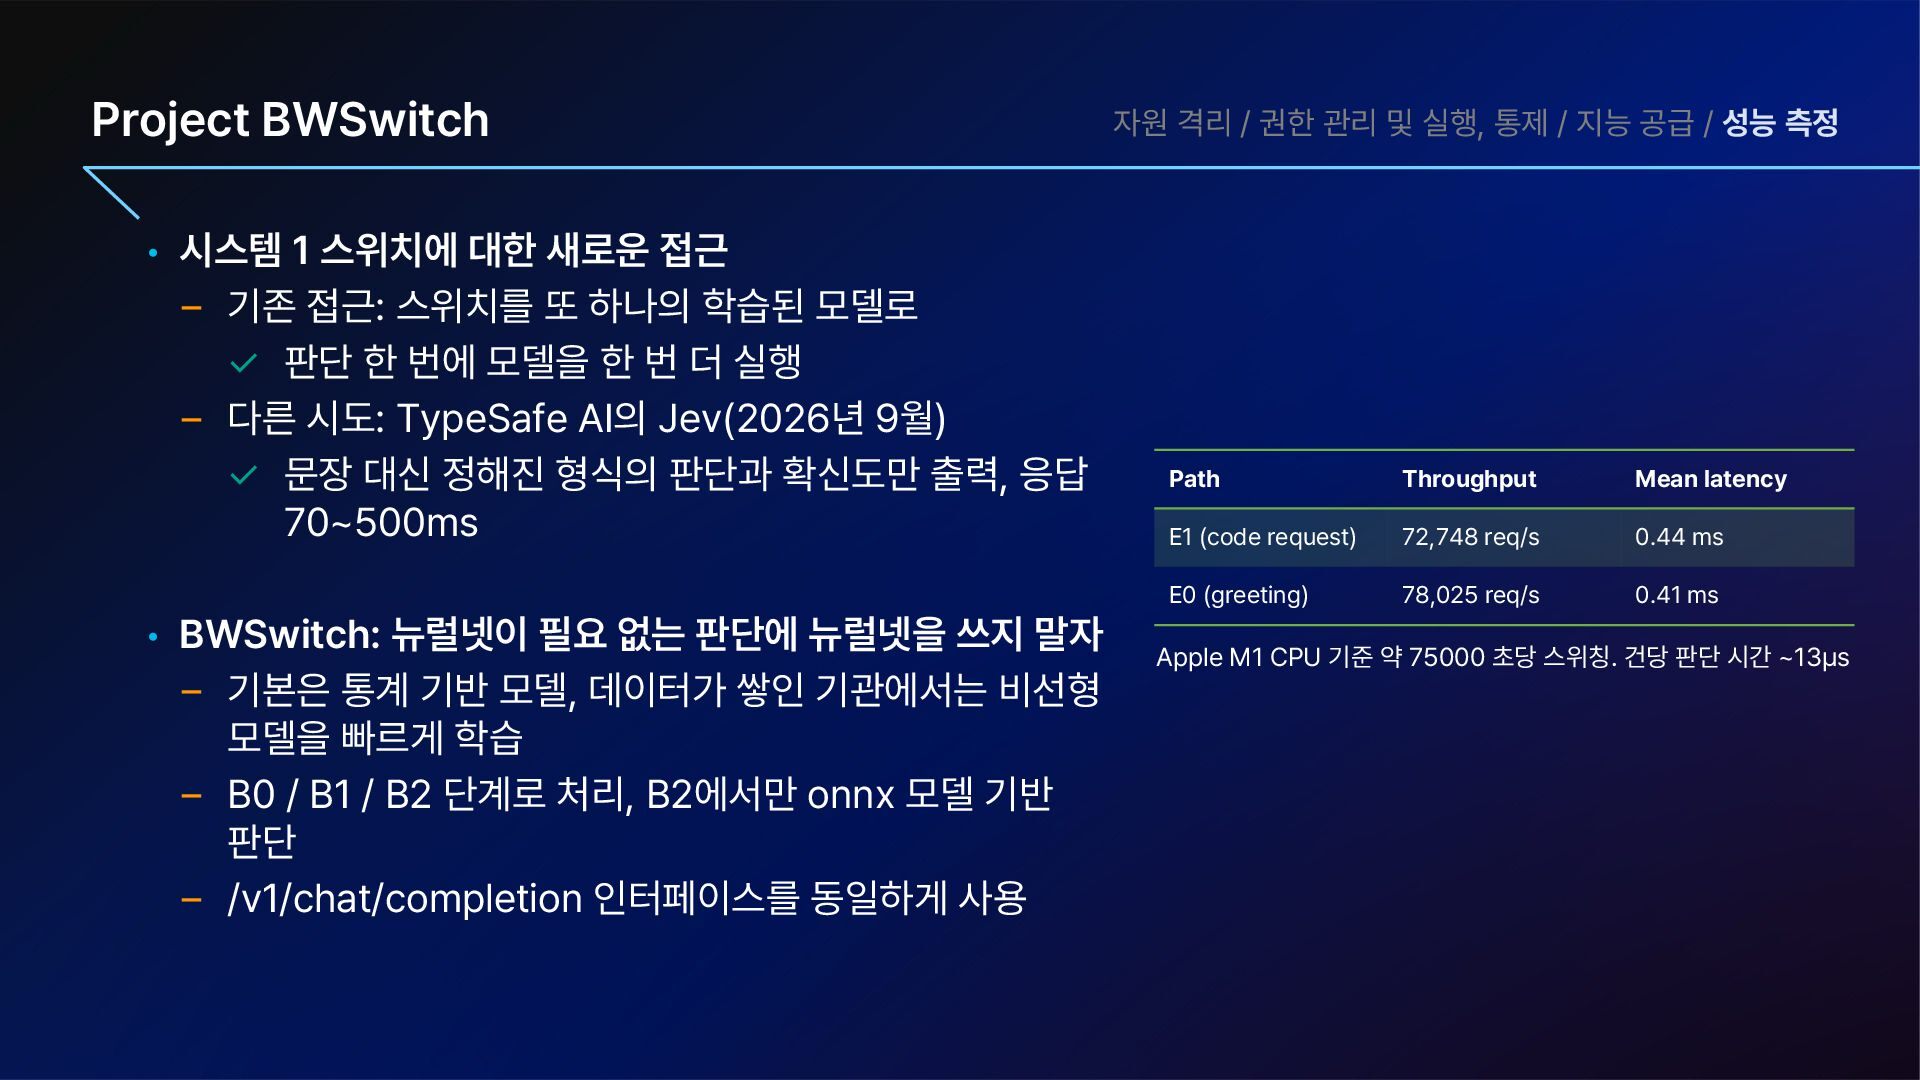
접근: 스위치를 또 하나의 학습된 모델로 판단 한 번에 모델을 한 번 더 실행 다른 시도: TypeSafe AI의 Jev 2026년 9월 문장 대신 정해진 형식의 판단과 확신도만 출력, 응답 70 500ms • BWSwitch: 뉴럴넷이 필요 없는 판단에 뉴럴넷을 쓰지 말자 기본은 통계 기반 모델, 데이터가 쌓인 기관에서는 비선형 모델을 빠르게 학습 B0 / B1 / B2 단계로 처리, B2에서만 onnx 모델 기반 판단 /v1/chat/completion 인터페이스를 동일하게 사용 자원 격리 / 권한 관리 및 실행, 통제 / 지능 공급 / 성능 측정 Path Throughput Mean latency E1 code request 72,748 req/s 0.44 ms E0 greeting 78,025 req/s 0.41 ms Apple M1 CPU 기준 약 75000 초당 스위칭. 건당 판단 시간 13 s


 lablup
 axbom
 aleyda
 portentint
 colly
 skipperchong
 marktimemedia
 marcelosomers
 morganepeng
 eileencodes
 pwiseman
 yeseniaperezcruz
 kimpetersen