Upgrade to Pro — share decks privately, control downloads, hide ads and more …

[Track 1] Mannequin: 인간 시연을 로봇 데이터로 바꾸는 RLWRLD의...

Avatar for Lablup Inc. Lablup Inc.
October 18, 2026
4

[Track 1] Mannequin: 인간 시연을 로봇 데이터로 바꾸는 RLWRLD의 데이터 파이프라인

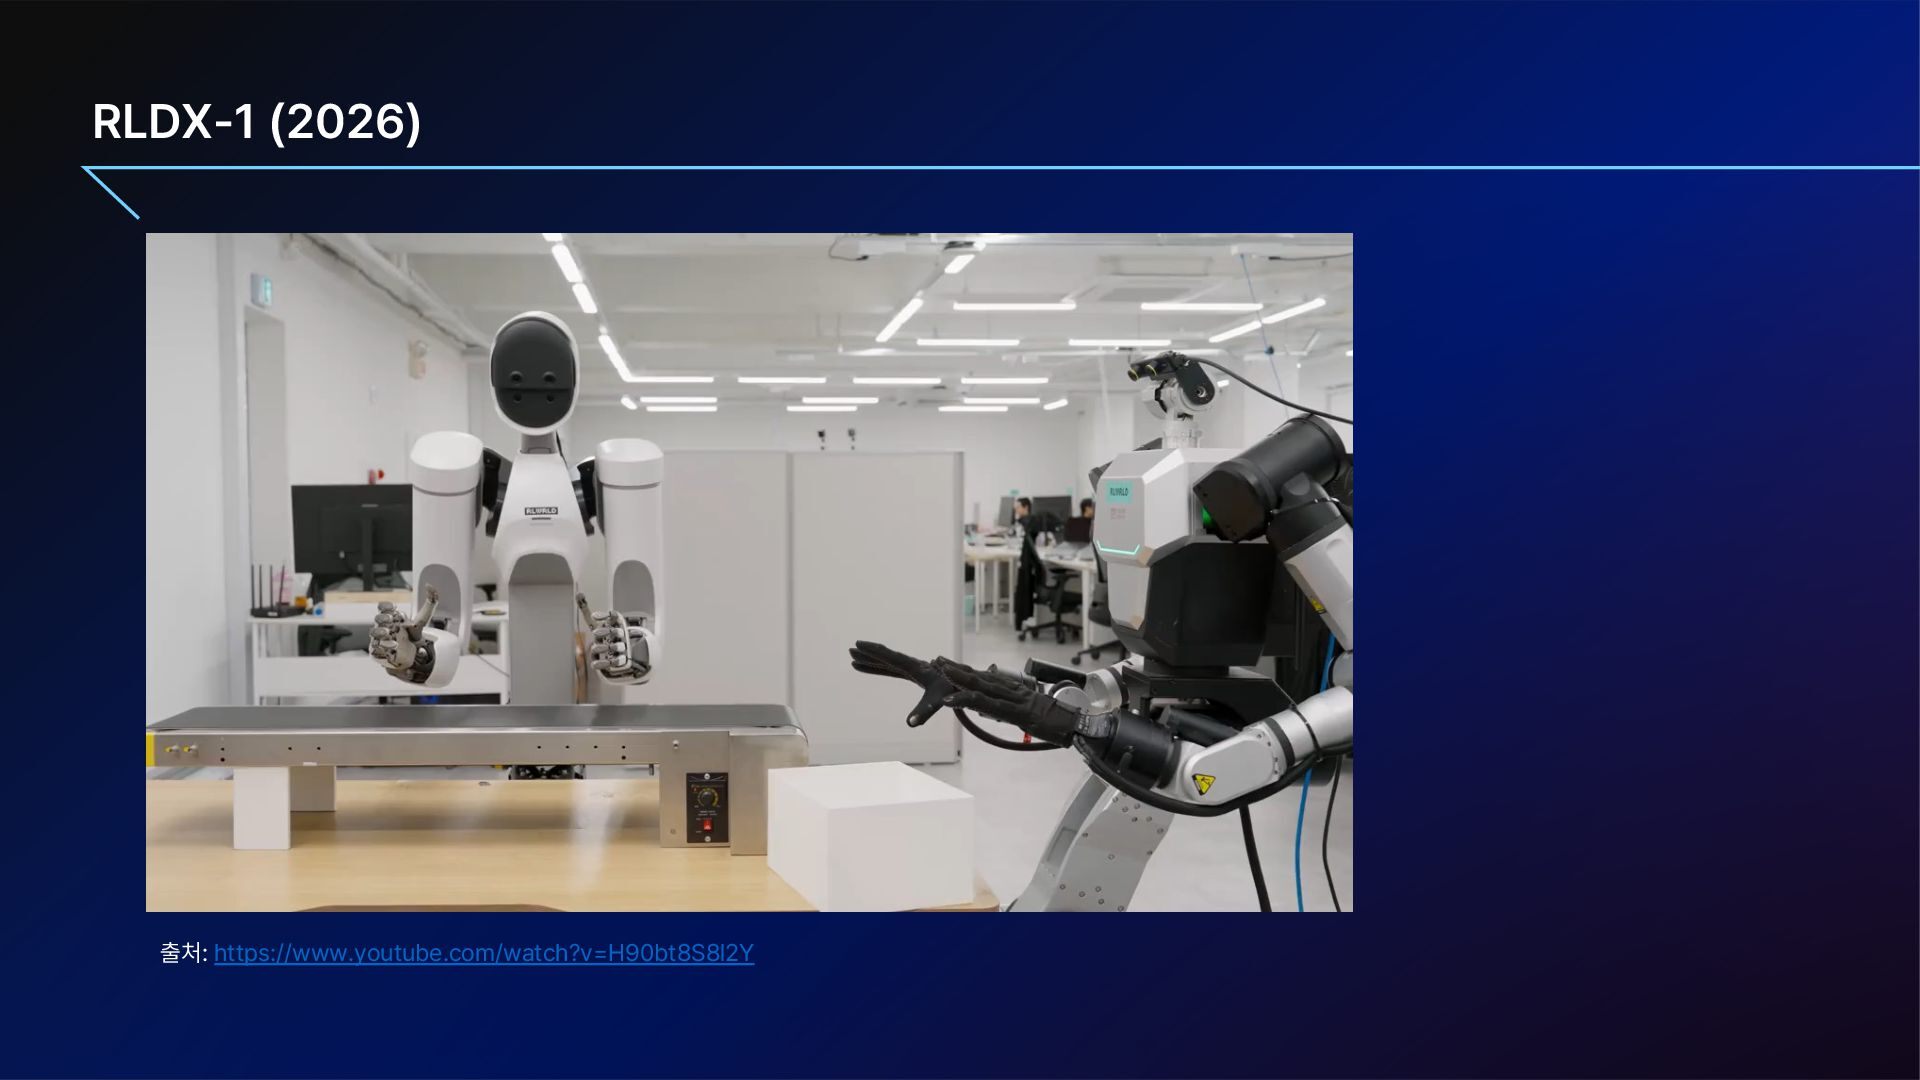
현재 Physical AI 연구의 가장 큰 병목 중 하나는 고품질 로봇 데이터가 절대적으로 부족하다는 점입니다. RLWRLD에서는 인간 시연을 활용해 로봇 학습 데이터를 확장성 있게 생성하는 기술을 연구하고 있습니다. Mannequin은 RLWRLD에서 개발한 데이터 파이프라인으로, 인간 시연 데이터를 로봇 embodiment에 맞게 변환하여 Robotics Foundation Model 학습에 바로 활용할 수 있는 로봇 데이터를 생성합니다. 이번 발표에서는 Mannequin의 전체 파이프라인과 핵심 기술, 그리고 실제 로봇 데이터 생성 사례를 소개합니다.

Avatar for Lablup Inc.

Lablup Inc.

October 18, 2026

More Decks by Lablup Inc.

Transcript

  1. 발표자 소개 김상우 Lennon 로봇 및 인간 데이터 수집 파이프라인을

    개발하고 있으며, 로봇이 3D 물리 세계를 인식하고 이해하는 방법을 연구하고 있습니다. RLWLRD Software Engineer 2025 Present Upstage MLOps/Software Engineer 2022 2025
  2. 1 Part 1. Data Gap in Robotics 2 Part 2.

    Human Video Data in Robotics 3 Part 3. RLWRLD Mannequin
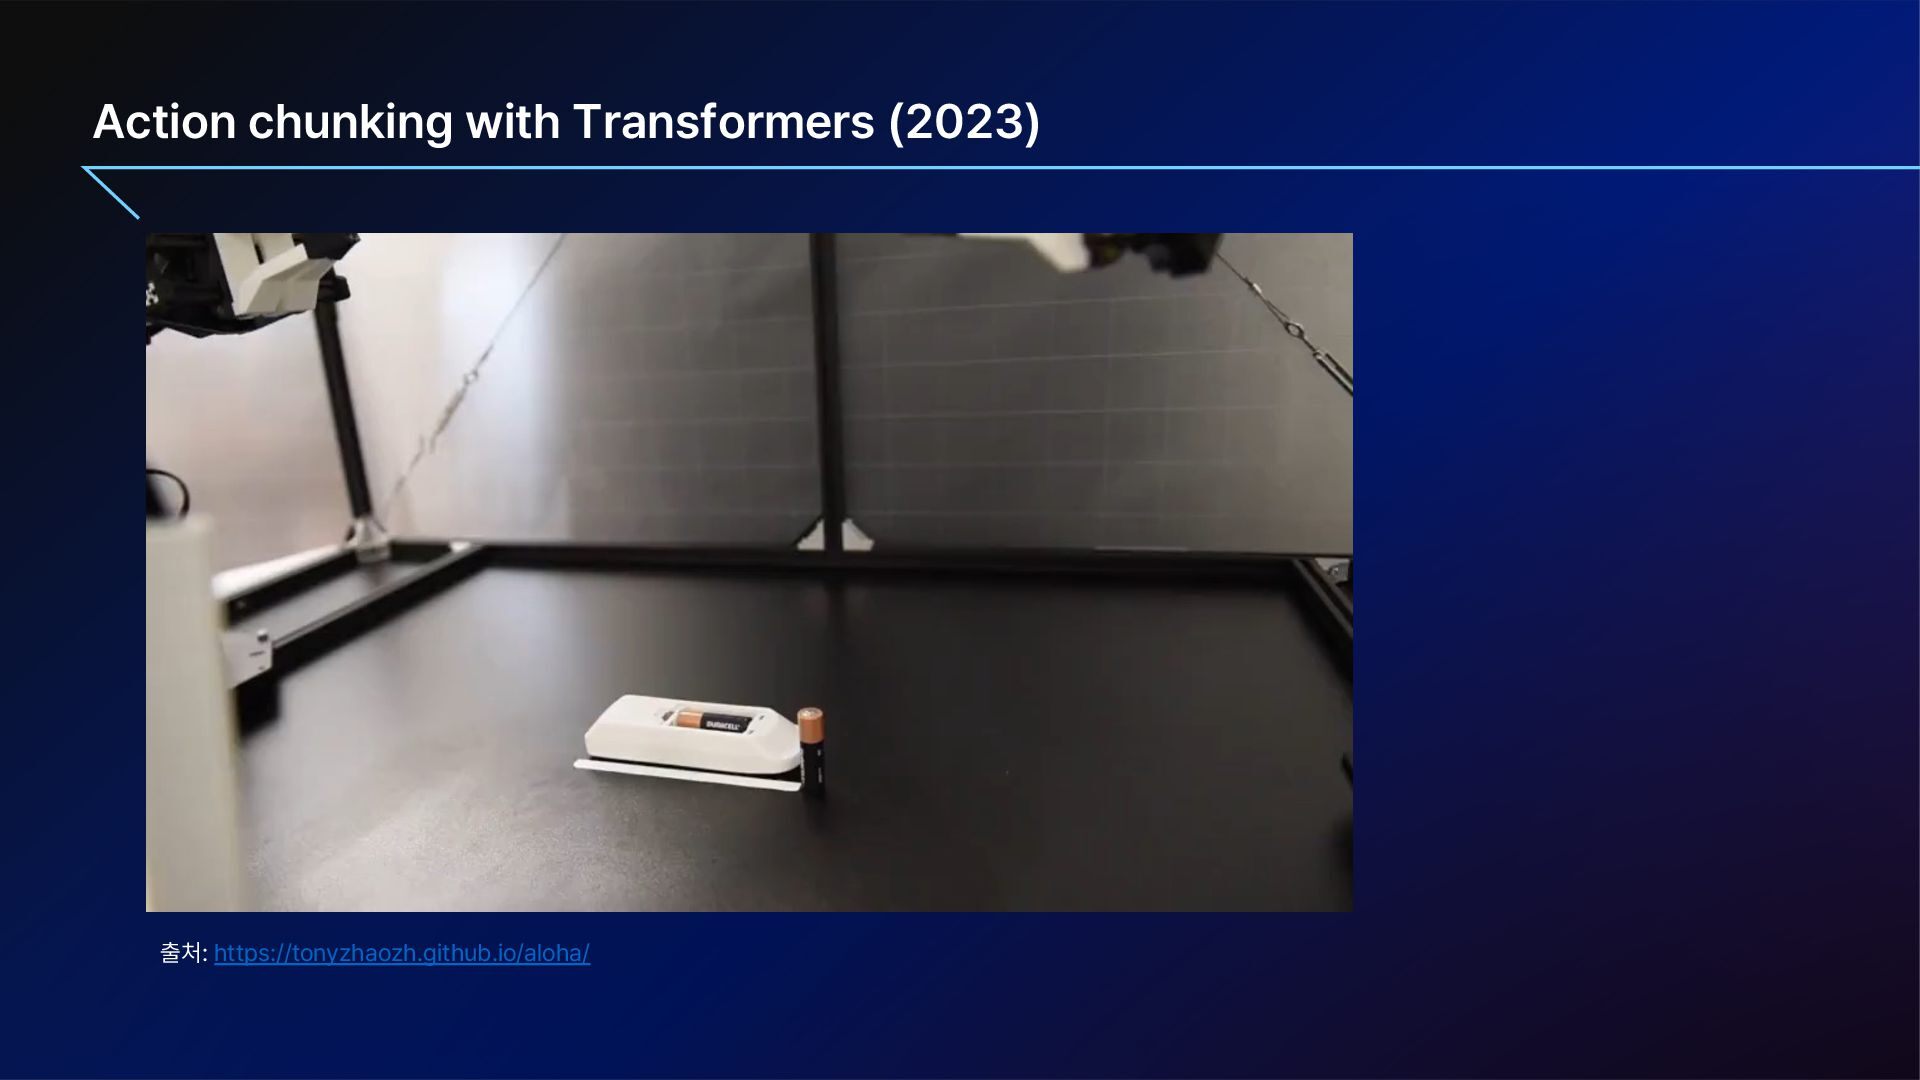
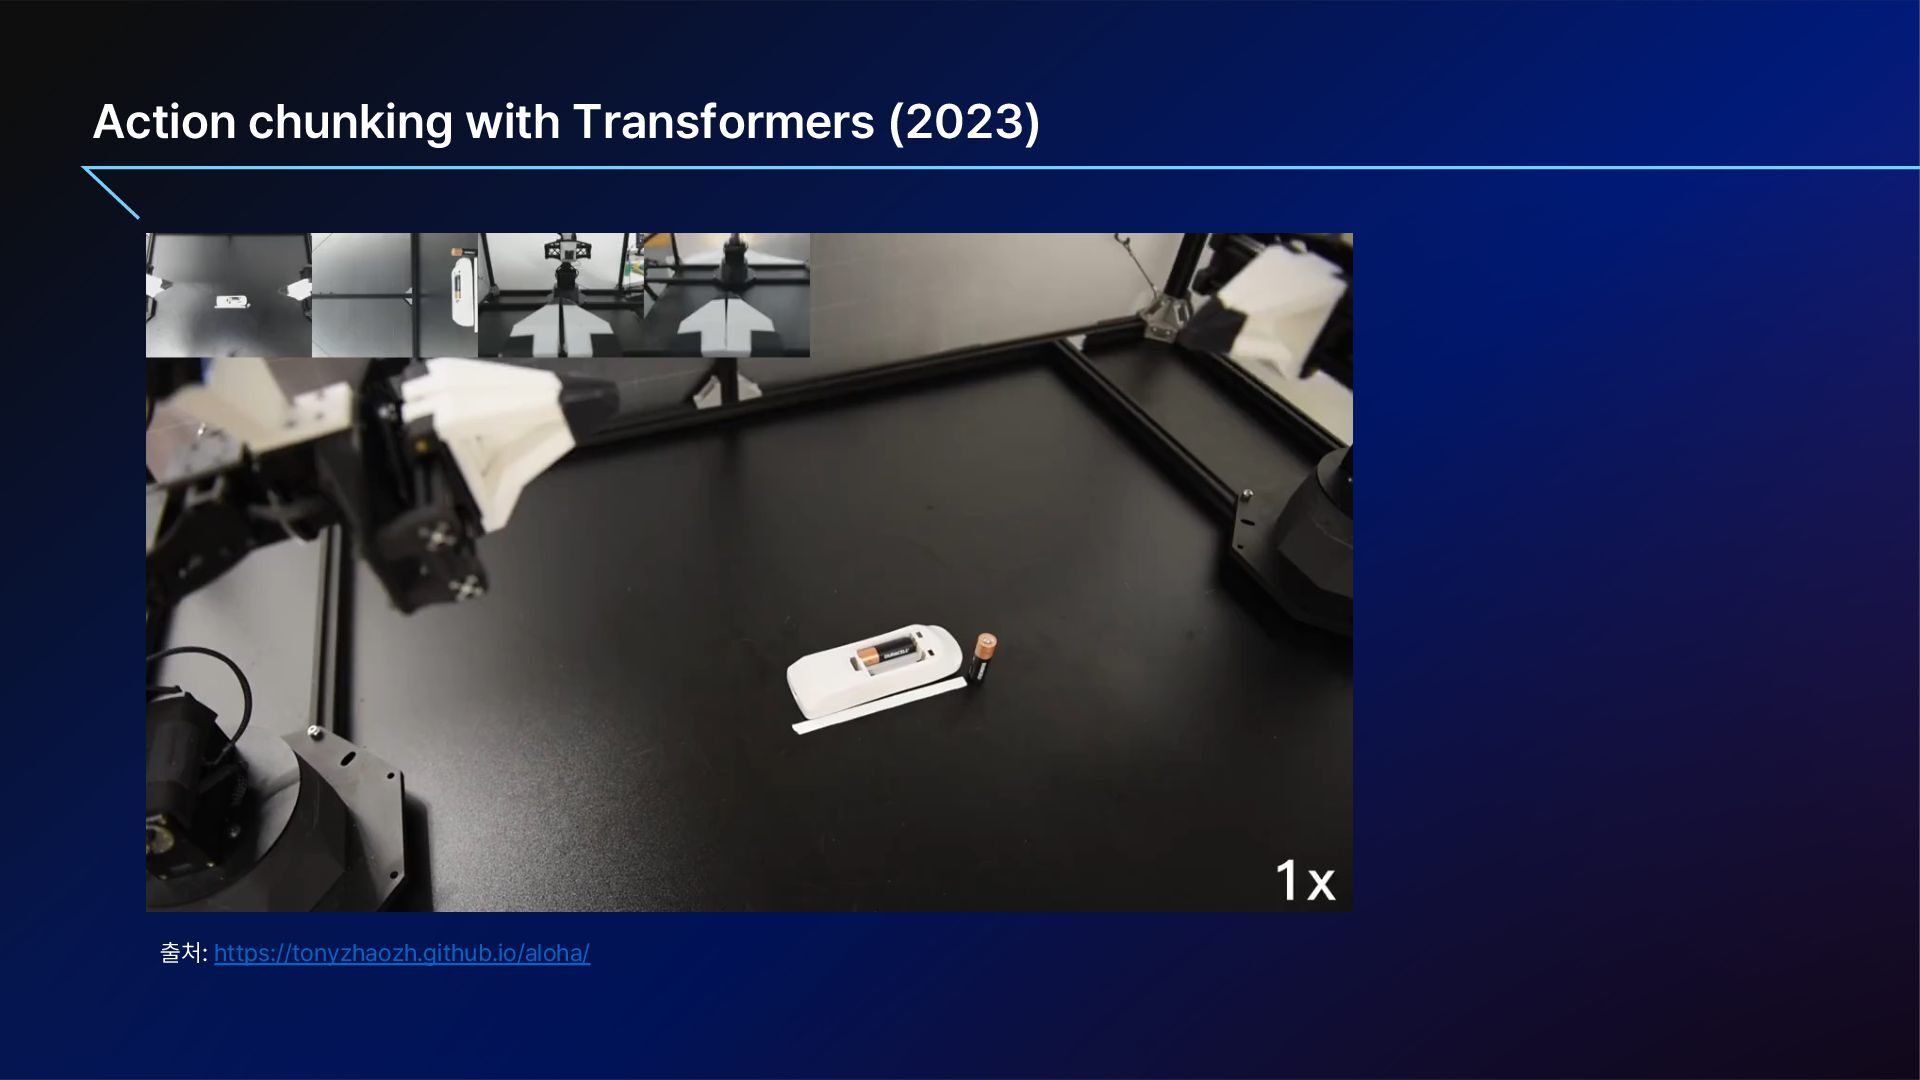
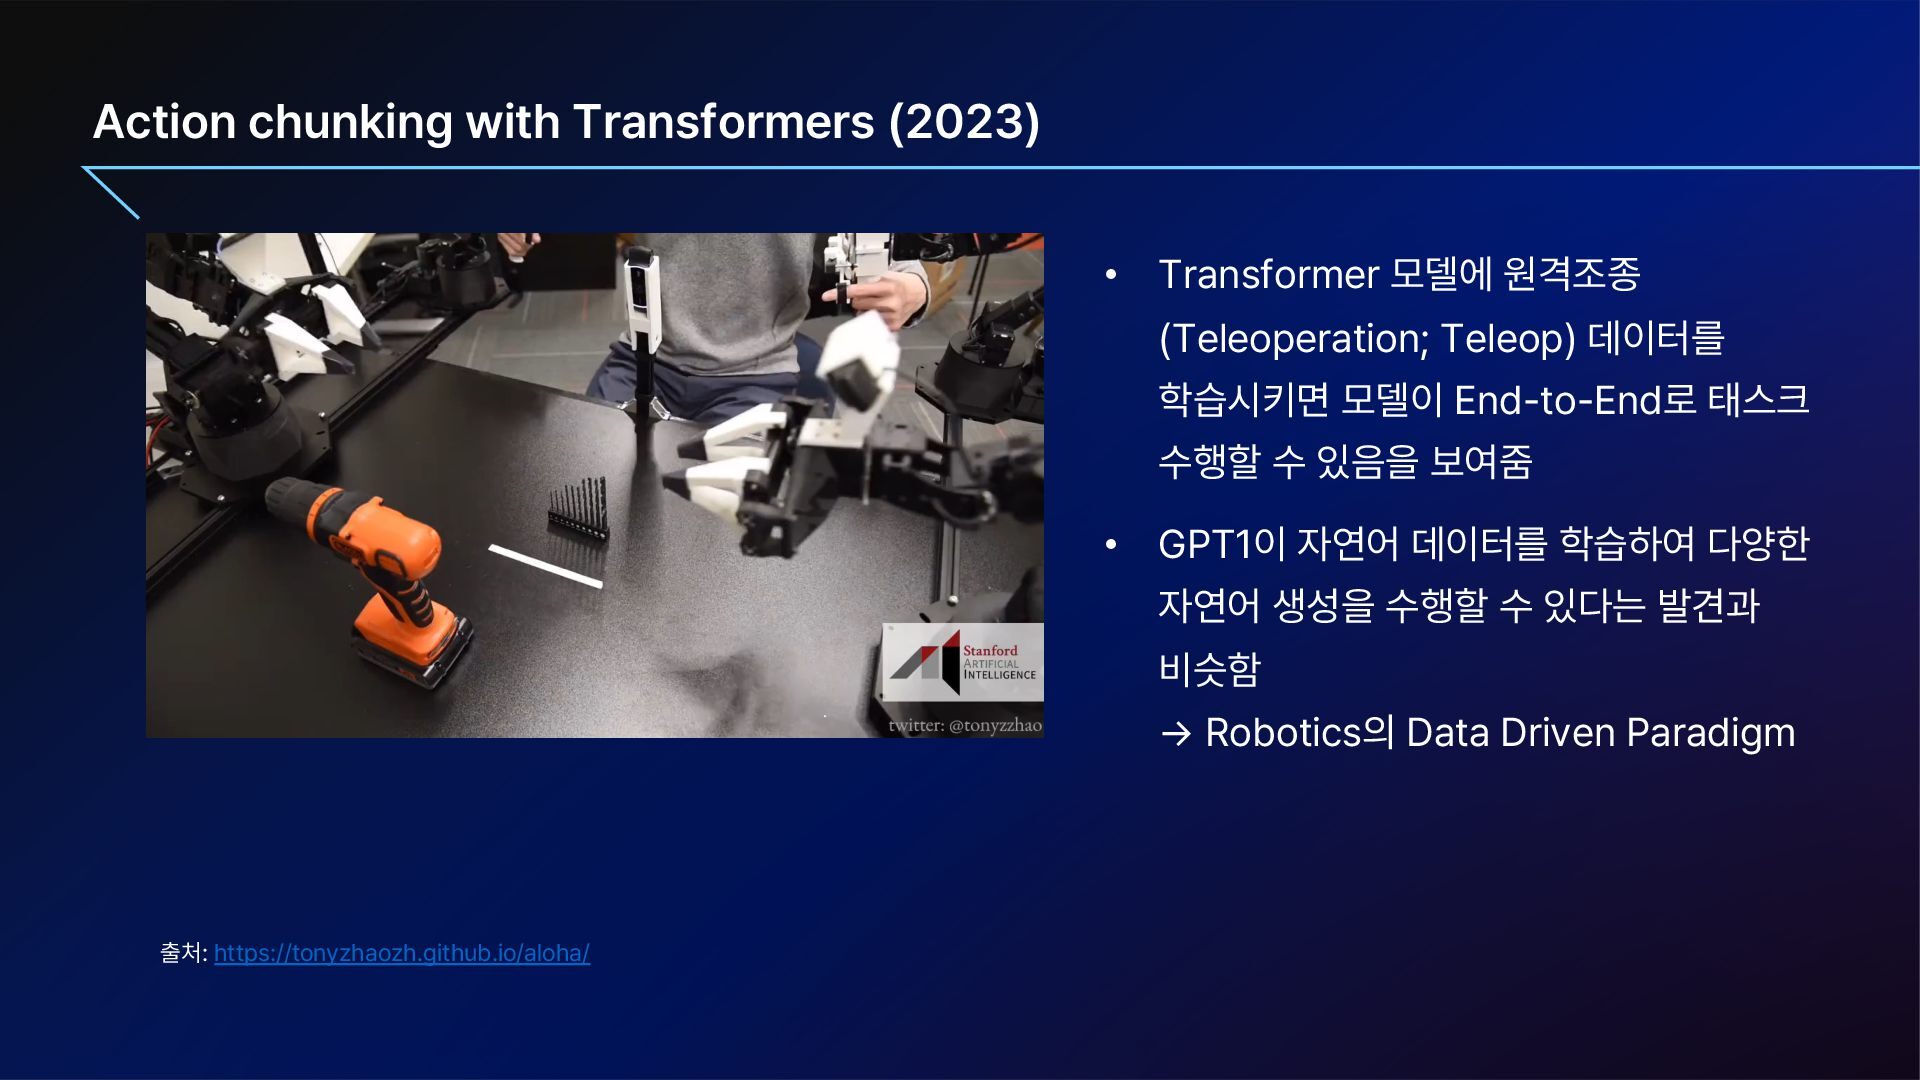
  3. Action chunking with Transformers 2023 • Transformer 모델에 원격조종 Teleoperation;

    Teleop 데이터를 학습시키면 모델이 End to End로 태스크 수행할 수 있음을 보여줌 • GPT1이 자연어 데이터를 학습하여 다양한 자연어 생성을 수행할 수 있다는 발견과 비슷함 Robotics의 Data Driven Paradigm 출처: https://tonyzhaozh.github.io/aloha/
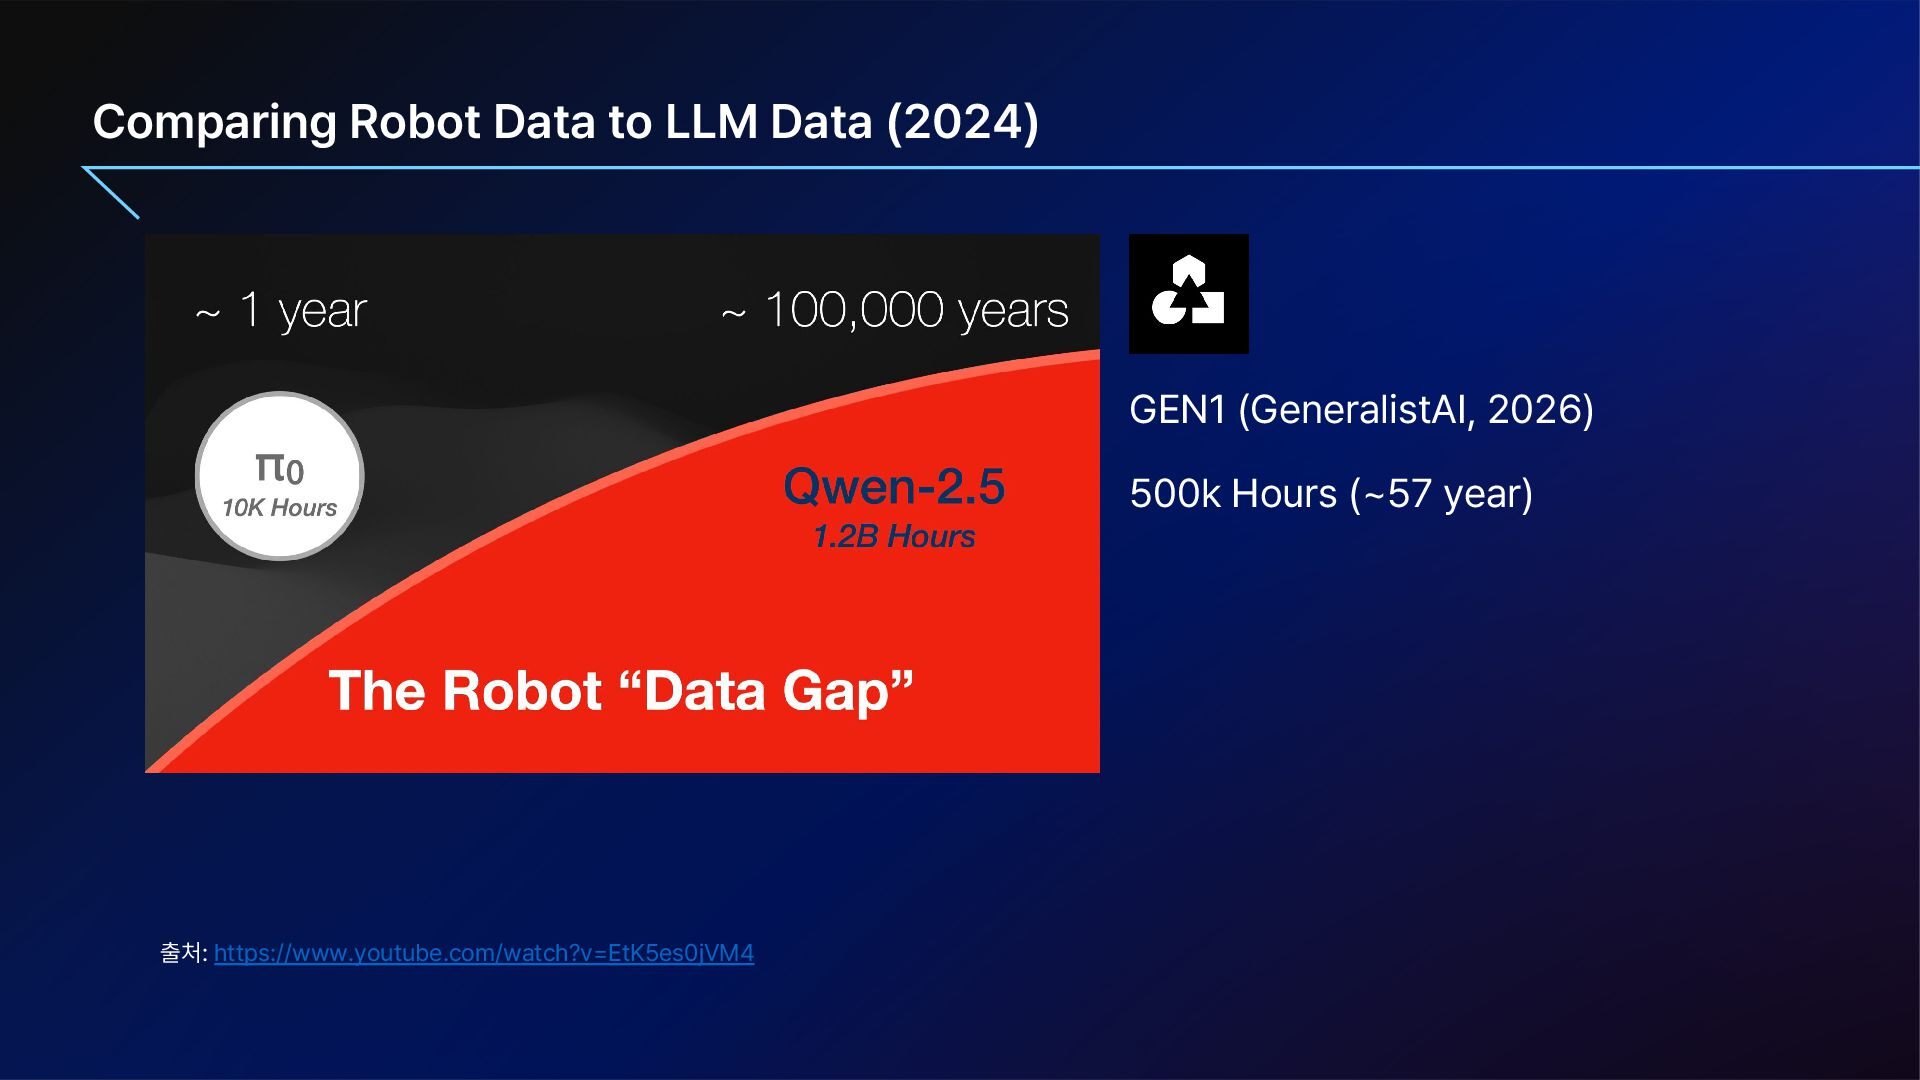
  4. Comparing Robot Data to LLM Data 2024 GEN1 GeneralistAI, 2026

    500k Hours 출처: https://www.youtube.com/watch?v EtK5es0jVM4 57 year
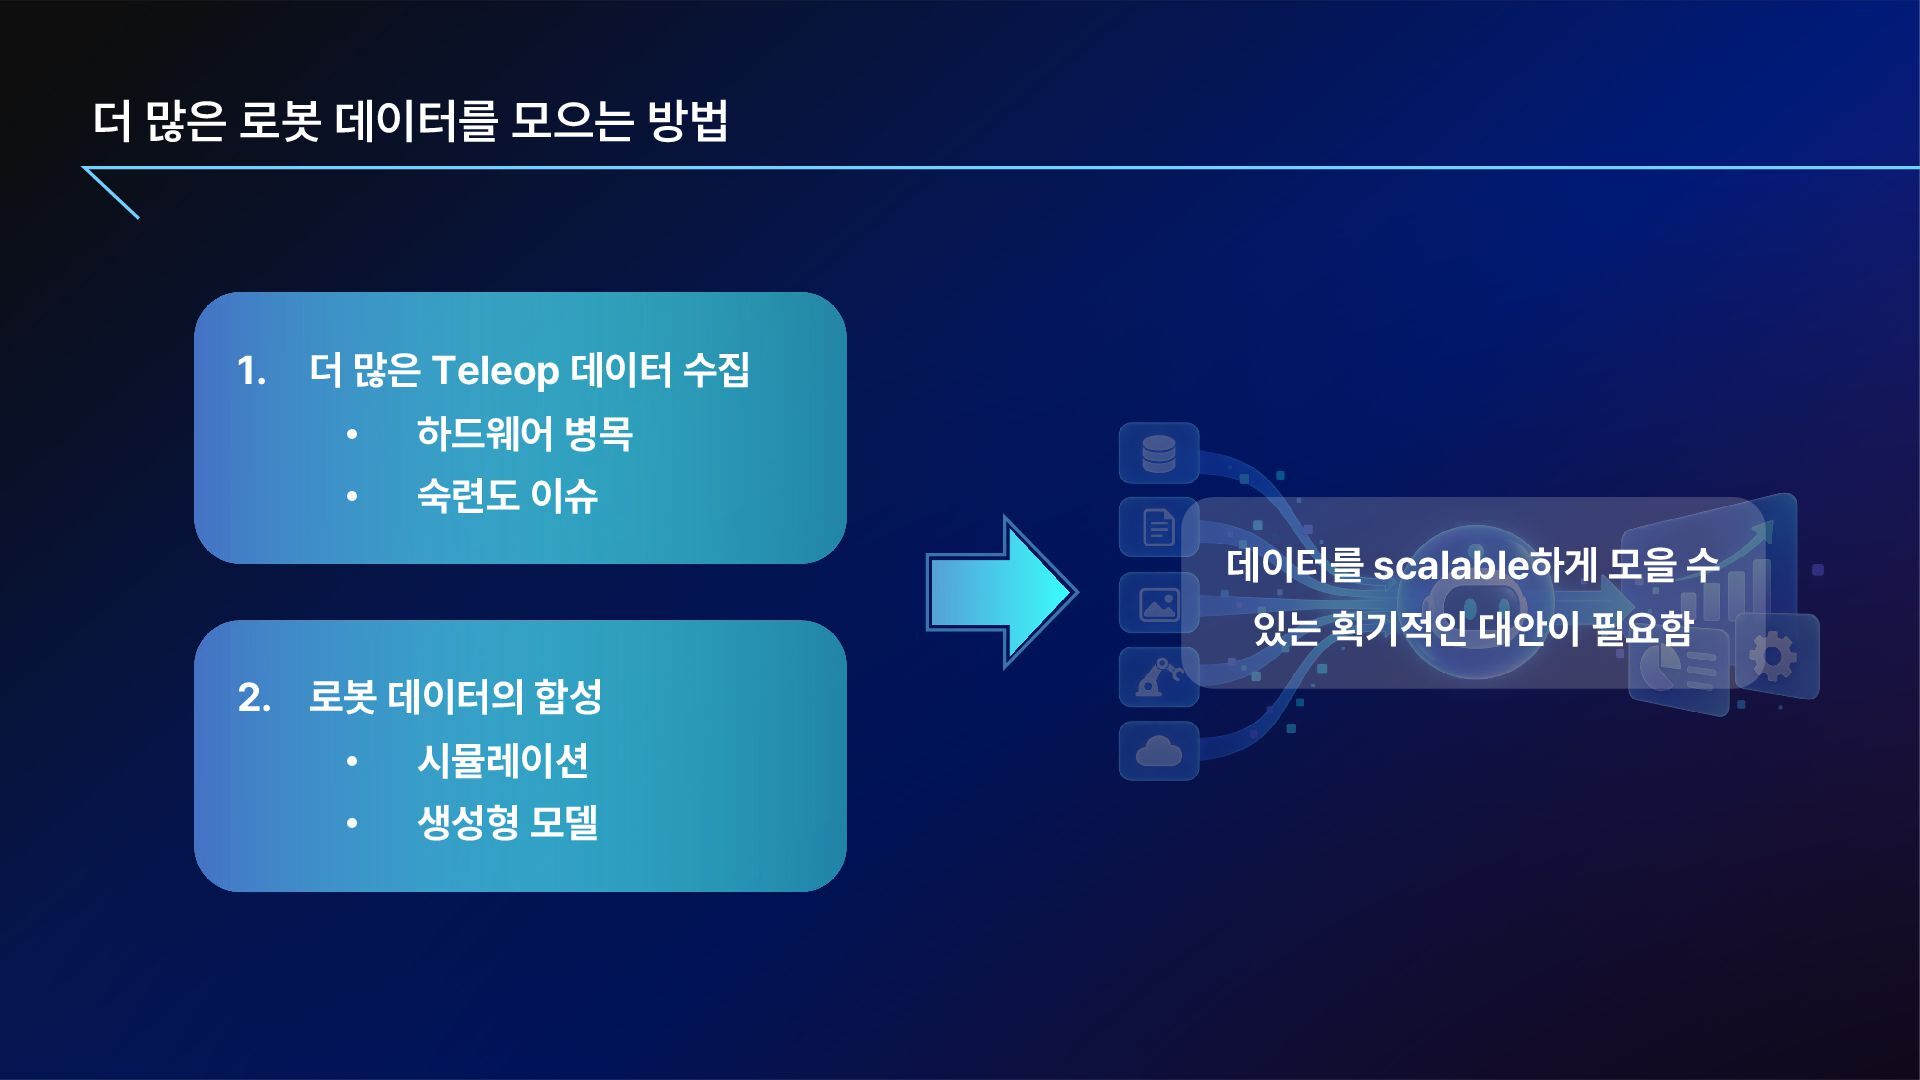
  5. 더 많은 로봇 데이터를 모으는 방법 1. 더 많은 Teleop

    데이터 수집 • 하드웨어 병목 • 숙련도 이슈 데이터를 scalable하게 모을 수 있는 획기적인 대안이 필요함 2. 로봇 데이터의 합성 • 시뮬레이션 • 생성형 모델
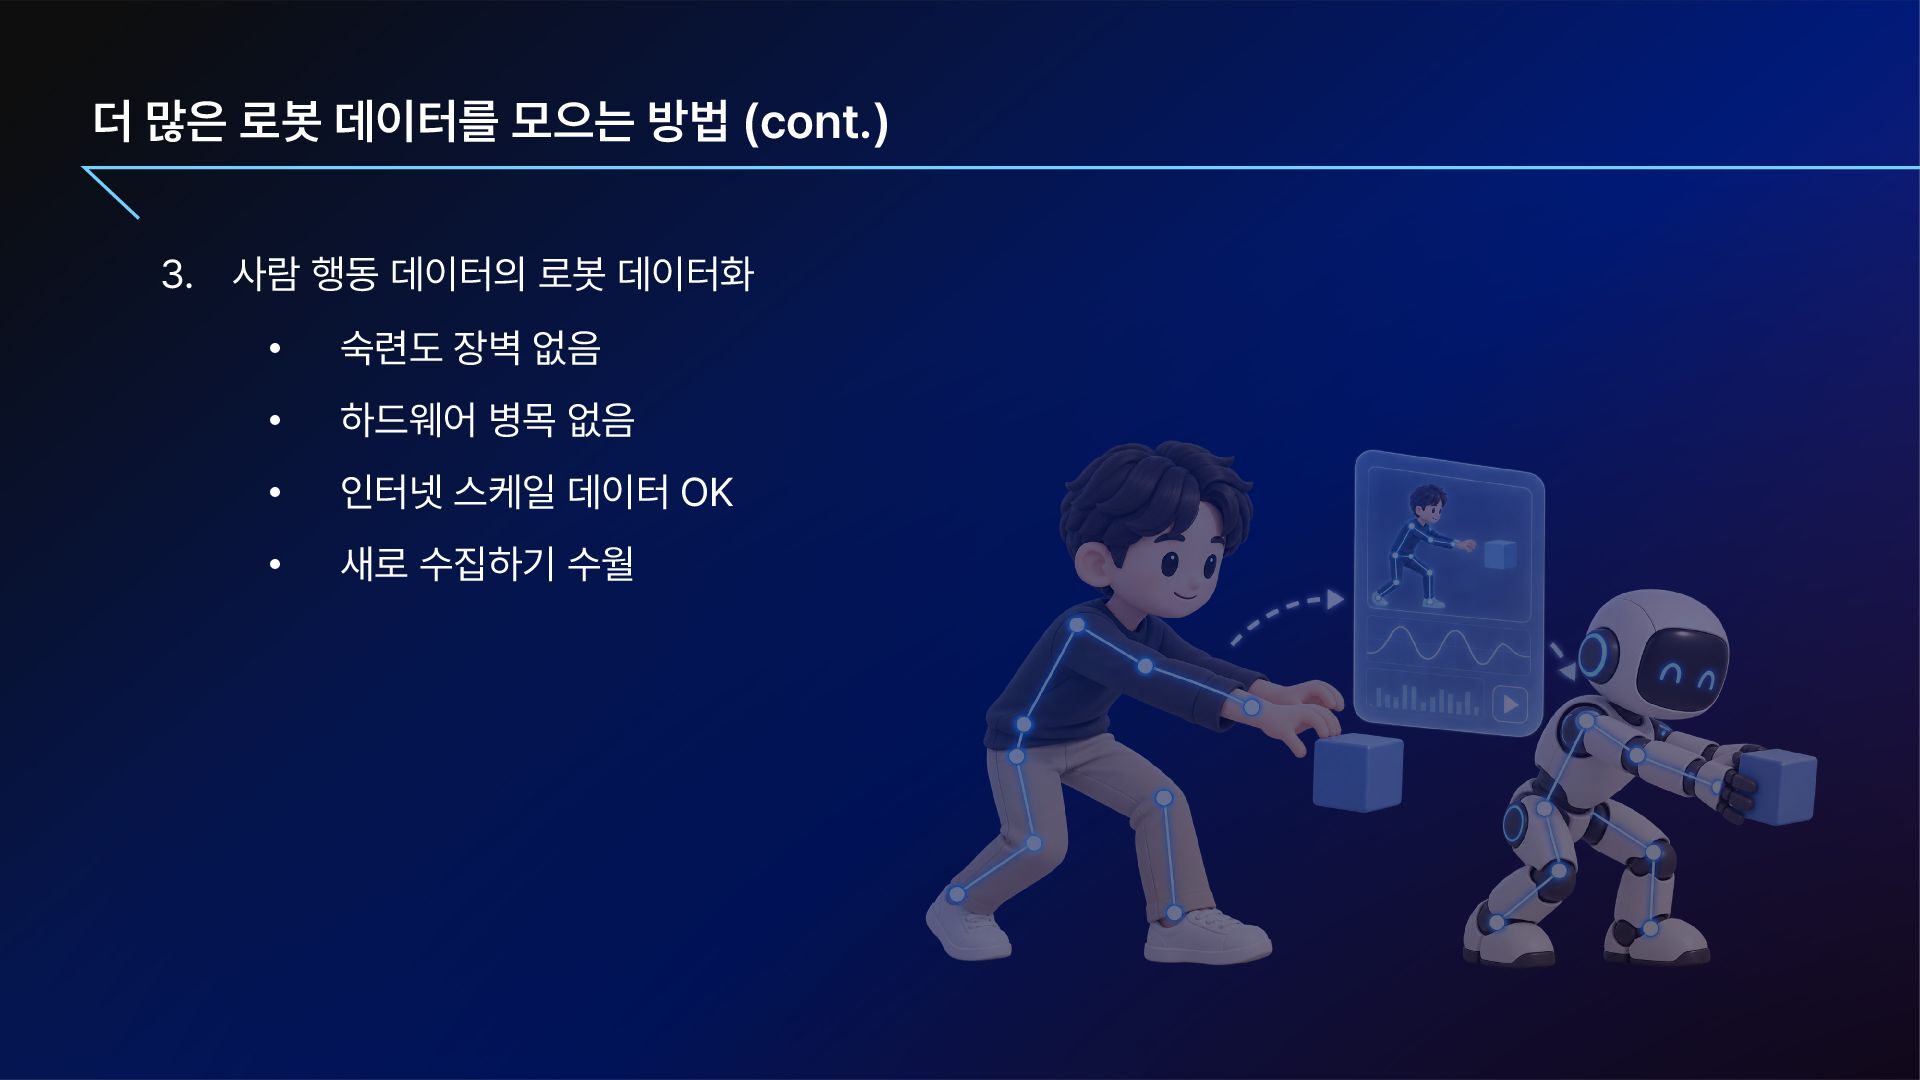
  6. 더 많은 로봇 데이터를 모으는 방법 cont. 3. 사람 행동

    데이터의 로봇 데이터화 • 숙련도 장벽 없음 • 하드웨어 병목 없음 • 인터넷 스케일 데이터 OK • 새로 수집하기 수월
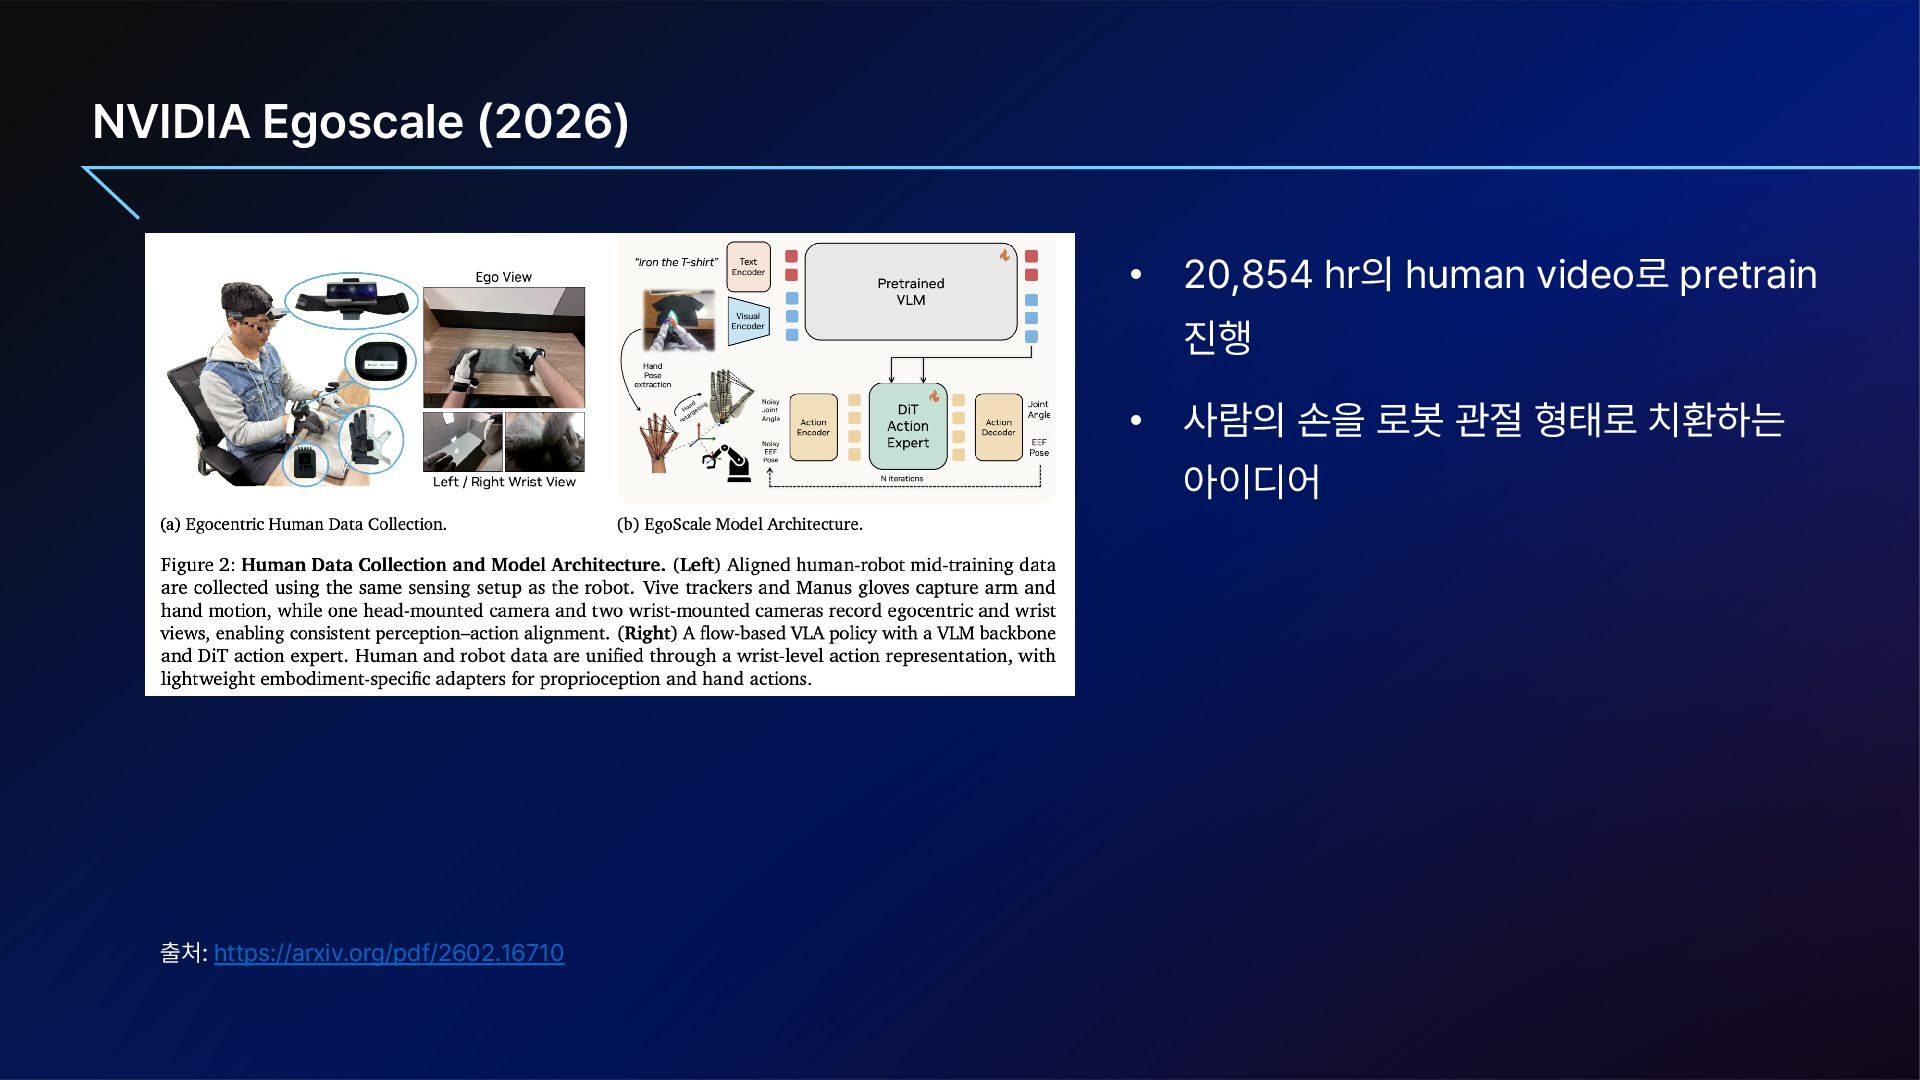
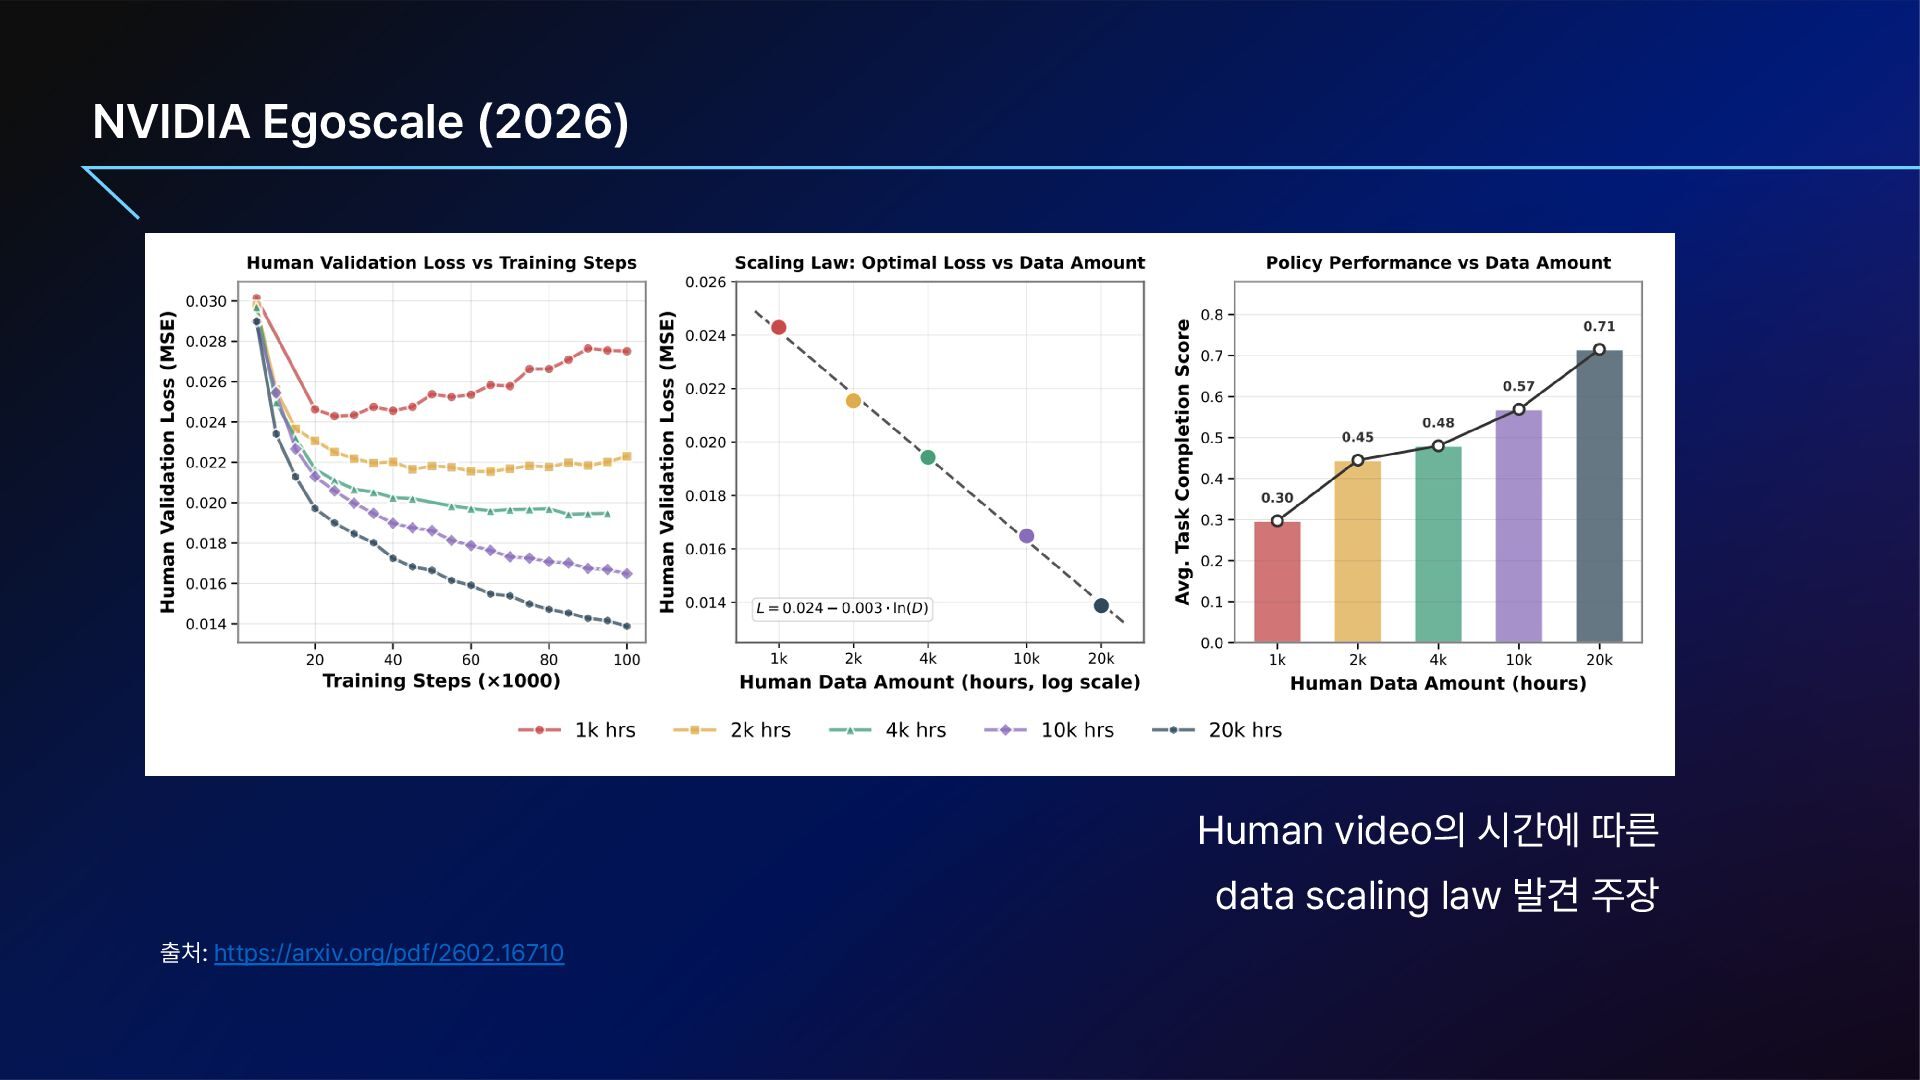
  7. NVIDIA Egoscale 2026 • 20,854 hr의 human video로 pretrain 진행

    • 사람의 손을 로봇 관절 형태로 치환하는 아이디어 출처: https://arxiv.org/pdf/2602.16710
  8. NVIDIA Egoscale 2026 Human video의 시간에 따른 data scaling law

    발견 주장 출처: https://arxiv.org/pdf/2602.16710
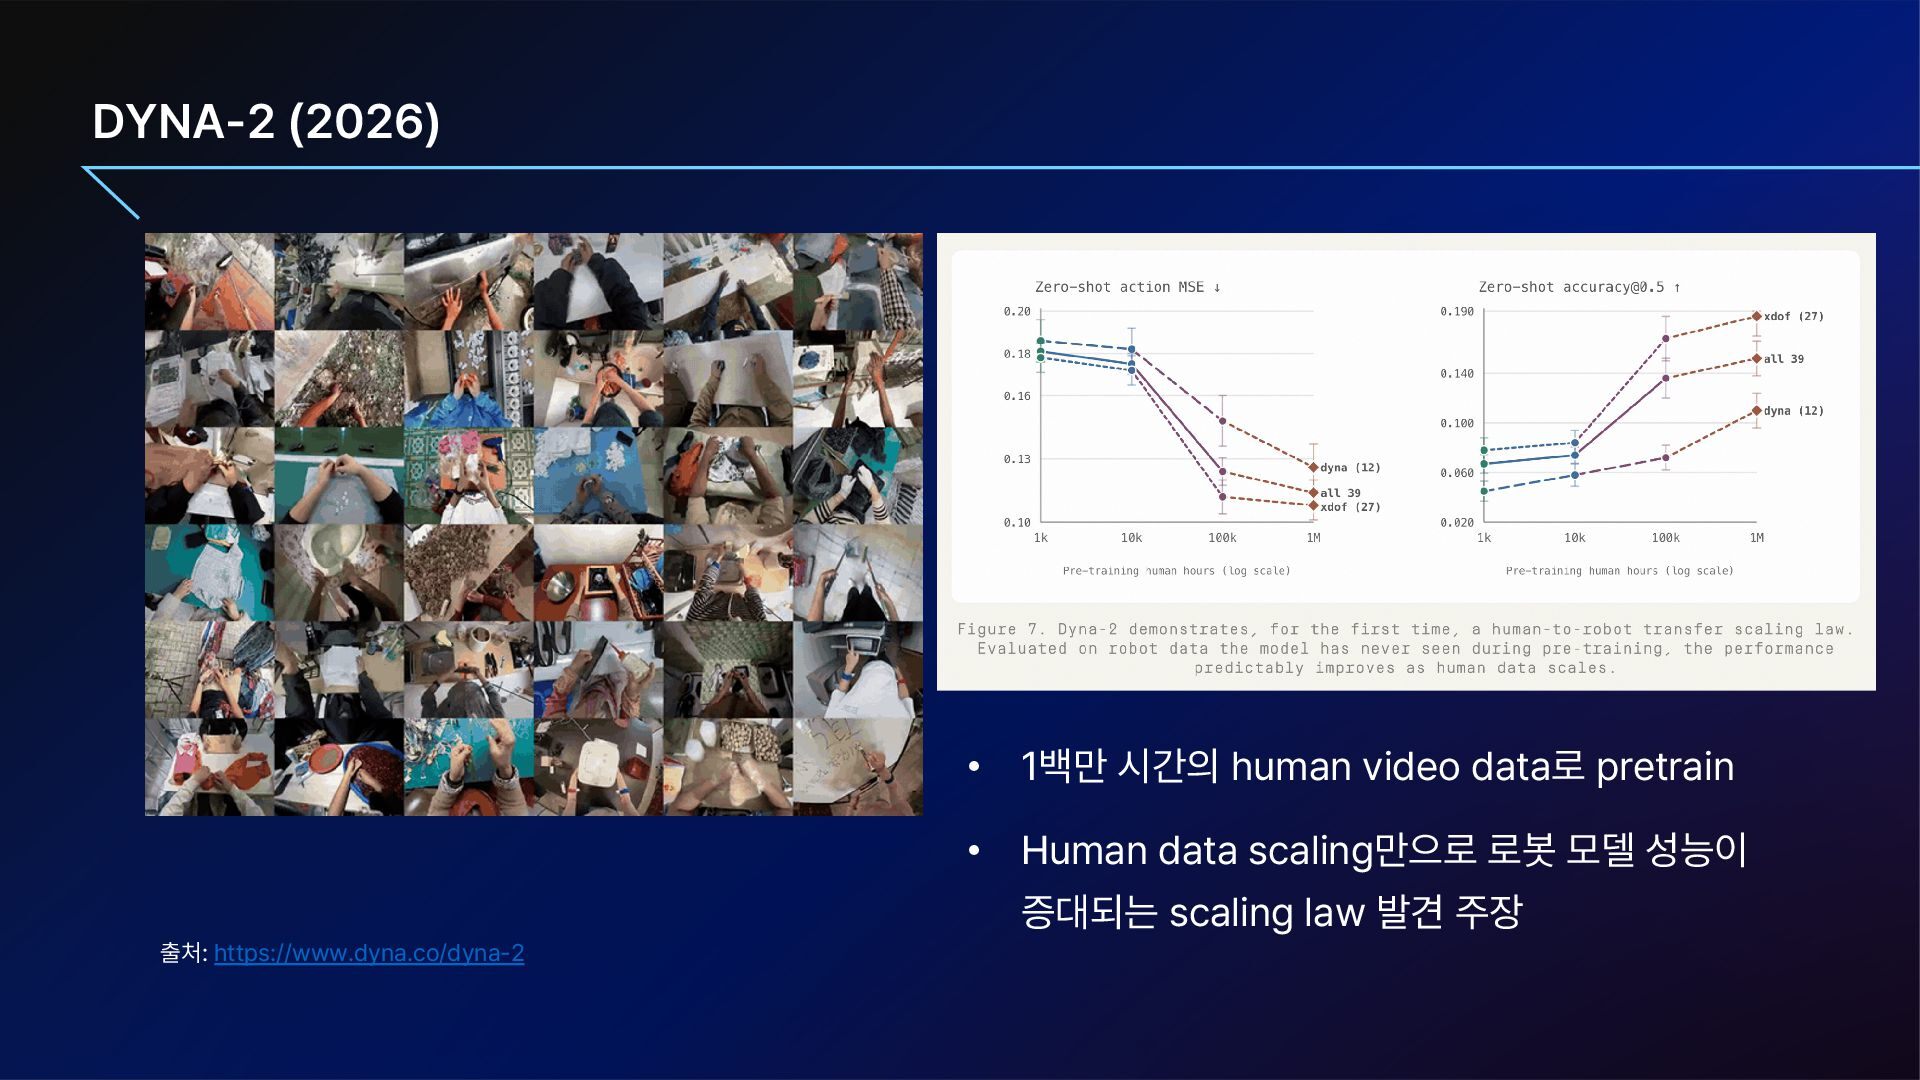
  9. DYNA 2 2026 • 1백만 시간의 human video data로 pretrain

    • Human data scaling만으로 로봇 모델 성능이 증대되는 scaling law 발견 주장 출처: https://www.dyna.co/dyna 2
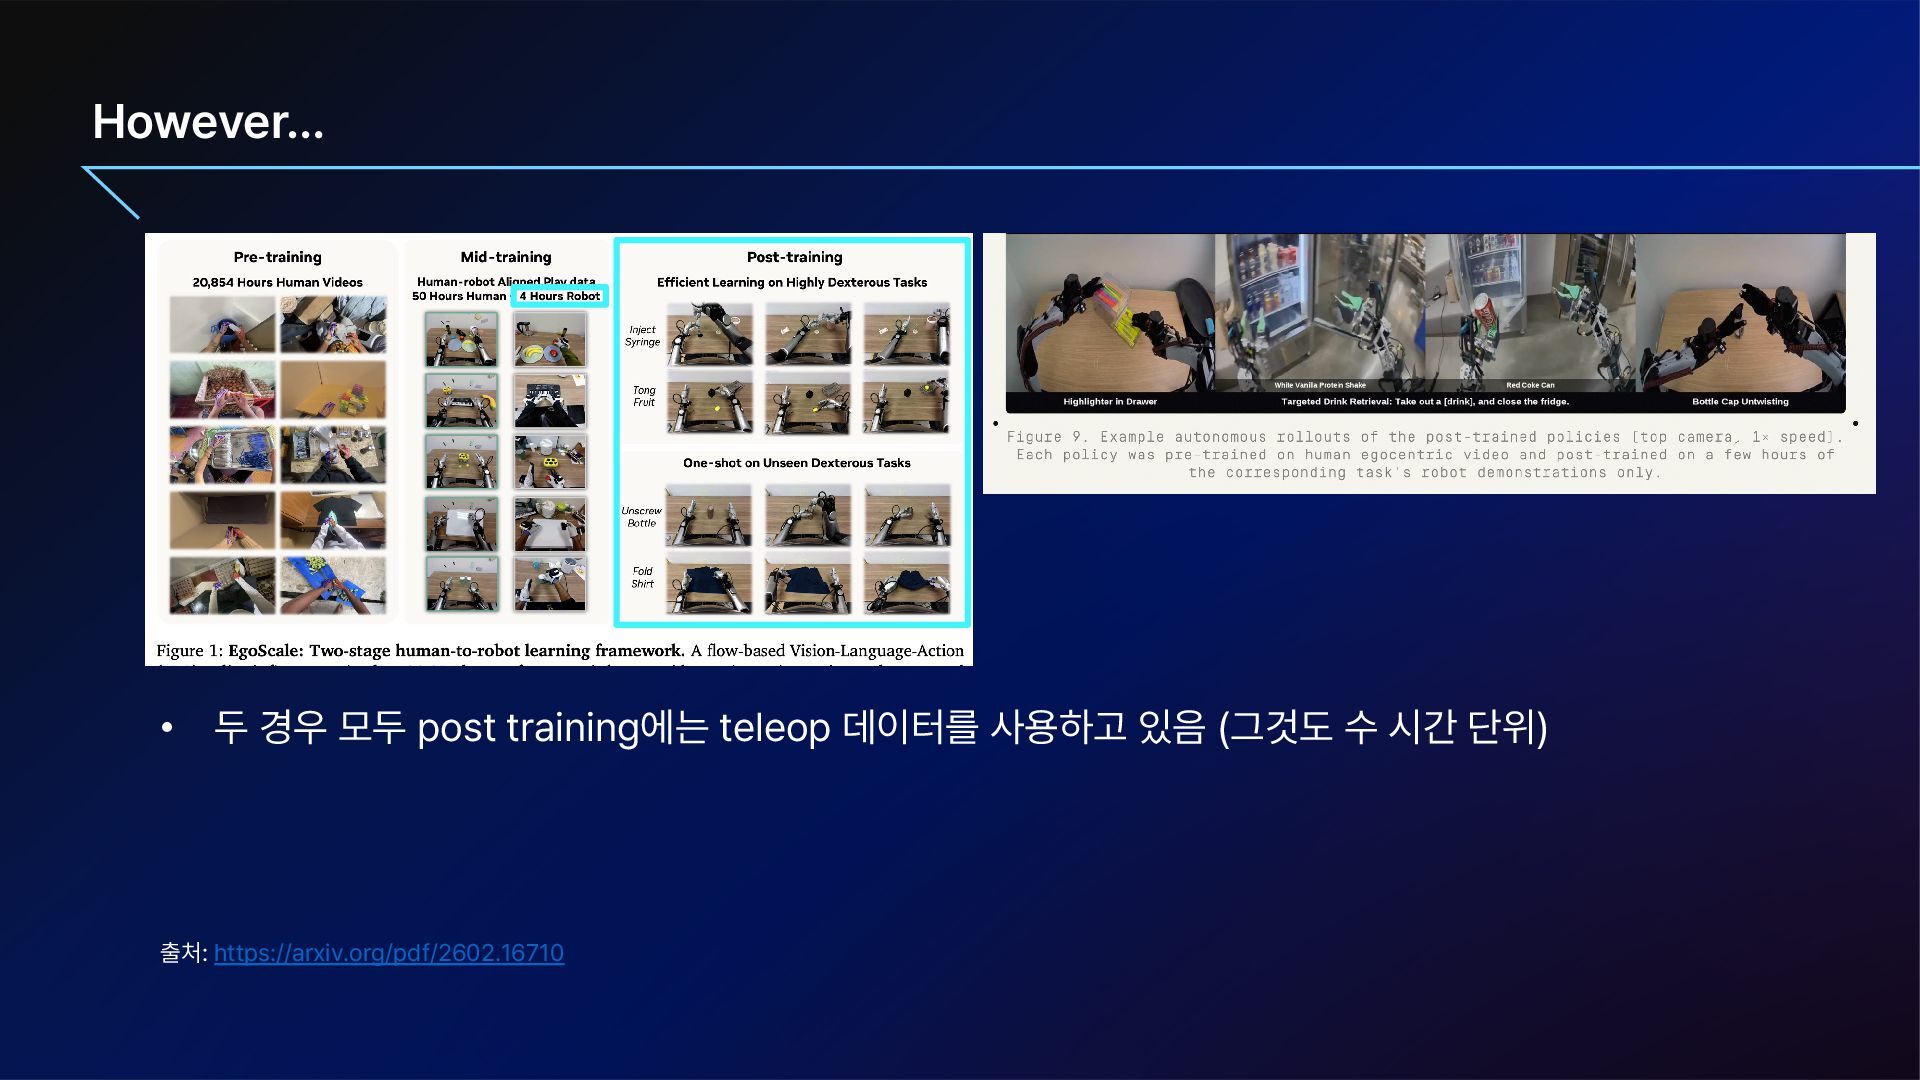
  10. However… • 두 경우 모두 post training에는 teleop 데이터를 사용하고

    있음 그것도 수 시간 단위 출처: https://arxiv.org/pdf/2602.16710
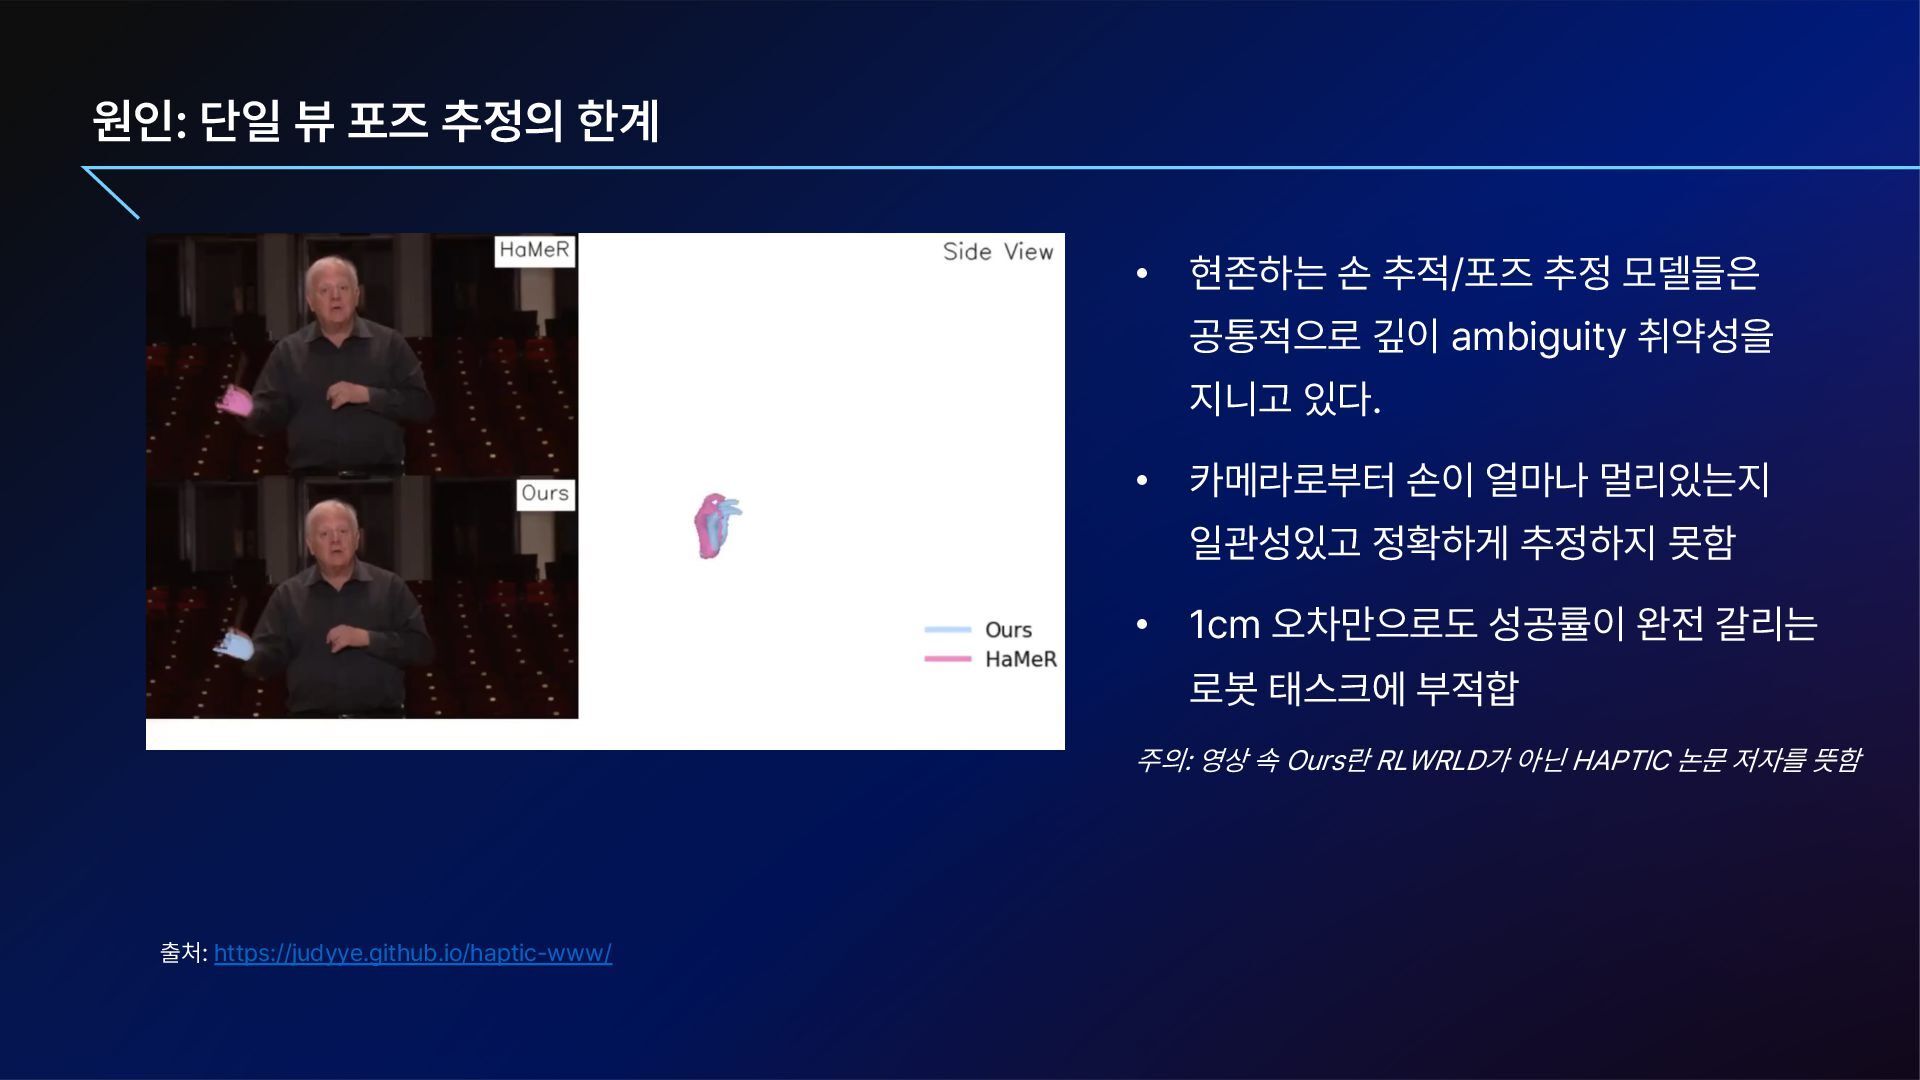
  11. 원인: 단일 뷰 포즈 추정의 한계 • 현존하는 손 추적/포즈

    추정 모델들은 공통적으로 깊이 ambiguity 취약성을 지니고 있다. • 카메라로부터 손이 얼마나 멀리있는지 일관성있고 정확하게 추정하지 못함 • 1cm 오차만으로도 성공률이 완전 갈리는 로봇 태스크에 부적합 주의: 영상 속 Ours란 RLWRLD가 아닌 HAPTIC 논문 저자를 뜻함 출처: https://judyye.github.io/haptic www/
  12. Mannequin 사람 행동 영상 기반 고정밀 로봇 데이터셋을 합성하는 RLWRLD의

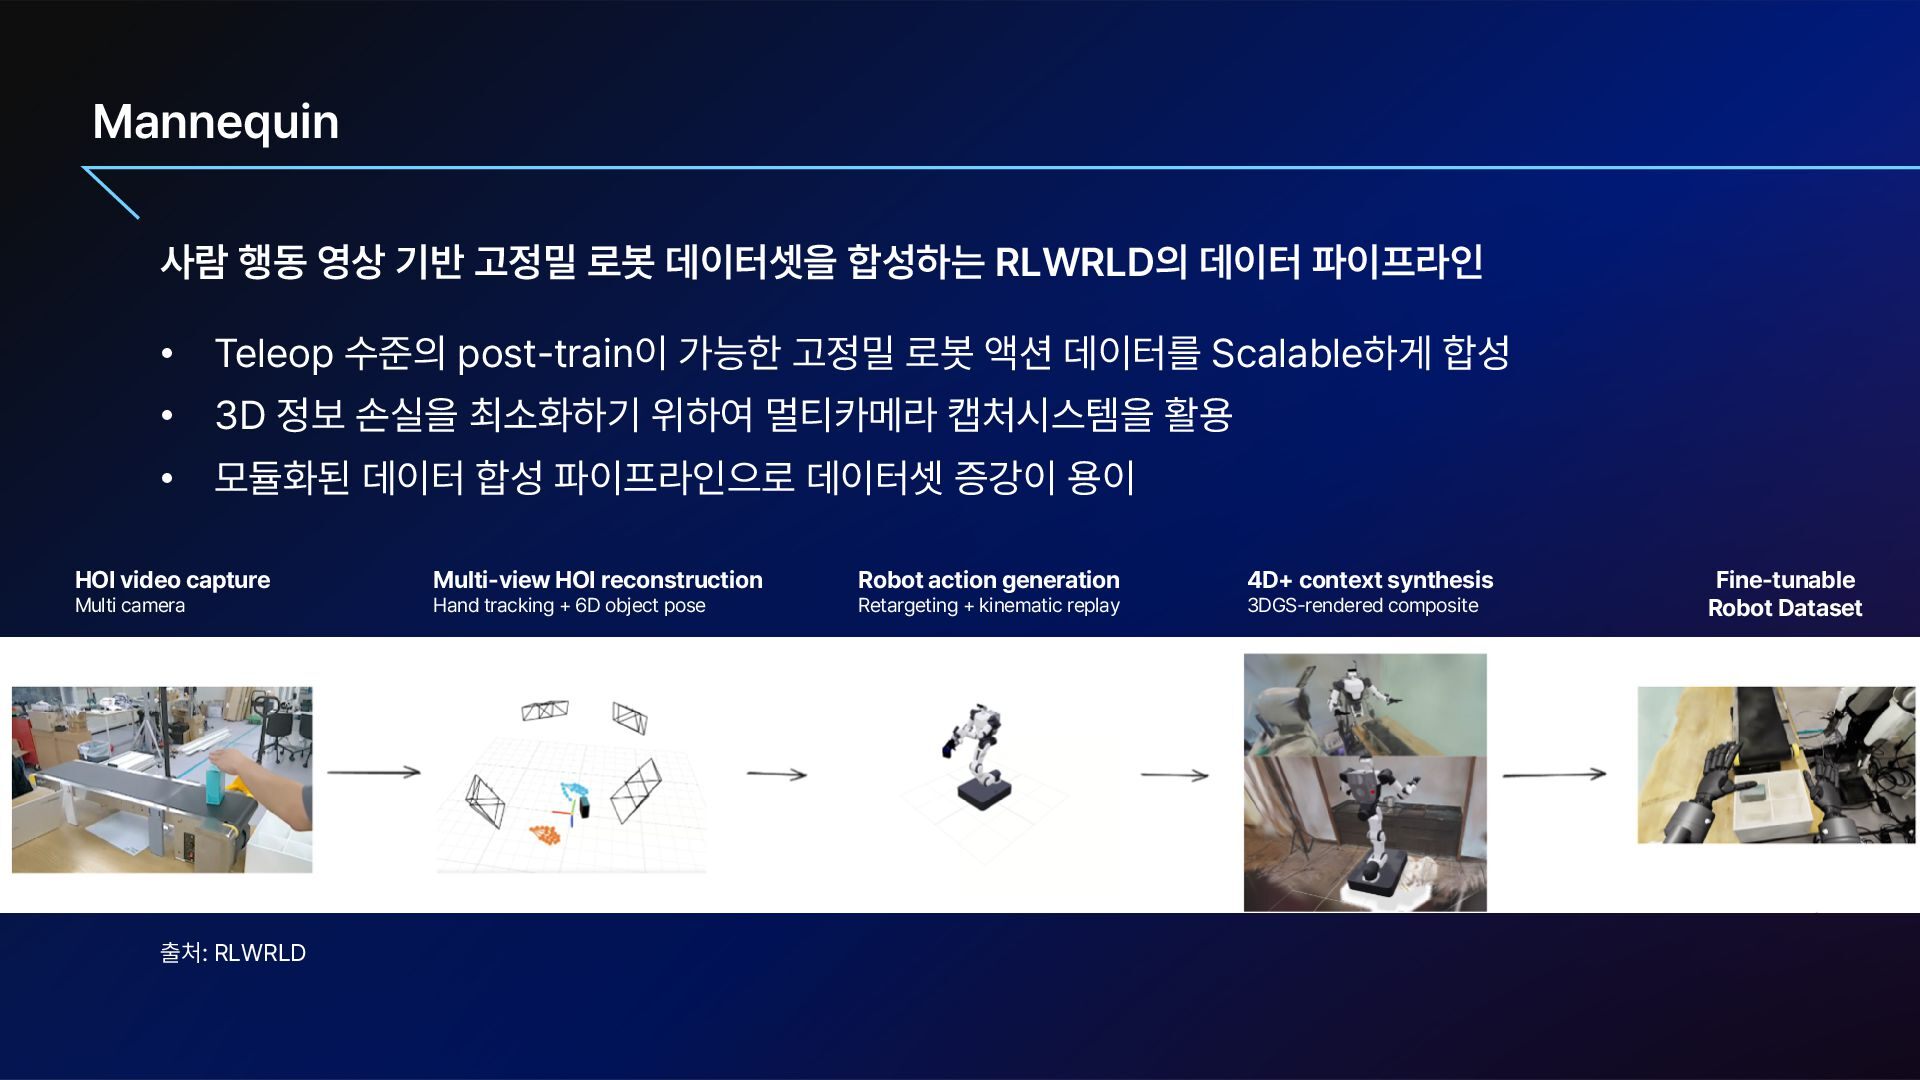
    데이터 파이프라인 • Teleop 수준의 post train이 가능한 고정밀 로봇 액션 데이터를 Scalable하게 합성 • 3D 정보 손실을 최소화하기 위하여 멀티카메라 캡처시스템을 활용 • 모듈화된 데이터 합성 파이프라인으로 데이터셋 증강이 용이 HOI video capture Multi camera 출처: RLWRLD Multi view HOI reconstruction Hand tracking 6D object pose Robot action generation Retargeting kinematic replay 4D context synthesis 3DGS rendered composite Fine tunable Robot Dataset
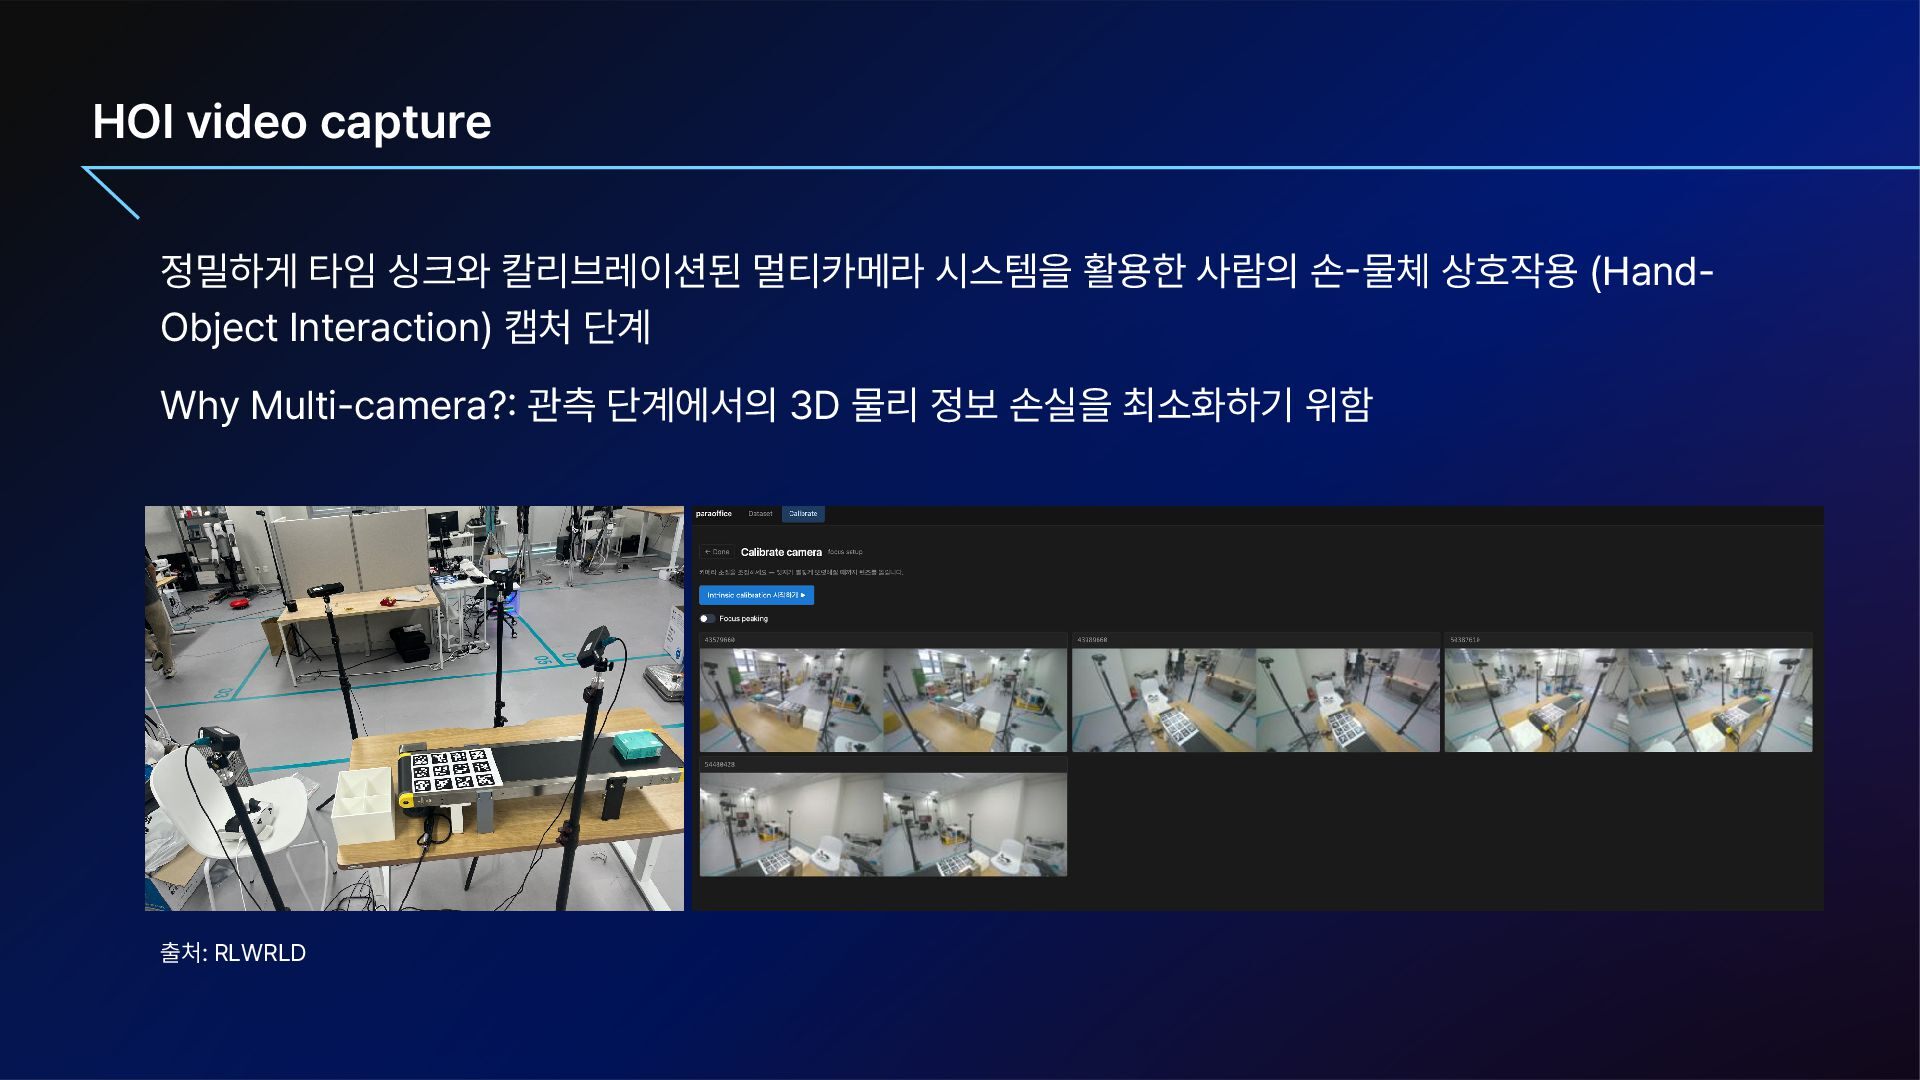
  13. HOI video capture 정밀하게 타임 싱크와 칼리브레이션된 멀티카메라 시스템을 활용한

    사람의 손 물체 상호작용 Hand Object Interaction 캡처 단계 Why Multi camera? 관측 단계에서의 3D 물리 정보 손실을 최소화하기 위함 출처: RLWRLD
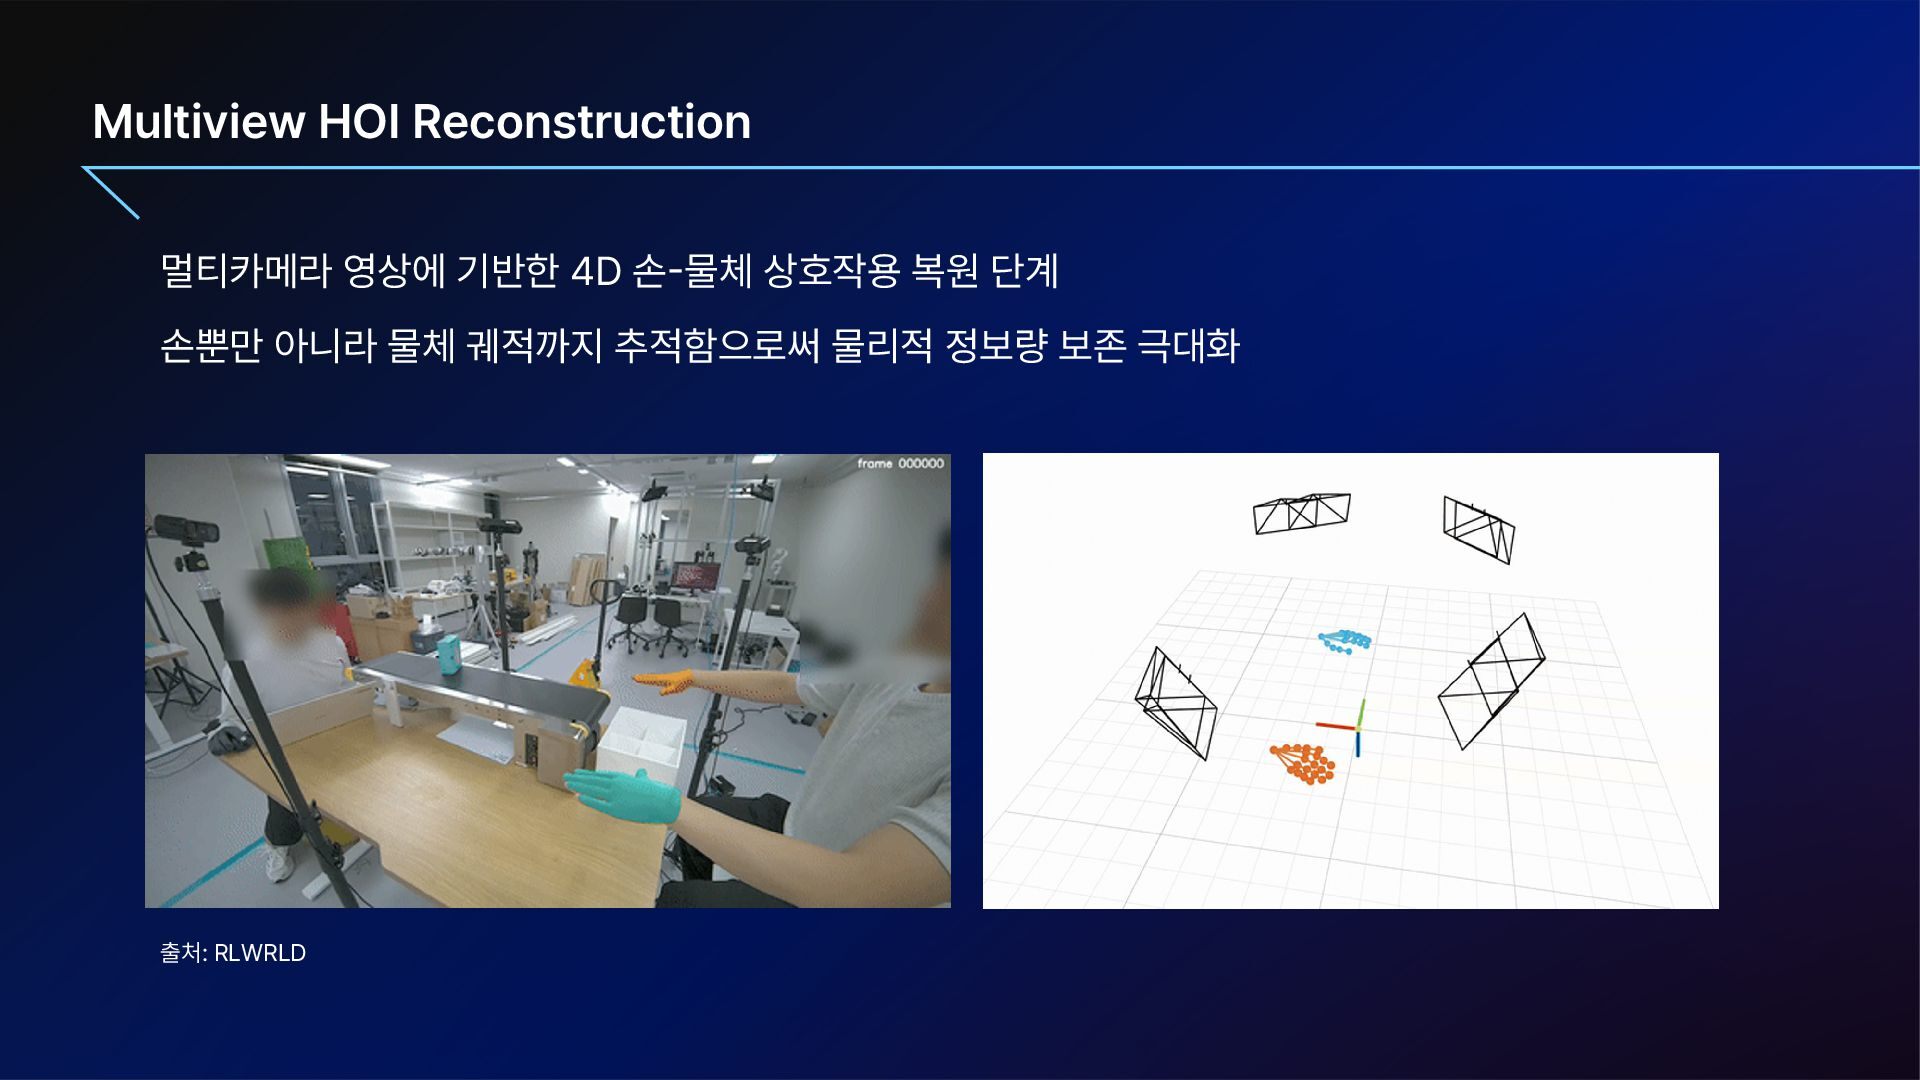
  14. Multiview HOI Reconstruction 멀티카메라 영상에 기반한 4D 손 물체 상호작용

    복원 단계 손뿐만 아니라 물체 궤적까지 추적함으로써 물리적 정보량 보존 극대화 출처: RLWRLD
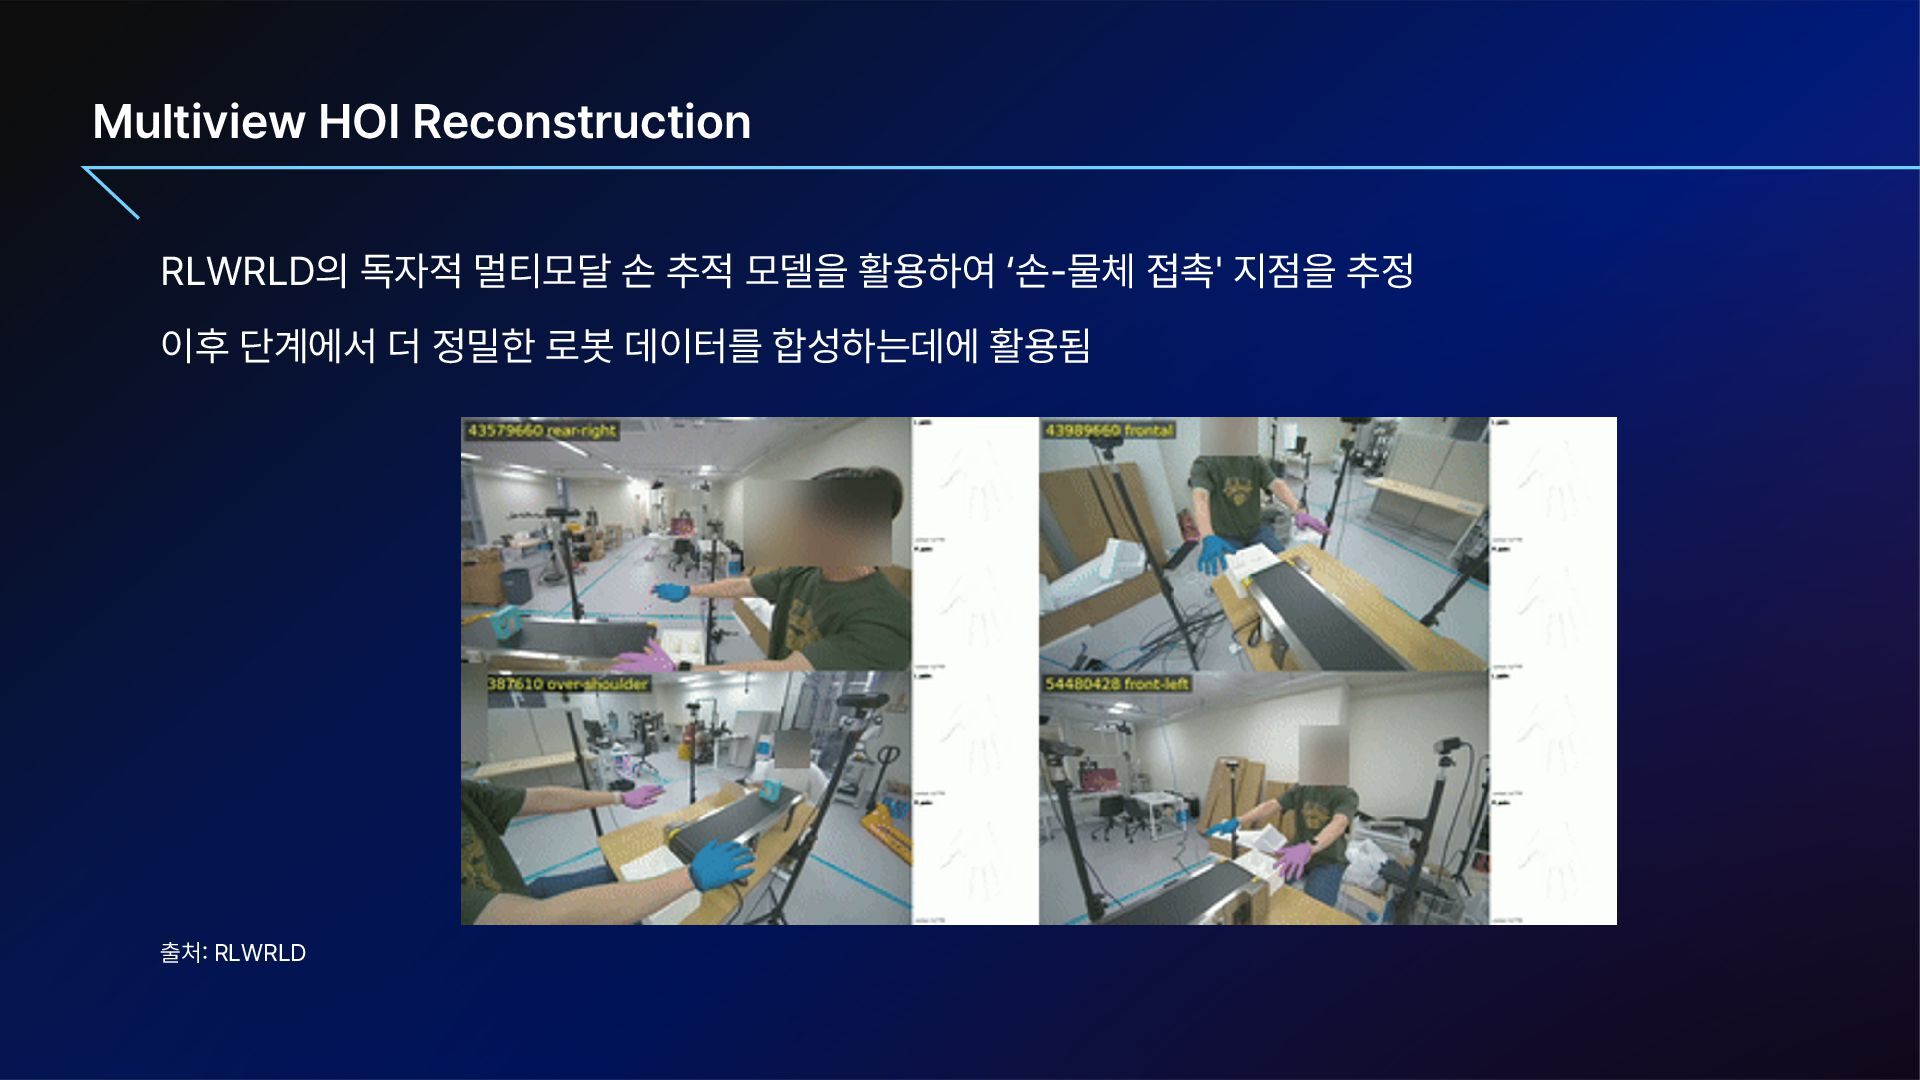
  15. Multiview HOI Reconstruction RLWRLD의 독자적 멀티모달 손 추적 모델을 활용하여

    손 물체 접촉 지점을 추정 이후 단계에서 더 정밀한 로봇 데이터를 합성하는데에 활용됨 출처 RLWRLD
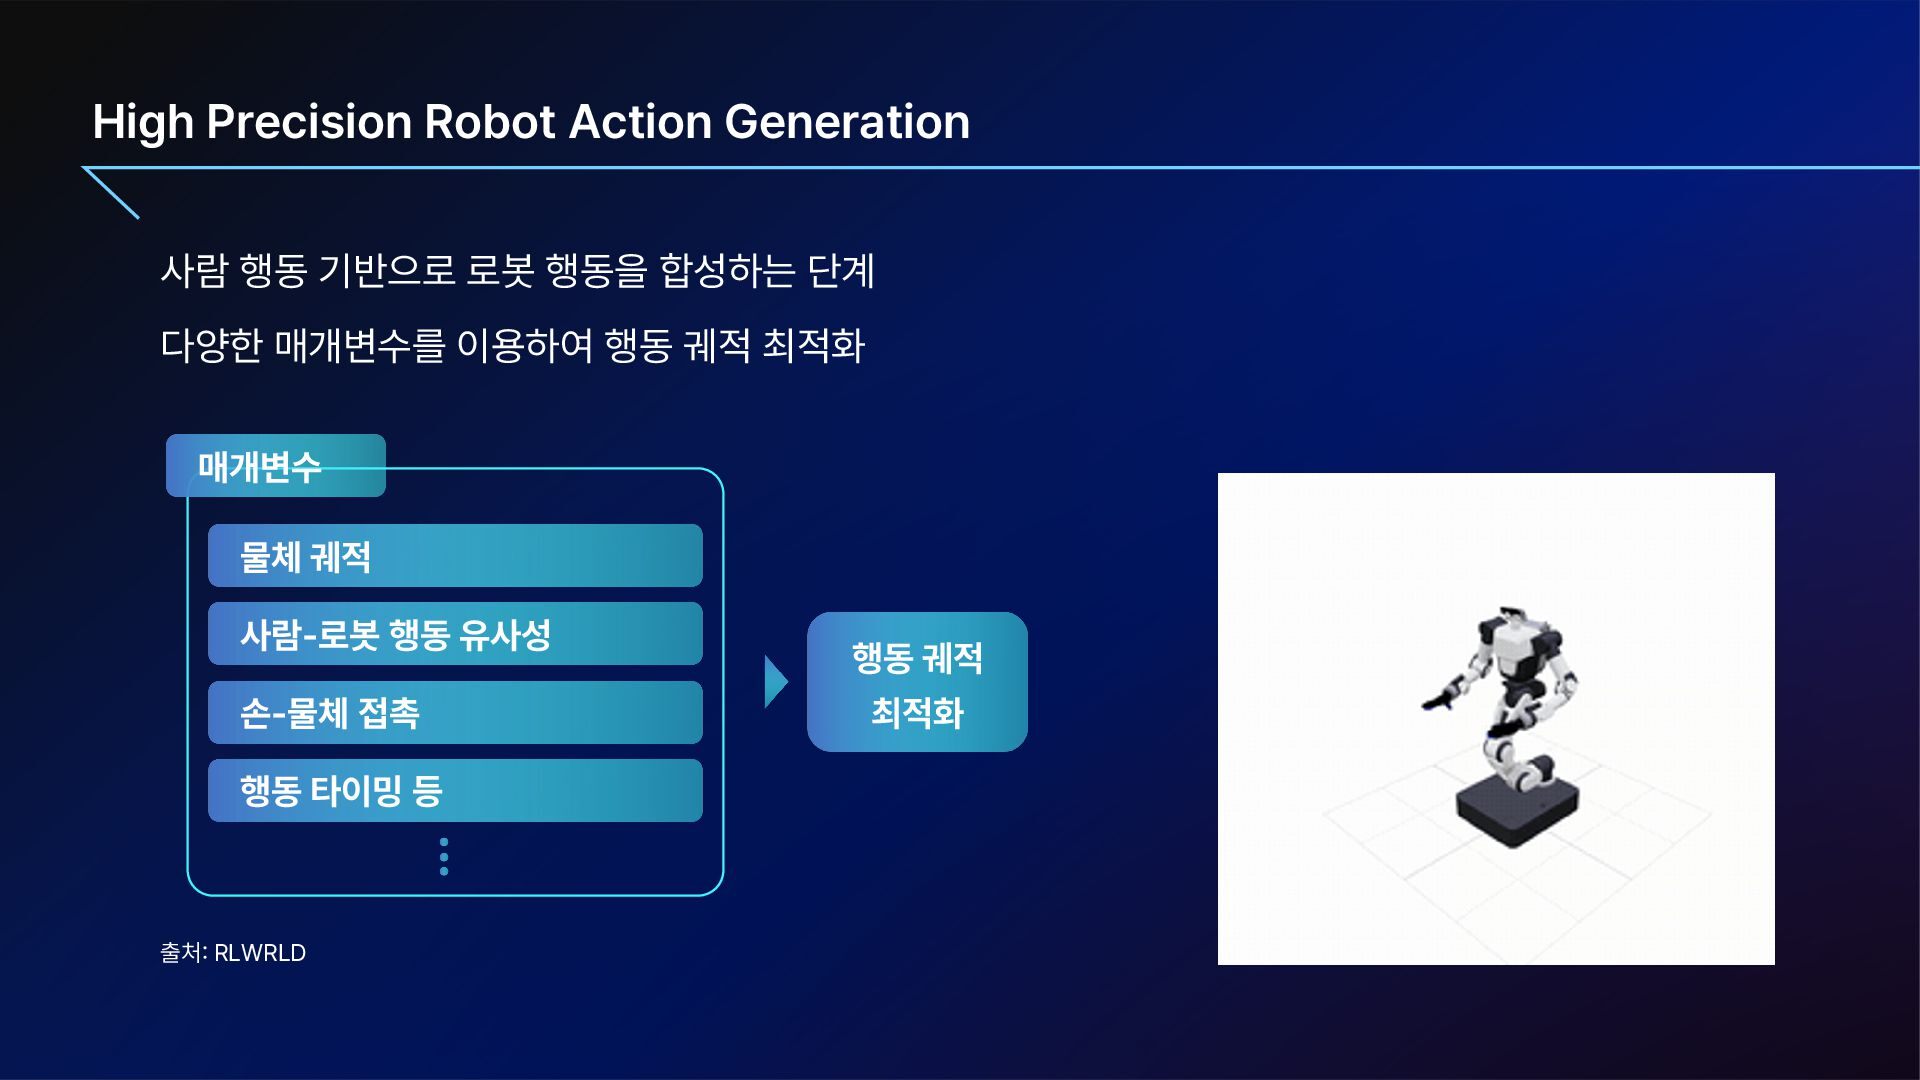
  16. High Precision Robot Action Generation 사람 행동 기반으로 로봇 행동을

    합성하는 단계 다양한 매개변수를 이용하여 행동 궤적 최적화 매개변수 물체 궤적 사람 로봇 행동 유사성 손 물체 접촉 행동 타이밍 등 출처 RLWRLD 행동 궤적 최적화
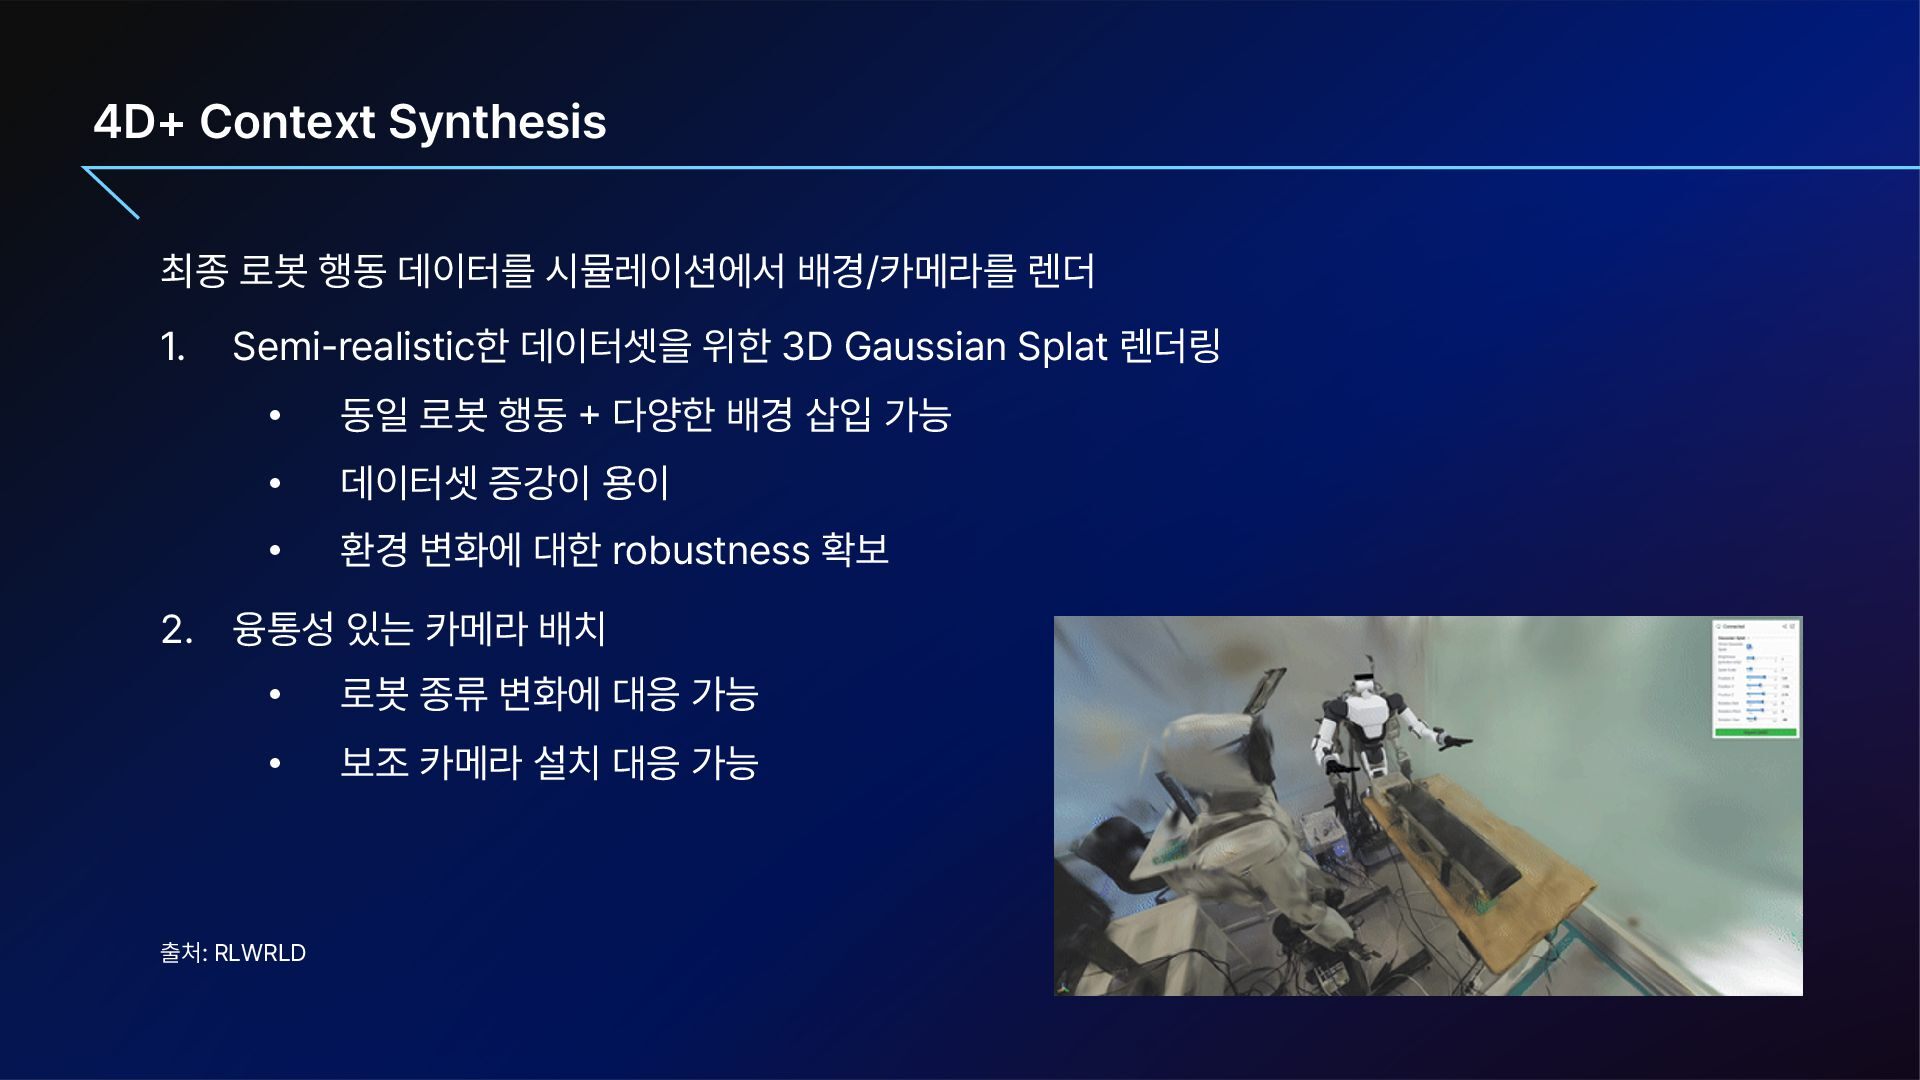
  17. 4D Context Synthesis 최종 로봇 행동 데이터를 시뮬레이션에서 배경/카메라를 렌더

    1. Semi realistic한 데이터셋을 위한 3D Gaussian Splat 렌더링 • 동일 로봇 행동 다양한 배경 삽입 가능 • 데이터셋 증강이 용이 • 환경 변화에 대한 robustness 확보 2. 융통성 있는 카메라 배치 • 로봇 종류 변화에 대응 가능 • 보조 카메라 설치 대응 가능 출처: RLWRLD
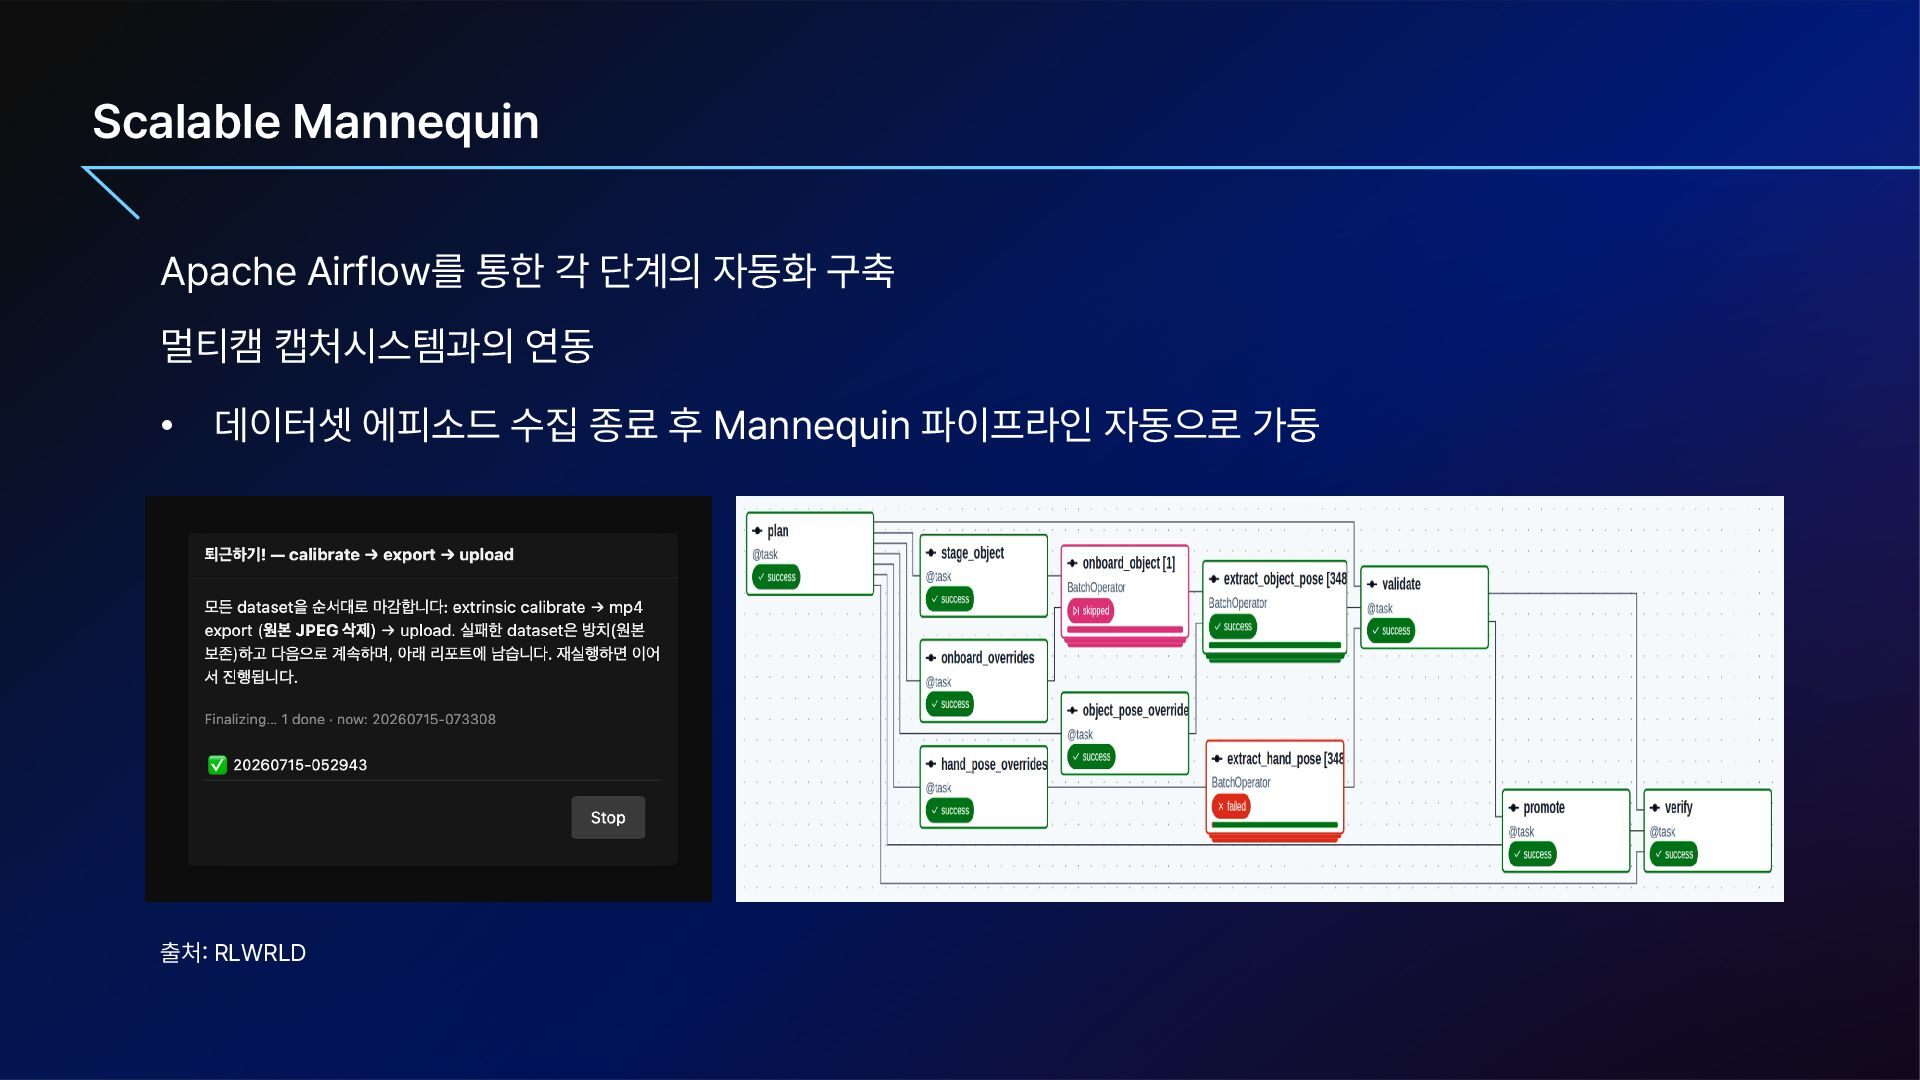
  18. Scalable Mannequin Apache Airflow를 통한 각 단계의 자동화 구축 멀티캠

    캡처시스템과의 연동 • 데이터셋 에피소드 수집 종료 후 Mannequin 파이프라인 자동으로 가동 출처 RLWRLD
  19. Q A