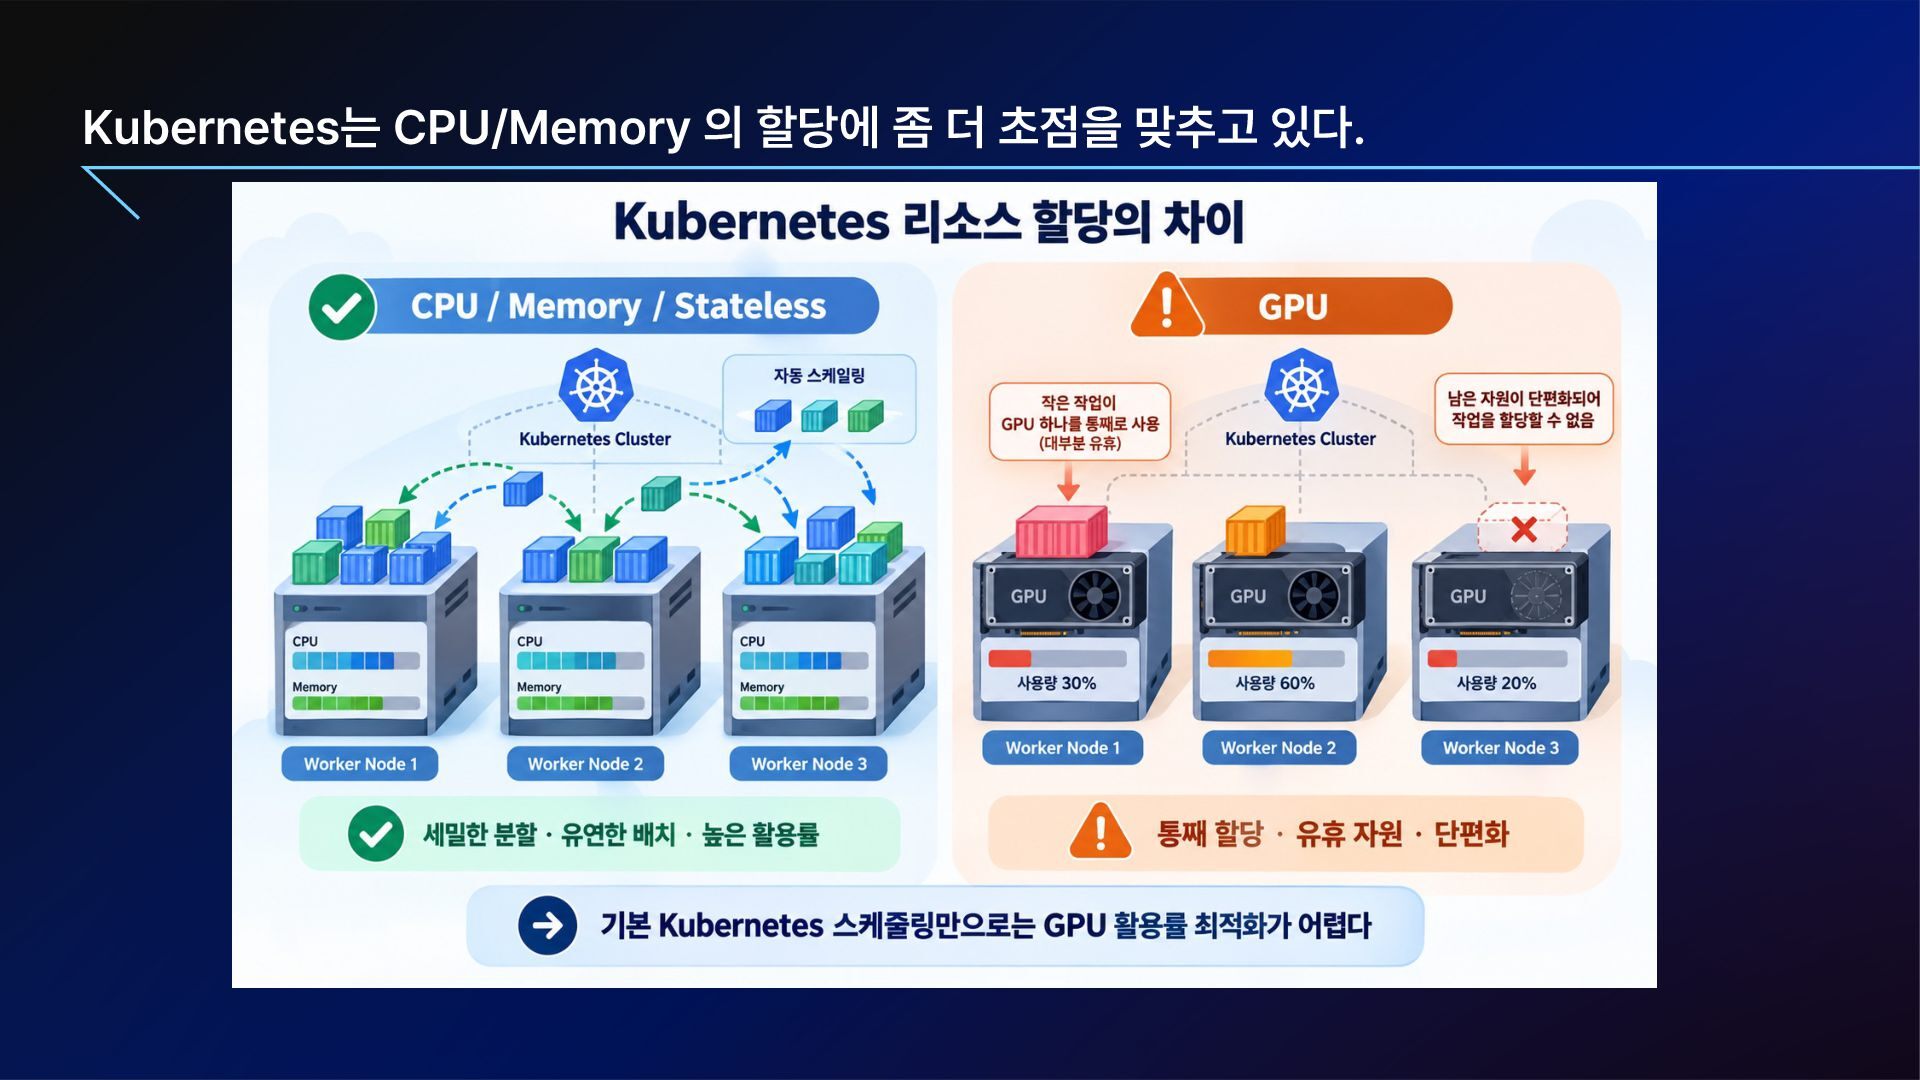
쿠버네티스는 인프라의 OS라고 불릴 정도로 많은 곳에서 사용되고 있습니다. 다만 CPU, 메모리를 제어하는 목적으로 시작해서 GPU를 효율적으로 사용하기에는 미흡한 부분들도 있는데, Device Plugin 방식부터 시작해서 DRA까지, 현재 쿠버네티스에서 GPU를 어떻게 사용하고 있는지, 어떤 문제점이 있는지 살펴봅니다.
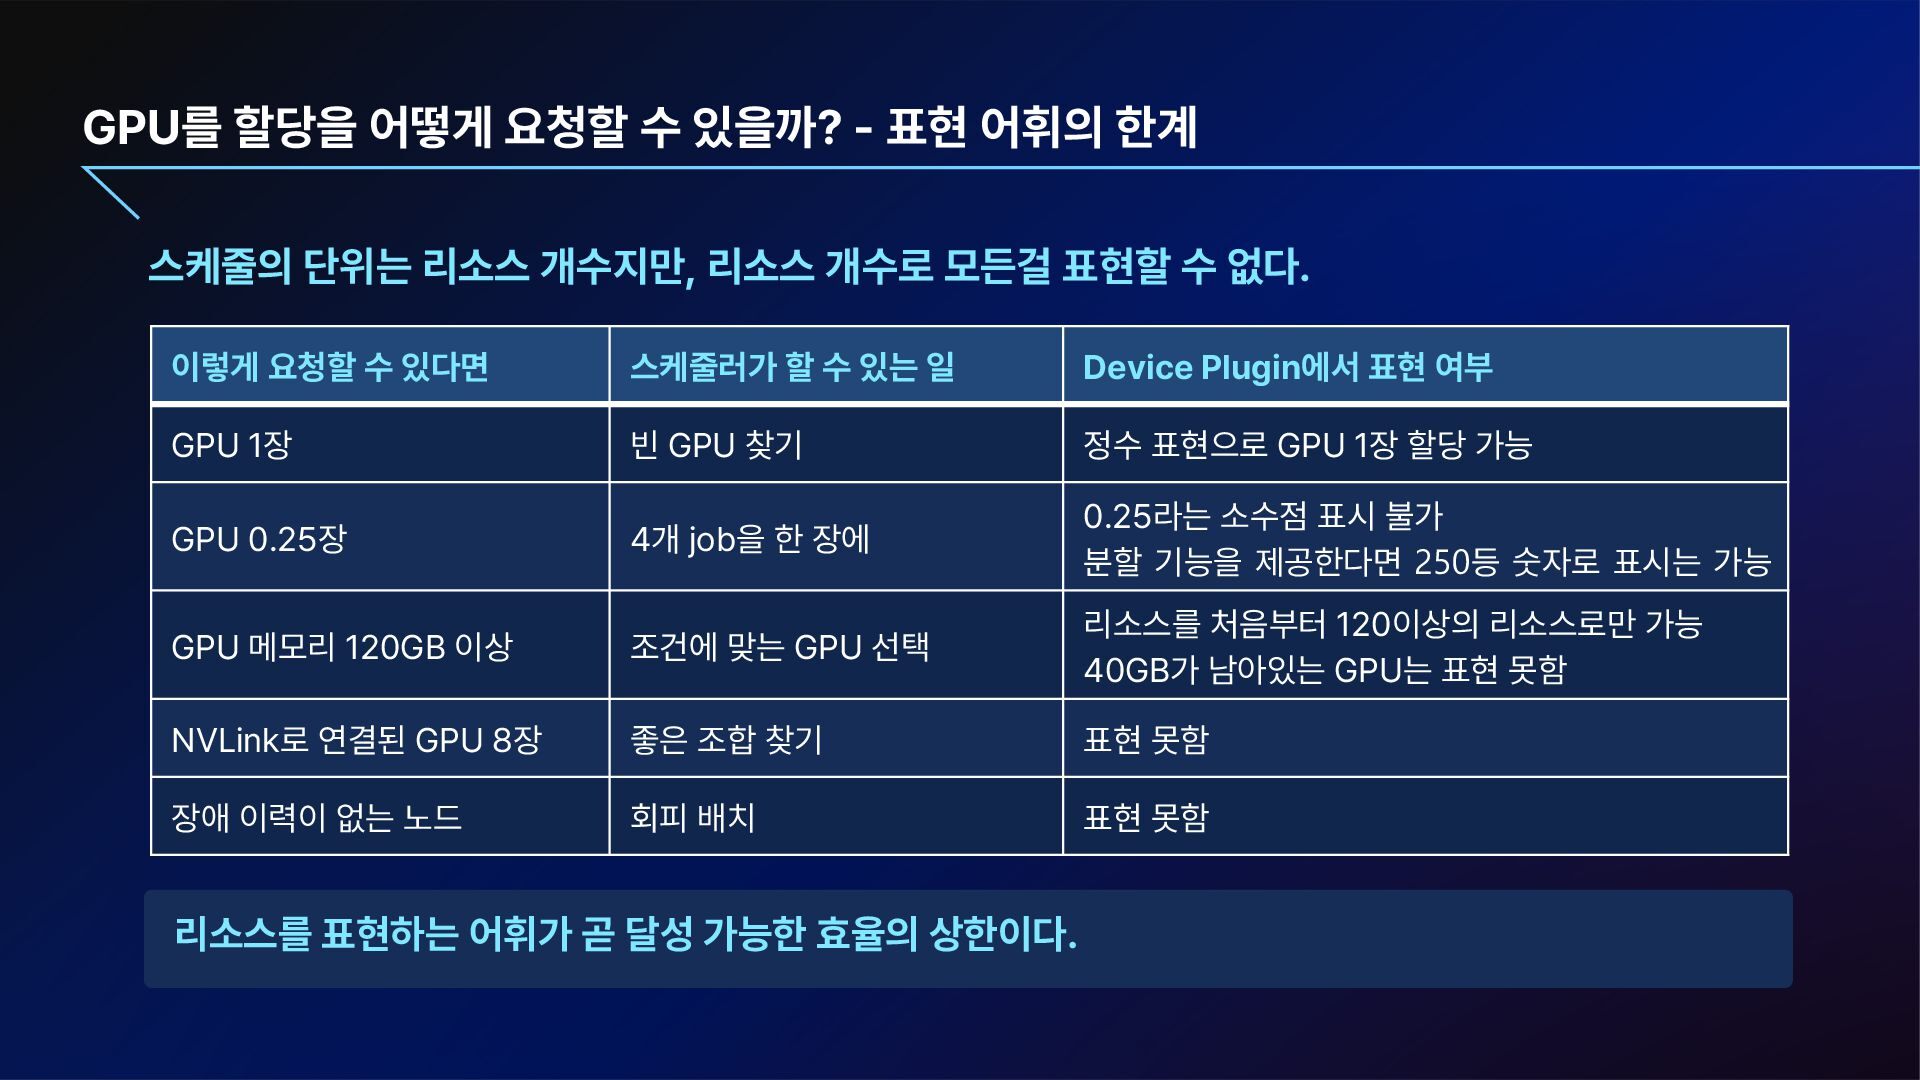
단위는 리소스 개수지만, 리소스 개수로 모든걸 표현할 수 없다. 이렇게 요청할 수 있다면 스케줄러가 할 수 있는 일 Device Plugin에서 표현 여부 GPU 1장 빈 GPU 찾기 정수 표현으로 GPU 1장 할당 가능 GPU 0.25장 4개 job을 한 장에 0.25라는 소수점 표시 불가 분할 기능을 제공한다면 250등 숫자로 표시는 가능 GPU 메모리 120GB 이상 조건에 맞는 GPU 선택 리소스를 처음부터 120이상의 리소스로만 가능 40GB가 남아있는 GPU는 표현 못함 NVLink로 연결된 GPU 8장 좋은 조합 찾기 표현 못함 장애 이력이 없는 노드 회피 배치 표현 못함 리소스를 표현하는 어휘가 곧 달성 가능한 효율의 상한이다.
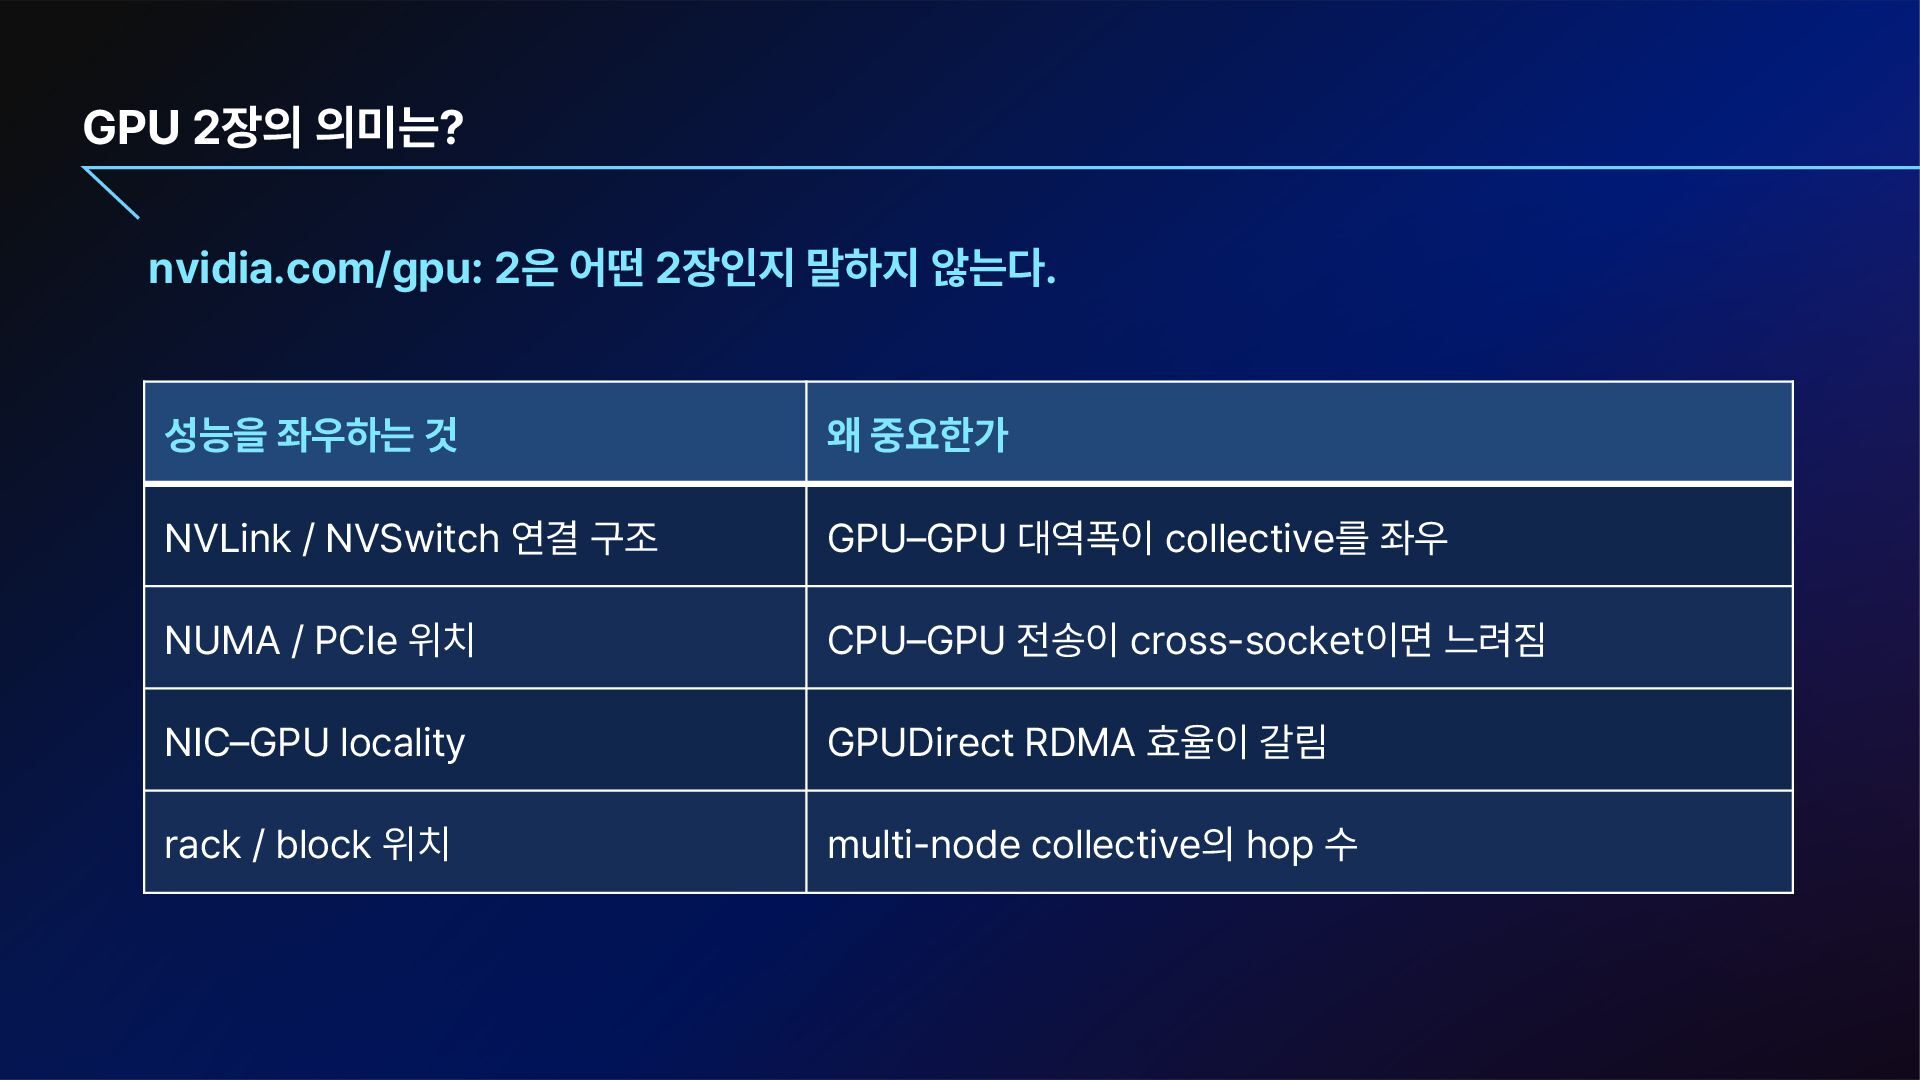
좌우하는 것 왜 중요한가 NVLink / NVSwitch 연결 구조 GPU GPU 대역폭이 collective를 좌우 NUMA / PCIe 위치 CPU GPU 전송이 cross socket이면 느려짐 NIC GPU locality GPUDirect RDMA 효율이 갈림 rack / block 위치 multi node collective의 hop 수
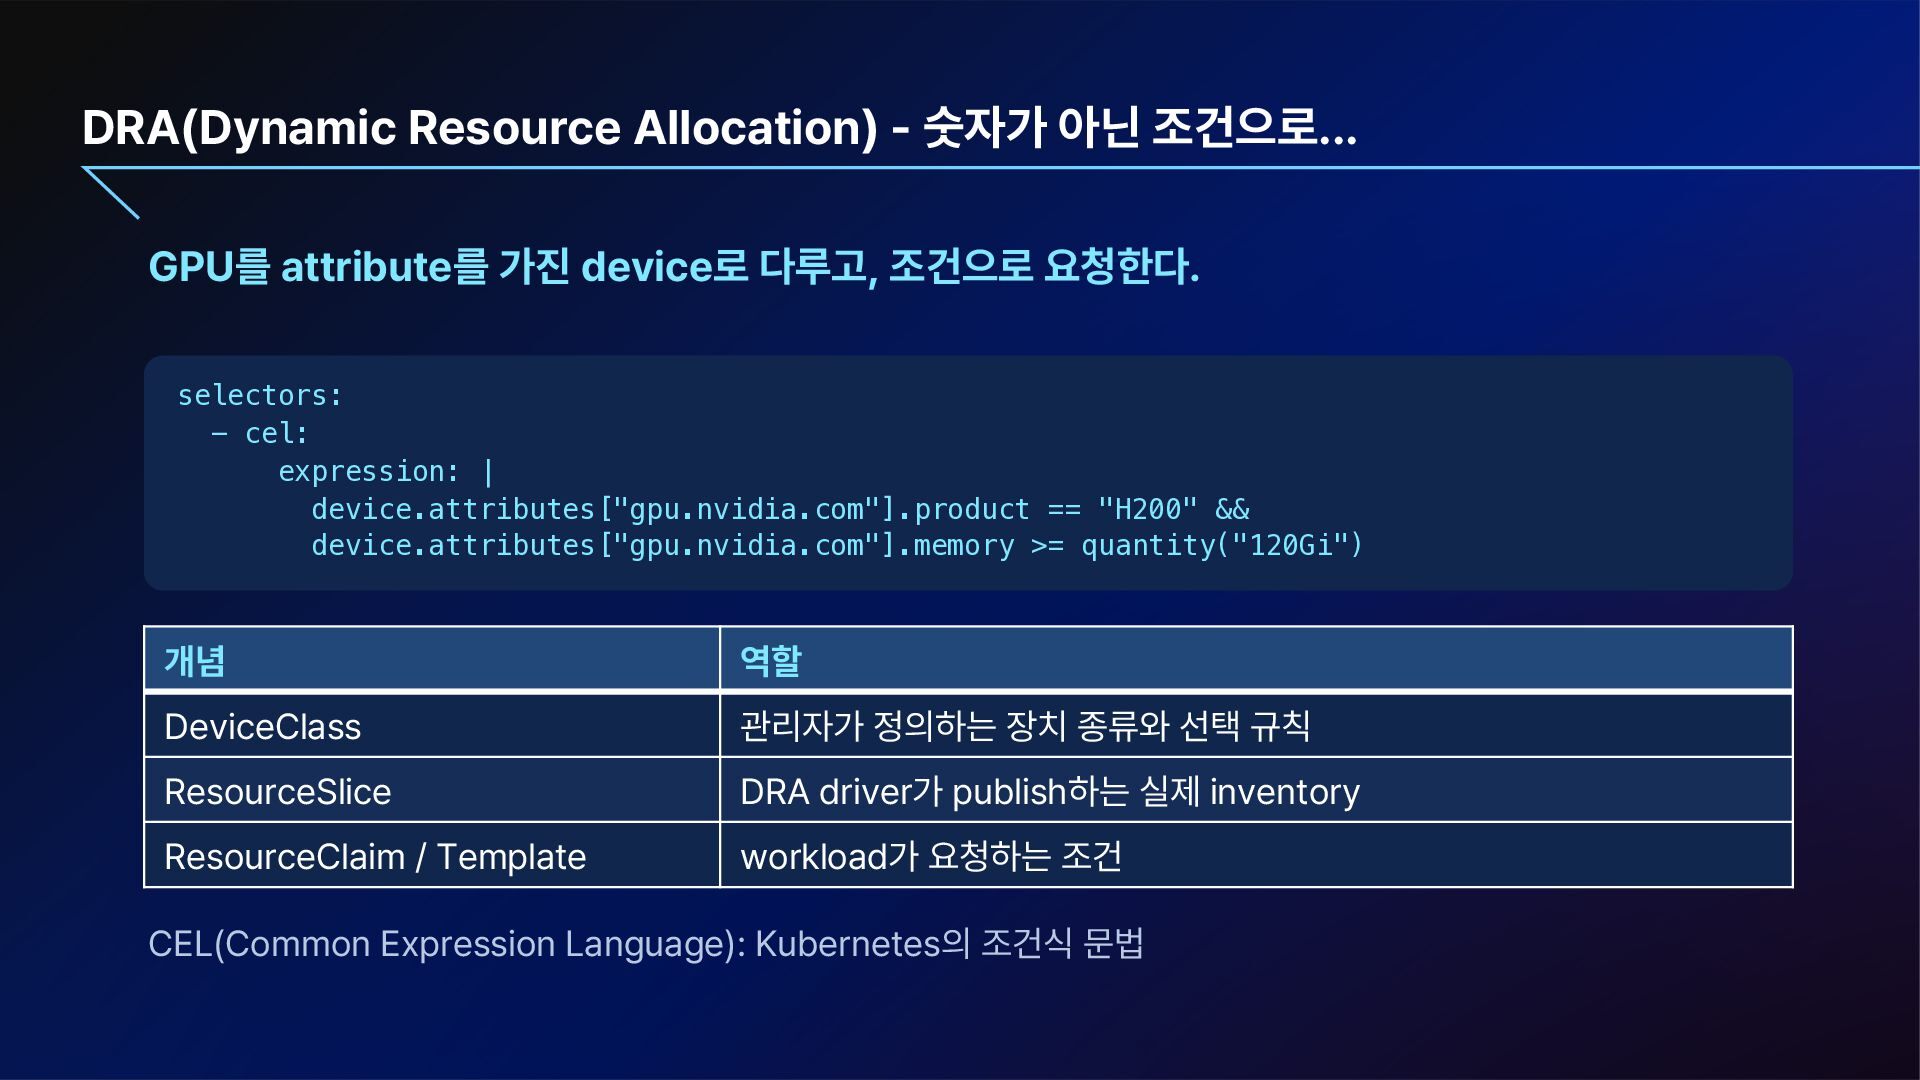
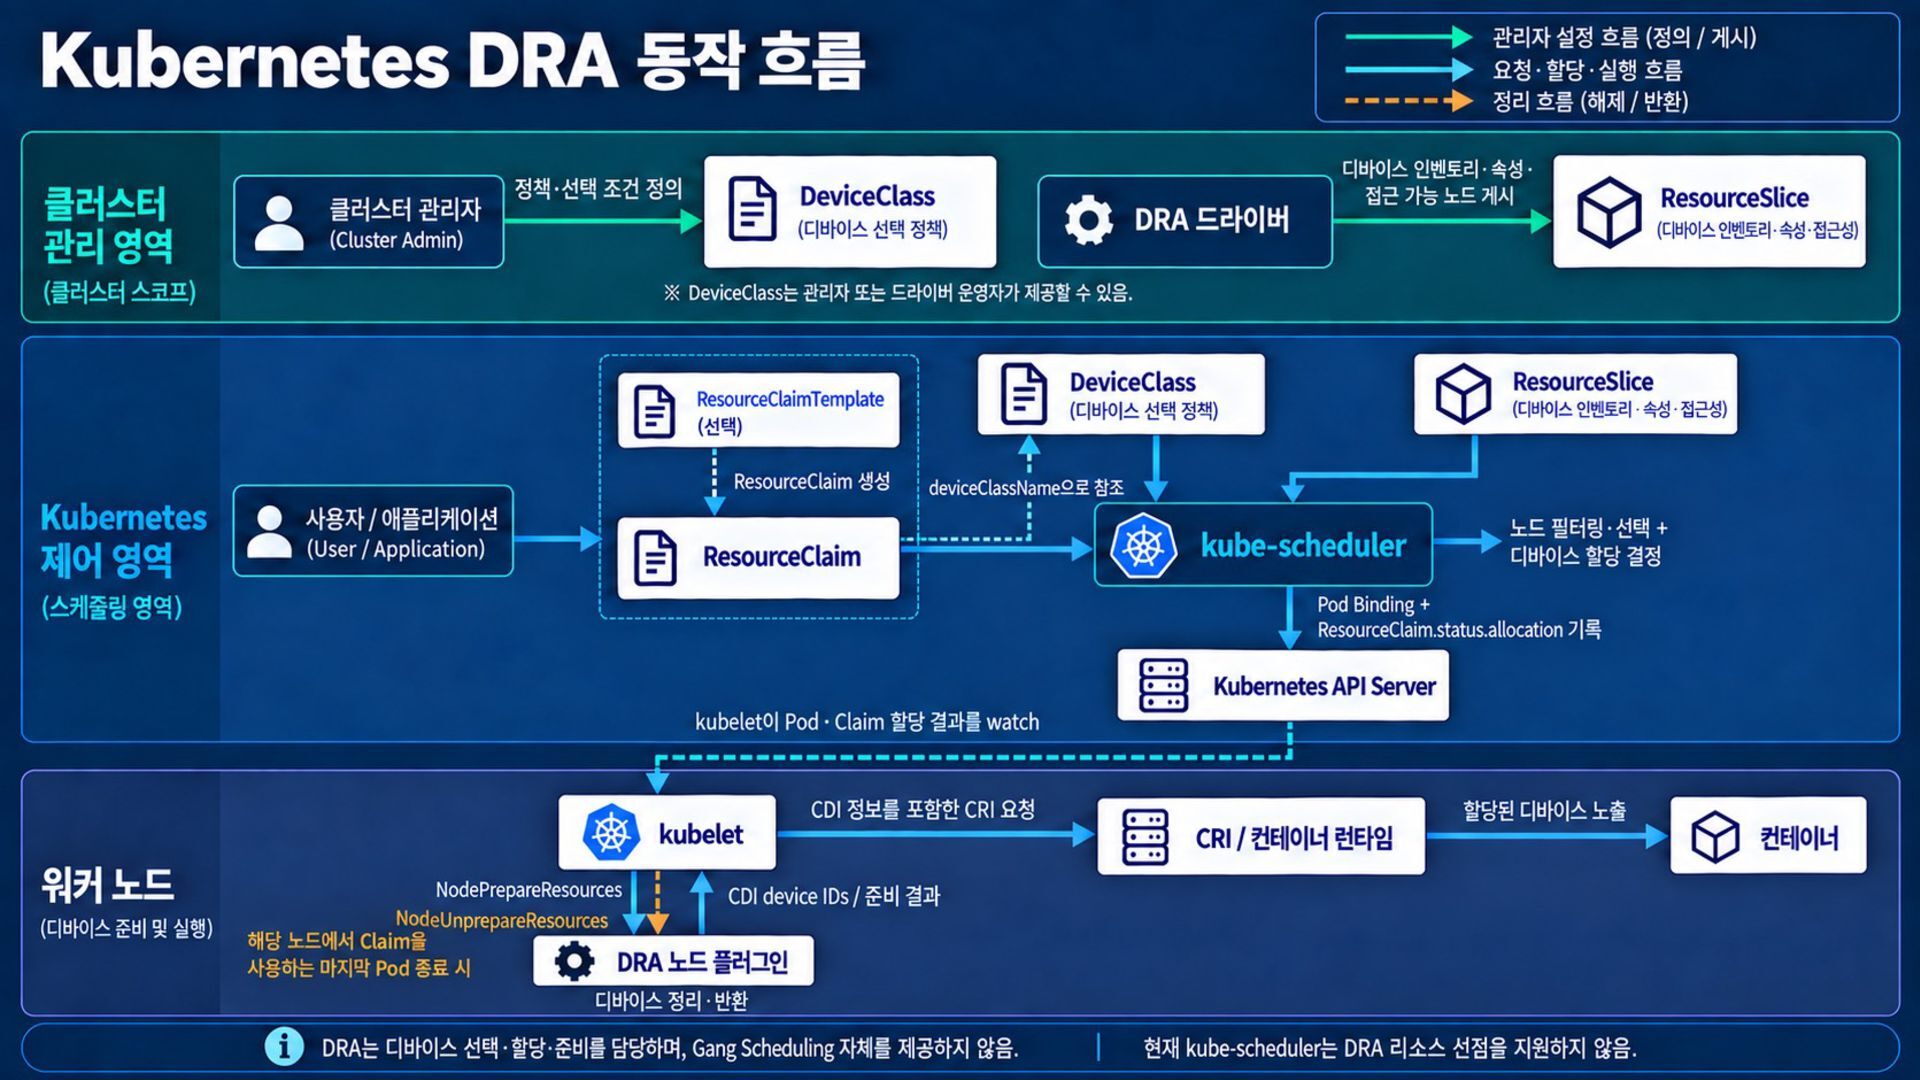
device로 다루고, 조건으로 요청한다. selectors: - cel: expression: | device.attributes["gpu.nvidia.com"].product == "H200" && device.attributes["gpu.nvidia.com"].memory >= quantity("120Gi") 개념 역할 DeviceClass 관리자가 정의하는 장치 종류와 선택 규칙 ResourceSlice DRA driver가 publish하는 실제 inventory ResourceClaim / Template workload가 요청하는 조건 CEL Common Expression Language : Kubernetes의 조건식 문법
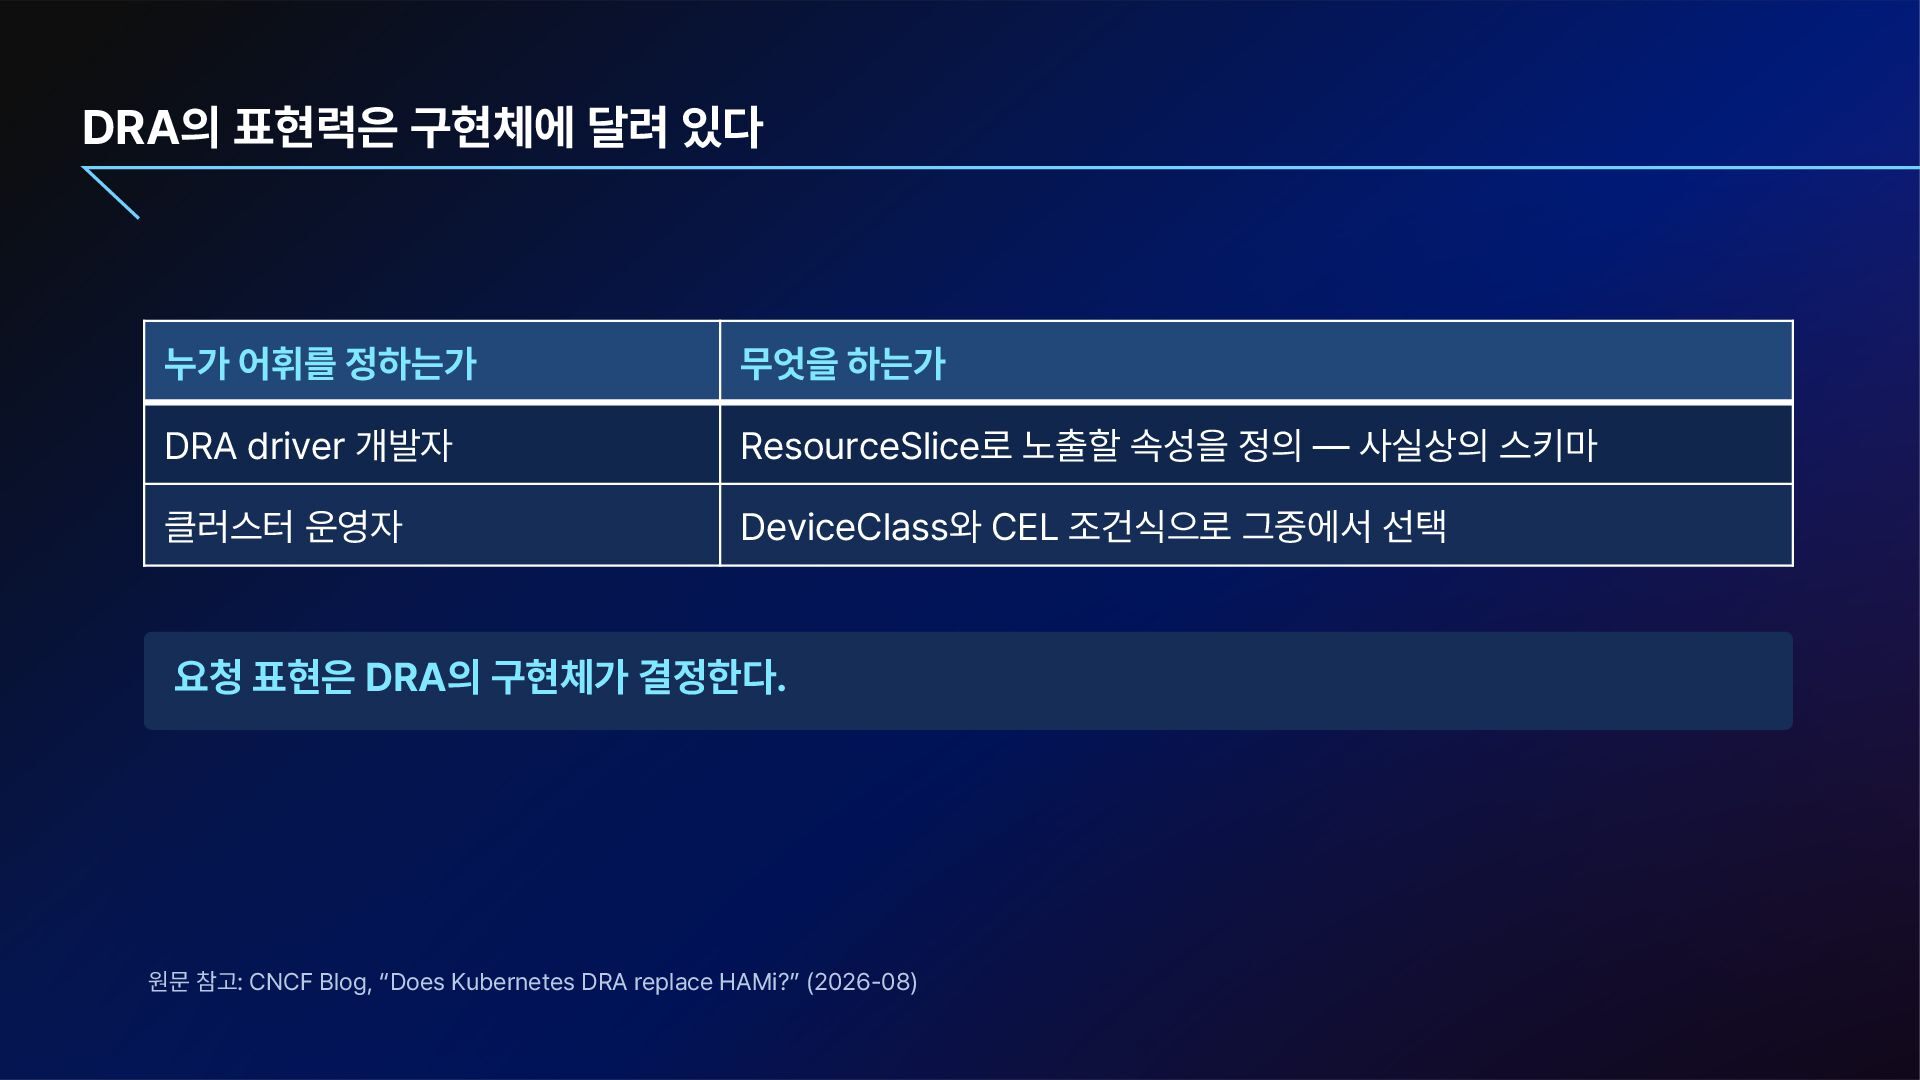
DRA driver 개발자 ResourceSlice로 노출할 속성을 정의 클러스터 운영자 DeviceClass와 CEL 조건식으로 그중에서 선택 요청 표현은 DRA의 구현체가 결정한다. 원문 참고: CNCF Blog, Does Kubernetes DRA replace HAMi? 2026 08 사실상의 스키마
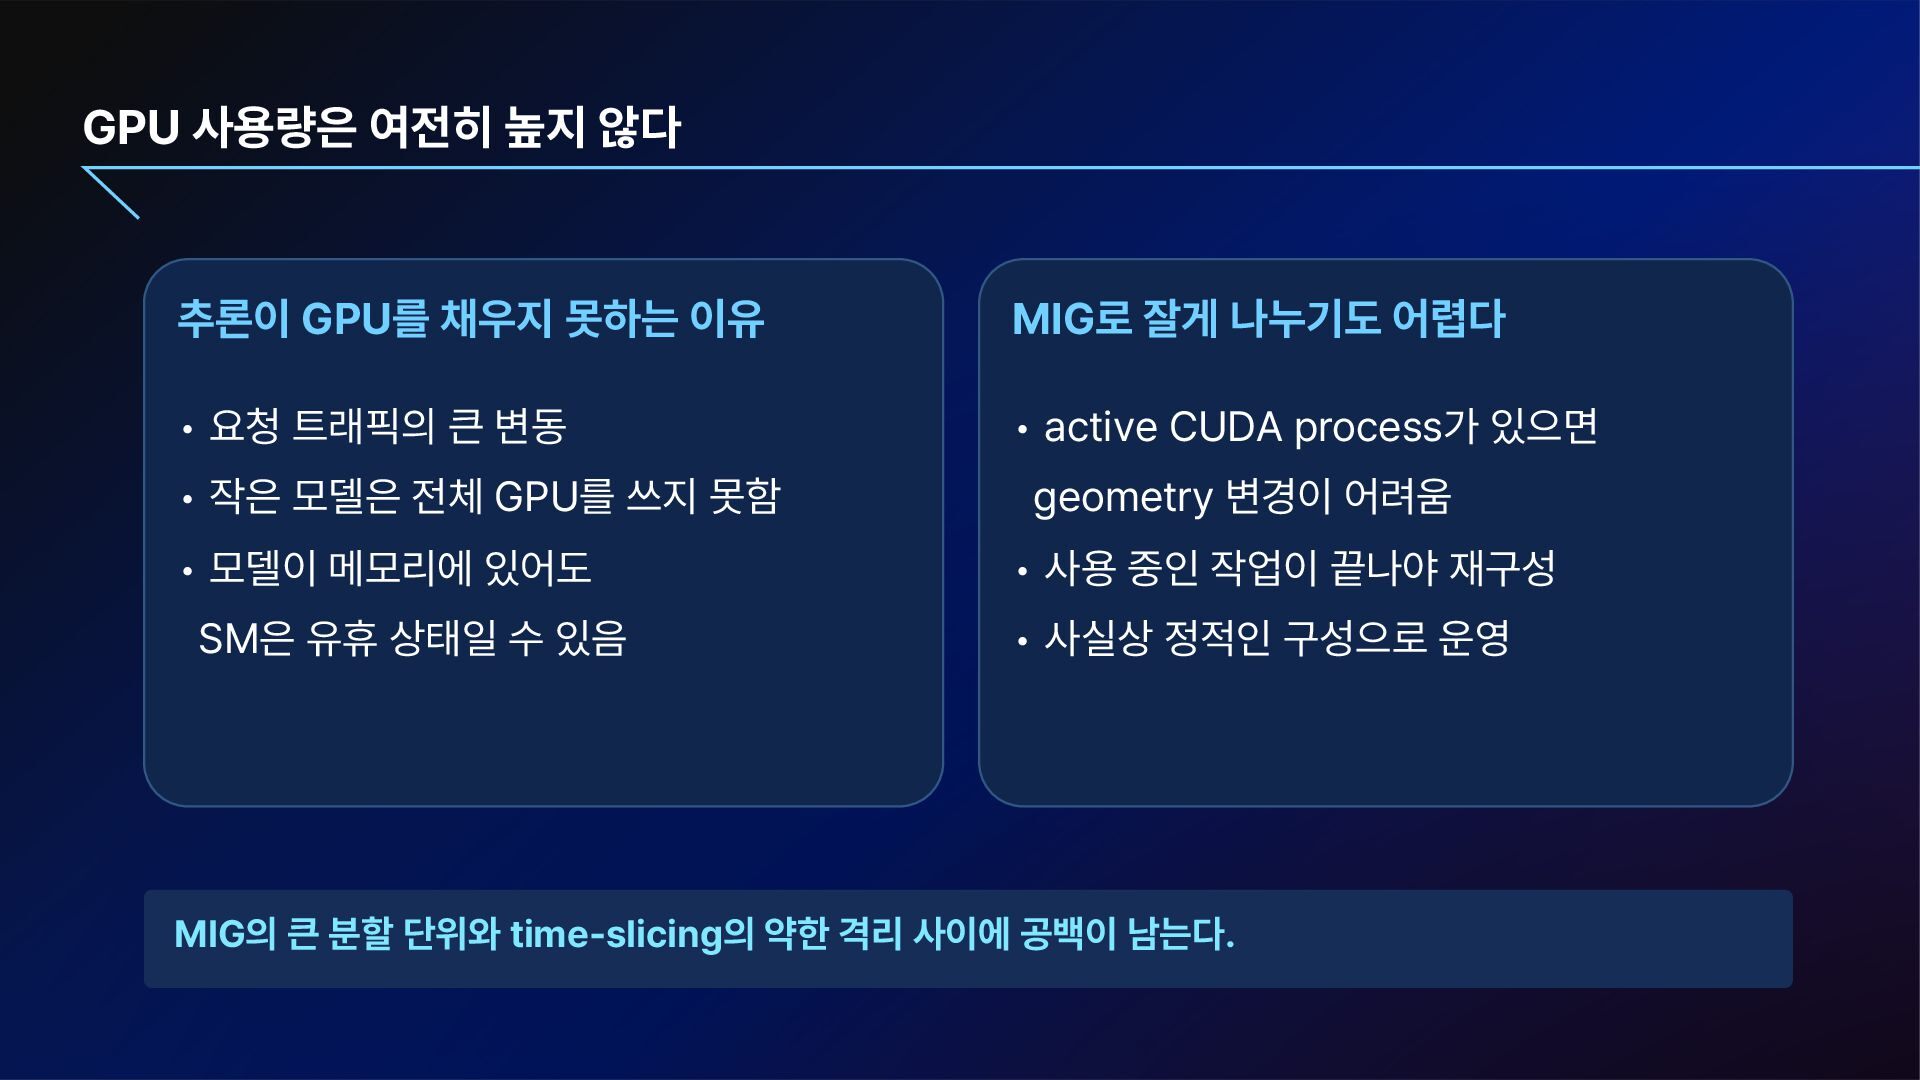
MIG로 잘게 나누기도 어렵다 • 요청 트래픽의 큰 변동 • active CUDA process가 있으면 • 작은 모델은 전체 GPU를 쓰지 못함 geometry 변경이 어려움 • 모델이 메모리에 있어도 • 사용 중인 작업이 끝나야 재구성 SM은 유휴 상태일 수 있음 • 사실상 정적인 구성으로 운영 MIG의 큰 분할 단위와 time slicing의 약한 격리 사이에 공백이 남는다.
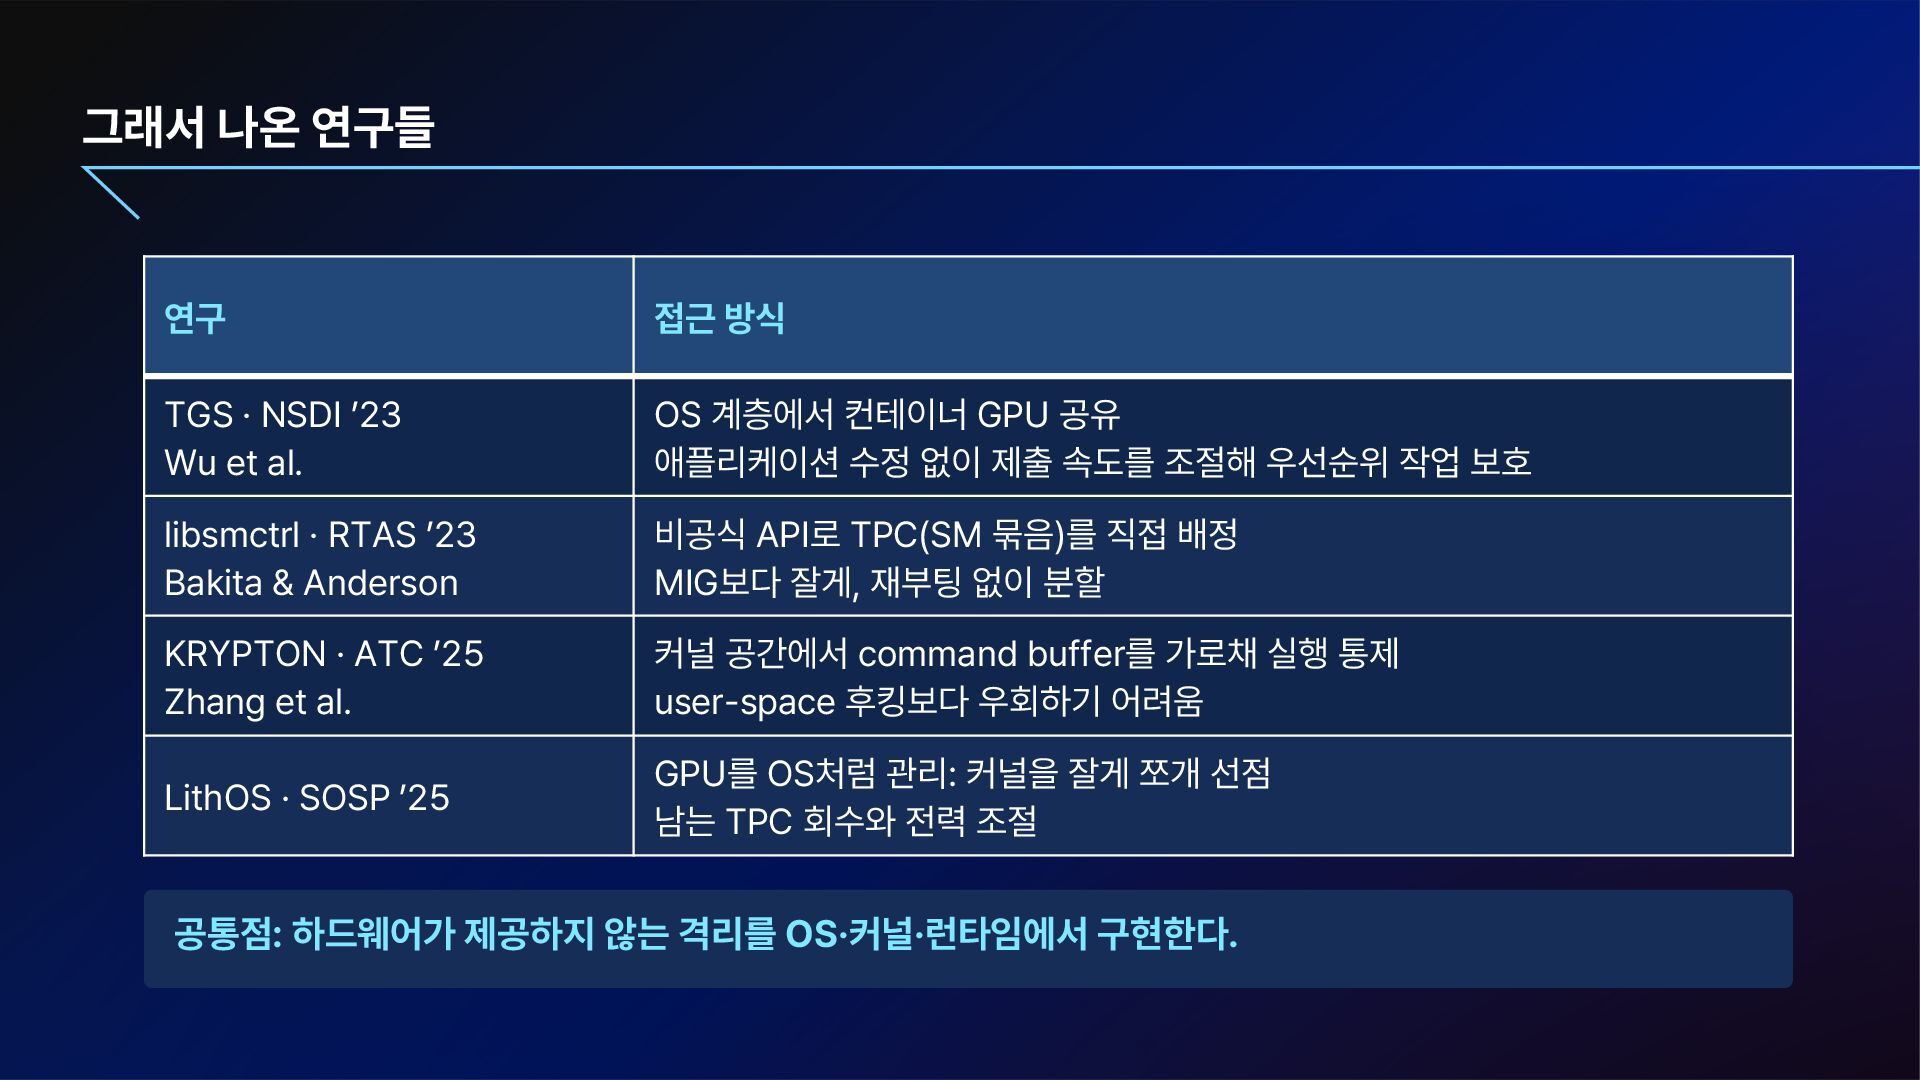
Wu et al. OS 계층에서 컨테이너 GPU 공유 애플리케이션 수정 없이 제출 속도를 조절해 우선순위 작업 보호 libsmctrl · RTAS 23 Bakita Anderson 비공식 API로 TPC SM 묶음 를 직접 배정 MIG보다 잘게, 재부팅 없이 분할 KRYPTON · ATC 25 Zhang et al. 커널 공간에서 command buffer를 가로채 실행 통제 user space 후킹보다 우회하기 어려움 LithOS · SOSP 25 GPU를 OS처럼 관리: 커널을 잘게 쪼개 선점 남는 TPC 회수와 전력 조절 공통점: 하드웨어가 제공하지 않는 격리를 OS·커널·런타임에서 구현한다.
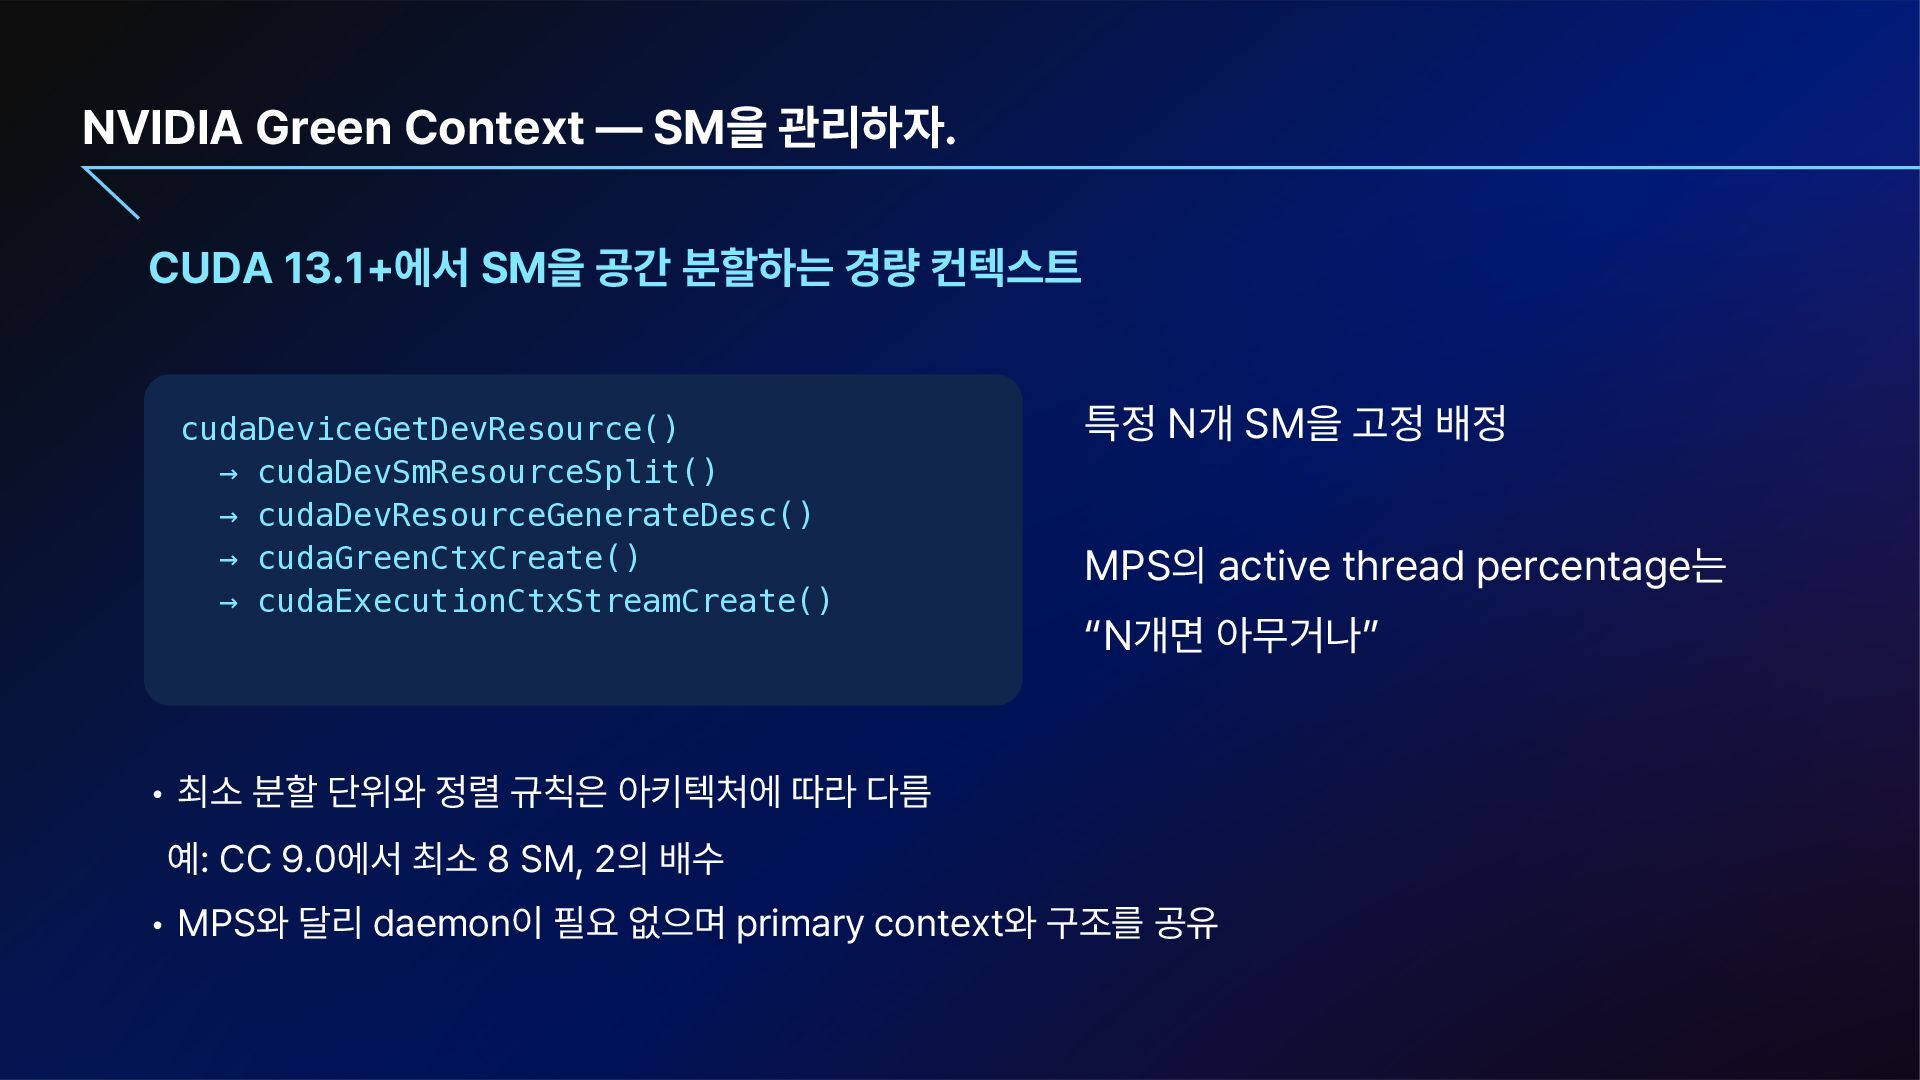
분할하는 경량 컨텍스트 cudaDeviceGetDevResource() → cudaDevSmResourceSplit() → cudaDevResourceGenerateDesc() → cudaGreenCtxCreate() → cudaExecutionCtxStreamCreate() 특정 N개 SM을 고정 배정 MPS의 active thread percentage는 N개면 아무거나 • 최소 분할 단위와 정렬 규칙은 아키텍처에 따라 다름 예: CC 9.0에서 최소 8 SM, 2의 배수 • MPS와 달리 daemon이 필요 없으며 primary context와 구조를 공유
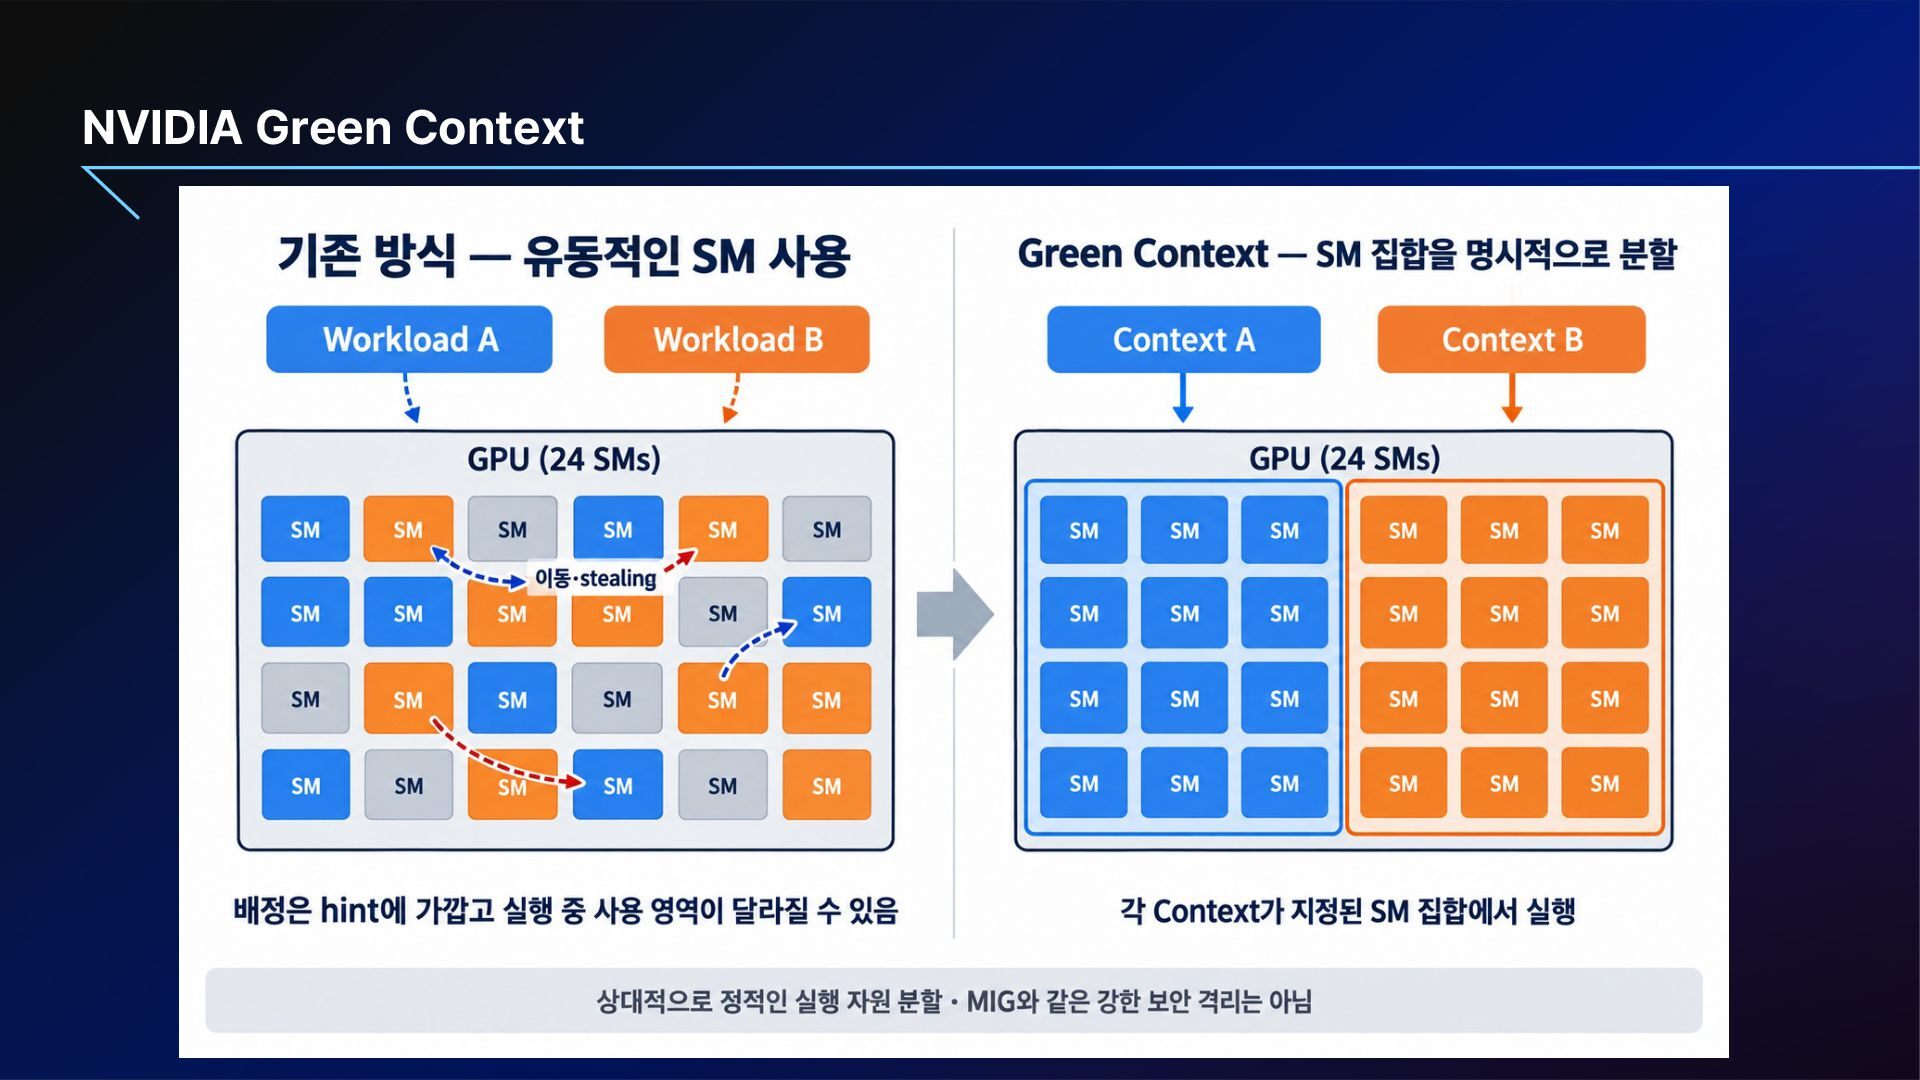
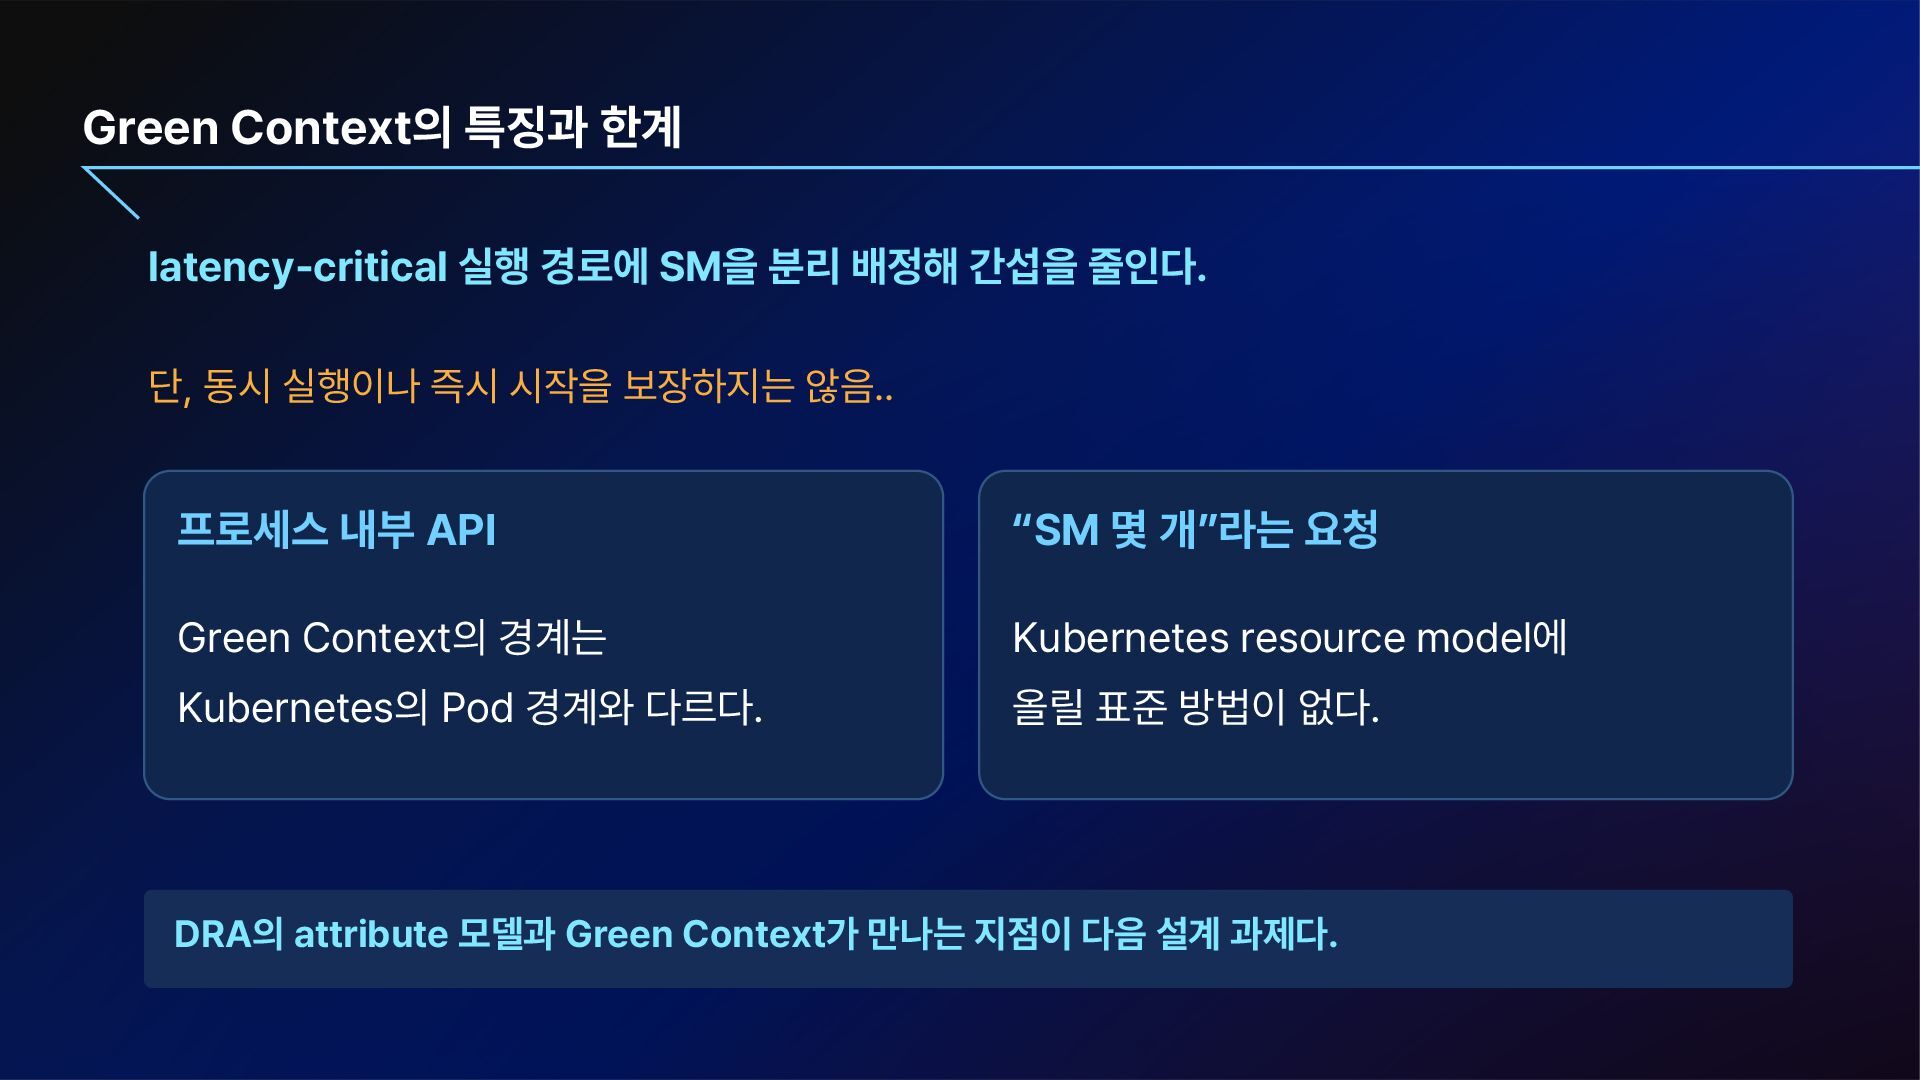
배정해 간섭을 줄인다. 단, 동시 실행이나 즉시 시작을 보장하지는 않음.. 프로세스 내부 API SM 몇 개 라는 요청 Green Context의 경계는 Kubernetes resource model에 Kubernetes의 Pod 경계와 다르다. 올릴 표준 방법이 없다. DRA의 attribute 모델과 Green Context가 만나는 지점이 다음 설계 과제다.
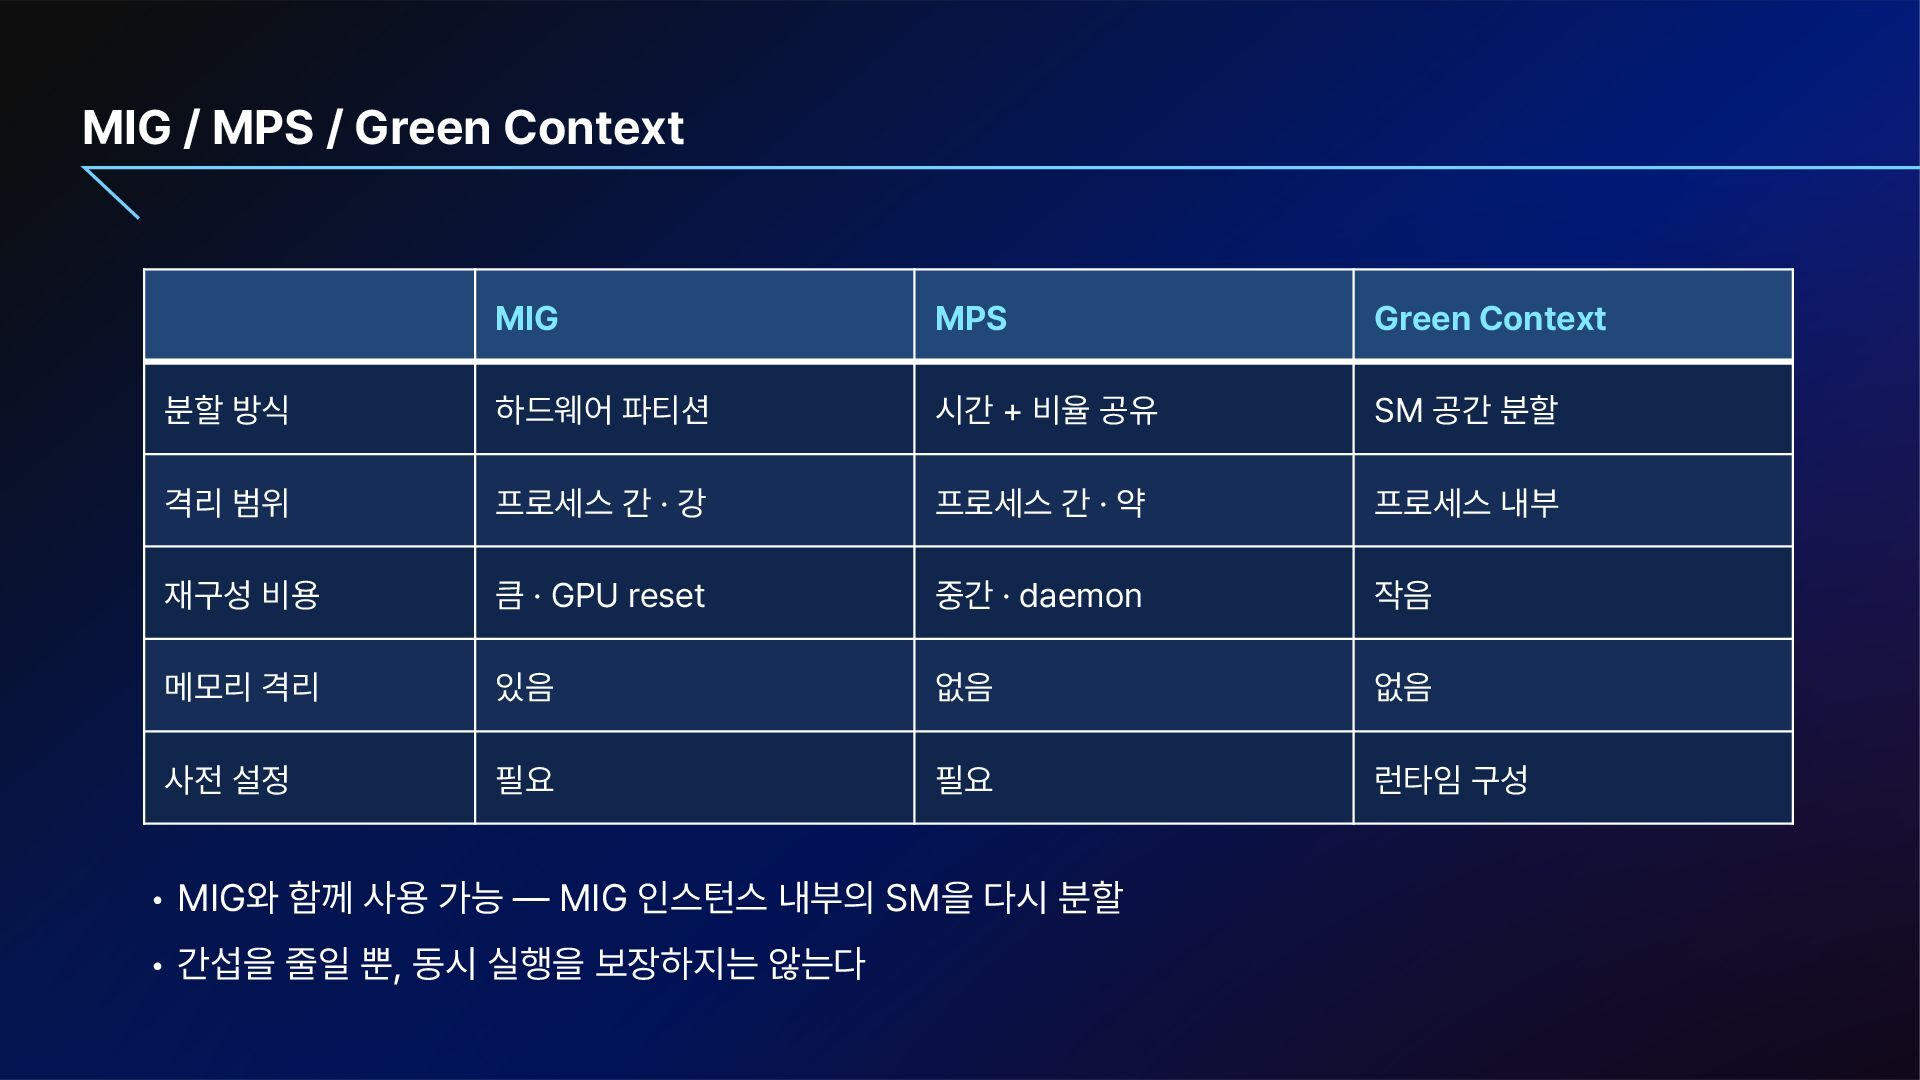
하드웨어 파티션 시간 비율 공유 SM 공간 분할 격리 범위 프로세스 간 · 강 프로세스 간 · 약 프로세스 내부 재구성 비용 큼 · GPU reset 중간 · daemon 작음 메모리 격리 있음 없음 없음 사전 설정 필요 필요 런타임 구성 • MIG와 함께 사용 가능 Green Context MIG 인스턴스 내부의 SM을 다시 분할 • 간섭을 줄일 뿐, 동시 실행을 보장하지는 않는다
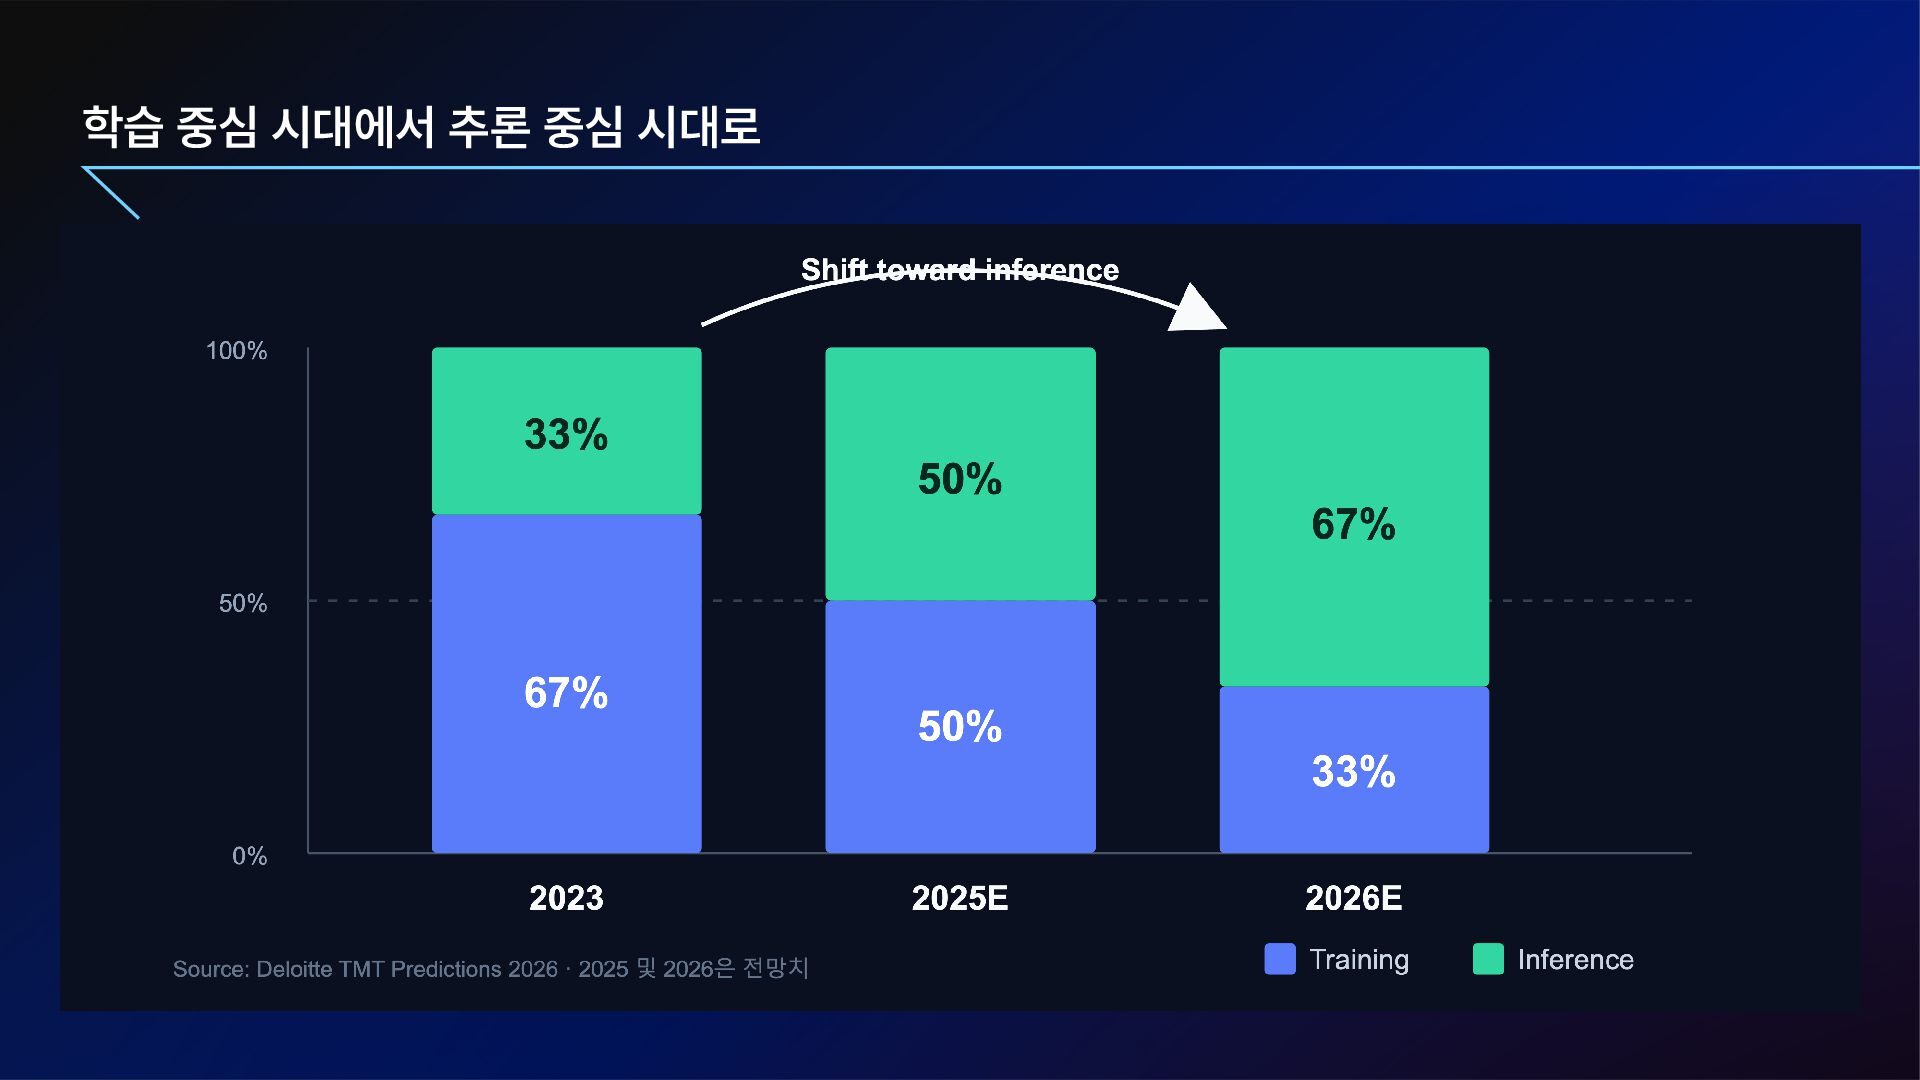
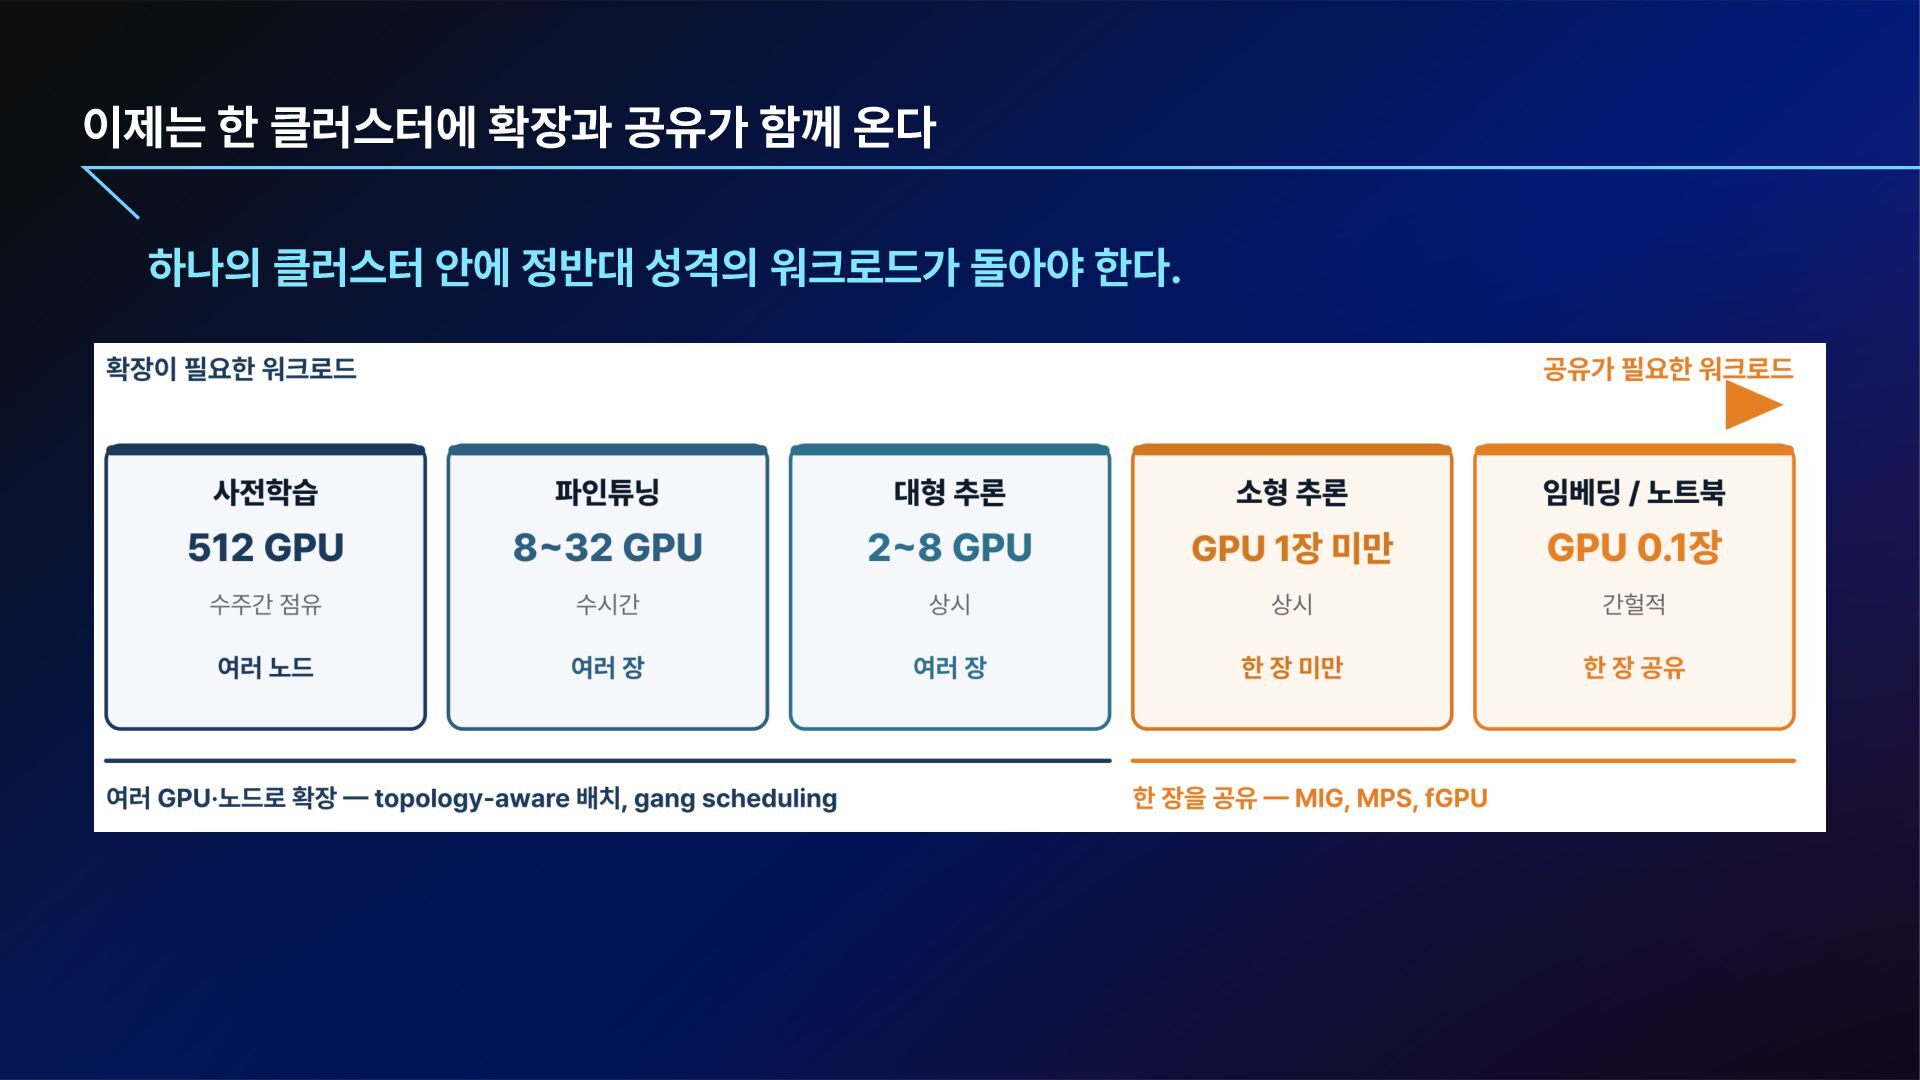
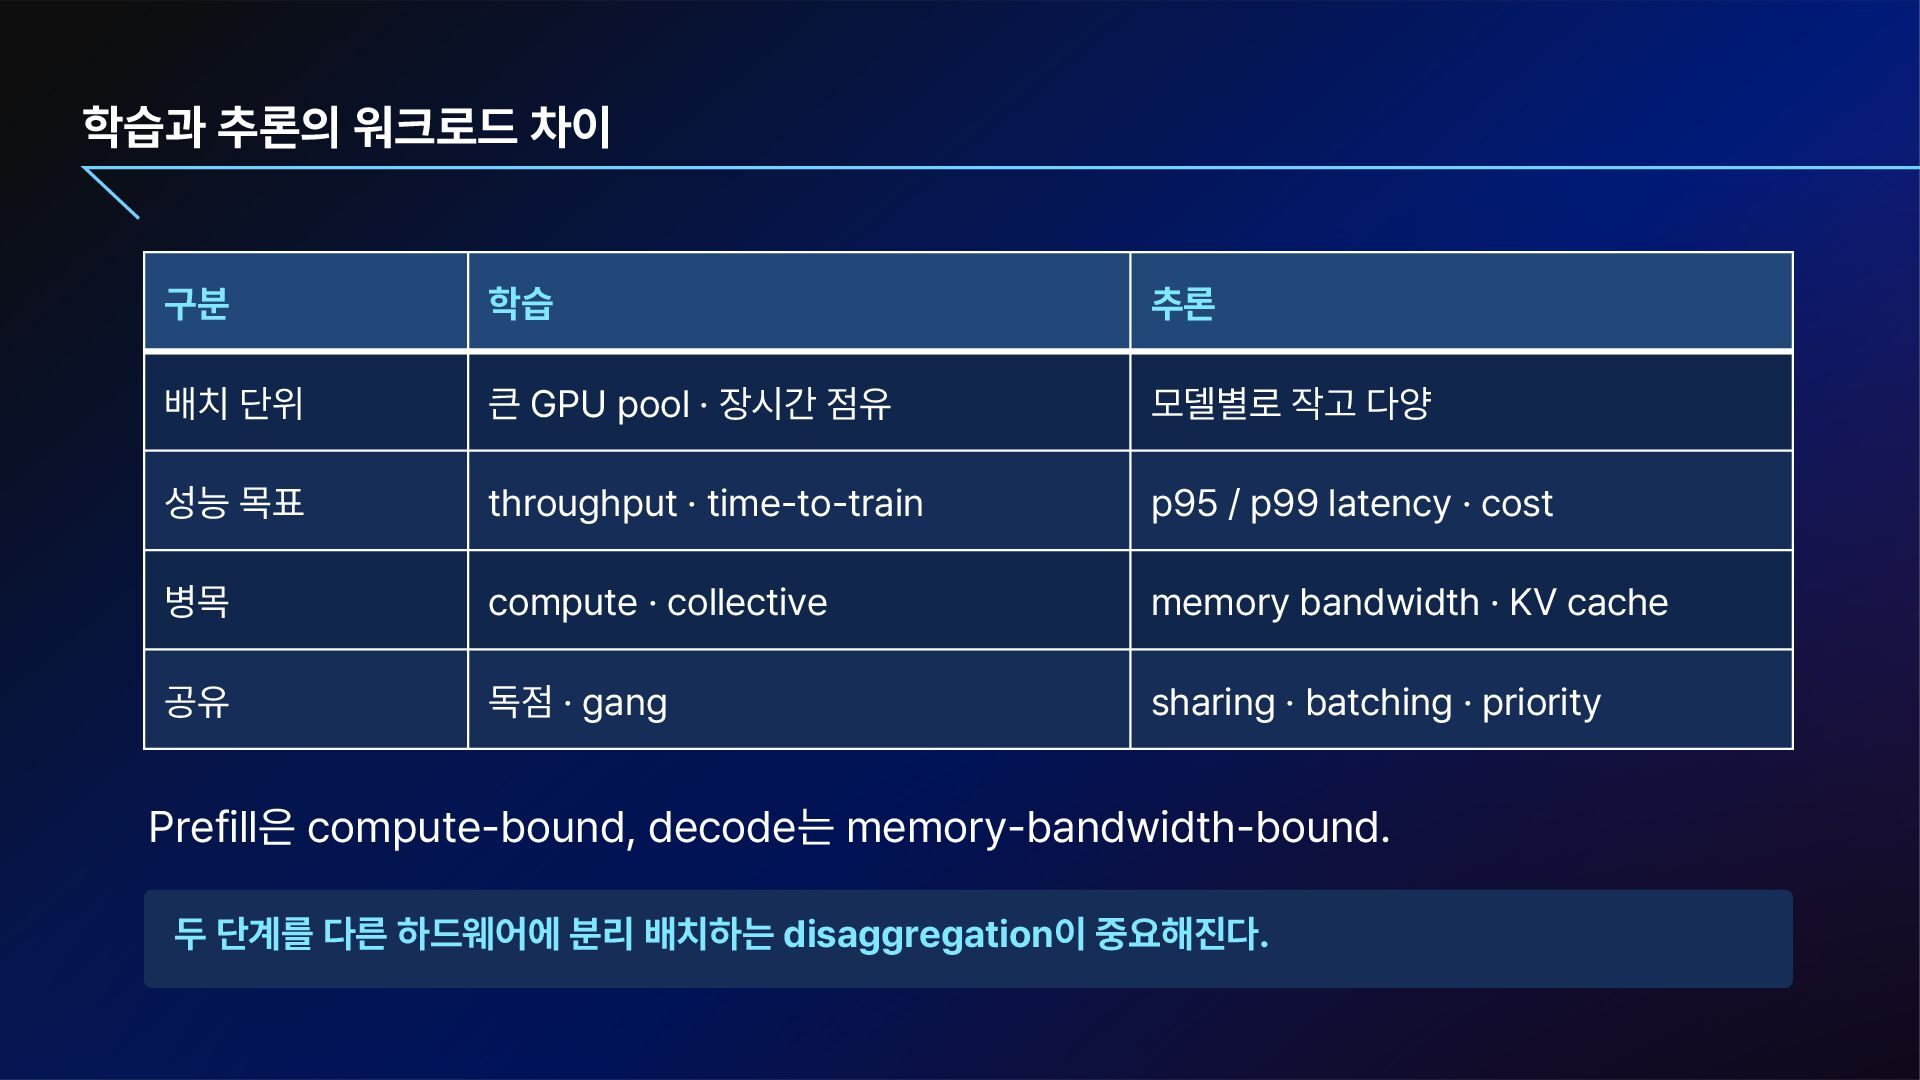
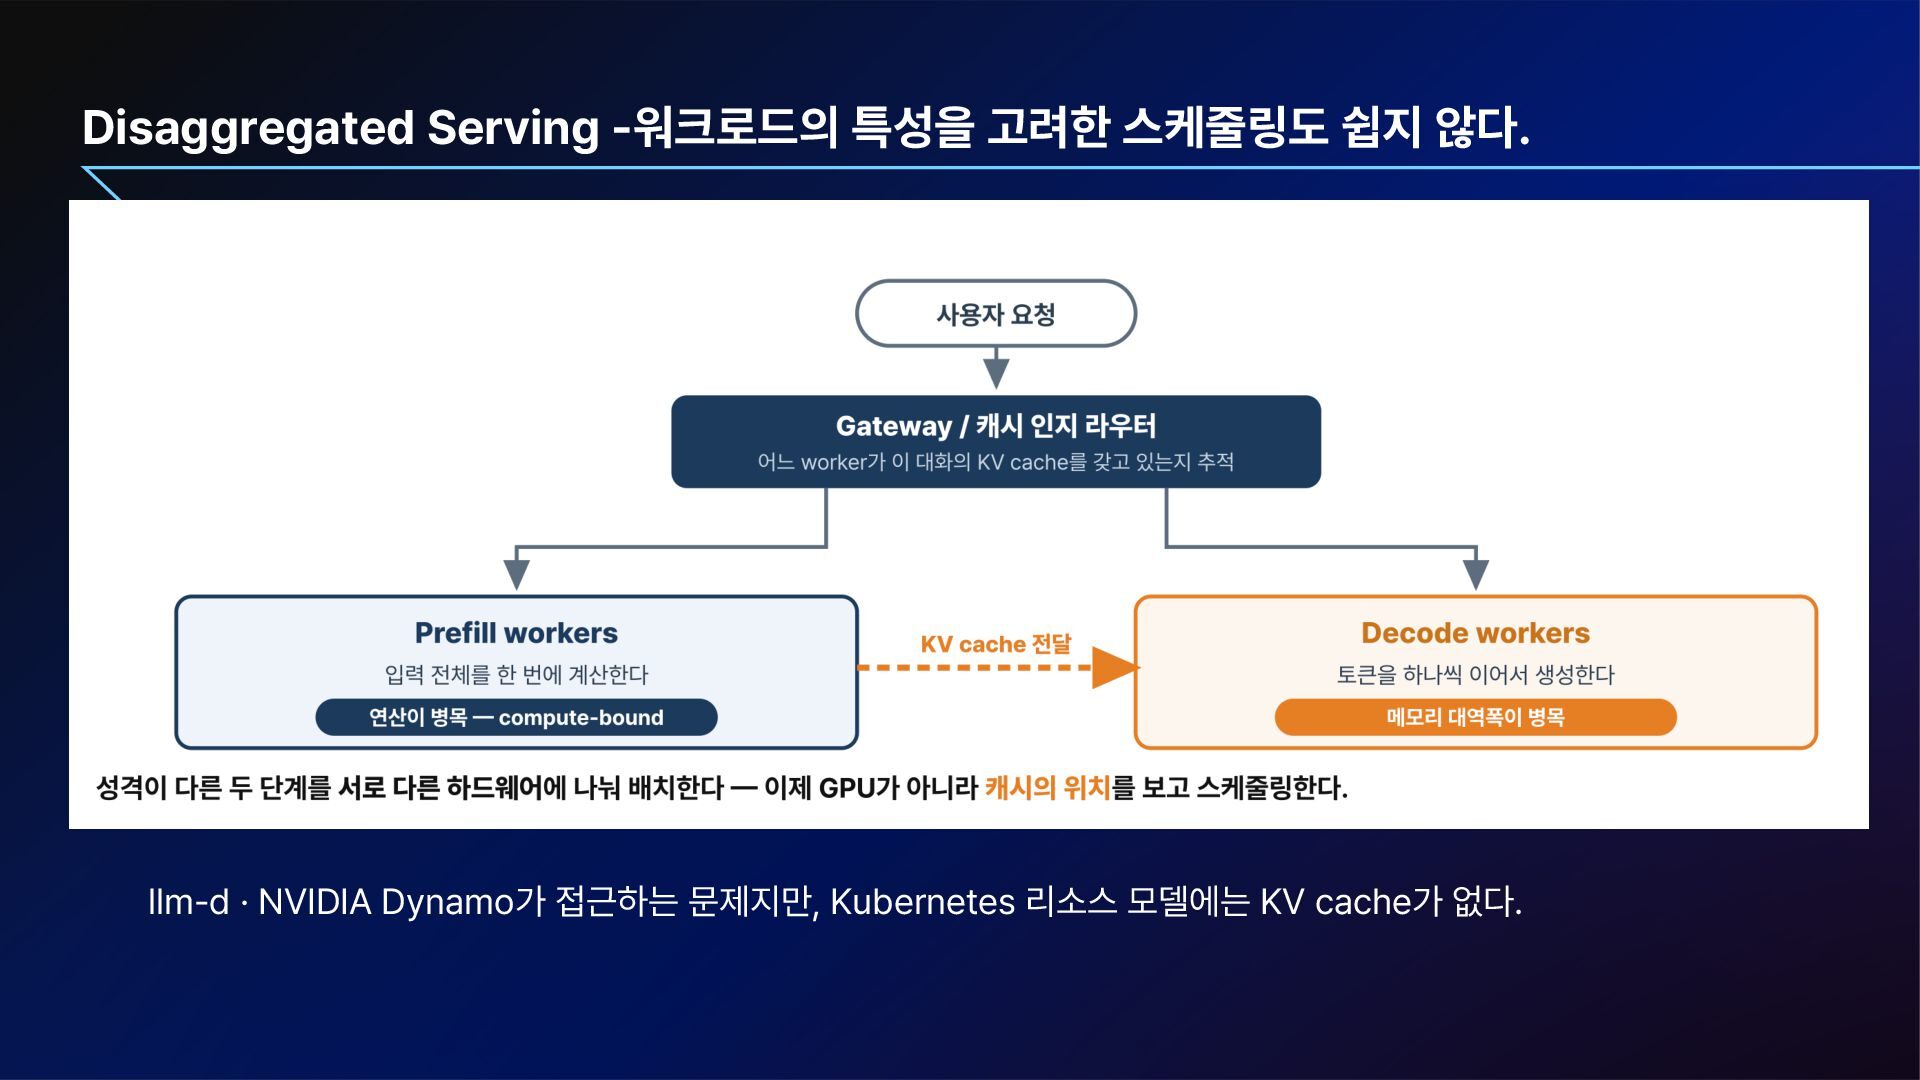
GPU pool · 장시간 점유 모델별로 작고 다양 성능 목표 throughput · time to train p95 / p99 latency · cost 병목 compute · collective memory bandwidth · KV cache 공유 독점 · gang sharing · batching · priority Prefill은 compute bound, decode는 memory bandwidth bound. 두 단계를 다른 하드웨어에 분리 배치하는 disaggregation이 중요해진다.
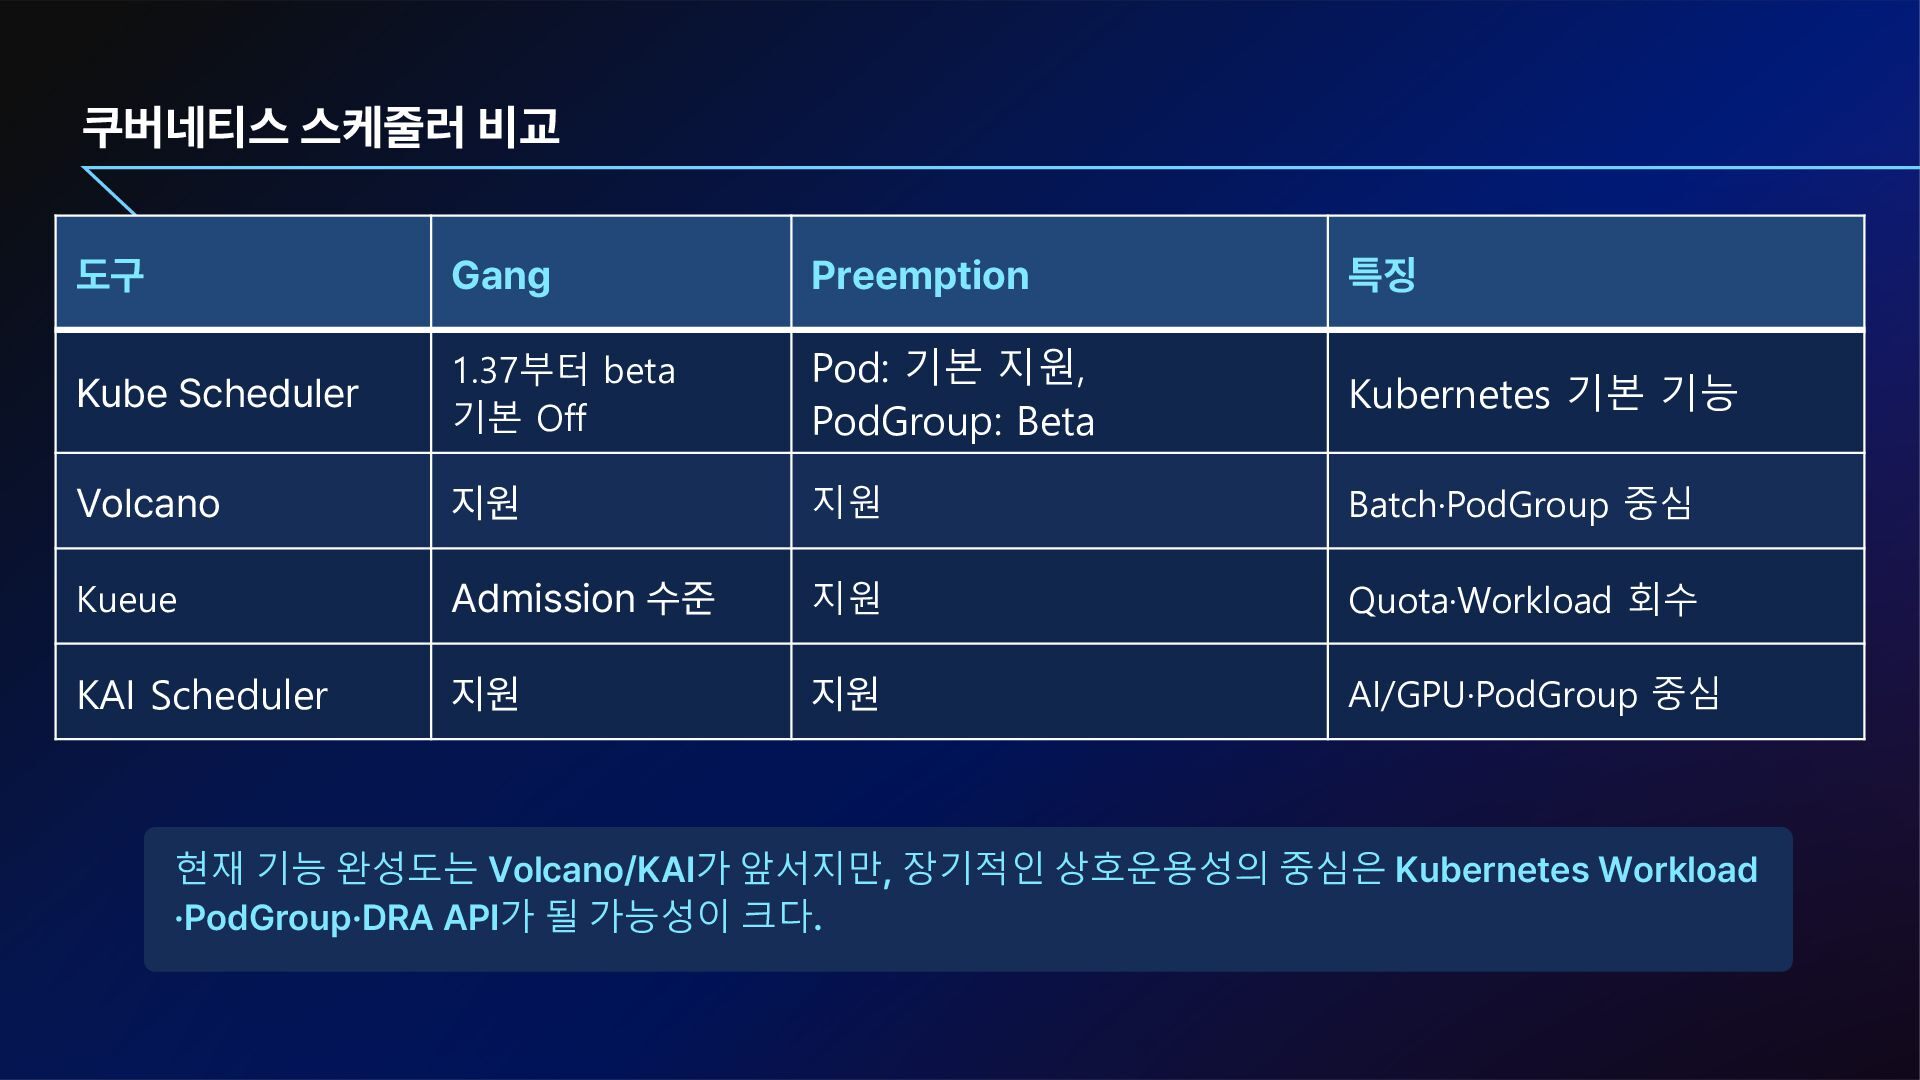
beta 기본 Off Pod: 기본 지원, PodGroup: Beta Kubernetes 기본 기능 Volcano 지원 지원 Batch·PodGroup 중심 Kueue Admission 수준 지원 Quota·Workload 회수 KAI Scheduler 지원 지원 AI/GPU·PodGroup 중심 현재 기능 완성도는 Volcano/KAI가 앞서지만, 장기적인 상호운용성의 중심은 Kubernetes Workload ·PodGroup·DRA API가 될 가능성이 크다.


 lablup
 maggiecrowley
 tapps
 tmiket
 madoxten
 stephenakadiri
 szymonslowik
 davidcarrasco
 honnibal
 sarafernandez
 eitanlees
 eileencodes
 aleyda