AI가 코드를 무한히 만들어낼 수 있는 시대, 소프트웨어 개발의 가치는 '구현'에서 '설계'로 이동하고 있습니다. 무엇을 만들 것인가를 넘어, 얼마나 잘 동작하고 지속 가능하며 가치 있게 만들 것인가가 중요해집니다. 이미 다가온 AGI 시대에 설계의 본질을 통해 개발자의 역할을 다시 생각해봅니다.
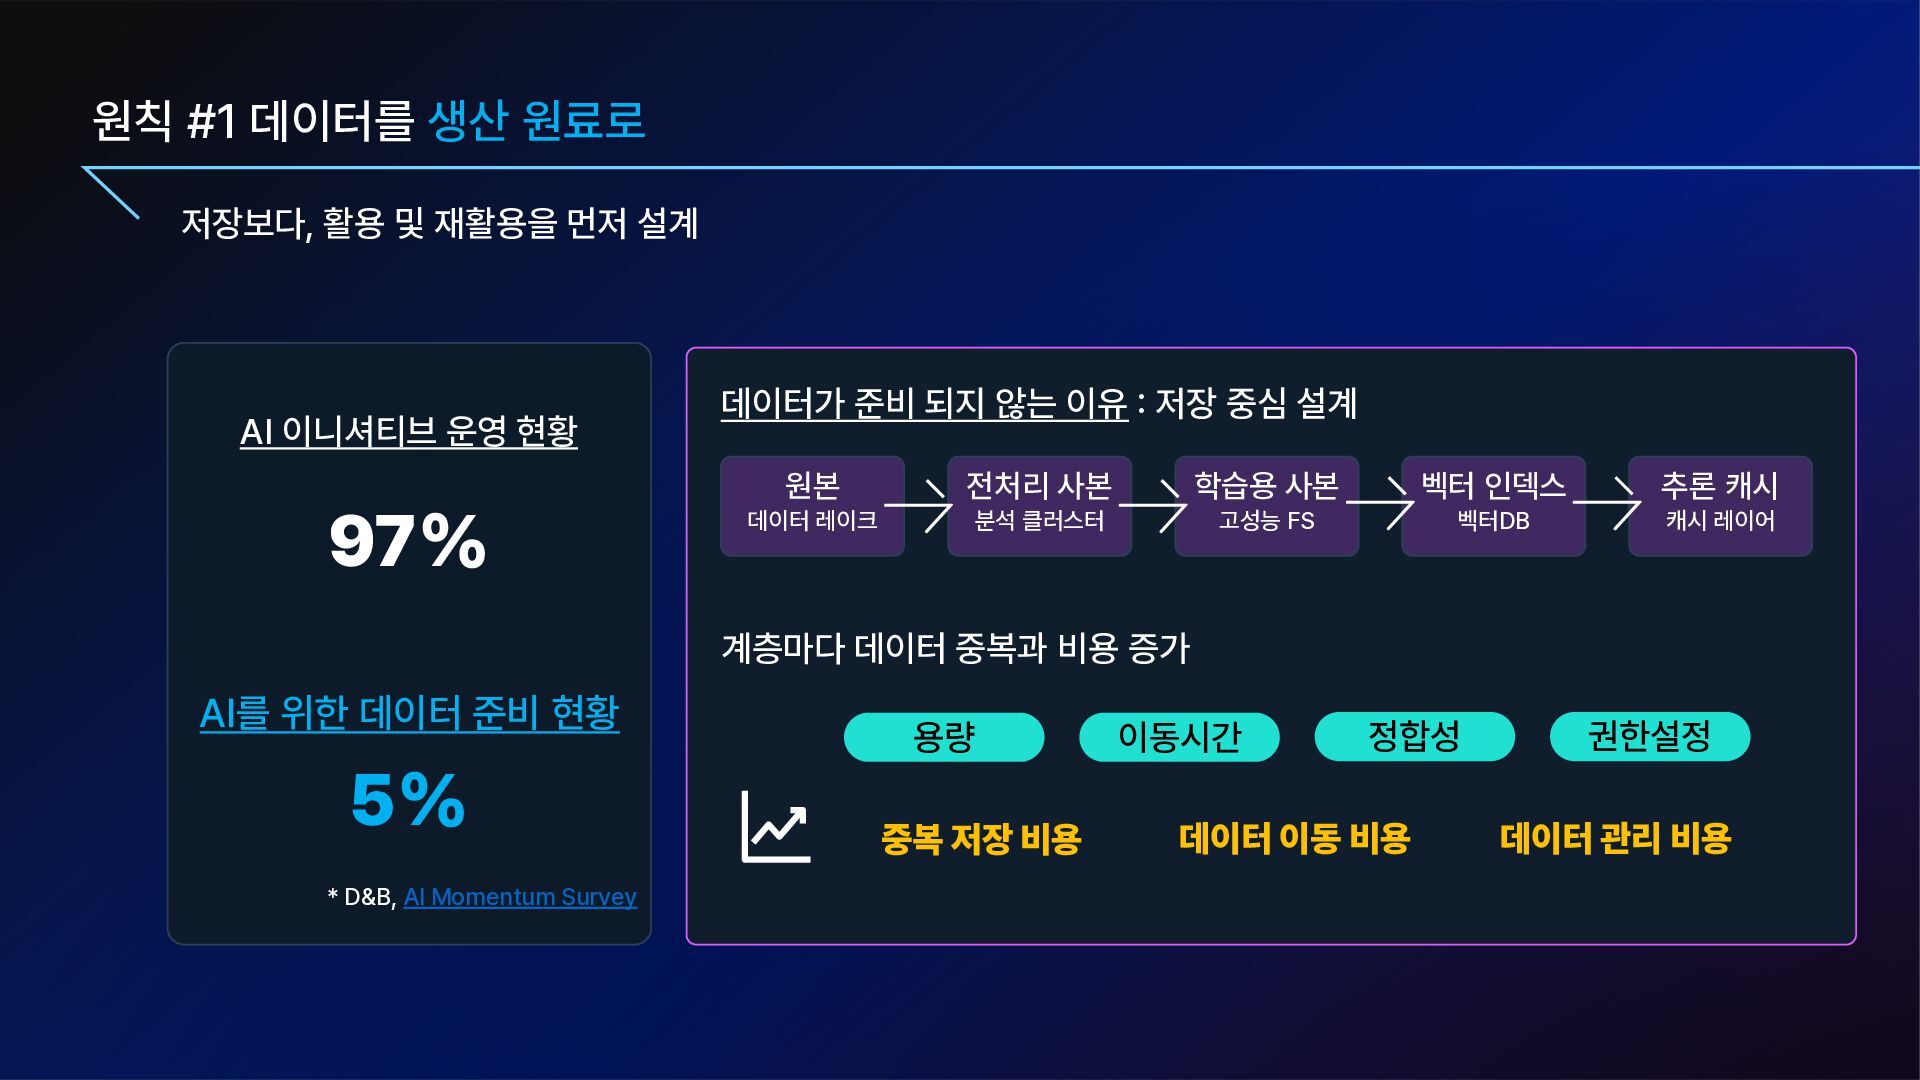
설계 AI 이니셔티브 운영 현황 97% 데이터가 준비 되지 않는 이유 : 저장 중심 설계 원본 전처리 사본 학습용 사본 벡터 인덱스 추론 캐시 데이터 레이크 분석 클러스터 고성능 FS 벡터DB 캐시 레이어 계층마다 데이터 중복과 비용 증가 AI를 위한 데이터 준비 현황 5% * D&B, AI Momentum Survey 용량 중복 저장 비용 이동시간 정합성 데이터 이동 비용 권한설정 데이터 관리 비용
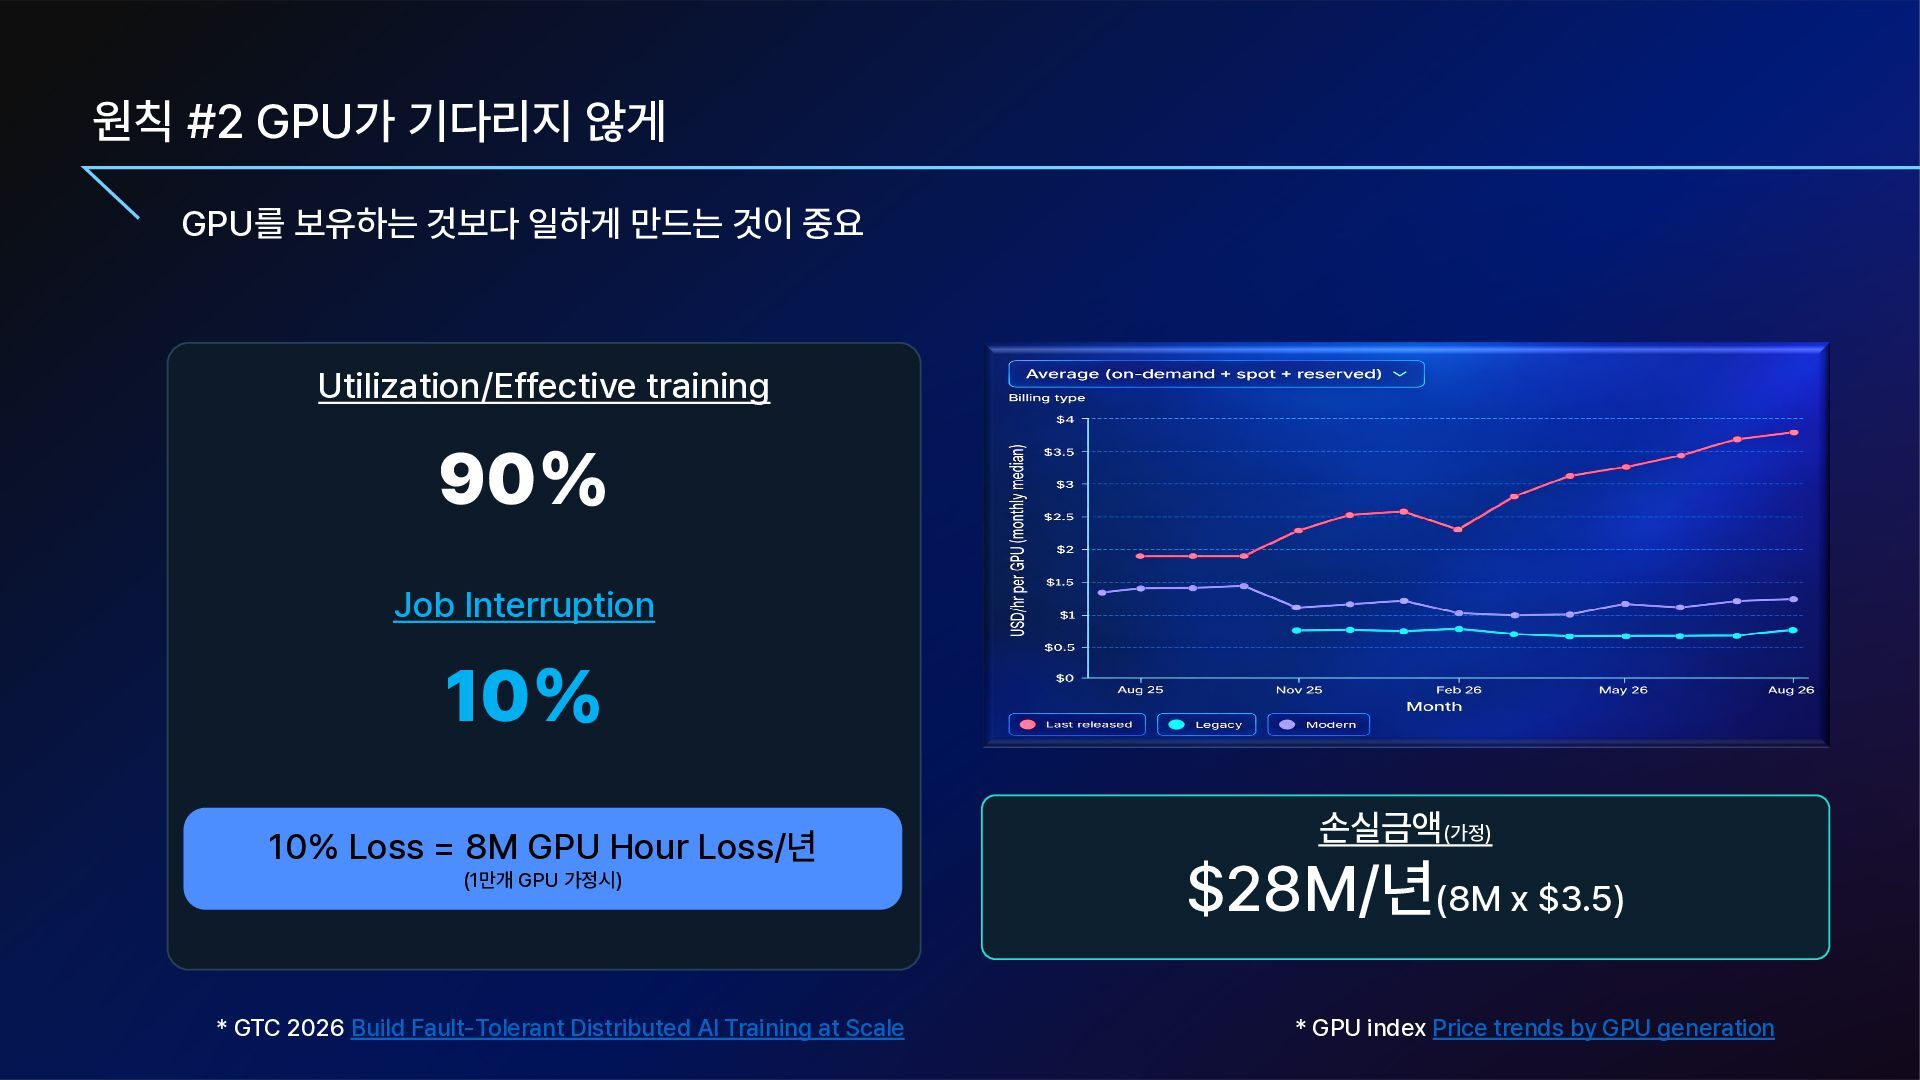
것이 중요 Utilization/Effective training 90% Job Interruption 10% 10% Loss = 8M GPU Hour Loss/년 (1만개 GPU 가정시) * GTC 2026 Build Fault-Tolerant Distributed AI Training at Scale 손실금액(가정) $28M/년(8M x $3.5) * GPU index Price trends by GPU generation
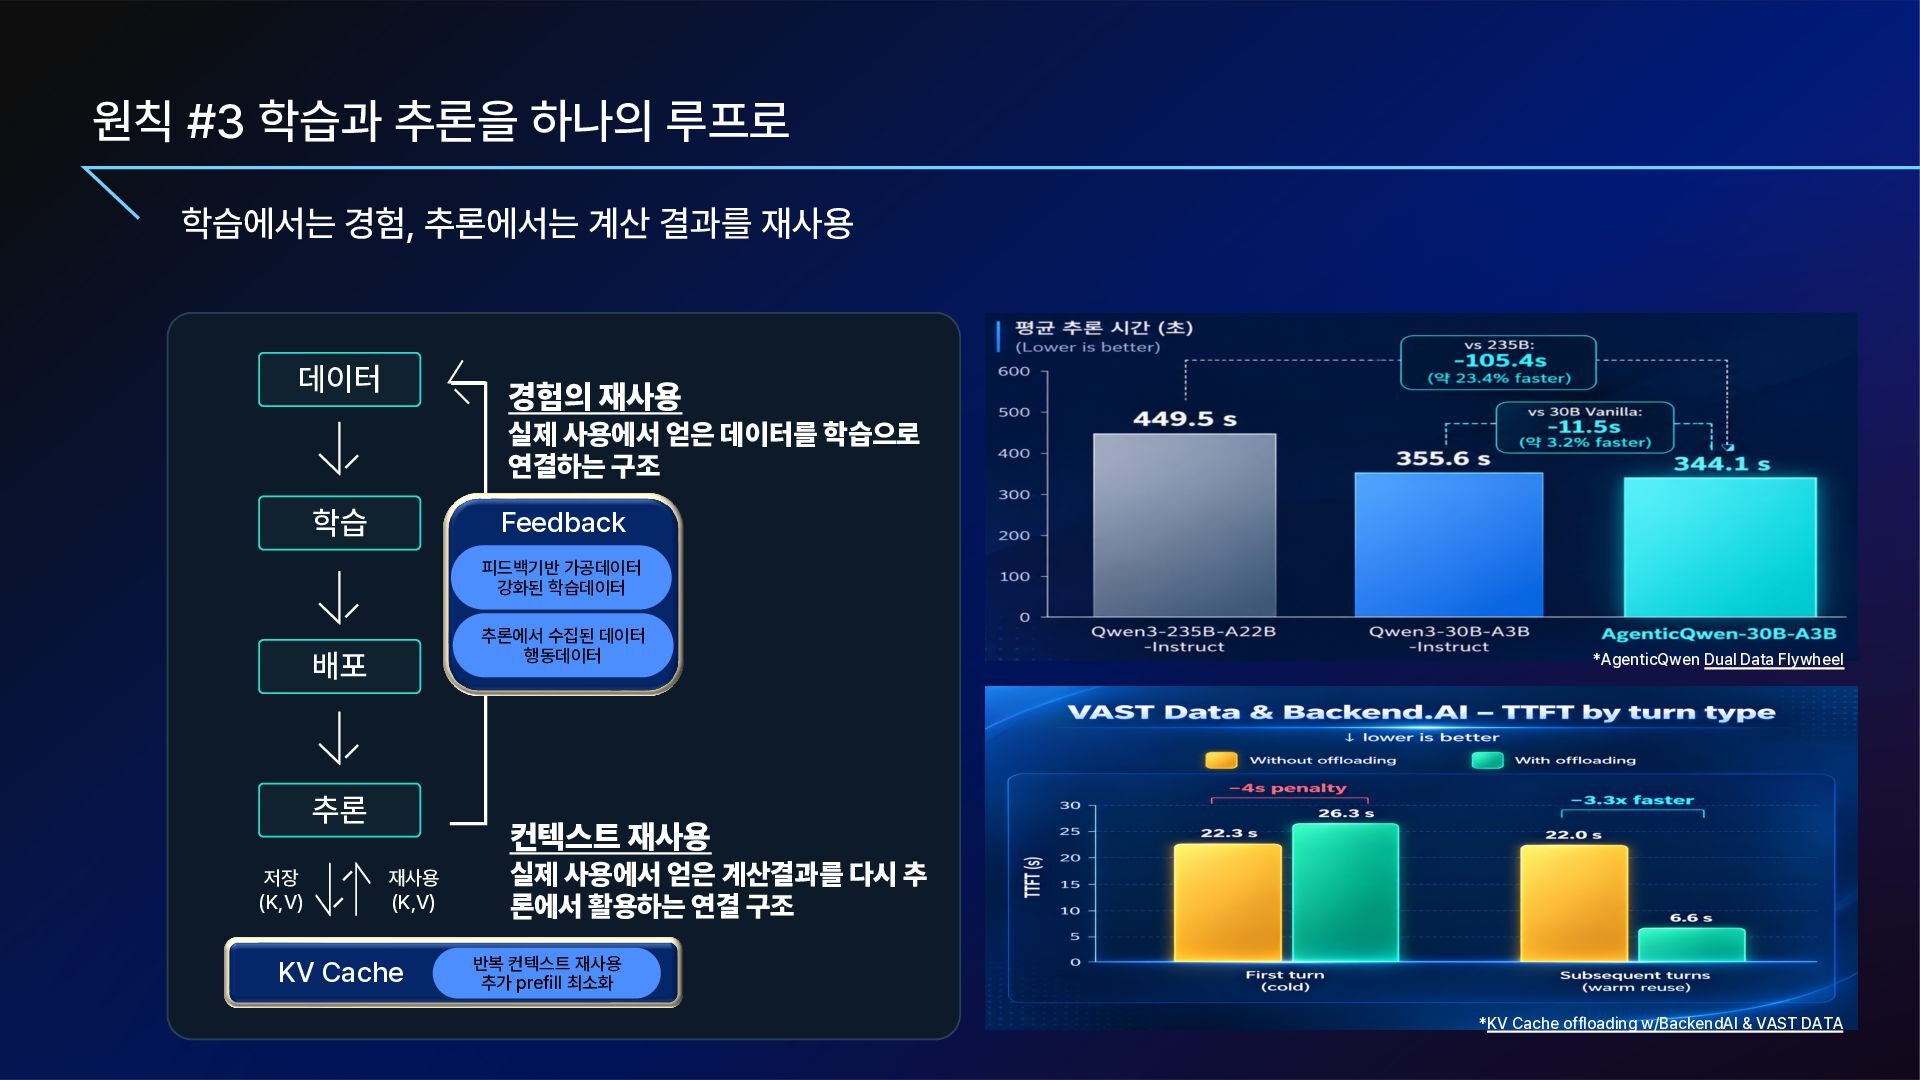
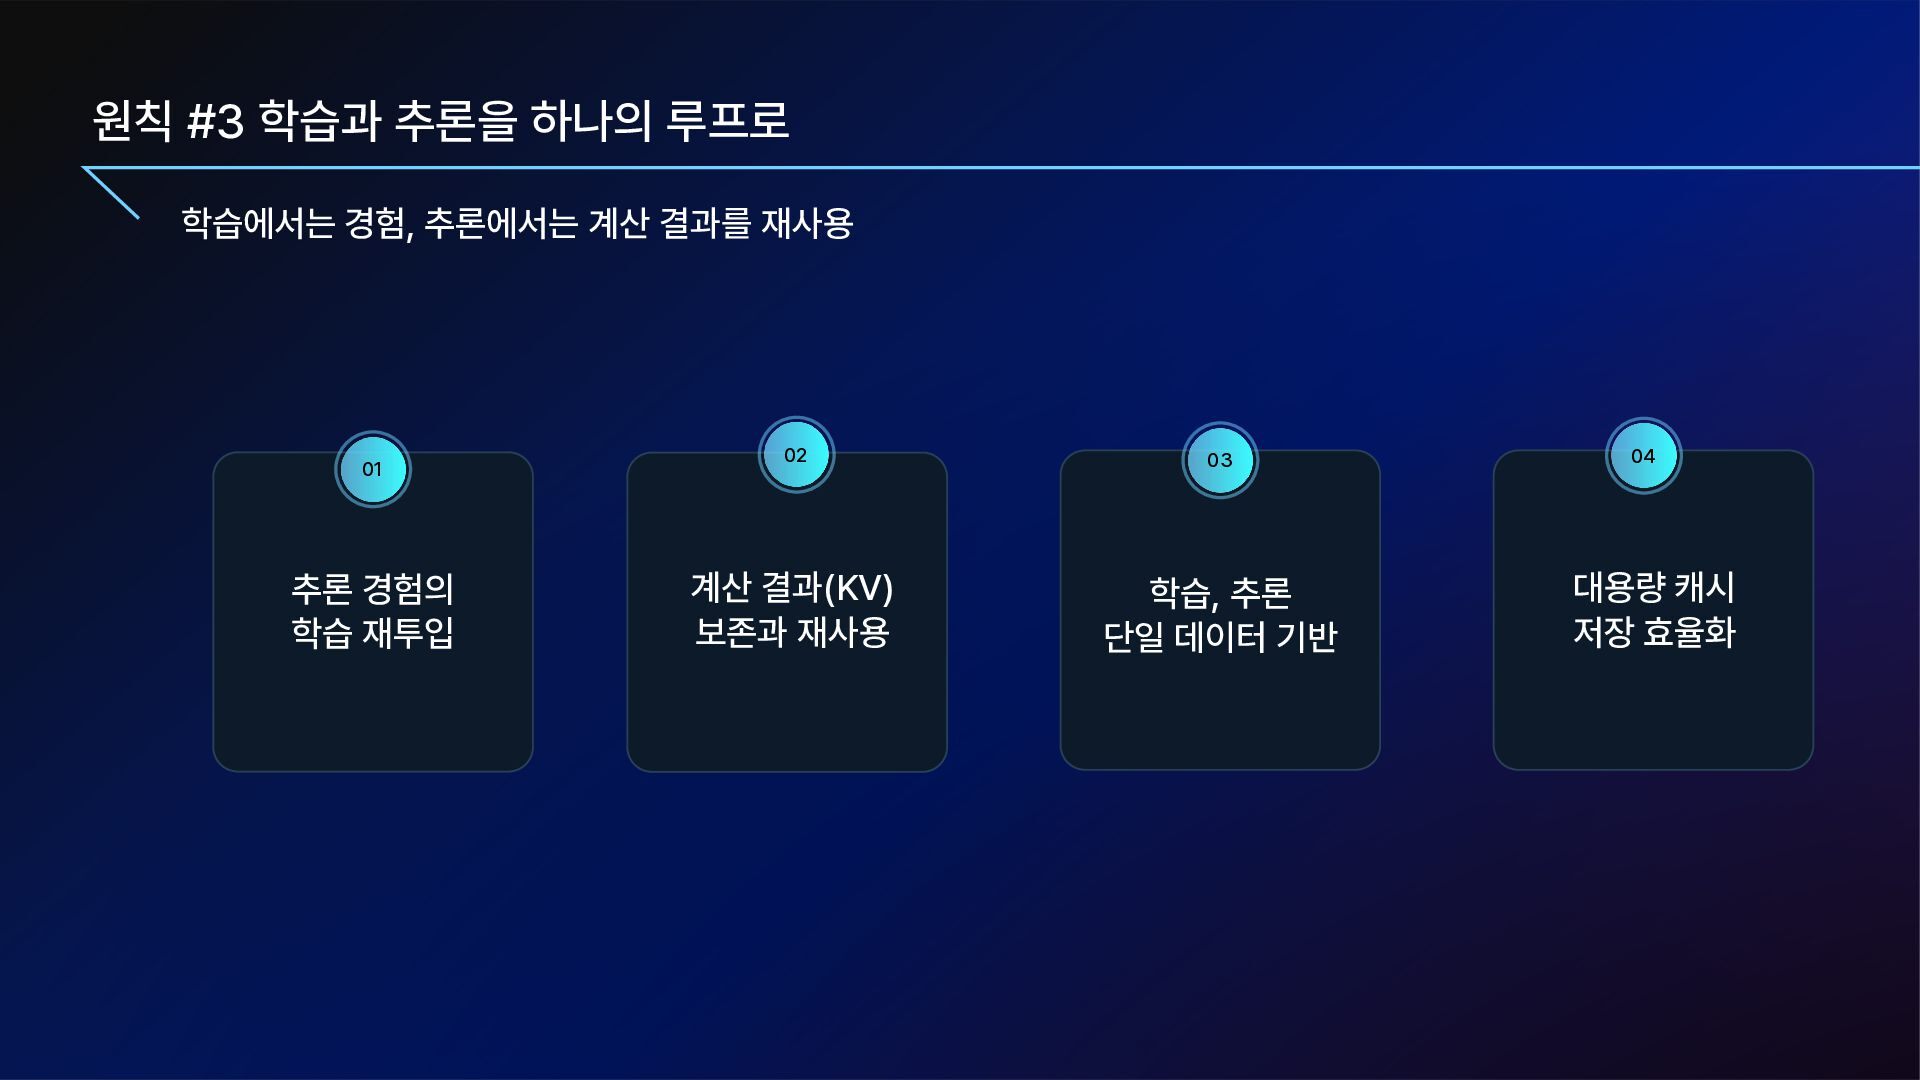
결과를 재사용 데이터 경험의 재사용 실제 사용에서 얻은 데이터를 학습으로 연결하는 구조 학습 Feedback 피드백기반 가공데이터 강화된 학습데이터 추론에서 수집된 데이터 행동데이터 배포 추론 저장 (K,V) *AgenticQwen Dual Data Flywheel 컨텍스트 재사용 재사용 (K,V) KV Cache 실제 사용에서 얻은 계산결과를 다시 추 론에서 활용하는 연결 구조 반복 컨텍스트 재사용 추가 prefill 최소화 *KV Cache offloading w/BackendAI & VAST DATA
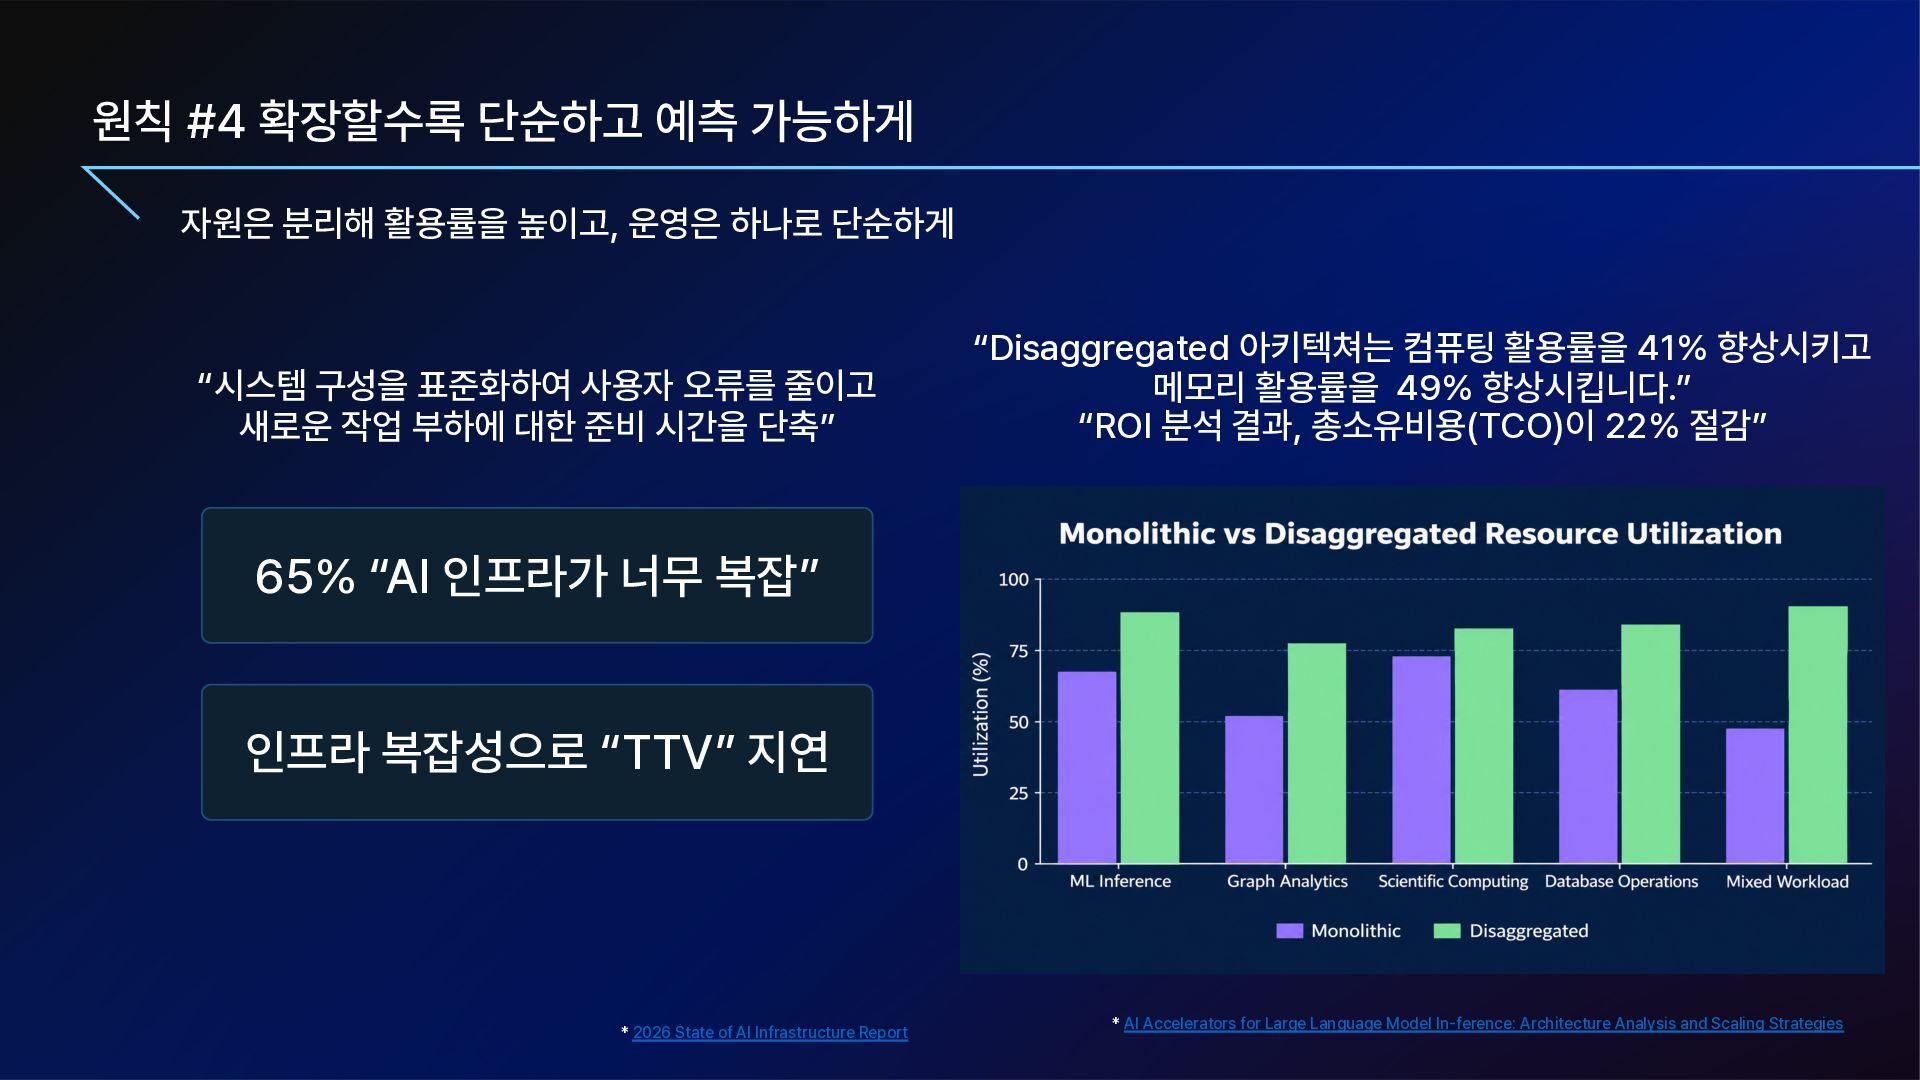
운영은 하나로 단순하게 “시스템 구성을 표준화하여 사용자 오류를 줄이고 새로운 작업 부하에 대한 준비 시간을 단축” “Disaggregated 아키텍쳐는 컴퓨팅 활용률을 41% 향상시키고 메모리 활용률을 49% 향상시킵니다.” “ROI 분석 결과, 총소유비용(TCO)이 22% 절감” 65% “AI 인프라가 너무 복잡” 인프라 복잡성으로 “TTV” 지연 * 2026 State of AI Infrastructure Report * AI Accelerators for Large Language Model In-ference: Architecture Analysis and Scaling Strategies
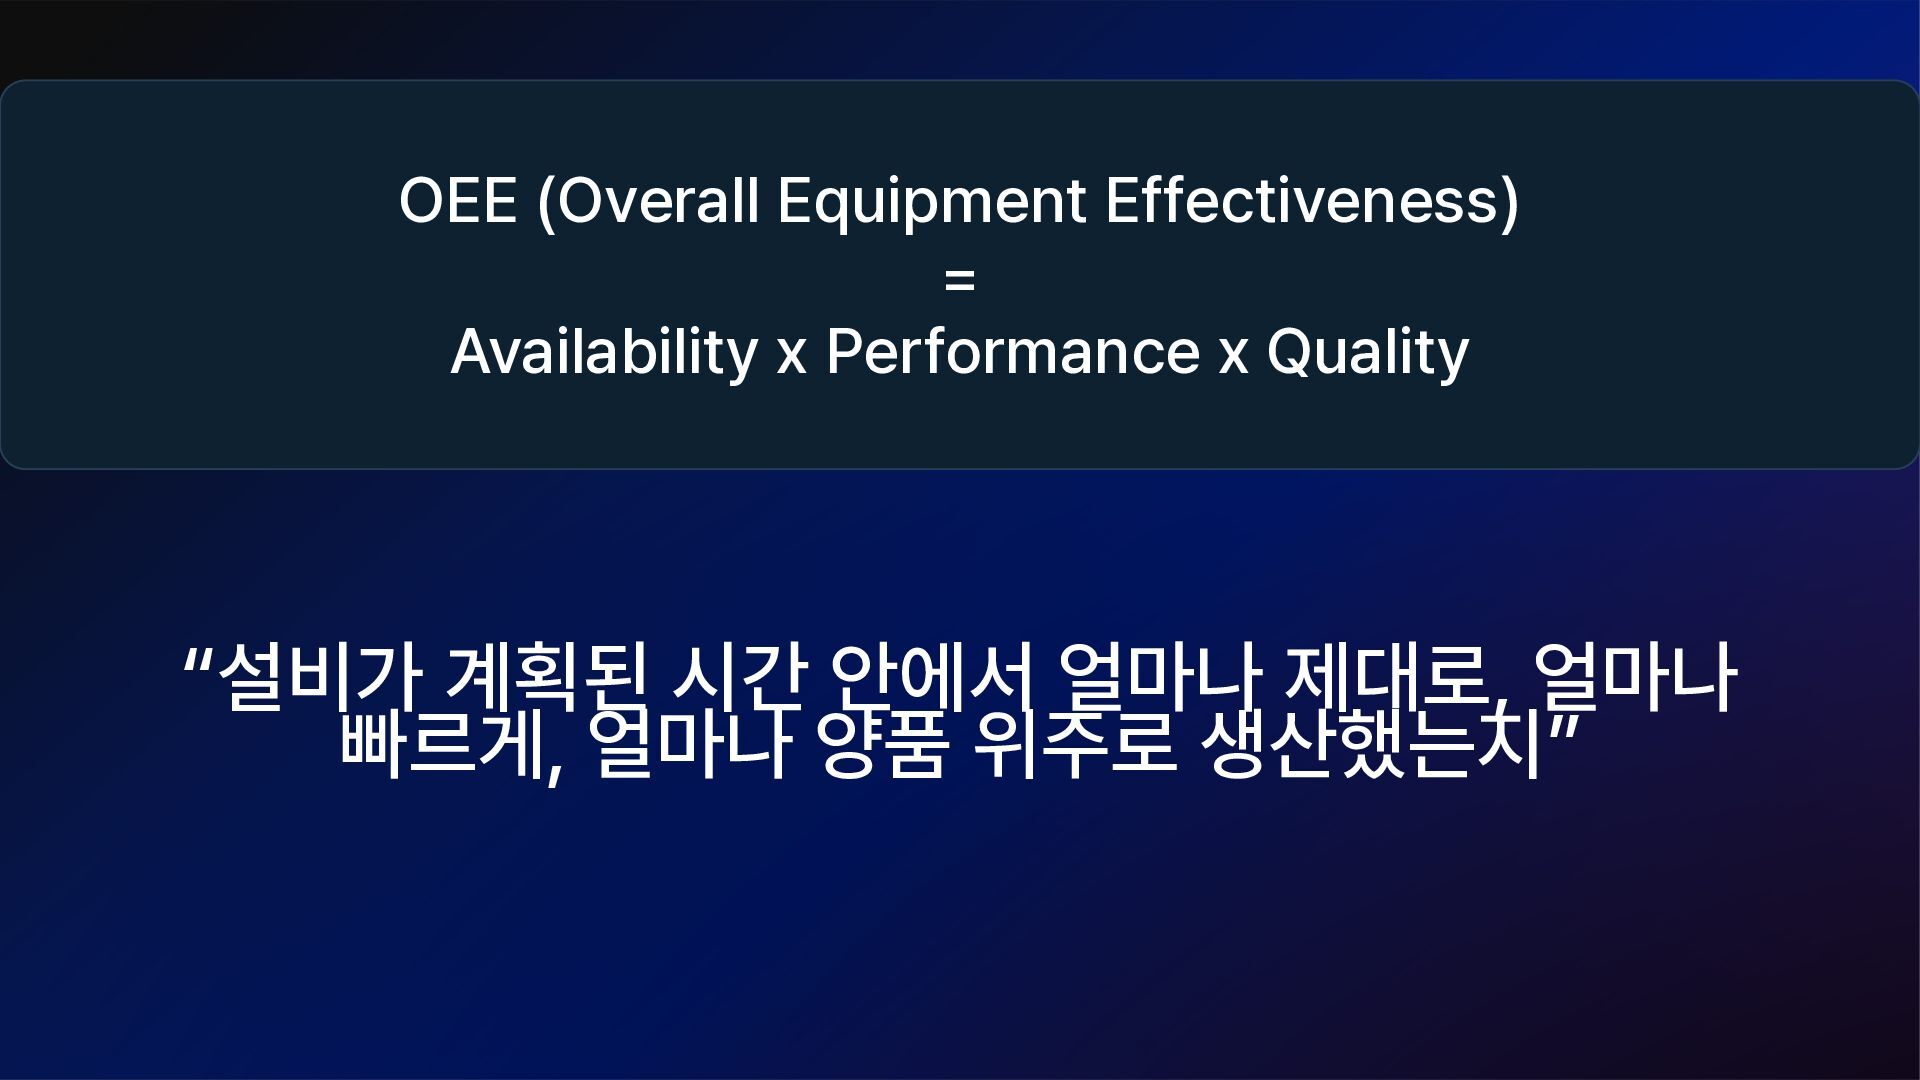
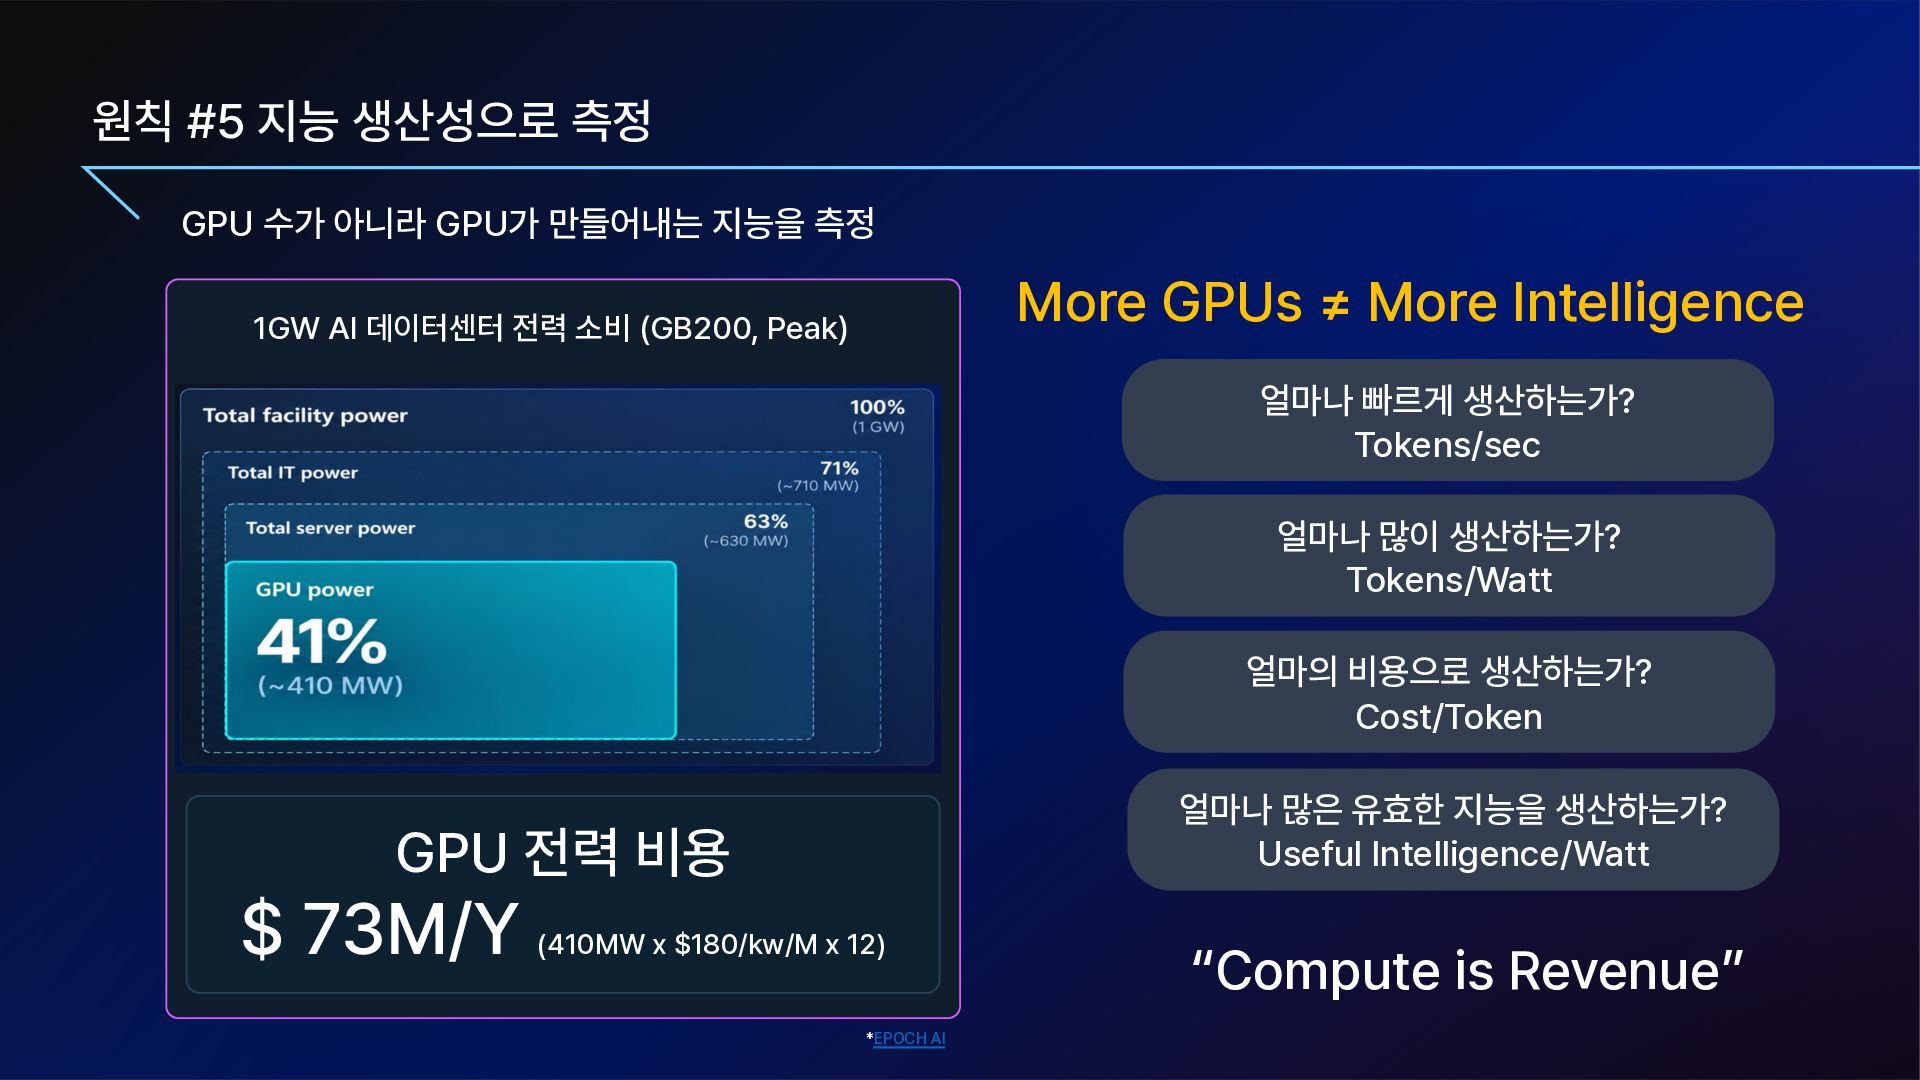
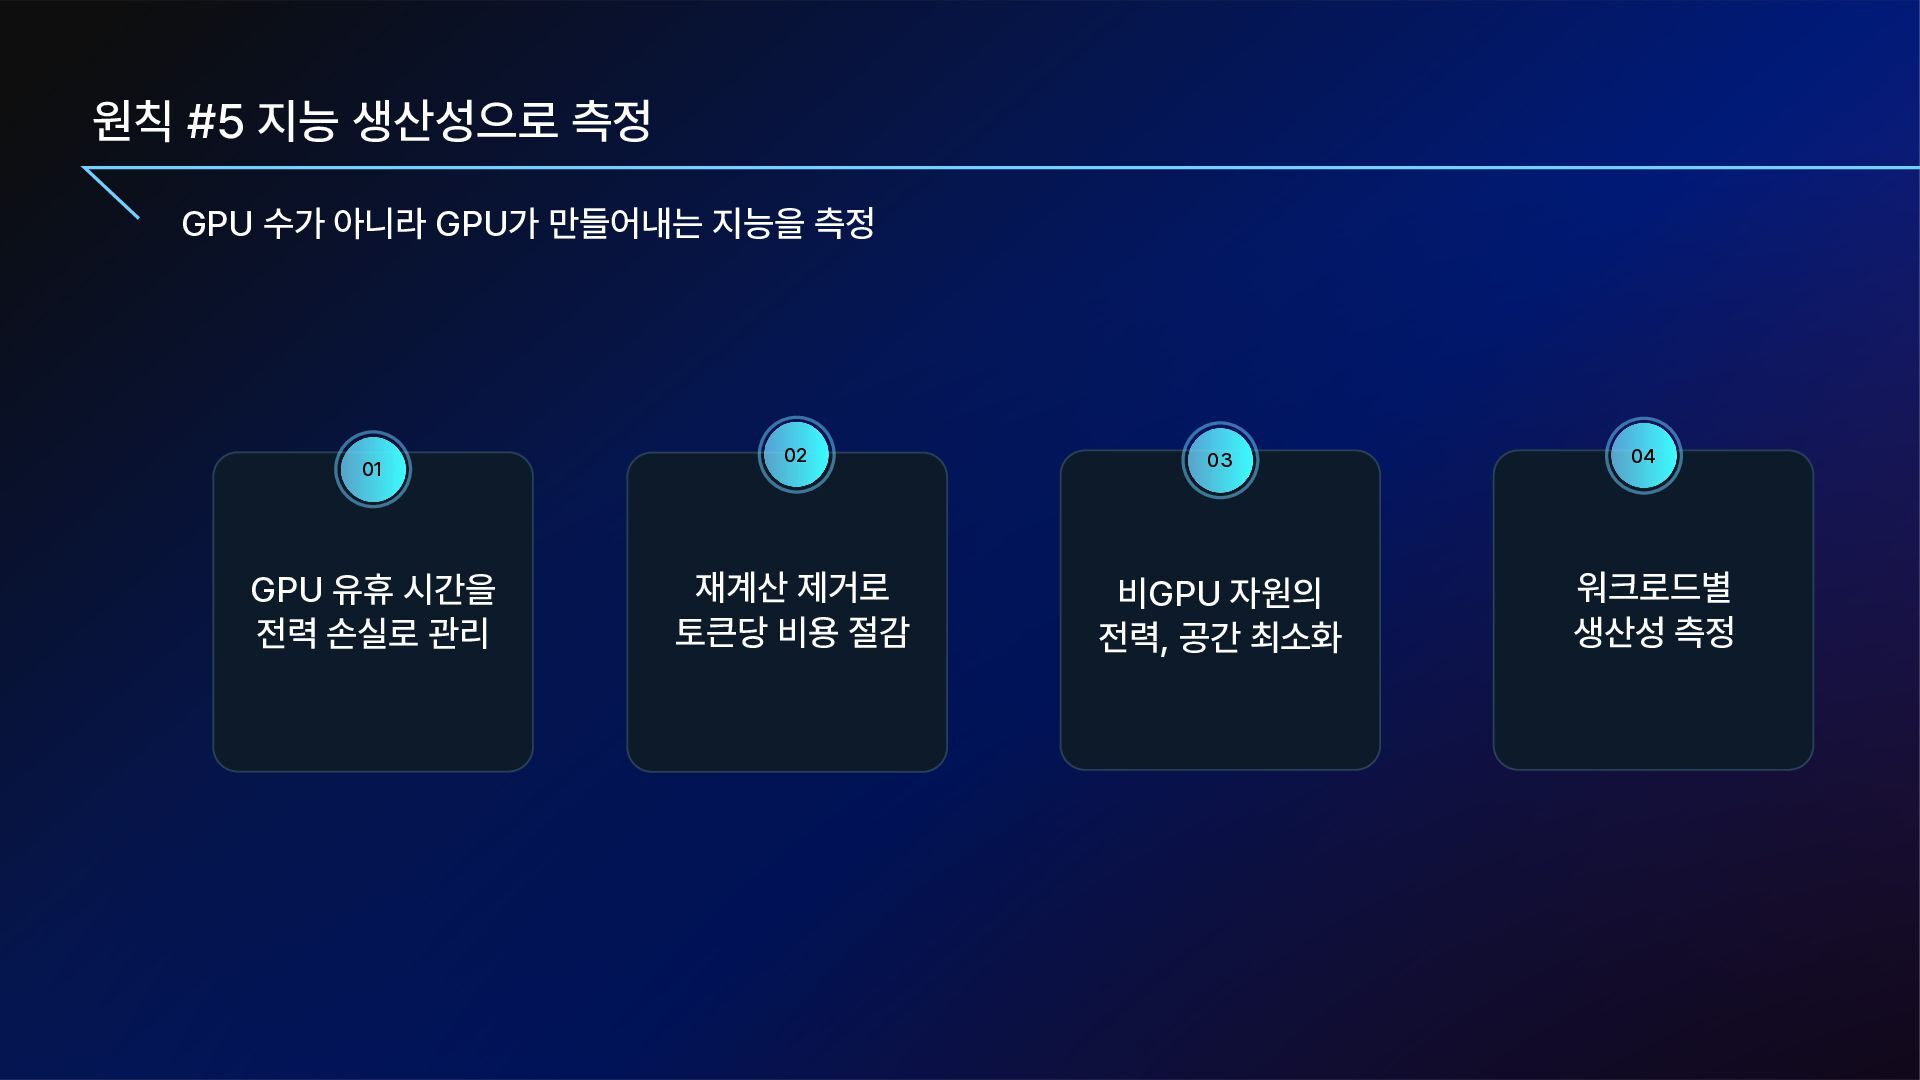
지능을 측정 More GPUs ≠ More Intelligence 1GW AI 데이터센터 전력 소비 (GB200, Peak) 얼마나 빠르게 생산하는가? Tokens/sec 얼마나 많이 생산하는가? Tokens/Watt 얼마의 비용으로 생산하는가? Cost/Token 얼마나 많은 유효한 지능을 생산하는가? Useful Intelligence/Watt GPU 전력 비용 $ 73M/Y (410MW x $180/kw/M x 12) *EPOCH AI “Compute is Revenue”
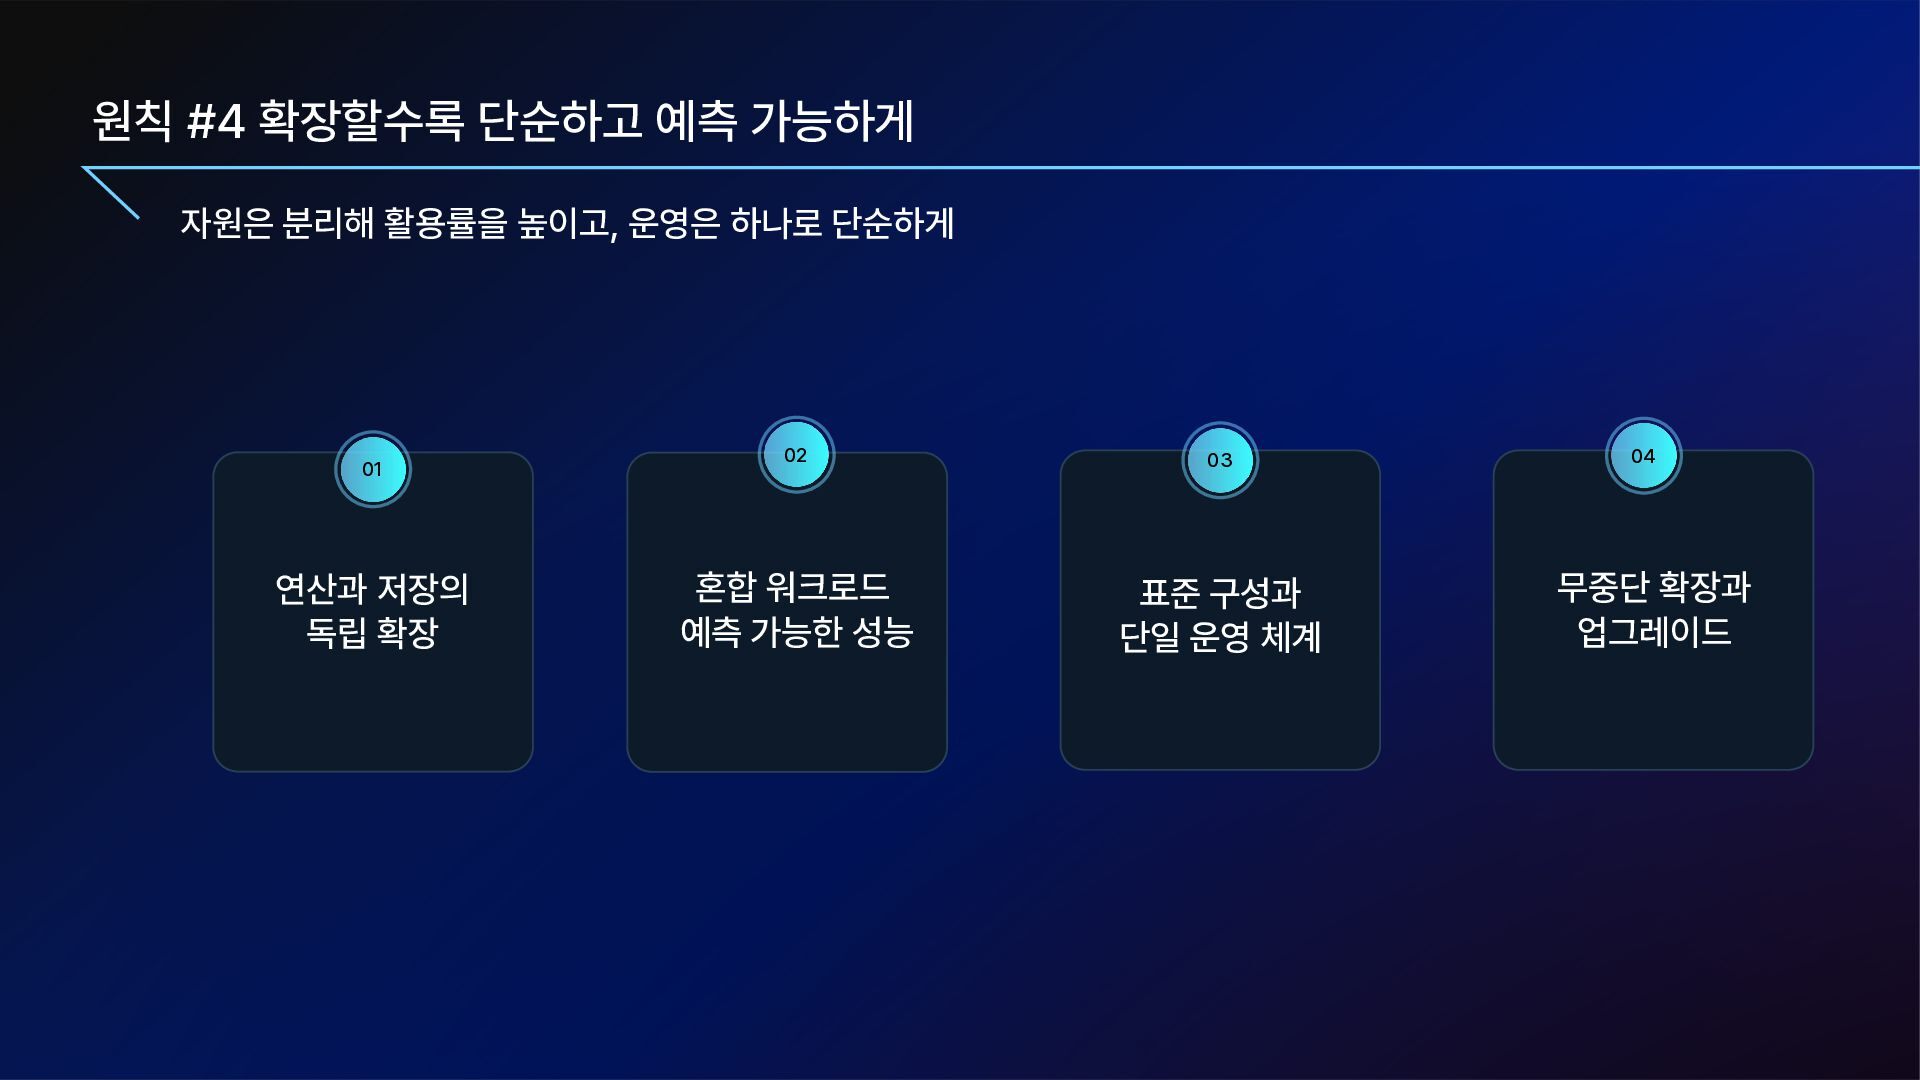
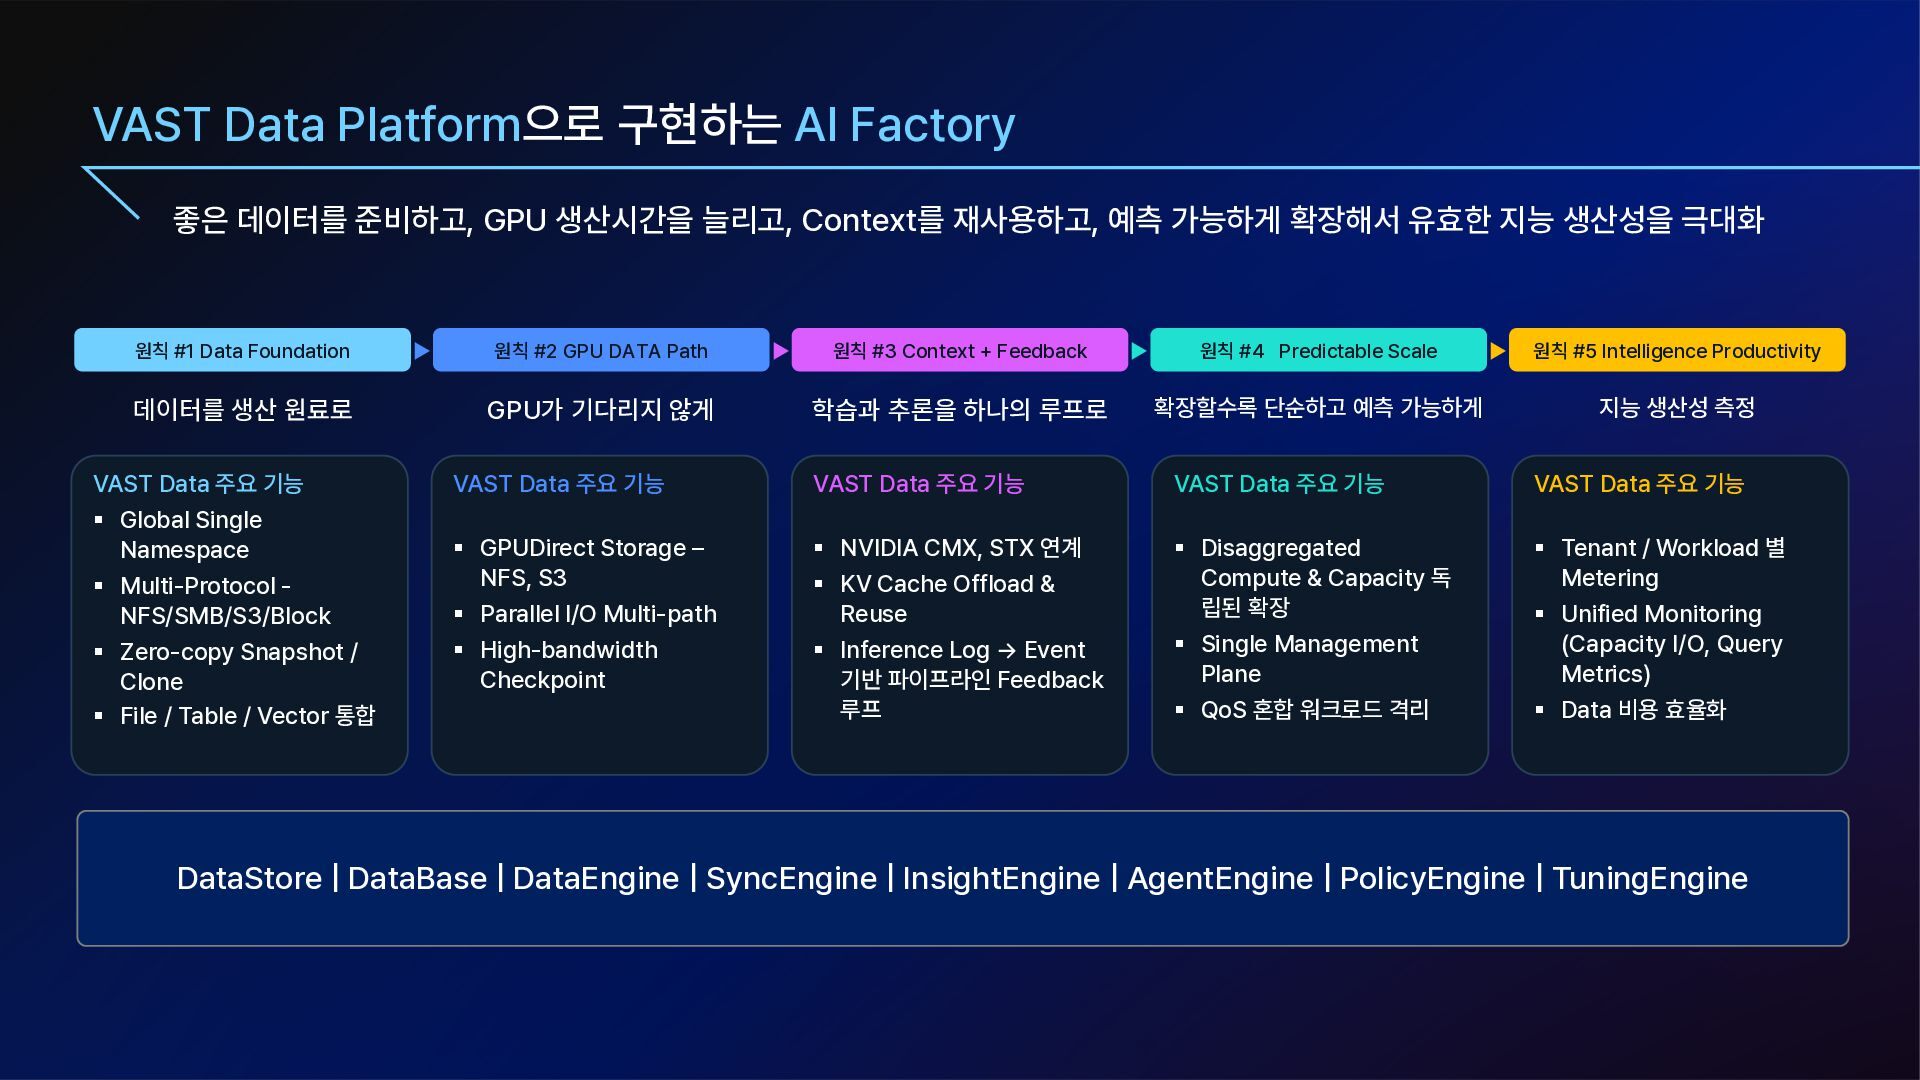
생산시간을 늘리고, Context를 재사용하고, 예측 가능하게 확장해서 유효한 지능 생산성을 극대화 원칙 #1 Data Foundation 데이터를 생산 원료로 VAST Data 주요 기능 § Global Single Namespace § Multi-Protocol NFS/SMB/S3/Block § Zero-copy Snapshot / Clone § File / Table / Vector 통합 ▶ 원칙 #2 GPU DATA Path GPU가 기다리지 않게 ▶ 원칙 #3 Context + Feedback 학습과 추론을 하나의 루프로 ▶ 원칙 #4 Predictable Scale 확장할수록 단순하고 예측 가능하게 ▶ 원칙 #5 Intelligence Productivity 지능 생산성 측정 VAST Data 주요 기능 VAST Data 주요 기능 VAST Data 주요 기능 VAST Data 주요 기능 § GPUDirect Storage – NFS, S3 § Parallel I/O Multi-path § High-bandwidth Checkpoint § NVIDIA CMX, STX 연계 § KV Cache Offload & Reuse § Inference Log → Event 기반 파이프라인 Feedback 루프 § Disaggregated Compute & Capacity 독 립된 확장 § Single Management Plane § QoS 혼합 워크로드 격리 § Tenant / Workload 별 Metering § Unified Monitoring (Capacity I/O, Query Metrics) § Data 비용 효율화 DataStore | DataBase | DataEngine | SyncEngine | InsightEngine | AgentEngine | PolicyEngine | TuningEngine


 lablup
 garrettdimon
 ivargrimstad
 nmsamuel
 lara
 mfonobong
 cassininazir
 jlugia
 portentint
 watany
 codingconduct
 coloredviolet
 palkan